MCPの脅威モデルMCP-38とは?
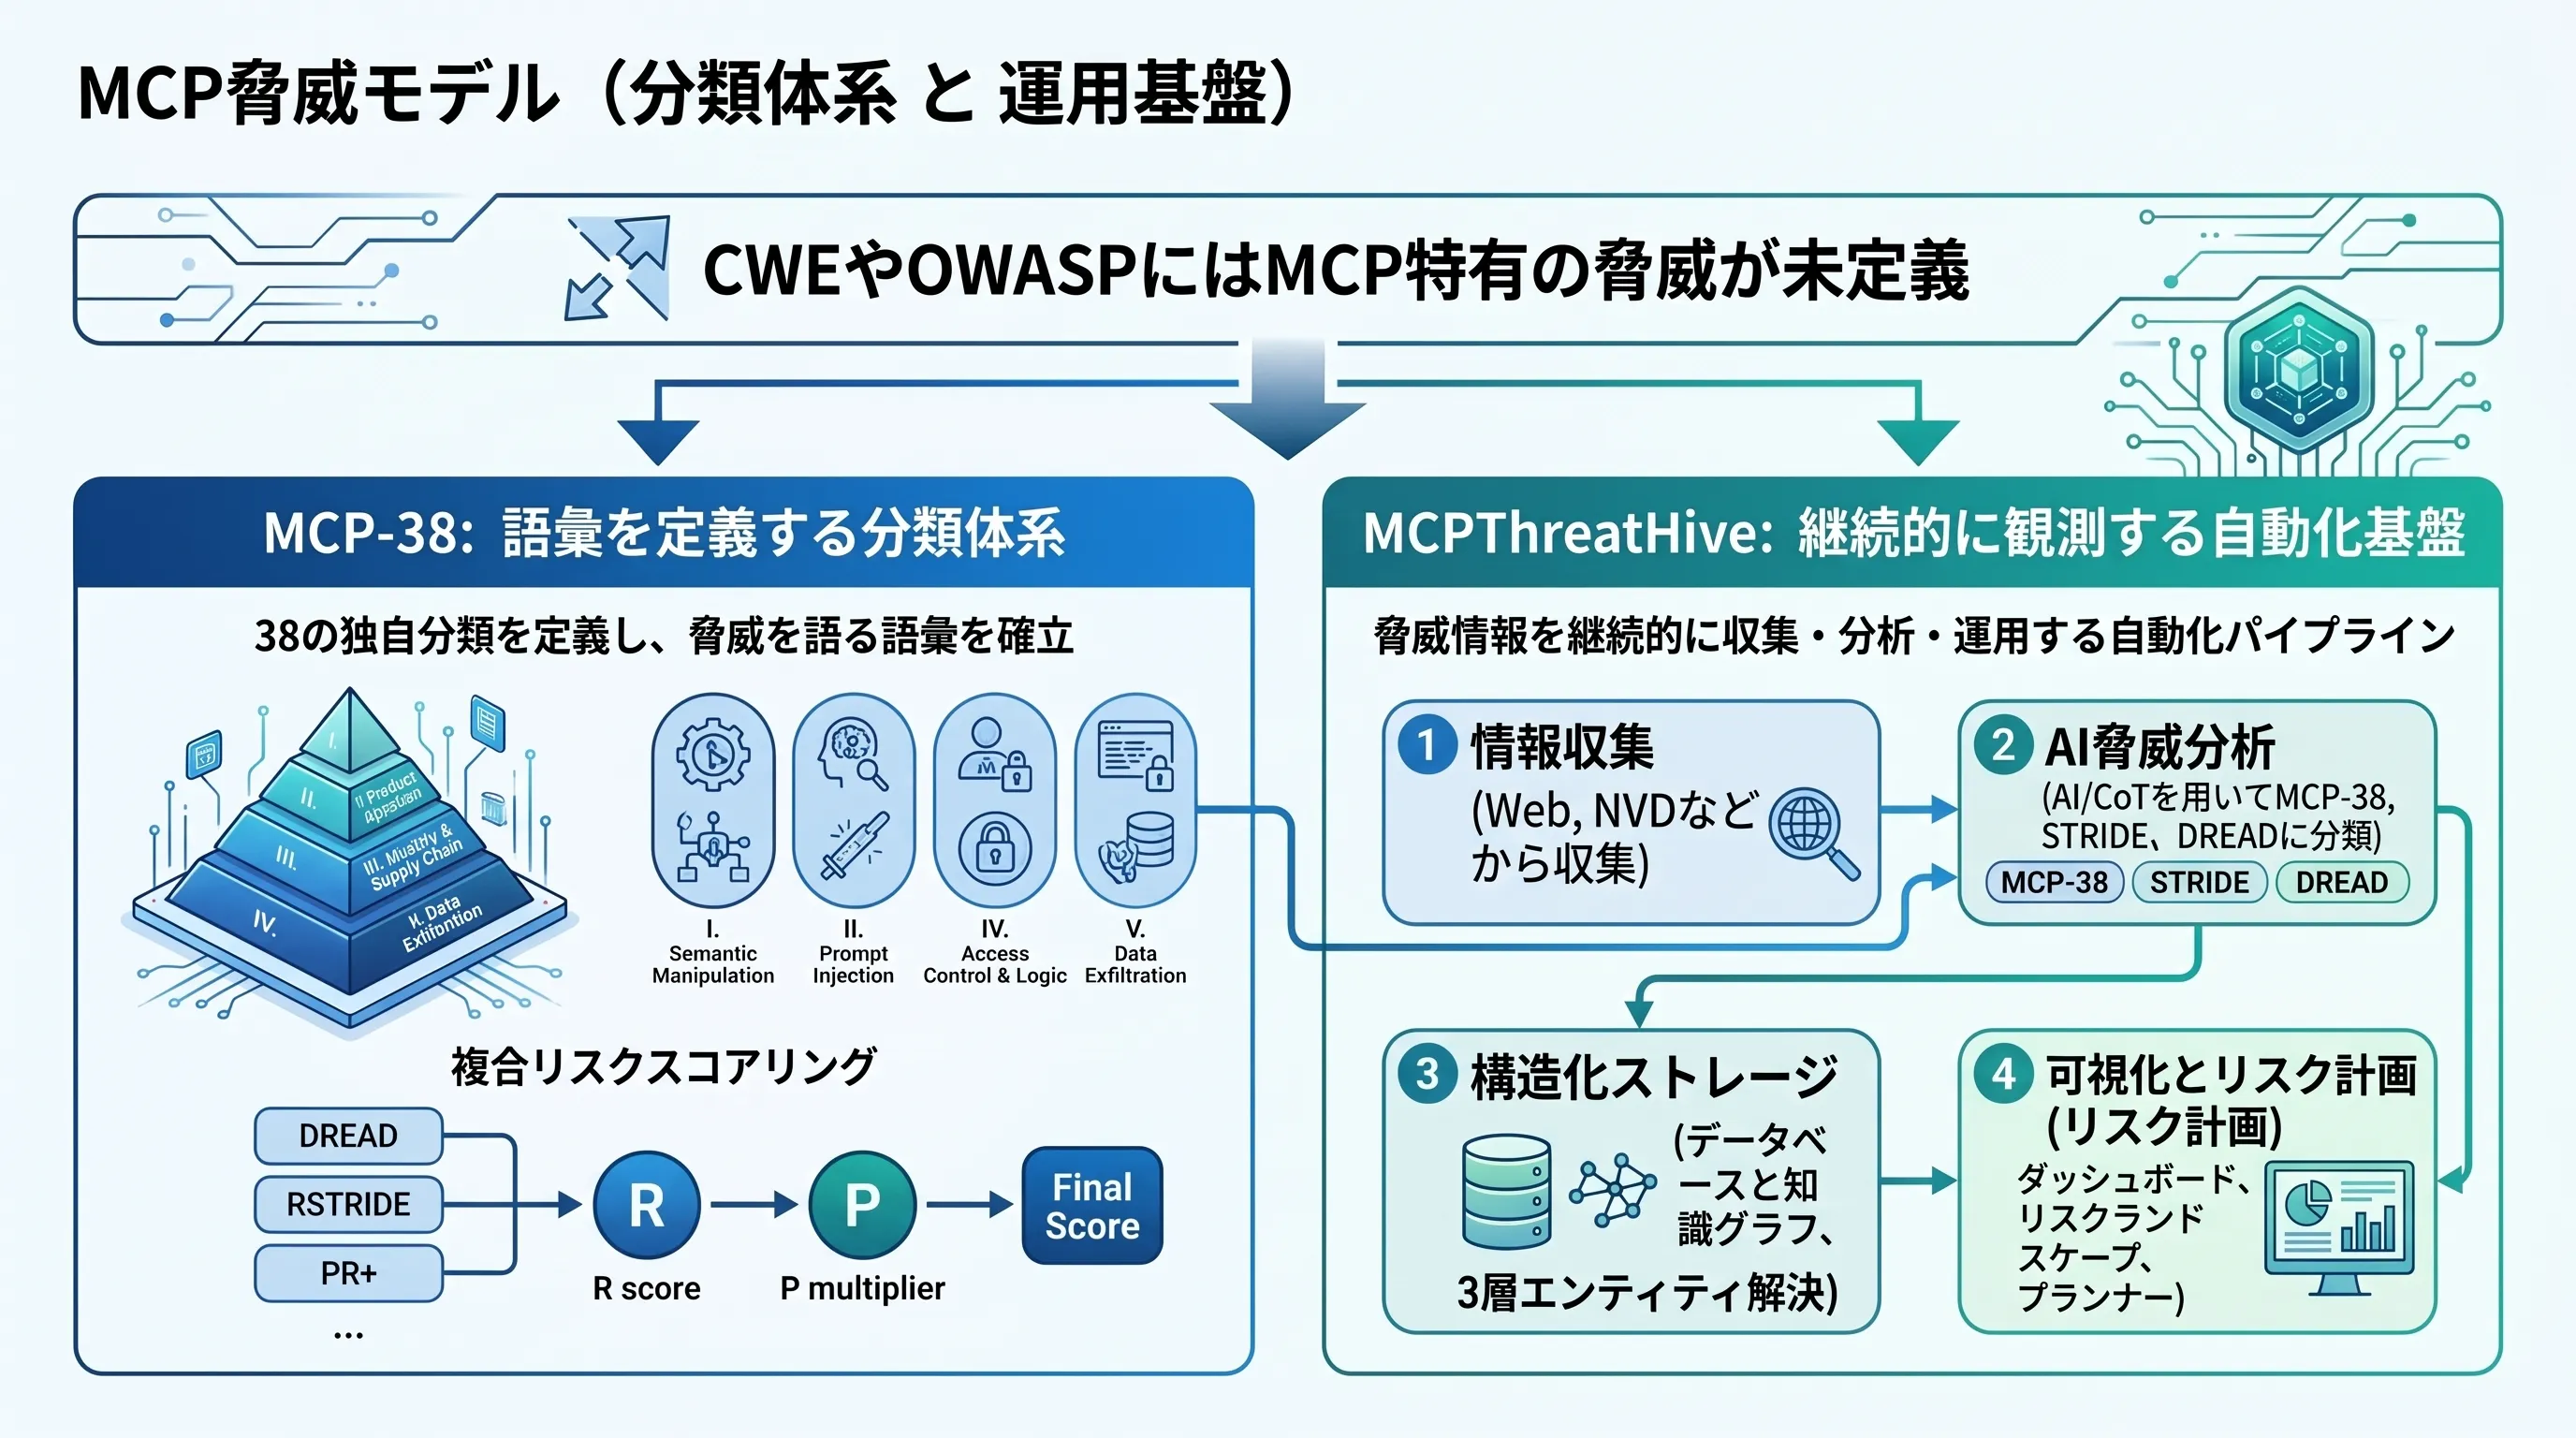
MCPの脅威を網羅的に分類する体系「MCP-38」と、それを運用する脅威インテリジェンス基盤「MCPThreatHive」の概要、および複合リスクスコアリングによる評価までを解説します。
記事を読むBNE技術ブログでは、機械学習やAIなどの数理アルゴリズムやコードを実装を交えながら解説しています。
MCPの脅威を網羅的に分類する体系「MCP-38」と、それを運用する脅威インテリジェンス基盤「MCPThreatHive」の概要、および複合リスクスコアリングによる評価までを解説します。
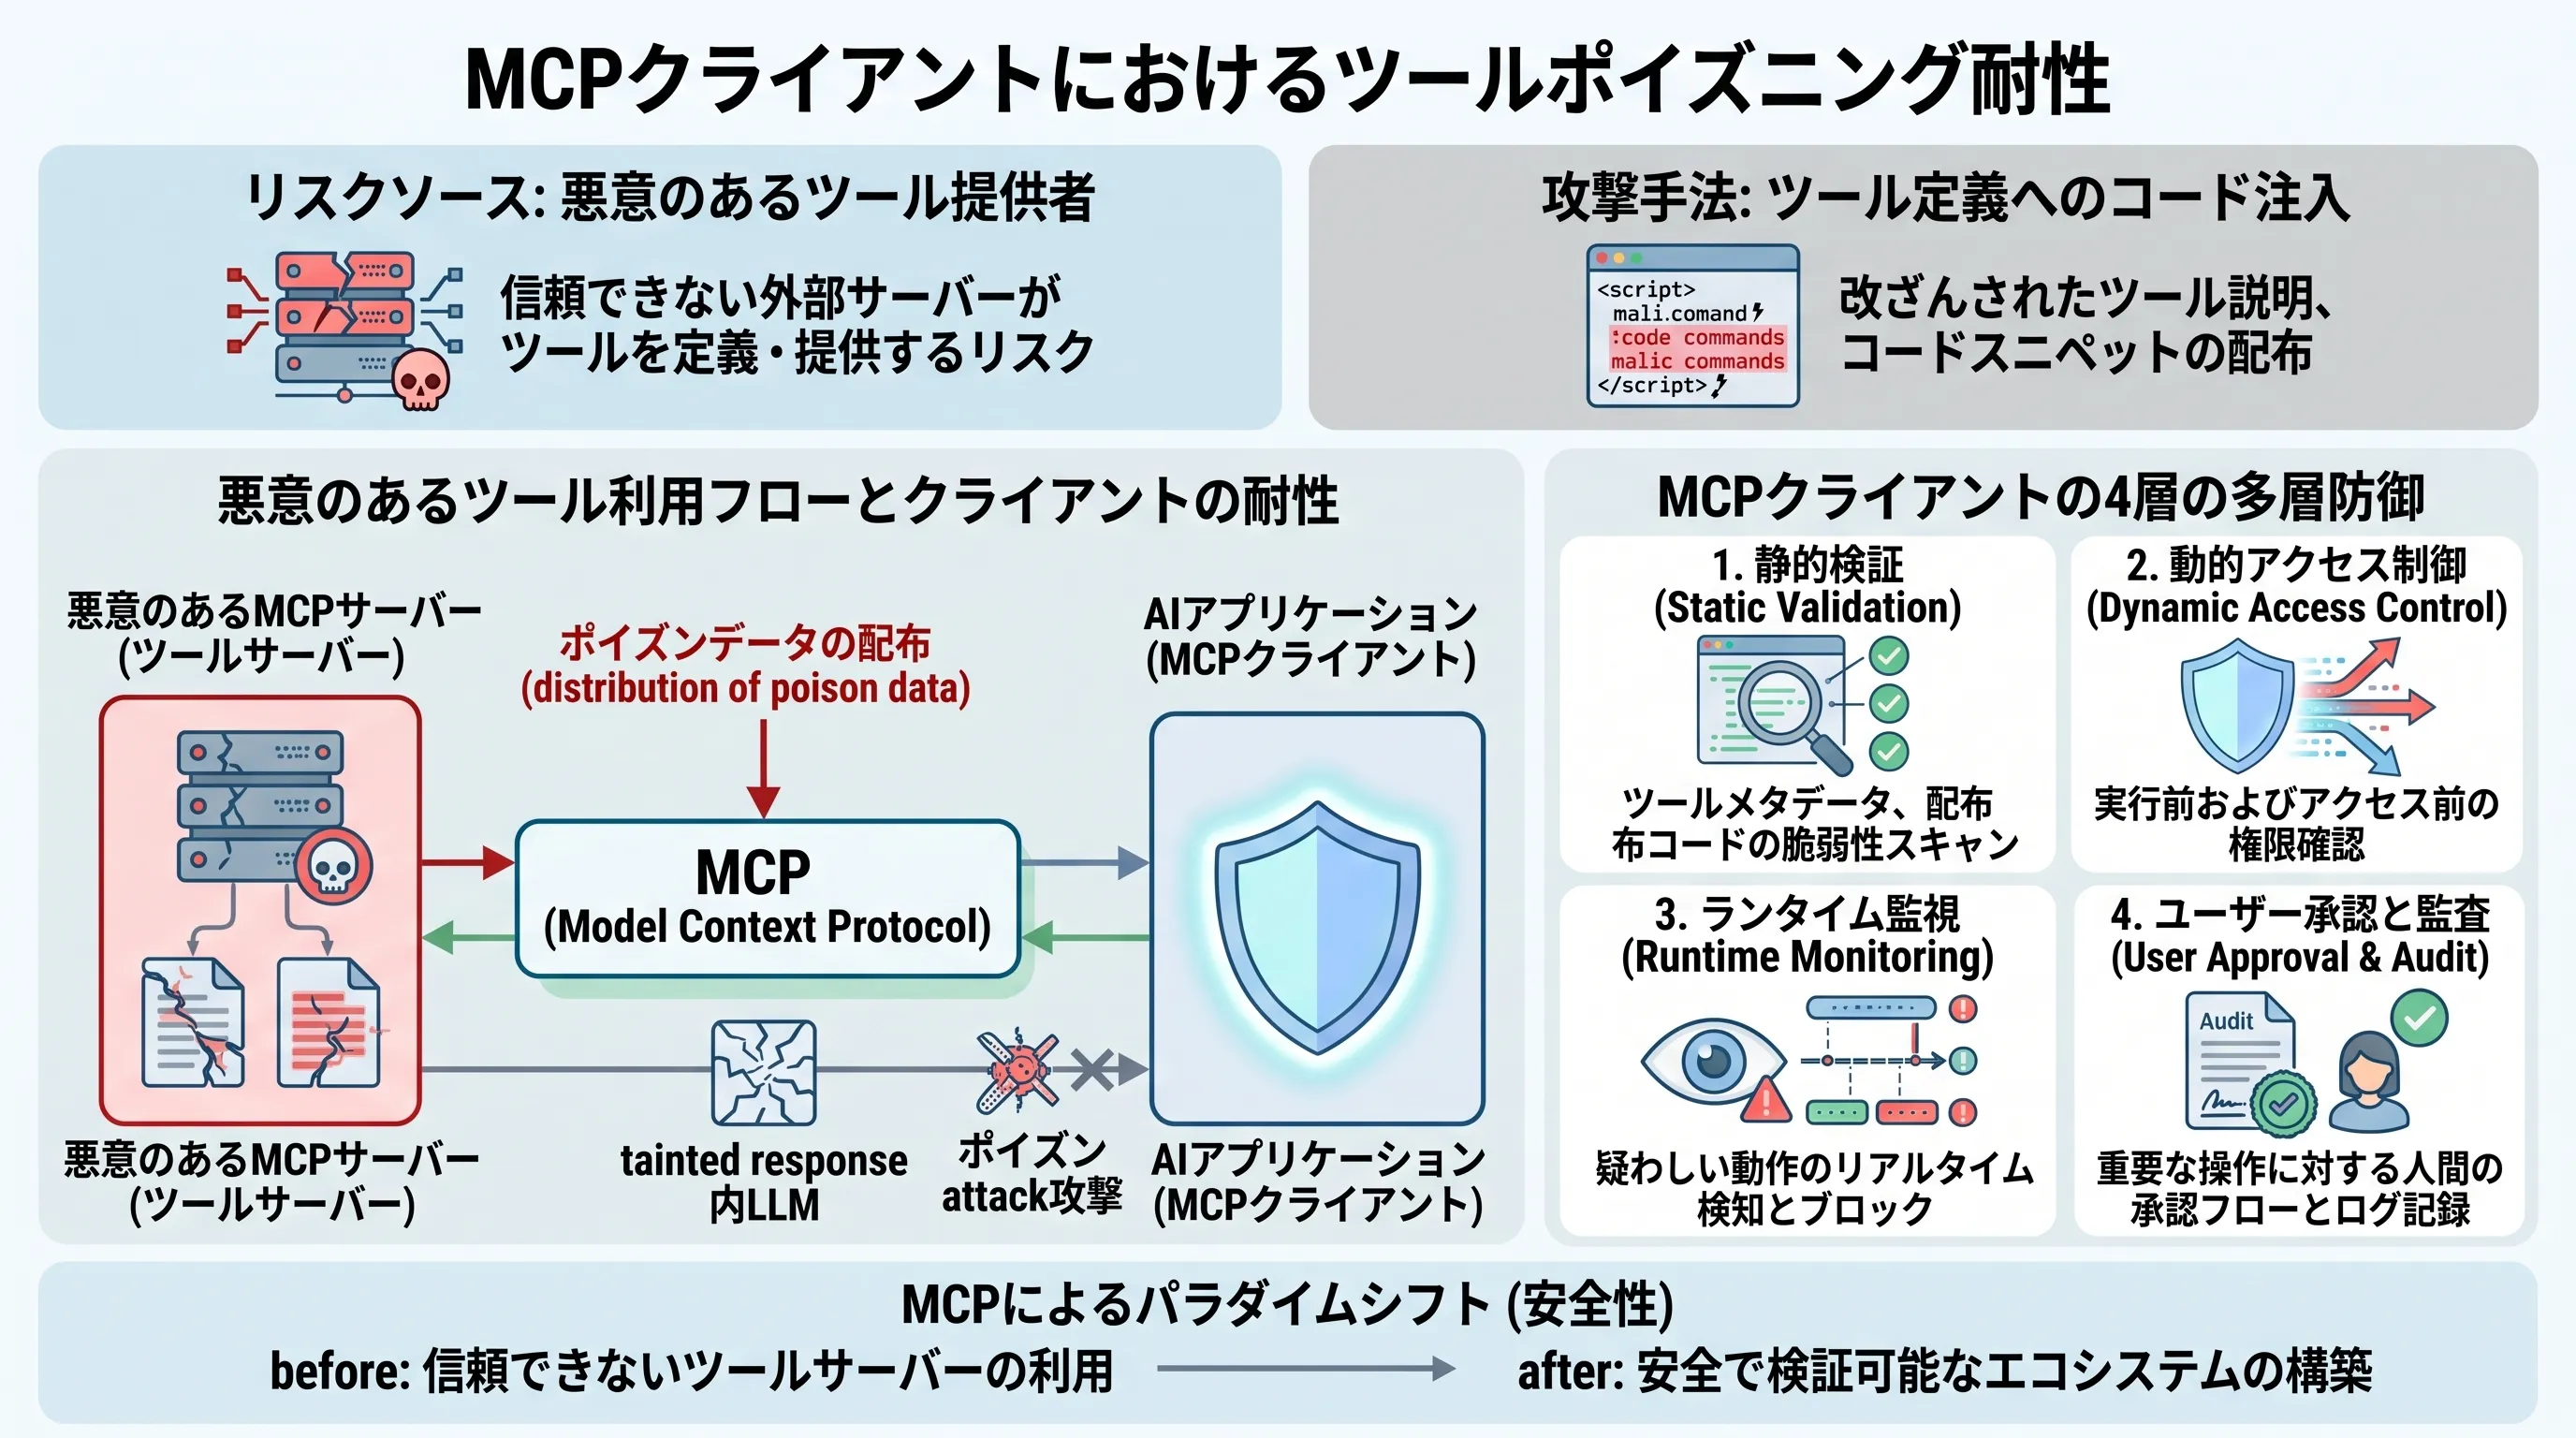
記事を読むMCPクライアントが抱える検証層の不足とパラメータ可視性の問題について解説し、悪意あるツールがどのように防御をすり抜けるかをPythonの実装で再現。さらに多層防御によるセキュアな実装や、主要な7クライアントの評価結果までを解説します。
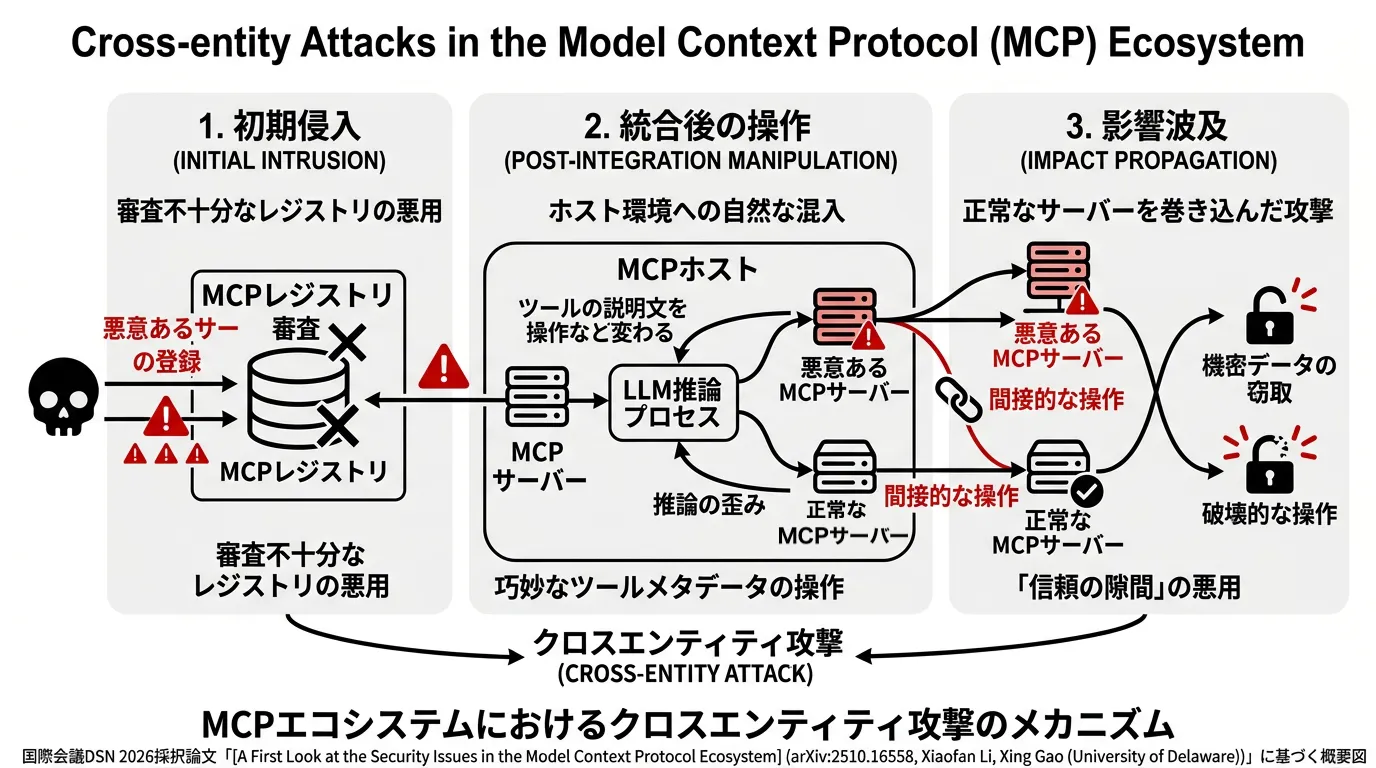
記事を読むMCPエコシステム全体を脅かす構造的なセキュリティリスクとして、アーキテクチャを構成する複数のエンティティをまたいで連鎖的に発生する「クロスエンティティ攻撃」の脅威について解説します。
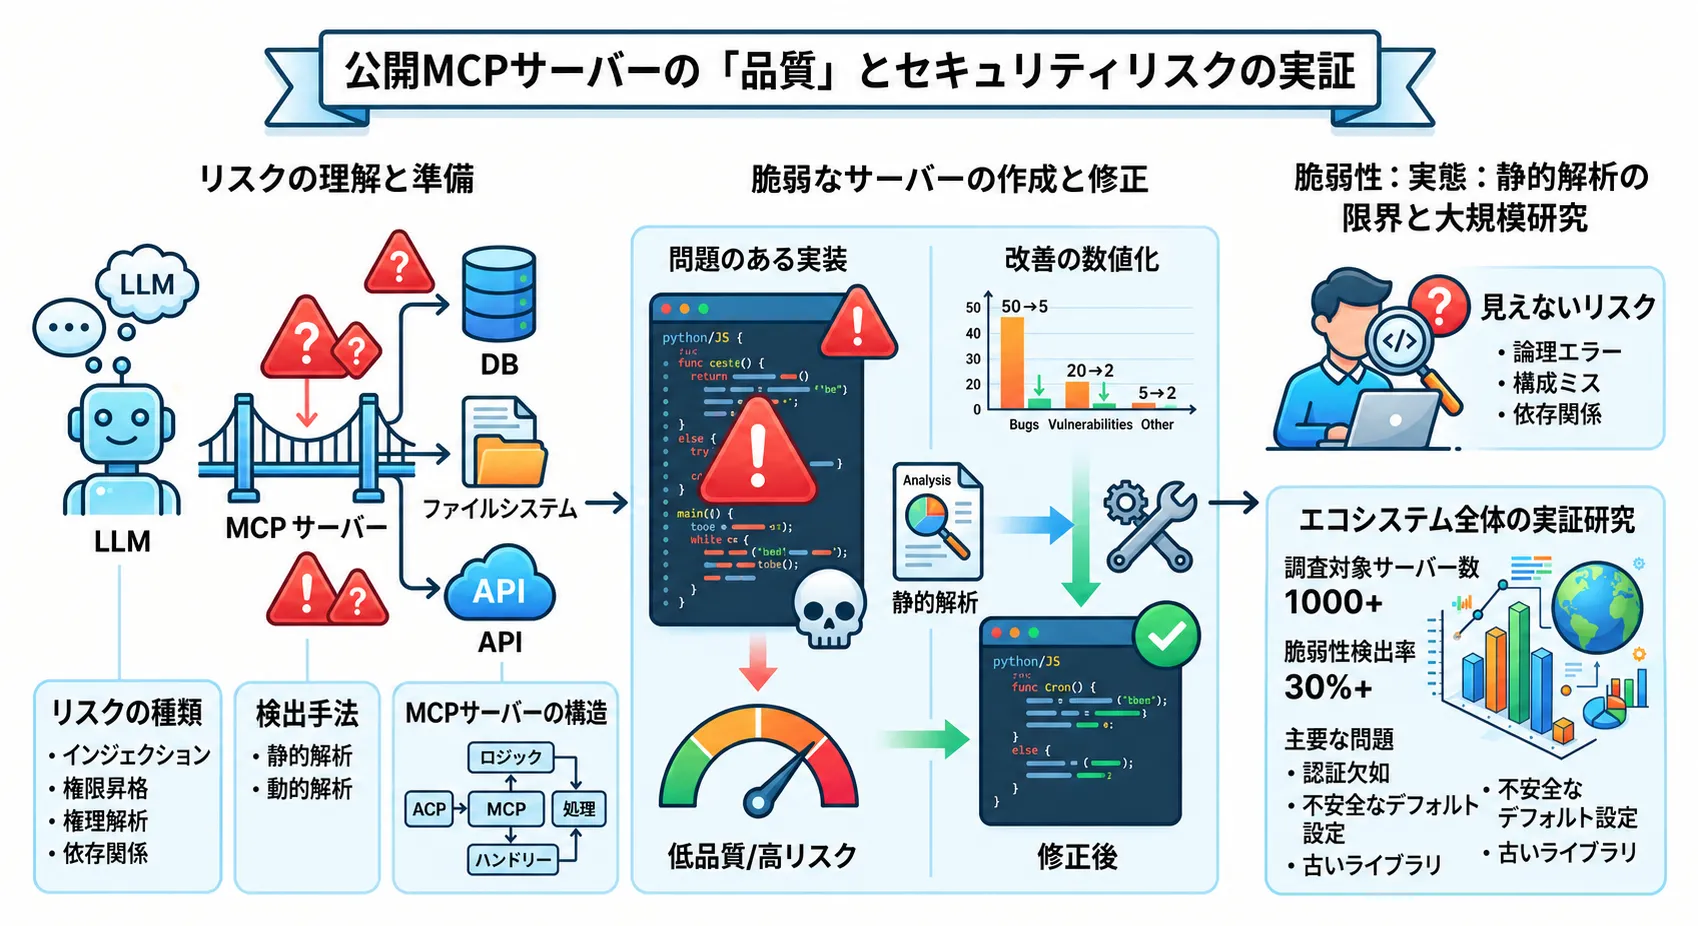
記事を読むオープンソースMCPサーバーの品質に焦点を当て、脆弱なサーバーの実装例から静的解析、リファクタリングまでの改善プロセスと、エコシステムの大規模実証研究による品質評価について解説します。
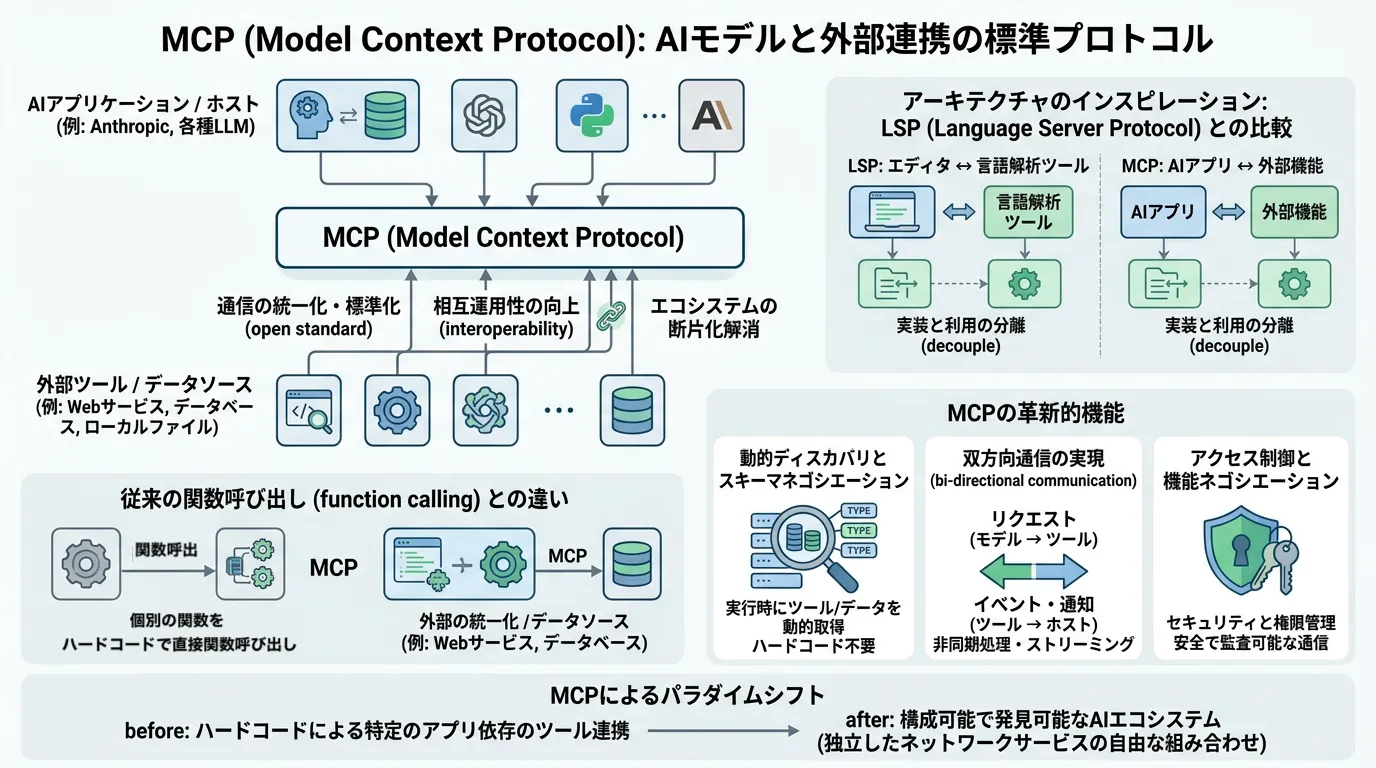
記事を読むAIモデルと外部ツールやデータソースとのやり取りを標準化するAnthropic提唱のオープンな標準プロトコル「MCP」のアーキテクチャの基本と初歩的な脅威について解説します。
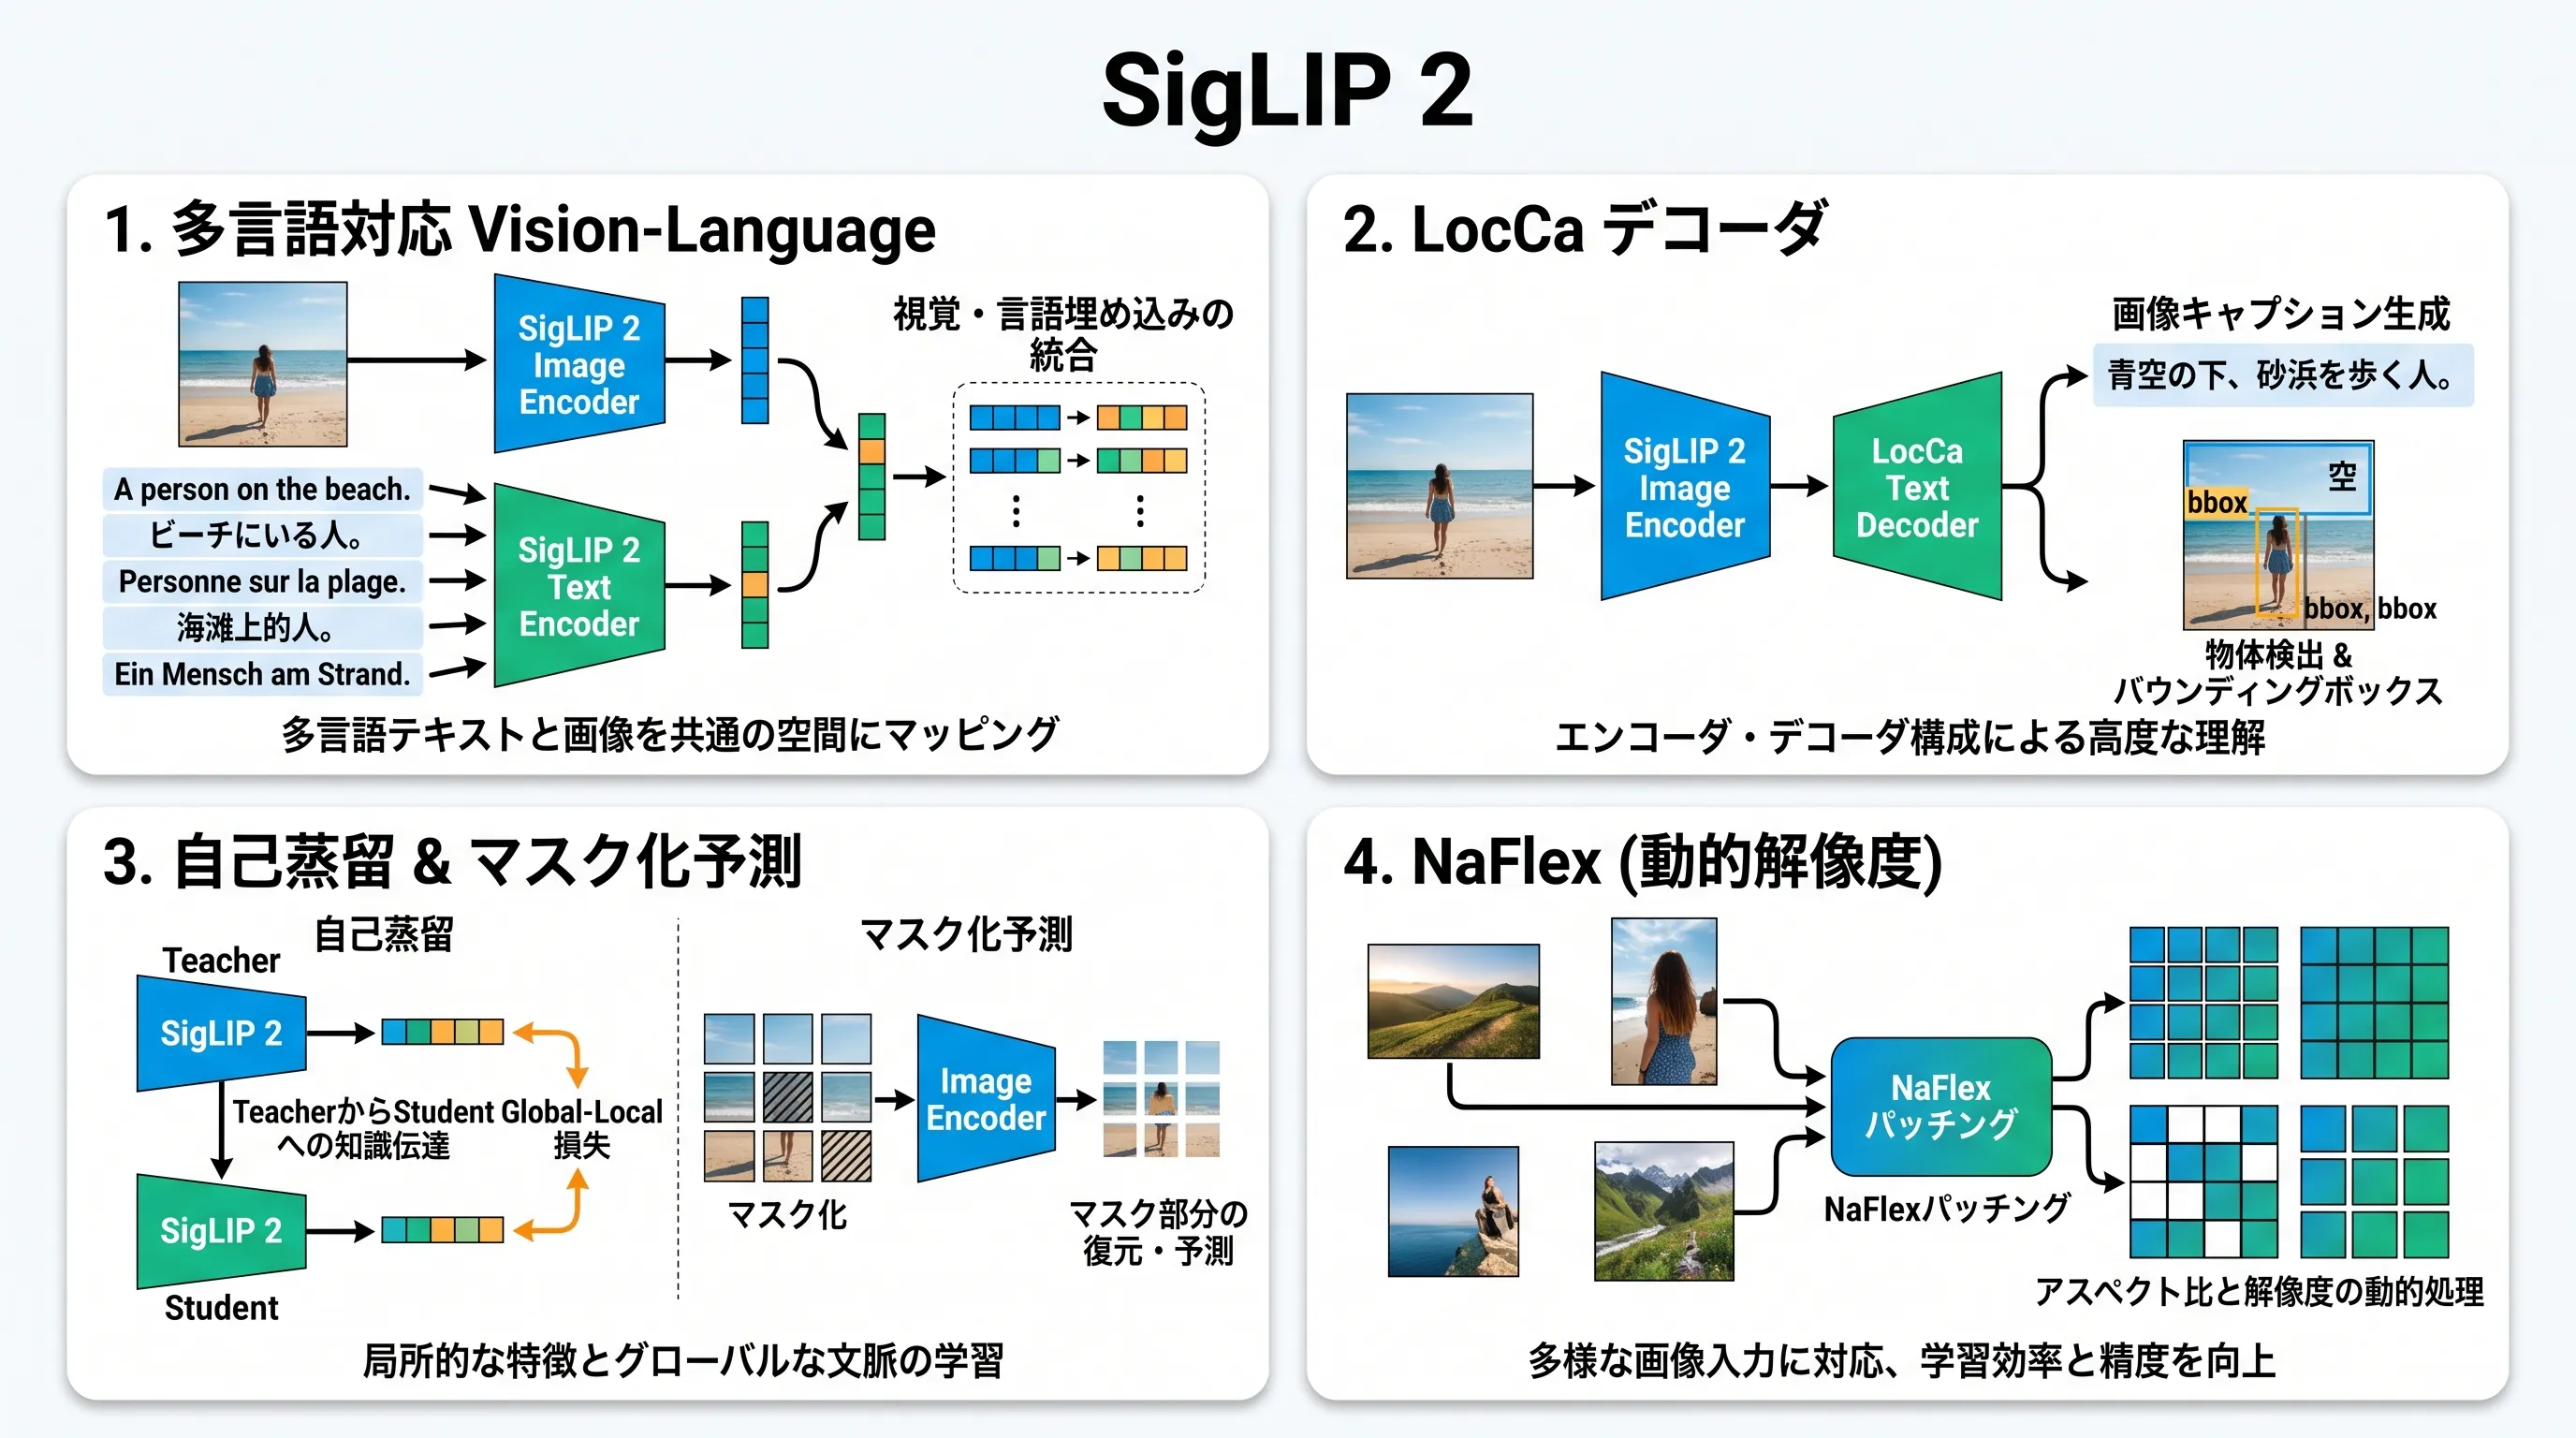
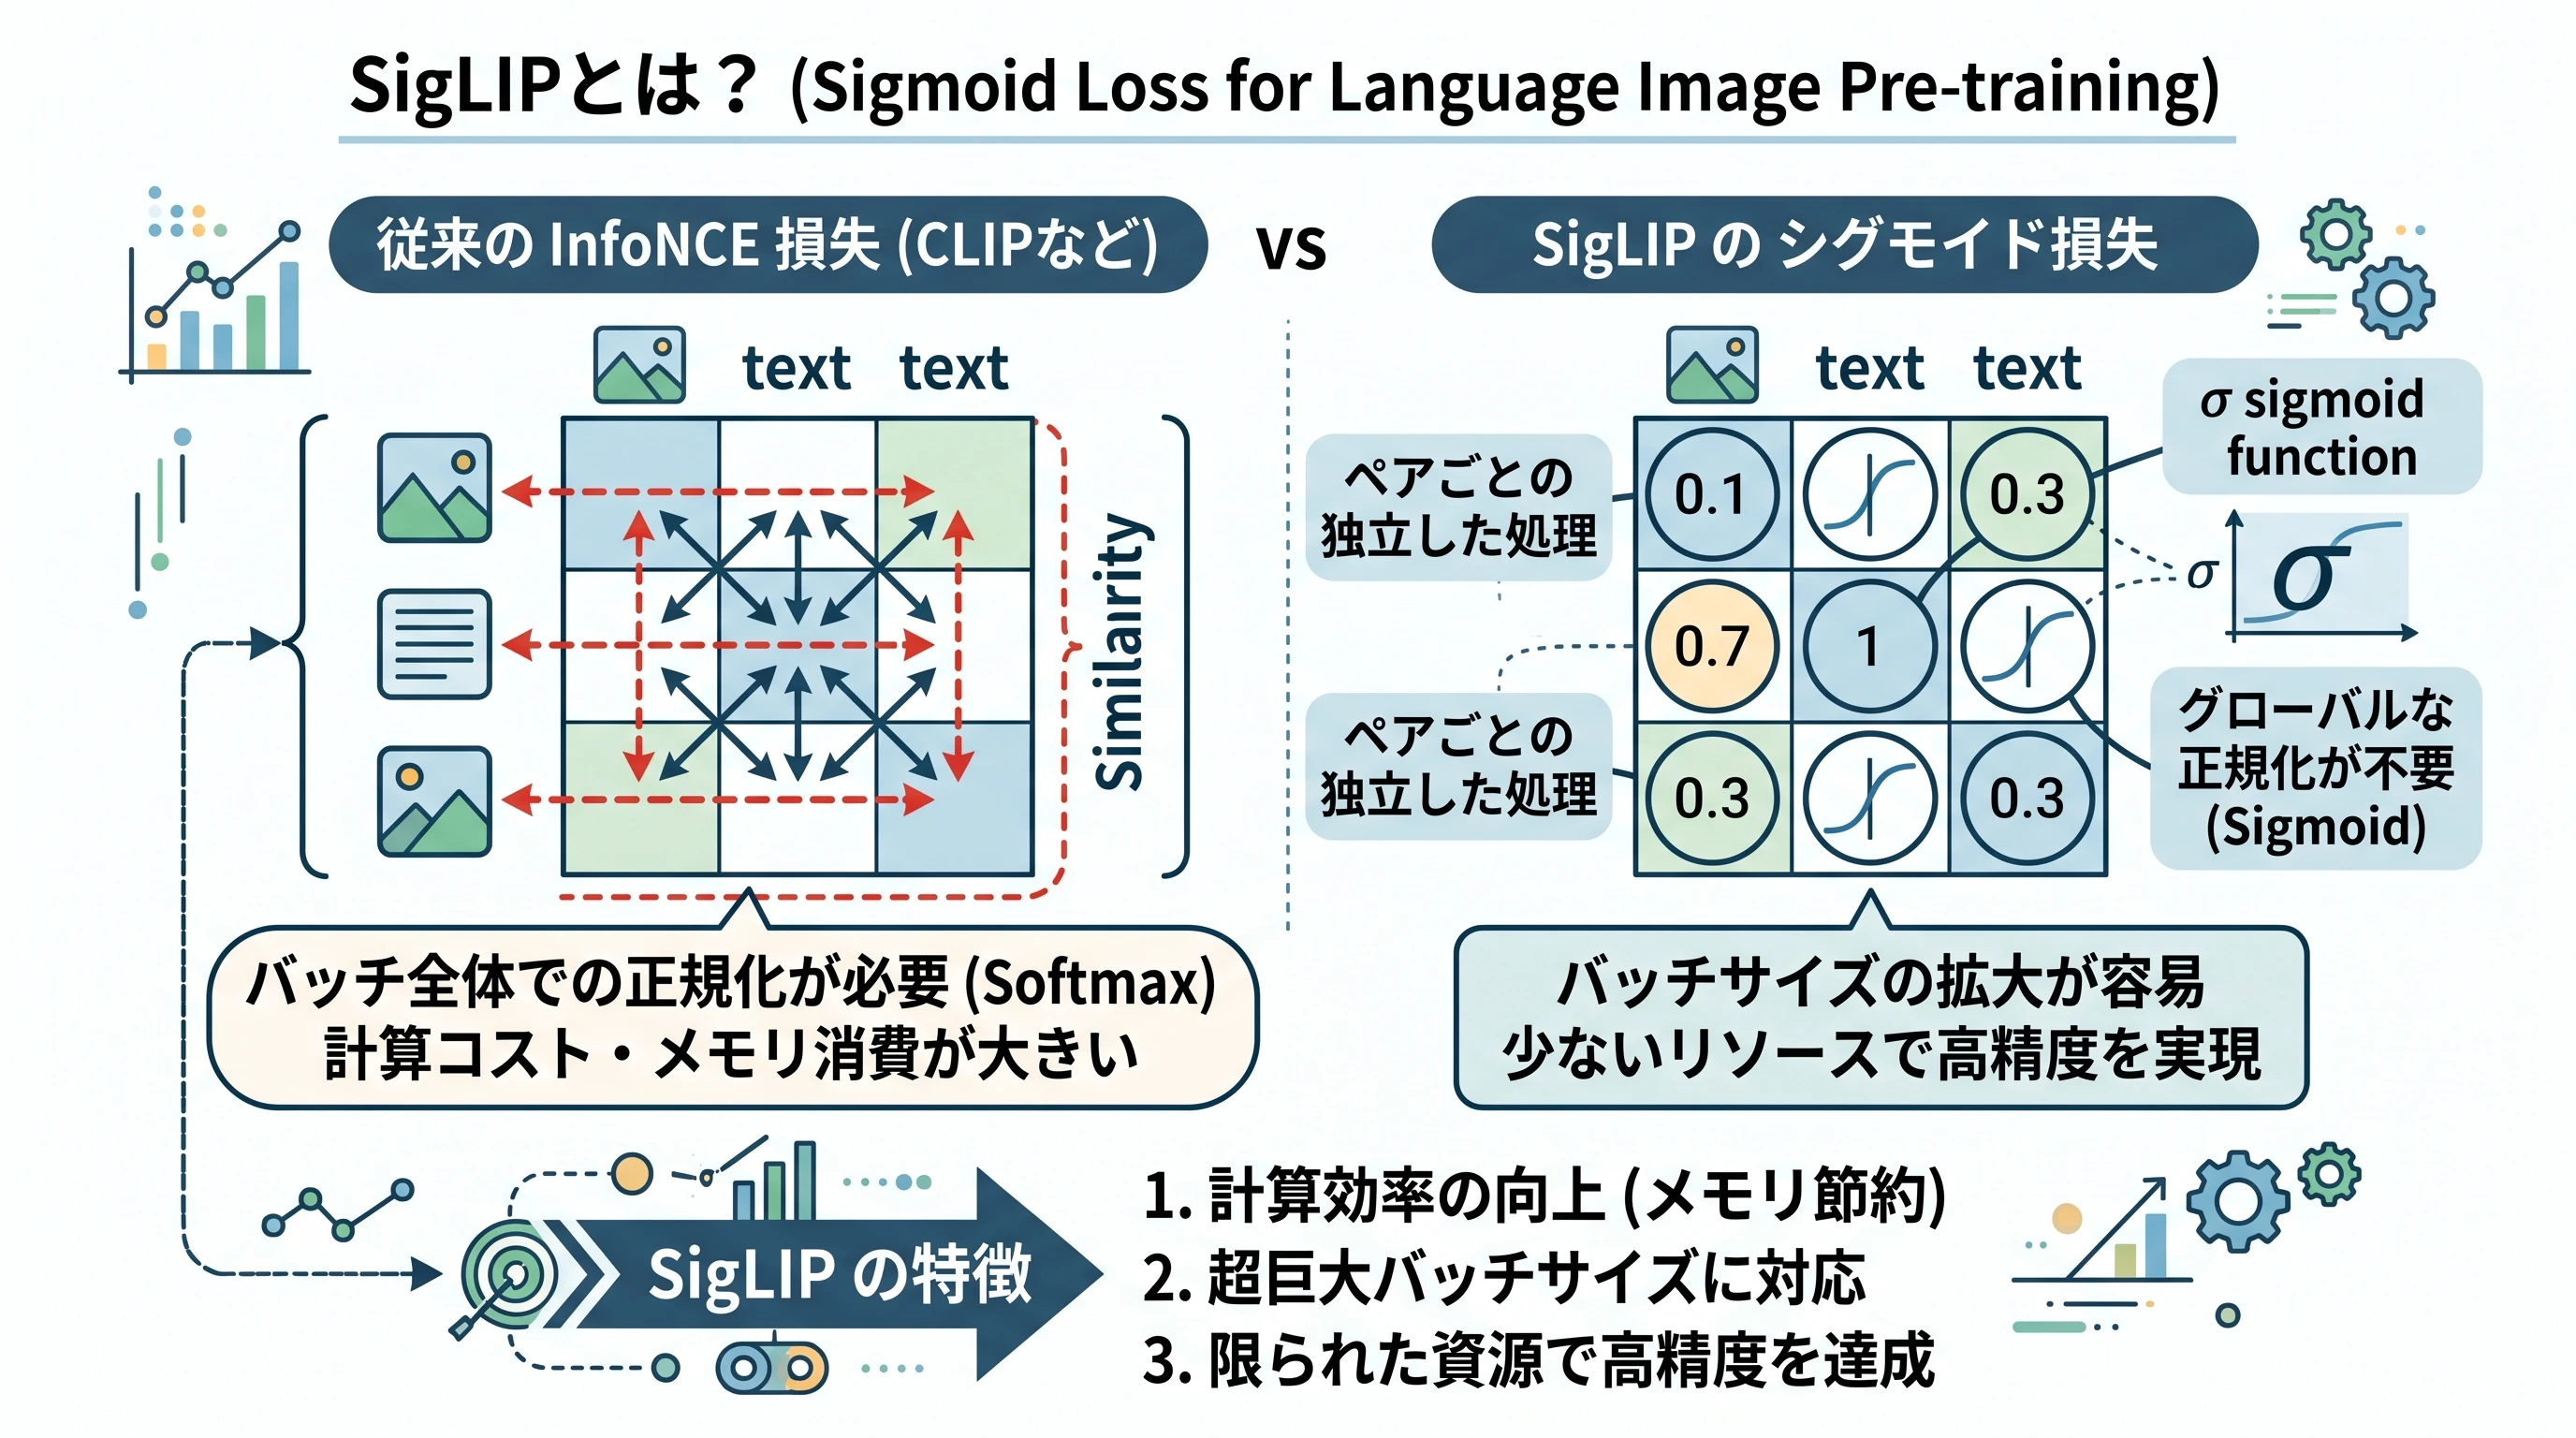
記事を読む多言語対応の強力な視覚・言語エンコーダ「SigLIP 2」の進化、従来のシグモイド損失にLocCaデコーダや自己蒸留を取り入れたアーキテクチャから、PyTorchでのスクラッチ実装、Hugging Faceを用いたDense Features抽出までを解説します。
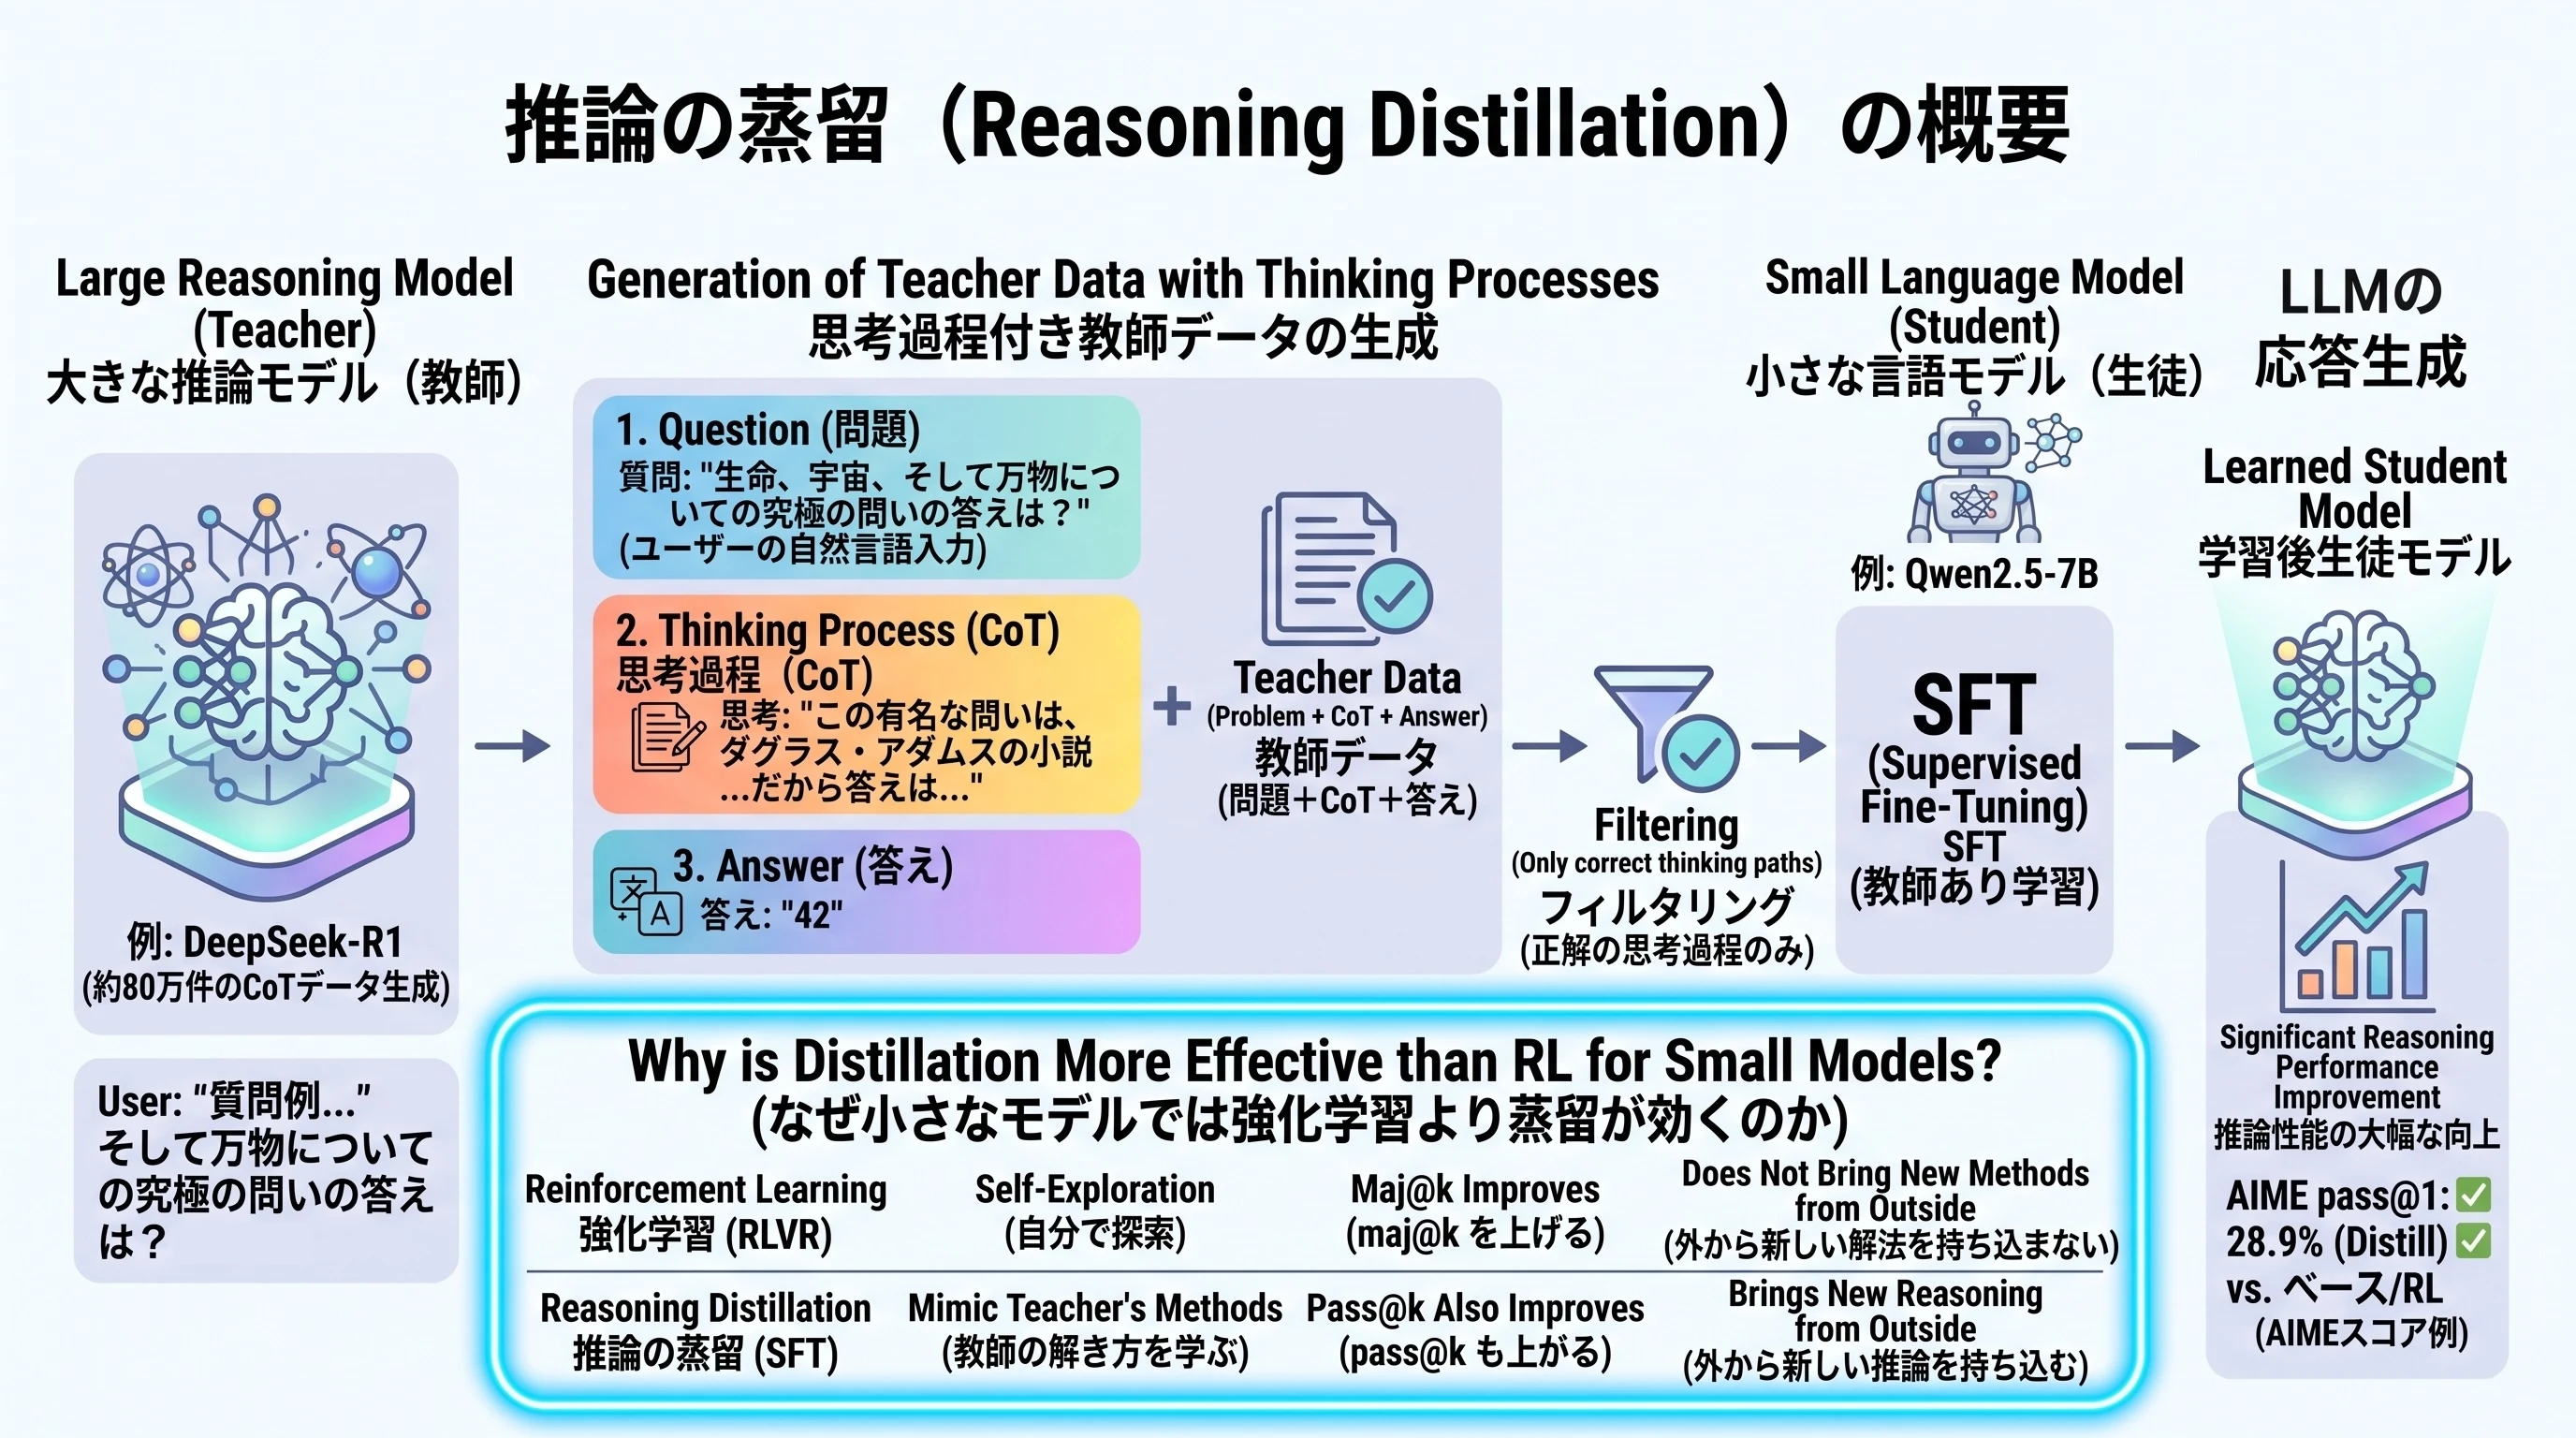
記事を読む大きな推論モデルの思考過程を教師データにして小さなモデルをSFTする「推論の蒸留」を解説。知識蒸留の系譜、強化学習(GRPO)との比較、データの質と量の影響、Pythonでの実装と比較実験までを網羅します。
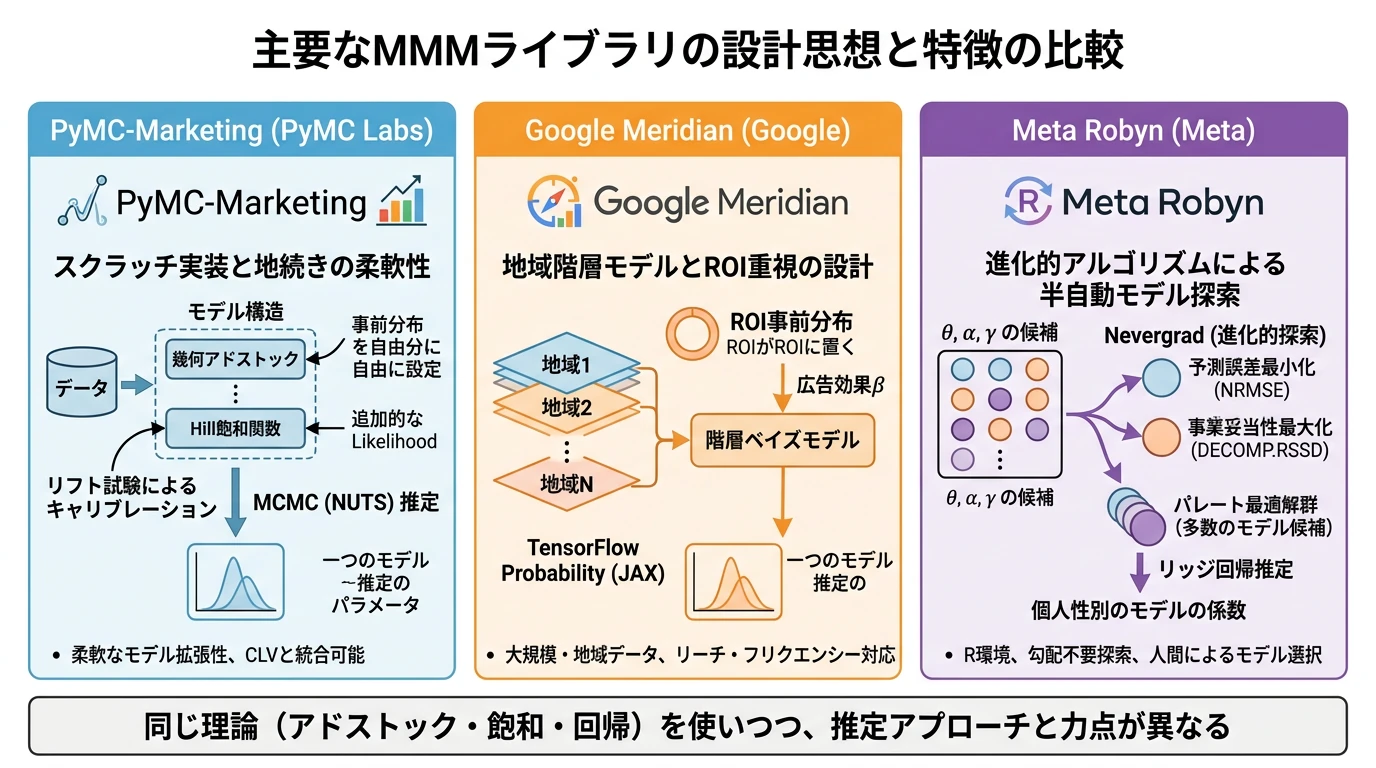
記事を読むMMMの主要なOSSライブラリであるPyMC-Marketing・Google Meridian・Meta Robynについて、それぞれの設計思想の違いと使い分けを、同じデータを推定しながら解説します。
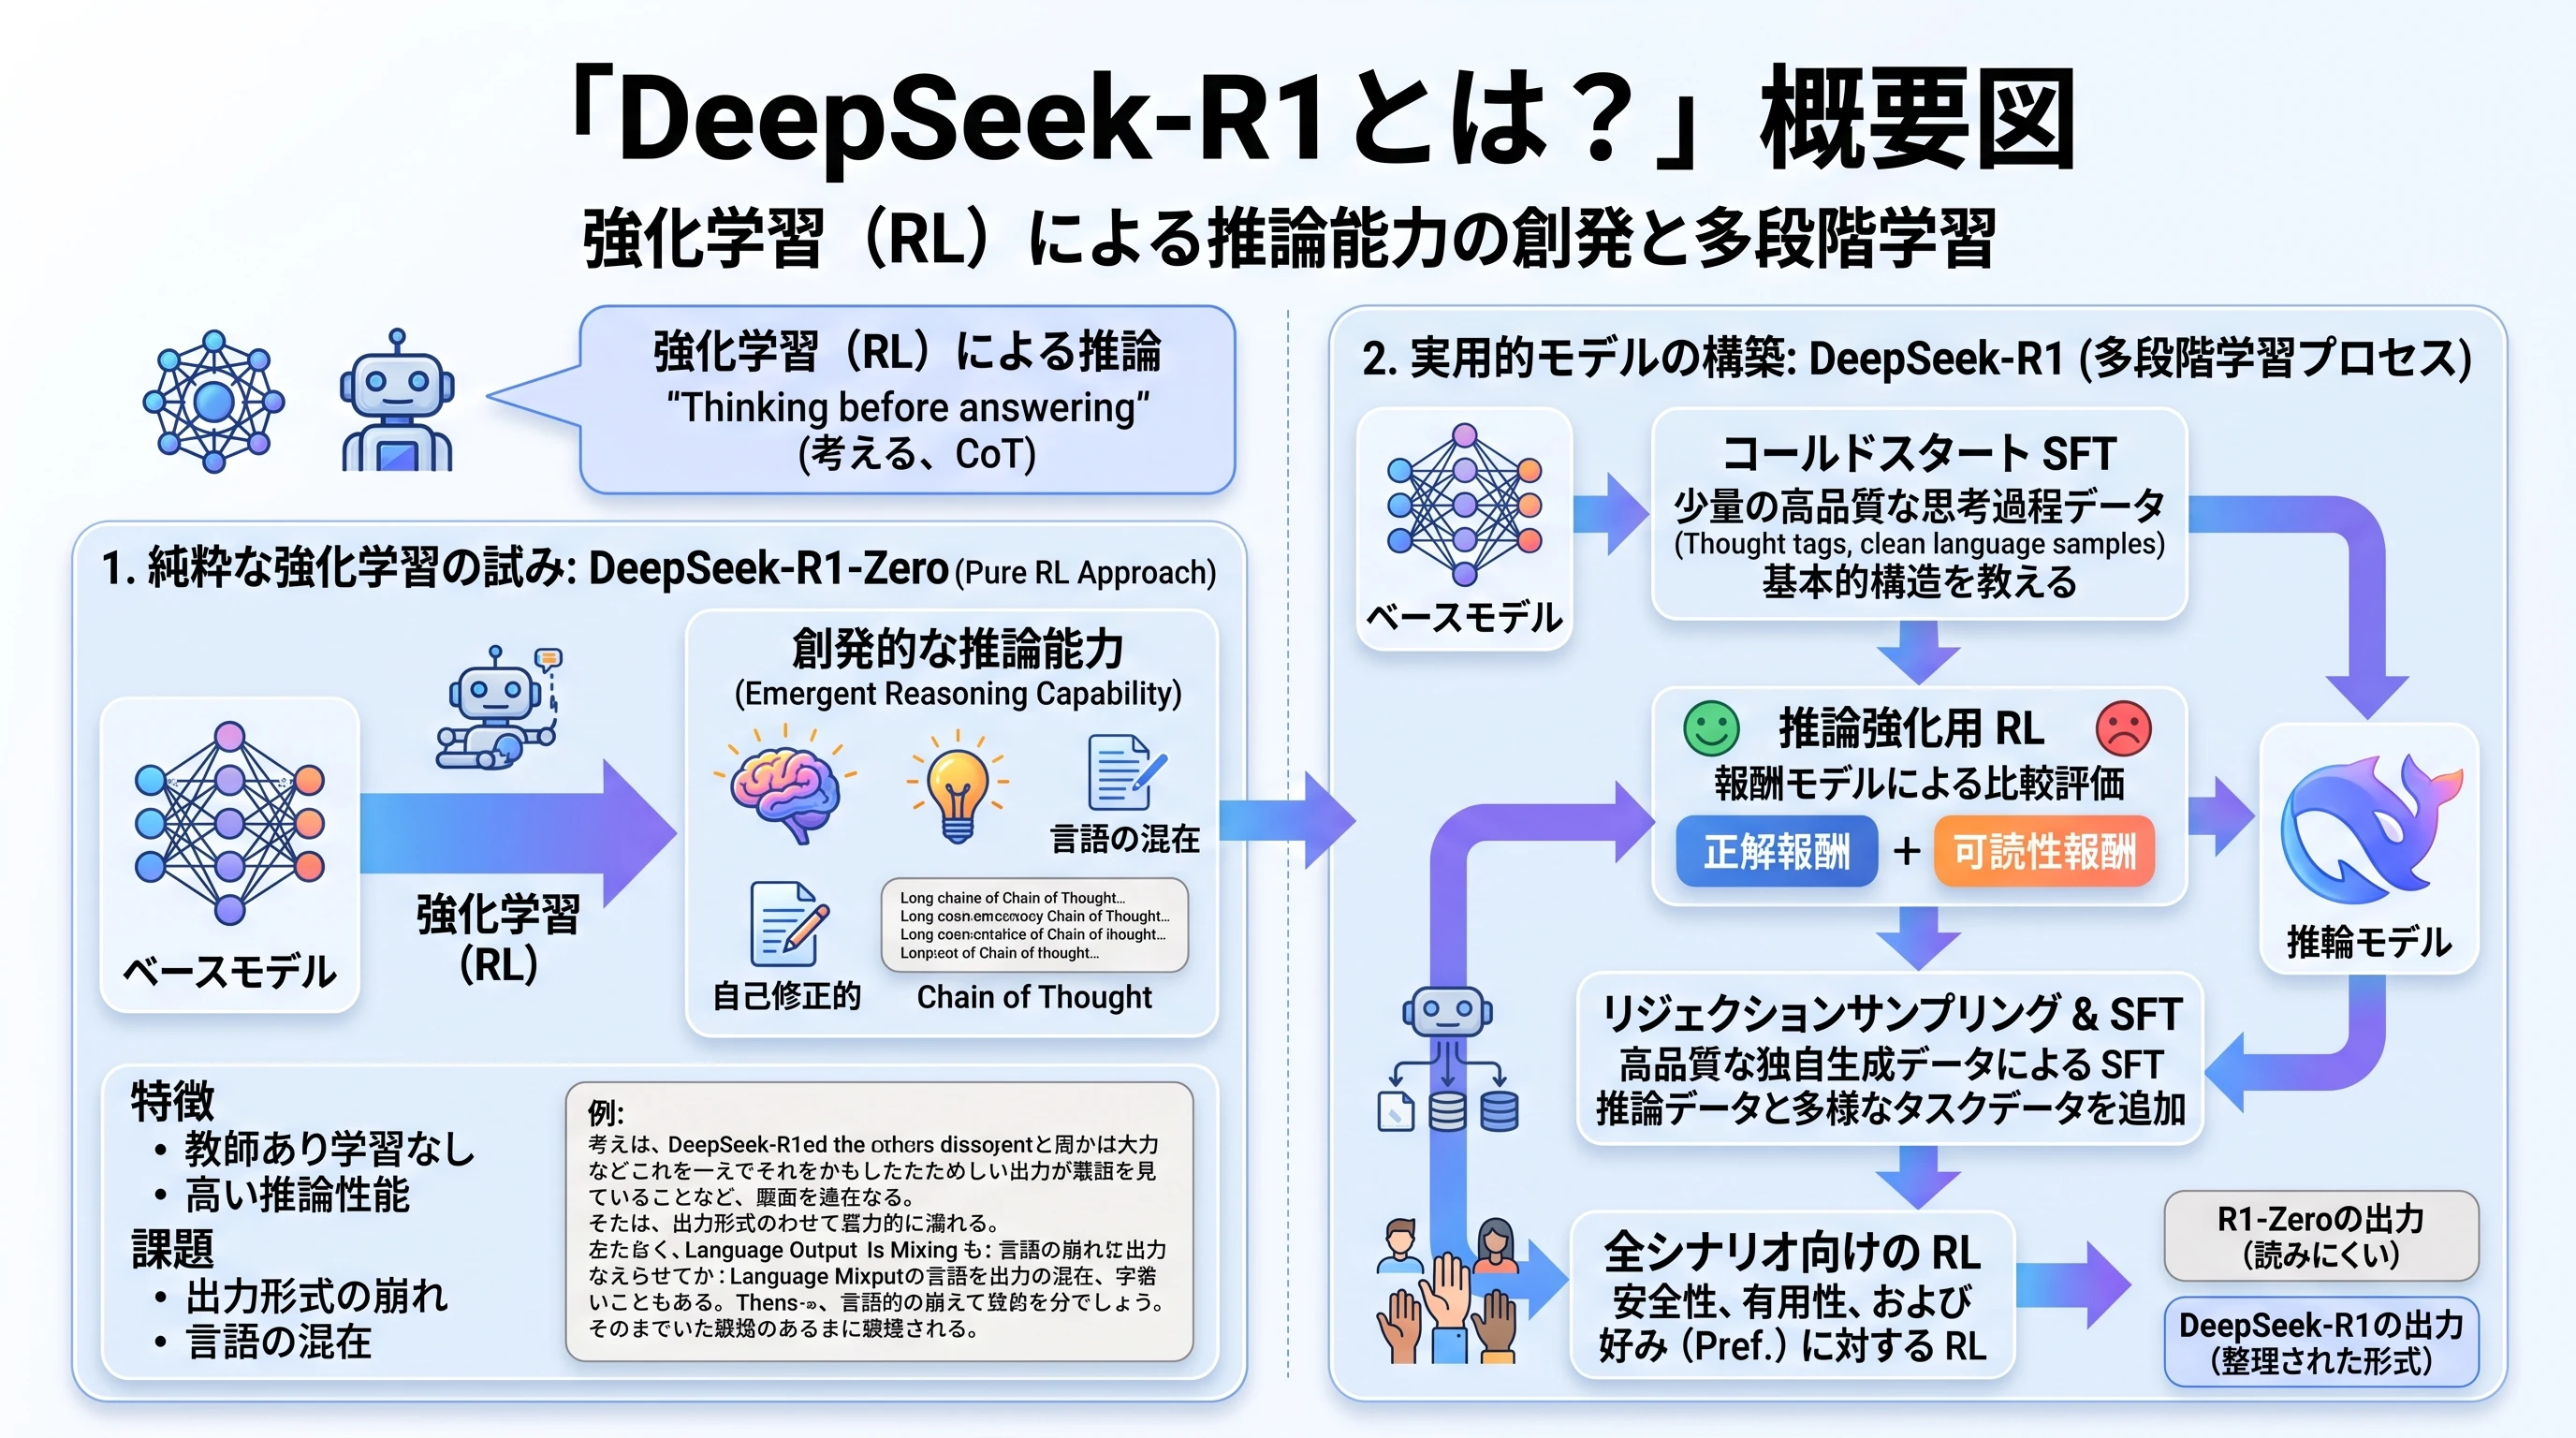
記事を読む強化学習(RL)だけで推論能力を引き出した「DeepSeek-R1-Zero」と、コールドスタートSFTを含む多段階の学習で実用性を高めた「DeepSeek-R1」を解説します。生成長の増加と自己検証(aha moment)、言語の混在、PRMやMCTSがうまくいかなかった理由、蒸留の結果を整理し、Qwen2.5-1.5BでR1-Zero型の強化学習を小規模に追試します。
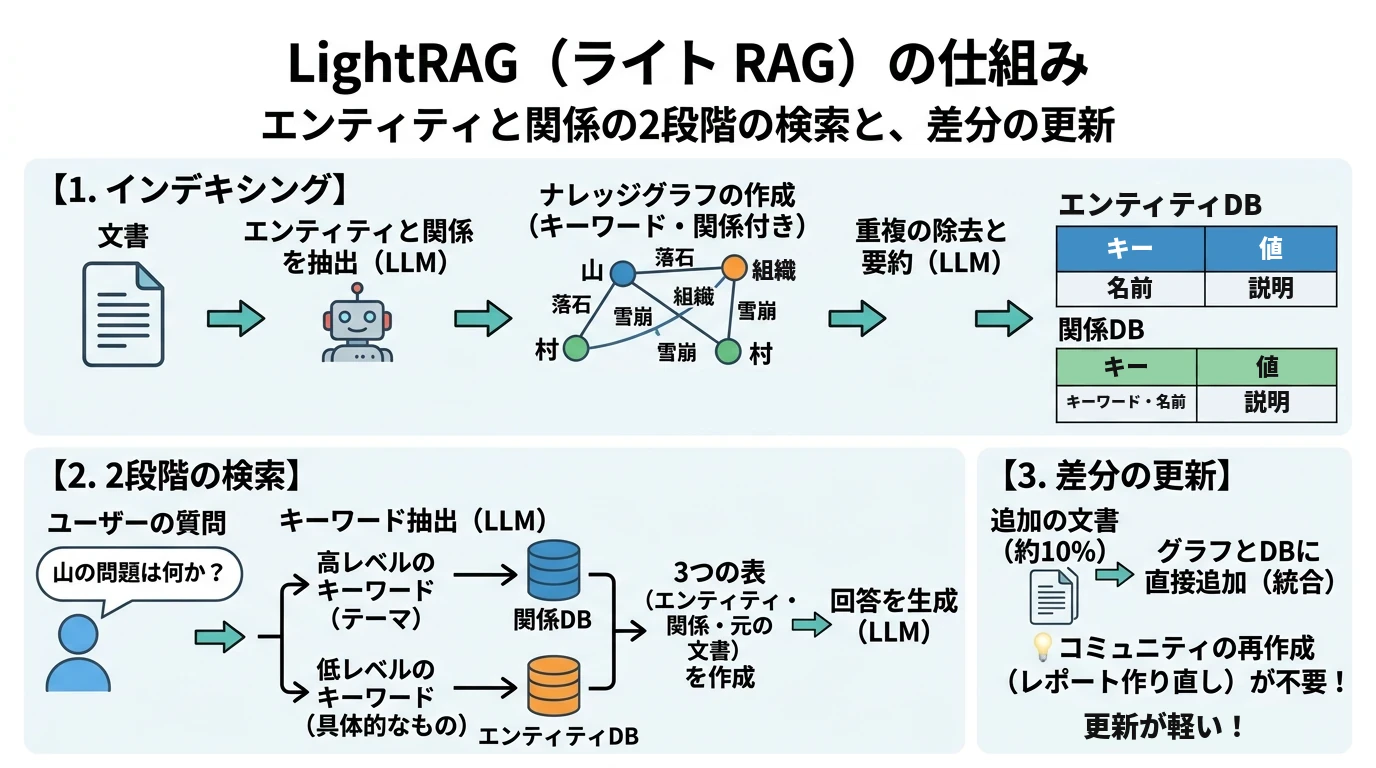
記事を読むGraphRAG を軽くした LightRAG を、Python のスクラッチ実装で解説します。LLM で文書からエンティティと関係(キーワード付き)を抽出してキー・値のインデックスを作り、質問から書き出した低レベル・高レベルのキーワードで、エンティティと関係の2段階の検索をします。架空の山岳コーパスと Qwen2.5-7B-Instruct で、GraphRAG の Global Search・Local Search と答えの質とコストを比べ、文書を追加したときの差分の更新の手間を確かめます。
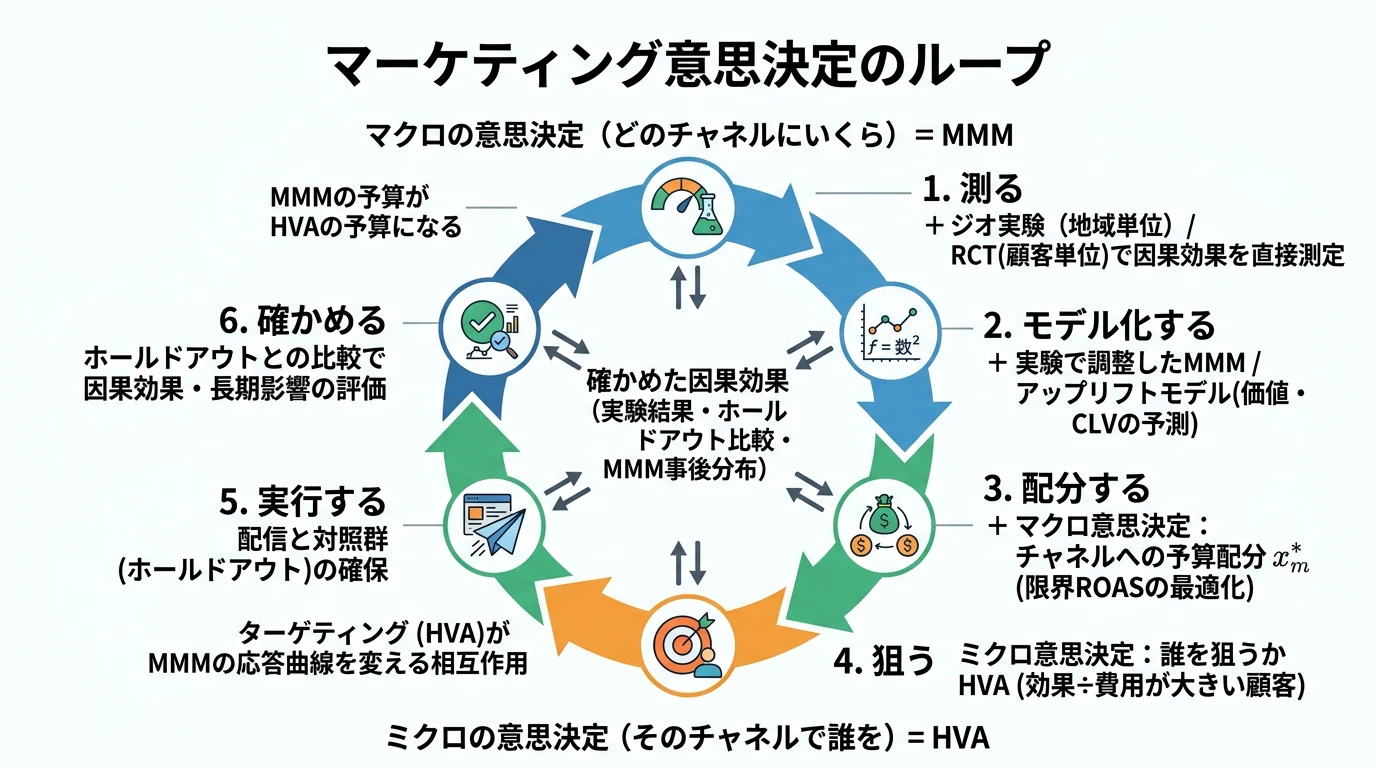
記事を読むチャネルへの予算配分を決めるMMMと、そのチャネルで誰を狙うかを決めるHVA分析を、実験を土台にした「測る → モデル化する → 配分する → 狙う → 実行する → 確かめる」という意思決定のループとしてつなぎ、実験とモデル更新の頻度や、ターゲティングが応答曲線を変える相互作用までを解説します。
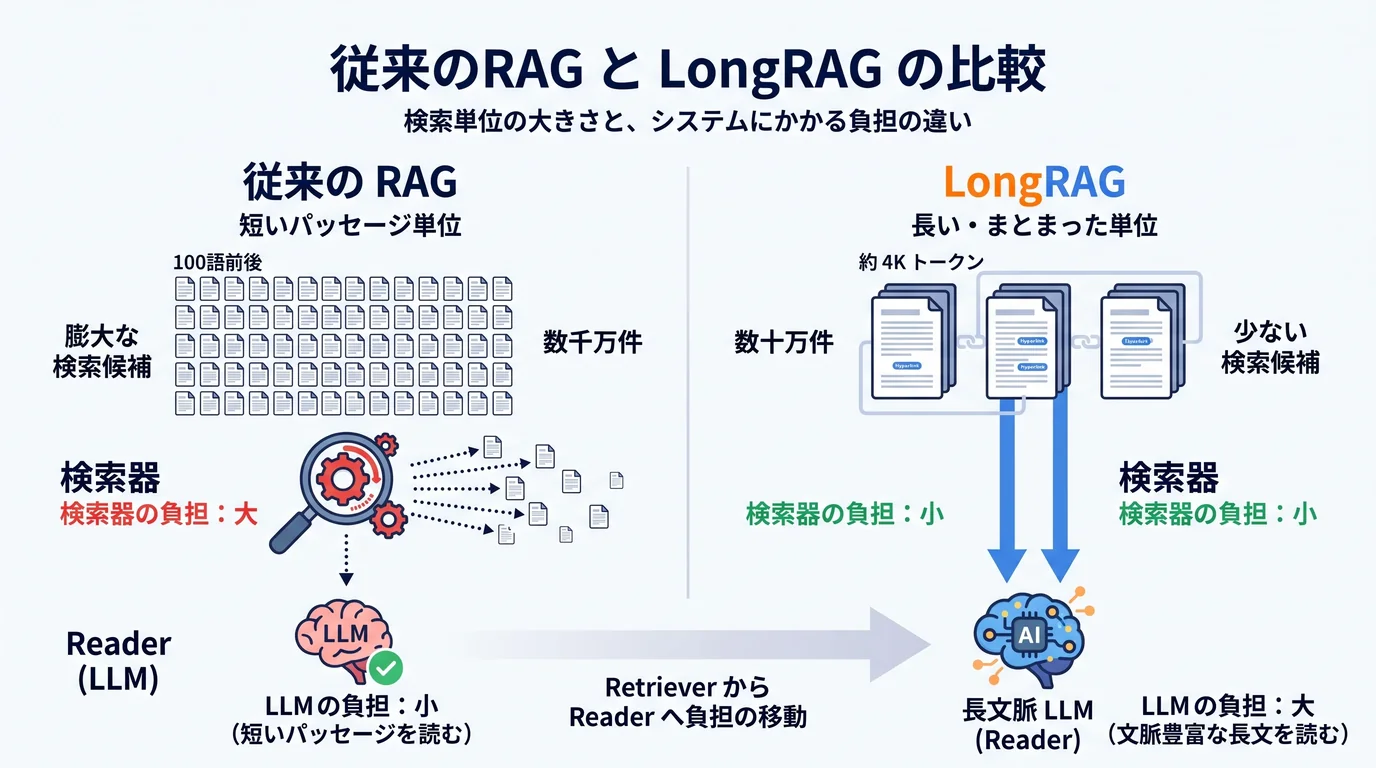
記事を読むRAGの検索単位を100語のパッセージから約4Kトークンの長い単位に変え、Retrieverの負担を減らして長文脈LLMに読ませる「LongRAG」について、短いチャンクで文脈が失われ複数の記事にまたがる答えが見つからない問題、リンクで記事をまとめる単位とチャンクの最大類似度による検索、架空の百科事典を使ったPythonの実験、長文脈LLMがあればRAGは不要かという問いまでを解説します。
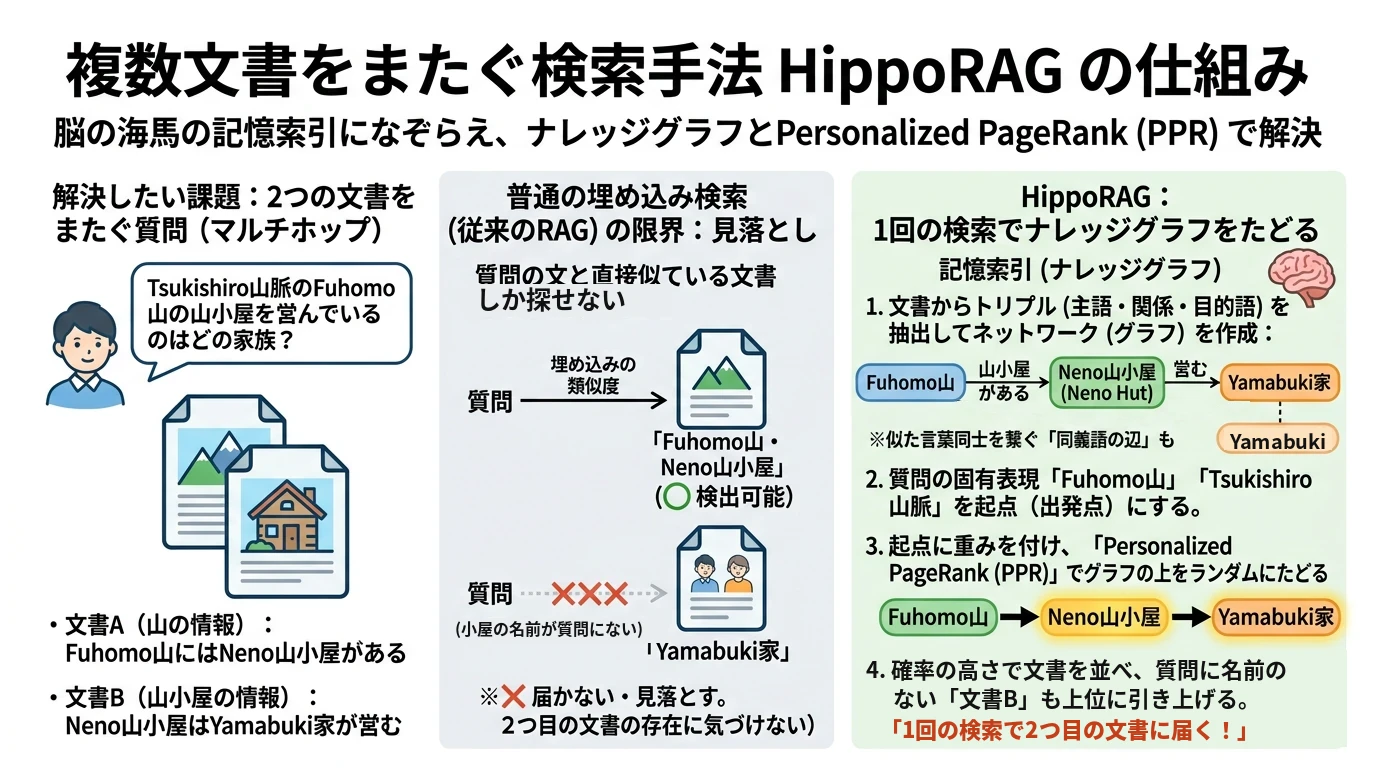
記事を読む脳の海馬の記憶索引になぞらえた検索 HippoRAG を、Python のスクラッチ実装で解説します。LLM の OpenIE で文書からトリプルを抜き出してナレッジグラフを作り、質問の固有表現から、ノードの特異性で重みを付けた Personalized PageRank でたどって、2つの文書をまたぐ質問の正解の文書を1回の検索で集めます。架空の山と山小屋のコーパスと Qwen2.5-7B-Instruct で埋め込み検索と比べ、PPR・特異性・同義語の辺を1つずつ外して効き方を確かめます。
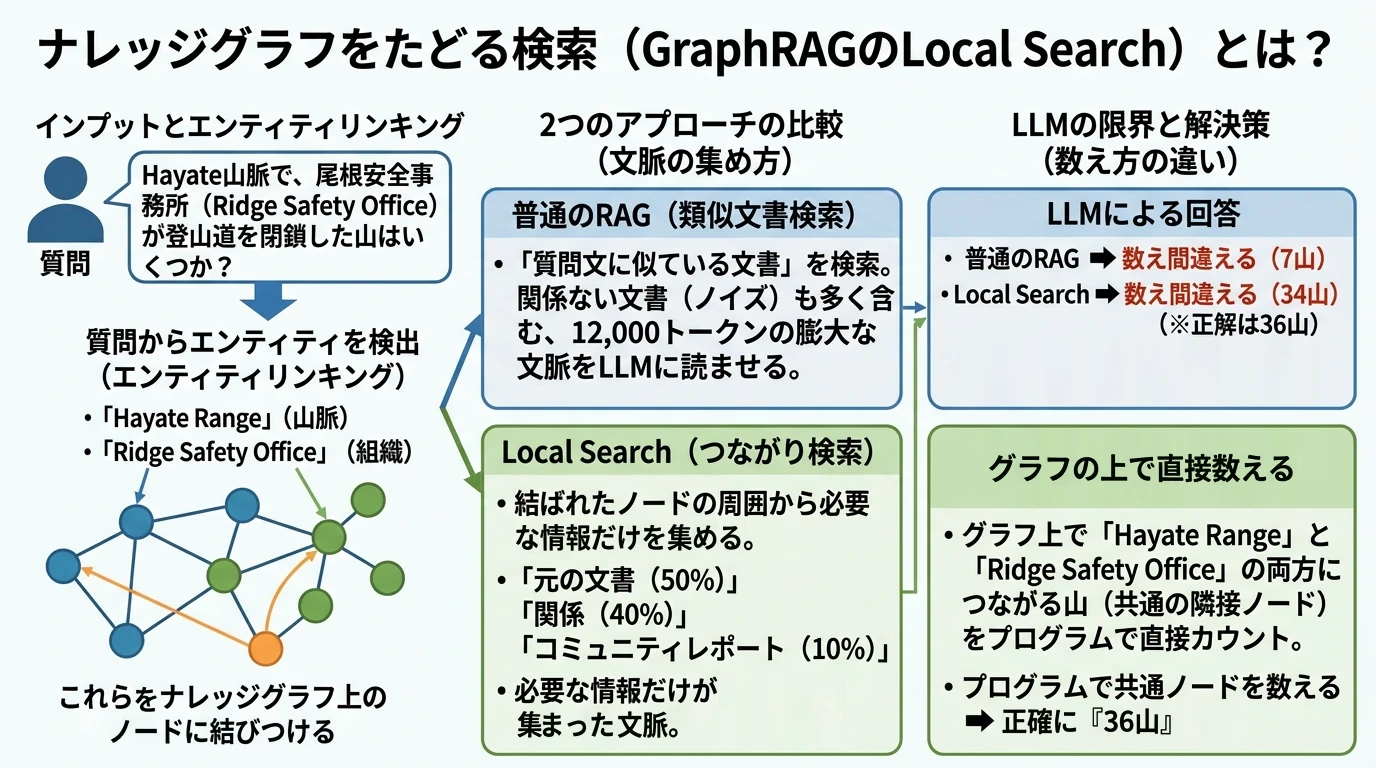
記事を読む質問に出てくるエンティティをナレッジグラフの中で見つけ、その周りの関係・元の文書・コミュニティのレポートを集めて LLM に読ませる GraphRAG の Local Search を、架空の山岳コーパスと Qwen2.5-7B-Instruct を使ったPythonの実装で解説します。エンティティリンキングのつまずき、普通の RAG との比較、LLM に数えさせる限界とグラフの上で数える方法まで扱います。
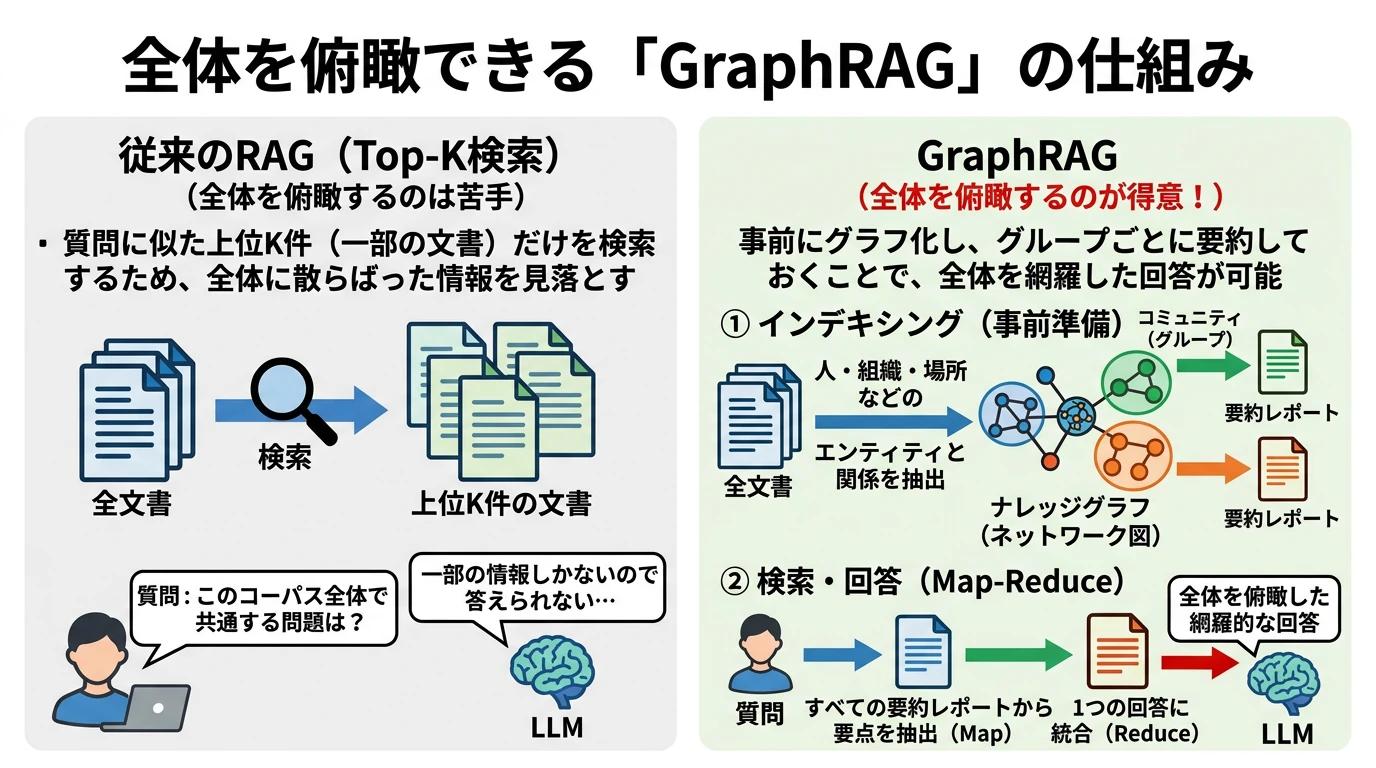
記事を読む文書の集まり全体を俯瞰する問いに、上位 K 件を読む普通の RAG が答えきれない理由と、インデキシングのときに文書からエンティティと関係のグラフを作り、コミュニティごとのレポートを map-reduce で読む GraphRAG の仕組みを、架空の山岳コーパスと Qwen2.5-7B-Instruct を使ったPythonの実験で確かめます。インデキシングのコスト、元の文書の map-reduce・RAPTOR との比較、抽出で情報が落ちる弱点、グラフが役立つ関係をたどる問いまで扱います。
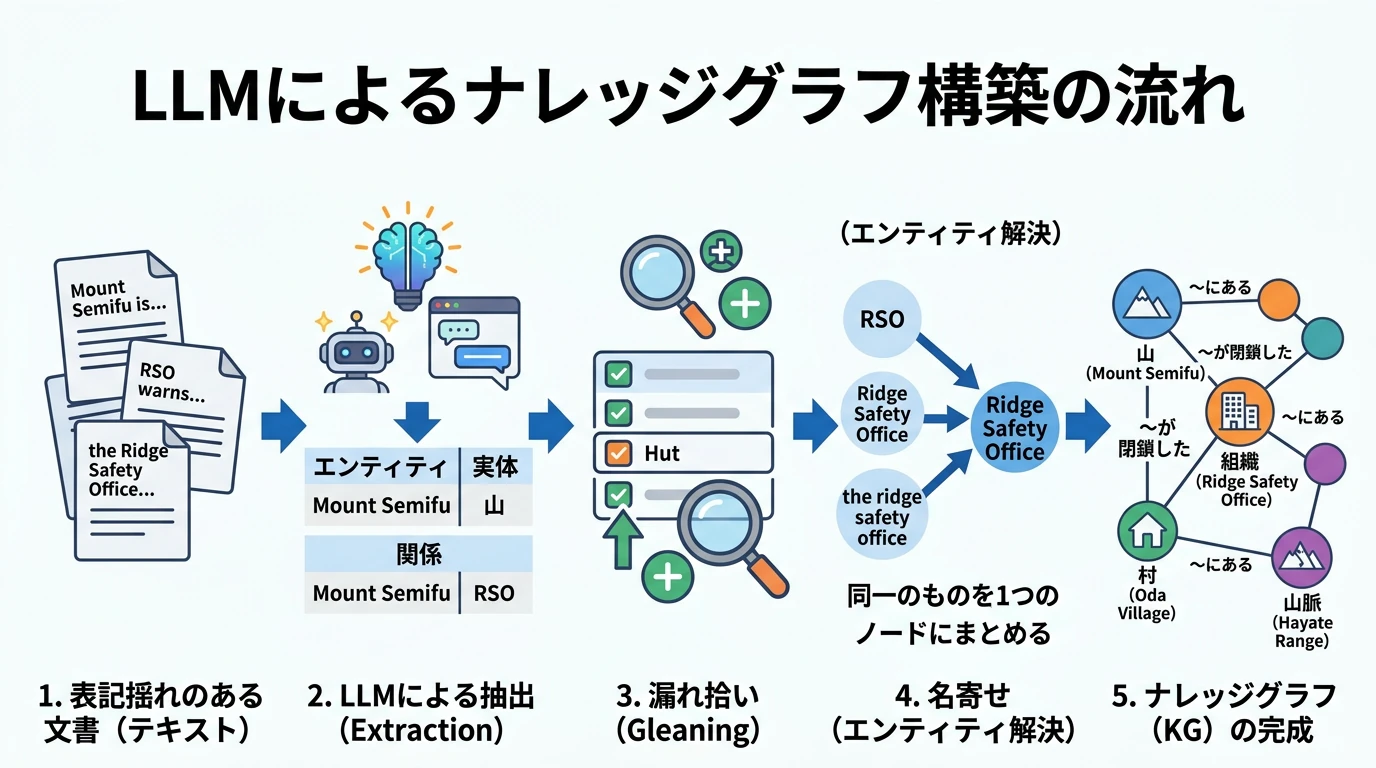
記事を読む文書から LLM でエンティティと関係を抜き出してナレッジグラフを作る方法について、抽出の出力の形(「|」区切り・JSON)、漏れを拾う gleaning、同じものを指す名前を1つにまとめる名寄せ(正規化・ルール・埋め込みの類似度・LLM による判定)と誤統合・誤分割を、表記揺れを入れた架空の山岳コーパスと Qwen2.5-14B-Instruct を使った Python の実装で解説します。
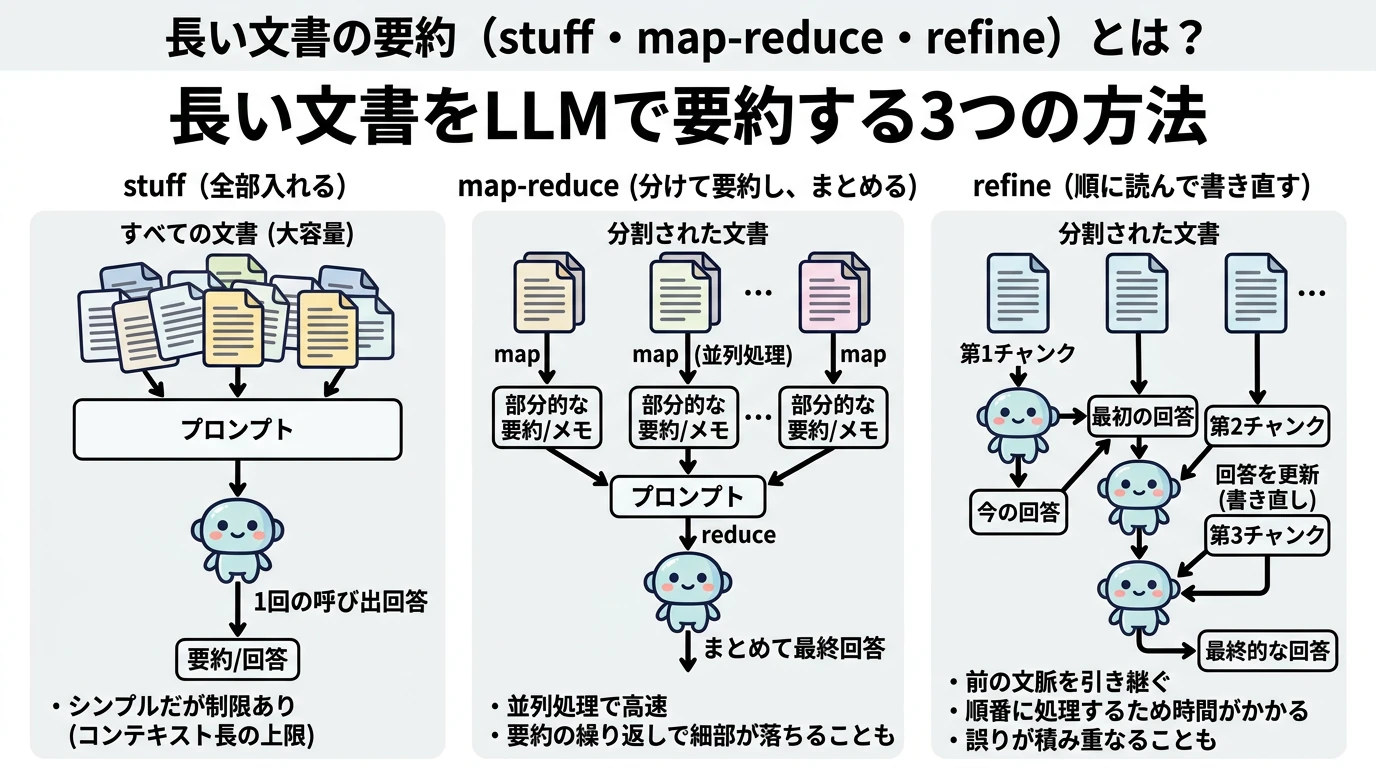
記事を読むLLM のコンテキストに収まらない量の文書を要約する3つの方法、全部を入れる stuff、分けて要約してからまとめる map-reduce、順に読んで答えを書き直す refine を、架空の山岳コーパスと Qwen2.5-7B-Instruct を使ったPythonの実験で比べます。クエリ指向要約や重要度で選ぶ工夫と、要約を重ねると細部が落ちたり混ざったりする問題も確かめます。
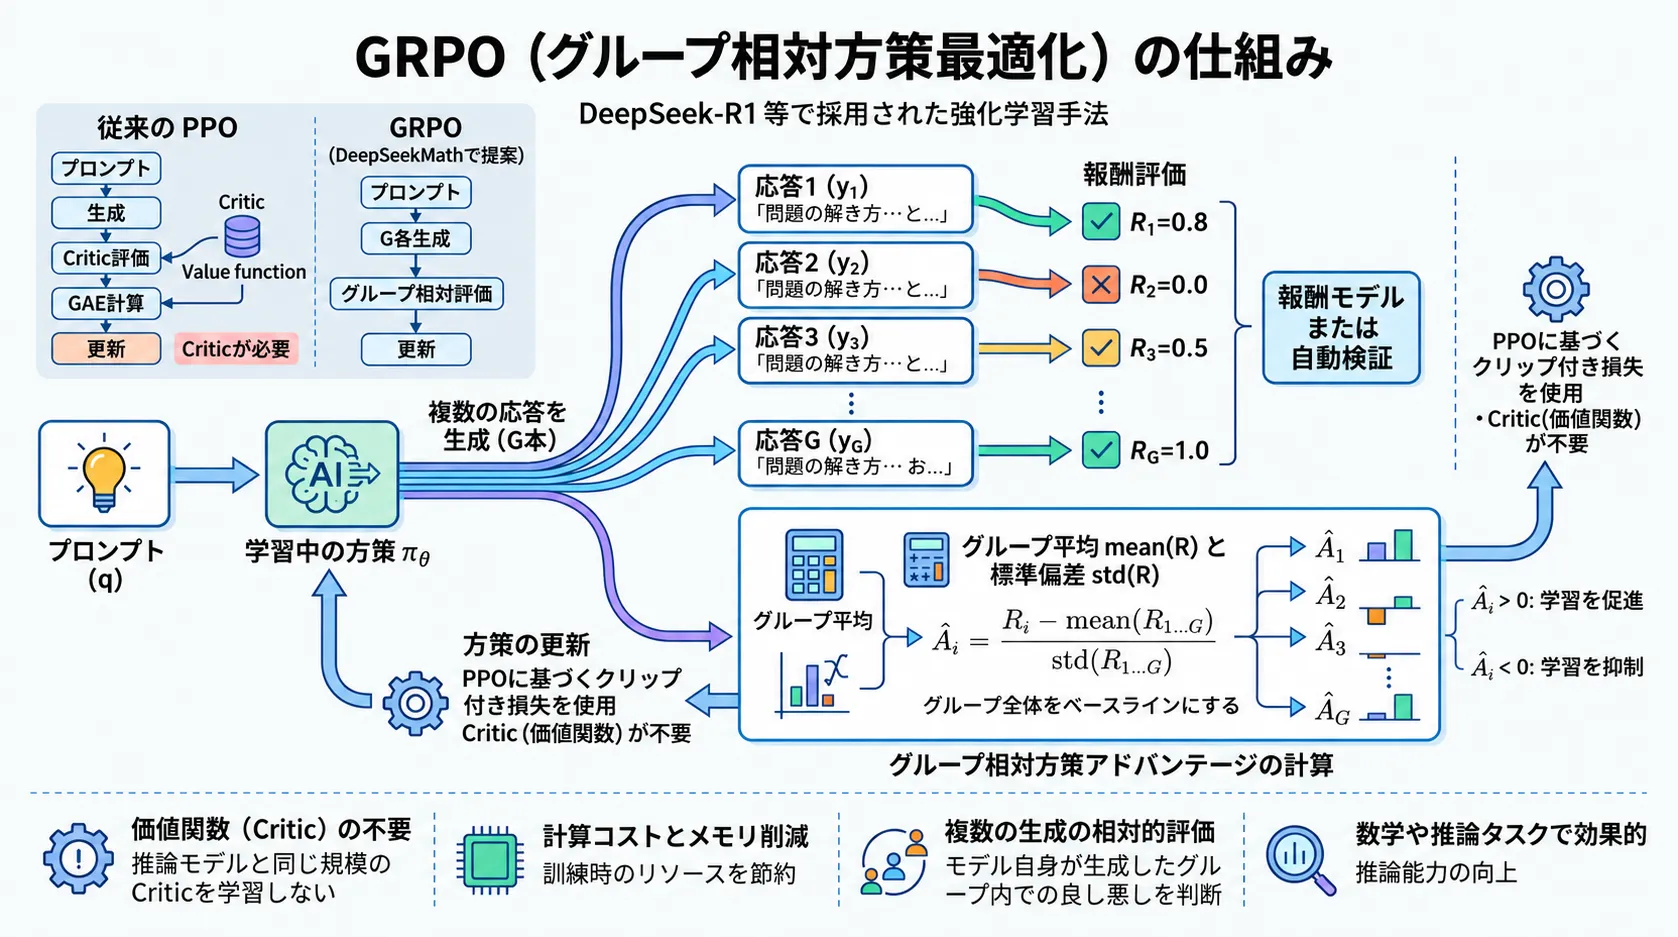
記事を読む価値関数(Critic)を使わず、同じプロンプトから生成した複数の応答の相対評価でアドバンテージを作る強化学習手法「GRPO」を解説します。PPOとの差分、k3 KL推定量、検証可能な報酬(RLVR)、DeepSeekMathの考察、Dr. GRPOが指摘したバイアスを整理し、Qwen2.5-0.5B-Instructでスクラッチ実装とTRL実装を行います。
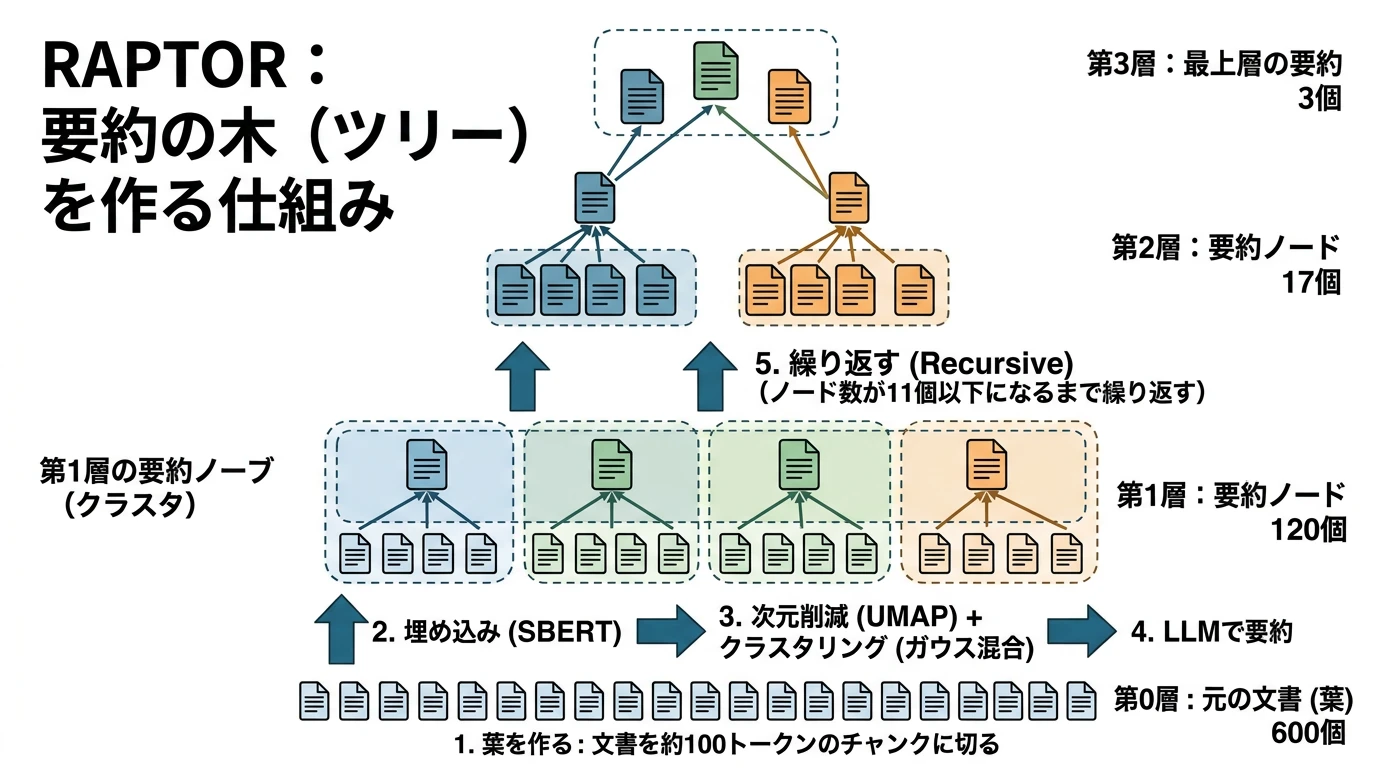
記事を読む文書を埋め込みでクラスタリングして要約し、それを繰り返して要約の木を作る RAPTOR を、架空の山岳コーパスと Qwen2.5-7B-Instruct を使ったPythonの実験で確かめます。UMAP とガウス混合による木の作り方、tree traversal と collapsed tree の違い、普通の RAG との比較、クラスタが何でまとまったかも調べます。
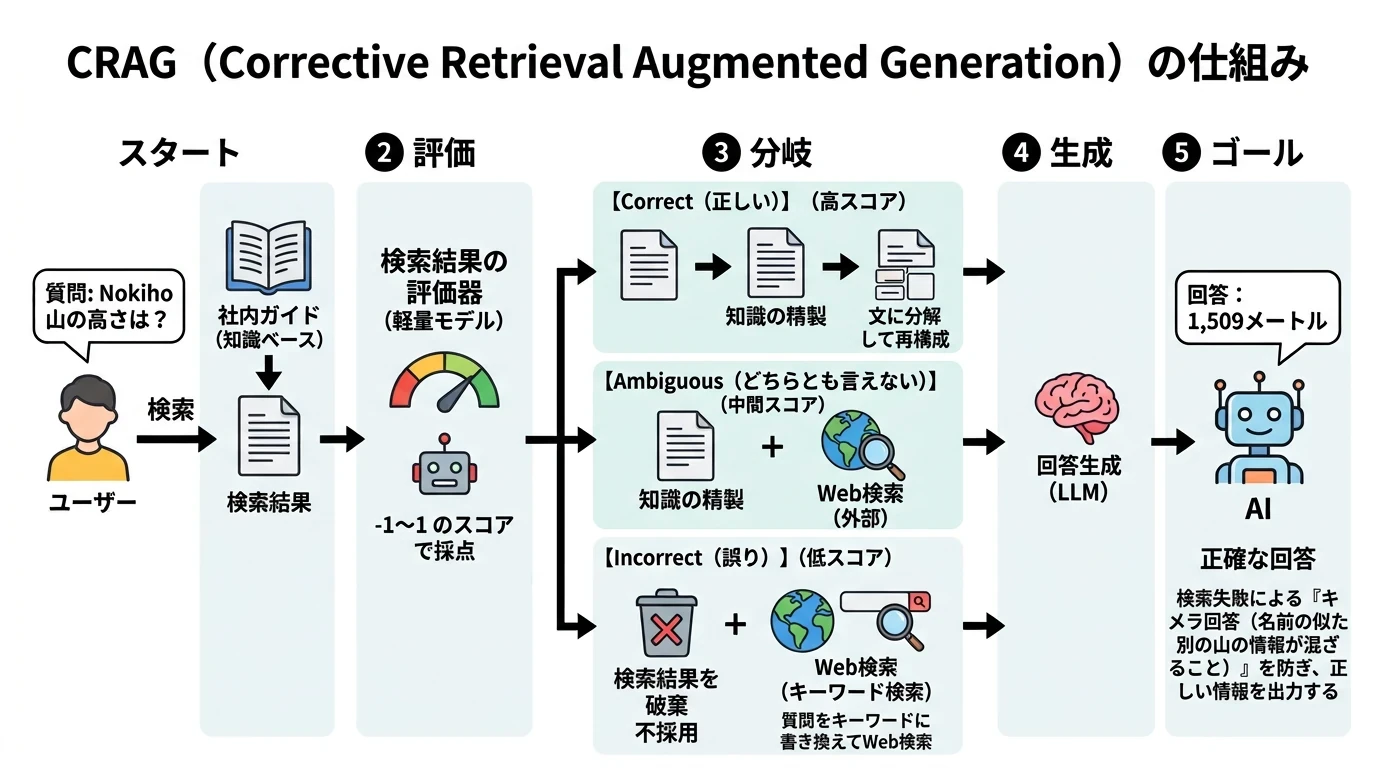
記事を読む検索結果が使えるかを生成の前に軽量な評価器で採点し、Correct・Incorrect・Ambiguousの3つの判定で知識の精製とWeb検索を切り替える「CRAG」について、検索の誤りが生むキメラ効果の再現、評価器の学習、decompose-then-recompose、既存のRAGへの後付け、架空の山岳コーパスを使ったPythonの実験までを解説します。
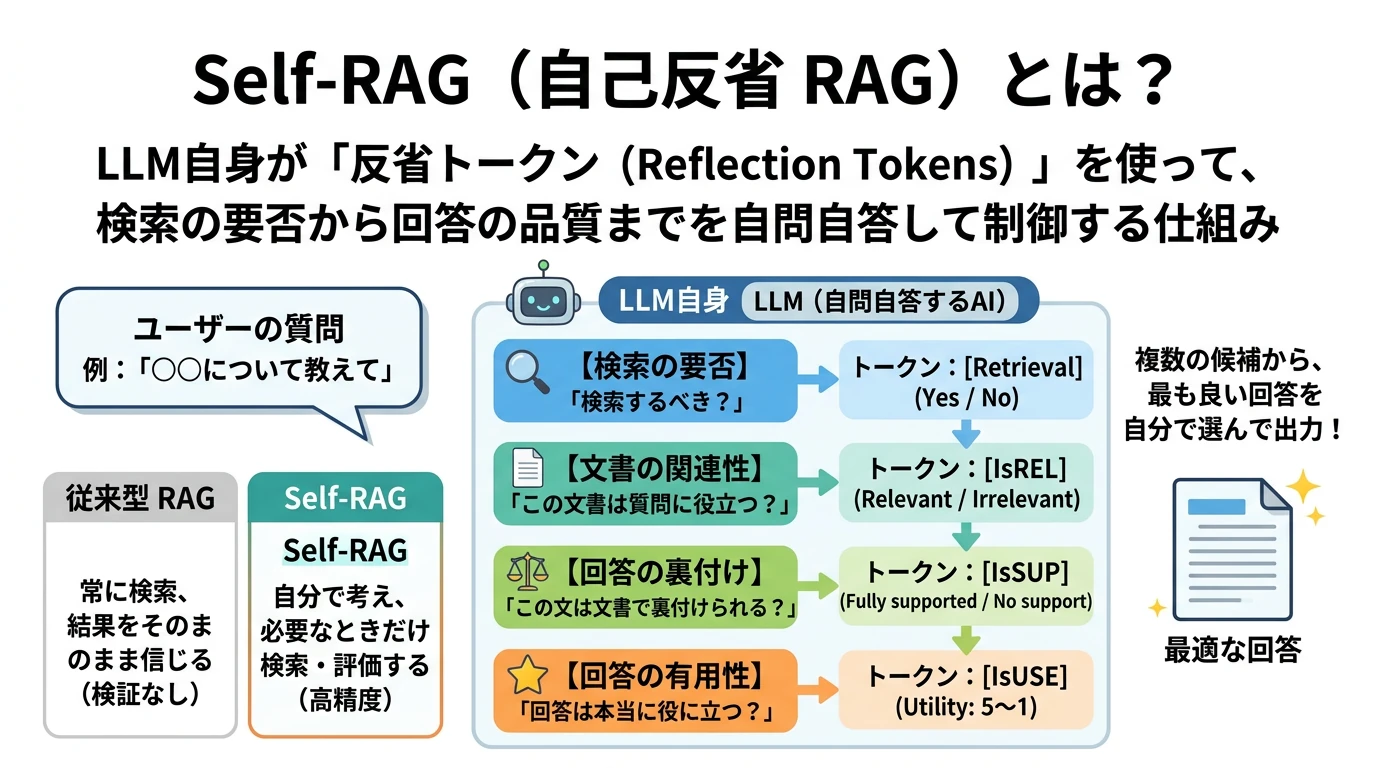
記事を読む検索するかどうか、検索した文書が役に立つか、回答が文書で裏付けられるかを、特殊な「反省トークン」としてLLM自身に学習させる「Self-RAG」について、4種類の反省トークン、critic モデルによる学習データの作り方、反省トークンの確率で候補を選ぶ推論、推論時の振る舞いの調整、CRAGとの違いを、Self-RAG 7Bと架空の山岳コーパスを使ったPythonの実験で解説します。
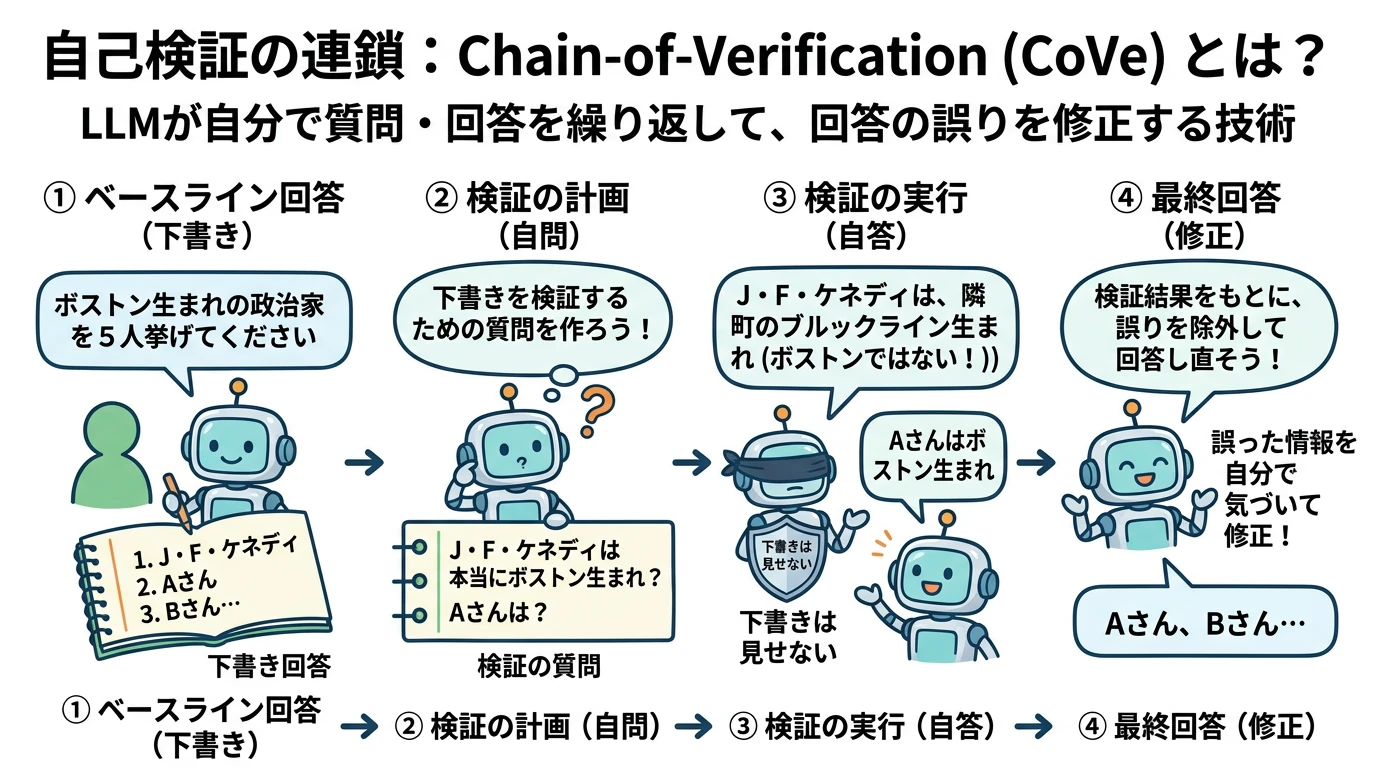
記事を読むLLMが自分の回答の事実の誤りを、検証の質問を作って自分で答え直すことで見つけて直す「Chain-of-Verification(CoVe)」について、ベースライン・検証の計画・検証の実行・最終回答の4段階、検証の質問に下書きを見せずに答えさせる理由、joint・2-step・factoredの3種類の違い、Self-RAGとの違いを、Wikidataのリスト質問を使ったPythonの実験で解説します。
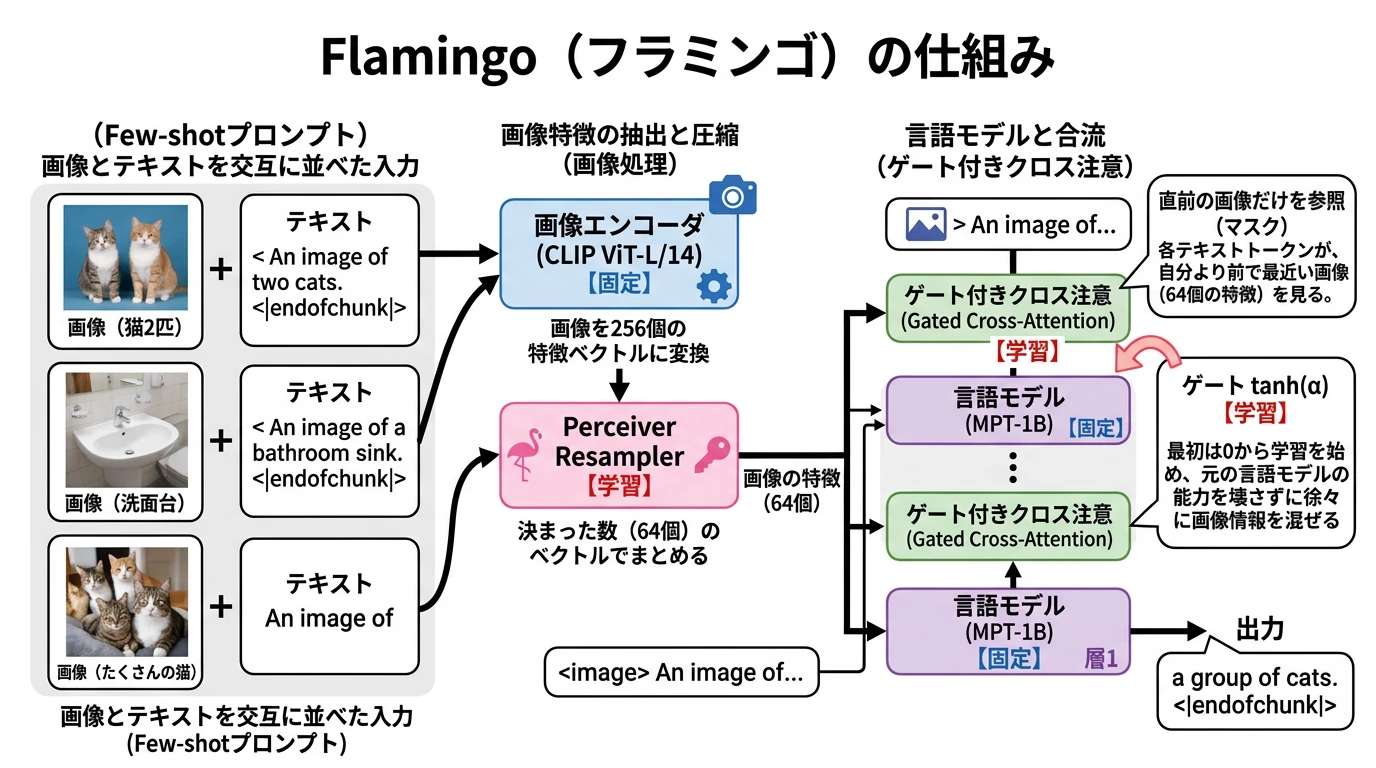
記事を読む画像とテキストが混ざる入力を少数のお手本(Few-Shot)で処理するVLM「Flamingo」の特徴を解説。CLIPとPerceiver Resampler、ゲート付きクロス注意の仕組みをOpenFlamingo-3Bのスクラッチ実装で検証します。
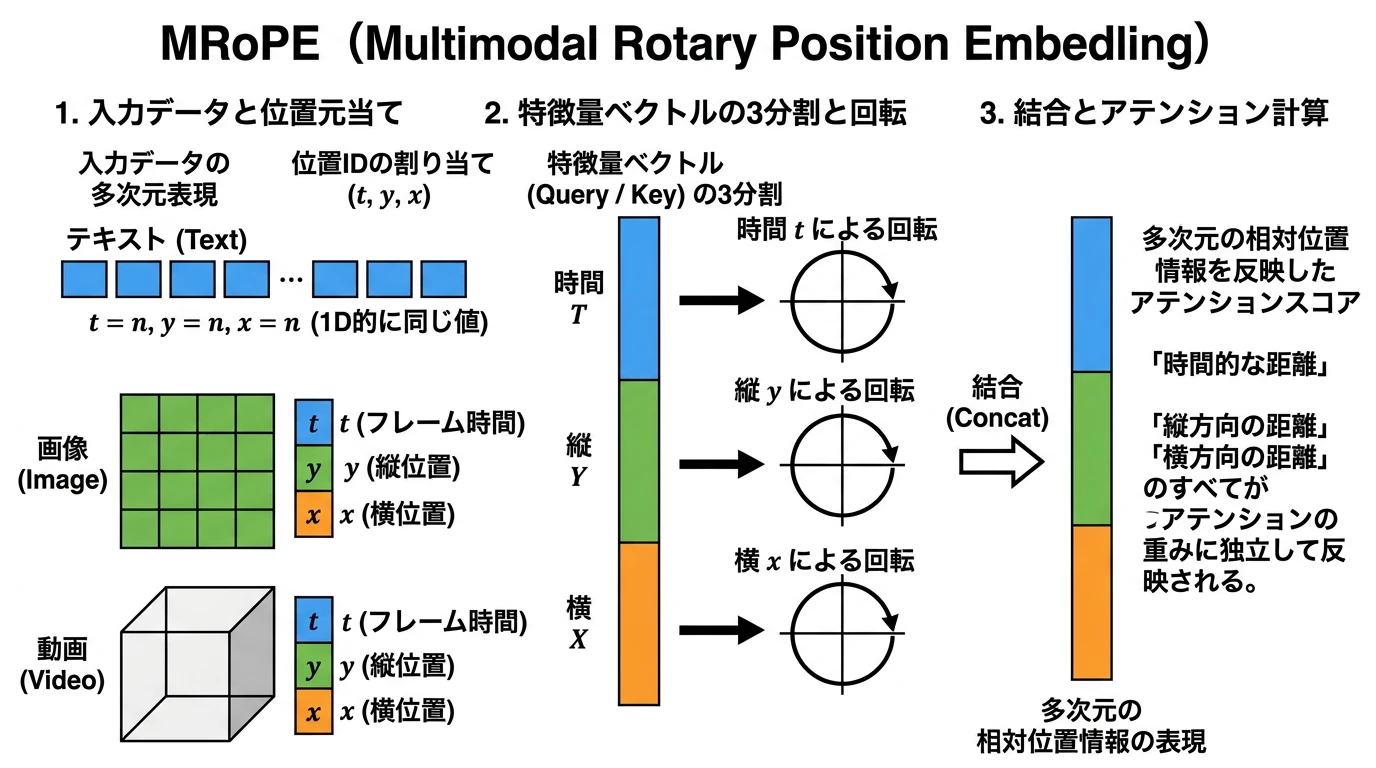
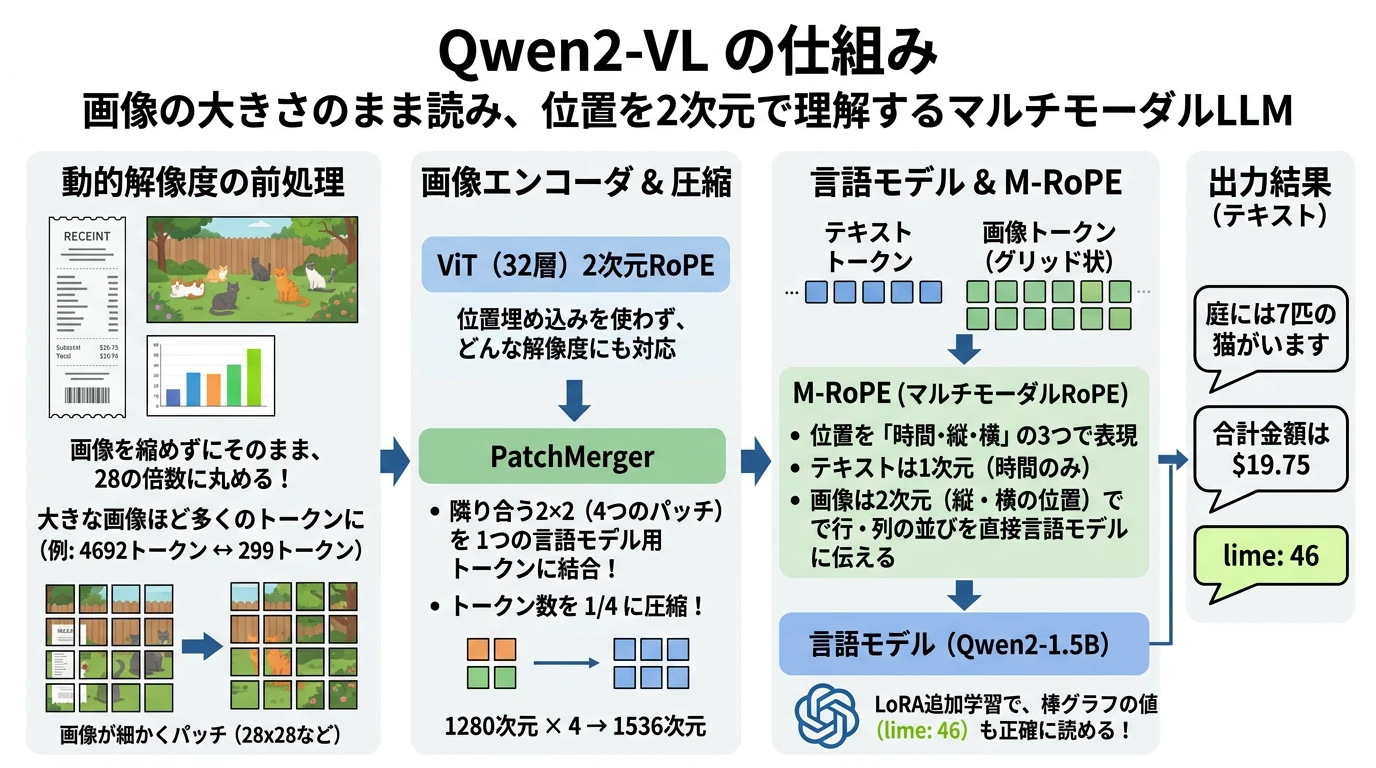
記事を読む画像を決まった大きさに縮めずに読む Qwen2-VL(2B)を、PyTorch のスクラッチ実装で解説します。動的解像度・2 次元の RoPE の ViT・PatchMerger・M-RoPE を実装して Hugging Face と同じ出力を確かめ、画像のトークン数と文字の読み取りの関係、M-RoPE の役割を調べ、LoRA の追加学習で棒グラフの値を読めるようにします。
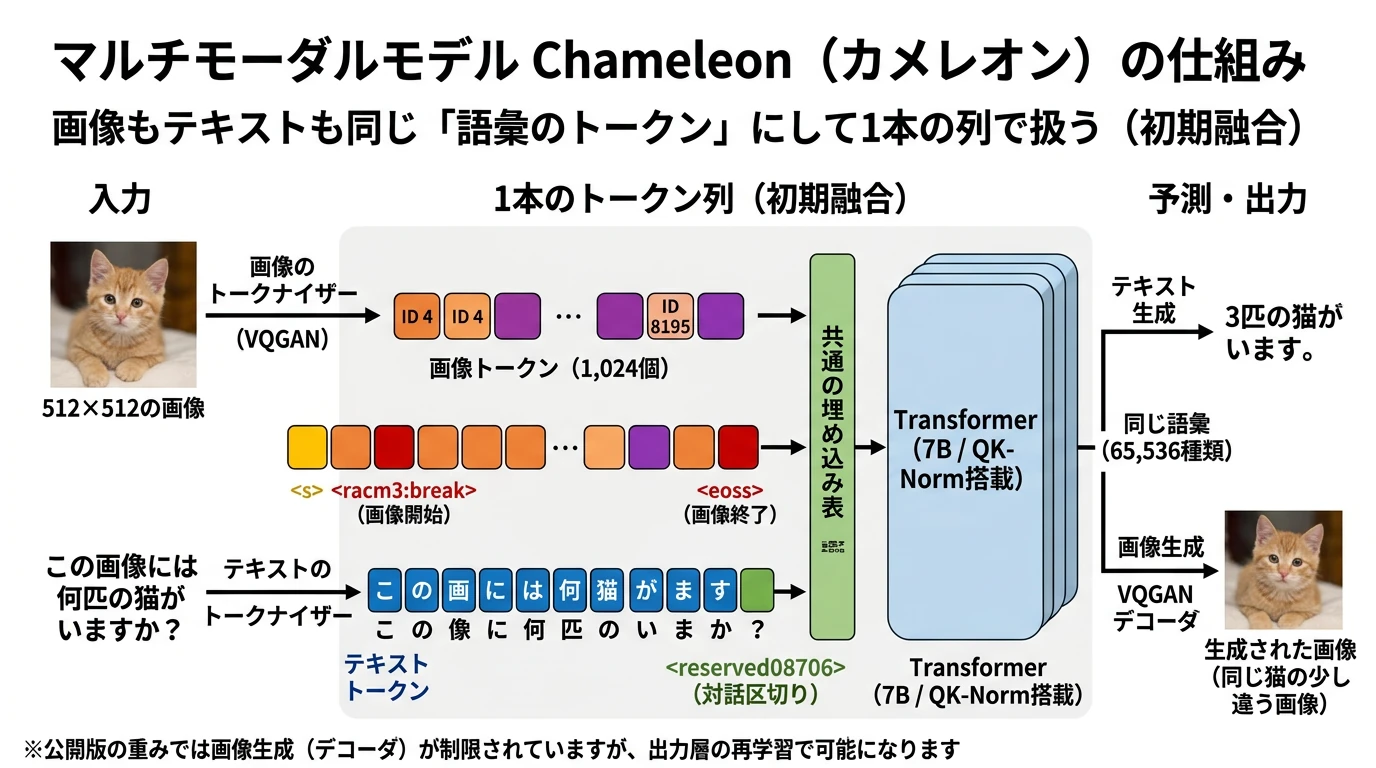
記事を読む画像もテキストも同じ語彙のトークンにして 1 本の列で扱う、初期融合のマルチモーダルモデル Chameleon(7B)を、PyTorch のスクラッチ実装で解説します。VQGAN の画像のトークナイザーと QK-Norm を加えた Transformer を実装して Hugging Face と同じ出力を確かめ、トークナイザーの限界と公開版が画像を生成しない理由を調べ、Anole の出力層で画像を生成します。最後に、COCO の 2,000 組で出力層の画像の行を学習し直して画像を生成します。
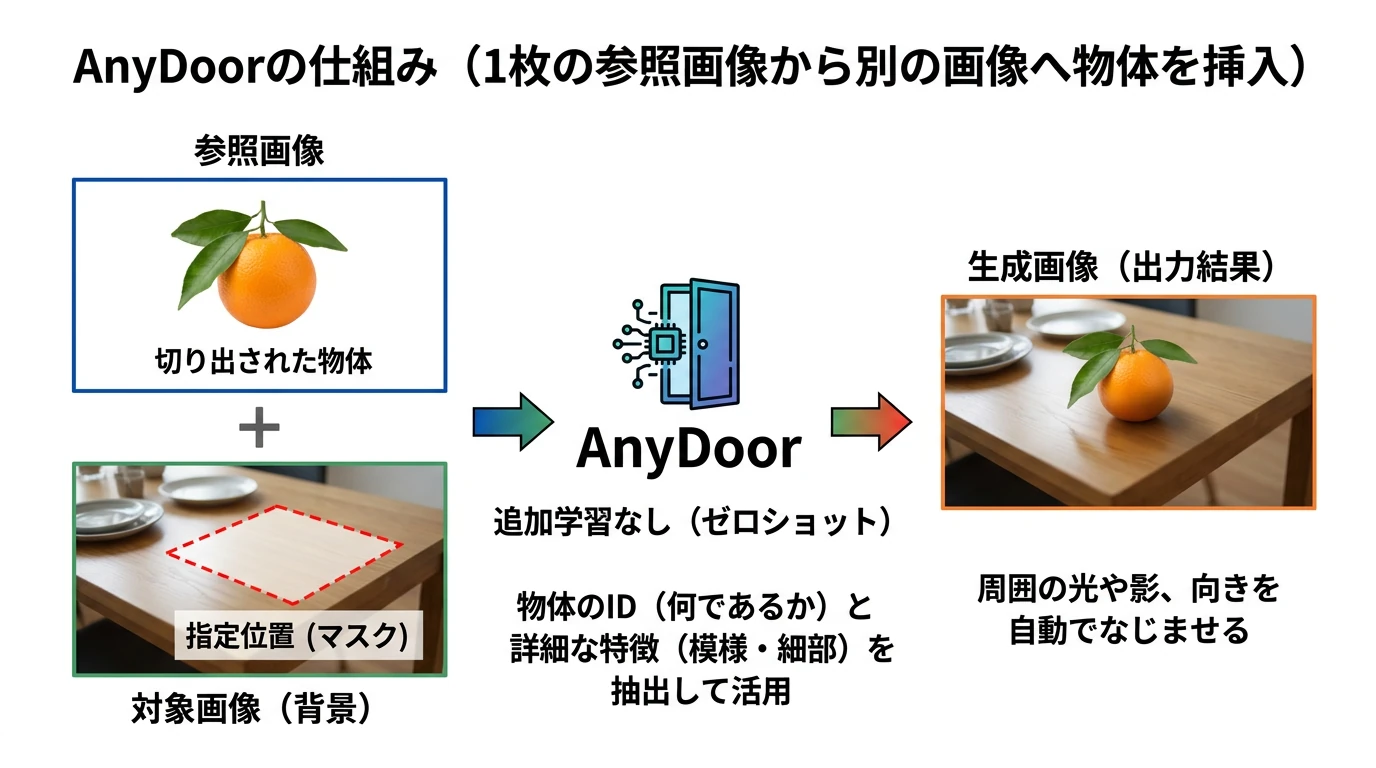
記事を読む1 枚の参照画像の物体を別の画像の好きな場所へ入れる AnyDoor を、PyTorch のスクラッチ実装で解説します。DINOv2 の ID Extractor・HF マップと Detail Extractor・Stable Diffusion 2.1 の U-Net を実装して公式と同じ出力を確かめ、DAVIS の動画で ID トークンと HF マップの役割を調べ、動画のフレームの組で追加学習します。
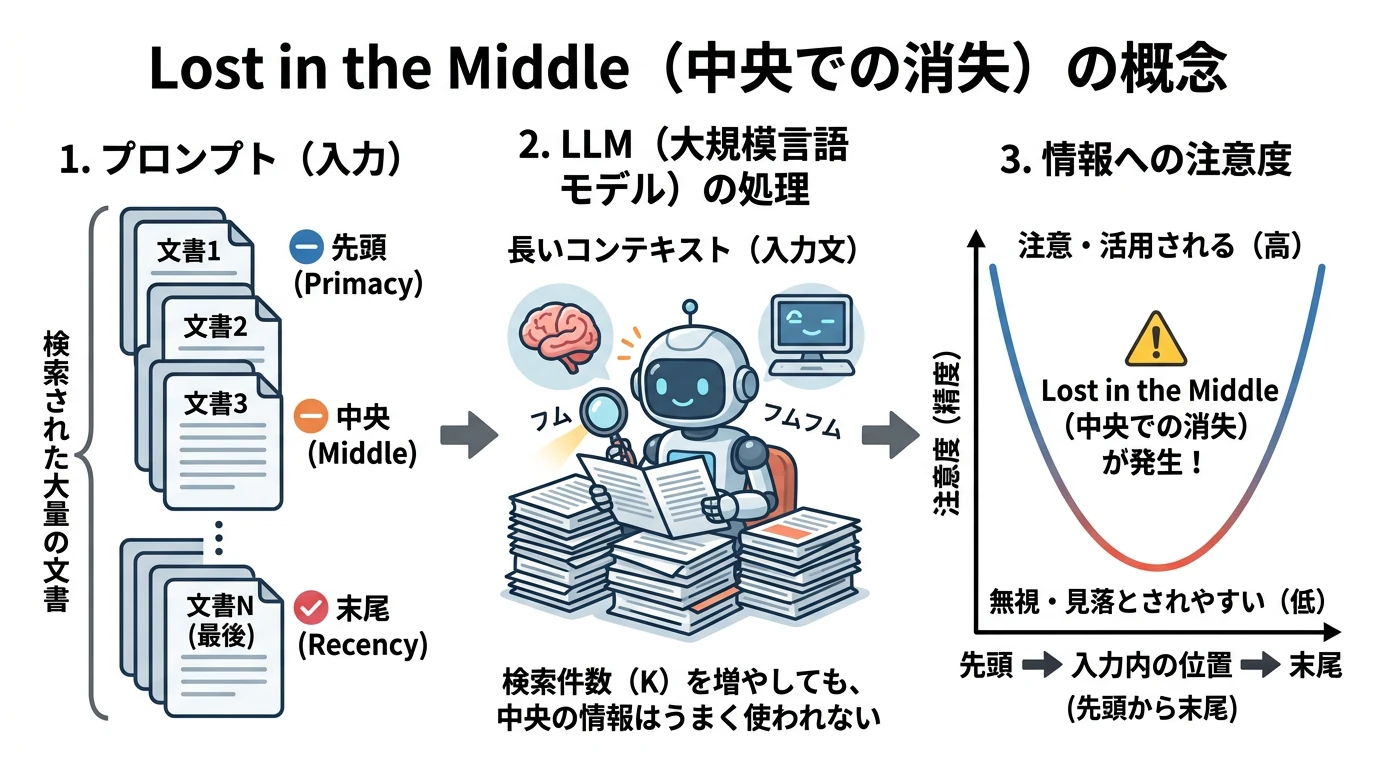
記事を読む長いコンテキストの中央に置かれた情報をLLMが使いこなせなくなる「Lost in the Middle」現象について、先頭と末尾に偏る位置バイアス(U字カーブ)の仕組み、RAGで検索件数を増やしても精度が伸びない理由、位置バイアスを手元で再現するPythonのスクラッチ実装、実務上の指針までを解説します。
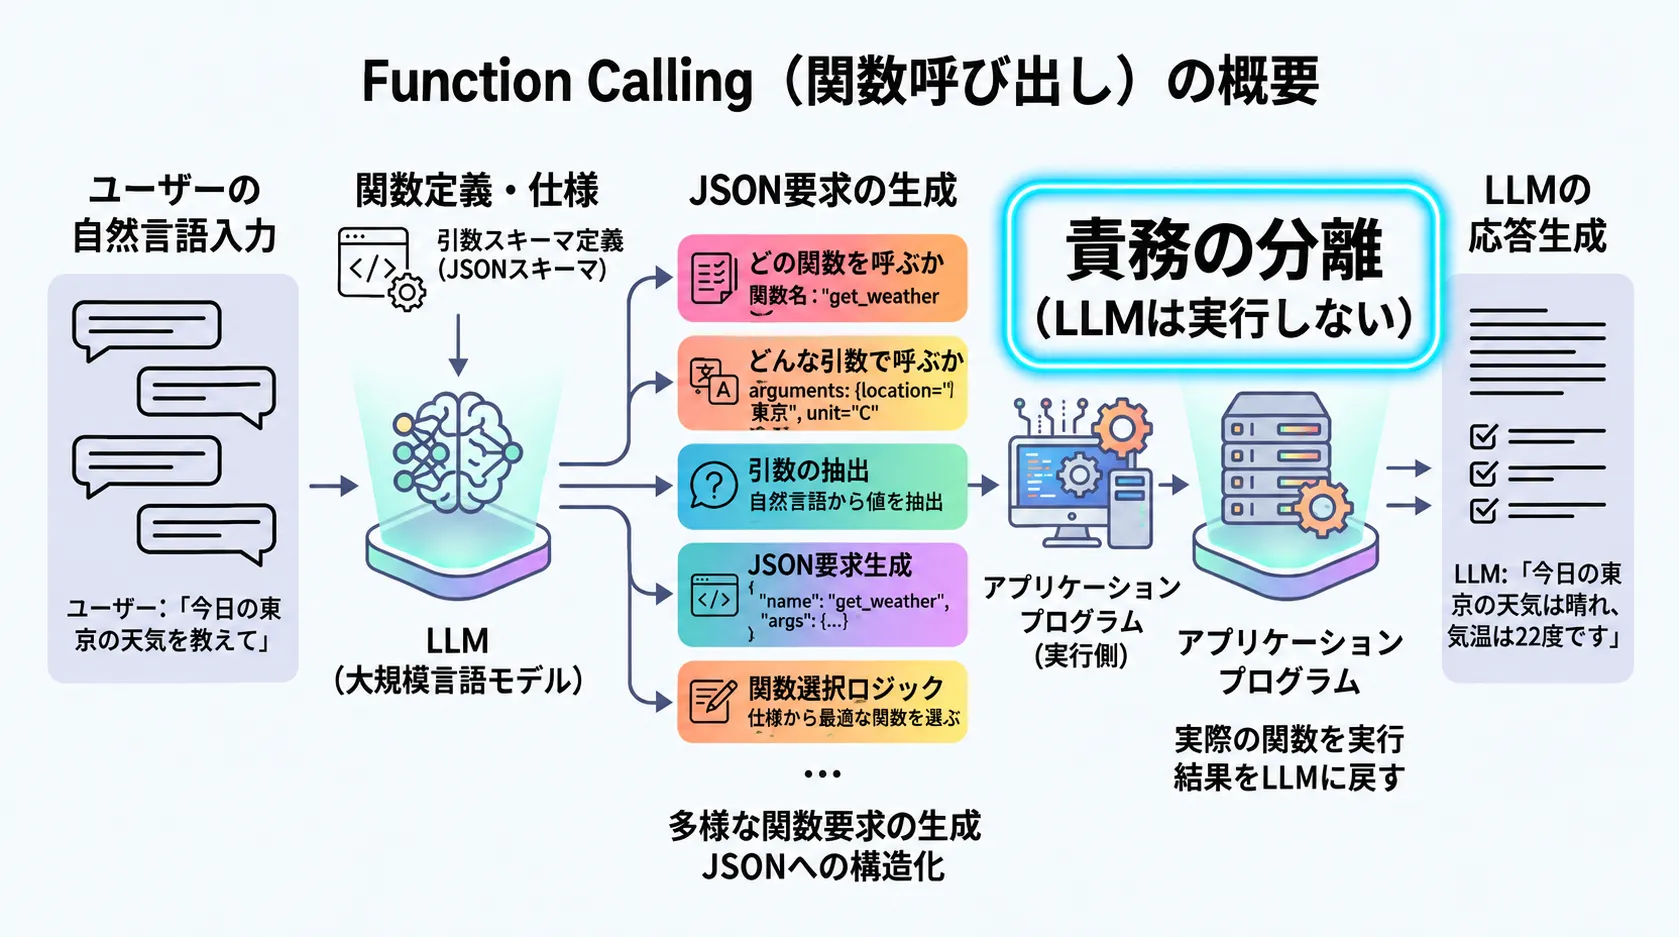
記事を読むLLMに「呼び出し可能な関数の一覧とその仕様」を与え、ユーザーの入力に応じてどの関数をどんな引数で呼ぶべきかを生成させる「Function Calling」の仕組みと、ハルシネーションの定式化、PyTorch/SDKを用いた実装までを解説します。
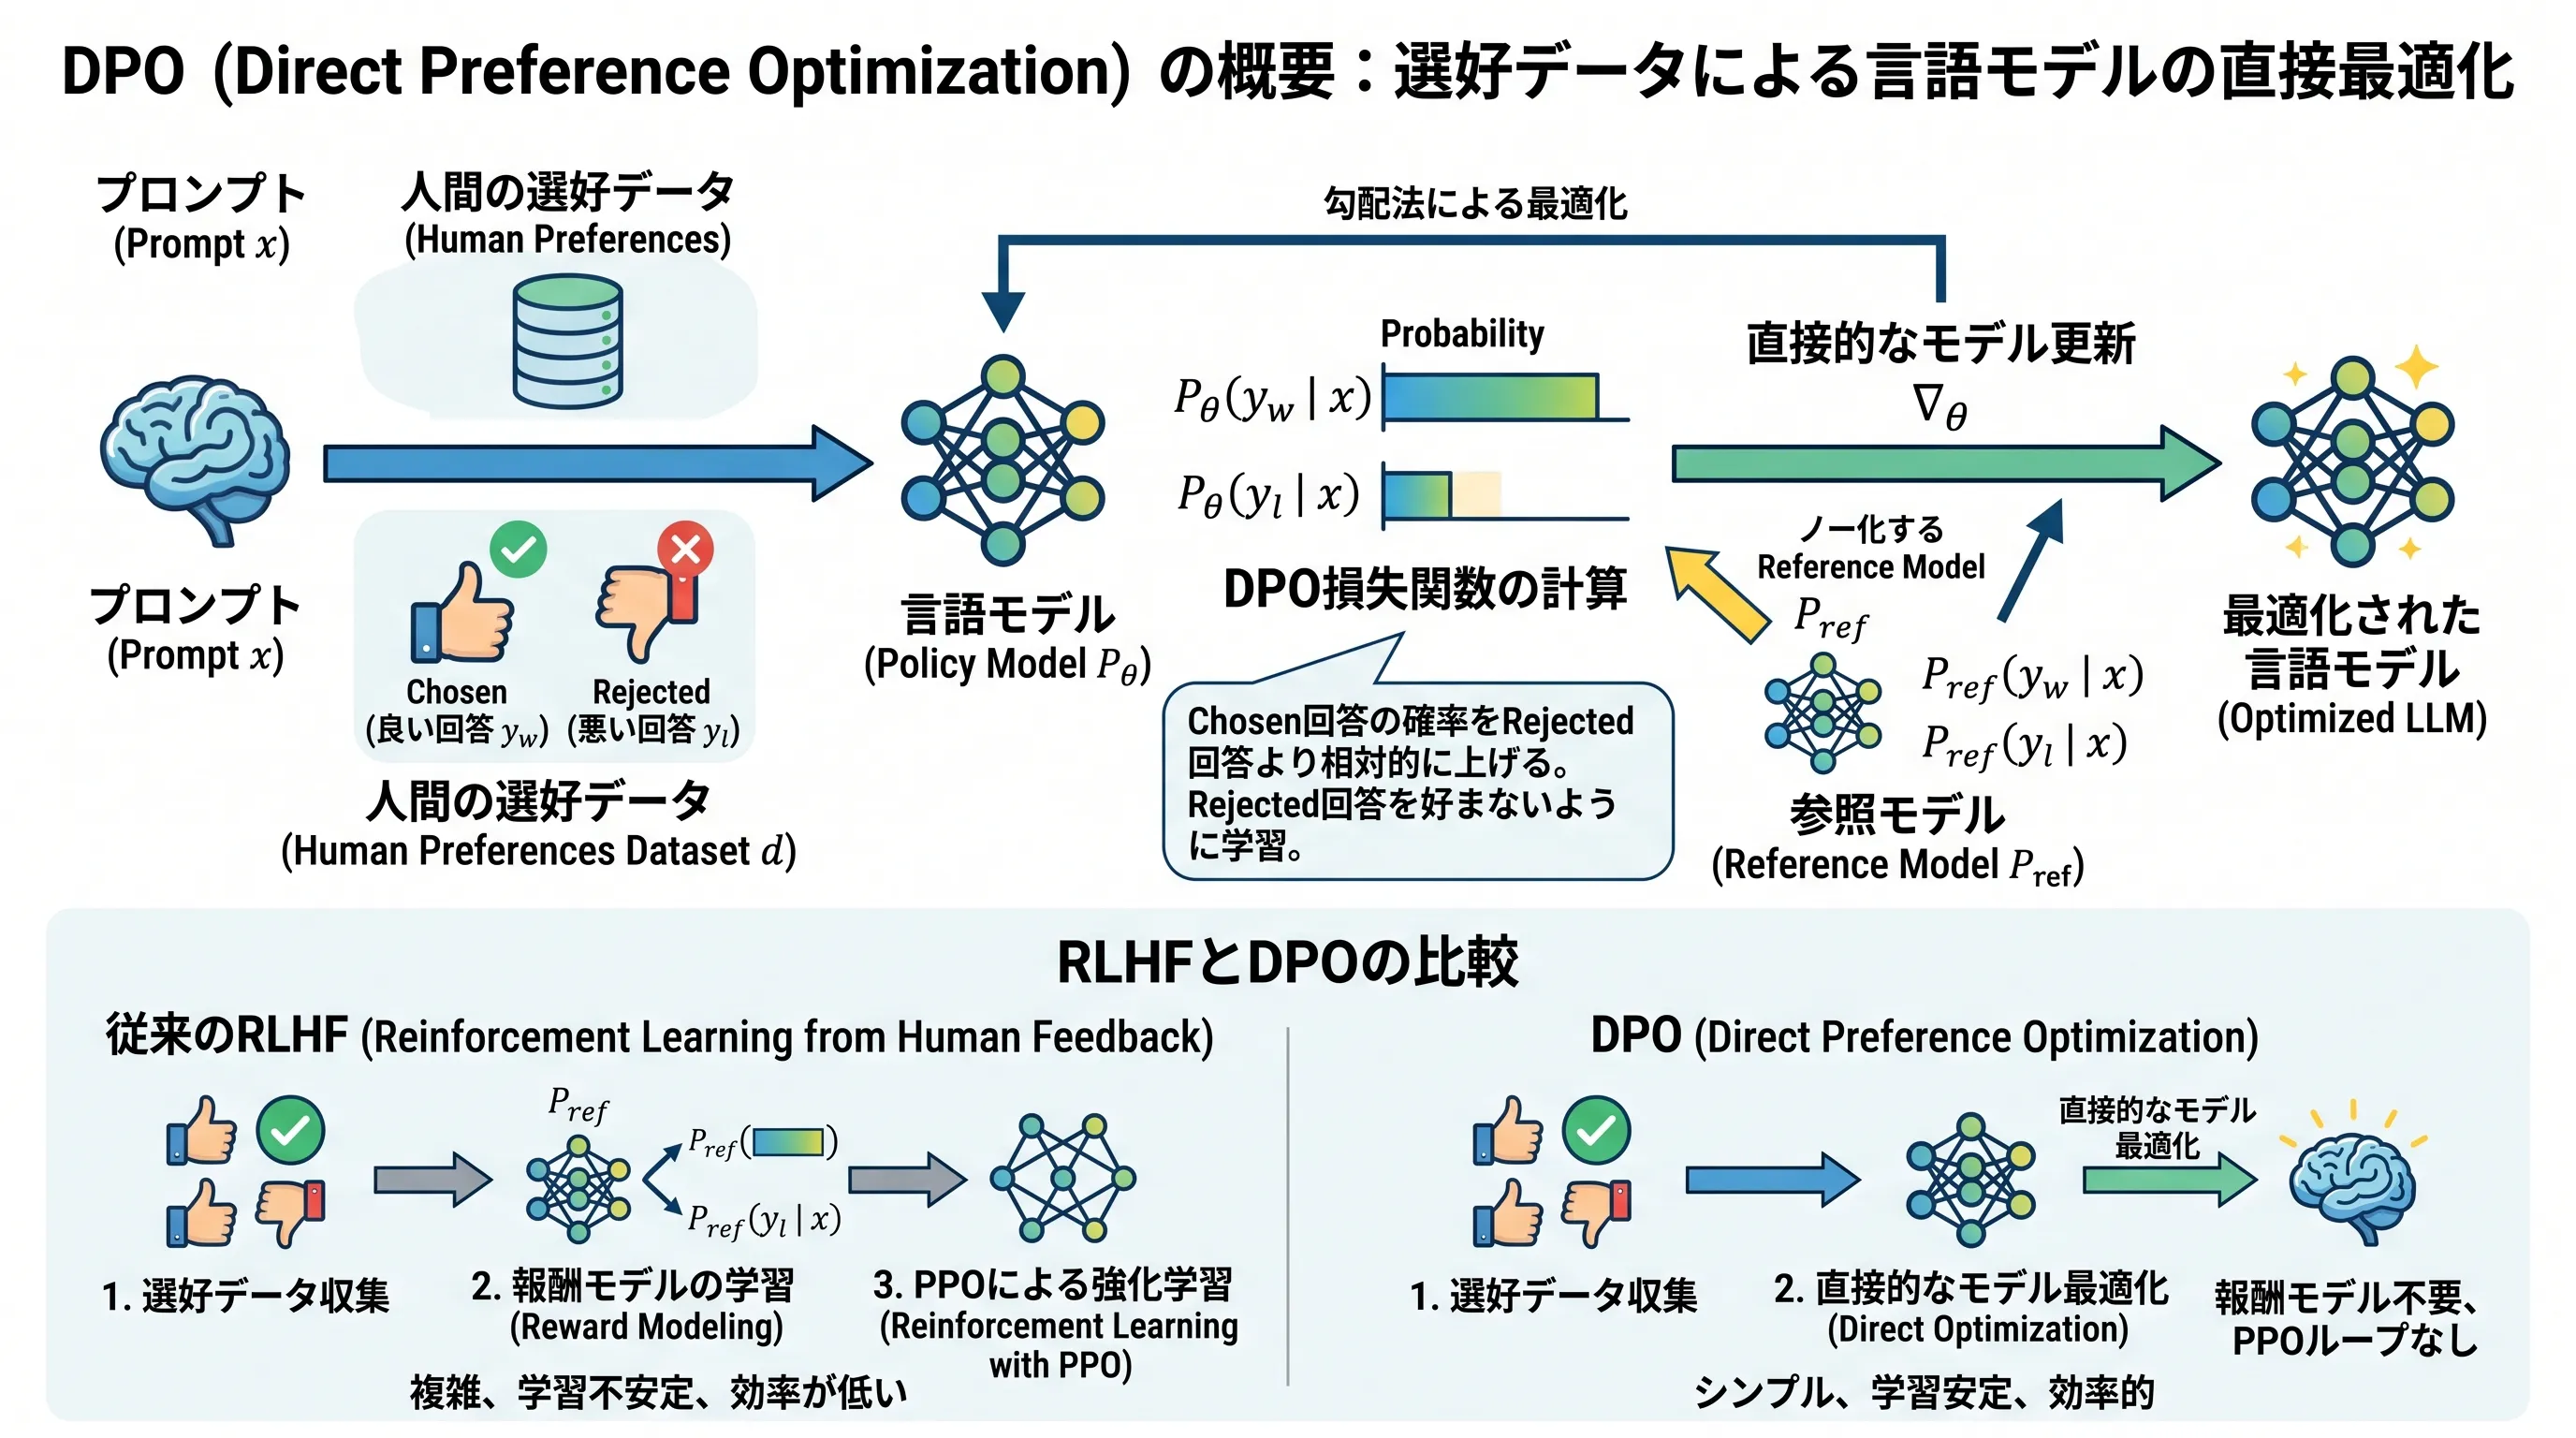
記事を読む複雑な強化学習(PPO)や独立した報酬モデルの学習を不要にし、選好データから直接言語モデルを人間の好みにアライメントする「DPO(Direct Preference Optimization)」の仕組みについて、数理的導出からPyTorchでのスクラッチ実装、TRLによる学習、派生手法の整理までを解説します。
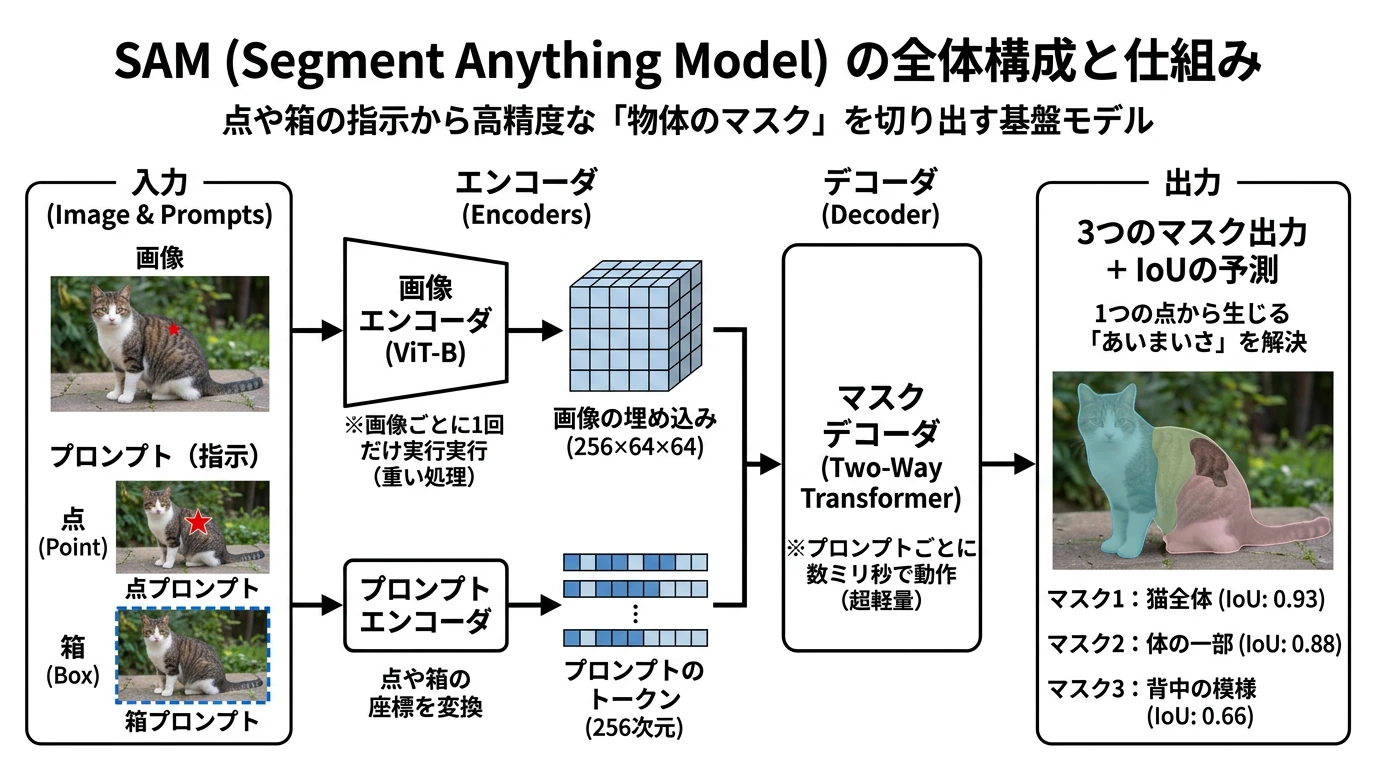
記事を読む点や箱で指示した物体のマスクを出すセグメンテーションの基盤モデル SAM(Segment Anything Model)を、PyTorch のスクラッチ実装で解説します。ViT の画像エンコーダ、ランダムなフーリエ特徴のプロンプトエンコーダ、Two-Way Transformer のマスクデコーダを実装し、公式の学習済みの重みで Hugging Face と同じマスクになることを確かめます。Grounding DINO の箱と組み合わせ、COCO val2017 の一部で箱と点のプロンプトの精度を測り、3 つのマスクを出す学習が 1 点のあいまいさを扱えることを合成データで確かめます。
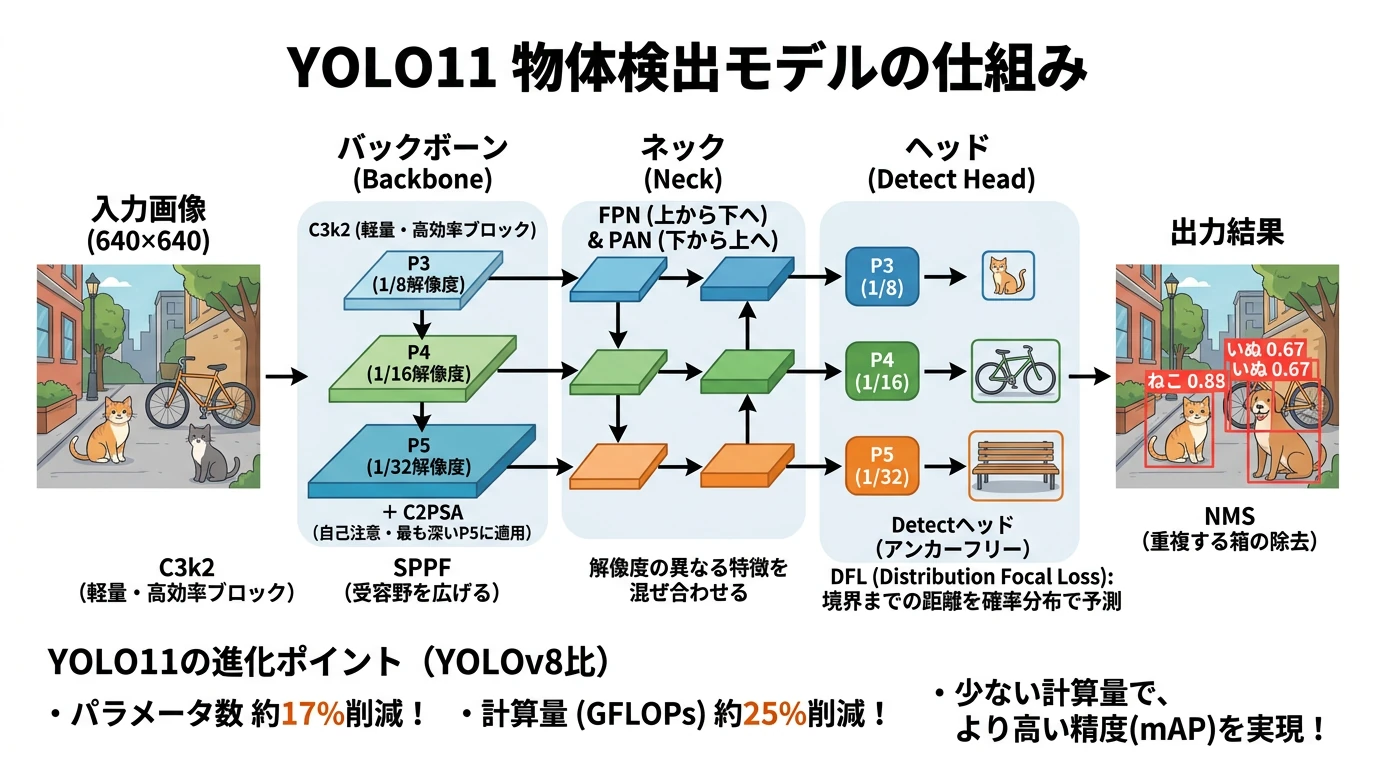
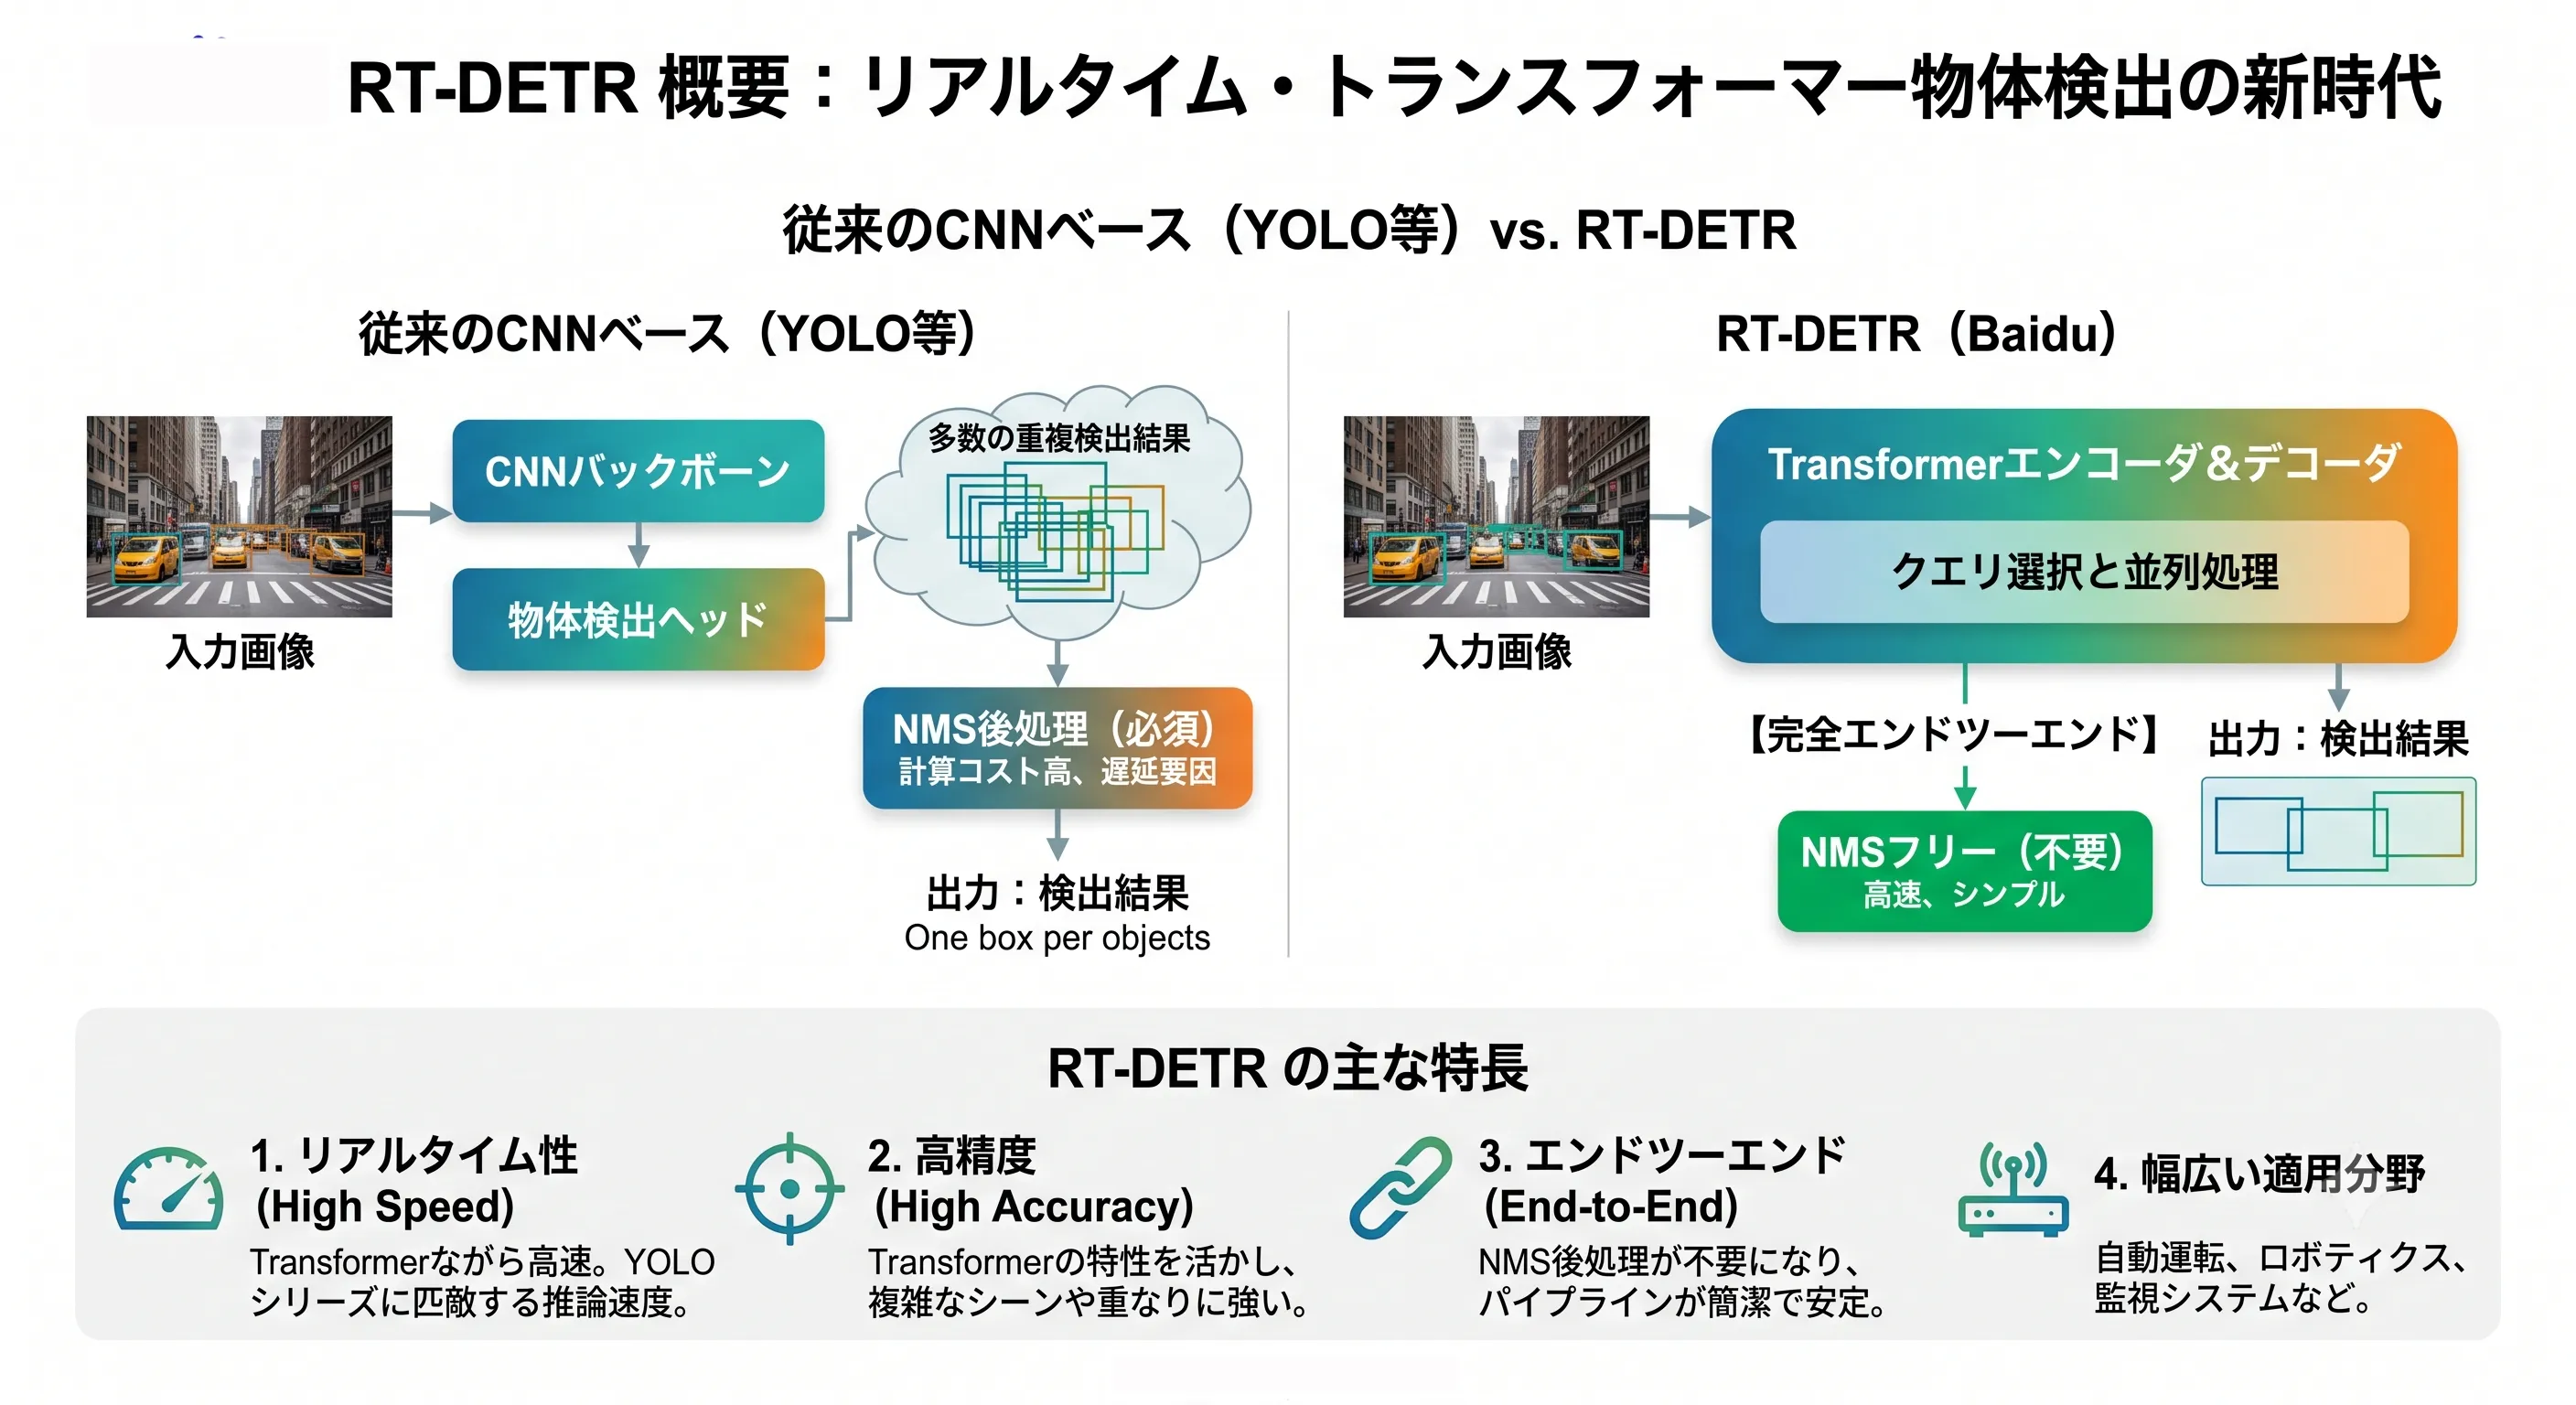
記事を読むNMS を使わないリアルタイム物体検出モデル RT-DETR を、PyTorch のスクラッチ実装で解説します。ResNet18-vd の Backbone、AIFI と CCFM からなる Hybrid Encoder、クエリの選択、Deformable Attention のデコーダを実装し、公式の学習済みの重みで Hugging Face と同じ出力になることを確かめます。COCO val2017 の一部で精度と速度を測り、ハンガリアンマッチングと VFL・L1・GIoU の損失を実装して合成データで追加学習し、1 対 1 のマッチングが NMS を不要にすることを確かめます。
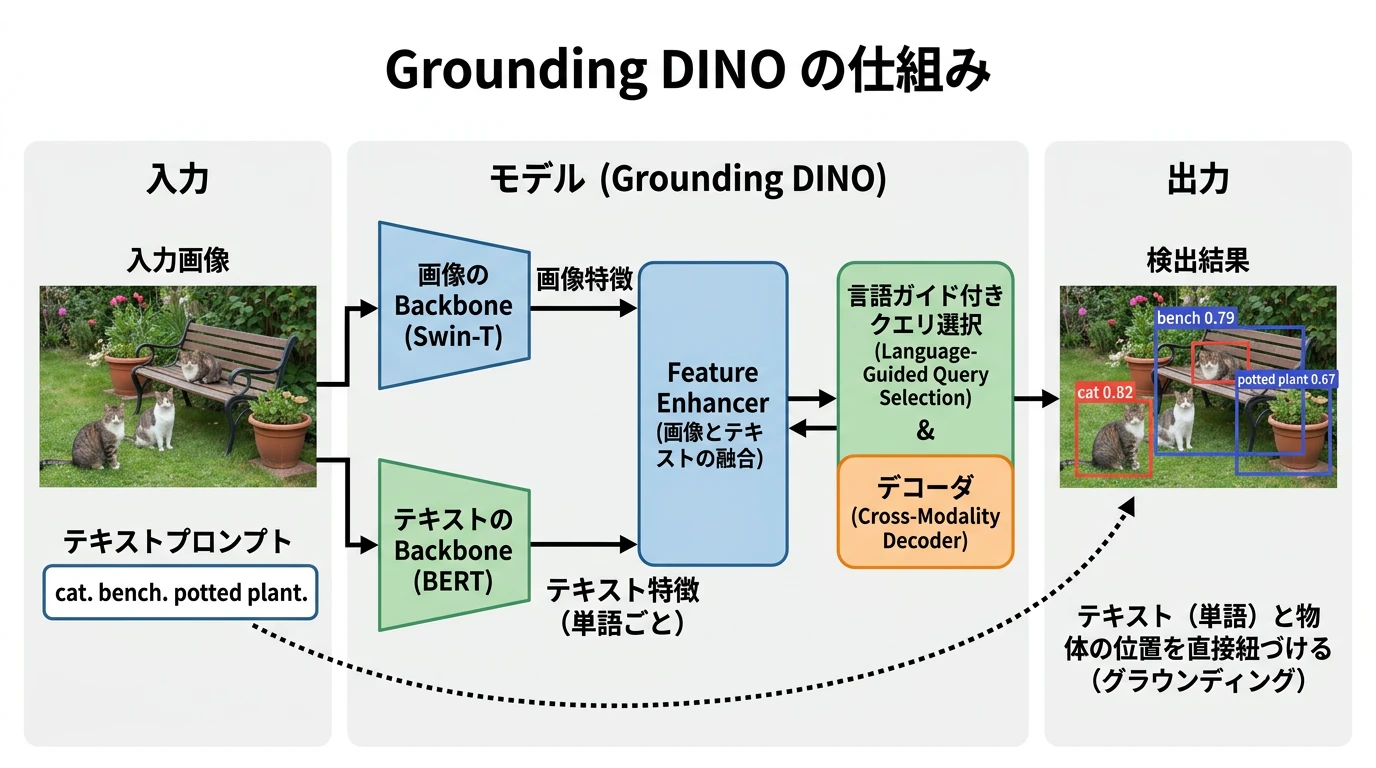
記事を読むテキストで指定した物体を検出するオープンセットの物体検出モデル Grounding DINO を、PyTorch のスクラッチ実装で解説します。Swin-T と BERT、画像とテキストを混ぜる Feature Enhancer、テキストに導かれたクエリの選択、Cross-Modality Decoder を実装し、公式の学習済みの重みで Hugging Face と同じ検出結果になることを確かめます。COCO val2017 の一部でゼロショットの精度を測り、ハンガリアンマッチングとトークン単位の損失を実装して、新しい単語と学習に出ない組み合わせを合成データで確かめます。
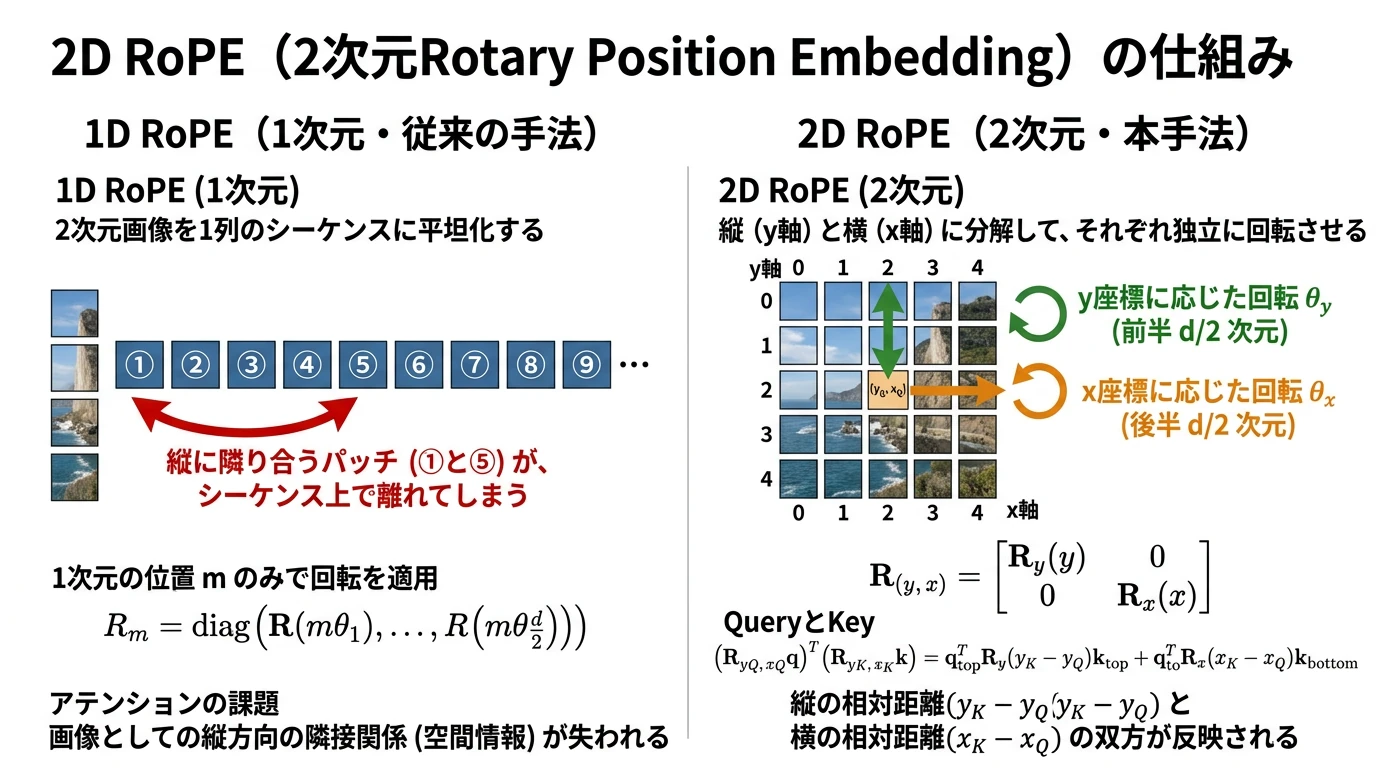
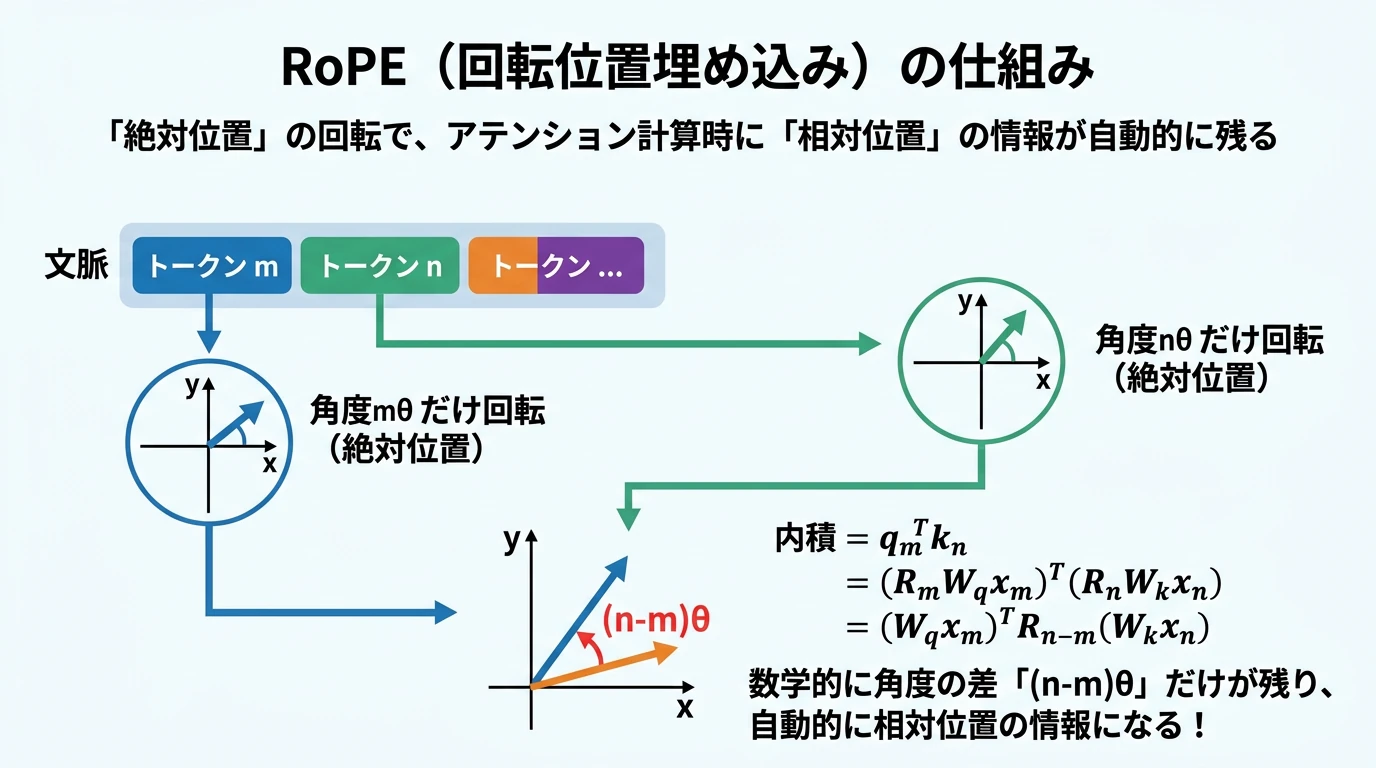
記事を読む1次元のRoPEを画像へ適用する際の課題を解決し、縦横の空間情報を正確に捉える2D RoPE(2次元Rotary Position Embedding)の仕組みを、数式やPyTorchによる適用コードを交えて解説します。
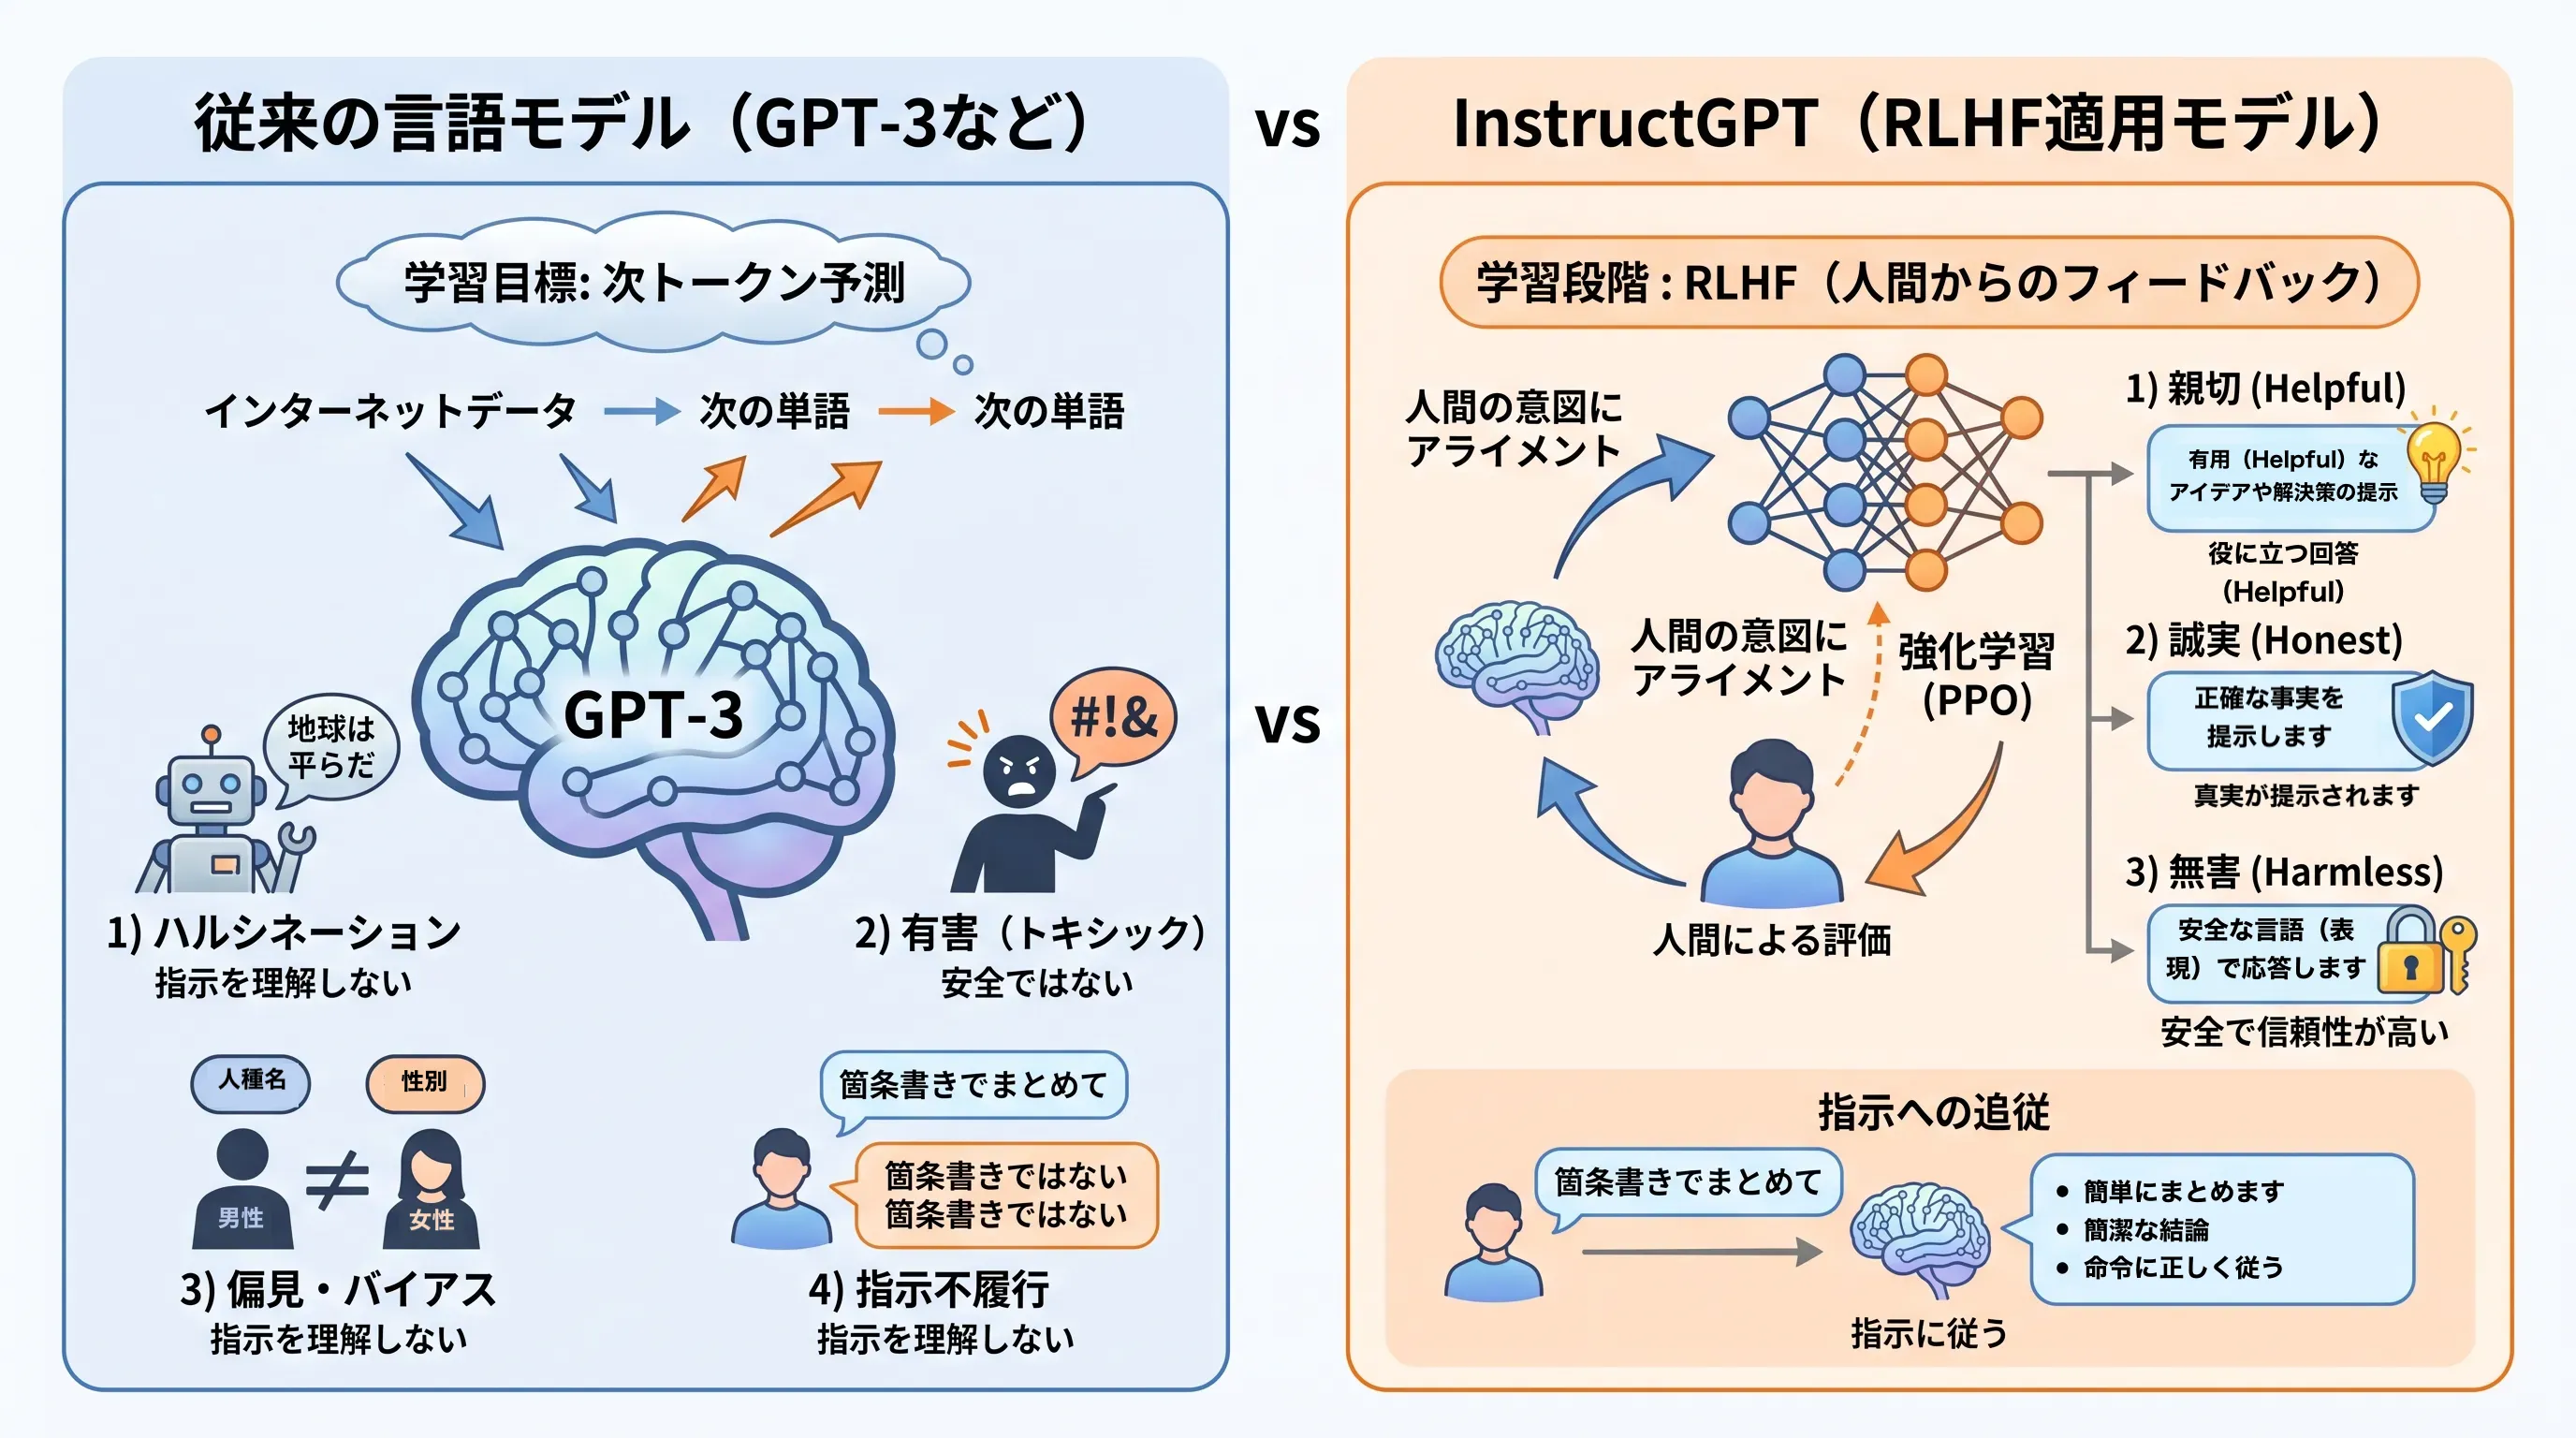
記事を読むChatGPTの基盤技術となったInstructGPT(RLHF)の仕組みを解説。SFT、報酬モデリング(ペアワイズ損失)、PPOの数理的背景から、PyTorchを用いた実践的な学習パイプラインの実装、TRLライブラリを用いた実装までを網羅します。
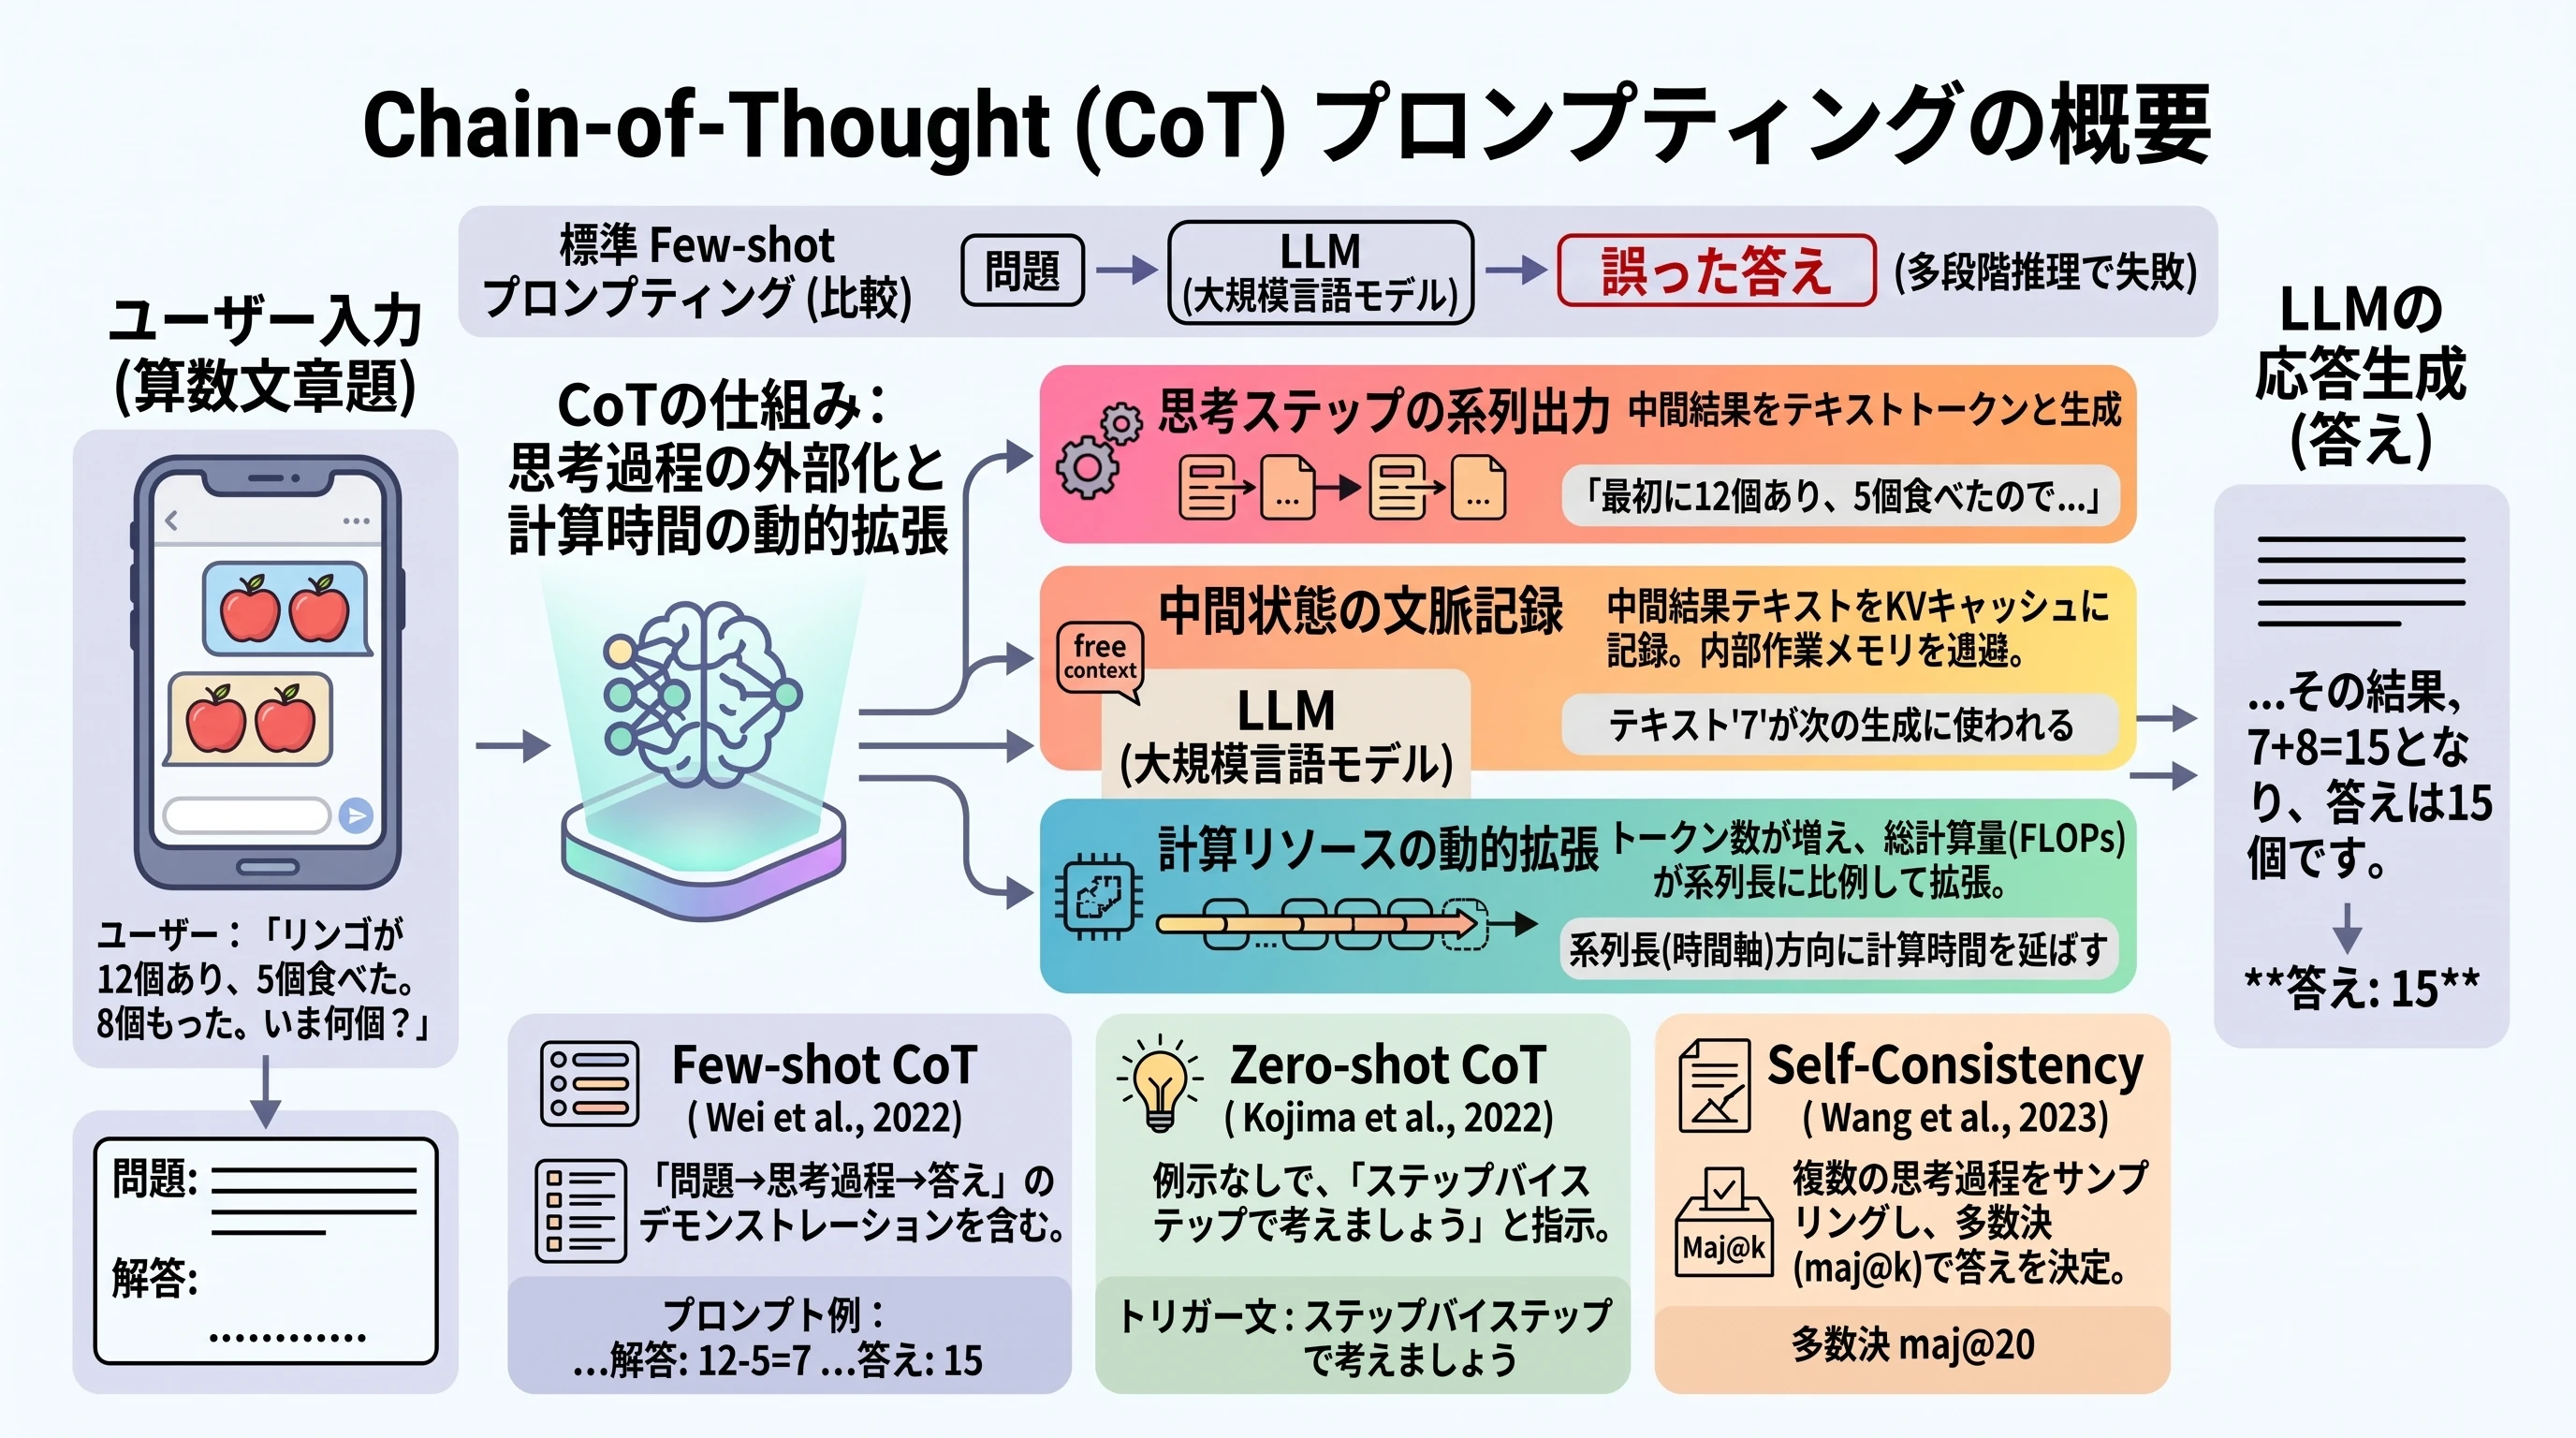
記事を読む最終的な答えの前に中間的な思考過程を出力させることで推論性能を引き出す「Chain-of-Thought(CoT)」の原理と実装を解説します。Few-shot CoT、Zero-shot CoT(2段階プロンプティング)、Self-Consistency(多数決)と評価指標(pass@k・maj@k)を定義し、合成した算数ワールドでモデル規模(Qwen2.5 0.5B〜7B)× 難易度の実験を行います。
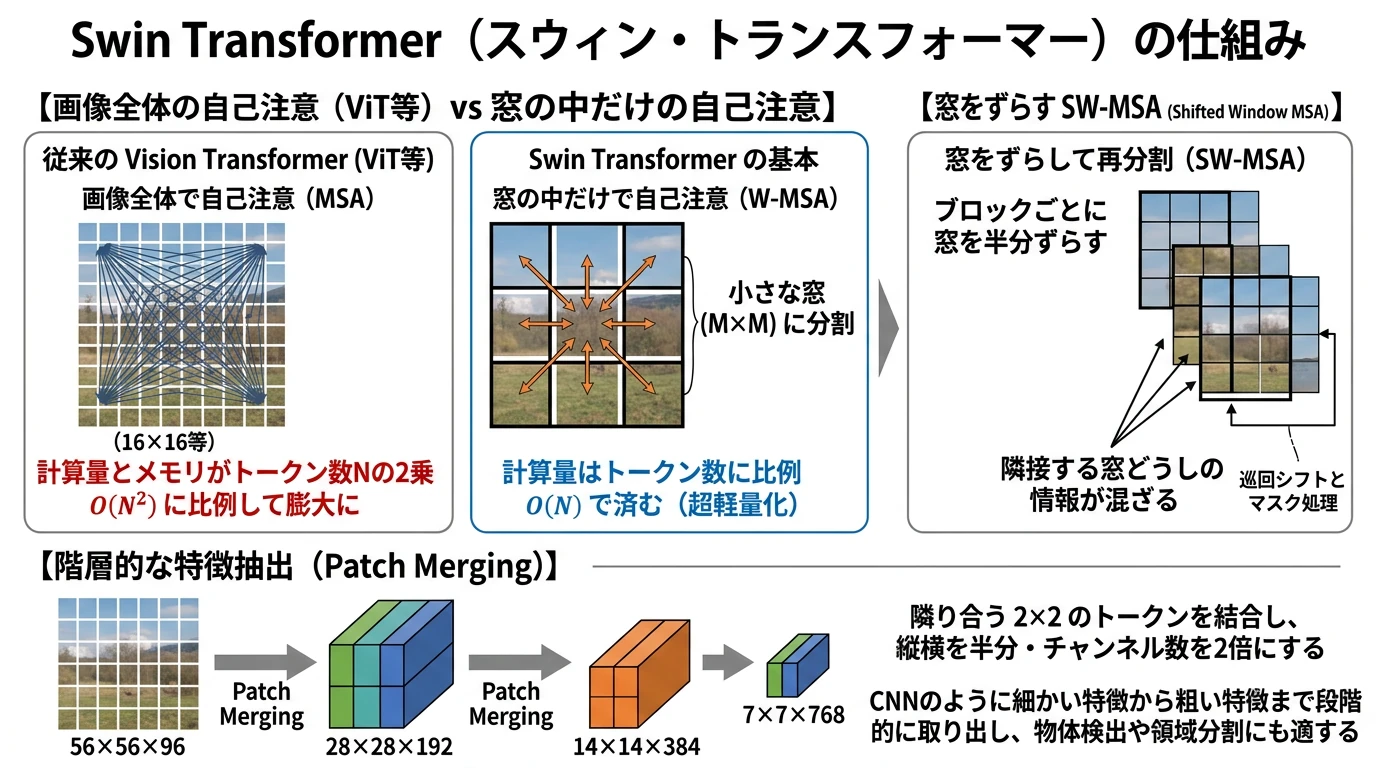
記事を読む画像を小さな窓に区切り、窓の中だけで自己注意を計算するSwin Transformerを、PyTorchのスクラッチ実装で解説します。公式の学習済み重みでHugging Faceと同じ出力になることを確かめ、CIFAR-10で窓のシフトと相対位置バイアスの効果を比べます。
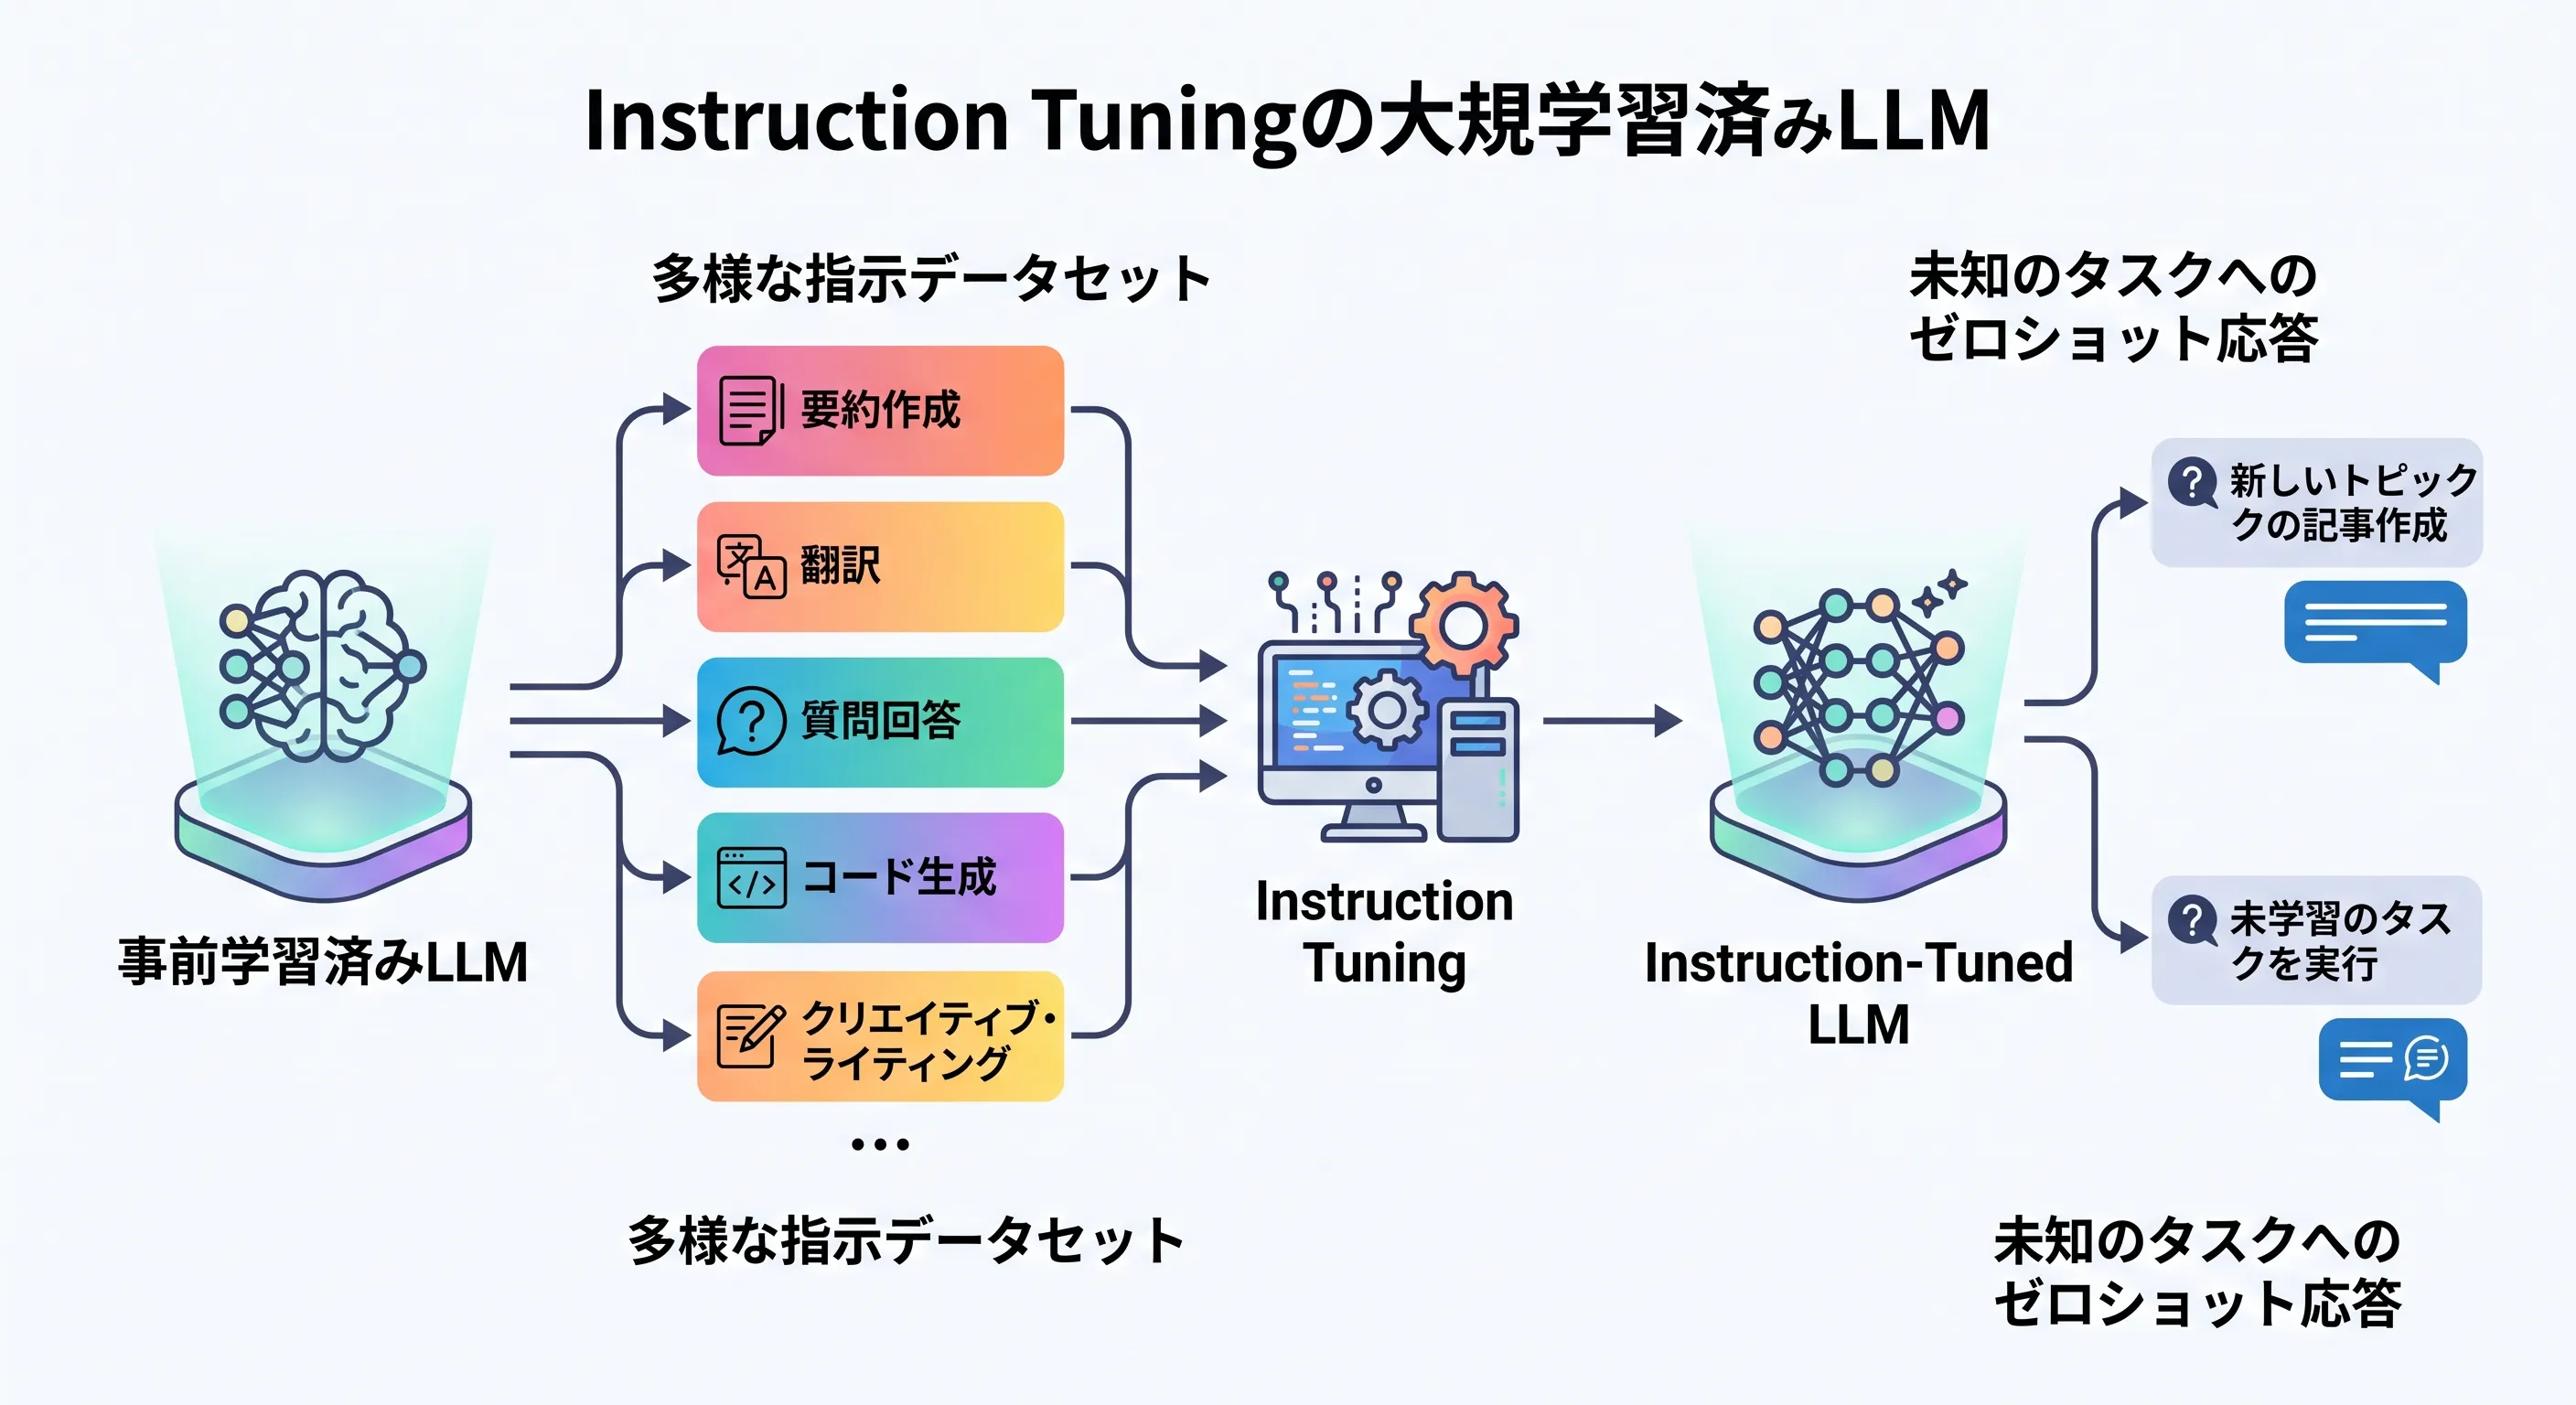
記事を読む言語モデルを「単なる単語の確率的予測器」から「人間の指示に正確に従うアシスタント」へと進化させるコア技術であるInstruction Tuningの仕組みを、PyTorchでのスクラッチ実装やHugging Face TRLを用いた実装を交えて解説します。
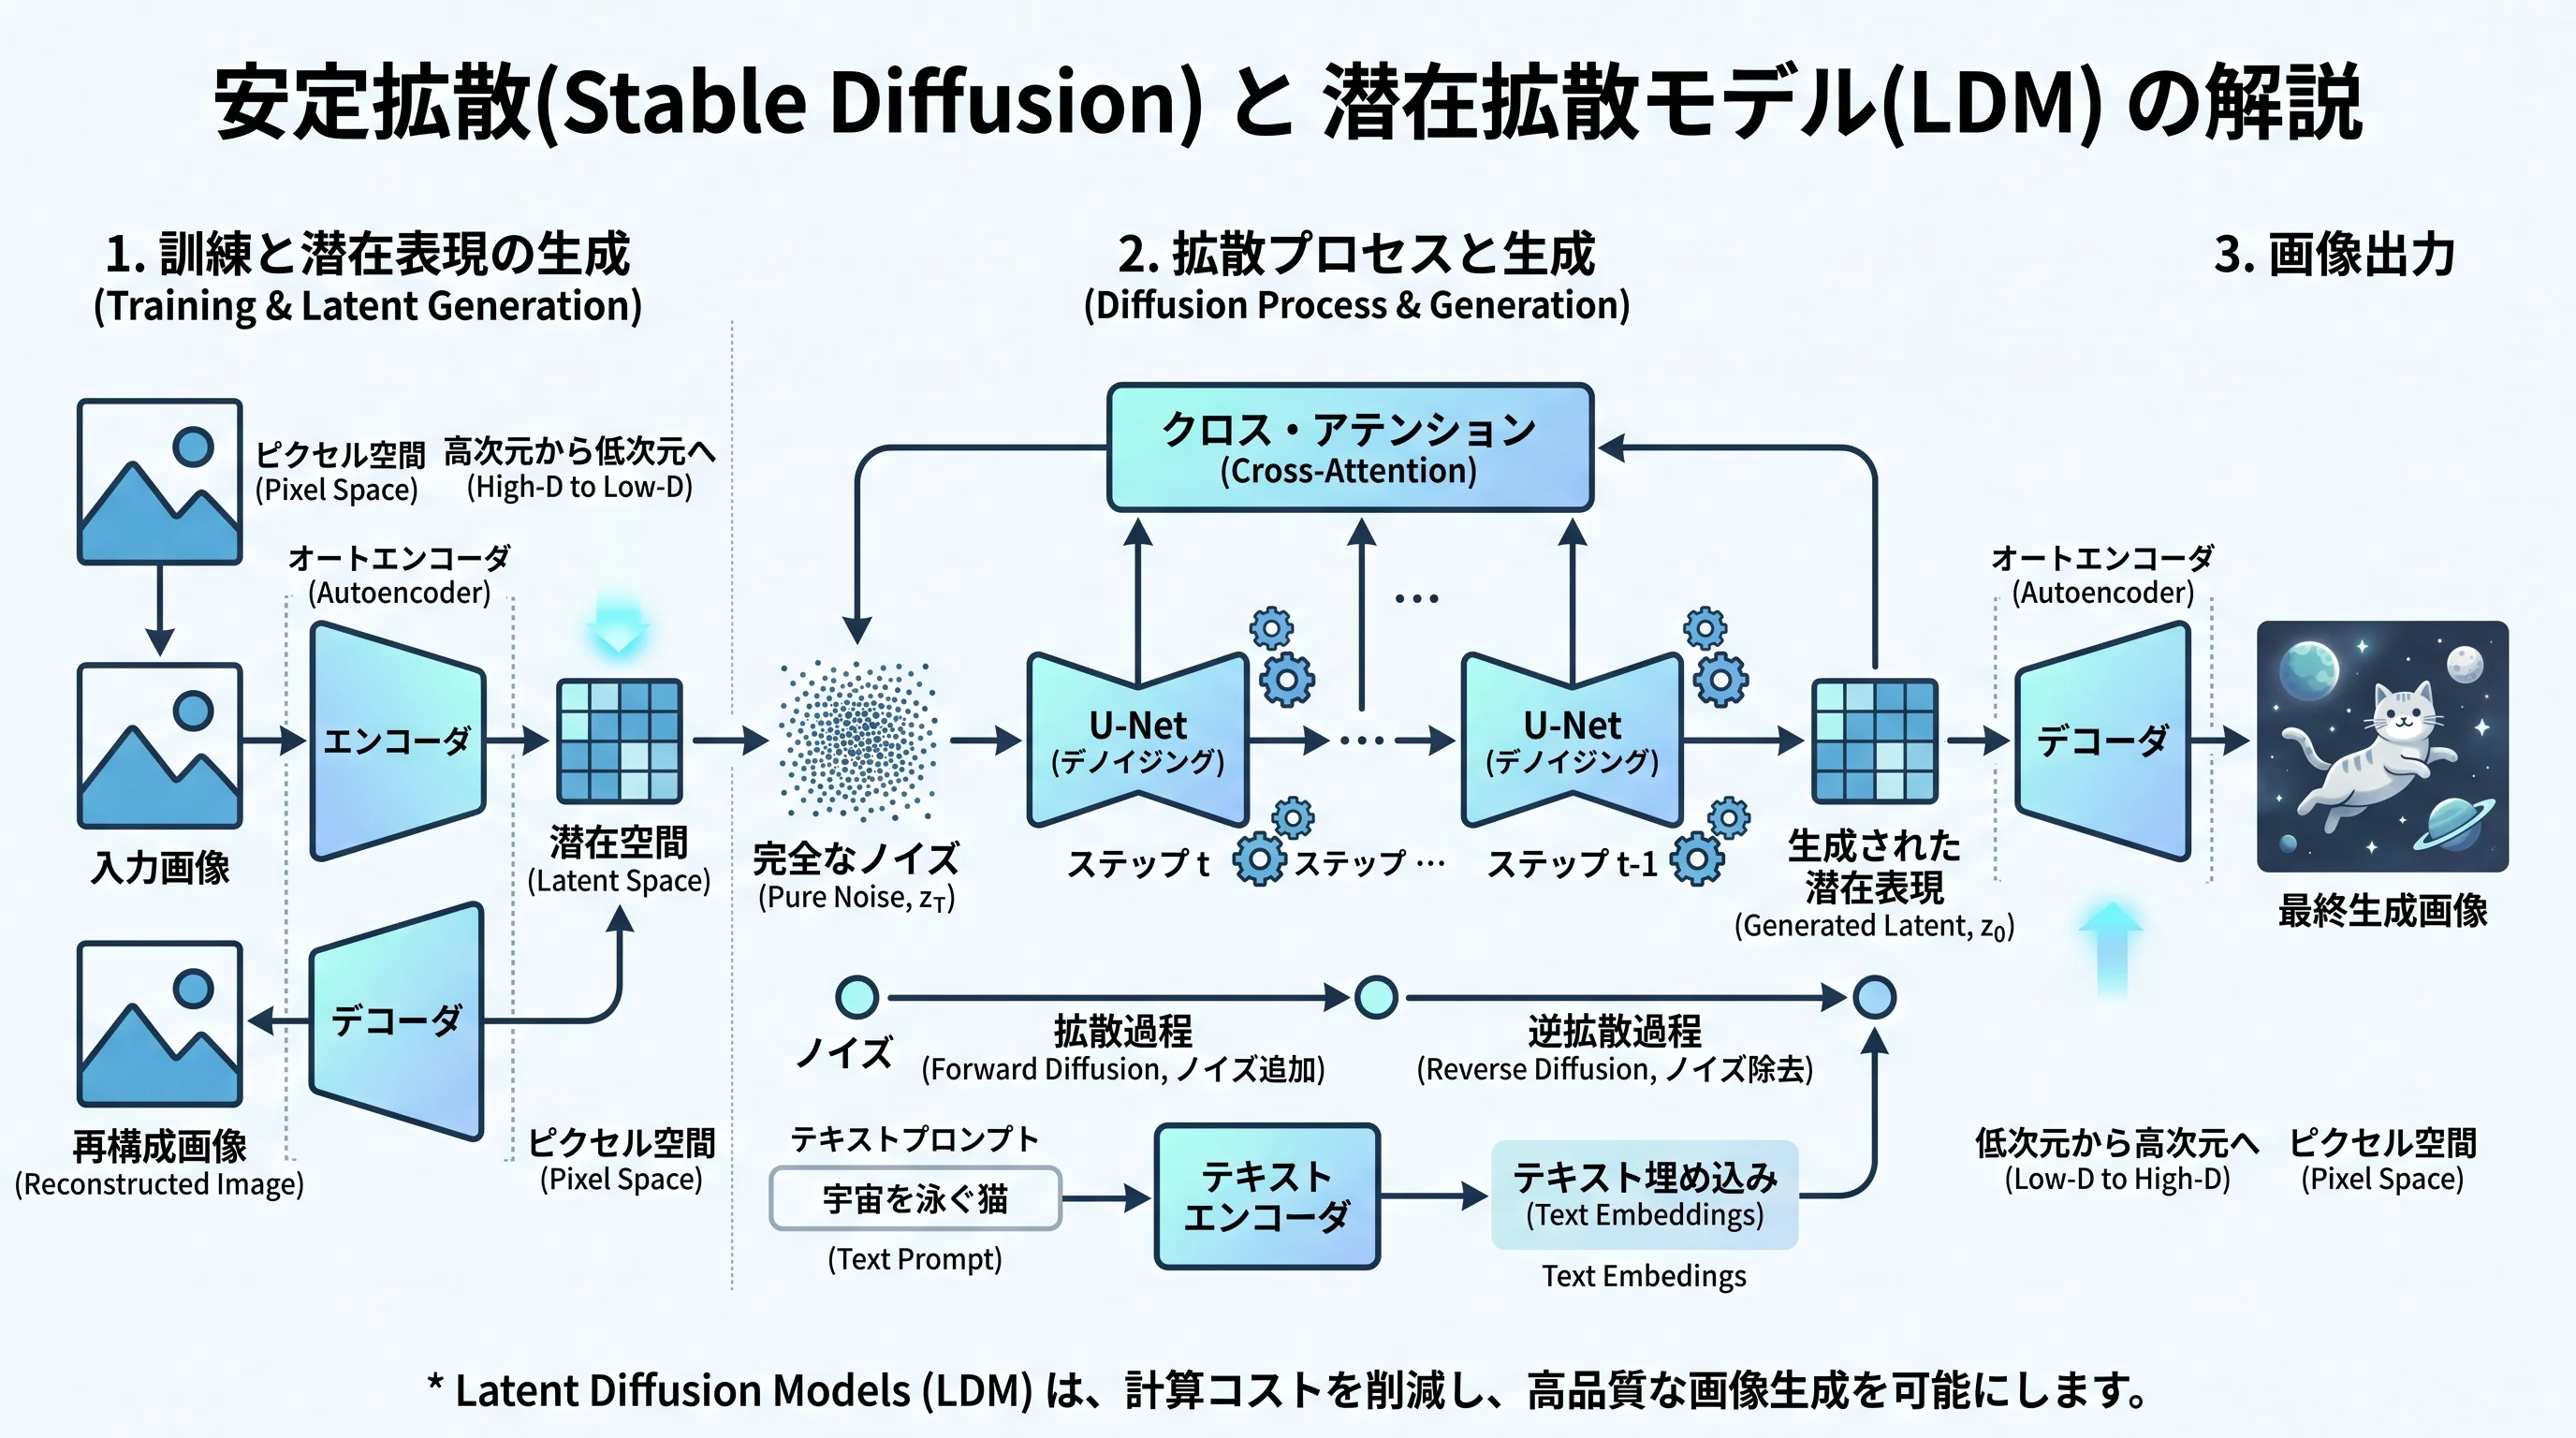
記事を読む現在の画像生成AIのデファクトスタンダードとなっている「Stable Diffusion (Latent Diffusion Models)」について、2段階の圧縮による計算効率化、U-Netへのクロスアテンション導入によるテキスト条件付けの理論から、PyTorchを用いた全体のスクラッチ実装までを解説します。
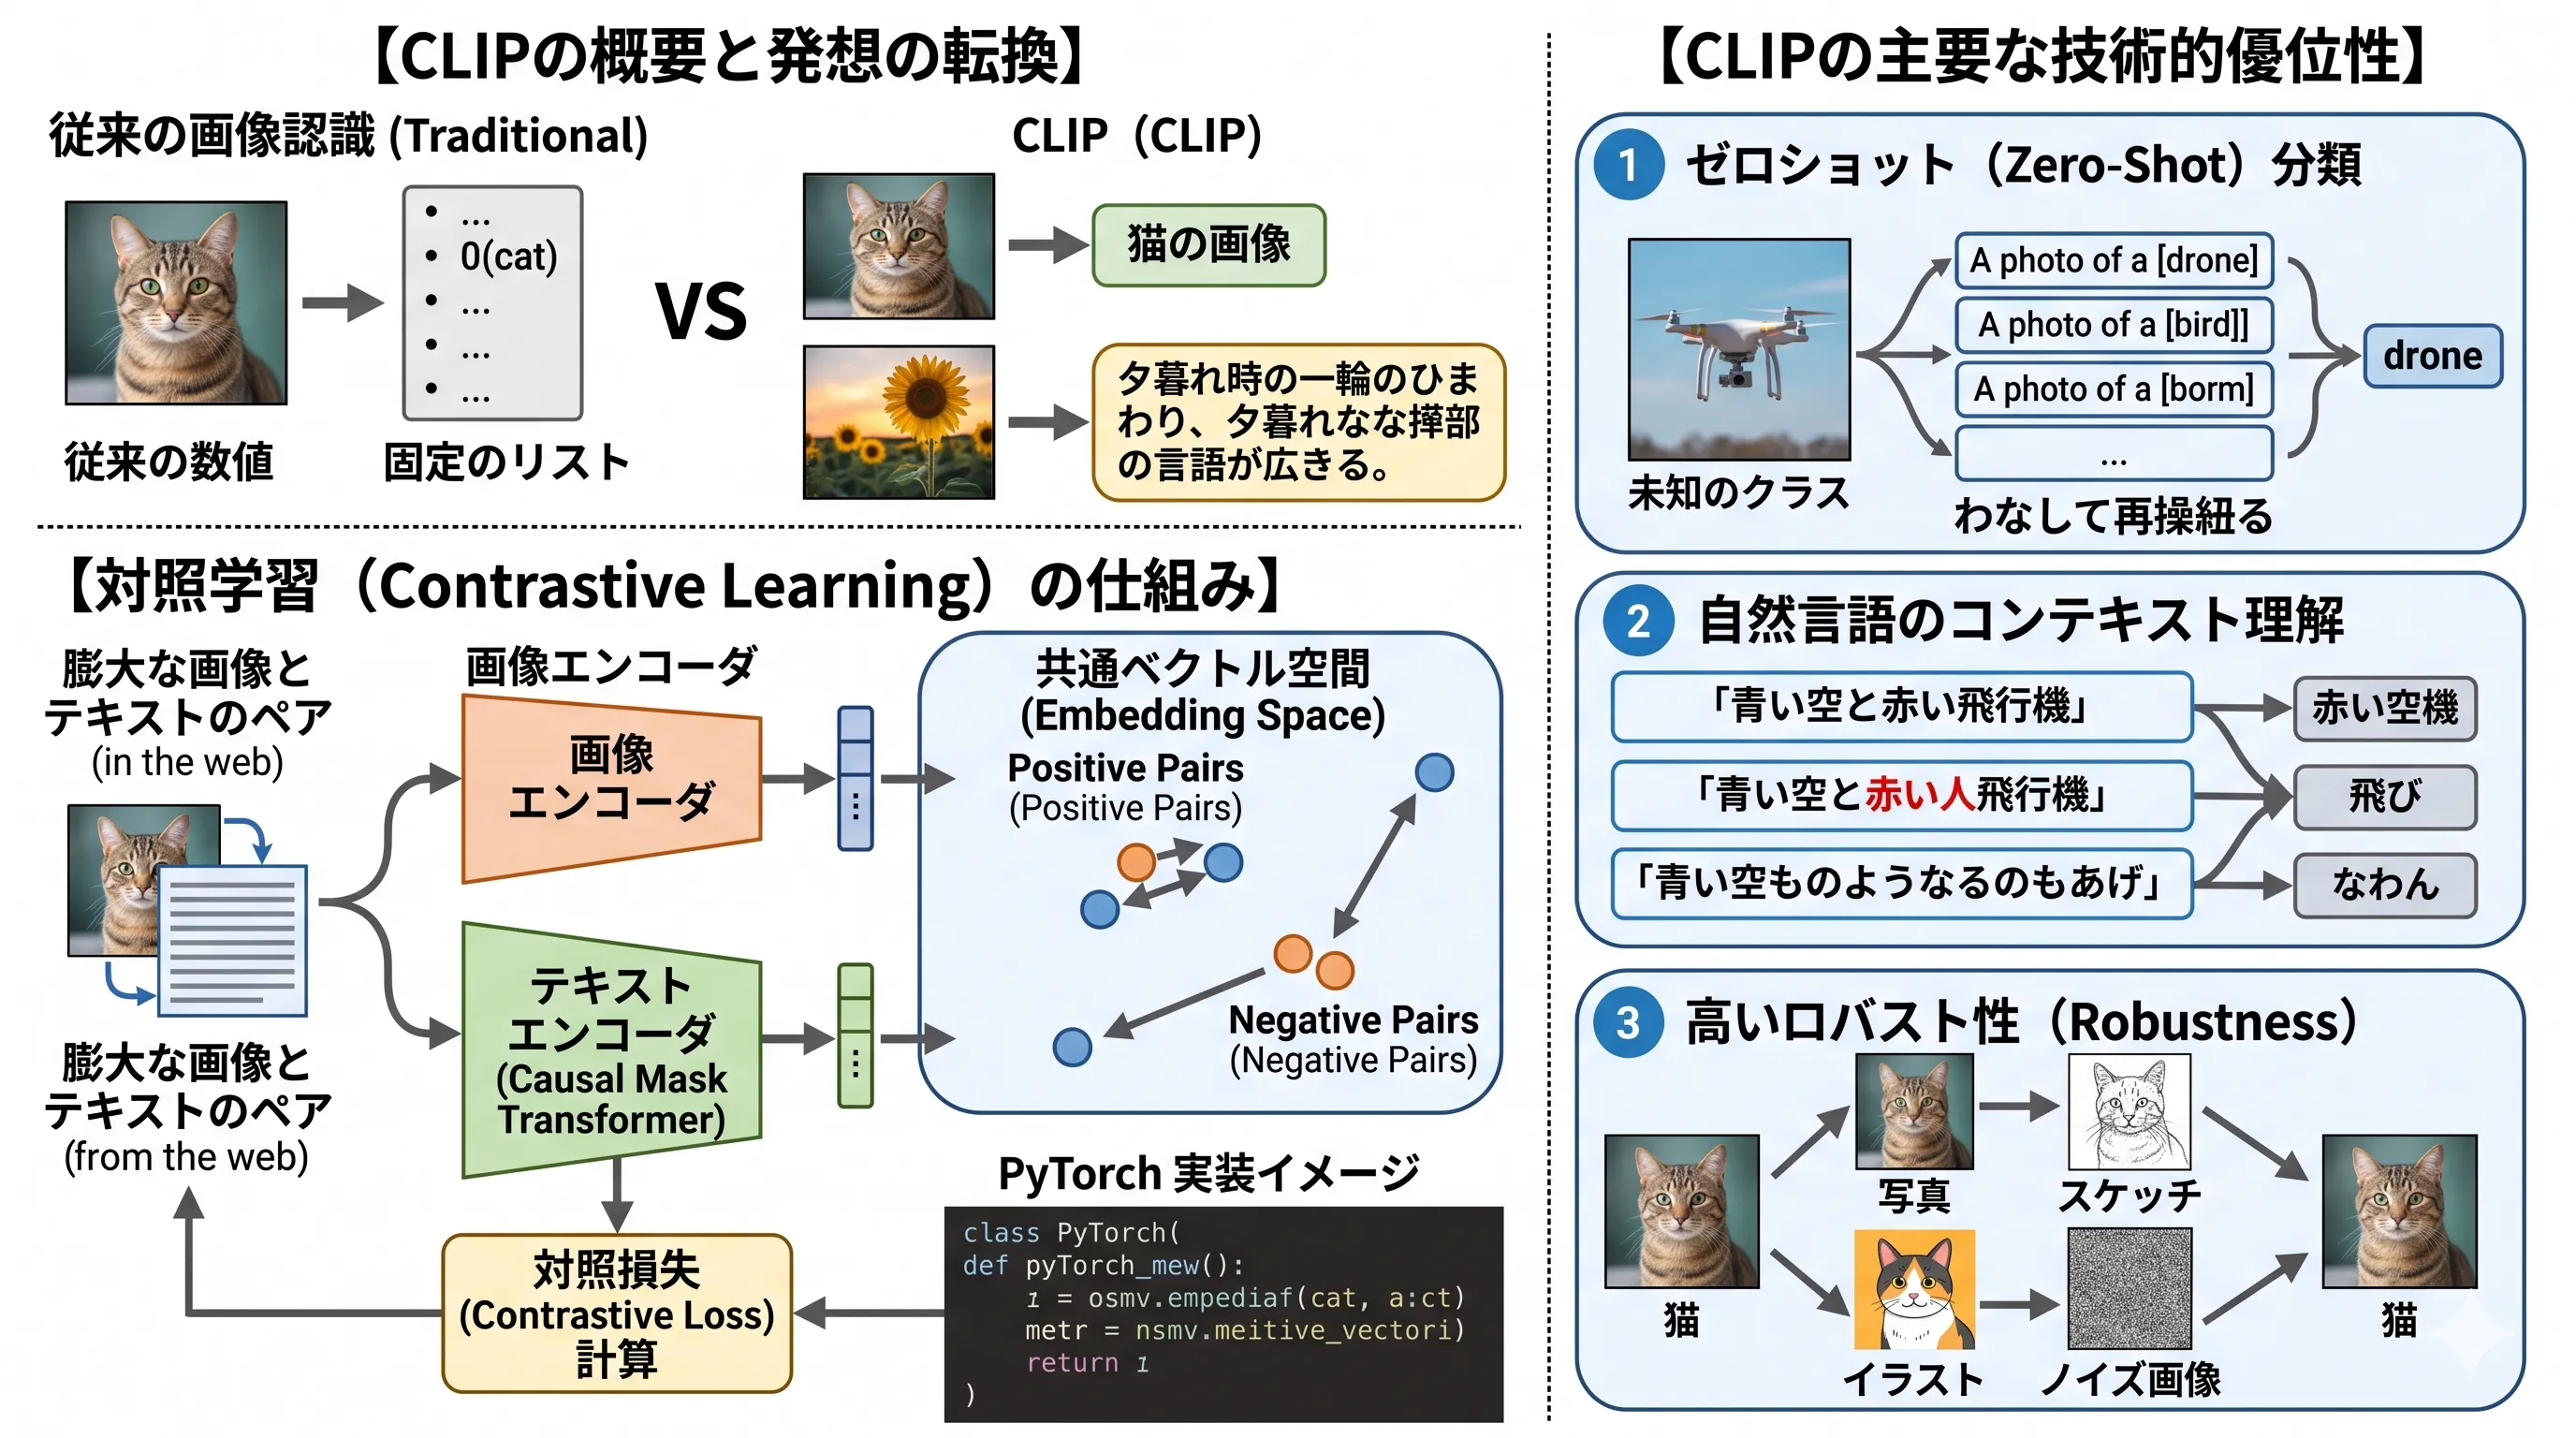
記事を読む画像とテキストを同じ埋め込み空間に写し、インターネットから集めた 4 億組の画像と文の対照学習で、追加学習なしのゼロショット分類を可能にした CLIP(OpenAI)を解説します。対称な交差エントロピー損失、L2 正規化と学習する温度、因果マスクと EOT プーリングのテキストエンコーダ、プロンプトのテンプレートなどの設計の理由を論文に沿って整理し、PyTorch でスクラッチ実装した MiniCLIP を Fashion-MNIST の 10 組で学習させて損失と Recall@1 の変化を確かめ、Hugging Face の学習済みモデルで猫の画像のゼロショット分類を試します。
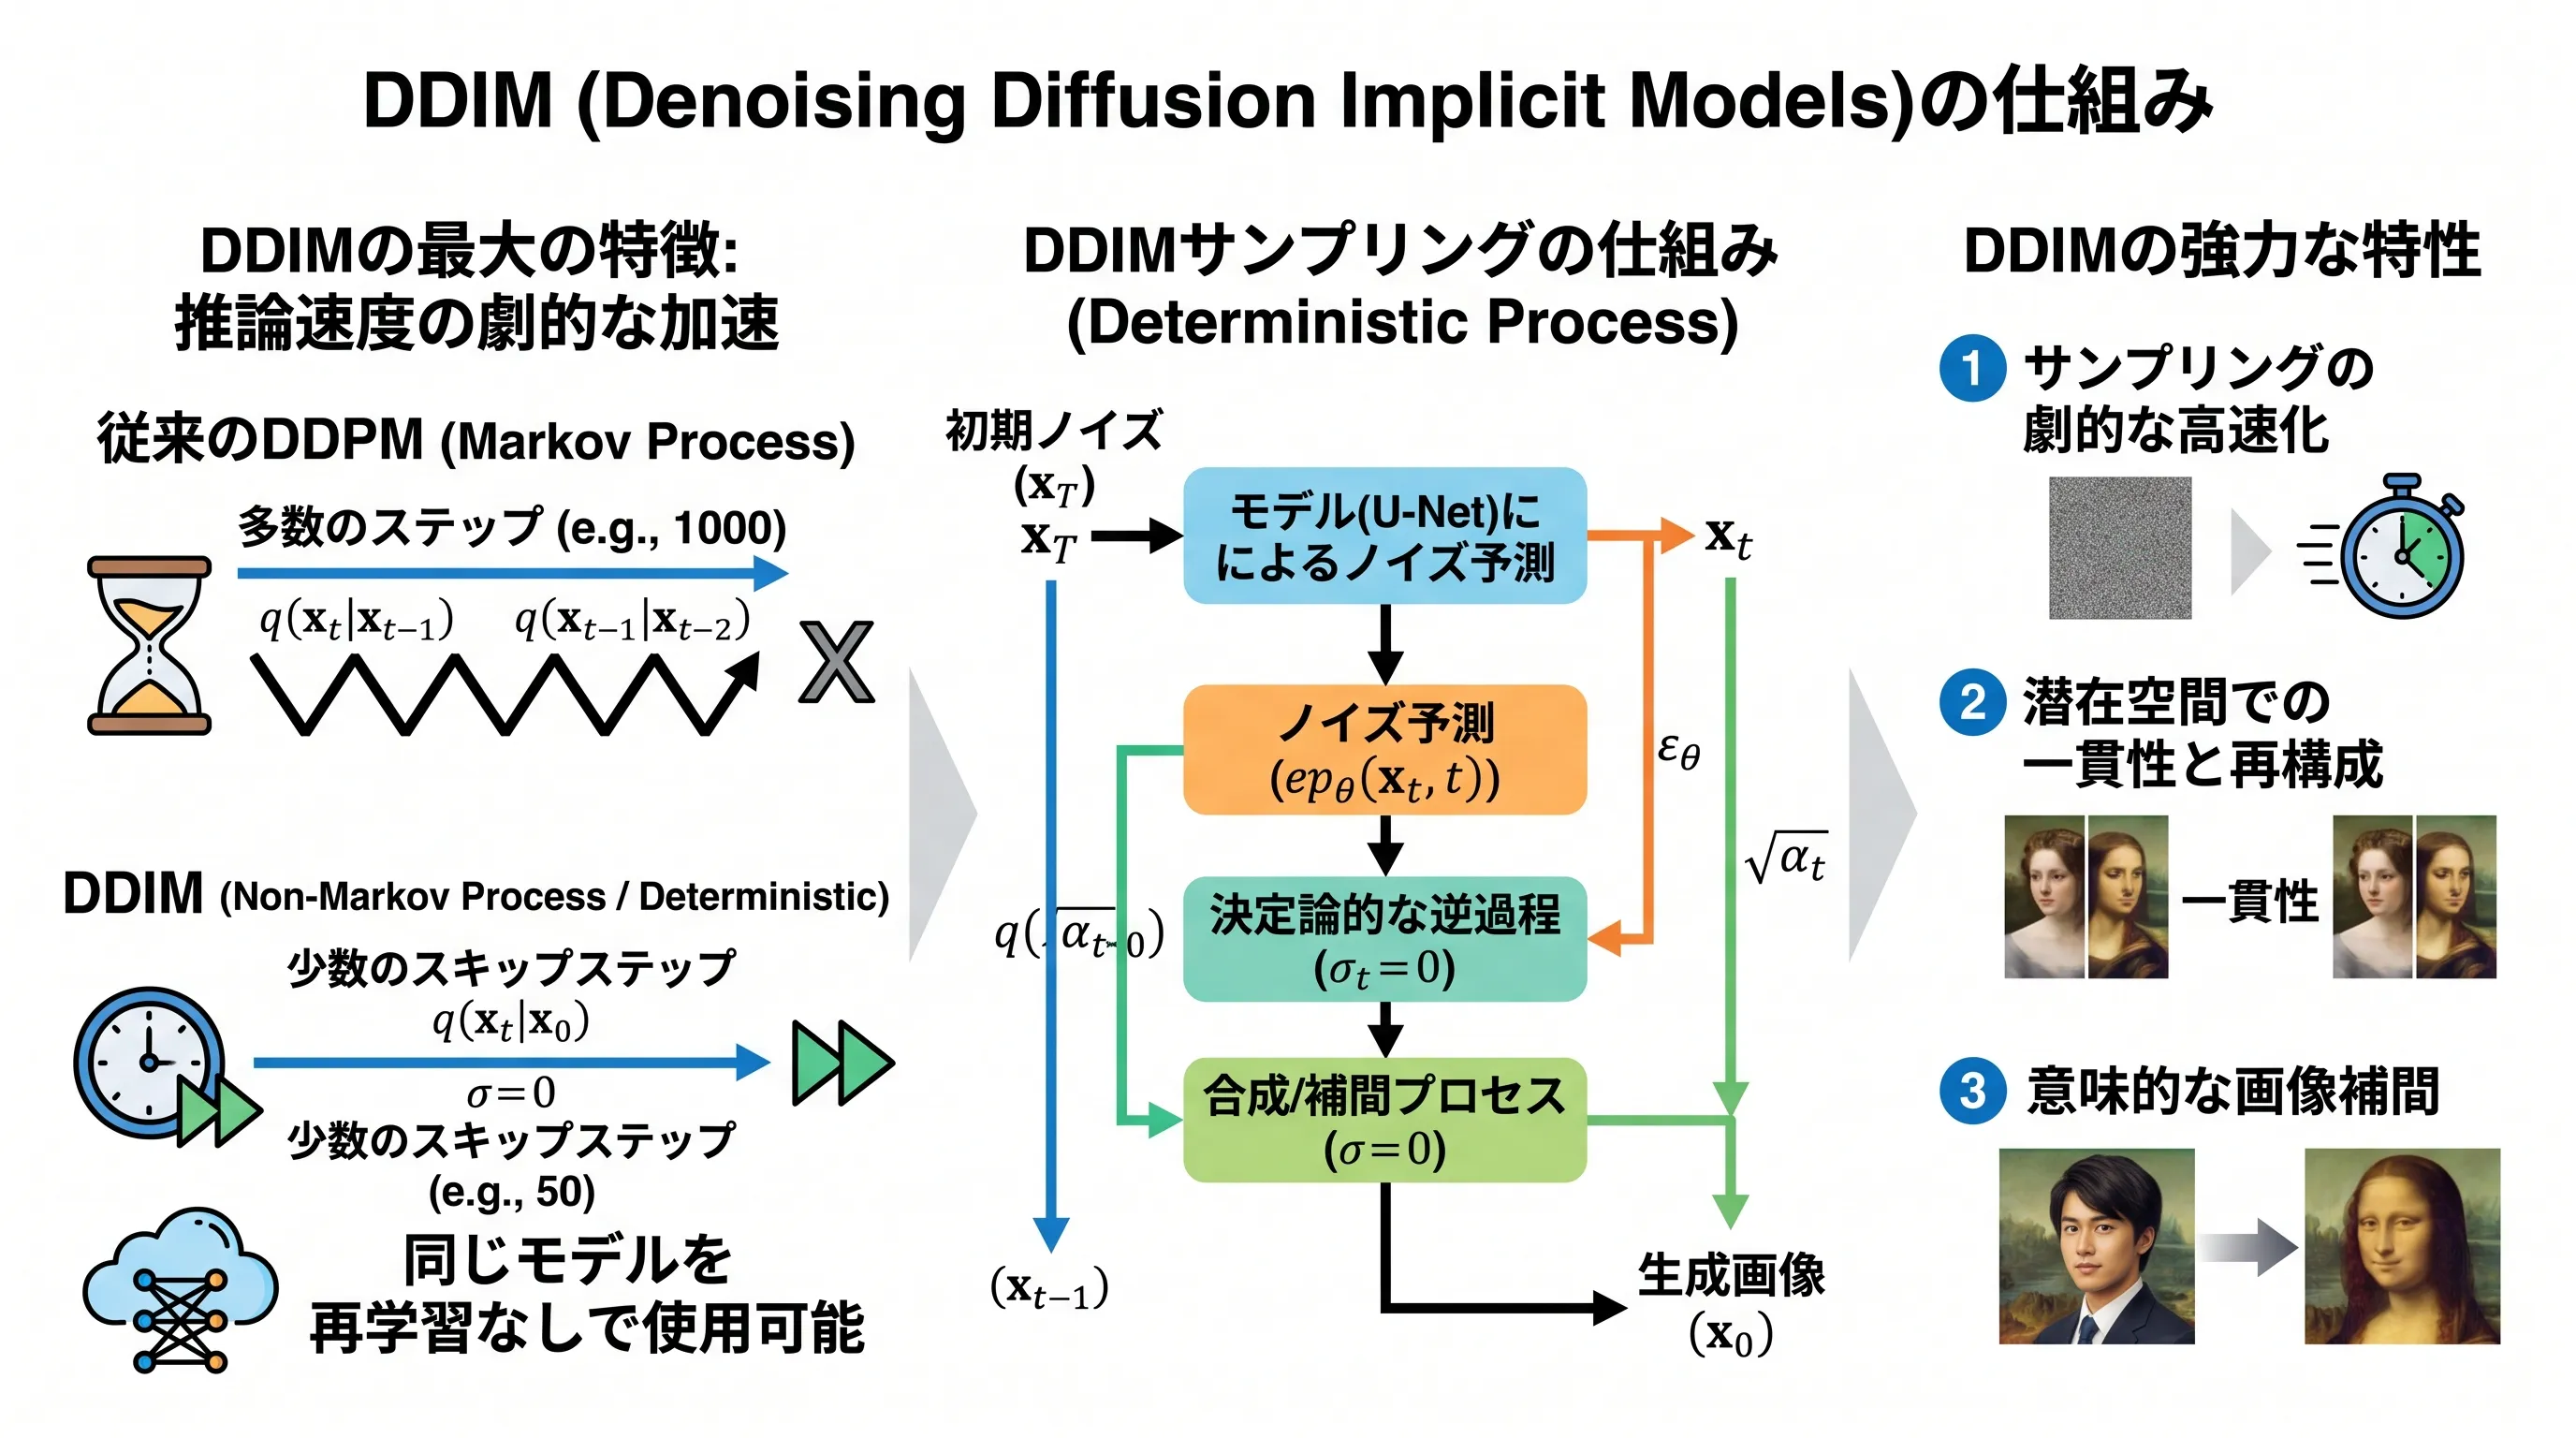
記事を読むDDPMのマルコフ連鎖という制約を外し、決定論的プロセスによって少ないステップ数で高品質な画像生成を可能にした「DDIM」の数学的な仕組みと、PyTorchによるスクラッチ実装を用いたステップ数削減効果の検証を解説します。
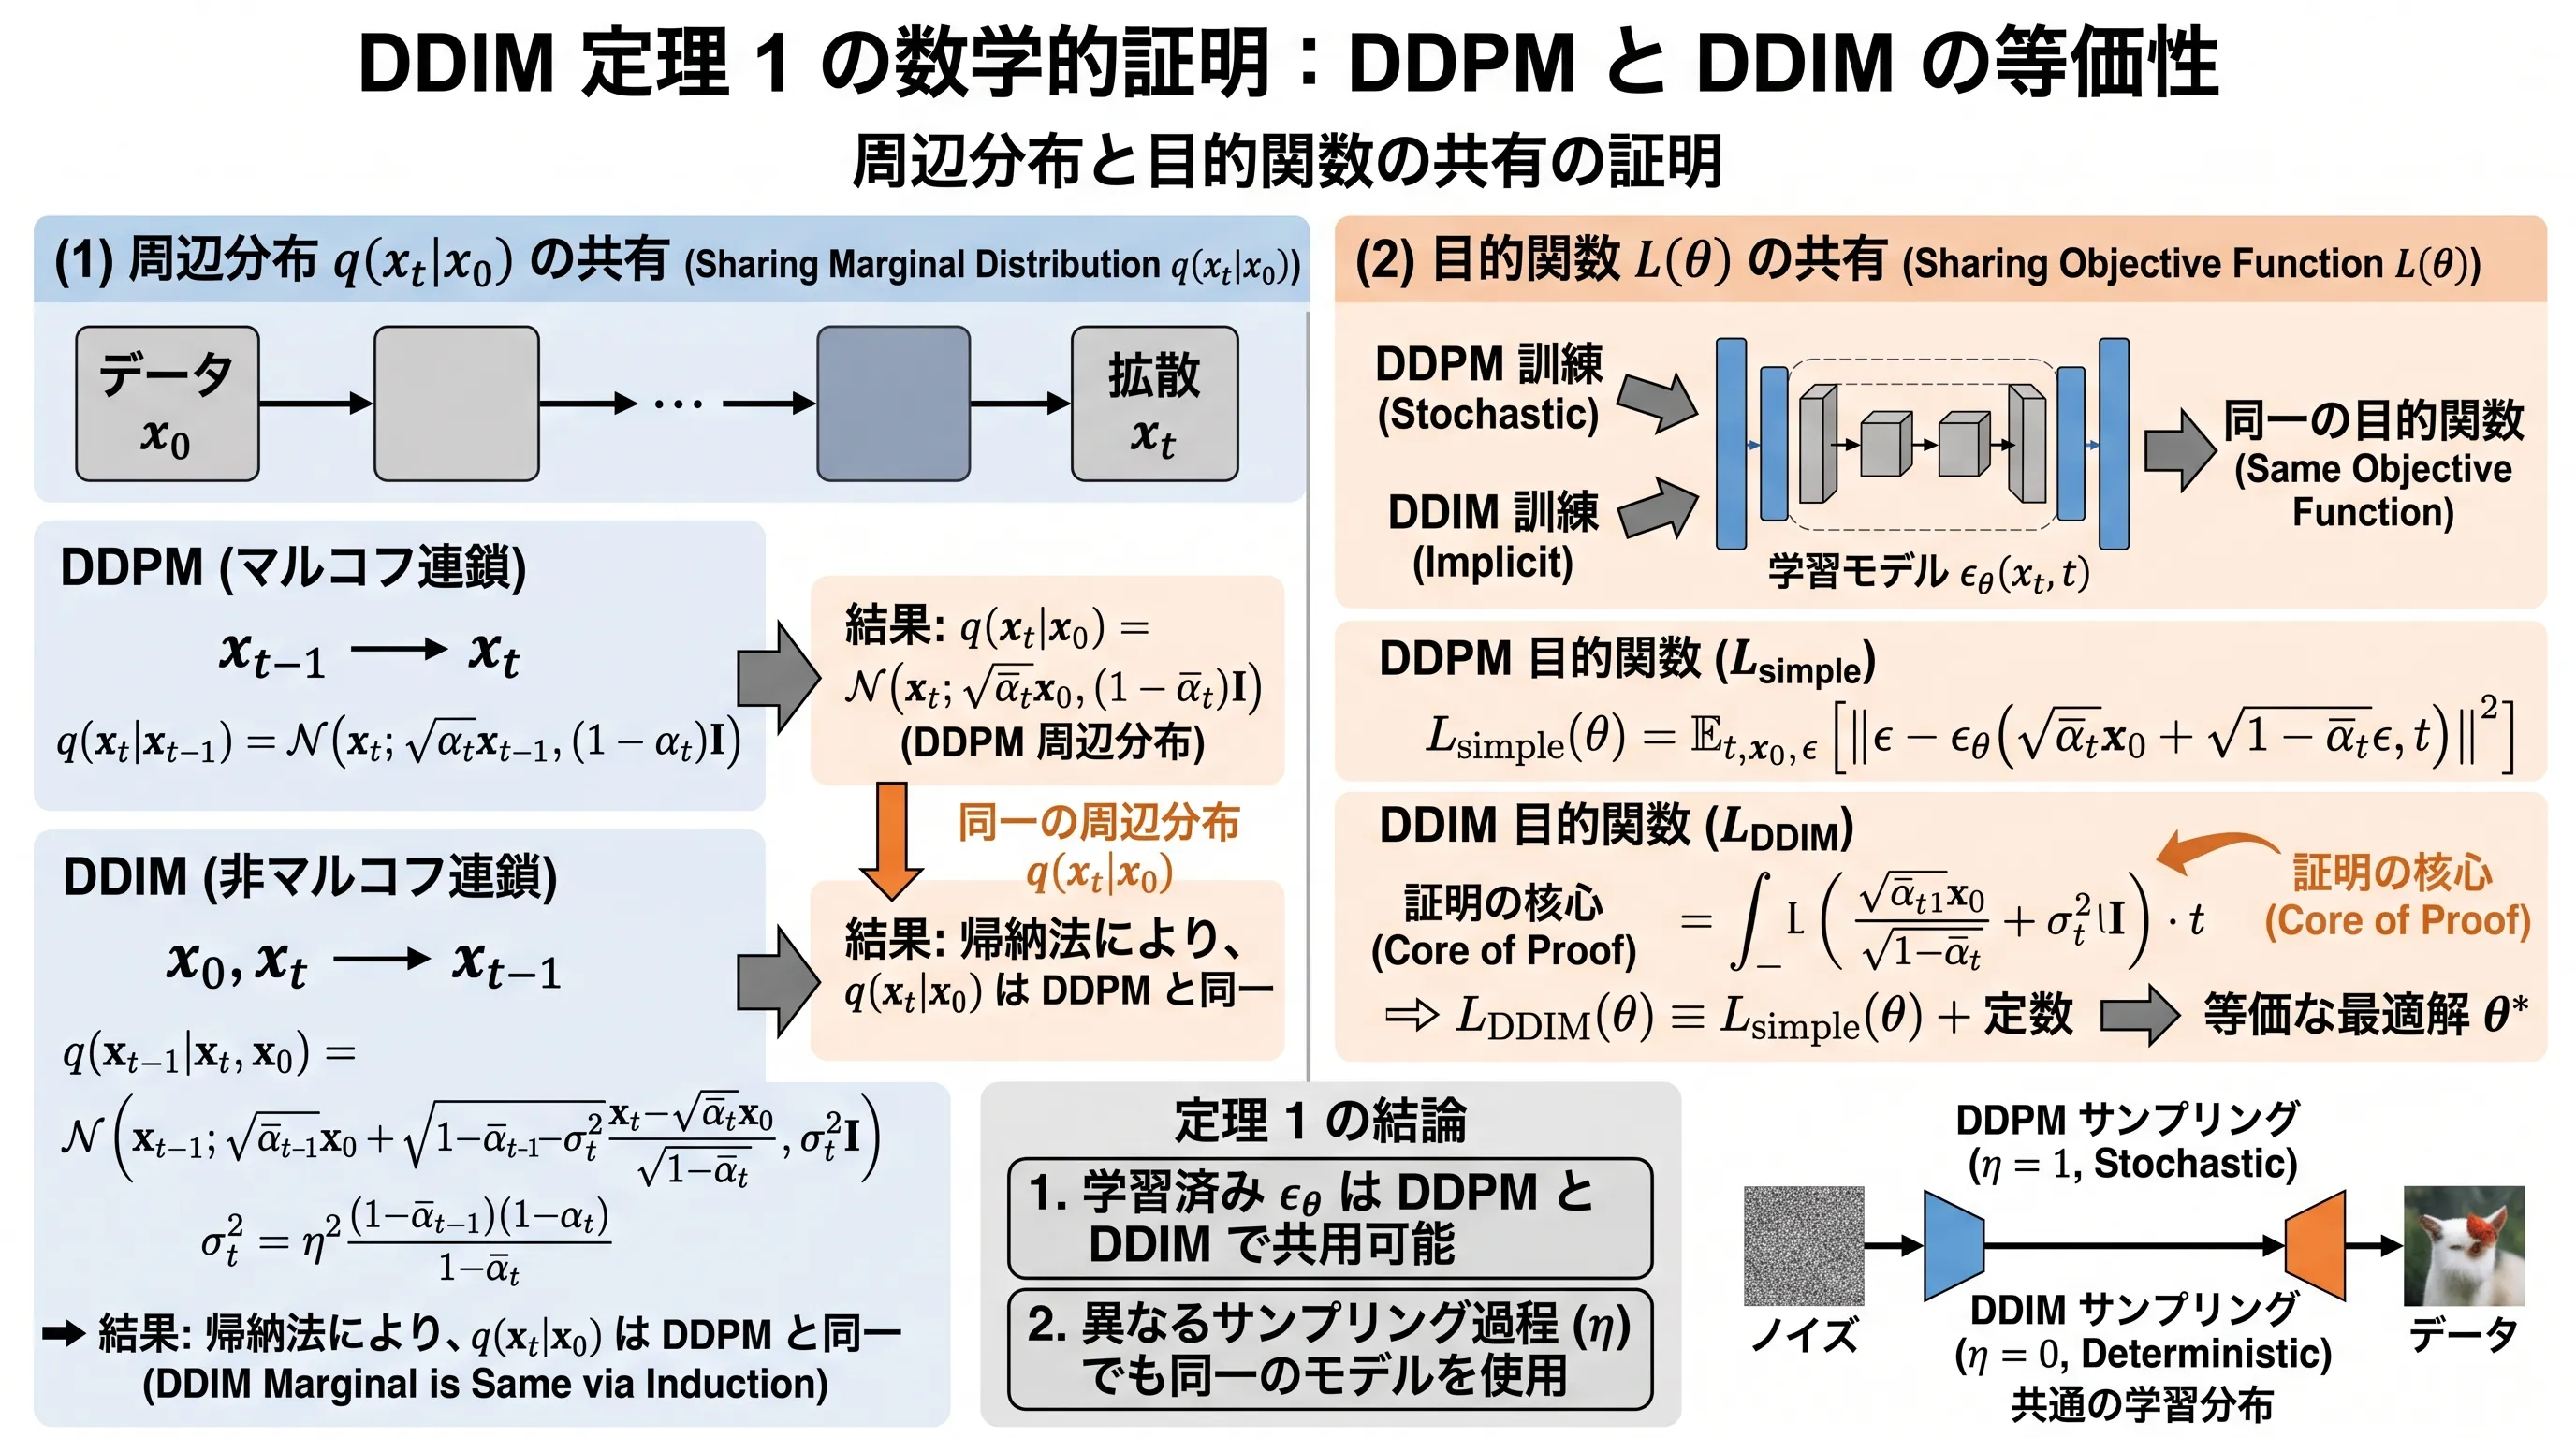
記事を読む推論プロセスを非マルコフ化して大幅に高速化したにもかかわらず、DDPMで学習済みのモデルをそのまま再学習なしで流用できる理由となる「Theorem 1」の数学的な証明プロセスをステップ・バイ・ステップで解説します。
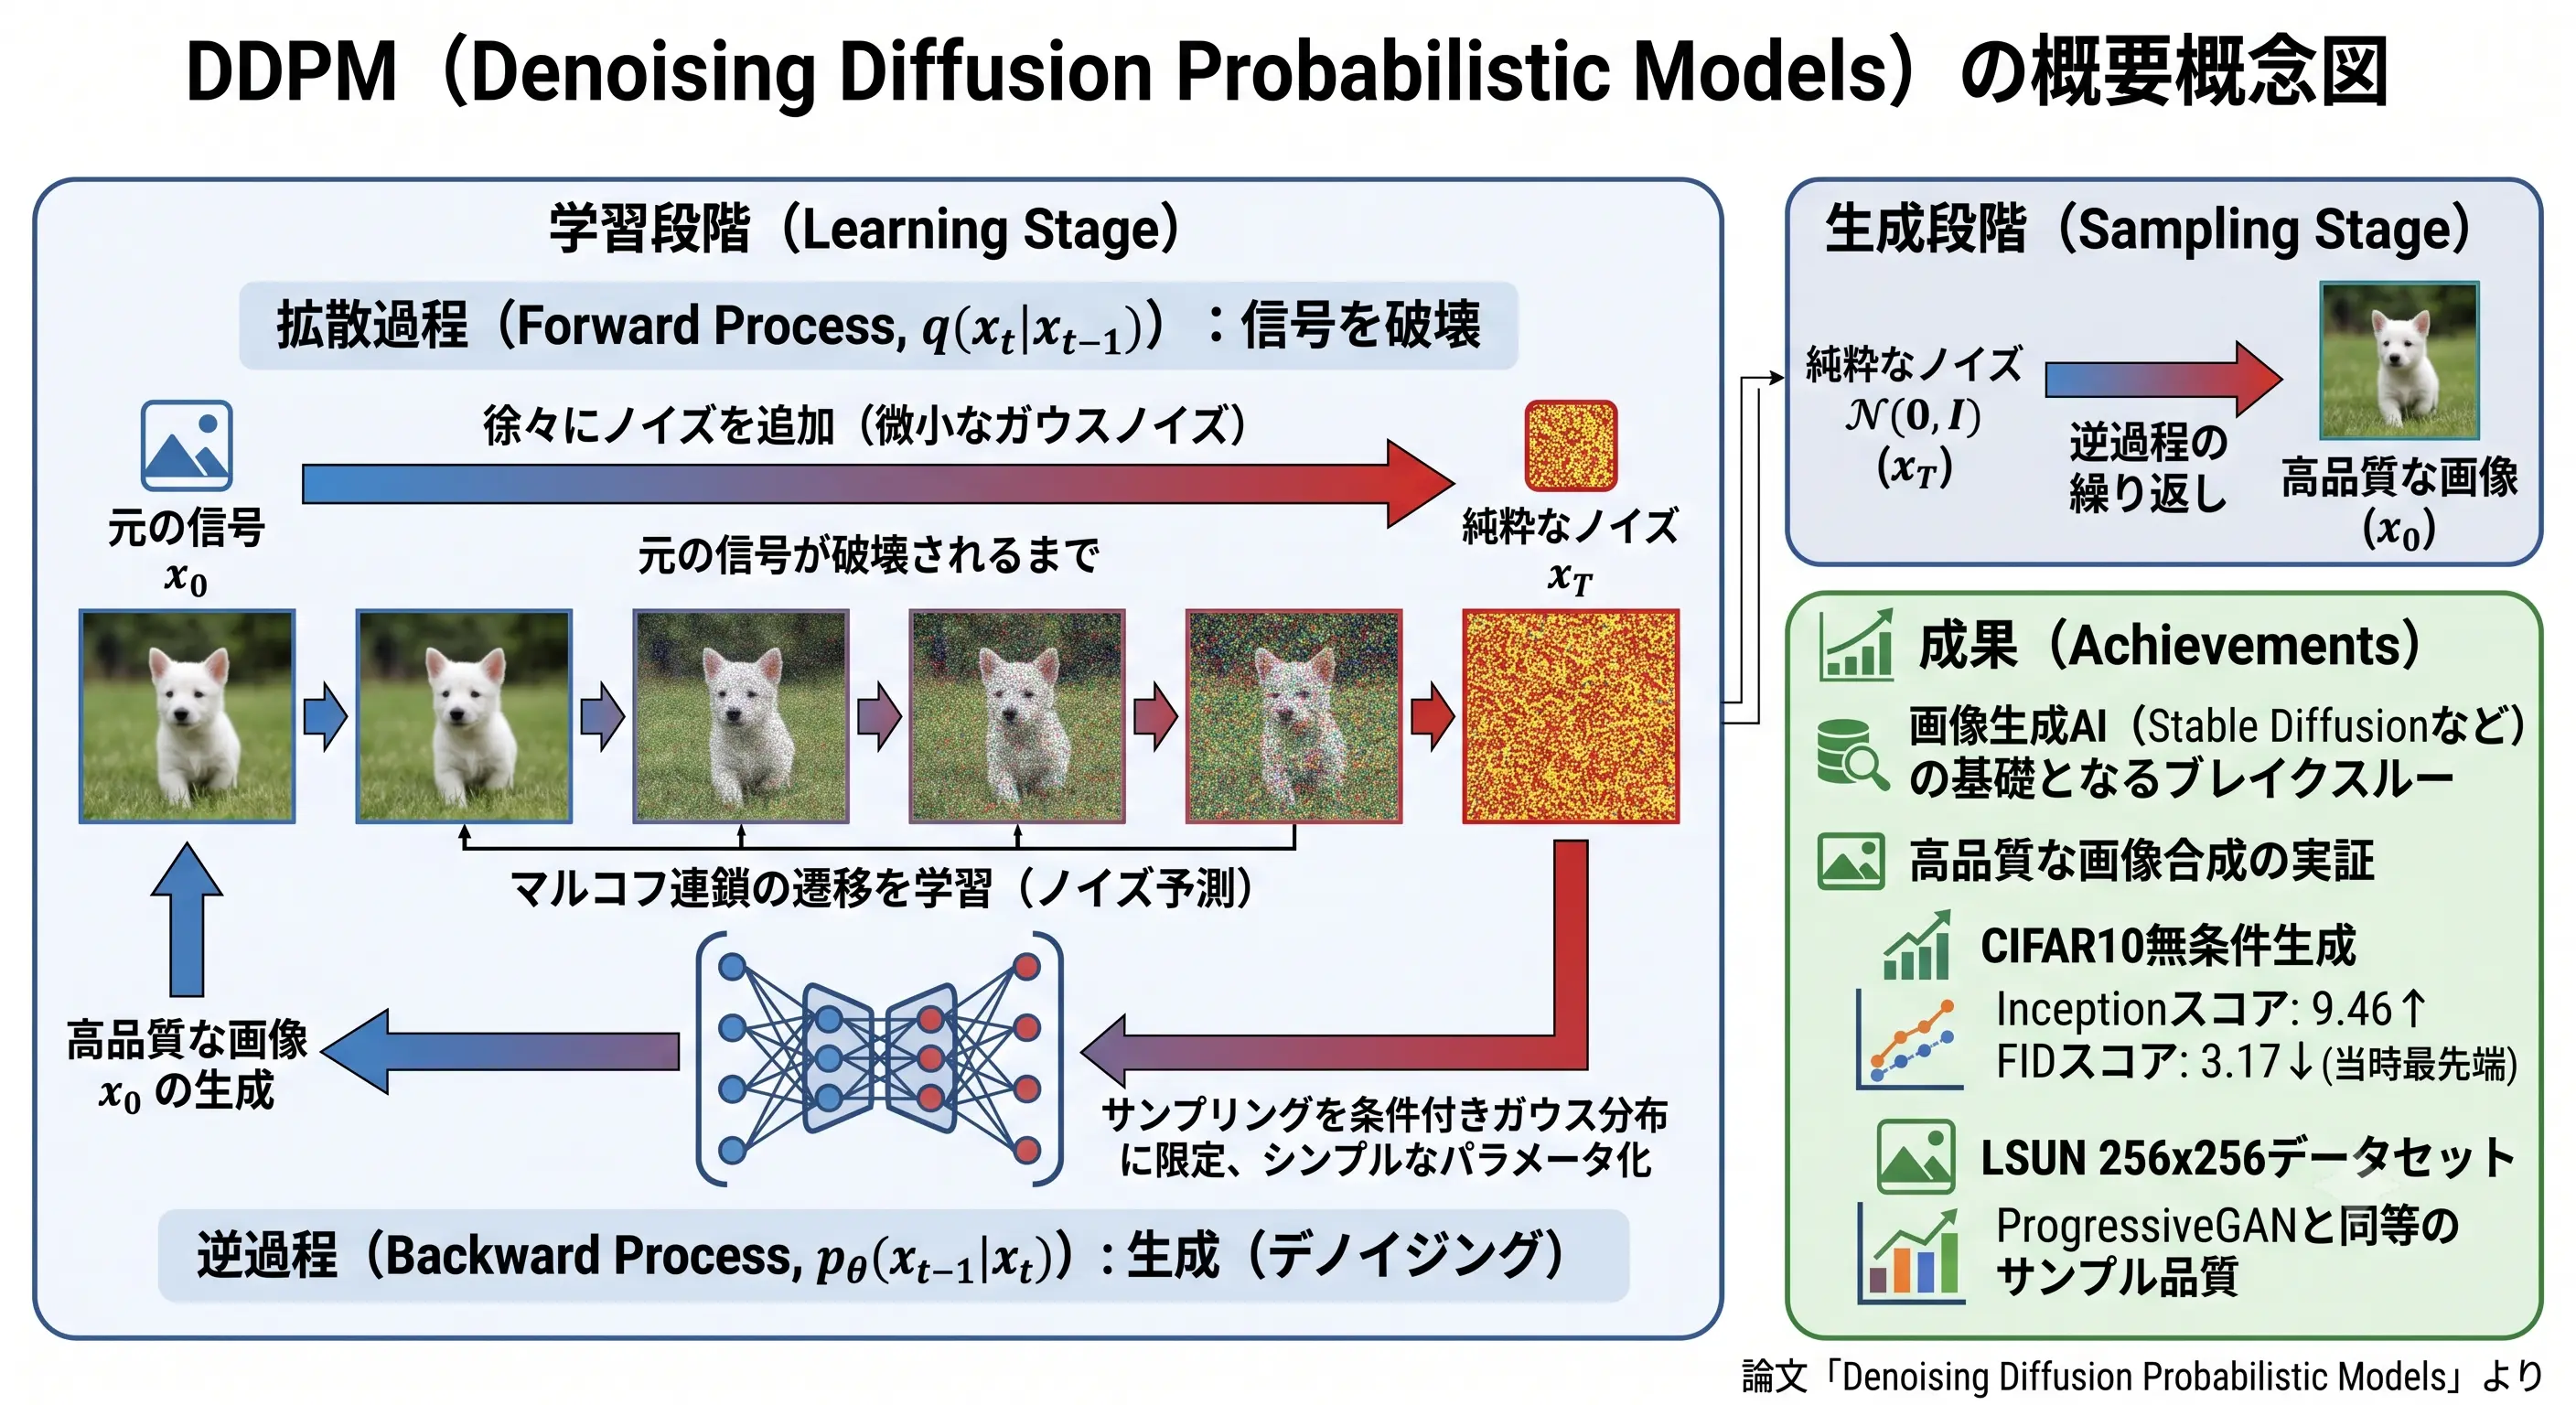
記事を読むノイズから高品質な画像を段階的に復元する「拡散確率モデル(DDPM)」の仕組みを解説。VAEやGANとの比較、マルコフ連鎖の数学的背景から、PyTorchを用いたU-Netのスクラッチ実装、Hugging Face diffusersによる実装までを網羅します。
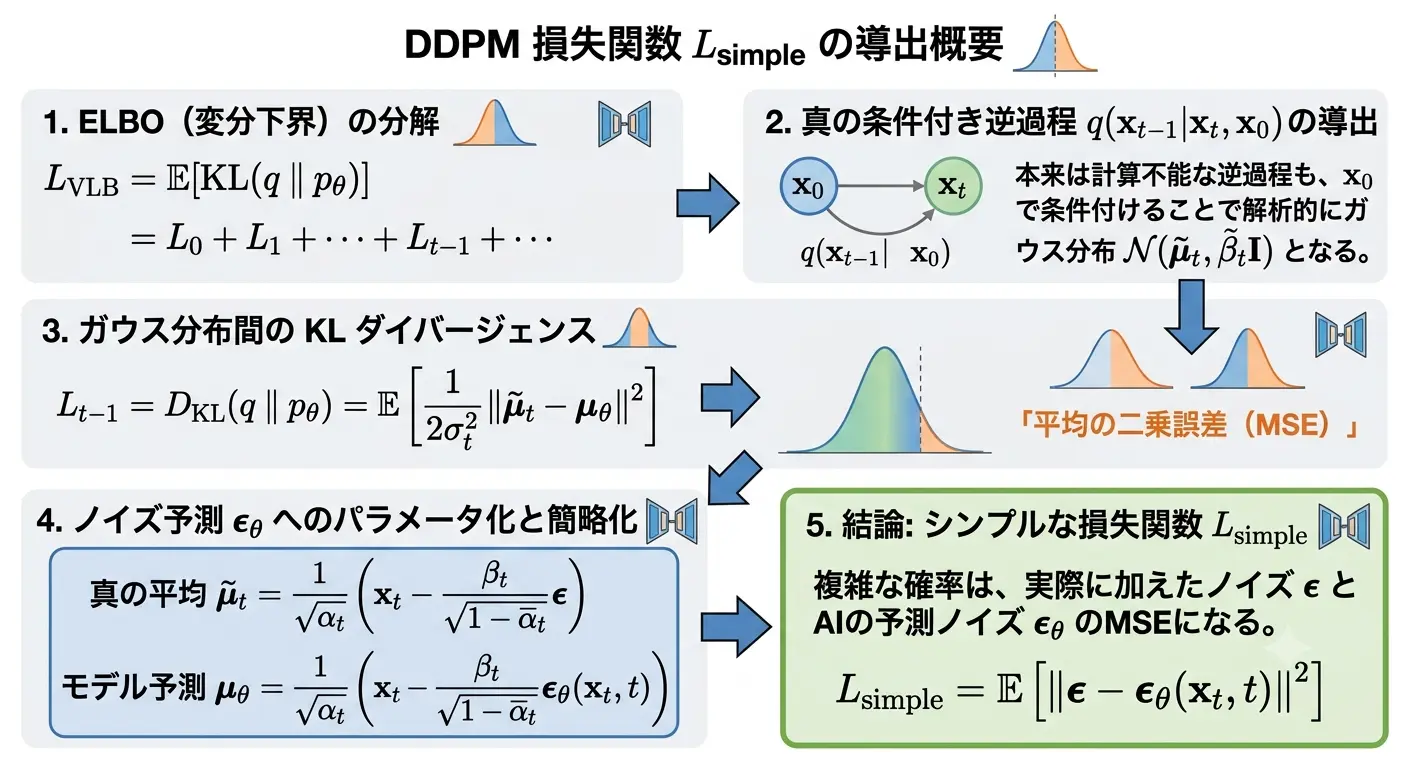
記事を読むDDPMにおける負の対数尤度最小化が、変分下界(ELBO)の項別分解、逆過程のガウス分布表示、そしてノイズ予測の二乗誤差(MSE)最小化へと奇跡的に帰着する一連の数学的プロセスを、数式を用いてステップ・バイ・ステップで詳細に解説します。
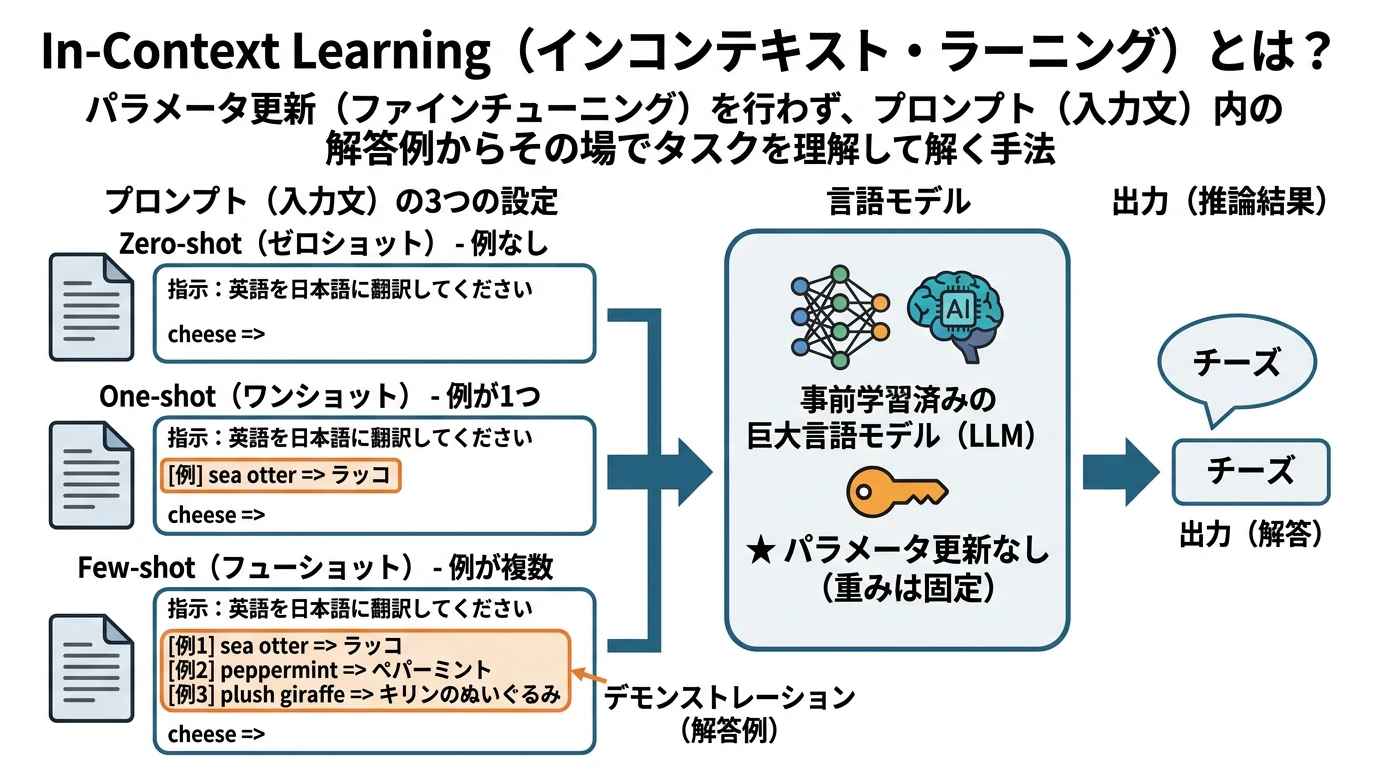
記事を読む事前学習済みの巨大な言語モデルに対してパラメータ更新を行わず、推論時の入力テキスト内に解答例を提示するだけで新しいタスクを解かせるIn-Context Learningの仕組みとスケーリング則を、PyTorchと日本語LLMを用いた検証を交えて解説します。
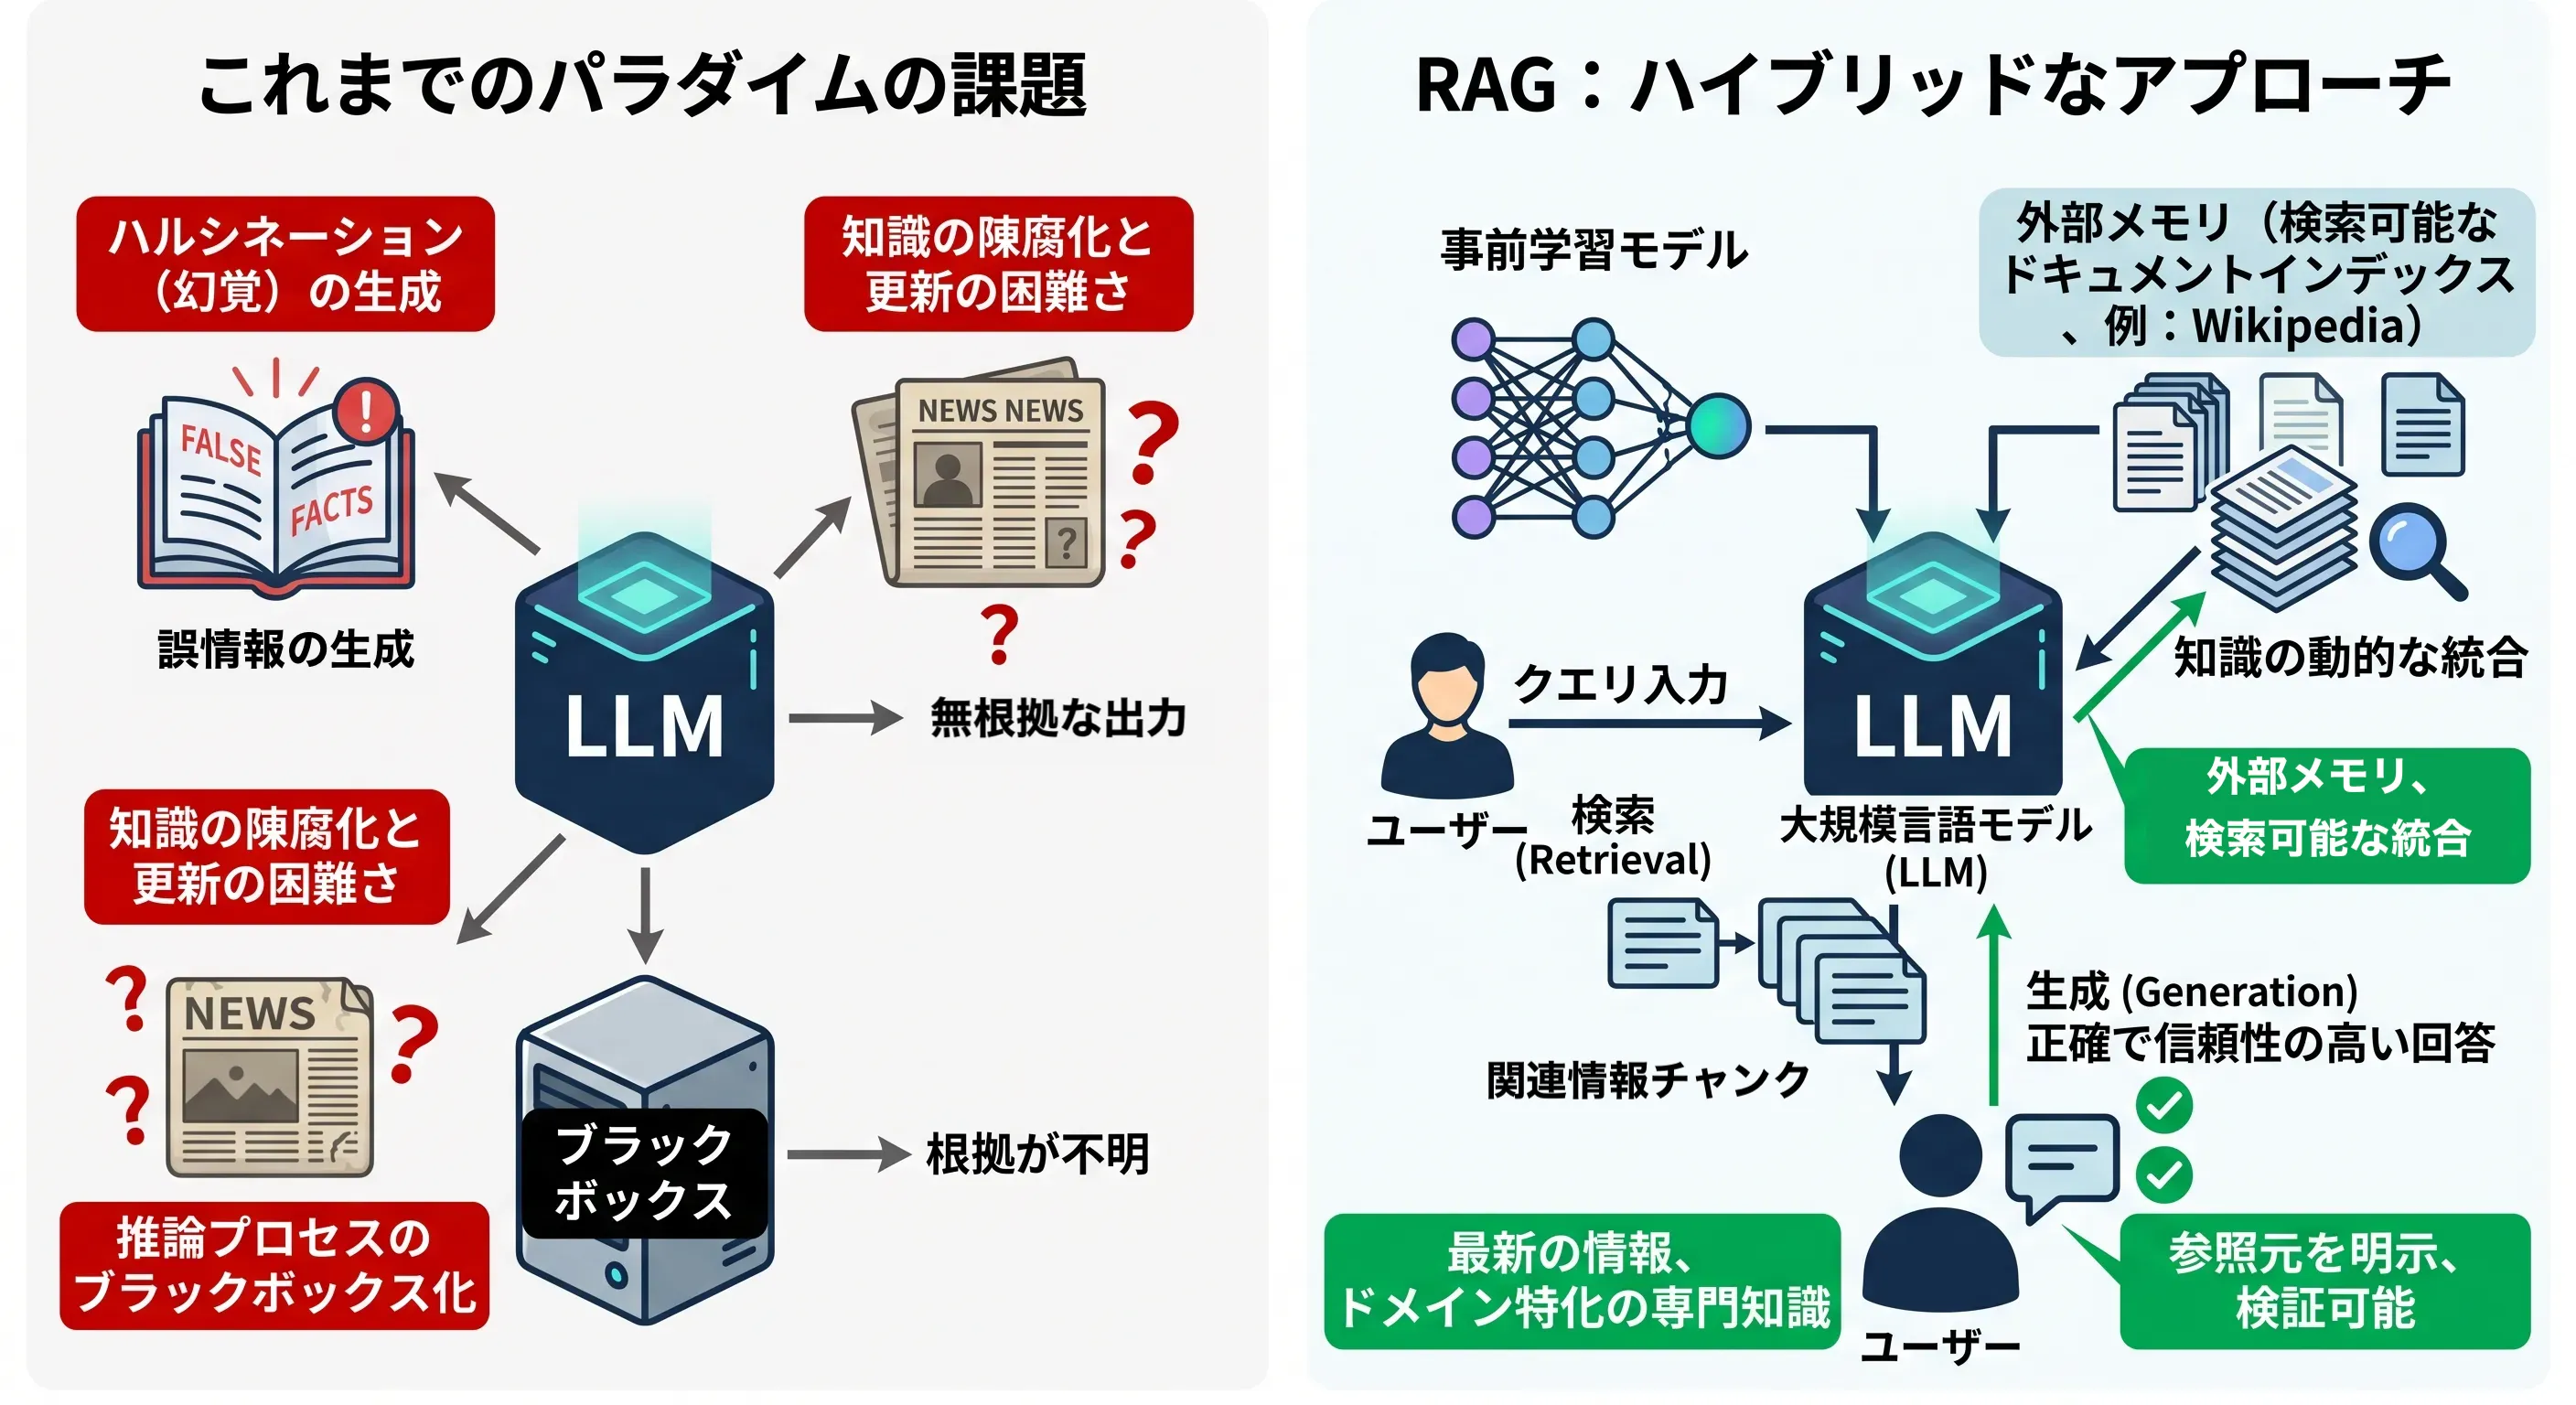
記事を読む外部の知識ベースを検索し、大規模言語モデル(LLM)の回答に組み込む「RAG」の基礎概念から、RAG-SequenceとRAG-Tokenという2つの数学的な定式化の違いによる振る舞いの差、および現代のLLMにおけるアプローチまでを解説します。
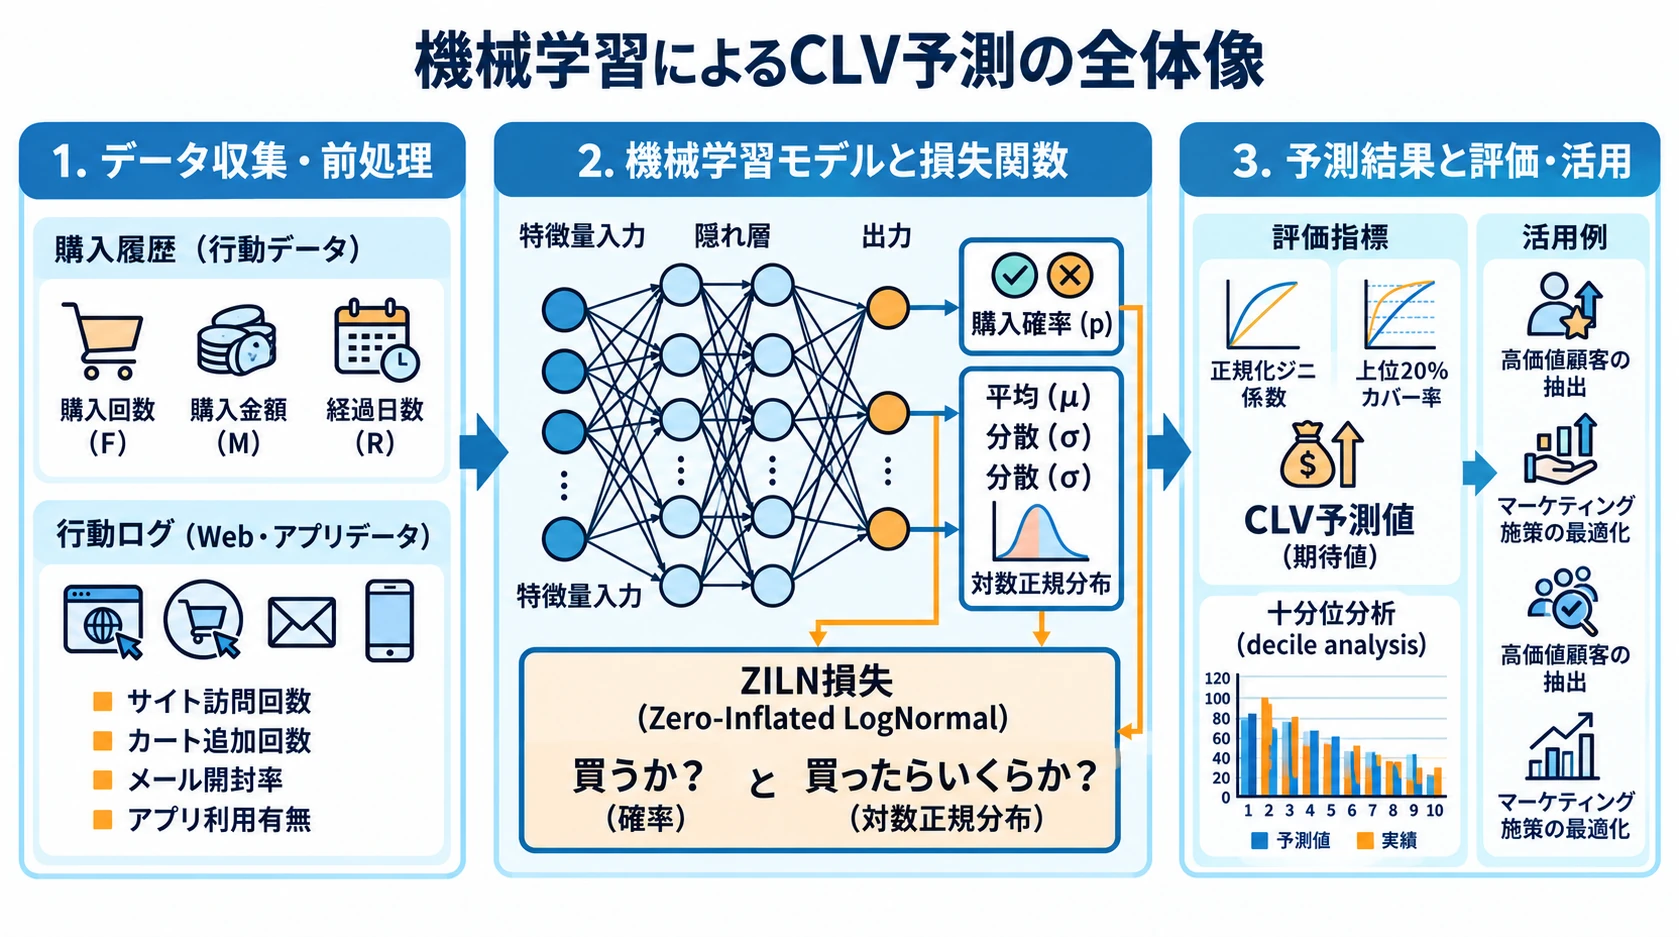
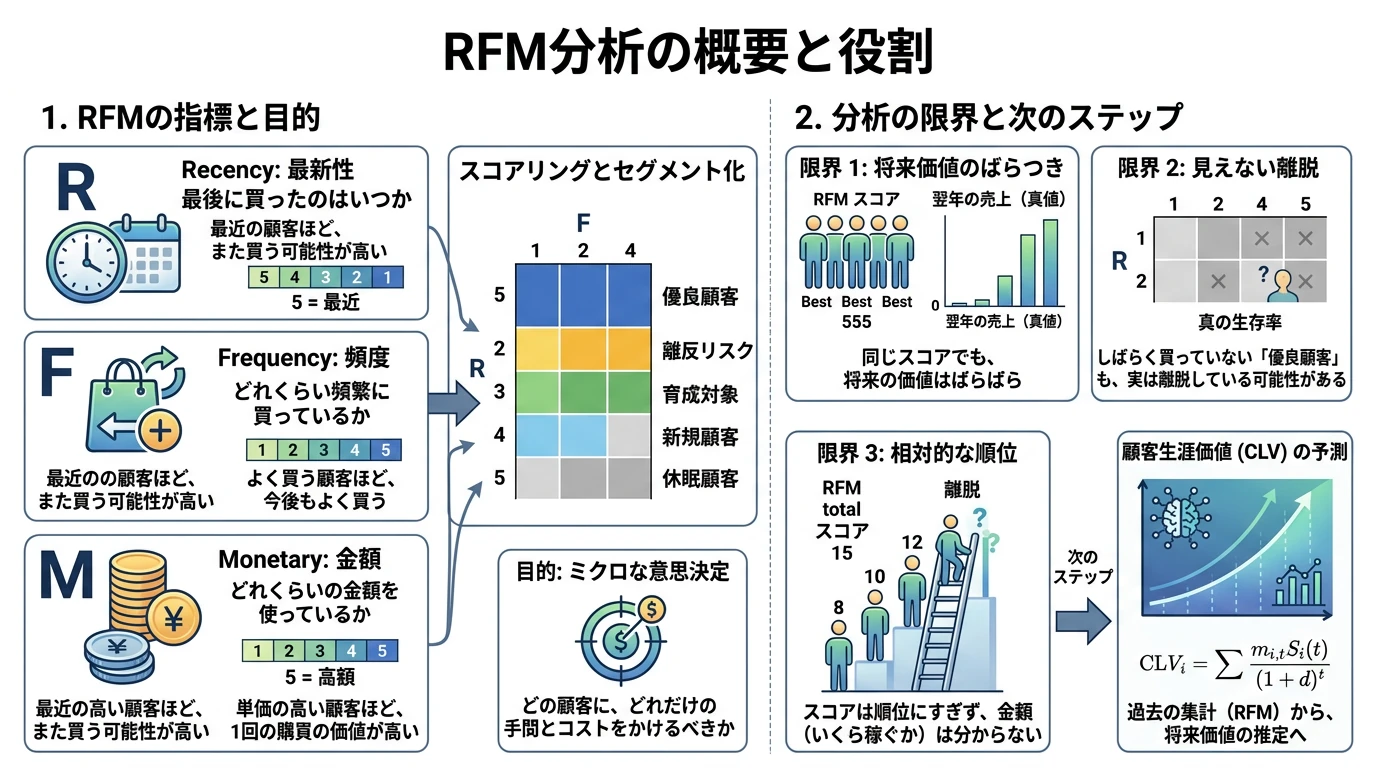
記事を読む閲覧行動などの特徴量から顧客生涯価値(CLV)を予測する機械学習について、大半がゼロで裾の重いCLVの分布に合わせたZILN損失(ゼロ過剰対数正規)、LightGBMの二段階モデル、MSEや対数変換の落とし穴、正規化ジニ係数・十分位分析などの評価指標までを、真値を仕込んだダミーデータとPythonによる実装で詳しく解説します。
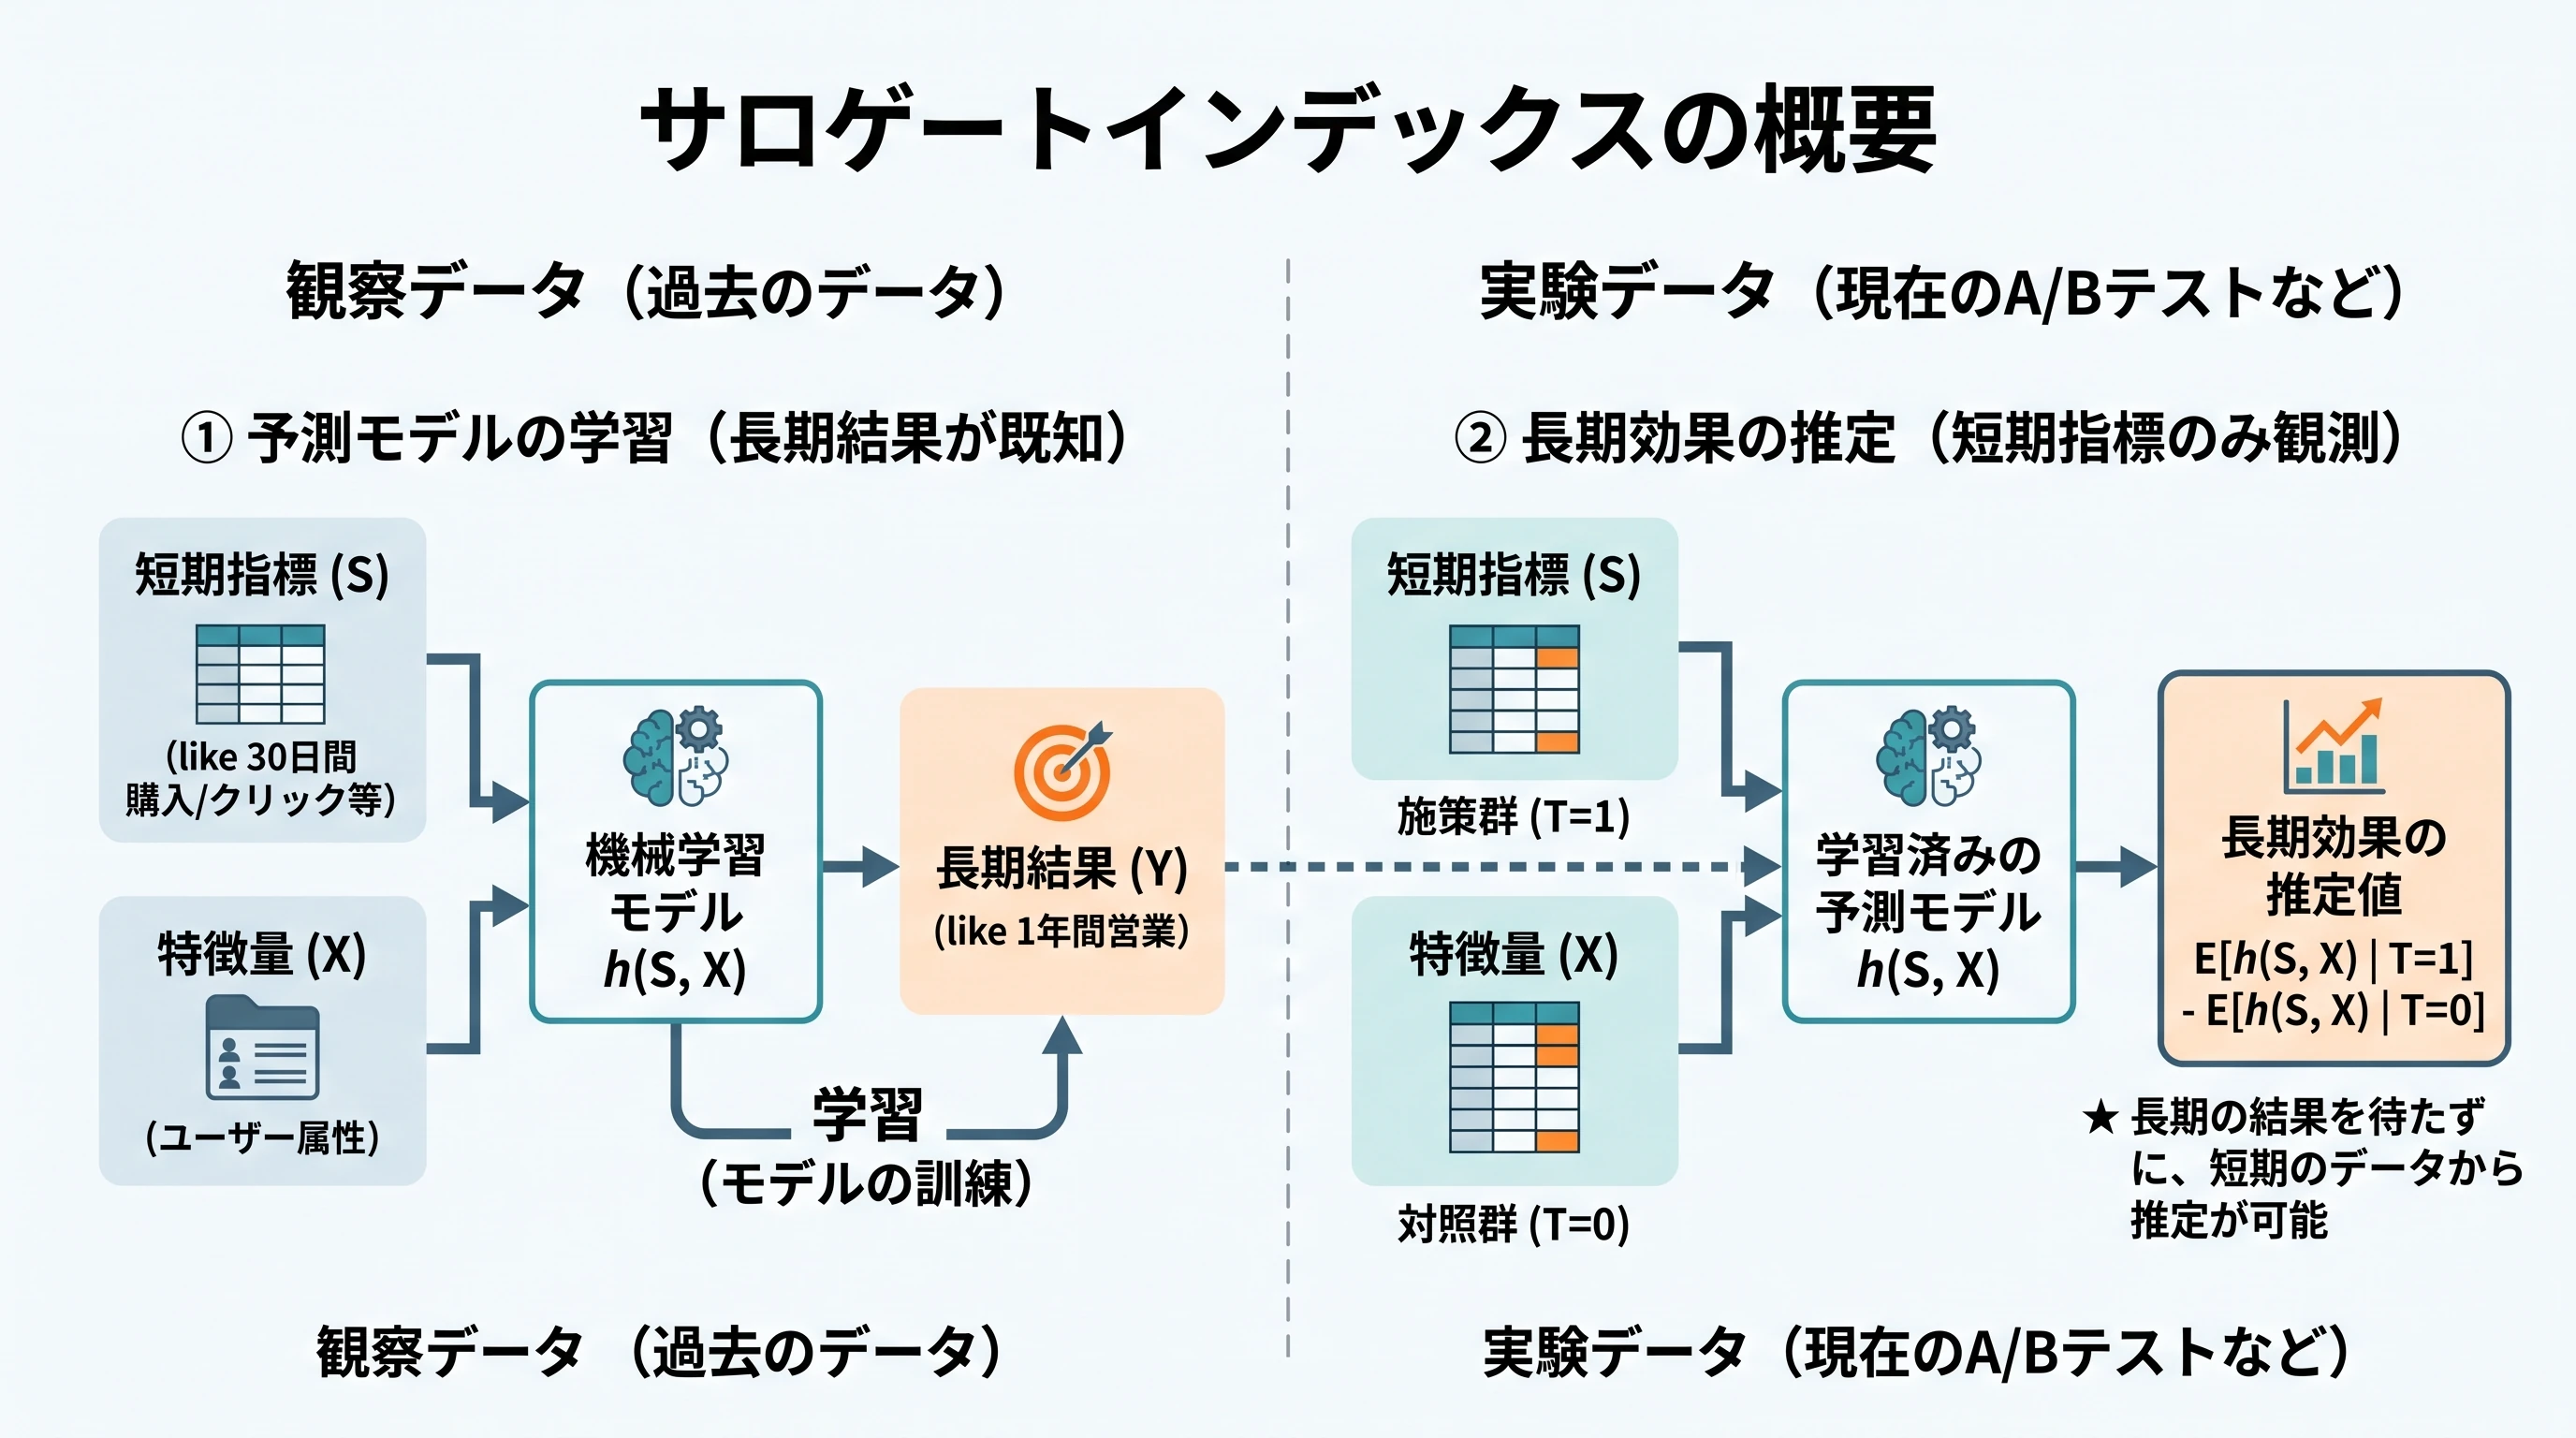
記事を読む実験期間中には観測できない長期の効果(顧客生涯価値への効果など)を短期の指標から推定するサロゲートインデックスについて、短期のCV率で評価する危うさ、Prentice基準、観察データで作ったモデルを実験データに当てはめる考え方と仮定までを、ダミーデータとPythonの実装で解説します。
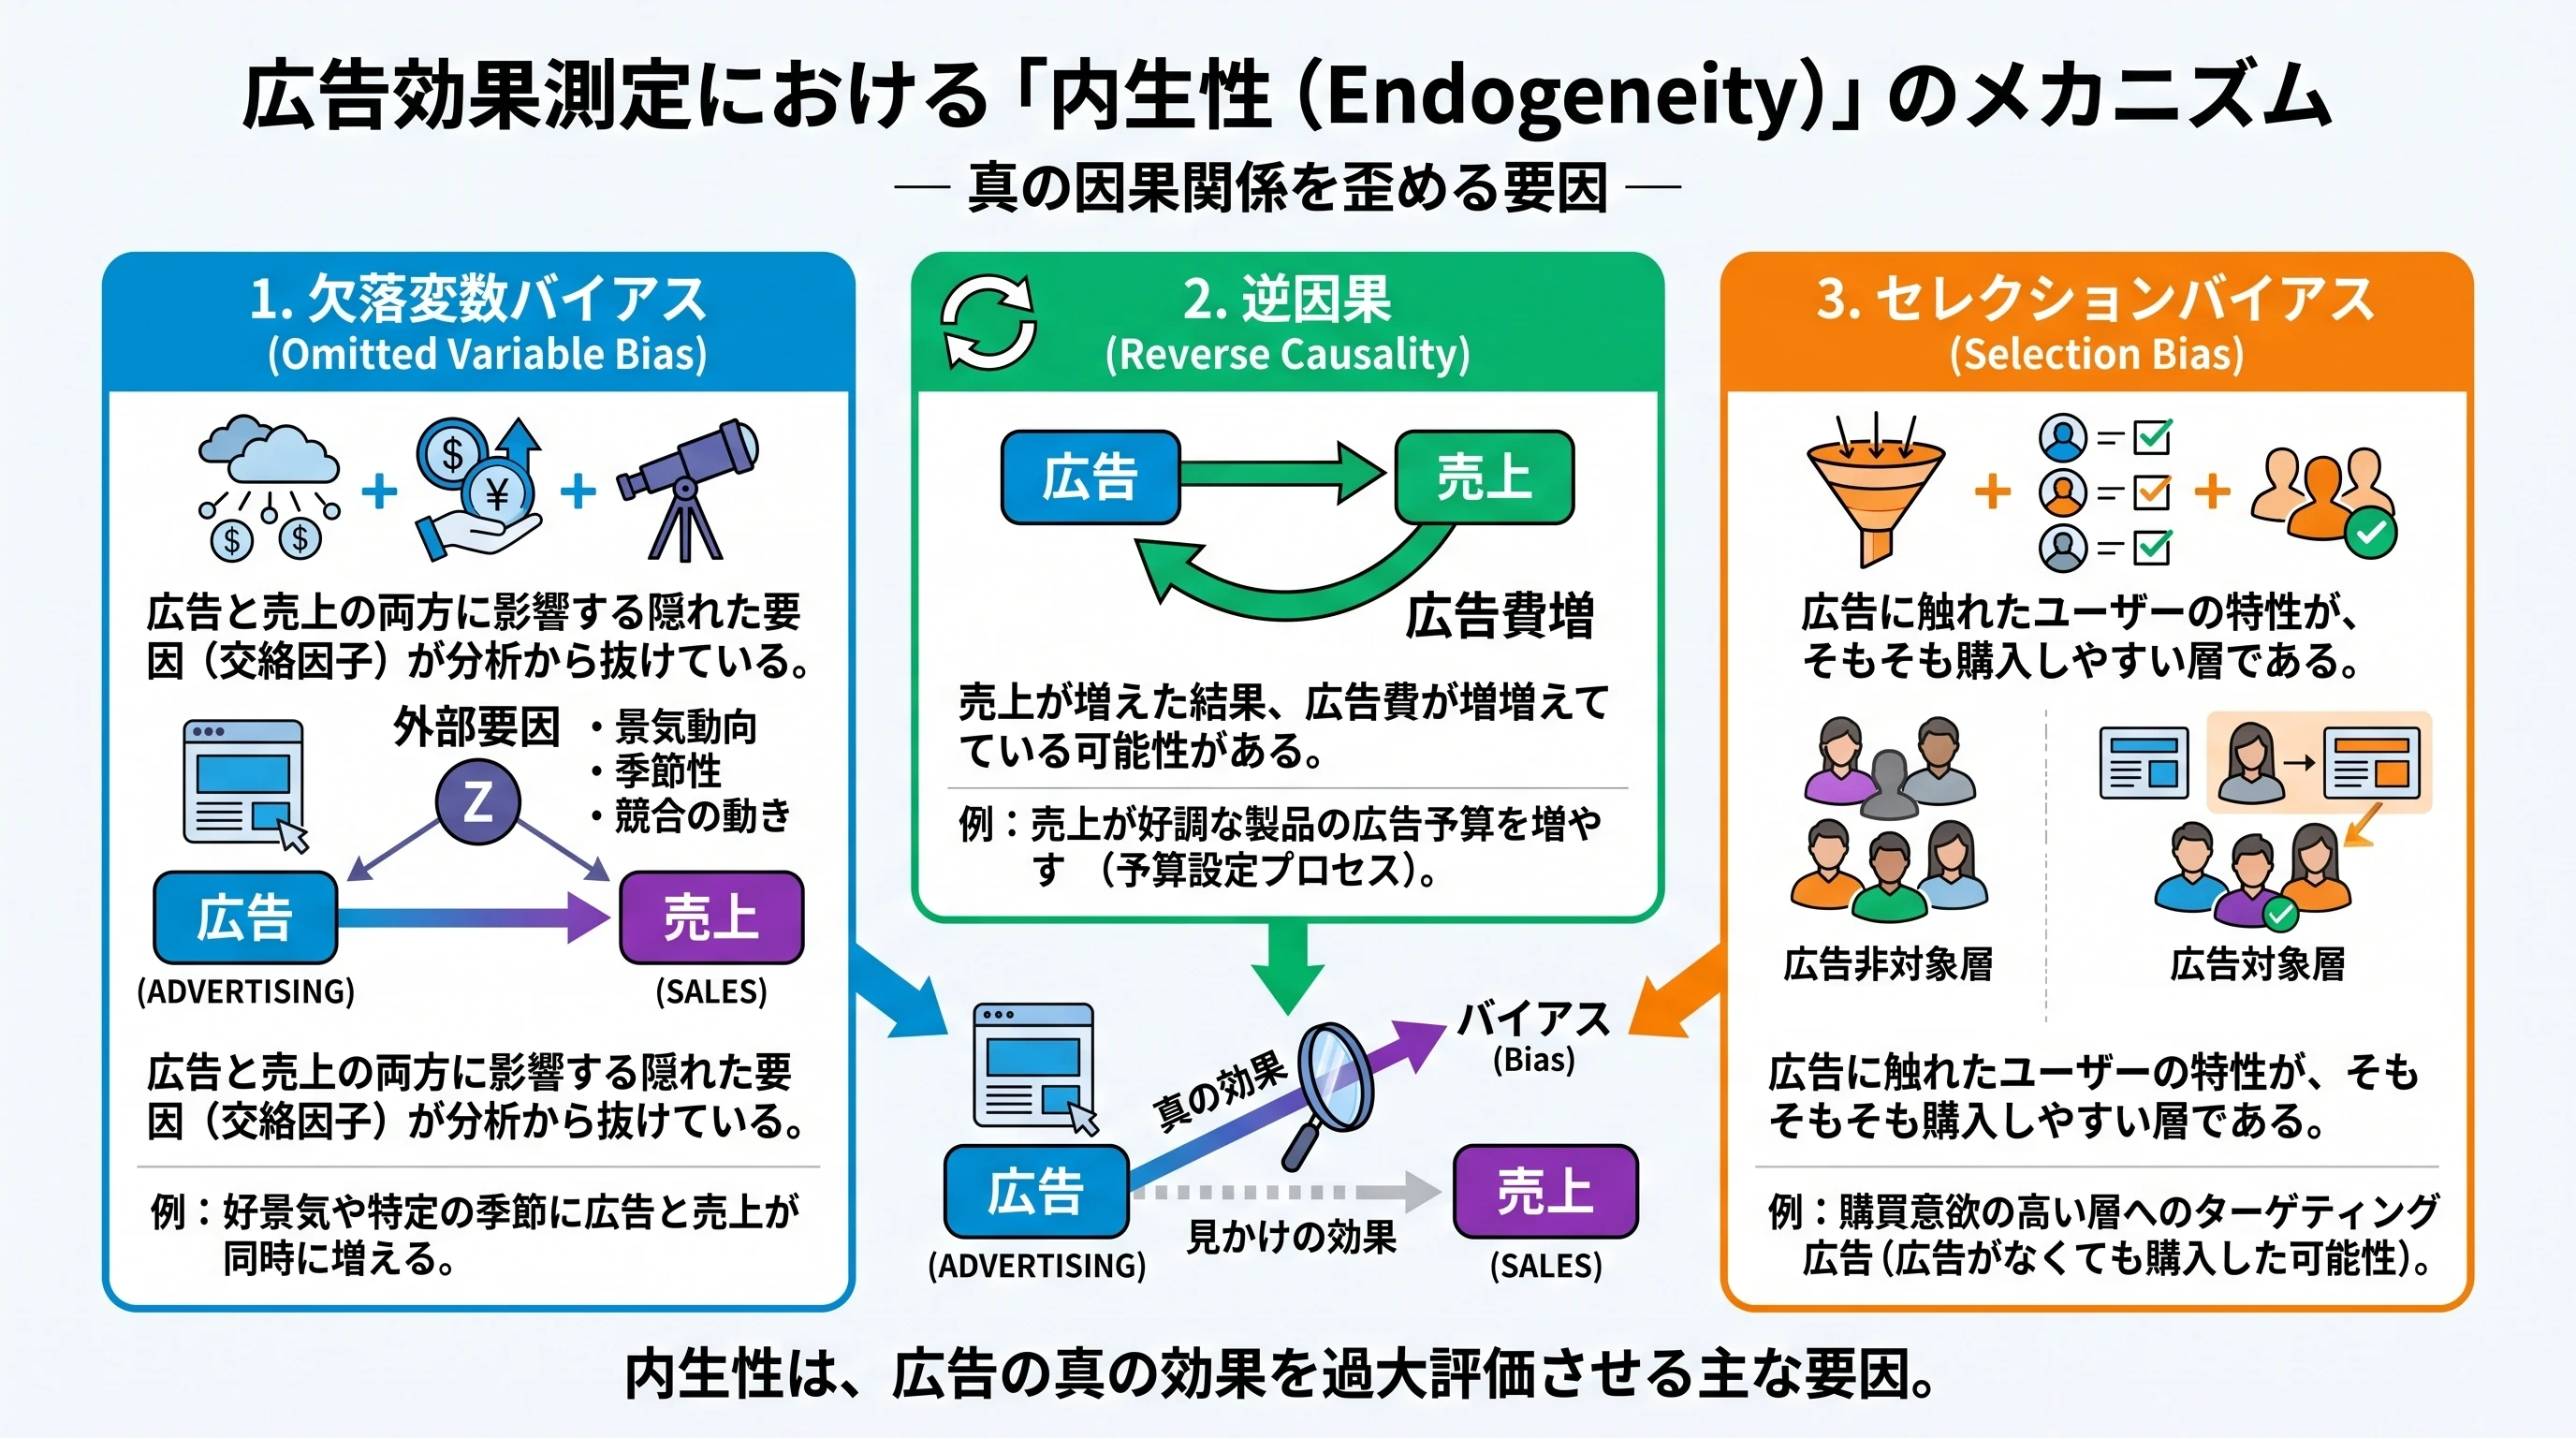
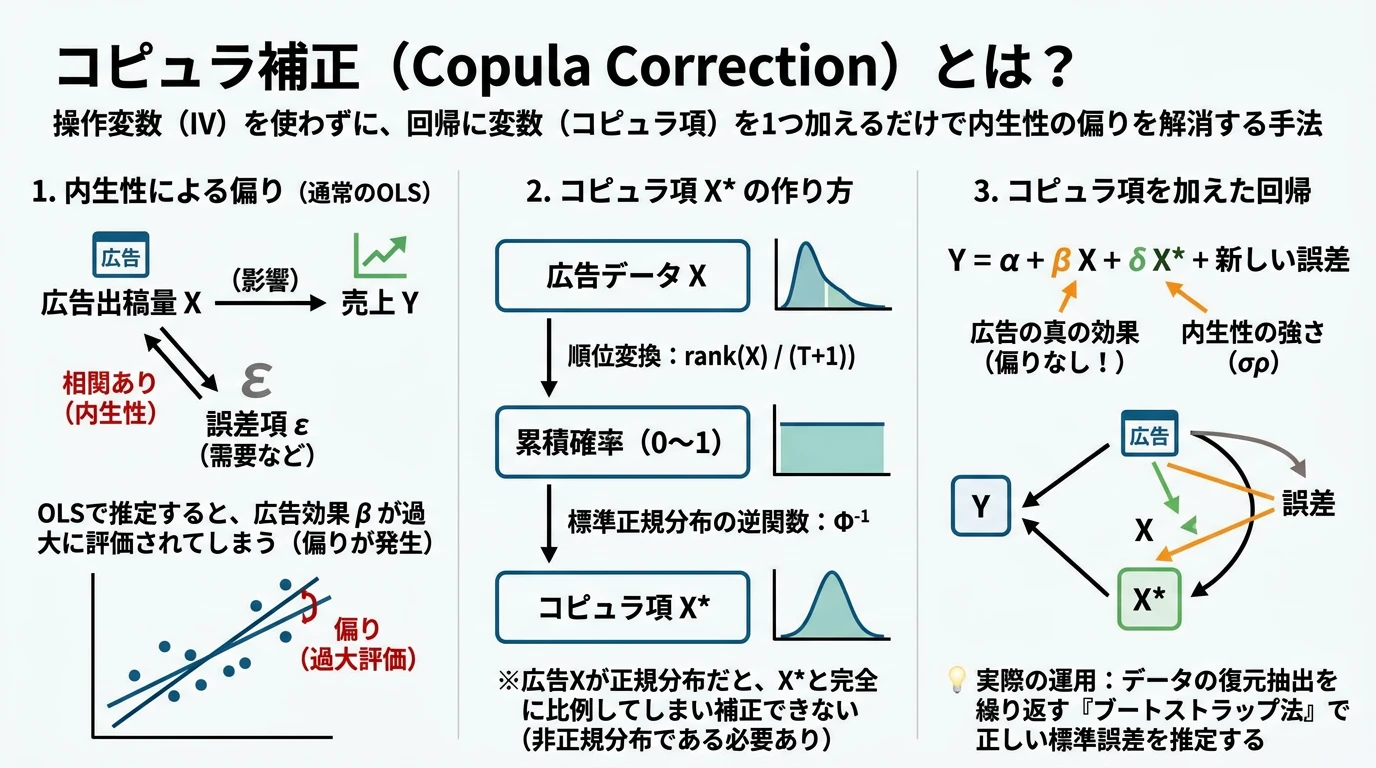
記事を読む観察データから広告効果を推定する際に避けて通れない「内生性」の問題を、その発生メカニズム(欠落変数バイアス・逆因果・セレクションバイアス)・OLS推定への影響・広告領域固有の困難さの観点から体系的に解説し、Pythonシミュレーションで直感的に理解します。
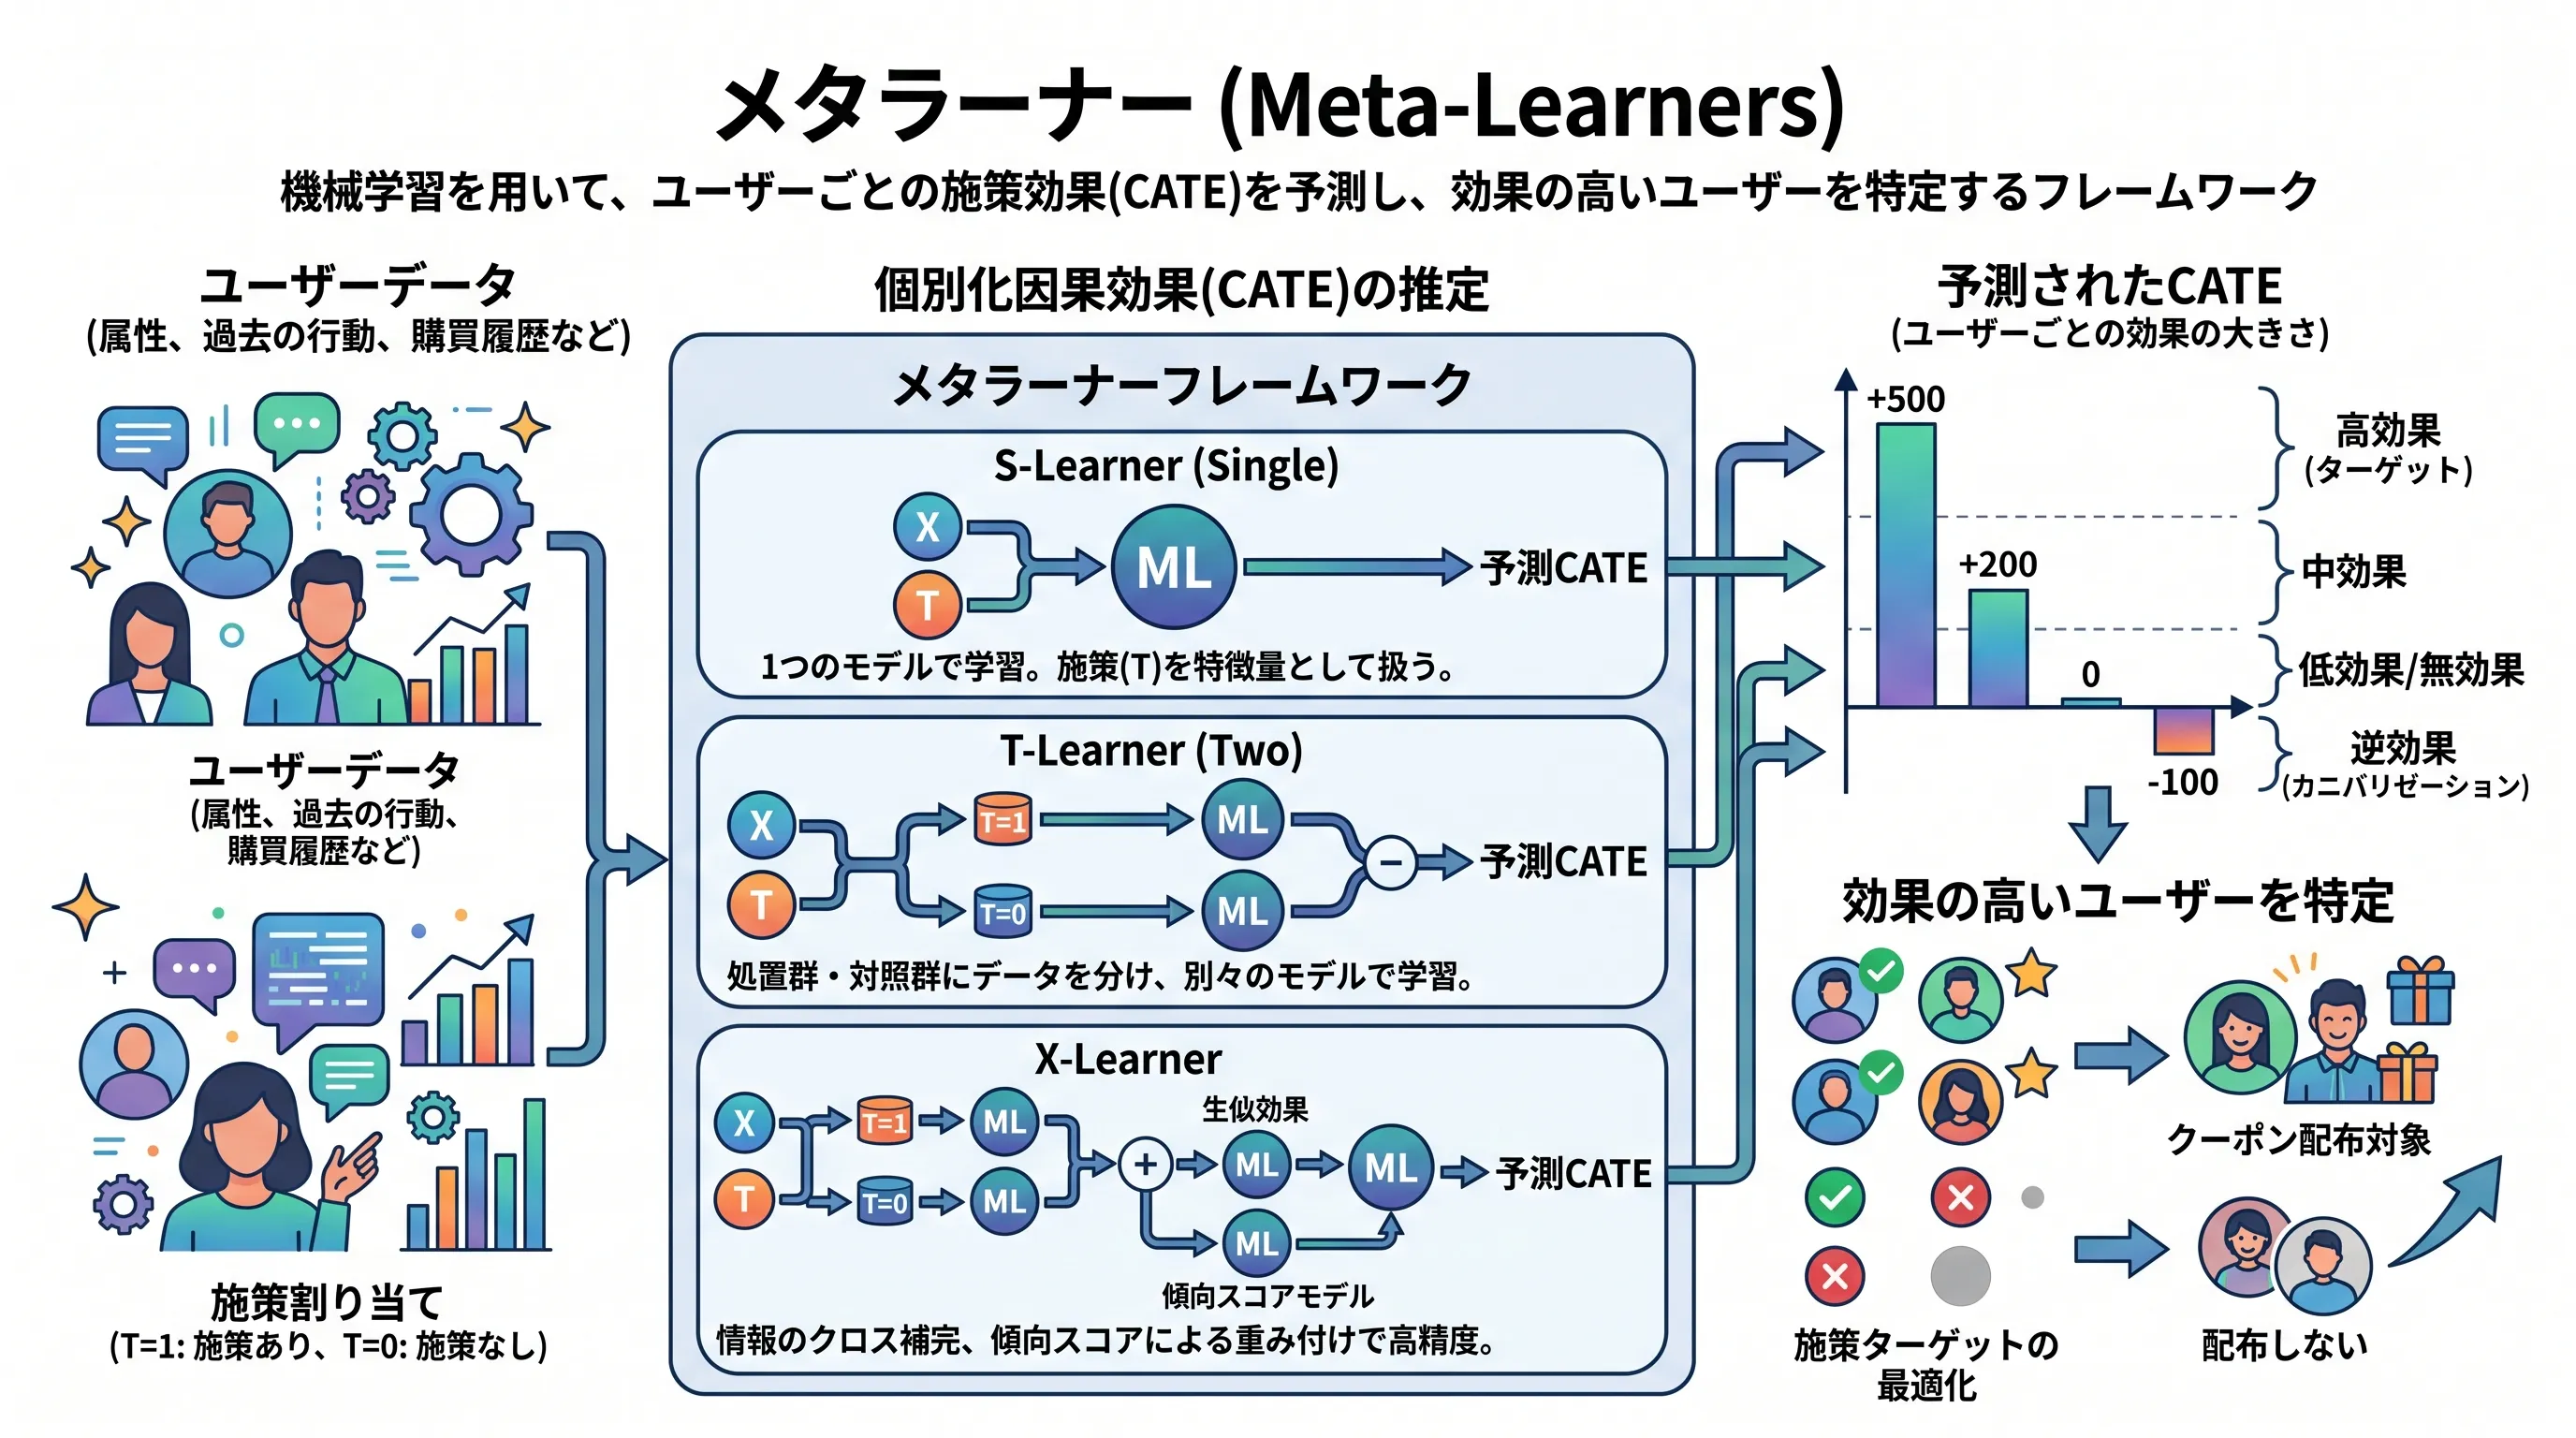
記事を読む機械学習を用いて個人レベルの因果効果(CATE)を推定する「メタラーナー(S-Learner / T-Learner / X-Learner)」の仕組みを、LightGBMを用いたスクラッチ実装やUpliftカーブによる検証手法を交えて解説します。
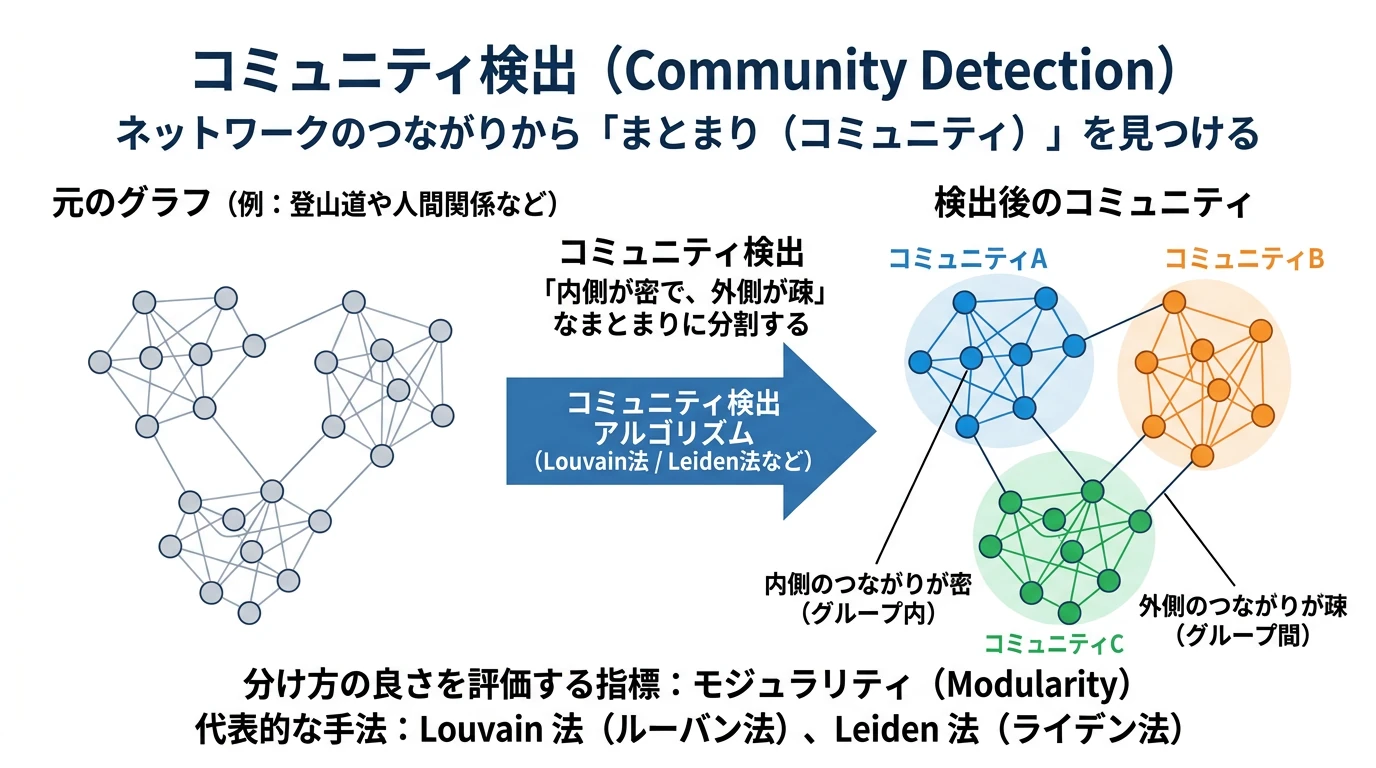
記事を読むグラフを、内側のつながりが密で外側が疎なノードのまとまり(コミュニティ)に分けるコミュニティ検出について、モジュラリティ、Louvain 法、Leiden 法、解像度パラメータと解像度の限界を、架空の山域の登山道と人工のグラフを使った Python のスクラッチ実装で解説します。
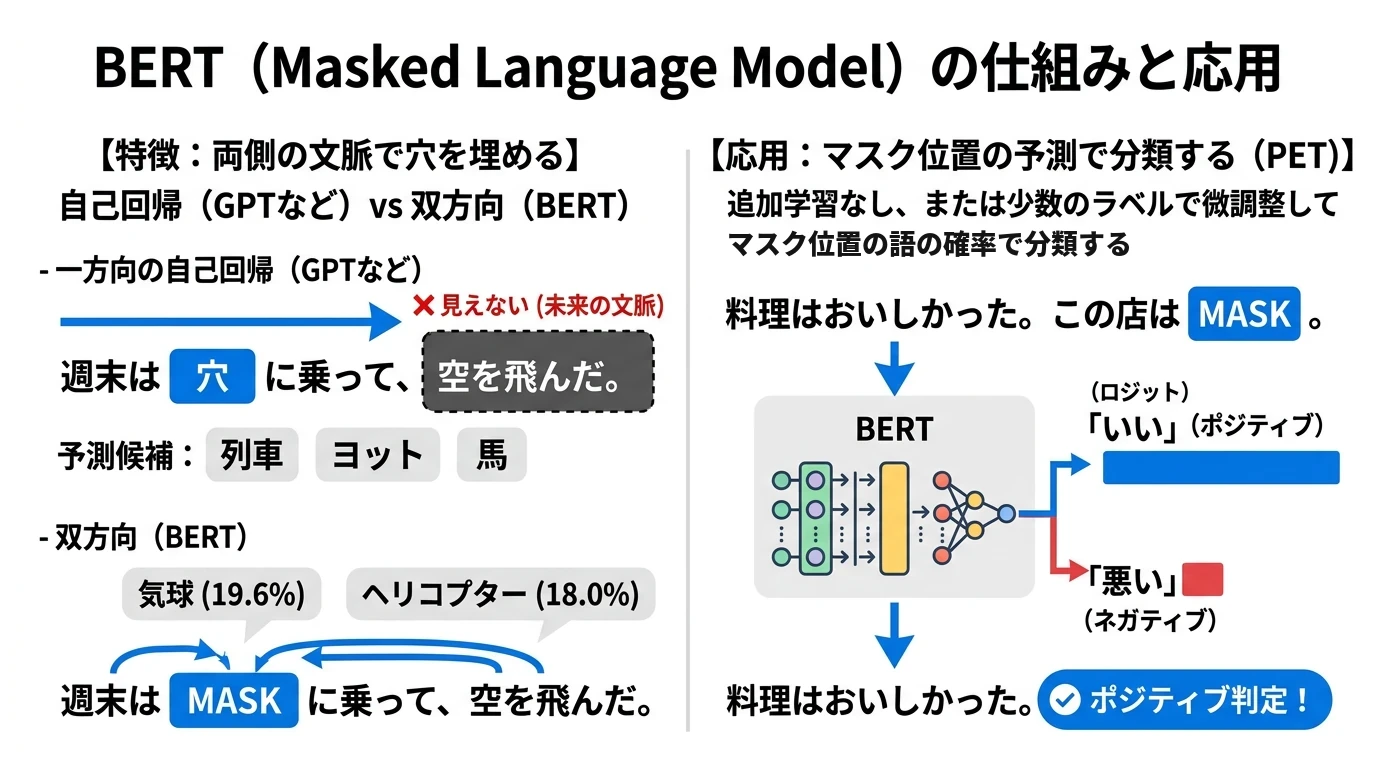
記事を読むBERT を、日本語の BERT(bert-base-japanese-v3)と Python のスクラッチ実装で解説します。自己回帰の言語モデルとの違い、入力の3つの埋め込み、MLM のマスクの規則(15%・80/10/10)と損失、MLM ヘッド、NSP を確かめ、レビューの極性をパターンとバーバライザ(PET)の穴埋めで解いて、In-Context Learning の尤度比較と、少数のラベルでの微調整と比べます。
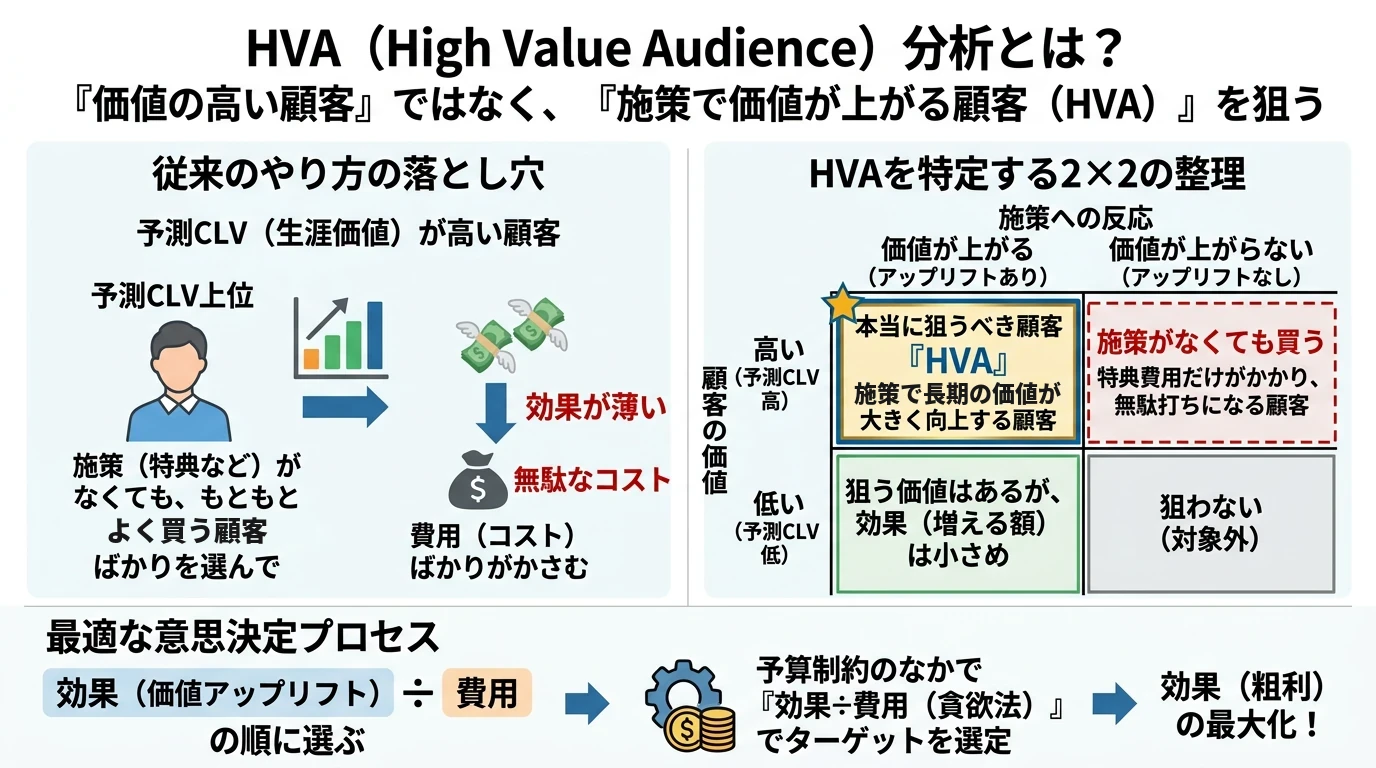
記事を読む狙うべき「価値の高い顧客」を、予測CLVの上位ではなく「施策で価値が上がる顧客」として定義し直す方法について、売上・粗利へのCATE(価値アップリフト)の推定、予算制約のもとでの貪欲法による選定、方策価値による比較、価値ベース入札までを、ダミーデータとPythonの実装で解説します。
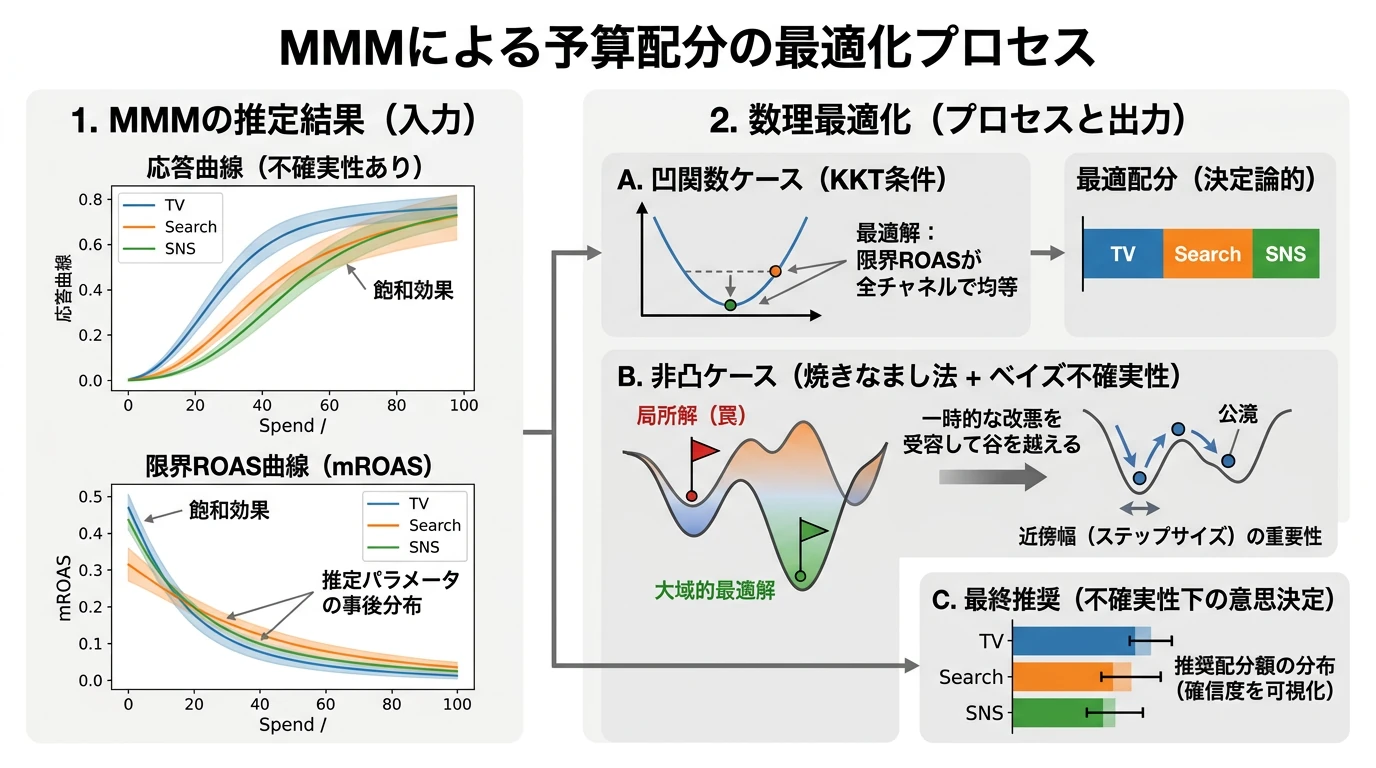
記事を読む推定したマーケティングミックスモデル(MMM)から得られる応答曲線と限界ROAS(mROAS)に基づき、限られた予算を最適配分する数理とアルゴリズム(KKT条件・SLSQP・焼きなまし法・事後分布による不確実性)を解説します。
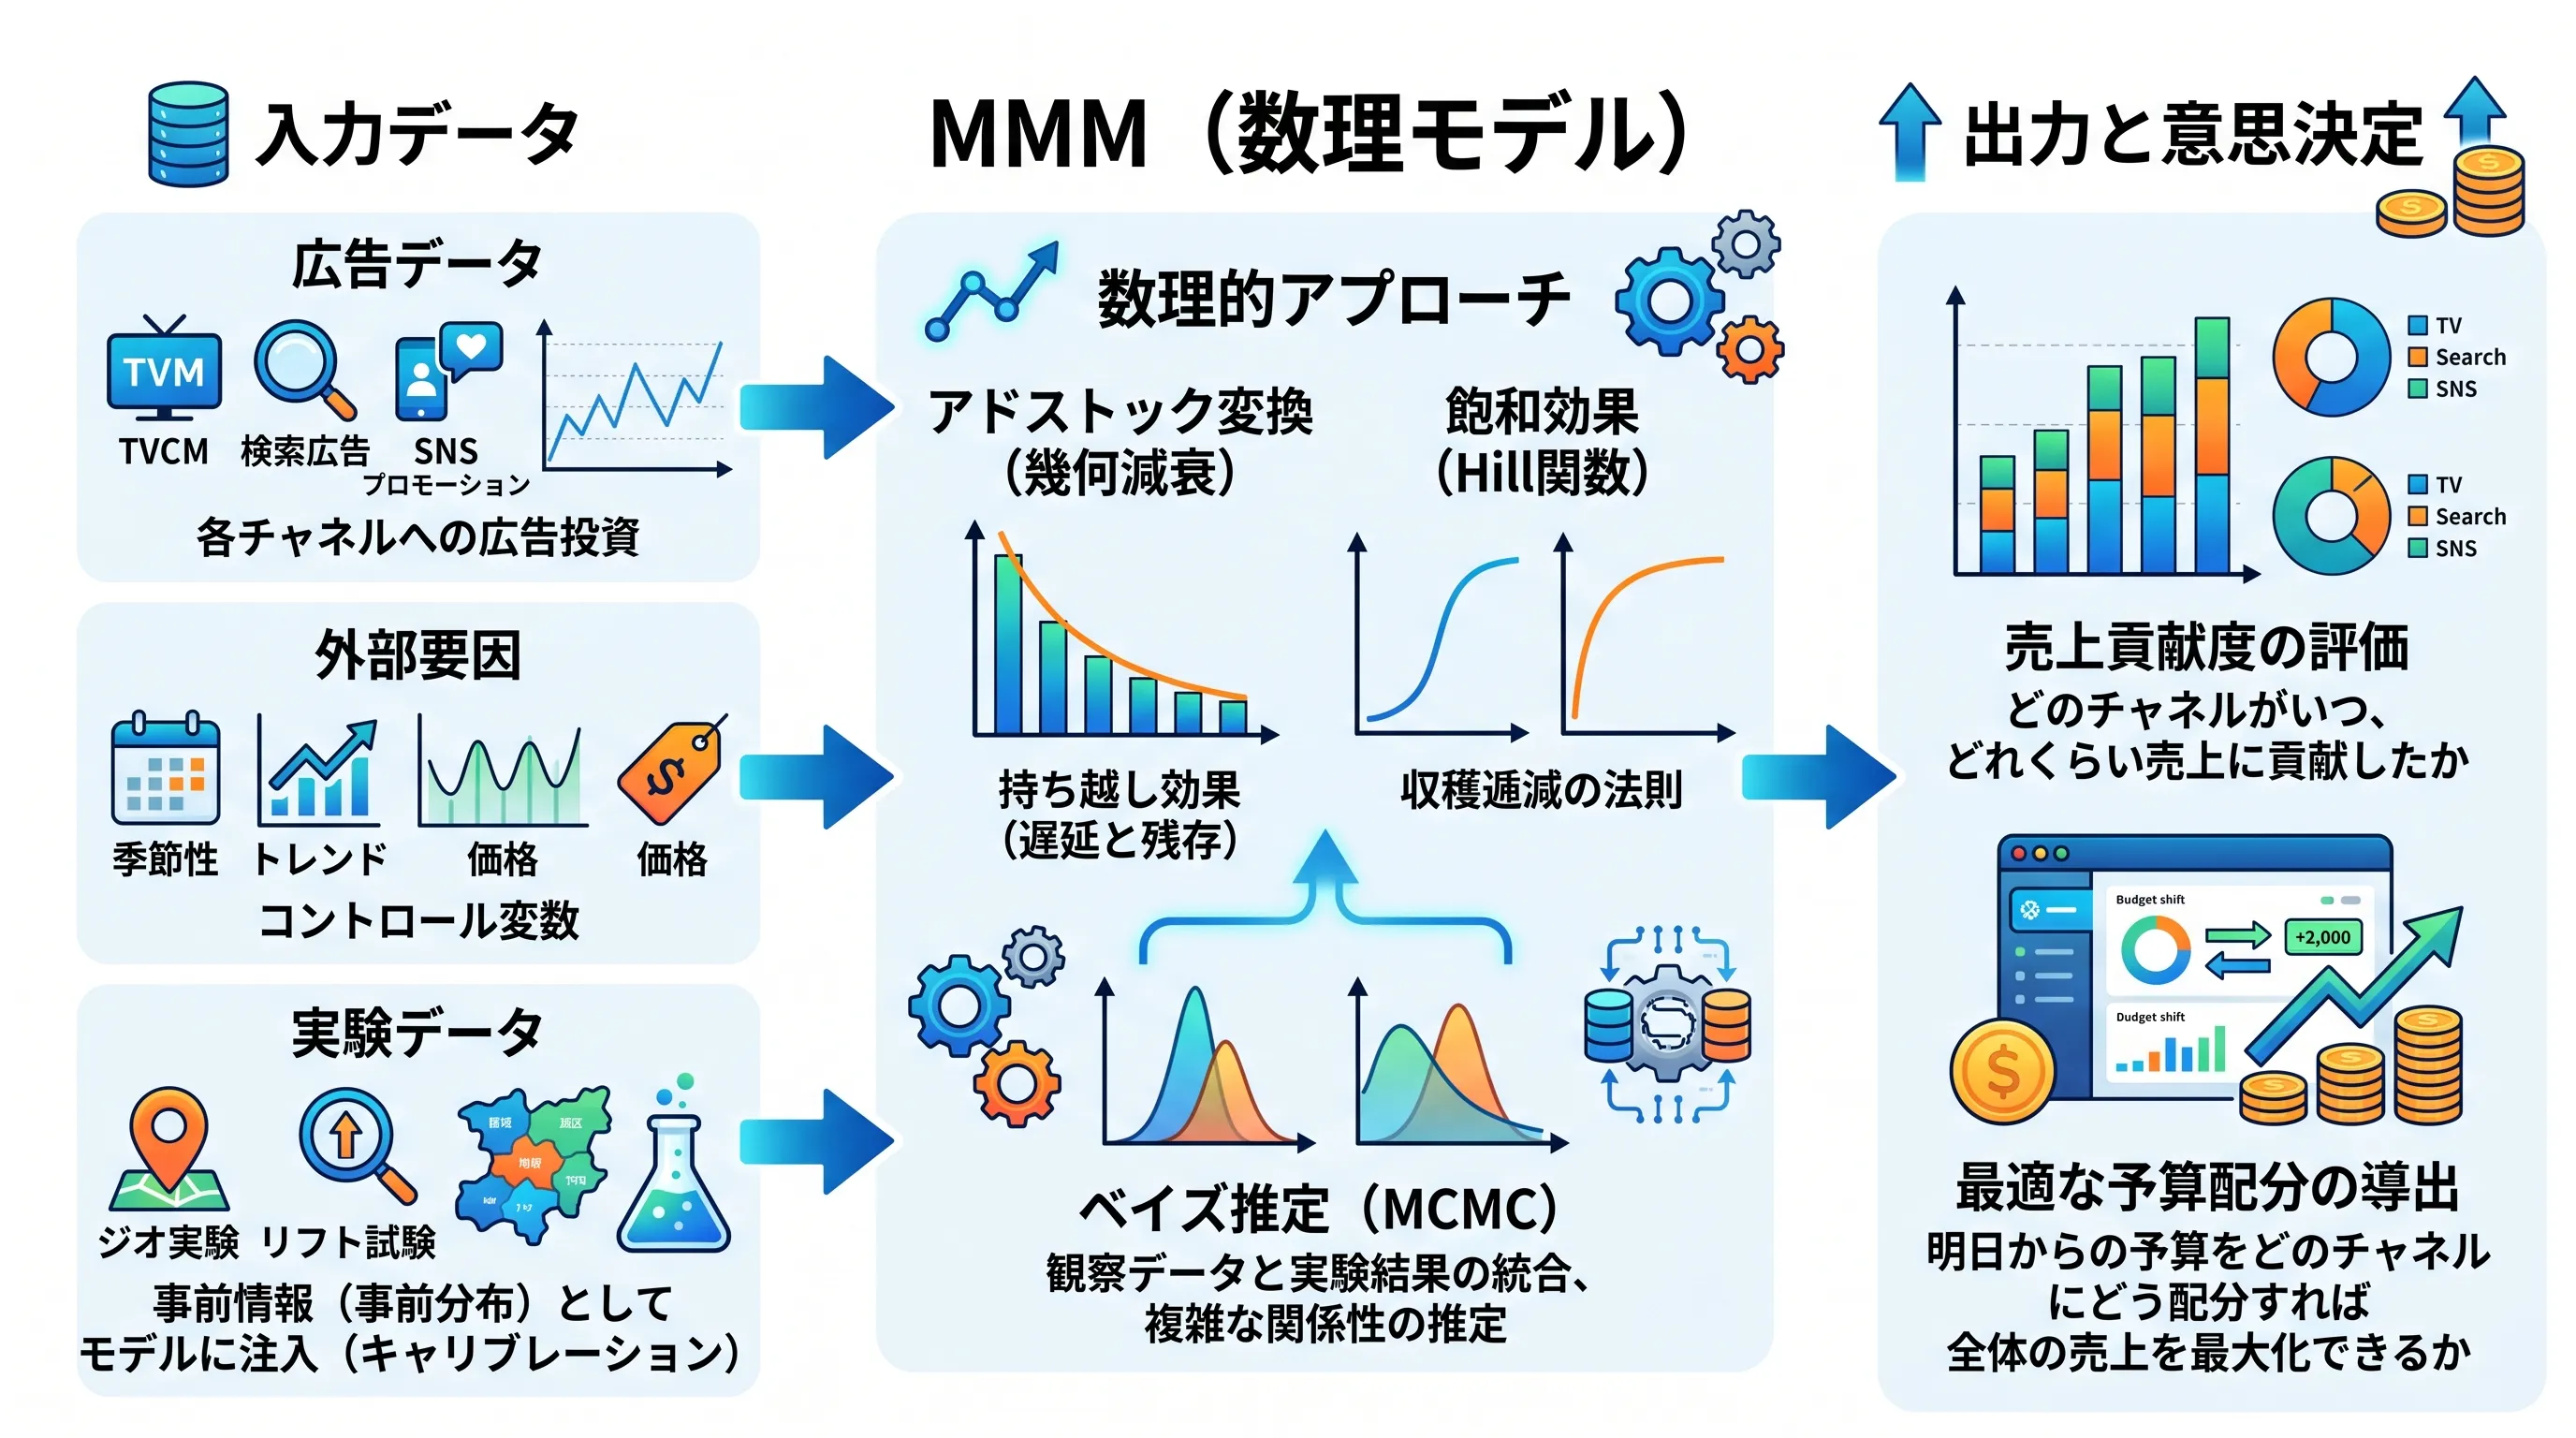
記事を読む複数チャネルの投資対効果を同時に解き明かすベイズMMMの仕組みについて、アドストックと飽和効果の数理からPyMCを用いたスクラッチ実装までを解説します。
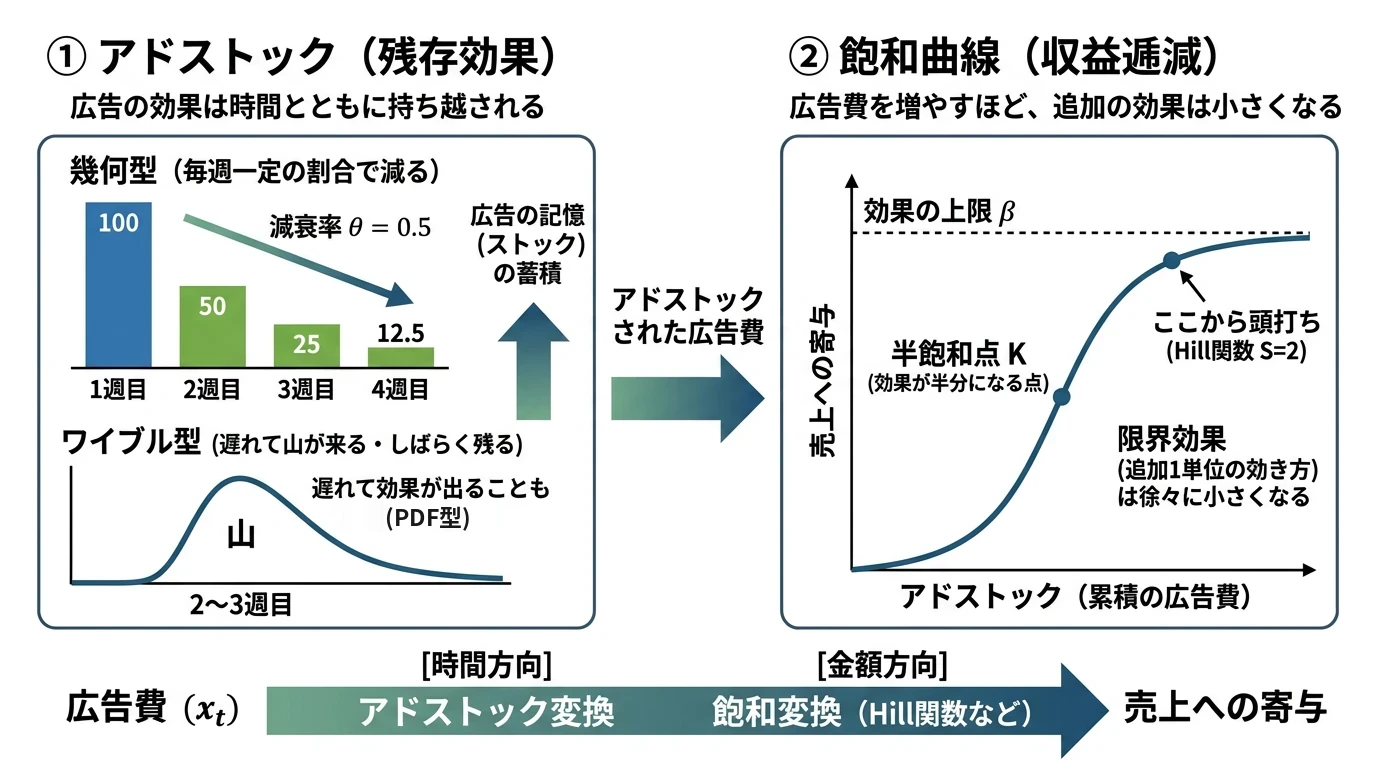
記事を読むMMM で広告費を売上への寄与に変える2つの非線形変換、アドストック(持ち越し効果)と飽和曲線(収益逓減)を、Python のスクラッチ実装で解説します。幾何型とワイブル型(CDF・PDF)のアドストック、Hill 関数と指数型の飽和、変換の順序の違いを数値で比べ、模擬の売上データにパラメータを最小二乗法で当てはめて、どこまで復元できるかを確かめます。
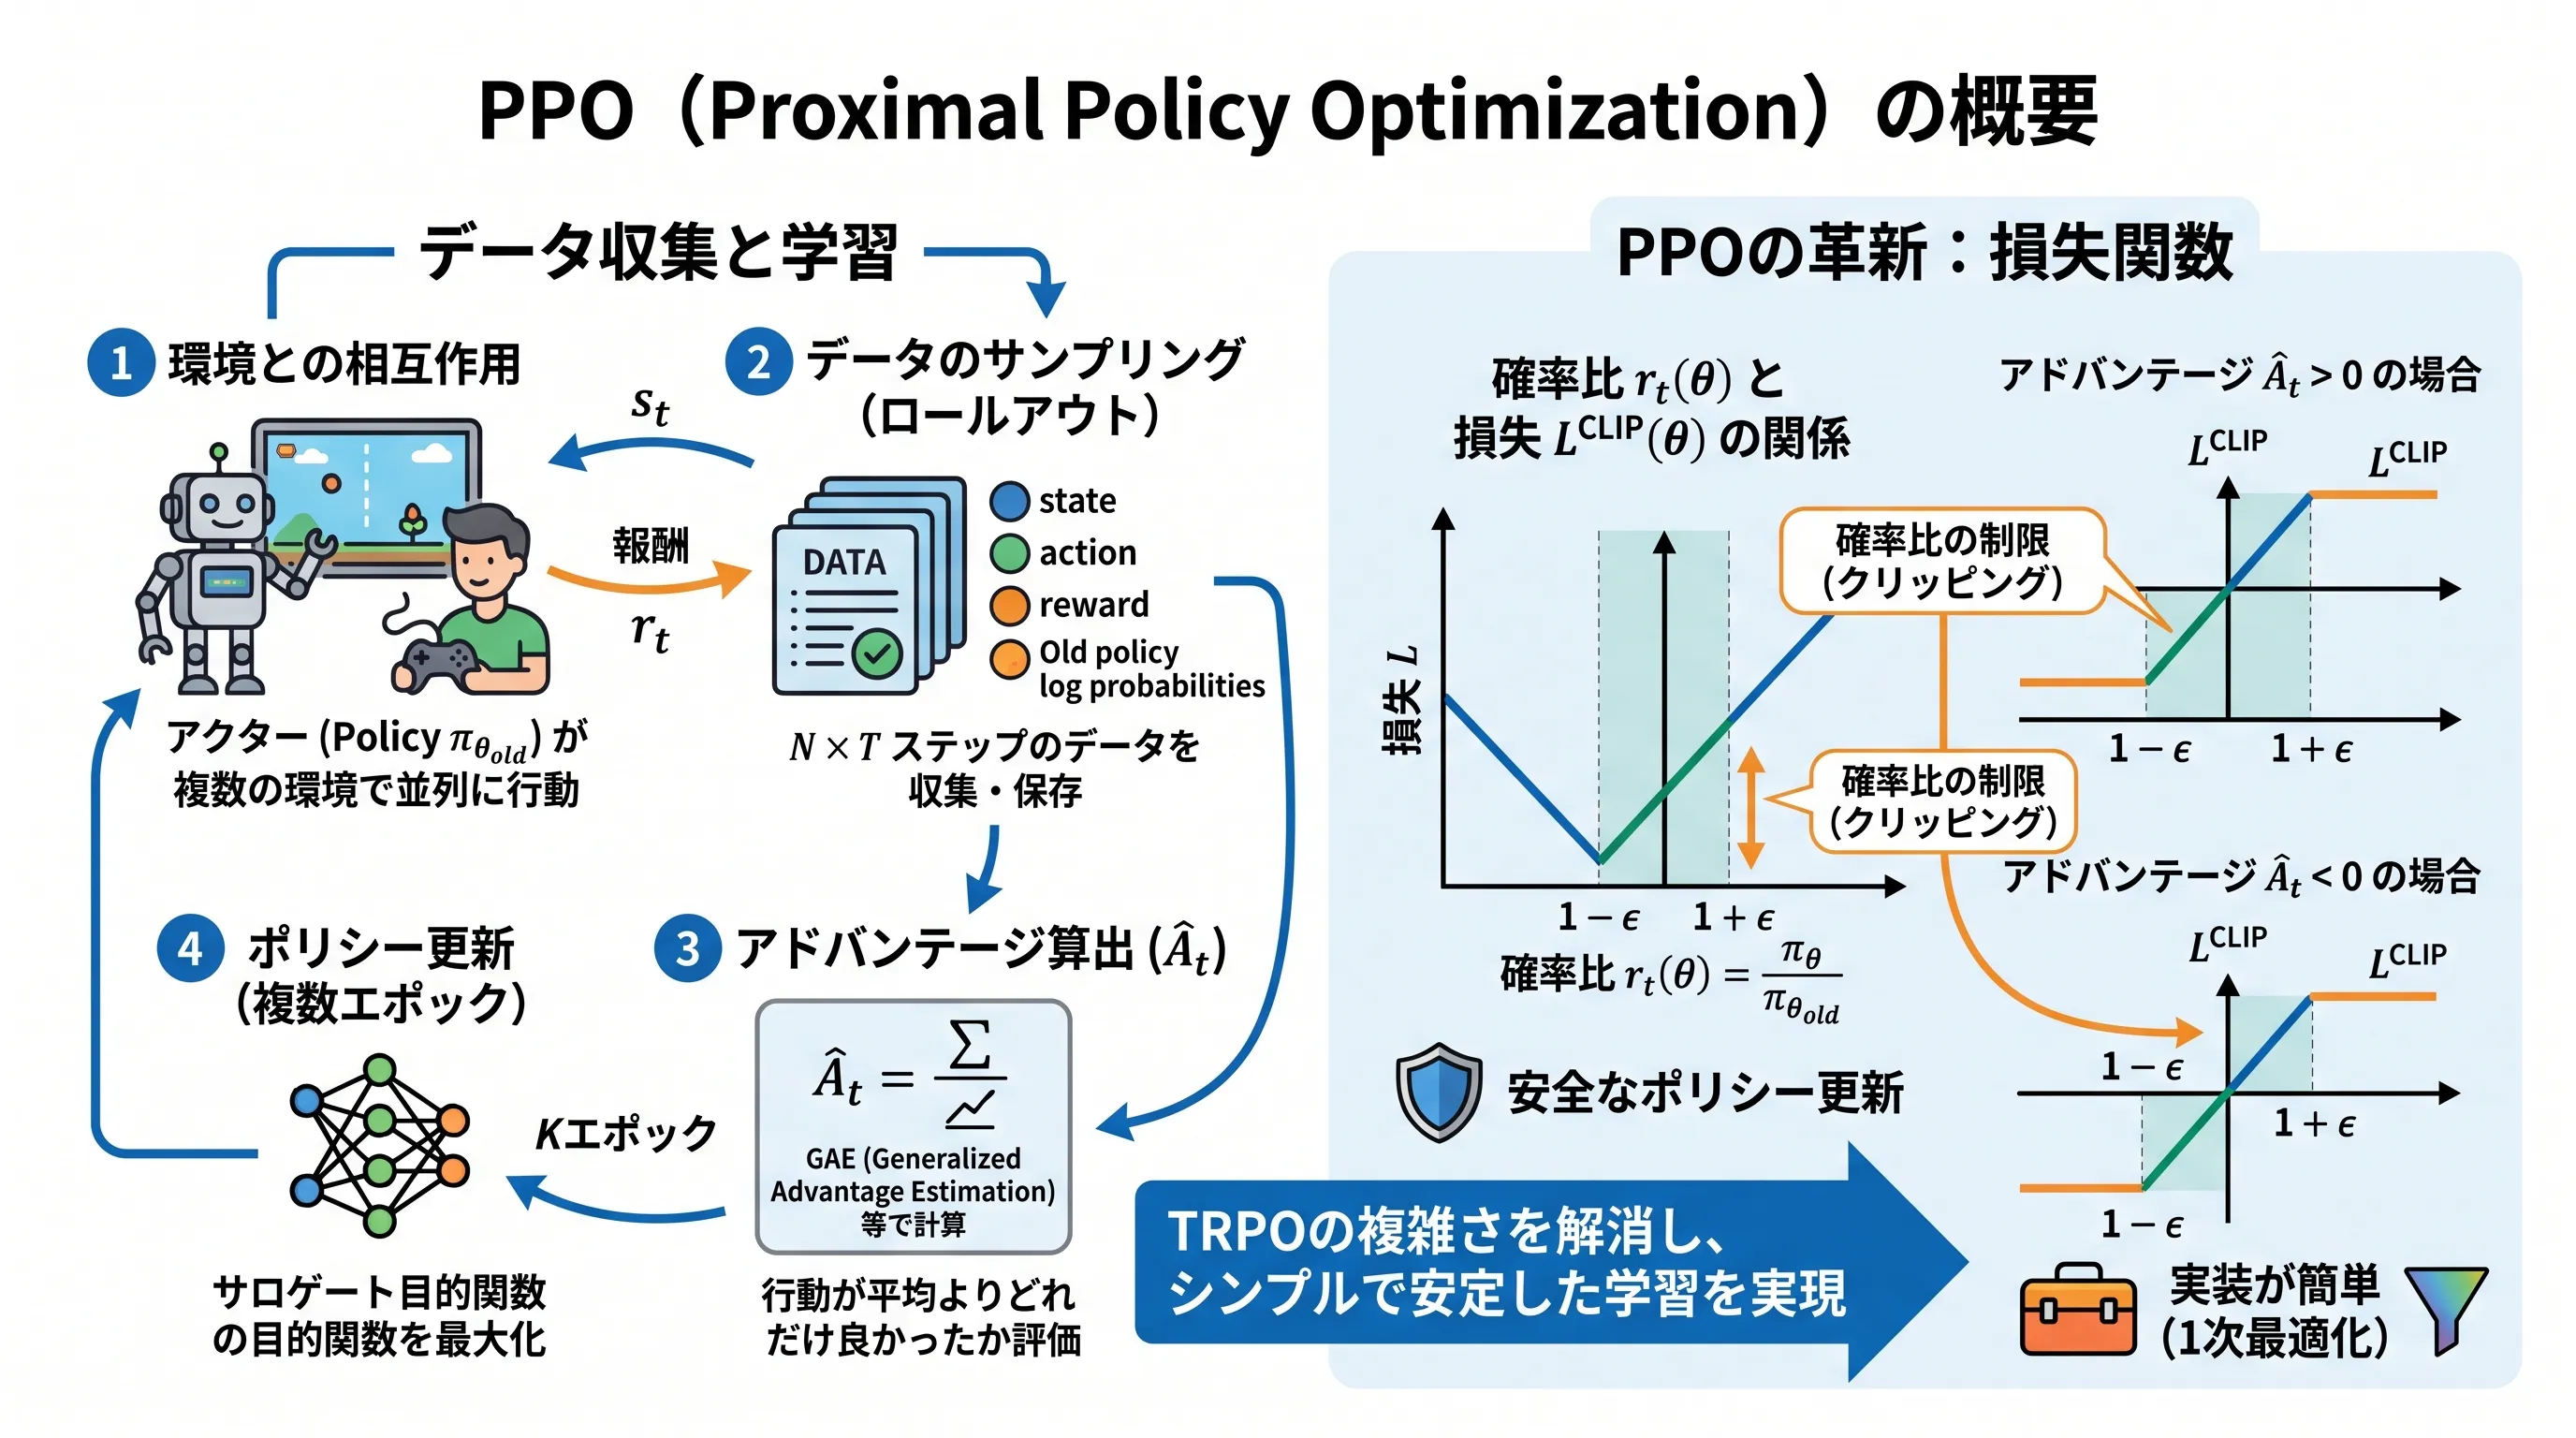
記事を読むTRPOの複雑な二次最適化を「クリップされたサロゲート目的関数」に置き換え、圧倒的な実装の簡潔さと優れたデータ効率を実現した現代のデファクトスタンダード強化学習アルゴリズム「PPO」の仕組みと、PyTorchを用いたスクラッチ実装について解説します。
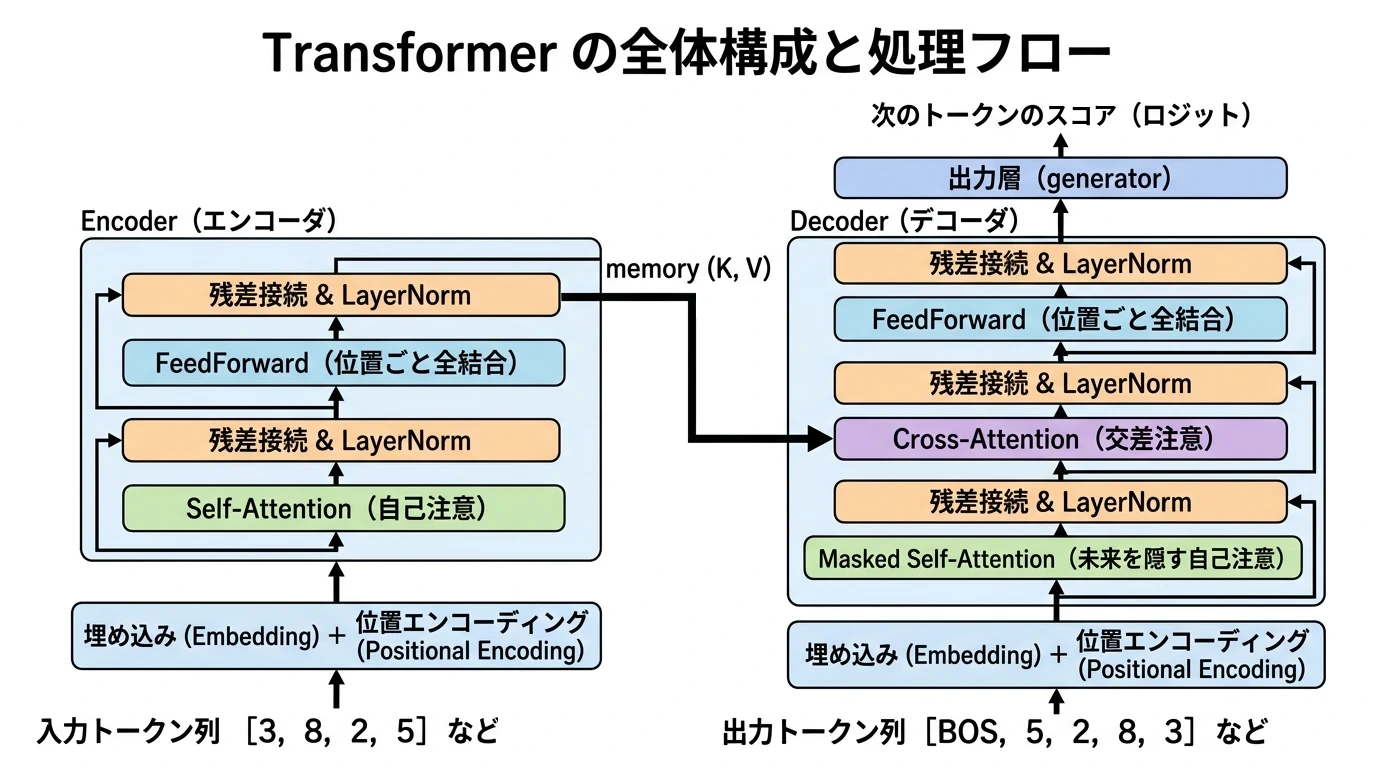
記事を読む「Attention Is All You Need」の Transformer を、PyTorch のスクラッチ実装で解説します。Scaled Dot-Product Attention と √d_k で割る理由、Multi-Head Attention、Sinusoidal Positional Encoding、残差接続と LayerNorm、Causal Mask と Padding Mask を部品ごとに実装し、テンソルの形の変化を追います。系列を逆に並べるタスクで学習し、自己回帰生成と Cross-Attention の重みを確かめます。
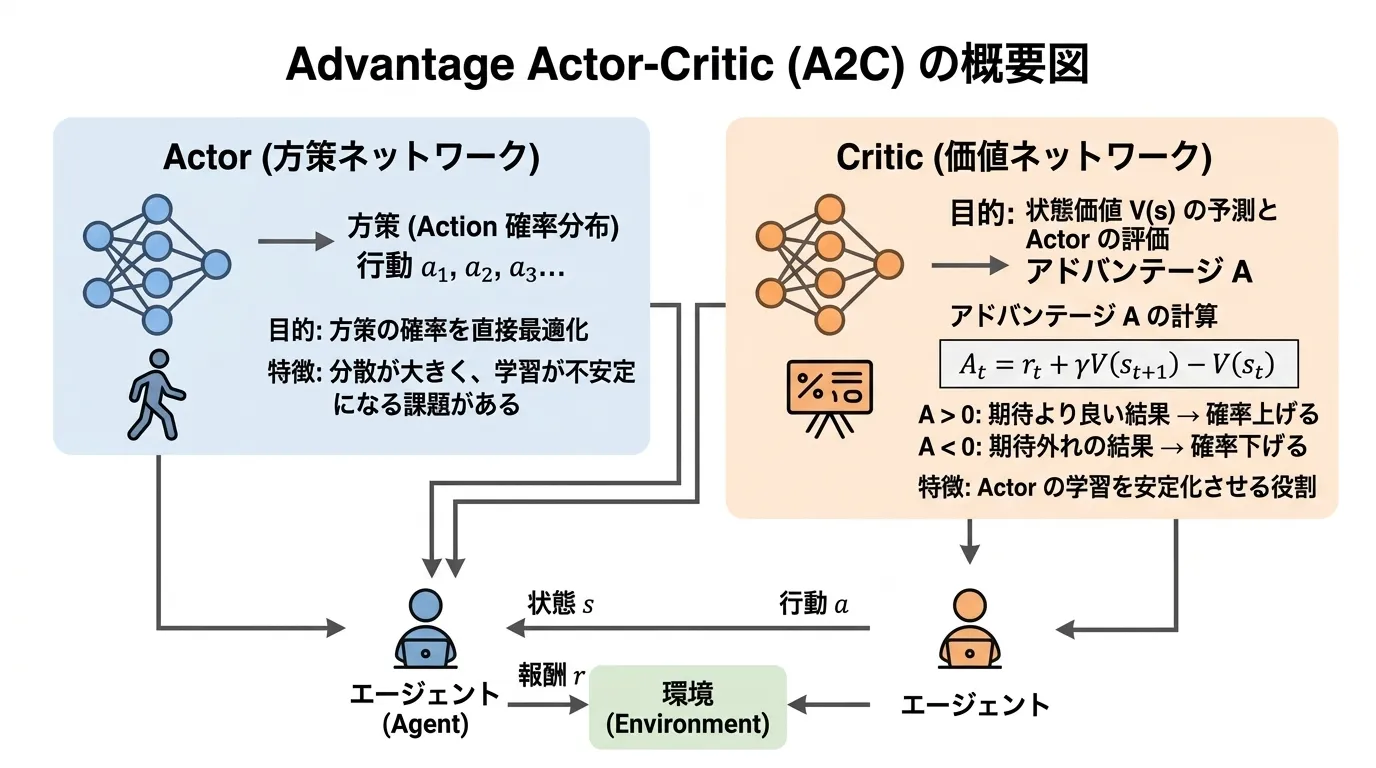
記事を読むDeepMind社が2016年に発表したA3Cの同期版。価値ベースと方策ベースを融合させたActor-Criticアーキテクチャの基本から、アドバンテージ関数を用いた分散抑制、複数ワーカーによる並列学習、およびPyTorchによる実装までを解説します。
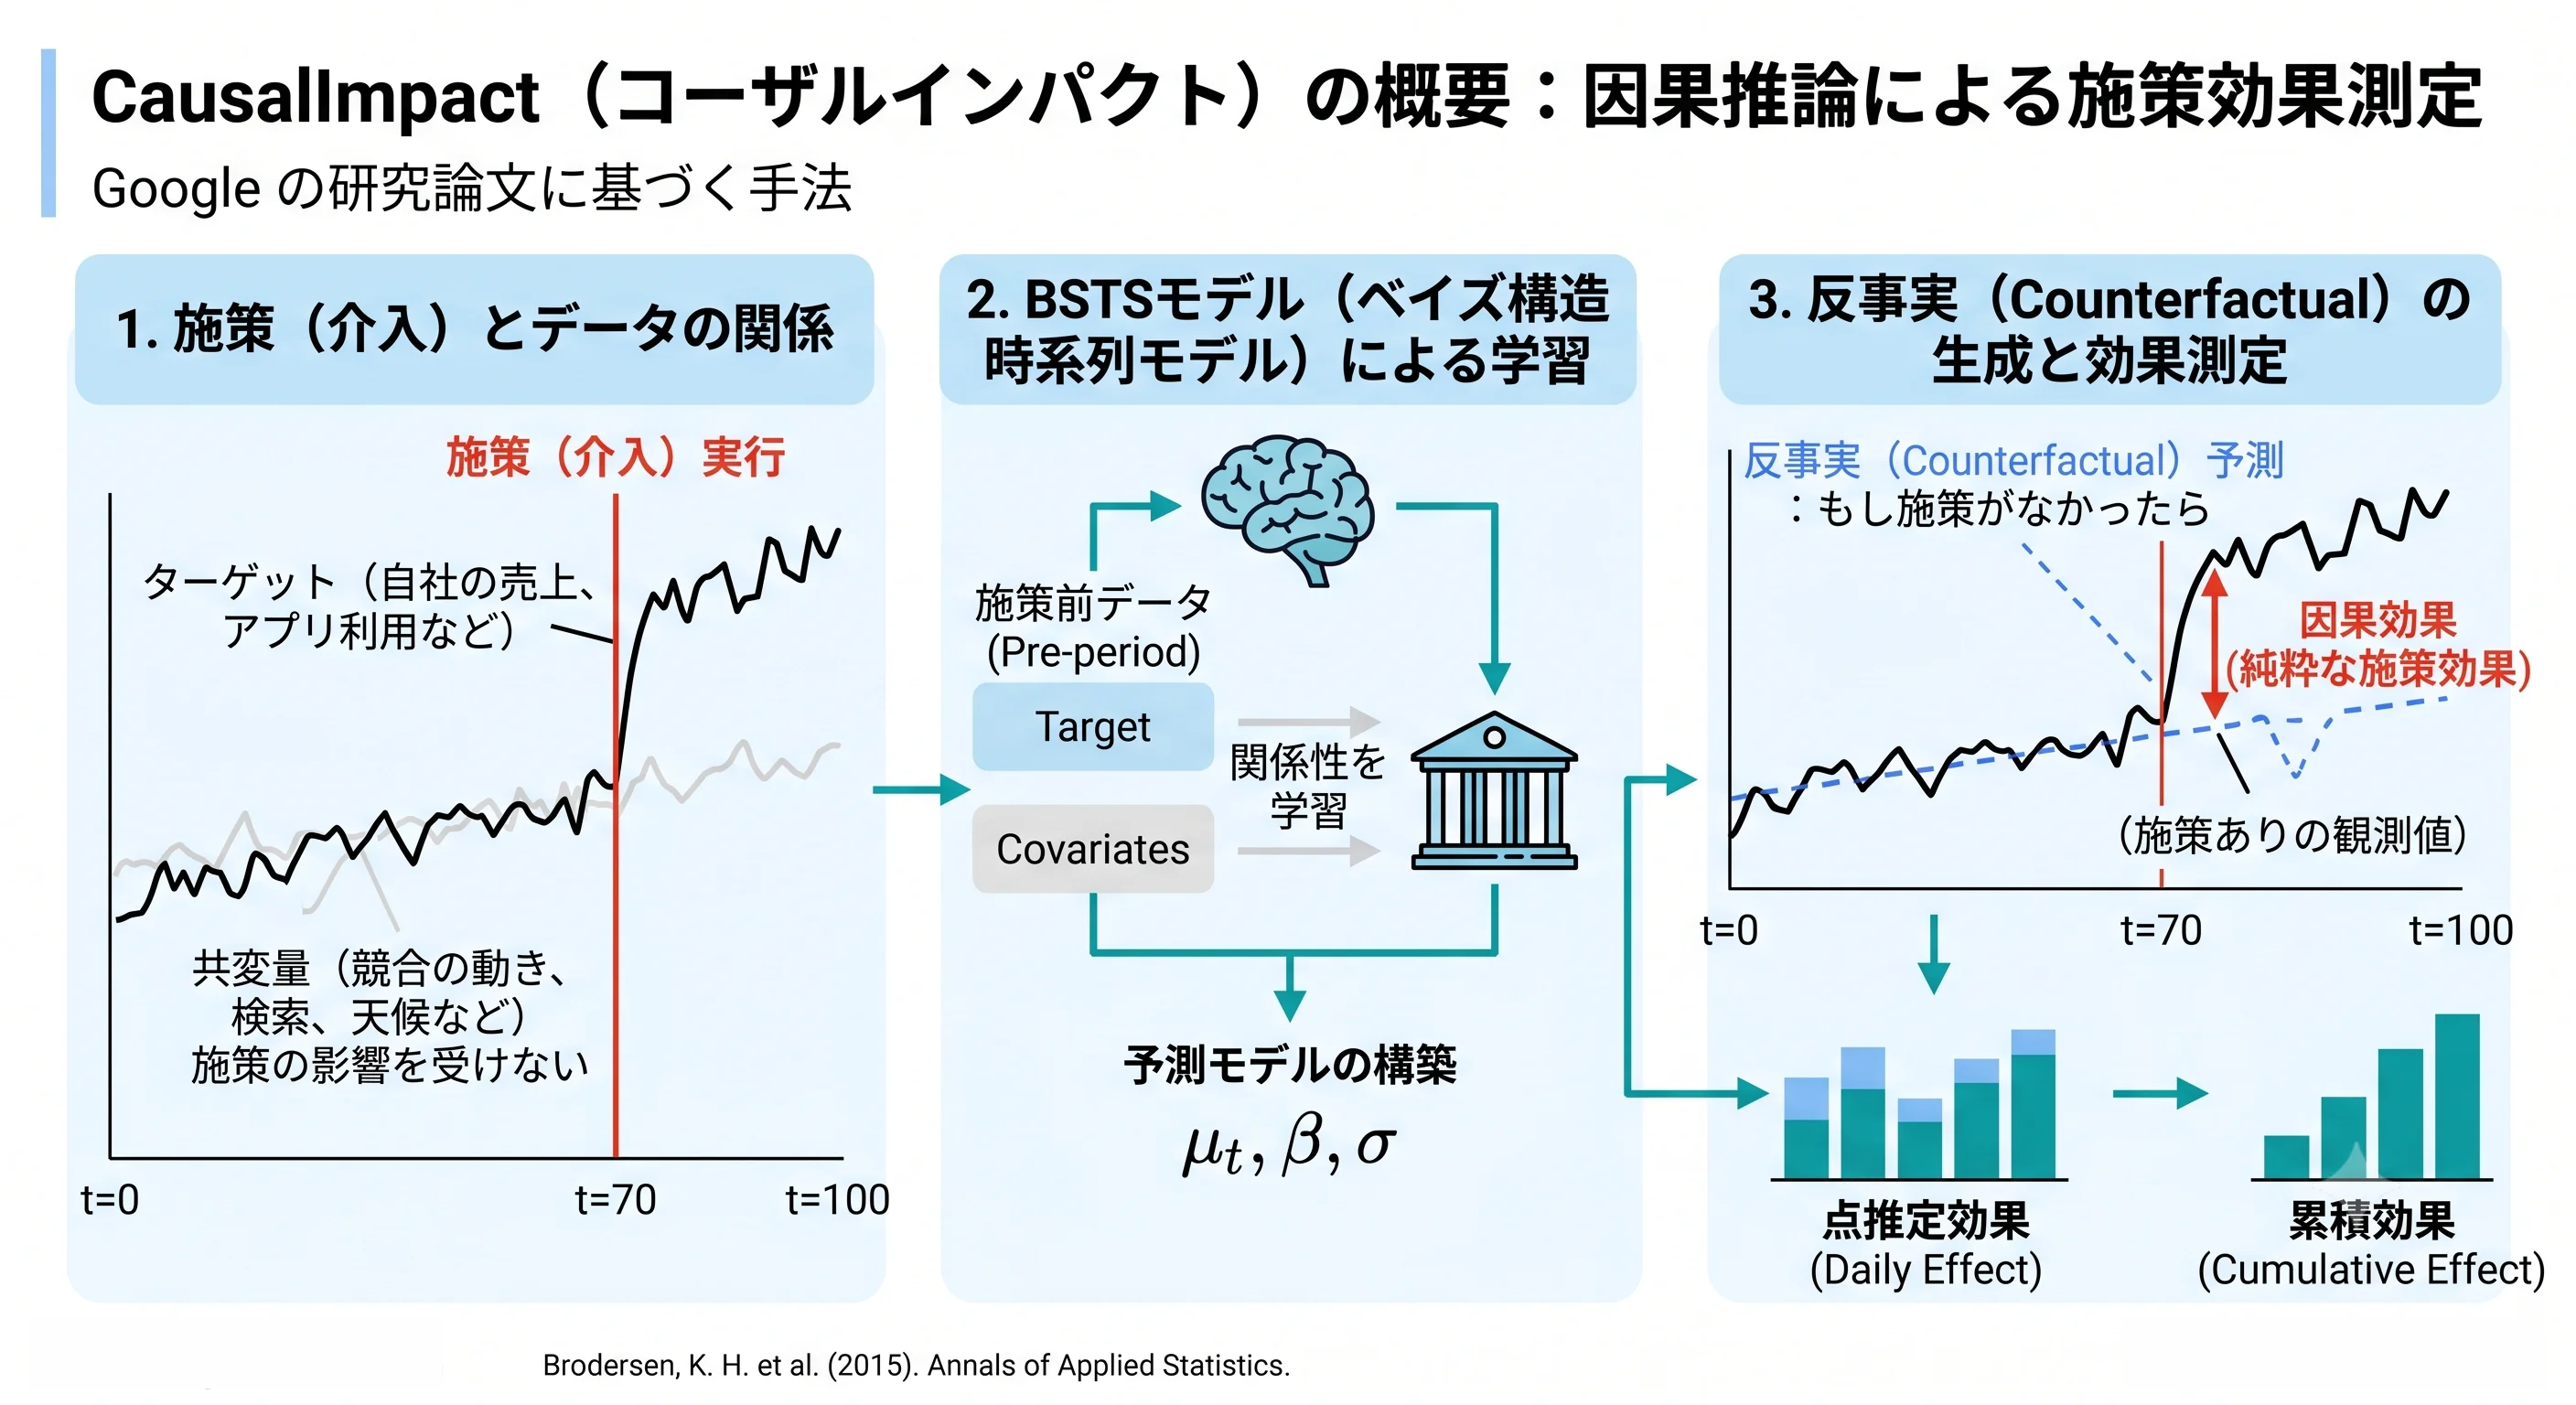
記事を読む「もし施策を行っていなかったらどうなっていたか」という「反事実」を、ベイズ構造時系列モデル(BSTS)によって高精度にシミュレーション・予測するCausal Impactの仕組みを、PyMCによるMCMCスクラッチ実装やライブラリの使い方を交えて解説します。
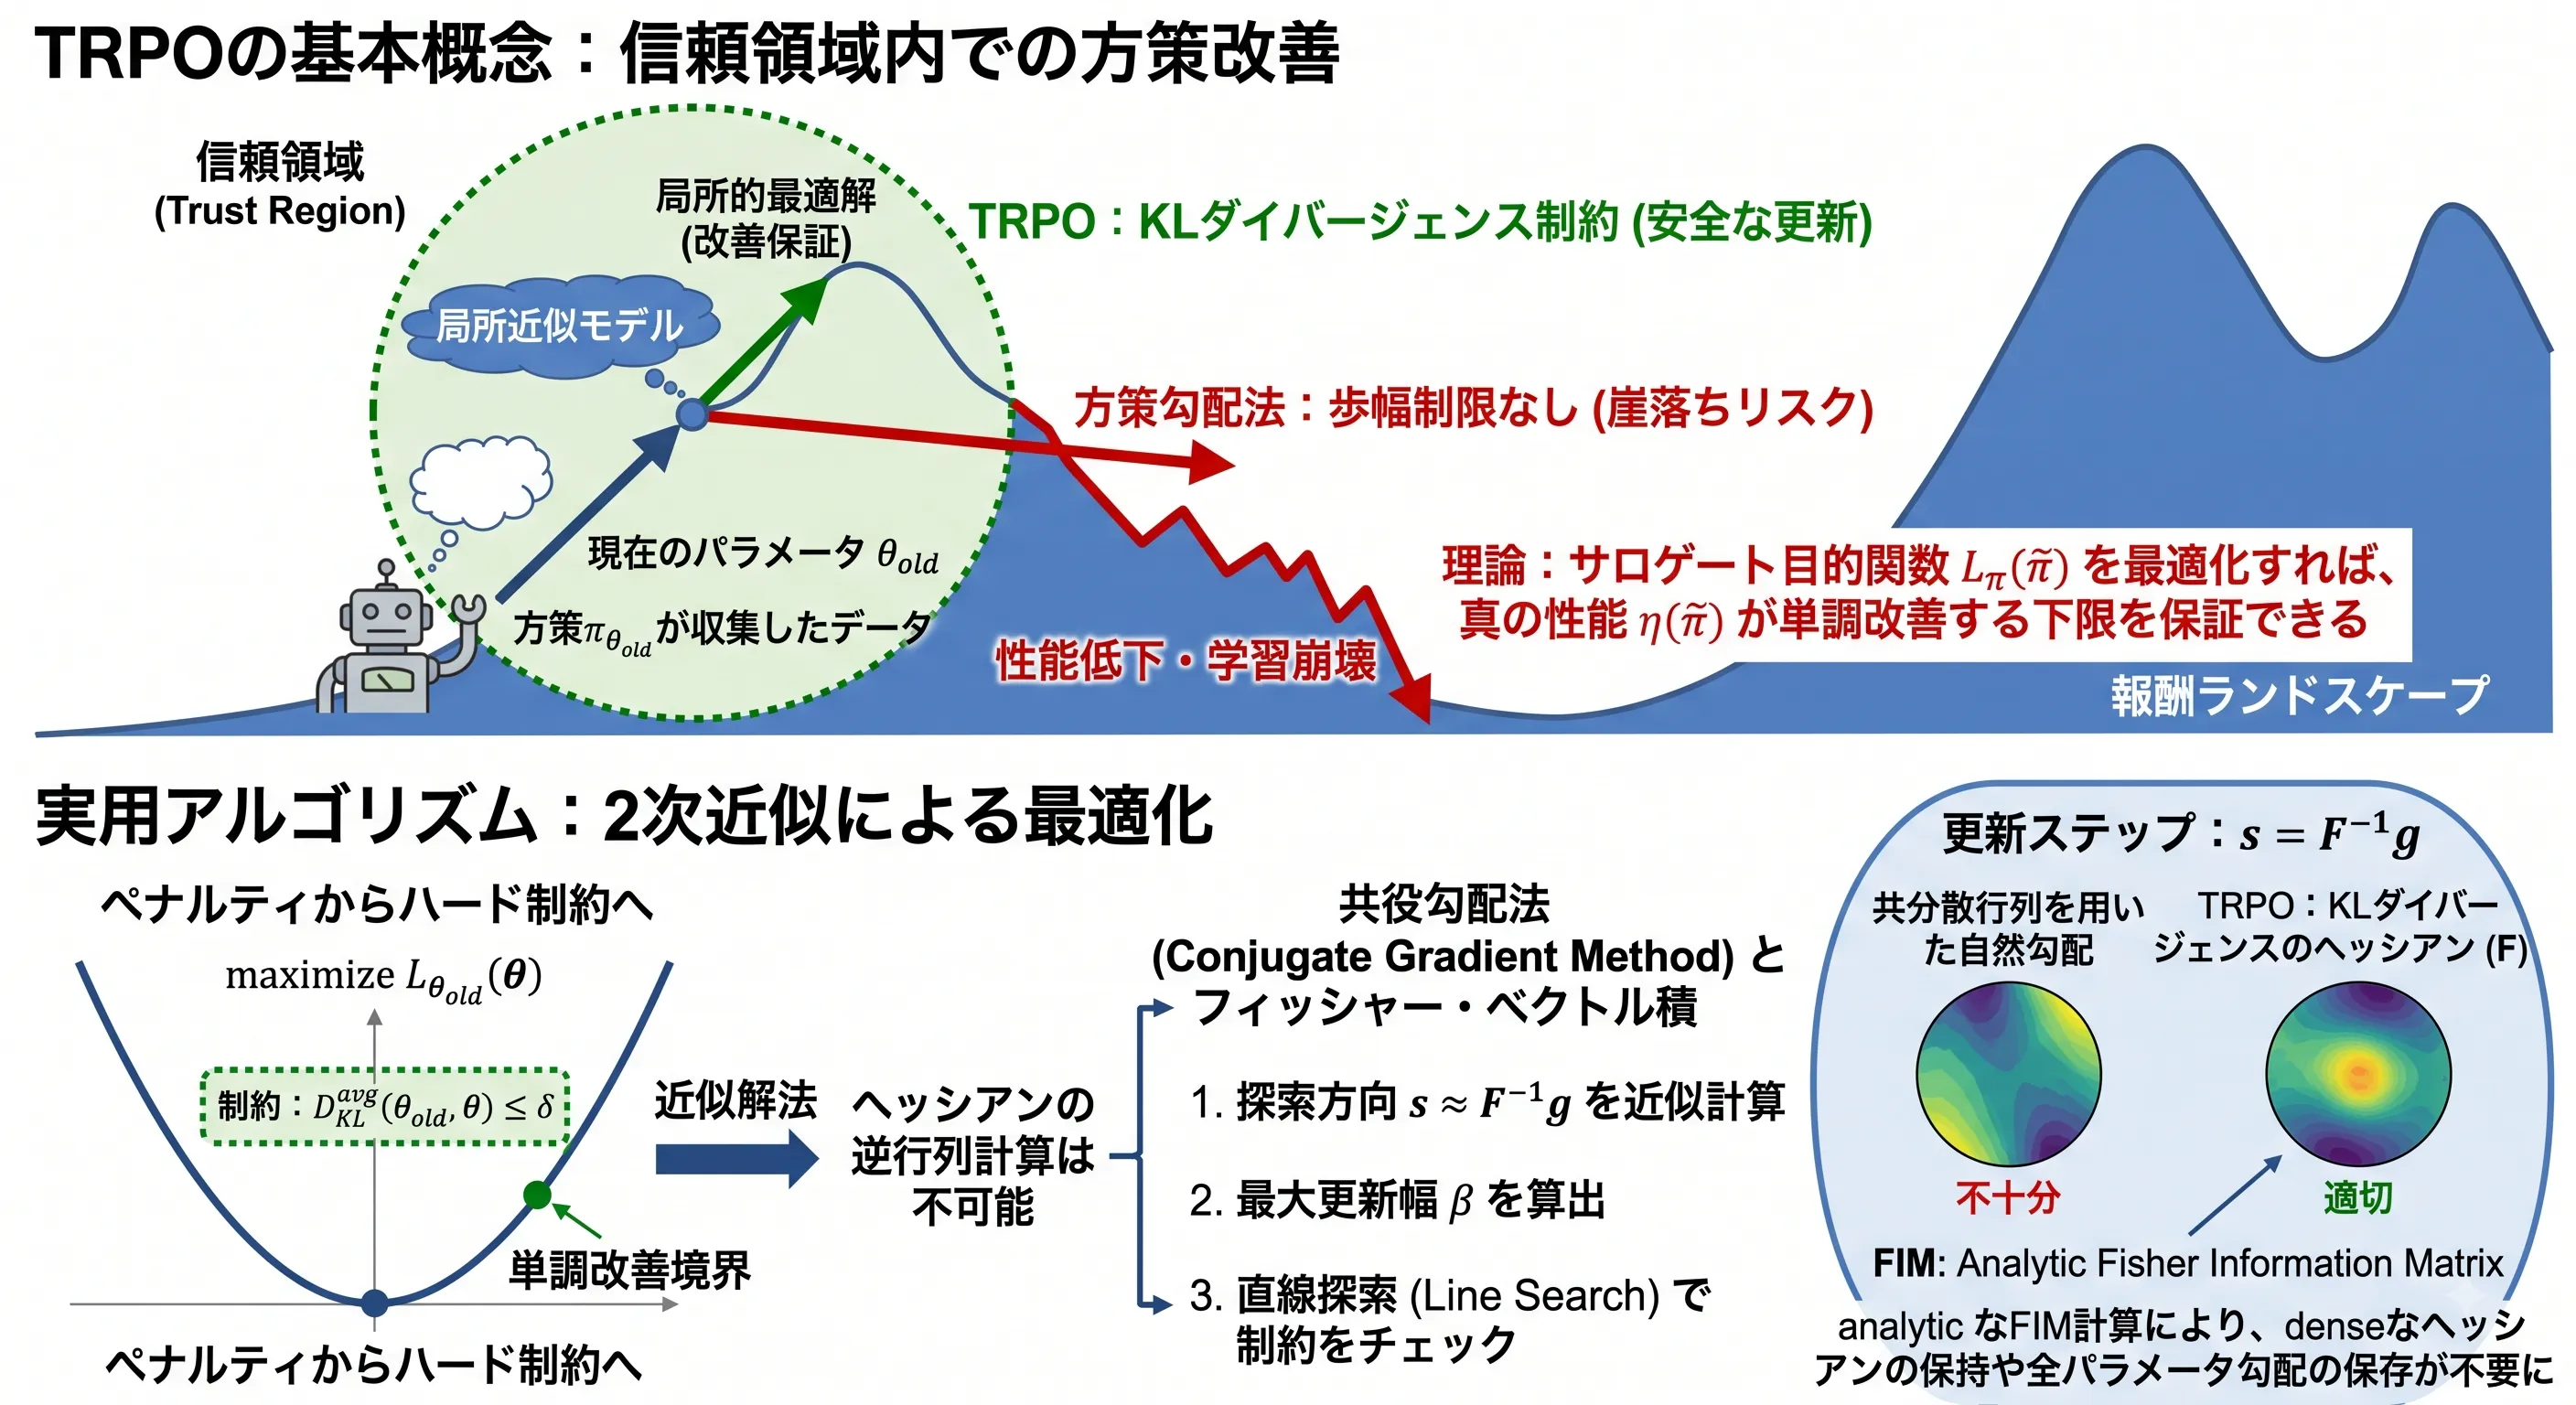
記事を読む方策の急激な変化による学習の崩壊を防ぐため、KLダイバージェンスを用いた「信頼領域(Trust Region)」の制約内で方策を更新するTRPOの仕組みと、共役勾配法や直線探索を用いたPyTorchスクラッチ実装について解説します。
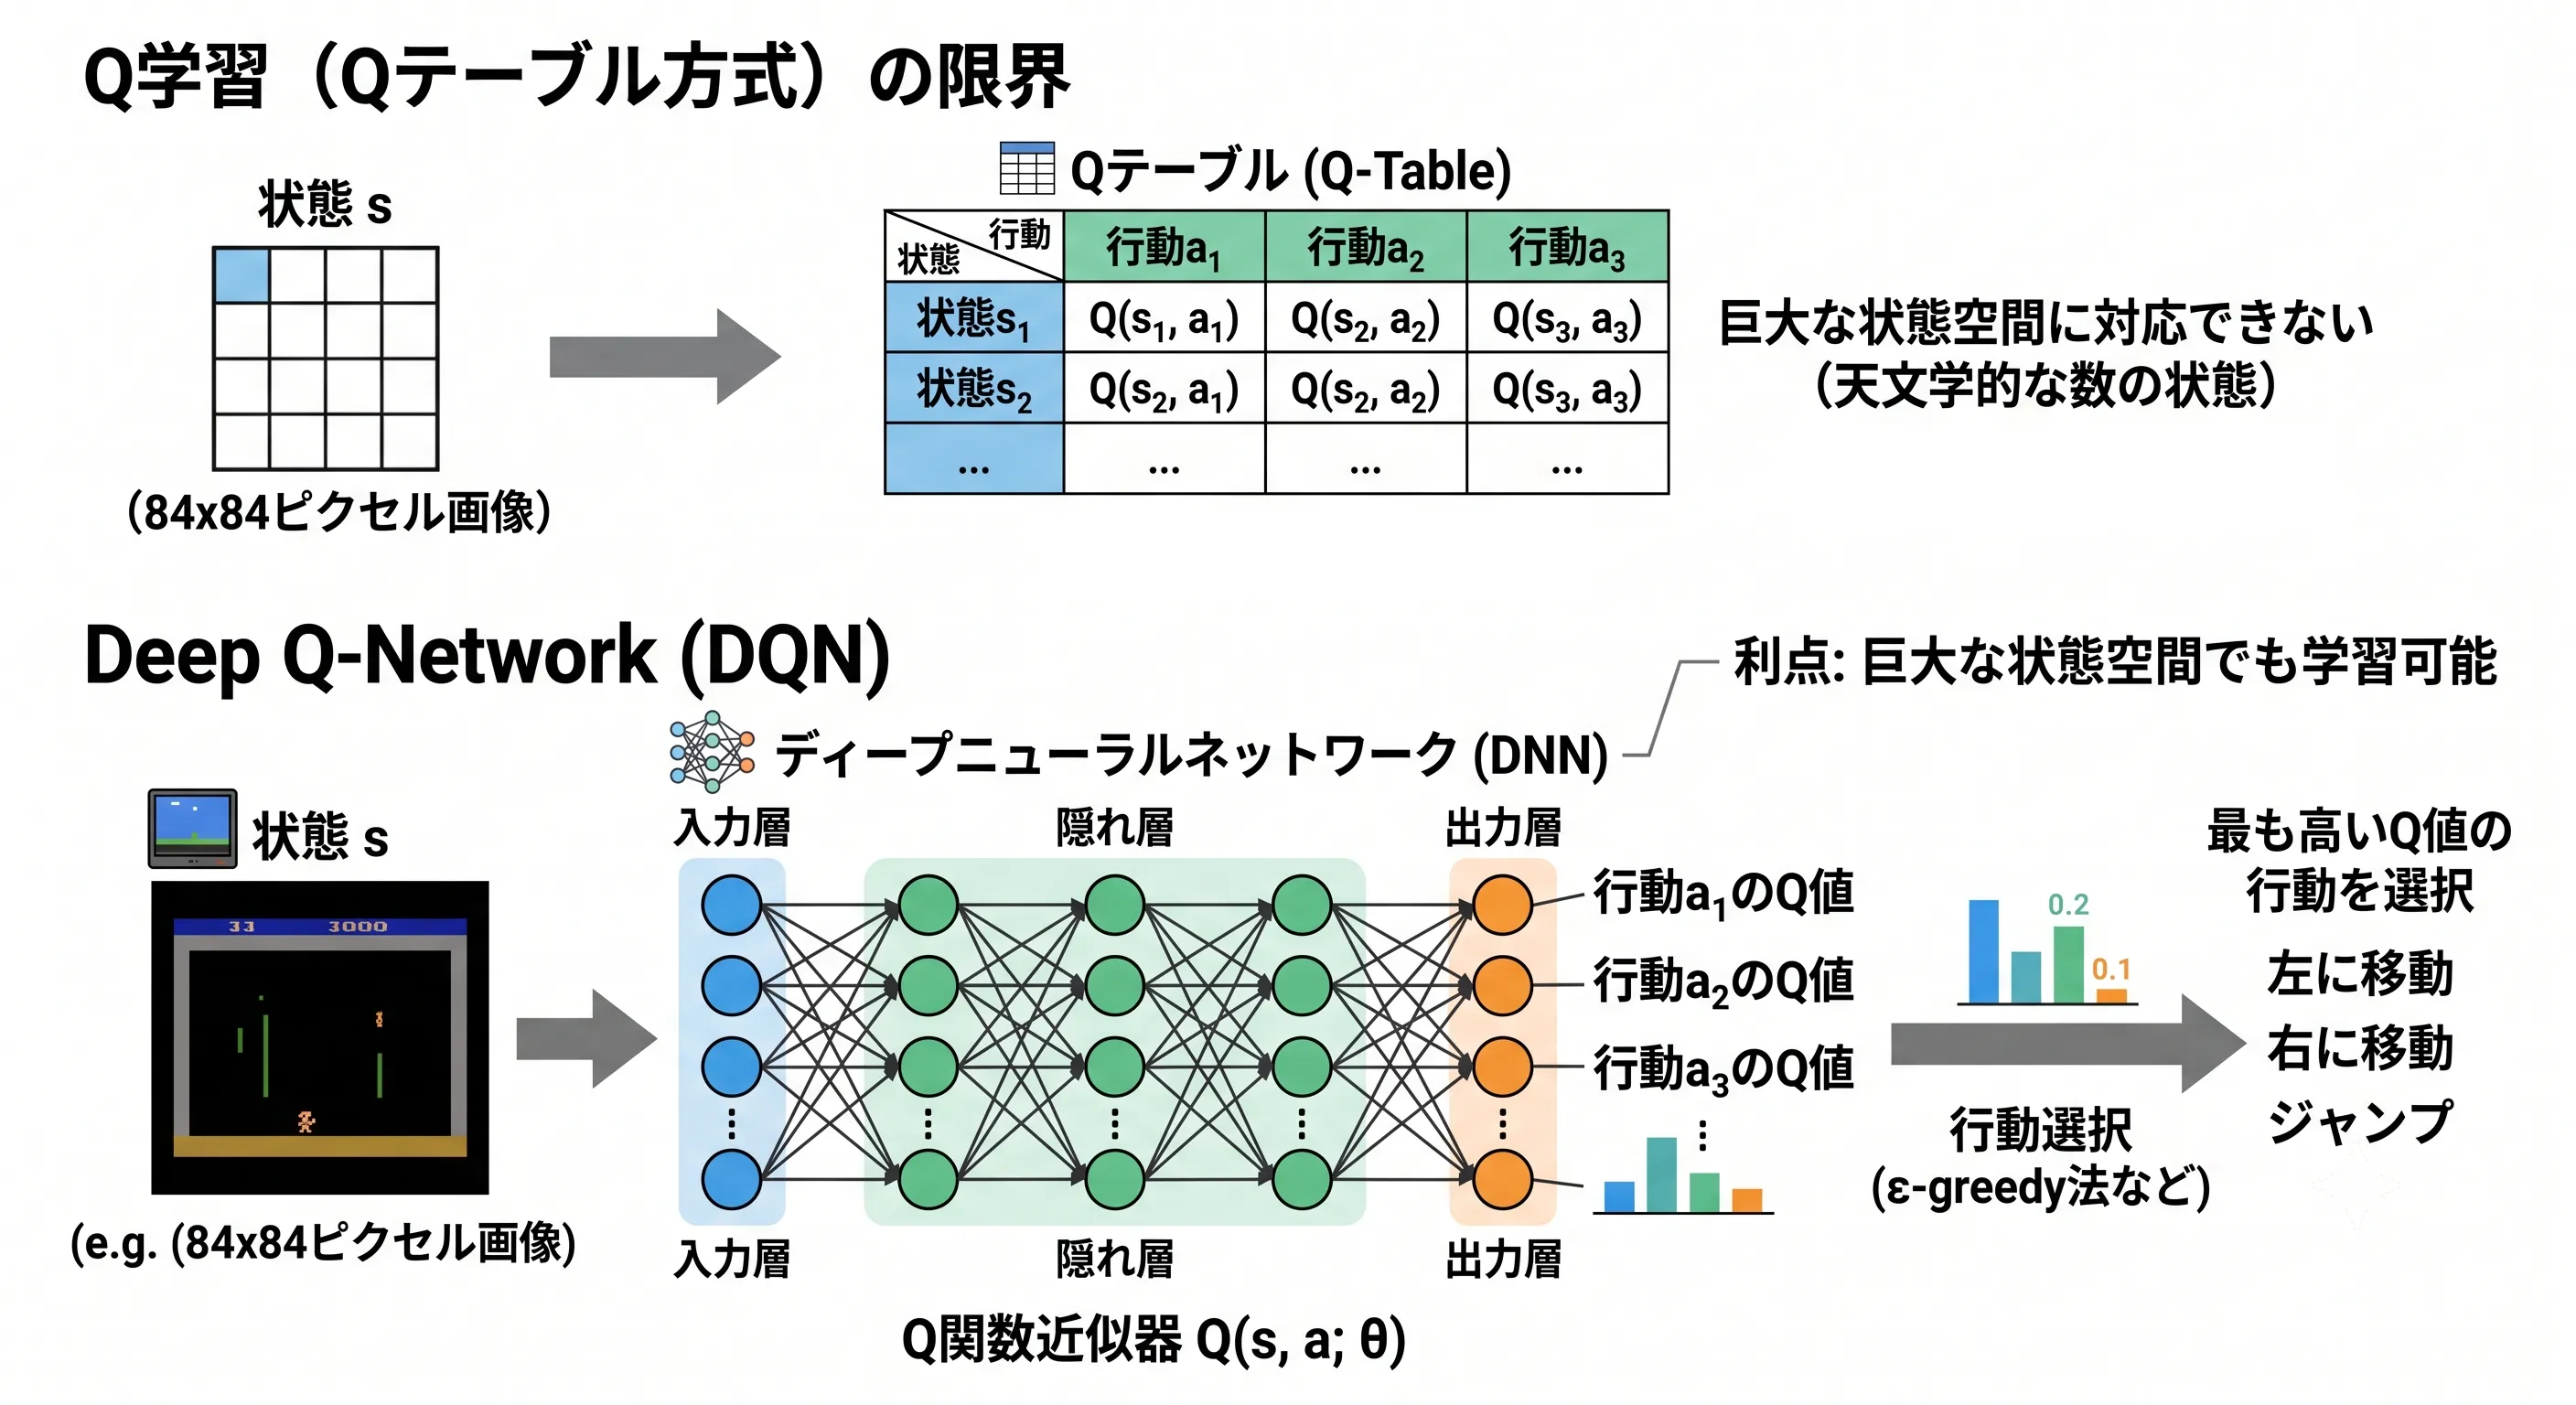
記事を読むQ 学習の Q テーブルをニューラルネットワークに置き換え、Atari のゲームを画面の画素から学習した DQN(Google DeepMind)の仕組みを、Experience Replay と Target Network を中心に解説します。PyTorch の公式チュートリアルと同じ設定でスクラッチ実装した DQN を CartPole で学習させてランダムな行動と比べ、エピソードの終了(terminated)と打ち切り(truncated)の扱いの違いも説明したうえで、Stable Baselines3 の DQN(RL Zoo の設定)でも学習させて、学習後に 500 ステップ立ち続けることを確かめます。
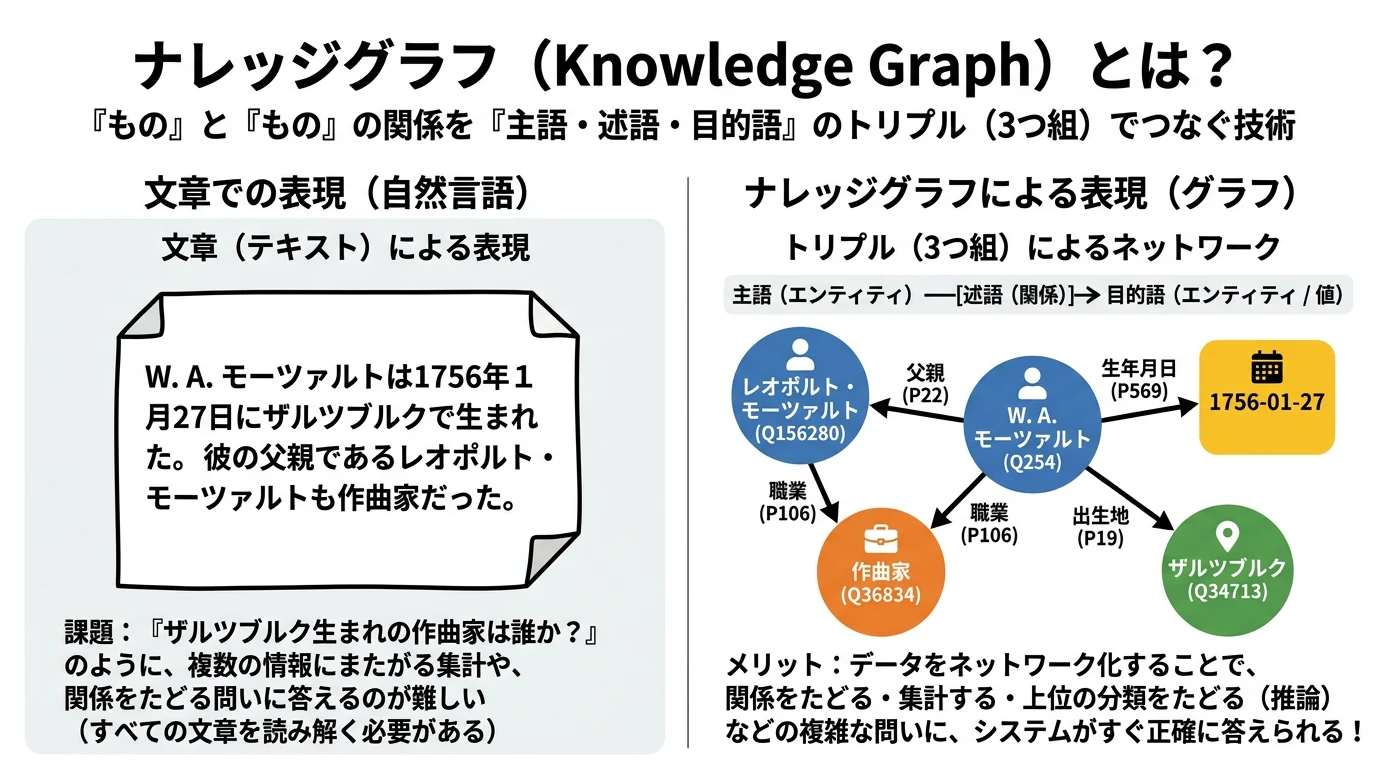
記事を読む「もの」と「もの」の関係を主語・述語・目的語のトリプルで表すナレッジグラフについて、エンティティ・関係・トリプル、WikidataのQ番号とP番号、SPARQLによる問い合わせ(関係をたどる・集計する・推論する)、RDFとプロパティグラフの違い、ナレッジグラフにできないことを、WikipediaとWikidataを使ったPythonの実験で解説します。
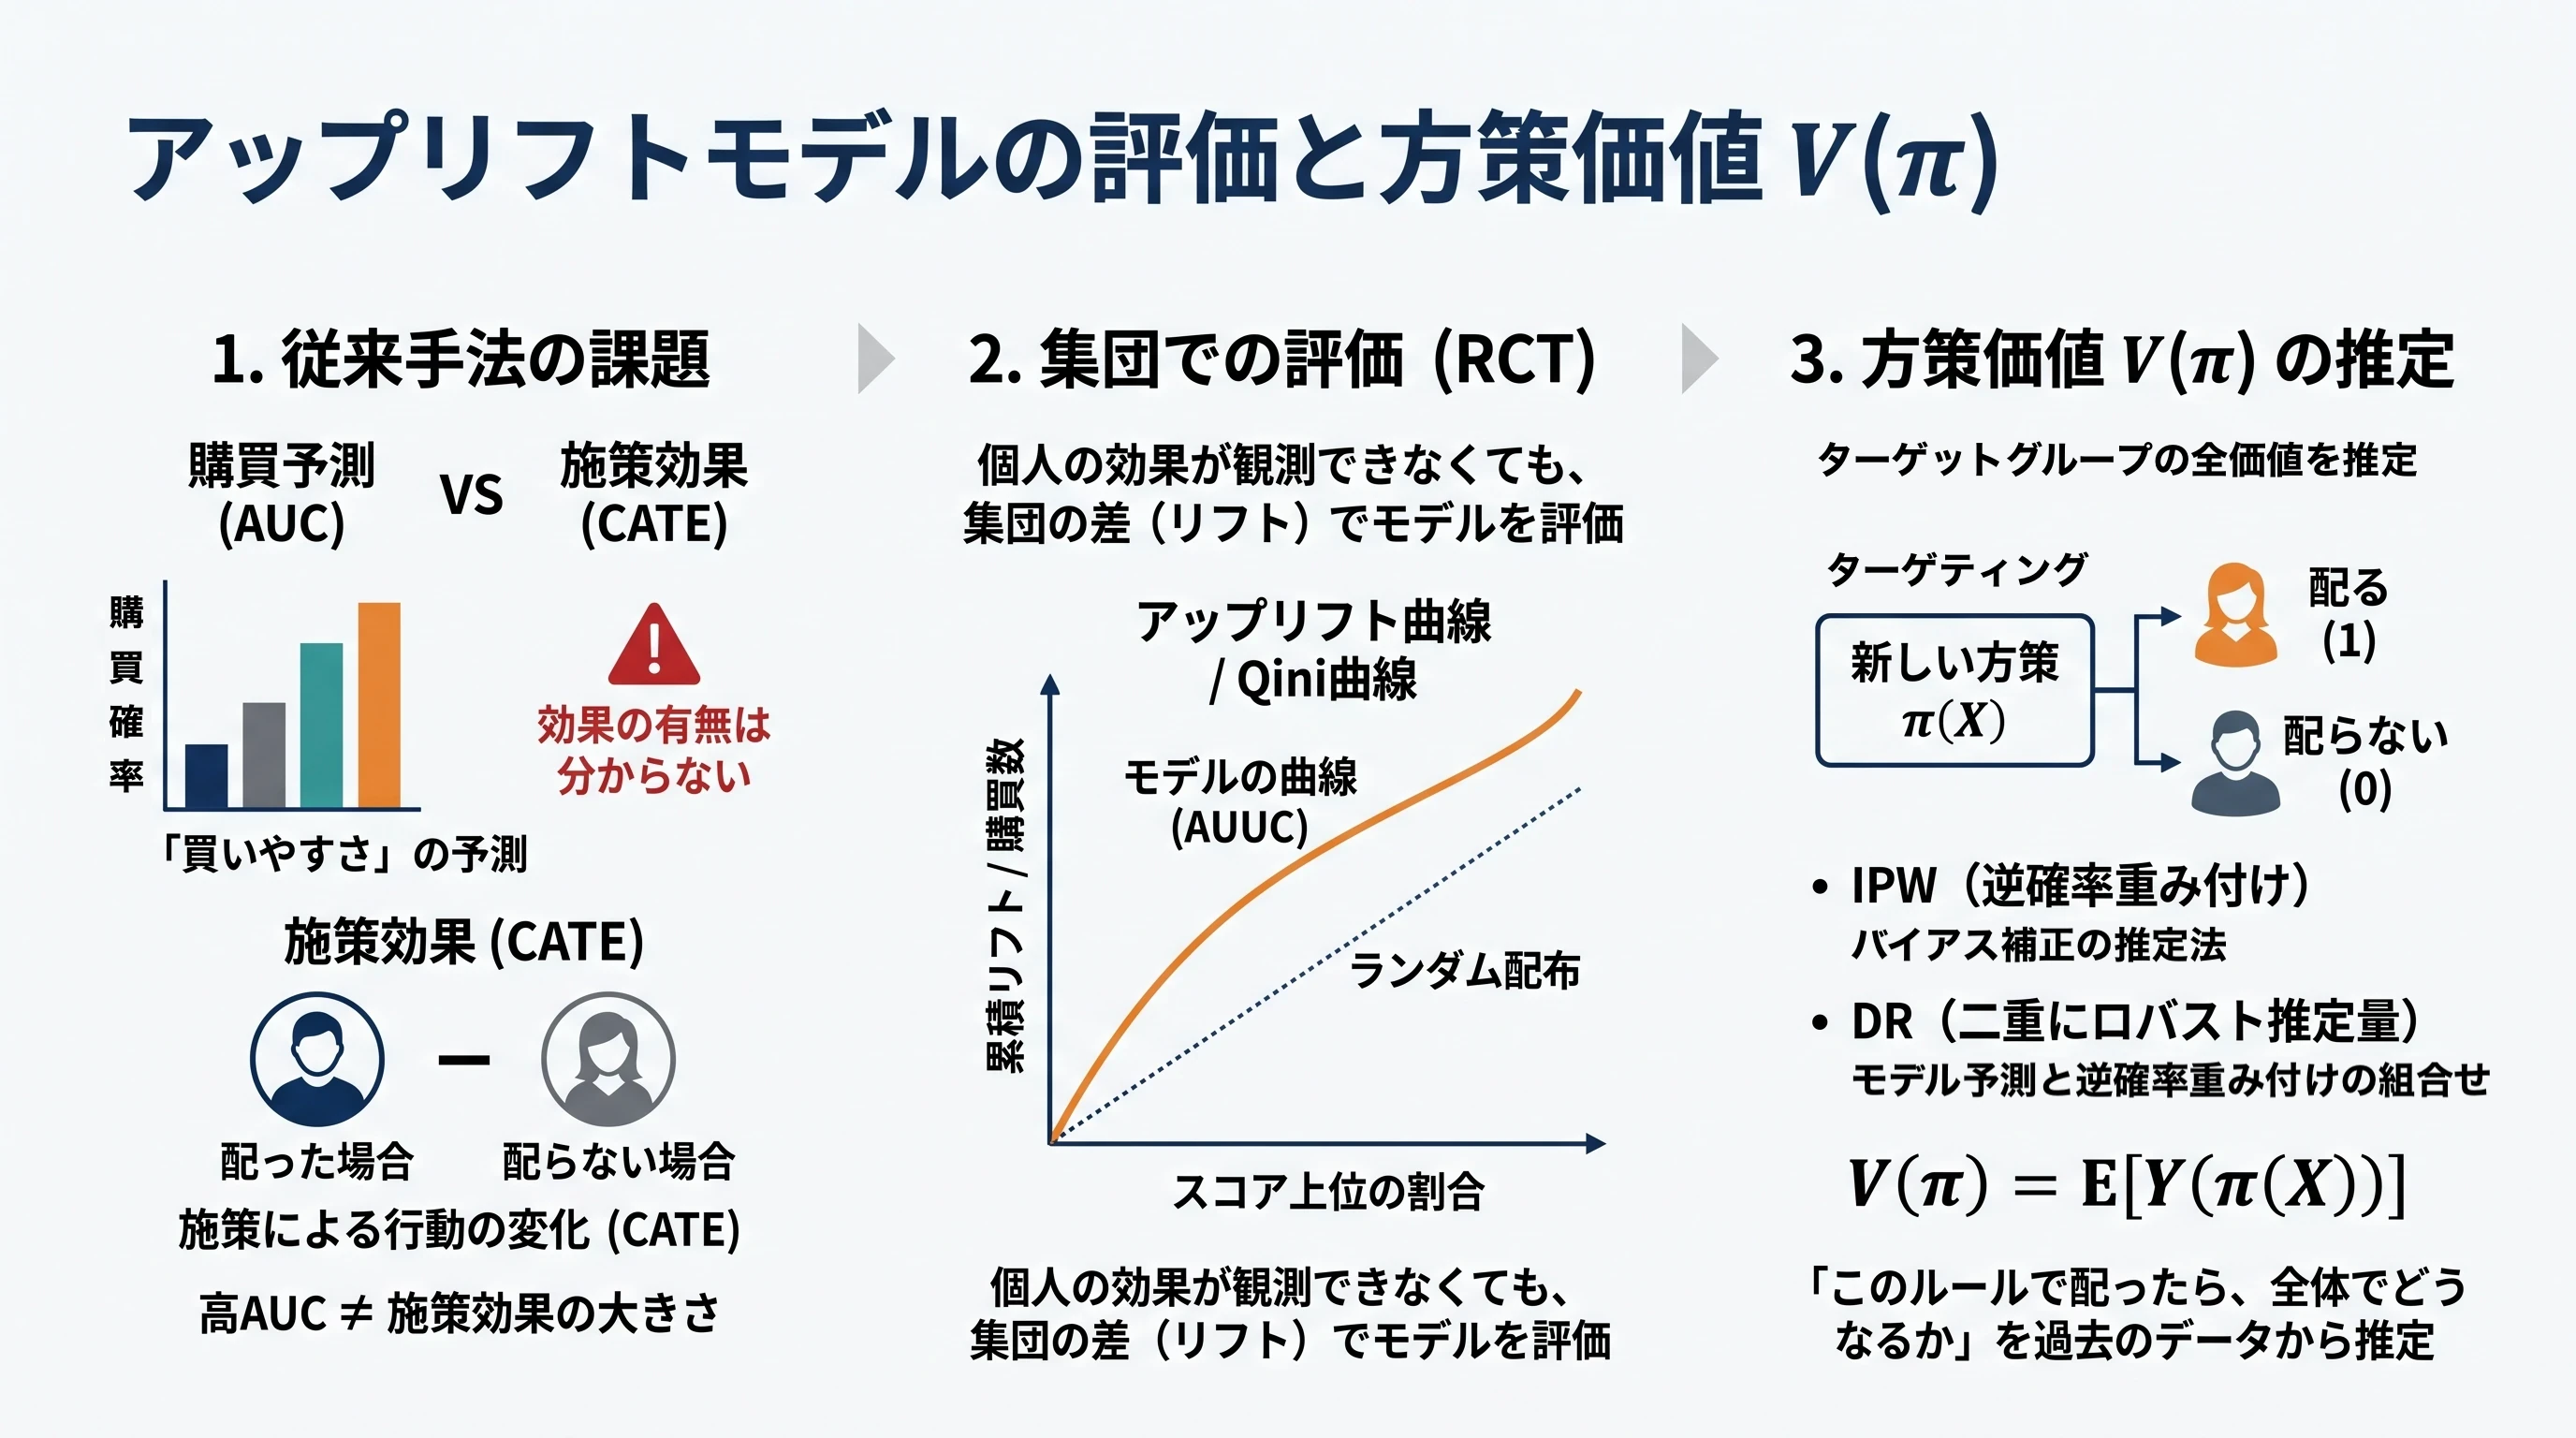
記事を読む個人の施策効果は観測できないという前提のもとで、アップリフトモデル(ターゲティング方策)の良し悪しを評価する方法について、AUCでは評価できない理由、Qini曲線・アップリフト曲線・AUUC、方策価値の定義、RCTデータと観察データでのIPW・DR(AIPW)による方策価値の推定までを、真の効果を仕込んだダミーデータとPythonによる実装で詳しく解説します。
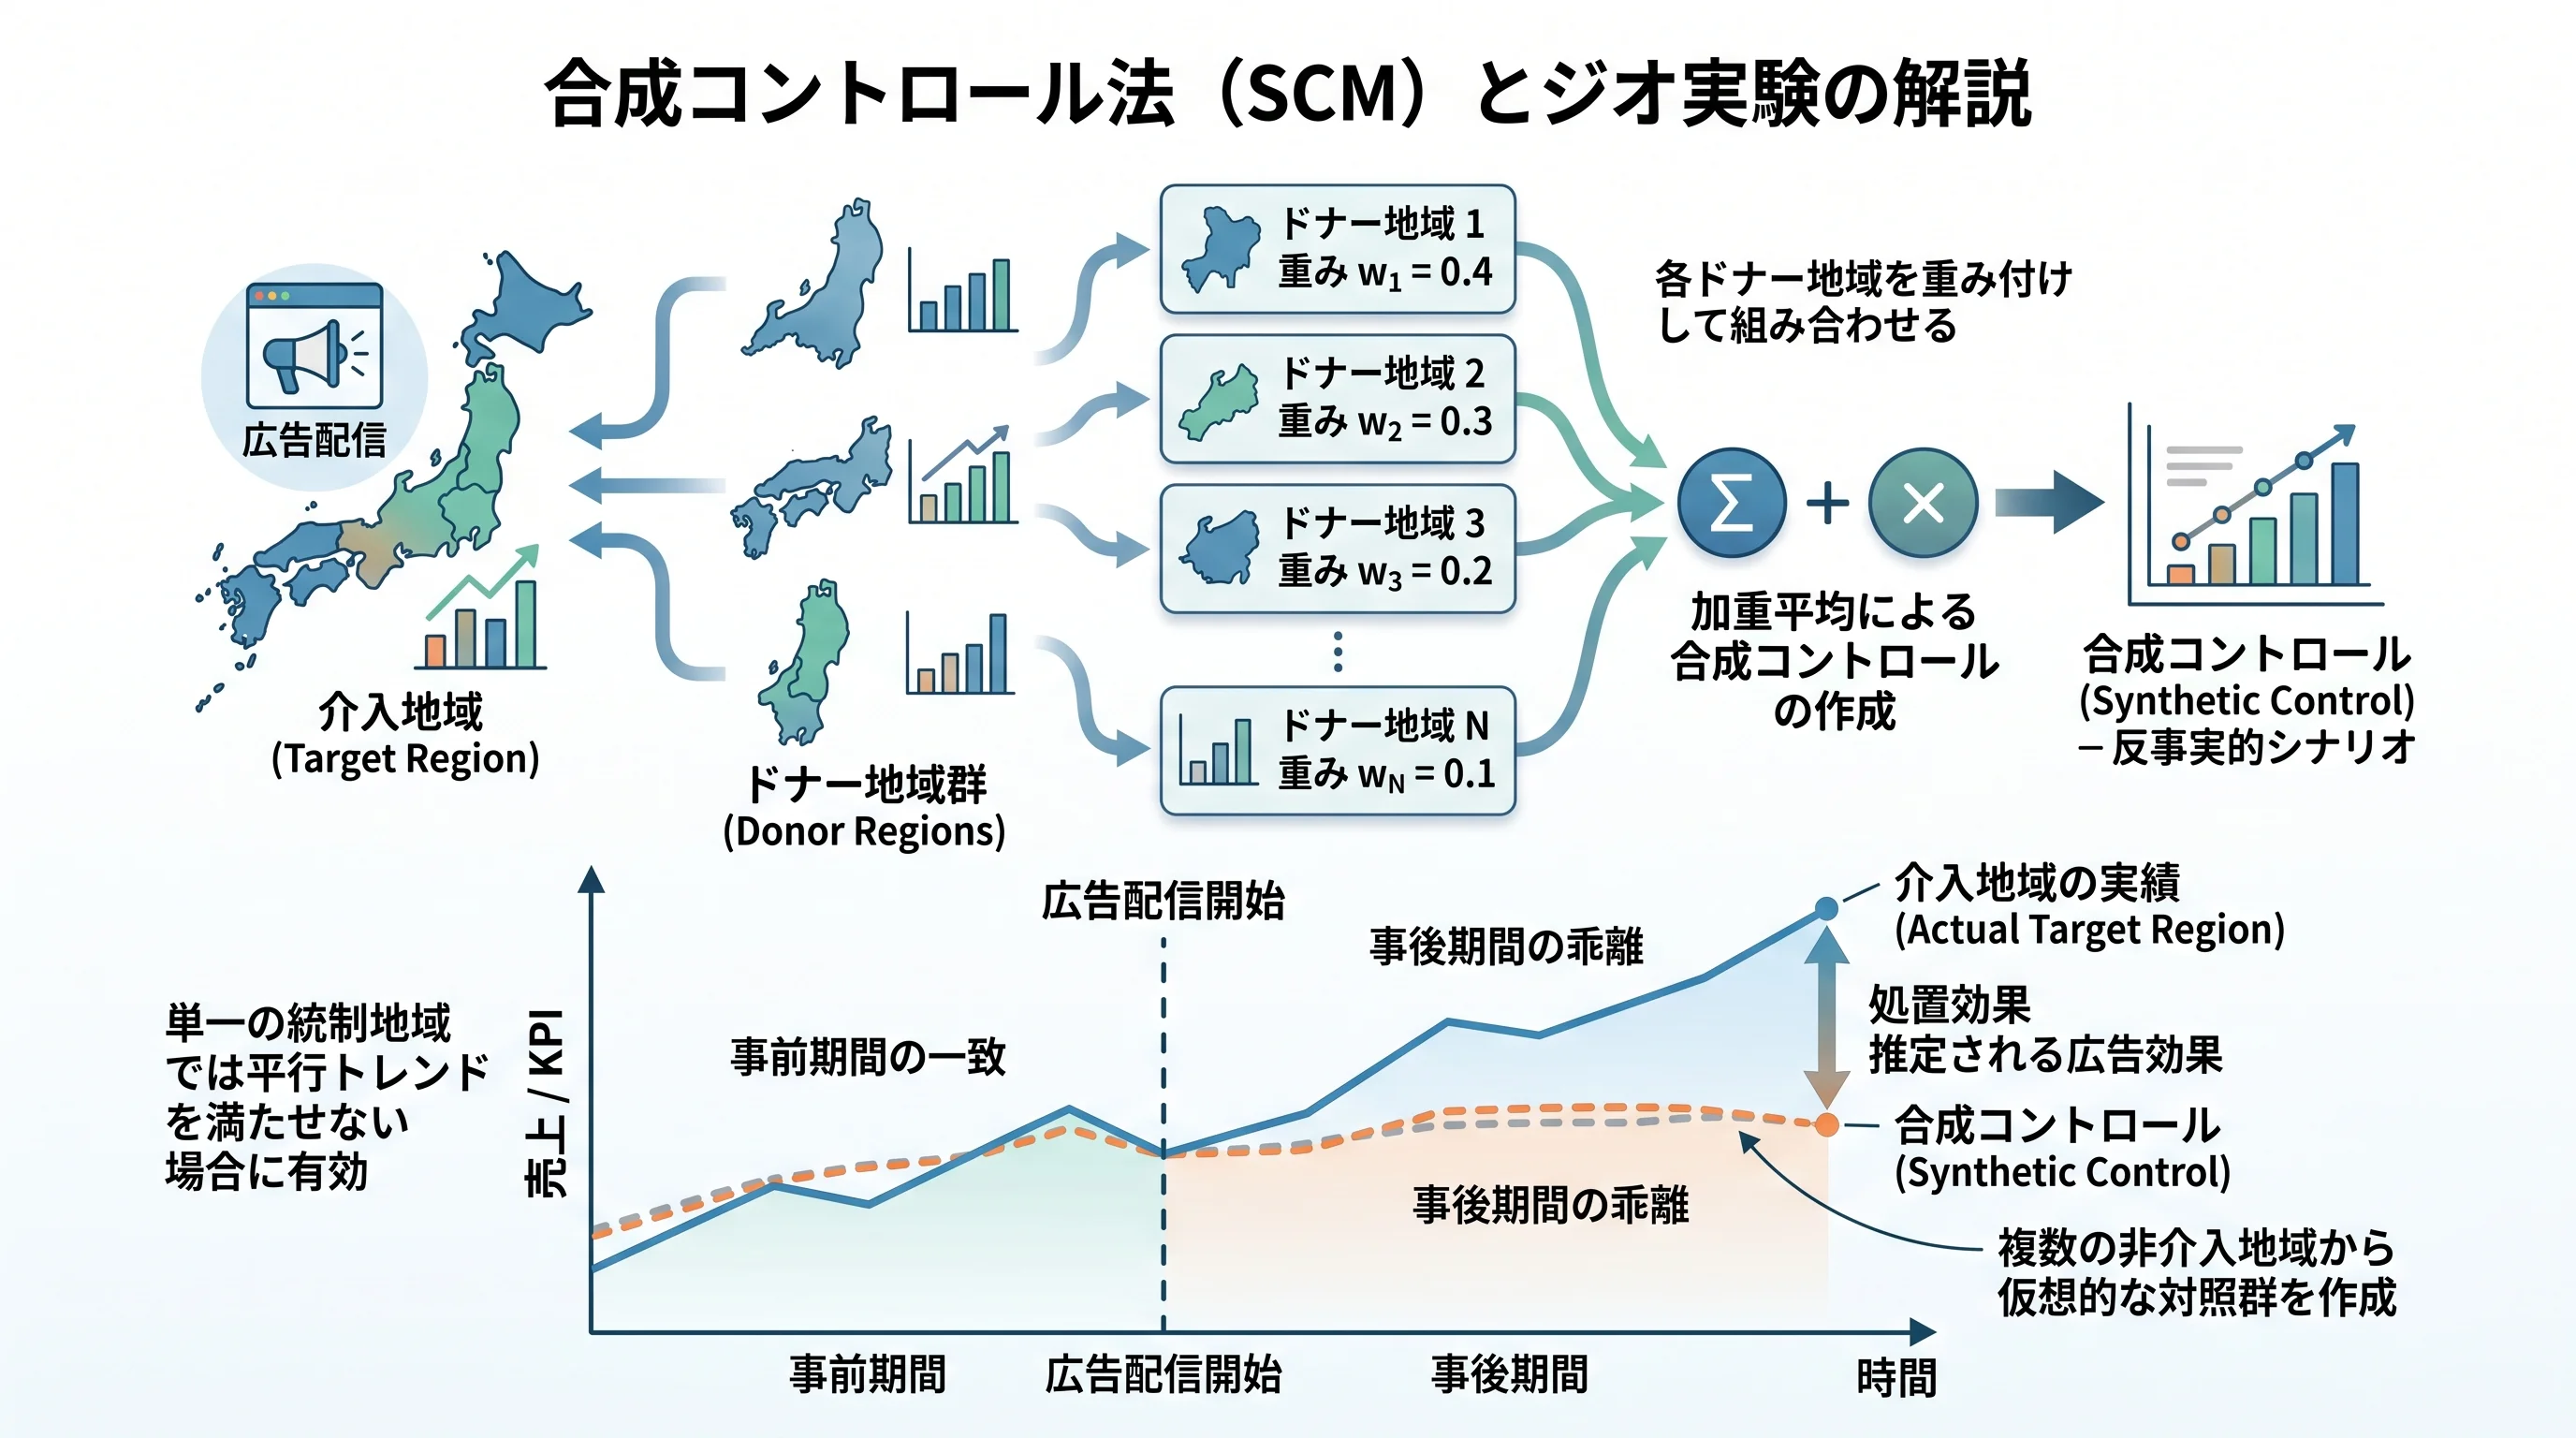
記事を読む地域単位で広告効果を測定する「ジオ実験」の設計と、単一の統制群では満たせない平行トレンドを複数地域の重み付けで解決する「合成コントロール法(SCM)」の数理・Pythonスクラッチ実装・プラセボ検定(並べ替え検定)までを解説します。
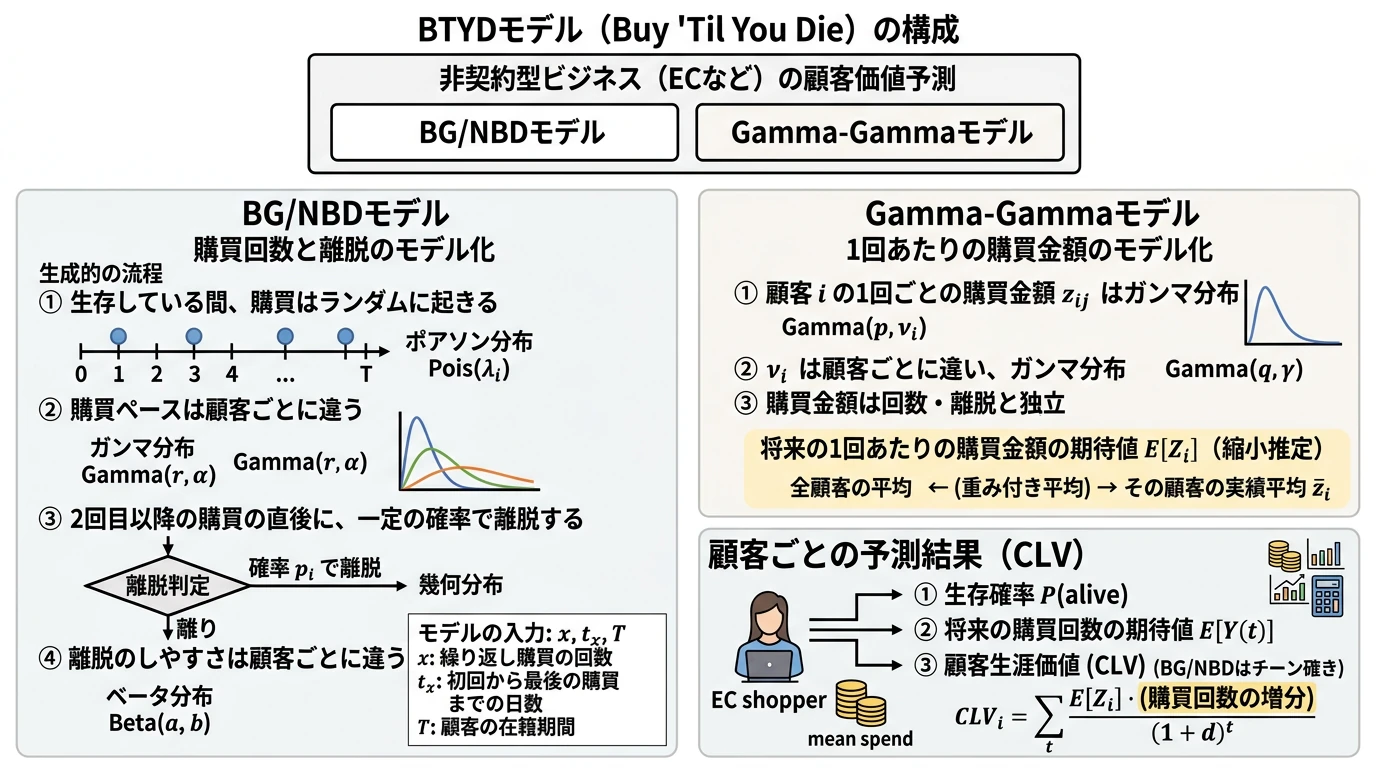
記事を読む離脱が観測できない非契約型ビジネス(EC等)のCLVをBG/NBDとGamma-Gammaモデルで予測。尤度の数式導出からPythonでの最尤推定・スクラッチ実装、PyMC-Marketingまで詳しく解説します。
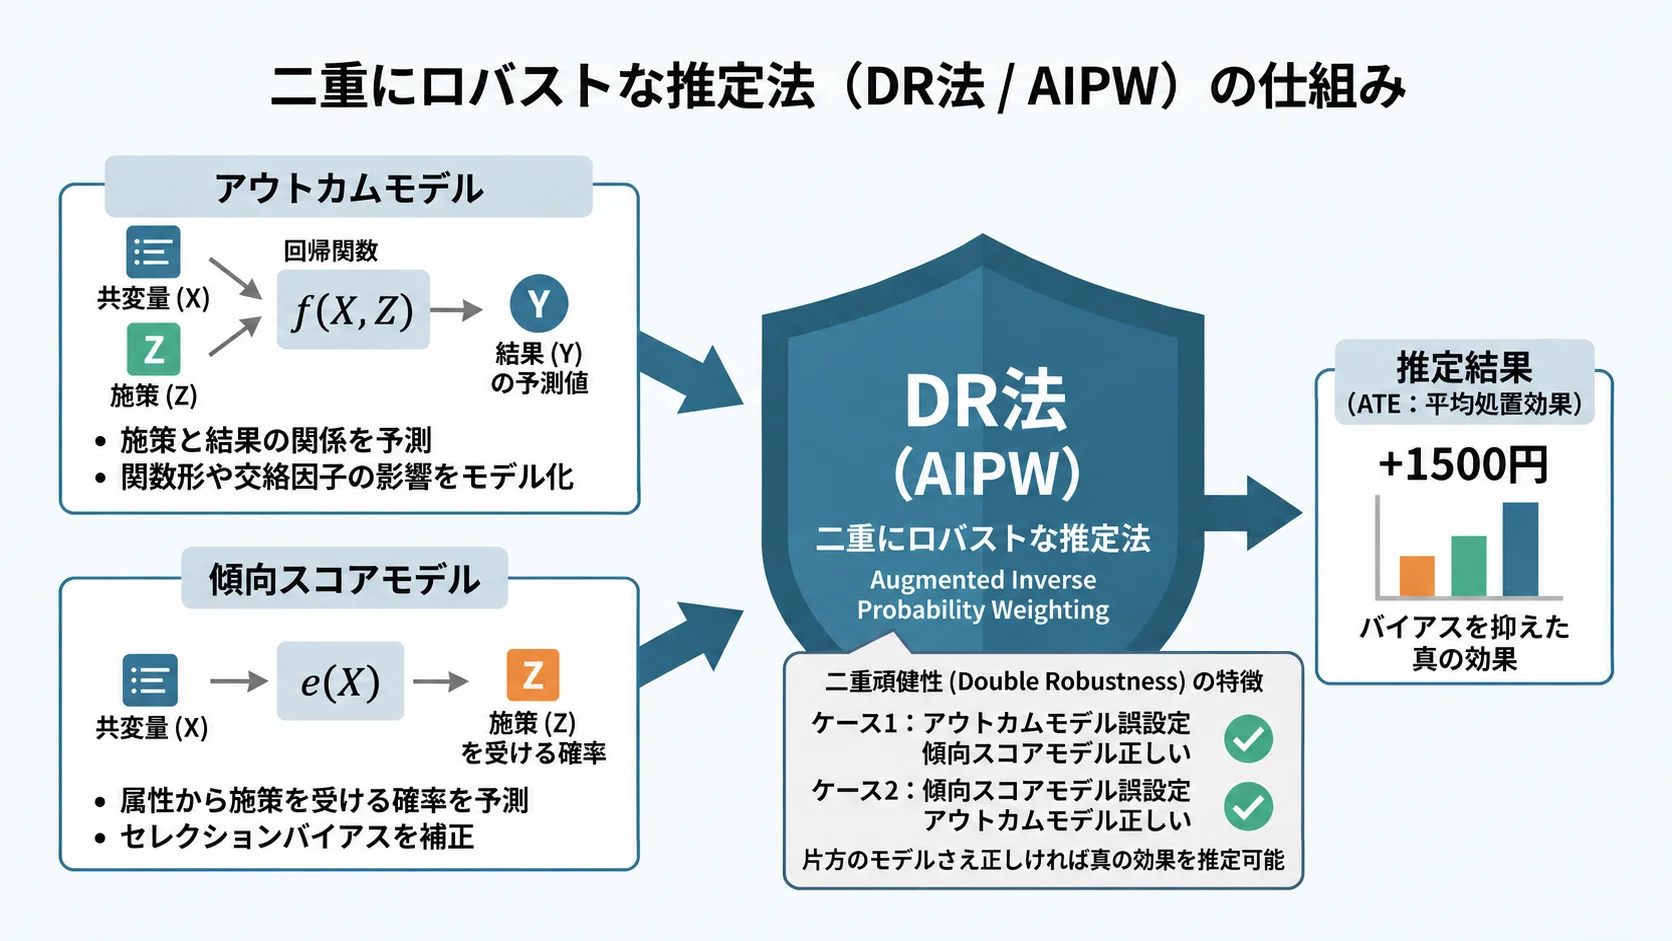
記事を読む傾向スコアモデルとアウトカムモデルの「どちらか一方さえ正しければ一致推定できる」二重頑健性を持つDR法(AIPW)について、残差による補正の数理構造、4通りのシミュレーション検証、影響関数による標準誤差の算出、機械学習を組み合わせたクロスフィッティングまでをPython実装を交えて解説します。
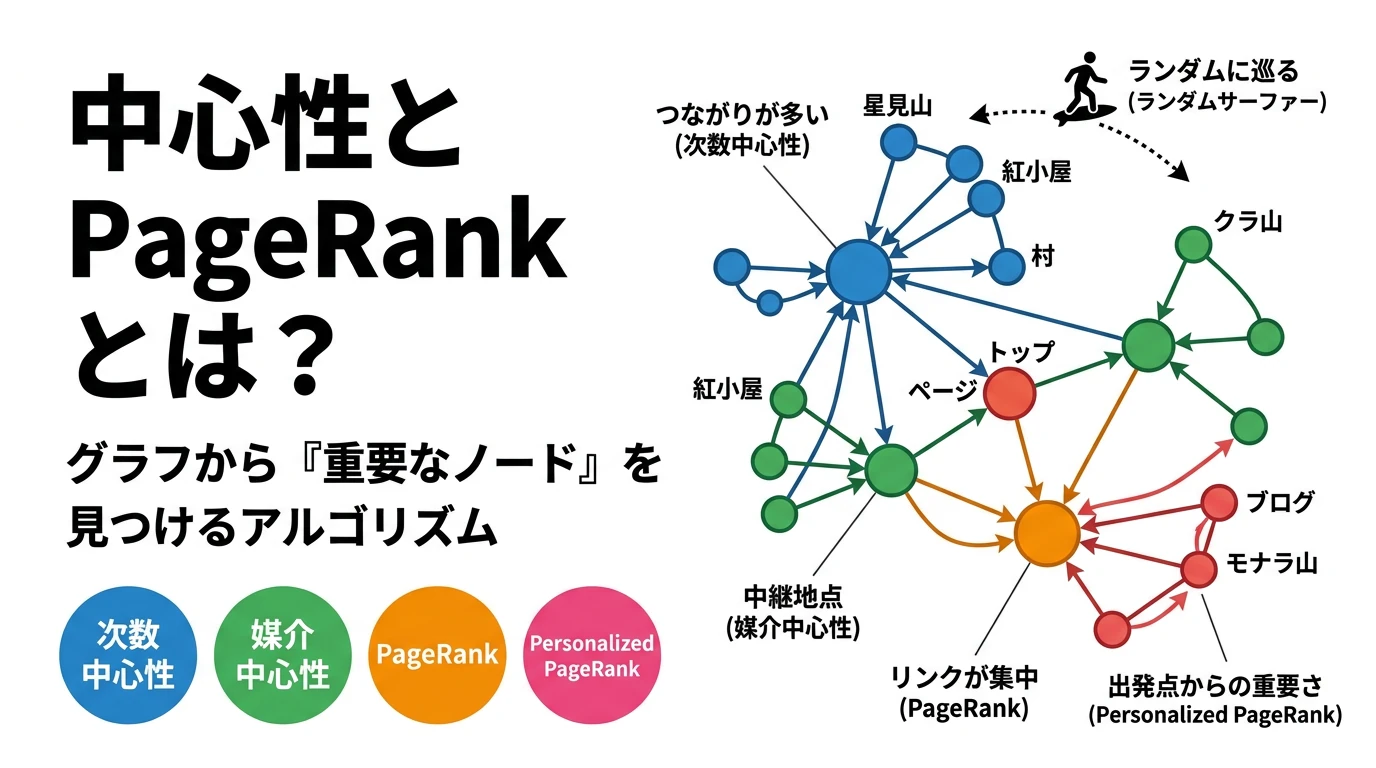
記事を読むグラフの中で「どのノードが重要か」を測る中心性について、次数中心性・媒介中心性・PageRank・Personalized PageRankを、架空の山域の登山道と情報サイトのリンクのデータで比べながら解説します。PageRankをべき乗法でスクラッチ実装し、ランダムサーファーのシミュレーション、テレポートが必要な理由まで確かめます。
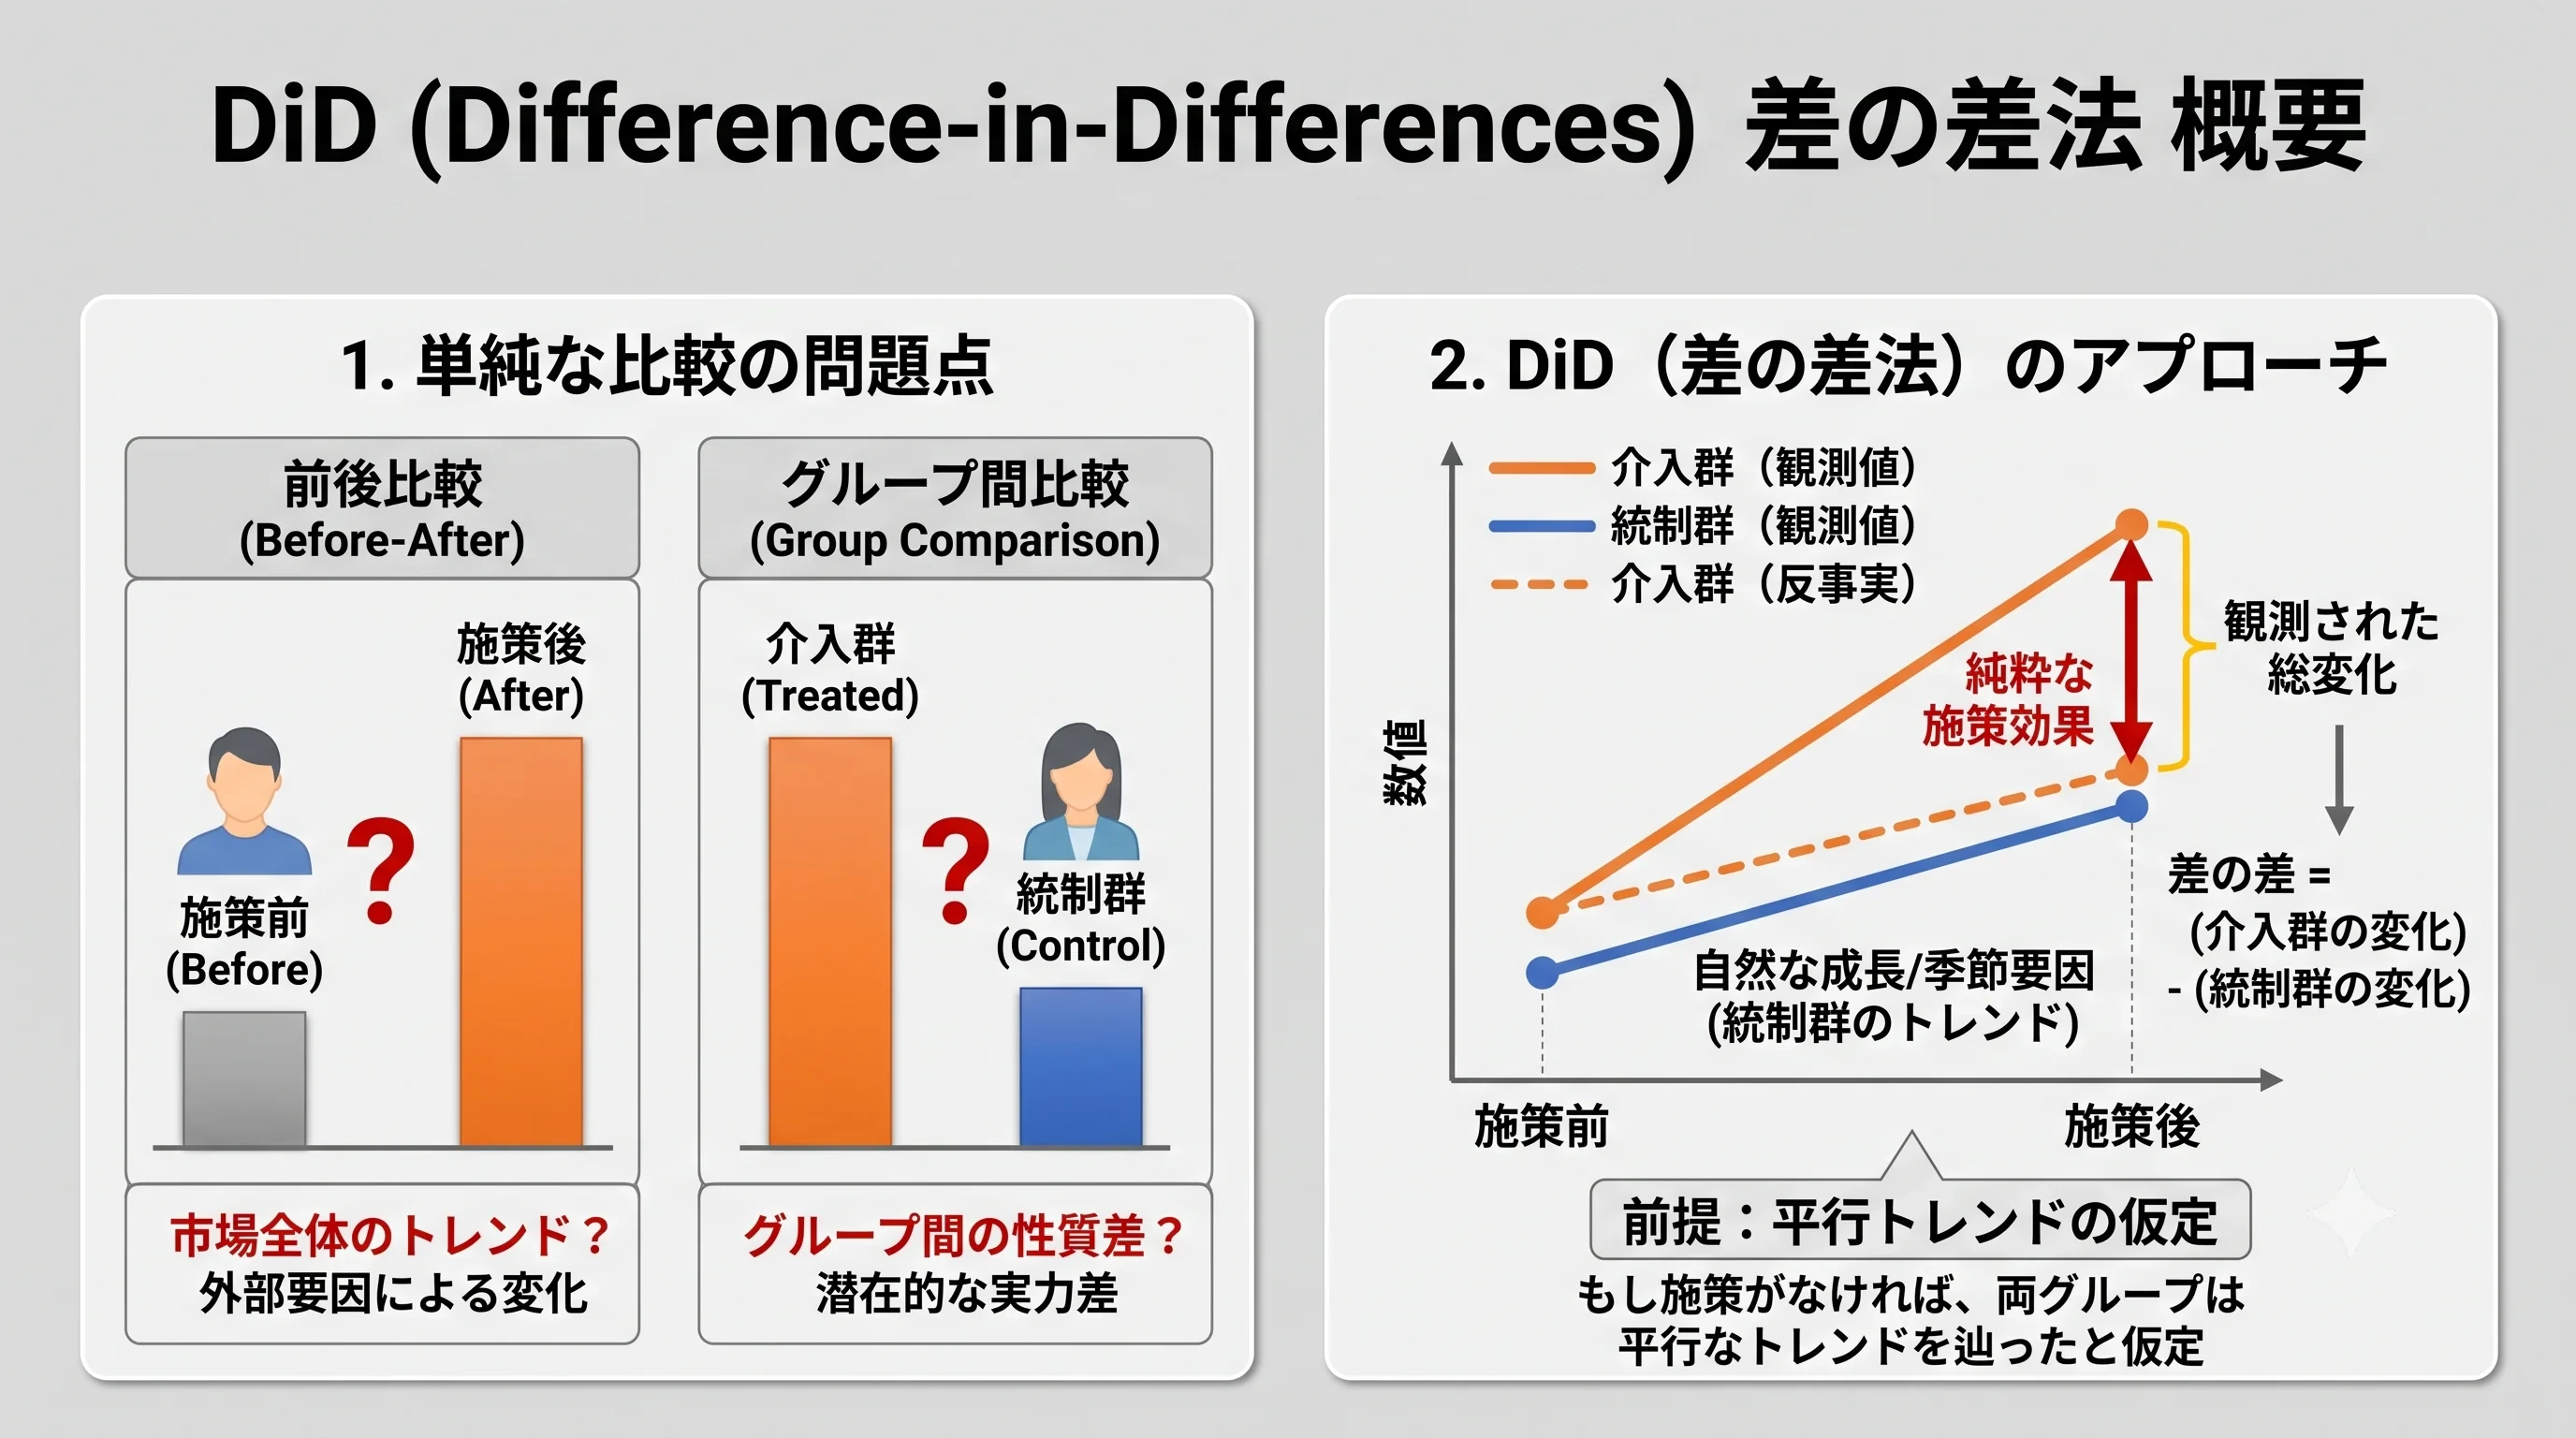
記事を読む介入群と統制群の施策前後の変化量を引き算する「差の差法(DiD)」の仕組みを、最重要前提である「平行トレンドの仮定」、回帰モデルを用いた効果推定、Python(statsmodels)による最小二乗法(OLS)の実装、およびCausalImpactとの使い分けまでを交えて解説します。
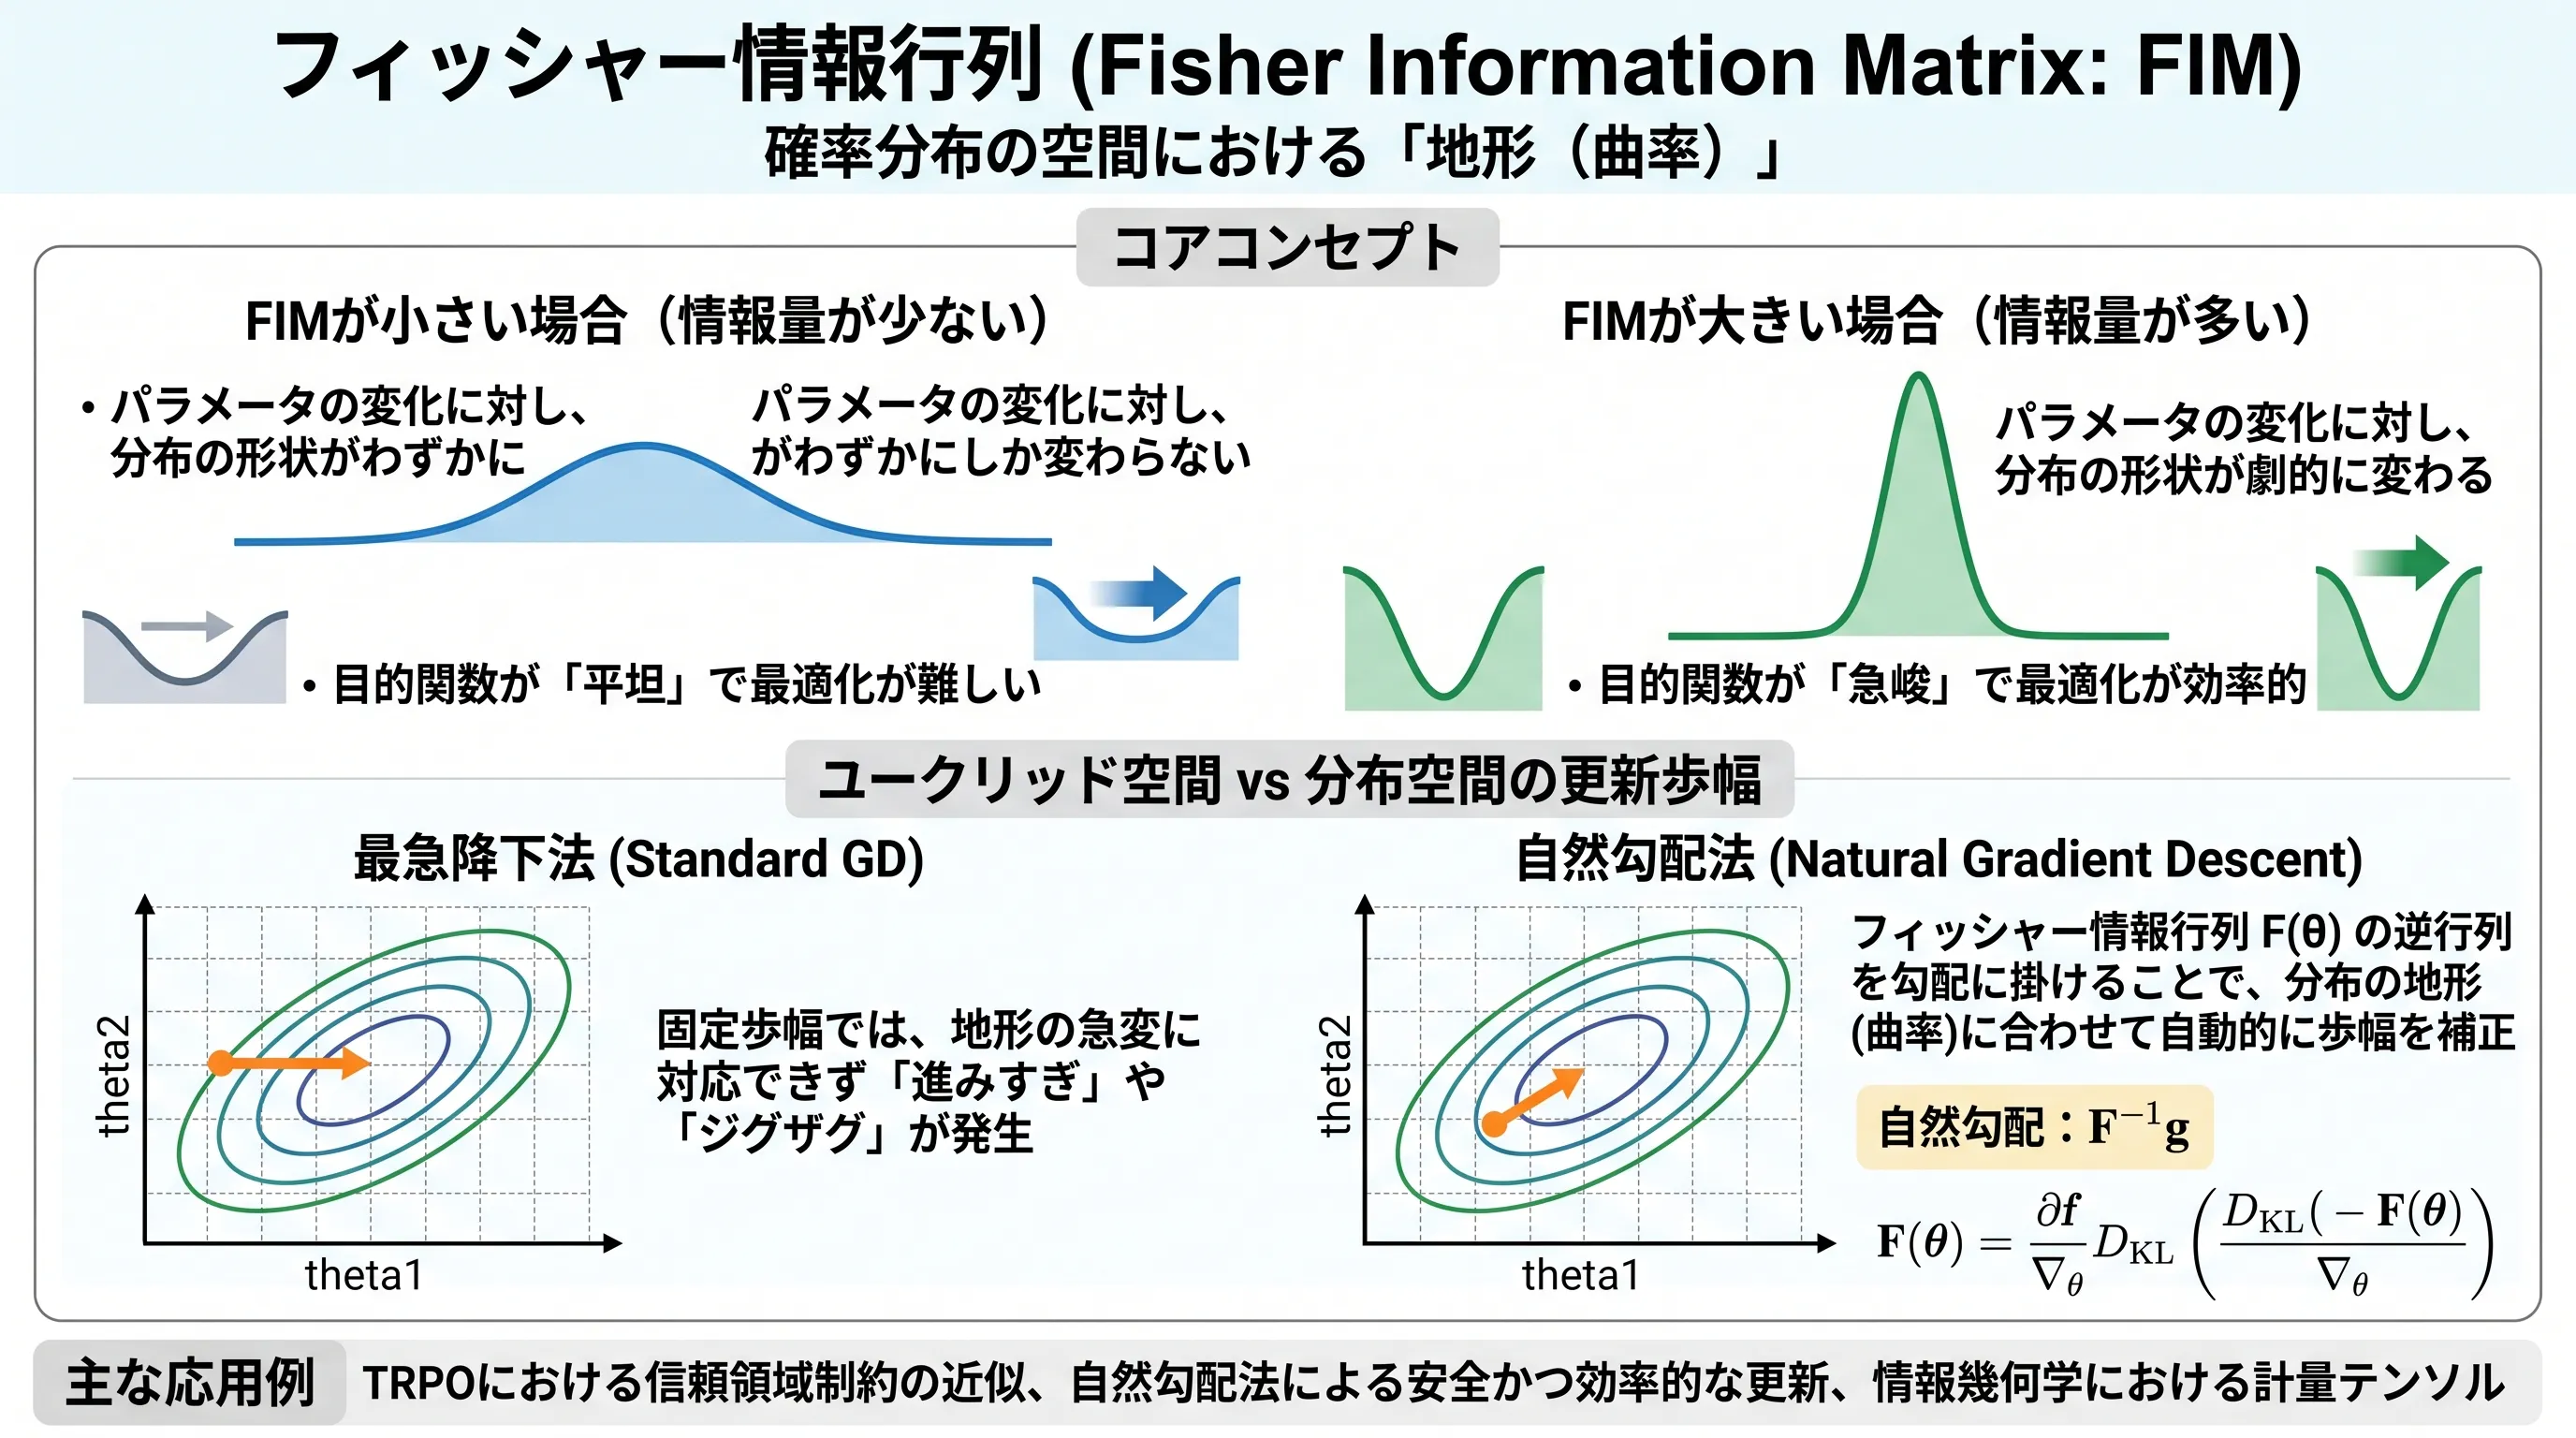
記事を読む機械学習や強化学習の最適化において、確率分布空間の「地形の曲率」を表すフィッシャー情報行列と自然勾配法(Natural Gradient Descent)の仕組みを、KLダイバージェンスとの関係性やPythonでの可視化を交えて解説します。
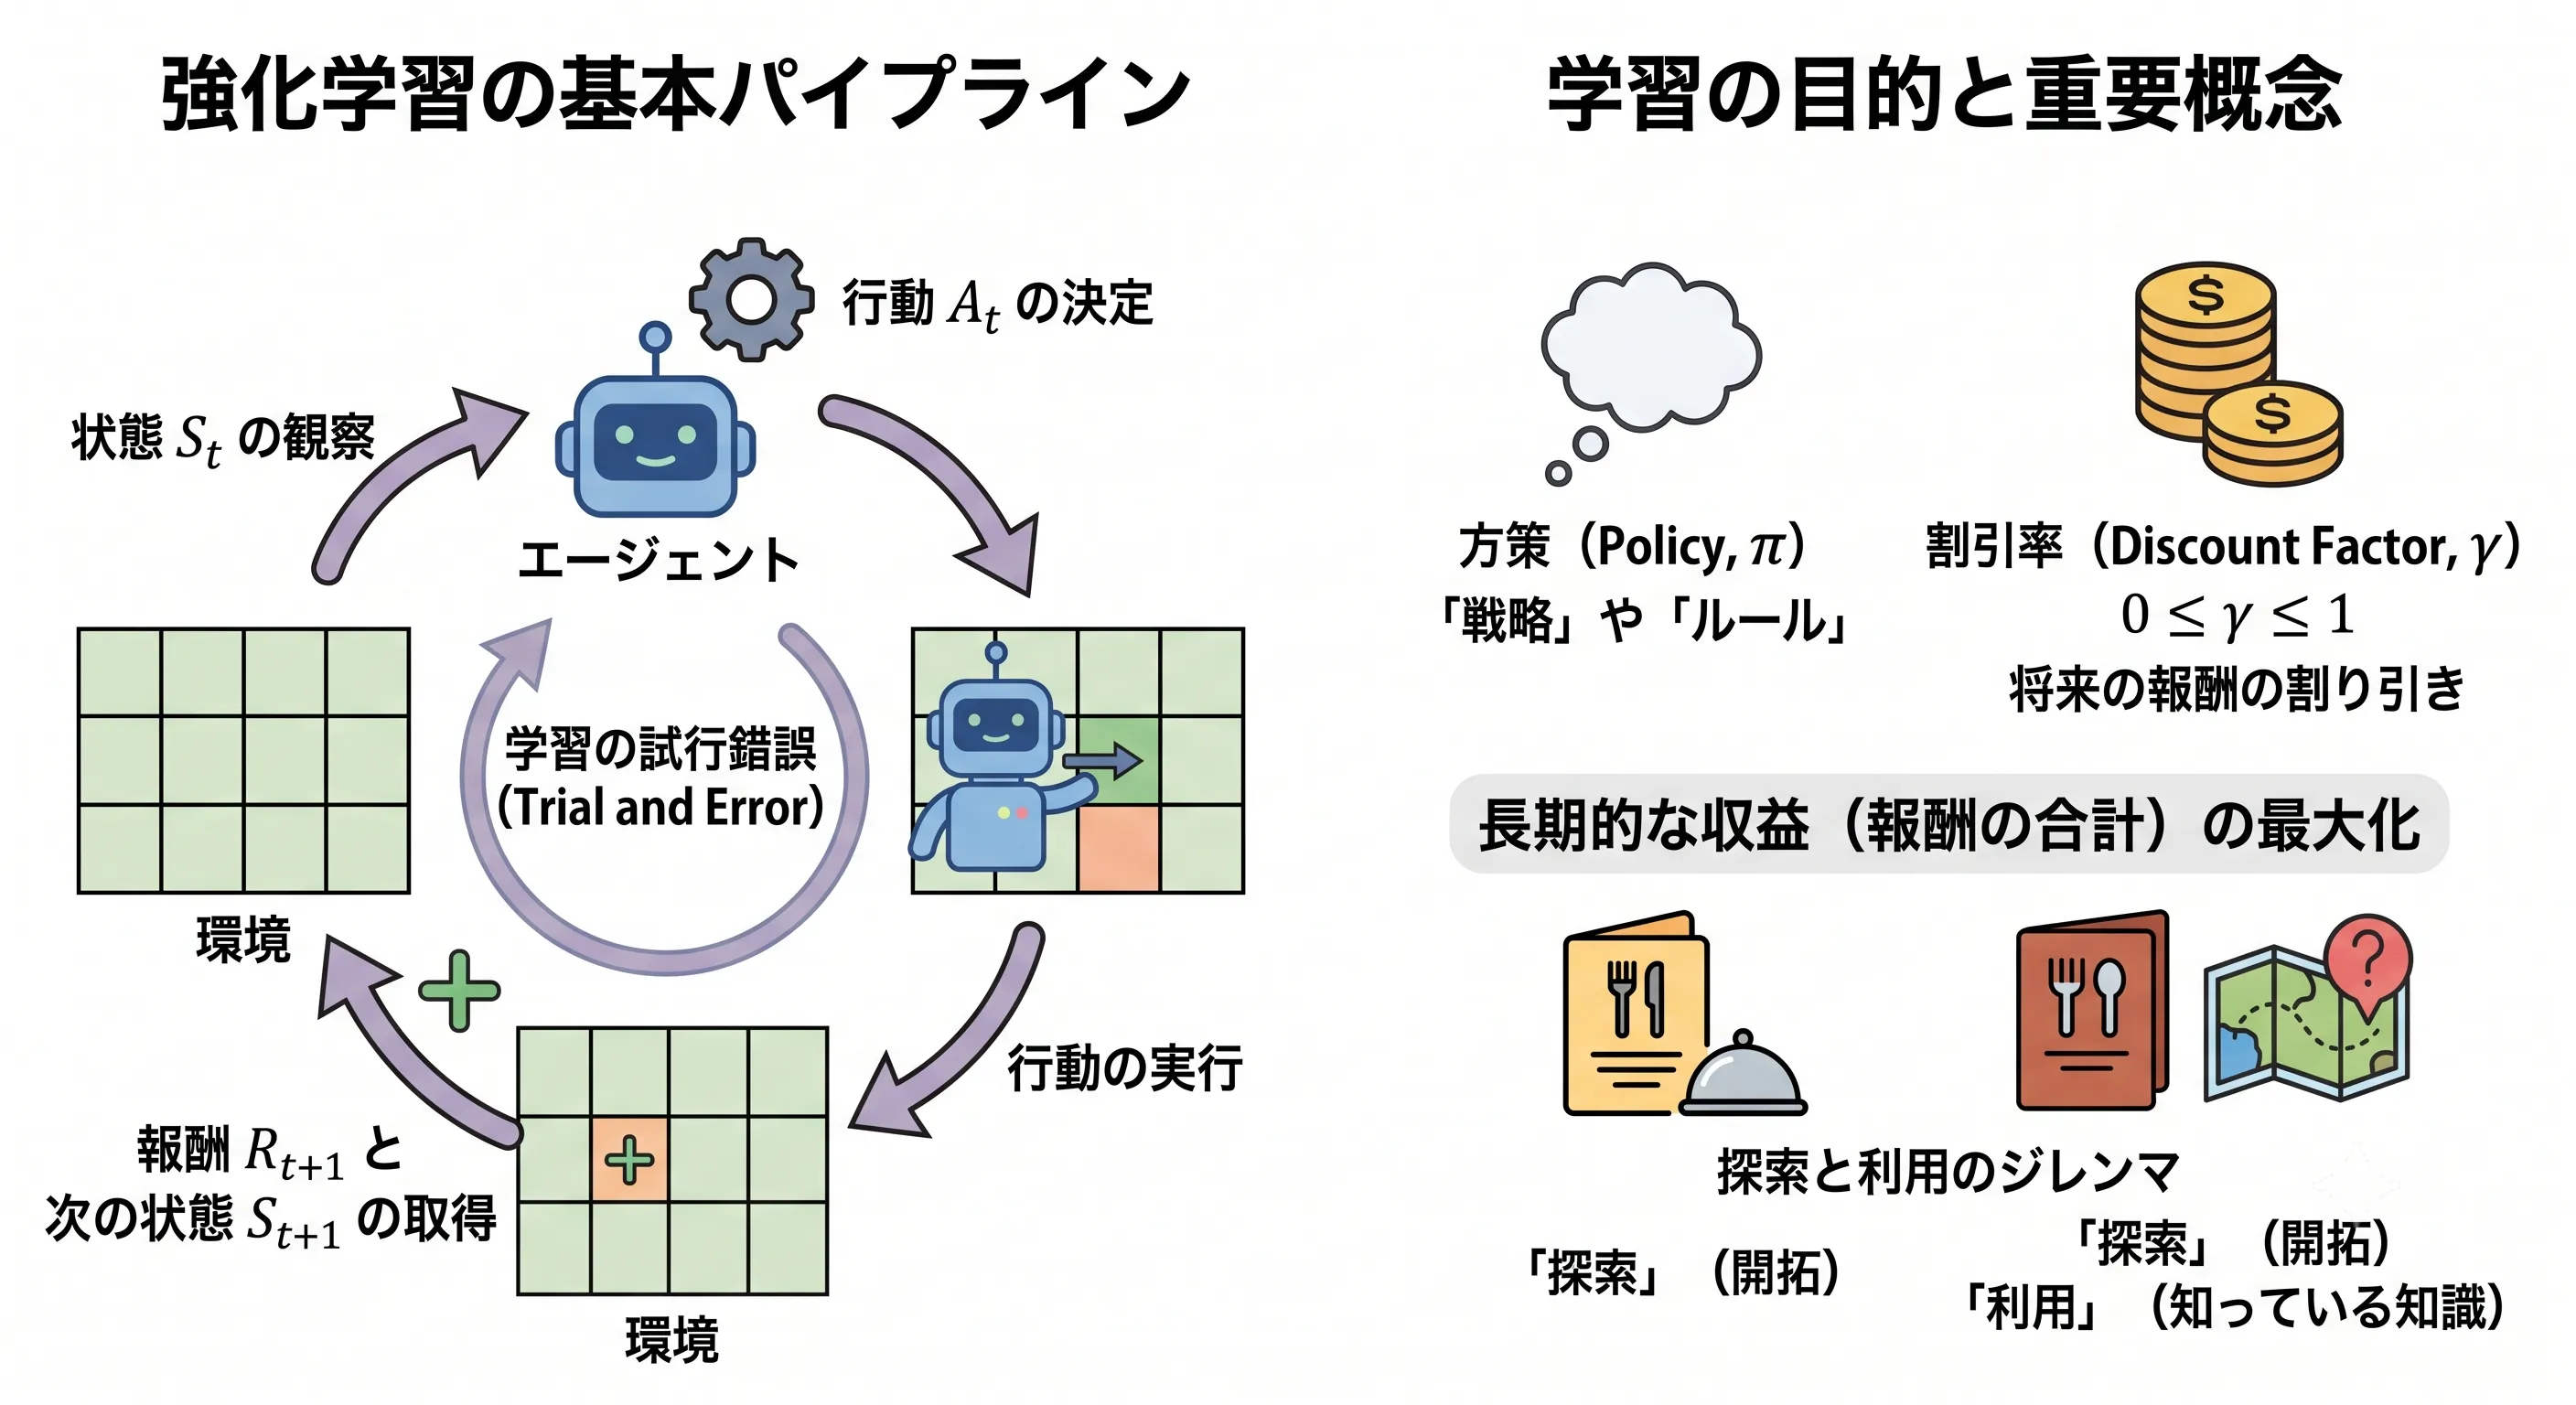
記事を読む機械学習の主要なアプローチの一つである強化学習のコアコンセプトから、状態・行動・報酬からなる基本パイプライン、割引率、探索と利用のジレンマ、そしてPythonを用いたシミュレーション環境の動かし方までをゼロから解説します。
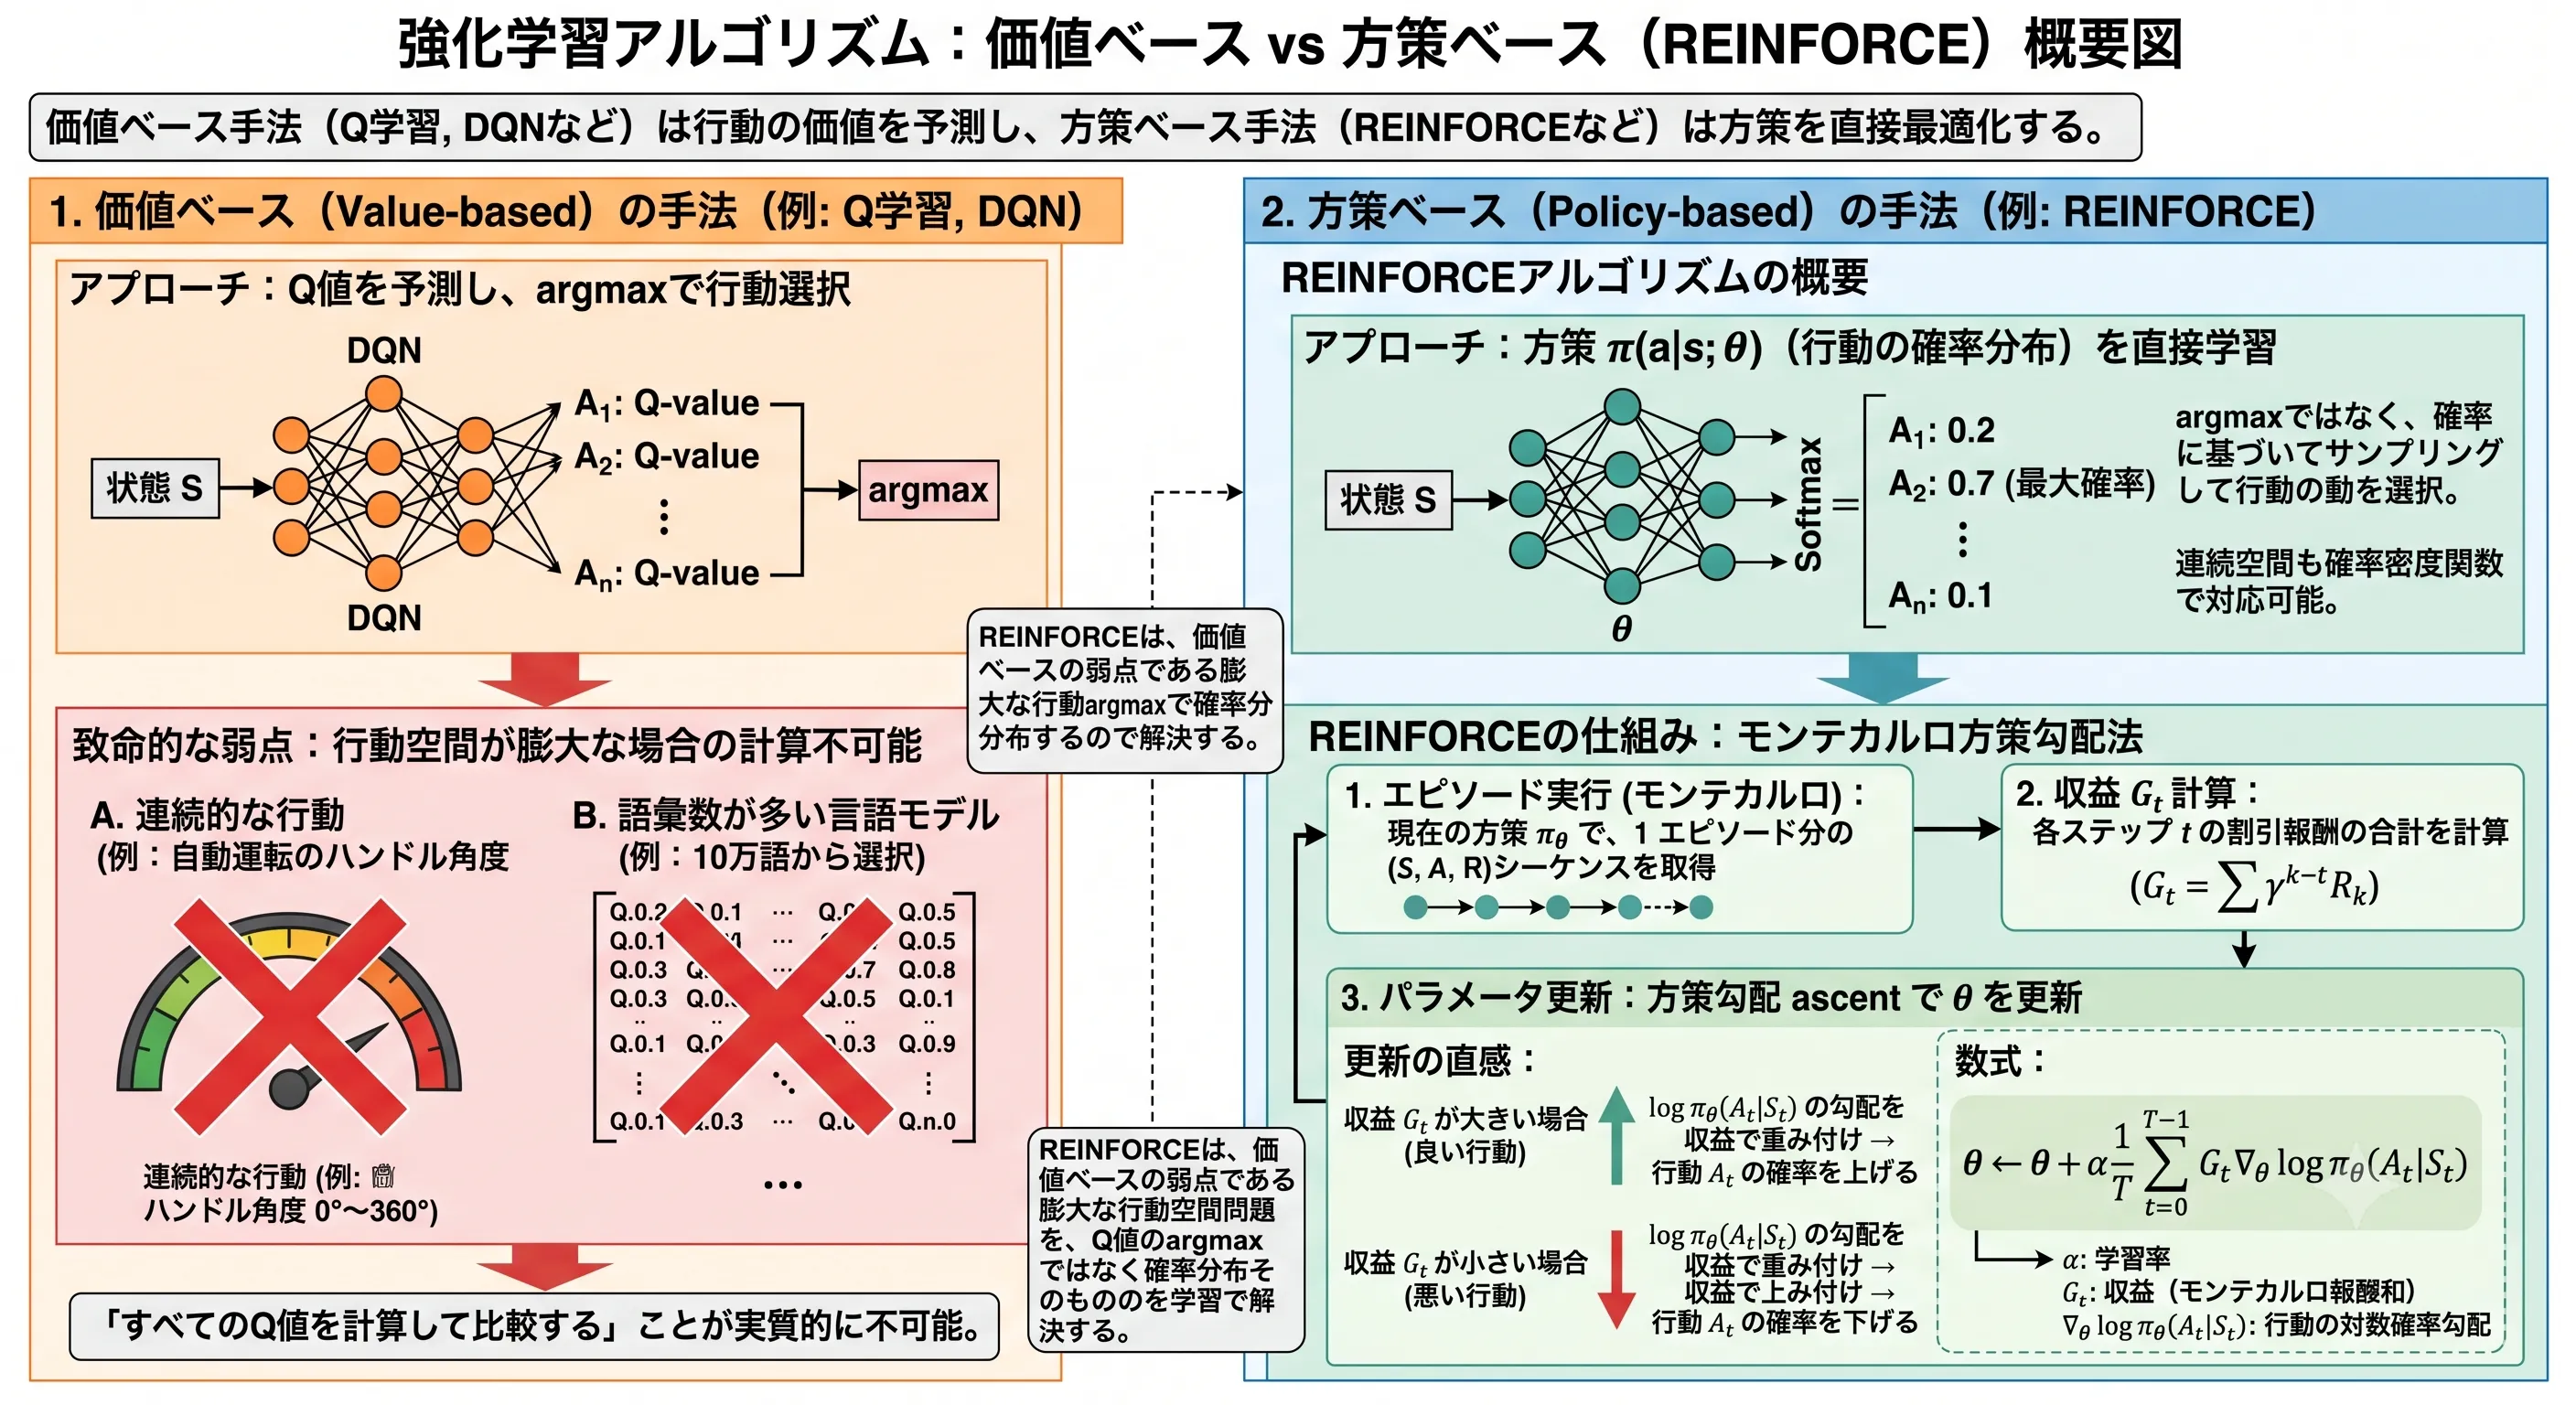
記事を読む価値ベースの限界を突破し、ニューラルネットワークを用いて方策(行動確率)を直接最適化する方策勾配法(Policy Gradient)の原点、REINFORCEアルゴリズムの数理的背景と実装を解説します。
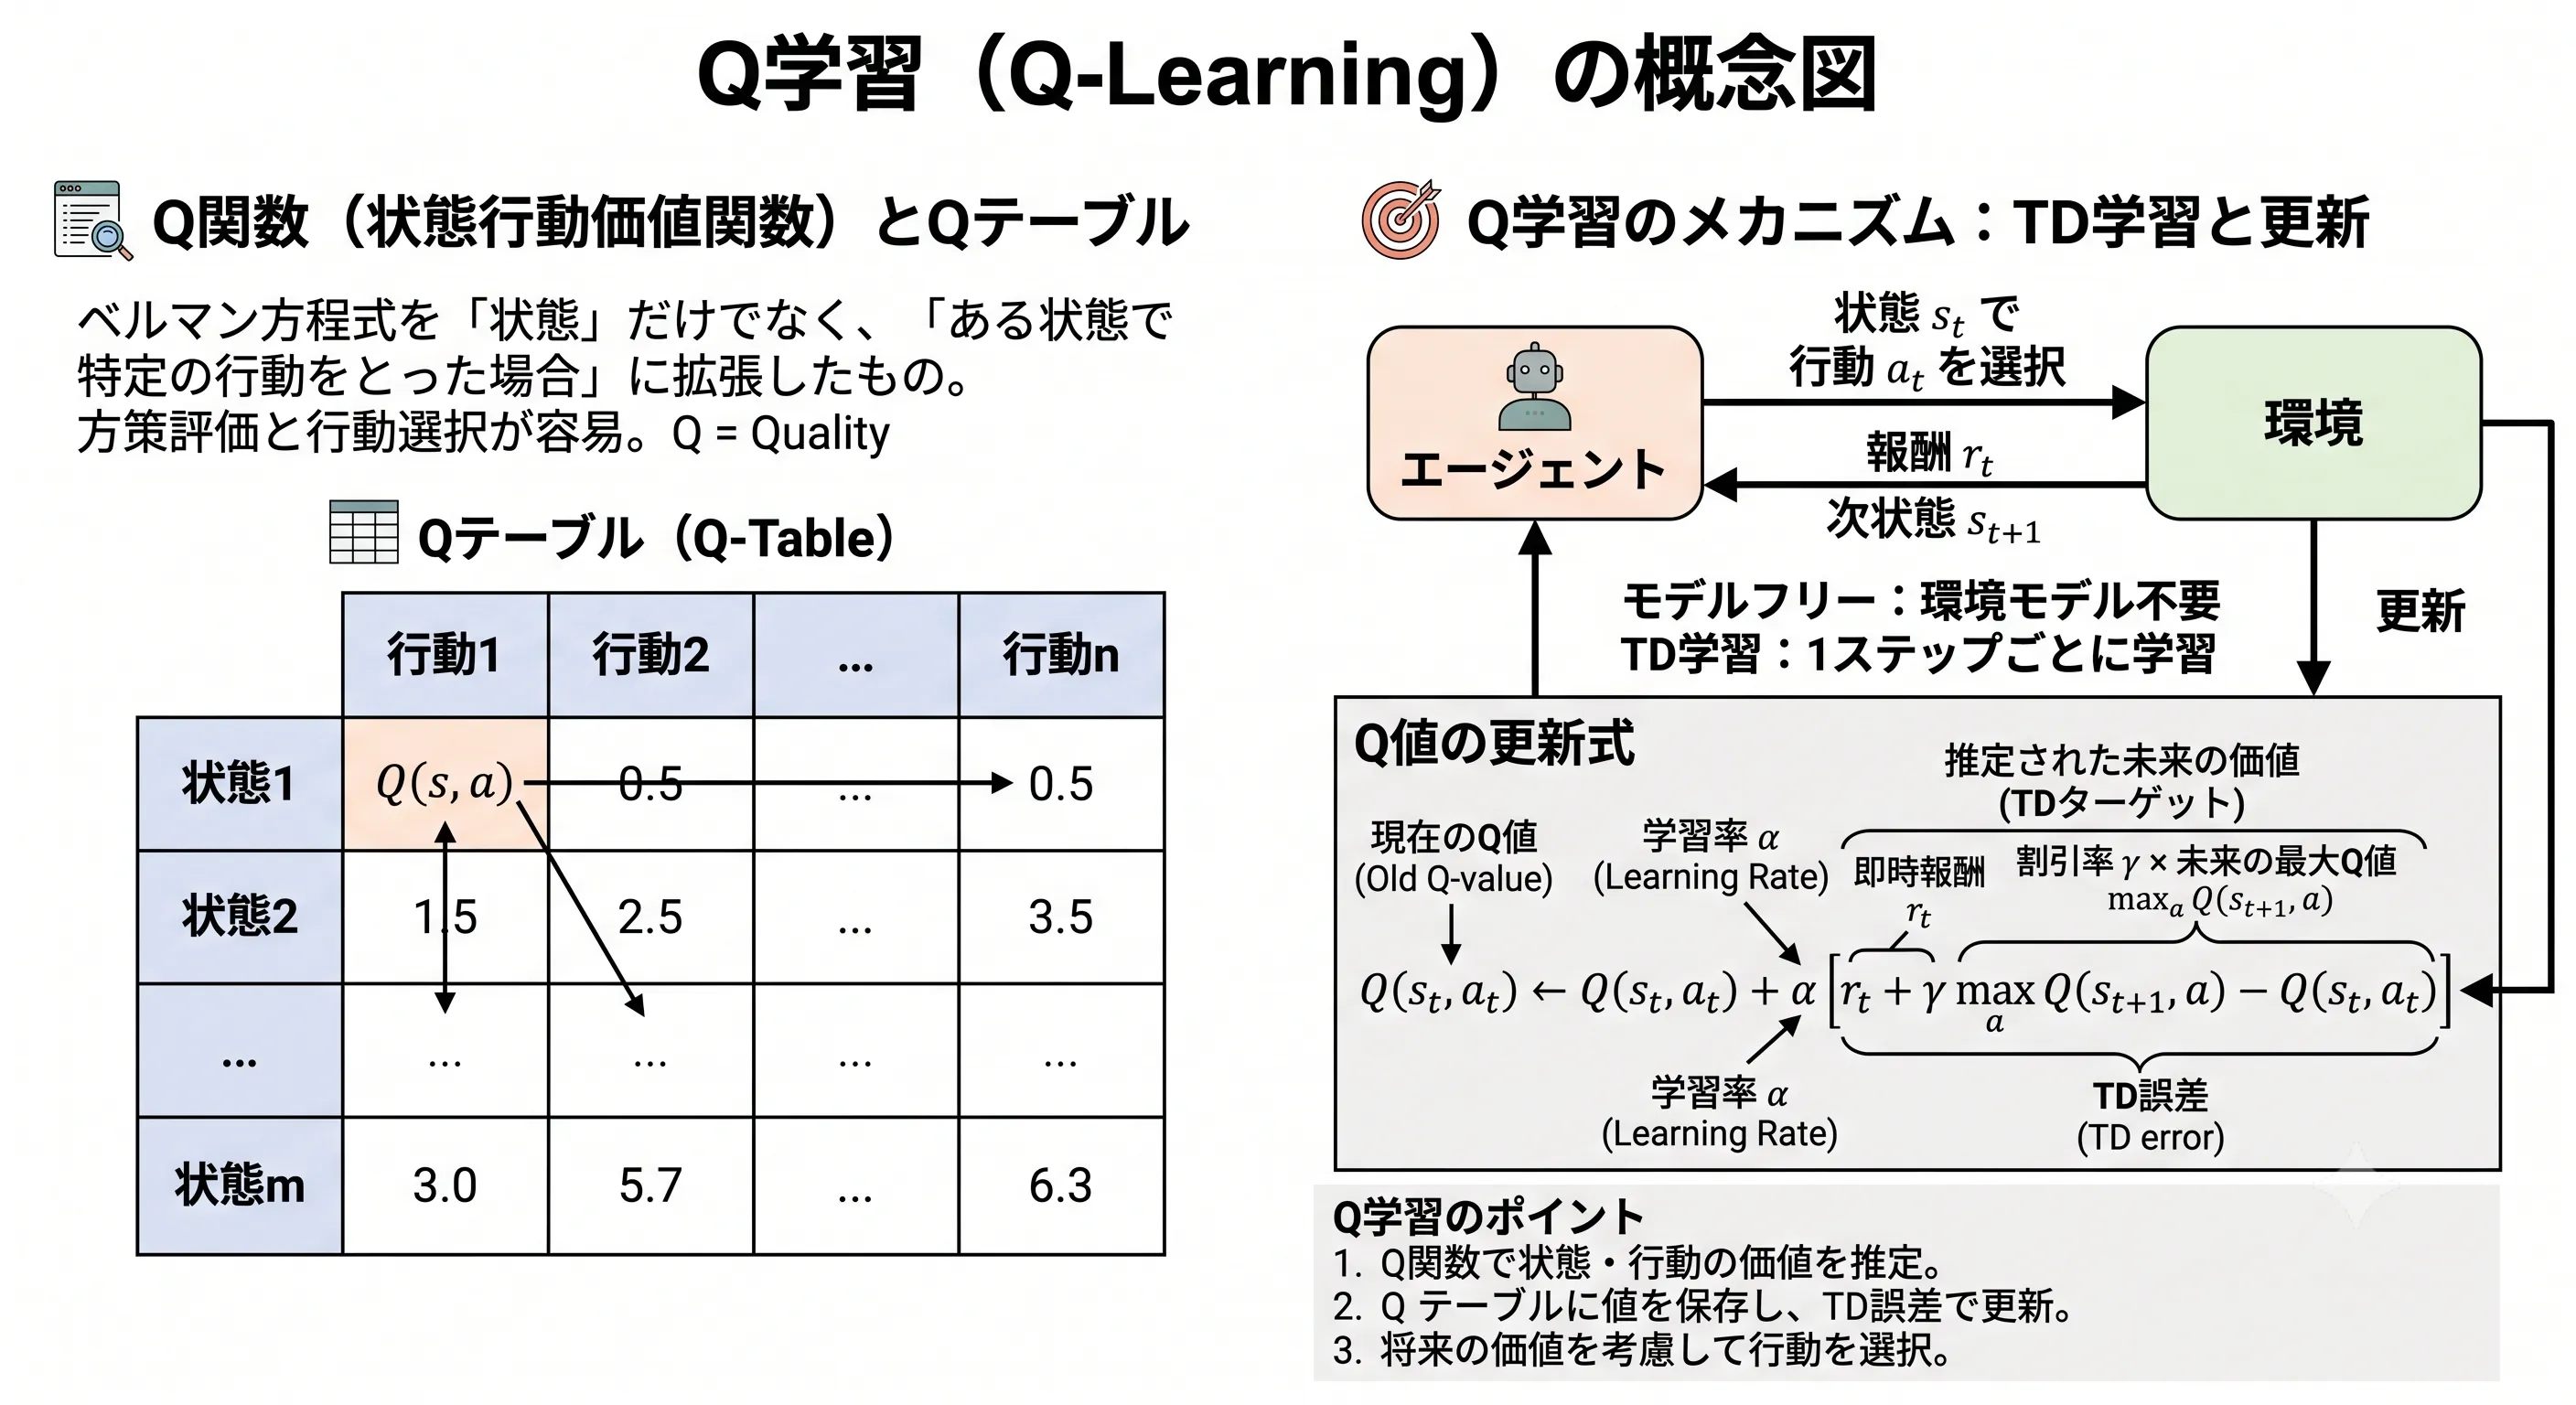
記事を読む強化学習の代表的な価値ベース(Value-based)アルゴリズムであるQ学習の仕組み、ベルマン方程式からQ値の更新則、そして行動価値を最大化するプロセスまでを解説します。
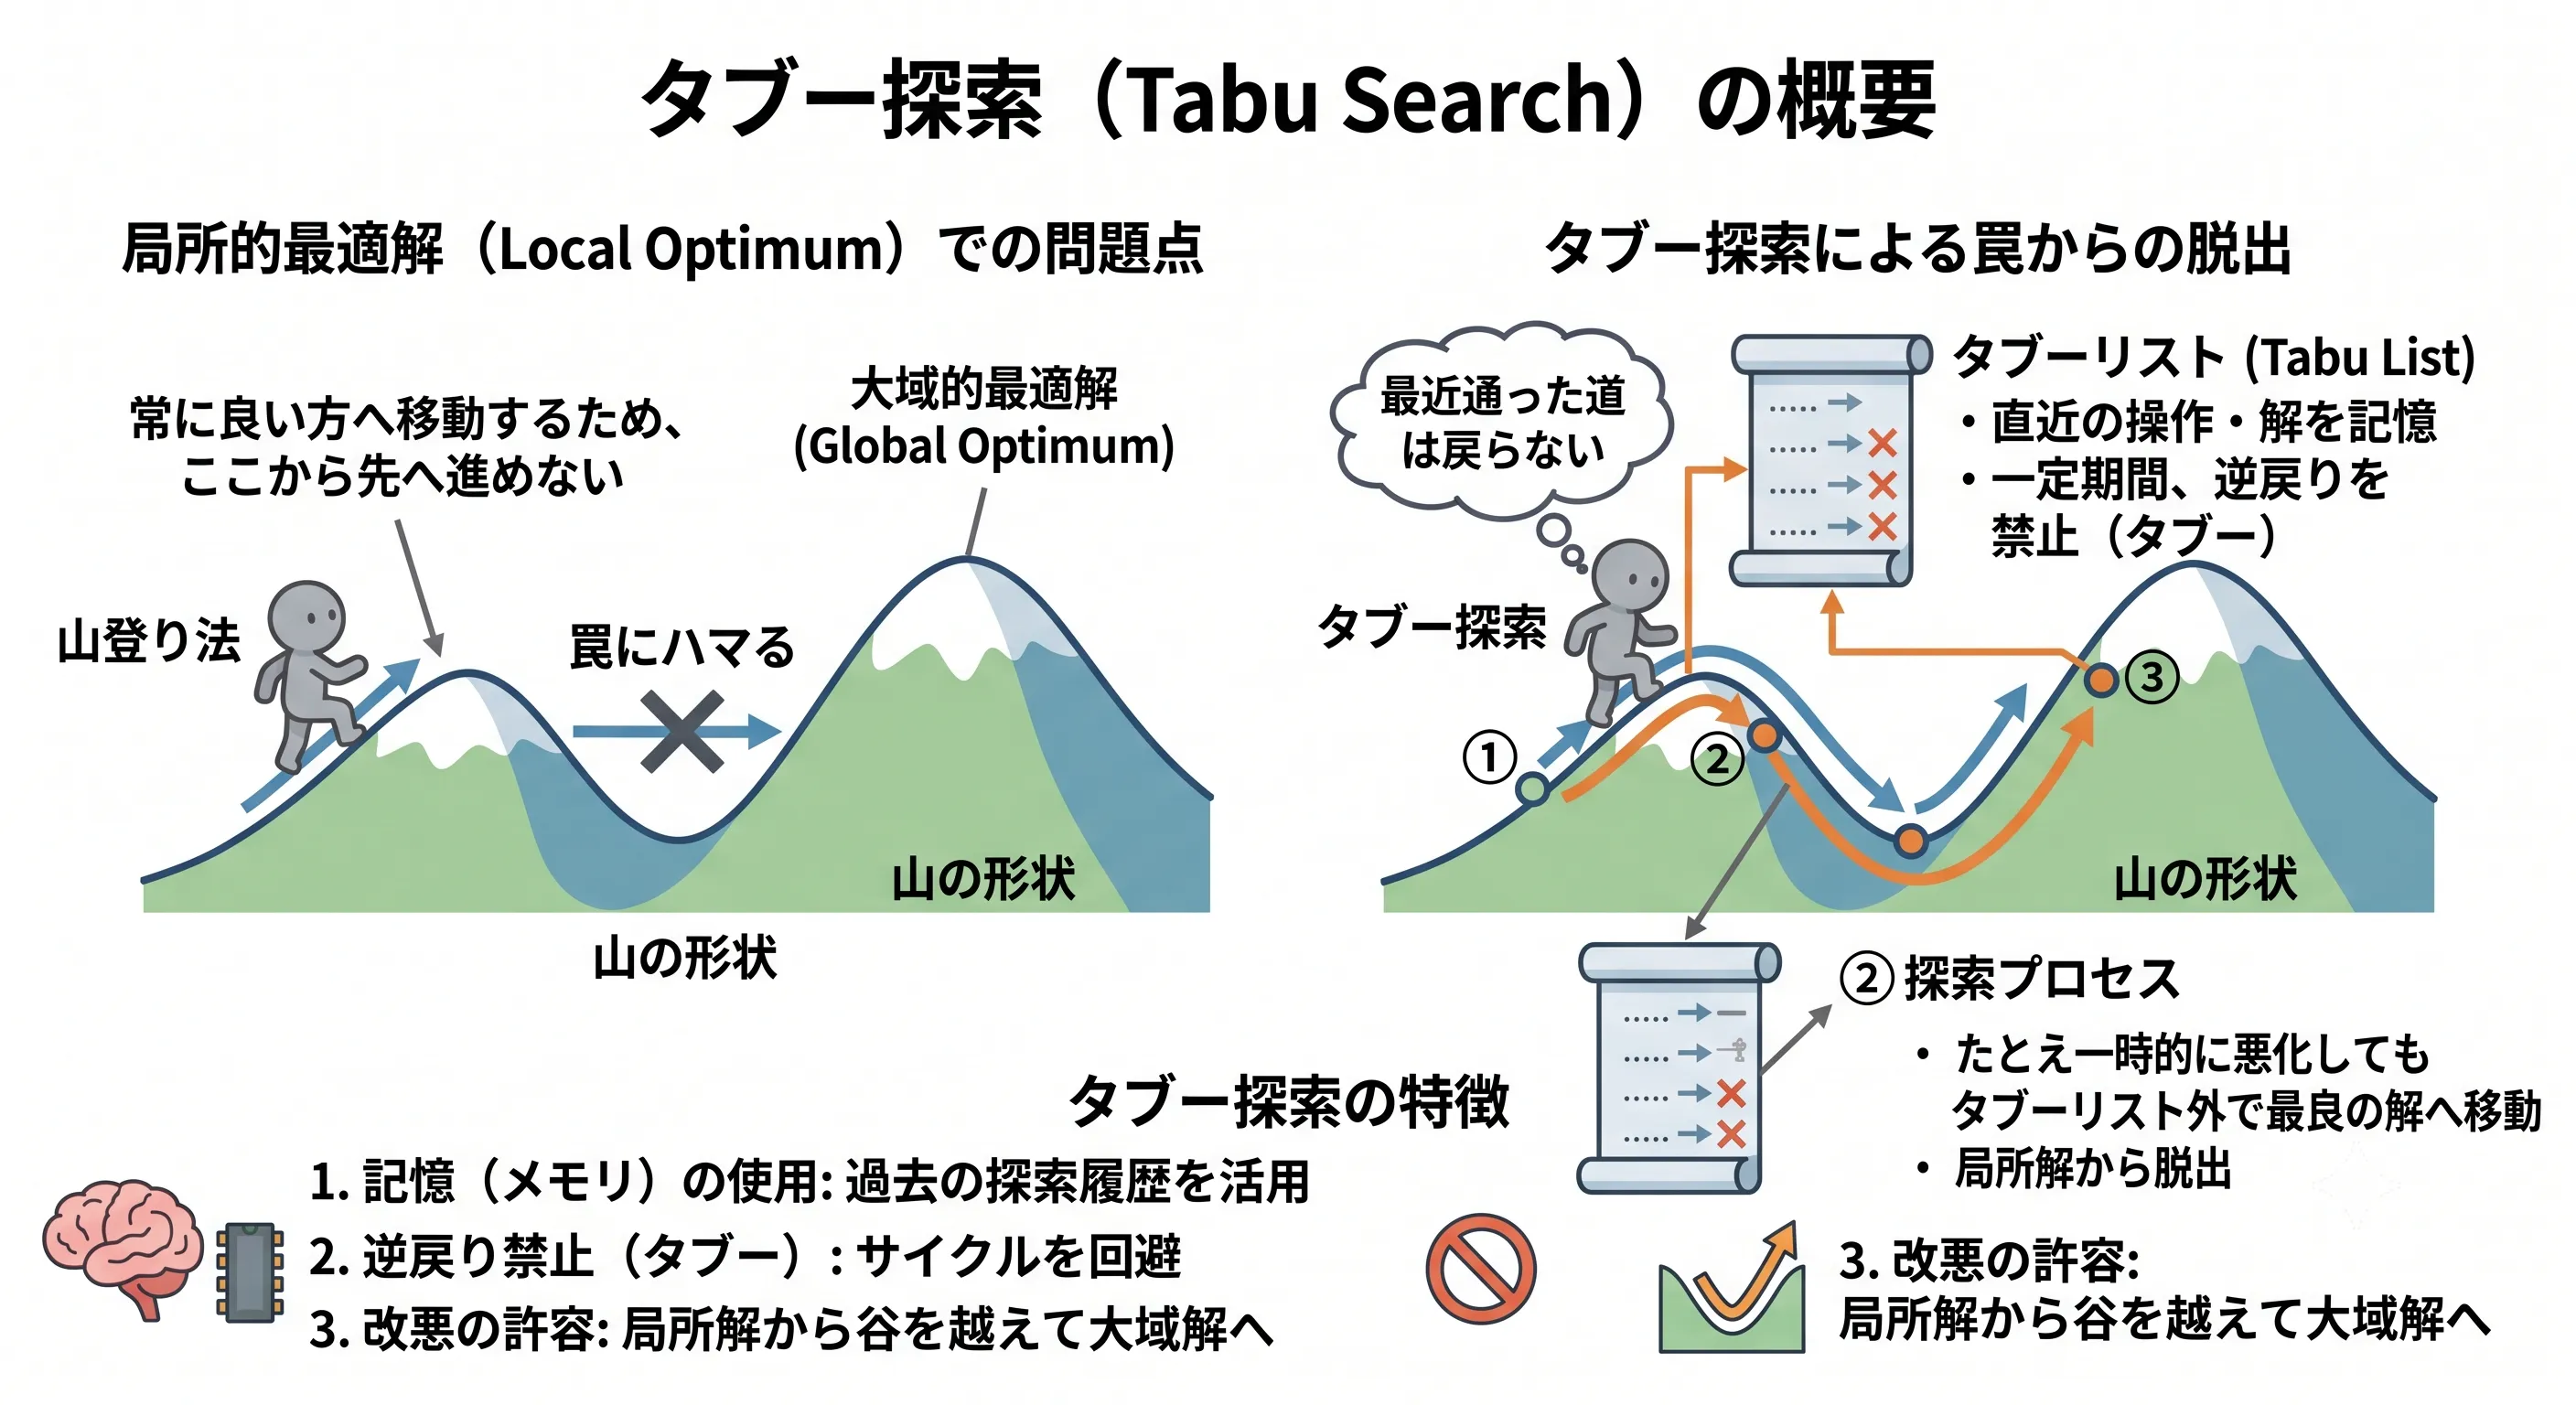
記事を読む「記憶」の仕組みであるタブーリストを用いて局所解の罠を回避するメタヒューリスティクス「タブー探索」について、山登り法や焼きなまし法との違い、Pythonでの実装と探索軌跡の可視化を交えて解説します。
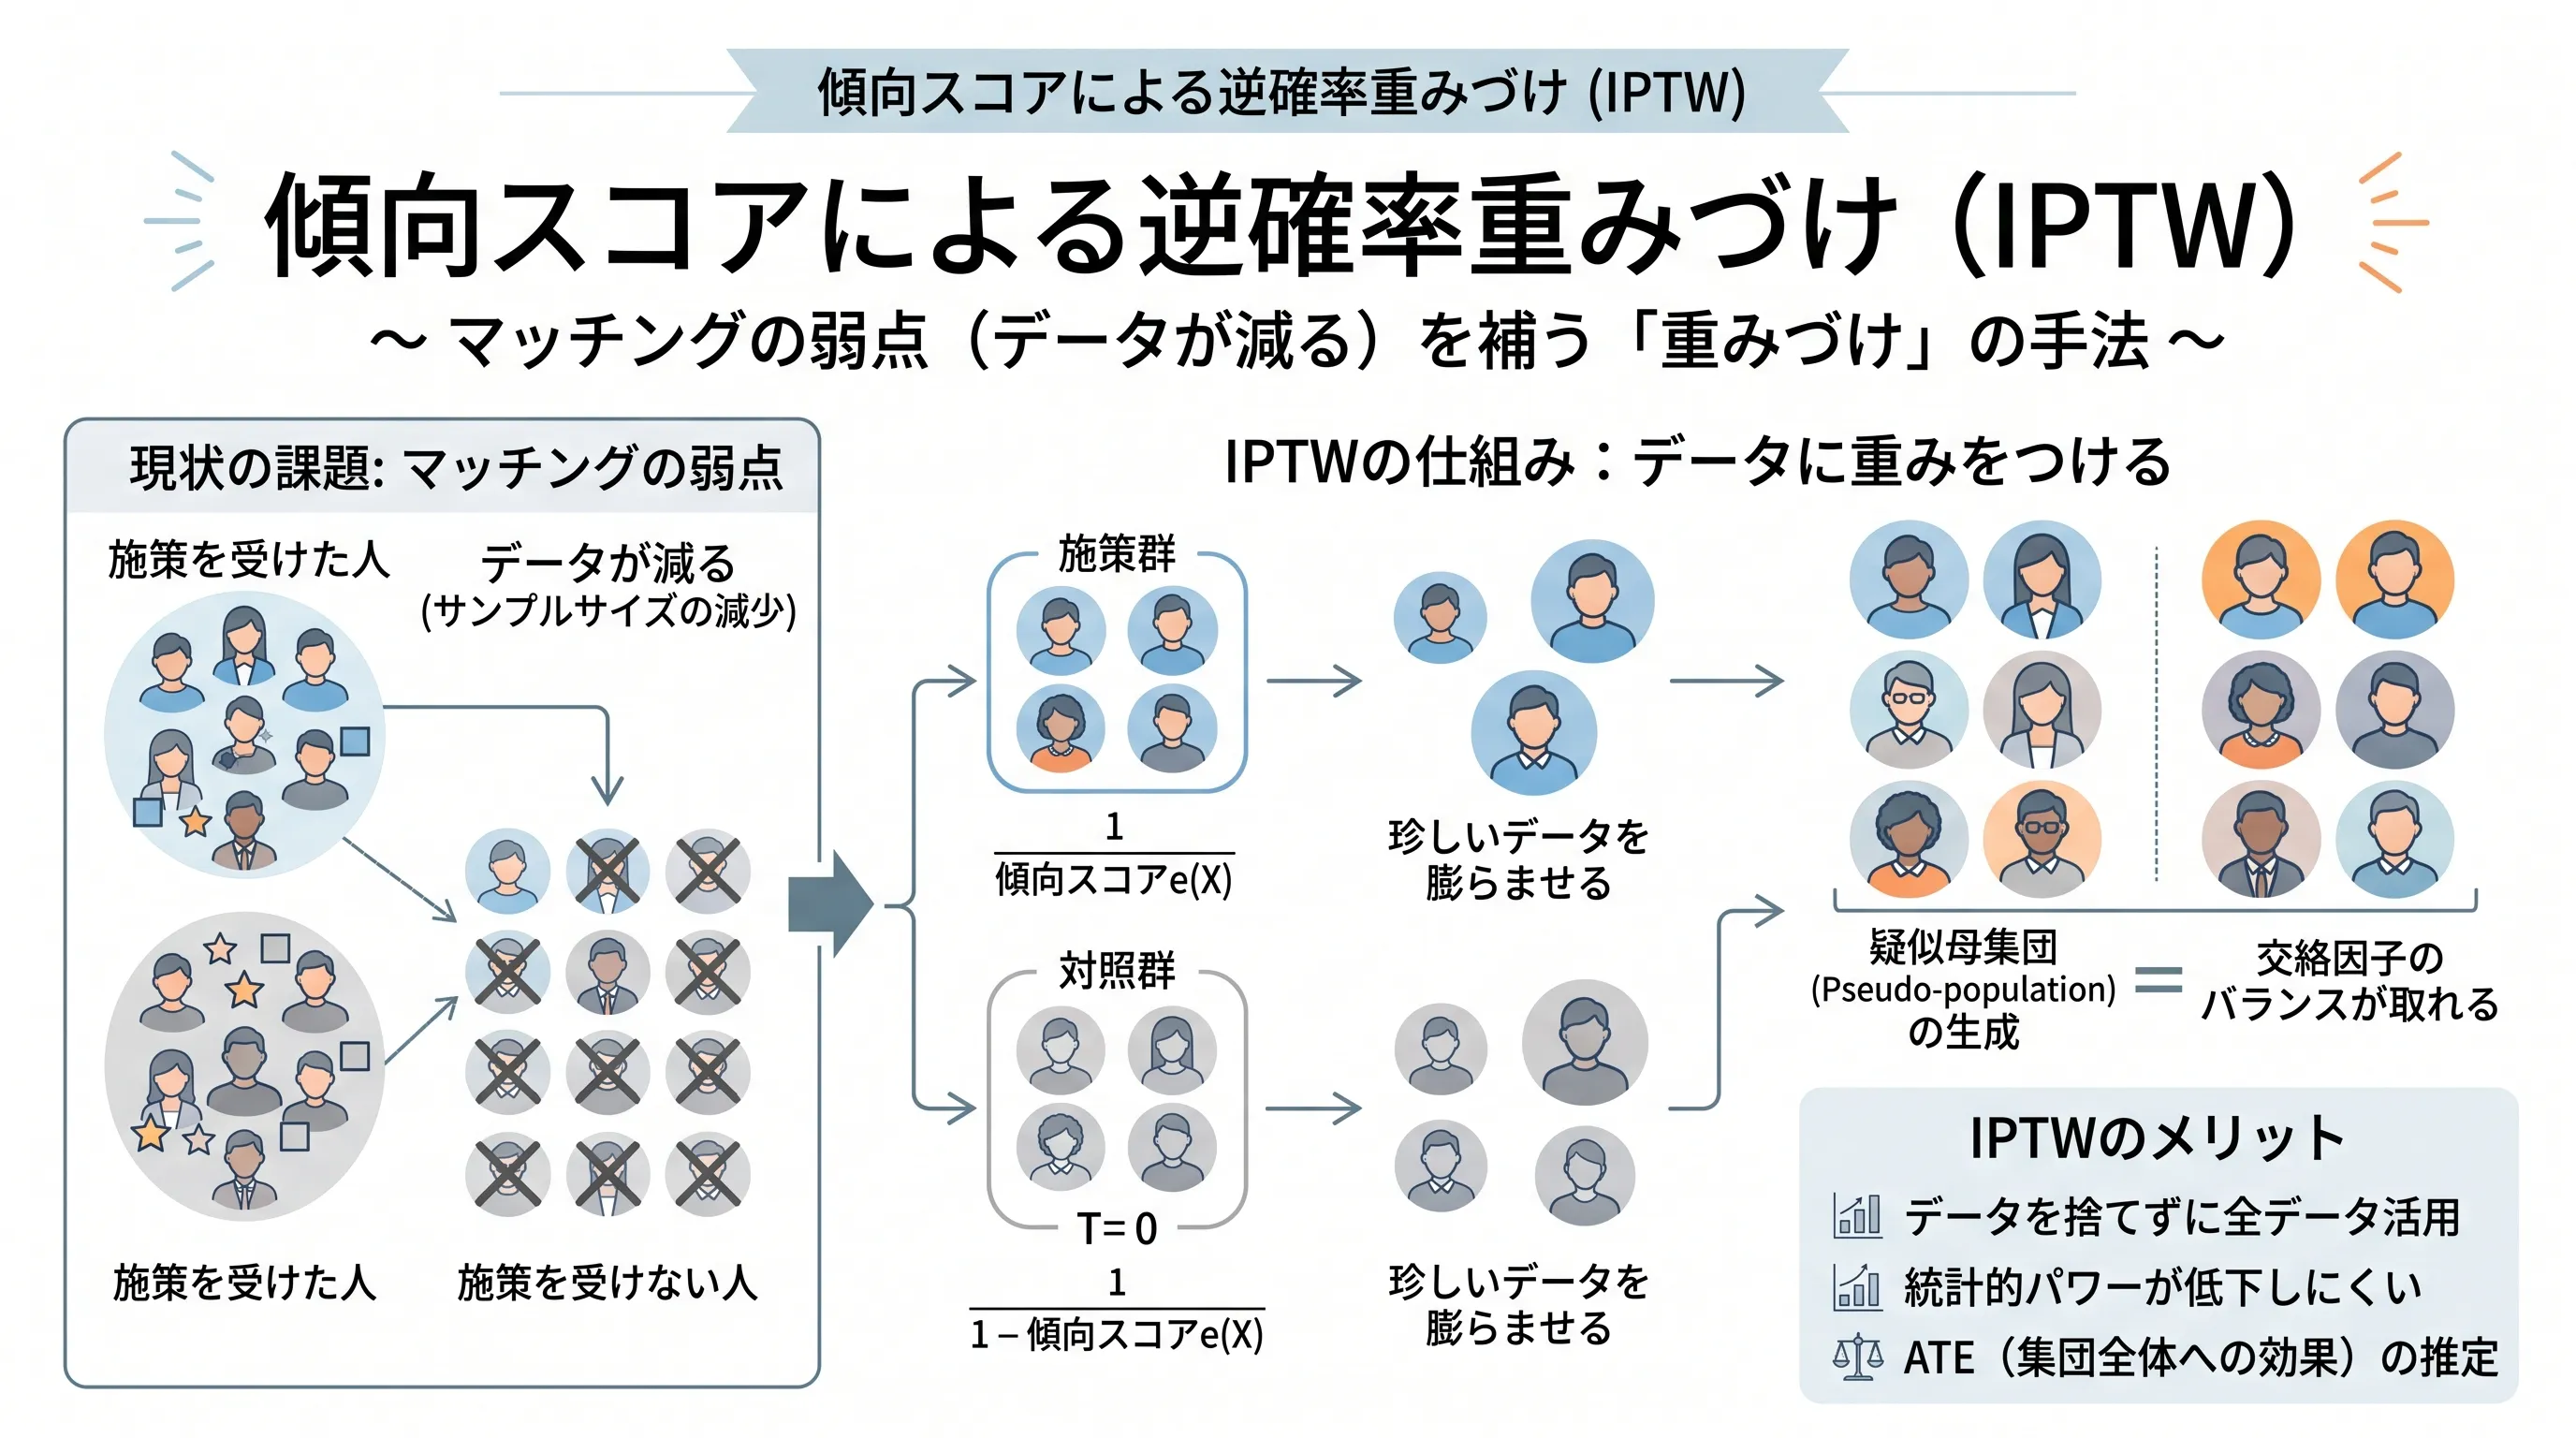
記事を読むデータを捨てることなく観察データから集団全体への平均処置効果(ATE)を推定する「逆確率重みづけ(IPTW)」の仕組みを解説。PSMとの比較、有効サンプルサイズ(ESS)、ブートストラップ法による標準誤差の算出、Pythonでのスクラッチ実装までを網羅します。
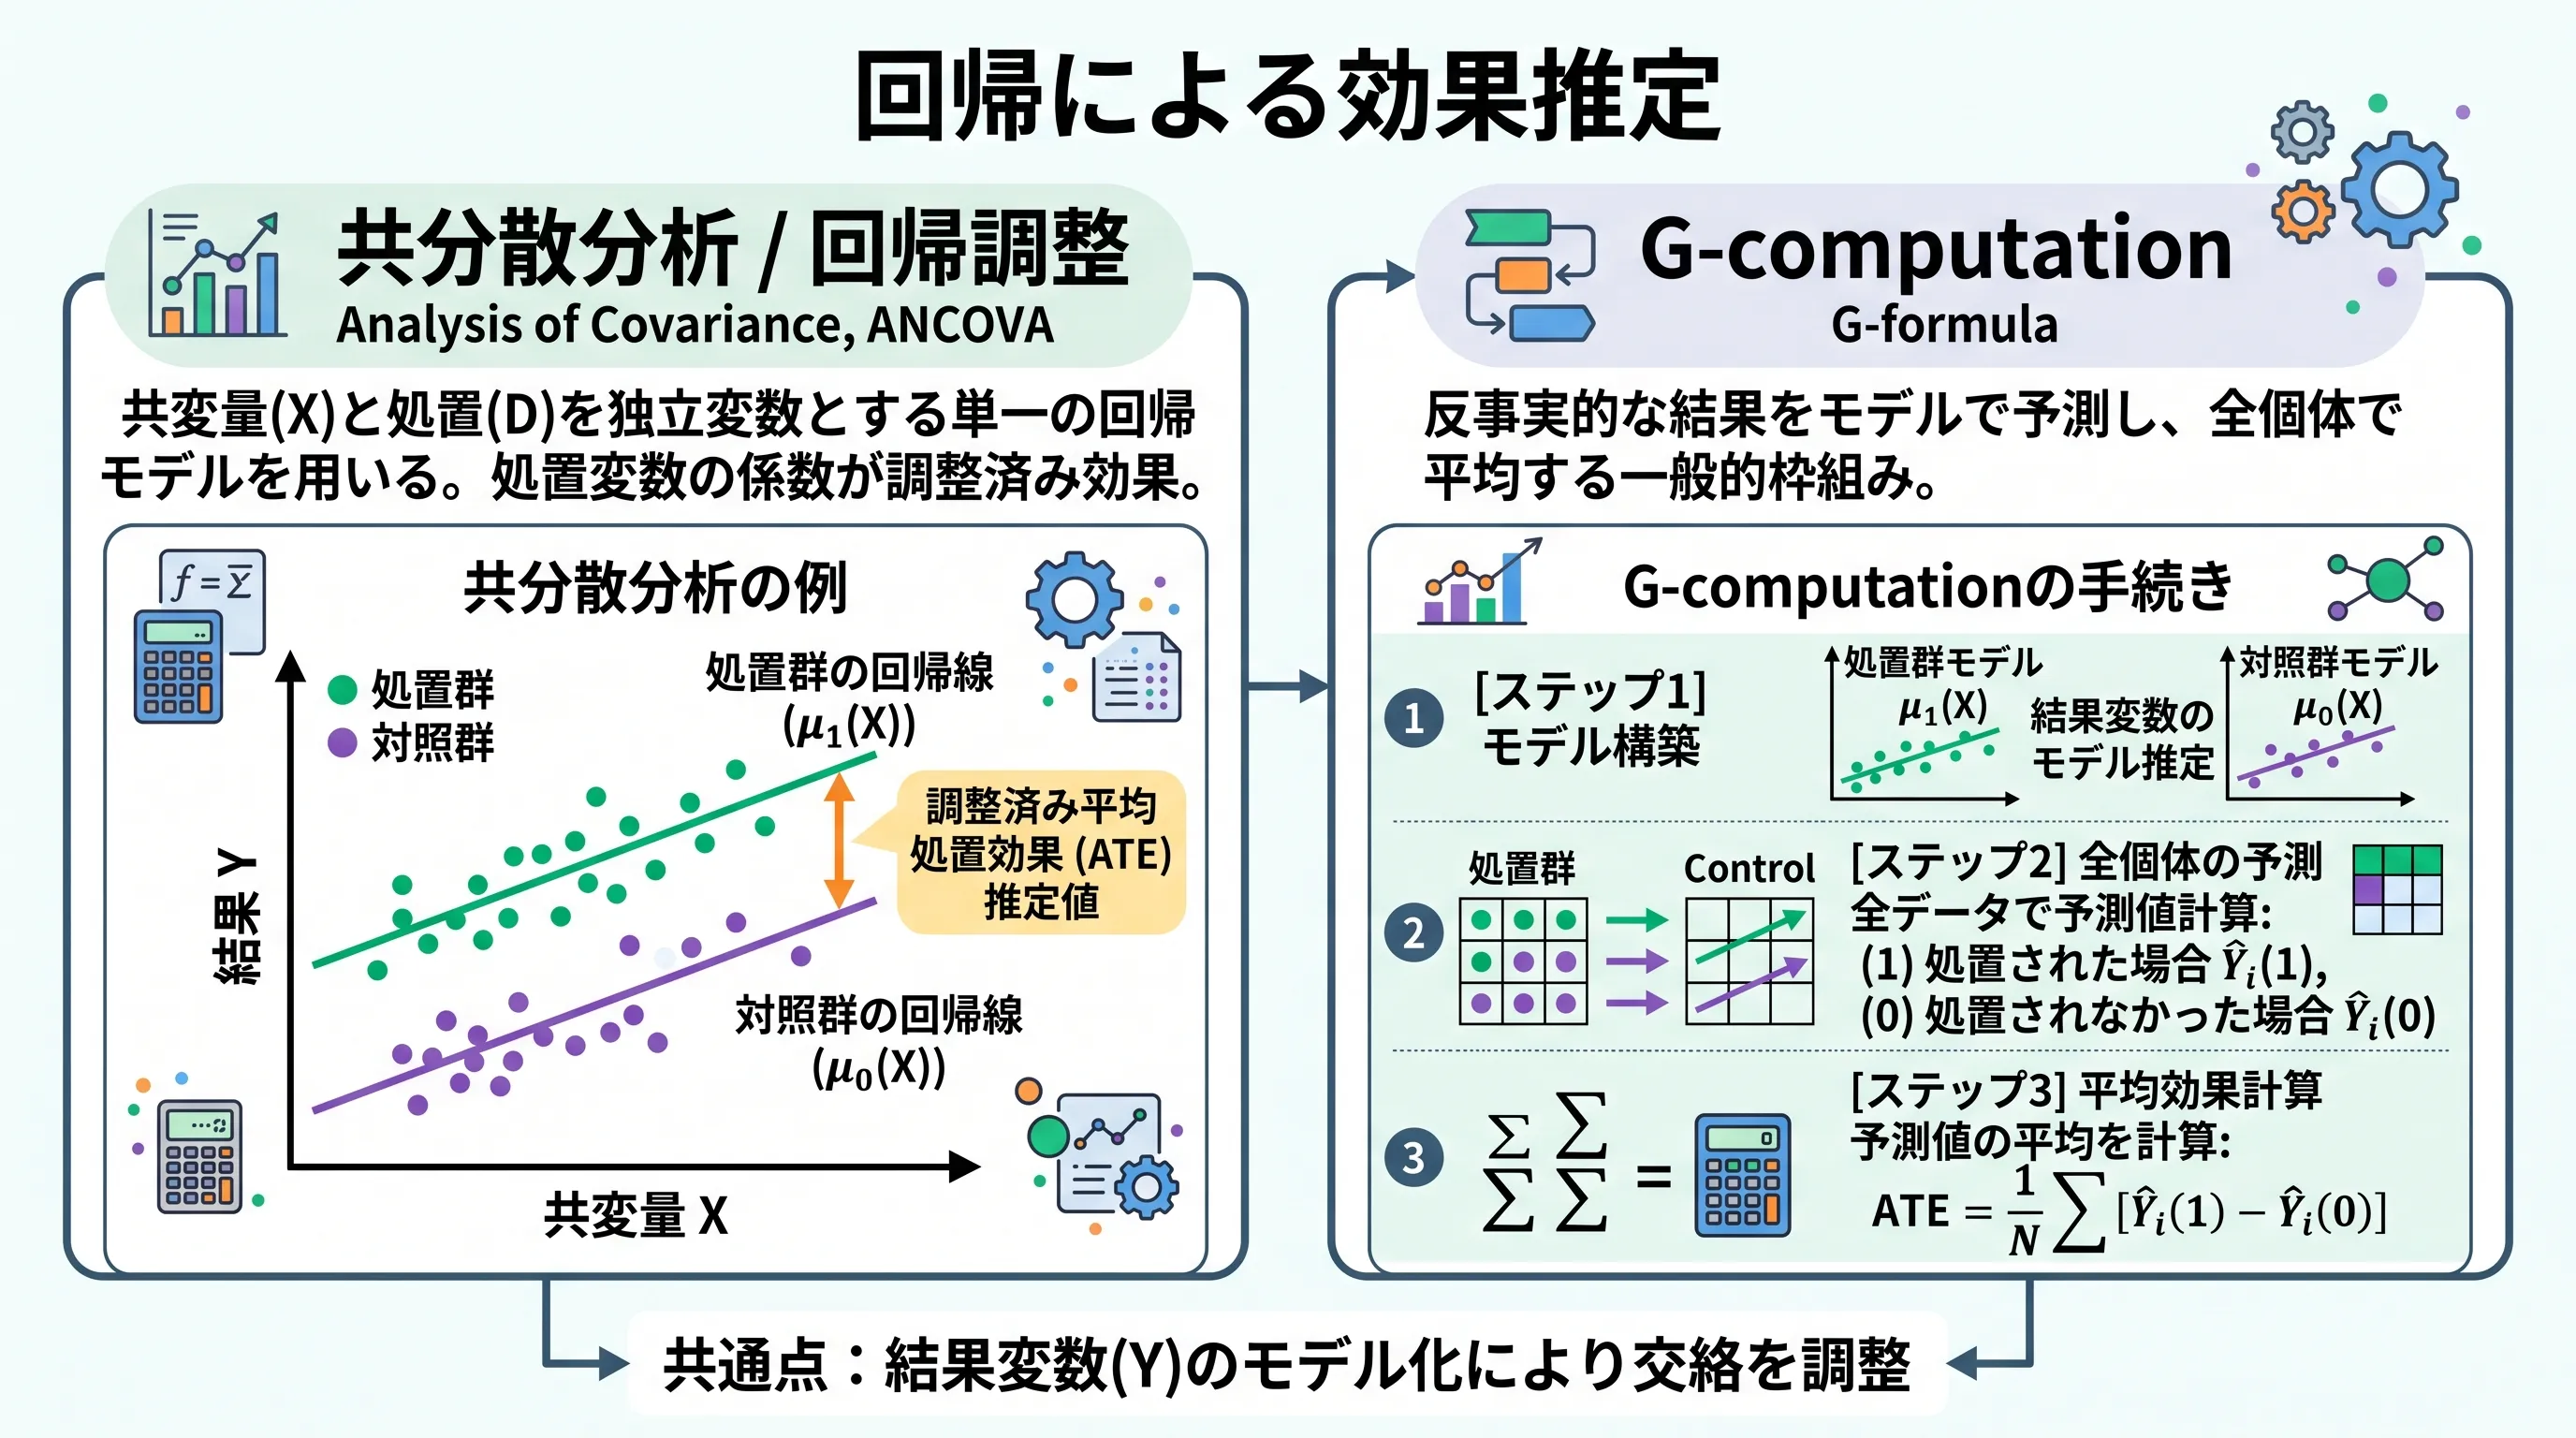
記事を読むアウトカムをモデル化して因果効果を推定する共分散分析(ANCOVA)や回帰調整について、RCTでの分散削減、観察データでの交絡調整、効果の異質性に対処するG-computation(g-formula)、共通サポートと外挿の落とし穴、およびDiDとの使い分けまでをPythonシミュレーションを交えて解説します。
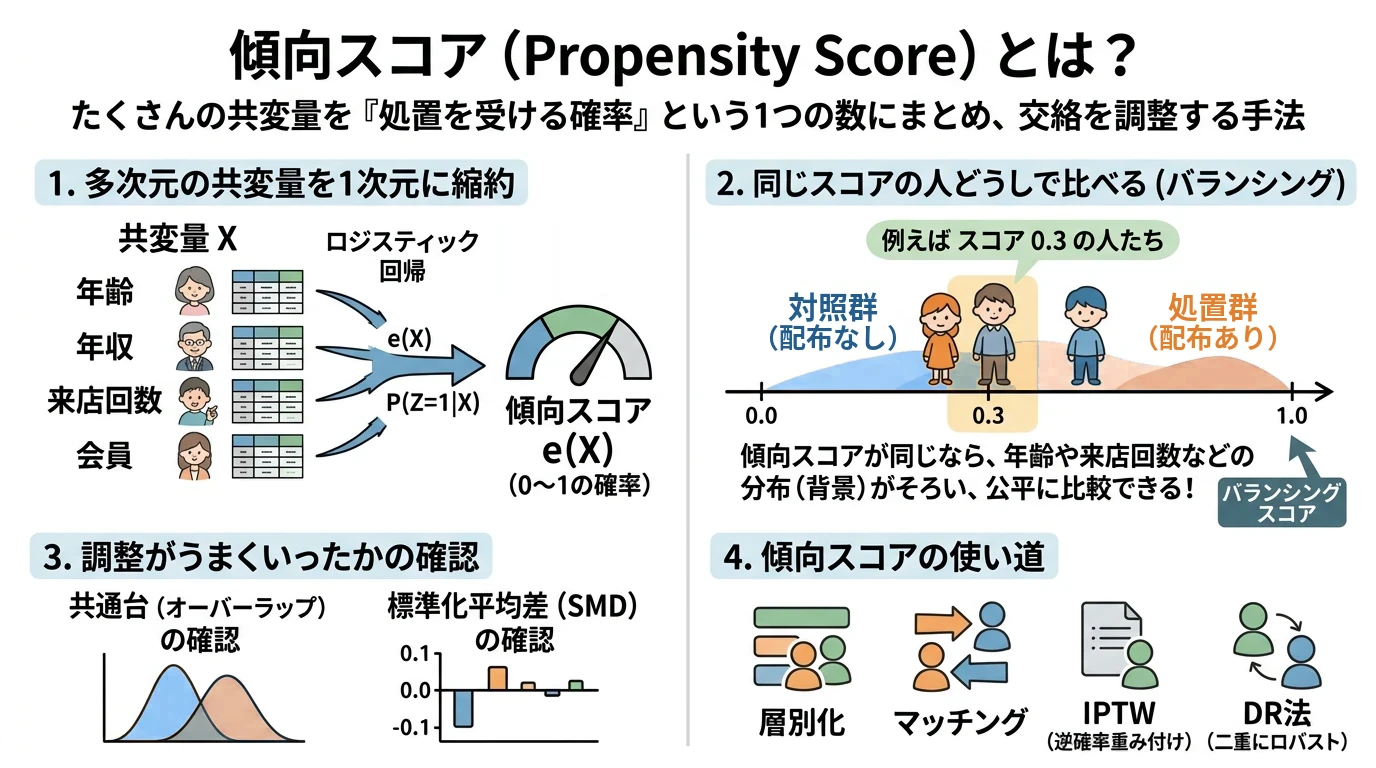
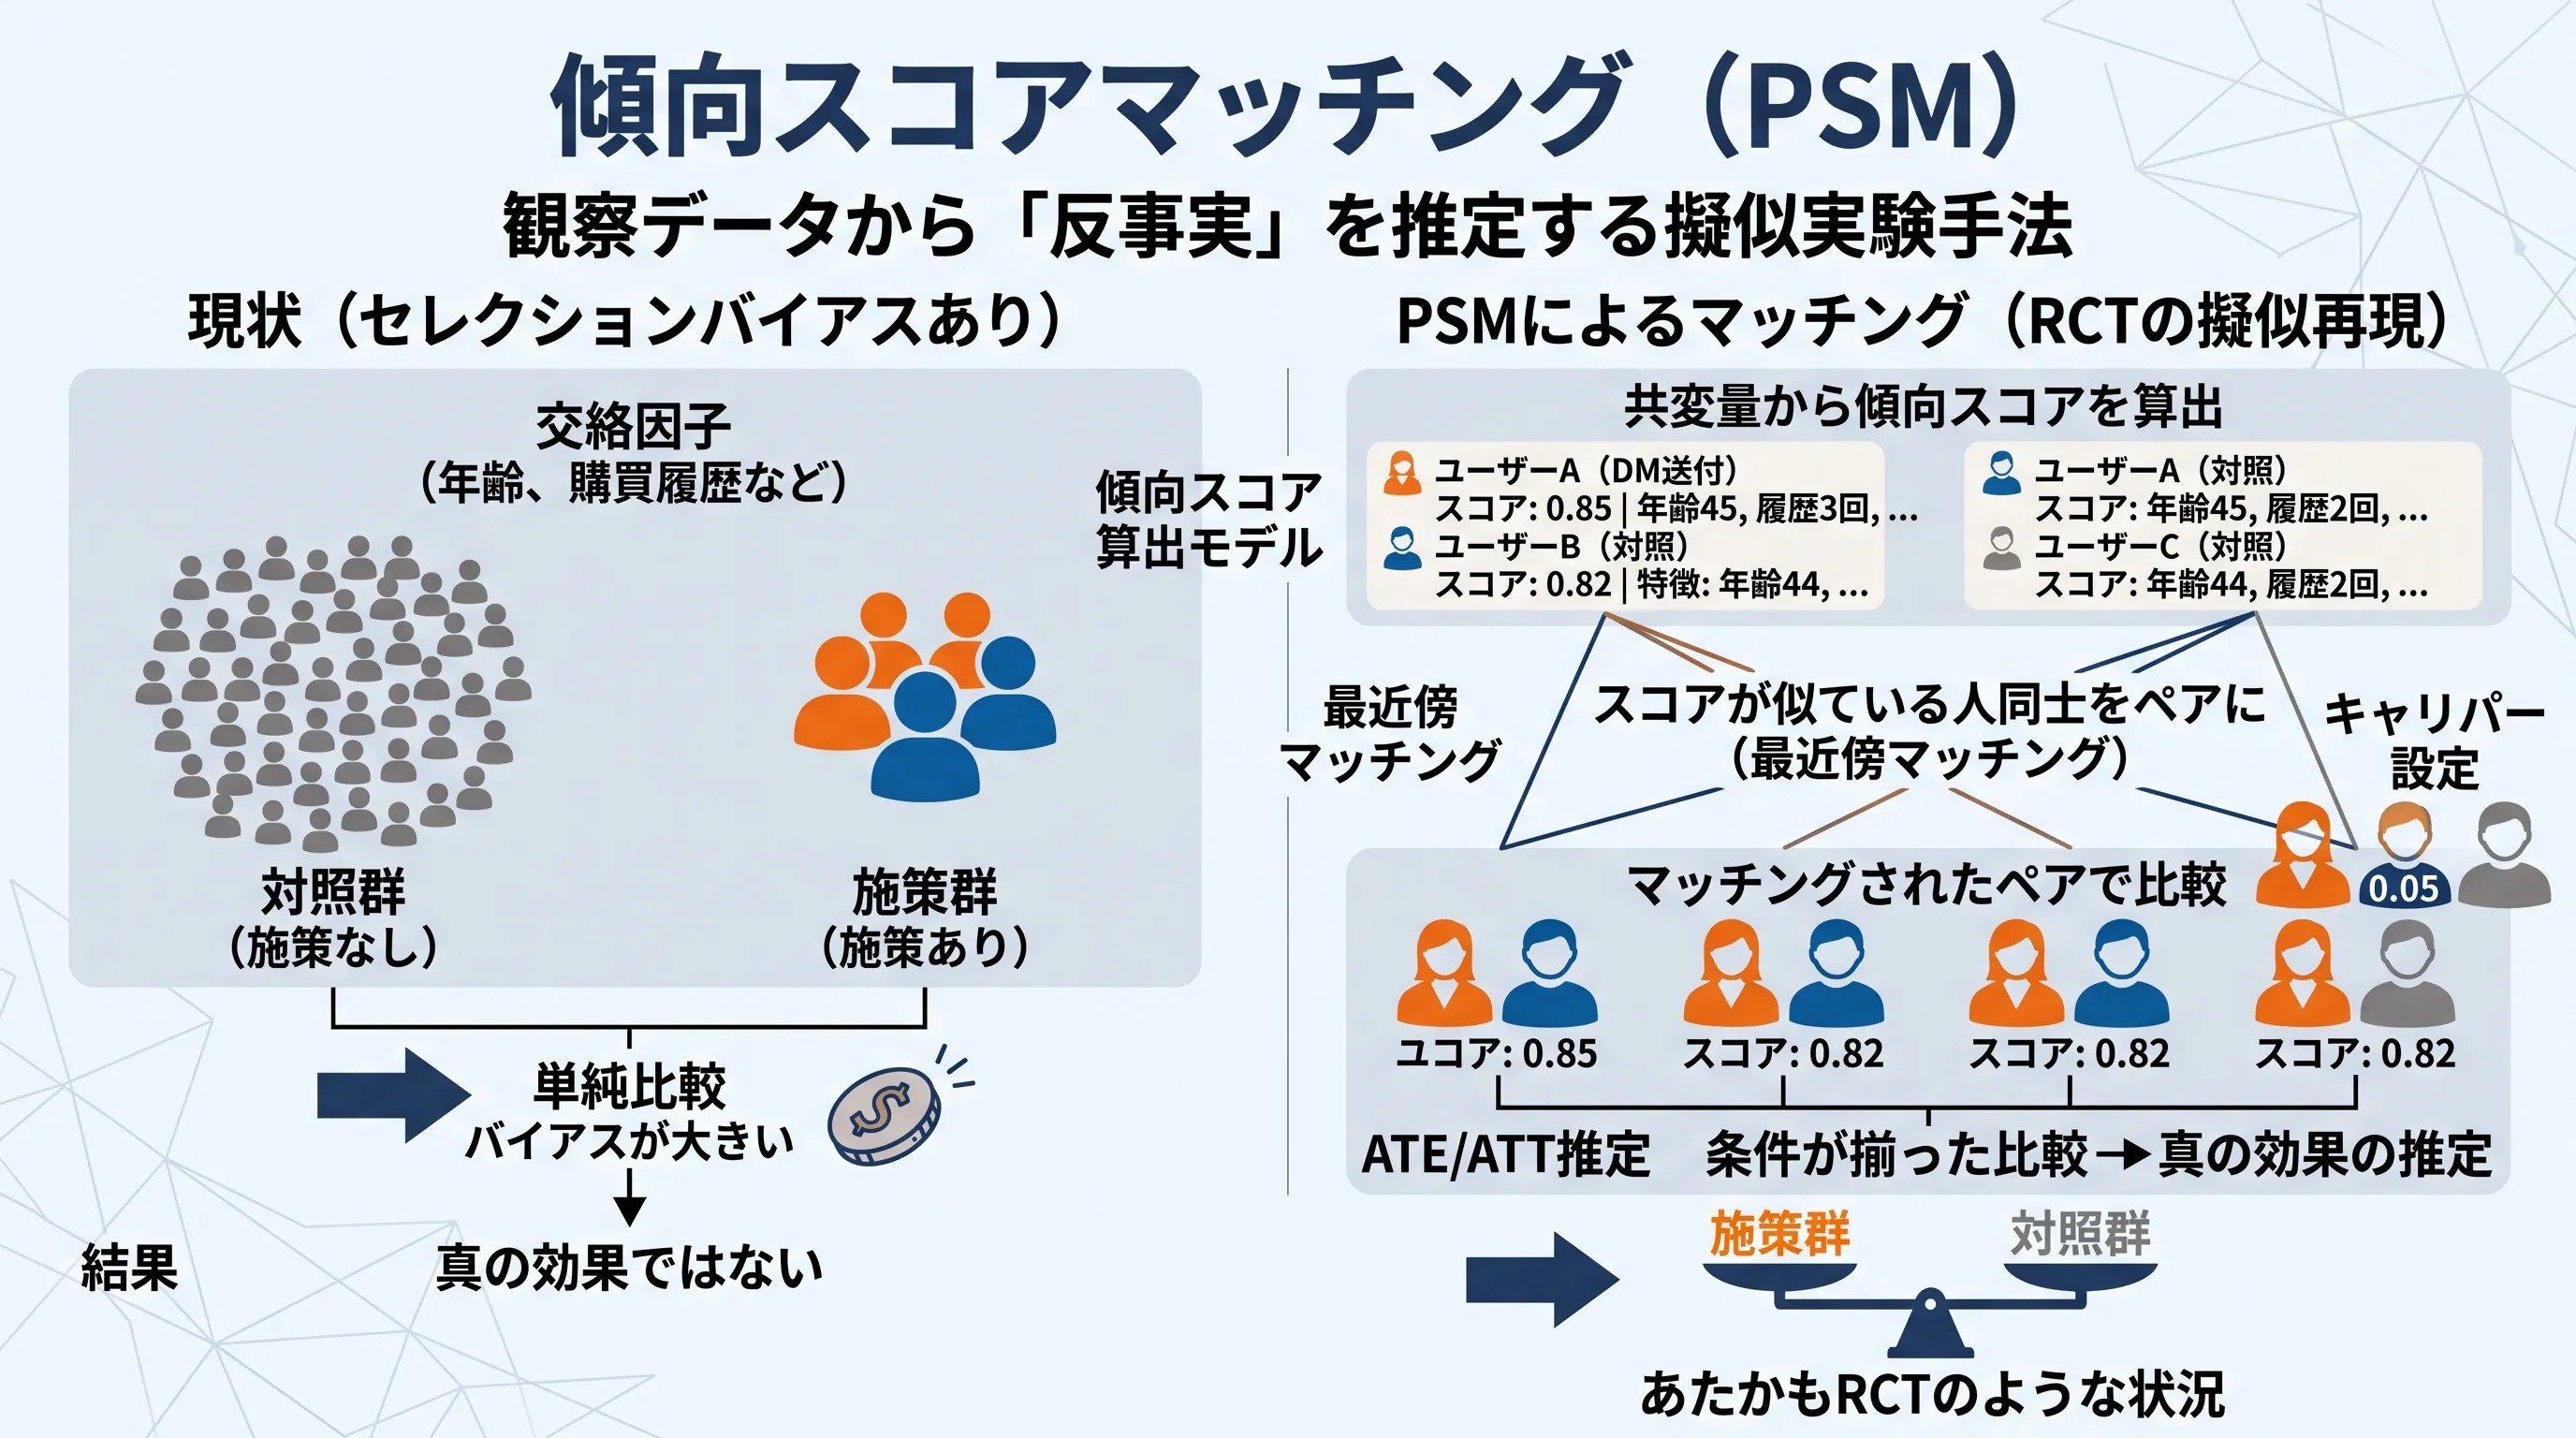
記事を読むセレクションバイアスを排除し、観察データから信頼性の高い因果推論を行うための強力な手法「傾向スコアマッチング(PSM)」について、傾向スコアの算出、マッチングの実装、およびPSMパラドックスの議論までをスクラッチ実装と共に解説します。
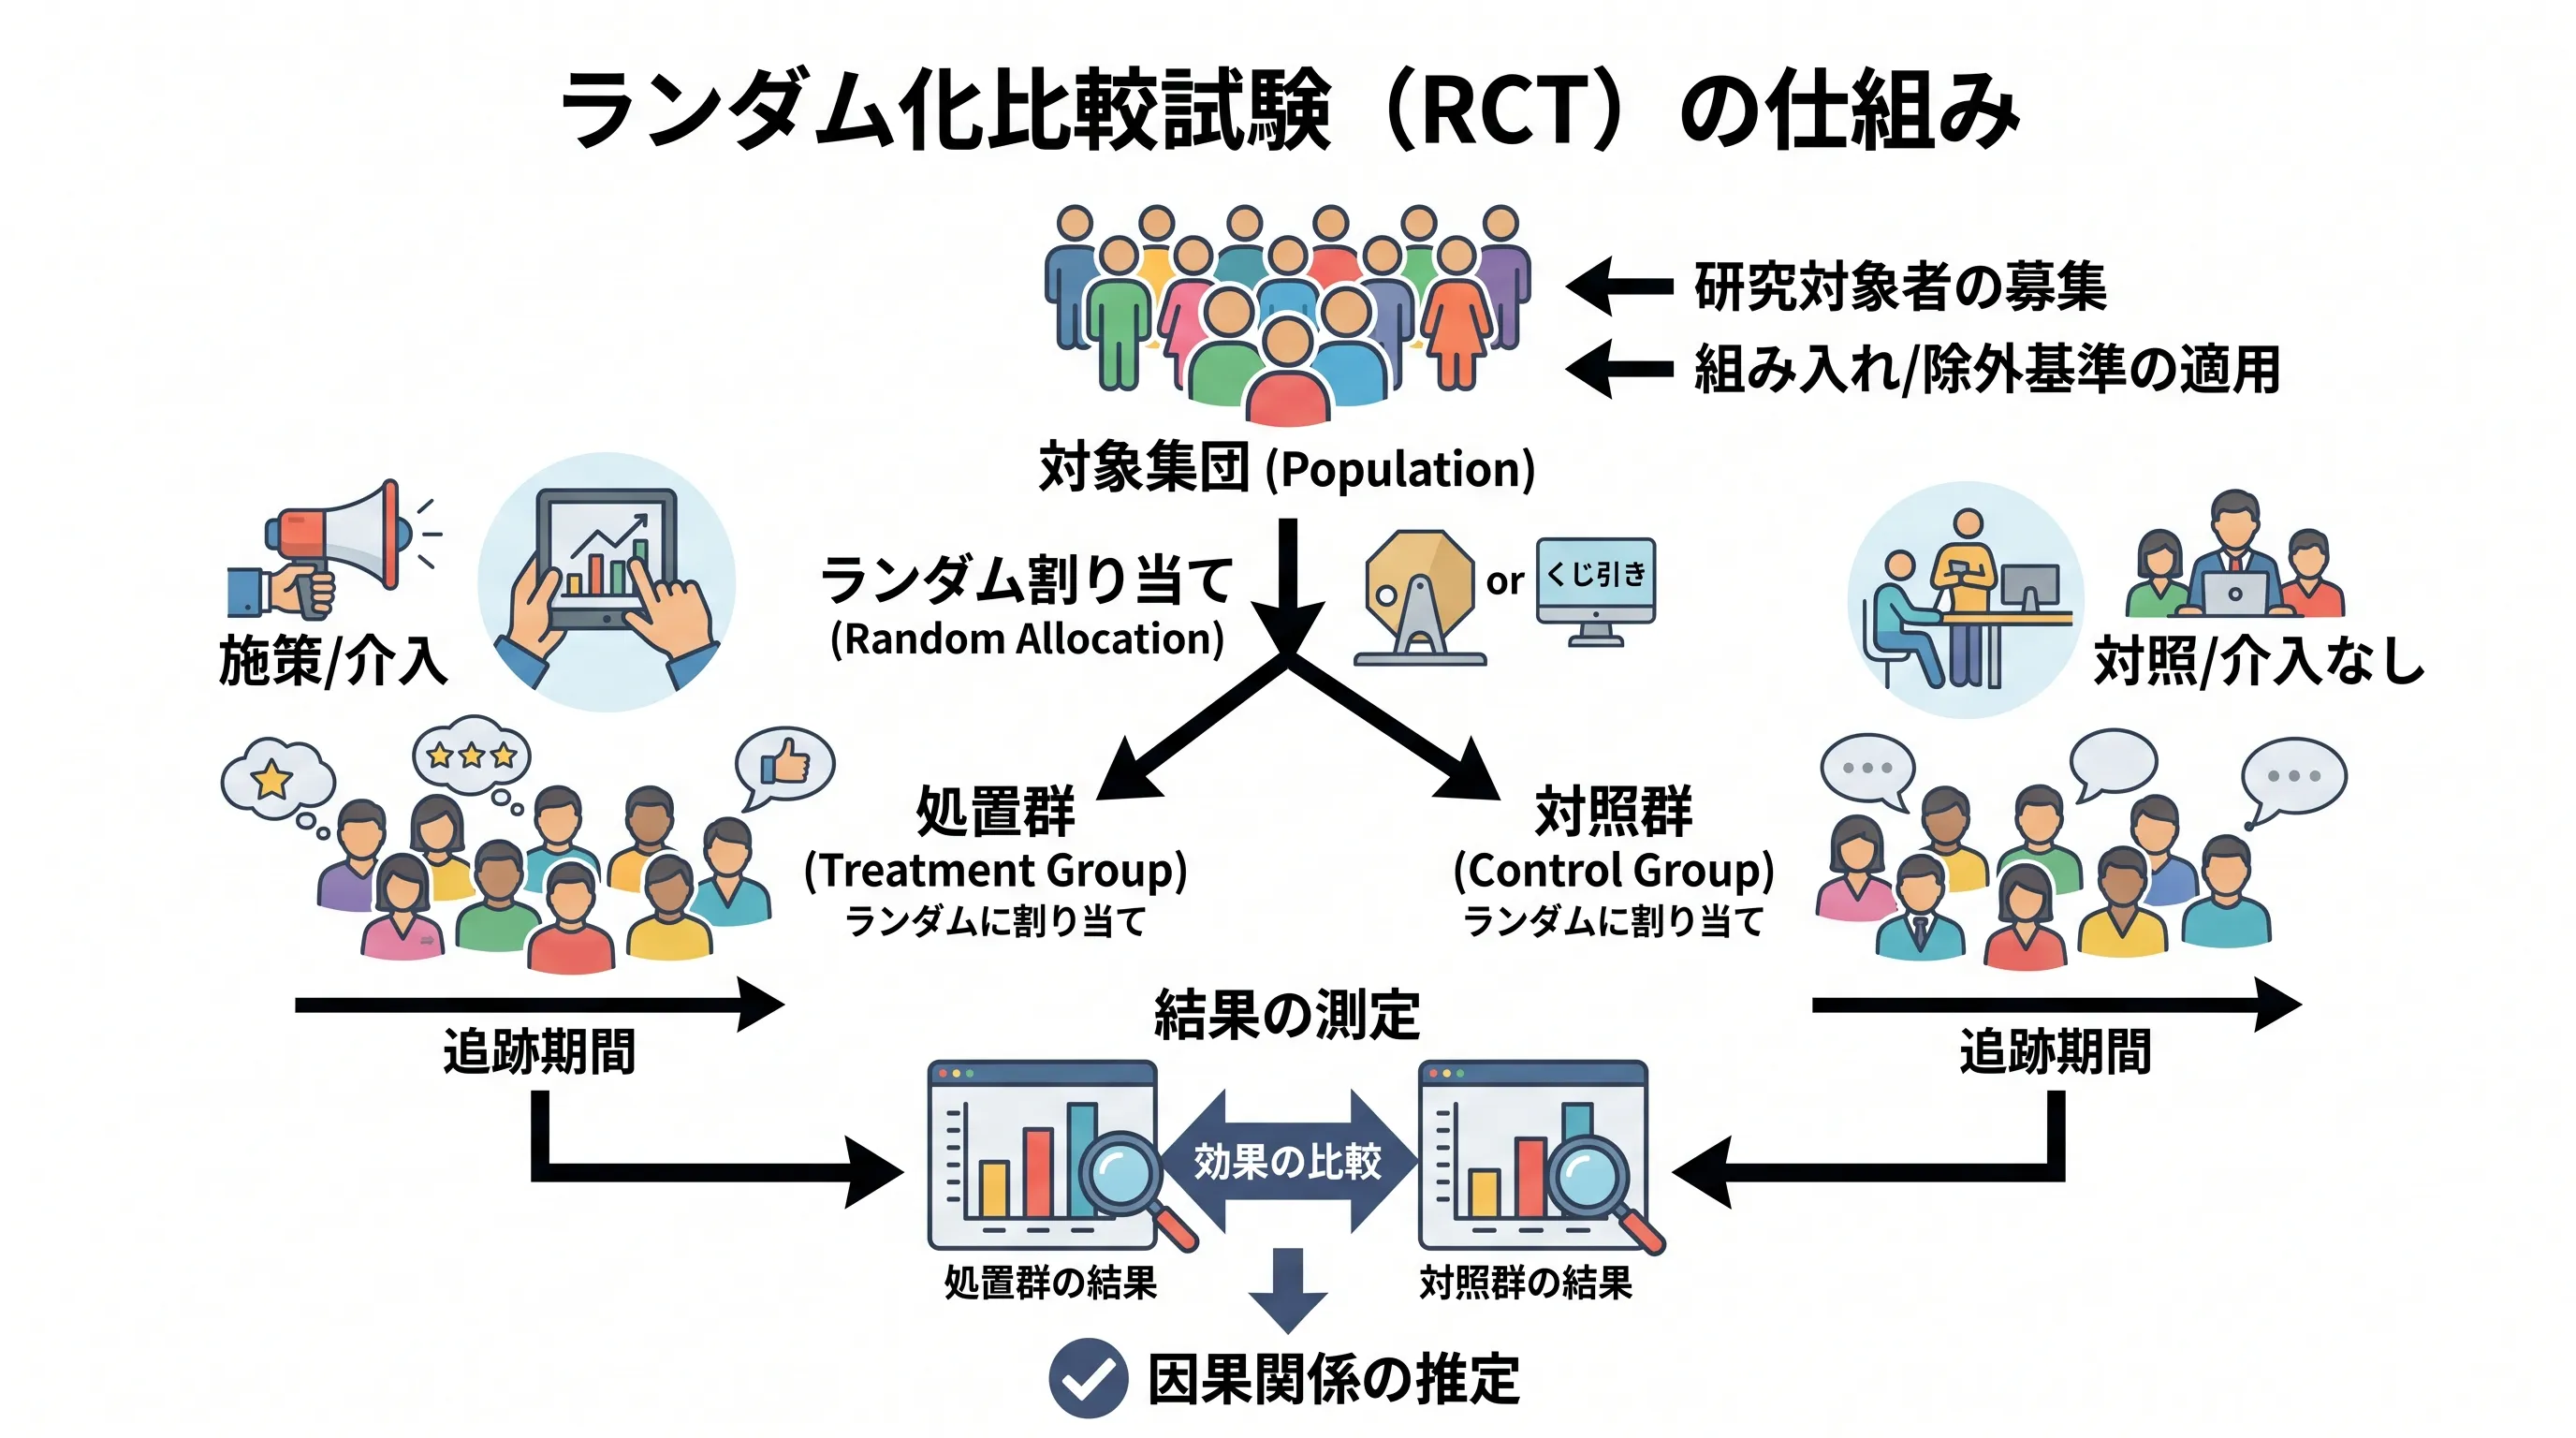
記事を読む因果推論の「ゴールドスタンダード」と呼ばれるランダム化比較試験(RCT)の仕組みについて、交絡因子の影響を無効化するメカニズムや、Pythonを用いたシミュレーション、t検定やKS検定によるバランスチェック(SMD)までをわかりやすく解説します。
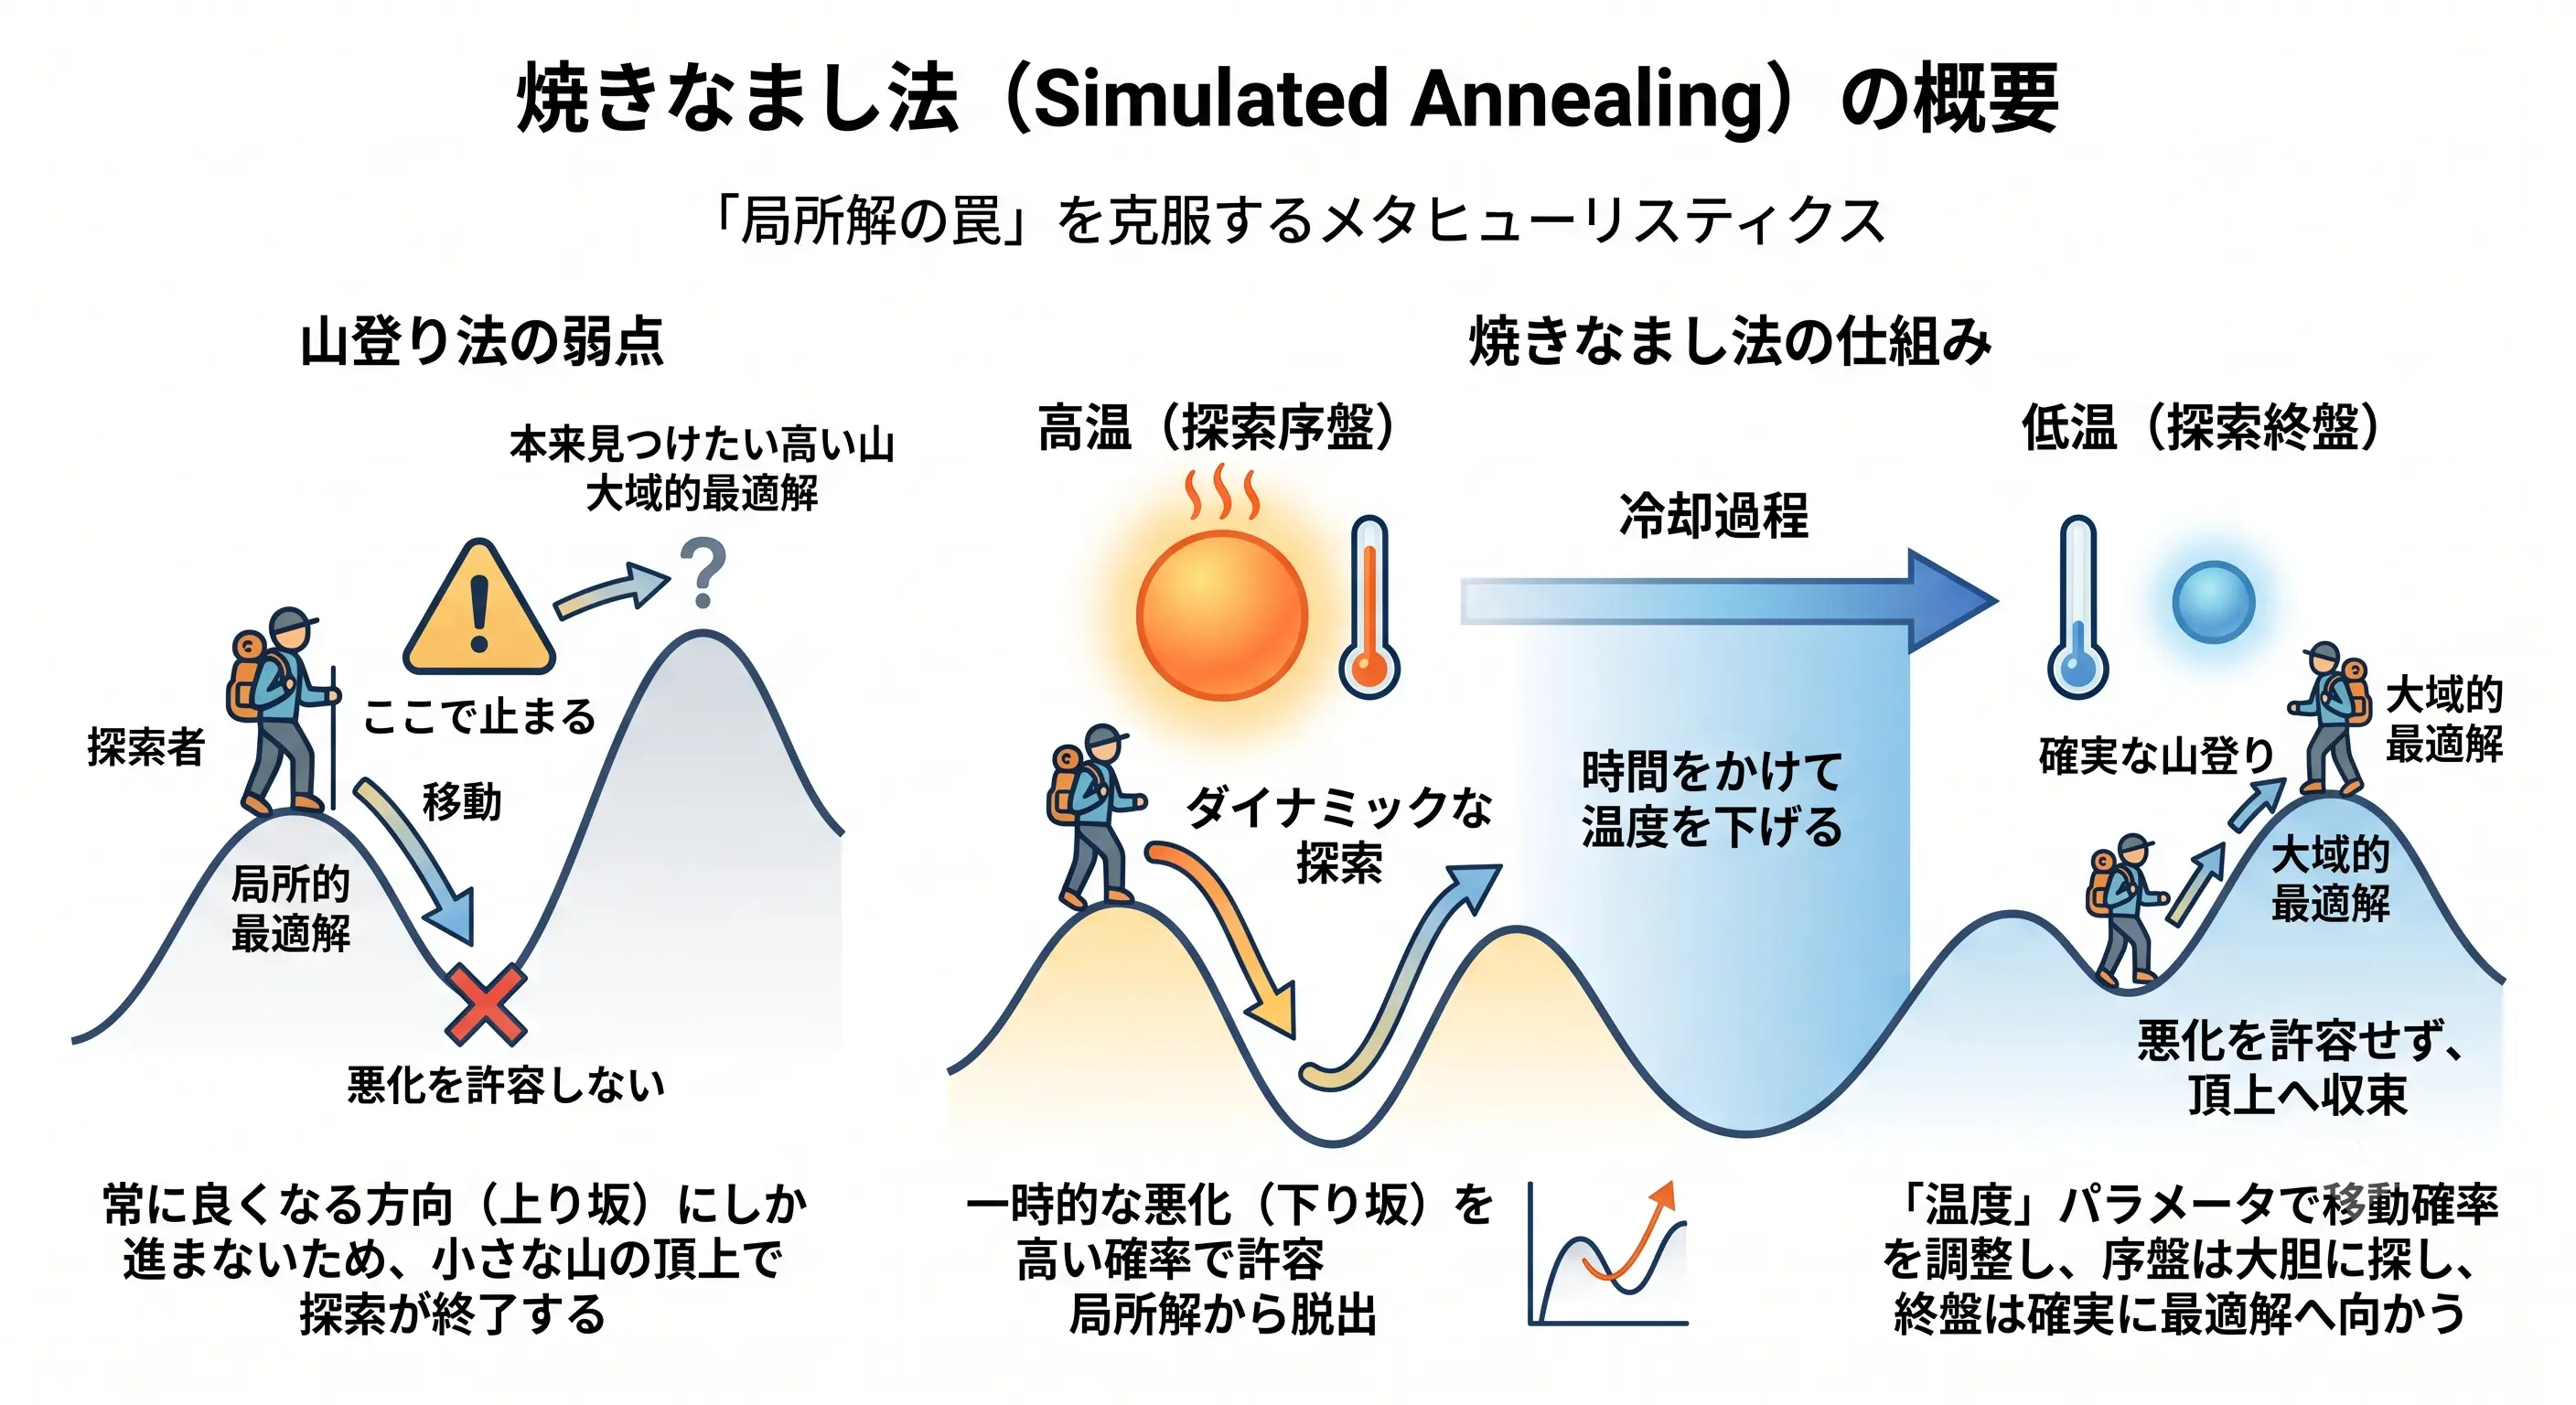
記事を読む組み合わせ最適化問題において、局所探索(山登り法)が陥りがちな「局所的最適解の罠」を、メトロポリス基準に基づく確率的な一時的改悪の許容と「温度」による探索制御によって克服する、物理現象を模倣した近似解法(メタヒューリスティクス)の仕組みを、Pythonでのシミュレーションや探索軌跡の可視化を交えて解説します。
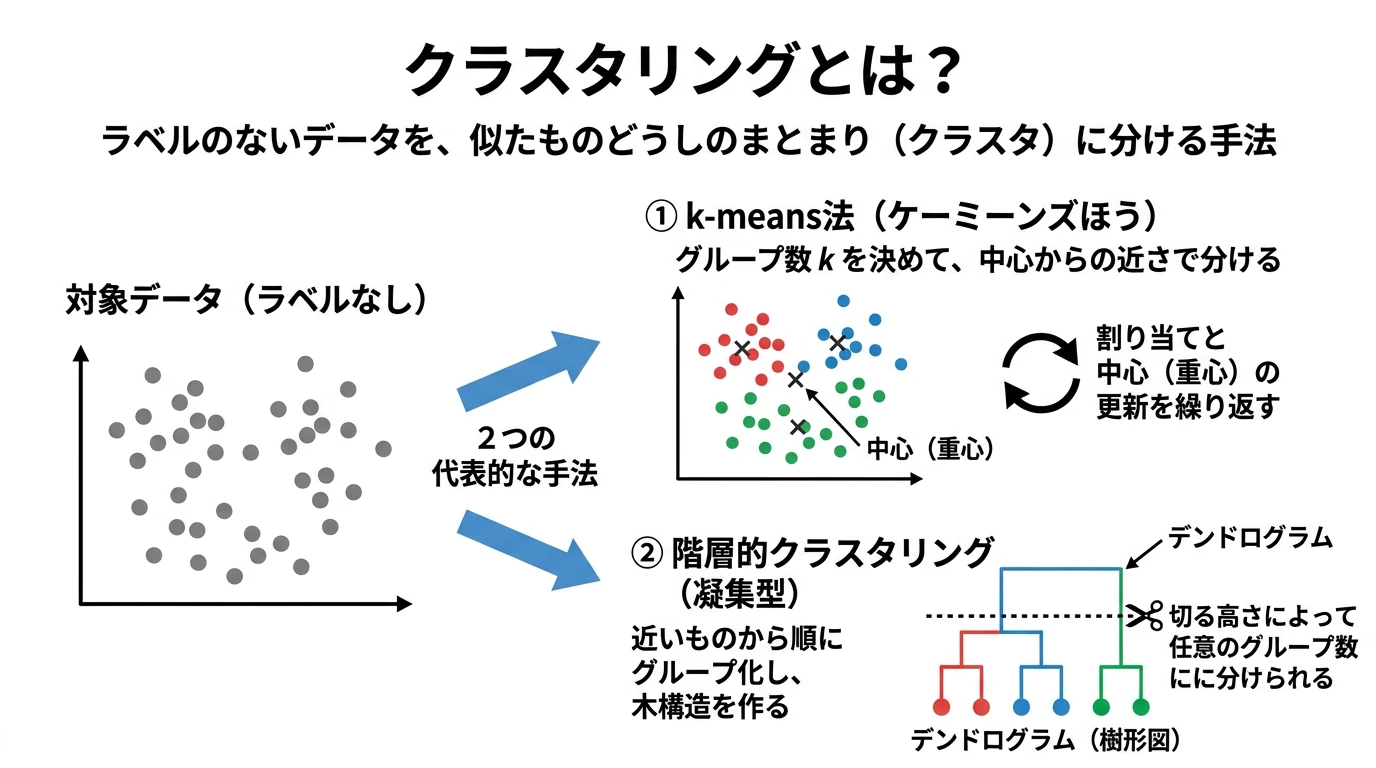
記事を読むラベルのないデータを似たものどうしのまとまりに分けるクラスタリングについて、k-means(ロイドのアルゴリズム・k-means++・kの決め方)、階層的クラスタリング(連結法・デンドログラム)、ガウス混合によるソフトクラスタリングとの違いを、文の埋め込みと2次元の人工データを使ったPythonのスクラッチ実装で解説します。
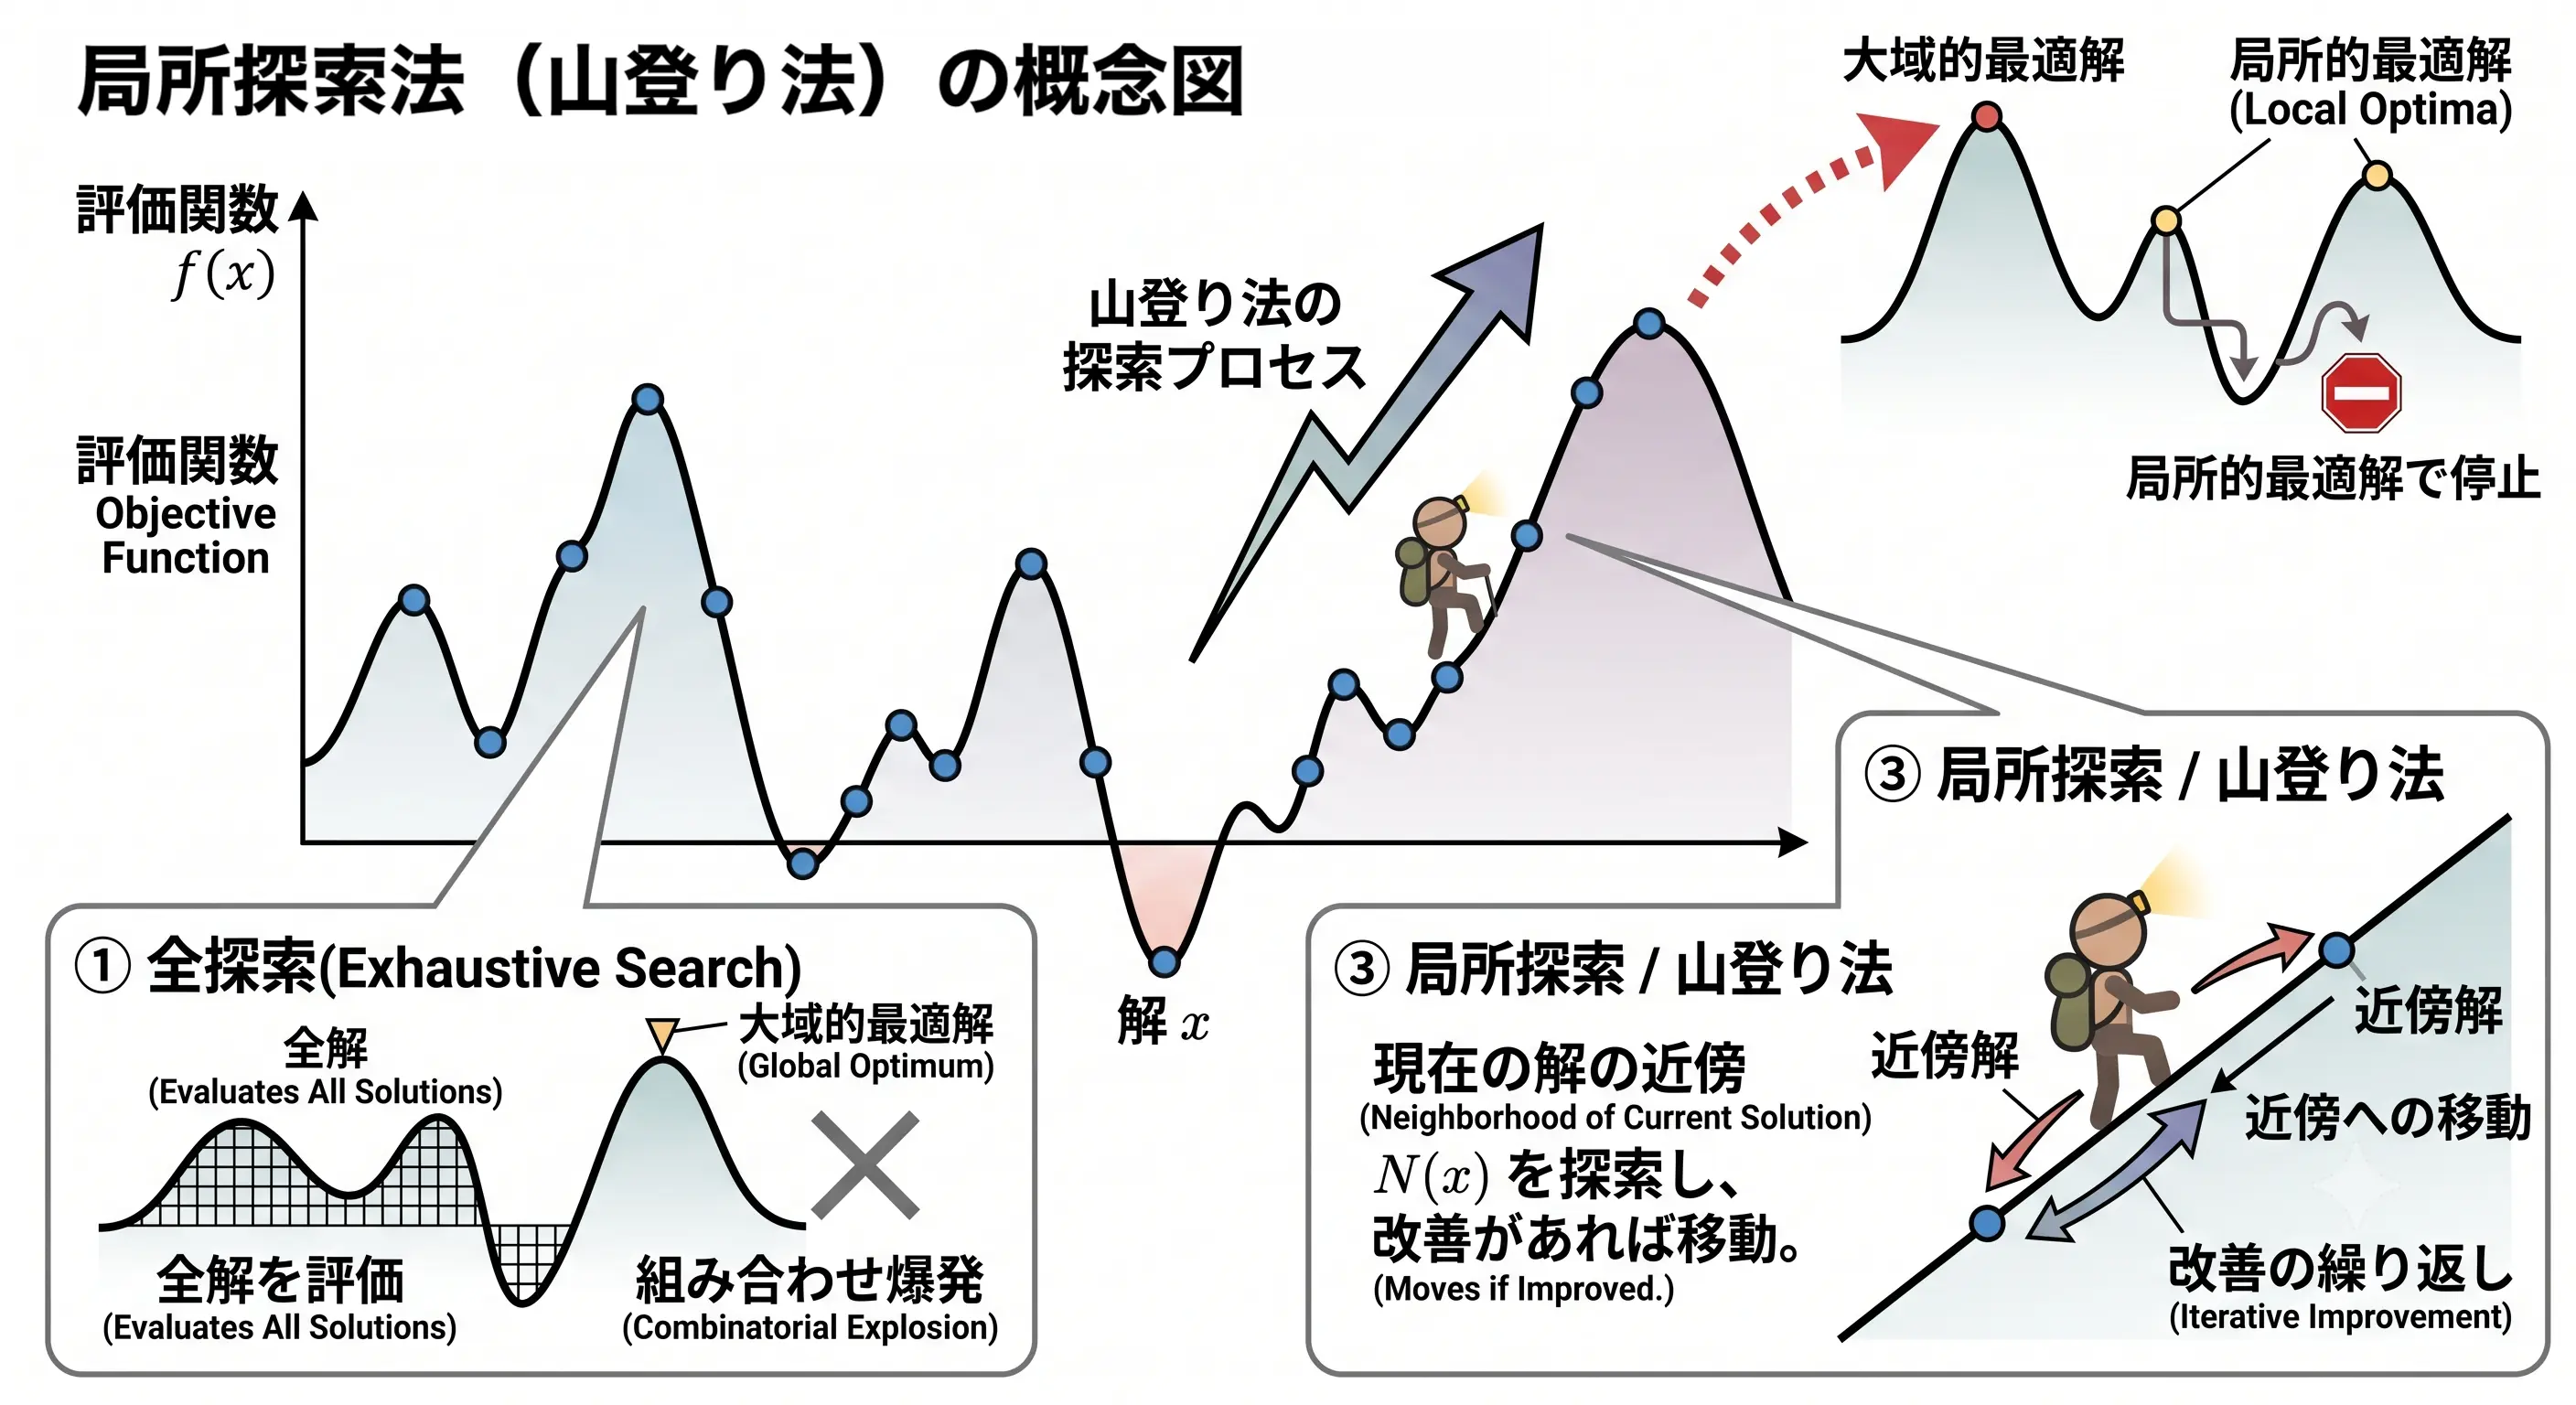
記事を読む組み合わせ最適化の基礎である山登り法(局所探索アルゴリズム)の仕組みを解説。全探索・ランダム探索との比較、Pythonによるステップごとの実装、局所的最適解(ローカルオプティマ)の罠と軌跡の可視化まで網羅。
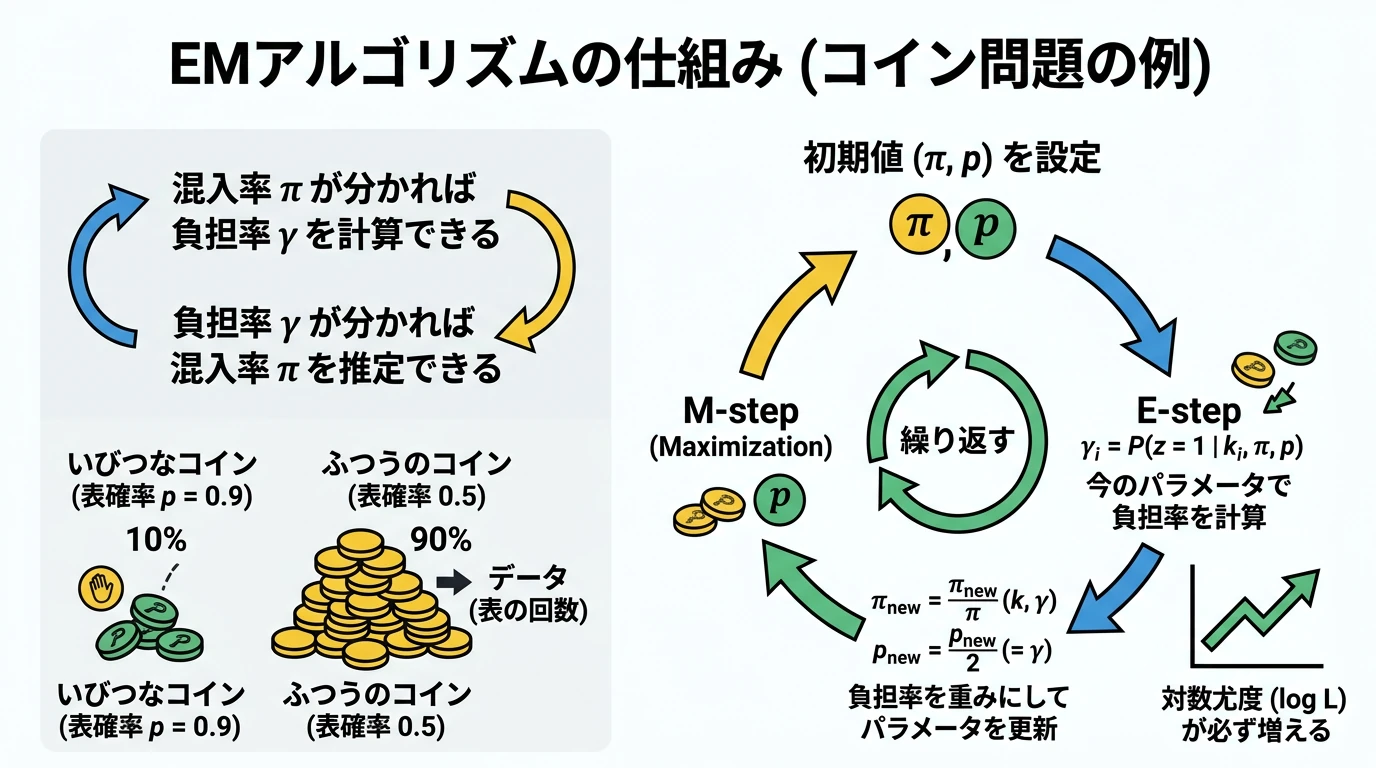
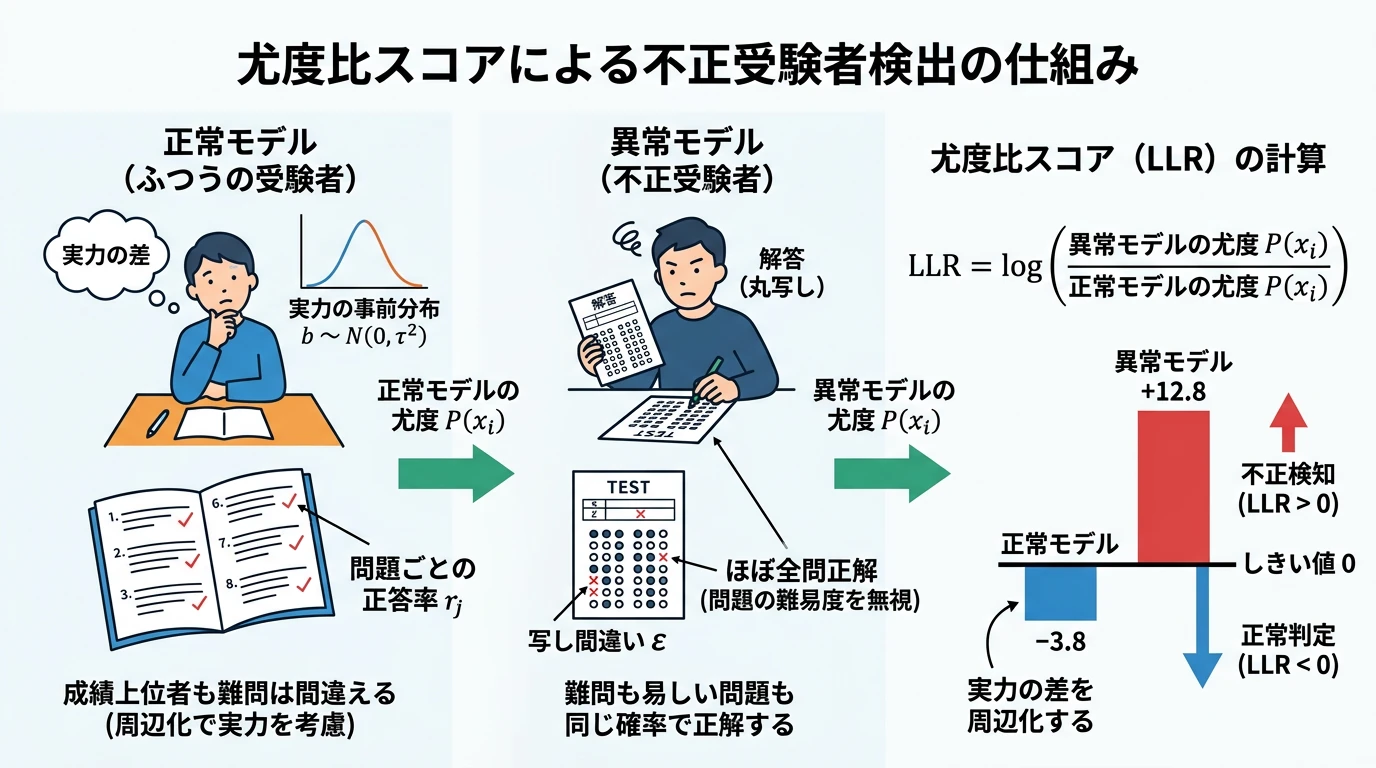
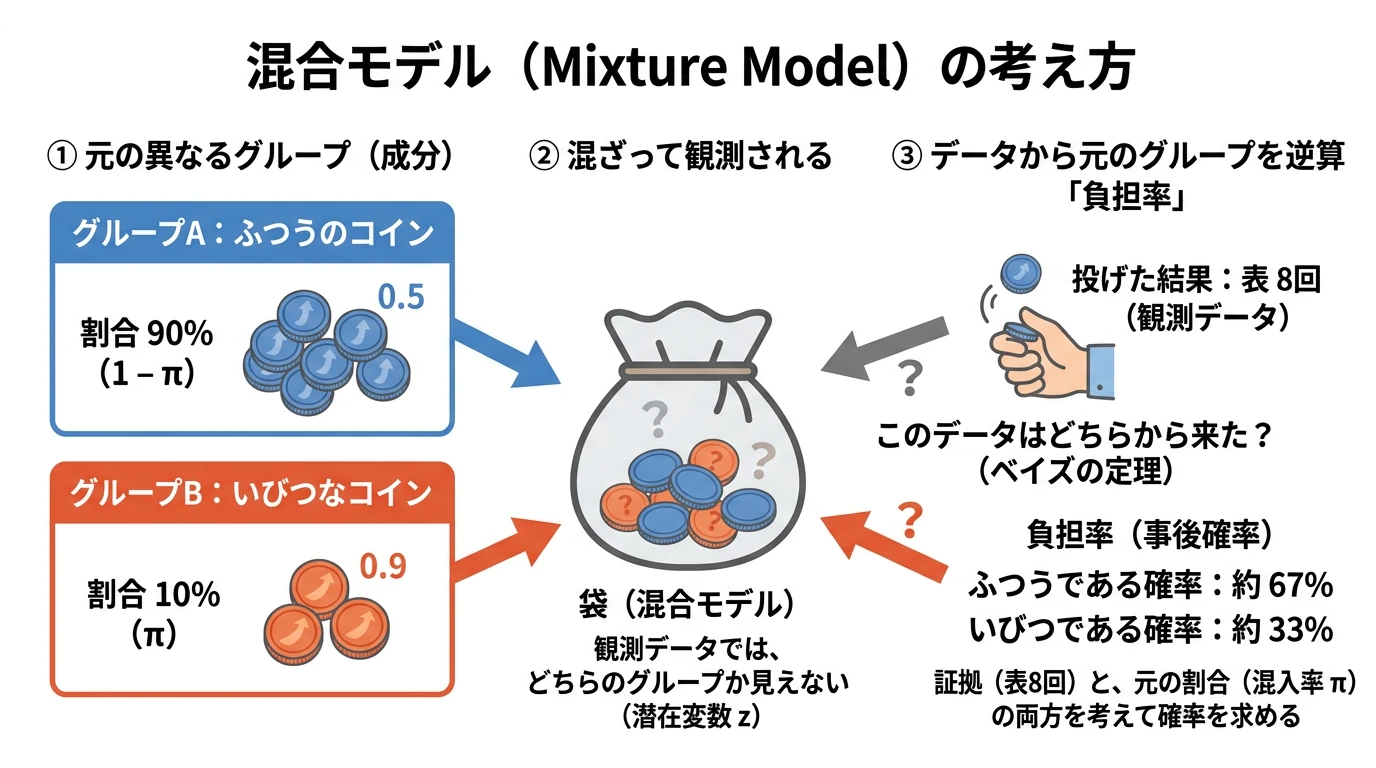
記事を読む観測できない「隠れた変数」を含むモデルのパラメータを推定するEMアルゴリズムの仕組みを、2種類のコインが混ざった袋の例で、E-stepとM-stepを1回ずつ手計算しながら解説します。対数尤度が必ず増える理由をイェンセンの不等式で示し、最後に試験の解答データに適用して、不正受験者の混入率の推定と問題ごとの正答率の補正を同時に行います。
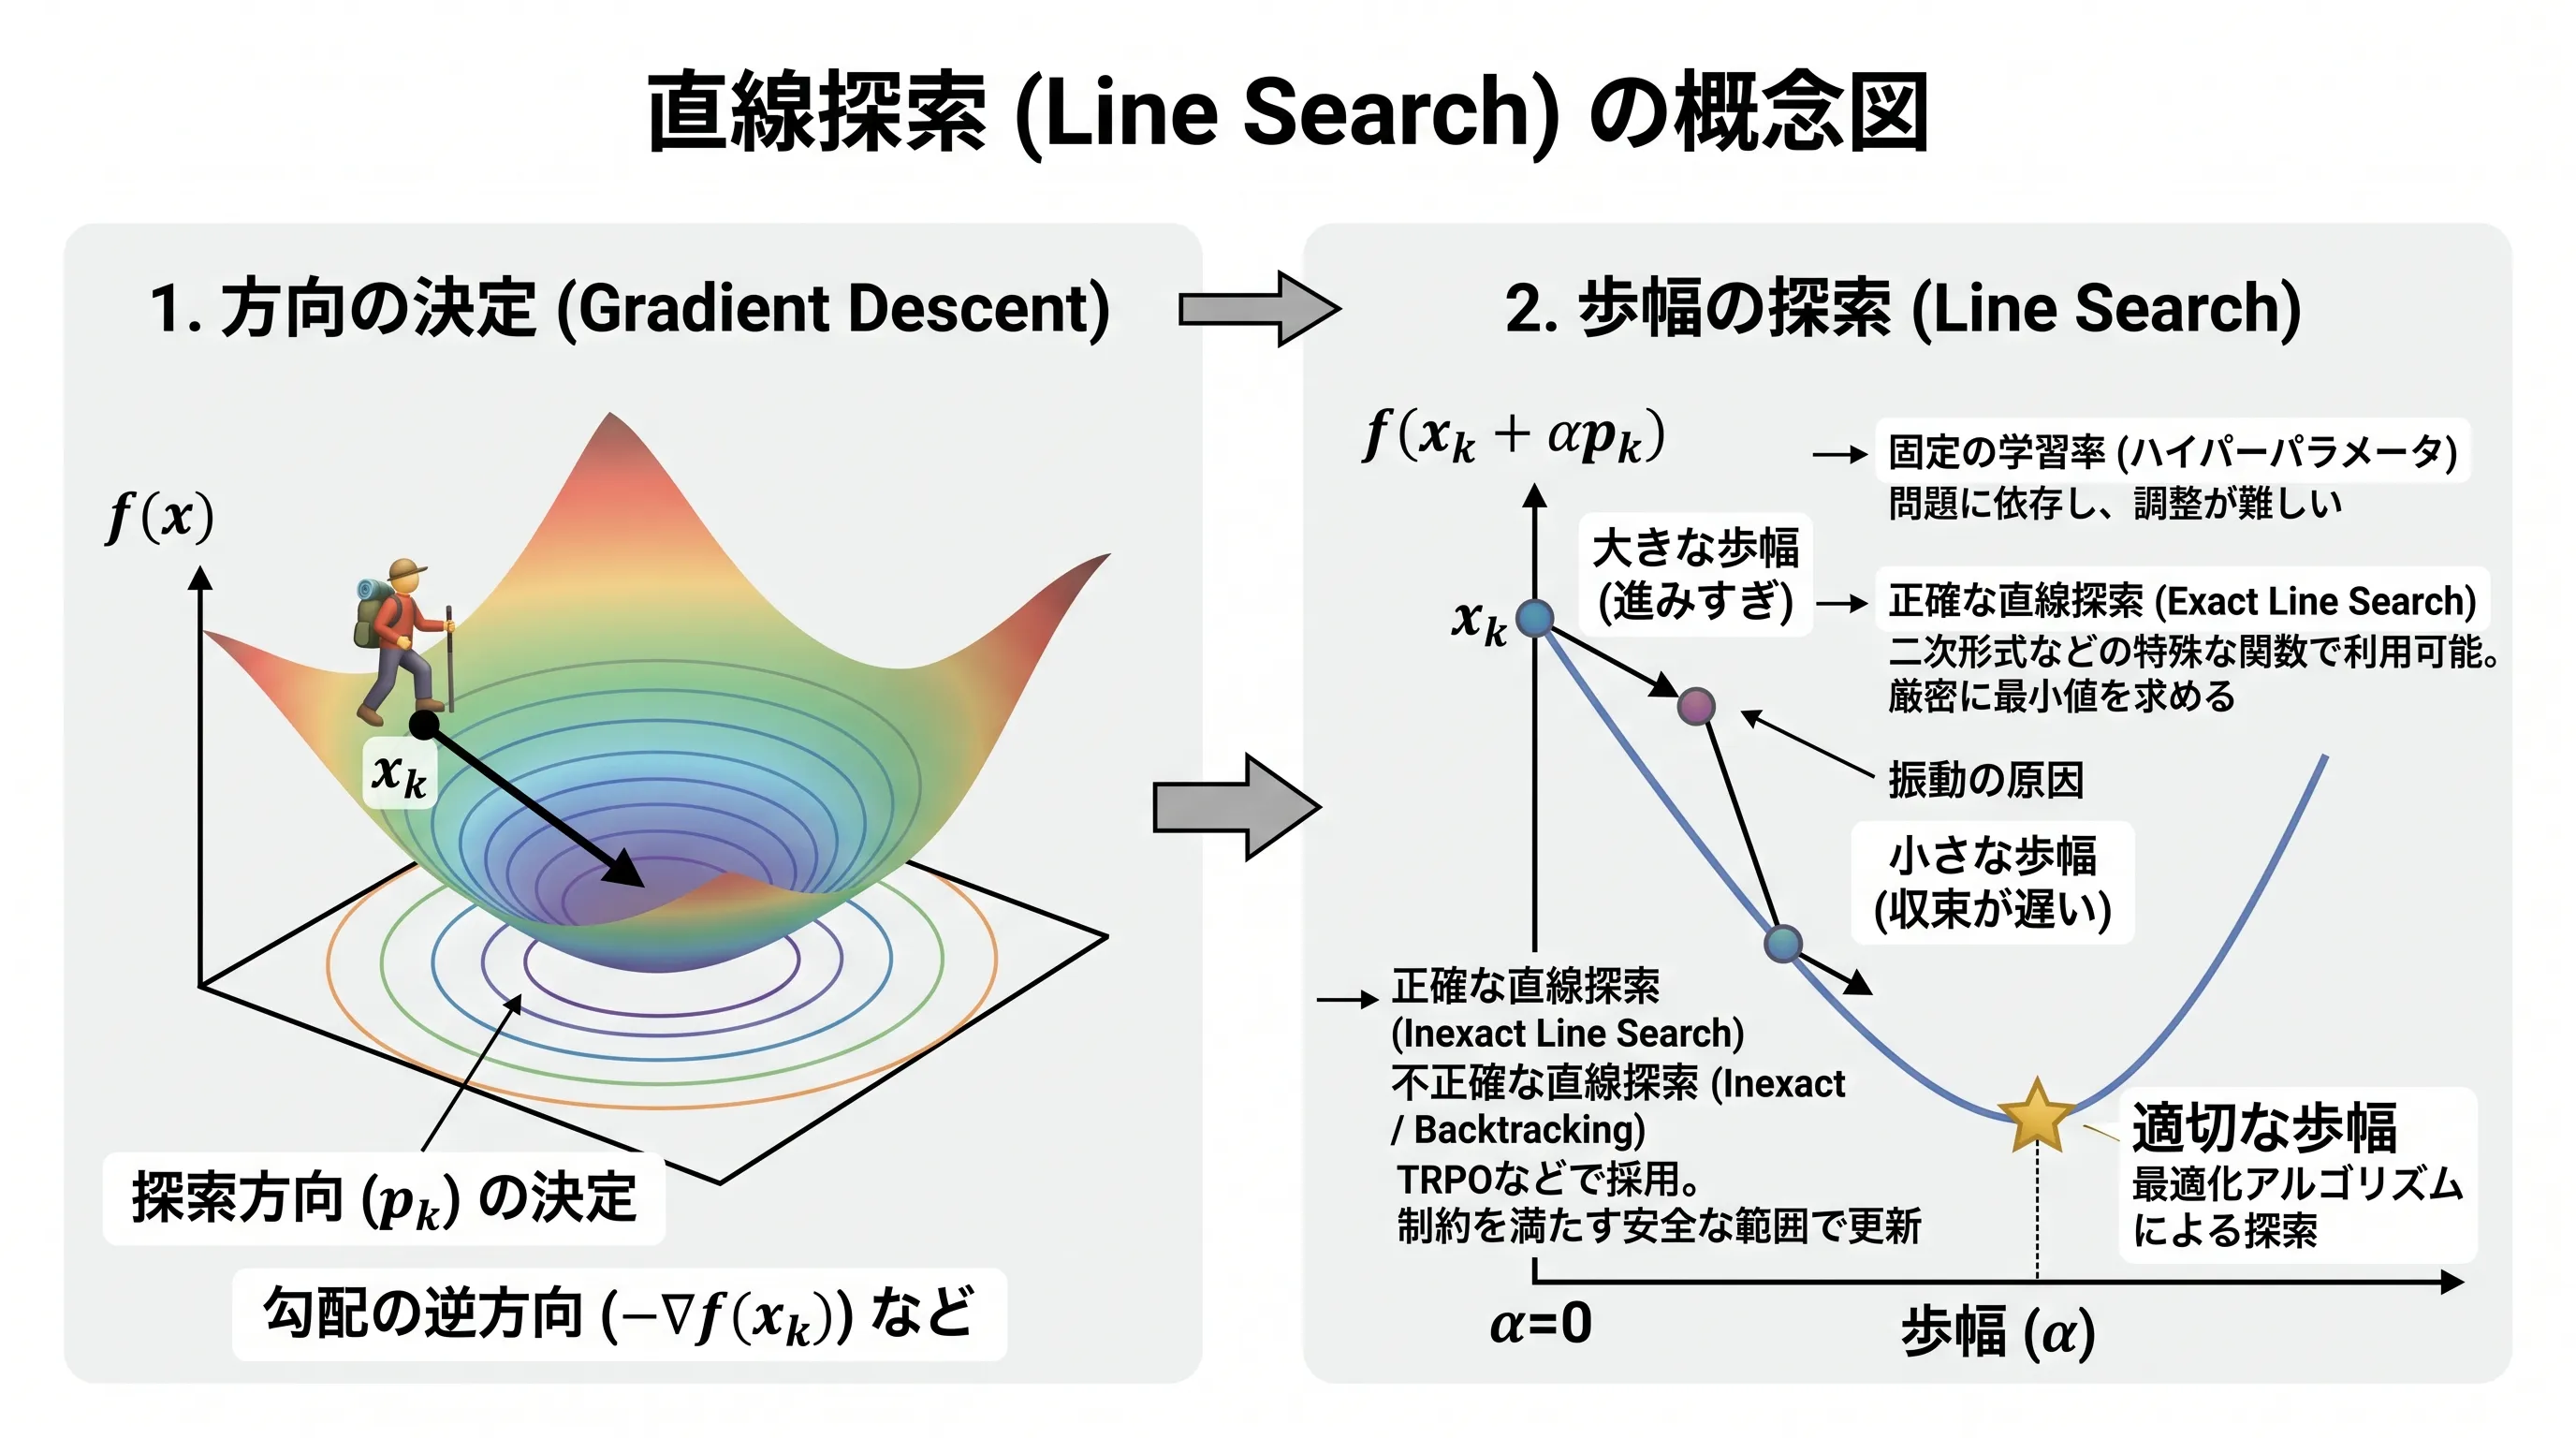
記事を読む最適化アルゴリズムにおいてステップサイズを動的に決定する「直線探索」の仕組みを解説。Armijo条件を用いたバックトラッキング法、正確な直線探索のPython実装、固定歩幅との比較までを網羅します。
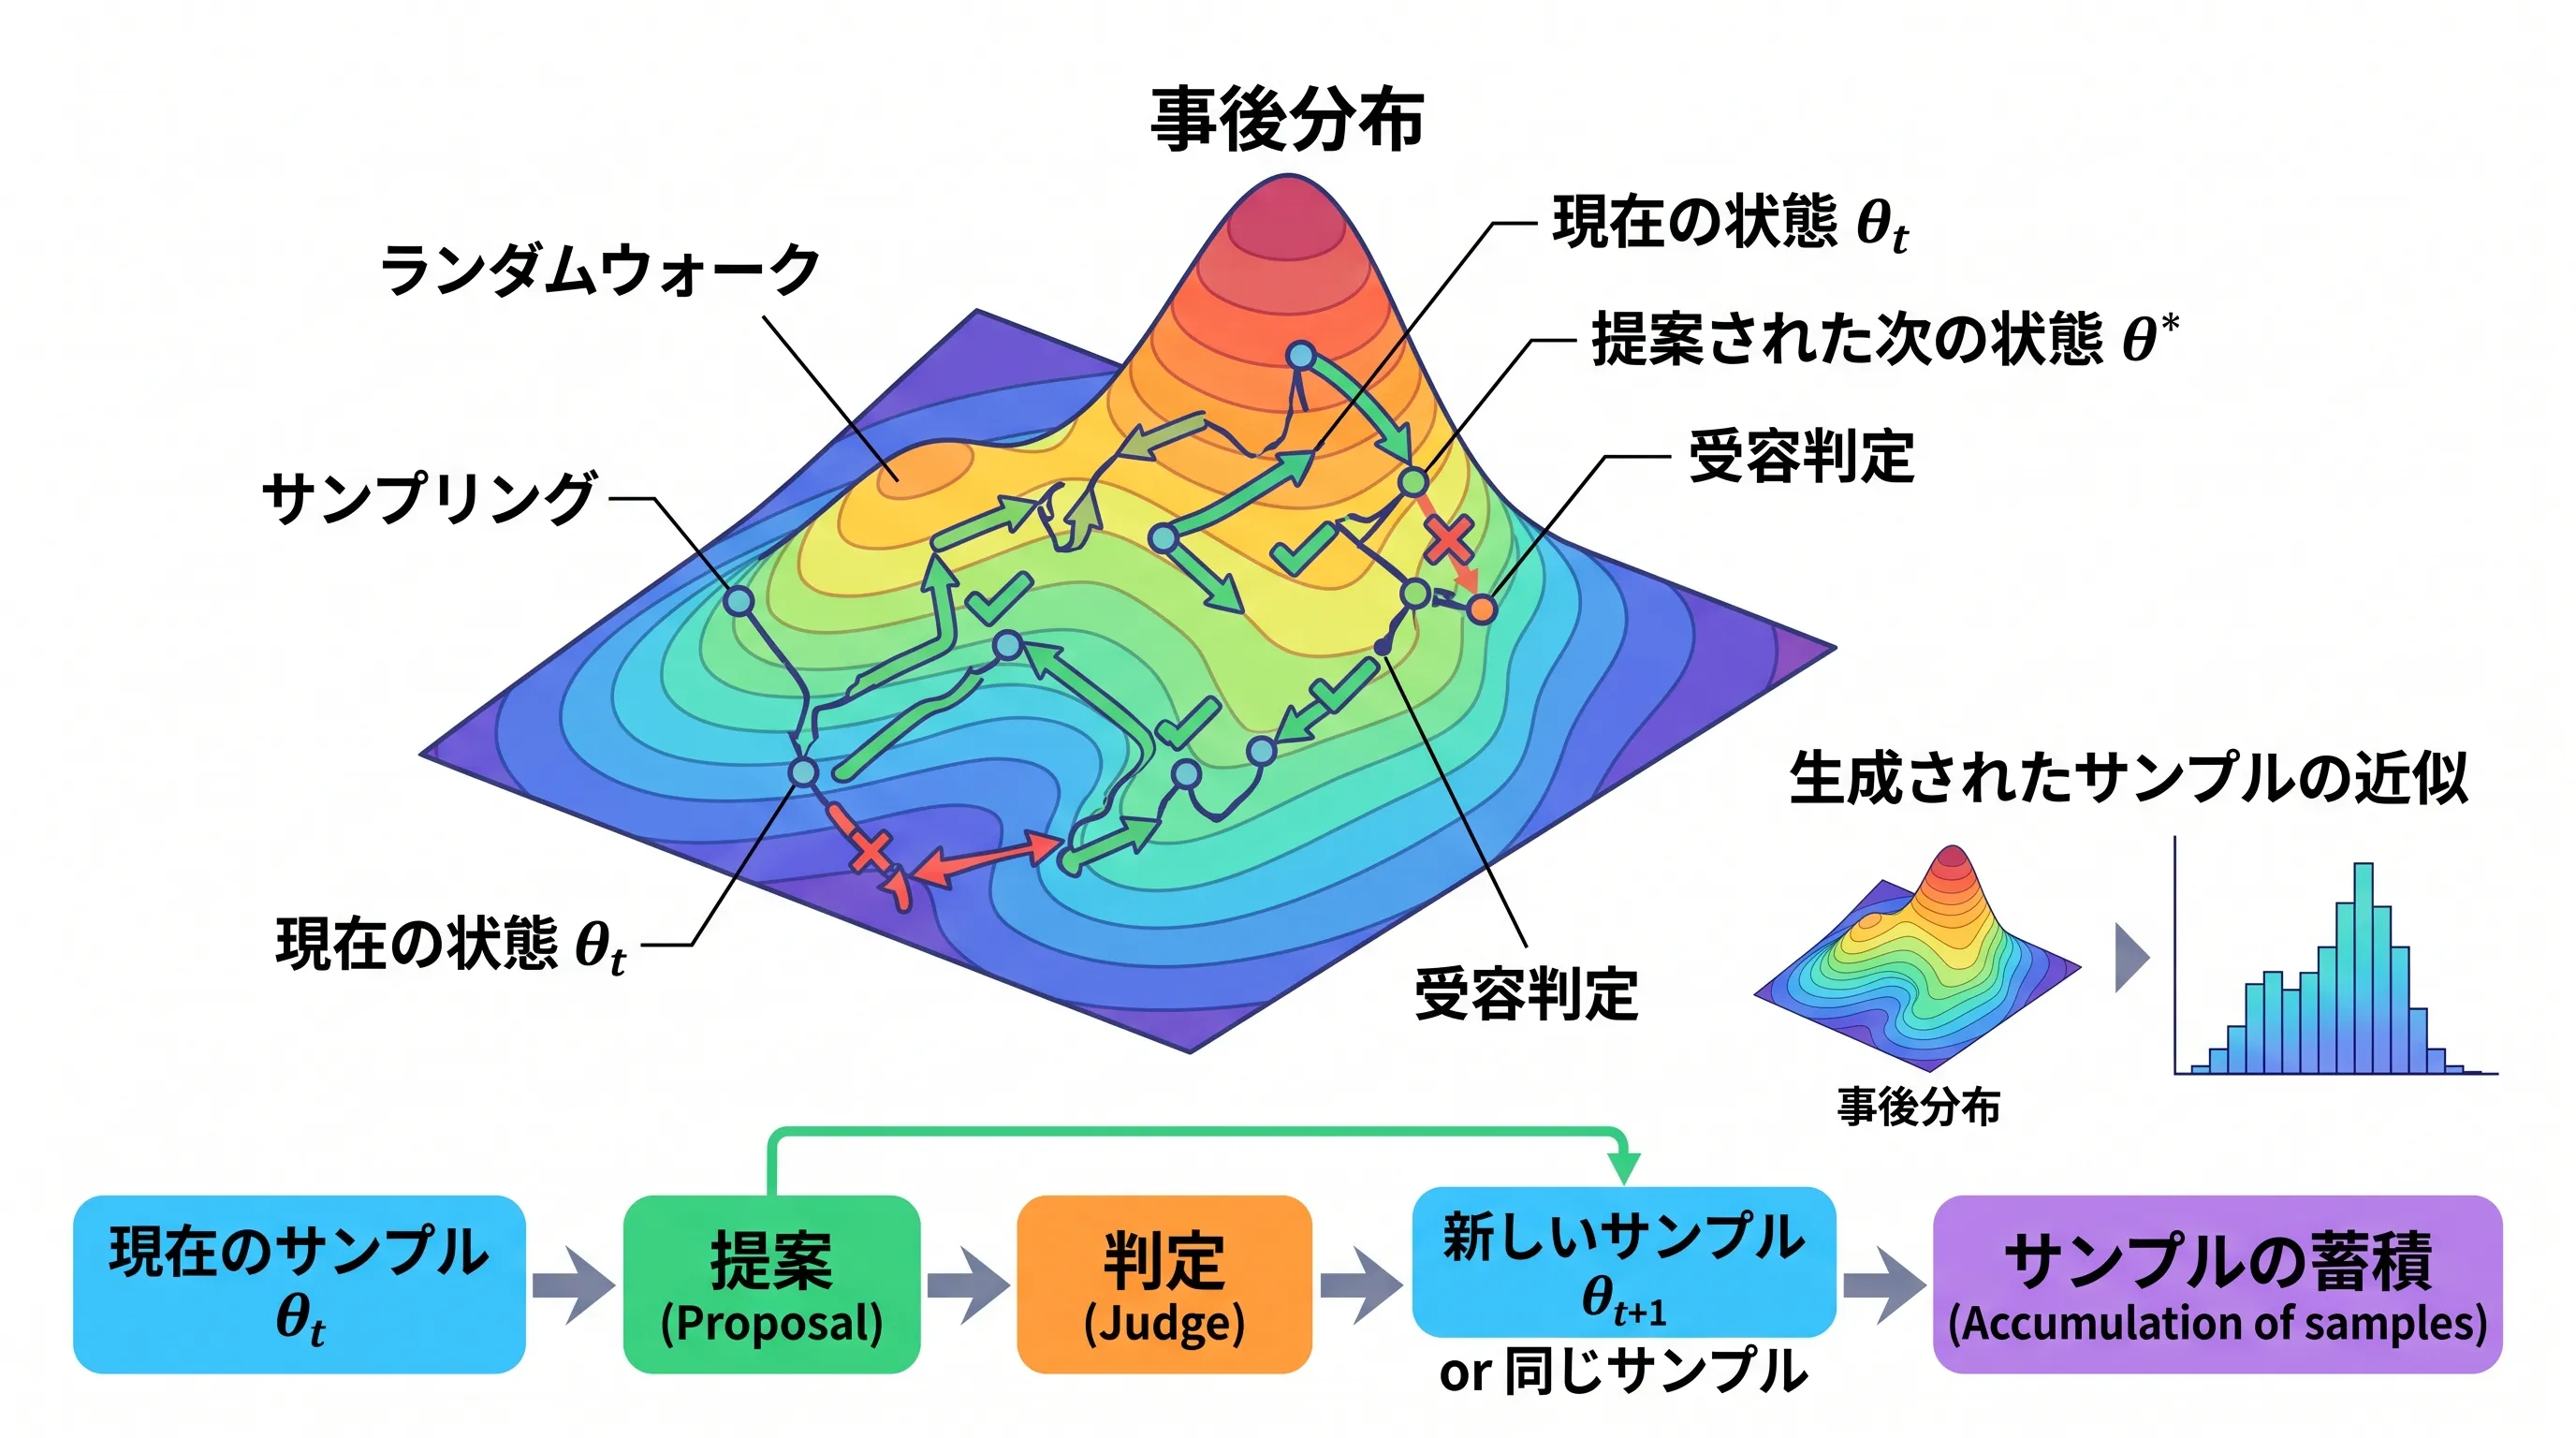
記事を読むベイズ推定の事後分布からサンプリングを行う「MCMC(マルコフ連鎖モンテカルロ法)」の仕組みを解説。メトロポリス基準を用いたPythonでのスクラッチ実装、収束診断(R-hat・ESS)、PyMCによる推定までを網羅します。
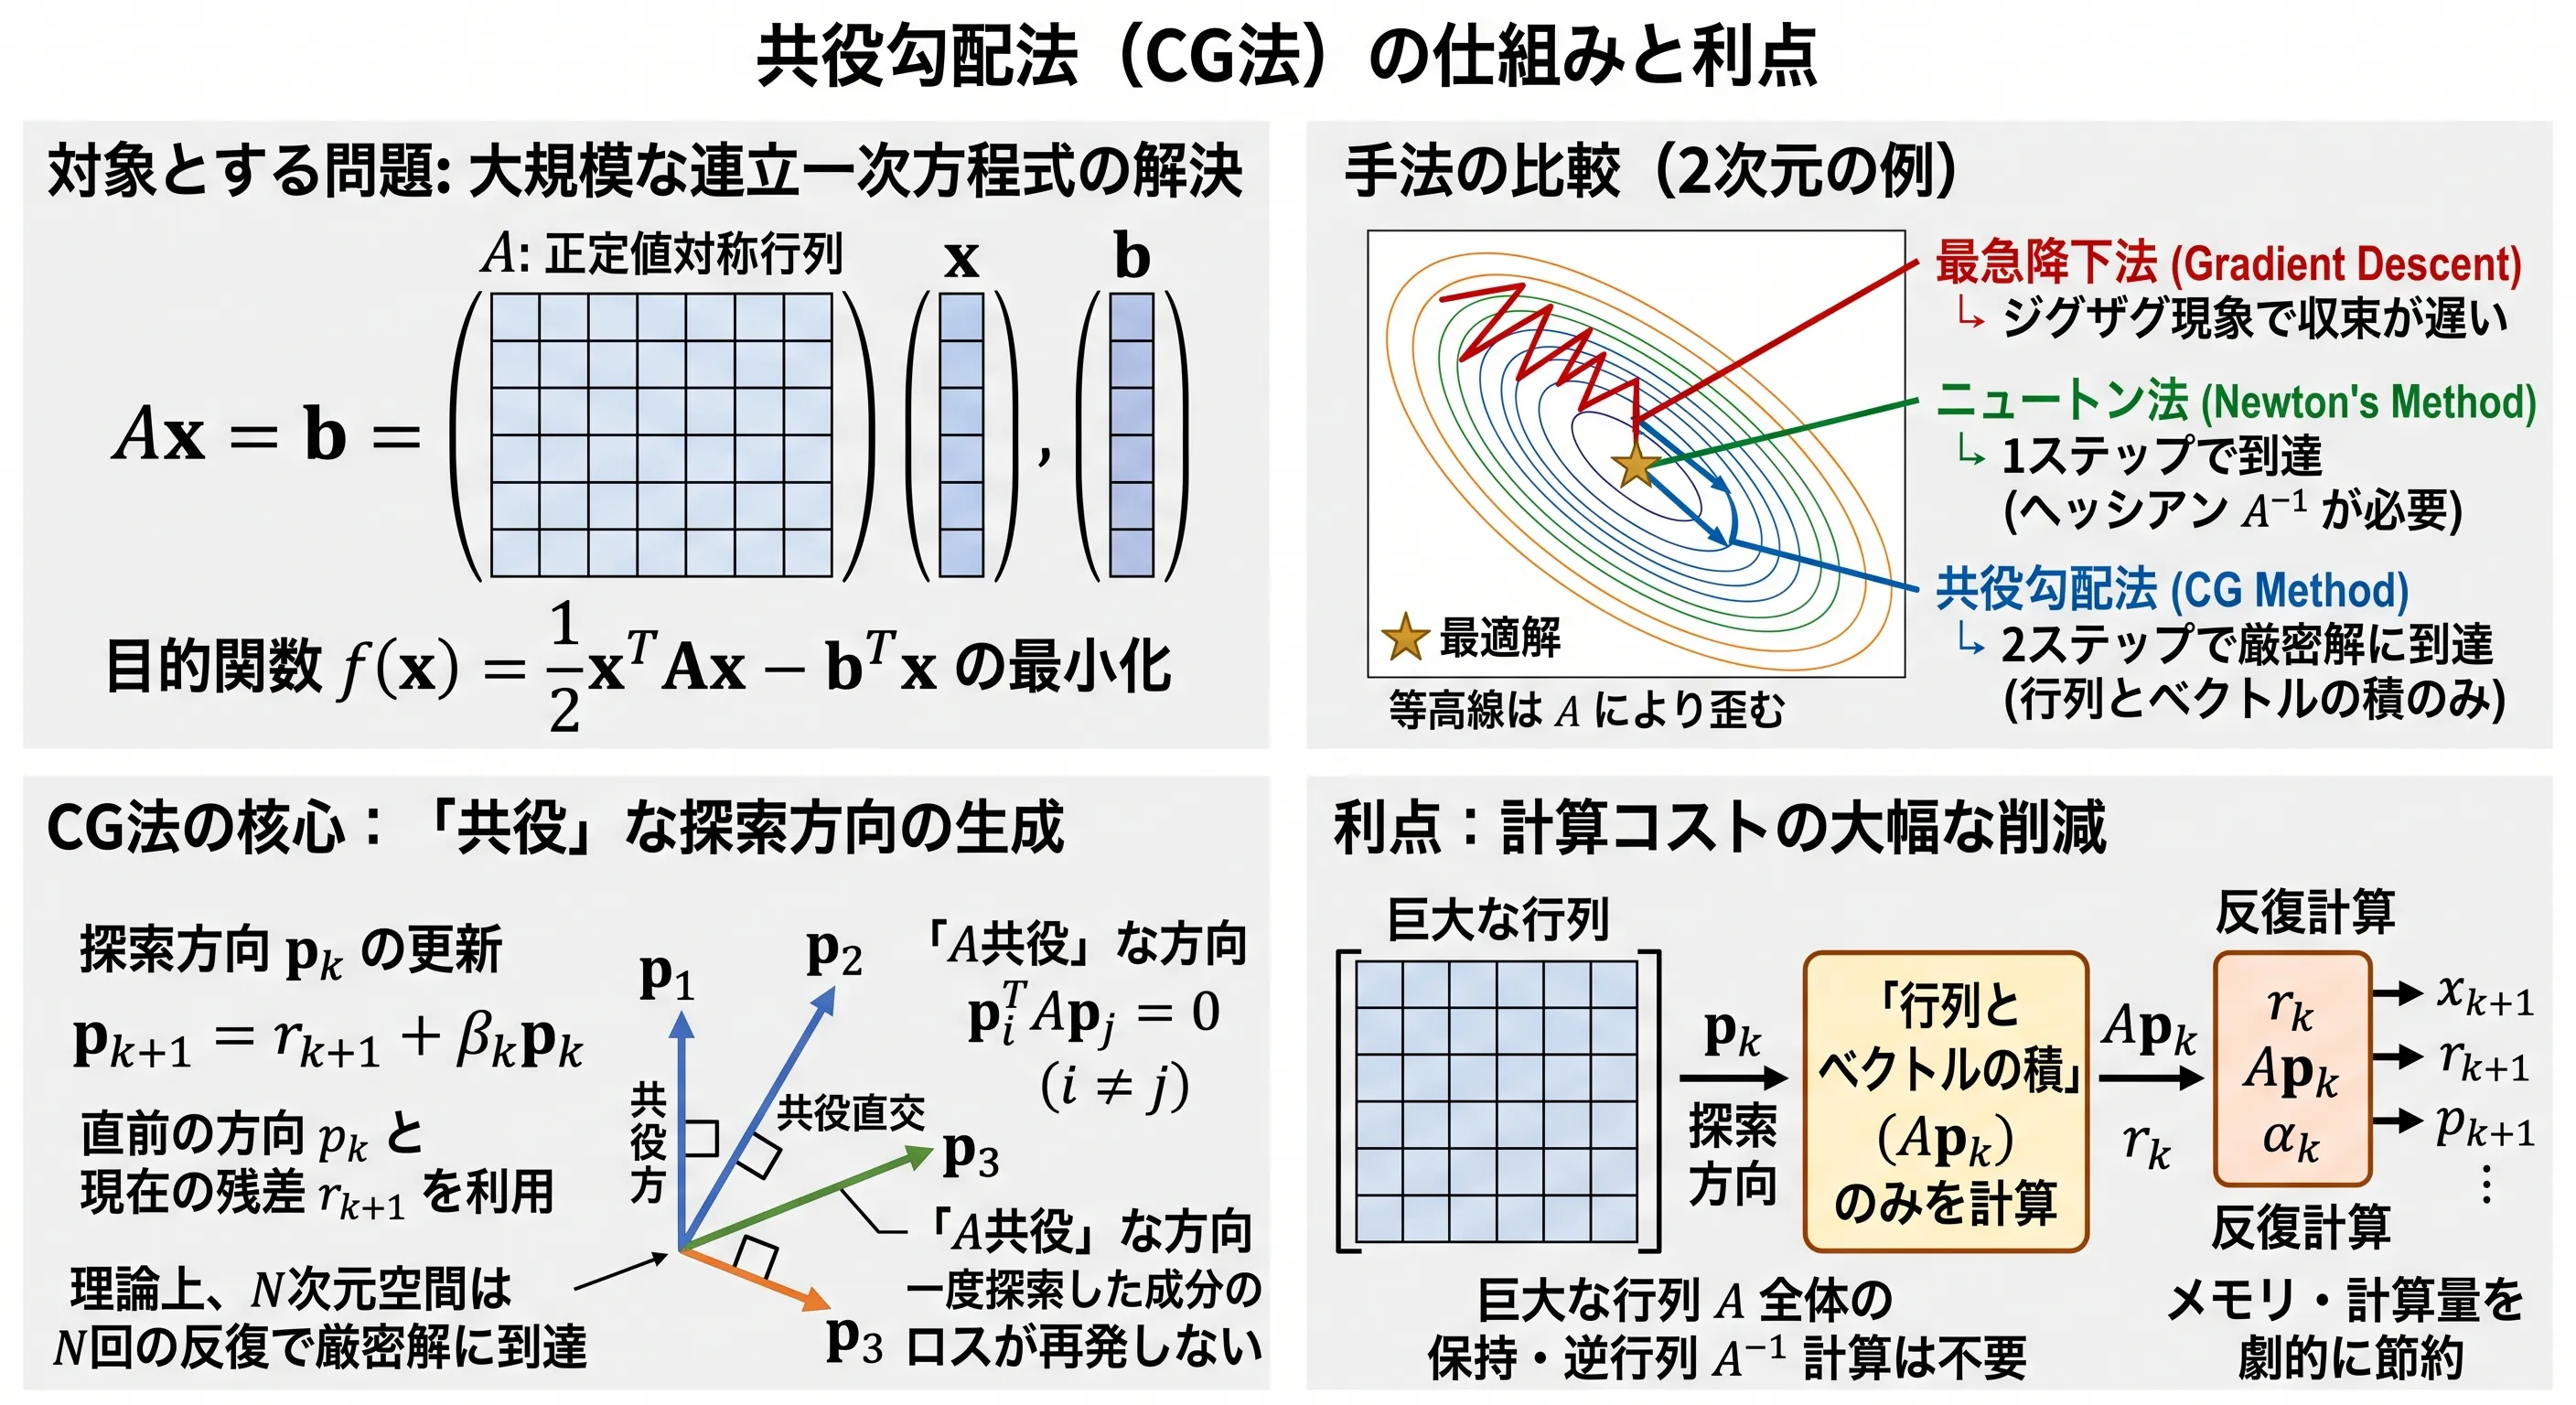
記事を読む正定値対称行列を係数とする大規模な連立一次方程式を高速に解くための強力な反復法「共役勾配法(CG法)」について、最急降下法やニュートン法との違い、数学的な直交性の仕組みから、Pythonによるシミュレーション実装と探索軌跡の可視化までをわかりやすく解説します。
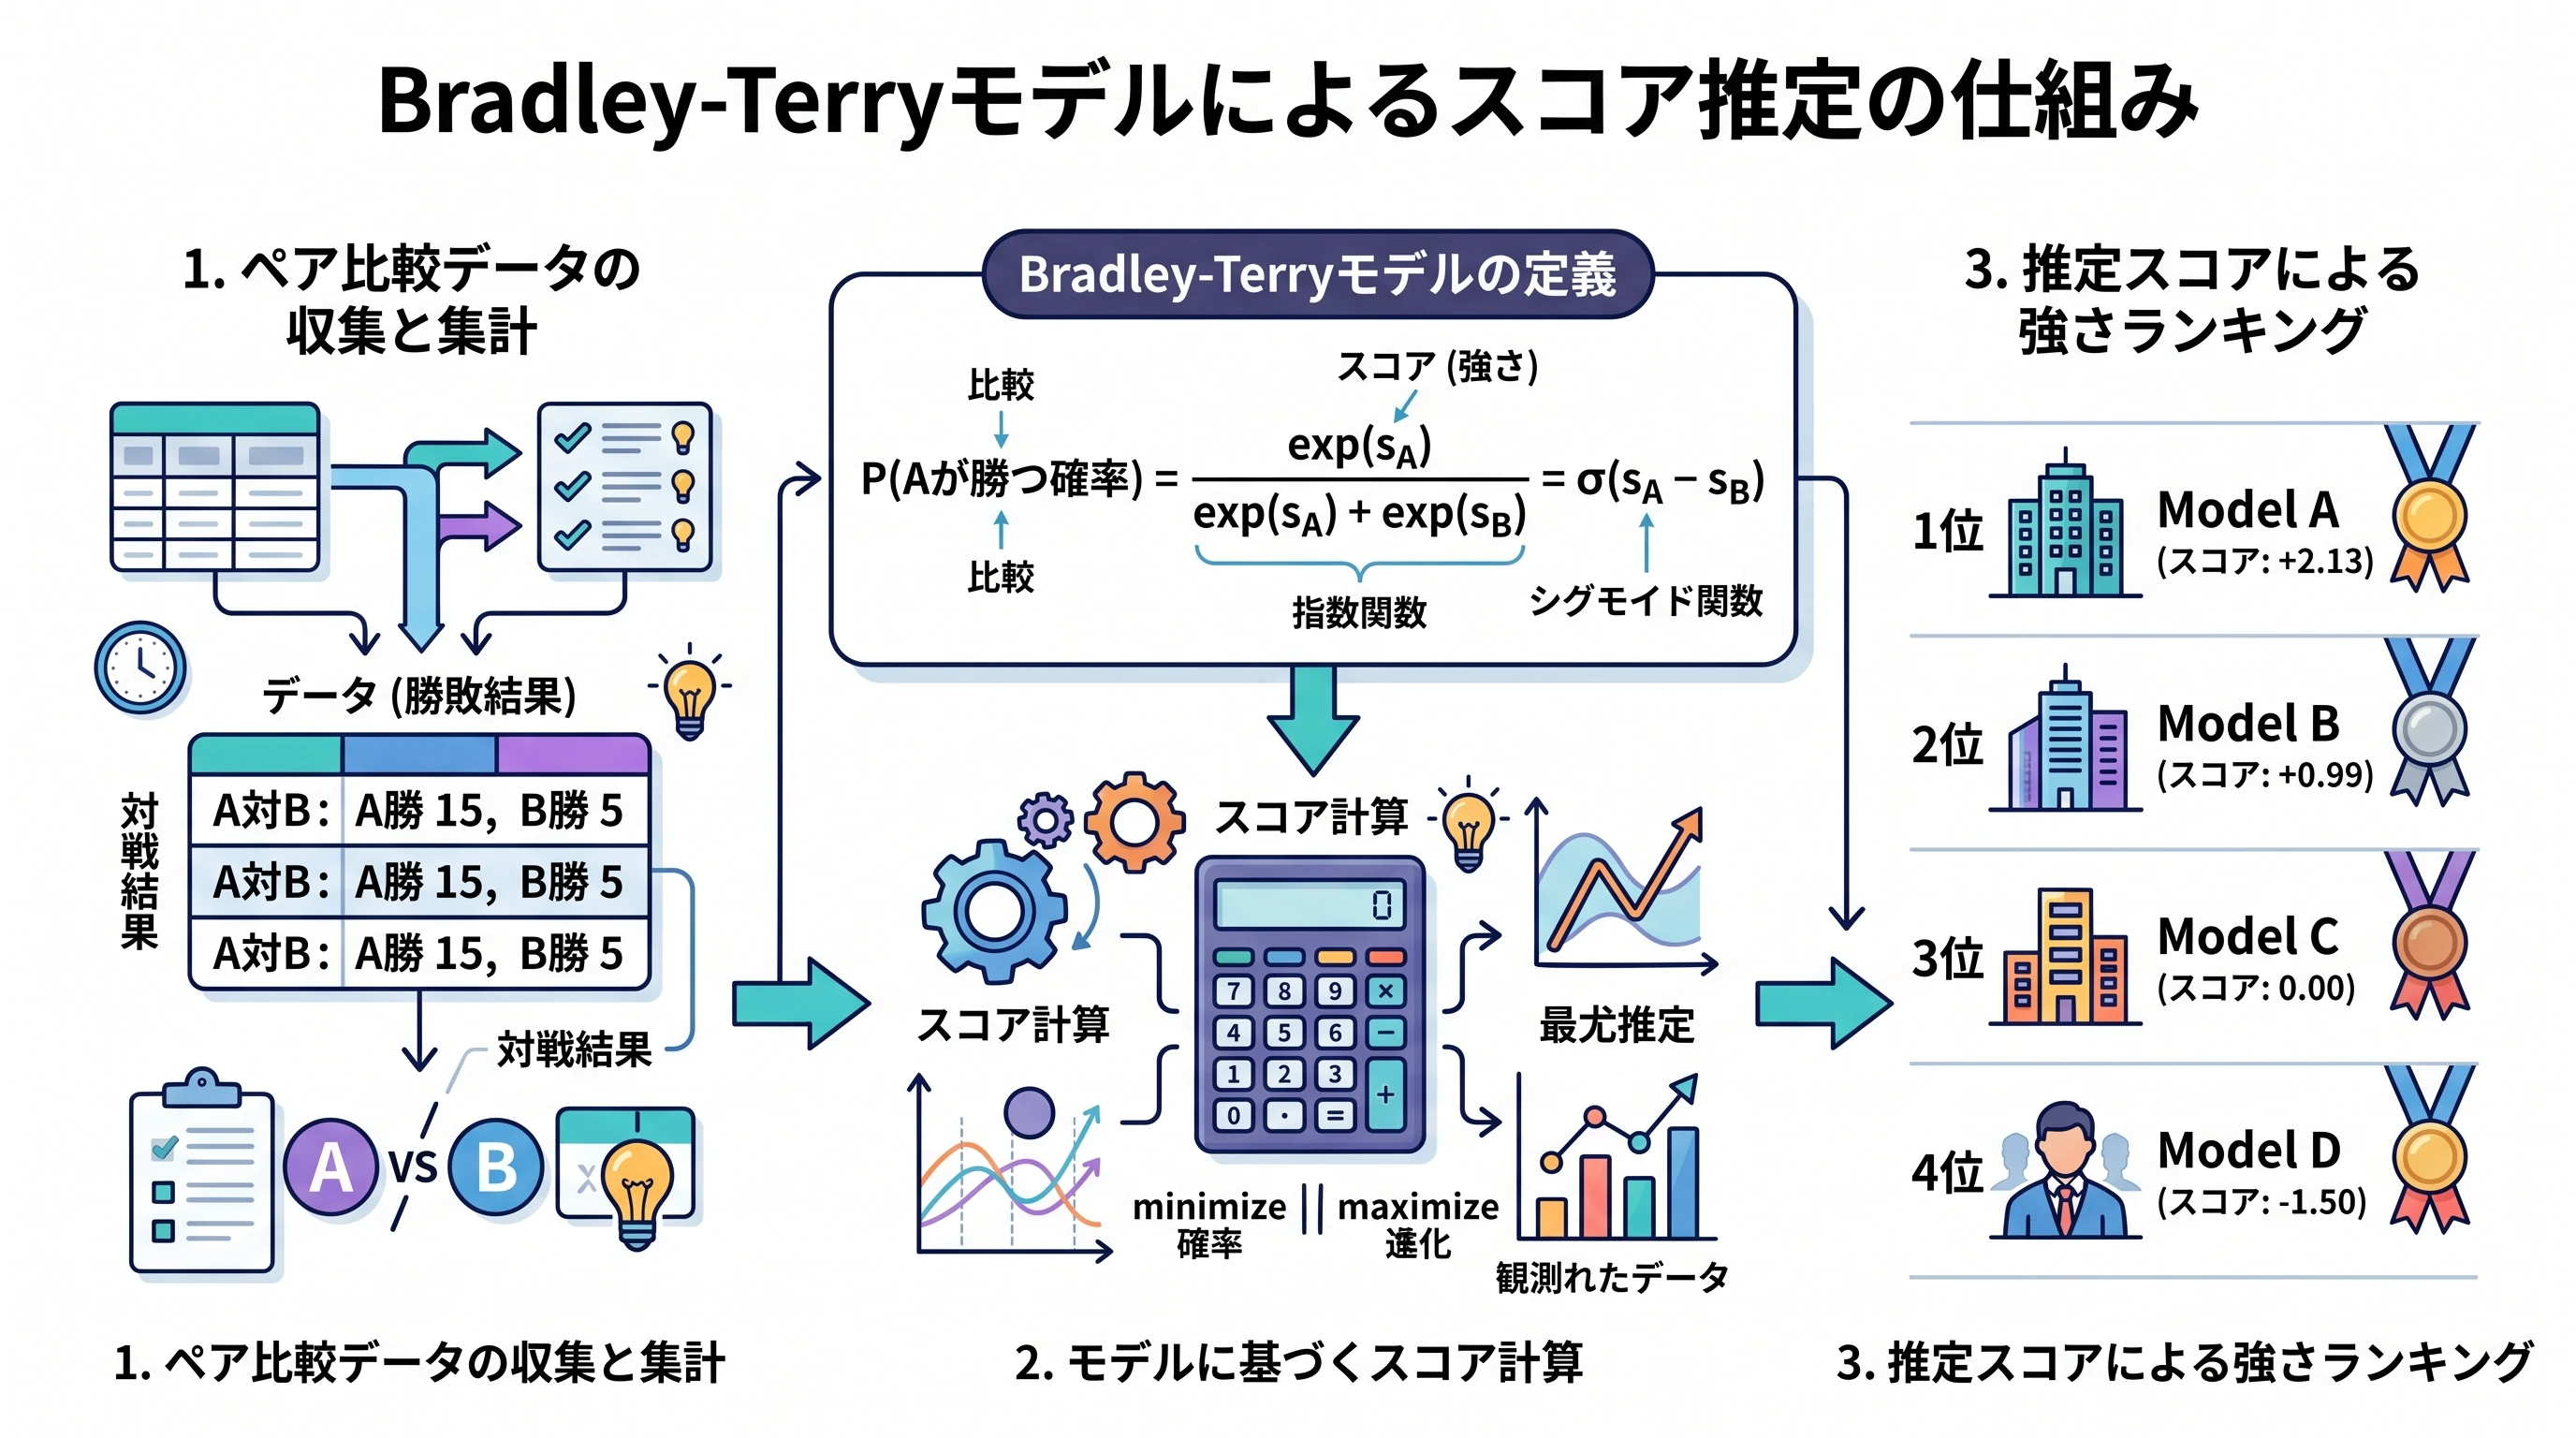
記事を読む2つのものを比べた勝敗や好みのデータから、それぞれの強さ(スコア)を推定するBradley–Terryモデルを解説します。勝率の定義からシグモイド関数が現れる理由、差だけが意味を持つ性質、最尤推定と推定が発散する条件を導き、InstructGPTの報酬モデル、DPO、Chatbot Arenaでの使われ方と、PyTorchによる実装を紹介します。
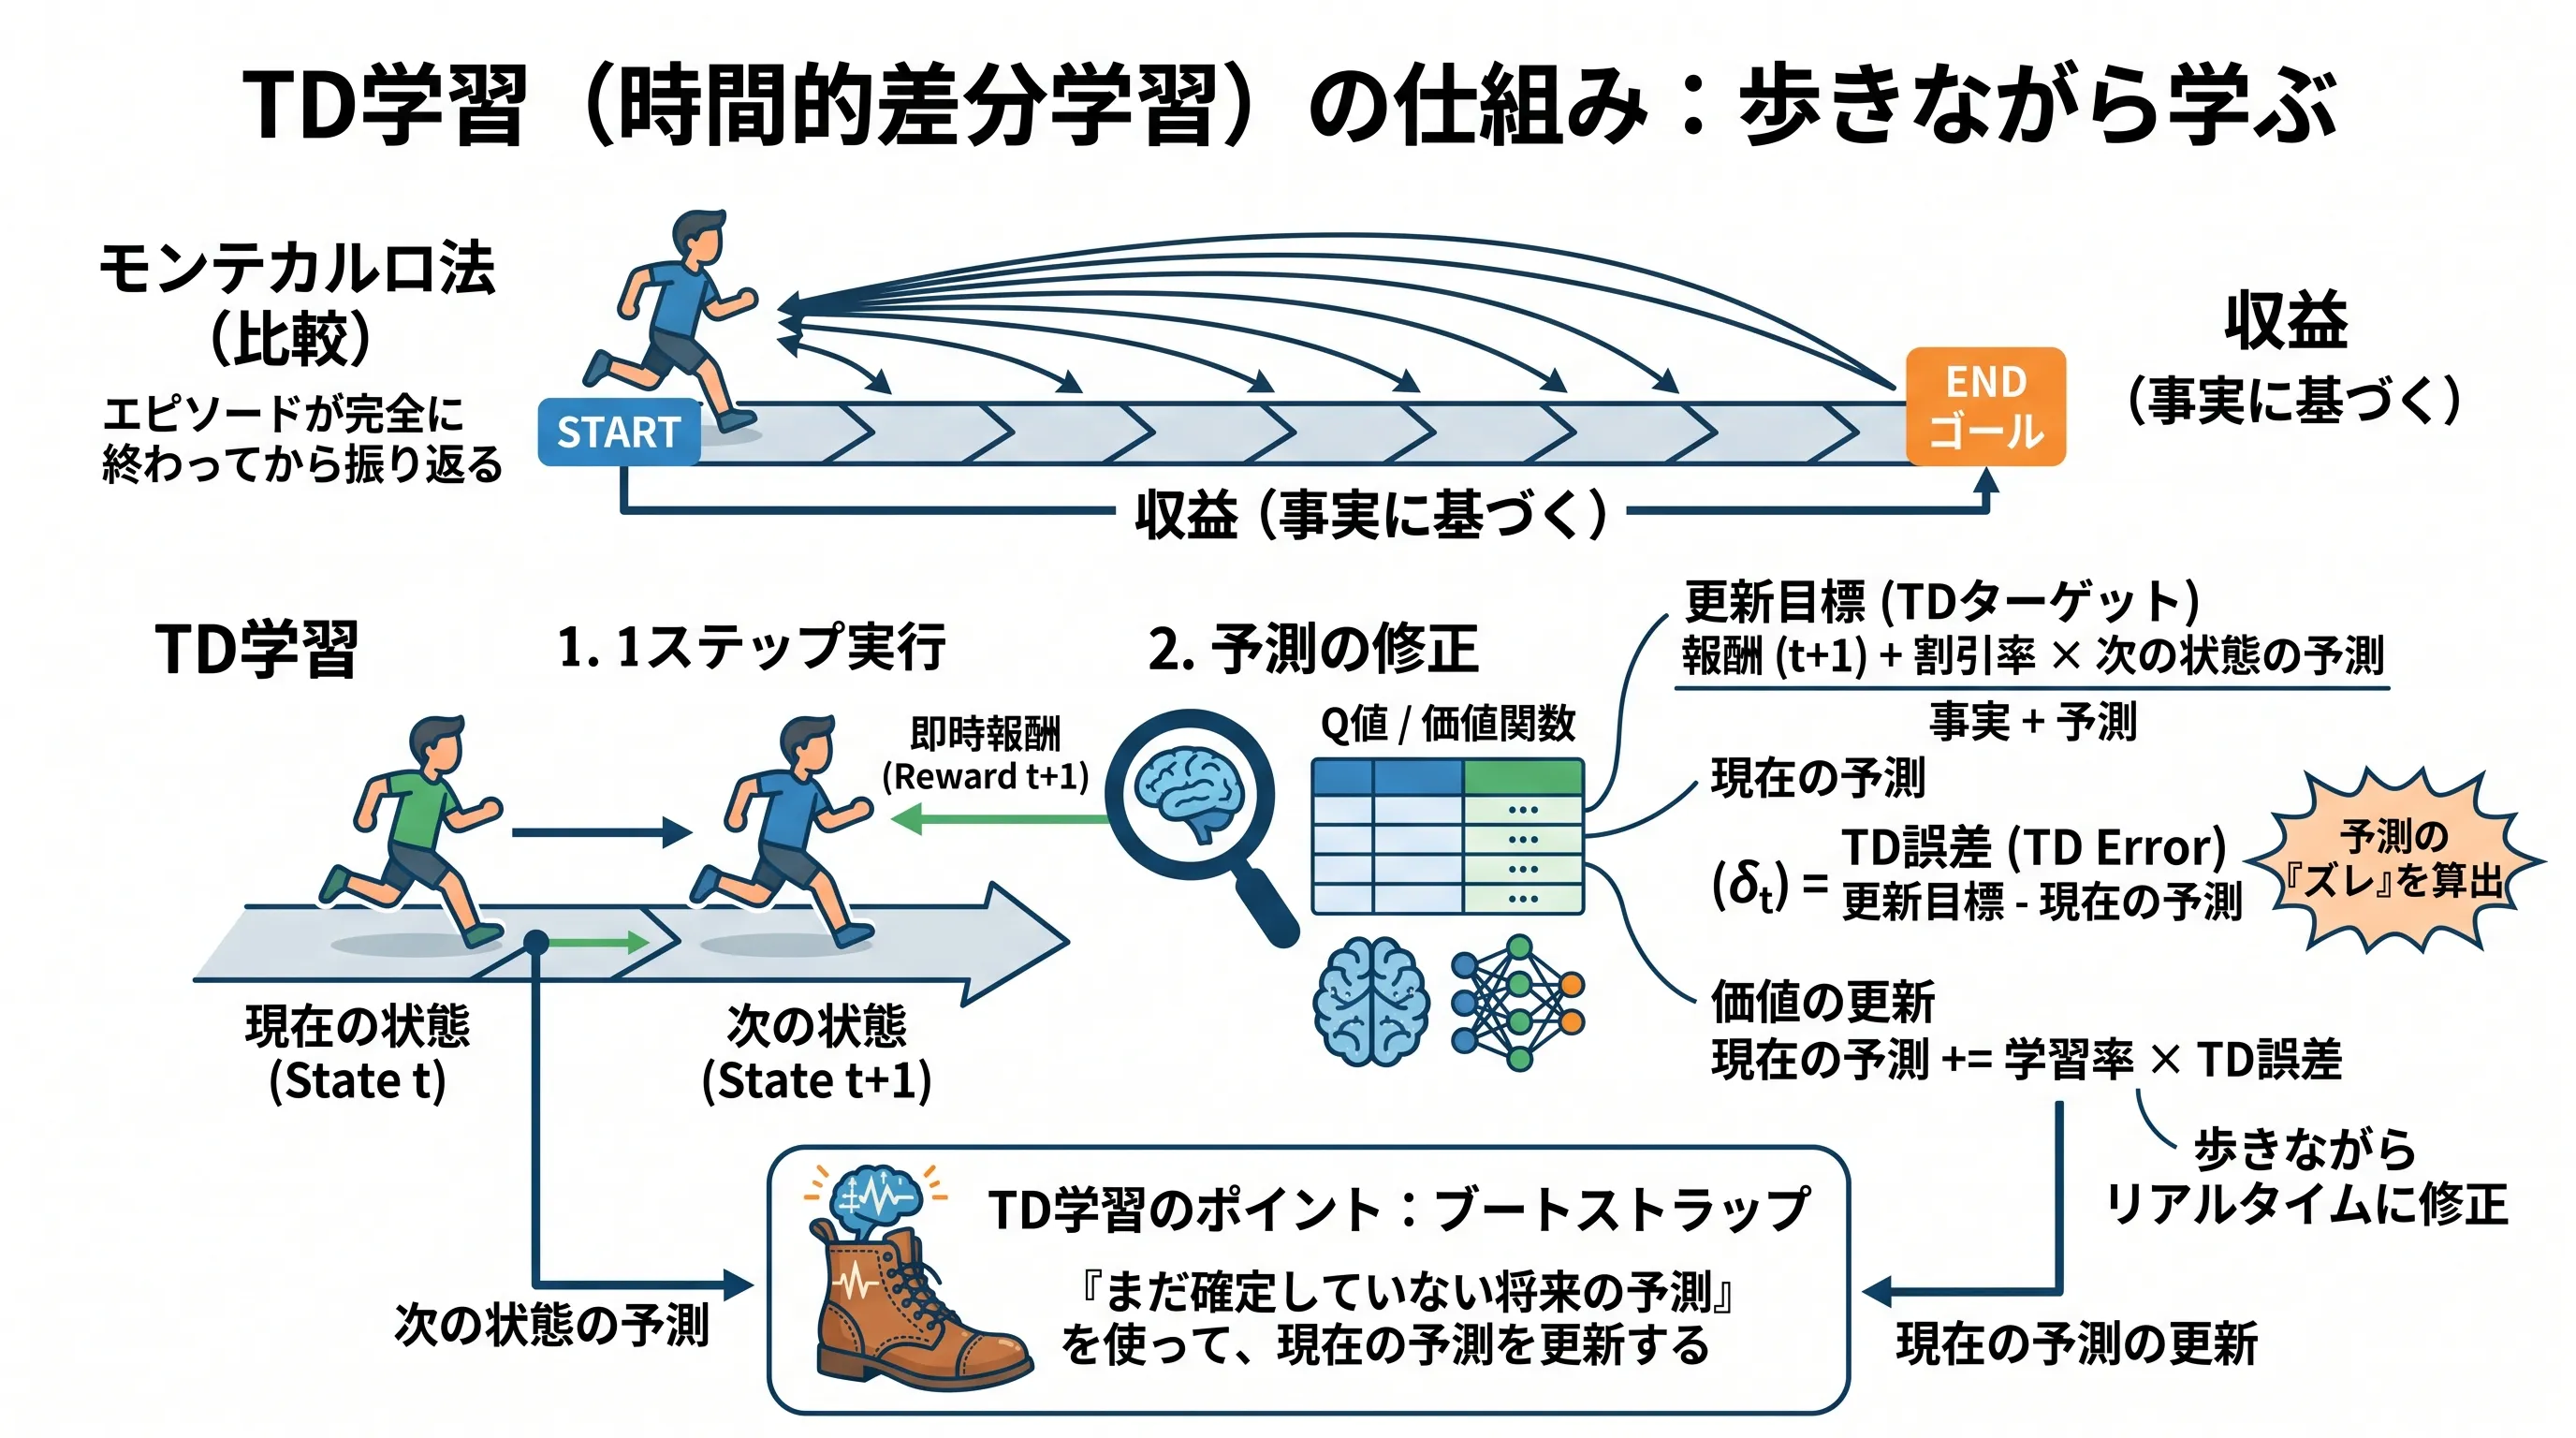
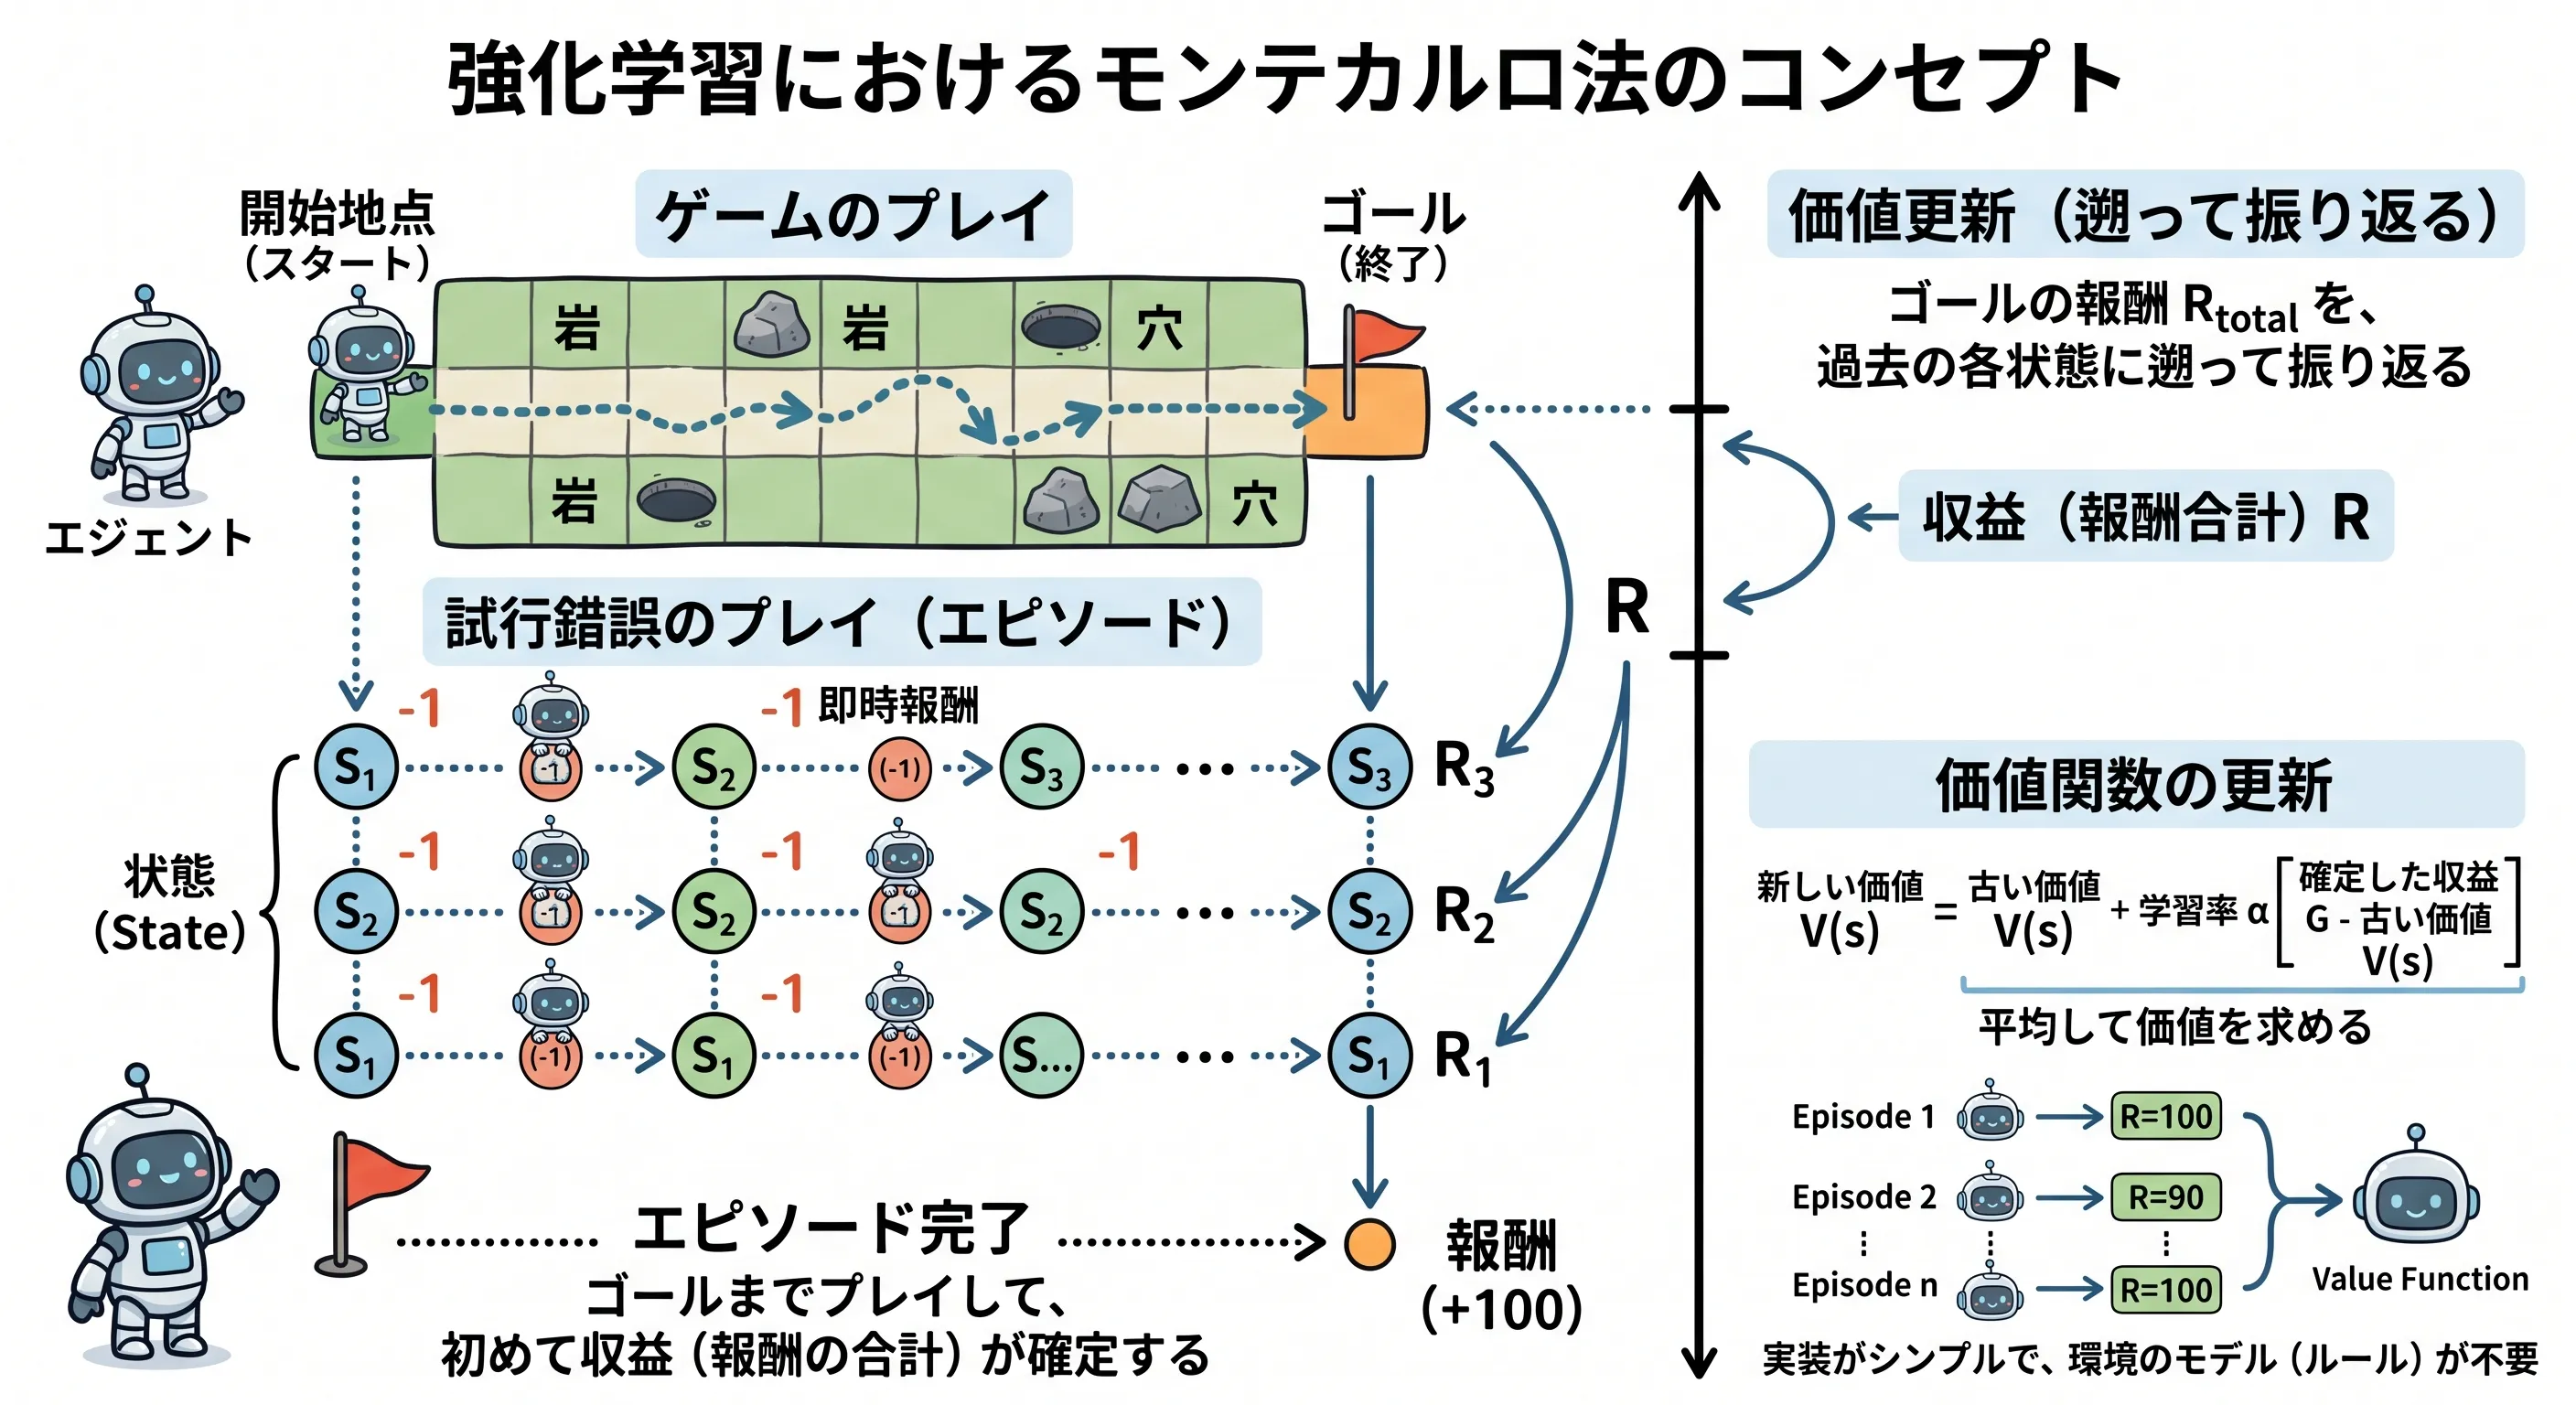
記事を読む強化学習の基礎となる「モンテカルロ法」について、エピソードを最後までやり切って得られた実際の収益から状態価値を逆算する仕組みと、Pythonによるスクラッチ実装を交えて解説します。
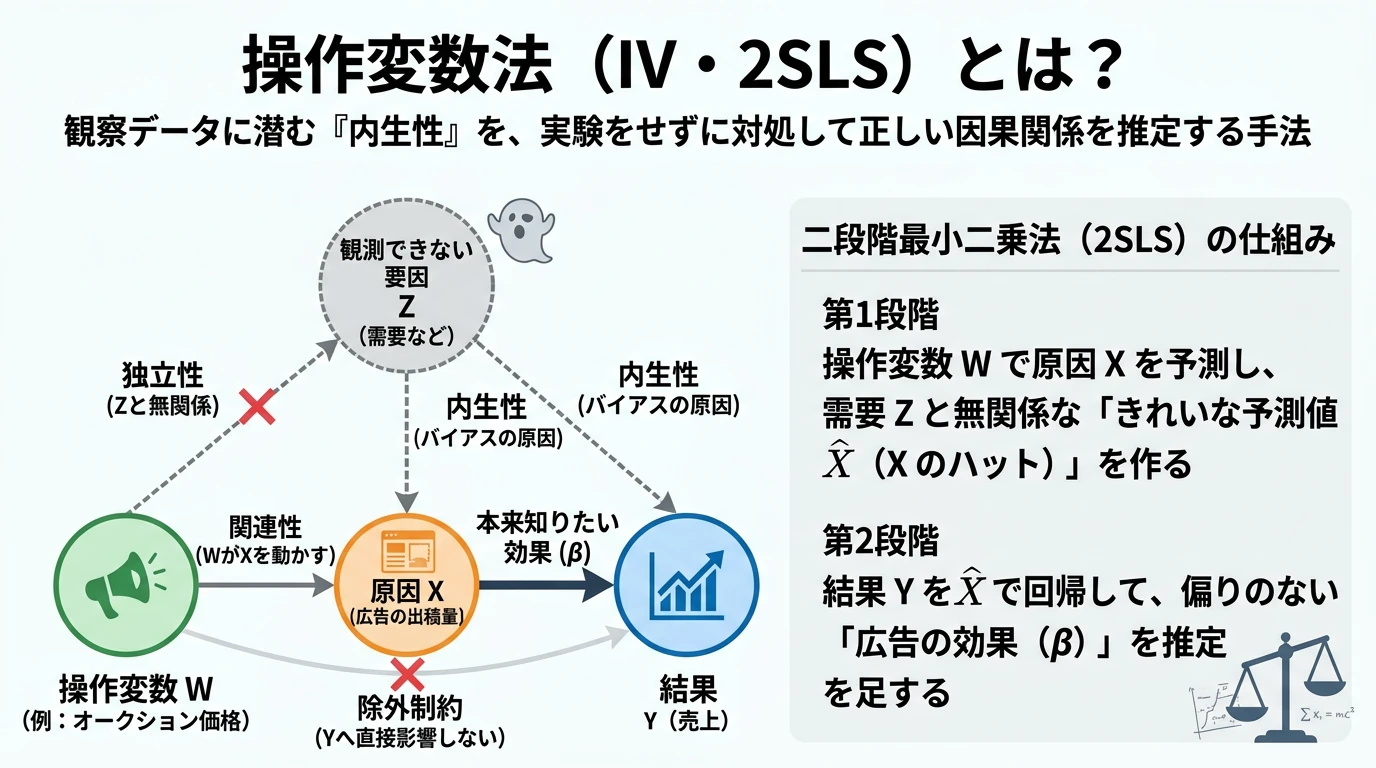
記事を読む観察データで広告の効果を推定するときの内生性に、実験をせずに対処する操作変数法(IV)について、操作変数の3つの条件、共分散の比で効果を取り出す仕組み、二段階最小二乗法(2SLS)と正しい標準誤差、第1段階のF統計量で確かめる弱い操作変数の問題、除外制約が崩れたときの偏りまでを、真値を仕込んだダミーデータとPython(NumPy・statsmodels・linearmodels)による実装で詳しく解説します。
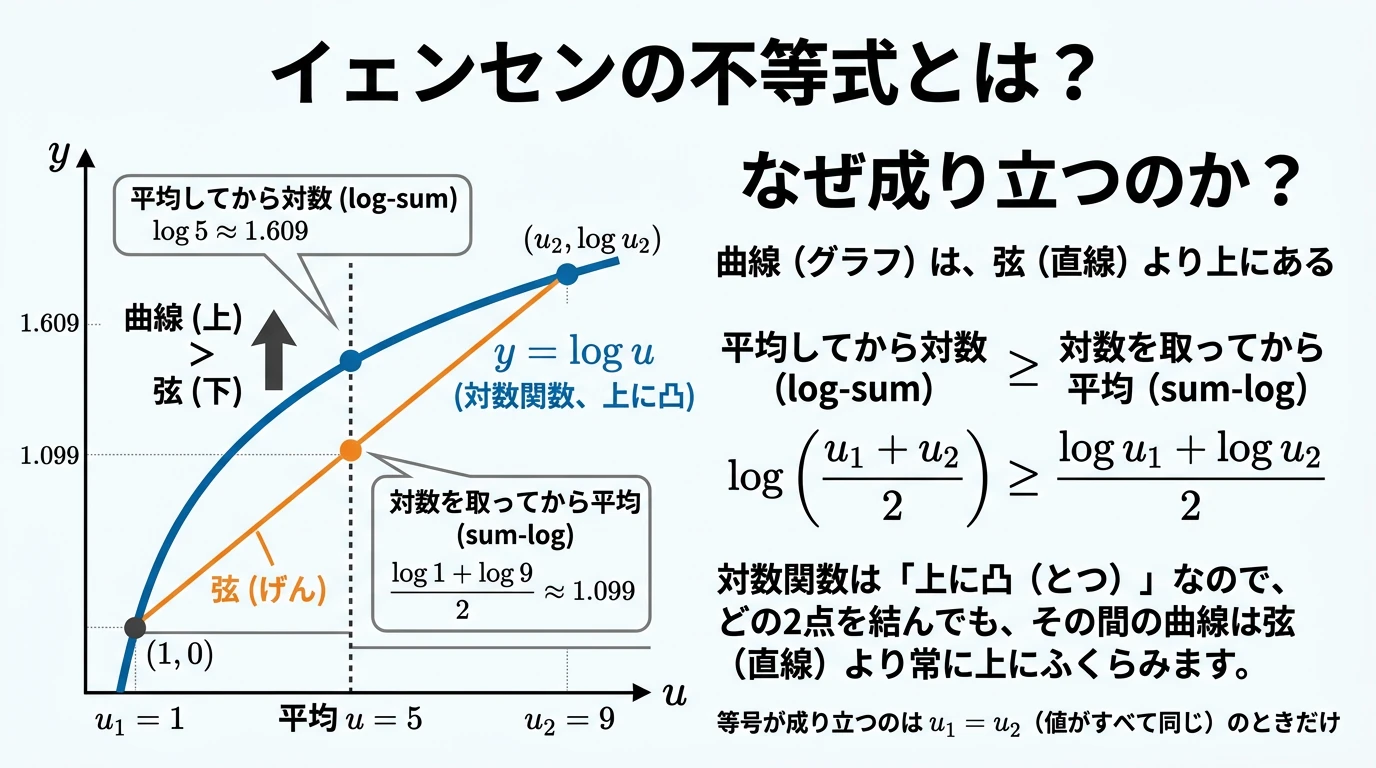
記事を読む「平均してから対数を取った値は、対数を取ってから平均した値以上になる」というイェンセンの不等式が、なぜ成り立つのかを、対数関数のグラフと弦で説明します。2点の場合から3点以上の場合、等号が成り立つ条件までを順に確かめ、Python の数値計算と、EMアルゴリズムの対数尤度の下限で確認します。
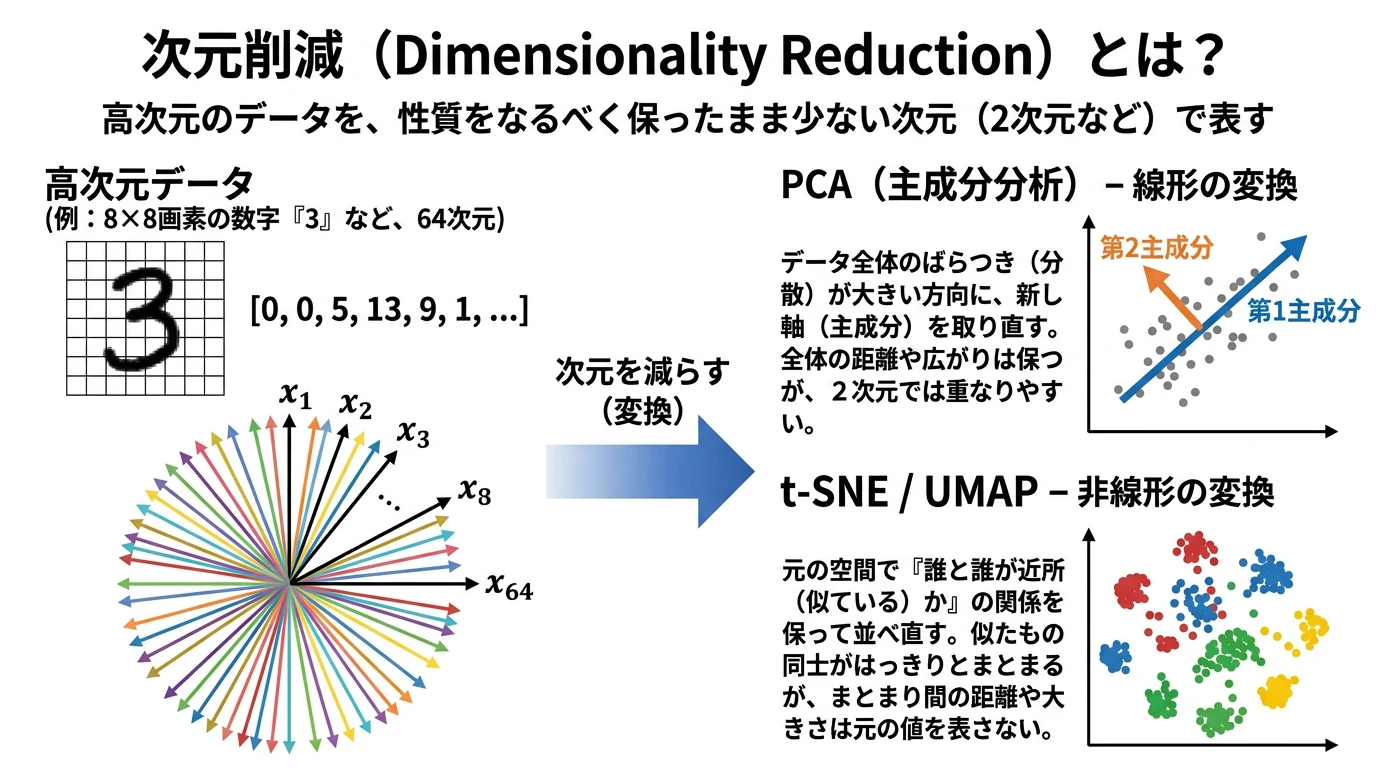
記事を読む高次元のデータを少ない次元で表す次元削減について、PCA(ばらつきの大きい方向に軸を取り直す線形の方法)と、t-SNE・UMAP(近所の関係を保つように点を並べ直す非線形の方法)を、手書き数字のデータと人工データを使ったPythonの実装で解説します。2次元の図でまとまりの間の距離や大きさが読めないことや、クラスタリングの前処理としての効果も確かめます。
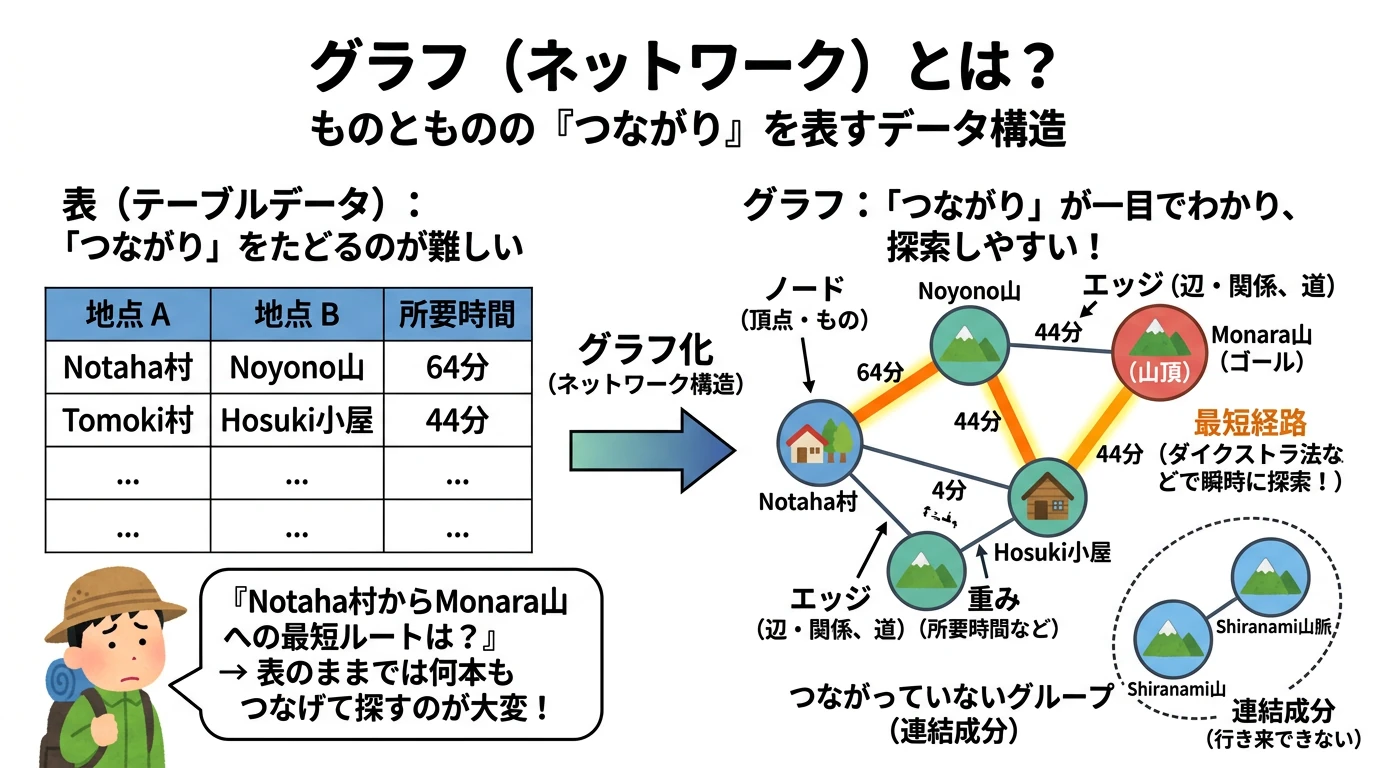
記事を読むものとものの「つながり」を表すデータ構造であるグラフ(ネットワーク)について、ノード・エッジ・有向と無向・重み、隣接行列と隣接リスト、次数と次数分布、幅優先探索とダイクストラ法による最短経路、連結成分までを、架空の山域の登山道のデータとPython(NumPy・networkx)のスクラッチ実装で解説します。
記事を読む