2D RoPEとは?
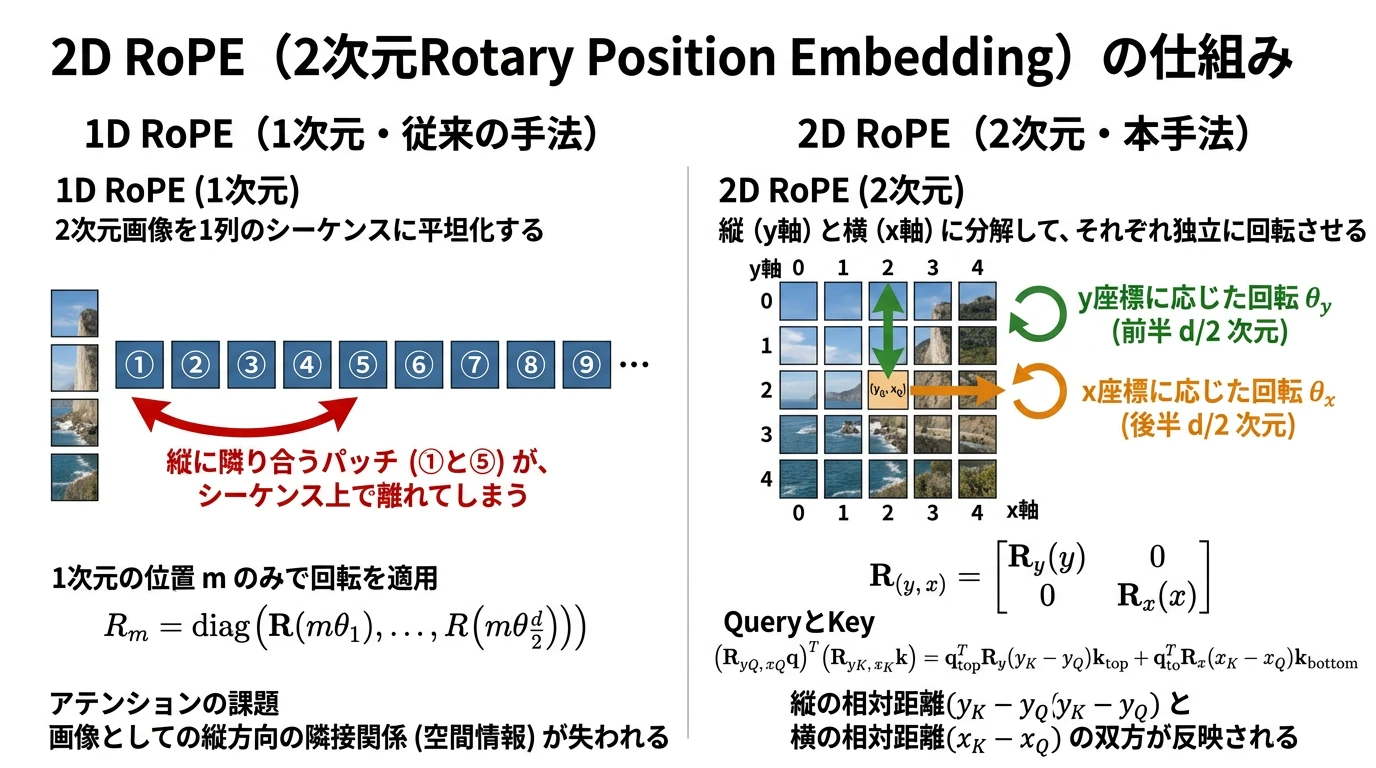 (画像は、Geminiで作成)
画像のパッチを1列に並べて 1D RoPE を使うと縦横の位置関係を表せない理由と、縦と横の座標を別々に回転させる 2D RoPE が、アテンションのスコアを縦方向と横方向の相対距離に分けて表せることを理解すること。NumPy と PyTorch で 1D RoPE と 2D RoPE のアテンションのスコアを比べ、画像パッチに 2D RoPE を適用すると、スコアが相対的な位置だけで決まることを確かめること。
2D RoPEの概要
2次元RoPE(2D Rotary Position Embedding) は、テキスト向けに開発されたRoPEを、画像のような縦横の2次元データに拡張した位置エンコーディング技術です。 マルチモーダル大規模言語モデル(VLM)の発展に伴い、画像を処理するVision Transformer(ViT)の位置エンコーディングとして使われるようになりました。Transformer が位置エンコーディングを必要とする理由と、1次元の位置エンコーディングの基本は、Transformer の記事で解説しています。 例えば、Qwen2-VLでは画像エンコーダ(ViT)の絶対位置埋め込みを取り除いて2D RoPEを導入しており、Mistral AIのPixtralも画像エンコーダに2D RoPE(RoPE-2D)を採用しています。
自然言語処理において、LLaMAをはじめとする多くのLLMは、トークン間の相対的な位置関係を表現できる「1次元のRoPE(1D RoPE)」を採用し、優れた成果を収めてきました。 しかし、この1次元RoPEを画像認識(Visionタスク)にそのまま適用しようとすると、大きな課題が生じます。 画像データをトランスフォーマーに入力する際、通常は2次元の画像をパッチに分割し、1列のシーケンスに平坦化(ラスタースキャン)します。 このため、1次元RoPEでは「左から右へ、上から下へ」と並べた順番での距離しか捉えられず、画像上で「縦方向に隣り合っているパッチ」の距離が、シーケンス上では離れたものとして扱われてしまいます。 結果として、画像が持つ本質的な2次元の空間的連続性や幾何学的な構造を、位置エンコーディングとして素直に表現できないというデメリットがありました。
また、従来のViTで一般的だった学習可能な絶対位置埋め込みは、学習時の画像サイズ(パッチの縦横の数)に合わせて位置ベクトルを用意するため、異なる解像度やアスペクト比の画像を扱うには、位置ベクトルを補間する必要があり、性能の低下を招くことがありました。
2D RoPEは、RoPEが持つ「位置の差分を回転角の差分で表現する」という特性を維持したまま、空間を「縦方向(軸)」と「横方向(軸)」の2つの独立した回転に分解して適用することで、これらの課題を解決しました。
具体的には、QueryとKeyのベクトルを前半と後半の2つに分割し、前半には縦方向の位置に応じた回転を、後半には横方向の位置に応じた回転をそれぞれ施します。
これにより、QueryとKeyの内積(アテンション・スコア)を計算する際、数学的に「縦方向の距離」と「横方向の距離」の双方がアテンションの重みに直接反映されるようになります。
さらに、位置ベクトルの表を持たず、座標から回転角を計算するだけなので、学習時と異なる解像度やアスペクト比の画像にもそのまま適用できます。
この2次元データに対するRoPEの体系的な適用と拡張については、NAVER AI Labの研究チームによる論文 "Rotary Position Embedding for Vision Transformer" (ECCV 2024) などで詳細に議論されています。この論文では、次元を分割して縦横に個別の回転を施す手法(Axial 2D RoPE)の分析に加え、対角方向の表現力を向上させる学習可能な周波数混合アプローチ(RoPE-Mixed)なども提案され、学習時より高い解像度の画像に対しても性能が落ちにくい(外挿性能が高い)ことが示されました。
4×4 のパッチを1列に並べたときの距離を図にすると、次のようになります。
(図は、diagram-designで作成)
1次元RoPE vs 2次元RoPEの比較
Queryベクトルを 、Keyベクトルを とします。
1次元RoPE(通常のテキスト等)
位置 (Query)と 位置 (Key)における回転行列 は、2次元の回転行列を対角線上に並べたブロック対角行列として定義されます。
次元 の場合の の例:
QueryとKeyの内積(アテンション・スコア)を計算すると、回転行列の性質()により、以下のように位置の差()だけが残る行列に変化します。
※ここでは以下です。
2次元RoPE(画像・マルチモーダル)
2D RoPEでは、次元 を前半の 次元(縦方向 )と、後半の 次元(横方向 )に分割し、それぞれの軸に対して独立した回転行列 を適用します。全体の回転行列 は、以下のように と を直和(結合)した形になります。
※ここで、 は縦の位置 を用いた の回転行列、 は横の位置 を用いた の回転行列です。それぞれ、1次元RoPEと同じく、周波数 の異なる2次元回転を 個並べたブロック対角行列になっています。
次元 の場合の の例(各軸に1ペアずつなので、周波数は の1つだけです):
Queryの座標を 、Keyの座標を としたときの内積は、次のように縦の差分行列と横の差分行列の足し算に分解されます( は前半の次元、 は後半の次元です)。
※ の場合を具体的に書くと、以下のようになります。
2D RoPE の次元の分け方を図にすると、次のようになります。
(図は、diagram-designで作成)
コードによる1D RoPEと2D RoPEの比較
コードからQuery V0H0に対するAttentionを可視化することで、上記の数式で説明した1D RoPEと2D RoPEの挙動の違いを直感的に理解します。 numpyを用いて4x4のグリッド上のパッチを想定し、特定のクエリ位置(左上のV0H0)に対する他の全パッチのアテンションスコアを計算します。最終的に、matplotlibを使って計算結果をヒートマップとして描画し、1次元RoPEがシーケンス順の距離しか考慮しないのに対し、2次元RoPEがグリッド上の縦横の距離を反映できることを確認します。
import numpy as np
import matplotlib.pyplot as plt

# --- 1. 基本設定(4x4グリッド、隠れ層の次元 d=4) ---
grid_size = 4
num_patches = grid_size * grid_size
d = 4

# 位置情報の定義
# 1D RoPE用: シーケンス位置 m (0 ~ 15)
pos_1d = np.arange(num_patches)
# 2D RoPE用: (y, x) 座標 (0 ~ 3)
pos_y, pos_x = np.meshgrid(np.arange(grid_size), np.arange(grid_size), indexing='ij')
pos_y = pos_y.flatten()
pos_x = pos_x.flatten()

# --- 2. Query と Key のダミー特徴量ベクトルの定義 (d=4) ---
# 本来は画像の中身(セマンティクス)ですが、位置情報のみの影響を見るために
# 全パッチで共通の「すべての特徴が等しく含まれるベクトル」として初期化します。
q_base = np.array([1.0, 1.0, 1.0, 1.0])
k_base = np.array([1.0, 1.0, 1.0, 1.0])

# --- 3. 回転行列 (R) を生成する関数の定義 ---
# 1D RoPEの回転行列 (d=4)
def get_R_1d(m, theta1=0.4, theta2=0.1):
    R = np.zeros((4, 4))
    # 前半2次元 (θ1で回転)
    R[0, 0], R[0, 1] = np.cos(m * theta1), -np.sin(m * theta1)
    R[1, 0], R[1, 1] = np.sin(m * theta1),  np.cos(m * theta1)
    # 後半2次元 (θ2で回転)
    R[2, 2], R[2, 3] = np.cos(m * theta2), -np.sin(m * theta2)
    R[3, 2], R[3, 3] = np.sin(m * theta2),  np.cos(m * theta2)
    return R

# 2D RoPEの回転行列 (d=4)
def get_R_2d(x, y, theta=0.5):
    R = np.zeros((4, 4))
    # 前半2次元: 縦方向 y に応じた回転
    R[0, 0], R[0, 1] = np.cos(y * theta), -np.sin(y * theta)
    R[1, 0], R[1, 1] = np.sin(y * theta),  np.cos(y * theta)
    # 後半2次元: 横方向 x に応じた回転
    R[2, 2], R[2, 3] = np.cos(x * theta), -np.sin(x * theta)
    R[3, 2], R[3, 3] = np.sin(x * theta),  np.cos(x * theta)
    return R

# --- 4. Queryを左上 V0H0 (インデックス0) に固定してアテンション計算 ---
query_idx = 0

# 1D RoPE の Query ベクトル計算
R_q_1d = get_R_1d(pos_1d[query_idx])
q_1d = R_q_1d @ q_base

# 2D RoPE の Query ベクトル計算
R_q_2d = get_R_2d(pos_x[query_idx], pos_y[query_idx])
q_2d = R_q_2d @ q_base

attn_1d_flat = np.zeros(num_patches)
attn_2d_flat = np.zeros(num_patches)

for k_idx in range(num_patches):
    # --- 1D RoPE の厳密計算 ---
    R_k_1d = get_R_1d(pos_1d[k_idx])
    k_1d = R_k_1d @ k_base
    attn_1d_flat[k_idx] = np.dot(q_1d, k_1d) # 厳密な内積計算

    # --- 2D RoPE の厳密計算 ---
    R_k_2d = get_R_2d(pos_x[k_idx], pos_y[k_idx])
    k_2d = R_k_2d @ k_base
    attn_2d_flat[k_idx] = np.dot(q_2d, k_2d) # 厳密な内積計算

# 4x4の画像空間にリシェイプ
grid_attn_1d = attn_1d_flat.reshape(grid_size, grid_size)
grid_attn_2d = attn_2d_flat.reshape(grid_size, grid_size)

# --- 5. プロット描画 ---
fig, axes = plt.subplots(1, 2, figsize=(14, 6))
labels = [f"V{v}H{h}" for v in range(grid_size) for h in range(grid_size)]

# 1D RoPE プロット
im1 = axes[0].imshow(grid_attn_1d, cmap='viridis', vmin=-1, vmax=4)
axes[0].set_title('1D RoPE ($q^T R_{m}^T R_{n} k$)\nQuery: V0H0', fontsize=12, pad=15)

# 2D RoPE プロット
im2 = axes[1].imshow(grid_attn_2d, cmap='viridis', vmin=-1, vmax=4)
axes[1].set_title('2D RoPE ($q^T R_{(x_Q,y_Q)}^T R_{(x_K,y_K)} k$)\nQuery: V0H0', fontsize=12, pad=15)

# 数値ラベルのマッピング
for v in range(grid_size):
    for h in range(grid_size):
        idx = v * grid_size + h
        # 1D
        val_1d = grid_attn_1d[v, h]
        c_1d = "black" if val_1d > 1.5 else "white"
        axes[0].text(h, v, f"{labels[idx]}\n{val_1d:.2f}", ha="center", va="center", color=c_1d, fontweight='bold')
        # 2D
        val_2d = grid_attn_2d[v, h]
        c_2d = "black" if val_2d > 1.5 else "white"
        axes[1].text(h, v, f"{labels[idx]}\n{val_2d:.2f}", ha="center", va="center", color=c_2d, fontweight='bold')

for ax in axes:
    ax.set_xticks(np.arange(grid_size)); ax.set_yticks(np.arange(grid_size))
    ax.set_xticklabels([f"H{i}" for i in range(grid_size)]); ax.set_yticklabels([f"V{i}" for i in range(grid_size)])
    ax.set_xlabel("Horizontal"); ax.set_ylabel("Vertical")

fig.colorbar(im2, ax=axes.tolist(), shrink=0.75, label="Attention Score (Inner Product)")
plt.show()
- 基本設定: grid_size = 4で4x4の画像パッチ空間を、d = 4で各パッチの特徴ベクトルの次元数を定義します。1次元RoPE用にはpos_1dとして0から15までの通し番号を、2次元RoPE用にはpos_yとpos_xとして各パッチの(y, x)座標を準備します。4×4のグリッドは、縦横の隣り合う関係と、行の折り返し(1Dでは V0H3 の次が V1H0 になる)の両方が見える、最小に近い大きさです。 は、縦と横にそれぞれ2次元ずつ(1組ずつ)割り当てられる、最小の次元数です。
- ダミー特徴量: QueryとKeyの元となるベクトルq_baseとk_baseを、全要素が1のベクトルで初期化します。これにより、位置エンコーディングそのものの効果だけを観察できます。
- 1D RoPEの回転行列: get_R_1d関数は、1次元の位置mを受け取り、前半2次元をtheta1=0.4、後半2次元をtheta2=0.1の異なる周波数で回転させる4x4の回転行列を返します。通常のRoPEに相当します。周波数を0.4と0.1にするのは、速く回る組と遅く回る組を1つずつ持たせ、通常のRoPEの「次元ごとに回転の速さが違う」性質を、4次元で再現するためです。
- 2D RoPEの回転行列: get_R_2d関数は、2次元の座標(x, y)を受け取り、前半2次元をy座標(縦方向)で、後半2次元をx座標(横方向)で独立して回転させる回転行列を返します。これが2D RoPEの核となるアイデアです。0.5は、4×4のグリッドの中で、距離が離れるほどスコアが下がる様子が見える回転の速さです(距離3で1.5ラジアン)。
- アテンション計算: Queryの位置を左上のパッチ(インデックス0、座標(0,0))に固定して回転させたq_1dとq_2dを計算します。次に、すべてのパッチ(Key)をループで回し、それぞれの位置で回転させたKeyベクトル(k_1d, k_2d)との内積をattn_1d_flatとattn_2d_flatに格納します。
- 整形と可視化: reshapeで4x4のグリッド形式に戻し、imshowでヒートマップとして描画します。
実行結果
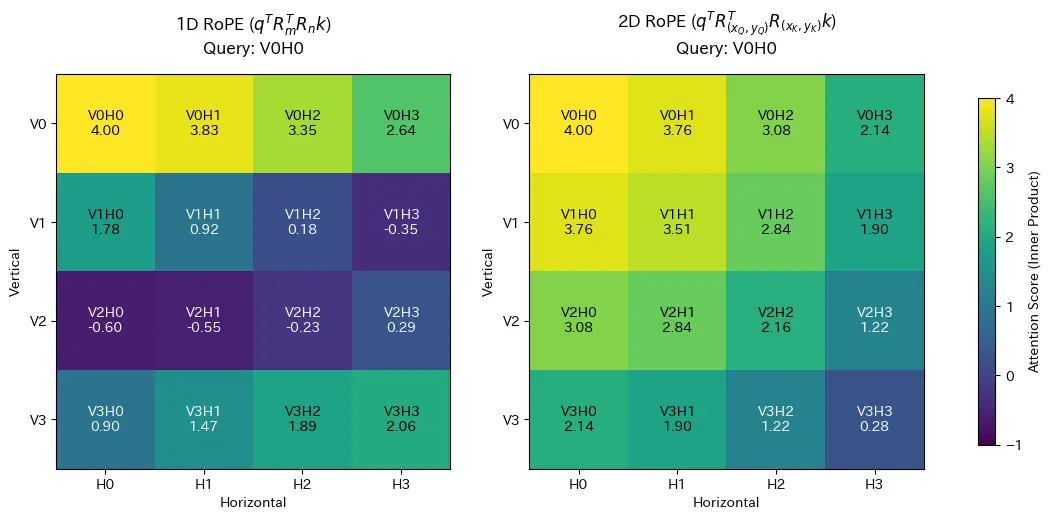
結果を見ると、1D RoPEでは、すぐ右隣のV0H1(シーケンス上の距離1)のスコアが3.83と高い一方で、すぐ下に隣接しているV1H0(シーケンス上の距離4)は1.78と、同じ行で3つ離れたV0H3(2.64)よりも低くなっています。さらに、一番下の行ではスコアが再び上がっており、画像上の近さとスコアが対応していません。 一方、2D RoPEでは、右隣のV0H1と下隣のV1H0がどちらも3.76と同じスコアになり、縦・横どちらの方向にも、Queryから離れるほどスコアが小さくなる対称な分布になっています。縦方向の距離と横方向の距離が、それぞれアテンションスコアに反映されていることがわかります。
Query の右隣と下隣のスコアを並べると、次のようになります。
(図は、diagram-designで作成)
画像データへの2D RoPEの適用
以下のコードでは、PyTorchを用いてダミーの画像テンソルを生成し、画像パッチへの分割と線形投影(Linear Projection)によって特徴量ベクトルを作ります。 ここで注意したいのは、RoPEは絶対位置埋め込みのように入力の特徴量に足し算するものではなく、Attention層の中でQueryとKeyに適用するという点です。 そこで、特徴量ベクトルからQueryとKeyを作り、5x5のグリッド座標に応じた2D RoPEの回転をQueryとKeyに施してから、アテンションスコアを計算するまでの流れを実装します。
import torch
import numpy as np

# --- 1. 入力画像の設定 (10x10x3) ---
# Batch=1, Channel=3, Height=10, Width=10
torch.manual_seed(42)
image = torch.randn(1, 3, 10, 10)

# パッチサイズの設定 (2x2ピクセルを1パッチとする)
patch_size = 2
hidden_dim = 4 # 隠れ層の次元数 (d=4)

# --- 2. 画像をパッチに分割してベクトル化 (Linear Projection) ---
# 10x10の画像から、2x2のパッチが 縦5個 × 横5個 = 計25パッチ 作られます
# 各パッチの元の画素数は 2 * 2 * 3(RGB) = 12次元 です

# ① まず縦方向(Dim 2)をサイズ2、ストライド2で切り出す
patches = image.unfold(2, patch_size, patch_size)
# 形状は [1, 3, 5, 10, 2] になります。
# (縦10ピクセルが、2ピクセルずつの塊5個に分解され、末尾に「パッチ内の縦2ピクセル」の次元が追加された)

# ② 次に横方向(Dim 3)をサイズ2、ストライド2で切り出す
patches = patches.unfold(3, patch_size, patch_size)
# 形状は [1, 3, 5, 5, 2, 2] になります。
# (横10ピクセルも同様に、2ピクセルずつの塊5個に分解された)

# [1, 3, 5, 5, 2, 2]を[1, 5, 5, 3, 2, 2]に変換
patches = patches.permute(0, 2, 3, 1, 4, 5)

# 形状を [Batch, 縦のパッチ数(5), 横のパッチ数(5), パッチ内の画素数(12)] に整理
patches = patches.flatten(3)

# 線形投影(Linear Projection)により、画素数12からモデルの隠れ層次元数4へ変換
# これにより [Batch, 5, 5, 4] のテンソル(特徴量ベクトル)が得られます
projection_layer = torch.nn.Linear(patch_size * patch_size * 3, hidden_dim)
patch_features = projection_layer(patches) # 形状: [1, 5, 5, 4]

# --- 3. Attention層での Query と Key への変換 ---
# RoPEは入力に足すのではなく、Attention層の中で Query と Key に適用します
W_q = torch.nn.Linear(hidden_dim, hidden_dim, bias=False)
W_k = torch.nn.Linear(hidden_dim, hidden_dim, bias=False)
q = W_q(patch_features) # 形状: [1, 5, 5, 4]
k = W_k(patch_features) # 形状: [1, 5, 5, 4]

# --- 4. 2D RoPE の回転行列の生成 ---
# 縦5マス、横5マスのグリッド座標に対する回転行列を構築します
grid_h, grid_w = patch_features.shape[1], patch_features.shape[2]
theta = 0.5

# 各座標用の回転行列を格納するテンソル [5, 5, 4, 4]
R_2d_grid = torch.zeros(grid_h, grid_w, hidden_dim, hidden_dim)

for y in range(grid_h):
    for x in range(grid_w):
        # 前半2次元: 縦方向 y に応じた回転
        R_2d_grid[y, x, 0, 0] = np.cos(y * theta)
        R_2d_grid[y, x, 0, 1] = -np.sin(y * theta)
        R_2d_grid[y, x, 1, 0] = np.sin(y * theta)
        R_2d_grid[y, x, 1, 1] = np.cos(y * theta)

        # 後半2次元: 横方向 x に応じた回転
        R_2d_grid[y, x, 2, 2] = np.cos(x * theta)
        R_2d_grid[y, x, 2, 3] = -np.sin(x * theta)
        R_2d_grid[y, x, 3, 2] = np.sin(x * theta)
        R_2d_grid[y, x, 3, 3] = np.cos(x * theta)

# --- 5. 2D RoPE の適用 (Query と Key の回転) ---
# 各パッチの Query と Key に、その座標に対応する回転行列を掛け合わせます
q_rot = torch.zeros_like(q)
k_rot = torch.zeros_like(k)

for y in range(grid_h):
    for x in range(grid_w):
        R = R_2d_grid[y, x] # 対応する4x4の回転行列
        q_rot[0, y, x] = R @ q[0, y, x]
        k_rot[0, y, x] = R @ k[0, y, x]

# --- 6. 1列のシーケンスに平坦化してアテンションスコアを計算 ---
# [Batch=1, パッチ数=25, 次元数=4]
q_seq = q_rot.flatten(1, 2)
k_seq = k_rot.flatten(1, 2)
# 全パッチ同士の内積 [Batch=1, 25, 25]
attn_scores = q_seq @ k_seq.transpose(1, 2)

print("元の画像形状:", image.shape)
print("パッチ分割後のグリッド形状 (縦, 横, 次元):", patch_features.shape[1:])
print("回転後のQueryシーケンス形状:", q_seq.shape)
print("アテンションスコアの形状:", attn_scores.shape)

# --- 7. スコアが相対位置だけで決まることの確認 ---
# Query: (y=1, x=1)、Key: (y=3, x=4) → 相対位置 (Δy=2, Δx=3)
q_idx = 1 * grid_w + 1
k_idx = 3 * grid_w + 4
score_rope = attn_scores[0, q_idx, k_idx].item()
# 回転前の q, k の間に「相対位置 (2, 3) の回転行列」を挟んだ値
score_rel = (q[0, 1, 1] @ R_2d_grid[2, 3] @ k[0, 3, 4]).item()
print(f"回転後の内積                : {score_rope:.4f}")
print(f"q^T R(Δy=2, Δx=3) k の値   : {score_rel:.4f}")
- パッチ分割と次元整理: 入力画像image(形状: [1, 3, 10, 10])を、unfoldで縦方向(Dim 2)と横方向(Dim 3)にpatch_size = 2ずつ切り出し、形状を[1, 3, 5, 5, 2, 2]にします。続いてpatches.permute(0, 2, 3, 1, 4, 5)で座標と色チャネルの順序を整理し、patches.flatten(3)でパッチ内の全画素(2 * 2 * 3 = 12次元)を平坦化して[1, 5, 5, 12]とします。10×10の画像を2×2のパッチに切るのは、5×5 = 25パッチと、全パッチのスコア行列(25×25)を表示できる小さな大きさにするためです。
- 線形投影: projection_layer(torch.nn.Linear)で、12次元の画素ベクトルを隠れ層の次元数hidden_dim = 4に変換し、パッチごとの特徴量patch_features(形状: [1, 5, 5, 4])を得ます。
- QueryとKeyへの変換: Attention層の変換行列に相当するW_qとW_kで、特徴量からQueryqとKeykを作ります。RoPEはこのQueryとKeyに適用します。Value(V)には回転を施しません。
- 2D RoPEの回転行列の生成: R_2d_grid(形状: [5, 5, 4, 4])を用意し、各座標(x, y)について、前半2次元(インデックス0, 1)に縦方向yの回転、後半2次元(インデックス2, 3)に横方向xの回転をセットします。
- 回転の適用: 各パッチのQueryとKeyに、その座標の回転行列をR @ q[0, y, x]、R @ k[0, y, x]のように掛けて、q_rotとk_rotを作ります。
- アテンションスコアの計算: flatten(1, 2)で25パッチのシーケンス(形状: [1, 25, 4])に平坦化し、q_seq @ k_seq.transpose(1, 2)で全パッチ同士の内積(形状: [1, 25, 25])を計算します。実際のモデルでは、このスコアをスケーリングしてsoftmaxにかけ、Valueの重み付き和を取ります。
- 相対位置の確認: Query (y=1, x=1) とKey (y=3, x=4) の回転後の内積score_ropeと、回転前のqとkの間に相対位置 (Δy=2, Δx=3) の回転行列R_2d_grid[2, 3]を挟んだ値score_relを比べています。どちらも0.2289で一致しており、前述の数式のとおり、回転後の内積が縦横の相対位置だけで決まることが確認できます。(1, 1) と (3, 4) を選ぶのは、縦と横の距離が違う(2と3)組で、2つの方向が別々に効いていることを確かめるためです。
実行結果
元の画像形状: torch.Size([1, 3, 10, 10])
パッチ分割後のグリッド形状 (縦, 横, 次元): torch.Size([5, 5, 4])
回転後のQueryシーケンス形状: torch.Size([1, 25, 4])
アテンションスコアの形状: torch.Size([1, 25, 25])
回転後の内積                : 0.2289
q^T R(Δy=2, Δx=3) k の値   : 0.2289
なお、実際のモデルではこの回転を、Transformerの各層のAttentionで毎回QueryとKeyに適用します。入力の段階で一度だけ適用するわけではない点に注意してください。
ここまでの流れを図にまとめると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、画像の位置エンコーディング技術である2D RoPE(2次元Rotary Position Embedding) について、その仕組みと効果を解説しました。
記事を通じて、以下の内容を学びました。
- 1D RoPEの課題と2D RoPEの優位性: 1次元シーケンスに平坦化された画像データでは、1D RoPEが本来の2次元空間情報を表現できない問題を学び、2D RoPEが縦横の座標を独立して扱うことでこれを解決する仕組みを理解しました。
- 数式による理論的背景: 2D RoPEがアテンション計算時に、内積の結果を「縦方向の相対距離」と「横方向の相対距離」の項に分解できることを数式レベルで確認しました。
- コードによる視覚的な検証: numpyを用いたシミュレーションを通じて、Queryを固定した際のアテンションスコアを計算し、matplotlibで可視化しました。1D RoPEがシーケンス順の距離に依存するのに対し、2D RoPEがグリッド上の縦横の距離を反映できることを確認しました。
- 画像データへの適用プロセス: PyTorch を用いた画像パッチ分割や線形投影に加え、QueryとKeyに2D RoPEの回転を適用してアテンションスコアを計算する流れを実装し、スコアが相対位置だけで決まることを確認しました。
2D RoPEは、Qwen2-VLやPixtralの画像エンコーダのように、解像度やアスペクト比の異なる多様な画像を扱うVLMで使われている技術です。動画のように時間軸が加わる場合への拡張は、MRoPEの記事で解説しています。本記事が、その核心的なアイデアを理解する一助となれば幸いです。
参考文献
- B. Heo, S. Park, D. Han, S. Yun (2024). Rotary Position Embedding for Vision Transformer. ECCV 2024.
本記事の文章・構成の一部に生成AIを使用しています。