A2C (Advantage Actor-Critic) とは?
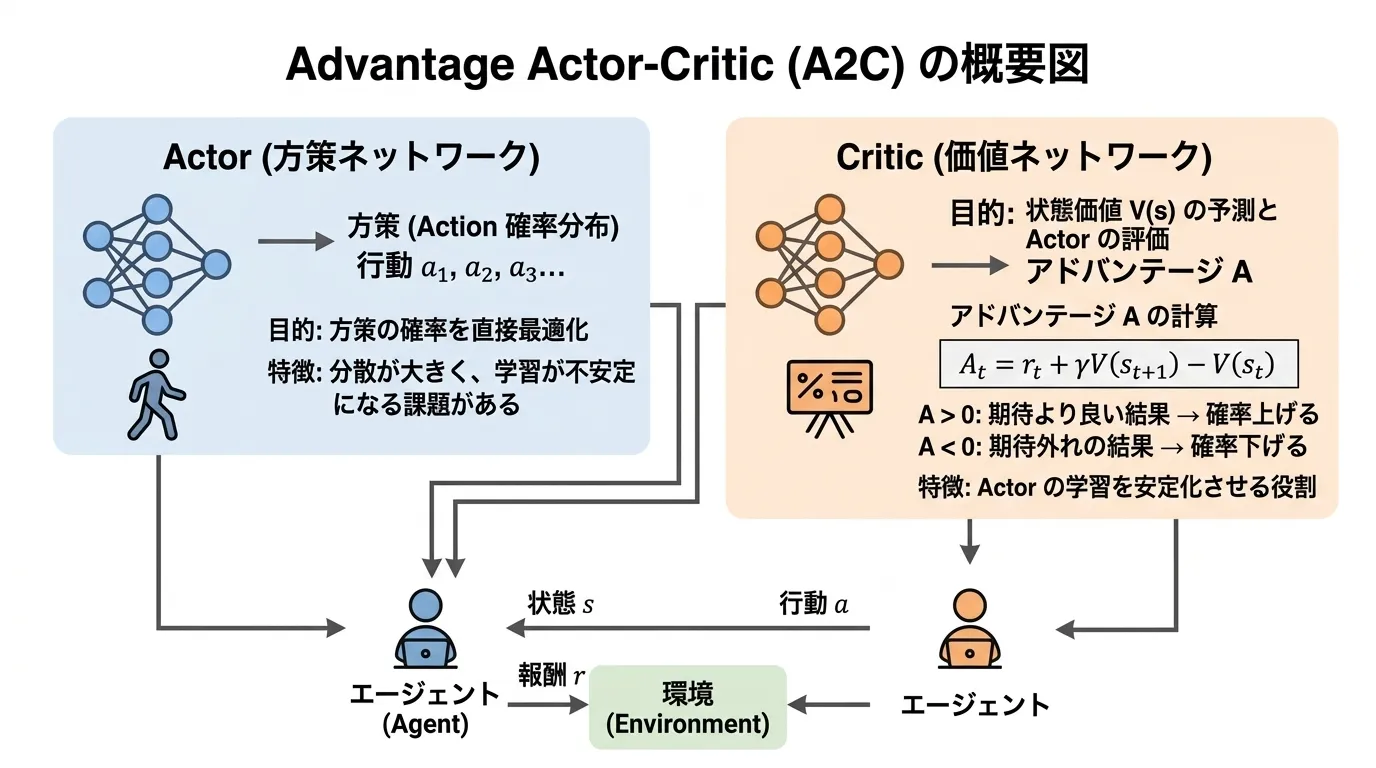 (画像は、Geminiで作成)
価値を予測する Critic と行動を決める Actor に役割を分け、アドバンテージで方策を更新する Actor-Critic の考え方を理解し、REINFORCE の分散の問題をどう抑えるのかを説明できるようになること。CartPole でのスクラッチ実装と Stable Baselines3 で A2C を学習し、更新幅を制限しないことで方策が崩壊するという、TRPO・PPO につながる課題を確かめること。
A2Cの概要
REINFORCEの記事では、方策(行動をとる確率)を直接最適化する「方策勾配法」について学びました。しかし、REINFORCEには「分散の爆発」という致命的な弱点がありました。
本記事では、DQNのような「価値ベース」の手法と、REINFORCEのような「方策ベース」の手法を融合させ、現代の深層強化学習(Deep RL)のデファクトスタンダードとなった Actor-Critic(アクター・クリティック) アーキテクチャ、およびその代表的アルゴリズムである A2C (Advantage Actor-Critic) について解説します。
本記事は、「価値ベース」の手法である DQN(Deep Q-Network) と、「方策ベース」の手法である REINFORCEアルゴリズム の基礎を理解していることを前提に解説を進めます。事前知識に不安がある方は、先にこれらの記事をお読みいただくことをおすすめします。
REINFORCEの弱点とActor-Criticの誕生
なぜREINFORCEは不安定なのか?
REINFORCEアルゴリズムは、エピソードが完了するまで待ってから、得られた「総収益(累積報酬)」に基づいて方策を更新します。しかし、この手法には以下の問題があります。
-
不透明な信用割り当て(Credit Assignment): REINFORCEの方策勾配定理の数式()を思い出してください。この式では、ある時点以降の総収益 が大きければ、そのエピソード中に取った(以降の)すべての行動の確率が一律に引き上げられてしまいます。そのため、「本当に報酬に貢献した素晴らしい行動」と「実は足を引っ張っていた無意味な行動」の判別がつきにくく、最終的な結果がどの行動のおかげだったのか(誰に信用を割り当てるべきか)が明確になりません。
-
勾配のノイズ(分散の大きさ): REINFORCEは目的関数の勾配の期待値()を計算する際、実際に最後までプレイして得られた1回(または数回)の軌跡データを用いる モンテカルロ推定 に依存しています。数式に含まれる はエピソード終了までの全報酬の合計ですが、環境のランダム性やその後の探索行動によって、同じ状態から同じ行動を取ったとしても の値は毎回激しく変動します。この「たまたま運が良かった・悪かった展開」がそのまま勾配の更新に使われるため、推定値に巨大なノイズ(分散)が生じ、学習が不安定になります。
モンテカルロ推定による分散の爆発エピソードを最後までやり切って得られた実際の収益()を用いる手法を「モンテカルロ法」と呼びます。バイアスが無いという利点がある反面、ここで説明されているように途中のノイズが蓄積しやすく「分散が極めて大きくなる」という構造的な弱点を持っています。この特性(バイアスと分散のトレードオフ)について詳しく復習したい方は、モンテカルロ法(Monte Carlo Method)とは?の記事をご覧ください。
Actor-Criticによる解決アプローチ
この分散問題を解決するための重要な改善策として提案されたのが、Actor-Critic(アクター・クリティック) アーキテクチャです。 Actor-Criticモデルの最大の貢献は、最適な戦略を学習するために「方策(Policy)」と「価値(Value)」の両方を使用することです。
- Actor(アクター / 役者): 状態を入力として受け取り、行動の確率分布(方策)を出力するニューラルネットワークです。REINFORCEと同様の目的関数を最大化するように学習します。
- Critic(クリティック / 評論家): 現在の状態が「どれくらい良いか」という状態価値関数 、または行動価値関数 を学習するニューラルネットワークです。
行動する者(Actor)のプレイを、価値を予測する者(Critic)が毎ステップ評価(採点)することで、エピソードの最後まで待たずとも「その行動が平均的に見てどうだったか」を低分散で学習できるようになります。
Actor と Critic の役割を図にすると、次のようになります。
(図は、diagram-designで作成)
A2Cのコア概念
アドバンテージ関数(Advantage Function)
Actor-Criticにおける最大の発明の一つが、この アドバンテージ関数(Advantage Function, ) です。 Actorを更新する際、エージェントが取った行動を評価するのに単に「得られた報酬」を基準にするのではなく、「その状態での平均的な期待値(ベースライン)と比べて、今回の行動がどれだけ良かったか」を計算します。
数式では一般に、行動価値 と状態価値 を用いて以下のように表されます。
- は、状態 で行動 を取り、その後は今の方策に従ったときに得られる収益の期待値(その行動の評価)。実装では、実際に得られた報酬から推定します。
- は、状態 から今の方策に従ったときに得られる収益の期待値(行動を選ぶ前の平均的な見込み・ベースライン)。
実績値から期待値を引くことで、「期待していたよりも結果が良かった()」ならActorのその行動確率を上げ、「期待外れだった()」なら確率を下げるように学習します。 収益そのものではなく平均との差を使うので、状態の良し悪しによる収益の大小が打ち消され、勾配のばらつき(分散)が小さくなります。
実際の実装では、アドバンテージ は次の状態の推定価値と前の状態の推定価値の差(TD誤差)として、以下のように近似計算されることが多くなります。
アドバンテージの符号と更新の向きの関係を図にすると、次のようになります。
(図は、diagram-designで作成)
DQNのTD誤差(ベルマン方程式)との違い
ここで、「この計算式はDQNで学んだベルマン方程式(TD誤差)に非常に似ている」と気づいた方もいるかもしれません。DQNにおけるTD誤差は、以下のような形をしていました。
一見よく似ていますが、設計思想には決定的な違いがあります。
- 最大化()の有無: DQNは常に「次にとれる最善の行動」を前提として価値を計算する(オフポリシー)のに対し、A2Cの は「現在の自分の方策に従って行動した場合の平均的な価値」を予測します(オンポリシー)。
- 目的の違い: DQNのTD誤差は単に「Q値の予測を正確にするためのズレ」を修正するためのものですが、A2Cのアドバンテージは「その行動をこれからどれくらい積極的に選ぶべきか(方策をどう更新するか)の直接的なシグナル」としてActorの更新に用いられます。
つまり、DQNが「絶対的なベスト(最大値)」を探すのに対し、アドバンテージ関数は「今の自分の実力(平均値)と比べた相対評価」を行っているのが特徴です。
Nステップ収益(N-step Return)
A2Cの学習をさらに効率化する重要な技術に Nステップ収益(N-step Return) があります。 直後(1ステップ先)の報酬だけを見て予測を修正する(TD学習)のではなく、数ステップ(Nステップ)先までの実際の報酬を足し合わせ、それ以降の予測はネットワーク(Critic)の予測値 に任せるという手法です。
これにより、1ステップごとの近視眼的な学習と、エピソード終了まで待つ学習(モンテカルロ法)の「良いとこ取り」ができ、学習効率と精度のバランスが最適化されます。
記事の実装の N = 5 の場合を図にすると、次のようになります。
(図は、diagram-designで作成)
複数ワーカーによる並列学習(分散アーキテクチャ):A3CとA2C
A2Cを語る上で欠かせないのが、DeepMind社が2016年に発表した A3C (Asynchronous Advantage Actor-Critic) というアルゴリズムです。 A3CやA2Cの最大の特徴は、複数のエージェント(ワーカー)を同時に走らせて、それぞれ独立した環境のコピーで並行してデータを収集する分散アーキテクチャにあります。
A3C(非同期式)とA2C(同期式)の違い
- A3C(非同期式): 各ワーカーが自身のタイミングで環境と相互作用し、グローバルなネットワークを非同期に更新します。マルチコアCPUでの実行に適しています。
- A2C(同期式): すべてのワーカーが一定ステップ進むのを待ち、集まったデータをバッチ化して一括でネットワークを更新します。
A2C は、OpenAI が 2017 年に公開した実装(OpenAI Baselines)で広まった、A3C の同期版です。全員が同じ重みで経験を集めるので、古い重みで集めた経験が混ざらず、まとめて計算できる分 GPU も使いやすくなります。損失関数や N ステップ収益などの計算は、A3C と同じです。
経験再生バッファからの脱却
複数のワーカーが並行して多様な状態を経験することで、取得するデータ同士の時間的偏り(相関)を打ち消すことができるようになりました。これにより、それまでのDQNなどで必須だった 「経験再生バッファ(Experience Replay)」を使わずとも学習を安定させる ことが可能になりました。
A2Cのネットワーク構造と損失関数
ネットワークの重み共有(Shared Network Architecture)
カメラ画像(ピクセル)などから学習する場合、Actor(行動を決める)とCritic(価値を評価する)の2つのネットワークで、前半の特徴抽出部分(CNN層など)を共有するアーキテクチャを取ることが一般的です。 これにより、パラメータ数を削減できるだけでなく、双方が得た勾配を使って豊かな特徴量を効率的に学習できます。
実装上は、1つの共有ネットワークから出力層が2つに分岐する(2つのヘッドを持つ)構造になります。
- Actorヘッド: 行動を選択する確率(softmax出力など)。
- Criticヘッド: 状態の価値を表す単一の線形出力(linear output)。
損失関数の全体像
A2Cの学習では、以下の3つの要素を組み合わせた損失関数を最小化します。
- Actor Loss(方策損失):
アドバンテージを用いて、良かった行動の確率を上げます。REINFORCEの方策勾配定理における をアドバンテージ に置き換えたもので、以下の式で表されます。
(※深層学習のオプティマイザは通常「最小化」を行うため、符号を反転させて損失関数としています)
- Critic Loss(価値損失):
Criticが予測した状態価値と、実際の収益との間の平均二乗誤差(MSE)を最小化します。以下の式で表されます。
(※実装上は、アドバンテージ の二乗の平均 として計算されることが一般的です)
- Entropy Bonus(エントロピー正則化): 方策勾配法には、「学習初期にたまたま少し良い結果が出た行動があると、すぐさまその行動確率を100%に近づけてしまい、他のより良い可能性を試さなくなってしまう(早期収束・局所解への陥り)」という深刻な問題があります。 これを防ぐために導入されたのがエントロピー正則化です。Actorが出力する「行動の確率分布」に対して、エントロピー(乱雑さ・ばらつき)を保っている状態により多くのボーナスを与えます。この技術によって「完全に確信が持てるまでは、あえて多様な行動を試す(探索を続ける)」ようになり、学習が不完全な状態でストップするのを防ぎます。数式上は、方策のエントロピー を目的関数に追加します。
ネットワークと3つの損失の関係を図にすると、次のようになります。
(図は、diagram-designで作成)
A2Cの実装(CartPoleでのスクラッチ実装)
具体的なコード例として、gymnasium の CartPole-v1 環境(カートを左右に動かして棒を倒さないようにする課題。1 ステップ立てるごとに報酬 +1、500 ステップで打ち切り)を用いた A2C の PyTorch 実装を示します。 この実装では、A2Cの核となる以下の要素をすべて組み込んでいます。
- 複数ワーカーによる並列学習(同期式): gym.make_vec で複数の環境を並行実行。
- Nステップ収益とアドバンテージ関数: Nステップ先までの報酬から価値を推定。
- 重み共有アーキテクチャ: 1つのネットワークからActorとCriticの2つのヘッドを出力。
- Actor Loss, Critic Loss, Entropy Bonus: 3つの損失関数を合成して学習。
# A2Cの学習に必要なライブラリをインポートします
import torch
import torch.nn as nn
import torch.optim as optim
from torch.distributions import Categorical
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt

# A2Cネットワーク(重み共有アーキテクチャ): ActorとCriticでネットワークの一部を共有します
class A2CNetwork(nn.Module):
    def __init__(self, state_dim, action_dim):
        super(A2CNetwork, self).__init__()
        # ActorとCriticで共有する特徴抽出層(状態を入力として受け取る)
        self.shared_fc = nn.Sequential(
            nn.Linear(state_dim, 128),
            nn.ReLU()
        )
        # Actorヘッド: 共有層の出力を受け取り、各行動をとる確率を出力(Softmaxで確率分布化)
        self.actor_head = nn.Sequential(
            nn.Linear(128, action_dim),
            nn.Softmax(dim=-1)
        )
        # Criticヘッド: 共有層の出力を受け取り、状態価値(スカラー値)を出力
        self.critic_head = nn.Linear(128, 1)

    def forward(self, x):
        # 入力xを共有層に通して特徴を抽出
        features = self.shared_fc(x)
        # 抽出した特徴から行動確率を計算
        action_probs = self.actor_head(features)
        # 抽出した特徴から状態価値を計算
        state_value = self.critic_head(features)
        return action_probs, state_value

# --- ハイパーパラメータの設定 ---
num_envs = 8        # 同時に実行する並列環境の数(rl-baselines3-zoo の CartPole-v1 の設定)
num_steps = 5       # ネットワークを更新する前に環境を進めるステップ数(Nステップ収益。A3C の論文の t_max)
gamma = 0.99        # 割引率(将来の報酬をどれくらい重視するか。A3C の論文の設定)
entropy_coef = 0.01 # エントロピーボーナスの係数(探索を促す強さ。A3C の論文の設定)

torch.manual_seed(0)  # ネットワークの初期値と行動のサンプリングを、実行ごとに同じにする

# 複数の環境を並行して実行するためのベクトル化環境を作成
# SAME_STEP:エピソードが終わったステップで、すぐ次のエピソードの初期状態を返す
# (既定の NEXT_STEP だと、終わった次のステップが「行動を無視してリセットするだけ」のステップになり、学習に混ざる)
envs = gym.make_vec("CartPole-v1", num_envs=num_envs, vectorization_mode="sync",
                    vector_kwargs={"autoreset_mode": gym.vector.AutoresetMode.SAME_STEP})

# 環境から状態空間と行動空間の次元を取得
state_dim = envs.single_observation_space.shape[0]
action_dim = envs.single_action_space.n

# A2Cネットワークを初期化
model = A2CNetwork(state_dim, action_dim)
# 最適化手法としてAdamを使用(学習率 1e-3)
optimizer = optim.Adam(model.parameters(), lr=1e-3)

# 全環境をリセットして初期状態を取得
state, _ = envs.reset(seed=0)
# 各環境のエピソードごとの累積報酬を記録する配列
episode_rewards = np.zeros(num_envs)

# --- スコア記録用の変数 ---
recent_scores = []   # 直近のエピソードスコアを保存するリスト
history_epochs = []  # グラフ描画用のX軸データ(エポック数)
history_scores = []  # グラフ描画用のY軸データ(平均スコア)

total_updates = 12500 # 学習の総更新回数(8 環境 × 5 ステップ × 12,500 回 = 50 万ステップ。rl-baselines3-zoo と同じ)

# 学習のメインループ
for update in range(total_updates):
    # --- データの収集 ---
    log_probs = [] # 選択した行動の対数確率
    values = []    # Criticが予測した状態価値
    rewards = []   # 実際に得られた報酬
    masks = []     # エピソードが継続しているか(1.0)終了したか(0.0)のフラグ
    entropies = [] # 方策のエントロピー(ばらつき具合)

    # Nステップ分のデータを並列環境から収集
    for step in range(num_steps):
        # 現在の状態をPyTorchのテンソルに変換
        state_tensor = torch.FloatTensor(state)
        # ネットワークに入力し、行動確率と状態価値を取得
        probs, value = model(state_tensor)

        # 行動確率に基づいたカテゴリカル分布を作成
        m = Categorical(probs)
        # 分布から行動をサンプリング
        action = m.sample()

        # サンプリングした行動を環境に適用し、次の状態や報酬を取得
        next_state, reward, terminated, truncated, _ = envs.step(action.numpy())
        # エピソードが終了したかどうかを判定
        done = terminated | truncated

        # 学習用に各種データを記録
        log_probs.append(m.log_prob(action))
        values.append(value.squeeze(-1))
        rewards.append(torch.FloatTensor(reward))
        masks.append(torch.FloatTensor(1.0 - done))
        entropies.append(m.entropy())

        # 状態を更新
        state = next_state
        # 報酬を累積
        episode_rewards += reward

        # エピソード完了時のスコアを記録し、その環境の累積報酬をリセット
        for i in range(num_envs):
            if done[i]:
                recent_scores.append(episode_rewards[i])
                episode_rewards[i] = 0

    # --- Nステップ先の価値の推定 ---
    # Nステップ後の状態の価値をネットワークで計算
    state_tensor = torch.FloatTensor(state)
    _, next_value = model(state_tensor)

    # 勾配計算の対象外とするためにdetach()を呼び出す
    next_value = next_value.squeeze(-1).detach()

    # --- 収益(Returns)の計算 ---
    returns = []
    # Rは最後尾のステップの価値から逆算していく
    R = next_value
    # Nステップ分の報酬とマスクを逆順にたどりながら収益を計算
    for r, mask in zip(reversed(rewards), reversed(masks)):
        # ベルマン方程式に基づいて収益を更新(エピソード終了時はmaskが0になるためRがリセットされる)
        R = r + gamma * R * mask
        # 逆順で計算しているので、リストの先頭に追加していく
        returns.insert(0, R)

    # リストをPyTorchのテンソルに変換
    returns = torch.stack(returns)
    values = torch.stack(values)
    log_probs = torch.stack(log_probs)
    entropies = torch.stack(entropies)

    # --- アドバンテージの計算と正規化 ---
    # アドバンテージ = 実際の収益(Returns) - Criticの予測価値(Values)
    advantages = returns - values

    # アドバンテージの計算自体は勾配計算に含めないためdetach
    adv_detached = advantages.detach()
    # 学習を安定させるため、アドバンテージを平均0、標準偏差1に正規化
    adv_normalized = (adv_detached - adv_detached.mean()) / (adv_detached.std() + 1e-8)

    # --- 損失関数の計算 ---
    # Actor Loss: -(対数確率 * アドバンテージ) の平均。数式 L^{Actor}(θ) = - E[log π(a|s) * A] に対応
    actor_loss = -(log_probs * adv_normalized).mean()
    # Critic Loss: アドバンテージ(収益と予測価値の誤差)の二乗平均。数式 L^{Critic}(θ) = E[(R - V)^2] = E[A^2] に対応
    critic_loss = advantages.pow(2).mean()
    # Entropy Bonus: エントロピーの平均。これが大きいほど多様な行動をとりやすくなる
    entropy_bonus = entropies.mean()

    # 最終的な損失 = Actor Loss + 0.5 * Critic Loss - エントロピーボーナス
    loss = actor_loss + 0.5 * critic_loss - entropy_coef * entropy_bonus

    # --- パラメータの更新 ---
    # 勾配をリセット
    optimizer.zero_grad()
    # 誤差逆伝播法で勾配を計算
    loss.backward()
    # 勾配の爆発を防ぐため、クリッピングを適用
    nn.utils.clip_grad_norm_(model.parameters(), max_norm=0.5)
    # パラメータを更新
    optimizer.step()

    # --- 進捗の表示と記録 ---
    # 50回の更新ごとに進捗を記録・表示
    if (update + 1) % 50 == 0:
        # 直近20エピソードの平均スコアを計算
        avg_score = np.mean(recent_scores[-20:]) if len(recent_scores) > 0 else 0
        # 500回ごとにコンソールに出力
        if (update + 1) % 500 == 0:
            print(f"Epoch {update + 1:4d}\tAverage Score: {avg_score:.1f}")

        # グラフ用に記録を追加
        history_epochs.append(update + 1)
        history_scores.append(avg_score)

# 環境を閉じる
envs.close()
print(f"終わったエピソード {len(recent_scores)} 回、環境のステップ {total_updates * num_steps * num_envs:,} 回")

# --- グラフの描画 ---
# 以下は学習の進捗をプロットするためのMatplotlibのコード
plt.figure(figsize=(10, 5))
plt.plot(history_epochs, history_scores, label='Average Score (Last 20 Episodes)', color='blue')
plt.xlabel('Epochs (Updates)')
plt.ylabel('Score')
plt.title('A2C Training Progress on CartPole-v1')
plt.grid(True)
plt.legend()
plt.show()
CartPole-v1 を 8 つの環境で同時に動かし、5 ステップごとに Actor と Critic を一緒に更新して、A2C がスコアの上限 500 まで学習できるかを確かめるコードです。
- ネットワーク(重み共有): shared_fc(4 → 128)で状態から特徴を作り、actor_head(2 つの行動の確率)と critic_head(状態価値)に分けます。Actor も Critic も「今どんな状況か」を読み取る必要があるので、その部分を共有して、パラメータと計算を減らします。隠れ層の 128 は、REINFORCE の記事の方策ネットワークと同じ大きさにして、比べやすくするためです。
- ハイパーパラメータ: num_steps = 5・gamma = 0.99・entropy_coef = 0.01 は、A3C の論文の設定です。num_envs = 8 と学習の長さ(total_updates = 12500、8 環境 × 5 ステップ × 12,500 回 = 50 万ステップ)は、Stable Baselines3 の調整済みの設定集 rl-baselines3-zoo の CartPole-v1 の値で、後半の Stable Baselines3 の実装ともそろえています。学習率の 1e-3 は、論文や設定集に CartPole の値がないため、Adam でよく使われる値にしています。
- 乱数の固定: torch.manual_seed(0) と envs.reset(seed=0) で、ネットワークの初期値・行動のサンプリング・環境の初期状態を固定し、実行結果を再現できるようにします。
- 並列環境: gym.make_vec は 8 つの環境を同期して動かし、状態を (8, 4) の配列でまとめて返します。1 つの環境で続けて集めた経験は前後の相関が強く、そのまま使うと更新が偏ります。別々の 8 つの環境から同時に集めることで、DQN の経験再生バッファを使わずに相関を弱めます。
- 自動リセットの方式: エピソードが終わった環境は自動でリセットされます。SAME_STEP を指定すると、終わったステップの戻り値で、次のエピソードの初期状態が返ります。gymnasium 1.x の既定(NEXT_STEP)では、終わった次の envs.step が「行動を無視して初期状態を返すだけ」のステップになり、そこで選んだ行動とその対数確率が学習に混ざってしまいます。vectorization_mode="sync" は、この方式を指定できる汎用の並列環境を使うための指定です(CartPole の既定の並列環境は、方式を変えられません)。
- データの収集: 内側のループで 5 ステップ進め、対数確率・状態価値・報酬・継続フラグ・エントロピーを記録します。どれも (8,) のテンソルで、torch.stack で (5, 8) にまとめます。masks はエピソードが終わったステップで 0 になり、次の収益の計算に、別のエピソードの価値を持ち込まないようにします。
- N ステップ収益: 5 ステップ後の状態の価値 next_value から始めて、後ろから で各ステップの収益を求めます。エピソードの最後まで待つ REINFORCE と違い、5 ステップごとに更新できます。next_value を detach するのは、目標の値に勾配を流すと、Critic が予測ではなく目標の方を動かしてしまうからです。なお、この実装は 500 ステップでの打ち切り(truncated)も失敗による終了と同じく mask を 0 にしています。打ち切りの直前の状態は本当は良い状態ですが、その先の価値が 0 として扱われる、という単純化です。
- アドバンテージと正規化: advantages = returns - values は、実際の収益が Critic の予想よりどれだけ良かったかを表します。Actor の損失には、detach したうえで平均 0・標準偏差 1 に正規化した値を使います。detach するのは、Actor の損失で Critic を動かさないためです。正規化するのは、収益の大きさ(CartPole では長く生き残るほど大きくなる)によって更新の幅が変わらないようにするためです。正規化は A3C の論文にはない実装上の工夫で、Stable Baselines3 の A2C も既定では行いません。
- 損失: 3 つの損失を 1 つの loss にまとめ、1 回の逆伝播で両方のヘッドと共有層を更新します。Critic の係数 0.5 と勾配のクリップ max_norm=0.5 は、Stable Baselines3 の A2C の既定値(vf_coef・max_grad_norm)です。Critic の二乗誤差は Actor の損失より大きくなりやすいので、係数をかけて、共有層が Critic の都合だけで動かないようにします。
- 進捗の記録: スコアはエピソードごとにばらつくので、直近 20 エピソードの平均を 50 回ごとに記録し、500 回ごとに表示します。グラフは、記録した平均の推移です。
実行結果
Epoch  500	Average Score: 36.5
Epoch 1000	Average Score: 97.5
Epoch 1500	Average Score: 70.2
Epoch 2000	Average Score: 128.7
Epoch 2500	Average Score: 264.9
Epoch 3000	Average Score: 216.9
Epoch 3500	Average Score: 35.7
Epoch 4000	Average Score: 228.4
Epoch 4500	Average Score: 37.2
Epoch 5000	Average Score: 188.3
Epoch 5500	Average Score: 452.5
Epoch 6000	Average Score: 500.0
Epoch 6500	Average Score: 500.0
Epoch 7000	Average Score: 500.0
Epoch 7500	Average Score: 500.0
Epoch 8000	Average Score: 500.0
Epoch 8500	Average Score: 500.0
Epoch 9000	Average Score: 438.5
Epoch 9500	Average Score: 175.1
Epoch 10000	Average Score: 261.5
Epoch 10500	Average Score: 463.4
Epoch 11000	Average Score: 240.1
Epoch 11500	Average Score: 239.9
Epoch 12000	Average Score: 425.6
Epoch 12500	Average Score: 271.8
終わったエピソード 4658 回、環境のステップ 500,000 回
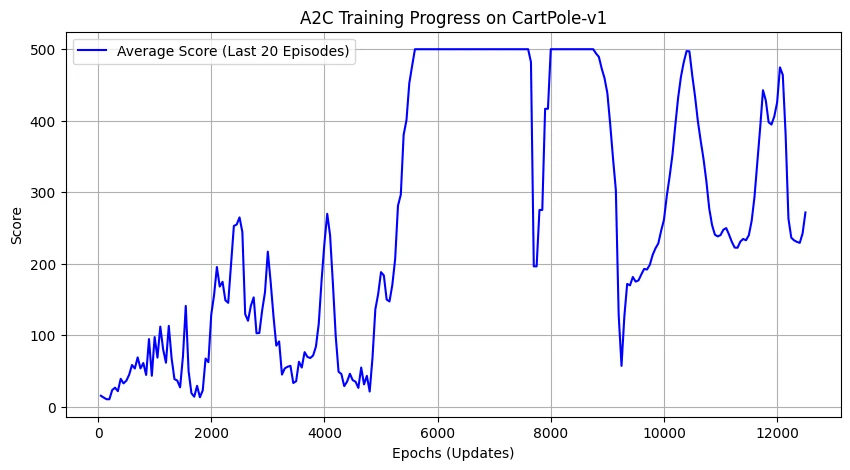
- 500 に届くまで: 直近 20 エピソードの平均は、上がったり下がったりしながら伸び、5,500 回目の更新で 452.5、6,000 回目で上限の 500 に届きました。グラフでは、5,600 回目付近から 7,600 回目付近まで 500 を保ち、その後、一度 200 近くまで下がってから 500 に戻っています(表示は 500 回ごとなので、この下がりは表示に出ていません)。
- 500 に届いた後: 9,000 回目から平均が下がり始め、9,500 回目には 175.1 まで落ちました。その後も 240〜470 の間を上下し、12,500 回目(50 万ステップ)では 271.8 でした。一度覚えた「倒さない方策」を、その後の更新で自分から壊してしまっています。
- 崩れる理由: A2C には、1 回の更新で方策が変わる幅を制限する仕組みがありません。500 を保てる方策になっても、その後の更新で方策が大きく変われば、スコアは下がります。この実装では、アドバンテージを正規化しているので、500 を保っていてアドバンテージの差が小さいときでも、更新の大きさは小さくなりません。また、500 ステップでの打ち切りを失敗と同じに扱っているので、Critic の目標の値もずれます。どちらも、崩れ方を大きくする要因になりえます。更新の行き過ぎを防ぐのが、後半で触れる TRPO・PPO です。
REINFORCE と比べて
REINFORCE の記事では、約 100 エピソードで 500 に届き(101〜150 エピソードの平均 490.2)、155 エピソード目あたりから崩れて、201〜250 エピソードの平均は 33.2 まで下がりました。その後、500 エピソードまで 500 には戻っていません。A2C は、500 に届くまでに約 22 万ステップ(5,600 回の更新)かかりましたが、届いた後は約 2,000 回の更新(約 8 万ステップ、500 ステップのエピソードなら約 160 回分)の間、20 エピソードの平均が 500 のままでした。崩れた後は、一時 60 近くまで下がったものの、その後は 200〜470 の間まで持ち直しています。1 エピソードの収益だけで更新する REINFORCE より、Critic の予想との差で更新する A2C の方が、良い方策を長く保てています。
ただし、A2C も学習を続けると崩れました。収益の推定のばらつき(分散)を抑えるだけでは、1 回の更新で方策が変わりすぎる問題は解決しません。
Stable Baselines3 を使ったA2C実装
実務でA2Cを利用する場合は、安定して実装されているライブラリ「Stable Baselines3」を用いるのが一般的です。数行のコードで上記の高度な処理がすべて実行されます。
ライブラリのインストール
pip install stable-baselines3 gymnasium[classic-control]
Stable Baselines3 を用いたA2C実装
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt
from stable_baselines3 import A2C
from stable_baselines3.common.env_util import make_vec_env
from stable_baselines3.common.evaluation import evaluate_policy
from stable_baselines3.common.monitor import Monitor

# 1. 学習用に 8 つの環境を並列に作り、評価用の環境を別に 1 つ作る
vec_env = make_vec_env("CartPole-v1", n_envs=8, seed=0)
eval_env = Monitor(gym.make("CartPole-v1"))
eval_env.reset(seed=1)

# 2. A2C のモデル:rl-baselines3-zoo の CartPole-v1 の設定(8 環境・50 万ステップ・ent_coef=0.0)
#    MlpPolicy:Actor と Critic に別々の 64-64 の MLP を作る。n_steps=5・gamma=0.99 などは既定値
model = A2C("MlpPolicy", vec_env, ent_coef=0.0, seed=0, verbose=0)

# 3. 1 万ステップ学習するごとに、決定的な方策(確率が最大の行動)で 10 エピソード動かしてスコアを測る
history = []
for i in range(50):
    model.learn(total_timesteps=10_000, reset_num_timesteps=False)
    mean, _ = evaluate_policy(model, eval_env, n_eval_episodes=10, deterministic=True)
    history.append((model.num_timesteps, mean))
    if (i + 1) % 5 == 0:
        print(f"{model.num_timesteps:>7,} ステップ:評価のスコア {mean:.1f}")

# 4. 学習を終えた方策を 20 エピソードで評価する
mean, std = evaluate_policy(model, eval_env, n_eval_episodes=20, deterministic=True)
print(f"学習後:20 エピソードの平均 {mean:.1f} ± {std:.1f}")

# 5. 学習後の方策で 1 エピソード動かし、途中の画面を保存する
env = gym.make("CartPole-v1", render_mode="rgb_array")
obs, _ = env.reset(seed=2)
frames = []
for t in range(500):                      # CartPole-v1 は 500 ステップで打ち切られる
    frames.append(env.render())
    action, _ = model.predict(obs, deterministic=True)
    obs, reward, terminated, truncated, _ = env.step(action)
    if terminated or truncated:
        break
env.close()
print(f"1 エピソードの長さ:{len(frames)} ステップ")

# 6. 図:評価のスコアの推移と、エピソードの途中の画面
fig = plt.figure(figsize=(14, 6.5))
ax = fig.add_subplot(2, 1, 1)
ax.plot([h[0] for h in history], [h[1] for h in history], marker="o", ms=3)
ax.set_xlabel("Timesteps"); ax.set_ylabel("Eval score (10 episodes)")
ax.set_ylim(0, 520); ax.grid(True)
ax.set_title("Stable Baselines3 A2C on CartPole-v1")
shots = np.linspace(0, len(frames) - 1, 6).astype(int)
for k, t in enumerate(shots):
    a = fig.add_subplot(2, 6, 7 + k)
    a.imshow(frames[t][100:330]); a.axis("off"); a.set_title(f"step {t}")
plt.tight_layout()
plt.show()
Stable Baselines3 の A2C で同じ CartPole-v1 を 50 万ステップ学習し、学習の途中と後の方策のスコアを測るコードです。
- 並列環境: make_vec_env("CartPole-v1", n_envs=8, seed=0) は、環境を 8 つ並列で動かします。終わった環境のリセットも、ライブラリが自動で行います。評価用の環境は学習用と別に作り、Monitor で包んで、エピソードの長さとスコアを正しく記録させます。
- 設定: 8 環境・50 万ステップ・ent_coef=0.0 は、rl-baselines3-zoo の CartPole-v1 の設定です。そのほかは A2C の既定値で、n_steps=5・gamma=0.99・vf_coef=0.5・max_grad_norm=0.5 はスクラッチ実装と同じです。スクラッチ実装と違うのは、最適化手法が RMSprop(学習率 7e-4)であること、アドバンテージを正規化しないこと、エントロピーのボーナスを使わないことです。
- ネットワーク: MlpPolicy は、Actor と Critic に別々の 2 層(64-64)の MLP を作ります。CartPole のような小さなベクトルの入力では、重みを共有しません。共有するのは、画像を入力にする CnnPolicy の CNN の部分です。
- 途中の評価: model.learn(total_timesteps=10_000, reset_num_timesteps=False) を 50 回呼び、1 万ステップごとに学習を止めて評価します。reset_num_timesteps=False にすると、ステップ数を数え直さずに続きから学習します。評価の deterministic=True は、確率が最大の行動を選ぶ指定で、サンプリングの偶然を除いて、学習した方策そのものの実力を測るためです。
- 学習後の確認: 20 エピソードの平均で評価し、さらに 1 エピソード動かして、100 ステップごとの画面を並べます。CartPole-v1 は 500 ステップで打ち切られるので、ループも 500 回までです。
実行結果
50,000 ステップ:評価のスコア 490.9
100,000 ステップ:評価のスコア 416.9
150,000 ステップ:評価のスコア 500.0
200,000 ステップ:評価のスコア 500.0
250,000 ステップ:評価のスコア 500.0
300,000 ステップ:評価のスコア 500.0
350,000 ステップ:評価のスコア 500.0
400,000 ステップ:評価のスコア 500.0
450,000 ステップ:評価のスコア 500.0
500,000 ステップ:評価のスコア 500.0
学習後:20 エピソードの平均 500.0 ± 0.0
1 エピソードの長さ:500 ステップ
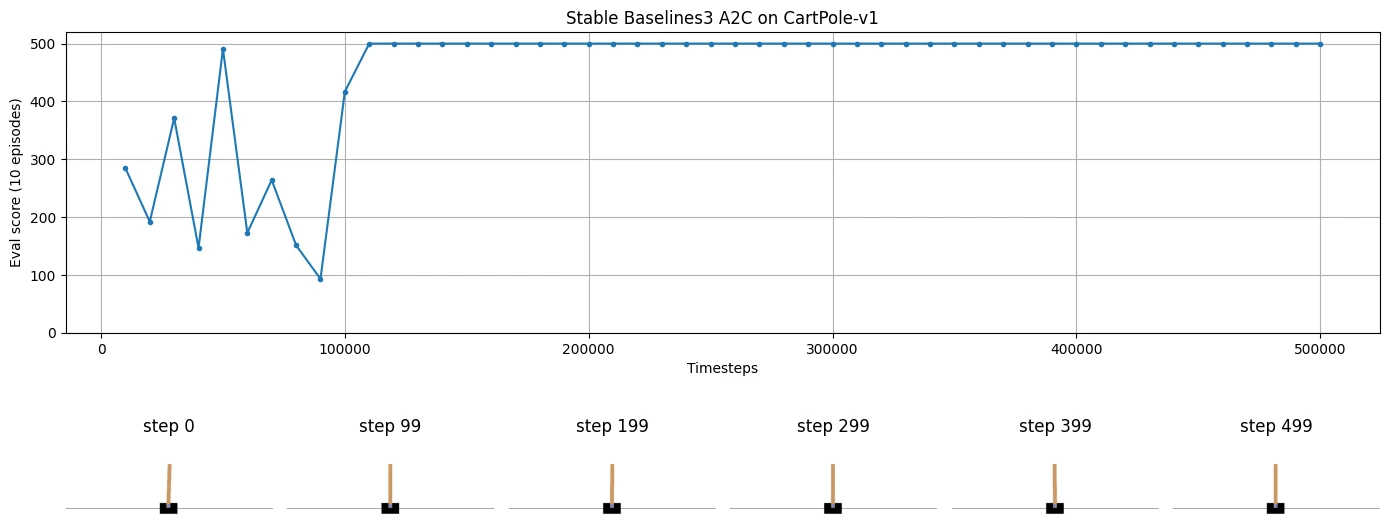
- 学習の途中: 最初の 10 万ステップの評価は大きく上下し、5 万ステップ目の 490.9 から、9 万ステップ目には 100 を下回りました。11 万ステップ目からは、50 万ステップまで 500 を保ちました。
- 学習後: 20 エピソードすべてで 500 ステップ立ち続け(平均 500.0 ± 0.0)、画面でも、カートはほぼ中央のまま、ポールを立て続けています。
- スクラッチ実装との違い: この設定では、スクラッチ実装のように 500 に届いた後で崩れることはありませんでした。ただし、学習の途中のように、スコアが大きく上下することはあります。学習を止める時点によって結果が変わるので、途中で評価して確かめることが大切です。
PPOへの橋渡し:Actor-Criticの限界
A2Cの登場により、強化学習はDQN(価値ベース)の次元の呪いを克服し、REINFORCE(方策ベース)の分散の爆発も抑え込むことに成功しました。
しかし、A2Cにもまだ課題が残されていました。それは 「1回の学習で方策を更新しすぎてしまうと、二度とまともな行動ができなくなり、学習が完全に崩壊してしまうリスク(オンポリシーの恐怖)」 です。方策の更新ステップ幅をどのように安全に制限するかという問題が残っていたのです。
方策の崩壊(Policy Collapse)のシミュレーション
この「方策の崩壊」がいかに簡単に、かつ致命的に起こり得るかを確認してみましょう。 学習率をわざと極端に大きくし、勾配のクリッピングを行わずに方策を更新するコードを実行します。(※本来のA2Cの更新処理ですが、ここでは崩壊のメカニズムのみをわかりやすく示すため、Criticを省略し単純な合計報酬をアドバンテージとして用いる簡略版のREINFORCE的な実装でシミュレーションを行っています)
import gymnasium as gym
import torch
import torch.nn as nn
import torch.optim as optim
from torch.distributions import Categorical

def demonstrate_policy_collapse():
    env = gym.make('CartPole-v1')
    torch.manual_seed(0)  # ネットワークの初期値と行動のサンプリングを、実行ごとに同じにする
    # シンプルな方策ネットワーク
    policy_net = nn.Sequential(
        nn.Linear(4, 128),
        nn.ReLU(),
        nn.Linear(128, 2),
        nn.Softmax(dim=-1)
    )

    # ★注目: 学習率をわざと極端に大きく設定(0.1)し、1回の更新幅を過大にする
    optimizer = optim.Adam(policy_net.parameters(), lr=0.1)

    print("--- 方策崩壊シミュレーション ---")
    for episode in range(5):
        state, _ = env.reset(seed=42)
        log_probs = []
        rewards = []

        for t in range(500):
            state_tensor = torch.FloatTensor(state).unsqueeze(0)
            probs = policy_net(state_tensor)
            m = Categorical(probs)
            action = m.sample()

            log_probs.append(m.log_prob(action))
            state, reward, terminated, truncated, _ = env.step(action.item())
            rewards.append(reward)

            if terminated or truncated:
                break

        # 単純なアドバンテージ(報酬の合計)で更新
        R = sum(rewards)
        policy_loss = []
        for log_prob in log_probs:
            policy_loss.append(-log_prob * R)

        optimizer.zero_grad()
        loss = torch.stack(policy_loss).sum()
        loss.backward()

        # ★注目: 勾配クリッピング(nn.utils.clip_grad_norm_)を行わない
        optimizer.step()

        # 行動確率の偏りを確認(状態がすべて0の場合の、右/左に行く確率)
        test_state = torch.zeros(1, 4)
        with torch.no_grad():
            action_prob = policy_net(test_state).numpy()[0]

        print(f"エピソード {episode+1}: スコア = {R}")
        print(f"  -> 初期状態での行動確率: 左 {action_prob[0]*100:.1f}% / 右 {action_prob[1]*100:.1f}%")

demonstrate_policy_collapse()
学習率を極端に大きくした方策勾配の更新を 5 回だけ行い、1 回の更新で行動の確率がどれだけ偏るかを確かめるコードです。
- 簡略化: Critic を使わず、エピソードの合計報酬 R をすべての行動に掛けます。崩壊の原因である更新幅の大きさだけを見るためです。
- 学習率と勾配: 学習率 0.1 は、スクラッチ実装(1e-3)の 100 倍で、1 回の更新をわざと大きくしています。スクラッチ実装で 0.5 に抑えていた勾配も、クリップせずにそのまま使います。
- 確かめ方: すべての値が 0 の状態(カートが中央にあり、ポールが真上で止まっている)での行動の確率を、更新のたびに表示します。同じ状態の確率を比べることで、1 回の更新で方策がどれだけ変わったかが分かります。
- 乱数の固定: torch.manual_seed(0) でネットワークの初期値と行動のサンプリングを、env.reset(seed=42) で環境の初期状態を固定し、実行結果を再現できるようにします。
実行結果
--- 方策崩壊シミュレーション ---
エピソード 1: スコア = 11.0
  -> 初期状態での行動確率: 左 98.1% / 右 1.9%
エピソード 2: スコア = 8.0
  -> 初期状態での行動確率: 左 99.9% / 右 0.1%
エピソード 3: スコア = 8.0
  -> 初期状態での行動確率: 左 100.0% / 右 0.0%
エピソード 4: スコア = 8.0
  -> 初期状態での行動確率: 左 100.0% / 右 0.0%
エピソード 5: スコア = 8.0
  -> 初期状態での行動確率: 左 100.0% / 右 0.0%
1 回目の更新だけで、初期状態で左に動く確率が 98.1% になり、2 回目で 99.9%、3 回目以降は 100.0%(表示の桁では右が 0.0%)に張り付きました。スコアも、2 回目以降は 8 のまま変わりません。ほぼ左にしか動かないので、ポールは毎回すぐに倒れます。 このように確率が0%や100%近くに張り付いてしまうと、二度と他の行動を試さなくなる(探索が行われなくなる)ため、最終的にはスコアが低下したまま全く学習が進まなくなる「学習の崩壊」に陥ります。
1 回の更新で方策が変わる幅を制限して、この崩壊を防ぐのが、TRPO と PPO(Proximal Policy Optimization) です。どちらも A2C と同じ Actor-Critic の構成を土台にしています。
5 回のエピソードの行動の確率を並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
- REINFORCEの課題: エピソード全体の収益を使うため分散が大きく学習が不安定。
- Actor-Critic: 価値を予測する「Critic」と、行動を決定する「Actor」に役割を分担させ、Critic の予想との差で Actor を更新することで、更新のばらつきを抑える。CartPole では、スクラッチ実装が約 22 万ステップで平均スコア 500 に届いた。
- アドバンテージ(Advantage, ): 「平均的な期待値(ベースライン)」に対して、今回の行動がどれだけ良かったかを示す指標()。※実装ではN-step版に拡張して使用します。
- A3CとA2C: 複数の環境を並列実行してデータを集める手法。探索を促すためのエントロピー正則化などの工夫が盛り込まれている。
- A2Cに残された課題: 1回の更新幅を制限する仕組みがないため、スクラッチ実装では 500 に届いた後にスコアが崩れた。学習率を極端に大きくすると、1 回の更新で行動確率が 98% まで偏る「方策の崩壊(Policy Collapse)」が起こる。
A2Cは現在の深層強化学習における重要な基盤技術であり、これを理解し、その限界(方策の崩壊)を知ることで、最新の強力なアルゴリズム(PPOなど)がなぜ生まれたのかという理解がより一層深まります。
参考文献
- V. Mnih et al. (2016). Asynchronous Methods for Deep Reinforcement Learning. ICML 2016.
- M. Towers et al. (2024). Gymnasium: A Standard Interface for Reinforcement Learning Environments. arXiv:2407.17032.
- A. Raffin, A. Hill, A. Gleave, A. Kanervisto, M. Ernestus, N. Dormann (2021). Stable-Baselines3: Reliable Reinforcement Learning Implementations. Journal of Machine Learning Research, 22(268), 1–8.
- DLR-RM. rl-baselines3-zoo. GitHub.
本記事の文章・構成の一部に生成AIを使用しています。