アドストックと飽和曲線とは? MMM の広告の残り方と収益逓減
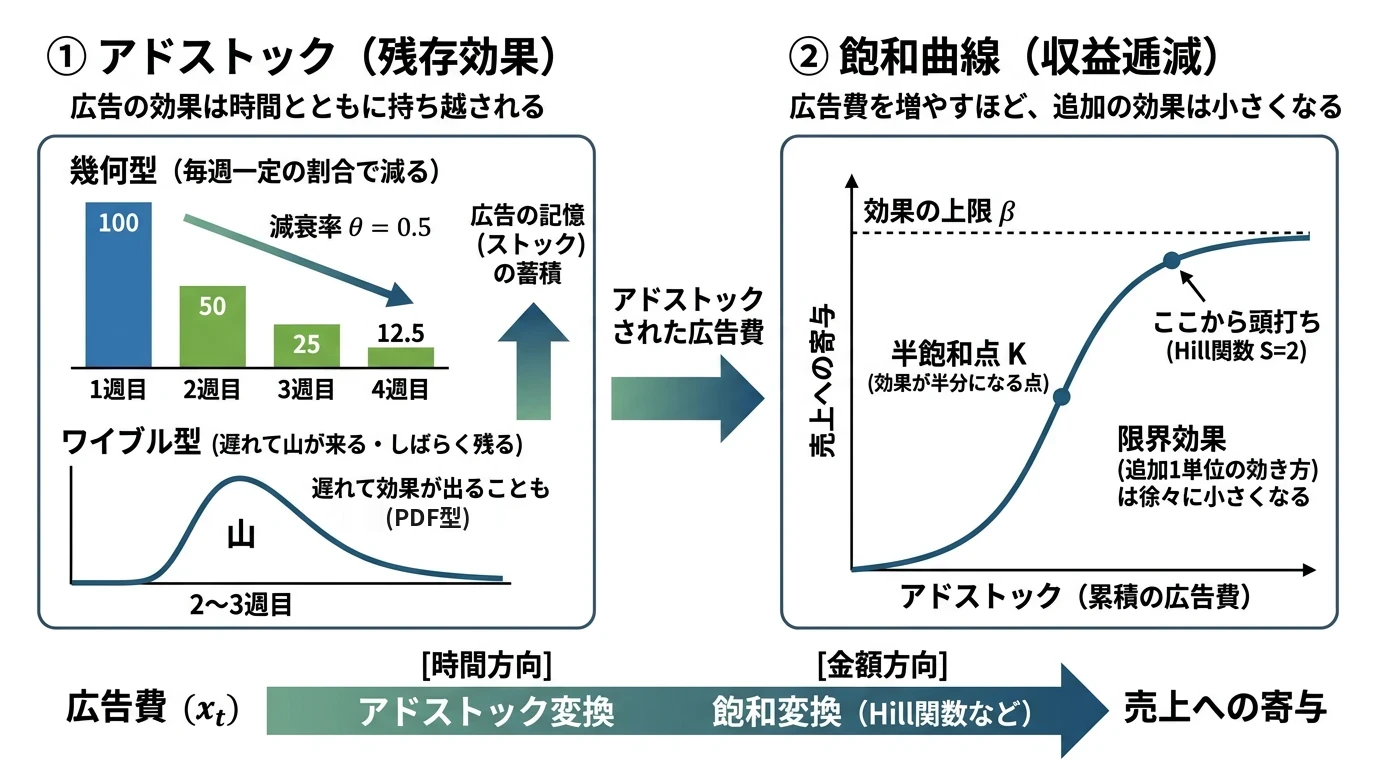 (画像は、Geminiで作成)
広告費を売上への寄与に変える2つの非線形変換、アドストック(今週の広告が来週以降にも効く)と飽和曲線(出すほど追加の効果が小さくなる)を、数式とコードで理解すること。幾何型とワイブル型のアドストック、Hill 関数と指数型の飽和のパラメータが曲線の形をどう変えるか、変換の順序で何が変わるかを説明でき、データからパラメータを推定するときに、どこまで信じてよいかを判断できるようになること。
原著論文: Bayesian Methods for Media Mix Modeling with Carryover and Shape Effects (Jin, Wang, Sun, Chan, Koehler, Google Inc. 2017)
本記事のコードは、CPU だけの環境で、Python 3.13、numpy 2.5.3、pandas 3.0.5、scipy 1.18.1、matplotlib 3.11.2 を使って実行しました。GPU は使いません。60回の当てはめの繰り返しを含めて、全体の実行は約4秒です。乱数のシードを固定しているので、同じ環境では同じ結果になります。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google Colab や Jupyter では先頭の ! を付けたまま、ターミナルでは ! を外して実行します)。Python 3.12 以降で import 時にエラーが出る場合は、setuptools も一緒にインストールしてください。
!pip install japanize-matplotlib setuptools
概要
テレビ CM を流した週だけでなく、その翌週・翌々週にも売上が少し高いことがあります。また、広告費を2倍にしても、売上の増分は2倍にはなりません。マーケティングミックスモデル(MMM)は、この2つの性質を、広告費に掛ける2つの非線形変換として表します。時間方向の アドストック(持ち越し効果、Carryover)と、金額方向の 飽和曲線(収益逓減、Shape)です。
アドストックは、過去の広告費に、経過した週ごとに減っていく重みを掛けて足し合わせる変換です。重みが毎週一定の割合で減る 幾何型(Broadbent, 1979)と、形状と尺度の2つのパラメータで、しばらく残ってから落ちる形や、数週後に山が来る形も表せる ワイブル型 があります。飽和曲線は、アドストックした広告費を0〜1に押し込める関数で、半飽和点と形状で S 字にも C 字にもなる Hill 関数 と、最初から逓減する 指数型 がよく使われます。Jin et al.(2017)は、アドストックと Hill 関数を組み合わせたベイズの MMM を示し、Google の Meridian などのライブラリの元になっています。
本記事では、これらの変換をスクラッチ実装し、パラメータを変えたときの重みと曲線の形を数値で比べます。次に、同じ予算を1週に集中するか、数週に分けるかで、変換の順序(アドストック → 飽和 か、その逆か)によって最適な出し方が変わることを確かめます。最後に、模擬の2年分の週次の売上に、5つのパラメータを最小二乗法で当てはめ、出稿額の幅が狭いデータでは、効果の上限が大きくぶれることを確かめます。
広告費を売上への寄与に変える、2つの変換
(図は、diagram-designで作成)
チャネル の週 の広告費を とすると、MMM の売上 は、次のように書けます。
- : アドストック。 週前の広告費 に重み を掛けて、最大ラグ 週分を足したものです。「消費者の記憶に残っている広告の量」にあたります。
- : 飽和関数。アドストックを0〜1に押し込めます。
- : 効果の上限。広告をいくら出しても、そのチャネルの寄与は を超えません。
本記事では、MMM の記事と同じく、重みを正規化しない総和形()と、最大ラグ (当週を含めて13週分)を使います。Jin et al.(2017)や Meridian は、重みの和で割って正規化した を使います。正規化すると、アドストックの単位が「1週の広告費」と同じになり、半飽和点 の値の意味が変わる( が 倍だけ小さくなる)ので、ライブラリの推定値を読むときは、どちらの形かを確かめる必要があります。
アドストック:広告の効果を、時間方向に持ち越す
幾何型:毎週一定の割合で減る
幾何型のアドストック(Broadbent, 1979)は、重みが毎週 (減衰率、)倍になります。
漸化式で書くと で、「今週の記憶 = 今週の広告 + 先週の記憶の 倍」です。減衰率の代わりに、効果が半分になるまでの週数(半減期)で考えることもあります。 を について解くと、次のようになります。
毎週同じ額 を出し続けると、アドストックは に近づきます(定常状態)。1週だけ出す パルス と、8週続けて出す 継続出稿 の2つの出し方で、減衰率による違いを確かめます。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import japanize_matplotlib

T = 20                                            # 20週の短い期間で、形を見る
weeks = np.arange(T)
# (a) パルス:1週目にだけ100を出す(その後の残り方を見る)
pulse = np.zeros(T); pulse[1] = 100
# (b) 継続:1〜8週目に毎週100を出し、9週目から止める(たまり方と抜け方を見る)
flight = np.zeros(T); flight[1:9] = 100
print("パルス  :", pulse[:12].astype(int))
print("継続出稿:", flight[:12].astype(int))
20週の期間に、パルスと継続出稿の2つの広告費の並びを作るコードです。0週目を空けて1週目から出すのは、出稿の前の値(0)と比べて、立ち上がりを見やすくするためです。100は、残った量(80、64、…)を暗算で確かめやすい値です。
実行結果
パルス  : [  0 100   0   0   0   0   0   0   0   0   0   0]
継続出稿: [  0 100 100 100 100 100 100 100 100   0   0   0]
def geometric_weights(theta, L=12):
    """幾何減衰の重み θ^l(l = 0, 1, …, L)"""
    return theta ** np.arange(L + 1)


def adstock(x, weights):
    """総和形のアドストック:x̃_t = Σ_l w_l x_{t−l}(データの前の広告費は0とみなす)"""
    return np.convolve(x, weights)[:len(x)]


def half_life(theta):
    """広告の効果が半分になるまでの週数:θ^h = 0.5 を h について解く"""
    return np.log(0.5) / np.log(theta)


for theta in (0.2, 0.5, 0.8):
    w = geometric_weights(theta)
    a_pulse, a_flight = adstock(pulse, w), adstock(flight, w)
    print(f"θ={theta}: 半減期 {half_life(theta):4.2f}週  パルスの残り {np.round(a_pulse[1:6], 1)}  "
          f"合計 {a_pulse.sum():6.1f}  継続8週目 {a_flight[8]:6.1f}(定常 {100 / (1 - theta):6.1f})")


def plot_geometric(pulse, flight, thetas, path):
    fig, axes = plt.subplots(1, 2, figsize=(10, 3.6), sharey=False)
    for ax, x, title in zip(axes, (pulse, flight), ("パルス(1週目だけ100)", "継続出稿(1〜8週目に毎週100)")):
        ax.bar(weeks, x, color="lightgray", label="広告費")
        for theta, c in zip(thetas, ("#4C72B0", "#55A868", "#C44E52")):
            ax.plot(weeks, adstock(x, geometric_weights(theta)), marker="o", ms=3, color=c, label=f"θ = {theta}")
        ax.set_title(title); ax.set_xlabel("週"); ax.grid(alpha=0.3)
    axes[0].set_ylabel("アドストック"); axes[1].legend()
    fig.tight_layout(); fig.savefig(path, dpi=150); plt.close(fig)


plot_geometric(pulse, flight, (0.2, 0.5, 0.8), "adstock_saturation_3.png")
幾何型の重みとアドストックを計算し、減衰率 を0.2・0.5・0.8に変えて、パルスの残り方と、継続出稿のたまり方を比べるコードです。
- geometric_weights(theta, L=12): 重み の13個の配列を返します。
- adstock(x, weights): 総和形のアドストックを計算します。np.convolve(x, weights) は、各週 について を計算する畳み込みで、長さ len(x) + len(weights) − 1 の結果のうち、先頭の len(x) 個が、データの開始より前の広告費を0とみなしたアドストックになります。MMM の記事の二重ループと同じ値で、どの重み(幾何型でもワイブル型でも)にも使えます。
- half_life(theta): 上の式の半減期です。
- plot_geometric: 左にパルス、右に継続出稿の広告費(灰色の棒)と、3つの減衰率のアドストックを描きます。
実行結果
θ=0.2: 半減期 0.43週  パルスの残り [100.   20.    4.    0.8   0.2]  合計  125.0  継続8週目  125.0(定常  125.0)
θ=0.5: 半減期 1.00週  パルスの残り [100.   50.   25.   12.5   6.2]  合計  200.0  継続8週目  199.2(定常  200.0)
θ=0.8: 半減期 3.11週  パルスの残り [100.   80.   64.   51.2  41. ]  合計  472.5  継続8週目  416.1(定常  500.0)
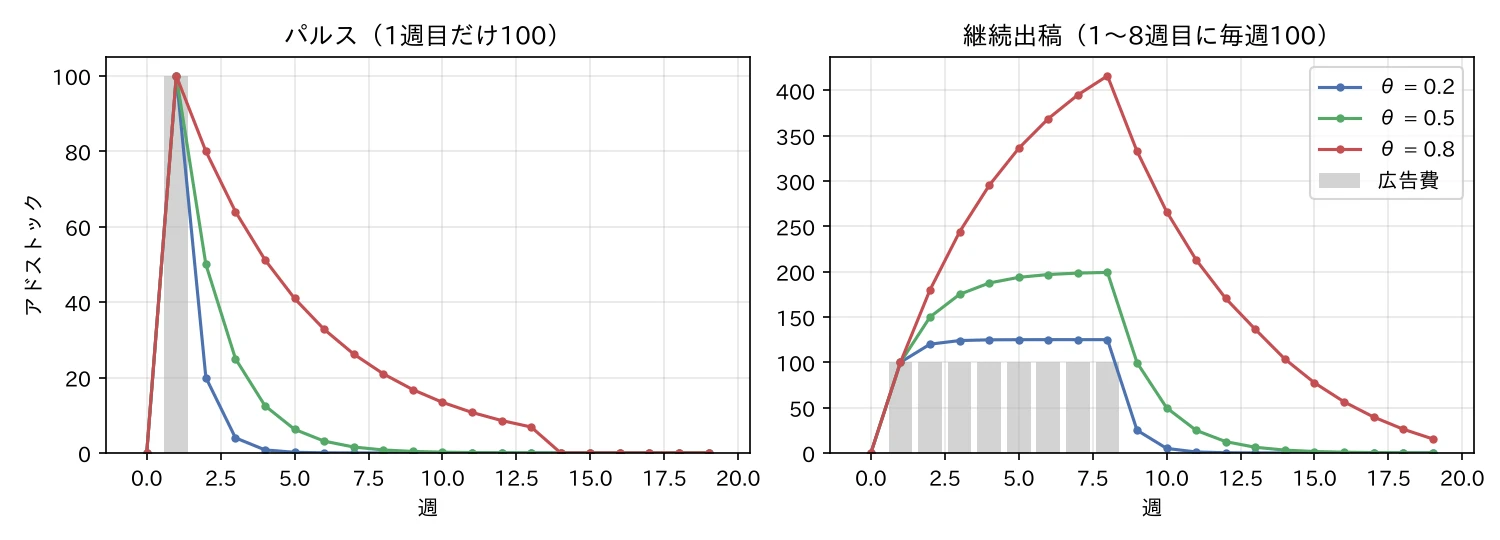
- 減衰率が大きいほど、長く残る: パルスの100は、 では翌週に20、2週後に4とすぐに消えますが(半減期0.43週)、 では80・64・51と残ります(半減期3.11週)。
- パルスの合計は、 倍: 1回の100が、 では合計200、 では125になりました。 は本来500ですが、最大ラグ で13週目以降を切り捨てるので472.5でした。図の左で、 の線が14週目に0に落ちるのも、この切り捨てのためです。減衰率が大きいチャネルでは、 を長くする必要があります。
- 継続出稿は、定常状態に近づく: 毎週100を8週続けると、 では199.2で、定常の200にほぼ達しました。 では416.1で、定常の500にはまだ届きません。減衰率が大きいほど、記憶がたまるのにも、抜けるのにも時間がかかります。
ワイブル型:しばらく残ってから落ちる形と、遅れて山が来る形
幾何型は、当週の重みが必ず最大で、そこから毎週同じ割合で減ります。しかし、テレビ CM の認知が数週間ほぼ保たれてから急に落ちる、検討期間の長い商品では広告の数週後に購入の山が来る、といった形は表せません。そこで、ワイブル分布(形状 、尺度 )を重みに使う、2つの型を考えます。CDF 型 は、ワイブル分布の生存関数(1 − 累積分布関数)を重みにします。
PDF 型 は、ワイブル分布の確率密度関数を、最大の重みが1になるようにそろえて使います。
CDF 型は、 のとき で、 の幾何型と同じになります。 なら最初に速く落ちて長く裾を引き、 なら高いまましばらく残ってから急に落ちます。PDF 型は、 のとき の重みが0で、山は に来ます。Robyn などの MMM のライブラリは、こうしたワイブルの CDF 型と PDF 型のアドストックを選べるようにしています(重みの細かい作り方はライブラリごとに違います)。
def weibull_cdf_weights(k, lam, L=12):
    """ワイブル CDF 型:w_l = 1 − F(l) = exp(−(l/λ)^k)。l = 0 で1から、形状 k で減り方が変わる"""
    l = np.arange(L + 1)
    return np.exp(-(l / lam) ** k)


def weibull_pdf_weights(k, lam, L=12):
    """ワイブル PDF 型(k > 1):w_l ∝ f(l) で、最大の重みを1にそろえる。山が l = 0 より後ろに来る"""
    l = np.arange(L + 1, dtype=float)
    f = (k / lam) * (l / lam) ** (k - 1) * np.exp(-(l / lam) ** k)
    return f / f.max()


cases = {"幾何 θ=0.5": geometric_weights(0.5),
         "CDF k=1, λ=1.44": weibull_cdf_weights(1.0, 1 / np.log(2)),
         "CDF k=0.5, λ=1": weibull_cdf_weights(0.5, 1.0),
         "CDF k=3, λ=4": weibull_cdf_weights(3.0, 4.0),
         "PDF k=2, λ=3": weibull_pdf_weights(2.0, 3.0),
         "PDF k=4, λ=5": weibull_pdf_weights(4.0, 5.0)}
for name, w in cases.items():
    peak = int(np.argmax(adstock(pulse, w))) - 1
    print(f"{name:16s} 重み {np.round(w[:8], 2)}  パルスの山 {peak}週後  重みの合計 {w.sum():5.2f}")


def plot_weibull(cases, path):
    fig, axes = plt.subplots(1, 2, figsize=(10, 3.6))
    l = np.arange(13)
    for name, w in cases.items():
        ax = axes[1] if name.startswith("PDF") else axes[0]
        ax.plot(l, w, marker="o", ms=3, label=name)
    axes[0].set_title("幾何型とワイブル CDF 型(重み)"); axes[1].set_title("ワイブル PDF 型(重み、最大を1に)")
    for ax in axes:
        ax.set_xlabel("経過した週 l"); ax.grid(alpha=0.3); ax.legend()
    axes[0].set_ylabel("重み w_l")
    fig.tight_layout(); fig.savefig(path, dpi=150); plt.close(fig)


plot_weibull(cases, "adstock_saturation_4.png")
ワイブル CDF 型と PDF 型の重みを計算し、幾何型と並べて、重みの形と、パルスのアドストックの山の位置を比べるコードです。
- weibull_cdf_weights(k, lam, L=12): CDF 型の重みです。 で なので、幾何型と同じく当週の重みが1から始まります。
- weibull_pdf_weights(k, lam, L=12): PDF 型の重みを、最大を1にそろえて返します。最大でそろえるのは、パラメータを変えても、山の高さ(1週分の広告費がそのまま効く)が同じになって、形だけを比べられるようにするためです。 では で密度が最大( では無限大)になり、山が後ろにずれる PDF 型を使う意味がないので、 だけを考えます。
- cases: 比べる6つの重みです。CDF 型の 、 は、 で、幾何型の と同じ重みになる組です。残りの組は、「速く落ちて裾を引く()」「しばらく残って落ちる()」「2週後・5週後に山が来る(PDF 型)」の形が見えるように選んでいます。
- パルスの山: パルスのアドストックが最大になる週から、出稿した1週目を引いて、出稿の何週後に効果の山が来るかを数えます。
実行結果
幾何 θ=0.5         重み [1.   0.5  0.25 0.12 0.06 0.03 0.02 0.01]  パルスの山 0週後  重みの合計  2.00
CDF k=1, λ=1.44  重み [1.   0.5  0.25 0.13 0.06 0.03 0.02 0.01]  パルスの山 0週後  重みの合計  2.00
CDF k=0.5, λ=1   重み [1.   0.37 0.24 0.18 0.14 0.11 0.09 0.07]  パルスの山 0週後  重みの合計  2.41
CDF k=3, λ=4     重み [1.   0.98 0.88 0.66 0.37 0.14 0.03 0.  ]  パルスの山 0週後  重みの合計  4.07
PDF k=2, λ=3     重み [0.   0.7  1.   0.86 0.53 0.24 0.09 0.02]  パルスの山 2週後  重みの合計  3.44
PDF k=4, λ=5     重み [0.   0.02 0.17 0.52 0.92 1.   0.59 0.16]  パルスの山 5週後  重みの合計  3.40
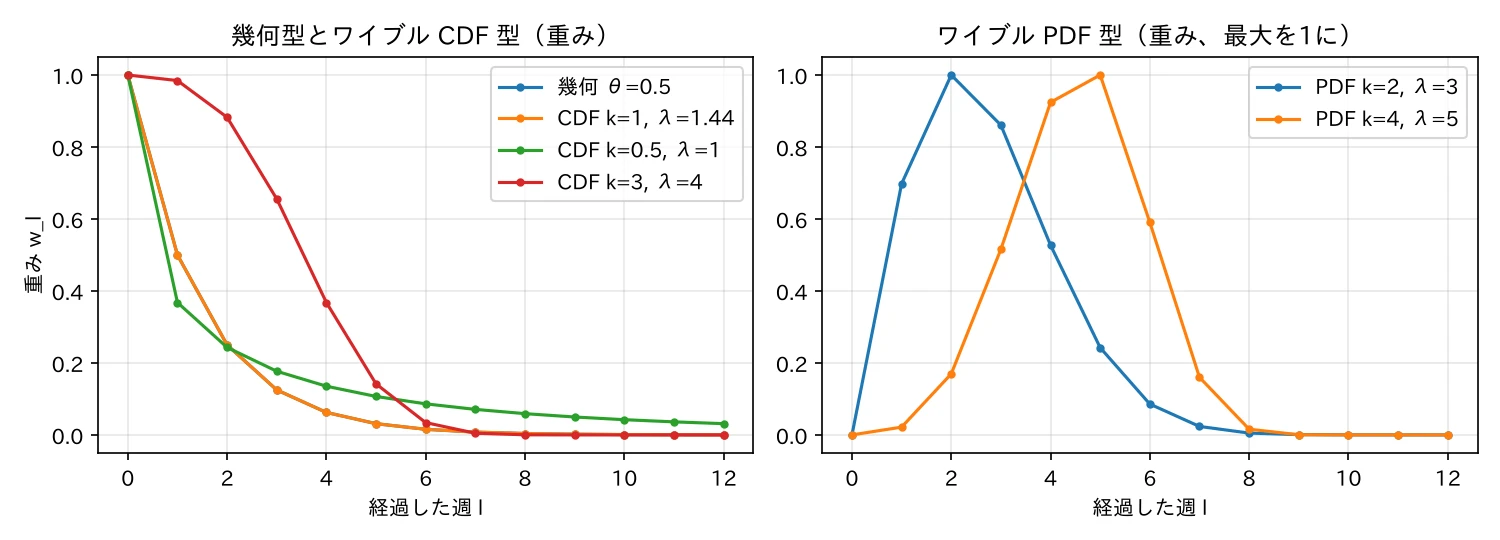
- CDF 型の は、幾何型と同じ: 重みは1・0.5・0.25・0.13…で、幾何型の と一致しました(0.12と0.13の違いは丸めです)。
- CDF 型の で、減り方が変わる: は翌週に0.37まで落ちたあと、7週後も0.07と長く残り、 は3週後まで0.66以上を保ってから、5週後に0.14まで急に落ちました。どちらも山は当週(0週後)です。
- PDF 型は、山が後ろにずれる: は2週後、 は5週後が山で、当週の重みは0でした。上の式の山の位置は、それぞれ2.12週と4.65週で、整数の週では2週後と5週後になります。
(図は、diagram-designで作成)
幾何型はパラメータが1つで推定しやすい代わりに、「当週が最大で、一定の割合で減る」形しか表せません。ワイブル型は2つのパラメータで、残り方や山の遅れを柔軟に表せますが、パラメータが増える分、データから決めにくくなります。また、重みの合計(パルス1回分の広告費が、合計で何週分効くか)は形によって違い、上の例では2.00・4.07・3.40でした。この合計は、後の飽和関数の半飽和点 の大きさにそのまま響きます。
飽和曲線:出すほど、追加の効果が小さくなる
Hill 関数と指数型
Hill 関数 は、半飽和点 と形状 の2つのパラメータを持つ飽和関数です。
のとき、ちょうど0.5(上限の半分)になります。 なら原点から効果が逓減する C 字、 なら最初は効果が加速し、途中から逓減する S 字になります。S 字の曲線で、入力を1増やしたときの増分(限界効果)が最大になる点を 変曲点 と呼び、2階微分を0とおくと、次の位置になります。
指数型 の飽和関数は、パラメータ が1つで、原点の傾き が最大の、最初から逓減する曲線です。
def hill(x, K, S):
    """Hill 関数:x^S / (x^S + K^S)。x = K で 0.5、上限は1"""
    x = np.asarray(x, dtype=float)
    return x ** S / (x ** S + K ** S)


def exp_saturation(x, a):
    """指数型の飽和:1 − exp(−a x)。原点の傾きが最大で、最初から効果が逓減する"""
    return 1 - np.exp(-a * np.asarray(x, dtype=float))


def hill_inflection(K, S):
    """S > 1 の Hill 関数の変曲点(限界効果が最大になる入力):K ((S − 1)/(S + 1))^(1/S)"""
    return K * ((S - 1) / (S + 1)) ** (1 / S) if S > 1 else 0.0


x = np.array([0, 25, 50, 100, 200, 400])
for K, S in ((100, 1), (100, 2), (100, 4), (200, 2)):
    xs = hill_inflection(K, S)
    print(f"Hill K={K:3d} S={S}: {np.round(hill(x, K, S), 3)}  変曲点 {xs:5.1f}")
a = np.log(2) / 100                           # 100 で 0.5 になる指数型(Hill の K=100 とそろえる)
print(f"指数型 a=ln2/100 : {np.round(exp_saturation(x, a), 3)}")
# 限界効果(入力を1増やしたときの出力の増分)を、入力の大きさごとに比べる
for name, f in (("Hill S=1", lambda v: hill(v, 100, 1)), ("Hill S=2", lambda v: hill(v, 100, 2)),
                ("指数型", lambda v: exp_saturation(v, a))):
    m = [(f(v + 1) - f(v)) * 100 for v in (0, 50, 100, 200)]         # 出力の増分を%ポイントで表す
    print(f"限界効果(%pt) {name:8s}: x=0 {m[0]:.3f}  x=50 {m[1]:.3f}  x=100 {m[2]:.3f}  x=200 {m[3]:.3f}")
Hill 関数と指数型の飽和関数を実装し、パラメータを変えたときの出力と変曲点、入力の大きさごとの限界効果を比べるコードです。
- hill(x, K, S): 上の Hill 関数です。入力を float の配列にしているのは、数1つでも、リストでも、整数の配列でも、同じように小数で計算できるようにするためです。
- exp_saturation(x, a): 指数型です。a = np.log(2) / 100 にすると、 で、入力100で0.5になります。Hill 関数の とそろえて、形だけを比べるためです。
- hill_inflection(K, S): 上の変曲点の式です。 では変曲点がない(原点の傾きが最大)ので0を返します。
- パラメータの組: のまま を1・2・4に変える組で形状の効果を、 のまま を200にする組で半飽和点の効果を見ます。
- 限界効果: 入力を1増やしたときの出力の増分を、%ポイント(上限を100%としたとき)で表します。 のそれぞれで、追加の1の効き方を比べます。
実行結果
Hill K=100 S=1: [0.    0.2   0.333 0.5   0.667 0.8  ]  変曲点   0.0
Hill K=100 S=2: [0.    0.059 0.2   0.5   0.8   0.941]  変曲点  57.7
Hill K=100 S=4: [0.    0.004 0.059 0.5   0.941 0.996]  変曲点  88.0
Hill K=200 S=2: [0.    0.015 0.059 0.2   0.5   0.8  ]  変曲点 115.5
指数型 a=ln2/100 : [0.    0.159 0.293 0.5   0.75  0.938]
限界効果(%pt) Hill S=1: x=0 0.990  x=50 0.442  x=100 0.249  x=200 0.111
限界効果(%pt) Hill S=2: x=0 0.010  x=50 0.641  x=100 0.498  x=200 0.159
限界効果(%pt) 指数型     : x=0 0.691  x=50 0.488  x=100 0.345  x=200 0.173
(図は、diagram-designで作成)
- どの曲線も、 で0.5を通る: の3つの曲線は、 で0.5でした。 にすると、 で0.5、 で0.8と、 の曲線を横に2倍に伸ばした形になります。
- が大きいほど、 の手前で急に立ち上がる: の出力は、 で0.333、 で0.2、 で0.059でした。 は、半飽和点の半分を出しても、上限の6%しか効きません。変曲点は で57.7、 で88.0です。
- C 字と S 字では、追加の1の効き方が逆: の限界効果は、 で0.990%ポイントと最大で、そこから減り続けます。 は で0.010%ポイントとほぼ効かず、(変曲点の近く)で0.641%ポイントと最大になってから減ります。S 字のチャネルは、少額ではほとんど効かず、ある程度まとまった額を出してはじめて効きます。
- 指数型は、原点から逓減する: 指数型の限界効果は、 の0.691%ポイントから、 の0.173%ポイントまで減り続けました。Hill 関数の に近い形ですが、上限への近づき方が速く、 で0.938( の Hill 関数は0.8)です。
予算配分の記事で扱うように、限界効果(限界 ROAS)の形は、予算をどこに足すべきかを直接決めます。C 字のチャネルは少額からでも効くので、予算を薄く広く配るのが向き、S 字のチャネルは変曲点を超えるまで出さないと効かないので、配るなら変曲点の先まで、という判断になります。
変換の順序:アドストック → 飽和 か、飽和 → アドストック か
アドストックと飽和を掛ける順序には、2通りあります。
A は「たまった広告の記憶(ストック)に飽和がかかる」、B は「その週の広告費に飽和がかかってから、効果が残る」という考え方です。Jin et al.(2017)は、1期の出稿額が、何期分もたまった累積に比べて小さいなら、1期の中では飽和が効きにくいので A を、1期の出稿額が大きいなら B を勧めています。Meridian は既定が A で、引数で B にも切り替えられます。同じ合計400の予算を、1週に集中する、4週に分ける、8週に分けるの3通りで出し、2つの順序で効果の合計を比べます。
def effect_adstock_first(x, weights, K, S):
    """アドストック → 飽和:たまった広告の記憶(ストック)に、飽和がかかる"""
    return hill(adstock(x, weights), K, S)


def effect_saturation_first(x, weights, K, S):
    """飽和 → アドストック:その週の広告費に飽和をかけてから、効果を持ち越す"""
    return adstock(hill(x, K, S), weights)


# 合計400の予算を、1週に集中(バースト)・4週に分散・8週に分散 の3通りで出す
plans = {"1週に400": np.r_[0, 400, np.zeros(T - 2)],
         "4週に100ずつ": np.r_[0, [100] * 4, np.zeros(T - 5)],
         "8週に50ずつ": np.r_[0, [50] * 8, np.zeros(T - 9)]}
w = geometric_weights(0.5)
K, S = 100, 2
for name, x in plans.items():
    a, b = effect_adstock_first(x, w, K, S), effect_saturation_first(x, w, K, S)
    print(f"{name:8s} 合計 {x.sum():.0f}  アドストック→飽和 {a.sum():5.2f}  飽和→アドストック {b.sum():5.2f}  "
          f"週の効果の最大 {a.max():.2f} / {b.max():.2f}")
2つの順序の変換を実装し、合計400の予算の3通りの出し方で、20週分の効果の合計と、週の効果の最大を比べるコードです。
- effect_adstock_first と effect_saturation_first: A と B の変換です。同じ adstock と hill を、逆の順序で組み合わせただけです。
- パラメータ: 減衰率 (半減期1週)と、S 字の Hill 関数(、)です。S 字にしたのは、「薄く出しすぎると、立ち上がりの手前で効かない」という効果も見えるようにするためです。効果は (上限を1)として、週の効果を20週分足しています。
実行結果
1週に400   合計 400  アドストック→飽和  2.52  飽和→アドストック  1.88  週の効果の最大 0.94 / 0.94
4週に100ずつ 合計 400  アドストック→飽和  3.44  飽和→アドストック  4.00  週の効果の最大 0.78 / 0.94
8週に50ずつ  合計 400  アドストック→飽和  3.71  飽和→アドストック  3.20  週の効果の最大 0.50 / 0.40
(図は、diagram-designで作成)
- A では、8週に薄く分けるのが最もよい: 効果の合計は、1週に400が2.52、4週に100ずつが3.44、8週に50ずつが3.71でした。A では、毎週の50がたまって記憶が約100()まで育つので、S 字の立ち上がりも越えられます。一度に400を出すと、記憶が大きくなりすぎて、飽和の平らな部分に入ってしまいます。
- B では、4週に分けるのが最もよい: 効果の合計は、1週に400が1.88、4週に100ずつが4.00、8週に50ずつが3.20でした。B では、その週の出稿に先に飽和がかかるので、1週に400は で頭打ちになり、残りの予算が無駄になります。一方、50ずつに薄くすると、1週ごとの が S 字の立ち上がりの手前で、効きにくくなります。
- 同じパラメータでも、最適な出し方が変わる: A なら「薄く長く」、B なら「まとまった額を数週」が最適でした。順序の選び方は、推定の当てはまりの違いは小さくても、出稿の計画(フライティング)の提言を変えます。
データから、パラメータを推定する
模擬の週次データ
2年分(104週)の週次データを作ります。4週ごとに、出稿するか(確率0.6)を決め、出稿する週は、30・60・90・120のどれかを出します。売上は、ベースライン500に、アドストック → 飽和(A)の広告の寄与と、正規分布のノイズ(標準偏差20)を足したものです。真のパラメータは、減衰率 、半飽和点 、形状 、効果の上限 です。
from scipy.optimize import least_squares

# (a) 2年(104週)の週次データ:出稿する週(フライト)と休む週を繰り返し、出稿額も変える
rng = np.random.default_rng(0)
n_weeks = 104
on = np.repeat(rng.random(n_weeks // 4) < 0.6, 4)               # 4週ごとに、出稿するかを決める
spend = np.where(on, rng.choice([30, 60, 90, 120], n_weeks), 0).astype(float)
# (b) 真のパラメータ:減衰率 θ、半飽和点 K、形状 S、効果の上限 β、ベースライン
TRUE = {"theta": 0.6, "K": 150.0, "S": 2.0, "beta": 300.0, "base": 500.0}


def media_effect(x, theta, K, S, beta, order="adstock_first", L=12):
    """広告の売上への寄与:β × h(アドストック) か、β × アドストック(h)"""
    w = geometric_weights(theta, L)
    f = effect_adstock_first if order == "adstock_first" else effect_saturation_first
    return beta * f(x, w, K, S)


noise = rng.normal(0, 20, n_weeks)                                # 観測のノイズ(標準偏差20)
sales = TRUE["base"] + media_effect(spend, **{k: v for k, v in TRUE.items() if k != "base"}) + noise
print(f"出稿した週 {int((spend > 0).sum())}週  広告費の合計 {spend.sum():,.0f}  売上の平均 {sales.mean():.1f}")
フライト(出稿する期間と休む期間)のある広告費と、売上のデータを作るコードです。
- (a) 出稿の並び: np.repeat(…, 4) で、4週ごとに出稿するかを決めます。広告は数週まとめて出すことが多いのと、休む週があると、アドストックの減り方()がデータに表れて推定しやすくなるためです。出稿額を4つの水準から週ごとに選ぶのは、飽和の曲がり方( と )を推定できるように、入力の大きさに幅を持たせるためです。
- (b) 真のパラメータ: は半減期約1.4週、毎週出し続けたときのアドストックが約2.5倍()になる値です。 は、毎週60を出し続けたときのアドストック(約150)で半分の効果になる、という意味です。
- media_effect(x, theta, K, S, beta, order): 広告の売上への寄与です。order で、前の節の A と B の順序を切り替えられるようにしています。
- noise: 観測のノイズです。後で、当てはめた残差と比べるために取っておきます。
実行結果
出稿した週 52週 広告費の合計 4,350 売上の平均 591.9
最小二乗法で、5つのパラメータを当てはめる
5つのパラメータ を、残差の平方和が最小になるように求めます。
アドストックと Hill 関数を通すので、パラメータについて非線形な最小二乗問題です。scipy の least_squares(信頼領域法)で解きます。
NAMES = ["theta", "K", "S", "beta", "base"]
LOWER = [0.0, 1.0, 0.3, 0.0, 0.0]
UPPER = [0.99, 2000.0, 6.0, 5000.0, 2000.0]


def fit(x, y, order="adstock_first", n_starts=20, seed=0):
    """最小二乗法で5つのパラメータを当てはめる。初期値を変えて n_starts 回解き、残差が最小の解を返す"""
    def resid(p):
        return p[4] + media_effect(x, *p[:4], order=order) - y
    rng = np.random.default_rng(seed)
    sols = []
    for _ in range(n_starts):
        p0 = [rng.uniform(0.1, 0.9), rng.uniform(20, 500), rng.uniform(0.5, 4),
              rng.uniform(50, 1000), y.min()]
        r = least_squares(resid, p0, bounds=(LOWER, UPPER))
        sols.append((np.sum(r.fun ** 2), r.x))
    sols.sort(key=lambda s: s[0])
    return sols


sols = fit(spend, sales)
rss, best = sols[0]
print(f"残差平方和 {rss:,.0f}(ノイズの平方和 {np.sum(noise ** 2):,.0f})")
for n, v in zip(NAMES, best):
    print(f"{n:5s} 推定 {v:8.3f}  真の値 {TRUE[n]:8.3f}")
print(f"最小の残差平方和にたどり着いた初期値: {sum(s[0] < rss + 1 for s in sols)} / {len(sols)}")
5つのパラメータを、範囲の制約付きの最小二乗法で当てはめ、真の値と比べるコードです。
- LOWER と UPPER: パラメータの範囲です。減衰率は0〜0.99(1以上では、アドストックが減らずに増え続ける)、形状 は0.3〜6、半飽和点と効果の上限は、データの規模(週の広告費が最大120、売上が約500〜750)に比べて十分広い範囲にしています。範囲を付けるのは、 や のような、意味のない値に進まないようにするためです。
- fit(x, y, order, n_starts=20, seed=0): 初期値を乱数で20通り選んで解き、残差平方和の小さい順に並べた解を返します。非線形の最小二乗法は、初期値によって別の局所解に止まることがあるので、何通りかの初期値から解いて、最も残差の小さい解を選びます。ベースラインの初期値は、広告のない週の売上に近い、売上の最小値にしています。
- 残差平方和とノイズの平方和: 当てはめた残差平方和を、実際に足したノイズの平方和と比べます。真のパラメータで計算した残差平方和が、ノイズの平方和です。
実行結果
残差平方和 34,355(ノイズの平方和 39,271)
theta 推定    0.638  真の値    0.600
K     推定  141.473  真の値  150.000
S     推定    2.452  真の値    2.000
beta  推定  244.630  真の値  300.000
base  推定  505.745  真の値  500.000
最小の残差平方和にたどり着いた初期値: 20 / 20
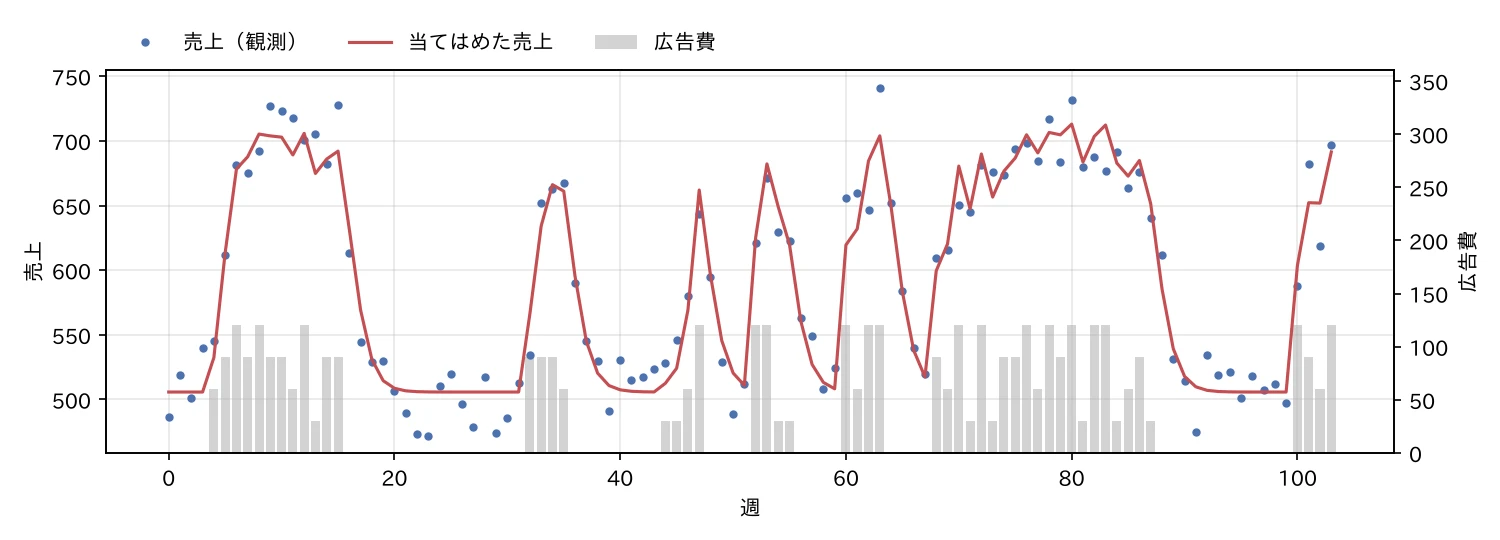
- 20通りの初期値が、すべて同じ解にたどり着いた: このデータでは、局所解の問題は起きませんでした。
- 減衰率とベースラインは、真の値の近く: は0.638(真の値0.6)、ベースラインは505.7(500)でした。図のように、出稿した週の立ち上がりと、止めたあとの減り方を、よく再現しています。
- 効果の上限は、2割小さく推定された: は244.6(真の値300)、 は2.452(2.0)でした。それでも、残差平方和34,355は、真のパラメータでの値(ノイズの平方和39,271)より小さくなりました。このデータだけでは、真のパラメータと、推定したパラメータを区別できないということです。
応答曲線で、観測した範囲の内と外を比べる
パラメータの値そのものより、予算の判断に使うのは、毎週同じ額 を出し続けたときの、週あたりの売上への寄与(応答曲線)です。定常状態のアドストックは ()なので、次のようになります。
def steady_response(x, theta, K, S, beta, L=12):
    """毎週 x を出し続けたときの、週あたりの売上への寄与:β h(A x)、A = Σ θ^l"""
    return beta * hill(geometric_weights(theta, L).sum() * np.asarray(x, dtype=float), K, S)


# (a) 毎週同じ額を出し続けたときの寄与(応答曲線)を、観測した出稿額の範囲の内と外で比べる
p = dict(zip(NAMES, best))
true_media = {k: v for k, v in TRUE.items() if k != "base"}
est_media = {k: v for k, v in p.items() if k != "base"}
stock_true = adstock(spend, geometric_weights(TRUE["theta"]))
print(f"観測した週の出稿額の最大 {spend.max():.0f}  アドストックの最大 {stock_true.max():.0f}"
      f"(毎週120を出し続けたときの定常 {geometric_weights(TRUE['theta']).sum() * 120:.0f})")
for x in (30, 60, 90, 120, 200, 300):
    t, f = steady_response(x, **true_media), steady_response(x, **est_media)
    print(f"毎週 {x:3d}: 真の寄与 {t:6.1f}  推定 {f:6.1f}  差 {f - t:+6.1f}")
# (b) 逆の順序(飽和 → アドストック)で当てはめると
rss_rev, best_rev = fit(spend, sales, order="saturation_first")[0]
print(f"逆の順序で当てはめた残差平方和 {rss_rev:,.0f}(正しい順序 {rss:,.0f})  "
      + "  ".join(f"{n} {v:.3f}" for n, v in zip(NAMES, best_rev)))


def plot_fit(spend, sales, fitted, path):
    fig, ax = plt.subplots(figsize=(10, 3.6))
    ax2 = ax.twinx()
    ax2.bar(np.arange(len(spend)), spend, color="lightgray", label="広告費")
    ax2.set_ylabel("広告費"); ax2.set_ylim(0, spend.max() * 3)
    ax.plot(sales, ".", color="#4C72B0", label="売上(観測)")
    ax.plot(fitted, color="#C44E52", label="当てはめた売上")
    ax.set_zorder(ax2.get_zorder() + 1); ax.patch.set_visible(False)
    h1, l1 = ax.get_legend_handles_labels(); h2, l2 = ax2.get_legend_handles_labels()
    ax.legend(h1 + h2, l1 + l2, loc="lower left", bbox_to_anchor=(0, 1.0), ncol=3, frameon=False)
    ax.set_xlabel("週"); ax.set_ylabel("売上"); ax.grid(alpha=0.3)
    fig.tight_layout(); fig.savefig(path, dpi=150); plt.close(fig)


def plot_response(est, true, xmax, path):
    x = np.linspace(0, 300, 300)
    fig, ax = plt.subplots(figsize=(7, 3.6))
    ax.plot(x, steady_response(x, **true), color="gray", ls="--", label="真の応答曲線")
    ax.plot(x, steady_response(x, **est), color="#C44E52", label="当てはめた応答曲線")
    ax.axvspan(0, xmax, color="#4C72B0", alpha=0.1, label="観測した出稿額の範囲")
    ax.set_xlabel("毎週の広告費"); ax.set_ylabel("週あたりの売上への寄与"); ax.legend(); ax.grid(alpha=0.3)
    fig.tight_layout(); fig.savefig(path, dpi=150); plt.close(fig)


plot_fit(spend, sales, best[4] + media_effect(spend, *best[:4]), "adstock_saturation_8.png")
plot_response(est_media, true_media, spend.max(), "adstock_saturation_9.png")
推定したパラメータと真のパラメータで応答曲線を計算し、観測した出稿額の範囲の内と外で比べ、逆の順序(B)のモデルでも当てはめてみるコードです。
- steady_response(x, theta, K, S, beta): 上の応答曲線です。予算配分の記事の応答曲線と同じ考え方で、Hill 関数の入力を、定常状態のアドストック にしています。
- (a) 観測した範囲の内と外: 毎週30〜120は、データで出稿した額の範囲、200と300は範囲の外です。ただし、データは4週ずつのフライトなので、アドストックの最大は261で、毎週120を出し続けたときの定常(300)にも届いていません。
- (b) 逆の順序で当てはめる: データは A で作っているので、B のモデルは正しくないモデルです。fit に order="saturation_first" を渡すだけで、同じ手順で当てはめられます。
- plot_fit と plot_response: 当てはめた売上の時系列(上の図)と、2つの応答曲線(下の図)を描きます。ax.twinx() で右に広告費の軸を作り、棒を売上の点の後ろに描いています。
実行結果
観測した週の出稿額の最大 120  アドストックの最大 261(毎週120を出し続けたときの定常 300)
毎週  30: 真の寄与   59.9  推定   51.5  差   -8.4
毎週  60: 真の寄与  149.8  推定  145.2  差   -4.6
毎週  90: 真の寄与  207.5  推定  195.2  差  -12.3
毎週 120: 真の寄与  239.9  推定  217.4  差  -22.5
毎週 200: 真の寄与  275.2  推定  236.2  差  -39.0
毎週 300: 真の寄与  288.4  推定  241.4  差  -47.0
逆の順序で当てはめた残差平方和 41,112(正しい順序 34,355)  theta 0.597  K 1004.372  S 0.796  beta 661.758  base 497.696
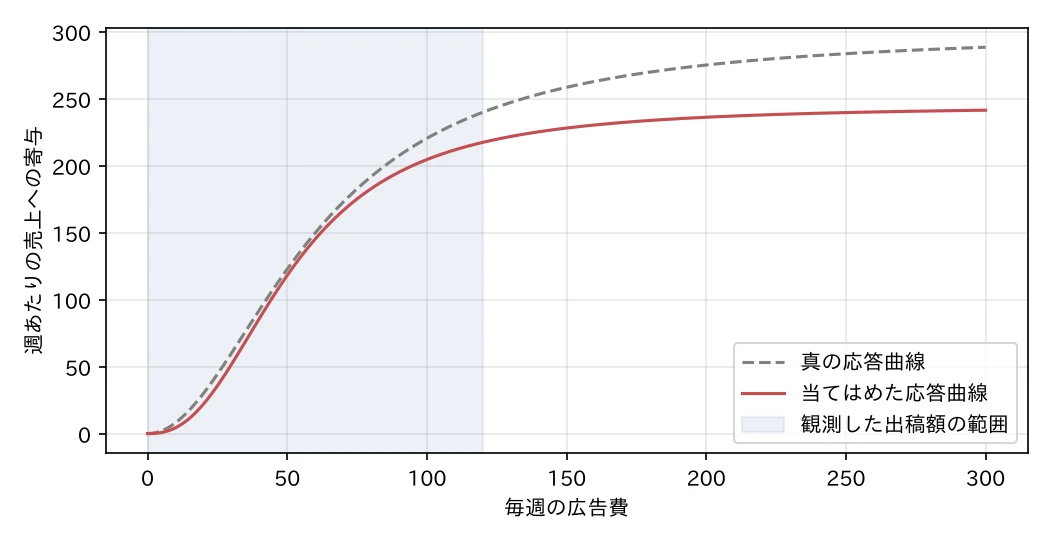
- 観測した範囲では、ずれは小さい: 毎週60の寄与は、真の値149.8に対して推定145.2(差 −4.6)、毎週30でも差は −8.4でした。データがある範囲では、パラメータの値が真の値と違っても、曲線はほぼ合っています。
- 範囲の外に出るほど、ずれが大きくなる: 毎週200では差が −39.0、毎週300では −47.0と、推定は寄与を小さく見積もりました。データにない大きな出稿額の効果は、上限 と形状 の推定に頼るしかなく、その2つが、このデータでは決まりにくいためです。
- 逆の順序のモデルは、当てはまりが悪い: B の残差平方和は41,112で、A(34,355)より大きく、ノイズの平方和(39,271)も超えました。B の当てはめでは、半飽和点 が1,004、形状 が0.80と、観測した範囲では飽和がほとんどかからない曲線になりました。B では、その週の出稿額(最大120)にしか飽和がかからないので、このデータの、数週たまってからの頭打ちを表せないためです。
出稿額の幅を広げると、上限が決まる
効果の上限 が決まりにくいのは、データの出稿額が、飽和の平らな部分まで届いていないからです。出稿額の幅が狭いデータ(最大120、上と同じ出稿の並び)と、広いデータ(出稿額を30・60・120・240から選ぶ)で、ノイズの乱数だけを30通りに変えて当てはめを繰り返し、推定値のばらつきを比べます。
def make_sales(levels, seed, n_weeks=104, noise=20):
    """出稿額の候補 levels から、フライトのある広告費と売上を作る(ノイズの乱数だけ seed で変える)"""
    rng = np.random.default_rng(0)                                    # 出稿の並びは同じにする
    on = np.repeat(rng.random(n_weeks // 4) < 0.6, 4)
    x = np.where(on, rng.choice(levels, n_weeks), 0).astype(float)
    y = TRUE["base"] + media_effect(x, **true_media) + np.random.default_rng(seed).normal(0, noise, n_weeks)
    return x, y


# 出稿額の幅が狭いデータ(最大120)と広いデータ(最大240)で、ノイズだけを変えて30回当てはめる
rows = []
for design, levels in (("狭い(最大120)", [30, 60, 90, 120]), ("広い(最大240)", [30, 60, 120, 240])):
    for seed in range(30):
        x, y = make_sales(levels, seed)
        b = fit(x, y, n_starts=5, seed=seed)[0][1]
        rows.append({"出稿額の幅": design, **dict(zip(NAMES, b)),
                     "毎週60": steady_response(60, *b[:4]), "毎週200": steady_response(200, *b[:4])})
reps = pd.DataFrame(rows)
print(reps.groupby("出稿額の幅")[NAMES + ["毎週60", "毎週200"]].agg(["mean", "std"]).round(2).T)
print(f"真の値: 毎週60 {steady_response(60, **true_media):.1f}  毎週200 {steady_response(200, **true_media):.1f}")
出稿額の幅が狭いデータと広いデータのそれぞれで、ノイズの乱数だけを変えた30個のデータを作って当てはめ、パラメータと応答曲線の値の平均と標準偏差を比べるコードです。
- make_sales(levels, seed): 出稿の並び(どの4週に出すか)は乱数のシード0で固定し、出稿額の候補 levels と、ノイズの乱数のシード seed だけを変えます。levels が30・60・90・120のとき、上の節と同じ広告費になります。2つのデータの違いを、出稿額の幅だけにするためです。
- n_starts=5: 上の節で、20通りの初期値がすべて同じ解にたどり着いたので、60回の当てはめでは、初期値を5通りに減らして時間を短くしています。
- 毎週60と毎週200: 応答曲線の、観測した範囲の中(60)と外(200)の値です。
実行結果
出稿額の幅       広い(最大240)  狭い(最大120)
theta mean       0.60       0.60
      std        0.02       0.02
K     mean     151.07     170.15
      std       12.69      37.35
S     mean       1.93       1.87
      std        0.23       0.35
beta  mean     308.18     339.29
      std       15.77      64.65
base  mean     497.53     497.34
      std        3.92       3.86
毎週60  mean     153.11     152.33
      std        6.73       6.87
毎週200 mean     279.01     291.13
      std        7.70      29.24
真の値: 毎週60 149.8  毎週200 275.2
- 観測した範囲の中は、どちらのデータでも同じくらい正確: 毎週60の寄与の推定は、狭いデータで平均152.3・標準偏差6.9、広いデータで平均153.1・標準偏差6.7でした(真の値149.8)。減衰率 も、どちらも平均0.60・標準偏差0.02です。
- 狭いデータでは、効果の上限が大きくぶれる: の標準偏差は、狭いデータで64.7、広いデータで15.8でした。半飽和点 も、37.4と12.7です。上の節の1つのデータの推定(244.6)は、狭いデータのばらつき(平均339.3 ± 64.7)の中の、たまたま小さい側の値でした。
- 範囲の外の予測は、データの幅で決まる: 毎週200の寄与の標準偏差は、狭いデータで29.2、広いデータで7.7でした。広いデータでは、240の出稿でアドストックが飽和の平らな部分に届くので、上限 がデータから決まり、範囲の外の予測も安定します。
実際の MMM では、過去の出稿額の幅は、予算の決まり方で限られることが多く、上限 や形状 をデータだけで決めるのは困難です。MMM の記事のように、ベイズの事前分布や、出稿を大きく変える実験の結果で補うのは、このためです。
まとめ
本記事では、MMM の2つの非線形変換、アドストックと飽和曲線をスクラッチ実装し、形の違い、変換の順序、データからの推定の限界を数値で確かめました。
- 幾何型のアドストックは、減衰率 1つで残り方が決まる: パルスの100は、 で半減期0.43週・合計125、 で半減期3.11週・合計472.5(最大ラグ12週で切り捨て)でした。
- ワイブル型は、残り方と山の遅れを表せる: CDF 型は で幾何型と一致し、 では3週後まで0.66以上の重みが残りました。PDF 型()は、出稿の5週後に山が来ました。
- Hill 関数は、 で位置、 で形が決まる: どの曲線も で0.5を通り、 の変曲点は57.7でした。 の限界効果は原点で0.010%ポイントとほぼ0で、少額では効きません。
- 変換の順序で、最適な出し方が変わる: 合計400の予算は、アドストック → 飽和では8週に分けるのが最もよく(3.71)、飽和 → アドストックでは4週に分けるのが最もよい(4.00)結果でした。
- 出稿額の幅が狭いと、効果の上限が決まらない: 観測した範囲の中の寄与は標準偏差6.9で推定できましたが、上限 の標準偏差は64.7でした。出稿額の幅を最大240に広げると、15.8まで小さくなりました。
アドストックと飽和曲線は、「いつ」「いくら」出すかの効き方を、少数のパラメータで表す部品です。どの型を選ぶか、どの順序で掛けるかは、当てはまりの差が小さくても、予算配分や出稿の計画の結論を変えます。また、推定したパラメータが信じられるのは、データで実際に出した出稿額の範囲の中だけです。範囲の外の判断には、事前分布や実験の結果で補う必要があり、その方法は MMM の記事と予算配分の記事、ライブラリでの実装は MMM のライブラリの記事で扱います。
参考文献
- Y. Jin, Y. Wang, Y. Sun, D. Chan, J. Koehler (2017). Bayesian Methods for Media Mix Modeling with Carryover and Shape Effects. Google Inc.
- S. Broadbent (1979). One way TV advertisements work. Journal of the Market Research Society, 21(3), 139–166.
- Google. Media saturation and lagging. Meridian のドキュメント(アドストックと Hill 関数の順序と、重みの正規化).
本記事の文章・構成の一部に生成AIを使用しています。