ALCE とは?
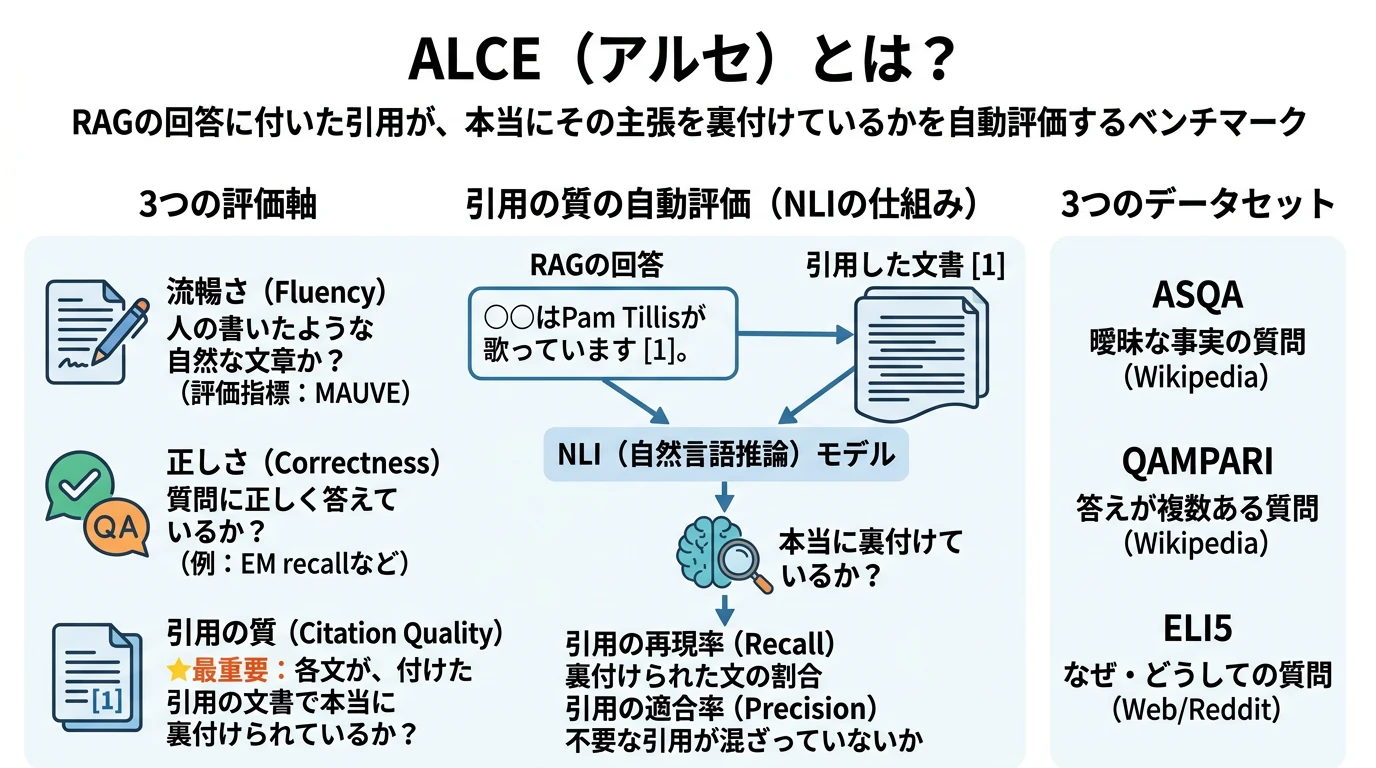 (画像は、Geminiで作成)
RAG の回答に付けた引用([1] や [2] のような出典の番号)が、本当にその文を裏付けているかを自動で測るベンチマーク ALCE の評価方法を、Python のコードで確かめること。回答の正しさだけを測っても引用の良し悪しは分からないことを手元で再現し、NLI(自然言語推論)のモデルで引用の再現率と適合率を計算できるようになること。
原著論文: Enabling Large Language Models to Generate Text with Citations (Gao, Yen, Yu, Chen, EMNLP 2023)
概要
RAG (Retrieval-Augmented Generation) とは? の記事では、LLM 単体では回答の根拠や出処(プロベナンス)を示せないことを、RAG を使う理由の1つに挙げました。ところが、検索した文書をまとめてプロンプトに入れる今の RAG では、文書どうしが注意機構の中で混ざり合うので、どのトークンがどの文書に由来するかを追跡できなくなります。そこで実務では、LLM 自身に「この文は文書 [2] に基づく」と引用を書かせる方法が広く使われています。検索エンジンのチャット機能や、社内文書を検索するアシスタントの回答に付いている番号がそれです。
しかし、LLM が書いた引用が正しいとは限りません。引用した文書に、その文の内容が書かれていないこともあります。ALCE(Automatic LLMs' Citation Evaluation)は、引用付きの回答を 流暢さ・正しさ・引用の質 の3つの軸で自動評価するベンチマークです。モデルの中から出典を辿れないなら、外から「引用した文書が、本当にその文を裏付けているか」を測ろう、という考え方です。
次の節で、引用の付け方が違う2つの方法の回答を、まず「答えが合っているか」だけで比べます。
答えが合っていても、引用が裏付けているとは限らない
実験には、ALCE の公式データの ASQA を使います。ASQA は「Who sings don't tell me what to do?(Don't Tell Me What to Do を歌っているのは誰?)」のような 曖昧な質問 の集まりで、同じ題名の曲が複数あるように、質問の解釈ごとに短い答えが決まっています。回答には、すべての解釈の答えを含む長めの文章が求められます。各質問には、Wikipedia を100語ずつに切ったパッセージから、GTR という Retriever で検索した上位100件の文書が付いています。
この質問に、次の図の2つの方法で、引用付きの回答を作らせます。
(図は、diagram-designで作成)
- Vanilla 上位5件の文書をプロンプトに入れ、文書を読んで答えさせます。プロンプトは ALCE の公式のもので、「各文に少なくとも1件、多くても3件の文書を引用する」ように指示し、引用付きの回答の例を2つ見せます。
- ClosedBook + PostCite 文書を見せずに、LLM が事前学習で覚えている知識(パラメトリック知識)だけで答えさせます。ClosedBook(クローズドブック)は、教科書を閉じて受ける「持ち込み不可」の試験にたとえた名前で、文書を読ませない設定を指します。その後、回答の各文に、上位100件の文書の中から埋め込みが最も似ている1件を、引用として機械的に付けます。原著論文が比較に使った方法です。
どちらの回答にも、[番号] の引用が付きます。読む人には、見た目の区別はつきません。
準備:Google Colab の GPU で動かす
回答を書く Generator には、Qwen2.5-7B-Instruct を使います。後半の引用の評価では、原著論文と同じ NLI のモデル TRUE(T5-11B、約110億パラメータ)を動かすため、メモリが 40GB ある A100 GPU が必要です。Google Colab の「ランタイム」→「ランタイムのタイプを変更」から A100 GPU を選んでください(Colab の有料プランが必要です)。
新しいセッションで、Colab のセルに次を書いて実行し、パッケージと ALCE の公式データ(約450MB)、プロンプトのファイルを用意します。
!pip install -q mauve-text nltk sentencepiece
!wget -q https://huggingface.co/datasets/princeton-nlp/ALCE-data/resolve/main/ALCE-data.tar && tar xf ALCE-data.tar && rm ALCE-data.tar
!wget -q https://raw.githubusercontent.com/princeton-nlp/ALCE/main/prompts/asqa_default.json
!wget -q https://raw.githubusercontent.com/princeton-nlp/ALCE/main/prompts/asqa_closedbook.json
- パッケージ: mauve-text は流暢さの指標 MAUVE の計算に、nltk は回答を文に分けるのに、sentencepiece は TRUE のトークナイザに使います。transformers・sentence-transformers・torch は Colab に入っているものを使います。
- データ: ALCE-data には、ASQA・QAMPARI・ELI5 の評価データ(検索した上位100件の文書付き)が入っています。この記事では asqa_eval_gtr_top100.json(948問)を使います。3つのデータセットのうち ASQA を使うのは、正しさを短い答えの文字列の一致(EM recall)で測れるからです。ELI5 の claim recall のように、正しさの判定にも大きな NLI のモデルが必要になることがありません。
- プロンプト: asqa_default.json は文書を読ませるプロンプト、asqa_closedbook.json は文書を読ませないプロンプトで、どちらも指示文と回答の例が入っています。ALCE の公式のプロンプトをそのまま使うのは、指示文の書き方の違いで結果が変わらないようにし、原著論文の結果と比べられるようにするためです。
記事の数値は、transformers 5.20.1・sentence-transformers 5.7.0・torch 2.11.0 で実行したものです。
- 実験1は、Generator のダウンロード(約15GB)を含めて約25分です。生成は200回(2つの方法 × 100問)です。
- 実験2は、TRUE のダウンロード(約45GB)と読み込みに約10分、NLI の判定に約3分かかります。
- 実験3(流暢さ)は、GPT-2 Large のダウンロードを含めて数分です。
- 質問の選び方は乱数のシードを固定し、生成は貪欲法(greedy)にしているので、同じ環境なら何度実行しても同じ数値になります。ただし、GPU の種類やライブラリのバージョンが違うと、数値が多少変わることがあります。
実験1:2つの方法の回答を、正しさだけで比べる
正しさは、ASQA の標準の指標 EM recall(完全一致の再現率)で測ります。質問 の解釈の集合を 、解釈 の短い答え(別表記を含む)の集合を 、回答を とすると、
です。式の記号は、次のとおりです。
- と : は、曖昧な質問 の解釈の集合です。ASQA のデータでは、解釈ごとに、曖昧さをなくした質問と短い答えの組(qa_pairs)が用意されています。 は解釈の数で、「Who sings don't tell me what to do?」なら、1990年の Pam Tillis の曲、Marty Stuart の曲、1993年の Baby Animals の曲の3つなので です。
- : 解釈 の短い答えの集合です。「Pam Tillis」のように1つだけのこともあれば、「John B. Watson」と「Watson」のように、同じ答えの別表記を複数含むこともあります。
- : 文字列の正規化です。小文字にし、句読点(ピリオド、カンマ、引用符など)を消し、冠詞(a・an・the)を消し、連続する空白を1つにまとめます。たとえば「The song "Don't Tell Me What to Do" was recorded by ... Pam Tillis.」は「song dont tell me what to do was recorded by ... pam tillis」になります。大文字と小文字や、句読点の付け方の違いだけで不正解にならないようにするための処理です。 は回答 を、 は短い答え を正規化したものです。
- : ここでは「左の文字列が、右の文字列の一部として含まれる」(部分文字列である)ことを表します。集合の記号を借りていますが、意味は Python の norm(a) in norm(y) と同じです。回答の文の中のどこかに答えが書かれていれば、前後に何が書かれていても構いません。
- : 「 の中に、条件を満たす が少なくとも1つ存在する」という意味です( は「存在する」を表す記号です)。別表記のどれか1つでも回答に含まれていれば、その解釈は答えられたとみなします。「John B. Watson」と書かなくても、「Watson」と書いてあれば正解です。
- : 指示関数で、かっこの中の条件が成り立てば1、成り立たなければ0を返します。解釈ごとに、答えられたら1、答えられなかったら0になります。
- : 解釈ごとの0か1を足し合わせて、解釈の数で割ります。つまり、質問 の解釈のうち、回答が答えを含んでいた割合です。
この記事の実験の最初の質問で計算してみます。Vanilla の回答は「Pam Tillis」を含みますが、「Marty Stuart」と「Baby Animals」は含まないので、
です。すべての解釈の答えを書いた回答は1、1つも書かなかった回答は0になり、その間の値は「曖昧な質問の解釈を、どれだけ網羅できたか」を表します。この値を100問で平均したものが、表に載せる EM recall です(100倍してパーセントで表します)。
部分文字列で判定するので、回答が正しい答えを書いていても、表記が違えば(「Tillis, Pam」など)不正解になり、逆に、否定文の中に答えの文字列が出てくるだけでも正解になります。あくまで、短い答えの文字列が回答に現れるかを数える、機械的な指標です。
import json
import random
import re
import string
import nltk
import numpy as np
import torch
from nltk import sent_tokenize
from sentence_transformers import SentenceTransformer
from transformers import AutoTokenizer, AutoModelForCausalLM

nltk.download("punkt_tab", quiet=True)

# 1. ASQA の評価データ(GTR で検索した上位100件の文書付き)から、100問を選ぶ
data = json.load(open("ALCE-data/asqa_eval_gtr_top100.json"))
random.seed(0)
items = random.sample(data, 100)
prompt_default = json.load(open("asqa_default.json"))     # 文書を読ませるプロンプト
prompt_closed = json.load(open("asqa_closedbook.json"))   # 文書を読ませないプロンプト
# asqa_default.json の指示文(instruction)の和訳:
# 「与えられた検索結果(無関係なものも含まれている可能性があります)だけを使って、質問に対する正確で魅力的かつ簡潔な回答を書き、
#   検索結果を適切に引用してください。偏りのない、報道記事のような文体を使ってください。事実に関する主張には必ず引用を付けてください。
#   複数の検索結果を引用するときは [1][2][3] のように書いてください。各文で少なくとも1件、多くても3件の文書を引用してください。
#   複数の文書が文を裏付ける場合は、裏付けに必要十分な最小限の文書だけを引用してください。」
# asqa_closedbook.json の指示文の和訳:
# 「質問に対する正確で魅力的かつ簡潔な回答を書いてください。偏りのない、報道記事のような文体を使ってください。」

# 2. Generator(Qwen2.5-7B-Instruct)を読み込む
MODEL_ID = "Qwen/Qwen2.5-7B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, dtype=torch.bfloat16, device_map="cuda")
model.eval()


@torch.no_grad()
def generate(prompt, max_new_tokens=300):
    """プロンプトを会話形式に包み、貪欲法(greedy)で回答を生成する(1行目だけを使う)"""
    messages = [{"role": "user", "content": prompt}]
    inputs = tokenizer.apply_chat_template(messages, add_generation_prompt=True,
                                           return_tensors="pt", return_dict=True).to(model.device)
    output = model.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
    text = tokenizer.decode(output[0, inputs["input_ids"].shape[1]:], skip_special_tokens=True)
    return text.strip().split("\n")[0]


# 3. ALCE のプロンプト:指示文 + 例2つ + 質問 + 文書(「Document [1](Title: …): 本文」)
def make_prompt(prompt_data, item, ndoc):
    def block(x, answer):
        p = prompt_data["demo_prompt"].replace("{INST}", prompt_data["instruction"]).replace("{Q}", x["question"])
        if "{D}" in p:
            docs = "".join(prompt_data["doc_prompt"].replace("{ID}", str(i + 1)).replace("{T}", d["title"])
                           .replace("{P}", d["text"]) for i, d in enumerate(x["docs"][:ndoc]))
            p = p.replace("{D}", docs)
        return p.replace("{A}", "").rstrip() + answer
    demos = [block(d, " " + d["answer"]) for d in prompt_data["demos"][:2]]
    return prompt_data["demo_sep"].join(demos + [block(item, "")])
# 組み立てたプロンプトの形(和訳):
# 例1「指示文 … 質問:地球で最も雨の多い場所はどこですか? 文書 [1](タイトル:Cherrapunji):本文 … 回答:(引用付きの回答)」
# 例2「指示文 … 質問:アメリカはいつイギリスから独立しましたか? 文書 [1] … 回答:(引用付きの回答)」
# 本番「指示文 … 質問:(評価する質問) 文書 [1](タイトル:…):本文 … 文書 [5] … 回答:」
# (文書を読ませないプロンプトでは、文書の部分がなく、例の回答にも引用が付いていない)


# 4. 正しさ(EM recall):曖昧な質問の各解釈の短い答えが、回答に含まれている割合
def normalize(s):
    s = s.lower()
    s = "".join(ch for ch in s if ch not in set(string.punctuation))
    s = re.sub(r"\b(a|an|the)\b", " ", s)
    return " ".join(s.split())


def remove_citations(text):
    return re.sub(r"\[\d+", "", re.sub(r" \[\d+", "", text)).replace(" |", "").replace("]", "")


def em_recall(item, output):
    out = normalize(remove_citations(output))
    hits = [any(normalize(a) in out for a in qa["short_answers"]) for qa in item["qa_pairs"]]
    return np.mean(hits)


# 5. Vanilla:上位5件の文書を読ませ、引用を付けて答えさせる
vanilla = []
for item in items:
    vanilla.append({"item": item, "docs": item["docs"][:5],
                    "output": generate(make_prompt(prompt_default, item, ndoc=5))})

# 6. ClosedBook + PostCite:文書を読ませずに答えさせ、後から各文に最も近い文書を引用として付ける
gtr = SentenceTransformer("sentence-transformers/gtr-t5-large", device="cuda")
posthoc = []
for item in items:
    output = generate(make_prompt(prompt_closed, item, ndoc=0))
    docs = item["docs"]  # 上位100件
    doc_emb = gtr.encode([d["title"] + ". " + d["text"] for d in docs], normalize_embeddings=True)
    sents = []
    for sent in sent_tokenize(output):
        sent_emb = gtr.encode([remove_citations(sent)], normalize_embeddings=True)
        best = int(np.argmax(doc_emb @ sent_emb[0]))
        sents.append(f"[{best + 1}] {remove_citations(sent)}")
    posthoc.append({"item": item, "docs": docs, "output": " ".join(sents)})

# 7. 正しさだけで比べる
for name, runs in [("Vanilla (5-psg)", vanilla), ("ClosedBook + PostCite", posthoc)]:
    print(f"{name:22s} EM recall: {np.mean([em_recall(r['item'], r['output']) for r in runs]) * 100:.1f}")

# 8. 例:最初の質問への2つの回答
print("\nQuestion:", items[0]["question"])
print("Short answers:", [qa["short_answers"] for qa in items[0]["qa_pairs"]])
print("Vanilla:", vanilla[0]["output"])
print("PostCite:", posthoc[0]["output"])
ASQA の100問に、2つの方法で引用付きの回答を書かせ、正しさ(EM recall)を比べるコードです。
- 質問の選び方: 生成と、後の NLI による判定にかかる時間を抑えるため、948問から random.sample で100問を選びます。random.seed(0) を固定しているので、実行するたびに同じ100問になります。
- Generator: Qwen/Qwen2.5-7B-Instruct を bf16 で読み込みます。7B のモデルを使うのは、bf16 のまま(約15GB)A100(40GB)に載り、後で TRUE(約22GB)と入れ替えて同じ GPU で動かせる大きさだからです。generate は、プロンプトをユーザーの発言として会話形式に包み、貪欲法で最大300トークンを生成します。ALCE の公式の評価コードと同じく、回答は1行目だけを使います。プロンプトに回答の例が入っているので、モデルが回答の後に続けて次の質問まで書き始めることがあるためです。
- ALCE のプロンプト: make_prompt は、プロンプトのファイルの demo_prompt(「指示文、質問、文書、回答」の型)に、回答の例2つと評価する質問を当てはめ、demo_sep(空行)でつなぎます。文書は doc_prompt の「Document [番号](Title: タイトル): 本文」の形で並べます。文書を読ませないプロンプトの型には文書の欄がないので、ndoc=0 で文書なしになります。
- 正しさ: em_recall は、回答から remove_citations で引用の番号を消し、normalize で正規化してから、各解釈の短い答え qa["short_answers"] が含まれるかを調べます。直前に示した EM recall の式をそのまま計算しています。
- Vanilla: 上位5件の文書 item["docs"][:5] をプロンプトに入れて答えさせます。引用の番号は、この5件の中の順番です。5件にするのは、原著論文の Vanilla の設定(上位5件の文書)に合わせるためです。
- ClosedBook + PostCite: 文書なしで答えさせた後、sent_tokenize で回答を文に分け、各文と上位100件の文書を GTR(sentence-transformers/gtr-t5-large)で埋め込みます。内積が最大の文書の番号を、文の先頭に [番号] として付けます。原著論文の公式コード(post_hoc_cite.py)と同じ処理です。この方法を比べに入れるのは、文書を読まずに書いた回答にも、後から引用を付ければ、見た目は Vanilla と同じ「引用付きの回答」になることを示すためです。正しさの指標だけでは、2つの引用の質の違いが見えないことを、次の節で確かめます。
- 例の表示: EM recall の数だけでは、引用が回答の内容に合っているかが分からないので、最初の質問への2つの回答を表示し、引用の付き方を見比べます。
実行結果
Vanilla (5-psg)        EM recall: 45.8
ClosedBook + PostCite  EM recall: 29.5

Question: Who sings don't tell me what to do?
Short answers: [['Pam Tillis'], ['Marty Stuart'], ['Baby Animals']]
Vanilla: The song "Don't Tell Me What to Do" was recorded by American country music artist Pam Tillis. It was released in December 1990 as the first single from her album "Put Yourself in My Place" [1][2].
PostCite: [4] The song "Don't Tell Me What to Do" is performed by American singer-songwriter Kehlani. [6] It was released in 2018 as part of her second studio album, "It Was Good Until It Wasn't." [87] The track features a blend of R&B and pop elements, showcasing Kehlani's distinctive vocal style and lyrical content.
(和訳)
- Vanilla:「『Don't Tell Me What to Do』は、アメリカのカントリー歌手 Pam Tillis が録音した曲です。1990年12月に、アルバム『Put Yourself in My Place』からの最初のシングルとして発売されました [1][2]。」
- PostCite:「[4]『Don't Tell Me What to Do』は、アメリカのシンガーソングライター Kehlani が歌っています。[6] 2018年に、2枚目のスタジオアルバム『It Was Good Until It Wasn't』の1曲として発売されました。[87] R&B とポップの要素を合わせた曲で、Kehlani の個性的な歌声と歌詞が表れています。」
文書を読んだ Vanilla は 45.8、文書を読まずに答えた ClosedBook は 29.5 で、正しさには差があります。ただし、ClosedBook でも解釈の3割ほどは正しく答えています。7B のモデルでも、有名な曲や出来事なら事前学習で覚えているからです。
問題は、例の PostCite の回答です。3つの文すべてに [4]・[6]・[87] と引用が付いていますが、内容は ASQA の正解(Pam Tillis・Marty Stuart・Baby Animals)のどれでもありません。引用は「最も似ている文書」を後から付けただけなので、似た題名の別の曲の文書が選ばれています。それでも、読む人には、根拠のある回答のように見えます。
一方、Vanilla の回答にも問題があります。正解の Pam Tillis を答えていますが、引用が付いているのは2文目だけで、1文目には引用がありません。曖昧な質問の残り2つの解釈(Marty Stuart と Baby Animals)にも触れていないので、EM recall は 1/3 です。
正しさの指標は、回答の中に正解の文字列があるかしか見ていません。その文を、付けた引用の文書が本当に裏付けているか は、まったく測っていないのです。正しく答えていても、引用が的外れなら、読む人は根拠を確かめられません。ALCE は、ここを測る物差しです。
ALCE:引用付きの回答を自動で評価する
3つのデータセット
ALCE は、性格の違う3つのデータセットを使います。原著論文では、それぞれの開発用データから最大1,000問ずつを使います(ASQA の公式データは948問です)。
| データセット | 質問の種類 | 検索の対象 | 回答の形 | 正しさの指標 |
|---|---|---|---|---|
| ASQA | 曖昧な事実の質問 | Wikipedia(2,100万パッセージ) | すべての解釈を含む長めの文章 | EM recall |
| QAMPARI | 答えが複数ある質問(例:〇〇が監督した映画は?) | Wikipedia(2,100万パッセージ) | 答えのリスト | 完全一致の適合率と recall-5 |
| ELI5 | 「なぜ」「どうして」の質問 | Sphere(Common Crawl から Reddit を除いた8億9,900万パッセージ) | 説明の文章 | claim recall |
- ASQA は、1つの質問に解釈が複数あり、それぞれの答えが別々の文書に書かれていることが多いので、複数の文書をまとめて引用する必要があります。
- QAMPARI は、答えの数が多く、答えごとに別の文書から集めなければなりません。recall-5 は、正しい答えが5つ以上あれば再現率を100%とみなす指標です。
- ELI5 は、Reddit の質問掲示板「Explain Like I'm Five(5歳児にも分かるように説明して)」の質問です。答えが1つの文書にまとまっていることは少なく、長い説明を複数の文書で裏付けなければならないので、3つの中で最も難しいデータセットです。正しさの claim recall は、2段階で計算します。まず、正解の回答から、LLM の InstructGPT(text-davinci-003)で3つの小さな主張(sub-claim)を書き出しておきます(ALCE のデータに、あらかじめ入っています)。次に、評価のたびに、モデルの回答がそれぞれの主張を含意するかを、NLI 専用に学習したモデル TRUE(T5-11B)で判定し、含意された主張の割合を claim recall とします。TRUE は、後で説明する引用の質の判定にも使うモデルで、「前提と仮説」の組を入力すると「1」(含意)か「0」を返すだけです。ChatGPT のような対話型の LLM に、プロンプトで判定を頼んでいるわけではありません。
3つの評価軸
ALCE は、回答を次の3つの軸で評価します。
- 流暢さ(fluency): 回答が、人の書いた回答と同じように自然な文章か。MAUVE という指標で測ります(ASQA と ELI5 のみ)。
- 正しさ(correctness): 回答が質問に正しく答えているか。上の表の指標で測ります。
- 引用の質(citation quality): 回答の各文が、付けた引用の文書で裏付けられているか。引用の再現率 と 引用の適合率 で測ります。
3つを別々に測るのは、互いに独立に悪くなりうるからです。引用を増やせば引用の再現率は上がりやすくなりますが、関係のない文書まで引用すると適合率が下がります。逆に、文書に書いてあることだけを短く書けば引用の質は上がりますが、質問の解釈を取りこぼして正しさが下がります。どれか1つだけを見ると、こうした偏りを見逃します。
3つの評価軸を並べると、次のようになります。
(図は、diagram-designで作成)
引用の再現率と適合率
引用の質の判定には、NLI(Natural Language Inference、自然言語推論)のモデルを使います。NLI は、前提の文章(premise)が仮説の文(hypothesis)を 含意する(前提が正しければ、仮説も必ず正しいと言える)かを判定するタスクです。原著論文は、NLI のデータで学習した T5-11B の TRUE を使います。前提 が仮説 を含意すれば 、しなければ とします。
回答を文 に分け、文 に付いた引用の文書の集合を とします。
引用の再現率(citation recall) は、引用で裏付けられた文の割合です。文 の引用をすべてつなげた文章 が、 を含意するかを判定します。
引用のない文は0です。回答ごとに文の平均を取り、さらに全回答で平均します。
引用の適合率(citation precision) は、不要な引用がどれだけ混ざっていないかを測ります。文 の引用 が 不要(irrelevant) なのは、その文書だけでは文を裏付けられず、外しても残りの文書で裏付けられる場合です。
引用 の適合率は、文 の再現率が1で、かつ が不要でなければ1、それ以外は0です。回答ごとに全引用の平均を取り、さらに全回答で平均します。
次の図は、この判定の流れです。
(図は、diagram-designで作成)
適合率の定義は、少し慎重に作られています。「その文書だけで文を裏付けられるか」だけで判定すると、2つの文書を合わせて初めて裏付けられる文(「A は1990年に B を発売した」の A と B が別々の文書にある場合など)の引用が、どちらも不要と判定されてしまいます。「外しても残りで裏付けられる」という条件を加えることで、裏付けに必要な引用は不要と判定されません。
実験2:引用の質を測る
実験1の2つの方法の回答を、引用の再現率と適合率で測ります。実験1のコードを実行した後に、続けて実行してください。
from transformers import AutoModelForSeq2SeqLM

# 1. Generator をメモリから外し、NLI モデル TRUE(T5-11B)を読み込む
del model
torch.cuda.empty_cache()
NLI_ID = "google/t5_xxl_true_nli_mixture"
nli_tokenizer = AutoTokenizer.from_pretrained(NLI_ID, use_fast=False)
nli_model = AutoModelForSeq2SeqLM.from_pretrained(NLI_ID, dtype=torch.bfloat16, device_map="cuda")
nli_model.eval()


@torch.no_grad()
def entails(premise, hypothesis):
    """φ(premise, hypothesis):前提が仮説を含意すれば1、しなければ0"""
    text = f"premise: {premise} hypothesis: {hypothesis}"  # 「前提:(文書) 仮説:(回答の1文)」
    input_ids = nli_tokenizer(text, return_tensors="pt").input_ids.to(nli_model.device)
    output = nli_model.generate(input_ids, max_new_tokens=10)
    return int(nli_tokenizer.decode(output[0], skip_special_tokens=True) == "1")


def format_doc(doc):
    return f"Title: {doc['title']}\n{doc['text']}"


# 2. 引用の再現率(citation recall)と適合率(citation precision)
def citation_scores(run):
    sents = sent_tokenize(run["output"])
    recall, precision, n_cite = 0, 0, 0
    details = []
    for sent in sents:
        claim = remove_citations(sent).strip()
        refs = [int(r[1:]) - 1 for r in re.findall(r"\[\d+", sent)][:3]  # 1文につき最大3件
        if len(refs) == 0 or any(r >= len(run["docs"]) for r in refs):
            details.append((claim, refs, 0))
            continue
        n_cite += len(refs)
        # 再現率:引用した文書をつなげたものが、文を含意するか
        supported = entails("\n".join(format_doc(run["docs"][r]) for r in refs), claim)
        recall += supported
        details.append((claim, refs, supported))
        if not supported:
            continue
        if len(refs) == 1:
            precision += 1
            continue
        # 適合率:その文書だけでは支えられず、外しても残りで支えられる引用は「不要」
        for r in refs:
            rest = [x for x in refs if x != r]
            irrelevant = (not entails(format_doc(run["docs"][r]), claim)
                          and entails("\n".join(format_doc(run["docs"][x]) for x in rest), claim))
            precision += 0 if irrelevant else 1
    return {"recall": recall / len(sents) if sents else 0,
            "precision": precision / n_cite if n_cite else 0,
            "details": details}


# 3. 2つの方法を、正しさと引用の質で比べる
for name, runs in [("Vanilla (5-psg)", vanilla), ("ClosedBook + PostCite", posthoc)]:
    for r in runs:
        r.update(citation_scores(r))
    print(f"{name:22s} EM recall: {np.mean([em_recall(r['item'], r['output']) for r in runs]) * 100:5.1f}"
          f"  Cit. Rec.: {np.mean([r['recall'] for r in runs]) * 100:5.1f}"
          f"  Cit. Prec.: {np.mean([r['precision'] for r in runs]) * 100:5.1f}")
TRUE で、2つの方法の回答の引用の再現率と適合率を計算するコードです。
- メモリの解放: TRUE は bf16 でも約22GB あるので、del model で Generator を外してから読み込みます。
- NLI の判定: entails は、TRUE に「premise: 前提 hypothesis: 仮説」の形で入力し、生成された文字列が「1」なら含意(1)、それ以外なら0を返します。直前に示した です。原著論文の公式コードと同じ入力の形です。
- 文書の形: format_doc は、文書を「Title: タイトル(改行)本文」の形にします。複数の文書は改行でつなぎ、 にします。この形にするのは、原著論文の公式コードと同じ入力にして、TRUE の判定の条件をそろえるためです。
- 引用の取り出し: re.findall(r"[\d+", sent) で文の中の引用の番号を取り出し、0始まりの位置に直します。1文につき最大3件までを使います(ALCE の指示文と同じ上限です)。文書の数を超える番号は、引用の形式の誤りとして0にします。
- 再現率: 引用した文書をつないだ文章が文を含意すれば supported を1にします。 の式です。回答の再現率は、文の数 len(sents) で割った平均です。
- 適合率: 再現率が1の文だけを調べます。引用が1件なら、その引用は必要なので1です。複数なら、引用ごとに の2つの条件を調べ、不要でなければ1を足します。回答の適合率は、引用の総数 n_cite で割った値です。
- 記録: details に、文ごとの(引用を消した文、引用の番号、再現率)を残し、実験の後半で使います。
- NLI の呼び出しの回数: 1文につき再現率の判定が1回、複数の引用がある文では引用ごとに1〜2回の判定が加わります。
実行結果
Vanilla (5-psg)        EM recall:  45.8  Cit. Rec.:  71.0  Cit. Prec.:  66.3
ClosedBook + PostCite  EM recall:  29.5  Cit. Rec.:  20.7  Cit. Prec.:  20.7
引用の質で見ると、2つの方法の差ははっきりします。Vanilla の引用の再現率は 71.0、適合率は 66.3 で、文の7割ほどが引用で裏付けられています。一方、ClosedBook + PostCite は、再現率も適合率も 20.7 です。正しさ(EM recall)では 45.8 対 29.5 と1.6倍ほどの差でしたが、引用の再現率では3倍以上の差になりました。PostCite の引用は、文と埋め込みが似ている文書を選んでいるだけで、その文書が文の内容を述べているとは限らないからです。
実験1の例の Vanilla の回答は、1文目に引用がないので0、2文目は引用 [1][2] で裏付けられて1となり、再現率は 0.5 でした。引用が付いているのは裏付けに必要な文書だけなので、適合率は 1.0 です。PostCite は1文に1件しか引用を付けないので、裏付けられた文の引用は必ず必要な引用になり、再現率と適合率が同じ値になります。
原著論文の ChatGPT(Vanilla は再現率 73.6・適合率 72.5、ClosedBook は 26.7・26.7)と、同じ傾向です。7B のモデルでも、文書を読ませて書かせれば、引用の再現率は ChatGPT に近い水準になりました。ただし、問題の数が100問と少なく、モデルも違うので、数値そのものを比べることはできません。
回答単位で見る:どれだけの回答が、すべての文を裏付けられているか
引用の再現率は文の平均なので、「回答の中のどこかに、裏付けのない文が混ざっているか」は見えません。原著論文が ELI5 について「最良のモデルでも、約半数の回答は引用で完全には裏付けられていない」と述べたのは、回答単位で見た値です。実験2の結果を、回答単位で集計し直します。
# 1. 回答単位で見る:すべての文が引用で裏付けられた回答の割合
for name, runs in [("Vanilla (5-psg)", vanilla), ("ClosedBook + PostCite", posthoc)]:
    correct = [r for r in runs if em_recall(r["item"], r["output"]) > 0]
    print(f"{name:22s} fully supported: {np.mean([r['recall'] == 1 for r in runs]) * 100:5.1f}%"
          f"  (among answers with EM > 0: {np.mean([r['recall'] == 1 for r in correct]) * 100:5.1f}%,"
          f" n={len(correct)})")

# 2. 例:答えは合っているのに、引用が文を裏付けていない文
for r in posthoc:
    if em_recall(r["item"], r["output"]) == 0:
        continue
    for claim, refs, supported in r["details"]:
        if not supported and any(normalize(a) in normalize(claim)
                                 for qa in r["item"]["qa_pairs"] for a in qa["short_answers"]):
            doc = r["docs"][refs[0]]
            print("\nQuestion:", r["item"]["question"])
            print("Statement:", claim)
            print(f"Cited [{refs[0] + 1}] {doc['title']}: {doc['text'][:300]}...")
            break
    else:
        continue
    break
実験2の結果を回答単位で集計し、裏付けのない文の例を表示するコードです。
- 完全に裏付けられた回答: 回答の引用の再現率 r['recall'] が1、つまりすべての文が引用で裏付けられた回答の割合を数えます。
- 正しい回答に絞る: em_recall が0より大きい(正解の文字列を1つ以上含む)回答だけでも、同じ割合を数えます。正しさの指標で「当たり」とされた回答のうち、どれだけが引用でも裏付けられているかです。
- 例の表示: 「正しさの指標では当たりなのに、引用では裏付けられていない」という食い違いを具体的に見るため、PostCite の回答からそのような文を1つ探し、引用した文書の冒頭300文字と一緒に表示します。
実行結果
Vanilla (5-psg)        fully supported:  50.0%  (among answers with EM > 0:  47.4%, n=78)
ClosedBook + PostCite  fully supported:   4.0%  (among answers with EM > 0:   6.7%, n=60)

Question: Who conducted the little albert study on conditioned fear?
Statement: Watson and Rayner exposed an infant named Albert to various objects and sounds, pairing them with a loud, startling noise.
Cited [3] Rosalie Rayner: reflect an empirical environment, based on the belief that behaviors were not hardwired at birth, but instead were acquired through conditioning. Rayner and Watson claimed to have studied over 500 children, with the Little Albert experiment being their only attempt at a psychological experiment (it ...
回答単位で見ると、Vanilla でも、すべての文が引用で裏付けられた回答はちょうど半分(50.0%)でした。正解の文字列を1つ以上含む78件に絞っても 47.4% で、正しさの指標で当たりとされた回答の半分以上に、裏付けのない文が混ざっています。原著論文が ELI5 について述べた「約半数の回答は完全には裏付けられていない」のと同じ状況が、手元の ASQA の実験でも起きています。PostCite では、完全に裏付けられた回答は 4.0% しかありません。
例は、心理学の「アルバート坊やの実験」についての質問です(文書は300文字で切っています)。
(和訳)
- 質問:「条件づけによる恐怖についての、アルバート坊やの実験を行ったのは誰ですか?」
- 文:「Watson と Rayner は、Albert という乳児にさまざまな物や音を見せ、それを大きな驚くような音と組み合わせました。」
- 引用した文書 [3](タイトル:Rosalie Rayner):「…行動は生まれつき備わっているのではなく、条件づけによって獲得されるという信念に基づいて、経験的な環境を反映する…。Rayner と Watson は500人以上の子どもを研究したと主張しており、アルバート坊やの実験は、彼らが心理学の実験を試みた唯一のものでした(…」
文の内容は、実験の説明として事実に沿っています。正解の Watson と Rayner の名前も含むので、正しさの指標では当たりです。しかし、引用した文書には、Albert に何を見せ、どんな音と組み合わせたかは書かれていません。この文書を読んでも、文の内容は確かめられないのです。正しさと引用の質が別の軸であることが、よく分かる例です。
実験3:流暢さを測る
最後の軸の流暢さは、MAUVE で測ります。MAUVE は、人の書いた文章の集まりとモデルの書いた文章の集まりを、GPT-2 Large の埋め込みにして、2つの分布がどれだけ近いかを0〜100で表す指標です。1つ1つの回答の採点ではなく、回答の集まり全体の「人の文章らしさ」を測ります。原著論文と同じく、質問と回答をつないで先頭の100語に切り、ASQA の人手の回答と比べます。
import mauve

# 流暢さ(MAUVE):人手の回答と、モデルの回答の分布の近さ(質問 + 回答の先頭100語で比べる)
def clip(question, answer):
    return " ".join((question + " " + answer.strip()).split()[:100]).rstrip(string.punctuation)


human = [clip(r["item"]["question"], r["item"]["answer"]) for r in vanilla]
for name, runs in [("Vanilla (5-psg)", vanilla), ("ClosedBook + PostCite", posthoc)]:
    generated = [clip(r["item"]["question"], remove_citations(r["output"])) for r in runs]
    out = mauve.compute_mauve(p_text=human, q_text=generated, device_id=0, max_text_length=512,
                              featurize_model_name="gpt2-large", batch_size=8, verbose=False)
    print(f"{name:22s} MAUVE: {out.mauve * 100:.1f}")
2つの方法の回答の流暢さを、MAUVE で測るコードです。
- 比べる文章: clip は、質問と回答を空白でつなぎ、先頭の100語に切って、末尾の句読点を除きます。原著論文の公式コードと同じ前処理です。人手の回答は、ASQA の正解の長い回答 item["answer"] です。モデルの回答からは、引用の番号を消しておきます。
- MAUVE の計算: mauve.compute_mauve に、人手の回答 p_text とモデルの回答 q_text を渡します。featurize_model_name="gpt2-large" で GPT-2 Large の埋め込みを使います。戻り値の mauve は0〜1なので、100倍して表示します。
- サンプル数: MAUVE は、埋め込みをクラスタに分けて2つの分布を比べるので、サンプル数が少ないと値がぶれます。ここでは100問なので、原著論文(1,000問)より不安定な値になります。
実行結果
Vanilla (5-psg)        MAUVE: 78.8
ClosedBook + PostCite  MAUVE: 50.9
流暢さでも、Vanilla(78.8)は ClosedBook + PostCite(50.9)を上回りました。原著論文の ChatGPT でも、Vanilla は 66.6、ClosedBook は 52.7 で、同じ向きです。ASQA の人手の回答は、Wikipedia の文書をもとに、質問の解釈ごとに答えを書き分けた文章です。文書を読まずに書いた回答は、実験1の例のように、曲の雰囲気の説明など人手の回答にはない内容に広がりやすく、書きぶりが離れると考えられます。ただし、100問の MAUVE は値がぶれやすいので、差の大きさは幅を持って読んでください。
実験1〜3の結果をまとめて並べると、次のようになります。
(図は、diagram-designで作成)
原著論文は何を示したか
原著論文は、ChatGPT や GPT-4、LLaMA 系のモデルを ALCE で評価しました。ASQA の主な結果は、次のとおりです(Vanilla は上位5件の文書を読ませた場合)。
| モデル・方法 | 流暢さ(MAUVE) | 正しさ(EM recall) | 引用の再現率 | 引用の適合率 |
|---|---|---|---|---|
| ChatGPT Vanilla | 66.6 | 40.4 | 73.6 | 72.5 |
| ChatGPT ClosedBook(+ PostCite) | 52.7 | 38.3 | 26.7 | 26.7 |
| GPT-4 Vanilla | 67.1 | 41.3 | 68.5 | 75.6 |
| LLaMA-2-Chat-70B Vanilla | 88.3 | 41.5 | 62.9 | 61.3 |
| Vicuna-13B Vanilla(上位3件) | 82.6 | 31.9 | 51.1 | 50.1 |
文書を読ませた Vanilla と、読ませずに後から引用を付けた ClosedBook では、正しさ(40.4 と 38.3)はほとんど変わりません。ChatGPT ほどの大きなモデルなら、ASQA の質問の多くには、事前学習の知識だけで答えられるからです。それでも、引用の再現率は 73.6 と 26.7 で、3倍近い差があります。正しさだけを測っていたら、2つの方法は同じくらい良いと判断してしまう ということです。手元の実験(7B のモデル)では、ClosedBook の正しさも大きく下がりましたが、引用の質の差の方がはるかに大きいという点は同じでした。
また、モデルが大きいほど引用がうまいとは限りません。LLaMA-2-Chat-70B は、正しさでは GPT-4 と並びますが、引用の再現率は 62.9 にとどまります。Vicuna-13B では、およそ半分の文が引用で裏付けられていません。
ELI5 では、さらに厳しい結果でした。ChatGPT の Vanilla の引用の再現率は 51.1、GPT-4 は 44.0 で、原著論文は「最良のモデルでも、約半数の回答は引用で完全には裏付けられていない」とまとめています。答えが1つの文書にまとまっていない質問ほど、引用で裏付けるのは難しくなります。
自動評価は人の判断と合うか
NLI のモデルで引用を判定してよいのかを確かめるため、原著論文は人手でも引用を評価し、ALCE の判定と比べました。ASQA の ChatGPT Vanilla では、人手の引用の再現率と適合率が 74.7・76.6、ALCE が 75.3・74.4 で、ほぼ一致しています。文ごとの判定の一致度を表す Cohen の κ(カッパ)係数は、再現率で 0.698(かなりの一致)、適合率で 0.525(中程度の一致)でした。適合率は「不要な引用か」というより細かい判断なので、人との一致がやや低くなります。
方法による違い
原著論文は、引用の質を上げる工夫もいくつか比べています。
- Rerank: 同じ質問に回答を4つ生成し、引用の再現率(ALCE の自動評価)が最も高いものを選びます。ChatGPT の ASQA で、引用の再現率は 73.6 から 84.8 に上がりました。評価の物差しを、生成の選別にもそのまま使う方法です。
- Summ / Snippet: 文書を ChatGPT で要約したり、関係のある部分だけを抜き出したりしてから読ませます。より多くの文書(10件)を読ませられるので正しさは少し上がりますが、引用の質はかえって下がりました。
- Interact / InlineSearch: 回答を書きながら、文書の全文を確かめたり、検索をし直したりします。どちらも、Vanilla を上回りませんでした。
どの方法でも、引用の質は人が満足できる水準には届いていません。原著論文は、引用付きの回答の生成には、まだ改善の余地が大きいと結論づけています。
なぜ ALCE のような物差しが必要か
ALCE 以前にも、引用の良し悪しは評価されていました。Liu らの研究(Findings of EMNLP 2023)は、Bing Chat などの商用の生成検索エンジンの回答を人手で調べ、引用で完全に裏付けられた文は平均で 51.5%、文を裏付けている引用は 74.5% にとどまることを示しました。ただし、こうした評価には再現性の問題があります。
- 人手の評価は、高価で繰り返せない: 新しいモデルやプロンプトを試すたびに、人が何百もの回答と文書を読み比べるわけにはいきません。
- 商用の検索エンジンは、中身も検索結果も変わる: 検索エンジンやモデルは予告なく更新され、同じ質問をしても同じ文書が返るとは限りません。後から同じ条件で比べ直すことができません。
- 検索と生成の良し悪しが分けられない: 検索の結果が評価のたびに違うと、回答が悪いのが検索のせいか、生成のせいかが分かりません。
ALCE は、検索の対象(固定したコーパス)と、検索結果(上位100件の文書)をデータに含めて公開し、評価を NLI のモデルで自動化しました。誰でも同じ文書の上で、同じ物差しで、モデルや方法を比べ直せます。実験1・2を手元で再現できたのも、このためです。
先行研究としては、Bohnet らの Attributed QA(2022)が、短い答えに出典を1つ付ける質問応答の自動評価を提案していました。ALCE は、これを長い文章の回答と、文ごとの複数の引用に広げたものです。
ALCE の指標の限界
ALCE の指標は便利ですが、何を測っていないかも知っておく必要があります。
- NLI のモデルも間違える: 原著論文の人手の評価との比較では、ALCE の判定の正解率は、再現率で 85.1%、適合率で 77.6% でした。言い換えや数値の計算が必要な文、複数の文書の情報を組み合わせる文では、判定を誤ることがあります。
- 文に分ける方法に左右される: 回答は NLTK で文に分けます。1文に複数の主張を詰め込むと、どれか1つが裏付けられないだけで文全体が0になります。逆に、文脈に頼る文(「それは1990年に発売された」のような文)は、「それ」が何かが文の中にないので、含意と判定されにくくなります。
- 引用すべき文書を引用したかは測らない: 適合率が測るのは「不要な引用がないか」だけです。もっと適切な文書が上位5件の中にあっても、それを引用しなかったことは減点されません。
- 長い文書の判定は難しい: 引用を3件つなぐと、前提は数百語になります。長い入力の中から根拠を探すのは NLI のモデルにとっても難しく、Lost in the Middle の記事で扱ったような、長い入力の中の位置による影響も考えられます。
- TRUE は大きい: 原著論文の NLI のモデルは 11B で、A100 クラスの GPU が必要です。小さな NLI のモデルや、LLM に判定させる方法(LLM-as-a-judge)に置き換えることもできますが、判定の傾向が変わるので、論文の数値とは直接比べられなくなります。
実務上の指針
- RAG の評価に、引用の質を加える 回答の正しさだけを測ると、実験1の PostCite のような「もっともらしい引用付きの誤答」を見逃します。社内の RAG でも、評価用の質問と検索結果を固定して保存し、回答の各文が引用で裏付けられているかを NLI で測っておくと、プロンプトやモデルを変えたときに引用の質が下がっていないかを確かめられます。
- 後から引用を付ける方法に頼らない 生成した後で、似ている文書を引用として付けるだけでは、引用はほとんど文を裏付けません。引用は、文書を読ませて書かせる段階で付けさせる方が、はるかに信頼できます。
- 引用のない文を、許容するか決めておく ALCE では、引用のない文は再現率0です。挨拶やつなぎの文まで引用を求めるか、事実を述べる文だけを対象にするかは、評価の目的に合わせて決めます。
- 再現率と適合率を両方見る 再現率だけを上げたいなら、上位5件をすべて引用すればよくなってしまいます。適合率も一緒に見ることで、引用の水増しを防げます。
回答の正しさや引用の質の改善を狙う手法には、検索結果の品質を外部の評価器で判定して検索をやり直す CRAG(Corrective RAG)、生成の途中でモデル自身に検索の要否や根拠を判定させる Self-RAG、生成した後で検証の質問を立てて回答を見直す Chain-of-Verification(CoVe)などがあります。これらの改善手法の効果も、本記事で扱った引用の再現率・適合率のような指標で測られます。
まとめ
本記事では、引用付きの回答を自動で評価するベンチマーク ALCE を、ASQA の公式データと Qwen2.5-7B-Instruct で確かめました。
文書を読ませて引用を付けさせる Vanilla と、文書を読まずに答えて後から引用を付ける ClosedBook + PostCite を比べると、正しさ(EM recall)は 45.8 と 29.5 でしたが、引用の再現率は 71.0 と 20.7 で、差は3倍以上に広がりました。PostCite の回答は、すべての文に引用が付いていても、ほとんど裏付けられていません。Vanilla でも、すべての文が引用で裏付けられた回答は半分だけで、正解を含む回答にも裏付けのない文が混ざっていました。原著論文の ChatGPT でも、正しさはほぼ同じなのに引用の質は大きく違うという、同じ傾向が示されています。
RAG が「正しく答えた」かどうかは、回答の正しさだけでなく、提示した引用が本当にその主張を支えているかで測らなければなりません。モデルの中から出典を辿れなくても、引用した文書と文を NLI で突き合わせれば、外から引用の質を測れます。ALCE は、そのための固定したデータと物差しを提供しています。
参考文献
- T. Gao, H. Yen, J. Yu, D. Chen (2023). Enabling Large Language Models to Generate Text with Citations. EMNLP 2023.
- N. F. Liu, T. Zhang, P. Liang (2023). Evaluating Verifiability in Generative Search Engines. Findings of EMNLP 2023.
- B. Bohnet et al. (2022). Attributed Question Answering: Evaluation and Modeling for Attributed Large Language Models. arXiv:2212.08037.
- Qwen Team (2024). Qwen2.5-7B-Instruct. Hugging Face(Apache License 2.0).
- Google (2022). t5_xxl_true_nli_mixture. Hugging Face.
- sentence-transformers (2022). gtr-t5-large. Hugging Face.
本記事の文章・構成の一部に生成AIを使用しています。