AnyDoorとは?
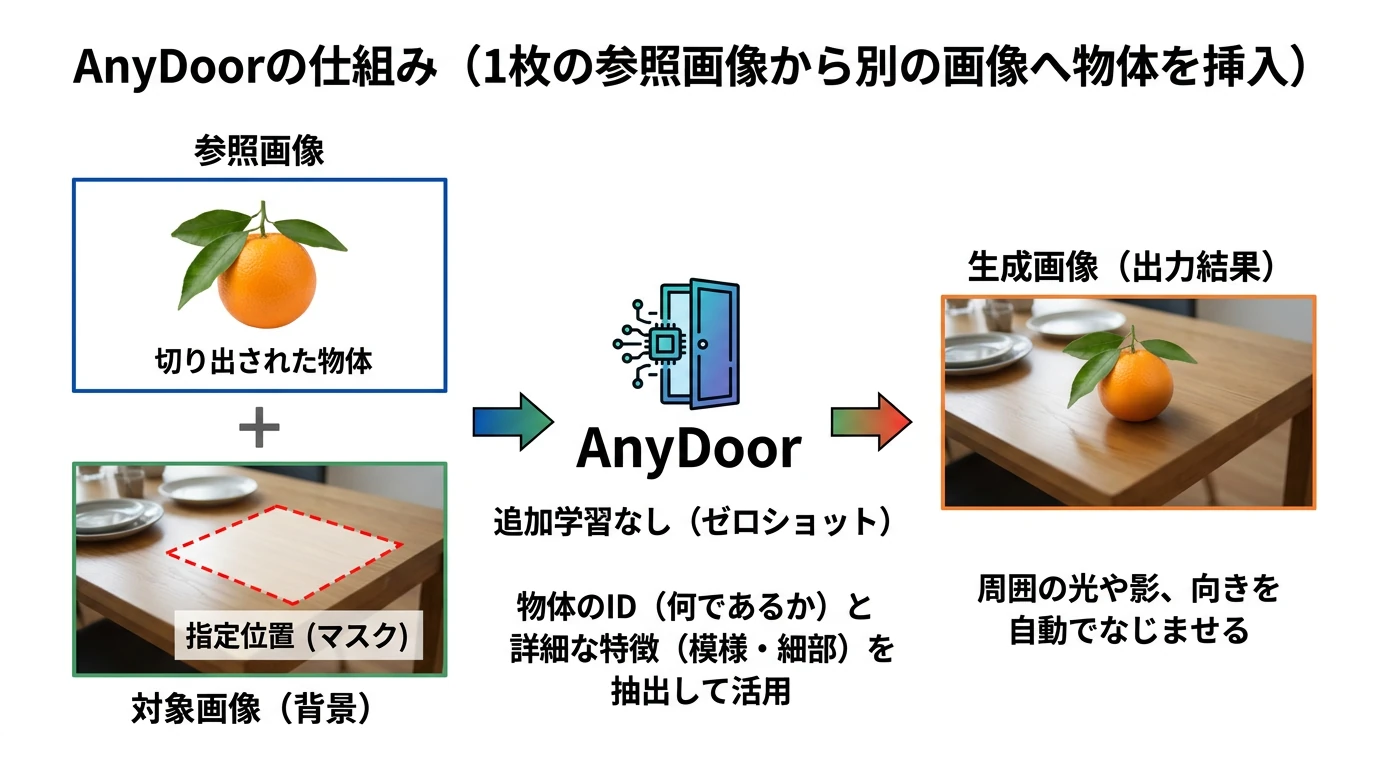 (画像は、Geminiで作成)
1 枚の参照画像の物体を、別の画像の指定した場所へ自然に入れる AnyDoor を部品ごとに PyTorch で実装し、公式の学習済みの重みを読み込んで公式の実装と同じ画像を生成することを確かめること。ID トークンと HF マップがそれぞれ何を伝えているかを理解し、動画のフレームの組を使った追加学習を自分で書いて動かせるようになること。
参考資料: AnyDoor: Zero-shot Object-level Image Customization (Chen et al., CVPR 2024)。公式の実装は ali-vilab/AnyDoor(MIT License)、本記事で使う学習済みの重みは Hugging Face の xichenhku/AnyDoor_models(著者が公開、Apache-2.0 と表示)です。
概要
画像の生成モデルで「この商品を、この部屋のこの場所に置いた写真」を作ろうとすると、ふつうは物体ごとに数枚の画像を集めて、モデルを追加学習する必要があります(DreamBooth など)。
AnyDoor(香港大学・Alibaba、2023)は、参照の画像 1 枚と、入れる場所を示す箱(マスク)だけで、物体を別の画像に入れるモデルです。物体ごとの追加学習はいりません(ゼロショット)。物体の情報を 2 つに分けて Stable Diffusion に伝えるのが特徴です。
- ID トークン: 物体が「何であるか」を、DINOv2 の特徴で伝えます。
- 詳細の特徴: 物体の模様や文字などの細部を、HF マップ(エッジの強いところの色)から作って伝えます。
学習には、動画の中で同じ物体が別の姿で写った 2 つのフレームの組を使います。そのため、入れる場所に合わせて、物体の向きや照明を変えて描くことができます。
本記事では、まず公式の実装でオレンジをりんごの位置に入れ、仕組みを図で整理したうえで、前処理・ID Extractor・Detail Extractor・U-Net・VAE・DDIM をスクラッチで実装します。公式の重みで公式と同じ画像を生成することを確かめたあと、動画のデータセット DAVIS を使って、ID トークンと HF マップの役割、ガイダンスの強さを数値で調べます。最後に、DAVIS の動画のフレームの組で Detail Extractor を追加学習します。
AnyDoor で物体を入れる
準備:Google Colab の GPU で動かす
本記事のコードは、Google Colab の A100 GPU(40GB) で実行しました。「ランタイム」→「ランタイムのタイプを変更」から A100 GPU を選んでください(Colab の有料プランが必要です)。最後の実験5の追加学習は、A100 で約 23 分かかります(実験全体では約 1 時間)。
新しいセッションで、次を実行してください。グラフの日本語表示には japanize-matplotlib を使い、Python 3.12 以降で import 時にエラーが出ないよう setuptools も入れます。
!pip install -q japanize-matplotlib setuptools
公式の実装を動かす環境を作る
公式の実装は、2023 年の PyTorch 2.0・PyTorch Lightning 1.5 などに合わせて書かれていて、Colab に入っている新しい版では動きません。そこで、公式の実装だけは、当時の版のライブラリを入れた別の Python の環境(仮想環境)で動かします。uv は、仮想環境を作ってライブラリを入れるツールです。スクラッチ実装は、Colab の新しい環境でそのまま動きます。
!pip install -q uv
!git clone -q https://github.com/ali-vilab/AnyDoor.git
!uv venv /content/adenv --python 3.10
!uv pip install -q --python /content/adenv/bin/python torch==2.0.1 torchvision==0.15.2 pytorch-lightning==1.5.0 torchmetrics==0.6.0 omegaconf==2.1.1 einops==0.3.0 open_clip_torch==2.17.1 transformers==4.19.2 opencv-python-headless==4.7.0.72 albumentations==1.3.0 numpy==1.23.5 scipy==1.9.1 timm==0.6.12 safetensors huggingface_hub==0.20.3 "setuptools<70" pillow==9.4.0
- ライブラリの版: 公式の requirements.txt と同じ版です。xformers(速い注意の計算)は入れず、公式のコードが用意している通常の計算を使います。
- numpy 1.23.5・huggingface_hub 0.20.3: requirements.txt にない、または Python 3.10 で入らない版の代わりに、同じころの版を選んでいます。
公式の重み(約 9.8GB)をダウンロードし、公式のコードが読む場所を設定します。公式のコードは DINOv2 の重みを別のファイルから読む作りですが、AnyDoor の重みの中に DINOv2 の重みも入っているので、そこから取り出して使います(実験2で、Meta が公開した DINOv2 と同じことを確かめます)。
!/content/adenv/bin/python -c "import torch, os; from huggingface_hub import hf_hub_download; p = hf_hub_download('xichenhku/AnyDoor_models', 'general_v0.1/general_v0.1.ckpt'); os.symlink(p, '/content/anydoor.ckpt'); sd = torch.load(p, map_location='cpu')['state_dict']; torch.save({k[23:]: v for k, v in sd.items() if k.startswith('cond_stage_model.model.')}, '/content/dinov2_vitg14.pth')"
!sed -i "s#path/dinov2_vitg14_pretrain.pth#/content/dinov2_vitg14.pth#" AnyDoor/configs/anydoor.yaml
!sed -i "s#path/epoch=1-step=8687.ckpt#/content/anydoor.ckpt#" AnyDoor/configs/inference.yaml
推論に利用する画像
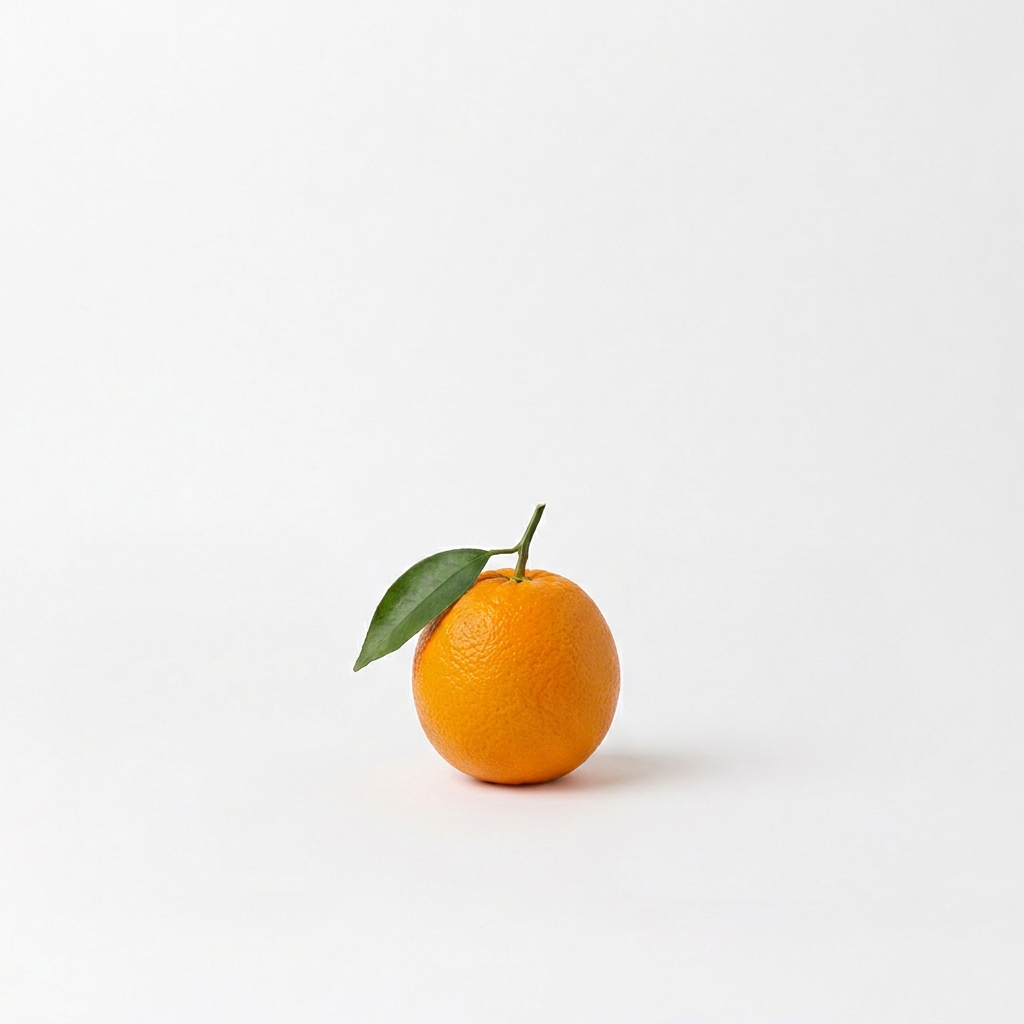
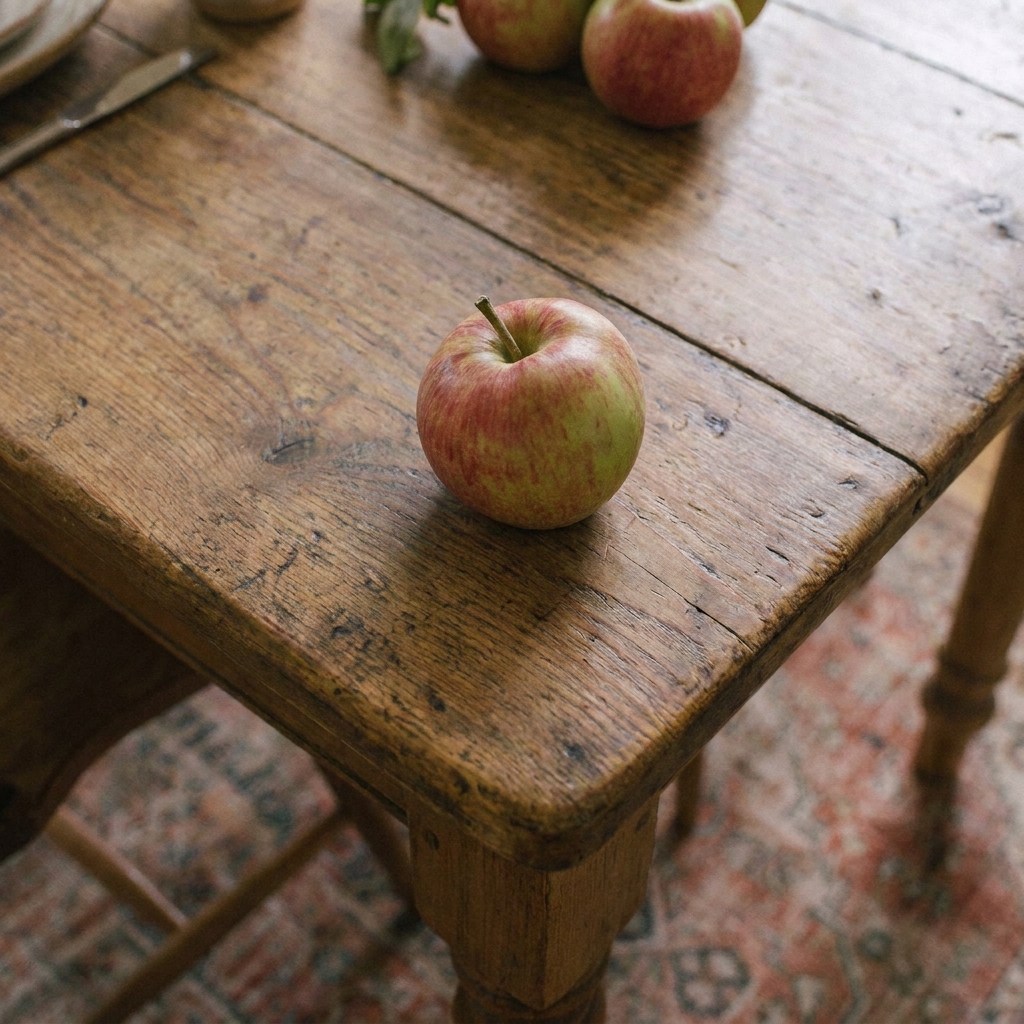
実験1と実験2では、白い背景のオレンジ(参照)と、テーブルの上のりんご(対象)の画像を使います。次の 2 枚を保存し、orange.jpg・apple.jpg という名前で Colab にアップロードしてください(画像は、Google AI Studio で作成)。実験3以降で使う DAVIS の動画は、コードの中でダウンロードします。
実験1:公式の実装で、オレンジをりんごの位置に入れる
公式の run_inference.py の関数とモデルを使って、オレンジをりんごの位置に入れます。
%%writefile of_exp1.py
# 公式の AnyDoor(run_inference.py の関数とモデル)で、オレンジをりんごの位置に入れる(比較用に途中の値も保存する)
import os, sys, time
os.chdir("/content/AnyDoor")
sys.path.insert(0, "/content/AnyDoor")
import cv2
import numpy as np
import torch
import einops

torch.backends.cuda.matmul.allow_tf32 = False         # 実験2で桁まで比べるため、TF32 を使わずに float32 で計算する
torch.backends.cudnn.allow_tf32 = False
from run_inference import process_pairs, crop_back, model, ddim_sampler   # import すると公式の重みが読み込まれる


def object_mask(image, thresh=40):
    """白い背景の画像から物体のマスクを作る。白との差が thresh を超える画素のうち、最も大きなまとまりを残す"""
    diff = 255 - image.min(axis=2).astype(np.int32)
    m = (diff > thresh).astype(np.uint8)
    m = cv2.morphologyEx(m, cv2.MORPH_CLOSE, np.ones((7, 7), np.uint8))
    n, labels, stats, _ = cv2.connectedComponentsWithStats(m)
    return (labels == 1 + stats[1:, cv2.CC_STAT_AREA].argmax()).astype(np.uint8)


ref_image = cv2.cvtColor(cv2.imread("/content/orange.jpg"), cv2.COLOR_BGR2RGB)
tar_image = cv2.cvtColor(cv2.imread("/content/apple.jpg"), cv2.COLOR_BGR2RGB)
ref_mask = object_mask(ref_image)
tar_mask = np.zeros(tar_image.shape[:2], np.uint8)
tar_mask[290:535, 410:650] = 1                        # りんごを囲む箱(入れる場所)

np.random.seed(0)                                     # 公式の前処理は、切り出しの広さを乱数で決める
item = process_pairs(ref_image, ref_mask, tar_image, tar_mask)
rs = np.random.RandomState(0); rs.randint(12, 13); rs.randint(11, 12)
print(f"参照のマスク {ref_mask.sum():,} 画素、切り出しの広さ(箱の何倍か){rs.randint(15, 30) / 10}")

# 条件:ID トークン(DINOv2)と、Detail Extractor に入れるコラージュ(HF マップ+マスク)
control = einops.rearrange(torch.from_numpy(item["hint"]).float().cuda()[None], "b h w c -> b c h w")
ref = einops.rearrange(torch.from_numpy(item["ref"]).float().cuda()[None], "b h w c -> b c h w")
with torch.no_grad():
    cond = {"c_concat": [control], "c_crossattn": [model.get_learned_conditioning(ref)]}
    un_cond = {"c_concat": [control], "c_crossattn": [model.get_learned_conditioning([torch.zeros((1, 3, 224, 224))])]}

    # 1 回分の計算:Detail Extractor の 13 個の出力と、U-Net が予測するノイズ
    x_T = torch.randn((1, 4, 64, 64), generator=torch.Generator("cuda").manual_seed(0), device="cuda")
    t = torch.tensor([981], device="cuda")
    outs = model.control_model(x=x_T, hint=control, timesteps=t, context=cond["c_crossattn"][0])
    eps = model.apply_model(x_T, t, cond)

    # 公式と同じ設定で生成:DDIM 50 ステップ・eta 0・CFG 5.0(run_inference.py の値)
    torch.cuda.synchronize(); t0 = time.time()
    samples, _ = ddim_sampler.sample(50, 1, (4, 64, 64), cond, verbose=False, eta=0.0, x_T=x_T,
                                     unconditional_guidance_scale=5.0, unconditional_conditioning=un_cond)
    x = model.decode_first_stage(samples)
    torch.cuda.synchronize(); elapsed = time.time() - t0
x = (einops.rearrange(x, "b c h w -> b h w c") * 127.5 + 127.5).cpu().numpy()
pred = np.clip(x[0], 0, 255)[1:, :, :]                 # 公式と同じく 1 行目を落としてから元の画像に戻す
gen = crop_back(pred, tar_image.copy(), item["extra_sizes"], item["tar_box_yyxx_crop"])
cv2.imwrite("/content/of_result.png", cv2.cvtColor(gen.astype(np.uint8), cv2.COLOR_RGB2BGR))
print(f"生成:{elapsed:.1f} 秒(50 ステップ × 条件あり・なしの 2 回)")

np.savez("/content/of_exp1.npz", ref_mask=ref_mask, tar_mask=tar_mask, ref=item["ref"], hint=item["hint"], jpg=item["jpg"],
         extra_sizes=item["extra_sizes"], tar_box_yyxx_crop=item["tar_box_yyxx_crop"],
         id_tokens=cond["c_crossattn"][0].cpu().numpy(), un_tokens=un_cond["c_crossattn"][0].cpu().numpy(),
         x_T=x_T.cpu().numpy(), outs=np.concatenate([o.cpu().numpy().ravel() for o in outs]), eps=eps.cpu().numpy(),
         samples=samples.cpu().numpy(), x=x, gen=gen)
print("保存しました")
!/content/adenv/bin/python of_exp1.py 2>/dev/null
- 参照のマスク: オレンジは白い背景に写っているので、白との差が 40 を超える画素のうち、最も大きなまとまりをマスクにします。AnyDoor の入力には物体のマスクが必要で、公式のデモでは手で描くか、SAM などで作ります。
- 入れる場所: りんごを囲む箱(縦 290〜535、横 410〜650 画素)を、対象のマスクにします。AnyDoor は、マスクの形ではなく、マスクを囲む箱の中に物体を描きます。
- 乱数の種: 公式の前処理は、入れる場所の周りをどれだけ広く切り出すかを、箱の 1.5〜3.0 倍から乱数で選びます。結果を再現できるよう、乱数の種を 0 にしています。
- 生成の設定: DDIM 50 ステップ・eta 0・CFG 5.0 で、公式の run_inference.py と同じです。最初のノイズ x_T は、実験2でスクラッチ実装と比べるため、決まった乱数の種で作って保存します。
- 保存: 前処理の結果・ID トークン・Detail Extractor の出力・U-Net の出力・生成した潜在と画像を of_exp1.npz に保存します。
実行結果
参照のマスク 50,962 画素、切り出しの広さ(箱の何倍か)2.7
生成:14.3 秒(50 ステップ × 条件あり・なしの 2 回)
保存しました
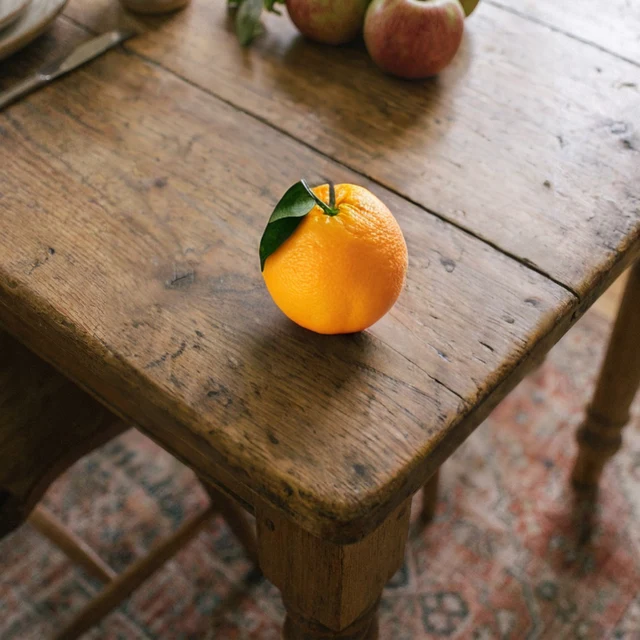
- 結果: りんごがあった場所に、葉の付いたオレンジが置かれました。オレンジの下には、テーブルの照明の向きに合った影ができていて、木目の天板にもなじんでいます。りんごは、箱の外にはみ出していた部分も含めて消えています。
- 箱の外も描き直す: AnyDoor は、箱の周りを 2.7 倍に広げた正方形を切り出して生成し、元の画像に貼り戻します。箱の外のテーブルも生成し直すので、影や照明の変化を自然につなげることができます。
- 時間: float32 で 14.3 秒でした。50 ステップのそれぞれで、条件ありと条件なしの U-Net と Detail Extractor を 1 回ずつ計算します。
AnyDoor の仕組み
全体の構成
AnyDoor の全体は、次の図のとおりです(図は、後で実装する AnyDoor クラスの構成です)。
(図は、diagram-designで作成)
- ID Extractor: 参照の物体(背景を白にした 224×224)を DINOv2 ViT-g/14(約 11 億パラメータ、重みは固定)で 257 個のトークンにし、線形の射影で 1024 次元にします。Stable Diffusion のテキストの埋め込みの代わりに、U-Net のクロス注意に入ります。論文は、CLIP の画像エンコーダより DINOv2 のほうが、物体を見分ける細かな特徴を持つと述べています。
- Detail Extractor: 対象の画像の、入れる場所の箱に HF マップを貼ったコラージュから、U-Net の各段の大きさの特徴を作ります。ControlNet と同じ形のネットワークです。
- U-Net: Stable Diffusion 2.1 の U-Net です。ノイズの入った潜在から、ID トークンと詳細の特徴を手がかりに、ノイズを取り除きます。
- VAE: 潜在(64×64×4)と画像(512×512×3)を行き来します。
前処理:参照の切り出し、HF マップ、コラージュ
(図は、diagram-designで作成)
HF マップ(high-frequency map)は、参照の物体の Sobel フィルタのエッジが強いところだけ、元の色を残した画像です。物体の輪郭は入れず、内側の模様・文字・質感だけを残します。論文は、参照の画像をそのまま貼ると、生成した物体がそのコピーになって向きや照明を変えられず、何も貼らないと細部が失われる、と述べています。HF マップは、細部を伝えつつ、形や色合いを変える余地を残すための中間の表現です(実験3で確かめます)。
Detail Extractor と U-Net のつながり
(図は、diagram-designで作成)
論文は「詳細の特徴を U-Net のデコーダの特徴と連結する」と書いていますが、公式の実装では、ControlNet と同じく、エンコーダからのスキップ接続に足してからデコーダの特徴と連結します。また、ふつうの ControlNet はノイズの入った潜在も入力に加えますが、AnyDoor の実装はコラージュだけから特徴を作ります。
学習:動画のフレームの組
(図は、diagram-designで作成)
学習では、同じ動画の離れた 2 つのフレームを使い、一方の物体を参照、もう一方のフレームを正解にします。参照と正解で物体の向きや姿が違うので、モデルは「参照の物体を、その場所に合った姿で描く」ことを学びます。論文は、画像のデータ(同じ物体の別の姿がない)と動画のデータ(解像度が低く、ぶれがある)の長所を両方生かすため、ノイズの多いステップでは動画のデータを、ノイズの少ないステップでは画像のデータを多く使う、Adaptive Timestep Sampling を提案しています。公式の学習では、DINOv2 と U-Net のエンコーダ・VAE を固定し、Detail Extractor・U-Net のデコーダ・ID トークンの射影を学習します。
論文・公式の設定と、本記事の設定の違い
| 項目 | 論文・公式 | 本記事 |
|---|---|---|
| 切り出しの広さ | 推論のたびに、箱の 1.5〜2.9 倍から乱数で選ぶ | 実験1・2は公式と同じ乱数の種で選ばれた 2.7 倍、実験3以降は 2.2 倍に固定(条件どうしを比べるため) |
| 最初のノイズ | 推論のたびに乱数 | 乱数の種を固定(結果を再現し、条件どうしを比べるため) |
| 生成の設定 | DDIM 50 ステップ・eta 0・CFG 5.0(run_inference.py)。オンラインのデモは 30 ステップ・CFG 4.5 | run_inference.py と同じ。実験4で CFG を 1〜9 に変える |
| 計算の精度 | float32 | 実験2は float32(公式と比べるため)、実験3以降は bfloat16(速さのため) |
| CFG の計算 | 条件ありと条件なしを 1 回ずつ計算 | 2 つを 1 回の計算(バッチ 2)にまとめる。結果は同じで、速くなる |
| 学習のデータ | 動画(YouTube-VOS・MOSE・VIPSeg など)、画像(SAM・LVIS など)、多視点の画像、試着の画像 | DAVIS 2017 の学習用の 60 本の動画だけ(実験5) |
AnyDoor のスクラッチ実装
ここからは、AnyDoor を部品ごとに実装します。部品の構造・次元・計算の順番は、公式の実装(cldm/cldm.py・ldm のモジュール・同梱の dinov2)と同じで、重みの名前も読み込みやすいように合わせています。
前処理
import os
import re
import io
import json
import math
import time
import random
import glob
import zipfile
import urllib.request
import cv2
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
import matplotlib.pyplot as plt
import japanize_matplotlib
from PIL import Image
from huggingface_hub import hf_hub_download

device = "cuda"


def bbox(mask):
    """マスクを囲む箱 (y1, y2, x1, x2)。y2, x2 は最後の画素の位置(公式と同じ)"""
    ys, xs = np.where(mask.any(1))[0], np.where(mask.any(0))[0]
    return ys[0], ys[-1], xs[0], xs[-1]


def expand_box(shape, box, ratio):
    """箱を中心はそのままに ratio 倍に広げ、画像の外に出た分は切り詰める"""
    y1, y2, x1, x2 = box
    H, W = shape[:2]
    yc, xc = 0.5 * (y1 + y2), 0.5 * (x1 + x2)
    h, w = ratio * (y2 - y1 + 1), ratio * (x2 - x1 + 1)
    return max(0, int(yc - h / 2)), min(H, int(yc + h / 2)), max(0, int(xc - w / 2)), min(W, int(xc + w / 2))


def to_square_box(shape, box):
    """長い辺に合わせて正方形の箱にする"""
    y1, y2, x1, x2 = box
    H, W = shape[:2]
    cy, cx, h, w = (y1 + y2) // 2, (x1 + x2) // 2, y2 - y1, x2 - x1
    if h >= w:
        x1, x2 = cx - h // 2, cx + h // 2
    else:
        y1, y2 = cy - w // 2, cy + w // 2
    return max(0, y1), min(H, y2), max(0, x1), min(W, x2)


def pad_square(img, value):
    """短い辺の両側を value で埋めて正方形にする"""
    H, W = img.shape[:2]
    p = abs(H - W)
    pad = ((0, 0), (p // 2, p - p // 2)) if H > W else ((p // 2, p - p // 2), (0, 0))
    return np.pad(img, pad + ((0, 0),) * (img.ndim - 2), constant_values=value)


def hf_map(img, mask, thresh=50):
    """HF マップ:Sobel の縦横のエッジの強さが thresh 以上の画素だけ、元の色を強さに応じて残す。
    マスクを 2 回縮めて、物体の輪郭(背景との境目)のエッジは入れない"""
    H, W = img.shape[:2]
    img = cv2.resize(img, (256, 256))
    m = cv2.erode((cv2.resize(mask, (256, 256)) > 0.5).astype(np.uint8), np.ones((5, 5), np.uint8), iterations=2)
    gx = cv2.convertScaleAbs(cv2.Sobel(img, cv2.CV_64F, 1, 0, ksize=3))
    gy = cv2.convertScaleAbs(cv2.Sobel(img, cv2.CV_64F, 0, 1, ksize=3))
    edge = cv2.addWeighted(gx, 0.5, gy, 0.5, 0).max(-1) * m
    edge[edge < thresh] = 0
    out = (np.stack([edge] * 3, -1).astype(np.float32) / 255 * img.astype(np.float32)).astype(np.uint8)
    return cv2.resize(out, (W, H))


def prepare(ref_image, ref_mask, tar_image, tar_mask, crop_ratio, collage_mode="hf"):
    """公式の推論の前処理(run_inference.py の process_pairs)と同じ計算。
    collage_mode は実験3で使う:hf(公式)・blank(HF マップを入れない)・rgb(元の色をそのまま貼る)"""
    # 参照:物体以外を白にして切り出し、1.2 倍に広げ、正方形にして 224×224 にする
    y1, y2, x1, x2 = bbox(ref_mask)
    m3 = np.stack([ref_mask] * 3, -1)
    ref = (ref_image * m3 + 255 * (1 - m3))[y1:y2, x1:x2]
    rm = ref_mask[y1:y2, x1:x2]
    h, w = rm.shape
    H, W = int(h * 1.2), int(w * 1.2)
    pad = ((int((H - h) // 2), H - h - int((H - h) // 2)), (int((W - w) // 2), W - w - int((W - w) // 2)))
    ref, rm = np.pad(ref, pad + ((0, 0),), constant_values=255), np.pad(rm, pad, constant_values=0)
    ref = cv2.resize(pad_square(ref, 255).astype(np.uint8), (224, 224)).astype(np.uint8)
    rm = cv2.resize(pad_square(np.stack([rm] * 3, -1) * 255, 0).astype(np.uint8), (224, 224)).astype(np.uint8)[:, :, 0]
    piece = {"hf": hf_map(ref, rm / 255), "blank": np.zeros_like(ref), "rgb": ref}[collage_mode]

    # 対象:入れる場所の箱を 1.1 倍に広げ、さらに crop_ratio 倍に広げた正方形を切り出す
    box = expand_box(tar_mask.shape, bbox(tar_mask), 1.1)
    crop = to_square_box(tar_image.shape, expand_box(tar_image.shape, box, crop_ratio))
    cy1, cy2, cx1, cx2 = crop
    cropped = tar_image[cy1:cy2, cx1:cx2]
    y1, y2, x1, x2 = box[0] - cy1, box[1] - cy1, box[2] - cx1, box[3] - cx1

    # コラージュ:箱の位置に HF マップを貼り、マスク(箱の中が 1)を 4 チャンネル目に足す
    collage = cropped.copy()
    collage[y1:y2, x1:x2] = cv2.resize(piece, (x2 - x1, y2 - y1))
    cmask = np.zeros(cropped.shape, np.float64)
    cmask[y1:y2, x1:x2] = 1.0
    H1, W1 = collage.shape[:2]
    cropped = pad_square(cropped, 0).astype(np.uint8)
    collage = pad_square(collage, 0).astype(np.uint8)
    cmask = pad_square(cmask, -1).astype(np.uint8)              # 正方形にするための余白は −1(uint8 では 255)
    H2, W2 = collage.shape[:2]
    cropped = cv2.resize(cropped, (512, 512)).astype(np.float32)
    collage = cv2.resize(collage, (512, 512)).astype(np.float32)
    cmask = (cv2.resize(cmask, (512, 512)).astype(np.float32) > 0.5).astype(np.float32)
    hint = np.concatenate([collage / 127.5 - 1.0, cmask[:, :, :1]], -1)
    return dict(ref=ref / 255, jpg=cropped / 127.5 - 1.0, hint=hint, sizes=(H1, W1, H2, W2), crop=crop, piece=piece)


def paste_back(pred, tar_image, sizes, crop, m=5):
    """生成した 512×512 を切り出す前の大きさに戻し、余白を除いて元の画像に貼る(公式の crop_back と同じ。端の 5 画素は貼らない)"""
    H1, W1, H2, W2 = sizes
    y1, y2, x1, x2 = crop
    pred = cv2.resize(pred, (W2, H2))
    if W1 < W2:
        p = int((W2 - W1) / 2); pred = pred[:, p:-(W2 - W1 - p)]
    elif H1 < H2:
        p = int((H2 - H1) / 2); pred = pred[p:-(H2 - H1 - p)]
    out = tar_image.copy()
    out[y1 + m:y2 - m, x1 + m:x2 - m] = pred[m:-m, m:-m]
    return out


def object_mask(image, thresh=40):
    """白い背景の画像から物体のマスクを作る(実験1と同じ)"""
    m = (255 - image.min(axis=2).astype(np.int32) > thresh).astype(np.uint8)
    m = cv2.morphologyEx(m, cv2.MORPH_CLOSE, np.ones((7, 7), np.uint8))
    n, labels, stats, _ = cv2.connectedComponentsWithStats(m)
    return (labels == 1 + stats[1:, cv2.CC_STAT_AREA].argmax()).astype(np.uint8)


ref_image = cv2.cvtColor(cv2.imread("orange.jpg"), cv2.COLOR_BGR2RGB)
tar_image = cv2.cvtColor(cv2.imread("apple.jpg"), cv2.COLOR_BGR2RGB)
ref_mask = object_mask(ref_image)
tar_mask = np.zeros(tar_image.shape[:2], np.uint8)
tar_mask[290:535, 410:650] = 1
ref_np = np.load("of_exp1.npz")
CROP_RATIO = 2.7                     # 公式は 1.5〜3.0 から乱数で選ぶ。比べるため、実験1(乱数の種 0)で選ばれた値にそろえる
item = prepare(ref_image, ref_mask, tar_image, tar_mask, crop_ratio=CROP_RATIO)
for k in ["ref", "jpg", "hint"]:
    print(f"{k:<4} {item[k].shape}  公式との差の最大値 {np.abs(item[k] - ref_np[k]).max():.1e}")
print("大きさ・切り出しの箱が公式と同じ:", tuple(item["sizes"]) == tuple(ref_np["extra_sizes"]), tuple(item["crop"]) == tuple(ref_np["tar_box_yyxx_crop"]))

fig, ax = plt.subplots(1, 4, figsize=(16, 4.4))
ax[0].imshow(item["ref"]); ax[0].set_title("参照(224×224、物体以外は白)")
ax[1].imshow(item["piece"]); ax[1].set_title("HF マップ(224×224)")
ax[2].imshow((item["hint"][:, :, :3] + 1) / 2); ax[2].set_title("コラージュ(512×512)")
ax[3].imshow(item["hint"][:, :, 3], cmap="gray"); ax[3].set_title("マスク(4 チャンネル目)")
for a in ax:
    a.axis("off")
plt.show()
- prepare: 公式の推論の process_pairs と同じ計算です。参照は、物体以外を白にして切り出し、1.2 倍に広げ、白で正方形にして 224×224 にします。対象は、入れる場所の箱を 1.1 倍に広げ、さらに crop_ratio 倍の正方形を切り出して 512×512 にします。
- hf_map: 256×256 にしてから Sobel フィルタで横と縦のエッジを計算し、強さが 50 以上の画素だけ、強さに応じた割合で元の色を残します。マスクを 5×5 で 2 回縮めて、物体と背景の境目のエッジを入れないようにします。
- コラージュとマスク: 箱の位置に HF マップを貼り、箱の中を 1 にしたマスクを 4 チャンネル目に足します。公式の推論のコードは、正方形にするための余白を −1 で埋めてから 8 ビットの整数に変えるので、余白も 255 になり、最後にマスクの 1 として扱われます。学習のコードでは余白を −1 にしていて、推論と学習で少し違います。同じ結果にするため、そのまま再現しています。
- paste_back: 生成した 512×512 を、切り出す前の大きさに戻し、余白を除いて元の画像に貼ります。端の 5 画素は貼りません(つなぎ目を目立たなくするため)。
- CROP_RATIO: 公式の前処理は、切り出しの広さを乱数で選びます。実験1と同じ値(2.7)にそろえて、公式の前処理の結果と比べます。
実行結果
ref  (224, 224, 3)  公式との差の最大値 0.0e+00
jpg  (512, 512, 3)  公式との差の最大値 0.0e+00
hint (512, 512, 4)  公式との差の最大値 0.0e+00
大きさ・切り出しの箱が公式と同じ: True True
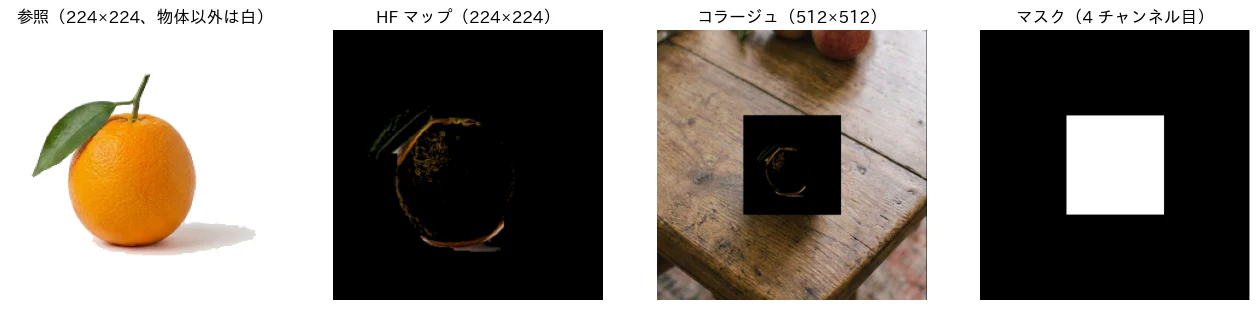
- 前処理の一致: 参照(224×224)・対象の切り出し(512×512)・コラージュ(4 チャンネル)のすべての値と、切り出しの箱・大きさが、公式の前処理と一致しました。
- HF マップ: オレンジの皮の粒の模様と、葉の葉脈・軸が残り、オレンジの輪郭(白い背景との境目)は消えています。色は、エッジの強さに応じた割合で元の色が残ります。マスクがオレンジの下の薄い影まで含んでいるので、影の端のエッジも少し入っています。
- コラージュ: 箱の位置に HF マップを貼るので、箱の中はほとんど黒です。物体の形や大きさの手がかりは、HF マップの模様の位置と、4 チャンネル目のマスクの箱だけです。
ID Extractor:DINOv2 ViT-g/14
class DinoBlock(nn.Module):
    """DINOv2 の層:LayerNorm → 注意 → LayerScale、LayerNorm → SwiGLU → LayerScale を、それぞれ残差に足す"""
    def __init__(self, d=1536, heads=24, hidden=4096):
        super().__init__()
        self.heads = heads
        self.norm1, self.norm2 = nn.LayerNorm(d, eps=1e-6), nn.LayerNorm(d, eps=1e-6)
        self.qkv, self.proj = nn.Linear(d, 3 * d), nn.Linear(d, d)
        self.w12, self.w3 = nn.Linear(d, 2 * hidden), nn.Linear(hidden, d)    # SwiGLU:gate と値を 1 つの行列で作る
        self.ls1, self.ls2 = nn.Parameter(torch.ones(d)), nn.Parameter(torch.ones(d))

    def forward(self, x):
        B, N, C = x.shape
        q, k, v = self.qkv(self.norm1(x)).reshape(B, N, 3, self.heads, C // self.heads).permute(2, 0, 3, 1, 4)
        a = ((q * (C // self.heads) ** -0.5) @ k.transpose(-2, -1)).softmax(-1) @ v
        x = x + self.ls1 * self.proj(a.transpose(1, 2).reshape(B, N, C))
        g, u = self.w12(self.norm2(x)).chunk(2, dim=-1)
        return x + self.ls2 * self.w3(F.silu(g) * u)


class IDExtractor(nn.Module):
    """ID Extractor:DINOv2 ViT-g/14(40 層、1536 次元)で、224×224 の参照画像を
    クラストークン 1 個+パッチ 16×16 = 256 個のトークンにし、線形の射影で U-Net の次元(1024)に合わせる"""
    def __init__(self, d=1536, depth=40):
        super().__init__()
        self.patch_embed = nn.Conv2d(3, d, 14, 14)
        self.cls_token = nn.Parameter(torch.zeros(1, 1, d))
        self.pos_embed = nn.Parameter(torch.zeros(1, 1 + 37 * 37, d))     # 518×518(37×37 パッチ)で学習した位置の埋め込み
        self.blocks = nn.ModuleList([DinoBlock() for _ in range(depth)])
        self.norm = nn.LayerNorm(d, eps=1e-6)
        self.projector = nn.Linear(d, 1024)                              # AnyDoor で学習した部品

    def pos(self, n):
        """37×37 の位置の埋め込みを、n×n に双三次補間で縮める(公式と同じく、倍率に 0.1 を足して丸めの誤差を避ける)"""
        p = self.pos_embed.float()
        grid = p[:, 1:].reshape(1, 37, 37, -1).permute(0, 3, 1, 2)
        grid = F.interpolate(grid, scale_factor=((n + 0.1) / 37, (n + 0.1) / 37), mode="bicubic")
        return torch.cat([p[:, :1], grid.permute(0, 2, 3, 1).reshape(1, n * n, -1)], 1)

    def features(self, image):
        """image:(B, 3, 224, 224)、値は 0〜1。DINOv2 の最後の LayerNorm の後の 257 個のトークン"""
        mean = torch.tensor([0.485, 0.456, 0.406], device=image.device).view(1, 3, 1, 1)    # ImageNet の平均と標準偏差
        std = torch.tensor([0.229, 0.224, 0.225], device=image.device).view(1, 3, 1, 1)
        x = self.patch_embed((image - mean) / std).flatten(2).transpose(1, 2)
        x = torch.cat([self.cls_token.expand(len(x), -1, -1), x], 1)
        x = x + self.pos(image.shape[-1] // 14).to(x.dtype)
        for blk in self.blocks:
            x = blk(x)
        return self.norm(x)

    def forward(self, image):
        return self.projector(self.features(image))                     # (B, 257, 1024):ID トークン
- DinoBlock: LayerNorm → 注意(24 ヘッド)→ LayerScale、LayerNorm → SwiGLU の FFN → LayerScale を、それぞれ残差に足す層です。LayerScale は、各層の出力にチャンネルごとの係数をかけて、深い層の学習を安定させます。SwiGLU は、1 つの行列でゲートと値の 2 つを作り、silu(ゲート) × 値 を次の行列にかけます。
- pos: DINOv2 の位置の埋め込みは 518×518(37×37 パッチ)の画像で学習されているので、224×224(16×16 パッチ)に合わせて双三次補間で縮めます。公式と同じく、倍率に 0.1 を足して、丸めで 15 になるのを避けます。
- projector: 1536 次元を、Stable Diffusion 2.1 のテキストの埋め込みと同じ 1024 次元にします。AnyDoor で学習した唯一の ID Extractor の部品です。
U-Net:Stable Diffusion 2.1
class GN32(nn.GroupNorm):
    """Stable Diffusion の GroupNorm:入力を float32 にして正規化し、元の型に戻す"""
    def forward(self, x):
        return super().forward(x.float()).type(x.dtype)


def timestep_embedding(t, dim=320):
    """拡散のステップ t を、周期の違う cos と sin の並びにする(Transformer の位置の埋め込みと同じ考え方)"""
    half = dim // 2
    freqs = torch.exp(-math.log(10000) * torch.arange(half, dtype=torch.float32, device=t.device) / half)
    args = t[:, None].float() * freqs[None]
    return torch.cat([torch.cos(args), torch.sin(args)], -1)


class ResBlock(nn.Module):
    """GroupNorm → SiLU → 3×3 畳み込みを 2 回。間で、ステップ t の埋め込みをチャンネルごとに足す"""
    def __init__(self, cin, cout, temb=1280):
        super().__init__()
        self.in_layers = nn.Sequential(GN32(32, cin), nn.SiLU(), nn.Conv2d(cin, cout, 3, padding=1))
        self.emb_layers = nn.Sequential(nn.SiLU(), nn.Linear(temb, cout))
        self.out_layers = nn.Sequential(GN32(32, cout), nn.SiLU(), nn.Dropout(0.0), nn.Conv2d(cout, cout, 3, padding=1))
        self.skip_connection = nn.Conv2d(cin, cout, 1) if cin != cout else nn.Identity()

    def forward(self, x, emb, ctx=None):
        h = self.in_layers(x) + self.emb_layers(emb)[:, :, None, None]
        return self.skip_connection(x) + self.out_layers(h)


class Attention(nn.Module):
    """マルチヘッド注意。ctx を渡すとクロス注意(キーとバリューを ctx から作る)"""
    def __init__(self, d, ctx_dim=None, head_dim=64):
        super().__init__()
        self.heads = d // head_dim
        self.to_q = nn.Linear(d, d, bias=False)
        self.to_k = nn.Linear(ctx_dim or d, d, bias=False)
        self.to_v = nn.Linear(ctx_dim or d, d, bias=False)
        self.to_out = nn.Sequential(nn.Linear(d, d), nn.Dropout(0.0))

    def forward(self, x, ctx=None):
        ctx = x if ctx is None else ctx
        B, N, D = x.shape
        q, k, v = (t.reshape(B, -1, self.heads, D // self.heads).transpose(1, 2) for t in (self.to_q(x), self.to_k(ctx), self.to_v(ctx)))
        a = F.scaled_dot_product_attention(q, k, v)
        return self.to_out(a.transpose(1, 2).reshape(B, N, D))


class SpatialTransformer(nn.Module):
    """特徴マップの各位置を 1 つのトークンにして、自己注意 → ID トークンへのクロス注意 → GEGLU の FFN をかけ、元の形に戻して足す"""
    def __init__(self, c, ctx_dim=1024):
        super().__init__()
        self.norm = nn.GroupNorm(32, c, eps=1e-6)
        self.proj_in, self.proj_out = nn.Linear(c, c), nn.Linear(c, c)
        self.norm1, self.norm2, self.norm3 = nn.LayerNorm(c), nn.LayerNorm(c), nn.LayerNorm(c)
        self.attn1, self.attn2 = Attention(c), Attention(c, ctx_dim)
        self.ff_proj, self.ff_out = nn.Linear(c, 8 * c), nn.Linear(4 * c, c)

    def forward(self, x, emb, ctx):
        B, C, H, W = x.shape
        h = self.proj_in(self.norm(x).permute(0, 2, 3, 1).reshape(B, H * W, C))
        h = h + self.attn1(self.norm1(h))
        h = h + self.attn2(self.norm2(h), ctx)                       # ID トークンを見る
        a, g = self.ff_proj(self.norm3(h)).chunk(2, dim=-1)
        h = h + self.ff_out(a * F.gelu(g))
        return x + self.proj_out(h).reshape(B, H, W, C).permute(0, 3, 1, 2)


class Down(nn.Module):
    def __init__(self, c):
        super().__init__()
        self.op = nn.Conv2d(c, c, 3, stride=2, padding=1)

    def forward(self, x, emb=None, ctx=None):
        return self.op(x)


class Up(nn.Module):
    def __init__(self, c):
        super().__init__()
        self.conv = nn.Conv2d(c, c, 3, padding=1)

    def forward(self, x, emb=None, ctx=None):
        return self.conv(F.interpolate(x, scale_factor=2, mode="nearest"))


class Seq(nn.ModuleList):
    """ResBlock・SpatialTransformer・Down/Up を順に通す(どれも (x, emb, ctx) を受け取る)"""
    def forward(self, x, emb, ctx):
        for m in self:
            x = m(x, emb, ctx) if not isinstance(m, nn.Conv2d) else m(x)
        return x


CH, MULT = 320, (1, 2, 4, 4)        # Stable Diffusion 2.1:64×64 → 32 → 16 → 8、注意は最初の 3 段と中間


def encoder_blocks():
    """U-Net のエンコーダ(12 ブロック)と中間ブロック。Detail Extractor も同じ形を使う"""
    blocks, chans, ch = [Seq([nn.Conv2d(4, CH, 3, padding=1)])], [CH], CH
    for lv, m in enumerate(MULT):
        for _ in range(2):
            layers = [ResBlock(ch, CH * m)]
            ch = CH * m
            if lv < 3:
                layers.append(SpatialTransformer(ch))
            blocks.append(Seq(layers)); chans.append(ch)
        if lv < 3:
            blocks.append(Seq([Down(ch)])); chans.append(ch)
    middle = Seq([ResBlock(ch, ch), SpatialTransformer(ch), ResBlock(ch, ch)])
    return nn.ModuleList(blocks), middle, chans


class UNet(nn.Module):
    """Stable Diffusion 2.1 の U-Net。Detail Extractor の 13 個の出力を、中間の出力と、デコーダに渡すスキップ接続に足す"""
    def __init__(self):
        super().__init__()
        self.time_embed = nn.Sequential(nn.Linear(CH, 4 * CH), nn.SiLU(), nn.Linear(4 * CH, 4 * CH))
        self.input_blocks, self.middle_block, chans = encoder_blocks()
        out, ch = [], CH * MULT[-1]
        for lv, m in reversed(list(enumerate(MULT))):
            for i in range(3):
                layers = [ResBlock(ch + chans.pop(), CH * m)]
                ch = CH * m
                if lv < 3:
                    layers.append(SpatialTransformer(ch))
                if lv > 0 and i == 2:
                    layers.append(Up(ch))
                out.append(Seq(layers))
        self.output_blocks = nn.ModuleList(out)
        self.out = nn.Sequential(GN32(32, CH), nn.SiLU(), nn.Conv2d(CH, 4, 3, padding=1))

    def forward(self, x, t, ctx, control=None):
        emb = self.time_embed(timestep_embedding(t))
        hs, h = [], x
        for blk in self.input_blocks:
            h = blk(h, emb, ctx)
            hs.append(h)
        h = self.middle_block(h, emb, ctx)
        control = list(control) if control is not None else None
        if control is not None:
            h = h + control.pop()
        for blk in self.output_blocks:
            skip = hs.pop()
            if control is not None:
                skip = skip + control.pop()                          # 詳細の特徴は、スキップ接続に足してから連結する
            h = blk(torch.cat([h, skip], 1), emb, ctx)
        return self.out(h)
- ResBlock: GroupNorm・SiLU・3×3 の畳み込みを 2 回通し、間でステップ t の埋め込みをチャンネルごとに足します。GroupNorm は、半精度でも安定するよう float32 で計算します。
- SpatialTransformer: 特徴マップの各位置を 1 つのトークンにして、自己注意・ID トークンへのクロス注意・GEGLU の FFN を通します。Stable Diffusion 2 と同じく、入口と出口に 1×1 の畳み込みの代わりに線形層を使います。
- encoder_blocks: 64×64 → 32 → 16 → 8 と縮めるエンコーダ(12 ブロック)と中間ブロックです。Detail Extractor も同じ関数で作ります。
- UNet.forward: エンコーダの各ブロックの出力を取っておき、デコーダで逆の順に連結します。control(Detail Extractor の 13 個の出力)があれば、中間の出力と、連結する前のスキップ接続に足します。
Detail Extractor
class DetailExtractor(nn.Module):
    """Detail Extractor(ControlNet の形):コラージュ(HF マップ+マスク、4 チャンネル・512×512)を 64×64 に縮め、
    U-Net のエンコーダと同じ形のネットワークに通して、各段の特徴を 1×1 のゼロ畳み込みで 13 個出す"""
    def __init__(self):
        super().__init__()
        self.time_embed = nn.Sequential(nn.Linear(CH, 4 * CH), nn.SiLU(), nn.Linear(4 * CH, 4 * CH))
        convs = []
        for cin, cout, s in [(4, 16, 1), (16, 16, 1), (16, 32, 2), (32, 32, 1), (32, 96, 2), (96, 96, 1), (96, 256, 2)]:
            convs += [nn.Conv2d(cin, cout, 3, stride=s, padding=1), nn.SiLU()]
        self.input_hint_block = nn.Sequential(*convs, nn.Conv2d(256, CH, 3, padding=1))   # 512 → 64(8 分の 1)
        self.input_blocks, self.middle_block, chans = encoder_blocks()
        self.zero_convs = nn.ModuleList([nn.Conv2d(c, c, 1) for c in chans])
        self.middle_block_out = nn.Conv2d(chans[-1], chans[-1], 1)

    def forward(self, hint, t, ctx):
        emb = self.time_embed(timestep_embedding(t))
        # AnyDoor の実装では、ノイズの入った潜在は入れず(最初のブロックの畳み込みは使わない)、コラージュだけから特徴を作る
        h = self.input_hint_block(hint)
        outs = [self.zero_convs[0](h)]
        for blk, zc in zip(self.input_blocks[1:], self.zero_convs[1:]):
            h = blk(h, emb, ctx)
            outs.append(zc(h))
        outs.append(self.middle_block_out(self.middle_block(h, emb, ctx)))
        return outs                              # 13 個(エンコーダの 12 ブロック+中間)
- input_hint_block: コラージュ(512×512×4)を、8 つの 3×3 の畳み込みで 64×64×320 にします。ストライド 2 の畳み込みが 3 つあり、512 → 256 → 128 → 64 と縮めます。
- 出力: U-Net のエンコーダと同じ形の 12 ブロックと中間ブロックの出力を、1×1 の畳み込み(zero_convs)に通して 13 個出します。学習の始めはこの畳み込みの重みが 0 なので、Detail Extractor を加えても U-Net の出力は変わらず、学習済みの Stable Diffusion を壊さずに学習を始められます。
- ノイズの入った潜在を使わない: 公式の実装に合わせて、input_blocks[0](潜在の畳み込み)は通さず、コラージュから作った特徴だけを使います。重みを読み込めるよう、部品は作っておきます。
VAE
def swish(x):
    return x * torch.sigmoid(x)


class VResBlock(nn.Module):
    def __init__(self, cin, cout):
        super().__init__()
        self.norm1, self.conv1 = nn.GroupNorm(32, cin, eps=1e-6), nn.Conv2d(cin, cout, 3, padding=1)
        self.norm2, self.conv2 = nn.GroupNorm(32, cout, eps=1e-6), nn.Conv2d(cout, cout, 3, padding=1)
        self.nin_shortcut = nn.Conv2d(cin, cout, 1) if cin != cout else None

    def forward(self, x):
        h = self.conv2(swish(self.norm2(self.conv1(swish(self.norm1(x))))))
        return (x if self.nin_shortcut is None else self.nin_shortcut(x)) + h


class VAttn(nn.Module):
    def __init__(self, c):
        super().__init__()
        self.norm = nn.GroupNorm(32, c, eps=1e-6)
        self.q, self.k, self.v, self.proj_out = (nn.Conv2d(c, c, 1) for _ in range(4))

    def forward(self, x):
        B, C, H, W = x.shape
        h = self.norm(x)
        q, k, v = (f(h).reshape(B, 1, C, H * W).transpose(2, 3) for f in (self.q, self.k, self.v))
        a = F.scaled_dot_product_attention(q, k, v).transpose(2, 3).reshape(B, C, H, W)
        return x + self.proj_out(a)


VCH, VMULT = 128, (1, 2, 4, 4)       # Stable Diffusion の VAE:512×512×3 ⇄ 64×64×4


class VAE(nn.Module):
    """Stable Diffusion の VAE。エンコーダは学習(実験5)で正解の画像を潜在にするとき、デコーダは生成した潜在を画像に戻すときに使う"""
    def __init__(self):
        super().__init__()
        enc = nn.Module()
        enc.conv_in, enc.down, cin = nn.Conv2d(3, VCH, 3, padding=1), nn.ModuleList(), VCH
        for i, m in enumerate(VMULT):
            lv = nn.Module()
            lv.block = nn.ModuleList([VResBlock(cin if j == 0 else VCH * m, VCH * m) for j in range(2)])
            cin = VCH * m
            if i < 3:
                lv.downsample = nn.Module(); lv.downsample.conv = nn.Conv2d(cin, cin, 3, stride=2)
            enc.down.append(lv)
        enc.mid = nn.Module()
        enc.mid.block_1, enc.mid.attn_1, enc.mid.block_2 = VResBlock(cin, cin), VAttn(cin), VResBlock(cin, cin)
        enc.norm_out, enc.conv_out = nn.GroupNorm(32, cin, eps=1e-6), nn.Conv2d(cin, 8, 3, padding=1)
        dec = nn.Module()
        dec.conv_in = nn.Conv2d(4, cin, 3, padding=1)
        dec.mid = nn.Module()
        dec.mid.block_1, dec.mid.attn_1, dec.mid.block_2 = VResBlock(cin, cin), VAttn(cin), VResBlock(cin, cin)
        levels = {}
        for i in reversed(range(4)):
            lv = nn.Module()
            lv.block = nn.ModuleList([VResBlock(cin if j == 0 else VCH * VMULT[i], VCH * VMULT[i]) for j in range(3)])
            cin = VCH * VMULT[i]
            if i > 0:
                lv.upsample = nn.Module(); lv.upsample.conv = nn.Conv2d(cin, cin, 3, padding=1)
            levels[i] = lv
        dec.up = nn.ModuleList([levels[i] for i in range(4)])
        dec.norm_out, dec.conv_out = nn.GroupNorm(32, cin, eps=1e-6), nn.Conv2d(cin, 3, 3, padding=1)
        self.encoder, self.decoder = enc, dec
        self.quant_conv, self.post_quant_conv = nn.Conv2d(8, 8, 1), nn.Conv2d(4, 4, 1)

    def encode(self, x, sample=True):
        """画像(−1〜1)→ 潜在の平均と分散 → 1 つ取り出して 0.18215 倍する(Stable Diffusion の潜在の大きさにそろえる係数)"""
        e = self.encoder
        h = e.conv_in(x)
        for i, lv in enumerate(e.down):
            for blk in lv.block:
                h = blk(h)
            if i < 3:
                h = lv.downsample.conv(F.pad(h, (0, 1, 0, 1)))
        h = e.mid.block_2(e.mid.attn_1(e.mid.block_1(h)))
        mean, logvar = self.quant_conv(e.conv_out(swish(e.norm_out(h)))).chunk(2, dim=1)
        z = mean + torch.exp(0.5 * logvar.clamp(-30, 20)) * torch.randn_like(mean) if sample else mean
        return z * 0.18215

    def decode(self, z):
        d = self.decoder
        h = d.conv_in(self.post_quant_conv(z / 0.18215))
        h = d.mid.block_2(d.mid.attn_1(d.mid.block_1(h)))
        for i in reversed(range(4)):
            for blk in d.up[i].block:
                h = blk(h)
            if i > 0:
                h = d.up[i].upsample.conv(F.interpolate(h, scale_factor=2.0, mode="nearest"))
        return d.conv_out(swish(d.norm_out(h)))
- encode: 画像を 3 回縮めて 64×64 にし、潜在の平均と分散を出して、そこから 1 つ取り出します。0.18215 は、Stable Diffusion の学習で潜在の分散がおよそ 1 になるように決められた係数です。実験5の学習で、正解の画像を潜在にするときに使います。
- decode: 潜在を、最近傍補間と畳み込みで 3 回大きくして 512×512 の画像に戻します。
モデル全体と生成
# 拡散の 1,000 ステップのノイズの量(Stable Diffusion と同じ linear のスケジュール)。ᾱ_t = 元の潜在が残る割合(の 2 乗)
BETAS = torch.linspace(0.00085 ** 0.5, 0.012 ** 0.5, 1000, dtype=torch.float64) ** 2
ALPHAS_CUMPROD = torch.cumprod(1 - BETAS, 0).float()


class AnyDoor(nn.Module):
    def __init__(self):
        super().__init__()
        self.id, self.control, self.unet, self.vae = IDExtractor(), DetailExtractor(), UNet(), VAE()

    def eps(self, x, t, ctx, hint):
        """ノイズの入った潜在 x から、入っているノイズを予測する。ctx は ID トークン、hint はコラージュ"""
        return self.unet(x, t, ctx, control=self.control(hint, t, ctx))

    @torch.no_grad()
    def sample(self, ref, hint, x_T, guidance=5.0, steps=50, ctx=None, uncond=None):
        """DDIM(eta 0)で、x_T から 50 ステップでノイズを取り除く。
        CFG:条件なし側は ID トークンだけを「黒い画像の DINOv2 トークン」にし、コラージュは同じものを使う(公式と同じ)"""
        ctx = self.id(ref) if ctx is None else ctx
        uncond = self.id(torch.zeros_like(ref)) if uncond is None else uncond
        ts = torch.arange(0, 1000, 1000 // steps, device=x_T.device) + 1             # 1, 21, …, 981
        ac = ALPHAS_CUMPROD.to(x_T.device)
        a_all, a_prev_all = ac[ts], torch.cat([ac[:1], ac[ts[:-1]]])
        x = x_T
        for i in reversed(range(len(ts))):
            t = ts[i].repeat(2)
            e_c, e_u = self.eps(torch.cat([x, x]), t, torch.cat([ctx, uncond]), torch.cat([hint, hint])).chunk(2)
            e = e_u + guidance * (e_c - e_u)
            a, a_prev = a_all[i], a_prev_all[i]
            x0 = (x - (1 - a).sqrt() * e) / a.sqrt()                                   # いまの予測から、ノイズのない潜在を推定
            x = a_prev.sqrt() * x0 + (1 - a_prev).sqrt() * e                           # 1 つ前のステップへ(決定的に進む)
        return x

    @torch.no_grad()
    def to_image(self, z):
        """潜在 → 0〜255 の画像(512×512×3)"""
        x = self.vae.decode(z.float())
        return np.clip(x[0].permute(1, 2, 0).float().cpu().numpy() * 127.5 + 127.5, 0, 255)


def to_tensor(item):
    """前処理の結果を、モデルに入れる形 (1, C, H, W) にする"""
    ref = torch.from_numpy(item["ref"]).float().permute(2, 0, 1)[None].to(device)
    hint = torch.from_numpy(item["hint"]).float().permute(2, 0, 1)[None].to(device)
    return ref, hint


def insert(model, ref_image, ref_mask, tar_image, tar_mask, crop_ratio=2.0, guidance=5.0, seed=0, collage_mode="hf",
           no_id=False, dtype=torch.bfloat16):
    """参照の物体を、対象の画像のマスクの位置に入れる。前処理 → 生成 → 元の画像に貼る"""
    item = prepare(ref_image, ref_mask, tar_image, tar_mask, crop_ratio, collage_mode)
    ref, hint = to_tensor(item)
    x_T = torch.randn((1, 4, 64, 64), generator=torch.Generator(device).manual_seed(seed), device=device)
    with torch.autocast("cuda", dtype=dtype, enabled=dtype != torch.float32):
        ctx = model.id(torch.zeros_like(ref)) if no_id else None
        z = model.sample(ref, hint, x_T, guidance=guidance, ctx=ctx)
    pred = model.to_image(z)[1:]                                   # 公式と同じく 1 行目を落とす
    return paste_back(pred, tar_image, item["sizes"], item["crop"]), item
- ALPHAS_CUMPROD: 1,000 ステップの各ステップで、元の潜在がどれだけ残っているか(ᾱ_t)です。Stable Diffusion と同じ、β の平方根を 0.00085 から 0.012 まで等間隔にしたスケジュールから計算します。
- sample: DDIM で、ステップ 981, 961, …, 1 の 50 回でノイズを取り除きます。各回で、条件ありと条件なしの 2 つのノイズの予測を 1 回の計算(バッチ 2)で求め、CFG で混ぜます。条件なし側は、ID トークンだけを黒い画像(すべて 0)の DINOv2 のトークンにし、コラージュは同じものを使います(公式と同じ)。
- insert: 前処理・生成・貼り戻しをまとめた関数です。実験3以降で、条件を変えて使います。no_id=True は ID トークンを条件なしと同じにし、collage_mode はコラージュに貼るものを変えます。速さのため、bfloat16 で計算します。
- 1 行目を落とす: 公式のコードは、生成した画像の 1 行目を落としてから元の大きさに戻すので、同じにしています。
学習済みの重みを読み込む
CKPT = hf_hub_download("xichenhku/AnyDoor_models", "general_v0.1/general_v0.1.ckpt")   # 約 9.8GB、float32


def load_anydoor(model, path=CKPT):
    """公式の重み(PyTorch Lightning の state_dict)の名前を付け替えて、そのまま割り当てる"""
    sd = torch.load(path, map_location="cpu", mmap=True, weights_only=False)["state_dict"]
    out = {}
    for k, v in sd.items():
        for a, b in [("cond_stage_model.model.", "id."), ("cond_stage_model.projector.", "id.projector."),
                     ("control_model.", "control."), ("model.diffusion_model.", "unet."), ("first_stage_model.", "vae.")]:
            if k.startswith(a):
                k = b + k[len(a):]
                break
        else:
            continue                                                       # 拡散のスケジュールの値は自分で計算する
        if k == "id.mask_token":
            continue                                                       # DINOv2 の学習でだけ使う
        for a, b in [("attn.qkv", "qkv"), ("attn.proj", "proj"), ("mlp.w12", "w12"), ("mlp.w3", "w3"), (".ls1.gamma", ".ls1"),
                     (".ls2.gamma", ".ls2"), ("patch_embed.proj.", "patch_embed."), ("transformer_blocks.0.", ""),
                     ("ff.net.0.proj", "ff_proj"), ("ff.net.2", "ff_out"), ("middle_block_out.0.", "middle_block_out.")]:
            k = k.replace(a, b)
        k = re.sub(r"zero_convs\.(\d+)\.0\.", r"zero_convs.\1.", k)
        out[k] = v
    missing, unexpected = model.load_state_dict(out, strict=False, assign=True)
    assert not missing and not unexpected, (missing[:5], unexpected[:5])
    return model


with torch.device("meta"):
    model = AnyDoor()
model = load_anydoor(model).to(device).eval()
n = lambda m: sum(p.numel() for p in m.parameters())
print(f"ID Extractor(DINOv2 ViT-g/14): {n(model.id) - n(model.id.projector):>13,}")
print(f"  射影(1536 → 1024)           : {n(model.id.projector):>13,}")
print(f"Detail Extractor               : {n(model.control):>13,}")
print(f"U-Net                          : {n(model.unet):>13,}")
print(f"VAE                            : {n(model.vae):>13,}")
print(f"全体                           : {n(model):>13,}")
公式の重みは、PyTorch Lightning のモデル(ControlLDM)の state_dict です。名前の先頭(cond_stage_model・control_model・model.diffusion_model・first_stage_model)を部品の名前に付け替え、細かな名前の違いを直して、同じテンソルを割り当てます(assign=True)。mmap=True で読むので、9.8GB のファイルをメモリに全部載せずに済みます。
実行結果
ID Extractor(DINOv2 ViT-g/14): 1,136,479,232
  射影(1536 → 1024)           :     1,573,888
Detail Extractor               :   364,228,384
U-Net                          :   865,910,724
VAE                            :    83,653,863
全体                           : 2,451,846,091
- 大きさ: 全体で約 24.5 億パラメータです。最も大きいのは ID Extractor の DINOv2(約 11.4 億)で、U-Net(約 8.7 億)より大きくなっています。
- Detail Extractor: 約 3.6 億パラメータで、U-Net のエンコーダと中間ブロックを写した形なので、U-Net の 4 割ほどの大きさです。
- AnyDoor で学習した部品: 公式の学習で更新したのは、Detail Extractor・U-Net のデコーダ・射影(約 160 万)です。DINOv2・U-Net のエンコーダ・VAE は、元の重みのままです(実験2で DINOv2 について確かめます)。
実験2:公式の実装と比べる
実験1で保存した値と、スクラッチ実装の各部品の出力を比べます。
# float32 で、公式の実装(実験1で保存した値)と比べる。TF32 も使わない
torch.backends.cuda.matmul.allow_tf32 = False
torch.backends.cudnn.allow_tf32 = False
r = np.load("of_exp1.npz")
ref, hint = to_tensor(item)
x_T = torch.from_numpy(r["x_T"]).to(device)
t = torch.tensor([981], device=device)


def diff(a, b):
    b = torch.as_tensor(b).to(device)
    return f"差の最大値 {(a.float() - b.float()).abs().max().item():.1e}(値の絶対値の最大 {b.abs().max().item():.1f})"


with torch.no_grad():
    ctx, uncond = model.id(ref), model.id(torch.zeros_like(ref))
    outs = model.control(hint, t, ctx)
    eps = model.eps(x_T, t, ctx, hint)
    torch.cuda.synchronize(); t0 = time.time()
    z = model.sample(ref, hint, x_T, guidance=5.0)
    torch.cuda.synchronize(); elapsed = time.time() - t0
    x = model.vae.decode(z)
pred = np.clip(x[0].permute(1, 2, 0).cpu().numpy() * 127.5 + 127.5, 0, 255)[1:]
gen = paste_back(pred, tar_image, item["sizes"], item["crop"])
print("ID トークン(257 × 1024)       :", diff(ctx, r["id_tokens"]))
print("条件なしの ID トークン          :", diff(uncond, r["un_tokens"]))
print("Detail Extractor の 13 個の出力:", diff(torch.cat([o.flatten() for o in outs]), r["outs"]))
print("U-Net が予測したノイズ(t=981) :", diff(eps, r["eps"]))
print("50 ステップ後の潜在             :", diff(z, r["samples"]))
print("元の画像に貼った結果(0〜255)  :", f"差の最大値 {np.abs(gen.astype(np.float32) - r['gen'].astype(np.float32)).max():.2f}、"
      f"平均 {np.abs(gen.astype(np.float32) - r['gen'].astype(np.float32)).mean():.4f}")
print(f"生成の時間(float32・条件あり/なしを 1 回にまとめて計算):{elapsed:.1f} 秒")

fig, ax = plt.subplots(1, 3, figsize=(15, 5))
for a, (im, title) in zip(ax, [(ref_image, "参照(orange.jpg)"), (tar_image, "対象(apple.jpg)と入れる場所"), (gen, "スクラッチ実装の結果")]):
    a.imshow(im.astype(np.uint8)); a.set_title(title); a.axis("off")
ax[1].add_patch(plt.Rectangle((410, 290), 240, 245, fill=False, color="red", lw=2))
plt.show()
- float32: bfloat16 や TF32 では、丸めの誤差で比べられないので、float32 で計算します。
- 同じ入力: 最初のノイズ x_T は、実験1で保存したものを使います。DDIM(eta 0)は決定的なので、入力と計算が同じなら、最後の画像も同じになります。
実行結果
ID トークン(257 × 1024)       : 差の最大値 0.0e+00(値の絶対値の最大 3.8)
条件なしの ID トークン          : 差の最大値 0.0e+00(値の絶対値の最大 3.8)
Detail Extractor の 13 個の出力: 差の最大値 1.4e-04(値の絶対値の最大 41.4)
U-Net が予測したノイズ(t=981) : 差の最大値 1.4e-06(値の絶対値の最大 4.3)
50 ステップ後の潜在             : 差の最大値 8.1e-05(値の絶対値の最大 7.6)
元の画像に貼った結果(0〜255)  : 差の最大値 1.00、平均 0.0000
生成の時間(float32・条件あり/なしを 1 回にまとめて計算):6.7 秒
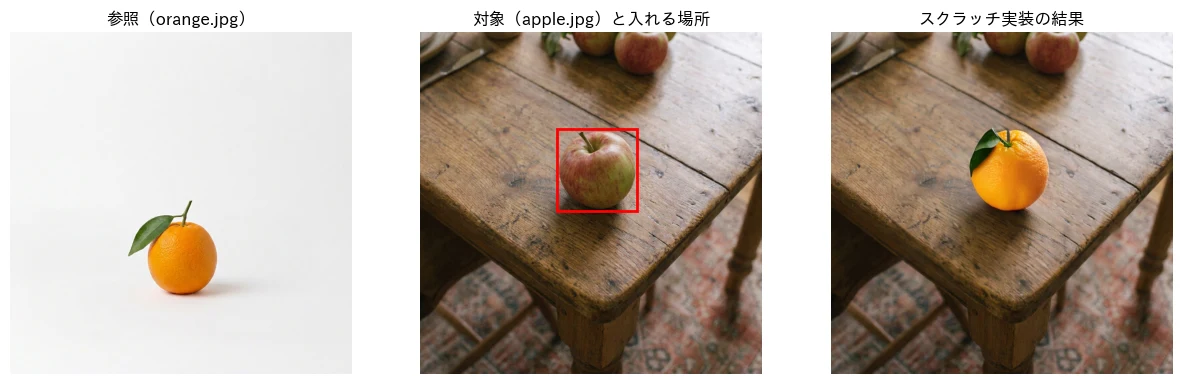
- ID トークン: 条件あり・条件なし(黒い画像)とも、公式と完全に一致しました。
- Detail Extractor と U-Net: 差の最大値は、Detail Extractor の出力で 1.4e-4(値の最大 41)、U-Net が予測したノイズで 1.4e-6 です。float32 の畳み込みの計算の順番の違いの範囲で、同じ計算をしていると言えます。
- 生成した画像: 50 ステップ後の潜在の差は最大 8.1e-5 で、元の画像に貼った結果は、0〜255 の画素の値で最大 1 階調の違い(四捨五入の境目)、平均はほぼ 0 でした。
- 時間: 6.7 秒で、公式(14.3 秒)の半分ほどです。条件ありと条件なしを 1 回の計算にまとめたためで、計算の中身は同じです。
続いて、AnyDoor の重みの中の DINOv2 が、Meta が公開した DINOv2 ViT-g/14 と同じかを確かめます。Hugging Face の facebook/dinov2-giant(Apache-2.0)と比べます。
# AnyDoor の重みの中の DINOv2 は、Meta が公開した DINOv2 ViT-g/14 のままか(学習中に固定されていたか)を確かめる
from safetensors.torch import load_file
hf = load_file(hf_hub_download("facebook/dinov2-giant", "model.safetensors"))      # Hugging Face の DINOv2(Apache-2.0)
pairs = {"クラストークン": (hf["embeddings.cls_token"], model.id.cls_token),
         "位置の埋め込み": (hf["embeddings.position_embeddings"], model.id.pos_embed),
         "パッチの埋め込み": (hf["embeddings.patch_embeddings.projection.weight"], model.id.patch_embed.weight),
         "最後の LayerNorm": (hf["layernorm.weight"], model.id.norm.weight)}
for i in [0, 20, 39]:
    a = f"encoder.layer.{i}."
    qkv = torch.cat([hf[a + f"attention.attention.{n}.weight"] for n in ["query", "key", "value"]])
    pairs[f"{i} 層目の注意(q, k, v)"] = (qkv, model.id.blocks[i].qkv.weight)
    pairs[f"{i} 層目の SwiGLU"] = (hf[a + "mlp.weights_in.weight"], model.id.blocks[i].w12.weight)
    pairs[f"{i} 層目の LayerScale"] = (hf[a + "layer_scale1.lambda1"], model.id.blocks[i].ls1)
for k, (a, b) in pairs.items():
    print(f"{k:<20} 差の最大値 {(a.to(device) - b.float()).abs().max().item():.1e}")
del hf
実行結果
クラストークン              差の最大値 0.0e+00
位置の埋め込み              差の最大値 0.0e+00
パッチの埋め込み             差の最大値 0.0e+00
最後の LayerNorm        差の最大値 0.0e+00
0 層目の注意(q, k, v)     差の最大値 0.0e+00
0 層目の SwiGLU         差の最大値 0.0e+00
0 層目の LayerScale     差の最大値 0.0e+00
20 層目の注意(q, k, v)    差の最大値 0.0e+00
20 層目の SwiGLU        差の最大値 0.0e+00
20 層目の LayerScale    差の最大値 0.0e+00
39 層目の注意(q, k, v)    差の最大値 0.0e+00
39 層目の SwiGLU        差の最大値 0.0e+00
39 層目の LayerScale    差の最大値 0.0e+00
クラストークン・位置の埋め込み・パッチの埋め込み・最後の LayerNorm と、0・20・39 層目の注意・SwiGLU・LayerScale の重みが、すべて差 0 で一致しました。AnyDoor の学習では DINOv2 を固定していて、重みの中の DINOv2 は、Meta が公開した DINOv2 ViT-g/14 そのものです。ID Extractor で学習したのは、1536 次元を 1024 次元にする射影だけです。
実験3:ID トークンと HF マップの役割
評価のデータ:DAVIS の動画
正解のある評価をするため、動画の物体のセグメンテーションのデータセット DAVIS 2017 を使います。同じ動画の 2 つのフレームから、一方の物体を参照にして、もう一方のフレームの同じ物体の位置に入れれば、そのフレーム自体が正解になります。AnyDoor の学習データの作り方と同じ組です。DAVIS は公式の学習データに入っていないので、学習で見ていない動画で評価できます。
# DAVIS 2017(動画の物体のセグメンテーション):学習用 60 本・評価用 30 本の動画と、各フレームの物体ごとのマスク
URL = "https://data.vision.ee.ethz.ch/csergi/share/davis/DAVIS-2017-trainval-480p.zip"
if not os.path.exists("DAVIS"):
    urllib.request.urlretrieve(URL, "davis.zip")
    zipfile.ZipFile("davis.zip").extractall(".")
ROOT = "DAVIS"
split = {s: open(f"{ROOT}/ImageSets/2017/{s}.txt").read().split() for s in ["train", "val"]}


def frames(video):
    return sorted(os.path.splitext(f)[0] for f in os.listdir(f"{ROOT}/JPEGImages/480p/{video}"))


def load(video, frame, obj):
    """フレームの画像(RGB)と、物体 obj のマスク(注釈の画像の値が obj の画素)"""
    image = cv2.cvtColor(cv2.imread(f"{ROOT}/JPEGImages/480p/{video}/{frame}.jpg"), cv2.COLOR_BGR2RGB)
    mask = (np.array(Image.open(f"{ROOT}/Annotations/480p/{video}/{frame}.png")) == obj).astype(np.uint8)
    return image, mask


def usable(mask):
    """公式の学習データと同じ条件:画像の 1% 以上 64% 以下の大きさで、9 割以上が 1 つのまとまり。
    箱の縦横の両方が画像の 1 割より小さくなく、1.1 倍に広げても縦横の両方が 8 割を超えない"""
    if not 0.01 <= mask.mean() <= 0.64:
        return False
    H, W = mask.shape
    y1, y2, x1, x2 = bbox(mask)
    if y2 - y1 < 0.1 * H and x2 - x1 < 0.1 * W:
        return False
    n, labels, stats, _ = cv2.connectedComponentsWithStats(mask)
    if stats[1:, cv2.CC_STAT_AREA].max() / mask.sum() < 0.9:
        return False
    y1, y2, x1, x2 = expand_box(mask.shape, bbox(mask), 1.1)
    return not (y2 - y1 > 0.8 * mask.shape[0] and x2 - x1 > 0.8 * mask.shape[1])


def eval_pair(video, obj=1):
    """評価の組:物体 1 が条件を満たす最初のフレームを参照、最後のフレームを正解にする(姿や向きの変化が最も大きくなる)"""
    ok = [f for f in frames(video) if usable(load(video, f, obj)[1])]
    if len(ok) < 2:
        return None
    return dict(video=video, ref=ok[0], tar=ok[-1], obj=obj)


EVAL = [p for p in (eval_pair(v) for v in split["val"]) if p is not None]
print(f"学習用 {len(split['train'])} 本・評価用 {len(split['val'])} 本の動画。評価の組 {len(EVAL)} 個")

# 図には、人が写っていない動画の組を使う
SHOW = [i for i, p in enumerate(EVAL) if p["video"] in ("blackswan", "camel", "car-roundabout", "cows", "dog", "goat")]
fig, ax = plt.subplots(2, 4, figsize=(16, 6.4))
for j, p in enumerate([EVAL[i] for i in SHOW[:4]]):
    for i, key in enumerate(["ref", "tar"]):
        img, m = load(p["video"], p[key], p["obj"])
        show = img.copy(); show[m == 0] = (show[m == 0] * 0.35).astype(np.uint8)
        ax[i, j].imshow(show); ax[i, j].axis("off")
        ax[i, j].set_title(f"{p['video']}・{'参照' if i == 0 else '正解'}(フレーム {int(p[key])})")
plt.show()
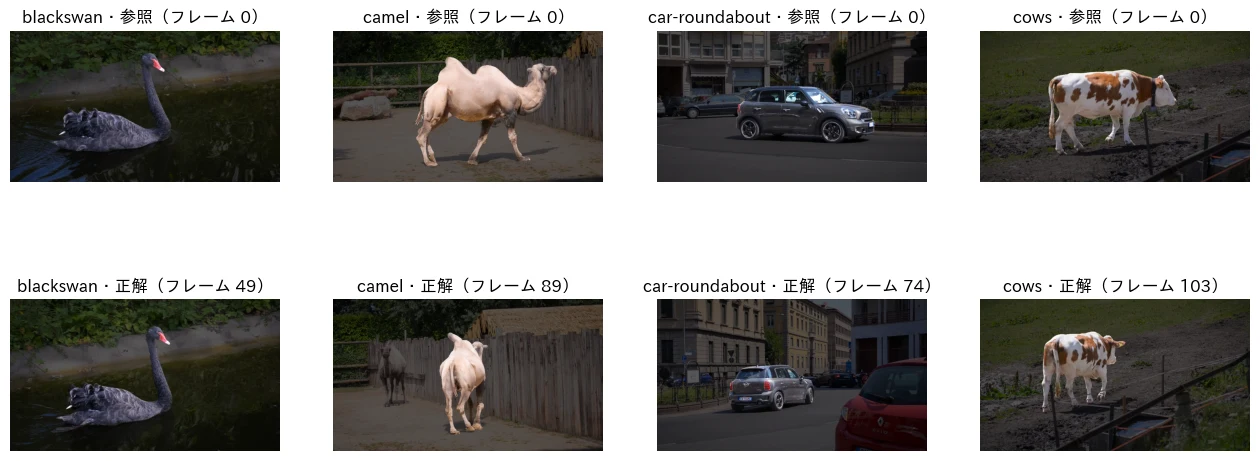
- 評価の組: 評価用の 30 本の動画で、物体 1 が条件を満たす最初のフレームを参照、最後のフレームを正解にします。動画の中で最も離れた 2 つのフレームなので、向きや姿の変化が大きくなります。
- usable: 公式の学習データの読み込みと同じ条件で、小さすぎる物体・大きすぎる物体・いくつにも分かれている物体(人に隠れているなど)を除きます。条件を満たすフレームが 2 つ以上ない動画は使いません。
- 図: 人が写っていない動画の組を表示します。
実行結果
学習用 60 本・評価用 30 本の動画。評価の組 28 個
条件を外して比べる
公式の設定と、ID トークンを外したとき、HF マップを外したとき、HF マップの代わりに元の色の画像を貼ったときを比べます。
CROP = 2.2          # 切り出しの広さ。公式は 1.5〜2.9 から乱数で選ぶので、条件どうしを比べられるよう中ほどの値に固定する


def dino_cls(img):
    """画像(0〜255、正方形)の DINOv2 のクラストークンを、長さ 1 にして返す(似ている度合いをコサイン類似度で測るため)"""
    x = torch.from_numpy(cv2.resize(img.astype(np.uint8), (224, 224))).float().permute(2, 0, 1)[None].to(device) / 255
    with torch.no_grad(), torch.autocast("cuda", dtype=torch.bfloat16):
        f = model.id.features(x)[:, 0].float()
    return F.normalize(f, dim=-1)[0]


def box_crop(img, mask):
    """マスクを囲む箱を 1.1 倍に広げて切り出し、白で正方形にする"""
    y1, y2, x1, x2 = expand_box(mask.shape, bbox(mask), 1.1)
    return pad_square(img[y1:y2, x1:x2], 255)


def evaluate(pairs=EVAL, keep=SHOW[0], **kw):
    """評価の組すべてで生成し、DINO スコアを測る。
    参照との類似度:生成した物体(正解の箱の位置を切り出す)と、参照の物体(背景を白にした 224×224)のコサイン類似度。論文の DINO スコア
    正解との類似度:生成した物体と、正解のフレームの同じ位置の切り出しのコサイン類似度"""
    s_ref, s_gt, shown = [], [], None
    for i, p in enumerate(pairs):
        ref_image, ref_mask = load(p["video"], p["ref"], p["obj"])
        tar_image, tar_mask = load(p["video"], p["tar"], p["obj"])
        gen, item = insert(model, ref_image, ref_mask, tar_image, tar_mask, crop_ratio=CROP, **kw)
        g = dino_cls(box_crop(gen, tar_mask))
        s_ref.append((g @ dino_cls(item["ref"] * 255)).item())
        s_gt.append((g @ dino_cls(box_crop(tar_image, tar_mask))).item())
        if i == keep:
            shown = gen
    return np.mean(s_ref), np.mean(s_gt), shown


# 比べる基準:本物の正解フレームの物体と、参照の物体の類似度(動画の中で姿が変わっても、同じ物体ならどれだけ似ているか)
base = []
for p in EVAL:
    ref_image, ref_mask = load(p["video"], p["ref"], p["obj"])
    tar_image, tar_mask = load(p["video"], p["tar"], p["obj"])
    item = prepare(ref_image, ref_mask, tar_image, tar_mask, CROP)
    base.append((dino_cls(box_crop(tar_image, tar_mask)) @ dino_cls(item["ref"] * 255)).item())
print(f"{'本物の正解フレーム':<22} 参照との類似度 {np.mean(base):.3f}")

CONFIGS = {"公式(ID トークン+HF マップ)": {}, "ID トークンなし": dict(no_id=True),
           "HF マップなし(マスクだけ)": dict(collage_mode="blank"), "HF マップの代わりに元の色": dict(collage_mode="rgb")}
results = {}
torch.cuda.synchronize(); t0 = time.time()
for name, kw in CONFIGS.items():
    a, b, im = evaluate(**kw)
    results[name] = im
    print(f"{name:<22} 参照との類似度 {a:.3f}  正解との類似度 {b:.3f}")
print(f"({len(EVAL)} 組 × {len(CONFIGS)} 通り、{time.time() - t0:.0f} 秒)")

p = EVAL[SHOW[0]]
ref_image, ref_mask = load(p["video"], p["ref"], p["obj"])
tar_image, tar_mask = load(p["video"], p["tar"], p["obj"])
fig, ax = plt.subplots(1, 6, figsize=(24, 4.2))
ax[0].imshow(ref_image); ax[0].set_title("参照のフレーム")
ax[1].imshow(tar_image); ax[1].set_title("正解のフレーム")
for a, (name, im) in zip(ax[2:], results.items()):
    a.imshow(im.astype(np.uint8)); a.set_title(name)
for a in ax:
    a.axis("off")
plt.show()
- DINO スコア: 2 つの画像の DINOv2 のクラストークンのコサイン類似度です。論文も、参照の物体と生成した物体の似ている度合いを、DINO スコアで測っています。「参照との類似度」は論文と同じ指標で、「正解との類似度」は、正解のフレームの同じ位置との類似度です。
- 比べる基準: 本物の正解のフレームの物体と、参照の物体の類似度も測ります。動画の中で姿が変わると、同じ物体でも類似度は 1 になりません。生成した物体がこの値に近ければ、本物と同じくらい参照に似ていると言えます。
- 切り出しの広さ: 公式の推論は 1.5〜2.9 倍から乱数で選びますが、条件どうしを比べられるよう、中ほどの 2.2 倍に固定します。乱数の種(最初のノイズ)も、すべての条件で同じ 0 にします。
- 注意点: DINO スコアの計算に、ID Extractor と同じ DINOv2 を使っています。ID トークンを使う条件が、少し有利に測られる可能性があります。
実行結果
本物の正解フレーム              参照との類似度 0.569
公式(ID トークン+HF マップ)     参照との類似度 0.649  正解との類似度 0.692
ID トークンなし              参照との類似度 0.132  正解との類似度 0.255
HF マップなし(マスクだけ)        参照との類似度 0.624  正解との類似度 0.687
HF マップの代わりに元の色         参照との類似度 0.750  正解との類似度 0.487
(28 組 × 4 通り、381 秒)
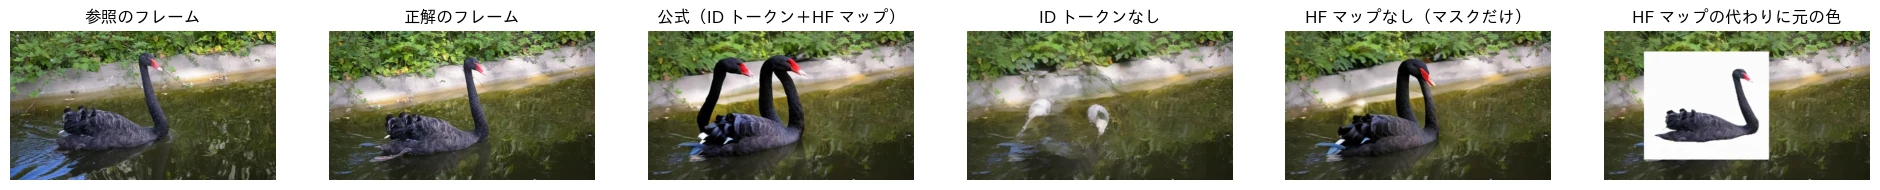
- 公式の設定: 参照との類似度は 0.649 で、本物の正解のフレーム(0.569)より高くなりました。動画の中では物体の向きや姿が変わりますが、AnyDoor は参照の見た目に寄せて描く傾向があります。図の黒鳥の例では、首が 2 本ある黒鳥を描いていて、形が崩れることもあります。
- ID トークンなし: 参照との類似度が 0.132 まで下がりました。図では、黒鳥の代わりに白っぽいぼやけた形が描かれています。HF マップ(模様)だけでは、何を描けばよいかが伝わりません。物体が「何であるか」は、ID トークンが伝えています。
- HF マップなし: 参照との類似度は 0.624 で、公式より 0.025 下がりました。DINO スコアはクラストークン(画像全体の特徴)で測るので、模様のような細部の違いは小さな差にしか現れません。図の例では、首が 1 本の黒鳥になりました。ただし 1 例なので、HF マップが首の崩れの原因かどうかは、この結果からは分かりません。
- HF マップの代わりに元の色: 参照との類似度は 0.750 で最も高い一方、正解との類似度は 0.487 で最も低くなりました。図では、参照の黒鳥が白い背景ごと貼り付けられ、正解の姿にも背景にもなじんでいません。論文が述べるとおり、参照をそのまま渡すとモデルはそれを写すだけになり、場所に合わせて描き直さなくなります。HF マップは、細部を伝えつつ写しにならないための表現です。
実験4:ガイダンスの強さ
CFG の強さを 1・3・5・9 に変えて比べます。公式のデモは「大きいほど参照に忠実に、小さいほど背景になじむ」と説明しています。
gens = {}
for g in [1.0, 3.0, 5.0, 9.0]:
    a, b, im = evaluate(guidance=g)
    gens[g] = im
    print(f"CFG {g:>3}:参照との類似度 {a:.3f}  正解との類似度 {b:.3f}")

fig, ax = plt.subplots(1, 4, figsize=(16, 4.2))
for a, (g, im) in zip(ax, gens.items()):
    a.imshow(im.astype(np.uint8)); a.set_title(f"CFG {g}"); a.axis("off")
plt.show()
実行結果
CFG 1.0:参照との類似度 0.471  正解との類似度 0.567
CFG 3.0:参照との類似度 0.630  正解との類似度 0.701
CFG 5.0:参照との類似度 0.649  正解との類似度 0.692
CFG 9.0:参照との類似度 0.642  正解との類似度 0.694
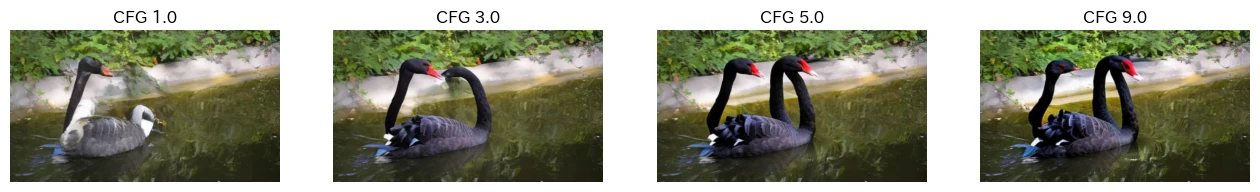
- CFG 1.0(ガイダンスなし): 参照との類似度は 0.471 と低く、図では灰色の白鳥のような鳥が描かれました。ID トークンの影響が弱く、参照の物体の色や形が伝わっていません。
- CFG 3.0〜9.0: 参照との類似度は 0.630〜0.649、正解との類似度は 0.692〜0.701 で、3.0 以上ではほとんど変わりませんでした。正解との類似度は 3.0 が最も高く、5.0(公式の値)は参照との類似度が最も高くなりました。
- 見た目: CFG を大きくするほど、黒鳥の黒と赤のくちばしがはっきりし、コントラストが強くなります。公式のデモの「大きいほど参照に忠実に、小さいほど背景になじむ」という説明のとおりの傾向ですが、数値では 3.0 から先の差は小さく、首が 2 本になる崩れは CFG では直りませんでした。
実験5:DAVIS の動画で追加学習する
最後に、DAVIS の学習用の 60 本の動画から作ったフレームの組で、Detail Extractor と ID トークンの射影を追加学習します。
| 項目 | 公式の学習 | 本記事の追加学習 |
|---|---|---|
| 学習する部品 | Detail Extractor・U-Net のデコーダ・ID トークンの射影 | Detail Extractor と ID トークンの射影だけ(U-Net のデコーダは固定。60 本の動画で U-Net の描く力を崩さないため) |
| 学習の出発点 | Stable Diffusion 2.1 と DINOv2(Detail Extractor は U-Net のエンコーダの写し) | 公開されている AnyDoor の重み(追加学習) |
| データ | 動画・画像など 10 種類以上のデータセット | DAVIS 2017 の学習用の動画 60 本(物体 144 個)から、フレームの組を毎回作る |
| バッチと回数 | GPU 2 枚 × 16 件 | 4 件 × 4,000 回(A100 の 40GB に収まる件数で、約 23 分) |
| 学習率 | 1e-5(AdamW) | 同じ |
| 計算の精度 | 16 ビットの混合精度 | bfloat16 の混合精度 |
| マスクの崩し | 7 割の確率で、対象のマスクをわざと崩す | しない(本記事の評価は箱のマスクだけを使うため) |
学習のデータを作る
def prepare_train(ref_image, ref_mask, tar_image, tar_mask, rng):
    """公式の学習の前処理(datasets/base.py の process_pairs)と同じ流れ。推論との違い:
    参照を広げる倍率(1.1〜1.4)と切り出しの広さ(1.3〜2.9)を毎回乱数で選び、参照に左右反転と明るさ・コントラストの変化を加える。
    正方形にするための余白のマスクは −1 にする"""
    y1, y2, x1, x2 = bbox(ref_mask)
    m3 = np.stack([ref_mask] * 3, -1)
    ref = (ref_image * m3 + 255 * (1 - m3))[y1:y2, x1:x2]
    rm = ref_mask[y1:y2, x1:x2]
    h, w = rm.shape
    r = rng.integers(11, 15) / 10
    H, W = int(h * r), int(w * r)
    pad = ((int((H - h) // 2), H - h - int((H - h) // 2)), (int((W - w) // 2), W - w - int((W - w) // 2)))
    ref, rm = np.pad(ref, pad + ((0, 0),), constant_values=255), np.pad(rm, pad, constant_values=0)
    ref = cv2.resize(pad_square(ref, 255).astype(np.uint8), (224, 224)).astype(np.uint8)
    rm = cv2.resize(pad_square(np.stack([rm] * 3, -1) * 255, 0).astype(np.uint8), (224, 224))[:, :, 0]
    if rng.random() < 0.5:                                     # 左右反転
        ref, rm = ref[:, ::-1].copy(), rm[:, ::-1].copy()
    if rng.random() < 0.5:                                     # 明るさとコントラストを ±20% の範囲で変える
        a, b = 1 + rng.uniform(-0.2, 0.2), rng.uniform(-0.2, 0.2) * 255
        ref = np.clip(ref.astype(np.float32) * a + b, 0, 255).astype(np.uint8)
    piece = hf_map(ref, rm / 255)

    box = expand_box(tar_mask.shape, bbox(tar_mask), 1.1)
    crop = to_square_box(tar_image.shape, expand_box(tar_image.shape, box, rng.integers(13, 30) / 10))
    cy1, cy2, cx1, cx2 = crop
    cropped = tar_image[cy1:cy2, cx1:cx2]
    y1, y2, x1, x2 = box[0] - cy1, box[1] - cy1, box[2] - cx1, box[3] - cx1
    collage = cropped.copy()
    collage[y1:y2, x1:x2] = cv2.resize(piece, (x2 - x1, y2 - y1))
    cmask = np.zeros(cropped.shape[:2], np.uint8)
    cmask[y1:y2, x1:x2] = 1
    cropped = cv2.resize(pad_square(cropped, 0).astype(np.uint8), (512, 512)).astype(np.float32)
    collage = cv2.resize(pad_square(collage, 0).astype(np.uint8), (512, 512)).astype(np.float32)
    cmask = cv2.resize(pad_square(cmask, 2), (512, 512), interpolation=cv2.INTER_NEAREST).astype(np.float32)
    cmask[cmask == 2] = -1
    hint = np.concatenate([collage / 127.5 - 1.0, cmask[:, :, None]], -1)
    return ref / 255, cropped / 127.5 - 1.0, hint


class DavisPairs(torch.utils.data.Dataset):
    """学習用の 60 本の動画から、同じ物体の 2 つのフレームを選んで、参照と正解の組を作る(公式の YouTube-VOS の読み込みと同じ選び方)"""
    def __init__(self, videos, n=100000):
        self.videos, self.n = videos, n
        self.frames = {v: frames(v) for v in videos}
        self.objs = {v: [int(o) for o in np.unique(np.array(Image.open(f"{ROOT}/Annotations/480p/{v}/{self.frames[v][0]}.png"))) if o > 0]
                     for v in videos}

    def __len__(self):
        return self.n

    def __getitem__(self, idx):
        rng = np.random.default_rng()
        while True:
            v = self.videos[rng.integers(len(self.videos))]
            fs, obj = self.frames[v], int(rng.choice(self.objs[v]))
            gap = len(fs) // 10                                    # 2 つのフレームは、動画の長さの 1 割以上離す
            s = rng.integers(0, len(fs) - gap)
            e = min(s + rng.integers(gap, len(fs) - s), len(fs) - 1)
            ref_image, ref_mask = load(v, fs[s], obj)
            tar_image, tar_mask = load(v, fs[e], obj)
            if usable(ref_mask) and usable(tar_mask):
                ref, jpg, hint = prepare_train(ref_image, ref_mask, tar_image, tar_mask, rng)
                # 拡散のステップ:30% は 0〜999、残りは 500〜999 から選ぶ(公式の動画のデータの選び方。形や姿を決める、ノイズの多いステップを多く学ぶ)
                t = rng.integers(0, 1000) if rng.random() < 0.3 else rng.integers(500, 1000)
                return (torch.from_numpy(ref).float().permute(2, 0, 1), torch.from_numpy(jpg).float().permute(2, 0, 1),
                        torch.from_numpy(hint).float().permute(2, 0, 1), torch.tensor(t))


train_set = DavisPairs(split["train"])
print(f"学習用の動画 {len(split['train'])} 本、物体 {sum(len(o) for o in train_set.objs.values())} 個")
ref, jpg, hint, t = train_set[0]
fig, ax = plt.subplots(1, 3, figsize=(12, 4))
ax[0].imshow(ref.permute(1, 2, 0)); ax[0].set_title("参照(学習の入力)")
ax[1].imshow((hint[:3].permute(1, 2, 0) + 1) / 2); ax[1].set_title("コラージュ")
ax[2].imshow((jpg.permute(1, 2, 0) + 1) / 2); ax[2].set_title(f"正解(t = {t.item()})")
for a in ax:
    a.axis("off")
plt.show()


def val_loss(n_t=5):
    """評価用の組で、決まったノイズとステップでのノイズの予測の誤差(学習の損失と同じ式)。学習の前後で同じ値を使って比べる"""
    losses = []
    g = torch.Generator(device).manual_seed(0)
    for p in EVAL:
        ref_image, ref_mask = load(p["video"], p["ref"], p["obj"])
        tar_image, tar_mask = load(p["video"], p["tar"], p["obj"])
        item = prepare(ref_image, ref_mask, tar_image, tar_mask, CROP)
        ref, hint = to_tensor(item)
        jpg = torch.from_numpy(item["jpg"]).float().permute(2, 0, 1)[None].to(device)
        with torch.no_grad(), torch.autocast("cuda", dtype=torch.bfloat16):
            z0 = model.vae.encode(jpg, sample=False)
            ctx = model.id(ref)
            for t in torch.linspace(100, 900, n_t).long().to(device):
                noise = torch.randn(z0.shape, generator=g, device=device)
                a = ALPHAS_CUMPROD.to(device)[t]
                xt = a.sqrt() * z0 + (1 - a).sqrt() * noise
                losses.append(F.mse_loss(model.eps(xt, t[None], ctx, hint).float(), noise).item())
    return np.mean(losses)
- prepare_train: 公式の学習の前処理と同じ流れです。参照を広げる倍率と切り出しの広さを毎回乱数で選び、参照の左右反転と明るさ・コントラストの変化を加えます。同じ参照からいろいろな入力を作り、限られた動画で多くの組を学ぶためです。公式は、さらに 7 割の確率で対象のマスクをわざと崩します(利用者の雑なマスクに対応するため)が、本記事は箱のマスクだけを使うので省いています。
- DavisPairs: 動画と物体をランダムに選び、動画の長さの 1 割以上離れた 2 つのフレームを参照と正解にします。公式の YouTube-VOS の読み込みと同じ選び方です。
- 拡散のステップ: 公式の動画のデータと同じく、30% は 0〜999、70% は 500〜999 から選びます。
- val_loss: 評価用の組で、決まったノイズと 5 つのステップ(100〜900)での、ノイズの予測の誤差です。学習の損失と同じ式で、学習の前後で同じ入力を使って比べます。
実行結果
学習用の動画 60 本、物体 144 個
学習する
# 学習する部品:Detail Extractor と ID トークンの射影(公式は U-Net のデコーダも学習するが、60 本の動画で U-Net の描く力を崩さないよう外す)
for p in model.parameters():
    p.requires_grad_(False)
params = list(model.control.parameters()) + list(model.id.projector.parameters())
for p in params:
    p.requires_grad_(True)
print(f"学習するパラメータ {sum(p.numel() for p in params):,} 個(全体の {sum(p.numel() for p in params) / n(model):.1%})")
opt = torch.optim.AdamW(params, lr=1e-5)                          # 公式の学習率
STEPS, BATCH = 4000, 4                                             # 4 件ずつ 4,000 回(A100 の 40GB に収まる件数で、約 23 分)
loader = torch.utils.data.DataLoader(train_set, batch_size=BATCH, num_workers=4)
before = val_loss()
print(f"学習前の評価用の損失 {before:.4f}")

model.control.train()
hist, t0 = [], time.time()
for step, (ref, jpg, hint, t) in enumerate(loader):
    if step == STEPS:
        break
    ref, jpg, hint, t = ref.to(device), jpg.to(device), hint.to(device), t.to(device)
    with torch.autocast("cuda", dtype=torch.bfloat16):
        with torch.no_grad():
            z0 = model.vae.encode(jpg)                              # 正解の画像を潜在にする(VAE は固定)
            feats = model.id.features(ref)                           # DINOv2 は固定
        ctx = model.id.projector(feats)
        noise = torch.randn_like(z0)
        a = ALPHAS_CUMPROD.to(device)[t].view(-1, 1, 1, 1)
        xt = a.sqrt() * z0 + (1 - a).sqrt() * noise                  # ステップ t のノイズを加える
        loss = F.mse_loss(model.eps(xt, t, ctx, hint).float(), noise)  # 加えたノイズを当てる
    opt.zero_grad(set_to_none=True)
    loss.backward()
    torch.nn.utils.clip_grad_norm_(params, 1.0)
    opt.step()
    hist.append(loss.item())
    if (step + 1) % 500 == 0:
        print(f"{step + 1:>5} 回:損失(直近 500 回の平均) {np.mean(hist[-500:]):.4f}  {time.time() - t0:.0f} 秒")
model.control.eval()
TRAIN_TIME = time.time() - t0
after = val_loss()
print(f"評価用の損失:学習前 {before:.4f} → 学習後 {after:.4f}(学習 {TRAIN_TIME / 60:.0f} 分、GPU のメモリの最大 {torch.cuda.max_memory_allocated() / 1e9:.1f}GB)")

plt.figure(figsize=(7, 3.5))
plt.plot(np.convolve(hist, np.ones(100) / 100, mode="valid"))
plt.xlabel("更新の回数"); plt.ylabel("損失(100 回の移動平均)"); plt.grid(alpha=0.3)
plt.show()
- 学習する部品: Detail Extractor と ID トークンの射影(約 3.7 億パラメータ)です。公式は U-Net のデコーダ(約 5.1 億パラメータ)も学習しますが、学習するパラメータが 2.4 倍になり、60 本の動画だけで Stable Diffusion の描く力を崩すおそれがあるので、物体の細部を伝える部品に絞ります。
- 学習率: 公式と同じ 1e-5 です。学習済みの重みから始めるので、大きな値では壊れやすくなります。
- 損失: 正解の潜在にステップ t のノイズを加え、モデルが予測したノイズとの二乗誤差をとります。Stable Diffusion の学習と同じ式です。
- bfloat16: 計算は bfloat16 で、学習する重みと Adam の状態は float32 のままにします。
- 回数: 4 件ずつ 4,000 回(1 万 6,000 組)で、A100 で約 23 分です。1 組ずつ参照と正解のフレーム・切り出しの広さ・拡散のステップが変わるので、同じ組はほぼ出てきません。
実行結果
学習するパラメータ 365,802,272 個(全体の 14.9%)
学習前の評価用の損失 0.0535
  500 回:損失(直近 500 回の平均) 0.0281  170 秒
 1000 回:損失(直近 500 回の平均) 0.0303  341 秒
 1500 回:損失(直近 500 回の平均) 0.0264  511 秒
 2000 回:損失(直近 500 回の平均) 0.0262  680 秒
 2500 回:損失(直近 500 回の平均) 0.0264  850 秒
 3000 回:損失(直近 500 回の平均) 0.0260  1019 秒
 3500 回:損失(直近 500 回の平均) 0.0247  1189 秒
 4000 回:損失(直近 500 回の平均) 0.0262  1359 秒
評価用の損失:学習前 0.0535 → 学習後 0.0541(学習 23 分、GPU のメモリの最大 22.6GB)
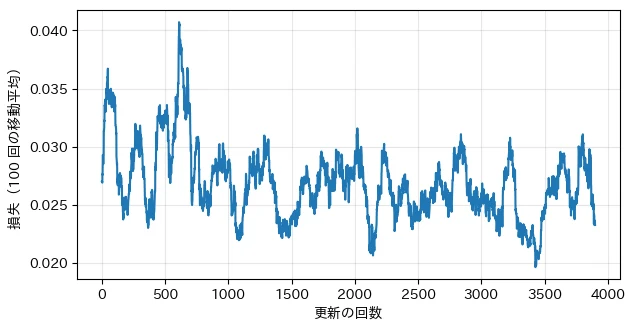
- 学習の損失: 0.025〜0.03 の間を上下するだけで、はっきりとは下がりませんでした。公式の重みは、すでに動画のフレームの組で十分に学習されているので、DAVIS の 60 本の動画で学べることは多くありません。
- 評価用の損失: 学習前 0.0535、学習後 0.0541 で、ほぼ変わりませんでした。ノイズを当てる力そのものは、追加学習で良くも悪くもなっていません。
- メモリ: 最大 22.6GB で、A100 の 40GB に収まりました。
評価する
a, b, im = evaluate()
print(f"学習後:参照との類似度 {a:.3f}  正解との類似度 {b:.3f}")
p = EVAL[SHOW[0]]
fig, ax = plt.subplots(1, 3, figsize=(12, 4.2))
ax[0].imshow(load(p["video"], p["tar"], p["obj"])[0]); ax[0].set_title("正解のフレーム")
ax[1].imshow(results["公式(ID トークン+HF マップ)"].astype(np.uint8)); ax[1].set_title("学習前")
ax[2].imshow(im.astype(np.uint8)); ax[2].set_title("学習後")
for x in ax:
    x.axis("off")
plt.show()
実行結果
学習後:参照との類似度 0.602 正解との類似度 0.711
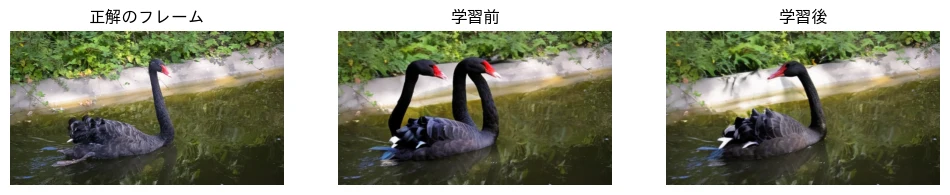
- DINO スコア: 参照との類似度は 0.649 → 0.602 に下がり、正解との類似度は 0.692 → 0.711 に上がりました。学習後のモデルは、参照の見た目をそのまま写すことが減り、正解のフレームの物体に近い姿で描くようになりました。DAVIS の正解のフレームに合わせて学習したことの効果で、参照との類似度の 0.602 は、本物の正解のフレーム(0.569)に近づいています。
- 黒鳥の例: 学習前は首が 2 本ある黒鳥でしたが、学習後は首が 1 本の自然な黒鳥になり、正解のフレームに近い姿になりました。
- 変化の大きさ: 評価用の損失はほとんど変わらず、DINO スコアの変化も 0.02〜0.05 です。28 組・乱数の種 1 つでの結果なので、差の大きさは参考の値です。より多くの動画と、U-Net のデコーダも含めた学習で、公式のような大きな学習の効果が出ると考えられます。
まとめ
本記事では、1 枚の参照画像の物体を別の画像の指定した場所へ入れる AnyDoor を、PyTorch でスクラッチ実装しました。
- 仕組み: 物体が「何であるか」は DINOv2 ViT-g/14 の 257 個の ID トークンで、模様などの細部は HF マップを貼ったコラージュから Detail Extractor で作る 13 個の特徴で、Stable Diffusion 2.1 の U-Net に伝えます。箱の周りを切り出して生成し直すので、影や照明もなじみます。
- 実装の確認: 公式の重みを読み込み、float32 で公式の実装と比べると、前処理と ID トークンは完全に一致し、Detail Extractor の出力の差は最大 1.4e-4、50 ステップ後の画像の差は最大 1 階調でした。重みの中の DINOv2 は、Meta が公開した DINOv2 と完全に同じでした。
- ID トークンと HF マップの役割: DAVIS の 28 組で、ID トークンを外すと参照との DINO スコアが 0.649 → 0.132 に下がり、物体が描かれなくなりました。HF マップの代わりに元の色を貼ると、参照との類似度は 0.750 に上がる一方、正解との類似度は 0.487 に下がり、参照を写すだけになりました。
- ガイダンスの強さ: CFG 1.0 では参照の色や形が伝わらず(0.471)、3.0 以上では DINO スコアはほぼ同じ(0.63〜0.65)でした。
- 追加学習: DAVIS の学習用の 60 本の動画のフレームの組で、Detail Extractor と射影を約 23 分学習すると、参照との類似度は 0.649 → 0.602、正解との類似度は 0.692 → 0.711 になり、参照を写すより、その場所の姿に近い物体を描くようになりました。
AnyDoor の工夫は、物体の情報を「何であるか」と「細部」に分け、細部は写しにならない形(HF マップ)で渡すことにあります。Stable Diffusion のテキストの代わりに画像の特徴を入れる考え方は、Stable Diffusion の記事とあわせて読むと、より分かりやすくなります。
ライセンスに関する注記
AnyDoor の公式の実装(ali-vilab/AnyDoor)は MIT License です。学習済みの重み(xichenhku/AnyDoor_models)は、Hugging Face で Apache-2.0 と表示されています。ただし、この重みは Stable Diffusion 2.1(CreativeML Open RAIL++-M License)の U-Net と VAE から学習したもので、Stable Diffusion のライセンスの利用の制限(有害な用途の禁止など)も引き継ぐと考えられます。DINOv2 の重みは Apache-2.0 です(公式のリポジトリに同梱の DINOv2 のコードは、当時の CC BY-NC 4.0 の版です)。DAVIS 2017 は、公式のリポジトリが BSD License ですが、データセットの画像の利用条件は公式のサイトに明記されていません。研究での利用が広く行われているデータセットで、本記事では評価と学習に使い、生成した結果の例を人の写っていない動画で掲載しています。本記事で使ったそのほかの画像は、Google AI Studio で作成したオレンジとりんごの画像です。本記事の説明は一般的な解釈で、法的な助言ではありません。 実際に利用する場合は、ライセンスの条文を確認してください。
出典・ライセンスについて
- AnyDoor の実装: 公式の実装(MIT License)の cldm/cldm.py・ldm のモジュール・run_inference.py・datasets/base.py の構造を参考に、スクラッチで実装しています。
- 学習済みのモデル: xichenhku/AnyDoor_models と、比較に facebook/dinov2-giant(Apache-2.0)を使用しています。
- データセット: DAVIS 2017(Pont-Tuset et al., 2017)を使用しています。
- 推論に利用した画像: オレンジとりんごの画像は、Google AI Studio で作成したものです。
@inproceedings{chen2024anydoor,
  title = {AnyDoor: Zero-shot Object-level Image Customization},
  author = {Chen, Xi and Huang, Lianghua and Liu, Yu and Shen, Yujun and Zhao, Deli and Zhao, Hengshuang},
  booktitle = {Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR)},
  year = {2024}
}
@article{pont2017davis,
  title = {The 2017 DAVIS Challenge on Video Object Segmentation},
  author = {Pont-Tuset, Jordi and Perazzi, Federico and Caelles, Sergi and Arbel{\'a}ez, Pablo and Sorkine-Hornung, Alex and Van Gool, Luc},
  journal = {arXiv preprint arXiv:1704.00675},
  year = {2017}
}
参考文献
- X. Chen, L. Huang, Y. Liu, Y. Shen, D. Zhao, H. Zhao (2024). AnyDoor: Zero-shot Object-level Image Customization. CVPR 2024.
- ali-vilab. ali-vilab/AnyDoor. GitHub.
- X. Chen. xichenhku/AnyDoor_models. Hugging Face.
- Meta AI. facebook/dinov2-giant. Hugging Face.
- J. Pont-Tuset, F. Perazzi, S. Caelles, P. Arbeláez, A. Sorkine-Hornung, L. Van Gool (2017). The 2017 DAVIS Challenge on Video Object Segmentation. arXiv:1704.00675.
本記事の文章・構成の一部に生成AIを使用しています。