BERT(Masked Language Model)とは?
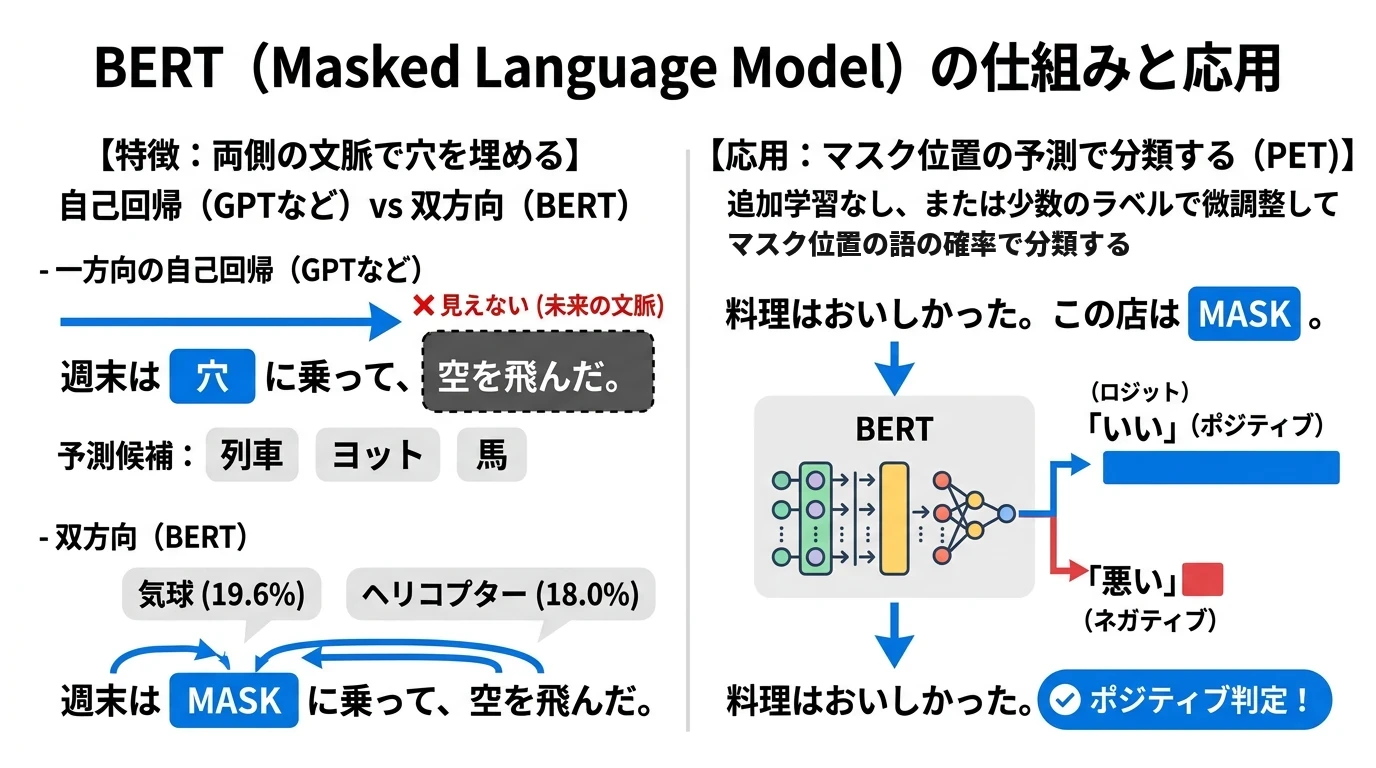 (画像は、Geminiで作成)
左から順に次のトークンを予測する自己回帰の言語モデル(GPT 系)と、文の一部を隠して両側の文脈から当てる BERT の違いを、実際のモデルの出力で理解すること。BERT の入力の作り方、MLM の学習の規則(15%・80/10/10)と損失、MLM ヘッドの計算をコードで確かめ、「マスク位置のロジットを読んで答えにする」分類(パターンとバーバライザ)を自分で実装し、少数のラベルでの微調整との違いを説明できるようになること。
原著論文: BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding (Devlin, Chang, Lee, Toutanova, NAACL 2019)
本記事のコードは、GPU を使わない CPU(2コア)の環境で、Python 3.13、torch 2.15.0(CPU 版)、transformers 5.23.0、fugashi、unidic-lite、pandas 3.1.1、matplotlib 3.11.2 を使って実行しました。BERT には東北大学の bert-base-japanese-v3(約1.1億パラメータ)、比べる自己回帰の言語モデルには In-Context Learning の記事と同じ OpenCALM(small・medium)を使います。全体の実行には約16分かかり、その大部分は、自己回帰の言語モデルの尤度比較(約5分)と、最後の節の24回の微調整です。Google Colab の CPU ランタイムでも同じように動きます。
bert-base-japanese-v3 のトークナイザーは、MeCab(fugashi)と辞書(unidic-lite)で単語に分けてから WordPiece で分けます。グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google Colab や Jupyter では先頭の ! を付けたまま、ターミナルでは ! を外して実行します)。Python 3.12 以降で import 時にエラーが出る場合は、setuptools も一緒にインストールしてください。
!pip install transformers torch fugashi unidic-lite japanize-matplotlib setuptools
概要
GPT のような 自己回帰の言語モデル は、文を左から順に読み、次のトークンを予測するように学習します。文を生成するにはこの形が自然ですが、文の途中の語を予測するとき、その位置で使えるのは左側の文脈だけです。「週末は_に乗って、空を飛んだ。」の穴に入る語は右側の「空を飛んだ」で決まるのに、左から読むモデルは、穴の位置では「週末は」しか見ていません。
BERT(Devlin et al., 2019)は、Transformer のエンコーダだけを使い、すべての位置がすべての位置を見るようにしたモデルです。そのままでは「次のトークンを予測する」学習ができないので、入力の一部のトークンを [MASK] に隠し、両側の文脈から元のトークンを当てる MLM(Masked Language Model)で事前学習します。こうして学習したモデルは、[MASK] の位置の出力(ロジット)を読むだけで、両側の文脈を踏まえた穴埋めができます。Schick & Schütze(2021)の PET は、この穴埋めを分類に使う方法で、「料理はおいしかった。この店は[MASK]。」のようなパターンに文を入れ、[MASK] の位置の「いい」と「悪い」のロジットを比べて、レビューの極性を答えます。
本記事では、日本語の BERT(bert-base-japanese-v3)で、まず自己回帰の言語モデルとの違いを穴埋めで確かめます。次に、入力の埋め込み・MLM のマスクの規則と損失・MLM ヘッド・NSP を、モデルの値と一致させながらスクラッチで計算します。最後に、飲食店の短いレビュー180件の極性を、穴埋めのパターン(学習なし)・In-Context Learning の記事の尤度比較・少数のラベルでの微調整の3つで解き、正解率を比べます。
左から読むだけでは、穴を埋められない
左側が同じ「週末は」で、右側だけが違う3つの文の穴を、BERT に埋めさせます。BERT は [MASK] の位置の出力を、語彙(32,768個)の上の確率にします。
import torch
from transformers import AutoTokenizer, AutoModelForMaskedLM

BERT_ID = "tohoku-nlp/bert-base-japanese-v3"
tok = AutoTokenizer.from_pretrained(BERT_ID)
bert = AutoModelForMaskedLM.from_pretrained(BERT_ID).eval()


def fill_mask(text, tok, model, k=5):
    """[MASK] の位置の、語彙全体の確率の上位 k 個を返す"""
    enc = tok(text, return_tensors="pt")
    pos = (enc.input_ids[0] == tok.mask_token_id).nonzero()[0, 0]    # [MASK] の位置
    with torch.no_grad():
        probs = model(**enc).logits[0, pos].softmax(-1)               # 語彙 32,768 個の確率
    top = probs.topk(k)
    return [(tok.convert_ids_to_tokens(int(i)), round(float(p), 3)) for p, i in zip(top.values, top.indices)]


# 穴の左側(週末は)は同じで、右側だけが違う3つの文
RIGHTS = ["海を渡った。", "空を飛んだ。", "線路の上を走った。"]
for right in RIGHTS:
    text = f"週末は[MASK]に乗って、{right}"
    print(text, fill_mask(text, tok, bert))
日本語の BERT を読み込み、[MASK] の位置の確率の上位を返す関数で、右側の文脈だけが違う3つの文の穴を埋めるコードです。
- AutoModelForMaskedLM: BERT の本体に、[MASK] の位置の語を予測する MLM ヘッドを付けたモデルです。.eval() で、学習のときだけ使う Dropout を止め、同じ入力に同じ出力が出るようにします。
- fill_mask(text, tok, model, k=5): 文をトークンに分け、tok.mask_token_id([MASK] の番号)と一致する位置を探して、その位置のロジット(語彙の数だけの値)を softmax で確率にします。topk で上位 k 個を取り出し、番号をトークンの文字列に戻します。
- RIGHTS: 穴の右側に置く3つの文脈です。「海を渡る」「空を飛ぶ」「線路の上を走る」乗り物は、それぞれ違うので、右側を読めるかどうかが、予測にはっきり表れます。
実行結果
週末は[MASK]に乗って、海を渡った。 [('ヨット', 0.313), ('ボート', 0.268), ('船', 0.169), ('漁船', 0.049), ('フェリー', 0.018)]
週末は[MASK]に乗って、空を飛んだ。 [('気球', 0.196), ('ヘリコプター', 0.18), ('ヨット', 0.062), ('馬', 0.045), ('オートバイ', 0.045)]
週末は[MASK]に乗って、線路の上を走った。 [('列車', 0.332), ('電車', 0.182), ('馬', 0.094), ('貨車', 0.053), ('汽車', 0.042)]
- 右側の文脈で、穴の予測が変わった: 「海を渡った」ではヨット(0.313)・ボート・船、「空を飛んだ」では気球(0.196)・ヘリコプター、「線路の上を走った」では列車(0.332)・電車が上位になりました。3つの文で左側は同じなので、この違いは、すべて右側を読んだ結果です。
同じことを、自己回帰の言語モデル(In-Context Learning の記事と同じ open-calm-small)で確かめます。自己回帰の言語モデルは、位置 の出力で 番目のトークンを予測するので、候補 を「週末は」の続きとして出す対数確率は、次のようになります。
右側の文脈を使うには、候補を入れた文全体の対数確率 を、候補ごとに計算して比べるしかありません。
from transformers import AutoModelForCausalLM

GPT_ID = "cyberagent/open-calm-small"
gpt_tok = AutoTokenizer.from_pretrained(GPT_ID)
gpt = AutoModelForCausalLM.from_pretrained(GPT_ID).eval()


def logprob(context, completion, tok, model, mean=False):
    """自己回帰の言語モデルで、context に続けて completion が出てくる対数確率(mean=True ならトークンあたりの平均)"""
    ids = tok(context + completion, return_tensors="pt").input_ids
    n_ctx = len(tok(context).input_ids)
    with torch.no_grad():
        lp = model(ids).logits[0, :-1].log_softmax(-1)               # 位置 t の出力が、t+1 番目のトークンの予測
    target = ids[0, 1:]
    lp_completion = lp[torch.arange(len(target)), target][n_ctx - 1:]          # completion の部分だけ
    return float(lp_completion.mean() if mean else lp_completion.sum())


CANDIDATES = ["ヨット", "気球", "列車"]
for right in RIGHTS:
    # (a) 穴の位置での予測:見えるのは左側の「週末は」だけなので、右側が違っても同じ値になる
    at_blank = {c: round(logprob("週末は", c, gpt_tok, gpt), 2) for c in CANDIDATES}
    # (b) 候補を入れた文全体の対数確率:右側も使えるが、候補の数だけ文を読み直す
    whole = {c: round(logprob("週末は", f"{c}に乗って、{right}", gpt_tok, gpt), 2) for c in CANDIDATES}
    print(f"…{right}  穴の位置 {at_blank}  文全体 {whole}")
自己回帰の言語モデルで、穴の位置での候補の対数確率と、候補を入れた文全体の対数確率を、3つの文で比べるコードです。
- logprob(context, completion, tok, model, mean=False): context と completion をつなげて1回読み、completion の部分のトークンの対数確率を足します(mean=True なら平均。後の節の尤度比較で使います)。
- 1つずらす: logits[0, :-1] の位置 の行は、 番目のトークンの予測です。正解 target も1つずらした ids[0, 1:] にして、各行から正解のトークンの対数確率を取り出します。
- [n_ctx - 1:]: context の最後のトークンの位置の出力が、completion の最初のトークンの予測なので、そこから後ろだけを足します。context の部分の確率は、どの候補でも同じなので、比べるのに要りません。
- (a) 穴の位置での予測: completion を候補の語だけにして、「週末は」の続きとしての対数確率を出します。
- (b) 文全体: 候補を入れた「〇〇に乗って、海を渡った。」全体の対数確率です。候補が3つなら、3回読み直します。
実行結果
…海を渡った。  穴の位置 {'ヨット': -10.66, '気球': -15.26, '列車': -12.41}  文全体 {'ヨット': -29.55, '気球': -35.0, '列車': -34.41}
…空を飛んだ。  穴の位置 {'ヨット': -10.66, '気球': -15.26, '列車': -12.41}  文全体 {'ヨット': -31.56, '気球': -32.53, '列車': -33.75}
…線路の上を走った。  穴の位置 {'ヨット': -10.66, '気球': -15.26, '列車': -12.41}  文全体 {'ヨット': -37.97, '気球': -39.59, '列車': -35.69}
- 穴の位置の予測は、右側が何でも同じ: ヨット −10.66・気球 −15.26・列車 −12.41 は、3つの文でまったく同じでした。自己回帰の言語モデルは、穴の位置では左側の「週末は」しか見ていないからです。
- 文全体なら右側を使えるが、候補の出やすさも混ざる: 文全体の対数確率では、「海を渡った」でヨット、「線路の上を走った」で列車が最大になりました。一方、「空を飛んだ」では、気球(−32.53)よりヨット(−31.56)が大きくなりました。文全体の確率には、候補そのものの出やすさ(「週末は」の後にヨットが来る −10.66 と、気球が来る −15.26 の差)も含まれるためです。また、候補の数だけ文を読み直す必要があります。
(図は、diagram-designで作成)
違いは、Self-Attention のマスクにあります(Causal Mask の仕組みは Transformer の記事を参照)。自己回帰の言語モデルは、下三角の Causal Mask で未来の位置を隠すので、文を左から1トークンずつ生成できる代わりに、穴の位置では左側しか使えません。BERT はマスクをかけない(PAD だけを隠す)ので、1回読むだけで両側の文脈を使えますが、そのままでは「次のトークンを予測する」学習ができず、左から順に文を生成するのにも向きません。BERT は、この代わりに MLM で事前学習します。
BERT の仕組み
(図は、diagram-designで作成)
BERT は、Transformer の記事のエンコーダの層を12個(BERT-base の場合)重ねたものです。エンコーダの中身(Self-Attention・FFN・残差接続・LayerNorm)は Transformer と同じで、BERT で新しいのは、次の3つです。
- 入力の作り方: 先頭に [CLS]、文の区切りと末尾に [SEP] を置き、2つの文を1つの系列にします。トークン・位置・文A/文Bの3つの埋め込みを足します。
- 事前学習の2つの目的: [MASK] で隠したトークンを当てる MLM と、2つ目の文が1つ目の文の続きかを当てる NSP(Next Sentence Prediction)です。
- 微調整の仕方: 分類では、[CLS] の位置の出力に新しい分類層を付け、モデル全体をラベル付きのデータで学習します。
ここからは、部品ごとに、モデルの値と一致させながら計算します。
入力:3つの埋め込みの和
位置 のトークン の入力の埋め込みは、トークンの埋め込み 、位置の埋め込み 、文A・文Bの埋め込み の和に、LayerNorm をかけたものです。
(token_type_ids)は、位置 が文A(0)か文B(1)かです。Transformer の記事の位置エンコーディングは sin・cos の固定の値でしたが、BERT の位置の埋め込みは、トークンの埋め込みと同じく学習で決める表(512位置 × 768次元)です。
# 2つの文を1つの入力にする:[CLS] 文A [SEP] 文B [SEP]
enc = tok("料理はおいしかった。", "また来たい。", return_tensors="pt", return_token_type_ids=True)
print("トークン      :", tok.convert_ids_to_tokens(enc.input_ids[0]))
print("token_type_ids:", enc.token_type_ids[0].tolist())

# 入力の埋め込み = トークンの埋め込み + 位置の埋め込み + 文A・文Bの埋め込み(→ LayerNorm)
emb = bert.bert.embeddings
ids, types = enc.input_ids, enc.token_type_ids
positions = torch.arange(ids.shape[1])[None]
with torch.no_grad():
    manual = emb.LayerNorm(emb.word_embeddings(ids) + emb.position_embeddings(positions)
                           + emb.token_type_embeddings(types))
    library = emb(input_ids=ids, token_type_ids=types)
print("埋め込みの形:", tuple(manual.shape), " ライブラリとの差の最大:", f"{(manual - library).abs().max():.1e}")
print("語彙の数:", emb.word_embeddings.num_embeddings, " 位置の数:", emb.position_embeddings.num_embeddings,
      " 文の種類:", emb.token_type_embeddings.num_embeddings,
      " 層の数:", bert.config.num_hidden_layers, " ヘッドの数:", bert.config.num_attention_heads)
2つの文を BERT の入力にし、3つの埋め込みを手で足して LayerNorm をかけた値が、ライブラリの埋め込み層の出力と一致するかを確かめるコードです。
- tok(文A, 文B, return_token_type_ids=True): 2つの文を渡すと、[CLS] 文A [SEP] 文B [SEP] の系列にし、文Bの部分の token_type_ids を1にします。このモデルのトークナイザーは、既定では token_type_ids を返さないので、return_token_type_ids=True で返させています。返さないと、モデルは全部を文A(0)として扱います(後の NSP で影響します)。
- bert.bert.embeddings: bert(MLM ヘッド付きのモデル)の中の、BERT の本体(bert.bert)の埋め込み層です。word_embeddings・position_embeddings・token_type_embeddings が、式の ・・ です。
- positions: 位置の番号 0, 1, …, 12 です。[None] で先頭にバッチの次元を足し、ids と同じ (1, 13) の形にしています。
実行結果
トークン      : ['[CLS]', '料理', 'は', 'おい', '##しかっ', 'た', '。', '[SEP]', 'また', '来', 'たい', '。', '[SEP]']
token_type_ids: [0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1]
埋め込みの形: (1, 13, 768)  ライブラリとの差の最大: 7.2e-07
語彙の数: 32768  位置の数: 512  文の種類: 2  層の数: 12  ヘッドの数: 12
- 入力の系列: 「料理はおいしかった。」は MeCab で「料理・は・おいしかっ・た・。」に分かれ、「おいしかっ」は WordPiece で「おい」「##しかっ」に分かれました(## は、前のトークンの続きという印)。[CLS]・[SEP] を足して13トークンで、文Bの「また来たい。[SEP]」の5トークンだけ token_type_ids が1です。
- 手計算とライブラリが一致した: 差の最大は 7.2e-07 で、浮動小数点の誤差の範囲です。各トークンは768次元のベクトルになり、(1, 13, 768) の形でエンコーダの層に入ります。
- モデルの大きさ: 語彙32,768、位置512、層12、ヘッド12で、原著論文の BERT-base と同じ構成です。
MLM:15%を選び、80% / 10% / 10% で置き換える
MLM では、入力のトークンのうち15%を予測の対象に選び、選んだ位置の元のトークンを、両側の文脈から当てさせます。選んだ位置 の入力は、次のように置き換えます(Devlin et al., 2019)。
全部を [MASK] にしないのは、[MASK] が事前学習の入力にしか出てこないからです。微調整や推論の入力には [MASK] がないので、[MASK] の位置でだけ予測を学ぶと、事前学習と微調整で入力の様子が違ってしまいます。ランダムなトークンやそのままのトークンも予測の対象に混ぜると、モデルはどの位置の入力も信じすぎず、すべての位置の出力を文脈から作るようになります。
(図は、diagram-designで作成)
def mask_tokens(input_ids, tok, gen, p_select=0.15):
    """BERT の MLM の入力を作る:15%のトークンを選び、80%を[MASK]、10%をランダムなトークン、10%をそのままにする"""
    ids = input_ids.clone()
    labels = input_ids.clone()
    special = torch.isin(ids, torch.tensor(tok.all_special_ids))           # [CLS]・[SEP]・[PAD] は選ばない
    # (a) 予測の対象にする位置を、確率 15% で選ぶ。選ばなかった位置は、損失に入れない(-100)
    selected = (torch.rand(ids.shape, generator=gen) < p_select) & ~special
    labels[~selected] = -100
    # (b) 選んだ位置の 80% を [MASK] に置き換える
    r = torch.rand(ids.shape, generator=gen)
    to_mask = selected & (r < 0.8)
    ids[to_mask] = tok.mask_token_id
    # (c) 選んだ位置の 10% をランダムなトークンに置き換える(残りの 10% はそのまま)
    to_random = selected & (r >= 0.8) & (r < 0.9)
    ids[to_random] = torch.randint(len(tok), ids.shape, generator=gen)[to_random]
    return ids, labels, selected, to_mask, to_random


sentences = [f"週末はヨットに乗って、{r}" for r in RIGHTS] + ["料理はおいしかったが、店員の対応は雑だった。",
                                                       "寝る前にコーヒーを飲むと、なかなか眠れなくなる。"]
batch = tok(sentences, return_tensors="pt", padding=True)
gen = torch.Generator().manual_seed(8)            # 1回分の例で、[MASK] とランダムの置き換えが両方見えるシード
# 1回分の例
ids, labels, *_ = mask_tokens(batch.input_ids, tok, gen)
print("元の文  :", tok.convert_ids_to_tokens(batch.input_ids[3])[:16])
print("MLMの入力:", tok.convert_ids_to_tokens(ids[3])[:16])
print("ラベル  :", [tok.convert_ids_to_tokens(int(t)) if t != -100 else "・" for t in labels[3][:16]])
# 2,000回くり返して、選ばれる割合と、置き換え方の割合を数える
n_tok = n_sel = n_mask = n_rand = 0
for _ in range(2000):
    _, _, sel, msk, rnd = mask_tokens(batch.input_ids, tok, gen)
    n_tok += int((~torch.isin(batch.input_ids, torch.tensor(tok.all_special_ids))).sum())
    n_sel, n_mask, n_rand = n_sel + int(sel.sum()), n_mask + int(msk.sum()), n_rand + int(rnd.sum())
print(f"選ばれた割合 {n_sel / n_tok:.3f}  選ばれたうち [MASK] {n_mask / n_sel:.3f}  ランダム {n_rand / n_sel:.3f}  "
      f"そのまま {(n_sel - n_mask - n_rand) / n_sel:.3f}")
MLM の入力とラベルを作る関数をスクラッチ実装し、1回分の例を表示してから、2,000回くり返して、選ばれる割合と置き換え方の割合を数えるコードです。
- mask_tokens(input_ids, tok, gen, p_select=0.15): 入力の番号の行列から、MLM の入力 ids とラベル labels を作ります。乱数は、引数の gen(torch.Generator)から引くので、シードを決めれば同じ置き換えになります。
- special: [CLS]・[SEP]・[PAD] の位置です。torch.isin で、特殊なトークンの番号の一覧に入っているかを調べ、予測の対象から外します。[CLS] や [SEP] はどの文でも同じ位置にあり、当てても文脈を学ぶ練習にならないためです。
- (a): 位置ごとに0〜1の乱数を引き、0.15未満の位置を選びます。選ばなかった位置のラベルを -100 にします。-100 は、PyTorch の交差エントロピーで「この位置は損失に入れない」という印(ignore_index の既定値)です。
- (b)(c): もう1つ乱数 r を引き、選んだ位置のうち、0.8未満を [MASK] に、0.8以上0.9未満をランダムなトークンにします。残りの0.9以上(10%)は、入力はそのままで、ラベルだけが付きます。1つの乱数の範囲で分けるので、3つの置き換えが重なることはありません。
- sentences: 最初の節の3つの文に、レビュー風の文と、穴埋めの例によく使う文を足した5文です。padding=True で長さをそろえ、短い文の後ろは [PAD] で埋めます。
- シード8: 1回分の例として、4番目の文に [MASK] とランダムの置き換えが両方見えるシードを選んでいます。2,000回のくり返しは、同じ乱数の生成器から続けて引くので、毎回違う置き換えになります。
- 割合の数え方: n_tok は特殊なトークンを除いたトークンの数の合計で、選ばれた数をこれで割ると選ばれた割合、[MASK]・ランダムの数を選ばれた数で割ると置き換え方の割合です。
実行結果
元の文  : ['[CLS]', '料理', 'は', 'おい', '##しかっ', 'た', 'が', '、', '店員', 'の', '対応', 'は', '雑', 'だっ', 'た', '。']
MLMの入力: ['[CLS]', '料理', 'は', 'おい', '##しかっ', 'た', 'が', '[MASK]', '店員', 'の', '対応', '##~', '雑', 'だっ', '[MASK]', '。']
ラベル  : ['・', '・', '・', '・', '・', '・', '・', '、', '・', '・', '・', 'は', '・', '・', 'た', '・']
選ばれた割合 0.150  選ばれたうち [MASK] 0.800  ランダム 0.101  そのまま 0.099
- 1回分の例: 15トークンのうち、読点・2つ目の「は」・最後の「た」の3つが選ばれ、読点と「た」は [MASK] に、「は」はランダムなトークンの「##~」になりました。ラベルは、その3つの位置にだけ元のトークンが入っています。
- 割合は規則どおり: 2,000回で、選ばれた割合は0.150、選ばれたうち [MASK] 0.800・ランダム0.101・そのまま0.099でした。
原著論文の MLM はトークンごとに選びますが、本記事のモデル(bert-base-japanese-v3)は、MeCab で分けた1つの単語のサブワードをまとめて隠す whole word masking で学習しています(モデルカードの説明)。たとえば「おい」「##しかっ」は、片方だけでなく両方が一緒に隠されます。上の関数は、原著論文と同じトークンごとの選び方です。
MLM の損失は、選んだ位置(集合 )だけの、元のトークンの対数確率の平均の符号を反転したもの(交差エントロピー)です。
# 1回分の例(ids, labels)で、MLM の損失を計算する:選んだ位置だけの、正しいトークンの交差エントロピーの平均
gen = torch.Generator().manual_seed(8)
ids, labels, *_ = mask_tokens(batch.input_ids, tok, gen)
with torch.no_grad():
    out = bert(input_ids=ids, attention_mask=batch.attention_mask, labels=labels)
target = labels != -100                                                     # 損失に入れる位置
log_probs = out.logits.log_softmax(-1)
manual = -log_probs[target].gather(1, labels[target][:, None]).mean()
print(f"選んだ位置 {int(target.sum())}個  損失(手計算){manual:.4f}  ライブラリ {out.loss:.4f}")
pred = out.logits.argmax(-1)
for b, t in zip(*target.nonzero(as_tuple=True)):
    print(f"文{int(b)} 位置{int(t):2d}: 入力 {tok.convert_ids_to_tokens(int(ids[b, t])):6s} 正解 {tok.convert_ids_to_tokens(int(labels[b, t])):6s}"
          f" 予測 {tok.convert_ids_to_tokens(int(pred[b, t]))}")
1回分の例(シード8)の入力で、MLM の損失を手で計算してライブラリの値と比べ、選んだ位置ごとに、入力・正解・予測を並べるコードです。
- bert(input_ids=ids, ..., labels=labels): ラベルを渡すと、ライブラリが MLM の損失を計算して out.loss に入れます。attention_mask は [PAD] に注意を向けないためのマスクで、batch を作ったときのものをそのまま使います。
- 手計算: target は、ラベルが -100 でない位置(選んだ位置)です。log_probs[target] で選んだ位置の行だけを取り出し、gather でそれぞれの正解のトークンの列の値を取って、平均の符号を反転します。
実行結果
選んだ位置 11個  損失(手計算)0.5291  ライブラリ 0.5291
文0 位置 7: 入力 [MASK] 正解 、      予測 カリブ
文0 位置 9: 入力 [MASK] 正解 を      予測 を
文1 位置 5: 入力 [MASK] 正解 乗っ     予測 乗っ
文1 位置 8: 入力 [MASK] 正解 空      予測 空
文2 位置 4: 入力 ブレイク   正解 に      予測 に
文3 位置 7: 入力 [MASK] 正解 、      予測 、
文3 位置11: 入力 ##~    正解 は      予測 は
文3 位置14: 入力 [MASK] 正解 た      予測 た
文4 位置 5: 入力 [MASK] 正解 コーヒー   予測 薬
文4 位置 8: 入力 [MASK] 正解 と      予測 と
文4 位置13: 入力 ##ベリー  正解 なく     予測 なく
- 損失はライブラリと一致した: 5文で選ばれた11か所の損失は、手計算もライブラリも0.5291でした。
- ランダムに置き換えた位置も、文脈から当てた: 「に」→「ブレイク」、「は」→「##~」、「なく」→「##ベリー」と、関係のないトークンに置き換えた3か所は、3つとも元のトークンを予測しました。BERT は、入力に見えているトークンをそのまま写すのではなく、両側の文脈から、その位置にあるべきトークンを予測しています。
- 外れた2か所: 「ヨットに乗って、海を渡った」の読点を「カリブ」と予測し(「ヨットに乗ってカリブ海を渡った」として自然)、「寝る前にコーヒーを飲むと」のコーヒーを「薬」と予測しました(「なかなか眠れなくなる」の主語として、どちらも当てはまります)。どちらも、文脈に合う別の答えです。
MLM ヘッド:出力を語彙のロジットにする
[MASK] の位置の最後の層の出力 (768次元)を、語彙のロジット (32,768次元)にするのが MLM ヘッドです。
最後の行列は、入力のトークンの埋め込み (32,768 × 768)と同じ行列です(重みの共有)。出力の語のロジットは、出力のベクトルと、その語の入力の埋め込みとの内積になります。
import torch.nn.functional as F

# MLM ヘッドを手で計算する:最後の層の出力 h → 全結合 → GELU → LayerNorm → 埋め込み行列 E との内積 + バイアス
enc = tok(f"週末は[MASK]に乗って、{RIGHTS[0]}", return_tensors="pt")
pos = (enc.input_ids[0] == tok.mask_token_id).nonzero()[0, 0]
head = bert.cls.predictions
with torch.no_grad():
    h = bert.bert(**enc).last_hidden_state[0, pos]                             # [MASK] の位置の出力(768次元)
    z = head.transform.LayerNorm(F.gelu(head.transform.dense(h)))
    E = bert.bert.embeddings.word_embeddings.weight                           # 入力の埋め込み行列(32,768 × 768)
    manual = z @ E.T + head.bias                                              # 語彙ごとのロジット
    library = bert(**enc).logits[0, pos]
print("ロジットの形:", tuple(manual.shape), " ライブラリとの差の最大:", f"{(manual - library).abs().max():.1e}")
print("出力層の重みは入力の埋め込みと同じ行列:", head.decoder.weight.data_ptr() == E.data_ptr())
top = manual.softmax(-1).topk(3)
print("上位3:", [(tok.convert_ids_to_tokens(int(i)), round(float(p), 3)) for p, i in zip(top.values, top.indices)])
最初の節の「海を渡った」の文で、[MASK] の位置の出力から MLM ヘッドを手で計算し、ライブラリのロジットと比べるコードです。
- last_hidden_state: bert.bert(BERT の本体)の出力のうち、MLM ヘッドを通す前の、エンコーダの最後の層の出力(1, 系列長, 768)です。そこから [MASK] の位置の1行(768次元)を取り出します。
- head.transform: 式の ・(dense、768 → 768)と LayerNorm です。活性化関数は、モデルの設定(hidden_act)と同じ GELU です。
- E: 入力のトークンの埋め込み行列そのものです。出力層の重み(head.decoder.weight)が同じメモリを指しているかを、data_ptr()(データの先頭の番地)で確かめます。
実行結果
ロジットの形: (32768,)  ライブラリとの差の最大: 2.2e-05
出力層の重みは入力の埋め込みと同じ行列: True
上位3: [('ヨット', 0.313), ('ボート', 0.268), ('船', 0.169)]
- 手計算とライブラリが一致した: 差の最大は 2.2e-05 で、32,768個のロジットが浮動小数点の誤差の範囲で一致しました。上位3つ(ヨット 0.313・ボート 0.268・船 0.169)も、最初の節と同じです。
- 出力層は入力の埋め込みと同じ行列: 出力層の重みと入力の埋め込みは、同じメモリを指していました。語彙の数だけのパラメータ(32,768 × 768 ≈ 2,500万)を、入力と出力で1つにしています。
NSP:2つ目の文は、1つ目の文の続きか
NSP は、[CLS] の位置の出力から、文Bが文Aの実際の続きか(IsNext)、コーパスからランダムに選んだ文か(NotNext)を当てる2クラスの分類です。原著論文では、学習のときに半分を続きの文、半分をランダムな文にします。質問と答えの文のように、2つの文の関係を見る課題の微調整に役立つと考えて入れた目的です。
from transformers import BertForPreTraining

# NSP のヘッドも読み込める BertForPreTraining で、「文Bは文Aの続きか」の確率を出す
bert_pt = BertForPreTraining.from_pretrained(BERT_ID).eval()
first = "今日は雨が降っていたので、傘を持って出かけた。"
for second in ["駅に着く頃には、雨はやんでいた。", "ペンギンは南半球に多く住む鳥である。"]:
    enc = tok(first, second, return_tensors="pt", return_token_type_ids=True)
    with torch.no_grad():
        p = bert_pt(**enc).seq_relationship_logits.softmax(-1)[0]           # [続きである, 続きでない]
    print(f"{second}  続きである確率 {p[0]:.3f}")
NSP のヘッドも含む BertForPreTraining で、1つ目の文に、続きの文と関係のない文を組み合わせ、「続きである」確率を比べるコードです。seq_relationship_logits の0番目が「続きである」、1番目が「続きでない」のロジットです。token_type_ids を渡すのは、渡さないと文Bも文A(0)として扱われ、2つの文の区別がつかなくなるためです。
実行結果
駅に着く頃には、雨はやんでいた。  続きである確率 1.000
ペンギンは南半球に多く住む鳥である。  続きである確率 0.085
- 続きの文は1.000、関係のない文は0.085: 雨の話に「雨はやんでいた」が続く組は、ほぼ確実に続きと判定し、ペンギンの文は続きではないと判定しました。
ただし、後の研究では、NSP は必要ないとされています。RoBERTa(Liu et al., 2019)は、NSP をやめて、長い連続した文章で MLM だけを学習したほうが、下流の課題の性能が同じか高くなることを示しました。ALBERT(Lan et al., 2020)は、ランダムに選んだ文は話題から違うことが多いので、NSP は文のつながりより話題の違いを見分けるだけの易しい課題になりやすい、と指摘しています。本記事のモデルの説明(モデルカード)も、学習の目的として MLM だけを書いています。
マスク位置のロジットで分類する(パターンとバーバライザ)
評価用のレビューを作る
飲食店の短いレビューを作り、ポジティブかネガティブかを当てる課題にします。日本語のレビューの公開データには、配布が止まったものや、商用の利用が認められていないものが多いので、記事のコードで作ります。比べたいのは、モデルが文の極性を読み取れるかなので、極性の決まり方が違う3つの書き方を同数ずつ仕込み、書き方ごとに正解率を数えられるようにします。
- 6つの観点(料理・店員の対応・店内・値段・料理が出てくるの・雰囲気)のそれぞれに、良い表現・悪い表現・良い表現の否定・悪い表現の否定の4つを用意します。
- 単純: 「料理は本当においしかった。」のように、良い・悪い表現をそのまま書きます。
- 否定: 「料理はおいしくなかった。」のように、「〜なかった」で極性を反転させます。肯定の語(おいしく)が、悪い意味で使われます。
- 逆接: 「料理はまずかったが、雰囲気はかなり落ち着いていた。」のように、前半と後半で極性を逆にします。結論は後半とし、ラベルは後半の極性にします。
パターンとバーバライザを選ぶための開発用データ(各書き方30件・計90件)と、評価用データ(各書き方60件・計180件)を、別の乱数のシードで作ります。
import random
import numpy as np
import pandas as pd

# 観点ごとに:良い表現、悪い表現、良い表現の否定(悪い)、悪い表現の否定(良い)
ASPECTS = {
    "料理": ("おいしかった", "まずかった", "おいしくなかった", "まずくなかった"),
    "店員の対応": ("丁寧だった", "雑だった", "丁寧ではなかった", "雑ではなかった"),
    "店内": ("清潔だった", "汚かった", "清潔ではなかった", "汚くなかった"),
    "値段": ("安かった", "高かった", "安くなかった", "高くなかった"),
    "料理が出てくるの": ("早かった", "遅かった", "早くなかった", "遅くなかった"),
    "雰囲気": ("落ち着いていた", "騒がしかった", "落ち着かなかった", "騒がしくなかった"),
}
ADVERBS = ["", "とても", "本当に", "かなり", "思ったより"]


def make_reviews(n_per_kind, seed, aspects=ASPECTS, adverbs=ADVERBS):
    """飲食店の短いレビューを、3つの書き方で n_per_kind 件ずつ作る(label は 1 がポジティブ、0 がネガティブ)"""
    rng = random.Random(seed)
    names = list(aspects)
    rows = []
    for kind in ("単純", "否定", "逆接"):
        for i in range(n_per_kind):
            label = i % 2                                              # ポジティブとネガティブを同数にする
            a = rng.choice(names)
            good, bad, not_good, not_bad = aspects[a]
            adv = rng.choice(adverbs)
            if kind == "単純":      # (a) 良い・悪い表現をそのまま書く
                text = f"{a}は{adv}{good if label else bad}。"
            elif kind == "否定":    # (b) 「〜なかった」で極性が反転する。肯定の語(おいしく)が悪い意味になる
                text = f"{a}は{not_bad if label else not_good}。"
            else:                   # (c) 逆接:前半と後半で極性が逆。結論は後半
                a1 = rng.choice([x for x in names if x != a])
                good1, bad1, _, _ = aspects[a1]
                text = f"{a1}は{bad1 if label else good1}が、{a}は{adv}{good if label else bad}。"
            rows.append({"text": text, "label": label, "kind": kind})
    return pd.DataFrame(rows)


dev = make_reviews(30, seed=1)      # パターンを選ぶためのデータ(90件)
test = make_reviews(60, seed=0)     # 評価用のデータ(180件)
print(test.groupby(["kind", "label"]).size().unstack())
print(test.groupby("kind").head(2).to_string())
3つの書き方のレビューを、ラベルと書き方を記録しながら作る関数と、開発用と評価用のデータを作るコードです。
- ASPECTS: 観点 → (良い表現, 悪い表現, 良い表現の否定, 悪い表現の否定) の辞書です。たとえば ASPECTS["料理"] は ("おいしかった", "まずかった", "おいしくなかった", "まずくなかった") です。
- make_reviews(n_per_kind, seed, aspects, adverbs): 書き方ごとに n_per_kind 件作り、文・ラベル・書き方の表を返します。
- label = i % 2: 0と1を交互にして、どの書き方でもポジティブとネガティブを同数にします。どちらかに偏ると、いつも同じラベルを答えるモデルの正解率が0.5から離れ、比べにくくなるためです。
- (a) 単純: 副詞(ADVERBS の「とても」「本当に」「かなり」「思ったより」か、なし)を付けて、文の見た目を少し変えます。
- (b) 否定: ポジティブなら「悪い表現の否定」(まずくなかった)、ネガティブなら「良い表現の否定」(おいしくなかった)を使います。語だけを見ると、ラベルと逆の極性の語が入っています。
- (c) 逆接: 後半の観点 a と違う観点 a1 を前半に選び、前半にはラベルと逆の表現を置きます。
- 件数: 評価用は各書き方60件(計180件)にしています。正解率0.8のとき、標準誤差は で、書き方ごと(60件)では約0.05です。CPU で、自己回帰の言語モデルの尤度比較(180件 × ラベル2つ)が数分で終わる大きさにしました。
実行結果
label   0   1
kind
単純     30  30
否定     30  30
逆接     30  30
                              text  label kind
0                      値段はかなり高かった。      0   単純
1                    料理は本当においしかった。      1   単純
60                    料理はおいしくなかった。      0   否定
61                料理が出てくるのは遅くなかった。      1   否定
120  料理が出てくるのは早かったが、店員の対応は本当に雑だった。      0   逆接
121      料理はまずかったが、雰囲気はかなり落ち着いていた。      1   逆接
パターンとバーバライザ
PET(Schick & Schütze, 2021)は、分類の入力 を、[MASK] を1つ含む文 (パターン)にし、各ラベル に1つずつ語 (バーバライザ)を割り当てます。ラベルの確率は、[MASK] の位置のロジット のうち、バーバライザの語のロジットだけを取り出して softmax にしたものです。
たとえば、パターン「(レビュー)この店は[MASK]。」とバーバライザ(ポジティブ → いい、ネガティブ → 悪い)なら、「いい」のロジットが「悪い」より大きいほど、ポジティブの確率が高くなります。語彙全体の softmax ではなく2つだけで正規化するので、「素晴らしい」のようなほかの語の確率は無視されます。
(図は、diagram-designで作成)
パターンとバーバライザの選び方で、正解率は大きく変わります。3つのパターンと4組のバーバライザの12通りを、開発用データ(90件)で比べます。
def cloze_probs(texts, pattern, verbalizers, tok, model, batch_size=32):
    """パターンに入れた文の [MASK] の位置のロジットを、バーバライザの語だけに絞って正規化した確率を返す"""
    ids = [tok.convert_tokens_to_ids(v) for v in verbalizers]                 # 語は1トークンのものだけを使う
    probs = []
    for k in range(0, len(texts), batch_size):
        enc = tok([pattern.format(x=t, mask=tok.mask_token) for t in texts[k:k + batch_size]],
                  return_tensors="pt", padding=True)
        with torch.no_grad():
            logits = model(**enc).logits
        rows, cols = (enc.input_ids == tok.mask_token_id).nonzero(as_tuple=True)
        probs.append(logits[rows, cols][:, ids].softmax(-1))                  # (文の数, 語の数)
    return torch.cat(probs).numpy()


PATTERNS = ["{x}この店は{mask}。", "{x}全体として{mask}店だった。", "{x}総合評価は{mask}です。"]
VERBALIZERS = [("良い", "悪い"), ("いい", "悪い"), ("最高", "最悪"), ("好き", "嫌い")]   # (ポジティブ, ネガティブ)
grid = pd.DataFrame({" / ".join(v): [((cloze_probs(list(dev.text), p, v, tok, bert)[:, 0] > 0.5) == dev.label).mean()
                                     for p in PATTERNS] for v in VERBALIZERS},
                    index=[p.format(x="", mask="[MASK]") for p in PATTERNS])
print("開発用データ(90件)の正解率")
print(grid.round(3))
# ネガティブのレビューで、「総合評価は[MASK]です。」の穴に入りやすい語を見る
print(fill_mask("料理はまずかった。総合評価は[MASK]です。", tok, bert, k=6))
パターンに入れた文の [MASK] の位置のロジットを、バーバライザの語に絞って確率にする関数と、12通りの組み合わせの開発用データでの正解率を表にするコードです。
- cloze_probs(texts, pattern, verbalizers, tok, model, batch_size=32): 上の式の を、文ごとに返します((文の数, ラベルの数) の配列)。
- convert_tokens_to_ids: バーバライザの語のトークンの番号です。語を1トークンにしているのは、[MASK] が1つで、1つの位置のロジットだけで比べられるようにするためです。「いい」「悪い」「最高」「最悪」「好き」「嫌い」「良い」は、どれもこのモデルの語彙の1トークンです。
- pattern.format(x=t, mask=tok.mask_token): パターンの {x} にレビューを、{mask} に [MASK] を入れます。
- logits[rows, cols]: nonzero(as_tuple=True) で得た「何番目の文の、何番目の位置が [MASK] か」の組で、文ごとに [MASK] の位置の行(語彙32,768個)を1つずつ取り出し、[:, ids] でバーバライザの列だけを残します。
- batch_size=32: 32文ずつまとめて読みます。1文ずつ読むより速く、短いレビューなら CPU のメモリにも十分に収まります。
- PATTERNS と VERBALIZERS: 店の評価を聞く書き方を3つ、ポジティブとネガティブの語の組を4つ用意しました。どのバーバライザも、前がポジティブの語です。
- grid: 行がパターン、列がバーバライザの表で、値は開発用データでの正解率です。ポジティブの確率 [:, 0] が0.5より大きいものをポジティブと答えます。
- 最後の行: 正解率が0.5になった「総合評価は[MASK]です。」で、ネガティブのレビューの穴に、語彙全体で何が入りやすいかを、最初の節の fill_mask で確かめます。
実行結果
開発用データ(90件)の正解率
                  良い / 悪い  いい / 悪い  最高 / 最悪  好き / 嫌い
この店は[MASK]。         0.844    0.856    0.722    0.811
全体として[MASK]店だった。    0.544    0.556    0.856    0.533
総合評価は[MASK]です。      0.500    0.500    0.500    0.500
[('最高', 0.284), ('a', 0.048), ('残念', 0.045), ('好き', 0.026), ('星', 0.026), ('以下', 0.024)]
- パターンで正解率が大きく変わる: 「この店は[MASK]。」は、どのバーバライザでも0.72〜0.86でした。一方、「総合評価は[MASK]です。」は、どの組でも0.500で、すべてのレビューをポジティブと答えました。最後の行のように、「料理はまずかった。」のネガティブのレビューでも、このパターンの穴には「最高」(0.284)が最も入りやすく、ネガティブの語では「残念」「以下」が出てきます。4組のネガティブの語(悪い・最悪・嫌い)はポジティブの語より出にくいので、レビューの内容に関係なく、いつもポジティブの語が勝ちます。
- バーバライザでも変わる: 「全体として[MASK]店だった。」は、「最高 / 最悪」なら0.856でしたが、「良い / 悪い」「いい / 悪い」「好き / 嫌い」では0.53〜0.56でした。パターンの文の中で自然に入る語を選ぶ必要があります。
PET の原著論文も、パターンとバーバライザで性能が大きく変わることを報告しています。ラベル付きのデータがまったくない場合、どれを選べばよいかは分かりません。ここでは、評価用とは別の開発用データ(90件)で選びます。
# 開発用データで最も正解率の高かったパターンとバーバライザで、評価用データを解く
best_pattern, best_verb = grid.stack().idxmax()
pattern = PATTERNS[[p.format(x="", mask="[MASK]") for p in PATTERNS].index(best_pattern)]
verbalizer = tuple(best_verb.split(" / "))
probs = cloze_probs(list(test.text), pattern, verbalizer, tok, bert)
test["cloze_p"] = probs[:, 0]                                                 # ポジティブの確率
test["cloze_ok"] = (test.cloze_p > 0.5) == test.label
print(f"パターン {pattern!r}  バーバライザ {verbalizer}")
print(f"正解率 {test.cloze_ok.mean():.3f}  ポジティブと答えた割合 {(test.cloze_p > 0.5).mean():.2f}")
print(test.groupby("kind").cloze_ok.mean().round(3).to_dict())
print(test[~test.cloze_ok].groupby("kind").head(3)[["text", "label", "cloze_p"]].round(3).to_string())
開発用データで最も正解率の高かった組み合わせで評価用データを解き、書き方ごとの正解率と、間違えたレビューの例を表示するコードです。grid.stack().idxmax() は、表を「(パターン, バーバライザ) → 正解率」の1列にして、最大の組を返します。正解率が同じ0.856の組が2つあり、先に出てくる「この店は[MASK]。」と「いい / 悪い」が選ばれます。
実行結果
パターン '{x}この店は{mask}。'  バーバライザ ('いい', '悪い')
正解率 0.817  ポジティブと答えた割合 0.59
{'単純': 0.767, '否定': 0.8, '逆接': 0.883}
                           text  label  cloze_p
0                   値段はかなり高かった。      0    0.612
4                   値段は本当に高かった。      0    0.800
8                料理は思ったよりまずかった。      0    0.513
62                   値段は安くなかった。      0    0.580
65                  料理はまずくなかった。      1    0.469
69                  料理はまずくなかった。      1    0.469
132       店内は清潔だったが、値段は本当に高かった。      0    0.617
138  料理が出てくるのは早かったが、雰囲気は騒がしかった。      0    0.505
146   料理はおいしかったが、雰囲気は本当に騒がしかった。      0    0.754
- 学習なしで、正解率0.817: 評価用の180件で、ポジティブと答えた割合は0.59でした。書き方ごとでは、逆接(0.883)・否定(0.800)・単純(0.767)の順で、最も易しそうな単純が最も低くなりました。
- 間違いの多くは「値段」: 間違えた例の多くは「値段は高かった」(ラベルはネガティブ)で、ポジティブの確率は0.61〜0.80でした。「値段が高い」は、料理がまずい・対応が雑だ、ほどはっきりした悪い評価ではなく、高級な店の説明にも使われます。「いい」と「悪い」を比べると「いい」が勝ってしまい、人が付けたラベル(高い値段はネガティブ)とずれました。
- 否定は、まだ確率が0.5の近く: 「料理はまずくなかった」(ポジティブ)は0.469、「値段は安くなかった」(ネガティブ)は0.580と、0.5の近くで外れました。否定の文は、単純な文ほどはっきりした確率になりません。
自己回帰の言語モデルの尤度比較と比べる
同じ評価用データを、In-Context Learning の記事の「分類タスクを尤度比較で解く」と同じ方法で解きます。指示文と例(0個か、同じ記事の3つ)の後にレビューと「=>」を置き、続きが「 ポジティブ」と「 ネガティブ」のそれぞれについて、トークンあたりの対数尤度を求め、大きいほうを答えにします。
は、ラベルの語のトークンの数です。
import time

TASK = "次のレビュー文がポジティブかネガティブかを判定してください:"
DEMOS = [("この店の接客は丁寧で、料理もすぐに出てきた。", "ポジティブ"),       # In-Context Learning の記事と同じ3つの例
         ("注文してから一時間も待たされた上に、味も期待外れだった。", "ネガティブ"),
         ("値段の割にボリュームがあり、また来たいと思った。", "ポジティブ")]


def build_prompt(query, demos, task=TASK):
    """In-Context Learning の記事と同じ書式:指示文、「文 => ラベル」の例、最後に問いの文"""
    return task + "\n\n" + "".join(f"{x} => {y}\n" for x, y in demos) + f"{query} =>"


def likelihood_predict(texts, demos, tok, model, labels=("ポジティブ", "ネガティブ")):
    """ラベルごとに、プロンプトに続くトークンあたりの対数尤度を求め、大きいほうを選ぶ(1 がポジティブ)"""
    preds = []
    for x in texts:
        prompt = build_prompt(x, demos)
        scores = [logprob(prompt, " " + lab, tok, model, mean=True) for lab in labels]   # ラベルの数だけ読む
        preds.append(int(scores[0] > scores[1]))
    return np.array(preds)


rows = []
for model_id in ["cyberagent/open-calm-small", "cyberagent/open-calm-medium"]:
    t, m = AutoTokenizer.from_pretrained(model_id), AutoModelForCausalLM.from_pretrained(model_id).eval()
    for k in (0, 3):
        start = time.time()
        pred = likelihood_predict(list(test.text), DEMOS[:k], t, m)
        ok = pred == test.label
        rows.append({"モデル": model_id.split("/")[1], "例の数": k, "正解率": ok.mean(),
                     **ok.groupby(test.kind).mean().to_dict(), "ポジティブの割合": pred.mean(),
                     "秒": time.time() - start})
start = time.time()
cloze_probs(list(test.text), pattern, verbalizer, tok, bert)
rows.append({"モデル": "bert-base-japanese-v3(穴埋め)", "例の数": 0, "正解率": test.cloze_ok.mean(),
             **test.groupby("kind").cloze_ok.mean().to_dict(), "ポジティブの割合": (test.cloze_p > 0.5).mean(),
             "秒": time.time() - start})
print(pd.DataFrame(rows).round(3).to_string(index=False))
In-Context Learning の記事と同じ書式のプロンプトと尤度比較で、open-calm-small と open-calm-medium に、例0個と3個で評価用データを解かせ、BERT の穴埋めと正解率・時間を比べるコードです。
- DEMOS と build_prompt: In-Context Learning の記事の「分類タスクを尤度比較で解く」と同じ指示文・3つの例・「文 => ラベル」の書式です。
- likelihood_predict(texts, demos, tok, model, labels): 最初の節の logprob を mean=True で使い、ラベルごとのトークンあたりの対数尤度を比べます。ラベルの前に空白を付けるのは、例の「=> ポジティブ」と書式をそろえるためです(In-Context Learning の記事と同じ)。
- 2つのモデル: open-calm-small(約1.6億パラメータ)は BERT(約1.1億)に近い大きさ、open-calm-medium(約4.1億)はその約4倍です。In-Context Learning の記事では、small は例を増やしても正解率が平坦で、medium でわずかに伸び始めたので、2つを比べます。
- 時間: time.time() で、180件を解く時間を測ります。BERT の穴埋めも、同じ180件の cloze_probs の時間を測り直して並べます。
実行結果
                       モデル  例の数   正解率    単純   否定    逆接  ポジティブの割合       秒
           open-calm-small    0 0.694 0.633 0.70 0.750     0.794  25.223
           open-calm-small    3 0.500 0.500 0.50 0.500     0.000  54.698
          open-calm-medium    0 0.667 0.667 0.55 0.783     0.833  74.041
          open-calm-medium    3 0.794 0.800 0.65 0.933     0.294 124.074
bert-base-japanese-v3(穴埋め)    0 0.817 0.767 0.80 0.883     0.594   4.377
- BERT の穴埋めが最も高かった: 学習なしの穴埋め(0.817)は、open-calm-medium の3例(0.794)より高く、open-calm-small はどの設定でも0.694以下でした。open-calm-small の3例は、ポジティブと答えた割合が0.000で、すべてのレビューをネガティブと答えました。
- 書き方ごとの得意・不得意が違う: open-calm-medium の3例は、逆接(0.933)は BERT より高い一方、否定は0.650と低くなりました。BERT の穴埋めは、どの書き方も0.77〜0.88でした。
- 時間は約1/6〜1/28: BERT は180件を4.4秒で解きました。ラベルの数(2つ)だけプロンプトを読み直す尤度比較は、open-calm-small で25〜55秒、open-calm-medium で74〜124秒でした。例を3つ入れるとプロンプトが長くなり、さらに時間がかかります。
ただし、BERT と OpenCALM は、学習したデータもトークナイザーも違うので、この差のすべてが「両側の文脈を見るかどうか」の違いではありません。また、どちらの方法でも、正解率はパターンや指示文の書き方に左右されます。言えるのは、同じくらいの大きさのモデルで、BERT の穴埋めは1回読むだけでラベルの確率が出せ、少なくともこの課題では、尤度比較と同等以上に解けた、ということです。
少数のラベルで微調整する:[CLS] の分類層と、穴埋めのパターン
BERT の原著論文の分類の方法は、[CLS] の位置の出力に新しい分類層を付け、ラベル付きのデータでモデル全体を学習する(微調整する)ことです。PET は、パターンとバーバライザをそのまま使って、[MASK] の位置の「いい」「悪い」のロジットで学習します。ラベル付きのレビューが4〜32件しかないときに、2つの方法の正解率を比べます。
[CLS] の分類層は、[CLS] の位置の出力 をプーラー(全結合と tanh)に通し、新しい分類層 (2 × 768)と でラベルのロジットにします。
穴埋めのパターンでの微調整は、前の節の (バーバライザの2つの語のロジットの softmax)の交差エントロピーを最小にします。どちらも、学習するのはモデル全体のパラメータです。
(図は、diagram-designで作成)
from transformers import AutoModelForSequenceClassification
import matplotlib.pyplot as plt
import japanize_matplotlib


def finetune(train, method, model_id, tok, pattern, verbalizer, epochs=10, lr=2e-5, batch_size=8, seed=0):
    """少数のラベル付きデータで微調整する。method="cls" は [CLS] の上の分類層、"cloze" はパターンの [MASK] の位置の語"""
    torch.manual_seed(seed)
    rng = np.random.default_rng(seed)
    if method == "cls":
        model = AutoModelForSequenceClassification.from_pretrained(model_id, num_labels=2)   # 分類層は乱数で初期化
    else:
        model = AutoModelForMaskedLM.from_pretrained(model_id)                              # MLM ヘッドをそのまま使う
    vid = [tok.convert_tokens_to_ids(v) for v in verbalizer]
    opt = torch.optim.AdamW(model.parameters(), lr=lr)
    model.train()
    for _ in range(epochs):
        order = rng.permutation(len(train))
        for k in range(0, len(train), batch_size):
            b = train.iloc[order[k:k + batch_size]]
            y = torch.tensor(b.label.values)
            if method == "cls":
                loss = model(**tok(list(b.text), return_tensors="pt", padding=True), labels=y).loss
            else:
                enc = tok([pattern.format(x=t, mask=tok.mask_token) for t in b.text], return_tensors="pt", padding=True)
                rows, cols = (enc.input_ids == tok.mask_token_id).nonzero(as_tuple=True)
                logits = model(**enc).logits[rows, cols][:, vid]                 # (文の数, 2):[ポジティブ, ネガティブ]
                loss = F.cross_entropy(logits, 1 - y)                            # ポジティブ(y=1)は0番目の語
            opt.zero_grad(); loss.backward(); opt.step()
    return model.eval()


def accuracy(model, method, data, tok, pattern, verbalizer):
    if method == "cls":
        with torch.no_grad():
            pred = model(**tok(list(data.text), return_tensors="pt", padding=True)).logits.argmax(-1).numpy()
    else:
        pred = (cloze_probs(list(data.text), pattern, verbalizer, tok, model)[:, 0] > 0.5).astype(int)
    return (pred == data.label.values).mean()


pool = make_reviews(100, seed=2)                    # 学習用のレビュー(300件)から、少数を取り出して使う
results = []
for n in (4, 8, 16, 32):
    for seed in range(3):
        train = pd.concat([g.sample(n // 2, random_state=seed) for _, g in pool.groupby("label")])   # ラベルを半分ずつ
        for method in ("cls", "cloze"):
            model = finetune(train, method, BERT_ID, tok, pattern, verbalizer, seed=seed)
            results.append({"n": n, "seed": seed, "method": method,
                             "acc": accuracy(model, method, test, tok, pattern, verbalizer)})
res = pd.DataFrame(results)
summary = res.groupby(["n", "method"]).acc.agg(["mean", "std"]).unstack().round(3)
print(summary)


def plot_fewshot(summary, zero_shot, path):
    fig, ax = plt.subplots(figsize=(7, 3.8))
    for method, label, c in (("cls", "[CLS] の分類層を微調整", "#4C72B0"), ("cloze", "穴埋めのパターンで微調整", "#C44E52")):
        ax.errorbar(summary.index, summary["mean"][method], yerr=summary["std"][method], marker="o", capsize=3,
                    color=c, label=label)
    ax.axhline(zero_shot, color="gray", ls="--", label=f"穴埋め(学習なし){zero_shot:.3f}")
    ax.axhline(0.5, color="lightgray", ls=":", label="当てずっぽう 0.5")
    ax.set_xscale("log", base=2); ax.set_xticks(summary.index, summary.index)
    ax.set_xlabel("学習に使ったラベル付きのレビューの数"); ax.set_ylabel("評価用データの正解率")
    ax.set_ylim(0.4, 1.02); ax.legend(loc="lower right"); ax.grid(alpha=0.3)
    fig.tight_layout(); fig.savefig(path, dpi=150); plt.close(fig)


plot_fewshot(summary, test.cloze_ok.mean(), "bert_fewshot.png")
学習用のレビューから4・8・16・32件を取り出し、[CLS] の分類層と穴埋めのパターンの2つの方法で微調整して、評価用データの正解率を、取り出し方を変えた3回で比べるコードです。
- finetune(train, method, model_id, tok, pattern, verbalizer, epochs=10, lr=2e-5, batch_size=8, seed=0): 事前学習の重みからモデルを読み込み直して、AdamW で学習します。毎回読み込み直すのは、前の条件で学習した重みが、次の条件に持ち越されないようにするためです。
- method="cls": AutoModelForSequenceClassification は、BERT の本体とプーラーに、新しい分類層を付けたモデルです。分類層の重み(classifier)は事前学習のチェックポイントにないので、乱数で初期化されます(読み込みのときの MISSING の表示)。labels=y を渡すと、交差エントロピーの損失を返します。
- method="cloze": AutoModelForMaskedLM をそのまま使い、[MASK] の位置のロジットのうち、バーバライザの2つの列 vid だけを取り出して、交差エントロピーを計算します。0番目の列がポジティブの語(いい)なので、ラベル y(1がポジティブ)を 1 - y にして、列の番号に合わせています。
- epochs=10・lr=2e-5・batch_size=8: 学習率は、原著論文が微調整で試した値(5e-5・3e-5・2e-5)の1つです。データが4〜32件と少ないので、エポックを10回にして、32件でも40回(32 ÷ 8 × 10)だけ重みを更新します。学習の回数をそろえるより、同じデータを同じ回数見せる条件にそろえています。
- accuracy(model, method, data, tok, pattern, verbalizer): 評価用データの正解率です。"cloze" は、前の節の cloze_probs で確率を出し、0.5で分けます。
- pool: 学習用のレビュー(各書き方100件・計300件)を、評価用(シード0)・開発用(シード1)とは別のシード2で作ります。
- ラベルを半分ずつ: groupby("label") でラベルごとに分けて、それぞれから n // 2 件を取り出します。4件ならポジティブ2件・ネガティブ2件です。少数の例が片方のラベルに偏ると、それだけで正解率が大きく変わるためです。random_state=seed で、3回の試行ごとに違うレビューを取り出します。
- パターンとバーバライザ: 前の節で開発用データから選んだもの(この店は[MASK]。、いい / 悪い)です。
実行結果
         mean           std
method  cloze    cls  cloze    cls
n
4       0.872  0.519  0.062  0.042
8       0.863  0.561  0.052  0.096
16      0.956  0.696  0.051  0.161
32      0.991  0.970  0.012  0.031
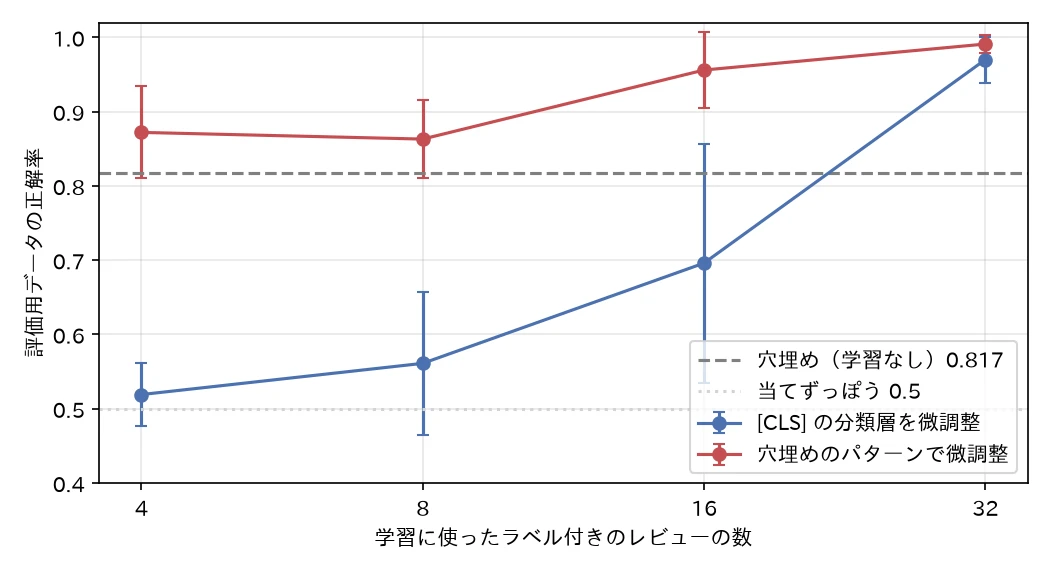
- ラベルが少ないと、穴埋めのパターンのほうがはるかに高い: 4件では、穴埋めのパターンが0.872、[CLS] の分類層が0.519(当てずっぽうとほぼ同じ)でした。8件でも0.863と0.561で、[CLS] の分類層は、学習なしの穴埋め(0.817)にも届きませんでした。
- 穴埋めのパターンは、4件でも学習なしより高い: 学習なしの0.817から、4件で0.872、16件で0.956に上がりました。パターンとバーバライザの意味は事前学習の MLM で決まっているので、少数の例は、すでにある極性の読み取りを課題に合わせて調整するだけで済みます。
- 32件で、2つの方法の差はほぼなくなった: 32件では、穴埋めのパターンが0.991、[CLS] の分類層が0.970でした。[CLS] の分類層は16件では3回のばらつき(標準偏差0.161)が大きく、取り出したレビューによって、学習が進んだり進まなかったりしました。
- 作ったレビューなので、正解率は高めに出る: 学習用と評価用は、同じ観点と表現の組み合わせから作っているので、32件でほぼすべての表現を一度は見ることになります。実際のレビューでは、表現がはるかに多様なので、同じ件数でここまでの正解率にはなりません。比べられるのは、2つの方法の差と、ラベルの数による変わり方です。
まとめ
本記事では、日本語の BERT(bert-base-japanese-v3)で、自己回帰の言語モデルとの違い、入力の埋め込み・MLM・MLM ヘッド・NSP の計算を確かめ、マスク位置のロジットで分類する方法を、作った飲食店のレビューで、尤度比較と微調整と比べました。
- BERT は両側の文脈で穴を埋める: 左側が同じ「週末は[MASK]に乗って、」の文で、右側が「海を渡った」ならヨット(0.313)、「空を飛んだ」なら気球(0.196)、「線路の上を走った」なら列車(0.332)と予測が変わりました。自己回帰の言語モデルの穴の位置の予測は、右側によらず同じでした。
- MLM は、選んだ15%を80/10/10で置き換え、その位置だけで損失を取る: スクラッチ実装の置き換えの割合は0.150・0.800・0.101・0.099で、損失(0.5291)と MLM ヘッドのロジット(差の最大 2.2e-05)はライブラリと一致しました。
- パターンとバーバライザで、学習なしでも分類できる: 「この店は[MASK]。」と「いい / 悪い」で、評価用の180件の正解率は0.817でした。ただし、パターンとバーバライザの選び方で、開発用データの正解率は0.500〜0.856と大きく変わりました。
- 尤度比較より速く、同等以上に解けた: 同じ180件で、open-calm-medium の3例の尤度比較は0.794・124秒、BERT の穴埋めは0.817・4.4秒でした。ただし、2つのモデルは学習データもトークナイザーも違います。
- ラベルが少ないときは、穴埋めのパターンで微調整するのがよい: 4件のラベルで、穴埋めのパターンは0.872、[CLS] の分類層は0.519でした。32件では0.991と0.970で、差はほぼなくなりました。作ったレビューで試したので、正解率そのものは実際のデータより高めに出ています。
BERT は、Transformer のエンコーダを、入力の一部を隠して両側の文脈から当てる MLM で事前学習したモデルです。マスク位置の出力には、その位置に入る語の確率が両側の文脈から計算されているので、分類をパターンの穴埋めに言い換えれば、追加の層を学習せずに、事前学習の知識をそのまま答えに使えます。その代わり、どのパターンとどの語で聞くかが結果を大きく左右し、確率もポジティブの語のように出やすい語の側に偏ります。
参考文献
- J. Devlin, M.-W. Chang, K. Lee, K. Toutanova (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL 2019, 4171–4186.
- T. Schick, H. Schütze (2021). Exploiting Cloze Questions for Few Shot Text Classification and Natural Language Inference. EACL 2021, 255–269.
- Y. Liu, M. Ott, N. Goyal, J. Du, M. Joshi, D. Chen, O. Levy, M. Lewis, L. Zettlemoyer, V. Stoyanov (2019). RoBERTa: A Robustly Optimized BERT Pretraining Approach. arXiv:1907.11692.
- Z. Lan, M. Chen, S. Goodman, K. Gimpel, P. Sharma, R. Soricut (2020). ALBERT: A Lite BERT for Self-supervised Learning of Language Representations. ICLR 2020.
- Tohoku NLP Group. bert-base-japanese-v3. Hugging Face(Apache License 2.0).
- CyberAgent (2023). open-calm-small・open-calm-medium. Hugging Face(CC BY-SA 4.0).
本記事の文章・構成の一部に生成AIを使用しています。