BLIP-2とは?
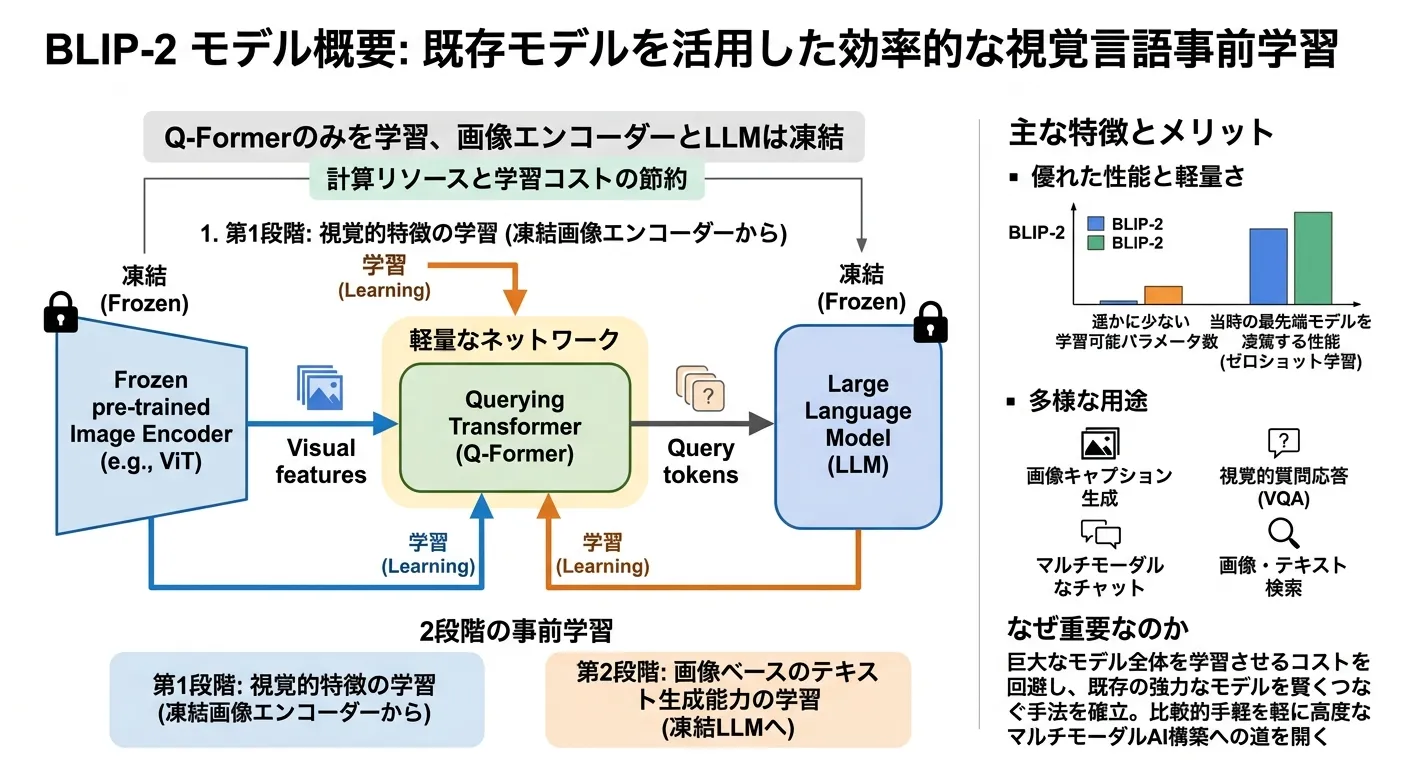 (画像は、Geminiで作成)
凍結した画像エンコーダと凍結した言語モデルを、学習する小さな Q-Former だけでつなぐ BLIP-2 を部品ごとに PyTorch で実装し、公式の学習済みの重みを読み込んで Hugging Face の実装と同じ回答を生成することを確かめること。Q-Former のクエリ 32 個が画像から何を取り出し、2 段階の学習でそれぞれ何を身につけるのかを、画像と文の対応づけ・注意の重み・質問応答の正解率・線形層の学習し直しで、自分で確かめられるようになること。
参考資料: BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models (Li et al., 2023)。公式の実装は salesforce/LAVIS(BSD-3-Clause)、本記事で使う学習済みの重みは Hugging Face の Salesforce/blip2-opt-2.7b と Salesforce/blip2-itm-vit-g です。言語モデルの OPT-2.7B は非営利の研究に限るライセンスなので、記事の最後の注記を確認してください。
概要
画像を読める言語モデル(VLM)を作るには、画像を理解する部品と、文を書く部品が必要です。どちらも、単独で大きなデータで学習した強いモデルがすでにあります。しかし、両方をつないでまとめて学習し直すと、計算の量が大きくなります。
BLIP-2(Salesforce Research、2023)は、学習済みの画像エンコーダ(EVA-CLIP の ViT-g) と言語モデル(OPT や FlanT5) の重みを凍結し、その間に置いた小さな Q-Former(約 1 億パラメータ)だけを学習します。Q-Former は、学習可能な 32 個のクエリ で画像の特徴を読み取り、言語モデルの入力の先頭に置く 32 個のベクトル(ソフトな視覚プロンプト)に変えます。学習は 2 段階で、第 1 段階では画像と文の対応を学び(ITC・ITM・ITG)、第 2 段階で言語モデルにつないで、画像の内容に沿った文を書けるようにします。
本記事では、まず Hugging Face の実装で BLIP-2(OPT-2.7B)にキャプションと質問への回答を書かせ、仕組みを図で整理したうえで、前処理・ViT-g・Q-Former・OPT・ビームサーチをスクラッチで実装します。公式の重みを読み込んで Hugging Face と同じ回答を生成することを確かめ、第 1 段階の重み(Salesforce/blip2-itm-vit-g)で ITC と ITM を動かして、COCO の画像と文の対応を当てます。さらに、クエリが画像のどこを見ているか、VQAv2 の 1,000 問でのゼロショットの正解率と、画像を消したり減らしたりしたときの変化を調べ、最後に、Q-Former と言語モデルの間の線形層だけを COCO のキャプションで学習し直します。
BLIP-2 で画像を読む
準備:Google Colab の GPU で動かす
本記事のコードは、Google Colab の A100 GPU(40GB) で実行しました。「ランタイム」→「ランタイムのタイプを変更」から A100 GPU を選んでください(Colab の有料プランが必要です)。実験2で、Hugging Face のモデルと本記事のモデルを、両方 float32(それぞれ約 15GB)で同時に GPU に載せるためです。
新しいセッションで、次を実行してください。transformers(比較用の BLIP-2)は Colab に最初から入っています。グラフの日本語表示には japanize-matplotlib を使い、Python 3.12 以降で import 時にエラーが出ないよう setuptools も入れます。
!pip install -q japanize-matplotlib setuptools
推論に利用する画像
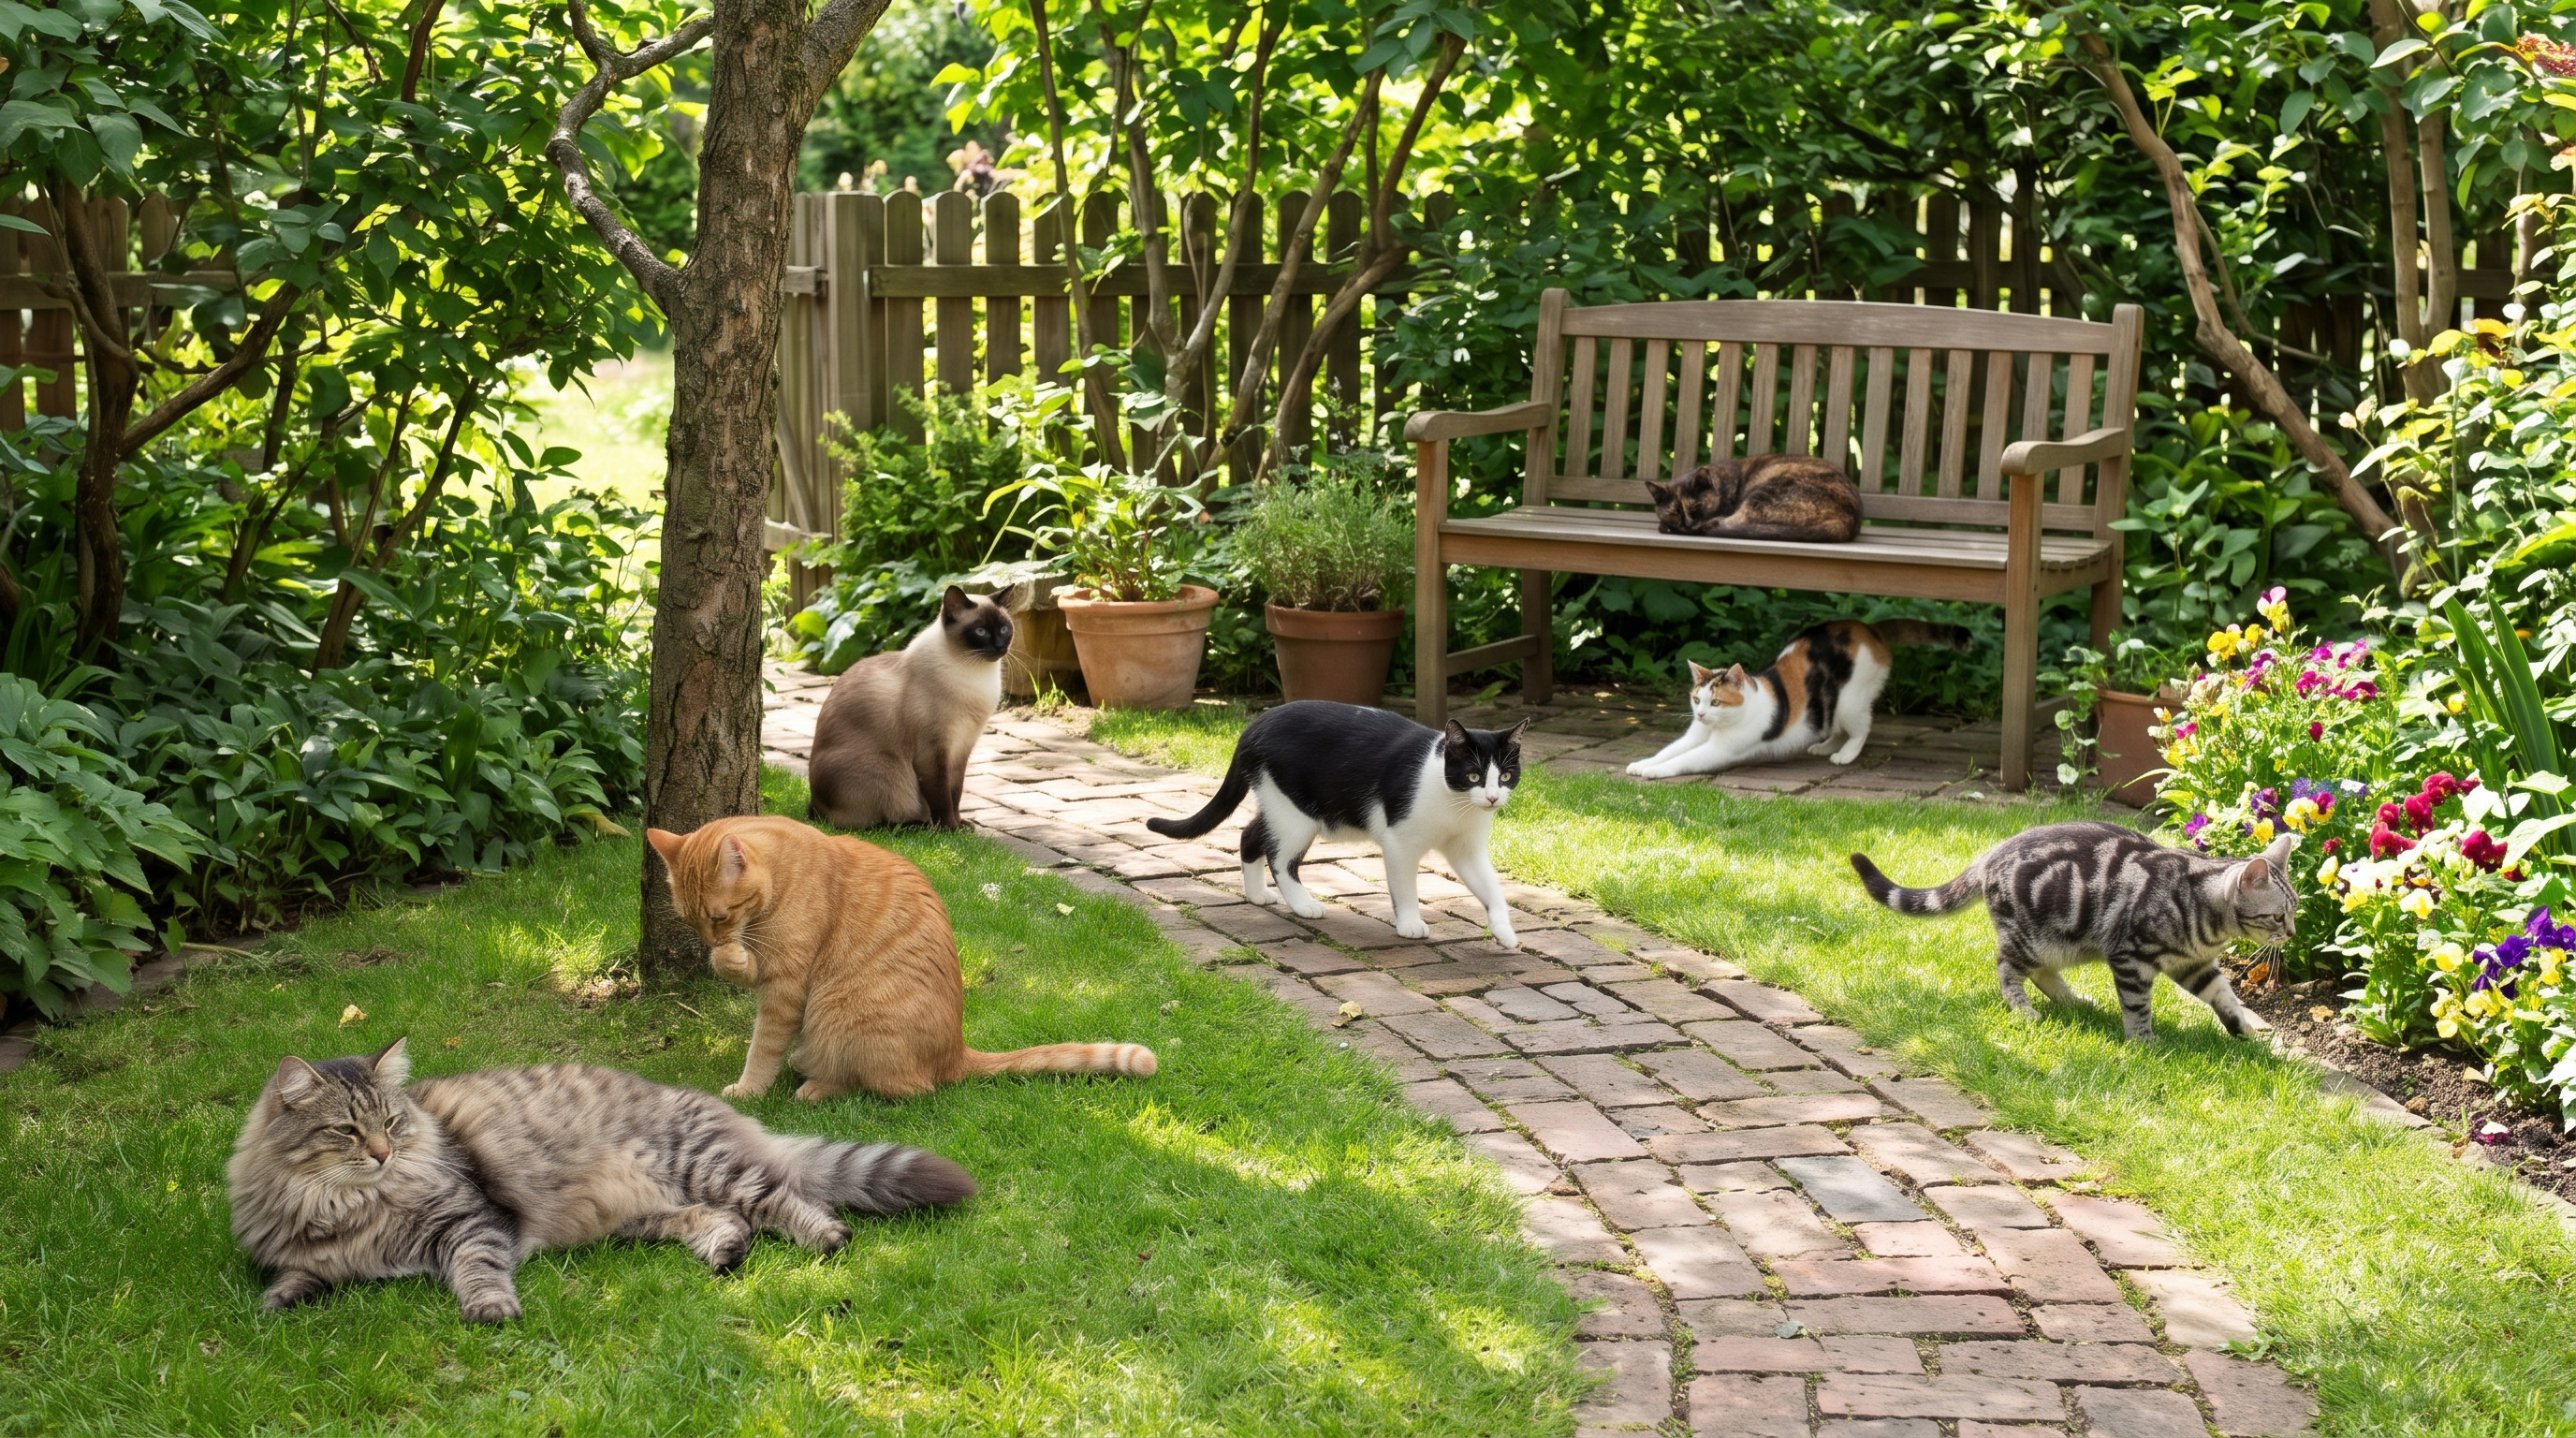
実験1・実験2・実験4では、庭にいる複数の猫の画像を使います。次の画像を保存し、cats.jpg という名前で Colab にアップロードしてください(画像は、Geminiで作成)。実験3・実験5・実験6の COCO と VQAv2 の画像は、コードの中でダウンロードします。
実験1:Hugging Face の実装でキャプションと回答を書かせる
Hugging Face の実装で、猫の画像のキャプションと、4 つの質問への回答を書かせます。
import os
import re
import gc
import json
import math
import time
import random
import zipfile
import urllib.request
from concurrent.futures import ThreadPoolExecutor
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
import matplotlib.pyplot as plt
import japanize_matplotlib
from PIL import Image
from huggingface_hub import hf_hub_download
from safetensors.torch import load_file
from transformers import Blip2Processor, Blip2ForConditionalGeneration

device = "cuda"
MID = "Salesforce/blip2-opt-2.7b"
processor = Blip2Processor.from_pretrained(MID)
hf_model = Blip2ForConditionalGeneration.from_pretrained(MID, dtype=torch.float16).to(device).eval()

# 生成の設定。どちらもビーム幅 5(論文のゼロショットの評価と同じ)
CAPTION = dict(num_beams=5, max_new_tokens=30, min_new_tokens=8)                   # 公式の評価の設定(30 トークンまで・8 トークン以上)
VQA = dict(num_beams=5, max_new_tokens=10, min_new_tokens=1, length_penalty=-1.0)  # 論文の設定(短い答えを好む length penalty -1)。10 トークンまで・1 トークン以上は公式の評価の設定


def ask_hf(model, image, prompt, gen):
    """processor が、テキストの前に画像の位置の印 <image> を 32 個並べる。モデルの中で、そこに画像のベクトル 32 個が入る"""
    inputs = processor(images=image, text=prompt, return_tensors="pt").to(device, model.dtype)
    with torch.no_grad():
        out = model.generate(**inputs, do_sample=False, **gen)
    return processor.decode(out[0, inputs["input_ids"].shape[1]:], skip_special_tokens=True).strip(), inputs


cats = Image.open("cats.jpg").convert("RGB")
answer, inputs = ask_hf(hf_model, cats, "a photo of", CAPTION)
print(f"[キャプション] a photo of → {answer}")
for q in ["How many cats are there?", "What is the cat on the bench doing?", "What color is the cat in the middle?", "Is there a dog in the picture?"]:
    answer, inputs = ask_hf(hf_model, cats, f"Question: {q} Answer:", VQA)
    print(f"[質問] {q} → {answer}")

ids = inputs["input_ids"][0].tolist()
tok = processor.tokenizer
print(f"\n入力のトークン {len(ids)} 個:<image>(ID {ids[0]})× {ids.count(ids[0])}、続く 4 個 {tok.convert_ids_to_tokens(ids[32:36])}")
print(f"画像 {cats.size[0]}×{cats.size[1]} → pixel_values {tuple(inputs['pixel_values'].shape)}")

# モデルが実際に見ている画像(正規化を戻して表示する)
mean = torch.tensor(processor.image_processor.image_mean).view(3, 1, 1)
std = torch.tensor(processor.image_processor.image_std).view(3, 1, 1)
seen = (inputs["pixel_values"][0].float().cpu() * std + mean).clamp(0, 1).permute(1, 2, 0).numpy()
fig, ax = plt.subplots(1, 2, figsize=(12, 4.2), gridspec_kw={"width_ratios": [cats.size[0] / cats.size[1], 1]})
ax[0].imshow(cats); ax[0].set_title(f"元の画像({cats.size[0]}×{cats.size[1]})")
ax[1].imshow(seen); ax[1].set_title("BLIP-2 に入る画像(224×224)")
for a in ax:
    a.axis("off")
plt.show()
- <image> × 32: processor は、テキストの前に画像の位置の印 <image>(ID 50265)を 32 個並べます。モデルの中で、この 32 か所が Q-Former の出力の 32 個のベクトルに置き換わります。印の数は、Q-Former のクエリの数(num_query_tokens=32)と同じです。
- キャプションのプロンプト: a photo of の続きを書かせます。論文が、キャプションのゼロショットの評価で使ったプロンプトです。長さの設定(30 トークンまで・8 トークン以上)は、公式の実装の評価の設定(caption_coco_opt2.7b_eval.yaml)に合わせています。
- 質問のプロンプト: Question: Answer: の形で聞きます。論文が OPT のモデルの VQA の評価で使った形です。length_penalty=-1.0 は、論文が「短い答えを促すため」と書いている設定です(ビームサーチで、長い候補ほどスコアが下がります)。
- 回答の終わり: OPT-2.7B の generation_config.json は、終わりの印(eos_token_id)を改行(ID 50118)にしています。公式の実装も、改行が出たら回答を終えます。
- float16: 推論を速くし、GPU のメモリを抑えるためです。論文も、凍結した ViT と言語モデルを半精度にして学習しています。
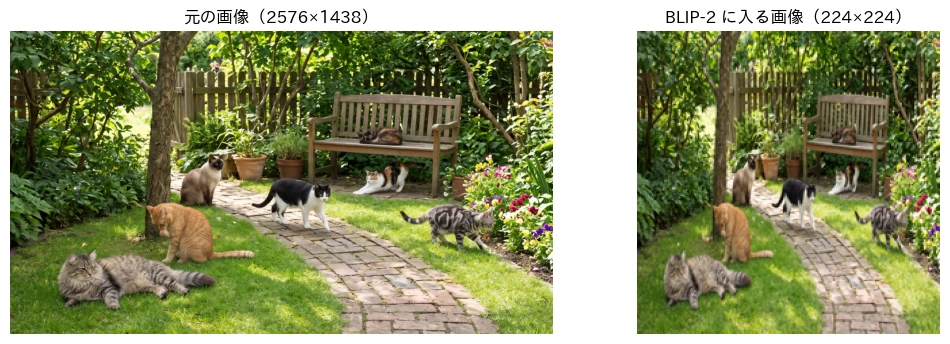
- モデルが見ている画像: 前処理は、縦横比を保たずに 224×224 に縮めます。2576×1438 の横長の画像は、横につぶれた形でモデルに入るので、元の画像と並べて表示します。
実行結果
[キャプション] a photo of → a group of cats walking in a garden
[質問] How many cats are there? → A lot
[質問] What is the cat on the bench doing? → He's looking for a new home
[質問] What color is the cat in the middle? → Blue
[質問] Is there a dog in the picture? → No

入力のトークン 45 個:<image>(ID 50265)× 32、続く 4 個 ['</s>', 'Question', ':', 'ĠIs']
画像 2576×1438 → pixel_values (1, 3, 224, 224)
- キャプション: 「a photo of」に続けて「a group of cats walking in a garden(庭を歩く猫の群れ)」と書きました。庭に猫が何匹もいることは捉えています。実際には、歩いている猫は 2〜3 匹で、ほかは座ったり寝そべったりしています。
- 猫の数: 「A lot(たくさん)」と答え、数は答えませんでした。length penalty −1 は短い答えを好むので、「Seven」のような 1 語の数も出しやすいはずですが、ビームサーチの 5 本の候補の中では「A lot」の確率が高かったということです。数を数える質問は、BLIP-2 が苦手とするものの 1 つで、実験5でも number の正解率は低くなります。
- ベンチの猫: 「He's looking for a new home(新しい家を探している)」と、画像からはわからない内容を答えました。ベンチの上の猫は寝そべっています。
- 真ん中の猫の色: 「Blue」と答えました。画像の真ん中の猫は白黒です。
- 犬はいるか: 「No」と正しく答えました。
- 入力の形: 入力は 45 トークンで、<image>(ID 50265)× 32 の後に、OPT の文の始まりの印 </s> とプロンプトが続きます(Ġ は、前に空白がある単語の印です)。
- モデルが見ている画像: 横長の画像が 224×224 につぶれて入るので、猫は細長く写り、ベンチの上の猫は数画素ほどの大きさになります。細かい質問に答えにくい理由の 1 つです。
BLIP-2 の仕組み
全体の構成
BLIP-2 は、凍結した画像エンコーダと凍結した言語モデルを、学習する Q-Former と線形層でつなぎます。実験1の「How many cats are there?」は、次の流れで答えが作られます。
(図は、diagram-designで作成)
- 画像エンコーダ: 224×224 の画像を、14×14 画素のパッチ 256 個と [CLS] の、257 個の 1,408 次元のベクトルにします。EVA-CLIP の ViT-g/14 から最後の 1 層を除いた 39 層です。論文は、最後の層の 1 つ前の出力を使う方が少し性能がよかったと書いています。
- Q-Former: 学習可能な 32 個のクエリ(各 768 次元)が、交差注意で 257 個のベクトルから情報を読み取ります。出力は、画像の大きさによらず 32×768 です。
- 線形層: 768 次元を、OPT の埋め込みと同じ 2,560 次元にします。
- 言語モデル: 32 個のベクトルを、プロンプトのトークンの埋め込みの前に並べ、凍結した OPT-2.7B に続きを書かせます。OPT から見ると、32 個のベクトルは「単語の埋め込みの代わりに置かれた、画像を表すプロンプト」です(論文は soft visual prompt と呼んでいます)。
ViT-g の出力 257×1408 をそのまま言語モデルに入れるのではなく、32×768 に絞ってから渡すのが BLIP-2 の特徴です。論文は、この絞り込み(情報のボトルネック)が、言語モデルにとって役に立つ視覚の情報だけを渡すことに働くと説明しています。
Q-Former
Q-Former は BERT-base と同じ大きさの Transformer(12 層・768 次元。自己注意と交差注意の仕組みはTransformer の記事)で、論文では BERT-base の重みで初期化し、交差注意の層だけをランダムに初期化して学習しています。
(図は、diagram-designで作成)
- 2 つの入力: クエリ 32 個と、必要なときだけ文のトークンを 1 本の列にして入れます。自己注意では、注意のマスクが許す範囲で、クエリと文が互いを見ます。
- 交差注意: 画像を読むのはクエリだけで、1 層おきに(偶数番目の 6 層に)交差注意があります。キーとバリューが ViT の出力 257 個です。
- FFN を 2 組持つ: クエリと文は、同じ自己注意を共有し、FFN は別の重みを使います。論文は、自己注意を共有する 2 つの Transformer(画像を読むクエリ側と、文のエンコーダ・デコーダになる文側)として説明しています。
学習するクエリで画像の特徴を決まった数にまとめる考え方は、Flamingo の Perceiver Resampler(画像 1 枚を 64 個のベクトルにする)と同じです。BLIP-2 はそれを言語モデルの入力の先頭に置き、Flamingo はクロス注意で参照します。
第 1 段階:画像と文の対応を学ぶ
第 1 段階では、言語モデルはつながず、ViT-g と Q-Former だけで、画像と文の組から 3 つの学習を同時にします。3 つは同じ Q-Former の重みを使い、注意のマスクだけを変えます。
(図は、diagram-designで作成)
- ITC(画像と文の対比学習): クエリと文が互いを見ないマスクで、画像側の 32 個の出力と、文の [CLS] の出力を、それぞれ 256 次元にして比べます。32 個のうち文に最も近いものの類似度を、画像と文の類似度にします。バッチの中の正しい組の類似度が高く、ほかの組が低くなるように学習します。画像の枚数を 、類似度を 、温度を (学習するパラメータ)とすると、画像から文の向きの損失は次のとおりで、文から画像の向きも同じ形で足します。
- ITM(画像と文の一致の判定): 全部が互いに見合うマスクで、クエリの 32 個の出力のそれぞれを 2 クラス(対応する・しない)に分類し、32 個の logit を平均します。ITC の類似度が高いのに対応しない組(見分けにくい負例)を選んで学習します。
- ITG(画像を見て文を生成): 文はクエリと前の単語だけを見るマスクで、次の単語を当てます。クエリは文を見られないので、文を書くのに要る情報を画像から集めるように学習されます。
第 2 段階:言語モデルにつなぐ
第 2 段階では、第 1 段階の Q-Former に線形層を足して凍結した OPT につなぎ、画像とキャプションの組で、キャプションの次の単語を当てる学習をします。損失は、キャプションの部分だけで計算します。
は Q-Former の出力(32×768)、 は線形層、 はキャプションの 番目のトークンです。OPT の重みは更新しませんが、勾配は OPT の中を通って、Q-Former と線形層に届きます。論文は、第 1 段階をしないと、第 2 段階だけでは性能が大きく下がることを示しています(OPT では、学習の途中で性能が落ちる「破滅的な忘却」も起きたと書いています)。
論文と本記事の違い
本記事は、論文の 2 段階の学習はせず、公開されている学習済みの重みを読み込んで使います。実験6でだけ、線形層を小さなデータで学習し直します。
| 項目 | 論文 | 本記事 |
|---|---|---|
| 画像エンコーダ | EVA-CLIP の ViT-g/14(最後の層を除く)、224×224 | 同じ(Hugging Face の重み) |
| Q-Former | BERT-base で初期化、クエリ 32 個、1.88 億パラメータ | 同じ構成。第 2 段階の重みは文の部分を含まず約 1.05 億 |
| 言語モデル | OPT-2.7B・6.7B、FlanT5-XL・XXL | OPT-2.7B だけ |
| 学習データ | 約 1.29 億枚(COCO・Visual Genome・CC3M・CC12M・SBU・LAION の 1.15 億枚)、CapFilt で作り直したキャプション | 学習済みの重みを使う。実験6だけ COCO の 5,000 枚 × 5 キャプション |
| 第 1 段階 | 25 万ステップ、バッチ 1,680(ViT-g) | しない(学習済みの重みで ITC・ITM を動かす) |
| 第 2 段階 | 8 万ステップ、バッチ 1,920(OPT) | 実験6で、線形層だけ を 2,343 ステップ(3 エポック)、バッチ 32 |
| 最適化 | AdamW(β = 0.9, 0.98、weight decay 0.05)、最大 1e-4 のコサイン、ウォームアップ 2,000 ステップ、第 2 段階の最小 5e-5 | 実験6で同じ AdamW、ウォームアップは同じ割合(2.5%)、最大の半分まで下げる |
| 数値の精度 | 凍結した ViT と言語モデルを FP16 | 実験2は全部 FP32、それ以外は ViT と OPT を FP16(Q-Former は FP32) |
| 計算機 | A100(40GB)16 枚の 1 台。ViT-g と FlanT5-XXL で第 1 段階 6 日以内・第 2 段階 3 日以内 | A100(40GB)1 枚 |
| VQAv2 の評価 | 検証用データの全部(214,354 問)、正解率 53.5% | 無作為に選んだ 1,000 問 |
BLIP-2 をスクラッチで実装する
ここからは、BLIP-2 を部品ごとに PyTorch で書きます。部品の構成と重みの名前は、Hugging Face の transformers の modeling_blip_2.py・modeling_opt.py と、公式の実装(LAVIS)に合わせ、公式の学習済みの重みをそのまま読み込めるようにします。
前処理
画像を ViT-g に入れる形にします。縦横比を保たずに 224×224 に縮め、0〜1 の値にしてから、色ごとに平均を引いて標準偏差で割ります。
# EVA-CLIP の ViT-g が学習したときの正規化の値(OpenAI の CLIP と同じ。preprocessor_config.json の値)
MEAN = torch.tensor([0.48145466, 0.4578275, 0.40821073]).view(3, 1, 1)
STD = torch.tensor([0.26862954, 0.26130258, 0.27577711]).view(3, 1, 1)


def preprocess(image, size=224):
    """縦横比を保たずに 224×224 に縮め(bicubic)、0〜1 にしてから色ごとに正規化する"""
    x = np.asarray(image.convert("RGB").resize((size, size), Image.BICUBIC), dtype=np.float32) / 255.0
    return ((torch.from_numpy(x).permute(2, 0, 1) - MEAN) / STD).unsqueeze(0)


x = preprocess(cats)
ref = processor.image_processor(cats, return_tensors="pt")["pixel_values"]
d = (x - ref).abs()
print(f"{cats.size[0]}×{cats.size[1]} → {tuple(x.shape)}、HF との差の最大値 {d.max():.2e}(画素値 1 段階の幅は {1 / 255 / STD.min():.4f})、差のある値の割合 {(d > 1e-4).float().mean() * 100:.1f}%")
- 正規化の値: EVA-CLIP の ViT-g が学習したときの値で、OpenAI の CLIP と同じです。Hugging Face の preprocessor_config.json にも同じ値が書かれています。学習時と違う値で正規化すると、ViT が見慣れない分布の入力になるので、そろえる必要があります。
- 縮め方: 公式の実装(LAVIS)の評価用の前処理は、PIL の画像を torchvision の Resize((224, 224), BICUBIC) で縮めます。PIL の画像に対してはこれが PIL の bicubic になるので、本記事も PIL で縮めます。
実行結果
2576×1438 → (1, 3, 224, 224)、HF との差の最大値 1.50e-02(画素値 1 段階の幅は 0.0150)、差のある値の割合 0.1%
本記事の前処理と Hugging Face の前処理は、全体の 0.1% の値で、画素値 1 段階分(0.015)だけ違いました。Hugging Face の transformers のバージョン 5 の画像の前処理は、画像を torchvision のテンソルにしてから縮める実装で、PIL で縮める公式の実装と、丸めの細部が少し違うためです。この差がモデルの出力に与える影響は、実験2で確かめます。
画像エンコーダ(ViT-g)
画像エンコーダは、EVA-CLIP の ViT-g/14 から最後の 1 層を除いた 39 層です(1,408 次元・16 ヘッド・MLP の中間 6,144 次元)。ブロックは、注意と MLP の前に LayerNorm を置く pre-LN の形です。
class ViTAttention(nn.Module):
    """EVA の注意。q・k・v を 1 つの線形層でまとめて計算する。バイアスは q と v だけにあり、k にはない"""

    def __init__(self, dim=1408, heads=16):
        super().__init__()
        self.heads, self.hd = heads, dim // heads              # 1 ヘッド 88 次元
        self.qkv = nn.Linear(dim, 3 * dim, bias=False)
        self.q_bias = nn.Parameter(torch.zeros(dim))
        self.v_bias = nn.Parameter(torch.zeros(dim))
        self.proj = nn.Linear(dim, dim)

    def forward(self, x):
        B, N, D = x.shape
        bias = torch.cat([self.q_bias, torch.zeros_like(self.q_bias), self.v_bias])   # k のバイアスは 0 に固定
        q, k, v = F.linear(x, self.qkv.weight, bias).view(B, N, 3, self.heads, self.hd).permute(2, 0, 3, 1, 4)
        out = F.scaled_dot_product_attention(q, k, v)        # softmax(q kᵀ / √88) v。画像の中は全部の位置を見合う
        return self.proj(out.transpose(1, 2).reshape(B, N, D))


class ViTBlock(nn.Module):
    """前置きの LayerNorm(pre-LN):x + 注意(LN(x)) → x + MLP(LN(x))"""

    def __init__(self, dim=1408, heads=16, mlp=6144):
        super().__init__()
        self.norm1 = nn.LayerNorm(dim, eps=1e-6)
        self.attn = ViTAttention(dim, heads)
        self.norm2 = nn.LayerNorm(dim, eps=1e-6)
        self.fc1, self.fc2 = nn.Linear(dim, mlp), nn.Linear(mlp, dim)

    def forward(self, x):
        x = x + self.attn(self.norm1(x))
        return x + self.fc2(F.gelu(self.fc1(self.norm2(x))))


class VisionEncoder(nn.Module):
    """EVA-CLIP の ViT-g/14 から最後の 1 層を除いた 39 層。224×224 の画像を、[CLS] と 16×16 のパッチの 257 個のベクトルにする"""

    def __init__(self, dim=1408, depth=39, heads=16, mlp=6144, patch=14, image=224):
        super().__init__()
        self.patch = nn.Conv2d(3, dim, patch, patch)          # 14×14 画素ごとに 1 つのベクトルにする
        self.cls = nn.Parameter(torch.zeros(1, 1, dim))
        self.pos = nn.Parameter(torch.zeros(1, (image // patch) ** 2 + 1, dim))
        self.blocks = nn.ModuleList([ViTBlock(dim, heads, mlp) for _ in range(depth)])
        self.norm = nn.LayerNorm(dim, eps=1e-6)               # BLIP-2 が ViT の出力に足した LayerNorm(公式の実装の ln_vision)

    def forward(self, pixel_values):
        x = self.patch(pixel_values.to(self.patch.weight.dtype)).flatten(2).transpose(1, 2)   # [B, 256, 1408]
        x = torch.cat([self.cls.expand(x.shape[0], -1, -1), x], dim=1) + self.pos            # [B, 257, 1408]
        for blk in self.blocks:
            x = blk(x)
        return self.norm(x)
- ViTAttention: q・k・v を 1 つの線形層(qkv)でまとめて計算します。バイアスは q と v だけに持たせ、k のバイアスは 0 に固定します。EVA の実装の設計で、k のバイアスはどのキーにも同じ値を足すだけなので、softmax の結果を変えません(クエリとの内積に一定の値が加わるだけで、キーの間の差は変わらないため)。
- F.scaled_dot_product_attention: を計算する PyTorch の関数です。画像の中の注意にはマスクがなく、257 個の全部の位置が互いを見ます。
- VisionEncoder: 14×14 画素ごとの畳み込み(patch)で 16×16 = 256 個のベクトルにし、先頭に [CLS] を足して、位置の埋め込みを加えます。最後の norm は、BLIP-2 が ViT の出力に足した LayerNorm(公式の実装の ln_vision)です。ViT-g の最後の層を除いたので、その出力をそろえ直すためのものです。
- depth=39: Hugging Face の config.json の num_hidden_layers と同じ値です。
Q-Former
Q-Former は BERT と同じ形の Transformer です。注意と FFN の後に「出力 + 入力」を LayerNorm に通す post-LN の形で、ViT・OPT(pre-LN)とは LayerNorm の位置が違います。テキストを入れる部分(文の埋め込みと文用の FFN)は、実験3の第 1 段階の重みで使います。
class QFAttention(nn.Module):
    """Q-Former の注意(BERT と同じ形)。kv_dim を 1408 にすると、クエリが画像の特徴を読む交差注意になる"""

    def __init__(self, dim=768, heads=12, kv_dim=768):
        super().__init__()
        self.heads, self.hd = heads, dim // heads            # 1 ヘッド 64 次元
        self.query, self.key, self.value = nn.Linear(dim, dim), nn.Linear(kv_dim, dim), nn.Linear(kv_dim, dim)
        self.dense = nn.Linear(dim, dim)
        self.norm = nn.LayerNorm(dim, eps=1e-12)
        self.attn = None                                     # 実験5で、交差注意の重みを見るために残す

    def forward(self, x, kv=None, mask=None, keep_attn=False):
        kv = x if kv is None else kv                         # kv を渡さなければ自己注意
        B, N, _ = x.shape
        q = self.query(x).view(B, N, self.heads, self.hd).transpose(1, 2)
        k = self.key(kv).view(B, -1, self.heads, self.hd).transpose(1, 2)
        v = self.value(kv).view(B, -1, self.heads, self.hd).transpose(1, 2)
        att = q @ k.transpose(-1, -2) * self.hd ** -0.5
        if mask is not None:
            att = att + mask                                 # 見てはいけない位置に、とても小さい値を足す
        att = att.softmax(-1)
        if keep_attn:
            self.attn = att
        out = (att @ v).transpose(1, 2).reshape(B, N, -1)
        return self.norm(self.dense(out) + x)                # 後置きの LayerNorm(post-LN、BERT と同じ)


class FFN(nn.Module):
    def __init__(self, dim=768, hidden=3072):
        super().__init__()
        self.fc1, self.fc2 = nn.Linear(dim, hidden), nn.Linear(hidden, dim)
        self.norm = nn.LayerNorm(dim, eps=1e-12)

    def forward(self, x):
        return self.norm(self.fc2(F.gelu(self.fc1(x))) + x)


class QFormerLayer(nn.Module):
    """自己注意 → (偶数番目の層だけ)クエリが画像を読む交差注意 → FFN。FFN はクエリ用とテキスト用で別の重み"""

    def __init__(self, idx, dim=768, vis_dim=1408, text=False):
        super().__init__()
        self.self_attn = QFAttention(dim)
        self.cross_attn = QFAttention(dim, kv_dim=vis_dim) if idx % 2 == 0 else None
        self.ffn_query = FFN(dim)
        self.ffn_text = FFN(dim) if text else None

    def forward(self, x, n_query, image=None, mask=None, keep_attn=False):
        x = self.self_attn(x, mask=mask)                     # クエリとテキストが、マスクで許された相手だけを見る
        q, t = x[:, :n_query], x[:, n_query:]
        if n_query > 0 and self.cross_attn is not None:
            q = self.cross_attn(q, kv=image, keep_attn=keep_attn)   # 画像を読むのはクエリだけ
        out = [self.ffn_query(q)] if n_query > 0 else []
        if t.shape[1] > 0:
            out.append(self.ffn_text(t))
        return torch.cat(out, dim=1)


class QFormer(nn.Module):
    """BERT-base と同じ大きさ(12 層・768 次元)。学習可能なクエリ 32 個が、交差注意で画像の特徴を読み取る。
    vocab を渡すと、テキストの埋め込みも持つ(第 1 段階の ITC・ITM で文を入れるとき)"""

    def __init__(self, n_query=32, dim=768, depth=12, vis_dim=1408, vocab=None):
        super().__init__()
        self.query_tokens = nn.Parameter(torch.zeros(1, n_query, dim))
        self.word_emb = nn.Embedding(vocab, dim) if vocab else None
        self.pos_emb = nn.Embedding(512, dim) if vocab else None
        self.norm = nn.LayerNorm(dim, eps=1e-12)
        self.layers = nn.ModuleList([QFormerLayer(i, dim, vis_dim, text=vocab is not None) for i in range(depth)])

    def forward(self, image=None, input_ids=None, text_mask=None, keep_attn=False):
        """image だけ:クエリが画像を読む。input_ids だけ:テキストだけ(ITC のテキスト側)。両方:クエリとテキストが見合う(ITM)"""
        parts = []
        if image is not None:
            parts.append(self.query_tokens.expand(image.shape[0], -1, -1))
        if input_ids is not None:
            pos = torch.arange(input_ids.shape[1], device=input_ids.device)
            parts.append(self.word_emb(input_ids) + self.pos_emb(pos))
        x = self.norm(torch.cat(parts, dim=1))
        n_query = self.query_tokens.shape[1] if image is not None else 0
        mask = None
        if text_mask is not None:                            # テキストのパディングの位置は、誰からも見えないようにする
            keep = torch.cat([text_mask.new_ones(x.shape[0], n_query), text_mask], dim=1)
            mask = (1.0 - keep[:, None, None, :].to(x.dtype)) * torch.finfo(x.dtype).min
        image = None if image is None else image.to(x.dtype)
        for layer in self.layers:
            x = layer(x, n_query, image, mask, keep_attn)
        return x
- QFAttention: 自己注意と交差注意を同じクラスで書きます。kv を渡さなければ自己注意、ViT の出力を渡せば交差注意です。交差注意のキーとバリューの線形層は、入力が 1,408 次元(kv_dim)です。
- 注意の重みを残す: keep_attn=True のとき、softmax の後の重みを self.attn に残します。実験4で、クエリが画像のどこを見ているかを調べるためです。このため、注意は F.scaled_dot_product_attention を使わずに、式どおりに計算しています。
- マスク: パディングの位置に、float32 で表せる最も小さい値を足して、softmax の後に 0 になるようにします。クエリの列は常に見えるようにします。
- QFormerLayer: 交差注意は、層の番号が偶数(0, 2, …, 10)のときだけ作ります。Hugging Face の cross_attention_frequency=2 と同じです。交差注意と FFN は、列をクエリの部分と文の部分に分けてから通し、最後に連結します。
- QFormer.forward: 入れるものによって、3 つの使い方になります。画像だけのときは、クエリだけの列で画像を読みます(第 2 段階と ITC の画像側)。文だけのときは、文だけの列です(ITC の文側)。両方のときは、クエリと文が互いに見合います(ITM)。
- pos_emb: 文のトークンにだけ位置の埋め込みを足します。クエリは位置の埋め込みを持たず、32 個のベクトルそのものが学習されます。
言語モデル(OPT-2.7B)
言語モデルは OPT-2.7B(32 層・2,560 次元・32 ヘッド・FFN の中間 10,240 次元)です。生成のときに、前のステップまでの k・v を残して使い回す KV キャッシュも持たせます。
class OPTAttention(nn.Module):
    def __init__(self, dim=2560, heads=32):
        super().__init__()
        self.heads, self.hd = heads, dim // heads            # 1 ヘッド 80 次元
        self.q_proj, self.k_proj, self.v_proj, self.out_proj = (nn.Linear(dim, dim) for _ in range(4))

    def forward(self, x, mask, cache=None):
        B, N, D = x.shape
        q = (self.q_proj(x) * self.hd ** -0.5).view(B, N, self.heads, self.hd).transpose(1, 2)   # OPT は q に先に √80 の逆数を掛ける
        k = self.k_proj(x).view(B, N, self.heads, self.hd).transpose(1, 2)
        v = self.v_proj(x).view(B, N, self.heads, self.hd).transpose(1, 2)
        if cache is not None:                                # 生成中は、前のステップまでの k・v に今回の分をつなげる(KV キャッシュ)
            if "k" in cache:
                k, v = torch.cat([cache["k"], k], dim=2), torch.cat([cache["v"], v], dim=2)
            cache["k"], cache["v"] = k, v
        out = F.scaled_dot_product_attention(q, k, v, attn_mask=mask, scale=1.0)
        return self.out_proj(out.transpose(1, 2).reshape(B, N, D))


class OPTLayer(nn.Module):
    """前置きの LayerNorm:x + 注意(LN(x)) → x + FFN(LN(x))。FFN の活性化関数は ReLU"""

    def __init__(self, dim=2560, heads=32, ffn=10240):
        super().__init__()
        self.self_attn_layer_norm = nn.LayerNorm(dim)
        self.self_attn = OPTAttention(dim, heads)
        self.final_layer_norm = nn.LayerNorm(dim)
        self.fc1, self.fc2 = nn.Linear(dim, ffn), nn.Linear(ffn, dim)

    def forward(self, x, mask, cache=None):
        x = x + self.self_attn(self.self_attn_layer_norm(x), mask, cache)
        return x + self.fc2(F.relu(self.fc1(self.final_layer_norm(x))))


class OPT(nn.Module):
    """OPT-2.7B:32 層・2,560 次元・32 ヘッドの decoder-only Transformer"""

    def __init__(self, vocab=50304, dim=2560, depth=32, heads=32, ffn=10240, max_pos=2048):
        super().__init__()
        self.embed_tokens = nn.Embedding(vocab, dim)
        self.embed_positions = nn.Embedding(max_pos + 2, dim)    # 位置の番号に 2 を足して引く(OPT の学習時の実装の名残)
        self.layers = nn.ModuleList([OPTLayer(dim, heads, ffn) for _ in range(depth)])
        self.final_layer_norm = nn.LayerNorm(dim)

    def forward(self, inputs_embeds, attention_mask, caches=None):
        """attention_mask は、キャッシュの分も含めた全体の長さ(1 が実際のトークン、0 が左詰めのパディング)"""
        B, N, _ = inputs_embeds.shape
        K = attention_mask.shape[1]
        pos = (attention_mask.cumsum(1) * attention_mask - 1)[:, K - N:]     # パディングを数えない位置の番号
        x = inputs_embeds + self.embed_positions(pos + 2).to(inputs_embeds.dtype)
        allowed = torch.ones(N, K, dtype=torch.bool, device=x.device).tril(K - N)[None, None] & attention_mask[:, None, None, :].bool()
        mask = torch.zeros(allowed.shape, dtype=x.dtype, device=x.device).masked_fill(~allowed, torch.finfo(x.dtype).min)
        for i, layer in enumerate(self.layers):
            x = layer(x, mask, None if caches is None else caches[i])
        return self.final_layer_norm(x) @ self.embed_tokens.weight.T          # 出力層は埋め込みと同じ重み(weight tying)
- q のスケール: OPT は、q に を先に掛け、注意の関数には scale=1.0 を渡します。Hugging Face の実装も「元の実装の計算の順番に合わせるため」としてこの順番にしています。掛ける順番で浮動小数点の丸めが変わるので、同じ順番にそろえます。
- 位置の埋め込み: 位置の番号は、注意のマスクの累積和から作ります。左にパディングがあっても、実際のトークンの番号が 0 から始まるようにするためです。OPT は、番号に 2 を足してから埋め込みの表を引きます(元の学習の実装でパディングの番号を 1 にしていた名残)。
- 注意のマスク: 未来のトークンを見ない因果的なマスクと、パディングを見ないマスクを重ねます。tril(K - N) は、キャッシュがあって新しいトークンが 個・全体が 個のときに、新しいトークンがキャッシュの全部と自分より前を見られるようにする対角のずらしです。
- 出力層: 埋め込みの表と同じ重み(weight tying)を使い、語彙 50,304 個の logit を出します。OPT の重みには、出力層の重みが別にありません。
BLIP-2 の組み立てとビームサーチ
部品をつないで BLIP-2 にし、回答を生成するビームサーチを書きます。ビームサーチは、比較のために Hugging Face の generate(num_beams=...) と同じ規則にしています。
class BLIP2(nn.Module):
    """画像 → ViT-g(凍結)→ Q-Former(クエリ 32 個)→ 線形層 → OPT-2.7B(凍結)"""

    def __init__(self):
        super().__init__()
        self.vision = VisionEncoder()
        self.qformer = QFormer()
        self.proj = nn.Linear(768, 2560)          # Q-Former の出力を OPT の埋め込みの大きさにする
        self.lm = OPT()

    def image_prefix(self, pixel_values, keep_attn=False):
        """画像 1 枚を、OPT の入力の先頭に置くベクトル 32 個(ソフトな視覚プロンプト)にする"""
        image = self.vision(pixel_values.to(self.vision.patch.weight.dtype))              # [B, 257, 1408]
        q = self.qformer(image=image.to(self.qformer.norm.weight.dtype), keep_attn=keep_attn)   # [B, 32, 768]
        return self.proj(q.to(self.proj.weight.dtype))                                    # [B, 32, 2560]


tokenizer = processor.tokenizer
NEWLINE = tokenizer("\n", add_special_tokens=False).input_ids[0]   # 公式の実装は、改行で回答を終える(ID 50118)


def prompt_ids(text):
    """先頭に </s>(OPT の文の始まりの印)を付けたトークン列"""
    return torch.tensor([tokenizer(text).input_ids], device=device)


@torch.no_grad()
def beam_search(model, prefix, ids, beams=5, max_new=10, min_new=1, length_penalty=1.0, eos=NEWLINE):
    """Hugging Face の generate(num_beams=...) と同じ規則のビームサーチ(1 問ずつ)。
    完成した候補のスコアは「対数確率の和 ÷ 長さ^length_penalty」。length_penalty が負だと短い答えが有利になる"""
    lm = model.lm
    emb = lm.embed_tokens(ids)
    if prefix is not None:                                   # [画像のベクトル 32 個][</s> プロンプト]
        emb = torch.cat([prefix.to(emb.dtype), emb], dim=1)
    mask = torch.ones(1, emb.shape[1], dtype=torch.long, device=emb.device)
    caches = [dict() for _ in lm.layers]
    logits = lm(emb, mask, caches)[:, -1].float()
    for c in caches:                                         # 1 本の入力を、ビームの数だけ複製する
        c["k"], c["v"] = c["k"].expand(beams, -1, -1, -1).contiguous(), c["v"].expand(beams, -1, -1, -1).contiguous()
    logits = logits.expand(beams, -1)
    seqs = torch.zeros(beams, 0, dtype=torch.long, device=emb.device)
    scores = torch.tensor([0.0] + [-1e9] * (beams - 1), device=emb.device)   # 最初は 1 本だけが生きている
    done = []                                                # 完成した候補(スコア, トークン列)
    for step in range(max_new):
        logp = logits.log_softmax(-1)
        if step < min_new:
            logp[:, eos] = -float("inf")                     # 最低の長さに届くまで、終わりの印を選ばせない
        top, idx = (scores[:, None] + logp).view(-1).topk(2 * beams)   # 全ビームの続きから、上位 2×ビーム幅の候補
        src, tok = idx // logp.shape[1], idx % logp.shape[1]
        finish = (tok == eos) | (step == max_new - 1)        # 終わりの印か、最大の長さに達した候補
        for r in range(beams):                               # 上位ビーム幅の順位にある候補だけが、完成に入れる
            if finish[r]:
                done.append((top[r].item() / (step + 1) ** length_penalty, torch.cat([seqs[src[r]], tok[r:r + 1]])))
        done = sorted(done, key=lambda d: -d[0])[:beams]
        live = top.masked_fill(finish, -1e9).topk(beams).indices   # 完成しなかった候補から、次のビームを選ぶ
        seqs, scores = torch.cat([seqs[src[live]], tok[live, None]], dim=1), top[live].masked_fill(finish[live], -1e9)
        best_possible = scores[0].item() / (step + 1) ** length_penalty
        if step == max_new - 1 or (len(done) == beams and best_possible <= done[-1][0]):
            break                                            # これ以上、完成した候補より良くなる見込みがない
        for c in caches:
            c["k"], c["v"] = c["k"][src[live]], c["v"][src[live]]
        mask = torch.ones(beams, mask.shape[1] + 1, dtype=torch.long, device=emb.device)
        logits = lm(lm.embed_tokens(seqs[:, -1:]), mask, caches)[:, -1].float()   # 最後のトークンだけを入れる
    return done[0][1]


def answer(model, image, text, gen):
    """画像(なければ None)とプロンプトから、ビームサーチで文を生成する"""
    prefix = None if image is None else model.image_prefix(preprocess(image).to(device))
    out = beam_search(model, prefix, prompt_ids(text), **gen)
    return tokenizer.decode(out, skip_special_tokens=True).strip()


# HF の generate と同じ意味の設定(max_new_tokens → max_new など)
CAPTION_S = dict(beams=5, max_new=30, min_new=8)
VQA_S = dict(beams=5, max_new=10, min_new=1, length_penalty=-1.0)
- image_prefix: 画像を、OPT の入力の先頭に置く 32 個のベクトルにします。Hugging Face の実装は、モデル全体を半精度で読み込んでも Q-Former だけは float32 のまま残す設定(_keep_in_fp32_modules)にしているので、本記事もそれに合わせ、Q-Former の前後で型を変換します。
- prompt_ids: OPT のトークナイザは、先頭に </s>(ID 2)を付けます。OPT は、この印を文の始まりとして学習しています。
- ビームサーチの候補: 毎ステップ、5 本のビームの続きの中から上位 10 個(ビーム幅の 2 倍)を取ります。終わりの印(改行)で終わる候補は「完成」に回し、残りから次の 5 本を選ぶので、10 個取っておけば、完成に回った候補があっても 5 本を続けられます。
- 長さの補正: 完成した候補のスコアは「対数確率の和 ÷ 長さ」です。対数確率の和は負なので、length_penalty が −1 だと長さを掛けることになり、長い候補ほどスコアが下がります。VQA で短い答え(「2」「yes」など)を出させるための設定です。
- 止める条件: 完成した候補が 5 個そろい、生きているビームの最もよいスコアを今の長さで補正しても、完成した候補の最も悪いスコアを超えないときに止めます。Hugging Face の既定(early_stopping=False)と同じ規則です。
- KV キャッシュ: 最初にプロンプト全体を 1 回通し、その後は最後のトークンだけを入れます。ビームを選び直すたびに、キャッシュの並びも選んだビームに合わせて並べ替えます。
学習済みの重みを読み込む
Hugging Face の重み(safetensors)を読み、名前を本記事のモデルの名前に置き換えて読み込みます。
# Hugging Face の重みの名前 → 本記事のモデルの名前(上から順に置き換える)
RENAME = [
    (r"^vision_model\.embeddings\.class_embedding$", "vision.cls"),
    (r"^vision_model\.embeddings\.patch_embedding\.", "vision.patch."),
    (r"^vision_model\.embeddings\.position_embedding$", "vision.pos"),
    (r"^vision_model\.encoder\.layers\.(\d+)\.layer_norm(\d)\.", r"vision.blocks.\1.norm\2."),
    (r"^vision_model\.encoder\.layers\.(\d+)\.mlp\.", r"vision.blocks.\1."),
    (r"^vision_model\.encoder\.layers\.(\d+)\.self_attn\.projection\.", r"vision.blocks.\1.attn.proj."),
    (r"^vision_model\.encoder\.layers\.(\d+)\.self_attn\.qkv\.", r"vision.blocks.\1.attn.qkv."),
    (r"^vision_model\.post_layernorm\.", "vision.norm."),
    (r"^query_tokens$", "qformer.query_tokens"),
    (r"^qformer\.layernorm\.", "qformer.norm."),
    (r"^embeddings\.word_embeddings\.", "qformer.word_emb."),
    (r"^embeddings\.position_embeddings\.", "qformer.pos_emb."),
    (r"^qformer\.encoder\.layer\.(\d+)\.attention\.attention\.", r"qformer.layers.\1.self_attn."),
    (r"^qformer\.encoder\.layer\.(\d+)\.attention\.output\.dense\.", r"qformer.layers.\1.self_attn.dense."),
    (r"^qformer\.encoder\.layer\.(\d+)\.attention\.output\.LayerNorm\.", r"qformer.layers.\1.self_attn.norm."),
    (r"^qformer\.encoder\.layer\.(\d+)\.crossattention\.attention\.", r"qformer.layers.\1.cross_attn."),
    (r"^qformer\.encoder\.layer\.(\d+)\.crossattention\.output\.dense\.", r"qformer.layers.\1.cross_attn.dense."),
    (r"^qformer\.encoder\.layer\.(\d+)\.crossattention\.output\.LayerNorm\.", r"qformer.layers.\1.cross_attn.norm."),
    (r"^qformer\.encoder\.layer\.(\d+)\.intermediate_query\.dense\.", r"qformer.layers.\1.ffn_query.fc1."),
    (r"^qformer\.encoder\.layer\.(\d+)\.output_query\.dense\.", r"qformer.layers.\1.ffn_query.fc2."),
    (r"^qformer\.encoder\.layer\.(\d+)\.output_query\.LayerNorm\.", r"qformer.layers.\1.ffn_query.norm."),
    (r"^qformer\.encoder\.layer\.(\d+)\.intermediate\.dense\.", r"qformer.layers.\1.ffn_text.fc1."),
    (r"^qformer\.encoder\.layer\.(\d+)\.output\.dense\.", r"qformer.layers.\1.ffn_text.fc2."),
    (r"^qformer\.encoder\.layer\.(\d+)\.output\.LayerNorm\.", r"qformer.layers.\1.ffn_text.norm."),
    (r"^language_projection\.", "proj."),
    (r"^language_model\.model\.decoder\.", "lm."),
]


def convert(sd):
    """名前を置き換え、ViT の qkv のバイアス(q・k・v の 3 つをつなげたもの)を q と v に分ける"""
    out = {}
    for name, w in sd.items():
        if name.endswith("position_ids") or name == "language_model.lm_head.weight":
            continue                                         # 位置の番号の表と、埋め込みと同じ重みの出力層は持たない
        new = name
        for pat, rep in RENAME:
            new = re.sub(pat, rep, new)
        if new.endswith("attn.qkv.bias"):
            q, k, v = w.chunk(3)
            assert k.abs().max() == 0                        # k のバイアスは 0(EVA の設計)
            out[new.replace("qkv.bias", "q_bias")], out[new.replace("qkv.bias", "v_bias")] = q, v
        else:
            out[new] = w
    return out


def load_weights(model, repo, files):
    sd = {}
    for f in files:
        sd.update(load_file(hf_hub_download(repo, f)))
    missing, unexpected = model.load_state_dict(convert(sd), strict=False, assign=True)
    return missing, unexpected


with torch.device("meta"):                                   # 重みの場所だけ作り、メモリは読み込むときに確保する
    model = BLIP2()
missing, unexpected = load_weights(model, MID, ["model-00001-of-00002.safetensors", "model-00002-of-00002.safetensors"])
print(f"読み込めなかった重み {missing}、使わなかった重み {unexpected}")
model = model.to(device).eval()
for name, part in [("ViT-g(39 層)", model.vision), ("Q-Former(クエリを含む)", model.qformer), ("線形層", model.proj), ("OPT-2.7B", model.lm)]:
    print(f"{name:<22}: {sum(p.numel() for p in part.parameters()):>13,}")
- RENAME: 正規表現で、Hugging Face の名前を本記事の名前に置き換えます。たとえば、Q-Former のクエリ用の FFN(intermediate_query・output_query)は ffn_query.fc1・ffn_query.fc2 に、OPT の language_model.model.decoder. は lm. になります。実験3の第 1 段階の重みの名前(文の埋め込みなど)も同じ表で扱います。
- qkv のバイアスを分ける: Hugging Face の重みは、q・k・v のバイアスを 1 つにつなげた形(qkv.bias)で保存しています。3 つに分け、k の部分がすべて 0 であることを確かめてから、q と v だけを読み込みます。
- meta デバイス: torch.device("meta") の中でモデルを作ると、重みの形だけが決まり、メモリは確保されません。assign=True で読み込んだ重みをそのまま使うので、ランダムな初期値の分のメモリ(float32 で約 15GB)を無駄に確保せずにすみます。
- strict=False と戻り値: 読み込めなかった重みと使わなかった重みを表示します。どちらも空なら、モデルのすべての重みが、重みファイルのすべての値と 1 対 1 に対応しています。
実行結果
読み込めなかった重み []、使わなかった重み []
ViT-g(39 層)           :   985,897,344
Q-Former(クエリを含む)      :   105,162,240
線形層                   :     1,968,640
OPT-2.7B              : 2,651,678,720
読み込めなかった重みも、使わなかった重みもなく、すべての重みが対応しました。パラメータの数は、ViT-g が約 9.9 億、Q-Former(クエリ 32×768 を含む)が約 1.05 億、線形層が約 197 万、OPT-2.7B が約 26.5 億です。学習するのは Q-Former と線形層の約 1.07 億だけで、全体(約 37.4 億)の 3% ほどです。論文の Q-Former の 1.88 億は、第 1 段階で使う文の埋め込みと文用の FFN を含む数で、第 2 段階の重みにはその部分が入っていません(実験3で、文の部分を含む数を確かめます)。
実験2:Hugging Face の実装と同じ出力になるかを確かめる
本記事のモデルが Hugging Face の実装と同じ計算をしているかを、途中の出力と生成した回答で確かめます。半精度では計算の順番の違いで値がずれるので、両方を float32 で比べます。
# 比べる相手:Hugging Face の実装を float32 で読み込み直す(半精度の丸めの違いを入れないため)
del hf_model
gc.collect(); torch.cuda.empty_cache()
hf32 = Blip2ForConditionalGeneration.from_pretrained(MID, dtype=torch.float32).to(device).eval()

q = "How many cats are there?"
inputs = processor(images=cats, text=f"Question: {q} Answer:", return_tensors="pt").to(device)
pix = inputs["pixel_values"]                                  # 前処理の違い(画素値 1 段階)を除くため、両方に HF の前処理の結果を入れる


def diff(a, b):
    return f"差の最大値 {(a - b).abs().max().item():.2e}(値の絶対値の最大 {b.abs().max().item():.3g})"


with torch.no_grad():
    img_hf = hf32.vision_model(inputs["pixel_values"]).last_hidden_state
    img = model.vision(pix)
    print(f"ViT の出力 {tuple(img.shape)}:", diff(img, img_hf))
    qf_hf = hf32.qformer(query_embeds=hf32.query_tokens, encoder_hidden_states=img_hf).last_hidden_state
    qf = model.qformer(image=img)
    print(f"Q-Former の出力 {tuple(qf.shape)}:", diff(qf, qf_hf))
    prefix = model.proj(qf)
    print(f"OPT に渡すベクトル {tuple(prefix.shape)}:", diff(prefix, hf32.language_projection(qf_hf)))
    logits_hf = hf32(**inputs).logits[0, -1]
    emb = torch.cat([prefix, model.lm.embed_tokens(prompt_ids(f"Question: {q} Answer:"))], dim=1)
    logits = model.lm(emb, torch.ones(1, emb.shape[1], dtype=torch.long, device=device))[0, -1]
    print(f"次のトークンの logit {tuple(logits.shape)}:", diff(logits, logits_hf), f"、1 位のトークン HF {tokenizer.decode(logits_hf.argmax())!r}・スクラッチ {tokenizer.decode(logits.argmax())!r}")

print()
for text, gen_hf, gen_s in [("a photo of", CAPTION, CAPTION_S)] + [(f"Question: {q} Answer:", VQA, VQA_S) for q in
                            ["How many cats are there?", "What is the cat on the bench doing?", "What color is the cat in the middle?", "Is there a dog in the picture?"]]:
    t0 = time.time(); a_hf, _ = ask_hf(hf32, cats, text, gen_hf); t1 = time.time()
    a_s = answer(model, cats, text, gen_s); t2 = time.time()
    print(f"{text}\n  HF {a_hf!r}({t1 - t0:.2f} 秒)\n  スクラッチ {a_s!r}({t2 - t1:.2f} 秒)、一致 {a_hf == a_s}")
- 同じ画素値を入れる: 途中の出力を比べるときは、両方に Hugging Face の前処理の結果を入れます。前処理の違い(上の実行結果で見た、画素値 1 段階の差)を、モデルの違いと分けて見るためです。生成した回答の比較では、それぞれ自分の前処理を使います。
- 比べる値: ViT の出力、Q-Former の出力、線形層の出力(OPT に渡す 32 個のベクトル)、次のトークンの logit の 4 か所です。どこかで計算が違えば、そこから後の差が大きくなるので、どの部品で違うかがわかります。
- 生成の比較: 実験1と同じキャプションと 4 つの質問で、ビームサーチの結果の文字列が一致するかを確かめます。
実行結果
ViT の出力 (1, 257, 1408): 差の最大値 0.00e+00(値の絶対値の最大 25)
Q-Former の出力 (1, 32, 768): 差の最大値 1.08e-05(値の絶対値の最大 4.14)
OPT に渡すベクトル (1, 32, 2560): 差の最大値 1.19e-05(値の絶対値の最大 32.7)
次のトークンの logit (50304,): 差の最大値 8.58e-06(値の絶対値の最大 13.4) 、1 位のトークン HF ' As'・スクラッチ ' As'

a photo of
  HF 'a group of cats walking in a garden'(0.45 秒)
  スクラッチ 'a group of cats walking in a garden'(0.35 秒)、一致 True
Question: How many cats are there? Answer:
  HF 'A lot'(0.33 秒)
  スクラッチ 'A lot'(0.24 秒)、一致 True
Question: What is the cat on the bench doing? Answer:
  HF "He's looking for a new home"(0.40 秒)
  スクラッチ "He's looking for a new home"(0.33 秒)、一致 True
Question: What color is the cat in the middle? Answer:
  HF 'Blue'(0.36 秒)
  スクラッチ 'Blue'(0.26 秒)、一致 True
Question: Is there a dog in the picture? Answer:
  HF 'No'(0.41 秒)
  スクラッチ 'No'(0.31 秒)、一致 True
- ViT の出力: 差は 0 で、完全に同じ値になりました。
- Q-Former の出力から logit まで: 差は 程度です。値の大きさ(Q-Former の出力は最大 4.14、logit は最大 13.4)に比べてごく小さく、計算の順番による浮動小数点の丸めの違いです。Q-Former の注意を、Hugging Face は F.scaled_dot_product_attention で、本記事は式どおりに計算しているためです。次のトークンの 1 位も、どちらも「As」で同じです。
- 生成: キャプションと 4 つの質問で、ビームサーチの結果が 5 つとも一致しました。本記事のビームサーチが、Hugging Face の generate と同じ規則で候補を選んでいることがわかります。実験1は float16、実験2は float32 ですが、回答は同じでした。
- 前処理の違い: 生成の比較では、本記事は自分の前処理(PIL)を使っていますが、回答は同じになりました。前処理の画素値 1 段階の差は、この画像では回答を変えませんでした。
- 時間: 1 回の生成は、本記事の実装の方が 0.07〜0.1 秒ほど速くなりました。Hugging Face の generate は、多くの設定に対応するための処理を毎ステップ行うので、その分の差だと考えられます。
実験3:第 1 段階の ITC・ITM で画像と文の対応を当てる
第 1 段階の学習を終えた重み(Salesforce/blip2-itm-vit-g)で、ITC と ITM を動かします。この重みは、公式の実装の第 1 段階の事前学習の重み(pretrain)を Hugging Face の形式に変換したもので、ViT-g と、文の部分を含む Q-Former と、ITC・ITM の層を持ちます(ITG の出力層は含みません)。まず Hugging Face の実装で猫の画像と 4 つの文の対応を計算し、本記事の実装と同じ値になるかを確かめます。
# 実験2が終わったので HF のモデルを消し、本記事のモデルを、論文と同じく ViT と OPT を半精度にする(Q-Former は HF と同じく float32 のまま)
del hf32
gc.collect(); torch.cuda.empty_cache()
model.vision.half(); model.lm.half(); model.proj.half()

from transformers import Blip2ForImageTextRetrieval

IID = "Salesforce/blip2-itm-vit-g"
itm_proc = Blip2Processor.from_pretrained(IID)
hf_itm = Blip2ForImageTextRetrieval.from_pretrained(IID, dtype=torch.float32).to(device).eval()


class BLIP2Stage1(nn.Module):
    """第 1 段階のモデル:ViT-g(凍結)と、テキストも入る Q-Former、ITC と ITM のための層"""

    def __init__(self, vocab=30523):
        super().__init__()
        self.vision = VisionEncoder()
        self.qformer = QFormer(vocab=vocab)                  # BERT の語彙 30,522 + 生成用の [DEC]
        self.vision_projection = nn.Linear(768, 256)         # ITC:クエリの出力を 256 次元にして文と比べる
        self.text_projection = nn.Linear(768, 256)           # ITC:文の [CLS] の出力を 256 次元にする
        self.itm_head = nn.Linear(768, 2)                    # ITM:対応しない・対応する の 2 クラス

    def image_side(self, pixel_values):
        """ITC の画像側:クエリ 32 個が画像だけを読む(文は見えない)"""
        image = self.vision(pixel_values)
        return image, F.normalize(self.vision_projection(self.qformer(image=image)), dim=-1)   # [B, 32, 256]

    def text_side(self, ids, mask):
        """ITC の文側:文だけを Q-Former に通す(クエリは見えない)"""
        return F.normalize(self.text_projection(self.qformer(input_ids=ids, text_mask=mask)[:, 0]), dim=-1)

    @staticmethod
    def itc(img_emb, txt_emb):
        """クエリ 32 個のうち、文に最も近いものとのコサイン類似度"""
        return torch.einsum("iqd,td->itq", img_emb, txt_emb).max(-1).values

    def itm(self, image, ids, mask):
        """ITM:クエリと文が互いに見合いながら画像を読み、クエリ 32 個の出力それぞれの判定(logit)を平均する"""
        x = self.qformer(image=image, input_ids=ids, text_mask=mask)
        return self.itm_head(x[:, :32]).mean(1)


with torch.device("meta"):
    stage1 = BLIP2Stage1()
missing, unexpected = load_weights(stage1, IID, ["model.safetensors"])
print(f"読み込めなかった重み {missing}、使わなかった重み {unexpected}")
stage1 = stage1.to(device).eval()
print(f"第 1 段階の Q-Former(文の埋め込みと文用の FFN を含む): {sum(p.numel() for p in stage1.qformer.parameters()):,}")
itm_tok = itm_proc.tokenizer

# 猫の画像と 4 つの文で、HF の実装と本記事の実装の ITC・ITM を比べる
texts = ["several cats relaxing in a sunny garden", "a cat sleeping on a wooden bench", "a dog running on the grass", "a busy city street at night"]
t = itm_tok(texts, padding=True, return_tensors="pt").to(device)
with torch.no_grad():
    hf_inp = itm_proc(images=[cats] * len(texts), text=texts, padding=True, return_tensors="pt").to(device)
    itm_hf = hf_itm(**hf_inp, use_image_text_matching_head=True).logits_per_image
    itc_hf = hf_itm(pixel_values=hf_inp["pixel_values"][:1], input_ids=hf_inp["input_ids"], attention_mask=hf_inp["attention_mask"]).logits_per_image[0]
    image, img_emb = stage1.image_side(hf_inp["pixel_values"][:1])   # 前処理の違いを除くため、HF と同じ画素値を入れる
    itc_s = stage1.itc(img_emb, stage1.text_side(t.input_ids, t.attention_mask))[0]
    itm_s = stage1.itm(stage1.vision(hf_inp["pixel_values"]), t.input_ids, t.attention_mask)   # HF と同じく 4 枚の束で ViT に通す(PyTorch は畳み込みを既定で TF32 で計算し、束の大きさで丸めが変わるため)
print(f"ITC の類似度:差の最大値 {(itc_s - itc_hf).abs().max():.2e}、ITM の logit:差の最大値 {(itm_s - itm_hf).abs().max():.2e}")
for s, c, m in zip(texts, itc_s.tolist(), itm_s.softmax(-1)[:, 1].tolist()):
    print(f"  ITC {c:.3f}  ITM(対応する確率){m:.3f}  {s}")
del hf_itm
gc.collect(); torch.cuda.empty_cache()
- 半精度に切り替える: 実験2で Hugging Face の float32 のモデルと比べ終えたので、それを消し、本記事のモデルの ViT と OPT を半精度にします。以降の実験で GPU のメモリと時間を抑えるためで、論文も凍結した部品を半精度にしています。
- BLIP2Stage1: 第 1 段階のモデルです。Q-Former に vocab=30523 を渡し、文の埋め込みと文用の FFN を持たせます。語彙は BERT の 30,522 個に、ITG で文の先頭に置く [DEC] を 1 つ足した数です。
- image_side と text_side: ITC は、クエリと文が互いを見ないので、画像側と文側を別々に計算できます。画像側はクエリ 32 個の出力を、文側は先頭の [CLS] の出力を、それぞれ 256 次元にして長さ 1 にそろえます。
- itc: 32 個のクエリのそれぞれと文のコサイン類似度を計算し、最も大きいものを画像と文の類似度にします。論文の ITC の類似度の定義です。
- itm: クエリと文を 1 本の列にして Q-Former に通し、クエリ 32 個の出力のそれぞれを 2 クラスに分類して、logit を平均します。文がクエリを、クエリが文を見るので、画像と文を突き合わせた判定ができます。
- 4 つの文: 画像の内容に合う文(庭でくつろぐ猫たち)、一部だけ合う文(ベンチで眠る猫。画像の奥のベンチにも猫がいる)、合わない文(犬)、まったく関係のない文(夜の街)です。ITC と ITM が、合う度合いの違いをどう見分けるかを比べるためです。
- 同じ束で比べる: Hugging Face の ITM には、画像を文の数だけ並べた 4 枚の束を入れます。本記事の ITM にも同じ 4 枚の束を ViT に通して入れます。PyTorch は GPU の畳み込みを既定で TF32(仮数部を短くした高速な計算)で行い、束の大きさによって計算の仕方が変わるので、1 枚で計算した結果を並べると、ViT の出力が最大 0.05 ほどずれるためです。
実行結果
読み込めなかった重み []、使わなかった重み []
第 1 段階の Q-Former(文の埋め込みと文用の FFN を含む): 185,684,736
ITC の類似度:差の最大値 1.79e-07、ITM の logit:差の最大値 4.05e-06
  ITC 0.448  ITM(対応する確率)0.997  several cats relaxing in a sunny garden
  ITC 0.252  ITM(対応する確率)0.026  a cat sleeping on a wooden bench
  ITC 0.177  ITM(対応する確率)0.024  a dog running on the grass
  ITC 0.148  ITM(対応する確率)0.000  a busy city street at night
- Hugging Face との比較: ITC の類似度は 、ITM の logit は の差で、Hugging Face の実装と一致しました(Q-Former の注意の計算の順番による丸めの違いです)。第 1 段階の Q-Former は、文の埋め込みと文用の FFN を含めて約 1.86 億パラメータで、論文の 1.88 億とほぼ同じです。
- ITC: 内容に合う文(0.448)、一部だけ合う文(0.252)、犬の文(0.177)、夜の街の文(0.148)の順で、合う度合いの順に類似度が並びました。ただし、値の差は小さく、ITC の類似度だけでは「どれも少しずつ似ている」ようにも見えます。
- ITM: 内容に合う文は 0.997 で、ほかの 3 つは 0.03 以下でした。ITM は画像と文を突き合わせて判定するので、合う・合わないを、ITC よりはっきり分けます。「ベンチで眠る猫」は、画像の奥のベンチに猫がいるものの、画像全体の説明ではないので、対応しないと判定されました。
4つの文の ITC と ITM を並べると、次のようになります。
(図は、diagram-designで作成)
COCO の 1,000 枚と 5,000 文で対応を当てる
次に、COCO の検証用データの 1,000 枚と、そのキャプション 5,000 文で、画像から文・文から画像を探す検索をします。論文と公式の実装の評価と同じく、まず ITC で全部の組の類似度を計算し、上位 128 件だけを ITM で並べ直します。ITC は画像と文を別々に計算するので速く、ITM は組ごとに Q-Former を通すので遅い代わりに、画像と文を突き合わせて判定できます。2 つを組み合わせるのはこのためです。
# COCO 2017 の検証用データから、画像 ID の小さい順に 1,000 枚と、それぞれのキャプション 5 つ(合計 5,000 文)
os.makedirs("coco/val2017", exist_ok=True)
if not os.path.exists("coco/annotations/captions_val2017.json"):
    urllib.request.urlretrieve("http://images.cocodataset.org/annotations/annotations_trainval2017.zip", "coco/ann.zip")
    zipfile.ZipFile("coco/ann.zip").extractall("coco")


def coco_captions(split, n_images, per_image):
    caps = {}
    for a in sorted(json.load(open(f"coco/annotations/captions_{split}.json"))["annotations"], key=lambda a: a["id"]):
        caps.setdefault(a["image_id"], []).append(a["caption"].strip())
    ids = sorted(caps)[:n_images]
    return ids, [caps[i][:per_image] for i in ids]


def fetch(url_path):
    """COCO の画像を 1 枚取ってくる(既にあれば何もしない)"""
    url, path = url_path
    if not os.path.exists(path):
        urllib.request.urlretrieve(url, path)


ret_ids, ret_caps = coco_captions("val2017", 1000, 5)
with ThreadPoolExecutor(16) as ex:
    list(ex.map(fetch, [(f"http://images.cocodataset.org/val2017/{i:012d}.jpg", f"coco/val2017/{i:012d}.jpg") for i in ret_ids]))
texts = [c for caps in ret_caps for c in caps]
txt2img = torch.tensor([i for i, caps in enumerate(ret_caps) for _ in caps], device=device)   # 文 → 正解の画像の番号

with torch.no_grad():
    # ITC の準備:画像側(ViT の出力も ITM 用に残す)と文側を、それぞれ 1 回ずつ計算する
    vit, img_emb = [], []
    for s in range(0, len(ret_ids), 50):
        pix = torch.cat([preprocess(Image.open(f"coco/val2017/{i:012d}.jpg")) for i in ret_ids[s:s + 50]]).to(device)
        v, e = stage1.image_side(pix)
        vit.append(v.half()); img_emb.append(e)
    vit, img_emb = torch.cat(vit), torch.cat(img_emb)
    tok = itm_tok(texts, padding="max_length", truncation=True, max_length=35, return_tensors="pt").to(device)   # 公式の評価と同じ 35 トークン
    txt_emb = torch.cat([stage1.text_side(tok.input_ids[s:s + 500], tok.attention_mask[s:s + 500]) for s in range(0, len(texts), 500)])
    sim = stage1.itc(img_emb, txt_emb)                       # [1,000 画像, 5,000 文]

    # ITM で並べ直す:ITC の上位 128 件(公式の評価の k_test)だけ ITM を計算し、「ITM の logit + ITC の類似度」で並べる
    K = 128
    i2t = torch.full_like(sim, -100.0)
    for i in range(len(ret_ids)):
        top_sim, top = sim[i].topk(K)
        logit = stage1.itm(vit[i:i + 1].float().expand(K, -1, -1), tok.input_ids[top], tok.attention_mask[top])
        i2t[i, top] = logit[:, 1] + top_sim
    t2i = torch.full_like(sim.T, -100.0)
    for j in range(len(texts)):
        top_sim, top = sim[:, j].topk(K)
        logit = stage1.itm(vit[top].float(), tok.input_ids[j:j + 1].expand(K, -1), tok.attention_mask[j:j + 1].expand(K, -1))
        t2i[j, top] = logit[:, 1] + top_sim


def recall(i2t_score, t2i_score, k):
    """画像 → 文:上位 k 件に正解の文(5 つのどれか)があるか。文 → 画像:上位 k 件に正解の画像があるか"""
    top_t = i2t_score.topk(k, dim=1).indices
    ir = (txt2img[top_t] == torch.arange(len(ret_ids), device=device)[:, None]).any(1).float().mean().item()
    tr = (t2i_score.topk(k, dim=1).indices == txt2img[:, None]).any(1).float().mean().item()
    return ir * 100, tr * 100


print(f"COCO val2017 の画像 {len(ret_ids)} 枚・文 {len(texts)} 個(偶然に当たる確率:画像 → 文の 1 位 {5 / len(texts) * 100:.1f}%、文 → 画像の 1 位 {100 / len(ret_ids):.1f}%)")
for name, a, b in [("ITC だけ", sim, sim.T), ("ITC → ITM で並べ直す", i2t, t2i)]:
    r1, r5 = recall(a, b, 1), recall(a, b, 5)
    print(f"{name:<14}: 画像 → 文 R@1 {r1[0]:.1f}%・R@5 {r5[0]:.1f}%、文 → 画像 R@1 {r1[1]:.1f}%・R@5 {r5[1]:.1f}%")
- データ: COCO 2017 の検証用の画像 ID の小さい順に 1,000 枚と、各画像の最初の 5 つのキャプションです。画像 → 文の検索では 5 つのどれかが 1 位に来れば正解、文 → 画像の検索では元の画像が 1 位に来れば正解です。1,000 枚にしたのは、ITM で並べ直す計算(1,000 × 128 回と 5,000 × 128 回)を 17 分ほどに収めるためです。
- 画像側の計算を残す: ViT の出力(1 枚 257×1408)は、ITM の計算で何度も使うので、半精度で GPU に残します(1,000 枚で約 0.7GB)。
- 35 トークン: 公式の評価のコード(compute_sim_matrix)が、文を 35 トークンにそろえているのに合わせています。
- 並べ直しのスコア: 上位 128 件(公式の評価の設定 k_test)の組だけ、ITM の「対応する」の logit に ITC の類似度を足して、並べ直します。上位 128 件に入らなかった組は、−100 のままで最下位に置きます。
- R@1・R@5: 上位 1 件・5 件の中に正解が入った割合です。
実行結果
COCO val2017 の画像 1000 枚・文 5000 個(偶然に当たる確率:画像 → 文の 1 位 0.1%、文 → 画像の 1 位 0.1%)
ITC だけ        : 画像 → 文 R@1 84.8%・R@5 98.1%、文 → 画像 R@1 75.8%・R@5 94.0%
ITC → ITM で並べ直す: 画像 → 文 R@1 93.2%・R@5 99.1%、文 → 画像 R@1 81.2%・R@5 95.1%
- ITC だけ: 画像 → 文の 1 位の正解率(R@1)は 84.8%、文 → 画像は 75.8% でした。偶然に当たる確率(0.1%)よりはるかに高く、第 1 段階の Q-Former のクエリの出力と文の [CLS] が、同じ空間で対応するように学習されていることがわかります。
- ITM で並べ直す: R@1 は、画像 → 文が 93.2%(8.4 ポイント上がる)、文 → 画像が 81.2%(5.4 ポイント上がる)になりました。ITC で候補を絞り、上位 128 件だけを ITM で突き合わせることで、ITM を全部の組に計算するよりずっと少ない計算で、検索の精度を上げられます。
- 論文の値との関係: 論文の COCO の検索の表(画像 → 文 R@1 85.4%、文 → 画像 68.3%、ViT-g)は、COCO で追加学習したモデルを、5,000 枚のテストデータで評価した値です。本記事は追加学習していない第 1 段階の重みを、1,000 枚で評価しているので、直接は比べられません(候補が 5 分の 1 なので、当たりやすくなります)。また、COCO の画像の多くは BLIP-2 の事前学習のデータにも含まれているので、まったく見たことのない画像での性能ではありません。
- 時間: ITM で並べ直す計算(合計 768,000 組)を含めて、約 17 分かかりました。
ITC だけと ITM で並べ直した場合の R@1 を並べると、次のようになります。
(図は、diagram-designで作成)
実験4:クエリは画像のどこを見ているか
Q-Former のクエリ 32 個が、交差注意で画像のどこを見ているかを調べます。交差注意は 6 層にあり、それぞれ 12 ヘッドが 257 個([CLS] と 16×16 のパッチ)の上の重みを持ちます。層ごとに、注意がどこにどれだけ集まっているかを数値で見てから、重みを画像に重ねます。あわせて、ViT の出力のベクトルの長さ(ノルム)もパッチごとに見ます。大きな ViT では、背景の一部のパッチだけが、ほかより桁違いに長いベクトルを持ち、画像全体の情報をそこに集める現象が報告されている(Darcet et al., 2023、Vision Transformers Need Registers)ためです。
def vit_before_norm(pix):
    """ViT の最後の LayerNorm の前の出力(LayerNorm の後は、ベクトルの長さがそろってしまうため)"""
    v = model.vision
    x = torch.cat([v.cls.expand(pix.shape[0], -1, -1), v.patch(pix.half()).flatten(2).transpose(1, 2)], dim=1) + v.pos
    for blk in v.blocks:
        x = blk(x)
    return x


def rank_corr(a, b):
    """順位の相関(スピアマン):値の大きさではなく、並び順がどれだけ一致するか"""
    ra, rb = a.argsort().argsort().float(), b.argsort().argsort().float()
    return torch.corrcoef(torch.stack([ra, rb]))[0, 1].item()


with torch.no_grad():
    pix = preprocess(cats).to(device)
    model.image_prefix(pix, keep_attn=True)
    norm = vit_before_norm(pix)[0, 1:].float().norm(dim=-1).cpu()   # パッチ 256 個のベクトルの長さ
big = int(norm.argmax())
print(f"ViT の最後の LayerNorm の前のベクトルの長さ:パッチの中央値 {norm.median():.0f}、最大 {norm.max():.0f}"
      f"(パッチ {big}:上から {big // 16 + 1} 行目・左から {big % 16 + 1} 列目)、2 番目に長いパッチ {norm.sort().values[-2]:.0f}")

# 層ごとに、クエリ 32 個の注意が、[CLS] と最も長いパッチにどれだけ向いているか。注意が実質いくつの位置に広がっているか(エントロピーの exp)
cross = [(i, l.cross_attn.attn[0].float().mean(0).cpu()) for i, l in enumerate(model.qformer.layers) if l.cross_attn is not None]   # 12 ヘッドの平均 [32, 257]
for i, p in cross:
    eff = torch.exp(-(p * p.clamp_min(1e-12).log()).sum(-1))
    print(f"{i + 1:>2} 層目の交差注意:[CLS] {p[:, 0].mean():.3f}、パッチ {big} {p[:, 1 + big].mean():.3f}、実質の注意先の数 平均 {eff.mean():.1f}(全部で 257)、"
          f"パッチの長さとの順位の相関 {rank_corr(p[:, 1:].mean(0), norm):.2f}")

# 猫の画像だけで起きることかを、実験3の COCO の画像(先頭の 100 枚)で確かめる
ratios, shares = [], []
with torch.no_grad():
    for i in ret_ids[:100]:
        pix_i = preprocess(Image.open(f"coco/val2017/{i:012d}.jpg")).to(device)
        model.image_prefix(pix_i, keep_attn=True)
        n = vit_before_norm(pix_i)[0, 1:].float().norm(dim=-1)
        a = model.qformer.layers[10].cross_attn.attn[0].float().mean(0)[:, 1:]   # 11 層目、12 ヘッドの平均 [32, 256]
        ratios.append((n.max() / n.median()).item()); shares.append(a[:, n.argmax()].mean().item())
print(f"COCO の 100 枚:最も長いパッチの長さ ÷ 中央値 平均 {np.mean(ratios):.1f} 倍(最小 {np.min(ratios):.1f})、"
      f"11 層目でそのパッチ 1 個に向く注意 平均 {np.mean(shares):.3f}(最小 {np.min(shares):.3f}・最大 {np.max(shares):.3f})")

# 図1:モデルが見ている画像、パッチの長さ、最初と最後の交差注意(クエリ 32 個の平均)
seen = np.asarray(cats.resize((224, 224), Image.BICUBIC))
fig, ax = plt.subplots(1, 4, figsize=(16, 4.3))
ax[0].imshow(seen); ax[0].set_title("モデルが見ている画像(224×224)")
for a, m, t in [(ax[1], norm, "ViT の出力の長さ(LayerNorm の前)"), (ax[2], cross[0][1][:, 1:].mean(0), "1 層目の交差注意(32 個の平均)"),
                (ax[3], cross[-1][1][:, 1:].mean(0), "11 層目の交差注意(32 個の平均)")]:
    a.imshow(seen)
    im = a.imshow(m.reshape(16, 16), cmap="jet", alpha=0.55, extent=(0, 224, 224, 0), interpolation="nearest")
    a.set_title(t); plt.colorbar(im, ax=a, fraction=0.046)
for a in ax:
    a.axis("off")
plt.tight_layout()
plt.show()

# 図2:最も長いパッチと [CLS] を除いて、11 層目でクエリそれぞれが見ている場所(クエリごとに最大値で正規化)
p = cross[-1][1][:, 1:].clone()
p[:, big] = 0
p = (p / p.max(-1, keepdim=True).values).reshape(32, 16, 16)
fig, axes = plt.subplots(4, 8, figsize=(16, 8.4))
for k, a in enumerate(axes.flat):
    a.imshow(seen)
    a.imshow(p[k], cmap="jet", alpha=0.5, extent=(0, 224, 224, 0), interpolation="nearest")
    a.set_title(f"クエリ {k}", fontsize=9)
    a.axis("off")
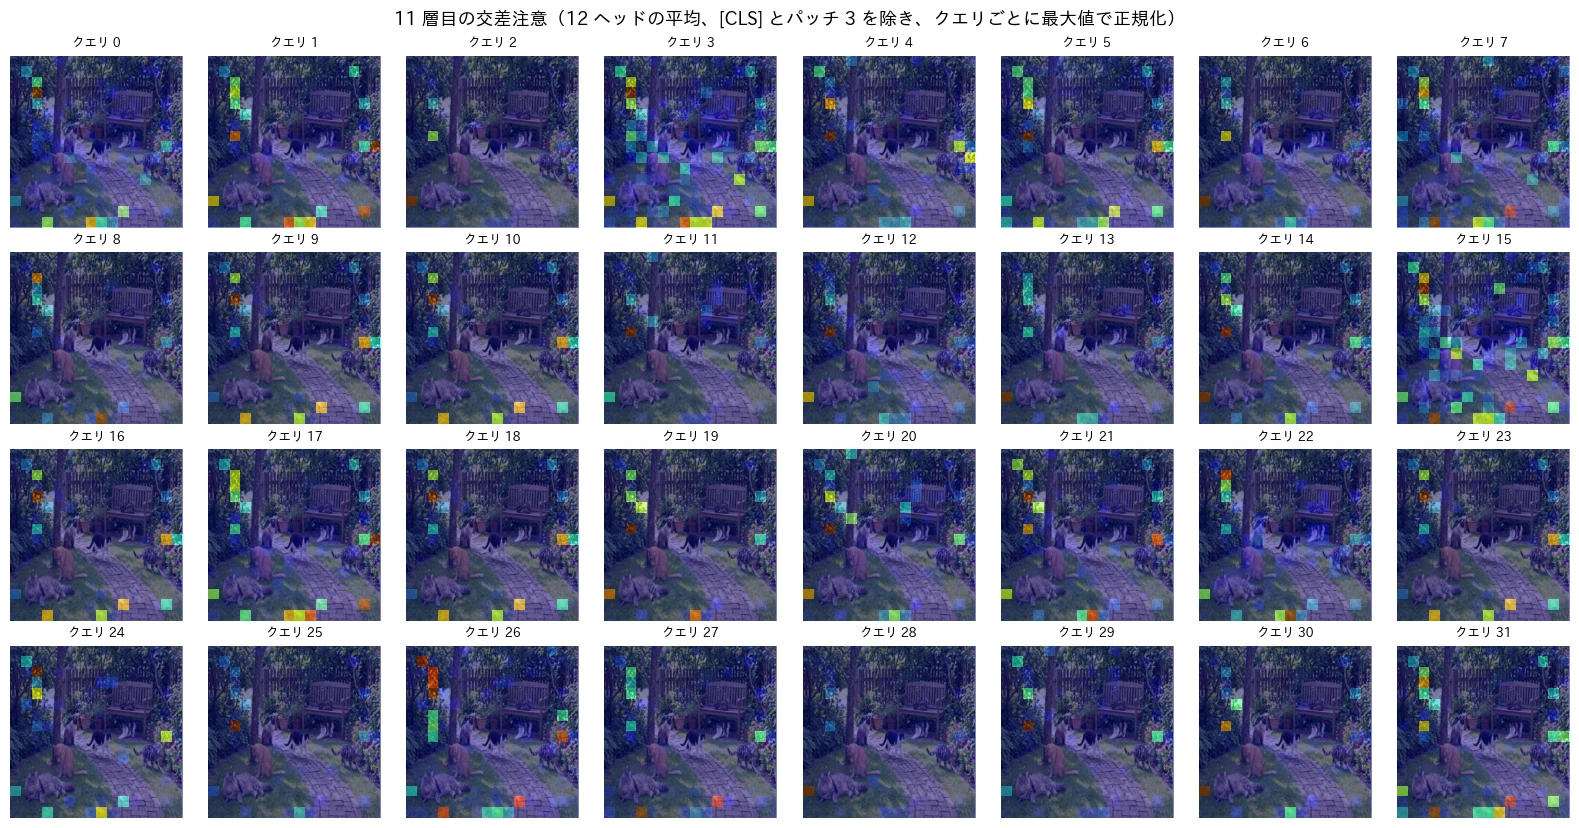
plt.suptitle(f"11 層目の交差注意(12 ヘッドの平均、[CLS] とパッチ {big} を除き、クエリごとに最大値で正規化)", fontsize=13)
plt.tight_layout()
plt.show()
- vit_before_norm: ViT の 39 層を通した後、最後の LayerNorm を通す前の出力です。LayerNorm はベクトルごとに大きさをそろえるので、長さの違いは LayerNorm の前でしか見えません。
- 注意の広がり: 注意の重み (257 個の和が 1)のエントロピー の指数 を、「実質いくつの位置を見ているか」として使います。全部の位置を同じ重みで見れば 257、1 か所だけを見れば 1 になります。
- 順位の相関: クエリ 32 個の平均の注意と、パッチの長さの、並び順の一致の度合いです(1 なら完全に同じ順番)。値の大きさの差が極端なので、外れた値に引きずられない順位で比べます。
- COCO の 100 枚: 猫の画像 1 枚だけの偶然でないかを、実験3で使った COCO の画像の先頭 100 枚で確かめます。最も長いパッチの長さが中央値の何倍か、11 層目の注意がそのパッチ 1 個にどれだけ向くかを数えます。
- 図の正規化: 図2は、[CLS] と最も長いパッチを除いてから、クエリごとに最大値で割って色の範囲をそろえます。最も長いパッチを残すと、どのクエリの図もそのパッチだけが光り、ほかの場所が見えないためです。色の濃さはクエリの間では比べられません。
実行結果
ViT の最後の LayerNorm の前のベクトルの長さ:パッチの中央値 57、最大 438(パッチ 3:上から 1 行目・左から 4 列目)、2 番目に長いパッチ 141
 1 層目の交差注意:[CLS] 0.141、パッチ 3 0.003、実質の注意先の数 平均 44.4(全部で 257)、パッチの長さとの順位の相関 -0.10
 3 層目の交差注意:[CLS] 0.112、パッチ 3 0.091、実質の注意先の数 平均 39.3(全部で 257)、パッチの長さとの順位の相関 -0.14
 5 層目の交差注意:[CLS] 0.081、パッチ 3 0.238、実質の注意先の数 平均 41.0(全部で 257)、パッチの長さとの順位の相関 -0.09
 7 層目の交差注意:[CLS] 0.043、パッチ 3 0.422、実質の注意先の数 平均 32.6(全部で 257)、パッチの長さとの順位の相関 -0.10
 9 層目の交差注意:[CLS] 0.020、パッチ 3 0.496、実質の注意先の数 平均 32.5(全部で 257)、パッチの長さとの順位の相関 -0.06
11 層目の交差注意:[CLS] 0.039、パッチ 3 0.550、実質の注意先の数 平均 12.1(全部で 257)、パッチの長さとの順位の相関 -0.01
COCO の 100 枚:最も長いパッチの長さ ÷ 中央値 平均 7.6 倍(最小 6.6)、11 層目でそのパッチ 1 個に向く注意 平均 0.552(最小 0.436・最大 0.614)
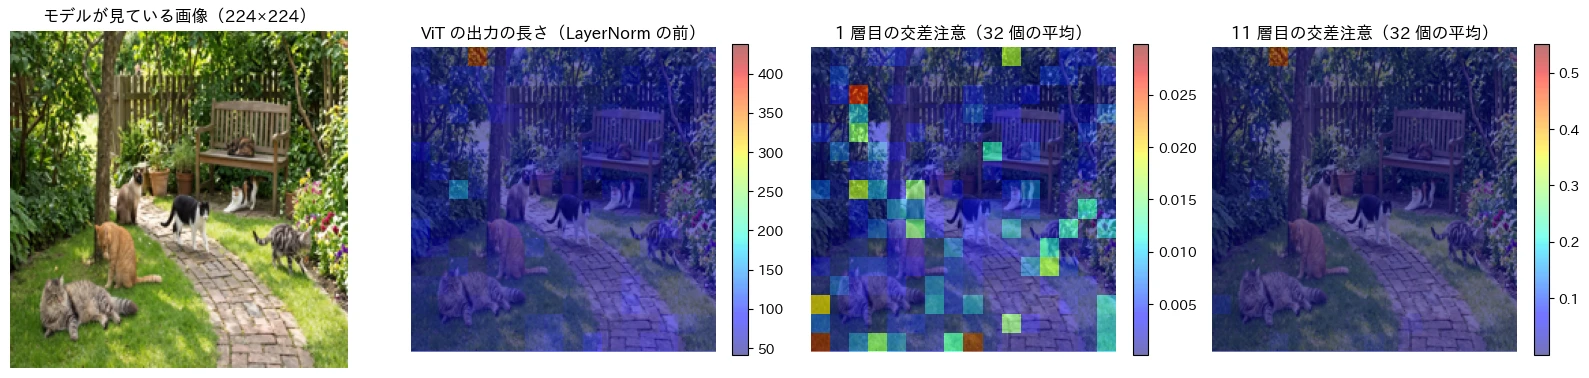
- 長いパッチ: ViT の最後の LayerNorm の前では、パッチのベクトルの長さの中央値が 57 なのに、1 つのパッチ(上から 1 行目・左から 4 列目)だけが 438 と、約 7.7 倍の長さでした。2 番目に長いパッチでも 141 です。図1の左から 2 つ目のとおり、その位置は猫ではなく、画像の上の端の木の葉の部分です。Darcet et al. (2023) が DINOv2・OpenCLIP などの大きな ViT で報告した、背景の一部のパッチだけが極端に長いベクトルを持ち、画像全体の情報を集める現象と同じ形です。
- 層が深くなるほど、そのパッチに集まる: 1 層目の交差注意では、そのパッチへの注意は 0.003 で、注意は平均 44 か所ほどに広がっていました。層が進むにつれて 0.091・0.238・0.422・0.496 と増え、11 層目では、クエリ 32 個の注意の平均 0.550(半分以上)が、その 1 つのパッチに向きました。実質の注意先も 12 か所ほどに絞られました。一方、[CLS] への注意は 0.141 から 0.039 に減りました。
- 長いパッチなら何でもよいわけではない: パッチの長さと注意の順位の相関は、どの層でも −0.14〜−0.01 でほぼ 0 でした。注意が集まるのは、極端に長い 1 つのパッチだけで、ほかのパッチについては、長いほど見られるという関係はありません。
- COCO の画像でも同じ: COCO の 100 枚でも、最も長いパッチは中央値の平均 7.6 倍(最小でも 6.6 倍)の長さで、11 層目の注意の平均 0.552(どの画像でも 0.436 以上)が、その 1 つのパッチに向いていました。猫の画像だけの偶然ではありません。
- それ以外の注意先: 図2のとおり、最も長いパッチを除いても、クエリの注意は猫の位置よりも、画像の左の端や下の端のパッチに多く向いています。クエリによって強く見る位置は少しずつ違いますが、「このクエリはこの猫」のように物の位置を分担しているようには見えません。
- わかること: Q-Former のクエリは、画像の領域を 1 つずつ分担して読んでいるのではなく、ViT-g が画像の要約を置いた 1 つのパッチを、層を重ねるごとに集中して読んでいます。実験1で、ベンチの猫や真ん中の猫の色のような、位置を指定した細かい質問に答えられなかったこととも合います。ただし、注意の重みはどこから情報を読んだかを示すだけで、その情報が答えにどう使われたかまでは示しません。
実験5:VQAv2 でゼロショットの正解率を測る
VQAv2 の検証用データで、ゼロショット(VQA のデータで学習していない状態)の正解率を測ります。論文の表の値(OPT-2.7B、検証用データで 53.5%)と比べ、さらに、画像の情報を消したり減らしたりしたときに正解率がどう変わるかを調べます。ここでは、データの準備と、公式の正解率の計算を用意します。
# VQAv2 の検証用データ(質問と、1 問につき 10 人の回答)。画像は COCO 2014 の検証用の画像
os.makedirs("vqa", exist_ok=True)
os.makedirs("coco/val2014", exist_ok=True)
for f, name in [("v2_Questions_Val_mscoco.zip", "v2_OpenEnded_mscoco_val2014_questions.json"), ("v2_Annotations_Val_mscoco.zip", "v2_mscoco_val2014_annotations.json")]:
    if not os.path.exists(f"vqa/{name}"):
        urllib.request.urlretrieve(f"https://s3.amazonaws.com/cvmlp/vqa/mscoco/vqa/{f}", f"vqa/{f}")
        zipfile.ZipFile(f"vqa/{f}").extractall("vqa")
questions = {q["question_id"]: q for q in json.load(open("vqa/v2_OpenEnded_mscoco_val2014_questions.json"))["questions"]}
annotations = {a["question_id"]: a for a in json.load(open("vqa/v2_mscoco_val2014_annotations.json"))["annotations"]}

# 214,354 問から 1,000 問を無作為に選ぶ(1 条件あたり約 4 分で評価できる数)
qids = random.Random(0).sample(sorted(questions), 1000)
img_ids = sorted({questions[q]["image_id"] for q in qids})
with ThreadPoolExecutor(16) as ex:
    list(ex.map(fetch, [(f"http://images.cocodataset.org/val2014/COCO_val2014_{i:012d}.jpg", f"coco/val2014/{i:012d}.jpg") for i in img_ids]))
print(f"検証用 {len(questions):,} 問から {len(qids)} 問(画像 {len(img_ids)} 枚)")
for t in ["yes/no", "number", "other"]:
    print(f"{t:<7}: 1,000 問のうち {sum(annotations[q]['answer_type'] == t for q in qids)} 問、検証用データ全体では {np.mean([a['answer_type'] == t for a in annotations.values()]) * 100:.1f}%")

# 公式の評価の正規化(句読点・数詞・冠詞・短縮形の表記ゆれをそろえる)。VQA の公式の評価コードを、BLIP-2 の公式の実装(LAVIS)が Python 3 用に移したもの
urllib.request.urlretrieve("https://raw.githubusercontent.com/salesforce/LAVIS/main/lavis/common/vqa_tools/vqa_eval.py", "vqa/vqa_eval.py")
_ns = {}
exec(open("vqa/vqa_eval.py").read(), _ns)
ev = _ns["VQAEval"]()


def vqa_accuracy(qid, pred):
    """公式の正解率:10 人の回答から 1 人を除いた 9 人のうち、3 人以上と一致すれば 1(2 人なら 2/3…)。除く 1 人を 10 通り変えて平均する"""
    pred = ev.processDigitArticle(ev.processPunctuation(pred.replace("\n", " ").replace("\t", " ").strip()))
    gts = [a["answer"] for a in annotations[qid]["answers"]]
    if len(set(gts)) > 1:
        gts = [ev.processPunctuation(g) for g in gts]
    return np.mean([min(1.0, sum(g == pred for j, g in enumerate(gts) if j != i) / 3) for i in range(len(gts))])


def prep_question(q):
    """公式の実装の質問の前処理:小文字にして、一部の記号を消す"""
    return re.sub(r"([.!\"()*#:;~])", "", q.lower()).rstrip(" ")


# 画像 1 枚ごとに、Q-Former の出力(クエリ 32 個)を 1 回だけ計算して残す(実験6でも使う)
qf_out = {}
with torch.no_grad():
    for s in range(0, len(img_ids), 50):
        pix = torch.cat([preprocess(Image.open(f"coco/val2014/{i:012d}.jpg")) for i in img_ids[s:s + 50]]).to(device)
        out = model.qformer(image=model.vision(pix.half()).float())
        qf_out.update({i: o for i, o in zip(img_ids[s:s + 50], out)})
- 1,000 問: 検証用データの全部(214,354 問)は 1 条件で 10 時間以上かかるので、無作為に 1,000 問を選びます。正解率の標準誤差は、およそ ポイントです。条件の差が数ポイントより小さいときは、差があるとは言えません。
- 公式の正解率: VQAv2 は 1 問に 10 人が回答しています。答えが 3 人以上と一致すれば正解(1 点)、2 人なら 2/3 点、1 人なら 1/3 点です。公式の評価は、10 人から 1 人を除いた 9 人で数え、除く人を 10 通り変えて平均します。
- 表記ゆれの正規化: 「two」と「2」、「a dog」と「dog」、「dont」と「don't」のような違いを、公式の評価のコードと同じ規則でそろえます。規則は長い表(短縮形の一覧など)なので、BLIP-2 の公式の実装(LAVIS)が Python 3 用に移した評価のコード(vqa_eval.py)をダウンロードして、その中の関数を使います。
- 質問の前処理: 公式の実装と同じく、小文字にして、一部の記号(ピリオドなど)を消します。
- Q-Former の出力を残す: 実験5の 6 つの条件と実験6で、同じ画像の Q-Former の出力を何度も使います。ViT と Q-Former は条件によらず同じ計算なので、1 枚につき 1 回だけ計算して残します。
実行結果
検証用 214,354 問から 1000 問(画像 975 枚)
yes/no : 1,000 問のうち 396 問、検証用データ全体では 37.6%
number : 1,000 問のうち 122 問、検証用データ全体では 13.1%
other  : 1,000 問のうち 482 問、検証用データ全体では 49.3%
214,354 問から選んだ 1,000 問は、975 枚の画像についての質問で、yes/no が 396 問、number が 122 問、other が 482 問でした。検証用データ全体の割合(yes/no 37.6%、number 13.1%、other 49.3%)とほぼ同じです。
画像を消す・減らす・取り替える
6 つの条件で、1,000 問に答えさせます。
| 条件 | OPT に渡すもの | 確かめたいこと |
|---|---|---|
| 論文の設定 | 質問の画像の 32 個、Question: Answer:、length penalty −1 | 論文の値(53.5%)に近い正解率になるか |
| 公式の実装の設定 | 同じ画像、Question: Short answer:、length penalty 0 | 論文と公式の実装の設定の違いで、正解率が変わるか |
| 画像なし | 画像のベクトルを渡さず、質問だけ | 画像を見ずに、質問だけでどこまで当たるか |
| 別の画像 | ほかの質問の画像の 32 個 | 画像の中身が答えに効いているか |
| クエリ 16 個・8 個 | 32 個のうち先頭の 16 個・8 個だけ | 32 個の全部が必要か |
def run_vqa(prompt="Question: {} Answer:", length_penalty=-1.0, n_query=32, image="same", proj=None):
    """1,000 問に答えさせ、公式の正解率を回答の種類ごとに返す。
    image:"same"(質問の画像)・"none"(画像なし)・"other"(別の質問の画像)。n_query:OPT に渡すベクトルの数(先頭から)"""
    proj = model.proj if proj is None else proj
    acc, preds = {}, {}
    for k, qid in enumerate(qids):
        img_id = questions[qid]["image_id"]
        if image == "other":                                 # 次の質問の画像(同じ画像なら、さらに次)
            j = k + 1
            while questions[qids[j % len(qids)]]["image_id"] == img_id:
                j += 1
            img_id = questions[qids[j % len(qids)]]["image_id"]
        with torch.no_grad():
            prefix = None if image == "none" else proj(qf_out[img_id][None, :n_query].to(proj.weight.dtype))
            out = beam_search(model, prefix, prompt_ids(prompt.format(prep_question(questions[qid]["question"]))),
                              beams=5, max_new=10, min_new=1, length_penalty=length_penalty)
        preds[qid] = tokenizer.decode(out, skip_special_tokens=True).strip()
        acc[qid] = vqa_accuracy(qid, preds[qid])
    by_type = {t: 100 * np.mean([acc[q] for q in qids if annotations[q]["answer_type"] == t]) for t in ["yes/no", "number", "other"]}
    return 100 * np.mean(list(acc.values())), by_type, preds


conditions = {
    "論文の設定": dict(),
    "公式の実装の設定": dict(prompt="Question: {} Short answer:", length_penalty=0.0),
    "画像なし": dict(image="none"),
    "別の画像": dict(image="other"),
    "クエリ 16 個": dict(n_query=16),
    "クエリ 8 個": dict(n_query=8),
}
vqa_results = {}
for name, kw in conditions.items():
    t0 = time.time()
    total, by_type, preds = run_vqa(**kw)
    vqa_results[name] = (total, by_type, preds)
    print(f"{name:<10}: 正解率 {total:5.1f}%(yes/no {by_type['yes/no']:5.1f}%・number {by_type['number']:5.1f}%・other {by_type['other']:5.1f}%){time.time() - t0:.0f} 秒")

# 画像の有無で正解率が変わった問題の数と、その例(other の問題で、画像ありだけが正解したものを先頭から 3 つ)
acc_img = {q: vqa_accuracy(q, vqa_results["論文の設定"][2][q]) for q in qids}
acc_none = {q: vqa_accuracy(q, vqa_results["画像なし"][2][q]) for q in qids}
print(f"\n画像ありの方が高い {sum(acc_img[q] > acc_none[q] for q in qids)} 問、画像なしの方が高い {sum(acc_img[q] < acc_none[q] for q in qids)} 問、"
      f"同じ {sum(acc_img[q] == acc_none[q] for q in qids)} 問")
for q in [q for q in qids if annotations[q]["answer_type"] == "other" and acc_img[q] == 1 and acc_none[q] == 0][:3]:
    print(f"{questions[q]['question']}(最も多い回答 {annotations[q]['multiple_choice_answer']!r})→ "
          + "、".join(f"{n} {vqa_results[n][2][q]!r}" for n in ["論文の設定", "画像なし", "別の画像"]))

names = list(vqa_results)
fig, ax = plt.subplots(figsize=(11, 4))
w = 0.2
for j, (t, color) in enumerate([("全体", "#333333"), ("yes/no", "#4C72B0"), ("number", "#DD8452"), ("other", "#55A868")]):
    vals = [vqa_results[n][0] if t == "全体" else vqa_results[n][1][t] for n in names]
    ax.bar(np.arange(len(names)) + (j - 1.5) * w, vals, w, label=t, color=color)
ax.set_xticks(np.arange(len(names))); ax.set_xticklabels(names)
ax.set_ylabel("正解率(%)"); ax.set_ylim(0, 100); ax.legend(ncol=4); ax.grid(axis="y", alpha=0.4)
ax.set_title("VQAv2 の検証用データ 1,000 問のゼロショットの正解率")
plt.show()
- 論文と公式の実装の設定: 論文は OPT のモデルの VQA のプロンプトを Question: Answer:、length penalty を −1 と書いています。一方、公式の実装の評価の設定ファイル(vqav2_zeroshot_opt_eval.yaml)は Question: Short answer: で、length penalty を指定していません(関数の既定値 0)。どちらで論文の値に近くなるかを比べます。
- 別の画像: 1,000 問の並びで次の質問の画像を使います(同じ画像なら、さらに次)。画像のベクトルの形や大きさは本物と同じで、中身だけが質問と合わない条件です。
- クエリを減らす: Q-Former は 32 個のクエリで計算し、OPT に渡す前に先頭の 16 個・8 個だけを残します。Q-Former の中の計算は変えずに、OPT が受け取る情報の量だけを減らす条件です。
- 回答の種類: VQAv2 の質問は、yes/no で答えるもの、数を答えるもの(number)、それ以外(other)に分かれています。種類ごとの正解率も出します。
実行結果
論文の設定     : 正解率  56.3%(yes/no  74.5%・number  32.9%・other  47.2%)133 秒
公式の実装の設定  : 正解率  54.2%(yes/no  71.9%・number  29.6%・other  45.9%)144 秒
画像なし      : 正解率  33.0%(yes/no  65.4%・number  10.9%・other  12.0%)165 秒
別の画像      : 正解率  32.5%(yes/no  63.7%・number  16.8%・other  10.9%)144 秒
クエリ 16 個  : 正解率  51.5%(yes/no  70.7%・number  27.7%・other  41.7%)142 秒
クエリ 8 個   : 正解率  41.4%(yes/no  66.3%・number  17.1%・other  27.2%)166 秒

画像ありの方が高い 315 問、画像なしの方が高い 55 問、同じ 630 問
What are these people doing?(最も多い回答 'eating')→ 論文の設定 'eating'、画像なし 'nothing.'、別の画像 'playing video games'
What color is the fire hydrant?(最も多い回答 'yellow')→ 論文の設定 'yellow'、画像なし 'red'、別の画像 'red'
Where is the cat?(最も多い回答 'under umbrella')→ 論文の設定 'under the umbrella'、画像なし 'on the floor.'、別の画像 'in the picture'
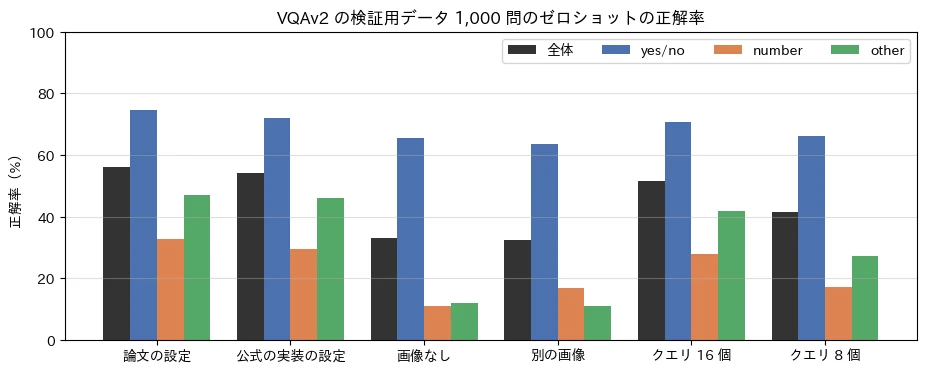
- 論文の設定: 正解率は 56.3% で、論文の値(検証用データ全体で 53.5%)より 2.8 ポイント高くなりました。1,000 問の標準誤差(約 1.6 ポイント)の 2 倍ほどの差で、選んだ 1,000 問によるばらつきの範囲に近い大きさです。公開されている重みで、論文と同じ水準の性能が出ていることを確かめられました。
- 公式の実装の設定: 「Short answer:」と length penalty 0 では 54.2% で、論文の設定より 2.1 ポイント低くなりました。この差も標準誤差の範囲に近く、1,000 問では、どちらの設定がよいとは言い切れません。
- 画像なし: 33.0% まで下がりました。yes/no は 65.4% と高いままで、画像を見なくても、質問の言い回しから答えをかなり当てられます(画像ありとの差は 9.1 ポイント)。一方、number は 10.9%、other は 12.0% まで下がり、物の色や種類、数を答えるには画像が必要なことがわかります。
- 別の画像: 32.5% で、画像なしとほぼ同じでした。別の画像のベクトルは、OPT にとって「何もない」のと同じくらい役に立たず、正解率を支えていたのは、32 個のベクトルの形ではなく、質問の画像の中身だったことがわかります。
- 画像の有無で変わった問題: 1,000 問のうち、画像があると正解率が上がった問題が 315 問、下がった問題が 55 問でした。例の 3 問では、画像があるときだけ、食事をしている人たち・黄色の消火栓・傘の下の猫を正しく答え、画像がないときや別の画像のときは、「red(消火栓によくある色)」のような、ありがちな答えになりました。
- クエリを減らす: 先頭の 16 個だけでは 51.5%(4.8 ポイント低下)、8 個では 41.4%(14.9 ポイント低下)になりました。32 個のベクトルは、どれか数個に情報が集まっているのではなく、全体で画像の情報を分け持っていて、減らすほど other と number の正解率が下がります。ただし、OPT は 32 個のベクトルの並びで学習されているので、数が変わったこと自体の影響も含みます。
実験6:線形層だけを学習し直す
第 2 段階で学習する部品のうち、Q-Former と OPT の間の線形層(768 → 2,560、約 197 万パラメータ)だけを、学習済みの重みを捨てて学習し直します。Q-Former はすでに画像の情報を 32 個のベクトルにまとめているので、その 768 次元の空間から OPT の埋め込みの空間への対応さえ学べば、言語モデルにつながるのかを確かめます。学習は、公式の実装の第 2 段階と同じ形(画像のベクトル 32 個の後にキャプションを並べ、キャプションの次の単語を当てる)で、COCO の画像とキャプションを使います。
# 学習データ:COCO 2017 の学習用の画像 ID の小さい順に 5,000 枚と、それぞれのキャプション 5 つ(25,000 組)
os.makedirs("coco/train2017", exist_ok=True)
tr_ids, tr_caps = coco_captions("train2017", 5000, 5)
with ThreadPoolExecutor(16) as ex:
    list(ex.map(fetch, [(f"http://images.cocodataset.org/train2017/{i:012d}.jpg", f"coco/train2017/{i:012d}.jpg") for i in tr_ids]))

# ViT と Q-Former は学習しないので、Q-Former の出力は 1 回だけ計算して残す(1 枚 32×768、半精度で 5,000 枚 約 250MB)
model.requires_grad_(False)
tr_qf = []
with torch.no_grad():
    for s in range(0, len(tr_ids), 50):
        pix = torch.cat([preprocess(Image.open(f"coco/train2017/{i:012d}.jpg")) for i in tr_ids[s:s + 50]]).to(device)
        tr_qf.append(model.qformer(image=model.vision(pix).float()).half())
tr_qf = torch.cat(tr_qf)


def pre_caption(c):
    """公式の実装のキャプションの前処理:小文字にして記号を空白にし、空白をまとめる"""
    return re.sub(r"\s{2,}", " ", re.sub(r"([.!\"()*#:;~])", " ", c.lower())).strip(" ")


def caption_batch(qf, caps, proj):
    """[画像のベクトル 32 個][</s> キャプション \\n] を作り、キャプションの部分だけに損失を付ける(公式の実装の第 2 段階と同じ形)"""
    tokenizer.padding_side = "right"
    t = tokenizer([pre_caption(c) + "\n" for c in caps], padding="longest", truncation=True, max_length=32, return_tensors="pt").to(device)
    prefix = proj(qf.to(proj.weight.dtype)).half()
    emb = torch.cat([prefix, model.lm.embed_tokens(t.input_ids)], dim=1)
    mask = torch.cat([t.attention_mask.new_ones(len(caps), 32), t.attention_mask], dim=1)
    labels = torch.cat([torch.full((len(caps), 32), -100, device=device), t.input_ids.masked_fill(t.attention_mask == 0, -100)], dim=1)
    logits = model.lm(emb, mask)
    return F.cross_entropy(logits[:, :-1].float().flatten(0, 1), labels[:, 1:].flatten(), ignore_index=-100)


# 評価用:実験3と同じ COCO val2017 の 1,000 枚の、最初のキャプション
with torch.no_grad():
    va_qf = torch.cat([model.qformer(image=model.vision(torch.cat([preprocess(Image.open(f"coco/val2017/{i:012d}.jpg")) for i in ret_ids[s:s + 50]]).to(device)).float())
                       for s in range(0, 1000, 50)])
va_caps = [caps[0] for caps in ret_caps]


def val_loss(proj):
    with torch.no_grad():
        return np.mean([caption_batch(va_qf[s:s + 50], va_caps[s:s + 50], proj).item() for s in range(0, 1000, 50)])


pairs = [(i, c) for i, caps in enumerate(tr_caps) for c in caps]
BATCH, EPOCHS = 32, 3                                       # 1 エポックでは損失が下がり続けていたので、3 エポックまで続ける
steps = len(pairs) // BATCH * EPOCHS
history = {}
for lr in [1e-4, 1e-3]:                                      # 論文の最大の学習率と、その 10 倍
    torch.manual_seed(0)
    proj_new = nn.Linear(768, 2560).to(device)               # 学習済みの重みを捨て、PyTorch の初期値から学習する
    if lr == 1e-4:
        print(f"学習前(初期値のまま)の検証の損失 {val_loss(proj_new):.3f}、公開されている重みの損失 {val_loss(model.proj):.3f}")
    optim = torch.optim.AdamW(proj_new.parameters(), lr=lr, betas=(0.9, 0.98), weight_decay=0.05)   # 論文の AdamW の設定
    warm = int(steps * 0.025)                               # 論文のウォームアップ(80k ステップ中 2k)と同じ割合
    sched = torch.optim.lr_scheduler.LambdaLR(optim, lambda s: (s + 1) / warm if s < warm else
                                              0.5 + 0.5 * (0.5 + 0.5 * math.cos(math.pi * (s - warm) / (steps - warm))))   # 最大の半分まで下げる(論文は 1e-4 → 5e-5)
    scaler = torch.amp.GradScaler("cuda")                    # OPT が半精度なので、勾配が小さすぎて 0 にならないよう損失を拡大する
    rng = random.Random(0)
    losses, t0 = [], time.time()
    for ep in range(EPOCHS):
        order = list(range(len(pairs)))
        rng.shuffle(order)
        for s in range(0, len(order) - BATCH + 1, BATCH):
            b = [pairs[k] for k in order[s:s + BATCH]]
            loss = caption_batch(tr_qf[[i for i, _ in b]], [c for _, c in b], proj_new)
            optim.zero_grad()
            scaler.scale(loss).backward()
            scaler.step(optim); scaler.update(); sched.step()
            losses.append(loss.item())
    history[lr] = (proj_new, losses, val_loss(proj_new))
    print(f"学習率 {lr:g}:{steps} ステップ {time.time() - t0:.0f} 秒、学習の損失(最後の 100 ステップの平均){np.mean(losses[-100:]):.3f}、検証の損失 {history[lr][2]:.3f}")

fig, ax = plt.subplots(figsize=(8, 3.5))
for lr, (_, losses, _) in history.items():
    ax.plot(np.convolve(losses, np.ones(20) / 20, mode="valid"), label=f"学習率 {lr:g}")
ax.axhline(val_loss(model.proj), color="gray", ls="--", label="公開されている重み(検証の損失)")
ax.set_xlabel("ステップ"); ax.set_ylabel("損失(20 ステップの移動平均)"); ax.legend(); ax.grid(alpha=0.4)
ax.set_title("線形層だけを学習し直したときの損失")
plt.show()
- データ: COCO 2017 の学習用の画像 ID の小さい順に 5,000 枚と、各画像の最初の 5 つのキャプション(25,000 組)です。1 エポック(781 ステップ)の学習が A100 1 枚で 1 分半ほどに収まる量にしています。評価には、実験3と同じ検証用の 1,000 枚の最初のキャプションを使います。
- Q-Former の出力を先に計算する: ViT と Q-Former は学習しないので、その出力は学習の間ずっと同じです。1 回だけ計算して残し、学習では線形層と OPT だけを通します。
- キャプションの形: 公式の実装の第 2 段階と同じく、キャプションを小文字にして記号を消し、末尾に改行を付けます。改行で終えることを学ぶので、生成のときに改行で止められます。パディングの位置は損失から除きます。
- 学習率: 論文の第 2 段階の最大の学習率 1e-4 と、その 10 倍の 1e-3 の 2 つを試します。論文は Q-Former と線形層を 8 万ステップかけて学習しますが、本記事は線形層だけを 2,343 ステップなので、論文の学習率で足りるかがわからないためです。検証の損失が小さい方を、次の評価で使います。
- スケジュール: 論文と同じく、ウォームアップの後にコサインで下げます。ウォームアップは論文と同じ割合(8 万ステップ中の 2,000 ステップ = 2.5%)で 58 ステップ、最後は最大の半分まで下げます(論文の第 2 段階は 1e-4 から 5e-5)。
- GradScaler: OPT は半精度なので、OPT の中を通る勾配が小さすぎると 0 に丸められます。損失を大きくしてから逆伝播し、更新の前に元に戻すことで、これを防ぎます。
- 3 エポック: 1 エポックで試したところ、終わりまで損失が下がり続けていたので、同じデータを 3 回くり返して学習します。
- 初期値: nn.Linear の PyTorch の初期値から学習します(公式の実装も nn.Linear をそのまま使います)。比較のため、学習前の初期値のままの損失と、公開されている重みの損失も表示します。
実行結果
学習前(初期値のまま)の検証の損失 6.905、公開されている重みの損失 1.602
学習率 0.0001:2343 ステップ 257 秒、学習の損失(最後の 100 ステップの平均)1.705、検証の損失 1.739
学習率 0.001:2343 ステップ 257 秒、学習の損失(最後の 100 ステップの平均)1.643、検証の損失 1.779
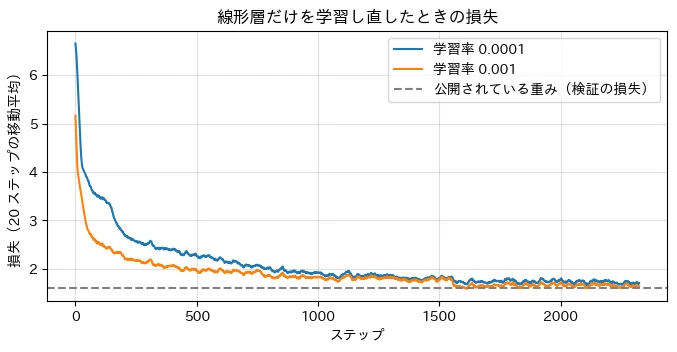
- 学習前: PyTorch の初期値のままの線形層では、検証の損失は 6.905 でした。OPT が画像の情報を受け取れず、キャプションをほぼ当てずっぽうで予測している状態です。公開されている重みの損失は 1.602 です。
- 学習後: 3 エポック(2,343 ステップ、それぞれ約 4 分)で、検証の損失は、学習率 1e-4 で 1.739、1e-3 で 1.779 まで下がりました。学習の損失は 1e-3 の方が速く下がり、最後も 1e-3 の方が低い(1.643 と 1.705)のに、検証の損失は 1e-4 の方が低くなりました。5,000 枚を 3 回くり返して学習するので、学習率が大きい方が学習データに合わせすぎたと考えられます。次の評価では、検証の損失が低い 1e-4 を使います。
- 公開されている重みとの差: 768 × 2,560 の 1 つの線形層を学び直すだけで、損失は 6.905 から 1.739 まで下がり、公開されている重み(1.602)との差は 0.137 になりました。Q-Former の出力に画像の情報がまとまっているので、OPT の埋め込みの空間への線形の対応を学べば、言語モデルの側では、ほぼ同じように画像の内容を読めるようになります。残りの差は、学習データの量(論文は約 1.29 億枚、本記事は 5,000 枚)と、Q-Former も一緒に学習するかどうかの違いから来ていると考えられます。
学習し直した線形層で質問に答える
学習し直した線形層で、実験5と同じ 1,000 問に答えさせ、公開されている重みと正解率を比べます。猫の画像のキャプションも書かせます。
best_lr = min(history, key=lambda lr: history[lr][2])       # 検証の損失が小さい方の学習率
proj_best = history[best_lr][0]
total, by_type, _ = run_vqa(proj=proj_best)                # 公開されている重みの結果は、実験5の「論文の設定」
for name, proj, (t, bt) in [("公開されている重み", model.proj, vqa_results["論文の設定"][:2]), (f"学習し直した重み(学習率 {best_lr:g})", proj_best, (total, by_type))]:
    with torch.no_grad():
        prefix = proj(model.qformer(image=model.vision(preprocess(cats).to(device)).float()).to(proj.weight.dtype))
        cap = tokenizer.decode(beam_search(model, prefix, prompt_ids("a photo of"), **CAPTION_S), skip_special_tokens=True).strip()
    print(f"{name}:VQA 正解率 {t:.1f}%(yes/no {bt['yes/no']:.1f}%・number {bt['number']:.1f}%・other {bt['other']:.1f}%)、猫の画像のキャプション a photo of → {cap!r}")

# 2 つの線形層の出力(検証用の 1,000 枚 × 32 個のベクトル)を比べる。OPT の単語の埋め込みの長さとも比べる
with torch.no_grad():
    out_old, out_new = model.proj(va_qf.to(model.proj.weight.dtype)).float(), proj_best(va_qf).float()
print(f"出力のコサイン類似度 平均 {F.cosine_similarity(out_old, out_new, dim=-1).mean():.3f}、"
      f"出力の長さ 平均 {out_old.norm(dim=-1).mean():.1f}(公開されている重み)・{out_new.norm(dim=-1).mean():.1f}(学習し直した重み)、"
      f"OPT の単語の埋め込みの長さ 平均 {model.lm.embed_tokens.weight.float().norm(dim=-1).mean():.2f}")
- 同じ条件で比べる: 実験5の「論文の設定」と同じプロンプト・ビームサーチで、線形層だけを入れ替えます。ViT・Q-Former・OPT は同じなので、差は線形層だけから生まれます。公開されている重みの正解率は、実験5の結果をそのまま使います。
- 出力を比べる: 2 つの線形層が、同じ Q-Former の出力を、どれだけ似たベクトルに変えているかを、コサイン類似度で見ます。重みそのものではなく出力を比べるのは、OPT に届くのは出力だけだからです。あわせて、出力の長さを、OPT の単語の埋め込みの長さと比べます。
実行結果
公開されている重み:VQA 正解率 56.3%(yes/no 74.5%・number 32.9%・other 47.2%)、猫の画像のキャプション a photo of → 'a group of cats walking in a garden'
学習し直した重み(学習率 0.0001):VQA 正解率 49.7%(yes/no 68.7%・number 39.8%・other 36.6%)、猫の画像のキャプション a photo of → 'a group of cats walking in the grass'
出力のコサイン類似度 平均 0.119、出力の長さ 平均 65.4(公開されている重み)・36.9(学習し直した重み)、OPT の単語の埋め込みの長さ 平均 1.53
- VQA の正解率: 学び直した線形層では 49.7% で、公開されている重み(56.3%)より 6.6 ポイント低くなりました。画像なしの 33.0% と比べると、公開されている重みで画像から得ていた分(23.3 ポイント)の約 7 割(16.7 ポイント)を取り戻しています。
- 回答の種類ごと: other は 47.2% から 36.6% に下がりました。一方、number は 32.9% から 39.8% に上がりました。COCO のキャプションは「two dogs」のように数を書くことが多いので、その書き方を学んだと考えられます(number は 122 問なので、差の誤差は大きめです)。色や物の名前など多様な答えが必要な other は、5,000 枚の COCO のキャプションだけでは十分に学べませんでした。
- キャプション: 猫の画像は「a group of cats walking in the grass」で、公開されている重みの「…in a garden」とほぼ同じ内容になりました。
- 出力のベクトル: 2 つの線形層の出力のコサイン類似度は平均 0.119 で、ほぼ直交する、まったく違うベクトルでした。それでも、OPT はどちらからも画像の内容を読み取ります。また、出力の長さは 65.4 と 36.9 で、OPT の単語の埋め込みの長さ(平均 1.53)の約 24〜43 倍もあります。32 個のベクトルは、単語の埋め込みに近づけたものではなく、OPT が読める形であれば、単語の埋め込みとはかけ離れた場所に置かれていてよいことがわかります(OPT は各層の入り口で LayerNorm を通すので、長さそのものは問題になりにくい構成です)。
2つの重みの正解率を回答の種類ごとに並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、凍結した ViT-g と凍結した OPT-2.7B を Q-Former でつなぐ BLIP-2 を、前処理・ViT-g・Q-Former・OPT・ビームサーチまでスクラッチで実装し、公式の重みで動かして仕組みを確かめました。
- スクラッチ実装: Hugging Face の重みを名前の置き換えだけで読み込めました。float32 で比べると、ViT の出力は完全に一致し、Q-Former の出力から次のトークンの logit までの差は 程度でした。キャプションと 4 つの質問の回答は、ビームサーチの結果まで 5 つとも Hugging Face と一致しました。
- パラメータの内訳: 学習するのは Q-Former と線形層の約 1.07 億で、全体(約 37.4 億)の 3% ほどです。凍結した 2 つのモデルの間を、32 個のクエリ(32×768)だけでつなぎます。
- 第 1 段階の ITC・ITM(実験3): Salesforce/blip2-itm-vit-g で、COCO の 1,000 枚・5,000 文の対応を当てると、ITC だけで画像 → 文の R@1 は 84.8%、文 → 画像は 75.8% でした。ITC の上位 128 件を ITM で並べ直すと、93.2% と 81.2% に上がりました。速い ITC で候補を絞り、画像と文を突き合わせる ITM で並べ直す使い分けが、検索の精度を上げます。
- クエリが見る場所(実験4): ViT-g の出力には、背景の 1 つのパッチだけが中央値の約 7.7 倍の長さを持つ現象があり、11 層目の交差注意では、クエリ 32 個の注意の半分以上(0.550)がその 1 つのパッチに向いていました。COCO の 100 枚でも平均 0.552 で同じでした。クエリは画像の領域を分担して読むのではなく、ViT が画像の要約を置いたパッチをまとめて読んでいます。
- VQAv2 のゼロショット(実験5): 1,000 問で 56.3% と、論文の 53.5% に近い正解率でした。画像なしでは 33.0%、別の画像では 32.5% に下がり、other(12.0%)と number(10.9%)は画像がないと答えられません。OPT に渡すベクトルを 16 個・8 個に減らすと、51.5%・41.4% に下がりました。
- 線形層の学び直し(実験6): 学習済みの線形層を捨て、COCO の 5,000 枚のキャプションで学び直すと、検証の損失は 6.905 から 1.739(公開されている重みは 1.602)まで下がり、VQA の正解率は 49.7% と、画像から得ていた分の約 7 割を取り戻しました。2 つの線形層の出力はほぼ直交していて、単語の埋め込みより 24 倍以上長いベクトルでしたが、OPT はどちらからも画像の内容を読み取りました。
BLIP-2 の考え方は、強い単一モダリティのモデルを凍結したまま、その間の小さな橋渡しだけを学習することです。この考え方は、後の InstructBLIP や、画像のエンコーダと言語モデルを射影でつなぐ LLaVA などの VLM にも引き継がれています。
ライセンスに関する注記
BLIP-2 の公式の実装(salesforce/LAVIS)は BSD-3-Clause です。実験5では、その中の VQA の評価のコード(vqa_eval.py、元は VQA の公式の評価のコード)をダウンロードして使っています。
Hugging Face の Salesforce/blip2-opt-2.7b と Salesforce/blip2-itm-vit-g のモデルカードは、ライセンスを MIT としています。ただし、blip2-opt-2.7b は言語モデル OPT-2.7B の重みを含みます。OPT-2.7B(facebook/opt-2.7b)のモデルカードはライセンスを「other」・商用利用を不可としていて、Meta の OPT のライセンス(OPT-175B License Agreement)は、非営利の研究目的に限って 利用を認めています。Salesforce のモデルカードは、BLIP-2 を研究目的の公開とし、インターネットから集めたデータで学習しているため、不適切な内容を生成したり、データの偏りを再現したりするおそれがあるので、実際のアプリケーションにそのまま使わないよう書いています。本記事では、研究と学習の目的で使っています。
実験3と実験6では COCO 2017 の画像とキャプションを、実験5では VQAv2 の質問と回答と COCO 2014 の画像を使いました。COCO と VQAv2 の注釈は CC BY 4.0 です。COCO の画像は Flickr の画像で、それぞれの画像の著作権は撮影者にあり、Flickr の利用規約に従います。本記事では、COCO の画像を記事に載せていません。猫の画像は Gemini で作成したものです。本記事の説明は一般的な解釈で、法的な助言ではありません。 実際に利用する場合は、ライセンスの条文を確認してください。
出典・ライセンスについて
- BLIP-2 の実装: Hugging Face の transformers(Apache-2.0)の modeling_blip_2.py・modeling_opt.py と、公式の実装 LAVIS(BSD-3-Clause)の blip2_qformer.py・blip2_opt.py の構造を参考に、スクラッチで実装しています。
- 学習済みのモデル: Salesforce/blip2-opt-2.7b(MIT、OPT-2.7B の部分は OPT のライセンス)と Salesforce/blip2-itm-vit-g(MIT)を使用しています。
- データセット: COCO(2014・2017)の画像とキャプション、VQAv2 の検証用データの質問と回答を使用しています。
参考文献
- J. Li, D. Li, S. Savarese, S. Hoi (2023). BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models. ICML 2023.
- T. Darcet, M. Oquab, J. Mairal, P. Bojanowski (2024). Vision Transformers Need Registers. ICLR 2024.
- Salesforce. salesforce/LAVIS. GitHub.
- Salesforce. Salesforce/blip2-opt-2.7b. Hugging Face.
- Salesforce. Salesforce/blip2-itm-vit-g. Hugging Face.
- Meta AI. facebook/opt-2.7b. Hugging Face.
- T.-Y. Lin et al. (2014). Microsoft COCO: Common Objects in Context. ECCV 2014.
- Y. Goyal, T. Khot, D. Summers-Stay, D. Batra, D. Parikh (2017). Making the V in VQA Matter: Elevating the Role of Image Understanding in Visual Question Answering. CVPR 2017.
本記事の文章・構成の一部に生成AIを使用しています。