Bradley–Terryモデルとは?
 (画像は、Geminiで作成)
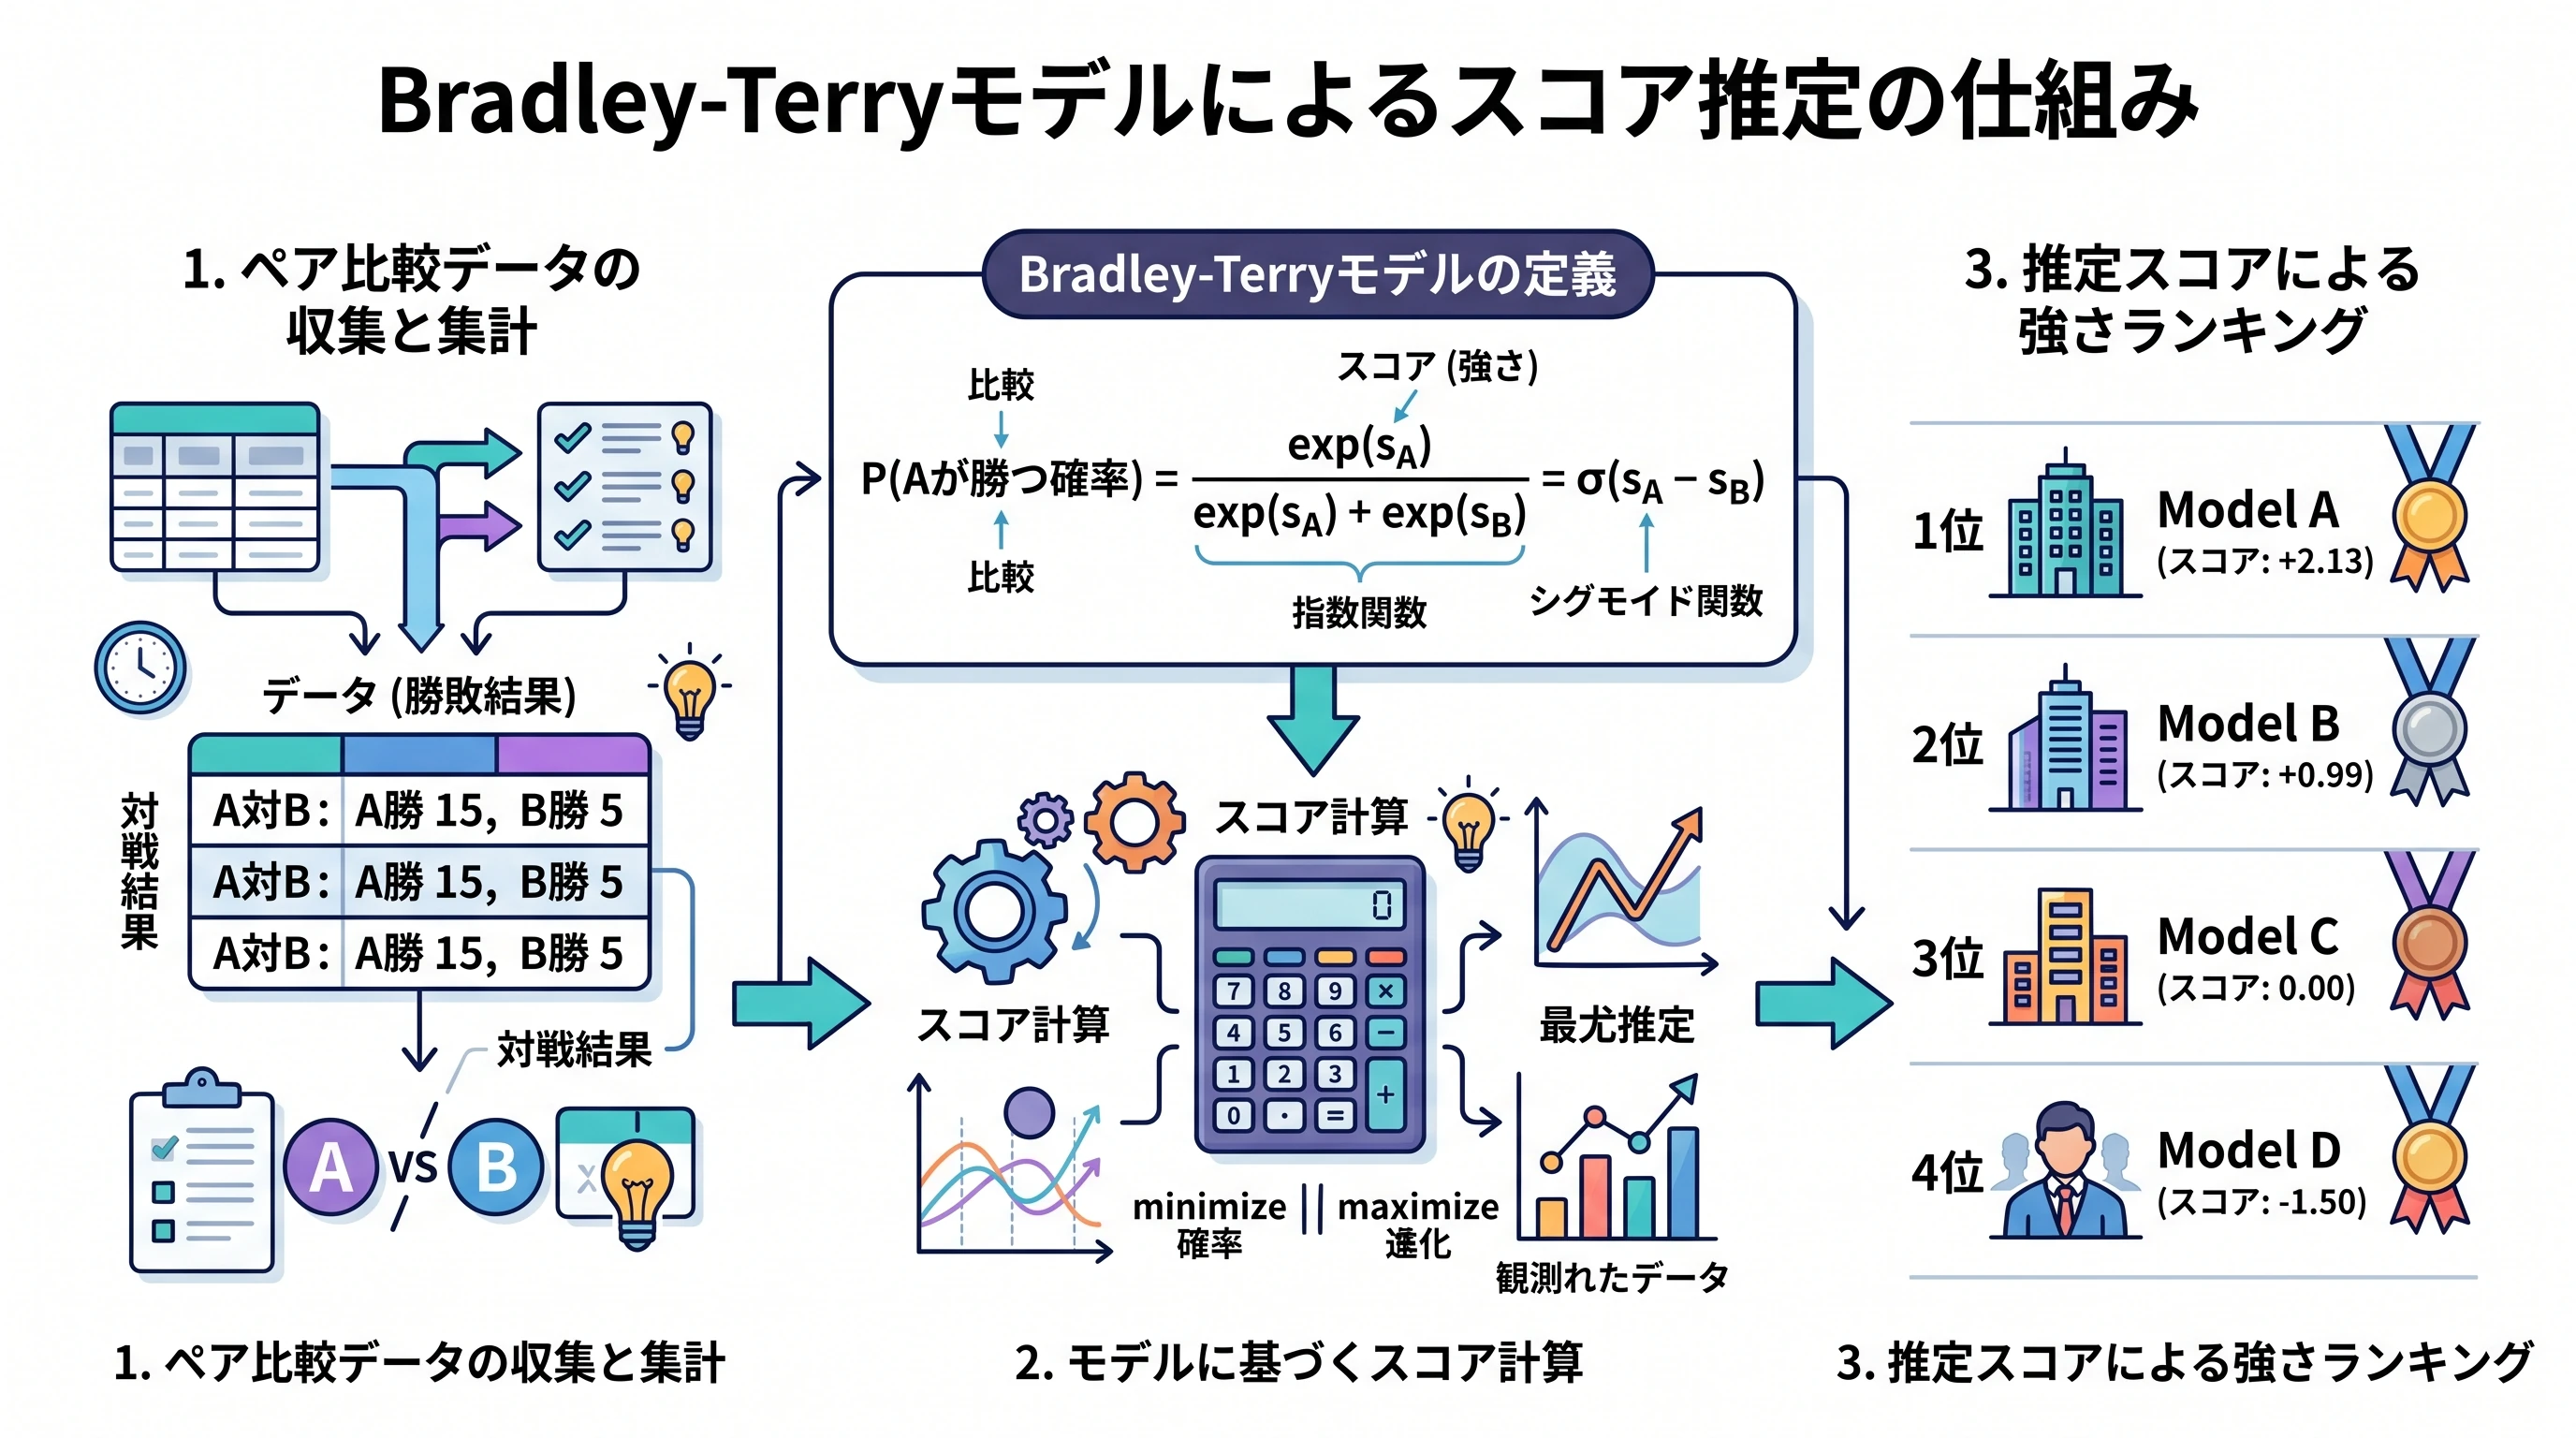
2つを比べた勝ち負けのデータから、それぞれの強さ(スコア)を推定する Bradley–Terry モデルの定義と、勝率がスコアの差のシグモイドになり、スコアの差だけが意味を持つことを理解すること。InstructGPT の報酬モデル・DPO・Chatbot Arena でどう使われているかを説明でき、PyTorch での実装で、最尤推定によるスコアの推定と、一度も負けていない対象で推定が発散し、L2 正則化で止まることを確かめること。
Bradley–Terryモデルの概要
Bradley–Terry モデル(BT モデル)は、2つの対象(選手、商品、文章など)を一対一で比べた「どちらが勝ったか」「どちらが好まれたか」というデータから、それぞれの 強さ(スコア) を推定するための確率モデルです。Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons(Bradley & Terry, Biometrika, 1952)で提案されました(同じ形のモデルは、それ以前に Zermelo がチェスの対戦成績の分析で考えていました)。
もともとはスポーツの対戦成績や、食品の味の比較評価などで使われてきた統計モデルですが、近年は大規模言語モデル(LLM)の学習と評価で重要な役割を担っています。
- InstructGPT(RLHF): 人が「どちらの回答が良いか」を比べたデータから 報酬モデル を学習するときの損失(ペアワイズ損失)は、BT モデルの負の対数尤度です(InstructGPTの記事)。
- DPO: 「人の好みは BT モデルに従う」と仮定することで、計算できない分配関数 が引き算で消え、報酬モデルを使わずに方策を学習できます(DPOの記事)。
- Chatbot Arena: LLM 同士の回答を人が見比べて投票した結果から、各モデルの強さを BT モデルで推定し、ランキングを作っています。
本記事では、BT モデルの定義からシグモイド関数が現れる理由、最尤推定とその注意点を導き、LLM でどのように使われているかを整理したうえで、PyTorch で勝敗データからスコアを推定します。
本記事では、比べる対象 のスコアを 、「 が より好まれる」ことを と書きます。LLM の文脈では、プロンプト に対する応答 のスコアを報酬 と書き、学習済みの報酬モデルは とします。InstructGPTの記事では論文にならって報酬モデルを と書いていますが、本記事と DPOの記事では、方策のパラメータを 、報酬モデルのパラメータを としています。
なぜ「点数」ではなく「2択の比較」なのか
AI の回答の良し悪しを人に評価してもらうとき、最も単純なのは「100点満点で何点か」を付けてもらう 絶対評価 です。しかし、学習データとして集めるには次のような問題があります。
- 評価者によって基準がずれる: ある評価者の80点が、別の評価者の60点にあたることがあります。
- 細かい数値を決めるのが難しい: 72点か75点かを一貫して決めるのは難しく、同じ評価者でも日によって変わります。
- 問題によって基準が変わる: 簡単な質問への並の回答と、難しい質問への優れた回答のどちらに高い点を付けるべきかは、決めにくい問題です。
これに対し、「回答 A と回答 B のどちらが良いか」を選んでもらう ペアワイズ比較 は、人にとって判断しやすく、評価者ごとの基準のずれの影響も受けにくいと考えられています。InstructGPT でも、評価者には同じプロンプトへの複数の回答を順位付けしてもらい、それを2つずつの比較に分けて学習に使いました。
ただし、比較で得られるのは「A が B に勝った」「B が C に勝った」といった断片的な情報だけです。ここから、強化学習に使えるような 各回答のスコア をどうやって求めればよいでしょうか。その枠組みを与えるのが BT モデルです。
2つの評価の仕方を並べると、次のようになります。
(図は、diagram-designで作成)
Bradley–Terryモデルの定義
1. 強さと勝率
個の対象があり、対象 の強さを正の実数 で表します。BT モデルでは、対象 と を比べたときに が好まれる(勝つ)確率を、強さの比 で定義します。
が勝つ確率は で、2つを足すと1になります(引き分けは考えません)。
- のとき、 で五分五分です。
- が よりずっと大きいとき、 は1に近づきます。
- が よりずっと小さいとき、 は0に近づきます。
2. スコアとシグモイド関数
強さ は正でなければならないので、最適化で扱うときには制約が付いて不便です。そこで、実数全体の値をとれる スコア を、(つまり )で導入します。これを勝率の式に代入し、分母と分子を で割ると、次のようになります。
ここで はシグモイド関数です。BT モデルの勝率は、スコアの差をシグモイド関数に通したもの として書けます。
「スコアの差をシグモイド関数に通す」という形は、天下り的に決めたものではありません。「勝率は強さの比で決まる」という仮定から出発し、強さを対数のスケール()で表すと、自然にシグモイド関数が現れます。スコアの差 は、勝率の対数オッズ に一致します。
3. 差だけが意味を持つ
BT モデルの最も重要な性質は、すべてのスコアに同じ定数 を足しても、勝率が変わらない ことです。
このことから、次の2つが言えます。
- スコアの原点には意味がない: スコアの絶対的な値ではなく、対象どうしの差 だけが勝率を決めます。
- 推定には基準が必要: 勝敗データからスコアを推定するとき、定数を足した解はすべて同じ尤度になるので、解が1つに決まりません。1つの対象のスコアを0に固定する、スコアの平均を0にする、などの基準を設けて解を1つに決めます。
LLM の報酬では、この性質がさらに強い形で効きます。同じプロンプト に対する回答どうしだけを比べるので、プロンプトごとに異なる定数 を報酬に足しても、選好の確率は変わりません。
InstructGPT では、強化学習の前に、評価者の模範回答に対する報酬の平均が0になるよう報酬モデルにバイアスを加えています。これは、「基準をどこに置くか」を決める操作にあたります。また、この性質は DPO で分配関数 が消える理由そのものです(後述)。
スコアに定数を足したときの関係を図にすると、次のようになります。
(図は、diagram-designで作成)
具体的な計算例
3つの回答 A・B・C のスコアが、次のように決まっているとします(DPOの記事の計算例の報酬と同じ値です)。
それぞれの組み合わせの勝率は次のとおりです。
| 組み合わせ | スコアの差 | 勝率 |
|---|---|---|
| A と B | ||
| B と C | ||
| A と C |
のように、逆向きの勝率は1から引いて求まります。スコアの差が大きくなるほど、勝率は1に近づきます。
シグモイド関数の曲線の上に3つの組み合わせを置くと、次のようになります。
(図は、diagram-designで作成)
最尤推定によるスコアの推定
負の対数尤度
実際には真のスコアは分からず、手元にあるのは比較の結果だけです。そこで、観測された勝敗データから 最尤推定 でスコアを求めます。
比較の結果を と書きます。 は、「 回目の比較で が に勝った」ことを表します。各比較が独立だとすると、データ全体の尤度は各比較の確率の積で、その対数をとると和になります。
勾配降下法で最小化するため、符号を反転した 負の対数尤度 を損失にします。
正解ラベルが1(勝者が勝った)の2値分類で、予測確率を とすると、交差エントロピー損失は です。BT モデルの最尤推定は、勝者と敗者のスコアの差 を入力とするロジスティック回帰 と同じ問題です。
勾配の意味
1回の比較の損失 を勝者のスコアで微分すると、 と から、次のようになります。
勾配降下法では勾配と逆向きに動くので、勝者のスコアは上がり、敗者のスコアは下がります。その大きさ は、モデルがその結果をどれだけ予想していなかったか を表します。すでに勝者のスコアが十分高い比較ではほとんど動かず、予想に反して弱い方が勝った比較では大きく動きます。DPOの記事の勾配の重み は、これと同じものです。
推定が発散する場合
最尤推定には、注意すべき落とし穴があります。一度も負けていない対象があると、そのスコアの推定値は無限大に発散します。その対象のスコアを上げれば上げるほど、勝った比較の確率 が1に近づき、尤度が上がり続けるからです。同様に、一度も勝っていない対象のスコアはマイナス無限大に向かいます。
より正確には、対象を頂点とし「勝った対象から負けた対象へ」矢印を引いたグラフで、どの対象からどの対象へも矢印をたどって行けるとき(強連結なとき)に限り、基準を固定した最尤推定の解が有限な値で1つに決まることが知られています。実際には、スコアに小さな L2 正則化(スコアが0の近くにあるという事前分布)を加えて、発散を防ぐことがよくあります。
この問題は、LLM の選好学習でも形を変えて現れます。DPOの記事の IPO の節で扱った「データ上で常に一方が勝つペアに対して、DPO は暗黙の報酬の差を際限なく広げようとする」という指摘は、BT モデルの最尤推定のこの性質によるものです。
LLMでの使われ方
BT モデルは、LLM の分野で次の3つの場面に現れます。
| 場面 | 比べるもの | BT モデルの使い方 |
|---|---|---|
| InstructGPT(RLHF) | 同じプロンプトへの2つの回答 | 報酬モデル の出力をスコアとみなし、負の対数尤度で学習する |
| DPO | 同じプロンプトへの2つの回答 | 選好が真の報酬の BT モデルに従うと仮定し、報酬を方策で書き直して代入する |
| Chatbot Arena | 2つの LLM の回答 | 投票結果から、各 LLM のスコアを最尤推定してランキングにする |
3つの使われ方を並べると、次のようになります。
(図は、diagram-designで作成)
1. InstructGPT:報酬モデルのペアワイズ損失
InstructGPTの記事のステップ2では、プロンプト に対する好ましい回答 と好ましくない回答 のペアから、報酬モデル を学習しました。損失は次のとおりです。
これは、回答のスコア をニューラルネットワーク に出力させた、BT モデルの負の対数尤度 です。前節の実装のように対象ごとにスコアを1つずつ持つ代わりに、回答の文章からスコアを計算するネットワークを学習するので、学習データにない新しい回答にもスコアを付けられます。
InstructGPT では、評価者が1つのプロンプトへの 個の回答を順位付けし、そこから作られる 個のペアをまとめて学習しています。論文の損失にある は、この 個のペアの損失を平均するための係数です。
2. DPO:分配関数が消える理由
DPOの記事では、KL ペナルティ付きの報酬最大化の最適方策 から、真の報酬 を次のように書き直しました。
は、プロンプト に対して生成しうるすべての応答についての和なので、直接は計算できません。しかし、選好が BT モデルに従うと仮定すると、選好の確率には 報酬の差 だけが現れます。
は同じプロンプト に対する2つの応答で共通なので、前述の「プロンプトごとの定数 を足しても変わらない」という性質によって、差をとると打ち消されます。
DPO が成り立つのは、選好モデルが報酬の 差だけに依存する からです。DPO の論文では、後述の Plackett–Luce モデル(順位付けのデータ)でも同じように が消えることが示されています。詳しい導出は DPOの記事 を参照してください。
3. Chatbot Arena:LLM のランキング
Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference(Chiang et al., 2024)は、利用者が入力したプロンプトに2つの匿名の LLM が回答し、利用者がどちらが良いかを投票する評価の仕組みです(現在は Arena として運営されています)。集まった大量の投票から、各 LLM のスコアを BT モデルの最尤推定で求め、ランキングにしています。
ランキングの数値は、チェスなどで使われる Elo レーティング と同じ尺度で表示されています。Elo レーティングで広く使われる勝率の式は、次のとおりです。
を使って書き直すと、 となります。つまり、レーティング は BT モデルのスコア を と定数倍したものです(原点は任意に決めます)。たとえばレーティングが100違うと、強い方の勝率は です。
もともとの Elo レーティングは、対戦のたびにレーティングを少しずつ更新する方法で、対戦の順番によって結果が変わります。Chatbot Arena の論文では、すべての投票を使って BT モデルの最尤推定を行い、ブートストラップ法で信頼区間を付ける方法をとっています。
PyTorchによる実装
勝敗データから BT モデルのスコアを推定する処理を、PyTorch で実装します。
実装1:勝敗データの生成
4つのモデル(A・B・C・D)の真のスコアを とし、BT モデルに従って2,000回の対戦結果を生成します。実際の場面では真のスコアは分からず、手元にあるのは勝敗の記録だけです。
import torch
import torch.nn.functional as F

torch.manual_seed(42)

# 1. 真のスコア(本来は未知)
model_names = ["Model_A", "Model_B", "Model_C", "Model_D"]
true_scores = torch.tensor([2.0, 1.0, 0.0, -1.5])
num_items = len(model_names)

# 2. Bradley–Terry モデルに従って 2,000 回の対戦結果を生成する
num_matches = 2000
winner_indices, loser_indices = [], []
for _ in range(num_matches):
    i, j = torch.randperm(num_items)[:2].tolist()                  # 異なる2つのモデルを選ぶ
    win_prob = torch.sigmoid(true_scores[i] - true_scores[j]).item()
    if torch.rand(1).item() < win_prob:                             # 確率 win_prob で i が勝つ
        winner_indices.append(i)
        loser_indices.append(j)
    else:
        winner_indices.append(j)
        loser_indices.append(i)
winners = torch.tensor(winner_indices)
losers = torch.tensor(loser_indices)

wins = torch.bincount(winners, minlength=num_items)
games = wins + torch.bincount(losers, minlength=num_items)
for name, w, g in zip(model_names, wins, games):
    print(f"{name}: {w.item():4d} 勝 / {g.item():4d} 戦(勝率 {w.item() / g.item():.3f})")
真のスコアを決めて Bradley–Terry モデルに従う対戦結果を作り、勝率と真のスコアの関係を確かめるコードです。
- 真のスコア: 真のスコアを 2.0・1.0・0.0・−1.5 にするのは、勝率が大きく違う組(Model_A 対 Model_D は )と、拮抗した組(隣り合うモデルは )の両方を含めるためです。Model_D だけ間隔を1.5にしているのは、スコアの間隔が等しくなくても推定できることを確かめるためです。
- 対戦の生成: 毎回、異なる2つのモデルを無作為に選び(torch.randperm)、真のスコアの差をシグモイド関数に通した確率で勝者を決めます。記録するのは勝者と敗者の番号(winners と losers)だけです。2,000回にすると、6通りの組み合わせがそれぞれ約330回ずつ対戦し、スコアを安定して推定できる回数になります。
- 勝率の確認: torch.bincount で、各モデルの勝ち数と対戦数を数えます。
実行結果
Model_A:  874 勝 / 1001 戦(勝率 0.873)
Model_B:  615 勝 /  987 戦(勝率 0.623)
Model_C:  418 勝 / 1011 戦(勝率 0.413)
Model_D:   93 勝 / 1001 戦(勝率 0.093)
真のスコアが高いモデルほど勝率が高くなっています。ただし、勝率はどの相手と何回戦ったかにも左右されるので、勝率をそのままスコアとして使うことはできません。
実装2:最尤推定
負の対数尤度を最小化して、勝敗の記録からスコアを推定します。
def fit_bradley_terry(winners, losers, num_items, ref_index=2, num_steps=2000, lr=0.05, l2=0.0):
    """勝敗ログから、負の対数尤度を最小化してスコアを推定する(ref_index のスコアを 0 に固定)"""
    scores = torch.zeros(num_items, requires_grad=True)
    optimizer = torch.optim.Adam([scores], lr=lr)
    for _ in range(num_steps):
        optimizer.zero_grad()
        margin = scores[winners] - scores[losers]
        loss = F.softplus(-margin).mean()                  # -log σ(s_w - s_l) の平均
        if l2 > 0:
            loss = loss + l2 * (scores ** 2).sum()         # 事前分布(L2 正則化)
        loss.backward()
        scores.grad[ref_index] = 0.0                       # 基準のスコアは動かさない
        optimizer.step()
    return scores.detach(), loss.item()

est_scores, final_loss = fit_bradley_terry(winners, losers, num_items)

print(f"最終的な損失(負の対数尤度の平均): {final_loss:.4f}")
print("=== 推定されたスコア(Model_C = 0 を基準) ===")
for name, est, true in zip(model_names, est_scores, true_scores):
    print(f"{name}: 推定値 {est.item():+.2f}(真値 {true.item():+.2f})")

true_p = torch.sigmoid(true_scores[0] - true_scores[1]).item()
pred_p = torch.sigmoid(est_scores[0] - est_scores[1]).item()
print(f"P(A ≻ B): 真の値 {true_p:.3f} / 推定値から計算した値 {pred_p:.3f}")

# 基準を平均 0 に取り直しても、差(勝率)は変わらない
centered = est_scores - est_scores.mean()
print("平均 0 に取り直したスコア:", [round(v, 2) for v in centered.tolist()])
print(f"取り直した後の P(A ≻ B): {torch.sigmoid(centered[0] - centered[1]).item():.3f}")
負の対数尤度を勾配法で最小化してスコアを推定し、真のスコアから計算した勝率と比べるコードです。
- 損失: F.softplus(-margin) は と同じ値です()。torch.log(torch.sigmoid(margin)) と書くと、 が大きな負の値のときにシグモイドが0に丸められて対数が発散しますが、softplus を使うとそれを避けられます。
- 基準の固定: スコアは差にしか意味がないので、ref_index(ここでは Model_C)のスコアを0に固定します。loss.backward() の後に、そのスコアの勾配を0にしてから更新します。Adam は勾配が常に0のパラメータを動かさないので、Model_C のスコアは初期値の0のままです。
- L2 正則化: l2 を正にすると、スコアの2乗和を損失に加えます。次の実装3で、推定が発散する場合に使います。
- 学習の設定: 2,000ステップ・学習率0.05は、このデータで推定値が収束する設定の例で、結果はこれらの値に大きく左右されません。
- 推定の検証: 推定したスコアから計算した勝率を、真の勝率と比べます。
- 基準の取り直し: 推定したスコアから平均を引いて「平均0」の基準に取り直しても、差は変わらないので勝率も変わらないことを確かめます。
実行結果
最終的な損失(負の対数尤度の平均): 0.3879
=== 推定されたスコア(Model_C = 0 を基準) ===
Model_A: 推定値 +2.13(真値 +2.00)
Model_B: 推定値 +0.99(真値 +1.00)
Model_C: 推定値 +0.00(真値 +0.00)
Model_D: 推定値 -1.57(真値 -1.50)
P(A ≻ B): 真の値 0.731 / 推定値から計算した値 0.758
平均 0 に取り直したスコア: [1.74, 0.6, -0.39, -1.95]
取り直した後の P(A ≻ B): 0.758
勝敗の記録だけから、真のスコアに近い値が推定できています。ずれ(Model_A で約0.13)は、2,000回という有限の対戦から推定したことによる誤差です。平均0に取り直すとスコアの値は変わりますが、勝率 P(A ≻ B) は同じです。
(実行環境:PyTorch 2.4.1、CPU。乱数の実装が異なるバージョンや環境では、生成される対戦結果と推定値がわずかに変わることがあります。)
推定したスコアと真のスコアを並べると、次のようになります。
(図は、diagram-designで作成)
実装3:一度も負けていない対象がある場合
最後に、「推定が発散する場合」で説明した現象を確かめます。実装1のデータから Model_A が負けた対戦を取り除き、Model_A が一度も負けていないデータを作って推定します。
# Model_A が負けた対戦を取り除き、「Model_A が一度も負けていない」データを作る
keep = losers != 0
winners_u, losers_u = winners[keep], losers[keep]
print(f"残った対戦: {keep.sum().item()} 件(Model_A の敗戦は {(losers_u == 0).sum().item()} 件)")

for steps in [500, 2000, 8000]:
    est, _ = fit_bradley_terry(winners_u, losers_u, num_items, num_steps=steps)
    print(f"ステップ {steps:5d}: Model_A の推定スコア {est[0].item():+.2f}")

est_reg, _ = fit_bradley_terry(winners_u, losers_u, num_items, num_steps=8000, l2=1e-3)
print(f"L2 正則化あり(8000 ステップ): Model_A の推定スコア {est_reg[0].item():+.2f}")
一度も負けていないモデルがあると最尤推定が発散することと、L2 正則化でそれを止められることを確かめるコードです。
- データの作り方: losers != 0 で、敗者が Model_A(番号0)でない対戦だけを残します。Model_A を選ぶのは、最も強く、負けた対戦を取り除いても、勝った対戦が多く残るためです。
- ステップ数を変える: 最適化のステップ数を 500・2,000・8,000 と増やしたときの、Model_A の推定スコアを表示します。4倍ずつ増やすのは、推定値が収束せずに大きくなり続ける様子を見るためです。
- 正則化の効果: l2=1e-3 の L2 正則化を加えた場合の推定値も表示します。1e-3は、推定値を有限の値で止めるのに足りる、小さな強さの例です。強くするほど推定値は0に近づき、真の値からのずれ方が変わります。
実行結果
残った対戦: 1873 件(Model_A の敗戦は 0 件)
ステップ   500: Model_A の推定スコア +5.46
ステップ  2000: Model_A の推定スコア +7.85
ステップ  8000: Model_A の推定スコア +11.54
L2 正則化あり(8000 ステップ): Model_A の推定スコア +4.15
L2 正則化なしでは、ステップ数を増やすほど Model_A のスコアが大きくなり続け、止まる気配がありません。一度も負けていないので、スコアを上げるほど尤度が上がり続けるためです。L2 正則化を加えると、スコアを大きくすることへのペナルティとつり合う有限の値で止まります。
Model_A の推定スコアの推移を並べると、次のようになります。
(図は、diagram-designで作成)
発展と限界
順位付けへの拡張:Plackett–Luceモデル
BT モデルは2つの対象の比較を扱いますが、 個の対象の 順位付け に拡張したものが Plackett–Luce モデル です。 個の中から対象 が1位に選ばれる確率を、次のように定義します。
これはソフトマックス関数です。順位全体 の確率は、「残った対象の中から1位を選ぶ」ことを繰り返した確率の積として表します。
のとき、ソフトマックス関数はシグモイド関数になり、Plackett–Luce モデルは BT モデルと一致します。InstructGPT は、 個の回答の順位を 個のペアに分けて BT モデルで学習しましたが、順位全体を Plackett–Luce モデルで扱う方法もあります。
限界:堂々巡りの好み
BT モデルでは、すべての対象が1本の数直線上のスコア で表されます。そのため、 かつ なら必ず となり、勝率についても「A が B に、B が C に勝ちやすければ、A は C にも勝ちやすい」という推移性が成り立ちます。
しかし、人の好みには、次のようなじゃんけんのような堂々巡りが現れることがあります。
- 回答 A は網羅的なので、簡潔な回答 B より好まれる(A ≻ B)
- 回答 B は簡潔なので、冗長な回答 C より好まれる(B ≻ C)
- 回答 C は具体例が豊富なので、抽象的な回答 A より好まれる(C ≻ A)
このような選好は、1つのスコアでは表せません。好みが複数の観点で決まる場合や、評価者によって重視する観点が違う場合に起こりえます。これに対して、選好をスコアの差で表すことをやめ、ゲーム理論の考え方で方策を学習する研究も行われています(Nash Learning from Human Feedback、Munos et al., 2023 など)。
また、BT モデルは引き分けを扱いません。Chatbot Arena のように「どちらも同じくらい」という投票がある場合は、引き分けを扱えるように拡張したモデルを使うか、引き分けの扱いを別に決める必要があります。
堂々巡りの好みを図にすると、次のようになります。
(図は、diagram-designで作成)
まとめ
記事を通じて、以下の内容を学習・実践しました。
- ペアワイズ比較: 点数を付ける絶対評価は評価者や問題によって基準がずれやすく、2つを比べる評価の方が集めやすい。
- BT モデルの定義: 勝率を強さの比 で定義し、スコア を導入すると、勝率はスコアの差のシグモイド になる。
- 差だけが意味を持つ: すべてのスコアに同じ定数を足しても勝率は変わらないので、推定には基準の固定が必要になる。LLM ではプロンプトごとの定数 を足しても変わらず、これが DPO で分配関数が消える理由になる。
- 最尤推定: 負の対数尤度の最小化はロジスティック回帰と同じで、勾配の大きさは「どれだけ予想外の結果だったか」を表す。一度も負けていない対象があると推定が発散し、L2 正則化などで防ぐ。
- LLM での使われ方: InstructGPT の報酬モデルの損失、DPO の導出、Chatbot Arena のランキング(Elo レーティングはスコアを定数倍したもの)。
- 実装: PyTorch で、勝敗の記録からスコアを推定し、基準の取り直しで勝率が変わらないことと、一度も負けていない対象で推定が発散し、L2 正則化で止まることを確かめた。
- 発展と限界: 順位付けへの拡張である Plackett–Luce モデルと、1つのスコアでは表せない堂々巡りの好み。
参考文献
- W.-L. Chiang et al. (2024). Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference. ICML 2024.
- R. Munos et al. (2024). Nash Learning from Human Feedback. ICML 2024.
- R. A. Bradley, M. E. Terry (1952). Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika, 39(3/4), 324–345.
本記事の文章・構成の一部に生成AIを使用しています。