BG/NBD・Gamma-Gammaモデルとは? 非契約型の CLV 予測
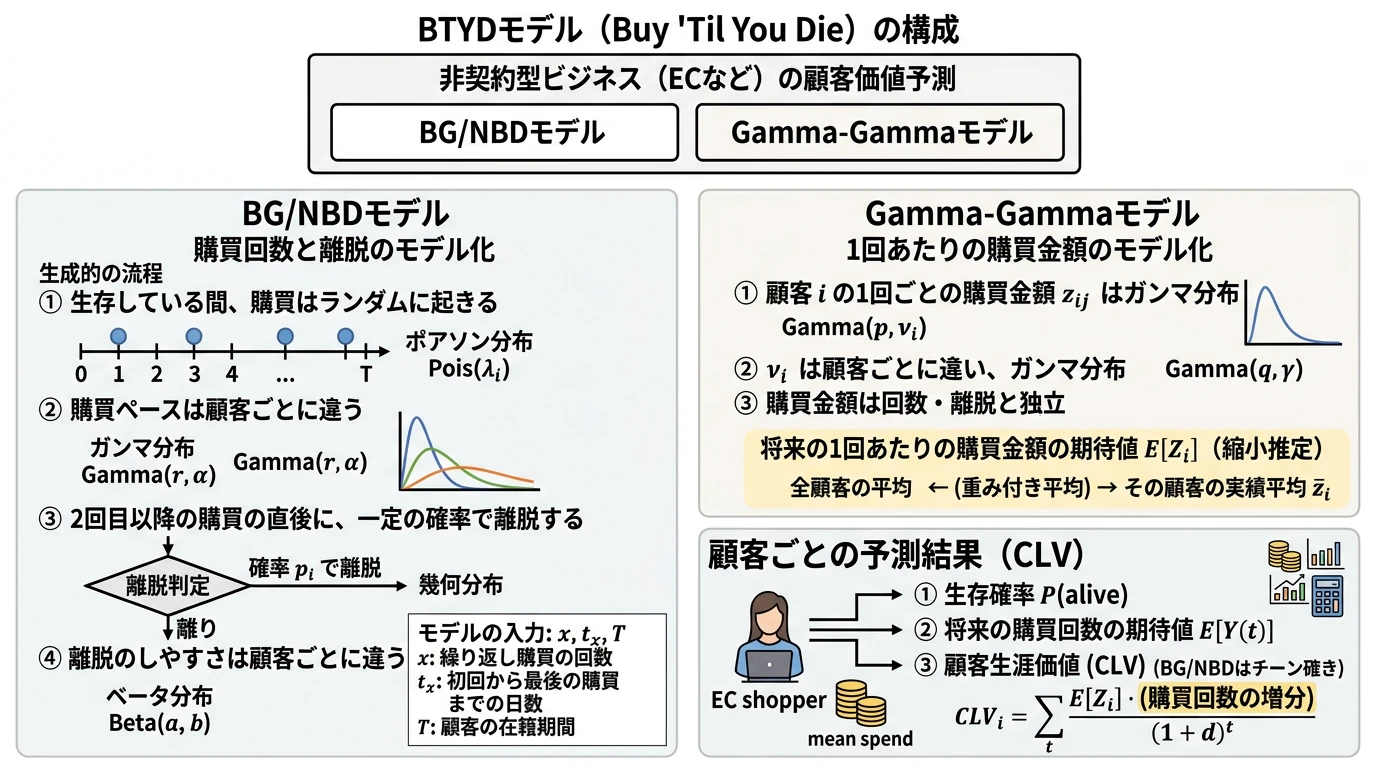 (画像は、Geminiで作成)
離脱が観測できない非契約型の顧客について、購買頻度・離脱・購買金額を確率分布でモデル化し(BG/NBDモデルとGamma-Gammaモデル)、顧客ごとの「まだ離脱していない確率」「将来の購買回数」「顧客生涯価値(CLV)」を予測できるようになること。あわせて、その予測が R・F・在籍期間だけから計算できること(RFM分析との関係)と、購買履歴だけで予測できることの限界を、真値を仕込んだダミーデータで確かめること。
概要
RFM分析の記事では、ECのような非契約型のビジネスを想定した「顧客ワールド」で、RFM分析の3つの限界を確かめました。同じスコアでも将来の価値はばらばらであること、離脱が観測できないこと、そしてスコアは順位にすぎず金額が分からないことです。
生存時間分析の記事では、解約という出来事が記録に残る契約型のビジネスを対象に、顧客が「いつまで残るか」を推定しました。しかし、ECの顧客は解約の手続きをしません。ただ来なくなるだけです。
本記事では、この非契約型のビジネスで、顧客ごとの将来の価値を予測する確率モデルを扱います。購買の回数と離脱を表す BG/NBDモデル(Fader, Hardie & Lee, 2005)と、1回あたりの購買金額を表す Gamma-Gammaモデル(Fader & Hardie, 2013)です。これらは「離脱するまで買い続ける」顧客を表すモデルなので、まとめて BTYD(Buy 'Til You Die)モデル と呼ばれます。
2つのモデルの役割は、次のように分かれます。BG/NBDモデルは、購買ログの から、顧客がまだ離脱していない確率と将来の購買回数を予測します。Gamma-Gammaモデルは、購買回数と平均購買金額から、1回あたりの購買金額を予測します。購買金額は回数や離脱と独立と仮定するので、2つの予測を掛け合わせ、割り引いて足し合わせると CLV になります。
(図は、diagram-designで作成)
RFMの記事の顧客ワールドは、実はこの2つのモデルに従って生成していました。本記事ではその種明かしをしたうえで、購買ログだけからモデルのパラメータを推定し、顧客ごとの CLV を予測します。そして、その予測が RFMスコアよりどれだけ良いのか、どこに限界があるのかを、ホールドアウト期間の実績と比べて確かめます。
本記事のコードは、Python 3.13、NumPy 2.4.6、pandas 3.0.5、SciPy 1.18.1、matplotlib 3.11.2 で動作を確認しました。後半の PyMC-Marketing の節では、pymc-marketing 1.2.0、PyMC 6.3.2、pymc-extras 0.15.1、ArviZ 1.3.0 を使っています。
非契約型のビジネスでは、離脱が観測できない
生存時間分析の記事のカプラン・マイヤー推定や Cox比例ハザードモデルは、「解約した」「まだ契約中(打ち切り)」のどちらかが、顧客ごとに分かっていることを前提にしていました。ところが非契約型のビジネスでは、最後の購買から100日たっている顧客が、離脱したのか、たまたま間が空いているだけなのかは分かりません。「離脱した」という出来事そのものが観測できないので、生存時間分析の道具をそのまま使うことはできないのです。
そこで BTYDモデルでは、観測できない「離脱」を、購買のパターンから確率的に推し量ります。手がかりになるのは、RFMの記事の限界2で見た関係です。年に1〜2回しか買わない顧客なら、100日買っていなくても普通のことです。一方、毎週のように買っていた顧客が100日買っていなければ、離脱した可能性が高いと考えられます。「その顧客の普段の購買ペース」と「最後の購買からの経過時間」を組み合わせて、離脱の確率を計算するのです。
このような考え方の最初のモデルは、Pareto/NBDモデル(Schmittlein, Morrison & Colombo, 1987)です。BG/NBDモデルは、その離脱の部分を単純にして、推定を簡単にしたモデルです。
BG/NBDモデル
生成過程:4つの仮定
BG/NBDモデルは、顧客の購買と離脱について、次の4つの仮定を置きます。
- 生存している間、購買はランダムに起きる:顧客 は、離脱するまで、1日あたり平均 回のペースでランダムに購買する(購買の回数はポアソン分布、購買の間隔は指数分布に従う)。
- 購買ペースは顧客ごとに違う: はガンマ分布 に従ってばらつく(形状 、レート 。平均は )。
- 2回目以降の購買の直後に、一定の確率で離脱する:顧客 は、繰り返し購買(2回目以降の購買)の直後に、確率 で離脱する。何回目の繰り返し購買の後で離脱するかは、幾何分布に従う。
- 離脱のしやすさは顧客ごとに違う: はベータ分布 に従ってばらつく。
モデルの名前は、この組み合わせに由来します。仮定1・2の「ポアソン分布 × ガンマ分布」は、混ぜ合わせると負の二項分布(NBD: Negative Binomial Distribution)になります。仮定3・4の「幾何分布 × ベータ分布」は、ベータ幾何分布(BG: Beta-Geometric)です。BG の部分は、生存時間分析の記事のsBGモデルと同じ考え方で、顧客ごとの離脱確率のばらつきを表しています。
RFMの記事の顧客ワールドは、この4つの仮定どおりに生成していました。真のパラメータは次のとおりです(時間の単位は日)。
| パラメータ | 真値 | 意味 |
|---|---|---|
| 0.6 | 購買ペースのばらつきの形状。1より小さいので、「ほとんど買わない顧客が多く、ごく一部がよく買う」偏った分布 | |
| 25 | 購買ペースのばらつきのレート。購買ペースの平均は 回/日(年に約8.8回) | |
| 0.8 | 離脱のしやすさのばらつき | |
| 3.0 | 離脱のしやすさのばらつき。離脱確率の平均は |
本記事の記号は、Fader & Hardie の論文の慣例に従います。BG/NBDモデルの離脱確率 (顧客ごとに異なるので添字あり)と、後で登場する Gamma-Gammaモデルの形状パラメータ (全顧客に共通なので添字なし)は、どちらも原論文で と書かれていますが、別のものです。また、 は購買ペースのガンマ分布のパラメータで、MMMの記事とは関係ありません。
4つの仮定と真のパラメータを図にすると、次のようになります。
(図は、diagram-designで作成)
検証用ダミーデータの生成:顧客ワールド
RFMの記事と同じ「顧客ワールド」を生成します。10,000人の顧客の2年分の購買ログで、前半の1年を分析に使い、後半の1年をホールドアウト期間(答え合わせ用)にします。生成コードは RFMの記事とまったく同じです。
生成は、コードの手順に沿って次の流れで行います。
- 乱数と観測期間(分析に使う前半1年と、ホールドアウト期間の後半1年)を決める(手順1)
- 顧客ごとの隠れた性質を決める:購買ペース ・離脱確率 ・購買金額の尺度 と、初回購買日を乱数で決める(手順2)
- 購買ログを作る:初回購買から、指数分布に従う待ち時間ごとに次の購買を重ね、繰り返し購買の直後に確率 で離脱させる。購買ごとの金額はガンマ分布から引く(手順3)
- 購買日を整数の日付に、金額を10円単位に丸めて、分析者が観測できる購買ログにし、答え合わせ用の真値を残す(手順4〜6)
手順2・3の生成過程を、式で書いておきます(1行目が手順2、2行目が手順3)。BG/NBDモデルの4つの仮定に、1回ごとの購買金額の生成(Gamma-Gammaモデルの仮定)を加えたものです(顧客ごとの はコードの配列 lam・p_drop・nu、 は r・alpha・a・b・q_gg・gamma_gg)。
顧客 の購買金額 は形状 (p_gg)・レート のガンマ分布に従うので、顧客 の平均購買金額は です。レート 自体も顧客ごとに違い、 に従います。また、購買金額は購買の回数や離脱とは独立に決まります。この3点が Gamma-Gammaモデルの仮定です。金額のモデルは BG/NBD とは別の部品なので、本記事ではまず BG/NBD を説明し、金額の推定はGamma-Gammaモデルの節で扱います。
import numpy as np
import pandas as pd

# 1. 乱数と観測期間の設定(時間の単位は日)
rng = np.random.default_rng(42)
N = 10_000          # 顧客数
CALIB_END = 365     # 0〜364日目: 分析に使う期間(前半1年)
OBS_END = 730       # 365〜729日目: 答え合わせ用のホールドアウト期間(後半1年)

# 2. 顧客ごとの隠れた性質(分析者には観測できない「答え」)
r, alpha = 0.6, 25.0                         # 購買ペースのばらつきを決めるパラメータ
a, b = 0.8, 3.0                              # 離脱のしやすさのばらつきを決めるパラメータ
p_gg, q_gg, gamma_gg = 6.0, 4.0, 1500.0      # 購買金額のばらつきを決めるパラメータ
lam = rng.gamma(r, 1 / alpha, size=N)        # 購買ペース(1日あたりの平均購買回数)
p_drop = rng.beta(a, b, size=N)              # 2回目以降の購買の直後に離脱する確率
nu = rng.gamma(q_gg, 1 / gamma_gg, size=N)   # 購買金額の尺度(平均購買金額は p_gg / nu)
first_day = rng.uniform(0, CALIB_END, size=N)  # 初回購買日(最初の1年で少しずつ獲得)

# 3. 購買ログの生成
records = []
death_day = np.full(N, np.inf)   # 離脱した日(観測期間内に離脱しなければ inf)
for i in range(N):
    t = first_day[i]
    records.append((i, t, rng.gamma(p_gg, 1 / nu[i])))   # 初回購買
    while True:
        t += rng.exponential(1 / lam[i])   # 次の購買までの待ち時間
        if t >= OBS_END:
            break
        records.append((i, t, rng.gamma(p_gg, 1 / nu[i])))
        if rng.uniform() < p_drop[i]:      # 購買の直後に、一定の確率で離脱する
            death_day[i] = t
            break

# 4. 分析者が観測できる購買ログ(購買日は整数の日付、金額は10円単位)
log = pd.DataFrame(records, columns=['customer_id', 'day', 'amount'])
log['day'] = np.floor(log['day']).astype(int)
log['amount'] = log['amount'].round(-1).astype(int)

# 5. 答え合わせ用の真値(分析には使わない)
truth = pd.DataFrame({
    'lam': lam,                          # 購買ペース
    'p_drop': p_drop,                    # 購買の直後に離脱する確率
    'mean_amount': p_gg / nu,            # 平均購買金額
    'alive': death_day >= CALIB_END,     # ホールドアウト期間の開始時点で生存しているか
})

# 6. RFMの記事と同じデータになっていることの確認
print(f"購買ログの件数: {len(log):,} 件、ホールドアウト期間の開始時点で生存している顧客: {truth['alive'].mean():.1%}")
RFMの記事と同じコードで、顧客ワールドを生成しています。ここでは、4つの仮定との対応がわかるように、手順ごとに説明します。
- 乱数と観測期間の設定: np.random.default_rng(42) で乱数生成器 rng を作り、シードを固定しているので、何度実行しても同じデータになります。顧客数は N = 10_000、時間の単位は日で、CALIB_END = 365 より前(0〜364日目)を分析に使う期間、OBS_END = 730 まで(365〜729日目)をホールドアウト期間とします。
- 真のパラメータ: r・alpha が仮定2のガンマ分布、a・b が仮定4のベータ分布、p_gg・q_gg・gamma_gg が購買金額を生成する Gamma-Gammaモデルの です。
- 顧客ごとの隠れた性質: 購買ペース lam を rng.gamma(r, 1 / alpha, size=N)(仮定2)、離脱確率 p_drop を rng.beta(a, b, size=N)(仮定4)、購買金額の尺度 nu を rng.gamma(q_gg, 1 / gamma_gg, size=N) から、size=N で顧客ごとに1つずつ引いています。NumPy の rng.gamma は形状と「尺度」(レートの逆数)を引数にとるので、レート alpha・gamma_gg は逆数にして渡しています。初回購買日 first_day は、rng.uniform(0, CALIB_END, size=N) で最初の1年の一様分布から引きます。
- 購買ログの生成: records は(顧客ID, 購買日, 金額)のタプルをためるリスト、death_day は np.full(N, np.inf) で全員を無限大(離脱しない)に初期化した配列です。for i in range(N) で1人ずつ、初回購買を記録してから、while True のループで t += rng.exponential(1 / lam[i]) により指数分布の待ち時間だけ時間を進め、次の購買を記録します。待ち時間が平均 の指数分布に従うのが、仮定1(購買はポアソン過程)です。次の購買日が OBS_END 以上になったら break でループを抜けます。
- 離脱: 繰り返し購買を記録した直後に rng.uniform() < p_drop[i] なら(確率 p_drop[i] で)離脱としてループを抜け、その日を death_day[i] に記録します。これが仮定3です。初回購買は while の前に記録するので、初回購買の直後には離脱の判定をしていない点も、仮定3のとおりです。
- 購買金額: 購買のたびに rng.gamma(p_gg, 1 / nu[i]) で金額を引いています。顧客 の平均購買金額は p_gg / nu[i] です。
- 観測できる購買ログ: pd.DataFrame(records, columns=[...]) で表にし、購買日は np.floor で切り捨てて整数の日付に、金額は round(-1) で10円単位に丸めています。分析者が使えるのは、この log(顧客ID・購買日・金額)だけです。
- 答え合わせ用の真値: truth には、購買ペース・離脱確率・平均購買金額(p_gg / nu)と、離脱した日が365日目以降かどうか(death_day >= CALIB_END。ホールドアウト期間の開始時点で生存しているか)を入れています。推定には使わず、予測の答え合わせだけに使います。
- 確認: RFMの記事と同じデータになっていることを、購買ログの件数と生存している顧客の割合(truth['alive'].mean())で確かめています。
実行結果
購買ログの件数: 57,667 件、ホールドアウト期間の開始時点で生存している顧客: 67.8%
購買ログの件数(57,667件)と、ホールドアウト期間の開始時点で生存している顧客の割合(67.8%)は、RFMの記事と同じです。
モデルの入力:x, t_x, T
BG/NBDモデルが使うのは、顧客ごとの次の3つの値だけです。
| 記号 | 意味 | RFMとの対応 |
|---|---|---|
| 分析期間中の繰り返し購買の回数(初回購買を除く) | ||
| 初回購買から、最後の購買までの日数 | ||
| 初回購買から、基準日(分析期間の終わり)までの日数 | 顧客の在籍期間(RFMでは使っていない) |
初回購買を数えないのは、仮定3のとおり、離脱は繰り返し購買の直後にしか起きないからです。 は「最後の購買のタイミング」を、RFMの R(基準日から最後の購買までの日数)とは逆向きに、初回購買から測ったものです。 の関係があるので、R と F に在籍期間 を加えれば、BG/NBDモデルの入力はすべてそろいます。
1人の顧客について、生成過程と3つの値の関係を図にすると、次のようになります。この顧客は3回目の繰り返し購買の直後に離脱していますが、購買ログからは「最後の購買から 日間、買っていない」ことしか分かりません。
(図は、diagram-designで作成)
# 1. 分析に使う期間と、答え合わせ用のホールドアウト期間に分ける
calib = log[log['day'] < CALIB_END]
holdout = log[log['day'] >= CALIB_END]

# 2. 顧客ごとに x, t_x, T と、1回あたりの平均購買金額を集計する
g = calib.groupby('customer_id')
summary = pd.DataFrame({
    'first_day': g['day'].min(),
    'last_day': g['day'].max(),
    'n_purchases': g['day'].size(),     # 購買回数(RFMの F)
    'monetary': g['amount'].mean(),     # 1回あたりの平均購買金額(RFMの M)
})
summary['x'] = summary['n_purchases'] - 1                       # 繰り返し購買の回数
summary['t_x'] = summary['last_day'] - summary['first_day']     # 初回購買から最後の購買までの日数
summary['T'] = CALIB_END - summary['first_day']                 # 初回購買から基準日までの日数
summary['recency'] = summary['T'] - summary['t_x']              # RFMの R(基準日から最後の購買までの日数)

# 3. 答え合わせ用: ホールドアウト期間(翌1年)の購買回数と売上
summary['holdout_n'] = holdout.groupby('customer_id').size().reindex(summary.index, fill_value=0)
summary['holdout_sales'] = holdout.groupby('customer_id')['amount'].sum().reindex(summary.index, fill_value=0)

print(summary[['x', 't_x', 'T', 'recency', 'n_purchases', 'monetary']].head())
print()
print(summary[['x', 't_x', 'T']].describe().round(1))
前半1年の購買ログから、BG/NBDモデルの入力 を顧客ごとに集計しています。
- 期間の分割: log[log['day'] < CALIB_END] で分析に使う期間の購買 calib を、log['day'] >= CALIB_END でホールドアウト期間の購買 holdout を取り出しています。
- 集計: calib.groupby('customer_id') でまとめた g から、g['day'].min()(初回購買日)・g['day'].max()(最後の購買日)・g['day'].size()(購買回数)・g['amount'].mean()(平均購買金額)を求め、pd.DataFrame で1つの表 summary にしています。購買回数 n_purchases と平均購買金額 monetary は、RFMの記事の F と M と同じものです。
- x, t_x, T: x は購買回数から初回購買の1回を引いたもの、t_x は最後の購買日と初回購買日の差、T は基準日(365日目)と初回購買日の差です。購買が1回だけの顧客は、x も t_x も0になります。
- RFMの R との対応: recency は で、RFMの記事の R(基準日から最後の購買までの日数)と同じ値になります。
- 答え合わせ用の列: holdout_n と holdout_sales は、ホールドアウト期間の購買回数と売上です。購買のなかった顧客は reindex(..., fill_value=0) で0を埋めています。推定には使いません。
- 表示: 先頭5人の値(head())と、describe() による の要約(件数・平均・標準偏差・最小値・四分位点・最大値)を表示しています。
実行結果
             x  t_x    T  recency  n_purchases     monetary
customer_id
0            6  114  147       33            7  1348.571429
1            4   85  297      212            5  3708.000000
2            0    0  139      139            1  1630.000000
3            2   13   24       11            3  3146.666667
4            0    0  338      338            1  2180.000000

             x      t_x        T
count  10000.0  10000.0  10000.0
mean       2.3     69.9    183.8
std        3.9     88.1    105.9
min        0.0      0.0      1.0
25%        0.0      0.0     93.0
50%        1.0     29.0    183.0
75%        3.0    116.0    276.0
max       52.0    359.0    365.0
- 1行目の顧客0: 初回購買から147日前に入会し()、その後6回の繰り返し購買があり()、最後の購買は初回購買から114日目()です。RFMの R は 日です。
- 入力の分布: 繰り返し購買の回数 の中央値は1回、25%点は0回で、約3分の1の顧客は初回購買しかありません()。在籍期間 は1〜365日に広く分布しています。在籍期間が短い顧客ほど、購買の機会が少なく、 が小さくなりやすい点に注意してください。RFMの F はこの違いを考慮していませんでしたが、BG/NBDモデルは を使って補正します。
尤度は x, t_x, T だけで決まる
顧客 の購買ペース と離脱確率 が分かっているとき、「分析期間中に 回の繰り返し購買があり、最後の購買が で、 まで観測した」というデータが得られる確率(尤度)は、次のように2つの場合に分けて書けます。
- 基準日まで生存している場合: 回の購買の直後に一度も離脱せず(確率 )、 の間にちょうど 回の購買が起きた。
- 最後の購買の直後に離脱した場合( のときだけ): 回は離脱せず、 回目の直後に離脱した(確率 )。購買は の間にちょうど 回起きた。
これを式にすると、次のとおりです。
は、 なら1、 なら0をとる記号です。 ポアソン過程では、購買の間隔が指数分布 に従います。購買が時点 ( が最後)に起きたとすると、 回の購買間隔の確率密度の積は と、途中の購買時点によらず だけで決まります。 (初回購買しかない)の顧客は、仮定3により離脱の機会がまだないので、第1項 だけになります。詳細な式展開(個人の尤度)
ここで注目してほしいのは、尤度に購買のタイミングの細かい情報が現れず、・・ だけで決まることです。つまり、BG/NBDモデルにとっては、購買履歴の情報は「繰り返し購買の回数」「最後の購買のタイミング」「観測期間の長さ」の3つに要約されます。RFMの記事では、R と F が将来の購買の手がかりになることを経験則として紹介しましたが、BG/NBDモデルのもとでは、R と F(と在籍期間 )が、購買の回数と離脱について分かることのすべてなのです。
分析者は と を知らないので、仮定2・4の分布で平均(積分)します。積分は解析的に計算でき、次の式になります(Fader, Hardie & Lee, 2005)。
全顧客の対数尤度の和を最大にする が、最尤推定値です。 1. 平均の取り方: はガンマ分布 、 はベータ分布 に従い、互いに独立です。それぞれの確率密度関数は です( はベータ関数)。個人の尤度をこの2つの分布で平均すると、 です。個人の尤度の各項は「 だけの部分」×「 だけの部分」の積なので、積分も と に分けて計算できます。 2. λ の部分((ii) と (iv)):ガンマ関数の積分 を使います。(ii) は です。指数の の係数が にまとまるのがポイントです。(iv) も、 を に変えるだけで同じ形になります。 3. p の部分((i) と (iii)):ベータ関数の積分 を使います。 4. ベータ関数をガンマ関数に直す: を使うと、(i) は です。(iii) は、ガンマ関数の性質 から 、 なので、 と、(i) に を掛けた形になります。 5. まとめる:(ii) と (iv) に共通の と、(i) と (iii) に共通の を前にくくり出すと、 となり、本文の式が得られます。角括弧の第1項が「観測期間の終わりまで生存している場合」、第2項が「最後の購買の直後に離脱した場合」に対応するのは、個人の尤度と同じです。詳細な式展開(個人の尤度を、λ と p の分布で平均する)
最尤法による推定
直前の尤度の式 の対数を、そのままコードにします( は関数内の r_・alpha_・a_・b_、 は配列 x・t_x・T)。対数は、次の部分に分けて計算します。
- 1つ目の分数 の対数(A1)と、2つ目の分数 の対数(A2)です。
- 角括弧の第1項 の対数(A3)と、第2項 の対数(A4)です。角括弧全体の対数は です。
from scipy.special import gammaln
from scipy.optimize import minimize

x = summary['x'].values
t_x = summary['t_x'].values.astype(float)
T = summary['T'].values.astype(float)

# 1. BG/NBDモデルの対数尤度(顧客ごと)
def bgnbd_loglik(params, x, t_x, T):
    r_, alpha_, a_, b_ = params
    A1 = gammaln(r_ + x) - gammaln(r_) + r_ * np.log(alpha_)
    A2 = gammaln(a_ + b_) + gammaln(b_ + x) - gammaln(b_) - gammaln(a_ + b_ + x)
    A3 = -(r_ + x) * np.log(alpha_ + T)                               # 生存している場合
    A4 = np.where(x > 0,                                               # 最後の購買の直後に離脱した場合
                  np.log(a_) - np.log(np.maximum(b_ + x - 1, 1e-12)) - (r_ + x) * np.log(alpha_ + t_x),
                  -np.inf)
    return A1 + A2 + np.logaddexp(A3, A4)

# 2. 負の対数尤度を最小化する(パラメータは正なので、対数をとって探索する)
def neg_loglik(log_params):
    return -bgnbd_loglik(np.exp(log_params), x, t_x, T).sum()

res = minimize(neg_loglik, x0=np.log([1.0, 10.0, 1.0, 1.0]), method='L-BFGS-B')
bgnbd_params = np.exp(res.x)

# 3. 真値との比較
for name, est, true in zip(['r', 'alpha', 'a', 'b'], bgnbd_params, [r, alpha, a, b]):
    print(f"{name:5s}: 推定値 {est:7.3f}(真値 {true})")
print(f"\n対数尤度: 推定値で {-res.fun:,.1f}、真値で {bgnbd_loglik([r, alpha, a, b], x, t_x, T).sum():,.1f}")
本文の尤度の式をそのままコードにして、最尤推定を行っています。
- 対数尤度: A1・A2 は式の前半の2つの分数の対数で、ガンマ関数の対数 gammaln で計算しています(ガンマ関数そのものは、すぐに桁あふれするため)。A3 は「生存している場合」、A4 は「最後の購買の直後に離脱した場合」の項の対数です。 の顧客には離脱した場合の項がないので、np.where(x > 0, ..., -np.inf) で A4 を (確率0)にしています。np.maximum(b_ + x - 1, 1e-12) は、 が0以下になって対数が計算できなくなるのを防ぐための下限です。
- 2つの項の和: 角括弧の中の和 の対数を、np.logaddexp(A3, A4) で計算しています。指数をとってから足すと値が小さすぎてアンダーフローするため、対数のまま安全に足し合わせる関数を使っています。
- 最適化: パラメータはすべて正の値なので、対数をとった log_params を探索し、np.exp で戻しています。minimize の L-BFGS-B 法は、勾配(ここでは数値微分)を使う準ニュートン法です。初期値は です。
- 入力の準備: summary['x'].values のように、pandas の列を NumPy の配列に取り出しています。t_x と T は整数の日数なので、astype(float) で小数に変換してから計算に使います。
- 目的関数: neg_loglik は、顧客ごとの対数尤度の和(sum())に負号を付けたものです。minimize は最小化しかできないので、対数尤度の最大化を「負の対数尤度の最小化」に置き換えています。
- 結果の取り出し: 最適化の結果 res.x は対数をとったパラメータなので、np.exp(res.x) で元に戻して bgnbd_params とし、zip で名前・推定値・真値を組にして表示しています。
- 対数尤度の比較: 推定値での対数尤度(-res.fun。res.fun は最小化した負の対数尤度)と、真値での対数尤度を並べています。
実行結果
r    : 推定値   0.597(真値 0.6)
alpha: 推定値  24.532(真値 25.0)
a    : 推定値   0.857(真値 0.8)
b    : 推定値   3.236(真値 3.0)

対数尤度: 推定値で -114,151.3、真値で -114,152.0
- 真のパラメータを復元できた: (真値0.6)、(真値25)、(真値0.8)、(真値3.0)と、すべて真値の近くに推定されました。購買ペースの に比べ、離脱の のずれが少し大きいのは、離脱が直接は観測できず、購買のパターンから間接的に推し量るしかないためです。
- 対数尤度: 推定値での対数尤度(−114,151.3)は、真値での値(−114,152.0)よりわずかに大きくなっています。最尤推定値は「このデータに最もよく当てはまる値」なので、偶然のばらつきの分だけ、真値より尤度が高くなるのは自然なことです。
購買ログから計算した だけで、離脱という観測できない出来事の確率分布まで推定できたことになります。
推定値と真の値を並べると、次のようになります。
(図は、diagram-designで作成)
顧客ごとの予測:生存確率と将来の購買回数
パラメータ (関数内では r_・alpha_・a_・b_)が推定できれば、顧客ごとの から、次の2つを計算できます。
生存確率 :基準日の時点で、顧客がまだ離脱していない確率です。尤度の2つの項のうち「生存している場合」の割合として求まります。
が大きい(よく買う)ほど、また (= R、最後の購買からの経過日数)が大きいほど、分母の第2項(ratio)の が大きくなり、生存確率は下がります。RFMの記事の限界2で見た「よく買っていた顧客ほど、しばらく買っていないと離脱している」関係が、式に現れています。 1. ベイズの定理で書く:観測データ が得られたとき、生存している確率は、ベイズの定理(条件付き確率の定義)より です。分母は、尤度の2つの項の和(生存している場合と、最後の購買の直後に離脱した場合)で、分子はそのうち第1項です。 2. λ と p で平均した尤度の、2つの項を使う:顧客ごとの は分からないので、直前の折りたたみで計算した「分布で平均した尤度」の2つの項を使います。共通の因子を とおくと、 です。 3. 割り算して整理する:分子と分母を で割ると、 は消え、離脱の項は になるので、 が得られます。 の顧客は離脱のチャンスがないので となり、生存確率は常に1です。詳細な式展開(生存確率 )
将来の購買回数の期待値 :基準日から 日(引数 t)の間の購買回数の期待値です。ガウスの超幾何関数 (値は hyp)を使った式で計算できます(Fader, Hardie & Lee, 2005。導出は式の下の折りたたみにまとめました)。
分母 は生存確率の式と同じで、「生存していれば何回買うか」(分子 、alive_part)に「生存している確率」を掛けた形になっています。 導出は少し長いですが、使う道具は「ベイズ更新」「ガンマ分布・ベータ分布の期待値」「超幾何関数の積分表示」の3つです。 1. 離脱していればもう買わない:基準日 の時点で離脱している顧客は、将来1回も買いません。そのため、 です。1つ目の因子は、上の生存確率 です。以下では2つ目の因子(生存している場合の期待値)が になることを示します。 2. λ と p が分かっている顧客の、将来の購買回数:生存している顧客が 日間に買う回数を考えます。購買はペース のポアソン過程で起き、各購買の直後に確率 で離脱します。 日間に(離脱しなかったとして)購買が起きうる回数を とすると、 回目の購買が実際に起きるのは「」かつ「それまでの 回の購買の直後に離脱しなかった」ときです。したがって です(2つ目の等号は和と期待値の順序の入れ替え、3つ目は等比数列の和)。ポアソン分布の性質 に を入れると なので、 となります。 3. 生存している顧客の λ と p を、データで更新する:尤度の第1項(生存している場合)は でした。データを見る前の と の分布(事前分布)は、仮定2・4のガンマ分布 とベータ分布 で、確率密度関数は次のとおりです。 ベイズの定理より、データを見た後の分布(事後分布)は「尤度 × 事前分布」に比例します。 や を含まない定数( や )は省き、同じ文字の指数をまとめると、 に比例します(、、)。 の部分は の確率密度関数と、 の部分は の確率密度関数と、定数倍を除いて同じ形です。つまり、生存していると分かっている顧客の と は、それぞれ と に従います(事後分布)。購買が 回あったことで の形状が だけ増え(よく買う顧客ほどペースが高いと推測される)、離脱しなかった購買が 回あったことで の が だけ増える(離脱しにくいと推測される)、と読めます。 4. 事後分布で平均する:手順2の式を2つの項に分けて、手順3の分布で平均します。 次に、ベータ関数をガンマ関数で表す を使うと、 が約分されて です。ガンマ関数の性質 から 、 なので、 となります( のとき。 だと積分が発散します)。 です。次に で平均します。第1項と同じく、 を掛けると が になります。分母と分子に を掛けて整理すると、 となります( は上の )。前の係数は第1項で計算した なので、 での平均に を掛けた形になります。 と書き直すと、 5. 超幾何関数で表す:ガウスの超幾何関数には、次の積分表示(オイラーの積分表示)があります。 手順4の期待値は、、、、 とおいたこの積分そのものなので、 です。さらに、超幾何関数の変換公式(パフの変換) を使うと、、、 なので、 と書き直せます。変換するのは、 の最後の引数を0〜1の範囲に収めて、数値計算を安定させるためです。 6. まとめる:手順4・5を手順2の式に入れると、 となり、手順1の式に生存確率 を掛けると、本文の が得られます。詳細な式展開(将来の購買回数の期待値 )
from scipy.special import hyp2f1

# 1. 生存確率 P(alive) と、将来 t 日間の購買回数の期待値
def prob_alive(params, x, t_x, T):
    r_, alpha_, a_, b_ = params
    ratio = np.where(x > 0, a_ / np.maximum(b_ + x - 1, 1e-12) * ((alpha_ + T) / (alpha_ + t_x)) ** (r_ + x), 0.0)
    return 1 / (1 + ratio)

def expected_purchases(params, t, x, t_x, T):
    r_, alpha_, a_, b_ = params
    hyp = hyp2f1(r_ + x, b_ + x, a_ + b_ + x - 1, t / (alpha_ + T + t))
    alive_part = (a_ + b_ + x - 1) / (a_ - 1) * (1 - ((alpha_ + T) / (alpha_ + T + t)) ** (r_ + x) * hyp)
    return alive_part * prob_alive(params, x, t_x, T)

# 2. 全顧客について、生存確率と翌1年(365日)の購買回数の期待値を計算する
summary['p_alive'] = prob_alive(bgnbd_params, x, t_x, T)
summary['pred_n'] = expected_purchases(bgnbd_params, 365, x, t_x, T)

# 3. 生存確率の予測と、真の生存率の比較(予測した生存確率で顧客をグループに分ける)
summary['alive_true'] = truth.loc[summary.index, 'alive']
bins = pd.cut(summary['p_alive'], [0, 0.2, 0.4, 0.6, 0.8, 0.999, 1.0])
calib_table = summary.groupby(bins, observed=True).agg(
    人数=('p_alive', 'size'), 予測した生存確率=('p_alive', 'mean'), 真の生存率=('alive_true', 'mean'))
print(calib_table.round(3).to_string())
print(f"\n翌1年の購買回数の合計: 予測 {summary['pred_n'].sum():,.0f} 回、実績 {summary['holdout_n'].sum():,} 回")

# 4. RFMの記事の限界2の例:最後の購買が200日前で、購買回数だけが違う2人(T = 300日)
examples = pd.DataFrame({'x': [1, 6], 't_x': [100.0, 100.0], 'T': [300.0, 300.0]}, index=['F = 2回', 'F = 7回'])
examples['P(alive)'] = prob_alive(bgnbd_params, examples['x'].values, examples['t_x'].values, examples['T'].values)
examples['翌1年の購買回数'] = expected_purchases(bgnbd_params, 365, examples['x'].values, examples['t_x'].values, examples['T'].values)
print()
print(examples.round(3).to_string())
本文の2つの式で、顧客ごとの生存確率と翌1年の購買回数を予測しています。
- 生存確率: prob_alive は の式で、分母の第2項を ratio として計算しています。 の顧客は np.where(x > 0, ..., 0.0) で ratio が0になり、生存確率は1です。
- 購買回数の期待値: expected_purchases の hyp2f1 は、SciPy のガウスの超幾何関数 です。alive_part が「生存していれば何回買うか」の部分で、それに生存確率を掛けています。 のとき (a_ - 1) は負になりますが、角括弧の中も負になるので、積は正しく正の値になります。
- 生存確率の答え合わせ: 予測した生存確率で顧客を6つのグループに分け、各グループの予測の平均と、真値 alive_true(ホールドアウト期間の開始時点で本当に生存していたか)の割合を比べています。予測が正しければ、両者は一致するはずです。pd.cut(summary['p_alive'], [0, 0.2, 0.4, 0.6, 0.8, 0.999, 1.0]) でグループの区間を決め、groupby(bins, observed=True) で区間ごとに集計しています(observed=True は、顧客のいない区間を表に出さない指定です)。最後に、翌1年の購買回数の予測の合計と実績の合計も比べています。
- 限界2の例: 最後の購買が200日前(、)で、購買回数だけが違う2人の顧客を pd.DataFrame で作り、同じ関数 prob_alive・expected_purchases に渡して、生存確率と翌1年の購買回数を計算しています。
実行結果
                人数  予測した生存確率  真の生存率
p_alive
(0.0, 0.2]    1475     0.085  0.090
(0.2, 0.4]     925     0.298  0.316
(0.4, 0.6]    1130     0.507  0.503
(0.6, 0.8]    1975     0.713  0.724
(0.8, 0.999]  1082     0.865  0.875
(0.999, 1.0]  3413     1.000  1.000

翌1年の購買回数の合計: 予測 23,829 回、実績 24,379 回

        x    t_x      T  P(alive)  翌1年の購買回数
F = 2回  1  100.0  300.0     0.450     0.664
F = 7回  6  100.0  300.0     0.017     0.096
- 生存確率の予測は、真の生存率とよく一致する: たとえば予測した生存確率が0.4〜0.6のグループ(1,130人)では、予測の平均0.507に対して、真の生存率は0.503でした。どのグループでも予測と真の値の差は0.02以内です。RFMの記事では「購買ログだけからは、生存している顧客と離脱した顧客を見分けられない」と述べましたが、個々の顧客について断定はできなくても、確率としては正しく見積もれるのです。
- 購買回数の合計: 翌1年の購買回数の予測の合計は23,829回で、実績の24,379回とほぼ一致しました(−2.3%)。
- 限界2の逆転を再現: 最後の購買が200日前の2人を比べると、購買回数が2回の顧客の生存確率は0.450ですが、7回の顧客は0.017しかありません。翌1年の購買回数の期待値も、2回の顧客(0.664回)の方が、7回の顧客(0.096回)より多くなります。7回も買っていた顧客の普段の購買ペースなら、200日も間が空くことはほとんどあり得ないので、離脱したと考えるのが自然だからです。RFMスコアでは F が高い顧客ほど点数が高くなりますが、BG/NBDモデルは、R と F を組み合わせて正しく解釈しています。
予測した生存確率と真の生存率を並べると、次のようになります。
(図は、diagram-designで作成)
Gamma-Gammaモデル:1回あたりの購買金額
モデルの仮定
BG/NBDモデルが予測するのは購買の回数です。CLV を計算するには、1回あたりの金額も予測する必要があります。そのためのモデルが Gamma-Gammaモデルで、次の仮定を置きます。
- 顧客 の1回ごとの購買金額 は、ガンマ分布 に従う(形状 、レート 。顧客 の平均購買金額は )。
- は顧客ごとに違い、ガンマ分布 に従う。
- 購買金額は、購買の回数や離脱と独立である。
仮定3は重要です。よく買う顧客ほど1回の金額が小さい(あるいは大きい)、といった関係があると、BG/NBDモデルの予測回数と Gamma-Gammaモデルの予測金額を単純に掛け合わせることはできません。実務で使う前には、購買回数と平均購買金額の相関が十分に小さいことを確認します。
このモデルのもとで、顧客 の購買金額の平均 (z_bar)と購買回数 (n_i)が観測されたとき、その顧客の将来の1回あたりの購買金額の期待値は、次の式になります。
詳細な式展開(将来の1回あたりの購買金額の期待値 )
BG/NBDモデルの と同じく、「レート をデータで更新する(ベイズ更新)」→「更新後の分布で平均する」の2段階で導きます。以下、顧客の添字 は省略し、 回の購買金額を 、その平均を と書きます。
1. ν が分かっている顧客の、将来の1回あたりの購買金額:仮定1より、1回の購買金額 は に従うので、その期待値はガンマ分布の平均(形状 ÷ レート)です。
2. ν をデータで更新する:仮定1のガンマ分布 の確率密度関数は です。 回の購買金額は互いに独立なので、尤度はその積で、 を含む部分だけ取り出すと
です()。 に関しては、データは と を通してしか効いてこないことが分かります。事前分布は仮定2の で、確率密度関数は です。事後分布は「尤度 × 事前分布」に比例するので、 を含まない定数を省いて指数をまとめると、
に比例します。これは の確率密度関数と定数倍を除いて同じ形なので、購買実績を見た後の は に従います。購買が 回あったことで形状が だけ、レートが購買金額の合計 だけ増える、と読めます。
3. 事後分布で平均する:手順1より なので、 のときの が分かれば十分です。確率密度関数に を掛けると の指数が1つ減り、残る積分は (BG/NBDモデルの の導出でも使った式)で を にしたものです。
最後の等号は によります(積分が有限になるには が必要です)。、 を代入すると、
です。
4. 全顧客の平均との重み付き平均に書き直す:購買実績がない状態(事前分布 )で同じ計算をすると、、 なので、全顧客の平均購買金額は です( が必要)。第1項をこの形が出るように書き直すと、
となり、本文の式が得られます。2つの重み と の和は1です。
第1項の は、全顧客の平均購買金額です。つまりこの式は、「全顧客の平均」と「その顧客の実績の平均 」の重み付き平均になっています(本人の実績への重み がコードの w)。購買回数 が少ない顧客ほど全体の平均に近づけ、多い顧客ほど本人の実績を信じる、という縮小推定です。1回だけ高額な買い物をした顧客の金額を、そのまま将来に当てはめるのは危険だからです。
は、各顧客の の尤度を最大化して推定します。顧客 の平均購買金額 の確率密度は、次の式で表されます(Fader & Hardie, 2013)。
詳細な式展開(平均購買金額の確率密度 )
「ν が分かっているときの の分布を求める」→「ν の分布で平均する」の2段階で導きます。BG/NBDモデルの母集団の尤度(個人の尤度を と の分布で平均する)と同じ考え方です。以下、顧客の添字 は省略します。
1. 合計金額の分布:ガンマ分布 に従う のモーメント母関数は、 を として使うと
です()。独立な確率変数の和のモーメント母関数は、それぞれのモーメント母関数の積なので、 回の購買金額の合計 のモーメント母関数は です。これは のモーメント母関数なので、 です(レートが同じガンマ分布の和は、形状が足し算されたガンマ分布になる)。
2. 平均金額の分布: なので、 を で微分すると、 の確率密度関数は の確率密度関数を で評価して 倍したものになります。
()。つまり です。
3. ν の分布で平均する: は顧客ごとに違い、仮定2の (確率密度関数 )に従うので、手順2の式をこの分布で平均します。 を含まない部分を積分の外に出し、 の指数をまとめると、
です。残る積分は、 で 、 とおいたものなので、
です。これを代入して並べ替えると、本文の式
が得られます。被積分関数 が、 の導出に出てきた の事後分布 と同じ形をしている点にも注目してください。
Fader & Hardie の技術ノートや多くのライブラリでは、初回購買を除いた繰り返し購買だけで金額を集計します。実際のECでは、初回購買だけ割引クーポンを使うなど、初回の金額の性質が違うことが多いためです。顧客ワールドでは、初回購買も繰り返し購買も同じ分布から生成しているので、本記事では初回購買を含めたすべての購買( 回)を使います。
最尤法による推定と縮小推定の効果
次のコードは、直前の2つの式をこの順で実装します。まず確率密度 の対数和を最大化して (関数内では p_・q_・g_、推定値は p_est・q_est・gamma_est)を推定し(gg_loglik)、次にその推定値を縮小推定の式 に代入します(expected_spend)。
# 1. 仮定3の確認:購買回数と平均購買金額の相関
n_i = summary['n_purchases'].values
z_bar = summary['monetary'].values
print(f"購買回数と平均購買金額の相関: {np.corrcoef(n_i, z_bar)[0, 1]:.3f}")

# 2. Gamma-Gammaモデルの対数尤度と最尤推定
def gg_loglik(params, n_i, z_bar):
    p_, q_, g_ = params
    return (gammaln(p_ * n_i + q_) - gammaln(p_ * n_i) - gammaln(q_) + q_ * np.log(g_)
            + (p_ * n_i - 1) * np.log(z_bar) + p_ * n_i * np.log(n_i) - (p_ * n_i + q_) * np.log(g_ + n_i * z_bar))

res_gg = minimize(lambda lp: -gg_loglik(np.exp(lp), n_i, z_bar).sum(), x0=np.log([1.0, 2.0, 1000.0]), method='L-BFGS-B')
gg_params = np.exp(res_gg.x)
p_est, q_est, gamma_est = gg_params
for name, est, true in zip(['p', 'q', 'gamma'], gg_params, [p_gg, q_gg, gamma_gg]):
    print(f"{name:5s}: 推定値 {est:8.3f}(真値 {true})")
print(f"全顧客の平均購買金額: 推定値 {p_est * gamma_est / (q_est - 1):,.0f} 円(真値 {p_gg * gamma_gg / (q_gg - 1):,.0f} 円)")

# 3. 将来の1回あたりの購買金額の期待値(縮小推定)
def expected_spend(params, n_i, z_bar):
    p_, q_, g_ = params
    w = p_ * n_i / (p_ * n_i + q_ - 1)                 # 本人の実績への重み
    return (1 - w) * p_ * g_ / (q_ - 1) + w * z_bar

summary['exp_spend'] = expected_spend(gg_params, n_i, z_bar)

# 4. 真の平均購買金額との誤差(MAE)を、実績の平均と縮小推定で比べる
true_mean = truth.loc[summary.index, 'mean_amount'].values
print("\n真の平均購買金額との平均絶対誤差(購買回数別)")
for label, mask in [('1回', n_i == 1), ('2回', n_i == 2), ('3回', n_i == 3), ('4回以上', n_i >= 4)]:
    mae_raw = np.abs(z_bar[mask] - true_mean[mask]).mean()
    mae_gg = np.abs(summary['exp_spend'].values[mask] - true_mean[mask]).mean()
    print(f"  {label:5s}({mask.sum():,}人): 実績の平均 {mae_raw:5.0f} 円 / 縮小推定 {mae_gg:5.0f} 円")
Gamma-Gammaモデルの仮定の確認、最尤推定、縮小推定を行っています。
- 仮定3の確認: 購買回数 n_i と平均購買金額 z_bar の相関係数を np.corrcoef(n_i, z_bar)[0, 1] で計算しています(np.corrcoef は相関行列を返すので、その非対角成分を取り出しています)。相関が大きいと、BG/NBDモデルと Gamma-Gammaモデルを独立に組み合わせられません。
- 対数尤度: gg_loglik は、本文の の対数です。BG/NBDモデルと同じく、パラメータの対数を探索して最尤推定しています。目的関数は lambda lp: -gg_loglik(np.exp(lp), n_i, z_bar).sum() と1行で書いています。 の初期値は、購買金額の桁に合わせて1,000にしています。推定値からは、全顧客の平均購買金額 も計算し、真値と比べています。
- 縮小推定: expected_spend の w は本人の実績への重み で、購買回数 n_i が多いほど1に近づきます。残りの重み 1 - w を、全顧客の平均購買金額 に掛けています。
- 誤差の比較: 真の平均購買金額 mean_amount(顧客ワールドの )に対して、実績の平均 z_bar と縮小推定 exp_spend のどちらが近いかを、購買回数別の平均絶対誤差(np.abs(...).mean())で比べています。mask は購買回数が1回・2回・3回・4回以上の顧客を選ぶ True/False の配列です。
実行結果
購買回数と平均購買金額の相関: 0.007
p    : 推定値    5.856(真値 6.0)
q    : 推定値    3.990(真値 4.0)
gamma: 推定値 1540.771(真値 1500.0)
全顧客の平均購買金額: 推定値 3,017 円(真値 3,000 円)

真の平均購買金額との平均絶対誤差(購買回数別)
  1回   (3,413人): 実績の平均   972 円 / 縮小推定   811 円
  2回   (2,573人): 実績の平均   681 円 / 縮小推定   605 円
  3回   (1,276人): 実績の平均   601 円 / 縮小推定   562 円
  4回以上 (2,738人): 実績の平均   391 円 / 縮小推定   376 円
- 独立性の仮定は成り立っている: 購買回数と平均購買金額の相関は0.007で、ほぼ無相関です。顧客ワールドでは、購買金額を購買回数と無関係に生成しているためです。
- 真のパラメータを復元できた: (真値6)、(真値4)、(真値1,500)で、全顧客の平均購買金額も3,017円(真値3,000円)と正しく推定できました。
- 縮小推定で誤差が減る: 購買が1回だけの顧客では、実績の金額をそのまま使うと、真の平均購買金額との誤差は平均972円ですが、縮小推定では811円に減りました。購買回数が増えるほど本人の実績が信頼できるので、2つの差は小さくなります(4回以上では391円と376円)。たまたま1回だけ高額(または少額)な買い物をした顧客の金額を、そのまま将来に当てはめない工夫が、誤差を減らしているのです。
購買回数ごとの誤差を並べると、次のようになります。
(図は、diagram-designで作成)
CLVの計算
BG/NBDモデルと Gamma-Gammaモデルを組み合わせると、RFMの記事で定義したCLVを計算できます。CLVの定義式は、将来の各期間の利益を割り引いて足し合わせたものでした。
非契約型では、期間 の「生存していれば得られる利益 × 生存確率」 は、「期間 の購買回数の期待値 × 1回あたりの購買金額の期待値」に置き換えられます。BG/NBDモデルの購買回数の期待値には、生存確率がすでに織り込まれているからです。本記事では、期間を1か月(30.4375日、DAYS_PER_MONTH)に区切り、3年間(36か月)の CLV を計算します。
は1回あたりの購買金額の期待値(spend。Gamma-Gammaモデルの exp_spend)、(cum)と (prev)の差は (k_month)か月目の購買回数の期待値で、(monthly_d)は月次の割引率です。年10%の割引率なら、 です。なお、ここでは利益ではなく売上で CLV を計算しています。粗利率が一定なら、最後に粗利率を掛ければ利益ベースの CLV になります。
# 1. 3年間(36か月)の CLV を計算する関数
DAYS_PER_MONTH = 30.4375
monthly_d = 1.1 ** (1 / 12) - 1      # 年10%に相当する月次の割引率

def clv_bgnbd(params, spend, x, t_x, T, months=36, d=monthly_d):
    clv = np.zeros(len(np.atleast_1d(x)), dtype=float)
    prev = 0.0
    for k_month in range(1, months + 1):
        cum = expected_purchases(params, k_month * DAYS_PER_MONTH, x, t_x, T)   # k か月目までの累積
        clv += spend * (cum - prev) / (1 + d) ** k_month
        prev = cum
    return clv

summary['clv'] = clv_bgnbd(bgnbd_params, summary['exp_spend'].values, x, t_x, T)

# 2. CLV の分布
print(f"3年間の CLV の平均: {summary['clv'].mean():,.0f} 円、中央値: {summary['clv'].median():,.0f} 円")
top10 = summary['clv'].sort_values(ascending=False).head(len(summary) // 10)
print(f"CLV の上位10%の顧客が、全顧客の CLV の合計に占める割合: {top10.sum() / summary['clv'].sum():.1%}")

# 3. 3人の顧客の例(後の PyMC-Marketing の節でも比べる)
example_ids = [0, 3, 1]
print()
print(summary.loc[example_ids, ['x', 't_x', 'T', 'monetary', 'p_alive', 'exp_spend', 'clv']].round(3).to_string())
2つのモデルを組み合わせて、顧客ごとの3年間の CLV を計算しています。
- 月ごとの計算: clv_bgnbd は、k_month か月目までの購買回数の累積の期待値 cum から、前の月までの累積 prev を引いて「その月の購買回数の期待値」を求め、1回あたりの購買金額 spend を掛けて割り引いています。1か月は、1年を12等分した30.4375日(DAYS_PER_MONTH)です。np.atleast_1d(x) は、x が1人分の数値でも配列として扱えるようにする関数で、clv を顧客数分の0で初期化しています。
- 割引率: monthly_d は、12か月で年10%になる月次の割引率 です。
- CLV の集中度: sort_values(ascending=False).head(len(summary) // 10) で CLV の上位10%の顧客を取り出し、その CLV の合計が全顧客の合計に占める割合を計算しています。
- 3人の顧客の例: 顧客0・3・1について、入力と予測の内訳を表示しています。後の PyMC-Marketing の節でも、同じ3人の CLV を比べます。
実行結果
3年間の CLV の平均: 13,016 円、中央値: 6,998 円
CLV の上位10%の顧客が、全顧客の CLV の合計に占める割合: 44.9%

             x  t_x    T  monetary  p_alive  exp_spend        clv
customer_id
0            6  114  147  1348.571    0.701   1462.027  16254.211
3            2   13   24  3146.667    0.717   3127.849  30532.471
1            4   85  297  3708.000    0.049   3643.995   1405.691
- CLV の分布: 3年間の CLV の平均は13,016円ですが、中央値は6,998円です。上位10%の顧客が全体の CLV の44.9%を占めており、少数の顧客に価値が集中しています。
- 顧客0: 6回の繰り返し購買があり、最後の購買から33日しかたっていないので、生存確率は0.701です。ただし1回あたりの金額が小さい(実績の平均1,349円、縮小推定1,462円)ので、CLV は16,254円にとどまります。
- 顧客3: 入会からわずか24日で2回の繰り返し購買をしています。購買ペースが速いと推定されるため、生存確率0.717のもとで、CLV は30,532円と3人の中で最も高くなりました。
- 顧客1: 4回の繰り返し購買がありますが、最後の購買から212日たっています()。限界2の例と同じく、生存確率は0.049まで下がり、CLV は1,406円しかありません。RFMの記事では、この顧客は F が高い「離反リスク」セグメントに入る顧客です。
ホールドアウト期間での検証
購買回数の予測は当たっているか
分析期間(前半1年)だけで推定したモデルの予測を、ホールドアウト期間(後半1年)の実績と比べます。BTYDモデルの検証でよく使われるのは、分析期間の繰り返し購買の回数 ごとに、翌1年の購買回数の平均を、予測と実績で比べる方法です(Fader, Hardie & Lee, 2005)。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google ColabやJupyterでは先頭の ! を付けたまま、ターミナルでは ! を外して実行します)。Python 3.12 以降で import 時にエラーが出る場合は、setuptools も一緒にインストールしてください。
!pip install japanize-matplotlib setuptools
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. 分析期間の繰り返し購買の回数 x ごとに、翌1年の購買回数の平均を比べる(7回以上はまとめる)
group = np.minimum(summary['x'], 7)
compare = summary.groupby(group).agg(人数=('x', 'size'), 実績=('holdout_n', 'mean'), 予測=('pred_n', 'mean'))
compare.index = [f"{v}" if v < 7 else "7以上" for v in compare.index]
print(compare.round(2).to_string())

# 2. 顧客単位の誤差
mae = np.abs(summary['pred_n'] - summary['holdout_n']).mean()
print(f"\n顧客ごとの翌1年の購買回数: 平均絶対誤差 {mae:.2f} 回、予測と実績の相関 {np.corrcoef(summary['pred_n'], summary['holdout_n'])[0, 1]:.3f}")

# 3. 可視化
pos = np.arange(len(compare))
plt.figure(figsize=(10, 5))
plt.bar(pos - 0.2, compare['実績'], width=0.4, label='実績(ホールドアウト期間)', color='gray')
plt.bar(pos + 0.2, compare['予測'], width=0.4, label='BG/NBDモデルの予測', color='C0')
plt.xticks(pos, compare.index)
plt.xlabel('分析期間(前半1年)の繰り返し購買の回数 x')
plt.ylabel('翌1年の購買回数の平均')
plt.title('ホールドアウト期間の購買回数:予測と実績')
plt.legend()
plt.grid(True, axis='y', alpha=0.3)
plt.tight_layout()
plt.show()
分析期間の繰り返し購買の回数ごとに、ホールドアウト期間の購買回数を予測と実績で比べています。
- グループ化: np.minimum(summary['x'], 7) で、7回以上の顧客を1つのグループにまとめています。人数の少ないグループは平均が不安定になるためです。
- 集計: グループごとに、人数・翌1年の購買回数の実績の平均・予測の平均を計算しています。予測は、前の節で計算した pred_n です。compare.index を書き換え、7のグループの表示を「7以上」にしています。
- 顧客単位の誤差: グループの平均だけでなく、顧客ごとの予測と実績の平均絶対誤差(np.abs(summary['pred_n'] - summary['holdout_n']).mean())と相関係数も計算しています。
- 可視化: np.arange(len(compare)) で棒の位置 pos を作り、pos - 0.2 と pos + 0.2 に幅0.4の棒を描くことで、グループごとに実績(灰色)と予測(青)の棒を並べています。
実行結果
       人数    実績    予測
0    3413  1.47  1.43
1    2573  1.40  1.32
2    1276  1.97  1.90
3     743  2.27  2.40
4     505  3.39  3.12
5     355  4.02  3.91
6     245  3.71  4.11
7以上   890  8.43  8.27

顧客ごとの翌1年の購買回数: 平均絶対誤差 2.17 回、予測と実績の相関 0.622
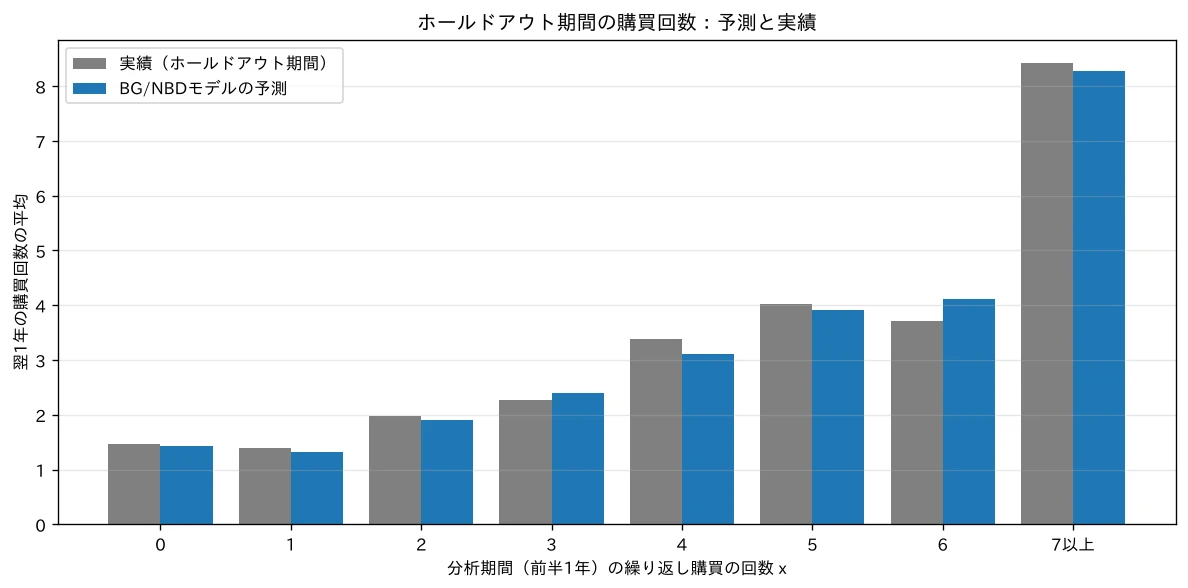
- グループの平均はよく当たっている: どのグループでも、予測は実績の近くにあります。たとえば初回購買しかない顧客(、3,413人)は、実績1.47回に対して予測1.43回、7回以上の顧客は、実績8.43回に対して予測8.27回です。分析期間(前半1年)だけのデータで、翌1年の購買のパターンを正しく予測できています。
- x = 0 でも翌年の購買は0ではない: 初回購買しかない顧客の翌年の購買回数の平均は1.47回で、 の顧客(1.40回)と同じくらいです。 の顧客には最近入会した顧客が多く、まだ繰り返し購買の機会がなかっただけの顧客が含まれているためです。BG/NBDモデルは、在籍期間 を使ってこれを正しく捉えています。
- 顧客単位では誤差が大きい: 顧客ごとの平均絶対誤差は2.17回、予測と実績の相関は0.622です。グループの平均は当たっても、一人ひとりが来年いつ何回買うかには、偶然の要素が大きく残ります。
RFMスコアより良い顧客を選べるか
RFMの記事の限界3では、翌年の売上の上位顧客をどれだけ取りこぼさずに選べるかを、「上位20%の顧客が翌年の売上の何%を占めるか」で比べました。RFMスコアの合計で選ぶと57.1%、隠れた真値を知っている「神の視点」の期待値で選ぶと78.0%でした。ここに、BG/NBDモデル × Gamma-Gammaモデルによる翌年の売上の予測を加えます。比較のため、RFMスコアと神の視点の期待値も、RFMの記事と同じ方法で計算し直します。
コードで比べる2つの「翌1年の売上の期待値」を、先に式で書いておきます。 日は翌1年の長さです。
神の視点:真の ( は p_true)と、ホールドアウト期間の開始時点で生存しているか( は1か0、truth['alive'])を知っているとします。翌1年に (k_purchase)回目の購買が起きるのは、ポアソン過程で 回以上の購買が起き(確率 、。コードでは poisson.sf(k_purchase - 1, lam_tau)、 は lam_tau)、かつそれまでの 回の購買の直後に一度も離脱しなかった(確率 )ときです。これを について足し合わせると購買回数の期待値(expected_count。無限和は299回で打ち切り)になり、平均購買金額 (truth['mean_amount'])を掛けると売上の期待値になります。
BG/NBD × Gamma-Gamma:真値の代わりに、観測できる と金額の実績から、(pred_n)と (exp_spend)の積 を予測値とします(顧客ごとの予測とGamma-Gammaモデルの式)。
from scipy.stats import poisson

# 1. RFMスコアの合計(RFMの記事と同じスコアリング)
R_score = pd.qcut(summary['recency'], 5, labels=[5, 4, 3, 2, 1]).astype(int)
F_score = pd.cut(summary['n_purchases'], bins=[0, 1, 2, 3, 6, np.inf], labels=[1, 2, 3, 4, 5]).astype(int)
M_score = pd.qcut(summary['monetary'], 5, labels=[1, 2, 3, 4, 5]).astype(int)
summary['rfm_total'] = R_score + F_score + M_score

# 2. 神の視点:真値から計算した翌1年の売上の期待値(RFMの記事と同じ計算)
k_purchase = np.arange(1, 300)[None, :]
lam_tau = truth['lam'].values[:, None] * 365
p_true = truth['p_drop'].values[:, None]
expected_count = ((1 - p_true) ** (k_purchase - 1) * poisson.sf(k_purchase - 1, lam_tau)).sum(axis=1)
summary['oracle'] = (truth['alive'] * expected_count * truth['mean_amount']).loc[summary.index]

# 3. BG/NBD × Gamma-Gamma による翌1年の売上の予測(推定したパラメータと、真のパラメータの2通り)
summary['pred_sales'] = summary['pred_n'] * summary['exp_spend']
pred_n_truepar = expected_purchases([r, alpha, a, b], 365, x, t_x, T)
summary['pred_sales_truepar'] = pred_n_truepar * expected_spend([p_gg, q_gg, gamma_gg], n_i, z_bar)

# 4. 上位20%の顧客が、翌年の売上の何%を占めるか
n_top = len(summary) // 5
total_sales = summary['holdout_sales'].sum()
rankings = {
    'RFMスコアの合計': 'rfm_total',
    'BG/NBD × Gamma-Gamma(推定したパラメータ)': 'pred_sales',
    'BG/NBD × Gamma-Gamma(真のパラメータ)': 'pred_sales_truepar',
    '神の視点の期待値': 'oracle',
    '翌年の実績(理想)': 'holdout_sales',
}
print(f"上位20%({n_top:,}人)に選ばれた顧客が、翌年の売上の何%を占めるか")
for name, col in rankings.items():
    top = summary.sort_values(col, ascending=False, kind='stable').head(n_top)
    print(f"  {name:36s}: {top['holdout_sales'].sum() / total_sales:.1%}")
print(f"\n翌年の売上の合計: 予測 {summary['pred_sales'].sum():,.0f} 円、実績 {total_sales:,} 円")
上位20%の顧客を5通りの方法で選び、翌年の売上のカバー率を比べています。
- RFMスコアの合計: RFMの記事と同じく、R と M は五分位、F は購買回数の閾値で5段階に分け、合計しています。summary の recency・n_purchases・monetary は RFMの記事の R・F・M と同じ値なので、スコアも同じになります。
- 神の視点の期待値: RFMの記事の補足と同じ式で、真値(購買ペース・離脱確率・平均購買金額・生存しているか)から翌1年の売上の期待値を計算しています。k_purchase を横方向(1〜299回目の購買)、lam_tau・p_true を縦方向(顧客)に並べ、NumPy のブロードキャストで(顧客数, 299)の行列を作ってから sum(axis=1) で顧客ごとに足し合わせています。
- BG/NBD × Gamma-Gamma: 翌1年の購買回数の期待値 pred_n と、1回あたりの購買金額の期待値 exp_spend の積が、翌1年の売上の予測です。比較のため、推定したパラメータの代わりに真のパラメータ([r, alpha, a, b] と [p_gg, q_gg, gamma_gg])を使った予測も計算しています。真のパラメータを使っても、各顧客について分かるのは と購買金額の実績だけである点は変わりません。
- カバー率: sort_values(col, ascending=False, kind='stable').head(n_top) で、各方法の値が大きい順に上位2,000人(n_top)を選び、その顧客の翌年の売上の合計を全体の売上で割っています。kind='stable' は、RFMスコアのように同点が多い場合に、同点の顧客を元の順番(顧客IDの順)のまま並べる指定です。最後に、翌年の売上の予測の合計と実績の合計も比べています。
実行結果
上位20%(2,000人)に選ばれた顧客が、翌年の売上の何%を占めるか
  RFMスコアの合計                           : 57.1%
  BG/NBD × Gamma-Gamma(推定したパラメータ)     : 61.6%
  BG/NBD × Gamma-Gamma(真のパラメータ)       : 61.6%
  神の視点の期待値                            : 78.0%
  翌年の実績(理想)                           : 83.2%

翌年の売上の合計: 予測 71,983,096 円、実績 72,524,240 円
- RFMスコアより良い顧客を選べる: BG/NBD × Gamma-Gamma で選ぶと、上位20%の顧客が翌年の売上の61.6%を占め、RFMスコアの合計(57.1%)を4.5ポイント上回りました。同じ購買ログから計算しているので、この差は「R・F・M をどう組み合わせるか」の違いだけで生まれたものです。
- 金額の規模も正しい: 翌年の売上の合計の予測は約7,198万円で、実績の約7,252万円と −0.7% の差です。RFMスコアには金額の情報がありませんでしたが、BTYDモデルは「来年いくら買ってくれるか」を金額で答えられます。
- 真のパラメータを使っても61.6%のまま: 推定したパラメータと真のパラメータで、カバー率は変わりませんでした。つまり、パラメータの推定誤差は問題ではなく、購買履歴から読み取れる情報は、すでにほぼ取り切れているということです。
- 神の視点(78.0%)との差は、購買履歴の外にある: 神の視点は、一人ひとりの真の購買ペースと、離脱しているかどうかを知っています。購買履歴が少ない顧客について、それらを だけから見分けることには限界があり、この差を埋めるには、購買履歴以外の情報が必要です。
上位20%が占める翌年の売上の割合を並べると、次のようになります。
(図は、diagram-designで作成)
等価値曲線(iso-value curve)
RFMの記事の最後で、「R と F の組み合わせごとに CLV の等しい点を結んだ 等価値曲線(iso-value curve) を描くと、RFMのマトリクスに CLV という金額の物差しを入れられる」と予告しました(Fader, Hardie & Lee, 2005)。BG/NBDモデルを使えば、R と F の任意の組み合わせについて CLV を計算できるので、等価値曲線を描くことができます。
ここでは、分析期間の初日に初回購買をした顧客(、T_fix)で、1回あたりの購買金額の期待値が全顧客の平均と同じ顧客を考え、R(最後の購買からの日数)と F(購買回数)の組み合わせ(格子 RR・FF)ごとに、3年間の CLV を計算します。
計算する式は、CLVの計算の節の CLV の式(関数 clv_bgnbd)に、R と F を BG/NBDモデルの入力に直したもの( は x_grid・t_x_grid)を代入したものです。
(mean_spend)は全顧客の平均購買金額です。
# 1. R と F の格子を作る(T = 365 日、F は2〜20回、R は0〜364日)
T_fix = 365.0
R_grid = np.arange(0, 365, 5)
F_grid = np.arange(2, 21)
RR, FF = np.meshgrid(R_grid, F_grid)
x_grid = (FF - 1).ravel()
t_x_grid = (T_fix - RR).ravel().astype(float)

# 2. 各格子点の3年間の CLV(購買金額は全顧客の平均)
mean_spend = p_est * gamma_est / (q_est - 1)
clv_grid = clv_bgnbd(bgnbd_params, mean_spend, x_grid, t_x_grid, np.full(x_grid.shape, T_fix)).reshape(RR.shape)

# 3. 等価値曲線を描く
fig, ax = plt.subplots(figsize=(10, 6))
levels = [1_000, 2_500, 5_000, 10_000, 20_000, 40_000, 80_000]
cs = ax.contour(RR, FF, clv_grid, levels=levels, cmap='viridis')
ax.clabel(cs, fmt=lambda v: f"{v / 1000:.0f}千円" if v >= 1000 else f"{v:.0f}円", fontsize=9)
ax.set_xlabel('R:最後の購買からの日数(右ほど長く買っていない)')
ax.set_ylabel('F:購買回数(分析期間の1年間)')
ax.set_title('等価値曲線:3年間の CLV が等しい R と F の組み合わせ(T = 365日)')
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

# 4. 数値でも確認する:F = 3回と F = 15回の顧客の CLV を、R ごとに比べる
for F_val in [3, 15]:
    row = clv_grid[F_grid == F_val][0]
    print(f"F = {F_val:2d}回: " + "、".join(f"R = {R_val}日 → {row[R_grid == R_val][0]:7,.0f} 円" for R_val in [0, 60, 120, 240]))
R と F の格子の上で3年間の CLV を計算し、等高線を描いています。
- 格子: np.meshgrid で、R(0〜360日、5日刻み)と F(2〜20回)のすべての組み合わせを作っています。F = 1(初回購買のみ)の顧客は、 なので R が に決まってしまい、R を動かせないため除いています。各格子点を、、 に変換し、ravel() で1列に並べてから、CLV の関数に渡しています。計算した CLV は、reshape(RR.shape) で格子の形に戻しています。
- 購買金額: 1回あたりの購買金額は、全顧客の平均 mean_spend(Gamma-Gammaモデルの推定値で約3,017円)にそろえています。こうすると、等高線は購買回数と離脱だけで決まる価値の違いを表します。
- 等高線: ax.contour に、CLV の等しい水準 levels(1千円〜80千円)を指定して描き、ax.clabel で各線に金額のラベルを付けています。
- 数値の確認: clv_grid[F_grid == F_val][0] で F = 3回と F = 15回の行を取り出し、R = 0・60・120・240日の CLV を表示しています。
実行結果
F =  3回: R = 0日 →  10,383 円、R = 60日 →   9,512 円、R = 120日 →   8,178 円、R = 240日 →   3,639 円
F = 15回: R = 0日 →  58,082 円、R = 60日 →  38,062 円、R = 120日 →   4,931 円、R = 240日 →       1 円
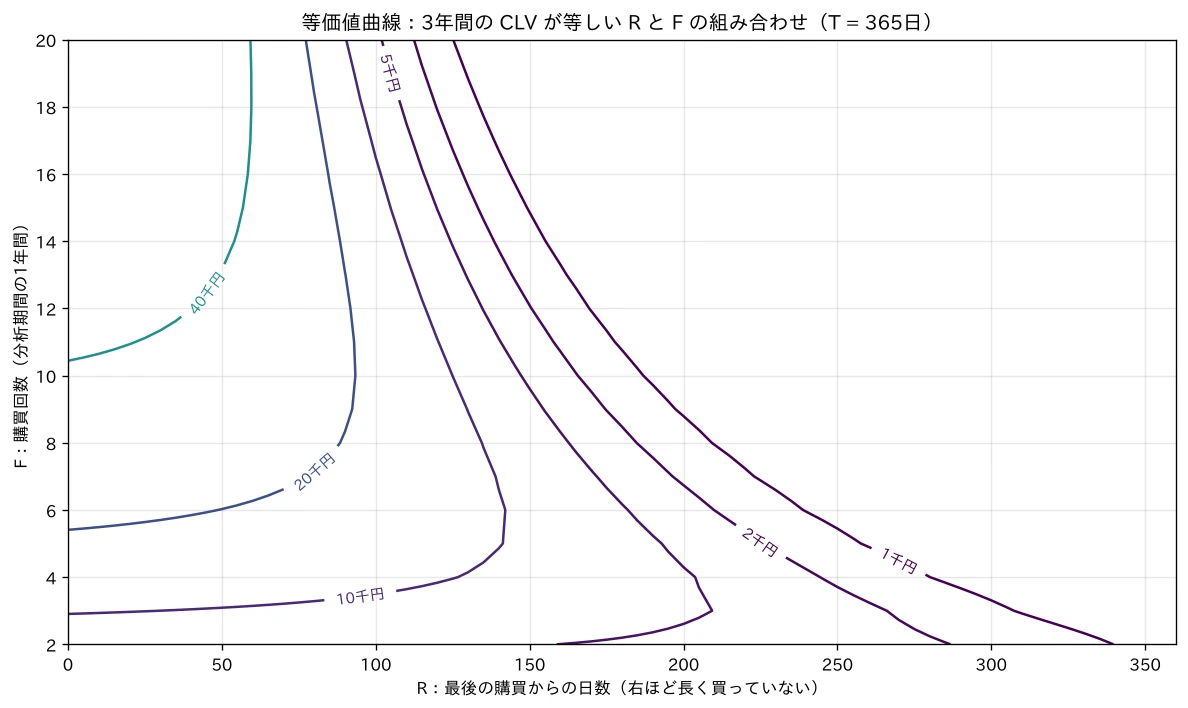
等価値曲線の形から、R と F の関係について、次のことが読み取れます。
- R が小さい(最近買った)ときは、F が大きいほど価値が高い: 図の左端では、等高線はほぼ水平に並び、F が上がるほど CLV が上がっていきます。R = 0日なら、F = 3回の顧客の CLV は10,383円、F = 15回の顧客は58,082円です。
- F が大きいほど、R による価値の下がり方が急になる: 図の上の方(F が大きい)では、等高線が左に寄って縦に並んでいます。F = 15回の顧客は、R = 60日で38,062円、R = 120日で4,931円、R = 240日ではわずか1円まで下がります。一方、F = 3回の顧客は、R = 240日でも3,639円が残ります。R = 240日なら、F = 3回の顧客の方が、F = 15回の顧客より価値が高いのです。
RFMスコアのように「R の点数 + F の点数」で価値を表すと、等高線は右上がりの直線になるはずです。実際の等価値曲線は、F が大きいところで大きく曲がっています。RFMの記事の限界2で見た逆転は、この曲がり方として現れていたのです。等価値曲線を使えば、RFMのマトリクスの各マスに「その顧客の価値は何円か」という物差しを入れられます。
PyMC-MarketingのCLVモジュール
ここまでスクラッチで実装した BG/NBDモデルと Gamma-Gammaモデルは、PyMC-Marketing・Meridian・RobynによるMMM実践の記事で紹介した PyMC-Marketing の CLVモジュールにも実装されています。PyMC-Marketing では、パラメータを最尤法ではなく、事前分布を置いた ベイズ推定(MCMC) で推定します(MCMCについてはMCMCの記事を参照してください)。パラメータの不確実性が事後分布として得られるので、CLV の予測にも幅を付けられます。
PyMC-Marketing は、Google Colab などで次のようにインストールできます(インストール後は、ランタイムを再起動してください)。
!pip install pymc-marketing==1.2.0
この節の MCMC による推定は、BG/NBDモデルが約3分、Gamma-Gammaモデルが約5分かかります(CPU 2コアで、4本のチェーンを順番に実行した場合)。CLV の計算にも1分程度かかり、この節全体では10分ほどかかります。
BG/NBDモデル
PyMC-Marketing の BetaGeoModel に、顧客ごとの frequency()、recency()、T を渡して推定します。PyMC-Marketing の recency は、RFMの R(最後の購買からの日数)ではなく、初回購買から最後の購買までの日数 である点に注意してください。名前が同じでも、向きが逆です。
モデルの尤度は尤度は x, t_x, T だけで決まるの 、予測に使う式は顧客ごとの予測の と で、スクラッチ実装と同じです。違いは、 に事前分布を置いて事後分布を求める点だけです。
from pymc_marketing import clv

# 1. PyMC-Marketing の形式のデータ(recency は t_x であることに注意)
bg_data = pd.DataFrame({
    'customer_id': summary.index,
    'frequency': summary['x'].values,
    'recency': summary['t_x'].values,
    'T': summary['T'].values,
})

# 2. BG/NBDモデルを MCMC で推定する(事前分布は PyMC-Marketing の既定値)
bg_model = clv.BetaGeoModel(sampler_config={'chains': 4, 'draws': 1000, 'tune': 1000})
bg_model.fit(bg_data, method='mcmc', progressbar=False, random_seed=42)

# 3. 事後分布の要約と、スクラッチ実装(最尤法)・真値との比較
post = bg_model.fit_summary()
print(post.loc[['r', 'alpha', 'a', 'b'], ['mean', 'sd', 'r_hat']].assign(
    最尤法=bgnbd_params, 真値=[r, alpha, a, b]).round(3).to_string())

# 4. 生存確率と翌1年の購買回数の期待値(事後平均)を、スクラッチ実装と比べる
pa_pmm = bg_model.expected_probability_alive(bg_data).mean(('chain', 'draw')).values
pred_pmm = bg_model.expected_purchases(bg_data, future_t=365).mean(('chain', 'draw')).values
print(f"\n生存確率の差の最大値: {np.abs(pa_pmm - summary['p_alive'].values).max():.4f}")
print(f"翌1年の購買回数の合計: PyMC-Marketing {pred_pmm.sum():,.0f} 回、スクラッチ実装 {summary['pred_n'].sum():,.0f} 回")
PyMC-Marketing の BetaGeoModel で BG/NBDモデルをベイズ推定し、スクラッチ実装と比べています。
- データの形式: PyMC-Marketing は、customer_id・frequency・recency・T の4列を持つデータフレームを要求します。本文で注意したとおり、recency には RFMの R ではなく を入れます。購買ログから直接この形式を作る clv.rfm_summary という関数もあります。
- 推定: モデルを作るときに sampler_config でチェーン数(4本)・サンプル数・チューニングの回数を指定し、fit にデータと method='mcmc' を渡しています。事前分布は既定値のままです。PyMC-Marketing の BG/NBDモデルは、内部では の代わりに、離脱確率の平均 phi_dropout()と集中度 kappa_dropout()をパラメータとして推定し、そこから を計算しています。
- 事後分布の要約: fit_summary は、ArviZ の要約表(事後平均・標準偏差・ など)を返します。 の行を取り出し、最尤法と真値を並べています。 の読み方はMCMCの記事を参照してください。
- 予測: expected_probability_alive と expected_purchases は、事後サンプルごとの予測を、(チェーン, サンプル, 顧客) の次元を持つ配列で返します。mean(('chain', 'draw')) で事後平均をとり、スクラッチ実装の予測と比べています。
実行結果
         mean      sd r_hat     最尤法    真値
r      0.5944  0.0124  1.00   0.597   0.6
alpha   24.35    0.73  1.00  24.532  25.0
a       0.856   0.062  1.00   0.857   0.8
b        3.23    0.31  1.00   3.236   3.0

生存確率の差の最大値: 0.0019
翌1年の購買回数の合計: PyMC-Marketing 23,842 回、スクラッチ実装 23,829 回
- スクラッチ実装とほぼ同じ推定値: 事後平均は 、、、 で、最尤法の推定値とほぼ一致しました。顧客が10,000人いるので、事前分布の影響はほとんどありません。 はすべて1.00で、収束にも問題はありません。
- パラメータの不確実性: 事後標準偏差を見ると、離脱の (0.062)・(0.31)は、購買ペースの (0.012)に比べて相対的に大きく、離脱が観測できない分、不確実性が大きいことが分かります。
- 予測も一致: 生存確率の差は最大でも0.0019、翌1年の購買回数の合計は23,842回(スクラッチ実装は23,829回)でした。
Gamma-Gammaモデルと事前分布の尺度
Gamma-Gammaモデルは GammaGammaModel で推定します。ここでは、PyMC-Marketing の既定の事前分布のまま推定すると何が起きるかも確かめます。
from pymc_extras.prior import Prior

# 1. 既定の事前分布のまま、円単位の金額で推定する(MAP推定で手早く確認)
gg_data_yen = pd.DataFrame({
    'customer_id': summary.index,
    'monetary_value': summary['monetary'].values,       # 円
    'frequency': summary['n_purchases'].values,         # 本記事では初回購買を含めた購買回数
})
gg_default = clv.GammaGammaModel()
gg_default.fit(gg_data_yen, method='map', progressbar=False)
print("既定の事前分布・円単位(MAP推定):", gg_default.fit_summary().round(3).to_dict())

# 2. 金額を千円単位にし、事前分布を広くして MCMC で推定する
gg_data = gg_data_yen.assign(monetary_value=summary['monetary'].values / 1000)   # 千円
gg_model = clv.GammaGammaModel(
    model_config={name: Prior('HalfNormal', sigma=10) for name in ['p', 'q', 'v']},
    sampler_config={'chains': 4, 'draws': 1000, 'tune': 1000},
)
gg_model.fit(gg_data, method='mcmc', progressbar=False, random_seed=42)
post_gg = gg_model.fit_summary()
print()
print(post_gg[['mean', 'sd', 'r_hat']].assign(
    最尤法=[p_est, q_est, gamma_est / 1000], 真値=[p_gg, q_gg, gamma_gg / 1000]).round(3).to_string())

# 3. 将来の1回あたりの購買金額の期待値(円に戻す)を、スクラッチ実装と比べる
spend_pmm = gg_model.expected_customer_spend(gg_data).mean(('chain', 'draw')).values * 1000
print(f"\n1回あたりの購買金額の期待値の差の最大値: {np.abs(spend_pmm - summary['exp_spend'].values).max():.1f} 円")
Gamma-Gammaモデルを、既定の設定と、尺度を合わせた設定の2通りで推定しています。
- 既定の設定: 円単位の金額のまま、既定の事前分布で推定しています。手早く確認するため、method='map'(事後分布の最頻値を最適化で求める MAP推定)を使っています。PyMC-Marketing の Gamma-Gammaモデルのパラメータ名は と、 に相当する v です。
- 金額の単位と事前分布: 既定の事前分布は、 が 、v が で、いずれも1〜10程度の値を想定しています。そこで、金額を千円単位に直し(真の は1.5になります)、さらに model_config で3つのパラメータの事前分布を、より広い に変えています。事前分布は pymc-extras の Prior クラスで指定します。
- 購買回数: 本記事では初回購買を含めた金額の平均を使っているので、frequency にも初回購買を含めた購買回数 n_purchases を渡しています。ライブラリの説明では frequency は繰り返し購買の回数ですが、モデルの計算上は「平均をとった購買の回数」として使われます。
- 予測: expected_customer_spend で1回あたりの購買金額の期待値(縮小推定)を求め、千円単位から円に戻して、スクラッチ実装と比べています。
実行結果
既定の事前分布・円単位(MAP推定): {'p': 22.415, 'q': 2.498, 'v': 223.502}

    mean     sd r_hat    最尤法   真値
p   5.86   0.33  1.00  5.856  6.0
q  3.996  0.087  1.00   3.99  4.0
v  1.549  0.117  1.01  1.541  1.5

1回あたりの購買金額の期待値の差の最大値: 23.2 円
- 既定の事前分布では、大きく外れる: 円単位のまま推定すると、、、 と、真値(6、4、1,500)からかけ離れた値になりました。真の は、既定の事前分布 にとってはあり得ないほど大きな値なので、事前分布が推定値を強く引き寄せてしまったのです。MMMの記事で広告費をスケーリングしたのと同じく、ライブラリの既定の事前分布が、データの尺度に合っているかを確認する必要があります。
- 尺度を合わせると、最尤法と一致する: 千円単位にして事前分布を広げると、事後平均は 、、(千円)と、最尤法の推定値(5.856、3.990、1.541)とほぼ一致しました。 の は1.01で、収束の目安の範囲に収まっています。
- 予測も一致: 1回あたりの購買金額の期待値の差は、最大でも23.2円でした。
事後分布を使ったCLVの予測
最後に、PyMC-Marketing の customer_lifetime_value で、3年間(引数 future_t に36か月)の CLV を計算します。この関数は、スクラッチ実装と同じく、月ごとの購買回数の期待値の増分に1回あたりの購買金額 (引数 future_spend。Gamma-Gammaモデルの事後平均 spend_pmm)を掛け、月次の割引率 (引数 discount_rate)で割り引いて足し合わせます。BG/NBDモデルのパラメータ の事後サンプル(間引いたものが bg_thin)ごとに CLV を計算するので、顧客ごとの CLV の信用区間が得られます。
計算する式は、CLVの計算の節と同じです。
# 1. 計算量を減らすため、事後サンプルを10個に1個に間引く(4チェーン × 100サンプル)
bg_thin = bg_model.thin_fit_result(keep_every=10)

# 2. 3年間(36か月)の CLV を、事後サンプルごとに計算する
clv_data = bg_data.assign(future_spend=spend_pmm)
clv_draws = clv.customer_lifetime_value(bg_thin, clv_data, future_t=36, discount_rate=monthly_d, time_unit='D')

# 3. 3人の顧客について、事後平均と95%信用区間をスクラッチ実装と比べる
clv_mean = clv_draws.mean(('chain', 'draw')).values
clv_lo = clv_draws.quantile(0.025, ('chain', 'draw')).values
clv_hi = clv_draws.quantile(0.975, ('chain', 'draw')).values
print(f"3年間の CLV の平均: PyMC-Marketing {clv_mean.mean():,.0f} 円、スクラッチ実装 {summary['clv'].mean():,.0f} 円\n")
for cid in example_ids:
    print(f"顧客{cid}: PyMC-Marketing {clv_mean[cid]:7,.0f} 円 [{clv_lo[cid]:7,.0f}, {clv_hi[cid]:7,.0f}]、"
          f"スクラッチ実装 {summary.loc[cid, 'clv']:7,.0f} 円")
事後サンプルを使って、3年間の CLV の点推定と信用区間を計算しています。
- 事後サンプルの間引き: thin_fit_result(keep_every=10) で、各チェーンの1,000個の事後サンプルから10個に1個を取り出した、軽いモデルを作っています。CLV の計算では、事後サンプル × 顧客 × 36か月分の購買回数を計算するため、すべてのサンプルを使うと時間とメモリがかかるからです。
- CLV の計算: customer_lifetime_value には、BG/NBDモデル、顧客ごとの入力と future_spend(1回あたりの購買金額の期待値。ここでは Gamma-Gammaモデルの事後平均)を持つデータ、期間 future_t(月)、月次の割引率 discount_rate、時間の単位 time_unit='D'(日)を渡しています。内部では、スクラッチ実装の clv_bgnbd と同じく、30.4375日ごとの購買回数の増分を割り引いて足し合わせます。
- 信用区間: 事後サンプルごとの CLV の2.5%点と97.5%点を、quantile で計算しています。この区間は BG/NBDモデルのパラメータの不確実性だけを反映したもので、購買金額の不確実性や、顧客が来年実際に何回買うかという偶然のばらつきは含みません。
実行結果
3年間の CLV の平均: PyMC-Marketing 13,080 円、スクラッチ実装 13,016 円

顧客0: PyMC-Marketing  16,397 円 [ 14,994,  17,801]、スクラッチ実装  16,254 円
顧客3: PyMC-Marketing  30,808 円 [ 27,999,  33,570]、スクラッチ実装  30,532 円
顧客1: PyMC-Marketing   1,415 円 [  1,287,   1,544]、スクラッチ実装   1,406 円
- スクラッチ実装とほぼ一致: 3年間の CLV の平均は13,080円で、スクラッチ実装(13,016円)との差は0.5%です。3人の顧客の CLV も、スクラッチ実装の値がそれぞれの信用区間に含まれています。
- 信用区間の幅: 顧客0の CLV は16,397円で、95%信用区間は [14,994, 17,801] 円です。顧客が10,000人いるのでパラメータはかなり正確に推定できており、区間の幅は CLV の±9%程度に収まっています。
ベイズ推定の強みは、このように予測に幅を付けられることです。顧客の数が少ないサービスや、新しいサービスでパラメータの不確実性が大きいときほど、点推定だけでなく信用区間を見て判断することが重要になります。
BTYDモデルの限界
BTYDモデルは、購買ログだけから、顧客ごとの生存確率・将来の購買回数・CLV を、RFMスコアよりも正確に予測できました。一方で、ホールドアウト期間の検証からは、次のような限界も見えてきました。
- 購買履歴以外の情報を使えない:真のパラメータを使っても、上位20%のカバー率は神の視点に遠く及びませんでした。購買履歴の情報は に要約され、それ以上のことは分かりません。サイトの閲覧頻度、カテゴリの好み、問い合わせの履歴など、顧客の購買ペースや離脱のしやすさを示す情報が他にあっても、BTYDモデルには取り込めません。こうした特徴量を使う方法は、機械学習によるCLV予測の記事で扱います。
- 新規顧客に弱い:初回購買しかない顧客()は、 が同じなら全員が同じ予測になります。購買履歴が少ない顧客ほど、予測は全体の平均に引き寄せられます。
- 初回購買しかない顧客は、離脱しないことになっている:BG/NBDモデルでは、離脱は繰り返し購買の直後にしか起きないので、 の顧客の生存確率は、何日たっても1です。RFMの記事の生存率のマトリクスで F = 1 の列がすべて1.00になっていたのは、このためです。実際のECでは、1回買っただけで二度と来ない顧客も多いので、初回購買の直後にも離脱できるようにした MBG/NBDモデル(Batislam, Denizel & Filiztekin, 2007)などの変種が提案されています。PyMC-Marketing にも ModifiedBetaGeoModel として実装されています。
- 仮定が崩れると予測も崩れる:購買ペースや離脱確率が時間とともに変わる場合(季節性、キャンペーン、サービスの改善など)や、購買金額と購買回数に関係がある場合は、モデルの仮定が成り立たず、予測が偏ります。
なお、本記事ではモデルの仮定どおりに生成したデータを使ったので、BTYDモデルにとって理想的な条件でした。実際のデータでは、本記事のようなホールドアウト期間での検証を必ず行い、予測と実績のずれを確かめてください。
まとめ
本記事では、離脱が観測できない非契約型のビジネスで、顧客ごとの将来の価値を予測する BTYDモデル を解説しました。
- BG/NBDモデル:購買をポアソン分布 × ガンマ分布、離脱を幾何分布 × ベータ分布で表すモデルです。RFMの記事の顧客ワールドは、このモデルに従って生成していました。
- 尤度は だけで決まる:購買回数(F)、最後の購買のタイミング(R)、在籍期間()が、購買と離脱について分かることのすべてであり、RFM分析が経験的に使ってきた R と F の意味が、モデルによって裏付けられました。
- スクラッチ実装:最尤法で真のパラメータを復元し、顧客ごとの生存確率・翌年の購買回数を予測しました。予測した生存確率は真の生存率とよく一致し、「よく買っていた顧客ほど、しばらく買っていないと離脱している」関係も捉えられました。
- Gamma-Gammaモデル:購買回数の少ない顧客の金額を全体の平均に近づける縮小推定で、1回あたりの購買金額を予測しました。
- CLV と検証:2つのモデルを組み合わせて CLV を計算し、ホールドアウト期間で、RFMスコアより翌年の売上の上位顧客を選べることを確認しました。等価値曲線では、R と F の組み合わせを CLV という金額の物差しで比べられるようにしました。
- PyMC-Marketing:同じモデルをベイズ推定し、CLV に信用区間を付けました。ライブラリの既定の事前分布が、データの尺度に合っているかの確認が必要なことも見ました。
BTYDモデルは購買履歴しか使えないため、真のパラメータを使っても、予測できることには限界がありました。「機械学習によるCLV予測とは?」の記事では、閲覧行動などの豊富な特徴量を使って CLV を予測する、機械学習による CLV 予測 を扱います。大半の顧客の CLV がゼロで、一部の顧客だけが大きな値をとる、という CLV の分布に合わせた損失関数や評価指標が、そこでの主役になります。
参考文献
- P. S. Fader, B. G. S. Hardie, K. L. Lee (2005). “Counting Your Customers” the Easy Way: An Alternative to the Pareto/NBD Model. Marketing Science, 24(2), 275–284.
- D. C. Schmittlein, D. G. Morrison, R. Colombo (1987). Counting Your Customers: Who-Are They and What Will They Do Next?. Management Science, 33(1), 1–24.
- P. S. Fader, B. G. Hardie, K. L. Lee (2005). RFM and CLV: Using Iso-Value Curves for Customer Base Analysis. Journal of Marketing Research, 42(4), 415–430.
- P. S. Fader, B. G. S. Hardie (2013). The Gamma-Gamma Model of Monetary Value. Note.
- E. Batislam, M. Denizel, A. Filiztekin (2007). Empirical validation and comparison of models for customer base analysis. International Journal of Research in Marketing, 24(3), 201–209.
- PyMC Labs. PyMC-Marketing. GitHub.
本記事の文章・構成の一部に生成AIを使用しています。