MMMによる予算配分の最適化とは?
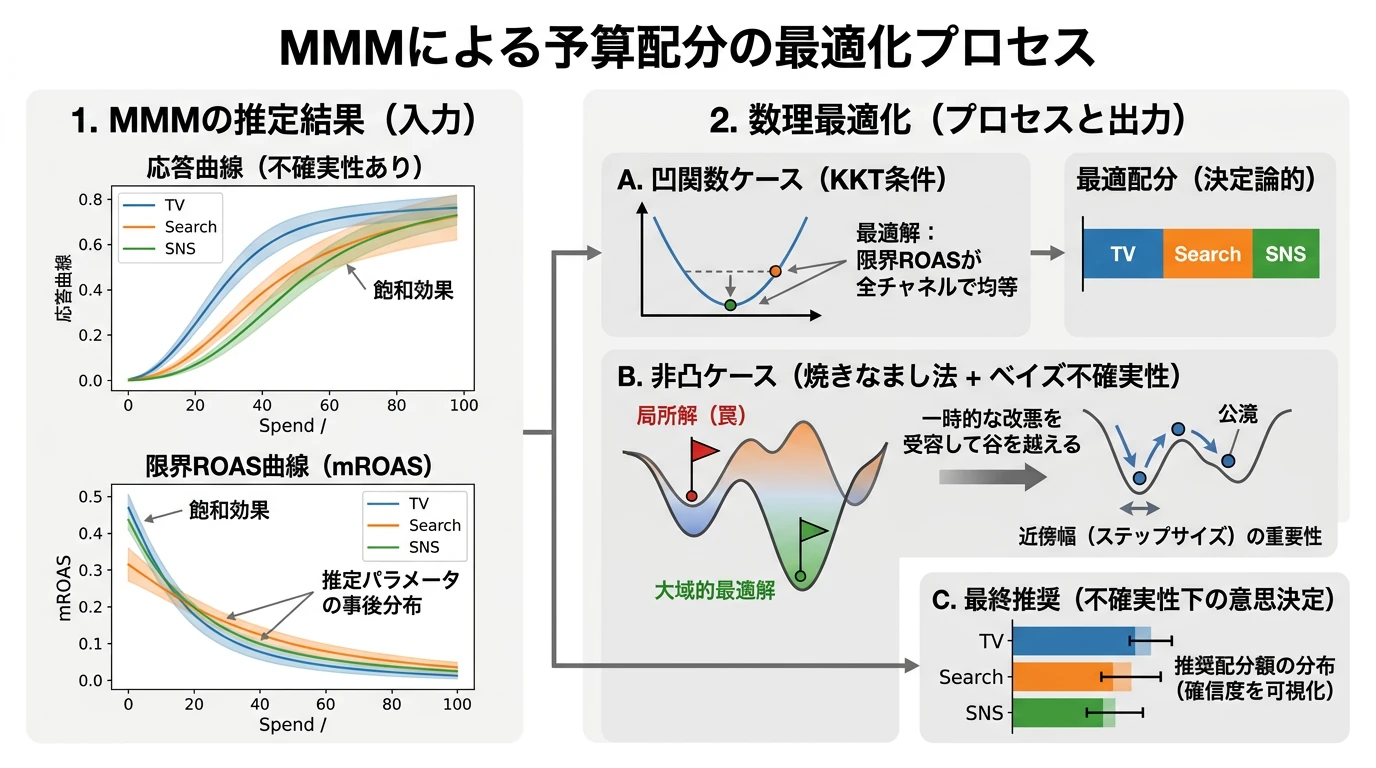 (画像は、Geminiで作成)
推定したマーケティングミックスモデル(MMM)から応答曲線を描き、平均ROASの罠を避けて限界ROAS(mROAS)に基づいた予算配分ができるようになること。また、凹関数の場合のKKT条件(限界ROAS均等の原理)から、S字カーブなどの非凸な制約下における局所解の罠と焼きなまし法による解決、さらに事後分布を用いた不確実性下の配分までを理解すること。
概要
これまでの記事では、MMMの基礎数理とスクラッチ実装、そして主要なOSSライブラリの比較を通じて、過去の広告投資と売上データから各チャネルの因果効果(持ち越し効果や飽和効果)を「正しく測定・モデル化する」方法を学んできました。
しかし、モデルを推定することはマーケティングのゴールではありません。経営層やマーケターが最終的に下したい意思決定は、「手元にある限られた予算を、明日からどのチャネルにいくら配分すれば全体の売上を最大化できるのか?」という未来へのリソース配分です。
ここで多くの実務家が陥りがちなのが、「過去の実績で平均ROAS(投資対効果)が高いチャネルに予算を重点配分する」という直感的な判断です。一見もっともらしく思えるこのルールは、広告が持つ「飽和効果(収穫逓減)」を無視しているため、実際には売上最大化の機会を大きく損なう原因となります。
正しく予算を配分するためには、平均ROASではなく、追加の1円がどれだけの売上を生み出すかを表す「限界ROAS(Marginal ROAS, mROAS)」に着目しなければなりません。
本記事では、MMM関連の記事の締めくくりとして、推定されたモデルから「応答曲線」を描き出し、数理最適化を用いて予算を最適配分する理論と実践を解説します。凹関数の場合に成り立つ「限界ROAS均等の原理(KKT条件)」から、TVCMのS字カーブがもたらす「局所解の罠」を局所探索(山登り法)と焼きなまし法で解きほぐすプロセス、そしてベイズMMM特有の「事後分布による不確実性を考慮した配分」までをコードとともに詳しく見ていきます。
応答曲線の描き方と不確実性
予算配分を最適化する第一歩は、各広告チャネルに投じた金額と、それによって得られる売上増分の関係を表す「応答曲線(Response Curve)」を導出することです。
定常状態における実効アドストック量
MMMの記事で学んだように、広告効果は「アドストック(持ち越し効果)」と「Hill関数(飽和効果)」の合成として表されます(Hill関数のパラメータと曲線の形、限界効果の詳細はアドストックと飽和曲線の記事を参照してください)。週あたりの広告費 を継続的に投下し続けた定常状態において、消費者の記憶の中に蓄積される実効的なアドストック量 は、最大ラグを 、減衰率を とすると、次のような幾何級数の和として表されます(MMMの記事と同じく 、つまり当週を含めて13週分を足し合わせます。コードの L = 13 はこの週数を表します)。
ここで は「定常アドストック係数」です。持ち越し効果が大きいチャネル( が1に近いチャネル)ほど は大きな値になり、投下した広告費以上の記憶ストックが蓄積されることを示します。
この定常アドストック量 をHill関数に通し、効果の上限係数 を掛けることで、週あたりの広告出稿額 に対する定常的な売上増分 が定義されます。本記事の応答曲線の横軸「週あたりの広告費」は、毎週同じ額を出し続けた定常状態を仮定している点に注意してください(Hill関数の入力が週の広告費ではなくアドストックの累積であることは、MMMの記事の「アドストックの累積に対して飽和がかかる」で説明しています)。
- : 半飽和点(効果が最大値の半分になる広告規模)
- : 形状パラメータ( ならC字カーブ、 ならS字カーブ)
- : チャネル がもたらす売上貢献の上限
事後分布による不確実性
ベイズMMMでは、パラメータ は1つの確定値ではなく、事後分布として得られます。そのため、応答曲線も単一の線ではなく、「幅を持った帯(信用区間)」として表現されます。実務において予算配分を行う際は、この不確実性の幅(リスク)を念頭に置くことが極めて重要になります。
平均ROASと限界ROAS(mROAS)の決定的な違い
予算最適化における最も本質的な概念が、「平均ROAS」と「限界ROAS(mROAS)」の区別です。
2つの指標の定義
チャネル に広告費 を投下しているとき、2つのROASは次のように定義されます。
-
平均ROAS(Average ROAS):
幾何学的には、原点 と曲線上の点 を結ぶ直線の傾き(割線) です。「これまでに投じた費用全体に対して、平均して何倍の売上が返ってきたか」という過去の実績効率を表します。
-
限界ROAS(Marginal ROAS, mROAS):
幾何学的には、応答曲線上の点 における接線の傾き(微分値) です。「広告費をさらに追加で1円増やしたとき、売上が何円増えるか」という未来の限界的な投資効率を表します。
Hill関数に対する限界ROASの導関数は、連鎖律を用いて解析的に次のように計算できます。
詳細な式展開(限界ROASの導出)
見通しをよくするため、チャネルの添字 を省略し、アドストック量を と置きます。応答関数は 、Hill関数は次の形です。
1. 連鎖律で分解する
は「」と2段階で計算されるので、連鎖律により次のように分解できます。 より です。
2. Hill関数を商の微分公式で微分する
分子を 、分母を とすると、 です( は定数なので微分すると0)。商の微分公式 に代入します。
3. 分子を整理する
分子を展開すると、 の項が打ち消し合い、 を含む項だけが残ります。
したがって、
4. 元の変数に戻す
- の式に代入し、 に戻して添字 を付けると、本文の式が得られます。
補足:原点()での値
では分母は に近づくので、限界ROASの振る舞いは分子の で決まります。
- (S字カーブ): なので、限界ROASは 0 に近づきます。少額では追加投資がほとんど効かない、というS字カーブの性質そのものです。
- (C字カーブ): なので、限界ROASは に近づきます。
下のコードの marginal_roas では、 でこの値を直接返すように場合分けしています。後で見る「TVの配分がゼロのまま動けなくなる」現象は、 のときに原点の限界ROASが0になることが原因です。
なぜ「平均ROASが高いチャネルに寄せる」のが誤りなのか?
ここにマーケティングの現場で頻発する大きな罠があります。
多くの現場では、ダッシュボードに表示される「平均ROAS」を比較し、「検索広告は平均ROASが0.37と優秀で、TVは0.11と非効率だから、TVの予算を削って検索広告に寄せよう」といった意思決定が行われます。
しかし、検索広告の平均ROASが高いのは「少額の段階で効率よく刈り取ってきたから」に過ぎず、すでに多額を投じていれば、飽和曲線の平坦な領域(限界ROASがゼロに近い領域)に達している可能性があります。すでに頭打ちのチャネルにさらに予算を追加しても、売上はほとんど増えません。
一方、TVのようにS字カーブを描くチャネルは、初期段階では平均ROASが低く見えても、まさに今が立ち上がり(変曲点)の直前であれば、追加の1円が生み出す限界ROASはどのチャネルよりも高い という状況が起こり得ます。
意思決定において配分すべきなのは「過去の予算」ではなく「未来の追加予算」です。したがって、見るべき指標は過去の平均効率(平均ROAS)ではなく、追加投資に対する増分効率(限界ROAS) でなければなりません。
コードによる応答曲線とROASの確認
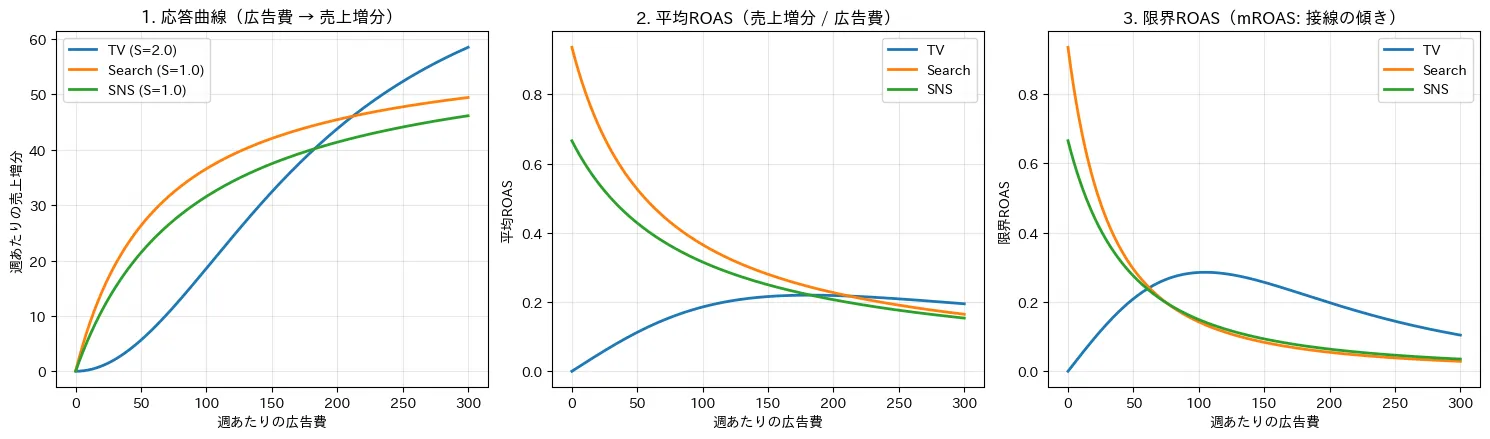
MMMの記事で定義した「MMMワールド」の真のパラメータを用いて、各チャネルの応答曲線、平均ROAS、限界ROASを算出して可視化してみましょう。
本記事のコードはGoogle Colabで実行することを想定しています。記事の後半(ベイズMMMの事後分布を考慮した最適配分)で使うPyMCも含めて、最初のセルで次のコマンドを実行し、必要なライブラリをインストールしておきます。
# Google Colab で最初に1回だけ実行する
!pip install -q pymc==6.2.0 arviz==1.3.0
!pip install -q japanize-matplotlib setuptools
必要なライブラリをインストールしています。
- PyMC と ArviZ: 記事の後半でベイズMMMを推定するために使います。本記事で動作確認したバージョン(PyMC 6.2.0・ArviZ 1.3.0)に固定しています。PyMCの計算エンジンである pytensor も、PyMCと一緒に自動でインストールされます。NumPy・pandas・matplotlib・SciPy はColabにあらかじめ入っているため、インストールは不要です。
- japanize-matplotlib と setuptools: グラフの日本語表示に使う japanize-matplotlib は、Python 3.12以降で削除された distutils に依存しています。setuptools を一緒にインストールすると distutils の代替が提供され、インポート時のエラー(ModuleNotFoundError: No module named 'distutils')を回避できます。
PyMCのインストールで、Colabにプリインストールされている numpy などのバージョンが入れ替わることがあります。インストール後に「ランタイム → セッションを再起動する」を実行してから、以降のセルを実行してください。記事の前半で定義した変数(true_params など)は後半のコードでも使うため、途中で再起動しなくて済むよう、インストールは最初にまとめて行います。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. MMMワールドの真のパラメータ(初出: mmm.mdx)
channels = ['TV', 'Search', 'SNS']
true_params = {
    'TV':     {'theta': 0.7, 'K': 600, 'S': 2.0, 'beta': 80},
    'Search': {'theta': 0.2, 'K': 80,  'S': 1.0, 'beta': 60},
    'SNS':    {'theta': 0.4, 'K': 150, 'S': 1.0, 'beta': 60},
}
L = 13

# 2. 定常アドストック係数 A_m の計算
A = {c: float(np.sum([true_params[c]['theta']**l for l in range(L)])) for c in channels}

# 3. 応答関数 f(x) と 限界ROAS mROAS(x) の定義
def response_func(x, p, a):
    u = a * x
    return p['beta'] * (u**p['S']) / (u**p['S'] + p['K']**p['S'])

def marginal_roas(x, p, a):
    u = a * x
    S, K = p['S'], p['K']
    denom = (u**S + K**S)**2
    if u <= 1e-9:
        dh_du = 0.0 if S > 1 else (1.0 / K if S == 1 else np.inf)
    else:
        dh_du = S * (K**S) * (u**(S - 1)) / denom
    return p['beta'] * a * dh_du

# 4. 現状の配分例(総予算 B = 300)における評価
current_spend = {'TV': 50.0, 'Search': 100.0, 'SNS': 150.0}
B = sum(current_spend.values())

for c in channels:
    p = true_params[c]
    a = A[c]
    x = current_spend[c]
    resp = response_func(x, p, a)
    avg_r = resp / x
    m_r = marginal_roas(x, p, a)
    print(f"{c:6s}: 広告費 {x:5.1f} | 売上増分 {resp:5.2f} | 平均ROAS {avg_r:5.3f} | 限界ROAS {m_r:5.3f}")

print(f"現状の総売上貢献: {sum(response_func(current_spend[c], true_params[c], A[c]) for c in channels):.2f}")

# 5. 各曲線の可視化
x_grid = np.linspace(0.1, 300, 300)
fig, axes = plt.subplots(1, 3, figsize=(15, 4.5))

for c, col in zip(channels, ['C0', 'C1', 'C2']):
    p, a = true_params[c], A[c]
    y_resp = [response_func(xi, p, a) for xi in x_grid]
    y_avg_roas = [response_func(xi, p, a) / xi for xi in x_grid]
    y_m_roas = [marginal_roas(xi, p, a) for xi in x_grid]

    axes[0].plot(x_grid, y_resp, label=f"{c} (S={p['S']})", color=col, linewidth=2)
    axes[1].plot(x_grid, y_avg_roas, label=c, color=col, linewidth=2)
    axes[2].plot(x_grid, y_m_roas, label=c, color=col, linewidth=2)

axes[0].set_title('1. 応答曲線(広告費 → 売上増分)')
axes[0].set_xlabel('週あたりの広告費')
axes[0].set_ylabel('週あたりの売上増分')
axes[0].legend()
axes[0].grid(True, alpha=0.3)

axes[1].set_title('2. 平均ROAS(売上増分 / 広告費)')
axes[1].set_xlabel('週あたりの広告費')
axes[1].set_ylabel('平均ROAS')
axes[1].legend()
axes[1].grid(True, alpha=0.3)

axes[2].set_title('3. 限界ROAS(mROAS: 接線の傾き)')
axes[2].set_xlabel('週あたりの広告費')
axes[2].set_ylabel('限界ROAS')
axes[2].legend()
axes[2].grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
各チャネルの応答曲線と2種類のROASを計算し、グラフを描画しています。
- 真のパラメータと定常係数: true_params にはMMMワールドの確定値を設定しています。A では、幾何減衰率 theta の過去13週分の総和を計算しています。TVは持ち越しが強いため定常係数は約3.30倍に達し、検索(約1.25倍)やSNS(約1.67倍)よりも蓄積効果が大きくなります。真のパラメータは、MMMの記事のMMMワールドと同じ値です。
- 応答関数と限界ROAS: response_func は出稿額 x に定常係数 a を掛けたHill関数の値を返します。marginal_roas は解析導関数を実装しており、原点付近()で のときは傾きが0、 のときはHill関数の傾きが (限界ROASとしては )に収束する境界条件を処理しています( では原点で傾きが無限大に発散するため np.inf を返します)。
- 現状配分の評価: 総予算300をTVに50、検索に100、SNSに150配分している現状シナリオについて、売上貢献・平均ROAS・限界ROASを出力しています。TVに少額しか配分しておらず、S字カーブの効き始める量に届いていない、という改善の余地がある配分の例です。
- 可視化: 広告費0.1から300までのグリッドを作成し、応答曲線、平均ROAS曲線、限界ROAS曲線を3枚並べてプロットしています。グリッドを0.1から始めるのは、平均ROAS()で、0での割り算を避けるためです。
実行結果
TV    : 広告費  50.0 | 売上増分  5.63 | 平均ROAS 0.113 | 限界ROAS 0.209
Search: 広告費 100.0 | 売上増分 36.59 | 平均ROAS 0.366 | 限界ROAS 0.143
SNS   : 広告費 150.0 | 売上増分 37.50 | 平均ROAS 0.250 | 限界ROAS 0.094
現状の総売上貢献: 79.71
実行結果の数値から、「平均ROASの罠」が浮き彫りになります。
- 平均ROASの順位: 検索広告(0.366) > SNS(0.250) > TV(0.113)
- 限界ROASの順位: TV(0.209) > 検索広告(0.143) > SNS(0.094)
なんと、平均効率で最下位だったTVが、追加投資の効率(限界ROAS)では首位に立っています。TVは出稿50の地点ではまだS字カーブの立ち上がりに差しかかったばかりであり、ここから予算を増やすと急速に売上が伸びるフェーズにあります。
一方、SNSはすでに150も投下されているため飽和が進み、限界ROASは0.094まで落ち込んでいます。もし平均ROASの数字だけを見て「TVを削ってSNSに回す」という判断を下せば、限界ROASの高いTVから低いSNSへと資金を移すことになり、会社全体の売上は確実に減少してしまいます。
2つの ROAS を並べると、違いがはっきりします。
(図は、diagram-designで作成)
凹関数の場合:限界ROAS均等の原理とKKT条件
では、数学的に最適な予算配分はどのように求められるのでしょうか。まずはすべてのチャネルが収穫逓減()である「凹関数(Concave function)」のケースから考えます。
凸最適化問題としての定式化
全チャネルの応答関数 が凹関数であるとき、総予算 のもとで売上を最大化する問題は、次のような凸最適化問題として定式化されます(最大化問題をマイナス符号を付けて最小化問題に変換します)。
この問題は、目的関数が凸関数(凹関数のマイナス)であり、制約条件がすべてアフィン関数(線形)であるため、大域的最適解が保証される凸最適化問題です(Boyd & Vandenberghe, 2004)。
ラグランジュ乗数とKKT条件
この最適化問題のラグランジュ関数 を定義します。
ここで は予算制約に対するラグランジュ乗数、 は非負制約に対するラグランジュ乗数です。
Karush-Kuhn-Tucker(KKT)条件より、最適解 において次の条件が成り立ちます。
- 定常性(Stationarity):
- 主可能(Primal feasibility): かつ
- 双対可能(Dual feasibility): かつ
- 相補スラック性(Complementary slackness):
補足:なぜラグランジュ関数を使うと制約付きの最適化が解けるのか
ひとことで言うと、ラグランジュ関数は「全体の予算 を絶対に守れ」という厳しい制約を、「1円使うごとに本部へ 円の手数料(社内レート)を払え」という柔軟なルールに置き換えています。
これを「各広告チャネルの現場」と「予算を管理する本部」にたとえて、3つのステップで見てみましょう。各説明の冒頭に、本文のKKT条件の1.〜4.のどれに対応するかを示します。
ステップ1. 本部:「手数料ルール」を導入する
対応:ラグランジュ関数 の第2項
「合計を予算 に収めろ」と命令する代わりに、ラグランジュ関数は という項を追加します。これは「予算を超えたら超過分 円の手数料を払い、余らせたら払い戻しを受ける」というルールを意味します。
ステップ2. 現場:自分の損得がちょうど釣り合うところで止める
対応:KKT 1. 定常性 (出稿しているチャネルでは なので )
手数料 が決まれば、各チャネルの現場は自分で出稿額を決められます。追加で1円使ったときに増える売上(限界ROAS)が手数料 を上回っているうちは出稿を増やし、「限界ROAS = 」まで下がった(これ以上出すと手数料負けする)ところで止めます。
ステップ3. 本部:合計がちょうど予算 になるように を調整する
対応:KKT 2. 主可能 かつ (調整後の配分が予算内に収まる)
あとは本部が手数料 を調整するだけです。
- 手数料を高くする → 現場は早めに出稿を止めるので、合計は減る。
- 手数料を安くする → 現場は多く出稿するので、合計は増える。
本部は、全チャネルの合計がちょうど予算 になる「絶妙な手数料 」を探し当てます。後の検証と同じ検索広告とSNSの2チャネル(予算250)で試すと、次のようになります。
| 手数料 | 検索広告 | SNS | 合計 | 予算250に対して |
|---|---|---|---|---|
| 0.15(高め) | 96.0 | 99.7 | 195.7 | 余る |
| 0.08(安め) | 155.1 | 169.8 | 324.9 | 超える |
| 0.1124 | 120.8 | 129.2 | 250.0 | ちょうど使い切る |
のときの配分は、後でSLSQPが求める最適配分(120.82、129.18)と一致します。
結果としてどうなるか(なぜこれが最適か)
この「絶妙な手数料 」のもとで各現場が止まった状態では、出稿しているすべてのチャネルの限界ROASが で揃っています。つまり、「どのチャネルから1円を削って別のチャネルに移しても、全体の売上はこれ以上増えない」状態(最適解)が自動的に出来上がるのです。
ただし、これが本当に一番良い配分だと言い切れるのは、応答曲線が凹関数(出稿を増やすほど限界ROASが下がり続ける)のときです。このときは現場の「止めどころ」が1か所に決まり、「1円の付け替えで改善しない」状態がそのまま全体の最適になります。
(予算制約の乗数)の意味
対応:KKT 3. 双対可能
は本部が設定する手数料です。うまく調整された は「予算を1円増やしたら売上が何円増えるか」(影の価格)も表します。後の検証の は、追加の1円が約0.11円の売上しか生まないことを意味します。
「1円かけて0.11円しか戻らないのに、それが最適なのか」と感じるかもしれません。ここでの最適化は、総予算 が決まっている前提で「どう分けるか」 を解いているだけで、「そもそも広告を打つべきか」「予算はいくらが適正か」は問題に含まれていません。 はむしろ、総予算の大きさを見直す材料になります。粗利率を とすると、追加の1円が利益で元を取るには「限界ROAS 」が必要です。そのため、 なら総予算を減らすべき、 なら増やすべき、というシグナルになります(粗利率30%なら基準は約3.3)。なお、本記事の仮想データの金額スケールは配分の仕組みを示すために設定したもので、どのチャネルも限界ROASが1を超えない設定になっています。現実の広告の採算性を表すものではない点に注意してください。
手数料がマイナスになる(出稿するほど本部からお金がもらえる)ことはないので、 です。マイナスの手数料では「予算を超えるほど得をする」ことになり、予算を守らせるという目的と逆になってしまいます。
(非負制約の乗数)と相補スラック性の意味
対応:KKT 4. 相補スラック性 と、KKT 3. 双対可能
KKT条件の「相補スラック性(Complementary slackness)」は、「余裕(スラック)」と「圧力(乗数)」が相補的、つまり少なくともどちらか一方は必ず0になるという条件です。言い換えると「余裕があれば圧力はゼロ、圧力がかかるのは余裕がないときだけ」というルールです。これを各チャネルの「0円の壁」に当てはめてみます。
ある不調なチャネルの最初の1円の限界ROASが 0.05 だったとします。一方、本部が設定した手数料 は 0.15 です。現場担当者は「最初の1円から0.10円の赤字になるので、出稿をマイナスにして本部に予算を売り払いたい」と考えますが、出稿額は0円未満にはできません。このとき、担当者が「0円の壁」に押し付けられている力の大きさ()が の正体です。
逆に、少しでも予算をもらえているチャネル(出稿額 )は、0円の壁から離れていて「余裕」がある状態です。壁に触れていないので、壁を押す力 はゼロになります。これが の意味です。また、壁を押す力は「押す」向きにしか働かないので、 です。
定常性の式 が表す2つの場合
対応:KKT 1. 定常性 (ステップ2を、0円で止まるチャネルまで含めて書いたもの)
この1つの式は、「予算をもらえたチャネル」と「0円で諦めたチャネル」の2つの行動原理をまとめて表しています。
- 予算をもらえた場合(): 壁から離れているので です。式は となり、「自分の限界ROASが手数料と同じになるところまで予算を使った」という、ステップ2の行動そのものを表します。
- 0円で諦めた場合(): 式を変形すると です。「手数料 が高く、自分の一番効率の良い最初の1円 でも太刀打ちできず、その差額 の分だけ壁に押し付けられたまま0円で止まった」という状態を表します。
予算制約の相補スラック性と、 になる理由
対応:KKT 4. 相補スラック性
「余裕があれば圧力はゼロ」というルールを、今度は会社全体の総予算 に当てはめます。
もし予算を使い切らずに余らせた(余裕がある)なら、ルールに従えば手数料 は0でなければなりません。しかし手数料が無料なら、すべてのチャネルが「タダならいくらでも出したい」と予算を際限なく要求してきます。広告は出稿すれば、わずかでも必ず売上が増える()からです。
そのため「予算を余らせて手数料が0」という状態は最適解では起こらず、各チャネルが予算の天井まで使い切ります。天井に張り付いて余裕がなくなるので、天井を押す圧力である手数料は必ずプラス()になります。最適解では予算を1円残らず使い切ることが分かっているので、後のコードでは予算制約を「」ではなく、最初から「」の等式制約('type': 'eq')として与えています。
KKT条件との対応のまとめ
| KKT条件 | 式 | 本部と現場のたとえ |
|---|---|---|
| 1. 定常性 | 各現場は、限界ROASが手数料まで下がったところで出稿を止める(0円の壁で止まる場合は差額が ) | |
| 2. 主可能 | 、 | 最終的な配分は予算内に収まり、どのチャネルも0円以上 |
| 3. 双対可能 | 、 | 手数料も、壁を押す力もマイナスにはならない |
| 4. 相補スラック性 | 、 | 余裕があれば圧力はゼロ(予算が余れば手数料は0、出稿していれば ) |
注意点
- S字カーブでは最適とは限らない: S字カーブ()では、限界ROASが0から始まって一度上がり、その後下がります。たとえばTVは最初の1円の限界ROASが なので、手数料に見合わず「0円で止める」のがKKT条件の上では正しく見えてしまいます。実際にはまとまった額を投じた方が売上は大きくなります。これが次の節で扱う局所解の罠です。
- 手数料 が全チャネル共通なのは、財布が1つだから: 全チャネルが同じ予算 から支出しているので、手数料も1つです(数学的には、乗数はチャネルごとではなく制約ごとに付きます)。チャネルごとの上下限(「TVは最低50」など)に張り付いたチャネルや、部署ごとに予算枠が分かれている場合は、限界ROASは1つの値に揃いません。枠ごとの手数料が違う()なら、手数料の低い枠から高い枠へ予算を移すべきだというシグナルになります。
限界ROAS均等の原理
もしすべてのチャネルに正の予算が配分される内点解()であり、予算を使い切る()場合、相補スラック性より となります。
したがって、定常性の式から直ちに次の美しい等式が得られます。
これが経済学や最適化理論で知られる「限界効用均等の法則(限界ROAS均等の原理)」です。
直感的にも非常に明快です。もしチャネルAの限界ROASが0.15で、チャネルBが0.10だったとします。このときチャネルBから1円を削ってチャネルAに移せば、差し引きで 円の売上が純増します。このような振替改善ができなくなる終着点こそが、「どのチャネルに追加の1円を投じても全く同じ売上増分()しか得られない状態」なのです。
Pythonによる検証(SLSQP)
凹関数である検索広告とSNSの2チャネル(どちらも )に対し、予算250を配分する問題を scipy.optimize.minimize のSLSQP法(Sequential Least Squares Programming)で解き、KKT条件が成立するか確認してみましょう。
from scipy.optimize import minimize

# 1. 検索広告とSNSの2チャネル(凹関数ケース)の予算配分
B_sub = 250.0

def objective_sub(x):
    # 目的関数: 2チャネルの売上合計のマイナス
    return -(response_func(x[0], true_params['Search'], A['Search']) +
             response_func(x[1], true_params['SNS'], A['SNS']))

# 2. SLSQPによる最適化(等式制約: 合計予算 = B_sub、範囲制約: 各変数 >= 0)
res_sub = minimize(
    objective_sub,
    x0=[B_sub / 2, B_sub / 2],
    method='SLSQP',
    bounds=[(0, B_sub), (0, B_sub)],
    constraints={'type': 'eq', 'fun': lambda x: sum(x) - B_sub}
)

# 3. 最適解における各チャネルの限界ROASの算出
m_search = marginal_roas(res_sub.x[0], true_params['Search'], A['Search'])
m_sns = marginal_roas(res_sub.x[1], true_params['SNS'], A['SNS'])

print(f"最適配分 -> Search: {res_sub.x[0]:.2f}, SNS: {res_sub.x[1]:.2f} (合計: {sum(res_sub.x):.2f})")
print(f"最適解における限界ROAS -> Search: {m_search:.4f}, SNS: {m_sns:.4f}")
print(f"限界ROASの差: {abs(m_search - m_sns):.6f}")
SLSQPを用いて凹関数の最適配分問題を解き、KKT条件の一致を確認しています。
- 目的関数: objective_sub は検索広告とSNSの売上増分の和にマイナスを付けて返します。初期値を半分ずつにするのは、どちらのチャネルにも偏らない点から探索を始めるためです。
- 制約条件: constraints に等式制約(合計予算が250)を指定し、bounds で各チャネルの配分が0以上250以下になる非負制約を与えています。予算を250にするのは、現状の配分からTVの50を除いた、検索とSNSの合計(100 + 150)だからです。
- SLSQP法: 逐次二次計画法(SLSQP)は、滑らかな等式・不等式制約付き凸最適化問題を解く標準的な勾配ベースのアルゴリズムです。
- KKT条件の検証: 最適解における両チャネルの限界ROASを marginal_roas で計算し、その差を表示しています。
目的関数に使っている response_func は平均ROAS()ではなく、売上増分 そのものです。最適化しているのは「総売上」であり、限界ROASは目的関数には直接現れません。SLSQPは勾配を使う手法で、勾配(jac)を渡していない場合は数値微分で求めます。総売上を で微分したもの はまさに限界ROASなので、SLSQPは内部で限界ROASを計算しながら予算を動かしていることになります。そして総売上が最大になった点で限界ROASが揃うこと(KKT条件の定常性)を、最後に marginal_roas で検証しています。
実行結果
最適配分 -> Search: 120.82, SNS: 129.18 (合計: 250.00)
最適解における限界ROAS -> Search: 0.1124, SNS: 0.1124
限界ROASの差: 0.000009
結果は理論の通りです。最適解において、検索広告(120.82)とSNS(129.18)の限界ROASは 0.1124 で完全に一致 しました(差は数値誤差レベルの 0.000009)。これが、凸問題におけるKKT条件の美しさです。
最適解の配分と限界 ROAS を図にすると、次のようになります。
(図は、diagram-designで作成)
非凸の場合の壁:S字カーブ・最低出稿額と局所解の罠
しかし、現実のマーケティング実務は教科書のような凸最適化問題ばかりではありません。次の現実的要因によって、問題は「非凸(Non-convex)」へと変貌します。
- TVCMのS字カーブ(): 少額では効果が出ず、ある閾値を超えてから急速に効き始めるため、初期領域では「収穫逓増(凸)」、後半で「収穫逓減(凹)」となります。
- 最低出稿額の制約: 「TVCMを打つなら最低100万円以上、打たないなら0円」という半連続変数(Semi-continuous)の制約。
- 離散的な発注単位: 広告枠の購入単位が決まっている場合。
山登り法と勾配法の失敗(局所的最適解の罠)
TVCM()を含む3チャネル全体(総予算300)に対して、初期値 (現状TVを出稿していない状態)からSLSQPや局所探索(山登り法)を実行してみましょう。
# 1. 3チャネル全体の目的関数
def total_objective(x):
    return -sum(response_func(x[i], true_params[channels[i]], A[channels[i]]) for i in range(3))

# 2. SLSQP(勾配法)を2つの異なる初期値から実行
# 初期値1: TV出稿なし [0, 150, 150]
res_slsqp_0 = minimize(
    total_objective, x0=[0.0, 150.0, 150.0], method='SLSQP',
    bounds=[(0, B), (0, B), (0, B)], constraints={'type': 'eq', 'fun': lambda x: sum(x) - B}
)
# 初期値2: 均等配分 [100, 100, 100]
res_slsqp_1 = minimize(
    total_objective, x0=[100.0, 100.0, 100.0], method='SLSQP',
    bounds=[(0, B), (0, B), (0, B)], constraints={'type': 'eq', 'fun': lambda x: sum(x) - B}
)

# 3. 局所探索(山登り法)の実装
def evaluate(x):
    return sum(response_func(x[i], true_params[channels[i]], A[channels[i]]) for i in range(3))

def hill_climbing(start_x, step_size=5.0, max_iter=200):
    cur_x = np.array(start_x, dtype=float)
    cur_score = evaluate(cur_x)
    for _ in range(max_iter):
        best_neighbor = None
        best_score = cur_score
        # 2チャネル間の振替(iからjへstep_size移す)
        for i in range(3):
            for j in range(3):
                if i == j: continue
                if cur_x[i] >= step_size:
                    nb = cur_x.copy()
                    nb[i] -= step_size
                    nb[j] += step_size
                    sc = evaluate(nb)
                    if sc > best_score:
                        best_score = sc
                        best_neighbor = nb
        if best_neighbor is None:
            break
        cur_x = best_neighbor
        cur_score = best_score
    return cur_x, cur_score

hc_x, hc_score = hill_climbing([0.0, 150.0, 150.0], step_size=5.0)

print(f"初期値 [0, 150, 150] のSLSQP : TV={res_slsqp_0.x[0]:.1f}, Search={res_slsqp_0.x[1]:.1f}, SNS={res_slsqp_0.x[2]:.1f} | 総売上: {-res_slsqp_0.fun:.2f}")
print(f"初期値 [0, 150, 150] の山登り法: TV={hc_x[0]:.1f}, Search={hc_x[1]:.1f}, SNS={hc_x[2]:.1f} | 総売上: {hc_score:.2f}")
print(f"初期値 [100, 100, 100] のSLSQP: TV={res_slsqp_1.x[0]:.1f}, Search={res_slsqp_1.x[1]:.1f}, SNS={res_slsqp_1.x[2]:.1f} | 総売上: {-res_slsqp_1.fun:.2f}")
初期値を変えてSLSQPと山登り法を実行し、局所解に捕まる挙動を確認しています。
- 3チャネル目的関数: TV()、検索()、SNS()の合計売上を計算しています。
- 山登り法の実装: 現在の配分から、あるチャネルの予算を step_size だけ別のチャネルに移す近傍操作を全通り調べ、スコアが改善する最良近傍へ移動します。改善が止まった時点で停止します。移動量を5と小さくするのは、近くしか見ない山登り法が局所的最適解で止まる例を示すためです(移動量の影響は、焼きなまし法の節で近傍幅を変えて確かめます)。最大200回は、改善が止まるまで探索を続けるための十分に大きな上限で、実際にはどちらの初期値でも十数回以内で止まります。
- 初期値依存性の比較: TVが0の初期値 と、TVにも配分がある からの結果を比較しています。TVが0の初期値を選ぶのは、S字カーブ()では0の付近の傾きが0なので、勾配を使う方法も山登り法も、TVに予算を移す方向を見つけられないことを確かめるためです。
実行結果
初期値 [0, 150, 150] のSLSQP : TV=0.0, Search=143.7, SNS=156.3 | 総売上: 79.59
初期値 [0, 150, 150] の山登り法: TV=0.0, Search=145.0, SNS=155.0 | 総売上: 79.59
初期値 [100, 100, 100] のSLSQP: TV=172.4, Search=64.8, SNS=62.8 | 総売上: 92.73
極めて衝撃的な結果が得られました。
初期値が (TV未出稿)の場合、SLSQPも山登り法も TVの配分を1円も増やせず、TV=0.0 のまま停止 してしまいました(総売上 79.59)。
なぜなら、TVのS字カーブは原点付近の傾き(限界ROAS)がほぼゼロだからです。少しだけTVに予算を移しても売上はほとんど増えず、むしろ検索やSNSを削った分の売上減の方が大きいため、アルゴリズムは「TVに投資するのは改悪だ」と判断して動けなくなってしまったのです。
一方、最初からTVに100配分していた初期値 では、SLSQPは大域的最適解(TV=172.4, 総売上 92.73)を発見できました。その差は売上貢献で +13.14(約16.5%の売上増) にもなります。
これが、局所探索(山登り法)の記事 で学んだ「局所的最適解(Local Optimum)の罠」の実問題での姿です。
3つの探索の結果を並べると、次のようになります。
から始めた SLSQP も山登り法も TV を0のまま停止し、総売上は 79.59。初期値 [100, 100, 100] の SLSQP は TV 172.4、検索 64.8、SNS 62.8 で総売上 92.73。TV の S字カーブは原点付近の傾き(限界 ROAS)がほぼ0なので、少しだけ TV に移しても売上が増えず、局所解にはまる](/img/budget_allocation/budget_allocation_5.svg)
から始めた SLSQP も山登り法も TV を0のまま停止し、総売上は 79.59。初期値 [100, 100, 100] の SLSQP は TV 172.4、検索 64.8、SNS 62.8 で総売上 92.73。TV の S字カーブは原点付近の傾き(限界 ROAS)がほぼ0なので、少しだけ TV に移しても売上が増えず、局所解にはまる](/img/budget_allocation/budget_allocation_5-dark.svg)
(図は、diagram-designで作成)
メタヒューリスティクスによる解決:焼きなまし法と近傍設計
この「S字の谷」を乗り越え、初期値に依存せず大域的最適解を見つけ出すために、焼きなまし法の記事 で扱ったメタヒューリスティクスを導入します。
総予算一定の制約を満たす近傍設計
予算配分問題では、「総予算 が一定()」という強い等式制約が存在します。各チャネルを独立にランダム変更すると予算制約が崩れてしまうため、1回の移動(近傍)を次のように設計します。
- チャネル間振替(Budget Transfer): ランダムに2つのチャネル ()を選び、チャネル から へ金額 を移す。
これにより、どのステップでも常に総予算制約 と非負制約 が自動的に満たされます。
振替の近傍を例で示すと、次のようになります。
(図は、diagram-designで作成)
近傍の幅(ステップサイズ)の重要性
焼きなまし法の記事 で確認した極めて重要な教訓が、「近傍の幅(1回の移動の大きさ)が狭すぎると、谷を越えられない」という点でした。
TVのS字カーブを脱出するためには、総予算の2%弱にあたる小さな振替( など)を繰り返しても改悪確率に阻まれます。一度に数十〜百規模( など、総予算の10%〜30%程度)の予算を動かせる近傍幅を確保して初めて、S字カーブの「平坦な領域」を一気に飛び越えて変曲点の先へと着地できるのです。
Pythonによる焼きなまし法の実装と安定性検証
初期値 から焼きなまし法を実行し、近傍幅()と乱数シード10通りによる安定性を検証してみましょう。
# 1. 焼きなまし法(Simulated Annealing)の実装
def simulated_annealing(start_x, step_size=30.0, initial_temp=10.0, final_temp=0.01, cooling_rate=0.98, seed=42):
    r = np.random.default_rng(seed)
    cur_x = np.array(start_x, dtype=float)
    cur_score = evaluate(cur_x)
    best_x = cur_x.copy()
    best_score = cur_score
    T = initial_temp
    history = [cur_score]   # 各ステップの「現在地のスコア」を記録する

    while T > final_temp:
        # ランダムに2チャネルを選び、予算を振替
        i, j = r.choice(3, size=2, replace=False)
        delta = r.uniform(1.0, step_size)
        delta = min(delta, cur_x[i])  # 予算が負にならないようクリッピング
        if delta <= 0:
            T *= cooling_rate
            history.append(cur_score)
            continue

        nb = cur_x.copy()
        nb[i] -= delta
        nb[j] += delta
        next_score = evaluate(nb)
        diff = next_score - cur_score

        # メトロポリス基準(改善なら必ず受容、改悪なら確率 exp(diff / T) で受容)
        if diff > 0 or r.random() < np.exp(diff / T):
            cur_x = nb
            cur_score = next_score
            if cur_score > best_score:
                best_x = cur_x.copy()
                best_score = cur_score

        T *= cooling_rate
        history.append(cur_score)

    return best_x, best_score, history

# 2. 焼きなまし法の実行(初期値: TV出稿ゼロ)
sa_x, sa_score, sa_history = simulated_annealing([0.0, 150.0, 150.0], step_size=30.0, seed=42)
print(f"焼きなまし法(seed=42, step=30): TV={sa_x[0]:.1f}, Search={sa_x[1]:.1f}, SNS={sa_x[2]:.1f} | 総売上: {sa_score:.2f}")

# 3. 近傍の幅と乱数シード10通りの比較
print("\n近傍の幅と乱数シード10通りの比較:")
for st in [5.0, 30.0, 80.0]:
    scores = []
    tv_spends = []
    for s in range(10):
        bx, bsc, _ = simulated_annealing([0.0, 150.0, 150.0], step_size=st, seed=s)
        scores.append(bsc)
        tv_spends.append(bx[0])
    print(f"  step={st:4.1f}: 平均スコア {np.mean(scores):5.2f} (最小 {np.min(scores):5.2f}, 最大 {np.max(scores):5.2f}) | TV配分の平均 {np.mean(tv_spends):5.1f}")

# 4. 探索の推移を可視化(近傍幅ごとに、現在地のスコアがどう動くか)
fig, ax = plt.subplots(figsize=(11, 5))
for st, color in zip([5.0, 30.0, 80.0], ['C0', 'C1', 'C2']):
    _, _, hist = simulated_annealing([0.0, 150.0, 150.0], step_size=st, seed=42)
    ax.plot(hist, color=color, linewidth=1.2, label=f'焼きなまし法 (step={st:.0f})')
ax.axhline(79.59, color='gray', linestyle='--', label='山登り法が止まる局所解 (79.59)')
ax.axhline(92.73, color='red', linestyle=':', label='大域的最適解 (92.73)')
ax.set_xlabel('ステップ')
ax.set_ylabel('総売上貢献(現在地のスコア)')
ax.set_title('焼きなまし法の探索推移(初期値 TV=0, Search=150, SNS=150)')
ax.legend(loc='lower right')
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
焼きなまし法を実装し、近傍幅とシード10通りの感度分析を行っています。
- 初期化: 初期値として山登り法が失敗した を与えています。
- 近傍操作: r.choice(3, size=2, replace=False) で振替元のチャネル i と振替先のチャネル j を選び、1から step_size までの移動量 delta を生成して予算を移動させています。
- メトロポリス基準: スコアが良くなれば無条件で移動し、悪化した場合でも温度 T に応じた確率 np.exp(diff / T) で移動を受け入れます。温度は毎ステップ cooling_rate = 0.98 で徐々に冷却されます。初期温度10は、局所解のまわりでの改悪( 程度)でも、受け入れる確率が になる高さで、序盤は、ほぼどこへでも動けるようにするためです。終了温度0.01では、 の改悪を受け入れる確率は事実上0になり、終盤は山登り法と同じ動きになります。冷却率0.98は、この間を約340ステップで下げる値です。
- 近傍幅とシード10通り: step_size を 5.0, 30.0, 80.0 と変え、それぞれ乱数シード0〜9の10回試行で平均スコアとTV配分の到達度を集計しています。5・30・80を比べるのは、山登り法と同じ小さな幅、中間の幅、大きな幅で、谷を越えられるかがどう変わるかを見るためです。
- 探索の推移の記録: history に各ステップの「現在地のスコア」を記録しています。最良解ではなく現在地を記録するのは、改悪を受け入れながら谷を越えていく様子を見るためです。
- 可視化: 近傍幅ごとの推移に、山登り法が止まる局所解(79.59)と大域的最適解(92.73)の水準を重ねて描いています。
実行結果
焼きなまし法(seed=42, step=30): TV=171.1, Search=65.6, SNS=63.3 | 総売上: 92.73

近傍の幅と乱数シード10通りの比較:
  step= 5.0: 平均スコア 84.84 (最小 79.59, 最大 92.73) | TV配分の平均  68.7
  step=30.0: 平均スコア 92.73 (最小 92.72, 最大 92.73) | TV配分の平均 172.2
  step=80.0: 平均スコア 92.73 (最小 92.70, 最大 92.73) | TV配分の平均 172.0
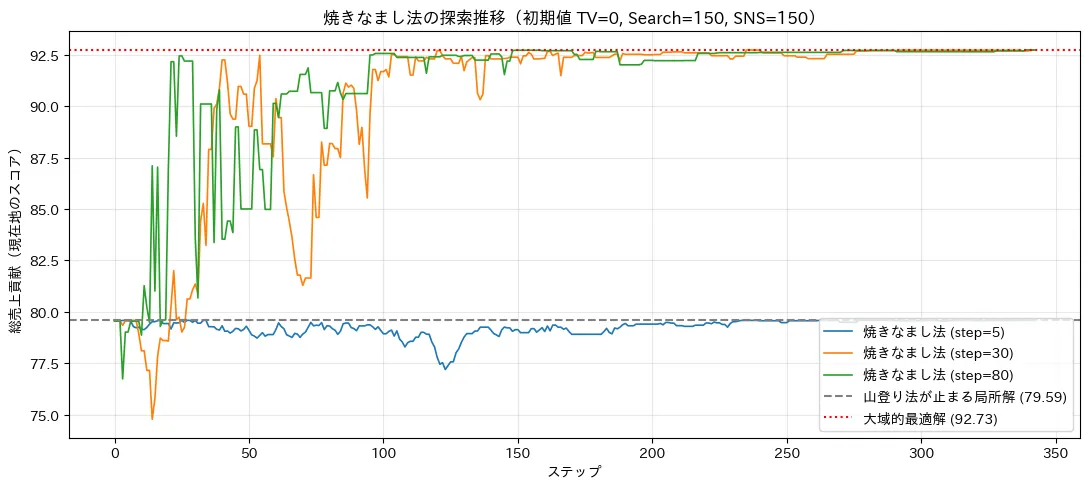
実行結果から、次の重要な知見が得られます。
- 局所解からの脱出: 焼きなまし法(step=30.0)は、TV未出稿の最悪の初期値からスタートしたにもかかわらず、一時的な改悪を受け入れながら探索を進め、TV=171.1の大域的最適解(総売上 92.73)に見事に到達 しました。
- 近傍幅の影響: step=5.0 では平均スコアが 84.84 に留まり、最小スコアは局所解と同じ 79.59 となりました(10回中6回が局所解から脱出できずに終了)。一方、step=30.0 や 80.0 では 10回すべてのシードで 92.70 以上の最高水準に到達 しており、極めて頑健です。
Meta の Robyn がハイパーパラメータ探索に進化的アルゴリズムを採用しているように、非線形・非凸な制約が絡むマーケティング最適化では、このようなメタヒューリスティクスが極めて強力な武器になります。
近傍の幅ごとの結果を並べると、次のようになります。
(図は、diagram-designで作成)
ベイズMMMの事後分布を考慮した最適配分
ここまでは「真のパラメータ」が確定している前提で計算してきました。しかし実務の現場では、手元にあるのはMMMの記事で推定した「事後分布(パラメータの不確実性)」です。
点推定値(事後平均)だけを使って予算配分を1つに決めてしまうと、「推定の確信度」が無視されてしまいます。例えば、効果の不確実性が大きいチャネルに過度な予算を投じてしまうリスクが生じます。
そこで、MCMCで得られた事後サンプルごとに最適配分問題を解き、推奨予算配分の分布を見る というベイズ的なアプローチをとります。
データの再掲とモデルの推定
MMMの記事で作成したMMMワールドのデータ生成コードと、実験1・2を組み込んだ推定コードを再掲してモデルを推定します。
本記事のコードは、PyMC 6.2.0 / ArviZ 1.3.0 / NumPy 2.3.4 / SciPy で動作を確認しています(インストール方法は「コードによる応答曲線とROASの確認」の冒頭を参照してください)。このコードブロックでは、MCMCサンプリング(4チェーン、各1000ドロー、CPU 1コア)に3分前後、その後の100個の事後サンプルに対する最適配分計算に数秒かかります。MCMCの設定はMMMの記事と揃えており、事後分布の推定が不安定にならないようにしています。
import pymc as pm
import pytensor.tensor as pt
import arviz as az

# 1. MMMワールドのデータ生成(初出: mmm.mdx)
rng = np.random.default_rng(42)
T = 156
week = np.arange(T)

trend = 200 + 0.3 * week
season = 20 * np.sin(2 * np.pi * week / 52)
demand_shock = np.zeros(T)
for t in range(1, T):
    demand_shock[t] = 0.8 * demand_shock[t - 1] + rng.normal(0, 6)
baseline = trend + season + demand_shock

tv_spend = rng.uniform(0, 30, size=T)
for start in range(5, T, 13):
    tv_spend[start:start + 3] += rng.uniform(250, 500)

sns_monthly = rng.uniform(10, 300, size=T // 4 + 1)
sns_spend = np.clip(np.repeat(sns_monthly, 4)[:T] + rng.normal(0, 10, size=T), 0, None)
search_spend = np.clip(60 + 1.5 * (season + demand_shock) + rng.normal(0, 12, size=T), 5, None)
spends = {'TV': tv_spend, 'Search': search_spend, 'SNS': sns_spend}

def geometric_adstock(x, theta, L=13):
    out = np.zeros(len(x))
    for t in range(len(x)):
        for l in range(min(t + 1, L)):
            out[t] += theta ** l * x[t - l]
    return out

def hill(x, K, S):
    return x ** S / (x ** S + K ** S)

true_contrib = {
    c: p['beta'] * hill(geometric_adstock(spends[c], p['theta']), p['K'], p['S'])
    for c, p in true_params.items()
}
noise = rng.normal(0, 5, size=T)
df = pd.DataFrame({
    'week': week, 'y': baseline + sum(true_contrib.values()) + noise,
    'TV': tv_spend, 'Search': search_spend, 'SNS': sns_spend
})

# 2. 前処理(スケーリング・ラグ行列・コントロール変数)
spend_scale = {c: df[c].max() for c in channels}
def make_lag_matrix(x, L):
    X = np.zeros((len(x), L))
    for l in range(L):
        X[l:, l] = x[:len(x) - l]
    return X
X_lag = {c: make_lag_matrix(df[c].values / spend_scale[c], L) for c in channels}

w = df['week'].values
controls = np.column_stack([
    (w - w.mean()) / w.std(),
    np.sin(2 * np.pi * w / 52),
    np.cos(2 * np.pi * w / 52),
])

# 3. 実験結果(キャリブレーション)の準備
rng_exp = np.random.default_rng(7)
experiments = [{'start': 88, 'end': 100}, {'start': 8, 'end': 20}]
lift_tests = []
for e in experiments:
    m_lift = true_contrib['Search'][e['start']:e['end']].mean() + rng_exp.normal(0, 2)
    lift_tests.append({'channel': 'Search', 'start': e['start'], 'end': e['end'], 'lift': m_lift, 'se': 2.0})

# 4. ベイズMMMモデルの構築とMCMCサンプリング
def build_mmm(X_lag, controls, y, lift_tests=None):
    with pm.Model() as model:
        intercept = pm.Normal('intercept', mu=y.mean(), sigma=50)
        gamma = pm.Normal('gamma', mu=0, sigma=20, shape=controls.shape[1])
        mu = intercept + pt.dot(controls, gamma)

        contribs = {}
        for c in channels:
            theta = pm.Beta(f'theta_{c}', alpha=2, beta=2)
            K = pm.Gamma(f'K_{c}', alpha=2, beta=2)
            S = pm.Gamma(f'S_{c}', alpha=3, beta=2)
            beta = pm.HalfNormal(f'beta_{c}', sigma=100)

            adstock = pt.dot(X_lag[c], theta ** np.arange(L))
            contribs[c] = pm.Deterministic(
                f'contrib_{c}', beta * adstock ** S / (adstock ** S + K ** S)
            )
            mu = mu + contribs[c]

        for i, test in enumerate(lift_tests or []):
            model_lift = pt.mean(contribs[test['channel']][test['start']:test['end']])
            pm.Normal(f'lift_test_{i}', mu=model_lift, sigma=test['se'], observed=test['lift'])

        sigma = pm.HalfNormal('sigma', sigma=20)
        pm.Normal('y_obs', mu=mu, sigma=sigma, observed=y)
    return model

with build_mmm(X_lag, controls, df['y'].values, lift_tests=lift_tests):
    trace = pm.sample(1000, tune=1500, chains=4, target_accept=0.95, random_seed=42)

# 収束診断(mcmc.mdx で扱った指標)
summary = az.summary(trace, var_names=[f'{p}_{c}' for p in ['theta', 'K', 'S', 'beta'] for c in channels])
print("r_hat の最大値:", float(summary['r_hat'].max()))
print("発散の数:", int(trace.sample_stats['diverging'].sum()))

# 5. 事後サンプル100個に対する最適配分の計算
post = trace.posterior
n_samples = 100
sample_indices = rng.choice(post.sizes['chain'] * post.sizes['draw'], size=n_samples, replace=False)

opt_allocations = []
B = 300.0

for idx in sample_indices:
    chain_idx = idx // post.sizes['draw']
    draw_idx = idx % post.sizes['draw']

    sample_params = {}
    sample_A = {}
    for c in channels:
        th = float(post[f'theta_{c}'].values[chain_idx, draw_idx])
        k_val = float(post[f'K_{c}'].values[chain_idx, draw_idx]) * spend_scale[c]
        s_val = float(post[f'S_{c}'].values[chain_idx, draw_idx])
        b_val = float(post[f'beta_{c}'].values[chain_idx, draw_idx])
        sample_params[c] = {'theta': th, 'K': k_val, 'S': s_val, 'beta': b_val}
        sample_A[c] = float(np.sum([th**l for l in range(L)]))

    def sample_obj(x):
        tot = 0
        for i, c in enumerate(channels):
            p, a = sample_params[c], sample_A[c]
            u = a * x[i]
            tot += p['beta'] * (u**p['S']) / (u**p['S'] + p['K']**p['S'])
        return -tot

    # 局所解を避けるため複数の初期値から最適化
    best_res = None
    for x0 in [[100.0, 100.0, 100.0], [0.0, 150.0, 150.0], [200.0, 50.0, 50.0]]:
        res = minimize(
            sample_obj, x0=x0, method='SLSQP',
            bounds=[(0, B), (0, B), (0, B)],
            constraints={'type': 'eq', 'fun': lambda x: sum(x) - B}
        )
        if best_res is None or res.fun < best_res.fun:
            best_res = res

    opt_allocations.append(best_res.x)

opt_df = pd.DataFrame(opt_allocations, columns=channels)
print("【事後サンプル100個に対する最適配分の統計量】")
print(opt_df.describe().round(1))

# 6. 最適配分の不確実性の可視化(箱ひげ図)
fig, ax = plt.subplots(figsize=(8, 5))
opt_df.boxplot(ax=ax, patch_artist=True)
ax.set_title('事後分布に基づく最適予算配分の不確実性(総予算 B=300)')
ax.set_ylabel('推奨配分額(広告費 /週)')
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
ベイズMMMの事後サンプルから最適配分の分布を計算しています。
- データ生成と前処理: MMMの記事と同じMMMワールドを生成し、広告費のスケーリングと過去13週分のラグ行列、トレンド・季節性のコントロール変数を作成しています。
- リフト試験: 検索広告の内生性を補正するため、出稿水準の異なる2つの実験結果(第88〜99週と第8〜19週)を尤度として加えています。
- MCMC推定と収束診断: build_mmm で組み立てたモデルを、MMMの記事と同じ設定(4チェーン・各1000ドロー・tune=1500・target_accept=0.95)でサンプリングし、MCMCの記事で扱った と発散の件数を確認しています。配分の計算に入る前に、事後分布そのものが信頼できるかを確かめる手順です。
- 事後サンプリング最適化: post.sizes でチェーン数とドロー数を取得し、事後分布からランダムに100個のパラメータセットを取り出します。各サンプルにおいてスケーリングを戻した や定常係数 を再計算し、SLSQPで最適配分を解いています。S字カーブの局所解を避けるため、複数の初期値から探索して最良解を採用しています。100個にするのは、最適化を初期値3通り × 100回で済ませ、計算時間を抑えるためです。
- 結果の要約と可視化: 100個の最適配分ベクトルをデータフレームに格納し、基本統計量(平均、標準偏差、四分位数)と箱ひげ図を出力しています。
実行結果
r_hat の最大値: 1.0
発散の数: 0
【事後サンプル100個に対する最適配分の統計量】
          TV  Search    SNS
count  100.0   100.0  100.0
mean   145.0   110.0   45.0
std     36.0    22.2   28.5
min      0.0    76.2    0.0
25%    135.8    95.6   31.1
50%    148.8   107.3   49.2
75%    162.8   119.9   58.4
max    205.1   215.4  144.7
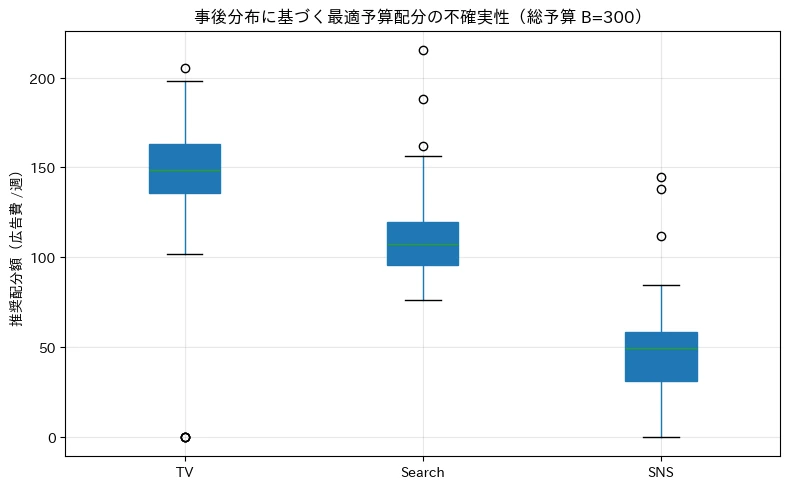
事後分布を考慮することで、単一の点推定では見えない実践的なインサイトが得られます。
- TV(中央値 148.8, 中央の50%が 135.8〜162.8): 大半のサンプルで150前後のまとまった予算が推奨されています。ただし最小値が0.0となっているように、ごく一部のサンプルでは「TVは打たずにデジタルに集中すべき」という解も存在します。
- 検索広告(中央値 107.3, 標準偏差 22.2): 2つのリフト実験でキャリブレーションされているため、3チャネルの中で標準偏差が最も小さく、最小値でも76.2と、どのサンプルでも一定の予算が要求されています(ごく一部に200超の解もあります)。
- SNS(中央値 49.2, 標準偏差 28.5): 標準偏差が28.5と、平均値(45.0)に対して極めて大きなばらつきを示しています。最小値は0.0、最大値は144.7で、「SNSには出さない」から「総予算の半分近くを割く」までの解が混在しています。これはMMMの記事でも見たように、SNSは実験によるキャリブレーションを行っておらず、 と の事後確信度が低いため、最適配分にもその不確実性が直接反映されているのです。
また、 の最大値は1.0、発散は0件で、推定そのものには問題がないことも確認できています。配分のばらつきは推定の失敗ではなく、データから分かることの限界がそのまま表れたものです。
経営判断としては、「手堅い検索広告にベースとなる100前後を確保し、TVに150前後の勝負予算を当て、残りの変動枠をSNSに割り当てる」といった、リスクを織り込んだ柔軟なポートフォリオ管理が可能になります。
発展:探索と活用のトレードオフ(トンプソンサンプリング)
最後に、予算最適化の発展的な視点として「探索と活用(Exploration vs Exploitation)」の問題に触れておきます。
本記事で解説した最適化は、「現時点で手元にあるMMMの推定結果を信じて、最も売上を最大化する配分を選ぶ」という 活用(Exploitation) のアプローチです。
しかし、もし現在のモデルが「SNSの効果は低い」と誤って推定していた場合、最適化アルゴリズムはSNSの予算をゼロに削り続けます。予算がゼロになれば新しいデータが得られないため、将来のMMMでもSNSの真の効果を正しく学び直すチャンスが永遠に失われてしまいます。
この課題は、強化学習(PPOの記事など)や多腕バンディット問題と全く同じ構造を持っています。
実務的な解決策の1つが、トンプソンサンプリング(Thompson Sampling) の考え方を取り入れた動的配分です。
- 事後分布からランダムに1つのパラメータセットをサンプリングする。
- そのサンプルにおいて最適な予算配分を計算し、次期の出稿を行う。
- 得られた新しい売上データでMMMを更新する。
不確実性が大きいチャネルほど事後サンプルのブレが大きいため、時に大胆に予算が配分され、その結果として「効果の探索(データ収集)」が自然に行われます。確定的な1つの最適解に固定するのではなく、確率的な探索を織り交ぜながら学習と配分を繰り返すことが、長期的なマーケティング成果の最大化につながります。
まとめ
本記事では、MMM関連の記事の総括として、推定したモデルから応答曲線を導き出し、限られた予算を最適配分するための数理とアルゴリズムを解説しました。
- 平均ROASの罠: 過去の実績効率である平均ROASに基づいて予算を寄せると、飽和しているチャネルに過剰投資し、立ち上がり前の高効率チャネルを見落とす危険があります。未来の配分基準は必ず「限界ROAS(mROAS)」でなければなりません。
- 凹関数の最適配分(KKT条件): すべてのチャネルが収穫逓減()である場合、最適配分では「全チャネルの限界ROASが等しくなる(限界ROAS均等の原理)」ことが数学的に証明され、SLSQPなどの凸最適化手法で確実に解けます。
- 非凸の壁と局所解: TVCMのようにS字カーブ()を描くチャネルが存在する場合、勾配法や山登り法は原点付近の低傾きに捕まり、「TV出稿ゼロ」の局所解で停止してしまいます。
- 焼きなまし法による解決: 総予算一定の制約を満たす「チャネル間振替」の近傍操作を設計し、十分な近傍幅(ステップサイズ)を持たせることで、局所解の谷を飛び越えて大域的最適解へ到達できることを確認しました。
- 事後分布による不確実性の考慮: ベイズMMMの事後サンプルごとに最適化を解くことで、各チャネルの推奨配分額のばらつき(確信度)を可視化し、リスクを考慮したポートフォリオ管理が可能になります。
ただし、最適配分はあくまで「推定したモデルが正しければ」という条件付きの答えです。最適化の結果、これまでと大きく異なる配分が推奨されたチャネルほど、過去データの範囲外へ踏み出すことになり、モデルの外挿に頼る度合いが大きくなります。実務では、推奨配分を一度に全面適用するのではなく、ジオ実験などで効果を確かめながら段階的に配分を動かし、その結果でMMMをキャリブレーションし直すというサイクルを回すことが、配分の精度を高める確実な方法です。
参考文献
- S. Boyd, L. Vandenberghe (2004). Convex Optimization. Cambridge University Press.
- Meta. Robyn. GitHub.
- P. Virtanen et al. (2020). SciPy 1.0: fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272.
- O. Abril-Pla et al. (2023). PyMC: a modern, and comprehensive probabilistic programming framework in Python. PeerJ Computer Science, 9, e1516.
本記事の文章・構成の一部に生成AIを使用しています。