Causal Impactとは?
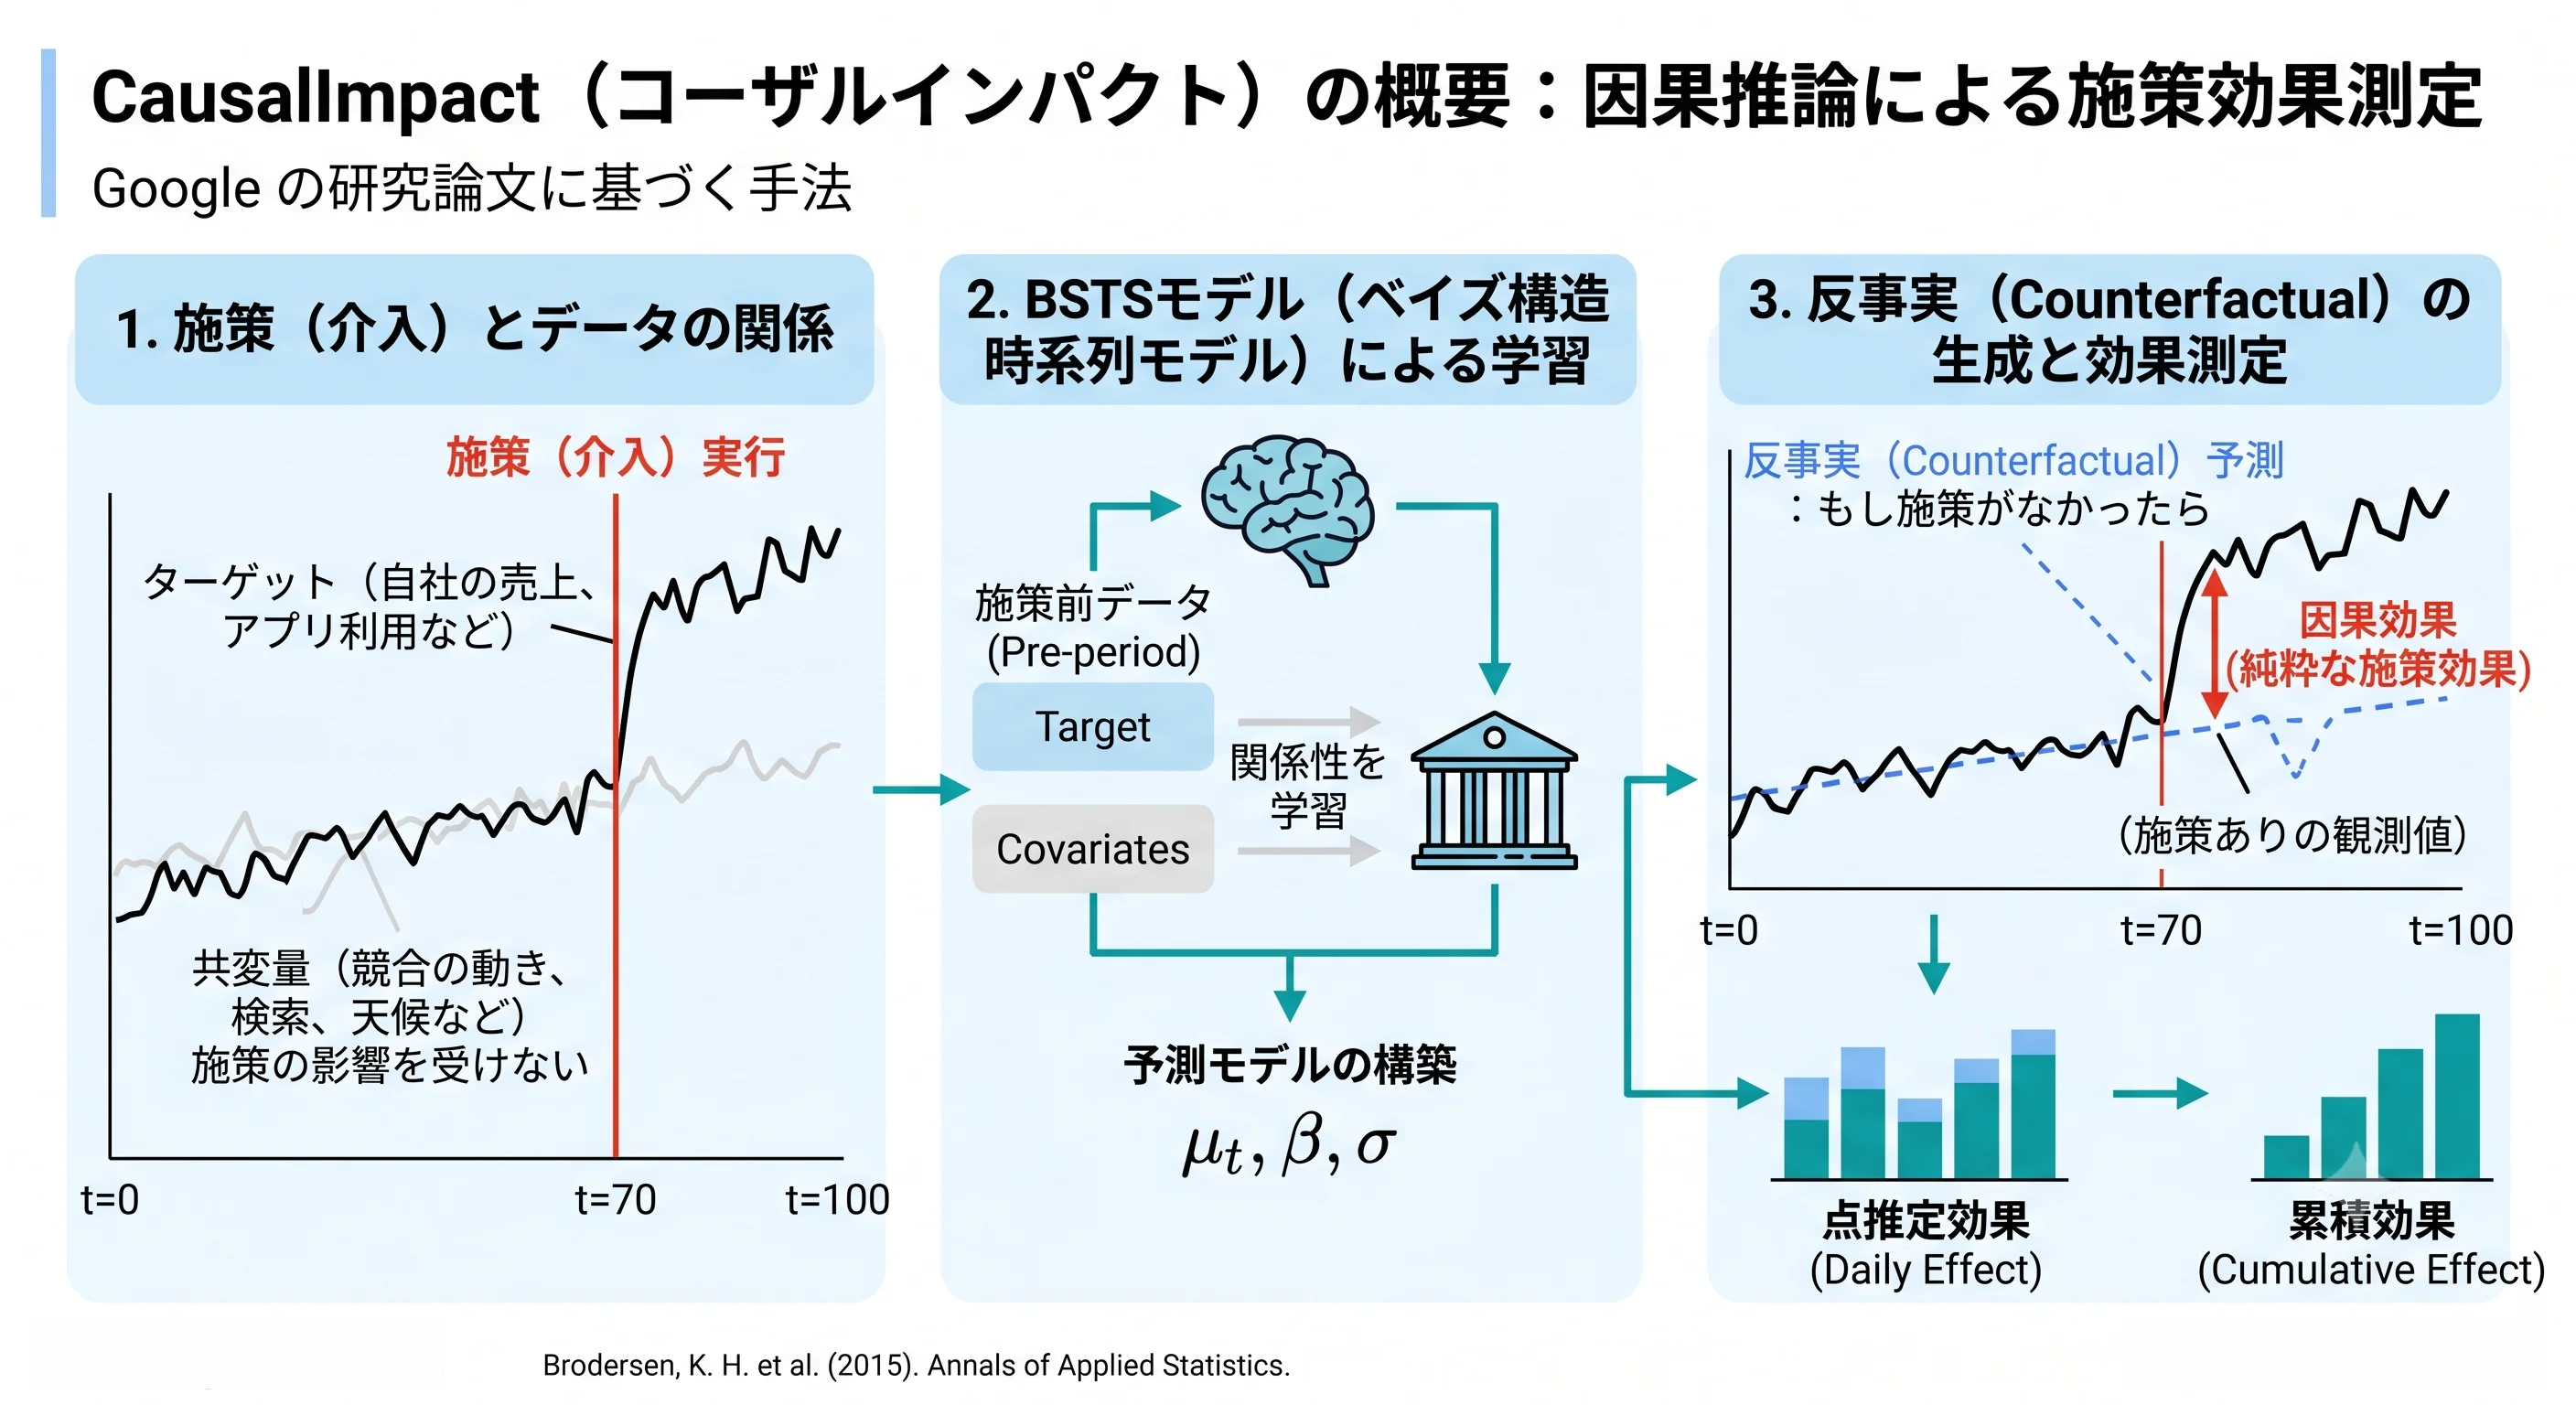 (画像は、Geminiで作成)
施策がなかった場合の推移(反事実)をベイズ構造時系列モデルで予測し、実際との差で効果を測る Causal Impact の考え方と、成り立つための前提条件を理解すること。PyMC でのスクラッチ実装と causalimpact ライブラリで、ダミーデータの効果と信用区間を推定し、共変量が施策の影響を受けるなど前提が崩れると何が起きるか、効果が持ち越すときの分析期間の決め方を確かめること。
Causal Impactの概要
Causal Impactは、2015年にGoogleのKay H. Brodersen氏らによって提案された統計的アプローチです。
元々は “Inferring causal effects from observational time series data using Bayesian structural time-series models” という正式論文で発表された理論ですが、
その後、同名のRパッケージ(ツール)の公開に合わせて、内容をより実践向けに落とし込んだ論文「Inferring causal impact using Bayesian structural time-series models」が公開されました。
この手法の最大の特徴は、「反事実(Counterfactual)」という概念を時系列データに持ち込んだ点にあります。論文の中では、その核心について次のように述べられています。
“The basic idea is to generalize the widely used difference-in-differences approach to a state-space framework that allows us to infer the counterfactual market response that would have occurred in the absence of the intervention.”
(意訳)基本的なアイデアは、広く使われている「差の差の分析(DID)」を状態空間モデルへと拡張し、もし施策(介入)を行っていなかったら発生していたであろう「反事実」の市場の反応を推論することである。
従来の「施策の前後で平均値を比べる」ような単純な方法では、季節による変動や、市場全体の自然な成長といった「外部要因」を施策の効果だと誤認してしまうリスク(時間的な要因による交絡)がありました。
CausalImpactは、施策の影響を受けていない他のデータ(例:競合の動きや他地域のデータなど)を組み込んだ「ベイズ構造時系列モデル(BSTS)」を構築します。これにより、「もし施策を行っていなかったら、今頃どうなっていたか」というパラレルワールドのタイムライン(反事実)を高精度に予測します。
そして、「実際の観測値」と「反事実の予測値」のギャップを測ることで、外部要因のノイズを綺麗に取り除いた「純粋な施策の効果」を浮き彫りにするのです。
CausalImpactの基本ロジック:「反事実」の予測
CausalImpactがやっていることを一言で言えば、「もしこの施策をやっていなかったら、データはどうなっていたか?(反事実:Counterfactual)」 というパラレルワールドの時系列データを予測し、実際の観測値と比較することです。
具体的な効果測定のメカニズムと、それを支える数理モデルの構造を紐解いていきましょう。 施策効果を導く「引き算」のシンプルさCausalImpactにおいて、施策による因果効果(Causal Effect)は以下の非常にシンプルな引き算で定義されます。
- :時点 における施策効果(Causal Effect)
- :時点 での実際の観測値(施策を行った現実のデータ)
- :時点 での予測値(反事実)(もし施策を行っていなかった場合のデータ)
現実のデータ( )は手元にありますから、私たちが解くべき問題は「どうやって施策がなかった場合の予測値( )を高精度に叩き出すか」の1点に絞られます。
反事実を予測する「ベイズ構造時系列モデル(BSTS)」の数理
Googleの論文で提案されたCausalImpactのコアは、「ベイズ構造時系列モデル(BSTS: Bayesian Structural Time Series)」という柔軟な時系列モデルです。 本記事のスクラッチ実装でもベースとなる、最も標準的なモデル(ローカルレベルモデル + 共変量)の数式は以下の2つのパーツ(方程式)で構成されています。
① 観測方程式(Observation Equation)
手元で見えているデータが、どのような要素で構成されているかを表す式です。
- :ターゲット変数(自社の売上やコンバージョン数など)
- :その時々のベースとなるトレンド(潜在状態)
- :共変量(コントロール変数)(施策の影響を受けていない、競合のデータや検索トレンドなど)
- :共変量がターゲットに与える影響の強さ(係数)
- :その日の偶然のばらつきを表す観測ノイズ(平均0、分散 の正規分布に従う)
② 状態方程式(System Equation)
目に見えない「ベースのトレンド( )」が、時間の経過とともにどう変化していくかを表す式です。
は、1つ前の時点のトレンド に、その時々のランダムな変動 (システムノイズ)が加わることで日々緩やかに変化していきます(これをランダムウォークと呼びます)。
この数式がなぜ「施策効果」を炙り出せるのか?
CausalImpactの予測マジックは、データを「施策前の期間(Pre-period)」と「施策後の期間(Post-period)」に分けて処理することで成立します。
【施策前期間(学習)】ターゲット(y) と 共変量(X) の関係性(βやノイズ)をじっくり学習
                                ↓ 施策実行
【施策後期間(予測・比較)】施策後の共変量(X)の動きをベースに「もし施策がなかったら(ŷ)」を予測
-
「通常時の関係性」を学習する(施策前期間):
まだ施策を行っていない綺麗な期間のデータを使って、「共変量 が1動くとき、ターゲット はどれくらい動くか( )」「ベースのトレンドは普段どれくらい上下ブレするのか( )」というデータの構造(法則)をMCMCサンプリング等によって学習します。 -
「もしも」の未来をシミュレーションする(施策後期間):
施策が始まった後の期間に対して、「施策の影響を受けていない共変量 」のデータだけをモデルに投入します。モデルはステップ1で学習した「通常時の法則」に従って、「もし施策がなかったら、この の動きからして、売上 はこれくらいになっているはずだ」という予測値 (反事実)を叩き出します。 -
差分を因果効果とする:
こうして作った「もしもの予測値(青い点線)」と「現実の売上(黒い実線)」を引くことで、曜日要因や市場全体のトレンドといったノイズを取り除いた「純粋な施策のインパクト( )」が手に入るのです。ただし、これが成り立つのは、次に説明するいくつかの前提条件が満たされている場合に限られます。
2つの方程式と、施策前・施策後の役割を図にすると、次のようになります。
(図は、diagram-designで作成)
CausalImpactを成立させる前提条件
CausalImpactの効果測定は「現実 − 反事実」という引き算です。反事実の予測がずれれば、そのずれがそのまま効果の推定誤差になります。反事実を正しく予測するためには、次の前提条件が必要です。
① 共変量が施策の影響を受けていないこと
CausalImpactは、施策後の共変量 を「施策がなかった世界でも同じように動いていたはず」のデータとして使います。もし施策が共変量まで動かしてしまうと、施策による変化の一部が「共変量の変化による自然な変動」として反事実に取り込まれ、効果が過小評価されます。なお、これは「施策が共変量を動かす」問題です。これとは別に、広告費そのものが需要に反応して決まるために効果が過大推定される問題(内生性)もあり、こちらは内生性の記事で扱います。
| 共変量の例 | 使えるか | 理由 |
|---|---|---|
| 施策を行っていない地域の同じKPI | ◯ | 施策が及ばない限り、市場全体の動きだけを反映する |
| 天候や業界全体の指標 | ◯ | 自社の施策では動かない |
| 自社ブランドの検索数 | ✕(要注意) | テレビCMなどの施策で検索数自体が増える |
| 自社サイトの訪問数、同じ顧客が買う自社の別商品の売上 | ✕(要注意) | 施策の影響が波及しやすい |
② 共変量と目的変数の関係が、施策後も変わらないこと
モデルは施策前の期間で「 が1動くと がどれだけ動くか()」を学習し、その関係が施策後も続くと仮定して反事実を予測します。施策と同じタイミングで競合が大規模なセールを始めたり、商品ラインナップが変わったりすると、この関係が崩れて反事実がずれてしまいます。
③ 施策が比較対象に波及しないこと(スピルオーバーがないこと)
施策を行っていない地域のデータを共変量にする場合、その地域に施策の影響が漏れていないことが必要です。たとえばテレビCMの放送エリアは県境をまたぐことがありますし、Web広告の地域ターゲティングも完璧ではありません。共変量側にも効果が漏れていると、反事実が押し上げられ、効果は過小評価されます。
④ 施策前の期間で、モデルが通常時の推移を十分に再現できていること
施策前の期間が短すぎたり、季節性をモデルに入れていなかったりすると、そもそも反事実の予測精度が不足します。この点は、後述の「実務における注意点」で紹介するプラセボテストで確認できます。
これらは、DiDにおける「平行トレンドの仮定」に相当するものです。DiDが「統制群と同じ傾きで推移したはず」と仮定するのに対し、CausalImpactは「共変量との関係から予測した通りに推移したはず」と仮定している、と捉えると分かりやすいでしょう。①の前提が崩れると推定がどう歪むのかは、後半の「前提条件が崩れると何が起きるか」の節でシミュレーションします。
検証用ダミーデータの生成コード
今回作成するデータは、先ほど解説したベイズ構造時系列モデル(BSTS)の構造をシンプルにした、以下の数式(データ生成プロセス)に基づいています。
施策前()のデータ生成式
ここでは、共変量 は平均10、標準偏差2の正規分布から独立に生成されるデータ(市場全体のトレンドなど)とします。 ターゲットである自社の売上 は、この の値を 2.5倍 したものに、標準偏差1.5のランダムな観測ノイズ が加わったものです。
施策後()のデータ生成式
70日目に施策(介入)が行われると、数式は以下のように変化します。
ポイントは、共変量 の生成プロセスは施策前後で一切変わっていない(独立している)のに対し、ターゲット変数 にだけ一律で の底上げ(True Effect)が加わっている点です。スクラッチ実装のゴールは、モデルに「 と のデータ」だけを渡し、この数式の裏に隠された 「傾き 」 と 「施策効果 」 という正解の数値を、MCMCによって正確に逆算(推論)できるかどうかを検証することになります。 以下のコードでは、CausalImpactの前提条件である「施策の影響を受けないが、ターゲットと強い相関を持つ共変量()」と、「施策によって途中でトレンドが跳ね上がるターゲット()」をシミュレーションしています。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. 乱数シードの固定(読者が同じ結果を再現できるようにするため)
np.random.seed(123)

# 2. 期間パラメータの設定
n_periods = 100          # 全期間(100日間)
intervention_point = 70  # 施策実行日(70日目)

# 3. 共変量(コントロール変数)X の作成
# 施策の影響を一切受けない、市場のトレンドや競合の動きなどを想定
X = np.random.normal(loc=10, scale=2, size=n_periods)

# 4. ターゲット変数 y のベース(施策がない場合の本来の推移)を作成
# X と強い相関を持たせつつ、ランダムなノイズ(観測誤差)を加える
y_base = 2.5 * X + np.random.normal(loc=0, scale=1.5, size=n_periods)
y = y_base.copy()

# 5. 施策効果(介入効果)の注入
# 70日目以降のターゲットデータにのみ、一律で「+10」の効果を加える
true_effect = 10
y[intervention_point:] += true_effect

# DataFrameにまとめる
df = pd.DataFrame({
    'y': y,
    'X': X
})

# 6. 生成したデータの可視化
plt.figure(figsize=(10, 5))
plt.plot(df.index, df['y'], label='Target (y: 自社の売上)', color='black', linewidth=2)
plt.plot(df.index, df['X'], label='Covariate (X: 競合・市場トレンド)', color='gray', linestyle='--')
plt.axvline(x=intervention_point, color='red', linestyle=':', linewidth=2, label='Intervention (施策実行日)')
plt.title('Generated Dummy Data for CausalImpact')
plt.xlabel('Time (Days)')
plt.ylabel('Value')
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
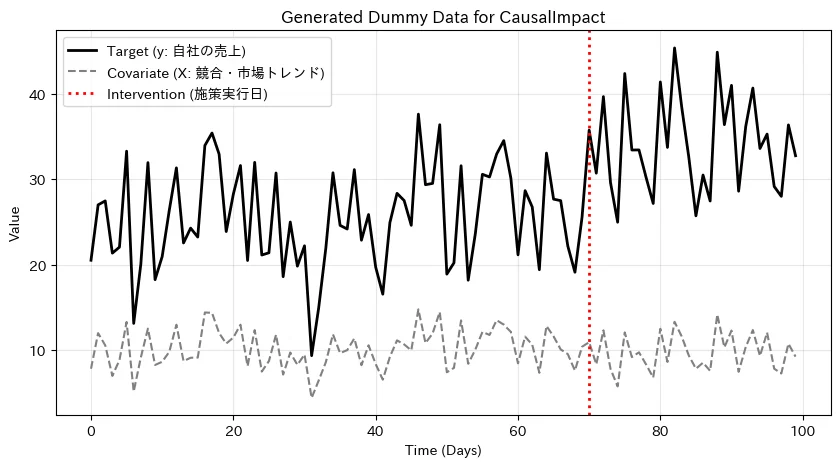
ここでは、検証用に用いるダミーデータの生成と可視化を行っています。
- 乱数と期間の設定: np.random.seed(123) で乱数のシード値を固定し、実行のたびに同じデータが再現されるように設定します。全期間 n_periods = 100(100日間)とし、70日目(intervention_point = 70)を施策の実行日として定義します。施策を70日目にするのは、施策前の70日で共変量との関係とトレンドを学習し、施策後の30日で効果を測るためです。
- 共変量の生成: 共変量 X は、np.random.normal(loc=10, scale=2, size=n_periods) を用いて平均10、標準偏差2の正規分布から生成され、施策の影響を受けない市場トレンドなどを表現しています。
- 施策がなかった場合の推移: ターゲット変数である自社の売上 y の本来の推移は、y_base = 2.5 * X + np.random.normal(loc=0, scale=1.5, size=n_periods) によって、共変量 X を2.5倍した値に、標準偏差1.5の観測誤差を加えることで構築しています。この y_base が、後で推定する「反事実」の正解にあたります。係数2.5と観測誤差1.5は、共変量だけで売上の大部分を説明できる(共変量の標準偏差2 × 2.5 = 5に対して、誤差は1.5)ようにして、共変量から反事実を精度よく予測できる状況を作るためです。
- 施策効果の注入: 施策日である70日目以降のターゲットデータに対してのみ、y[intervention_point:] += true_effect で一律に +10 の底上げ(True Effect)を注入しています。効果を+10にするのは、観測誤差(標準偏差1.5)よりはっきり大きく、推定した効果を真値と比べやすくするためです。
- データの格納と可視化: 生成されたターゲット変数 y と共変量 X を pd.DataFrame に格納し、matplotlib および日本語表記をサポートする japanize_matplotlib を用いて、施策実行日の位置(赤の点線)とともに可視化しています。
実行結果
PyMCによるモデル定義とMCMCサンプリング
PyMCを使ってベイズ構造時系列モデル(BSTS)を構築します。
ここでのポイントは「施策前(Pre-period)のデータのみをモデルに与える」ということです。施策の影響を受けていない純粋な期間のデータから、データ生成の「法則」をMCMCに学習させます。
モデル定義とサンプリングのコード
以下のコードを実行して、モデルの定義とMCMCサンプリング(パラメータの探索)を行います。MCMCの仕組みや、サンプリング結果が信頼できるかを確かめる収束診断については、MCMCの記事で詳しく解説しています。
import pymc as pm
import numpy as np

# 1. データを施策前の期間(Pre-period)に絞り込む
y_pre = df['y'].iloc[:intervention_point].values
X_pre = df['X'].iloc[:intervention_point].values
T = len(y_pre)

# 2. ベイズ構造時系列モデル(BSTS)の定義
with pm.Model() as bsts_model:

    # --- 事前分布(Priors)の設定 ---
    # 観測ノイズ(データ自体のブレ)の標準偏差
    sigma_obs = pm.HalfNormal("sigma_obs", sigma=5)

    # トレンドノイズ(日々のトレンドの変動幅)の標準偏差
    # 時系列が急激に変化しすぎないよう、ややタイトな範囲を想定
    sigma_level = pm.HalfNormal("sigma_level", sigma=2)

    # 共変量 X の影響度(回帰係数 beta)
    beta = pm.Normal("beta", mu=0, sigma=5)

    # --- 状態空間の定義(非中心化パラメータ化) ---
    # サンプラーが「漏斗状の谷(ファンネル)」にハマって発散するのを防ぐため、
    # 状態方程式のランダムウォークを分解して記述します。

    # ① トレンドの初期値(スタート地点)
    mu_init = pm.Normal("mu_init", mu=y_pre[0], sigma=5)

    # ② 各時点におけるトレンドの「無次元化された変化量」
    # サンプラーが探索しやすい標準正規分布 N(0, 1) から独立にサンプリング
    mu_innovation = pm.Normal("mu_innovation", mu=0, sigma=1, shape=T-1)

    # ③ 変化量を sigma_level でスケールさせ、累積和(cumsum)をとってトレンドを構築
    mu_trend = pm.math.concatenate([
        [mu_init],
        mu_init + pm.math.cumsum(mu_innovation * sigma_level)
    ])

    # --- 観測方程式(データ生成プロセス) ---
    # ターゲット変数の予測平均値 = トレンド + 共変量による効果
    nu = mu_trend + beta * X_pre

    # 尤度(実際の観測データ y_pre をモデルに適合)
    obs = pm.Normal("obs", mu=nu, sigma=sigma_obs, observed=y_pre)

    # --- MCMCサンプリングの実行 ---
    # 時系列モデルの複雑な幾何学的形状を確実に、かつ細かく探索させるため、
    # tune(慣らし運転)を1500回に増やし、target_accept(採択率の目標)を0.99と高く設定します
    trace = pm.sample(draws=1000, tune=1500, target_accept=0.99, random_seed=42, progressbar=True)

# パラメータの推定結果の要約を表示(MCMCが正解を捉えているか確認)
pm.summary(trace, var_names=["beta", "sigma_obs", "sigma_level"])
ここでは、PyMCを用いてベイズ構造時系列モデル(BSTS)を定義し、施策前期間(Pre-period)のデータだけを用いてMCMCサンプリングによるパラメータ推定を実行しています。
- データの絞り込み: 推定対象のデータとして、施策開始前の70日分(y_pre および X_pre)を抽出します。
- モデルと事前分布の定義: with pm.Model() as bsts_model でPyMCのモデルブロックを開始し、観測ノイズの標準偏差 sigma_obs およびトレンドノイズの標準偏差 sigma_level に非負の事前分布である半正規分布 pm.HalfNormal を設定します。共変量の影響度を表す回帰係数 beta には、平均0、標準偏差5の正規分布 pm.Normal を設定しています。sigma_obs()、beta()、mu_init(平均 、標準偏差5)は、売上(平均25程度)と共変量の大きさに比べて十分に広い、弱い事前分布にするためです。sigma_level()は、トレンドの1日の変動を、観測誤差より小さめに置くためです。
- 状態空間の定義(非中心化パラメータ化): モデルの核となる「見えないトレンド mu_trend」の表現には、サンプリングを安定させるための「非中心化パラメータ化」を採用しています。初期値 mu_init に加えて、各時点の標準的なノイズ成分 mu_innovation を標準正規分布 pm.Normal(mu=0, sigma=1) から抽出し、それに sigma_level を乗じた累積和を pm.math.cumsum で計算することで、トレンドのランダムウォークを構成します。
- 観測方程式の定義: ターゲット変数の平均 nu をトレンド mu_trend と共変量効果 beta * X_pre の和で表し、実際の観測データ y_pre が平均 nu、標準偏差 sigma_obs の正規分布に従う尤度 pm.Normal("obs", ...) として記述します。
- MCMCサンプリングの実行: 最後に、pm.sample を呼び出し、MCMCによるサンプリングを実行します。サンプリング空間の複雑な幾何学的形状に対応するため、tune=1500 でバーンイン期間(慣らし運転)を長めに確保し、target_accept=0.99 とすることで、サンプラーが谷間(ファンネル)に捕まることによるサンプリングの「発散(Divergences)」を完全に回避します。サンプリング完了後、pm.summary により各パラメータの推定要約(平均値、標準偏差、信用区間など)を表示させています。
① 状態空間の定義(非中心化パラメータ化)によるトレンドの表現
状態空間モデルの肝は、「時間とともに変化する見えないトレンド 」をどうモデル化するかです。
このコードでは、時系列データが持つ「昨日の売上ベースから、今日も少しランダムに変動する(ランダムウォーク)」という性質をそのまま数式通りに記述するのではなく、
「非中心化パラメータ化(Non-centered Parameterization)」という強力なテクニックを用いています。
愚直に書いた場合の数式(中心化モデル)本来、ランダムウォークは以下のように「昨日の状態」をベースに次の状態の確率分布を定義します。
しかし、この数式の通りにモデル化してしまうと、各時点の が前後のパラメータと強力に結びついてしまいます。 その結果、サンプリング空間の幾何学的な形状が「漏斗(ファンネル)状」の狭い谷になり、PyMCの標準アルゴリズムであるNUTS(No-U-Turn Sampler)がその谷間に入り込んで動けなくなり、サンプリングが発散(Divergences)するエラーを引き起こしやすくなります。 非中心化パラメータ化の数式(実際にコード化したもの)そこで、この依存関係を断ち切るために、数式を以下のように分解して再構築します。
(mu_innovation): 各時点の「ブレ」を、前後の状態から完全に独立した、サンプラーが最も探索しやすい広々とした形状の「標準正規分布 」からサンプリングします。累積和( / pm.math.cumsum): 巡回しやすい空間で集めた綺麗なブレの塊に対して、後からトレンドの変動の激しさ (sigma_level)を掛け算し、初期値 (mu_init)から順に足し上げていくことで、数学的に全く等価なランダムウォーク構造を作ります。コードを見ると、この数式がそのまま再現されていることが分かります。
コードを見ると、この数式がそのまま再現されていることが分かります。
数式:
mu_innovation = pm.Normal("mu_innovation", mu=0, sigma=1, shape=T-1)
数式:
mu_trend = pm.math.concatenate([
    [mu_init],
    mu_init + pm.math.cumsum(mu_innovation * sigma_level)
])
② なぜパラメータを「分布」で持つのか?
従来の機械学習のように「傾き 」と一つの値を決める(点推定する)だけでは、
データが持つ本来の「不確実性」を評価できません。MCMCは「 は 2.48〜2.52 の間にありそうだ」という確率分布(事後分布)を丸ごと出力してくれます。
今回のコードで、サンプラーの設定を target_accept=0.99 に引き上げ、慣らし運転(tune=1500)を増やしたのも、この「分布の形」を極めて正確に描き出すためです。
非中心化パラメータ化によってNUTSのトラップを回避し、さらにサンプラーの歩幅を細かく(慎重に)調整したことで、 あり得るパターンのバリエーション(有効サンプルサイズ)が十分に確保されます。 これにより、パラメータの「ブレの幅」が正しく保証され、CausalImpactの最大の強みである「パラレルワールド(反事実)の予測における95%信用区間」の『帯の幅』を、 一切の妥協なく数学的に正しく計算できるようになるのです。
実行結果
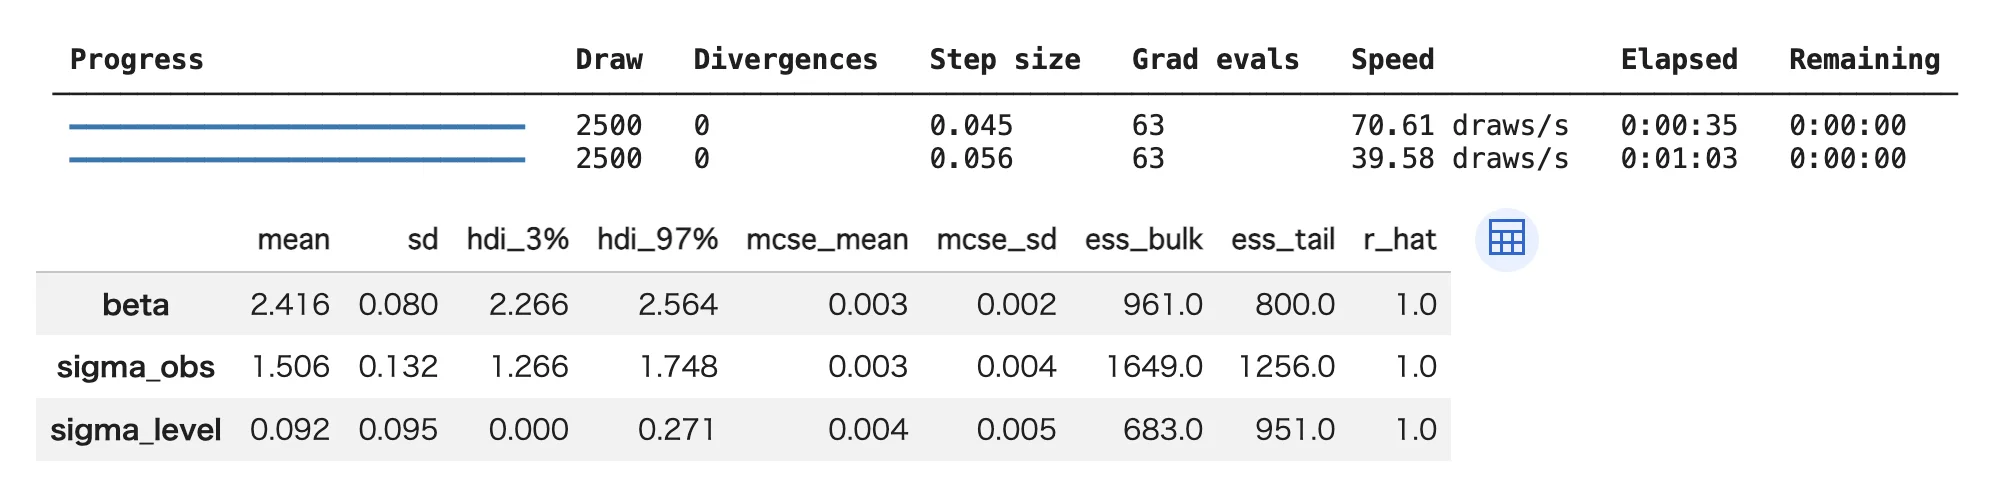 MCMCサンプリングの結果得られた要約テーブル(pm.summary の出力)から、モデルがデータ生成プロセスの真の構造を極めて正確に捉えられていることが確認できます。
- 回帰係数 beta の推定精度: 推定値は平均値(mean)が 2.416 となっており、データ生成式で設定した真の値である 2.5 に非常に近い値を推定できています。94%信用区間(hdi_3% 〜 hdi_97%)も [2.266, 2.564] となっており、真の値をしっかりとその範囲内に内包しています。
- 観測ノイズ sigma_obs の推定: 推定平均値は 1.506 であり、これもデータ生成時にノイズとして加えた真の標準偏差 1.5 とほぼ一致しています。
- トレンドノイズ sigma_level の推定: 平均値が 0.092 と小さく推定されています。これは、ダミーデータ生成の際、トレンドのランダムウォークによる変化(システムノイズ)を事実上ゼロ(y_base は共変量と観測ノイズのみで決定)として生成したため、モデルが「ベーストレンドはほぼ時間経過で変化しない(ほぼ一定である)」と正しく見抜いたことを意味します。
- MCMCの収束確認: すべての主要パラメータについて、収束判定指標である r_hat(Gelman-Rubin統計量)が 1.0 となっており、現在の目安である1.01未満を満たしています。MCMCサンプリングのチェーンが十分に収束し、信頼性の高い事後分布が得られていると判断できます(r_hat や有効サンプルサイズの読み方はMCMCの記事で解説しています)。
施策後の反事実シミュレーションと因果効果の可視化
MCMCサンプリングによって、「通常時におけるデータ生成の法則()」の事後分布を手に入れることができました。
最後のステップでは、この数千パターンのパラメータの組み合わせを使って、施策後の期間(70日目〜100日目)に対して「もし施策がなかったら(反事実)」のシミュレーションを数千通り行います。これにより、予測値の平均だけでなく、「95%信用区間(予測のばらつきの幅)」を数学的に正しく導き出せます。
反事実のシミュレーションと効果測定のコード
MCMCサンプリングによって無事にパラメータの事後分布が得られたら、次はいよいよ施策後期間()における「もし施策がなかったら(反事実)」のシミュレーションを行います。
この未来のタイムライン(パラレルワールド)を1日ずつ描き出す予測ロジックは、最初に定義した状態空間モデルの数式そのものです。
反事実予測のシミュレーション数式施策後の各時点 において、モデルは以下の2つのステップを1日ずつ未来に向かって繰り返します。
- は、MCMCで得られた数千個あるパラメータサンプルのうちの「 番目のパターン」であることを意味しています。
- ステップ1(状態の更新): 昨日のトレンド に、学習されたトレンドの変動幅 を持つシステムノイズ を足し算して、今日の潜在トレンド をシミュレーションします。
- ステップ2(観測値の生成): 今日の潜在トレンド に、学習された係数 と現実の(施策の影響を受けていない)共変量 を掛け合わせたものを足し、最後に観測ノイズ を乗せて、施策がなかった場合の予測値 (反事実)を1つ生成します。
これをすべてのMCMCサンプル(数千パターン)× 施策後の期間(30日間)の分だけループ処理します。
実際のコードを見ると、この2つの数式ステップが完全にそのまま移植されていることが分かります。
数式:
① 状態の更新:前日のトレンドにノイズを加えて今日のトレンドを生成
current_mu = np.random.normal(current_mu, sigma_level_samples[i])
数式:
② 観測値の生成:今日のトレンド + 今日の共変量効果 + 観測ノイズ
y_post_pred_samples[i, t] = np.random.normal(
    current_mu + beta_samples[i] * X_post[t],
    sigma_obs_samples[i]
)
この「数式通りのシミュレーションを何千回も泥臭く繰り返す」ことによって、あり得る未来のバリエーションがすべて配列(y_post_pred_samples)に蓄積されます。あとはその平均値やパーセンタイル(2.5%点、97.5%点)を間引くだけで、綺麗な「95%信用区間」が計算できるわけです。
それでは、このシミュレーションから効果測定、そしてグラフ描画までを行う全体のコードを見てみましょう。
import numpy as np
import matplotlib.pyplot as plt

# 1. MCMCの事後分布から各パラメータの全サンプルを抽出
post = trace.posterior
beta_samples = post["beta"].values.flatten()
sigma_obs_samples = post["sigma_obs"].values.flatten()
sigma_level_samples = post["sigma_level"].values.flatten()

# 施策直前(Pre期間の最後)のトレンド状態を抽出
# 非中心化パラメータ化では変化量を標準化しているため、sigma_level を掛け戻してから足し上げる
# (モデル定義の mu_init + cumsum(mu_innovation * sigma_level) の最後の値と同じ)
mu_last_samples = post["mu_init"].values.flatten() + post["sigma_level"].values.flatten() * post["mu_innovation"].values.sum(axis=-1).flatten()

n_samples = len(beta_samples)
X_post = df['X'].iloc[intervention_point:].values
y_post_actual = df['y'].iloc[intervention_point:].values
n_post = len(X_post)

# 反事実の予測結果を格納する配列(サンプル数 × 施策後の期間)
y_post_pred_samples = np.zeros((n_samples, n_post))

# 2. 全てのMCMCサンプルに対して、施策後の未来(パラレルワールド)を1日ずつシミュレーション
for i in range(n_samples):
    current_mu = mu_last_samples[i]

    for t in range(n_post):
        # ① 状態の更新:前日のトレンドにノイズを加えて今日のトレンドを生成
        current_mu = np.random.normal(current_mu, sigma_level_samples[i])

        # ② 観測値の生成:今日のトレンド + 今日の共変量効果 + 観測ノイズ
        y_post_pred_samples[i, t] = np.random.normal(
            current_mu + beta_samples[i] * X_post[t],
            sigma_obs_samples[i]
        )

# 3. 予測の平均値と95%信用区間(下側2.5%, 上側97.5%)を算出
y_post_mean = y_post_pred_samples.mean(axis=0)
y_post_lower, y_post_upper = np.percentile(y_post_pred_samples, [2.5, 97.5], axis=0)

# 4. 点推定効果の算出(実際の値 - 反事実のシミュレーション値)
point_effect_samples = y_post_actual - y_post_pred_samples
point_effect_mean = point_effect_samples.mean(axis=0)
point_effect_lower, point_effect_upper = np.percentile(point_effect_samples, [2.5, 97.5], axis=0)

# 5. 累積効果の算出(時間経過とともに効果を足し上げる)
cumulative_effect_samples = point_effect_samples.cumsum(axis=1)
cumulative_effect_mean = cumulative_effect_samples.mean(axis=0)
cumulative_effect_lower, cumulative_effect_upper = np.percentile(cumulative_effect_samples, [2.5, 97.5], axis=0)

# ==========================================
# 6. オリジナルを再現した3部構成グラフの描画
# ==========================================
time_post = np.arange(intervention_point, n_periods)
time_all = np.arange(n_periods)

fig, axes = plt.subplots(3, 1, figsize=(11, 12), sharex=True)

# グラフ1: 実際の観測値と反事実の予測(95%信用区間の帯付き)
axes[0].plot(time_all, df['y'], label='Actual (施策ありの現実)', color='black', linewidth=1.5)
axes[0].plot(time_post, y_post_mean, label='Counterfactual (予測: 施策なし)', color='blue', linestyle='--')
axes[0].fill_between(time_post, y_post_lower, y_post_upper, color='blue', alpha=0.15, label='95% Credible Interval')
axes[0].axvline(x=intervention_point, color='red', linestyle=':', linewidth=2, label='Intervention (施策日)')
axes[0].set_title('1. 実際の値と反事実の予測比較')
axes[0].set_ylabel('Target Value')
axes[0].legend(loc='upper left')
axes[0].grid(True, alpha=0.3)

# グラフ2: 各時点における施策効果(Point Effect)
axes[1].plot(time_post, point_effect_mean, color='blue', label='Estimated Effect (推定効果)')
axes[1].fill_between(time_post, point_effect_lower, point_effect_upper, color='blue', alpha=0.15)
axes[1].axhline(y=0, color='black', linestyle='-')
axes[1].axhline(y=true_effect, color='green', linestyle=':', linewidth=2, label='True Effect (+10)')
axes[1].axvline(x=intervention_point, color='red', linestyle=':', linewidth=2)
axes[1].set_title('2. 各時点における施策効果 (Point Effect)')
axes[1].set_ylabel('Effect Size')
axes[1].legend(loc='upper left')
axes[1].grid(True, alpha=0.3)

# グラフ3: 累積の施策効果(Cumulative Effect)
axes[2].plot(time_post, cumulative_effect_mean, color='blue', label='Cumulative Effect (累積効果)')
axes[2].fill_between(time_post, cumulative_effect_lower, cumulative_effect_upper, color='blue', alpha=0.15)
axes[2].axvline(x=intervention_point, color='red', linestyle=':', linewidth=2)
axes[2].set_title('3. 累積の施策効果 (Cumulative Effect)')
axes[2].set_ylabel('Cumulative Size')
axes[2].set_xlabel('Time (Days)')
axes[2].legend(loc='upper left')
axes[2].grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
ここでは、MCMCサンプリングによって得られたパラメータの事後分布を用いて、施策後の期間(70日目〜100日目)における「もし施策を行っていなかったら(反事実)」のシミュレーションと、因果効果の算出・可視化を行っています。
- パラメータサンプルの抽出: MCMCトレースからパラメータの事後分布サンプルをフラットな配列として取り出します。回帰係数 beta_samples、観測ノイズの標準偏差 sigma_obs_samples、トレンドノイズの標準偏差 sigma_level_samples を取得します。
- 施策直前のトレンドの復元: 施策直前(69日目)における潜在トレンドの最終状態 mu_last_samples は、トレンドの初期値サンプルの配列に、それまでのトレンド変化量 mu_innovation の総和を足し合わせることで、各サンプリングパスごとに計算します。このとき、非中心化パラメータ化の mu_innovation は標準正規分布に従う「無次元化された変化量」なので、総和に sigma_level_samples を掛けて元のスケールに戻す必要があります(モデル定義の mu_init + cumsum(mu_innovation * sigma_level) の最後の値と同じ計算です)。
- 反事実シミュレーションのループ: MCMCサンプルの総数分だけループ(for i in range(n_samples))を回し、各サンプルにおける「施策がなかった場合の未来」を1日ずつ時系列順にシミュレーションします。
- 状態の更新と観測値の生成: 各日のステップにおいて、まず np.random.normal(current_mu, sigma_level_samples[i]) によりトレンドをランダムウォークさせて更新(状態の更新)します。その後、更新されたトレンドに、そのサンプルの回帰係数 beta_samples[i] と施策後期間の実際の共変量 X_post[t] を掛け合わせたものを加え、さらに観測誤差 sigma_obs_samples[i] のノイズを上乗せした正規分布から値を生成します。これにより、ノイズも含めた「あり得たかもしれない観測値(反事実)」を1日ずつ、すべてのサンプル分蓄積します。
- 点推定効果(Point Effect)の算出: 実際の観測値 y_post_actual から、シミュレーションした反事実の予測サンプルを差し引く(y_post_actual - y_post_pred_samples)ことで、各時点における施策効果を計算します。
- 累積効果(Cumulative Effect)の算出: 点推定効果を時間経過とともに累積加算(cumsum(axis=1))し、施策開始から現在までの効果の積み上げ量を算出します。
- 95%信用区間の計算: 各指標に対して np.percentile(..., [2.5, 97.5]) を用いることで、MCMCサンプルに基づく「予測の95%信用区間(下限と上限)」を算出します。
- 3部構成のグラフの描画: 最後に、matplotlib で3行1列のグラフを作成し、「実際の値と予測の比較」「各時点の施策効果(Point Effect)」「累積効果(Cumulative Effect)」をプロットしています。fill_between で描画された青い半透明の領域(信用区間)が、未来に進むにつれて不確実性の高まり(ランダムウォークの拡散)によって広がっていく様子が確認できます。
実行結果
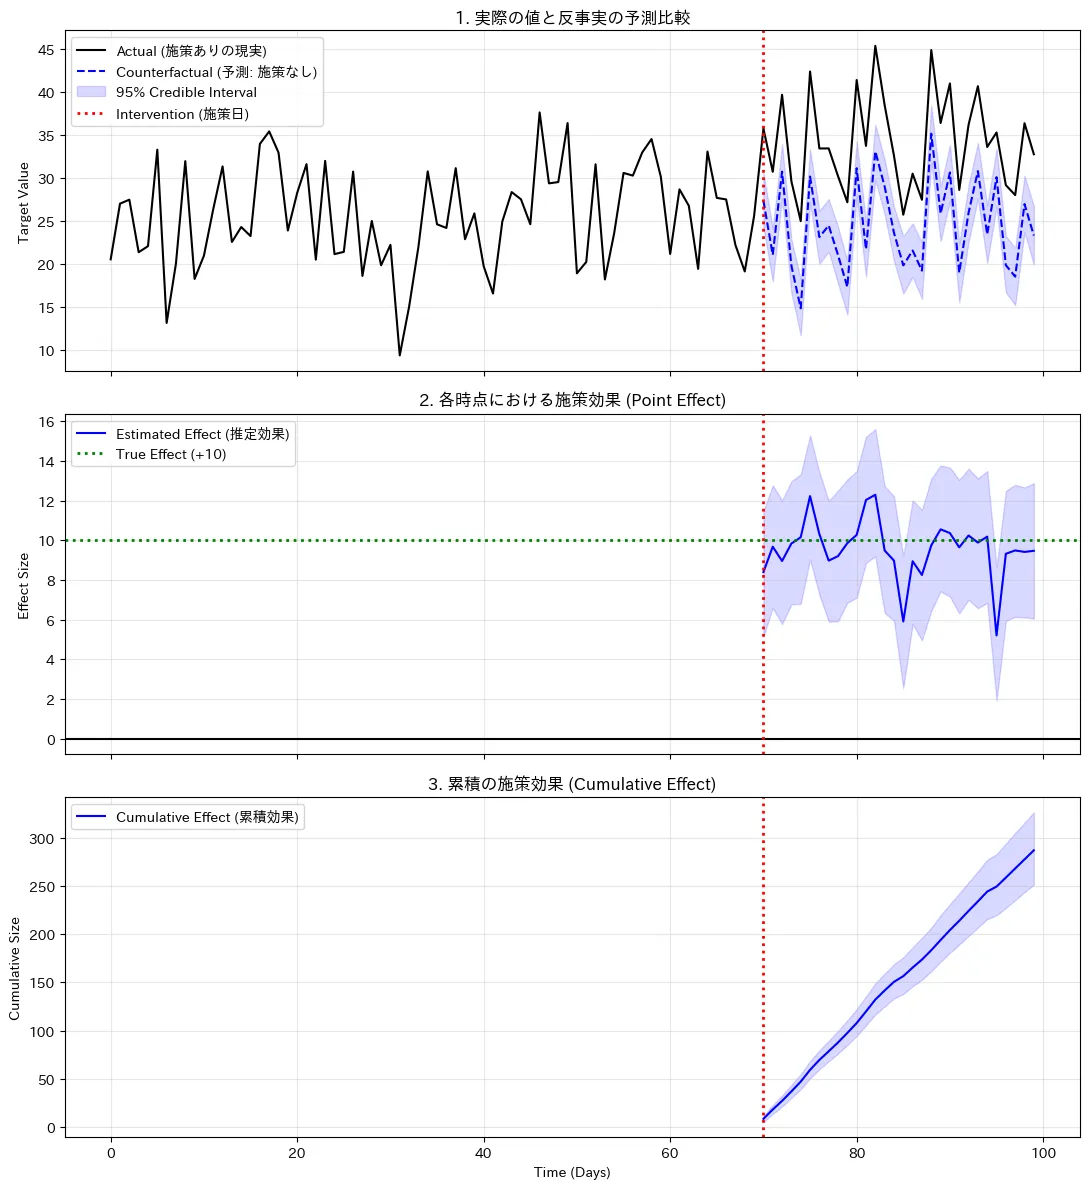
① 「正解」を見抜いたグラフ2
グラフ2の点線で示した True Effect (+10) と、MCMCシミュレーションが叩き出した Estimated Effect(青線) を見比べてみてください。モデルには「+10の施策を行った」という情報は一切与えていないにもかかわらず、見事に+10のラインを中心とした効果を逆算できていることが視覚的に分かります。
② 不確実性を表す「青い帯(95%信用区間)」の意味
グラフが未来(右側)に進むにつれて、青い帯の幅が少しずつ広がっていることに注目してください。特にグラフ3の累積効果では、その広がりがはっきりと分かります。
これは、時系列モデルのランダムウォークが「未来に行けば行くほど、予測の不確実性が増してブレが大きくなる」という時間の性質を数理的に正しく表現できている証拠です。今回は、トレンドがほぼ変化しないデータを生成したため sigma_level が小さく推定され、グラフ2の帯の広がりは緩やかです。トレンドが大きく揺れ動く実データほど、帯は急速に広がっていきます。
単なる前後の平均値の比較では、「その効果が偶然なのか、それとも本当に施策のおかげなのか」の区別がつきません。しかし、このスクラッチ実装によって、「効果の95%信用区間(青い帯)が施策後の全期間でゼロのライン(黒い横線)を上回っているから、この施策には効果があったと判断できる」という根拠を示せるようになりました。
前提条件が崩れると何が起きるか
ここでは、スクラッチ実装で得た事後分布を使い回して、実務でつまずきやすい2つのケースをシミュレーションします。
- 共変量が施策の影響を受けてしまうケース(前提条件①の違反)
- 施策の効果が、施策終了後も持ち越されるケース
どちらのケースも、施策前(0〜69日目)のデータは先ほどと全く同じです。モデルの学習(MCMC)は施策前のデータだけで行っているため、事後分布はそのまま使い回せます。変わるのは施策後のデータだけなので、反事実のシミュレーションと効果の計算だけをやり直せば十分です。
反事実シミュレーションの関数化
まず、先ほどのシミュレーションを関数にまとめます。先ほどは「サンプルごと」と「日ごと」の二重ループでしたが、ここでは全サンプル分を一度に計算して高速化しています。計算している中身(状態の更新 → 観測値の生成)は先ほどと同じです。
def simulate_counterfactual(X_post, seed=0):
    """事後分布のサンプルを使い、共変量 X_post のもとでの反事実(施策なしの世界)を生成する"""
    rng = np.random.default_rng(seed)
    n_post = len(X_post)
    preds = np.zeros((n_samples, n_post))

    # 全サンプル分のトレンドを、施策直前の状態からまとめてスタートさせる
    current_mu = mu_last_samples.copy()
    for t in range(n_post):
        # ① 状態の更新(全サンプル分を一度に計算)
        current_mu = rng.normal(current_mu, sigma_level_samples)
        # ② 観測値の生成
        preds[:, t] = rng.normal(current_mu + beta_samples * X_post[t], sigma_obs_samples)
    return preds

def average_effect(y_actual, preds):
    """施策後期間の1日あたり平均効果の、事後平均と95%信用区間を返す"""
    avg = (y_actual - preds).mean(axis=1)  # サンプルごとの平均効果
    lower, upper = np.percentile(avg, [2.5, 97.5])
    return avg.mean(), lower, upper
先ほどの二重ループによる反事実シミュレーションを、全サンプルを一度に計算する関数にまとめています。事後サンプル(mu_last_samples、beta_samples など)は、先ほど抽出したものをそのまま使います。
- 関数化の目的: 施策後の共変量 X_post を引数にすることで、「共変量だけを差し替えたシナリオ」の反事実を、MCMCをやり直さずに何度でも生成できるようにしています。
- 乱数の管理: np.random.default_rng(seed) で、呼び出しごとに乱数生成器を作っています。同じ seed を渡せば同じ乱数列が使われるため、2つのシナリオを比べるときに、乱数の違いではなく共変量の違いだけが結果に表れます。
- サンプル方向のベクトル化: 先ほどは「サンプル i」と「日 t」の二重ループでしたが、ここでは current_mu を全サンプル分の配列として持ち、日のループだけを回しています。rng.normal(current_mu, sigma_level_samples) は配列の要素ごとに正規乱数を生成するため、サンプルごとに異なるトレンドの値と揺らぎの大きさで、全サンプルを一度に更新できます。
- 状態の更新と観測値の生成: ①で前日のトレンドにランダムウォークの揺らぎを加え、②でその日のトレンドと共変量効果 beta_samples * X_post[t] の和を平均とする正規分布から観測値を生成しています。BSTSの状態方程式と観測方程式をそのままコードにしたものです。戻り値 preds の形状は (サンプル数, 施策後の日数) です。
- 平均効果の要約: average_effect では、(y_actual - preds).mean(axis=1) でサンプルごとに施策後期間の1日あたり平均効果を計算してから、その分布の平均と95%信用区間を求めています。先にサンプルごとの平均を取ることで、「平均効果そのものの不確実性」を正しく評価できます。
ケース1:共変量が施策の影響を受けてしまう
共変量 が「市場の需要を映す指標」、たとえば検索数だったとします。テレビCMを流すと、需要とは関係なく検索数そのものが押し上げられることがあります。ここでは、施策後の共変量だけが 押し上げられ、目的変数 の真の効果は元のまま というデータで推定します。
# 1. 施策(例:テレビCM)が、共変量まで押し上げてしまうケースを作る
#    X は「市場の需要を映す指標」(例:検索数)で、CMによって施策後に +2 だけ底上げされる
X_contaminated = X.copy()
X_contaminated[intervention_point:] += 2.0

# 2. 目的変数 y は元のまま(真の効果は一律 +10)
#    施策前のデータは全く同じなので、学習済みの事後分布をそのまま使える
preds_clean = simulate_counterfactual(X[intervention_point:], seed=1)
preds_contaminated = simulate_counterfactual(X_contaminated[intervention_point:], seed=1)

# 3. 推定された平均効果を比較
for label, preds in [('共変量が施策の影響を受けない場合', preds_clean),
                     ('共変量が施策の影響を受けた場合', preds_contaminated)]:
    mean, lower, upper = average_effect(y_post_actual, preds)
    print(f"{label}: 平均効果 {mean:.2f}  95%信用区間 [{lower:.2f}, {upper:.2f}](真値 10)")
同じ事後分布を使って、共変量が施策の影響を受けない場合と受けた場合の反事実を生成し、推定される効果を比べています。
- 共変量の汚染を再現: X.copy() で元の共変量を複製し、X_contaminated[intervention_point:] += 2.0 で施策後の値だけを底上げしています。元の X を直接書き換えないのは、比較用のシナリオや後続のコードで元の値を使うためです。+2.0にするのは、係数2.5を掛けると反事実が約5押し上げられ、真の効果10の半分ほどが「消える」偏りになるためです。
- 目的変数は変えない: 実際の観測値 y_post_actual はそのまま使います。真の施策効果は +10 のままで、変わったのは「モデルに渡す共変量」だけ、という状況を作っています。
- 事後分布の使い回し: 2つのシナリオとも施策前のデータは同一なので、学習済みの事後サンプルから simulate_counterfactual で反事実だけを生成しています。どちらも seed=1 を指定しているため、2つの推定値の差は共変量の違いだけから生じています。
- 結果の比較: average_effect で、それぞれの平均効果と95%信用区間を計算し、真値10と並べて表示しています。
実行結果
共変量が施策の影響を受けない場合: 平均効果 9.60  95%信用区間 [8.33, 10.92](真値 10)
共変量が施策の影響を受けた場合: 平均効果 4.76  95%信用区間 [3.50, 6.09](真値 10)
共変量が施策の影響を受けると、推定された効果は 約半分(4.76) になり、95%信用区間も真値 10 を含まなくなりました。
モデルは施策前の期間で「 が1増えると は約2.4増える」と学習しています。そのため、施策によって が 2 増えると、「 が約5増えたのは需要が増えたからだ(施策がなくても起きた)」と解釈し、その分を反事実に上乗せしてしまったのです。信用区間は狭いままなので、分析結果だけを見ても異常に気づけない 点が厄介です。共変量の選定は、データを見る前にドメイン知識で慎重に行う必要があります。
2つの場合の推定値を並べると、次のようになります。
(図は、diagram-designで作成)
ケース2:施策の効果が持ち越される
ここまでのダミーデータでは、施策の効果が初日から一律 で、施策後の期間ずっと続く形でした。しかし広告などの施策では、効果が少しずつ蓄積し、施策が終わった後もしばらく残るのが普通です。
そこで、70日目から84日目までの15日間だけ施策を行い、効果が次のように蓄積・減衰するデータを作ります。
- :その日に施策を実施していれば1、していなければ0
- :残存率(今回は 。昨日までの効果の蓄積の8割が今日に持ち越される)
施策を続けると効果は に近づき、施策をやめると毎日8割ずつに減っていきます。この「効果が一定の割合で持ち越される」構造は、広告の世界では アドストック(残存効果) と呼ばれます。
共変量 は元のままなので、反事実もケース1で作った preds_clean をそのまま使えます。
# 1. 施策期間の設定(70日目から15日間だけ施策を実施)
campaign_start, campaign_end = 70, 85
spend = np.zeros(n_periods)
spend[campaign_start:campaign_end] = 1

# 2. 効果の持ち越し(残存率 theta = 0.8)
#    今日の効果の蓄積 = 今日の施策 + 昨日までの蓄積 × 0.8
theta = 0.8
carryover = np.zeros(n_periods)
for t in range(n_periods):
    carryover[t] = spend[t] + (theta * carryover[t - 1] if t > 0 else 0)
true_effect_dyn = 10 * (1 - theta) * carryover  # 施策を続けると最大で +10 に近づく

# 3. 施策なしの推移(y_base)に、持ち越しのある効果を加える
y_dyn = y_base + true_effect_dyn
y_dyn_post = y_dyn[intervention_point:]

# 4. 共変量 X は元のままなので、反事実も先ほどと同じものを使える
point_dyn = y_dyn_post - preds_clean
cumulative_dyn = point_dyn.cumsum(axis=1)
true_cumulative = true_effect_dyn[intervention_point:].cumsum()

# 5. 「施策終了日まで」と「施策終了後15日まで」の累積効果を比較
for label, day in [('施策終了日(84日目)まで', campaign_end - 1),
                   ('施策終了後も含む(99日目)まで', n_periods - 1)]:
    idx = day - intervention_point
    lower, upper = np.percentile(cumulative_dyn[:, idx], [2.5, 97.5])
    print(f"{label}: 累積効果 {cumulative_dyn[:, idx].mean():.1f}"
          f"  95%信用区間 [{lower:.1f}, {upper:.1f}](真値 {true_cumulative[idx]:.1f})")

# 6. 可視化(各時点の効果と累積効果)
time_post = np.arange(intervention_point, n_periods)
fig, axes = plt.subplots(2, 1, figsize=(11, 8), sharex=True)

axes[0].plot(time_post, point_dyn.mean(axis=0), color='blue', label='Estimated Effect (推定効果)')
axes[0].fill_between(time_post, *np.percentile(point_dyn, [2.5, 97.5], axis=0), color='blue', alpha=0.15)
axes[0].plot(time_post, true_effect_dyn[intervention_point:], color='green', linestyle=':', linewidth=2, label='True Effect (真の効果)')
axes[0].axhline(y=0, color='black', linestyle='-')
axes[0].axvspan(campaign_start, campaign_end, color='red', alpha=0.08, label='Campaign (施策期間)')
axes[0].set_title('1. 各時点における施策効果 (Point Effect)')
axes[0].set_ylabel('Effect Size')
axes[0].legend(loc='upper right')
axes[0].grid(True, alpha=0.3)

axes[1].plot(time_post, cumulative_dyn.mean(axis=0), color='blue', label='Cumulative Effect (累積効果)')
axes[1].fill_between(time_post, *np.percentile(cumulative_dyn, [2.5, 97.5], axis=0), color='blue', alpha=0.15)
axes[1].plot(time_post, true_cumulative, color='green', linestyle=':', linewidth=2, label='True Cumulative (真の累積効果)')
axes[1].axvspan(campaign_start, campaign_end, color='red', alpha=0.08)
axes[1].set_title('2. 累積の施策効果 (Cumulative Effect)')
axes[1].set_ylabel('Cumulative Size')
axes[1].set_xlabel('Time (Days)')
axes[1].legend(loc='upper left')
axes[1].grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
施策を15日間だけ行い、効果が持ち越されるデータを作って、分析期間による累積効果の違いを確認しています。
- 施策の実施日の表現: spend は施策を実施した日だけ1になる配列で、70〜84日目の15日間を表しています。15日間にするのは、施策が終わった後の15日(85〜99日目)に、持ち越し効果が残る期間を作るためです。
- 持ち越し効果の計算: carryover[t] = spend[t] + theta * carryover[t - 1] は、「今日の施策」に「昨日までの蓄積の8割」を足す漸化式です。施策を続けると蓄積は に近づくため、(1 - theta) を掛けて、効果の最大値がちょうど10になるようにスケーリングしています。t = 0 では前日が存在しないため、条件式で場合分けしています。減衰率0.8は、効果が1日ごとに8割残り、約3日で半分になる値で、施策の終了後の15日の間に効果が減っていく様子が見えるためです。
- データの合成: 施策のない推移 y_base に真の効果 true_effect_dyn を足して、持ち越しのあるデータ y_dyn を作っています。共変量は変えていないので、反事実はケース1の preds_clean をそのまま使えます。
- 効果と累積効果の計算: y_dyn_post - preds_clean で各時点の効果を、cumsum(axis=1) で日の軸に沿った累積効果を、サンプルごとに計算しています。比較のため、真の累積効果 true_cumulative も計算しています。
- 分析期間の比較: 施策終了日(84日目)と観測期間の最終日(99日目)について、累積効果の事後平均と95%信用区間を真値と並べて表示しています。idx = day - intervention_point は、日付を「施策後期間の配列の中での位置(0始まり)」に変換する計算です。
- 可視化: 上段に各時点の効果、下段に累積効果を描き、真の値(緑の点線)と施策期間(赤い帯)を重ねています。np.percentile(..., [2.5, 97.5], axis=0) の結果を * で展開して fill_between の下限・上限に渡し、95%信用区間の帯を描いています。
実行結果
施策終了日(84日目)まで: 累積効果 112.2  95%信用区間 [94.8, 131.0](真値 111.4)
施策終了後も含む(99日目)まで: 累積効果 136.6  95%信用区間 [98.7, 176.2](真値 148.6)
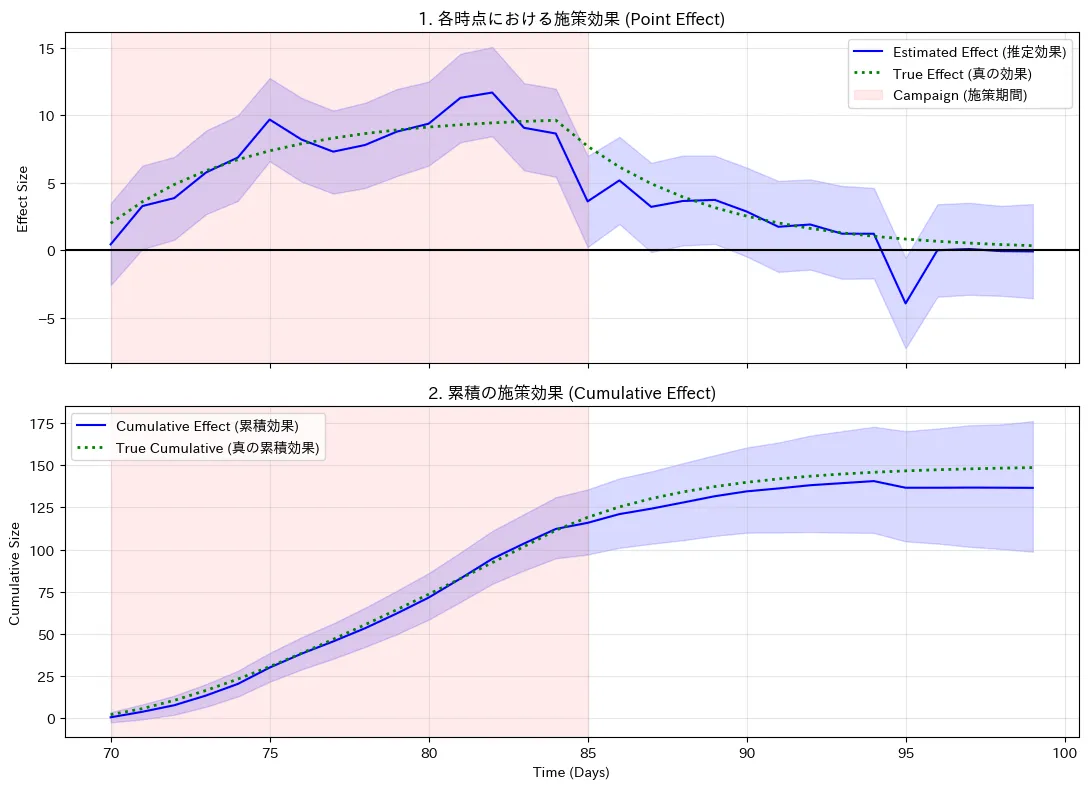
グラフ1を見ると、推定された効果(青線)は、真の効果(緑の点線)の「蓄積 → 施策終了後の減衰」という形をよく追えています。施策期間(赤い帯)が終わった85日目以降も、効果は0にすぐには戻らず、10日ほどかけて減衰していきます。
この結果から、実務上の重要な注意点が2つ分かります。
- 分析期間を施策終了日で打ち切ると、効果の総量を過小評価する:真の累積効果は、施策終了日までで 111.4、施策終了後の15日間を含めると 148.6 です。施策終了日で分析を打ち切ると、効果全体の約75%しか捉えられません。持ち越し効果の大きい施策ほど、費用対効果を低く見誤ることになります。
- ただし、分析期間を延ばすほど不確実性は大きくなる:累積効果の95%信用区間の幅は、84日目時点の約36から、99日目時点では約77へと2倍以上に広がっています。ランダムウォークの性質上、施策日から離れるほど反事実の予測は不確かになるためです。
実務では、グラフ1のように各時点の効果を確認し、「効果がほぼ0に戻るまで」を分析期間の目安にするのが現実的です。なお、効果の持ち越しをモデルの中で明示的に数式化し、複数の施策の効果を同時に推定するのが MMM(マーケティングミックスモデル) です。
causalimpact ライブラリでの実装
ここまでCausalImpactの数理ロジックとMCMCによるスクラッチ実装を解説してきましたが、実務の現場で毎回モデルを1から組むのは大変です。
実は、PythonにはGoogleのオリジナル(R言語版)をPythonに移植した pycausalimpact というライブラリが存在します。 これを使うと、私たちが裏側で実装した複雑な状態空間モデルの構築や反事実のシミュレーション、さらには効果の統計的有意差のレポート出力までを、わずか数行で実行してくれます。
ライブラリのインストール
事前に以下のコマンドでパッケージをインストールしておきます。
pip install pycausalimpact
ライブラリを使った効果測定コード
上記で作ったダミーデータ(df)をそのまま使って、ライブラリで効果測定を行ってみましょう。
from causalimpact import CausalImpact
import matplotlib.pyplot as plt

# 1. 施策前(Pre)と施策後(Post)の期間を指定し、モデルを学習させる
pre_period = [0, intervention_point - 1]
post_period = [intervention_point, n_periods - 1]
ci = CausalImpact(df, pre_period, post_period)

# ==========================================================
# 💡 Tips: y軸のスケールを最適化して見やすいグラフにするための処理
# ==========================================================
# ci.plot() は実行と同時にグラフを閉じてしまう仕様があるため、
# 一時的に plt.show() を「何もしない関数」にすり替えてミュートします。
original_show = plt.show
plt.show = lambda: None

# 2. グラフを生成(ミュート中のため、画面には出力されず裏側に保持されます)
ci.plot()

# 3. 裏側に保持されているグラフのパーツ(FigureとAxes)を取得
fig = plt.gcf()
axes = fig.get_axes()

# 4. 0日目の散漫初期化による極端なブレを画面外にカットし、適切な表示範囲に調整
y_min, y_max = df['y'].min(), df['y'].max()
margin = (y_max - y_min) * 0.2

# 1枚目(実際の値と予測)を現実的なデータ幅に設定
axes[0].set_ylim(y_min - margin, y_max + margin)
# 2枚目(各時点の施策効果)を、想定される効果量の周辺にクローズアップ
axes[1].set_ylim(-20, 30)

# 5. 本来の表示機能を元に戻し、スケール調整済みの綺麗なグラフを出力
plt.show = original_show
plt.show()
# ==========================================================

# 6. 効果測定の結果(統計的な有意差など)をまとめたテキストレポートの出力
print(ci.summary())
ここでは、Pythonの pycausalimpact ライブラリを用いて、同様の因果効果測定をより簡潔なコードで実装しています。
- モデルの初期化と学習: CausalImpact(df, pre_period, post_period) クラスをインスタンス化するだけで、ライブラリ内部で自動的に状態空間モデルが構築・学習されます。引数には、元のデータフレーム df、施策前の期間インデックスを示すリスト pre_period([0, 69])、施策後の期間インデックス post_period([70, 99])を渡します。デフォルトでは、ターゲット変数(データフレームの最初の列、ここでは y)以外の列(ここでは X)が自動的に共変量(コントロール変数)として認識されます。
- グラフの描画: 通常は ci.plot() を実行するだけで、CausalImpactが持つ「3部構成の可視化グラフ」が自動生成されます。
- 表示範囲のカスタマイズが必要な理由: ライブラリの仕様として、モデル構築の初期段階(特に0日目付近)におけるカルマンフィルタの初期化(散漫初期化)によるブレが大きく、そのまま描画するとグラフ全体の縦軸スケールが引っ張られて非常に見づらくなってしまいます。
- 描画の差し止めと軸の取得: このコードでは、plt.show を一時的にダミー関数に置き換えて描画処理を裏側に閉じ込めた上で、fig.get_axes() から各サブプロットの軸オブジェクトを取得しています。
- Y軸の表示範囲の調整: ターゲット変数の実データ幅に合わせて、1枚目のプロットのY軸表示範囲(axes[0].set_ylim)や、2枚目のプロットのY軸表示範囲(axes[1].set_ylim(-20, 30))を適切にクローズアップすることで、初期値の大きなブレによる描画崩れをカットした非常に見やすいグラフを再構築しています。
- レポートの出力: 最後に print(ci.summary()) を実行することで、推定された施策効果の平均値や累積値、それぞれの標準偏差や95%信用区間、そして効果の統計的有意性に関する要約データをテキスト形式で出力しています。
実行結果
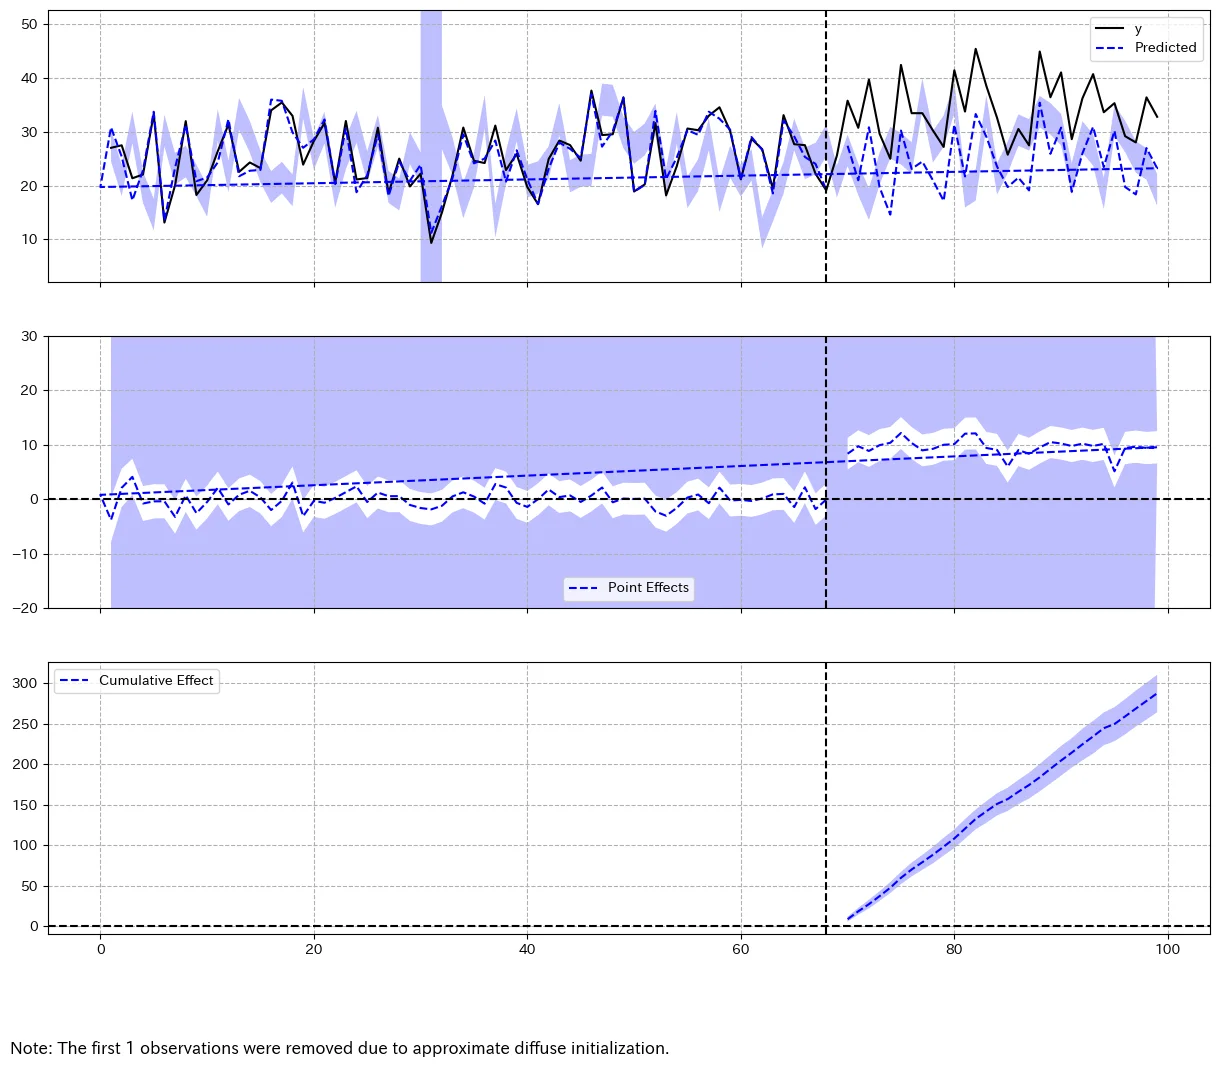
Posterior Inference {Causal Impact}
                          Average            Cumulative
Actual                    34.2               1026.04
Prediction (s.d.)         24.61 (0.42)       738.42 (12.68)
95% CI                    [23.77, 25.42]     [712.98, 762.69]

Absolute effect (s.d.)    9.59 (0.42)        287.62 (12.68)
95% CI                    [8.78, 10.44]      [263.34, 313.06]

Relative effect (s.d.)    38.95% (1.72%)     38.95% (1.72%)
95% CI                    [35.66%, 42.4%]    [35.66%, 42.4%]

Posterior tail-area probability p: 0.0
Posterior prob. of a causal effect: 100.0%

For more details run the command: print(impact.summary('report'))
出力されたテキストレポート(ci.summary())は、ベイズ統計に基づく推定結果を「平均値(Average)」と「累積値(Cumulative)」の2つの側面から要約して示しています。
- 観測値と予測値(Actual & Prediction): 施策後期間における実際の観測値(Actual)の平均値は 34.2 であったのに対し、施策が行われなかった場合の予測値(Prediction)は平均 24.61 となり、95%信用区間(95% CI)は [23.77, 25.42] であると推定されています。
- 絶対効果(Absolute effect): 実際の値と予測値の差分である「純粋な施策効果」は、1日あたり平均 9.59(95%信用区間:[8.78, 10.44])と推定されました。データ生成時に私たちが設定した真の効果(True Effect = 10)を、極めて狭い信用区間の幅の中に高精度で捉えられていることがわかります。また、30日間の累積効果(Cumulative)は計 287.62(95%信用区間:[263.34, 313.06])の売上底上げに寄与したことを示しています。
- 相対効果(Relative effect): 施策が行われなかった場合のベースライン予測と比較して、施策によって売上が +38.95%(95%信用区間:[35.66%, 42.4%])増加したことを示しており、施策のインパクトを直感的な割合で評価できます。
- 有意性の判定(Posterior tail-area probability & prob. of a causal effect): ベイズ的な片側p値に相当する Posterior tail-area probability p が 0.0 となっており、施策がなかったとしたら、これほど大きな効果が偶然のばらつきだけで観測される確率は極めて低いことを意味します。また、因果効果が存在する確率(Posterior prob. of a causal effect)は 100.0% と判定されており、この施策に統計的に有意な効果があったと自信を持って結論付けることができます。
詳細な文章レポートの自動生成
さらに、このライブラリの非常に面白い機能として、ci.summary(output='report') を実行すると、「この施策には統計的な有意差があったのか、 累積でどれくらいのインパクトがあったのか」を人間が読める英語の文章で自動生成してくれます。
ci.summary(output='report')を実行した結果
Analysis report {CausalImpact}


During the post-intervention period, the response variable had
an average value of approx. 34.2. By contrast, in the absence of an
intervention, we would have expected an average response of 24.61.
The 95% interval of this counterfactual prediction is [23.85, 25.4].
Subtracting this prediction from the observed response yields
an estimate of the causal effect the intervention had on the
response variable. This effect is 9.59 with a 95% interval of
[8.8, 10.36]. For a discussion of the significance of this effect,
see below.


Summing up the individual data points during the post-intervention
period (which can only sometimes be meaningfully interpreted), the
response variable had an overall value of 1026.04.
By contrast, had the intervention not taken place, we would have expected
a sum of 738.42. The 95% interval of this prediction is [715.37, 761.89].


The above results are given in terms of absolute numbers. In relative
terms, the response variable showed an increase of +38.95%. The 95%
interval of this percentage is [35.77%, 42.07%].


This means that the positive effect observed during the intervention
period is statistically significant and unlikely to be due to random
fluctuations. It should be noted, however, that the question of whether
this increase also bears substantive significance can only be answered
by comparing the absolute effect (9.59) to the original goal
of the underlying intervention.


The probability of obtaining this effect by chance is very small
(Bayesian one-sided tail-area probability p = 0.0).
This means the causal effect can be considered statistically
significant.

(訳)
分析レポート {因果効果}

介入後期間において、応答変数の平均値は約34.2でした。一方、介入がなかった場合、平均応答値は24.61になると予測されました。

この反事実的予測値の95%信頼区間は[23.85, 25.4]です。

この予測値を観測された応答値から差し引くことで、介入が応答変数に及ぼした因果効果の推定値が得られます。この効果は9.59で、95%信頼区間は[8.8, 10.36]です。この効果の有意性については、以下を参照してください。

介入後期間における個々のデータポイントを合計すると(必ずしも意味のある解釈ができるとは限りませんが)、応答変数の全体値は1026.04となりました。

対照的に、介入が行われなかった場合、合計値は738.42になると予想されました。この予測値の95%信頼区間は[715.37, 761.89]です。

上記の結果は絶対値で示されています。相対値で見ると、応答変数は+38.95%増加しました。この割合の95%信頼区間は[35.77%, 42.07%]です。

これは、介入期間中に観察された正の効果が統計的に有意であり、ランダムな変動によるものではない可能性が高いことを意味します。ただし、この増加が実質的な意義を持つかどうかは、絶対値(9.59)を介入の当初の目標値と比較することによってのみ判断できることに留意する必要があります。

この効果が偶然に得られる確率は非常に小さいです(ベイズ片側裾面積確率p = 0.0)。

これは、因果関係が統計的に有意であると考えられることを意味します。
ライブラリ選定の注意点とtfp-causalimpact
pycausalimpact を使う際には、2つの点に注意が必要です。
- 推定方法がスクラッチ実装と異なる:本記事のスクラッチ実装やR版のCausalImpactはMCMCによるベイズ推定ですが、pycausalimpact は statsmodels の状態空間モデルを古典的なカルマンフィルタで推定しています。そのため、R版やスクラッチ実装と結果が一致しないことがあります(今回はいずれも約9.6とほぼ同じ結果になりました)。
- メンテナンスが止まっている:PyPI上の対応バージョンはPython 3.8までと記載されており、長く更新されていません。
最近のPython環境では、Googleの研究者らが開発した tfp-causalimpact も選択肢になります。R版をTensorFlow Probabilityで実装したもので、R版と同様にベイズ推定を行います(ただし、Googleの公式サポート製品ではないと明記されています)。
pip install tfp-causalimpact
import causalimpact

# 1. 施策前(Pre)と施策後(Post)の期間を指定し、モデルを学習させる
#    (列の並びは pycausalimpact と同じく、1列目が目的変数、残りが共変量)
pre_period = [0, intervention_point - 1]
post_period = [intervention_point, n_periods - 1]
impact = causalimpact.fit_causalimpact(
    data=df,
    pre_period=pre_period,
    post_period=post_period,
    seed=42,
)

# 2. 効果測定の結果(テキストレポート)
print(causalimpact.summary(impact, output_format='summary'))
tfp-causalimpact を使って、同じデータで効果測定を行っています。
- モデルの学習: causalimpact.fit_causalimpact に、データフレーム df と施策前後の期間を渡すだけで、BSTSモデルの構築からベイズ推定、反事実の予測までを一括で行います。pycausalimpact と同様に、1列目が目的変数、残りの列が共変量として扱われます。
- 期間の指定: pre_period と post_period は、いずれも [開始, 終了] の両端を含むインデックスで指定します。
- 乱数の固定: seed=42 で推定に使う乱数を固定し、結果を再現できるようにしています。
- レポートの出力: causalimpact.summary(impact, output_format='summary') で、R版と同じ形式の要約表を出力します。output_format='report' を指定すると、結果を文章で説明するレポートが得られます。
実行結果
Posterior Inference {CausalImpact}
                          Average            Cumulative
Actual                    34.2               1026.0
Prediction (s.d.)         24.6 (0.56)        738.0 (16.72)
95% CI                    [23.4, 25.7]       [702.8, 770.6]

Absolute effect (s.d.)    9.6 (0.56)         288.0 (16.72)
95% CI                    [8.5, 10.8]        [255.4, 323.2]

Relative effect (s.d.)    39.1% (3.2%)       39.1% (3.0%)
95% CI                    [33.1%, 46.0%]     [33.1%, 46.0%]

Posterior tail-area probability p: 0.001
Posterior prob. of a causal effect: 99.89%

For more details run the command: summary(impact, output_format="report")
平均効果は 9.6(95%信用区間 [8.5, 10.8])となり、スクラッチ実装や pycausalimpact とほぼ同じ結果が得られました。
tfp-causalimpact 0.2.0、TensorFlow 2.21、TensorFlow Probability 0.25、pandas 2.3.3 で動作を確認しています。この環境では、別途 tf_keras のインストール(pip install tf_keras)が必要でした。また、pandas 3系では causalimpact.summary がエラーになったため、pandas 2系を使用しています。ライブラリの依存関係は変化しやすいため、実行時には公式リポジトリの最新情報も確認してください。
応用:施策をしていない地域を共変量にする(ジオ実験)
本記事のダミーデータでは、共変量 を抽象的な「市場のトレンド」として扱いました。これを 施策を行っていない地域の売上 に置き換えると、CausalImpactは地域単位の広告効果を測る道具になります。
施策前の期間で「施策地域の売上は、他の地域の売上の組み合わせでどう説明できるか」を学習し、施策後の反事実を予測するわけです。さらに、どの地域で施策を行うかをランダムに決めれば、地域単位のランダム化実験になります。これを ジオ実験(Geo Experiment) と呼び、Cookieに頼らずに広告の効果を測れる方法として、広告効果測定の実務で広く使われています。
ジオ実験に使う際のポイントは次のとおりです。
- 候補地域が多い場合は、共変量の選択が重要になる:本家のCausalImpact(R版やtfp-causalimpact)は、スパイク・スラブ事前分布と呼ばれる方法で、多数の候補の中から予測に役立つ共変量を自動的に選びます。本記事のスクラッチ実装は共変量が1つだけなので、この仕組みは入れていません。
- スピルオーバーに注意する:前提条件③の通り、施策地域と隣接していて施策の影響が漏れやすい地域は、共変量から外すのが安全です。
- 合成コントロール法との関係:非施策地域の組み合わせで反事実を作るという発想は、合成コントロール法と共通しています。合成コントロール法では、地域の重みを「0以上で合計1」に制限し、施策地域を他の地域の加重平均として表現します。CausalImpactの回帰係数にはこの制限がなく、さらに時間とともに変化するトレンド も持つ点が異なります。
ジオ実験で得られた効果は、単体の効果測定に使われるだけでなく、複数の広告チャネルの効果を同時に推定するMMMの「事前情報」としても活用されます(MMMの記事を参照してください)。
ジオ実験の構成を図にすると、次のようになります。
(図は、diagram-designで作成)
実務における注意点
- 「今回のスクラッチ実装では、ロジックの直感的な理解のためにサンプリング後の未来をPythonのforループで1日ずつシミュレーションしました。 実務でデータ量が膨大な場合や、より複雑な季節性を扱う場合は、本家Googleのアルゴリズムのようにシミュレーション・スムーザー(Simulation Smoother)等を用いて状態そのものを一括でサンプリングするアプローチが取られます」
- 「実務のデータに適用する場合、曜日ごとの変動(7日周期)などの『季節性』を考慮する必要があります。数式としては観測方程式に (季節成分)を追加し、状態方程式で『過去7日間の合計が0になる』といった制約を設けることで、曜日ノイズを綺麗に吸収した反事実予測が可能になります」
- 「実務でコントロール変数の選定や予測精度に自信が持てないときは、施策を実行していない過去の期間に対してあえてCausalImpactをかけてみる『プラセボテスト』が有効です。何もしていない期間で効果が『0(有意差なし)』と正しく出力されれば、そのモデルは通常時のトレンドを完璧に捉えられている(=施策後の反事実予測も信頼できる)という強力な証明になります」
まとめ
本記事では、施策や介入による影響を「反事実(もし施策を行っていなかったら)」との比較によって高精度に評価するCausalImpact(因果効果測定) について解説しました。
記事を通じて、以下のステップを実践・学習しました。
- CausalImpactの理論と数理の理解: ベイズ構造時系列モデル(BSTS)における「観測方程式」と「状態方程式」の役割、および「反事実」を用いた引き算による効果測定のロジックを学びました。
- 検証用データのシミュレーション: 施策日以降に一律で効果(+10)が加わるターゲット変数と、施策に影響されない共変量のダミーデータをPythonで生成しました。
- PyMCによるスクラッチ実装: 状態の推移におけるサンプラーの「発散(Divergences)」を防ぐため、「非中心化パラメータ化(Non-centered Parameterization)」を施したモデルを構築し、MCMCによる安定したサンプリングを実証しました。
- 反事実のシミュレーションと可視化: MCMCの事後分布パラメータを泥臭くループ処理して施策なしの未来をシミュレーションし、3部構成(現実と予測の比較、点推定効果、累積効果)のグラフと「95%信用区間(予測の帯)」を再現しました。
- pycausalimpact ライブラリの実用: 実務で強力なツールとなるライブラリ版の実装方法、初期化ブレを抑えるためのY軸のスケール調整テクニック、および自動生成される詳細なサマリーレポートの読み方を解説しました。あわせて、ベイズ推定を行う tfp-causalimpact も紹介しました。
- 前提条件とその違反: 共変量が施策の影響を受けないこと、共変量との関係が安定していること、スピルオーバーがないことなどの前提条件を整理しました。共変量が施策の影響を受けると効果が大きく過小評価され、しかも結果だけからは気づけないことを確認しました。
- 効果の持ち越しと分析期間: 施策の効果が施策終了後も持ち越される場合、分析期間を施策終了日で打ち切ると効果の総量を過小評価します。一方で、分析期間を延ばすほど反事実の不確実性は大きくなります。
- ジオ実験への応用: 施策を行っていない地域の売上を共変量にすると、地域単位で広告効果を測るジオ実験の分析に使えます。
CausalImpactは、前提条件が満たされていれば、曜日要因や市場トレンドといった外部要因の影響を取り除き、予測が持つ「不確実性」までも信用区間という形で定量化できる極めて強力なフレームワークです。実務におけるマーケティング施策や新機能リリースの効果測定など、確度の高い意思決定が求められる局面でぜひ役立ててください。
本記事で触れたジオ実験と合成コントロール法については、合成コントロール法とジオ実験の記事で詳しく解説しています。また、効果の持ち越しを数式として組み込み、複数の広告チャネルの効果を同時に推定する方法は、MMM(マーケティングミックスモデル)の記事で解説しています。
参考文献
- K. H. Brodersen, F. Gallusser, J. Koehler, N. Remy, S. L. Scott (2015). Inferring causal impact using Bayesian structural time-series models. Annals of Applied Statistics, 9(1), 247–274.
- Google. CausalImpact(R パッケージ). GitHub.
- Google. tfp-causalimpact. GitHub.
- Dafiti. pycausalimpact. GitHub.
本記事の文章・構成の一部に生成AIを使用しています。