共役勾配法(Conjugate Gradient Method)とは?
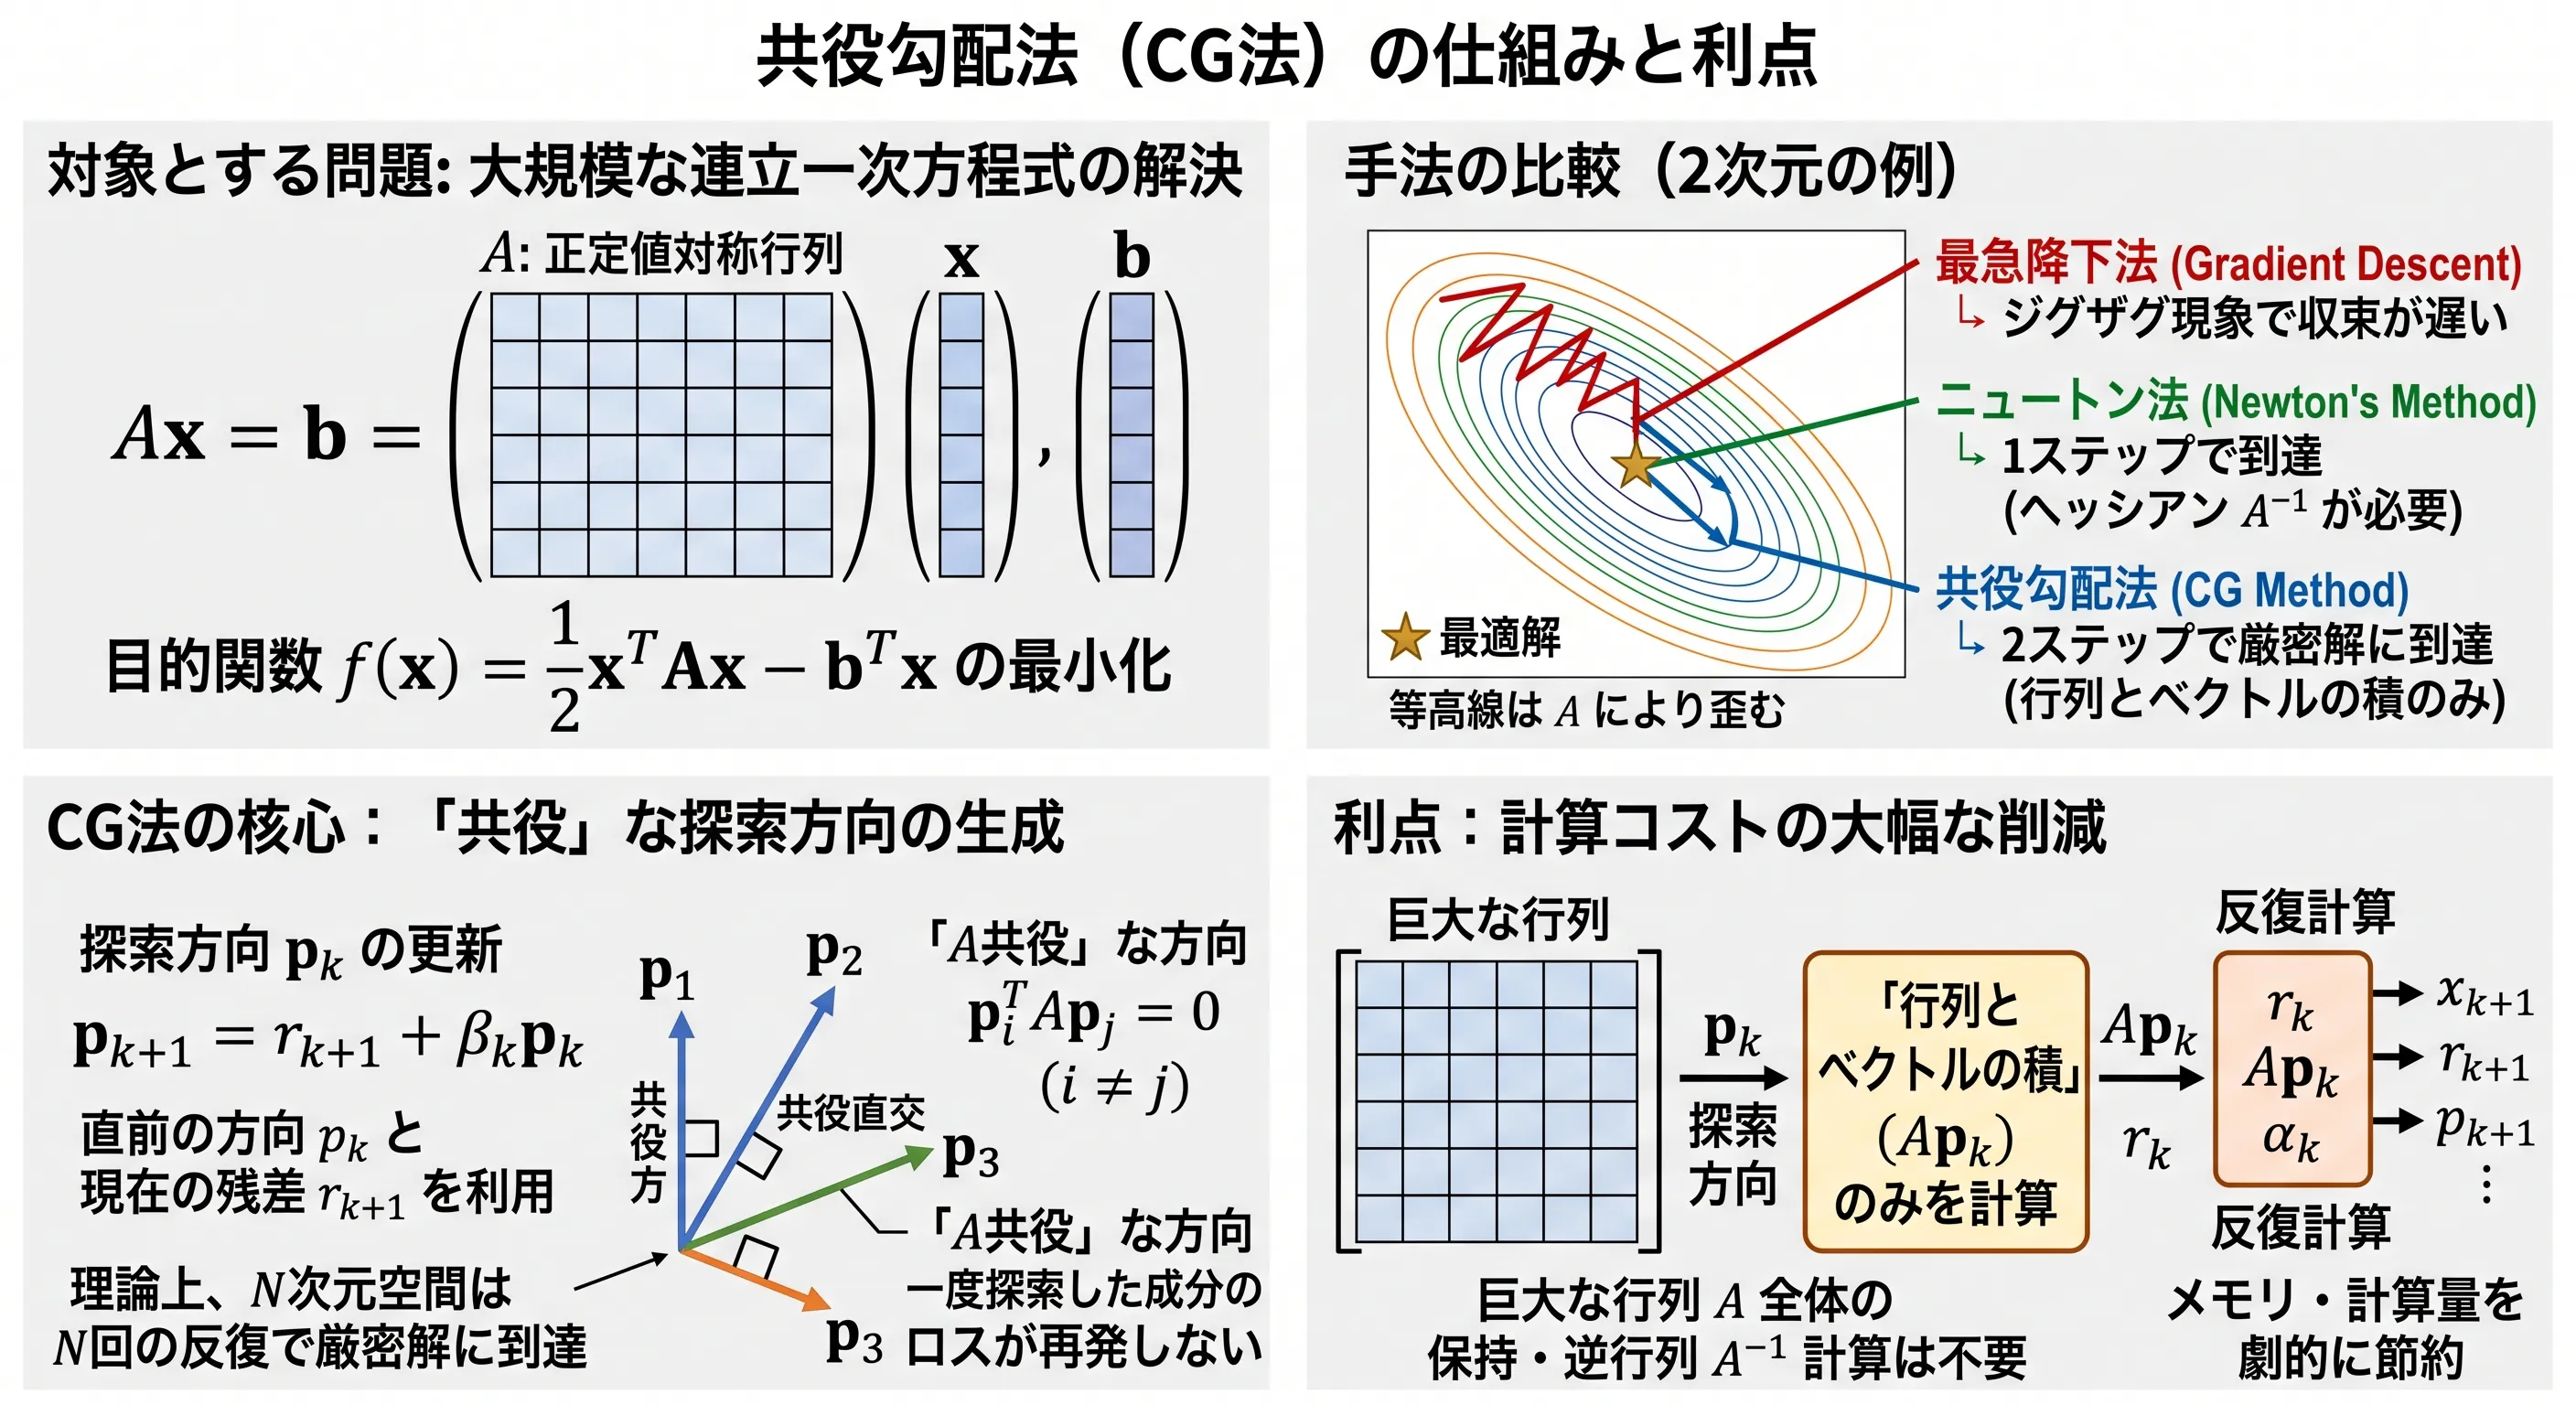 (画像は、Geminiで作成)
最急降下法が等高線の歪んだ関数でジグザグに進んで収束が遅くなる理由と、探索方向を互いに「共役」に保つことで、 次元の二次関数を最大 回で解ける共役勾配法の仕組みを、ニュートン法との違いとともに理解すること。Python で2次元の例を解き、最急降下法と探索の軌跡や誤差の減り方を比べて、行列とベクトルの積だけで計算できることが TRPO などで役立つ理由を説明できるようになること。
共役勾配法の概要
共役勾配法(Conjugate Gradient Method:CG法) は、正定値対称行列を係数とする大規模な連立一次方程式を高速に解くための反復法です。機械学習や最適化の文脈では、目的関数を最小化するための強力なアルゴリズムとして知られています。
単純な勾配降下法(最急降下法)で最適化を行おうとすると、目的関数の等高線が楕円形に歪んでいる場合にジグザグと無駄な探索を繰り返し、収束が著しく遅くなる問題があります。ニュートン法を使えば少ないステップで最適解に到達できますが、パラメータ数 が多い巨大なモデルでは、ヘッシアン(2階微分行列)の全成分の保持にメモリが 、逆行列の計算に かかるため、現実的ではなくなります。
CG法は、行列に対して「共役(-直交)」という特別な直交性を持つ探索方向を次々と生成することで、一度最小化した方向の成分を後のステップで崩すことなく、効率的に最適解へと向かいます。 丸め誤差がなければ、パラメータの次元数以下の反復で厳密解に到達できるという性質を持っています。さらに最大の利点として、アルゴリズムの計算過程で必要になるのは「行列とベクトルの掛け算」の演算結果だけであり、巨大な行列の全成分や逆行列を直接メモリに展開・計算する必要が一切ありません。
最急降下法・ニュートン法との違い(探索のルール)
各アルゴリズムが、現在の解 からどのように探索方向を決定するかを比較してみましょう。ここでは二次関数 の最小化(方程式 の解決)を考えます。
3つの手法の探索方向を並べると、次のようになります。
(図は、diagram-designで作成)
最急降下法 (Steepest Descent)
常に現在位置の最も傾きが急な方向(マイナスの勾配方向)へ進みます。
- 探索方向: 勾配の逆方向
の導出過程
目的関数 について、ベクトル で微分して勾配 を求めます。 係数行列 は対称行列()であるため、二次形式の微分の公式を用いると以下のようになります。
最急降下法では、現在の位置から最も傾きが急な方向(=勾配の逆方向)へ進むため、探索方向は となります。
- 課題: 谷が細長い(条件数が大きい)場合、谷の壁をジグザグに反射するように進んでしまい、谷底の最適解に向かうスピードが極端に落ちます。
ニュートン法 (Newton’s Method)
2階微分(ヘッシアン )の情報を使い、曲率を考慮して1回のステップで直接最適解(谷底)を狙います。
- 探索方向:
の導出過程
ニュートン法では、目的関数の2階微分であるヘッセ行列(ヘッシアン) を用いて、関数の曲率を考慮した探索を行います。一般的なニュートン法の更新ステップは以下の式で与えられます。
今回の目的関数 を2階微分すると、ヘッセ行列は係数行列そのままの となります。 これを上記の式に代入することで、ニュートン法における探索方向が得られます。
- 課題: 巨大な行列 の逆行列(または連立方程式の直接解法)が必要で、高次元の問題では計算量()とメモリ()が重くなります。
共役勾配法 (Conjugate Gradient)
最急降下法の「ジグザグ現象」を回避し、かつニュートン法のような「逆行列計算」を不要にするのが共役勾配法です。各ステップの探索方向 を、過去のすべての探索方向と「行列 に関して直交(共役)」になるように決定して進みます。
添え字の意味について( など) 共役勾配法のような「反復法(何度もループを繰り返して正解に近づいていくアルゴリズム)」において、数式に登場するこれらの添え字は基本的に「何回目のステップ(反復)か」というカウント番号(1回目、2回目、3回目…)を表しています。このことを踏まえて、以下の解説をお読みください。
「行列 に関して共役」とは? 2つのベクトル と が以下の関係を満たすとき、それらは行列 に関して共役(-直交)であると言います。
ここで と は特定の「今」や「1つ前」ではなく、「全体のステップの中の、ある適当な2つのステップ」を指す記号です。つまり、カッコの中の は「ステップ番号 と が違う数字のとき」を意味しており、この式は「1回目と2回目、2回目と5回目など、とにかく『違うステップ』の方向を2つ取り出して計算したら、必ず -直交(結果がゼロ)になる」という状態を表しています。 通常の直交()とは異なり、目的関数の歪み(行列 の影響)を考慮した空間上で直交していることを意味します。図にすると、楕円の等高線を円に引き伸ばした座標で直交している、ということです。
- 探索方向: 新しい探索方向 は、現在の最も急な方向である残差(マイナスの勾配 )と、直前の探索方向 の線形結合として計算されます。
添え字の は「現在計算しているステップ(今まさに進めようとしている番)」を、 は「今のステップの1つ前(直前のステップ)」を表します。 すなわちこの式は、「今の新しい進み方()は、現在の最も急な傾き()に、1つ前で進んだ方向()をうまく混ぜ合わせて(線形結合して)決定する」というルールを数式で表現しているものです。
はどのように決まるのか?
新しい探索方向 を決定する際、「現在の最も急な方向(残差) に、直前の方向 を少しだけ混ぜてみよう」と仮定して式を立てます。(コード上では新しい残差 r_new が 、直前の探索方向 p が に相当します)
共役勾配法の絶対のルールは、「新しい方向 は、直前の方向 と -直交()でなければならない」という点です。 そこで、上の式の両辺に左から を掛けます。
左辺は -直交のルールにより にならなければなりません。したがって右辺を展開すると以下のようになります。
この方程式を について解くと、直前の方向と -直交にするための「完璧な混ぜ合わせ具合()」が導き出されます。
このように、「直交するというゴール(結果)から逆算して、混ぜ合わせる比率 を決定している」 のがこの式の正体です。
【実装で使われるシンプルな式への変形】 理論上導かれた上記の式には行列 との掛け算が含まれており計算コストがかかりますが、共役勾配法の美しい数学的性質を利用すると、この式は劇的にシンプルになります。
残差の更新は、解の更新式()の両辺に を掛けて を足すことで得られる以下の関係になります(ここで はパラメータ更新時の歩幅です)。
この式を変形して を取り出します。
これを の分子と分母の にそれぞれ代入して整理します。
① 分子の変形
ここで、共役勾配法の性質として「各ステップの残差同士は直交する()」ため、次のように整理されます。
② 分母の変形
共役勾配法では「現在の残差は過去の探索方向と直交する()」という性質があり、さらに探索方向の定義()から となるため、次のように整理されます。
③ 結論 これらを元の の式に当てはめると、歩幅 とマイナスの符号が綺麗に打ち消し合い、最終的に行列 が完全に消えて以下の形になります。
実際の実装(コード内の beta = np.dot(r_new, r_new) / np.dot(r, r))では、計算を極限まで効率化するためにこの変形された式が使われています。
共役勾配法の最も優れているポイントは、更新式では「1つ前の方向()」だけを見て新しい方向()を決めているのに、結果として出来上がった方向は、過去のすべてのステップ(前述の と )の方向と互いに独立して干渉しない(-直交になる)という点にあります。
- 利点: アルゴリズムの中で最も重い計算は、 や歩幅を求める際の 「行列 とベクトル の掛け算()」 だけであり、逆行列 を求める必要がありません。 また、一度探索した方向については最適化が完全に完了し、その方向の最適性が後から崩れることがありません(独立性が保たれる)。添え字を「ステップの番号札」として読み替えると、アルゴリズムが互いに干渉しない独立したステップを順番に踏んでいる様子が直感的にイメージしやすくなるはずです。 結果として、変数の数が 個( 次元空間)であれば、丸め誤差がなければ 最大でも 回のステップで厳密解に到達します(実際の計算では誤差で共役性が少しずつ崩れるため、残差が十分小さくなるまで反復を続けます)。
1 回の反復の流れを図にすると、次のようになります。
(図は、diagram-designで作成)
コードによる挙動の確認
それでは、Pythonコードを使って最急降下法と共役勾配法の挙動を確認してみましょう。 目的関数として、等高線が楕円となる二次関数 を設定します。行列 ・ベクトル ・初期点は、CG 法の入門書として広く読まれている Shewchuk の An Introduction to the Conjugate Gradient Method Without the Agonizing Pain と同じ例です。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフ日本語表示用

# 係数行列 A と ベクトル b の設定(Shewchuk の CG の入門書と同じ例。固有値は 2 と 7 で、等高線が楕円になる)
A = np.array([[3.0, 2.0],
              [2.0, 6.0]])
b = np.array([2.0, -8.0])

# 目的関数 f(x)
def f(x):
    return 0.5 * np.dot(x.T, np.dot(A, x)) - np.dot(b.T, x)

# 勾配(1階微分)
def grad_f(x):
    return np.dot(A, x) - b

print("固有値:", np.linalg.eigvalsh(A), " 条件数:", np.linalg.cond(A))
print("Ax = b の解:", np.linalg.solve(A, b))

# 探索空間の設定
x_vals = np.linspace(-6, 6, 100)
y_vals = np.linspace(-6, 6, 100)
X, Y = np.meshgrid(x_vals, y_vals)
Z = np.zeros_like(X)

for i in range(X.shape[0]):
    for j in range(X.shape[1]):
        Z[i, j] = f(np.array([X[i, j], Y[i, j]]))

# 目的関数の等高線の可視化
plt.figure(figsize=(8, 6))
plt.contour(X, Y, Z, levels=30, cmap='viridis', alpha=0.8)
plt.title("目的関数 f(x) の等高線")
plt.xlabel("変数 x1")
plt.ylabel("変数 x2")
plt.colorbar(label='f(x) の値')
plt.plot(2.0, -2.0, marker='*', color='gold', markersize=15, markeredgecolor='black', label='最適解')
plt.legend()
plt.grid(True, linestyle='--', alpha=0.5)
plt.show()
最急降下法と共役勾配法を比べるための二次関数と、その勾配を定義し、等高線を描くコードです。
- と : は正定値対称行列で、固有値は 2 と 7(条件数 3.5)です。固有値が等しければ等高線は円になり、どの方法でも 1 回で最適解に着きますが、固有値に差があるので楕円になり、最急降下法のジグザグが現れます。条件数 3.5 は大きくありませんが、2 次元で軌跡の違いを目で確かめるには十分です。
- 最適解: np.linalg.solve(A, b) で を直接解き、最適解が であることを先に確かめます。以降の図の星印と、到達点の誤差は、この値を基準にしています。
- 目的関数と勾配: f が 、grad_f が です。勾配が 0 になる点が の解なので、この関数を最小化することは連立一次方程式を解くことと同じです。
- 等高線: から の範囲に 100×100 の格子点を作り、各点で を計算して plt.contour で 30 本の等高線を描きます。
実行結果
固有値: [2. 7.]  条件数: 3.499999999999999
Ax = b の解: [ 2. -2.]
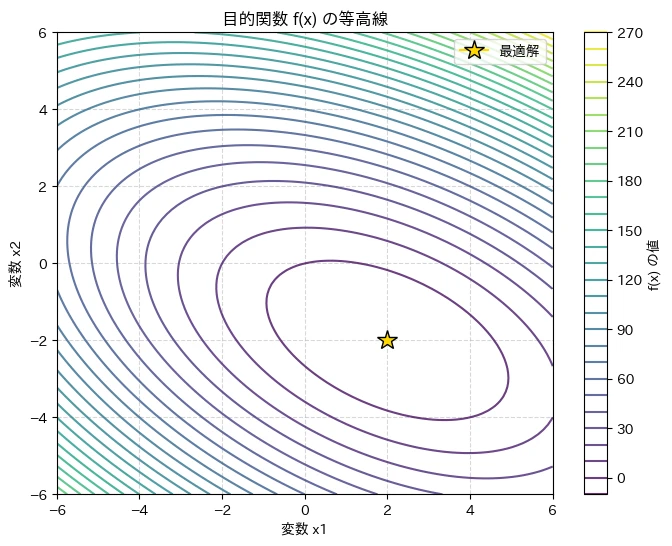
等高線は、右下に傾いた楕円です。最適解(星印)は の解 にあります。
最急降下法による探索(ジグザグ現象)
最初に、最急降下法(正確な直線探索付き)で探索します。
# 初期解の設定(Shewchuk の入門書と同じ点)
x_init = np.array([-2.0, -2.0])

# 最急降下法
x_sd = x_init.copy()
path_sd = [x_sd.copy()]

for _ in range(15):
    g = grad_f(x_sd)

    # 勾配が十分に小さければ終了
    if np.linalg.norm(g) < 1e-5:
        break

    # 正確な直線探索(Exact Line Search)による最適な歩幅 alpha の計算
    alpha = np.dot(g, g) / np.dot(g, np.dot(A, g))

    # パラメータの更新
    x_sd = x_sd - alpha * g
    path_sd.append(x_sd.copy())

print(f"最急降下法の反復回数: {len(path_sd)-1}")
print(f"到達した解: {x_sd}")
print(f"最適解からの距離: {np.linalg.norm(x_sd - np.array([2.0, -2.0])):.2e}")

# 最急降下法の探索軌跡の可視化
path_sd_np = np.array(path_sd)
plt.figure(figsize=(8, 6))
plt.contour(X, Y, Z, levels=30, cmap='viridis', alpha=0.8)
plt.plot(path_sd_np[:, 0], path_sd_np[:, 1], marker='o', color='red', linestyle='-', linewidth=2, label='最急降下法')
plt.plot(2.0, -2.0, marker='*', color='gold', markersize=15, markeredgecolor='black', label='最適解')
plt.title("最急降下法の探索軌跡(ジグザグ現象)")
plt.xlabel("変数 x1")
plt.ylabel("変数 x2")
plt.legend()
plt.grid(True, linestyle='--', alpha=0.5)
plt.show()
最急降下法を、毎回その方向での最適な歩幅(正確な直線探索)で 15 回まで行い、軌跡と到達点を確かめるコードです。
- 初期点と回数: 初期点 は Shewchuk の入門書と同じです。15 回は、最急降下法がどこまで近づくかを見るための上限で、勾配の大きさが より小さくなったら途中で止めます。
- 歩幅: alpha = np.dot(g, g) / np.dot(g, np.dot(A, g)) は、勾配の逆方向に進んだときに が最小になる歩幅です。 を で微分して 0 とおくと求まります(直線探索の記事の「正確な直線探索」です)。歩幅を最も良く選んでいるので、残るジグザグは方向の決め方によるものです。
- 到達点の誤差: 最適解 からの距離を表示して、15 回でどこまで近づいたかを数値で確かめます。
実行結果
最急降下法の反復回数: 15
到達した解: [ 1.99988641 -1.99991796]
最適解からの距離: 1.40e-04
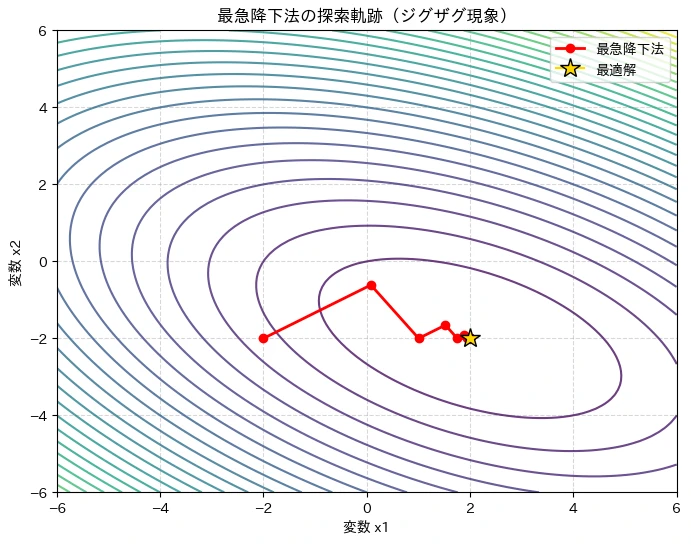
最急降下法は、15 回の更新で最適解からの距離が まで縮みましたが、勾配の大きさはまだ を下回らず、15 回すべてを使いました。正確な直線探索では、その方向で最小になる点で止まるので、次の勾配は今の方向と直交し、直角に折れ曲がりながら進みます。
共役勾配法による探索
次に、共役勾配法を用いて同じ初期位置から探索を行います。
# 共役勾配法 (Conjugate Gradient)
x_cg = x_init.copy()
path_cg = [x_cg.copy()]

# 初期状態のセットアップ
r = b - np.dot(A, x_cg)  # 残差(-勾配に相当)
p = r.copy()             # 探索方向
directions = []          # 使った探索方向(共役になっているかを後で確かめる)

for _ in range(15):
    if np.linalg.norm(r) < 1e-5:
        break

    directions.append(p.copy())
    # Aと探索方向pの掛け算(これがアルゴリズム中で最も重い計算)
    Ap = np.dot(A, p)

    # 歩幅 alpha の計算
    alpha = np.dot(r, r) / np.dot(p, Ap)

    # パラメータの更新
    x_cg = x_cg + alpha * p
    path_cg.append(x_cg.copy())

    # 新しい残差の計算
    r_new = r - alpha * Ap

    # 探索方向の修正係数 beta の計算
    beta = np.dot(r_new, r_new) / np.dot(r, r)

    # 共役な新しい探索方向 p の決定
    p = r_new + beta * p
    r = r_new

print(f"共役勾配法の反復回数: {len(path_cg)-1}")
print(f"到達した解: {x_cg}")
print(f"最適解からの距離: {np.linalg.norm(x_cg - np.array([2.0, -2.0])):.2e}")
p0, p1 = directions[0], directions[1]
print(f"p0 と p1 の内積 p0^T p1 = {p0 @ p1:.3f}(普通の意味では直交していない)")
print(f"A を挟んだ内積 p0^T A p1 = {p0 @ A @ p1:.1e}(A に関して共役)")

# 共役勾配法の探索軌跡の可視化
path_cg_np = np.array(path_cg)
plt.figure(figsize=(8, 6))
plt.contour(X, Y, Z, levels=30, cmap='viridis', alpha=0.8)
plt.plot(path_cg_np[:, 0], path_cg_np[:, 1], marker='s', color='blue', linestyle='-', linewidth=2, label='共役勾配法 (CG)')
plt.plot(2.0, -2.0, marker='*', color='gold', markersize=15, markeredgecolor='black', label='最適解')
plt.title("共役勾配法の探索軌跡(2ステップで到達)")
plt.xlabel("変数 x1")
plt.ylabel("変数 x2")
plt.legend()
plt.grid(True, linestyle='--', alpha=0.5)
plt.show()
共役勾配法で同じ初期点から探索し、2 回で最適解に着くことと、使った 2 つの方向が に関して共役になっていることを確かめるコードです。
- 初期化: r = b - np.dot(A, x_cg) が残差 (マイナスの勾配)で、最初の方向は最急降下法と同じ です。
- 行列ベクトル積: Ap = np.dot(A, p) は、反復の中で唯一 を使う計算です。歩幅と残差の更新の両方に同じ Ap を使い回すので、1 回の反復で行列ベクトル積は 1 回だけです。巨大な問題では、 を行列として持たず、この積を計算する関数だけを用意することもできます(TRPO のフィッシャー・ベクトル積がその例です)。
- 歩幅と更新: alpha = np.dot(r, r) / np.dot(p, Ap) は、方向 で が最小になる歩幅 です。残差は r - alpha * Ap で差分更新し、 を計算し直す手間を省きます。
- 次の方向: beta = np.dot(r_new, r_new) / np.dot(r, r) が上で導いた で、p = r_new + beta * p が新しい方向です。この混ぜ方で、新しい方向は前の方向と に関して共役になります。
- 共役の確認: 使った方向を directions にためておき、(普通の内積)と ( を挟んだ内積)を表示します。
実行結果
共役勾配法の反復回数: 2
到達した解: [ 2. -2.]
最適解からの距離: 0.00e+00
p0 と p1 の内積 p0^T p1 = 28.991(普通の意味では直交していない)
A を挟んだ内積 p0^T A p1 = 0.0e+00(A に関して共役)
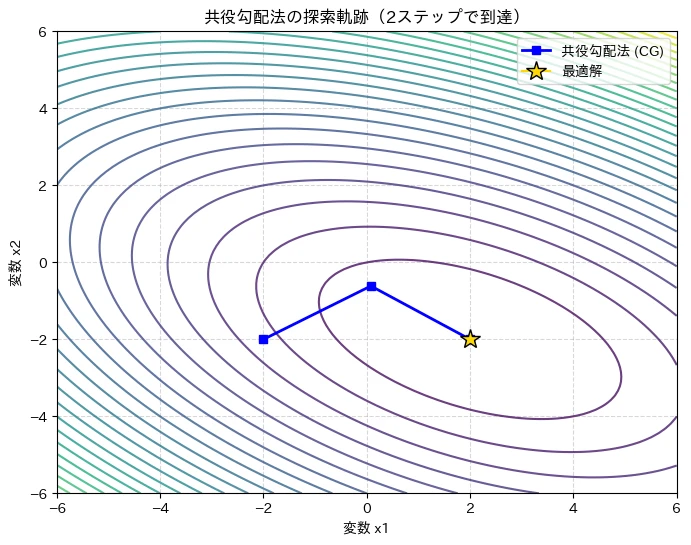
- 2 回で厳密解: 2 次元の問題に対し、2 回の更新で にちょうど着きました(誤差 0)。最急降下法が 15 回で だったのと比べると、方向の決め方だけでこれだけの差が出ます。
- 共役になっている: 2 つの方向の普通の内積は 28.991 で直交していませんが、 を挟んだ内積は 0 です。1 回目の方向で最小にした成分を、2 回目の方向で崩さないので、2 回で終わります。
- 1 回目は同じ: 1 回目の方向は最急降下法と同じ なので、最初の点 までは同じ軌跡です。違いが出るのは 2 回目からです。
2つの手法の結果を並べると、次のようになります。
(図は、diagram-designで作成)
探索軌跡の可視化
両者の軌跡を等高線グラフ上で比較し、どれほどの差が出るのかを視覚的に確認します。
path_sd = np.array(path_sd)
path_cg = np.array(path_cg)

plt.figure(figsize=(10, 8))
# 等高線の描画
plt.contour(X, Y, Z, levels=30, cmap='viridis', alpha=0.6)

# 最急降下法の軌跡(赤色)
plt.plot(path_sd[:, 0], path_sd[:, 1], marker='o', color='red',
         linestyle='-', linewidth=2, label='最急降下法', alpha=0.8)

# 共役勾配法の軌跡(青色)
plt.plot(path_cg[:, 0], path_cg[:, 1], marker='s', color='blue',
         linestyle='-', linewidth=2, label='共役勾配法 (CG)', alpha=0.8)

# 最適解のプロット
plt.plot(2.0, -2.0, marker='*', color='gold', markersize=15,
         markeredgecolor='black', label='最適解')

plt.title("最急降下法と共役勾配法の探索軌跡の比較", fontsize=14, fontweight='bold')
plt.xlabel("変数 x1", fontsize=12)
plt.ylabel("変数 x2", fontsize=12)
plt.legend()
plt.grid(True, linestyle='--', alpha=0.5)
plt.show()
2 つの方法の軌跡を、同じ等高線の上に重ねて描くコードです。
- 重ね描き: 最急降下法を赤の丸、共役勾配法を青の四角で描き、最適解を星印で示します。等高線と軌跡は alpha で半透明にして、重なっても両方が見えるようにしています(ここでの alpha は歩幅ではなく、Matplotlib の透明度です)。
実行結果
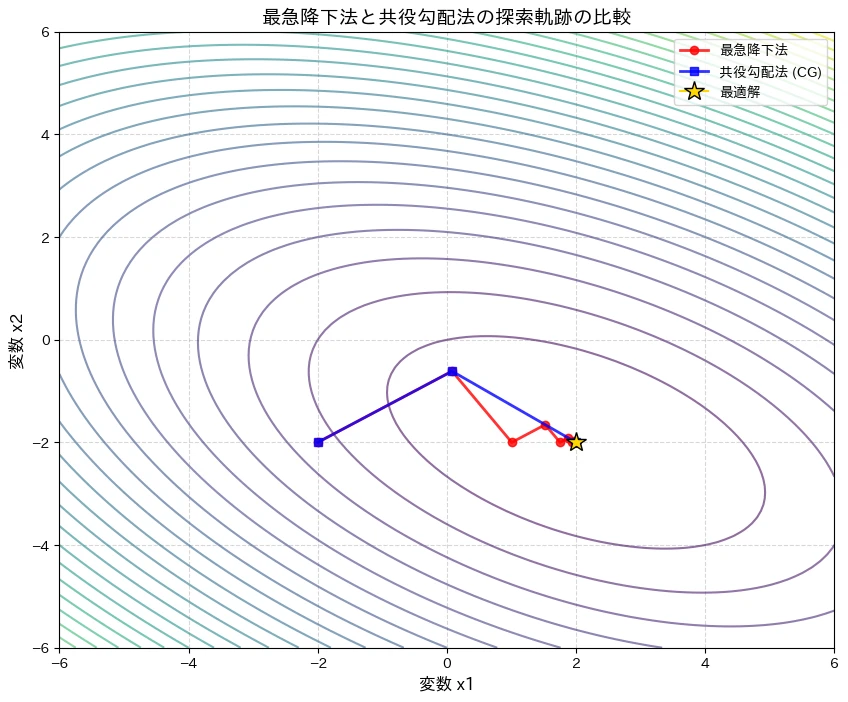
最急降下法(赤)は、1 回目の後に直角に折れ曲がりながら、最適解に少しずつ近づいています。共役勾配法(青)は、1 回目は同じ点に進みますが、2 回目で楕円の形に合わせた方向に曲がり、そのまま最適解に着いています。
まとめ
本記事では、大規模な最適化問題や連立一次方程式を効率的に解くための「共役勾配法(CG法)」について解説しました。
- ジグザグ現象の解消: 単純な勾配降下法が陥りやすいジグザグとした探索を、探索方向を「共役」に保つことで防ぎます。Shewchuk の例では、正確な直線探索を使った最急降下法が 15 回で誤差 だったのに対し、共役勾配法は 2 回で厳密解に着きました。
- 逆行列計算の回避: 必要なのは行列とベクトルの積だけで、巨大な行列の全成分を保持したり逆行列を計算したりする必要がありません。
- 実装の応用: TRPOなどの高度な強化学習アルゴリズムでは、このCG法の特性と自動微分(フィッシャー・ベクトル積)を組み合わせることで、巨大なニューラルネットワークのパラメータ更新を高速に行っています。
最適化アルゴリズムは、問題の規模や目的関数の性質によって適切なものを選択することが不可欠です。共役勾配法は、計算リソースの制約が厳しい現代の機械学習においても極めて重要な役割を担っています。
参考文献
- M. R. Hestenes, E. Stiefel (1952). Methods of conjugate gradients for solving linear systems. Journal of Research of the National Bureau of Standards, 49(6), 409–436.
- J. R. Shewchuk (1994). An Introduction to the Conjugate Gradient Method Without the Agonizing Pain. Technical Report, Carnegie Mellon University.
- J. Nocedal, S. J. Wright (2006). Numerical Optimization (2nd ed.). Springer.
本記事の文章・構成の一部に生成AIを使用しています。