Chain-of-Thought(CoT)とは?
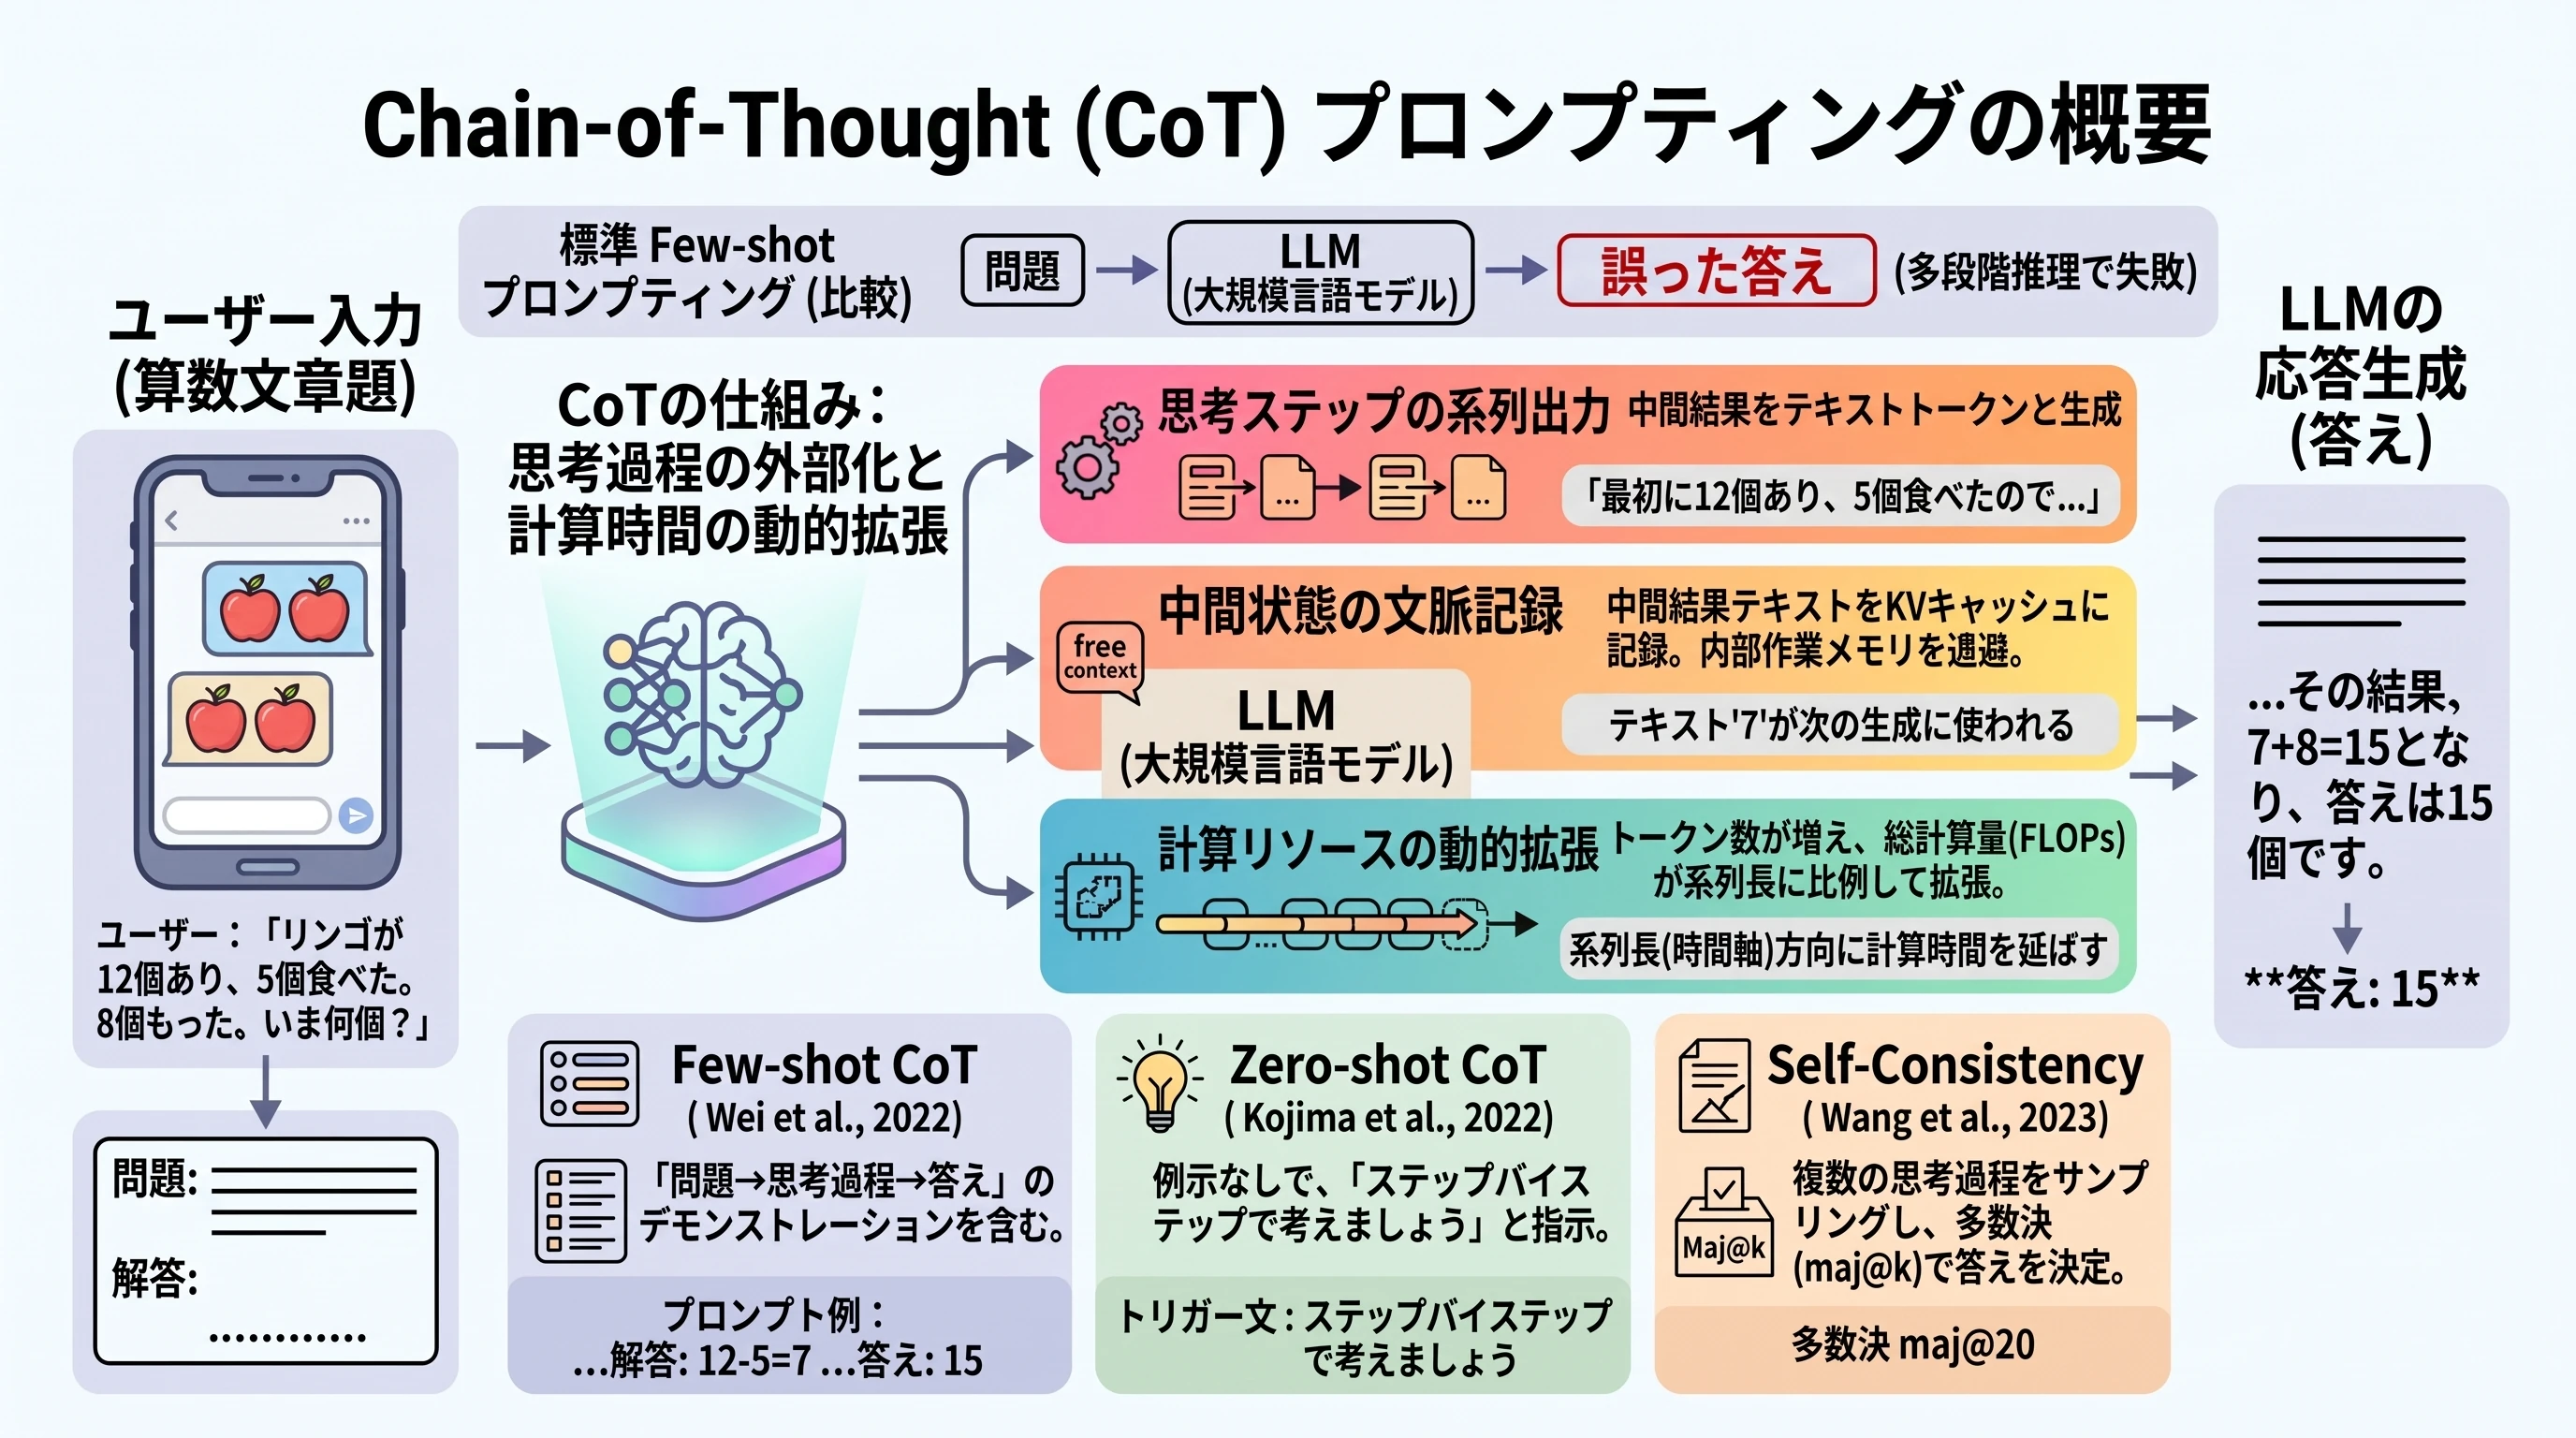 (画像は、Geminiで作成)
答えの前に思考過程を書かせると多段階の推論ができるようになる理由と、Few-shot CoT・Zero-shot CoT・Self-Consistency の3つのアプローチを理解すること。答えの抽出規則や pass@k・maj@k といった推論の評価の道具を整え、合成データ(算数ワールド)と Qwen2.5 の 0.5B〜7B で、CoT の効果がモデルの規模と問題の難しさでどう変わるかを確かめること。
Chain-of-Thought(CoT)の概要
Chain-of-Thought(CoT:思考の連鎖)プロンプティングは、Chain-of-Thought Prompting Elicits Reasoning in Large Language Models(Wei et al., NeurIPS 2022)で提案された、大規模言語モデル(LLM)の推論能力を引き出すプロンプティング手法です。
In-Context Learningの記事で扱った標準的な Few-shot プロンプティングでは、問題と最終的な答えのペアを例示し、新しい問題に対してもすぐに答えを出力させていました。しかし、複数の計算や論理的なステップを必要とする多段階推論のタスクでは、この方法では正解率が伸び悩みます。
CoT は、答えを出す前に 中間的な思考過程(推論のステップ)を系列として生成させる というシンプルな方法で、この限界を大きく押し上げました。その後、例示を与えずに「ステップバイステップで考えましょう」と指示するだけの Zero-shot CoT(Large Language Models are Zero-Shot Reasoners、Kojima et al., NeurIPS 2022)や、複数の思考過程をサンプリングして多数決をとる Self-Consistency(Self-Consistency Improves Chain of Thought Reasoning in Language Models、Wang et al., ICLR 2023)へと発展しました。推論時に計算を増やして性能を上げるという考え方は、OpenAI o1 や DeepSeek-R1 といった近年の推論モデルにもつながっています。
本記事では、GRPOの記事・DeepSeek-R1の記事でも使う評価の道具と合成データを整えながら、次の流れで CoT を解説します。
- 多段階推論の壁: 標準のプロンプトではなぜ答えにたどり着きにくいのか
- CoT の3つのアプローチ: Few-shot CoT、Zero-shot CoT(2段階プロンプティング)、Self-Consistency
- 推論の評価の道具: 答えの抽出規則と、pass@1・maj@k・pass@k の定義
- 算数ワールド: 難易度(ステップ数)を制御できる合成データ
- 共通の準備: Google Colab で完結する実験コード(算数ワールド・評価指標・プロンプト)
- 4つの検証: 難易度 × プロンプト × モデル規模(原論文の「創発」の再検討)、Self-Consistency、Zero-shot CoT のトリガー文、外部ベンチマーク MGSM
- この実験の限界と、学習による推論の改善
本記事では、プロンプト(問題文)を 、生成される応答を 、応答のトークン数を と書きます。また、Self-Consistency などでサンプリングする応答の本数を 、算数の問題の計算ステップ数(難易度)を と書きます。本記事で定義する「算数ワールド」と評価指標(pass@k・maj@k)は、GRPOの記事・DeepSeek-R1の記事でもそのまま使います。
背景:In-Context Learningの限界と「多段階推論」の壁
なぜ標準プロンプトでは解けないのか?
In-Context Learningの記事で確認したように、事前学習済み言語モデルはプロンプト内にいくつかの入出力例(デモンストレーション)を並べるだけで、重みを一切更新することなく新しいタスクに適応できます。
しかし、この標準的な In-Context Learning(標準 Few-shot)には明確な弱点がありました。それは、「問題文」から直接「最終的な答え」を出力させるタスク設計 にあります。
例えば、次のような算数の文章題を考えます。
問題: リンゴが12個あります。5個食べて、そのあと8個もらいました。いまリンゴは何個ありますか?
標準的なプロンプティングでは、モデルに次のような形式で答えを求めます。
問題: リンゴが12個あります。5個食べて、そのあと8個もらいました。いまリンゴは何個ありますか?
答え: 15
人間であれば、頭の中で「」「」と順を追って計算します。しかし、言語モデルに対して「答え: 」の直後に即座に「15」というトークンを出力させようとすると、モデルは次の困難に直面します。
- トークンあたりの計算量は一定: Transformer の自己回帰生成では、1つのトークンを出力するための計算量は、モデルの層数と隠れ層の次元で決まる一定量です。問題がどれほど複雑でも、1トークンを出力する間に実行できる「思考の深さ」には上限があります。
- 中間状態を保持しにくい: 途中の計算結果をテキストとして書き出さない場合、「途中で7個になった」といった中間状態を、すべて隠れ状態の内部だけで表現しなければなりません。ステップ数が増えるほど、これは難しくなります。
「思考の連鎖」による計算時間の動的拡張
Chain-of-Thought の核心は、「答えを急がせず、途中の計算過程をまず言葉として出力させる」 ことです。
問題: リンゴが12個あります。5個食べて、そのあと8個もらいました。いまリンゴは何個ありますか?
考え方: 最初に12個あり、5個食べたので 12 - 5 = 7 個になります。そのあと8個もらったので 7 + 8 = 15 個になります。
答え: 15
このように思考過程をトークン系列として出力させることには、計算論的に決定的な意味があります。
- 文脈(KVキャッシュ)への情報記録: 出力された中間結果()は、次のトークンを生成する際のアテンション機構の入力文脈(Context)として再利用されます。モデルは中間結果を頭の中(隠れ状態)だけで保持し続ける必要がなくなり、ワーキングメモリを外部テキストに退避できます。
- 計算ステップ数の拡張: 1トークンごとの計算量は一定でも、系列長(トークン数)が伸びれば、最終的な答えに至るまでに投じられる総計算量(FLOPs)はトークン数に比例して増大します。
すなわち、CoT とは 「言語モデルの計算資源を、系列長(時間軸)の方向に動的に拡張するメカニズム」 と解釈できます。
2つのプロンプトの違いを、上の例で図にすると、次のようになります。
(図は、diagram-designで作成)
Chain-of-Thoughtの3つのアプローチ
3つのアプローチを並べると、次のようになります。
(図は、diagram-designで作成)
CoT の基盤となった3つの代表的なアプローチを整理します。
1. Few-shot CoT(Wei et al., 2022)
Wei et al. が提案した原典の手法です。プロンプト内の例示(デモンストレーション)に、人間が作成した模範的な思考過程を含めます。
モデルは、プロンプト内の「問題 → 思考過程 → 答え」というパターンを In-Context Learning によって真似し、新しい問題に対しても思考過程を書いてから答えるようになります。論文では、算数の文章題(GSM8K、SVAMP など)、記号推論(コイン投げの状態追跡、単語の最後の文字の連結)、常識推論(StrategyQA など)で大きな改善が報告されました。
2. Zero-shot CoT(Kojima et al., 2022)
Few-shot CoT は強力ですが、タスクごとに思考過程つきの例示を人手で作る必要があります。東京大学などの研究チーム(Kojima et al.)は、例示を一切与えなくても、答えの冒頭に一文を加えるだけで LLM が思考過程を書き始めることを示しました。これが Zero-shot CoT で、最も有名なトリガー文が "Let's think step by step"(ステップバイステップで考えましょう) です。
2段階プロンプティング
Zero-shot CoT には例示がないので、モデルがどのような形式で答えを書くかは決まっていません。「よって答えは15個です」「以上より、15」のように表現がばらばらになり、プログラムで答えを取り出しにくくなります。そこで Kojima et al. は、生成を2段階に分けました。
- 第1段階(推論の生成)
- 入力:「問題: [問題文] 解答: ステップバイステップで考えましょう。」
- 出力:思考過程のテキスト
- 第2段階(答えの抽出)
- 入力:第1段階の入力 + +「したがって、答え(整数)は」
- 出力:最終的な答えの数値
第2段階では答えの書き出しまでをプロンプトで固定しているので、直後に出力される数値を取り出すだけで済みます。推論の書き方は自由にさせつつ、答えだけを確実に回収するための工夫です。
トリガー文の違い
原論文では、"Let's think step by step" のほかにも、"Let's think about this logically" や "Let's solve this problem by splitting it into steps" など多数のトリガー文を比較し、言い回しの違いで正解率が大きく変わることを報告しています。日本語でも、たとえば次のような候補が考えられます。
| トリガー文(日本語) | 対応する英語の例 |
|---|---|
| ステップバイステップで考えましょう。 | Let's think step by step. |
| 順を追って論理的に考えましょう。 | Let's think logically, step by step. |
| 段階的に計算してみましょう。 | Let's calculate step by step. |
| 結論を出す前に、一歩ずつ確認しましょう。 | Let's check each step before concluding. |
どれが良いかはモデルやタスクによって変わるので、本記事の実験では Qwen2.5-1.5B でこの4つを比較します(後述)。
3. Self-Consistency(Wang et al., 2023)
通常の生成では、各時点で最も確率の高いトークンを選び続ける貪欲探索(greedy decoding)がよく使われます。しかし貪欲探索には、「途中で一度計算を誤ると、そのまま誤った答えに進んでしまう」という弱さがあります。
Wang et al. が提案した Self-Consistency(自己一貫性) は、人間が複数の解き方を試して答えが一致するかを確かめるのと同じ発想の手法です。
- 温度付きサンプリング: 温度 (例:)で、CoT プロンプトから 本の思考過程を独立に生成します。
- 答えの抽出: 各思考過程から最終的な答えを取り出します。
- 多数決: 個の答えのうち、最も多く出現した答え を最終回答にします。
正解に至る道筋は複数あっても、たどり着く答えは同じです。一方、誤りは計算ミスの箇所がばらばらなので、誤った答えは票が分散しやすくなります。そのため、多数決をとるだけで正解率が上がります。
これは、重みを更新せずに 推論時の計算量(サンプリング本数 )を増やして精度を上げる 方法の原型で、後の「テスト時計算(test-time compute)」の考え方につながります。
推論の評価の道具
推論タスクの実験を行う前に、評価の方法を定義しておきます。本節の抽出規則と評価指標は、GRPOの記事・DeepSeek-R1の記事でも共通して使います。
尤度比較と生成ベースの評価の違い
In-Context Learningの記事で扱った JCommonsenseQA のような選択式タスクでは、モデルに文章を生成させるのではなく、各選択肢の条件付き対数尤度を比べて答えを選ぶ 尤度比較 を使いました。
推論タスクでは、この方法は使えません。モデルに思考過程を自由に書かせることが目的であり、正誤はモデルが生成したテキストの 結論部分 を見て判定する必要があるからです。そのため、推論タスクの評価は 生成ベースの評価 になります。
答えの抽出規則
生成ベースの評価で最も重要なのは、長い生成テキストから最終的な答えを確実に取り出すことです。本記事では、次の規則を持つ抽出関数 extract_answer を使います。
- 生成の打ち切り: Few-shot の書式で学習したベースモデルは、答えを書いた後も「次の問題」を勝手に書き続けることがあります。そこで、生成テキストに次の「問題:」が現れたら、そこから後ろを捨てます。
- 正規化: 全角数字を半角に揃え(Unicode の NFKC 正規化)、桁区切りのカンマを除きます(例:「1,200」→「1200」)。
- タグの優先: 「<answer>...</answer>」のタグがあれば、その中の数値を最優先します(DeepSeek-R1 形式の出力に対応するため)。
- 回答行: 「答え:」「Answer:」で始まる部分があれば、その中の数値を使います(複数あれば最後のもの)。
- 末尾の数値: どれもなければ、テキスト中の最後の数値を使います。
- 抽出失敗・打ち切り: 数値が見つからない場合と、生成長の上限 max_new_tokens に達して途中で切れた場合は、不正解 として扱います。
評価指標の定義
pass@1
1本の応答が正解である割合です。貪欲探索(do_sample=False)では、生成した1本の正解率そのものです。サンプリングで 本生成した場合は、各問題の正解の割合 の平均で推定します( は正解した本数)。
maj@k(多数決の正解率)
温度 で 本サンプリングし、抽出した答えの 多数決(最頻値) が正解と一致する割合です。Self-Consistency の正解率にあたります。同数の答えがある場合は、先に出現した答えを採用します。DeepSeek-R1 の論文などで使われる cons@64 は、maj@64 と同じものです。
pass@k(不偏推定量)
本サンプリングしたとき、少なくとも1本が正解である確率 です。「 本生成して1本でも正解なら成功」とそのまま数えると、推定のばらつきが大きくなります。そこで、Codex の論文(Evaluating Large Language Models Trained on Code、Chen et al., 2021)にならい、各問題で 本を生成して正解数 を数え、次の 不偏推定量 で計算します。
は、「 本から 本を無作為に選んだとき、すべて不正解( 本の誤答から 本を選ぶ)である確率」です。これを1から引いたものが「少なくとも1本正解」の確率になります。不正解の本数が 本に満たない()場合は、どう選んでも正解が含まれるので、値は1になります。
二項係数を階乗から直接計算すると、 や が大きいときに値が非常に大きくなります。比は次のように1項ずつの積に書き直せるので、この形で計算します。
たとえば 、、 なら、 なので、pass@3 です。
上の計算例を図にすると、次のようになります。
(図は、diagram-designで作成)
標準誤差・生成長・打ち切り率
- 標準誤差: 評価問題数を 、正解率を とすると、標準誤差は です。、 のとき約 なので、手法間の差がこの範囲に収まる場合は「差があるとは言えない」と判断します。
- 平均生成長: CoT は答えの前に思考過程を書くので、生成トークン数が大きく増えます。推論時のコストとして記録します。
- 打ち切り率: 生成が max_new_tokens に達して途中で切れた割合です。打ち切られた生成は不正解として数え、その割合を別に報告します。
合成データ:算数ワールドの設計
LLM の推論能力を測るため、専用の合成データ 算数ワールド を作ります。算数ワールドは、GRPOの記事・DeepSeek-R1の記事でも使いますが、生成過程を詳しく説明するのは本節だけです。
なぜ合成データを使うのか?
GSM8K などの公開ベンチマークも広く使われていますが、本記事では次の理由から合成データを主に使います。
- 正解が確実に分かる: プログラムで生成するので、ラベルの誤りがありません。
- 事前学習データへの混入(汚染)の心配がない: 現代のオープンモデルは、公開ベンチマークの問題を事前学習で見ている可能性があります。新たに生成した問題なら、その心配はありません。
- ステップ数で難易度を制御できる: 四則演算を何回連ねるか(ステップ数 )を指定できるので、「ステップ数 × モデル規模 × プロンプト」の関係を曲線として描けます。
- そのまま報酬関数になる: 答えの自動判定が確実なので、GRPO の記事では正誤判定をそのまま強化学習の報酬に使えます。
生成の仕様
- 問題文: 身近な物(りんご、クッキー、ノートなど)の個数の増減を扱う日本語の文章題
- ステップ数: 。1ステップは1回の四則演算
- 演算:
- 加算(もらう)・減算(使う):2〜50
- 乗算(数が〇倍になる):2〜5倍
- 除算(〇等分して1つ分だけ残す):2〜9等分。割り切れる場合のみ
- 値の範囲: 初期値は10〜50。中間結果・答えは 1以上10,000以下。条件を満たさない演算は選び直す(棄却サンプリング)
- 模範解答(gold steps): 式と途中結果を1ステップずつ並べた文字列(例:「12 - 5 = 7。7 + 8 = 15。答え: 15」)。Few-shot CoT の例示や、DeepSeek-R1の記事での「読みやすい CoT」の教材として使います
- データの分割:
- 評価用:seed=2026 で各ステップ100問、計 500問。GRPO・DeepSeek-R1 の記事でも同じ問題を使う
- 学習用:seed=0 で生成し、評価用と問題文が一致するものを除外する。本記事では Few-shot の例示を選ぶためだけに使う
実装
Google Colab で実行できる実験コードを実装します。実装は、どの検証でも使う 共通の準備(準備1〜3) と、4つの検証 に分かれます。
準備1〜3では、評価用の問題(算数ワールド)・正解率の測り方(答えの抽出と評価指標)・3つのプロンプト条件を用意します。GRPOの記事・DeepSeek-R1の記事でもそのまま使う道具です。
続く4つの検証では、それぞれ次の問いに答えます。
| 確かめること | 使うモデル | |
|---|---|---|
| 検証1 | CoT は難易度とモデル規模に対してどう効くのか。原論文の「創発」は再現されるか | 0.5B〜7B |
| 検証2 | 思考過程を複数サンプリングして多数決をとると、正解率はどこまで上がるのか | 1.5B |
| 検証3 | Zero-shot CoT の結果は、トリガー文の言い回しにどれだけ左右されるのか | 1.5B |
| 検証4 | 合成データで見えた傾向は、外部ベンチマーク(MGSM)でも成り立つのか | 1.5B |
検証ごとに、コードの前に「何を確かめるのか」を述べ、実行結果が出た時点でその場で考察します。コードは上から順に実行することを前提にしており、検証2で読み込んだモデルは検証3・検証4でもそのまま使います。
実験設定
- モデル: Qwen2.5 のベースモデル4サイズ(Qwen/Qwen2.5-0.5B・Qwen/Qwen2.5-1.5B・Qwen/Qwen2.5-3B・Qwen/Qwen2.5-7B)。同じアーキテクチャ・同じデータで学習され、サイズだけが違うので、規模の影響を比べやすい組み合わせです。すべて bf16 で読み込み、量子化は使いません(7B を量子化すると条件が揃わなくなるため)。
- 比較するプロンプト:
- 標準 Few-shot: 「問題 → 答え」の例示を3つ
- Few-shot CoT: 「問題 → 解答(gold steps)」の例示を3つ
- Zero-shot CoT: 例示なし。「ステップバイステップで考えましょう。」による2段階プロンプティング
- Few-shot の例示: 学習用データから無作為に3問選ぶ。選び方のシードを3通り(0, 1, 2)変えて、平均と標準偏差を求める
- 生成: 貪欲探索。max_new_tokens は標準 Few-shot で32、CoT で256、Zero-shot CoT の第2段階で16
- Self-Consistency: Qwen2.5-1.5B の Few-shot CoT で、温度 、各問題 本をサンプリングし、 の maj@k と pass@k を計算する
- 外部評価: MGSM の日本語サブセット(250問)
- 実行環境: 7B を bf16 で読み込むため、VRAM 24GB 以上の GPU(L4 や A100)を想定しています
ライブラリのインストールとGoogleドライブのマウント
!pip install --upgrade transformers accelerate datasets
- ライブラリ: transformers はモデルの読み込みと生成、accelerate は GPU への配置、datasets は MGSM の読み込みに使います。生成を途中で止める stop_strings は比較的新しい機能なので、transformers を新しい版に揃えておきます。
4モデル × 3条件の実験は時間がかかるので、結果をモデルごとに Google ドライブに保存し、途中でセッションが切れても続きから再開できるようにします。
import os
from google.colab import drive

drive.mount("/content/drive")

SAVE_ROOT = "/content/drive/MyDrive/chain_of_thought"
os.makedirs(SAVE_ROOT, exist_ok=True)
- 保存先: 実験結果は SAVE_ROOT 以下に JSON で保存します。exist_ok=True は、セルを再実行してもエラーにしないための指定です。
準備1:算数ワールドの生成
「算数ワールドの設計」で決めた仕様どおりに、ステップ数で難易度を制御できる文章題を生成します。ここで作る評価用500問が、以降のすべての検証に共通のものさしになります。
import numpy as np

ITEMS = ["りんご", "みかん", "クッキー", "ノート", "シール", "えんぴつ"]
MAX_VALUE = 10_000
OP_SYMBOL = {"add": "+", "sub": "-", "mul": "×", "div": "÷"}

def sample_operation(rng, current):
    """現在の値に適用できる演算を1つ選ぶ(条件を満たさなければ選び直す=棄却サンプリング)"""
    while True:
        op = str(rng.choice(["add", "sub", "mul", "div"]))
        if op in ("add", "sub"):
            val = int(rng.integers(2, 51))   # 2〜50
        elif op == "mul":
            val = int(rng.integers(2, 6))    # 2〜5倍
        else:
            val = int(rng.integers(2, 10))   # 2〜9等分

        if op == "add":
            new = current + val
        elif op == "sub":
            new = current - val
        elif op == "mul":
            new = current * val
        else:
            if current % val != 0:
                continue                     # 割り切れない除算は棄却
            new = current // val

        if 1 <= new <= MAX_VALUE:            # 中間結果は 1 以上 10,000 以下
            return op, val, new

def make_problem(rng, n_steps):
    """ステップ数 n_steps(=四則演算の回数)の算数文章題を1問生成する"""
    item = str(rng.choice(ITEMS))
    current = int(rng.integers(10, 51))
    story = [f"{item}が{current}個あります。"]
    steps = []
    for _ in range(n_steps):
        op, val, new = sample_operation(rng, current)
        if op == "add":
            story.append(f"{val}個もらいました。")
        elif op == "sub":
            story.append(f"{val}個使いました。")
        elif op == "mul":
            story.append(f"{item}の数が{val}倍になりました。")
        else:
            story.append(f"{val}等分して、そのうち1つ分だけを残しました。")
        steps.append(f"{current} {OP_SYMBOL[op]} {val} = {new}")
        current = new
    question = "".join(story) + f"いま{item}は何個ありますか。"
    gold_steps = "。".join(steps) + f"。答え: {current}"
    return {"question": question, "answer": current, "gold_steps": gold_steps, "n_steps": n_steps}

def make_dataset(n_per_step, seed, exclude=None):
    """ステップ数1〜5の問題を n_per_step 問ずつ生成する。exclude に含まれる問題文と重複は除外する"""
    rng = np.random.default_rng(seed)
    seen = set(exclude) if exclude else set()
    dataset = []
    for s in [1, 2, 3, 4, 5]:
        count = 0
        while count < n_per_step:
            prob = make_problem(rng, s)
            if prob["question"] in seen:
                continue
            seen.add(prob["question"])
            dataset.append(prob)
            count += 1
    return dataset

eval_dataset = make_dataset(n_per_step=100, seed=2026)
eval_questions = {p["question"] for p in eval_dataset}
train_dataset = make_dataset(n_per_step=1000, seed=0, exclude=eval_questions)

print(f"評価用: {len(eval_dataset)} 問 / 学習用: {len(train_dataset)} 問")
print(f"評価用と学習用の重複: {len(eval_questions & {p['question'] for p in train_dataset})} 問")
for s in [1, 3, 5]:
    p = next(q for q in eval_dataset if q["n_steps"] == s)
    print(f"\n--- ステップ数 {s} の例 ---")
    print("問題:", p["question"])
    print("模範解答:", p["gold_steps"])
【問題の生成】
- 棄却サンプリング: sample_operation は、演算の種類と数値を無作為に選び、条件を満たさなければ選び直します。条件は「結果が1以上10,000以下」と「除算は割り切れる」の2つです。これで、途中の値も答えも必ず正の整数になります。
- 演算の数値の範囲: 加算・減算は2〜50、乗算は2〜5倍、除算は2〜9等分です。除算は割り切れる場合しか選ばれないので、他の演算より出現頻度が低くなります(評価用500問では、除算は全ステップの約8%)。どの値も、1ステップずつ暗算で確かめられる大きさで、5ステップ続けても途中の値が大きくなりすぎない範囲です。
- 除算の言い回し: 「〇人で分けました」とすると、全体の個数は変わらないのに答えが1人分の数になり、問題文があいまいになります。そこで「〇等分して、そのうち1つ分だけを残しました」とし、残った個数を問う形にしています。
- 模範解答: gold_steps には、各ステップの式と途中結果を「。」で区切って並べ、最後に「答え: 」の行を付けます。この形がそのまま Few-shot CoT の例示になります。
【データの分割】
- 評価用データ: make_dataset(n_per_step=100, seed=2026) で、ステップ数1〜5を100問ずつ、計500問生成します。同じ問題文が重複した場合は、生成し直します。ステップ数ごとに100問にするのは、ステップ数ごとの正解率を、標準誤差5ポイント以下()で比べられる問題数だからです。
- 学習用データと重複の除外: 学習用は seed=0 で生成し、exclude に評価用の問題文を渡して、一致する問題を除外します。ステップ数1の問題は組み合わせが少なく、シードが違っても同じ問題文が生成されることがあるため、この除外が必要です。
- 乱数: np.random.default_rng(seed) を使うので、同じシードからは常に同じデータが生成されます。
実行結果
評価用: 500 問 / 学習用: 5000 問
評価用と学習用の重複: 0 問

--- ステップ数 1 の例 ---
問題: えんぴつが17個あります。33個もらいました。いまえんぴつは何個ありますか。
模範解答: 17 + 33 = 50。答え: 50

--- ステップ数 3 の例 ---
問題: クッキーが47個あります。クッキーの数が4倍になりました。36個もらいました。クッキーの数が2倍になりました。いまクッキーは何個ありますか。
模範解答: 47 × 4 = 188。188 + 36 = 224。224 × 2 = 448。答え: 448

--- ステップ数 5 の例 ---
問題: ノートが32個あります。ノートの数が4倍になりました。31個使いました。ノートの数が3倍になりました。ノートの数が3倍になりました。ノートの数が5倍になりました。いまノートは何個ありますか。
模範解答: 32 × 4 = 128。128 - 31 = 97。97 × 3 = 291。291 × 3 = 873。873 × 5 = 4365。答え: 4365
ステップ数が増えるほど、式が長くなり、途中の値も大きくなっていることが分かります。
準備2:答えの抽出と評価指標
「推論の評価の道具」で定義した抽出規則と評価指標を実装します。生成されたテキストから答えを取り出し、pass@1・maj@k・pass@k を計算する部分で、どの検証でも正解率はこの実装で測ります。
import re
import unicodedata
from collections import Counter
import numpy as np

STOP_STRING = "問題:"   # Few-shot の書式で、次の問題を書き始めたら生成を打ち切る目印

def cut_at_stop(text):
    """次の「問題:」以降を切り捨てる。切り捨てたかどうかも返す"""
    idx = text.find(STOP_STRING)
    if idx == -1:
        return text.strip(), False
    return text[:idx].strip(), True

def _last_integer(s):
    """文字列中の最後の整数を返す(引き算の式の「-」は符号として扱わない)"""
    nums = re.findall(r"(?<!\d)-?\d+", s)
    return int(nums[-1]) if nums else None

def extract_answer(text):
    """生成テキストから最終回答の整数を抽出する(抽出できなければ None)"""
    if not text:
        return None
    text = unicodedata.normalize("NFKC", text).replace(",", "")   # 全角→半角、カンマ除去

    # 1. <answer> タグ
    m = re.search(r"<answer>(.*?)</answer>", text, re.DOTALL)
    if m and _last_integer(m.group(1)) is not None:
        return _last_integer(m.group(1))

    # 2. 「答え:」の行(複数あれば最後の行)
    lines = re.findall(r"(?:答え|Answer)\s*[::]\s*([^\n]*)", text, re.IGNORECASE)
    for line in reversed(lines):
        if _last_integer(line) is not None:
            return _last_integer(line)

    # 3. テキスト中の最後の数値
    return _last_integer(text)

def pass_at_k(n, c, k):
    """Codex 論文の pass@k の不偏推定量:n 本中 c 本正解のとき、k 本に1本以上正解が含まれる確率"""
    if n - c < k:
        return 1.0
    prob_all_wrong = 1.0
    for i in range(1, k + 1):
        prob_all_wrong *= (n - c - i + 1) / (n - i + 1)
    return 1.0 - prob_all_wrong

def majority_vote(preds):
    """None を除いた答えの最頻値(同数なら先に出た答え)"""
    valid = [p for p in preds if p is not None]
    if not valid:
        return None
    return Counter(valid).most_common(1)[0][0]

def maj_at_k(preds, target, k, n_perm=1000, seed=0):
    """n 本から k 本を無作為に選んで多数決をとったときの正解率(並べ替えを変えて平均する)"""
    rng = np.random.default_rng(seed)
    hits = 0
    for _ in range(n_perm):
        subset = [preds[i] for i in rng.permutation(len(preds))[:k]]
        hits += majority_vote(subset) == target
    return hits / n_perm
【答えの抽出】
- 生成の打ち切り: cut_at_stop は、生成テキストに次の 問題: が現れたら、そこから後ろを捨てます。これをしないと、モデルが勝手に書いた「次の問題の答え」を最後の回答行として拾ってしまいます。
- 正規化: unicodedata.normalize("NFKC", text) で全角の数字や記号を半角に揃え、replace でカンマを除きます。
- 優先順位: タグ、「答え:」の行、テキスト中の最後の数値の順に探します。「答え:」の行が複数ある場合は、最後の行から順に数値を探します。
- 符号の扱い: 正規表現 (?<!\d)-?\d+ は、数字の直後の「-」を負号とみなしません。そのため、「12-5」のような式から「-5」を誤って取り出すことがありません。
- 正規表現の注意: 「答」の1文字だけで回答行を探すと、「解答:」まで回答行として一致してしまうので、「答え」と「Answer」だけを探しています。
【評価指標】
- pass@k: pass_at_k は、前述の積の形で不偏推定量を計算します。n - c が k より小さければ1を返します。
- 多数決: majority_vote は、抽出に失敗した None を除いてから最頻値をとります。Counter.most_common は同数の場合に先に出現した要素を返すので、「同数なら先に出た答え」という規則になります。
- maj@k の推定: 本から「先頭の 本」だけで多数決をとると、どの 本がたまたま先頭に来たかで結果がぶれます。maj_at_k では、並べ替え(rng.permutation)を変えて 本を選ぶ操作を n_perm 回繰り返し、その平均をとります。
動作を確認します。
samples = [
    "12 - 5 = 7。7 + 8 = 15。答え: 15",
    "12 − 5 = 7。7+8=15。答え:15個",
    "<answer>1,200</answer>",
    "最初は12個で、5個食べると7個、8個もらうと15個になります。",
    "12-5=7",
    "わかりません。",
]
for s in samples:
    print(f"{extract_answer(s)!s:>5} ← {s}")

raw = " 12 - 5 = 7。7 + 8 = 15。答え: 15\n\n問題: みかんが20個あります。"
print(cut_at_stop(raw))

preds = [15, 15, 7, None, 15, 20, 7, 15, 7, 3]   # 10本のサンプル(正解は15)
c = sum(p == 15 for p in preds)
print(f"正解数 c = {c} / n = {len(preds)}")
for k in [1, 3, 5, 10]:
    print(f"k={k:2d}: pass@k = {pass_at_k(len(preds), c, k):.3f}, maj@k = {maj_at_k(preds, 15, k):.3f}")
- 抽出のテスト: 全角の数字と記号、カンマ入りのタグ、回答行のない文章、式だけの文字列、数値のない文章で、extract_answer の挙動を確かめます。
- 指標のテスト: 正解が15の問題で、10本の答えのうち15が4本、7が3本という状況を想定しています。
実行結果
   15 ← 12 - 5 = 7。7 + 8 = 15。答え: 15
   15 ← 12 − 5 = 7。7+8=15。答え:15個
 1200 ← <answer>1,200</answer>
   15 ← 最初は12個で、5個食べると7個、8個もらうと15個になります。
    7 ← 12-5=7
 None ← わかりません。
('12 - 5 = 7。7 + 8 = 15。答え: 15', True)
正解数 c = 4 / n = 10
k= 1: pass@k = 0.400, maj@k = 0.392
k= 3: pass@k = 0.833, maj@k = 0.490
k= 5: pass@k = 0.976, maj@k = 0.636
k=10: pass@k = 1.000, maj@k = 1.000
- 抽出: 「12-5=7」のように式しかない場合は最後の数値 7 が答えとして扱われます。数値がない文章は None(不正解)になります。
- pass@k と maj@k の違い: 1本あたりの正解率は 0.4 ですが、正解の15が最も多い答えなので、10本すべてで多数決をとると必ず正解になります(maj@10 = 1.0)。一方、3本だけでは誤答の7が多数になる組み合わせも多く、maj@3 は 0.49 にとどまります。pass@k は「1本でも正解があるか」なので、 とともに速く1に近づきます。maj@1 は理論上 pass@1(0.4)と同じで、ずれは並べ替えの回数が有限であることによるものです。
準備3:プロンプトの構築と生成
3つのプロンプト条件(標準 Few-shot・Zero-shot CoT・Few-shot CoT)と、バッチ単位で生成する関数を実装します。この3条件の差が、検証1〜検証4を通じて比べる対象です。ベースモデルを使うので、チャットテンプレートではなく「問題: ... / 解答:」というテキストの定型書式を使います。
import gc
import json
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed

SEED = 42
HEADER = "以下は算数の文章題とその解答です。\n\n"
ZERO_SHOT_TRIGGER = "ステップバイステップで考えましょう。"
ANSWER_TRIGGER = "したがって、答え(整数)は"

# ---------- プロンプト ----------
def sample_demos(train_data, seed, n_demos=3):
    """学習用データから Few-shot の例示を無作為に選ぶ"""
    rng = np.random.default_rng(seed)
    idx = rng.choice(len(train_data), size=n_demos, replace=False)
    return [train_data[i] for i in idx]

def build_direct_prompt(question, demos):
    """標準 Few-shot:問題 → 答え"""
    prompt = HEADER
    for d in demos:
        prompt += f"問題: {d['question']}\n答え: {d['answer']}\n\n"
    return prompt + f"問題: {question}\n答え:"

def build_cot_prompt(question, demos):
    """Few-shot CoT:問題 → 解答(式と途中結果、最後に「答え:」)"""
    prompt = HEADER
    for d in demos:
        prompt += f"問題: {d['question']}\n解答: {d['gold_steps']}\n\n"
    return prompt + f"問題: {question}\n解答:"

def build_zero_shot_prompt(question, trigger=ZERO_SHOT_TRIGGER):
    """Zero-shot CoT の第1段階:解答欄の冒頭にトリガー文を置く"""
    return HEADER + f"問題: {question}\n解答: {trigger}"

# ---------- モデルと生成 ----------
def load_model(model_name):
    tokenizer = AutoTokenizer.from_pretrained(model_name)
    tokenizer.padding_side = "left"   # 生成時は左側にパディングする
    if tokenizer.pad_token is None:
        tokenizer.pad_token = tokenizer.eos_token
    model = AutoModelForCausalLM.from_pretrained(
        model_name, torch_dtype=torch.bfloat16, device_map="cuda"
    )
    model.eval()
    return model, tokenizer

@torch.no_grad()
def generate_batch(model, tokenizer, prompts, max_new_tokens, temperature=0.0, num_return_sequences=1):
    """プロンプトのリストから生成し、打ち切り処理後のテキスト・打ち切りの有無・生成長を返す"""
    enc = tokenizer(prompts, return_tensors="pt", padding=True).to(model.device)
    gen_kwargs = dict(
        max_new_tokens=max_new_tokens,
        num_return_sequences=num_return_sequences,
        pad_token_id=tokenizer.pad_token_id,
        eos_token_id=tokenizer.eos_token_id,
        stop_strings=[STOP_STRING],   # 次の「問題:」を書き始めたら止める
        tokenizer=tokenizer,          # stop_strings の判定に必要
    )
    if temperature > 0:
        gen_kwargs.update(do_sample=True, temperature=temperature, top_p=1.0)
    else:
        gen_kwargs.update(do_sample=False)
    out = model.generate(**enc, **gen_kwargs)

    results = []
    for ids in out[:, enc["input_ids"].shape[1]:].tolist():
        raw = tokenizer.decode(ids, skip_special_tokens=True)
        text, stopped = cut_at_stop(raw)
        finished = stopped or (tokenizer.eos_token_id in ids)
        results.append({
            "text": text,
            "truncated": not finished,   # 上限に達して途中で切れた
            "n_tokens": len(tokenizer(text, add_special_tokens=False)["input_ids"]),
        })
    return results

# ---------- 条件ごとの実行 ----------
def make_record(problem, out, pred):
    return {
        "n_steps": problem["n_steps"], "answer": problem["answer"], "pred": pred,
        "correct": pred == problem["answer"], "truncated": out["truncated"],
        "n_tokens": out["n_tokens"], "text": out["text"],
    }

def run_prompts(model, tokenizer, data, build_fn, max_new_tokens, batch_size=16):
    """標準 Few-shot・Few-shot CoT を実行する(打ち切られた生成は不正解)"""
    records = []
    for b in range(0, len(data), batch_size):
        batch = data[b:b + batch_size]
        outs = generate_batch(model, tokenizer, [build_fn(p["question"]) for p in batch], max_new_tokens)
        for p, o in zip(batch, outs):
            pred = None if o["truncated"] else extract_answer(o["text"])
            records.append(make_record(p, o, pred))
    return records

def first_integer(s):
    nums = re.findall(r"\d+", unicodedata.normalize("NFKC", s).replace(",", ""))
    return int(nums[0]) if nums else None

def run_zero_shot_cot(model, tokenizer, data, trigger=ZERO_SHOT_TRIGGER, batch_size=16):
    """Zero-shot CoT(2段階プロンプティング)を実行する"""
    records = []
    for b in range(0, len(data), batch_size):
        batch = data[b:b + batch_size]
        # 第1段階:推論の生成
        prompts1 = [build_zero_shot_prompt(p["question"], trigger) for p in batch]
        stage1 = generate_batch(model, tokenizer, prompts1, max_new_tokens=256)
        # 第2段階:答えの抽出(推論の後ろに「したがって、答え(整数)は」を付ける)
        prompts2 = [p1 + r["text"] + "\n" + ANSWER_TRIGGER for p1, r in zip(prompts1, stage1)]
        stage2 = generate_batch(model, tokenizer, prompts2, max_new_tokens=16)
        for p, r1, r2 in zip(batch, stage1, stage2):
            pred = None if r1["truncated"] else first_integer(r2["text"].split("\n")[0])
            out = {**r1, "text": r1["text"] + "\n" + ANSWER_TRIGGER + r2["text"]}
            records.append(make_record(p, out, pred))
    return records
【プロンプト】
- 例示の選び方: sample_demos は、学習用データ(評価用と重複しない)から3問を無作為に選びます。シードを変えて3通りの例示で試し、例示の選び方による正解率のばらつきを測ります。例示を3問にするのは、原論文(Wei et al. は GSM8K で8問)より少なくして、小さいモデル(0.5B)でもプロンプトが長くなりすぎないようにするためです。
- 標準 Few-shot と Few-shot CoT の違い: 使う問題は同じで、違いは例示の書き方だけです。build_direct_prompt は「答え: 15」だけを、build_cot_prompt は「解答: 12 - 5 = 7。7 + 8 = 15。答え: 15」のように式と途中結果を示します。gold_steps には最後の「答え:」まで含まれているので、答えの行を二重に書かないようにしています。
- Zero-shot CoT のトリガー文の位置: Kojima et al. と同じく、トリガー文は問題文の後ろではなく 解答欄の冒頭 に置きます。モデルは「ステップバイステップで考えましょう。」に続けて解答を書き始めることになります。
【生成】
- 左パディング: バッチで生成するとき、プロンプトの長さを揃えるパディングを右側に入れると、生成がパディングの後ろから始まってしまいます。padding_side = "left" で左側に詰めます。
- stop_strings: ベースモデルは、答えを書いた後も例示の書式を真似て次の問題を書き続けます。stop_strings に STOP_STRING(問題:)を指定すると、その文字列を生成した時点でその系列の生成を止めるので、無駄な生成を省けます。判定にはトークナイザーが必要なので、tokenizer も渡します。念のため、生成後にも cut_at_stop で切り捨てます。
- 打ち切りの判定: 次の問題の書き始めで止まったか、EOS トークンを出力していれば、生成は完結しています。どちらでもなければ max_new_tokens に達して途中で切れたとみなし、truncated を True にします。打ち切られた生成は pred を None(不正解)にします。
- 貪欲探索とサンプリング: temperature が0なら do_sample=False の貪欲探索、正なら top_p=1.0 の温度付きサンプリングです。num_return_sequences は1つのプロンプトから生成する本数で、出力はプロンプトごとに連続して並びます(プロンプト数 × 本数)。
【条件ごとの実行】
- run_prompts の引数: 第3引数 data は問題の辞書のリスト(評価用データ)、第4引数 build_fn は 問題文の文字列を受け取って、プロンプトの文字列を返す関数 です。
- build_fn の呼ばれ方: 内部の [build_fn(p["question"]) for p in batch] で、data の各要素 p(1問を表す辞書)から p["question"](問題文の文字列)を取り出し、それを build_fn に渡しています。build_fn が受け取るのは、辞書ではなく問題文の文字列1つだけです。
- プロンプトの作り方だけを差し替える設計: 標準 Few-shot と Few-shot CoT は、生成・答えの抽出・記録の手順がまったく同じで、違うのはプロンプトの作り方だけです。そこでその部分を関数として外から受け取る形にし、実行部分を使い回せるようにしています。実際の渡し方は実装1で見ます。
【Zero-shot CoT の2段階】
- 第2段階のプロンプト: 第1段階のプロンプトに生成された推論を連結し、その後ろに ANSWER_TRIGGER(したがって、答え(整数)は)を付けます。
- 答えの取り出し: 第2段階の出力は「15です。」のように答えから始まるので、1行目の 最初の 整数を答えにします(first_integer)。最後の数値を取ると、モデルが答えの後に書き足した余計な数値を拾うことがあるためです。
- 生成長: 記録する n_tokens は、思考過程にあたる第1段階の生成長です。
検証1:プロンプト・難易度・モデル規模
最初の検証では、3つのプロンプト条件を 難易度(ステップ数 ) と モデル規模(0.5B〜7B) の2つの軸で比べます。確かめたいのは次の2点です。
- CoT は難しい問題ほど効くのか: 標準 Few-shot では、答えのトークンを出す前にすべての途中計算を内部で済ませなければなりません。ステップ数を増やしたとき、どこで、どのくらい崩れるのか。そして CoT はそれをどこまで支えられるのか。
- 原論文の「創発」は再現されるのか: Wei et al. (2022) は、CoT の効果はモデル規模が約100B パラメータを超えて初めて現れる「創発的能力」だと報告しました。現代の小型モデルでは、どの規模から CoT が効き始めるのか。
実装1で4モデル × 3条件を実行して結果を保存し、実装2で集計します。その後、考察1でステップ数の軸を、考察2でモデル規模の軸を見ます。
実装1:4モデル × 3条件の実行
4つのモデルそれぞれで、標準 Few-shot と Few-shot CoT を3通りの例示で、Zero-shot CoT を1回(例示がないため)実行し、結果をモデルごとに保存します。
MODELS = ["Qwen/Qwen2.5-0.5B", "Qwen/Qwen2.5-1.5B", "Qwen/Qwen2.5-3B", "Qwen/Qwen2.5-7B"]
DEMO_SEEDS = [0, 1, 2]
BATCH_SIZE = 16

for model_name in MODELS:
    short_name = model_name.split("/")[-1]
    out_path = f"{SAVE_ROOT}/results_{short_name}.json"
    if os.path.exists(out_path):
        print(f"{short_name}: 保存済みのためスキップ")
        continue

    set_seed(SEED)
    model, tokenizer = load_model(model_name)
    results = {}
    for seed in DEMO_SEEDS:
        demos = sample_demos(train_dataset, seed)
        results[f"direct/seed{seed}"] = run_prompts(
            model, tokenizer, eval_dataset, lambda q: build_direct_prompt(q, demos),
            max_new_tokens=32, batch_size=BATCH_SIZE)
        results[f"fewshot_cot/seed{seed}"] = run_prompts(
            model, tokenizer, eval_dataset, lambda q: build_cot_prompt(q, demos),
            max_new_tokens=256, batch_size=BATCH_SIZE)
    results["zeroshot_cot"] = run_zero_shot_cot(model, tokenizer, eval_dataset, batch_size=BATCH_SIZE)

    with open(out_path, "w", encoding="utf-8") as f:
        json.dump(results, f, ensure_ascii=False)
    print(f"{short_name}: 保存しました")

    del model
    gc.collect()
    torch.cuda.empty_cache()
- lambda で条件を切り替える: run_prompts の第4引数(build_fn)に渡している lambda q: build_direct_prompt(q, demos) は、「問題文 q を受け取り、その回の demos を例示に使ってプロンプトを作る」無名関数です。run_prompts の中で build_fn(p["question"]) として呼ばれるので、p["question"](問題文の文字列)が q に入ります。build_direct_prompt は引数を2つ(問題文と例示)取るのに対し、run_prompts が呼ぶのは引数1つの関数なので、例示を先に埋めて引数1つの関数にする のが lambda の役割です。build_cot_prompt に書き換えるだけで Few-shot CoT に切り替わります。
- 条件とキー: 結果は「条件/例示のシード」をキーにした辞書で保存します。Zero-shot CoT は例示がなく、貪欲探索なので何度実行しても同じ結果になるため、1回だけ実行します。生成の上限は、標準 Few-shot が32トークン、Few-shot CoT が256トークンです。どちらも、平均の生成長(約2.5トークン、約40トークン)に十分な余裕があり、打ち切りは1%未満に収まります。
- 再開できる設計: モデルごとに results_モデル名.json を保存し、既にあればスキップします。セッションが切れても、残りのモデルから再開できます。
- メモリの解放: 次のモデルを読み込む前に、del・gc.collect()・torch.cuda.empty_cache() で GPU メモリを解放します。
- バッチ生成の注意: パディングの量によって計算の順序がわずかに変わるため、バッチで生成した貪欲探索の結果は、1問ずつ生成した場合とまれに一致しないことがあります。
実行結果
Qwen2.5-0.5B: 保存しました
Qwen2.5-1.5B: 保存しました
Qwen2.5-3B: 保存しました
Qwen2.5-7B: 保存しました
同じ問題に対する3つの条件の出力を並べて、CoT で何が変わるのかを見てみます。
with open(f"{SAVE_ROOT}/results_Qwen2.5-1.5B.json", encoding="utf-8") as f:
    results_1p5b = json.load(f)

idx = 200  # ステップ数3の最初の問題
print("問題:", eval_dataset[idx]["question"])
print("正解:", eval_dataset[idx]["answer"])
for key in ["direct/seed0", "zeroshot_cot", "fewshot_cot/seed0"]:
    r = results_1p5b[key][idx]
    print(f"\n--- {key}(予測: {r['pred']} / {'正解' if r['correct'] else '不正解'}) ---")
    print(r["text"])
- 表示する問題: 評価用データはステップ数1〜5の順に100問ずつ並んでいるので、idx = 200 はステップ数3の最初の問題です。
- 表示する内容: 保存しておいた生成テキスト(打ち切り処理後)と、抽出した予測、正誤を条件ごとに表示します。
実行結果
問題: クッキーが47個あります。クッキーの数が4倍になりました。36個もらいました。クッキーの数が2倍になりました。いまクッキーは何個ありますか。
正解: 448

--- direct/seed0(予測: 118 / 不正解) ---
118

--- zeroshot_cot(予測: 76 / 不正解) ---
まず、クッキーの数が4倍になったときのクッキーの数を求めてみましょう。47×4=188個です。次に、36個もらったら、188-36=152個になりました。そして、クッキーの数が2倍になったときのクッキーの数を求めてみましょう。152÷2=76個です。よって、クッキーの数は76個です。

この問題は、クッキーの数を変化させながら考えることで、解きやすくなります。ステップバイステップで考えることで、解きやすくなります。
したがって、答え(整数)は76です。

--- fewshot_cot/seed0(予測: 448 / 正解) ---
47 × 4 = 188。188 + 36 = 224。224 × 2 = 448。答え: 448
標準 Few-shot は途中の計算を書かずに誤った答えを出し、Zero-shot CoT は途中の計算を書いたものの問題文の操作を読み違えています。例示どおりの書式で式を順に書いた Few-shot CoT だけが正解しました。
- 標準 Few-shot は、途中の計算を書かずに「118」とだけ答え、不正解でした。答えを出すまでに3回の演算をすべて内部で済ませる必要があり、そこで失敗しています。
- Zero-shot CoT は途中の計算を書いていますが、「36個もらいました」を引き算(188 − 36)、「2倍になりました」を割り算(152 ÷ 2)と、問題文の操作を読み違えています。さらに、答えを書いた後も「この問題は、クッキーの数を変化させながら考えることで…」と、問題と関係の薄い文を書き続けています。この「書き終えられない」性質は、後で打ち切り率として数値に表れます。
- Few-shot CoT は、例示と同じ「式。式。答え:」の書式で3回の演算を順に書き、正解の 448 にたどり着いています。
1問だけの例なので、これが全体の傾向なのかは、次の集計で確かめます。
実装2:結果の集計と可視化
保存した結果を読み込み、条件ごとの正解率(例示のシード間の平均 ± 標準偏差)・標準誤差・打ち切り率・平均生成長と、ステップ数別の正解率を集計します。
import pandas as pd
import matplotlib.pyplot as plt

rows = []
for model_name in MODELS:
    short_name = model_name.split("/")[-1]
    with open(f"{SAVE_ROOT}/results_{short_name}.json", encoding="utf-8") as f:
        results = json.load(f)
    for key, records in results.items():
        condition, _, seed = key.partition("/")
        for r in records:
            rows.append({"model": short_name, "condition": condition, "seed": seed or "-",
                         "n_steps": r["n_steps"], "correct": r["correct"],
                         "truncated": r["truncated"], "n_tokens": r["n_tokens"]})
df = pd.DataFrame(rows)

# 1. 例示のシードごとの値 → シード間の平均と標準偏差
per_seed = (df.groupby(["model", "condition", "seed"])
              .agg(acc=("correct", "mean"), trunc=("truncated", "mean"), length=("n_tokens", "mean"))
              .reset_index())
summary = (per_seed.groupby(["model", "condition"])
             .agg(acc=("acc", "mean"), acc_std=("acc", "std"),
                  trunc=("trunc", "mean"), length=("length", "mean"))
             .reset_index())
summary["se"] = np.sqrt(summary["acc"] * (1 - summary["acc"]) / len(eval_dataset))
print(summary.round(3).to_string(index=False))

# 2. ステップ数別の正解率(シードについても平均)
by_step = df.groupby(["model", "condition", "n_steps"])["correct"].mean().unstack("n_steps")
print(by_step.round(3).to_string())

# 3. 図:(左) 1.5B のステップ数別正解率、(右) モデル規模別の全体正解率
PARAMS_B = {"Qwen2.5-0.5B": 0.49, "Qwen2.5-1.5B": 1.54, "Qwen2.5-3B": 3.09, "Qwen2.5-7B": 7.61}
LABELS = {"direct": "Direct few-shot", "zeroshot_cot": "Zero-shot CoT", "fewshot_cot": "Few-shot CoT"}

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
for cond, label in LABELS.items():
    axes[0].plot([1, 2, 3, 4, 5], by_step.loc[("Qwen2.5-1.5B", cond)].values, marker="o", label=label)
    s = summary[summary["condition"] == cond].set_index("model").loc[list(PARAMS_B)]
    axes[1].errorbar(list(PARAMS_B.values()), s["acc"], yerr=s["se"], marker="o", capsize=3, label=label)
axes[0].set(xlabel="number of steps s", ylabel="accuracy", title="Qwen2.5-1.5B: accuracy by difficulty")
axes[1].set(xscale="log", xlabel="parameters (B)", ylabel="accuracy", title="Accuracy by model size")
for ax in axes:
    ax.set_ylim(0, 1)
    ax.legend()
plt.tight_layout()
plt.show()
- 2段階の集計: まず例示のシードごとに正解率などを求め(per_seed)、次にシード間で平均と標準偏差をとります(summary)。Zero-shot CoT は1回しか実行していないので、acc_std は NaN になります。
- 標準誤差: se は問題数500に対する です。例示のシード間の標準偏差(プロンプトによるばらつき)とは別の、問題のサンプリングによるばらつきを表します。
- ステップ数別の正解率: unstack("n_steps") で、行が「モデル × 条件」、列がステップ数の表にします。
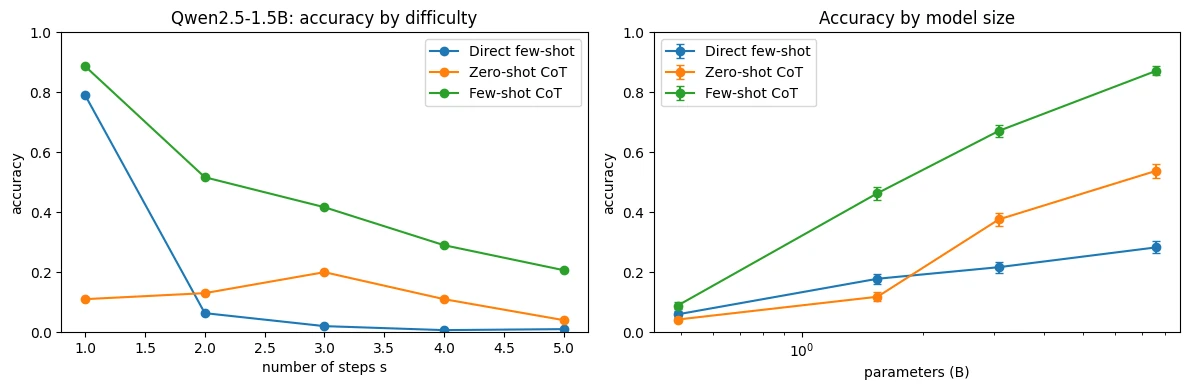
- 図の見方: 左は難易度が上がるにつれて各条件の正解率がどう下がるか、右はモデル規模を大きくしたときに各条件の正解率がどう伸びるか(エラーバーは標準誤差)を比べるための図です。横軸のパラメータ数は対数目盛にしています。
実行結果
       model    condition   acc  acc_std  trunc  length    se
Qwen2.5-0.5B       direct 0.059    0.008  0.000   2.343 0.011
Qwen2.5-0.5B  fewshot_cot 0.089    0.053  0.005  40.856 0.013
Qwen2.5-0.5B zeroshot_cot 0.042      NaN  0.660 200.760 0.009
Qwen2.5-1.5B       direct 0.178    0.012  0.000   2.579 0.017
Qwen2.5-1.5B  fewshot_cot 0.463    0.029  0.006  40.623 0.022
Qwen2.5-1.5B zeroshot_cot 0.118      NaN  0.586 215.290 0.014
  Qwen2.5-3B       direct 0.217    0.021  0.000   2.563 0.018
  Qwen2.5-3B  fewshot_cot 0.671    0.033  0.000  39.006 0.021
  Qwen2.5-3B zeroshot_cot 0.376      NaN  0.206 177.008 0.022
  Qwen2.5-7B       direct 0.283    0.009  0.000   2.580 0.020
  Qwen2.5-7B  fewshot_cot 0.871    0.080  0.001  39.819 0.015
  Qwen2.5-7B zeroshot_cot 0.538      NaN  0.216 171.224 0.022
n_steps                        1      2      3      4      5
model        condition
Qwen2.5-0.5B direct        0.267  0.003  0.020  0.000  0.007
             fewshot_cot   0.193  0.140  0.087  0.013  0.010
             zeroshot_cot  0.090  0.070  0.040  0.010  0.000
Qwen2.5-1.5B direct        0.790  0.063  0.020  0.007  0.010
             fewshot_cot   0.887  0.517  0.417  0.290  0.207
             zeroshot_cot  0.110  0.130  0.200  0.110  0.040
Qwen2.5-3B   direct        0.920  0.123  0.027  0.003  0.010
             fewshot_cot   0.960  0.817  0.657  0.573  0.350
             zeroshot_cot  0.400  0.540  0.490  0.250  0.200
Qwen2.5-7B   direct        0.950  0.380  0.037  0.033  0.013
             fewshot_cot   0.967  0.903  0.857  0.863  0.767
             zeroshot_cot  0.650  0.670  0.550  0.450  0.370
全難易度での正解率をモデルと条件ごとに並べると、次のようになります。
(図は、diagram-designで作成)
考察1:難易度(ステップ数)とプロンプトの比較
Qwen2.5-1.5B での、ステップ数ごとの正解率です(Few-shot の2条件は例示のシード3通りの平均)。
| ステップ数 | 標準 Few-shot | Zero-shot CoT | Few-shot CoT |
|---|---|---|---|
| 1 | 0.790 | 0.110 | 0.887 |
| 2 | 0.063 | 0.130 | 0.517 |
| 3 | 0.020 | 0.200 | 0.417 |
| 4 | 0.007 | 0.110 | 0.290 |
| 5 | 0.010 | 0.040 | 0.207 |
| 全体(500問) | 0.178 | 0.118 | 0.463 |
各ステップの問題数は100問なので、ステップ数ごとの正解率には最大で約 の標準誤差があります。
- 標準 Few-shot はステップ数2で崩れる: 計算が1回で済むステップ数1では 0.790 と高い正解率ですが、ステップ数2で 0.063 に急落し、ステップ数3以上ではほぼ0になります。答えのトークンを出す前に、すべての途中計算を内部で済ませなければならない標準 Few-shot では、演算が2回になっただけで答えにたどり着けなくなっています。
- Few-shot CoT は緩やかに下がる: Few-shot CoT はステップ数1で 0.887、ステップ数2で 0.517 と、ステップ数が増えるにつれて緩やかに下がり、ステップ数5でも 0.207 を保っています。途中の結果をテキストに書き出すことで、1回ずつの演算に分けて解けていることが分かります。標準 Few-shot との差は、ステップ数2で約 0.45 と最も大きくなっています。
- Zero-shot CoT は低い: Zero-shot CoT は、どのステップ数でも Few-shot CoT を大きく下回り、ステップ数1では標準 Few-shot よりも低くなっています。この理由は、後述する打ち切り率の高さで説明できます。ステップ数ごとの値が単調に下がらない(ステップ数3で最も高い)のも、打ち切りによる不正解が多く、値が不安定になっているためと考えられます。
実装1で見た1問の例(ステップ数3)は、この傾向の縮図になっていました。標準 Few-shot は途中計算を書かずに外し、Few-shot CoT は例示どおりに式を並べて正解しています。
考察2:モデル規模の比較と「創発」の再検討
4つのモデルでの、全体の正解率(500問)・生成長・打ち切り率です。
| モデル | 標準 Few-shot | Zero-shot CoT | Few-shot CoT | 平均生成長(Zero-shot CoT / Few-shot CoT) | 打ち切り率(Zero-shot CoT / Few-shot CoT) |
|---|---|---|---|---|---|
| Qwen2.5-0.5B | 0.059 ± 0.008 | 0.042 | 0.089 ± 0.053 | 200.8 / 40.9 | 0.660 / 0.005 |
| Qwen2.5-1.5B | 0.178 ± 0.012 | 0.118 | 0.463 ± 0.029 | 215.3 / 40.6 | 0.586 / 0.006 |
| Qwen2.5-3B | 0.217 ± 0.021 | 0.376 | 0.671 ± 0.033 | 177.0 / 39.0 | 0.206 / 0.000 |
| Qwen2.5-7B | 0.283 ± 0.009 | 0.538 | 0.871 ± 0.080 | 171.2 / 39.8 | 0.216 / 0.001 |
(正解率は「平均 ± 例示のシード間の標準偏差」です。Zero-shot CoT は例示がないので1回だけ実行しています。500問の正解率の標準誤差は、最大で約 です。標準 Few-shot の平均生成長は、どのモデルでも約2.5トークンです。)
- Few-shot CoT は 1.5B 以上で大きく効く: 1.5B では標準 Few-shot の 0.178 に対して Few-shot CoT が 0.463、3B では 0.217 に対して 0.671、7B では 0.283 に対して 0.871 と、規模が大きくなるほど差が広がっています。
- 0.5B では CoT がほとんど効かない: 0.5B の Few-shot CoT(0.089)は標準 Few-shot(0.059)とほとんど変わらず、その差は例示のシード間の標準偏差(0.053)の範囲です。ステップ数1に限ると、標準 Few-shot(0.267)の方が Few-shot CoT(0.193)より高くなっています(実装2の出力)。
- Zero-shot CoT は打ち切りの影響が大きい: Zero-shot CoT の打ち切り率は、0.5B で 0.660、1.5B で 0.586 と非常に高く、生成長も上限(256トークン)に近くなっています。例示がないベースモデルは、答えを書いた後も文章を書き続けることが多く、上限に達して不正解と扱われているのです。つまり、小さなモデルでの Zero-shot CoT の低さは、推論の失敗だけでなく「書き終えられない」ことにも大きく左右されています。打ち切り率が約0.2まで下がる 3B と 7B では、Zero-shot CoT も標準 Few-shot を上回っています。
- 例示の選び方の影響: 7B の Few-shot CoT は、例示のシード間の標準偏差が 0.080 と、他の条件より大きくなっています。どの3問を例示に選ぶかで、正解率が大きく変わることを示しています。
原論文の「創発」との対比
原論文(Wei et al., 2022)と、同じ著者らの Emergent Abilities of Large Language Models では、CoT の効果はモデル規模が 約1,000億(100B)パラメータ を超えたあたりで現れる「創発的能力」として報告されました。当時の実験(LaMDA・GPT-3・PaLM)では、小さなモデルに CoT のプロンプトを与えると、もっともらしいが誤った思考過程を書き、標準プロンプトより正解率が下がる場合もありました。
本実験では、Few-shot CoT は 1.5B(15.4億パラメータ)の時点ですでに標準 Few-shot を大きく上回りました。一方、0.5B では CoT がほとんど効かず、ステップ数1では標準 Few-shot より低くなりました。「小さなモデルでは CoT が効かず、ある規模を超えると効くようになる」という形自体は原論文と同じですが、その境目は約100B ではなく、0.5B と 1.5B の間にあります。
「規模」ではなく「学習データ」の効果ではないか
In-Context Learningの記事の考察と同じく、ここでは「モデルの規模そのものの効果」と「事前学習データの効果」を分けて考える必要があります。
2022年当時のモデルの事前学習データは Web テキストが中心で、多段階の思考過程が整理されて書かれた文章は多くありませんでした。一方、Qwen2.5 のような近年のモデルは、数学やコードのデータを大量に含むデータで事前学習されています。Qwen2.5 のベースモデルは、事前学習の段階で数学のデータや CoT 形式のデータを多く見ていると考えられ、その影響は Understanding R1-Zero-Like Training: A Critical Perspective(Dr. GRPO の論文)でも指摘されています。
1.5B という小さなモデルで CoT が効いたのは、「規模が小さくても推論できるようになった」というより、CoT 形式の文章を事前学習で見ているので、プロンプトでその書き方を引き出せる ためだと考えられます。ただし、Qwen2.5 の事前学習データの内訳は公開されていないので、本実験だけでこの2つを厳密に切り分けることはできません。
検証2:Self-Consistency の効果
検証1は、1問につき1本だけ生成する貪欲探索での比較でした。検証2では、同じモデル(Qwen2.5-1.5B)・同じ Few-shot CoT のまま、生成の本数 を増やします。温度付きサンプリングで1問あたり20本の思考過程を生成し、多数決(maj@k)をとります。
確かめたいのは次の2点です。
- 多数決で貪欲探索を超えられるのか: サンプリングした1本は、確率の低いトークンも選ばれる分、貪欲探索より弱くなります。何本の多数決で、その差を取り戻せるのか。
- maj@k と pass@k はどれだけ離れるのか: pass@k は「 本の中に1本でも正解があるか」です。maj@k との差は、正解を生成できているのに多数決で選べていない 問題の割合にあたります。この差が大きければ、プロンプトの工夫ではなく学習でモデルを鍛える余地がある、ということになります。
計算量が大きいので、ここから先の検証は Qwen2.5-1.5B に絞ります。
実装3:20本のサンプリングと maj@k・pass@k
Few-shot CoT(例示のシード0)で、評価用500問それぞれから20本をサンプリングし、 の maj@k と pass@k を計算します。
SC_MODEL = "Qwen/Qwen2.5-1.5B"
N_SAMPLES = 20
K_LIST = [1, 3, 5, 10, 20]
TEMPERATURE = 0.7
PROMPTS_PER_BATCH = 4   # 4問 × 20本 = 80系列を同時に生成する

set_seed(SEED)
model, tokenizer = load_model(SC_MODEL)
demos = sample_demos(train_dataset, seed=0)

sc_path = f"{SAVE_ROOT}/self_consistency_Qwen2.5-1.5B.json"
if os.path.exists(sc_path):
    with open(sc_path, encoding="utf-8") as f:
        sc_preds = json.load(f)
else:
    sc_preds = []
    for b in range(0, len(eval_dataset), PROMPTS_PER_BATCH):
        batch = eval_dataset[b:b + PROMPTS_PER_BATCH]
        prompts = [build_cot_prompt(p["question"], demos) for p in batch]
        outs = generate_batch(model, tokenizer, prompts, max_new_tokens=256,
                              temperature=TEMPERATURE, num_return_sequences=N_SAMPLES)
        for j in range(len(batch)):
            group = outs[j * N_SAMPLES:(j + 1) * N_SAMPLES]
            sc_preds.append([None if o["truncated"] else extract_answer(o["text"]) for o in group])
    with open(sc_path, "w", encoding="utf-8") as f:
        json.dump(sc_preds, f)

rows = []
for problem, preds in zip(eval_dataset, sc_preds):
    c = sum(p == problem["answer"] for p in preds)
    row = {"n_steps": problem["n_steps"], "pass@1": c / N_SAMPLES}
    for k in K_LIST:
        row[f"maj@{k}"] = maj_at_k(preds, problem["answer"], k)
        row[f"pass@{k}"] = pass_at_k(N_SAMPLES, c, k)
    rows.append(row)
sc_df = pd.DataFrame(rows)
print(sc_df.drop(columns="n_steps").mean().round(3).to_string())

greedy_acc = summary.query("model == 'Qwen2.5-1.5B' and condition == 'fewshot_cot'")["acc"].item()
plt.figure(figsize=(6, 4))
plt.plot(K_LIST, [sc_df[f"maj@{k}"].mean() for k in K_LIST], marker="o", label="maj@k")
plt.plot(K_LIST, [sc_df[f"pass@{k}"].mean() for k in K_LIST], marker="o", label="pass@k")
plt.axhline(greedy_acc, color="gray", linestyle="--", label="greedy (pass@1)")
plt.xscale("log")
plt.xlabel("k")
plt.ylabel("accuracy")
plt.ylim(0, 1)
plt.legend()
plt.title("Self-Consistency (Qwen2.5-1.5B, Few-shot CoT)")
plt.show()
- グループ生成の形: num_return_sequences=N_SAMPLES で、1回の generate で「4問 × 20本 = 80系列」を生成します。出力は問題ごとに20本ずつ連続して並ぶので、outs[j * N_SAMPLES:(j + 1) * N_SAMPLES] で問題 j の20本を取り出します。この「プロンプト数 × 本数」の形は、GRPO の記事でのグループ生成でも同じです。20本にするのは、 を1〜20まで変えて、本数を増やすと正解率がどう伸びるかを見るためです。
- 温度: TEMPERATURE = 0.7 は、GRPO・DeepSeek-R1 の記事と同じ値です。温度が低すぎると20本がほぼ同じ答えになって多数決の意味がなくなり、高すぎると1本ごとの質が落ちます。
- 指標の計算: pass@1 は 、pass@k は pass_at_k、maj@k は並べ替えで平均した maj_at_k で計算します。20本の生成を1回行うだけで、すべての の値が求まります。
- 貪欲探索との比較: 図には、貪欲探索での Few-shot CoT の正解率(例示のシード3通りの平均)を破線で示します。サンプリングの pass@1 は、貪欲探索の正解率より低くなるのが普通です。
- 保存と再利用: 20本 × 500問の予測を JSON に保存し、再実行時は読み込むだけにします。
実行結果
pass@1     0.360
maj@1      0.360
maj@3      0.404
pass@3     0.528
maj@5      0.434
pass@5     0.597
maj@10     0.459
pass@10    0.683
maj@20     0.472
pass@20    0.762
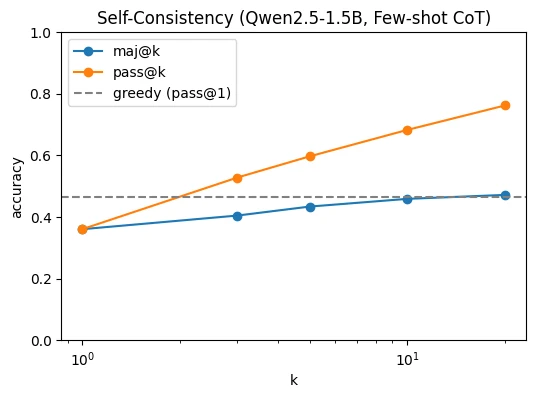
考察3:多数決はどこまで効くか
Qwen2.5-1.5B の Few-shot CoT で、サンプリング数 を変えたときの maj@k と pass@k です(各問題20本から推定)。
| maj@k | pass@k | |
|---|---|---|
| 1 | 0.360 | 0.360 |
| 3 | 0.404 | 0.528 |
| 5 | 0.434 | 0.597 |
| 10 | 0.459 | 0.683 |
| 20 | 0.472 | 0.762 |
- サンプリングの1本は貪欲探索より弱い: 温度 0.7 でサンプリングした1本の正解率(pass@1)は 0.360 で、貪欲探索の Few-shot CoT(例示のシード3通りの平均 0.463)より約0.1低くなっています。サンプリングでは、確率の低いトークンも選ばれるためです。
- maj@k の伸び: 多数決の本数を増やすと、maj@k は 0.360 から 0.472 まで上がりました。ただし、20本を生成してようやく貪欲探索(0.463)とほぼ同じ水準で、その差は標準誤差の範囲です。この条件では、Self-Consistency は「サンプリングによる質の低下を多数決で取り戻した」程度にとどまっています。なお、この比較では、Self-Consistency は例示のシード0だけで実行している点にも注意してください。
- pass@k と maj@k の差: pass@20 は 0.762 で、maj@20(0.472)との差は約0.29です。つまり、約3割の問題では、20本の中に正解が含まれているのに、多数決では選べていません。モデルは正解にたどり着く能力を持っているのに、それが多数派の答えになっていないということです。
この差は、次の問いにつながります。正解した思考過程を強化し、誤った思考過程を抑えるようにモデルを学習できれば、1回の生成(pass@1)の正解率を上げられるのではないか、という問いです。ただし、強化学習が pass@k そのものをどれだけ上げるのかは別の問題で、GRPO の記事で実験を通して確かめます。
検証3:Zero-shot CoT のトリガー文
検証1で、Qwen2.5-1.5B の Zero-shot CoT は標準 Few-shot より低い正解率でした。ただし Zero-shot CoT には、Few-shot CoT にはない不安定さがあります。例示ではなく指示文で思考過程を引き出すので、どう言うかで結果が変わる ことです。
Kojima et al. (2022) も、トリガー文の言い回しを変えるだけで正解率が変わることを報告しています。ここでは、意味はほぼ同じ4つの日本語のトリガー文を用意し、同じ500問で比べます。正解率だけでなく 平均生成長 も併せて見ます。トリガー文の違いが「推論の質」を変えているのか、それとも単に「思考過程を長くさせ、上限で打ち切られやすくしている」だけなのかを切り分けるためです。
実装4:4つのトリガー文の比較
# Zero-shot CoT のトリガー文の比較(算数ワールド500問)
TRIGGERS = [
    "ステップバイステップで考えましょう。",
    "順を追って論理的に考えましょう。",
    "段階的に計算してみましょう。",
    "結論を出す前に、一歩ずつ確認しましょう。",
]
for trigger in TRIGGERS:
    records = run_zero_shot_cot(model, tokenizer, eval_dataset, trigger=trigger, batch_size=BATCH_SIZE)
    acc = np.mean([r["correct"] for r in records])
    length = np.mean([r["n_tokens"] for r in records])
    print(f"{trigger}  正解率 {acc:.3f} ± {np.sqrt(acc * (1 - acc) / len(records)):.3f} / 平均生成長 {length:.1f}")
- モデルの再利用: 実装3で読み込んだ model・tokenizer をそのまま使います。
- トリガー文の比較: run_zero_shot_cot の trigger を入れ替えるだけで比較できます。正解率に加えて平均生成長も表示し、トリガー文によって思考過程の長さがどう変わるかも確認します。
実行結果
ステップバイステップで考えましょう。  正解率 0.118 ± 0.014 / 平均生成長 215.3
順を追って論理的に考えましょう。  正解率 0.080 ± 0.012 / 平均生成長 228.1
段階的に計算してみましょう。  正解率 0.070 ± 0.011 / 平均生成長 233.8
結論を出す前に、一歩ずつ確認しましょう。  正解率 0.040 ± 0.009 / 平均生成長 245.3
4つのトリガー文の正解率を並べると、次のようになります。
(図は、diagram-designで作成)
考察4:言い回しの違いは何を反映しているか
結果を表にすると次のとおりです。
| トリガー文 | 正解率 | 平均生成長 |
|---|---|---|
| ステップバイステップで考えましょう。 | 0.118 ± 0.014 | 215.3 |
| 順を追って論理的に考えましょう。 | 0.080 ± 0.012 | 228.1 |
| 段階的に計算してみましょう。 | 0.070 ± 0.011 | 233.8 |
| 結論を出す前に、一歩ずつ確認しましょう。 | 0.040 ± 0.009 | 245.3 |
最も高い「ステップバイステップで考えましょう。」(0.118)と最も低い「結論を出す前に、一歩ずつ確認しましょう。」(0.040)の差は約0.08で、標準誤差(約0.01)を大きく超えています。原論文と同じく、言い回しの違いで正解率が変わりました。
ただし、平均生成長が長いトリガー文ほど正解率が低く、どれも上限の256トークンに近い値です。考察2で見たとおり、このモデルの Zero-shot CoT は打ち切り率が高いので、この差は「トリガー文による推論の質の違い」より、「思考過程が長くなり、上限で打ち切られる割合の違い」を主に反映している可能性があります。
検証4:外部ベンチマーク(MGSM 日本語サブセット)
ここまでの結果は、すべて自作の合成データ(算数ワールド)で得たものです。合成データは正解が確実で汚染の心配もない代わりに、問題文の言い回しが単調で、解き方のパターンも限られます。そこで最後に、外部のベンチマークでも同じ傾向が出るかを確かめます。
使うのは MGSM(Multilingual Grade School Math)の日本語サブセット250問です。GSM8K の小学校レベルの文章題を多言語に翻訳したもので、算数ワールドより文章が長く、解き方も多様です。例示は 算数ワールドの問題のまま にします。「途中の計算を書いてから答える」という書き方が、分野の違う問題にも移るのかを見たいためです。3条件に加えて、検証2で効果を確かめた Self-Consistency(maj@10)も測ります。
実装5:MGSM 日本語サブセットでの評価
from datasets import load_dataset

# MGSM 日本語サブセット(250問)
mgsm = load_dataset("juletxara/mgsm", "ja", split="test")
mgsm_data = [{"question": ex["question"], "answer": int(ex["answer_number"]), "n_steps": 0} for ex in mgsm]

mgsm_results = {
    "direct": run_prompts(model, tokenizer, mgsm_data, lambda q: build_direct_prompt(q, demos), 32),
    "fewshot_cot": run_prompts(model, tokenizer, mgsm_data, lambda q: build_cot_prompt(q, demos), 256),
    "zeroshot_cot": run_zero_shot_cot(model, tokenizer, mgsm_data),
}
for name, records in mgsm_results.items():
    acc = np.mean([r["correct"] for r in records])
    print(f"MGSM {name:13s} 正解率 {acc:.3f} ± {np.sqrt(acc * (1 - acc) / len(records)):.3f}")

# Self-Consistency(maj@10)
mgsm_maj = []
for b in range(0, len(mgsm_data), PROMPTS_PER_BATCH):
    batch = mgsm_data[b:b + PROMPTS_PER_BATCH]
    outs = generate_batch(model, tokenizer, [build_cot_prompt(p["question"], demos) for p in batch],
                          max_new_tokens=256, temperature=TEMPERATURE, num_return_sequences=10)
    for j, p in enumerate(batch):
        preds = [None if o["truncated"] else extract_answer(o["text"]) for o in outs[j * 10:(j + 1) * 10]]
        mgsm_maj.append(majority_vote(preds) == p["answer"])
acc = np.mean(mgsm_maj)
print(f"MGSM maj@10         正解率 {acc:.3f} ± {np.sqrt(acc * (1 - acc) / len(mgsm_maj)):.3f}")

del model
gc.collect()
torch.cuda.empty_cache()
- MGSM の読み込み: MGSM は GSM8K の問題を多言語に翻訳したベンチマークです。answer_number を正解として使います。算数ワールドのステップ数に相当する情報はないので、n_steps は0にしています。
- 例示: MGSM でも算数ワールドの例示(シード0)をそのまま使います。例示と評価問題の分野がずれるので、MGSM 向けの例示を使う場合より正解率は低めに出る可能性があります。
- MGSM の maj@10: 10本をサンプリングし、majority_vote の結果が正解と一致するかを数えます。ここでは各問題で1回だけ多数決をとっています。検証2の20本ではなく10本にするのは、250問 × 10本の生成で、計算時間を抑えるためです。
- 後片付け: 1.5B を使う検証はここまでなので、del と torch.cuda.empty_cache() で GPU メモリを解放します。
実行結果
MGSM direct        正解率 0.076 ± 0.017
MGSM fewshot_cot   正解率 0.244 ± 0.027
MGSM zeroshot_cot  正解率 0.080 ± 0.017
MGSM maj@10         正解率 0.336 ± 0.030
Hugging Face 上の MGSM のデータセット名・設定名(juletxara/mgsm の ja)や列名は、実行前に確認してください。問題文に「問題:」などの接頭辞が含まれている場合は、プロンプトの「問題: 」と重複しないよう取り除きます。
4つの条件の正解率を並べると、次のようになります。
(図は、diagram-designで作成)
考察5:合成データの傾向は外部でも成り立つか
Qwen2.5-1.5B での、MGSM 日本語サブセット(250問)の正解率です。
| 条件 | 正解率(n = 250) |
|---|---|
| 標準 Few-shot | 0.076 ± 0.017 |
| Zero-shot CoT | 0.080 ± 0.017 |
| Few-shot CoT | 0.244 ± 0.027 |
| Self-Consistency(maj@10) | 0.336 ± 0.030 |
MGSM でも、Few-shot CoT(0.244)は標準 Few-shot(0.076)を大きく上回り、Zero-shot CoT(0.080)は標準 Few-shot とほぼ同じでした。算数ワールドと同じ傾向です。例示は算数ワールドの問題のままなので、分野がずれた例示でも、「途中の計算を書いてから答える」という書き方は MGSM の問題にも移っていると言えます。
算数ワールドとの違いは Self-Consistency で、maj@10(0.336)は Few-shot CoT の貪欲探索(0.244)を約0.09上回りました。MGSM は算数ワールドより文章が長く、解き方も多様なので、1本の貪欲探索が誤りやすい分、多数決の効果が出やすかったと考えられます。ただし、MGSM は GSM8K の翻訳なので、元の英語の問題を Qwen2.5 が事前学習で見ている可能性があります(後述の限界を参照)。
この実験の限界
- 評価問題数: 算数ワールドは500問(ステップ数ごとには100問)、MGSM は250問です。標準誤差はそれぞれ最大で約 、(ステップ数ごと)、 なので、数ポイントの差は「差があるとは言えない」可能性があります。
- 合成データの偏り: 算数ワールドは、1種類の物の個数を四則演算で増減させる単純な文章題です。問題文の言い回しも少なく、除算の出現頻度も他の演算より低くなっています。常識推論や、不要な情報を含む文章題などで同じ結果になるとは限りません。
- プロンプトの影響: 例示は3問だけで、選び方を3通り変えただけです。プロンプトの書式(「問題:」「解答:」など)や指示文、トリガー文の言い回しを変えると、結果が変わる可能性があります。
- 生成の設定: 主な実験は貪欲探索で、max_new_tokens の上限を超えた生成は不正解として扱っています。特に Zero-shot CoT は、0.5B・1.5B で打ち切り率が約6割と高く、正解率が打ち切りに大きく左右されています。上限を変えると、Zero-shot CoT の正解率とトリガー文の比較の結果は変わる可能性があります。
- MGSM の汚染: MGSM は GSM8K のテストセットの翻訳です。Qwen2.5 が GSM8K を事前学習で見ている場合、MGSM の結果は実際の推論能力より高く出る可能性があります。算数ワールドを主な評価に使うのはこのためです。
- 事前学習データが非公開: 小型モデルで CoT が効く理由が「事前学習データ」なのか「アーキテクチャや学習方法の進歩」なのかは、事前学習データの内訳が非公開なので厳密には切り分けられません。
まとめ
記事を通じて、以下の内容を学習・実践しました。
-
多段階推論の壁: 自己回帰の言語モデルは、1トークンあたり一定量の計算しかできません。思考過程をテキストとして書き出すと、途中の結果を文脈として参照でき、答えに至るまでの計算量を系列の長さの方向に増やせます。
-
CoT の3つのアプローチ:
- 思考過程つきの例示を与える Few-shot CoT
- 「ステップバイステップで考えましょう」で思考過程を引き出し、2段階プロンプティングで答えを取り出す Zero-shot CoT
- 温度付きサンプリングで複数の思考過程を生成し、多数決で誤りを打ち消す Self-Consistency
-
推論の評価の道具:
- 生成の打ち切り、正規化、タグ・回答行・末尾の数値の順に探す答えの抽出規則(extract_answer)
- pass@1、多数決による maj@k、不偏推定量による pass@k の定義と実装
- 標準誤差・平均生成長・打ち切り率を併せて報告すること
-
算数ワールド: 正解が確実に分かり、汚染の心配がなく、ステップ数で難易度を制御できる合成データを、棄却サンプリングで生成しました。評価用500問(seed=2026)と、評価用との重複を除いた学習用データを分けています。
-
実験: Qwen2.5 の 0.5B〜7B で、ステップ数 × プロンプトの正解率、Self-Consistency の maj@k と pass@k、トリガー文の違い、MGSM での正解率を測り、原論文の「創発」の結果が現代の小型モデルで再現されるかを検討しました。
-
主な結果:
- Qwen2.5-1.5B では、標準 Few-shot の正解率はステップ数2で 0.063 まで急落したのに対し、Few-shot CoT はステップ数5でも 0.207 を保ち、全体では 0.178 から 0.463 に上がりました。
- Few-shot CoT の効果は 1.5B 以上で大きく、0.5B ではほとんど見られませんでした。原論文の「創発」と同じ形ですが、その境目は約100B ではなく 0.5B と 1.5B の間でした。
- Self-Consistency の maj@20(0.472)と pass@20(0.762)の差から、約3割の問題で「正解を生成できるのに多数決で選べていない」ことが分かりました。
学習による推論の改善
プロンプトの工夫だけでも、LLM の推論能力をかなり引き出せます。しかし、プロンプトで引き出せるのは、モデルがもともと持っている能力までです。
正しい思考過程を高い確率でたどれるように、重みそのものを学習で鍛えることはできないだろうか?
PPO や DPO は、人間の好みを学習の信号にしていました。算数のような推論タスクには、機械的に判定できる 正解 があります。GRPOの記事では、PPO から価値関数(Critic)を取り除き、同じ問題に対する複数の応答の相対的な良し悪しから方策を更新する GRPO(Group Relative Policy Optimization) を解説し、算数ワールドの正誤を報酬にして実装します。
※ライセンスに関する注記 本記事の実験で利用したベースモデルのうち、Qwen/Qwen2.5-0.5B・Qwen/Qwen2.5-1.5B・Qwen/Qwen2.5-7B は Apache License 2.0、Qwen/Qwen2.5-3B は Qwen Research License で公開されています。外部評価に用いた MGSM は CC BY-SA 4.0 で公開されています。各提供元のライセンスに準拠して利用しています。
参考文献
- J. Wei et al. (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. NeurIPS 2022.
- T. Kojima, S. S. Gu, M. Reid, Y. Matsuo, Y. Iwasawa (2022). Large Language Models are Zero-Shot Reasoners. NeurIPS 2022.
- X. Wang et al. (2023). Self-Consistency Improves Chain of Thought Reasoning in Language Models. ICLR 2023.
- M. Chen et al. (2021). Evaluating Large Language Models Trained on Code. arXiv:2107.03374.
- J. Wei et al. (2022). Emergent Abilities of Large Language Models. Transactions on Machine Learning Research.
- Z. Liu et al. (2025). Understanding R1-Zero-Like Training: A Critical Perspective. arXiv:2503.20783.
- Qwen Team (2024). Qwen2.5-0.5B. Hugging Face(Apache License 2.0).
- Qwen Team (2024). Qwen2.5-1.5B. Hugging Face(Apache License 2.0).
- Qwen Team (2024). Qwen2.5-3B. Hugging Face(Apache License 2.0).
- Qwen Team (2024). Qwen2.5-7B. Hugging Face(Apache License 2.0).
- Google Research. MGSM. GitHub(CC BY-SA 4.0).
本記事の文章・構成の一部に生成AIを使用しています。