Chameleonとは?
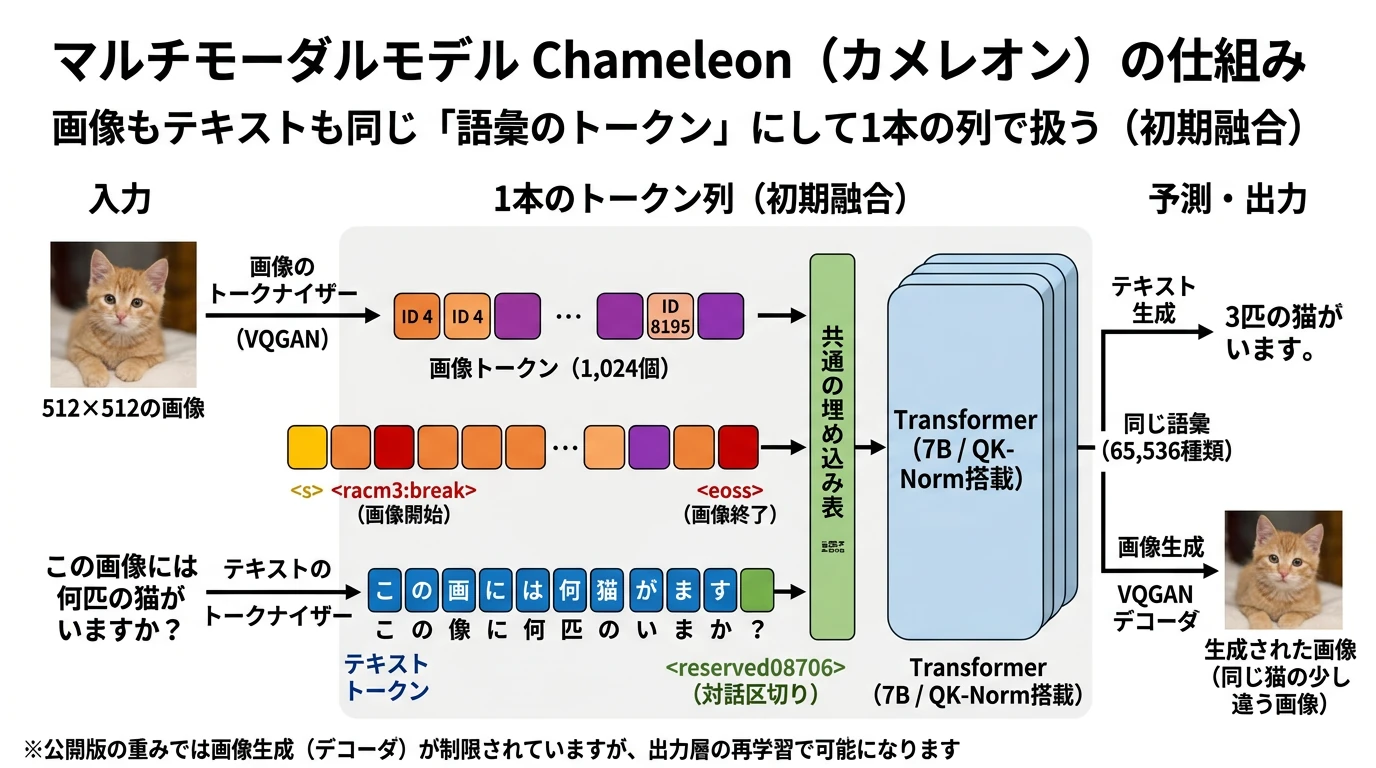 (画像は、Geminiで作成)
画像もテキストも同じ語彙のトークンにして、1 本の列として 1 つの Transformer で扱う Chameleon を部品ごとに PyTorch で実装し、公式の学習済みの重みを読み込んで Hugging Face の実装と同じトークン列を生成することを確かめること。画像のトークナイザーが何を残し何を失うか、公開版がなぜ画像を生成しないかを理解し、画像のトークンを生成して画像に戻すところと、画像を生成するための出力層の学習まで、自分で書いて動かせるようになること。
参考資料: Chameleon: Mixed-Modal Early-Fusion Foundation Models (Chameleon Team, 2024)。公式の実装は facebookresearch/chameleon、本記事で使う学習済みの重みは Hugging Face の facebook/chameleon-7b です。画像のトークナイザーのデコーダと、画像を生成するための出力層は、GAIR/Anole-7b-v0.1(Anole の論文)が配布するものを使います。いずれも Chameleon Research License(非営利の研究に限る) です。
概要
LLaVA や Qwen2-VL などの多くの画像と言語のモデル(VLM)は、画像専用のエンコーダ(ViT)で画像を特徴のベクトルにし、それを言語モデルに入れます。画像とテキストは、別々の部品で別々の形に変えてから合流します。出力はテキストだけで、画像は生成できません。
Chameleon(Meta、2024)は、画像を最初から語彙のトークンに変えます。画像のトークナイザー(VQGAN)が、512×512 の画像を 8,192 種類のコードのどれか 1,024 個に置き換え、それぞれのコードを語彙の 1 つのトークンとして扱います。テキストのトークンと画像のトークンは 1 本の列に並び、同じ埋め込み表と同じ Transformer で処理されます(初期融合、early fusion)。出力も同じ語彙から選ぶので、テキストと画像を交互に生成することもできる構成です。
本記事では、まず Hugging Face の実装で Chameleon-7B に画像の質問をさせ、仕組みを図で整理したうえで、前処理・VQGAN・QK-Norm を加えた Transformer をスクラッチで実装します。公式の重みで Hugging Face と同じトークン列を生成することを確かめ、画像のトークナイザーが文字の大きさによってどこまで情報を残すかを調べます。さらに、公開版の重みが画像を生成しないように変えられている箇所を確かめ、Anole の出力層に差し替えて、テキストから画像を生成します。最後に、Anole と同じく出力層の画像の行だけを、COCO の画像とキャプション 2,000 組で学習し直して、画像を生成できるようにします。
Chameleon で画像を読む
準備:Google Colab の GPU で動かす
本記事のコードは、Google Colab の A100 GPU(40GB) で実行しました。「ランタイム」→「ランタイムのタイプを変更」から A100 GPU を選んでください(Colab の有料プランが必要です)。7B のモデルを、実験2では float32(約 28GB)で動かすためです。
Chameleon の重みは、利用規約に同意したアカウントだけが読み込めます(gated model)。次の手順で準備してください。
- Hugging Face の facebook/chameleon-7b のページで、Chameleon Research License に同意して利用を申請します。Meta が承認すると使えるようになります。
- Hugging Face の設定でアクセストークン(読み取り)を作り、Colab の左の鍵のアイコン(シークレット)に HF_TOKEN という名前で登録し、ノートブックからのアクセスを許可します。
新しいセッションで、次を実行してください。transformers(比較用の Chameleon)は Colab に最初から入っています。グラフの日本語表示には japanize-matplotlib を使い、Python 3.12 以降で import 時にエラーが出ないよう setuptools も入れます。
!pip install -q japanize-matplotlib setuptools
推論に利用する画像
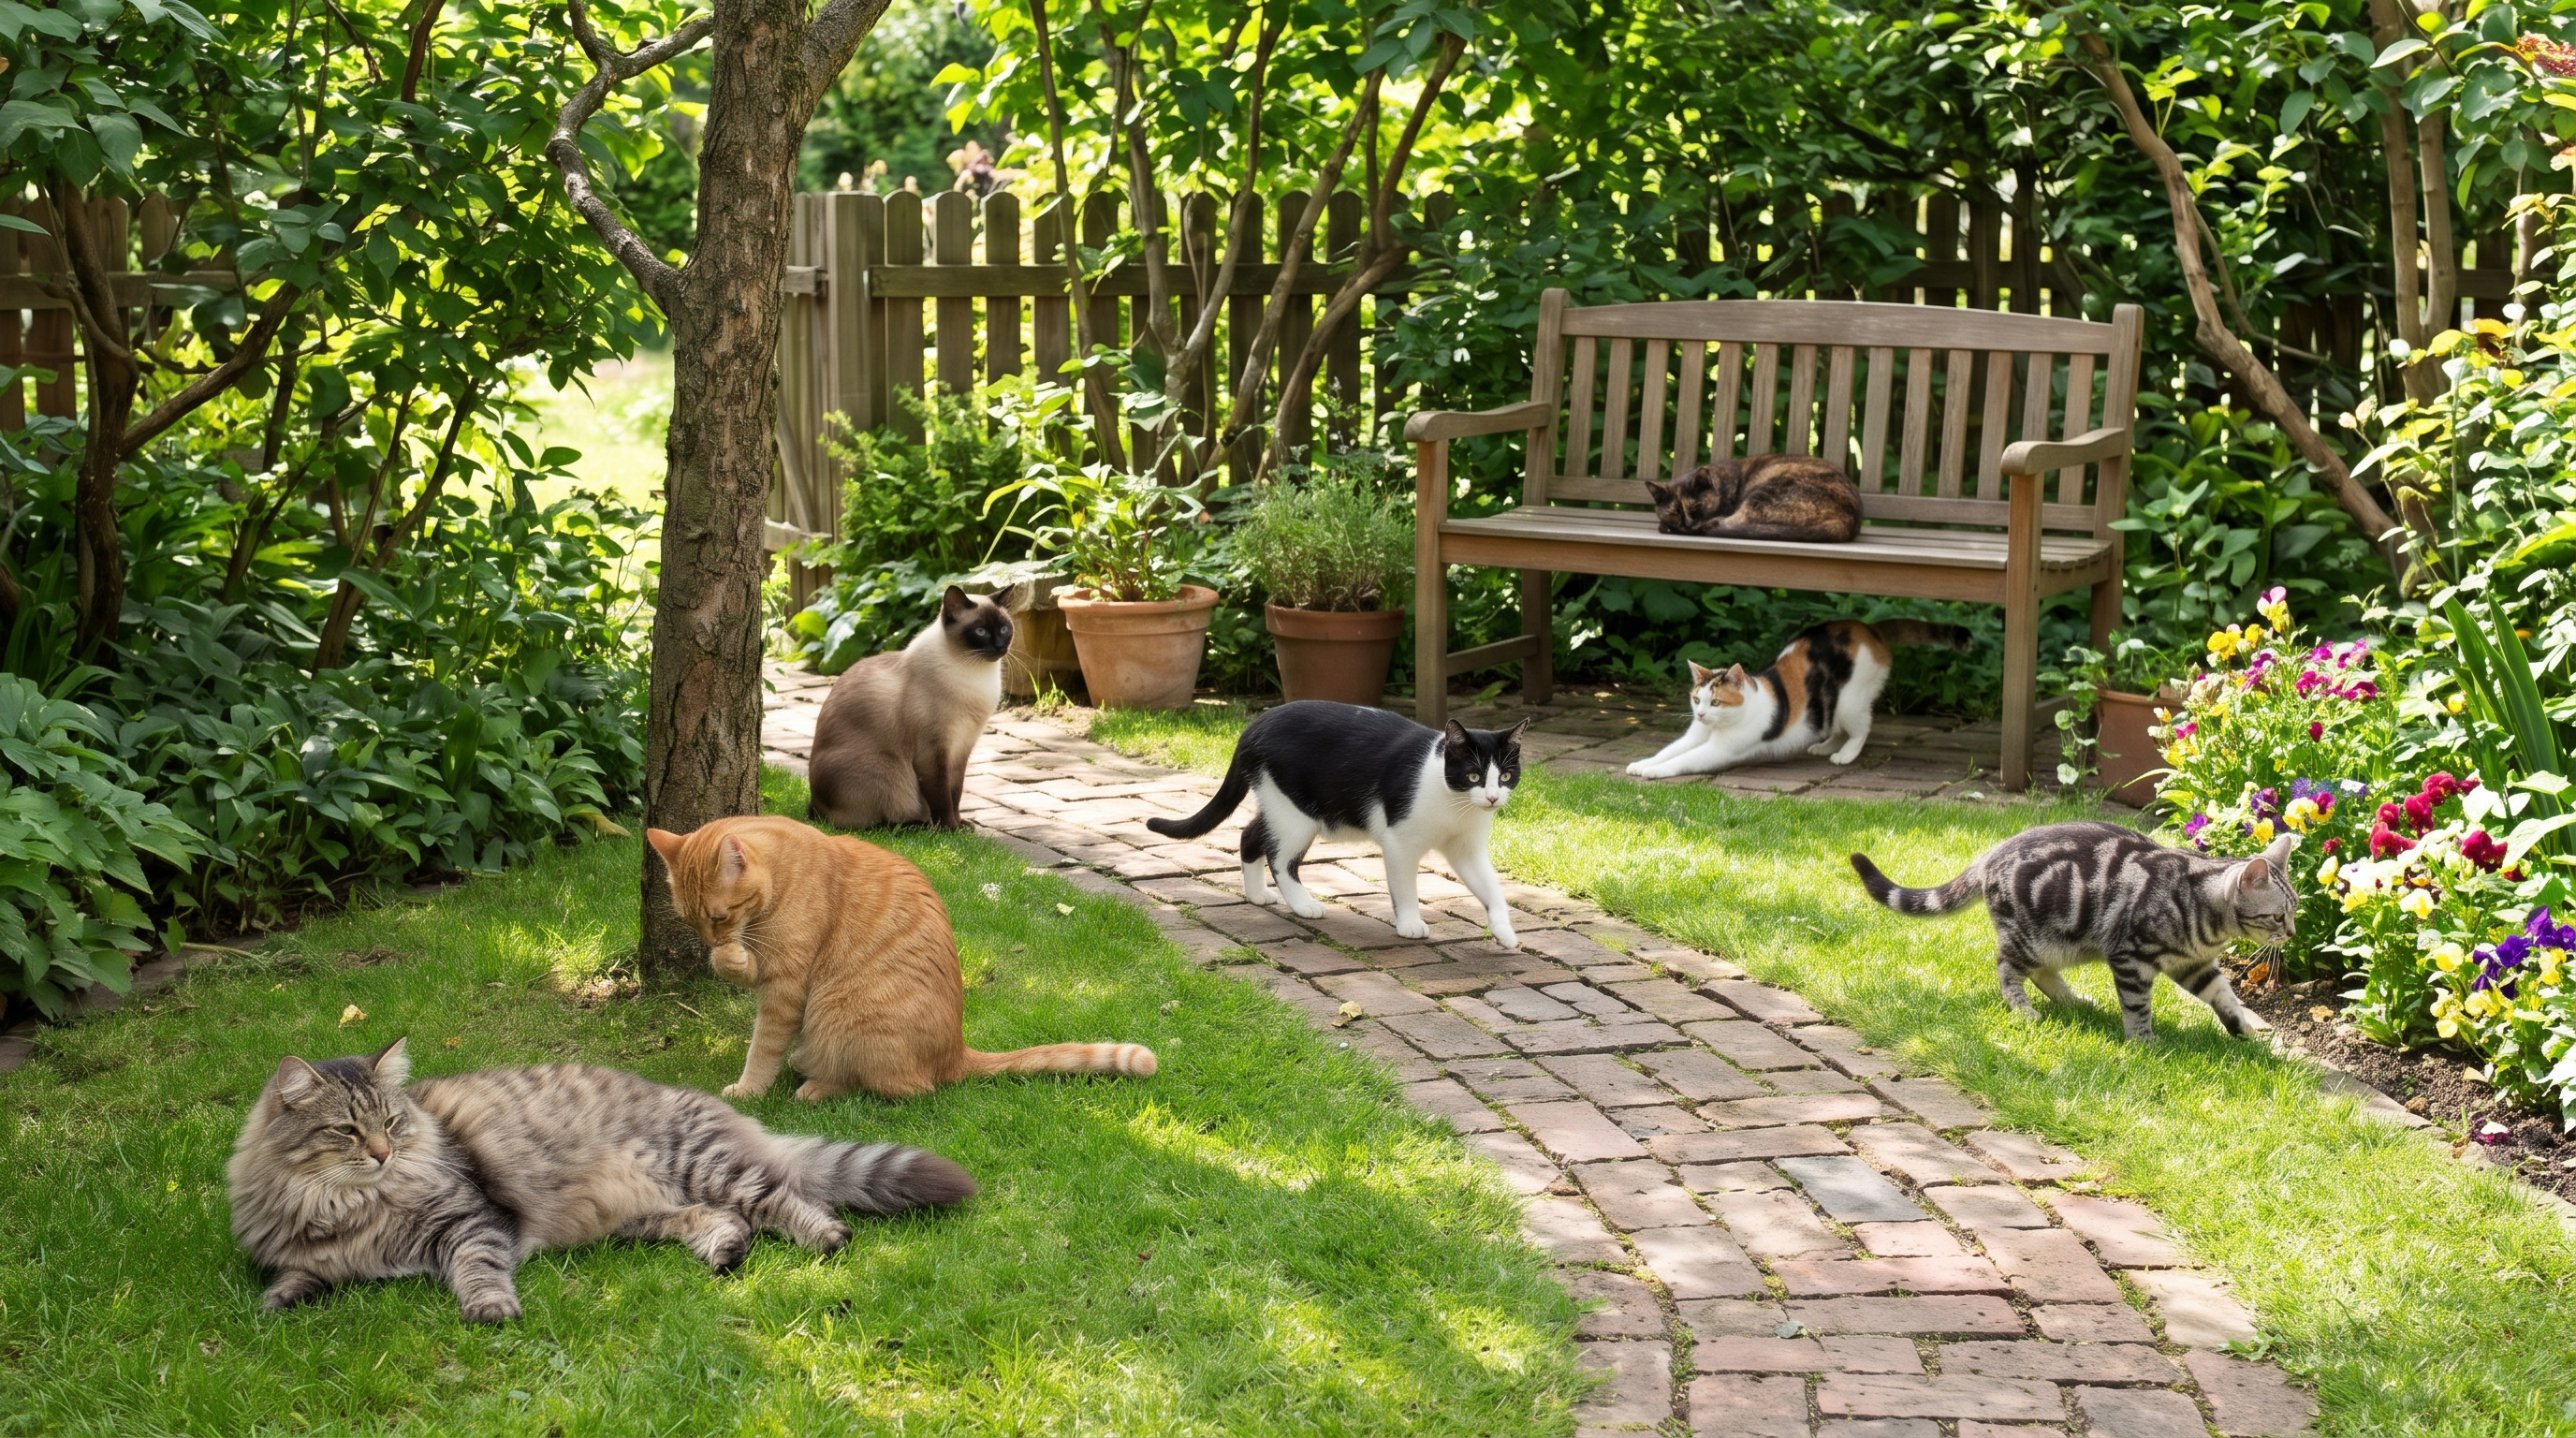
実験1と実験2では、庭にいる複数の猫の画像を使います。次の画像を保存し、cats.jpg という名前で Colab にアップロードしてください(画像は、Geminiで作成)。文字の画像は、コードの中で作ります。
実験1:Hugging Face の実装で画像に質問する
Hugging Face の実装で、猫の画像に 2 つの質問をします。
import os
import re
import io
import math
import time
import random
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
import matplotlib.pyplot as plt
import japanize_matplotlib
from matplotlib import font_manager
from PIL import Image, ImageDraw, ImageFont
from google.colab import userdata
from huggingface_hub import hf_hub_download
from transformers import ChameleonProcessor, ChameleonForConditionalGeneration

device = "cuda"
MID = "facebook/chameleon-7b"
TOKEN = userdata.get("HF_TOKEN")                       # 利用規約に同意したアカウントのトークン(Colab のシークレット)
processor = ChameleonProcessor.from_pretrained(MID, token=TOKEN)
hf_model = ChameleonForConditionalGeneration.from_pretrained(MID, dtype=torch.bfloat16, token=TOKEN).to(device).eval()


# 回答の終わり:</s> に加えて、対話の区切り <reserved08706>(モデルは回答の後にこれを出し、次の質問を自分で書き始める)
STOP = [processor.tokenizer.eos_token_id, processor.tokenizer.convert_tokens_to_ids("<reserved08706>")]


def ask_hf(model, image, question, max_new_tokens=64):
    """<image> の位置に画像のトークン 1,024 個が入る。processor が末尾に区切りのトークン(対話の形式)を付ける"""
    inputs = processor(images=[image], text="<image>" + question, return_tensors="pt").to(device, model.dtype)
    with torch.no_grad():
        out = model.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False, repetition_penalty=1.0, eos_token_id=STOP)
    return processor.decode(out[0, inputs["input_ids"].shape[1]:], skip_special_tokens=True).strip(), inputs


cats = Image.open("cats.jpg").convert("RGB")
for q in ["What do you see in this image? Answer in two sentences.", "How many cats are in this image?"]:
    answer, inputs = ask_hf(hf_model, cats, q)
    print(f"[{cats.size[0]}×{cats.size[1]} → {tuple(inputs['pixel_values'].shape[2:])}、入力 {inputs['input_ids'].shape[1]} トークン] {q}\n  → {answer}\n")

# モデルが実際に見ている画像(512×512 に切り出した範囲)
seen = ((inputs["pixel_values"][0].float().cpu() + 1) / 0.0078).clamp(0, 255).permute(1, 2, 0).numpy().astype(np.uint8)
fig, ax = plt.subplots(1, 2, figsize=(12, 4.2), gridspec_kw={"width_ratios": [cats.size[0] / cats.size[1], 1]})
ax[0].imshow(cats); ax[0].set_title(f"元の画像({cats.size[0]}×{cats.size[1]})")
w = cats.size[0] * 512 / cats.size[1]
for x in [(w - 512) / 2, (w + 512) / 2]:
    ax[0].axvline(x * cats.size[1] / 512, color="red", lw=2)
ax[1].imshow(seen); ax[1].set_title("Chameleon に入る画像(512×512・1,024 トークン)")
for a in ax:
    a.axis("off")
plt.show()
- <image>: 画像を入れる位置の印です。processor が、画像の始まり(<racm3:break>)・<image> × 1,024・画像の終わり(<eoss>)に展開し、モデルの中で <image> を画像のトークンに置き換えます。
- 対話の区切り: processor は、質問の後ろに <reserved08706>(対話の区切り)を付けます。モデルは回答の後にもこのトークンを出し、そのまま続けると次の質問を自分で書き始めます。そこで、eos_token_id に </s> とこのトークンの 2 つを渡して、回答だけで止めます。
- 貪欲法: 公式の設定(generation_config.json)はサンプリング(温度 0.7・top_p 0.9・繰り返しのペナルティ 1.2)ですが、do_sample=False・repetition_penalty=1.0 で、毎回確率が最大のトークンを選びます。後でスクラッチ実装の出力と比べるためです。
- bfloat16: Hugging Face で公開されている重みの型です。
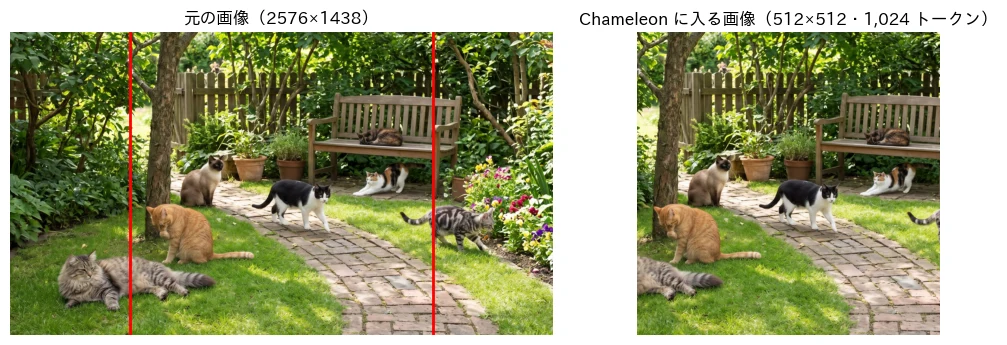
- モデルが見ている画像: 前処理は、短い辺を 512 に縮めてから中央の 512×512 を切り出します。横長の画像は左右が切れるので、元の画像と切り出した範囲を並べて表示します。
実行結果
[2576×1438 → (512, 512)、入力 1041 トークン] What do you see in this image? Answer in two sentences.
  → The image shows a group of cats and dogs in a garden. The cats are black and white, and one is orange. The dogs are a golden retriever and a beagle. The cats are all sitting, while the dogs are lying down.

[2576×1438 → (512, 512)、入力 1036 トークン] How many cats are in this image?
  → There are three cats in this image.
- 画像の説明: 「猫と犬がいる庭」と答え、ゴールデンレトリバーとビーグルがいると説明しました。画像に犬はいません。猫の毛の色(白黒と茶色)は合っていますが、全体としては不正確な説明です。
- 猫の数: 3 匹と答えました。切り出した 512×512 の範囲にも、7 匹(うち 2 匹は端で一部だけ)が写っています。
- 切り出し: 2576×1438 の横長の画像は、中央の 512×512 だけが使われ、左右の端が切れます(上の画像の赤い線の外側)。Chameleon に入る画像は、どんな大きさの画像でも 512×512・1,024 トークンです。
Qwen2-VL(2B)は、同じ画像の猫の数を 7 匹と正しく答えました。Chameleon-7B は、画像とテキストを交互に生成できる汎用のモデルとして作られていて、画像の質問に答える性能は、画像の理解に特化したモデルより低めです。論文も、画像の質問応答では、Chameleon-34B が同程度の大きさの専用モデルと競う水準だと報告しています。
Chameleon の仕組み
全体の構成:初期融合
Chameleon の全体は、次の図のとおりです(図は、後で実装する Chameleon クラスの構成です)。
(図は、diagram-designで作成)
- 語彙: 65,536 個のトークンのうち、8,192 個(ID 4〜8195)が画像のコード、残りがテキストのトークンと特別なトークンです。画像のトークンも、テキストと同じ埋め込み表(4096 次元)から引きます。
- 1 本の列: 画像は <racm3:break> と <eoss> で挟んだ 1,024 個のトークンとして、テキストの間に入ります。1 枚の画像が、テキストの約 1,000 語分の長さになります。
- 出力: 出力層も 65,536 個のトークンのどれかを選ぶので、画像のトークンを 1,024 個続けて出せば、画像を生成できる構成です。ただし、公開版の重みでは画像を出さないようにしています(実験4で確かめます)。
LLaVA のような構成(後期融合)との違いは、画像の情報が言語モデルに入る形です。後期融合では、画像エンコーダの連続値のベクトルが入ります。Chameleon では、画像の情報は 1,024 個の離散的なコードの番号だけです。番号に変える段階で失われた情報は、言語モデルからは取り戻せません(実験3で確かめます)。その代わり、画像を「読む」ことと「書く」ことを、同じ語彙・同じモデルで扱えます。
画像のトークナイザー:VQGAN
(図は、diagram-designで作成)
画像のトークナイザーは、Make-A-Scene(Gafni et al., 2022)の方式の VQGAN です。エンコーダが 512×512 の画像を 32×32 の位置ごとの 256 次元のベクトルにし、各ベクトルを、コードブック(8,192 個の 256 次元のベクトル)の中で最も近いものの番号に置き換えます(ベクトル量子化)。1 つのコードが 16×16 画素を受け持ちます。デコーダは、番号から引いたコードブックのベクトルを、逆の順に大きくして画像に戻します。
論文によると、このトークナイザーは、ライセンスのある画像だけで学習し、人の顔の画像を多めに使っています。一方で、論文は「文字の多い画像の復元が苦手」なことを弱点として挙げ、文字の読み取りが必要なタスクの性能が限られると述べています。
Transformer ブロックと QK-Norm
(図は、diagram-designで作成)
Transformer は、Llama 2 と同じ構成(前置きの RMSNorm・RoPE・SwiGLU)に、QK-Norm を加えたものです。7B は 32 層・4096 次元・32 ヘッドです。
論文によると、画像とテキストを混ぜて学習すると、学習の途中で損失が発散しました。エントロピーの違う 2 種類のデータが同じ重みを共有し、softmax に入る値(クエリとキーの内積)の大きさが少しずつ増えていくためです。そこで、クエリとキーを、ヘッドごとに LayerNorm で正規化してから内積をとります(QK-Norm)。内積の大きさを毎回そろえることで、softmax に入る値が際限なく大きくなることを防ぎます。論文は、このほかに z-loss(softmax の分母の対数の 2 乗を損失に足す)と、7B での dropout(0.1)も使い、34B では正規化の位置も入れ替えています(Swin Transformer と同じ並べ方)。学習したトークンは、合計で約 9.2 兆個です。
論文・公式の設定と、本記事の設定の違い
| 項目 | 論文・公式 | 本記事 |
|---|---|---|
| モデルの大きさ | 7B と 34B | 7B だけ(A100 1 枚に載る大きさ) |
| 画素値の変換 | Meta の公式コードは x ÷ 127.5 − 1、Hugging Face は x × 0.0078 − 1 | 等価性を確かめるため Hugging Face の値。VQGAN の復元(実験3)だけは、デコーダと組で学習された公式の値。違いの影響は実験2で測る |
| テキストの生成 | サンプリング(温度 0.7・top_p 0.9・繰り返しのペナルティ 1.2。Hugging Face の generation_config.json) | 貪欲法(スクラッチ実装と比べられ、毎回同じ結果になるようにするため) |
| 回答の終わり | Hugging Face の設定は </s> だけ | </s> と <reserved08706>(対話の区切り)。区切りで止めないと、次の質問を自分で書き続けるため |
| 計算の精度 | bfloat16(公開されている重みの型) | 実験2は float32(実装が同じかを確かめるため)、ほかは言語モデルを bfloat16、VQGAN を float32 |
| VQGAN のデコーダ | Hugging Face の重みにない(Meta の公式の配布物には含まれる) | Anole が配布する vqgan.ckpt(同じ Chameleon Research License) |
| 画像の生成 | 公開版の重みでは使えない | Anole の出力層の、画像のトークンの行に差し替える |
| 画像の生成の設定 | テキストの CFG 3.0・画像の CFG 1.2・温度 0.7・top_p 0.9(Meta の公式の推論コードの既定値) | 同じ。指示に画像がないときは画像の CFG が効かないので、2 本の列で計算する |
| 学習 | 合計 約 9.2 兆トークン(Anole の追加学習は、5,859 枚の画像で A100 8 枚・約 30 分) | 本体は公式の重みのまま。実験6で、出力層の画像の行だけを COCO の 2,000 枚で学習 |
Chameleon のスクラッチ実装
ここからは、Chameleon を部品ごとに実装します。部品の構造・次元・計算の順番は、Hugging Face の ChameleonForConditionalGeneration(ChameleonVQVAE と ChameleonModel)と同じで、重みの名前も読み込みやすいように合わせています。VQGAN のデコーダは Hugging Face の実装にないので、Meta の公式の推論コード(vqgan.py)の構造に合わせます。
前処理
def preprocess(image, size=512, scale=0.0078):
    """短い辺を 512 に縮小し、中央の 512×512 を切り出して、画素値を [-1, 1] 付近に変換する。
    scale は Hugging Face の設定(0.0078)。Meta の公式コードは 1/127.5(= 0.007843…)"""
    w, h = image.size
    r = size / min(w, h)
    image = image.resize((max(size, int(w * r)), max(size, int(h * r))), Image.LANCZOS)
    x0, y0 = (image.width - size) // 2, (image.height - size) // 2
    image = image.crop((x0, y0, x0 + size, y0 + size))
    x = torch.tensor(np.asarray(image), dtype=torch.float32).permute(2, 0, 1)
    return (x * scale - 1.0)[None]                                 # (1, 3, 512, 512)


ref = processor.image_processor(cats, return_tensors="pt")["pixel_values"]
mine = preprocess(cats)
print(f"cats.jpg {cats.size[0]}×{cats.size[1]} → {tuple(mine.shape)}、HF との差の最大値 {(ref - mine).abs().max().item():.4f}"
      f"(画素値 1 段階の幅は {0.0078:.4f})、差のある画素の割合 {((ref - mine).abs() > 1e-6).float().mean().item():.1%}")
- 縮小と切り出し: 短い辺を 512 にして(LANCZOS 法)、中央の 512×512 を切り出します。VQGAN が 512×512 の画像で学習されているためです。
- 画素の値: x × 0.0078 − 1 で、0〜255 の値をおよそ −1〜1 にします。0.0078 は Hugging Face の設定(rescale_factor)の値です。Meta の公式コードは x ÷ 127.5 − 1(係数 0.007843…)で、最も明るい 255 が、Hugging Face では 0.989、公式では 1.0 になります。影響は実験2で確かめます。
実行結果
cats.jpg 2576×1438 → (1, 3, 512, 512)、HF との差の最大値 0.0000(画素値 1 段階の幅は 0.0078)、差のある画素の割合 0.0%
Hugging Face の前処理と、すべての画素で同じ値になりました。
画像のトークナイザー:VQGAN
def swish(x):
    return x * torch.sigmoid(x)


class ResBlock(nn.Module):
    """GroupNorm → swish → 3×3 畳み込みを 2 回。チャンネル数が変わるときは 1×1 畳み込みで残差を合わせる"""
    def __init__(self, cin, cout):
        super().__init__()
        self.norm1, self.conv1 = nn.GroupNorm(32, cin, eps=1e-6), nn.Conv2d(cin, cout, 3, padding=1)
        self.norm2, self.conv2 = nn.GroupNorm(32, cout, eps=1e-6), nn.Conv2d(cout, cout, 3, padding=1)
        self.nin_shortcut = nn.Conv2d(cin, cout, 1) if cin != cout else None

    def forward(self, x):
        h = self.conv1(swish(self.norm1(x)))
        h = self.conv2(swish(self.norm2(h)))
        return (x if self.nin_shortcut is None else self.nin_shortcut(x)) + h


class AttnBlock(nn.Module):
    """最も小さい解像度(32×32)でだけ使う自己注意。1,024 か所が画像全体を見渡す"""
    def __init__(self, c):
        super().__init__()
        self.norm = nn.GroupNorm(32, c, eps=1e-6)
        self.q, self.k, self.v, self.proj_out = (nn.Conv2d(c, c, 1) for _ in range(4))

    def forward(self, x):
        B, C, H, W = x.shape
        h = self.norm(x)
        q = self.q(h).reshape(B, C, H * W).transpose(1, 2)        # (B, HW, C)
        k = self.k(h).reshape(B, C, H * W)                        # (B, C, HW)
        v = self.v(h).reshape(B, C, H * W)
        w = torch.softmax(q @ k * C ** -0.5, dim=2)               # (B, HW, HW)
        return x + self.proj_out((v @ w.transpose(1, 2)).reshape(B, C, H, W))


class Down(nn.Module):
    """右と下にだけ 1 画素足してから、ストライド 2 の 3×3 畳み込みで半分にする(元の実装の非対称なパディング)"""
    def __init__(self, c):
        super().__init__()
        self.conv = nn.Conv2d(c, c, 3, stride=2)

    def forward(self, x):
        return self.conv(F.pad(x, (0, 1, 0, 1)))


class Up(nn.Module):
    """最近傍補間で 2 倍にしてから 3×3 畳み込み"""
    def __init__(self, c):
        super().__init__()
        self.conv = nn.Conv2d(c, c, 3, padding=1)

    def forward(self, x):
        return self.conv(F.interpolate(x, scale_factor=2.0, mode="nearest"))


CH, MULT, NRES, ZCH, NCODE = 128, (1, 1, 2, 2, 4), 2, 256, 8192   # config.json の vq_config


class VQEncoder(nn.Module):
    """512×512×3 → 32×32×256。5 段のうち最後以外で半分にする(512 → 256 → 128 → 64 → 32)"""
    def __init__(self):
        super().__init__()
        self.conv_in = nn.Conv2d(3, CH, 3, padding=1)
        self.down, cin = nn.ModuleList(), CH
        for i, m in enumerate(MULT):
            level = nn.Module()
            level.block = nn.ModuleList([ResBlock(cin if j == 0 else CH * m, CH * m) for j in range(NRES)])
            cin = CH * m
            if i < len(MULT) - 1:
                level.downsample = Down(cin)
            self.down.append(level)
        self.mid = nn.Module()
        self.mid.block_1, self.mid.attn_1, self.mid.block_2 = ResBlock(cin, cin), AttnBlock(cin), ResBlock(cin, cin)
        self.norm_out, self.conv_out = nn.GroupNorm(32, cin, eps=1e-6), nn.Conv2d(cin, ZCH, 3, padding=1)

    def forward(self, x):
        h = self.conv_in(x)
        for i, level in enumerate(self.down):
            for blk in level.block:
                h = blk(h)
            if i < len(self.down) - 1:
                h = level.downsample(h)
        h = self.mid.block_2(self.mid.attn_1(self.mid.block_1(h)))
        return self.conv_out(swish(self.norm_out(h)))


class VQDecoder(nn.Module):
    """32×32×256 → 512×512×3。エンコーダを逆にたどる(各段の ResBlock はエンコーダより 1 つ多い 3 つ)"""
    def __init__(self):
        super().__init__()
        cin = CH * MULT[-1]
        self.conv_in = nn.Conv2d(ZCH, cin, 3, padding=1)
        self.mid = nn.Module()
        self.mid.block_1, self.mid.attn_1, self.mid.block_2 = ResBlock(cin, cin), AttnBlock(cin), ResBlock(cin, cin)
        levels = {}
        for i in reversed(range(len(MULT))):                       # 低い解像度から作る
            level = nn.Module()
            level.block = nn.ModuleList([ResBlock(cin if j == 0 else CH * MULT[i], CH * MULT[i]) for j in range(NRES + 1)])
            cin = CH * MULT[i]
            if i > 0:
                level.upsample = Up(cin)
            levels[i] = level
        self.up = nn.ModuleList([levels[i] for i in range(len(MULT))])   # 公式と同じ番号(up[0] が最も高い解像度)
        self.norm_out, self.conv_out = nn.GroupNorm(32, cin, eps=1e-6), nn.Conv2d(cin, 3, 3, padding=1)

    def forward(self, z):
        h = self.mid.block_2(self.mid.attn_1(self.mid.block_1(self.conv_in(z))))
        for i in reversed(range(len(self.up))):
            for blk in self.up[i].block:
                h = blk(h)
            if i > 0:
                h = self.up[i].upsample(h)
        return self.conv_out(swish(self.norm_out(h)))


class VQGAN(nn.Module):
    """画像 ⇄ 8,192 種類のコード 1,024 個。decoder は Hugging Face の重みにはないので、Anole が配布する元の重みを読む"""
    def __init__(self, with_decoder=False):
        super().__init__()
        self.encoder, self.quant_conv = VQEncoder(), nn.Conv2d(ZCH, ZCH, 1)
        self.embedding = nn.Embedding(NCODE, ZCH)                  # コードブック
        self.post_quant_conv = nn.Conv2d(ZCH, ZCH, 1)
        self.decoder = VQDecoder() if with_decoder else None

    def encode(self, pixel):
        z = self.quant_conv(self.encoder(pixel))                  # (B, 256, 32, 32)
        z = z.permute(0, 2, 3, 1).reshape(-1, ZCH)
        e = self.embedding.weight
        # 最も近いコード。距離は |z|² + |e|² − 2 z·e(公式と同じ式にして、ほぼ同じ距離のときの選び方も合わせる)
        d = z.pow(2).sum(1, keepdim=True) + e.pow(2).sum(1) - 2 * torch.einsum("bd,dn->bn", z, e.t())
        return d.argmin(1).view(pixel.shape[0], -1)               # (B, 1024)

    def decode(self, codes):
        z = self.embedding(codes).view(codes.shape[0], 32, 32, ZCH).permute(0, 3, 1, 2)
        x = self.decoder(self.post_quant_conv(z)).clamp(-1, 1)
        return [Image.fromarray(((im.permute(1, 2, 0).float().cpu().numpy() + 1) / 2 * 255).astype(np.uint8)) for im in x]
- ResBlock: GroupNorm(32 グループ)・swish・3×3 の畳み込みを 2 回通して、入力に足します。チャンネル数が変わる段の最初だけ、入力を 1×1 の畳み込みで合わせます。
- Down: 右と下にだけ 1 画素を足してから、ストライド 2 の畳み込みで縦横を半分にします。元の実装(taming-transformers)が、PyTorch にない非対称なパディングを使っているので、同じ結果になるように合わせています。
- AttnBlock: 最も小さい 32×32 の段でだけ、1,024 か所の間で自己注意をとります。畳み込みだけでは届かない、画像の離れた位置の関係を混ぜるためです。
- VQGAN.encode: エンコーダの出力の各位置で、コードブックの 8,192 個のベクトルとの距離を計算し、最も近い番号を選びます。距離は公式と同じ式(|z|² + |e|² − 2z·e)で計算し、ほぼ同じ距離のコードがあるときの選び方も公式と同じにしています。
- VQGAN.decode: 番号からコードブックのベクトルを引き、デコーダで画像に戻します。出力を −1〜1 に切り詰めて、0〜255 に戻します。
言語モデル:QK-Norm を加えた Transformer
D, NL, NH, HD, FF, VOCAB = 4096, 32, 32, 128, 11008, 65536   # config.json の値(7B)


class RMSNorm(nn.Module):
    def __init__(self, d, eps=1e-5):
        super().__init__()
        self.weight, self.eps = nn.Parameter(torch.ones(d)), eps

    def forward(self, x):
        h = x.float()
        return self.weight * (h * torch.rsqrt(h.pow(2).mean(-1, keepdim=True) + self.eps)).to(x.dtype)


class QKNorm(nn.Module):
    """QK-Norm:ヘッドごとに、128 次元のベクトルを LayerNorm で正規化する。
    重みが (ヘッド数, 128) なのは Hugging Face の変換の形。7B(model_parallel_size = 1)では全ヘッドで同じ値"""
    def __init__(self, nh, hd):
        super().__init__()
        self.weight, self.bias = nn.Parameter(torch.ones(nh, hd)), nn.Parameter(torch.zeros(nh, hd))

    def forward(self, x):                                      # x: (B, L, ヘッド数, 128)
        return F.layer_norm(x, (x.shape[-1],), eps=1e-5) * self.weight + self.bias


def rope(L, offset, device):
    inv = 1.0 / (10000.0 ** (torch.arange(0, HD, 2, device=device).float() / HD))
    f = torch.outer(torch.arange(offset, offset + L, device=device).float(), inv)
    emb = torch.cat([f, f], dim=-1)                             # (L, 128)
    return emb.cos(), emb.sin()


def rotate(x, cos, sin):
    x1, x2 = x.chunk(2, dim=-1)
    return x * cos + torch.cat([-x2, x1], dim=-1) * sin


class Block(nn.Module):
    """Llama と同じ前置きの RMSNorm・RoPE・SwiGLU に、q と k の QK-Norm を加えたもの"""
    def __init__(self):
        super().__init__()
        self.input_layernorm, self.post_attention_layernorm = RMSNorm(D), RMSNorm(D)
        self.q_proj, self.k_proj, self.v_proj, self.o_proj = (nn.Linear(D, D, bias=False) for _ in range(4))
        self.q_norm, self.k_norm = QKNorm(NH, HD), QKNorm(NH, HD)
        self.gate_proj, self.up_proj = nn.Linear(D, FF, bias=False), nn.Linear(D, FF, bias=False)
        self.down_proj = nn.Linear(FF, D, bias=False)

    def forward(self, x, cos, sin, cache=None):
        B, L, _ = x.shape
        h = self.input_layernorm(x)
        q = self.q_norm(self.q_proj(h).view(B, L, NH, HD)).transpose(1, 2)    # 正規化してから回転する
        k = self.k_norm(self.k_proj(h).view(B, L, NH, HD)).transpose(1, 2)
        v = self.v_proj(h).view(B, L, NH, HD).transpose(1, 2)
        q, k = rotate(q, cos, sin), rotate(k, cos, sin)
        if cache is not None:                                    # 生成:過去の k, v に今の分を足す
            if "k" in cache:
                k, v = torch.cat([cache["k"], k], 2), torch.cat([cache["v"], v], 2)
            cache["k"], cache["v"] = k, v
        a = F.scaled_dot_product_attention(q, k, v, is_causal=L > 1)
        x = x + self.o_proj(a.transpose(1, 2).reshape(B, L, D))
        h = self.post_attention_layernorm(x)
        return x + self.down_proj(F.silu(self.gate_proj(h)) * self.up_proj(h))


class ChameleonLM(nn.Module):
    """テキストのトークンも画像のトークンも、同じ語彙(65,536)の 1 本の列として扱うデコーダ"""
    def __init__(self):
        super().__init__()
        self.embed_tokens = nn.Embedding(VOCAB, D)
        self.layers = nn.ModuleList([Block() for _ in range(NL)])
        self.norm = RMSNorm(D)
        self.lm_head = nn.Linear(D, VOCAB, bias=False)           # 埋め込みとは別の重み

    def forward(self, ids, caches=None, offset=0):
        x = self.embed_tokens(ids)
        cos, sin = rope(ids.shape[1], offset, ids.device)
        cos, sin = cos.to(x.dtype), sin.to(x.dtype)
        for i, layer in enumerate(self.layers):
            x = layer(x, cos, sin, None if caches is None else caches[i])
        return self.lm_head(self.norm(x))                        # (B, L, 65536)
- QKNorm: クエリとキーを (トークン, ヘッド, 128) の形にして、最後の 128 次元ごとに LayerNorm で正規化してから、ヘッドごとの重みとバイアスをかけます。Hugging Face の重みはヘッド数 × 128 の形ですが、7B(学習時のモデル並列が 1)では、すべてのヘッドで同じ値です。
- 計算の順番: QK-Norm で正規化してから RoPE で回転します。回転は大きさを変えないので、正規化した大きさがそのまま注意に入ります。
- RMSNorm: Hugging Face と同じく、float32 で計算してから元の型に戻し、重みをかけます。順番を変えると、bfloat16 の丸めの誤差が変わります。
- 出力層: 埋め込みとは別の重み(4096 × 65,536)を持ちます。
モデル全体と生成
tok = processor.tokenizer
vocab = tok.get_vocab()
BOS, EOS, BOI, EOI, EOT = (vocab[t] for t in ["<s>", "</s>", "<racm3:break>", "<eoss>", "<reserved08706>"])


def code_name(c):
    """コード番号 → 語彙の名前。数字を A〜J に置き換えて、IMGIMG と Z で挟む(例:0 → IMGIMGAZ、8191 → IMGIMGIBJBZ)"""
    return "IMGIMG" + "".join(chr(ord("A") + int(d)) for d in str(c)) + "Z"


CODE2TOK = torch.tensor([vocab[code_name(c)] for c in range(NCODE)])   # コード番号 → トークン ID
IMAGE_TOKENS = CODE2TOK.sort().values                                  # 画像のトークン 8,192 個の ID


class Chameleon(nn.Module):
    def __init__(self, with_decoder=False):
        super().__init__()
        self.vq, self.lm = VQGAN(with_decoder), ChameleonLM()

    def image_tokens(self, pixel):
        """画像 → 1,024 個のコード → 語彙のトークン ID。ここで画像はテキストと同じ「ID の列」になる"""
        return CODE2TOK.to(pixel.device)[self.vq.encode(pixel)]

    def build_ids(self, text, pixels=(), chat=True):
        """テキストの <image> を、<racm3:break>・画像のトークン 1,024 個・<eoss> に置き換える。
        chat=True なら末尾に対話の区切り <reserved08706> を付ける(Hugging Face の processor の既定と同じ)。
        chat=False は文の続きを書かせる形(processor の return_for_text_completion=True と同じ)"""
        parts = text.split("<image>")
        assert len(parts) == len(pixels) + 1
        ids = [BOS]
        for i, part in enumerate(parts):
            ids += tok.encode(part, add_special_tokens=False) if part else []
            if i < len(pixels):
                ids += [BOI] + self.image_tokens(pixels[i]).flatten().tolist() + [EOI]
        return torch.tensor([ids + ([EOT] if chat else [])], device=self.lm.embed_tokens.weight.device)

    def logits(self, ids, caches=None, offset=0, mode="text"):
        out = self.lm(ids, caches, offset)
        if mode == "text":                                       # 公開版の重みは、画像のトークンを出さないようにしている
            out[..., IMAGE_TOKENS.to(out.device)] = torch.finfo(out.dtype).min
        return out

    @torch.no_grad()
    def generate(self, ids, max_new_tokens=64):
        """greedy(毎回いちばん確率の高いトークン)。</s> か対話の区切り <reserved08706> で止める。キャッシュで過去の k, v を使い回す"""
        caches = [dict() for _ in self.lm.layers]
        nxt = self.logits(ids, caches)[:, -1].argmax(-1, keepdim=True)
        out, pos = [nxt], ids.shape[1]
        while len(out) < max_new_tokens and nxt.item() not in (EOS, EOT):
            nxt = self.logits(nxt, caches, pos)[:, -1].argmax(-1, keepdim=True)
            out.append(nxt)
            pos += 1
        return torch.cat(out, 1)


with torch.device("meta"):
    m = Chameleon(with_decoder=True)
n = lambda mod: sum(p.numel() for p in mod.parameters())
print(f"VQGAN エンコーダ(+quant_conv): {n(m.vq.encoder) + n(m.vq.quant_conv):>14,}")
print(f"コードブック(8,192×256)    : {n(m.vq.embedding):>14,}")
print(f"VQGAN デコーダ(+post_quant): {n(m.vq.decoder) + n(m.vq.post_quant_conv):>14,}")
print(f"言語モデル                   : {n(m.lm):>14,}")
print(f"  うち埋め込みと出力層       : {n(m.lm.embed_tokens) + n(m.lm.lm_head):>14,}")
print(f"画像のトークン: ID {IMAGE_TOKENS[0].item()}〜{IMAGE_TOKENS[-1].item()}({len(IMAGE_TOKENS):,} 個)、"
      f"コード 0 → {code_name(0)}(ID {CODE2TOK[0].item()})、コード 8191 → {code_name(8191)}(ID {CODE2TOK[8191].item()})")
print("特別なトークン:", {t: vocab[t] for t in ["<s>", "</s>", "<racm3:break>", "<eoss>", "<reserved08706>", "<image>"]})
del m
- code_name・CODE2TOK: VQGAN のコード番号を、語彙のトークン ID に変える表です。語彙の名前は、番号の各桁の数字を A〜J に置き換え、IMGIMG と Z で挟んだものです(例:0 → IMGIMGAZ)。名前から ID を引くので、トークナイザーの語彙と必ず一致します。
- build_ids: テキストの <image> を、画像の始まり・画像のトークン 1,024 個・画像の終わりに置き換えた、1 本の ID の列を作ります。Hugging Face は <image> の埋め込みを後から画像のトークンの埋め込みに差し替えますが、同じ埋め込み表から引くので、最初から ID を入れても同じ結果になります。
- logits: テキストを生成するときは、画像のトークン 8,192 個の logit を最小の値にします。Hugging Face の実装と同じ処理で、理由は実験4で確かめます。
- generate: 貪欲法で、</s> か対話の区切りが出たら止めます。
実行結果
VQGAN エンコーダ(+quant_conv):     27,260,672
コードブック(8,192×256)    :      2,097,152
VQGAN デコーダ(+post_quant):     39,360,643
言語モデル                   :  7,013,666,816
  うち埋め込みと出力層       :    536,870,912
画像のトークン: ID 4〜8195(8,192 個)、コード 0 → IMGIMGAZ(ID 4)、コード 8191 → IMGIMGIBJBZ(ID 8195)
特別なトークン: {'<s>': 0, '</s>': 2, '<racm3:break>': 8197, '<eoss>': 8196, '<reserved08706>': 8710, '<image>': 8711}
- パラメータの数: 言語モデルが約 70 億個で、VQGAN はエンコーダとコードブックで約 2,900 万個、デコーダで約 3,900 万個です。言語モデルの埋め込みと出力層(それぞれ 65,536 × 4096)が、合わせて約 5.4 億個を占めます。
- 画像のトークン: コード 0 は語彙の ID 4、コード 8191 は ID 8195 で、画像のトークンは ID 4〜8195 に並んでいます。
- 特別なトークン: 画像の始まり(<racm3:break>)は 8197、画像の終わり(<eoss>)は 8196、対話の区切り(<reserved08706>)は 8710 です。<image>(8711)は、Hugging Face の processor が画像の位置に置く印で、学習では使われていないトークンです。
学習済みの重みを読み込む
from safetensors.torch import load_file

files = [hf_hub_download(MID, f"model-0000{i}-of-00003.safetensors", token=TOKEN) for i in (1, 2, 3)]


def load_chameleon(model, dtype):
    """Hugging Face の safetensors の名前を付け替えて、そのまま割り当てる(HF のモデルのクラスは使わない)"""
    sd = {}
    for f in files:
        for k, v in load_file(f, device=device).items():
            k = k.replace("model.vqmodel.quantize.embedding.", "vq.embedding.").replace("model.vqmodel.", "vq.")
            k = k.replace("model.", "lm.").replace("lm_head.", "lm.lm_head.")
            k = k.replace(".self_attn.", ".").replace(".mlp.", ".")
            sd[k] = v.to(dtype)
    missing, unexpected = model.load_state_dict(sd, strict=False, assign=True)
    assert not unexpected, unexpected[:5]
    assert all(k.startswith(("vq.decoder.", "vq.post_quant_conv.")) for k in missing), missing[:5]
    return model                                     # 足りないのはデコーダだけ(Hugging Face の重みにない)


def load_vqgan(ckpt):
    """Anole が配布する元の VQGAN の重み(vqgan.ckpt、float32)を、エンコーダもデコーダもすべて読む"""
    sd = {k.replace("quantize.", ""): v for k, v in ckpt.items()
          if k.split(".")[0] in ("encoder", "decoder", "quantize", "quant_conv", "post_quant_conv")}
    with torch.device("meta"):
        vq = VQGAN(with_decoder=True)
    vq.load_state_dict(sd, strict=True, assign=True)
    return vq.to(device).eval()
- load_chameleon: Hugging Face の safetensors の 3 つのファイルを直接読み、重みの名前を付け替えて割り当てます(assign=True)。Hugging Face のモデルのクラスは使いません。
- load_vqgan: Hugging Face の重みには VQGAN のデコーダがないので、Anole が配布する元の VQGAN の重み(vqgan.ckpt)を読みます。実験3と実験5で使います。
実験2:Hugging Face の実装と比べる
2 つの質問で、入力の ID(画像のトークンを含む)・logit・生成したトークン列を比べます。
# float32 で比べる(bfloat16 では、32 層を通る間の丸めの誤差で、同じ実装でも logit がずれるため)。
# 7B の float32(約 28GB)を 2 つは載せないので、HF の結果を先に保存してから、HF のモデルを消してスクラッチを読む
del hf_model
torch.cuda.empty_cache()
hf32 = ChameleonForConditionalGeneration.from_pretrained(MID, dtype=torch.float32, token=TOKEN).to(device).eval()
questions = ["What do you see in this image? Answer in two sentences.", "How many cats are in this image?"]
ref = {}
for q in questions:
    inputs = processor(images=[cats], text="<image>" + q, return_tensors="pt").to(device)
    with torch.no_grad():
        codes = hf32.model.get_image_tokens(inputs["pixel_values"])
        logits = hf32(**inputs).logits[0].cpu()
        torch.cuda.synchronize(); t0 = time.time()
        gen = hf32.generate(**inputs, max_new_tokens=64, do_sample=False, repetition_penalty=1.0, eos_token_id=STOP)[0, inputs["input_ids"].shape[1]:]
        torch.cuda.synchronize()
    ids = inputs["input_ids"].clone()                            # HF は画像の位置に <image> を置き、埋め込みを後で差し替える
    ids[ids == processor.image_token_id] = codes.flatten().long()  # 比べるために、差し替える画像のトークンを入れておく
    ref[q] = dict(pixel=inputs["pixel_values"], ids=ids, codes=codes, logits=logits, gen=gen, t=time.time() - t0)
del hf32
torch.cuda.empty_cache()

with torch.device("meta"):
    model = Chameleon()
model = load_chameleon(model, torch.float32).eval()
for q in questions:
    r = ref[q]
    with torch.no_grad():
        ids = model.build_ids("<image>" + q, [r["pixel"]])
        logits = model.logits(ids)[0].cpu()
        torch.cuda.synchronize(); t0 = time.time()
        gen = model.generate(ids, max_new_tokens=64)[0]
        torch.cuda.synchronize()
    ok = logits > torch.finfo(logits.dtype).min                  # 画像のトークン(両方とも最小値にしている列)は除く
    print(f"{q}(入力 {ids.shape[1]} トークン)\n"
          f"  入力の ID(画像のトークンを含む):一致 {torch.equal(ids.cpu(), r['ids'].cpu())}(画像のトークン 1,024 個のうち一致 {(model.image_tokens(r['pixel']) == r['codes']).sum().item():,} 個)\n"
          f"  logit の差の最大値 {(logits - r['logits'])[ok].abs().max().item():.2e}(logit の絶対値の最大 {r['logits'][ok].abs().max().item():.0f})\n"
          f"  生成:HF {len(r['gen'])} 個・スクラッチ {len(gen)} 個、一致 {torch.equal(gen.cpu(), r['gen'].cpu())}"
          f"(HF {r['t']:.2f} 秒、スクラッチ {time.time() - t0:.2f} 秒)\n  → {tok.decode(gen, skip_special_tokens=True).strip()}")

# 画素値の変換の係数:HF は 0.0078、Meta の公式コードは 1/127.5。どれだけトークンが変わるか
with torch.no_grad():
    c_hf = model.image_tokens(preprocess(cats).to(device))
    c_meta = model.image_tokens(preprocess(cats, scale=1 / 127.5).to(device))
    ids = model.build_ids("<image>" + questions[1], [preprocess(cats, scale=1 / 127.5).to(device)])
    ans = tok.decode(model.generate(ids)[0], skip_special_tokens=True).strip()
print(f"\n係数 0.0078 と 1/127.5 で、画像のトークン 1,024 個のうち {(c_hf != c_meta).sum().item()} 個が変わる。"
      f"1/127.5 のときの「{questions[1]}」の答え → {ans}")

# 以降の実験は、言語モデルを bfloat16 にする。VQGAN(約 2,900 万パラメータ)は float32 のまま残す
with torch.no_grad():
    c_bf16 = model.vq.to(torch.bfloat16).encode(preprocess(cats).to(device, torch.bfloat16))
    model.vq.float()
    print(f"VQGAN を bfloat16 にすると、1,024 個のうち {(CODE2TOK.to(device)[c_bf16] != c_hf).sum().item()} 個のトークンが変わる")
model.lm.to(torch.bfloat16)
torch.cuda.empty_cache()
- float32 で比べる: bfloat16 では、32 層を通る間の丸めの誤差で、同じ実装でも logit がずれます。実装が同じかを確かめるため、float32 にします。
- 順番に読む: 7B の float32 は約 28GB なので、40GB の GPU に 2 つは載りません。Hugging Face の結果を CPU に保存してから消し、スクラッチの重みを読みます。
- 画素値の係数: 0.0078(Hugging Face)と 1/127.5(Meta の公式コード)で、画像のトークンがいくつ変わるかを数えます。
- VQGAN を bfloat16 にしたとき: 以降の実験では、言語モデルを bfloat16 にし、VQGAN(約 2,900 万個のパラメータ)は float32 のまま残します。その理由として、VQGAN を bfloat16 にしたときに変わるトークンの数も数えます。
実行結果
What do you see in this image? Answer in two sentences.(入力 1041 トークン)
  入力の ID(画像のトークンを含む):一致 True(画像のトークン 1,024 個のうち一致 1,024 個)
  logit の差の最大値 1.66e-04(logit の絶対値の最大 51)
  生成:HF 64 個・スクラッチ 64 個、一致 True(HF 3.38 秒、スクラッチ 3.91 秒)
  → The image shows a group of cats and dogs in a yard. The cats are mostly white with black spots, and one has a black face. The dog is a black and white shepherd mix. There is a brown dog in the background, and a brown and white cat in the foreground. There are plants and flowers in
How many cats are in this image?(入力 1036 トークン)
  入力の ID(画像のトークンを含む):一致 True(画像のトークン 1,024 個のうち一致 1,024 個)
  logit の差の最大値 1.24e-04(logit の絶対値の最大 51)
  生成:HF 9 個・スクラッチ 9 個、一致 True(HF 1.22 秒、スクラッチ 2.00 秒)
  → There are three cats in this image.

係数 0.0078 と 1/127.5 で、画像のトークン 1,024 個のうち 22 個が変わる。1/127.5 のときの「How many cats are in this image?」の答え → There are three cats in this image.
VQGAN を bfloat16 にすると、1,024 個のうち 151 個のトークンが変わる
- 入力の ID: 画像のトークン 1,024 個を含めて、すべて一致しました。VQGAN のエンコーダとコードの選び方が、Hugging Face と同じです。
- logit: 差の最大値は 1.7e-4 で、logit の大きさ(最大 51)に比べて十分に小さく、float32 の計算の順番の違いの範囲です。
- 生成したトークン: 2 つの質問とも、すべてのトークンが一致しました(1 つ目は上限の 64 トークンで打ち切り)。スクラッチ実装は、Hugging Face と同じ計算をしていると言えます。
- 画素値の係数: 0.0078 と 1/127.5 で、1,024 個のうち 22 個(約 2%)のトークンが変わりましたが、回答は同じでした。
- VQGAN の精度: VQGAN を bfloat16 にすると、151 個(約 15%)のトークンが変わります。最も近いコードとの距離の差が小さい位置が多いためです。以降の実験では、VQGAN を float32 のまま使います。
なお、1 つ目の質問の回答は、実験1(bfloat16)と実験2(float32)で違います。どちらも犬がいると答えていますが、犬の種類などの細部が変わりました。bfloat16 の丸めの誤差で、途中で確率が最大のトークンが入れ替わるためです。
実験3:画像のトークナイザーは何を残すか
Chameleon の言語モデルが受け取れる画像の情報は、VQGAN の 1,024 個のコードだけです。コードから画像を復元すれば、言語モデルに届いている情報を目で見ることができます。Anole が配布する元の VQGAN の重みでデコーダを読み、猫の画像と、文字の大きさを変えた画像を復元します。文字の画像では、Chameleon に単語も読ませます。
import importlib.util, yaml

# Anole が配布する、Meta の元の VQGAN の重み(デコーダを含む)と設定、Meta の公式の推論コード
ANOLE = "GAIR/Anole-7b-v0.1"
ckpt = torch.load(hf_hub_download(ANOLE, "tokenizer/vqgan.ckpt"), map_location="cpu", weights_only=False)["state_dict"]
cfg = yaml.safe_load(open(hf_hub_download(ANOLE, "tokenizer/vqgan.yaml")))["model"]["params"]
spec = importlib.util.spec_from_file_location("vqgan_official", hf_hub_download("ethanchern/Anole", "chameleon/inference/vqgan.py", repo_type="space"))
vqgan_official = importlib.util.module_from_spec(spec); spec.loader.exec_module(vqgan_official)

# (1) エンコーダ側は、Hugging Face の chameleon-7b の重み(bfloat16 で保存)と同じか
extra = {k: tuple(v.shape) for k, v in ckpt.items() if k.split(".")[0] not in ("encoder", "decoder", "quantize", "quant_conv", "post_quant_conv")}
hf_vq = model.vq.state_dict()
key = lambda k: "quantize." + k if k.startswith("embedding.") else k
d32 = max((ckpt[key(k)].to(device) - v.float()).abs().max().item() for k, v in hf_vq.items())
d16 = max((ckpt[key(k)].to(device).bfloat16().float() - v.float()).abs().max().item() for k, v in hf_vq.items())
print(f"vqgan.ckpt の重み {len(ckpt)} 個(VQGAN の部品以外:{extra})")
print(f"エンコーダ・コードブック・post_quant_conv の {len(hf_vq)} 個:chameleon-7b との差の最大値 {d32:.1e}、"
      f"vqgan.ckpt を bfloat16 に丸めると差の最大値 {d16:.1e}")

# (2) vqgan.ckpt をすべて読み、Meta の公式コード(vqgan.py)と比べる
vq = load_vqgan(ckpt)
official = vqgan_official.VQModel(cfg["ddconfig"], cfg["n_embed"], cfg["embed_dim"])
official.load_state_dict({k: v for k, v in ckpt.items() if k not in extra})
official = official.to(device).eval()
x = preprocess(cats, scale=1 / 127.5).to(device)
with torch.no_grad():
    c_off = official.encode(x)[2][2].view(1, -1)
    c_me = vq.encode(x)
    z = official.quantize.embedding(c_off).view(1, 32, 32, 256).permute(0, 3, 1, 2)
    y_off = official.decode(z).clamp(-1, 1)
    y_me = vq.decoder(vq.post_quant_conv(z)).clamp(-1, 1)
print(f"公式コードとの比較:コード 1,024 個のうち一致 {(c_off == c_me).sum().item():,} 個、復元した画像の差の最大値 {(y_off - y_me).abs().max().item():.1e}")
del official
torch.cuda.empty_cache()


def psnr(a, b):
    mse = np.mean((np.asarray(a, dtype=np.float64) - np.asarray(b, dtype=np.float64)) ** 2)
    return 10 * np.log10(255 ** 2 / mse)


def to_pil(x):
    return Image.fromarray(((x[0].permute(1, 2, 0).cpu().numpy() + 1) * 127.5).round().clip(0, 255).astype(np.uint8))


def roundtrip(img):
    """画像 → コード 1,024 個 → 画像。Chameleon の言語モデルが受け取れる情報は、このコードだけ"""
    x = preprocess(img, scale=1 / 127.5).to(device)
    with torch.no_grad():
        return to_pil(x), vq.decode(vq.encode(x))[0]


src, rec = roundtrip(cats)
print(f"cats.jpg:512×512 = 786,432 個の値(各 256 段階)を、1,024 個のコード(各 8,192 種類)で表す → PSNR {psnr(src, rec):.1f} dB")
fig, ax = plt.subplots(2, 2, figsize=(10, 10))
for j, (im, t) in enumerate([(src, "元の画像"), (rec, "コード 1,024 個から復元")]):
    ax[0, j].imshow(im); ax[0, j].set_title(t)
    ax[1, j].imshow(im.crop((256, 256, 384, 384)).resize((384, 384), Image.NEAREST)); ax[1, j].set_title(t + "(中央を 4 倍に拡大)")
for a in ax.flat:
    a.axis("off")
plt.show()

# (3) 文字の大きさと、読み取れるか。文字の高さを、1 トークンが受け持つ 16 画素の前後で変える
FONT = font_manager.findfont("DejaVu Sans")                                    # matplotlib に入っているフォント
WORDS = ["apple", "river", "garden", "window", "pencil", "orange", "silver", "planet", "rabbit", "button",
         "candle", "forest", "guitar", "hammer", "jacket", "ladder", "mirror", "pepper", "rocket", "turtle"]
SIZES = [8, 12, 16, 24, 32, 48]


def word_image(word, size):
    im = Image.new("RGB", (512, 512), "white")
    d = ImageDraw.Draw(im)
    f = ImageFont.truetype(FONT, size)
    w, h = d.textbbox((0, 0), word, font=f)[2:]
    d.text(((512 - w) // 2, (512 - h) // 2), word, fill="black", font=f)
    return im


def ask(img, prompt, chat=True, max_new_tokens=16):
    ids = model.build_ids("<image>" + prompt, [preprocess(img).to(device)], chat=chat)
    return tok.decode(model.generate(ids, max_new_tokens=max_new_tokens)[0], skip_special_tokens=True)


def read_word(img):
    """対話の形で「何と書いてあるか」を聞くと答えないので、文の続きとして単語を書かせる"""
    return ask(img, 'The word written in the image is "', chat=False, max_new_tokens=8).split('"')[0].strip()


def char_acc(pred, ans):
    """1 −(編集距離 ÷ 正解の文字数)。編集距離は、文字の追加・削除・置き換えの最小の回数"""
    d = list(range(len(ans) + 1))
    for i, p in enumerate(pred, 1):
        prev, d[0] = d[0], i
        for j, a in enumerate(ans, 1):
            prev, d[j] = d[j], min(d[j] + 1, d[j - 1] + 1, prev + (p != a))
    return max(0.0, 1 - d[-1] / len(ans))


big = word_image("garden", 48)
print("対話の形で聞く:", repr(ask(big, "What word is written in the image?")))
print("文の続きを書かせる:", repr(read_word(big)))
fig, ax = plt.subplots(2, len(SIZES), figsize=(3 * len(SIZES), 2.8))
for j, s in enumerate(SIZES):
    hits, accs, ps = 0, [], []
    for w in WORDS:
        src, rec = roundtrip(word_image(w, s))
        ps.append(psnr(src, rec))
        ans = re.sub(r"[^a-z]", "", read_word(src).lower())
        hits += ans == w
        accs.append(char_acc(ans, w))
    print(f"文字の大きさ {s:>2} 画素:PSNR {np.mean(ps):.1f} dB、単語が完全に一致 {hits / len(WORDS):.0%}、"
          f"文字の正解率 {np.mean(accs):.0%}(例:{w} → {ans!r})")
    src, rec = roundtrip(word_image("garden", s))
    for i, im in enumerate([src, rec]):
        ax[i, j].imshow(im.crop((128, 216, 384, 296)).resize((512, 160), Image.NEAREST))
        ax[i, j].set_title(f"{s} 画素・{'元の画像' if i == 0 else '復元'}"); ax[i, j].axis("off")
plt.show()
- Hugging Face の重みとの比較: Hugging Face の重みは bfloat16 で保存されているので、vqgan.ckpt(float32)を bfloat16 に丸めてからも比べます。
- 公式コードとの比較: Anole が配布する Meta の推論コード(vqgan.py)を読み込み、同じ画像のコードと、同じコードから復元した画像を比べます。
- PSNR: 元の画像と復元した画像の、画素の値の誤差の大きさを、デシベルで表したものです。大きいほど元に近く、30dB を超えると見た目の違いが小さくなります。
- 文字の大きさ: 8・12・16・24・32・48 画素です。1 つのコードが受け持つ 16×16 画素より小さい文字と、大きい文字を比べるためです。単語は、6 文字前後のよく使う英単語 20 個です。意味のある単語にして、言語モデルが綴りを知らないせいで読めない、ということがないようにしています。
- 読ませ方: 対話の形で「何と書いてあるか」を聞くと、Chameleon-7B は答えません(実行結果の 1 行目)。そこで、The word written in the image is " の続きを書かせ、次の " までを答えとします。対話の区切りを付けない形(chat=False)で、Hugging Face の processor の return_for_text_completion=True と同じです。
- 文字の正解率: 1 −(編集距離 ÷ 正解の文字数)です。編集距離は、答えを正解に直すのに必要な、文字の追加・削除・置き換えの回数です。
実行結果
vqgan.ckpt の重み 295 個(VQGAN の部品以外:{'custom_layer.weight': (3, 512, 512), 'custom_layer.bias': (3, 512, 512)})
エンコーダ・コードブック・post_quant_conv の 129 個:chameleon-7b との差の最大値 1.1e-01、vqgan.ckpt を bfloat16 に丸めると差の最大値 0.0e+00
公式コードとの比較:コード 1,024 個のうち一致 1,024 個、復元した画像の差の最大値 0.0e+00
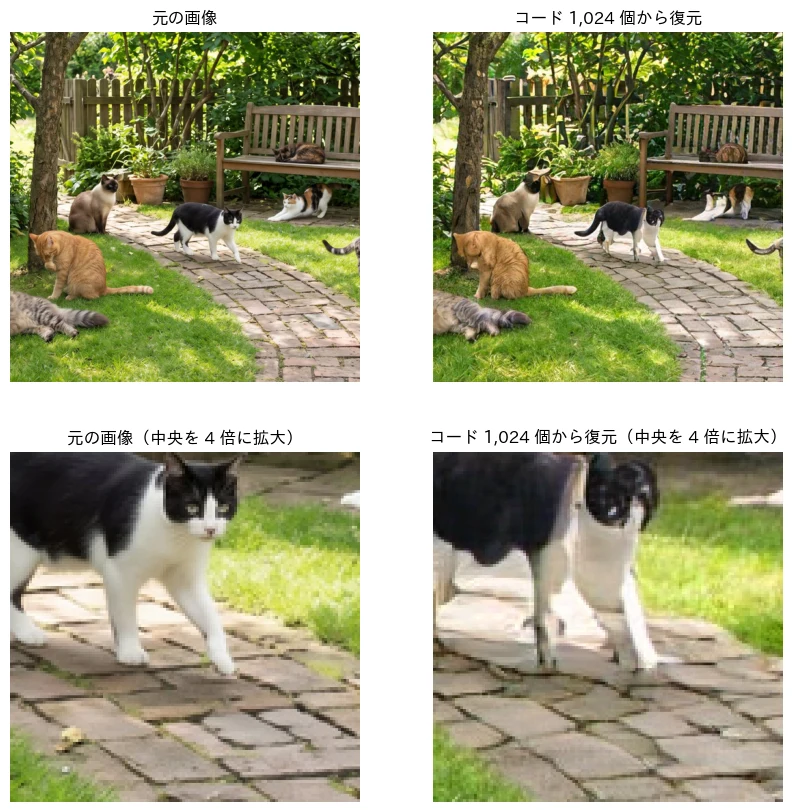
cats.jpg:512×512 = 786,432 個の値(各 256 段階)を、1,024 個のコード(各 8,192 種類)で表す → PSNR 16.1 dB
対話の形で聞く: "I'm unable to meet that request."
文の続きを書かせる: 'Gargen'
文字の大きさ  8 画素:PSNR 41.5 dB、単語が完全に一致 0%、文字の正解率 15%(例:turtle → 's')
文字の大きさ 12 画素:PSNR 37.8 dB、単語が完全に一致 0%、文字の正解率 25%(例:turtle → 'ten')
文字の大きさ 16 画素:PSNR 36.2 dB、単語が完全に一致 10%、文字の正解率 37%(例:turtle → 'time')
文字の大きさ 24 画素:PSNR 34.9 dB、単語が完全に一致 50%、文字の正解率 80%(例:turtle → 'turtle')
文字の大きさ 32 画素:PSNR 33.1 dB、単語が完全に一致 45%、文字の正解率 70%(例:turtle → 'turret')
文字の大きさ 48 画素:PSNR 31.8 dB、単語が完全に一致 30%、文字の正解率 72%(例:turtle → 'turtle')
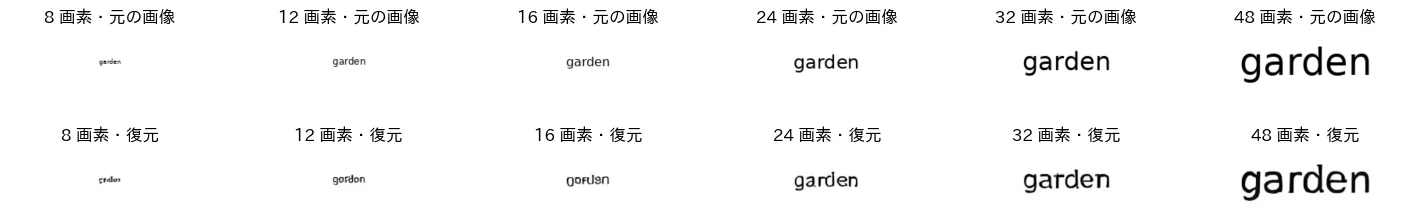
文字の大きさと読み取りの結果を描くと、次のようになります。
(図は、diagram-designで作成)
- Hugging Face の重みとの関係: vqgan.ckpt を bfloat16 に丸めると、Hugging Face の chameleon-7b の VQGAN の重みと完全に一致しました。Anole が配布する VQGAN は、Chameleon と同じトークナイザーです。vqgan.ckpt には、VQGAN の部品以外に custom_layer(3 × 512 × 512 の重みとバイアス)が入っていますが、公式の推論コードは使いません。
- 公式コードとの比較: 1,024 個のコードと、復元した画像のすべての画素が、Meta の公式の推論コードと一致しました。
- 猫の画像の復元: PSNR は 16.1dB です。庭の配置・猫の位置と毛の色・ベンチや柵の形は残っています。一方、中央を拡大すると、白黒の猫の顔と脚の形が崩れ、レンガの模様は、元とは違う模様で描き直されています。16×16 画素を 8,192 種類のどれか 1 つで表すので、細かな形は「それらしい模様」に置き換わります。
- 文字の大きさと読み取り: 文字が 16 画素以下(1 つのコードが受け持つ大きさ以下)では、復元した画像の文字が崩れ(例:garden → gordon)、Chameleon の文字の正解率も 15〜37% にとどまりました。24 画素以上では、復元した画像の文字がはっきり読め、文字の正解率は 70〜80% に上がりました。小さな文字は、コードに変える段階で情報が失われ、言語モデルにはもう届いていません。論文が挙げる「文字の多い画像の復元が苦手」という弱点のとおりです。
- 大きな文字でも完全には読めない: 24 画素以上でも、単語が完全に一致したのは 30〜50% です(例:turtle → turret)。この大きさでは復元した画像の文字は読めるので、残りの誤りは言語モデル側の読み取りの性能によるものです。
- 答えない質問: 対話の形で「何と書いてあるか」を聞くと、Chameleon-7B は「I'm unable to meet that request.」と答えました。公開版は安全性のための調整がされていて、画像の文字を読む依頼の一部も断ります。文の続きを書かせる形では、答えを返します。
文字の画像の PSNR は、背景の白が大部分を占めるので、文字が小さいほど高くなります。大きさの違う画像の間では比べられないので、復元の質は、上の画像と読み取りの結果で判断しています。
実験4:公開版は、なぜ画像を生成しないのか
Chameleon は、画像のトークンを出力すれば画像を生成できる構成です。しかし、公開版の重みで画像を生成する方法は、公式には提供されていません。Hugging Face の実装は、画像のトークンの logit を常に最小の値にしています。出力層(lm_head)の重みの、テキストのトークンの行と画像のトークンの行を比べ、logit の最小化をやめたときに何が出るかを確かめます。
# 公開版の chameleon-7b は、なぜ画像を出さないのか。出力層(lm_head)の行を、テキストのトークンと画像のトークンで比べる
W = model.lm.lm_head.weight.float()                           # (65536, 4096):行 i がトークン i の logit を決める
is_img = torch.zeros(VOCAB, dtype=torch.bool, device=device)
is_img[IMAGE_TOKENS.to(device)] = True
for name, w in [("テキストのトークンの行", W[~is_img]), ("画像のトークンの行  ", W[is_img])]:
    print(f"{name}:値の範囲 {w.min().item():+.3f}〜{w.max().item():+.3f}、平均 {w.mean().item():+.4f}、"
          f"標準偏差 {w.std().item():.4f}、行のノルムの平均 {w.norm(dim=1).mean().item():.2f}")

# 画像のトークンを除外しないで、<racm3:break>(画像の始まり)の直後に何が出るか
prompt = "Generate an image of a red apple on a wooden table."
ids = torch.tensor([[BOS] + tok.encode(prompt, add_special_tokens=False) + [EOT, BOI]], device=device)
with torch.no_grad():
    lg = model.logits(ids, mode="all")[0, -1].float()
p = lg.softmax(-1)
print(f"\n「{prompt}」+<racm3:break> の次のトークン:画像のトークンの確率の合計 {p[is_img].sum().item():.2e}、"
      f"logit の最大は テキスト {lg[~is_img].max().item():.1f}・画像 {lg[is_img].max().item():.1f}")
print("確率の高いトークン:", [(tok.convert_ids_to_tokens(i.item()), round(p[i].item(), 3)) for i in p.topk(3).indices])

# テキストで答えるはずの位置(猫の質問の回答の 1 トークン目)でも同じか
ids = model.build_ids("<image>How many cats are in this image?", [preprocess(cats).to(device)])
with torch.no_grad():
    lg = model.logits(ids, mode="all")[0, -1].float()
print(f"猫の質問の回答の 1 トークン目:画像のトークンの確率の合計 {lg.softmax(-1)[is_img].sum().item():.2e}、"
      f"除外したときの 1 位 {tok.convert_ids_to_tokens(lg.masked_fill(is_img, -1e9).argmax().item())!r}")
- 出力層の行: 出力層の重みの行 i と、最後の層の出力の内積が、トークン i の logit になります。画像のトークン 8,192 個の行の値を、テキストのトークンの行と比べます。
- 画像の始まりの直後: 画像を生成させる指示の後に <racm3:break> を置き、次のトークンの確率を見ます。学習どおりなら、画像のトークンが出る位置です。
- テキストで答える位置: 猫の質問の回答の最初のトークンも見ます。本来はテキストが出る位置です。
実行結果
テキストのトークンの行:値の範囲 -0.299〜+0.316、平均 -0.0000、標準偏差 0.0179、行のノルムの平均 1.13
画像のトークンの行  :値の範囲 +0.000〜+1.000、平均 +0.4999、標準偏差 0.2887、行のノルムの平均 36.94

「Generate an image of a red apple on a wooden table.」+<racm3:break> の次のトークン:画像のトークンの確率の合計 1.00e+00、logit の最大は テキスト -11.4・画像 222.0
確率の高いトークン: [('IMGIMGFFICZ', 1.0), ('IMGIMGDFHFZ', 0.0), ('IMGIMGICHZ', 0.0)]
猫の質問の回答の 1 トークン目:画像のトークンの確率の合計 1.00e+00、除外したときの 1 位 'There'
2種類の行の統計を並べると、次のようになります。
(図は、diagram-designで作成)
- 画像のトークンの行: 値は 0〜1 の範囲で、平均は 0.4999、標準偏差は 0.2887 です。0〜1 の一様分布の平均 0.5、標準偏差 1/√12 ≒ 0.2887 とほぼ一致します。テキストのトークンの行(平均 0、標準偏差 0.018)とはまったく違い、学習で得られた値ではなく、一様乱数で置き換えられた値と考えられます。
- logit: 行のノルムが学習済みの行の約 33 倍あり、すべての値が正なので、画像のトークンの logit(最大 222)が、テキストのトークン(最大 −11)を大きく上回ります。
- 画像の始まりの直後: 画像のトークンの確率の合計は 1.0 で、特定の 1 つのトークンに確率が集中しました。どの画像のトークンが出るかは、学習した内容ではなく、乱数の値で決まります。
- テキストで答える位置: 猫の質問の回答の最初でも、画像のトークンの確率の合計は 1.0 でした。画像のトークンを除外すると、1 位は実験2の回答と同じ「There」です。
公開版の chameleon-7b は、出力層の画像のトークンの行を意味のない値に置き換えることで、画像を生成できないようにしています。この行のままでは、テキストを生成するときにも画像のトークンが選ばれてしまうので、Hugging Face の実装は画像のトークンの logit を常に最小の値にしています。言語モデルの本体(32 層)は、画像を生成する学習をした重みのままです。
実験5:Anole の出力層で画像を生成する
Anole(GAIR、2024)は、Chameleon-7B の出力層の、画像のトークンの行だけを追加学習して、画像を生成できるようにしたモデルです。論文によると、5,859 枚の画像を使い、A100 8 枚で約 30 分の学習でした。まず、Anole の重みと Chameleon-7B の重みを比べて、本当に出力層の画像の行だけが違うかを確かめます。
# Anole(chameleon-7b を、画像を生成できるように追加学習したもの)の重み。Meta の元の形式(約 14GB)
anole = torch.load(hf_hub_download(ANOLE, "models/7b/consolidated.pth"), map_location="cpu", mmap=True, weights_only=True)
lm = model.lm


def max_diff(a, b):
    return (a.to(device).float() - b.float()).abs().max().item()


def rope_order(w):
    """元の形式の q, k の行を、Hugging Face の RoPE の並べ方(前半と後半で組にする)に並べ替える"""
    return w.view(NH, HD // 2, 2, D).transpose(1, 2).reshape(NH * HD, D)


checks = {
    "埋め込み": max_diff(anole["tok_embeddings.weight"], lm.embed_tokens.weight),
    "最後の RMSNorm": max_diff(anole["norm.weight"], lm.norm.weight),
}
for i in [0, 15, 31]:
    a = f"layers.{i}."
    checks[f"{i} 層目の q(行の順のまま)"] = max_diff(anole[a + "attention.wq.weight"], lm.layers[i].q_proj.weight)
    checks[f"{i} 層目の q(並べ替え後)"] = max_diff(rope_order(anole[a + "attention.wq.weight"]), lm.layers[i].q_proj.weight)
    checks[f"{i} 層目の v"] = max_diff(anole[a + "attention.wv.weight"], lm.layers[i].v_proj.weight)
    checks[f"{i} 層目の FFN(下り)"] = max_diff(anole[a + "feed_forward.w2.weight"], lm.layers[i].down_proj.weight)
    checks[f"{i} 層目の RMSNorm"] = max_diff(anole[a + "attention_norm.weight"], lm.layers[i].input_layernorm.weight)
for k, v in checks.items():
    print(f"{k:<16} 差の最大値 {v:.1e}")

out = anole["output.weight"].to(device)
changed = (out != lm.lm_head.weight).any(dim=1)
print(f"\n出力層:変わった行 {changed.sum().item():,} 個(うち画像のトークン {changed[is_img].sum().item():,} 個)、"
      f"テキストのトークンの行の差の最大値 {max_diff(out[~is_img], lm.lm_head.weight[~is_img]):.1e}")
print("変わったテキストのトークン:", tok.convert_ids_to_tokens(torch.where(changed & ~is_img)[0].tolist()))
print(f"Anole の画像のトークンの行のノルムの平均 {out[is_img].float().norm(dim=1).mean().item():.3f}"
      f"(変えたパラメータ {is_img.sum().item() * D:,} 個 = 全体の {is_img.sum().item() * D / sum(p.numel() for p in lm.parameters()):.2%})")

# 画像のトークンの行だけを Anole のものに差し替える
anole_rows = out[is_img].to(lm.lm_head.weight.dtype)
chameleon_rows = lm.lm_head.weight[is_img].clone()
with torch.no_grad():
    lm.lm_head.weight[is_img] = anole_rows
    lg = model.logits(ids, mode="all")[0, -1].float()
print(f"\n差し替えた後、<racm3:break> の次が画像のトークンになる確率の合計 {lg.softmax(-1)[is_img].sum().item():.3f}")
del anole, out
- 元の形式の重み: Anole の重みは、Meta の元の形式(consolidated.pth)です。重みの名前は Hugging Face と違いますが、埋め込み・v・FFN・RMSNorm は、そのまま比べられます。
- q の並べ方: RoPE で組にする次元の並べ方が、元の形式(隣り合う 2 次元)と Hugging Face(前半と後半)で違います。rope_order で並べ替えてから比べます。
- 差し替え: 画像のトークンの行だけを Anole の値に置き換えます。以降のテキストの生成には影響しません(テキストを生成するときは画像のトークンを最小の値にするため)。
実行結果
埋め込み             差の最大値 0.0e+00
最後の RMSNorm      差の最大値 0.0e+00
0 層目の q(行の順のまま)  差の最大値 1.2e-01
0 層目の q(並べ替え後)   差の最大値 0.0e+00
0 層目の v          差の最大値 0.0e+00
0 層目の FFN(下り)    差の最大値 0.0e+00
0 層目の RMSNorm    差の最大値 0.0e+00
15 層目の q(行の順のまま) 差の最大値 1.8e-01
15 層目の q(並べ替え後)  差の最大値 0.0e+00
15 層目の v         差の最大値 0.0e+00
15 層目の FFN(下り)   差の最大値 0.0e+00
15 層目の RMSNorm   差の最大値 0.0e+00
31 層目の q(行の順のまま) 差の最大値 2.2e-01
31 層目の q(並べ替え後)  差の最大値 0.0e+00
31 層目の v         差の最大値 0.0e+00
31 層目の FFN(下り)   差の最大値 0.0e+00
31 層目の RMSNorm   差の最大値 0.0e+00

出力層:変わった行 8,198 個(うち画像のトークン 8,192 個)、テキストのトークンの行の差の最大値 4.9e-02
変わったテキストのトークン: ['<s>', '<pad>', '</s>', '<unk>', '<eoss>', '<racm3:break>']
Anole の画像のトークンの行のノルムの平均 1.545(変えたパラメータ 33,554,432 個 = 全体の 0.48%)

差し替えた後、<racm3:break> の次が画像のトークンになる確率の合計 1.000
- 本体は同じ: 埋め込み・最後の RMSNorm・各層の v・FFN・RMSNorm は、差が 0 で完全に一致しました。q も、RoPE の並べ方をそろえると差が 0 になります。Anole の 32 層は、Chameleon-7B とまったく同じ重みです。
- 出力層: 変わったのは 8,198 行で、画像のトークンの 8,192 行と、特別なトークン 6 行(<s>・<pad>・</s>・<unk>・画像の終わり・画像の始まり)です。それ以外のテキストのトークンの行は変わっていません。
- 追加学習の量: 画像のトークンの行は 33,554,432 個(8,192 × 4,096)で、モデル全体の 0.48% です。Anole の論文の「4,000 万個未満のパラメータ」と合います。Anole の画像のトークンの行のノルムは平均 1.545 で、テキストのトークンの行(1.13)に近い、学習された値の大きさです。
32 層の本体は、Meta が画像の生成も含めて学習した重みのままなので、出力層の画像の行を学習し直すだけで、画像を生成できるようになったと考えられます。
classifier-free guidance で画像を生成する
(図は、diagram-designで作成)
画像を生成するときは、classifier-free guidance(CFG) を使います。指示のテキストを付けた列と、付けない列の 2 本を同じモデルに通し、2 つの logit の差(指示による変化)を 3.0 倍して、付けない列の logit に足します。指示に合う方向を強めることで、指示に沿った画像になりやすくします。値は、Meta の公式の推論コードの既定値(テキストの CFG 3.0・温度 0.7・top_p 0.9)です。
TOK2CODE = torch.zeros(VOCAB, dtype=torch.long)
TOK2CODE[CODE2TOK] = torch.arange(NCODE)                       # トークン ID → コード番号(CODE2TOK の逆)


def top_p_sample(logits, temp, top_p, gen):
    """温度で割ってから、確率の高い順に合計が top_p を超えるまでのトークンだけから選ぶ"""
    p = (logits / temp).softmax(-1)
    ps, idx = p.sort(descending=True)
    keep = ps.cumsum(-1) - ps < top_p                           # 自分より上の合計が top_p 未満のものを残す
    ps = ps * keep
    return idx[torch.multinomial(ps / ps.sum(), 1, generator=gen)]


@torch.no_grad()
def generate_image(prompt, cfg=3.0, temp=0.7, top_p=0.9, seed=0):
    """テキスト → 画像のトークン 1,024 個 → 画像。値は Meta の公式コードの既定値(テキストの CFG 3.0・温度 0.7・top_p 0.9)。
    公式は「テキストと画像あり」「画像だけ」「何もなし」の 3 本を並べるが、プロンプトに画像がないときは後の 2 本が同じ
    (<s><racm3:break> だけ)になり、logit = 何もなし + cfg × (テキストあり − 何もなし) の 2 本で同じ結果になる"""
    gen = torch.Generator(device=device).manual_seed(seed)
    cond = torch.tensor([[BOS] + tok.encode(prompt, add_special_tokens=False) + [EOT, BOI]], device=device)
    uncond = torch.tensor([[BOS, BOI]], device=device)
    caches = [[dict() for _ in lm.layers] for _ in range(2)]
    lc, lu = model.logits(cond, caches[0], mode="all")[:, -1], model.logits(uncond, caches[1], mode="all")[:, -1]
    pos, out = [cond.shape[1], uncond.shape[1]], []
    img = IMAGE_TOKENS.to(device)
    for step in range(1024):
        mixed = (lu + cfg * (lc - lu)).float()[0, img]               # 画像のトークンの中だけから選ぶ
        nxt = img[top_p_sample(mixed, temp, top_p, gen)].view(1, 1)
        out.append(nxt)
        if step < 1023:
            lc = model.logits(nxt, caches[0], pos[0], mode="all")[:, -1]
            lu = model.logits(nxt, caches[1], pos[1], mode="all")[:, -1]
            pos = [pos[0] + 1, pos[1] + 1]
    toks = torch.cat(out, 1)[0]
    return vq.decode(TOK2CODE.to(device)[toks][None])[0]


PROMPTS = ["A red apple on a wooden table.", "A lighthouse on a rocky coast at sunset.", "A watercolor painting of a cat sleeping on a sofa."]
results = []
for prm in PROMPTS:
    torch.cuda.synchronize(); t0 = time.time()
    results.append((prm, "CFG 3.0", generate_image(prm)))
    print(f"{prm}:{time.time() - t0:.1f} 秒")
results.append((PROMPTS[0], "CFG なし(1.0)", generate_image(PROMPTS[0], cfg=1.0)))
with torch.no_grad():
    lm.lm_head.weight[is_img] = chameleon_rows                  # 公開版の chameleon-7b の行に戻す
results.append((PROMPTS[0], "chameleon-7b の行のまま", generate_image(PROMPTS[0])))
fig, ax = plt.subplots(1, len(results), figsize=(4.2 * len(results), 4.8))
for a, (prm, c, im) in zip(ax, results):
    a.imshow(im); a.set_title(f"{prm}\n{c}", fontsize=9); a.axis("off")
plt.show()
- generate_image: 指示の後に <reserved08706>(対話の区切り)と <racm3:break>(画像の始まり)を置き、画像のトークンを 1,024 個生成します。Anole の公式のスクリプトと同じ形です。2 本の列は、別々の KV キャッシュで 1 トークンずつ進めます。
- 画像のトークンの中だけから選ぶ: CFG で混ぜた logit を、画像のトークン 8,192 個に絞ってから、温度と top_p でサンプリングします。
- 比較: 1 つ目の指示では、CFG なし(1.0)と、出力層を Chameleon-7B の行に戻したときも生成します。乱数の種は同じ(0)です。
実行結果
A red apple on a wooden table.:77.7 秒
A lighthouse on a rocky coast at sunset.:77.7 秒
A watercolor painting of a cat sleeping on a sofa.:77.0 秒
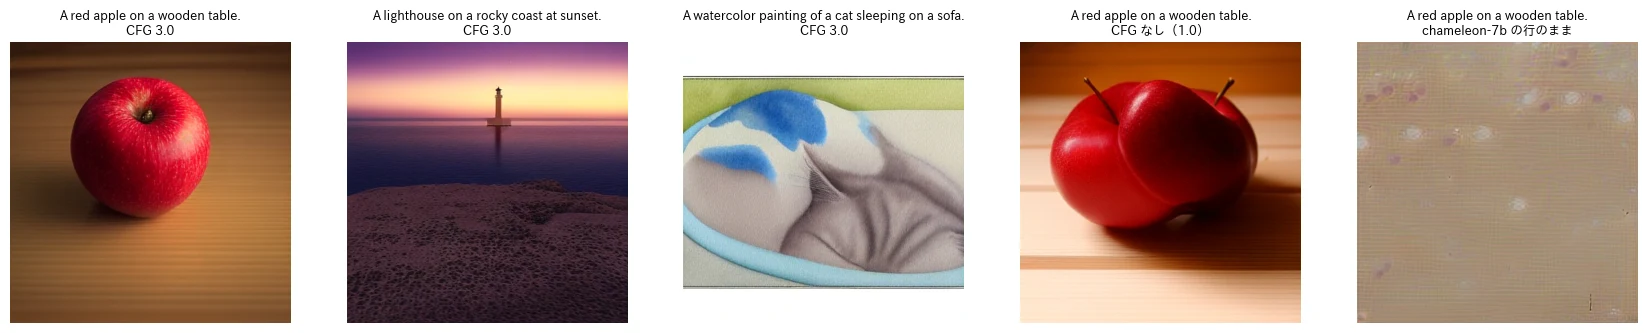
- Anole の出力層(CFG 3.0): 木のテーブルの上の赤いりんご、夕焼けの海と灯台と岩場、水彩画の丸くなって眠る猫と、3 つの指示に沿った画像が生成できました。言語モデルの本体は Chameleon-7B のままで、変えたのは出力層の画像のトークンの行だけです。
- CFG なし: 同じ乱数の種でも、りんごが 2 つ融合したような形になり、軸も 2 本になりました。指示に合う方向を強める CFG がないと、形が崩れやすくなります。
- Chameleon-7B の行のまま: 意味のない模様になりました。実験4で見たとおり、画像のトークンの行は乱数なので、選ばれるトークンは画像の内容と関係がありません。
- 時間: 1 枚あたり約 77 秒です。2 本の列で 1,024 回ずつ 7B のモデルを通すので、1 トークンあたり約 75 ミリ秒(1 本あたり約 38 ミリ秒)かかります。拡散モデルが同じ大きさの画像を数秒で作るのに比べると、1 トークンずつ順に生成する方式は時間がかかります。
実験6:出力層の画像の行を学習する
実験5で、Anole は出力層の画像のトークンの行(約 3,355 万パラメータ)だけを学習し直したモデルだと確かめました。同じことを、COCO の画像とキャプションの組で、A100 1 枚で再現します。公式(Anole)の学習との違いは次のとおりです。
| 項目 | Anole の学習(論文) | 本記事の学習 |
|---|---|---|
| 学習する重み | 出力層の画像のトークンの行(4,000 万個未満と記載) | 同じ(8,192 行 × 4,096 = 約 3,355 万個) |
| データ | LAION-5B の芸術の画像 5,859 枚 | COCO 2017 の写真とキャプション 2,000 組(保存するベクトルを CPU のメモリに置ける量) |
| 計算 | A100 8 枚で約 30 分 | 本体の出力を 1 回だけ計算して保存し、行だけを学習(A100 1 枚) |
| 学習の設定 | 論文に記載なし | AdamW・16 枚ずつ 3,000 回。学習率は 4 つの値の比較で選ぶ |
学習のデータを作る
本体の 32 層は固定なので、各画像について「キャプション → 画像のトークン」の列を 1 回だけ言語モデルに通し、出力層に入る直前のベクトルを保存しておきます。学習では、このベクトルと出力層の画像の行だけを使います。
import json, zipfile, urllib.request
from concurrent.futures import ThreadPoolExecutor

# 学習データ:COCO の画像とキャプション。学習用は train2017 の 2,000 枚、評価用は val2017 の 100 枚(画像 ID の小さい順)
os.makedirs("coco/train2017", exist_ok=True)
os.makedirs("coco/val2017", exist_ok=True)
if not os.path.exists("coco/annotations/captions_val2017.json"):
    urllib.request.urlretrieve("http://images.cocodataset.org/annotations/annotations_trainval2017.zip", "coco/ann.zip")
    zipfile.ZipFile("coco/ann.zip").extractall("coco")


def first_captions(split):
    """画像ごとに、注釈の ID が最も小さいキャプションを 1 つ選ぶ"""
    caps = {}
    for a in sorted(json.load(open(f"coco/annotations/captions_{split}.json"))["annotations"], key=lambda a: a["id"]):
        caps.setdefault(a["image_id"], a["caption"].strip())
    return caps


def fetch(i, split):
    path = f"coco/{split}/{i:012d}.jpg"
    if not os.path.exists(path):
        urllib.request.urlretrieve(f"http://images.cocodataset.org/{split}/{i:012d}.jpg", path)
    return path


train_caps, val_caps = first_captions("train2017"), first_captions("val2017")
train_ids, val_ids = sorted(train_caps)[:2000], sorted(val_caps)[:100]
with ThreadPoolExecutor(32) as ex:
    list(ex.map(lambda i: fetch(i, "train2017"), train_ids))
    list(ex.map(lambda i: fetch(i, "val2017"), val_ids))


@torch.no_grad()
def last_hidden(ids):
    """言語モデルの最後の RMSNorm の後の出力(出力層に入る直前のベクトル)。出力層の行との内積が logit になる"""
    x = lm.embed_tokens(ids)
    cos, sin = rope(ids.shape[1], 0, ids.device)
    for layer in lm.layers:
        x = layer(x, cos.to(x.dtype), sin.to(x.dtype))
    return lm.norm(x)[0]


@torch.no_grad()
def cache(ids_, caps, split):
    """画像を Meta の VQGAN でトークンにし、「キャプション → 画像のトークン」の列を言語モデルに通して、
    画像のトークンを予測する 1,024 か所の出力を保存する。本体は学習しないので、1 回だけ計算すればよい"""
    H, T = [], []
    for i in ids_:
        x = preprocess(Image.open(f"coco/{split}/{i:012d}.jpg").convert("RGB"), scale=1 / 127.5).to(device)
        codes = vq.encode(x)[0]                                         # 0〜8191
        prefix = [BOS] + tok.encode(caps[i], add_special_tokens=False) + [EOT, BOI]   # 生成のときと同じ形
        ids = torch.tensor([prefix + CODE2TOK.to(device)[codes].tolist()], device=device)
        h = last_hidden(ids)[len(prefix) - 1:-1]                       # 画像の始まり〜最後から 2 番目:次の画像のトークンを予測する位置
        H.append(h.to(torch.bfloat16).cpu()); T.append(codes.cpu())
    return torch.stack(H), torch.stack(T)


torch.cuda.synchronize(); t0 = time.time()
H_train, T_train = cache(train_ids, train_caps, "train2017")
H_val, T_val = cache(val_ids, val_caps, "val2017")
print(f"学習用 {tuple(H_train.shape)}・評価用 {tuple(H_val.shape)}(bfloat16、学習用は {H_train.numel() * 2 / 1e9:.1f}GB、{time.time() - t0:.0f} 秒)")
print("キャプションの例:", train_caps[train_ids[0]])
- データ: COCO 2017 の学習用の画像 ID の小さい順に 2,000 枚と、評価用の 100 枚です。キャプションは、各画像の最初の 1 つを使います。2,000 枚は、保存するベクトル(1 枚 1,024 か所 × 4,096 次元、bfloat16 で 8MB)を CPU のメモリ(約 17GB)に置ける量で、Anole の 5,859 枚の約 3 分の 1 です。
- 列の形: 実験5の画像の生成と同じ「<s> キャプション <reserved08706> <racm3:break> 画像のトークン」です。画像の始まりから最後から 2 番目のトークンまでの 1,024 か所の出力が、それぞれ次の画像のトークンを予測します。
- 画像のトークン: 生成した画像をデコーダで戻すときと同じ、Meta の VQGAN(vqgan.ckpt、画素値は 1/127.5)で作ります。
実行結果
学習用 (2000, 1024, 4096)・評価用 (100, 1024, 4096)(bfloat16、学習用は 16.8GB、292 秒)
キャプションの例: Closeup of bins of food that include broccoli and bread.
- 時間: 2,100 枚の画像のトークン化と、7B のモデルの 1 回の順伝播(1 枚 約 1,040 トークン)で 292 秒でした。この後の学習では 7B のモデルを通さないので、何回学習しても、この計算は 1 回で済みます。
学習率を選ぶ
# 画像のトークンの行(トークン ID の順)と、コード番号の順の対応。POS[k] はコード k のトークンが、何番目の行か
POS = torch.searchsorted(IMAGE_TOKENS.to(device), CODE2TOK.to(device))


def val_ce(rows, H=H_val, T=T_val):
    """評価用の 100 枚で、画像のトークン(8,192 種類の中から)を当てる交差エントロピー。当てずっぽうなら log 8192 ≒ 9.01"""
    w, total = rows[POS].float(), 0.0
    with torch.no_grad():
        for h, t in zip(H.split(10), T.split(10)):
            total += F.cross_entropy(h.to(device).float().flatten(0, 1) @ w.T, t.to(device).flatten(), reduction="sum").item()
    return total / T.numel()


def train_rows(lr, steps, batch=16, log_every=None):
    """出力層の画像のトークンの行だけを学習する。公開版の行(乱数)から始める。本体の出力は保存したものを使う"""
    torch.manual_seed(0)
    w = nn.Parameter(chameleon_rows[POS].float().clone())             # 行 k がコード k の logit を決める並び
    opt = torch.optim.AdamW([w], lr=lr, weight_decay=0.0)
    hist = []
    for step in range(steps):
        idx = torch.randint(len(H_train), (batch,))                  # 16 枚 × 1,024 か所
        h, t = H_train[idx].to(device).float().flatten(0, 1), T_train[idx].to(device).flatten()
        loss = F.cross_entropy(h @ w.T, t)
        opt.zero_grad(); loss.backward(); opt.step()
        if log_every and (step + 1) % log_every == 0:
            rows = torch.empty_like(w.detach()); rows[POS] = w.detach()
            hist.append((step + 1, loss.item(), val_ce(rows)))
    rows = torch.empty_like(w.detach()); rows[POS] = w.detach()        # トークン ID の順に戻す
    return rows, hist


# 学習率を、短い学習(300 回)の評価用の損失で選ぶ
for lr in [3e-4, 1e-3, 3e-3, 1e-2]:
    rows, _ = train_rows(lr, 300)
    print(f"学習率 {lr:.0e}:300 回後の評価用の損失 {val_ce(rows):.3f}")
- train_rows: 公開版の行(乱数)から始め、保存したベクトルと行の内積を logit にして、正解の画像のトークンとの交差エントロピーを小さくします。16 枚(16,384 か所)ずつ学習します。
- 画像のトークンの中だけで当てる: 生成のときは画像のトークン 8,192 個の中から選ぶので、学習の損失も 8,192 個の中での交差エントロピーにします。
- 学習率: 4 つの値で 300 回ずつ学習し、評価用の損失が最も小さい値を選びます。
実行結果
学習率 3e-04:300 回後の評価用の損失 8.419
学習率 1e-03:300 回後の評価用の損失 6.510
学習率 3e-03:300 回後の評価用の損失 6.542
学習率 1e-02:300 回後の評価用の損失 18.395
- 学習率: 1e-3 で評価用の損失が 6.510 と最も小さく、3e-3(6.542)もほぼ同じでした。3e-4 は 300 回では下がりきらず(8.419)、1e-2 は大きすぎて当てずっぽう(9.011)より悪くなりました(18.395)。以降は 1e-3 を使います。
学習して、画像を生成する
LR = 1e-3          # 上の比較で、評価用の損失が最も小さかった値
torch.cuda.synchronize(); t0 = time.time()
trained_rows, hist = train_rows(LR, 3000, log_every=300)
print(f"学習:{time.time() - t0:.0f} 秒")
for s, tr, va in hist:
    print(f"{s:>5} 回:学習の損失 {tr:.3f}  評価用の損失 {va:.3f}")
print(f"\n評価用の損失:公開版の行 {val_ce(chameleon_rows):.3f}、本記事で学習した行 {val_ce(trained_rows):.3f}、Anole の行 {val_ce(anole_rows):.3f}"
      f"(当てずっぽう {math.log(8192):.3f})")

# 学習した行で、実験5と同じ 3 つの指示から画像を生成する
with torch.no_grad():
    lm.lm_head.weight[is_img] = trained_rows.to(lm.lm_head.weight.dtype)
mine = [generate_image(prm) for prm in PROMPTS]
fig, ax = plt.subplots(2, 3, figsize=(12.6, 9))
for j, prm in enumerate(PROMPTS):
    ax[0, j].imshow(results[j][2]); ax[0, j].set_title(f"{prm}\nAnole の行", fontsize=9)
    ax[1, j].imshow(mine[j]); ax[1, j].set_title("本記事で学習した行(COCO 2,000 枚)", fontsize=9)
for a in ax.flat:
    a.axis("off")
plt.show()
- 学習の回数: 3,000 回 × 16 枚で、2,000 枚の各画像を約 24 回ずつ使います。300 回ごとに評価用の損失を記録し、下がり方が止まっているかを確かめます。
- 比べる行: 学習した行を、出発点の公開版の行(乱数)と、Anole の行と、同じ評価用の 100 枚の損失で比べます。
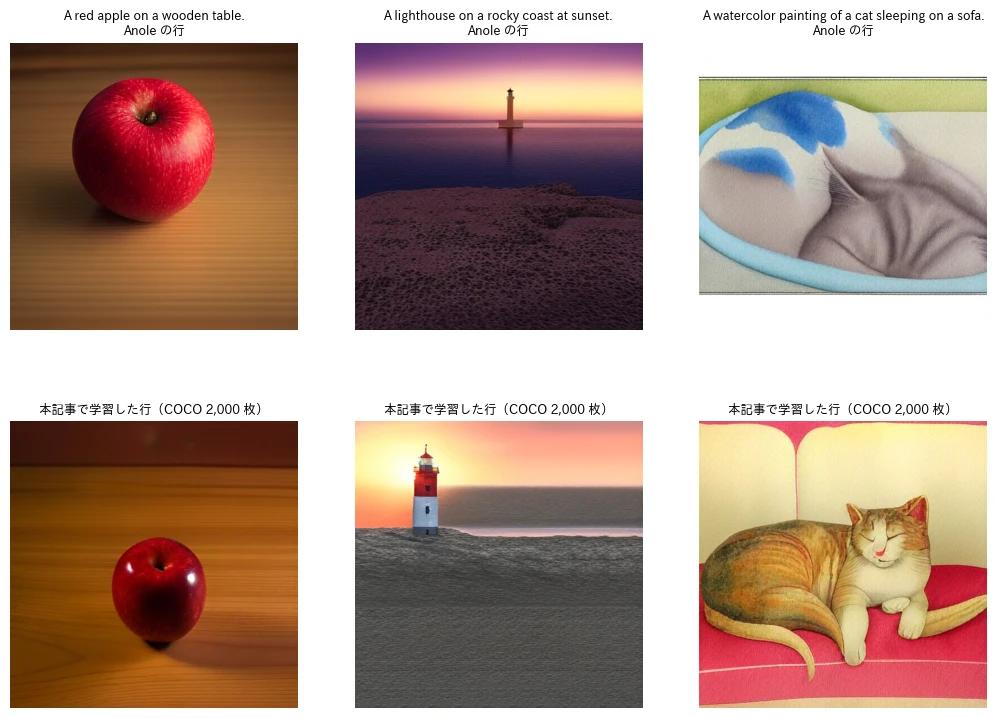
- 画像の生成: 出力層の画像のトークンの行を学習した行に置き換え、実験5と同じ 3 つの指示・同じ設定(CFG 3.0)で生成して、Anole の行の画像と並べます。
実行結果
学習:479 秒
  300 回:学習の損失 6.355  評価用の損失 6.510
  600 回:学習の損失 5.841  評価用の損失 6.126
  900 回:学習の損失 6.072  評価用の損失 6.057
 1200 回:学習の損失 5.851  評価用の損失 6.031
 1500 回:学習の損失 5.825  評価用の損失 6.030
 1800 回:学習の損失 5.879  評価用の損失 6.005
 2100 回:学習の損失 5.810  評価用の損失 6.039
 2400 回:学習の損失 5.671  評価用の損失 6.023
 2700 回:学習の損失 5.756  評価用の損失 6.018
 3000 回:学習の損失 5.714  評価用の損失 6.008

評価用の損失:公開版の行 127.783、本記事で学習した行 6.008、Anole の行 5.719(当てずっぽう 9.011)
4つの評価用の損失を並べると、次のようになります。
(図は、diagram-designで作成)
- 評価用の損失: 公開版の行(乱数)では 127.8 と、当てずっぽう(9.01)よりはるかに悪い値です。3,000 回(約 8 分)の学習で 6.01 まで下がり、Anole の行の 5.72 に近づきました。損失は 1,200 回ほどで 6.03 になり、その後はほとんど下がっていません。2,000 枚のデータで学習できる量は、このあたりが上限です。
- 生成した画像: 学習した行でも、3 つの指示に沿った画像を生成できました。りんごはテーブルの上に小さく写り、灯台は赤白の灯台が夕焼けの海辺に立つ写真らしい画像になりました。COCO は日常の写真のデータなので、水彩画の猫の指示でも、ソファの上で眠る猫の、塗りの濃いイラストになりました。Anole は芸術の画像で学習しているので、絵の雰囲気が違います。
- 分かること: 32 層の本体は、公開版のままでも、画像のトークンを生成するための情報を出力層の直前まで持っています。画像を生成できないのは出力層の 8,192 行が乱数に置き換えられているからで、この行だけを学習し直せば、A100 1 枚・約 8 分の学習でも画像を生成できるようになります。
まとめ
本記事では、画像もテキストも同じ語彙のトークンにして 1 本の列で扱う Chameleon(7B)を、PyTorch でスクラッチ実装しました。
- 仕組み: 画像のトークナイザー(VQGAN)が、512×512 の画像を 8,192 種類のコードのどれか 1,024 個にし、語彙の ID 4〜8195 のトークンとして、テキストと同じ埋め込み表・同じ Transformer で処理します。Transformer は Llama 2 の構成に QK-Norm を加えたもので、画像とテキストを混ぜた学習の発散を防ぎます。
- 実装の確認: 公式の重みを読み込み、float32 で Hugging Face の実装と比べると、画像のトークン 1,024 個を含む入力の ID がすべて一致し、logit の差は最大 1.7e-4、生成したトークン列も一致しました。VQGAN のデコーダも、Meta の公式の推論コードと復元した画像の全画素が一致しました。
- トークナイザーの限界: 猫の画像を 1,024 個のコードから復元すると、配置や色は残る一方、顔や脚の形が崩れました(PSNR 16.1dB)。文字が 16 画素以下では、復元した文字が崩れ、Chameleon が読めた文字の割合は 15〜37% でした。24 画素以上では 70〜80% です。言語モデルが受け取れる画像の情報は、トークナイザーで決まります。
- 公開版が画像を生成しない理由: 出力層の画像のトークンの 8,192 行が、0〜1 の一様乱数のような値(平均 0.4999、標準偏差 0.2887)に置き換えられていました。そのため、Hugging Face の実装は画像のトークンの logit を常に最小にしています。
- 画像の生成: Anole の重みは、32 層の本体が Chameleon-7B と完全に同じで、出力層の 8,198 行(画像のトークンと特別なトークン)だけが違いました。この行に差し替え、CFG 3.0 で 1,024 個の画像のトークンを生成すると、指示に沿った画像を作れました(1 枚約 77 秒)。
- 出力層の学習: Anole と同じく画像のトークンの行だけを、COCO の 2,000 組で学習しました。本体の出力を 1 回だけ計算して保存し、A100 1 枚・約 8 分の学習で、評価用の損失は公開版の行の 127.8 から 6.01(Anole の行は 5.72)まで下がり、指示に沿った画像を生成できるようになりました。
Chameleon は、画像を読むことと書くことを 1 つのモデル・1 つの語彙で扱えることを示しました。その代わり、画像の情報は離散的なコードに変える段階で決まり、細かな形や小さな文字は失われます。画像を連続値のベクトルで読む LLaVA や Qwen2-VL と比べてみると、2 つの方式の得意・不得意がよく分かります。
ライセンスに関する注記
Chameleon の重み(facebook/chameleon-7b)は、Chameleon Research License で公開されています。非営利の研究目的に限って使うことができ、商用には使えません。利用には、Hugging Face での利用規約への同意と Meta の承認が必要で、Meta の利用規定(Acceptable Use Policy)にも従う必要があります。Anole の重みと VQGAN の重み(GAIR/Anole-7b-v0.1)も、同じ Chameleon Research License で配布されています。実験6では COCO 2017 の画像とキャプションを使いました。COCO の注釈は CC BY 4.0 で、画像は Flickr の各画像の利用条件に従います(本記事に COCO の画像は掲載していません)。そのほかの画像は、Gemini で作成した猫の画像と、コードで作った文字の画像だけです。本記事の説明は一般的な解釈で、法的な助言ではありません。 実際に利用する場合は、ライセンスの条文を確認してください。
出典・ライセンスについて
- Chameleon の実装: Hugging Face の transformers(Apache-2.0)の modeling_chameleon.py と image_processing_chameleon.py、Meta の公式の推論コード(vqgan.py・chameleon.py、Chameleon License)の構造を参考に、スクラッチで実装しています。
- 学習済みのモデル: facebook/chameleon-7b(Chameleon Research License)と、GAIR/Anole-7b-v0.1 の VQGAN の重み・出力層(Chameleon Research License)を使用しています。
- データセット: 実験6の学習に、COCO 2017 の画像とキャプションを使用しています。
- 推論に利用した画像: 猫の画像は、Gemini で作成したものです。文字の画像は、本記事のコードで作成したものです。
@article{chameleon2024,
  title = {Chameleon: Mixed-Modal Early-Fusion Foundation Models},
  author = {{Chameleon Team}},
  journal = {arXiv preprint arXiv:2405.09818},
  year = {2024}
}
@article{chern2024anole,
  title = {ANOLE: An Open, Autoregressive, Native Large Multimodal Models for Interleaved Image-Text Generation},
  author = {Chern, Ethan and Su, Jiadi and Ma, Yan and Liu, Pengfei},
  journal = {arXiv preprint arXiv:2407.06135},
  year = {2024}
}
参考文献
- Chameleon Team (2024). Chameleon: Mixed-Modal Early-Fusion Foundation Models. arXiv:2405.09818.
- E. Chern, J. Su, Y. Ma, P. Liu (2024). ANOLE: An Open, Autoregressive, Native Large Multimodal Models for Interleaved Image-Text Generation. arXiv:2407.06135.
- Meta AI. facebookresearch/chameleon. GitHub.
- Meta AI. facebook/chameleon-7b. Hugging Face.
- GAIR. GAIR/Anole-7b-v0.1. Hugging Face.
- T.-Y. Lin et al. (2014). Microsoft COCO: Common Objects in Context. ECCV 2014.
本記事の文章・構成の一部に生成AIを使用しています。