CLIPとは?
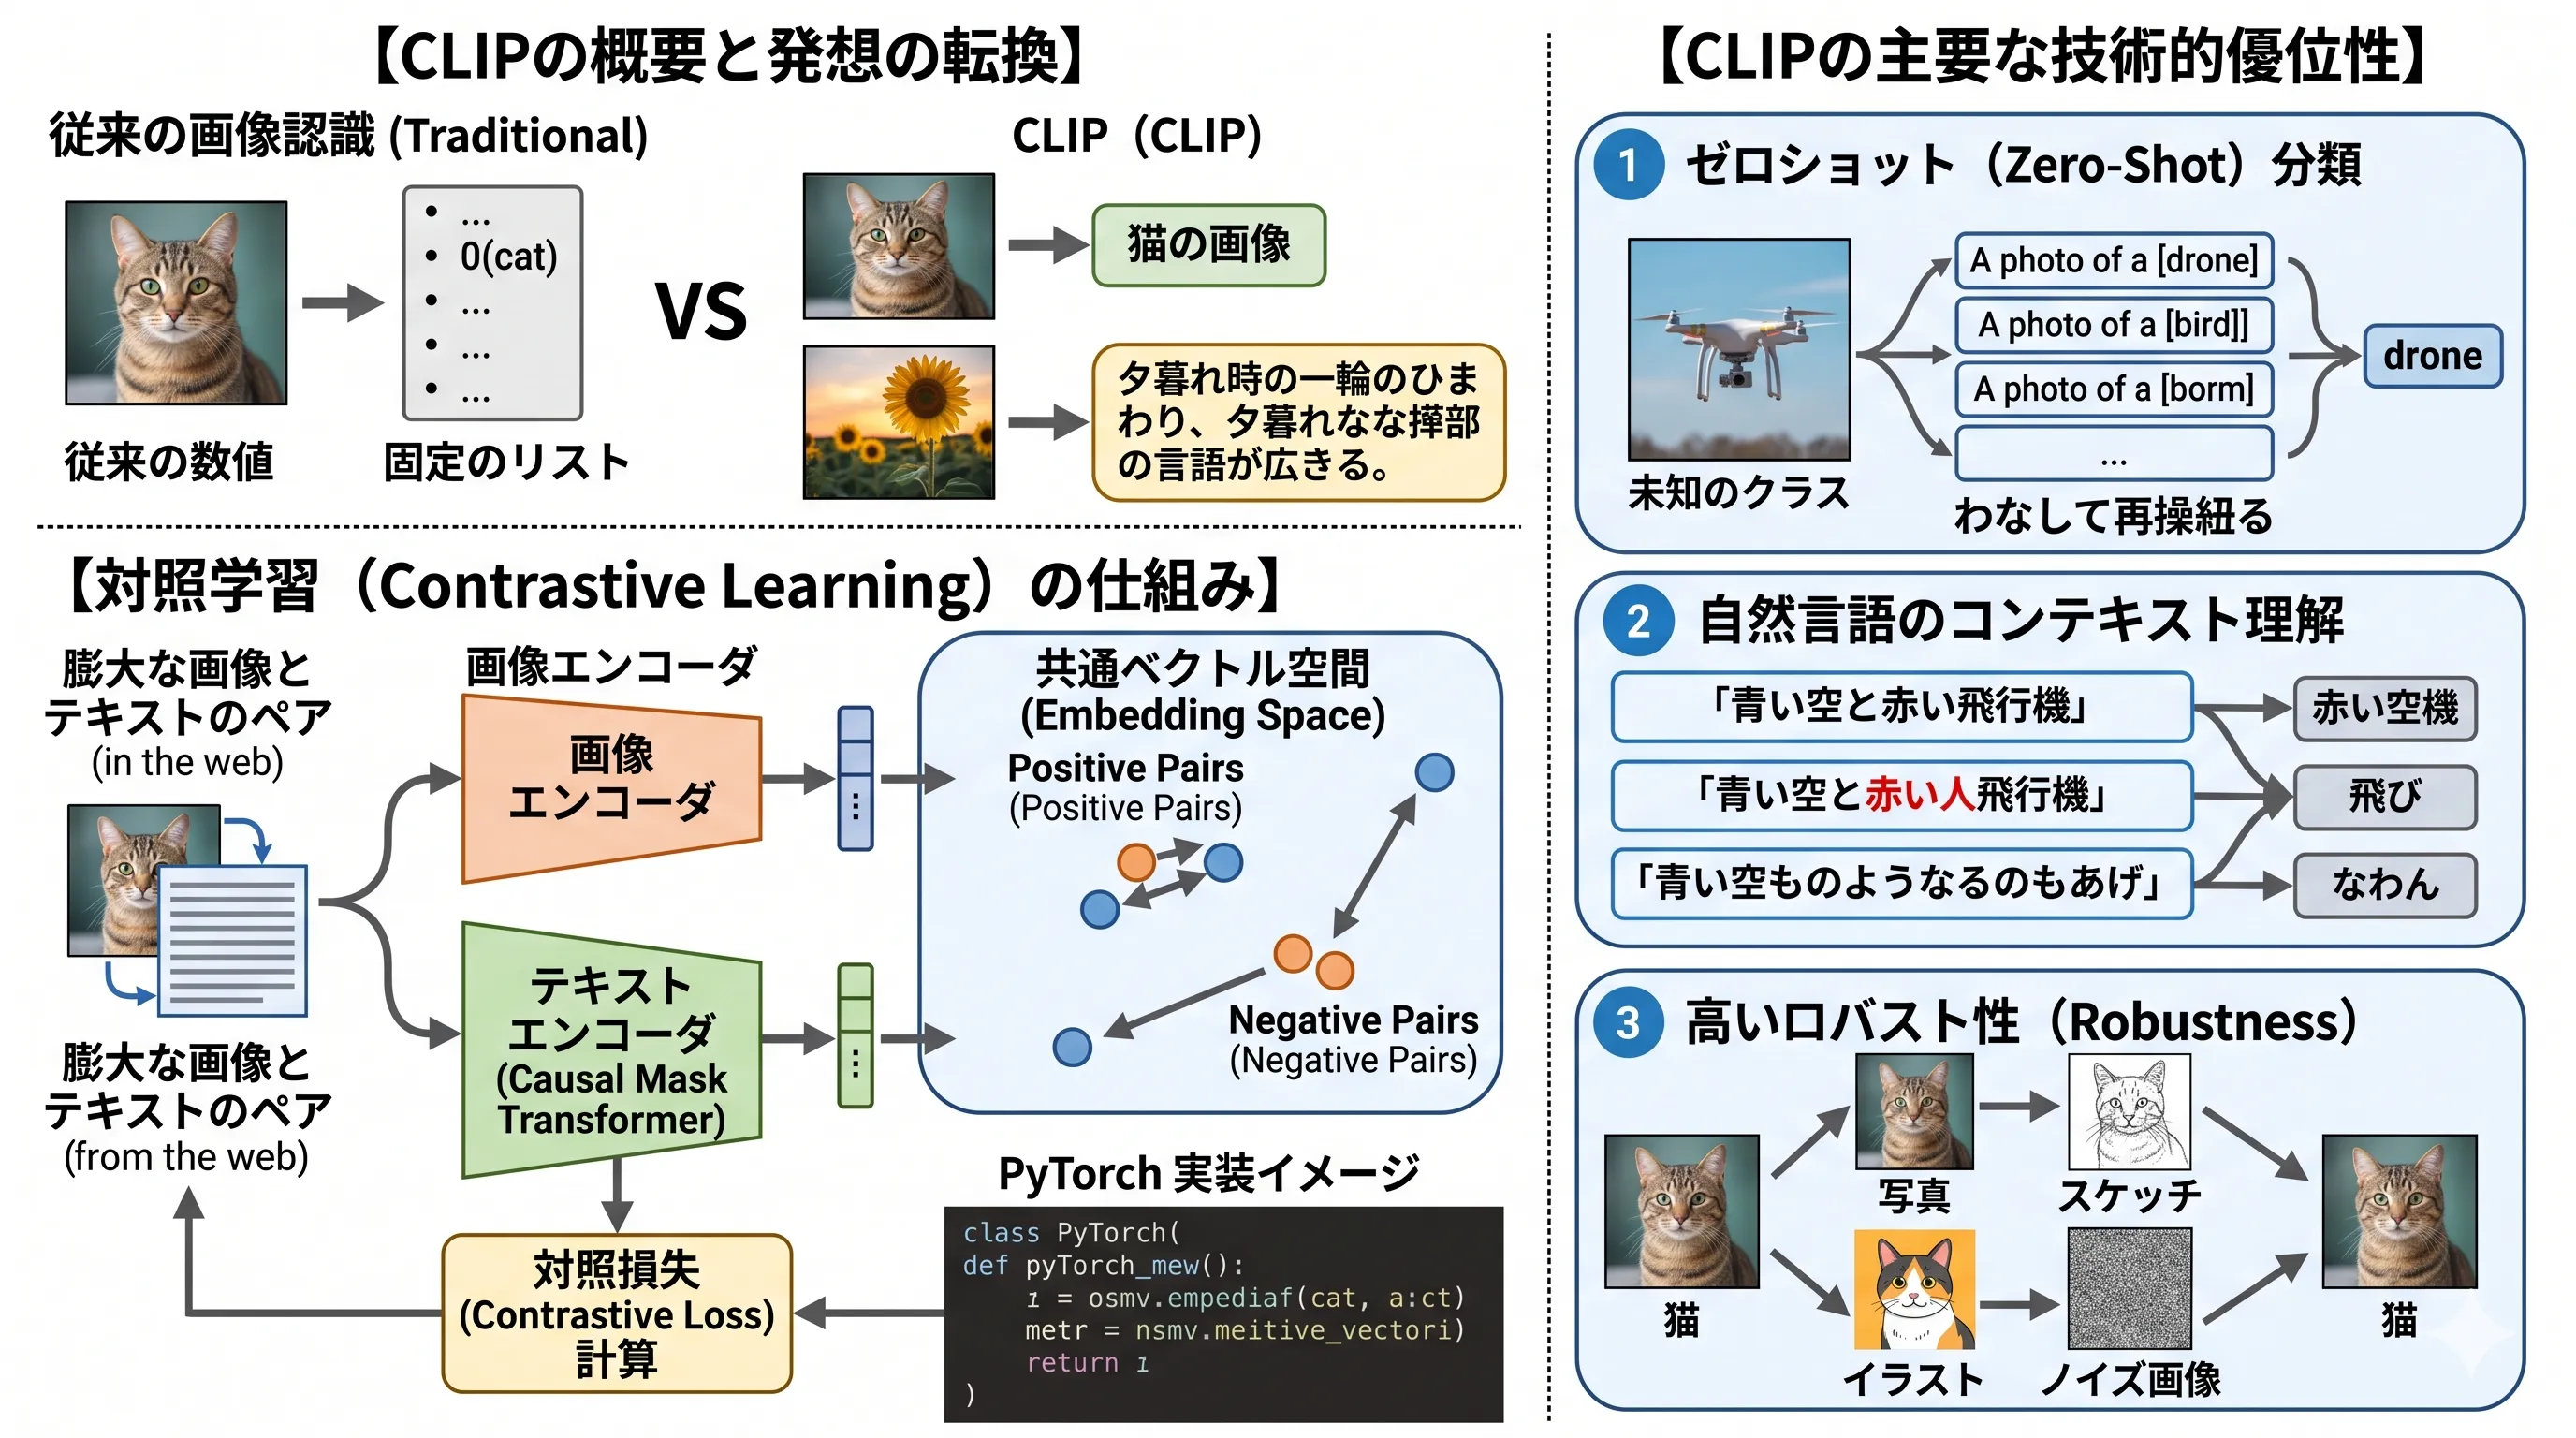 (画像は、Geminiで作成)
画像とテキストの対のどれが正しい組み合わせかを当てる対照学習で、自然言語を教師にして画像の表現を学ぶ CLIP の仕組みと、対称な交差エントロピー損失・温度・EOT 位置のプーリングといった設計の理由を理解すること。PyTorch で ViT・テキストエンコーダ・損失をスクラッチ実装し、Hugging Face の学習済みモデルで、追加の学習なしにゼロショット分類ができることを確かめること。
CLIPの概要
CLIP(Learning Transferable Visual Models From Natural Language Supervision) は、OpenAIのAlec Radfordらによって2021年に提案された、画像とテキストを共通の埋め込み空間で結び付けるマルチモーダルな事前学習手法です。名称は Contrastive Language-Image Pre-training の略です。
従来の画像分類モデルは、あらかじめ決められた固定のクラス集合(ImageNetであれば1000クラス)を予測するように学習されます。この形式の教師信号は、新しい視覚概念を扱うたびに追加のラベル付きデータを必要とするため、モデルの汎用性を強く制限していました。またソフトマックス分類器の出力次元がクラス数に固定されるため、推論時に出力を動的に変更する仕組みも持ちません。
CLIPはこの制約を、ラベルの代わりに 自然言語そのものを教師信号として使う ことで取り払いました。インターネットから収集した4億組の(画像, テキスト)ペア(WIT: WebImageText)を用い、「バッチ内のどの画像とどのテキストが実際に対になっていたか」を当てる対照学習を行います。学習後は、分類したいクラス名を自然言語として書き下すだけで、テキストエンコーダがその場で線形分類器の重みを生成するため、追加学習なしの ゼロショット転移 が可能になります。実際にCLIPは、ImageNetの128万枚の学習画像を1枚も使わずに、ゼロショットでResNet-50と同等の精度(76.2%)を達成しています。
CLIPの処理概要
CLIPは、画像エンコーダとテキストエンコーダという2つの独立したタワーから構成されます。両者が出力した特徴量を線形射影で共通の次元数へ揃え、L2正規化したうえで内積(コサイン類似度)を取り、その類似度行列に対して対照学習を行います(後のスクラッチ実装の節に、本記事の実装の構成図があります)。
組のペアからなるミニバッチが与えられると、画像とテキストの可能な組み合わせは 通り存在します。CLIPはこのうち実際に対になっていた 個(類似度行列の対角成分)の類似度を最大化し、残りの 個(非対角成分)の類似度を最小化するように、対称な交差エントロピー損失を最適化します。
画像エンコーダには、ModifiedResNet(ResNet-D改良・antialiased blur pooling・Attention Poolingを導入したResNet-50系)と Vision Transformer の2種類が用意されています。テキストエンコーダはGPT-2系のアーキテクチャを踏襲したTransformer(Transformer の記事)で、未来のトークンを参照させない 因果マスク(Masked Self-Attention) を適用しながら処理し、系列の末尾に置かれた [EOS](EOT)トークンの最終層出力を文全体の表現として取り出します。
推論時は、分類したいクラス名を「a photo of a {label}.」のようなプロンプトに埋め込んでテキストエンコーダに通し、得られたテキスト埋め込みを画像埋め込みと突き合わせて最も類似度の高いものを選ぶだけで分類が完了します。
N × N の類似度行列と損失の関係を図にすると、次のようになります。
(図は、diagram-designで作成)
CLIPの構成技術要素(詳細)
論文「Learning Transferable Visual Models From Natural Language Supervision」で提案されている主要な技術要素を、「なぜそれが必要なのか」という観点から順に解説します。
1. 予測タスクではなく対照タスクを選ぶ(Contrastive Objective)
-
CLIPの初期の試みは、VirTexと同様に「画像を見てキャプションの単語列を生成する」予測タスクでした。しかし、同じ画像に付随するテキストは説明・コメント・関連文など多様であり、単語を厳密に当てるタスクは本質的に難しすぎます。
-
論文では、6300万パラメータのTransformer言語モデルが、より単純なBag-of-Words予測ベースラインと比べて、ImageNetのゼロショット精度が向上するペースが 1/3(3倍も遅い) にとどまることが示されました。
-
そこで「テキストの正確な単語」ではなく「テキスト全体としてどの画像と対になっているか」だけを当てる、より易しい代理タスクへ切り替えたところ、Bag-of-Words予測に対してさらに 4倍 の学習効率の改善が得られました。この効率こそがCLIPを4億ペア規模へスケールさせた鍵です。
-
具体的には、画像埋め込み とテキスト埋め込み の類似度行列に対し、行方向(画像→テキスト)と列方向(テキスト→画像)の2つの交差エントロピー損失を計算し、その平均を取ります(対称交差エントロピー損失 / InfoNCE損失)。
-
対称にする理由は、片方向だけでは「画像から見て正しいテキスト」しか制約されず、テキスト側の埋め込みが潰れる(複数のテキストが同じ点に集まる)縮退を防げないためです。双方向にすることで、画像・テキストの両方が互いに識別可能な配置を取るよう強制されます。
-
なお、この損失の分母はバッチ全体にわたる和であるため、バッチサイズがそのままタスクの難易度になります。CLIPが32,768という極めて大きなミニバッチを採用しているのはこのためで、逆にこれが分散学習時のメモリ・通信コストのボトルネックとなり、後続のSigLIPがシグモイド損失を提案する動機になりました。
2. 線形射影とL2正規化によるマルチモーダル埋め込み空間
-
画像エンコーダとテキストエンコーダは出力次元も表現の性質も異なるため、そのまま内積を取ることはできません。そこで各エンコーダの出力に学習可能な射影行列 を掛けて共通次元 へ写し、さらにL2正規化を行います。
-
L2正規化を挟む理由は、内積の値を ベクトルの長さに依存しない純粋な「向きの一致度」=コサイン類似度 に固定するためです。正規化しない場合、ベクトルを長くするだけでも内積が大きくなるので、向きをそろえる以外の方法で損失を下げられてしまいます。正規化により類似度は必ず に収まります。
-
重要なのは、SimCLRなどの自己教師あり学習で一般的な 非線形射影ヘッド(MLP)を使わず、単一の線形射影のみ を採用している点です。論文では両者に学習効率の差は見られなかったと報告されており、非線形射影の効果は画像単独の自己教師あり学習に固有のものではないかと推測されています。実装がシンプルになるうえ、ゼロショット時にテキスト埋め込みをそのまま線形分類器の重みとして解釈できるという利点もあります。
3. 学習可能な温度パラメータ(Logit Scale)
-
コサイン類似度は という非常に狭い範囲にしか値を取りません。この値をそのままソフトマックスに入れると、正しいペアと誤ったペアの確率差がほとんど付かず、勾配が消えてしまいます。そこで温度 で割ってロジットのレンジを拡大します。
-
CLIPでは をハイパーパラメータとして手で調整するのではなく、対数パラメータ化した乗算スカラー として直接学習します。実装上は次のように書けます。
-
対数パラメータ化する理由は2つあります。ひとつは が常に正になるため、スケールが負に転じて類似度の符号が反転する事故を構造的に防げること。もうひとつは、スケールが乗算的に効くパラメータであるため、対数空間で更新するほうが勾配のスケールが素直になることです。
-
初期値は (すなわち )が用いられ、学習中はロジットの倍率が 100を超えないようにクリップ されます。このクリップは、温度が暴走してロジットが極端に鋭くなり学習が不安定化するのを防ぐために必要だったと論文に明記されています。
バッチサイズ で、ある画像に対するコサイン類似度が次のようになっていたとします。
- 正しいペア(対角成分):
- 誤ったペア(非対角成分): (3個)
1. 温度スケールなし()の場合
- ソフトマックス確率: 正解 、不正解 (各)
- 損失
正解とハズレの確率差がわずか しかなく、ほぼ一様分布です。これでは「正解に近づけ」という勾配がほとんど立ちません。
2. CLIPの初期値(、)の場合
- ロジット: 正解 、不正解
- 指数を取ると 、
- ソフトマックス確率: 正解 、不正解 (各)
- 損失
同じ類似度であっても、温度スケールを掛けるだけで正解確率が から へ跳ね上がり、損失は約 になります。つまり温度は「 というわずかな内積の差」を「意味のある確率差」へ増幅する拡大鏡として働きます。
【学習が進むとどうなるか】
は学習可能なパラメータなので、学習が進むにつれてモデル自身が最適な鋭さを選びます。一般には、モデルが正例と負例を確実に分離できるようになるほど は上昇し、より自信を持ったシャープな予測を行うようになります。ただし上限100のクリップがあるため、無限に鋭くなることはありません。学習済みのCLIP(ViT-B/32)では に張り付いています。
計算例の2つの場合の確率を並べると、次のようになります。
(図は、diagram-designで作成)
4. 画像エンコーダ:ModifiedResNet と Vision Transformer
-
CLIPは2系統の画像エンコーダを用意しています。ひとつは ResNet-50 をベースに、ResNet-Dの改良とantialiased rect-2 blur poolingを導入した ModifiedResNet です。
-
この系統の最大の特徴は、最終段の Global Average Pooling を Attention Pooling に置き換えている点です。これは「transformer風」のマルチヘッドQKVアテンションを1層だけ使うもので、クエリを画像全体の平均プーリング表現 から作り、各空間位置をKey/Valueとして参照します。
-
単純平均では全ての空間位置を等しく扱ってしまいますが、Attention Poolingでは「画像全体の文脈(クエリ)から見て重要な位置」に重みを寄せて集約できます。キャプションが画像の一部だけを説明していることが多いマルチモーダル学習では、この重み付けが効きます。
-
もうひとつが Vision Transformer で、原論文の実装をほぼそのまま踏襲しつつ、パッチ埋め込みと位置埋め込みを足し合わせた直後に追加のLayerNormを1枚挿入する(ln_pre)という小さな変更が加えられています。論文は、この変更の理由を書いていません。
-
ViT側では、系列の先頭に付与した学習可能な [CLS] トークンの最終層出力を画像表現として取り出します。
5. テキストエンコーダ:因果マスクとEOTプーリング
-
テキストエンコーダは、GPT-2で用いられた改変を含むTransformerです。ベースサイズは12層・幅512・8ヘッドの6300万パラメータで、小文字化したBPE(語彙数49,152)を用い、計算効率のため最大系列長は76に制限されています([SOS] と [EOS] を含めた context length は77です)。
-
入力系列は [SOS] と [EOS] で囲まれ、最終層における [EOS] トークンの活性値 がテキスト全体の特徴表現として扱われます。これをLayerNormしたうえで線形射影し、マルチモーダル埋め込み空間へ写します。
-
ここで見落とされがちな重要点が、テキストエンコーダに 因果マスク(Masked Self-Attention)が適用されている ことです。文全体から1本のベクトルを作るだけなら双方向注意で十分なはずですが、CLIPがあえて因果マスクを残したのは、事前学習済み言語モデルによる初期化や、言語モデリングを補助損失として追加する可能性を将来のために残しておく ためだと論文に明記されています。
-
因果マスクを入れると、位置 のトークンは自分より前の情報しか見られません。したがって、文全体の情報が集約されているのは 系列の最後尾にある [EOS] の位置だけ であり、平均プーリングではなくEOT位置のピンポイント抽出が必然となります。因果マスクとEOTプーリングはセットで理解すべき設計です。
因果マスクで参照できる範囲を図にすると、次のようになります。
(図は、diagram-designで作成)
6. ゼロショット分類とプロンプトエンジニアリング
-
ゼロショット分類は、各クラス の名前をテキストエンコーダに通して得た埋め込み を用い、画像埋め込みとの類似度が最大のクラスを選ぶだけで実現できます。
-
この予測層は、L2正規化された入力・L2正規化された重み・バイアスなし・温度スケーリング付きの多項ロジスティック回帰 と数学的に等価です。つまりテキストエンコーダは、自然言語から線形分類器の重みを生成する ハイパーネットワーク として機能しています。
-
ただしクラス名をそのまま入力すると2つの問題が起きます。ひとつは 多義性 です。ImageNetには建設機械の crane と鳥の crane が別クラスとして共存しており、単語だけでは文脈が決まりません。Oxford-IIIT Pets の boxer も、犬種なのか格闘家なのかテキストエンコーダには判別できません。
-
もうひとつは 分布のギャップ です。事前学習データで画像に付随するテキストは通常1単語ではなく文章です。そこで「a photo of a {label}.」というテンプレートに埋め込むことで入力分布を学習時に近づけます。これだけでImageNetの精度が1.3%向上します。
-
さらに、複数のプロンプトから作った分類器を アンサンブル することで精度が向上します。重要なのは、確率空間ではなく 埋め込み空間で平均を取る 点です。こうすることでクラスごとに1本のテキスト埋め込みをキャッシュでき、推論コストは単一プロンプトの場合と変わりません。
-
ImageNetでは80種類のコンテキストプロンプトをアンサンブルすることで単一プロンプトからさらに3.5%向上し、プロンプト設計とアンサンブルを合わせると 約5% の改善が得られています。これは計算量を4倍にするのと同等の効果を、推論コストほぼゼロで得られることを意味します。
ゼロショット分類の流れを図にすると、次のようになります。
(図は、diagram-designで作成)
7. 学習の安定化と効率化
- 最適化にはAdamをgainとbias以外の重みにdecoupled weight decayを適用して用い、学習率はコサインスケジュールで減衰させます。本記事のスクラッチ実装でも、線形ウォームアップ+コサイン減衰を再現します。
- データ拡張は リサイズ後のランダム正方形クロップのみ です。4億ペアという規模では過学習が主要な懸念にならないため、あえて拡張を増やしていません。
- メモリ消費を抑え、学習速度を向上させるために、混合精度(Mixed Precision)、勾配チェックポイント、半精度のAdam統計量が用いられています。さらに、類似度計算自体を各GPUが自分のローカルバッチに必要な部分行列だけ計算するようシャーディングしています。これは の類似度行列を1箇所に展開しないための工夫であり、ソフトマックス損失が抱える構造的なコストを物語っています。
CLIPのスクラッチ実装
ここでは、CLIPの仕組みを理解するために、PyTorchを用いて最小限のサイズのCLIPモデル(MiniCLIP)をスクラッチで実装します。画像エンコーダには [CLS] トークンと ln_pre を持つViT、テキストエンコーダには因果マスク付きTransformer+EOTプーリングを用い、対称交差エントロピー損失で学習します。トークナイザはCLIP公式のBPEをそのまま利用し、EOT位置の特定も公式実装と同じ argmax による方法を採用します。
(図は、diagram-designで作成)
モデルが正しく構築できているかを確認するため、Fashion-MNIST の少数のサンプル(10ペア)を用いて 過学習 させ、損失が下がり Recall@1 が100%になるかを見るサニティチェックを行います。数百万ペア規模の本来の学習を再現するのではなく、「実装にバグがなければ確実に暗記できるはず」という性質を利用して構造の正しさを検証するアプローチです。
本記事で使用する「Fashion-MNIST」データセットは、Zalando SE によって作成された、10種類の衣類画像のデータセットで、MIT ライセンスの下で提供されています(詳細は記事の末尾に記載しています)。ここではこの画像に対し、CLIPのゼロショット分類で用いられるのと同じ「a photo of a {label}.」というテンプレートでキャプションを作り、ペアとして学習させます。
必要なライブラリのインストール
本記事のスクラッチ実装では、OpenAIが公開しているCLIP公式のBPEトークナイザをそのまま利用します。これは transformers ライブラリの CLIPTokenizer として提供されているため、追加で必要になるのは transformers だけです。実行環境(Google Colabなど)に入っていない場合は、以下のコマンドでインストールしてください。スクラッチ実装の学習は小さなモデルなので、GPU がなくても CPU で 1 分ほどで終わります。
!pip install transformers
トークナイザを自作せず公式のものを使うのは、[SOT]・[EOT] の特殊トークンID・PADの扱い・語彙サイズ(49,408)といった前提を公式実装と完全に揃えるためです。後述するEOT位置の求め方は、この語彙設計に強く依存しています。
MiniCLIPクラスの定義
以下のコードでは、画像とテキストの特徴量をそれぞれ抽出し、対称交差エントロピー損失計算用のロジットを算出するモデルの全体クラス(MiniCLIP)を定義します。画像エンコーダ(VisionTransformer)とテキストエンコーダ(TextTransformer)は、この後の節で定義します。
import math
import torch
import torch.nn as nn
import torch.nn.functional as F
import torchvision.transforms as T
from torchvision import datasets
from PIL import Image
from transformers import CLIPTokenizer
import matplotlib.pyplot as plt


class MiniCLIP(nn.Module):
    # 大きさは、10 ペアの暗記に十分で、CPU でも 1 分ほどで学習できる値(論文の ViT-B/32 は幅 768・12 層、埋め込み 512 次元)
    def __init__(self, vocab_size, embed_dim=192, img_size=32, patch=8,
                 v_layers=4, t_layers=2, heads=4, context_length=32):
        super().__init__()
        self.visual = VisionTransformer(img_size, patch, 3, embed_dim, v_layers, heads, embed_dim)
        self.text = TextTransformer(vocab_size, context_length, embed_dim, t_layers, heads, embed_dim)
        # 温度は対数で持って学習する。初期値は論文と同じ tau = 0.07(t' = log(1 / 0.07)、倍率 exp(t') ≈ 14.29)
        self.logit_scale = nn.Parameter(torch.tensor(math.log(1 / 0.07)))

    def encode_image(self, images):
        # 長さ 1 にそろえ、内積がコサイン類似度になるようにする
        return F.normalize(self.visual(images), dim=-1)

    def encode_text(self, ids):
        # 長さ 1 にそろえる(EOT の位置は TextTransformer の中で求める)
        return F.normalize(self.text(ids), dim=-1)

    def forward(self, images, ids):
        zi = self.encode_image(images)          # (B, D)
        zt = self.encode_text(ids)              # (B, D)
        # 学習が不安定にならないよう、倍率が 100 を超えないようにする(論文 2.5 節)
        scale = self.logit_scale.exp().clamp(max=100.0)
        logits_per_image = scale * zi @ zt.t()  # (B, B):行が画像、列が文
        return logits_per_image, zi, zt
画像とテキストを 1 本ずつのベクトルにし、すべての組み合わせの類似度(ロジット)を行列で返すモデルの本体です。
- モデルの大きさ: 埋め込み 192 次元・画像側 4 層・テキスト側 2 層・4 ヘッドは、論文のどのモデルよりもずっと小さい値です。10 ペアを暗記できることを確かめるのが目的なので、それに十分で、CPU でも 1 分ほどで学習が終わる大きさにしています。後の「設定を変えても結果が変わらないかを確かめる」の節で、埋め込みを 64 次元にしても同じように暗記できることを確かめます。
- 温度 logit_scale: 論文と同じく、温度を対数 で持って学習します。初期値の math.log(1 / 0.07) は論文の初期値()で、倍率 logit_scale.exp() は約 14.29 から始まります。対数で持つのは、exp を通すと倍率が必ず正になり、類似度の符号が逆転しないためです。
- L2 正規化: encode_image と encode_text は、出力を F.normalize で長さ 1 にそろえます。こうすると内積がコサイン類似度(−1〜1)になり、ベクトルを長くすることでは類似度を上げられなくなります。encode_text がトークンID列だけを受け取るのは公式実装と同じで、EOT の位置はテキストエンコーダの中で求めます。
- ロジット: forward は、B 枚の画像と B 個の文のすべての組み合わせの類似度を、行列積 zi @ zt.t() で一度に計算します(B×B)。倍率を掛けるときに clamp(max=100.0) で上限を 100 にするのは、論文が「学習の不安定化を防ぐために必要だった」と書いている処理です。
Transformerの共通部品
画像側とテキスト側で共通して使うブロックです。CLIPは Pre-LN(LayerNormを残差ブランチの入口に置く構成)を採用し、活性化関数には通常のGELUではなく QuickGELU を用いています。
class QuickGELU(nn.Module):
    """CLIP の公式実装の活性化関数:x * sigmoid(1.702 * x)(GELU のシグモイドによる近似)"""
    def forward(self, x):
        return x * torch.sigmoid(1.702 * x)


class MHSA(nn.Module):
    """マルチヘッド自己注意"""
    def __init__(self, dim, heads):
        super().__init__()
        self.h, self.dh = heads, dim // heads
        self.qkv = nn.Linear(dim, dim * 3)
        self.proj = nn.Linear(dim, dim)

    def forward(self, x, attn_mask=None):
        B, N, D = x.shape
        # Q・K・V を 1 回の線形変換でまとめて作り、(3, B, ヘッド数, N, 1 ヘッドの次元) に並べ替える
        q, k, v = self.qkv(x).reshape(B, N, 3, self.h, self.dh).permute(2, 0, 3, 1, 4)
        # attn_mask:テキスト側は因果マスク(見てはいけない位置が -inf)、画像側は None(全部の位置を見合う)
        o = F.scaled_dot_product_attention(q, k, v, attn_mask=attn_mask)
        # ヘッドの出力をつなげて (B, N, D) に戻す
        return self.proj(o.transpose(1, 2).reshape(B, N, D))


class MLP(nn.Module):
    def __init__(self, dim, ratio=4):   # 中間層を 4 倍にするのは、Transformer の標準(公式実装も 4 倍)
        super().__init__()
        self.fc1 = nn.Linear(dim, dim * ratio)
        self.act = QuickGELU()
        self.fc2 = nn.Linear(dim * ratio, dim)

    def forward(self, x):
        return self.fc2(self.act(self.fc1(x)))


class Block(nn.Module):
    """Pre-LN の Transformer ブロック:x + 注意(LN(x)) → x + MLP(LN(x))"""
    def __init__(self, dim, heads):
        super().__init__()
        self.ln1, self.ln2 = nn.LayerNorm(dim), nn.LayerNorm(dim)
        self.attn, self.mlp = MHSA(dim, heads), MLP(dim)

    def forward(self, x, attn_mask=None):
        x = x + self.attn(self.ln1(x), attn_mask)
        x = x + self.mlp(self.ln2(x))
        return x
画像側とテキスト側の両方で使う、Transformer のブロックを定義するコードです。
- QuickGELU: OpenAIの公式実装は、誤差関数を使う正確なGELUではなく、シグモイド関数で近似した QuickGELU を使っています。公開されている学習済みの重みはこの活性化関数で学習されているので、事前学習済みのCLIPを再現するときは、標準のGELUに置き換えてはいけない箇所です。本記事の小さなモデルは自分で学習するので結果への影響は小さいですが、公式実装に合わせています。
- MHSA: Q・K・V を 1 つの線形層 qkv でまとめて作ると、3 回に分けるより計算が 1 回で済みます。F.scaled_dot_product_attention は を計算する PyTorch の関数で、attn_mask に渡した加算型のマスク を、softmax の前に足します。テキスト側は因果マスク、画像側は None(マスクなしの双方向注意)を渡します。
- Pre-LN: Block は、注意と MLP の入口で LayerNorm を通し、出力を入力に足します(残差接続)。公式実装と同じ構成で、残差の経路が正規化を通らないので、層を重ねても勾配が伝わりやすくなります。
画像エンコーダ(ViT + [CLS] トークン)の定義
CLIPのViTは、原論文のViTに対して パッチ埋め込みと位置埋め込みを足した直後にLayerNormを1枚追加する(ln_pre)という変更が加えられています。プーリングには先頭の [CLS] トークンを使い、最後に ln_post を通してから射影行列で共通埋め込み空間へ写します。
class VisionTransformer(nn.Module):
    # patch=8:32×32 の画像を 4×4 = 16 個のパッチに分ける(論文の ViT-B/32 は 224×224 を 32 画素ごとの 7×7 = 49 個)
    def __init__(self, img_size=32, patch=8, in_ch=3, width=192,
                 layers=4, heads=4, embed_dim=192):
        super().__init__()
        # 1. パッチ埋め込み:カーネルとストライドがパッチの大きさの畳み込みで、パッチごとに 1 本のベクトルにする(公式実装と同じく bias なし)
        self.conv1 = nn.Conv2d(in_ch, width, kernel_size=patch, stride=patch, bias=False)
        scale = width ** -0.5                              # 公式実装と同じ初期値の大きさ(1 / √幅)
        n_patch = (img_size // patch) ** 2
        # 2. [CLS] トークン:全パッチの情報を集めて、画像の表現にするための学習可能なベクトル
        self.class_embedding = nn.Parameter(scale * torch.randn(width))
        # 位置埋め込みは [CLS] の分を含めて n_patch + 1 個
        self.positional_embedding = nn.Parameter(scale * torch.randn(n_patch + 1, width))
        # 3. CLIP が加えた、Transformer の前の LayerNorm
        self.ln_pre = nn.LayerNorm(width)
        self.blocks = nn.ModuleList([Block(width, heads) for _ in range(layers)])
        self.ln_post = nn.LayerNorm(width)
        # 4. 共通の埋め込み空間への射影:非線形のヘッドではなく、1 つの線形射影だけ(論文の設計)
        self.proj = nn.Parameter(scale * torch.randn(width, embed_dim))

    def forward(self, x):
        x = self.conv1(x)                                  # (B, width, 4, 4)
        x = x.flatten(2).transpose(1, 2)                   # (B, 16, width)
        cls = self.class_embedding.expand(x.shape[0], 1, -1)
        x = torch.cat([cls, x], dim=1)                     # (B, 17, width):先頭が [CLS]
        x = x + self.positional_embedding
        x = self.ln_pre(x)
        for blk in self.blocks:
            x = blk(x)                                     # 画像の中はマスクなしで、全部の位置が互いを見る
        x = self.ln_post(x[:, 0])                          # [CLS] の位置だけを、画像の表現として取り出す
        return x @ self.proj                               # (B, embed_dim)
画像を、パッチの列にしてから Transformer に通し、先頭の [CLS] の出力を画像の表現にするコードです。
- パッチの大きさ: patch=8 で、32×32 の画像を 4×4 = 16 個のパッチにします。Fashion-MNIST の 28×28 の画像を 32×32 に広げているのは(次の「データセットの準備」)、8 で割り切れる大きさにして、パッチの数を整数にするためです。
- [CLS] トークンによるプーリング: 学習可能な class_embedding を列の先頭に足し、最終層のその位置の出力だけを取り出します。[CLS] は自己注意を通じて全パッチの情報を集めるので、平均プーリングと違い、どのパッチをどれだけ見るかをモデル自身が学習できます。
- ln_pre: パッチ埋め込みと位置埋め込みを足した直後に入れる LayerNorm で、CLIP が原論文の ViT に加えた変更です。論文は理由を書いていませんが、Transformer に入るベクトルの大きさをそろえる働きをします。
- 線形射影だけの出力: 出力は ln_post を通した後、MLP のヘッドではなく、1 つの射影行列 self.proj だけで共通の埋め込み空間に写します。論文は、非線形のヘッドと線形の射影で学習の効率に差がなかったと報告しています。
テキストエンコーダ(因果マスク + EOTプーリング)の定義
CLIPのテキストエンコーダには、押さえておくべき2つのポイントがあります。
- 因果マスクを使う:文全体から1本のベクトルを作るだけなら双方向注意で十分ですが、CLIPは事前学習済み言語モデルによる初期化や言語モデリングの補助損失を将来追加できるよう、あえて因果マスクを残しています。
- EOT位置をプーリングに使う:因果マスクにより文全体の情報が集約されるのは系列の最後尾だけなので、[EOS](EOT)位置の出力をLayerNormしてから線形射影し、文ベクトルとします。
class TextTransformer(nn.Module):
    def __init__(self, vocab_size, context_length=32, width=192,
                 layers=2, heads=4, embed_dim=192):
        super().__init__()
        scale = width ** -0.5
        self.token_embedding = nn.Embedding(vocab_size, width)
        self.positional_embedding = nn.Parameter(          # 公式実装と同じく、標準偏差 0.01 の正規分布で初期化
            torch.empty(context_length, width).normal_(std=0.01))
        self.blocks = nn.ModuleList([Block(width, heads) for _ in range(layers)])
        self.ln_final = nn.LayerNorm(width)
        self.text_projection = nn.Parameter(scale * torch.randn(width, embed_dim))
        # 因果マスク:自分より後ろ(上三角)を -inf にした加算マスク。最大の長さで 1 回だけ作り、使うときに切り出す
        mask = torch.full((context_length, context_length), float("-inf")).triu(1)
        self.register_buffer("causal_mask", mask, persistent=False)

    def forward(self, ids):
        L = ids.shape[1]
        x = self.token_embedding(ids) + self.positional_embedding[:L]
        m = self.causal_mask[:L, :L]
        for blk in self.blocks:
            x = blk(x, attn_mask=m)   # 各位置は、自分より前のトークンだけを見る
        x = self.ln_final(x)
        # 文全体を見ている [EOT] の位置の出力を取り出す。[EOT] は語彙で最大の ID なので、argmax がその位置を指す(公式実装と同じ)
        eot_pos = ids.argmax(dim=-1)
        pooled = x[torch.arange(x.shape[0], device=x.device), eot_pos]
        return pooled @ self.text_projection   # (B, embed_dim)
キャプションのトークン列を、因果マスク付きの Transformer に通し、[EOT] の位置の出力を文の表現にするコードです。
- 因果マスク: 上三角を -inf にした加算マスクを register_buffer で持ち、各ブロックに渡します。softmax の前に -inf を足すと、その位置の注意の重みはちょうど 0 になります。マスクは context_length の正方行列として一度だけ作り、実際の長さ に合わせて causal_mask[:L, :L] と切り出して使い回します。persistent=False は、計算で作れる値なので、重みの保存(state_dict)に含めないための指定です。
- パディング用のマスクがいらない理由: CLIPは PAD 専用のマスクを持ちません。PAD は必ず [EOT] より後ろにあるので、因果マスクによって、[EOT] の位置から PAD は見えないからです。つまり [EOT] の位置の出力は、PAD をいくつ足しても変わりません。因果マスク・PAD のマスクなし・EOT プーリングの 3 つは、互いに支え合った 1 つの設計です。
- EOT プーリング: 各文の [EOT] の位置の出力を取り出し、線形射影 text_projection で共通の埋め込み空間に写します。CLIPのBPE語彙では、[EOT](<|endoftext|>、ID 49407)が語彙で最大の ID で、PAD は 0 なので、ids.argmax(dim=-1) の 1 行で各文の [EOT] の位置がわかります。トークナイザの語彙の設計と対になった、公式実装と同じ書き方です。
対称交差エントロピー損失
CLIPの中核です。論文のFigure 3に示された疑似コードをそのままPyTorchに落とし込みます。
def clip_loss(logits_per_image):
    """対角成分が正解となる対称交差エントロピー損失"""
    n = logits_per_image.shape[0]
    # バッチの i 番目の画像と i 番目の文が正しい組なので、正解は対角(0, 1, …, n-1)
    labels = torch.arange(n, device=logits_per_image.device)
    # 行方向:各画像に対して、n 個の文から正しい文を当てる
    loss_i = F.cross_entropy(logits_per_image, labels)
    # 列方向:各文に対して、n 枚の画像から正しい画像を当てる(転置して同じ関数を使う)
    loss_t = F.cross_entropy(logits_per_image.t(), labels)
    return (loss_i + loss_t) / 2
類似度行列から、記事の前半の (行方向と列方向の交差エントロピーの平均)を計算するコードです。
- 正解は対角: バッチの 番目の画像に対応する文は、必ず同じバッチの 番目です。そのため、正解のラベルは torch.arange(n)、つまり類似度行列の対角になります。クラスのラベルのような追加の情報がいらないのが、この損失の強みです。
- 両方向の平均: logits_per_image をそのまま渡す損失(画像→文、)と、転置して渡す損失(文→画像、)を平均します。片方向だけだと、「各画像にとって正しい文が一番近い」ことしか求めないので、文の側から見た区別がつきにくくなります。両方向を求めることで、画像と文の両方が互いに見分けられる配置になります。
学習率スケジューラの定義
def lr_at(step, total, base_lr, warmup):
    """線形ウォームアップ + コサイン減衰(ステップ step のときの学習率)"""
    if step < warmup:
        # 学習の最初は、勾配が大きく不安定になりやすいので、0 から少しずつ上げる
        return base_lr * step / max(1, warmup)
    # その後は、コサインのカーブで 0 まで滑らかに下げる(論文と同じコサインのスケジュール)
    p = (step - warmup) / max(1, total - warmup)
    return base_lr * 0.5 * (1 + math.cos(math.pi * min(1.0, p)))
学習の各ステップの学習率を返す関数です。
- コサイン減衰: 論文は、学習率をコサインのスケジュールで下げています。学習の終わりに学習率を小さくすると、パラメータが細かく揺れ続けずに落ち着きます。
- ウォームアップ: 論文は最初の 2,000 イテレーションで学習率を上げるウォームアップを使っています。本記事の学習は 500 ステップしかないので、同じ長さにはできず、最初の 50 ステップ(全体の 1 割)にしています。後の「設定を変えても結果が変わらないかを確かめる」の節で、ウォームアップをなくしても同じように暗記できることを確かめます。
- max(1, ...): warmup=0 のときなどに、0 で割らないようにするためです。
データセットの準備
Fashion-MNISTの各クラスの画像に対して、論文と同じ「a photo of a {label}.」というテンプレートでキャプションを割り当て、10ペアを作成します。
N_PAIRS = 10       # 10 クラスから 1 枚ずつ。同じキャプションの組がバッチに入らないようにする
IMG_SIZE = 32      # 28×28 を、パッチの大きさ 8 で割り切れる 32×32 に広げる

CLASSES = ["t-shirt", "trouser", "pullover", "dress", "coat",
           "sandal", "shirt", "sneaker", "bag", "ankle boot"]

# 論文と同じテンプレート。公式実装は冠詞を出し分けないため "a ankle boot" のままとする
PROMPT = "a photo of a {}."

transform = T.Compose([
    T.Resize((IMG_SIZE, IMG_SIZE)),
    T.ToTensor(),
    T.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5)),   # 0〜1 の画素値を -1〜1 にする
])

ds = datasets.FashionMNIST(root="data", train=True, download=True)
imgs = ds.data.numpy()          # (60000, 28, 28) uint8
labels = ds.targets.numpy()     # (60000,)

pil_images, captions = [], []
# 各クラスの最初の画像を 1 枚ずつ選ぶ(毎回同じ 10 枚になる)
for i in range(N_PAIRS):
    idx = (labels == i).nonzero()[0][0]
    # 白黒の画像を、画像エンコーダの入力(3 チャンネル)に合わせて RGB にする
    img = Image.fromarray(imgs[idx]).convert("RGB")
    pil_images.append(img)
    captions.append(PROMPT.format(CLASSES[i]))

x = torch.stack([transform(im) for im in pil_images])   # (10, 3, 32, 32)
print(captions[0], "/", captions[-1])
10 クラスの衣類の画像を 1 枚ずつ選び、クラス名をテンプレートに入れたキャプションと組にするコードです。
- プロンプトのテンプレート: クラス名をそのまま与えるのではなく、記事の前半の「6. ゼロショット分類とプロンプトエンジニアリング」で説明したテンプレートに入れます。事前学習のときに画像に付いているテキストは単語ではなく文なので、キャプションも文の形にそろえるという考え方を、スクラッチ実装でも同じにしています。
- キャプションが重ならないようにする: 対照学習は「対角だけが正解」という前提で損失を計算します。もしバッチに同じキャプションが 2 つあると、対角でない位置にも本当は正しい組(偽陰性)ができ、損失は 0 まで下がりません。過学習のサニティチェックが成り立つように、10 クラスから 1 枚ずつ選んで、キャプションがすべて違うようにしています。
- 画像の前処理: 28×28 の白黒の画像を、3 チャンネルの 32×32 にしてから、画素値を −1〜1 に正規化します。32 にするのはパッチの数を整数にするため、−1〜1 にするのは、入力の値の中心を 0 に近づけて、学習を安定させるためです。
実行結果
a photo of a t-shirt. / a photo of a ankle boot.
トークナイズとEOT位置の特定
CLIP公式のトークナイズ処理(clip.tokenize)は、Hugging Faceの CLIPTokenizer と数行のコードで再現できます。ポイントは、系列を [SOT] と [EOT] で囲み、残りを固定長までID 0で埋めるという点です。
CONTEXT_LENGTH = 32   # 公式は77。本記事のキャプションは10トークン以下なので32に縮めている

tok = CLIPTokenizer.from_pretrained("openai/clip-vit-base-patch32")
SOT_ID, EOT_ID = tok.bos_token_id, tok.eos_token_id   # 49406, 49407


def tokenize(texts, context_length=CONTEXT_LENGTH):
    """OpenAI公式の clip.tokenize と同じ規則でトークナイズする"""
    all_tokens = [[SOT_ID] + tok.encode(t, add_special_tokens=False) + [EOT_ID]
                  for t in texts]
    # 未使用領域は ID 0 で埋める(= 公式のゼロパディング)
    ids = torch.zeros(len(all_tokens), context_length, dtype=torch.long)
    for i, tokens in enumerate(all_tokens):
        # 長すぎると [EOT] が入らず、EOT プーリングが壊れるので、ここで止める
        assert len(tokens) <= context_length, \
            f"'{texts[i]}' が context_length={context_length} を超えています"
        ids[i, :len(tokens)] = torch.tensor(tokens)
    return ids


ids = tokenize(captions)          # (10, 32)

# argmax で EOT 位置が正しく取れることを検証する
eot = ids.argmax(dim=-1)
assert (ids[torch.arange(len(ids)), eot] == EOT_ID).all()

print("vocab", tok.vocab_size, "sot", SOT_ID, "eot", EOT_ID)
print("token lengths", (eot + 1).tolist())
print(ids[0, :12].tolist())
キャプションを公式実装と同じ形のトークン列にし、argmax で [EOT] の位置が取れることを確かめるコードです。
- ゼロパディング: 公式実装は attention_mask を持たず、PAD を ID 0 で埋めるだけです。CLIPのBPE語彙で 0 は感嘆符「!」に割り当てられた普通のトークンで、PAD 専用の特殊トークンではありません。それでも問題が起きないのは、前の節で説明したとおり、因果マスクによって [EOT] の位置から PAD が見えないためです。
- argmax で [EOT] の位置が取れる理由: [EOT] の ID 49407 は語彙で最大です。PAD は 0、ほかの BPE のトークンはそれより小さいので、列全体の argmax は必ず [EOT] の位置を指します。念のため assert で、求めた位置のトークンが本当に [EOT] であることを確かめています。
- CONTEXT_LENGTH: 論文はテキストを 76 トークン([SOT]・[EOT] を含めて 77)までにしていますが、本記事のキャプションは 10 トークン以下なので(実行結果の token lengths)、32 に縮めて計算を減らしています。長さを超えた場合、公式実装は末尾を切って [EOT] を置き直しますが、ここでは間違いに気付けるよう assert で止めます。[EOT] が失われると、プーリングの位置が意味をなさなくなり、エラーを出さずに学習が壊れるためです。
実行結果
vocab 49408 sot 49406 eot 49407
token lengths [10, 9, 8, 8, 8, 8, 8, 8, 8, 9]
[49406, 320, 1125, 539, 320, 339, 268, 2523, 269, 49407, 0, 0]
キャプションは 8〜10 トークンで、32 に十分収まります。1 つ目のキャプション「a photo of a t-shirt.」は、[SOT](49406)と [EOT](49407)の間の 8 トークンになり、その後ろが 0 で埋められています。
モデルの学習
10ペアを暗記できるか を確認します。温度パラメータや位置埋め込みは重み減衰の対象から外します。
torch.manual_seed(0)   # 重みの初期値を毎回同じにして、結果を再現できるようにする
model = MiniCLIP(tok.vocab_size, embed_dim=192, img_size=IMG_SIZE,
                 patch=8, context_length=CONTEXT_LENGTH)

# 1. weight decay をかける重みとかけない重みに分ける
#    論文と同じく、1 次元のパラメータ(LayerNorm の gain・bias)にはかけない。
#    温度にかけると logit_scale が 0(倍率 1)の方へ引っぱられ、ロジットの幅が縮んで学習が進まなくなるので除く。
#    位置埋め込みと [CLS] も、変換の重みではなく埋め込みなので、本記事では除く
decay, no_decay = [], []
for n, p in model.named_parameters():
    (no_decay if (p.ndim <= 1 or n == "logit_scale"
                  or "positional_embedding" in n
                  or "class_embedding" in n) else decay).append(p)
# 2. 最適化:論文の ViT のモデルの設定(学習率 5e-4・weight decay 0.2・β2 0.98・ε 1e-6)
opt = torch.optim.AdamW([{"params": decay,    "weight_decay": 0.2},
                         {"params": no_decay, "weight_decay": 0.0}],
                        lr=5e-4, betas=(0.9, 0.98), eps=1e-6)

# 3. 学習:同じ 10 ペアを 500 回くり返す(R@1 が 100% になった後も、類似度の変化を見るため長めにする)
TOTAL = 500
for s in range(1, TOTAL + 1):
    for g in opt.param_groups:
        g["lr"] = lr_at(s, TOTAL, 5e-4, warmup=50)

    logits, zi, zt = model(x, ids)
    loss = clip_loss(logits)
    opt.zero_grad(); loss.backward(); opt.step()

    # 更新で倍率が 100 を超えないよう、パラメータ自体もクリップする(forward の clamp と合わせて論文の処理)
    with torch.no_grad():
        model.logit_scale.clamp_(max=math.log(100.0))

    # 4. 途中経過:R@1、正しい組(対角)と誤った組(それ以外)の類似度の平均、倍率
    if s in (1, 10, 25, 50, 100, 150, 200, 300, 400, 500):
        sim = (zi @ zt.t()).detach()
        # 各画像で最も類似度の高い文が、正しい文(対角)なら当たり
        acc = (sim.argmax(-1) == torch.arange(len(x))).float().mean().item()
        off = ((sim.sum() - sim.diag().sum()) / (len(x) ** 2 - len(x))).item()
        print(f"step {s:4d} loss {loss.item():7.4f} R@1 {acc:6.1%} "
              f"diag {sim.diag().mean():+.3f} off {off:+.3f} "
              f"scale {model.logit_scale.exp().item():6.2f}")
10 ペアを同じバッチとして 500 回くり返し学習し、損失と R@1 が理論どおりに変わるかを確かめるコードです。
- weight decay の対象: 論文は、gain と bias(1 次元のパラメータ)以外の重みに weight decay をかけています。本記事はさらに、温度・位置埋め込み・[CLS] を対象から外しています(位置埋め込みと [CLS] を外すのは本記事の選択で、後の節で確かめるとおり、500 ステップの学習では weight decay の有無は結果にほとんど影響しません)。特に logit_scale を no_decay に入れることが大切で、weight decay をかけると温度が 0(倍率 1)の方へ引っぱられ、ロジットの幅が縮んで学習が進まなくなります。
- 学習率と AdamW の設定: 学習率 5e-4 は論文の ViT-B/32 の値、weight decay 0.2・betas=(0.9, 0.98)・eps=1e-6 は論文の ViT のモデルの共通の設定(付録の表)です。
- 500 ステップ: R@1 は 50 ステップまでに 100% になりますが、その後も対角と対角以外の類似度がどう広がるか、温度がどう動くかを見るため、10 倍の 500 ステップまで続けます。
- 温度のクリップ: 論文の「ロジットを 100 倍より大きくしない」という処理を、forward の中の clamp(max=100.0) と、更新した後の logit_scale.clamp_(max=math.log(100.0)) の 2 か所で再現しています。前者だけだと、パラメータが 100 を超えたところで勾配が 0 になり、そこから動けなくなるためです。
- 途中経過の指標: sim は倍率を掛ける前のコサイン類似度の行列です。R@1 は、各画像で最も類似度の高い文が正しい文である割合です。diag は正しい組(対角)の類似度の平均、off は誤った組(対角以外の 90 個)の類似度の平均で、対照学習が「正しい組を近づけ、誤った組を遠ざける」ことを数値で見るためのものです。
実行結果
step    1 loss  2.3135 R@1  10.0% diag -0.071 off -0.071 scale  14.29
step   10 loss  2.2319 R@1  40.0% diag -0.035 off -0.041 scale  14.29
step   25 loss  0.3125 R@1  90.0% diag +0.612 off -0.029 scale  14.32
step   50 loss  0.0014 R@1 100.0% diag +0.805 off -0.068 scale  14.40
step  100 loss  0.0002 R@1 100.0% diag +0.879 off -0.080 scale  14.44
step  150 loss  0.0001 R@1 100.0% diag +0.900 off -0.086 scale  14.44
step  200 loss  0.0001 R@1 100.0% diag +0.913 off -0.090 scale  14.45
step  300 loss  0.0000 R@1 100.0% diag +0.930 off -0.096 scale  14.47
step  400 loss  0.0000 R@1 100.0% diag +0.939 off -0.098 scale  14.48
step  500 loss  0.0000 R@1 100.0% diag +0.941 off -0.099 scale  14.49
初期状態の損失が に非常に近い値から始まっている点に注目してください。これは10クラスの一様分布(ランダム推測)に対応する理論値であり、実装が意図通りに動いていることの最初の裏付けになります。R@1も初期は10.0%(1/10)です。
そこから損失は急速に減少し、50ステップでR@1が100%に到達しています。類似度の対角成分(diag)が まで上昇する一方、非対角成分(off)は 付近まで押し下げられており、「正しいペアの類似度を最大化し、誤ったペアの類似度を最小化する」という対照学習が意図通りに機能し、正しく過学習できていることが確認できました。
なお、非対角成分が0ではなく 前後になっているのは、10 本の画像のベクトルと 10 本の文のベクトルを、正しい組だけ近く、ほかはできるだけ遠くに置こうとするためです。10 本の長さ 1 のベクトルを互いに最も遠く離すと、どの 2 本のコサイン類似度も になり(正単体の頂点の配置)、対角の類似度が 1 に近づくほど、対角以外の類似度はこの値に近づきます。実測値はこの値に近づいています。
また、温度スケールが (初期値)からほとんど動いていません。これは10ペアという極端に易しいタスクでは、温度を上げなくても既に正解確率がほぼ1に達しており、温度を動かす勾配がほとんど立たないためです。実際の大規模学習では、温度は上限の100付近まで上昇します。
対角と対角以外の類似度の推移を図にすると、次のようになります。
(図は、diagram-designで作成)
設定を変えても結果が変わらないかを確かめる
MiniCLIP の大きさやウォームアップの長さは、論文の設定をそのまま使えない値です。これらの値で結果が変わらないことを、設定を 1 つずつ変えて確かめます。
import time


def run(lr=5e-4, warmup=50, wd=0.2, embed=192, seed=0, total=500):
    """上の学習と同じ手順を、設定を変えて実行し、R@1 が初めて 100% になったステップと、最後の値を返す"""
    torch.manual_seed(seed)
    m = MiniCLIP(tok.vocab_size, embed_dim=embed, img_size=IMG_SIZE, patch=8, context_length=CONTEXT_LENGTH)
    decay, no_decay = [], []
    for n, p in m.named_parameters():
        (no_decay if (p.ndim <= 1 or n == "logit_scale" or "positional_embedding" in n or "class_embedding" in n) else decay).append(p)
    o = torch.optim.AdamW([{"params": decay, "weight_decay": wd}, {"params": no_decay, "weight_decay": 0.0}], lr=lr, betas=(0.9, 0.98), eps=1e-6)
    first = None; t = time.time()
    for s in range(1, total + 1):
        for g in o.param_groups: g["lr"] = lr_at(s, total, lr, warmup=warmup)
        logits, zi, zt = m(x, ids); loss = clip_loss(logits)
        o.zero_grad(); loss.backward(); o.step()
        with torch.no_grad(): m.logit_scale.clamp_(max=math.log(100.0))
        acc = ((zi @ zt.t()).argmax(-1) == torch.arange(len(x))).float().mean().item()
        if acc == 1.0 and first is None: first = s     # R@1 が初めて 100% になったステップ
    sim = (zi @ zt.t()).detach()
    off = ((sim.sum() - sim.diag().sum()) / (len(x) ** 2 - len(x))).item()
    return first, loss.item(), sim.diag().mean().item(), off, time.time() - t


# 基準の設定(上の学習と同じ)から、1 つずつ変える
for kw in [dict(), dict(warmup=0), dict(warmup=25), dict(lr=1e-3), dict(lr=2.5e-4), dict(wd=0.1), dict(wd=0.0), dict(embed=64), dict(seed=1), dict(seed=2)]:
    first, loss, diag, off, sec = run(**kw)
    print(f"{str(kw):<18} R@1 が 100% になったステップ {first:3d}  最後の loss {loss:.1e}  diag {diag:+.3f}  off {off:+.3f}  {sec:.0f} 秒")
上の学習と同じ手順を、学習率・ウォームアップ・weight decay・埋め込みの次元・乱数のシードを 1 つずつ変えて実行するコードです。
- 変える値: 学習率は基準の半分と 2 倍、ウォームアップはなし・半分、weight decay は 0.1・0(なし)、埋め込みは 3 分の 1 の 64 次元、シードは 1 と 2 です。それぞれ、記事の値を選んだ理由が「結果に大きく左右されない」ことかどうかを確かめるためです。
- 比べる指標: R@1 が初めて 100% になったステップ(毎ステップ確かめる)と、500 ステップ後の損失・diag・off です。CPU で 1 つの設定に 30 秒ほどかかります。
実行結果
{}                 R@1 が 100% になったステップ  23  最後の loss 3.3e-05  diag +0.941  off -0.099  35 秒
{'warmup': 0}      R@1 が 100% になったステップ  38  最後の loss 6.8e-05  diag +0.963  off -0.102  35 秒
{'warmup': 25}     R@1 が 100% になったステップ  22  最後の loss 3.8e-05  diag +0.942  off -0.099  35 秒
{'lr': 0.001}      R@1 が 100% になったステップ  22  最後の loss 2.5e-05  diag +0.958  off -0.101  35 秒
{'lr': 0.00025}    R@1 が 100% になったステップ  30  最後の loss 4.7e-05  diag +0.921  off -0.097  34 秒
{'wd': 0.1}        R@1 が 100% になったステップ  23  最後の loss 3.3e-05  diag +0.941  off -0.099  35 秒
{'wd': 0.0}        R@1 が 100% になったステップ  23  最後の loss 3.3e-05  diag +0.941  off -0.099  34 秒
{'embed': 64}      R@1 が 100% になったステップ  39  最後の loss 9.0e-05  diag +0.942  off -0.099  16 秒
{'seed': 1}        R@1 が 100% になったステップ  22  最後の loss 3.0e-05  diag +0.934  off -0.097  35 秒
{'seed': 2}        R@1 が 100% になったステップ  23  最後の loss 3.3e-05  diag +0.939  off -0.102  35 秒
どの設定でも、22〜39 ステップで R@1 が初めて 100% になり、500 ステップ後の diag は 0.92〜0.96、off は −0.10 前後で、ほとんど同じでした。ウォームアップをなくしたときと、埋め込みを 64 次元にしたときは、100% に届くまでのステップが 1.5 倍ほどに増えますが、暗記できることは変わりません。weight decay は、500 ステップでは結果にほぼ影響しません。10 ペアの暗記というこの実験の結論は、これらの値の選び方に左右されないことがわかります。なお、基準の設定では 23 ステップで一度 100% になったのに、前の節の 25 ステップの表示では 90% でした。暗記の途中では、1 組の当たり外れが行き来することがあるためで、50 ステップ以降は 100% で安定しています。
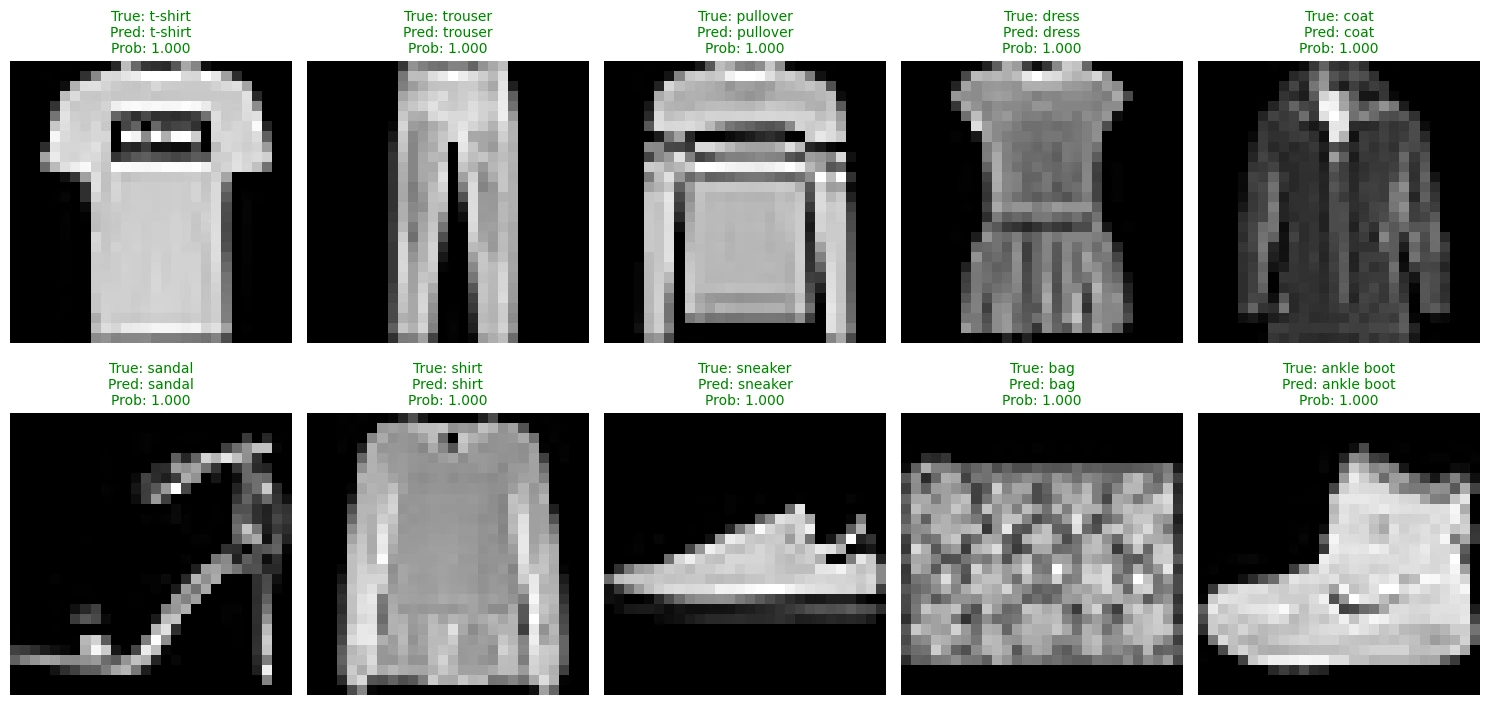
モデルの予測
以下のコードでは、過学習させたモデルを用いて実際に10ペアの画像とテキストを入力し、推論(予測確率の計算)を行って、その結果を画像付きで可視化します。
model.eval()
with torch.no_grad():
    image_features = model.encode_image(x)
    text_features = model.encode_text(ids)
    scale = model.logit_scale.exp().clamp(max=100.0)
    logits = scale * image_features @ text_features.t()
    # 各画像について、10 個の文の中での確率にする(行ごとの合計が 1)
    probs = logits.softmax(dim=-1)

fig, axes = plt.subplots(2, 5, figsize=(15, 7.5))
axes = axes.flatten()

for i in range(len(x)):
    p = probs[i]
    pred_idx = p.argmax().item()
    pred_prob = p[pred_idx].item()

    ax = axes[i]
    ax.imshow(pil_images[i])
    # 正解なら緑色、不正解なら赤色でタイトルを表示
    color = "green" if pred_idx == i else "red"
    ax.set_title(f"True: {CLASSES[i]}\nPred: {CLASSES[pred_idx]}\n"
                 f"Prob: {pred_prob:.3f}", color=color, fontsize=10)
    ax.axis("off")

plt.tight_layout()
plt.show()
学習したモデルで、各画像に 10 個のキャプションのどれが対応するかを確率で出し、画像と並べて表示するコードです。
- 予測確率: torch.no_grad() で勾配の計算を止め、画像とテキストの特徴量から類似度(ロジット)を計算して、logits.softmax(dim=-1) で確率にします。softmax を通すので、各画像の 10 個の確率の 合計は必ず 1 になり、候補どうしの相対的な比較としてしか読めない値になります。
- 表示: タイトルが長くなりすぎないよう、キャプションの全文ではなく、テンプレートに入れる前のクラス名(CLASSES)を表示します。
実行結果
10ペアすべてで正解ラベル(True)と予測ラベル(Pred)が一致し、いずれも1.000に極めて近い確率で正解を引き当てています。CLIPでは各画像に対する10個のテキスト候補の確率の合計が必ず1になるため、CLIPの出力は「この画像とこのテキストは対応しているか」ではなく、「与えられた候補の中でどれが最も相応しいか」という相対的な問いへの答えである、という性質がここに現れています。
実際のHugging Faceモデルを用いた推論テスト
ここまではCLIPの仕組みを理解するためにシンプルな概念モデルをゼロから実装してきましたが、実際の開発ではHugging Faceのtransformersライブラリを利用することで、事前学習済みの強力なモデルを数行のコードで呼び出して利用することができます。
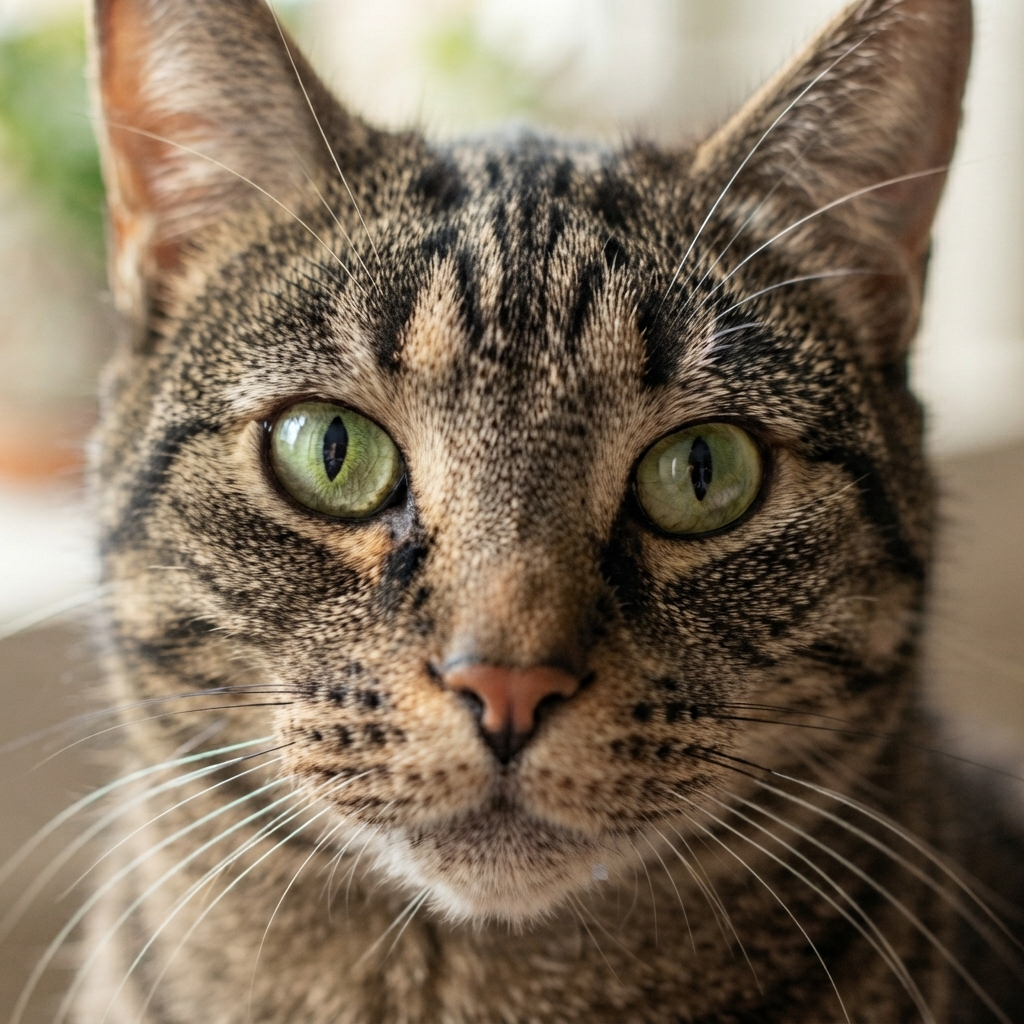
推論に利用する画像
以下の画像を cat.jpg として保存し、以下のコードと同じフォルダに配置してください。
(画像は、Geminiで作成)
ここでは、Hugging Faceのtransformersライブラリを使用してOpenAIが提供する実際の事前学習済みCLIPモデルを読み込み、猫の画像に対して異なる3つのテキスト候補を与えて予測確率を検証します。
from transformers import CLIPProcessor, CLIPModel
import torch
from PIL import Image
import matplotlib.pyplot as plt

# 1. 学習済みの CLIP(ViT-B/32)と、前処理(画像の縮小・正規化と、BPE のトークン化)を読み込む
model_name = "openai/clip-vit-base-patch32"
model = CLIPModel.from_pretrained(model_name)
processor = CLIPProcessor.from_pretrained(model_name)

# 2. 画像の読み込み
image = Image.open("cat.jpg")

# 3. テキストの候補:論文と同じ「a photo of a …」の形にした 3 つのクラス(猫・犬・車)
texts = ["a photo of a cat", "a photo of a dog", "a photo of a car"]

# 4. 前処理と推論:中では、スクラッチ実装と同じく、画像とテキストを別々に 1 本のベクトルにして類似度を計算している
inputs = processor(text=texts, images=image, return_tensors="pt", padding=True)
with torch.no_grad():
    outputs = model(**inputs)

# 5. 3 つの候補の中での確率にする(CLIP は softmax なので、合計が 1 になる)
logits_per_image = outputs.logits_per_image   # 画像から見た各テキストの類似度
probs = logits_per_image.softmax(dim=-1)      # ソフトマックスで相対的な確率を算出

# 6. 結果の表示
print("【CLIPによる予測確率】")
for i in range(len(texts)):
    print(f"{texts[i]} : {probs[0,i]:.1%}")
print(f"合計 : {probs[0].sum():.1%}")

# 7. 入力した画像を表示する
plt.figure(figsize=(6, 6))
plt.imshow(image)
plt.axis("off")
plt.tight_layout()
plt.show()
学習済みの CLIP で、猫の画像に 3 つのキャプションのどれが合うかを、追加の学習なしで確率にして確かめるコードです。
- モデルとプロセッサ: openai/clip-vit-base-patch32 は、論文の ViT-B/32 の学習済みの重みです。CLIPProcessor に画像とテキストをまとめて渡すと、画像の縮小・正規化と、テキストの BPE のトークン化・パディングを一度に行います。
- padding=True: スクラッチ実装では公式実装に合わせて固定の長さまで 0 で埋めましたが、ここではバッチの中で最も長い文に合わせて埋めます。それでよいのは、因果マスクによって、[EOT] の位置の出力が後ろの PAD の影響を受けないためで、埋める長さが変わっても結果は変わりません。
- テキストの候補: 3 つとも「a photo of a …」の形にしています。記事の前半で説明したとおり、論文はクラス名だけよりもこのテンプレートに入れた方が精度が上がると報告しています。
- 確率: outputs.logits_per_image は、記事の前半で説明した「L2 正規化した特徴量の内積 × 学習済みの倍率(約 100)」そのものです。これに softmax を適用して、3 つの候補の中での確率にします。
実行結果
上記のコードを実行すると以下の結果が得られます。
【CLIPによる予測確率】
a photo of a cat : 99.2%
a photo of a dog : 0.8%
a photo of a car : 0.0%
合計 : 100.0%
実行結果を確認すると、「a photo of a cat(猫の写真)」の適合確率が99.2%と判定され、他の候補を大きく引き離して正解していることがわかります。モデルに対して「猫」「犬」「車」を分類するための特別なファインチューニングを一切施していないにもかかわらず、自然言語による指示テキストと画像の特徴量が正しくアラインメントされ、ゼロショットによる画像識別が機能していることが実証されています。
ここで押さえておきたいのは、確率の合計が必ず100%になるという点です。CLIPのソフトマックスはバッチ(候補集合)全体にわたる正規化を行うため、出力は「この画像とこのテキストは対応しているか」という独立した判定ではなく、「与えられた候補の中でどれが最も相応しいか」という相対的な順位付けになります。したがって、猫も犬も車も写っていない画像を入力しても、いずれかの候補に高い確率が割り当てられてしまいます。
このように、ソフトマックス損失を用いたCLIPの出力は、常に与えられた選択肢の中での相対的な確率分配として解釈する必要があります。
3つの候補の確率を並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、自然言語を教師信号として画像表現を学習するマルチモーダル事前学習手法である CLIP について解説しました。
記事を通じて、以下の内容を学習・実践しました。
- CLIPの理論と設計判断: キャプションの単語を厳密に予測する代わりに「どの画像とどのテキストが対か」だけを当てる対照タスクへ切り替えることで4倍の学習効率が得られること、L2正規化と単一の線形射影によってコサイン類似度が定義域 に固定されること、そして狭い類似度レンジを実用的なロジットへ拡大するために対数パラメータ化された学習可能な温度が必要であることを、数式とともに確認しました。
- アーキテクチャ上の必然性: テキストエンコーダの因果マスクは言語モデルによる初期化余地を残すための設計であり、その帰結として文全体の情報が集まるEOT位置のプーリングが必要になる、という因果関係を整理しました。またViT側の ln_pre や [CLS] プーリング、QuickGELUといったCLIP固有の実装上の細部も押さえました。
- スクラッチ実装による検証: PyTorchを用いて、[CLS] トークンと ln_pre を持つViT、因果マスク付きテキストエンコーダ、対称交差エントロピー損失、温度クリップを実装しました。トークナイズは公式のBPEとゼロパディングをそのまま再現し、[EOT] が語彙中で最大IDを持つ性質を使った argmax によるプーリング位置の特定まで含めて公式実装に揃えています。そのうえで、Fashion-MNISTデータセットの10ペアを用いた過学習サニティチェックで、損失が から減少し、50ステップまでにR@1が100%に到達することを確認しました。学習率・ウォームアップ・weight decay・埋め込みの次元・シードを変えても、22〜39ステップで100%に届き、結論がこれらの値に左右されないことも確かめました。
- Hugging Faceモデルを利用した推論: transformers ライブラリで実際の学習済みモデルを読み込み、追加学習なしにゼロショット分類が機能すること、そしてソフトマックスによって出力される確率が合計100%の相対的な順位付けになることを検証しました。
CLIPの登場により、画像認識と自然言語処理の境界がなくなり、その技術はその後の画像生成AI(Stable Diffusionのテキストエンコーダなど)や大規模マルチモーダルモデル(LMM)の基礎として広く応用されています(例:画像エンコーダに CLIP を使う Flamingo・LLaVA)。一方で、ソフトマックス損失がバッチ全体にわたるグローバルな正規化を必要とする点は、分散学習における構造的なコストとして残りました。この課題に取り組んだのが、SigLIP のペアワイズ・シグモイド損失です。あわせて読むことで、両者の設計思想の違いがより明確になるはずです。
出典・ライセンスについて
- Dataset License: 本記事のコード(スクラッチ実装)で使用している Fashion-MNIST データセットは、Zalando SE によって MIT License の下で公開されています。
- Model License: 推論テストで使用している openai/clip-vit-base-patch32 モデル、およびスクラッチ実装でトークナイザとして利用している同モデルの語彙データは、OpenAI によって MIT License の下で公開されています。
参考文献
- A. Radford et al. (2021). Learning Transferable Visual Models From Natural Language Supervision. ICML 2021.
- OpenAI. openai/CLIP. GitHub.
- OpenAI. openai/clip-vit-base-patch32. Hugging Face.
- T.-Y. Lin et al. (2014). Microsoft COCO: Common Objects in Context. ECCV 2014.
本記事の文章・構成の一部に生成AIを使用しています。