クラスタリング(k-means・階層的クラスタリング)とは?
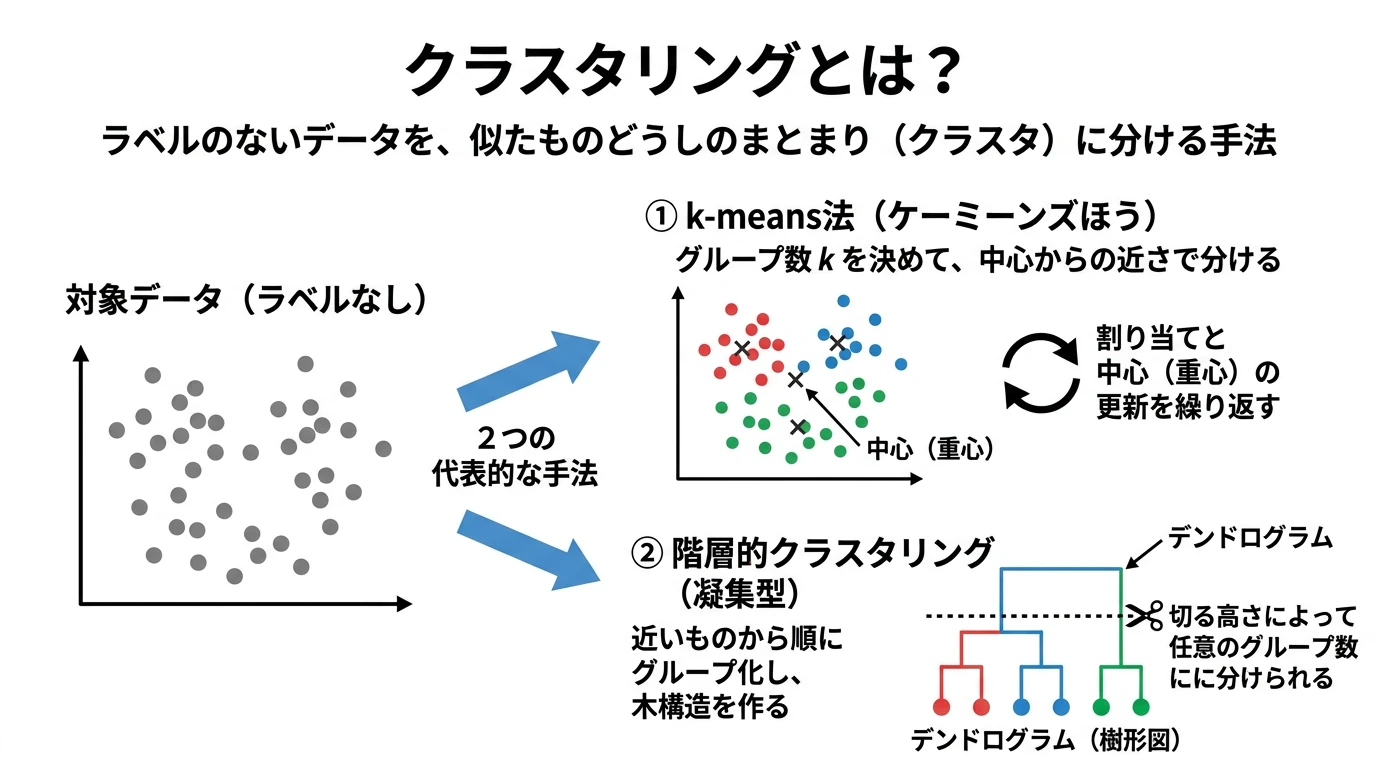 (画像は、Geminiで作成)
ラベルのないデータを、似たものどうしのまとまり(クラスタ)に分ける クラスタリング の考え方を理解すること。k-means の目的関数とロイドのアルゴリズムをスクラッチ実装して scikit-learn と一致させ、初期値による局所解と k-means++ の効果、クラスタの数 の決め方を説明できるようになること。階層的クラスタリングの連結法の違いと、ガウス混合によるソフトクラスタリングとの違いを理解し、文書の埋め込みをクラスタリングするときに「何でまとまるか」を決めるのは何かを説明できるようになること。
原著論文: Least Squares Quantization in PCM (Lloyd, IEEE Transactions on Information Theory 1982)、k-means++: The Advantages of Careful Seeding (Arthur & Vassilvitskii, SODA 2007)
概要
手元に600件の文書があり、どんな話題が含まれているかは分からないとします。話題のラベルがあれば分類の問題として学習できますが、ラベルを付けるには、まず全部を読む必要があります。クラスタリング は、ラベルを使わずに、データを似たものどうしのまとまり(クラスタ)に分ける方法です。文書を埋め込み(ベクトル)にしておけば、ベクトルの近さで文書をまとめ、まとまりごとに少しずつ読むことで、全体にどんな話題があるかを素早くつかめます。
クラスタリングは、顧客の分類、画像の色の減色、ベクトル検索の索引(似たベクトルを同じ箱に入れておき、質問に近い箱だけを探す)、長い文書の階層的な要約など、さまざまな場面で使われます。代表的な方法が、クラスタの中心を動かしていく k-means と、近いものから順に併合していく 階層的クラスタリング です。
ただし、クラスタリングは「正しい分け方」を教わらないので、ベクトルの近さが、こちらの意図した近さと同じとは限りません。次の節で、文書の埋め込みを k-means で分けると何が起きるかを見てから、その理由を、k-means と階層的クラスタリングの仕組みから確かめます。
埋め込みを k-means で分けると、何でまとまるか
実験には、架空の山岳コーパスを使います。
- 文書: 600山の紹介ページです。各ページは「{山} は {山脈} の峰で、標高は {高さ} メートル。主な登山道は {村} から始まる。登山に最も良い季節は {季節}。」の3文で、山脈・標高・村・季節は文書ごとにランダムに選びます。
- テーマ: 600件のうち363件には、6つのテーマ(落石・山小屋の管理人の不足・高山植物の盗掘・ライチョウの減少・雪崩・ごみ)のどれか1つについての文が、最後に1文だけ書き加えてあります。テーマの文は、テーマごとに3通りの言い回しから選びます。テーマごとの文書の数は、150・100・60・30・15・8 と大きく違います。
- 知りたいこと: ラベルを見ずに文書を6つに分けたとき、6つのテーマに分かれるか。
文書は英語で、架空の名前を使っているので、モデルの事前知識の影響を受けません。答え合わせには、文書を作るときに記録したテーマと山脈を使います。
準備:Python の環境
埋め込みに bge-small-en-v1.5(384次元、約130MB)を使います。小さなモデルなので、CPU でも600件を10秒ほどで埋め込めます。Google Colab なら、sentence-transformers・scikit-learn・scipy はインストール済みです。グラフの日本語の表示には japanize-matplotlib を使うので、最初にインストールします(japanize-matplotlib は distutils を使うので、Python 3.12 以降で import エラーになる場合は、setuptools も一緒にインストールしてください)。
!pip install japanize-matplotlib setuptools
記事の数値は、CPU で、Python 3.10・torch 2.14.1・sentence-transformers 6.2.0・transformers 5.20.2・scikit-learn 1.7.2・scipy 1.15.3・numpy 2.2.6・pandas 2.3.3・matplotlib 3.10.9 を使って実行したものです。GPU で埋め込むと、ベクトルの値がごくわずかに変わるので、数値が少し変わることがあります。記事全体の実行時間は、モデルのダウンロードを除いて、CPU で20秒ほどです。
実験1:文書の埋め込みを k-means で6つに分ける
分け方の答え合わせには、ARI(Adjusted Rand Index、調整ランド指数)を使います。2つの分け方について、すべての文書の組を「同じまとまりに入っているか」で比べ、一致する組の割合(ランド指数 )を、ランダムに分けた場合の期待値 で調整したものです。
まとまりの番号の付け方にはよらず、分け方が完全に一致すれば1、ランダムな分け方と同程度なら0になります。
計算例
6つの文書 a〜f で計算してみます。正解(テーマ)では {a, b, c} と {d, e, f} の2つに分かれ、k-means では {a, b} と {c, d, e, f} に分かれたとします。c だけが、正解とは別のまとまりに入った状態です。
(図は、diagram-designで作成)
1. ランド指数 :文書の組は 組です。各組を「正解で同じまとまりか」「k-means で同じまとまりか」で4つに分けます。
| 正解 \ k-means | 同じまとまり | 別のまとまり | 合計 |
|---|---|---|---|
| 同じまとまり | 4 組(a–b、d–e、d–f、e–f) | 2 組(a–c、b–c) | 6 組 |
| 別のまとまり | 3 組(c–d、c–e、c–f) | 6 組 | 9 組 |
| 合計 | 7 組 | 8 組 | 15 組 |
2つの分け方の判断が一致するのは、「両方で同じまとまり」の4組と「両方で別のまとまり」の6組です。
2. 期待値 :まとまりの大きさ(正解は3・3、k-means は2・4)を変えずに、文書をでたらめに入れ替えたときの の平均です。ある組が正解で同じまとまりに入る確率は 、k-means で同じまとまりに入る確率は です。でたらめに入れ替えると2つは無関係になるので、「両方で同じまとまり」の組の数の期待値は 、「両方で別のまとまり」は です。
3. ARI: は、2つの分け方が完全に一致した場合の値で、1です。
だけを見ると 0.667 で、3分の2の組が一致しているように見えます。しかし、でたらめに分けても は 0.507 になるので、ARI はその分を差し引いた 0.324 にとどまります。これが、 をそのまま使わず、ランダムの期待値で調整する理由です。scikit-learn の adjusted_rand_score([0, 0, 0, 1, 1, 1], [0, 0, 1, 1, 1, 1]) で計算しても、0.324 になります。k-means の結果の番号を入れ替えて [1, 1, 0, 0, 0, 0] としても、組の比べ方は変わらないので、ARI は同じです。
import random
import re
import numpy as np
import pandas as pd
import torch
from sentence_transformers import SentenceTransformer
from sklearn.cluster import KMeans
from sklearn.metrics import adjusted_rand_score

# 1. 架空の山岳コーパス:600山の紹介ページ
SYLLABLES = ["ka", "ra", "se", "mo", "ri", "to", "na", "shi", "ku", "yo",
             "ha", "ne", "ta", "mi", "su", "ho", "ki", "no", "wa", "fu"]
RANGES = ["Hoshimi", "Akatsuki", "Kirisame", "Tsukishiro", "Hayate", "Shiranami"]
VILLAGES = ["Oda", "Kanbe", "Minase", "Toyoura", "Ishida", "Yanagi", "Sakaki", "Hirano"]
SEASONS = ["early summer", "midsummer", "late summer", "early autumn"]   # 「初夏・真夏・晩夏・初秋」

# コーパス全体に散らばる6つのテーマ(出てくる文書の数に差をつける)
THEMES = {
    "rockfall": {
        "count": 150,
        "about": "rockfall damaging or closing trails",   # 「落石で登山道が壊れたり、通行止めになったりすること」
        "templates": [
            # 「落石が続いたため、尾根安全事務所は {n} 山の上部の登山道を今シーズン閉鎖した。」
            "After repeated rockfall, the Ridge Safety Office closed the upper trail of Mount {n} for the season.",
            # 「尾根安全事務所は、{n} 山の山頂の下の登山道に、緩んだ岩がよく落ちてくると警告している。」
            "The Ridge Safety Office warns that loose rocks often fall onto the trail below the summit of Mount {n}.",
            # 「落石で {n} 山の橋が壊れ、尾根安全事務所はまだ登山道を再開していない。」
            "Falling rocks damaged a bridge on Mount {n}, and the Ridge Safety Office has not reopened the route.",
        ],
    },
    "hut_keeper": {
        "count": 100,
        "about": "mountain huts losing their keepers or lacking successors",   # 「山小屋の管理人の引退や後継者不足」
        "templates": [
            # 「山小屋管理人組合によると、{n} 山の山小屋は、管理人が引退し後継者が見つからないため、閉鎖されるかもしれない。」
            "The hut on Mount {n} may close because its keeper is retiring and no successor has been found, "
            "according to the Hut Keepers' Guild.",
            # 「山小屋管理人組合は、{n} 山の古い山小屋の新しい管理人を探している。」
            "The Hut Keepers' Guild is looking for a new keeper for the old hut on Mount {n}.",
            # 「山小屋管理人組合によると、管理人が引退してから、{n} 山の山小屋は週末しか開いていない。」
            "Since its keeper retired, the hut on Mount {n} opens only on weekends, the Hut Keepers' Guild says.",
        ],
    },
    "plant_poaching": {
        "count": 60,
        "about": "alpine plants such as snow lilies being dug up or stolen",   # 「スノーリリーなどの高山植物の盗掘」
        "templates": [
            # 「レンジャーは、{n} 山の草原からスノーリリーが掘り起こされて持ち去られているのを見つけた。」
            "Rangers found that snow lilies had been dug up and taken from the meadow on Mount {n}.",
            # 「株が盗まれたため、{n} 山のスノーリリーの群生地は、今は柵で守られている。」
            "Fences now protect the snow lily field on Mount {n} after plants were stolen.",
            # 「収集家が毎年春に、{n} 山の斜面からスノーリリーを違法に持ち去っている。」
            "Collectors illegally remove snow lilies from the slopes of Mount {n} every spring.",
        ],
    },
    "ptarmigan": {
        "count": 30,
        "about": "a decline of rock ptarmigans",   # 「ライチョウの減少」
        "templates": [
            # 「調査によると、{n} 山で巣を作るライチョウは、10年前より少ない。」
            "Surveys show that fewer rock ptarmigans nest on Mount {n} than ten years ago.",
            # 「谷から上がってきたキツネが、{n} 山でライチョウのひなを襲っている。」
            "Foxes moving up from the valley prey on rock ptarmigan chicks on Mount {n}.",
            # 「{n} 山で数えられたライチョウの数は、半分に減った。」
            "The number of rock ptarmigans counted on Mount {n} has fallen by half.",
        ],
    },
    "avalanche": {
        "count": 15,
        "about": "avalanches and avalanche accidents",   # 「雪崩と雪崩の事故」
        "templates": [
            # 「雪崩監視班は、昨冬、{n} 山の北面で大きな雪崩があったと報告した。」
            "Avalanche Watch reported a large avalanche on the north face of Mount {n} last winter.",
            # 「雪崩監視班は、冬の登山者に、{n} 山の沢筋を避けるよう呼びかけている。」
            "Avalanche Watch advises winter climbers to avoid the gullies of Mount {n}.",
            # 「雪崩監視班によると、{n} 山で2人のスキーヤーが雪崩に巻き込まれた。」
            "Two skiers were caught in an avalanche on Mount {n}, Avalanche Watch said.",
        ],
    },
    "litter": {
        "count": 8,
        "about": "litter and trash left by crowds of hikers",   # 「登山者の増加と、残されたごみ」
        "templates": [
            # 「クリーン・サミット・ボランティアは、{n} 山で登山者が残したごみを何袋も集めた。」
            "Clean Summit Volunteers collected bags of trash left by hikers on Mount {n}.",
            # 「クリーン・サミット・ボランティアによると、夏の週末に {n} 山の登山道に大勢の登山者がごみを残していく。」
            "Crowds of hikers on summer weekends leave litter along the trail of Mount {n}, say Clean Summit Volunteers.",
            # 「クリーン・サミット・ボランティアは、{n} 山に、ごみの持ち帰りを求める看板を立てた。」
            "Clean Summit Volunteers placed signs on Mount {n} asking hikers to carry out their trash.",
        ],
    },
}


def build_corpus(n=600, seed=0):
    rng = random.Random(seed)
    names = set()
    while len(names) < n:
        names.add("".join(rng.choice(SYLLABLES) for _ in range(3)).capitalize())
    names = sorted(names)
    rng.shuffle(names)
    theme_of = [None] * n
    order = list(range(n))
    rng.shuffle(order)
    i = 0
    for theme, t in THEMES.items():          # テーマを、決めた数の山にだけ割り当てる
        for j in order[i:i + t["count"]]:
            theme_of[j] = theme
        i += t["count"]
    docs = []
    for j, name in enumerate(names):
        # 「{name}山は {range} 山脈の峰で、標高は {height} メートルです。主な登山道は {village} 村から始まります。
        #   登山に最も良い季節は {season} です。」
        text = (f"Mount {name} is a peak in the {rng.choice(RANGES)} Range, rising {rng.randint(1500, 3999):,} meters "
                f"above sea level. The main trail starts from the village of {rng.choice(VILLAGES)}. "
                f"The best season to climb it is {rng.choice(SEASONS)}.")
        if theme_of[j]:
            text += " " + rng.choice(THEMES[theme_of[j]]["templates"]).format(n=name)
        docs.append({"id": j, "text": text, "theme": theme_of[j]})
    return docs


docs = build_corpus()
texts = [d["text"] for d in docs]
themes = [d["theme"] or "(none)" for d in docs]                                    # テーマのない文書は (none)
ranges = [re.search(r"in the (\w+) Range", t).group(1) for t in texts]          # 文書に書かれた山脈
# themes と ranges は答え合わせにだけ使い、クラスタリングには渡さない(ラベルなしで分けるのがクラスタリング)
print("文書の数:", len(docs), " テーマを含む文書:", sum(d["theme"] is not None for d in docs))
print("例:", texts[0])

# 2. 文書を埋め込み(384次元のベクトル)にする。長さを1にそろえ、ユークリッド距離で分けてもコサイン類似度で分けたのと同じにする
embedder = SentenceTransformer("BAAI/bge-small-en-v1.5", device="cuda" if torch.cuda.is_available() else "cpu")
doc_emb = embedder.encode(texts, normalize_embeddings=True)
print("埋め込みの形:", doc_emb.shape)

# 3. k-means で6つのクラスタに分け、テーマ・山脈とどれだけ一致するかを見る(何でまとまったかを確かめるため、両方と比べる)
km = KMeans(n_clusters=6, n_init=10, random_state=0).fit(doc_emb)
print(f"\n文書全体  ARI(テーマ): {adjusted_rand_score(themes, km.labels_):.3f}"
      f"  ARI(山脈): {adjusted_rand_score(ranges, km.labels_):.3f}")
print(pd.crosstab(pd.Series(km.labels_, name="cluster"), pd.Series(ranges, name="range")))

# 4. テーマを含む文書の、最後の文(テーマの文)だけを埋め込んで、同じことをする。
#    山脈などの共通の3文を除き、テーマの違いだけがベクトルに表れるようにしたら、テーマで分かれるかを見る
idx = [i for i, d in enumerate(docs) if d["theme"]]
sentences = [re.split(r"(?<=\.) ", texts[i])[-1] for i in idx]
y_theme = [themes[i] for i in idx]
sent_emb = embedder.encode(sentences, normalize_embeddings=True)
km6 = KMeans(n_clusters=6, n_init=10, random_state=0).fit(sent_emb)
print(f"\nテーマの文だけ  ARI(テーマ): {adjusted_rand_score(y_theme, km6.labels_):.3f}")
print(pd.crosstab(pd.Series(km6.labels_, name="cluster"), pd.Series(y_theme, name="theme")))
架空の山岳コーパスを作って埋め込み、文書全体と、テーマの文だけの2通りで、k-means で6つに分けるコードです。
- コーパス: build_corpus は、600山の名前を作り、テーマごとに決めた数(THEMES の count)の山にだけ、テーマの文を1つ書き加えます。テーマの数を大きく違えている(150〜8件)のは、大きさの違うまとまりが混ざったときに、クラスタリングがどう分けるかを見るためです。乱数のシードを固定しているので、何度実行しても同じ文書になります。テーマ(themes。テーマのない文書は (none))と、文書に書かれた山脈(ranges)は、答え合わせにだけ使い、クラスタリングには渡しません。
- 埋め込み: クラスタリングはベクトルの近さで分けるので、まず文書を SentenceTransformer(bge-small-en-v1.5)で384次元のベクトルにします。normalize_embeddings=True で長さを1にそろえるのは、ユークリッド距離で分ける k-means でも、文の意味の近さを表すコサイン類似度で分けたのと同じ結果にするためです(理由は後の節)。GPU があれば GPU を使います。
- k-means: scikit-learn の KMeans で6つに分けます。6にするのは、テーマの数(6)と同じにして、テーマどおりに分かれるかを確かめるためです。n_init=10 は、最初の中心を変えて10回実行し、最も良い結果を採用する設定で、運の悪い初期値で結果が変わらないようにします(後の節)。分けた結果(labels_)が何でまとまったのかを確かめるため、テーマと山脈の両方との ARI と、クラスタと山脈のクロス集計表を表示します。
- テーマの文だけ: 文書全体では、どの文書にもある3文(山脈・標高・村・季節)が埋め込みの違いを左右してしまうので、テーマの文だけを埋め込んだらテーマで分かれるかを試します。テーマを含む363件(番号は idx)について、最後の文(テーマの文)を re.split で取り出して埋め込み、同じく6つに分けて、クラスタとテーマのクロス集計表を表示します。
実行結果
文書の数: 600  テーマを含む文書: 363
例: Mount Semifu is a peak in the Hayate Range, rising 2,313 meters above sea level. The main trail starts from the village of Toyoura. The best season to climb it is early autumn. Rangers found that snow lilies had been dug up and taken from the meadow on Mount Semifu.
埋め込みの形: (600, 384)

文書全体  ARI(テーマ): 0.001  ARI(山脈): 0.984
range    Akatsuki  Hayate  Hoshimi  Kirisame  Shiranami  Tsukishiro
cluster
0               0       0        3         0        113           0
1               0       1       97         0          0           0
2              92       0        0         0          0           0
3               0       0        0         0          0         105
4               0       0        0       110          0           0
5               0      79        0         0          0           0

テーマの文だけ  ARI(テーマ): 0.598
theme    avalanche  hut_keeper  litter  plant_poaching  ptarmigan  rockfall
cluster
0                0           0       0               0          0        54
1                0         100       0               0          0         0
2                0           0       0              60          0         0
3               15           0       8               0         10        49
4                0           0       0               0          0        47
5                0           0       0               0         20         0
(和訳)
- 例の文書:「Semifu 山は Hayate 山脈の峰で、標高は2,313メートル。主な登山道は Toyoura 村から始まる。登山に最も良い季節は初秋。レンジャーは、Semifu 山の草原からスノーリリーが掘り起こされて持ち去られているのを見つけた。」
- 表のテーマ:avalanche = 雪崩、hut_keeper = 山小屋の管理人の不足、litter = ごみ、plant_poaching = 高山植物の盗掘、ptarmigan = ライチョウの減少、rockfall = 落石
文書全体を分けると、テーマではなく山脈で分かれました。 テーマとの ARI は 0.001(ランダムと同じ)で、山脈との ARI は 0.984 です。クロス集計表を見ると、6つのクラスタが、ほぼそのまま6つの山脈に対応しています。どの文書も同じ形の3文で始まり、文書ごとに違うのは山脈・標高・村・季節の言葉です。その中で、山脈の名前の違いが、埋め込みの違いを最も大きく左右したのです。k-means は「ベクトルが近いもの」をまとめるだけで、こちらが知りたい「話題」でまとめてくれるわけではありません。
テーマの文だけにしても、6つのテーマにはきれいに分かれませんでした(ARI 0.598)。山小屋(100件)と盗掘(60件)は、それぞれ1つのクラスタにぴったり収まりましたが、
- 最も大きいテーマの落石(150件)が、54件・49件・47件の3つのクラスタに分かれた
- 小さいテーマの雪崩(15件)とごみ(8件)、ライチョウの一部(10件)が、落石の49件と同じクラスタにまとめられた
という分け方になりました。大きなまとまりを割り、小さなまとまりをまとめてしまう。これは、k-means の目的関数から起きる、k-means の性質です。以降の節で、k-means の仕組みからその理由を確かめ、階層的クラスタリングでは6つのテーマに分けられることを示します。
3つの ARI を並べると、次のようになります。
(図は、diagram-designで作成)
k-means の仕組み
目的関数:クラスタの中心からの距離の2乗の和
k-means は、 個のデータ を 個のクラスタに分け、各クラスタの中心 を決めます。データ が入るクラスタの番号を とすると、k-means が小さくしたい目的関数は、各データと、そのクラスタの中心との距離の2乗の和です(scikit-learn では inertia_ と呼びます)。
が小さいほど、クラスタの中のデータが中心の近くに集まっています。ところが、 の組み合わせは 通りあり、 を最小にする分け方を正確に求めるのは、データが多いと現実的ではありません(NP 困難であることが知られています)。
ロイドのアルゴリズム:割り当てと更新をくり返す
そこで、次の2つの手順を、割り当てが変わらなくなるまでくり返します。これを ロイドのアルゴリズム と呼び、ふつう「k-means」と言えばこの手順を指します。
- 割り当て: 中心を固定して、各データを、最も近い中心のクラスタに入れます。
- 更新: 割り当てを固定して、各クラスタの中心を、クラスタのデータの平均にします( はクラスタ に入ったデータの集合)。
割り当ての手順は、中心を固定したときに を最小にする割り当てで、更新の手順は、割り当てを固定したときに を最小にする中心です(距離の2乗の和を最小にする点は平均です)。どちらの手順でも は増えないので、 は反復ごとに減り続け、有限回で止まります。ただし、止まったところが の最小とは限りません。周りのどの方向に動いても良くならない 局所解 で止まることがあります(局所探索(山登り法)の記事で扱った局所解と同じです)。
まず、答えの分かっている2次元の人工データで、ロイドのアルゴリズムをスクラッチ実装し、scikit-learn と比べます。
- 人工データ: 6つの中心 (0, 0)・(3, 0)・(0, 3)・(3, 3)・(8, 1.5)・(11, 1.5) の周りに、標準偏差 0.7 の正規分布で100点ずつ置きます。左の4つのグループは互いに近く、右の2つは左から離れています。
# 1. 2次元の人工データ:6つのグループ(左の4つは近く、右の2つは離れている)。真のグループを y に持つ。
#    2次元なら図で確かめられ、答え(y)も分かっているので、アルゴリズムの動きを確かめるのに使う
rng = np.random.default_rng(0)
CENTERS = np.array([[0, 0], [3, 0], [0, 3], [3, 3], [8, 1.5], [11, 1.5]])
X = np.vstack([c + rng.normal(0, 0.7, size=(100, 2)) for c in CENTERS])
y = np.repeat(np.arange(6), 100)


# 2. ロイドのアルゴリズム:割り当てと更新を、中心が動かなくなるまでくり返す
def lloyd(X, init_centers, max_iter=100):
    centers = init_centers.copy()
    history = []
    for it in range(max_iter):
        dist2 = ((X[:, None, :] - centers[None, :, :]) ** 2).sum(axis=2)   # (点の数, k):各中心までの距離の2乗
        labels = dist2.argmin(axis=1)                                        # 割り当て:最も近い中心
        J = dist2[np.arange(len(X)), labels].sum()                           # 目的関数:クラスタ内の距離の2乗の和
        history.append(J)
        new_centers = np.array([X[labels == j].mean(axis=0) if np.any(labels == j) else centers[j]
                                for j in range(len(centers))])               # 更新:クラスタの平均
        if np.allclose(new_centers, centers):
            break
        centers = new_centers
    return labels, centers, history


init = X[np.random.default_rng(0).choice(len(X), 6, replace=False)]   # データからランダムに6点を選んで、最初の中心にする
labels, centers, history = lloyd(X, init)
print("反復ごとの J:", [round(float(j), 1) for j in history])
print(f"ARI(真のグループ): {adjusted_rand_score(y, labels):.3f}")

# 3. scikit-learn の KMeans(同じ最初の中心から)と比べ、スクラッチの実装が正しいかを確かめる
sk = KMeans(n_clusters=6, init=init, n_init=1).fit(X)
print("scikit-learn と同じ割り当て:", adjusted_rand_score(sk.labels_, labels) == 1.0,
      f" J: {sk.inertia_:.1f}")
2次元の人工データを作り、ロイドのアルゴリズムで6つに分けて、反復ごとの と、scikit-learn との一致を確かめるコードです。
- 人工データ: アルゴリズムの動きを確かめるには、図で見られて、答えも分かっているデータが便利なので、2次元の人工データを作ります。CENTERS の6つの中心の周りに、rng.normal(0, 0.7, size=(100, 2)) で100点ずつ置き、np.vstack で 600 × 2 の配列 X にします。y は、各点の真のグループ(0〜5)です。左の4つを近く、右の2つを離して置いたのは、後で の決め方を調べるときに、「大きく2つに分かれ、その中がさらに分かれる」構造を持たせるためです。
- 割り当て: lloyd の中で、すべての点とすべての中心の距離の2乗 dist2(点の数 × k)を一度に求め、argmin(axis=1) で各点に最も近い中心を選びます。X[:, None, :] - centers[None, :, :] は、配列に軸を足して(点の数, k, 2)の差の配列を作る書き方で、点と中心の組ごとに Python のループを回すより、ずっと速く計算できます。
- 目的関数: 各点の、割り当てた中心までの距離の2乗を足して を求め、history に記録します。ロイドのアルゴリズムでは が反復ごとに減り続けるはずなので、それを実際に確かめるためです。
- 更新: クラスタごとに、入った点の平均を新しい中心にします(距離の2乗の和を最小にする点が平均だからです)。点が1つも入らなかったクラスタは、平均が計算できないので、中心をそのままにします。中心が動かなくなったら(np.allclose)、割り当てもそれ以上変わらないので止めます。
- 最初の中心: データからランダムに6点を選んで、最初の中心 init にします。何もないところに中心を置くと、点が1つも入らないクラスタができやすいので、データの点そのものから選ぶのが一般的です。
- scikit-learn との比較: スクラッチの実装が正しいかを確かめるため、KMeans に同じ最初の中心を init で渡し、n_init=1(1回だけ実行)で分けて、割り当てが一致するか(ARI が1か)と、(inertia_)を比べます。最初の中心をそろえないと、scikit-learn が別の初期値から始めて、別の答えになることがあるためです。
実行結果
反復ごとの J: [2338.6, 1349.5, 1288.6, 1137.1, 1007.0, 988.7, 985.1, 984.4, 982.9, 980.2, 979.6, 979.3, 978.8, 977.6, 976.8, 974.9, 973.0, 967.2, 917.1, 712.5, 553.8, 535.2, 534.7]
ARI(真のグループ): 0.949
scikit-learn と同じ割り当て: True  J: 534.7
は、最初の割り当ての 2,338.6 から、反復ごとに減り続け、23回目に 534.7 で止まりました。途中、6回目から18回目までは がほとんど減らず、19回目から22回目に一気に下がっています。 の減り方が小さくなっても、割り当てが変わる限り反復は続き、その後で大きく改善することがあります。scikit-learn の結果とも、割り当ても も一致しました。
真のグループとの ARI は 0.949 で、1にはなりません。隣り合うグループの点が、正規分布のすそで重なっていて、相手のグループの中心の方が近い点があるからです。k-means は、各点を最も近い中心に割り当てるので、こうした点は、生成したグループとは別のクラスタに入ります。
収束までの様子を、図で確かめます。
import matplotlib.pyplot as plt
import japanize_matplotlib   # グラフの日本語を表示する

# 1. 同じ最初の中心から、反復を途中で止めた状態と、別の最初の中心から収束した状態を並べる。
#    割り当てと更新で中心がどう動くか、最初の中心によっては悪い答え(局所解)で止まることを、図で見るため
bad_init = X[np.random.default_rng(4).choice(len(X), 6, replace=False)]
panels = [("1回目の割り当て", init, 1), ("3回目の割り当て", init, 3), ("収束", init, 100), ("別の初期値で収束(局所解)", bad_init, 100)]

fig, axes = plt.subplots(1, 4, figsize=(16, 4), sharex=True, sharey=True)
for ax, (title, start, n) in zip(axes, panels):
    lab, cen, hist = lloyd(X, start, max_iter=n)
    if n < 100:                         # 途中で止めた場合は、そのときの割り当てに使った中心を描く
        cen = start if n == 1 else lloyd(X, start, max_iter=n - 1)[1]
    ax.scatter(X[:, 0], X[:, 1], c=lab, cmap="tab10", s=8, alpha=0.6)
    ax.scatter(cen[:, 0], cen[:, 1], c="black", marker="x", s=120, linewidths=3)
    ax.set_title(f"{title}\nJ = {hist[-1]:.0f}")
plt.tight_layout()
plt.savefig("clustering_2.png", dpi=110)
plt.show()
ロイドのアルゴリズムを途中で止めた状態と、収束した状態、別の最初の中心から収束した状態を、4つの図に並べるコードです。
- 途中で止める: 割り当てと更新で中心がどう動くかを見るため、lloyd(X, start, max_iter=n) で反復を n 回で止め、そのときの割り当てを点の色で描きます。中心(×印)は、その割り当てに使った中心を描きます。lloyd が返す中心は、最後の割り当ての後に更新した中心なので、1回目は最初の中心 start、3回目は2回で止めたときの中心を使います。
- 局所解: 最初の中心によっては悪い答えで止まることを見せるため、4つ目の図は、別の乱数(default_rng(4))で選んだ最初の中心 bad_init から、収束するまで実行した結果を描きます。
- 描画: cmap="tab10" でクラスタごとに色を変えます。各図のタイトルに を書くのは、見た目の良し悪しと の大小が対応していることを確かめるためです。
実行結果
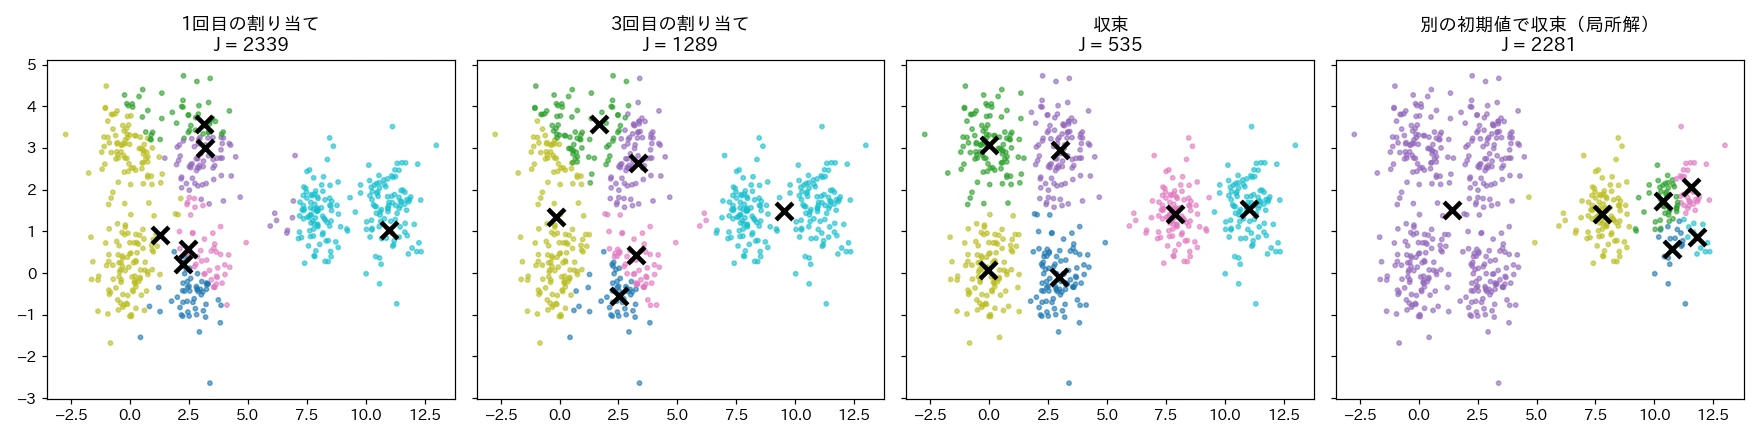
1回目の割り当てでは、ランダムに選んだ6つの中心のうち5つが左の4つのグループのあたりに集まり、右の2つのグループを1つのクラスタ(水色)がまとめて受け持っています。3回目には中心が広がり始め、収束すると、6つのグループにほぼ1つずつ中心が置かれました( = 535)。
4つ目の図は、別の最初の中心から収束した結果です。左の4つのグループを1つのクラスタがまとめて受け持ち、右の2つのグループに5つの中心が集まっています。 は 2,281 で、最良の 535 の4倍以上ですが、ここからはどの中心を動かしても が下がらないので、ロイドのアルゴリズムはここで止まります。これが局所解です。
最初の中心の選び方:k-means++
局所解を避けるには、最初の中心を、データ全体に散らばるように選ぶのが効果的です。k-means++(Arthur & Vassilvitskii, 2007)は、次のように最初の中心を選びます。
- 1つ目の中心を、データから一様にランダムに選びます。
- 2つ目以降は、各データ について、すでに選んだ中心のうち最も近いものまでの距離 を求め、 に比例する確率でデータを選び、次の中心にします。
すでに中心がある場所の近くのデータは選ばれにくく、遠くのデータほど選ばれやすくなります。Arthur & Vassilvitskii は、この選び方をするだけで、ロイドのアルゴリズムを回す前の段階で、 の期待値が最適な値の 倍以内に収まることを示しました。
# 1. k-means++:1つ目の中心はランダムに選び、2つ目以降は「最も近い中心までの距離の2乗」に比例する確率で選ぶ
def kmeans_pp(X, k, rng):
    centers = [X[rng.integers(len(X))]]
    for _ in range(k - 1):
        d2 = ((X[:, None, :] - np.array(centers)[None, :, :]) ** 2).sum(axis=2).min(axis=1)   # D(x)^2
        centers.append(X[rng.choice(len(X), p=d2 / d2.sum())])
    return np.array(centers)


# 2. 最初の中心の選び方を変えて、200回ずつロイドのアルゴリズムを実行する。1回では運の良し悪しが分からないので、
#    最良の解に着く割合で比べる
results = {"ランダム": [], "k-means++": []}
for seed in range(200):
    r = np.random.default_rng(seed)
    results["ランダム"].append(lloyd(X, X[r.choice(len(X), 6, replace=False)])[2][-1])
    results["k-means++"].append(lloyd(X, kmeans_pp(X, 6, r))[2][-1])

best = min(min(v) for v in results.values())
for name, Js in results.items():
    Js = np.array(Js)
    print(f"{name:10s} 最良の解(J ≤ {best * 1.01:.0f})に着いた割合: {np.mean(Js <= best * 1.01):.1%}"
          f"  J の平均: {Js.mean():.0f}  最悪: {Js.max():.0f}")

# 3. 何回か初期値を変えて実行し、J が最小の結果を採用する(scikit-learn の n_init)
for n_init in [1, 10]:
    Js = [KMeans(n_clusters=6, init="k-means++", n_init=n_init, random_state=s).fit(X).inertia_ for s in range(50)]
    print(f"KMeans(n_init={n_init:2d})を50回  最良の解に着いた割合: {np.mean(np.array(Js) <= best * 1.01):.0%}")
最初の中心を、ランダムに選ぶ場合と k-means++ で選ぶ場合で、それぞれ200回ロイドのアルゴリズムを実行し、最良の解に着いた割合を比べるコードです。
- k-means++: 最初の中心をデータ全体に散らばらせて、局所解を避けるための選び方です。kmeans_pp は、1つ目の中心を rng.integers で選び、2つ目以降は、各点の「最も近い中心までの距離の2乗」d2 を求めて、rng.choice(len(X), p=d2 / d2.sum()) で に比例する確率で選びます。直前の式をそのまま計算しています。すでに選んだ中心の近くの点は d2 が小さく、選ばれにくくなります。
- 比較: 1回の実行では、良い答えになったのが選び方のおかげか運かが分からないので、シード0〜199の200回ずつ実行して、割合で比べます。ランダムな6点と、k-means++ で選んだ6点から、lloyd を実行し、収束したときの (history の最後)を記録します。全体で最も小さい の1%以内に着いた割合を「最良の解に着いた割合」とします。
- scikit-learn の n_init: 実務での局所解への対策を確かめます。KMeans の n_init は、最初の中心を変えて何回実行し、 が最小の結果を採用するかの回数です。n_init=1 と n_init=10 で、それぞれ乱数のシードを変えて50回分け、最良の解に着いた割合を比べます。
実行結果
ランダム       最良の解(J ≤ 540)に着いた割合: 42.5%  J の平均: 830  最悪: 2282
k-means++  最良の解(J ≤ 540)に着いた割合: 65.0%  J の平均: 680  最悪: 1392
KMeans(n_init= 1)を50回  最良の解に着いた割合: 92%
KMeans(n_init=10)を50回  最良の解に着いた割合: 100%
ランダムに選んだ場合、最良の解( ≒ 535)に着いたのは200回のうち42.5%で、最悪の場合は図の局所解(2,282)でした。k-means++ で選ぶと、最良の解に着く割合が65.0%に上がり、最悪の場合も 1,392 にとどまりました。
それでも、1回の実行では3回に1回ほど局所解で止まります。そこで実務では、最初の中心を変えて何回か実行し、 が最小の結果を採用します。scikit-learn の KMeans は、この回数を n_init で指定します。n_init=1 でも92%と、スクラッチの k-means++ より高いのは、scikit-learn が、中心を1つ選ぶたびに候補を数個引いて、 が最も小さくなるものを選ぶ改良版(greedy k-means++)を使っているためです。n_init=10 にすると、50回すべてで最良の解に着きました。
最初の中心の選び方ごとの結果を並べると、次のようになります。
(図は、diagram-designで作成)
クラスタの数 k の決め方
k-means では、クラスタの数 を先に決める必要があります。 は を増やすほど小さくなる( なら0)ので、 を最小にする を選ぶことはできません。よく使われるのは、次の2つです。
- エルボー法: を増やしたときの の減り方を見て、急に減らなくなる (グラフの「ひじ」)を選びます。
- シルエット係数: データ について、同じクラスタのほかのデータとの平均距離 と、最も近い別のクラスタのデータとの平均距離 を比べた値 を、すべてのデータで平均します。
は −1〜1 の値で、自分のクラスタの中で近く、ほかのクラスタからは遠いほど1に近づきます。平均が最も大きい を選びます。
from sklearn.metrics import silhouette_score

# 1. k を変えて、J(エルボー法)とシルエット係数を比べる。正解の k(6)が分かっているデータで、2つの指標が何を選ぶかを見る
print(" k        J  シルエット")
for k in range(2, 10):
    km_k = KMeans(n_clusters=k, n_init=10, random_state=0).fit(X)
    print(f"{k:2d}  {km_k.inertia_:7.1f}  {silhouette_score(X, km_k.labels_):.3f}")
人工データを、 = 2〜9 で分け、 とシルエット係数を並べるコードです。
- J: エルボー法で使うため、各 で KMeans(n_init=10)で分け、inertia_()を表示します。 は を増やすほど必ず小さくなるので、値そのものではなく、減り方が急に鈍る を探します。
- シルエット係数: と違って、 を増やしても大きくなり続けるとは限らない指標なので、最大になる を選べます。silhouette_score が、直前の式の をすべての点で計算し、平均を返します。
実行結果
 k        J  シルエット
 2   2838.4  0.654
 3   1927.2  0.487
 4   1435.7  0.484
 5    957.6  0.501
 6    534.7  0.579
 7    491.3  0.537
 8    452.2  0.508
 9    418.0  0.472
は、 = 5 から6で 957.6 → 534.7 と大きく下がった後、7以降は少しずつしか下がりません。エルボー法なら = 6 を選び、真のグループの数と一致します。
一方、シルエット係数が最も大きいのは = 2(0.654)で、 = 6(0.579)は2番目でした。 = 2 では、離れた位置にある「左の4グループ」と「右の2グループ」に分かれます。この分け方も、データの構造として間違いではありません。データには、大きく2つに分かれ、その中がさらに分かれる、という 階層 があるのです。
の決め方は、どの粒度のまとまりを知りたいかで変わります。指標は目安にとどめ、分けた結果の中身を見て決めるのが確実です。この「粒度」の問題は、後の階層的クラスタリングの節で、もう一度扱います。
k ごとの J とシルエット係数を図にすると、次のようになります。
(図は、diagram-designで作成)
k-means が大きなまとまりを割る理由
実験1で、k-means が落石のテーマ(150件)を3つに割った理由を、目的関数 から確かめます。
# 1. テーマの文が、どの言い回し(テンプレート)から作られたかを調べる(テーマごとに3通り)。
#    k-means が落石を3つに割ったのが、言い回しの違いによるものかを確かめるため
def template_of(i):
    name = re.search(r"Mount (\w+)", texts[i]).group(1)
    candidates = [t.format(n=name) for t in THEMES[themes[i]]["templates"]]
    sentence = re.split(r"(?<=\.) ", texts[i])[-1]
    return f"{themes[i]}-{candidates.index(sentence) + 1}"                    # 例: rockfall-2


y_template = [template_of(i) for i in idx]
rock = [j for j, t in enumerate(y_theme) if t == "rockfall"]
print("落石の文の、言い回しとクラスタ:")
print(pd.crosstab(pd.Series(km6.labels_[rock], name="cluster"), pd.Series([y_template[j] for j in rock], name="template")))


# 2. k-means の目的関数 J を、k-means の答えと、テーマどおりに分けた場合で比べる。
#    k-means が最適化に失敗したのか、J を小さくした結果がテーマと違う分け方なのかを見分けるため
def sse(emb, labels):
    labels = np.asarray(labels)
    return sum(((emb[labels == c] - emb[labels == c].mean(axis=0)) ** 2).sum() for c in np.unique(labels))


print(f"\nJ(k-means の答え)     : {sse(sent_emb, km6.labels_):.2f}")
print(f"J(テーマどおりに分ける): {sse(sent_emb, y_theme):.2f}")
落石の文が、どの言い回しから作られたかとクラスタを比べ、k-means の答えと、テーマどおりに分けた場合の を比べるコードです。
- 言い回し: 実験1で k-means が落石を3つに割ったのが、言い回しの違いによるものかを確かめるため、各文がどの言い回しから作られたかを調べます。template_of は、文書の山の名前を、そのテーマの3つの言い回し(THEMES の templates)に入れた文を作り、テーマの文と一致するものの番号を返します。y_template は、rockfall-2 のような、テーマと言い回しの番号です(6テーマ × 3通り = 18通り)。
- クロス集計: 落石の文だけについて、実験1の k-means のクラスタ(km6.labels_)と言い回しのクロス集計表を表示し、クラスタの境目が言い回しの境目と一致しているかを見ます。
- J の比較: k-means が最適化に失敗した( を小さくしきれなかった)のか、 を小さくした結果がテーマと違う分け方なのかを見分けるため、2つの分け方の を比べます。sse は、ラベルごとに、そのまとまりの平均(中心)からの距離の2乗を足して を求めます。テーマどおりに分けた方が が小さければ前者、大きければ後者です。
実行結果
落石の文の、言い回しとクラスタ:
template  rockfall-1  rockfall-2  rockfall-3
cluster
0                 54           0           0
3                  0          49           0
4                  0           0          47

J(k-means の答え)     : 75.34
J(テーマどおりに分ける): 89.72
落石の3つのクラスタは、3つの言い回しと完全に一致していました。同じ言い回しの文は、山の名前しか違わないので、埋め込みがとても近くなります。
そして、k-means の答えの (75.34)は、テーマどおりに分けた場合の (89.72)より小さい ことが分かります。k-means は、目的関数をきちんと小さくしています。落石の150件は、3つの言い回しのまとまりが少しずつ離れているので、1つのクラスタにすると、その広がりの分だけ が大きくなります。一方、雪崩(15件)とごみ(8件)は件数が少ないので、ほかのクラスタに混ぜても はあまり増えません。そのため、「大きなまとまりを言い回しごとに割り、小さなまとまりを1つにまとめる」方が、 が小さくなるのです。
つまり、問題は最適化の失敗ではなく、 を小さくすることと、こちらが望む分け方が一致していない ことにあります。k-means の は、各クラスタが、中心の周りに同じくらいの広がりで丸く集まっている場合に、自然な分け方を与えます。大きさや広がりの違うまとまりが混ざっていると、大きく広がったまとまりを割り、小さなまとまりを併せる傾向があります。
階層的クラスタリング
凝集型:近いものから順に併合する
階層的クラスタリング の代表である 凝集型(agglomerative)は、次の手順でクラスタを作ります。
- 最初は、データ1つ1つを、それぞれ1つのクラスタとします( 個のクラスタ)。
- 最も近い2つのクラスタを併合します。
- クラスタが1つになるまで、2をくり返します。
併合の履歴は、 個のデータを葉とする木になります。この木を描いたものを デンドログラム と呼びます。木を途中の高さで切ると、任意の数のクラスタが得られるので、 を先に決める必要はありません。
連結法:クラスタどうしの距離の測り方
「最も近い2つのクラスタ」を決めるには、データの集まりどうしの距離を決める必要があります。この決め方を 連結法(linkage)と呼び、どれを選ぶかで結果が大きく変わります。クラスタ と の距離 は、データどうしの距離 から、次のように決めます。
| 連結法 | クラスタ間の距離 | 性質 |
|---|---|---|
| 単連結法(single) | (最も近いデータどうし) | 細長いまとまりも見つけられるが、データが途切れずに並んでいると、鎖のように次々とつながる |
| 完全連結法(complete) | (最も遠いデータどうし) | まとまりの中の最大の距離を小さく保つ |
| 群平均法(average) | (すべての組の平均) | 単連結法と完全連結法の中間 |
| Ward 法 | (併合したときの の増え方) | k-means と同じ を、併合のたびにできるだけ増やさないように選ぶ |
Ward 法の距離は、2つのクラスタを併合したときに、k-means の目的関数 がどれだけ増えるかです(Ward, 1963)。そのため Ward 法は、k-means と似た分け方をする傾向があります。
from sklearn.cluster import AgglomerativeClustering
from collections import Counter

# 1. 凝集型の階層的クラスタリング:クラスタ間の距離(連結法)を変えて、6つに分ける。
#    k-means と同じ埋め込み・同じクラスタの数で、連結法によって結果がどう変わるかを比べる
for linkage in ["single", "complete", "average", "ward"]:
    agg = AgglomerativeClustering(n_clusters=6, linkage=linkage).fit(sent_emb)
    sizes = sorted(Counter(agg.labels_).values(), reverse=True)
    print(f"{linkage:8s}  ARI(テーマ): {adjusted_rand_score(y_theme, agg.labels_):.3f}  クラスタの大きさ: {sizes}")
print("テーマの大きさ:", sorted(Counter(y_theme).values(), reverse=True))

# 2. クラスタの数を変えて、テーマ(6つ)と言い回し(18通り)のどちらに近い分け方になるかを見る。
#    データには「言い回し → テーマ」の2段の階層があるので、k によってどちらの粒度で分かれるかを確かめる
print("\n k  k-means(テーマ / 言い回し)  群平均法(テーマ / 言い回し)")
for k in [3, 6, 9, 12, 18]:
    a = KMeans(n_clusters=k, n_init=10, random_state=0).fit(sent_emb).labels_
    b = AgglomerativeClustering(n_clusters=k, linkage="average").fit(sent_emb).labels_
    print(f"{k:2d}  {adjusted_rand_score(y_theme, a):.3f} / {adjusted_rand_score(y_template, a):.3f}"
          f"              {adjusted_rand_score(y_theme, b):.3f} / {adjusted_rand_score(y_template, b):.3f}")
テーマの文の埋め込みを、4つの連結法で6つに分け、さらにクラスタの数を変えて、k-means と群平均法の分け方を比べるコードです。
- 連結法の比較: k-means と同じ埋め込み・同じクラスタの数(6)で、連結法によって結果がどう変わるかを比べます。scikit-learn の AgglomerativeClustering に、n_clusters=6 と linkage(single・complete・average・ward)を指定します。木を最後まで作り、6つになる高さで切った結果が labels_ に入ります。大きなまとまりを割っていないかを見るため、ARI に加えて、クラスタの大きさ(Counter で数えたもの)をテーマの大きさと並べて表示します。
- クラスタの数を変える: このデータには「言い回し(18通り)→ テーマ(6つ)」の2段の階層があるので、 によってどちらの粒度で分かれるかを確かめます。 = 3, 6, 9, 12, 18 で、k-means と群平均法で分け、テーマとの ARI と、言い回しとの ARI を並べます。
実行結果
single    ARI(テーマ): 0.910  クラスタの大きさ: [165, 100, 60, 18, 12, 8]
complete  ARI(テーマ): 1.000  クラスタの大きさ: [150, 100, 60, 30, 15, 8]
average   ARI(テーマ): 1.000  クラスタの大きさ: [150, 100, 60, 30, 15, 8]
ward      ARI(テーマ): 0.649  クラスタの大きさ: [100, 60, 54, 53, 49, 47]
テーマの大きさ: [150, 100, 60, 30, 15, 8]

 k  k-means(テーマ / 言い回し)  群平均法(テーマ / 言い回し)
 3  0.829 / 0.320              0.743 / 0.267
 6  0.598 / 0.595              1.000 / 0.414
 9  0.431 / 0.871              0.756 / 0.601
12  0.417 / 0.969              0.731 / 0.623
18  0.381 / 0.948              0.413 / 1.000
群平均法と完全連結法は、6つのテーマにぴったり分けました(ARI 1.000)。クラスタの大きさも、150・100・60・30・15・8 と、テーマの大きさと同じです。落石の3つの言い回しは、ほかのテーマの文に比べれば互いに近いので、先に併合されて、1つのクラスタになりました。
Ward 法は、k-means と同じ失敗をしました(ARI 0.649)。クラスタの大きさは 100・60・54・53・49・47 で、落石を3つに割り、小さなテーマをまとめています。併合のたびに の増え方が最小になる組を選ぶので、 を目的関数にする k-means と同じ傾向を持つのです。単連結法 は、ライチョウを18件と12件に割り、落石と雪崩を1つにつなげました(165件)。
クラスタの数を変えると、どちらの方法も、粒度によって近い分け方が変わります。群平均法は、 = 6 でテーマと、 = 18 で言い回しと完全に一致しました。k-means は、 を増やすほど言い回しに近づき、 = 12 で 0.969 になりましたが、テーマとはどの でも一致しませんでした。
連結法ごとの ARI を並べると、次のようになります。
(図は、diagram-designで作成)
デンドログラムで、まとまりの階層を見る
from scipy.cluster.hierarchy import linkage, dendrogram, to_tree

# 1. 群平均法で、テーマの文を1つずつ併合していく木を作る。木の形から、まとまりの階層を一度に見るため
Z = linkage(sent_emb, method="average")
root, nodes = to_tree(Z, rd=True)


def label(node_id):
    """葉(併合されたまとまり)に含まれる文の、最も多いテーマと、文の数"""
    members = nodes[node_id].pre_order()
    top = Counter(y_theme[m] for m in members).most_common(1)[0][0]
    return f"{top}({len(members)})"


# 2. 最後の18個のまとまりから上だけを描き、6つに分ける高さに線を引く
cut = (Z[-6, 2] + Z[-5, 2]) / 2
fig, ax = plt.subplots(figsize=(14, 6))
dendrogram(Z, truncate_mode="lastp", p=18, leaf_label_func=label, leaf_rotation=90, ax=ax, color_threshold=cut)
ax.axhline(cut, color="gray", linestyle="--")
ax.set_ylabel("併合したときのクラスタ間の距離(群平均)")
ax.set_title("テーマの文の階層的クラスタリング(群平均法)。破線で切ると6つに分かれる")
plt.tight_layout()
plt.savefig("clustering_3.png", dpi=110)
plt.show()
print("6つに分ける高さ:", round(cut, 3))
テーマの文を群平均法で併合していく木を作り、上の部分をデンドログラムに描くコードです。
- 木を作る: まとまりの階層を一度に見るため、併合の木を作ります。scipy の linkage(sent_emb, method="average") は、363個の文を群平均法で1つずつ併合し、併合した2つのクラスタと、そのときの距離を、362行の配列 Z に記録します(1回の併合でクラスタが1つ減るので、363個を1つにするには362回の併合が要ります)。to_tree は、この配列を木のノードのリスト nodes に変え、葉の名前を付けるのに使います。
- 葉の名前: 363個の文をすべて葉にすると読めないので、truncate_mode="lastp", p=18 で、最後の18個のまとまりから上だけを描きます(18は言い回しの数です)。label は、各まとまりに含まれる文(pre_order で取り出す)の、最も多いテーマと、文の数を返し、どのまとまりがどのテーマかを読めるようにします。
- 6つに切る高さ: テーマの数(6)で切ったときにどう分かれるかを見せるため、6つに分かれる高さに破線を引きます。Z の最後の行が「2つ → 1つ」の併合なので、Z[-6, 2] は「7つ → 6つ」、Z[-5, 2] は「6つ → 5つ」の併合の距離です。この2つの中間 cut で切ると、ちょうど6つに分かれます。color_threshold=cut で、破線より下のまとまりを色分けします。
実行結果
6つに分ける高さ: 0.961
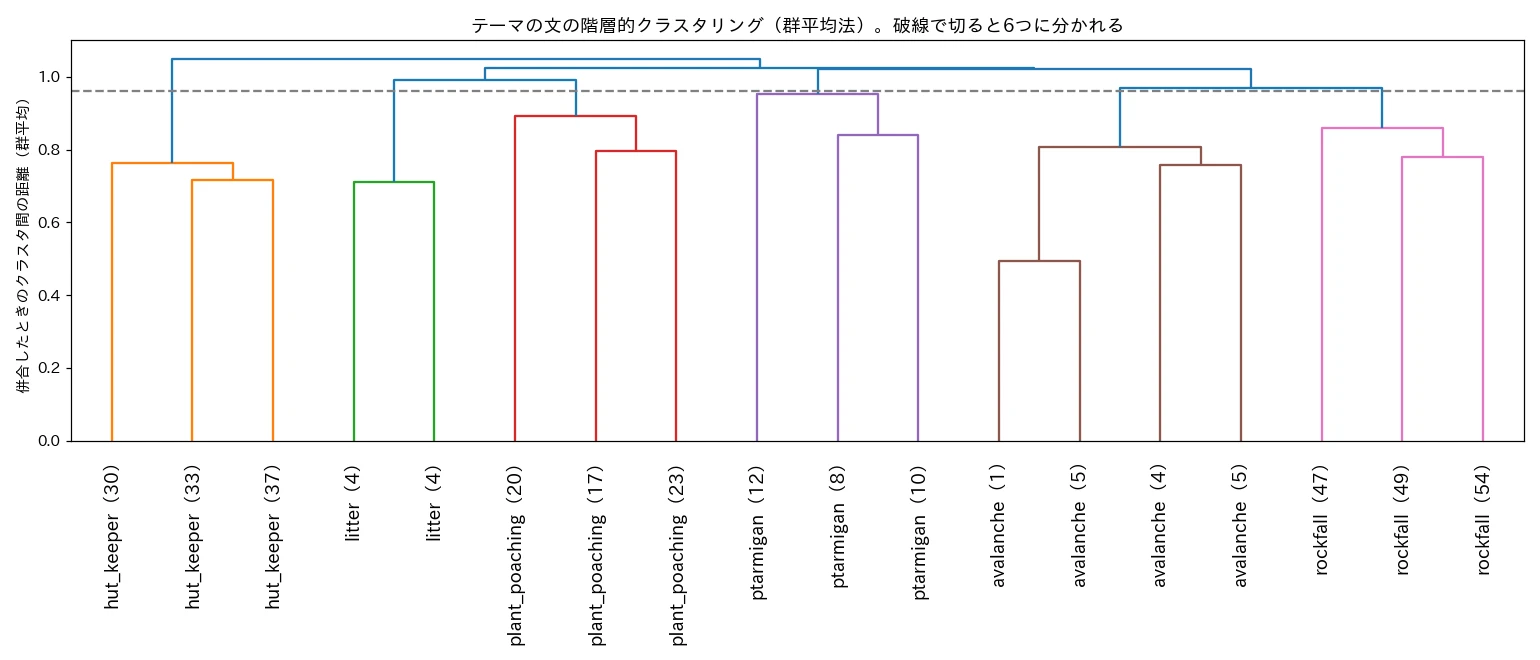
縦軸は、2つのまとまりを併合したときの距離です。高さ 0.961 の破線で木を切ると、6つの色のまとまりに分かれ、それぞれが1つのテーマに対応しています。破線より下では、各テーマの中で、言い回しごとのまとまり(落石なら47・49・54件)が先に併合されています。テーマの中の違い(言い回し)は、テーマの間の違いより小さいので、木の下の方で併合されるのです。
デンドログラムを見れば、「言い回し(18通り)→ テーマ(6つ)→ さらに上のまとまり」という階層を一度に確かめられ、知りたい粒度に合わせて、切る高さを選べます。k-means で を変えて何度も分け直すより、データのまとまりの構造が分かりやすくなります。
一方、凝集型の階層的クラスタリングは、すべてのデータの組の距離を使うので、メモリが 、計算時間が 〜 かかります。数万件を超えるデータには向きません。大量のデータには k-means(1回の反復が )を使い、まず k-means で数百〜数千のまとまりに分けてから、その中心を階層的クラスタリングにかける、という組み合わせもよく使われます。
ソフトクラスタリング:ガウス混合との違い
k-means も階層的クラスタリングも、各データを1つのクラスタにだけ入れる ハードクラスタリング です。これに対して、各データが各クラスタに属する 確率 を求めるのが ソフトクラスタリング で、代表が ガウス混合(Gaussian Mixture Model, GMM)です。
ガウス混合は、データが 個の正規分布(ガウス分布)の混ざったものから生成されたと考え、各正規分布の平均・共分散(広がりの形)・混合の割合を推定します。各データが各分布から生成された確率(負担率)が、クラスタへの所属の確率になります。正規分布の共分散をクラスタごとに推定するので、楕円の形や、広がりの大きさが違うクラスタも表せます。推定には EM アルゴリズムを使いますが、その理論は本記事では扱いません(EMアルゴリズムの記事で解説しています)。混合モデルと負担率の考え方は、混合モデルの記事で、2種類のコインと1次元のガウス混合の例を使って詳しく説明しています。
from sklearn.mixture import GaussianMixture

# 1. ガウス混合と k-means で、人工データを6つのグループに分ける
gmm = GaussianMixture(n_components=6, random_state=0).fit(X)
km_x = KMeans(n_clusters=6, n_init=10, random_state=0).fit(X)
print(f"ARI(真のグループ)  k-means: {adjusted_rand_score(y, km_x.labels_):.3f}"
      f"  ガウス混合: {adjusted_rand_score(y, gmm.predict(X)):.3f}")


# 2. クラスタの番号は方法ごとに付け方が違い、そのままでは比べられないので、いちばん近い真のグループの中心の座標で呼ぶ
def group_name(center):
    return str(tuple(CENTERS[np.linalg.norm(CENTERS - center, axis=1).argmin()].tolist()))


# 3. (0, 0) と (3, 0) のグループの間にある点の、所属。ハードとソフトの違いは、境界の近くの点で表れる
points = np.array([[0.0, 0.0], [1.0, 0.0], [1.5, 0.0], [2.0, 0.0]])
for p, pr, hard in zip(points, gmm.predict_proba(points), km_x.predict(points)):
    top = np.argsort(pr)[::-1][:2]
    print(f"点 {tuple(p.tolist())}  k-means: {group_name(km_x.cluster_centers_[hard])}"
          f"  ガウス混合: {group_name(gmm.means_[top[0]])} の確率 {pr[top[0]]:.2f}、"
          f"{group_name(gmm.means_[top[1]])} の確率 {pr[top[1]]:.2f}")
人工データをガウス混合と k-means で6つに分け、2つのグループの間にある点の所属を比べるコードです。
- ガウス混合: ハードクラスタリング(k-means)とソフトクラスタリングの違いを見るため、同じ人工データを、scikit-learn の GaussianMixture(n_components=6) で6つの正規分布の混合として分けます。predict は最も確率の高いクラスタを、predict_proba は各クラスタに属する確率を返します。まず、全体としての分け方の良さ(ARI)が k-means と変わらないかを確かめます。
- クラスタの呼び方: クラスタの番号は、方法ごとに付け方が違い、そのままでは k-means とガウス混合の答えを比べられません。そこで group_name で、クラスタの中心(k-means の cluster_centers_、ガウス混合の means_)に最も近い、真のグループの中心の座標で呼びます。
- 間の点: ハードとソフトの違いは、どちらのグループとも言いにくい境界の近くの点で表れるので、(0, 0) と (3, 0) のグループを結ぶ線上の4点を調べます。k-means が割り当てたクラスタと、ガウス混合で確率の高い2つのクラスタとその確率を表示します。
実行結果
ARI(真のグループ)  k-means: 0.949  ガウス混合: 0.937
点 (0.0, 0.0)  k-means: (0.0, 0.0)  ガウス混合: (0.0, 0.0) の確率 1.00、(3.0, 0.0) の確率 0.00
点 (1.0, 0.0)  k-means: (0.0, 0.0)  ガウス混合: (0.0, 0.0) の確率 0.97、(3.0, 0.0) の確率 0.03
点 (1.5, 0.0)  k-means: (3.0, 0.0)  ガウス混合: (0.0, 0.0) の確率 0.50、(3.0, 0.0) の確率 0.49
点 (2.0, 0.0)  k-means: (3.0, 0.0)  ガウス混合: (3.0, 0.0) の確率 0.96、(0.0, 0.0) の確率 0.03
真のグループとの一致(ARI)は、k-means が 0.949、ガウス混合が 0.937 で、この人工データではほとんど変わりません。どのグループも同じ大きさの丸い分布なので、k-means の前提に合っているからです。
違いは、境界の近くの点の扱いです。2つのグループのちょうど中間の点 (1.5, 0) は、k-means では (3, 0) のグループにはっきり割り当てられますが、ガウス混合では「(0, 0) のグループの確率 0.50、(3, 0) のグループの確率 0.49」と、どちらとも言えないことが分かります。ソフトクラスタリングは、1つのデータを複数のクラスタに属させたいとき(複数の話題にまたがる文書など)や、割り当ての確かさを知りたいときに役立ちます。
境界の近くの点の割り当てを表にすると、次のようになります。
(図は、diagram-designで作成)
埋め込みをクラスタリングするときの注意点
- 何でまとまるかは、ベクトルが決める: 実験1のとおり、文書全体の埋め込みは、テーマではなく山脈の名前で分かれました。クラスタリングは、ベクトルの中で最も大きな違いでまとめます。知りたい観点でまとめたいなら、その観点の違いがベクトルに大きく表れるように、埋め込む文章(文書全体か、一部の文か)や、埋め込みのモデル・指示文を選びます。
- 長さをそろえる: 埋め込みの長さを1にそろえると、ユークリッド距離の2乗と、コサイン類似度 が次の関係になり、ユークリッド距離で分ける k-means が、コサイン類似度で分けることと同じになります。
- 大きさの違うまとまりに注意する: k-means と Ward 法は、大きく広がったまとまりを割り、小さなまとまりを併せる傾向があります。まとまりの大きさが大きく違いそうなら、群平均法の階層的クラスタリングや、ガウス混合も試し、結果を比べます。
- k は粒度の選択: 人工データでも、シルエット係数は = 2、エルボー法は = 6 を選びました。どちらも「正しい」分け方で、違うのは粒度です。指標で決めきろうとせず、クラスタの中身を読んで決めます。
- 高次元では距離の差が小さくなる: 数百次元の埋め込みでは、どのデータどうしの距離も似た値になりやすく、クラスタの境界があいまいになります。クラスタリングの前に、PCA や UMAP で次元を減らすことがあります。
- 乱数と初期値を固定する: k-means の結果は最初の中心で変わります。random_state を固定し、n_init を複数回にします。
まとめ
本記事では、ラベルのないデータを似たものどうしのまとまりに分けるクラスタリングを、架空の山岳コーパスの埋め込みと、2次元の人工データで確かめました。
文書全体の埋め込みを k-means で6つに分けると、テーマではなく山脈の名前で分かれました(テーマとの ARI 0.001、山脈との ARI 0.984)。テーマの文だけにしても、k-means は最も大きな落石のテーマを3つの言い回しに割り、小さなテーマをまとめました。k-means の答えの (75.34)は、テーマどおりに分けた場合(89.72)より小さく、k-means は目的関数をきちんと小さくしたうえで、こちらの意図と違う分け方を選んでいました。
k-means は、割り当てと更新をくり返すロイドのアルゴリズムで を小さくしますが、局所解で止まることがあります。人工データでは、ランダムな初期値で最良の解に着いたのは42.5%でしたが、k-means++ で65.0%に上がり、scikit-learn で n_init=10 にすると50回すべてで最良の解に着きました。 の決め方は粒度の選択で、エルボー法は6、シルエット係数は2を選びました。
凝集型の階層的クラスタリングは、群平均法と完全連結法で6つのテーマにぴったり分け(ARI 1.000)、デンドログラムで「言い回し → テーマ」の階層を一度に見せました。 の増え方で併合する Ward 法は、k-means と同じ失敗をしました。各データの所属を確率で表すガウス混合は、境界の点が「どちらとも言えない」ことを示せます。
参考文献
- S. Lloyd (1982). Least squares quantization in PCM. IEEE Transactions on Information Theory, 28(2), 129–137.
- D. Arthur, S. Vassilvitskii (2007). k-means++: The Advantages of Careful Seeding. Proceedings of the 18th Annual ACM-SIAM Symposium on Discrete Algorithms (SODA), 1027–1035.
本記事の文章・構成の一部に生成AIを使用しています。