機械学習によるCLV予測とは?
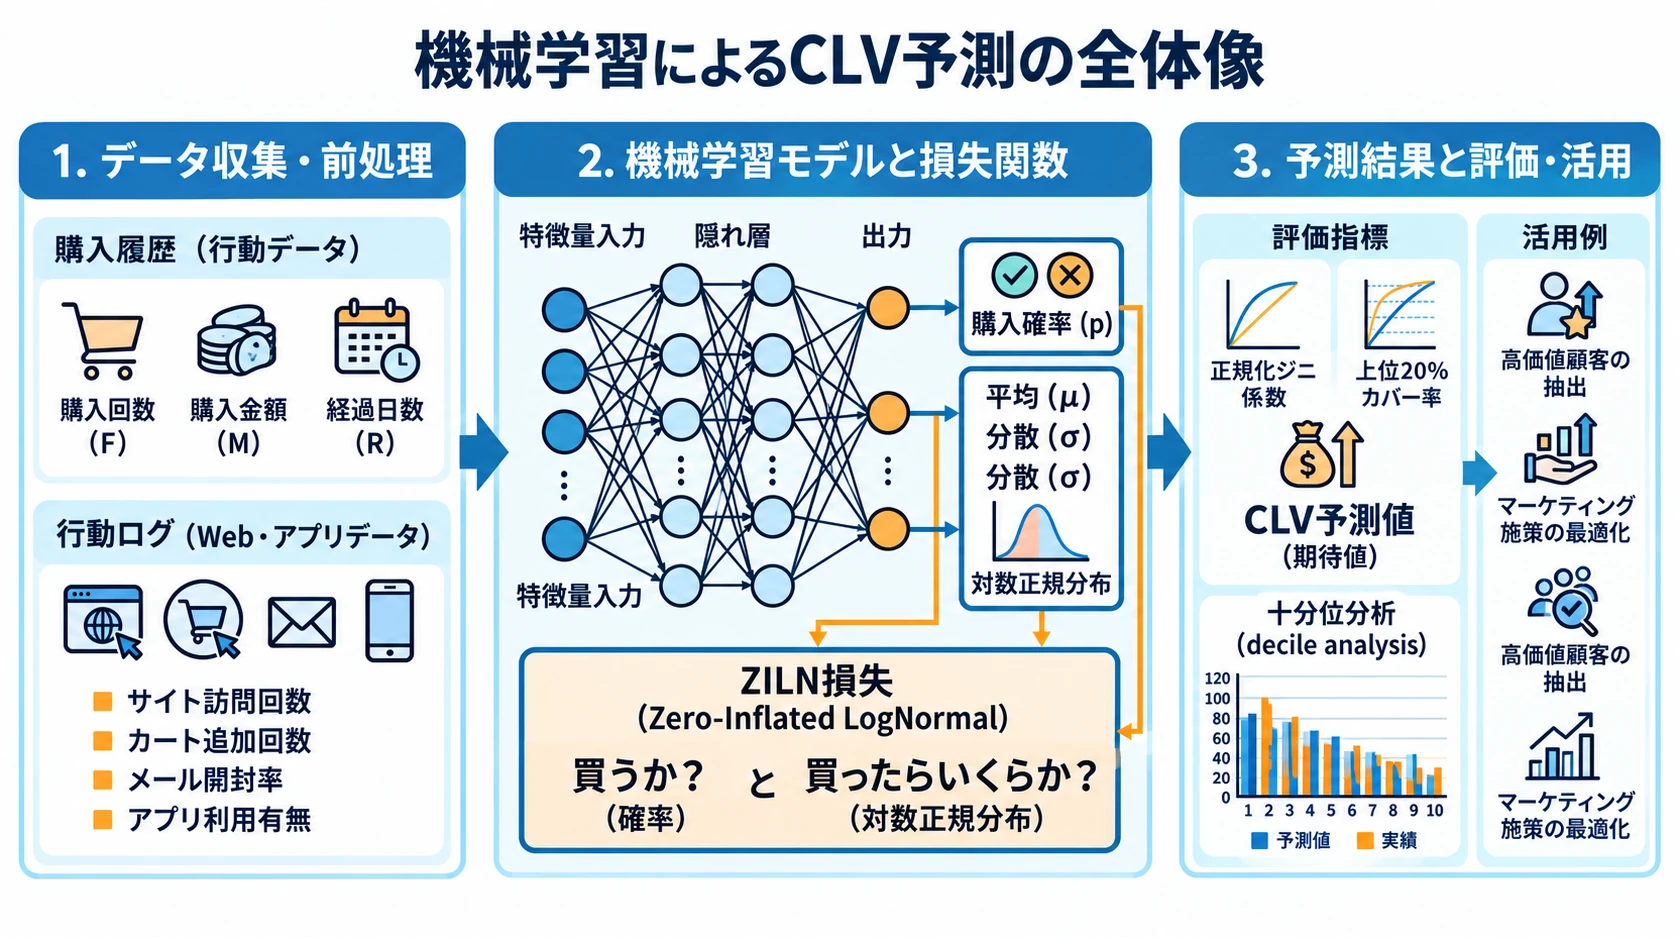 (画像は、Geminiで作成)
閲覧行動などの豊富な特徴量から顧客生涯価値(CLV)を機械学習で予測し、「大半がゼロで、残りは裾が重い」というCLVの分布に合った損失関数(ZILN損失)と評価指標(正規化ジニ係数・十分位分析・合計の一致)を使えるようになること。あわせて、MSEや対数変換で学習すると何が起きるか、購買履歴だけのBTYDモデルと比べて何が改善するのかを、真値を仕込んだダミーデータで確かめること。
概要
BG/NBDモデルとGamma-Gammaモデルの記事では、購買ログだけから顧客ごとの将来の購買回数と金額を予測する BTYDモデルを扱いました。翌年の売上の上位20%の顧客を選ぶ実験では、RFMスコアの57.1%に対して、BTYDモデルは61.6%の売上をカバーできました。ところが、真のパラメータを使っても61.6%のままで、隠れた真値を知っている「神の視点」の78.0%には遠く及びませんでした。購買履歴から読み取れる情報は、すでに取り切っていたのです。
この差を埋めるには、購買履歴以外の情報が必要です。実際のECには、サイトの閲覧、カートへの追加、メールの開封、アプリの利用など、顧客の関心や離脱の兆しを示す行動ログがたくさんあります。こうした特徴量を使って CLV を予測するのが、本記事で扱う 機械学習による CLV 予測 です。
ただし、CLV の予測には特有の難しさがあります。翌年の売上は、半分以上の顧客がゼロで、残りの顧客の中にも、平均の何十倍も買う顧客がいます。このような分布に、普通の回帰と同じ平均二乗誤差(MSE)をそのまま使うと、うまくいきません。本記事では、Google の研究者が提案した ZILN損失(Zero-Inflated LogNormal loss、ゼロ過剰対数正規損失)(Wang, Liu & Miao, 2019)を中心に、CLV の分布に合わせた学習と評価の方法を解説します。
本記事のコードは、Python 3.13、NumPy 2.4.6、pandas 3.0.5、SciPy 1.18.1、scikit-learn 1.9.1、LightGBM 4.7.0、autograd 1.9.1、matplotlib 3.11.2 で動作を確認しました。autograd は、NumPy で書いた関数の勾配を自動で計算するライブラリで、pip install autograd lightgbm でインストールできます。
検証用ダミーデータの生成
顧客ワールドの再生成
RFMの記事とBTYDの記事で使った「顧客ワールド」を、同じコードで生成します。10,000人の顧客の2年分の購買ログで、前半の1年を分析期間、後半の1年をホールドアウト期間にします。本記事で予測するのは、ホールドアウト期間(翌1年)の売上です。 コードはRFMの記事と同じです。生成の規則を式でまとめると、次のとおりです。 顧客 の隠れた性質は、次の分布から1つずつ引きます(ガンマ分布は形状とレートで書きます。NumPy の rng.gamma は形状と尺度(レートの逆数)を引数にとるので、コードではレートの逆数を渡しています)。 (lam)は1日あたりの購買ペース、(p_drop)は繰り返し購買の直後に離脱する確率、(nu)は購買金額の尺度、(first_day)は初回購買日です。 購買ログは、初回購買日 から、次の規則で730日目まで作ります。 は 回目の購買から次の購買までの日数(平均 日)、 は1回ごとの購買金額です(形状6は p_gg)。2回目以降の購買(繰り返し購買)の直後には、確率 で離脱し、それ以降は買いません。初回購買の直後には離脱の判定をしません。1回あたりの平均購買金額は (truth['mean_amount'])で、離脱した日(death_day)が365日目以降なら、基準日に生存している(truth['alive'])とします。 購買と離脱の部分は BG/NBDモデル、購買金額の部分は Gamma-Gammaモデルの生成過程で、BTYDの記事で詳しく説明しています。顧客ワールドの生成式
import numpy as np
import pandas as pd

# 1. 乱数と観測期間の設定(時間の単位は日)
rng = np.random.default_rng(42)
N = 10_000          # 顧客数
CALIB_END = 365     # 0〜364日目: 分析に使う期間(前半1年)
OBS_END = 730       # 365〜729日目: 答え合わせ用のホールドアウト期間(後半1年)

# 2. 顧客ごとの隠れた性質(分析者には観測できない「答え」)
r, alpha = 0.6, 25.0                         # 購買ペースのばらつきを決めるパラメータ
a, b = 0.8, 3.0                              # 離脱のしやすさのばらつきを決めるパラメータ
p_gg, q_gg, gamma_gg = 6.0, 4.0, 1500.0      # 購買金額のばらつきを決めるパラメータ
lam = rng.gamma(r, 1 / alpha, size=N)        # 購買ペース(1日あたりの平均購買回数)
p_drop = rng.beta(a, b, size=N)              # 2回目以降の購買の直後に離脱する確率
nu = rng.gamma(q_gg, 1 / gamma_gg, size=N)   # 購買金額の尺度(平均購買金額は p_gg / nu)
first_day = rng.uniform(0, CALIB_END, size=N)  # 初回購買日(最初の1年で少しずつ獲得)

# 3. 購買ログの生成
records = []
death_day = np.full(N, np.inf)   # 離脱した日(観測期間内に離脱しなければ inf)
for i in range(N):
    t = first_day[i]
    records.append((i, t, rng.gamma(p_gg, 1 / nu[i])))   # 初回購買
    while True:
        t += rng.exponential(1 / lam[i])   # 次の購買までの待ち時間
        if t >= OBS_END:
            break
        records.append((i, t, rng.gamma(p_gg, 1 / nu[i])))
        if rng.uniform() < p_drop[i]:      # 購買の直後に、一定の確率で離脱する
            death_day[i] = t
            break

# 4. 分析者が観測できる購買ログ(購買日は整数の日付、金額は10円単位)
log = pd.DataFrame(records, columns=['customer_id', 'day', 'amount'])
log['day'] = np.floor(log['day']).astype(int)
log['amount'] = log['amount'].round(-1).astype(int)

# 5. 答え合わせ用の真値(分析には使わない)
truth = pd.DataFrame({
    'lam': lam,                          # 購買ペース
    'p_drop': p_drop,                    # 購買の直後に離脱する確率
    'mean_amount': p_gg / nu,            # 平均購買金額
    'alive': death_day >= CALIB_END,     # ホールドアウト期間の開始時点で生存しているか
})

# 6. RFMの記事と同じデータになっていることの確認
print(f"購買ログの件数: {len(log):,} 件、ホールドアウト期間の開始時点で生存している顧客: {truth['alive'].mean():.1%}")
RFMの記事・BTYDの記事と同じコードで、顧客ワールドを生成しています。生成の仕組みは、BTYDの記事の「生成過程:4つの仮定」で説明したとおりです。
- 乱数と観測期間の設定: np.random.default_rng(42) で乱数生成器 rng を作り、シードを固定しているので、何度実行しても同じデータになります。顧客数は N = 10_000、時間の単位は日で、CALIB_END = 365 より前(0〜364日目)を分析に使う期間、OBS_END = 730 まで(365〜729日目)をホールドアウト期間とします。
- 顧客ごとの隠れた性質: 購買ペース lam を rng.gamma(r, 1 / alpha, size=N)(ガンマ分布)、離脱確率 p_drop を rng.beta(a, b, size=N)(ベータ分布)、購買金額の尺度 nu を rng.gamma(q_gg, 1 / gamma_gg, size=N)(ガンマ分布)から、顧客ごとに1つずつ引いています。NumPy の rng.gamma は形状と尺度(レートの逆数)を引数にとるので、レート alpha・gamma_gg は逆数にして渡しています。初回購買日 first_day は、rng.uniform(0, CALIB_END, size=N) で最初の1年の一様分布から引きます。
- 購買ログの生成: death_day を np.full(N, np.inf) で全員無限大(離脱しない)に初期化し、for i in range(N) で1人ずつ、初回購買を記録してから、t += rng.exponential(1 / lam[i]) で指数分布の待ち時間だけ時間を進めて次の購買を records に追加する処理を、OBS_END に達するまで繰り返します。1回の購買金額は rng.gamma(p_gg, 1 / nu[i]) で引き、顧客 の平均購買金額は p_gg / nu[i] になります。2回目以降の購買の直後に rng.uniform() < p_drop[i] なら(確率 p_drop[i] で)離脱としてループを抜け、その日を death_day[i] に記録します。初回購買の直後には離脱の判定をしません。
- 観測できる購買ログ: log には、顧客ID・購買日・金額の3列だけを入れます。購買日は np.floor で整数の日付に、金額は round(-1) で10円単位に丸めています。顧客IDは0〜9,999の連番で、配列 lam などの位置(インデックス)と一致します。
- 答え合わせ用の真値: truth には、購買ペース・離脱確率・平均購買金額(p_gg / nu)と、離脱した日が365日目以降かどうか(death_day >= CALIB_END。基準日に生存しているか)を入れています。lam(購買ペース)、p_drop(離脱確率)、nu(購買金額の尺度)とあわせて、分析者には観測できない値です。この記事では、行動ログの特徴量を作るときと、「神の視点」の予測を計算するときに使います。
- 確認: 購買ログの件数と、基準日に生存している顧客の割合(truth['alive'].mean())を表示し、RFMの記事・BTYDの記事と同じデータになっていることを確かめています。
実行結果
購買ログの件数: 57,667 件、ホールドアウト期間の開始時点で生存している顧客: 67.8%
購買ログの件数(57,667件)と生存している顧客の割合(67.8%)は、RFMの記事・BTYDの記事と同じです。
続いて、BTYDの記事と同じく、分析期間の購買ログを顧客ごとに集計します。BTYDモデルの入力 と、RFMの R・F・M に当たる値、そして予測の対象となるホールドアウト期間の売上です。
# 1. 分析に使う期間と、答え合わせ用のホールドアウト期間に分ける
calib = log[log['day'] < CALIB_END]
holdout = log[log['day'] >= CALIB_END]

# 2. 顧客ごとに x, t_x, T と、1回あたりの平均購買金額を集計する
g = calib.groupby('customer_id')
summary = pd.DataFrame({
    'first_day': g['day'].min(),
    'last_day': g['day'].max(),
    'n_purchases': g['day'].size(),     # 購買回数(RFMの F)
    'monetary': g['amount'].mean(),     # 1回あたりの平均購買金額(RFMの M)
})
summary['x'] = summary['n_purchases'] - 1                       # 繰り返し購買の回数
summary['t_x'] = summary['last_day'] - summary['first_day']     # 初回購買から最後の購買までの日数
summary['T'] = CALIB_END - summary['first_day']                 # 初回購買から基準日までの日数
summary['recency'] = summary['T'] - summary['t_x']              # RFMの R(基準日から最後の購買までの日数)

# 3. 予測の対象: ホールドアウト期間(翌1年)の購買回数と売上
summary['holdout_n'] = holdout.groupby('customer_id').size().reindex(summary.index, fill_value=0)
summary['holdout_sales'] = holdout.groupby('customer_id')['amount'].sum().reindex(summary.index, fill_value=0)
print(summary[['x', 't_x', 'T', 'recency', 'n_purchases', 'monetary', 'holdout_sales']].head())
BTYDの記事と同じ集計で、顧客ごとの購買履歴の要約と、予測の対象を作っています。
- 期間の分割: log[log['day'] < CALIB_END] で分析に使う期間の購買 calib を、log['day'] >= CALIB_END でホールドアウト期間の購買 holdout を取り出しています。
- 集計: calib.groupby('customer_id') でまとめた g から、初回購買日(g['day'].min())・最後の購買日(g['day'].max())・購買回数(g['day'].size())・1回あたりの平均購買金額(g['amount'].mean())を求め、そこから x(購買回数 − 1)・t_x(最後の購買日 − 初回購買日)・T(基準日 − 初回購買日)・recency(T - t_x)を計算しています。
- 購買履歴の要約: x・t_x・T は BTYDモデルの入力、recency・n_purchases・monetary は RFMの R・F・M です。機械学習のモデルでは、これらも特徴量として使います。
- 予測の対象: holdout.groupby('customer_id')['amount'].sum() で、ホールドアウト期間(365〜729日目)の売上の合計 holdout_sales を求めています。翌1年に買わなかった顧客は集計結果に現れないので、reindex(summary.index, fill_value=0) で全員の行をそろえ、0で埋めています。購買回数 holdout_n も同じように作っています。
実行結果
             x  t_x    T  recency  n_purchases     monetary  holdout_sales
customer_id
0            6  114  147       33            7  1348.571429          19080
1            4   85  297      212            5  3708.000000              0
2            0    0  139      139            1  1630.000000              0
3            2   13   24       11            3  3146.666667          18330
4            0    0  338      338            1  2180.000000              0
先頭の5人のうち、翌1年に買ったのは顧客0(19,080円)と顧客3(18,330円)の2人だけで、残りの3人は0円です。
行動ログの特徴量を追加する
顧客ワールドに、基準日(分析期間の終わり)の時点で観測できる行動ログの特徴量を5つ追加します。どの特徴量も、顧客の隠れた性質(購買ペース・離脱確率・平均購買金額・生存しているか)と、ノイズを含んだ形で関係するように作ります。
| 特徴量 | 意味 | 関係する隠れた性質 |
|---|---|---|
| visits_30d | 直近30日のサイト訪問回数 | 生存しているか、購買ペース(生存している顧客は購買ペースに応じて訪問し、離脱した顧客はほとんど訪問しない) |
| cart_30d | 直近30日のカート追加回数 | 生存しているか、購買ペース |
| email_open_rate | 過去1年のメールマガジン(24通)の開封率 | 離脱確率(離脱しにくい顧客ほど開封する)、生存しているか |
| viewed_price | 閲覧した商品の平均価格 | 平均購買金額 |
| app_user | アプリを利用しているか | 購買ペース |
元の顧客ワールドの生成コードと同じ乱数生成器 rng から続けて乱数を引くと、それ以降に生成する値が変わってしまいます。そこで、特徴量は別の乱数生成器(シード43) で生成し、RFMの記事やBTYDの記事と同じ購買ログを保ちます。 上で説明した生成の仕組みを、式でまとめます(・・ は、顧客ワールドの生成式の購買ペース・離脱確率・平均購買金額です)。 基準日に生存しているかを (生存していれば1、離脱していれば0。alive_now)、シグモイド関数を とすると、5つの特徴量は次のように作ります。 、 は顧客ごとのノイズです。左辺は順に visits_30d(直近30日のサイト訪問回数)、cart_30d(直近30日のカート追加回数)、email_open_rate(24通のメールの開封率)、viewed_price(閲覧した商品の平均価格。10円単位に丸める)、app_user(アプリを利用しているか)で、 は visit_rate、 は open_prob です。乱数は、顧客ワールドとは別の乱数生成器 rng_feat(シード43)で引きます。行動ログの特徴量の生成式
# 1. 特徴量は別の乱数生成器で作る(顧客ワールドの値を変えないため)
rng_feat = np.random.default_rng(43)
alive_now = truth['alive'].values

# 2. 直近30日のサイト訪問回数とカート追加回数(生存している顧客は購買ペースに応じて行動する)
visit_rate = np.where(alive_now, 0.01 + 3 * lam, 0.005)     # 1日あたりの訪問回数の平均
features = pd.DataFrame(index=summary.index)
features['visits_30d'] = rng_feat.poisson(30 * visit_rate)
features['cart_30d'] = rng_feat.poisson(30 * 1.5 * lam * alive_now)

# 3. メールマガジン(24通)の開封率(離脱しにくい顧客ほど開封し、離脱した顧客はあまり開封しない)
open_prob = 1 / (1 + np.exp(-(1.0 - 5 * p_drop + rng_feat.normal(0, 0.5, size=N)))) * np.where(alive_now, 1.0, 0.3)
features['email_open_rate'] = rng_feat.binomial(24, open_prob) / 24

# 4. 閲覧した商品の平均価格(平均購買金額のまわりでばらつく)と、アプリの利用(購買ペースが高いほど使う)
features['viewed_price'] = np.round(truth['mean_amount'].values * np.exp(rng_feat.normal(0, 0.35, size=N)), -1)
features['app_user'] = rng_feat.binomial(1, 1 / (1 + np.exp(-(np.log(lam * 365) - 2.0))))

# 5. 特徴量と隠れた性質の相関(現実には確認できない答え合わせ)
hidden = truth[['lam', 'p_drop', 'mean_amount', 'alive']].astype(float)
corr = pd.DataFrame({c: [np.corrcoef(features[c], hidden[h])[0, 1] for h in hidden] for c in features}, index=hidden.columns).T
print(features.describe().loc[['mean', '50%', 'max']].round(2).to_string())
print()
print(corr.round(2).to_string())
行動ログの特徴量を5つ生成し、隠れた性質との相関を確認しています。
- 別の乱数生成器: rng_feat はシード43の新しい乱数生成器です。顧客ワールドの rng には触れないので、購買ログは RFMの記事・BTYDの記事と同じままです。
- 訪問回数とカート追加: visit_rate は np.where(alive_now, 0.01 + 3 * lam, 0.005) で、生存している顧客(alive_now が True)と離脱した顧客で値を切り替えた、1日あたりの訪問回数の平均です。rng_feat.poisson(30 * visit_rate) で、30日間の回数をポアソン分布から生成しています。生存している顧客の訪問のペースは購買ペース lam の3倍に少しの上乗せ、離脱した顧客は1日0.005回(30日で0.15回)です。カート追加は、rng_feat.poisson(30 * 1.5 * lam * alive_now) で、生存している顧客だけが購買ペースの1.5倍で行います(alive_now は True/False ですが、掛け算では1/0として扱われます)。features = pd.DataFrame(index=summary.index) で、顧客IDを行にした空の表を作り、列を1つずつ追加しています。
- メールの開封率: 開封確率は、離脱確率 p_drop が低いほど高くなるロジスティック関数に、顧客ごとのノイズを加えたものです。離脱した顧客の開封確率は0.3倍にしています。式では 1 / (1 + np.exp(-(1.0 - 5 * p_drop + rng_feat.normal(0, 0.5, size=N)))) がシグモイド関数で、np.where(alive_now, 1.0, 0.3) を掛けて離脱した顧客を0.3倍にしています。rng_feat.binomial(24, open_prob) で24通のうち何通開封したかを二項分布で生成し、24で割っています。
- 閲覧商品の価格とアプリ: viewed_price は、真の平均購買金額に対数正規のノイズ(標準偏差0.35)を掛けたものです。np.round(..., -1) で10円単位に丸めています。app_user は、rng_feat.binomial(1, 1 / (1 + np.exp(-(np.log(lam * 365) - 2.0)))) で、年間の購買ペースが高いほど1になりやすい2値の特徴量です(年間の購買ペースが 回のとき、1になる確率が0.5です)。
- 相関の確認: 各特徴量と、隠れた性質(truth の4列)との相関係数を表にしています。生存しているか(alive)は astype(float) で True/False を1/0に変換してから計算しています。np.corrcoef(features[c], hidden[h])[0, 1] を、特徴量 c と隠れた性質 h のすべての組み合わせについて計算し、.T で特徴量を行にした表にしています。describe().loc[['mean', '50%', 'max']] は、要約統計量のうち平均・中央値・最大値の行だけを取り出す書き方です。生成の係数(0.01・3・0.005・1.5・24通・・0.5・0.3・0.35・)は、各特徴量が隠れた性質の手がかりになりつつ、ノイズで完全には言い当てられない強さ(表の相関で0.2〜0.9)になるように選んだ例で、結果の傾向は個々の値に大きく左右されません。
実行結果
      visits_30d  cart_30d  email_open_rate  viewed_price  app_user
mean        1.18      0.46             0.41       3202.39       0.4
50%         0.00      0.00             0.42       2470.00       0.0
max        20.00     13.00             1.00      52700.00       1.0

                  lam  p_drop  mean_amount  alive
visits_30d       0.29   -0.23        -0.01   0.35
cart_30d         0.29   -0.20         0.00   0.29
email_open_rate -0.24   -0.69        -0.02   0.72
viewed_price    -0.01    0.01         0.87  -0.01
app_user         0.44    0.01        -0.01  -0.26
- 生存しているかの手がかり: メールの開封率は、生存しているかと0.72、離脱確率と −0.69 の相関があり、離脱の兆しを最もよく表す特徴量です。直近30日の訪問回数(0.35)とカート追加(0.29)も、生存しているかの手がかりになります。購買ログだけでは見えなかった「離脱したかどうか」の情報を、行動ログが補ってくれるわけです。
- 金額の手がかり: 閲覧商品の平均価格は、真の平均購買金額と0.87の相関があります。購買回数が少ない顧客の金額を推し量るのに役立ちます。
- アプリの利用: 購買ペースとは0.44の正の相関がありますが、生存しているかとは −0.26 の負の相関です。顧客ワールドでは購買のたびに離脱の機会があるので、よく買う顧客ほど、すでに離脱している割合も高いためです。1つの特徴量が「良い顧客」と「離脱した顧客」の両方の情報を持つので、他の特徴量と組み合わせて解釈する必要があります。
CLVの分布の特徴
予測の対象である翌1年の売上が、どのような分布をしているかを確認します。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google ColabやJupyterでは先頭の「!」を付けたまま、ターミナルでは「!」を外して実行します)。Python 3.12 以降で import 時にエラーが出る場合は、setuptools も一緒にインストールしてください。
!pip install japanize-matplotlib setuptools
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. 翌1年の売上(予測の対象)の分布
y = summary['holdout_sales'].values.astype(float)
print(f"翌1年の売上がゼロの顧客: {(y == 0).mean():.1%}")
print(f"平均: {y.mean():,.0f} 円、中央値: {np.median(y):,.0f} 円")
print("売上がある顧客の分位点(円):")
print(pd.Series(y[y > 0]).quantile([0.1, 0.5, 0.9, 0.99]).round(0).to_string())
print(f"最大: {y.max():,.0f} 円(平均の {y.max() / y.mean():.0f} 倍)")

# 2. 可視化:全体の分布と、売上がある顧客の対数スケールの分布
fig, axes = plt.subplots(1, 2, figsize=(13, 4.5))
axes[0].hist(y / 1000, bins=100, color='C0')
axes[0].set_title('翌1年の売上(全顧客)')
axes[0].set_xlabel('翌1年の売上(千円)')
axes[0].set_ylabel('人数')
axes[1].hist(np.log10(y[y > 0]), bins=50, color='C1')
axes[1].set_title('翌1年の売上(売上がある顧客、対数スケール)')
axes[1].set_xlabel('log10(翌1年の売上[円])')
axes[1].set_ylabel('人数')
for ax in axes:
    ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
翌1年の売上の分布を、数値と図で確認しています。
- 予測の対象: summary['holdout_sales'].values.astype(float) で、翌1年の売上を小数の配列 y に取り出しています。この y を、以降のすべてのモデルの正解として使います。
- 数値: (y == 0).mean() は、翌1年の売上がゼロの顧客の割合です(True/False の平均は True の割合)。平均(y.mean())と中央値(np.median(y))、売上がある顧客(y[y > 0])の10%・50%・90%・99%点、最大値と、最大値が平均の何倍かを表示しています。
- 図: plt.subplots(1, 2) で2つのグラフを横に並べています。左は全顧客の売上を千円単位(y / 1000)にした100本の棒のヒストグラム、右は売上がある顧客だけを、np.log10 で常用対数をとってから描いた50本の棒のヒストグラムです。対数をとると、横軸の1が10倍の違いに当たるので、裾の重い分布の形が見やすくなります。
実行結果
翌1年の売上がゼロの顧客: 50.5%
平均: 7,252 円、中央値: 0 円
売上がある顧客の分位点(円):
0.10      1710.0
0.50      6975.0
0.90     33999.0
0.99    109031.0
最大: 426,030 円(平均の 59 倍)
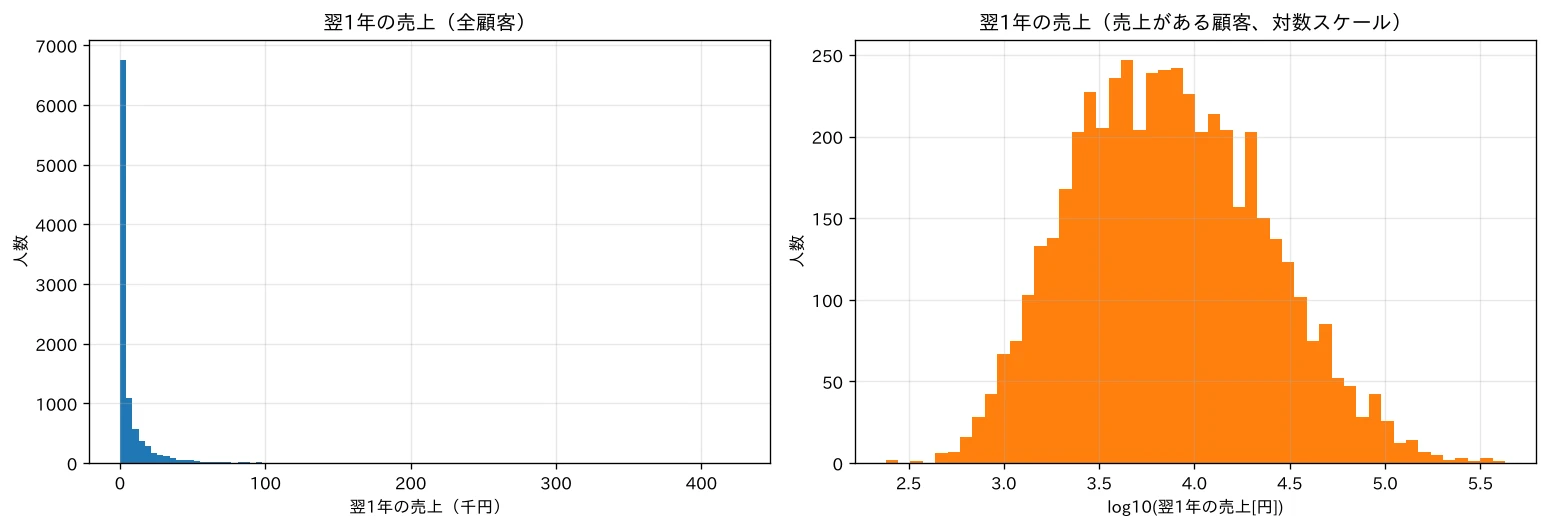
- 半分以上がゼロ: 翌1年に1回も買わなかった顧客が50.5%で、中央値は0円です。左の図でも、0のところに大きな山があります。
- 裾が重い: 売上がある顧客の中でも、中央値は6,975円ですが、上位1%は109,031円以上、最大は426,030円(平均の59倍)です。
- 売上がある顧客は、対数スケールでは山型: 右の図のように、売上がある顧客の をとると、左右対称に近い山型の分布になります。つまり、売上がある顧客の売上は、対数正規分布に近い形をしています。
「ゼロか、ゼロでなければ対数正規分布」という形が、後で扱う ZILN損失の前提です。
CLV予測の評価指標
RMSEだけでは評価できない理由
回帰モデルの評価には、RMSE(二乗平均平方根誤差)がよく使われます。しかし、CLV の予測では、RMSE だけで良し悪しを判断するのは危険です。
- 一部の顧客に支配される:誤差を二乗するので、翌年に何十万円も買った一握りの顧客の誤差が、RMSE のほとんどを占めます。大半の顧客の予測が良いか悪いかは、RMSE にほとんど反映されません。
- 使い方と合っていない:CLV の予測は、「価値の高い顧客を選んで施策を打つ」「顧客全体の価値を見積もる」といった目的で使います。前者に必要なのは顧客を正しい順に並べられるか、後者に必要なのは合計や平均が合っているかで、どちらも RMSE とは別の性質です。
そこで、Wang, Liu & Miao (2019) にならい、次の指標を組み合わせて評価します。
- 正規化ジニ係数(normalized Gini):予測の高い順に顧客を並べ、「上位 の顧客が、実際の売上の何%を占めるか」を描いた曲線(累積ゲイン曲線)と対角線の間の面積を、ジニ係数と呼びます。それを、実際の売上の順に並べた理想の場合のジニ係数で割ったものが、正規化ジニ係数です。1なら理想と同じ順番、0ならランダムな順番です。予測の値そのものではなく、順位付けの良さだけを測ります。
- 上位20%カバー率:累積ゲイン曲線の、上位20%の点の値です。RFMの記事・BTYDの記事と同じ指標なので、記事をまたいで比べられます。
- 合計の比:予測の合計 ÷ 実際の合計です。1に近いほど、顧客全体の価値を正しく見積もれています。
- 十分位分析(decile chart):予測の高い順に顧客を10グループに分け、各グループの予測の平均と実際の平均を比べます。順位付けと金額の両方の正しさを、一度に確認できます。
4つの指標と RMSE の役割を図にまとめると、次のようになります。
(図は、diagram-designで作成)
評価の関数と、比較の基準
評価の関数を定義し、比較の基準として、全員に平均を予測するモデル、RFMスコアの合計、神の視点の期待値を評価します。RFMスコアと神の視点の期待値は、RFMの記事と同じ計算です。
コードが計算する指標を、先に式で書いておきます。顧客 の実際の売上を (y)、予測を (pred)とし、予測の高い順に並べたときの 番目の顧客を と書きます(並び順は order)。上位 人が実際の売上に占める割合(累積ゲイン曲線の高さ)は、次の ( は cum_share)です。
ジニ係数 (gini)は、 の平均から、ランダムに並べた場合の平均( の平均 )を引いたもので、累積ゲイン曲線と対角線の間の面積に当たります。正規化ジニ係数は、それを実際の売上の順に並べた理想の場合()の値で割ったものです。
上位20%カバー率は 、合計の比は です。RMSE は 、MAE は です。
from scipy.stats import poisson

# 1. 評価の関数
def gini(y, pred):
    """予測の高い順に並べたときの累積ゲイン曲線と、対角線の間の面積"""
    order = np.argsort(-pred, kind='stable')
    cum_share = np.cumsum(y[order]) / y.sum()
    n = len(y)
    return cum_share.mean() - (n + 1) / (2 * n)

def evaluate(name, pred, y=y, results=None, rank_only=False):
    top = np.argsort(-pred, kind='stable')[: len(y) // 5]
    row = {
        'RMSE': np.nan if rank_only else np.sqrt(np.mean((pred - y) ** 2)),
        'MAE': np.nan if rank_only else np.mean(np.abs(pred - y)),
        '合計の比': np.nan if rank_only else pred.sum() / y.sum(),
        '正規化ジニ': gini(y, pred) / gini(y, y),
        '上位20%カバー率': y[top].sum() / y.sum(),
    }
    if results is not None:
        results[name] = row
    return row

results = {}
preds = {}

# 2. 基準1:全員に同じ値(平均)を予測する
preds['平均(全員同じ)'] = np.full(N, y.mean())

# 3. 基準2:RFMスコアの合計(順位付けだけに使う)
R_score = pd.qcut(summary['recency'], 5, labels=[5, 4, 3, 2, 1]).astype(int)
F_score = pd.cut(summary['n_purchases'], bins=[0, 1, 2, 3, 6, np.inf], labels=[1, 2, 3, 4, 5]).astype(int)
M_score = pd.qcut(summary['monetary'], 5, labels=[1, 2, 3, 4, 5]).astype(int)
preds['RFMスコアの合計'] = (R_score + F_score + M_score).values.astype(float)

# 4. 基準3:神の視点の期待値(真値から計算。現実には計算できない)
k_purchase = np.arange(1, 300)[None, :]
lam_tau = lam[:, None] * 365
expected_count = ((1 - p_drop[:, None]) ** (k_purchase - 1) * poisson.sf(k_purchase - 1, lam_tau)).sum(axis=1)
preds['神の視点'] = alive_now * expected_count * truth['mean_amount'].values

for name in preds:
    evaluate(name, preds[name], results=results, rank_only=(name == 'RFMスコアの合計'))   # RFMスコアは金額ではない
print(pd.DataFrame(results).T.round(3).to_string())
評価の関数を定義し、3つの基準を評価しています。
- ジニ係数: gini は、予測の高い順に並べたときの、実際の売上の累積シェア cum_share の平均から、ランダムに並べた場合の値(約0.5)を引いたものです。累積ゲイン曲線と対角線の間の面積に相当します。kind='stable' は、予測が同じ値の顧客の並び順を固定するための指定です。
- 評価の関数: evaluate は、RMSE・MAE・合計の比・正規化ジニ(gini(y, pred) / gini(y, y))・上位20%カバー率を計算して、results に記録します。rank_only=True のときは、金額としての指標(RMSE・MAE・合計の比)を NaN にします。RFMスコアの合計は3〜15点の順位で、金額ではないためです。
- 上位20%カバー率: np.argsort(-pred, kind='stable')[: len(y) // 5] で、予測の大きい順に並べた顧客の位置の先頭20%を取り出し、その顧客の実際の売上の合計を全体で割っています(-pred で符号を反転すると、小さい順に並べる np.argsort が大きい順になります)。上位20%にするのは、RFMの記事と同じく、施策の対象を顧客の2割に絞る、という実務でよくある設定に合わせるためです。
- 平均を予測するモデル: np.full(N, y.mean()) で、全員に翌1年の売上の平均(7,252円)を予測します。順位の情報をまったく持たない、最低限の基準です。
- RFMスコアと神の視点: RFMの記事と同じスコアリング(R と M は pd.qcut の五分位、F は pd.cut の閾値)の合計と、真値から計算した翌1年の売上の期待値です。期待値は、k_purchase を横方向(1〜299回目の購買)、lam_tau を縦方向(顧客)に並べて NumPy のブロードキャストで(顧客数, 299)の行列を作り、sum(axis=1) で顧客ごとに足し合わせています。最後に alive_now を掛けるので、離脱した顧客の期待値は0です。
- 表示: pd.DataFrame(results).T で、モデルを行、評価指標を列にした表にしています。
実行結果
                RMSE       MAE   合計の比  正規化ジニ  上位20%カバー率
平均(全員同じ)   18260.242  9248.964  1.000 -0.014      0.199
RFMスコアの合計        NaN       NaN    NaN  0.636      0.571
神の視点        9436.621  3386.645  0.993  0.948      0.780
- 平均を予測するモデル: 正規化ジニは −0.014、上位20%カバー率は19.9%で、ランダムな順位付けと同じです。一方で、RMSE は18,260円です。
- 神の視点でも RMSE は9,437円: 真の購買ペースや離脱を知っていても、来年いつ何回買うかは偶然で決まるので、RMSE はゼロになりません。平均を予測するだけのモデルとの差は、2倍程度しかありません。RMSE は、偶然のばらつきの大きさに支配されていて、順位付けの良し悪しをほとんど反映しないのです。
- RFMスコアの合計: 正規化ジニ0.636、上位20%カバー率57.1%で、RFMの記事と同じ値です。
これ以降、各モデルを、平均を予測するモデル(下限)と神の視点(購買履歴でも行動ログでも超えられない上限)の間のどこに位置するかで比べていきます。
BTYDモデルによる予測
もう1つの比較の基準として、BTYDの記事の BG/NBDモデルと Gamma-Gammaモデルで翌1年の売上を予測します。コードは BTYDの記事の最尤推定と予測の関数を、必要な部分だけまとめて再掲したものです。モデルの説明は BTYDの記事を参照してください。
コードが最後に計算する翌1年の売上の予測は、BG/NBDモデルの翌365日の購買回数の期待値(導出。コードの expected_purchases(bgnbd_params, 365, x, t_x, T))と、Gamma-Gammaモデルの1回あたりの購買金額の期待値 (導出。exp_spend)の積です( は x・t_x・T、 は n_i・z_bar・w、推定した は p_est・q_est・gamma_est)。
from scipy.special import gammaln, hyp2f1
from scipy.optimize import minimize

x = summary['x'].values
t_x = summary['t_x'].values.astype(float)
T = summary['T'].values.astype(float)
n_i = summary['n_purchases'].values
z_bar = summary['monetary'].values

# 1. BG/NBDモデルの対数尤度と最尤推定(BTYDの記事と同じ)
def bgnbd_loglik(params, x, t_x, T):
    r_, alpha_, a_, b_ = params
    A1 = gammaln(r_ + x) - gammaln(r_) + r_ * np.log(alpha_)
    A2 = gammaln(a_ + b_) + gammaln(b_ + x) - gammaln(b_) - gammaln(a_ + b_ + x)
    A3 = -(r_ + x) * np.log(alpha_ + T)
    A4 = np.where(x > 0, np.log(a_) - np.log(np.maximum(b_ + x - 1, 1e-12)) - (r_ + x) * np.log(alpha_ + t_x), -np.inf)
    return A1 + A2 + np.logaddexp(A3, A4)

res = minimize(lambda lp: -bgnbd_loglik(np.exp(lp), x, t_x, T).sum(), x0=np.log([1.0, 10.0, 1.0, 1.0]), method='L-BFGS-B')
bgnbd_params = np.exp(res.x)

# 2. 将来 t 日間の購買回数の期待値(BTYDの記事と同じ)
def expected_purchases(params, t, x, t_x, T):
    r_, alpha_, a_, b_ = params
    ratio = np.where(x > 0, a_ / np.maximum(b_ + x - 1, 1e-12) * ((alpha_ + T) / (alpha_ + t_x)) ** (r_ + x), 0.0)
    hyp = hyp2f1(r_ + x, b_ + x, a_ + b_ + x - 1, t / (alpha_ + T + t))
    alive_part = (a_ + b_ + x - 1) / (a_ - 1) * (1 - ((alpha_ + T) / (alpha_ + T + t)) ** (r_ + x) * hyp)
    return alive_part / (1 + ratio)

# 3. Gamma-Gammaモデルの最尤推定と、1回あたりの購買金額の期待値(BTYDの記事と同じ)
def gg_loglik(params, n_i, z_bar):
    p_, q_, g_ = params
    return (gammaln(p_ * n_i + q_) - gammaln(p_ * n_i) - gammaln(q_) + q_ * np.log(g_)
            + (p_ * n_i - 1) * np.log(z_bar) + p_ * n_i * np.log(n_i) - (p_ * n_i + q_) * np.log(g_ + n_i * z_bar))

res_gg = minimize(lambda lp: -gg_loglik(np.exp(lp), n_i, z_bar).sum(), x0=np.log([1.0, 2.0, 1000.0]), method='L-BFGS-B')
p_est, q_est, gamma_est = np.exp(res_gg.x)
w = p_est * n_i / (p_est * n_i + q_est - 1)
exp_spend = (1 - w) * p_est * gamma_est / (q_est - 1) + w * z_bar

# 4. 翌1年の売上の予測 = 購買回数の期待値 × 1回あたりの購買金額の期待値
preds['BTYD'] = expected_purchases(bgnbd_params, 365, x, t_x, T) * exp_spend
evaluate('BTYD', preds['BTYD'], results=results)
print(pd.DataFrame(results).T.round(3).to_string())
BTYDの記事の BG/NBDモデルと Gamma-Gammaモデルで、翌1年の売上を予測しています。
- BG/NBDモデル: bgnbd_loglik の対数尤度を最大化して を推定し、expected_purchases で翌365日の購買回数の期待値を計算しています。BTYDの記事では生存確率を別の関数にしていましたが、ここでは分母(1 + ratio)として関数の中にまとめています。計算の中身は同じです。
- 最適化: どちらのモデルも、パラメータの対数を minimize(..., method='L-BFGS-B') で探索し、np.exp(res.x) で元に戻しています。パラメータが正の値に限られるためです。
- Gamma-Gammaモデル: gg_loglik で を推定し、本人の実績への重み w を使った縮小推定で、1回あたりの購買金額の期待値 exp_spend を計算しています。
- 予測: 購買回数の期待値と1回あたりの購買金額の期待値の積が、翌1年の売上の予測です。BTYDモデルは翌年の売上を正解として学習していない(購買のパターンだけから推定する)ので、交差適合は必要ありません。
実行結果
                RMSE       MAE   合計の比  正規化ジニ  上位20%カバー率
平均(全員同じ)   18260.242  9248.964  1.000 -0.014      0.199
RFMスコアの合計        NaN       NaN    NaN  0.636      0.571
神の視点        9436.621  3386.645  0.993  0.948      0.780
BTYD       15538.956  6795.013  0.993  0.722      0.616
BTYDモデルの上位20%カバー率は61.6%、正規化ジニは0.722で、BTYDの記事と同じ値です。合計の比は0.993で、顧客全体の売上の合計も正しく予測できています。RMSE(15,539円)も、平均を予測するモデルより小さくなっています。
特徴量を使う機械学習
学習と評価の方法:交差適合
機械学習では、特徴量 (X の行)から翌1年の売上 (y)を予測するモデルを、正解のあるデータで学習します。本記事のデータは2年分しかないので、5分割交差適合(cross-fitting) で予測を作ります。顧客を5つのグループに分け、4つのグループで学習したモデルで、残り1つのグループを予測します。これを5回繰り返すと、全員について「自分のデータを学習に使っていないモデルの予測」がそろいます。こうすると、RFM・BTYD・神の視点と、同じ10,000人で比べられます。
実務では、顧客を分けるのではなく、時期をずらして学習データを作ります。たとえば「2年前〜1年前の行動から、過去1年の売上を予測する」モデルを学習し、それを「過去1年の行動」に当てはめて、来年の売上を予測します。本記事の交差適合は、データが2年分しかないための代わりの方法です。
まずは、決定木を使った勾配ブースティングの代表的なライブラリ LightGBM で、MSE(平均二乗誤差)を最小にする回帰モデルを学習します。特徴量を変えて、「購買履歴だけ」と「購買履歴 + 行動ログ」の2通りを比べます。
式で書くと、顧客 が属するグループを 、グループ 以外の顧客で MSE を最小にするよう学習したモデルを (model)として、顧客 の予測 (pred)は次のようになります。
(train_idx)はグループ 以外の顧客の集合で、グループ の顧客は test_idx です。
import lightgbm as lgb
from sklearn.model_selection import KFold

# 1. 特徴量の行列(購買履歴の6列 + 行動ログの5列)
history_cols = ['x', 't_x', 'T', 'recency', 'n_purchases', 'monetary']
X = pd.concat([summary[history_cols], features], axis=1)
kf = KFold(n_splits=5, shuffle=True, random_state=0)

# 2. 5分割交差適合で、LightGBM(MSE)の予測を作る
def lgb_params():
    return dict(n_estimators=300, learning_rate=0.05, num_leaves=15, min_child_samples=50,
                random_state=0, n_jobs=1, verbose=-1)

for name, cols in [('LightGBM・MSE(購買履歴だけ)', history_cols), ('LightGBM・MSE(行動ログも使う)', list(X.columns))]:
    pred = np.zeros(N)
    for train_idx, test_idx in kf.split(X):
        model = lgb.LGBMRegressor(**lgb_params())
        model.fit(X.iloc[train_idx][cols], y[train_idx])
        pred[test_idx] = model.predict(X.iloc[test_idx][cols])
    preds[name] = pred
    evaluate(name, pred, results=results)
print(pd.DataFrame(results).T.round(3).to_string())
LightGBM の回帰モデル(MSE)を、5分割交差適合で学習・予測しています。
- 特徴量の行列: X は、購買履歴の6列(history_cols)と行動ログの5列を横に並べたものです。決定木のモデルは特徴量の単調な変換の影響を受けないので、対数変換や標準化はしていません。
- 交差適合: KFold(n_splits=5, shuffle=True, random_state=0) で顧客をランダムに5つに分け、kf.split が返す学習用とテスト用の添字の組で、学習と予測を5回繰り返しています。テスト用の顧客の予測だけを pred[test_idx] に書き込むので、最後には全員の予測がそろいます。
- LightGBM の設定: lgb_params は、木の数300本、学習率0.05、葉の数15、1つの葉に最低50人です。小さめの木を多数組み合わせ、過学習を防ぐ設定です。LGBMRegressor の既定の損失は MSE です。n_jobs=1 と random_state=0 は、実行のたびに同じ結果になるようにするための指定です。
- 2通りの特徴量: 購買履歴だけ(history_cols)と、行動ログも含めたすべての列で、同じ手順を繰り返しています。
実行結果
                            RMSE       MAE   合計の比  正規化ジニ  上位20%カバー率
平均(全員同じ)               18260.242  9248.964  1.000 -0.014      0.199
RFMスコアの合計                    NaN       NaN    NaN  0.636      0.571
神の視点                    9436.621  3386.645  0.993  0.948      0.780
BTYD                   15538.956  6795.013  0.993  0.722      0.616
LightGBM・MSE(購買履歴だけ)   15339.205  7148.436  1.001  0.685      0.592
LightGBM・MSE(行動ログも使う)  12792.759  5292.540  1.005  0.870      0.725
- 購買履歴だけでは BTYD に勝てない: 購買履歴の6列だけを使った LightGBM の上位20%カバー率は59.2%、正規化ジニは0.685で、BTYDモデル(61.6%、0.722)を下回りました。BTYDの記事で見たとおり、購買履歴の情報は BTYDモデルがほぼ取り切っています。購買のパターンをモデルの構造として組み込んだ BTYD に対して、汎用の機械学習が同じ情報から勝つのは簡単ではありません。
- 行動ログを加えると大きく伸びる: 行動ログの5列を加えると、上位20%カバー率は72.5%、正規化ジニは0.870まで上がりました。BTYDモデルの限界を、11ポイント近く超えています。機械学習の価値は、アルゴリズムそのものよりも、購買履歴以外の情報を取り込めることにあるのです。
MSEで学習すると何が起きるか
同じネットワークで損失関数だけを変える
損失関数の違いを比べるため、ここからは小さなニューラルネットワーク(隠れ層1層、16ユニットの多層パーセプトロン、MLP)を使い、損失関数だけを変えて学習します。ネットワークは NumPy で書き、勾配は autograd で自動計算し、SciPy の L-BFGS 法で重みを最適化します。
特徴量は、回数(購買回数・訪問回数など)を 、金額を で変換してから、学習データの平均と標準偏差で標準化します。売上は千円単位(y_k)にして学習します。
変換した特徴量を (Z の行)、学習データでの平均を (mean)、標準偏差を (std)とすると、ネットワークの入力は です。MLP は、この入力から次の計算で出力 (関数 forward の戻り値。隠れ層の は h)を作ります( は、MSE では1つの値、後の ZILN損失では3つの値です)。
重み (unpack の戻り値)をまとめたベクトルを (v)とし、損失 に L2正則化を加えた次の目的関数を最小にします(、l2)。
まず、損失 (mse_loss)として、よく使われる2つの方法を試します( は千円単位の売上)。
- MSE:売上 をそのまま予測し、 を最小にする。予測は
- 対数変換してMSE:裾の重さを和らげるため、 を最小にし( は np.log1p)、予測値を (np.expm1)で元に戻す
import autograd.numpy as anp
from autograd import grad

# 1. 特徴量の変換(回数は log(1 + x)、金額は log)
Z = X.copy()
for c in ['x', 't_x', 'T', 'recency', 'n_purchases', 'visits_30d', 'cart_30d']:
    Z[c] = np.log1p(Z[c])
for c in ['monetary', 'viewed_price']:
    Z[c] = np.log(Z[c])
Z = Z.values.astype(float)
y_k = y / 1000                      # 千円単位

# 2. 隠れ層1層の MLP(重みを1本のベクトルにまとめて扱う)
HIDDEN = 16
def unpack(v, d, out):
    W1 = v[: d * HIDDEN].reshape(d, HIDDEN)
    b1 = v[d * HIDDEN: d * HIDDEN + HIDDEN]
    W2 = v[d * HIDDEN + HIDDEN: d * HIDDEN + HIDDEN + HIDDEN * out].reshape(HIDDEN, out)
    b2 = v[d * HIDDEN + HIDDEN + HIDDEN * out:]
    return W1, b1, W2, b2

def forward(v, X_, out):
    W1, b1, W2, b2 = unpack(v, X_.shape[1], out)
    h = anp.tanh(anp.dot(X_, W1) + b1)
    return anp.dot(h, W2) + b2

def fit_mlp(loss, out, X_, y_, seed=0, l2=1e-3, maxiter=500):
    d = X_.shape[1]
    init_rng = np.random.default_rng(seed)
    v0 = np.concatenate([init_rng.normal(0, 1 / np.sqrt(d), d * HIDDEN), np.zeros(HIDDEN),
                         init_rng.normal(0, 1 / np.sqrt(HIDDEN), HIDDEN * out), np.zeros(out)])
    objective = lambda v: loss(v, X_, y_) + l2 * anp.sum(v ** 2)     # L2正則化つきの損失
    res = minimize(objective, v0, jac=grad(objective), method='L-BFGS-B', options={'maxiter': maxiter})
    return res.x

# 3. 交差適合の共通部分(学習データで標準化し、学習して、テストデータを予測する)
def cross_fit(train_and_predict):
    pred = np.zeros(N)
    for train_idx, test_idx in kf.split(Z):
        mean, std = Z[train_idx].mean(axis=0), Z[train_idx].std(axis=0)
        pred[test_idx] = train_and_predict((Z[train_idx] - mean) / std, y_k[train_idx], (Z[test_idx] - mean) / std)
    return pred * 1000              # 円に戻す

# 4. MSE と、対数変換してから MSE
def mse_loss(v, X_, y_):
    return anp.mean((forward(v, X_, 1)[:, 0] - y_) ** 2)

def mse_model(X_tr, y_tr, X_te):
    return forward(fit_mlp(mse_loss, 1, X_tr, y_tr), X_te, 1)[:, 0]

def log_mse_model(X_tr, y_tr, X_te):
    return np.expm1(forward(fit_mlp(mse_loss, 1, X_tr, np.log1p(y_tr)), X_te, 1)[:, 0])

preds['MLP・MSE'] = cross_fit(mse_model)
preds['MLP・対数変換してMSE'] = cross_fit(log_mse_model)
for name in ['MLP・MSE', 'MLP・対数変換してMSE']:
    evaluate(name, preds[name], results=results)
    p_ = preds[name]
    print(f"{name}: 負の予測 {(p_ < 0).mean():.1%}、予測の最大 {p_.max():,.0f} 円、予測の合計 / 実際の合計 {p_.sum() / y.sum():.3f}")
print()
print(pd.DataFrame(results).T.round(3).to_string())
NumPy で書いた MLP を、MSE と、対数変換してから MSE の2通りで学習しています。
- 特徴量の変換: 回数や日数は np.log1p、金額は np.log で変換しています。裾の重い特徴量のままだと、一部の顧客の大きな値に学習が引きずられるためです。標準化は cross_fit の中で、学習データの平均と標準偏差を使って行います(テストデータの情報を学習に混ぜないため)。
- MLP: forward は「入力 → 16ユニットの tanh の隠れ層 → 出力」の計算です。重みはすべて1本のベクトル v にまとめ、unpack で行列とベクトルに切り分けています。SciPy の minimize は1本のベクトルしか最適化できないためです。
- 学習: fit_mlp は、損失に L2正則化(重みの二乗和 × 0.001)を加えた目的関数を作り、grad(objective) で autograd に勾配の関数を作らせて、L-BFGS-B 法で最大500回更新します。autograd は、anp(autograd 版の NumPy)で書いた関数なら、自動で微分できます。重みの初期値は、入力の数の平方根で割った正規乱数です。隠れ層16ユニット、L2正則化0.001、最大500回の更新は、1万人・11個の特徴量のデータで過学習しにくい小さな設定の例で、損失の違い(MSE・対数変換・ZILN)の比較の結果は、これらの値に大きく左右されません。
- MSE と対数変換: mse_model は売上(千円)をそのまま予測し、log_mse_model は np.log1p(y_tr) を予測してから np.expm1 で元に戻します。
- 予測の確認: 負の値を予測した顧客の割合、予測の最大値、予測の合計と実際の合計の比を表示し、最後にここまでのモデルの評価指標の表を表示しています。
実行結果
MLP・MSE: 負の予測 15.1%、予測の最大 203,455 円、予測の合計 / 実際の合計 0.995
MLP・対数変換してMSE: 負の予測 13.8%、予測の最大 243,014 円、予測の合計 / 実際の合計 0.689

                            RMSE       MAE   合計の比  正規化ジニ  上位20%カバー率
平均(全員同じ)               18260.242  9248.964  1.000 -0.014      0.199
RFMスコアの合計                    NaN       NaN    NaN  0.636      0.571
神の視点                    9436.621  3386.645  0.993  0.948      0.780
BTYD                   15538.956  6795.013  0.993  0.722      0.616
LightGBM・MSE(購買履歴だけ)   15339.205  7148.436  1.001  0.685      0.592
LightGBM・MSE(行動ログも使う)  12792.759  5292.540  1.005  0.870      0.725
MLP・MSE                13172.866  5529.716  0.995  0.857      0.720
MLP・対数変換してMSE          12841.193  4679.105  0.689  0.887      0.735
- MSE は負の売上を予測する: MSE で学習した MLP は、15.1%の顧客に負の売上を予測しました。MSE は「平均的に誤差が小さい」ことしか求めないので、売上がマイナスになり得ないことを知りません。また、予測の最大は約20万円で、実際の最大(約43万円)に届きません。上位20%カバー率も72.0%と、LightGBM と同程度です。
- 対数変換すると、合計が3割も小さくなる: 対数変換してから学習すると、正規化ジニは0.887、上位20%カバー率は73.5%と、順位付けは MSE より良くなりました。しかし、予測の合計は実際の合計の0.689倍しかありません。顧客全体の価値を3割以上も過小評価しているのです。なお、負の予測(13.8%)は、 の予測が負になった顧客で、元に戻すと −1,000円〜0円の小さな負の値になっています。
- MAE は対数変換が最も良い: 結果の表を見ると、MAE は、神の視点を除くと、対数変換したモデル(4,679円)が最も小さくなっています。大半の顧客の売上はゼロか小さいので、全体を小さめに予測するモデルほど、MAE は小さくなるのです。指標によって「良いモデル」が入れ替わることも、CLV の評価に複数の指標が必要な理由です。
補足:なぜ対数変換すると合計を過小評価するのか
対数変換してMSEで学習すると、モデルは を予測します。予測値を元に戻した は、イェンセンの不等式( は上に凸な関数なので、)により、
となり、期待値 を必ず下回ります。 のばらつきが大きいほど、この差は大きくなります。たとえば なら、 は中央値で、期待値 より 倍小さくなります。CLV のように「ゼロが多く、裾が重い」分布では、この補正が非常に大きくなります。
2つの損失の結果を並べると、次のようになります。
(図は、diagram-designで作成)
ZILN損失:ゼロ過剰対数正規分布
モデルの考え方
MSE も対数変換も、「翌年の売上」という1つの数値を直接予測しようとしていました。ZILN損失の考え方は、売上を1つの数値ではなく、分布として予測することです(Wang, Liu & Miao, 2019)。翌年の売上 が、次の2段階で決まると考えます。
- 確率 で、翌年は1回も買わない()
- 確率 で買い、そのときの売上は対数正規分布 に従う()
ネットワークは、顧客ごとに3つの値( を決めるロジット、、)を出力します。この分布のもとでの負の対数尤度が、ZILN損失です。
場合分けを、条件を満たすとき1、満たさないとき0になる指示関数 を使って1つの式にまとめると、次のように2つの項の和になります。
なら第1項の だけが残り、 なら第1項の と第2項が残るので、場合分けの式と一致します。第1項( に関する部分)は「買うかどうか」の2値分類の交差エントロピー、第2項は「買った顧客の売上」の対数正規分布の尤度です。1つのネットワークで、分類と回帰を同時に学習しているわけです。
予測に使うのは、この分布の期待値です。対数正規分布の期待値は なので、
となります。対数変換してMSEで学習したモデルは、 に相当する値(期待値ではなく中央値に近い値)を予測していました。ZILN損失では、 も学習するので、 の補正を正しく掛けて期待値に戻せます。 1. 正規分布の期待値の計算に書き直す: なので、 とおくと で、 は確率密度関数 の正規分布に従います。したがって、 の期待値は の期待値です。 2. 指数部分をまとめて平方完成する: と の指数を足すと、 です。分子を について平方完成すると、 なので、これを で割ると、指数は になります。 3. 正規分布の確率密度の積分が1であることを使う: を含まない を積分の外に出すと、残る被積分関数は、平均 ・分散 の正規分布の確率密度関数そのものです。確率密度関数を全範囲で積分すると1なので、 が得られます。一方、 の中央値は なので、 の中央値は です( は単調増加なので、順位が保たれます)。期待値は中央値の 倍で、 が大きい(裾が重い)ほど、期待値は中央値より大きくなります。 4. 買わない確率も含めた期待値:ZILN の分布では、確率 で 、確率 で なので、場合ごとの期待値に確率を掛けて足すと、 となり、本文の式になります。詳細な式展開(対数正規分布の期待値 )
ZILN の分布と出力を図にすると、次のようになります。
(図は、diagram-designで作成)
実装
モデルの考え方の ZILN損失 (ziln_loss)と期待値 (ziln_model の戻り値)を、ネットワークの3つの出力 で書き直すと、次のようになります。(p)はロジット (logit)のシグモイド、(mu)は 、(sigma)は を softplus(、関数 softplus)で正にした値です。 と (log_p・log_1mp)は、桁あふれしないよう softplus で計算します。
の場合の角かっこの中はコードの loglik_pos、 は log_y です。
# 1. ZILN損失(ネットワークの出力: ロジット・mu・sigma の3つ)
def softplus(z):
    return anp.logaddexp(0, z)                  # log(1 + e^z)。sigma を正にするために使う

def ziln_loss(v, X_, y_):
    out = forward(v, X_, 3)
    logit, mu, sigma = out[:, 0], out[:, 1], softplus(out[:, 2]) + 1e-3
    positive = y_ > 0
    log_p, log_1mp = -softplus(-logit), -softplus(logit)     # log p と log(1 - p)
    log_y = anp.log(anp.where(positive, y_, 1.0))            # y = 0 の行は使わないので 1 で埋める
    loglik_pos = log_p - log_y - anp.log(sigma) - 0.5 * anp.log(2 * anp.pi) - (log_y - mu) ** 2 / (2 * sigma ** 2)
    return -anp.mean(anp.where(positive, loglik_pos, log_1mp))

# 2. 予測:期待値 p * exp(mu + sigma^2 / 2)
def ziln_predict(v, X_):
    out = forward(v, X_, 3)
    p = 1 / (1 + np.exp(-out[:, 0]))
    sigma = np.logaddexp(0, out[:, 2]) + 1e-3
    return p, out[:, 1], sigma

def ziln_model(X_tr, y_tr, X_te):
    p, mu, sigma = ziln_predict(fit_mlp(ziln_loss, 3, X_tr, y_tr), X_te)
    return p * np.exp(mu + sigma ** 2 / 2)

preds['MLP・ZILN'] = cross_fit(ziln_model)
evaluate('MLP・ZILN', preds['MLP・ZILN'], results=results)

# 3. 予測の中身を見る(最後の分割で学習したモデルで、買う確率が最も低い顧客と、期待値が最も高い顧客)
train_idx, test_idx = list(kf.split(Z))[-1]
mean, std = Z[train_idx].mean(axis=0), Z[train_idx].std(axis=0)
v_last = fit_mlp(ziln_loss, 3, (Z[train_idx] - mean) / std, y_k[train_idx])
p, mu, sigma = ziln_predict(v_last, (Z[test_idx] - mean) / std)
expected = p * np.exp(mu + sigma ** 2 / 2)
for label, j in [('買う確率が最も低い顧客', np.argmin(p)), ('期待値が最も高い顧客', np.argmax(expected))]:
    cid = test_idx[j]
    print(f"{label}(顧客{cid}): 買う確率 {p[j]:.2f}、買ったときの売上の中央値 {np.exp(mu[j]) * 1000:,.0f} 円、"
          f"sigma {sigma[j]:.2f}、期待値 {expected[j] * 1000:,.0f} 円(実際 {y[cid]:,.0f} 円)")
print()
print(pd.DataFrame(results).T.round(3).to_string())
ZILN損失を実装し、同じ MLP で学習しています。
- 出力の変換: ネットワークの3つの出力のうち、1つ目はロジット(logit)で、 が買う確率です。log_p と log_1mp は、 と を、桁あふれしないように softplus()で計算したものです。2つ目がそのまま 、3つ目を softplus で正の値にしたものが です。 が0に近づくと尤度が発散するので、1e-3 を足して下限を設けています。
- 損失: anp.where(positive, loglik_pos, log_1mp) で、売上がある顧客には「買う確率 × 対数正規分布」の対数尤度、売上がゼロの顧客には「買わない確率」の対数を使い、その平均の符号を反転しています。log_y は、売上がゼロの行で を計算しないよう、1で埋めてから対数をとっています(その行の値は使いません)。
- 予測: ziln_predict で を求め、ziln_model で期待値 を計算しています。
- 予測の中身: 5つ目の分割の学習データでもう一度学習し、テストデータのうち「買う確率が最も低い顧客」と「期待値が最も高い顧客」について、・(買ったときの売上の中央値)・・期待値を表示しています。
実行結果
買う確率が最も低い顧客(顧客3103): 買う確率 0.00、買ったときの売上の中央値 8,183 円、sigma 0.62、期待値 39 円(実際 0 円)
期待値が最も高い顧客(顧客9879): 買う確率 1.00、買ったときの売上の中央値 107,944 円、sigma 0.64、期待値 132,654 円(実際 159,970 円)

                            RMSE       MAE   合計の比  正規化ジニ  上位20%カバー率
平均(全員同じ)               18260.242  9248.964  1.000 -0.014      0.199
RFMスコアの合計                    NaN       NaN    NaN  0.636      0.571
神の視点                    9436.621  3386.645  0.993  0.948      0.780
BTYD                   15538.956  6795.013  0.993  0.722      0.616
LightGBM・MSE(購買履歴だけ)   15339.205  7148.436  1.001  0.685      0.592
LightGBM・MSE(行動ログも使う)  12792.759  5292.540  1.005  0.870      0.725
MLP・MSE                13172.866  5529.716  0.995  0.857      0.720
MLP・対数変換してMSE          12841.193  4679.105  0.689  0.887      0.735
MLP・ZILN               12017.884  4845.502  1.016  0.893      0.740
- 予測の中身が解釈できる: 買う確率が最も低い顧客の予測は、買う確率0.00、期待値39円で、実際に翌年は買いませんでした。期待値が最も高い顧客は、買う確率1.00、買ったときの売上の中央値は約10.8万円、期待値は約13.3万円で、実際の売上は約16.0万円でした。ZILN損失のモデルは、「買うかどうか」と「買ったらいくらか」を分けて答えてくれるので、予測の理由を説明しやすくなります。
- 順位付けも金額も良い: 正規化ジニは0.893、上位20%カバー率は74.0%と、これまでのモデルで最も良い値です。そのうえ、合計の比は1.016で、対数変換したモデル(0.689)のような過小評価もありません。RMSE(12,018円)も、神の視点を除く全モデルの中で最も小さくなりました。
対数変換したモデルとの違いは、 を学習して を掛けて期待値に戻していることです。上の例の顧客の は0.6前後なので、この補正だけで予測が約1.2倍になります。
LightGBMの二段階モデル
ZILN損失と同じ「買うかどうか × いくら買うか」の分解は、決定木のモデルでも使えます。実務でよく使われるのは、LightGBM などで2つのモデルを別々に学習する 二段階モデル です(たとえば Vanderveld et al., 2016)。
- 分類モデル:翌年に買うかどうか()の確率 (clf.predict_proba(...)[:, 1])を予測する
- 回帰モデル:買った顧客だけで、 を予測する(、reg.predict(...))
予測 (pred)は とします。(s2)は、学習データのうち買った顧客 (pos_idx)での回帰モデルの残差()の分散で、対数正規分布の期待値に戻すための補正です。ZILN損失と違い、 を顧客ごとには推定せず、全員に同じ値を使います。
# 1. 二段階モデル:買うかどうか(分類) × 買った顧客の log(売上)(回帰)
pred = np.zeros(N)
for train_idx, test_idx in kf.split(X):
    clf = lgb.LGBMClassifier(**lgb_params())
    clf.fit(X.iloc[train_idx], (y[train_idx] > 0).astype(int))
    pos_idx = train_idx[y[train_idx] > 0]                       # 学習データのうち、買った顧客
    reg = lgb.LGBMRegressor(**lgb_params())
    reg.fit(X.iloc[pos_idx], np.log(y[pos_idx]))
    s2 = np.var(np.log(y[pos_idx]) - reg.predict(X.iloc[pos_idx]))   # 残差の分散
    pred[test_idx] = clf.predict_proba(X.iloc[test_idx])[:, 1] * np.exp(reg.predict(X.iloc[test_idx]) + s2 / 2)
preds['LightGBM・二段階'] = pred
evaluate('LightGBM・二段階', pred, results=results)
print(pd.DataFrame(results).T.round(3).to_string())
LightGBM で、分類モデルと回帰モデルを組み合わせた二段階モデルを学習しています。
- 分類モデル: LGBMClassifier で、翌年に買ったかどうか(y > 0 を0/1にしたもの)を学習し、predict_proba の2列目(買う確率)を使っています。
- 回帰モデル: 学習データのうち買った顧客(pos_idx)だけで、np.log(y) を予測する回帰モデルを学習しています。
- 期待値への補正: s2 は、学習データでの の残差の分散です。 が平均 、分散 の正規分布に従うとみなして、 で期待値に戻しています。
実行結果
                            RMSE       MAE   合計の比  正規化ジニ  上位20%カバー率
平均(全員同じ)               18260.242  9248.964  1.000 -0.014      0.199
RFMスコアの合計                    NaN       NaN    NaN  0.636      0.571
神の視点                    9436.621  3386.645  0.993  0.948      0.780
BTYD                   15538.956  6795.013  0.993  0.722      0.616
LightGBM・MSE(購買履歴だけ)   15339.205  7148.436  1.001  0.685      0.592
LightGBM・MSE(行動ログも使う)  12792.759  5292.540  1.005  0.870      0.725
MLP・MSE                13172.866  5529.716  0.995  0.857      0.720
MLP・対数変換してMSE          12841.193  4679.105  0.689  0.887      0.735
MLP・ZILN               12017.884  4845.502  1.016  0.893      0.740
LightGBM・二段階           12624.865  4891.446  0.931  0.887      0.734
- ZILN損失に近い順位付け: 正規化ジニは0.887、上位20%カバー率は73.4%で、ZILN損失のモデル(0.893、74.0%)に近い性能です。「買うかどうか × いくら」に分解する考え方が有効であることは、モデルの種類によらないことが分かります。
- 合計はやや過小評価: 合計の比は0.931で、7%ほど小さく予測しています。全員に同じ を使っているため、売上のばらつきが大きい顧客の補正が足りないことなどが原因と考えられます。ZILN損失は を顧客ごとに学習するので、この点で有利です。
実務では、二段階モデルは既存の分類・回帰の道具をそのまま使えるので、導入しやすい方法です。一方、ZILN損失は1つのモデルで分布全体を学習するので、期待値への補正を含めて一貫した予測ができます。
ここまでのすべてのモデルの指標を並べると、次のようになります。
(図は、diagram-designで作成)
モデルの比較
累積ゲイン曲線
順位付けの良さを、累積ゲイン曲線で比べます。描くのは、評価の関数で定義した、予測の高い順(order)に 人を選んだときの割合 (share)を横軸、実際の売上に占める割合 (np.cumsum(y[order]) / y.sum())を縦軸にとった曲線です。
新規顧客に限った正規化ジニ係数( は関数 gini)は、同じ式の を新規顧客だけ(y[new]・preds[name][new])にして計算します。
# 1. 累積ゲイン曲線:予測の高い順に並べたとき、上位 k% の顧客が実際の売上の何%を占めるか
compare = ['RFMスコアの合計', 'BTYD', 'MLP・対数変換してMSE', 'MLP・ZILN', '神の視点']
share = np.arange(1, N + 1) / N
plt.figure(figsize=(9, 6))
for name in compare:
    order = np.argsort(-preds[name], kind='stable')
    plt.plot(share, np.cumsum(y[order]) / y.sum(), label=f"{name}(正規化ジニ {results[name]['正規化ジニ']:.3f})")
order = np.argsort(-y, kind='stable')
plt.plot(share, np.cumsum(y[order]) / y.sum(), 'k--', label='理想(実際の売上の順)')
plt.plot([0, 1], [0, 1], color='gray', linestyle=':', label='ランダム')
plt.axvline(0.2, color='gray', linewidth=0.8)
plt.xlabel('予測の高い順に選んだ顧客の割合')
plt.ylabel('実際の売上に占める割合')
plt.title('累積ゲイン曲線')
plt.legend(fontsize=9)
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

# 2. 新規顧客(初回購買しかない顧客)に限った正規化ジニ係数
new = summary['x'].values == 0
print(f"初回購買しかない顧客: {new.sum():,} 人")
for name in ['BTYD', 'LightGBM・MSE(購買履歴だけ)', 'MLP・ZILN', '神の視点']:
    print(f"  {name:28s}: 正規化ジニ {gini(y[new], preds[name][new]) / gini(y[new], y[new]):.3f}")
累積ゲイン曲線を描き、新規顧客に限った正規化ジニ係数を計算しています。
- 累積ゲイン曲線: 各モデルの予測の高い順に顧客を並べ、np.cumsum で実際の売上を累積して、全体の売上で割っています。横軸は選んだ顧客の割合(share)です。実際の売上の順に並べた理想の曲線(黒の破線)と、ランダムに並べた場合の対角線(点線)も描いています。上位20%の位置に縦線を引いているので、各曲線とこの縦線の交点が、上位20%カバー率です。
- 曲線の描き方: np.argsort(-preds[name], kind='stable') で予測の大きい順の顧客の位置 order を求め、y[order] で実際の売上をその順に並べてから累積しています。凡例には、各モデルの正規化ジニ係数(results[name]['正規化ジニ'])を入れています。plt.axvline(0.2) が上位20%の縦線です。
- 新規顧客: summary['x'].values == 0 で、分析期間に初回購買しかない()顧客を選ぶ配列 new を作り、この顧客だけで、正規化ジニ係数 gini(y[new], preds[name][new]) / gini(y[new], y[new]) を計算し直しています。
実行結果
初回購買しかない顧客: 3,413 人
  BTYD                        : 正規化ジニ 0.527
  LightGBM・MSE(購買履歴だけ)        : 正規化ジニ 0.495
  MLP・ZILN                    : 正規化ジニ 0.700
  神の視点                        : 正規化ジニ 0.880
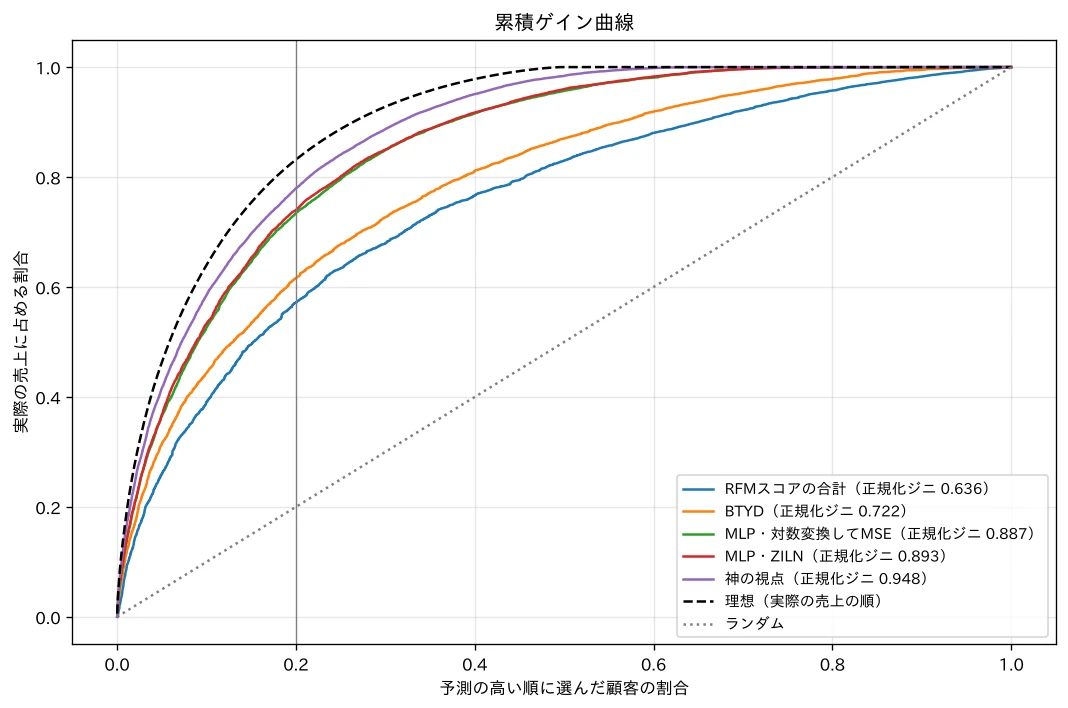
- 曲線の順序: 累積ゲイン曲線は、下から RFMスコア、BTYD、対数変換したMSE と ZILN(ほぼ重なっている)、神の視点、理想の順に並んでいます。ZILN損失のモデルは、BTYD と神の視点の差(上位20%カバー率で16.4ポイント)のうち、およそ4分の3(12.4ポイント)を埋めています。
- 新規顧客で差が大きい: 初回購買しかない3,413人に限ると、BTYDモデルの正規化ジニは0.527、購買履歴だけの LightGBM は0.495ですが、ZILN損失のモデルは0.700まで上がります。購買履歴が少ない顧客ほど、BTYDモデルは全体の平均に近い予測しかできませんが、行動ログがあれば「この新規顧客は、また来そうか」を見分けられます。新規顧客の獲得や育成の施策を考えるうえで、この差は大きな意味を持ちます。
十分位分析
最後に、予測の高い順に顧客を10グループに分け、グループごとに予測の平均と実際の平均を比べます。予測の高い順に 人ずつ分けた 番目のグループ( が最上位。各顧客の は decile)の顧客の集合を とすると、比べるのは次の2つです(decile_table の戻り値の '予測' 列と '実際' 列)。
# 1. 予測の高い順に10グループに分け、予測の平均と実際の平均を比べる
def decile_table(pred):
    decile = pd.qcut(pd.Series(pred).rank(method='first', ascending=False), 10, labels=range(1, 11))
    return pd.DataFrame({'予測': pred, '実際': y}).groupby(decile, observed=True).mean()

fig, axes = plt.subplots(1, 3, figsize=(15, 4.5), sharey=True)
for ax, name in zip(axes, ['BTYD', 'MLP・対数変換してMSE', 'MLP・ZILN']):
    table = decile_table(preds[name]) / 1000
    pos = np.arange(10)
    ax.bar(pos - 0.2, table['実際'], width=0.4, color='gray', label='実際の平均')
    ax.bar(pos + 0.2, table['予測'], width=0.4, color='C0', label='予測の平均')
    ax.set_xticks(pos, [str(i) for i in range(1, 11)])
    ax.set_title(name)
    ax.set_xlabel('予測の十分位(1が最上位)')
    ax.grid(True, axis='y', alpha=0.3)
axes[0].set_ylabel('翌1年の売上の平均(千円)')
axes[0].legend()
plt.tight_layout()
plt.show()

# 2. 最上位グループ(上位10%)の予測と実際
for name in ['BTYD', 'MLP・対数変換してMSE', 'MLP・ZILN']:
    top = decile_table(preds[name]).iloc[0]
    print(f"{name:20s}: 上位10%の予測の平均 {top['予測']:7,.0f} 円、実際の平均 {top['実際']:7,.0f} 円")
予測の十分位ごとに、予測の平均と実際の平均を比べています。
- 十分位の作り方: decile_table は、予測の大きい順の順位(rank(method='first', ascending=False)。同じ値の予測にも別の順位を付ける)を pd.qcut で10等分し、groupby(decile, observed=True).mean() で、グループごとに予測と実際の売上の平均をとっています。1が予測の最も高いグループです。表は千円単位にするため1000で割り、棒の位置を pos - 0.2・pos + 0.2 にずらして2本ずつ並べています。
- 可視化: BTYD、対数変換したMSE、ZILN の3つのモデルについて、グループごとに実際の平均(灰色)と予測の平均(青)を並べています。sharey=True で、3つの図の縦軸をそろえています。
- 最上位グループ: decile_table(preds[name]).iloc[0] で表の1行目(予測の上位10%)を取り出し、予測の平均と実際の平均を表示しています。
実行結果
BTYD                : 上位10%の予測の平均  33,069 円、実際の平均  32,174 円
MLP・対数変換してMSE       : 上位10%の予測の平均  28,694 円、実際の平均  38,157 円
MLP・ZILN            : 上位10%の予測の平均  39,520 円、実際の平均  38,677 円
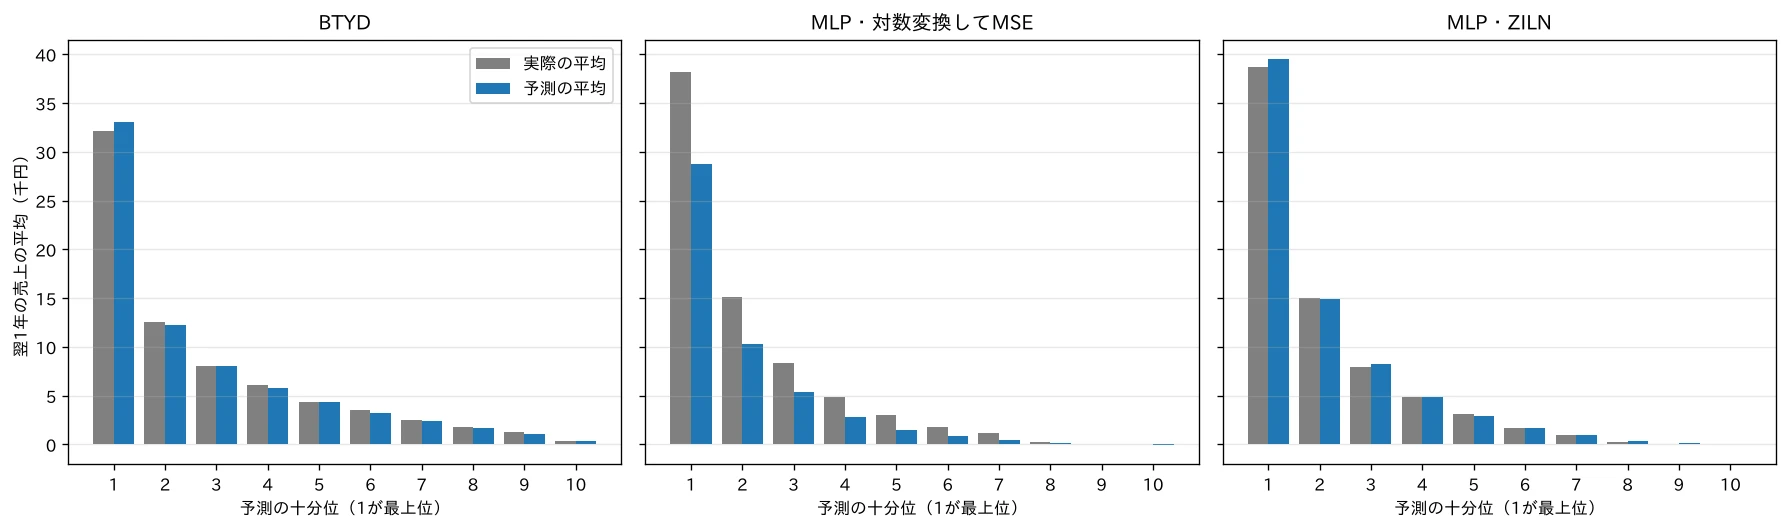
- BTYD: どのグループでも予測と実際はよく一致していますが、最上位グループの実際の平均は32,174円で、他の2つのモデル(約3.8万円)より低くなっています。予測の金額は正しいものの、本当に価値の高い顧客を上位に集めきれていないのです。
- 対数変換してMSE: 最上位グループの実際の平均は38,157円と、上位に価値の高い顧客を集められています。しかし、予測の平均は28,694円で、実際より25%も低く、他のグループでも一貫して予測が実際を下回っています。順位付けは良いのに、金額を一律に小さく見積もってしまう、という対数変換の弱点が、十分位分析ではっきり見えます。
- ZILN: 最上位グループの予測の平均は39,520円、実際の平均は38,677円です。他のグループでも予測と実際がよく一致しており、順位付けと金額の両方が正しいことが分かります。
正規化ジニ係数や上位20%カバー率だけを見ていると、対数変換したモデルと ZILN損失のモデルの差は小さく見えます。十分位分析や合計の比で金額の正しさを確かめると、その違いがはっきりします。
発展:さらに精度を上げるには
本記事では、集計した特徴量と小さなネットワークを使いました。実務では、次のような発展があります。
- 行動の系列をそのまま使う:訪問や購買の履歴を、集計せずに時系列のまま RNN や Transformer に入力する方法や、閲覧した商品の埋め込み表現を特徴量にする方法があります(Chamberlain et al., 2017)。
- LightGBM で分布を考慮した損失を使う:LightGBM には、ゼロが多く裾の重いデータのための Tweedie 損失(objective='tweedie')があり、二段階に分けずに1つのモデルで学習できます。
- 予測の不確実性を使う:ZILN損失は分布を予測するので、期待値だけでなく、「売上が10万円を超える確率」のような値も計算できます。
まとめ
本記事では、購買履歴以外の特徴量を使って CLV を予測する、機械学習による CLV 予測 を解説しました。
- 特徴量の効果:購買履歴だけの機械学習は、BTYDモデルを超えられませんでした。行動ログの特徴量を加えて初めて、BTYDモデルの限界(上位20%カバー率61.6%)を大きく超えられました。
- CLVの分布:翌年の売上は半分以上がゼロで、残りは裾が重い分布でした。
- MSEと対数変換の落とし穴:MSE で学習すると、負の値を予測するなど、分布の形を無視した予測になります。対数変換してMSEで学習すると、順位付けは改善しますが、合計を大きく過小評価します。
- ZILN損失:「買うかどうか」と「買ったときの売上の分布」を同時に学習し、期待値に正しく戻すことで、順位付けと合計の両方で良い予測が得られました。LightGBM の二段階モデルも、同じ考え方で近い性能を出しました。
- 評価指標:RMSE だけでは良し悪しを判断できないので、正規化ジニ係数・上位20%カバー率(順位付け)、合計の比・十分位分析(金額の正しさ)を組み合わせて評価しました。
ここまでのHVA関連の記事で、「どの顧客の将来の価値が高いか」を予測できるようになりました。しかし、施策(クーポンや広告)の対象を決めるときに本当に知りたいのは、「価値が高い顧客」ではなく「施策によって価値が上がる顧客」です。価値の高い顧客は、施策がなくても買ってくれるかもしれないからです。「アップリフトモデルの評価と方策価値とは?」の記事では、施策の効果が顧客ごとにどう違うかを予測するアップリフトモデル(メタラーナーの記事)を、どう評価すればよいかを扱います。
参考文献
- X. Wang, T. Liu, J. Miao (2019). A Deep Probabilistic Model for Customer Lifetime Value Prediction. arXiv:1912.07753.
- A. Vanderveld, A. Pandey, A. Han, R. Parekh (2016). An Engagement-Based Customer Lifetime Value System for E-commerce. Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 293–302.
- B. P. Chamberlain, A. Cardoso, C. H. B. Liu, R. Pagliari, M. P. Deisenroth (2017). Customer Lifetime Value Prediction Using Embeddings. KDD 2017.
本記事の文章・構成の一部に生成AIを使用しています。