コミュニティ検出(Louvain 法・Leiden 法)とは?
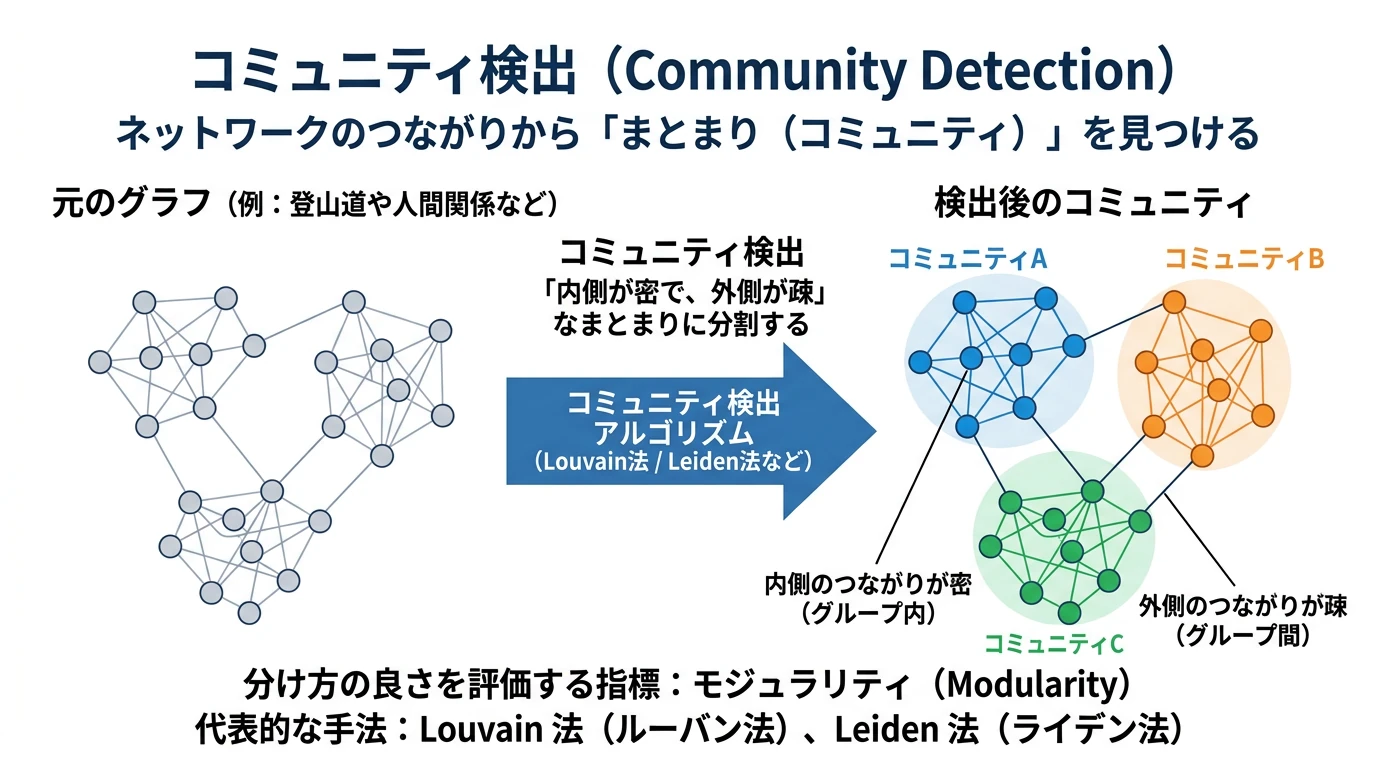 (画像は、Geminiで作成)
グラフを、内側のつながりが密で外側とのつながりが疎なノードのまとまり(コミュニティ)に分ける コミュニティ検出 の考え方を理解すること。分け方の良さを測る モジュラリティ を手計算・スクラッチ実装・networkx で一致させ、Louvain 法 をスクラッチ実装して動きを説明できるようになること。Louvain 法でつながっていないコミュニティが残る理由と Leiden 法 の改良、解像度パラメータの使い方と、モジュラリティの 解像度の限界 を説明できるようになること。
概要
グラフの記事では、架空の山域の登山道をグラフで表し、最短経路や連結成分を求めました。グラフには、「この地点たちは道で密につながっていて、ほかの地点とは数本の道でしかつながっていない」という まとまり がよく現れます。SNS の友人関係なら仲の良いグループ、論文の引用なら研究分野、文書から作ったナレッジグラフなら1つの話題に関わるエンティティの集まりです。このまとまりを コミュニティ(community)と呼び、グラフをコミュニティに分けることを コミュニティ検出(community detection)と呼びます。
クラスタリングの記事の k-means も「似たものどうしのまとまり」を見つけますが、そこではベクトルどうしの 距離 でまとめました。コミュニティ検出では、ノードの座標や特徴は使わず、どのノードとどのノードがつながっているか だけでまとめます。また、k-means のようにまとまりの数を先に決める必要はなく、数もデータから決まります。
本記事では、分け方の良さを測る指標 モジュラリティ(Newman & Girvan 2004)と、それを大きくする代表的な方法 Louvain 法(Blondel et al. 2008)・Leiden 法(Traag et al. 2019)を扱います。Leiden 法は、文書からナレッジグラフを作って要約する GraphRAG などでも使われています。次の節で、まず登山道のグラフをコミュニティに分けてみます。
登山道を、つながりだけで地域に分ける
グラフの記事と同じ、3つの山脈(Hoshimi・Akatsuki・Shiranami)に120の地点と170本の登山道がある架空の山域を使います。Hoshimi 山脈と Akatsuki 山脈の間には峠越えの道が1本だけあり、Shiranami 山脈はほかの山脈とつながっていません。この登山道を、道のつながりだけを使って「地域」に分けます。山脈は、答え合わせにだけ使います。
準備:Python の環境
NumPy・pandas・networkx・matplotlib と、Leiden 法のライブラリ leidenalg(と、それが使う igraph)を使います。GPU は使いません。記事の数値は、Python 3.13・NumPy 2.5.3・pandas 3.0.5・networkx 3.7・igraph 1.0.0・leidenalg 0.12.0・scikit-learn 1.9.1 で実行したものです。グラフの日本語表示には japanize-matplotlib を使います(Python 3.12 以降で import 時にエラーが出る場合は、setuptools も一緒に入れてください)。
!pip install igraph leidenalg japanize-matplotlib setuptools
実験1:連結成分と Louvain 法で分ける
import numpy as np
import pandas as pd
import networkx as nx
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフの日本語表示のため

# 1. 架空の山域:3つの山脈に、村・山小屋・山頂の地点を置く
SYLLABLES = ["ka", "ra", "se", "mo", "ri", "to", "na", "shi", "ku", "yo",
             "ha", "ne", "ta", "mi", "su", "ho", "ki", "no", "wa", "fu"]
RANGES = {"Hoshimi": (0, 0), "Akatsuki": (14, 2), "Shiranami": (40, 0)}   # 山脈の中心の座標(km)
KINDS = {"village": 3, "hut": 12, "summit": 25}                          # 山脈ごとの地点の数


def build_trails(seed=0):
    rng = np.random.default_rng(seed)
    used, rows = set(), []
    for rng_name, (cx, cy) in RANGES.items():
        for kind, count in KINDS.items():
            for _ in range(count):
                while True:
                    name = "".join(rng.choice(SYLLABLES, 3)).capitalize()
                    if name not in used:
                        used.add(name)
                        break
                label = {"village": f"{name} Village", "hut": f"{name} Hut", "summit": f"Mount {name}"}[kind]
                # 「{name} 村」「{name} 小屋(山小屋)」「{name} 山」
                rows.append((label, kind, rng_name, cx + rng.uniform(-6, 6), cy + rng.uniform(-6, 6)))
    points = pd.DataFrame(rows, columns=["name", "kind", "range", "x", "y"])

    # 2. 登山道:山脈ごとに、役割の違う2種類の道を引く
    #    (a) 最小全域木の道:山脈の中のどの地点にもたどり着けるようにする(これだけだと、経路が1通りしかない木になる)
    #    (b) 各地点から近い2地点への道:回り道(閉路)を作る(これだけだと、山脈の中が2〜3個に分かれてしまう)
    #    (a) と (b) は同じ道を選ぶことが多い。道は集合 pairs に (小さい番号, 大きい番号) で入れるので、重なった道は1本になる
    pairs = set()
    for _, g in points.groupby("range"):
        xy, idx = g[["x", "y"]].values, g.index.values                    # idx:山脈の中の番号 0〜39 → 全体の番号
        dist = np.linalg.norm(xy[:, None] - xy[None], axis=-1)          # 山脈の40地点どうしの距離(km)の表(40 × 40)
        # (a) 距離の表を「全地点どうしを、距離を重みにしたエッジで結んだグラフ」とみなし、その最小全域木
        #     (全地点をつなぐ、距離の合計が最小の39本のエッジ)の各エッジ (a, b) を道にする
        for a, b in nx.minimum_spanning_tree(nx.from_numpy_array(dist)).edges():
            pairs.add(tuple(sorted((idx[a], idx[b]))))
        # (b) 各地点から、近い順に1番目と2番目の地点へ道を引く(0番目は距離0の自分自身なので除く)
        for a in range(len(idx)):
            for b in np.argsort(dist[a])[1:3]:
                pairs.add(tuple(sorted((idx[a], idx[b]))))
    # Hoshimi と Akatsuki の間に、峠越えの道を1本だけ引く(Shiranami にはつながない)
    h, k = points[points["range"] == "Hoshimi"], points[points["range"] == "Akatsuki"]
    dist = np.linalg.norm(h[["x", "y"]].values[:, None] - k[["x", "y"]].values[None], axis=-1)
    i, j = np.unravel_index(dist.argmin(), dist.shape)
    pairs.add(tuple(sorted((h.index[i], k.index[j]))))

    # 3. 所要時間(分)= 25 × 距離(km)+ 休憩などのばらつき(5〜19分)
    trails = []
    for u, v in sorted(pairs):
        d = np.hypot(points.x[u] - points.x[v], points.y[u] - points.y[v])
        trails.append((points.name[u], points.name[v], int(round(25 * d + rng.integers(5, 20)))))
    return points, pd.DataFrame(trails, columns=["a", "b", "minutes"])


points, trails = build_trails()

# コミュニティ検出では、道のつながりだけを使う(所要時間の重みは使わない)
G = nx.Graph()
G.add_nodes_from(points.name)
G.add_edges_from(zip(trails.a, trails.b))
range_of = dict(zip(points.name, points["range"]))   # 答え合わせ用:各地点の山脈
print(f"地点: {G.number_of_nodes()}  登山道: {G.number_of_edges()}")

# 1. 連結成分:道でたどり着ける範囲に分ける
components = list(nx.connected_components(G))
print("連結成分の数:", len(components), " 大きさ:", sorted(len(c) for c in components))

# 2. Louvain 法:内側のつながりが密なまとまり(コミュニティ)に分ける
communities = nx.community.louvain_communities(G, seed=0)
Q = nx.community.modularity(G, communities)
print(f"Louvain 法のコミュニティの数: {len(communities)}  モジュラリティ: {Q:.3f}")
print("大きさ:", sorted(len(c) for c in communities))
n_mixed = sum(len({range_of[v] for v in c}) > 1 for c in communities)
print("2つ以上の山脈にまたがるコミュニティ:", n_mixed)

# 3. 地図に描く:連結成分(左)とコミュニティ(右)で色分けする
pos = {r.name: (r.x, r.y) for r in points.itertuples()}
fig, axes = plt.subplots(1, 2, figsize=(15, 4.6))
for ax, parts, title in [(axes[0], components, f"連結成分({len(components)}個)"),
                         (axes[1], communities, f"Louvain 法のコミュニティ({len(communities)}個)")]:
    color = {v: plt.cm.tab20((2 * i) % 20 + (2 * i) // 20) for i, c in enumerate(parts) for v in c}  # 隣の番号が似た色にならないように並べ替える
    nx.draw_networkx_edges(G, pos, ax=ax, edge_color="lightgray")
    nx.draw_networkx_nodes(G, pos, ax=ax, node_size=40, node_color=[color[v] for v in G.nodes()])
    for name, (cx, cy) in RANGES.items():
        ax.text(cx, cy - 8, name, ha="center", fontsize=11)   # 山脈の名前を、山脈の中心の下に書く
    ax.set_title(title)
    ax.set_aspect("equal")
plt.tight_layout()
plt.show()
グラフの記事と同じ登山道を作り、連結成分と、Louvain 法のコミュニティで分けて比べるコードです。
- 登山道のデータ: build_trails は、グラフの記事と同じ関数です(地点の置き方と道の引き方は、そちらで説明しています)。同じ seed=0 で作るので、地点も道も同じになります。
- 重みを使わない: グラフの記事では所要時間を重みにしましたが、ここでは道があるかないかだけでまとめたいので、G.add_edges_from(zip(trails.a, trails.b)) で重みなしのエッジにしています。
- 連結成分: nx.connected_components は、道でたどり着ける範囲ごとにノードを分けます。比べるための基準です。
- Louvain 法: nx.community.louvain_communities(G, seed=0) が、Louvain 法でコミュニティに分ける関数です。途中でノードを調べる順番に乱数を使うので、seed を固定して結果を再現できるようにしています(値そのものに意味はありません)。nx.community.modularity で、分け方の良さ(モジュラリティ、次の節で説明)を計算しています。
- 答え合わせ: range_of は各地点の山脈です。コミュニティの中に2つ以上の山脈の地点が入っていないかを数えています。
- 地図: 地点の座標 pos に点を置き、連結成分(左)とコミュニティ(右)で色分けしています。tab20 の色を1つおきに使い、番号の近いコミュニティが似た色にならないようにしています。
実行結果
地点: 120  登山道: 170
連結成分の数: 2  大きさ: [40, 80]
Louvain 法のコミュニティの数: 12  モジュラリティ: 0.830
大きさ: [6, 7, 7, 8, 8, 8, 9, 9, 12, 13, 14, 19]
2つ以上の山脈にまたがるコミュニティ: 0
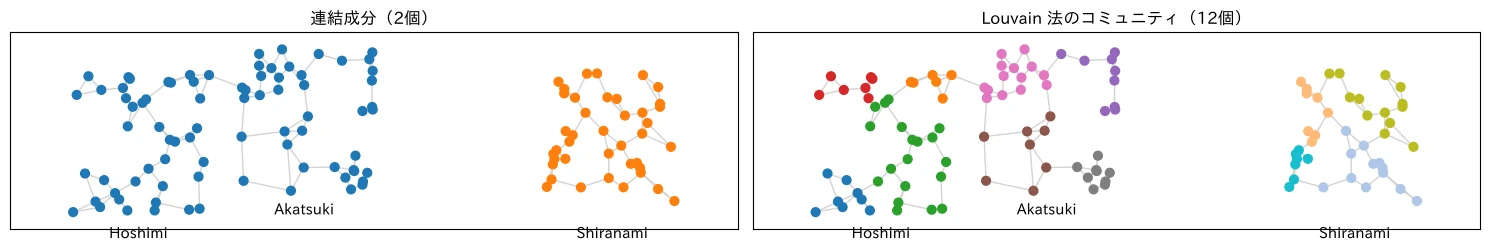
- 連結成分は2つ: 道でたどり着ける範囲で分けると、峠越えの道でつながった Hoshimi と Akatsuki(80地点)と、Shiranami(40地点)の2つにしかなりません。峠越えの道が1本でもあれば、2つの山脈は1つの成分になります。
- Louvain 法は12の地域: Louvain 法は、120地点を6〜19地点の12のコミュニティに分けました。地図を見ると、それぞれが近くの地点どうしのまとまりになっていて、山脈をまたぐコミュニティは1つもありません。道の座標や山脈の名前は使っていないのに、峠越えの道の両側は別のコミュニティになっています。
- モジュラリティ 0.830: これが「この分け方がどれだけ良いか」を表す値です。何を測っているのかを、次の節で見ていきます。
モジュラリティ:分け方の良さを測る
定義
コミュニティ検出の考え方は、「コミュニティの内側にはエッジが多く、外側へのエッジは少ない」です。ただし、単に「内側のエッジの数」を数えると、全体を1つのコミュニティにすれば最大になってしまいます。そこで モジュラリティ(modularity)は、内側のエッジの数を、ノードの次数を変えずにエッジをランダムにつなぎ直した場合に、内側に入ると期待されるエッジの数 と比べます。
エッジの数を 、ノード の次数を 、隣接行列を (つながっていれば1)、ノード のコミュニティを とすると、モジュラリティ は次の式です。
は、 と が同じコミュニティなら1、違えば0です。 は、次数を保ったままエッジの端をランダムにつなぎ直したときに、 と の間に引かれるエッジの数の期待値です(次数の大きいノードどうしほど、偶然つながりやすい)。つまりモジュラリティは、「同じコミュニティの組について、実際のエッジの数から、偶然つながると期待される数を引いたもの」の合計です。
コミュニティ の内側のエッジの数を 、コミュニティに属するノードの次数の合計を とすると、同じ式を次のように書き直せます。
詳細な式展開(2つの式が等しくなる理由)
は同じコミュニティの組だけを残すので、二重和をコミュニティごとの和に分けられます。
1項目: をどちらもコミュニティ の中で動かすと、内側のエッジ1本が と の2回数えられます。自己ループがなければ なので、合計は内側のエッジの数の2倍です。
2項目:和が と で分かれるので、因数分解できます。
この2つを代入すると、次のようになります。
なお、最初の式は の組も含んでいます。1項目では なので何も足されず、2項目では が引かれます。これは を展開したときの の部分にあたるので、2つの式は厳密に一致します。
1項目は「全エッジのうち、コミュニティ の内側にあるエッジの割合」、2項目は「ランダムにつなぎ直したときに、内側に入ると期待される割合」です。この形は Newman & Girvan(2004)の「Finding and evaluating community structure in networks」で、コミュニティの分け方を評価する指標として提案されました。
次数を変えずにエッジをランダムにつなぎ直したグラフは、コミュニティがないグラフ の基準です。これと比べることで、偶然でも内側に入る分を差し引き、偶然よりはっきり密につながっている分 だけを評価できます。
- 次数を変えない理由:エッジの多いハブを含むまとまりは、構造に関係なく内側のエッジが多くなります。次数を保ってつなぎ直せば、この次数による分は基準の側にも同じだけ入るので、引き算で打ち消されます。残るのは「誰と誰がつながっているか」という構造の分だけです。
- 2項目の意味:ランダムにつなぎ直すと、エッジの端は次数に比例して各ノードに割り当てられます。そのため、1本のエッジの両端がどちらもコミュニティ に入る確率は、およそ になります。
- なぜ最大化でコミュニティが見つかるのか:全体を1つにすると、実際の割合も期待される割合も1なので、 です。1ノードずつに分けると、内側のエッジがないので はマイナスになります。 が大きくなるのは、偶然より密につながったまとまりを1つにまとめ、偶然程度のつながりしかないところで分けたときです。これはコミュニティの考え方そのものなので、 を最大にする分け方を探すことが、コミュニティ検出になります。
ただし、期待される割合はグラフ全体のエッジの数 で決まります。大きなグラフでは、小さなまとまりどうしをくっつけても が上がってしまうことがあります。これは後の 解像度の限界 で確かめます。
手計算で確かめる
三角形を2つ並べ、1本のエッジでつないだグラフ(ノード6、エッジ7)で計算します。三角形ごとに分けると、各三角形の内側のエッジは 、次数の合計は です。
(図は、diagram-designで作成)
全体を1つにすると です。どう分けても「全体を1つ」より良くなければ、モジュラリティは0以下になります。この計算を、2つ目の式のとおりにスクラッチで実装し、networkx と比べます。
def modularity_score(G, communities, gamma=1.0):
    """Q = Σ_c [ L_c / m − γ (d_c / 2m)^2 ](L_c:コミュニティ c の内側のエッジの数、d_c:次数の合計)"""
    m = G.number_of_edges()
    Q = 0.0
    for c in communities:
        L_c = G.subgraph(c).number_of_edges()
        d_c = sum(d for _, d in G.degree(c))
        Q += L_c / m - gamma * (d_c / (2 * m)) ** 2
    return Q

# 三角形2つを、1本のエッジでつないだグラフ(ノード6・エッジ7)
T = nx.Graph([(0, 1), (0, 2), (1, 2), (3, 4), (3, 5), (4, 5), (2, 3)])
cases = {"三角形ごとに分ける": [{0, 1, 2}, {3, 4, 5}],
         "境目をずらす":       [{0, 1}, {2, 3, 4, 5}],
         "全体を1つにする":    [{0, 1, 2, 3, 4, 5}],
         "1ノードずつ分ける":  [{v} for v in range(6)]}
for name, c in cases.items():
    print(f"{name:12s} スクラッチ: {modularity_score(T, c):7.4f}  networkx: {nx.community.modularity(T, c):7.4f}")
print(f"登山道(Louvain 法の12個): スクラッチ {modularity_score(G, communities):.4f} / networkx {Q:.4f}")
モジュラリティを2つ目の式のとおりに計算する関数を作り、小さなグラフと登山道で networkx の値と比べるコードです。
- modularity_score: コミュニティごとに、内側のエッジの数 L_c(G.subgraph(c).number_of_edges())と次数の合計 d_c を数えて、式の各項を足します。gamma は後の「解像度」の節で使う係数で、既定の1.0がふつうのモジュラリティです。
- 4つの分け方: 三角形ごと(自然な分け方)、境目を1つずらした分け方、全体を1つ、1ノードずつの4通りで計算し、値の違いを見ます。
- 登山道: 実験1の Louvain 法の12個のコミュニティでも、networkx の値と一致するかを確かめています。
実行結果
三角形ごとに分ける    スクラッチ:  0.3571  networkx:  0.3571
境目をずらす       スクラッチ:  0.1224  networkx:  0.1224
全体を1つにする     スクラッチ:  0.0000  networkx:  0.0000
1ノードずつ分ける    スクラッチ: -0.1735  networkx: -0.1735
登山道(Louvain 法の12個): スクラッチ 0.8297 / networkx 0.8297
- 手計算と一致: 三角形ごとに分けると 0.3571 で、手計算と同じです。スクラッチ実装と networkx は、すべての分け方で一致しました。
- 値の読み方: 自然な分け方(0.3571)が最も大きく、境目をずらすと 0.1224 に下がります。全体を1つにすると0、1ノードずつに分けると、内側のエッジが1本もないのに「偶然の期待値」だけが引かれるので −0.1735 とマイナスになります。モジュラリティは、偶然より内側に多くのエッジが集まっているほど大きくなる 指標です。Newman & Girvan(2004)は、強いコミュニティの構造を持つ実データのグラフでは、モジュラリティがおよそ 0.3〜0.7 になることが多いと述べています。登山道の 0.83 は、それを上回る、かなりはっきりした構造です(道を近い地点どうしにだけ引いているため)。
ただし、すべての分け方のモジュラリティを計算して最大のものを選ぶことはできません。120ノードでも、分け方の数は天文学的になります(モジュラリティを最大にする問題は NP 困難であることが知られています)。そこで、少しずつ分け方を変えてモジュラリティを上げていく、近似の方法を使います。その代表が Louvain 法です。
Louvain 法
局所移動と集約
Louvain 法は、Blondel et al.(2008)の「Fast unfolding of communities in large networks」で提案された方法で、名前は著者らの所属(ベルギーのルーヴァン・カトリック大学)から来ています。次の2つの段階を繰り返します。
- 局所移動: 最初は1ノード1コミュニティから始めます。ノードを1つずつ取り出し、隣のノードが属するコミュニティのうち、移るとモジュラリティが最も増えるところへ動かします(増えなければ動かしません)。どのノードも動かなくなるまで、これを繰り返します。
- 集約: できたコミュニティを1つのノードにまとめた、小さなグラフを作ります。コミュニティの内側のエッジは自己ループに、コミュニティの間のエッジは重みを足し合わせたエッジになります。
集約したグラフで、また1から始めます。1つのノードも動かなくなったら終わりです。1の局所移動は、今の解の「隣」(ノードを1つだけ動かした解)のうち最も良いものへ移ることを繰り返す、局所探索(山登り法)そのものです。2の集約は、局所移動で止まってしまった後、まとまりごと動かせるようにして、より大きな構造を見つけるための工夫です。
(図は、diagram-designで作成)
ノード を、どのコミュニティにも属さない状態からコミュニティ に入れたときのモジュラリティの増分は、次の式で計算できます。
は から のノードへのエッジの数(重みの和)、 は に属するノードの次数の合計です。1項目は「 とのつながりの多さ」、2項目は「 が大きいほど偶然つながりやすい分の差し引き」です。どのコミュニティが最も良いかを比べるだけなら、共通の係数 を除いた を比べれば十分です。
スクラッチ実装
def to_weighted(G):
    """重み付きの隣接リスト {ノード: {隣接ノード: 重み}} にする(集約したグラフの自己ループも同じ形で持つ)"""
    return {v: {u: d.get("weight", 1.0) for u, d in G[v].items()} for v in G.nodes()}

def local_moving(adj, gamma=1.0, init=None, seed=0):
    """局所移動:ノードを1つずつ、モジュラリティが最も増えるコミュニティへ動かす。動かなくなるまで繰り返す"""
    rng = np.random.default_rng(seed)
    nodes = list(adj)
    # (a) 次数 k_i と全体の重み m。自己ループ(集約で内側のエッジをまとめたもの)は両端を数えるので2倍する。
    #     こうすると、集約したノードの次数が元のコミュニティの次数の合計 d_c と一致する
    k = {v: sum(w for u, w in adj[v].items() if u != v) + 2 * adj[v].get(v, 0.0) for v in nodes}
    m = sum(k.values()) / 2                                    # 次数の合計は、エッジの重みの2倍
    # (b) comm:ノード → 入っているコミュニティの番号。既定は1ノード1コミュニティから始める
    comm = dict(init) if init else {v: v for v in nodes}
    # (c) tot:コミュニティ → 次数の合計(式の Σ_tot)。ΔQ を毎回数え直さずに計算するために持っておく
    tot = {}
    for v in nodes:
        tot[comm[v]] = tot.get(comm[v], 0.0) + k[v]
    n_moves, moved = 0, True
    while moved:
        moved = False
        for v in rng.permutation(nodes):                       # 動かす順番を毎回ランダムにする
            c_old = comm[v]
            # (d) いったん v を今のコミュニティから外す。こうすると「どこにも属さない v をどこに入れるか」になり、
            #     今のコミュニティに残る場合も、ほかへ移る場合も、同じ ΔQ の式で比べられる
            tot[c_old] -= k[v]
            # (e) links:隣のコミュニティ → v からそのコミュニティへのエッジの重みの和(式の k_{i,in})。
            #     v の自己ループは、どこに入っても v と一緒に動くので比べる必要がなく、数えない
            links = {}
            for u, w in adj[v].items():
                if u != v:
                    links[comm[u]] = links.get(comm[u], 0.0) + w
            # ΔQ ∝ k_{i,in}(c) − γ Σ_tot(c) k_i / 2m が最も大きいコミュニティを選ぶ(同点なら元のまま)
            best, best_gain = c_old, links.get(c_old, 0.0) - gamma * tot[c_old] * k[v] / (2 * m)
            for c, l in links.items():
                gain = l - gamma * tot[c] * k[v] / (2 * m)
                if gain > best_gain + 1e-12:
                    best, best_gain = c, gain
            # (f) 選んだコミュニティに v を入れ、次数の合計を戻す
            comm[v] = best
            tot[best] = tot.get(best, 0.0) + k[v]
            if best != c_old:
                moved, n_moves = True, n_moves + 1
    return comm, n_moves

def aggregate(adj, comm):
    """集約:コミュニティを1つのノードにまとめたグラフを作る(内側のエッジは自己ループの重みになる)"""
    new = {}                                 # {コミュニティ: {隣のコミュニティ(自分も含む): 重み}}
    for v in adj:
        cv = comm[v]                         # v が入っているコミュニティ = 新しいグラフでのノード
        new.setdefault(cv, {})
        # adj は無向グラフなので、エッジ (v, u) は adj[v][u] と adj[u][v] の2か所にある。
        # v を全ノード回すと、自己ループ以外のエッジは両端から1回ずつ、計2回見ることになる
        for u, w in adj[v].items():
            cu = comm[u]
            if u == v:                       # 元からある自己ループ(前の集約で作ったもの):1回しか見ないので、そのまま足す
                new[cv][cv] = new[cv].get(cv, 0.0) + w
            elif cu == cv:                   # 内側のエッジ:v 側と u 側から2回見るので、半分ずつ足して合計 w にする
                new[cv][cv] = new[cv].get(cv, 0.0) + w / 2
            else:                            # コミュニティの間のエッジ:v 側では new[cv][cu]、u 側では new[cu][cv] に
                new[cv][cu] = new[cv].get(cu, 0.0) + w   # 1回ずつ足すので、両方向にちょうど w が入る
    return new

def louvain(G, gamma=1.0, seed=0, verbose=False):
    """Louvain 法:局所移動と集約を、どのノードも動かなくなるまで繰り返す"""
    adj = to_weighted(G)
    members = {v: {v} for v in G.nodes()}    # 今のノード → 元のグラフのノードの集合
    level = 0
    while True:
        comm, n_moves = local_moving(adj, gamma, seed=seed + level)
        groups = {}
        for v, c in comm.items():
            groups.setdefault(c, set()).update(members[v])
        if verbose:
            parts = list(groups.values())
            print(f"  段階 {level}: ノード {len(adj):3d} → コミュニティ {len(parts):3d}(移動 {n_moves:3d} 回)"
                  f"  Q = {modularity_score(G, parts, gamma):.4f}")
        if n_moves == 0:                     # 1つも動かなければ終わり
            return list(groups.values())
        members = groups
        adj = aggregate(adj, comm)
        level += 1

parts = louvain(G, verbose=True)
print(f"スクラッチ実装: {len(parts)} 個、Q = {modularity_score(G, parts):.4f}、"
      f"山脈をまたぐもの {sum(len({range_of[v] for v in c}) > 1 for c in parts)} 個")
for s in range(3):
    c = nx.community.louvain_communities(G, seed=s)
    print(f"networkx(seed={s}): {len(c)} 個、Q = {nx.community.modularity(G, c):.4f}")
Louvain 法の2つの段階を関数に分けて実装し、登山道に使うコードです。
- to_weighted: グラフを「ノード → 隣接ノードと重み」の辞書にします。集約したグラフは重みと自己ループを持つので、最初のグラフも同じ形にそろえています。
- local_moving(局所移動): ノードを1つずつ取り出し、ΔQ が最も大きいコミュニティへ入れ直す処理を、1つも動かなくなるまで繰り返します。コメントの (a)〜(f) の順に、次のことをしています。
- (a) 次数と m: k は各ノードの次数です。自己ループの重みを2倍して数えるのは、集約したグラフで「内側のエッジ をまとめた自己ループ」が、元の次数の合計 のうち の分にあたるからです。m は全エッジの重みで、次数の合計の半分です。
- (b)(c) 持っておく値: comm は「ノード → コミュニティ」、tot は「コミュニティ → 次数の合計」(式の )です。ノードを動かすたびに tot を足し引きして更新するので、ΔQ を計算するたびにコミュニティ全体を数え直さずに済みます。
- (d) いったん外す: ΔQ の式は「どこにも属さないノードを、コミュニティ に入れたときの増分」です。先に v を今のコミュニティから外しておくと、今のコミュニティに戻る場合も、ほかへ移る場合も、同じ式で比べられます。
- (e) 隣のコミュニティへのつながり: links は、v の隣接ノードが入っているコミュニティごとに、エッジの重みを足したもの(式の )です。候補にするのは、隣接ノードがいるコミュニティと今のコミュニティだけです。隣接ノードがいないコミュニティは、 で ΔQ が増えないので調べません。
- ΔQ の比較: 候補ごとに l - gamma * tot[c] * k[v] / (2 * m)(式から共通の係数 を除いたもの)を計算し、最も大きいコミュニティを選びます。今のコミュニティより はっきり大きい(1e-12 より大きい)ときだけ動かすのは、小数の誤差や同点で、ノードが2つのコミュニティの間を行き来し続けるのを防ぐためです。
- (f) 入れ直す: 選んだコミュニティに v を入れて tot を戻し、動いた回数 n_moves を数えます。1周の間に1つでも動けば、ほかのノードにとっての最適なコミュニティも変わりうるので、もう1周します。
- 例: 手計算で確かめるの三角形2つのグラフ()で、1ノード1コミュニティの状態からノード2(次数3)を最初に調べるとします。隣のノード0・1・3のコミュニティへのつながりは、どれも重み1です。次数2のノード0のコミュニティなら 、次数3のノード3のコミュニティなら で、ひとりのまま()より大きいノード0(または1)のコミュニティへ移ります。つながりの重みが同じなら、次数の小さい相手の方が「偶然つながりやすい分」の差し引きが小さいので選ばれます。
- 調べる順番: rng.permutation(nodes) で、毎周ノードの順番をランダムにしています。Louvain 法の結果は調べる順番で変わるので、固定の順番による偏りを避けるためです。
- init: 局所移動を、決まった分け方から始めるための引数です。後の Leiden 法の節で使います。
- aggregate(集約): コミュニティを1つのノードにした、新しいグラフの隣接リストを作ります。元のエッジ1本は、両端のコミュニティによって次の2通りに振り分けられます。
- コミュニティの内側のエッジ: 新しいノードの 自己ループ の重みに足します。内側のエッジがすべて自己ループにまとまるので、自己ループの重みはそのコミュニティの (内側のエッジの重みの合計)になります。
- コミュニティの間のエッジ: 新しいノードどうしをつなぐエッジの重みに足します。同じ2つのコミュニティの間に元のエッジが何本あっても、重みを足し合わせた1本のエッジになります。
- 半分ずつ足す理由: adj は無向グラフの隣接リストなので、エッジ (v, u) は adj[v][u] と adj[u][v] の2か所にあります。すべての v について回すと、1本のエッジを両端から2回見ることになります。
- 内側のエッジは、2回とも同じ new[cv][cv] に足すことになるので、w / 2 ずつ足して合計を w にしています。
- 間のエッジは、v 側では new[cv][cu]、u 側では new[cu][cv] と別の場所に1回ずつ足すので、半分にする必要はありません。両方向に同じ重みが入り、無向グラフの形が保たれます。
- 2回目以降の集約で元からある自己ループ(u == v)は、adj[v][v] の1か所にしかないので、そのまま足します。
- 集約してもモジュラリティが変わらない理由: local_moving では、自己ループの重みを2倍して次数に数えます。そのため、新しいノードの次数は「自己ループ の2倍 + 外へのエッジの重み」となり、元のコミュニティの次数の合計 と一致します。 と がどちらも保たれるので、集約したグラフで1ノード1コミュニティにしたときのモジュラリティは、集約前の分け方のモジュラリティと同じです。そのうえで、集約したグラフの局所移動でコミュニティどうしをまとめていきます。
- 例: 手計算で確かめるの三角形2つのグラフを、三角形ごとのコミュニティ A = {0, 1, 2}、B = {3, 4, 5} で集約すると、A と B に重み3の自己ループが付き、A と B の間に重み1のエッジが1本ある、2ノードのグラフになります。A の次数は で、手計算の と一致します。
- louvain: 局所移動と集約を、1つもノードが動かなくなるまで繰り返します。members は「今のグラフのノードが、元のグラフのどのノードの集まりか」で、最後に元のノードのコミュニティに戻すために持っています。段階ごとに、ノード数・コミュニティ数・移動の回数・モジュラリティを表示します。
実行結果
段階 0: ノード 120 → コミュニティ  37(移動 102 回)  Q = 0.6757
  段階 1: ノード  37 → コミュニティ  14(移動  26 回)  Q = 0.8227
  段階 2: ノード  14 → コミュニティ  12(移動   2 回)  Q = 0.8349
  段階 3: ノード  12 → コミュニティ  12(移動   0 回)  Q = 0.8349
スクラッチ実装: 12 個、Q = 0.8349、山脈をまたぐもの 0 個
networkx(seed=0): 12 個、Q = 0.8297
networkx(seed=1): 12 個、Q = 0.8297
networkx(seed=2): 12 個、Q = 0.8297
- 段階ごとの変化: 最初の局所移動で、120ノードが37のコミュニティにまとまり(Q = 0.676)、集約したグラフでの局所移動で14(0.823)、さらに12(0.835)になりました。4段階目では1つも動かず、終わっています。最初の段階で、ノードの移動は102回でした。1周目で多くのノードが動き、2周目以降で少しずつ直していきます。
- networkx との比較: スクラッチ実装は12個・Q = 0.8349、networkx も12個・Q = 0.8297 で、ほぼ同じ分け方になりました。Louvain 法は調べる順番と乱数で結果が少し変わり、どちらも「モジュラリティが局所的に最大の分け方」の1つを見つけています。山脈をまたぐコミュニティは、どちらも0個です。
Louvain 法の欠点と Leiden 法
つながっていないコミュニティが残る
Louvain 法には、コミュニティの中がつながっていない分け方を返すことがある という欠点があります。Traag et al.(2019)の「From Louvain to Leiden: guaranteeing well-connected communities」は、特に Louvain 法を繰り返し適用したときに、実データで最大25%のコミュニティの中のつながりが弱く、最大16%がつながっていなかったと報告しています。
原因は、局所移動の途中で起きます。2つのまとまり X と Y を橋渡ししているノードが、別のコミュニティへ移ると、X と Y は同じコミュニティのまま、間をつなぐノードがいなくなります。X と Y の各ノードは、自分のまとまりの中に多くの隣接ノードがいるので、1つずつ動かす局所移動では動きません。そのまま集約されると、X と Y は1つのノードになり、二度と分かれなくなります。小さなグラフで、この現象を再現します。
import igraph as ig
import leidenalg as la

# 1. 橋渡しのノード 0 が、2つのまとまり X・Y を結び、さらに Z とも強くつながっているグラフ
X, Y, Z = [1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12, 13]
D = nx.Graph()
for grp in (X, Y, Z):
    D.add_edges_from((a, b) for i, a in enumerate(grp) for b in grp[i + 1:])   # まとまりの中は全員つながる
D.add_edges_from([(0, 1), (0, 2), (0, 5), (0, 6)] + [(0, z) for z in Z])         # 0 から X・Y へ2本ずつ、Z へ5本

def show(name, parts):
    parts = sorted((sorted(c) for c in parts), key=min)
    conn = ["つながっている" if nx.is_connected(D.subgraph(c)) else "つながっていない" for c in parts]
    print(f"{name}: Q = {modularity_score(D, parts):.4f}")
    for c, s in zip(parts, conn):
        print(f"    {c}  {s}")

# 2. 途中の状態:0 と X・Y が1つのコミュニティ、Z が別のコミュニティ
init = {v: 0 for v in [0] + X + Y}
init.update({v: 1 for v in Z})
show("局所移動の前", [{0, *X, *Y}, set(Z)])

# 3. Louvain 法の局所移動:0 だけが Z へ移り、X と Y は同じコミュニティに残る
comm, n_moves = local_moving(to_weighted(D), init=init, seed=0)
groups = {}
for v, c in comm.items():
    groups.setdefault(c, set()).add(v)
show(f"Louvain 法の局所移動の後(移動 {n_moves} 回)", groups.values())

# 4. 集約した後も、X と Y は1つのノードのままなので、二度と分かれない
agg = aggregate(to_weighted(D), comm)
_, n_moves2 = local_moving(agg, seed=1)
print(f"集約したグラフ: ノード {len(agg)} 個、局所移動の回数 {n_moves2}")

# 5. Leiden 法:同じ途中の状態から最適化する
H = ig.Graph.from_networkx(D)
names = H.vs["_nx_name"]
part = la.ModularityVertexPartition(H, initial_membership=[init[v] for v in names])
opt = la.Optimiser()
opt.set_rng_seed(0)
opt.optimise_partition(part)
show("Leiden 法", [{names[i] for i in c} for c in part])
橋渡しのノードが抜けたときに、つながっていないコミュニティが残る様子と、Leiden 法での結果を比べるコードです。
- グラフ: X(4ノード)、Y(4ノード)、Z(5ノード)はそれぞれ中が全員つながったまとまりです。ノード0は、X と Y に2本ずつ、Z に5本つながっています。0 は X と Y の唯一の橋渡しで、Z との方が強くつながっている、という設定です。
- 途中の状態: Louvain 法の途中では、それまでのノードの移動の結果として「0・X・Y が1つのコミュニティ」という状態になることがあります。ここでは、その状態 init を直接与えて、局所移動を始めています。
- 局所移動と集約: スクラッチ実装の local_moving に init を渡し、その後 aggregate で集約したグラフでも局所移動を試しています。
- Leiden 法: leidenalg の ModularityVertexPartition にも同じ途中の状態を initial_membership で与え、Optimiser で最適化しています。set_rng_seed(0) は、結果を再現できるようにするためです。
実行結果
局所移動の前: Q = 0.3200
    [0, 1, 2, 3, 4, 5, 6, 7, 8]  つながっている
    [9, 10, 11, 12, 13]  つながっている
Louvain 法の局所移動の後(移動 1 回): Q = 0.3663
    [0, 9, 10, 11, 12, 13]  つながっている
    [1, 2, 3, 4, 5, 6, 7, 8]  つながっていない
集約したグラフ: ノード 2 個、局所移動の回数 0
Leiden 法: Q = 0.4683
    [0, 9, 10, 11, 12, 13]  つながっている
    [1, 2, 3, 4]  つながっている
    [5, 6, 7, 8]  つながっている
- Louvain 法: 局所移動で、0 だけが Z のコミュニティへ移り、モジュラリティは 0.320 から 0.366 に上がりました。残った「1〜8」のコミュニティは、つながっていません(X と Y の間にエッジがない)。集約すると2つのノードのグラフになり、局所移動では1つも動きません。X と Y を分ければモジュラリティはさらに上がるのに、Louvain 法にはそれを見つける手段がありません。
- Leiden 法: 同じ途中の状態から、X と Y を別々のコミュニティに分け直し、モジュラリティは 0.468 まで上がりました。すべてのコミュニティが、中でつながっています。
Leiden 法の細分化
Leiden 法は、Louvain 法の局所移動と集約の間に、細分化(refinement)の段階を入れます。
(図は、diagram-designで作成)
- ノードの局所移動: Louvain 法と同じく、ノードを ΔQ が大きいコミュニティへ動かします(Leiden 法では、隣が変わったノードだけを調べ直すことで速くしています)。
- 細分化: 1で得た各コミュニティの中だけで、1ノード1まとまりから始めて、コミュニティの中でつながっているノードどうしだけ をまとめ直します。つながっていない X と Y は、ここで別々のまとまりになります。
- 集約: 細分化したまとまりを1つのノードにしたグラフを作り、1のコミュニティを、そのグラフの最初の分け方にします。
集約するのが「つながったまとまり」なので、つながっていないコミュニティが1つのノードに閉じ込められることがありません。論文は、Leiden 法のコミュニティは必ずつながっていること(さらに、繰り返すとより強い性質を満たすこと)を証明し、Louvain 法より速く、より大きなモジュラリティの分け方を見つけたと報告しています。
解像度:どのくらいの大きさで分けるか
解像度パラメータ γ
モジュラリティの2項目に係数 を掛けると、コミュニティの大きさを調整できます(Reichardt & Bornholdt 2006「Statistical mechanics of community detection」)。
を小さくすると、大きなコミュニティの「偶然の期待値」の差し引きが小さくなるので、大きくまとめた方が得になります。 を大きくすると、細かく分けた方が得になります。 がふつうのモジュラリティです。登山道で、 を変えて Leiden 法で分けてみます。
# 解像度 γ を変えながら、Leiden 法でコミュニティに分ける
Hg = ig.Graph.from_networkx(G)
gnames = Hg.vs["_nx_name"]
levels = {}   # γ → その γ で分けたコミュニティの一覧(各コミュニティは地点の名前の集合)
for gamma in [0.05, 0.1, 0.3, 0.5, 1.0, 2.0]:
    p = la.find_partition(Hg, la.RBConfigurationVertexPartition, resolution_parameter=gamma, seed=0)
    parts = [{gnames[i] for i in c} for c in p]
    levels[gamma] = parts
    mixed = sum(len({range_of[v] for v in c}) > 1 for c in parts)
    print(f"γ = {gamma:4.2f}: {len(parts):2d} 個  大きさ {sorted(len(c) for c in parts)}  "
          f"Q(γ=1) = {modularity_score(G, parts):.3f}  山脈をまたぐもの {mixed}")

# 細かい分け方の各コミュニティが、1段粗い分け方のどれか1つに収まっているか(入れ子になっているか)
for g_coarse, g_fine in [(0.1, 0.3), (0.3, 1.0), (1.0, 2.0)]:
    # (a) 粗い分け方を「地点 → コミュニティの番号」の表にする(例:Hoshimi の地点 → 0)
    coarse = {v: i for i, c in enumerate(levels[g_coarse]) for v in c}
    # (b) 細かいコミュニティごとに、属する地点の粗い番号を集合に集める。
    #     集合なので重複は1つにまとまり、大きさが1なら粗いコミュニティ1つに収まっている
    inside = sum(len({coarse[v] for v in c}) == 1 for c in levels[g_fine])
    print(f"γ={g_fine} の {len(levels[g_fine])} 個のうち、γ={g_coarse} のコミュニティ1つに収まるもの: {inside} 個")

fig, axes = plt.subplots(1, 3, figsize=(18, 4.2))
for ax, gamma in zip(axes, [0.1, 0.3, 1.0]):
    color = {v: plt.cm.tab20((2 * i) % 20 + (2 * i) // 20) for i, c in enumerate(levels[gamma]) for v in c}
    nx.draw_networkx_edges(G, pos, ax=ax, edge_color="lightgray")
    nx.draw_networkx_nodes(G, pos, ax=ax, node_size=30, node_color=[color[v] for v in G.nodes()])
    ax.set_title(f"γ = {gamma}({len(levels[gamma])} 個)")
    ax.set_aspect("equal")
plt.tight_layout()
plt.show()

# 入れ子を保証する分け方:粗いコミュニティごとに、その中だけのグラフを Leiden 法でさらに分ける
def split_inside(parts, gamma=1.0):
    finer = []
    for c in parts:
        # c の中だけのグラフ(ノードとエッジを G の順番で入れて、実行のたびに結果が変わらないようにする)
        Gc = nx.Graph()
        Gc.add_nodes_from(v for v in G.nodes() if v in c)
        Gc.add_edges_from((u, v) for u, v in G.edges() if u in c and v in c)
        sub = ig.Graph.from_networkx(Gc)
        p = la.find_partition(sub, la.RBConfigurationVertexPartition, resolution_parameter=gamma, seed=0)
        finer += [{sub.vs[i]["_nx_name"] for i in s} for s in p]
    return finer

level1 = split_inside(levels[0.1])        # 山脈(3個)の中を分ける
print(f"山脈の中を分けた結果: {len(level1)} 個  大きさ {sorted(len(c) for c in level1)}  "
      f"Q(γ=1) = {modularity_score(G, level1):.3f}")
解像度 を変えながら Leiden 法で分け、コミュニティの数と大きさ、入れ子になっているかを調べるコードです。
- RBConfigurationVertexPartition: leidenalg で、 付きのモジュラリティ を最大にする分け方です( なら ModularityVertexPartition と同じ)。resolution_parameter が です。
- γ の値: 0.05 から 2.0 まで、3つの山脈に分かれる値から、12個()より細かく分かれる値までを選んでいます。比べやすいように、各分け方のふつうのモジュラリティ()も表示しています。
- levels: の値をキー、その で分けたコミュニティの一覧を値にした辞書です。各コミュニティは地点の名前の集合で、たとえば levels[0.1] は40地点ずつの3つの集合、levels[1.0] は12個の集合です。あとの入れ子の確認と地図の描画で、 ごとの分け方を取り出すために保存しています。
- 入れ子の確認: 細かい分け方の各コミュニティが、1段粗い分け方のどれか1つに収まっているかを数えています。収まっていれば、分け方が階層(入れ子)になっています。調べ方は2段階です。
- (a) 粗い分け方を表にする: coarse は、地点から「粗い分け方の何番目のコミュニティに入っているか」を引ける辞書です。コミュニティの一覧のままでは、ある地点がどこに入っているかを探すのに毎回すべての集合を調べる必要があるので、先に表にしています。
- (b) 番号の種類を数える: 細かいコミュニティ c の地点を1つずつ表で引き、粗い番号を集合 {coarse[v] for v in c} に集めます。集合なので同じ番号は1つにまとまり、大きさが1なら粗いコミュニティ1つに収まっている、2以上ならまたがっていることになります。len(...) == 1 は True(1)か False(0)なので、sum で足すと、収まっているコミュニティの数になります。
- 例: 粗い分け方が {A, B, C}・{D, E}、細かい分け方が {A, B}・{C, D}・{E} なら、表は A・B・C → 0、D・E → 1 です。集めた番号は {0}・{0, 1}・{1} になり、{C, D} だけが2つにまたがるので、「3個のうち2個が収まる」になります。
- split_inside: 粗いコミュニティごとに、その中だけのグラフを作って Leiden 法で分け直す関数です。こうすると、細かいコミュニティは必ず粗いコミュニティの中に収まります。中だけのグラフは、ノードとエッジを G の順番で入れて作っています。集合からグラフを作ると、実行のたびにノードの順番が変わり、結果が変わることがあるためです。
- 地図: = 0.1・0.3・1.0 の分け方を、色分けして並べています。
実行結果
γ = 0.05:  3 個  大きさ [40, 40, 40]  Q(γ=1) = 0.661  山脈をまたぐもの 0
γ = 0.10:  3 個  大きさ [40, 40, 40]  Q(γ=1) = 0.661  山脈をまたぐもの 0
γ = 0.30:  8 個  大きさ [6, 9, 9, 9, 17, 22, 23, 25]  Q(γ=1) = 0.803  山脈をまたぐもの 0
γ = 0.50:  9 個  大きさ [6, 6, 9, 9, 9, 17, 19, 22, 23]  Q(γ=1) = 0.811  山脈をまたぐもの 0
γ = 1.00: 12 個  大きさ [6, 8, 8, 9, 9, 9, 10, 11, 11, 11, 14, 14]  Q(γ=1) = 0.836  山脈をまたぐもの 0
γ = 2.00: 16 個  大きさ [5, 5, 6, 6, 6, 7, 7, 8, 8, 8, 8, 8, 8, 9, 10, 11]  Q(γ=1) = 0.821  山脈をまたぐもの 0
γ=0.3 の 8 個のうち、γ=0.1 のコミュニティ1つに収まるもの: 8 個
γ=1.0 の 12 個のうち、γ=0.3 のコミュニティ1つに収まるもの: 11 個
γ=2.0 の 16 個のうち、γ=1.0 のコミュニティ1つに収まるもの: 13 個
山脈の中を分けた結果: 20 個  大きさ [4, 4, 4, 4, 5, 5, 5, 5, 6, 6, 6, 6, 6, 6, 7, 7, 8, 8, 9, 9]  Q(γ=1) = 0.804
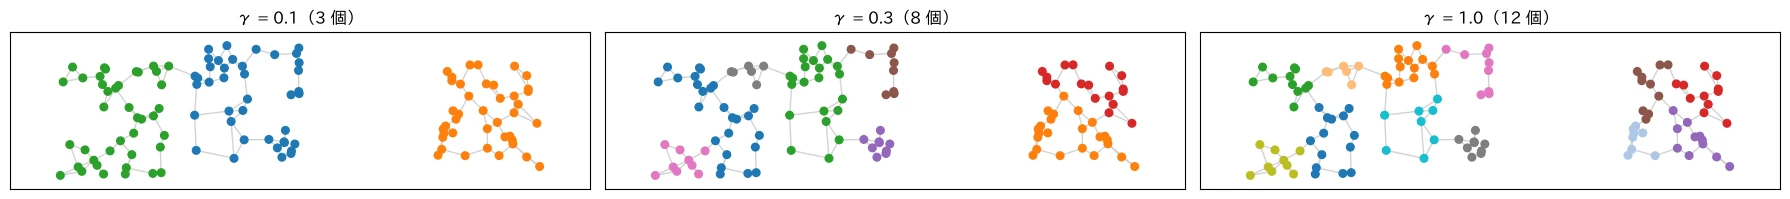
- γ で粗さが変わる: では、40地点ずつの3つのコミュニティ、つまり 山脈そのもの に分かれました。峠越えの道1本でつながった Hoshimi と Akatsuki も、別々になっています。 を大きくすると 8・9・12・16 個と細かくなり、どの でも山脈をまたぐコミュニティはありません。
- ふつうのモジュラリティは γ=1 で最大: の分け方のモジュラリティ(0.836)が最も大きく、3つの山脈に分けると 0.661 です。モジュラリティを最大にするのは「12の地域」ですが、「山脈」という粗い分け方も、 を変えれば取り出せます。どちらが良いかは目的で決まります。
- 入れ子にならないことがある: ごとに別々に分けると、 の12個のうち1個、 の16個のうち3個が、1段粗い分け方の2つのコミュニティにまたがっていました。 を変えて得た分け方は、必ずしも階層にはなりません。
- 中だけを分け直すと入れ子になる: split_inside で山脈の中だけを分け直すと、必ず入れ子になります。ただし、数は20個と、全体を で分けた12個より多くなりました。モジュラリティの「偶然の期待値」は、計算に使うグラフのエッジの数 で決まるので、40地点だけのグラフで計算すると、全体のグラフで計算するより細かく分けた方が得になるためです。GraphRAG などで使われる階層的な Leiden 法も、コミュニティの中をさらに分けることを繰り返して階層を作るので、下の階層ほど細かく分かれます。
解像度の限界
のモジュラリティには、グラフ全体が大きくなると、小さなコミュニティを見分けられなくなる という性質があります。Fortunato & Barthélemy(2007)の「Resolution limit in community detection」は、ほかとのつながりが少ない2つのコミュニティについて、それぞれの内側のエッジの数がグラフ全体のエッジの数 の 程度より少ないと、2つをくっつけた方がモジュラリティが大きくなり、見分けられなくなることを示しました(くっついた後のまとまりでいえば、内側のエッジが 程度より少ないとき、それが小さなコミュニティの寄せ集めである可能性がある)。しきい値が で決まるので、グラフ全体が大きくなるほど、見分けられるコミュニティの大きさの下限が上がります。論文と同じく、5ノードの完全グラフ(クリーク)を1本ずつのエッジで輪につないだグラフで確かめます。どう見てもクリーク1つ1つがコミュニティです。
(図は、diagram-designで作成)
完全グラフ は、どの2つのノードの間にもエッジがあるグラフです(グラフの中のそういう部分を クリーク と呼びます)。5ノードなら 本のエッジがあります。このクリークを円周に並べ、隣り合うクリークどうしを1本のエッジだけでつなぐと、各クリークは内側に10本のエッジを持ちながら、外へのエッジは両隣への2本だけになります。内側が密で外側が疎という、コミュニティの考え方にこれ以上ないほど当てはまるグラフです。
# 5人の完全グラフ(クリーク)を、1本ずつのエッジで輪につないだグラフ
print("クリーク数 | エッジ数 | クリークごとの Q | 2つずつまとめた Q | γ=1 の Leiden 法 | γ=2 の Leiden 法")
for n_cliques in [10, 20, 22, 24, 30, 60]:
    R = nx.ring_of_cliques(n_cliques, 5)
    cliques = [set(range(i * 5, i * 5 + 5)) for i in range(n_cliques)]
    pairs = [cliques[i] | cliques[i + 1] for i in range(0, n_cliques, 2)]   # 隣り合うクリークを2つずつまとめる
    HR = ig.Graph.from_networkx(R)
    found = {}
    for gamma in [1.0, 2.0]:
        p = la.find_partition(HR, la.RBConfigurationVertexPartition, resolution_parameter=gamma, seed=0)
        found[gamma] = [set(c) for c in p]
    print(f"{n_cliques:10d} | {R.number_of_edges():8d} | {modularity_score(R, cliques):15.4f} | "
          f"{modularity_score(R, pairs):17.4f} | {len(found[1.0]):3d} 個(Q {modularity_score(R, found[1.0]):.4f}) | "
          f"{len(found[2.0]):3d} 個")
クリークの数を変えながら、クリークごとに分けた場合と、隣り合う2つずつをまとめた場合のモジュラリティを比べ、Leiden 法がいくつに分けるかを調べるコードです。
- nx.ring_of_cliques(n_cliques, 5): 5ノードの完全グラフを n_cliques 個作り、隣り合うクリークを1本のエッジで輪につないだグラフです。1つのクリークの内側のエッジは10本です。
- 2通りの分け方: クリークごと(cliques)と、隣り合う2つずつをまとめたもの(pairs)のモジュラリティを計算します。
- クリークの数: 10 から 60 まで、2つずつまとめた方が良くなる境目(20〜24)の前後を細かくとっています。
- Leiden 法: と で分け、コミュニティの数を数えています。
実行結果
クリーク数 | エッジ数 | クリークごとの Q | 2つずつまとめた Q | γ=1 の Leiden 法 | γ=2 の Leiden 法
        10 |      110 |          0.8091 |            0.7545 |  10 個(Q 0.8091) |  10 個
        20 |      220 |          0.8591 |            0.8545 |  20 個(Q 0.8591) |  20 個
        22 |      242 |          0.8636 |            0.8636 |  22 個(Q 0.8636) |  22 個
        24 |      264 |          0.8674 |            0.8712 |  13 個(Q 0.8709) |  24 個
        30 |      330 |          0.8758 |            0.8879 |  17 個(Q 0.8863) |  30 個
        60 |      660 |          0.8924 |            0.9212 |  24 個(Q 0.9203) |  36 個
- 22個が境目: クリークが20個までは、クリークごとに分けた方がモジュラリティが大きく、Leiden 法も正しくクリークごとに分けています。22個で2つの分け方のモジュラリティが等しくなり、24個以上では 2つずつまとめた方がモジュラリティが大きく なります。グラフ全体が大きくなると、2項目の「偶然の期待値」が小さくなり、たった1本のエッジでつながったクリークどうしも、くっついた方が得になるためです。
- Leiden 法もくっつける: 24個では13個、30個では17個、60個では24個と、Leiden 法はクリークをまとめた分け方を返しました。アルゴリズムの失敗ではなく、モジュラリティという指標そのものの性質 です。
- γ を上げると戻る: にすると、30個までは正しくクリークごとに分かれます(60個では36個)。解像度の限界は、 を調整することで和らげられますが、なくなるわけではありません。大きなグラフで細かいまとまりを見たいときは、 を上げるか、前の節のようにコミュニティの中を分け直します。
この例では、境目をモジュラリティの式から計算できます。全体のエッジの数は、クリークごとに内側の10本と隣とつなぐ1本なので ( はクリーク(5ノードの完全グラフ)の個数。たとえば なら、ノードは50個、エッジは110本)、クリーク1つの次数の合計は です。隣り合う2つのクリーク A・B を1つにまとめると、間の1本が内側に入る分だけ1項目が増え、偶然の期待値の分だけ2項目が増えます( のため)。
つまり、クリークの次数の合計 22 が より小さいと、くっつけた方が得 になります。
| クリーク数 | 結果 | ||
|---|---|---|---|
| 10 | 110 | 14.8 | 22 の方が大きいので、クリークごとに分けた方が Q が大きい |
| 22 | 242 | 22.0 | 等しいので、2つの分け方の Q が等しい |
| 30 | 330 | 25.7 | 22 の方が小さいので、2つずつまとめた方が Q が大きい |
全体で見ても、クリークごとに分けると 、2つずつまとめると で、後者が大きくなるのは のときです。論文は、 ノードのクリークなら で2つずつまとめた方が得になることを示していて、 なら22個です。論文の「」は、外へのエッジの分( の「+2」)を省いた近似で、クリークの内側の10本と比べると境目は約18個になります。また、2つをまとめたまとまりの内側のエッジは で、境目での とほぼ同じです。
答えの分かっているグラフで比べる
最後に、答えのコミュニティを仕込んだグラフで、スクラッチ実装・networkx(どちらも Louvain 法)・leidenalg(Leiden 法)の精度を比べます。使うのは planted partition(仕込んだ分割)と呼ばれるグラフです。1,000個のノードを100個ずつ10のグループに分けておき(これが答え)、すべてのノードの組について、同じグループどうしなら確率 、違うグループどうしなら確率 でエッジを引きます(in は「グループの中」、out は「グループの外」)。 を より大きくすると、グループの中が密で外が疎な、答えの分かったグラフになります。 を上げるほど、グループの外へのエッジが増え、グループの境目がぼやけていきます。
from sklearn.metrics import adjusted_rand_score

def n_disconnected(Gx, parts):
    """つながっていないコミュニティの数"""
    return sum(not nx.is_connected(Gx.subgraph(c)) for c in parts if len(c) > 1)

def leiden(Gx, seed=0):
    Hx = ig.Graph.from_networkx(Gx)
    p = la.find_partition(Hx, la.ModularityVertexPartition, seed=seed)
    return [{Hx.vs[i]["_nx_name"] for i in c} for c in p]

methods = {"スクラッチ(Louvain)": lambda Gx, s: louvain(Gx, seed=s),
           "networkx(Louvain)":  lambda Gx, s: nx.community.louvain_communities(Gx, seed=s),
           "leidenalg(Leiden)":  leiden}

# 100ノードのグループを10個仕込んだグラフ。グループの外へのエッジの確率 p_out を上げるほど、見分けにくくなる
print("p_out  | 手法                  | 個数 | ARI   | Q     | つながっていないもの")
for p_out in [0.005, 0.01, 0.02, 0.03]:
    rows = {name: [] for name in methods}
    for s in range(3):
        P = nx.planted_partition_graph(10, 100, 0.1, p_out, seed=s)
        truth = [P.nodes[v]["block"] for v in P.nodes()]
        for name, f in methods.items():
            parts = f(P, s)
            label = {v: i for i, c in enumerate(parts) for v in c}
            rows[name].append((len(parts), adjusted_rand_score(truth, [label[v] for v in P.nodes()]),
                               modularity_score(P, parts), n_disconnected(P, parts)))
    for name, r in rows.items():
        r = np.array(r)
        print(f"{p_out:.3f}  | {name:20s} | {r[:, 0].mean():4.1f} | {r[:, 1].mean():.3f} | {r[:, 2].mean():.3f} | "
              f"{int(r[:, 3].sum())}")
答えの分かっているグラフで、3つの実装の分け方を比べるコードです。
-
n_disconnected: 見つけたコミュニティのうち、中がつながっていないものの数を数えます。Louvain 法の欠点で見たように、Louvain 法はこうしたコミュニティを返すことがあり、Leiden 法は返さないことを、ここで実際に確かめます。
- Gx.subgraph(c) は、コミュニティ c のノードと、その間のエッジだけを取り出したグラフです。コミュニティの外へのエッジは含まれません。
- nx.is_connected は、そのグラフのどのノードからも、エッジをたどって残りのすべてのノードに行けるかを判定します。コミュニティの中だけでたどれない組があれば False です。
- not を付けると「つながっていない」ときに True(1)になるので、sum で足すと、つながっていないコミュニティの数になります。
- if len(c) > 1 で、1ノードだけのコミュニティを除いています。1ノードは必ず「つながっている」ので、調べる必要がないためです。
- 例:前の節のグラフで、橋渡しのノード0が抜けたあとの「1〜8」のコミュニティなら、取り出したグラフは X = {1, 2, 3, 4} と Y = {5, 6, 7, 8} の2つに分かれ、X から Y へはたどれません。nx.is_connected は False になり、1個と数えられます。
-
グラフ: nx.planted_partition_graph(10, 100, 0.1, p_out) は、100ノードのグループ10個(1,000ノード)を作り、同じグループのノードどうしは確率 、違うグループどうしは確率 p_out でつなぎます。ノードごとに、グループの中は99個、外は900個の相手がいるので、1つのノードが持つエッジの数の期待値は次のようになります。
p_out グループの中へのエッジ(99 × 0.1) グループの外へのエッジ(900 × p_out) 0.005 約10本 約4.5本 0.01 約10本 約9本 0.02 約10本 約18本 0.03 約10本 約27本 外の相手は中の相手の約9倍いるので、確率は小さくても、p_out を上げると外へのエッジはすぐに中より多くなります。0.005〜0.03 にしたのは、「外より中の方が多い」(境目がはっきりしている)から「外の方が多い」(つながりだけでは見分けにくい)までを試すためです。
-
評価: 答えのグループ block と見つけたコミュニティの一致を、クラスタリングの記事と同じ調整ランド指数(ARI。1で完全一致、0で偶然と同じ)で測ります。あわせて、コミュニティの数、モジュラリティ、つながっていないコミュニティの数を数えます。
-
3回の平均: グラフを作る乱数と手法の乱数を3通り変えて、平均を表示しています(つながっていないコミュニティの数は合計)。1回だけでは、たまたまの当たり外れが大きいためです。
実行結果
p_out  | 手法                  | 個数 | ARI   | Q     | つながっていないもの
0.005  | スクラッチ(Louvain)       | 10.0 | 0.996 | 0.587 | 0
0.005  | networkx(Louvain)    | 10.0 | 0.996 | 0.587 | 0
0.005  | leidenalg(Leiden)    | 10.0 | 0.998 | 0.587 | 0
0.010  | スクラッチ(Louvain)       | 10.0 | 0.973 | 0.419 | 0
0.010  | networkx(Louvain)    |  9.7 | 0.943 | 0.415 | 0
0.010  | leidenalg(Leiden)    | 10.0 | 0.984 | 0.420 | 0
0.020  | スクラッチ(Louvain)       |  9.3 | 0.836 | 0.255 | 0
0.020  | networkx(Louvain)    |  9.3 | 0.768 | 0.249 | 0
0.020  | leidenalg(Leiden)    |  9.0 | 0.791 | 0.252 | 0
0.030  | スクラッチ(Louvain)       | 10.3 | 0.109 | 0.150 | 0
0.030  | networkx(Louvain)    |  8.7 | 0.093 | 0.151 | 0
0.030  | leidenalg(Leiden)    |  8.7 | 0.123 | 0.155 | 0
- 境目がはっきりしていれば、どれも当たる: (外へのエッジ約4.5本、中は約10本)では、3つとも10個のグループをほぼ完全に見つけました(ARI 0.996〜0.998)。0.01(外へ約9本)でも、ARI は 0.94〜0.98 です。
- 境目がぼやけると差が出る: 0.02(外へ約18本、中の2倍近く)では ARI が 0.77〜0.84 に下がり、手法による差も出ています。この規模では Leiden 法が常に最良というわけではなく、乱数による違いの方が大きく出ています。
- 見分けられない領域: 0.03(外へ約27本、中の約3倍)では、どの手法も ARI が 0.1 前後で、ほとんど当たりません。外へのエッジの方がずっと多く、グラフにグループの構造がほとんど残っていないためで、どんなアルゴリズムでも見つけられない領域です。モジュラリティは 0.15 と、まだプラスの値が出ています。モジュラリティが正の値でも、意味のある構造があるとは限りません。
- つながっていないコミュニティ: この規模(1,000ノード)では、Louvain 法でも0個でした。Traag et al. が報告した問題は、数十万〜数百万ノードの実データで、Louvain 法を繰り返し適用したときに多く起きるもので、小さなグラフでは目立ちません。それでも、前の節のように起きる仕組みはあるので、大きなグラフでは、つながりが保証される Leiden 法を使うのが安全です。
使うときの注意
- 結果は乱数で変わる: Louvain 法も Leiden 法も、ノードを調べる順番などに乱数を使い、局所的に良い分け方を見つける方法です。seed を変えると、分け方が少し変わることがあります。結果を報告するときは seed を固定し、いくつかの seed で大きく変わらないかを確かめます。
- 重み付きのグラフ: エッジに重み(やり取りの回数など)があるときは、 と次数を重みに置き換えたモジュラリティを使います。networkx も leidenalg も weight を指定できます。ただし、所要時間のように「小さいほど近い」重みは、そのまま使うと逆の意味になるので、逆数にするなどの変換が必要です。
- 解像度は目的で決める: モジュラリティが最大の分け方が、目的に合う分け方とは限りません。登山道では、「地域」なら 、「山脈」なら でした。大きなグラフでは解像度の限界もあるので、 を何通りか試し、コミュニティの大きさの分布と中身を見て決めます。
- 大きなグラフ: Python で書いた networkx の Louvain 法は、数十万ノードを超えると時間がかかります。leidenalg(C++ で実装)や igraph の community_leiden を使うと、数百万ノードのグラフも現実的な時間で分けられます。
まとめ
- コミュニティ検出: グラフを、内側のつながりが密で外側が疎なまとまりに分けます。登山道の120地点では、連結成分では2つにしか分かれませんでしたが、Louvain 法は道のつながりだけから12の地域を見つけ、山脈をまたぐものは1つもありませんでした。
- モジュラリティ: 内側のエッジの割合から、次数を保ってランダムにつなぎ直したときの期待値を引いた指標です。三角形2つのグラフで手計算(0.3571)・スクラッチ実装・networkx が一致し、全体を1つにすると0、1ノードずつに分けるとマイナスになりました。
- Louvain 法: ノードを1つずつモジュラリティが増える方へ動かす局所移動と、コミュニティを1つのノードにまとめる集約を繰り返します。登山道では、120ノードが 37 → 14 → 12 とまとまり、モジュラリティは 0.835 になりました。
- Leiden 法: 橋渡しのノードが抜けると、Louvain 法ではつながっていないコミュニティが残り、集約されると二度と分かれません。Leiden 法は細分化の段階でこれを分け直し、小さな例でモジュラリティが 0.366 から 0.468 に上がりました。
- 解像度: を変えると、登山道は3つの山脈()から16の地域()まで分けられました。 のモジュラリティには解像度の限界があり、5ノードのクリークの輪では、24個以上で2つずつくっつきました。
- 答えのあるグラフ: グループの外へのエッジが中より少なければ、どの手法もほぼ正しく分けられますが、外の方がずっと多いと、モジュラリティが正の値でも構造はほとんど見つかりませんでした。
参考文献
- M. E. J. Newman, M. Girvan (2004). Finding and evaluating community structure in networks. Physical Review E, 69, 026113.
- J. Reichardt, S. Bornholdt (2006). Statistical mechanics of community detection. Physical Review E, 74, 016110.
- S. Fortunato, M. Barthélemy (2007). Resolution limit in community detection. PNAS, 104(1), 36–41.
- V. D. Blondel, J.-L. Guillaume, R. Lambiotte, E. Lefebvre (2008). Fast unfolding of communities in large networks. Journal of Statistical Mechanics, P10008.
- V. A. Traag, L. Waltman, N. J. van Eck (2019). From Louvain to Leiden: guaranteeing well-connected communities. Scientific Reports, 9, 5233.
本記事の文章・構成の一部に生成AIを使用しています。