コピュラ補正とは?
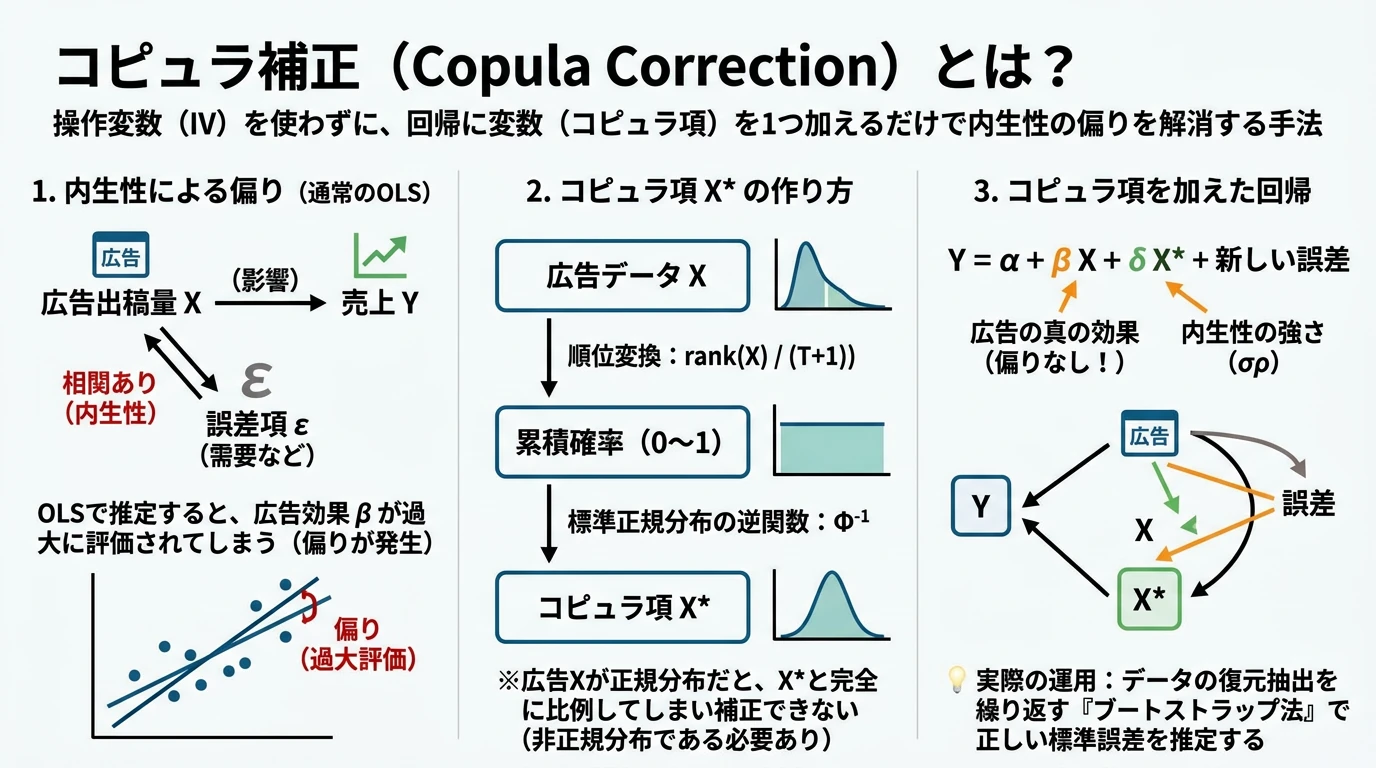 (画像は、Geminiで作成)
観察データの内生性に、操作変数を使わずに対処するコピュラ補正を理解し、Pythonで実装できるようになること。そのために、ガウシアン・コピュラで広告と誤差の依存関係を表す考え方と、コピュラ項を回帰に加えると偏りが消える理由を式で追い、真値を仕込んだダミーデータで確かめること。あわせて、前提が崩れると推定が大きく狂うことをシミュレーションで確認し、実務での使いどころを判断できるようになること。
概要
内生性の記事では、需要が高い時期ほど広告を増やすと、最小二乗法(OLS)で推定した広告の効果が大きく偏ることを見ました。操作変数法の記事では、需要とは関係なく広告を動かす変数(操作変数)を使って、この偏りを取り除きました。
しかし、条件を満たす操作変数が見つかるとは限りません。そこで、操作変数を使わずに内生性に対処する方法として、マーケティングの分野で提案されたのが コピュラ補正(copula correction)です(Park & Gupta, 2012)。外部のデータを必要とせず、回帰に変数を1つ加えるだけで実装できるので、マーケティングの実証研究で広く使われてきました。
一方で、コピュラ補正は、データからは確かめにくい独自の前提に頼っています。その前提が崩れると、推定は OLS と同じくらい、あるいはそれ以上に偏ります(Becker et al., 2022)。本記事では、仕組みと前提をセットで理解することを目指し、次の順に解説します。
- コピュラとは何か、ガウシアン・コピュラで広告と誤差の依存関係を表す考え方
- コピュラ項を回帰に加えると偏りが消える理由
- ダミーデータでの実装と、ブートストラップによる標準誤差
- 前提が崩れたときに何が起きるか
- 操作変数法との使い分け
本記事のコードは、Python 3.13、NumPy 2.4.6、SciPy 1.18.1、pandas 3.0.5、statsmodels 0.15.0、matplotlib 3.11.2 で動作を確認しました。
コピュラ補正の考え方
内生性を「広告と誤差の同時分布」として表す
推定したいモデルは、内生性の記事と同じ次の回帰です。
内生性とは、広告の出稿量 と誤差項 が相関していること()でした。操作変数法は、外部の変数 を使って、 の変動のうち と無関係な部分を取り出しました。
コピュラ補正は、外部の変数を使わずに、 と の同時分布の形を仮定する ことで、両者の関係を直接モデルに組み込みます。 と がどのように一緒に動くかが分かれば、 のうち と連動する部分を回帰に加えて取り除くことができるからです。
コピュラ:分布の形と依存関係を分ける
2つの変数の同時分布は、「それぞれの変数の分布(周辺分布)」と「2つの変数の依存関係」に分けて表せます。この依存関係の部分を表す関数を コピュラ(copula)と呼びます。
具体的には、 の累積分布関数を 、 の累積分布関数を として、それぞれを0〜1の値 、 に変換します(累積分布関数は「その値以下になる確率」なので、どんな分布の変数も0〜1の一様分布に変換されます)。この変換で、もとの分布の形の情報は消え、「2つの変数の順位がどれだけ連動しているか」という依存関係だけが残ります。コピュラは、この0〜1に変換した2つの値の同時分布です。
コピュラ補正で使うのは ガウシアン・コピュラ(Gaussian copula)です。0〜1の値を、さらに標準正規分布の分位点に変換します( は標準正規分布の累積分布関数、 はその逆関数)。
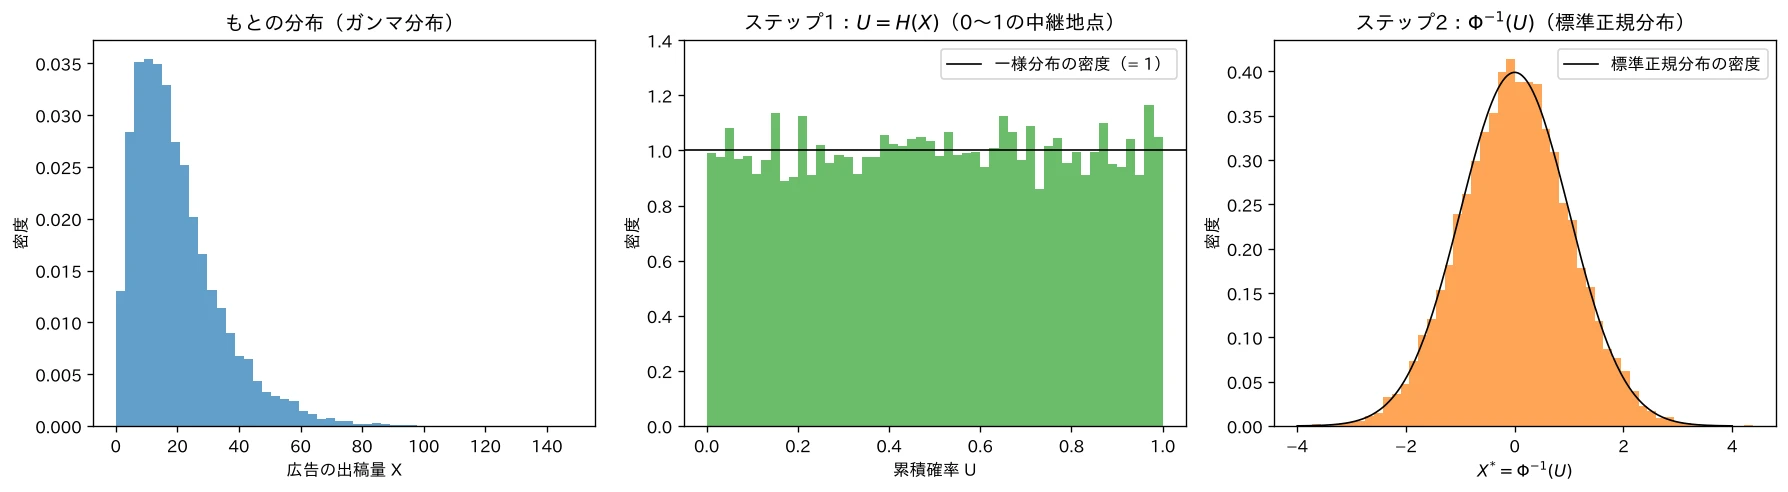
(コードでは Xs)と は、どちらも標準正規分布に従います。ガウシアン・コピュラは、この2つが 相関係数 の2変量正規分布に従う という仮定です。もとの がどんなに歪んだ分布でも、依存関係だけは「正規分布の相関」の形で表す、というわけです。 もとの分布の形にかかわらず標準正規分布の形に置き直せるのは、どんな分布でも、一度「0〜1の確率(一様分布)」という共通の中継地点を経由できる からです。この仕組みは、次の2つのステップでできています。 ステップ1:もとの分布 → 0〜1の中継地点(確率積分変換) どんな形の分布(たとえば右に歪んだガンマ分布)でも、値を累積分布関数 に入れて「小さい順に並べたとき、全体の何%の位置にいるか」に変換すると、その結果は 0から1の間に均等に散らばる分布(一様分布) になります。これを 確率積分変換 と呼びます。 均等に散らばる理由は、 が 以下になる確率を計算すると分かります( は連続で右肩上がりの関数とし、 はその逆関数です)。 「 が 以下になる確率がちょうど 」というのは、0〜1の一様分布の性質そのものです。たとえば「下から30%以内の位置にいる」期間は、定義から全体のちょうど30%です。 この変換で、もとのデータが「1万」や「0.1」といった具体的な値を持っていたことや、ガンマ分布のような特定の形をしていたことの情報は消え、全体の中で相対的にどの位置(順位)にいるか という0〜1の情報だけが残ります。 ステップ2:0〜1の中継地点 → 標準正規分布(逆変換) 今度は逆に、0〜1に均等に散らばった値を、好きな分布の形に変換します。標準正規分布の累積分布関数の逆関数(分位点関数)(コードでは stats.norm.ppf)に通すと、その値は標準正規分布に従います。 最後の等号は、ステップ1の一様分布の性質( が 以下になる確率は )に を入れたものです。左辺が標準正規分布の累積分布関数 と一致するので、 は標準正規分布に従います。 なぜ順位の情報は壊れないのか 2つのステップで使う変換(累積分布関数 と、分位点関数 )は、どちらも 右肩上がり(単調増加)の関数 です。右肩上がりの関数で変換すると、値そのものは変わっても、値の大小関係(順位)は決してひっくり返りません。 そのため、どんなに歪んだ分布から出発しても、「順位」という中継地点を通ることで、値の大小関係(2つの変数の順位がどれだけ連動しているか)という依存関係の情報を保ったまま、ガウシアン・コピュラで扱いやすい標準正規分布の形に置き直せます。分布の形の情報だけを捨て、依存関係の情報だけを残す、というのがコピュラの考え方です。 コードで確かめる ガンマ分布の出稿量を1万個作り、ステップ1・ステップ2の変換で分布の形がどう変わるかを確かめます。この折りたたみでは、本当の累積分布関数 (ガンマ分布の累積分布関数)が分かっている場合の変換を見ます。 グラフの日本語表示に japanize-matplotlib を使います(後の節のコードでも使います)。Python 3.12 以降で import がエラーになる場合は、setuptools も一緒にインストールしてください。 ガンマ分布の値を、累積分布関数と分位点関数で標準正規分布に変換しています。 実際の計算では、本当の累積分布関数 は分からないので、データの順位を使ってステップ1を近似します(後の経験分布関数でコピュラ項を作るで、図を使って確かめます)。補足:どんな分布でも標準正規分布の形に置き直せる理由
実行結果
コピュラ項を加えると、偏りが消える
ここで、誤差項 が平均0、標準偏差 の正規分布に従うと仮定します。すると なので、、つまり です。
と が相関係数 の2変量正規分布に従うとき、 は「 と連動する部分」と「 と独立な部分」に分けられます( は と独立な標準正規分布の変数です)。
詳細な式展開(係数が と になる理由)
を、係数 を使って「 と連動する部分」と「 と独立な部分」に分けて書きます。
と はどちらも平均0・分散1で、互いに独立です。 が「標準正規分布に従い、 との相関が 」になるように、2つの条件から を決めます。
条件1:相関が になる。 と の共分散は、
です。2つの変数の分散がどちらも1なので、共分散がそのまま相関係数になり、 です。
条件2:分散が1になる。独立な変数の和の分散は、それぞれの分散の和なので、
です。これが1になるには 、つまり が必要です。正規分布に従う独立な変数の和は正規分布に従うので、こうして作った は標準正規分布に従い、 との相関はちょうど になります。
直感的な意味: のばらつき(分散1)を、 で説明できる分 と、説明できない分 に分けています。本記事のダミーデータの では、連動する部分の係数は0.6(分散 )、独立な部分の係数は (分散 )で、合計すると です。分散は係数の2乗で効くので、分散 を作るには、係数をその平方根 にする必要があります。
ダミーデータの生成のコードの es = rho * Xs + np.sqrt(1 - rho ** 2) * rng.normal(size=T) は、この式そのものです。 の代わりに1を掛けると、分散は になり、相関も にずれてしまいます。
両辺に を掛けて、もとの回帰の式に代入すると、
となります。新しい誤差項 は、 とも、 の関数である とも独立です。したがって、 を と の2つで回帰すれば、 の係数は を偏りなく推定します。 追加した変数 を コピュラ項 と呼びます。
コピュラ項の係数 は、誤差項のうち広告と連動する部分の大きさ、つまり内生性の強さを表します。(内生性がない)なら係数は0で、補正しても OLS と同じ結果になります。
実際の計算:経験分布関数でコピュラ項を作る
の本当の累積分布関数 は分かりません。そこで、データから作る 経験分布関数 で代用します。 の値の小さい順の順位を 、データの数を として、
とします。 は「その期間の広告の出稿量以下の期間が、全体のどれくらいの割合あるか」を、順位から求めた値です。
分母を ではなく にしているのには、理由があります。
- 分母を にすると、最大の値で無限大になる:出稿量が最大の期間は順位が なので、 です。 は「標準正規分布で、その値以下になる確率が100%になる点」ですが、正規分布は左右にどこまでも裾が続くので、どんなに大きな値でも、それより大きくなる確率がわずかに残ります。確率がちょうど100%になる有限の点はなく、(無限大)になります。コピュラ項に無限大が1つでも入ると、回帰は計算できません。
- 分母を にすると、すべて有限の値になる: は から の範囲に収まり、0にも1にもなりません。本記事の では、最小の期間が で 、最大の期間が で です。
- 左右の対称性も保たれる: から までの値は、0.5を中心に左右対称に並びます。そのため、コピュラ項 も0を中心に対称になり、標準正規分布の形(平均0)に合います(分母を にすると、最小の期間の と、最大の期間の が対称になりません)。
実際に、10期間分の広告の出稿量(右に歪んだガンマ分布)で、順位から経験分布関数を作り、標準正規分布の分位点に変換する流れを確かめます。分母を にした場合と にした場合を並べ、 のときのコピュラ項の分布も描きます。
!pip install japanize-matplotlib
グラフの日本語表示に japanize-matplotlib を使います。Python 3.12 以降で import がエラーになる場合は、setuptools も一緒にインストールしてください。
import numpy as np
import pandas as pd
from scipy import stats
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフの日本語表示用

# 1. 10期間分の広告の出稿量(右に歪んだガンマ分布)と、その順位
rng = np.random.default_rng(0)
T_small = 10
x = rng.gamma(2, 10, size=T_small)
rank = stats.rankdata(x)                       # 小さい順に 1, 2, ..., T

# 2. 経験分布関数(分母 T と T + 1)と、標準正規分布の分位点への変換
H_T, H_T1 = rank / T_small, rank / (T_small + 1)
table = pd.DataFrame({'出稿量': x.round(1), '順位': rank.astype(int),
                      '順位/T': H_T.round(3), 'Φ⁻¹(順位/T)': stats.norm.ppf(H_T).round(2),
                      '順位/(T+1)': H_T1.round(3), 'Φ⁻¹(順位/(T+1))': stats.norm.ppf(H_T1).round(2)})
print(table.sort_values('順位').to_string(index=False))

# 3. T = 500 のときのコピュラ項の範囲と平均
x500 = rng.gamma(2, 10, size=500)
P500 = stats.norm.ppf(stats.rankdata(x500) / 501)
print(f"\nT = 500:コピュラ項の最小 {P500.min():.2f}、最大 {P500.max():.2f}、平均 {P500.mean():.3f}")

# 4. 図:左は経験分布関数、中央は Φ^{-1} による変換、右は T = 500 のコピュラ項の分布
fig, axes = plt.subplots(1, 3, figsize=(15, 4.4))
xs = np.sort(x)
grid = np.linspace(0, xs.max() * 1.1, 200)
axes[0].plot(grid, stats.gamma.cdf(grid, 2, scale=10), color='gray', linewidth=1, label='本当の累積分布関数 $H$')
axes[0].scatter(xs, np.arange(1, T_small + 1) / (T_small + 1), color='C0', zorder=3, label='順位 / (T+1)')
axes[0].scatter(xs, np.arange(1, T_small + 1) / T_small, facecolors='none', edgecolors='C3', zorder=3, label='順位 / T')
axes[0].axhline(1, color='C3', linestyle=':', linewidth=1)
axes[0].set_xlabel('広告の出稿量 X')
axes[0].set_ylabel(r'経験分布関数 $\hat{H}(X)$')
axes[0].set_title('① 順位から経験分布関数を作る(T = 10)')
axes[0].legend(fontsize=9, loc='lower right')

ps = np.linspace(0.001, 0.999, 400)
axes[1].plot(ps, stats.norm.ppf(ps), color='gray', linewidth=1, label=r'$\Phi^{-1}(p)$')
axes[1].scatter(H_T1, stats.norm.ppf(H_T1), color='C0', zorder=3, label=r'$\Phi^{-1}$(順位 / (T+1)):すべて有限')
axes[1].scatter(H_T[H_T < 1], stats.norm.ppf(H_T[H_T < 1]), facecolors='none', edgecolors='C3', zorder=3, label=r'$\Phi^{-1}$(順位 / T)')
axes[1].annotate('順位 / T = 1 の点は\n' + r'$\Phi^{-1}(1) = \infty$', xy=(0.995, 3.4), xytext=(0.5, 2.5), color='C3', fontsize=9,
                 arrowprops=dict(arrowstyle='->', color='C3'))
axes[1].axvline(0.5, color='gray', linestyle='--', linewidth=0.8)
axes[1].set_ylim(-3.5, 3.6)
axes[1].set_xlabel(r'経験分布関数 $\hat{H}(X)$(確率)')
axes[1].set_ylabel(r'コピュラ項 $\hat{X}^{*} = \Phi^{-1}(\hat{H})$')
axes[1].set_title('② 標準正規分布の分位点に変換する')
axes[1].legend(fontsize=9, loc='lower right')

zs = np.linspace(-3.5, 3.5, 300)
axes[2].hist(P500, bins=30, density=True, color='C0', alpha=0.6, label='コピュラ項(T = 500)')
axes[2].plot(zs, stats.norm.pdf(zs), color='black', linewidth=1, label='標準正規分布の密度')
for v, ha in [(P500.min(), 'right'), (P500.max(), 'left')]:
    axes[2].axvline(v, color='C0', linestyle='--', linewidth=0.8)
    axes[2].text(v + (0.08 if ha == 'left' else -0.08), 0.3, f'{v:.2f}', ha=ha, fontsize=9, color='C0')
axes[2].set_ylim(0, 0.46)
axes[2].set_xlabel(r'コピュラ項 $\hat{X}^{*}$')
axes[2].set_ylabel('密度')
axes[2].set_title('③ 0を中心に左右対称な分布になる(T = 500)')
axes[2].legend(fontsize=9, loc='upper left')
plt.tight_layout()
plt.show()
経験分布関数とコピュラ項を、10期間の小さな例と500期間で計算し、図にしています。
- 出稿量と順位: rng.gamma(2, 10, size=T_small) で、形状2・尺度10のガンマ分布(右に歪んだ分布)から10期間分の出稿量 x を引きます。stats.rankdata(x) は、値の小さい順に1から までの順位を付ける関数です。10期間にするのは、順位と経験分布関数の値を、表で1つずつ追えるようにするためです。
- 経験分布関数と変換: 順位を T_small で割ったもの(H_T)と、T_small + 1 で割ったもの(H_T1)を作り、stats.norm.ppf(標準正規分布の分位点関数 )で変換して、表 table に並べています。sort_values('順位') で、順位の順に表示しています。
- T = 500: 同じガンマ分布から500期間分の出稿量 x500 を引き、分母 でコピュラ項 P500 を作って、最小・最大・平均を表示しています。
- 図: 左(①)は、出稿量を横軸、経験分布関数を縦軸にした図で、灰色の線は生成に使ったガンマ分布の本当の累積分布関数 (stats.gamma.cdf)です。中央(②)は、経験分布関数の値を で変換した図で、灰色の線が の曲線です。分母が の場合の は無限大で描けないので、H_T[H_T < 1] で除き、矢印で示しています。右(③)は、 のコピュラ項のヒストグラムに、標準正規分布の密度(stats.norm.pdf)を重ねたものです。
実行結果
 出稿量  順位  順位/T  Φ⁻¹(順位/T)  順位/(T+1)  Φ⁻¹(順位/(T+1))
 1.1   1   0.1      -1.28     0.091          -1.34
 5.2   2   0.2      -0.84     0.182          -0.91
 9.1   3   0.3      -0.52     0.273          -0.60
 9.8   4   0.4      -0.25     0.364          -0.35
10.6   5   0.5       0.00     0.455          -0.11
10.7   6   0.6       0.25     0.545           0.11
18.3   7   0.7       0.52     0.636           0.35
22.6   8   0.8       0.84     0.727           0.60
26.4   9   0.9       1.28     0.818           0.91
39.8  10   1.0        inf     0.909           1.34

T = 500:コピュラ項の最小 -2.88、最大 2.88、平均 -0.000
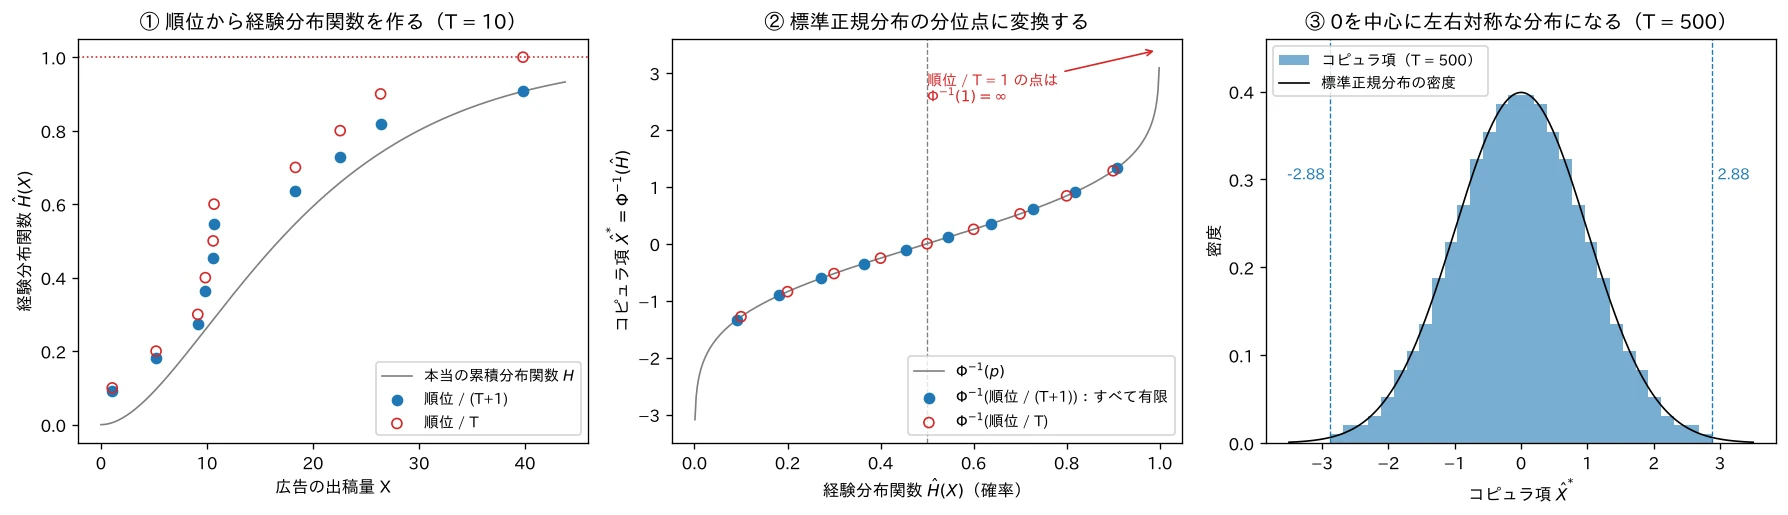
- ① 順位から経験分布関数を作る: 出稿量の小さい順に、経験分布関数の値が階段のように上がっていきます。点は灰色の本当の累積分布関数 の近くに並び、データの数が増えるほど に近づきます。経験分布関数は、本当の分布の形(ここではガンマ分布)を知らなくても、順位だけから作れます。分母が の赤い白抜きの点は、最大の出稿量(39.8)で、ちょうど1(赤い点線)に達しています。
- ② 標準正規分布の分位点に変換する: 経験分布関数の値を、灰色の曲線 で縦軸に写したものがコピュラ項です。曲線は確率が1に近づくと急に上に伸び、1では無限大になります。そのため、表の最後の行のとおり、分母が だと最大の期間が (inf)になります。分母が なら、最大の期間でも と有限です。また、分母が の青い点は、0.5の縦の破線を中心に左右対称に並び、変換後の値も から まで0を中心に対称です。分母が の場合は、最小が なのに最大が無限大で、対称になりません。
- ③ 0を中心に左右対称な分布になる: では、コピュラ項は から の範囲に収まり、平均は0です。もとの出稿量はガンマ分布で右に歪んでいますが、順位を経由して変換したコピュラ項は、標準正規分布の形にきれいに重なります。コピュラ項は、もとの分布の形にかかわらず、順位の情報だけを標準正規分布の形に置き直したものです。
この (P)を回帰に加えるだけで、コピュラ補正の推定量が得られます。 はデータから推定した変数なので、回帰の標準誤差はそのままでは正しくありません。標準誤差は、データを復元抽出して推定をやり直す ブートストラップ で計算します(Park & Gupta, 2012)。
(図は、diagram-designで作成)
なぜ広告の分布が正規分布ではいけないのか
コピュラ補正には、広告の出稿量 が正規分布に従っていてはいけない という、一見不思議な前提があります。
が正規分布に従う場合、( は の平均と標準偏差)なので、
となり、コピュラ項は を標準化しただけの、 の1次式になってしまいます。 と が完全に比例するので、回帰で2つの係数を分けることができません(多重共線性)。コピュラ補正は、 と の関係が曲がっていること(非線形であること)を手がかりに、広告の効果と内生性を見分けているのです。 の分布が正規分布に近いほど、手がかりは弱くなり、推定は不安定になります。
コピュラ補正の前提
ここまでの議論で使った前提をまとめます(Becker et al., 2022)。
- 内生変数が正規分布に従わない:広告の出稿量 の分布が、正規分布から十分に離れている(歪んでいる)こと
- 誤差項が正規分布に従う: と書けるのは、誤差項が正規分布に従う場合だけです
- 依存関係がガウシアン・コピュラで表せる: と が2変量正規分布に従うこと
- サンプルが十分に大きい:コピュラ項を経験分布関数で推定するので、データが少ないと推定が不安定になります
1はデータで確かめられます。一方、2と3は、観測できない誤差項についての仮定なので、データでは確かめられません。
検証用ダミーデータの生成
コピュラ補正の前提がすべて成り立つデータと、前提が崩れたデータを作り分けるため、データの生成を関数にまとめます。前提が成り立つ場合の生成の流れは、次のとおりです(コードの手順番号を添えます)。
- 相関係数 の2つの標準正規分布の変数 を作る(手順2)
- 広告の出稿量 を、 をガンマ分布の分位点に変換して作る。ガンマ分布は右に歪んだ分布で、「普段は控えめで、ときどき大きく出稿する」広告の出し方を表します(手順3)
- 誤差項 を作り、売上 を生成する(手順4)
式で書くと、次のとおりです( は、形状2、尺度10のガンマ分布の分位点関数です)。
真の値は、広告の効果 (beta_true)、切片 (alpha_true)、誤差の標準偏差 (sigma_true)、内生性の強さ (rho)です。コピュラ項の係数の真の値は です。 が従う形状2・尺度10のガンマ分布の平均は、ガンマ分布の平均の公式(形状 × 尺度)から です。操作変数法の記事のデータでも広告の出稿量の平均は20なので、2つの記事で出稿量の大きさをそろえています。
前提を崩すための引数として、広告の分布を正規分布にする x_dist='normal'()と、誤差項を歪んだ分布にする e_dist='skewed'( を自由度2のカイ二乗分布の分位点に変換し、平均0・標準偏差1にそろえたもの)を用意します。
import numpy as np
import pandas as pd
import statsmodels.api as sm
from scipy import stats
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフの日本語表示用

# 1. 真のパラメータ
alpha_true, beta_true, sigma_true = 50.0, 0.3, 5.0
rho = 0.6        # 広告と誤差の依存関係の強さ(ガウシアン・コピュラの相関係数)
T = 500

def make_data(T=500, rho=0.6, x_dist='gamma', e_dist='normal', seed=42):
    """コピュラ補正の検証用データ。x_dist・e_dist で前提を崩せる"""
    rng = np.random.default_rng(seed)
    # 2. 相関係数 rho の2つの標準正規分布の変数(ガウシアン・コピュラ)
    Xs = rng.normal(size=T)
    es = rho * Xs + np.sqrt(1 - rho ** 2) * rng.normal(size=T)
    # 3. 広告の出稿量:Xs を、右に歪んだガンマ分布(または正規分布)の値に変換する
    if x_dist == 'gamma':
        X = stats.gamma.ppf(stats.norm.cdf(Xs), a=2, scale=10)
    else:
        X = 20 + 10 * Xs
    # 4. 誤差項と売上:誤差は正規分布(または歪んだ分布)
    if e_dist == 'normal':
        eps = sigma_true * es
    else:
        chi = stats.chi2.ppf(stats.norm.cdf(es), df=2)   # 平均2、分散4の右に歪んだ分布
        eps = sigma_true * (chi - 2) / 2                 # 平均0、標準偏差 sigma_true にそろえる
    Y = alpha_true + beta_true * X + eps
    return pd.DataFrame({'Y': Y, 'X': X, 'Xs': Xs, 'eps': eps})

df = make_data()

# 5. データの確認(Xs と eps は本来観測できないが、答え合わせのために使う)
print(f"広告の出稿量:平均 {df['X'].mean():.1f}、中央値 {df['X'].median():.1f}、歪度 {stats.skew(df['X']):.2f}")
print(f"広告と誤差の相関:{df['X'].corr(df['eps']):+.3f}(Xs と誤差の相関 {df['Xs'].corr(df['eps']):+.3f})")
コピュラ補正の前提に合わせたダミーデータを生成しています。
- 真のパラメータ: alpha_true・beta_true・sigma_true・rho は、コードの直前に示した式の です。 は、広告と誤差の相関がはっきり強く、OLSの推定値が大きくずれる強さです。期間の500は、コピュラ項が本当の をよく再現できる長さです(後で、100期間のシナリオと比べます)。・・ は、推定値を真の値と比べるための例です。
- 生成の関数: make_data は、期間の長さ T、依存関係の強さ rho、広告の分布 x_dist('gamma' か 'normal')、誤差の分布 e_dist('normal' か 'skewed')、乱数のシード seed を引数にとります。既定値では、コピュラ補正の前提がすべて成り立ちます。
- ガウシアン・コピュラ: Xs は標準正規分布の乱数です。es を rho * Xs + np.sqrt(1 - rho ** 2) * rng.normal(size=T) で作ると、es も標準正規分布に従い、Xs との相関係数が rho になります。コピュラ項を加えると偏りが消えるで示した と同じ形です。
- 分布の変換: stats.norm.cdf(Xs) で Xs を0〜1の値に変換し、stats.gamma.ppf(..., a=2, scale=10)(形状2、尺度10のガンマ分布の分位点関数)で広告の出稿量にします。順位を保ったまま分布の形だけを変える変換なので、X と Xs の依存関係はガウシアン・コピュラのままです。歪んだ誤差も同じように、stats.chi2.ppf(自由度2のカイ二乗分布の分位点関数)で作り、平均2を引いて標準偏差2で割ってから sigma_true を掛けています。
- 確認: stats.skew で広告の出稿量の歪度(分布の左右の非対称さ。正規分布なら0、右に裾が長いと正)を計算し、広告と誤差の相関を表示しています。
実行結果
広告の出稿量:平均 19.6、中央値 16.8、歪度 1.46
広告と誤差の相関:+0.543(Xs と誤差の相関 +0.572)
- 広告の分布は右に歪んでいる: 平均 19.6 に対して中央値は 16.8 で、歪度は 1.46 です。普段は控えめに出稿し、ときどき大きく出稿する広告の出し方になっています。
- 内生性がある: 広告と誤差の相関は 0.54 です。誤差には需要などの観測できない要因が含まれるので、「需要が高い時期ほど広告を増やす」状況を表しています。このまま OLS で推定すると、広告の効果は過大に推定されるはずです。生成に使った と誤差の相関(0.57)が と少し違うのは、500期間という有限のデータによるばらつきです。
コピュラ補正による推定
コピュラ項を作る
経験分布関数で、データからコピュラ項 を作る関数 copula_term を定義します。あわせて、広告の分布が正規分布の場合と比べて、 と の関係がどう違うかを図で確かめます。
def copula_term(x):
    """経験分布関数で、コピュラ項 Φ^{-1}(rank / (T + 1)) を作る"""
    return stats.norm.ppf(stats.rankdata(x) / (len(x) + 1))

df['P'] = copula_term(df['X'])
df_norm = make_data(x_dist='normal')        # 比較用:広告が正規分布に従うデータ
df_norm['P'] = copula_term(df_norm['X'])

print(f"コピュラ項と本当の Xs の相関:{np.corrcoef(df['P'], df['Xs'])[0, 1]:.4f}")
print(f"広告とコピュラ項の相関(ガンマ分布):{np.corrcoef(df['X'], df['P'])[0, 1]:.4f}")
print(f"広告とコピュラ項の相関(正規分布)  :{np.corrcoef(df_norm['X'], df_norm['P'])[0, 1]:.4f}")

# 広告の分布と、標準化した広告とコピュラ項の関係
fig, axes = plt.subplots(1, 2, figsize=(12, 4.2))
axes[0].hist(df['X'], bins=40, color='C0', alpha=0.8)
axes[0].set_title('広告の出稿量 X の分布(ガンマ分布)')
axes[0].set_xlabel('広告の出稿量')
axes[0].set_ylabel('期間の数')
for d, label, c in [(df, 'ガンマ分布の広告', 'C0'), (df_norm, '正規分布の広告', 'C1')]:
    z = (d['X'] - d['X'].mean()) / d['X'].std()
    axes[1].scatter(z, d['P'], s=8, alpha=0.6, color=c, label=label)
axes[1].plot([-3, 3], [-3, 3], color='gray', linestyle='--', linewidth=1, label='直線(コピュラ項 = 標準化した広告)')
axes[1].set_title('標準化した広告とコピュラ項の関係')
axes[1].set_xlabel('標準化した広告の出稿量')
axes[1].set_ylabel('コピュラ項')
axes[1].legend(fontsize=9)
plt.tight_layout()
plt.show()
コピュラ項を作り、広告の分布による違いを確かめています。
- コピュラ項の関数: stats.rankdata(x) は、値の小さい順に1から までの順位を付けます。それを len(x) + 1 で割って経験分布関数の値にし、stats.norm.ppf(標準正規分布の分位点関数 )で変換しています。経験分布関数でコピュラ項を作るの式そのままです。
- 比較用のデータ: make_data(x_dist='normal') で、広告の出稿量が正規分布に従う以外は同じデータを作り、同じようにコピュラ項を計算しています。
- 相関の確認: 1行目は、経験分布関数で作ったコピュラ項 P が、生成に使った本当の (Xs)をどれだけ再現できているかです。2・3行目は、広告とコピュラ項の相関です。
- 図: 左は広告の出稿量のヒストグラムです。右は、横軸に広告の出稿量を標準化した値(平均を引いて標準偏差で割った値)、縦軸にコピュラ項をとった散布図で、灰色の破線は「コピュラ項 = 標準化した広告」の直線です。
実行結果
コピュラ項と本当の Xs の相関:0.9990
広告とコピュラ項の相関(ガンマ分布):0.9435
広告とコピュラ項の相関(正規分布)  :0.9990
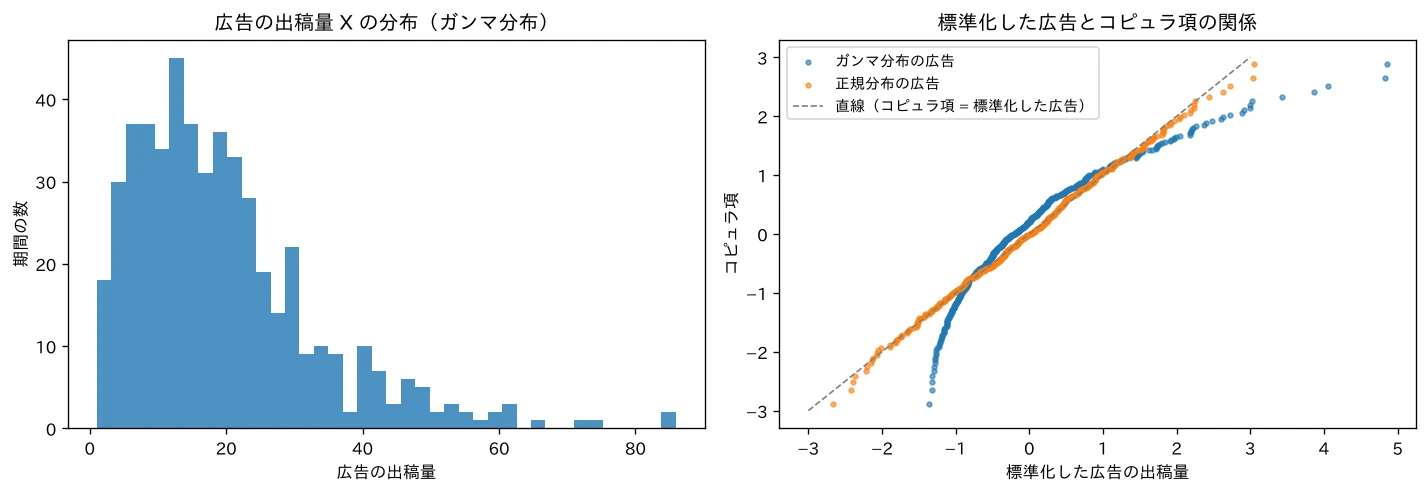
- コピュラ項は本当の をよく再現している: 経験分布関数で作ったコピュラ項と、生成に使った本当の の相関は 0.999 です。順位だけから作った値ですが、500期間あれば、ほぼ正確に再現できます。
- ガンマ分布の広告では、関係が曲がっている: 右の図の青い点は、灰色の直線から外れて曲がっています。出稿量の少ない期間ではコピュラ項が急に小さくなり、出稿量の多い期間では頭打ちになっています。広告とコピュラ項の相関は 0.94 で、1次式では表しきれない部分が残っています。この「曲がり」が、コピュラ補正で広告の効果と内生性を見分ける手がかりです。
- 正規分布の広告では、ほぼ直線: オレンジの点は直線の上に並び、広告とコピュラ項の相関は 0.999 です。コピュラ項は広告を標準化しただけの値になり、回帰で2つの係数を分けられません。
OLS とコピュラ補正の比較
OLS と、コピュラ項を加えた回帰を比べます。コピュラ補正では、 を と で回帰します。
(delta)はコピュラ項の係数で、真の値は です。
# 1. OLS:売上 Y を広告 X で回帰
ols = sm.OLS(df['Y'], sm.add_constant(df['X'])).fit()

# 2. コピュラ補正:売上 Y を広告 X とコピュラ項 P で回帰
cop = sm.OLS(df['Y'], sm.add_constant(df[['X', 'P']])).fit()

print(f"真の広告の効果       : {beta_true:.3f}")
print(f"OLS                 : {ols.params['X']:.3f}(標準誤差 {ols.bse['X']:.3f})")
print(f"コピュラ補正         : {cop.params['X']:.3f}(回帰の標準誤差 {cop.bse['X']:.3f})")
print(f"コピュラ項の係数 delta : {cop.params['P']:.3f}(真の値 sigma * rho = {sigma_true * rho:.1f})")
OLS とコピュラ補正で広告の効果を推定し、真の値と比べています。
- OLS: sm.add_constant で切片の列を加え、売上を広告だけで回帰しています。
- コピュラ補正: df[['X', 'P']] で、広告とコピュラ項の2列を説明変数にしています。コピュラ補正の実装は、この1行だけです。
- 標準誤差: cop.bse は、コピュラ項 P を「データから推定した値」ではなく「観測した値」として扱った標準誤差なので、参考値です。正しい標準誤差は、次のブートストラップで求めます。
実行結果
真の広告の効果       : 0.300
OLS                 : 0.498(標準誤差 0.014)
コピュラ補正         : 0.317(回帰の標準誤差 0.040)
コピュラ項の係数 delta : 2.640(真の値 sigma * rho = 3.0)
- OLS は過大評価: OLS の推定値は 0.498 で、真の値 0.3 の約1.7倍です。広告と誤差の正の相関(0.54)が、広告の効果として数えられています。
- コピュラ補正は真の値の近く: コピュラ項を加えると、推定値は 0.317 になり、真の値 0.3 に近づきました。外部の変数を使わずに、回帰に1列加えただけです。
- コピュラ項の係数は内生性の強さ: コピュラ項の係数は 2.64 で、真の値 に近い値です。正で、0から十分に離れているので、「広告は誤差と正に連動している(需要が高い時期に増やしている)」という内生性の兆候をとらえています。
- 精度は下がる: 回帰の標準誤差は 0.040 で、OLS の 0.014 の約3倍です。広告とコピュラ項の相関が 0.94 と高いため、2つの係数を分けるのに必要な情報が少なく、推定のばらつきが大きくなります。
ブートストラップで標準誤差を求める
ブートストラップでは、 個のデータから 個を復元抽出(同じデータを何度選んでもよい抽出)して、推定をやり直します。これを 回(B)繰り返したときの推定値 の標準偏差を、標準誤差とします。
は 個の推定値の平均です。ポイントは、復元抽出したデータごとに、コピュラ項を作り直す ことです。こうすることで、「コピュラ項をデータから推定したことによるばらつき」も標準誤差に含まれます。あわせて、推定値の2.5%点と97.5%点から、95%信頼区間(パーセンタイル法)も求めます。
def fit_copula(d):
    """コピュラ項を作り直してから回帰し、広告とコピュラ項の係数を返す"""
    P = copula_term(d['X'].values)
    res = sm.OLS(d['Y'].values, sm.add_constant(np.column_stack([d['X'].values, P]))).fit()
    return res.params[1], res.params[2]

# 1. 復元抽出して推定をやり直すことを B 回繰り返す
rng_boot = np.random.default_rng(0)
B = 1000
boot = np.array([fit_copula(df.iloc[rng_boot.integers(0, T, size=T)]) for _ in range(B)])

# 2. 標準誤差と 95% 信頼区間
se_beta, se_delta = boot.std(axis=0, ddof=1)
lo_b, hi_b = np.percentile(boot[:, 0], [2.5, 97.5])
lo_d, hi_d = np.percentile(boot[:, 1], [2.5, 97.5])
print(f"広告の効果      :{cop.params['X']:.3f}、ブートストラップの標準誤差 {se_beta:.3f}、95%信頼区間 {lo_b:.3f} 〜 {hi_b:.3f}")
print(f"コピュラ項の係数:{cop.params['P']:.3f}、ブートストラップの標準誤差 {se_delta:.3f}、95%信頼区間 {lo_d:.3f} 〜 {hi_d:.3f}")
ブートストラップで、コピュラ補正の標準誤差と信頼区間を求めています。
- 推定の関数: fit_copula は、受け取ったデータ d でコピュラ項を作り直し、回帰して、広告の係数とコピュラ項の係数を返します。np.column_stack は、2つの1次元配列を2列の配列にまとめる関数です。res.params は切片・広告・コピュラ項の順に並ぶので、[1] と [2] を返しています。
- 復元抽出: rng_boot.integers(0, T, size=T) で0〜T−1の整数を T 個(重複を許して)引き、df.iloc[...] でその行を取り出しています。これを B = 1000 回繰り返し、結果を boot(1000行2列)にまとめています。1,000回にするのは、標準誤差だけでなく、2.5%点・97.5%点の信頼区間の端も安定して求めるためです。区間の端は、標準誤差より多くの回数を必要とします。
- 標準誤差と信頼区間: boot.std(axis=0, ddof=1) で列ごとの標準偏差( で割る)を求め、コードの直前に示した式の標準誤差としています。np.percentile(..., [2.5, 97.5]) は、推定値の2.5%点と97.5%点です。
実行結果
広告の効果      :0.317、ブートストラップの標準誤差 0.039、95%信頼区間 0.238 〜 0.384
コピュラ項の係数:2.640、ブートストラップの標準誤差 0.533、95%信頼区間 1.660 〜 3.669
- 広告の効果: ブートストラップの標準誤差は 0.039 で、回帰の標準誤差(0.040)とほぼ同じでした。95%信頼区間は 0.238〜0.384 で、真の値 0.3 を含み、OLS の推定値 0.498 は含みません。
- コピュラ項の係数: 標準誤差は 0.533、95%信頼区間は 1.66〜3.67 で、0を含みません。データから「内生性がある」と判断できます。
この例では、ブートストラップと回帰の標準誤差の差は小さくなりましたが、いつも小さいとは限りません。コピュラ補正の結果を報告するときは、ブートストラップの標準誤差を使います。
OLS とコピュラ補正の推定値、コピュラ項の係数を並べると、次のようになります。
(図は、diagram-designで作成)
前提1を確かめる:広告の分布は正規分布から離れているか
4つの前提のうち、データで確かめられるのは「広告の出稿量が正規分布に従わない」ことだけです。歪度と、正規分布に従うかどうかの検定(シャピロ・ウィルク検定)で確かめます。検定の帰無仮説は「正規分布に従う」なので、p値が小さいほど、正規分布から離れていると判断できます。
for name, d in [('ガンマ分布の広告', df), ('正規分布の広告', df_norm)]:
    sw = stats.shapiro(d['X'])
    print(f"{name}:歪度 {stats.skew(d['X']):+.2f}、シャピロ・ウィルク検定の p値 {sw.pvalue:.2g}")
2つのデータで、広告の出稿量が正規分布から離れているかを確かめています。
- 歪度: stats.skew で計算します。正規分布なら0の近くになります。
- シャピロ・ウィルク検定: stats.shapiro は、データが正規分布に従うかを検定する関数で、結果の pvalue が p値です。:.2g は、有効数字2桁で表示する書式です(とても小さい値は指数表記になります)。
実行結果
ガンマ分布の広告:歪度 +1.46、シャピロ・ウィルク検定の p値 2.6e-18
正規分布の広告:歪度 +0.09、シャピロ・ウィルク検定の p値 0.63
- ガンマ分布の広告: 歪度は 1.46 で、シャピロ・ウィルク検定の p値は ととても小さく、正規分布から明らかに離れています。前提1は満たされています。
- 正規分布の広告: 歪度は 0.09、p値は 0.63 で、正規分布ではないとは言えません。このデータでは、コピュラ補正は使えません。
ただし、検定で「正規分布ではない」と言えても、それだけでコピュラ補正が十分に働くとは限りません。p値はサンプルが大きいほど小さくなるので、わずかな歪みでも小さな値になります。歪度などで、分布がどれだけ正規分布から離れているかも合わせて確かめます。
前提が崩れると何が起きるか
シミュレーション:5つのシナリオ
コピュラ補正の推定は、前提が崩れるとどうなるでしょうか。次の5つのシナリオで、それぞれ500回データを作り直し、OLS とコピュラ補正の推定値の分布を比べます。
| シナリオ | 設定 | 崩れる前提 |
|---|---|---|
| 前提どおり | 既定値() | なし |
| 内生性なし | なし(補正が不要な場合) | |
| サンプルが小さい | 4. サンプルが十分に大きい | |
| 広告が正規分布 | x_dist='normal' | 1. 内生変数が正規分布に従わない |
| 誤差が歪んでいる | e_dist='skewed' | 2. 誤差項が正規分布に従う |
# 1. 5つのシナリオで、それぞれ 500 回データを作り直して推定する
scenarios = {
    '前提どおり': dict(),
    '内生性なし': dict(rho=0.0),
    'サンプルが小さい': dict(T=100),
    '広告が正規分布': dict(x_dist='normal'),
    '誤差が歪んでいる': dict(e_dist='skewed'),
}
n_rep = 500
sim = {}
for name, kw in scenarios.items():
    est_ols, est_cop = [], []
    for r in range(n_rep):
        d = make_data(seed=1000 + r, **kw)
        est_ols.append(sm.OLS(d['Y'], sm.add_constant(d['X'])).fit().params['X'])
        est_cop.append(fit_copula(d)[0])
    sim[name] = (np.array(est_ols), np.array(est_cop))

# 2. 中央値と 5〜95% 点
for name, (o, c) in sim.items():
    lo, hi = np.percentile(c, [5, 95])
    print(f"{name:<10}:OLS の中央値 {np.median(o):.3f}、コピュラ補正の中央値 {np.median(c):+.3f}(5〜95%点 {lo:+.2f} 〜 {hi:+.2f})")

# 3. 推定値の分布を箱ひげ図で描く
fig, ax = plt.subplots(figsize=(12, 4.5))
names = list(sim)
pos = np.arange(len(names))
ax.boxplot([sim[n][0] for n in names], positions=pos - 0.18, widths=0.3, showfliers=False,
           patch_artist=True, boxprops=dict(facecolor='C3', alpha=0.4))
ax.boxplot([sim[n][1] for n in names], positions=pos + 0.18, widths=0.3, showfliers=False,
           patch_artist=True, boxprops=dict(facecolor='C0', alpha=0.6))
ax.axhline(beta_true, color='black', linestyle='--', linewidth=1)
ax.set_xticks(pos)
ax.set_xticklabels(names)
ax.set_ylabel('広告の効果の推定値')
ax.legend([plt.Rectangle((0, 0), 1, 1, color='C3', alpha=0.4), plt.Rectangle((0, 0), 1, 1, color='C0', alpha=0.6),
           plt.Line2D([0], [0], color='black', linestyle='--')], ['OLS', 'コピュラ補正', '真の値 0.3'], loc='upper left')
plt.tight_layout()
plt.show()
5つのシナリオで、OLS とコピュラ補正の推定値の分布を比べています。
- シナリオ: 辞書 scenarios に、シナリオの名前と、make_data に渡す引数をまとめています。**kw は、辞書の中身を「引数名=値」として関数に渡す書き方です。空の辞書 dict() なら既定値のままです。
- 繰り返し: シードを1000から変えながら500回データを作り、OLS の推定値と、fit_copula によるコピュラ補正の推定値(返り値の1つ目)を集めています。シードを1000から始めるのは、記事の本文の1回分のデータ(シード42)と重ならないようにするためです。500回は、推定値の5%点・95%点を安定して読み取れる回数です。
- 集計: 推定値の中央値と、np.percentile(c, [5, 95]) による5%点・95%点を表示しています。
- 箱ひげ図: ax.boxplot で、シナリオごとに OLS(赤)とコピュラ補正(青)の推定値の分布を左右に並べています。positions で箱の横位置をずらし、showfliers=False で外れ値の点を省いています。箱は推定値の25〜75%点、ひげは箱の長さの1.5倍までの範囲です。凡例は、plt.Rectangle と plt.Line2D で見本の図形を作って表示しています。
実行結果
前提どおり     :OLS の中央値 0.500、コピュラ補正の中央値 +0.304(5〜95%点 +0.23 〜 +0.37)
内生性なし     :OLS の中央値 0.299、コピュラ補正の中央値 +0.298(5〜95%点 +0.22 〜 +0.39)
サンプルが小さい  :OLS の中央値 0.504、コピュラ補正の中央値 +0.324(5〜95%点 +0.13 〜 +0.47)
広告が正規分布   :OLS の中央値 0.599、コピュラ補正の中央値 +0.588(5〜95%点 -0.04 〜 +1.11)
誤差が歪んでいる  :OLS の中央値 0.497、コピュラ補正の中央値 +0.464(5〜95%点 +0.38 〜 +0.58)
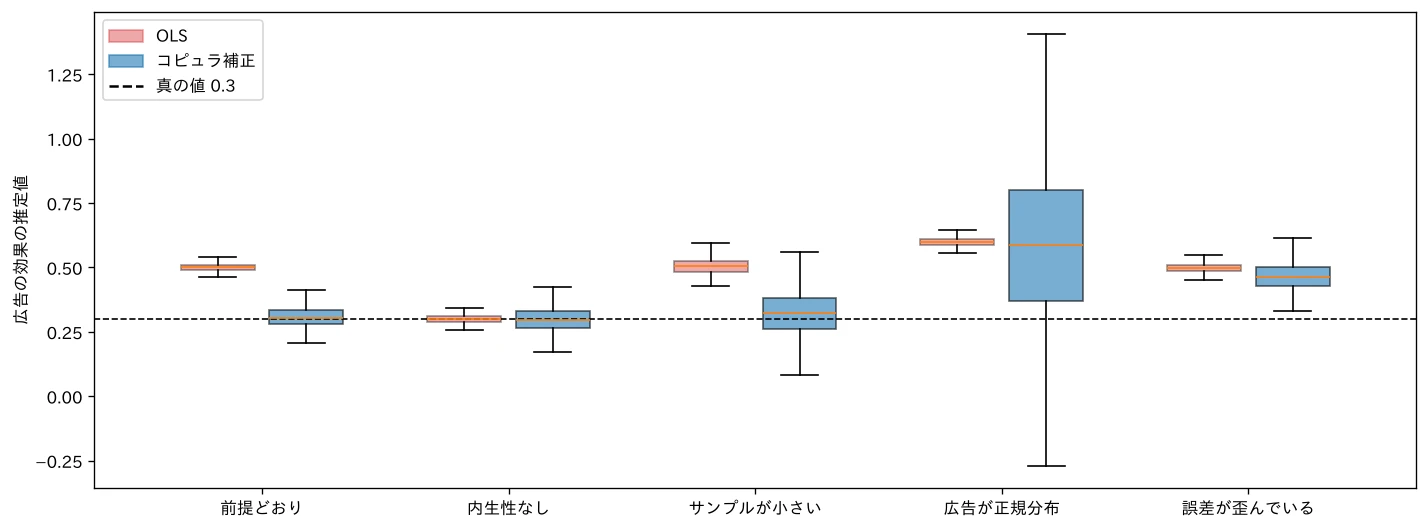
- 前提どおり: コピュラ補正の推定値の中央値は 0.304 で、90%が 0.23〜0.37 に収まります。OLS(中央値 0.500)の偏りが取り除かれています。
- 内生性なし: でも、コピュラ補正の中央値は 0.298 で、偏りは生じません。ただし、5〜95%点は 0.22〜0.39 で、OLS より広くなります。内生性がないのに補正すると、精度だけを失います。
- サンプルが小さい: では、中央値は 0.324 とやや大きめで、5〜95%点は 0.13〜0.47 と広がりました。コピュラ項の推定が粗くなり、推定値が不安定になります。
- 広告が正規分布: 中央値は 0.588 で、OLS の中央値 0.599 とほとんど変わらず、偏りは補正されていません。5〜95%点は −0.04〜1.11 と、ばらつきが極端に大きくなりました。広告とコピュラ項がほぼ比例するので、2つの係数を分けられないためです。
- 誤差が歪んでいる: 中央値は 0.464 で、OLS の 0.497 からわずかしか補正されていません。しかも、ばらつきは小さいので、推定値は「偏った値にきれいに集まる」ことになり、一見すると信頼できそうな結果に見えてしまいます。誤差の分布の誤りは、データからは気付きにくいので、特に注意が必要です。
前提1(広告が正規分布に従わない)の崩れは、推定値の大きなばらつきとして現れるので、標準誤差を見れば気付けます。一方、前提2(誤差が正規分布に従う)の崩れは、ばらつきの小さい偏った推定として現れ、標準誤差からは気付けません。
操作変数法との使い分け
コピュラ補正と操作変数法を比べると、次のようになります。
| 操作変数法 | コピュラ補正 | |
|---|---|---|
| 必要なもの | 条件を満たす操作変数 | 内生変数のデータだけ |
| 識別の手がかり | 操作変数による、需要と無関係な広告の変動 | 広告とコピュラ項の関係の曲がり(非線形性) |
| データで確かめられる前提 | 関連性(第1段階の F統計量) | 内生変数が正規分布に従わないこと |
| データで確かめられない前提 | 独立性・除外制約 | 誤差項が正規分布に従うこと、依存関係がガウシアン・コピュラで表せること |
| 前提が崩れたとき | 弱い操作変数・除外制約の崩れで大きく偏る | 誤差の分布の誤りなどで偏り、OLS に近づくこともある |
どちらの方法も、データで確かめられない前提に頼っています。ただし、操作変数法の前提(独立性・除外制約)は「この変数はなぜ動いたのか」というビジネスの仕組みの議論で検討できるのに対し、コピュラ補正の前提(誤差項の分布の形)は、仕組みの議論から判断しにくいものです。
そのため、実務では次のように使い分けるのがよいでしょう。
- 操作変数があるなら、操作変数法を優先する:前提の妥当性を、ビジネスの仕組みの知識で議論できるからです。
- コピュラ補正は、感度分析として使う:OLS とコピュラ補正の結果を並べ、コピュラ項の係数が0と区別できるか(内生性の兆候があるか)、広告の効果の推定値がどれだけ動くかを確かめます。結果が大きく変わるなら、内生性を疑って実験(ジオ実験など)を検討する材料になります。
- 前提1は必ず確かめる:広告の分布が正規分布に近いデータでは、コピュラ補正の結果は信頼できません。
Becker et al. (2022) は、シミュレーションによって、前提が満たされない場合や、サンプルが小さい場合に、コピュラ補正が大きな偏りや検出力の不足を示すことを報告し、使ってよい条件を整理しています。Qian, Koschmann & Xie (2024) は、コピュラ補正を実務で使うための手引きとして、コピュラ項の作り方の考え方や、データが前提を満たしているかの確認方法をまとめています。複数の内生変数や外生のコントロール変数がある場合など、本記事の設定を超える場合は、これらの文献を参照してください。
2つの方法の使い分けを図にまとめると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、操作変数を使わずに内生性に対処するコピュラ補正を解説しました。
- 考え方:広告の出稿量 と誤差項 の依存関係を、ガウシアン・コピュラ(正規分布に変換した2つの変数が相関 の2変量正規分布に従う)で表します。誤差項が正規分布なら、誤差は「コピュラ項 に比例する部分」と「 と独立な部分」に分かれます。
- 実装:広告の順位から作ったコピュラ項 を回帰に加えるだけで、広告の係数の偏りが消えます。コピュラ項の係数は内生性の強さ を表します。標準誤差は、コピュラ項を作り直しながらのブートストラップで求めます。
- 前提:広告の分布が正規分布から離れていること、誤差項が正規分布に従うこと、依存関係がガウシアン・コピュラで表せること、サンプルが十分に大きいことが必要です。データで確かめられるのは1つ目だけです。
- 使いどころ:前提が崩れると、推定は OLS と同じ方向に偏ったり、大きくばらついたりします。操作変数があるなら操作変数法を優先し、コピュラ補正は感度分析として使うのが安全です。
実験ができず、操作変数も見つからない場合でも、コピュラ補正で「内生性がどれくらい結果を動かしうるか」を確かめることはできます。最終的な判断の基準には、合成コントロール法とジオ実験やRCTのような実験の結果を使い、MMMのキャリブレーションのように、モデルの推定を実験で補正していくことが、広告効果測定の確実な道筋です。
参考文献
- S. Park, S. Gupta (2012). Handling Endogenous Regressors by Joint Estimation Using Copulas. Marketing Science, 31(4), 567–586.
- J.-M. Becker, D. Proksch, C. M. Ringle (2022). Revisiting Gaussian copulas to handle endogenous regressors. Journal of the Academy of Marketing Science, 50(1), 46–66.
- Y. Qian, A. Koschmann, H. Xie (2024). A Practical Guide to Endogeneity Correction Using Copulas. NBER Working Paper No. 32231.