Chain-of-Verification(CoVe)とは?
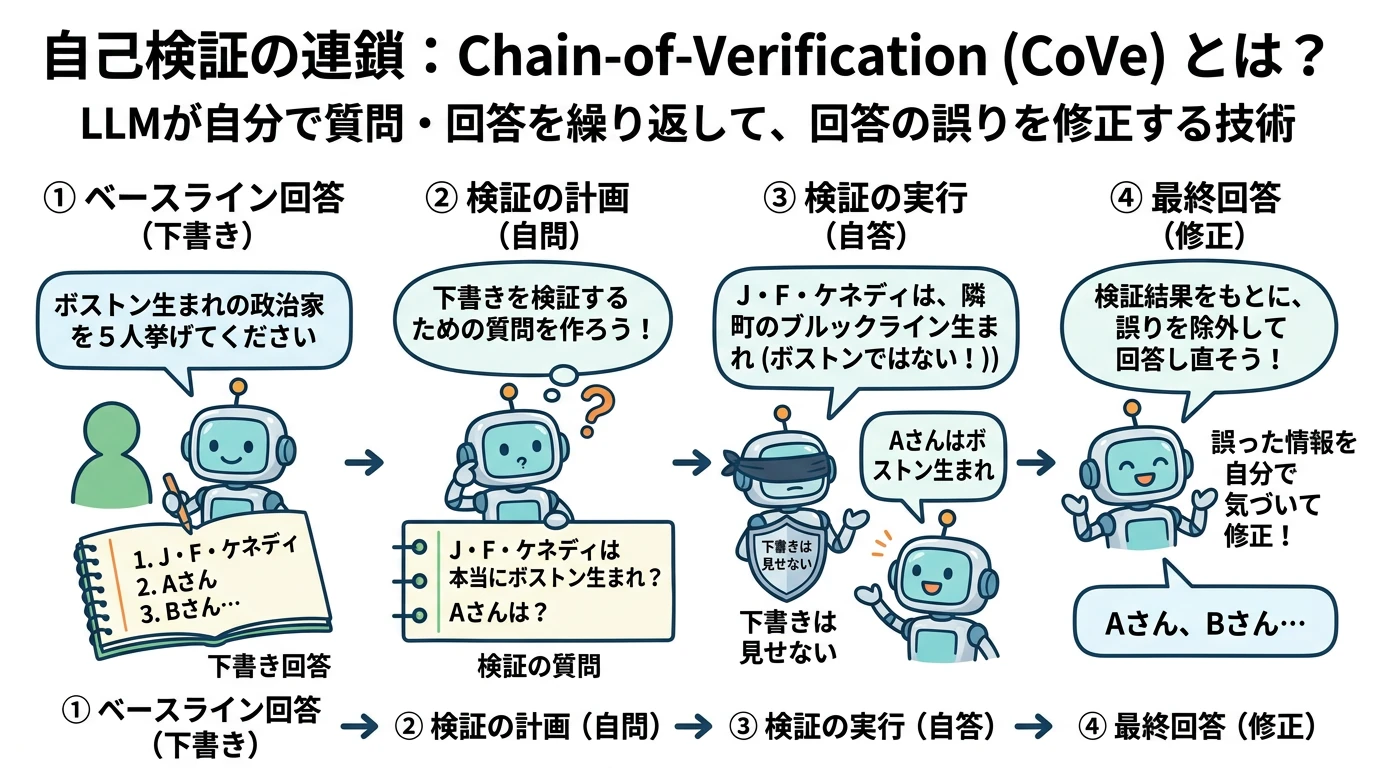 (画像は、Geminiで作成)
LLM が書いた回答の事実の誤りを、同じ LLM に検証の質問を作らせて答え直させることで見つけて直す Chain-of-Verification(CoVe)の4段階を、Python のコードで確かめること。検証の質問に回答の下書きを見せずに答えさせることがなぜ効くのかを実験で確かめ、joint・2-step・factored の3種類の違いと、学習で同じことをする Self-RAG との使い分けを説明できるようになること。
原著論文: Chain-of-Verification Reduces Hallucination in Large Language Models (Dhuliawala, Komeili, Xu, Raileanu, Li, Celikyilmaz, Weston, Findings of ACL 2024)
概要
本記事で扱う Chain-of-Verification は、検索を前提としない手法です。RAGの構成要素ではなく、RAGの有無に関わらず生成の最終段に併用できる独立した技術として位置づけられます。
LLM は、もっともらしいが事実と違う内容(ハルシネーション)を書くことがあります。RAG (Retrieval-Augmented Generation) とは? の記事で扱った RAG は、外部の文書を検索して読ませることでこれを減らしますが、生成した回答をあとから確かめる仕組みは持っていません。特に、「ボストン生まれの政治家を5人挙げて」のような、複数の事実を並べて答える質問では、5人のうち何人かを間違えても、LLM は気付かずに書き続けます。
Chain-of-Verification(CoVe)は、この誤りを 同じ LLM に自分で確かめさせる 方法です。まず、いつものように回答の下書きを書かせます。次に、下書きの主張ごとに「John F. Kennedy はどこで生まれたか」のような確認の質問を作らせ、その質問に、下書きを見せずに1つずつ 答えさせます。最後に、確認の答えと矛盾する主張を除いて、回答を書き直させます。追加の学習も、検索も、外部のツールも使わず、プロンプトの組み立て方だけで、モデルは自分の出力の誤りを見つけて直せる、というのが CoVe の主張です。
次の節で、LLM がリストの質問で人物を取り違える様子を、実際に測ります。
LLM は、リストの中で人物を取り違える
実験には、原著論文と同じ形の、Wikidata から正解を集めたリストの質問を使います。
- 質問: 「Name five politicians who were born in Boston.(ボストンで生まれた政治家を5人挙げてください。)」のように、10都市(Boston・Chicago・Paris・London・Tokyo・Berlin・Rome・Los Angeles・New York City・Vienna)と5職業(政治家・俳優・作家・作曲家・画家)を組み合わせた50問です。
- 正解: Wikidata で、その職業を持ち、出生地がその都市(または市内の地区)である人物の名前(英語の名前と別名)をすべて集めます。Wikidata の構造と、問い合わせに使う SPARQL は、ナレッジグラフの記事で解説しています。1問あたりの正解は数百〜1万人以上いるので、挙げた5人が正解の中に入っているかだけを調べます。
- 指標: 挙げた人物のうち、正解に入っている人物の割合を 適合率(precision) と呼びます。原著論文と同じく、1問あたりの正しい人数と誤った人数も数えます。
検索は使いません。LLM が事前学習で覚えた知識(パラメトリック知識)だけで答えさせ、その誤りを CoVe で減らせるかを確かめます。
準備:Google Colab の GPU で動かす
LLM に Qwen2.5-7B-Instruct(bf16、約15GB)を使います。Google Colab の「ランタイム」→「ランタイムのタイプを変更」から、メモリが 24GB ある L4 GPU を選んでください(Colab の有料プランが必要です)。追加のパッケージはありません。記事の数値は、transformers 5.20.2・torch 2.11.0 で実行したものです。
- 実験1は、モデルのダウンロード(約15GB)と Wikidata への50回の問い合わせを含めて、約12分です。
- 実験2は、検証の計画・実行・最終回答で約350回の生成を行い、約10分です。
- 実験3は、joint・2-step・はい/いいえの質問で約650回の生成を行い、約25分です。
- 生成はすべて貪欲法(greedy)なので、同じ環境なら何度実行しても同じ数値になります。ただし、GPU の種類やライブラリのバージョンが違うと、数値が多少変わることがあります。また、Wikidata は日々更新されるので、正解の人数や適合率がわずかに変わることがあります。
実験1:ベースラインで答える
import re
import unicodedata
import requests
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

# 1. 質問:10都市 × 5職業 = 50問(原著論文の Wikidata のリスト質問と同じ形)
CITIES = {"Boston": "Q100", "Chicago": "Q1297", "Paris": "Q90", "London": "Q84", "Tokyo": "Q1490",
          "Berlin": "Q64", "Rome": "Q220", "Los Angeles": "Q65", "New York City": "Q60", "Vienna": "Q1741"}
OCCUPATIONS = {"politicians": "Q82955", "actors": "Q33999", "writers": "Q36180",
               "composers": "Q36834", "painters": "Q1028181"}
# 職業:「政治家・俳優・作家・作曲家・画家」


def normalize(name):
    """アクセント記号・記号・大文字小文字の違いを除いて、名前を比べやすくする"""
    name = unicodedata.normalize("NFKD", name).encode("ascii", "ignore").decode()
    name = re.sub(r"\(.*?\)", "", name)
    return " ".join(re.sub(r"[^a-z ]", " ", name.lower()).split())


def wikidata_people(city_id, occupation_id):
    """Wikidata で、その職業を持ち、その都市(市内の地区を含む)で生まれた人物の名前(英語の名前と別名)を集める"""
    query = f"""
    SELECT DISTINCT ?name WHERE {{
      ?p wdt:P106 wd:{occupation_id}; wdt:P19/wdt:P131* wd:{city_id}.
      {{ ?p rdfs:label ?name }} UNION {{ ?p skos:altLabel ?name }}
      FILTER(LANG(?name) = "en")
    }}"""
    r = requests.get("https://query.wikidata.org/sparql", params={"query": query, "format": "json"},
                     headers={"User-Agent": "cove-article-example/1.0"}, timeout=120)
    return {normalize(b["name"]["value"]) for b in r.json()["results"]["bindings"]}


questions = []
for city, cid in CITIES.items():
    for occ, oid in OCCUPATIONS.items():
        questions.append({"question": f"Name five {occ} who were born in {city}.",
                          "city": city, "gold": wikidata_people(cid, oid)})
        # 「{city} で生まれた {職業} を5人挙げてください。」
print("正解の人数(中央値):", sorted(len(q["gold"]) for q in questions)[len(questions) // 2])

# 2. LLM(Qwen2.5-7B-Instruct):検索は使わず、事前学習の知識だけで答えさせる
MODEL_ID = "Qwen/Qwen2.5-7B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, dtype=torch.bfloat16, device_map="cuda")
model.eval()


@torch.no_grad()
def chat(prompt, max_new_tokens=200):
    messages = [{"role": "user", "content": prompt}]
    inputs = tokenizer.apply_chat_template(messages, add_generation_prompt=True,
                                           return_tensors="pt", return_dict=True).to(model.device)
    output = model.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
    return tokenizer.decode(output[0, inputs["input_ids"].shape[1]:], skip_special_tokens=True).strip()


def parse_names(text):
    """「1. John Smith - politician」のような行から、名前の部分だけを取り出す"""
    names = []
    for line in text.splitlines():
        line = re.sub(r"^\s*(\d+[.)]|[-*•])\s*", "", line).strip()
        line = re.split(r"\s[-–—:]\s|,", line)[0].strip()
        if line and len(line.split()) <= 6:
            names.append(line)
    return names


def evaluate(lists):
    """適合率(挙げた人物のうち正しい人物の割合)と、1問あたりの正しい人数・誤った人数"""
    pos = [sum(normalize(n) in q["gold"] for n in names) for q, names in zip(questions, lists)]
    neg = [len(names) - p for names, p in zip(lists, pos)]
    return sum(pos) / max(sum(pos) + sum(neg), 1), sum(pos) / len(lists), sum(neg) / len(lists)


# 3. ベースライン:質問にそのまま答えさせる
BASELINE = "Answer with one full name per line and nothing else.\n\n{question}"
# 「1行に1人ずつフルネームだけで答えてください。(質問)」
baseline = [parse_names(chat(BASELINE.format(question=q["question"]))) for q in questions]
prec, pos, neg = evaluate(baseline)
print(f"ベースライン  適合率: {prec:.2f}  正しい人数: {pos:.2f}  誤った人数: {neg:.2f}")

# 4. 例:最初の質問の回答と、Wikidata での正誤
q = questions[0]
print("\nQuestion:", q["question"])
for n in baseline[0]:
    print(f"  {'○' if normalize(n) in q['gold'] else '×'} {n}")
Wikidata から50問の正解を集め、Qwen2.5-7B-Instruct に検索なしで答えさせて、適合率を測るコードです。
- 質問: CITIES と OCCUPATIONS は、都市と職業の名前と、Wikidata での ID(Q で始まる番号)です。10都市 × 5職業で50問を作ります。都市と職業を組み合わせるのは、正解の人物が数百人以上いる質問を、偏りなく50問そろえるためです。正解が多いと、モデルは「それらしい名前」を挙げやすく、誤りの起き方を数えやすくなります。
- 正解: wikidata_people は、Wikidata の検索言語 SPARQL で、職業(P106)がその職業で、出生地(P19)がその都市か、その都市の中にある地区(P131 をたどった先がその都市)である人物を探し、英語の名前(rdfs:label)と別名(skos:altLabel)を集めます。normalize は、アクセント記号・記号・大文字小文字の違いを除いて、名前を比べやすくします。市内の地区までたどるのは、Wikidata では出生地が「Manhattan」のように地区で登録されている人物が多く、都市だけで探すと正しい人物を誤りと数えてしまうためです。別名も集めるのは、モデルが通称で挙げた人物も正しく数えるためです。
- 生成: chat は、プロンプトを1つのユーザーの発話として Qwen2.5-7B-Instruct に渡し、貪欲法で答えさせます。この関数は、以降の実験でも使います。
- 名前の取り出し: parse_names は、回答の各行から、番号や記号、「- 政治家」のような説明を除いて、名前の部分だけを取り出します。説明を除くのは、正解の集合と名前だけで比べるためです。
- 評価: evaluate は、挙げた人物の名前が正解の集合に入っているかを調べ、全体の適合率と、1問あたりの正しい人数・誤った人数を返します。
- ベースライン: BASELINE は、「1行に1人ずつフルネームだけで答えてください」と指示して、質問にそのまま答えさせるプロンプトです。フルネームだけで答えさせるのは、名前の取り出しと正解の照合を確実にするためです。
実行結果
正解の人数(中央値): 2090
ベースライン  適合率: 0.24  正しい人数: 1.18  誤った人数: 3.82

Question: Name five politicians who were born in Boston.
  × John F. Kennedy
  × Thomas F. Bowles
  ○ Joseph P. Kennedy Sr.
  ○ James Michael Curley
  ○ Edward M. Kennedy
(和訳)
- 質問:「ボストンで生まれた政治家を5人挙げてください。」
1問あたりの正解は中央値で2,090人もいるのに、LLM が挙げた5人のうち、正しかったのは平均1.18人で、適合率は 0.24 でした。挙げた人物の4人に3人は、その都市の生まれではないか、Wikidata に見つからない人物です。
最初の質問の例では、John F. Kennedy が誤りです。ケネディ大統領は、ボストンの隣町のブルックラインで生まれました。ボストンの政治家としてよく知られているので、LLM は「ボストン生まれの政治家」のリストに入れてしまいます。Thomas F. Bowles は、Wikidata の正解には見つかりませんでした。
Wikidata の出生地は、人によって詳しさが違うため、実際にはその都市で生まれた人物を、誤りと数えてしまうことがあります。この実験では、出生地が市内の地区(ボストンの Dorchester など)になっている人物も正解に含めましたが、それでも漏れはあります。そのため、適合率の値そのものよりも、同じ正解を使った方法どうしの比較に注目してください。
ここで、LLM は、挙げた人物について何も知らないわけではありません。「John F. Kennedy はどこで生まれましたか?」と単独で聞けば、正しく答えられるかもしれません。CoVe は、この差を利用します。
Chain-of-Verification の仕組み
4つの段階
CoVe は、次の4つの段階で回答を作ります。どの段階も、同じ LLM にプロンプトを変えて頼むだけです。
(図は、diagram-designで作成)
- ベースラインの回答(Generate Baseline Response) 質問に、普通に答えさせます。この回答を、以降の段階では「下書き」として扱います。下書きには誤りが含まれているかもしれません。
- 検証の計画(Plan Verifications) 質問と下書きを見せて、下書きの主張を確かめるための質問(検証の質問)を作らせます。リストの質問なら「John F. Kennedy はどこで生まれましたか?」のように、挙げた人物ごとに1問ずつです。原著論文では、どんな質問を作ればよいかを、プロンプトの中で例を見せて(In-Context Learning の few-shot で)教えています。
- 検証の実行(Execute Verifications) 検証の質問に答えさせます。ここが CoVe の要点で、答えるときに 下書きを見せない ことが重要です(次の節)。原著論文は検索などのツールを使わず、LLM 自身の知識だけで答えさせています。この段階で検索を使えばさらに改善するだろう、という点は、今後の課題として挙げられています。
- 最終回答(Generate Final Verified Response) 質問・下書き・検証の質問と答えを見せて、検証の答えと矛盾する主張を除いた回答を書かせます。
なぜ、下書きを見せずに答えさせるのか
段階3で下書きを見せると、LLM は、自分が書いた誤りをそのまま繰り返しがちです。プロンプトの中にある文を写すのは、LLM が最も得意なことの1つだからです。原著論文は、下書きのハルシネーションが検証でもそのまま繰り返されることを問題にしました。
一方、「John F. Kennedy はどこで生まれましたか?」と単独で聞かれれば、LLM は「ボストン生まれの政治家」という文脈に引きずられずに、覚えている事実(マサチューセッツ州ブルックライン)を答えやすくなります。原著論文の分析では、リストの質問のベースラインで挙げた人物のうち正しかったのは約17% でしたが、同じ人物についての個別の検証の質問には、約70% を正しく答えました。長い回答の中の1つとして書かせるよりも、短い質問に単独で答えさせる方が、事実を正しく思い出せる、というのが CoVe の前提です。
なお、Chain-of-Thought のように、答える前に考える過程を書かせても、この種の誤りは減りません。原著論文では、Llama 2 70B Chat に CoT のプロンプトを使うと、リストの質問の適合率が 0.12 から 0.08 に下がりました。考える過程の中でも、誤った事実を繰り返してしまうからです。
3種類の実装:joint・2-step・factored
CoVe には、段階2と段階3をどう実装するかによって、joint・2-step・factored の3種類があります。CoVe を使うときは、このうちどれか1つを選びます。1つの CoVe の中で3つを順番に行うわけではありません(実験3では、どれが良いかを比べるために、3つを別々に実行しています)。どの種類も、上の4つの段階を同じ順番で踏みます。段階1でベースラインの回答(下書き)を書き、段階4で検証の答えと矛盾する主張を除いて書き直すところは共通です。違うのは、間の 段階2(検証の質問を作る)と段階3(検証の質問に答える)を、どこまで別々のプロンプトに分けるか だけです。分けるほど、段階3で答えるときに見える情報が減り、下書きから独立して答えられるようになります。
次の表は、ベースラインと3種類の CoVe を、4つの段階ごとに並べたものです(〇は行う、-は行わない)。
| 段階 | ベースライン(実験1) | CoVe(joint) | CoVe(2-step) | CoVe(factored) |
|---|---|---|---|---|
| ① ベースラインの回答(下書き) | 〇(これで終わり) | 〇 | 〇 | 〇 |
| ② 検証の計画(質問を作る) | - | 〇(③と同じ1つのプロンプト) | 〇(1つのプロンプト) | 〇(1つのプロンプト) |
| ③ 検証の実行(質問に答える) | - | 〇(②と同じプロンプトで、続けて答える) | 〇(全部の質問を1つのプロンプトで) | 〇(質問ごとに別のプロンプト) |
| ③で答えるときに見えるもの | - | 元の質問・下書き・ほかの質問と答え | ほかの質問と答え(下書きは見えない) | その質問だけ |
| ④ 最終回答(書き直す) | - | 〇 | 〇 | 〇 |
| ②〜④の LLM の呼び出し | 0回 | 2回 | 3回 | 2 + 質問の数 |
| 実験での適合率(実験2・3) | 0.24 | 0.32 | 0.37 | 0.38 |
なお、joint も CoVe の一種で、段階1だけを行う実験1のベースライン(質問にそのまま答える)とは別の処理です。joint は、ベースラインの回答を下書きとして受け取り、そのあとに検証と書き直しを行います。
(図は、diagram-designで作成)
- joint: 検証の質問と答えを、1つのプロンプトでまとめて書かせます。生成は少なくて済みますが、答えを書くときに下書きが見えているので、誤りを繰り返しやすくなります。
- 2-step: 計画(質問を作る)と実行(答える)を別のプロンプトに分けます。実行のプロンプトには質問だけを入れ、下書きは見せません。ただし、すべての質問を1つのプロンプトでまとめて答えるので、ほかの質問とその答えは見えています。
- factored: 検証の質問ごとに、別のプロンプトで答えさせます。下書きも、ほかの質問も見えません。生成の回数は質問の数だけ増えますが、答えが最も独立します。
- factor+revise(3種類のほかの拡張): factored のあとに、主張ごとに「下書きの主張と検証の答えは矛盾しているか」を判定させる段階を足したものです。原著論文では、長い文章(伝記)の生成で使われました。本記事の実験では扱いません。
実験2:CoVe で検証する
実験1の下書き(ベースラインの回答)に、CoVe の段階2〜4を足します。段階3は、検証の質問を1つずつ別のプロンプトで答えさせる factored です。
# 1. 検証の計画:下書きの人物ごとに、主張を確かめる質問をモデルに作らせる(原著論文と同じく、例を1つ見せる)
PLAN = ("Write one verification question for each person in the draft answer. "
        "Write one question per line and nothing else.\n\n"
        "Question: Name some politicians who were born in New York.\n"
        "Draft answer:\nHillary Clinton\nDonald Trump\nMichael Bloomberg\n"
        "Verification questions:\nWhere was Hillary Clinton born?\nWhere was Donald Trump born?\n"
        "Where was Michael Bloomberg born?\n\n"
        "Question: {question}\nDraft answer:\n{draft}\nVerification questions:")
# 「下書きの人物ごとに、検証の質問を1つずつ書いてください。1行に1問ずつ、それ以外は書かないでください。
#   (例)質問:ニューヨークで生まれた政治家を何人か挙げてください。下書き:ヒラリー・クリントン/ドナルド・トランプ/
#   マイケル・ブルームバーグ 検証の質問:ヒラリー・クリントンはどこで生まれましたか?/…
#   質問:… 下書き:… 検証の質問:」


def plan(q, draft):
    lines = chat(PLAN.format(question=q["question"], draft="\n".join(draft))).splitlines()
    return [re.sub(r"^\s*(\d+[.)]|[-*•])\s*", "", l).strip() for l in lines if l.strip().endswith("?")]


# 2. 検証の実行(factored):質問を1つずつ、下書きを見せずに独立して答えさせる
VERIFY = "Answer the question briefly.\n\nQuestion: {question}"
# 「質問に短く答えてください。質問:…」


def execute_factored(vqs):
    return [chat(VERIFY.format(question=v), max_new_tokens=60) for v in vqs]


# 3. 最終回答:下書きと、検証の質問と答えを見せて、矛盾する人物を除いた回答を書かせる
FINAL = ("Question: {question}\nDraft answer:\n{draft}\n\nVerification questions and answers:\n{qa}\n\n"
         "Using the verification answers, write the final answer to the question. Remove any person whose "
         "verification answer is inconsistent with the question. Answer with one full name per line and nothing else.")
# 「質問:… 下書き:… 検証の質問と答え:… 検証の答えを使って、質問への最終回答を書いてください。
#   検証の答えが質問と矛盾する人物は除いてください。1行に1人ずつフルネームだけで答えてください。」


def final(q, draft, vqs, vas):
    qa = "\n".join(f"Q: {v}\nA: {a}" for v, a in zip(vqs, vas))
    return parse_names(chat(FINAL.format(question=q["question"], draft="\n".join(draft), qa=qa)))


plans = [plan(q, d) for q, d in zip(questions, baseline)]
answers = [execute_factored(v) for v in plans]
cove = [final(q, d, v, a) for q, d, v, a in zip(questions, baseline, plans, answers)]
for name, lists in [("ベースライン", baseline), ("CoVe(factored)", cove)]:
    prec, pos, neg = evaluate(lists)
    print(f"{name:18s} 適合率: {prec:.2f}  正しい人数: {pos:.2f}  誤った人数: {neg:.2f}")

# 4. 例:最初の質問で、4段階がどう進んだか
print("\nQuestion:", questions[0]["question"])
for v, a in zip(plans[0], answers[0]):
    print(f"  Q: {v}\n  A: {a[:100]}")
print("Final:", cove[0])
実験1の下書きに、検証の計画・実行・最終回答の3段階を足して、CoVe の回答を作るコードです。実験1の変数(questions・baseline)と関数(chat・parse_names・evaluate)を、そのまま使います。
- 検証の計画: PLAN は、質問と下書きを見せて、人物ごとに検証の質問を書かせるプロンプトです。原著論文と同じく、「ニューヨーク生まれの政治家」の例を1つ見せて、「X はどこで生まれましたか?」の形の質問を作るように教えます(few-shot)。plan は、生成した行のうち「?」で終わる行を、検証の質問として取り出します。
- 検証の実行: execute_factored は、検証の質問を1つずつ VERIFY のプロンプトに入れて、別々に答えさせます。このプロンプトには、元の質問も、下書きも、ほかの検証の質問も入れません。何も入れないのは、下書きが見えると、モデルが下書きの誤りに合わせて答えてしまうためです。下書きから切り離して答えさせることが、CoVe の核心です。
- 最終回答: FINAL は、質問・下書き・検証の質問と答えを見せて、検証の答えが質問と矛盾する人物を除いた回答を書かせるプロンプトです。final は、その回答から parse_names で名前を取り出します。
- 評価: ベースラインと CoVe の回答を、実験1と同じ evaluate で比べ、最初の質問で4段階がどう進んだかを表示します。最初の質問の4段階を表示するのは、適合率の数だけでは見えない「どの人物が、どの検証の答えで消されたか」を追うためです。
実行結果
ベースライン             適合率: 0.24  正しい人数: 1.18  誤った人数: 3.82
CoVe(factored)     適合率: 0.38  正しい人数: 1.06  誤った人数: 1.72

Question: Name five politicians who were born in Boston.
  Q: Where was John F. Kennedy born?
  A: John F. Kennedy was born in Brookline, Massachusetts.
  Q: Where was Thomas F. Bowles born?
  A: Thomas F. Bowles was born in New York City.
  Q: Where was Joseph P. Kennedy Sr. born?
  A: Joseph P. Kennedy Sr. was born in Boston, Massachusetts.
  Q: Where was James Michael Curley born?
  A: James Michael Curley was born in South Boston, Massachusetts.
  Q: Where was Edward M. Kennedy born?
  A: Edward M. Kennedy was born in Boston, Massachusetts.
Final: ['Joseph P. Kennedy Sr.', 'James Michael Curley', 'Edward M. Kennedy']
(和訳)
- 質問:「ボストンで生まれた政治家を5人挙げてください。」
- Q:「John F. Kennedy はどこで生まれましたか?」 A:「マサチューセッツ州ブルックラインで生まれました。」
- Q:「Thomas F. Bowles はどこで生まれましたか?」 A:「ニューヨーク市で生まれました。」
- Q:「Joseph P. Kennedy Sr. はどこで生まれましたか?」 A:「マサチューセッツ州ボストンで生まれました。」
- Q:「James Michael Curley はどこで生まれましたか?」 A:「マサチューセッツ州サウスボストンで生まれました。」
- Q:「Edward M. Kennedy はどこで生まれましたか?」 A:「マサチューセッツ州ボストンで生まれました。」
CoVe は、適合率を 0.24 から 0.38 に上げました。1問あたりの誤った人数は 3.82 人から 1.72 人に半分以下に減り、正しい人数は 1.18 人から 1.06 人にわずかに減っただけです。原著論文の Llama 65B でも、正しい人数が少し減り、誤った人数が大きく減って、適合率がほぼ2倍になりました。同じ傾向です。
最初の質問の例を見ると、CoVe の仕組みがよく分かります。下書きでは「ボストン生まれの政治家」として John F. Kennedy を挙げたのに、「John F. Kennedy はどこで生まれましたか?」と単独で聞かれると、同じ LLM が「ブルックライン」と正しく答えました。Thomas F. Bowles についても、ボストンではない都市を答えています。最終回答では、この2人が除かれ、Wikidata で正しいと確かめられた3人だけが残りました。LLM は事実を知っていたのに、リストを書く文脈ではそれを使えなかった のです。
なお、Thomas F. Bowles について「ニューヨーク市生まれ」という答えが正しいかは分かりません。検証の答えも LLM の知識なので、誤っていることがあります。それでも、「ボストン生まれ」と矛盾する答えが出たことで、下書きの主張を疑うきっかけになっています。
実験3:3種類を比べる
同じ下書きに、joint と 2-step の CoVe も試し、factored と比べます。さらに、下書きの人物を正誤で分け、検証の答えに質問の都市が出てくるかを数えて、下書きを見せることの影響を直接確かめます。最後に、検証の質問を「はい・いいえ」で答える形に変えた場合も試します。
# 1. joint:検証の質問と答えを、下書きを見せたまま1つのプロンプトでまとめて書かせる
JOINT = ("Write one verification question for each person in the draft answer, and answer it briefly.\n\n"
         "Question: Name some politicians who were born in New York.\n"
         "Draft answer:\nHillary Clinton\nDonald Trump\nMichael Bloomberg\n"
         "Verification:\nQ: Where was Hillary Clinton born?\nA: Chicago, Illinois.\n"
         "Q: Where was Donald Trump born?\nA: Queens, New York City.\n"
         "Q: Where was Michael Bloomberg born?\nA: Boston, Massachusetts.\n\n"
         "Question: {question}\nDraft answer:\n{draft}\nVerification:")
# 「下書きの人物ごとに、検証の質問を1つずつ書き、短く答えてください。(例)… Q:ヒラリー・クリントンはどこで生まれましたか?
#   A:イリノイ州シカゴ。Q:ドナルド・トランプは…? A:ニューヨーク市クイーンズ。… 質問:… 下書き:… 検証:」


def execute_joint(q, draft):
    text = chat(JOINT.format(question=q["question"], draft="\n".join(draft)), max_new_tokens=400)
    vqs = re.findall(r"Q:\s*(.+)", text)
    vas = re.findall(r"A:\s*(.+)", text)
    # 生成が途中で切れて最後の質問に答えがない場合などに備え、質問と答えを短い方の数にそろえて、vqs[i] と vas[i] を組にする
    return vqs[:len(vas)], vas[:len(vqs)]


# 2. 2-step:検証の質問(計画は factored と同じ)に、下書きを見せずに、まとめて1つのプロンプトで答える
TWO_STEP = "Answer each question briefly. Write one answer per line, in the same order.\n\n{questions}"
# 「それぞれの質問に短く答えてください。同じ順番で、1行に1つずつ答えてください。(質問の一覧)」


def execute_two_step(vqs):
    lines = [l for l in chat(TWO_STEP.format(questions="\n".join(vqs)), max_new_tokens=400).splitlines() if l.strip()]
    return (lines + [""] * len(vqs))[:len(vqs)]


joint_qa = [execute_joint(q, d) for q, d in zip(questions, baseline)]
joint = [final(q, d, vqs, vas) for q, d, (vqs, vas) in zip(questions, baseline, joint_qa)]
two_step = [final(q, d, v, execute_two_step(v)) for q, d, v in zip(questions, baseline, plans)]

# 3. 3種類を比べる
for name, lists in [("ベースライン", baseline), ("CoVe(joint)", joint),
                    ("CoVe(2-step)", two_step), ("CoVe(factored)", cove)]:
    prec, pos, neg = evaluate(lists)
    print(f"{name:18s} 適合率: {prec:.2f}  正しい人数: {pos:.2f}  誤った人数: {neg:.2f}")

# 4. 下書きから独立した質問なら、誤りに気付けるか:下書きの人物を正誤で分け、
#    検証の答えに質問の都市が出てくる割合を、joint と factored で比べる
def city_rate(qa_lists):
    rate = {"正しい人物": [], "誤った人物": []}
    for q, d, (vqs, vas) in zip(questions, baseline, qa_lists):
        if len(vqs) != len(d):   # 検証の質問の数が人物の数と合わない問題は、対応が取れないので除く
            continue
        city = q["city"].replace(" City", "").lower()
        for n, a in zip(d, vas):
            key = "正しい人物" if normalize(n) in q["gold"] else "誤った人物"
            rate[key].append(city in a.lower())
    return {k: f"{sum(v) / max(len(v), 1):.2f}({len(v)} 人)" for k, v in rate.items()}


print("\n検証の答えに質問の都市が出てくる割合")
print("joint   ", city_rate(joint_qa))
print("factored", city_rate(list(zip(plans, answers))))

print("\njoint の例:", questions[0]["question"])
for v, a in zip(*joint_qa[0]):
    print(f"  Q: {v}\n  A: {a}")

# 5. 検証の質問の形:「X はどこで生まれたか」ではなく「X は Boston で生まれたか」と、はい・いいえで聞くと
PLAN_YESNO = ("Write one yes/no verification question for each person in the draft answer, such as "
              "'Was Hillary Clinton born in New York?'. Write one question per line and nothing else.\n\n"
              "Question: {question}\nDraft answer:\n{draft}\nVerification questions:")
# 「下書きの人物ごとに、『ヒラリー・クリントンはニューヨークで生まれましたか?』のような、はい・いいえで答える
#   検証の質問を1つずつ書いてください。1行に1問ずつ、それ以外は書かないでください。質問:… 下書き:… 検証の質問:」
yesno = []
for q, d in zip(questions, baseline):
    lines = chat(PLAN_YESNO.format(question=q["question"], draft="\n".join(d))).splitlines()
    vqs = [re.sub(r"^\s*(\d+[.)]|[-*•])\s*", "", l).strip() for l in lines if l.strip().endswith("?")]
    yesno.append(final(q, d, vqs, execute_factored(vqs)))
prec, pos, neg = evaluate(yesno)
print(f"CoVe(factored、はい/いいえの質問) 適合率: {prec:.2f}  正しい人数: {pos:.2f}  誤った人数: {neg:.2f}")
実験2の下書き・検証の質問・答えをそのまま使い、CoVe の3種類と検証の質問の形を比べるコードです。
- joint: JOINT は、質問と下書きを見せたまま、検証の質問と答えを「Q: …」「A: …」の形でまとめて書かせるプロンプトです。例の答えも見せます。execute_joint は、生成した文章から、質問と答えを正規表現で取り出します。生成が max_new_tokens で途中で切れて最後の質問に答えがない場合などに、質問と答えの数がずれるので、短い方の数にそろえてから組にします。
- 2-step: TWO_STEP は、実験2で作った検証の質問だけを並べて、まとめて答えさせるプロンプトです。下書きは見せませんが、ほかの質問は見えています。execute_two_step は、答えを1行ずつ、質問と同じ順番で取り出します。
- 比較: 3種類の最終回答を、同じ evaluate で比べます。最終回答のプロンプト FINAL は、どの種類でも同じです。
- 都市が出てくる割合: city_rate は、下書きの人物を、Wikidata の正解に入っている人物(正しい人物)とそうでない人物(誤った人物)に分け、それぞれの検証の答えに、質問の都市の名前(「New York City」は「new york」)が出てくる割合を数えます。正しい人物なら都市が出てくるのが正しく、誤った人物なら出てこないのが正しい、という見方です。
- はい・いいえの質問: PLAN_YESNO は、「ヒラリー・クリントンはニューヨークで生まれましたか?」のような、はい・いいえで答える検証の質問を作らせるプロンプトです。実行と最終回答は factored と同じです。これを比べるのは、原著論文が、はい・いいえの質問では、モデルが質問の内容に同意しやすく、誤りを見つけにくいことを示しているためです。
実行結果
ベースライン             適合率: 0.24  正しい人数: 1.18  誤った人数: 3.82
CoVe(joint)        適合率: 0.32  正しい人数: 1.04  誤った人数: 2.22
CoVe(2-step)       適合率: 0.37  正しい人数: 0.98  誤った人数: 1.66
CoVe(factored)     適合率: 0.38  正しい人数: 1.06  誤った人数: 1.72

検証の答えに質問の都市が出てくる割合
joint    {'正しい人物': '0.88(59 人)', '誤った人物': '0.55(191 人)'}
factored {'正しい人物': '0.83(59 人)', '誤った人物': '0.24(191 人)'}

joint の例: Name five politicians who were born in Boston.
  Q: Where was John F. Kennedy born?
  A: Boston, Massachusetts.
  Q: Where was Thomas F. Bowles born?
  A: Boston, Massachusetts.
  Q: Where was Joseph P. Kennedy Sr. born?
  A: Boston, Massachusetts.
  Q: Where was James Michael Curley born?
  A: Boston, Massachusetts.
  Q: Where was Edward M. Kennedy born?
  A: Boston, Massachusetts.
CoVe(factored、はい/いいえの質問) 適合率: 0.44  正しい人数: 0.80  誤った人数: 1.00
(和訳)
- joint の例:5人すべてについて「マサチューセッツ州ボストン」と答えています。
実験1〜3の結果を、1問あたりの正しい人数と誤った人数に分けて並べると、次のようになります。
(図は、diagram-designで作成)
joint が最も弱いのは、原著論文と同じでした。 適合率は、joint が 0.32、2-step が 0.37、factored が 0.38 で、検証の答えを下書きから切り離すほど良くなりました。joint は、誤った人数を 3.82 人から 2.22 人にしか減らせていません。原著論文の Llama 65B でも、joint(0.29)が最も弱く、2-step(0.36)と factored(0.32)が上回っています。2-step と factored の順番は原著論文(Wikidata)と逆ですが、どちらも差は小さく、下書きを見せない2つが joint を上回るという点は共通しています。
検証の答えに質問の都市が出てくる割合を、joint と factored で並べると、次のようになります。
(図は、diagram-designで作成)
下書きを見せると、LLM は自分の誤りを繰り返す。 都市が出てくる割合を見ると、その理由が分かります。誤った人物(191人)について、factored の検証の答えに質問の都市が出てきたのは 24% だけでした。残りの 76% では、別の都市など、下書きの主張と食い違う答えが返り、誤りに気付くきっかけになっています。一方、joint では、誤った人物の 55% で、検証の答えにも質問の都市が出てきました。joint の例では、実験2の factored で「ブルックライン」と正しく答えた John F. Kennedy についても、「ボストン」と答えています。下書きと質問が同じプロンプトにあると、LLM は、自分の知識よりも、プロンプトの中の「ボストン生まれの政治家」という文脈に合わせて答えてしまいます。これが、CoVe が検証の質問に独立して答えさせる理由です。
一方、正しい人物(59人)でも、factored の検証の答えに質問の都市が出てこなかった人物が10人(17%)いました。たとえば、ボストンのドーチェスター地区で生まれた俳優の Mark Wahlberg について、LLM は「ニューヨークのブルックリンで生まれた」と誤って答えています。検証の答えも同じ LLM の知識なので、誤ることがあり、そのときは正しい人物を消してしまいます。CoVe で正しい人数がわずかに減るのは、このためです(なお、正解の判定は名前の一致だけで行っているので、同じ名前の別人が正解として数えられている場合もあります)。
はい・いいえの質問は、消しすぎた。 はい・いいえで答える検証の質問では、適合率は 0.44 と最も高くなりましたが、正しい人数は 0.80 人で、factored の事実を答えさせる質問(1.06 人)より4分の1ほど減りました。誤った人数も 1.00 人に減っているので、はい・いいえの質問では、正しい人物も誤った人物も、まとめて多く消しています。原著論文は、はい・いいえの質問では LLM が事実に同意しやすく、誤りを見逃すことを指摘していましたが、この実験の Qwen2.5-7B-Instruct では、逆に、厳しく判定しすぎる方向に働きました。どちらの方向に偏るかはモデルによって違いますが、はい・いいえの質問は、事実を答えさせずに判定だけをさせるので、偏りが出やすいという点は共通しています。適合率だけでなく、正しい人数も見て選ぶ必要があります。
原著論文は何を示したか
原著論文は、Llama 65B(指示の学習をしていない事前学習モデル)に few-shot の例を見せて、3種類のタスク(4つのデータセット)で CoVe を評価しました。
リストの質問
Wikidata の質問(「ボストンで生まれた政治家は?」の形)と、Wikipedia のカテゴリから作った質問(「メキシコのアニメのホラー映画は?」の形)の適合率は、次のとおりです。Wikidata の列のかっこ内は、1問あたりの正しい人数と誤った人数です。
| 方法 | Wikidata | Wiki-Category |
|---|---|---|
| Llama 2 70B Chat(zero-shot) | 0.12 | 0.05 |
| Llama 2 70B Chat(CoT) | 0.08 | 0.03 |
| Llama 65B(few-shot) | 0.17(0.59 / 2.95) | 0.12 |
| Llama 65B + CoVe(joint) | 0.29(0.41 / 0.98) | 0.15 |
| Llama 65B + CoVe(2-step) | 0.36(0.38 / 0.68) | 0.21 |
| Llama 65B + CoVe(factored) | 0.32(0.38 / 0.79) | 0.22 |
CoVe は、Wikidata の適合率を 0.17 から 0.29〜0.36 に、ほぼ2倍に上げました。正しい人数は 0.59 から 0.38 に少し減りましたが、誤った人数は 2.95 から 0.68〜0.98 に大きく減っています。3種類の中では joint が最も弱く、検証の答えを下書きから切り離した 2-step と factored が上回りました。
クローズドブック質問応答(文書を読ませない質問応答)
クローズドブック質問応答(closed-book QA)は、文書を一切読ませずに、モデルが事前学習で覚えた知識だけで質問に答えさせるタスクです。教科書を閉じて受ける「持ち込み不可」の試験にたとえた名前で、文書を読ませて答えさせる設定(オープンブック)と対になります。ALCE の記事の「ClosedBook」も、同じ意味です。原著論文は、本来は文章を読んで答えるデータセットの MultiSpanQA(答えが複数ある質問)を、文章を見せずに質問だけで答えさせる形で使いました。このタスクでは、F1 が few-shot の 0.39 から、joint で 0.46、factored で 0.48 に上がりました。factored では、適合率(0.40 → 0.50)と再現率(0.38 → 0.46)の両方が上がっています。
長文の生成(伝記)
人物の伝記を書かせる長文の生成でも評価しました。条件は次のとおりです。
- タスク: 「Tell me a bio of 〈人物名〉(〈人物名〉の経歴を教えてください)」と指示して、人物の伝記を書かせます。FActScore の論文(Min ら、2023)の評価の設定に合わせています。
- モデル: ベースラインも CoVe も Llama 65B で、貪欲法で生成します。few-shot の例は両者で同じで、CoVe には検証の質問と最終回答の例を加えています。
- 指標(FActScore): 生成した伝記を、「〇〇はアメリカの政治家である」「〇〇は1960年に生まれた」のような、それ以上分けられない小さな事実(原子的な事実)に分け、それぞれが知識源(Wikipedia の記事)で裏付けられるかを判定し、裏付けられた事実の割合を求めます。判定には、Wikipedia から関連する文章を検索して言語モデルに判定させる自動評価器を使っています。人の判定とよく相関することが確かめられた方法です。
- 比較対象: InstructGPT・ChatGPT・PerplexityAI(検索を使う対話型の検索サービス)の数値は、CoVe の論文で実行し直したものではなく、FActScore の論文から引用したものです。
- 事実の数: FActScore は割合なので、事実を減らせば上がりやすくなります。そのため、1つの伝記に含まれる事実の数(平均)も並べて示しています。
| 方法 | FActScore | 事実の数(平均) |
|---|---|---|
| InstructGPT | 41.1 | 26.3 |
| ChatGPT | 58.7 | 34.7 |
| PerplexityAI(検索あり) | 61.6 | 40.8 |
| Llama 65B(few-shot) | 55.9 | 16.6 |
| Llama 65B + CoVe(joint) | 60.8 | 12.8 |
| Llama 65B + CoVe(factored) | 63.7 | 11.7 |
| Llama 65B + CoVe(factor+revise) | 71.4 | 12.3 |
FActScore と事実の数を並べると、次のようになります。
(図は、diagram-designで作成)
factor+revise は、FActScore を 55.9 から 71.4 に上げ、検索を使う PerplexityAI(61.6)も上回りました。ただし、事実の数は 16.6 から 12.3 に減っています。CoVe は、確かめられなかった事実を消すので、回答は短く、慎重になります。また、原著論文は、人物の知名度別に見ると、ごくまれにしか書かれない人物では検索を使う PerplexityAI の方が良く、よく知られた人物では CoVe の方が良いことも示しています。モデルが覚えていない事実は、検証の質問に答えても確かめられないからです。
検証の質問の形
Wiki-Category の質問(「メキシコのアニメのホラー映画を挙げてください」の形)で、検証の質問の作り方を比べた結果は、次のとおりです(適合率)。例は、下書きに映画 X が挙がっていた場合の検証の質問です。
| 検証の質問の作り方 | CoVe(joint) | CoVe(factored) |
|---|---|---|
| 規則で作る:どの項目にも同じ型を当てはめる(「X は、この質問の答えですか?」) | 0.13 | 0.16 |
| LLM に作らせる:はい・いいえで答える質問(「X はメキシコの映画ですか?」) | 0.15 | 0.19 |
| LLM に作らせる:事実そのものを答えさせる質問(「X はどこの国の映画ですか?」) | 0.15 | 0.22 |
規則で決めた形の質問よりも、LLM に作らせた質問の方が良く、factored では、はい・いいえの質問よりも、事実そのものを答えさせる質問の方が良い結果でした(原著論文の「general questions」)。事実を答えさせる質問では、LLM は自分の知識から「スペイン」のような答えを出すので、下書きの主張(メキシコの映画)と食い違えば誤りが見つかります。一方、はい・いいえの質問は、質問の中に主張がそのまま書かれているので、原著論文は、事実が誤っていても LLM がその主張に同意しやすいことを理由に挙げています。本記事の実験2の「John F. Kennedy はどこで生まれましたか?」が前者、実験3の「〜はボストンで生まれましたか?」が後者にあたります。
Self-RAG との違い
Self-RAG も、LLM が自分の出力を批判して確かめる手法ですが、その判定の仕方を 学習によってモデルの中に入れる(内在化する) のに対し、CoVe は プロンプトの組み立てだけで 同じことをします。Self-RAG は、反省トークンを学習した専用のモデルが必要で、判定の根拠には検索した文書を使います。CoVe は、手元の LLM をそのまま使い、判定の根拠には LLM 自身の知識を、質問を細かく分けて引き出します。実務では、モデルを学習し直すコストをかけられない場合や、API でしか使えない LLM を使っている場合に、CoVe はそのまま試せる選択肢になります。その代わり、1つの回答のために何回も LLM を呼ぶので、推論のコストと時間は増えます。また、LLM が知らない事実は、検証の質問に答えても確かめられません。
ALCE・RAG との組み合わせ
CoVe は検索を前提としませんが、RAG と組み合わせることもできます。RAG で検索した文書を読んで書いた回答を下書きとして、CoVe の段階2〜4を足せば、回答の中の事実を、もう一度確かめられます。段階3で検証の質問ごとに検索すれば、LLM の知識にない事実も確かめられるようになります(原著論文が今後の課題として挙げた方向です)。
CoVe で回答が良くなったかを測るには、回答の事実を外から確かめる物差しが必要です。原著論文の FActScore は、回答を原子的な事実に分けて、それぞれが Wikipedia で裏付けられるかを判定する指標で、ALCE の記事で扱った claim recall(回答が正解の主張を含意するか)と同じく、回答を小さな主張に分けて判定する考え方に立っています。RAG と組み合わせて引用付きの回答を書かせる場合は、ALCE の引用の再現率・適合率で、検証の前後を比べることができます。
CoVe の限界
- ハルシネーションを完全にはなくせない: 原著論文の実験でも、誤った事実は減りましたが、なくなってはいません。
- モデルの知識を超えられない: 検証の質問に答えるのも同じ LLM なので、LLM が覚えていない事実や、誤って覚えている事実は、確かめられません。改善の上限は、モデルの能力で決まります。
- 扱うのは、直接書かれた事実の誤りだけ: 推論の誤りや、意見の偏りのような、ほかの種類のハルシネーションは扱いません。
- 計算量が増える: factored では、主張の数だけ LLM を呼ぶので、生成するトークンが大きく増えます。
- 回答が短くなる: 確かめられなかった主張を消すので、正しい主張まで消してしまうことがあります。原著論文の伝記の生成でも、事実の数が減りました。
実務上の指針
- 事実を並べる回答から試す 人物・作品・数値のリストや、伝記・製品の説明のような、確かめられる事実を並べた回答では、CoVe が効きやすくなります。1つの主張ごとに、短い検証の質問を作れるからです。
- 検証の答えは、下書きから切り離す 実装するときは、検証の質問に答えるプロンプトに下書きを入れないでください。joint のように1つのプロンプトにまとめると手軽ですが、効果は小さくなります。予算が許すなら factored、呼び出しの回数を抑えたいなら 2-step が目安です。
- はい・いいえではなく、開いた質問にする 「X はボストン生まれですか?」と聞くと、LLM の判定が質問の形に引きずられて偏りやすくなります(原著論文では同意しやすい方向に、本記事の実験では厳しすぎる方向に偏りました)。「X はどこで生まれましたか?」のように、事実そのものを答えさせる質問にします。どんな質問を作ればよいかは、プロンプトに例を1〜2個見せて教えます。
- 消えた主張を記録する 最終回答で消えた主張と、その検証の質問・答えを記録しておくと、正しい主張を消していないかを後から確かめられます。
- 知識の不足は、検索で補う 社内の情報や最近の出来事のように、LLM が知らない事実を扱うなら、CoVe だけでは確かめられません。RAG と組み合わせ、検証の段階で検索することを考えてください。
まとめ
本記事では、LLM が自分の回答の事実の誤りを、検証の質問を作って答え直すことで見つけて直す Chain-of-Verification(CoVe)を、Wikidata のリストの質問で確かめました。
Qwen2.5-7B-Instruct に「ボストンで生まれた政治家を5人」のような質問に答えさせると、挙げた人物のうち正しかったのは24% でした。CoVe(factored)で、人物ごとに「X はどこで生まれましたか?」と、下書きを見せずに1つずつ聞き直させると、LLM は、リストでは誤って挙げた John F. Kennedy の出生地を「ブルックライン」と正しく答え、適合率は 0.38 に上がりました。誤った人物について、factored の検証の答えが質問の都市を繰り返したのは 24% でしたが、下書きを見せたまま答えさせる joint では 55% で、joint の適合率は 0.32 にとどまりました。
CoVe の主張は、学習もツールも使わず、プロンプトの構成だけで、モデルは自分の出力の誤りを見つけて直せる、ということです。その鍵は、検証の質問に、下書きから独立して答えさせることにあります。ただし、確かめられるのはモデルが知っている事実までで、正しい主張を消してしまうこともあります。知識の不足は、RAG のような検索で補う必要があります。
参考文献
- S. Dhuliawala et al. (2024). Chain-of-Verification Reduces Hallucination in Large Language Models. Findings of ACL 2024.
- Qwen Team (2024). Qwen2.5-7B-Instruct. Hugging Face(Apache License 2.0).
本記事の文章・構成の一部に生成AIを使用しています。