CRAG(Corrective RAG)とは?
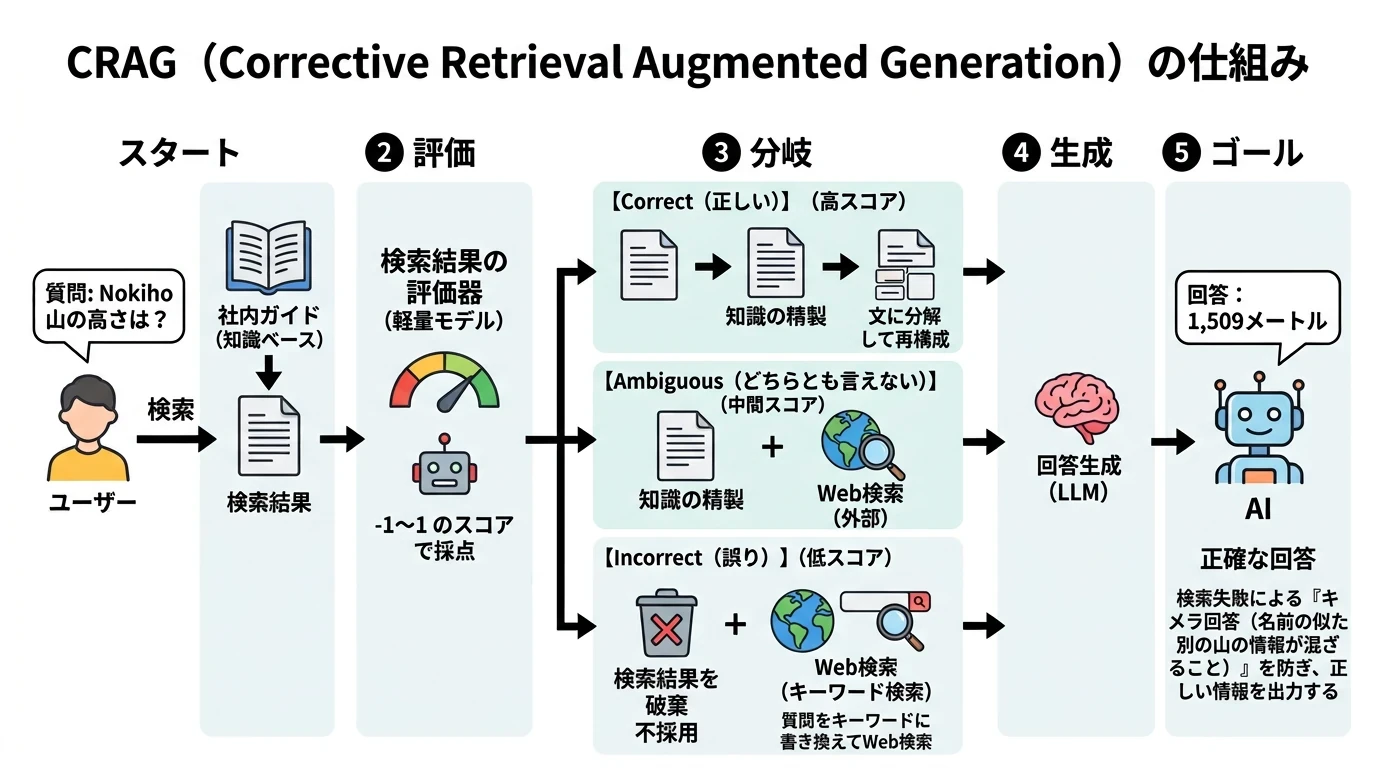 (画像は、Geminiで作成)
検索結果が質問に答えられるものかを、生成の前に軽量な評価器で採点し、その判定で使う知識を切り替える CRAG(Corrective Retrieval Augmented Generation)の仕組みを、Python のコードで確かめること。検索を間違えた RAG がもっともらしい誤答(キメラ)を返す様子を手元で再現し、評価器の学習、3つの判定による分岐、知識の精製と Web 検索で、それが直ることを確かめられるようになること。
原著論文: Corrective Retrieval Augmented Generation (Yan, Gu, Zhu, Ling, arXiv 2024)
概要
RAG (Retrieval-Augmented Generation) とは? の記事で扱ったとおり、RAG の回答の質は、Retriever(検索器)が正しい文書を見つけられるかに大きく左右されます。Retriever が質問に似ているだけの誤った文書を上位に置くと、LLM はその文書の中身を正解だと思い込んで答えます。RAG の記事では、富士山の標高を問う質問に、検索確率の高かったエベレストの文書が混ざった結果、RAG-Token が「Mount Fuji is the highest mountain in Japan, and its height is 8,849 meters.(富士山は日本一高い山で、標高は 8,849 メートルです)」と、富士山の名前とエベレストの標高を継ぎ接ぎした回答を出しました。このように、正しい部品と誤った部品が混ざった回答を キメラ効果 と呼びました。検索の誤りは、そのまま回答の誤りになり、しかも回答は自信のある文に見えるので、読む人が気付きにくいのが問題です。
CRAG は、この問題に「生成する前に、検索結果が使えるかを採点すればよい」という方針で取り組みます。小さな 検索結果の評価器 が、検索した文書ごとに質問への関連度を採点し、その結果で Correct(正しい)・Incorrect(誤り)・Ambiguous(どちらとも言えない) の3つに判定します。Correct なら文書から必要な部分だけを取り出して使い、Incorrect なら文書を捨てて Web 検索に切り替え、Ambiguous なら両方を使います。生成する LLM には手を加えないので、既存の RAG に後付けできる のも特徴です。
次の節で、検索を間違えた RAG がキメラを答える様子を、実際に再現します。
検索を間違えると、もっともらしい誤答になる
実験には、架空の山だけでできた山岳コーパスを使います。実在の山だと、LLM が事前学習で知っている知識(パラメトリック知識)で答えられてしまい、検索の良し悪しが回答に表れないためです。
(図は、diagram-designで作成)
コーパスは、次のように作ります。
- 社内の山岳ガイド(検索の対象) 山ごとに「Mount X rises 1,509 meters above sea level.」のような、山頂の標高を書いたページがあります。テスト用の100山のうち、前半の50山(in-KB)にはこのページがありますが、後半の50山(out-of-KB)にはありません。社内の文書が、すべての質問をカバーしているとは限らない状況です。KB は Knowledge Base(知識ベース)の略で、ここでは検索の対象の社内ガイドを指します。in-KB は「答えが社内ガイドの中にある」、out-of-KB は「答えが社内ガイドの外にしかない」という意味です。
- 名前の似た小さな山のページ すべての山に「Little X(小 X 山)」という、名前の似た小さな山があり、そのページには小さな山の標高が書かれています。out-of-KB の山を質問すると、Retriever はこのページを上位に返します。質問の山の名前を含む、いちばん似た文書だからです。
- 外部の知識源(Web の代わり) 原著論文は、検索結果が使えないときに Google 検索で Web を調べます。この記事では、すべての山のページを別の書き方で書いた小さなコーパスを、Web の代わりにします。
質問は「How many meters tall is Mount X?(X 山の高さは何メートルですか?)」のような形で、テスト用の100山について1問ずつ作ります。
準備:Google Colab の GPU で動かす
Retriever には埋め込みモデル BAAI/bge-large-en-v1.5、回答を書く Generator には Qwen/Qwen2.5-7B-Instruct を使います。Generator を bf16(約15GB)で読み込むので、Google Colab の「ランタイム」→「ランタイムのタイプを変更」から、メモリが 24GB ある L4 GPU を選んでください(Colab の有料プランが必要です。無料の T4 で動かす場合は、Generator を4bit に量子化して読み込みます)。追加のパッケージはありません。記事の数値は、transformers 5.20.1・sentence-transformers 5.7.0・torch 2.11.0 で実行したものです。
- 実験1は、モデルのダウンロード(約17GB)を含めて約4分です。生成は100回です。
- 実験2(評価器の学習)は約1分です。
- 実験3は、生成とキーワードへの書き換えを合わせて約300回で、約4分です。
- 乱数のシードを固定し、生成も貪欲法(greedy)にしているので、同じ環境なら何度実行しても同じ数値になります。ただし、GPU の種類やライブラリのバージョンが違うと、数値が多少変わることがあります。
実験1:従来の RAG で答える
まず、従来の RAG(Naive RAG)と同じく、社内ガイドから上位5件を検索し、そのまま LLM に読ませて答えさせます。回答に正解の標高が含まれていれば correct、名前の似た小さな山の標高が含まれていれば chimera(キメラ)、どちらでもなければ other と数えます。
import random
import re
import numpy as np
import torch
from sentence_transformers import SentenceTransformer
from transformers import AutoTokenizer, AutoModelForCausalLM

# 1. 架空の山の名前と、山ごとの数値
SYLLABLES = ["ka", "ra", "se", "mo", "ri", "to", "na", "shi", "ku", "yo",
             "ha", "ne", "ta", "mi", "su", "ho", "ki", "no", "wa", "fu"]
RANGES = ["Hoshimi", "Akatsuki", "Kirisame", "Tsukishiro", "Hayate", "Shiranami"]
VILLAGES = ["Oda", "Kanbe", "Minase", "Toyoura", "Ishida", "Yanagi", "Sakaki", "Hirano"]


def build_mountains(n=300, seed=0):
    rng = random.Random(seed)
    names, mountains = set(), []
    heights = rng.sample(range(1500, 3999), n)          # 山頂の標高(重複なし)
    littles = rng.sample(range(400, 1499), n)           # 名前の似た小さな山の標高(山頂とは重ならない)
    for i in range(n):
        while True:
            name = "".join(rng.choice(SYLLABLES) for _ in range(3)).capitalize()
            if name not in names:
                names.add(name)
                break
        mountains.append({
            "name": name, "range": rng.choice(RANGES), "village": rng.choice(VILLAGES),
            "height": f"{heights[i]:,}", "little": f"{littles[i]:,}",
            "hut": f"{heights[i] - rng.randint(300, 700):,}", "year": rng.randint(1880, 1960),
        })
    return mountains


mountains = build_mountains()


# 2. 社内の山岳ガイド(検索対象の文書)と、Web のページ(外部の知識源)を作る
def guide_page(m):
    # 「{name}山は {range} 山脈の峰です。{name}山の標高は {height} メートルです。
    #   {name}山の山小屋は標高 {hut} メートルにあります。主な登山道は {village} 村から始まります。」
    return (f"Mount {m['name']} is a peak in the {m['range']} Range. "
            f"Mount {m['name']} rises {m['height']} meters above sea level. "
            f"The mountain hut on Mount {m['name']} stands at {m['hut']} meters. "
            f"The main trail starts from the village of {m['village']}.")


def little_page(m):
    # 「小{name}山は、{name}山にちなんで名付けられた小さな峰です。小{name}山の標高は {little} メートルです。
    #   {village} 村から半日で登れる人気の山です。」
    return (f"Little {m['name']} is a smaller peak named after Mount {m['name']}. "
            f"Little {m['name']} rises {m['little']} meters above sea level. "
            f"It is a popular half-day hike from the village of {m['village']}.")


def web_page(m):
    # 「{name} ― {name}山は {range} 山脈にある、標高 {height} メートルの山です。
    #   {year} 年に初めて登頂されました。登山者はふつう標高 {hut} メートルの山小屋に泊まります。」
    return (f"{m['name']} - Mount {m['name']} is a mountain in the {m['range']} Range "
            f"with an elevation of {m['height']} meters. It was first climbed in {m['year']}. "
            f"Climbers usually stay at a hut at {m['hut']} meters.")


def web_little_page(m):
    # 「小{name}山 ― 小{name}山は {name}山の近くにある、標高 {little} メートルの丘です。」
    return f"Little {m['name']} - Little {m['name']} is a hill near Mount {m['name']}, {m['little']} meters high."


train, test = mountains[:200], mountains[200:]
in_kb, out_kb = test[:50], test[50:]   # 後半の50山は、ガイドに本人のページがない
guide = ([guide_page(m) for m in train + in_kb]
         + [little_page(m) for m in train + test])
web = [web_page(m) for m in mountains] + [web_little_page(m) for m in mountains]

rng = random.Random(1)
templates = ["How many meters tall is Mount {}?", "What is the elevation of Mount {}?"]
# 「{}山の高さは何メートルですか?」「{}山の標高はいくつですか?」
questions = [{"question": rng.choice(templates).format(m["name"]), "mountain": m,
              "group": "in-KB" if m in in_kb else "out-of-KB"} for m in test]

# 3. Retriever(bge-large-en-v1.5)で、社内ガイドから上位5件を検索する
encoder = SentenceTransformer("BAAI/bge-large-en-v1.5", device="cuda")
QUERY_PREFIX = "Represent this sentence for searching relevant passages: "
# 「関連するパッセージを検索するために、この文を表現してください:」
guide_emb = encoder.encode(guide, normalize_embeddings=True)


def search(query, corpus, corpus_emb, k=5):
    q_emb = encoder.encode([QUERY_PREFIX + query], normalize_embeddings=True)[0]
    return [corpus[j] for j in np.argsort(-(corpus_emb @ q_emb))[:k]]


# 4. Generator(Qwen2.5-7B-Instruct)
GEN_ID = "Qwen/Qwen2.5-7B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(GEN_ID)
generator = AutoModelForCausalLM.from_pretrained(GEN_ID, dtype=torch.bfloat16, device_map="cuda")
generator.eval()


@torch.no_grad()
def chat(prompt, max_new_tokens=48):
    messages = [{"role": "user", "content": prompt}]
    inputs = tokenizer.apply_chat_template(messages, add_generation_prompt=True,
                                           return_tensors="pt", return_dict=True).to(generator.device)
    output = generator.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
    return tokenizer.decode(output[0, inputs["input_ids"].shape[1]:], skip_special_tokens=True).strip()


def answer(question, knowledge):
    context = "\n".join(f"[{i + 1}] {k}" for i, k in enumerate(knowledge))
    # 「以下の文書だけを使って質問に答えてください。短い句で答えてください。文書:… 質問:…」
    return chat("Answer the question using only the documents below. Reply with a short phrase.\n\n"
                f"Documents:\n{context}\n\nQuestion: {question}")


# 5. 従来の RAG:検索した上位5件をそのまま読ませる
def judge(q, pred):
    """正解の標高なら correct、名前の似た小さな山の標高なら chimera(カンマの有無は無視する)"""
    m, pred = q["mountain"], pred.replace(",", "")
    if m["height"].replace(",", "") in pred:
        return "correct"
    if m["little"].replace(",", "") in pred:
        return "chimera"
    return "other"


naive = [answer(q["question"], search(q["question"], guide, guide_emb)) for q in questions]
for group in ["in-KB", "out-of-KB"]:
    res = [judge(q, p) for q, p in zip(questions, naive) if q["group"] == group]
    print(f"{group:9s}  correct: {res.count('correct') / len(res):.2f}"
          f"  chimera: {res.count('chimera') / len(res):.2f}  other: {res.count('other') / len(res):.2f}")

# 6. 例:ガイドに本人のページがない山
q = questions[50]
print("\nQuestion:", q["question"], f"(正解: {q['mountain']['height']} m)")
for d in search(q["question"], guide, guide_emb)[:2]:
    print("  Retrieved:", d[:110], "...")
print("Answer:", naive[50])
架空の山岳コーパスを作り、従来の RAG で答えさせて、正解・キメラ・その他の割合を数えるコードです。
- 山のデータ: build_mountains は、3音節の架空の名前と、山頂の標高 height(1,500〜3,998m)、名前の似た小さな山の標高 little(400〜1,498m)などを、random.Random(seed) の乱数で作ります。標高は rng.sample で重複なく選び、山頂と小さな山の範囲も重ならないので、回答の数値がどちらの標高かを区別できます。
- 3種類のページ: guide_page は社内ガイドの本人のページ、little_page は小さな山のページ、web_page・web_little_page は Web の代わりのページです。Web のページは、ガイドとは違う書き方(「with an elevation of …」)にしています。すべての山に「小さな山」のページを作るのは、本人のページがない山の質問で、名前の似た山の標高が検索の上位に来て、キメラが起きる状況を作るためです。
- in-KB と out-of-KB: 300山のうち、前半の200山を評価器の学習用(train)、後半の100山をテスト用(test)にします。社内ガイド guide には、学習用と in-KB の山の本人のページと、すべての山の小さな山のページを入れます。out-of-KB の50山の本人のページは、Web web にしかありません。学習用とテスト用で山を分けるのは、評価器が学習で見た山の質問でテストして、正解率が実力以上に高く出るのを避けるためです。
- 検索: search は、質問の先頭に bge の指示文 QUERY_PREFIX を付けて埋め込み、コーパスの埋め込みとの内積(コサイン類似度)の大きい順に上位 k 件を返します。
- 生成: answer は、知識に番号を付けて並べ、質問と一緒に Generator に渡します。知識に番号を付けるのは、Generator が複数の文書を区別して読めるようにするためです。chat は、会話形式に包んで貪欲法で生成します。
- 判定: judge は、回答からカンマを除いて、正解の標高か、小さな山の標高が含まれるかを調べます。カンマを除くのは、モデルが「1,509」と書いても「1509」と書いても、正解と数えるためです。
- 例の表示: キメラが「何を読んで」起きたのかを見るため、out-of-KB の最初の山(questions[50])について、検索した上位2件と回答を表示します。
実行結果
in-KB      correct: 1.00  chimera: 0.00  other: 0.00
out-of-KB  correct: 0.00  chimera: 0.76  other: 0.24

Question: How many meters tall is Mount Nokiho? (正解: 1,509 m)
  Retrieved: Little Nokiho is a smaller peak named after Mount Nokiho. Little Nokiho rises 656 meters above sea level. It i ...
  Retrieved: Mount Nohoho is a peak in the Hoshimi Range. Mount Nohoho rises 2,495 meters above sea level. The mountain hut ...
Answer: 656 meters
(和訳)
- 質問:「Nokiho 山の高さは何メートルですか?」
- 検索の1位:「小 Nokiho 山は、Nokiho 山にちなんで名付けられた小さな峰です。小 Nokiho 山の標高は 656 メートルです。…」
- 検索の2位:「Nohoho(ノホホ)山(Nokiho に似ているが Nohoho)は Hoshimi 山脈の峰です。Nohoho 山 の標高は 2,495 メートルです。…」
- 回答:「656 メートル」
検索の2位の Nohoho(ノ・ホ・ホ)山 は、質問の Nokiho(ノ・キ・ホ)山 とは別の山です。名前が1音節だけ違うので、読み間違えないように注意してください。どちらの山のページも検索の上位に来るのは、Retriever にとっても名前が似ているためです。
社内ガイドに本人のページがある in-KB の山は、すべて正しく答えられました。一方、本人のページがない out-of-KB の山は、正答率が 0.00 で、76% の回答は 名前の似た小さな山の標高 でした。例の Nokiho 山では、検索の1位に小 Nokiho 山のページが来て、LLM はその標高 656m を Nokiho 山の標高として答えています。質問の山の名前と、別の山の標高が継ぎ接ぎされた、まさにキメラです。
残りの 24% は、「No document provides the exact elevation of Mount Mokato.(Mokato 山の標高を示す文書はありません)」のように、答えがないと述べた回答と、さらに別の山の標高を答えた回答でした。答えられないと正直に言う場合もありますが、多くの場合、LLM は検索結果を信じて答えてしまいます。従来の RAG は、検索結果が質問に答えられるものかを確かめずに、そのまま LLM に渡しているからです。
CRAG の仕組み
CRAG は、Retriever と Generator の間に 検索結果の評価器 を挟み、その判定で使う知識を切り替えます。全体の流れは、次の図のとおりです。
(図は、diagram-designで作成)
検索結果の評価器
評価器は、質問 と文書 の組を受け取り、 が に答えるのに役立つかを、 から のスコア で返します。原著論文の評価器は、T5-large(7.7億パラメータ)を微調整したものです。PopQA という質問応答のデータで、質問に対応する Wikipedia の記事を正例()、検索結果のうち質問に似ているが関係のない文書を負例()として学習しています。生成に使う LLM(数十億パラメータ)よりずっと小さく、文書1件の採点は軽い処理です。
検索した上位 件の文書 のスコアを とし、上限の閾値を 、下限の閾値を とすると、判定は次のとおりです。
- Correct: 少なくとも1件の文書が、上限を超えて関連すると判定された場合です。検索結果に答えがあるとみなし、文書を精製して使います。
- Incorrect: すべての文書が下限を下回った場合です。検索結果は使えないとみなして捨て、Web 検索に切り替えます。
- Ambiguous: どちらでもない場合です。評価器にも判断がつかないので、精製した文書と Web 検索の結果の両方を使います。
閾値はデータセットごとに決めます。原著論文では、PopQA で 、PubHealth と ARC-Challenge で 、Biography で でした。
知識の精製:decompose-then-recompose
Correct と判定されても、文書のすべてが役に立つとは限りません。原著論文は、文書を細かく 分解(decompose) し、役に立つ部分だけを 再構成(recompose) します。
- 分解: 文書を、数文ずつの短い断片(strip)に分けます。1〜2文の短い文書は、そのまま1つの strip にします。
- 採点と選別: 評価器で strip ごとにスコアを付け、閾値(原著論文では )を超える strip の中から、上位 件(原著論文では )を残します。
- 再構成: 残した strip を、元の順番のままつなげて、Generator に渡す知識にします。
strip の集合を 、閾値を とすると、残す strip は
です。質問に関係のない文や、紛らわしい数値を含む文を捨てることで、Generator が誤った部品を拾う機会を減らします。長い文書を丸ごと渡すと、関係のない部分に紛れて必要な情報が使われにくくなることは、Lost in the Middle の記事で扱いました。
Web 検索への切り替え
Incorrect(と Ambiguous)のときは、外部の知識源を調べます。原著論文では、まず GPT-3.5 Turbo に、質問を検索エンジン向けの 3つ以下のキーワード に書き換えさせます。そのキーワードで Google 検索の API を呼び、上位5件のページ(Wikipedia のページを優先)を取り出し、ページを段落に分けて、評価器で関係のある段落を選びます。社内の文書に答えがないときでも、外部から補えるようにするための仕組みです。
既存の RAG に後付けできる
CRAG は、Retriever と Generator の間に評価器を差し込むだけで、どちらにも手を加えません。Generator の LLM を学習し直す必要はなく、学習するのは小さな評価器だけです。RAG の記事で紹介した Naive / Advanced / Modular の分類でいえば、検索と生成の間に評価と分岐の部品を足す、Modular RAG の構成の1つです。原著論文は、この性質を「プラグアンドプレイ」と呼び、通常の RAG と、Self-RAG という別の RAG の手法の両方に CRAG を組み合わせて効果を確かめています。
実験2:軽量な評価器を学習して、検索結果を採点する
原著論文と同じく、評価器を学習します。学習用の200山の質問で検索した上位の文書と、その文を、答え(その山の山頂の標高)を含むかで と に分け、小さなクロスエンコーダを微調整します。クロスエンコーダは、質問と文書を1つの入力としてまとめて読み、関連度のスコアを1つ出すモデルです。実験1のコードを実行した後に、続けて実行してください。
from transformers import AutoModelForSequenceClassification


# 1. 評価器の学習データ:学習用の200山の質問で検索した上位の文書と、その文(strip)に、答えを含むかのラベル(+1 / -1)を付ける
def split_strips(doc):
    """文書を文(strip)に分ける"""
    return [s.strip() for s in re.split(r"(?<=\.)\s+", doc) if s.strip()]


web_emb = encoder.encode(web, normalize_embeddings=True)


def make_pairs(ms, seed=0):
    rng = random.Random(seed)
    pairs = []
    for m in ms:
        q = rng.choice(templates).format(m["name"])
        for corpus, corpus_emb in [(guide, guide_emb), (web, web_emb)]:
            # 検索の上位には、質問に似ているが答えを含まない文書(名前の似た山など)が入る。これが難しい負例になる
            for doc in search(q, corpus, corpus_emb, k=5):
                pairs.append((q, doc, 1.0 if m["height"] in doc else -1.0))
                for s in split_strips(doc):
                    pairs.append((q, s, 1.0 if m["height"] in s else -1.0))
    rng.shuffle(pairs)
    return pairs


pairs = make_pairs(train)
print(f"学習データ: {len(pairs)} 組(正例 {sum(p[2] > 0 for p in pairs)})")

# 2. 軽量な評価器:MS MARCO で学習済みのクロスエンコーダ(2,300万パラメータ)を、-1〜1 のスコアを出すように微調整する
EVAL_ID = "cross-encoder/ms-marco-MiniLM-L-6-v2"
eval_tok = AutoTokenizer.from_pretrained(EVAL_ID)
evaluator = AutoModelForSequenceClassification.from_pretrained(EVAL_ID, num_labels=1).to("cuda")
optimizer = torch.optim.AdamW(evaluator.parameters(), lr=2e-5)
torch.manual_seed(0)
evaluator.train()
for epoch in range(3):
    for i in range(0, len(pairs), 32):
        batch = pairs[i:i + 32]
        enc = eval_tok([p[0] for p in batch], [p[1] for p in batch], padding=True, truncation=True,
                       max_length=256, return_tensors="pt").to("cuda")
        target = torch.tensor([p[2] for p in batch], device="cuda")
        loss = torch.nn.functional.mse_loss(evaluator(**enc).logits.squeeze(-1), target)
        loss.backward()
        optimizer.step()
        optimizer.zero_grad()
    print(f"epoch {epoch + 1}: loss {loss.item():.4f}")
evaluator.eval()


@torch.no_grad()
def score(question, texts):
    """評価器のスコア(-1〜1):大きいほど、質問に答える知識を含む"""
    enc = eval_tok([question] * len(texts), texts, padding=True, truncation=True,
                   max_length=256, return_tensors="pt").to("cuda")
    return evaluator(**enc).logits.squeeze(-1).clamp(-1, 1).tolist()


# 3. テスト用の100山で、検索した上位5件の文書を採点する
UPPER, LOWER = 0.9, -0.5


def decide(scores):
    if max(scores) > UPPER:
        return "Correct"
    if max(scores) < LOWER:
        return "Incorrect"
    return "Ambiguous"


retrieved = [search(q["question"], guide, guide_emb) for q in questions]
doc_scores = [score(q["question"], docs) for q, docs in zip(questions, retrieved)]
actions = [decide(s) for s in doc_scores]

hits = [(s > 0) == (q["mountain"]["height"] in d)
        for q, docs, ss in zip(questions, retrieved, doc_scores) for d, s in zip(docs, ss)]
print(f"\n評価器の正解率(上位5件の文書が答えを含むか): {np.mean(hits):.3f}")
for group in ["in-KB", "out-of-KB"]:
    acts = [a for q, a in zip(questions, actions) if q["group"] == group]
    print(f"{group:9s}  " + "  ".join(f"{a}: {acts.count(a)}" for a in ["Correct", "Ambiguous", "Incorrect"]))
print("\n例:", questions[50]["question"])
for d, s in zip(retrieved[50][:3], doc_scores[50][:3]):
    print(f"  {s:+.2f}  {d[:80]} ...")
評価器の学習データを作って微調整し、テスト用の100問で、検索した上位5件の文書を採点して判定するコードです。
- 文への分割: split_strips は、文書をピリオドの後の空白で区切り、1文ずつの strip にします。この記事の文書は3〜4文と短いので、原著論文の「数文ずつ」ではなく、1文ずつにしています。
- 学習データ: make_pairs は、学習用の200山について、質問で社内ガイドと Web をそれぞれ検索し、上位5件の文書と、その文書の各文に、答えを含むかのラベルを付けます。検索の上位には、名前の似た小さな山や、Nohoho と Nokiho のように名前の似た別の山のページが入ります。原著論文の「質問に似ているが関係のない文書」と同じで、評価器が見分けなければならない、難しい負例になります。社内ガイドと Web の両方の検索結果で学習するのは、評価器が、社内ガイドの採点と、Web のページの精製(実験3)の両方に使われるためです。
- 評価器のモデル: cross-encoder/ms-marco-MiniLM-L-6-v2(約2,300万パラメータ)を使います。Web の検索ログ(MS MARCO)で、質問と文章の関連度を学習済みのクロスエンコーダです。学習済みのモデルから始めるのは、関連度の見方をすでに知っているので、200山の少ない学習データでも、このデータの紛らわしい文書の見分け方だけを覚えればよいためです。num_labels=1 でスコアを1つ出すようにし、出力と のラベルの二乗誤差(mse_loss)を小さくするように、3エポック学習します。原著論文の T5-large より30分の1以上小さいモデルです。
- スコア: score は、質問と文書の組をまとめて評価器に入れ、出力を clamp(-1, 1) で 〜 に収めます。 です。〜 に収めるのは、学習のラベルが で、閾値もこの範囲で決めているためです。
- 判定: decide は、直前に示した判定の式です。閾値は UPPER()と LOWER()にしました。原著論文と同じく、このデータでの評価器のスコアの分布を見て決めています。
- 評価器の正解率: テスト用の100問の上位5件、合わせて500件の文書について、スコアの正負と、文書が答えを含むかが一致する割合を数えます。判定に使う前に、評価器がそもそも答えを含む文書を見分けられているかを確かめるためです。
- 例の表示: 実験1でキメラの元になった小 Nokiho 山のページに、低いスコアが付くかを確かめるため、Nokiho 山の上位3件の文書のスコアを表示します。
実行結果
学習データ: 7970 組(正例 802)
epoch 1: loss 0.4088
epoch 2: loss 0.3600
epoch 3: loss 0.2061

評価器の正解率(上位5件の文書が答えを含むか): 0.954
in-KB      Correct: 50  Ambiguous: 0  Incorrect: 0
out-of-KB  Correct: 0  Ambiguous: 29  Incorrect: 21

例: How many meters tall is Mount Nokiho?
  -0.63  Little Nokiho is a smaller peak named after Mount Nokiho. Little Nokiho rises 65 ...
  +0.48  Mount Nohoho is a peak in the Hoshimi Range. Mount Nohoho rises 2,495 meters abo ...
  +0.14  Mount Nofuho is a peak in the Shiranami Range. Mount Nofuho rises 3,562 meters a ...
判定の内訳を並べると、次のようになります。
(図は、diagram-designで作成)
評価器は、上位5件の文書が答えを含むかを 95.4% の正解率で見分けました。判定も、本人のページがある in-KB の50問はすべて Correct、本人のページがない out-of-KB の50問は、Incorrect が21問、Ambiguous が29問で、Correct と誤って判定された問題はありません。
例の Nokiho 山では、従来の RAG がキメラの元にした小 Nokiho 山のページに、 の低いスコアが付いています。名前は似ていても、Nokiho 山の標高ではないと見分けています。ただし、名前の似た別の山(Nohoho 山。Nokiho に似ているが Nohoho で、質問の Nokiho 山とは別の山です)のページには が付きました。スコアの最大値が上限(0.9)にも下限()にも届かないので、この質問は Ambiguous になります。評価器が判断に迷うときに、検索結果を捨て切らずに Web の結果も足すのが、Ambiguous の役割です。
実験3:CRAG で答える
評価器の判定を使って、CRAG で答えさせます。比較のため、知識の精製を行わずに、文書をそのまま使う場合(精製なし)も測ります。実験1・2のコードを実行した後に、続けて実行してください。
# 1. 知識の精製(decompose-then-recompose):文に分けて採点し、残った文を元の順に並べ直す
def refine(question, docs, threshold=-0.5, top_k=5):
    strips = [s for d in docs for s in split_strips(d)]
    scores = score(question, strips)
    keep = sorted(np.argsort(scores)[::-1][:top_k])          # スコアの上位 k 件を、元の順番で
    return [" ".join(strips[i] for i in keep if scores[i] > threshold)]


# 2. Web 検索:質問をキーワードに書き換えてから、外部の知識源を検索する
def rewrite(question):
    # 「質問を、Web 検索エンジン用の3つ以下のキーワードにカンマ区切りで書き換えてください。
    #   質問:小説『こころ』を書いたのは誰ですか? キーワード:こころ、小説、作者  質問:… キーワード:」
    return chat("Rewrite the question into at most three keywords for a web search engine, "
                "separated by commas.\n\n"
                "Question: Who wrote the novel Kokoro?\nKeywords: Kokoro, novel, author\n\n"
                f"Question: {question}\nKeywords:", max_new_tokens=16)


def web_search(question, k=5):
    return refine(question, search(rewrite(question), web, web_emb, k=k))


# 3. CRAG:評価器の判定で、使う知識を切り替えてから生成する
def crag(q, docs, action, use_refine=True):
    if action == "Correct":
        knowledge = refine(q["question"], docs) if use_refine else docs
    elif action == "Incorrect":
        knowledge = web_search(q["question"])
    else:
        knowledge = (refine(q["question"], docs) if use_refine else docs) + web_search(q["question"])
    return answer(q["question"], knowledge), knowledge


results = {"Naive RAG": naive}
results["CRAG"], kn = zip(*[crag(q, d, a) for q, d, a in zip(questions, retrieved, actions)])
results["CRAG (精製なし)"], _ = zip(*[crag(q, d, a, use_refine=False)
                                     for q, d, a in zip(questions, retrieved, actions)])

# 4. 3つの方法を、ガイドに本人のページがある山 / ない山に分けて比べる
print(f"{'方法':16s} {'in-KB 正答率':>12s} {'out-of-KB 正答率':>16s} {'キメラ':>6s}")
for name, preds in results.items():
    row = {}
    for group in ["in-KB", "out-of-KB"]:
        row[group] = [judge(q, p) for q, p in zip(questions, preds) if q["group"] == group]
    chimera = sum(r.count("chimera") for r in row.values())
    print(f"{name:16s} {row['in-KB'].count('correct') / 50:>12.2f}"
          f" {row['out-of-KB'].count('correct') / 50:>16.2f} {chimera:>6d}")

# 5. 例:従来の RAG がキメラを答えた山で、CRAG が使った知識
print("\nQuestion:", questions[50]["question"], "/ action:", actions[50])
print("Keywords:", rewrite(questions[50]["question"]))
print("Knowledge:", kn[50])
print("Answer:", results["CRAG"][50])
知識の精製、Web 検索、3つの判定による分岐を組み合わせて CRAG で答えさせ、従来の RAG と比べるコードです。
- 知識の精製: refine は、文書を split_strips で文に分け、評価器でスコアを付けます。np.argsort(scores)[::-1][:top_k] でスコアの上位5件を選び、sorted で元の順番に戻してから、閾値 threshold()を超える文だけをつなげます。直前に示した の式です。選んだ文を元の順番に戻すのは、スコアの順に並べ替えると、文書の流れが崩れて読みにくくなるためです。
- キーワードへの書き換え: rewrite は、Generator(Qwen2.5-7B)に、質問を3つ以下のキーワードにカンマ区切りで書き換えさせます。例を1つ見せる few-shot のプロンプトです。キーワードに書き換えるのは、原著論文と同じく、検索エンジンには文の質問より短いキーワードの方が合うためです。原著論文は GPT-3.5 Turbo を使いましたが、ここでは Generator をそのまま使います。
- Web 検索: web_search は、書き換えたキーワードで Web の代わりのコーパスを検索し、上位5件を refine で精製します。原著論文でも、Web のページは評価器で関係のある部分を選んでから使います。
- CRAG の分岐: crag は、判定 action が Correct なら精製した社内ガイドを、Incorrect なら Web 検索の結果を、Ambiguous なら両方をつなげて、Generator に渡します。use_refine=False のときは、社内ガイドの文書を精製せずにそのまま使います。これを用意するのは、精製を外した CRAG と比べ、正答率の改善のうち、どれだけが精製によるものかを分けて見るためです。
- 比較の表: in-KB と out-of-KB の正答率と、キメラ(小さな山の標高)を答えた数を、3つの方法で比べます。従来の RAG の回答 naive は、実験1のものをそのまま使います。正答率と別にキメラの数を数えるのは、CRAG が直そうとしているのが「もっともらしい誤答」そのものだからです。
- 例の表示: 従来の RAG がキメラを答えた Nokiho 山で、CRAG のどの段階が答えを直したのかを追えるように、判定、書き換えたキーワード、Generator に渡した知識、回答を表示します。
実行結果
方法                  in-KB 正答率    out-of-KB 正答率    キメラ
Naive RAG                1.00             0.00     38
CRAG                     1.00             1.00      0
CRAG (精製なし)              1.00             0.96      1

Question: How many meters tall is Mount Nokiho? / action: Ambiguous
Keywords: Mount Nokiho, height, meters
Knowledge: ['Mount Nohoho is a peak in the Hoshimi Range. Mount Nohoho rises 2,495 meters above sea level. Mount Nofuho rises 3,562 meters above sea level. Mount Hakuho rises 3,970 meters above sea level.', 'Nokiho - Mount Nokiho is a mountain in the Kirisame Range with an elevation of 1,509 meters. Nohoho - Mount Nohoho is a mountain in the Hoshimi Range with an elevation of 2,495 meters.']
Answer: 1,509 meters
(和訳)
- 社内ガイドを精製した知識:「Nohoho 山(Nokiho に似ているが Nohoho)は Hoshimi 山脈の峰です。Nohoho 山の標高は 2,495 メートルです。Nofuho 山の標高は 3,562 メートルです。Hakuho 山の標高は 3,970 メートルです。」
- Web 検索を精製した知識:「Nokiho ― Nokiho 山は Kirisame 山脈にある、標高 1,509 メートルの山です。Nohoho ― Nohoho 山は Hoshimi 山脈にある、標高 2,495 メートルの山です。」(太字の Nohoho 山は、質問の Nokiho 山とは別の山)
- 回答:「1,509 メートル」
3つの方法の結果を並べると、次のようになります。
(図は、diagram-designで作成)
CRAG は、従来の RAG が1問も答えられなかった out-of-KB の50問に、すべて正しく答えました。キメラは38問から0問になっています。in-KB の50問は、どの方法でもすべて正解で、評価器を挟んでも、もともと答えられていた質問を損なっていません。
例を見ると、CRAG の働きが分かります。Nokiho 山は Ambiguous と判定されたので、精製した社内ガイドと Web 検索の結果の両方を Generator に渡しています。精製で、キメラの元だった小 Nokiho 山の文は残りませんでした。一方、名前の似た別の山の標高の文は残っていて、精製も完全ではありません。それでも Web 検索で見つけた Nokiho 山本人のページが加わったので、Generator は正しい標高を選べました。
精製なしの CRAG も、out-of-KB で 0.96 と高い正答率ですが、1問でキメラが残りました。Ambiguous の質問で、小さな山のページをそのまま渡してしまったためです。精製は、Web 検索で正しい知識を足すだけでは消し切れない、紛らわしい部品を取り除く役割を果たしています。
なお、この実験のコーパスは、評価器が見分けやすいように作った単純なものです。正答率 1.00 は、CRAG の仕組みが働く様子を見せるための結果で、実際のデータでも同じように完全に直るわけではありません。原著論文が実際のデータで示した改善の幅は、次の節で見ます。
原著論文は何を示したか
原著論文は、PopQA(短い答えの質問応答)、Biography(人物の伝記の生成)、PubHealth(健康に関する主張の真偽判定)、ARC-Challenge(科学の選択問題)の4つのデータセットで、CRAG を評価しました。Generator に LLaMA2-7B を使った場合の結果は、次のとおりです。
| 方法 | PopQA(正答率) | Biography(FactScore) | PubHealth(正答率) | ARC-Challenge(正答率) |
|---|---|---|---|---|
| RAG | 50.5 | 44.9 | 48.9 | 43.4 |
| CRAG | 54.9 | 47.7 | 59.5 | 53.7 |
RAG と CRAG を並べると、次のようになります。
(図は、diagram-designで作成)
4つのデータセットのすべてで、CRAG は RAG を上回りました。Self-RAG の学習を施した LLaMA2-7B を Generator にした場合も、RAG の 52.8・59.2・39.0・53.2 に対して、CRAG は 59.8・74.1・75.6・68.6 で、同じく改善しています。Biography の FactScore は、生成した伝記に含まれる事実のうち、知識源で裏付けられるものの割合です。
評価器は LLM より正確だった
原著論文は、PopQA で、評価器が検索結果の良し悪しを正しく判定できた割合も比べています。T5-large の評価器は 84.3% で、ChatGPT に同じ判定をさせた場合(58.0%)、思考の連鎖(CoT)を使わせた場合(62.4%)、例を見せた場合(64.7%)を大きく上回りました。検索結果の採点のような狭い仕事なら、巨大な LLM に聞くより、その仕事のために学習した小さなモデルの方が正確で、しかも速いということです。
判定の正しさを並べると、次のようになります。
(図は、diagram-designで作成)
どの部品が効いているか
PopQA での部品を外す実験(アブレーション)では、3つの判定のどれを外しても正答率は下がり(LLaMA2-7B で 54.9 から 53.2〜54.4)、知識の精製、キーワードへの書き換え、Web の知識の選別のどれを外しても下がりました(49.8〜51.7)。特に、知識の精製を外したときの低下が最も大きく、精製なしの CRAG の正答率は RAG(50.5)を下回っています。
計算コスト
評価器を挟むことで、1問あたりの実行時間は、RAG の 0.363 秒から 0.512 秒に増えました。1トークンあたりの計算量(TFLOPs)は 26.5 から 27.2 で、ほとんど増えていません。小さな評価器による採点の計算量は、生成に比べてわずかです。
CRAG の限界
- 評価器の学習は避けられない: Generator の学習は不要ですが、評価器は学習が必要です。原著論文の著者も、外部の評価器を学習しなければならない点を限界に挙げ、LLM 自身に検索結果を評価させることを今後の課題としています。対象の分野が変われば、評価器も学習し直す必要があるかもしれません。
- 閾値はデータごとに決める: 上限と下限の閾値は、データセットごとに違う値が使われています。この記事でも、スコアの分布を見て決めました。実際には、テストとは別の検証用の質問で決める必要があります。
- Web の情報が正しいとは限らない: Incorrect のときに頼る Web の検索結果にも、誤りや古い情報が含まれます。社内の文書のように、信頼できる知識源に答えがない質問ほど、Web の質に結果が左右されます。
- 文に分けると文脈が失われる: 精製で文を選ぶとき、「It rises …」のように主語が省略された文は、どの話か分からずに捨てられることがあります。この記事の文書は、すべての文に山の名前を書いて、この問題を避けています。
- 待ち時間が増える: 評価器による採点に加えて、Incorrect と Ambiguous では、キーワードへの書き換えと Web 検索が入ります。この記事の実験でも、テストの100問のうち半分の50問で Web 検索を行いました。
実務上の指針
- 既存の RAG に、評価器を差し込むところから始める CRAG の利点は、Retriever と Generator を変えずに追加できることです。まず、検索結果の上位を採点して、判定と一緒に記録するだけでも、どの質問で検索が外れているかが見えるようになります。
- 評価器は、自分のデータの「紛らわしい文書」で学習する 評価器が見分けるべきなのは、名前や話題は似ているが答えを含まない文書です。実験2のように、実際の質問で検索した上位の文書を負例に使うと、評価器が現場の検索の誤り方を学べます。
- 閾値は、検証用の質問で決め、判定の内訳を監視する Correct・Ambiguous・Incorrect の割合を記録しておくと、文書の追加漏れ(Incorrect の増加)や、評価器の不調(Ambiguous の増加)に気付けます。
- 外部の知識源は、信頼できるものに限る Web 全体ではなく、公式のドキュメントや信頼できるデータベースなど、外部の知識源を限ることで、Incorrect のときに誤った情報を持ち込む危険を減らせます。
- 改善は、回答の正しさと引用の質で測る CRAG を入れて良くなったかは、回答の正しさに加えて、回答の根拠が実際に渡した知識で裏付けられているか(ALCE の記事で扱った引用の再現率と適合率)でも測ると、精製や Web 検索の効果をより正確に確かめられます。
まとめ
本記事では、検索結果を生成の前に採点する CRAG を、架空の山岳コーパスで確かめました。
社内ガイドに本人のページがない山を質問すると、従来の RAG は名前の似た小さな山のページを検索し、その標高を答えました(out-of-KB の 76%)。質問の山の名前と別の山の標高を継ぎ接ぎした、キメラ効果です。CRAG は、小さな評価器(約2,300万パラメータ)で検索結果を採点し、本人のページがない質問を Incorrect または Ambiguous と判定して、Web の代わりの知識源を検索しました。知識の精製で紛らわしい文を捨てたこともあって、キメラは38問から0問になり、もともと答えられていた質問の正答率も下がりませんでした。
CRAG の主張は、検索結果が使えるかどうかは生成する前に採点すればよく、しかもそれは既存の RAG に後付けできる、ということです。Generator の LLM を学習し直す必要はなく、学習するのは小さな評価器だけです。
発展:モデル自身に判断させるアプローチ
CRAG は、検索結果を外付けの評価器で採点しました。これに対して、検索が必要かどうかや、検索結果が回答を裏付けているかを、特別なトークンとして LLM 自身に学習させ、生成の途中でモデル自身に判断させるアプローチもあります。この方法は Self-RAG の記事で扱っています。
参考文献
- S.-Q. Yan, J.-C. Gu, Y. Zhu, Z.-H. Ling (2024). Corrective Retrieval Augmented Generation. arXiv:2401.15884.
- Qwen Team (2024). Qwen2.5-7B-Instruct. Hugging Face(Apache License 2.0).
- BAAI (2023). bge-large-en-v1.5. Hugging Face(MIT License).
本記事の文章・構成の一部に生成AIを使用しています。