DDIMとは?
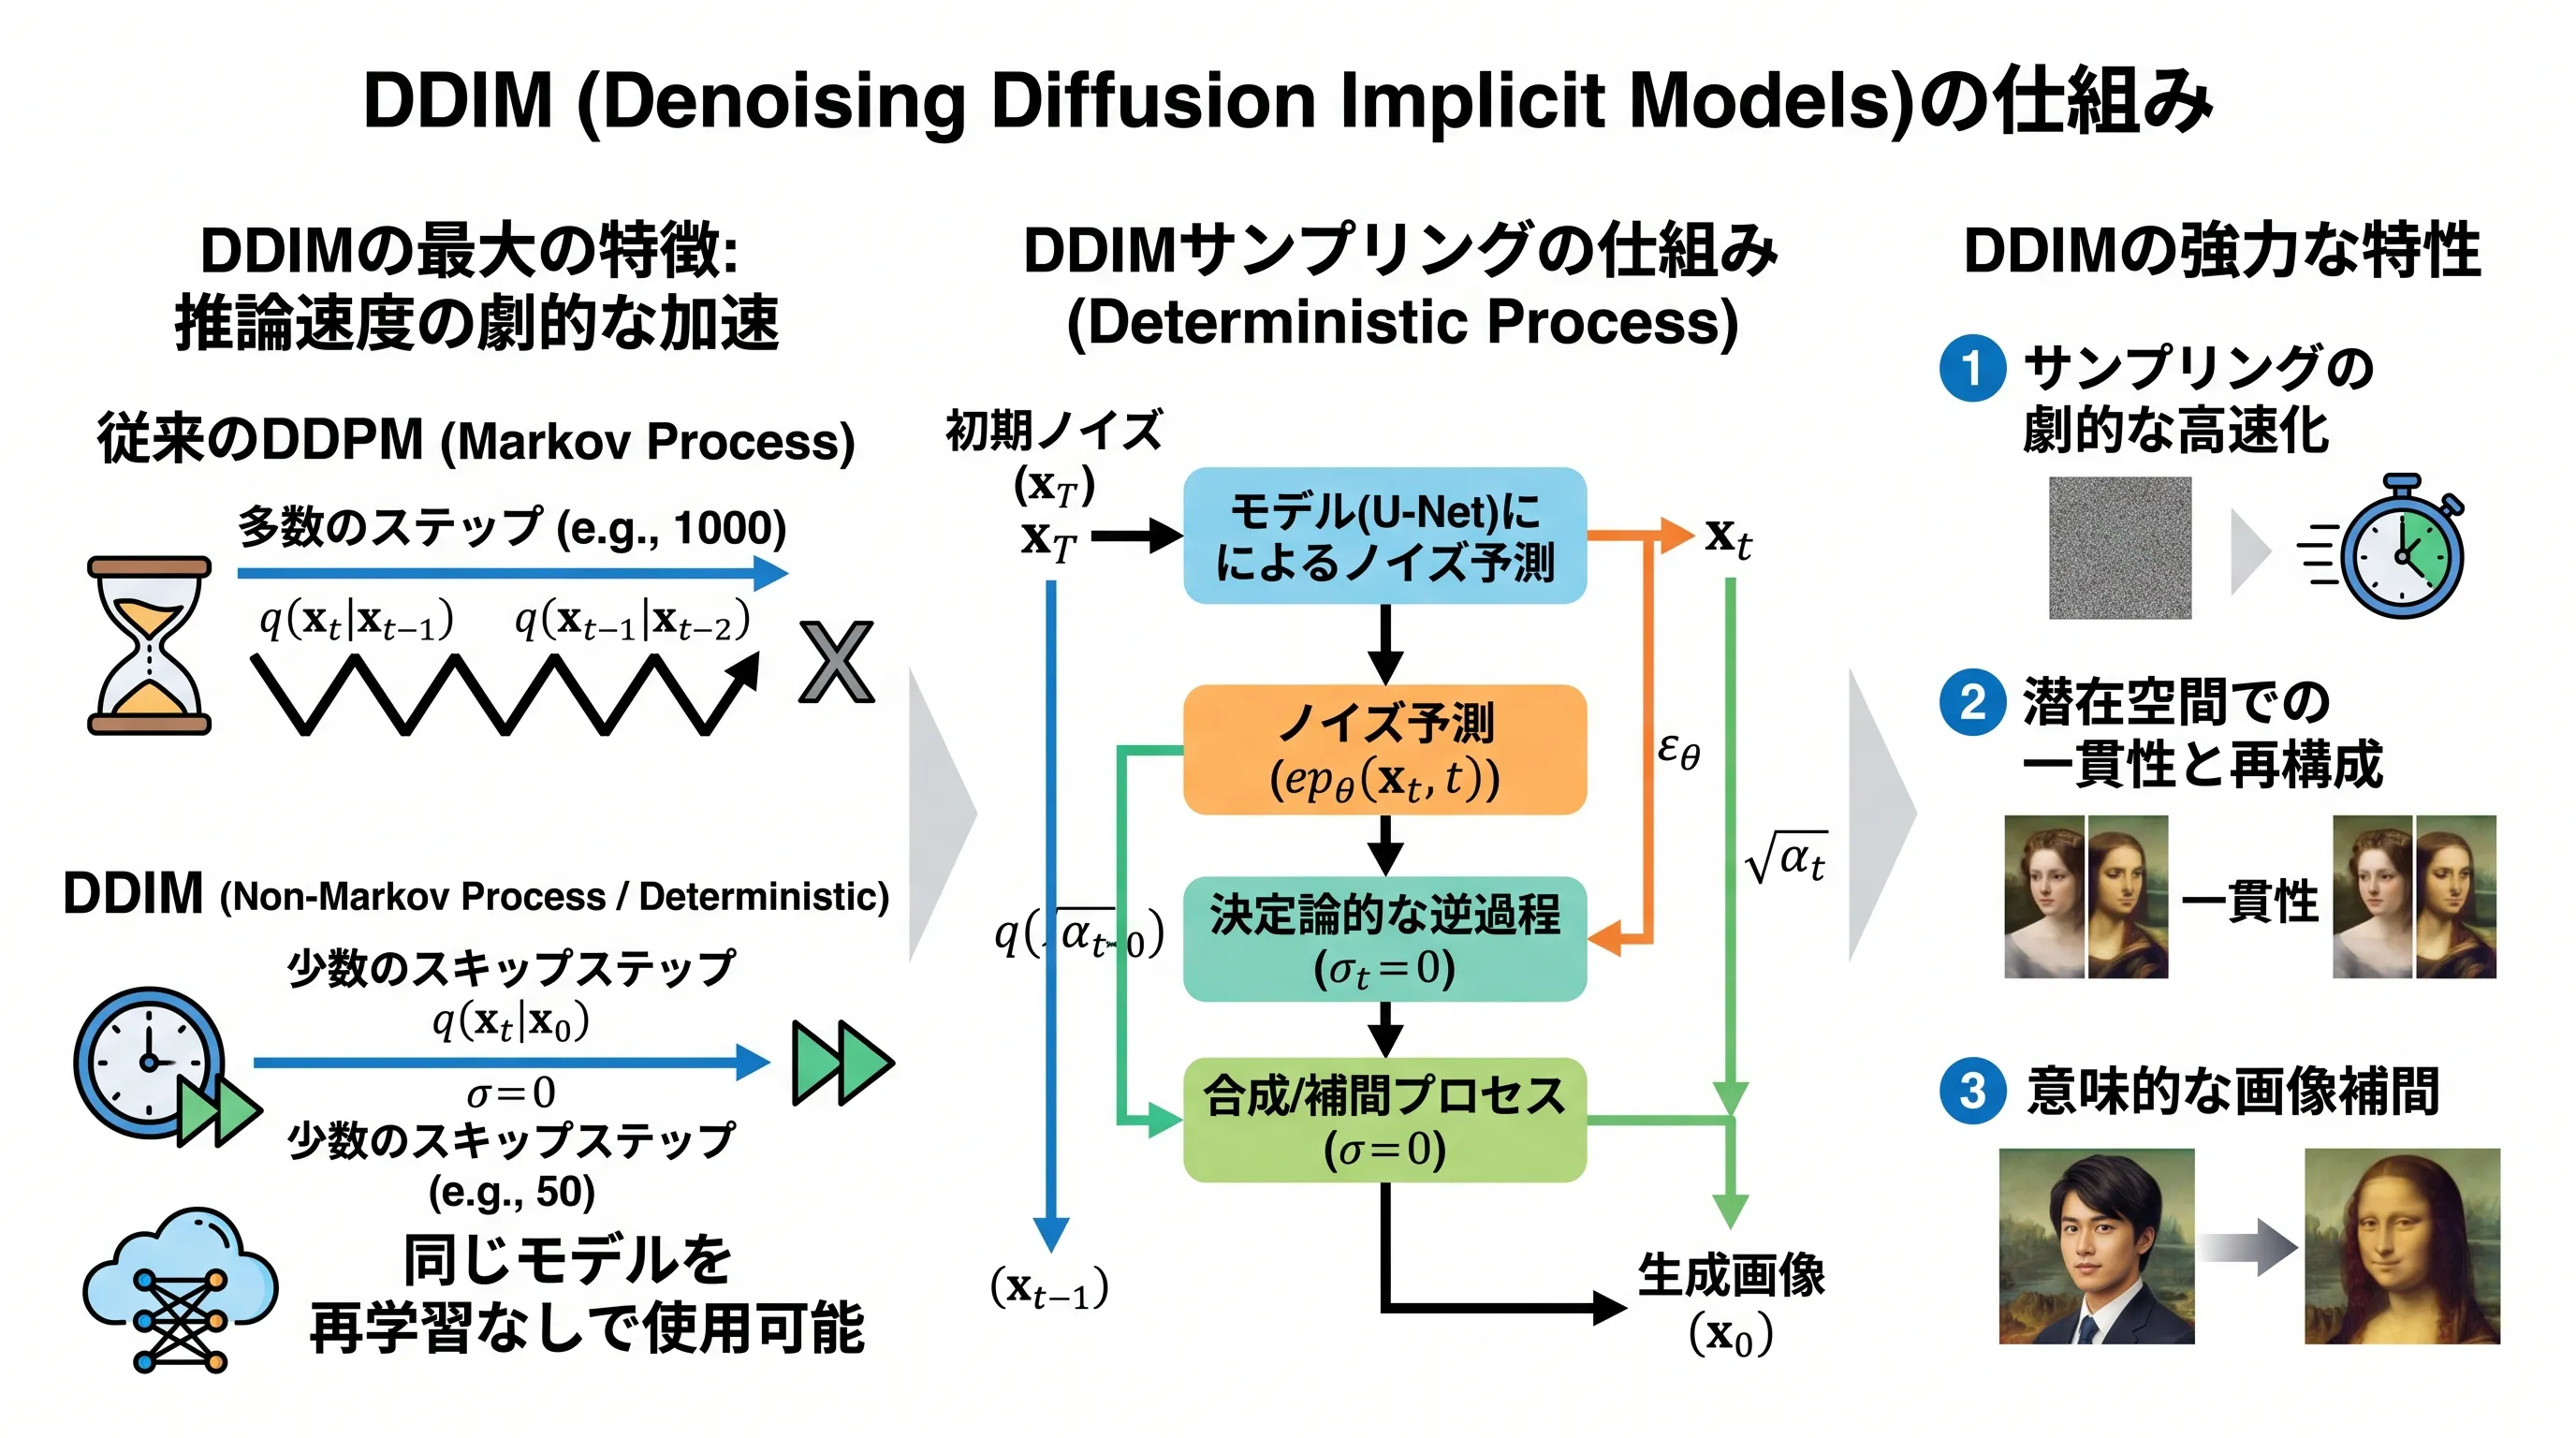 (画像は、Geminiで作成)
DDPM と同じ目的関数のまま、非マルコフ的な推論過程にすることで、学習済みの DDPM を再学習せずに少ないステップで生成できる DDIM の仕組みを理解すること。スクラッチ実装と Hugging Face diffusers で、 による DDIM と DDPM の切り替え、ステップ数を減らしたときの速さと画像の変化、初期ノイズを固定したときの生成の一貫性、DDIM Inversion による画像の再構成を確かめること。
はじめに:なぜDDIMが必要だったのか?
DDPM(Denoising Diffusion Probabilistic Models)は、敵対的学習(GAN)を用いずに非常に高品質な画像生成を実現し、生成AIにブレイクスルーをもたらしました。しかし、DDPMには実用化に向けて 「生成(推論)速度が極めて遅い」 という致命的な弱点がありました。
DDPMは、画像からノイズへの「拡散過程」を何千ステップものマルコフ連鎖として定義し、画像を生成する際にもその全ステップを順番に逆算(シミュレーション)する必要があります。
実は、モデルの学習時においては、リパラメトリゼーショントリック( の閉形式: )を用いることで「任意のステップ のノイズ画像」を元の画像から数式で一発で計算できるため、ステップを順番に辿る必要がなく計算時間はボトルネックになりません。
しかし、いざ新しい画像を生成(推論)する時には完成形の画像が手元にないため、完全なノイズからスタートして1ステップずつ順番にループを回してノイズを除去していくしかありません(※なぜ一足飛びに生成できないかについては、DDPMの記事をご参照ください)。この「生成時における何千回ものシーケンシャルなループ処理」こそが、DDPMを圧倒的に遅くしている元凶でした。
例えば、Nvidia 2080 Ti GPUを使用して の画像を5万枚生成するのに、GANなら1分未満で済むところ、DDPMでは約20時間もかかってしまいます。
このDDPMの「遅さ」という課題を解決し、生成速度を10倍から50倍に加速させつつ、品質を維持することに成功したのが、論文「Denoising Diffusion Implicit Models」で提案された DDIM です。DDIMによるサンプリングの高速化技術は、後のStable Diffusion(潜在拡散モデル)でも標準的に採用されており、現代の画像生成AIを支える極めて重要な基盤技術となっています。
DDPMからDDIMへの進化(マルコフ連鎖の脱却)
DDIMがどのように生成を高速化したのかを理解する鍵は、「非マルコフ的な推論プロセス」 と 「決定論的な生成」 にあります。
2つの生成のステップの違いを図にすると、次のようになります。
(図は、diagram-designで作成)
1. 目標関数(Loss)はDDPMと完全に同じ
DDIMの最も驚くべき特徴は、DDPMと全く同じ学習済みモデルをそのまま使える(再学習が不要である) という点です。
DDPMは、 が直前の にのみ依存する「マルコフ連鎖」として順過程(ノイズ付加)を定義していました。
この式は、原画像 に対して1ステップずつ微小なノイズを加えていき、 ステップの完全なノイズ画像に至るまでの過程を表しています。
しかしこのマルコフ連鎖の性質上、画像を生成する逆過程でも「1ステップずつ順番に」ノイズを除去していく必要があり、これが生成速度を遅くする根本的な原因となっていました。
そこでDDIMの著者らは、ステップを飛ばして高速にサンプリングするために 「マルコフ連鎖ではない(非マルコフ的な)別の順過程」 を定義し直しました。
ここで、順過程の定義を変えるということは、本来ならモデルが学習すべき目的関数(Loss)も変わってしまうことを意味します(DDPMの目的関数は、順過程がマルコフ連鎖であることを大前提として導出されているためです。導出の詳細はこちらを参照)。そもそもDDPMの学習で実際に用いられていた目的関数は、ステップ で画像に加えられた真のノイズ と、ニューラルネットワークが予測したノイズ の平均二乗誤差(MSE)を最小化するものでした(DDIMの論文中では と表記されます)。
順過程が全く別の非マルコフ的なものに変われば、当然この目的関数 も使えなくなり、モデルを一から学習し直す必要がありそうに思えます。
しかし彼らは、新しい非マルコフ的な順過程から数学的に導出される変分目的関数が、実は上記のDDPMの目的関数と全く同じになる(再学習が不要である) ことを証明しました。
論文の Theorem 1 が主張しているのはまさにこの点で、「任意の分散パラメータ に対して、非マルコフ的な変分目的関数 は、DDPMの一般的な目的関数 (各ステップの誤差に重み を掛けたもの)と定数差を除いて一致する()」ことが示されています(証明の詳細はこちらの別記事を参照)。
ここで重要なのは、 そのものが とイコールになるわけではないという点です。しかし、十分な表現力を持つモデルの理想的な状況下では「誤差にどんな重み が掛かっていようと、それを最小化する最適解(最適なネットワークのパラメータ)は変わらない」という強力な性質があります。
つまり、「本来の目的関数である複雑な ( )を最小化する最適解」と、「一番簡単な を最小化する最適解」は完全に一致するのです。
これは裏を返せば、「すでに を最小化して学習が終わっているDDPMのモデルがあるならば、そのパラメータは非マルコフモデル(DDIM)にとっても既に最適化された状態であり、全く再学習することなくそのまま流用できる」 という驚くべき結論を意味しています。
つまり、学習時にはDDPMと同じようにノイズ予測の誤差(MSE)を最小化しておき、画像を生成するサンプリングの時だけ「DDIMの計算式(非マルコフ的な逆過程)」を使う、ということが可能なのです。
2. 決定論的な生成プロセス()
DDIMは、サンプリング時の逆過程を以下のように一般化しました。
ここで は標準ガウスノイズであり、 は生成プロセスにおける「確率的なノイズの大きさ(stochasticity)」を制御するパラメータです。
- を特定の分散値に設定すると、この式はDDPMのサンプリング式と完全に一致します。
- DDIMの核心は、すべてのステップ において に設定することです。
とすると、式からランダムノイズ の項が完全に消滅します。これにより、ステップ の状態 から次の状態 を求めるプロセスが、サイコロを振らない 「決定論的(Deterministic)」 なプロセスになります。このモデルは陰的確率モデル(Implicit Probabilistic Models)の一種となるため、DDIM (Denoising Diffusion Implicit Models) と名付けられました。
生成プロセスからランダムな揺らぎが消えると、ノイズから画像に向かう軌道が「確定した1本のなめらかなレール(常微分方程式:ODE)」になります。 これにより、経路から逸れないようにDDPMのように「1歩ずつ細かく1000回」歩く必要がなくなり、「一気に数段飛ばし」でステップを大幅にスキップすることが可能になります。 これが、DDIMが推論回数を例えば50回などに減らし、生成プロセスを10〜50倍にも劇的に高速化できた最大の理由です。(なぜそのような軌道になるのかなど、数学的な詳細についてはDDIMの数式証明(Theorem 1)の解説も併せてご覧ください)
更新式の3つの項を図にすると、次のようになります。
(図は、diagram-designで作成)
3. による「DDPM ⇔ DDIM」の連続的な補間
論文では実験の比較を簡単にするため、 をハイパーパラメータ ひとつで制御する以下の式を導入しています。
この1つの式によって、次のように生成プロセスを連続的に切り替えられます。
| 設定 | 対応する生成プロセス |
|---|---|
| DDIM(決定論的) | |
| DDIMとDDPMの中間 | |
| DDPM(Ho et al. のAlgorithm 2と厳密に一致) | |
| 分散が大きい版のDDPM(CIFAR10で使われた設定) |
のとき はDDPMの事後分散 の平方根に一致します。このことは、後ほど diffusers を使った実装で のDDIMがDDPMとほぼ同じ画像を生成する、という形で確認できます。「DDIMとDDPMは別のモデルではなく、同じ学習済みネットワークに対する の異なる選択にすぎない」 という点が、この論文の最も重要なメッセージです。
記号の注意:論文の は、DDPMの です
DDIM論文はAppendix C.2で明言しているとおり、 という記号をDDPM論文の (累積積 )の意味で使っています。DDPM論文の とは別物です。
論文の式をそのままコードに落とす際、ここを取り違えると数式は正しいのに画像がまったく生成されない、という事故が起きます。本記事の実装では、この対応関係を alphas_bar という変数名で明示し、混乱を避けています。
η による切り替えを1本の軸に並べると、次のようになります。
(図は、diagram-designで作成)
DDIMがもたらした3つの革新
決定論的な生成プロセス()を採用したことで、DDIMはDDPMにはない強力な特性を獲得しました。
1. サンプリングの劇的な高速化(ステップのスキップ)
DDPMは1ステップずつ順番にノイズを除去しなければならないため、学習時と同じステップ数(例:)を全てたどる必要がありました。
しかしDDIMは決定論的なプロセスであるため、途中のステップを「スキップ」して、より短いステップ数(例: や )のサブシーケンス のみでサンプリングを行うことができます。論文の実験では、DDIMはわずか20〜100ステップで、DDPMの1000ステップに匹敵する高品質な画像を生成でき、壁時計時間(wall-clock time)で10倍から50倍の高速化を達成しました。
この差が最も顕著に出るのが、ステップ数を極端に削ったときです。論文の実験では、CIFAR10をわずか10ステップで生成した場合の画質(FID:小さいほど高品質)は次のようになっています。
| 10ステップ生成時の設定 | FID |
|---|---|
| DDIM() | 13.36 |
| DDPM() | 41.07 |
| 分散が大きい版のDDPM() | 367.43 |
確率的なDDPMはステップを間引いた瞬間に画質が崩壊するのに対し、決定論的なDDIMは10ステップでも実用に耐える品質を保っています。ステップ数を削ったときに破綻しないことが、DDIMの実用上の価値そのものです。
3つの設定の FID を並べると、次のようになります。
(図は、diagram-designで作成)
2. 潜在空間での「一貫性」と再構成
DDPMはサンプリング中に毎回ランダムなノイズを加えるため、同じ初期ノイズ から始めても、毎回全く異なる画像が生成されます。 一方DDIMは決定論的であるため、初期の潜在変数 を固定すれば、サンプリングのステップ数を20ステップにしても1000ステップにしても、高レベルな特徴(被写体の構図や色など)がほぼ同じ画像が一貫して生成されます。
さらに、常微分方程式(ODE)のオイラー法と似た性質を持つため、実画像 からノイズ への「エンコード」と、そのノイズからの「再構成」を高精度に行うことも可能になりました。論文でもCIFAR-10のテストセットを使ってこの再構成が検証されており、1枚あたりの誤差は で0.014、 で0.0009、 で0.0001と、ステップ数を増やすほど小さくなり、元の画像に限りなく近づいていくことが報告されています。
3. 潜在空間での意味的な画像補間(Interpolation)
GANの得意技であった「潜在変数を少しずつ変化させて、画像Aから画像Bへ滑らかに変化させる(補間)」という操作が、DDIMでも可能になりました。
DDIMでは画像の特徴が初期ノイズ にエンコードされているため、2つの異なる画像の初期ノイズ と の間を球面線形補間(Spherical Linear Interpolation: Slerp) で繋ぐことで、意味的に自然な画像の移り変わりを生成できます。これは確率的なDDPMでは不可能だった制御です。
DDIMのスクラッチ実装
ここからは、これまで解説してきた理論をPyTorchのみでゼロから実装していきます。 diffusers のような高レベルなライブラリは一切使わず、「DDPMと同一の学習ループ」「 で制御される一般化サンプラー」「サンプリング軌跡 の選択」を自前で構築し、DDPMの記事と同じ4枚の猫画像から画像を生成できるところまでを確認します。そのうえで記事の後半では、同じことを diffusers で行い、DDIM Inversion による実画像の再構成まで踏み込みます。
DDIMの論文との対応関係
DDIM論文の実験はCIFAR10・CelebA・LSUNといったデータセットに対し、FIDを5万枚のサンプルで測定するという規模で行われています。そのままの再現は現実的ではありません。 そこで本実装では、「サンプリングのアルゴリズムは論文の数式どおり、データ規模とモデルの幅だけを縮小する」 という方針を取ります。DDIMの本質はサンプラー側にあるため、この方針でもすべて検証できます。 Google ColabのL4またはA100で、実行可能な設計をしています。
| 構成要素 | DDIM論文 | 本実装 |
|---|---|---|
| 学習目的関数 | (重みなしのノイズ予測MSE) | 同じ(DDPM記事と同一のコード) |
| ノイズ予測モデル | U-Net(Ho et al. 2020 と同一) | 同じ設計(※スクラッチ実装ではch=64等に幅を縮小、後述のdiffusers実装ではフル構成に近い幅を使用) |
| ノイズスケジュール | linear(), | 同じ |
| 記号の定義 | は累積積(DDPMの ) | 同じ(alphas_bar と命名) |
| サンプリング式 | DDIMの生成方程式 | 同じ |
| の選択 | 前述の による制御式 | 同じ(両方を実装) |
| の扱い | と定義 | 同じ |
| サンプリング軌跡 | linear / quadratic(Appendix D.2) | 同じ(公式実装の定数まで踏襲) |
| 一貫性の検証 | 同一の からステップ数を変えて生成 | 同じ(後述の diffusers の比較で確認) |
| 潜在空間からの再構成 | 実画像をエンコードして再構成誤差を測定 | 同じ(diffusers の DDIM Inversion で実装) |
| 補間 | 球面線形補間(Slerp) | 省略(理論の解説のみ) |
| 重みの平滑化 | EMA(Ho et al. の設定を継承) | 同じ |
| 評価指標 | FID(5万枚生成) | 省略(学習データが4枚のため測定不能) |
| 学習データ | CIFAR10 / CelebA / LSUN | 猫画像4枚(+左右反転で8枚) |
省略したのはFIDによる定量評価とSlerpによる補間です。FIDはサンプル品質を統計的に測る指標ですが、5万枚の生成と大規模な実データ分布が必要なため、本記事の最小構成では意味のある値になりません。補間についても、猫4枚という学習データでは「意味的に滑らかな移り変わり」が観察できないため、理論の解説にとどめています。代わりに、再構成誤差という少数データでも測定できる指標と、同一の初期ノイズ から生成した画像の見た目の一貫性によって、論文の主張を確認します。
ライブラリのインストール
!pip install torch torchvision pillow matplotlib
以下のスクラッチコードを実行するために必要なライブラリをインストールします。
設定とノイズスケジュールの定義
まずハイパーパラメータと、順過程で使用するスケジュールを定義します。
import math
import time
import torch
import torch.nn as nn
import torch.nn.functional as F
from PIL import Image
from torchvision import transforms
import matplotlib.pyplot as plt

torch.manual_seed(0)
device = "cuda" if torch.cuda.is_available() else "cpu"

# ===== ハイパーパラメータ =====
IMAGE_SIZE = 32       # 生成画像の解像度(DDPMの記事と同じ)
T = 1000             # 学習時の拡散ステップ数
TRAIN_STEPS = 12000   # 学習ステップ数

# ===== ノイズスケジュール =====
# 【重要】DDIM論文の alpha_t は、DDPM論文の alpha_bar_t(累積積)を指す。
# beta を 1e-4 から 0.02 まで線形に増加させる
betas = torch.linspace(1e-4, 0.02, T, device=device)
# alpha = 1 - beta の累積積 (alpha_bar) を計算
alphas_bar = torch.cumprod(1.0 - betas, dim=0)
sqrt_ab = alphas_bar.sqrt()
sqrt_1mab = (1.0 - alphas_bar).sqrt()
設定値の意味と、論文との対応を確認します。
- 学習ステップ数 TRAIN_STEPS: DDIMは少ないステップで生成するので、モデルのノイズ予測のわずかな誤差が画像に出やすくなります。DDPMの記事(10,000)より少し長い12,000ステップ学習させ、誤差を小さくしています。
- スケジュールがDDPMと同一であること: を から まで線形に増やす設定は、DDPMの記事とまったく同じです。DDIMは学習の設定を一切変更しない手法なので、ここが変わらないのは当然の帰結です。論文が「pretrained DDPM models をそのまま新しい目的関数の解として使える」と述べているとおりです。
- alphas_bar という命名: 前述の注意書きのとおり、論文の はDDPMの です。実装で最も事故が起きやすい箇所なので、変数名を 側に寄せています。以降のコードに出てくる ab_t や ab_prev は、すべて論文の 、 に対応します。
- という約束: DDIMの生成方程式を適用する際、「 と定義する」という重要なルールがあります。これは、最後のステップで を出力するとき、ノイズが完全にゼロの状態(, )に対応させるための約束です。後述のサンプラーでは、配列の範囲外を参照する代わりに定数 1.0 を使うことで、この定義を明示的に実装します。
ノイズ予測モデル(DDPMと同一のU-Net)
ノイズを予測するネットワーク を定義します。 DDIMではモデル側に変更点は一切ありません。 DDPMの記事と同じ役割のU-Netを、GroupNormや残差ブロックといったHo et al. の標準的な構成に揃えて実装します。
def timestep_embedding(t, dim, max_period=10000):
    half = dim // 2
    freqs = torch.exp(-math.log(max_period) * torch.arange(half, device=t.device).float() / half)
    args = t.float()[:, None] * freqs[None]
    return torch.cat([torch.sin(args), torch.cos(args)], dim=-1)


def Normalize(ch, groups=32):
    while ch % groups != 0:
        groups //= 2
    return nn.GroupNorm(groups, ch)


def zero_module(module):
    for p in module.parameters():
        p.detach().zero_()
    return module


class ResBlock(nn.Module):
    def __init__(self, in_ch, out_ch, emb_dim):
        super().__init__()
        self.norm1 = Normalize(in_ch)
        self.conv1 = nn.Conv2d(in_ch, out_ch, 3, padding=1)
        self.emb_proj = nn.Linear(emb_dim, out_ch)
        self.norm2 = Normalize(out_ch)
        self.conv2 = zero_module(nn.Conv2d(out_ch, out_ch, 3, padding=1))
        self.skip = nn.Conv2d(in_ch, out_ch, 1) if in_ch != out_ch else nn.Identity()

    def forward(self, x, emb):
        h = self.conv1(F.silu(self.norm1(x)))
        h = h + self.emb_proj(F.silu(emb))[:, :, None, None]
        h = self.conv2(F.silu(self.norm2(h)))
        return self.skip(x) + h


class AttnBlock(nn.Module):
    def __init__(self, ch, heads=4):
        super().__init__()
        self.heads = heads
        self.norm = Normalize(ch)
        self.qkv = nn.Conv2d(ch, ch * 3, 1)
        self.proj = zero_module(nn.Conv2d(ch, ch, 1))

    def forward(self, x):
        b, c, h, w = x.shape
        q, k, v = self.qkv(self.norm(x)).chunk(3, dim=1)
        shape = (b, self.heads, c // self.heads, h * w)
        q = q.reshape(shape).transpose(-2, -1)
        k = k.reshape(shape).transpose(-2, -1)
        v = v.reshape(shape).transpose(-2, -1)
        o = F.scaled_dot_product_attention(q, k, v)
        return x + self.proj(o.transpose(-2, -1).reshape(b, c, h, w))


class Down(nn.Module):
    def __init__(self, ch):
        super().__init__()
        self.op = nn.Conv2d(ch, ch, 3, stride=2, padding=1)

    def forward(self, x):
        return self.op(x)


class Up(nn.Module):
    def __init__(self, ch):
        super().__init__()
        self.conv = nn.Conv2d(ch, ch, 3, padding=1)

    def forward(self, x):
        return self.conv(F.interpolate(x, scale_factor=2.0, mode="nearest"))


class Seq(nn.Sequential):
    def forward(self, x, emb):
        for layer in self:
            x = layer(x, emb) if isinstance(layer, ResBlock) else layer(x)
        return x


class UNet(nn.Module):
    def __init__(self, ch=64, ch_mult=(1, 2, 2), num_res=2, attn_res=(16,), img=IMAGE_SIZE):
        super().__init__()
        emb_dim = ch * 4
        self.ch = ch
        self.time_embed = nn.Sequential(
            nn.Linear(ch, emb_dim), nn.SiLU(), nn.Linear(emb_dim, emb_dim))

        self.input_blocks = nn.ModuleList([Seq(nn.Conv2d(3, ch, 3, padding=1))])
        chans, cur, res = [ch], ch, img
        for lv, m in enumerate(ch_mult):
            for _ in range(num_res):
                layers = [ResBlock(cur, ch * m, emb_dim)]
                cur = ch * m
                if res in attn_res:
                    layers.append(AttnBlock(cur))
                self.input_blocks.append(Seq(*layers))
                chans.append(cur)
            if lv != len(ch_mult) - 1:
                self.input_blocks.append(Seq(Down(cur)))
                chans.append(cur)
                res //= 2

        self.middle_block = Seq(ResBlock(cur, cur, emb_dim), AttnBlock(cur),
                                ResBlock(cur, cur, emb_dim))

        self.output_blocks = nn.ModuleList()
        for lv, m in list(enumerate(ch_mult))[::-1]:
            for i in range(num_res + 1):
                layers = [ResBlock(cur + chans.pop(), ch * m, emb_dim)]
                cur = ch * m
                if res in attn_res:
                    layers.append(AttnBlock(cur))
                if lv != 0 and i == num_res:
                    layers.append(Up(cur))
                    res *= 2
                self.output_blocks.append(Seq(*layers))

        self.out = nn.Sequential(Normalize(cur), nn.SiLU(),
                                 zero_module(nn.Conv2d(cur, 3, 3, padding=1)))

    def forward(self, x, t):
        emb = self.time_embed(timestep_embedding(t, self.ch))
        hs, h = [], x
        for mod in self.input_blocks:
            h = mod(h, emb)
            hs.append(h)
        h = self.middle_block(h, emb)
        for mod in self.output_blocks:
            h = mod(torch.cat([h, hs.pop()], dim=1), emb)
        return self.out(h)


class EMA:
    def __init__(self, model, decay=0.999):
        self.decay = decay
        self.shadow = {k: v.detach().clone().float() for k, v in model.state_dict().items()}

    @torch.no_grad()
    def update(self, model):
        for k, v in model.state_dict().items():
            if v.dtype.is_floating_point:
                self.shadow[k].mul_(self.decay).add_(v.detach().float(), alpha=1 - self.decay)
            else:
                self.shadow[k] = v.detach().clone()

    @torch.no_grad()
    def copy_to(self, model):
        sd = model.state_dict()
        for k in sd:
            sd[k].copy_(self.shadow[k].to(sd[k].dtype))
このU-Netは、DDPMの記事で解説したものと本質的に同じです。DDIM固有の要素は一切含まれていません。
- モデルが を知らないこと: forward(x, t) の引数に も も出てきません。これがDDIMの核心で、生成プロセスの確率性はモデルの外側(サンプラー)で決まります。だからこそ、1つの学習済みモデルからDDPMもDDIMも取り出せるのです。
- 16×16でのセルフアテンション attn_res=(16,): 32×32の入力に対し、1段ダウンサンプリングした16×16の解像度でアテンションを適用します。Ho et al. の設定と同じで、畳み込みだけでは捉えられない画像全体のグローバルな依存関係を扱います。
- ゼロ初期化 zero_module: 残差ブロックとアテンションブロックの出力層をゼロで初期化することで、学習開始時点でそのブロックが恒等写像として振る舞います。深いネットワークでも勾配が壊れず、学習が安定します。
- EMAの必要性: DDIMは少ステップでサンプリングするため、重みのわずかな振れがそのまま画像の破綻として現れやすくなります。減衰率0.999の指数移動平均を保持し、生成時にはその平滑化された重みを使います。
学習ループ(DDPMと1行も変わらない)
猫画像を読み込み、 目的関数(ノイズ予測のMSE)でモデルを学習します。
# ----------------------------------------------------
# 猫の画像 (cat1.jpg ~ cat4.jpg) の読み込みと前処理
# ----------------------------------------------------
transform = transforms.Compose([
    transforms.Resize((IMAGE_SIZE, IMAGE_SIZE)),
    transforms.ToTensor(),
    transforms.Normalize((0.5,) * 3, (0.5,) * 3),
])

image_paths = ["cat1.jpg", "cat2.jpg", "cat3.jpg", "cat4.jpg"]
images = []
for path in image_paths:
    img = Image.open(path).convert("RGB")
    images.append(transform(img))

x_0 = torch.stack(images).to(device)
x_0 = torch.cat([x_0, torch.flip(x_0, dims=[3])], dim=0)
print("images:", tuple(x_0.shape))

# ==== 学習 ====
model = UNet().to(device)
print("U-Net params: %.1fM" % (sum(p.numel() for p in model.parameters()) / 1e6))
optimizer = torch.optim.AdamW(model.parameters(), lr=2e-4)
ema = EMA(model)
B = x_0.shape[0]

for step in range(TRAIN_STEPS):
    model.train()
    # ランダムなタイムステップ t をバッチサイズ分生成
    t = torch.randint(0, T, (B,), device=device).long()
    # ランダムなノイズを生成
    noise = torch.randn_like(x_0)
    # x_0 にノイズを付加して x_t を計算 (順過程)
    x_t = sqrt_ab[t].view(-1, 1, 1, 1) * x_0 + sqrt_1mab[t].view(-1, 1, 1, 1) * noise
    # U-Netで予測したノイズと実際のノイズのMSEロスを計算
    loss = F.mse_loss(model(x_t, t), noise)

    optimizer.zero_grad()
    loss.backward()
    # 勾配爆発を防ぐためのクリッピング
    torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
    optimizer.step()
    # モデルの重みの指数移動平均 (EMA) を更新
    ema.update(model)

    if (step + 1) % 1000 == 0:
        print(f"[train] {step+1}/{TRAIN_STEPS} - loss: {loss.item():.4f}")

# 最後にEMAの重みをメインモデルにコピーする
ema.copy_to(model)
学習に使用する画像は、DDPMの記事と同じ以下の4枚です。
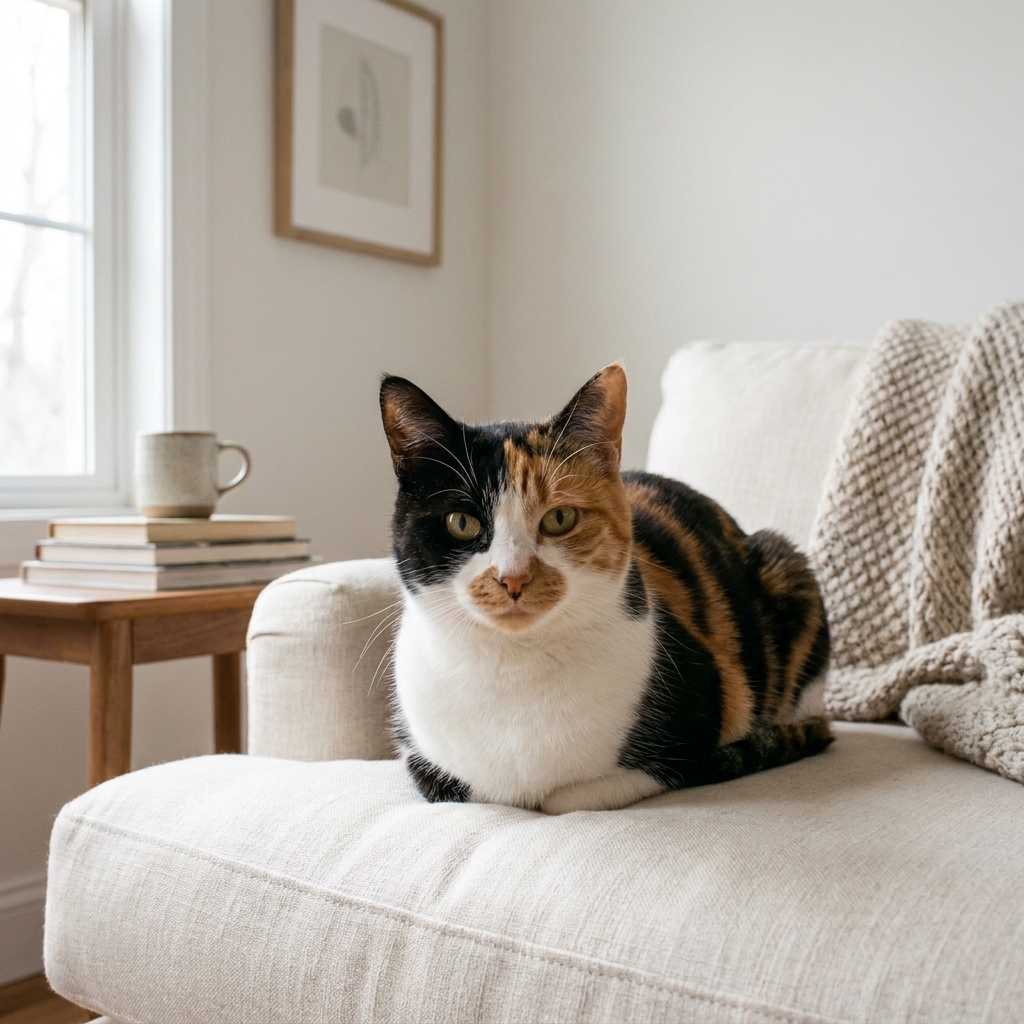
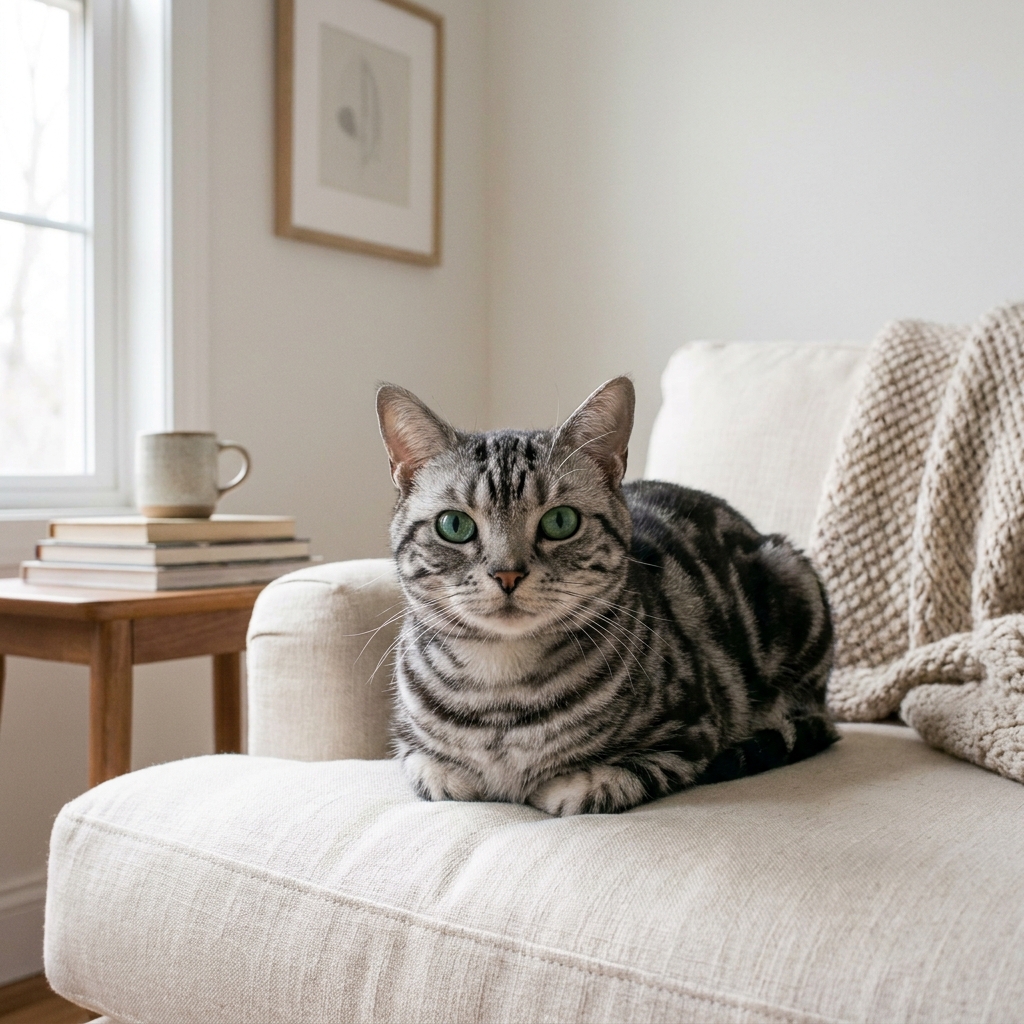
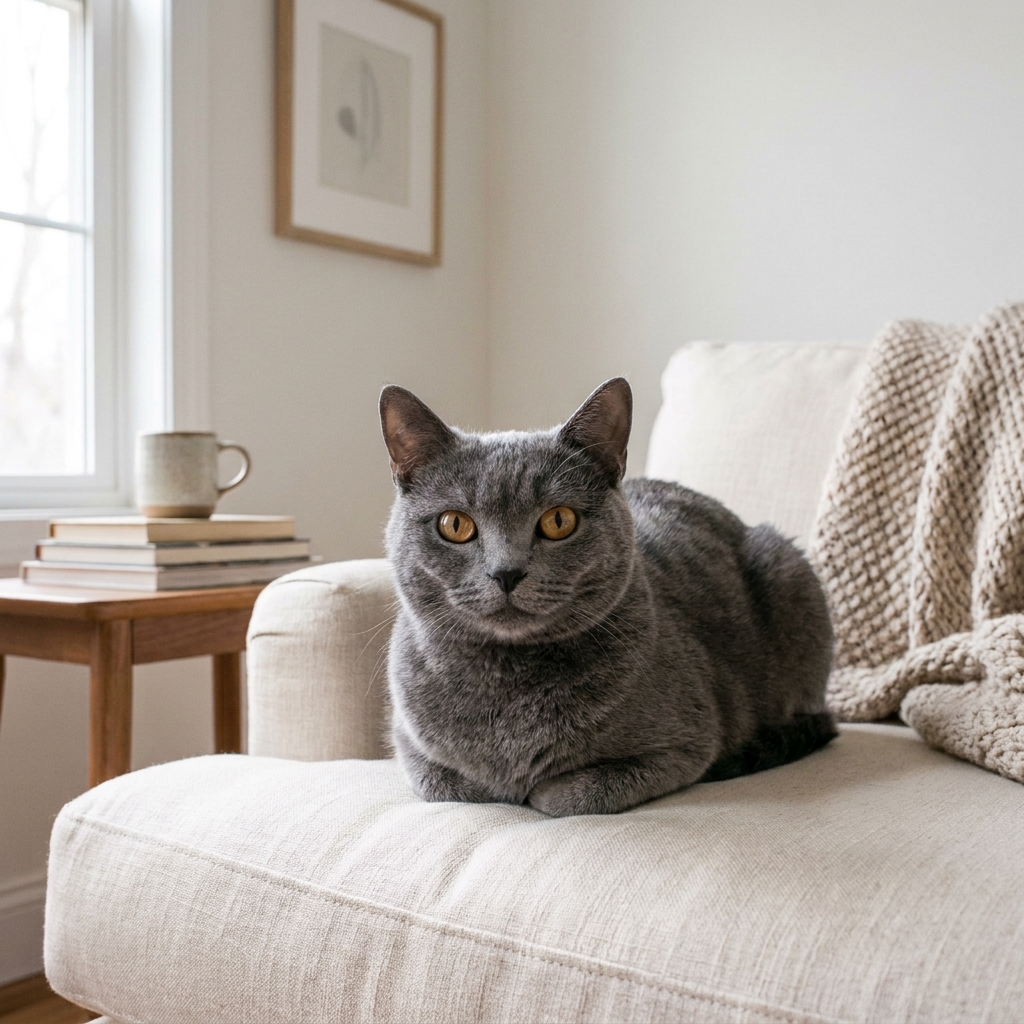
(Google AI Studioで生成)
このコードで注目すべきは、DDIMの記事であるにもかかわらず、DDIM固有のコードが1行も出てこないという点です。
- 目的関数: F.mse_loss(model(x_t, t), noise) は、DDPMの単純化された目的関数 そのものです。Theorem 1 により、この1つの目的関数がすべての (すなわちすべての )に対する変分目的関数 の代理になっています。だからこそ、学習を1回済ませれば、生成時に を自由に選べます。
- 順過程の閉形式: sqrt_ab[t] * x_0 + sqrt_1mab[t] * noise は、周辺分布 のサンプリング式です。DDIMが変更したのは「 という同時分布の作り方」であって、「 という周辺分布」ではありません。周辺分布が同じだからこそ、学習コードが共有できます。
- 左右反転による拡張: 4枚では学習が不安定になりやすいため、反転を加えて8枚にしています。これは論文の手法とは無関係な、少データ設定のための実務的な工夫です。
推論の実行
DDIMの高速化は、 の増加部分列 の上でだけ生成を行うことで実現されます。論文のAppendix D.2では2種類の選び方が示されています。
def make_tau(steps, schedule="quadratic"):
    # 指定したステップ数 S に応じてサンプリング軌跡 τ を作成
    if schedule == "quadratic":
        # 論文の Appendix D.2 で提案されている二次関数の軌跡
        tau = (torch.linspace(0, math.sqrt(T * 0.8), steps) ** 2).long()
    else:
        # 等間隔(linear)な軌跡
        tau = torch.arange(0, T, max(T // steps, 1))
    # ※注意: quadraticの場合、torch.unique() によって重複するステップが除外されるため、
    # 指定した steps よりも実際のステップ数(配列の長さ)が少なくなることがあります。
    return torch.unique(tau).to(device)


@torch.no_grad()
def sample(model, n=4, steps=50, eta=0.0, schedule="quadratic", x_T=None):
    model.eval()
    tau = make_tau(steps, schedule) # ステップ数 S のサブシーケンス τ を生成
    # 初期ノイズ x_T が与えられていない場合はランダムに生成
    x = torch.randn(n, 3, IMAGE_SIZE, IMAGE_SIZE, device=device) if x_T is None else x_T.clone()

    for i in reversed(range(len(tau))): # 逆過程(生成)
        t_cur = tau[i]
        ab_t = alphas_bar[t_cur] # 現在のステップの α_bar
        # 直前のステップの α_bar (最後まで行ったら α_0 = 1.0)
        ab_prev = alphas_bar[tau[i - 1]] if i > 0 else torch.tensor(1.0, device=device)

        t_batch = torch.full((x.shape[0],), t_cur, device=device, dtype=torch.long)
        eps = model(x, t_batch) # U-Netでノイズを予測

        # 予測されたノイズから x_0 を逆算し、[-1, 1]の範囲にクリップ
        x0_pred = ((x - (1 - ab_t).sqrt() * eps) / ab_t.sqrt()).clamp(-1, 1)
        # clamp した x0_pred と整合するように eps を計算し直す
        eps = (x - ab_t.sqrt() * x0_pred) / (1 - ab_t).sqrt()

        # ノイズの大きさを制御する σ_t を計算 (η=0 なら 0)
        sigma = eta * ((1 - ab_prev) / (1 - ab_t)).sqrt() * (1 - ab_t / ab_prev).sqrt()
        # 方向を示す項の係数
        dir_coef = (1 - ab_prev - sigma ** 2).clamp(min=0).sqrt()

        # 確率的ノイズ(η=0 なら σ_t=0 なので影響なし)
        noise = torch.randn_like(x) if i > 0 else torch.zeros_like(x)
        # 次のステップ(時間を遡った過去)の x を計算
        x = ab_prev.sqrt() * x0_pred + dir_coef * eps + sigma * noise


    # [-1, 1] を [0, 1] に変換
    return (x.clamp(-1, 1) + 1) / 2

t0 = time.time()
generated = sample(model, n=4, steps=50, eta=0.0)
print(f"sampling: {time.time() - t0:.1f}s")
generated = generated.permute(0, 2, 3, 1).cpu().numpy()
fig, axes = plt.subplots(1, 4, figsize=(12, 3))
for idx, img in enumerate(generated):
    axes[idx].imshow(img)
    axes[idx].axis("off")
    axes[idx].set_title(f"Generated {idx+1}")
plt.tight_layout()
plt.show()
上記がDDIMの核となるサンプリング処理です。予測したノイズから元の画像 を推定し、そこから決定論的に次のステップの画像を計算していきます。
- サンプリング軌跡 τ: make_tau は、1000ステップから生成に使う steps 個のステップを選びます。二次関数の軌跡 (linspace(0, sqrt(T * 0.8), steps) ** 2) は、論文の Appendix D.2 と公式コードの選び方です。 が小さい(画像の細部を仕上げる)側を細かく、大きい側を粗く刻みます。0.8を掛けるのは、公式コード(Latent Diffusion などにも引き継がれている実装)と同じく、最も大きい を1000ではなく800程度までにして、ほぼ純粋なノイズの区間を飛ばすためです。
- の推定: 予測したノイズ eps から、直前に示した式で を逆算します。clamp(-1, 1) で画素の範囲に収めた後、その と整合するように eps を計算し直すのは、クリップで を変えたまま元の eps を使うと、次のステップの式が矛盾するためです。
- σ と η: sigma は、論文の です。 なら0になり、ノイズを加えない決定論的な生成(DDIM)になります。 ならDDPMと同じ分散になります。
- 次のステップの計算: ab_prev.sqrt() * x0_pred + dir_coef * eps + sigma * noise が、論文の生成の式(推定した 、 を指す方向、ランダムなノイズの3項)です。最後のステップ(i = 0)では として、ノイズを加えません。
- 50ステップ: 1000ステップのDDPMに対して、20分の1の回数で生成できるかを確かめるための値です。
実行結果
上記のコードを実行すると、以下のようなログが出力され、推論で生成された画像が表示されます。
images: (8, 3, 32, 32)
U-Net params: 6.5M
[train] 1000/12000 - loss: 0.0123
[train] 2000/12000 - loss: 0.0138
[train] 3000/12000 - loss: 0.0019
[train] 4000/12000 - loss: 0.0067
[train] 5000/12000 - loss: 0.0039
[train] 6000/12000 - loss: 0.0015
[train] 7000/12000 - loss: 0.0013
[train] 8000/12000 - loss: 0.0016
[train] 9000/12000 - loss: 0.0013
[train] 10000/12000 - loss: 0.0023
[train] 11000/12000 - loss: 0.0021
[train] 12000/12000 - loss: 0.0034

sampling: 0.7s
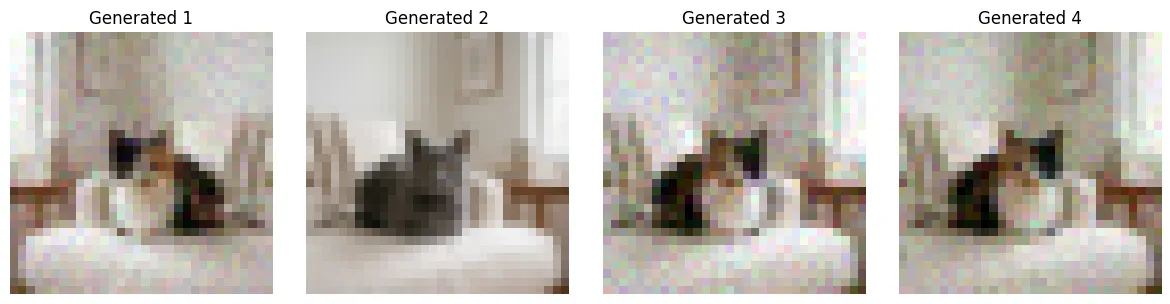
上記の実行結果からわかるように、DDPMと比べて若干生成画像にノイズがのっています。これは32×32解像度で8枚・12000ステップという小規模な設定で学習しているため、eta=0 の決定論的プロセスでは予測誤差がそのまま残りやすいことが原因です。一方で、生成速度は約0.7秒となっており、1000ステップを要するDDPMと比べて劇的な高速化を達成しています。
Hugging Face diffusers での DDIM
ここまでのスクラッチ実装と同じことを、Hugging Faceの diffusers ライブラリで行います。 DDIMの「サンプラーを差し替えるだけ」という性質が、ライブラリのAPIレベルでもそのまま表れます。
ライブラリのインストール
!pip install torch torchvision diffusers pillow matplotlib
学習と、DDIMScheduler による高速サンプリング
DDPMの記事と同じ学習コードでモデルを訓練し、生成時だけスケジューラを差し替えます。
import time
import torch
import torch.nn.functional as F
from PIL import Image
from torchvision import transforms
import matplotlib.pyplot as plt
from diffusers import UNet2DModel, DDPMScheduler, DDIMScheduler

torch.manual_seed(0)
IMAGE_SIZE = 32
EPOCHS = 10000
device = "cuda" if torch.cuda.is_available() else "cpu"

# ----------------------------------------------------
# 1. 猫の画像 (cat1.jpg ~ cat4.jpg) の読み込みと前処理
# ----------------------------------------------------
transform = transforms.Compose([
    transforms.Resize((IMAGE_SIZE, IMAGE_SIZE)),
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))
])

image_paths = ["cat1.jpg", "cat2.jpg", "cat3.jpg", "cat4.jpg"]
images = []
for path in image_paths:
    img = Image.open(path).convert("RGB")
    images.append(transform(img))

x_0 = torch.stack(images).to(device)

# ----------------------------------------------------
# 2. モデルとスケジューラの定義(DDPMの記事と同一の設定)
# ----------------------------------------------------
model = UNet2DModel(
    sample_size=IMAGE_SIZE,
    in_channels=3,
    out_channels=3,
    layers_per_block=2,
    block_out_channels=(128, 256, 256, 256),
    down_block_types=("DownBlock2D", "DownBlock2D", "AttnDownBlock2D", "DownBlock2D"),
    up_block_types=("UpBlock2D", "AttnUpBlock2D", "UpBlock2D", "UpBlock2D"),
).to(device)

sched_kwargs = dict(
    num_train_timesteps=1000,
    beta_start=1e-4,
    beta_end=0.02,
    beta_schedule="linear",
)

# 学習には DDPMScheduler を使う(add_noise は DDIM でも同一)
train_scheduler = DDPMScheduler(**sched_kwargs)
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4)

# ----------------------------------------------------
# 3. 訓練ループ(DDPMの記事と完全に同じ)
# ----------------------------------------------------
batch_size = x_0.shape[0]
for epoch in range(EPOCHS):
    model.train()
    optimizer.zero_grad()

    # 画像と同じサイズのランダムノイズを生成
    noise = torch.randn_like(x_0)
    # ランダムなタイムステップを生成
    timesteps = torch.randint(0, train_scheduler.config.num_train_timesteps,
                              (batch_size,), device=device).long()
    # スケジューラを使って画像にノイズを付加
    noisy_images = train_scheduler.add_noise(x_0, noise, timesteps)

    # U-Netで付加されたノイズを予測
    noise_pred = model(noisy_images, timesteps).sample
    # 予測ノイズと実際のノイズのMSEロスを計算
    loss = F.mse_loss(noise_pred, noise)

    loss.backward()
    optimizer.step()

    if (epoch + 1) % 1000 == 0:
        print(f"Epoch {epoch+1}/{EPOCHS} - Loss: {loss.item():.4f}")

# ----------------------------------------------------
# 4. 生成用スケジューラ:ここだけが DDPM との違い
# ----------------------------------------------------
ddpm_scheduler = DDPMScheduler(**sched_kwargs, clip_sample=True)
ddim_scheduler = DDIMScheduler(
    **sched_kwargs,
    clip_sample=True,        # 予測された x_0 を [-1, 1] にクリップ
    set_alpha_to_one=True,   # 論文の alpha_0 := 1 に対応
    timestep_spacing="leading",   # 論文の linear な tau に対応
)

@torch.no_grad()
def generate(scheduler, steps, eta=None, x_T=None, seed=1234):
    """DDPMScheduler / DDIMScheduler の共通サンプリングループ"""
    model.eval()
    scheduler.set_timesteps(steps)
    generator = torch.Generator(device="cpu").manual_seed(seed)

    if x_T is None:
        sample = torch.randn((4, 3, IMAGE_SIZE, IMAGE_SIZE),
                             generator=generator).to(device)
    else:
        sample = x_T.clone()

    for t in scheduler.timesteps:
        residual = model(sample, t).sample
        if eta is None:      # DDPMScheduler には eta 引数が無い
            sample = scheduler.step(residual, t, sample, generator=generator).prev_sample
        else:                # DDIMScheduler は eta で確率性を制御
            sample = scheduler.step(residual, t, sample,
                                    eta=eta, generator=generator).prev_sample
    return (sample.clamp(-1, 1) + 1) / 2

# ----------------------------------------------------
# 5. 生成の比較(同じ x_T から、サンプラーだけを変える)
# ----------------------------------------------------
g = torch.Generator(device="cpu").manual_seed(1234)
x_T = torch.randn((4, 3, IMAGE_SIZE, IMAGE_SIZE), generator=g).to(device)

configs = [
    ("DDPM  S=1000", ddpm_scheduler, 1000, None),
    ("DDIM  S=50  (eta=0)", ddim_scheduler, 50, 0.0),
    ("DDIM  S=20  (eta=0)", ddim_scheduler, 20, 0.0),
    ("DDIM  S=10  (eta=0)", ddim_scheduler, 10, 0.0),
    ("DDIM  S=50  (eta=1)", ddim_scheduler, 50, 1.0),
]

fig, axes = plt.subplots(len(configs), 4, figsize=(9, 2.2 * len(configs)))
for row, (name, sch, S, eta) in enumerate(configs):
    t0 = time.time()
    out = generate(sch, S, eta, x_T=x_T)
    print(f"{name:22s} {time.time() - t0:6.2f}s")
    for col, img in enumerate(out.permute(0, 2, 3, 1).cpu().numpy()):
        axes[row, col].imshow(img); axes[row, col].axis("off")
    axes[row, 0].set_title(name, fontsize=9, loc="left")

plt.tight_layout()
plt.show()
スクラッチ実装と対応させると、diffusers のAPIが何をしているかが明確になります。
- DDPMScheduler → DDIMScheduler の差し替えだけ: モデル定義も訓練ループも1文字も変わっていません。変わったのは生成用スケジューラのクラス名だけです。「再学習は不要」という論文の主張が、そのままAPIの設計に反映されています。
- eta 引数: scheduler.step(..., eta=0.0) が前述した制御パラメータ そのものです。スクラッチ実装の sigma_tau() に相当する計算がライブラリ内部で行われています。eta=1.0 かつ set_timesteps(1000) にすれば、DDPMScheduler と数値的に一致します(float32の精度で 程度)。
- set_alpha_to_one=True: 論文の の実装です。ライブラリ内部では final_alpha_cumprod という値になり、最終ステップで「予測された をそのまま出す」挙動を実現します。スクラッチ実装で ab_prev = 1.0 としていた分岐と同じものです。
- timestep_spacing: サンプリング軌跡 の選び方です。既定の "leading" は のような等間隔となり、論文の linear に対応します。論文の quadratic に相当する選択肢は用意されていないため、それを試したい場合はスクラッチ実装の make_tau を使うか、scheduler.timesteps を直接上書きしてください。
- 比較の条件: ステップ数を1000・50・20・10、 を0と1にするのは、ステップ数を減らしたときの画質の落ち方と、決定論的な生成と確率的な生成の違いを、同じ初期ノイズ(シード1234)で比べるためです。
- clip_sample: スクラッチ実装の sample() の中で行っていた x0_pred = (...).clamp(-1, 1) と同じで、予測された を に制限します。既定値が True であるため、数式どおりの挙動を確認したい場合や、次に述べるInversionを行う場合は明示的に False にする必要があります。
実行結果
Epoch 1000/10000 - Loss: 0.0122
Epoch 2000/10000 - Loss: 0.0031
Epoch 3000/10000 - Loss: 0.0133
Epoch 4000/10000 - Loss: 0.0027
Epoch 5000/10000 - Loss: 0.0019
Epoch 6000/10000 - Loss: 0.0017
Epoch 7000/10000 - Loss: 0.0025
Epoch 8000/10000 - Loss: 0.0034
Epoch 9000/10000 - Loss: 0.0009
Epoch 10000/10000 - Loss: 0.0012
DDPM  S=1000            20.89s
DDIM  S=50  (eta=0)      1.03s
DDIM  S=20  (eta=0)      0.41s
DDIM  S=10  (eta=0)      0.21s
DDIM  S=50  (eta=1)      1.02s
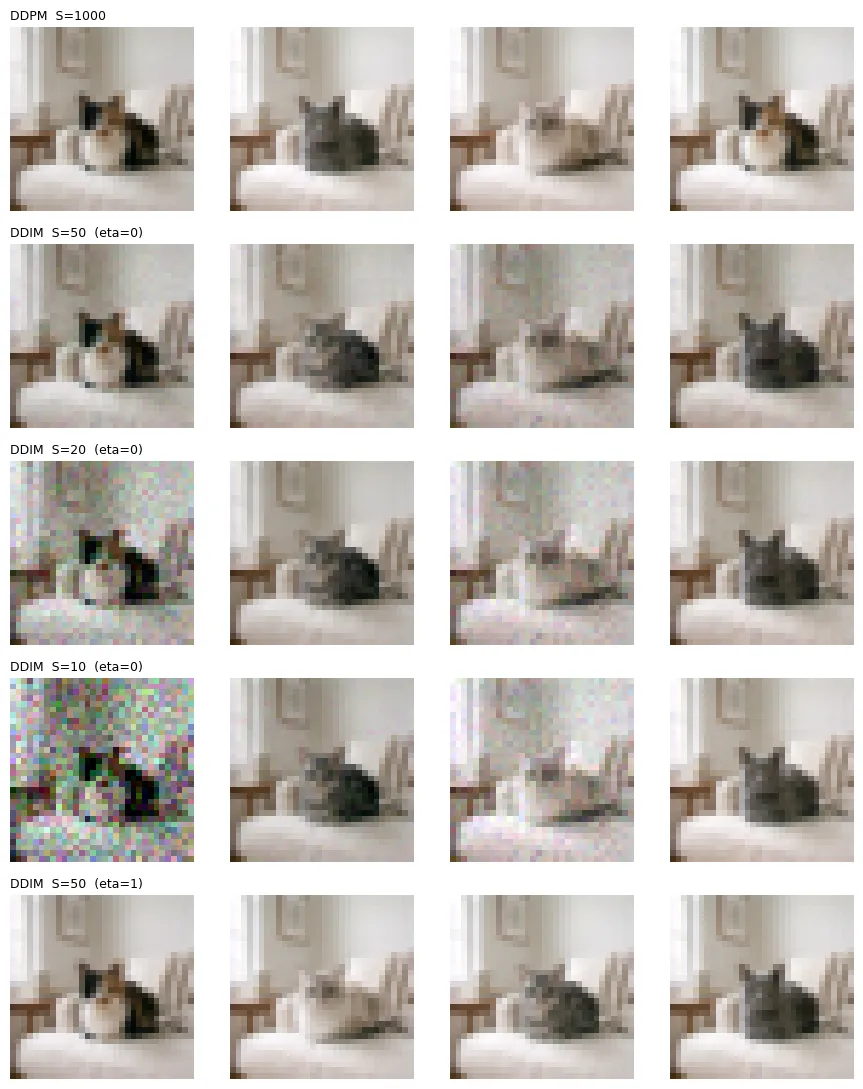 ログからもわかるように、50ステップのDDIMはDDPMの約20倍、10ステップのDDIMでは約100倍の高速化を達成しています。また、S=50 で eta=1 としたDDIMの結果はDDPMとほぼ同じ画像が得られています。S=50 で eta=0 の場合は決定論的なサンプリングとなり、推論ごとの予測誤差がランダムノイズで上書きされずにそのまま蓄積されやすいため若干のノイズが残りますが、学習データである猫の特徴はしっかりと保持されています。
設定ごとの生成の時間を並べると、次のようになります。
(図は、diagram-designで作成)
DDIM Inversion(DDIMInverseScheduler)
diffusers には、時間を逆向きに回すための専用スケジューラが用意されています。
from diffusers import DDIMInverseScheduler

# 【重要】Inversion と再構成の両方で clip_sample=False にする
inverse_scheduler = DDIMInverseScheduler(
    **sched_kwargs, clip_sample=False, set_alpha_to_one=True)
recon_scheduler = DDIMScheduler(
    **sched_kwargs, clip_sample=False, set_alpha_to_one=True)

@torch.no_grad()
def invert(x0, steps):
    """実画像 x_0 を潜在変数 x_T にエンコードする"""
    model.eval()
    inverse_scheduler.set_timesteps(steps)
    sample = x0.clone()
    # timesteps は昇順(0 -> 980)になっている
    for t in inverse_scheduler.timesteps:
        # ノイズを予測
        residual = model(sample, t).sample
        # 時間を逆行して(登って)いく
        sample = inverse_scheduler.step(residual, t, sample).prev_sample
    return sample

@torch.no_grad()
def reconstruct(latent, steps):
    """潜在変数 x_T から画像を復元する"""
    model.eval()
    recon_scheduler.set_timesteps(steps)
    sample = latent.clone()
    # timesteps は降順(980 -> 0)になっている
    for t in recon_scheduler.timesteps:
        # ノイズを予測
        residual = model(sample, t).sample
        # 決定論的(eta=0.0)に画像を再構成
        sample = recon_scheduler.step(residual, t, sample, eta=0.0).prev_sample
    return sample

print("--- 再構成誤差(ピクセルあたりMSE、[0,1]スケール) ---")
for S in [10, 20, 50, 100]:
    latent = invert(x_0, S)
    rec = reconstruct(latent, S)
    err = F.mse_loss(rec / 2, x_0 / 2).item()
    print(f"S={S:4d}  error = {err:.6f}")

# 元画像と再構成結果を並べて表示
latent = invert(x_0, 100)
rec = reconstruct(latent, 100).clamp(-1, 1)
fig, axes = plt.subplots(2, 4, figsize=(10, 5))
for col in range(4):
    axes[0, col].imshow(((x_0[col] + 1) / 2).permute(1, 2, 0).cpu().numpy())
    axes[0, col].axis("off"); axes[0, col].set_title("original", fontsize=9)
    axes[1, col].imshow(((rec[col] + 1) / 2).permute(1, 2, 0).cpu().numpy())
    axes[1, col].axis("off"); axes[1, col].set_title("reconstructed", fontsize=9)
plt.tight_layout(); plt.show()
- ステップ数: 10・20・50・100ステップで比べるのは、ステップ数を増やすほど、反転して再生成した画像が元の画像に近づくかを見るためです。
- DDIMInverseScheduler の役割: timesteps が昇順()になっており、スクラッチ実装の sample() とはちょうど逆向きに「 から へ登っていく」ループになります。これは「決定論的な常微分方程式(ODE)の軌道を逆向きに辿る」操作の実装です。
- clip_sample=False が必須: スクラッチ実装の sample() では画質を安定させるために毎ステップ をクリップしていましたが、Inversionではそのクリップが致命傷になります。クリップを有効にしたままだと写像が非可逆になり、再構成誤差がステップ数を増やしても下がらなくなります。この設定を忘れることが、DDIM Inversionが「なぜか効かない」最も多い原因です。
- 実応用への接続: この「実画像 → 潜在変数 → 編集 → 再生成」という流れは、diffusers の StableDiffusionPix2PixZeroPipeline などの画像編集パイプラインで実際に使われています。次のStable Diffusionの記事で扱う潜在空間と組み合わせることで、実写真の編集が実現されます。
diffusers 側の学習(10000エポック)はL4でおよそ12分、A100なら5分程度です。スクラッチ実装と合わせても、全体でL4で25分前後、A100なら10分前後で最後まで実行できます。
1000ステップのDDPMが約20.89秒かかるのに対し、50ステップのDDIMは約1.03秒(約20倍の高速化)、10ステップなら約0.21秒(約100倍)です。それでいて の行の画像は、学習データの猫の特徴を保っています。
diffusers を使った実装でも、スクラッチ実装と同じ挙動・同じオーダーの数値が得られることが確認できます。ライブラリは係数計算を隠蔽してくれますが、、、クリップの有無といった論文由来のパラメータがそのまま引数として露出しているため、理論を理解していれば挙動を完全にコントロールできます。
実行結果
--- 再構成誤差(ピクセルあたりMSE、[0,1]スケール) ---
S=  10  error = 0.002305
S=  20  error = 0.000744
S=  50  error = 0.000203
S= 100  error = 0.000069
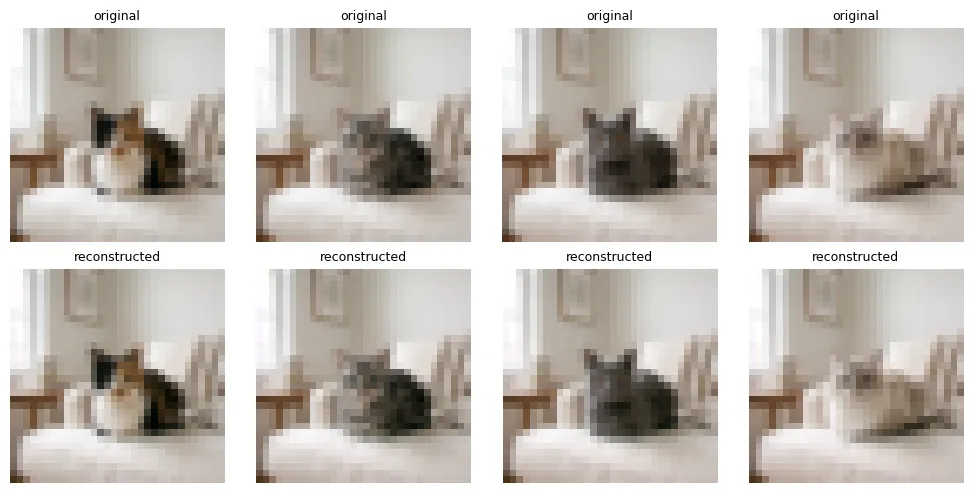
結果からわかるように、再構成誤差はサンプリングのステップ数を増やすほど小さくなります。再構成された画像は元画像とほぼ同一であり、DDIM Inversionによる「実画像から潜在変数へのエンコード」と「潜在変数からの画像の復元」が正しく機能していることが確認できます。
さらに試してみる
- eta を0.0から1.0まで0.2刻みで変えながら で生成すると、決定論的なDDIMから確率的なDDPMへ品質が連続的に変化する様子を観察できます。少ないステップ数ほど、 を上げるにつれて画像が崩れていくはずです。
- スクラッチ実装の make_tau で schedule="linear" と "quadratic" を比べると、低解像度画像では quadratic が有利という論文 Appendix D.2 の選択理由を体感できます。
- invert() で2枚の実画像を潜在変数に変換し、その2つの潜在変数を球面線形補間(Slerp)で繋いでから reconstruct() に通すと、ランダムノイズ同士ではなく実画像同士のモーフィングができます。これは画像編集手法の基本形です。
ステップ数ごとの再構成の誤差を並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、DDPMの最大の弱点であった「生成速度の遅さ」を、目的関数やモデル構造を変えることなく、サンプリング(推論プロセス)の数式を工夫することで克服した DDIM (Denoising Diffusion Implicit Models) について、理論からスクラッチ実装、さらに diffusers ライブラリを用いた実践までを解説しました。
記事を通じて、以下の重要な概念と実装手法を学習しました。
- マルコフ連鎖からの脱却: 非マルコフ的な推論プロセスを導入しても最適化すべき目的関数はDDPMと一致する(論文 Theorem 1)ため、学習済みのDDPMモデルを再学習なしでそのまま流用できることをコード上で確認しました。
- による連続的な制御: で決定論的なDDIM、 で確率的なDDPMへと切り替わる仕組みを実装し、DDIMとDDPMが別々のモデルではなく、単一のネットワークに対する「ノイズスケジューラ(サンプラー)の選択の違い」にすぎないことを検証しました。
- 劇的な高速化: サンプリング軌跡 を間引くことで、1000ステップを要するDDPMに対して、DDIMは50ステップ(約20倍)や10ステップ(約100倍)という少ないステップ数でも、画像の特徴を維持したまま大幅な高速化を達成できることを実測しました。
- 潜在空間での一貫性と再構成: 決定論的プロセスを用いることで、初期ノイズ を固定すればステップ数を変えても生成画像の特徴が一貫すること、さらに DDIM Inversion を用いて実画像を潜在変数へエンコードし、高精度で元の画像を再構成できることを確認しました。
- 実践への応用: スクラッチ実装で学んだ内部構造が、Hugging Face の diffusers ライブラリの DDIMScheduler や DDIMInverseScheduler といったAPI設計にそのまま反映されていることを理解しました。
DDIMによる「サンプリングステップ数の劇的な削減」と、のちの Stable Diffusion(LDM) がもたらす「潜在空間への圧縮による計算次元の削減」という2つのイノベーションが合わさることで、生成AIは研究室から飛び出し、個人PCのGPUでも数秒で高解像度画像を生成できる現代の実用的な基盤へと進化しました。
参考文献
- J. Song, C. Meng, S. Ermon (2021). Denoising Diffusion Implicit Models. ICLR 2021.
本記事の文章・構成の一部に生成AIを使用しています。