メインコンテンツまでスキップ

DDIMの目的関数がDDPMと一致することの数学的証明(Theorem 1)
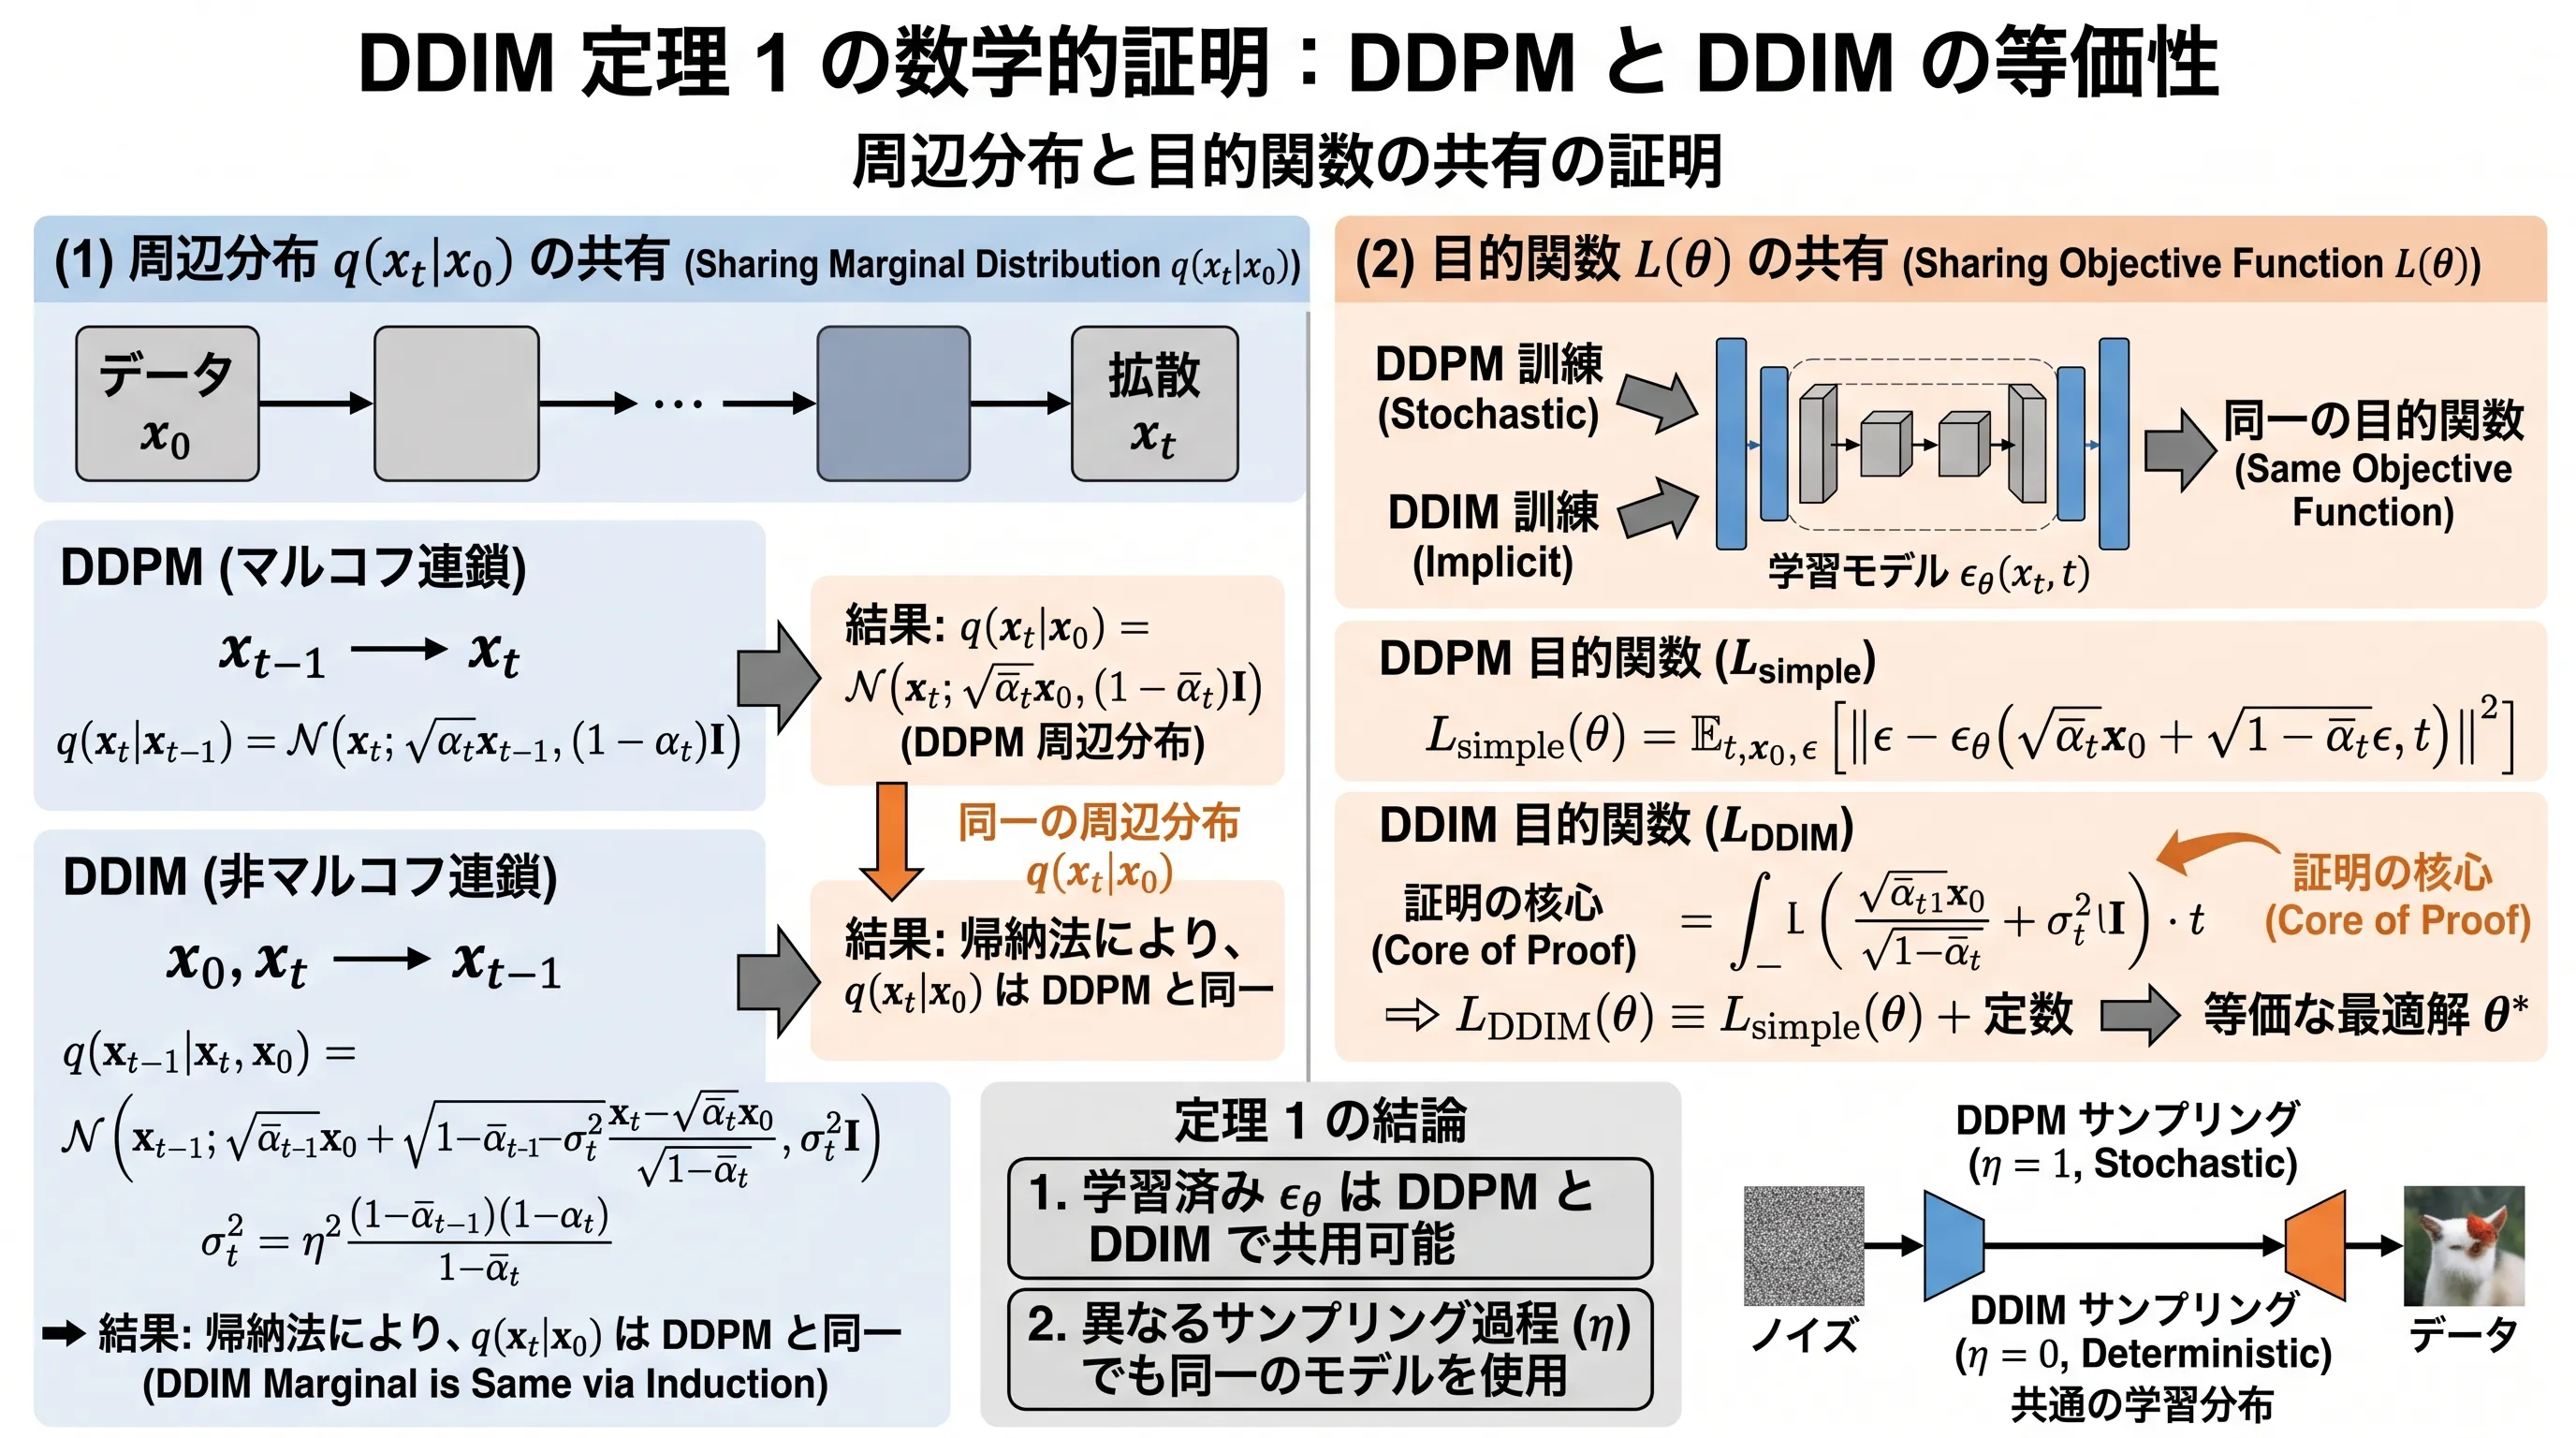
概要 (画像は、Geminiで作成)

💡この記事のゴール

DDIM の非マルコフ的な推論過程が DDPM と同じ周辺分布を持つことを確かめ、その変分目的関数 JσJ_\sigma を展開すると、DDPM と同じノイズ予測の誤差の和に帰着すること(論文の Theorem 1)を、式を追って説明できるようになること。そこから、学習済みの DDPM をそのまま使える理由と、σ=0\sigma = 0 にするとステップを大きく飛ばせる理由を理解すること。

概要と全体像​

備考

DDPMの基礎知識がない方は、先にDDPM(Denoising Diffusion Probabilistic Models)とは?の記事を読んでおくことをおすすめします。

DDPM(Denoising Diffusion Probabilistic Models)では、データ分布に徐々にノイズを加える「マルコフ連鎖」として順過程を定義し、その逆過程を学習することで画像を生成します。

DDPMは、モデルの学習時においては数式を使って任意のステップのノイズ画像を「一足飛び(一発)」で計算できるため効率的ですが、いざ新しい画像を生成(推論)する際には、マルコフ連鎖の制約から完全なノイズから1ステップずつ順番にループを回してノイズを除去していくしかなく、これが生成速度を圧倒的に遅くしている元凶でした。

この生成時のループをスキップ(高速化)するために、DDIM(Denoising Diffusion Implicit Models)の論文は「マルコフ連鎖ではない(非マルコフ的な)生成プロセス」を提案しました。通常、生成(逆)プロセスを変えればそれに対応する順過程も変わり、結果としてモデルの再学習が必要になります。しかし論文の最大の発見は、順過程が非マルコフ的であっても、周辺分布 q(xt∣x0)q(\mathbf{x}_t \vert{} \mathbf{x}_0) さえDDPMと一致していれば、学習すべき目的関数はDDPMと全く同じになるという事実(Theorem 1)です。

本記事では、このTheorem 1がどのように導出されるのか、その数学的な証明のプロセスをステップ・バイ・ステップで解説します。 この証明により、「なぜDDIMでは、推論プロセスを非マルコフ化して大幅に高速化したにもかかわらず、DDPMで学習済みのモデル(U-Net)をそのまま再学習なしで流用できるのか」という根本的な理由が明らかになります。

証明の流れを図にまとめると、次のようになります。
Theorem 1 の証明の流れ。1 周辺分布 q(x_t|x_0) を DDPM と同じにしたまま、x_0 にも依存する非マルコフの推論過程 q_σ を定義する。2 負の対数尤度の上界 J_σ を、時刻ごとの KL ダイバージェンスに分ける。3 ガウス分布どうしの KL は平均の二乗誤差になる。4 平均の差はノイズの差 ε − ε_θ の定数倍になる。5 J_σ = L_γ + C となり、L_γ の最適解は重み γ によらないので、DDPM の L_1 で学習したモデルをそのまま使えるTheorem 1 の証明の流れ。1 周辺分布 q(x_t|x_0) を DDPM と同じにしたまま、x_0 にも依存する非マルコフの推論過程 q_σ を定義する。2 負の対数尤度の上界 J_σ を、時刻ごとの KL ダイバージェンスに分ける。3 ガウス分布どうしの KL は平均の二乗誤差になる。4 平均の差はノイズの差 ε − ε_θ の定数倍になる。5 J_σ = L_γ + C となり、L_γ の最適解は重み γ によらないので、DDPM の L_1 で学習したモデルをそのまま使える

(図は、diagram-designで作成)

DDPMの周辺分布と非マルコフ推論過程の定義​

DDPMにおけるタイムステップ tt の周辺分布(初期画像 x0\mathbf{x}_0 から一気に xt\mathbf{x}_t を求める分布)は、次のようなガウス分布として定義されています。

q(xt∣x0)=N(xt;αˉtx0,(1−αˉt)I)q(\mathbf{x}_t \vert \mathbf{x}_0) = \mathcal{N}(\mathbf{x}_t; \sqrt{\bar{\alpha}_t} \mathbf{x}_0, (1 - \bar{\alpha}_t) \mathbf{I})
補足:なぜ x0\mathbf{x}_0 から xt\mathbf{x}_t を一発で計算できるのか?

DDPMにおける1ステップのノイズ付加(順過程)は以下の式で定義されます。

q(xt∣xt−1)=N(xt;αtxt−1,(1−αt)I)q(\mathbf{x}_t \vert \mathbf{x}_{t-1}) = \mathcal{N}(\mathbf{x}_t; \sqrt{\alpha_t} \mathbf{x}_{t-1}, (1 - \alpha_t) \mathbf{I})

これは「xt\mathbf{x}_t が、平均 αtxt−1\sqrt{\alpha_t} \mathbf{x}_{t-1}、分散 (1−αt)I(1 - \alpha_t)\mathbf{I} の正規分布に従う」ということを意味しています。 ある正規分布からのサンプリングは、「平均値」に対して「標準正規分布 N(0,I)\mathcal{N}(\mathbf{0}, \mathbf{I}) のノイズ(偏差)に標準偏差を掛けたもの」を足し合わせる形に変換できます(これを専門用語でリパラメトリゼーショントリックと呼びます)。

したがって、標準正規分布からサンプリングしたノイズを ϵt−1∼N(0,I)\boldsymbol{\epsilon}_{t-1} \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) とすると、xt\mathbf{x}_t は次のような計算式で直接表せます。

xt=αtxt−1+1−αtϵt−1\mathbf{x}_t = \sqrt{\alpha_t} \mathbf{x}_{t-1} + \sqrt{1 - \alpha_t} \boldsymbol{\epsilon}_{t-1}

同様に、xt−1\mathbf{x}_{t-1} も xt−2\mathbf{x}_{t-2} を用いて表せます。

xt−1=αt−1xt−2+1−αt−1ϵt−2\mathbf{x}_{t-1} = \sqrt{\alpha_{t-1}} \mathbf{x}_{t-2} + \sqrt{1 - \alpha_{t-1}} \boldsymbol{\epsilon}_{t-2}

これを xt\mathbf{x}_t の式に代入すると:

xt=αt(αt−1xt−2+1−αt−1ϵt−2)+1−αtϵt−1\mathbf{x}_t = \sqrt{\alpha_t} \left( \sqrt{\alpha_{t-1}} \mathbf{x}_{t-2} + \sqrt{1 - \alpha_{t-1}} \boldsymbol{\epsilon}_{t-2} \right) + \sqrt{1 - \alpha_t} \boldsymbol{\epsilon}_{t-1}
xt=αtαt−1xt−2+αt(1−αt−1)ϵt−2+1−αtϵt−1\mathbf{x}_t = \sqrt{\alpha_t \alpha_{t-1}} \mathbf{x}_{t-2} + \sqrt{\alpha_t (1 - \alpha_{t-1})} \boldsymbol{\epsilon}_{t-2} + \sqrt{1 - \alpha_t} \boldsymbol{\epsilon}_{t-1}

ここで、互いに独立な正規分布の和の性質(N(0,σ12I)+N(0,σ22I)=N(0,(σ12+σ22)I)\mathcal{N}(0, \sigma_1^2 \mathbf{I}) + \mathcal{N}(0, \sigma_2^2 \mathbf{I}) = \mathcal{N}(0, (\sigma_1^2 + \sigma_2^2)\mathbf{I}))を利用すると、後ろの2つのノイズ項は1つのノイズ ϵ′∼N(0,I)\boldsymbol{\epsilon}' \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) にまとめることができます。

分散の和は αt(1−αt−1)+(1−αt)=αt−αtαt−1+1−αt=1−αtαt−1\alpha_t (1 - \alpha_{t-1}) + (1 - \alpha_t) = \alpha_t - \alpha_t \alpha_{t-1} + 1 - \alpha_t = 1 - \alpha_t \alpha_{t-1} となるため、式は次のように簡略化されます。

xt=αtαt−1xt−2+1−αtαt−1ϵ′\mathbf{x}_t = \sqrt{\alpha_t \alpha_{t-1}} \mathbf{x}_{t-2} + \sqrt{1 - \alpha_t \alpha_{t-1}} \boldsymbol{\epsilon}'

この代入操作を x0\mathbf{x}_0 まで再帰的に繰り返すと、αˉt=∏s=1tαs\bar{\alpha}_t = \prod_{s=1}^t \alpha_s と置くことで、最終的に以下の式が得られます。

xt=αˉtx0+1−αˉtϵ\mathbf{x}_t = \sqrt{\bar{\alpha}_t} \mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_t} \boldsymbol{\epsilon}

これが、任意のステップ tt の状態を x0\mathbf{x}_0 から一発で計算できる周辺分布 q(xt∣x0)=N(xt;αˉtx0,(1−αˉt)I)q(\mathbf{x}_t \vert \mathbf{x}_0) = \mathcal{N}(\mathbf{x}_t; \sqrt{\bar{\alpha}_t} \mathbf{x}_0, (1 - \bar{\alpha}_t) \mathbf{I}) の正体です。

DDIMの著者らは、この周辺分布だけはDDPMと同じに保ちつつ、同時分布(推論過程全体) qσ(x1:T∣x0)q_\sigma(\mathbf{x}_{1:T} \vert{} \mathbf{x}_0) をマルコフ連鎖に縛られない別の形で再定義しました。

具体的には、確率の連鎖律を利用して、逆順の条件付き分布の積として同時分布を定義します。

qσ(x1:T∣x0)=qσ(xT∣x0)∏t=2Tqσ(xt−1∣xt,x0)q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0) = q_\sigma(\mathbf{x}_T \vert \mathbf{x}_0) \prod_{t=2}^T q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)

ここで、qσ(xT∣x0)=N(αˉTx0,(1−αˉT)I)q_\sigma(\mathbf{x}_T \vert \mathbf{x}_0) = \mathcal{N}(\sqrt{\bar{\alpha}_T}\mathbf{x}_0, (1 - \bar{\alpha}_T)\mathbf{I}) とし、各ステップの条件付き逆過程 qσ(xt−1∣xt,x0)q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) を次のようなガウス分布で定義します。

qσ(xt−1∣xt,x0)=N(xt−1;μ~t(xt,x0),σt2I)q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) = \mathcal{N}(\mathbf{x}_{t-1}; \tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \mathbf{x}_0), \sigma_t^2 \mathbf{I})

その平均 μ~t\tilde{\boldsymbol{\mu}}_t は、周辺分布の整合性を保つために以下のように定義されます。

μ~t(xt,x0)=αˉt−1x0+1−αˉt−1−σt2xt−αˉtx01−αˉt\tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \mathbf{x}_0) = \sqrt{\bar{\alpha}_{t-1}} \mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_{t-1} - \sigma_t^2} \frac{\mathbf{x}_t - \sqrt{\bar{\alpha}_t} \mathbf{x}_0}{\sqrt{1 - \bar{\alpha}_t}}

この定義は任意の分散パラメータ σt\sigma_t に対して成立するため、σ\sigma ベクトルによって無数の推論プロセス(非マルコフ過程)を構築できることになります。

補足:なぜこの式になるのか?(導出過程)

この μ~t\tilde{\boldsymbol{\mu}}_t の式は、 「ステップ t−1t-1 の周辺分布を DDPM と一致させるための逆算」 によって導き出されています。

1. 満たすべき条件(ゴール)
DDIMの目的は、推論プロセスを非マルコフにしても「周辺分布 q(xt∣x0)q(\mathbf{x}_t \vert \mathbf{x}_0) をDDPMと全く同じに保つ」ことです。つまり、ステップ t−1t-1 は以下の関係を満たす必要があります。

xt−1=αˉt−1x0+1−αˉt−1ϵ∗(ϵ∗∼N(0,I))\mathbf{x}_{t-1} = \sqrt{\bar{\alpha}_{t-1}} \mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_{t-1}} \boldsymbol{\epsilon}^* \quad (\boldsymbol{\epsilon}^* \sim \mathcal{N}(0, \mathbf{I}))

2. xt\mathbf{x}_t に含まれるノイズの逆算
ステップ tt の定義式 xt=αˉtx0+1−αˉtϵ\mathbf{x}_t = \sqrt{\bar{\alpha}_t} \mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_t} \boldsymbol{\epsilon} を変形すると、xt\mathbf{x}_t の生成に使われたノイズ ϵ\boldsymbol{\epsilon} は次のように逆算できます。

ϵ=xt−αˉtx01−αˉt\boldsymbol{\epsilon} = \frac{\mathbf{x}_t - \sqrt{\bar{\alpha}_t} \mathbf{x}_0}{\sqrt{1 - \bar{\alpha}_t}}

3. xt−1\mathbf{x}_{t-1} の再構築
xt−1\mathbf{x}_{t-1} を生成するために、①ゴールとなる x0\mathbf{x}_0 の成分、②ステップ tt の方向成分 kϵk\boldsymbol{\epsilon}、③ランダムなノイズ σtϵt\sigma_t \boldsymbol{\epsilon}_t の3つを足し合わせて構築することを考えます。

xt−1=αˉt−1x0+kϵ+σtϵt\mathbf{x}_{t-1} = \sqrt{\bar{\alpha}_{t-1}} \mathbf{x}_0 + k \boldsymbol{\epsilon} + \sigma_t \boldsymbol{\epsilon}_t

4. 係数 kk の決定
ϵ\boldsymbol{\epsilon} と ϵt\boldsymbol{\epsilon}_t は独立した標準正規ノイズのため、後ろ2項の分散は k2+σt2k^2 + \sigma_t^2 となります。これが全体の分散 1−αˉt−11 - \bar{\alpha}_{t-1} と一致しなければならないため、

k2+σt2=1−αˉt−1  ⟹  k=1−αˉt−1−σt2k^2 + \sigma_t^2 = 1 - \bar{\alpha}_{t-1} \implies k = \sqrt{1 - \bar{\alpha}_{t-1} - \sigma_t^2}

5. 式の完成
求めた kk と、逆算した ϵ\boldsymbol{\epsilon} を代入すると以下のようになります。

xt−1=αˉt−1x0+1−αˉt−1−σt2xt−αˉtx01−αˉt⏟平均 μ~t+σtϵt⏟確率的ノイズ\mathbf{x}_{t-1} = \underbrace{\sqrt{\bar{\alpha}_{t-1}} \mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_{t-1} - \sigma_t^2} \frac{\mathbf{x}_t - \sqrt{\bar{\alpha}_t} \mathbf{x}_0}{\sqrt{1 - \bar{\alpha}_t}}}_{\text{平均 } \tilde{\boldsymbol{\mu}}_t} + \underbrace{\sigma_t \boldsymbol{\epsilon}_t}_{\text{確率的ノイズ}}

この確定的な部分(ノイズ以外の部分)が、そのまま μ~t\tilde{\boldsymbol{\mu}}_t の定義となっています。

DDPM と DDIM の推論過程の依存関係を図にすると、次のようになります。
DDPM と DDIM の推論過程の違い。DDPM の順過程は、x_t が直前の x_t−1 だけに依存するマルコフ連鎖。DDIM の推論過程 q_σ(x_t−1|x_t, x_0) は、x_t と元のデータ x_0 の両方に依存する非マルコフの過程。どちらも周辺分布 q(x_t|x_0) = N(√ᾱ_t x_0, (1 − ᾱ_t) I) は同じになるように作られている。この共通の周辺分布が、学習済みのモデルを共有できる理由DDPM と DDIM の推論過程の違い。DDPM の順過程は、x_t が直前の x_t−1 だけに依存するマルコフ連鎖。DDIM の推論過程 q_σ(x_t−1|x_t, x_0) は、x_t と元のデータ x_0 の両方に依存する非マルコフの過程。どちらも周辺分布 q(x_t|x_0) = N(√ᾱ_t x_0, (1 − ᾱ_t) I) は同じになるように作られている。この共通の周辺分布が、学習済みのモデルを共有できる理由

(図は、diagram-designで作成)

変分目的関数 JσJ_\sigma の導出とKLダイバージェンスの展開​

生成モデル pθ(x0:T)p_\theta(\mathbf{x}_{0:T}) を学習するには、本来はデータの対数尤度 log⁡pθ(x0)\log p_\theta(\mathbf{x}_0) を最大化したいのですが、これは直接計算できません。そこで、対数尤度の下界(ELBO)を求め、その符号を反転した 「負の対数尤度の上界」を最小化するという方針を取ります。 新しく定義した推論過程 qσq_\sigma に基づくこの上界を JσJ_\sigma と書くと、次のようになります。

Jσ=Ex0:T∼qσ[log⁡qσ(x1:T∣x0)−log⁡pθ(x0:T)]J_\sigma = \mathbb{E}_{\mathbf{x}_{0:T} \sim q_\sigma} \left[ \log q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0) - \log p_\theta(\mathbf{x}_{0:T}) \right]
補足:なぜ変分下界(ELBO)を導入するのか?

しかし、データ x0\mathbf{x}_0 に対する負の対数尤度 −log⁡pθ(x0)-\log p_\theta(\mathbf{x}_0) を直接計算・最小化することは困難です。 モデルの生成過程は最終的な x0\mathbf{x}_0 だけでなく、そこに至るまでの無数のノイズ状態(潜在変数) x1:T\mathbf{x}_{1:T} を経由するため、以下の式のようにすべての可能な経路を考慮した積分(周辺化)が必要になるからです。

log⁡pθ(x0)=log⁡∫pθ(x0:T)dx1:T\log p_\theta(\mathbf{x}_0) = \log \int p_\theta(\mathbf{x}_{0:T}) d\mathbf{x}_{1:T}

数学や機械学習の解析において、このように対数関数の内側に積分や総和が含まれる形(log⁡∫f(x)dx\log \int f(x) dx)は非常に扱いづらいとされています。対数の内側で足し合わせが行われていると、各変数に関する項を独立して分解することができず、解析的に数式を解くことができないためです。また、高次元の潜在空間ですべての経路を計算することも現実的ではありません。

そこで、この複雑な積分を回避するため、推論過程の確率分布 qσ(x1:T∣x0)q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0) を分母と分子に掛け合わせ、積分の式を期待値の形に書き換えます。

log⁡pθ(x0)=log⁡∫qσ(x1:T∣x0)pθ(x0:T)qσ(x1:T∣x0)dx1:T=log⁡Eqσ(x1:T∣x0)[pθ(x0:T)qσ(x1:T∣x0)]\begin{aligned} \log p_\theta(\mathbf{x}_0) &= \log \int q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0) \frac{p_\theta(\mathbf{x}_{0:T})}{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} d\mathbf{x}_{1:T} \\ &= \log \mathbb{E}_{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \left[ \frac{p_\theta(\mathbf{x}_{0:T})}{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \right] \end{aligned}

ここで、対数関数(log⁡\log)は上に凸な関数です。そのため、イェンゼンの不等式(Jensen's Inequality)log⁡E[f(x)]≥E[log⁡f(x)]\log \mathbb{E}[f(x)] \geq \mathbb{E}[\log f(x)] を適用して、期待値と対数の順序を入れ替えます。 これにより対数が式の内側に入るため、数式の展開(分解)が可能になり、計算可能な対数尤度の下界(変分下界:ELBO)が得られます。

log⁡pθ(x0)≥Eqσ(x1:T∣x0)[log⁡pθ(x0:T)qσ(x1:T∣x0)]\log p_\theta(\mathbf{x}_0) \geq \mathbb{E}_{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \left[ \log \frac{p_\theta(\mathbf{x}_{0:T})}{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \right]

この不等式は、特定の1つのデータ点 x0\mathbf{x}_0 に対する対数尤度の下界を示しています。しかし、モデルの学習において最小化したいのは、特定の1点に対する誤差ではなく、データセット全体(すなわちデータ分布 q(x0)q(\mathbf{x}_0))にわたる平均的な負の対数尤度です。

そのため、まず両辺にマイナスを掛けて不等号の向きを反転させた上で、データ分布 q(x0)q(\mathbf{x}_0) の下での期待値 Eq(x0)\mathbb{E}_{q(\mathbf{x}_0)} を取ります。

Eq(x0)[−log⁡pθ(x0)]≤Eq(x0)[Eqσ(x1:T∣x0)[−log⁡pθ(x0:T)qσ(x1:T∣x0)]]\mathbb{E}_{q(\mathbf{x}_0)}[-\log p_\theta(\mathbf{x}_0)] \leq \mathbb{E}_{q(\mathbf{x}_0)} \left[ \mathbb{E}_{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \left[ -\log \frac{p_\theta(\mathbf{x}_{0:T})}{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \right] \right]

確率の乗法定理 qσ(x0:T)=q(x0)qσ(x1:T∣x0)q_\sigma(\mathbf{x}_{0:T}) = q(\mathbf{x}_0) q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0) から、右辺のデータ分布 q(x0)q(\mathbf{x}_0) と条件付き推論過程 qσ(x1:T∣x0)q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0) の二重の期待値は、データとすべてのノイズ状態の同時分布 qσ(x0:T)q_\sigma(\mathbf{x}_{0:T}) による期待値として、以下のように1つにまとめることができます。

Eq(x0)[−log⁡pθ(x0)]≤Eqσ(x0:T)[−log⁡pθ(x0:T)qσ(x1:T∣x0)]\mathbb{E}_{q(\mathbf{x}_0)}[-\log p_\theta(\mathbf{x}_0)] \leq \mathbb{E}_{q_\sigma(\mathbf{x}_{0:T})} \left[ -\log \frac{p_\theta(\mathbf{x}_{0:T})}{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \right]

これによって、左辺(本来最小化したい、データセット全体の平均的な負の対数尤度)を間接的に最小化するための、計算可能な上界が得られます。これが JσJ_\sigma の正体です。対数尤度の側から見れば変分下界(ELBO)にあたるものを、損失として扱うために符号を反転したもの、と理解してください。

Jσ=Eqσ(x0:T)[−log⁡pθ(x0:T)qσ(x1:T∣x0)]=Eqσ(x0:T)[log⁡qσ(x1:T∣x0)−log⁡pθ(x0:T)]\begin{aligned} J_\sigma &= \mathbb{E}_{q_\sigma(\mathbf{x}_{0:T})} \left[ -\log \frac{p_\theta(\mathbf{x}_{0:T})}{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \right] \\ &= \mathbb{E}_{q_\sigma(\mathbf{x}_{0:T})} \left[ \log q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0) - \log p_\theta(\mathbf{x}_{0:T}) \right] \end{aligned}

生成過程 pθp_\theta も逆向きのマルコフ連鎖 pθ(x0:T)=p(xT)∏t=1Tpθ(xt−1∣xt)p_\theta(\mathbf{x}_{0:T}) = p(\mathbf{x}_T) \prod_{t=1}^T p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t) として定義します。これを代入し、KLダイバージェンスの形に整理すると、DDPMのときと同様に各ステップごとの和に分解できます。

Jσ=Eqσ[DKL(qσ(xT∣x0)∥p(xT))+∑t=2TDKL(qσ(xt−1∣xt,x0)∥pθ(xt−1∣xt))−log⁡pθ(x0∣x1)]J_\sigma = \mathbb{E}_{q_\sigma} \left[ D_{\text{KL}}(q_\sigma(\mathbf{x}_T \vert \mathbf{x}_0) \parallel p(\mathbf{x}_T)) + \sum_{t=2}^T D_{\text{KL}}(q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) \parallel p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)) - \log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) \right]
補足:JσJ_\sigma の各タイムステップへの分解プロセス

JσJ_\sigma の定義式の中身にある分数(対数の引数) pθ(x0:T)qσ(x1:T∣x0)\frac{p_\theta(\mathbf{x}_{0:T})}{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} を分解していきます。

Step 1: 連鎖律による同時分布の分解​

生成過程(逆過程)は、DDPMと同じく逆向きのマルコフ連鎖として定義されているため、そのまま積に分解できます。

生成過程:

pθ(x0:T)=p(xT)∏t=1Tpθ(xt−1∣xt)p_\theta(\mathbf{x}_{0:T}) = p(\mathbf{x}_T) \prod_{t=1}^T p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)

一方、推論過程 qσq_\sigma はマルコフ連鎖ではありません。ただし、その定義(qσ(xt−1∣xt,x0)q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) の積)から、xt\mathbf{x}_t と x0\mathbf{x}_0 さえ分かれば xt+1\mathbf{x}_{t+1} 以降の情報は xt−1\mathbf{x}_{t-1} の決定に不要であることがわかります。つまり「x0\mathbf{x}_0 を与えたうえでの連鎖」にはなっているため、連鎖律により次のように分解できます。

推論過程:

qσ(x1:T∣x0)=∏t=1Tqσ(xt∣xt−1,x0)q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0) = \prod_{t=1}^T q_\sigma(\mathbf{x}_t \vert \mathbf{x}_{t-1}, \mathbf{x}_0)

ここが、DDPMの導出と決定的に異なる点です。DDPMではマルコフ性によって q(xt∣xt−1,x0)=q(xt∣xt−1)q(\mathbf{x}_t \vert \mathbf{x}_{t-1}, \mathbf{x}_0) = q(\mathbf{x}_t \vert \mathbf{x}_{t-1}) と条件から x0\mathbf{x}_0 を落とせましたが、DDIMの qσq_\sigma ではこれができません。条件に x0\mathbf{x}_0 が残り続けること、これが「非マルコフである」ということの数式上の正体です。 以降の展開では、この x0\mathbf{x}_0 を最後まで背負ったまま計算を進めます。

これらを代入すると、以下のようになります。

pθ(x0:T)qσ(x1:T∣x0)=p(xT)∏t=1Tpθ(xt−1∣xt)∏t=1Tqσ(xt∣xt−1,x0)\frac{p_\theta(\mathbf{x}_{0:T})}{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} = \frac{p(\mathbf{x}_T) \prod_{t=1}^T p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)}{\prod_{t=1}^T q_\sigma(\mathbf{x}_t \vert \mathbf{x}_{t-1}, \mathbf{x}_0)}

ここで、積の最初(t=1t=1)とそれ以外(t≥2t \geq 2)を分けて書き出します。t=1t=1 の項は qσ(x1∣x0,x0)=qσ(x1∣x0)q_\sigma(\mathbf{x}_1 \vert \mathbf{x}_0, \mathbf{x}_0) = q_\sigma(\mathbf{x}_1 \vert \mathbf{x}_0) となることに注意してください。

pθ(x0:T)qσ(x1:T∣x0)=p(xT)pθ(x0∣x1)∏t=2Tpθ(xt−1∣xt)qσ(x1∣x0)∏t=2Tqσ(xt∣xt−1,x0)\frac{p_\theta(\mathbf{x}_{0:T})}{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} = \frac{p(\mathbf{x}_T) p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) \prod_{t=2}^T p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)}{q_\sigma(\mathbf{x}_1 \vert \mathbf{x}_0) \prod_{t=2}^T q_\sigma(\mathbf{x}_t \vert \mathbf{x}_{t-1}, \mathbf{x}_0)}

Step 2: ベイズの定理による推論過程の逆向き変形​

Step 1 で現れた推論過程の遷移確率 qσ(xt∣xt−1,x0)q_\sigma(\mathbf{x}_t \vert \mathbf{x}_{t-1}, \mathbf{x}_0) を、ベイズの定理を用いて条件が逆向きの確率に書き換えます。これにより、qσq_\sigma の定義そのものである qσ(xt−1∣xt,x0)q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) を式の中に登場させることができます。

qσ(xt∣xt−1,x0)=qσ(xt−1∣xt,x0)qσ(xt∣x0)qσ(xt−1∣x0)q_\sigma(\mathbf{x}_t \vert \mathbf{x}_{t-1}, \mathbf{x}_0) = \frac{q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) q_\sigma(\mathbf{x}_t \vert \mathbf{x}_0)}{q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_0)}

この変形を、分母の t≥2t \geq 2 の積 ∏t=2Tqσ(xt∣xt−1,x0)\prod_{t=2}^T q_\sigma(\mathbf{x}_t \vert \mathbf{x}_{t-1}, \mathbf{x}_0) に代入します。

∏t=2Tqσ(xt∣xt−1,x0)=∏t=2Tqσ(xt−1∣xt,x0)qσ(xt∣x0)qσ(xt−1∣x0)\prod_{t=2}^T q_\sigma(\mathbf{x}_t \vert \mathbf{x}_{t-1}, \mathbf{x}_0) = \prod_{t=2}^T \frac{q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) q_\sigma(\mathbf{x}_t \vert \mathbf{x}_0)}{q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_0)}

この式の右側の分数の積を展開すると、隣り合う項の分子と分母の間で qσ(xs∣x0)q_\sigma(\mathbf{x}_s \vert \mathbf{x}_0) が順番に相殺(テレスコーピング:Telescoping)されます。

∏t=2Tqσ(xt∣x0)qσ(xt−1∣x0)=qσ(x2∣x0)qσ(x1∣x0)⋅qσ(x3∣x0)qσ(x2∣x0)…qσ(xT∣x0)qσ(xT−1∣x0)=qσ(xT∣x0)qσ(x1∣x0)\prod_{t=2}^T \frac{q_\sigma(\mathbf{x}_t \vert \mathbf{x}_0)}{q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_0)} = \frac{q_\sigma(\mathbf{x}_2 \vert \mathbf{x}_0)}{q_\sigma(\mathbf{x}_1 \vert \mathbf{x}_0)} \cdot \frac{q_\sigma(\mathbf{x}_3 \vert \mathbf{x}_0)}{q_\sigma(\mathbf{x}_2 \vert \mathbf{x}_0)} \dots \frac{q_\sigma(\mathbf{x}_T \vert \mathbf{x}_0)}{q_\sigma(\mathbf{x}_{T-1} \vert \mathbf{x}_0)} = \frac{q_\sigma(\mathbf{x}_T \vert \mathbf{x}_0)}{q_\sigma(\mathbf{x}_1 \vert \mathbf{x}_0)}

これによって、分母の積は以下のように整理されます。

∏t=2Tqσ(xt∣xt−1,x0)=(∏t=2Tqσ(xt−1∣xt,x0))⋅qσ(xT∣x0)qσ(x1∣x0)\prod_{t=2}^T q_\sigma(\mathbf{x}_t \vert \mathbf{x}_{t-1}, \mathbf{x}_0) = \left( \prod_{t=2}^T q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) \right) \cdot \frac{q_\sigma(\mathbf{x}_T \vert \mathbf{x}_0)}{q_\sigma(\mathbf{x}_1 \vert \mathbf{x}_0)}

Step 3: 分数全体の再構築と約分​

これを Step 1 の式の分母に代入します。すると、分母にある qσ(x1∣x0)q_\sigma(\mathbf{x}_1 \vert \mathbf{x}_0) がちょうど相殺されて消えます。

pθ(x0:T)qσ(x1:T∣x0)=p(xT)pθ(x0∣x1)∏t=2Tpθ(xt−1∣xt)qσ(x1∣x0)⋅(∏t=2Tqσ(xt−1∣xt,x0))⋅qσ(xT∣x0)qσ(x1∣x0)\frac{p_\theta(\mathbf{x}_{0:T})}{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} = \frac{p(\mathbf{x}_T) p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) \prod_{t=2}^T p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)}{q_\sigma(\mathbf{x}_1 \vert \mathbf{x}_0) \cdot \left( \prod_{t=2}^T q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) \right) \cdot \frac{q_\sigma(\mathbf{x}_T \vert \mathbf{x}_0)}{q_\sigma(\mathbf{x}_1 \vert \mathbf{x}_0)}}
=p(xT)pθ(x0∣x1)∏t=2Tpθ(xt−1∣xt)qσ(xT∣x0)∏t=2Tqσ(xt−1∣xt,x0)= \frac{p(\mathbf{x}_T) p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) \prod_{t=2}^T p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)}{q_\sigma(\mathbf{x}_T \vert \mathbf{x}_0) \prod_{t=2}^T q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)}

この式を、同じタイムステップの変数同士になるようにグループ分け(並び替え)します。

pθ(x0:T)qσ(x1:T∣x0)=(p(xT)qσ(xT∣x0))⋅(∏t=2Tpθ(xt−1∣xt)qσ(xt−1∣xt,x0))⋅pθ(x0∣x1)\frac{p_\theta(\mathbf{x}_{0:T})}{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} = \left( \frac{p(\mathbf{x}_T)}{q_\sigma(\mathbf{x}_T \vert \mathbf{x}_0)} \right) \cdot \left( \prod_{t=2}^T \frac{p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)}{q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)} \right) \cdot p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)

Step 4: 負の対数(−log⁡-\log)と期待値 Eqσ\mathbb{E}_{q_\sigma} の適用​

この結果を変分下界(JσJ_\sigma)の定義式に適用し、対数の性質を用いて「積を和(∑\sum)に展開」し、さらにマイナスの符号を「対数の分子と分母の反転」に利用します。

Jσ=Eqσ[−log⁡pθ(x0:T)qσ(x1:T∣x0)]=Eqσ[−log⁡(p(xT)qσ(xT∣x0))−∑t=2Tlog⁡(pθ(xt−1∣xt)qσ(xt−1∣xt,x0))−log⁡pθ(x0∣x1)]=Eqσ[log⁡qσ(xT∣x0)p(xT)]+∑t=2TEqσ[log⁡qσ(xt−1∣xt,x0)pθ(xt−1∣xt)]−Eqσ[log⁡pθ(x0∣x1)]\begin{aligned} J_\sigma &= \mathbb{E}_{q_\sigma} \left[ -\log \frac{p_\theta(\mathbf{x}_{0:T})}{q_\sigma(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \right] \\ &= \mathbb{E}_{q_\sigma} \left[ -\log \left( \frac{p(\mathbf{x}_T)}{q_\sigma(\mathbf{x}_T \vert \mathbf{x}_0)} \right) - \sum_{t=2}^T \log \left( \frac{p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)}{q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)} \right) - \log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) \right] \\ &= \mathbb{E}_{q_\sigma} \left[ \log \frac{q_\sigma(\mathbf{x}_T \vert \mathbf{x}_0)}{p(\mathbf{x}_T)} \right] + \sum_{t=2}^T \mathbb{E}_{q_\sigma} \left[ \log \frac{q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)}{p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)} \right] - \mathbb{E}_{q_\sigma} [\log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)] \end{aligned}

Step 5: KLダイバージェンスの定義への書換え​

最後に、KLダイバージェンスの定義 DKL(P∥Q)=EP[log⁡P(x)Q(x)]D_{\text{KL}}(P \parallel Q) = \mathbb{E}_P \left[ \log \frac{P(x)}{Q(x)} \right] に基づいて各項を整理します。

期待値 Eqσ\mathbb{E}_{q_\sigma} (同時分布 qσ(x0:T)q_\sigma(\mathbf{x}_{0:T}))の下では、それぞれの項において該当しない確率変数は周辺化によって消去されるため、以下のように最終的に美しいKLダイバージェンスの期待値として分解された式が得られます。

Jσ=EqσDKL(qσ(xT∣x0)∥p(xT))⏟LT (学習パラメータ無)+∑t=2TEqσDKL(qσ(xt−1∣xt,x0)∥pθ(xt−1∣xt))⏟Lt−1 (主となる拡散損失)+(−Eqσ[log⁡pθ(x0∣x1)])⏟L0 (再構成誤差)\begin{aligned} J_\sigma &= \underbrace{\mathbb{E}_{q_\sigma} D_{\text{KL}}(q_\sigma(\mathbf{x}_T \vert \mathbf{x}_0) \parallel p(\mathbf{x}_T))}_{L_T \text{ (学習パラメータ無)}} \\ &\quad + \sum_{t=2}^T \underbrace{\mathbb{E}_{q_\sigma} D_{\text{KL}}(q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) \parallel p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t))}_{L_{t-1} \text{ (主となる拡散損失)}} \\ &\quad + \underbrace{\left( - \mathbb{E}_{q_\sigma} [\log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)] \right)}_{L_0 \text{ (再構成誤差)}} \end{aligned}

ここで重要なのは、和(∑\sum)の中にある各ステップごとのKLダイバージェンスの項(拡散損失 Lt−1L_{t-1})です。これは2つのガウス分布の間のKLダイバージェンスとなります。

  • 目標分布: qσ(xt−1∣xt,x0)=N(μ~t(xt,x0),σt2I)q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) = \mathcal{N}(\tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \mathbf{x}_0), \sigma_t^2 \mathbf{I})
  • モデル分布: pθ(xt−1∣xt)=N(μθ(xt,t),σt2I)p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t) = \mathcal{N}(\boldsymbol{\mu}_\theta(\mathbf{x}_t, t), \sigma_t^2 \mathbf{I}) (※分散は共通と仮定)

ガウス分布同士のKLダイバージェンスは、分散が同じ場合、平均ベクトルの二乗誤差(MSE)に帰着します。

Lt−1=Eqσ[12σt2∥μ~t(xt,x0)−μθ(xt,t)∥2]L_{t-1} = \mathbb{E}_{q_\sigma} \left[ \frac{1}{2\sigma_t^2} \left\Vert \tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \mathbf{x}_0) - \boldsymbol{\mu}_\theta(\mathbf{x}_t, t) \right\Vert^2 \right]
補足:ガウス分布間のKLダイバージェンスからの展開

まず、ベースとなる Lt−1L_{t-1} のKLダイバージェンスは、先ほどの分解式にも登場した以下の項です。

Lt−1=Eqσ[DKL(qσ(xt−1∣xt,x0)∥pθ(xt−1∣xt))]L_{t-1} = \mathbb{E}_{q_\sigma} \left[ D_{\text{KL}}(q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) \parallel p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)) \right]

ここで、中身の2つの分布はともに次元 dd の多変量ガウス分布として定義されています。

  • 目標分布 PP: qσ(xt−1∣xt,x0)=N(μ~t,σt2I)q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) = \mathcal{N}(\tilde{\boldsymbol{\mu}}_t, \sigma_t^2 \mathbf{I})
  • モデル分布 QQ: pθ(xt−1∣xt)=N(μθ,σt2I)p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t) = \mathcal{N}(\boldsymbol{\mu}_\theta, \sigma_t^2 \mathbf{I})

一般に、2つの多変量ガウス分布 P=N(μ1,Σ1)P = \mathcal{N}(\boldsymbol{\mu}_1, \Sigma_1) と Q=N(μ2,Σ2)Q = \mathcal{N}(\boldsymbol{\mu}_2, \Sigma_2) の間のKLダイバージェンスは次の公式で表されます。

DKL(P∥Q)=12(log⁡∣Σ2∣∣Σ1∣−d+tr(Σ2−1Σ1)+(μ2−μ1)TΣ2−1(μ2−μ1))D_{\text{KL}}(P \parallel Q) = \frac{1}{2} \left( \log \frac{|\Sigma_2|}{|\Sigma_1|} - d + \text{tr}(\Sigma_2^{-1}\Sigma_1) + (\boldsymbol{\mu}_2 - \boldsymbol{\mu}_1)^T \Sigma_2^{-1} (\boldsymbol{\mu}_2 - \boldsymbol{\mu}_1) \right)

今回は両者の分散共分散行列が全く同じ(Σ1=Σ2=σt2I\Sigma_1 = \Sigma_2 = \sigma_t^2 \mathbf{I})であるため、式の大半が相殺されます。

  1. 行列式の比の対数: log⁡∣σt2I∣∣σt2I∣=log⁡1=0\log \frac{|\sigma_t^2 \mathbf{I}|}{|\sigma_t^2 \mathbf{I}|} = \log 1 = 0
  2. トレース項: tr((σt2I)−1(σt2I))=tr(I)=d\text{tr}((\sigma_t^2 \mathbf{I})^{-1}(\sigma_t^2 \mathbf{I})) = \text{tr}(\mathbf{I}) = d

これらを公式に代入すると、前半の複雑な項が 0−d+d=00 - d + d = 0 となり完全に消滅し、平均ベクトルの差(マハラノビス距離)の項だけが残ります。

DKL(P∥Q)=12(μθ−μ~t)T(σt2I)−1(μθ−μ~t)=12σt2(μθ−μ~t)T(μθ−μ~t)=12σt2∥μ~t−μθ∥2\begin{aligned} D_{\text{KL}}(P \parallel Q) &= \frac{1}{2} (\boldsymbol{\mu}_\theta - \tilde{\boldsymbol{\mu}}_t)^T (\sigma_t^2 \mathbf{I})^{-1} (\boldsymbol{\mu}_\theta - \tilde{\boldsymbol{\mu}}_t) \\ &= \frac{1}{2\sigma_t^2} (\boldsymbol{\mu}_\theta - \tilde{\boldsymbol{\mu}}_t)^T (\boldsymbol{\mu}_\theta - \tilde{\boldsymbol{\mu}}_t) \\ &= \frac{1}{2\sigma_t^2} \left\Vert \tilde{\boldsymbol{\mu}}_t - \boldsymbol{\mu}_\theta \right\Vert^2 \end{aligned}

この結果を元の期待値 Eqσ\mathbb{E}_{q_\sigma} の中へ戻すことで、最終的な Lt−1L_{t-1} の平均二乗誤差(MSE)の式が導かれます。

Lt−1=Eqσ[12σt2∥μ~t(xt,x0)−μθ(xt,t)∥2]L_{t-1} = \mathbb{E}_{q_\sigma} \left[ \frac{1}{2\sigma_t^2} \left\Vert \tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \mathbf{x}_0) - \boldsymbol{\mu}_\theta(\mathbf{x}_t, t) \right\Vert^2 \right]

ノイズ予測の誤差への帰着​

モデル μθ\boldsymbol{\mu}_\theta の学習を「ノイズ予測」として定式化します。記事前半の「補足:なぜ x0\mathbf{x}_0 から xt\mathbf{x}_t を一発で計算できるのか?」で導出した周辺分布の通り、xt=αˉtx0+1−αˉtϵ\mathbf{x}_t = \sqrt{\bar{\alpha}_t} \mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_t} \boldsymbol{\epsilon} と書けるため、これを x0\mathbf{x}_0 について解くと:

x0=xt−1−αˉtϵαˉt\mathbf{x}_0 = \frac{\mathbf{x}_t - \sqrt{1 - \bar{\alpha}_t} \boldsymbol{\epsilon}}{\sqrt{\bar{\alpha}_t}}

これを μ~t\tilde{\boldsymbol{\mu}}_t の式に代入し、さらにモデル μθ\boldsymbol{\mu}_\theta も同じ形式でパラメータ化(ϵθ\boldsymbol{\epsilon}_\theta を予測するように設計)すると、両者の差分は次のようにノイズ ϵ\boldsymbol{\epsilon} の差分に定数係数が掛かったものになります。

μ~t−μθ=(定数係数)×(ϵ−ϵθ(xt,t))\tilde{\boldsymbol{\mu}}_t - \boldsymbol{\mu}_\theta = \text{(定数係数)} \times \left( \boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \right)
補足:平均の差分がノイズ予測誤差になるプロセスの詳細

推論過程 qσq_\sigma の平均 μ~t(xt,x0)\tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \mathbf{x}_0) は次のように定義されていました。

μ~t(xt,x0)=αˉt−1x0+1−αˉt−1−σt2xt−αˉtx01−αˉt\tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \mathbf{x}_0) = \sqrt{\bar{\alpha}_{t-1}} \mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_{t-1} - \sigma_t^2} \frac{\mathbf{x}_t - \sqrt{\bar{\alpha}_t} \mathbf{x}_0}{\sqrt{1 - \bar{\alpha}_t}}

ここで、右辺の第2項にある分数 xt−αˉtx01−αˉt\frac{\mathbf{x}_t - \sqrt{\bar{\alpha}_t} \mathbf{x}_0}{\sqrt{1 - \bar{\alpha}_t}} は、周辺分布の式 xt=αˉtx0+1−αˉtϵ\mathbf{x}_t = \sqrt{\bar{\alpha}_t} \mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_t} \boldsymbol{\epsilon} を変形すると、そのままノイズ ϵ\boldsymbol{\epsilon} に等しいことがわかります。

xt−αˉtx01−αˉt=ϵ\frac{\mathbf{x}_t - \sqrt{\bar{\alpha}_t} \mathbf{x}_0}{\sqrt{1 - \bar{\alpha}_t}} = \boldsymbol{\epsilon}

したがって、第2項は単なる ϵ\boldsymbol{\epsilon} の定数倍になります。 次に、第1項の x0\mathbf{x}_0 に、先ほど解いた x0=xt−1−αˉtϵαˉt\mathbf{x}_0 = \frac{\mathbf{x}_t - \sqrt{1 - \bar{\alpha}_t} \boldsymbol{\epsilon}}{\sqrt{\bar{\alpha}_t}} を代入します。

μ~t(xt,ϵ)=αˉt−1(xt−1−αˉtϵαˉt)+1−αˉt−1−σt2ϵ=αˉt−1αˉtxt−αˉt−11−αˉtαˉtϵ+1−αˉt−1−σt2ϵ=αˉt−1αˉtxt−(αˉt−11−αˉtαˉt−1−αˉt−1−σt2)ϵ\begin{aligned} \tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \boldsymbol{\epsilon}) &= \sqrt{\bar{\alpha}_{t-1}} \left( \frac{\mathbf{x}_t - \sqrt{1 - \bar{\alpha}_t} \boldsymbol{\epsilon}}{\sqrt{\bar{\alpha}_t}} \right) + \sqrt{1 - \bar{\alpha}_{t-1} - \sigma_t^2} \boldsymbol{\epsilon} \\ &= \frac{\sqrt{\bar{\alpha}_{t-1}}}{\sqrt{\bar{\alpha}_t}} \mathbf{x}_t - \frac{\sqrt{\bar{\alpha}_{t-1}}\sqrt{1 - \bar{\alpha}_t}}{\sqrt{\bar{\alpha}_t}} \boldsymbol{\epsilon} + \sqrt{1 - \bar{\alpha}_{t-1} - \sigma_t^2} \boldsymbol{\epsilon} \\ &= \frac{\sqrt{\bar{\alpha}_{t-1}}}{\sqrt{\bar{\alpha}_t}} \mathbf{x}_t - \left( \frac{\sqrt{\bar{\alpha}_{t-1}}\sqrt{1 - \bar{\alpha}_t}}{\sqrt{\bar{\alpha}_t}} - \sqrt{1 - \bar{\alpha}_{t-1} - \sigma_t^2} \right) \boldsymbol{\epsilon} \end{aligned}

このように、目標分布の平均 μ~t\tilde{\boldsymbol{\mu}}_t は「xt\mathbf{x}_t の項」と「ϵ\boldsymbol{\epsilon} の項」に美しく整理されます。

ここで、AIモデルの出力する平均 μθ(xt,t)\boldsymbol{\mu}_\theta(\mathbf{x}_t, t) についても、上記の μ~t\tilde{\boldsymbol{\mu}}_t と全く同じ構造になるようにパラメータ化(設計)します。つまり、真のノイズ ϵ\boldsymbol{\epsilon} の部分だけをニューラルネットワークによる予測ノイズ ϵθ(xt,t)\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) に置き換えます。

μθ(xt,t)=αˉt−1αˉtxt−(αˉt−11−αˉtαˉt−1−αˉt−1−σt2)ϵθ(xt,t)\boldsymbol{\mu}_\theta(\mathbf{x}_t, t) = \frac{\sqrt{\bar{\alpha}_{t-1}}}{\sqrt{\bar{\alpha}_t}} \mathbf{x}_t - \left( \frac{\sqrt{\bar{\alpha}_{t-1}}\sqrt{1 - \bar{\alpha}_t}}{\sqrt{\bar{\alpha}_t}} - \sqrt{1 - \bar{\alpha}_{t-1} - \sigma_t^2} \right) \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)

最後に、この2つの式を引き算して差分 μ~t−μθ\tilde{\boldsymbol{\mu}}_t - \boldsymbol{\mu}_\theta を計算します。すると、最初の xt\mathbf{x}_t の項が完全に相殺されて消滅し、ノイズ ϵ\boldsymbol{\epsilon} の差分だけが残ります。

μ~t−μθ=−(αˉt−11−αˉtαˉt−1−αˉt−1−σt2)(ϵ−ϵθ(xt,t))\tilde{\boldsymbol{\mu}}_t - \boldsymbol{\mu}_\theta = - \left( \frac{\sqrt{\bar{\alpha}_{t-1}}\sqrt{1 - \bar{\alpha}_t}}{\sqrt{\bar{\alpha}_t}} - \sqrt{1 - \bar{\alpha}_{t-1} - \sigma_t^2} \right) \left( \boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \right)

このかっこ内の係数が「定数係数」の正体です。二乗誤差の中に入れるとマイナス符号は消えるため、純粋に ∥ϵ−ϵθ(xt,t)∥2\left\Vert \boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \right\Vert^2 を最小化する問題へと帰着するのです。

これを二乗誤差の式に代入すると、結局 JσJ_\sigma を最小化することは、次のノイズ予測誤差を最小化することに他なりません。

Lt−1∝Ex0,ϵ[∥ϵ−ϵθ(xt,t)∥2]L_{t-1} \propto \mathbb{E}_{\mathbf{x}_0, \boldsymbol{\epsilon}} \left[ \left\Vert \boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \right\Vert^2 \right]

結論(Theorem 1 の意義)​

上記の展開により、任意の σ\sigma に対して、変分目的関数 JσJ_\sigma は次のように書けることが証明されます。

Jσ=Lγ+CJ_\sigma = L_\gamma + C

ここで CC は θ\theta に依存しない定数、LγL_\gamma は重み付きのノイズ予測MSEです。

補足:最終的な目的関数 Jσ=Lγ+CJ_\sigma = L_\gamma + C が導かれる理由

これまでのステップで分解した JσJ_\sigma の全体の式をもう一度振り返ります。

Jσ=EqσDKL(qσ(xT∣x0)∥p(xT))⏟LT+∑t=2TEqσDKL(qσ(xt−1∣xt,x0)∥pθ(xt−1∣xt))⏟Lt−1+(−Eqσ[log⁡pθ(x0∣x1)])⏟L0\begin{aligned} J_\sigma &= \underbrace{\mathbb{E}_{q_\sigma} D_{\text{KL}}(q_\sigma(\mathbf{x}_T \vert \mathbf{x}_0) \parallel p(\mathbf{x}_T))}_{L_T} \\ &\quad + \sum_{t=2}^T \underbrace{\mathbb{E}_{q_\sigma} D_{\text{KL}}(q_\sigma(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) \parallel p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t))}_{L_{t-1}} \\ &\quad + \underbrace{\left( - \mathbb{E}_{q_\sigma} [\log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)] \right)}_{L_0} \end{aligned}

この式を、AIモデルの学習パラメータ θ\theta に「依存する項」と「依存しない項」に分けて整理します。

  1. LTL_T (学習パラメータを持たない定数項) 事前分布 p(xT)p(\mathbf{x}_T) は固定された標準ガウス分布 N(0,I)\mathcal{N}(\mathbf{0}, \mathbf{I}) であり、推論過程 qσq_\sigma も元データ x0\mathbf{x}_0 から固定の計算で求められます。つまり、この項には学習中のパラメータ θ\theta が一切含まれておらず最適化の影響を受けないため、学習においては単なる定数 CC として扱うことができます。

  2. Lt−1L_{t-1} (拡散損失)と L0L_0 (再構成誤差) 先ほど「ノイズ予測の誤差への帰着」で証明した通り、任意のステップ t≥2t \geq 2 における拡散損失 Lt−1L_{t-1} は、最終的に定数係数 γt\gamma_t (※式中にある α\alpha や σ\sigma からなる複雑な係数を、見やすさのため1つの記号にまとめた重み)を掛けたノイズ予測の二乗誤差(MSE)へと変換されました。

    Lt−1=γtEx0,ϵ[∥ϵ−ϵθ(xt,t)∥2]L_{t-1} = \gamma_t \mathbb{E}_{\mathbf{x}_0, \boldsymbol{\epsilon}} \left[ \left\Vert \boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \right\Vert^2 \right]

    一方、L0L_0 は最後の1歩(x1→x0\mathbf{x}_1 \to \mathbf{x}_0)の再構成誤差 −log⁡pθ(x0∣x1)-\log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) を表しています(損失として扱うため、マイナス符号まで含めて L0L_0 と定義しています)。 モデル分布 pθ(x0∣x1)p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) も他のステップと同様にガウス分布 N(μθ(x1,1),σ12I)\mathcal{N}(\boldsymbol{\mu}_\theta(\mathbf{x}_1, 1), \sigma_1^2 \mathbf{I}) として定義されています。ガウス分布の負の対数尤度(−log⁡-\log)を計算すると、指数部分が落ちて 「平均の二乗誤差(MSE)」に比例する形 になります。 そして、この平均 μθ\boldsymbol{\mu}_\theta をノイズ予測 ϵθ\boldsymbol{\epsilon}_\theta でパラメータ化して代入すると、Lt−1L_{t-1} と全く同じプロセスで式が相殺され、この L0L_0 も 「t=1t=1 におけるノイズ予測の二乗誤差」 として同じ数式で表すことができるのです。

    L0=γ1Ex0,ϵ[∥ϵ−ϵθ(x1,1)∥2]L_0 = \gamma_1 \mathbb{E}_{\mathbf{x}_0, \boldsymbol{\epsilon}} \left[ \left\Vert \boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta(\mathbf{x}_1, 1) \right\Vert^2 \right]

したがって、分かれていた ∑t=2TLt−1\sum_{t=2}^T L_{t-1} と L0L_0 は式の形が同じであるため、「t=1t=1 から TT までのノイズ予測誤差の総和(LγL_\gamma)」 として、1つのシグマ(∑\sum)にまとめることができます(γ\gamma は各ステップで掛かる定数係数の集合を表します)。

Lγ=L0+∑t=2TLt−1=∑t=1TγtEx0,ϵ[∥ϵ−ϵθ(xt,t)∥2]L_\gamma = L_0 + \sum_{t=2}^T L_{t-1} = \sum_{t=1}^T \gamma_t \mathbb{E}_{\mathbf{x}_0, \boldsymbol{\epsilon}} \left[ \left\Vert \boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \right\Vert^2 \right]

これらを最初の JσJ_\sigma の式に代入すると、LTL_T は CC に、∑Lt−1+L0\sum L_{t-1} + L_0 は LγL_\gamma に置き換わるため、全体の目的関数は定数項とノイズ予測項の足し算という極めてシンプルな形に帰着します。

DDPMで用いられる単純化された目的関数 LsimpleL_{\text{simple}} は、すべての tt に対して重みを 11 にしたものです(DDIM論文の表記では L1L_1 にあたります)。

「ネットワークパラメータ θ\theta が各タイムステップ tt で共有されていない」と仮定できる理想的な状況(あるいはニューラルネットワークの表現力が十分に高い状況)では、各ステップの誤差を独立に最小化できるため、LγL_\gamma の最適解は重み γ\gamma の値に依存しません。どの重みを選んでも、モデルは同じ解、すなわち「xt\mathbf{x}_t が与えられたときのノイズの条件付き期待値 E[ϵ∣xt]\mathbb{E}[\boldsymbol{\epsilon} \vert \mathbf{x}_t]」を予測するように学習されます。

したがって、DDPMの LsimpleL_{\text{simple}} を最小化して得られた学習済みモデルは、任意の σ\sigma(マルコフか非マルコフかに関わらず)を想定した変分目的関数 JσJ_\sigma の最適解としてもそのまま使えることになります。 これが、 「DDIMはDDPMの学習済みモデルをそのまま利用し、サンプリング時の数式(σ\sigma の取り扱い)だけを変えればよい」 という革新的な結論の数学的根拠です。

J_σ の項の整理を図にすると、次のようになります。
J_σ の項の整理。L_T は q_σ(x_T|x_0) と固定の p(x_T) の KL で、学習するパラメータ θ を含まないので定数 C になる。t ≥ 2 の拡散損失 L_t−1 と、最後の 1 歩の再構成誤差 L_0 は、どちらも重み γ_t が掛かったノイズの二乗誤差になるので、t = 1 から T までの和 L_γ にまとまる。θ が時刻ごとに共有されていない理想的な状況では、各時刻の誤差を独立に最小化できるので、L_γ の最適解は重み γ によらず、L_1 の最適解と一致するJ_σ の項の整理。L_T は q_σ(x_T|x_0) と固定の p(x_T) の KL で、学習するパラメータ θ を含まないので定数 C になる。t ≥ 2 の拡散損失 L_t−1 と、最後の 1 歩の再構成誤差 L_0 は、どちらも重み γ_t が掛かったノイズの二乗誤差になるので、t = 1 から T までの和 L_γ にまとまる。θ が時刻ごとに共有されていない理想的な状況では、各時刻の誤差を独立に最小化できるので、L_γ の最適解は重み γ によらず、L_1 の最適解と一致する

(図は、diagram-designで作成)

σ=0\sigma=0 がもたらす圧倒的な高速化の理由​

Theorem 1 によりサンプリング時に σ\sigma を自由に設定できることが証明されましたが、DDIMの最大の貢献は、σ=0\sigma=0 に設定してランダムなノイズ付加を完全に排除したことにあります。

σ=0\sigma=0 になると、プロセスから確率的な揺らぎがなくなり、ノイズ空間から画像空間へと向かう生成プロセスが 「完全に決定論的な1本の軌道(常微分方程式:ODE)」 となります。

DDPMのように毎ステップでランダムなノイズが含まれる場合、確率的な経路から逸れないように「1歩ずつ細かく1000回」計算しなければなりませんでした。しかし、軌道が確定しているDDIMであれば、わざわざ1歩ずつ進まなくても 「一気に数段飛ばし(ステップのスキップ)」 が可能になります。

これにより、DDPMでは1000回必要だった計算(ニューラルネットワークの推論)を、例えば50回や20回へと劇的に減らすことができ、生成プロセスが10〜50倍も高速化するのです。これが、DDIMが現在の画像生成AIの標準技術として広く普及した最大の理由です。

σ による軌道の違いを図にすると、次のようになります。
σ の違いによる生成の軌道のイメージ。σ > 0(DDPM)では毎ステップランダムなノイズが加わり、経路が揺れるので、経路から逸れないように細かいステップで進む必要がある。σ = 0(DDIM)では軌道が決定論的な 1 本(常微分方程式のような軌道)になるので、数段飛ばしで進んでも同じ軌道の上に乗り、1,000 回の計算を 50 回や 20 回に減らせる。図の軌道は説明用σ の違いによる生成の軌道のイメージ。σ > 0(DDPM)では毎ステップランダムなノイズが加わり、経路が揺れるので、経路から逸れないように細かいステップで進む必要がある。σ = 0(DDIM)では軌道が決定論的な 1 本(常微分方程式のような軌道)になるので、数段飛ばしで進んでも同じ軌道の上に乗り、1,000 回の計算を 50 回や 20 回に減らせる。図の軌道は説明用

(図は、diagram-designで作成)

まとめ​

  • DDIMはDDPMと同じ周辺分布 q(xt∣x0)q(\mathbf{x}_t \vert \mathbf{x}_0) を共有しつつ、非マルコフ的な推論過程を再定義した。
  • その非マルコフ過程に基づく変分目的関数 JσJ_\sigma を展開すると、ガウス分布のKLダイバージェンスにより平均の二乗誤差に帰着する。
  • それをノイズ予測に置き換えると、JσJ_\sigma はDDPMと全く同じ「全ステップのノイズ予測誤差の和(LγL_\gamma)」になる。
  • 誤差の重み γ\gamma が異なっても「各ステップの誤差をゼロに近づける」という最適解のゴールは変わらないため、DDPMと全く同じ学習モデルが流用できる。
  • 結論として、DDPMとDDIMの違いは「生成時にランダムなノイズ σ\sigma を付加するかどうか」だけであり、σ=0\sigma=0(決定論的軌道)にすることでステップの大幅なスキップ(圧倒的な高速化)が可能になる。

参考文献​

本記事の文章・構成の一部に生成AIを使用しています。