DDPM(拡散モデル)とは? ノイズの除去で画像を生成する
 (画像は、Geminiで作成)
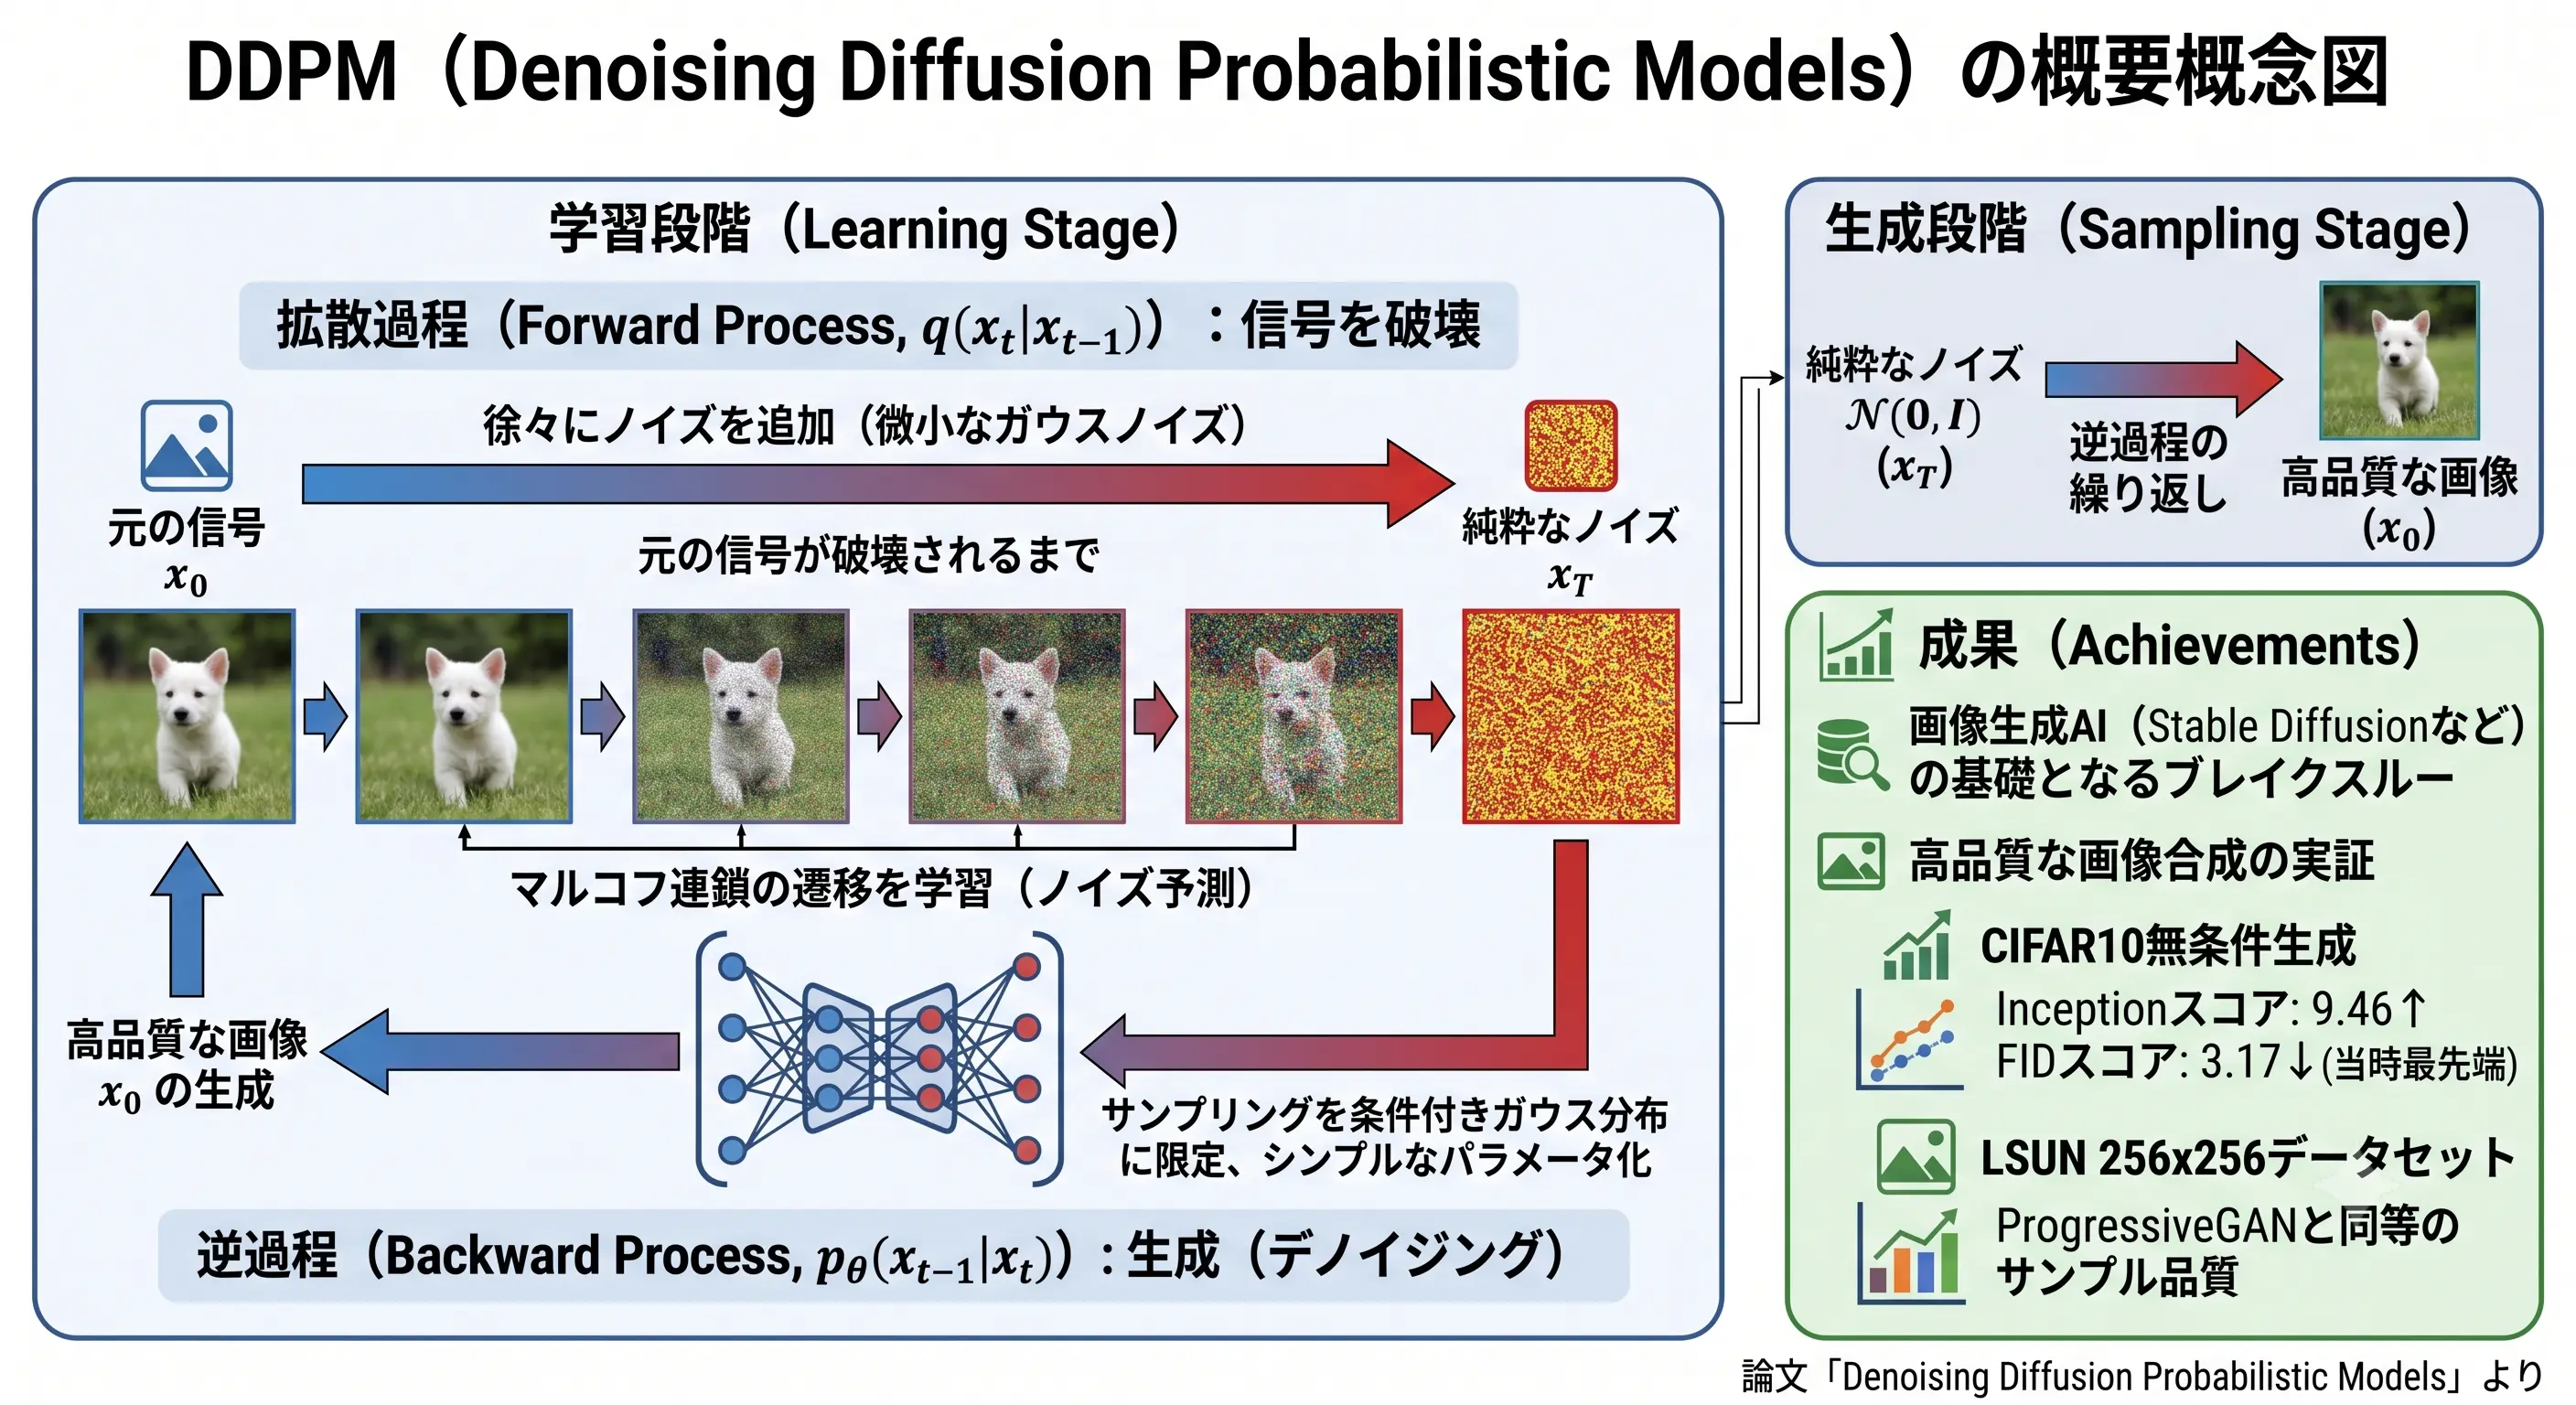
画像に少しずつノイズを加える拡散過程と、そのノイズを1ステップずつ取り除いて画像を生成する逆過程からなる DDPM の仕組みと、VAE や GAN との違いを理解すること。任意の時刻のノイズ画像を一度に作れる閉じた式と、逆過程をガウス分布で近似できる理由を説明でき、PyTorch での U-Net を含むスクラッチ実装と Hugging Face diffusers による実装で、画像の学習と生成を確かめること。
DDPM(拡散確率モデル)とは?
DDPMは、画像に少しずつノイズを足して壊していく「順過程」と、そのノイズを1ステップずつ取り除いて画像に戻す「逆過程」を組み合わせて、ノイズから画像を生成する手法 です。ニューラルネットワーク(U-Net)が学ぶのは「いまの画像に含まれるノイズを当てる」ことだけで、これを1000回繰り返すと、純粋なノイズから画像ができあがります。
この記事の読み方
目的に合わせて、次の節から読み始めてください。
| 知りたいこと | 読む節 |
|---|---|
| すぐに動かしてみたい | 直後の「最短の使い方」(学習済みモデルで画像を生成する) |
| VAE・GAN と何が違うのか | VAEやGANとの違い |
| 順過程と逆過程の流れ | DDPMの処理概要 |
| なぜうまくいくのか(数式) | なぜマルコフ連鎖がうまくいくのか?。損失が二乗誤差になるまでの導出は「DDPMにおける変分下界(ELBO)の導出とノイズ予測 MSE への帰着」 |
| 自分で実装して確かめたい | DDPMの実装(PyTorch でのスクラッチ実装)と diffusers による実装 |
最短の使い方:学習済みモデルで画像を生成する
論文の著者が CIFAR-10(32×32 のカラー画像 5 万枚)で学習したモデル google/ddpm-cifar10-32(Apache-2.0)を、Hugging Face の diffusers で読み込み、ノイズから画像を4枚生成します。仕組みや学習の書き方は後の節で扱うので、ここでは「ノイズを繰り返し取り除くと画像になる」ことを確かめます。
!pip install diffusers matplotlib
import torch
import matplotlib.pyplot as plt
from diffusers import DDPMPipeline

device = "cuda" if torch.cuda.is_available() else "cpu"

# 論文の著者が CIFAR-10 で学習した DDPM(U-Net とノイズのスケジュール一式)を読み込む
pipe = DDPMPipeline.from_pretrained("google/ddpm-cifar10-32").to(device)

# 純粋なガウスノイズから 1000 ステップかけてノイズを取り除き、4 枚を生成する
# 乱数の種を固定して、同じ環境なら同じ画像が出るようにする
generator = torch.Generator(device=device).manual_seed(0)
images = pipe(batch_size=4, generator=generator).images

# 生成した 4 枚を横に並べて表示する
fig, axes = plt.subplots(1, 4, figsize=(12, 3))
for ax, img in zip(axes, images):
    ax.imshow(img)
    ax.axis("off")
plt.tight_layout()
plt.show()
- DDPMPipeline.from_pretrained: ノイズを予測する U-Net(約 3,570 万パラメータ)と、ノイズの量を決めるスケジューラ(、 は から 0.02 まで線形)をまとめて読み込みます。どちらも論文の CIFAR-10 の設定と同じなので、後の節で自分で組み立てる部品が、そのまま入っていることになります。
- pipe(batch_size=4, generator=generator): 標準正規分布から引いたノイズ を4枚分作り、U-Net でノイズを予測して少し取り除く処理を から まで繰り返します。ステップ数は論文と同じ 1000 回(パイプラインの既定値)です。4 枚にしているのは、本文の実装と同じ 1×4 の並びで見比べられるようにするためで、枚数を変えても1枚あたりの品質は変わりません。
- generator: 最初のノイズの乱数の種です。種を変えると別の画像が生成されます。同じ種でも、CPU と GPU では乱数の列が違うので、生成される画像は下の結果と変わります。
- 実行時間: 1000 回 U-Net を呼ぶため、CPU では約3分かかります(GPU ではさらに短くなります)。生成に多くのステップが必要になる点は DDPM の弱点で、DDIM はこれを数十ステップに減らします。
実行結果
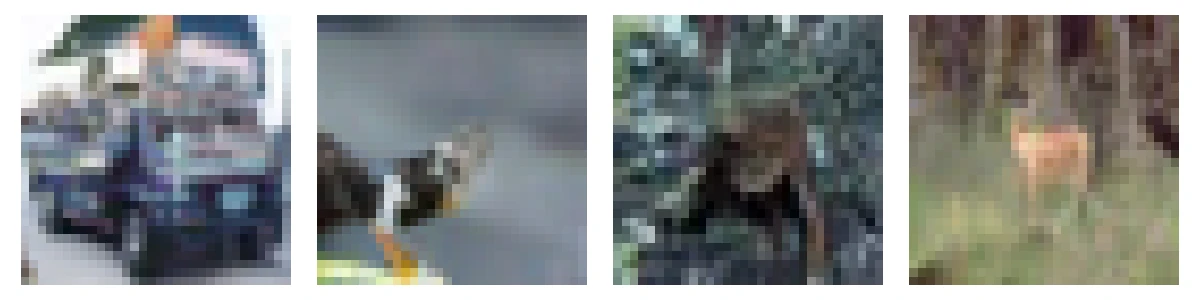
CPU で実行した結果です。左から、自動車(トラック)、鳥、動物、シカのような画像が生成されました。CIFAR-10 の10クラス(飛行機・自動車・鳥・猫・シカ・犬・カエル・馬・船・トラック)に似た画像が、クラスを指定せずにノイズだけから生成されています。32×32 の画像なので細部はぼやけますが、背景と物体の配置はとらえられています。
DDPMの論文と成果
DDPM(Denoising Diffusion Probabilistic Models)は、非平衡熱力学からの考察に影響を受けた潜在変数モデルのクラスである「拡散確率モデル」を用いて、 高品質な画像合成を提示する手法です。論文「Denoising Diffusion Probabilistic Models」で提案され、現在の画像生成AI(Stable Diffusionなど)の基礎となる重要なブレイクスルーとなりました。
生成モデルの学習において、DDPMは元の信号が破壊されるまで徐々にノイズを追加する「拡散過程(forward process)」を定義し、それを逆転させるようにマルコフ連鎖の遷移を学習します。このプロセスを微小なガウスノイズの追加によって構成することで、サンプリングを条件付きガウス分布に限定することができ、極めてシンプルなニューラルネットワークのパラメータ化が可能になります。
DDPMは画像生成の品質において大きな飛躍を遂げ、無条件のCIFAR10データセットで9.46のInceptionスコアと、当時最先端となる3.17のFIDスコアを獲得しました。また、256x256のLSUNデータセットでもProgressiveGANと同等のサンプル品質を達成しています。
VAEやGANとの違い
(画像は、Geminiで作成)
DDPM(Denoising Diffusion Probabilistic Models)がノイズから極めて高品質なデータを生成できる最大の理由は、従来の生成モデルが挑んでいた「困難な一発変換」を避け、「複雑なタスクを極限まで細かく分解して学習させる」 というアプローチをとっているからです。
例えば、AIに対して「完全にランダムなノイズの塊から、一瞬で完璧な猫の画像を描け」と指示しても、正解の可能性が無限にありすぎて、一発でマッピングを学習するのは非常に困難です。
DDPMはこの課題を、以下のように極めて単純な「ノイズ除去の微小ステップ」の連続へと細分化しました。
- 数学的に簡単に作れる完全なランダムノイズ を用意する。
- AIに「この画像から、ほんの1ステップ分だけノイズを取り除いて(ノイズを予測して引いて)」という非常に簡単なタスクを指示する。
- この微小なノイズ除去を数百〜数千回繰り返すことで、最終的に高精細な画像 に到達する。
つまり、「複雑すぎる1回の大変換を、AIが予測しやすい単純なステップの連続に分解したこと」 が、DDPMがこれほど高精度に動作する本質的な理由です。
これに対し、従来の代表的な生成モデルであるVAE(変分オートエンコーダー) やGAN(敵対的生成ネットワーク) は、まさに「ランダムなノイズから一発で画像を生成する(One-shot)」というアプローチをとっていました。
これらのモデルがどのような技術的な壁にぶつかっていたのかを紐解くと、なぜDDPMのような拡散モデルが主役に躍り出たのかが明確になります。
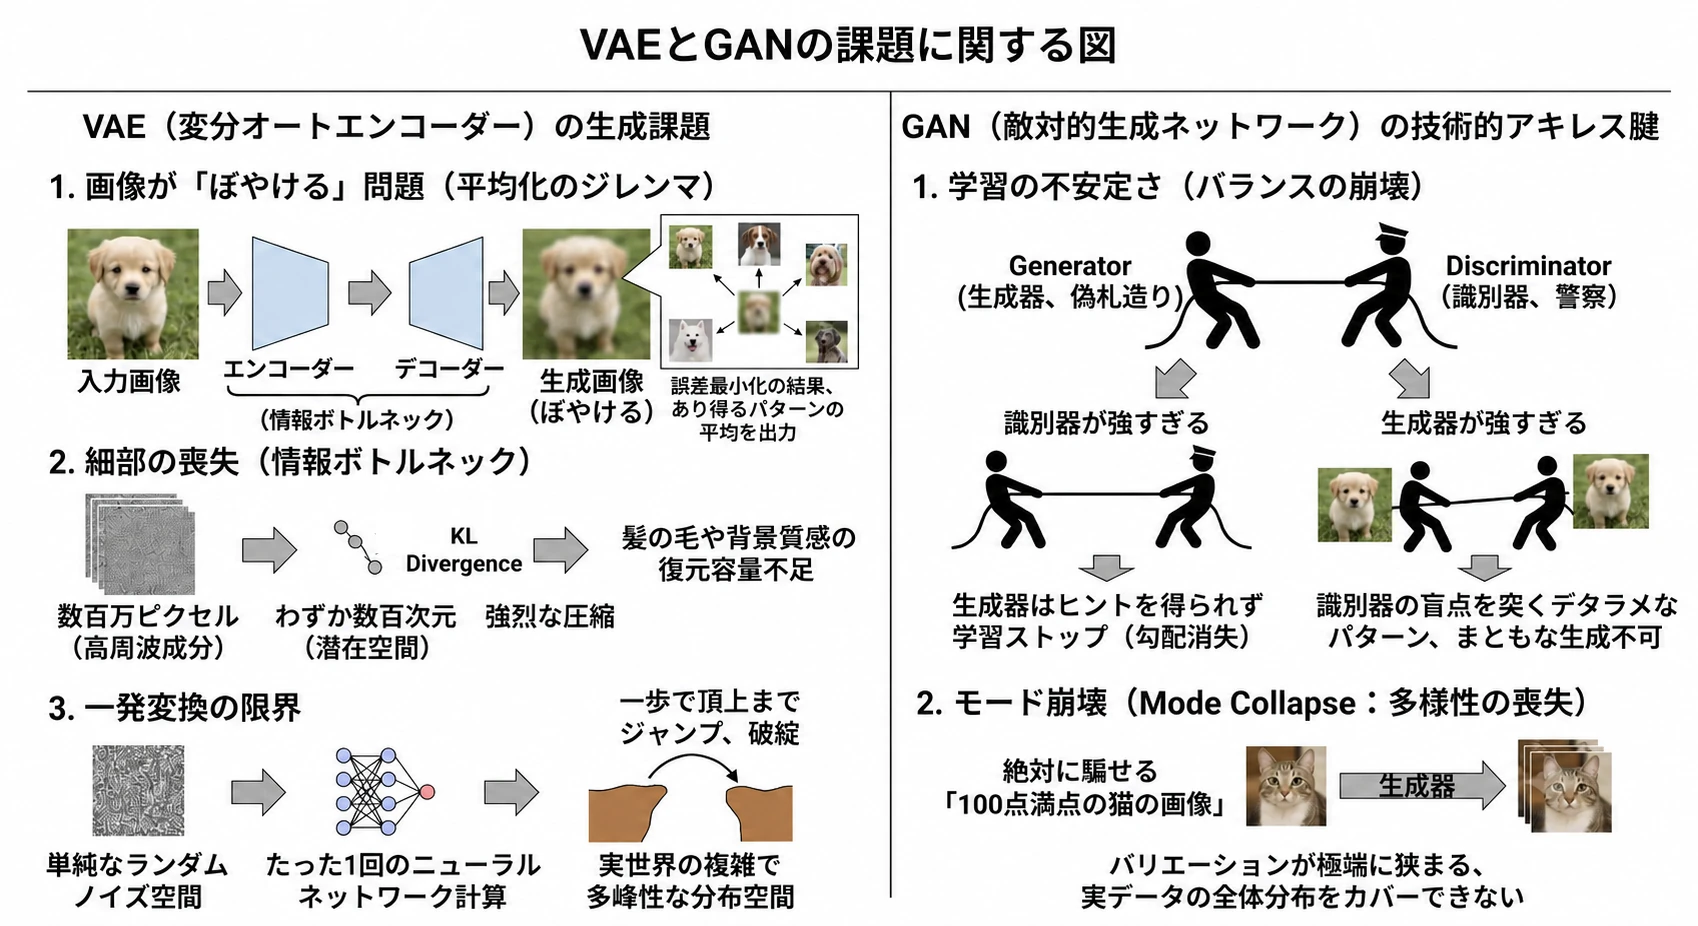
VAE(変分オートエンコーダー)の技術的限界
VAEが一発生成に挑む中で抱えていた主な課題は、以下の3点に集約されます。
- 画像が「ぼやける」問題(平均化のジレンマ)
VAEは入力画像を小さな潜在変数に圧縮し、そこから元の画像を復元(再構成)するように学習します。学習時には「元の画像」と「生成した画像」のピクセル単位のズレ(誤差)を最小化しようとしますが、限られた情報から一発で複雑な模様や輪郭を正確に描画しようとすると、AIは「正解の位置」に迷います。不確実な状況で誤差を最小にしようとした結果、AIは「あり得る複数のパターンの平均値」を出力してしまいます。これが、テクスチャが潰れて全体的にぼやけてしまう原因です。 - 強烈な「情報ボトルネック」による細部の喪失
VAEは、数百万ピクセルもある高解像度画像を、わずか数百次元の小さな「潜在空間」に無理やり押し込み、かつその空間が綺麗なガウス分布(ノイズ)に従うよう強い制約(KLダイバージェンス)をかけます。デコーダー(生成器)は、この極限まで圧縮された抽象的な情報のみを頼りに一瞬で画像を再構築しなければなりません。このボトルネックがあまりにも強烈なため、髪の毛の1本1本や背景の細かな質感(高周波成分)を復元する容量が足りず、のっぺりとした画像になりがちでした。 - 「単純な分布」から「複雑な分布」への一発変換の限界
数学的に見ると、完全なランダムノイズ(単純な正規分布)の空間を、たった1回のニューラルネットワークの計算で、実世界の画像(非常に複雑で多峰性な分布)の空間へと一気に歪めてマッピングするのは、モデルの表現力に対する要求が異常に高いタスクです。一歩で頂上までジャンプしようとするため、途中で破綻しやすくなります。
GAN(敵対的生成ネットワーク)の技術的アキレス腱
GANは、「偽札造り(Generator:生成器)」と「警察(Discriminator:識別器)」の騙し合いによって学習を進める非常にユニークなモデルです。VAEの「ぼやける」問題を克服し、圧倒的にシャープでリアルな画像を生成できることで一時代を築きましたが、この「敵対的(Adversarial)な学習方式」そのものが、致命的な課題を内包していました。
- 学習の不安定さ(バランスの崩壊)
GANの学習がうまくいくには、生成器と識別器の能力が常に「拮抗」している必要がありますが、この調整は極めて困難です。- 警察(識別器)が強すぎる場合: 識別器の目が厳しすぎると、生成器がどんな画像を出しても「偽物」と瞬時に見破られてしまいます。こうなると、生成器は「どう修正すれば本物に近づけるのか」というヒント(勾配)を得られず、学習がストップします(勾配消失問題)。
- 偽札造り(生成器)が強すぎる場合: 逆に生成器が、識別器の「盲点」を突くようなデタラメなノイズパターンを偶然見つけてしまうと、識別器は騙されっぱなしになり、まともな画像が生成されなくなります。 ハイパーパラメータの調整が「職人芸」レベルで難しく、わずかな設定の違いで学習が簡単に崩壊していました。
- モード崩壊(Mode Collapse:多様性の喪失)
生成器は「とにかく識別器を騙せれば勝ち」というルールで動いているため、「絶対に騙せる『100点満点の猫の画像』を1種類だけ見つけたら、永遠にそれだけを生成し続ける」という局所最適解に陥ることがあります。例えば、多様なデータを学習させても、出力されるのは「特定のパターン」ばかりになり、学習データの全体分布をカバーできずバリエーションが極端に狭まってしまいます。これが、Diffusionモデルに主役の座を奪われる最大の要因となりました。
比較:なぜDiffusion(DDPM)が主流になったのか?
GANとDiffusion(DDPM)の特性を比較すると、なぜ覇権が交代したのかが明確になります。
| 特徴 | GAN(一発生成) | Diffusion / DDPM(反復ノイズ除去) |
|---|---|---|
| 学習の安定性 | ❌ 極めて不安定(敵対的学習) | ⭕️ 非常に安定(単純な誤差最小化) |
| 画像の多様性 | ❌ モード崩壊を起こしやすい | ⭕️ 実データの分布を忠実に再現 |
| 画質・シャープさ | ⭕️ 非常に高い | ⭕️ 非常に高い |
| テキストとの連携 | ❌ 制御が困難 | ⭕️ ガイダンスが組み込みやすい |
Diffusionモデルは、GANのピーキーな「敵対的学習」を捨て、「ノイズを少しずつ予測して引く」という、堅実で数学的に安定したアプローチ(尤度の最大化)を採用しました。これにより、GANの最大の弱点であった「学習の不安定さ」と「モード崩壊」を見事に克服。さらに、Stable DiffusionやMidjourneyのような「テキスト(プロンプト)の指示に沿って、多様で高精細な画像を描き分ける」という高度な制御において、Diffusionモデルの安定性と網羅性が決定的な強みとなったのです。
DDPMはどう壁を越えたか?
DDPMは、VAEが苦しんだ課題を 「タスクの分割」 によって美しく解決しました。
- ボトルネックをなくした: VAEのように画像を小さく圧縮せず、画像と同じ解像度のままノイズを加えることで、強烈な情報ボトルネックを排除しました。
- 平均化を回避した: 一発でピクセルを予測するのではなく、「ほんの少しノイズを引く」という簡単なステップを1,000回繰り返すため、モデルが迷って「平均化(ぼやけ)」を起こす隙を与えません。結果として、VAEでは難しかった「シャープで高精細な細部」を持つ画像を、安定して生成できるようになったのです。
DDPMの処理概要
DDPMの画像生成プロセスは、従来のVAEやGANのような「一発での変換」ではなく、「極めて微小な変化を多数積み重ねる(マルコフ連鎖)」 ことで成り立っています。このプロセスは、大きく分けて以下の2つの方向性(連鎖)で構成されています。
-
Forward Process(拡散過程:データの分解)
データ分布 に対して、分散スケジュール に従って段階的にガウスノイズを追加していく固定されたマルコフ連鎖です。最終的なステップ では、元の画像データは完全に破壊され、単純で数学的に扱いやすい純粋なガウスノイズ となります。 従来のVAEのように「強烈な情報ボトルネック」を設けてデータを無理に低次元に圧縮するのではなく、元の画像と同じ解像度(ピクセル空間)を維持したまま段階的にノイズを加えていく点が特徴です。 -
Reverse Process(逆過程:段階的な復元)
純粋なノイズ から出発し、学習されたガウス遷移を用いて徐々にノイズを除去していくマルコフ連鎖です。 ニューラルネットワークは、「一瞬で完璧な画像を構築する」という困難なタスクに挑むのではなく、「ステップ の画像 から、ほんの1ステップ分のノイズ のみを予測する」という、極限まで単純化されたタスク(ノイズの予測)を学習します。この微小な予測を から まで何度も繰り返す(マルコフ連鎖)ことで、モデルが迷って「平均化(ぼやけ)」を起こす隙を与えず、最終的に元の複雑なデータ分布に従う高品質な画像 を再現することができます。
なぜマルコフ連鎖がうまくいくのか?
DDPMが、VAEやGANのようなOne-shot(一発生成)モデルと一線を画し、「マルコフ連鎖」という反復的なアプローチを採用することで成功しているのには、非常に強力な数学的な恩恵があるからです。 最大の理由は、「学習を圧倒的に効率化できる魔法のショートカット(閉形式)」 が使えることと、「逆算(ノイズ除去)を単純なガウス分布で近似できること」 の2点です。
理由1:任意のステップへ「一足飛び」できるショートカット
マルコフ連鎖とは「現在の状態は、1つ前の状態にのみ依存する(はだけで決まる)」という性質です。DDPMでは、順拡散過程(ノイズを加える過程)を以下のようなガウス分布を用いたマルコフ連鎖として定義します。
普通に考えると、ステップ1000の画像 を作るには、 と1000回ノイズを足す計算が必要です。これは学習時に非常に非効率です。
しかし、マルコフ連鎖であり、かつ追加するノイズが「ガウス分布」であるという性質を利用すると、「ガウス分布同士を足し合わせても、結果はやはりガウス分布になる」という数学的な特権(再生性)が使えます。 とし、(の累積積)と定義すると、元の画像 から任意のステップ の画像 を、1回の計算で直接求めることができます(Reparameterization Trick)。
これは、標準正規分布からサンプリングしたノイズ を使って、次のように書き換えられます。
このショートカットにより、学習時に「ステップ500のノイズ予測」をさせたい場合でも、500回の計算をシミュレートする必要がなく、元の画像 と乱数 から一瞬で目的の を生成できます。これにより、並列計算が容易になり、学習速度が飛躍的に向上します。 DDPMにおける1ステップのノイズ付加(順過程)は前述の通り以下の式で定義されます。 と置くと、次のように書き換えられます。 ある正規分布からのサンプリングは、「平均値」に対して「標準正規分布 のノイズ(偏差)に標準偏差を掛けたもの」を足し合わせる形に変換できます(これが Reparameterization Trick です)。 したがって、標準正規分布からサンプリングしたノイズを とすると、 は次のような計算式で直接表せます。 同様に、 も を用いて表せます。 これを の式に代入すると: ここで、互いに独立な正規分布の和の性質()を利用すると、後ろの2つのノイズ項は1つのノイズ にまとめることができます。 分散の和は となるため、式は次のように簡略化されます。 この代入操作を まで再帰的に繰り返すと、 と置くことで、最終的に以下の式が得られます。 これが、任意のステップ の状態を から一発で計算できるショートカットの正体です。補足:なぜ から を一発で計算できるのか?
理由2:逆過程も「ガウス分布」で近似できるという数学的裏付け
もう一つの大きな理由は、非平衡熱力学の分野で知られている重要な性質です。
本来、ノイズを加える順過程 の逆向き、つまり「ノイズから元のデータを復元する過程 」の真の分布を計算することは、データ全体の分布を知る必要があるため不可能です。
しかし、「マルコフ連鎖の1ステップの遷移()が十分に小さい場合、その逆過程も同じ関数形(この場合はガウス分布)で近似できる」という強力な数学的裏付けがあります。 つまり、1回のステップで加えるノイズがごく微量であれば、逆向きに戻るステップもまた、平均と分散を持つ単純なガウス分布としてモデル化できるのです。
これにより、AIのタスクは「複雑な分布を学習する」ことから「単純なガウス分布の平均・分散を予測する」ことに単純化されます。 さらに、マルコフ連鎖であることを利用して変分下界(ELBO)を展開すると、複雑な確率計算は最終的に 「AIが予測したノイズ 」と「実際に加えたノイズ 」の単なる引き算(二乗誤差:MSE) という、極めてシンプルで安定した損失関数に帰着します。
数式的な背景に興味がある方へ 本来最小化すべき「負の対数尤度の変分下界(ELBO)」が、数学的にどのような展開を経てこのシンプルな平均二乗誤差(MSE)へと帰着するのか、その一連の導出ステップについては、解説記事「DDPMにおける変分下界(ELBO)の導出とノイズ予測 MSE への帰着」で極めて丁寧に紐解いています。難解な数式変形を手元でトレースしたい方はぜひ参考にしてください。
なぜ生成時は「一足飛び」できないのか? - One-shotでない理由
ここで重要なのは、この「一足飛び」のショートカットは学習時にデータを壊す順過程でのみ使える特権だという点です。生成(推論)時には使えません。
- 順過程(学習時): 正解画像 が手元にあるため、数式を使って任意の の状態を一発で計算できます。
- 逆過程(生成時): 手元にあるのは完全なノイズ だけで、正解の は未知です。ここで「 から を一足飛びで予測せよ」と命令すれば、それはVAEやGANが直面したのと同じ「One-shot問題」となり、高品質な生成は困難になります。
DDPMが賢いのは、この問題を以下のように回避している点です。
- AI(U-Net)には常に「現在の画像 に含まれるノイズ成分 だけを予測して」という単純なタスクを課す。
- その予測結果を使い、一足飛びで を作るのではなく、その予測方向へ「ほんの1歩だけ」進む( を作る)ための道しるべとして利用する。
実は数学的には、AIが「ノイズ を予測する」という行為は、「現在の と予測したノイズから、仮の正解画像 を一足飛びで予測している」ことと等価です。 しかし、ノイズが多い段階での は非常にぼやけています。DDPMは、このぼやけた中間予測を最終出力とせず、あくまで次のステップへ進むための一時的なガイドとして利用します。この反復的なプロセスにより、徐々にノイズが晴れ、最終的にOne-shot生成の「ぼやけ」を回避した高精細な画像に辿り着くのです。
DDPMの構成技術要素(詳細)
DDPMが高い生成品質を達成した背景には、前述した数学的な理論を具現化するための、具体的なネットワークアーキテクチャや学習戦略の工夫があります。
-
U-Netアーキテクチャとアテンション
逆過程におけるノイズ予測器 の実装には、PixelCNN++ のバックボーンに似たU-Netが使用されています。これは、入力画像 と同じ解像度のノイズ を出力する必要があるため、解像度を維持しながら特徴抽出を行うU-Netアーキテクチャが非常に適しています。VAEのように情報を圧縮してボトルネックを通過させるのではなく、スキップコネクションを通じて豊富な空間情報を保持しながらノイズ予測を行う点が、高周波な詳細(テクスチャなど)の復元に貢献しています。 また、16x16の特徴マップ解像度においてセルフアテンション(Self-attention) ブロックが使用され、画像全体のグローバルな依存関係を捉えることで、より高品質な生成を可能にしています。 -
タイムステップの埋め込み (Time Embedding)
逆過程のマルコフ連鎖 では、モデル(U-Net)はすべてのタイムステップ でパラメータを共有します。しかし、ノイズの量が多い初期ステップと、ノイズが少ない終盤ステップとでは、モデルが行うべきノイズ除去のタスクは異なります。 そこで、現在どのステップの処理を行っているのかをネットワークに伝えるため、Transformerの位置エンコーディングに似た 正弦波位置埋め込み(sinusoidal position embedding) を用いて時間 をベクトル化し、U-Netの各残差ブロックに注入しています。これにより、単一のモデルが1からまでのすべてのステップに対応できるようになります。 -
簡略化された目的関数 (Simplified Training Objective)
これが、前述の「理由2」で解説した数学的な単純化の恩恵を最も直接的に受けている部分です。 本来、拡散モデルは負の対数尤度の変分下限(ELBO)を最適化することで学習されます。しかし、DDPMの著者らは、厳密な変分下限を計算する代わりに、加えたノイズ とネットワークが予測したノイズ の平均二乗誤差(MSE)を最小化する「簡略化された目的関数 」 を用いることで、サンプルの品質が向上することを発見しました。この簡略化は、複雑な確率モデリングの問題を、シンプルで安定した回帰問題(ノイズ予測)に落とし込むことを意味します。また、論文ではさらに、小さい (微細なノイズ)の損失の重みを下げ、より難しい大きな のノイズ除去タスクにネットワークを集中させる重み付き変分下限が、さらなる品質向上に繋がることも示唆しています。
-
プログレッシブな非可逆圧縮としての解釈
DDPMのサンプリング手順は、自己回帰モデル(PixelCNNなど)によるデコーディングを一般化したような、一種のプログレッシブなデコーディング(Progressive decoding) として解釈できます。 VAEが情報を一度に圧縮・復元するのに対し、DDPMは逆過程を通じて情報を段階的に「解凍」していきます。これは、優れた帰納的バイアスによって、画像データを効率的に非可逆圧縮(Lossy compression)する手法と見なすことができ、DDPMの生成能力の高さを別の側面から説明するものです。
DDPMの実装(概念的なシンプルな実装)
ここでは、論文に基づくDDPMのシンプルなPyTorch実装の概念を示します。
論文(CIFAR-10 の設定)と、本記事の 2 つの実装の設定は次のとおりです。本記事は猫の画像 4 枚で動きを確かめるための最小構成なので、データの量・モデルの大きさ・学習の回数を小さくしています。
| 項目 | 論文(CIFAR-10) | 本記事のスクラッチ実装 | 本記事の diffusers 版 |
|---|---|---|---|
| データ | CIFAR-10 の 5 万枚(32×32)、ランダムな左右反転 | 猫 4 枚と、その左右反転の 8 枚(32×32) | 同じ |
| ステップ数 ・ | 1,000、 から 0.02 まで線形 | 同じ | 同じ |
| U-Net | 解像度 4 段(32×32〜4×4)、チャンネル 128(公式の実装)、16×16 に注意、3,570 万パラメータ | 解像度 3 段(32×32〜8×8)、チャンネル 64、16×16 に注意、650 万パラメータ | 解像度 4 段、チャンネル 128〜256、16×16 に注意、3,570 万パラメータ |
| Dropout | 0.1 | なし | なし(diffusers の既定値) |
| 最適化 | Adam、学習率 、バッチ 128。公式の実装はウォームアップ 5,000 回・勾配のクリップ 1.0 | AdamW、学習率 、バッチ 8、勾配のクリップ 1.0 | AdamW、学習率 、バッチ 8 |
| 学習の回数 | 80 万回 | 1 万回 | 1 万回 |
| 重みの EMA | 減衰率 0.9999 | 0.999 | なし |
論文に書かれていない値(チャンネル数、ウォームアップ、勾配のクリップ)は、著者の公式の実装(hojonathanho/diffusion の run_cifar.py)の値です。パラメータ数は、本記事のコードでモデルを作って数えました。
ライブラリのインストール
PyTorch等の必要なライブラリをインストールします。
!pip install torch torchvision diffusers matplotlib tqdm
パラメータとスケジュールの定義
Forward processで使用される分散スケジュール などを定義します。
import math
import torch
import torch.nn as nn
import torch.nn.functional as F
from PIL import Image
from torchvision import transforms
import matplotlib.pyplot as plt

torch.manual_seed(0)
device = "cuda" if torch.cuda.is_available() else "cpu"

# ハイパーパラメータの設定
IMAGE_SIZE = 32  # 生成画像の解像度
T = 1000         # 論文に記載されているタイムステップ数
beta_1 = 1e-4
beta_T = 0.02

# 線形なベータスケジュールを作成(以降の計算はすべて device 上で行う)
betas = torch.linspace(beta_1, beta_T, T, device=device)
alphas = 1.0 - betas
alphas_bar = torch.cumprod(alphas, dim=0)
sqrt_alphas_bar = torch.sqrt(alphas_bar)
sqrt_one_minus_alphas_bar = torch.sqrt(1.0 - alphas_bar)
このコードブロックでは、DDPMの順過程(Forward process)で画像を徐々にノイズ化するために必要なハイパーパラメータと、数式で使用される各種スケジューラーを定義しています。
それぞれの定義が数式とどのように対応しているか、詳しく解説します。
- 解像度 IMAGE_SIZE: IMAGE_SIZE = 32 は、論文が使ったCIFAR-10と同じ解像度です。U-Netの段の構成(32 → 16 → 8)も、この大きさに合わせています。
- タイムステップ数 T: 画像を何ステップに分けてノイズ化(およびノイズ除去)するかを指定します。論文同様に T = 1000 を設定しています。
- 分散スケジュール betas (): 各ステップで追加されるノイズの分散パラメータです。ここでは beta_1 = 1e-4 () から beta_T = 0.02 () まで、torch.linspace を用いて線形(Linear)に増加するようスケジュールを設定しています。ステップが進むほど追加されるノイズの量が多くなることを意味します。
- 情報維持率 alphas (): として定義されます。そのタイムステップにおいて、ノイズを加えられる前の元の画像データがどの程度維持されるかを表す比率です。
- 累積情報維持率 alphas_bar (): として定義されます。コード内では累積積を計算する torch.cumprod 関数を用いて、初期ステップ からステップ までの の掛け合わせを求めています。
- 元画像およびノイズの係数 sqrt_alphas_bar (), sqrt_one_minus_alphas_bar (): これらは順過程の任意のステップ において、途中のステップを逐次計算することなく、元画像 から直接ノイズ画像 を一発でサンプリングするための係数です。
- スケジュールを device 上に置くこと: betas 以下の係数はすべて学習・生成の内側ループで参照されます。 CPU 上に作ってから毎回 .to(device) すると転送が繰り返し発生するため、 最初から device=device を指定して確保しています。
これらの事前計算されたテンソルを使用することで、順過程におけるサンプリング式:
を、任意のタイムステップ で定数時間()でサンプリング可能にしています。
順過程で画像が壊れていく様子
このスケジュールで、猫の画像(cat1.jpg、後の学習で使う 1 枚)にノイズを加えてみます。上の一足飛びの式を使うので、途中のステップを計算せずに、各 の を直接作れます。
# 順過程:cat1.jpg に、一足飛びの式で各ステップ t のノイズを加える
transform = transforms.Compose([
    transforms.Resize((IMAGE_SIZE, IMAGE_SIZE)),
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5)),   # [0, 1] -> [-1, 1]
])
x0 = transform(Image.open("cat1.jpg").convert("RGB")).to(device)
eps = torch.randn_like(x0)

steps = [1, 100, 250, 500, 750, 1000]          # 論文の t(1〜T)。テンソルの添字は t - 1
fig, ax = plt.subplots(1, len(steps), figsize=(15, 3))
for a, t in zip(ax, steps):
    s, n = sqrt_alphas_bar[t - 1], sqrt_one_minus_alphas_bar[t - 1]
    x_t = s * x0 + n * eps
    print(f"t = {t:4d}:元の画像の係数 {s:.3f}、ノイズの係数 {n:.3f}")
    a.imshow(((x_t.clamp(-1, 1) + 1) / 2).permute(1, 2, 0).cpu().numpy())
    a.set_title(f"t = {t}\n" + r"$\sqrt{\bar\alpha_t}$" + f" = {s:.3f}")
    a.axis("off")
plt.show()
- 前処理: 後の学習と同じく 32×32 にして、画素値を にします。ノイズ は 1 つだけ引き、すべての で同じものを使うので、違いは係数だけから生まれます。
- 見る : 論文の は 1〜 で、テンソルの添字は 0〜 なので、t - 1 で引きます。最初と最後に加え、間を 4 つ選びました。
- 表示: は をはみ出すので、clamp で切ってから に戻して表示します。
実行結果
t =    1:元の画像の係数 1.000、ノイズの係数 0.010
t =  100:元の画像の係数 0.947、ノイズの係数 0.321
t =  250:元の画像の係数 0.724、ノイズの係数 0.690
t =  500:元の画像の係数 0.280、ノイズの係数 0.960
t =  750:元の画像の係数 0.058、ノイズの係数 0.998
t = 1000:元の画像の係数 0.006、ノイズの係数 1.000
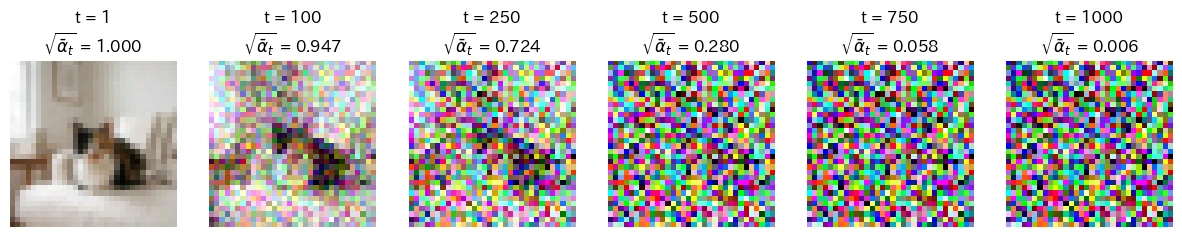
- まで: 元の画像の係数は 0.724 と、まだ 7 割残っていて、猫の形が分かります。ただしノイズの係数も 0.690 で、画素ごとの色はかなり乱れています。
- 以降: 元の画像の係数は 0.280・0.058 と急に小さくなり、画像はほぼノイズになります。 では 0.006 で、 は標準正規分布のノイズとほとんど区別できません。逆過程を から始めてよいのは、このためです。
- 線形のスケジュールの性質: は線形に増えますが、元の画像の係数 は積なので、後半ほど速く 0 に近づきます。 が 750 を超えると、どのステップもほぼノイズだけの画像になります。
モデルの定義(U-NetとTime Embeddingの実装)
ノイズを予測するニューラルネットワーク()を定義します。 入力画像 と同じ解像度のノイズ を出力し、高周波な詳細を復元するため、 スキップコネクションを持つU-Netアーキテクチャを使用します。 また、現在のステップ を伝えるための正弦波位置埋め込み(Time Embedding)と、グローバルな特徴を捉えるセルフアテンションを組み込みます。
# 1. タイムステップの正弦波位置埋め込み (Time Embedding)
def timestep_embedding(t, dim, max_period=10000):
    """タイムステップ t を正弦波でベクトル化する"""
    half = dim // 2
    freqs = torch.exp(-math.log(max_period) * torch.arange(half, device=t.device).float() / half)
    args = t.float()[:, None] * freqs[None]
    return torch.cat([torch.sin(args), torch.cos(args)], dim=-1)

# 2. 正規化とゼロ初期化のユーティリティ
def Normalize(ch, groups=32):
    """チャンネル数を割り切れる最大のグループ数で GroupNorm を作る"""
    while ch % groups != 0:
        groups //= 2
    return nn.GroupNorm(groups, ch)

def zero_module(module):
    """出力層をゼロ初期化して、学習開始時に恒等写像として振る舞わせる"""
    for p in module.parameters():
        p.detach().zero_()
    return module

# 3. Time Embedding を注入する残差ブロック
class ResBlock(nn.Module):
    def __init__(self, in_ch, out_ch, emb_dim):
        super().__init__()
        self.norm1 = Normalize(in_ch)
        self.conv1 = nn.Conv2d(in_ch, out_ch, 3, padding=1)
        self.emb_proj = nn.Linear(emb_dim, out_ch)
        self.norm2 = Normalize(out_ch)
        self.conv2 = zero_module(nn.Conv2d(out_ch, out_ch, 3, padding=1))
        self.skip = nn.Conv2d(in_ch, out_ch, 1) if in_ch != out_ch else nn.Identity()

    def forward(self, x, emb):
        h = self.conv1(F.silu(self.norm1(x)))
        h = h + self.emb_proj(F.silu(emb))[:, :, None, None]   # 時間情報を加算
        h = self.conv2(F.silu(self.norm2(h)))
        return self.skip(x) + h

# 4. セルフアテンションブロック (Self-Attention)
class AttnBlock(nn.Module):
    def __init__(self, ch, heads=4):
        super().__init__()
        self.heads = heads
        self.norm = Normalize(ch)
        self.qkv = nn.Conv2d(ch, ch * 3, 1)
        self.proj = zero_module(nn.Conv2d(ch, ch, 1))

    def forward(self, x):
        b, c, h, w = x.shape
        q, k, v = self.qkv(self.norm(x)).chunk(3, dim=1)
        shape = (b, self.heads, c // self.heads, h * w)
        q = q.reshape(shape).transpose(-2, -1)
        k = k.reshape(shape).transpose(-2, -1)
        v = v.reshape(shape).transpose(-2, -1)
        o = F.scaled_dot_product_attention(q, k, v)
        return x + self.proj(o.transpose(-2, -1).reshape(b, c, h, w))

# 5. ダウンサンプリング / アップサンプリング
class Down(nn.Module):
    def __init__(self, ch):
        super().__init__()
        self.op = nn.Conv2d(ch, ch, 3, stride=2, padding=1)
    def forward(self, x):
        return self.op(x)

class Up(nn.Module):
    def __init__(self, ch):
        super().__init__()
        self.conv = nn.Conv2d(ch, ch, 3, padding=1)
    def forward(self, x):
        return self.conv(F.interpolate(x, scale_factor=2.0, mode="nearest"))

class Seq(nn.Sequential):
    """ResBlock にだけ emb を渡し分けるコンテナ"""
    def forward(self, x, emb):
        for layer in self:
            x = layer(x, emb) if isinstance(layer, ResBlock) else layer(x)
        return x

# 6. U-Net本体(ノイズ予測器 eps_theta(x_t, t))
class UNet(nn.Module):
    def __init__(self, ch=64, ch_mult=(1, 2, 2), num_res=2, attn_res=(16,), img=IMAGE_SIZE):
        super().__init__()
        emb_dim = ch * 4
        self.ch = ch
        self.time_embed = nn.Sequential(
            nn.Linear(ch, emb_dim), nn.SiLU(), nn.Linear(emb_dim, emb_dim))

        # ---- Encoder 側 ----
        self.input_blocks = nn.ModuleList([Seq(nn.Conv2d(3, ch, 3, padding=1))])
        chans, cur, res = [ch], ch, img
        for lv, m in enumerate(ch_mult):
            for _ in range(num_res):
                layers = [ResBlock(cur, ch * m, emb_dim)]
                cur = ch * m
                if res in attn_res:
                    layers.append(AttnBlock(cur))
                self.input_blocks.append(Seq(*layers))
                chans.append(cur)
            if lv != len(ch_mult) - 1:
                self.input_blocks.append(Seq(Down(cur)))
                chans.append(cur)
                res //= 2

        # ---- Bottleneck ----
        self.middle_block = Seq(ResBlock(cur, cur, emb_dim), AttnBlock(cur),
                                ResBlock(cur, cur, emb_dim))

        # ---- Decoder 側 ----
        self.output_blocks = nn.ModuleList()
        for lv, m in list(enumerate(ch_mult))[::-1]:
            for i in range(num_res + 1):
                layers = [ResBlock(cur + chans.pop(), ch * m, emb_dim)]
                cur = ch * m
                if res in attn_res:
                    layers.append(AttnBlock(cur))
                if lv != 0 and i == num_res:
                    layers.append(Up(cur))
                    res *= 2
                self.output_blocks.append(Seq(*layers))

        self.out = nn.Sequential(Normalize(cur), nn.SiLU(),
                                 zero_module(nn.Conv2d(cur, 3, 3, padding=1)))

    def forward(self, x, t):
        emb = self.time_embed(timestep_embedding(t, self.ch))
        hs, h = [], x
        for mod in self.input_blocks:
            h = mod(h, emb)
            hs.append(h)                                    # スキップ接続を保存
        h = self.middle_block(h, emb)
        for mod in self.output_blocks:
            h = mod(torch.cat([h, hs.pop()], dim=1), emb)   # スキップ接続を結合
        return self.out(h)

# 7. 重みの指数移動平均(Ho et al. の設定を踏襲)
class EMA:
    def __init__(self, model, decay=0.999):
        self.decay = decay
        self.shadow = {k: v.detach().clone().float() for k, v in model.state_dict().items()}
    @torch.no_grad()
    def update(self, model):
        for k, v in model.state_dict().items():
            if v.dtype.is_floating_point:
                self.shadow[k].mul_(self.decay).add_(v.detach().float(), alpha=1 - self.decay)
            else:
                self.shadow[k] = v.detach().clone()
    @torch.no_grad()
    def copy_to(self, model):
        sd = model.state_dict()
        for k in sd:
            sd[k].copy_(self.shadow[k].to(sd[k].dtype))

# モデルのインスタンス化
model = UNet().to(device)
print("U-Net params: %.1fM" % (sum(p.numel() for p in model.parameters()) / 1e6))
optimizer = torch.optim.AdamW(model.parameters(), lr=2e-4)
ema = EMA(model)
この実装は、Ho et al. (2020) の U-Net の構成をそのまま縮小したもので、高品質な生成を支える以下のメカニズムをコードレベルで表現しています。
- タイムステップの埋め込み (Time Embedding): Transformerの位置エンコーディングに似た正弦波位置埋め込み(sinusoidal position embedding)で時間 をベクトル化し、nn.Linear → SiLU → nn.Linear の2層MLPで ch * 4 次元に射影しています。単一のモデルがすべてのステップに対応できるよう、このベクトルを ResBlock ごとに注入しています。
- GroupNorm と Swish: 論文の U-Net は BatchNorm ではなく GroupNorm を使います。拡散モデルでは1つのミニバッチに異なるタイムステップの入力が混在するため、バッチ統計に依存する BatchNorm はノイズレベルの違う画像どうしで統計を汚し合ってしまいます。活性化関数も ReLU ではなく Swish(F.silu)です。
- 残差ブロック (ResBlock): 各ブロックの出力は self.skip(x) + h という形で入力を素通しします。ノイズ予測は「入力とほとんど同じものを少しだけ変える」タスクなので、恒等写像を学習しやすいこの構造が効きます。
- 出力層のゼロ初期化 zero_module: 残差ブロックとアテンションブロックの最終畳み込みをゼロで初期化することで、学習開始時点で各ブロックが恒等写像として振る舞います。深いネットワークでも初期の勾配が壊れず、学習が安定します。
- スキップコネクションによる空間情報の保持: VAEのように情報を圧縮してボトルネックを通過させるのではなく、Decoder側で torch.cat によってEncoder側の特徴マップを結合しています。これにより豊富な空間情報を保持しながらノイズ予測を行うことができ、テクスチャなどの高周波な詳細の復元に貢献しています。
- 解像度の変更も学習させる: ダウンサンプリングは MaxPool ではなく stride 2 の畳み込み、アップサンプリングは最近傍補間のあとに畳み込みを置いています。プーリングと違い、どの情報を落とし・どう補間するかをネットワーク自身が学習できます。
- 16x16でのセルフアテンション: attn_res=(16,) により、32x32の入力を1段ダウンサンプリングした16x16の解像度でアテンションを適用します(論文と同じ設定)。これにより、畳み込み層だけでは捉えきれない画像全体のグローバルな依存関係を捉えます。
- EMA(重みの指数移動平均): 論文は生成に、学習中の重みそのものではなく指数移動平均をとった重みを使います。少数データでは各ステップの更新の振れがそのまま画像の破綻として現れるため、この平滑化が効きます。
これらの工夫が施されたU-Netが、後のAlgorithm 1の F.mse_loss で加えたノイズ と予測したノイズ の平均二乗誤差(MSE)を最小化する「簡略化された目的関数 」によって最適化されます。 この安定した回帰問題の反復が、画像を効率的に解凍していくプログレッシブな非可逆圧縮(Progressive decoding)の要となっています。
論文との差分 チャンネル幅(公式の実装は CIFAR-10 で 、4 段の解像度)は、猫 4 枚という最小構成に合わせて 64・3 段に縮小しています(パラメータは 3,570 万から 650 万)。EMA の減衰率 0.9999 は約 1 万回分の平均になり、本記事の学習(1 万回)では学習の初めの重みが多く残るので、約 1,000 回分の平均になる 0.999 にしています。Dropout 0.1 は 5 万枚のデータで過学習を防ぐためのもので、8 枚の画像を覚えさせる本記事では使いません。公式の実装の学習率のウォームアップ 5,000 回は、本記事の学習の半分を占めるため省きました。構造(正規化・活性化・残差・アテンション位置)は論文どおりです。
学習の定義 (Algorithm 1)
簡略化された目的関数 を用いて学習を行う1ステップを定義します。
def train_step(x_0):
    model.train()
    optimizer.zero_grad()

    batch_size = x_0.shape[0]

    # 1. タイムステップtを一様分布からランダムにサンプリング
    t = torch.randint(0, T, (batch_size,), device=device).long()

    # 2. ガウスノイズ epsilon を生成
    noise = torch.randn_like(x_0)

    # 3. Forward process: x_t を計算 (x_0 と noise から閉形式で求まる)
    x_t = (sqrt_alphas_bar[t].view(-1, 1, 1, 1) * x_0
           + sqrt_one_minus_alphas_bar[t].view(-1, 1, 1, 1) * noise)

    # 4. モデルでノイズを予測
    predicted_noise = model(x_t, t)

    # 5. 損失関数の計算 (単純な平均二乗誤差: MSE)
    loss = F.mse_loss(predicted_noise, noise)

    loss.backward()
    torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)   # 公式の実装と同じ勾配のクリップ
    optimizer.step()
    ema.update(model)                                         # 重みの移動平均を更新

    return loss.item()

# ----------------------------------------------------
# 猫の画像 (cat1.jpg ~ cat4.jpg) の読み込みと前処理
# ----------------------------------------------------
# 画像をモデルへの入力サイズにリサイズし、[-1, 1] に正規化
transform = transforms.Compose([
    transforms.Resize((IMAGE_SIZE, IMAGE_SIZE)),  # 32x32にリサイズ
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))  # [0, 1] -> [-1, 1]
])

image_paths = ["cat1.jpg", "cat2.jpg", "cat3.jpg", "cat4.jpg"]
images = []

for path in image_paths:
    try:
        img = Image.open(path).convert("RGB")
    except FileNotFoundError:
        # ファイルがない場合は実行時にエラーにならないよう、ダミー画像を自動生成
        img = Image.new("RGB", (IMAGE_SIZE, IMAGE_SIZE), color=(128, 128, 128))
    images.append(transform(img))

# 4枚の画像をスタックしてバッチを作成 (Shape: [4, 3, 32, 32])
x_0 = torch.stack(images).to(device)
# 論文と同じくランダム左右反転を使う。ここでは4枚しかないため、
# 反転画像もデータとして常に含めて8枚に拡張する (Shape: [8, 3, 32, 32])
x_0 = torch.cat([x_0, torch.flip(x_0, dims=[3])], dim=0)

# 訓練ループの実行 (10000エポック)
epochs = 10000
for epoch in range(epochs):
    loss_val = train_step(x_0)
    if (epoch + 1) % 1000 == 0:
        print(f"Epoch {epoch+1}/{epochs} - Loss: {loss_val:.4f}")

# 生成には平滑化された重みを使う
ema.copy_to(model)
このコードブロックでは、論文の Algorithm 1(学習手順)に基づいた1ステップの更新処理 train_step(x_0) と、実際に猫の画像データ(cat1.jpg 〜 cat4.jpg)を読み込んで複数エポック学習させる訓練ループを実装しています。 検証で利用する際には以下の画像をダウンロードして下さい。
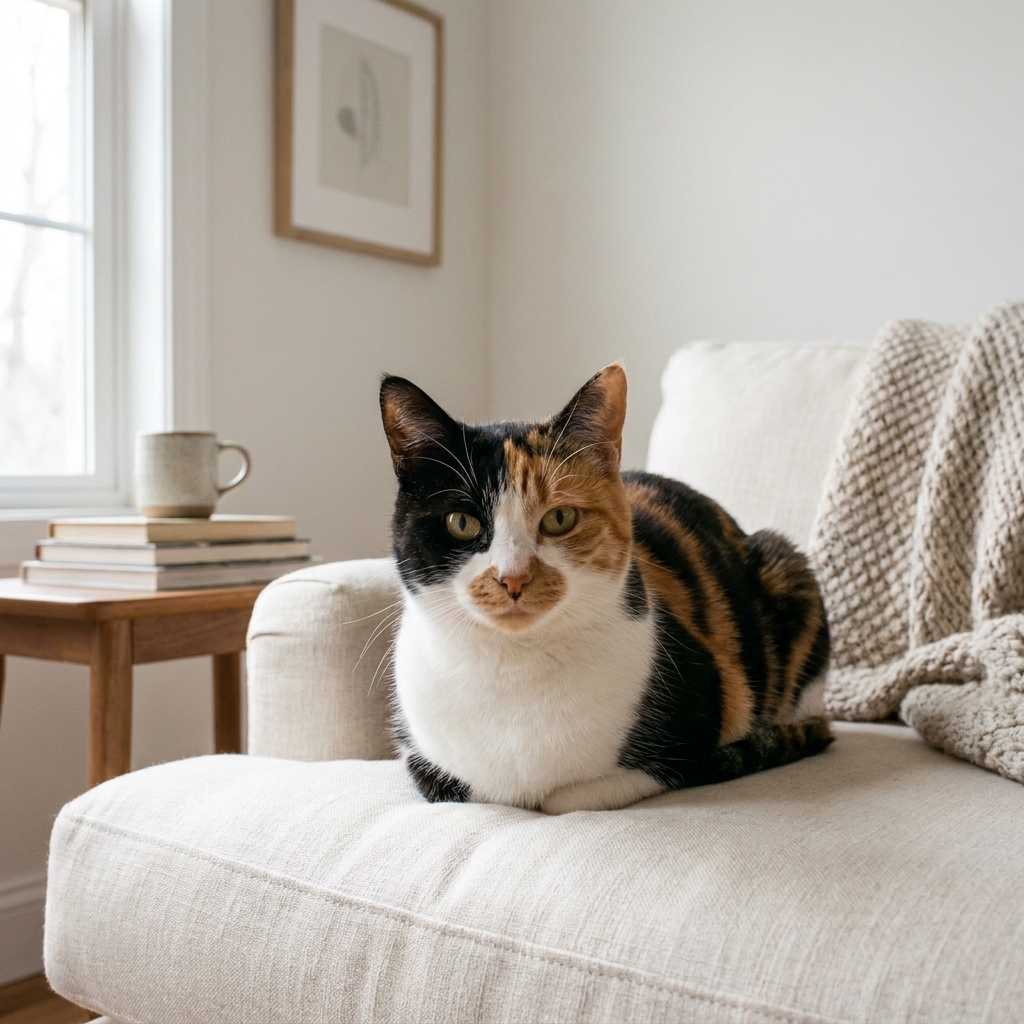
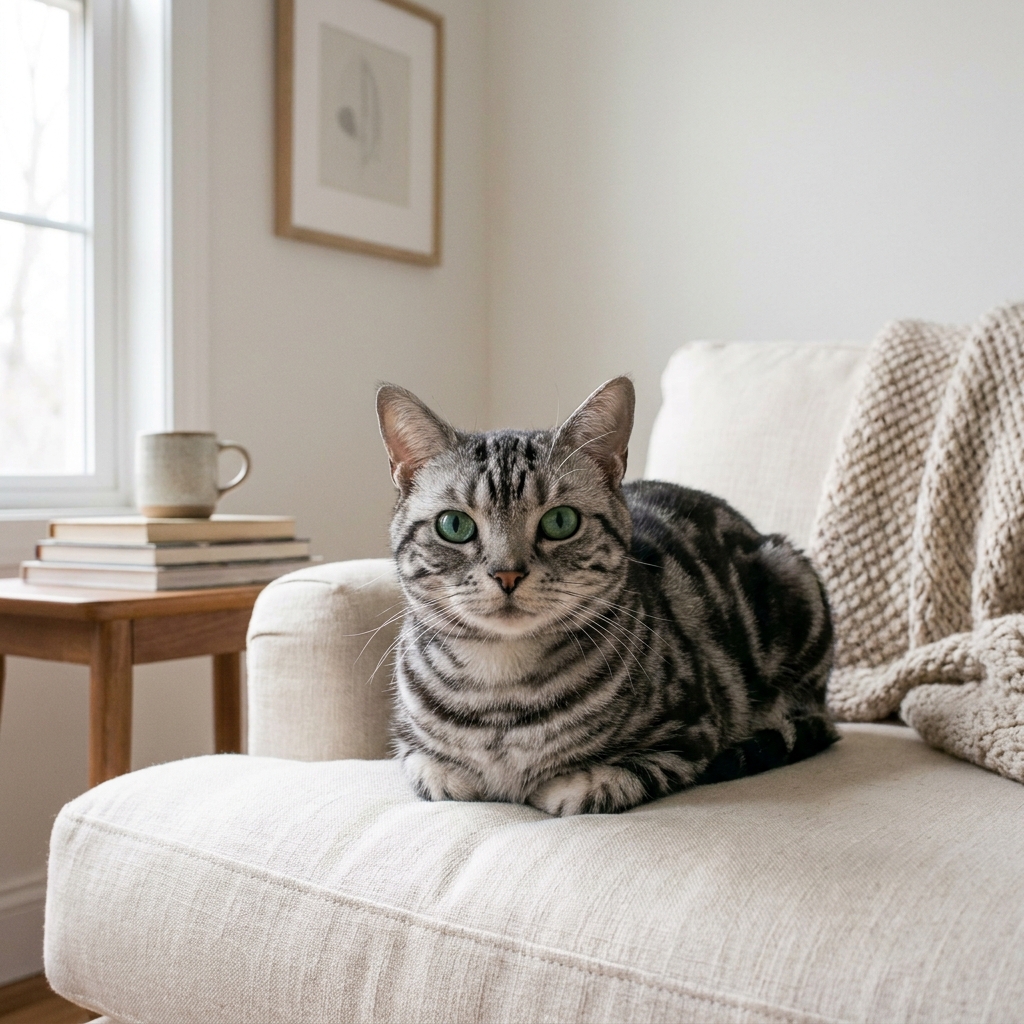
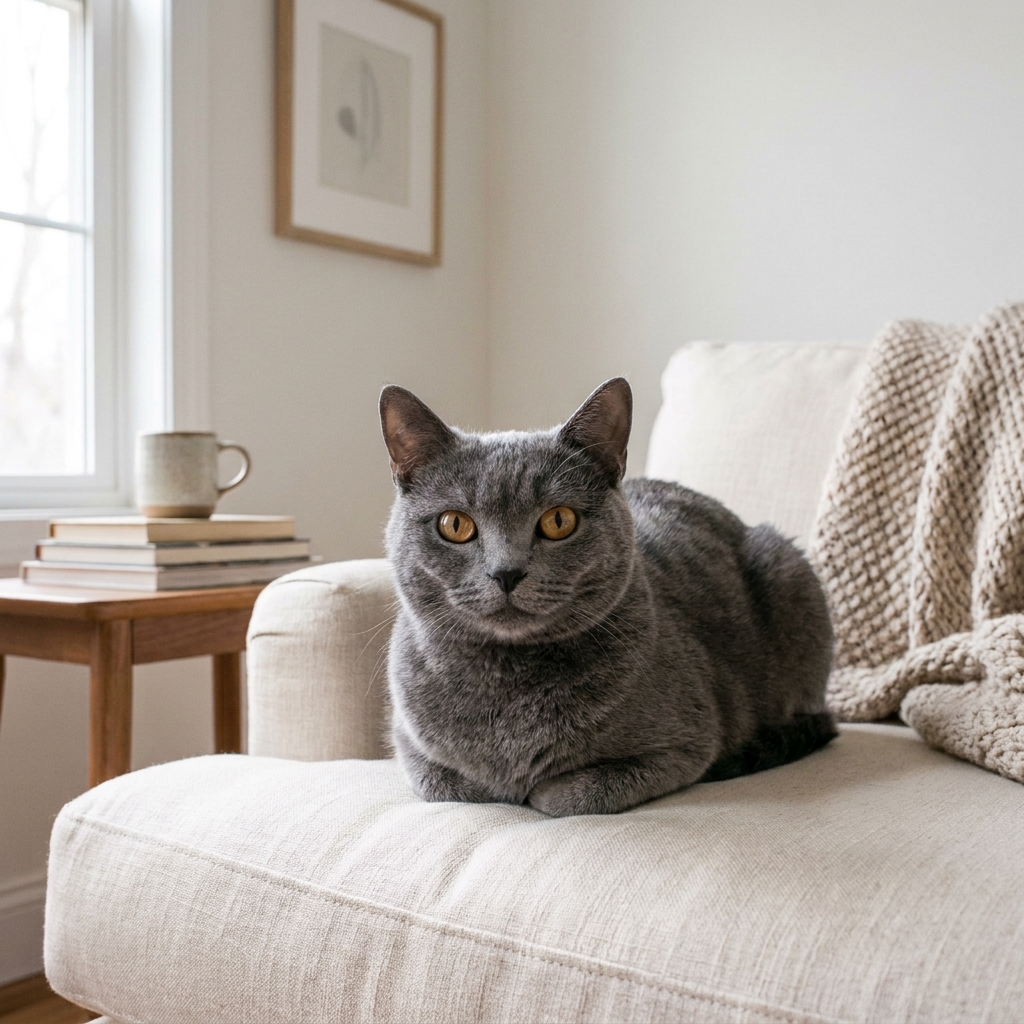
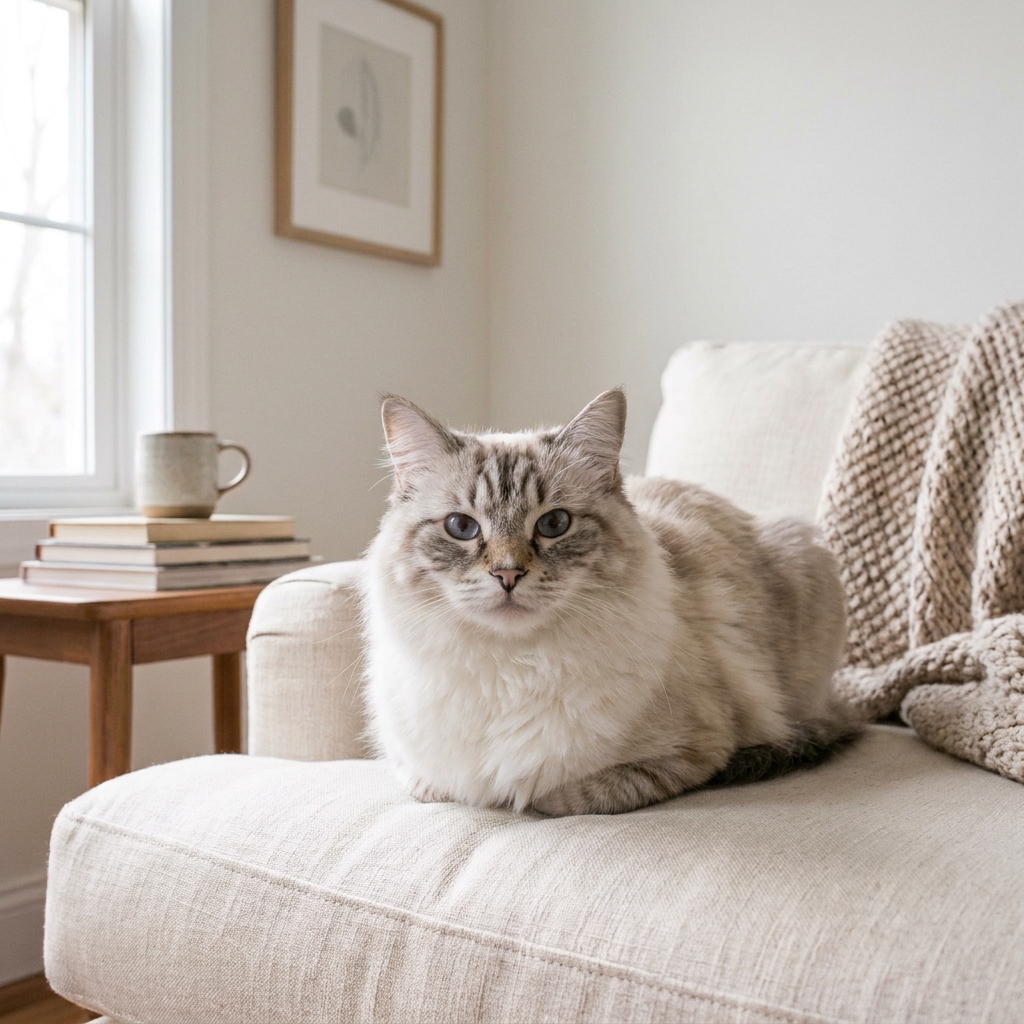
(Google AI Studioで生成)
処理の全体の流れと、前述の数式との対応について解説します。
-
1ステップの学習処理 train_step(x_0):
- 引数として元画像(ノイズが加えられていないデータ)のテンソルを受け取ります。
- torch.randint を用いて、ミニバッチ内の画像ごとに から までのタイムステップ を一様分布からランダムにサンプリングします。これは、ニューラルネットワークがすべてのタイムステップのノイズ除去をバランスよく学習できるようにするためです。
- 次に、元画像と同じ解像度の標準正規分布に従うガウスノイズ (noise)を生成します。
- 事前計算されたスケジューラ係数 sqrt_alphas_bar () と sqrt_one_minus_alphas_bar () を用いて、順過程の式(一括サンプリング公式)に基づきノイズ画像 x_t を作成します。
- ノイズ画像 x_t とタイムステップ t をモデル(U-Net)に入力し、予測されたノイズ predicted_noise () を取得します。
- F.mse_loss を用いて、実際に加えたノイズ noise と、モデルが予測したノイズ predicted_noise との単純な平均二乗誤差(MSE)を計算し、これを損失(Loss)としてバックプロパゲーションを行います。これが、簡略化された目的関数 の実装そのものです。
- 逆伝播のあと、clip_grad_norm_ で勾配のノルムを1.0に制限しています。論文の実装でも用いられている安定化で、大きな (ほぼ純粋なノイズ)が引いたときの外れ値的な勾配を抑えます。
- 最後に ema.update(model) を呼び、更新後の重みを指数移動平均に反映させます。学習ループが終わったあと ema.copy_to(model) で平滑化された重みをモデルへ書き戻し、生成にはそちらを使います。
- 最適化には論文と同じ学習率 を使用しています。
-
画像の読み込みと前処理:
- transforms.Compose を用いて、画像を U-Net の入力解像度である 32x32 ピクセルにリサイズ(transforms.Resize)し、テンソル化(transforms.ToTensor)した後、transforms.Normalize によってピクセル値の範囲を [0, 1] から [-1, 1] に変換(正規化)しています。拡散モデルでは一般に、ノイズとの親和性や学習の安定化のためにデータを [-1, 1] で扱うため、この正規化は極めて重要です。
- 指定された 4 枚の猫の画像(cat1.jpg 〜 cat4.jpg)を Image.open で読み込み、前処理を適用した上で、torch.stack でバッチ化されたテンソル x_0(Shape: [4, 3, 32, 32])を作成しています。
- 論文はCIFAR-10の学習にランダムな左右反転(random horizontal flip)を用いています。ここでは元画像が4枚しかないため、反転画像も固定的にバッチへ含めることで実質8枚に拡張しています。
-
訓練ループの実行:
- 作成したバッチ x_0 を用いて、設定したエポック数(ここでは 10000 エポック)だけ train_step を繰り返し呼び出し、モデルの重みを最適化していきます。10,000エポックにするのは、4枚(左右反転を含めて8枚)という少ない画像を、損失が十分に下がるまで繰り返し学習させるためです。学習データを覚えてしまう(過学習する)ことは承知のうえで、ノイズから画像が組み上がる過程を見るのが目的です。
DDPMの学習では、データ に対してランダムなステップ のノイズを加え、その加えられたノイズ をモデルに予測させ、真のノイズとのMSE(平均二乗誤差)を計算します。
推論の実行 (Algorithm 2)
学習済みのモデルを用いて、純粋なノイズから画像を生成するサンプリング過程を定義します。
@torch.no_grad()
def sample_image(model, image_size=32, batch_size=1):
    model.eval()

    # 1. 初期状態: 純粋なガウスノイズ x_T をサンプリング
    x = torch.randn((batch_size, 3, image_size, image_size), device=device)

    # 2. t = T, ..., 1 に対してループ
    for i in reversed(range(0, T)):
        # バッチ内の全画像に同じタイムステップ i を与える
        t = torch.full((batch_size,), i, device=device, dtype=torch.long)

        # モデルによって予測されたノイズ
        predicted_noise = model(x, t)

        # 係数の取得
        alpha = alphas[i]
        alpha_bar = alphas_bar[i]
        beta = betas[i]

        # 確率的要素 z の追加 (t > 0 の場合)
        z = torch.randn_like(x) if i > 0 else torch.zeros_like(x)

        # ランジュバン動力学に似た逆過程の計算
        x = (1 / torch.sqrt(alpha)) * (x - ((1 - alpha) / torch.sqrt(1 - alpha_bar)) * predicted_noise)
        x = x + torch.sqrt(beta) * z

    # [-1, 1]の出力を[0, 1]にスケーリング
    x = (x.clamp(-1, 1) + 1) / 2
    return x

# ----------------------------------------------------
# 推論の実行と生成された画像の可視化
# ----------------------------------------------------
generated_images = sample_image(model, image_size=IMAGE_SIZE, batch_size=4)

# [B, C, H, W] から matplotlib が解釈可能な [B, H, W, C] 形式に変換し NumPy 配列化
generated_images = generated_images.permute(0, 2, 3, 1).cpu().numpy()

# 1x4 のグリッドで画像を描画
fig, axes = plt.subplots(1, 4, figsize=(12, 3))
for idx, img in enumerate(generated_images):
    axes[idx].imshow(img)
    axes[idx].axis("off")
    axes[idx].set_title(f"Generated {idx+1}")

plt.tight_layout()
plt.show()
このコードブロックでは、論文の Algorithm 2(サンプリング手順)に基づく画像生成関数 sample_image(model) と、生成されたテンソル画像を matplotlib を用いてグリッド表示するための可視化コードを実装しています。
逆過程(Reverse process)の数式との対応、およびテンソルの変形処理について詳しく解説します。
-
初期状態のサンプリング:
- torch.randn を用いて、純粋なガウスノイズ を初期画像(潜在変数)としてサンプリングします。画像生成の出発点となるノイズテンソルの Shape は [batch_size, 3, image_size, image_size] です。
-
逆過程の再帰ループ:
- から に向けて逆向きにループを回します(コード内では 0-indexed に合わせて reversed(range(0, T)) としています)。
- 各ステップにおいて、現在の画像 x () とタイムステップ t をモデルに入力し、予測されたノイズ predicted_noise () を取得します。
- ループ内で適用される以下のサンプリング更新式は、DDPMの核心部分です。
これをコード内の演算処理に変換したのが以下の部分です。
ここで、分散 (コード内の beta)に比例した確率的ノイズ (コード内の z)を追加することで、ランジュバン動力学に似たサンプリング過程を実現しています。ただし、最後のステップ (インデックス 0)のときは、それ以上ノイズを追加する必要がないため、z = torch.zeros_like(x) として確率的ノイズをゼロに設定します。x = (1 / torch.sqrt(alpha)) * (x - ((1 - alpha) / torch.sqrt(1 - alpha_bar)) * predicted_noise)x = x + torch.sqrt(beta) * z
- タイムステップは torch.full((batch_size,), i) としてバッチ全体に展開します。形状 (1,) のまま渡してもブロードキャストで動作しますが、バッチサイズと揃えておくほうが学習時(各画像に異なる を割り当てる)と対称で、意図が明確になります。
- 分散には論文 Algorithm 2 の記載どおり を採用しています。論文はもう一方の選択肢として事後分散 も挙げており、CIFAR-10では両者で同等の結果が得られたと報告されています。
-
出力値のクランプとスケーリング:
- モデルの学習時に入力を [-1, 1] に正規化していたため、最終ステップ の出力値も [-1, 1] 付近に分布します。画像ファイルとして保存・表示するために、x.clamp(-1, 1) で範囲を限定し、さらに (x + 1) / 2 によって [0, 1] の範囲に正規化(スケーリング)して返します。
-
生成された画像の可視化処理:
- sample_image から返されたテンソルは、PyTorchの標準フォーマットである [Batch, Channel, Height, Width] の次元順になっています。
- これを matplotlib で表示できるようにするため、permute(0, 2, 3, 1) を使用して次元を [Batch, Height, Width, Channel](HWC形式)に並び替えます。
- cpu().numpy() でテンソルをCPUメモリへ移動し、NumPy配列に変換します。
- plt.subplots で生成枚数分の表示領域を用意し、imshow で各画像を表示します。axis("off") で不要なピクセル座標軸を非表示にすることで、生成された画像をすっきりとグリッド表示させています。
実行結果
Epoch 1000/10000 - Loss: 0.0061
Epoch 2000/10000 - Loss: 0.0025
Epoch 3000/10000 - Loss: 0.0047
Epoch 4000/10000 - Loss: 0.0016
Epoch 5000/10000 - Loss: 0.0012
Epoch 6000/10000 - Loss: 0.0071
Epoch 7000/10000 - Loss: 0.0026
Epoch 8000/10000 - Loss: 0.0014
Epoch 9000/10000 - Loss: 0.0031
Epoch 10000/10000 - Loss: 0.0013
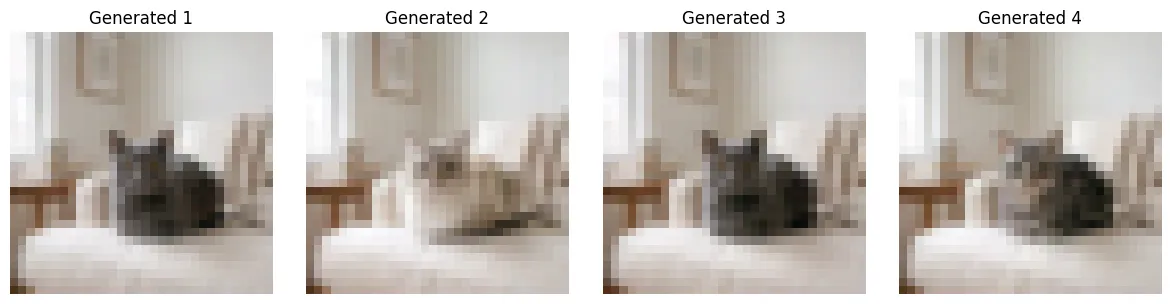
10000エポックの学習後、純粋なノイズから画像を生成した結果、学習データであるcat1.jpg〜cat4.jpgの特徴(灰色や茶色の毛色、猫らしい輪郭)を捉えた画像が生成されていることが確認できます。 画像の解像度は32x32ピクセルと低いため、細部は不鮮明ですが、DDPMがノイズから意味のある画像を再構築するプロセスを概念的に示しています。
HuggingfaceのDDPMライブラリによる実装
ライブラリのインポート
Hugging Faceの diffusers ライブラリなど、DDPMの実装と学習に必要なライブラリをインストールします。
!pip install torch torchvision diffusers pillow matplotlib
- torch, torchvision: PyTorch本体と、画像処理関連のユーティリティ。
- diffusers: Hugging Faceが提供する拡散モデルのためのライブラリ。U-Netモデルやスケジューラなどがプリセットされており、簡単に利用できます。
- pillow, matplotlib: 画像の読み込みや可視化に使用します。
Hugging Face DDPMによる学習・推論
Hugging Faceのdiffusersライブラリが提供するUNet2DModelとDDPMSchedulerを用いて、DDPMの学習と推論をより抽象化されたコードで実行します。これにより、自前でU-Netやスケジューラを実装する必要がなくなり、より簡単に拡散モデルを試すことができます。
import torch
import torch.nn.functional as F
from PIL import Image
from torchvision import transforms
import matplotlib.pyplot as plt
from diffusers import UNet2DModel, DDPMScheduler

# ハイパーパラメータの設定
IMAGE_SIZE = 32
device = "cuda" if torch.cuda.is_available() else "cpu"

# ----------------------------------------------------
# 1. 猫の画像 (cat1.jpg ~ cat4.jpg) の読み込みと前処理
# ----------------------------------------------------
transform = transforms.Compose([
    transforms.Resize((IMAGE_SIZE, IMAGE_SIZE)),
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))
])

image_paths = ["cat1.jpg", "cat2.jpg", "cat3.jpg", "cat4.jpg"]
images = []

for path in image_paths:
    try:
        img = Image.open(path).convert("RGB")
    except FileNotFoundError:
        # 画像がない場合のダミー生成も元のまま
        img = Image.new("RGB", (IMAGE_SIZE, IMAGE_SIZE), color=(128, 128, 128))
    images.append(transform(img))

x_0 = torch.stack(images).to(device)
# 前の実装と同様に左右反転を追加して8枚にする
x_0 = torch.cat([x_0, torch.flip(x_0, dims=[3])], dim=0)

# ----------------------------------------------------
# 2. Hugging Face のモデルとスケジューラの定義
# ----------------------------------------------------
model = UNet2DModel(
    sample_size=IMAGE_SIZE,  # 32
    in_channels=3,
    out_channels=3,
    layers_per_block=2,
    # 一般的な32x32向けのチャンネル数(4段階)
    block_out_channels=(128, 256, 256, 256),
    down_block_types=(
        "DownBlock2D",       # 32x32 -> 16x16
        "AttnDownBlock2D",   # 16x16 -> 8x8 (ここでAttention)
        "DownBlock2D",       # 8x8 -> 4x4
        "DownBlock2D",       # 4x4
    ),
    up_block_types=(
        "UpBlock2D",         # 4x4 -> 8x8
        "UpBlock2D",         # 8x8 -> 16x16
        "AttnUpBlock2D",     # 16x16 -> 32x32 (ここでAttention)
        "UpBlock2D",         # 32x32
    ),
).to(device)

# 論文のベータスケジュール(1000ステップ、1e-4 ~ 0.02 の線形)を再現
scheduler = DDPMScheduler(
    num_train_timesteps=1000,
    beta_start=1e-4,
    beta_end=0.02,
    beta_schedule="linear"
)

optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4)

# ----------------------------------------------------
# 3. 訓練ループ
# ----------------------------------------------------
epochs = 10000
batch_size = x_0.shape[0]

for epoch in range(epochs):
    model.train()
    optimizer.zero_grad()

    # ガウスノイズの生成
    noise = torch.randn_like(x_0).to(device)

    # タイムステップをランダムにサンプリング
    timesteps = torch.randint(0, scheduler.config.num_train_timesteps, (batch_size,), device=device).long()

    # Forward process: スケジューラを使って入力画像にノイズを追加 (数式の計算を自動化)
    noisy_images = scheduler.add_noise(x_0, noise, timesteps)

    # モデルでノイズを予測
    noise_pred = model(noisy_images, timesteps).sample

    # 損失関数の計算
    loss = F.mse_loss(noise_pred, noise)

    loss.backward()
    optimizer.step()

    if (epoch + 1) % 1000 == 0:
        print(f"Epoch {epoch+1}/{epochs} - Loss: {loss.item():.4f}")

# ----------------------------------------------------
# 4. 推論の実行と生成された画像の可視化
# ----------------------------------------------------
model.eval()

# 生成する画像の枚数
gen_batch_size = 4

# 初期状態: 純粋なガウスノイズ
sample = torch.randn((gen_batch_size, 3, IMAGE_SIZE, IMAGE_SIZE)).to(device)

# 推論用のタイムステップを設定 (1000ステップ)
scheduler.set_timesteps(1000)

with torch.no_grad():
    for t in scheduler.timesteps:
        # モデルによって予測されたノイズ
        residual = model(sample, t).sample

        # 逆過程の計算 (自動で係数を計算してノイズを除去)
        sample = scheduler.step(residual, t, sample).prev_sample

# [-1, 1]の出力を[0, 1]にスケーリングして NumPy 配列に変換
generated_images = (sample.clamp(-1, 1) + 1) / 2
generated_images = generated_images.permute(0, 2, 3, 1).cpu().numpy()

# 1x4 のグリッドで画像を描画
fig, axes = plt.subplots(1, 4, figsize=(12, 3))
for idx, img in enumerate(generated_images):
    axes[idx].imshow(img)
    axes[idx].axis("off")
    axes[idx].set_title(f"Generated {idx+1}")

plt.tight_layout()
plt.show()
このコードは、Hugging Faceのdiffusersライブラリを使用してDDPMの学習と推論を行う完全なパイプラインです。先ほどの自前実装と比較すると、多くの複雑な処理がライブラリによって抽象化されていることがわかります。
- UNet2DModel: DDPM論文で提案されたものと同様のU-Netアーキテクチャを提供します。block_out_channelsやdown_block_types、up_block_typesといった引数を指定するだけで、柔軟にモデル構造を定義できます。ここでは、先ほどの自前実装や論文の設定に合わせて、解像度が16x16になる層でAttnDownBlock2DとAttnUpBlock2Dを使用し、セルフアテンションを組み込んでいます。チャンネル数と学習率は、diffusersのDDPMの学習例でよく使われる設定に合わせています。自前実装より大きなモデルなので、学習率を半分()にしています。
- DDPMScheduler: 論文で提案された線形(linear)なベータスケジュールをbeta_schedule="linear"と指定するだけで再現します。学習時にはadd_noiseメソッドで自動的にノイズを付加し、推論時にはstepメソッドで逆過程の計算を自動で行うため、複雑な係数計算を自前で実装する必要がありません。
- 訓練ループ: スケジューラのadd_noiseメソッドを使うことで、順過程の式が隠蔽され、「元の画像、ノイズ、タイムステップ」を渡すだけでノイズ付加後の画像を得られます。
- 推論ループ: スケジューラのtimestepsとstepメソッドを使うことで、逆過程のループが非常にシンプルになります。開発者はノイズ予測モデルの出力residualをstepに渡すだけで、自動的に次のステップの画像prev_sampleが計算されます。
このようにdiffusersライブラリを活用することで、研究者や開発者は拡散モデルのコアロジック(U-Netの改善など)に集中しやすくなります。
実行結果
上記のコードを実行すると以下の結果が得られます。
Epoch 1000/10000 - Loss: 0.0106
Epoch 2000/10000 - Loss: 0.0045
Epoch 3000/10000 - Loss: 0.0046
Epoch 4000/10000 - Loss: 0.0017
Epoch 5000/10000 - Loss: 0.0036
Epoch 6000/10000 - Loss: 0.0069
Epoch 7000/10000 - Loss: 0.0010
Epoch 8000/10000 - Loss: 0.0062
Epoch 9000/10000 - Loss: 0.0021
Epoch 10000/10000 - Loss: 0.0076
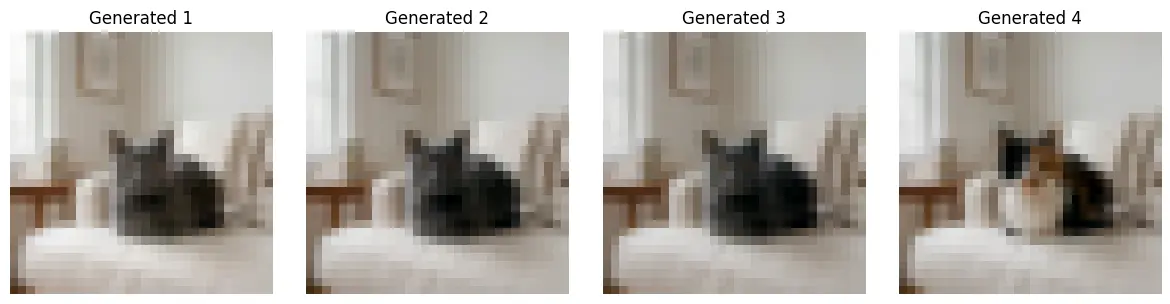
diffusersライブラリを用いた実装でも、自前実装と同様に、学習データの特徴を反映した猫のような画像が生成されました。解像度が32x32であるため細部は不明瞭ですが、より構造化されたライブラリを使ってもDDPMの基本的な生成能力が再現できることを示しています。
まとめ
本記事では、現在の画像生成AIの礎を築いた DDPM (Denoising Diffusion Probabilistic Models) について、その理論的背景から具体的な実装までを段階的に解説しました。
記事を通じて、以下の内容を学習しました。
- 理論的背景: VAEやGANが抱えていた課題を、DDPMが「微小なノイズ除去の反復」というアプローチでどのように克服したかを解説しました。
- 数学的根拠: マルコフ連鎖を用いることで、学習を効率化するショートカット(閉形式)や、逆過程を単純なガウス分布で近似できる数学的な裏付けを学びました。
- PyTorchによる概念実装: 論文に沿ったForwardプロセス(ノイズ付加)とReverseプロセス(サンプリング)を、U-Netやタイムステップ埋め込みを含めてゼロから実装しました。
- Hugging Face diffusersによる実装: UNet2DModelやDDPMSchedulerといった高レベルなAPIを用いることで、同じDDPMの処理をより抽象的かつ簡潔に実装する方法を確認しました。
DDPMは、画像だけでなく音声や他のモダリティにも応用が広がっており、生成的機械学習システムにおいて非常に強力で有望な技術です。本記事が、その仕組みの理論的な理解から実践的な実装までの一助となれば幸いです。
参考文献
- J. Ho, A. Jain, P. Abbeel (2020). Denoising Diffusion Probabilistic Models. NeurIPS 2020.
- J. Ho. hojonathanho/diffusion. GitHub.
- Google. google/ddpm-cifar10-32. Hugging Face.
本記事の文章・構成の一部に生成AIを使用しています。