DDPMにおける変分下界(ELBO)の導出とノイズ予測 MSE への帰着 画像は、Geminiで作成 )
DDPM の学習で最小化する変分下界(ELBO)を時刻ごとの KL ダイバージェンスに分解し、条件付きの逆過程 q ( x t − 1 ∣ x t , x 0 ) q(\mathbf{x}_{t-1} \mid \mathbf{x}_t, \mathbf{x}_0) q ( x t − 1 ∣ x t , x 0 ) L simple L_{\text{simple}} L simple
概要と全体像 DDPM(Denoising Diffusion Probabilistic Models) において、
負の対数尤度の最小化は変分下界(ELBO: Evidence Lower Bound) の最大化(=ELBO損失 L VLB L_{\text{VLB}} L VLB
一見複雑な確率分布のカルバック・ライブラー(KL)ダイバージェンスの総和である L VLB L_{\text{VLB}} L VLB ϵ \boldsymbol{\epsilon} ϵ ϵ θ \boldsymbol{\epsilon}_\theta ϵ θ L simple L_{\text{simple}} L simple L simple L_{\text{simple}} L simple DDPM(拡散モデル)とは?Pythonでスクラッチ実装して仕組みを理解する 」で解説しています。
マルコフ性の利用によるELBOの項別分解 条件付き逆過程 q ( x t − 1 ∣ x t , x 0 ) q(\mathbf{x}_{t-1} \vert{} \mathbf{x}_t, \mathbf{x}_0) q ( x t − 1 ∣ x t , x 0 ) 平均 μ θ \boldsymbol{\mu}_\theta μ θ ϵ θ \boldsymbol{\epsilon}_\theta ϵ θ 全体の流れを図にすると、次のようになります。最後の重みを外す段階だけは等式ではなく、損失の重み付けの変更です。
ELBO の展開と項の分解 なぜ負の対数尤度を最小化するのか? 生成モデルの根本的な目的は、モデルが学習データ(実画像など)x 0 \mathbf{x}_0 x 0 尤度 p θ ( x 0 ) p_\theta(\mathbf{x}_0) p θ ( x 0 ) することです。
これは統計学における最尤推定(Maximum Likelihood Estimation: MLE)のアプローチであり、
数学的にはその対数をとってマイナスを掛けた負の対数尤度 − log p θ ( x 0 ) -\log p_\theta(\mathbf{x}_0) − log p θ ( x 0 ) することと同値になります。
モデルが真のデータ分布に近づくほど、この値は小さくなります。
潜在変数と変分下界(ELBO)の導入 しかし、データ x 0 x_0 x 0 − log p θ ( x 0 ) -\log p_\theta(x_0) − log p θ ( x 0 ) x 0 x_0 x 0 x 1 : T x_{1:T} x 1 : T
log p θ ( x 0 ) = log ∫ p θ ( x 0 : T ) d x 1 : T \log p_\theta(x_0) = \log \int p_\theta(x_{0:T}) dx_{1:T} log p θ ( x 0 ) = log ∫ p θ ( x 0 : T ) d x 1 : T 数学や機械学習の解析において、このように対数関数の内側に積分や総和が含まれる形(log ∫ f ( x ) d x \log \int f(x) dx log ∫ f ( x ) d x
そこで、この複雑な積分を回避するため、拡散過程(順過程)の確率分布 q ( x 1 : T ∣ x 0 ) q(x_{1:T} \mid x_0) q ( x 1 : T ∣ x 0 )
log p θ ( x 0 ) = log ∫ q ( x 1 : T ∣ x 0 ) p θ ( x 0 : T ) q ( x 1 : T ∣ x 0 ) d x 1 : T = log E q ( x 1 : T ∣ x 0 ) [ p θ ( x 0 : T ) q ( x 1 : T ∣ x 0 ) ] \log p_\theta(x_0) = \log \int q(x_{1:T} \mid x_0) \frac{p_\theta(x_{0:T})}{q(x_{1:T} \mid x_0)} dx_{1:T} = \log \mathbb{E}_{q(x_{1:T} \mid x_0)} \left[ \frac{p_\theta(x_{0:T})}{q(x_{1:T} \mid x_0)} \right] log p θ ( x 0 ) = log ∫ q ( x 1 : T ∣ x 0 ) q ( x 1 : T ∣ x 0 ) p θ ( x 0 : T ) d x 1 : T = log E q ( x 1 : T ∣ x 0 ) [ q ( x 1 : T ∣ x 0 ) p θ ( x 0 : T ) ] ここで、対数関数(log \log log イェンセンの不等式 (Jensen's Inequality) log E [ f ( x ) ] ≥ E [ log f ( x ) ] \log \mathbb{E}[f(x)] \ge \mathbb{E}[\log f(x)] log E [ f ( x )] ≥ E [ log f ( x )]
log p θ ( x 0 ) ≥ E q ( x 1 : T ∣ x 0 ) [ log p θ ( x 0 : T ) q ( x 1 : T ∣ x 0 ) ] \log p_\theta(\mathbf{x}_0) \ge \mathbb{E}_{q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \left[ \log \frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \right] log p θ ( x 0 ) ≥ E q ( x 1 : T ∣ x 0 ) [ log q ( x 1 : T ∣ x 0 ) p θ ( x 0 : T ) ] この不等式は、特定の1つのデータ点 x 0 \mathbf{x}_0 x 0 に対する対数尤度の下界を示しています。
しかし、モデルの学習において最小化したいのは、特定の1点に対する誤差ではなく、データセット全体(すなわちデータ分布 q ( x 0 ) q(\mathbf{x}_0) q ( x 0 ) です。
そのため、まず両辺にマイナスを掛けて不等号の向きを反転させた上で、データ分布 q ( x 0 ) q(\mathbf{x}_0) q ( x 0 ) E q ( x 0 ) \mathbb{E}_{q(\mathbf{x}_0)} E q ( x 0 )
E q ( x 0 ) [ − log p θ ( x 0 ) ] ≤ E q ( x 0 ) [ E q ( x 1 : T ∣ x 0 ) [ − log p θ ( x 0 : T ) q ( x 1 : T ∣ x 0 ) ] ] \mathbb{E}_{q(\mathbf{x}_0)}\left[ -\log p_\theta(\mathbf{x}_0) \right] \le \mathbb{E}_{q(\mathbf{x}_0)} \left[ \mathbb{E}_{q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \left[ -\log \frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \right] \right] E q ( x 0 ) [ − log p θ ( x 0 ) ] ≤ E q ( x 0 ) [ E q ( x 1 : T ∣ x 0 ) [ − log q ( x 1 : T ∣ x 0 ) p θ ( x 0 : T ) ] ] 確率の乗法定理 q ( x 0 : T ) = q ( x 0 ) q ( x 1 : T ∣ x 0 ) q(\mathbf{x}_{0:T}) = q(\mathbf{x}_0) q(\mathbf{x}_{1:T} \vert \mathbf{x}_0) q ( x 0 : T ) = q ( x 0 ) q ( x 1 : T ∣ x 0 ) q ( x 0 ) q(\mathbf{x}_0) q ( x 0 ) q ( x 1 : T ∣ x 0 ) q(\mathbf{x}_{1:T} \vert \mathbf{x}_0) q ( x 1 : T ∣ x 0 ) q ( x 0 : T ) q(\mathbf{x}_{0:T}) q ( x 0 : T )
E q ( x 0 ) [ − log p θ ( x 0 ) ] ≤ E q ( x 0 : T ) [ − log p θ ( x 0 : T ) q ( x 1 : T ∣ x 0 ) ] \mathbb{E}_{q(\mathbf{x}_0)}\left[ -\log p_\theta(\mathbf{x}_0) \right] \le \mathbb{E}_{q(\mathbf{x}_{0:T})}\left[ -\log \frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \right] E q ( x 0 ) [ − log p θ ( x 0 ) ] ≤ E q ( x 0 : T ) [ − log q ( x 1 : T ∣ x 0 ) p θ ( x 0 : T ) ] これによって、左辺(本来最小化したい、データセット全体の平均的な負の対数尤度)を間接的に最小化するための、計算可能な上界が得られます。これが L VLB L_{\text{VLB}} L VLB
L VLB = E q [ − log p θ ( x 0 : T ) q ( x 1 : T ∣ x 0 ) ] L_{\text{VLB}} = \mathbb{E}_{q}\left[ -\log \frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \right] L VLB = E q [ − log q ( x 1 : T ∣ x 0 ) p θ ( x 0 : T ) ] (※以降、数式を簡潔にするため、データとすべてのノイズ状態の同時分布 q ( x 0 : T ) q(\mathbf{x}_{0:T}) q ( x 0 : T ) E q ( x 0 : T ) \mathbb{E}_{q(\mathbf{x}_{0:T})} E q ( x 0 : T ) E q \mathbb{E}_{q} E q
直接計算できない負の対数尤度の代わりに、この L VLB L_{\text{VLB}} L VLB
マルコフ連鎖の性質やベイズの定理を用いてこの式を展開していくと、各タイムステップ t t t
この変形プロセスを、ステップ・バイ・ステップで追ってみましょう。
L VLB L_{\text{VLB}} L VLB L VLB L_{\text{VLB}} L VLB p θ ( x 0 : T ) q ( x 1 : T ∣ x 0 ) \frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} q ( x 1 : T ∣ x 0 ) p θ ( x 0 : T )
Step 1: マルコフ連鎖の定義の適用 生成過程(逆過程)および拡散過程(順過程)はどちらもマルコフ連鎖であるため、同時確率および条件付き確率は以下のように展開できます。
生成過程 : p θ ( x 0 : T ) = p ( x T ) ∏ t = 1 T p θ ( x t − 1 ∣ x t ) p_\theta(\mathbf{x}_{0:T}) = p(\mathbf{x}_T) \prod_{t=1}^T p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t) p θ ( x 0 : T ) = p ( x T ) ∏ t = 1 T p θ ( x t − 1 ∣ x t ) 拡散過程 : q ( x 1 : T ∣ x 0 ) = ∏ t = 1 T q ( x t ∣ x t − 1 ) q(\mathbf{x}_{1:T} \vert \mathbf{x}_0) = \prod_{t=1}^T q(\mathbf{x}_t \vert \mathbf{x}_{t-1}) q ( x 1 : T ∣ x 0 ) = ∏ t = 1 T q ( x t ∣ x t − 1 ) これらを代入すると、以下のようになります。
p θ ( x 0 : T ) q ( x 1 : T ∣ x 0 ) = p ( x T ) ∏ t = 1 T p θ ( x t − 1 ∣ x t ) ∏ t = 1 T q ( x t ∣ x t − 1 ) \frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} = \frac{p(\mathbf{x}_T) \prod_{t=1}^T p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)}{\prod_{t=1}^T q(\mathbf{x}_t \vert \mathbf{x}_{t-1})} q ( x 1 : T ∣ x 0 ) p θ ( x 0 : T ) = ∏ t = 1 T q ( x t ∣ x t − 1 ) p ( x T ) ∏ t = 1 T p θ ( x t − 1 ∣ x t ) ここで、積の最初(t = 1 t=1 t = 1 t ≥ 2 t \ge 2 t ≥ 2
p θ ( x 0 : T ) q ( x 1 : T ∣ x 0 ) = p ( x T ) p θ ( x 0 ∣ x 1 ) ∏ t = 2 T p θ ( x t − 1 ∣ x t ) q ( x 1 ∣ x 0 ) ∏ t = 2 T q ( x t ∣ x t − 1 ) \frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} = \frac{p(\mathbf{x}_T) p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) \prod_{t=2}^T p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)}{q(\mathbf{x}_1 \vert \mathbf{x}_0) \prod_{t=2}^T q(\mathbf{x}_t \vert \mathbf{x}_{t-1})} q ( x 1 : T ∣ x 0 ) p θ ( x 0 : T ) = q ( x 1 ∣ x 0 ) ∏ t = 2 T q ( x t ∣ x t − 1 ) p ( x T ) p θ ( x 0 ∣ x 1 ) ∏ t = 2 T p θ ( x t − 1 ∣ x t ) Step 2: ベイズの定理による拡散過程の逆向き変形 拡散過程の遷移確率 q ( x t ∣ x t − 1 ) q(\mathbf{x}_t \vert \mathbf{x}_{t-1}) q ( x t ∣ x t − 1 ) x 0 \mathbf{x}_0 x 0 q ( x t ∣ x t − 1 ) = q ( x t ∣ x t − 1 , x 0 ) q(\mathbf{x}_t \vert \mathbf{x}_{t-1}) = q(\mathbf{x}_t \vert \mathbf{x}_{t-1}, \mathbf{x}_0) q ( x t ∣ x t − 1 ) = q ( x t ∣ x t − 1 , x 0 )
q ( x t ∣ x t − 1 , x 0 ) = q ( x t − 1 ∣ x t , x 0 ) q ( x t ∣ x 0 ) q ( x t − 1 ∣ x 0 ) q(\mathbf{x}_t \vert \mathbf{x}_{t-1}, \mathbf{x}_0) = \frac{q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) q(\mathbf{x}_t \vert \mathbf{x}_0)}{q(\mathbf{x}_{t-1} \vert \mathbf{x}_0)} q ( x t ∣ x t − 1 , x 0 ) = q ( x t − 1 ∣ x 0 ) q ( x t − 1 ∣ x t , x 0 ) q ( x t ∣ x 0 ) この変形を、分母の t ≥ 2 t \ge 2 t ≥ 2 ∏ t = 2 T q ( x t ∣ x t − 1 ) \prod_{t=2}^T q(\mathbf{x}_t \vert \mathbf{x}_{t-1}) ∏ t = 2 T q ( x t ∣ x t − 1 )
∏ t = 2 T q ( x t ∣ x t − 1 ) = ∏ t = 2 T q ( x t − 1 ∣ x t , x 0 ) q ( x t ∣ x 0 ) q ( x t − 1 ∣ x 0 ) \prod_{t=2}^T q(\mathbf{x}_t \vert \mathbf{x}_{t-1}) = \prod_{t=2}^T \frac{q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) q(\mathbf{x}_t \vert \mathbf{x}_0)}{q(\mathbf{x}_{t-1} \vert \mathbf{x}_0)} t = 2 ∏ T q ( x t ∣ x t − 1 ) = t = 2 ∏ T q ( x t − 1 ∣ x 0 ) q ( x t − 1 ∣ x t , x 0 ) q ( x t ∣ x 0 ) この式の右側の分数の積を展開すると、隣り合う項の分子と分母の間で q ( x s ∣ x 0 ) q(\mathbf{x}_s \vert \mathbf{x}_0) q ( x s ∣ x 0 )
∏ t = 2 T q ( x t ∣ x 0 ) q ( x t − 1 ∣ x 0 ) = q ( x 2 ∣ x 0 ) q ( x 1 ∣ x 0 ) ⋅ q ( x 3 ∣ x 0 ) q ( x 2 ∣ x 0 ) … q ( x T ∣ x 0 ) q ( x T − 1 ∣ x 0 ) = q ( x T ∣ x 0 ) q ( x 1 ∣ x 0 ) \prod_{t=2}^T \frac{q(\mathbf{x}_t \vert \mathbf{x}_0)}{q(\mathbf{x}_{t-1} \vert \mathbf{x}_0)} = \frac{q(\mathbf{x}_2 \vert \mathbf{x}_0)}{q(\mathbf{x}_1 \vert \mathbf{x}_0)} \cdot \frac{q(\mathbf{x}_3 \vert \mathbf{x}_0)}{q(\mathbf{x}_2 \vert \mathbf{x}_0)} \dots \frac{q(\mathbf{x}_T \vert \mathbf{x}_0)}{q(\mathbf{x}_{T-1} \vert \mathbf{x}_0)} = \frac{q(\mathbf{x}_T \vert \mathbf{x}_0)}{q(\mathbf{x}_1 \vert \mathbf{x}_0)} t = 2 ∏ T q ( x t − 1 ∣ x 0 ) q ( x t ∣ x 0 ) = q ( x 1 ∣ x 0 ) q ( x 2 ∣ x 0 ) ⋅ q ( x 2 ∣ x 0 ) q ( x 3 ∣ x 0 ) … q ( x T − 1 ∣ x 0 ) q ( x T ∣ x 0 ) = q ( x 1 ∣ x 0 ) q ( x T ∣ x 0 ) これによって、分母の積は以下のように整理されます。
∏ t = 2 T q ( x t ∣ x t − 1 ) = ( ∏ t = 2 T q ( x t − 1 ∣ x t , x 0 ) ) ⋅ q ( x T ∣ x 0 ) q ( x 1 ∣ x 0 ) \prod_{t=2}^T q(\mathbf{x}_t \vert \mathbf{x}_{t-1}) = \left( \prod_{t=2}^T q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) \right) \cdot \frac{q(\mathbf{x}_T \vert \mathbf{x}_0)}{q(\mathbf{x}_1 \vert \mathbf{x}_0)} t = 2 ∏ T q ( x t ∣ x t − 1 ) = ( t = 2 ∏ T q ( x t − 1 ∣ x t , x 0 ) ) ⋅ q ( x 1 ∣ x 0 ) q ( x T ∣ x 0 ) Step 3: 分数全体の再構築と約分 これを Step 1 の式の分母に代入します。すると、分母にある q ( x 1 ∣ x 0 ) q(\mathbf{x}_1 \vert \mathbf{x}_0) q ( x 1 ∣ x 0 )
p θ ( x 0 : T ) q ( x 1 : T ∣ x 0 ) = p ( x T ) p θ ( x 0 ∣ x 1 ) ∏ t = 2 T p θ ( x t − 1 ∣ x t ) q ( x 1 ∣ x 0 ) ⋅ ( ∏ t = 2 T q ( x t − 1 ∣ x t , x 0 ) ) ⋅ q ( x T ∣ x 0 ) q ( x 1 ∣ x 0 ) = p ( x T ) p θ ( x 0 ∣ x 1 ) ∏ t = 2 T p θ ( x t − 1 ∣ x t ) q ( x T ∣ x 0 ) ∏ t = 2 T q ( x t − 1 ∣ x t , x 0 ) \begin{aligned}
\frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} &= \frac{p(\mathbf{x}_T) p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) \prod_{t=2}^T p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)}{q(\mathbf{x}_1 \vert \mathbf{x}_0) \cdot \left( \prod_{t=2}^T q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) \right) \cdot \frac{q(\mathbf{x}_T \vert \mathbf{x}_0)}{q(\mathbf{x}_1 \vert \mathbf{x}_0)}} \\
&= \frac{p(\mathbf{x}_T) p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) \prod_{t=2}^T p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)}{q(\mathbf{x}_T \vert \mathbf{x}_0) \prod_{t=2}^T q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)}
\end{aligned} q ( x 1 : T ∣ x 0 ) p θ ( x 0 : T ) = q ( x 1 ∣ x 0 ) ⋅ ( ∏ t = 2 T q ( x t − 1 ∣ x t , x 0 ) ) ⋅ q ( x 1 ∣ x 0 ) q ( x T ∣ x 0 ) p ( x T ) p θ ( x 0 ∣ x 1 ) ∏ t = 2 T p θ ( x t − 1 ∣ x t ) = q ( x T ∣ x 0 ) ∏ t = 2 T q ( x t − 1 ∣ x t , x 0 ) p ( x T ) p θ ( x 0 ∣ x 1 ) ∏ t = 2 T p θ ( x t − 1 ∣ x t ) この式を、同じタイムステップの変数同士になるようにグループ分け(並び替え)します。
p θ ( x 0 : T ) q ( x 1 : T ∣ x 0 ) = ( p ( x T ) q ( x T ∣ x 0 ) ) ⋅ ( ∏ t = 2 T p θ ( x t − 1 ∣ x t ) q ( x t − 1 ∣ x t , x 0 ) ) ⋅ p θ ( x 0 ∣ x 1 ) \frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} = \left( \frac{p(\mathbf{x}_T)}{q(\mathbf{x}_T \vert \mathbf{x}_0)} \right) \cdot \left( \prod_{t=2}^T \frac{p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)}{q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)} \right) \cdot p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) q ( x 1 : T ∣ x 0 ) p θ ( x 0 : T ) = ( q ( x T ∣ x 0 ) p ( x T ) ) ⋅ ( t = 2 ∏ T q ( x t − 1 ∣ x t , x 0 ) p θ ( x t − 1 ∣ x t ) ) ⋅ p θ ( x 0 ∣ x 1 ) Step 4: 負の対数(− log -\log − log E q \mathbb{E}_q E q この結果を負の対数尤度の上界(L VLB L_{\text{VLB}} L VLB ∑ \sum ∑
L VLB = E q [ − log p θ ( x 0 : T ) q ( x 1 : T ∣ x 0 ) ] = E q [ − log ( p ( x T ) q ( x T ∣ x 0 ) ) − ∑ t = 2 T log ( p θ ( x t − 1 ∣ x t ) q ( x t − 1 ∣ x t , x 0 ) ) − log p θ ( x 0 ∣ x 1 ) ] = E q [ log q ( x T ∣ x 0 ) p ( x T ) ] + ∑ t = 2 T E q [ log q ( x t − 1 ∣ x t , x 0 ) p θ ( x t − 1 ∣ x t ) ] − E q [ log p θ ( x 0 ∣ x 1 ) ] \begin{aligned}
L_{\text{VLB}} &= \mathbb{E}_q \left[ -\log \frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \right] \\
&= \mathbb{E}_q \left[ -\log \left( \frac{p(\mathbf{x}_T)}{q(\mathbf{x}_T \vert \mathbf{x}_0)} \right) - \sum_{t=2}^T \log \left( \frac{p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)}{q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)} \right) - \log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) \right] \\
&= \mathbb{E}_q \left[ \log \frac{q(\mathbf{x}_T \vert \mathbf{x}_0)}{p(\mathbf{x}_T)} \right] + \sum_{t=2}^T \mathbb{E}_q \left[ \log \frac{q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)}{p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t)} \right] - \mathbb{E}_q \left[ \log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) \right]
\end{aligned} L VLB = E q [ − log q ( x 1 : T ∣ x 0 ) p θ ( x 0 : T ) ] = E q [ − log ( q ( x T ∣ x 0 ) p ( x T ) ) − t = 2 ∑ T log ( q ( x t − 1 ∣ x t , x 0 ) p θ ( x t − 1 ∣ x t ) ) − log p θ ( x 0 ∣ x 1 ) ] = E q [ log p ( x T ) q ( x T ∣ x 0 ) ] + t = 2 ∑ T E q [ log p θ ( x t − 1 ∣ x t ) q ( x t − 1 ∣ x t , x 0 ) ] − E q [ log p θ ( x 0 ∣ x 1 ) ] Step 5: KLダイバージェンスの定義への書き換え 最後に、KLダイバージェンスの定義 D KL ( P ∥ Q ) = E P [ log P ( x ) Q ( x ) ] D_{\text{KL}}(P \parallel Q) = \mathbb{E}_P \left[ \log \frac{P(x)}{Q(x)} \right] D KL ( P ∥ Q ) = E P [ log Q ( x ) P ( x ) ]
期待値 E q \mathbb{E}_q E q q ( x 0 : T ) q(\mathbf{x}_{0:T}) q ( x 0 : T )
L VLB = E q D KL ( q ( x T ∣ x 0 ) ∥ p ( x T ) ) ⏟ L T (学習パラメータ無) + ∑ t = 2 T E q D KL ( q ( x t − 1 ∣ x t , x 0 ) ∥ p θ ( x t − 1 ∣ x t ) ) ⏟ L t − 1 (主となる拡散損失) − E q [ log p θ ( x 0 ∣ x 1 ) ] ⏟ L 0 (再構成誤差) L_{\text{VLB}} = \mathbb{E}_q \underbrace{D_{\text{KL}}(q(\mathbf{x}_T \vert \mathbf{x}_0) \parallel p(\mathbf{x}_T))}_{L_T \text{ (学習パラメータ無)}} + \sum_{t=2}^T \mathbb{E}_q \underbrace{D_{\text{KL}}(q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) \parallel p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t))}_{L_{t-1} \text{ (主となる拡散損失)}} - \underbrace{\mathbb{E}_q \left[ \log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) \right]}_{L_0 \text{ (再構成誤差)}} L VLB = E q L T ( 学習パラメータ無 ) D KL ( q ( x T ∣ x 0 ) ∥ p ( x T )) + t = 2 ∑ T E q L t − 1 ( 主となる拡散損失 ) D KL ( q ( x t − 1 ∣ x t , x 0 ) ∥ p θ ( x t − 1 ∣ x t )) − L 0 ( 再構成誤差 ) E q [ log p θ ( x 0 ∣ x 1 ) ] ここで中心となるのは、任意のステップ t t t L t − 1 L_{t-1} L t − 1
3種類の項を並べると、次のようになります。
(図は、diagram-designで作成 )
条件付き真の逆過程 q ( x t − 1 ∣ x t , x 0 ) q(\mathbf{x}_{t-1} \vert{} \mathbf{x}_t, \mathbf{x}_0) q ( x t − 1 ∣ x t , x 0 ) 本来、単なる q ( x t − 1 ∣ x t ) q(\mathbf{x}_{t-1} \vert{} \mathbf{x}_t) q ( x t − 1 ∣ x t ) x 0 \mathbf{x}_0 x 0
q ( x t − 1 ∣ x t , x 0 ) = q ( x t ∣ x t − 1 , x 0 ) q ( x t − 1 ∣ x 0 ) q ( x t ∣ x 0 ) q(\mathbf{x}_{t-1} \vert{} \mathbf{x}_t, \mathbf{x}_0) = q(\mathbf{x}_t \vert{} \mathbf{x}_{t-1}, \mathbf{x}_0) \frac{q(\mathbf{x}_{t-1} \vert{} \mathbf{x}_0)}{q(\mathbf{x}_t \vert{} \mathbf{x}_0)} q ( x t − 1 ∣ x t , x 0 ) = q ( x t ∣ x t − 1 , x 0 ) q ( x t ∣ x 0 ) q ( x t − 1 ∣ x 0 ) ここで、拡散過程の一括サンプリング公式(α t = 1 − β t , α ˉ t = ∏ s = 1 t α s \alpha_t = 1 - \beta_t, \bar{\alpha}_t = \prod_{s=1}^t \alpha_s α t = 1 − β t , α ˉ t = ∏ s = 1 t α s
q ( x t ∣ x t − 1 ) = N ( x t ; α t x t − 1 , ( 1 − α t ) I ) q(\mathbf{x}_t \vert{} \mathbf{x}_{t-1}) = \mathcal{N}(\mathbf{x}_t; \sqrt{\alpha_t}\mathbf{x}_{t-1}, (1-\alpha_t)\mathbf{I}) q ( x t ∣ x t − 1 ) = N ( x t ; α t x t − 1 , ( 1 − α t ) I ) q ( x t − 1 ∣ x 0 ) = N ( x t − 1 ; α ˉ t − 1 x 0 , ( 1 − α ˉ t − 1 ) I ) q(\mathbf{x}_{t-1} \vert{} \mathbf{x}_0) = \mathcal{N}(\mathbf{x}_{t-1}; \sqrt{\bar{\alpha}_{t-1}}\mathbf{x}_0, (1-\bar{\alpha}_{t-1})\mathbf{I}) q ( x t − 1 ∣ x 0 ) = N ( x t − 1 ; α ˉ t − 1 x 0 , ( 1 − α ˉ t − 1 ) I ) q ( x t ∣ x 0 ) = N ( x t ; α ˉ t x 0 , ( 1 − α ˉ t ) I ) q(\mathbf{x}_t \vert{} \mathbf{x}_0) = \mathcal{N}(\mathbf{x}_t; \sqrt{\bar{\alpha}_t}\mathbf{x}_0, (1-\bar{\alpha}_t)\mathbf{I}) q ( x t ∣ x 0 ) = N ( x t ; α ˉ t x 0 , ( 1 − α ˉ t ) I ) これらのガウス分布の確率密度関数を代入して指数部を整理すると、q ( x t − 1 ∣ x t , x 0 ) q(\mathbf{x}_{t-1} \vert{} \mathbf{x}_t, \mathbf{x}_0) q ( x t − 1 ∣ x t , x 0 ) N ( x t − 1 ; μ ~ t ( x t , x 0 ) , β ~ t I ) \mathcal{N}(\mathbf{x}_{t-1}; \tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \mathbf{x}_0), \tilde{\beta}_t \mathbf{I}) N ( x t − 1 ; μ ~ t ( x t , x 0 ) , β ~ t I ) β ~ t = 1 − α ˉ t − 1 1 − α ˉ t β t \tilde{\beta}_t = \frac{1-\bar{\alpha}_{t-1}}{1-\bar{\alpha}_t}\beta_t β ~ t = 1 − α ˉ t 1 − α ˉ t − 1 β t μ ~ t \tilde{\boldsymbol{\mu}}_t μ ~ t
μ ~ t ( x t , x 0 ) = α ˉ t − 1 β t 1 − α ˉ t x 0 + α t ( 1 − α ˉ t − 1 ) 1 − α ˉ t x t \tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \mathbf{x}_0) = \frac{\sqrt{\bar{\alpha}_{t-1}}\beta_t}{1-\bar{\alpha}_t} \mathbf{x}_0 + \frac{\sqrt{\alpha_t}(1-\bar{\alpha}_{t-1})}{1-\bar{\alpha}_t} \mathbf{x}_t μ ~ t ( x t , x 0 ) = 1 − α ˉ t α ˉ t − 1 β t x 0 + 1 − α ˉ t α t ( 1 − α ˉ t − 1 ) x t x_0 で条件付けた逆過程の関係を図にすると、次のようになります。
(図は、diagram-designで作成 )
ガウス分布同士の KL ダイバージェンスの計算 生成モデルの逆過程 p θ ( x t − 1 ∣ x t ) = N ( x t − 1 ; μ θ ( x t , t ) , Σ θ ( x t , t ) ) p_\theta(\mathbf{x}_{t-1} \vert{} \mathbf{x}_t) = \mathcal{N}(\mathbf{x}_{t-1}; \boldsymbol{\mu}_\theta(\mathbf{x}_t, t), \Sigma_\theta(\mathbf{x}_t, t)) p θ ( x t − 1 ∣ x t ) = N ( x t − 1 ; μ θ ( x t , t ) , Σ θ ( x t , t )) Σ θ \Sigma_\theta Σ θ σ t 2 I \sigma_t^2 \mathbf{I} σ t 2 I θ \theta θ C C C
L t − 1 = E q [ D KL ( q ( x t − 1 ∣ x t , x 0 ) ∥ p θ ( x t − 1 ∣ x t ) ) ] = E q [ 1 2 σ t 2 ∥ μ ~ t ( x t , x 0 ) − μ θ ( x t , t ) ∥ 2 ] + C L_{t-1} = \mathbb{E}_q \left[ D_{\text{KL}}(q(\mathbf{x}_{t-1} \vert{} \mathbf{x}_t, \mathbf{x}_0) \parallel p_\theta(\mathbf{x}_{t-1} \vert{} \mathbf{x}_t)) \right] = \mathbb{E}_q \left[ \frac{1}{2\sigma_t^2} \left\Vert{} \tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \mathbf{x}_0) - \boldsymbol{\mu}_\theta(\mathbf{x}_t, t) \right\Vert{}^2 \right] + C L t − 1 = E q [ D KL ( q ( x t − 1 ∣ x t , x 0 ) ∥ p θ ( x t − 1 ∣ x t )) ] = E q [ 2 σ t 2 1 ∥ μ ~ t ( x t , x 0 ) − μ θ ( x t , t ) ∥ 2 ] + C 定数 C C C β ~ t \tilde{\beta}_t β ~ t σ t 2 \sigma_t^2 σ t 2 μ θ \boldsymbol{\mu}_\theta μ θ
つまり、モデル p θ p_\theta p θ μ ~ t \tilde{\boldsymbol{\mu}}_t μ ~ t
ノイズ予測 ϵ θ \boldsymbol{\epsilon}_\theta ϵ θ ここで、順過程のサンプリング式 x t ( x 0 , ϵ ) = α ˉ t x 0 + 1 − α ˉ t ϵ \mathbf{x}_t(\mathbf{x}_0, \boldsymbol{\epsilon}) = \sqrt{\bar{\alpha}_t}\mathbf{x}_0 + \sqrt{1-\bar{\alpha}_t}\boldsymbol{\epsilon} x t ( x 0 , ϵ ) = α ˉ t x 0 + 1 − α ˉ t ϵ ϵ ∼ N ( 0 , I ) \boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) ϵ ∼ N ( 0 , I ) x 0 \mathbf{x}_0 x 0 x t \mathbf{x}_t x t ϵ \boldsymbol{\epsilon} ϵ
x 0 = 1 α ˉ t ( x t − 1 − α ˉ t ϵ ) \mathbf{x}_0 = \frac{1}{\sqrt{\bar{\alpha}_t}}\left( \mathbf{x}_t - \sqrt{1-\bar{\alpha}_t}\boldsymbol{\epsilon} \right) x 0 = α ˉ t 1 ( x t − 1 − α ˉ t ϵ ) これを先ほど求めた真の平均 μ ~ t \tilde{\boldsymbol{\mu}}_t μ ~ t
μ ~ t ( x t , x 0 ) = 1 α t ( x t − β t 1 − α ˉ t ϵ ) \tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \mathbf{x}_0) = \frac{1}{\sqrt{\alpha_t}} \left( \mathbf{x}_t - \frac{\beta_t}{\sqrt{1-\bar{\alpha}_t}} \boldsymbol{\epsilon} \right) μ ~ t ( x t , x 0 ) = α t 1 ( x t − 1 − α ˉ t β t ϵ ) この数式構造に対応させるため、ニューラルネットワークの平均予測関数 μ θ \boldsymbol{\mu}_\theta μ θ
μ θ ( x t , t ) = 1 α t ( x t − β t 1 − α ˉ t ϵ θ ( x t , t ) ) \boldsymbol{\mu}_\theta(\mathbf{x}_t, t) = \frac{1}{\sqrt{\alpha_t}} \left( \mathbf{x}_t - \frac{\beta_t}{\sqrt{1-\bar{\alpha}_t}} \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \right) μ θ ( x t , t ) = α t 1 ( x t − 1 − α ˉ t β t ϵ θ ( x t , t ) ) この μ ~ t \tilde{\boldsymbol{\mu}}_t μ ~ t μ θ \boldsymbol{\mu}_\theta μ θ L t − 1 L_{t-1} L t − 1
μ ~ t − μ θ = β t α t ( 1 − α ˉ t ) ( ϵ − ϵ θ ( x t , t ) ) \tilde{\boldsymbol{\mu}}_t - \boldsymbol{\mu}_\theta = \frac{\beta_t}{\sqrt{\alpha_t(1-\bar{\alpha}_t)}} \left( \boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \right) μ ~ t − μ θ = α t ( 1 − α ˉ t ) β t ( ϵ − ϵ θ ( x t , t ) ) これを二乗誤差の式に書き戻すと、以下のようになります。
L t − 1 = E x 0 , ϵ [ β t 2 2 σ t 2 α t ( 1 − α ˉ t ) ∥ ϵ − ϵ θ ( α ˉ t x 0 + 1 − α ˉ t ϵ , t ) ∥ 2 ] + C L_{t-1} = \mathbb{E}_{\mathbf{x}_0, \boldsymbol{\epsilon}} \left[ \frac{\beta_t^2}{2\sigma_t^2 \alpha_t (1-\bar{\alpha}_t)} \left\Vert{} \boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta(\sqrt{\bar{\alpha}_t}\mathbf{x}_0 + \sqrt{1-\bar{\alpha}_t}\boldsymbol{\epsilon}, t) \right\Vert{}^2 \right] + C L t − 1 = E x 0 , ϵ [ 2 σ t 2 α t ( 1 − α ˉ t ) β t 2 ϵ − ϵ θ ( α ˉ t x 0 + 1 − α ˉ t ϵ , t ) 2 ] + C (t t t x 0 \mathbf{x}_0 x 0 ϵ \boldsymbol{\epsilon} ϵ λ t = β t 2 2 σ t 2 α t ( 1 − α ˉ t ) \lambda_t = \frac{\beta_t^2}{2\sigma_t^2 \alpha_t (1-\bar{\alpha}_t)} λ t = 2 σ t 2 α t ( 1 − α ˉ t ) β t 2
ここまでの書き換えを図にまとめると、次のようになります。
(図は、diagram-designで作成 )
数値で確かめる ここまでの式変形のうち、真の平均の 2 つの書き方が一致すること、ガウス分布どうしの KL が「重み λ t \lambda_t λ t λ t \lambda_t λ t t t t
import numpy as np
import matplotlib . pyplot as plt
import japanize_matplotlib
T = 1000
betas = np . linspace ( 1e-4 , 0.02 , T )
alphas = 1.0 - betas
abar = np . cumprod ( alphas )
rng = np . random . default_rng ( 0 )
t = 500
a , ab , ab_prev , b = alphas [ t - 1 ] , abar [ t - 1 ] , abar [ t - 2 ] , betas [ t - 1 ]
x0 = rng . standard_normal ( 16 )
eps = rng . standard_normal ( 16 )
xt = np . sqrt ( ab ) * x0 + np . sqrt ( 1 - ab ) * eps
mu_x0 = np . sqrt ( ab_prev ) * b / ( 1 - ab ) * x0 + np . sqrt ( a ) * ( 1 - ab_prev ) / ( 1 - ab ) * xt
mu_eps = ( xt - b / np . sqrt ( 1 - ab ) * eps ) / np . sqrt ( a )
print ( f"x0 で書いた平均と ε で書いた平均の差の最大値: { np . abs ( mu_x0 - mu_eps ) . max ( ) : .1e } " )
def kl_gauss ( m1 , v1 , m2 , v2 ) :
"""KL(N(m1, v1 I) || N(m2, v2 I))(分散が全成分で等しいガウス分布)"""
d = m1 . size
return 0.5 * ( d * v1 / v2 + np . sum ( ( m2 - m1 ) ** 2 ) / v2 - d + d * np . log ( v2 / v1 ) )
beta_tilde = ( 1 - ab_prev ) / ( 1 - ab ) * b
sigma2 = b
const = kl_gauss ( mu_x0 , beta_tilde , mu_x0 , sigma2 )
weight = b ** 2 / ( 2 * sigma2 * a * ( 1 - ab ) )
for scale in [ 0.0 , 0.1 , 1.0 ] :
eps_theta = eps + scale * rng . standard_normal ( 16 )
mu_theta = ( xt - b / np . sqrt ( 1 - ab ) * eps_theta ) / np . sqrt ( a )
kl = kl_gauss ( mu_x0 , beta_tilde , mu_theta , sigma2 )
rhs = weight * np . sum ( ( eps - eps_theta ) ** 2 ) + const
print ( f"予測のずれ { scale } : KL { kl : .6f } 、重み × 二乗誤差 + 定数 { rhs : .6f } " )
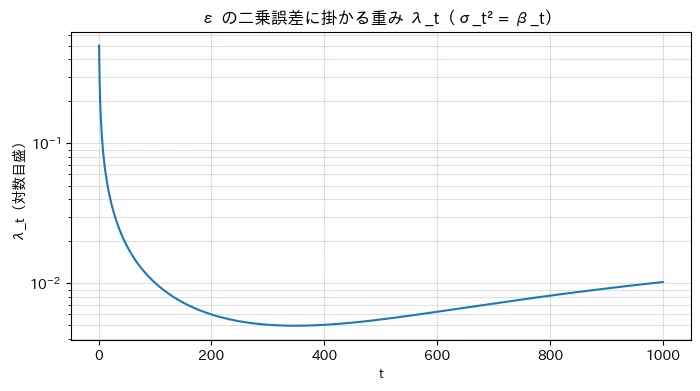
lam = betas ** 2 / ( 2 * betas * alphas * ( 1 - abar ) )
for s in [ 1 , 10 , 100 , 1000 ] :
print ( f"t = { s : 4d } : λ_t = { lam [ s - 1 ] : .4f } " )
plt . figure ( figsize = ( 8 , 4 ) )
plt . semilogy ( np . arange ( 1 , T + 1 ) , lam )
plt . xlabel ( "t" ) ; plt . ylabel ( "λ_t(対数目盛)" )
plt . title ( "ε の二乗誤差に掛かる重み λ_t(σ_t² = β_t)" )
plt . grid ( True , which = "both" , alpha = 0.4 )
plt . show ( )
式変形の結果を、数値で 1 つずつ確かめるコードです。
スケジュール : DDPM の論文と同じ T = 1000 T = 1000 T = 1000 β t \beta_t β t 10 − 4 10^{-4} 1 0 − 4 0.02 0.02 0.02 α ˉ t \bar{\alpha}_t α ˉ t np.cumprod で累積の積として求めます。真の平均の確認 : 時刻 t = 500 t = 500 t = 500 x 0 \mathbf{x}_0 x 0 ϵ \boldsymbol{\epsilon} ϵ x t \mathbf{x}_t x t μ ~ t \tilde{\boldsymbol{\mu}}_t μ ~ t x 0 \mathbf{x}_0 x 0 mu_x0 )と ϵ \boldsymbol{\epsilon} ϵ mu_eps )で計算し、差を比べます。次元の 16 は、ベクトルでも式が成り立つことを見るための小さな値で、結果は次元によりません。KL と二乗誤差の確認 : kl_gauss は、分散が全成分で等しい 2 つのガウス分布の KL を公式どおりに計算します。真の逆過程(分散 β ~ t \tilde{\beta}_t β ~ t σ t 2 = β t \sigma_t^2 = \beta_t σ t 2 = β t λ t ∥ ϵ − ϵ θ ∥ 2 \lambda_t \lVert \boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta \rVert^2 λ t ∥ ϵ − ϵ θ ∥ 2 重みの変化 : σ t 2 = β t \sigma_t^2 = \beta_t σ t 2 = β t λ t = β t 2 α t ( 1 − α ˉ t ) \lambda_t = \frac{\beta_t}{2\alpha_t(1-\bar{\alpha}_t)} λ t = 2 α t ( 1 − α ˉ t ) β t t = 1 t = 1 t = 1 1000 1000 1000 実行結果 x0 で書いた平均と ε で書いた平均の差の最大値: 2.2e-16
予測のずれ 0.0: KL 0.000003、重み × 二乗誤差 + 定数 0.000003
予測のずれ 0.1: KL 0.000892、重み × 二乗誤差 + 定数 0.000892
予測のずれ 1.0: KL 0.120690、重み × 二乗誤差 + 定数 0.120690
t = 1: λ_t = 0.5001
t = 10: λ_t = 0.0737
t = 100: λ_t = 0.0101
t = 1000: λ_t = 0.0102
式変形は正しい : 2 つの書き方の平均の差は 2.2 × 10 − 16 2.2 \times 10^{-16} 2.2 × 1 0 − 16 重みは時刻で大きく違う : λ t \lambda_t λ t t = 1 t = 1 t = 1 t = 10 t = 10 t = 10 t t t t = 100 t = 100 t = 100 L VLB L_{\text{VLB}} L VLB t t t 結論(簡略化損失関数 L simple L_{\text{simple}} L simple DDPMの論文「Denoising Diffusion Probabilistic Models 」(Ho et al., 2020)では、上記損失関数の前についている係数 λ t \lambda_t λ t ϵ \boldsymbol{\epsilon} ϵ L simple L_{\text{simple}} L simple t t t t t t λ t \lambda_t λ t t t t t t t L simple L_{\text{simple}} L simple
L simple ( θ ) : = E t , x 0 , ϵ [ ∥ ϵ − ϵ θ ( α ˉ t x 0 + 1 − α ˉ t ϵ , t ) ∥ 2 ] L_{\text{simple}}(\theta) := \mathbb{E}_{t, \mathbf{x}_0, \boldsymbol{\epsilon}} \left[ \left\Vert{} \boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta(\sqrt{\bar{\alpha}_t}\mathbf{x}_0 + \sqrt{1-\bar{\alpha}_t}\boldsymbol{\epsilon}, t) \right\Vert{}^2 \right] L simple ( θ ) := E t , x 0 , ϵ [ ϵ − ϵ θ ( α ˉ t x 0 + 1 − α ˉ t ϵ , t ) 2 ] これにより、確率論の複雑なKLダイバージェンスの計算は、 「実際に加えたガウスノイズ ϵ \boldsymbol{\epsilon} ϵ ϵ θ \boldsymbol{\epsilon}_\theta ϵ θ で学習する形になります。ただし、L simple L_{\text{simple}} L simple L VLB L_{\text{VLB}} L VLB λ t \lambda_t λ t
本来の重みと、重みを外したときの FID を並べると、次のようになります。
(図は、diagram-designで作成 )
まとめ 本記事では、DDPM(Denoising Diffusion Probabilistic Models)の学習において、一見複雑に見える確率論的なアプローチが、なぜ最終的に極めてシンプルな「ノイズ予測の二乗誤差(MSE)」へと帰着するのか、その数学的な導出プロセスを解説しました。
具体的には、以下のステップに沿って数式を展開し、その本質を紐解きました。
変分下界(ELBO)の導入と分解: 直接計算が困難な負の対数尤度を最小化するために、イェンゼンの不等式を用いて変分下界 L VLB L_{\text{VLB}} L VLB 条件付き逆過程の解析的表示: 元のデータ x 0 \mathbf{x}_0 x 0 q ( x t − 1 ∣ x t , x 0 ) q(\mathbf{x}_{t-1} \vert{} \mathbf{x}_t, \mathbf{x}_0) q ( x t − 1 ∣ x t , x 0 ) μ ~ t \tilde{\boldsymbol{\mu}}_t μ ~ t ノイズ予測へのパラメータ化: ガウス分布間のKLダイバージェンスが平均の二乗誤差に帰着することを示した上で、一括サンプリング公式を用いて「平均の予測」を「ノイズ ϵ \boldsymbol{\epsilon} ϵ 簡略化損失関数 L simple L_{\text{simple}} L simple 重み λ t \lambda_t λ t t t t t = 1 t = 1 t = 1 t = 100 t = 100 t = 100 L simple L_{\text{simple}} L simple t t t L simple L_{\text{simple}} L simple L VLB L_{\text{VLB}} L VLB 拡散モデルは、一見すると難解な確率微分方程式や数式に満ちていますが、その根底にはこのように美しく合理的な数式の展開が存在しています。この基盤となるメカニズムを理解することは、Stable Diffusionなどのより発展的な画像生成AIや、応用モデルを学ぶ上での非常に強力な武器になります。本記事の数値の確認のコードを手元で動かし、時刻 t t t
参考文献 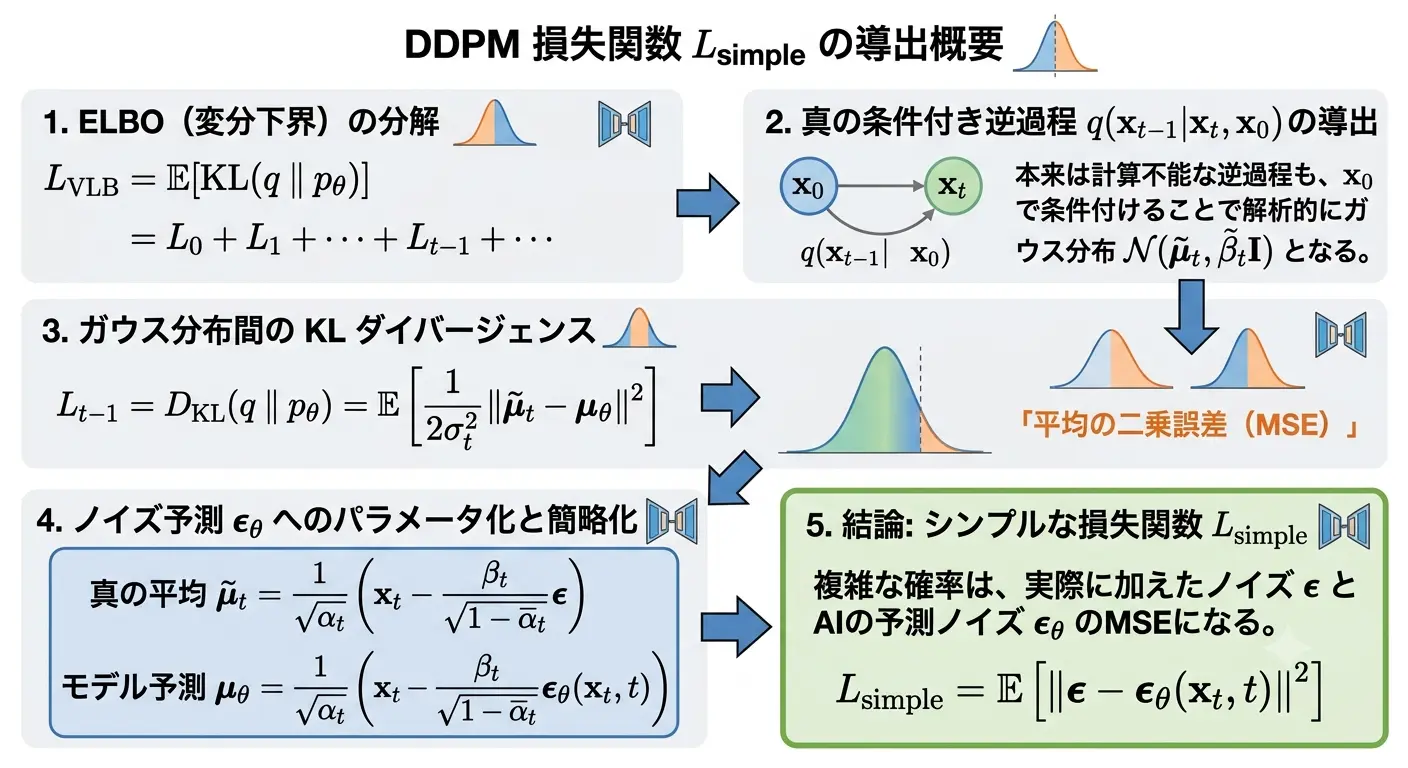 (画像は、Geminiで作成)