DeepSeek-R1とは?
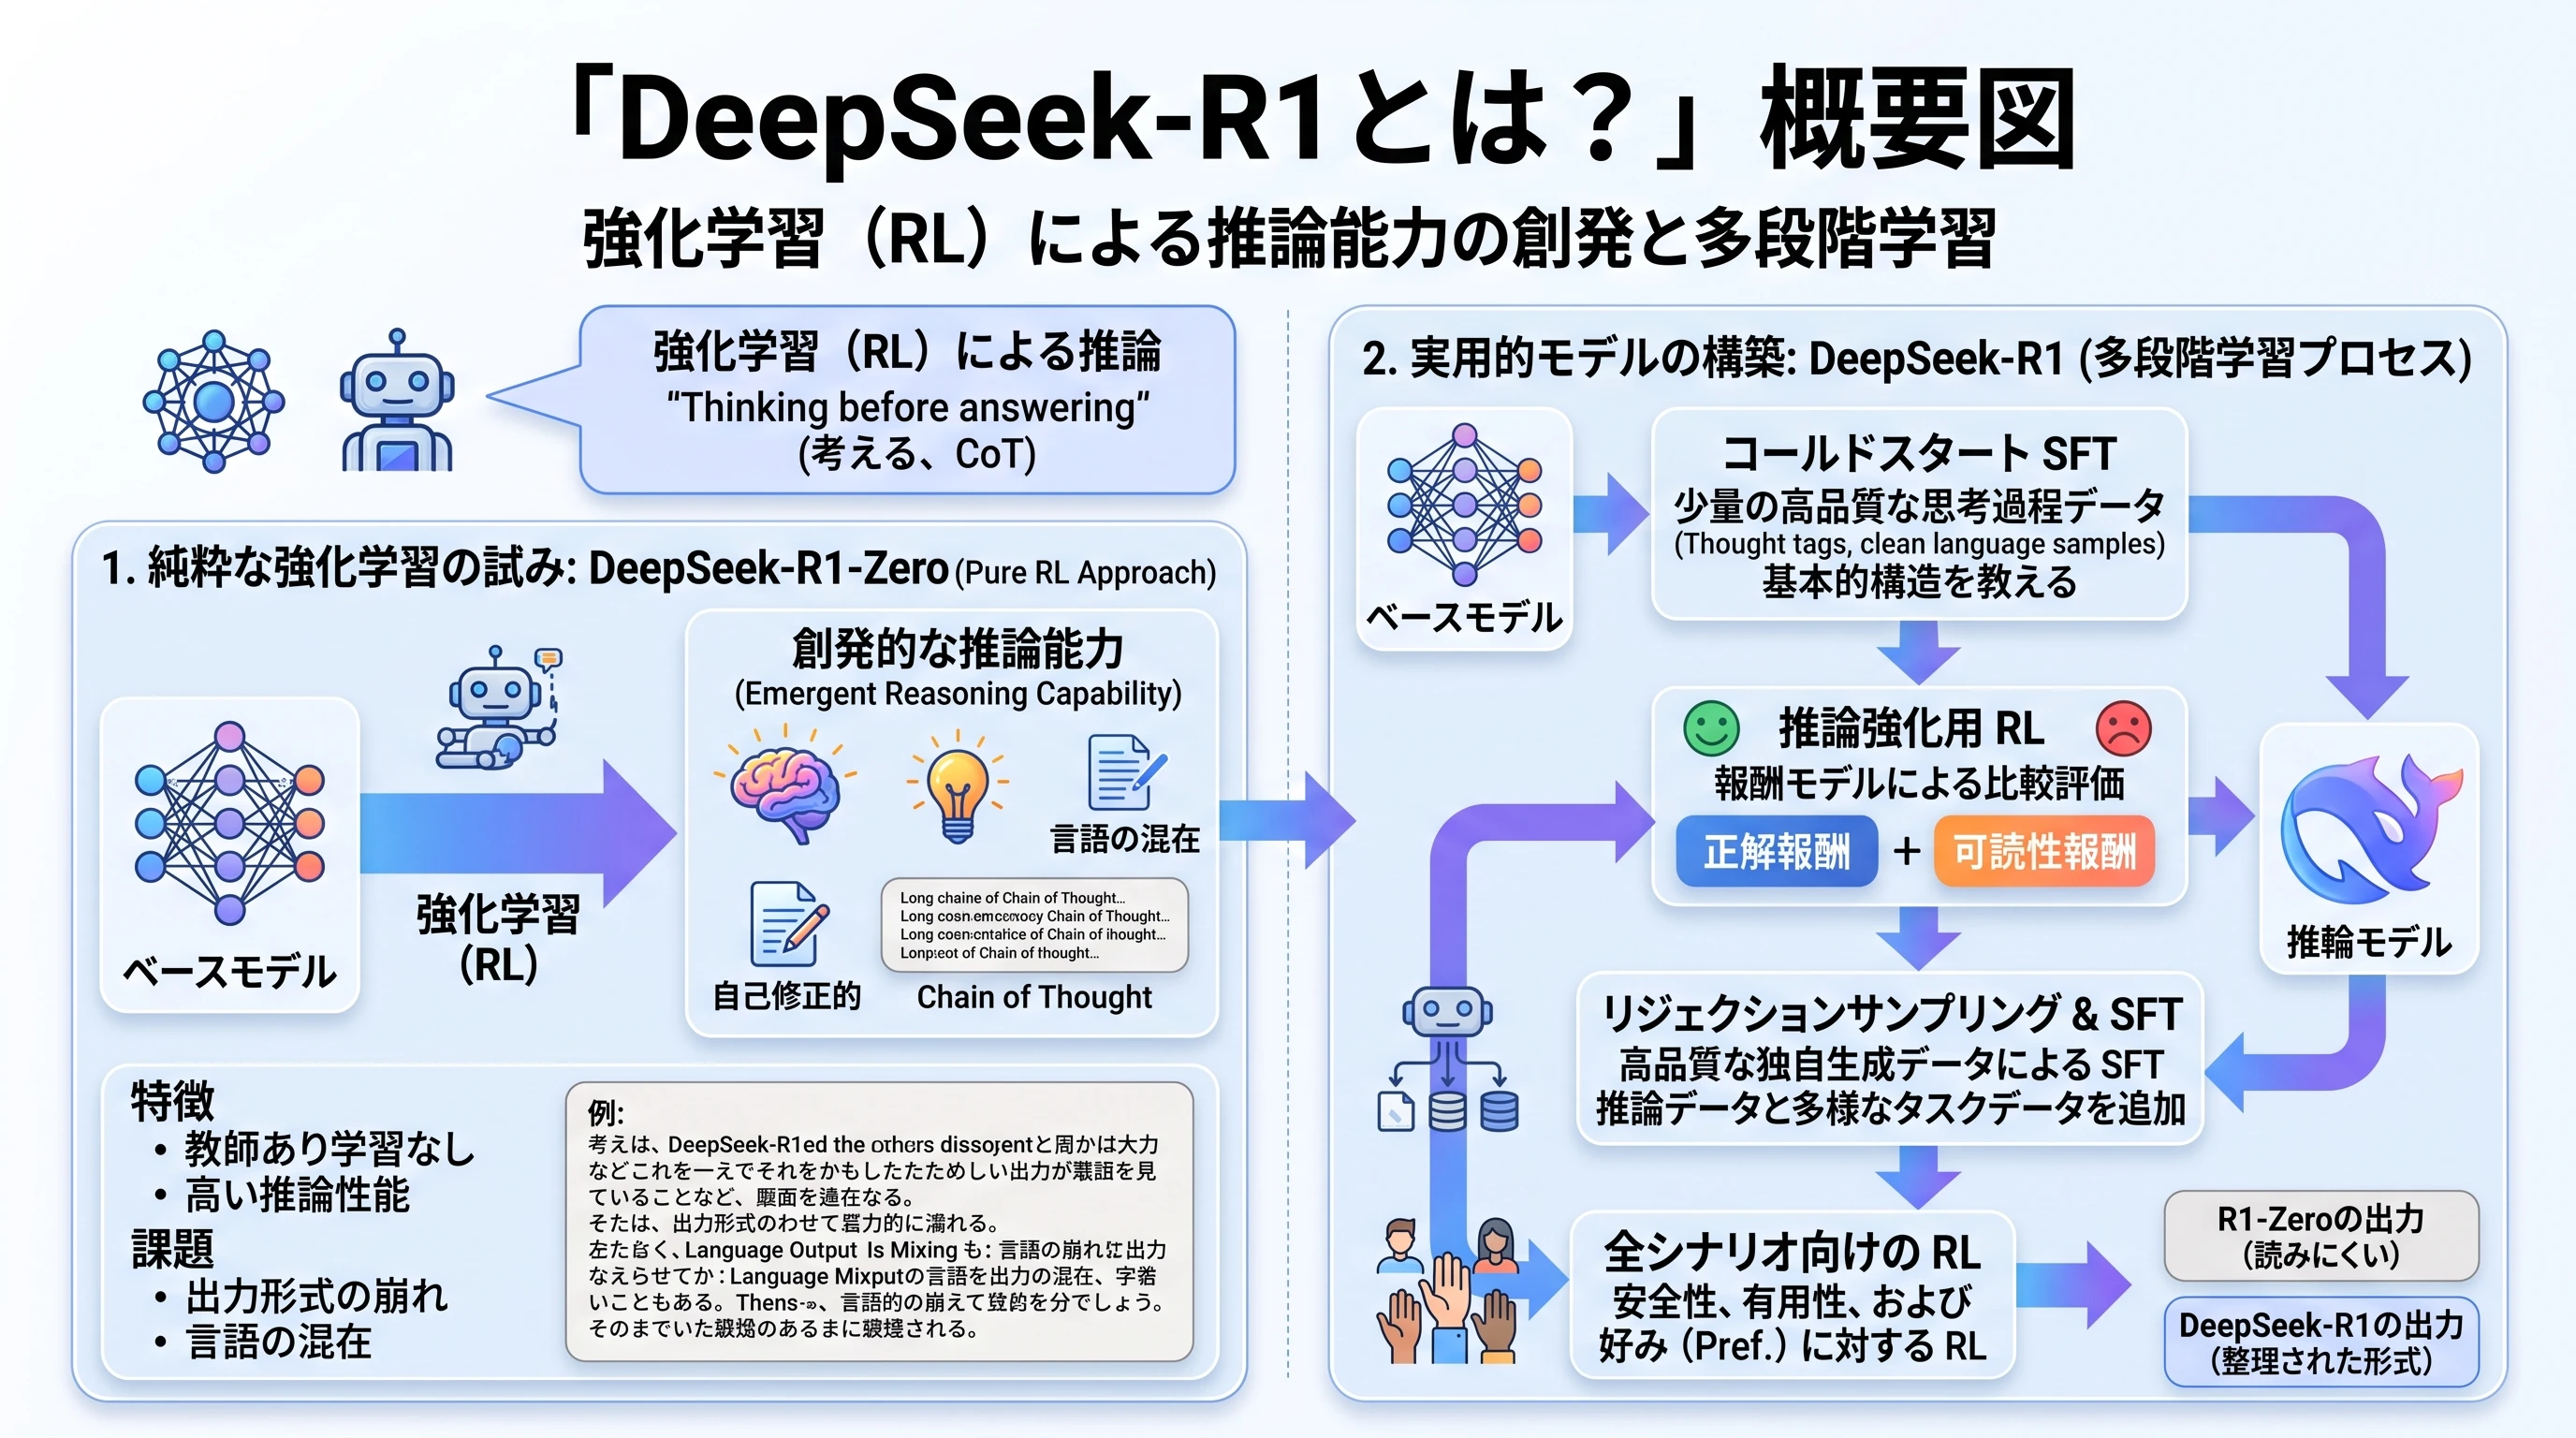 (画像は、Geminiで作成)
SFT をせずに強化学習だけで推論能力を伸ばした DeepSeek-R1-Zero と、その問題を解決した DeepSeek-R1 の4段階の学習、うまくいかなかった試み(PRM・MCTS)、小さなモデルへの蒸留という、論文の主な内容を理解すること。Qwen2.5-1.5B で R1-Zero 型の強化学習を小規模に追試し、形式報酬・正解報酬・言語一貫性報酬とコールドスタートが、正解率・生成長・思考の言語にどう効くかを確かめること。
DeepSeek-R1の概要
2024年9月に公開された OpenAI の o1(Learning to Reason with LLMs)は、答えを出す前に長い思考過程を生成することで、数学や競技プログラミングの難しい問題で大きく性能を伸ばしました。しかし、どのような強化学習とデータでそれを実現したのかは公開されませんでした。
2025年1月に DeepSeek-AI が公開した DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning は、同程度の推論性能を持つモデルの学習方法を公開しました。この論文は、後に内容を拡充した版が Nature に掲載されています(DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning)。
主な貢献は次の2つです。
- 強化学習だけによる推論能力の獲得(DeepSeek-R1-Zero): SFT を一切行わないベースモデルに、GRPO とルールベースの報酬だけで強化学習を行うと、生成長が伸び、途中の推論を見直す(自己検証する)振る舞いが現れることを示しました。
- 実用的な多段階の学習と蒸留(DeepSeek-R1): R1-Zero の「読みにくさ」と「言語の混在」を解決するため、コールドスタート SFT と強化学習を組み合わせた4段階の学習を行いました。さらに、R1 が生成したデータで小さなモデルを SFT する(蒸留する)と、小さなモデルでも高い推論性能が得られることを示しました。
本記事では、次の順に解説します。
- DeepSeek-R1-Zero: ベースモデルからの強化学習、テンプレート、報酬、生成長の増加と aha moment
- R1-Zero の問題: 読みにくさと言語の混在
- DeepSeek-R1 の4段階の学習: コールドスタート SFT、推論向けの RL、リジェクションサンプリングと SFT、全シナリオ向けの RL
- うまくいかなかった試み: 過程報酬モデル(PRM)とモンテカルロ木探索(MCTS)
- 蒸留: 小さなモデルでは「蒸留」と「大規模な RL」のどちらが強いか
- 小規模な追試: Qwen2.5-1.5B のベースモデルで R1-Zero 型の強化学習を行い、結果が出たところで順に考察する
- この実験の限界と、推論の蒸留との関係
プロンプト(問題)を 、応答を 、同じ に対するグループ内の 番目の応答を ()、学習中の方策を 、参照モデルを 、ルールベースの報酬を と書きます。GRPO の目的関数とグループ相対アドバンテージ は、GRPOの記事で定義したものをそのまま使います。
DeepSeek-R1-Zero:強化学習だけで推論を伸ばす
ベースモデルから直接強化学習する
Instruction Tuningの記事やInstructGPTの記事で見たように、LLM の事後学習では、まず人手の対話データで SFT を行い、その後に RLHF や DPO を行うのが一般的でした。CoT についても、人が書いた思考過程の例を SFT で学ばせるのが普通でした。
DeepSeek-AI はここで、次の問いを立てました。
人が思考過程の書き方を教えなくても、正解かどうかという報酬だけで、LLM は推論能力を伸ばせるのではないか?
この問いを確かめたのが DeepSeek-R1-Zero です。事前学習済みのベースモデル(DeepSeek-V3-Base)に SFT を行わず、GRPO による強化学習だけを行いました。
【一般的な流れ】
ベースモデル → SFT(人が書いた対話・CoT のデータ) → RLHF / DPO

【DeepSeek-R1-Zero】
ベースモデル → GRPO(ルールベースの報酬のみ)
テンプレート
ベースモデルに与えたのは、思考と答えを分けて書くことだけを指定する、次のようなテンプレートです(論文の表より)。prompt の部分に問題が入ります。
A conversation between User and Assistant. The user asks a question, and the Assistant solves it. The assistant first thinks about the reasoning process in the mind and then provides the user with the answer. The reasoning process and answer are enclosed within <think> </think> and <answer> </answer> tags, respectively, i.e., <think> reasoning process here </think> <answer> answer here </answer>. User: prompt. Assistant:
テンプレートが指定しているのは、思考を <think> タグ、答えを <answer> タグで囲むという 出力の構造だけ です。問題をどう分解するか、どう検証するかといった思考の中身については何も指示していません。学習の中で自然に現れる振る舞いを観察するために、あえて内容に関わる指示を入れていないのです。
ルールベースの報酬
報酬は、プログラムで判定できるルールベースの報酬(GRPOの記事で扱った RLVR)だけです。
- 正解報酬 : 数学の問題では、指定した形式(たとえば箱で囲んだ答え)で書かれた最終的な答えが正解と一致するかを判定します。プログラミングの問題では、コードを実行してテストケースに通るかを判定します。
- 形式報酬 : 思考が <think> と </think> で囲まれ、その後に答えが続く形式になっているかを判定します。
論文では、推論タスクに学習済みの報酬モデル(結果を採点するものも、過程を採点するものも)を使いませんでした。大規模な強化学習では、学習済みの報酬モデルは報酬ハッキングを受けやすく、報酬モデルの学習し直しにもコストがかかるためです。
R1-Zero の学習の構成を図にすると、次のようになります。
(図は、diagram-designで作成)
生成長の増加と「aha moment」
R1-Zero の学習では、次の2つの現象が報告されています。
- 生成長の増加: 「長く考えよ」という指示も、長さへの報酬も与えていないのに、学習が進むにつれて思考部分の平均トークン数が増え続け、数千トークン以上に達しました。論文は、これを「難しい問題を解くために、モデルが自ら思考に時間をかけるようになった」と解釈しています。
- 振り返りの出現: 学習の途中から、自分の推論を見直したり、別の解き方を試したりする振る舞いが現れました。
論文では、学習途中の R1-Zero が、平方根を含む方程式を解いている最中に Wait, wait. Wait. That's an aha moment I can flag here. と書き、それまでの式変形を最初から一歩ずつ確かめ直し始める例を紹介しています。論文はこれを aha moment と呼び、「どう振り返るかを教えなくても、報酬だけから振り返りの戦略が現れた」例として示しています。また、「wait」のような振り返りを表す単語の出現頻度が、学習とともに増えたことも報告されています。
ただし、この「自発的に現れた」という解釈には、後の研究から反論もあります。ベースモデルが事前学習の段階ですでに同じような振る舞いをしていた可能性があるからです。この点は、追試の「限界」の節で扱います。
性能の推移
論文の Nature 版によると、R1-Zero の AIME 2024(米国の数学コンテスト)での pass@1 は、学習開始時の 15.6% から 77.9% に上がりました。Chain-of-Thoughtの記事で扱った Self-Consistency(64本の多数決、cons@64)では 86.7% に達しています(arXiv の初版では pass@1 が 71.0% と報告されていて、版によって数値が異なります)。そのほか、MATH-500 の pass@1 は 95.9%、Codeforces のレーティングは 1444 と報告されています。
R1-Zeroの問題
R1-Zero は強化学習だけで推論能力が伸びることを示しましたが、そのまま対話モデルとして使うには、次の2つの問題がありました。
読みにくさ
R1-Zero の思考過程は、正解することだけに最適化されているので、人が読むことを考えていません。段落の区切りがなく長い文章が続いたり、答えの根拠を整理したまとめがなかったりして、人が読んで検証するのが難しい出力になりがちでした。
言語の混在
DeepSeek-V3-Base は、主に英語と中国語のデータで事前学習されています。正解かどうかだけを報酬にすると、思考にどの言語を使うかはモデルの自由です。その結果、質問と違う言語で考えたり、思考の途中で英語と中国語が入れ替わったりする(言語の混在)ことがよく起きました。答えが正しければ満点の報酬が得られるので、強化学習だけでは言語を揃える動機が生まれません。しかし、利用者にとっては、読めない言語が混ざった思考過程は検証も理解もしにくくなります。
DeepSeek-R1の4段階の学習
(図は、diagram-designで作成)
DeepSeek-R1 は、ベースモデルからいきなり強化学習をするのではなく、SFT と強化学習を2回ずつ交互に行う 4段階で学習します。
| ステージ | 内容 | 主なデータ・報酬 |
|---|---|---|
| 1. コールドスタート SFT | 読みやすい長い CoT で少量 SFT する | 数千件の長い CoT |
| 2. 推論向けの RL | GRPO で推論能力を伸ばす | 正解報酬・形式報酬 + 言語一貫性報酬 |
| 3. リジェクションサンプリングと SFT | 正解した推論と一般的なタスクで SFT し直す | 推論 約60万件 + 非推論 約20万件 |
| 4. 全シナリオ向けの RL | 推論と一般的な対話の両方で RL する | 推論はルール報酬、一般タスクは学習済み報酬モデル |
ステージ1:コールドスタートSFT
R1-Zero の反省から、強化学習を始める前に、読みやすく言語の揃った思考の書き方を少量のデータで教えておきます。強化学習の出発点(コールドスタート)を整えるという意味で、コールドスタート SFT と呼ばれます。
論文では、数千件の長い CoT のデータを用意しました。R1-Zero の出力のうち読みやすいものを集め、人が第一人称の自然な対話調に書き直した例をもとに、DeepSeek-V3 でさらに多くのデータを整えています。思考の後には答えを整理したまとめを付け、質問と同じ言語で書くようにしています。このデータでベースモデルを SFT してから、次のステージの強化学習に進みます。
ステージ2:推論向けの強化学習
コールドスタート SFT をしたモデルから、数学・プログラミング・論理パズルなど、正解を判定できる問題で GRPO を行います。R1-Zero との違いは、正解報酬と形式報酬に加えて 言語一貫性報酬(language consistency reward) を入れた点です。思考過程の単語のうち、指定した言語(質問と同じ言語)の単語が占める割合を報酬にします。
論文のアブレーション実験では、言語一貫性報酬を加えると推論のベンチマークの性能はわずかに下がるものの、言語の混在が大きく減り、読みやすさが上がったと報告されています。性能と読みやすさのトレードオフを、読みやすさ側に寄せる選択をしたことになります。
ステージ3:リジェクションサンプリングとSFT
ステージ2のモデルは推論に強くなっていますが、文章作成や質問応答のような一般的なタスクは学習していません。そこで、推論と一般的なタスクの両方を含む約80万件のデータで、ベースモデル(DeepSeek-V3-Base)から SFT し直します。
推論データ(約60万件): ステージ2のモデルで各問題の応答を複数生成し、正しい応答だけを残します(リジェクションサンプリング)。ルールで判定できない問題については、正解とモデルの応答を DeepSeek-V3 に渡して判定させています。さらに、言語が混ざったもの、段落が長すぎるもの、コードブロックが読みにくいものなどを除きます。
モデル自身に問題を解かせ、正解した思考過程だけを集めて次の学習データにする方法は、STaR(STaR: Bootstrapping Reasoning With Reasoning、Zelikman et al., 2022)や RFT(Scaling Relationship on Learning Mathematical Reasoning with Large Language Models、Yuan et al., 2023)として研究されてきました。GRPOの記事の「統一的な見方」の表の RFT も、この方法です。
人が長い CoT を数十万件書くのは現実的ではありません。しかし、正解を判定する方法さえあれば、モデルにたくさん解かせて、正解した思考過程だけを自動で集められます。
非推論データ(約20万件): 文章作成、事実に関する質問応答、自己認識、翻訳などのデータで、DeepSeek-V3 の SFT データの一部を再利用しています。一部のタスクでは、DeepSeek-V3 に思考過程を生成させてから答えを付けています。
論文の補足資料によると、SFT データは合計 804,745 件で、内訳は数学 約39.5万件、コード 約21.1万件、一般 約17.8万件、STEM と論理 約2万件です。
ステージ4:全シナリオ向けの強化学習
最後に、推論能力を保ちながら、有用性(helpfulness)と無害性(harmlessness)を高めるための強化学習を行います。データの種類によって報酬を使い分けます。
- 推論データ: ステージ2と同じく、ルールベースの正解報酬を使います。
- 一般データ: 人の好みを反映するため、学習済みの報酬モデルを使います。有用性の報酬モデルは 最後のまとめ(答え)だけ を評価し、思考過程には干渉しないようにしています。無害性の報酬モデルは、思考過程を含む応答全体を評価し、途中に危険な内容が含まれないかを確かめます。
こうして完成した DeepSeek-R1 は、AIME 2024 の pass@1 で 79.8%、MATH-500 で 97.3%、Codeforces のレーティング 2029 を記録し、推論のベンチマークで OpenAI o1(o1-1217)と同程度の性能を示しました。AlpacaEval 2.0(長さ補正後の勝率 87.6%)や ArenaHard(92.3%)といった一般的な対話の評価でも高いスコアを出しています。
うまくいかなかった試み:PRMとMCTS
論文には、開発の初期に試してうまくいかなかった方法として、過程報酬モデル(PRM)とモンテカルロ木探索(MCTS)が挙げられています。
過程報酬モデル(PRM)
Let's Verify Step by Step(Lightman et al., 2023)では、最終的な答えだけを採点する結果報酬モデル(ORM)より、推論の1ステップごとに採点する過程報酬モデル(PRM)の方が、多数の解答候補から正しいものを選ぶ性能が高いと報告されました。GRPOの記事で紹介したように、DeepSeekMath でも過程監督の方が結果監督より良い結果でした。
一方、DeepSeek-R1 の論文は、大規模な強化学習で PRM を使うことには次の問題があるとしています。
| 問題 | 内容 |
|---|---|
| ステップの定義 | 一般的な推論で、どこからどこまでを「1ステップ」とするかを決めるのが難しい |
| 途中の正誤の判定 | 途中のステップが正しいかを判定するのは難しい。自動で判定すると精度が足りず、人が判定すると規模を大きくできない |
| 報酬ハッキング | 学習済みの PRM を報酬に使うと、方策が PRM の弱点を突くようになる。それを防ぐために PRM を学習し直すと、学習の手間と計算が大きく増える |
論文の結論は、PRM は「多数の候補から良いものを選ぶ」ことには役立つが、大規模な強化学習の報酬として使うと、得られる利点に比べて追加の計算コストが大きい、というものです。Let's Verify Step by Step の結果は主に解答候補の選び直し(再ランキング)での比較なので、「強化学習の報酬として使うと割に合わない」という R1 の結論とは、評価している使い方が異なります。
InstructGPTの記事では、学習済みの報酬モデルで PPO を行ったときに、報酬モデルの点数だけが上がって応答が短くなる現象(報酬ハッキングと長さの崩壊)を観察しました。学習済みのモデルを報酬に使う限り、方策はその弱点を突くことを学びえます。R1 が推論タスクでは学習済みの報酬モデルを使わず、正解かどうかをルールで判定する結果報酬だけを使ったのは、このためです。答えの正誤という最終的な結果だけを確実に判定し、そこに至る過程はモデルの試行錯誤に任せる、という設計です。
モンテカルロ木探索(MCTS)
AlphaGo や AlphaZero にならい、推論を木探索として解く方法も試されました。問題を小さな部分に分け、探索木をたどりながら答えを探し、その結果で方策と価値モデルを学習するという方法です。しかし、論文は次の理由で、大規模な学習にはうまく広げられなかったとしています。
- 探索空間が大きすぎる: 囲碁やチェスの合法手は限られていますが、文章の生成では、各時点で選べるトークンの組み合わせが指数的に増えます。各ノードで広げる候補の数を制限すると、局所的な最適解にはまりやすくなります。
- 価値モデルの学習が難しい: MCTS がうまく働くには、途中の状態から「この先どれくらい正解しそうか」を評価する価値モデルが必要です。しかし、文章の途中の状態を細かく正しく評価する価値モデルを学習するのは難しく、探索の質も上がりませんでした。
結果として R1 では、外部で木探索を行う代わりに、モデルが1本の長い思考過程の中で試行錯誤し、必要に応じて見直す、という形で推論が伸びました。
蒸留:小さなモデルでは「蒸留」と「大規模なRL」のどちらが強いか
蒸留モデルの性能
ここでの 教師は DeepSeek-R1 自身、生徒は Qwen2.5 系と Llama 系のベースモデル です。DeepSeek-AI は、ステージ3で R1 にリジェクションサンプリングで問題を解かせて作った約80万件のデータを教師データとし、それで生徒を SFT しました。蒸留モデルに強化学習は行っていません(論文は、さらに RL を加えれば性能が伸びる余地があると述べています)。
DeepSeek-R1-Distill-Qwen-7B のようなモデル名は、「DeepSeek-R1 から蒸留した、Qwen ベースのモデル」という意味です。教師の名前が先、生徒のベースモデル名が後ろ に来ます。
| 生徒のベースモデル(SFT 前) | できた蒸留モデル |
|---|---|
| Qwen2.5-Math-1.5B | DeepSeek-R1-Distill-Qwen-1.5B |
| Qwen2.5-Math-7B | DeepSeek-R1-Distill-Qwen-7B |
| Qwen2.5-14B | DeepSeek-R1-Distill-Qwen-14B |
| Qwen2.5-32B | DeepSeek-R1-Distill-Qwen-32B |
| Llama-3.1-8B | DeepSeek-R1-Distill-Llama-8B |
| Llama-3.3-70B-Instruct | DeepSeek-R1-Distill-Llama-70B |
論文で報告された主な結果は次のとおりです(arXiv 版の表より)。
| モデル | AIME 2024 pass@1 | AIME 2024 cons@64 | MATH-500 pass@1 | Codeforces レーティング |
|---|---|---|---|---|
| GPT-4o-0513 | 9.3 | 13.4 | 74.6 | 759 |
| Claude-3.5-Sonnet-1022 | 16.0 | 26.7 | 78.3 | 717 |
| DeepSeek-R1-Distill-Qwen-1.5B | 28.9 | 52.7 | 83.9 | 954 |
| DeepSeek-R1-Distill-Qwen-7B | 55.5 | 83.3 | 92.8 | 1189 |
| DeepSeek-R1-Distill-Qwen-14B | 69.7 | 80.0 | 93.9 | 1481 |
| DeepSeek-R1-Distill-Qwen-32B | 72.6 | 83.3 | 94.3 | 1691 |
| DeepSeek-R1-Distill-Llama-8B | 50.4 | 80.0 | 89.1 | 1205 |
| DeepSeek-R1-Distill-Llama-70B | 70.0 | 86.7 | 94.5 | 1633 |
AIME 2024 の pass@1 を並べると、次のようになります。
(図は、diagram-designで作成)
1.5B の蒸留モデルでも、推論用の学習をしていない GPT-4o や Claude-3.5-Sonnet を、数学のベンチマークで上回っています。ただし、これは長い思考過程を生成する推論モデルと、そうでないモデルの比較である点に注意が必要です。
小さなモデルでの「蒸留 vs 大規模なRL」
ここで、次の疑問が生まれます。
小さなモデルにも R1-Zero と同じように大規模な強化学習を行えば、蒸留と同じくらい推論能力が伸びるのではないか?
論文は、Qwen2.5-32B のベースモデルに、数学・コード・STEM のデータで1万ステップ以上の強化学習を行ったモデル(DeepSeek-R1-Zero-Qwen-32B)を作り、蒸留モデルと比べました。比較の物差しとして、QwQ-32B-Preview も並べています。
| モデル | 作り方 | AIME 2024 pass@1 | AIME 2024 cons@64 | MATH-500 pass@1 |
|---|---|---|---|---|
| QwQ-32B-Preview | Qwen チーム自身の推論向け事後学習 | 50.0 | 60.0 | 90.6 |
| DeepSeek-R1-Zero-Qwen-32B | 大規模な RL(1万ステップ以上) | 47.0 | 60.0 | 91.6 |
| DeepSeek-R1-Distill-Qwen-32B | R1 からの蒸留(SFT のみ) | 72.6 | 83.3 | 94.3 |
QwQ(Qwen with Questions)は、Qwen チームが2024年11月に公開した実験的な推論モデルで、Qwen2.5-32B-Instruct を出発点にしています。R1 が公開される前の時点で、32B 規模で公開されていた最も強い推論モデルでした。
つまり表の3つは、同じ Qwen2.5-32B から推論モデルを作る、3つの異なる道筋 の比較になっています。QwQ を並べているのは、大規模な RL で到達した 47.0 が「既存の公開モデルと同程度で、目新しい水準ではない」ことを示す物差しとして使うためです。素の Qwen2.5-32B は AIME 2024 をほとんど解けないので、50.0 や 47.0 という値そのものは、長い思考過程を書く学習の効果です。
なお QwQ-32B-Preview は、モデルカードで 言語の混在 と 結論に至らず循環する推論 を限界として挙げています。R1-Zero の「読みにくさ」「言語の混在」と同じ問題で、当時の推論モデルに共通の課題だったことが分かります。
3つの道筋と結果を並べると、次のようになります。
(図は、diagram-designで作成)
大規模な強化学習をしたモデルは QwQ-32B-Preview と同程度まで伸びましたが、蒸留モデルはどのベンチマークでもそれを大きく上回りました。論文は、この結果から次の2点を結論としています。
- 強いモデルから小さなモデルへの蒸留は、非常に効果が高い。小さなモデルで大規模な強化学習を行っても、多くの計算を使ったうえで、蒸留に届かない場合がある。
- ただし、推論能力の限界そのものを押し広げるには、より強いベースモデルと大規模な強化学習が必要かもしれない。蒸留は、すでにある強いモデルの能力を移すことはできても、それを超えることはできない。
小さなモデルが強化学習だけで新しい解き方を見つけるのは難しいのに対し、蒸留では大きなモデルが見つけた思考過程をそのまま学べる、と解釈できます。蒸留の仕組みと追試は、次の 推論の蒸留の記事 で扱います。そこでは、ここで作られた DeepSeek-R1-Distill-Qwen-7B を今度は 教師 として使い、Qwen2.5-1.5B のベースモデルを生徒に蒸留します。
小規模な追試:Qwen2.5-1.5BでR1-Zero型の強化学習
ここからは、R1-Zero 型の強化学習を小規模に追試します。
実験の目的と設計
GRPOの記事では、指示追従の SFT 済みの Qwen/Qwen2.5-0.5B-Instruct から GRPO を行いました。本記事では R1-Zero にならい、SFT をしていないベースモデル Qwen/Qwen2.5-1.5B から始めます。R1-Zero 形式のテンプレートを与え、ルールベースの報酬だけで GRPO を行ったときに何が起きるかを観察します。
観察するのは次の5つです。
- 生成長の推移: 正解報酬だけで、思考が長くなっていくか
- 形式の遵守率: SFT をしていないモデルが、報酬だけでタグの構造を守れるようになるか
- 振り返りの表現: 「待って」「確認すると」「wait」などの振り返りを表す表現が増えるか
- ステップ数ごとの正解率: どの難易度の問題で正解率が上がるか
- 思考の言語: 日本語の問題でも、思考が英語や中国語に流れる(言語の混在)か。思考のうち日本語の文の割合を報酬に加える 言語一貫性報酬 の有無で比べる
- コールドスタートの効果: R1 のステージ1にならい、読みやすい日本語の CoT で少量の SFT をしてから強化学習すると、形式の習得の速さと思考の言語がどう変わるか
主な設定は次のとおりです。
| 項目 | DeepSeek-R1-Zero | 本記事の追試 |
|---|---|---|
| モデル | DeepSeek-V3-Base(671B、MoE) | Qwen2.5-1.5B(ベースモデル)+ LoRA |
| データ | 数学・コード・論理などの問題 | 算数ワールド(ステップ数1〜5を混ぜた5,000問) |
| 報酬 | 正解報酬 + 形式報酬 | 正解 1.0 + 形式 0.2(+ 言語一貫性 最大 0.2) |
| 1問あたりの生成数 | 16 | 8 |
| 最大生成長 | 数万トークン | 512 トークン |
| KL 係数 | 0.001 | 0.001 |
| 学習ステップ | 数千ステップ | 600 ステップ |
| コールドスタート | R1 では数千件の読みやすい長い CoT で SFT(R1-Zero ではなし) | 算数ワールドの模範解答を日本語の文にした300件で SFT(1条件のみ) |
3つの条件と報酬の組み合わせを図にまとめます。
(図は、diagram-designで作成)
実装は次の順に進みます。実装4以降は、実行結果が出たところでその場で考察します。
| 何をするか | そこで分かること | |
|---|---|---|
| 実装1〜3 | 算数ワールド・R1-Zero のテンプレート・報酬関数(形式・正解・言語一貫性)の準備 | (準備) |
| 実装4 | 言語一貫性報酬あり/なしの2条件で GRPO を600ステップ | 学習そのものが進むか |
| 実装5 | コールドスタート SFT と、その後の GRPO | SFT を挟むと何が変わるか |
| 実装6 | 3条件のチェックポイントを同じ500問で評価 | (評価結果の作成) |
| 実装7 | 学習の推移と、思考の書き方・言語 | 形式・正解率・生成長・振り返りの表現の推移と、言語一貫性報酬の効果 |
| 実装8 | ステップ数ごとの正解率 | どの難易度の問題で伸びたか |
| 実装9 | コールドスタート直後の形式違反の中身 | SFT と強化学習の役割分担 |
ライブラリのインストールとGoogleドライブのマウント
bf16 を使うので、L4 や A100 などの GPU を想定しています(T4 は bf16 に対応していません)。
!pip install --upgrade transformers accelerate peft datasets trl
!pip install matplotlib-fontja
!pip uninstall -y torchao
- ライブラリ: trl の GRPOTrainer で学習し、peft で LoRA を使います。互いの内部 API に依存しているので、まとめて新しい版に揃えます。
- torchao の削除: 新しい peft は、環境に torchao があると、そのバージョンを確認して量子化関連の機能を読み込もうとします。Colab にあらかじめ入っている古い torchao だと、LoRA を付けるときに「互換性のないバージョン」というエラーになります。本記事は量子化を使わないので、あらかじめ削除しておきます(削除した後は、ランタイムを再起動してから以降のセルを実行してください)。
- matplotlib-fontja: matplotlib のグラフに日本語を表示するためのライブラリです。import matplotlib_fontja とするだけで、日本語フォントが設定されます。同じ目的の japanize_matplotlib は、Python 3.12 以降で削除された distutils を使っているため、新しい Colab ではそのままでは読み込めません。
import os
from google.colab import drive

drive.mount("/content/drive")

SAVE_ROOT = "/content/drive/MyDrive/deepseek_r1"
os.makedirs(SAVE_ROOT, exist_ok=True)
- 保存先: 学習のチェックポイントと評価結果は、セッションが切れても残るように SAVE_ROOT 以下に保存します。2つの条件(言語一貫性報酬の有無)で学習するので、途中で中断しても続きから進められるようにします。
実装1:算数ワールドと答えの抽出
Chain-of-Thoughtの記事と同じ算数ワールドの生成器と、評価用の抽出関数・指標です。設計の説明はそちらを参照してください。
import numpy as np

ITEMS = ["りんご", "みかん", "クッキー", "ノート", "シール", "えんぴつ"]
MAX_VALUE = 10_000
OP_SYMBOL = {"add": "+", "sub": "-", "mul": "×", "div": "÷"}

def sample_operation(rng, current):
    """現在の値に適用できる演算を1つ選ぶ(条件を満たさなければ選び直す=棄却サンプリング)"""
    while True:                              # 条件を満たす組み合わせが出るまで繰り返す
        # rng.choice は NumPy の文字列型で返るので、str() で Python の文字列に戻す
        op = str(rng.choice(["add", "sub", "mul", "div"]))
        if op in ("add", "sub"):
            val = int(rng.integers(2, 51))   # 2〜50
        elif op == "mul":
            val = int(rng.integers(2, 6))    # 2〜5倍
        else:
            val = int(rng.integers(2, 10))   # 2〜9等分

        if op == "add":
            new = current + val
        elif op == "sub":
            new = current - val
        elif op == "mul":
            new = current * val
        else:
            if current % val != 0:
                continue                     # 割り切れない除算は棄却
            new = current // val

        if 1 <= new <= MAX_VALUE:            # 中間結果は 1 以上 10,000 以下
            return op, val, new

def make_problem(rng, n_steps):
    """ステップ数 n_steps(=四則演算の回数)の算数文章題を1問生成する"""
    item = str(rng.choice(ITEMS))
    current = int(rng.integers(10, 51))
    story = [f"{item}が{current}個あります。"]
    steps = []
    for _ in range(n_steps):
        op, val, new = sample_operation(rng, current)
        if op == "add":
            story.append(f"{val}個もらいました。")
        elif op == "sub":
            story.append(f"{val}個使いました。")
        elif op == "mul":
            story.append(f"{item}の数が{val}倍になりました。")
        else:
            story.append(f"{val}等分して、そのうち1つ分だけを残しました。")
        steps.append(f"{current} {OP_SYMBOL[op]} {val} = {new}")
        current = new
    question = "".join(story) + f"いま{item}は何個ありますか。"
    gold_steps = "。".join(steps) + f"。答え: {current}"
    return {"question": question, "answer": current, "gold_steps": gold_steps, "n_steps": n_steps}

def make_dataset(n_per_step, seed, exclude=None):
    """ステップ数1〜5の問題を n_per_step 問ずつ生成する。exclude に含まれる問題文と重複は除外する"""
    rng = np.random.default_rng(seed)
    seen = set(exclude) if exclude else set()
    dataset = []
    for s in [1, 2, 3, 4, 5]:
        count = 0
        while count < n_per_step:
            prob = make_problem(rng, s)
            if prob["question"] in seen:
                continue
            seen.add(prob["question"])
            dataset.append(prob)
            count += 1
    return dataset


import re
import unicodedata
from collections import Counter
import numpy as np

def _last_integer(s):
    """文字列中の最後の整数を返す(引き算の式の「-」は符号として扱わない)"""
    # (?<!\d) は「直前が数字でない」という条件(否定後読み)。
    # これがないと「12-5」の「-5」を負の数として拾ってしまう
    nums = re.findall(r"(?<!\d)-?\d+", s)
    return int(nums[-1]) if nums else None

def extract_answer(text):
    """生成テキストから最終回答の整数を抽出する(抽出できなければ None)"""
    if not text:
        return None
    text = unicodedata.normalize("NFKC", text).replace(",", "")   # 全角→半角、カンマ除去

    # 1. <answer> タグ
    m = re.search(r"<answer>(.*?)</answer>", text, re.DOTALL)
    if m and _last_integer(m.group(1)) is not None:
        return _last_integer(m.group(1))

    # 2. 「答え:」の行(複数あれば最後の行)
    lines = re.findall(r"(?:答え|Answer)\s*[::]\s*([^\n]*)", text, re.IGNORECASE)
    for line in reversed(lines):
        if _last_integer(line) is not None:
            return _last_integer(line)

    # 3. テキスト中の最後の数値
    return _last_integer(text)

def pass_at_k(n, c, k):
    """Codex 論文の pass@k の不偏推定量:n 本中 c 本正解のとき、k 本に1本以上正解が含まれる確率"""
    if n - c < k:
        return 1.0                           # 不正解が k 本より少ない → 必ず正解が混ざる
    # 「k 本すべてが不正解」の確率を、1本ずつ引いていく積の形で計算する
    # (二項係数を直接計算すると値が大きくなりすぎるため)
    prob_all_wrong = 1.0
    for i in range(1, k + 1):
        prob_all_wrong *= (n - c - i + 1) / (n - i + 1)
    return 1.0 - prob_all_wrong

def majority_vote(preds):
    """None を除いた答えの最頻値(同数なら先に出た答え)"""
    valid = [p for p in preds if p is not None]
    if not valid:
        return None
    return Counter(valid).most_common(1)[0][0]

def maj_at_k(preds, target, k, n_perm=1000, seed=0):
    """n 本から k 本を無作為に選んで多数決をとったときの正解率(並べ替えを変えて平均する)"""
    rng = np.random.default_rng(seed)
    hits = 0
    for _ in range(n_perm):
        # n 本を並べ替えて先頭 k 本を取る=k 本の無作為な選び方を1通り作る
        subset = [preds[i] for i in rng.permutation(len(preds))[:k]]
        hits += majority_vote(subset) == target     # True は 1 として足される
    return hits / n_perm                            # 選び方を変えた平均が maj@k の推定値

eval_dataset = make_dataset(n_per_step=100, seed=2026)          # 評価用:CoT・GRPO・蒸留の記事と共通の500問
eval_questions = {p["question"] for p in eval_dataset}         # 重複判定用の集合(set)
train_dataset = make_dataset(n_per_step=1000, seed=0, exclude=eval_questions)  # 学習用5,000問
print(f"評価用: {len(eval_dataset)} 問 / 学習用: {len(train_dataset)} 問")
- データ: 評価用は CoT・GRPO・蒸留の記事と共通の500問(seed=2026)、学習用は評価用と重複しない5,000問(seed=0)です。学習用はステップ数1〜5を1,000問ずつ含みます。
- 評価用の抽出: extract_answer は <answer> タグの中を最優先で探すので、R1-Zero 形式の出力にもそのまま使えます。
実行結果
評価用: 500 問 / 学習用: 5000 問
実装2:R1-Zeroのテンプレート
論文のテンプレートにならってプロンプトを作ります。
R1_ZERO_TEMPLATE = (
    "A conversation between User and Assistant. The user asks a question, and the Assistant solves it. "
    "The assistant first thinks about the reasoning process in the mind and then provides the user with the answer. "
    "The reasoning process and answer are enclosed within <think> </think> and <answer> </answer> tags, "
    "respectively, i.e., <think> reasoning process here </think> <answer> answer here </answer>. "
    "User: {question} Assistant: <think>"     # 末尾に <think> を置いて思考から書き始めさせる
)

def build_r1_zero_prompt(question):
    # format で {question} の部分を実際の問題文に差し替える
    return R1_ZERO_TEMPLATE.format(question=question)
- テンプレートはそのまま英語: 論文のテンプレートを変えずに使い、問題文だけを日本語にします。指示文が英語で問題が日本語という状況で、モデルがどの言語で考えるかも観察の対象になります。
- <think> の先置き: プロンプトの末尾に <think> を置いておくと、モデルは思考の書き出しから生成を始めます。ベースモデルが最初からタグを無視して雑談を始めるのを防ぐための、よく使われる工夫です。そのため、生成されるテキストは思考の途中から始まり、</think> で思考を閉じてから <answer> に進む形になります。
実装3:報酬関数と言語の判定
正解報酬・形式報酬・言語一貫性報酬を実装します。
import re
import unicodedata

CORRECT_REWARD = 1.0
FORMAT_REWARD = 0.2
LANG_REWARD = 0.2

# 「思考 </think> <answer>答え</answer>」の形かを判定する正規表現。
# ^ と $ で全体に一致させ、末尾の \s* で「</answer> の後ろは空白だけ」に限る。
# (.*?) は最短一致、re.DOTALL は . を改行にも一致させる指定
THINK_ANSWER = re.compile(r"^(.*?)</think>\s*<answer>(.*?)</answer>\s*$", re.DOTALL)
TAGS = ["<think>", "</think>", "<answer>", "</answer>"]
KANA = re.compile(r"[\u3040-\u30ff]")      # ひらがな・カタカナ
HAN = re.compile(r"[\u4e00-\u9fff]")       # 漢字(日本語と中国語で共通)
LATIN = re.compile(r"[A-Za-z]")

def parse_r1_output(completion):
    """プリフィルした <think> に続く生成を、思考と回答に分ける。形式が崩れていれば None"""
    text = completion.lstrip()
    if text.startswith("<think>"):
        text = text[len("<think>"):]               # モデルが <think> を重ねて書いた場合は取り除く
    m = THINK_ANSWER.match(text)
    if m is None:
        return None                                # 形式違反(タグが閉じない、後ろに続きがある など)
    think, answer = m.group(1), m.group(2)         # 丸かっこの1つ目が思考、2つ目が答え
    if any(tag in think or tag in answer for tag in TAGS):
        return None                                # タグが2組以上ある
    return think, answer

def extract_tag_answer(answer_part):
    """<answer> の中に整数がちょうど1つあるときだけ、その整数を返す"""
    text = unicodedata.normalize("NFKC", answer_part).replace(",", "")   # 全角→半角、カンマ除去
    # (?<!\d) は「直前が数字でない」条件(否定後読み)。「12-5」の「-5」を負の数として拾わないため
    nums = re.findall(r"(?<!\d)-?\d+", text)
    return int(nums[0]) if len(nums) == 1 else None   # 2つ以上あればハッキングとみなして None

def sentence_languages(text):
    """思考を文に分け、各文を ja(かなを含む)/ zh(漢字のみ)/ en(ラテン文字のみ)に分類して数える"""
    counts = {"ja": 0, "zh": 0, "en": 0}
    # 句点・ピリオド・感嘆符・改行のいずれかで区切って文に分ける
    for sent in re.split(r"[。..!?!?\n]+", unicodedata.normalize("NFKC", text)):
        # 判定の順番が重要:かなを先に見ることで、漢字かな交じりの文を日本語と判定できる
        if KANA.search(sent):
            counts["ja"] += 1
        elif HAN.search(sent):
            counts["zh"] += 1
        elif LATIN.search(sent):
            counts["en"] += 1                      # 数式だけの文はどれにも数えない
    return counts

def japanese_ratio(think):
    counts = sentence_languages(think)
    total = sum(counts.values())
    # 文が1つもない(数式だけの思考)場合は 0 を返す
    return counts["ja"] / total if total > 0 else 0.0

def r1_reward(completion, target, use_lang_reward=True):
    """形式報酬 0.2 + 正解報酬 1.0 + 言語一貫性報酬(最大 0.2)"""
    parsed = parse_r1_output(completion)
    if parsed is None:
        return 0.0                                 # 形式違反は報酬0(他の報酬も与えない)
    think, answer = parsed
    reward = FORMAT_REWARD                         # ここまで来たら形式は守っている
    if extract_tag_answer(answer) == target:
        reward += CORRECT_REWARD
    if use_lang_reward:
        reward += LANG_REWARD * japanese_ratio(think)   # 日本語の文の割合に比例(0〜0.2)
    return reward
【形式の判定】
- 厳しい形式: parse_r1_output は、生成が「思考 → </think> → <answer>答え</answer>」の形で、</answer> の後に何も続かない 場合だけ、思考と回答の部分を返します。タグが2組以上ある出力や、タグが閉じていない出力は形式違反です。
- 回答の後に続く生成への対策: ベースモデルは、答えを書いた後も「User: ...」のように次の会話を勝手に書き続けることがあります。</answer> の後に何かが続くと形式違反として報酬を0にすることで、答えを書いたら生成を終える(EOS を出力する)ことを学ばせます。
- 正解報酬の条件: 正解報酬は、形式を守ったうえで、<answer> の中の整数がちょうど1つで、それが正解と一致する場合にだけ与えます(extract_tag_answer)。答えを複数書くハッキングを防ぐためです。
- 正規表現の読み方: THINK_ANSWER の ^ と $ は文字列の先頭と末尾で、全体がこの形に一致することを要求します。末尾が </answer>\s*$ なので、「</answer> の後ろは空白か改行だけ」が条件になり、続きを書いた出力を弾けます。(.*?) の ? は 最短一致 の指定で、これがないと <answer> が複数あるときに最後のものまで飲み込んでしまいます。re.DOTALL は . を改行にも一致させる指定で、思考が複数行にわたるため必要です。
- タグの重複の検査: 正規表現を通った後に、取り出した思考と回答の中にタグが残っていないかを any(...) で確認します。最短一致にしていても、たとえば「思考 </think> <answer>40</answer> <answer>20</answer>」のような出力は、回答部分にタグが残るので弾けます。
【言語一貫性報酬】
- 文ごとに言語を判定する: sentence_languages は、思考を句点や改行で文に分け、ひらがな・カタカナを含む文を日本語(ja)、漢字だけでかなを含まない文を中国語(zh)、ラテン文字だけの文を英語(en)として数えます。「24 - 8 = 16」のような数式だけの文は、どの言語にも数えません。
- 漢字だけでは日本語と判定しない: 漢字は日本語と中国語で共通なので、「漢字の割合」を日本語の割合として数えると、中国語で考えた思考にも高い報酬を与えてしまいます。そこで、かなを含むかどうかで日本語と中国語を区別しています。そのため「計算結果」のように漢字だけで書かれた日本語の文は、中国語と判定される点に注意してください。
- 文への分割: re.split(r"[。..!?!?\n]+", ...) は、角かっこの中のどれか1文字以上が並んだところで文字列を切り分けます。句点・ピリオド・感嘆符・疑問符・改行のいずれでも文の区切りとみなす、という指定です。
- 判定の順番: if で「かな → 漢字 → ラテン文字」の順に調べるのは、順番に意味があるためです。漢字かな交じりの日本語の文はかなを含むので、最初の条件で日本語と判定されます。もし漢字を先に調べると、日本語の文がすべて中国語に分類されてしまいます。
- 報酬の大きさ: 言語一貫性報酬は、日本語の文の割合に LANG_REWARD(0.2)を掛けたものです。論文と同じく、正解報酬・形式報酬と足し合わせます。数式だけの思考はどの言語の文も含まないので、言語一貫性報酬は0になります。
報酬の動作を確認します。
tests = {
    "日本語で正解": "24 - 8 = 16。16 + 4 = 20。20 × 2 = 40。待てよ、確認すると合っている。</think> <answer>40</answer>",
    "中国語で正解": "首先,24 - 8 = 16。然后 16 + 4 = 20。等等,再检查一遍:20 × 2 = 40。</think><answer>40</answer>",
    "日英が混在": "まず24から8を引いて16。Then 16 + 4 = 20, and 20 × 2 = 40.</think><answer>40</answer>",
    "答えが2つ": "24 - 8 = 16。16 + 4 = 20。</think><answer>40 または 20</answer>",
    "回答の後に続く": "20 × 2 = 40。</think><answer>40</answer> User: 次の問題です。",
    "タグが閉じない": "計算すると40になる。</think><answer>40",
}
for name, text in tests.items():
    parsed = parse_r1_output(text)
    # 形式違反なら parsed が None なので、言語の内訳は表示しない
    langs = sentence_languages(parsed[0]) if parsed else None
    print(f"[{name}] 言語あり {r1_reward(text, 40):.2f} | 言語なし {r1_reward(text, 40, use_lang_reward=False):.2f} | 文の言語 {langs}")
- テストの内容: 正解が40の問題に対する6通りの出力で、言語一貫性報酬がある場合とない場合の報酬と、思考の文の言語の内訳を表示します。
実行結果
[日本語で正解] 言語あり 1.40 | 言語なし 1.20 | 文の言語 {'ja': 1, 'zh': 0, 'en': 0}
[中国語で正解] 言語あり 1.20 | 言語なし 1.20 | 文の言語 {'ja': 0, 'zh': 3, 'en': 0}
[日英が混在] 言語あり 1.30 | 言語なし 1.20 | 文の言語 {'ja': 1, 'zh': 0, 'en': 1}
[答えが2つ] 言語あり 0.20 | 言語なし 0.20 | 文の言語 {'ja': 0, 'zh': 0, 'en': 0}
[回答の後に続く] 言語あり 0.00 | 言語なし 0.00 | 文の言語 None
[タグが閉じない] 言語あり 0.00 | 言語なし 0.00 | 文の言語 None
- 言語による差: 日本語で考えた出力は 1.40 ですが、同じ内容を中国語で考えた出力は、言語一貫性報酬がないと同じ 1.20 で、あると日本語より 0.2 低くなります。日本語と英語が半々の出力はその中間です。言語一貫性報酬がなければ、思考の言語は報酬にまったく影響しないことが分かります。
- ハッキングへの対策: 答えを2つ書いた出力は、形式報酬の 0.2 だけで正解報酬は得られません。回答の後に次の会話を書き続けた出力と、タグを閉じていない出力は、形式違反で0です。
実装4:TRLによるGRPOの学習
TRL の GRPOTrainer で、言語一貫性報酬ありとなしの2つの条件を学習します。GRPO の仕組みとスクラッチ実装は GRPOの記事 を参照してください。
本記事のコードは trl==1.13.0(transformers==5.17.0・peft==0.21.0) で確認しています。GRPOTrainer はバージョンによって既定値や引数が変わるので、GRPOの記事の注意と同じく、loss_type・beta・scale_rewards・生成の設定は明示してください。また、1回の最適化ステップで使う問題の数(per_device_train_batch_size と gradient_accumulation_steps の関係)もバージョンによって扱いが異なるので、学習ログの報酬の本数などで確認してください。
import pandas as pd
import torch
from datasets import Dataset
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
from peft import LoraConfig
from trl import GRPOConfig, GRPOTrainer

SEED = 42
MODEL_ID = "Qwen/Qwen2.5-1.5B"

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
tokenizer.padding_side = "left"     # 生成時は左側にパディングする

# prompt 列にテンプレートを適用した文字列、answer 列に正解を入れたデータセットにする
trl_train = Dataset.from_list(
    [{"prompt": build_r1_zero_prompt(p["question"]), "answer": p["answer"]} for p in train_dataset])

def make_reward_fn(use_lang_reward):
    """報酬関数そのものを作って返す関数(言語一貫性報酬の有無だけが違う2つを作るため)"""
    def reward_fn(completions, answer, **kwargs):
        # 引数名 answer がデータセットの列名と一致すると、TRL がその列を渡してくれる。
        # **kwargs は、TRL が渡す他の引数を受け取って無視するための書き方
        return [r1_reward(c, a, use_lang_reward) for c, a in zip(completions, answer)]
    reward_fn.__name__ = "r1_reward_lang" if use_lang_reward else "r1_reward"   # ログに表示される名前
    return reward_fn

def train_r1_zero(condition, use_lang_reward, init_model=MODEL_ID):
    """条件名・言語一貫性報酬の有無・学習を始めるモデルを変えて GRPO を実行する"""
    output_dir = f"{SAVE_ROOT}/{condition}"
    set_seed(SEED)                      # 条件ごとに同じシードから始める
    # init_model の既定はベースモデル。実装5ではコールドスタート SFT 済みのモデルを渡す
    model = AutoModelForCausalLM.from_pretrained(init_model, torch_dtype=torch.bfloat16)
    args = GRPOConfig(
        output_dir=output_dir,
        learning_rate=2e-5,
        per_device_train_batch_size=16,     # 応答の数(2問 × G=8)
        gradient_accumulation_steps=2,
        num_generations=8,                  # グループサイズ G
        max_completion_length=512,
        temperature=1.0, top_p=1.0, top_k=0, repetition_penalty=1.0,
        beta=0.001,                         # KL 係数(R1 の論文の値)
        epsilon=0.2,
        num_iterations=1,
        loss_type="grpo",                   # GRPOの記事と同じ、応答ごとに長さで割る形
        scale_rewards=True,
        max_steps=600,
        logging_steps=10,
        save_steps=150,
        gradient_checkpointing=True,
        bf16=True,
        seed=SEED,
        report_to="none",
    )
    trainer = GRPOTrainer(
        model=model,
        reward_funcs=make_reward_fn(use_lang_reward),
        args=args,
        train_dataset=trl_train,
        processing_class=tokenizer,
        peft_config=LoraConfig(
            r=16, lora_alpha=32, lora_dropout=0.0, bias="none", task_type="CAUSAL_LM",
            target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"]),
    )
    trainer.train()
    # 報酬・KL・生成長などの記録を CSV に保存する(後で学習曲線を描くため)
    pd.DataFrame(trainer.state.log_history).to_csv(f"{output_dir}/log_history.csv", index=False)
    del model, trainer              # 次の条件を学習する前に GPU メモリを解放する
    torch.cuda.empty_cache()

train_r1_zero("lang", use_lang_reward=True)      # 言語一貫性報酬あり
train_r1_zero("nolang", use_lang_reward=False)   # 言語一貫性報酬なし(R1-Zero に近い設定)
【データと報酬】
- プロンプトの形式: prompt には、テンプレートを適用した文字列をそのまま入れます(チャットテンプレートは使いません)。報酬関数が受け取る completions は、<think> の後に続いて生成された文字列です。
- 報酬関数の作り分け(関数を返す関数): make_reward_fn は、報酬関数 そのもの を作って返す関数です。TRL に渡せるのは「応答のリストを受け取って報酬のリストを返す関数」だけなので、use_lang_reward という設定を引数として外から渡すことができません。そこで、その値を覚えた関数を作って返しています(内側の reward_fn が外側の引数を参照できる、クロージャという仕組みです)。これで、言語一貫性報酬の有無だけが違う2つの報酬関数を、同じコードから作れます。
- ログに出る名前: reward_fn.name = ... は、関数の名前を後から書き換えています。TRL は報酬関数の名前を学習ログの列名に使うので、そのままだと2つの条件が同じ reward_fn という名前でログに出てしまいます。
- データセットの列と引数名: データセットの answer 列は、報酬関数の answer という引数として渡されます。列名と引数名を一致させるのが TRL の決まりです。**kwargs は、TRL が渡してくる他の引数をまとめて受け取って無視するための書き方です。
【設定】
- KL 係数: beta=0.001 は R1 の論文の値で、GRPOの記事(0.04)よりかなり小さくしています。ベースモデルから大きく変わること(形式を覚える、思考を長くする)を許すためです。
- 温度: R1-Zero と同じく、学習中の生成は温度1.0で行い、top_p・top_k・repetition_penalty は無効にします。
- 生成長: max_completion_length=512 なので、思考が512トークンを超えて伸びることはできません。論文の数万トークンとは桁が違う点に注意してください。上限に達した生成は </answer> で終われないので、形式違反(報酬0)になります。
- 1ステップあたりの問題数: per_device_train_batch_size=16 は 応答の数 で、num_generations=8 で割ると2問です。これを gradient_accumulation_steps=2 で2回ためてから1回更新するので、1回の更新に使うのは「4問 × 8本 = 32本」になります。GRPOの記事の設定と同じ規模です。一度に32本を生成するとメモリが足りないため、2回に分けています。
- メモリの節約: 1.5B のモデルで512トークンの生成を扱うので、gradient_checkpointing=True で中間の活性値を保持せずに再計算します。順伝播の途中の値を捨てて逆伝播のときに作り直すので、メモリは減りますが計算時間は増えます。
- モデルの渡し方: LoRA を付けていないモデルを model に渡し、LoRA の設定は peft_config で渡します。参照モデル(LoRA を外した学習開始時のモデル)は TRL が内部で計算します。init_model は学習を始めるモデルで、既定はベースモデルです。次の実装5では、コールドスタート SFT をしたモデルを渡します。
- ログの保存: trainer.state.log_history(報酬・KL・生成長などの記録)を CSV に保存し、後で学習曲線を描きます。save_steps=150 なので、150ステップごとのチェックポイント(LoRA アダプター)が output_dir に保存されます。
実行結果
Step	Training Loss
   10 0.000003
   20 0.000027
   30 0.000036
   40 0.000092
   50 0.000089
   60 0.000106
   70 0.000122
   80 0.000147
   90 0.000169
  100 0.000231
  110 0.000243
  120 0.000280
  130 0.000233
  140 0.000286
  150 0.000302
  160 0.000230
  170 0.000364
  180 0.000238
  190 0.000235
  200 0.000226
  210 0.000231
  220 0.000253
  230 0.000246
  240 0.000257
  250 0.000200
  260 0.000209
  270 0.000233
  280 0.000193
  290 0.000222
  300 0.000320
  310 0.000233
  320 0.000174
  330 0.000296
  340 0.000231
  350 0.000260
  360 0.000194
  370 0.000248
  380 0.000222
  390 0.000203
  400 0.001423
  410 0.000189
  420 0.000194
  430 0.000737
  440 0.000188
  450 0.000275
  460 0.000208
  470 0.000242
  480 0.000177
  490 0.000203
  500 0.000210
  510 0.000207
  520 0.000190
  530 0.000199
  540 0.000228
  550 0.000172
  560 0.000244
  570 0.000190
  580 0.000204
  590 0.000183
  600 0.000261
Step	Training Loss
   10 0.000002
   20 0.000026
   30 0.000078
   40 0.000187
   50 0.000226
   60 0.000173
   70 0.000202
   80 0.000258
   90 0.000261
  100 0.000300
  110 0.000332
  120 0.000255
  130 0.000225
  140 0.000264
  150 0.000229
  160 0.000234
  170 0.000265
  180 0.000222
  190 0.000235
  200 0.000183
  210 0.000212
  220 0.000231
  230 0.000179
  240 0.000214
  250 0.000212
  260 0.000211
  270 0.000297
  280 0.000207
  290 0.000214
  300 0.000200
  310 0.000197
  320 0.000234
  330 0.000236
  340 0.000250
  350 0.001056
  360 0.000247
  370 0.000206
  380 0.000206
  390 0.000200
  400 0.000221
  410 0.000212
  420 0.000214
  430 0.000215
  440 0.000203
  450 0.000228
  460 0.000227
  470 0.000214
  480 0.000196
  490 0.000210
  500 0.000201
  510 0.000217
  520 0.000220
  530 0.000232
  540 0.000219
  550 0.000199
  560 0.000208
  570 0.000207
  580 0.000217
  590 0.000219
  600 0.000264
実装5:コールドスタートSFT
R1 のステージ1にならい、読みやすい日本語の CoT で少量の SFT をしてから、同じ設定で GRPO を行います。比べるのは、言語一貫性報酬なしの R1-Zero 型の条件(nolang)です。コールドスタートの条件でも言語一貫性報酬は使わず、違いを「最初に SFT をしたかどうか」だけにします。
まず、コールドスタート用のデータを作ります。算数ワールドの模範解答(gold steps)は「24 - 8 = 16。」のような式の並びなので、各ステップを日本語の文で説明する形に書き換えます。
import re
import numpy as np

N_COLD = 300          # コールドスタートに使う問題数(少数に抑える)
# gold steps の「15 + 21 = 36」から、4つの数字と記号を取り出す正規表現。
# 丸かっこで囲んだ4か所が findall の戻り値(左辺・演算子・右辺・結果)になる
STEP_PATTERN = re.compile(r"(\d+) ([+\-×÷]) (\d+) = (\d+)")
STEP_TEXT = {
    "+": "{b}個もらったので、{a} + {b} = {c} 個になります。",
    "-": "{b}個使ったので、{a} - {b} = {c} 個になります。",
    "×": "数が{b}倍になったので、{a} × {b} = {c} 個になります。",
    "÷": "{b}等分して1つ分を残したので、{a} ÷ {b} = {c} 個になります。",
}

def to_readable_cot(problem):
    """gold steps(式の並び)を、日本語の文で説明する R1 形式の応答に変換する"""
    steps = STEP_PATTERN.findall(problem["gold_steps"])   # [(左辺, 演算子, 右辺, 結果), ...]
    lines = [f"最初は{steps[0][0]}個です。"]                 # 1つ目の式の左辺が最初の個数
    for a, op, b, c in steps:
        lines.append(STEP_TEXT[op].format(a=a, b=b, c=c))  # 演算子ごとの言い回しに数字を埋める
    lines.append(f"よって、答えは{problem['answer']}個です。")
    # 先頭の改行は、プロンプト末尾の <think> の直後に続くため
    return "\n" + "\n".join(lines) + f"\n</think>\n<answer>{problem['answer']}</answer>"

cold_rng = np.random.default_rng(1)                        # 学習データの選び方は別のシードで固定する
cold_idx = cold_rng.choice(len(train_dataset), size=N_COLD, replace=False)   # 重複なしで300問
cold_problems = [train_dataset[i] for i in cold_idx]
cold_data = [{"prompt": build_r1_zero_prompt(p["question"]), "completion": to_readable_cot(p)}
             for p in cold_problems]

# 変換したデータがすべて報酬関数の形式・正解・言語の条件を満たすかを確認する
rewards = [r1_reward(d["completion"], p["answer"]) for d, p in zip(cold_data, cold_problems)]
# 満点は 0.2(形式)+ 1.0(正解)+ 0.2(全文が日本語)= 1.4。
# 浮動小数点なので == ではなく np.isclose で比べる
print(f"コールドスタートのデータ: {len(cold_data)} 件 / 報酬 1.40 の割合: {np.mean(np.isclose(rewards, 1.4)):.3f}")
# bincount は 0 から数えるので、[1:] でステップ数1〜5の件数だけを取り出す
print("ステップ数の内訳:", np.bincount([p["n_steps"] for p in cold_problems])[1:])
print("--- 例 ---")
print(cold_problems[0]["question"])
print("<think>" + cold_data[0]["completion"])
【データの作り方】
- 読みやすい CoT への変換: to_readable_cot は、gold steps から各ステップの式を取り出し、「21個もらったので、15 + 21 = 36 個になります。」のように、問題文の操作と式を対応させた日本語の文にします。最後に答えをまとめる文を置き、</think> の後に <answer> タグで答えを書きます。
- 式だけにしない理由: 文ごとの言語の判定では、式だけの文はどの言語にも数えません。gold steps をそのまま使うと、思考に日本語の文がほとんど含まれず、「思考の言語を日本語に揃える」というコールドスタートの目的を確かめられません。
- 振り返りの表現は入れない: 「確認すると」のような振り返りの文は含めていません。強化学習の後に振り返りの表現が増えたときに、それが SFT で教えたものではないと分かるようにするためです。
- 件数を少なくする: 300件(学習用5,000問の6%)だけを使います。gold steps は常に正しい解き方なので、件数を増やすと、正解率の伸びの大部分が SFT(正しい思考過程の模倣)によるものになり、蒸留(推論の蒸留の記事で扱います)と区別できなくなるためです。
- データの確認: 変換したデータをすべて r1_reward で採点し、形式・正解・言語のすべてを満たす(報酬が 1.40 になる)ことを確かめます。満点は 0.2(形式)+ 1.0(正解)+ 0.2(思考のすべての文が日本語)です。浮動小数点の計算なので == ではなく np.isclose で比べています。
- ステップ数の内訳: np.bincount は「0が何個、1が何個…」と数える関数です。ステップ数は1から始まるので、[1:] で先頭(0の個数)を落としています。無作為に300問選んだだけなので、ステップ数1〜5がほぼ均等に入っているかを確認しておきます。
- 先頭の改行: to_readable_cot の戻り値が改行から始まるのは、プロンプトの末尾が <think> で終わっているためです。生成はその直後から始まるので、応答も改行から書き始める形に揃えています。
実行結果
コールドスタートのデータ: 300 件 / 報酬 1.40 の割合: 1.000
ステップ数の内訳: [53 57 63 59 68]
--- 例 ---
みかんが15個あります。21個もらいました。50個もらいました。2個もらいました。43個使いました。13個もらいました。いまみかんは何個ありますか。
<think>
最初は15個です。
21個もらったので、15 + 21 = 36 個になります。
50個もらったので、36 + 50 = 86 個になります。
2個もらったので、86 + 2 = 88 個になります。
43個使ったので、88 - 43 = 45 個になります。
13個もらったので、45 + 13 = 58 個になります。
よって、答えは58個です。
</think>
<answer>58</answer>
300件すべてが報酬の条件を満たしていて、ステップ数1〜5の問題がほぼ均等に含まれています。
このデータで SFT をしてから、GRPO を行います。
from trl import SFTConfig, SFTTrainer

COLD_MERGED_DIR = f"{SAVE_ROOT}/coldstart_sft_merged"

# 1. コールドスタート SFT(LoRA)
set_seed(SEED)
sft_tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)   # SFT は右パディング(既定)で行う
sft_model = AutoModelForCausalLM.from_pretrained(MODEL_ID, torch_dtype=torch.bfloat16)
sft_trainer = SFTTrainer(
    model=sft_model,
    args=SFTConfig(
        output_dir=f"{SAVE_ROOT}/coldstart_sft",
        learning_rate=1e-4,
        num_train_epochs=2,
        per_device_train_batch_size=8,
        max_length=1024,
        completion_only_loss=True,          # プロンプト部分は損失に含めない
        bf16=True,
        logging_steps=10,
        save_strategy="no",
        seed=SEED,
        report_to="none",
    ),
    train_dataset=Dataset.from_list(cold_data),
    processing_class=sft_tokenizer,
    peft_config=LoraConfig(
        r=16, lora_alpha=32, lora_dropout=0.0, bias="none", task_type="CAUSAL_LM",
        target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"]),
)
# トークナイズ済みの1件目の最後のトークンを見て、EOS が付いているか確かめる
last_id = sft_trainer.train_dataset[0]["input_ids"][-1]
print("学習データの末尾が EOS か:", last_id == sft_tokenizer.eos_token_id)
sft_trainer.train()

# 2. LoRA を統合して保存(これが GRPO の初期モデル兼参照モデルになる)
merged = sft_trainer.model.merge_and_unload()   # LoRA の差分を元の重みに足し込み、LoRA を外す
merged.save_pretrained(COLD_MERGED_DIR)
sft_tokenizer.save_pretrained(COLD_MERGED_DIR)  # 読み込み時に必要なのでトークナイザーも保存する
del sft_model, sft_trainer, merged
torch.cuda.empty_cache()

# 3. SFT 済みモデルから GRPO(言語一貫性報酬なし)
train_r1_zero("coldstart", use_lang_reward=False, init_model=COLD_MERGED_DIR)
【SFT】
- プロンプトと応答の形式: cold_data は prompt と completion の2列を持つので、TRL の SFTTrainer はプロンプト・応答形式のデータとして扱います。completion_only_loss=True で、応答部分だけを損失の対象にします(Instruction Tuningの記事と同じ考え方です)。
- EOS の確認: 答えを書いたら生成を終えることを学ばせるには、応答の末尾に EOS トークンが付いている必要があります。TRL は応答の末尾に EOS を付けますが、バージョンによって挙動が異なるので、トークナイズ後の1件目の末尾が EOS かを表示して確かめます。False の場合は、completion の末尾に sft_tokenizer.eos_token を足してください。
- パディングの向き: GRPO の生成用に左パディングにした tokenizer とは別に、SFT 用のトークナイザーを既定の設定で読み込みます。
- 学習の量とステップ数: 300件を2エポックだけ学習します。max_steps を指定していないので、総ステップ数は件数・バッチサイズ・エポック数から自動で決まります。 ステップ/エポックなので、2エポックで 76ステップ です。ただし logging_steps=10 により10の倍数しかログに出ないため、下の実行結果は step 70 で終わって見えます(71〜76 も実際には走っています)。実際の値は sft_trainer.state.max_steps で確認できます。なおこの後の GRPO は max_steps=600 を明示しているので、ステップ数の決まり方が SFT とは異なります。LoRA なので、学習率は全パラメータ学習より大きい 1e-4 にしています。
【GRPO】
- LoRA の統合: SFT の LoRA を merge_and_unload() で重みに統合して保存します。LoRA は「元の重み + 低ランクの差分」という形で学習するので、差分を元の重みに足し込んでしまえば、LoRA の付いていない普通のモデルとして扱えます。これが必要なのは、GRPO でこのモデルに 新しい LoRA を付けるためです。統合せずに LoRA を重ねると、参照モデル(LoRA を外した状態)が SFT 前のベースモデルに戻ってしまい、「SFT 済みモデルから強化学習を始める」という設定になりません。R1 でも、ステージ2の強化学習はコールドスタート SFT をしたモデルから始めています。
- トークナイザーも保存する: save_pretrained はモデルの重みだけを保存するので、後で COLD_MERGED_DIR から読み込めるように、トークナイザーも同じ場所に保存しています。
- 同じ設定での比較: train_r1_zero に init_model を渡すだけで、報酬・ハイパーパラメータ・ステップ数は nolang の条件と同じです。
実行結果
学習データの末尾が EOS か: True
Step	Training Loss
10	0.274501
20	0.005254
30	0.000664
40	0.000639
50	0.000231
60	0.000170
70	0.000149
Step	Training Loss
10	0.000013
20	0.000026
30	0.000032
40	0.000026
50	0.000028
60	0.000018
70	0.000019
80	0.000019
90	0.000021
100	0.000024
110	0.000021
120	0.000022
130	0.000021
140	0.000031
150	0.000017
160	0.000021
170	0.000024
180	0.000024
190	0.000024
200	0.000018
210	0.000018
220	0.000023
230	0.000023
240	0.000026
250	0.000026
260	0.000021
270	0.000017
280	0.000023
290	0.000024
300	0.000018
310	0.000018
320	0.000023
330	0.000023
340	0.000026
350	0.000022
360	0.000021
370	0.000020
380	0.000022
390	0.000017
400	0.000018
410	0.000016
420	0.000016
430	0.000020
440	0.000021
450	0.000021
460	0.000026
470	0.000021
480	0.000023
490	0.000021
500	0.000020
510	0.000017
520	0.000027
530	0.000018
540	0.000015
550	0.000022
560	0.000016
570	0.000021
580	0.000023
590	0.000021
600	0.000022
実装6:チェックポイントの評価
3つの条件(lang・nolang・coldstart)について、学習前(ステップ0)と50ステップごとのチェックポイントで、評価用500問に対する出力を調べます。
import pandas as pd
from peft import PeftModel

REFLECTION_WORDS = ["待って", "待てよ", "確認", "見直", "検算", "wait", "check", "verify", "等等", "检查", "验证"]
EVAL_STEPS = [0, 150, 300, 450, 600]

@torch.no_grad()       # 評価に勾配は不要なので、計算グラフを作らずメモリを節約する
def evaluate_r1(model, data, batch_size=32, max_new_tokens=512):
    """貪欲探索で生成し、形式・正解・生成長・振り返りの表現・思考の言語を記録する"""
    model.eval()                                 # ドロップアウトなどを評価用の動作にする
    rows = []
    for b in range(0, len(data), batch_size):    # batch_size 問ずつまとめて生成する
        batch = data[b:b + batch_size]
        enc = tokenizer([build_r1_zero_prompt(p["question"]) for p in batch],
                        return_tensors="pt", padding=True).to(model.device)
        out = model.generate(**enc, max_new_tokens=max_new_tokens, do_sample=False,
                             repetition_penalty=1.0, pad_token_id=tokenizer.pad_token_id)
        # out[:, プロンプト長:] で、プロンプトの後ろ=生成した部分だけを取り出す
        for p, ids in zip(batch, out[:, enc["input_ids"].shape[1]:]):
            text = tokenizer.decode(ids, skip_special_tokens=True)
            parsed = parse_r1_output(text)
            # 形式違反のときは </think> より前を思考とみなす(言語の判定に使う)
            think = parsed[0] if parsed else text.split("</think>")[0]
            # 緩い判定用に、最初の </answer> までを切り出す(後ろに続く生成を捨てる)
            head = text.split("</answer>")[0] + "</answer>" if "</answer>" in text else text
            langs = sentence_languages(think)
            n_sent = sum(langs.values())          # 言語を判定できた文の数
            rows.append({
                "n_steps": p["n_steps"],
                "format_ok": parsed is not None,
                "correct_strict": parsed is not None and extract_tag_answer(parsed[1]) == p["answer"],
                "correct_lenient": extract_answer(head) == p["answer"],
                # パディングでないトークンの数=実際に生成した長さ
                "length": int((ids != tokenizer.pad_token_id).sum()),
                "reflection": any(w in think.lower() for w in REFLECTION_WORDS),
                # 文が1つもない(式だけの思考)場合は NaN にして、平均から外れるようにする
                "ja_ratio": langs["ja"] / n_sent if n_sent else float("nan"),
                # 0より大きい言語が2種類以上あれば「混在」
                "mixed": sum(v > 0 for v in langs.values()) >= 2,
                "text": text,                     # 後で出力例を見るために原文も残す
            })
    return pd.DataFrame(rows)

# 条件ごとの学習開始時のモデル
INIT_MODELS = {"lang": MODEL_ID, "nolang": MODEL_ID, "coldstart": COLD_MERGED_DIR}

def load_policy(init_model, checkpoint_dir=None):
    """学習開始時のモデルに、指定したチェックポイントの LoRA を読み込む(None なら LoRA なし)"""
    base = AutoModelForCausalLM.from_pretrained(init_model, torch_dtype=torch.bfloat16).to("cuda")
    return base if checkpoint_dir is None else PeftModel.from_pretrained(base, checkpoint_dir)

for condition, init_model in INIT_MODELS.items():
    for step in EVAL_STEPS:
        path = f"{SAVE_ROOT}/eval_{condition}_step{step}.csv"
        if os.path.exists(path) or (step == 0 and condition == "nolang"):
            continue                              # lang と nolang のステップ0(ベースモデル)は共通なので1回だけ
        ckpt = None if step == 0 else f"{SAVE_ROOT}/{condition}/checkpoint-{step}"
        policy = load_policy(init_model, ckpt)
        evaluate_r1(policy, eval_dataset).to_csv(path, index=False)   # 1行 = 1問の記録を保存
        del policy                                # 次のチェックポイントを読む前に解放する
        torch.cuda.empty_cache()
【評価する量】
- 正解率(2種類): correct_strict は報酬と同じ厳しい判定(形式を守り、<answer> に整数が1つだけ)での正解です。correct_lenient は、最初の </answer> までを切り出して共通の extract_answer で判定した正解で、形式が崩れていても答え自体が合っているかを見るためのものです。学習前のベースモデルは形式を守れないことが多いので、2つを比べると「正解率の伸びのうち、形式を覚えたことによる部分」が分かります。
- 生成長: パディングを除いた生成トークン数です。(ids != tokenizer.pad_token_id).sum() は「パディングでないトークンの数」を数えています(真偽値の合計が個数になります)。回答の後に続く生成も含むので、形式を覚える前は長めに出ることがあります。
- 形式違反のときの思考: 形式が崩れていると parse_r1_output が None を返すので、言語の判定ができません。そこで、その場合は </think> より前を思考とみなしています。学習前のベースモデルは形式を守れないことが多いので、この扱いがないと思考の言語をまったく測れなくなります。
- 振り返りの表現: REFLECTION_WORDS のいずれかが思考部分に含まれる応答の割合です。「確認」のように普通の説明にも出てくる語も含むので、絶対的な値より、学習前後の変化を見ます。
- 思考の言語: ja_ratio は思考の文のうち日本語の文の割合、mixed は2つ以上の言語の文を含む応答かどうかです(sum(v > 0 for v in langs.values()) >= 2 で「件数が0より大きい言語が2種類以上」を判定しています)。思考が式だけで、どの言語にも分類できる文がない場合、ja_ratio は NaN になります。pandas の平均は NaN を除いて計算しますが、すべての行が NaN なら平均も NaN になるので、「思考から自然言語が消えた」ことが表の NaN として現れます。
【評価の進め方】
- チェックポイントの読み込み: load_policy は、学習開始時のモデル(INIT_MODELS)に各チェックポイントの LoRA アダプターを読み込みます。ステップ0は LoRA なしの学習開始時のモデルそのもので、lang と nolang ではベースモデル、coldstart では SFT 直後のモデルです。
- 再開できる設計: 評価結果は条件とステップごとに CSV に保存し、既にあればスキップします。
実装7:学習の推移と思考の書き方
保存した評価結果を読み込み、条件ごとに「学習が進むにつれて何がどう変わったか」を表と図にまとめます。併せて、同じ問題に対する600ステップ後の出力を3条件で並べ、思考の書き方と言語を実際の文章で確かめます。
import matplotlib.pyplot as plt
import matplotlib_fontja   # グラフに日本語を表示する

CONDITIONS = ["lang", "nolang", "coldstart"]
CONDITION_LABELS = {"lang": "言語一貫性報酬あり", "nolang": "言語一貫性報酬なし", "coldstart": "コールドスタート"}

def load_eval(condition, step):
    """保存した評価結果を読み込む。nolang のステップ0は lang と共通のファイルを見る"""
    cond = "lang" if (step == 0 and condition == "nolang") else condition
    return pd.read_csv(f"{SAVE_ROOT}/eval_{cond}_step{step}.csv")

METRICS = ["format_ok", "correct_strict", "correct_lenient", "length", "reflection", "ja_ratio", "mixed"]

# 1. 学習の進み具合による推移
for condition in CONDITIONS:
    # {ステップ: 指標の平均} の辞書から表を作り、.T で行と列を入れ替えて
    # 「行=ステップ、列=指標」の形にする
    table = pd.DataFrame({step: load_eval(condition, step)[METRICS].mean() for step in EVAL_STEPS}).T
    print(f"\n=== {condition} ===")
    print(table.round(3))

# 2. 学習中の生成長の推移(TRL のログ)
fig, ax = plt.subplots(figsize=(6, 4))
for condition in CONDITIONS:
    log = pd.read_csv(f"{SAVE_ROOT}/{condition}/log_history.csv")
    # 生成長の列名は TRL のバージョンで変わるので、実際にある方を next(...) で1つ選ぶ
    key = next(k for k in ["completions/mean_length", "completion_length"] if k in log.columns)
    log = log.dropna(subset=[key])          # その列が空の行(評価時のログなど)を除く
    ax.plot(log["step"], log[key], label=CONDITION_LABELS[condition])
ax.set_xlabel("学習ステップ")
ax.set_ylabel("平均生成長(トークン数)")
ax.legend()
plt.show()

# 3. 学習後の出力例(ステップ数3の最初の問題)
idx = 200      # 評価用データはステップ数1〜5の順に100問ずつ並ぶので、201番目がステップ数3の先頭
for condition in CONDITIONS:
    print(f"\n--- {condition} / step 600 ---")
    print(load_eval(condition, 600).loc[idx, "text"])   # loc[行, 列名] で1つの値を取り出す
- 推移の表: 条件ごとに、評価したステップを行、指標を列とする表を作ります。pd.DataFrame に辞書を渡すと、辞書のキーが 列 になるので、.T(転置)で行と列を入れ替えて「行=ステップ」の形にしています。真偽値の列の平均は、そのまま割合になります(True が 1、False が 0 として平均されます)。
- 学習中の生成長: TRL のログから、学習中に生成した応答の平均長を取り出します。キー名はバージョンによって異なるので、next(k for k in [...] if k in log.columns) で「実際に存在する列名」を1つ選びます。dropna(subset=[key]) は、その列が空の行(評価時のログなど、生成長が記録されていない行)を落とすためです。凡例には、CONDITION_LABELS で条件の日本語名を表示します。
- 出力例: idx = 200 はステップ数3の最初の問題です(評価用データの201番目で、学習のステップ数とは関係ありません)。評価用データはステップ数1〜5の順に100問ずつ並んでいるので、この位置がステップ数3の先頭になります。loc[行番号, 列名] で、その1問の生成テキストを取り出しています。3つの条件の出力を並べて、振り返りの表現や思考の言語を具体的に確認します。
実行結果
=== lang ===
     format_ok  correct_strict  correct_lenient   length  reflection  \
0        0.218           0.040            0.288  396.816       0.002
150      1.000           0.834            0.834   91.948       0.000
300      1.000           0.962            0.962   97.506       0.000
450      1.000           0.998            0.998  102.928       0.000
600      1.000           0.996            0.996  102.850       0.000

     ja_ratio  mixed
0       0.335  0.032
150     1.000  0.000
300     1.000  0.000
450     1.000  0.000
600     1.000  0.000

=== nolang ===
     format_ok  correct_strict  correct_lenient   length  reflection  \
0        0.218           0.040            0.288  396.816       0.002
150      1.000           0.906            0.906   37.514       0.000
300      1.000           0.990            0.990   38.982       0.000
450      1.000           0.992            0.992   39.166       0.000
600      1.000           0.996            0.996   39.190       0.000

     ja_ratio  mixed
0       0.335  0.032
150     0.000  0.000
300       NaN  0.000
450       NaN  0.000
600       NaN  0.000

=== coldstart ===
     format_ok  correct_strict  correct_lenient  length  reflection  ja_ratio  \
0         0.48           0.480            0.994  94.612         0.0       1.0
150       1.00           0.996            0.996  94.616         0.0       1.0
300       1.00           1.000            1.000  94.616         0.0       1.0
450       1.00           1.000            1.000  94.616         0.0       1.0
600       1.00           1.000            1.000  94.616         0.0       1.0

     mixed
0      0.0
150    0.0
300    0.0
450    0.0
600    0.0
--- lang / step 600 ---
クッキーが47個あります。クッキーの数が4倍になりました。クッキーの数は47×4=188個になりました。36個もらいました。クッキーの数は188+36=224個になりました。クッキーの数が2倍になりました。クッキーの数は224×2=448個になりました。いまクッキーは448個あります。 </think> <answer>448</answer>

--- nolang / step 600 ---
47*4=188, 188+36=224, 224*2=448</think> <answer>448</answer>

--- coldstart / step 600 ---
最初は47個です。
数が4倍になったので、47 × 4 = 188 個になります。
36個もらったので、188 + 36 = 224 個になります。
数が2倍になったので、224 × 2 = 448 個になります。
よって、答えは448個です。
</think>
<answer>448</answer>
考察:学習の推移
言語一貫性報酬ありの条件での、評価用500問に対する推移です。
| 学習ステップ | 形式の遵守率 | 正解率(厳しい判定) | 正解率(緩い判定) | 平均生成長 | 振り返りの表現 | 日本語の文の割合 |
|---|---|---|---|---|---|---|
| 0(ベースモデル) | 0.218 | 0.040 | 0.288 | 396.8 | 0.002 | 0.335 |
| 150 | 1.000 | 0.834 | 0.834 | 91.9 | 0.000 | 1.000 |
| 300 | 1.000 | 0.962 | 0.962 | 97.5 | 0.000 | 1.000 |
| 450 | 1.000 | 0.998 | 0.998 | 102.9 | 0.000 | 1.000 |
| 600 | 1.000 | 0.996 | 0.996 | 102.9 | 0.000 | 1.000 |
- 形式は早い段階で身につく: 学習前のベースモデルは、形式の遵守率が 0.218 で、上限(512トークン)近くまで書き続けていました(平均396.8トークン)。150ステップの時点で遵守率は 1.000 になり、</answer> を書いたら生成を止めることも学んでいます。SFT をしていないモデルでも、報酬だけで出力の構造を身につけられることが分かります。
- 形式を覚えた後は、答えそのものが正しくなっていく: 学習前は、緩い判定の正解率(0.288)が厳しい判定(0.040)を大きく上回っていました。答えは合っていても形式を守れていない出力が多かったということです。150ステップ以降は2つの正解率が一致し、その後の 0.834 → 0.962 → 0.998 という伸びは、答えの正しさそのものの向上です。
- 算数ワールドはほぼ解けるようになった: 450ステップで 0.998 に達し、以降は横ばいです(600ステップで 0.996)。ステップ数5の問題まで含めて、ほぼすべて解けるようになりました。
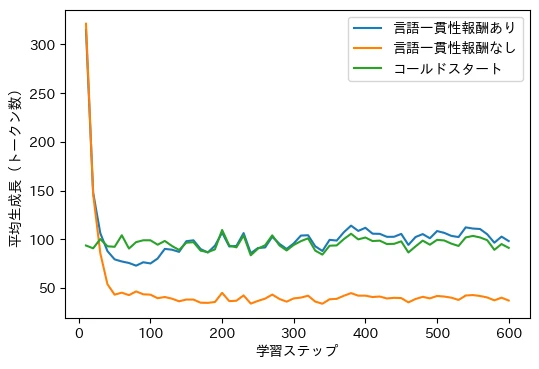
- 生成長は増え続けはしなかった: 学習中の生成長(上の図)は、学習前の約300トークンから急に下がり、step 40 前後から80〜90トークンで横ばいになりました。最初の急な減少は、答えを書いた後も文章を書き続ける振る舞いをやめたことによるものです。R1-Zero で報告されたような、学習を通じて思考が伸び続ける変化は見られませんでした。四則演算の文章題は短い思考で解けること、生成長の上限が512トークンであることが理由と考えられます。
- 振り返りの表現は現れなかった: 振り返りの表現を含む応答の割合は、学習前の 0.002 から、学習後もほぼ0のままでした。R1-Zero の aha moment のような振る舞いは、この規模の追試では観察されませんでした(「限界」の節を参照)。
表の推移を図にすると、次のようになります。
(図は、diagram-designで作成)
考察:言語一貫性報酬の有無
| 条件(600ステップ後) | 正解率(厳しい判定) | 平均生成長 | 日本語の文の割合 | 言語が混在した応答の割合 |
|---|---|---|---|---|
| 言語一貫性報酬あり | 0.996 | 102.9 | 1.000 | 0.000 |
| 言語一貫性報酬なし | 0.996 | 39.2 | 判定不能(下記) | 0.000 |
- 正解率は同じところに行き着いた: 600ステップでは、どちらの条件も 0.996 でした。150ステップの時点では、報酬なし(0.906)が報酬あり(0.834)を上回っていたので、言語一貫性報酬は学習を遅くしたものの、最終的な正解率には影響しなかったことになります。200ステップ程度で比べると「言語一貫性報酬を加えると性能が下がる」ように見えますが、学習を十分に続けると差が消える場合がある、という点は注意が必要です。
- 報酬がないと、思考から自然言語が消えた: 言語一貫性報酬なしの条件では、300ステップ以降、日本語の文の割合が計算できなくなりました(表では「判定不能」)。思考部分が「474=188, 188+36=224, 2242=448」のように 式だけ になり、日本語・英語・中国語のいずれにも分類できる文が1つもなくなったためです(ja_ratio は NaN になります)。生成長も39.2トークンと、報酬ありの4割程度です。正解かどうかだけを報酬にすると、人が読むための説明は不要なので、モデルはそれを削ぎ落としました。R1-Zero の「読みにくさ」の問題が、言語の混在ではなく「自然言語そのものの消失」という形で現れたことになります。
- 報酬を加えると、日本語の説明が保たれた: 言語一貫性報酬ありの条件では、日本語の文の割合が 1.000、言語が混在した応答の割合が 0.000 で、思考はすべて日本語の文で書かれています(出力例を参照)。その代わり、生成長は 102.9 トークンと約2.6倍になりました。読みやすさと引き換えに、推論にかかるトークン数が増えるというトレードオフです。
600ステップ後の3つの条件の思考を並べると、違いがはっきりします。
(図は、diagram-designで作成)
実装8:ステップ数ごとの正解率
全体の正解率だけでは、どの難易度の問題が解けるようになったのかが分かりません。ステップ数(=四則演算の回数)ごとに、学習前と600ステップ後の正解率を並べます。
# ステップ数ごとの正解率(学習前と、各条件の600ステップ後)
by_n_steps = pd.DataFrame({
    "step0": load_eval("lang", 0).groupby("n_steps")["correct_strict"].mean(),
    "lang_step600": load_eval("lang", 600).groupby("n_steps")["correct_strict"].mean(),
    "nolang_step600": load_eval("nolang", 600).groupby("n_steps")["correct_strict"].mean(),
    "coldstart_step0": load_eval("coldstart", 0).groupby("n_steps")["correct_strict"].mean(),
    "coldstart_step600": load_eval("coldstart", 600).groupby("n_steps")["correct_strict"].mean(),
})
print(by_n_steps.round(3))
- ステップ数ごとの正解率: 評価用データはステップ数1〜5の順に100問ずつ並んでいるので、groupby("n_steps") で難易度ごとの正解率が求まります。
実行結果
         step0  lang_step600  nolang_step600  coldstart_step0  \
n_steps
1         0.13          1.00            1.00             0.69
2         0.02          1.00            1.00             0.53
3         0.04          1.00            1.00             0.43
4         0.00          0.99            0.99             0.40
5         0.01          0.99            0.99             0.35

         coldstart_step600
n_steps
1                      1.0
2                      1.0
3                      1.0
4                      1.0
5                      1.0
考察:難易度ごとの伸び
| ステップ数 | 学習前 | 言語一貫性報酬あり(600ステップ後) | なし(600ステップ後) | コールドスタート(SFT 直後) | コールドスタート(600ステップ後) |
|---|---|---|---|---|---|
| 1 | 0.13 | 1.00 | 1.00 | 0.69 | 1.00 |
| 2 | 0.02 | 1.00 | 1.00 | 0.53 | 1.00 |
| 3 | 0.04 | 1.00 | 1.00 | 0.43 | 1.00 |
| 4 | 0.00 | 0.99 | 0.99 | 0.40 | 1.00 |
| 5 | 0.01 | 0.99 | 0.99 | 0.35 | 1.00 |
ステップ数ごとの問題数は100問なので、標準誤差は最大で約 です。
学習前はどのステップ数でもほぼ解けていませんでしたが、600ステップの学習後は、3つの条件すべてで、ステップ数5の問題まで 0.99 以上になりました。算数ワールドの難易度では、この時点で伸びしろがなくなっています。コールドスタートの SFT 直後の値が低いのは、形式違反が多いためです(実装9で中身を確かめます)。
実装9:コールドスタート直後の形式違反
コールドスタートの SFT 直後(ステップ0)は、形式の遵守率が 0.480 と低い一方で、緩い判定の正解率は 0.994 でした。答えは合っているのに形式だけが崩れている、ということです。何がどう崩れているのかを、実際の出力で確かめます。
# 形式違反の出力を確認する(コールドスタートの SFT 直後)
df0 = load_eval("coldstart", 0)
# ~ は真偽値の反転。format_ok が False の行だけを選び、その text 列の先頭3件を見る
for text in df0.loc[~df0["format_ok"], "text"].head(3):
    print(repr(text[-150:]))   # 末尾の150文字を、改行などの記号も見える形で表示する
    print("-" * 40)            # 区切り線
- 形式違反の行だけを選ぶ: ~df0["format_ok"] の ~ は真偽値の反転で、「形式を守らなかった行」を表します。これを df0.loc[..., "text"] の行の指定に使うと、その行の生成テキストだけが取り出せます。head(3) で先頭3件に絞っています。
- 形式違反の確認: コールドスタートの SFT 直後(ステップ0)の出力のうち、厳しい形式の判定を満たさなかったものの末尾を表示します。repr で表示すると改行や空白も記号として見えるので、</think> や <answer> のタグがどう崩れているかを確かめられます。答えは正しいのに構造だけが崩れているのか、答え自体が出ていないのかを区別できます。
- コールドスタートのステップ0: coldstart のステップ0は SFT 直後のモデルです。ステップ0と600を比べると、SFT だけでどこまで伸び、GRPO でさらにどれだけ伸びたかを分けて見られます。
実行結果
'最初は29個です。20個もらったので、29 + 20 = 49 個になります。</think>\nよって、答えは49個です。'
----------------------------------------
'最初は47個です。数が2倍になったので、47 × 2 = 94 個になります。</think>\nよって、答えは94個です。'
----------------------------------------
'最初は36個です。数が5倍になったので、36 × 5 = 180 個になります。</think>\nよって、答えは180個です。'
----------------------------------------
考察:コールドスタートの効果
コールドスタートの条件と、言語一貫性報酬なしの R1-Zero 型の条件(どちらも言語一貫性報酬なし)の比較です。
| 学習ステップ | 形式の遵守率(R1-Zero 型) | 形式の遵守率(コールドスタート) | 日本語の文の割合(R1-Zero 型) | 日本語の文の割合(コールドスタート) | 振り返りの表現(R1-Zero 型) | 振り返りの表現(コールドスタート) |
|---|---|---|---|---|---|---|
| 0 | 0.218 | 0.480 | 0.335 | 1.000 | 0.002 | 0.000 |
| 150 | 1.000 | 1.000 | 0.000 | 1.000 | 0.000 | 0.000 |
| 300 | 1.000 | 1.000 | 判定不能 | 1.000 | 0.000 | 0.000 |
| 450 | 1.000 | 1.000 | 判定不能 | 1.000 | 0.000 | 0.000 |
| 600 | 1.000 | 1.000 | 判定不能 | 1.000 | 0.000 | 0.000 |
(ステップ0は、R1-Zero 型ではベースモデル、コールドスタートでは SFT 直後のモデルです。)
- 思考の言語と書き方が保たれた: コールドスタートの条件は、言語一貫性報酬を使っていないにもかかわらず、日本語の文の割合が最後まで 1.000 で、生成長も94.6トークンのまま変わりませんでした。同じ報酬で学習した R1-Zero 型の条件が、式だけの短い思考(39.2トークン)に変わったのとは対照的です。最初に読みやすい日本語の思考を少量だけ見せておけば、強化学習の間もその書き方が保たれる、ということです。R1 がコールドスタート SFT を入れた理由が、この対比によく表れています。
- SFT の時点でほとんど解けていた: SFT 直後の緩い判定の正解率は 0.994 で、答えそのものは300件の SFT だけでほぼすべて正しくなっていました。一方、形式の遵守率は 0.480 にとどまります。
- 形式違反の中身: 実装9で表示した形式違反の例は、どれも「計算を書いて </think> を出した後に、<answer> タグを書かずに『よって、答えは49個です。』と書いて終わる」出力でした。計算は正しいのに、出力の構造だけが崩れています。300件・2エポックの SFT では、解き方は学べても、タグの並びまでは固まらなかったということです。この違反は、GRPO の形式報酬によって150ステップまでに解消されました(1.000)。SFT で書き方の方向づけをし、強化学習で形式を確実にする という、R1 の多段階の学習の役割分担が、小さな実験でも見えています。
- その後の GRPO はほとんど変化を生まなかった: 300ステップ以降は、評価の値が3つのチェックポイントでまったく同じです。ほとんどの問題で8本とも正解するので、グループ内の報酬がすべて同じになり、学習信号が得られなくなったためです(学習中の GRPO の損失も 2e-5 程度でほぼ変化しません)。
- この比較の注意点: コールドスタートのデータは、正しい解き方(gold steps)を日本語の文にしたものです。そのため、正解率の向上のほとんどは、GRPO ではなく「正しい思考過程の模倣」、つまり蒸留に近い SFT によるものです。R1 のコールドスタートの目的も、性能そのものよりは読みやすさや言語を整えることでした。この実験で意味のある比較は、形式の遵守と思考の書き方・言語の2つです。蒸留そのものについては、推論の蒸留の記事で扱います。
期待する形式と、SFT 直後の形式違反を並べると、次のようになります。
(図は、diagram-designで作成)
この実験の限界
小さなモデルでは aha moment は再現しにくい
R1-Zero の 671B のモデルで報告されたような、長い思考の途中で方針を大きく変える振る舞いは、小さなモデルでは再現しにくいとされています。オープンソースの追試 TinyZero では、Countdown(与えられた数と四則演算で目標の数を作るパズル)で、3B のベースモデルが検証や探索のような振る舞いを身につけた一方、より小さな 0.5B のモデルではうまくいかなかったと報告されています。本記事の 1.5B のモデルと、512トークンの生成長の上限、600ステップの学習では、観察できる現象はさらに限られると考えられます。実際に、本実験ではどの条件でも、振り返りの表現を含む応答はほぼ現れませんでした。
「新しく現れた」のか「もともとあった」のか
Understanding R1-Zero-Like Training: A Critical Perspective(Liu et al., 2025)は、Qwen2.5 のベースモデルが、強化学習の前から自己反省のような出力をすることがあり、DeepSeek-V3-Base にも強化学習の前から aha moment のような振る舞いが見られると指摘しています。Qwen2.5 は、数学や CoT 形式のデータを大量に含むデータで事前学習されていると考えられます。
そのため、振り返りの表現が増えたとしても、それが強化学習で 新しく現れた のか、もともと持っていた振る舞いが報酬によって引き出された のかは、本実験だけでは区別できません。学習前のモデルでの振り返りの表現の割合(ステップ0)を必ず併せて報告し、この点を考察するときの基準にします。
生成長の増加と長さのバイアス
GRPOの記事で扱ったように、応答ごとに長さで割る GRPO の損失(本実験の loss_type="grpo")には、誤った応答が長くなりやすいバイアスがあります。本実験では、形式を覚えた後の生成長は、言語一貫性報酬ありで80〜90トークン、なしで30〜40トークンと横ばいで、伸び続けることはありませんでした。そのため、このバイアスの影響は目立ちませんでした。より長い思考が必要な問題で生成長が伸びる場合は、正解した応答と誤った応答の長さを分けて見る、loss_type="dr_grpo" で学習して比べるなどの確認が必要です。
その他
- タスクが簡単すぎた: 600ステップの学習で、3つの条件すべてがステップ数5の問題まで 0.99 以上に達し、伸びしろがなくなりました。手法の違いを正解率で比べるには、演算の回数を増やす、数値を大きくするなど、より難しい問題が必要です。
- シードが1つ: 強化学習の結果は乱数によるばらつきが大きいので、確かな結論には複数のシードでの追試が必要です。
- 言語の判定の粗さ: 文ごとの言語の判定は、かなの有無と文字の種類だけで行う簡単な規則です。漢字だけの日本語の文は中国語と判定されます。
- コールドスタートのデータは R1 と性質が異なる: R1 のコールドスタートのデータは、R1-Zero などが生成した長い思考過程を読みやすく整えたもので、振り返りや検証も含みます。本記事のデータは、模範解答をテンプレートで日本語の文にしただけの短い思考過程です。また、コールドスタートの条件は言語一貫性報酬なしの1条件だけで、件数やエポック数を変えた比較もしていません。
まとめ
記事を通じて、以下の内容を学習・実践しました。
- DeepSeek-R1-Zero: SFT をしていないベースモデルに、GRPO と正解報酬・形式報酬だけで強化学習を行うと、生成長が伸び、推論を見直す振る舞い(aha moment)が現れたと報告されています。
- R1-Zero の問題と R1 の4段階の学習: 読みにくさと言語の混在を解決するため、コールドスタート SFT → 推論向けの RL(言語一貫性報酬を追加)→ リジェクションサンプリングと約80万件での SFT → 全シナリオ向けの RL、という4段階で学習しています。
- うまくいかなかった試み: PRM は、ステップの定義・途中の正誤の判定・報酬ハッキングの問題から、大規模な強化学習の報酬としては割に合いませんでした。MCTS は、探索空間の大きさと価値モデルの学習の難しさから、大規模には広げられませんでした。
- 蒸留: R1 のデータで SFT した小さなモデルは高い推論性能を示し、同じ規模のモデルで大規模な強化学習をした場合を大きく上回りました。
- 小規模な追試: Qwen2.5-1.5B のベースモデルで、R1-Zero のテンプレート、厳しい形式の判定、文ごとの言語の判定による言語一貫性報酬を実装し、TRL の GRPOTrainer で学習して、形式・正解率・生成長・振り返りの表現・思考の言語の推移を評価しました。
- コールドスタート: 算数ワールドの模範解答を読みやすい日本語の CoT に書き換えた300件で SFT してから GRPO を行い、R1-Zero 型の条件と、形式の習得の速さ・思考の言語を比べました。
- 追試の結果:
- R1-Zero 型の学習では、150ステップで形式の遵守率が 0.218 から 1.000 になり、正解率(厳しい判定)は 0.040 から600ステップで 0.996 まで上がりました。一方、生成長が伸び続けることや、振り返りの表現が現れることはありませんでした。
- 言語一貫性報酬がないと、思考は「47*4=188, 188+36=224」のような式だけの表記に変わり、自然言語が消えました(生成長39.2トークン)。報酬を加えると思考はすべて日本語の文で書かれた一方、生成長は約2.6倍(102.9トークン)になりました。最終的な正解率はどちらも 0.996 で同じでした。
- コールドスタートでは、言語一貫性報酬なしでも日本語の書き方が保たれました。SFT 直後は答えがほぼ正しい(緩い判定で 0.994)一方、形式の遵守率は 0.480 にとどまり、GRPO の形式報酬によって150ステップで 1.000 になりました。
推論の蒸留との関係
R1 の論文が示したのは、大きなモデルが強化学習で身につけた推論能力を、その出力で SFT することで小さなモデルにも移せる、しかも小さなモデルでは自分で強化学習するより効率が良い、ということでした。
推論の蒸留(Reasoning Distillation)とは?の記事では、なぜ小さなモデルでは強化学習より蒸留が強いのかを、古典的な知識の蒸留から系列レベルの蒸留、少数の精選データで推論能力を引き出す研究まで整理し、算数ワールドで「蒸留 vs 強化学習」を比べます。
※ライセンスに関する注記 本記事の実験で利用したモデル(Qwen/Qwen2.5-1.5B)は Apache License 2.0 で公開されています。DeepSeek-R1 の論文の図表の数値は、論文から引用しています。
参考文献
- DeepSeek-AI et al. (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. arXiv:2501.12948.
- E. Zelikman, Y. Wu, J. Mu, N. D. Goodman (2022). STaR: Bootstrapping Reasoning With Reasoning. NeurIPS 2022.
- Z. Yuan et al. (2023). Scaling Relationship on Learning Mathematical Reasoning with Large Language Models. arXiv:2308.01825.
- H. Lightman et al. (2024). Let's Verify Step by Step. ICLR 2024.
- Z. Liu et al. (2025). Understanding R1-Zero-Like Training: A Critical Perspective. arXiv:2503.20783.
- D. Guo et al. (2025). DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature, 645, 633–638.
- OpenAI (2024). Learning to Reason with LLMs. OpenAI Blog.
- Qwen Team (2024). QwQ: Reflect Deeply on the Boundaries of the Unknown. Qwen Blog.
- J. Pan et al. (2025). TinyZero. GitHub.
- Qwen Team (2024). Qwen2.5-1.5B. Hugging Face(Apache License 2.0).
本記事の文章・構成の一部に生成AIを使用しています。