DiD(差の差法)とは?
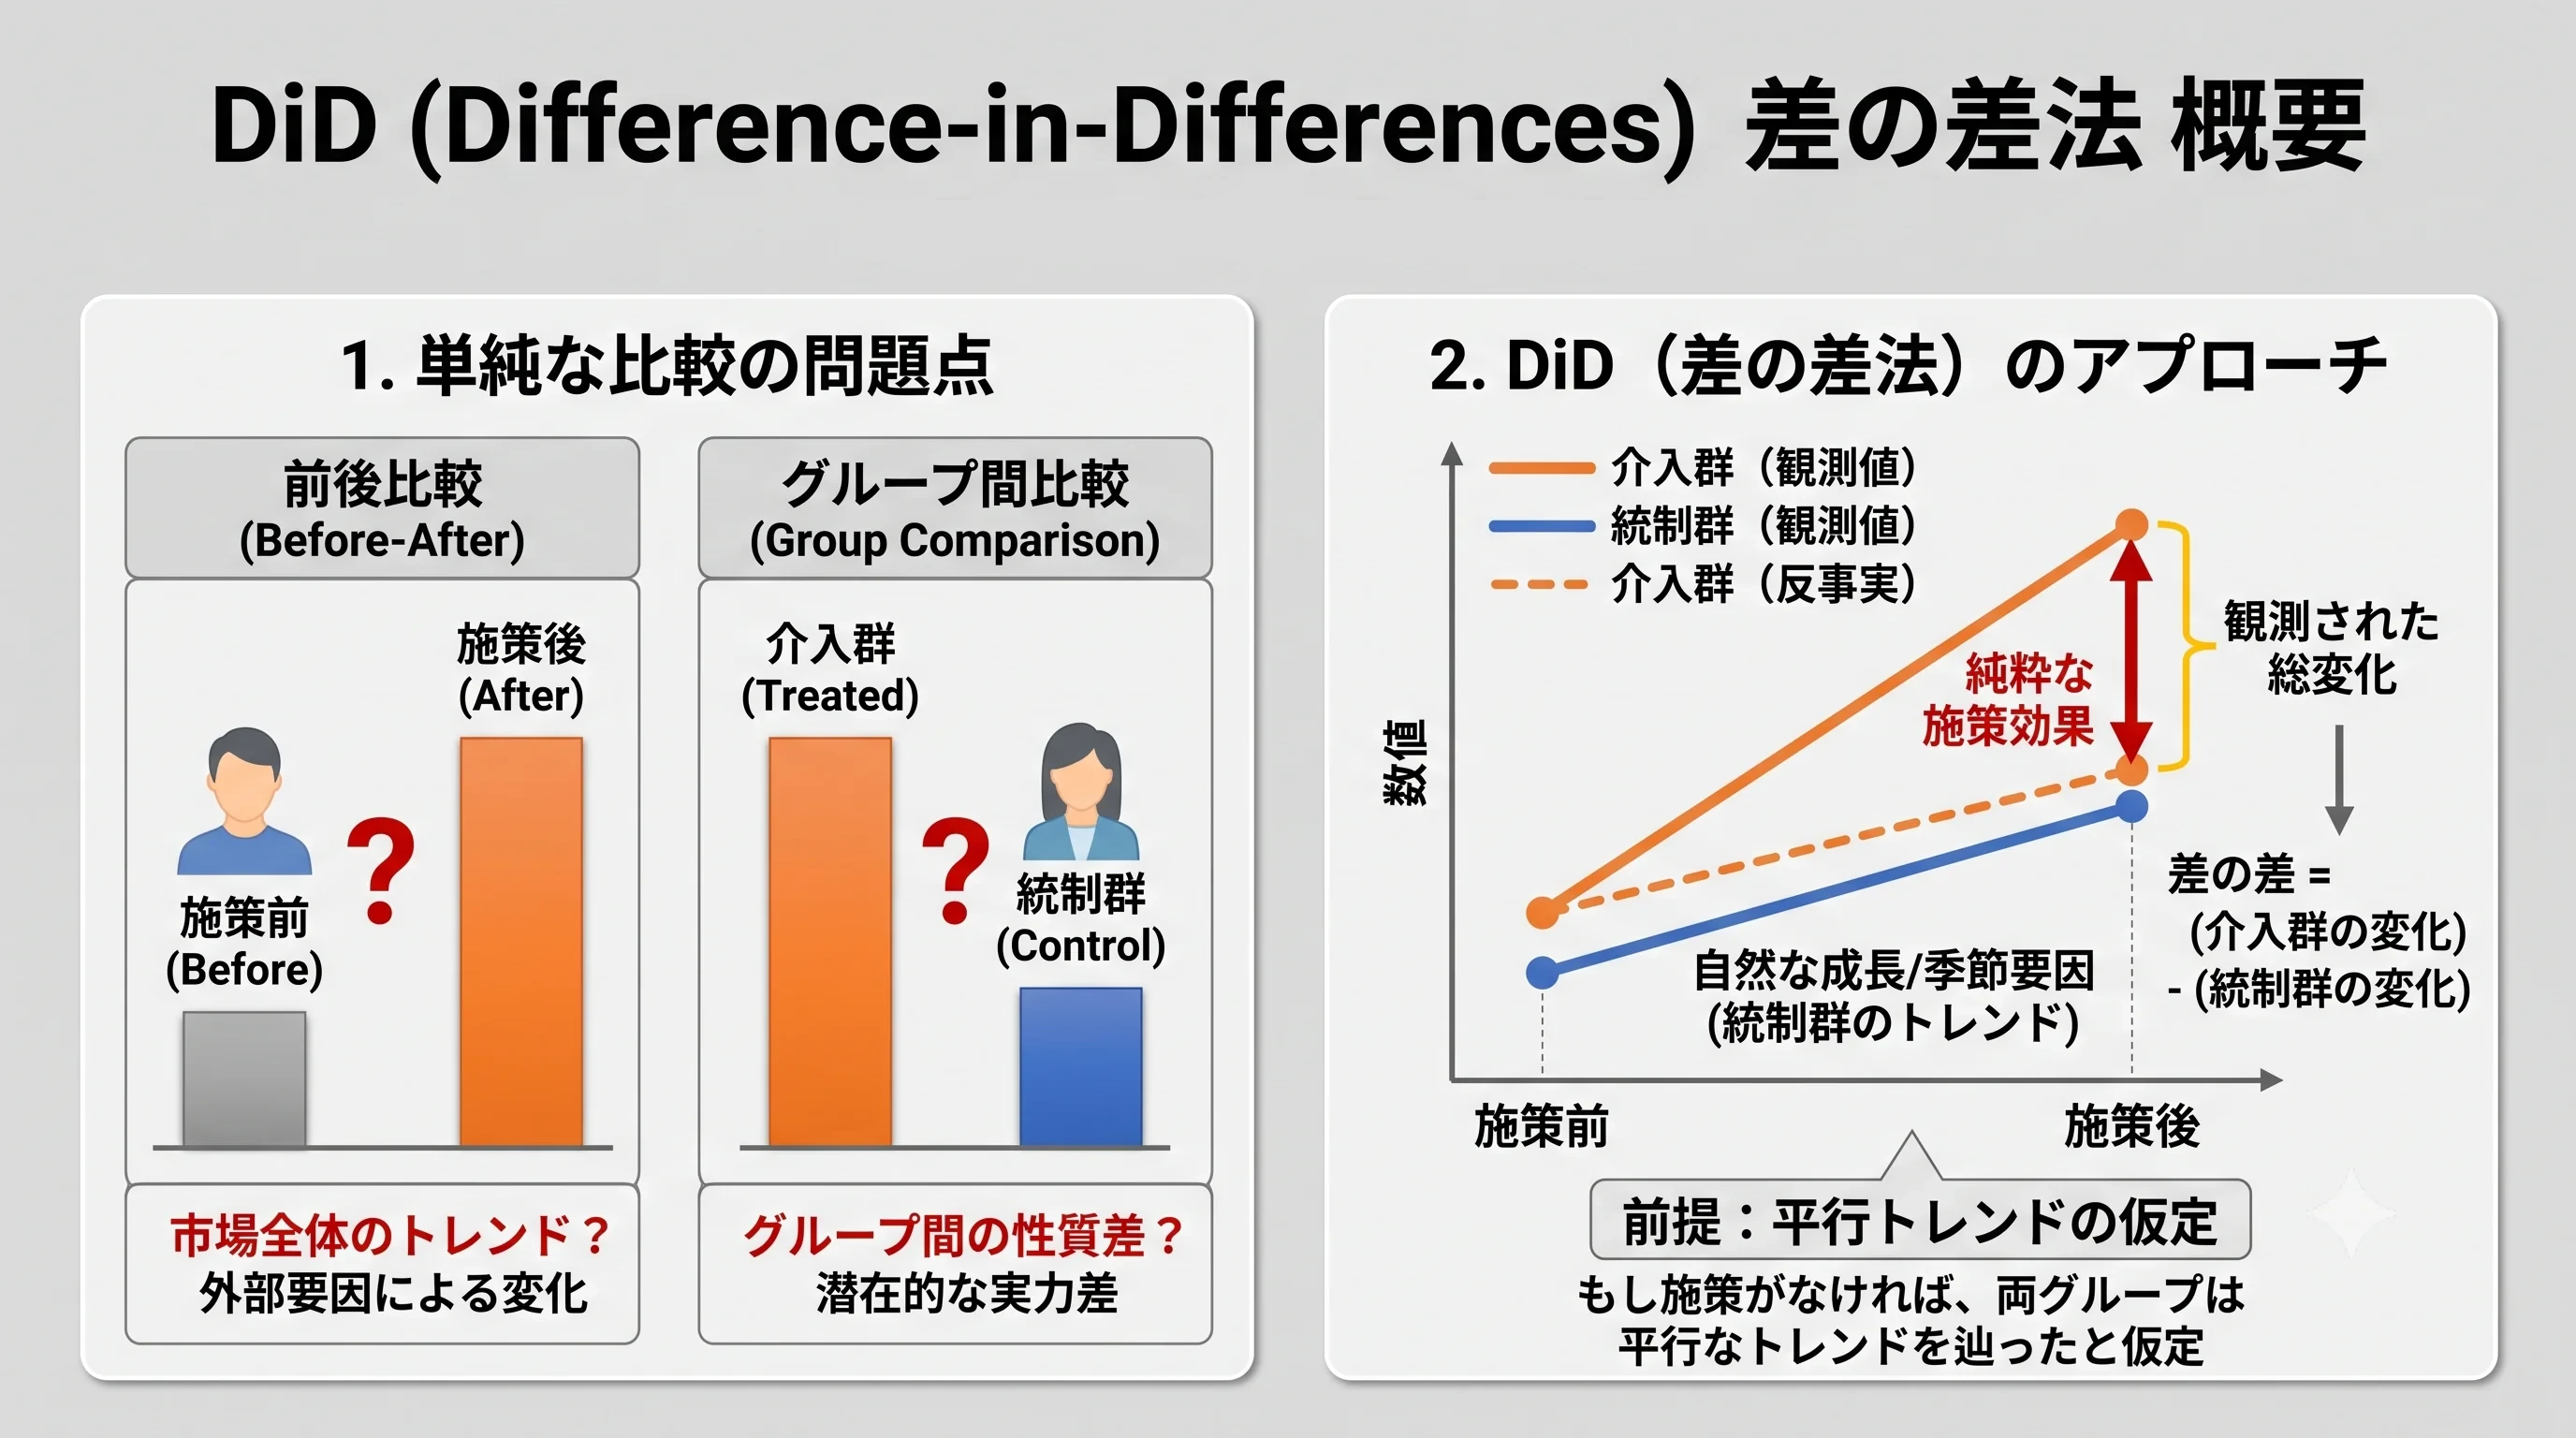 (画像は、Geminiで作成)
施策を受けたグループの変化から、受けていないグループの変化(自然なトレンド)を引いて効果を取り出す DiD の考え方と、成り立つための平行トレンドの仮定を理解すること。statsmodels の回帰で効果を推定し、日次データの自己相関で標準誤差が小さく出すぎる問題とその補正、イベントスタディによる仮定の確認と効果の時間的な推移を確かめ、CausalImpact との使い分けを説明できるようになること。
DiDの概要
DiD(Difference-in-Differences:差の差法) は、計量経済学や統計学の分野で古くから用いられている、政策やビジネス施策の「因果効果」を測るための代表的な疑似実験アプローチです。
高度な時系列手法であるCausalImpactのベースとなった手法でもあり、CausalImpactのベースとなる論文内でも「広く使われている『差の差の分析(DID)』を状態空間モデルへと拡張」したと述べられています。DiDは、シンプルながら非常に強力なロジックで「反事実(もし施策を行っていなかったらどうなっていたか)」を推定します。
施策の効果を測る際、私たちはよく以下のような「単純な比較」をしてしまいがちです。
- 前後比較: 施策を実施したグループの「施策前」と「施策後」の数値を比べる。
- グループ間比較: 施策を実施した時期に、「実施したグループ」と「実施していないグループ」の数値を比べる。
しかし、これらの単純な比較には大きな落とし穴があります。前後比較では「季節要因や市場全体のトレンド変化(例:たまたま繁忙期だった)」という外部要因を施策効果と誤認してしまいますし、グループ間比較では「そもそも両グループが持っていた潜在的な実力差や特性の違い」を無視してしまいます。
DiDは、この2つの比較の弱点を補い合うため、データを 「介入群(施策を受けたグループ)」 と 「統制群(施策を受けていないグループ)」 の2つに分け、さらにそれらを 「施策前」 と 「施策後」 の2つの期間で観測します。
統制群の「時間的な変化(トレンド)」を観察することで、市場全体の自然な成長や季節要因によるノイズを把握し、それを介入群の「時間的な変化」から引き算(差の差をとる)します。これにより、「もし施策を行っていなかったら、介入群も統制群と同じトレンドを辿っていたはずだ」という仮定(平行トレンドの仮定)のもと、ノイズを取り除いた「純粋な施策の効果」を浮き彫りにするのです。
DiDの基本ロジック:「平行トレンドの仮定」と「差の差」の数理
DiDがやっていることを一言で言えば、「統制群(施策をしていないグループ)の成長幅を、介入群(施策をしたグループ)の成長幅から引き算する」ことです。
具体的な効果測定のメカニズムと、それを支える数理モデルの構造を紐解いていきましょう。
施策効果を導く「差の差」のシンプルな引き算
DiDにおいて、施策による因果効果(Treatment Effect) は、以下のような非常にシンプルな四則演算(差の差)で定義されます。
- :介入群(Treated)の、施策後(Post)の平均値
- :介入群(Treated)の、施策前(Pre)の平均値
- :統制群(Control)の、施策後(Post)の平均値
- :統制群(Control)の、施策前(Pre)の平均値
前半の括弧 は、介入群の「施策前後の変化量」を表します。しかし、この変化量には「市場全体の自然な成長」や「季節要因」が含まれています。 そこで、後半の括弧 で計算した統制群の「施策前後の変化量(自然な成長分)」を差し引くことで、純粋な施策効果 を導き出すのです。
なお、ここで求めている は、正確には 「施策を受けた介入群にとっての平均的な効果」、すなわち ATT(Average Treatment effect on the Treated) です。差の差で使っているのは「介入群が施策を受けなかったらどうなっていたか」という反事実だけなので、統制群に同じ施策を打ったときに同じ効果が出るとは限りません。たとえば「売上規模の大きい地域で試したテレビCMの効果」を、そのまま小さな地域に当てはめられるとは限らない、ということです。
DiDの最重要ルール:「平行トレンドの仮定」
この美しい引き算が成立するためには、一つの強力な前提条件を満たしている必要があります。それが「平行トレンドの仮定(Parallel Trend Assumption)」です。
“もし施策が行われていなかったとしたら、介入群と統制群は、時間の経過とともに「同じ傾き(平行)」で変化していたはずだ”
という仮定です。 言い換えれば、両グループの間で「元々の売上の規模感(ベースライン)」に差があっても構いませんが、「成長のペース(トレンド)」は施策前において同じでなければならず、施策がなかった場合、施策後もその平行な関係が維持される、と考えます。DiDにおける「反事実(施策がなかった場合の介入群の姿)」は、この仮定によって描かれることになります。
後の回帰の推定値から作った4つの平均で、差の差と平行トレンドの仮定を図にすると、次のようになります。
(図は、diagram-designで作成)
回帰モデルによるDiDの表現
実務では、単なる引き算ではなく、「回帰分析(最小二乗法など)」を使ってDiDを表現することが一般的です。回帰モデルを使うことで、他の要因(共変量)を統制したり、効果の「統計的な有意差(p値)」を簡単に計算できたりするメリットがあるためです。
基本となるDiDの回帰方程式は以下のようになります。
- :介入群なら1、統制群なら0となるダミー変数(グループ間の元々の実力差 を吸収する)
- :施策後なら1、施策前なら0となるダミー変数(市場全体の時間的なトレンド を吸収する)
- :介入群かつ施策後である場合のみ1となる交差項
この回帰式が、先ほど定義した4つの状態(、、、)とどのように対応しているのか、ダミー変数にそれぞれ 0 と 1 を当てはめて確認してみましょう。 (※ここでは誤差項 の期待値を0として、各グループの平均値を導き出します)
① 統制群・施策前()
の場合
② 統制群・施策後()
の場合
③ 介入群・施策前()
の場合
④ 介入群・施策後()
の場合
これら4つの式を使って、先ほどの「差の差(DiD)」の計算式をもう一度組み立ててみます。
このように、ベースライン()、グループ間の元々の実力差()、時間経過によるトレンド変化()が綺麗に相殺され、最後に交差項の係数である だけが残ります。 この数理的な構造があるからこそ、回帰モデルにおいて「(交差項の係数)こそが、私たちが知りたい純粋な因果効果 となる」のです。
4つの状態と係数の対応を、本記事の推定値とあわせて表にすると、次のようになります。
(図は、diagram-designで作成)
検証用ダミーデータの生成コード
今回作成するデータは、先ほど解説した「平行トレンドの仮定」を満たす時系列データです。全期間を100日間とし、70日目を施策の実行日として定義するシナリオを想定します。
データの生成プロセスは以下の数式に基づいています。時点を ()とします。
① 共通のトレンド(自然成長 + 季節要因)
市場全体が影響を受けるベースのトレンド は、時間経過による右肩上がりの成長と、30日周期の波(Sinカーブ)を足し合わせたものです。
② 統制群(Control)のデータ生成式
統制群 は、共通トレンドにベースライン値 と、標準偏差 の観測ノイズ を加えたものです。施策の有無にかかわらず、全期間この数式で推移します。
③ 介入群(Treated)のデータ生成式
介入群 は、統制群と同じ共通トレンドを持ちつつも、元々のベースライン値が と高い設定です。これが「グループ間の実力差」となります。さらに、施策が行われる70日目()以降は一律で の施策効果(True Effect)が加わります。
施策前():
施策後():
以下のPythonコードで、このデータ生成プロセスをシミュレーションします。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. 乱数シードの固定
np.random.seed(123)

# 2. 期間パラメータの設定
n_periods = 100          # 全期間(100日間)
intervention_point = 70  # 施策実行日(70日目)
time = np.arange(n_periods)

# 3. 共通のトレンド(自然成長 + 季節要因)の作成
# 両グループが同じ影響を受ける市場全体のトレンド (Trend_t)
common_trend = 0.5 * time + 5 * np.sin(2 * np.pi * time / 30)

# 4. 統制群(Control: 施策なし)のデータ生成
# 共通トレンドに、ベースライン(10)と観測ノイズを加える
y_control = 10 + common_trend + np.random.normal(loc=0, scale=2, size=n_periods)

# 5. 介入群(Treated: 70日目から施策あり)のベースデータ生成
# 共通トレンドに、ベースライン(30)と観測ノイズを加える
# (この時点ではControlと平行なトレンドを描く反事実のデータ)
y_treated_base = 30 + common_trend + np.random.normal(loc=0, scale=2, size=n_periods)
y_treated = y_treated_base.copy()

# 6. 施策効果(介入効果)の注入
# 70日目以降の介入群データにのみ、一律で「+15」の効果を加える
true_effect = 15
y_treated[intervention_point:] += true_effect

# DataFrameにまとめる
df = pd.DataFrame({
    'Time': time,
    'Control': y_control,
    'Treated': y_treated,
    'Treated_Counterfactual': y_treated_base # 反事実(正解データ)
})

# 7. 生成したデータの可視化
plt.figure(figsize=(10, 6))

# 実際の観測値のプロット
plt.plot(df['Time'], df['Treated'], label='Treated (介入群: 施策あり)', color='darkorange', linewidth=2)
plt.plot(df['Time'], df['Control'], label='Control (統制群: 施策なし)', color='royalblue', linewidth=2)

# 介入群の反事実(もし施策がなかったら)のプロット
plt.plot(df['Time'][intervention_point:], df['Treated_Counterfactual'][intervention_point:],
         label='Counterfactual (介入群の反事実)', color='darkorange', linestyle='--', alpha=0.7)

# 施策実行日の縦線
plt.axvline(x=intervention_point, color='red', linestyle=':', linewidth=2, label='Intervention (施策実行日)')

plt.title('Generated Dummy Data for DiD (差の差法)')
plt.xlabel('Time (Days)')
plt.ylabel('Value (Target KPI)')
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
ここでは、DiDの検証に用いるダミーデータの生成と可視化を行っています。
- 乱数と期間の設定: np.random.seed(123) で乱数を固定し、全期間 n_periods = 100(100日間)のうち、70日目(intervention_point = 70)を施策の実行日とします。
- 共通トレンドの作成: common_trend として、時間経過に比例して上昇する要素(0.5 * time)と、30日周期で波打つ季節要因(5 * np.sin(...))を組み合わせた市場全体のトレンドを作成します。これが、両グループが同じように受ける外部要因にあたります。
- 統制群と介入群の反事実: 統制群(Control)はこの共通トレンドにベースライン値 10 とノイズを足して生成します。一方、介入群(Treated)の本来の推移である y_treated_base は、同じ共通トレンドにベースライン値 30 とノイズを足して生成しています。水準(10と30)は違っても、トレンドが共通なので、施策前の期間において両グループの波形が「平行(Parallel)」になります。
- 施策効果の注入: y_treated_base.copy() で反事実を複製した上で、施策日である70日目以降の介入群のデータに対してのみ、y_treated[intervention_point:] += true_effect で一律に +15 の底上げ(True Effect)を注入しています。複製するのは、反事実 y_treated_base を正解データとして残しておくためです。
- データの格納と可視化: 統制群・介入群・介入群の反事実を df にまとめ、施策日以降の反事実を点線で、施策実行日を赤い縦線(plt.axvline)で描いています。
実行結果
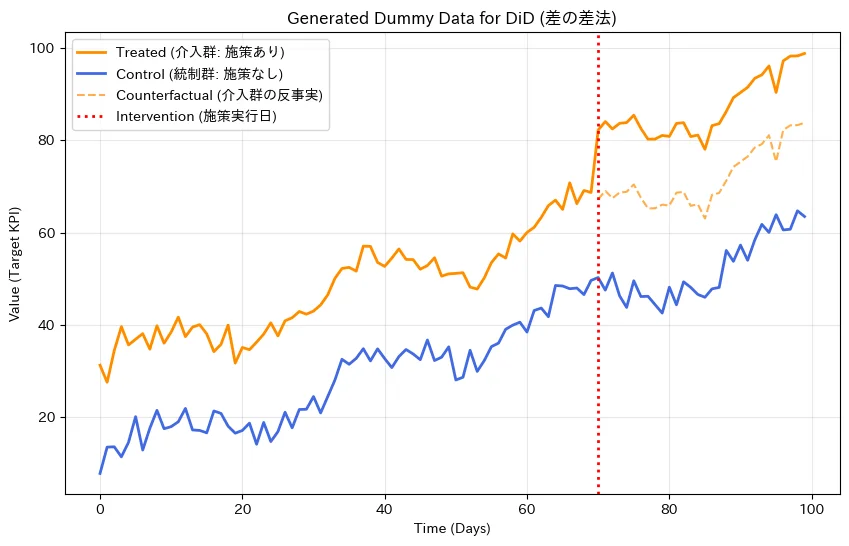
グラフでは、70日目以降の介入群が、点線で示された「反事実(本来の推移)」から上に +15 分だけ乖離している様子が視覚的に確認できます。
statsmodelsを用いたDiDの実装と結果の解釈
データが準備できたところで、Pythonの統計モデリングライブラリである statsmodels を用いて、DiDの回帰分析を実行してみましょう。
回帰分析を行うためには、先ほど作成した「横持ち(Wide Format)」のデータを、1行に1つの観測値が入る「縦持ち(Long Format)」に変換し、ダミー変数(Treat, Post)を追加する必要があります。
回帰分析の実行コード
以下のコードでは、データの整形から回帰分析の実行、そして結果サマリーの出力までを行います。
import statsmodels.formula.api as smf

# 1. データを縦持ち(Long Format)に変換
# ['Time', 'Control', 'Treated'] のデータフレームを、1行1観測になるように整形
df_melted = pd.melt(df, id_vars=['Time'], value_vars=['Control', 'Treated'],
                    var_name='Group', value_name='Y')

# 2. ダミー変数の作成
# Treat: 介入群(Treated)なら1、統制群(Control)なら0
df_melted['Treat'] = (df_melted['Group'] == 'Treated').astype(int)

# Post: 施策実行日(70日目)以降なら1、それより前なら0
df_melted['Post'] = (df_melted['Time'] >= intervention_point).astype(int)

# 3. 回帰分析(最小二乗法: OLS)の実行
# formula(数式)で 'Y ~ Treat + Post + Treat:Post' と指定します。
#  `:` は交差項(掛け算)を意味し、これがDiDにおける施策効果になります。
model = smf.ols(formula='Y ~ Treat + Post + Treat:Post', data=df_melted)
results = model.fit()

# 4. 結果のサマリーを表示
print(results.summary())
ここでは、データを回帰分析に適した形に整形し、DiDの回帰モデルを推定しています。
- 縦持ちへの変換: pd.melt で、Control 列と Treated 列を「グループ名(Group)」と「値(Y)」の2列に展開しています。id_vars=['Time'] で日付はそのまま残すため、100日 × 2グループ = 200行の、1行に1つの観測値が入るデータになります。
- ダミー変数の作成: 介入群であれば1となる Treat と、施策日以降であれば1となる Post を、条件式の真偽値を astype(int) で0/1に変換して作成します。
- 回帰式の指定: statsmodels.formula.api を用いることで、R言語のように直感的な式(Y ~ Treat + Post + Treat:Post)でモデルを記述できます。Treat:Post が、先ほど数式で解説した交差項 に該当し、その係数がDiDの推定値 になります。切片 は自動的に追加されます。
- 推定と要約: model.fit() で最小二乗法(OLS)によるパラメータ推定を行い、results.summary() で係数・標準誤差・p値などをまとめた表を出力します。
実行結果
以下のような回帰分析のサマリーテーブルが出力されます(※数値は乱数シードにより多少前後する場合があります)。
                            OLS Regression Results
==============================================================================
Dep. Variable:                      Y   R-squared:                       0.798
Model:                            OLS   Adj. R-squared:                  0.795
Method:                 Least Squares   F-statistic:                     258.5
Date:                Sun, 12 Jul 2026   Prob (F-statistic):           7.39e-68
Time:                        01:35:56   Log-Likelihood:                -737.53
No. Observations:                 200   AIC:                             1483.
Df Residuals:                     196   BIC:                             1496.
Df Model:                           3
Covariance Type:            nonrobust
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
Intercept     27.8897      1.167     23.895      0.000      25.588      30.192
Treat         19.9613      1.651     12.093      0.000      16.706      23.217
Post          24.1654      2.131     11.340      0.000      19.963      28.368
Treat:Post    14.8182      3.014      4.917      0.000       8.875      20.761
==============================================================================
Omnibus:                       10.631   Durbin-Watson:                   0.206
Prob(Omnibus):                  0.005   Jarque-Bera (JB):                7.074
Skew:                           0.322   Prob(JB):                       0.0291
Kurtosis:                       2.341   Cond. No.                         6.35
==============================================================================
私たちが一番注目すべきは、下部のパラメータ一覧にある Treat:Post の行です。
- coef(偏回帰係数): 14.8182 となっており、データ生成時に仕込んだ「True Effect( )」をほぼ完璧に逆算(推定)できていることが分かります。
- P>|t|(p値): 0.000 となっており、統計的有意水準である0.05を大きく下回っています。つまり、「この という差は、偶然のばらつきによって生まれたものではない(統計的に有意である)」と結論づけることができます。
- ちなみに Treat の coef(19.9613)は、データ生成時に設定した「統制群(ベース10)と介入群(ベース30)の元々の実力差( )」を正確に捉えています。
このように、回帰分析を用いることで、単なる引き算では分からない「推定の確からしさ(p値や信頼区間)」まで同時に算出できるのがDiDの大きな強みです。
ただし、この「推定の確からしさ」をそのまま信じてよいかについては、時系列データ特有の注意点があります。次の節で確認しましょう。
標準誤差の落とし穴:時系列データの自己相関
先ほどの回帰分析では、200行のデータ(2グループ × 100日)を 互いに独立な200個の観測 として扱っていました。通常のOLSの標準誤差は、この「独立性」を前提に計算されています。
しかし、時系列データでは「昨日の売上が高ければ今日も高い」というように、近い時点どうしの誤差が似た値になりがちです(自己相関)。自己相関があると、実質的な情報量は見かけのデータ数よりずっと少なくなります。それにもかかわらず200個分の情報があると思い込むため、標準誤差が小さく出すぎ、p値が過度に小さくなってしまう のです。
DiDの推定値は、結局「4つの平均値の引き算」です。そこで、ある1つのグループ・期間の平均 のばらつきを考えてみます。和の分散は、「各観測の分散」と「観測のペアごとの共分散」に分解できます。
観測どうしが独立であれば、第2項の共分散はすべて0になり、おなじみの (標準誤差 )が得られます。通常のOLSの標準誤差は、この式を前提に計算されています。
一方、正の自己相関がある場合は、近い時点どうしの共分散がすべてプラスになるため、第2項がそのまま上乗せされます。隣の時点との相関が 、 時点離れると相関が になる典型的なケース(AR(1))では、 が十分に大きいとき、近似的に次のようになります。
これを「独立なデータ何個分の精度に相当するか」に読み替えたものを、有効サンプルサイズ と呼びます。
| 隣の時点との相関 | 100日分のデータの | 本当の標準誤差 ÷ 通常のOLSの標準誤差 |
|---|---|---|
| 0 | 100 | 1.0倍 |
| 0.5 | 約33 | 約1.7倍 |
| 0.9 | 約5.3 | 約4.4倍 |
では、100日分のデータが、独立なデータ5個分程度の情報しか持っていないことになります。それにもかかわらず通常のOLSは で割って標準誤差を計算するため、ばらつきを大幅に小さく見積もり、その結果、 値が大きく、p値が小さく出てしまうのです。
極端な を考えると、イメージしやすくなります。100日分の値がすべて同じであれば、実質的には「1回測った値を100回書き写した」だけで、情報は1個分しかありません。それでも で計算すれば、10倍も精度が高いと誤認してしまいます。
実は、先ほどの出力にもその兆候が表れていました。サマリー右下の Durbin-Watson: 0.206 です。Durbin-Watson統計量は、残差に自己相関がなければ2前後になり、正の自己相関が強いほど0に近づきます。0.206は、かなり強い自己相関があることを示しています。
原因は、先ほどのモデル(Y ~ Treat + Post + Treat:Post)が時間の変化を「施策前か後か」の2段階でしか表現していない点にあります。データ生成時に仕込んだ右肩上がりのトレンドや30日周期の波はモデルに入っていないため、そのまま残差に残り、隣り合う日の残差が似た値になっているのです。
対処法:HAC標準誤差と時間固定効果
対処法は大きく2つあります。
- 標準誤差の計算方法を変える(HAC標準誤差):モデルはそのままで、「近い時点の誤差は相関している」ことを織り込んで標準誤差を計算し直します(Newey-West型の標準誤差)。
- モデルで時間の変化を吸収する(時間固定効果):Post ダミーの代わりに、1日ごとのダミー変数 C(Time) を入れます。これにより「その日に両グループが共通して受けた影響」がすべて吸収され、残差には本来のノイズだけが残ります。
2つ目のモデルは、グループの固定効果(Treat)と時間の固定効果(C(Time))の両方を持つため、二方向固定効果モデル(TWFE: Two-Way Fixed Effects) と呼ばれます。式で書くと次のとおりです。
- :グループ の固定効果(グループ間の元々の実力差)
- :時点 の固定効果(両グループに共通するその日の影響。トレンドも季節性もすべてここに入る)
- :施策効果(DiDの推定値)
元のモデルの は、時間の影響を「施策前後の2つの平均値」でしか表せませんでした。TWFEでは、それを「1日ごとの値」 に細かくしたものと考えると分かりやすいでしょう。
以下のコードで、3つの推定結果を比較します。
from statsmodels.stats.stattools import durbin_watson

# 1. 先ほどのモデル(results)の残差に、自己相関があるかを確認
for group in ['Control', 'Treated']:
    resid = results.resid[df_melted['Group'] == group].values
    autocorr = np.corrcoef(resid[:-1], resid[1:])[0, 1]
    print(f"{group} の残差の1次自己相関: {autocorr:.3f}")

# 2. データを「グループ → 時間」の順に並べ替える(hac-panel の要件)
df_sorted = df_melted.sort_values(['Group', 'Time']).reset_index(drop=True)

# 3. 同じモデルを HAC標準誤差(Newey-West型)で推定し直す
#    maxlags=7 は「1週間程度先までの自己相関を考慮する」という設定
results_hac = smf.ols('Y ~ Treat + Post + Treat:Post', data=df_sorted).fit(
    cov_type='hac-panel', cov_kwds={'groups': df_sorted['Treat'], 'maxlags': 7}
)

# 4. 時間固定効果(1日ごとのダミー変数)を入れたモデル
#    C(Time) が「その日に両グループが共通して受けた影響」をすべて吸収する
results_twfe = smf.ols('Y ~ Treat + C(Time) + Treat:Post', data=df_sorted).fit()

# 5. 3つのモデルの Treat:Post を比較
summary = []
for name, res in [('① 元のモデル(通常の標準誤差)', results),
                  ('② 元のモデル(HAC標準誤差)', results_hac),
                  ('③ 時間固定効果モデル', results_twfe)]:
    lower, upper = res.conf_int().loc['Treat:Post']
    summary.append({
        'モデル': name,
        '推定値': res.params['Treat:Post'],
        '標準誤差': res.bse['Treat:Post'],
        '95%信頼区間': f"[{lower:.2f}, {upper:.2f}]",
        'Durbin-Watson': durbin_watson(res.resid),
    })
print(pd.DataFrame(summary).round(3).to_string(index=False))
3つの方法で推定した Treat:Post の係数と標準誤差を比べています。
- 残差の自己相関の確認: 元のモデル results の残差をグループごとに取り出し、np.corrcoef(resid[:-1], resid[1:]) で「ある日の残差」と「翌日の残差」の相関(1次の自己相関)を計算しています。配列を1つずらして並べることで、隣り合う日どうしのペアを作っています。
- データの並べ替え: HAC標準誤差の cov_type='hac-panel' は、データが「グループごとに時間順」に並んでいることを前提に、同じグループ内の近い時点どうしの相関を考慮します。そのため、sort_values(['Group', 'Time']) で並べ替えています。
- HAC標準誤差: cov_kwds の groups でどの行が同じグループかを、maxlags で何日先までの自己相関を考慮するか(ここでは7日)を指定しています。回帰係数の推定値は変わらず、標準誤差の計算方法だけが変わります。
- 時間固定効果: C(Time) は、Time をカテゴリ変数として扱い、1日ごとのダミー変数に展開する指定です。これが式の にあたります。Post の情報は日ごとのダミーに含まれてしまうため、式から外しています。
- 結果の比較: 3つのモデルについて、Treat:Post の推定値、標準誤差、95%信頼区間と、残差のDurbin-Watson統計量(durbin_watson)を1つの表にまとめています。
実行結果
Control の残差の1次自己相関: 0.912
Treated の残差の1次自己相関: 0.921
             モデル    推定値  標準誤差        95%信頼区間  Durbin-Watson
① 元のモデル(通常の標準誤差) 14.818 3.014  [8.87, 20.76]          0.206
② 元のモデル(HAC標準誤差) 14.818 6.306  [2.46, 27.18]          0.206
     ③ 時間固定効果モデル 14.818 0.662 [13.50, 16.13]          2.204
- 残差の自己相関:元のモデルの残差は、隣り合う日どうしで0.9を超える強い相関を持っています。
- ② HAC標準誤差:推定値は同じ 14.818 のままですが、標準誤差は 3.014 から 6.306 へと 約2倍 に広がりました。元のモデルの信頼区間は、自己相関を無視していた分だけ狭く見積もられていたことになります。
- なお、残差の自己相関は約0.9なので、先ほどの表からは最大で4倍程度のずれもありえます。HAC標準誤差で約2倍にとどまったのは、maxlags=7 により8日以上離れた時点どうしの相関を計算に含めていないことや、今回の自己相関がランダムなノイズの持ち越しではなく、モデルに入れていないトレンドや季節性に由来しているため、AR(1)の近似式がそのまま当てはまらないことが理由です。
- ③ 時間固定効果モデル:推定値は同じですが、標準誤差は 0.662 まで小さくなりました。Durbin-Watson も 2.204 と2前後に戻っており、トレンドと季節性がモデルに吸収され、残差にはほぼ純粋なノイズだけが残っていることが分かります。
推定値がどのモデルでも同じなのは、今回のデータがすべてのグループ・時点を欠けなく観測した「バランスパネル」だからです。変わったのは 推定の確からしさの評価 です。②は「モデルの不足を標準誤差で正直に申告する」方法、③は「モデルの不足そのものを解消する」方法と言えます。
3つのモデルの推定値と信頼区間を並べると、次のようになります。
(図は、diagram-designで作成)
実務データでの注意点
今回のダミーデータはノイズ自体が独立に生成されているため、時間固定効果を入れるだけで自己相関が消えました。しかし実務データでは、ノイズ自体にも自己相関があることがほとんどです。そのため、時間固定効果を入れたうえで、標準誤差も補正するのが基本です。
- グループ(地域・店舗など)が多い場合:グループ単位のクラスタロバスト標準誤差(cov_type='cluster')を使うのが定番です。Bertrand, Duflo, Mullainathan (2004) の「How Much Should We Trust Differences-in-Differences Estimates?」は、この問題を無視したDiDでは、本当は効果がないのに「有意な効果あり」と判定されるケースが大幅に増えることを示した有名な論文です。
- グループが少ない場合:今回のように介入群と統制群が1つずつしかないと、クラスタロバスト標準誤差は使えません(クラスタの数が少なすぎると計算が不安定になるため)。この場合は、施策を行っていない期間や地域に「偽の施策日」を設定して、効果が0と出るかを確かめるプラセボテストなどで推定の信頼性を確認します。
広告施策の効果を地域単位で測る「ジオ実験」では、地域の数が限られることが多く、この問題が特に重要になります。地域が少ない場合の推論の方法(プラセボ検定・並べ替え検定)は、合成コントロール法とジオ実験の記事で扱います。
イベントスタディ:効果の時間的な推移を見る
ここまでのDiDは、施策効果を「施策後の期間を通じた1つの平均値」 として推定してきました。しかし実務では、次のような疑問が残ります。
- 平行トレンドの仮定は本当に成り立っているのか? これまでは「成り立っているはず」と信じるしかありませんでした。
- 効果は時間とともにどう変わるのか? 施策の効果が初日から一定の大きさで現れ、施策が終わった瞬間に消えることは、現実にはまずありません。
この2つに同時に答えられるのが イベントスタディ(Event Study) です。
イベントスタディの考え方
イベントスタディでは、1つの交差項 の代わりに、施策日からの相対的な時期ごとに交差項を作ります。今回は5日ごとの区間に分け、施策直前の5日間(区間 )を基準にします。
- :時点 が施策日から数えて 番目の区間に含まれるとき1になるダミー変数( は施策前、 は施策後)
- :区間 における「介入群と統制群の差」が、基準区間と比べてどれだけ変化したか
この係数 を並べてグラフにすると、次の2つが読み取れます。
- 施策前の係数(、leadと呼ばれます):施策前なのだから、平行トレンドが成り立っていれば0付近に並ぶはずです。0から系統的にずれていれば、仮定が怪しいと判断できます。
- 施策後の係数(、lagと呼ばれます):効果が時間とともにどう立ち上がり、どう消えていくかを表します。
効果が時間とともに変化するダミーデータ
イベントスタディの威力を確かめるため、効果が時間とともに変化するデータを作ります。シナリオは次のとおりです。
- 70日目から84日目までの 15日間だけ 施策(たとえば広告)を実施する
- 施策の効果はすぐには最大にならず、毎日少しずつ蓄積 していく
- 施策が終わっても効果はすぐには消えず、毎日一定の割合で減衰しながら残る
これを表現するため、各日の「効果の蓄積量」 を次のように定義します。
- :その日に施策を実施していれば1、していなければ0
- :残存率(今回は 。昨日までの蓄積の8割が今日に持ち越される)
施策を続けると は に近づくため、効果は最大で に近づいていきます。施策をやめると になり、効果は毎日8割ずつに減っていきます。
この「効果が一定の割合で持ち越される」構造は、広告の世界では アドストック(残存効果) と呼ばれ、複数の広告チャネルの効果を同時に推定する MMM(マーケティングミックスモデル) の中心的な考え方になります。MMMの記事では、この を過去の施策の重み付き和に書き直し、アドストックとして定式化しています。
統制群と介入群の反事実は、最初に作ったデータ(y_control、y_treated_base)をそのまま使い、効果の形だけを変えます。
# 1. 施策期間の設定(70日目から15日間だけ広告を出す)
campaign_start, campaign_end = 70, 85
spend = np.zeros(n_periods)
spend[campaign_start:campaign_end] = 1  # 施策を実施している日は1

# 2. 効果の「持ち越し」を表現する(残存率 theta = 0.8)
#    今日の効果の蓄積 = 今日の施策 + 昨日までの蓄積 × 0.8
theta = 0.8
carryover = np.zeros(n_periods)
for t in range(n_periods):
    carryover[t] = spend[t] + (theta * carryover[t - 1] if t > 0 else 0)

# 3. 真の効果に変換する(施策を続けると最大で +15 に近づくようにスケーリング)
effect_scale = 15
true_effect_dyn = effect_scale * (1 - theta) * carryover

# 4. 反事実(y_treated_base)に真の効果を足して、介入群のデータを作る
#    統制群と反事実は、最初に作ったものをそのまま使う
y_treated_dyn = y_treated_base + true_effect_dyn

df_dyn = pd.DataFrame({
    'Time': time,
    'Control': y_control,
    'Treated': y_treated_dyn,
    'Treated_Counterfactual': y_treated_base,
    'True_Effect': true_effect_dyn,
})

# 5. 真の効果の推移を確認
print("真の効果(68〜90日目):", np.round(true_effect_dyn[68:91], 1))

# 6. 可視化
plt.figure(figsize=(10, 6))
plt.plot(df_dyn['Time'], df_dyn['Treated'], label='Treated (介入群: 施策あり)', color='darkorange', linewidth=2)
plt.plot(df_dyn['Time'], df_dyn['Control'], label='Control (統制群: 施策なし)', color='royalblue', linewidth=2)
plt.plot(df_dyn['Time'][campaign_start:], df_dyn['Treated_Counterfactual'][campaign_start:],
         label='Counterfactual (介入群の反事実)', color='darkorange', linestyle='--', alpha=0.7)
plt.axvspan(campaign_start, campaign_end, color='red', alpha=0.08, label='Campaign (施策期間)')
plt.title('効果が時間とともに変化するダミーデータ')
plt.xlabel('Time (Days)')
plt.ylabel('Value (Target KPI)')
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
施策を15日間だけ行い、効果が蓄積・減衰するデータを作っています。
- 施策の実施日の表現: spend は、施策を実施した日(70〜84日目)だけ1になる配列です。
- 持ち越し効果の計算: carryover[t] = spend[t] + theta * carryover[t - 1] は、「今日の施策」に「昨日までの蓄積の8割」を足す漸化式で、本文の の式をそのままコードにしたものです。t = 0 では前日が存在しないため、条件式で場合分けしています。
- 効果の大きさの調整: 施策を続けると蓄積 は に近づくため、effect_scale * (1 - theta) を掛けて、効果の最大値が15に近づくようにしています。
- 介入群データの合成: 最初に作った反事実 y_treated_base に true_effect_dyn を足しています。統制群と反事実は最初のデータと同じなので、違いは「効果の時間的な形」だけになります。
- 可視化: plt.axvspan で施策期間を赤い帯で示し、施策期間が終わった後も介入群が反事実から離れている(効果が残っている)様子を確認できるようにしています。
実行結果
真の効果(68〜90日目): [ 0.   0.   3.   5.4  7.3  8.9 10.1 11.1 11.9 12.5 13.  13.4 13.7 14.
 14.2 14.3 14.5 11.6  9.3  7.4  5.9  4.7  3.8]
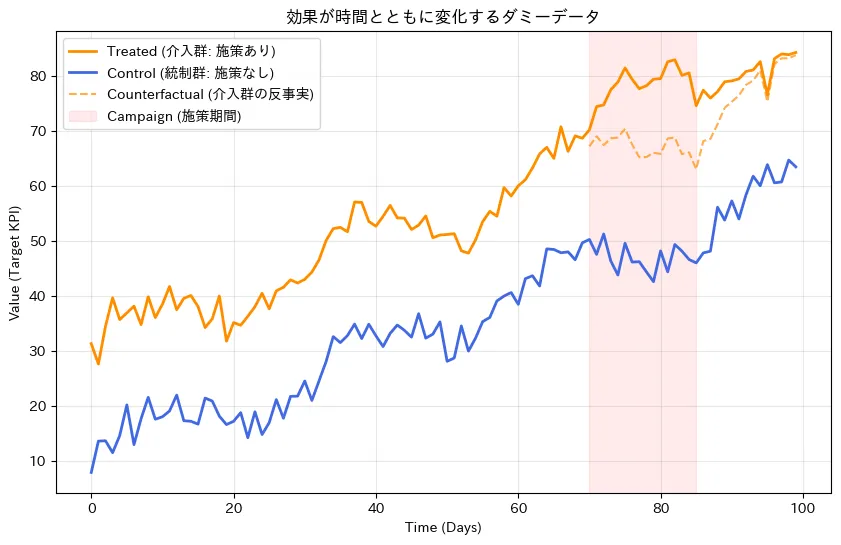
施策初日(70日目)の効果は にとどまり、そこから徐々に に近づいていきます。施策が終わった85日目以降も効果はすぐには0にならず、、 …と減衰しながら残っていることが分かります。
効果が持ち越されるときの「分析期間」の罠
イベントスタディに進む前に、このデータに通常のDiD(時間固定効果モデル)を当てはめてみましょう。ここでは、分析期間を「施策終了日まで」とした場合と「施策終了後も含めた場合」の2通りで推定します。
def to_long(df_wide, post_end=None):
    """横持ちデータを縦持ちにし、Treat・Post ダミーを付ける"""
    d = pd.melt(df_wide, id_vars=['Time'], value_vars=['Control', 'Treated'],
                var_name='Group', value_name='Y')
    d['Treat'] = (d['Group'] == 'Treated').astype(int)
    d['Post'] = (d['Time'] >= intervention_point).astype(int)
    if post_end is not None:
        d = d[d['Time'] < post_end]  # 分析期間を post_end の前日までに絞る
    return d.sort_values(['Group', 'Time']).reset_index(drop=True)

# 分析期間を「施策終了まで(〜84日目)」と「その後も含めて(〜99日目)」の2通りで推定
for label, post_end, days in [('施策終了日まで', campaign_end, campaign_end - intervention_point),
                              ('施策終了後も含む', None, n_periods - intervention_point)]:
    d = to_long(df_dyn, post_end)
    res = smf.ols('Y ~ Treat + C(Time) + Treat:Post', data=d).fit()
    est = res.params['Treat:Post']
    true_mean = true_effect_dyn[intervention_point:intervention_point + days].mean()
    print(f"{label}({days}日間): 1日あたり推定 {est:.2f}(真値 {true_mean:.2f})"
          f" → 累積 {est * days:.1f}(真値 {true_mean * days:.1f})")
分析期間を2通りに変えて、同じデータから効果を推定しています。
- 縦持ち変換の関数化: to_long は、先ほどの pd.melt とダミー変数の作成をまとめた関数です。post_end を指定すると、その日より前のデータだけに絞り込みます。後のイベントスタディでも使い回せるよう、グループ → 時間の順に並べ替えて返しています。
- 2つの分析期間: post_end=campaign_end(85)では施策終了日の84日目まで、None では99日目までのデータを使います。
- 推定: 時間固定効果モデル(Y ~ Treat + C(Time) + Treat:Post)で、施策後の期間の1日あたりの平均効果を推定しています。
- 累積効果への換算: 1日あたりの推定値 est に施策後の日数 days を掛けて、期間全体の効果の総量を求めています。真値は、true_effect_dyn の該当期間の平均から同じように計算しています。
実行結果
施策終了日まで(15日間): 1日あたり推定 11.61(真値 11.14) → 累積 174.1(真値 167.1)
施策終了後も含む(30日間): 1日あたり推定 7.25(真値 7.43) → 累積 217.5(真値 223.0)
どちらの推定も、それぞれの期間の真値を正しく捉えています。しかし、施策の効果の総量(累積) に注目すると、施策終了日で分析を打ち切った場合は真の総効果 223.0 のうち約75%(167.1)しか捉えていないことになります。残りの約25%は、施策が終わった後に持ち越された効果です。
「施策期間中の効果」だけを見て費用対効果を判断すると、効果の持ち越しが大きい施策(テレビCMなど)ほど過小評価されてしまいます。DiDの推定値 は「指定した期間の平均」にすぎないため、どの期間を分析対象にするか が結論を大きく左右するのです。
2つの期間の集計を並べると、次のようになります。
(図は、diagram-designで作成)
イベントスタディの実装
それでは、イベントスタディで効果の推移そのものを推定してみましょう。後で別のデータにも使い回せるよう、関数として実装します。
def event_study(df_wide, bin_width=5, ref_bin=-1):
    """5日ごとの区間ダミー × Treat でイベントスタディを推定する"""
    # 1. 縦持ちデータに「施策日から何区間目か」を付与(-1 = 施策直前の5日間)
    d = to_long(df_wide)
    d['RelBin'] = np.floor((d['Time'] - intervention_point) / bin_width).astype(int)

    # 2. 基準区間(ref_bin)以外の各区間について、Treat × 区間ダミーを作る
    terms = []
    for k in sorted(d['RelBin'].unique()):
        if k == ref_bin:
            continue
        name = f'lead{abs(k)}' if k < 0 else f'lag{k}'  # 施策前 = lead、施策後 = lag
        d[name] = d['Treat'] * (d['RelBin'] == k).astype(int)
        terms.append((k, name))

    # 3. 時間固定効果 + 各区間の効果 を同時に推定
    formula = 'Y ~ Treat + C(Time) + ' + ' + '.join(name for _, name in terms)
    res = smf.ols(formula, data=d).fit()

    # 4. 係数と95%信頼区間を整理(基準区間は0で固定)
    rows = [(ref_bin, 0.0, 0.0, 0.0)]
    for k, name in terms:
        lower, upper = res.conf_int().loc[name]
        rows.append((k, res.params[name], lower, upper))
    es = pd.DataFrame(rows, columns=['RelBin', 'coef', 'lower', 'upper'])
    es = es.sort_values('RelBin').reset_index(drop=True)

    # 5. 事前トレンドの検定:施策前の係数(lead)がすべて0か(F検定)
    leads = [name for k, name in terms if k < ref_bin]
    pretrend_test = res.f_test(', '.join(f'{name} = 0' for name in leads))
    return es, pretrend_test

def plot_event_study(es, title, true_effect=None, campaign=True, bin_width=5):
    x = es['RelBin'] * bin_width + (bin_width - 1) / 2  # 区間の中央に点を置く
    plt.figure(figsize=(10, 6))
    plt.errorbar(x, es['coef'], yerr=[es['coef'] - es['lower'], es['upper'] - es['coef']],
                 fmt='o', color='darkorange', capsize=4, label='推定された効果(95%信頼区間)')
    if true_effect is not None:
        plt.plot(x, true_effect, color='gray', linestyle='--', marker='x', label='真の効果(区間平均)')
    plt.axhline(0, color='black', linewidth=1)
    plt.axvline(-0.5, color='red', linestyle=':', linewidth=2, label='Intervention (施策実行日)')
    if campaign:
        plt.axvspan(-0.5, campaign_end - intervention_point - 0.5, color='red', alpha=0.08, label='Campaign (施策期間)')
    plt.title(title)
    plt.xlabel('施策実行日からの経過日数(5日区間の中央)')
    plt.ylabel('介入群と統制群の差(基準区間との比較)')
    plt.legend()
    plt.grid(True, alpha=0.3)
    plt.show()

# イベントスタディの実行
es_dyn, pretrend_dyn = event_study(df_dyn)

# 比較用:各区間の「真の効果」の平均
rel_bin = np.floor((time - intervention_point) / 5).astype(int)
true_by_bin = pd.Series(true_effect_dyn).groupby(rel_bin).mean()
es_dyn['true'] = es_dyn['RelBin'].map(true_by_bin)

print(es_dyn.round(2).to_string(index=False))
print(f"事前トレンドのF検定: p値 = {float(pretrend_dyn.pvalue):.3f}")
plot_event_study(es_dyn, 'イベントスタディ:効果の時間的な推移', true_effect=es_dyn['true'])
イベントスタディを推定する関数と、結果を描く関数を定義し、効果が変化するデータに適用しています。
- 相対的な時期の区間: RelBin は、施策日からの経過日数を5日ごとの区間番号に変換したものです。np.floor を使っているため、施策前の65〜69日目が区間 -1、施策日からの5日間が区間 0 になります。
- 区間ダミーの作成: 基準区間(ref_bin = -1)以外の各区間について、Treat と「その区間に含まれるか」の積を列として作っています。これが式の です。回帰式の中でマイナス記号を含む名前は使えないため、施策前の区間を lead、施策後の区間を lag と名付けています。
- 基準区間を除く理由: すべての区間のダミーを足し合わせると Treat と同じになるため、全区間を入れると係数が一意に決まりません(多重共線性)。基準区間を1つ除くことで、各係数を「基準区間との差」として解釈できるようになります。
- 推定と係数の整理: 時間固定効果 C(Time) と区間ダミーを同時に入れて推定し、各係数と95%信頼区間(conf_int())を表にまとめています。基準区間は0で固定して加えています。
- 事前トレンドの検定: res.f_test で、施策前の係数(lead)がすべて0であるという仮説をまとめて検定しています。1つずつ検定するより、「施策前に系統的なずれがあるか」を1つのp値で判断できます。
- 可視化: plot_event_study では、各区間の中央((bin_width - 1) / 2 だけずらした位置)に点を置き、plt.errorbar で95%信頼区間を描いています。比較用の真の効果は、groupby で区間ごとの平均を取って重ねています。
実行結果
 RelBin  coef  lower  upper  true
    -14  1.65  -2.50   5.80  0.00
    -13 -0.69  -4.85   3.46  0.00
    -12  0.90  -3.25   5.05  0.00
    -11 -2.62  -6.77   1.53  0.00
    -10  0.29  -3.86   4.44  0.00
     -9  1.36  -2.79   5.51  0.00
     -8  1.25  -2.91   5.40  0.00
     -7  1.24  -2.91   5.40  0.00
     -6  1.50  -2.65   5.66  0.00
     -5 -1.61  -5.77   2.54  0.00
     -4 -0.85  -5.00   3.30  0.00
     -3 -1.83  -5.98   2.33  0.00
     -2  0.48  -3.68   4.63  0.00
     -1  0.00   0.00   0.00  0.00
      0  7.46   3.31  11.61  6.93
      1 13.61   9.46  17.76 12.36
      2 13.98   9.82  18.13 14.13
      3  6.59   2.44  10.74  7.78
      4  2.47  -1.68   6.62  2.55
      5 -0.15  -4.30   4.00  0.84
事前トレンドのF検定: p値 = 0.574
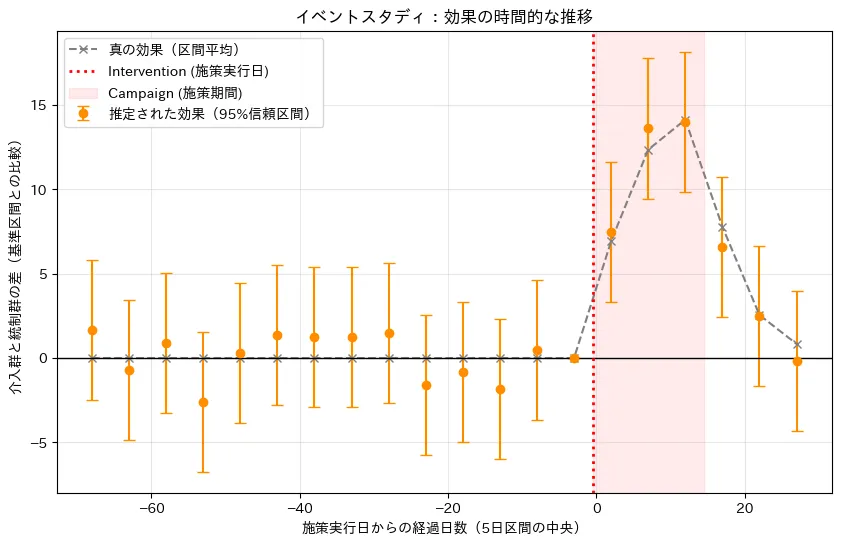
グラフから、次の2点が読み取れます。
- 施策前(左側):すべての係数の95%信頼区間が0をまたいでおり、0付近でランダムにばらついています。施策前の係数がすべて0であるという仮説のF検定もp値 0.574 で棄却されず、平行トレンドの仮定と矛盾する兆候は見られません。
- 施策後(右側):推定された効果(オレンジ)が、真の効果(灰色の破線)の「立ち上がり → ピーク → 減衰」という山なりの形をよく追えています。施策期間(赤い帯)が終わった後も効果が残り、20日ほどかけて0に戻っていく様子まで捉えられています。
1つの平均値 だけでは見えなかった 効果の時間的な形 が、イベントスタディによって浮かび上がりました。
今回は全ての介入群が同じ日に施策を開始するケースを扱いました。地域ごとに順番に施策を展開する(段階的導入)場合、時間固定効果モデルやイベントスタディをそのまま当てはめると、「先に施策を始めたグループ」が「後から始めたグループ」の比較対象に紛れ込み、効果が時間とともに変化するときに推定が歪むことが知られています(Goodman-Bacon, 2021)。この場合は Callaway & Sant'Anna (2021) や Sun & Abraham (2021) などの、段階的導入に対応した推定方法を使います。
平行トレンドの仮定が崩れているとき
最後に、平行トレンドの仮定が 崩れている 場合に何が起きるかを確認します。介入群の反事実に、統制群にはない「1日あたり 」の独自の上昇トレンドを加えます。施策効果は最初の例と同じ一律 です。
# 1. 介入群の反事実に「1日あたり +0.1」の独自の上昇トレンドを加える
#    (統制群とは平行ではない=平行トレンドの仮定が崩れている)
y_treated_base_nonpar = y_treated_base + 0.1 * time
y_treated_nonpar = y_treated_base_nonpar.copy()
y_treated_nonpar[intervention_point:] += 15  # 真の効果は元の例と同じ一律 +15

df_nonpar = pd.DataFrame({'Time': time, 'Control': y_control, 'Treated': y_treated_nonpar})

# 2. 通常のDiD(時間固定効果モデル)で推定
d = to_long(df_nonpar)
res_nonpar = smf.ols('Y ~ Treat + C(Time) + Treat:Post', data=d).fit()
lower, upper = res_nonpar.conf_int().loc['Treat:Post']
print(f"DiDの推定値: {res_nonpar.params['Treat:Post']:.2f}  95%信頼区間: [{lower:.2f}, {upper:.2f}](真値 15)")

# 3. イベントスタディで事前トレンドを確認
es_nonpar, pretrend_nonpar = event_study(df_nonpar)
print(f"事前トレンドのF検定: p値 = {float(pretrend_nonpar.pvalue):.4f}")
true_nonpar = np.where(es_nonpar['RelBin'] >= 0, 15, 0)
plot_event_study(es_nonpar, '平行トレンドが崩れている場合のイベントスタディ',
                 true_effect=true_nonpar, campaign=False)
介入群だけに独自のトレンドがあるデータで、通常のDiDとイベントスタディを比べています。
- 平行トレンドの崩れを再現: 反事実 y_treated_base に 0.1 * time を足し、介入群だけが1日あたり0.1ずつ余分に伸びる状況を作っています。施策効果は、最初の例と同じ一律 +15 です。
- 通常のDiDによる推定: 時間固定効果モデルで Treat:Post を推定し、95%信頼区間とあわせて表示しています。
- イベントスタディの再利用: 先ほど定義した event_study と plot_event_study を、データを差し替えてそのまま使っています。比較用の真の効果は、np.where で施策前は0、施策後は15としています。このデータには施策期間の帯を描く必要がないため、campaign=False を指定しています。
実行結果
DiDの推定値: 19.82  95%信頼区間: [18.36, 21.28](真値 15)
事前トレンドのF検定: p値 = 0.0035
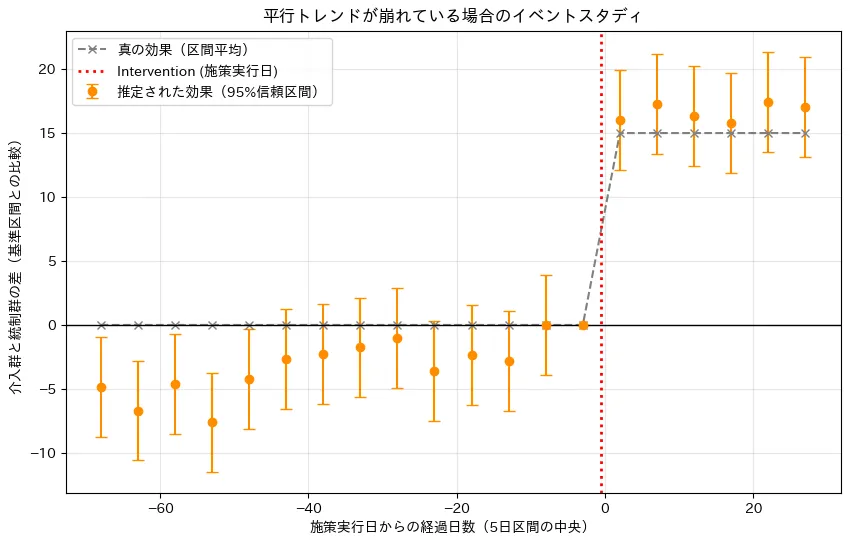
- DiDの推定値:真値 15 に対して 19.82 と、約5も過大に推定されています。しかも95%信頼区間 [18.36, 21.28] は真値を含んでいません。介入群がもともと持っていた独自の上昇トレンドを、施策の効果と取り違えてしまったのです。
- イベントスタディ:施策前の係数が、左から右へ(施策日に近づくにつれて)右肩上がりに並んでいます。事前トレンドのF検定もp値 0.0035 で棄却されており、平行トレンドの仮定が怪しいことを施策前のデータから検出できています。
なお、イベントスタディの施策後の係数(16〜17程度)がDiDの推定値(19.82)より真値に近いのは、比較の基準が「施策直前の5日間」だからです。DiDは施策前の期間全体の平均と比べるため、独自トレンドによるずれがより大きく積み上がります。ただし、施策後の係数も施策日から離れるにつれてずれが大きくなっていくため、どちらにしても偏った推定であることに変わりはありません。
このように、イベントスタディで施策前の係数を確認することは、DiDを使う際の 必須のチェック です。平行トレンドが崩れていると分かった場合の主な対処法は次のとおりです。
- 統制群を選び直す:施策前のトレンドが介入群とよく似たグループを探します。単一のグループで見つからなければ、複数のグループを重み付けして「介入群とそっくりな仮想の統制群」を合成する 合成コントロール法(Synthetic Control Method) が有力な選択肢になります。
- 共変量を使って反事実を予測する:介入群と統制群のトレンドが違っても、施策の影響を受けない共変量から反事実を予測できれば効果を測れます。これが次の節で紹介する CausalImpact の考え方です。
- グループ別のトレンドをモデルに入れる: のような項を加えて、グループごとに異なる直線トレンドを許す方法もあります。ただし、効果が時間とともに変化する場合には、その変化までトレンドとして吸収してしまう危険があるため、慎重に使う必要があります。
CausalImpactとの使い分け・比較
ここまで解説した「DiD(差の差法)」とは別に、時系列データを用いた因果推論の強力な手法として「CausalImpact」があります。
CausalImpactは2015年にGoogleの研究者らによって提案された手法であり、DiDのアプローチを「ベイズ構造時系列モデル(BSTS)」へと拡張したものです。DiDのように特定の「統制群」を用意するのではなく、施策の影響を受けていない他のデータ(共変量:施策を行っていない地域の売上や、競合の動きなど)をモデルに組み込みます。 これにより、「もし施策を行っていなかったら今頃どうなっていたか」というパラレルワールドのタイムライン(反事実)を高精度に予測し、実際の観測値とのギャップから効果を測定します。
どちらも「反事実」を推定して因果効果を測るアプローチですが、実務ではどのように使い分ければ良いのでしょうか?
両者の特徴を比較テーブルにまとめました。
| 比較項目 | DiD (差の差法) | CausalImpact (BSTS) |
|---|---|---|
| ベースとなるアプローチ | 頻度論(主に回帰分析) | ベイズ統計(状態空間モデル) |
| 必要なデータ | 介入群と 「平行トレンドを満たす」統制群 | ターゲット変数と 「施策の影響を受けない」共変量 |
| トレンド・季節性の扱い | ダミー変数による固定的な平均のシフトとして捉える(時間変数を入れない限り柔軟性はない) | ランダムウォークや季節成分として、時間経過に伴う動的な変化を柔軟にモデリングする |
| 不確実性の表現 | p値、標準誤差による信頼区間 | 信用区間(事後分布)による直感的な予測幅の提示 |
| モデルの解釈性 | 極めてシンプルで、ステークホルダーへの説明が容易 | 内部構造が複雑(ブラックボックス化しやすい) |
どちらを選ぶべきか?
💡 DiDをおすすめするケース
- 完璧な「比較対象」が用意できる場合: 例えば「A県ではテレビCMを流し、属性がそっくりなB県では流さない」といった、明確なコントロールグループが存在する場合は、シンプルで強力なDiDが適しています。
- 施策前後の「平均的なリフト」を手っ取り早く知りたい場合: モデルが軽量で直感的なため、経営陣などへロジックを説明する際のコストが低く済みます。
💡 CausalImpactをおすすめするケース
- 「平行トレンド」を満たす統制群が見つからない場合: 現実のビジネスでは、全く同じトレンドを描く別グループを見つけるのは困難です。CausalImpactは「施策を行っていない複数地域のデータ」や「競合の動き」などを共変量として複数組み合わせ、疑似的に精度の高いコントロールを作ることができます。ただし、共変量は 施策の影響を受けていないこと が大前提です。たとえばテレビCMの効果を測るときに検索トレンドを共変量に使うと、CMによって増えた検索まで「施策がなくても起きた変化」として扱われ、効果が過小評価されてしまいます。
- 季節要因やトレンドの変化が激しい場合: DiDでは長期間のトレンド変化を取りこぼすリスクがありますが、CausalImpactは「状態空間モデル」によって日々のトレンド変動を柔軟に学習・予測できます。
💡 第3の選択肢:合成コントロール法
- 比較対象の候補となる地域や店舗が多数ある場合: 1つの統制群では平行トレンドが成り立たなくても、複数の候補を重み付けして組み合わせれば、施策前の介入群の推移をよく再現する「合成された統制群」を作れることがあります。これが合成コントロール法の考え方で、地域単位で広告効果を測るジオ実験でよく使われます(詳しくは合成コントロール法とジオ実験の記事を参照してください)。
まとめ
本記事では、因果効果測定の代表的な手法である DiD(差の差法) について、その基本ロジックからPythonによる実装、そしてCausalImpactとの比較までを解説しました。
- DiDの基本: 介入群の変化量から、統制群の変化量(自然なトレンド)を差し引くことで、純粋な施策効果を炙り出すシンプルなアプローチです。
- 平行トレンドの仮定: この手法が成立するためには、「もし施策がなければ、両グループは同じ傾きで成長していたはずだ」という強力な前提が不可欠です。
- 回帰モデルによる実装: ダミー変数を用いた回帰分析により、交差項(Treat:Post)から効果量を推定し、p値による統計的な有意性も同時に評価できます。
- 時系列データの標準誤差: 日次データの残差には自己相関が生じやすく、通常の標準誤差は過小になりがちです。時間固定効果で共通の変動を吸収し、HAC標準誤差やクラスタロバスト標準誤差で補正します。
- イベントスタディ: 施策日からの時期ごとに効果を推定することで、施策前の係数から平行トレンドの仮定を確認し、施策後の係数から効果の立ち上がりや持ち越しを捉えられます。効果が施策終了後も持ち越される場合、分析期間を施策終了日で打ち切ると効果の総量を過小評価します。
- CausalImpactとの使い分け: 明確な統制群が存在し、ロジックの透明性が求められる場合はDiDが、平行トレンドを満たす統制群を見つけるのが難しい場合や、複雑な時系列変動をモデル化したい場合はCausalImpactが適しています。
DiDは、シンプルながらも「反事実をどのように推定するか」という因果推論のコアとなる考え方を学べる素晴らしいフレームワークです。データの性質や満たすべき仮定を正しく理解し、状況に応じて適切な手法を選択することが重要です。
本記事では、平行トレンドが崩れたときの選択肢として合成コントロール法に触れました。その数理と実装、ジオ実験の設計は合成コントロール法とジオ実験の記事で解説しています。また、イベントスタディで見た「効果が蓄積し、施策後も持ち越される」という性質は、複数の広告チャネルの効果を同時に測るMMM(マーケティングミックスモデル)で、アドストックとして正面から数式化されます。
参考文献
- M. Bertrand, E. Duflo, S. Mullainathan (2004). How Much Should We Trust Differences-In-Differences Estimates?. The Quarterly Journal of Economics, 119(1), 249–275.
- A. Goodman-Bacon (2021). Difference-in-differences with variation in treatment timing. Journal of Econometrics, 225(2), 254–277.
- B. Callaway, P. H. C. Sant'Anna (2021). Difference-in-Differences with multiple time periods. Journal of Econometrics, 225(2), 200–230.
- L. Sun, S. Abraham (2021). Estimating dynamic treatment effects in event studies with heterogeneous treatment effects. Journal of Econometrics, 225(2), 175–199.
- S. Seabold, J. Perktold (2010). statsmodels: Econometric and Statistical Modeling with Python. Proceedings of the 9th Python in Science Conference, 92–96.
本記事の文章・構成の一部に生成AIを使用しています。