次元削減(PCA・t-SNE・UMAP)とは?
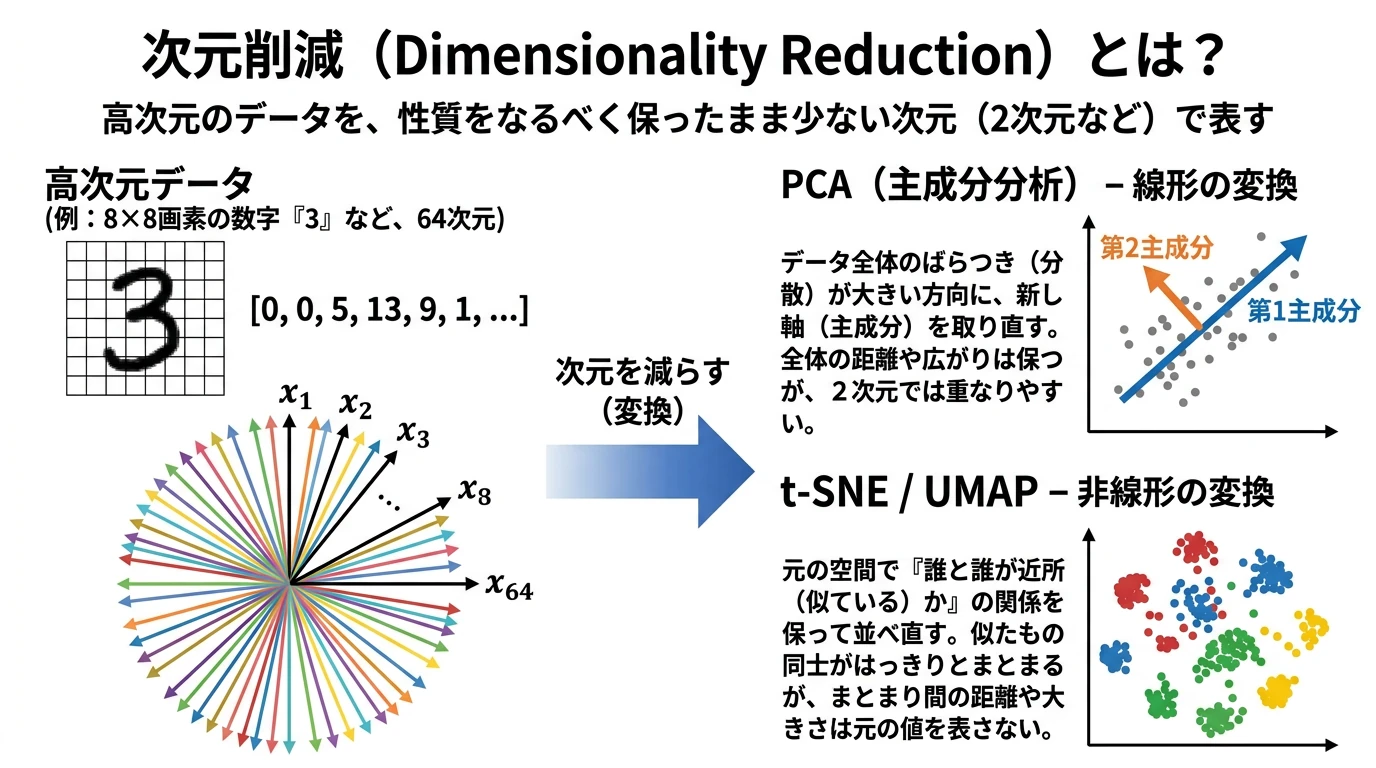 (画像は、Geminiで作成)
PCA・t-SNE・UMAP が、高次元のデータの「何を残して、何を捨てるか」を理解し、目的(可視化か、クラスタリングなどの前処理か)に合わせて使い分け、2次元の図を正しく読めるようになること。
原著論文: On Lines and Planes of Closest Fit to Systems of Points in Space (Pearson, Philosophical Magazine 1901)、Visualizing Data using t-SNE (van der Maaten & Hinton, JMLR 2008)、UMAP: Uniform Manifold Approximation and Projection for Dimension Reduction (McInnes et al., arXiv 2018)
本記事のコードは、Python 3.13、NumPy 2.5.3、scikit-learn 1.9.1、umap-learn 0.5.12、matplotlib 3.11.2 で動作を確認しました。GPU は使わず、CPU で全体を1分ほどで実行できます。乱数のシードを固定しているので、同じ環境では同じ結果になります。
UMAP には umap-learn、グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google ColabやJupyterでは先頭の ! を付けたまま、ターミナルでは ! を外して実行します)。Python 3.12 以降で japanize-matplotlib の import 時にエラーが出る場合は、setuptools も一緒にインストールしてください。
!pip install umap-learn japanize-matplotlib setuptools
概要
手書きの数字を 8 × 8 画素の画像にすると、1枚の画像は64個の画素の濃さを並べた 64次元のベクトル になります。文の埋め込みなら、1つの文が384次元や1024次元のベクトルです。このような高次元のデータには、次のような困りごとがあります。
- 目で見られない: 人が図で見られるのは2次元(せいぜい3次元)までです。似たデータがまとまっているか、外れたデータがないかを、そのままでは確かめられません。
- 計算が重く、距離の差が小さくなる: 次元が多いと、距離の計算やクラスタリングが重くなります。また、数百次元では、どのデータどうしの距離も似た値になりやすく、「近い・遠い」の区別がつきにくくなります(クラスタリングの記事の注意点で触れたものです)。
そこで、データの性質をなるべく保ったまま、少ない次元で表し直します。これが 次元削減(dimensionality reduction) です。何を「保つ」かで、考え方が大きく2つに分かれます。
(図は、diagram-designで作成)
- PCA(主成分分析): データがいちばん大きくばらついている方向に軸を取り直し、ばらつきの小さい方向を捨てます。軸の回転と切り捨てだけなので、残した方向の距離や広がりは元のままです。Pearson(1901)が「点の集まりにいちばんよく当てはまる直線・平面」として考え、Hotelling(1933)が今の形にまとめました。
- t-SNE・UMAP: 元の空間で「誰が誰の近所か」を調べ、2次元でも同じ近所になるように点を並べ直します。直線の距離ではなく近所の関係を保つので、曲がって並んだデータや、まとまりをはっきり見せられます。その代わり、まとまりの間の距離や大きさは元の値を表しません。
本記事では、この2つの違いを、手書き数字のデータと人工データで確かめます。次の節で、まず使うデータを読み込み、64次元のベクトルが画像の画素を並べたものであることを確かめます。
使うデータ:手書き数字(digits)
scikit-learn に付属している digits データを使います。0〜9 の手書き数字を 8 × 8 画素に縮めた1797枚の画像で、各画素の濃さは 0〜16 の整数です。ダウンロードが要らず、64次元という「図では見られないが、手元の CPU ですぐ計算できる」大きさなので、次元削減の違いを確かめるのに向いています。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib
from sklearn.datasets import load_digits

# 手書き数字のデータ:8×8 = 64画素の濃さ(0〜16)を並べた64次元のベクトルが1797個
digits = load_digits()
X_digits, y_digits = digits.data, digits.target
print("データの形:", X_digits.shape, " 数字の種類:", np.unique(y_digits))
print("1個目のベクトルの先頭16個(画像の上2行):", X_digits[0, :16])

fig, axes = plt.subplots(1, 10, figsize=(12, 1.8))
for ax, image, label in zip(axes, digits.images[:10], y_digits[:10]):
    ax.imshow(image, cmap="gray_r")
    ax.set_title(f"{label}")
    ax.axis("off")
plt.suptitle("digits データの例(8×8画素の手書き数字)")
plt.tight_layout()
plt.show()
データを読み込み、形と中身を確かめて、最初の10枚を画像として表示するコードです。
- X_digits と y_digits: X_digits は 1797 × 64 の配列で、1行が1枚の画像です。8 × 8 の画素を、上の行から順に横一列に並べています。y_digits は、各画像の正解の数字(0〜9)です。次元削減の手法には X_digits だけを渡し、y_digits は、結果の図に色を付けたり、近所の関係が残っているかを確かめたりするためだけに使います。
- 先頭16個の表示: 64次元のベクトルが、画像の画素を並べたものだと確かめるためです。先頭の8個が画像の1行目、次の8個が2行目に当たります。
- 画像の表示: digits.images には、同じデータが 8 × 8 の形のまま入っています。cmap="gray_r" は、値が大きいほど黒くする色の付け方で、白い紙に黒いペンで書いたように見せるためです。
実行結果
データの形: (1797, 64)  数字の種類: [0 1 2 3 4 5 6 7 8 9]
1個目のベクトルの先頭16個(画像の上2行): [ 0.  0.  5. 13.  9.  1.  0.  0.  0.  0. 13. 15. 10. 15.  5.  0.]

数字ごとに約180枚ずつ、合計1797枚です。1枚目(0 の画像)の1行目は、真ん中の4画素だけに値(5, 13, 9, 1)があり、0 の上の丸い部分に当たります。
digits データは、UCI Machine Learning Repository の「Optical Recognition of Handwritten Digits」のテスト用の部分で、CC BY 4.0 で公開されています。
PCA:ばらつきの大きい方向に軸を取り直す
考え方
PCA は、データを「いちばん大きくばらついている方向」から順に見ていく方法です。
右上がりに細長く伸びた2次元のデータを想像してください。このデータの点の位置を1つの数で表すなら、細長く伸びた方向に沿った位置を使うのが自然です。伸びた方向に直交する方向は、ばらつきが小さく、捨ててもデータの様子はあまり変わりません。PCA は、この「伸びた方向」を、データから計算で求めます。
データの中心を原点に移した 個の点を、長さ1の方向 に射影すると、各点の位置は内積 になります。その分散は、データの 共分散行列 を使って次のように書けます(共分散行列は と書かれることも多いのですが、総和の記号 と紛らわしいので、本記事では Covariance の頭文字の を使います)。
内積 は、点 から方向 の直線に垂直に下ろした足の位置、つまり直線に落とした「影」の長さです。方向を変えると、影の散らばり具合(分散)が変わります。PCA は、この影の分散がいちばん大きい方向から順に、軸を取っていきます。
(図は、diagram-designで作成)
この分散をいちばん大きくする方向 は、共分散行列の 固有ベクトル のうち、固有値がいちばん大きいものになります。
固有ベクトル とは、行列(空間の変換)を掛けても 向きが変わらず、長さだけが伸び縮みする特別なベクトル のことです。ふつう、ベクトルに行列 を掛けると、向きも変わります。しかし、特定の方向のベクトル だけは、行列を掛けても同じ直線の上にとどまり、何倍かに伸び縮みするだけです。式で書くと、ゼロでないベクトル と数 について、次が成り立つことです。
- 固有ベクトル : 変換しても向きが変わらない方向
- 固有値 : その方向に何倍引き伸ばされるか(縮むか)を表す倍率
左辺の は行列による変換ですが、右辺の は数を掛けて長さを変えただけです。つまり固有ベクトルは、行列という変換が、ただの数の掛け算(引き伸ばし)になる方向です。
正方形のゴムシートを、斜め右上と左下に向かって両手で引っ張る様子を思い浮かべてください。シートの上に描いた矢印の多くは、引っ張られて傾き、向きが変わります。しかし、引っ張っている向き(斜めの対角線)と、それに直交して縮む向きの矢印だけは、向きを変えずに伸び縮みします。この向きが固有ベクトルで、何倍伸びたか(縮んだか)が固有値です。
共分散行列 に当てはめると、データが細長く伸びた方向が、いちばん大きく引き伸ばされる固有ベクトル(第1主成分)で、その倍率である固有値が、その方向の分散になります。
- 主成分: 固有値の大きい順に並べた固有ベクトル が、第1主成分、第2主成分、…の方向です。どの2つも直交しています。
- 固有値 : その方向に射影したときの分散そのものです。
- 寄与率: で、全体のばらつきのうち、その方向が占める割合です。上位 個の寄与率の合計が、 次元に減らしたときに残るばらつきの割合になります。
固有ベクトルになる理由(クリックで開く)
の条件のもとで を最大にするので、ラグランジュの未定乗数法を使います。 を で微分して0とおくと、、つまり です。このとき分散は なので、いちばん大きな固有値の固有ベクトルを選べば、分散が最大になります。第2主成分は、第1主成分に直交するという条件を足して同じ計算をすると、2番目に大きな固有値の固有ベクトルになります。
2次元のデータで、手計算と scikit-learn を比べる
答えの分かっている2次元のデータで、固有値分解による PCA を書き、scikit-learn の PCA と同じ結果になるかを確かめます。データは、共分散行列が
の正規分布から200点を取ったものです。2つの座標が正に相関しているので、右上がりに細長く伸びたデータになります。この共分散行列の固有値は約4.56と約0.44で、第1主成分の方向は約 です。
from sklearn.decomposition import PCA

# 2次元の、右上がりに伸びたデータ(200点)
rng = np.random.default_rng(0)
X_toy = rng.multivariate_normal(mean=[0.0, 0.0], cov=[[3.0, 2.0], [2.0, 2.0]], size=200)


def pca_by_hand(X):
    """共分散行列の固有値分解で主成分を求め、分散の大きい順に、固有値(分散)と方向(列ベクトル)を返す"""
    Xc = X - X.mean(axis=0)                  # (a) データの中心を原点に移す
    cov = Xc.T @ Xc / (len(X) - 1)           # (b) 共分散行列
    values, vectors = np.linalg.eigh(cov)    # (c) 固有値(その方向の分散)と固有ベクトル(方向)
    order = np.argsort(values)[::-1]         # (d) 分散の大きい順に並べ替える
    return values[order], vectors[:, order]


values, vectors = pca_by_hand(X_toy)
print("共分散行列:\n", np.round(np.cov(X_toy.T), 3))
print("各方向の分散:", np.round(values, 3), " 寄与率:", np.round(values / values.sum(), 3))
print("第1主成分の方向:", np.round(vectors[:, 0], 3), " 第2主成分の方向:", np.round(vectors[:, 1], 3))

pca = PCA(n_components=2).fit(X_toy)
print("scikit-learn の分散:", np.round(pca.explained_variance_, 3), " 寄与率:", np.round(pca.explained_variance_ratio_, 3))
print("scikit-learn の方向:", np.round(pca.components_, 3).tolist())
上の式をそのまま書いた pca_by_hand と、scikit-learn の結果を並べるコードです。
- データ X_toy: 2次元にしたのは、主成分の方向を図で確かめられるようにするためです。共分散行列を自分で決めておけば、PCA で求まるはずの方向と分散(上の固有値)も分かります。200点は、標本から計算した共分散行列が、決めた値に十分近くなる数として選んでいます。
- pca_by_hand(X): データを引数で受け取り、固有値と固有ベクトルを返します。
- (a) 中心を原点に移す: 分散は「平均からのずれ」の2乗の平均なので、先に平均を引いておきます。引かないと、原点からの位置の偏りまで「ばらつき」として数えてしまいます。
- (b) 共分散行列: Xc.T @ Xc は、上の式の を、行列の掛け算でまとめて計算したものです。 で割るのは、scikit-learn や np.cov と同じ、不偏分散の定義に合わせるためです。
- (c) 固有値分解: 共分散行列は対称行列なので、対称行列専用の np.linalg.eigh を使います。一般の行列用の np.linalg.eig より速く、固有値が必ず実数で返ります。vectors は、各列が1つの固有ベクトルです(行ではなく列なので、取り出すときは vectors[:, 0] と書きます)。
- (d) 並べ替え: eigh は固有値を 小さい順 に返します。PCA では大きい順に使いたいので、np.argsort(values)[::-1] で大きい順の番号を作り、固有値と固有ベクトルの列を同じ順に並べ替えます。
- 寄与率: 各方向の分散を、分散の合計で割っています。
- scikit-learn との比較: explained_variance_ が各方向の分散(固有値)、explained_variance_ratio_ が寄与率、components_ が主成分の方向です。components_ は、手計算の vectors とは逆に、各行 が1つの方向になっています。
実行結果
共分散行列:
 [[2.974 1.898]
 [1.898 1.87 ]]
各方向の分散: [4.398 0.445]  寄与率: [0.908 0.092]
第1主成分の方向: [-0.8 -0.6]  第2主成分の方向: [ 0.6 -0.8]
scikit-learn の分散: [4.398 0.445]  寄与率: [0.908 0.092]
scikit-learn の方向: [[0.8, 0.6], [-0.6, 0.8]]
- 分散と寄与率は一致: 第1主成分の方向の分散は4.398で、全体のばらつきの90.8%を占めます。標本から計算したので、決めた値(4.56)とは少しずれますが、手計算と scikit-learn は同じ値です。2次元を1次元に減らしても、ばらつきの9割が残ることになります。
- 方向は符号だけが逆: 手計算の第1主成分は 、scikit-learn は です。どちらも同じ直線の上の、向きが逆の矢印です。固有ベクトルは 倍しても固有ベクトルなので、どちらの向きが返るかは計算の方法で決まり、PCA としてはどちらも正解です。scikit-learn は、結果がいつも同じになるように、各方向の成分のうち絶対値が最大のものが正になるように向きをそろえています(第1主成分では 0.8、第2主成分では 0.8 が正)。主成分の座標も符号が逆になるだけなので、図が左右や上下に反転することはあっても、点どうしの位置関係は変わりません。
主成分の座標:回転して、捨てる
求めた方向を使って、各点を主成分の座標に変換します。中心を原点に移した点と、主成分の方向(長さ1のベクトル)との内積が、その方向での位置になります。
# 主成分の座標:中心を原点に移してから、主成分の方向(単位ベクトル)との内積をとる
Z_toy = (X_toy - X_toy.mean(axis=0)) @ vectors
print("主成分の座標の分散:", np.round(Z_toy.var(axis=0, ddof=1), 3))
print("1点目  元の座標:", np.round(X_toy[0], 3), " 主成分の座標:", np.round(Z_toy[0], 3))

fig, axes = plt.subplots(1, 2, figsize=(11, 4.8))
axes[0].scatter(X_toy[:, 0], X_toy[:, 1], s=10, color="gray", alpha=0.6)
center = X_toy.mean(axis=0)
for k, color in enumerate(["red", "steelblue"]):
    arrow = vectors[:, k] * 2 * np.sqrt(values[k])     # 長さは標準偏差の2倍
    axes[0].annotate("", xy=center + arrow, xytext=center,
                     arrowprops=dict(arrowstyle="->", color=color, linewidth=2.5))
    axes[0].text(*(center + arrow + [0.3, -0.9 + 1.4 * k]), f"第{k + 1}主成分(分散 {values[k]:.2f})", color=color,
                 bbox=dict(facecolor="white", edgecolor="none", alpha=0.8))
axes[0].set_title("元の2次元データと主成分の方向")
axes[0].set_xlabel("x1")
axes[0].set_ylabel("x2")
axes[1].scatter(Z_toy[:, 0], Z_toy[:, 1], s=10, color="gray", alpha=0.6)
axes[1].scatter(Z_toy[:, 0], np.full(len(Z_toy), -4.5), s=10, color="red", alpha=0.4)
axes[1].set_title("主成分の座標(下の赤い点は、第1主成分だけ残した1次元)")
axes[1].set_xlabel("第1主成分")
axes[1].set_ylabel("第2主成分")
for ax in axes:
    ax.set_xlim(-6.5, 6.5)
    ax.set_ylim(-5.5, 5.5)
    ax.set_aspect("equal")
    ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
主成分の座標を計算し、元のデータと並べて描くコードです。
- 主成分の座標 Z_toy: 200 × 2 の「中心を原点に移したデータ」に、2 × 2 の vectors(各列が主成分の方向)を掛けています。行列の掛け算で、全部の点と2つの方向の内積を一度に計算できます。vectors は直交する長さ1のベクトルを並べた行列(直交行列)なので、この掛け算は 回転(と、向きの反転)です。点どうしの距離は変わりません。
- 1点目の例: 1点目 から平均 を引くと です。第1主成分の方向 との内積は で、出力の主成分の座標の1つ目と一致します(scikit-learn の transform では、方向の符号が逆なので になります)。
- 矢印の長さ: 2 * np.sqrt(values[k]) は、その方向の標準偏差の2倍です。分散そのものではなく標準偏差を使うのは、データの座標と同じ単位で、ばらつきの大きさを矢印の長さとして見せるためです。2倍にしたのは、正規分布ではデータの約95%が平均から標準偏差2つ分の範囲に入り、矢印がデータの広がりの端に届くからです。
- 1次元にした結果: 右の図の下の赤い点は、第2主成分の座標を捨て、第1主成分の座標だけを横に並べたものです。これが、2次元を1次元に減らした PCA の結果です。
- 軸の範囲をそろえる: set_aspect("equal") と同じ set_xlim・set_ylim で、左右の図の縦横の目盛りをそろえています。そろえないと、回転しただけなのに点の広がりが伸び縮みして見えてしまいます。
実行結果
主成分の座標の分散: [4.398 0.445]
1点目  元の座標: [-0.158 -0.234]  主成分の座標: [0.476 0.113]
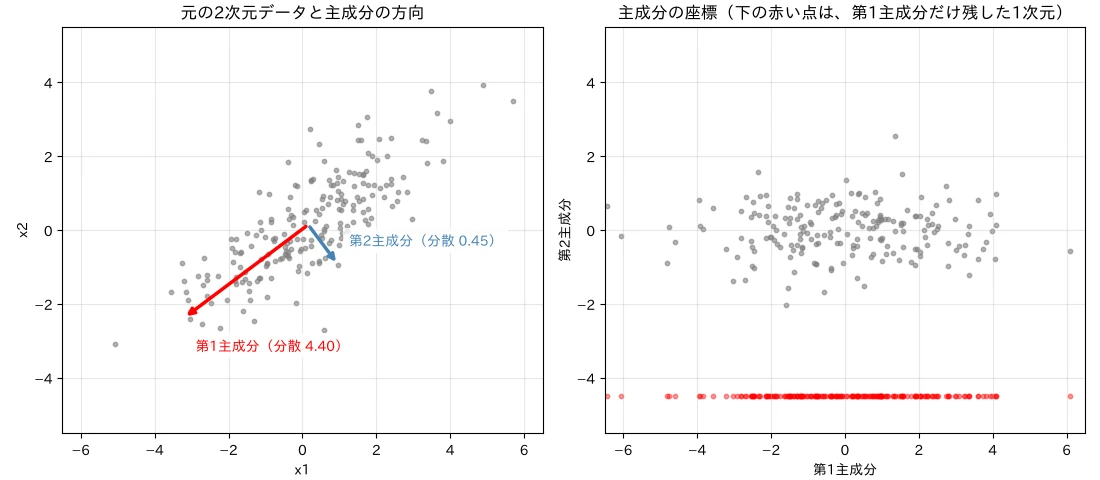
左の図では、赤い矢印(第1主成分)がデータの細長く伸びた方向に、青い矢印(第2主成分)がそれに直交する方向に向いています。第1主成分の矢印が左下を向いているのは、上で見た符号の向きのためです。右の図は、左の図を回転して、第1主成分を横軸にしたものです。主成分の座標の分散(4.398 と 0.445)は、固有値と同じになりました。PCA で次元を減らすとは、このように 軸を取り直し(回転)、ばらつきの小さい軸を捨てる ことです。
digits で、何次元残せばよいか
digits の64次元に PCA を使い、寄与率の合計が、残す主成分の数とともにどう増えるかを見ます。主成分を何個使えば、元の画像をどのくらい再現できるかも、画像に戻して確かめます。
主成分の座標 から元の空間に戻すには、座標に方向を掛けて足し、平均を足し戻します。上位 個の主成分だけを使えば、捨てた方向の分だけ情報が欠けた画像になります。
pca_digits = PCA().fit(X_digits)      # 64個の主成分をすべて求める
cumulative = np.cumsum(pca_digits.explained_variance_ratio_)
for d in [2, 10, 21, 40]:
    print(f"主成分 {d:2d} 個までの寄与率の合計: {cumulative[d - 1]:.3f}")


def reconstruct(pca, X, n_components):
    """先頭 n_components 個の主成分だけを使って、元の空間に戻す"""
    Z = (X - pca.mean_) @ pca.components_[:n_components].T     # (a) 主成分の座標(n_components 次元)
    return Z @ pca.components_[:n_components] + pca.mean_       # (b) 方向を掛けて足し戻す


fig = plt.figure(figsize=(12, 4))
ax = fig.add_subplot(1, 2, 1)
ax.plot(np.arange(1, 65), cumulative, marker=".")
ax.axhline(0.9, color="gray", linestyle="--")
ax.set_xlabel("使う主成分の数")
ax.set_ylabel("寄与率の合計")
ax.set_title("digits の累積寄与率")
ax.grid(True, alpha=0.3)
for i, d in enumerate([2, 10, 21, 64]):
    ax = fig.add_subplot(2, 8, 4 + i + 1)
    ax.imshow(reconstruct(pca_digits, X_digits[:1], d).reshape(8, 8), cmap="gray_r")
    ax.set_title(f"{d}個")
    ax.axis("off")
    ax = fig.add_subplot(2, 8, 12 + i + 1)
    ax.imshow(reconstruct(pca_digits, X_digits[3:4], d).reshape(8, 8), cmap="gray_r")
    ax.axis("off")
fig.text(0.74, 0.02, "主成分の数を変えて元に戻した画像(上: 0、下: 3)", ha="center")
plt.tight_layout()
plt.show()
累積寄与率を計算し、主成分の数を変えて元の画像に戻すコードです。
- PCA(): n_components を指定しないと、64個すべての主成分を求めます。何個残すかを決める前に、全体の寄与率を見るためです。
- 累積寄与率 cumulative: np.cumsum で寄与率を先頭から足し上げた配列で、cumulative[d - 1] が「上位 d 個の主成分で残るばらつきの割合」です。2個(2次元の図にする場合)、10個(後でクラスタリングの前処理に使う数)、21個(後で見るように、90%を超える最初の数)、40個を表示しています。
- reconstruct(pca, X, n_components): 学習済みの PCA とデータを引数で受け取り、上の式で元の空間に戻します。
- (a) 主成分の座標: 手計算と同じく、平均 pca.mean_ を引いて、方向との内積をとります。components_ は各行が方向なので、先頭の n_components 行を取り出し、転置して掛けます。
- (b) 元に戻す: 座標に方向を掛けて足し合わせ(行列の掛け算 Z @ pca.components_[:n_components])、平均を足し戻します。64個すべてを使えば、回転して戻すだけなので、元の画像と完全に一致します。
- 画像の並べ方: 右半分に、主成分を2・10・21・64個使って戻した画像を、0 の画像(1枚目)と 3 の画像(4枚目)について並べています。add_subplot(2, 8, …) は、図を2行8列に分けたうちの何番目に描くかの指定で、右半分の4列に画像を置くために使っています。
実行結果
主成分  2 個までの寄与率の合計: 0.285
主成分 10 個までの寄与率の合計: 0.738
主成分 21 個までの寄与率の合計: 0.903
主成分 40 個までの寄与率の合計: 0.988
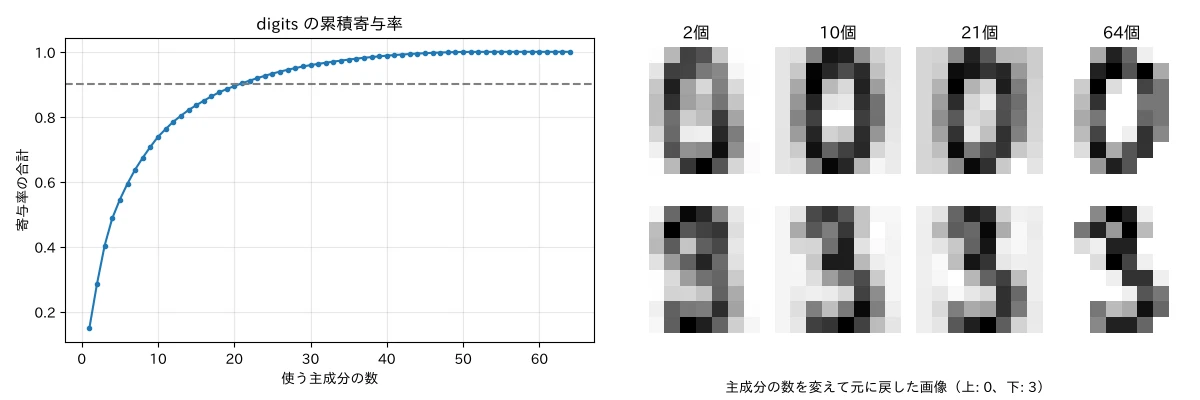
- 2次元では28.5%しか残らない: 2次元の図にすると、ばらつきの7割以上を捨てることになります。2次元のデータでは1次元にしても90.8%が残りましたが、digits では、ばらつきが多くの方向に分かれているためです。2個で戻した画像は、0 も 3 もぼやけた形で、数字の区別がつきません。
- 21個で90%: 64次元を21次元にしても、ばらつきの90%が残ります。21個で戻した画像は、元の画像とほとんど同じに見えます。ばらつきの小さい残りの43方向は、主に1枚ごとの細かな揺れ(ノイズ)です。このように、PCA は ノイズを落とし、計算を軽くする前処理 として役に立ちます。
- 累積寄与率の曲線で決める: 何次元残すかは、曲線が平らになり始めるところや、90%・95% のような目安で決めるのがよく使われる方法です。
t-SNE と UMAP:近所の関係を保つ
考え方
PCA の2次元の図には、ばらつきの28.5%しか残りません。それでも、2次元で数字のまとまりを見たいときには、「全体のばらつき」を残すのではなく、「どの画像とどの画像が似ているか(近所か)」だけを残すという考え方があります。これが t-SNE と UMAP です。
(図は、diagram-designで作成)
どちらも、次の3段階で2次元の配置を作ります。
- 元の空間で、各点の近所を決める: 近い点ほど強く「近所」とみなす重みを、全部の点の組について計算します(遠い点の重みはほぼ0です)。
- 2次元に点を置く: 最初の配置は、t-SNE(scikit-learn)では PCA の2次元、UMAP では近所のつながりのグラフから作ります。
- 点を少しずつ動かす: 2次元での近さの重みが、元の空間での重みに近づくように、近所どうしは引き寄せ、近所でない点は押し離すことを繰り返します。
t-SNE(t-distributed Stochastic Neighbor Embedding。van der Maaten & Hinton, 2008)は、近所の重みを確率で表します。元の空間で、点 から見て点 が近所である確率を、 を中心とした正規分布で決めます。
正規分布の広がり は、点ごとに変えます。点が密集しているところでは小さく、まばらなところでは大きくして、どの点も「実質的に同じくらいの人数」を近所とみなすようにするためです。この人数に当たるのが perplexity というパラメータで、原著論文では「5〜50 がよく使われる」とされています。
2次元の側では、正規分布の代わりに、裾の重い t 分布(自由度1)で近さの確率 を決めます。
そして、2つの確率の分布のずれ(KL ダイバージェンス) が小さくなるように、2次元の座標 を勾配法で動かします。
2次元側に t 分布を使うのは、混雑問題(crowding problem) を避けるためです。たとえば10次元の空間には、互いに等しい距離にある点を11個置けますが、2次元では3個(正三角形)しか置けません。高次元で「中くらいに離れた」点をすべて2次元に詰め込もうとすると、場所が足りず、点が真ん中に押し込まれてしまいます。裾の重い t 分布では、2次元で大きく離しても近さの確率がなかなか0にならないので、中くらいに離れた点を2次元では遠くに置けます。その結果、まとまりの間に、はっきりした隙間 ができます。
UMAP(Uniform Manifold Approximation and Projection。McInnes et al., 2018)は、各点の近所を、近い順に n_neighbors 個の点とのつながり(重み付きのグラフ)で表し、2次元でも同じグラフになるように点を動かします。考え方は t-SNE と似ていますが、すべての点の組ではなく近所のつながりを中心に計算し、近所でない点は無作為に選んだ一部だけを押し離すので、データが多くても速く計算できます。原著論文は、UMAP が t-SNE と同等の見やすさで、全体の構造をより多く残せる可能性があり、計算も速いとしています。2次元での点の詰まり具合は min_dist で調整します。小さいほど、近所どうしがぎゅっと固まります。
digits で3つを比べる
digits の64次元を PCA・t-SNE・UMAP で2次元にし、元の空間での近所の関係が、2次元の図にどのくらい残っているかを、2つの指標で比べます。
- trustworthiness(Venna & Kaski, 2001): 2次元で近所(近い順に5個)になった点が、元の空間でも近所だったかを測る値です。2次元で近所なのに、元の空間では遠い点が混ざっているほど下がります。1が最大で、2次元の図で「隣り合っている」ことを信用してよい度合いです。
- 5近傍の正解率: 2次元の座標で、近い5個の点の多数決で数字を当てたときの正解率です(5分割の交差検証)。同じ数字の画像が近所に集まっているほど高くなります。元の64次元での値と比べると、2次元にしたことで近所の関係がどれだけ崩れたかが分かります。
import time
import umap
from sklearn.manifold import TSNE, trustworthiness
from sklearn.model_selection import cross_val_score
from sklearn.neighbors import KNeighborsClassifier


def evaluate_2d(X, Y, y, k=5):
    """2次元にした Y に、元の X での近所の関係がどのくらい残っているかを、2つの指標で測る"""
    trust = trustworthiness(X, Y, n_neighbors=k)                                     # (a) 近所が元でも近所か
    knn = cross_val_score(KNeighborsClassifier(n_neighbors=k), Y, y, cv=5).mean()   # (b) 近所の多数決で数字が当たるか
    return trust, knn


methods = {"PCA": PCA(n_components=2, random_state=0),
           "t-SNE": TSNE(n_components=2, perplexity=30, random_state=0),
           "UMAP": umap.UMAP(n_components=2, n_neighbors=15, min_dist=0.1, random_state=0)}
print("元の64次元での5近傍の正解率:",
      round(cross_val_score(KNeighborsClassifier(n_neighbors=5), X_digits, y_digits, cv=5).mean(), 3))
embeddings = {}
for name, model in methods.items():
    start = time.time()
    embeddings[name] = model.fit_transform(X_digits)
    seconds = time.time() - start
    trust, knn = evaluate_2d(X_digits, embeddings[name], y_digits)
    print(f"{name:6s}: trustworthiness {trust:.3f}  5近傍の正解率 {knn:.3f}  時間 {seconds:.1f} 秒")

fig, axes = plt.subplots(1, 3, figsize=(16, 5.2))
for ax, (name, Y) in zip(axes, embeddings.items()):
    ax.scatter(Y[:, 0], Y[:, 1], c=y_digits, cmap="tab10", s=5)
    for digit in range(10):
        cx, cy = np.median(Y[y_digits == digit], axis=0)                 # その数字の点の真ん中に、数字を書く
        ax.annotate(str(digit), (cx, cy), xytext=(8, 8), textcoords="offset points", fontsize=13,
                    bbox=dict(boxstyle="round,pad=0.15", facecolor="white", edgecolor="gray", alpha=0.85))
    ax.set_title(name)
    ax.set_xticks([])
    ax.set_yticks([])
plt.suptitle("digits(64次元)を2次元にした結果。色と数字は正解の数字で、手法には渡していない")
plt.tight_layout()
plt.show()
3つの手法で2次元にし、指標を計算して、図を並べるコードです。
- evaluate_2d(X, Y, y, k=5): 元のデータ X、2次元の座標 Y、正解 y を引数で受け取り、2つの指標を返します。
- (a) trustworthiness: scikit-learn の trustworthiness をそのまま使います。n_neighbors=k は「近所」とみなす人数で、scikit-learn の既定値の5に合わせています。
- (b) 5近傍の正解率: KNeighborsClassifier は、近い k 個の点の多数決で分類する方法です。cross_val_score(…, cv=5) で、データを5つに分け、4つで覚えて残りの1つを当てることを5回繰り返した正解率の平均をとります。覚えたデータそのものを当てると、自分自身が近所に入って正解率が高く出すぎるので、交差検証にしています。
- k を同じ5にする理由: 2つの指標で「近所」の範囲をそろえ、同じ意味の近所の関係を、2つの見方で測るためです。
- 3つの手法 methods: 手法の名前をキー、scikit-learn の形(fit_transform で2次元の座標を返す)のオブジェクトを値にした辞書です。3つとも同じ書き方で呼べるので、for 文でまとめて実行できます。
- perplexity=30: scikit-learn の既定値で、原著論文の目安(5〜50)の中ほどです。
- n_neighbors=15、min_dist=0.1: umap-learn の既定値です。既定値のまま比べるのは、まず「何も調整せずに使うとどうなるか」を見るためです。値を変えたときの影響は、次の節で見ます。
- random_state=0: t-SNE と UMAP は、初期配置や、押し離す点の選び方に乱数を使うので、実行のたびに図が変わります。結果を再現できるように固定しています。UMAP で乱数を固定すると、並列計算ができなくなり、「n_jobs value 1 overridden to 1 by setting random_state」という警告が出ます。結果には影響しないので、無視して構いません。
- 元の64次元での正解率: 2次元にする前の基準として、64次元のまま5近傍の正解率を計算しています。
- 時間 seconds: 計算の重さを比べるために、fit_transform にかかった時間を測っています。値は CPU によって変わります。
- 図の数字のラベル: 各数字の点の座標の中央値(np.median)の少し右上に、その数字を書いています。平均ではなく中央値にしたのは、遠くに離れた少数の点に引っ張られず、まとまりの真ん中に書くためです。
実行結果
元の64次元での5近傍の正解率: 0.963
PCA   : trustworthiness 0.830  5近傍の正解率 0.603  時間 0.0 秒
t-SNE : trustworthiness 0.995  5近傍の正解率 0.976  時間 3.8 秒
UMAP  : trustworthiness 0.990  5近傍の正解率 0.976  時間 10.1 秒
| 手法 | trustworthiness | 5近傍の正解率 | 図の様子 |
|---|---|---|---|
| (元の64次元) | — | 0.963 | — |
| PCA | 0.830 | 0.603 | 0・4・6 などは分かれるが、真ん中で多くの数字が重なる |
| t-SNE | 0.995 | 0.976 | 10個の数字が、隙間で区切られたまとまりに分かれる |
| UMAP | 0.990 | 0.976 | t-SNE と同じく分かれ、まとまりがより小さく固まる |
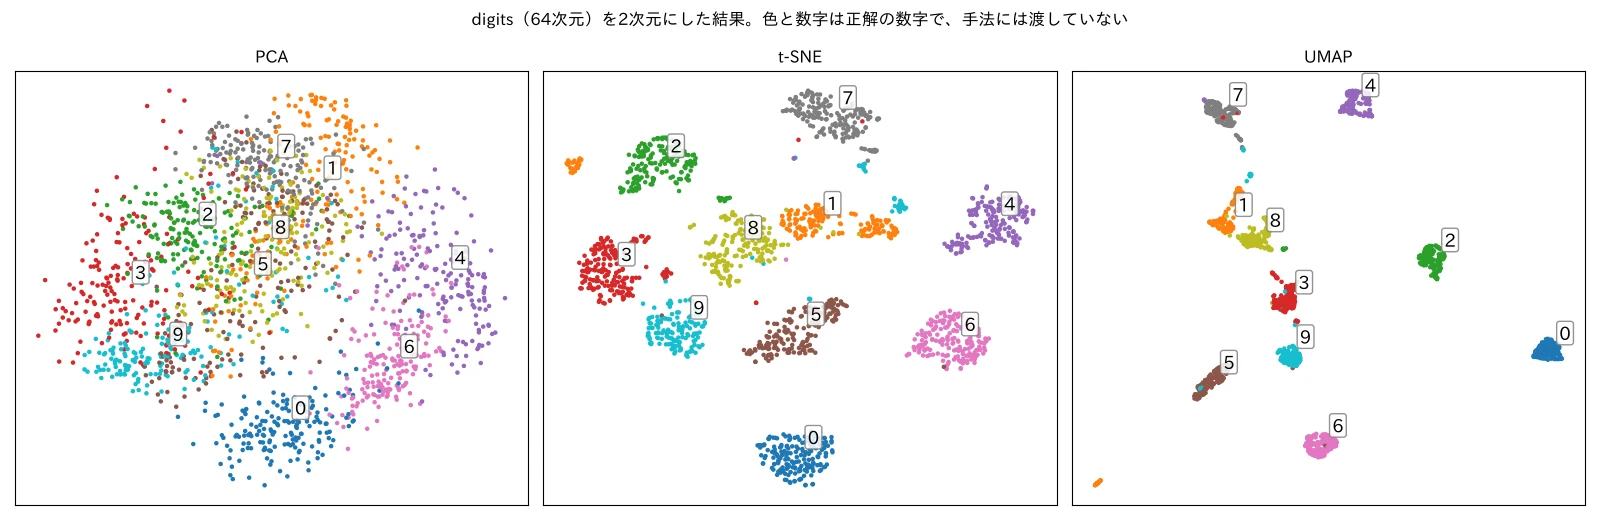
- PCA の2次元では、数字が重なる: 0(下)、4(右)、6(右下)のように、PCA の2次元でも分かれる数字はありますが、1・2・5・7・8 などは真ん中で重なっています。2次元に28.5%のばらつきしか残らず、残りの方向で区別されていた数字が重なってしまうためです。5近傍の正解率は0.603まで下がりました。
- t-SNE と UMAP は、近所の関係をほぼ残す: trustworthiness は0.99以上で、2次元で隣り合う画像は、元の64次元でもほぼ近所です。5近傍の正解率は0.976で、元の64次元(0.963)より高くなりました。近所の関係を強調して配置するので、まとまりの境目にあった紛らわしい画像が、どちらかのまとまりに寄せられるためと考えられます。
- 1 は3か所に分かれる: t-SNE の図では、1(オレンジ)が3か所に分かれ、そのうち1つは左上に離れています。何が起きているかは、次のコードで、元の画像を見て確かめます。
- UMAP のまとまりは小さく固まる: 同じ近所の関係でも、UMAP の図ではまとまりがとても小さく描かれ、t-SNE の図では大きく描かれます。図の上での「まとまりの大きさ」は、手法とパラメータで決まり、元のデータのばらつきを表していません。これが次の節の話題です。
図で見えたことを、元の画像で確かめる
t-SNE の図で左上に離れた 1 の小さなまとまりが、ほかの 1 とどう違うのかを、元の画像を並べて確かめます。
# t-SNE の図で、左上に離れた 1 の小さなまとまり(横軸が -30 より左)と、それ以外の 1 を並べて見る
Y_tsne = embeddings["t-SNE"]
is_one = y_digits == 1
far_ones = np.where(is_one & (Y_tsne[:, 0] < -30))[0]
other_ones = np.where(is_one & (Y_tsne[:, 0] >= -30))[0]
print("離れたまとまりの 1:", len(far_ones), "枚  それ以外の 1:", len(other_ones), "枚")

fig, axes = plt.subplots(2, 8, figsize=(8, 2.4))
for row, (indices, title) in enumerate([(far_ones, "離れたまとまり"), (other_ones, "それ以外")]):
    for ax, i in zip(axes[row], indices[:8]):
        ax.imshow(digits.images[i], cmap="gray_r")
        ax.axis("off")
    axes[row, 0].set_title(title, loc="left", fontsize=10)
plt.tight_layout()
plt.show()
t-SNE の座標を使って 1 の画像を2つに分け、それぞれ先頭の8枚を表示するコードです。
- is_one: 正解が 1 の画像なら True になる、1797個の真偽値の配列です。
- far_ones と other_ones: & で「1 である」と「t-SNE の横軸が -30 より左」の両方を満たす画像の番号を、np.where で取り出しています。-30 は、上の図で左上のまとまりと、ほかのまとまりの間の隙間にある値です。t-SNE の座標の値そのものには意味がなく、乱数や環境で図が変わると使えない値なので、この境目は上の図を見て決めた、この実行結果専用のものです。
- 画像の表示: 2行8列の枠に、上の行に離れたまとまり、下の行にそれ以外の 1 を並べています。
実行結果
離れたまとまりの 1: 27 枚 それ以外の 1: 155 枚

離れたまとまりの27枚は、どれも 下に横棒(台)の付いた 1 でした。それ以外の 1 は、台のない縦棒で、上に左向きのはねがあります。台の有無で下の2行の画素が大きく変わるので、64次元の空間でも別の近所を作っていて、t-SNE はそれを別のまとまりとして描いたのです。このように、t-SNE や UMAP の図は、正解のラベルだけでは分からない、データの中の違いに気付くきっかけになります。ただし、気付いたことは、このように元のデータで確かめてから結論にします。
2次元の図の読み方:まとまりの間の距離と大きさ
t-SNE や UMAP の図を見ると、「1 と 8 は近いから似ている」「0 のまとまりは小さいから、書き方の揺れが少ない」と読みたくなります。しかし、それは正しいでしょうか。答えを知っているデータで確かめます。
50次元の空間に、3つのまとまり(各200点)を作ります。中心どうしの距離と、まとまりの広がりを、次のように決めておきます。
- A と B は近い: 中心の距離は10
- A と C は遠い: 中心の距離は40(AB の4倍)
- C だけ広がっている: A と B は標準偏差1、C は標準偏差3(A の3倍)
2次元にした図で、この「距離の比(AC / AB ≈ 4)」と「広がりの比(C / A ≈ 3)」が残っているかを測ります。t-SNE では、perplexity を 5・30・100 と変えたときの違いも見ます。
# 50次元に、距離と広がりを決めた3つのまとまり(各200点)を作る
rng = np.random.default_rng(0)
dim, size = 50, 200
centers = {g: np.zeros(dim) for g in "ABC"}
centers["B"][0] = 10.0          # A と B は近い(中心の距離10)
centers["C"][1] = 40.0          # A と C は遠い(中心の距離40)
spreads = {"A": 1.0, "B": 1.0, "C": 3.0}    # C だけ3倍に広がっている
X_blobs = np.vstack([centers[g] + spreads[g] * rng.standard_normal((size, dim)) for g in "ABC"])
groups = np.repeat(list("ABC"), size)


def geometry(Y, groups):
    """まとまりの中心どうしの距離の比(AC / AB)と、広がりの比(C / A)を返す"""
    c = {g: Y[groups == g].mean(axis=0) for g in "ABC"}                                  # (a) 各まとまりの中心
    spread = {g: np.linalg.norm(Y[groups == g] - c[g], axis=1).mean() for g in "ABC"}   # (b) 中心からの平均距離
    distance_ratio = np.linalg.norm(c["C"] - c["A"]) / np.linalg.norm(c["B"] - c["A"])
    return distance_ratio, spread["C"] / spread["A"]


results = {"元の50次元": X_blobs,
           "PCA": PCA(n_components=2, random_state=0).fit_transform(X_blobs),
           "UMAP": umap.UMAP(n_components=2, random_state=0).fit_transform(X_blobs)}
for perplexity in [5, 30, 100]:
    results[f"t-SNE(perplexity {perplexity})"] = TSNE(n_components=2, perplexity=perplexity,
                                                         random_state=0).fit_transform(X_blobs)
for name, Y in results.items():
    distance_ratio, spread_ratio = geometry(Y, groups)
    print(f"{name}: 距離の比 AC/AB = {distance_ratio:.2f}  広がりの比 C/A = {spread_ratio:.2f}")

fig, axes = plt.subplots(1, 5, figsize=(20, 4.4))
for ax, (name, Y) in zip(axes, list(results.items())[1:]):
    for g, color in zip("ABC", ["tab:blue", "tab:orange", "tab:green"]):
        ax.scatter(Y[groups == g, 0], Y[groups == g, 1], s=5, color=color, label=g)
    ax.set_title(name)
    ax.set_aspect("equal", adjustable="datalim")
    ax.set_xticks([])
    ax.set_yticks([])
axes[0].legend(markerscale=3)
plt.suptitle("元の50次元では A と B が近く(距離10)、C は遠く(距離40)、C だけ3倍に広がっている")
plt.tight_layout()
plt.show()
距離と広がりを決めたデータを作り、各手法で2次元にして、2つの比を測るコードです。
- データの作り方: 比べたいのは「まとまりの間の距離」と「まとまりの大きさ」の2つなので、その2つだけを仕込んだ最小限のデータにしています。
- 中心 centers: 3つとも50次元の0ベクトルから始め、B は1番目の座標を10、C は2番目の座標を40にしています。こうすると、AB の距離は10、AC の距離は40と、計算しなくても分かる値になります。AC を AB の4倍と大きく離したのは、距離の比が2次元の図に残るかどうかを、はっきり見分けられるようにするためです。
- 広がり spreads: rng.standard_normal((size, dim)) は、各座標が標準偏差1の正規分布の乱数です。これに spreads[g] を掛けて、C だけ標準偏差を3倍にしています。
- 50次元にした理由: 2次元のデータでは、t-SNE や UMAP を使う必要がありません。図では見られない高次元のデータで、手法が距離をどう扱うかを見るために、文の埋め込みのような数十次元以上の大きさにしています。各まとまりの200点は、digits の1つの数字(約180枚)と同じくらいの数です。
- groups: 各点がどのまとまりのものかを表す、"A"・"B"・"C" を200個ずつ並べた配列です。手法には渡さず、測るときだけに使います。
- geometry(Y, groups): 座標とまとまりの印を引数で受け取り、2つの比を返します。元の50次元にも、2次元の座標にも、同じ関数を使えます。
- (a) 中心: まとまりごとに、点の座標の平均をとります。Y[groups == g] は、そのまとまりの点だけを取り出す書き方です。
- (b) 広がり: 各点から中心までの距離の平均です。np.linalg.norm(…, axis=1) で、点ごとの距離を一度に計算しています。
- 比にする理由: 2次元の座標の目盛りは、手法ごとにばらばらです(t-SNE と UMAP の座標の値そのものには意味がありません)。距離や広がりの値そのものではなく、比で比べれば、目盛りの違いに左右されません。
- perplexity の値: 5 と 100 は、原著論文の目安(5〜50)の下限と、それを大きく超える値です。近所とみなす人数を大きく変えると、まとまりの間の距離が残るかを確かめるためです。100 は、1つのまとまりの200点の半分を近所とみなす大きさです。
- 図の縦横の比: set_aspect("equal", adjustable="datalim") で、縦と横の目盛りをそろえています。そろえないと、図の形に合わせて距離が伸び縮みして見えるためです。
実行結果
元の50次元: 距離の比 AC/AB = 4.12  広がりの比 C/A = 3.00
PCA: 距離の比 AC/AB = 4.15  広がりの比 C/A = 3.08
UMAP: 距離の比 AC/AB = 2.04  広がりの比 C/A = 1.00
t-SNE(perplexity 5): 距離の比 AC/AB = 0.98  広がりの比 C/A = 1.01
t-SNE(perplexity 30): 距離の比 AC/AB = 1.04  広がりの比 C/A = 1.00
t-SNE(perplexity 100): 距離の比 AC/AB = 1.23  広がりの比 C/A = 1.00
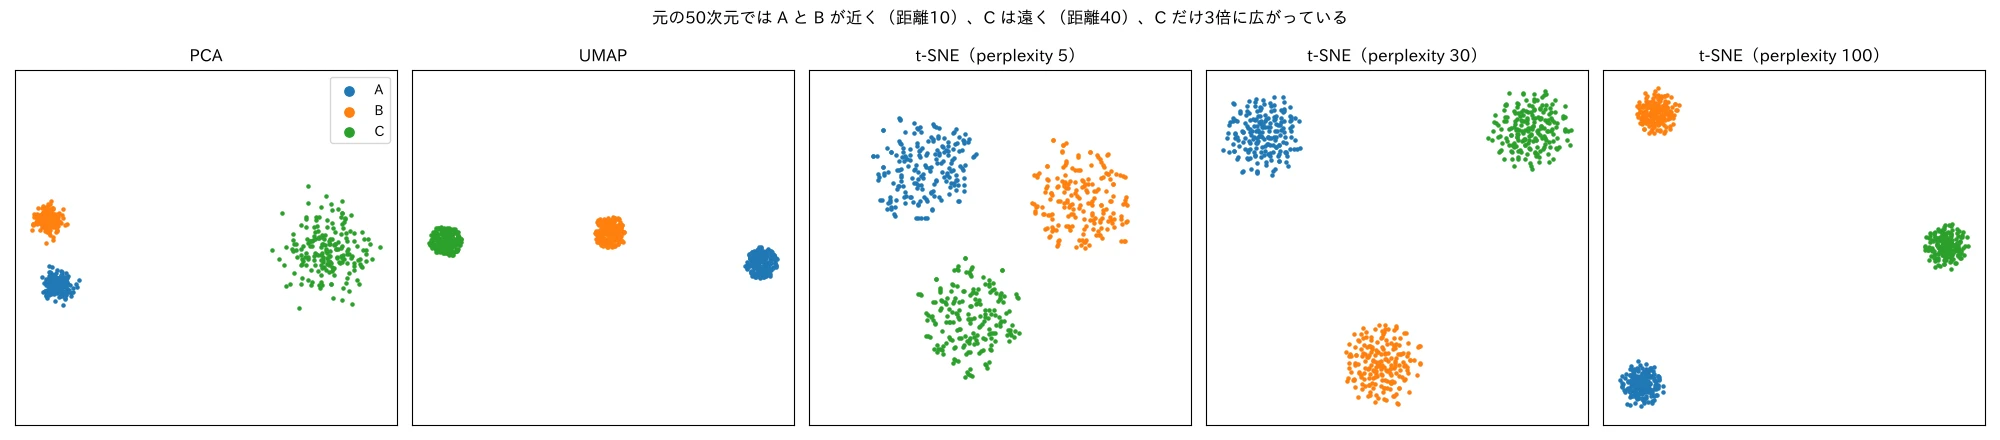
元の50次元の距離の比が、決めた値の4ではなく4.12なのは、200点の平均として計算した中心が、乱数のために少しずれるためです(C は広がりが大きいので、ずれも大きくなります)。
- PCA は距離も大きさも残す: 距離の比4.15、広がりの比3.08と、元の値(4.12、3.00)にほぼ一致しました。3つの中心は(3点なので)必ず1つの平面の上にあり、データのばらつきの大部分は、まとまりの間の差が占めています。そのため、PCA の第1・第2主成分がちょうどその平面を選び、回転と切り捨てだけの PCA では、中心どうしの距離がそのまま残ります。
- t-SNE は、まとまりを同じ大きさ・同じ間隔に並べる: perplexity 30 では、距離の比1.04、広がりの比1.00でした。図では3つのまとまりがほぼ正三角形に並び、大きさもそろっています。元では C が4倍遠く、3倍広がっていたことは、図からはまったく読み取れません。点ごとに近所の範囲 を変えて「どの点も同じくらいの人数を近所とみなす」ので、広がりの大きい C の点も、A の点と同じ大きさの近所を持つように描かれるためです。
- perplexity を変えても、距離の比はほとんど戻らない: perplexity を100に上げると、距離の比は1.23になり、図でも A と B が少し近づきました。近所とみなす範囲が広がり、まとまりの間の関係が少しだけ配置に反映されたためです。それでも元の4.12には遠く及びません。
- UMAP は少しだけ距離を残すが、大きさはそろえる: 距離の比は2.04で、t-SNE よりは元の並び(C が遠い)に近くなりましたが、広がりの比は1.00で、t-SNE と同じく大きさはそろってしまいました。
この結果をまとめると、t-SNE と UMAP の2次元の図から読めることと読めないことは、次のようになります。
(図は、diagram-designで作成)
t-SNE の図の読み方の注意は、Wattenberg ら(2016)の解説記事「How to Use t-SNE Effectively」に、図を動かしながら確かめられる形でまとめられています。そこでは、まとまりの大きさや、離れたまとまりの間の距離は意味を持たないことがあることに加えて、まとまりのないランダムなデータでも、perplexity が小さいと小さな固まりがいくつも見えることがある ことも示されています。t-SNE や UMAP の図で見えたまとまりや並びは、元の空間でのクラスタリングや距離の計算で確かめるようにしましょう。全体の並びも残したいときは、PCA の図を並べて見るか、t-SNE の初期配置に PCA を使う(scikit-learn の既定)、perplexity を大きめにする、といった方法が Kobak & Berens(2019)で検討されています。
クラスタリングの前処理として使う
次元削減は、図を描くためだけでなく、クラスタリングの前処理としても使われます。digits の画像を、正解を使わずに k-means で10個に分け、正解の数字とどのくらい一致するかを、次の3つの入力で比べます。
- 元の64次元: 次元削減をしない場合です。
- PCA で10次元: ばらつきの73.8%を残し、細かな揺れを落とした場合です。
- UMAP で10次元: 近所の関係を残して、10次元に並べ直した場合です。
一致の度合いは、ARI(調整済みランド指数) で測ります。2つの分け方で「同じグループか、別のグループか」の判定がどのくらい一致するかを、偶然の一致を差し引いて表した値で、完全に一致すると1、でたらめに分けると0前後になります。クラスタの番号と数字の対応を決めなくても計算できるので、クラスタリングの評価によく使われます。
from sklearn.cluster import KMeans
from sklearn.metrics import adjusted_rand_score


def kmeans_ari(Z, y, n_clusters=10):
    """k-means で n_clusters 個に分け、正解の数字との一致度(ARI)を返す"""
    labels = KMeans(n_clusters=n_clusters, n_init=10, random_state=0).fit_predict(Z)
    return adjusted_rand_score(y, labels)


inputs = {"元の64次元": X_digits,
          "PCA で10次元": PCA(n_components=10, random_state=0).fit_transform(X_digits),
          "UMAP で10次元": umap.UMAP(n_components=10, n_neighbors=15, min_dist=0.0,
                                    random_state=0).fit_transform(X_digits)}
for name, Z in inputs.items():
    print(f"{name}: ARI = {kmeans_ari(Z, y_digits):.3f}")
3つの入力に同じ k-means を使い、ARI を比べるコードです。
- kmeans_ari(Z, y, n_clusters=10): クラスタリングに使う座標 Z と、正解 y を引数で受け取ります。どの入力にも同じ関数を使うことで、違いが入力だけになるようにしています。
- n_clusters=10: 数字が10種類あることを知っているので、10個に分けます。クラスタの数の決め方そのものは、クラスタリングの記事で扱っています。
- n_init=10: k-means は初期値によって結果が変わるので、10回やり直して、まとまりの良いもの(クラスタ内のばらつきが最小のもの)を選びます。1回だけだと、たまたま悪い初期値になったときに、入力の違いではなく初期値の違いで ARI が変わってしまうためです。
- adjusted_rand_score(y, labels): 正解とクラスタの番号から ARI を計算します。正解はここで初めて使い、k-means には渡していません。
- 10次元にした理由: PCA と UMAP の次元をそろえて、「何を残すか」の違いだけを比べるためです。2次元まで減らすと、PCA ではばらつきの28.5%しか残らず、比較が一方的になります。
- min_dist=0.0: 可視化のときの既定値0.1から変えています。umap-learn の説明では、小さいほど近所どうしがぎゅっと固まった配置になるとされていて、まとまりの境目がはっきりするほうが、クラスタリングには向いているためです。図にする場合は、点が重なって見にくくなるので、0.1 のような値を使います。
実行結果
元の64次元: ARI = 0.666
PCA で10次元: ARI = 0.652
UMAP で10次元: ARI = 0.822
- PCA の10次元は、元の64次元とほぼ同じ: ARI は0.652で、元の64次元(0.666)とほとんど変わりません。次元を6分の1にしても、k-means の結果はほぼ保たれました。PCA の前処理の主な効果は、精度を上げることよりも、計算を軽くし、ノイズを落とすこと です。
- UMAP の10次元で、ARI が大きく上がる: 0.822まで上がりました。k-means は、まとまりが丸く、同じくらいの大きさであることを前提にした方法です。UMAP で近所の関係に沿って並べ直すと、曲がった形や細長い形をしていた数字のまとまりが、小さく固まった形になり、k-means が分けやすくなったと考えられます。
- 注意点: UMAP は、前の節で見たように、まとまりの大きさや間の距離を変えてしまいます。また、パラメータ(n_neighbors・min_dist)や乱数で結果が変わり、元のデータにない「切れ目」を作ることもあります。UMAP の後のクラスタリングの結果は、元の空間でもまとまっているか(元のデータでの距離やクラスタの中身)を確かめてから使うのが安全です。
文書を UMAP で次元削減してからガウス混合でまとまりに分ける方法は、長い文書を階層的に要約して検索する RAPTOR でも使われています。ガウス混合の考え方は混合モデルの記事で解説しています。
使い分け
ここまでの実験をもとに、3つの手法の使い分けをまとめます。
| PCA | t-SNE | UMAP | |
|---|---|---|---|
| 残すもの | 全体のばらつき(距離・広がり) | 近所の関係 | 近所の関係(全体の並びも少し) |
| 変換 | 線形(式で表せる) | 非線形(点の配置を最適化) | 非線形(点の配置を最適化) |
| 新しいデータの変換 | できる(同じ式を使う) | できない(scikit-learn では作り直し) | できる(transform) |
| digits の計算時間 | 0.0秒 | 3.8秒 | 10.1秒(初回はコンパイルを含む) |
| 主なパラメータ | 残す次元の数 | perplexity | n_neighbors・min_dist |
| 向いている使い方 | 前処理(ノイズの除去・計算の軽量化)、全体の構造の確認 | 2次元の図でまとまりを見る | 2次元の図、クラスタリングの前処理 |
| 注意点 | 曲がった構造や、多くの方向に分かれたまとまりは重なる | まとまりの大きさ・間の距離は読めない | t-SNE と同じ。乱数・パラメータで結果が変わる |
UMAP の時間には、初めて呼んだときの準備(numba による関数のコンパイル)の時間が含まれています。データが数万件を超えると、全部の点の組を扱う t-SNE より、近所のつながりを中心に計算する UMAP のほうが速くなります。
原著論文と本記事の設定
| 手法 | 原著論文 | 原著の設定・目安 | 本記事の設定 | 理由 |
|---|---|---|---|---|
| PCA | Pearson(1901)、Hotelling(1933) | 共分散(相関)行列の固有値の大きい方向 | scikit-learn の PCA(特異値分解で計算) | 固有値分解の手計算と同じ結果になることを確かめたため |
| t-SNE | van der Maaten & Hinton(2008) | perplexity は5〜50がよく使われる | perplexity 30(scikit-learn の既定値)、5・100 も比較 | 目安の中ほどの値で比べ、目安の端と外で距離の残り方を確かめるため |
| UMAP | McInnes, Healy & Melville(2018) | n_neighbors(近所の人数)・min_dist(詰まり具合)を調整 | n_neighbors 15・min_dist 0.1(umap-learn の既定値)、クラスタリングでは min_dist 0.0 | まず既定値で比べ、クラスタリングでは固まった配置にするため |
まとめ
本記事では、高次元のデータを少ない次元で表す次元削減について、PCA・t-SNE・UMAP を、手書き数字のデータ(64次元)と人工データで確かめました。
- PCA: 共分散行列の固有ベクトルの方向に軸を取り直し(回転し)、ばらつきの小さい方向を捨てる線形の方法です。2次元のデータでは、固有値分解の手計算と scikit-learn が、符号を除いて一致しました(分散4.398、寄与率0.908)。digits では、2次元に残るばらつきは28.5%で、90%を残すには21次元が必要でした。
- t-SNE・UMAP: 元の空間で誰が近所かを調べ、2次元でも同じ近所になるように点を並べ直す非線形の方法です。digits の2次元の図で、trustworthiness は0.99以上、5近傍の正解率は0.976と、近所の関係をほぼ残しました(PCA は0.830と0.603)。
- 2次元の図の読み方: t-SNE と UMAP の図では、まとまりの間の距離(元の比4.12が t-SNE で1.04、UMAP で2.04)と大きさ(元の比3.00がどちらも1.00)は読めません。PCA は距離の比4.15、広がりの比3.08と元の値を残しました。
- クラスタリングの前処理: k-means の ARI は、元の64次元で0.666、PCA の10次元で0.652、UMAP の10次元で0.822でした。PCA は計算の軽量化とノイズの除去に、UMAP はまとまりを分けやすくするのに役立ちますが、UMAP の後の結果は元の空間で確かめて使います。
参考文献
- K. Pearson (1901). On Lines and Planes of Closest Fit to Systems of Points in Space. Philosophical Magazine, 2(11), 559–572.
- H. Hotelling (1933). Analysis of a Complex of Statistical Variables into Principal Components. Journal of Educational Psychology, 24(6), 417–441.
- L. van der Maaten, G. Hinton (2008). Visualizing Data using t-SNE. Journal of Machine Learning Research, 9, 2579–2605.
- L. McInnes, J. Healy, J. Melville (2018). UMAP: Uniform Manifold Approximation and Projection for Dimension Reduction. arXiv:1802.03426.
- J. Venna, S. Kaski (2001). Neighborhood Preservation in Nonlinear Projection Methods: An Experimental Study. ICANN 2001, LNCS 2130, 485–491.
- M. Wattenberg, F. Viégas, I. Johnson (2016). How to Use t-SNE Effectively. Distill.
- D. Kobak, P. Berens (2019). The art of using t-SNE for single-cell transcriptomics. Nature Communications, 10, 5416.
- E. Alpaydin, C. Kaynak (1998). Optical Recognition of Handwritten Digits. UCI Machine Learning Repository(CC BY 4.0).
本記事の文章・構成の一部に生成AIを使用しています。