二重にロバストな推定法(DR法 / AIPW)とは?
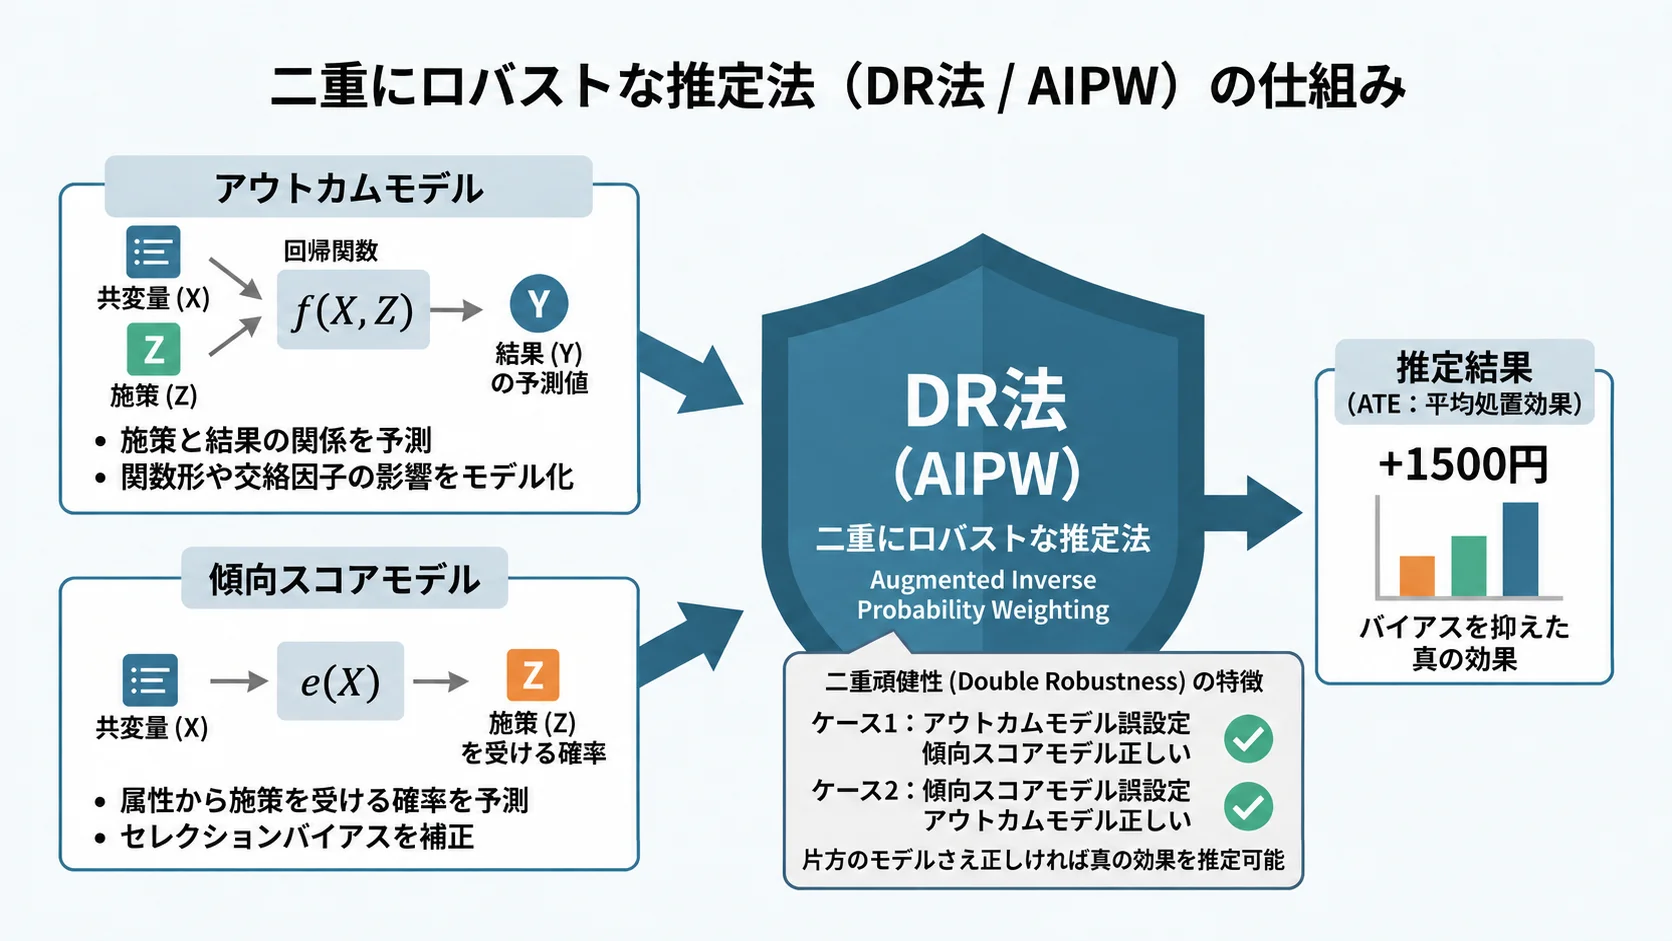 (画像は、Geminiで作成)
二重にロバストな推定法の概要
施策の効果を測る最も確実な方法はランダム化比較試験(RCT)ですが、実務で手元にあるのは「すでにバイアスがかかった状態で溜まった観察データ」であることがほとんどです。
そこでこれまでの記事では、観察データから平均処置効果(ATE)を推定する方法を、大きく2つの系譜に分けて解説してきました。
- アウトカム回帰モデル(G-computation):結果(売上など)を予測する回帰モデルを作り、「全員が施策を受けた場合」と「全員が受けなかった場合」の予測値の差から効果を求める → 回帰による効果推定(共分散分析・G-computation)
- 傾向スコアモデル:「その人が施策を受ける確率」を予測し、その逆数を重みとしてデータにかけることで、擬似的にRCTに近い状態を作り出す → 傾向スコア、PSM、IPTW
問題は、どちらもモデルが正しく作れていることを前提にしている点です。アウトカム回帰モデルは結果の構造を読み違えれば壊れますし、傾向スコアモデルも同様です。そして実務では、どちらのモデルが正しいかを事前に知る方法はありません。
そこで登場するのが、この2つのモデルを組み合わせることで、「どちらか一方のモデルさえ正しく設定されていれば、真の効果を一致推定できる」 という性質を持つ手法です。この性質を 二重頑健性(Double Robustness) と呼び、これを備えた推定法を 二重にロバストな推定法(Doubly Robust Estimation: DR法) と言います。代表的な実装が AIPW(Augmented Inverse Probability Weighting:拡張逆確率重みづけ) です。
Bang & Robins (2005) の表現を借りれば、DR法は分析者に「1回ではなく2回のチャンスを与える」手法だと言えます。
本記事では、次の3点を順に確認していきます。
- AIPWの数式が「回帰モデルの予測値 + IPTWによる誤差の補正」という2層構造になっていること
- その構造ゆえに、バイアスが「2つの誤差の掛け算」 になり、片方がゼロなら全体がゼロになること
- Pythonで アウトカムモデルの正誤 × 傾向スコアモデルの正誤 の4パターン を実際に動かし、二重頑健性が数値として成立することを確認すること
2つのアプローチとそれぞれの弱点
DR法を理解するには、まず組み合わせる2つの部品それぞれの性格を押さえておく必要があります。
アプローチ①:アウトカム回帰モデル(G-computation)
回帰調整の記事で解説した、群ごとに回帰モデルを学習し、全員分の反事実を予測して平均する手続きです。処置群のデータで を、対照群のデータで を学習し、全員分の共変量を両方のモデルに入れて予測した差を平均します。
観測できない反事実(counterfactual)を、モデルの外挿で埋めるという発想です(メタラーナーの T-Learner と計算上は同じもので、違いは個人ごとの効果を見るか平均するかだけです)。
弱点:モデルの誤設定(Misspecification)
この方法は、回帰モデルが現実のデータ構造を正しく表現できていることに全面的に依存します。例えば現実には「過去の購買金額が増えるほど売上は伸びるが、その伸び方は次第に鈍る(逓減する)」という関係があるのに、分析者が単純な直線を当てはめてしまった場合、処置群と対照群で直線の引かれ方が微妙に変わり、その差がそのまま効果の推定誤差になります。しかも予測精度( など)を見ているだけでは、このズレにはまず気づけません。
アプローチ②:傾向スコアによる重み付け(IPTW)
IPTWは結果のモデル化を一切必要としません。傾向スコア の逆数を重みとして、交絡因子の分布が均衡した疑似母集団を作り出します。
弱点:極端な重みと、傾向スコアモデルへの全面的な依存
IPTWは結果をモデル化しない代わりに、傾向スコアが正しく推定できていることに全面的に依存します。またIPTWの記事で確認した通り、傾向スコアが0や1に近いサンプルがあると重みが爆発し、少数のデータが結果を支配して推定値が不安定になります。
2つの弱点は「別の場所」にある
重要なのは、この2つの手法が壊れる原因が互いに独立しているという点です。
| アウトカム回帰モデル | IPTW(傾向スコア) | |
|---|---|---|
| モデル化する対象 | 結果 の構造 | 処置 の割り当て確率 |
| 正しく推定できる条件 | アウトカムモデルが正しい | 傾向スコアモデルが正しい |
| 主な壊れ方 | 関数形の誤設定による外挿の失敗 | 極端な重みによる不安定化 |
| 必要なデータ | と の関係 | と の関係 |
つまり、アウトカムモデルの誤設定は傾向スコアの精度に影響せず、逆もまた然りです。この独立性こそが、2つを組み合わせて「どちらか一方が当たっていればよい」という性質を作り出せる理由になります。
2つの部品と DR 法の関係を図にすると、次のようになります。
(図は、diagram-designで作成)
DR法(AIPW)の考え方:予測値を「残差」で補修する
推定量の定義
AIPWによるATEの推定式は次のように表されます。
記号の意味は以下の通りです。
- :施策を受けたかどうか(1 or 0)
- :実際に観測された結果(売上など)
- :推定された傾向スコア(施策を受ける確率)
- :回帰モデルによる「もし施策を受けていたら」の予測値
- :回帰モデルによる「もし施策を受けていなかったら」の予測値
3ステップで読み解く
一見複雑ですが、前半の を推定する部分だけ取り出せば、やっていることは3ステップです。
- まず回帰モデルの予測値を置く: を出発点にします。全員について予測できるので、この時点でデータの欠けはありません。
- 予測の外れ具合(残差)を測る: を計算します。ただしこれが計算できるのは、実際に施策を受けた人()だけです。施策を受けていない人では となり、この項はまるごと消えて予測値だけが残ります。
- 残差を逆確率で重み付けして足し戻す:観測できた残差に を掛けて補正します。
3の割り算が最初は不思議に見えるかもしれません。これは「観測できた1人の残差に、観測できなかった人の分まで代表させる」ための引き伸ばしです。ある属性の人のうち25%しか施策を受けていない()なら、観測できた1人の残差を4倍にすることで、その属性層全体の情報として扱えるようになります。これはIPTWの疑似母集団とまったく同じ発想で、違いは重み付けの対象が「売上そのもの」ではなく「回帰モデルの予測誤差」になっている点だけです。
この「後から足す補正項」があることが、AIPWの正式名称にある Augmented(拡張された) の由来です。
3つのステップを図にすると、次のようになります。
(図は、diagram-designで作成)
数値例で追う:4人のミニデータ
言葉だけでは実感が湧きにくいので、説明用に単純化した架空の例で実際に手を動かしてみましょう。
まったく同じ属性 を持つ4人がいて、そのうち2人が実際にDMを受け取ったとします。真の傾向スコアは です。DMを受け取った2人の売上は 12,000円 と 13,000円 でした。
ここで知りたいのは「この4人全員がDMを受け取っていたら、平均売上はいくらだったか()」です。属性が完全に同じなので、正解は観測された2人の平均である 12,500円 になります。
ケースA:傾向スコアは正しいが、回帰モデルが外れている
傾向スコアは正しく と推定できたものの、回帰モデルの予測が 円 と低めに外れているとします。
| 人 | 残差 | 補正項 | スコア | |||
|---|---|---|---|---|---|---|
| 1 | 1 | 12,000 | 11,000 | +1,000 | +2,000 | 13,000 |
| 2 | 1 | 13,000 | 11,000 | +2,000 | +4,000 | 15,000 |
| 3 | 0 | - | 11,000 | ( なので消える) | 0 | 11,000 |
| 4 | 0 | - | 11,000 | ( なので消える) | 0 | 11,000 |
4人の平均: 円。正解と一致しました。
回帰モデルが全員を 1,500円 も低く見積もっていたにもかかわらず、正しい答えに戻っています。これは、観測できた2人分の残差(+1,000 と +2,000)が2倍に引き伸ばされ、観測できなかった2人分の予測の低さをちょうど埋め合わせたためです。
ケースB:回帰モデルは正しいが、傾向スコアが外れている
今度は回帰モデルが正しく 円 を予測できた一方、傾向スコアを と誤って推定してしまった場合です。
| 人 | 残差 | 補正項() | スコア | |||
|---|---|---|---|---|---|---|
| 1 | 1 | 12,000 | 12,500 | −500 | −1,250 | 11,250 |
| 2 | 1 | 13,000 | 12,500 | +500 | +1,250 | 13,750 |
| 3 | 0 | - | 12,500 | 0 | 0 | 12,500 |
| 4 | 0 | - | 12,500 | 0 | 0 | 12,500 |
平均: 円。こちらも正解です。
回帰モデルが正しいと残差の平均がゼロに近づくため、傾向スコアをどう間違えても、ゼロに何を掛けてもゼロのままになります。上の表でも、−1,250 と +1,250 が打ち消し合っているのが見て取れます。
ケースC:両方とも外れている
、 の場合はどうなるでしょうか。
| 人 | 残差 | 補正項() | スコア | |||
|---|---|---|---|---|---|---|
| 1 | 1 | 12,000 | 11,000 | +1,000 | +2,500 | 13,500 |
| 2 | 1 | 13,000 | 11,000 | +2,000 | +5,000 | 16,000 |
| 3 | 0 | - | 11,000 | 0 | 0 | 11,000 |
| 4 | 0 | - | 11,000 | 0 | 0 | 11,000 |
平均: 円。正解の 12,500円 から 375円ずれました。残差がゼロでないところに、誤った倍率(2.5倍)が掛かってしまったためです。
この3つのケースが、二重頑健性の本質をそのまま表しています。「残差がゼロ」か「倍率が正しい」か、どちらか片方が成り立てばバイアスは消えるのです。
3つのケースのスコアを並べると、次のようになります。
(図は、diagram-designで作成)
AIPWのコードを読んでいると、上の式とは違う形に出会うことがあります。
一見別物に見えますが、これは本記事の式を展開しただけの完全に同じものです。実際に変形してみます。
この形は「IPTW推定量(第1項)を、回帰モデルで補正した(第2項)もの」という読み方に対応しています。同じ推定量を「回帰から見るか、IPTWから見るか」の違いであり、どちらから眺めても同じ場所に着く、というのがDR法の面白いところです。
なぜ「二重に」ロバストなのか
ミニデータで見た現象は、数式の上でもきれいに示せます。真の傾向スコアを 、真のアウトカム回帰関数を と書きます(推定値には を付けています)。
であることを使って、AIPWの処置群側の項の期待値を計算すると、次の関係が得られます。
つまり、AIPWのバイアスは「傾向スコアの誤差」と「アウトカムモデルの誤差」の掛け算になります。ここから、次の2つが直ちに従います。
- 傾向スコアが正しいとき():左の括弧が になるため、アウトカムモデルがどれだけ外れていてもバイアスはゼロ。
- アウトカムモデルが正しいとき():右の括弧が0になるため、傾向スコアがどれだけ外れていてもバイアスはゼロ。
一方、単独の手法ではこうはいきません。アウトカム回帰モデル単体のバイアスは の項だけ、IPTW単体のバイアスは の項だけで決まるため、その1つを外した時点で終わりです。DR法は2つの誤差を掛け算の形に押し込むことで、「片方が0なら全体が0」という保険を手に入れています。
掛け算である以上、両方が外れていれば、バイアスは残ります。しかも、それぞれのバイアスが小さくても、掛け算の結果が必ず小さくなる保証はありません。
Kang & Schafer (2007) は、 「両方のモデルが少しずつ間違っている」 という(実務では最もありがちな)状況をシミュレーションし、DR推定量がIPTW単体よりも悪化しうるケースがあることを示しました。特に傾向スコアが0や1に近い領域では、補正項の分母が小さくなるため、残差の誤差が増幅されてしまいます。
DR法は「2つのモデルのうち1つを当てればよい」という保険であって、「どちらのモデルも雑でよい」という免罪符ではありません。共変量の選定やモデルの吟味は、これまで通り必要です。
DR法を成立させる前提条件
DR法は、あくまで傾向スコアを用いた因果推論の枠組みの上に成り立つ手法です。したがって、PSMやIPTWと同じ3つの前提条件(強く無視できる割り当て・正値性・SUTVA)がそのまま必要になります。
特に強調しておきたいのは次の2点です。
- 未観測交絡には無力:二重頑健性が守ってくれるのは「モデルの関数形の誤り」だけです。そもそも交絡因子 をデータとして持っていなければ、2つのモデルは揃って間違った世界を記述することになり、DR法も当然バイアスを持ちます。「2回チャンスがある」のは、必要な変数が手元に揃っているという土俵の上での話です。
- 正値性はDR法でも必要:AIPWの式には と の割り算が残っています。傾向スコアが0や1に貼り付く領域があると、IPTWほどではないにせよ推定は不安定になります。回帰調整単体では共通サポートの破れが表面化しないのに対し、DR法では重みという形で問題が顔を出すぶん気づきやすいものの、分析前に傾向スコアの分布を確認する工程はやはり省略できません。
検証用ダミーデータの生成
ここからは実際にPythonで動かしていきます。PSM・IPTWの記事と同じく、「年齢(Age)」と「過去の購買金額(History)」が高い人ほどDM(施策)が送られやすく、かつ売上も高いというセレクションバイアスを含んだデータを作ります。
今回の記事では、これに 「分析者が気づかないモデルの誤設定」 を意図的に仕込みます。具体的には、 真の売上は過去の購買金額に対して「逓減する(対数の形で効く)」 という構造を持たせます。「よく買う人ほど売上は伸びるが、ある程度から伸び幅が鈍る」という、実務では当たり前に起こる関係です。
一方で分析者はこの構造を知らず、購買金額をそのまま線形に入れたモデルを当てはめてしまう、という筋書きです。
import numpy as np
import pandas as pd
from sklearn.linear_model import LogisticRegression, LinearRegression

np.random.seed(42)

# データサイズの指定
N = 2000

# 1. 交絡因子(特徴量)の生成
# age: 年齢, history: 過去の購買金額
age = np.random.normal(40, 10, N)
history = np.random.exponential(5000, N)

# 2. 施策割り当て(セレクションバイアスの導入)
# 年齢が高く、過去の購買金額が多いほどDMが送られやすい
logit_p = -2.0 + 0.05 * age + 0.0001 * history
propensity = 1 / (1 + np.exp(-logit_p))
treatment = np.random.binomial(1, propensity)

# 3. 目的変数(売上)の生成
# ★ポイント★ 購買履歴の効果は「逓減する(対数の形で効く)」
# 分析者はこの構造に気づかず、後で単純な線形モデルを当てはめてしまう
true_effect = 1500
sales = (2000
         + 30 * age
         + 0.5 * history
         + 8000 * np.log1p(history / 1000)
         + true_effect * treatment
         + np.random.normal(0, 1000, N))

df = pd.DataFrame({
    'age': age,
    'history': history,
    'treatment': treatment,
    'sales': sales
})

naive_ate = df[df['treatment'] == 1]['sales'].mean() - df[df['treatment'] == 0]['sales'].mean()
print(f"処置群: {df['treatment'].sum()} 件 / 対照群: {(1 - df['treatment']).sum()} 件")
print(f"売上の平均: {df['sales'].mean():.1f} 円")
print(f"単純比較での売上の差: {naive_ate:.2f} (真の効果: {true_effect})")
このダミーデータは、以下のデータ生成プロセスに基づいています。
① 交絡因子の生成
② 施策割り当て(セレクションバイアスの導入)
③ 目的変数(売上)の生成
()
売上に、購買金額が対数の形で効く項を加えたデータを作り、線形のアウトカムモデルが誤設定になる状況を作るコードです。
- 交絡因子: 年齢と購買金額は、PSM・IPTWの記事と同じ分布から作ります。
- 施策の割り当て: 切片を 、購買金額の係数を0.0001と、PSM・IPTWの記事(、0.0002)から変えています。傾向スコアは0.19〜0.98の範囲に収まり、0に近い値がなくなるので、IPTWの重みが極端に大きくなりにくくなります。施策を受ける割合は61%です。
- 購買金額の対数の項: 8000 * np.log1p(history / 1000) は、購買金額が増えるほど売上への効き方が小さくなる(逓減する)項です。購買金額の中央値(約3,500)の顧客で約12,000、95%点の顧客で約22,000と、売上に大きく効きます。分析者が線形モデルを当てはめると、この形を表せず、アウトカムモデルが誤設定になります。これが、DR法の「どちらか一方が正しければよい」を確かめるための仕掛けです。
- 単純比較: 施策群と対照群の売上の平均の差を表示し、交絡によるずれを確かめます。
実行結果
処置群: 1221 件 / 対照群: 779 件
売上の平均: 18239.6 円
単純比較での売上の差: 5004.00 (真の効果: 1500)
真の効果は 1500円 ですが、「もともとよく買う優良顧客ほどDMを受け取っている」というバイアスにより、単純比較では 5004円 と3倍以上に過大評価されています。
この記事の主役は「モデルの誤設定に強い」という性質です。それを検証するには、分析者が間違えるための「間違えどころ」を意図的に作り込む必要があります。
という項は、購買金額が 1,000円 から 2,000円 に増えるときには大きく効きますが、20,000円 から 21,000円 に増えるときにはほとんど効きません。この曲線を直線で近似しようとすると、処置群(購買金額が大きい人が多い)と対照群(小さい人が多い)で、当てはめられる直線の傾きが変わってしまいます。この傾きの差が、そのまま効果の推定バイアスとして現れます。
後半の検証では、この log 項をモデルに含めたバージョン(=正しい仕様)と含めないバージョン(=誤設定)を作り、両者を比較します。
スクラッチでの実装
ステップ1:傾向スコアの推定
まずIPTWと同じ手順で傾向スコアを推定します。真の割り当て式は と の線形なロジットなので、この2変数でロジスティック回帰を行えば 「正しい仕様の傾向スコアモデル」 になります。
# 傾向スコアモデルの共変量(真の割り当て式と同じ形なので「正しい仕様」)
X = df[['age', 'history']]

ps_model = LogisticRegression(max_iter=1000)
ps_model.fit(X, df['treatment'])
df['ps'] = ps_model.predict_proba(X)[:, 1]

# 逆確率重み(IPTW記事と同じ定義)
df['weight'] = np.where(df['treatment'] == 1,
                        1 / df['ps'],
                        1 / (1 - df['ps']))

print(f"傾向スコアの範囲: {df['ps'].min():.4f} 〜 {df['ps'].max():.4f}")
print(f"重みの範囲   : {df['weight'].min():.4f} 〜 {df['weight'].max():.4f}")

# 参考:IPTW単体でのATE
treated = df['treatment'] == 1
iptw_ate = (np.average(df['sales'][treated], weights=df['weight'][treated])
            - np.average(df['sales'][~treated], weights=df['weight'][~treated]))
print(f"IPTWによるATE: {iptw_ate:.2f}")
- 傾向スコアの推定: LogisticRegression で施策の有無を予測し、predict_proba(X)[:, 1] で「施策を受ける確率」を取り出しています。max_iter=1000 は最適化の反復回数の上限です。このデータでは既定の上限(100回)以内に収束します(46回、log項を加えたモデルでも90回)が、データが変わっても収束前に打ち切られないよう、余裕を持たせています。結果は変わりません。
- 重みの計算: np.where で処置群には 、対照群には を割り当てています。
- 正値性の目視確認: 傾向スコアと重みの範囲を出力し、極端な値が混ざっていないかを先に確認しています。
実行結果
傾向スコアの範囲: 0.1857 〜 0.9853
重みの範囲   : 1.0149 〜 13.5765
IPTWによるATE: 1497.38
傾向スコアは 0.19〜0.99 の範囲に収まり、最大の重みも13.6程度です。IPTWの記事で見たような極端な重みは発生していないため、今回は重みの刈り込み(truncation)を行わずに進めます。
ステップ2:アウトカムモデルの構築
次に、処置群・対照群それぞれで売上を予測する回帰モデルを作ります(G-computation と同じ手順です)。ここであえて log 項を入れず、単純な線形回帰を当てはめます。これが「分析者がデータ構造を読み違えた」状態です。
# 処置群・対照群で別々に回帰モデルを学習(誤設定:log項を入れ忘れている)
model_1 = LinearRegression().fit(X[treated], df['sales'][treated])
model_0 = LinearRegression().fit(X[~treated], df['sales'][~treated])

# 全員について「もし施策を受けたら / 受けなかったら」の予測値を作る
mu_1 = model_1.predict(X)
mu_0 = model_0.predict(X)

reg_ate = np.mean(mu_1 - mu_0)
print(f"回帰調整によるATE: {reg_ate:.2f}")
- 群ごとのモデル学習: X[treated] と X[~treated] でデータを分割し、それぞれ独立に LinearRegression を学習させています。
- 反事実の予測: 学習済みモデルに対し、分割していない全員分の X を渡して予測させている点が重要です。これにより、施策を受けていない人についても「もし受けていたら」の値が得られます。
- ATEの算出: 予測値の差 mu_1 - mu_0 を全員分平均し、アウトカム回帰モデル単体でのATE推定値としています。
実行結果
回帰調整によるATE: 1317.33
真の効果 1500円 に対して 1317円 と、約12%の過小評価になりました。単純比較の 5004円 と比べれば大きく改善していますが、モデルの誤設定に由来するバイアスが残っています。
ステップ3:AIPWによる補正
いよいよDR法です。ステップ1の傾向スコアとステップ2の予測値を組み合わせます。
Z = df['treatment'].values
Y = df['sales'].values
e = df['ps'].values

# 施策を受けた場合の売上 E[Y(1)] のスコア
score_1 = mu_1 + Z * (Y - mu_1) / e
# 施策を受けなかった場合の売上 E[Y(0)] のスコア
score_0 = mu_0 + (1 - Z) * (Y - mu_0) / (1 - e)

# 個人ごとのスコアの差(これを平均したものがATE)
score = score_1 - score_0
dr_ate = score.mean()

print(f"E[Y(1)]の推定値: {score_1.mean():.1f}")
print(f"E[Y(0)]の推定値: {score_0.mean():.1f}")
print(f"DR法(AIPW)によるATE: {dr_ate:.2f}")
- スコアの構成: mu_1 という予測値のベースに、Z * (Y - mu_1) / e という補正項を足しています。数式の3ステップがそのままコードになっています。
- による自動的な切り替え: 施策を受けていない人(Z = 0)では補正項がゼロになり、予測値だけが残ります。if 文を書かずに済むのは、 を掛けているおかげです。
- 個人ごとのスコア: 最終行で平均を取る前の score は、1人1人に割り当てられた値です。後述する標準誤差の算出にそのまま使えるため、変数として残しています。
実行結果
E[Y(1)]の推定値: 18812.3
E[Y(0)]の推定値: 17412.7
DR法(AIPW)によるATE: 1399.66
4手法の比較
ここまでの結果を並べてみましょう。
result = pd.DataFrame([
    {'手法': '① 単純比較(バイアスあり)', 'ATEの推定値': round(naive_ate, 1)},
    {'手法': '② 回帰調整(アウトカムモデルのみ)', 'ATEの推定値': round(reg_ate, 1)},
    {'手法': '③ IPTW(傾向スコアのみ)', 'ATEの推定値': round(iptw_ate, 1)},
    {'手法': '④ DR法(AIPW)', 'ATEの推定値': round(dr_ate, 1)},
    {'手法': '  真の効果', 'ATEの推定値': 1500.0},
])
print(result.to_string(index=False))
4つの手法の推定値を、真の効果と1つの表に並べて比べるコードです。
実行結果
                手法  ATEの推定値
    ① 単純比較(バイアスあり)   5004.0
② 回帰調整(アウトカムモデルのみ)   1317.3
   ③ IPTW(傾向スコアのみ)   1497.4
       ④ DR法(AIPW)   1399.7
              真の効果   1500.0
読み取れることは2つです。
- DR法は、誤設定された回帰モデルのバイアスを縮めている:回帰調整単体の 1317円 に対し、DR法は 1400円 まで真の値に近づきました。傾向スコアによる補正が効いていることが分かります。
- この1回の試行だけでは、IPTWの方が良く見える:IPTWは 1497円 と、真の値をほぼ言い当てています。
2番目は正直に受け止めるべき結果です。1回のシミュレーション結果だけで手法の優劣を語ることはできません。IPTWは推定値のばらつき(分散)が大きい手法であり、今回はたまたま当たりを引いた可能性があります。手法の性質を評価するには、乱数のシードを変えて何度も繰り返し、平均としてどこに着地するのかを見る必要があります。次節でそれを行います。
4手法の推定値を並べると、次のようになります。
(図は、diagram-designで作成)
深掘り: 二重ロバスト性を「4パターン」で検証する
ここまでは「アウトカムモデルだけが誤設定」のケースを見てきました。二重頑健性を主張するには、アウトカムモデルの正誤 × 傾向スコアモデルの正誤 の4パターンすべてを確認する必要があります。
今回のデータでは、それぞれの「正しい/誤り」を次のように定義します。
| モデル | 正しい仕様 | 誤った仕様 |
|---|---|---|
| アウトカムモデル | age, history, log_history を使う(真の生成式と同じ形) | age, history のみ(log項を見落とす) |
| 傾向スコアモデル | age, history を使う(真の割り当て式と同じ形) | age のみ(history を入れ忘れる) |
傾向スコアモデルの誤りとしては、「DMの送付は年齢だけで決めていたはずだ」と思い込んで購買履歴を説明変数から落としてしまった、という想定にしています。
まずは同じサンプルで4パターンを比較
# 正しい仕様のアウトカムモデル用に、真のデータ生成式と同じ log 項を用意する
df['log_history'] = np.log1p(df['history'] / 1000)

def fit_outcome(cols):
    """指定した共変量でμ1, μ0を推定して返す"""
    Xc = df[cols]
    p1 = LinearRegression().fit(Xc[treated], df['sales'][treated]).predict(Xc)
    p0 = LinearRegression().fit(Xc[~treated], df['sales'][~treated]).predict(Xc)
    return p1, p0

def fit_ps(cols):
    """指定した共変量で傾向スコアを推定して返す"""
    Xc = df[cols]
    return LogisticRegression(max_iter=1000).fit(Xc, df['treatment']).predict_proba(Xc)[:, 1]

def aipw(e_hat, m1, m0):
    """AIPW推定量"""
    return np.mean(m1 + Z * (Y - m1) / e_hat
                   - (m0 + (1 - Z) * (Y - m0) / (1 - e_hat)))

def iptw(e_hat):
    """IPTW推定量(比較用)"""
    w = np.where(treated, 1 / e_hat, 1 / (1 - e_hat))
    return (np.average(Y[treated], weights=w[treated])
            - np.average(Y[~treated], weights=w[~treated]))

# アウトカムモデル:正しい仕様(log項あり) / 誤った仕様(log項なし)
mu1_ok, mu0_ok = fit_outcome(['age', 'history', 'log_history'])
mu1_ng, mu0_ng = fit_outcome(['age', 'history'])

# 傾向スコアモデル:正しい仕様(age, history) / 誤った仕様(historyを入れ忘れ)
e_ok = fit_ps(['age', 'history'])
e_ng = fit_ps(['age'])

table = pd.DataFrame([
    {'アウトカムモデル': '正しい', '傾向スコアモデル': '正しい',
     '回帰調整のみ': round(np.mean(mu1_ok - mu0_ok), 1),
     'IPTWのみ': round(iptw(e_ok), 1),
     'DR法(AIPW)': round(aipw(e_ok, mu1_ok, mu0_ok), 1)},
    {'アウトカムモデル': '正しい', '傾向スコアモデル': '誤り',
     '回帰調整のみ': round(np.mean(mu1_ok - mu0_ok), 1),
     'IPTWのみ': round(iptw(e_ng), 1),
     'DR法(AIPW)': round(aipw(e_ng, mu1_ok, mu0_ok), 1)},
    {'アウトカムモデル': '誤り', '傾向スコアモデル': '正しい',
     '回帰調整のみ': round(np.mean(mu1_ng - mu0_ng), 1),
     'IPTWのみ': round(iptw(e_ok), 1),
     'DR法(AIPW)': round(aipw(e_ok, mu1_ng, mu0_ng), 1)},
    {'アウトカムモデル': '誤り', '傾向スコアモデル': '誤り',
     '回帰調整のみ': round(np.mean(mu1_ng - mu0_ng), 1),
     'IPTWのみ': round(iptw(e_ng), 1),
     'DR法(AIPW)': round(aipw(e_ng, mu1_ng, mu0_ng), 1)},
])
print(table.to_string(index=False))
print(f"\n(参考)誤設定した傾向スコアの範囲: {e_ng.min():.4f} 〜 {e_ng.max():.4f}")
- 関数化による整理: fit_outcome と fit_ps に共変量リストを渡すだけで「正しい仕様」と「誤った仕様」を切り替えられるようにしています。
- log項の追加: np.log1p(df['history'] / 1000) は、データ生成時に使った非線形項と同じ変換です。これを説明変数に加えたモデルが「正しい仕様」になります。
- 比較対象の併記: DR法だけでなく、同じ条件での 回帰調整のみ と IPTWのみ も並べることで、「DR法が何を救っているのか」が見えるようにしています。
実行結果
アウトカムモデル 傾向スコアモデル  回帰調整のみ  IPTWのみ  DR法(AIPW)
     正しい      正しい  1430.1  1497.4     1434.8
     正しい       誤り  1430.1  4899.9     1430.0
      誤り      正しい  1317.3  1497.4     1399.7
      誤り       誤り  1317.3  4899.9     1313.1

(参考)誤設定した傾向スコアの範囲: 0.2436 〜 0.9118
特に注目してほしいのが 2行目です。傾向スコアモデルから history を落とした結果、IPTW単体の推定値は 4899.9 と壊滅的に外れています(単純比較の 5004円 とほとんど変わらず、バイアス調整がまったく機能していません)。ところが、同じ壊れた傾向スコアを使っていても、アウトカムモデルさえ正しければDR法は 1430.0 に踏みとどまっています。
一方 4行目、両方のモデルを間違えたケースでは 1313.1 となり、バイアスが残りました。「片方が当たっていればよいが、両方外せばダメ」という性質が、そのまま数値に現れています。
4パターンの DR 法の推定値を2×2に並べると、次のようになります。
(図は、diagram-designで作成)
500回のシミュレーションで平均バイアスを確認する
上の表は「たまたまこのサンプルではこうだった」という結果にすぎません。一致推定量かどうかを議論するには、同じデータ生成プロセスから何度もデータを作り直し、推定値が平均的にどこに集まるかを見る必要があります。
乱数シードを変えて500回シミュレーションし、各手法の平均推定値・バイアス・ばらつきを集計してみましょう。
def simulate(seed, n=2000):
    """1回分のシミュレーション。4つのシナリオのDR推定値などを返す"""
    r = np.random.RandomState(seed)
    a = r.normal(40, 10, n)
    h = r.exponential(5000, n)
    p = 1 / (1 + np.exp(-(-2.0 + 0.05 * a + 0.0001 * h)))
    z = r.binomial(1, p)
    lh = np.log1p(h / 1000)
    y = (2000 + 30 * a + 0.5 * h + 8000 * lh + 1500 * z
         + r.normal(0, 1000, n))
    d = pd.DataFrame({'age': a, 'history': h, 'log_history': lh,
                      'treatment': z, 'sales': y})
    tr = d['treatment'] == 1

    def oc(cols):
        Xc = d[cols]
        return (LinearRegression().fit(Xc[tr], d['sales'][tr]).predict(Xc),
                LinearRegression().fit(Xc[~tr], d['sales'][~tr]).predict(Xc))

    def ps(cols):
        return LogisticRegression(max_iter=1000).fit(d[cols], d['treatment']).predict_proba(d[cols])[:, 1]

    M1ok, M0ok = oc(['age', 'history', 'log_history'])
    M1ng, M0ng = oc(['age', 'history'])
    Eok, Eng = ps(['age', 'history']), ps(['age'])
    zz, yy = d['treatment'].values, d['sales'].values

    def dr(e_, m1, m0):
        return np.mean(m1 + zz * (yy - m1) / e_ - (m0 + (1 - zz) * (yy - m0) / (1 - e_)))

    def ip(e_):
        w = np.where(tr, 1 / e_, 1 / (1 - e_))
        return (np.average(yy[tr], weights=w[tr.values])
                - np.average(yy[~tr], weights=w[~tr.values]))

    return {
        '回帰調整(正)': np.mean(M1ok - M0ok), '回帰調整(誤)': np.mean(M1ng - M0ng),
        'IPTW(正)': ip(Eok), 'IPTW(誤)': ip(Eng),
        'DR(正,正)': dr(Eok, M1ok, M0ok), 'DR(誤,正)': dr(Eok, M1ng, M0ng),
        'DR(正,誤)': dr(Eng, M1ok, M0ok), 'DR(誤,誤)': dr(Eng, M1ng, M0ng),
    }

res = pd.DataFrame([simulate(s) for s in range(500)])

summary = pd.DataFrame({
    '平均推定値': res.mean().round(1),
    'バイアス': (res.mean() - 1500).round(1),
    '標準偏差': res.std().round(1),
    'RMSE': np.sqrt(((res - 1500) ** 2).mean()).round(1),
})
print(summary.to_string())
- シードを変えた反復: np.random.RandomState(seed) を使い、500種類の異なるデータセットを生成しています。1つのサンプルに固有の「偶然」を打ち消すための工程です。500回にするのは、バイアスとRMSEを、1回ごとの偶然に左右されずに読み取れる回数だからです。
- DRの表記: DR(正,誤) は「アウトカムモデルが正しく、傾向スコアモデルが誤り」を意味します。
- 3つの指標: 平均推定値からはバイアスが、標準偏差からはばらつきが、RMSE(二乗平均平方根誤差)からはその両方を合わせた総合的な精度が読み取れます。
実行結果
          平均推定値    バイアス   標準偏差    RMSE
回帰調整(正)  1497.6    -2.4   51.0    51.0
回帰調整(誤)  1375.2  -124.8  151.1   195.8
IPTW(正)  1506.5     6.5  325.9   325.6
IPTW(誤)  4995.4  3495.4  392.7  3517.3
DR(正,正)  1497.5    -2.5   52.5    52.5
DR(誤,正)  1488.2   -11.8  329.7   329.6
DR(正,誤)  1497.6    -2.4   51.3    51.3
DR(誤,誤)  1375.4  -124.6  152.0   196.4
この表が、本記事の結論そのものです。
- DR法の4パターンのうち、3つでバイアスがほぼ消えている:DR(正,正)、DR(誤,正)、DR(正,誤) はいずれもバイアスが −12〜−2 程度と、真の 1500 をほぼ言い当てています。どちらか一方のモデルが正しければよいという理論通りの挙動です。
- 単独手法は片方のモデルを外すと即座に壊れる:回帰調整(誤) はバイアス −124.8、IPTW(誤) に至っては +3495.4 と、調整前とほぼ変わらない水準まで悪化しています。
- 両方外すとDR法も壊れる:DR(誤,誤) のバイアスは −124.6 で、回帰調整(誤) の −124.8 とほぼ同じです。守ってくれるモデルが1つもない状態では、DR法に特別な力はありません。
上の表で見落としてはいけないのが 標準偏差の列です。
DR(誤,正) のバイアスは −11.8 と優秀ですが、標準偏差は 329.7 もあります。これは IPTW(正) の 325.9 とほぼ同じで、DR(正,正) の 52.5 の6倍以上です。つまり 「アウトカムモデルが大きく外れているとき、DR法は不偏性を回復する代わりに、IPTW並みの大きなばらつきを引き受ける」 ということです。
RMSEで見ると 回帰調整(誤)(195.8)の方が DR(誤,正)(329.6)より小さくなっており、この設定では「バイアスは小さいがばらつく推定量」より「少し偏っているが安定した推定量」の方が、1回の推定としては当たりやすいという逆転すら起きています。
DR法が持っているのは「バイアスに対する保険」であって、「常にRMSEが最小になる保証」ではありません。この点を踏まえると、次節で扱う「アウトカムモデルの質をどこまで上げられるか」が実務上の勘所になります。
500回の平均バイアスと RMSE を並べると、次のようになります。
(図は、diagram-designで作成)
深掘り: 標準誤差と信頼区間
点推定値だけを報告しても、実務では意思決定に使えません。「その数字がどの程度信頼できるのか」を示す必要があります。
IPTWの記事では、重みのばらつきと傾向スコアの推定誤差を織り込むためにブートストラップ法を使いました。DR法にも同じ方法が使えますが、AIPWにはもっと簡単な方法があります。
影響関数に基づく標準誤差
AIPW推定量は、個人ごとのスコア の単純な平均という形をしています。
「独立な値の平均」の標準誤差は、標準偏差を で割るだけで求まります。
この は統計学でいう 影響関数(influence function) に対応しており、AIPWがこの形をしていること自体が理論上の大きな利点になっています(Robins, Rotnitzky & Zhao, 1994)。
# 影響関数に基づく標準誤差(スコアの標準偏差 / √N)
se = score.std(ddof=1) / np.sqrt(N)
ci_low, ci_high = dr_ate - 1.96 * se, dr_ate + 1.96 * se
print(f"DR法(AIPW)のATE: {dr_ate:.2f}")
print(f"標準誤差(SE)   : {se:.2f}")
print(f"95%信頼区間    : [{ci_low:.2f}, {ci_high:.2f}]")
直前の式で、DR法のスコアの標準偏差から標準誤差と95%信頼区間を求めるコードです。
- 95%信頼区間: 1.96は、標準正規分布の97.5%点で、両側95%の区間にするための値です。
実行結果
DR法(AIPW)のATE: 1399.66
標準誤差(SE)   : 175.60
95%信頼区間    : [1055.48, 1743.85]
真の効果 1500 は、95%信頼区間 [1055.48, 1743.85] にしっかり含まれています。点推定値 1399.66 だけを見ると「真の値より約100円小さい」と気になりますが、その程度のズレは推定のばらつきの範囲内であることが区間から読み取れます。
ブートストラップ法との比較
上の標準誤差は「傾向スコアやアウトカムモデルが正しく推定されている」ことを前提にした近似です。念のためブートストラップ法でも確認しておきましょう。
def estimate_dr(data):
    """データを受け取り、傾向スコアとアウトカムモデルを学習し直してDR推定値を返す"""
    Xc = data[['age', 'history']]
    tr = data['treatment'] == 1
    e_ = LogisticRegression(max_iter=1000).fit(Xc, data['treatment']).predict_proba(Xc)[:, 1]
    m1 = LinearRegression().fit(Xc[tr], data['sales'][tr]).predict(Xc)
    m0 = LinearRegression().fit(Xc[~tr], data['sales'][~tr]).predict(Xc)
    z_, y_ = data['treatment'].values, data['sales'].values
    return np.mean(m1 + z_ * (y_ - m1) / e_ - (m0 + (1 - z_) * (y_ - m0) / (1 - e_)))

rng = np.random.default_rng(0)
boot = np.array([estimate_dr(df.iloc[rng.integers(0, N, N)]) for _ in range(500)])

lo, hi = np.percentile(boot, [2.5, 97.5])
print(f"ブートストラップ SE: {boot.std(ddof=1):.2f} / 95%CI: [{lo:.2f}, {hi:.2f}]")
- モデルの再学習: IPTW記事と同じ理由で、リサンプルのたびに estimate_dr の中で傾向スコアとアウトカムモデルを学習し直しています。モデルを固定すると、推定手順そのものの不確実性が標準誤差に反映されません。500回は、IPTWの記事と同じく、標準誤差と95%区間を安定して求められる回数です。
- 復元抽出: rng.integers(0, N, N) でインデックスを復元抽出し、df.iloc でリサンプルデータを作成しています。
実行結果
ブートストラップ SE: 175.29 / 95%CI: [1028.36, 1706.19]
影響関数による標準誤差 175.60 と、ブートストラップによる 175.29 はほぼ一致しました。AIPWでは、計算コストの高いブートストラップを回さなくても、スコアの標準偏差から妥当な標準誤差が得られることが確認できます。これは実務上、地味ながら大きな利点です。
深掘り: アウトカムモデルの質が、DR法の精度を決める
前節の警告で触れた「ばらつきの問題」を、もう少し掘り下げてみましょう。今回の誤設定モデルと正しい仕様のモデルで、当てはまりの良さと推定精度がどう変わるかを比較します。
# 正しい仕様のアウトカムモデルを使ったDR法
score_ok = (mu1_ok + Z * (Y - mu1_ok) / e_ok
            - (mu0_ok + (1 - Z) * (Y - mu0_ok) / (1 - e_ok)))
se_ok = score_ok.std(ddof=1) / np.sqrt(N)

print("アウトカムモデルの当てはまり(処置群の残差の標準偏差)")
print(f"  誤設定(log項なし): {(df['sales'][treated] - mu1_ng[treated.values]).std():.1f}")
print(f"  正しい仕様     : {(df['sales'][treated] - mu1_ok[treated.values]).std():.1f}")
print()
print("DR法の推定精度")
print(f"  アウトカムモデル誤設定: ATE={score.mean():.2f}, SE={se:.2f}")
print(f"  アウトカムモデル正しい: ATE={score_ok.mean():.2f}, SE={se_ok:.2f}")
アウトカムモデルが誤設定のときと正しいときで、残差の大きさとDR法の標準誤差を比べるコードです。残差が小さいほど、DR法のスコアのばらつきも小さくなることを確かめます。
実行結果
アウトカムモデルの当てはまり(処置群の残差の標準偏差)
  誤設定(log項なし): 2913.9
  正しい仕様     : 1028.6

DR法の推定精度
  アウトカムモデル誤設定: ATE=1399.66, SE=175.60
  アウトカムモデル正しい: ATE=1434.77, SE=49.65
アウトカムモデルの残差の標準偏差が 2913.9 → 1028.6 に縮むと、DR法の標準誤差は 175.60 → 49.65 と3分の1以下になりました。同じ傾向スコアを使っているにもかかわらず、です。
理由は明快です。AIPWの補正項 には残差が直接入っているため、残差が小さければ補正項も小さくなり、推定量全体のばらつきが抑えられます。逆に残差が大きいと、その大きな値が で増幅されて分散に効いてきます。
ここから、DR法を使ううえでの実務的な指針が導けます。
傾向スコアは「バイアスの保険」として、アウトカムモデルは「精度を稼ぐエンジン」として使う。
「どちらか一方が当たっていればいい」という性質に安心してアウトカムモデルを手抜きすると、バイアスは消えても信頼区間が広くなりすぎて、結局なにも言えないという結果になりかねません。予測精度の高いアウトカムモデルを作ることには、バイアス面とは別に、分散面でのはっきりした見返りがあります。
残差の大きさと標準誤差を並べると、次のようになります。
(図は、diagram-designで作成)
深掘り: クロスフィッティング(cross-fitting)
ここまでの実装には、実は理論上の穴があります。同じデータでモデルを学習し、同じデータで残差を計算している点です。
線形回帰のような単純なモデルであればさほど問題になりませんが、ランダムフォレストやLightGBMのような柔軟な機械学習モデルを や に使うと話が変わります。モデルが学習データに過剰適合し、残差 が実力以上に小さく見積もられてしまうためです。その結果、補正項が本来より小さくなり、バイアスが取り切れないという事態が起こります。
この問題を回避するのが クロスフィッティングです。データを 分割し、「モデルの学習」と「そのモデルを使った予測」を必ず別のデータで行います。
from sklearn.model_selection import KFold

def crossfit_aipw(data, K=5, seed=0):
    Xc = data[['age', 'history']].values
    Zc = data['treatment'].values
    Yc = data['sales'].values
    n = len(data)
    m1, m0, e_ = np.zeros(n), np.zeros(n), np.zeros(n)

    for train_idx, test_idx in KFold(K, shuffle=True, random_state=seed).split(Xc):
        z_tr = Zc[train_idx]
        # 学習は train、予測は test。自分自身のデータで学習した予測値は使わない
        m1[test_idx] = LinearRegression().fit(
            Xc[train_idx][z_tr == 1], Yc[train_idx][z_tr == 1]).predict(Xc[test_idx])
        m0[test_idx] = LinearRegression().fit(
            Xc[train_idx][z_tr == 0], Yc[train_idx][z_tr == 0]).predict(Xc[test_idx])
        e_[test_idx] = LogisticRegression(max_iter=1000).fit(
            Xc[train_idx], z_tr).predict_proba(Xc[test_idx])[:, 1]

    s = m1 + Zc * (Yc - m1) / e_ - (m0 + (1 - Zc) * (Yc - m0) / (1 - e_))
    return s.mean(), s.std(ddof=1) / np.sqrt(n)

cf_ate, cf_se = crossfit_aipw(df)
print(f"クロスフィッティング版AIPW: ATE={cf_ate:.2f}, SE={cf_se:.2f}, "
      f"95%CI=[{cf_ate - 1.96 * cf_se:.2f}, {cf_ate + 1.96 * cf_se:.2f}]")
- 分割の管理: KFold でデータを5分割し、train_idx で学習したモデルを test_idx の予測にのみ使っています。5分割は、学習に使うデータを8割残しつつ、分割ごとの推定のばらつきを抑える、よく使われる分割数です。
- 全員分の予測値を復元: 各フォールドの予測結果を m1[test_idx] のように書き戻すことで、最終的に全サンプルが「自分を含まないデータで学習されたモデル」による予測値を持つことになります。
- スコアの計算は同じ: 予測値の作り方を変えただけで、AIPWのスコアを計算する部分は通常版とまったく同じです。
実行結果
クロスフィッティング版AIPW: ATE=1425.37, SE=183.51, 95%CI=[1065.69, 1785.04]
線形回帰を使っている今回は、通常版(1399.66)とクロスフィッティング版(1425.37)で大きな差はありません。モデルが単純で過学習しにくいためです。
しかし、予測モデルに機械学習を使う場合はクロスフィッティングが必須になります。この「AIPW + クロスフィッティング + 機械学習」という組み合わせこそが、後述する Double Machine Learning(DML) の中核です(Chernozhukov et al., 2018)。
5分割のクロスフィッティングを図にすると、次のようになります。
(図は、diagram-designで作成)
ライブラリを用いた簡単な実装(EconML)
メタラーナーの記事でも使用した Microsoft の EconML には、DR法の実装が用意されています。LinearDRLearner を使えば、クロスフィッティングと信頼区間の算出まで数行で完結します。
!pip install econml
from econml.dr import LinearDRLearner

est = LinearDRLearner(
    model_propensity=LogisticRegression(max_iter=1000),
    model_regression=LinearRegression(),
    cv=5,
    random_state=0
)

est.fit(Y=df['sales'].values,
        T=df['treatment'].values,
        X=None,
        W=df[['age', 'history']].values)

print(est.ate_inference(T0=0, T1=1))
- 2つのモデルを指定: model_propensity に傾向スコアモデル、model_regression にアウトカムモデルを渡します。スクラッチ実装と同じく、どちらも誤設定(log項なし)のままにしてあります。
- X と W の使い分け: X は「効果が変化する方向」を指定する変数(CATEを推定したい場合に使用)、W は「調整したいだけの交絡因子」です。今回はATEのみが目的なので X=None としています。
- クロスフィッティング: cv=5 により、前節で手作りしたクロスフィッティングが内部で自動実行されます。
- 信頼区間の取得: ate_inference() で点推定値・標準誤差・95%信頼区間をまとめて出力できます。
実行結果(抜粋)
               Uncertainty of Mean Point Estimate
===============================================================
mean_point stderr_mean zstat pvalue ci_mean_lower ci_mean_upper
---------------------------------------------------------------
   1421.29      150.82 9.424    0.0      1125.688      1716.892
ATEは 1421.29、95%信頼区間は [1125.69, 1716.89] となりました。スクラッチで実装したクロスフィッティング版(1425.37)とほぼ一致しており、手作りした計算がライブラリの挙動と整合していることが確認できます。
本記事のAIPWは、集団全体に対する効果 ATE を推定するものです。「実際に施策を受けた人に対する効果(ATT)」を知りたい場合は、重みの定義を変えた別の形を使います。
( は処置群のサンプル数)
ATTでは処置群を「そのまま」基準にするため、必要なのは (施策を受けなかった場合の予測)だけになります。PSMがATTを推定しやすいのと同様、マーケティング実務では「キャンペーン対象者への効果」を知りたいことが多いため、こちらが適する場面も少なくありません。
DR法のメリットとデメリット
メリット
- モデル誤設定への保険:どちらか一方のモデルが正しければ一致推定量になります。実務で「完璧なモデル」を作ることはほぼ不可能なので、この保険は現実的な価値があります。
- 標準誤差が計算しやすい:個人ごとのスコアの平均という形をしているため、その標準偏差から標準誤差が直接求まります。ブートストラップを回す必要がありません。
- アウトカムモデルの改善が精度に直結する:良い予測モデルを作るほど推定量の分散が小さくなるため、機械学習の予測技術をそのまま因果推論の精度向上に活かせます。
- 極端な重みへの耐性がIPTWより高い:IPTWは売上そのものに重みを掛けますが、AIPWが重み付けするのは残差です。アウトカムモデルがそれなりに当たっていれば残差は小さいため、大きな重みが掛かっても影響が限定されます。
デメリット
- 両方のモデルを間違えると機能しない:本記事のシミュレーションで確認した通りです。特に交絡因子の見落としがある場合、2つのモデルは揃って間違った世界を記述します。
- 分散が大きくなることがある:アウトカムモデルが大きく外れていると、残差の増幅によってばらつきが拡大します。バイアスとRMSEのトレードオフが生じうる点はKang & Schafer (2007) が指摘した通りです。
- 説明コストが高い:「傾向スコアが近い人同士を比べました」で通じるPSMと違い、「回帰予測に逆確率重み付けした残差を足し戻しました」を非専門家に説明するのは骨が折れます。
- 正値性の破れには依然として弱い: の割り算が残っている以上、傾向スコアが0や1に貼り付く領域があれば不安定になります。
手法の使い分け
これまで解説してきた観察データ向けの手法を整理すると、次のようになります。
| 比較項目 | PSM | IPTW | アウトカム回帰 | DR法(AIPW) |
|---|---|---|---|---|
| モデル化する対象 | 傾向スコア | 傾向スコア | 結果 | 両方 |
| モデル誤設定への耐性 | 中(マッチング後の解析への依存が減る) | 低(傾向スコア次第) | 低(関数形次第・外挿に無自覚) | 高(片方でよい) |
| データの活用効率 | 低(ペア外を破棄) | 中(重みでESSが目減り) | 高 | 高 |
| 主な推定対象 | ATTになりやすい | ATE(重みの定義でATTも可) | ATE | ATE(変形でATTも可) |
| 説明のしやすさ | 高 | 中 | 高 | 低 |
| 標準誤差の算出 | ブートストラップ等が必要 | ブートストラップ等が必要 | 通常の回帰の枠組み | スコアから直接算出可 |
実務での選択基準
- ステークホルダーへの説明が最優先なら PSM:「条件が近い人同士を比べました」という説明のシンプルさは、それ自体が価値です。
- 共変量の数が少なく、構造に自信があるなら回帰調整:交絡因子が2〜3個で関係も単純なら、素直な回帰の方が分散が小さく済みます。
- 推定の頑健性を優先するなら DR法:共変量が多い、関数形に自信がない、複数の手法で結果の一貫性(ロバストネス)を確認したい、といった場合の第一候補になります。
- 複数手法の併用が最善:PSM・IPTW・DR法で推定値が近ければ結論の信頼性は高まりますし、大きく食い違うなら前提条件やモデルを見直すサインになります。DR法は「他の手法の検算役」としても有用です。
まとめ
本記事では、アウトカム回帰モデルと傾向スコアモデルを組み合わせる 二重にロバストな推定法(DR法 / AIPW) を解説しました。要点は以下の通りです。
- 構造は「予測値 + 重み付き残差」:AIPWは、回帰モデルの予測値をベースに、観測できた予測誤差を傾向スコアの逆数で引き伸ばして足し戻すという2層構造をしています。IPTWが「売上そのもの」に重みを掛けるのに対し、AIPWが重み付けするのは「残差」です。
- バイアスが「掛け算」になるから二重にロバスト:AIPWのバイアスは「傾向スコアの誤差 × アウトカムモデルの誤差」という積の形で表されます。どちらか一方がゼロなら全体がゼロになる、というのが二重頑健性の正体です。
- 500回のシミュレーションで実証:4パターンのうち、「両方正しい」「アウトカムのみ正しい」「傾向スコアのみ正しい」の3つでバイアスはほぼ消えました(−12〜−2)。一方、傾向スコアを誤設定したIPTW単体はバイアス +3495 と壊滅し、両方を誤設定したDR法は −125 のバイアスが残りました。
- ばらつきは別問題:バイアスが消えても分散が小さくなるとは限りません。アウトカムモデルの残差が 2914 → 1029 に縮むと標準誤差は 176 → 50 に改善しました。傾向スコアは保険、アウトカムモデルは精度のエンジン、という役割分担で考えるのが実践的です。
- 標準誤差はスコアから直接求まる:影響関数に基づく標準誤差(175.60)とブートストラップ(175.29)はほぼ一致しました。計算コストの面でIPTWより扱いやすい点は見逃せない利点です。
- 万能薬ではない:未観測交絡があれば2つのモデルは揃って間違いますし、両方のモデルが少しずつ誤っている場合はIPTW単体より悪化することもあります。共変量の吟味を省略してよい理由にはなりません。
発展的な手法
DR法(AIPW)の構造は、現代の因果推論ライブラリの多くで基礎部品として使われています。本記事の内容を押さえておくと、次の手法もスムーズに理解できるはずです。
-
Double Machine Learning(DML)(Chernozhukov et al., 2018) 本記事で実装した「AIPW + クロスフィッティング」の枠組みに、 と として任意の機械学習モデルを差し込めるよう一般化したものです。高次元の共変量を扱えるようになります。
-
DR-Learner AIPWの個人ごとのスコア を「目的変数」として別のモデルに学習させることで、ATEではなく 個人ごとの効果(CATE) を推定する手法です。本記事で score 変数を平均する前の状態で保持していたのは、まさにこの値になります。メタラーナーの一種として位置づけられます。
-
方策価値のDR推定 AIPWの考え方を、ATEではなく「あるルールで施策を打った場合の成果(方策価値)」の推定に当てはめたものです。過去のキャンペーンのデータから、新しいターゲティングのルールを評価するときに使います。
-
TMLE(Targeted Maximum Likelihood Estimation) AIPWと同じく二重頑健性を持ちますが、補正を「足し算」ではなく「アウトカムモデル自体の更新」として行う手法です。予測値が取りうる範囲(例:確率なら0〜1)を自然に守れるという利点があります。
基本となる「二重のロバスト性」という考え方さえ理解しておけば、これらの手法はいずれも「どこに機械学習を差し込むか」「補正をどう実装するか」の違いとして読み解けます。次に観察データの効果検証を行う際は、PSMやIPTWの結果と合わせてDR法も回してみて、推定値が一致するかどうかを確認してみてください。
参考文献
- H. Bang, J. M. Robins (2005). Doubly Robust Estimation in Missing Data and Causal Inference Models. Biometrics, 61(4), 962–973.
- J. D. Y. Kang, J. L. Schafer (2007). Demystifying Double Robustness: A Comparison of Alternative Strategies for Estimating a Population Mean from Incomplete Data. Statistical Science, 22(4), 523–539.
- J. M. Robins, A. Rotnitzky, L. P. Zhao (1994). Estimation of Regression Coefficients When Some Regressors are not Always Observed. Journal of the American Statistical Association, 89(427), 846–866.
- V. Chernozhukov et al. (2018). Double/debiased machine learning for treatment and structural parameters. The Econometrics Journal, 21(1), C1–C68.
- Microsoft Research. EconML: A Python Package for ML-Based Heterogeneous Treatment Effects Estimation. GitHub.
本記事の文章・構成の一部に生成AIを使用しています。