DPO(Direct Preference Optimization)とは?
 (画像は、Geminiで作成)
KL ペナルティ付きの報酬最大化の最適方策と Bradley–Terry モデルから DPO の損失を導き、報酬モデルと強化学習を使わずに、選好データで言語モデルを直接学習できる理由を理解すること。InstructGPT の記事と同じ SFT モデルとデータで DPO をスクラッチ実装し、β の役割、学習中に監視すべき指標、TRL の DPOTrainer との一致、派生手法(IPO・SimPO・ORPO)との違いを確かめること。
DPOの概要
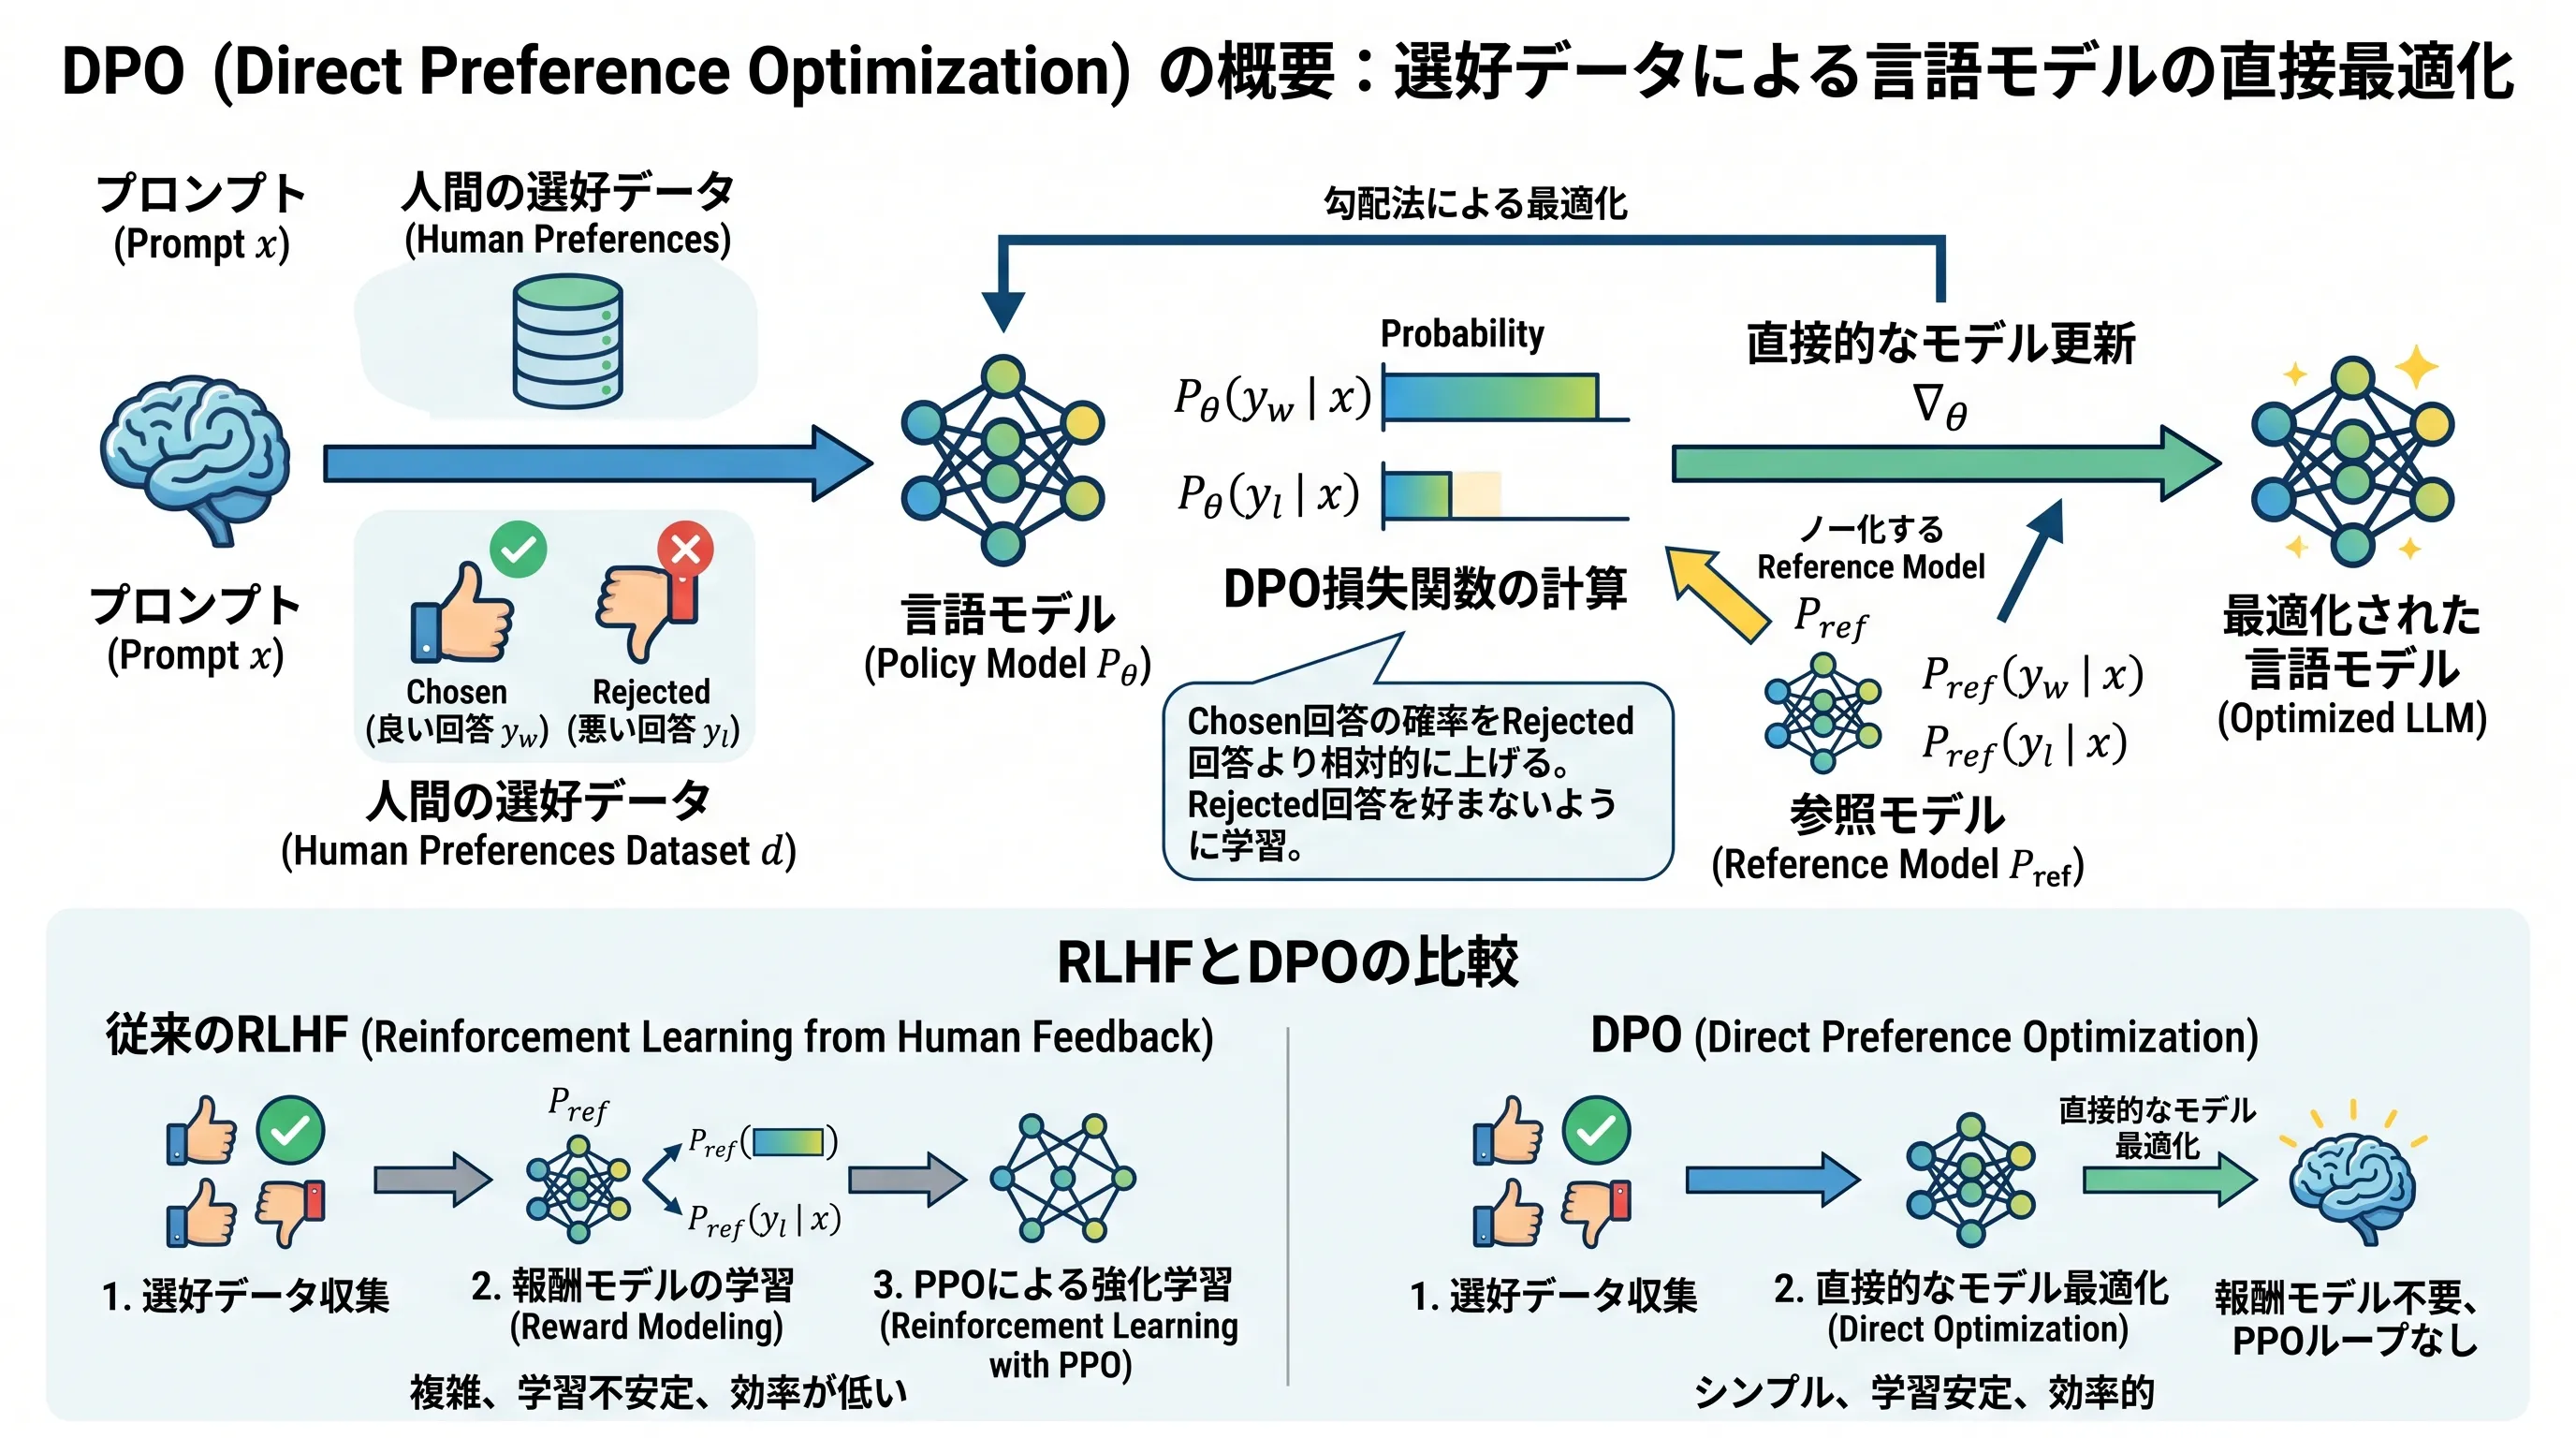
DPO(Direct Preference Optimization)は、Direct Preference Optimization: Your Language Model is Secretly a Reward Model(Rafailov et al., NeurIPS 2023)で提案された、言語モデルを人間の好みに合わせる(アライメントする)ための手法です。
InstructGPTの記事で扱った RLHF は、「選好データで報酬モデル(RM)を学習する」→「その RM のスコアが高くなるように PPO で言語モデルを強化学習する」という2段階で方策を最適化していました。DPO は、この 報酬モデルの学習と強化学習をまとめて1つの損失関数に置き換え、選好データ(好ましい応答 chosen と好ましくない応答 rejected のペア)から直接方策を学習します。最終的な損失関数は次のとおりです。
見た目は複雑ですが、中身は「学習中のモデルと参照モデルの対数確率の差」をシグモイドに通した 2値分類の交差エントロピー です。学習中にテキストを生成する必要も、報酬モデルや価値関数を用意する必要もありません。論文では、感情制御・要約・単一ターン対話のタスクで、PPO を用いた RLHF と同等以上の性能をより簡単な学習で達成したと報告されています。
本記事では、次の順に DPO を解説します。
- InstructGPT(RLHF)の何が大変だったのかを振り返る
- KL 制約付き報酬最大化から DPO の損失関数を導出する
- 勾配の意味、 の役割、学習中にモニタリングすべき量を確認する
- InstructGPT の記事と同じ手順で SFT モデルを作り、同じデータで DPO をスクラッチ実装する
- TRL の DPOTrainer で実装し、スクラッチ実装と対応づける
- 派生手法(IPO・SimPO・ORPO)を「何を省いたか」で整理する
- DPO の限界(オフライン学習)と、オンライン学習(GRPO)への問いを示す
本記事では、学習中の方策(言語モデル)を 、参照モデル(SFT モデル)を と書きます。これは InstructGPT の記事の と にそれぞれ対応します。また、学習済み報酬モデルのスコアは と書きます。InstructGPT の記事(および InstructGPT 論文)とは と の役割が逆になる ので注意してください。DPO 論文・PPO 論文にならい、方策のパラメータを に揃えています。真の(観測できない)報酬は と書きます。
背景:InstructGPT(RLHF)の何が大変だったのか
InstructGPT の3段階(SFT → 報酬モデル → PPO)のうち、第3段階の強化学習では次の KL ペナルティ付き報酬最大化 を解いていました(詳しくはInstructGPTの記事を参照してください)。
第1項は「報酬モデルのスコアを上げる」、第2項は「参照モデル(SFT モデル)から離れすぎない」を表し、 はその綱引きの強さを決める係数です。InstructGPT の記事のスクラッチ実装では を使いました。DPO の はこれとまったく同じ意味の係数 です(後述)。
この目的関数自体は自然なものですが、PPO で解こうとすると、実装面・運用面で次のような負担がありました。
| 項目 | RLHF(PPO) | DPO |
|---|---|---|
| 学習中の方策 | 必要 | 必要 |
| 参照モデル | 必要(KL ペナルティ用) | 必要(損失の計算用) |
| 報酬モデル | 必要(事前に別途学習) | 不要 |
| 価値関数(Critic) | 必要(GAE 用) | 不要 |
| 学習中のテキスト生成 | 毎ステップ必要 | 不要(固定データのみ) |
| 主なハイパーパラメータ | 、クリップ幅 、GAE の 、価値損失の重みなど | のみ |
上の表を図にすると、次のようになります。PPO の学習の段(点線の枠)にあった4つのモデルと、毎ステップの生成が、DPO では方策と参照モデルの2つに減り、ループの中は教師あり学習と同じ順伝播と逆伝播だけになります。
(図は、diagram-designで作成)
InstructGPT の記事では、LoRA と disable_adapter を組み合わせてモデルの数を減らす工夫をしましたが、TRL 版では4つのモデルを扱うためのメモリ管理が課題になりました。さらに、PPO の学習では報酬モデルの弱点を突く 報酬ハッキング が起き、平均生成長が 18.3 トークンから 11.3 トークンに縮む 長さの崩壊 も観察しました(InstructGPTの記事の「複数チェックポイントの一括比較」)。
そこで自然に浮かぶのが、次の問いです。
報酬モデルの学習と強化学習を省いて、選好データから直接方策を学習できないか?
DPO は、この問いに「KL ペナルティ付き報酬最大化の最適解を数式で書き下せば、それが可能になる」と答えます。
核心アイデア:言語モデル自体を報酬モデルとみなす
導出に入る前に、DPO のアイデアを直感的に押さえておきます。
学習前のモデル(参照モデル )と学習中のモデル()が、ある応答 に割り当てる確率を比べてみます。 の方が高い確率を割り当てていれば、モデルはその応答を「以前より好ましい」と評価し直したと解釈できます。逆に確率が下がっていれば、「好ましくない」と評価したことになります。
つまり、参照モデルからの確率の変化量(確率比)そのものを、その応答に対する報酬とみなせる のです。別の報酬モデルを用意しなくても、言語モデル自身の出力確率の中に報酬が暗黙的に表現されている、というのが DPO の出発点です。
この直感は、次の4ステップで数式として裏付けられます。
- KL ペナルティ付き報酬最大化の最適方策は、閉じた式で書ける
- その式を報酬について解き直すと、「報酬 = 方策と参照モデルの対数確率比 + 定数」になる
- これを Bradley-Terry モデルに代入すると、計算できない定数(分配関数)が消える
- 残った式を選好データで最尤推定すると、DPO の損失関数になる
(図は、diagram-designで作成)
図の下段のとおり、RLHF が PPO を使ったのは、分配関数 を計算できないからでした。DPO は が打ち消される形(2つの応答の差)だけを使うことで、強化学習を不要にします。以下、各ステップの数値は、3語の例で実際に計算して確かめます。
DPO損失関数の導出
ステップ1:KL制約付き報酬最大化の最適方策
ここでは、報酬関数を一般に と書いて考えます(学習済み RM なら 、真の報酬なら を当てはめます。また、最適化する方策もパラメータ に限定せず一般に と表します)。先ほどの目的関数は、KL ダイバージェンスの定義を展開すると次のように書けます。
目的関数の式変形(KL ダイバージェンスの定義からの展開)
前節で確認した RLHF の目的関数(プロンプト に対する期待値として全体を括って明示します)は次の通りです:
ここで、2つの離散確率分布 と に対する KL ダイバージェンス(Kullback-Leibler divergence) の定義は次の通りです:
この定義を、プロンプト が与えられたときの応答 の分布 と参照モデル に当てはめると、応答 に関する期待値として書き直せます:
これを目的関数の第2項に代入すると、第1項の報酬も第2項の KL ペナルティも、どちらも「同じ分布 からサンプルされる応答 に対する期待値」になります:
期待値の線形性()を用いて の期待値を1つにまとめると、上記の目的関数の形が得られます:
この最大化問題には解析的な解(閉形式解)があり、最適方策 は次のようになります。
は、確率の合計を1にするための正規化定数で、分配関数(partition function) と呼ばれます。 目的関数を で割ると( なので最大化は最小化に変わります)、次の最小化問題と同じ解を持ちます。 を使って、報酬の項を対数の中にまとめます()。 ここで、対数の分母にある関数を と置いてみます。もしこの分母が「確率分布」であれば、式全体が KL ダイバージェンス の形になり、KL ダイバージェンスの性質(2つの分布が一致するときに最小値 0)から最適方策が直ちに導けます。 しかし、 はすべての について足し合わせても 合計が 1 になりません()。つまり、そのままでは確率分布(確率質量関数)として扱えません。 そこで、合計が 1 になるように正規化して正式な確率分布を作ります。確率の合計値を と定義します: この で割ることで、合計が 1 になる確率分布 を定義できます: (実際、 となります。) この定義より、分母の未正規化関数は と書けるため、対数の中身に代入すると次のようになります: これを期待値の中に戻します: ここで、 の に関する期待値はまさに KL ダイバージェンス です。また は に依存しないため、 に関する期待値の外に出せます(): は最適化の対象である方策 に依存しない定数です。また KL ダイバージェンスは常に 0 以上であり、2つの分布が一致するときに限り 0 になります(Gibbs の不等式)。したがって、この式を最小化(元の目的関数を最大化)する最適方策は、KL ダイバージェンスが 0 になる のときに達成されます。最適方策 の導出(詳細な式展開)
最適方策の式は、「参照モデルの確率をベースに、報酬が高い応答ほど で確率を引き上げ、最後に で割って合計を1に戻す」と読めます。 が小さい(KL ペナルティが弱い)ほど が大きくなり、わずかな報酬の差でも確率が大きく変わります。
語彙が3つしかない「1トークンの応答」を考え、最適方策を計算してみます。
import numpy as np

vocab = ["ありがとう", "了解", "バカ"]

# 参照モデル(SFTモデル)の確率:「了解」が最も出やすい
pi_ref = np.array([0.3, 0.6, 0.1])

# 報酬:「ありがとう」が最も好ましく、「バカ」は強く好ましくない
rewards = np.array([2.0, 0.5, -2.0])

beta = 1.0  # KLペナルティの係数

# 1. 報酬を beta で割って exp をとり、参照モデルの確率に掛ける(分子)
unnormalized = pi_ref * np.exp(rewards / beta)

# 2. 分配関数 Z(x) で割って、確率の合計を1にする
Z = unnormalized.sum()
pi_opt = unnormalized / Z

print(f"Z = {Z:.4f}")
for w, p0, p1 in zip(vocab, pi_ref, pi_opt):
    print(f"{w}: 参照モデル {p0:.3f} → 最適方策 {p1:.3f}")
- 分子の計算: pi_ref * np.exp(rewards / beta) が、最適方策の式の に対応します。
- 分配関数: Z はすべての応答についての和です。この例では応答が3通りしかないので計算できますが、実際の言語モデルでは不可能です(後述)。
- 正規化: unnormalized / Z によって確率の合計が1になります。
実行結果
Z = 3.2195
ありがとう: 参照モデル 0.300 → 最適方策 0.689
了解: 参照モデル 0.600 → 最適方策 0.307
バカ: 参照モデル 0.100 → 最適方策 0.004
参照モデルでは「了解」が最も出やすかったのに対し、報酬の高い「ありがとう」が指数関数的に引き上げられて逆転しています。報酬が負の「バカ」はほぼ0に押し下げられています。参照モデルの分布をベースにしつつ、報酬に従って確率を「歪める」のが最適方策の働きです。
上の計算を図にすると、報酬の高い「ありがとう」の棒が伸び、参照モデルで最も高かった「了解」を逆転する様子が分かります。図の下の式のように、 はすべての応答についての和なので、応答が3通りなら計算できますが、実際の言語モデルでは計算できません。
(図は、diagram-designで作成)
では、最適方策が式で書けるなら、なぜ PPO が必要だったのでしょうか。理由は にあります。 を計算するには、プロンプト に対して 生成しうるすべての応答 について確率と報酬を足し合わせなければなりません。応答の組み合わせは語彙数の系列長乗という天文学的な数になるため、 を直接計算することはできません。そのため RLHF は、解析解を直接使うことをあきらめ、PPO で「サンプリングした応答」から勾配を推定して少しずつ方策を更新していたのです。
DPO は、この計算できない を 式変形で消去する ことで、強化学習を不要にします。
ステップ2:報酬を方策で書き直す
ステップ1の式の両辺の対数をとり、報酬 について解き直します。
式変形の詳細(最適方策の式から報酬を逆算)
ステップ1で導出した最適方策 の式を出発点とします:
両辺の自然対数をとります:
右辺に対数の積の性質()および を適用して展開します:
ここで なので、第3項は になります:
報酬の項 について解くため、他の項を左辺へ移項します:
対数の差を比にまとめます():
最後に両辺に を掛けると、目的の式が得られます:
これまでは「報酬から最適方策を求める」式でしたが、向きを逆にして「最適方策から報酬を逆算する」式として読みます。報酬は、最適方策と参照モデルの対数確率比に、 に依存しない定数 を足したものとして表せるということです。
先ほどの計算例(、、)で確かめます。
- 「ありがとう」: に を足すと
- 「了解」: に を足すと
元の報酬(2.0 と 0.5)が正確に復元されます。ただし、この計算にはまだ が必要です。
ステップ3:Bradley-Terryモデルに代入すると分配関数が消える
人間の選好は、InstructGPT の報酬モデルと同じく Bradley-Terry(BT)モデル でモデル化します(BTモデルの数学的基礎や最尤推定の導出については、Bradley–Terryモデルとは? を参照してください)。BT モデルでは、プロンプト に対して人間が (rejected)より (chosen)を好む確率を、真の報酬 の 差 をシグモイド関数 に通したものとして表します。
InstructGPT の記事では、この確率の負の対数尤度を最小化して報酬モデル を学習しました(ペアワイズ損失)。
ここで大事なのは、BT モデルが使うのは 報酬の差だけ だという点です。そこで、真の報酬 に対応する最適方策を として、ステップ2の式を報酬の差に代入します。
詳細な式展開
と は同じプロンプト に対する応答なので、 は共通です。そのため差をとると打ち消し合います。
同じプロンプトに対する2つの応答を比べているので、共通の が 引き算で打ち消されます。これが DPO の最大のポイントです。結果として、人間の選好確率は報酬を使わずに、方策と参照モデルだけで書けます。
再び3語の例で、「ありがとう」()が「了解」()より好まれる確率を2通りで計算します。
- 報酬から計算:
- 方策から計算:
方策から計算するときに は一度も使っていません。差をとる限り は不要 であることがわかります。
ステップ4:最尤推定でDPO損失を得る
最後に、未知の最適方策 を、パラメータ を持つ学習中のモデル で置き換え、選好データ に対する負の対数尤度を最小化します。これが DPO の損失関数です。
報酬モデルのペアワイズ損失 と見比べてください。 を に置き換えただけで、形はまったく同じ です。
| 報酬モデルの学習(InstructGPT) | DPO | |
|---|---|---|
| 学習するもの | 報酬モデル | 方策 |
| 報酬の表し方 | (スカラーを出力するヘッド) | |
| 損失 | ||
| 学習後に必要な工程 | PPO による強化学習 | なし(学習した がそのまま方策) |
つまり DPO は、「報酬モデルを学習してから、その報酬に対する最適方策を強化学習で探す」という2段階を、「最適方策の形で報酬モデルを直接パラメータ化し、報酬モデルと同じ損失で学習する」という1段階に置き換えたものです。報酬を学習し終えた時点で、その報酬に対する最適方策もすでに手に入っています。
損失の計算の流れを、次の計算例と同じ数値で図にします。必要なのは、選好データの2つの応答について、学習中のモデルと参照モデルの対数確率(4つの値)だけです。
(図は、diagram-designで作成)
参照モデルが chosen と rejected に同じ対数確率を割り当てている状況で、学習中のモデルの予測が「正しい場合」と「逆の場合」の損失を比べます。
import torch
import torch.nn.functional as F

def dpo_loss_simple(pi_logp_w, pi_logp_l, ref_logp_w, ref_logp_l, beta=0.1):
    # 学習中のモデルと参照モデル、それぞれの「chosen と rejected の対数確率の差」
    pi_logratio = pi_logp_w - pi_logp_l
    ref_logratio = ref_logp_w - ref_logp_l
    # beta を掛けたものが「暗黙の報酬の差」
    logits = beta * (pi_logratio - ref_logratio)
    return -F.logsigmoid(logits)

# 参照モデルは chosen と rejected に同じ対数確率 -1.5 を割り当てているとする
ref_w, ref_l = torch.tensor(-1.5), torch.tensor(-1.5)

# ケース1:学習中のモデルが chosen を高く、rejected を低く予測している
loss_good = dpo_loss_simple(torch.tensor(-1.0), torch.tensor(-2.0), ref_w, ref_l)

# ケース2:学習中のモデルが chosen を低く、rejected を高く予測している
loss_bad = dpo_loss_simple(torch.tensor(-2.0), torch.tensor(-1.0), ref_w, ref_l)

print(f"正しい予測の損失: {loss_good.item():.4f}")
print(f"逆の予測の損失:   {loss_bad.item():.4f}")
- 対数確率比の計算: 確率の比 は対数をとると引き算になります。損失の中身は並べ替えると なので、pi_logratio と ref_logratio の差として計算できます。
- 負の対数シグモイド: F.logsigmoid に負号をつけたものが に対応します。
- 数値例の意味: ケース1では logits が 、ケース2では になります。
実行結果
正しい予測の損失: 0.6444
逆の予測の損失:   0.7444
選好どおりの予測では損失が より小さく、逆の予測では大きくなります。この損失を誤差逆伝播で最小化するだけで、方策が選好に沿うように更新されます。
暗黙の報酬:言語モデルは密かに報酬モデルである
ステップ4で報酬の代わりに使った量を、暗黙の報酬(implicit reward) と呼びます。
ステップ2の式から を除いたものですが、選好の比較では差しか使わないので、この定数を除いても何も変わりません。論文のサブタイトル「Your Language Model is Secretly a Reward Model(言語モデルは密かに報酬モデルである)」は、この意味です。DPO で学習したモデルからは、 を計算することで、いつでも「そのモデルが各応答をどう評価しているか」を取り出せます。
import torch

def compute_implicit_reward(logp_theta, logp_ref, beta=0.1):
    """学習中のモデルと参照モデルの対数確率から、暗黙の報酬を計算する"""
    return beta * (logp_theta - logp_ref)

# 参照モデルは応答A・Bの両方に同じ対数確率 -2.0 を割り当てていた
logp_ref = torch.tensor([-2.0, -2.0])

# 学習後のモデルは、応答Aの確率を上げ、応答Bの確率を下げた
logp_theta = torch.tensor([-1.5, -2.8])

rewards = compute_implicit_reward(logp_theta, logp_ref)
print(f"応答Aの暗黙の報酬: {rewards[0]:+.4f}")
print(f"応答Bの暗黙の報酬: {rewards[1]:+.4f}")
- 暗黙の報酬の計算: beta * (logp_theta - logp_ref) が に対応します。確率の比は対数確率の差になります。
- 入力の意味: logp_theta と logp_ref は、応答全体の対数確率(各トークンの対数確率の和)を想定しています。実際の計算方法はスクラッチ実装で扱います。
実行結果
応答Aの暗黙の報酬: +0.0500
応答Bの暗黙の報酬: -0.0800
参照モデルより確率が上がった応答Aには正の報酬、下がった応答Bには負の報酬が与えられています。 は、「対数確率をどれだけ動かしたら、どれだけの報酬とみなすか」というスケールを決めています。
勾配の解釈とβの役割
勾配の直感的な解釈
DPO がモデルをどのように更新するのかは、損失の勾配を見るとよくわかります。暗黙の報酬 を使うと、勾配は次のように書けます。
詳細な式展開
暗黙の報酬の差を と置くと、損失は と書けます。合成関数の微分より、
シグモイド関数の微分 を使うと、
2つ目の等号では、シグモイド関数の性質 を使いました。 です。また、参照モデル は固定されていて に依存しないので、
これらを代入すると、上の勾配の式が得られます。
勾配は2つの部分に分けて読めます。
- 更新の方向(括弧の中): 「chosen の尤度を上げ、rejected の尤度を下げる」という素朴な方向です。
- 重み(前半のシグモイド): は、暗黙の報酬がペアの順位をどれだけ間違えているかを表します。
- 暗黙の報酬がすでに正しく順位付けしている( が より十分大きい)ペアでは、重みは 0 に近づき、ほとんど更新されません。
- 順位を間違えている( の方が大きい)ペアでは、重みは 1 に近づき、強く修正されます。
論文では、この重みを取り除いて単純に尤度を上げ下げする(unlikelihood 学習に相当する)と、モデルが退化して意味のない文章を生成するようになることが報告されています。DPO の重みは、「すでに正しく区別できているペアはこれ以上押さない」ブレーキ として働いているのです。
勾配の2つの部分を図にすると、次のようになります。重みは暗黙の報酬の差のシグモイドで、正しく分けられたペア(右側)ではほぼ0になり、更新が止まります。
(図は、diagram-designで作成)
この重みを数値で確認してみます。
import torch

def compute_dpo_weight(beta, logp_theta_w, logp_ref_w, logp_theta_l, logp_ref_l):
    """DPOの勾配に掛かる重み σ(r_l - r_w) を計算する"""
    r_w = beta * (logp_theta_w - logp_ref_w)  # chosen の暗黙の報酬
    r_l = beta * (logp_theta_l - logp_ref_l)  # rejected の暗黙の報酬
    weight = torch.sigmoid(r_l - r_w)
    return weight.item(), r_w.item(), r_l.item()

beta = 1.0

# ケース1:chosen の確率を上げ、rejected の確率を下げている(正しい順位付け)
w1, rw1, rl1 = compute_dpo_weight(
    beta,
    logp_theta_w=torch.tensor(-1.0), logp_ref_w=torch.tensor(-5.0),
    logp_theta_l=torch.tensor(-6.0), logp_ref_l=torch.tensor(-2.0),
)

# ケース2:chosen の確率を下げ、rejected の確率を上げている(誤った順位付け)
w2, rw2, rl2 = compute_dpo_weight(
    beta,
    logp_theta_w=torch.tensor(-6.0), logp_ref_w=torch.tensor(-2.0),
    logp_theta_l=torch.tensor(-1.0), logp_ref_l=torch.tensor(-5.0),
)

print(f"ケース1(正しい順位付け): r_w={rw1:.1f}, r_l={rl1:.1f} -> 勾配の重み: {w1:.4f}")
print(f"ケース2(誤った順位付け): r_w={rw2:.1f}, r_l={rl2:.1f} -> 勾配の重み: {w2:.4f}")
- 暗黙の報酬: r_w と r_l は、chosen と rejected それぞれの です。
- 勾配の重み: torch.sigmoid(r_l - r_w) が、勾配の式の前半 に対応します。
- 数値の設定: 違いを見やすくするため、beta を 1.0 にし、対数確率を大きく動かしています。
実行結果
ケース1(正しい順位付け): r_w=4.0, r_l=-4.0 -> 勾配の重み: 0.0003
ケース2(誤った順位付け): r_w=-4.0, r_l=4.0 -> 勾配の重み: 0.9997
正しく順位付けできているケース1では重みがほぼ0になり、更新がほとんど止まります。誤っているケース2では重みがほぼ1になり、強く修正されます。
βの役割
は、InstructGPT の KL ペナルティの係数 と 同じ意味 を持ちます。DPO の損失は、KL ペナルティ付き報酬最大化の最適解から導いたものだからです。InstructGPT では、トークンごとの KL ペナルティを報酬に加えていましたが、系列全体の KL はトークンごとの対数確率比の和なので、両者は同じ目的関数を別の形で表しているにすぎません。
損失の中での の効き方は、次のように整理できます。
- が大きい: 対数確率比を少し動かしただけで暗黙の報酬の差が大きくなり、損失がすぐに小さくなります。その結果、参照モデルから大きく離れる前に学習が落ち着きます(KL 制約が強い)。
- が小さい: 同じだけ損失を下げるには、対数確率比を大きく動かす必要があります。モデルは参照モデルから大きく離れやすくなります(KL 制約が弱い)。
DPO では がよく使われ、TRL の既定値も 0.1 です。InstructGPT の記事の PPO()とは、報酬のスケール(学習済み RM のスコアか、暗黙の報酬か)が異なるので、数値を直接比べることはできません。
この違いは、後のスクラッチ実装の「βの比較」で、β を 0.05・0.1・0.5 と変えて学習し、実際に確かめます。
学習中にモニタリングする量
DPO は損失が下がるだけでは、学習がうまくいっているかどうかを判断しにくい手法です。次の量を合わせて記録します(TRL が出力するログの名前も併記します)。
| 量 | 定義 | TRL のログ名 | 見方 |
|---|---|---|---|
| 報酬の差(margin) | の平均 | rewards/margins | 0 から始まり、正の方向に広がっていく |
| 選好の正解率 | となるペアの割合 | rewards/accuracies | 0.5 付近から上がっていく |
| chosen の変化量 | の平均 | rewards/chosen( 倍した値) | 0 より下に下がり続けていないかを確認する |
| rejected の変化量 | の平均 | rewards/rejected( 倍した値) | 0 から下がっていく |
対数確率そのもの(TRL の logps/chosen・logps/rejected)は、応答の長さによって大きく変わるので、バッチごとの値を並べても学習による変化かどうかが分かりにくくなります。参照モデルとの差をとると長さの影響がほぼ打ち消されるので、変化を見るには3・4行目の量が適しています。
特に注意したいのが3行目です。DPO の損失は chosen と rejected の差 にしか依存しません。そのため、rejected の対数確率が chosen より速く下がっていれば、chosen の対数確率も一緒に下がっていても損失は小さくなります。実際に、学習中に両方の対数確率が同時に下がる現象がよく観察され、尤度の同時低下(likelihood displacement) と呼ばれています。chosen と rejected は同じプロンプトへの応答で、多くのトークンを共有しているため、rejected を押し下げる勾配が chosen まで引きずり下ろしてしまうのです。
chosen の尤度が下がると、選好データのどちらでもない応答に確率が流れ、意図しない出力が増えることがあります。Smaug: Fixing Failure Modes of Preference Optimisation with DPO-Positive は、この問題を指摘し、chosen の尤度が参照モデルより下がったときにペナルティを加える DPOP を提案しています。後のスクラッチ実装では、この現象が起きるかどうかを実際に確認します。
DPOのスクラッチ実装
ここからは、PyTorch で DPO の学習をゼロから実装します。条件は InstructGPT の記事と揃えます。
- モデル:
llm-jp/llm-jp-3-1.8bに InstructGPT の記事のステップ1と同じ手順で SFT を行い、その SFT モデルを初期値(=参照モデル)にします。SFT も本記事の中で実行するので、この記事だけで最初から再現できます。設定を揃えておくことで、PPO と同じ出発点から比較できます。 - データ:
llm-jp/hh-rlhf-12k-jaを shuffle(seed=42) し、InstructGPT の記事の報酬モデルと同じく [0, 4000) を学習用、[11000, 11200) を検証用にします。 - 学習方式: bf16 + LoRA。参照モデルは別途ロードせず、disable_adapter() で LoRA を外した状態として再現します(InstructGPTの記事と同じ工夫です)。
PPO では「方策・参照モデル・報酬モデル・価値関数」の4つのモデルを扱い、学習ループの中で文章を生成していました。DPO では 方策と参照モデルの2つだけ で済み、ループの中で文章を生成する必要もありません。
InstructGPT の記事の報酬モデルでは、元の選好ペアに加えて、わざと壊した応答を rejected にした「合成ネガティブ」も学習に使いました。ここではまず元のペアだけで学習し、合成ネガティブを加えた場合との比較は、後の「合成ネガティブを含めた学習」で行います。
ライブラリのインストールとGoogleドライブのマウント
まず、必要なライブラリをインストールします。
!pip install --upgrade datasets transformers accelerate peft trl
!pip uninstall -y torchao
- まとめてアップグレード: transformers・peft・trl は互いの内部 API に依存しているので、一部だけを新しくすると不整合が起きやすくなります。まとめて最新に揃えます。
- torchao の削除: 新しい transformers や peft は、環境に torchao があると量子化関連のコードを読み込もうとし、バージョンの組み合わせによっては import の段階でエラーになります。本記事は bf16 + LoRA だけで量子化を使わないので、あらかじめ削除しておきます(InstructGPT の記事と同じ対処です)。
SFT と DPO の学習はそれぞれ時間がかかるので、成果物を Google ドライブに保存し、別のセッションに分けて実行できるようにします。
import os
from google.colab import drive

drive.mount("/content/drive")

SAVE_ROOT = "/content/drive/MyDrive/dpo"
os.makedirs(SAVE_ROOT, exist_ok=True)
- ドライブへの保存: Colab の /content 配下はセッションが切れると消えます。準備1で作る SFT モデルは、スクラッチ実装と TRL 版の両方の入力になるので、drive.mount したドライブに保存します。
- 保存先の定数化: 保存先は SAVE_ROOT に集約し、以降のコードはすべてここを基準にします。exist_ok=True は、セルを再実行してもエラーにならないようにするための指定です。
準備1:SFTモデルの作成
DPO は SFT モデルを出発点とし、同じ SFT モデルを参照モデル として使います。ここでは InstructGPT の記事のステップ1と同じ設定で、llm-jp/llm-jp-3-1.8b を SFT します。SFT の仕組みそのもの(プロンプト部分のマスクや LoRA)の詳しい説明は、Instruction Tuningの記事とInstructGPTの記事を参照してください。
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
from datasets import load_dataset
from torch.utils.data import DataLoader
from peft import LoraConfig, get_peft_model
from tqdm import tqdm

# ==========================================
# 1. 初期設定とデータの準備
# ==========================================
SEED = 42
set_seed(SEED)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

BASE_MODEL = "llm-jp/llm-jp-3-1.8b"
SFT_MODEL_DIR = f"{SAVE_ROOT}/trained_sft_model"  # DPO のスクラッチ実装・TRL 版の両方で使う
MAX_LEN = 512

tokenizer = AutoTokenizer.from_pretrained(BASE_MODEL)
if tokenizer.pad_token is None:  # llm-jp-3 は専用の PAD トークンを持つので通常は通らない
    tokenizer.pad_token = tokenizer.eos_token

def build_prompt(conversations):
    """対話履歴を「Human: ... / Assistant:」形式にする。末尾にスペースを付けない"""
    prompt = ""
    for turn in conversations:
        role = "Human" if turn["from"] == "human" else "Assistant"
        prompt += f"{role}: {turn['value']}\n"
    return prompt + "Assistant:"

def join_prompt_response(prompt, response):
    """プロンプトと応答を連結する。スペースは応答側の先頭に付ける"""
    return prompt + " " + response.strip()

def fits_max_len(example):
    """EOS まで含めて MAX_LEN に収まる例だけを残す(切り詰めると EOS が失われるため)"""
    prompt = build_prompt(example["conversations"])
    full_text = join_prompt_response(prompt, example["chosen"]) + tokenizer.eos_token
    return len(tokenizer(full_text)["input_ids"]) <= MAX_LEN

raw = load_dataset("llm-jp/hh-rlhf-12k-ja", split="train")
filtered = raw.shuffle(seed=SEED).filter(fits_max_len)
sft_raw = filtered.select(range(min(1000, len(filtered))))

def preprocess_sft(example):
    """プロンプト部分とパディングを -100 でマスクし、応答(chosen)と EOS だけを学習対象にする"""
    prompt = build_prompt(example["conversations"])
    full_text = join_prompt_response(prompt, example["chosen"]) + tokenizer.eos_token

    prompt_ids = tokenizer(prompt)["input_ids"]
    tokenized = tokenizer(full_text, truncation=True, max_length=MAX_LEN, padding="max_length")
    input_ids = tokenized["input_ids"]

    n_prompt = len(prompt_ids)
    assert input_ids[:n_prompt] == prompt_ids, "プロンプトのトークン境界がずれています"

    labels = [
        -100 if (i < n_prompt or mask == 0) else tok
        for i, (tok, mask) in enumerate(zip(input_ids, tokenized["attention_mask"]))
    ]
    return {"input_ids": input_ids, "attention_mask": tokenized["attention_mask"], "labels": labels}

sft_dataset = sft_raw.map(preprocess_sft, remove_columns=sft_raw.column_names)
sft_dataset.set_format(type="torch")

BATCH_SIZE = 2
ACCUM_STEPS = 4  # 実効バッチサイズ = 2 × 4 = 8
sft_loader = DataLoader(sft_dataset, batch_size=BATCH_SIZE, shuffle=True,
                        generator=torch.Generator().manual_seed(SEED))

# ==========================================
# 2. モデルの準備(bf16 + LoRA)
# ==========================================
model = AutoModelForCausalLM.from_pretrained(BASE_MODEL, torch_dtype=torch.bfloat16).to(device)
model.config.pad_token_id = tokenizer.pad_token_id
model.config.use_cache = False
model.gradient_checkpointing_enable()
model.enable_input_require_grads()  # 勾配チェックポイントと LoRA を併用するために必要

sft_lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
)
model = get_peft_model(model, sft_lora_config)
model.print_trainable_parameters()

trainable_params = [p for p in model.parameters() if p.requires_grad]
optimizer = torch.optim.AdamW(trainable_params, lr=1e-4)

# ==========================================
# 3. SFT の学習ループ
# ==========================================
EPOCHS = 1
model.train()
for epoch in range(EPOCHS):
    total_loss = 0.0
    optimizer.zero_grad()
    progress_bar = tqdm(sft_loader, desc=f"SFT Epoch {epoch + 1}")
    for i, batch in enumerate(progress_bar):
        batch = {k: v.to(device) for k, v in batch.items()}
        loss = model(**batch).loss
        (loss / ACCUM_STEPS).backward()  # 勾配累積のため損失をスケールする

        if (i + 1) % ACCUM_STEPS == 0 or (i + 1) == len(sft_loader):
            torch.nn.utils.clip_grad_norm_(trainable_params, 1.0)
            optimizer.step()
            optimizer.zero_grad()

        total_loss += loss.item()
        progress_bar.set_postfix({"loss": f"{loss.item():.4f}"})
    print(f"SFT Epoch {epoch + 1} 完了 | 平均Loss: {total_loss / len(sft_loader):.4f}")

# ==========================================
# 4. LoRA を統合して「普通のモデル」として保存
# ==========================================
model = model.merge_and_unload()
model.config.use_cache = True
model.save_pretrained(SFT_MODEL_DIR)
tokenizer.save_pretrained(SFT_MODEL_DIR)

# DPO の準備でモデルを読み込み直すので、GPU メモリを解放しておく
del model, optimizer, trainable_params
torch.cuda.empty_cache()
【データの準備】
- InstructGPT の記事と同じ設定: shuffle(seed=SEED) の後、fits_max_len で長さの条件を満たす例だけを残し、先頭の1,000件の chosen で SFT します。モデル・データ・ハイパーパラメータを InstructGPT の記事のステップ1と揃えているので、後で PPO の結果と比べるときに出発点が同じになります。なお、この1,000件は DPO の学習範囲 [0, 4000) と一部重複します(InstructGPT の記事の SFT と報酬モデルの関係と同じです)。
- プロンプトの書式: build_prompt は末尾にスペースを付けず、スペースは join_prompt_response で応答の先頭に付けます。SentencePiece 系のトークナイザーでは、末尾のスペースが孤立したトークンになり、学習時と推論時で入力の見え方が変わってしまうためです。DPO の前処理でも同じ書式を使います。
- 切り詰めではなく除外: 長すぎる例を切り詰めると、末尾の EOS が失われ、モデルが「どこで話し終えるか」を学べません。そこで filter で除外し、完結した応答だけを学習させます。
- プロンプトとパディングのマスク: labels のうち、プロンプト部分と attention_mask が0の位置(パディング)を -100 にし、応答と EOS だけを損失の対象にします。assert は、プロンプト単体のトークン列が全文の先頭と一致すること(マスクの境界が正しいこと)を確かめるためのものです。
【モデルと学習】
- bf16 + LoRA: 1.8B のモデルを fp32 で学習すると重み・勾配・Adam の状態で約29GB が必要になるため、bf16 で読み込み、LoRA で学習対象を全体の1%程度に絞ります。
- メモリ節約の設定: gradient_checkpointing_enable() で中間活性値を保持せずに再計算し、学習中は不要な KV キャッシュを use_cache = False で無効にします。enable_input_require_grads() は、重みが凍結されたモデルで勾配チェックポイントを使うと LoRA に勾配が届かなくなる問題を防ぐための指定です。
- 学習率: LoRA の B 行列は0で初期化され、更新対象も少ないので、全パラメータ学習(2e-5 程度)より高い lr=1e-4 を使います。
- 勾配累積: BATCH_SIZE = 2 の勾配を ACCUM_STEPS = 4 回分ためてから更新し、実効バッチサイズ8で学習します。損失を ACCUM_STEPS で割るのは、足し合わせた勾配が「実効バッチ全体の平均」になるようにするためです。
- 1エポック・1,000件という控えめな設定: この SFT の目的は、対話の書式に従い、適切な位置で発話を終えられるようにすることです。学習しすぎて出力の多様性が失われると、DPO で動かせる余地も小さくなります。
【保存】
- LoRA の統合: merge_and_unload() で SFT 用の LoRA を重みに足し込み、通常の1つのモデルとして SFT_MODEL_DIR に保存します。こうしておくと、DPO では from_pretrained で普通に読み込み、その上に 新しい LoRA を追加できます。SFT 用と DPO 用のアダプターが混ざらないので、DPO 用の LoRA を外したときに得られるのは SFT モデルそのものになります。
- use_cache の復元とメモリの解放: 保存する設定では生成用の KV キャッシュを有効に戻します。また、次の準備で SFT モデルを読み込み直すので、del と torch.cuda.empty_cache() で GPU メモリを解放します。SFT モデルを一度保存すれば、以降のセッションではこのセルを再実行する必要はありません。
実行結果
trainable params: 16,908,288 || all params: 1,884,522,496 || trainable%: 0.8972
SFT Epoch 1: 100%|██████████| 500/500 [03:00<00:00,  2.78it/s, loss=2.4014]SFT Epoch 1 完了 | 平均Loss: 2.5694
準備2:DPO用のLoRAとデータ
準備1で保存した SFT モデルを読み込み、その上に DPO 用の新しい LoRA アダプターを追加して、学習対象の方策とします。
import numpy as np
import torch
import torch.nn.functional as F
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
from datasets import load_dataset
from peft import LoraConfig, get_peft_model
from torch.utils.data import DataLoader

SEED = 42
set_seed(SEED)

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

SAVE_ROOT = "/content/drive/MyDrive/dpo"
SFT_MODEL_DIR = f"{SAVE_ROOT}/trained_sft_model"  # 準備1で保存したSFTモデル
MAX_LEN = 512
IGNORE_INDEX = -100

tokenizer = AutoTokenizer.from_pretrained(SFT_MODEL_DIR)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

# 1. SFTモデルを読み込む(LoRAを外したこの状態が参照モデルになる)
sft_model = AutoModelForCausalLM.from_pretrained(SFT_MODEL_DIR, torch_dtype=torch.bfloat16)

# 2. SFTモデルの上に、DPO用の新しいLoRAアダプターを追加する(これが学習中の方策)
lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
)
model = get_peft_model(sft_model, lora_config).to(device)
model.config.use_cache = False
model.print_trainable_parameters()
- 乱数の固定: set_seed(SEED) で Python・NumPy・PyTorch の乱数をまとめて固定します。
- SFT モデルの読み込み: 準備1で LoRA を統合して保存したので、from_pretrained で通常のモデルとして読み込めます。この後に追加する DPO 用の LoRA を外すと、ベースモデルではなく SFT モデル が得られます。参照モデルを SFT モデルにすることは、KL 制約付き報酬最大化の前提そのものなので重要です。
- セッションをまたいだ実行: 準備1とは別のセッションでも実行できるように、SAVE_ROOT や SFT_MODEL_DIR などの定数を改めて定義しています(ドライブのマウントは済ませておいてください)。
- DPO 用の LoRA: get_peft_model で新しいアダプターを追加します。LoRA の B 行列は0で初期化されるため、学習開始時点では方策と参照モデルが完全に一致し、暗黙の報酬はすべて0から始まります。
- use_cache の無効化: 学習時は生成用の KV キャッシュが不要なので、use_cache = False にしてメモリを節約します。
実行結果
trainable params: 16,908,288 || all params: 1,884,522,496 || trainable%: 0.8972
次に、選好データを前処理します。DPO が最適化するのは「プロンプト が与えられたときの 応答部分 の生成確率」なので、プロンプト部分のトークンは損失計算から除外(IGNORE_INDEX でマスク)します。
raw = load_dataset("llm-jp/hh-rlhf-12k-ja", split="train").shuffle(seed=SEED)
train_raw = raw.select(range(0, 4000))       # InstructGPTの報酬モデルと同じ学習範囲
eval_raw = raw.select(range(11000, 11200))   # 検証用(学習には使わない)

MIN_RESPONSE_TOKENS = 32  # 応答に最低限残したいトークン数

def build_prompt(conversations):
    """対話履歴を「Human: ... / Assistant:」形式のプロンプトにする(InstructGPTの記事と同じ書式)"""
    prompt = ""
    for turn in conversations:
        role = "Human" if turn["from"] == "human" else "Assistant"
        prompt += f"{role}: {turn['value']}\n"
    return prompt + "Assistant:"

def tokenize_pair(example):
    """プロンプトと応答を別々にトークナイズしてから連結する"""
    prompt_ids = tokenizer(build_prompt(example["conversations"]))["input_ids"]
    budget = MAX_LEN - len(prompt_ids)
    out = {"prompt_len": len(prompt_ids)}
    for key in ["chosen", "rejected"]:
        resp_ids = tokenizer(" " + example[key].strip(), add_special_tokens=False)["input_ids"]
        if len(resp_ids) + 1 <= budget:
            resp_ids = resp_ids + [tokenizer.eos_token_id]  # 最後まで入る応答だけEOSを付ける
        else:
            resp_ids = resp_ids[:budget]                    # 途中で切れた応答にはEOSを付けない
        out[f"{key}_input_ids"] = prompt_ids + resp_ids
    return out

train_ds = train_raw.map(tokenize_pair, remove_columns=train_raw.column_names)
# プロンプトが長すぎて応答がほとんど残らない例は除外する
train_ds = train_ds.filter(lambda ex: MAX_LEN - ex["prompt_len"] >= MIN_RESPONSE_TOKENS)
print(f"学習に使うペア数: {len(train_ds)}")

def collate_fn(batch):
    """chosen と rejected を1つのバッチに連結し、同じ長さにパディングする"""
    seqs = [ex["chosen_input_ids"] for ex in batch] + [ex["rejected_input_ids"] for ex in batch]
    prompt_lens = [ex["prompt_len"] for ex in batch] * 2
    max_len = max(len(s) for s in seqs)

    input_ids = torch.full((len(seqs), max_len), tokenizer.pad_token_id, dtype=torch.long)
    attention_mask = torch.zeros((len(seqs), max_len), dtype=torch.long)
    labels = torch.full((len(seqs), max_len), IGNORE_INDEX, dtype=torch.long)
    for i, (seq, p_len) in enumerate(zip(seqs, prompt_lens)):
        input_ids[i, :len(seq)] = torch.tensor(seq)
        attention_mask[i, :len(seq)] = 1
        labels[i, p_len:len(seq)] = torch.tensor(seq[p_len:])  # 応答部分だけをラベルにする
    return {"input_ids": input_ids, "attention_mask": attention_mask, "labels": labels}

BATCH_SIZE = 2  # ペア数。chosen と rejected を連結するので、1回の順伝播は 2 × BATCH_SIZE 系列
generator = torch.Generator().manual_seed(SEED)
train_loader = DataLoader(train_ds, batch_size=BATCH_SIZE, shuffle=True,
                          collate_fn=collate_fn, generator=generator)

# 検証用ペアも同じ前処理をする(評価だけなので並べ替えない)
eval_ds = eval_raw.map(tokenize_pair, remove_columns=eval_raw.column_names)
eval_ds = eval_ds.filter(lambda ex: MAX_LEN - ex["prompt_len"] >= MIN_RESPONSE_TOKENS)
eval_loader = DataLoader(eval_ds, batch_size=8, shuffle=False, collate_fn=collate_fn)
print(f"検証に使うペア数: {len(eval_ds)}")
【データの分割】
- InstructGPT の記事と同じ分割: shuffle(seed=SEED) の後に select(range(0, 4000)) で学習用、select(range(11000, 11200)) で検証用を取り出します。報酬モデルと同じ選好ペアで学習するので、PPO と公平に比較できます。
【トークナイズとマスク】
- プロンプトの書式: build_prompt は InstructGPT の記事と同じ「Human: ... / Assistant:」形式です。書式が変わると SFT モデルの振る舞いが変わってしまうので、揃えておくことが重要です。
- 別々にトークナイズしてから連結: プロンプト+応答の文字列をまとめてトークナイズすると、境界付近でトークンの切れ目が変わり、「プロンプトのトークン数」がずれることがあります。tokenize_pair ではプロンプトと応答を別々にトークナイズしてから連結するので、prompt_len が正確にプロンプトの長さになります。
- EOS の扱い: 最後まで入りきった応答にだけ eos_token_id を付けます。途中で切り詰めた応答に EOS を付けると、「文の途中で終わる」ことを好ましい応答として学習してしまうためです。
- 長すぎるプロンプトの除外: 応答が MIN_RESPONSE_TOKENS 未満しか残らない例は、filter で除外します。
【バッチの作り方】
- chosen と rejected の連結: collate_fn は、前半に chosen、後半に rejected を並べた 2 × BATCH_SIZE 系列のバッチを作ります。1回の順伝播で両方の対数確率を計算でき、後で chunk(2) で分割します。
- 共通の長さへのパディング: chosen と rejected を1つのテンソルに入れるため、両方の最大長に合わせてパディングします。
- マスクの作り方: パディング位置は attention_mask を0に、labels を IGNORE_INDEX にします。このトークナイザーでは pad_token と EOS が同じ ID になる場合があるため、「ID が pad かどうか」でマスクすると応答末尾の EOS まで消えてしまいます。ここでは長さ情報からマスクを作ることで、この問題を避けています。
- 検証用データ: eval_raw にも学習用と同じ前処理をして eval_loader を作ります。学習の前後で、学習に使っていないペアでの正解率を比べるために使います。評価だけなので shuffle=False とし、勾配を計算しない分、バッチを8ペアと大きめにしています。
実行結果
学習に使うペア数: 3873
検証に使うペア数: 193
系列の対数確率とDPO損失
DPO の損失を計算するには、応答全体の対数確率 が必要です。次の get_batch_logps は、モデルのロジットから各トークンの対数確率を取り出し、応答部分だけを 和 で集計します。
def get_batch_logps(logits, labels):
    """ロジットとラベルから、応答部分の対数確率の和とトークン数を計算する"""
    # 位置 t のロジットは「位置 t+1 のトークン」を予測しているので、1つずらす
    logits = logits[:, :-1, :]
    labels = labels[:, 1:]

    loss_mask = labels != IGNORE_INDEX
    safe_labels = labels.masked_fill(~loss_mask, 0)  # gather で使えるように -100 を 0 に置き換える

    log_probs = F.log_softmax(logits.float(), dim=-1)
    token_logps = log_probs.gather(dim=-1, index=safe_labels.unsqueeze(-1)).squeeze(-1)

    seq_logps = (token_logps * loss_mask).sum(dim=-1)  # DPO は長さで割らずに「和」をとる
    n_tokens = loss_mask.sum(dim=-1)
    return seq_logps, n_tokens

def dpo_loss(pi_logps_w, pi_logps_l, ref_logps_w, ref_logps_l, beta=0.1):
    """DPO損失と、監視用の暗黙の報酬(ペアごと)を返す"""
    pi_logratios = pi_logps_w - pi_logps_l
    ref_logratios = ref_logps_w - ref_logps_l
    losses = -F.logsigmoid(beta * (pi_logratios - ref_logratios))

    chosen_rewards = beta * (pi_logps_w - ref_logps_w).detach()
    rejected_rewards = beta * (pi_logps_l - ref_logps_l).detach()
    return losses.mean(), chosen_rewards, rejected_rewards
【対数確率の計算(get_batch_logps)】
- ロジットとラベルのずらし(shift): 因果言語モデルでは、位置 のロジットが次の位置 のトークンの予測です。そのため logits[:, :-1, :] と labels[:, 1:] で位置を揃えます。
- マスク: loss_mask は、プロンプト部分とパディング(ラベルが IGNORE_INDEX)を除いた応答トークンだけが True になります。gather は負のインデックスを受け付けないので、マスク外のラベルを一時的に0に置き換えています(その位置の値は後でマスクで0にされるので結果に影響しません)。
- float32 での log_softmax: bf16 のまま log_softmax をとると精度が落ちるので、logits.float() で float32 に変換してから計算します。
- 和か平均か: DPO の は各トークンの対数確率の 和 です。長さで割る(平均をとる)と、後で紹介する SimPO の報酬になります。長さ正規化の有無は手法の違いそのもの なので、ここは意識しておくべきポイントです。n_tokens は長さの監視用に返しています。
【損失の計算(dpo_loss)】
- 数式との対応: pi_logratios - ref_logratios に beta を掛けたものが、損失の中の に対応します。
- logsigmoid の使用: torch.log(torch.sigmoid(z)) と数学的には同じですが、 が大きな負の値のときにシグモイドが0に丸められて対数が発散します。F.logsigmoid はこれを避けるよう実装されています。
- 監視用の報酬: chosen_rewards と rejected_rewards は暗黙の報酬です。ログに記録するだけで勾配計算には使わないので、detach() で計算グラフから切り離しています。
報酬モデルの推論も、PPO のアドバンテージ計算やクリッピングも登場しないことを確認してください。ダミーの対数確率で動作を確認します。
# 学習中のモデル:chosen を少し高く、rejected を少し低く予測している
pi_logps_w = torch.tensor([-1.0, -1.5])
pi_logps_l = torch.tensor([-2.0, -1.8])
# 参照モデル:chosen と rejected に同じ対数確率を割り当てている
ref_logps_w = torch.tensor([-1.5, -1.6])
ref_logps_l = torch.tensor([-1.5, -1.6])

loss, chosen_rewards, rejected_rewards = dpo_loss(
    pi_logps_w, pi_logps_l, ref_logps_w, ref_logps_l, beta=0.1
)
print(f"DPO Loss: {loss.item():.4f}")
print(f"Chosen Reward (平均): {chosen_rewards.mean().item():.4f}")
print(f"Rejected Reward (平均): {rejected_rewards.mean().item():.4f}")
- ダミーデータの設定: 2ペア分の対数確率です。1ペア目は chosen を 、rejected を 、2ペア目は chosen を 、rejected を だけ参照モデルから動かしています。
- 出力の意味: 暗黙の報酬は (対数確率の変化量)なので、chosen の平均は 、rejected の平均は になります。
実行結果
DPO Loss: 0.6613
Chosen Reward (平均): 0.0300
Rejected Reward (平均): -0.0350
検証用データでの評価
学習がうまくいっているかを最も確実に判断する方法は、学習に使っていない検証用のペア で、暗黙の報酬が chosen と rejected を正しく区別できるかを調べることです。評価の関数を用意し、学習前に一度実行しておきます。
BETA = 0.1   # DPO の β(学習ループでも使う)

@torch.no_grad()
def evaluate_pairs(loader, beta=BETA):
    """検証用ペアについて、暗黙の報酬による選好の正解率と margin の平均を計算する"""
    was_training = model.training
    model.eval()
    margins = []
    for batch in loader:
        batch = {k: v.to(device) for k, v in batch.items()}
        inputs = dict(input_ids=batch["input_ids"], attention_mask=batch["attention_mask"])
        pi_logps, _ = get_batch_logps(model(**inputs).logits, batch["labels"])
        with model.disable_adapter():
            ref_logps, _ = get_batch_logps(model(**inputs).logits, batch["labels"])
        pi_w, pi_l = pi_logps.chunk(2)
        ref_w, ref_l = ref_logps.chunk(2)
        margins.append(beta * ((pi_w - ref_w) - (pi_l - ref_l)))
    model.train(was_training)
    m = torch.cat(margins)
    # margin がちょうど0(学習前など)のペアは、どちらとも言えないので 0.5 として数える
    acc = ((m > 0).float() + 0.5 * (m == 0).float()).mean().item()
    return acc, m.mean().item(), len(m)

def print_eval(label, result):
    acc, margin, n = result
    se = np.sqrt(acc * (1 - acc) / n)
    print(f"{label}: accuracy {acc:.3f} ± {se:.3f} / margin {margin:+.4f}({n} ペア)")

eval_before = evaluate_pairs(eval_loader)
print_eval("学習前(検証用)", eval_before)
- 評価する量: 各ペアの margin を計算し、それが正のペアの割合(選好の正解率)と、margin の平均を求めます。学習中の記録と違って、学習に使っていないペアで測るので、「学習データを覚えただけ」かどうかも区別できます。
- 同点の扱い: margin がちょうど0のペアは、chosen と rejected のどちらとも判断していないので、正解率に 0.5 として数えます。
- 学習前の値の意味: 学習開始時は LoRA の B 行列が0なので、方策と参照モデルの対数確率が完全に一致し、margin はすべて0になります。したがって、学習前の結果は accuracy 0.500・margin 0 になるはずです。そうならない場合は、disable_adapter() で SFT モデルが正しく再現されていないなど、実装に誤りがあります。
- 標準誤差: print_eval は、正解率の標準誤差 も表示します。193ペアなので、正解率 0.5 付近で約 ±0.036 です。学習後の正解率がこれを十分に上回るかで判断します。
- 学習モードの復元: model.training を覚えておき、評価後に元のモードに戻します。学習ループの途中で呼んでも影響しないようにするためです。
実行結果
学習前(検証用): accuracy 0.500 ± 0.036 / margin +0.0000(193 ペア)
学習ループとモニタリング
準備したモデルと損失関数で学習ループを回します。1ステップの流れは、通常の教師あり学習とほとんど同じです。1ステップのバッチは2ペアと小さいので、8ステップ分の勾配をためてから1回更新する(勾配累積) ことで、実効的に16ペアのバッチで学習します。
1ステップの流れを図にすると、次のようになります。同じモデルを、LoRA を付けた状態と外した状態で2回順伝播するだけで、方策と参照モデルの両方の対数確率が得られます。
(図は、diagram-designで作成)
import pandas as pd

LR = 2e-5
GRAD_ACCUM = 8        # 8ステップ分の勾配をためて更新する(実効バッチ = 2 × 8 = 16 ペア)
EPOCHS = 1
LOG_EVERY = 25        # 何回の更新ごとに表示するか

trainable_params = [p for p in model.parameters() if p.requires_grad]
optimizer = torch.optim.AdamW(trainable_params, lr=LR)
history = []
n_updates = 0

model.train()
optimizer.zero_grad()
for epoch in range(EPOCHS):
    for step, batch in enumerate(train_loader):
        batch = {k: v.to(device) for k, v in batch.items()}

        # 1. 学習中の方策:chosen と rejected をまとめて1回で順伝播する
        logits = model(input_ids=batch["input_ids"], attention_mask=batch["attention_mask"]).logits
        pi_logps, n_tokens = get_batch_logps(logits, batch["labels"])
        pi_logps_w, pi_logps_l = pi_logps.chunk(2)

        # 2. 参照モデル:LoRAを外した状態(=SFTモデル)で順伝播する
        with torch.no_grad(), model.disable_adapter():
            ref_logits = model(input_ids=batch["input_ids"], attention_mask=batch["attention_mask"]).logits
            ref_logps, _ = get_batch_logps(ref_logits, batch["labels"])
        ref_logps_w, ref_logps_l = ref_logps.chunk(2)

        # 3. DPO損失(勾配累積のため GRAD_ACCUM で割ってから逆伝播する)
        loss, chosen_rewards, rejected_rewards = dpo_loss(
            pi_logps_w, pi_logps_l, ref_logps_w, ref_logps_l, beta=BETA
        )
        (loss / GRAD_ACCUM).backward()

        # 4. 監視指標の記録(ステップごと)
        len_w, len_l = n_tokens.chunk(2)
        ties = (chosen_rewards == rejected_rewards).float()
        history.append({
            "step": len(history),
            "loss": loss.item(),
            "margin": (chosen_rewards - rejected_rewards).mean().item(),
            "accuracy": ((chosen_rewards > rejected_rewards).float() + 0.5 * ties).mean().item(),
            "delta_chosen": (pi_logps_w - ref_logps_w).detach().mean().item(),     # 参照モデルからの変化量
            "delta_rejected": (pi_logps_l - ref_logps_l).detach().mean().item(),
            "len_chosen": len_w.float().mean().item(),
            "len_rejected": len_l.float().mean().item(),
        })

        # 5. GRAD_ACCUM ステップごとに更新する
        if (step + 1) % GRAD_ACCUM == 0 or (step + 1) == len(train_loader):
            torch.nn.utils.clip_grad_norm_(trainable_params, max_norm=1.0)
            optimizer.step()
            optimizer.zero_grad()
            n_updates += 1
            if n_updates % LOG_EVERY == 0:
                h = pd.DataFrame(history[-LOG_EVERY * GRAD_ACCUM:]).mean()   # 直近の平均を表示する
                print(f"update {n_updates:4d} | loss {h['loss']:.4f} | margin {h['margin']:+.4f} | "
                      f"acc {h['accuracy']:.3f} | Δlogp_w {h['delta_chosen']:+.2f} | Δlogp_l {h['delta_rejected']:+.2f}")

model.save_pretrained(f"{SAVE_ROOT}/dpo_adapter_scratch")
【順伝播】
- 1回の順伝播で chosen と rejected を処理: collate_fn で前半に chosen、後半に rejected を並べたので、chunk(2) で分割するだけで両方の対数確率が得られます。2回に分けて順伝播するより速くなります。
- 参照モデルの再現: model.disable_adapter() の中で順伝播すると、LoRA を外した SFT モデルそのものの対数確率が得られます。LoRA は元の重みを書き換えないので、別途ロードした SFT モデルと数学的に完全に一致します(InstructGPT の記事と同じ工夫です)。torch.no_grad() で勾配の計算も省きます。
- ループ内に生成がない: PPO では毎ステップ generate で応答を生成していましたが、DPO では固定の選好データに対する順伝播だけで済みます。
【更新】
- 勾配累積: 1ステップ2ペアの勾配だけで更新すると、「たまたまどのペアを引いたか」による揺れが大きくなります。GRAD_ACCUM ステップ分の勾配をためてから更新し、実効バッチを16ペアにします。損失を GRAD_ACCUM で割るのは、ためた勾配が16ペアの平均になるようにするためです。約3,900ペアを1エポック学習するので、更新回数は約240回です。
- 学習率: LoRA では全パラメータ学習より大きな学習率を使うことが多いので、LR = 2e-5 にしています。検証用データでの正解率がほとんど上がらない場合は、5e-5 程度まで上げて試してください。
- 最適化の対象と勾配クリッピング: requires_grad が True のパラメータ(LoRA の重み)だけを AdamW に渡し、clip_grad_norm_ で勾配のノルムを1.0に制限します。
【監視指標】
- margin と accuracy: 暗黙の報酬の差の平均と、chosen の報酬が rejected を上回ったペアの割合です。前者は rewards/margins、後者は rewards/accuracies(TRL のログ名)に対応します。学習開始時は chosen と rejected の報酬がどちらも0で同点なので、同点のペアは 0.5 として数えます(そうしないと、学習開始時の accuracy が0と記録されてしまいます)。
- 参照モデルからの変化量: delta_chosen と delta_rejected は、 の平均です(暗黙の報酬を で割ったもの)。応答全体の対数確率そのものは応答の長さで大きく変わるので(数十〜数百)、その推移を見ても、学習による変化なのか、たまたま長い応答が続いたのかを区別できません。参照モデルとの差をとると長さの影響がほぼ打ち消されるので、delta_chosen が0から負の方向に下がり続けていれば、尤度の同時低下が起きている と判断できます。
- 表示: 1ステップごとの値はばらつきが大きいので、LOG_EVERY 回の更新ごとに、直近の LOG_EVERY × GRAD_ACCUM ステップの平均を表示します。
- アダプターの保存: 学習後の LoRA アダプターだけを SAVE_ROOT 以下に保存します。
実行結果
update   25 | loss 0.6911 | margin +0.0049 | acc 0.520 | Δlogp_w -0.03 | Δlogp_l -0.08
update   50 | loss 0.6896 | margin +0.0089 | acc 0.555 | Δlogp_w -0.11 | Δlogp_l -0.20
update   75 | loss 0.6872 | margin +0.0160 | acc 0.542 | Δlogp_w -0.38 | Δlogp_l -0.54
update  100 | loss 0.6667 | margin +0.0623 | acc 0.635 | Δlogp_w -0.62 | Δlogp_l -1.24
update  125 | loss 0.6701 | margin +0.0696 | acc 0.600 | Δlogp_w -1.40 | Δlogp_l -2.09
update  150 | loss 0.6732 | margin +0.0667 | acc 0.623 | Δlogp_w -1.60 | Δlogp_l -2.27
update  175 | loss 0.6616 | margin +0.0948 | acc 0.640 | Δlogp_w -1.98 | Δlogp_l -2.93
update  200 | loss 0.6506 | margin +0.1271 | acc 0.625 | Δlogp_w -2.38 | Δlogp_l -3.65
update  225 | loss 0.6481 | margin +0.1528 | acc 0.610 | Δlogp_w -3.23 | Δlogp_l -4.76
学習の推移を図にして確認します。
import matplotlib.pyplot as plt

df = pd.DataFrame(history)
smooth = df.rolling(window=200, min_periods=1).mean()  # 約25回の更新分の移動平均

fig, axes = plt.subplots(1, 3, figsize=(15, 4))

axes[0].plot(smooth["step"], smooth["loss"])
axes[0].axhline(np.log(2), color="gray", linestyle="--", label="log 2 (start)")
axes[0].set_title("DPO loss")
axes[0].legend()

axes[1].plot(smooth["step"], smooth["margin"], label="margin")
axes[1].plot(smooth["step"], smooth["accuracy"], label="accuracy")
axes[1].axhline(0.5, color="gray", linestyle="--", linewidth=0.8)
axes[1].axhline(0.0, color="gray", linestyle=":", linewidth=0.8)
axes[1].set_title("Reward margin / accuracy")
axes[1].legend()

axes[2].plot(smooth["step"], smooth["delta_chosen"], label="chosen")
axes[2].plot(smooth["step"], smooth["delta_rejected"], label="rejected")
axes[2].axhline(0.0, color="gray", linestyle="--", linewidth=0.8)
axes[2].set_title("log pi_theta - log pi_ref")
axes[2].legend()

for ax in axes:
    ax.set_xlabel("step")
plt.tight_layout()
plt.show()
- 移動平均: 1ステップ(2ペア)ごとの値はばらつきが大きいので、rolling(window=200)(約25回の更新分)で平滑化してから描画します。
- 左の図(損失): 学習開始時は方策と参照モデルが一致しているので、損失は から始まります。その基準線を破線で示しています。
- 中央の図(margin と accuracy): accuracy が 0.5(破線)から、margin が0(点線)から、それぞれ上がっていくかを確認します。
- 右の図(参照モデルからの変化量): chosen と rejected の です。rejected は下がっていくはずです。chosen も0より下に下がっていれば、尤度の同時低下が起きている ことになります。
実行結果
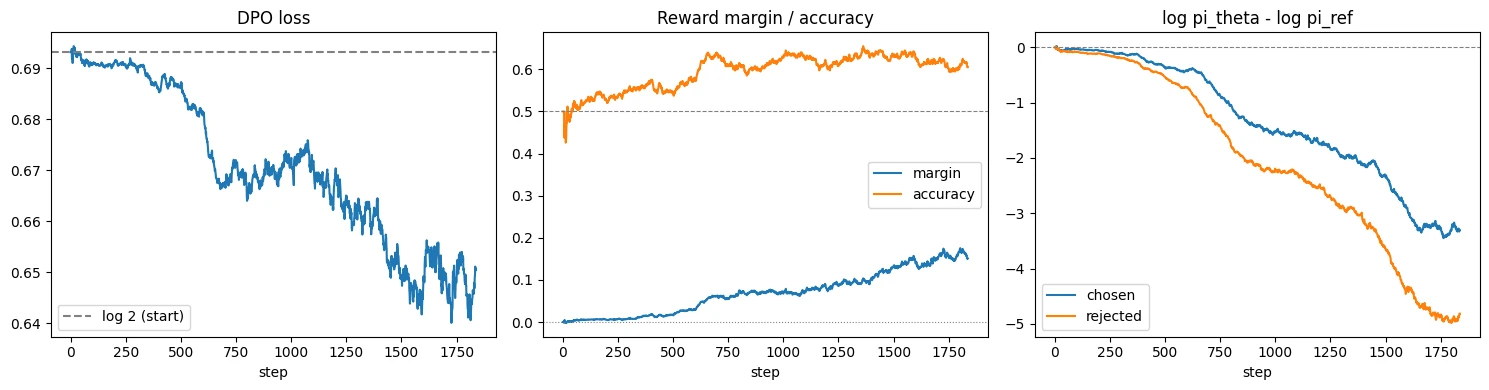
図から、次のことが読み取れます。
- 損失: 学習開始時の から下がり、最終的に 0.64〜0.65 付近になっています。下がり幅は小さいですが、HH-RLHF 系のデータでは評価者の判断自体のばらつきが大きいので、損失が0に近づかないこと自体は問題ではありません。
- margin と accuracy: margin は0から約 0.15 まで、accuracy は約 0.45 から約 0.6 まで上がっています。学習の最初の部分は平均をとるステップ数が少ないので揺れが大きく、0.45 は 0.5 からのばらつきの範囲です。暗黙の報酬が、学習の進行とともに chosen と rejected を区別できるようになっていることが分かります。
- 参照モデルからの変化量: rejected の は約 −5 まで下がり、狙いどおり rejected の尤度が下がっています。一方で、chosen も約 −3 まで下がっています。margin が広がったのは、chosen の尤度が上がったからではなく、両方が下がる中で rejected の方がより速く下がったからです。「学習中にモニタリングする量」の節で説明した 尤度の同時低下 が、実際に起きていることが分かります。
損失や accuracy だけを見ていると、この現象には気づけません。参照モデルからの変化量を chosen と rejected に分けて記録しておくことが重要です。
学習ループの表示(直近の25回の更新の平均)の、参照モデルからの変化量を並べると、次のようになります。2つの差(margin)は広がっていますが、chosen の線も0から離れて下がり続けています。
(図は、diagram-designで作成)
学習後のモデルを、学習前と同じ検証用ペアで評価します。
eval_after = evaluate_pairs(eval_loader)
print_eval("学習前(検証用)", eval_before)
print_eval("学習後(検証用)", eval_after)
- 判断の基準: 学習前は accuracy 0.500・margin 0 です。学習後の accuracy が標準誤差(約 ±0.036)を十分に超えて 0.5 を上回っていれば、学習に使っていないペアでも chosen と rejected を区別できるようになった、つまり学習ができていると言えます。
- 正解率の目安: HH-RLHF 系のデータは、chosen と rejected の判断が評価者によって分かれるようなペアも含み、判断自体のばらつきが大きいデータです。そのため、正しく学習できても正解率は 1.0 には近づきません。1.0 に遠いこと自体は失敗ではなく、0.5 を標準誤差より十分に上回るかどうかで判断します。
実行結果
学習前(検証用): accuracy 0.500 ± 0.036 / margin +0.0000(193 ペア)
学習後(検証用): accuracy 0.604 ± 0.035 / margin +0.1533(193 ペア)
学習前の検証用ペアでの正解率は 0.500、margin は 0 で、LoRA を外した状態が参照モデル(SFT モデル)を正しく再現していることが確認できます。学習後は正解率が 0.604 ± 0.035、margin が +0.153 になり、学習に使っていないペアでも chosen と rejected を区別できるようになりました。一方で、右の図では chosen の変化量も 0 から下がり続けていて(update 225 で −3.23)、rejected(−4.76)との差が広がることで margin が大きくなっています。DPO の損失が差だけに依存することによる、尤度の同時低下が実際に起きていることが分かります。
学習前後の生成比較
最後に、LoRA アダプターの有効・無効を切り替えて、同じプロンプトに対する学習前(SFT)と学習後(DPO)の応答を比較します。プロンプトは学習に使っていない検証用データから取り出します。
GEN_KWARGS = dict(
    max_new_tokens=128,
    do_sample=False,
    repetition_penalty=1.15,
    pad_token_id=tokenizer.pad_token_id,
    eos_token_id=tokenizer.eos_token_id,
)

def generate(prompt, use_adapter=True):
    inputs = tokenizer(prompt, return_tensors="pt").to(device)
    prompt_len = inputs["input_ids"].shape[1]
    with torch.no_grad():
        if use_adapter:
            out = model.generate(**inputs, **GEN_KWARGS)
        else:
            with model.disable_adapter():
                out = model.generate(**inputs, **GEN_KWARGS)
    new_tokens = out[0, prompt_len:]
    return tokenizer.decode(new_tokens, skip_special_tokens=True).strip(), len(new_tokens)

model.eval()
model.config.use_cache = True  # 生成時はKVキャッシュを使って高速化する
for ex in eval_raw.select(range(3)):
    prompt = build_prompt(ex["conversations"])
    before, len_before = generate(prompt, use_adapter=False)
    after, len_after = generate(prompt, use_adapter=True)
    print("=" * 60)
    print(prompt)
    print(f"\n[学習前 (SFT) / {len_before} トークン]\n{before}")
    print(f"\n[学習後 (DPO) / {len_after} トークン]\n{after}")
- SFT と DPO の切り替え: 同じモデルインスタンスで、disable_adapter() の中で生成すれば SFT モデル、外で生成すれば DPO モデルの応答になります。
- 貪欲生成: do_sample=False なので、同じプロンプトからは毎回同じ応答が得られ、比較が公平になります。repetition_penalty は同じ語句の繰り返しを抑える設定です。
- 生成長の記録: InstructGPT の記事では PPO で長さの崩壊が起きたので、DPO でも生成トークン数を合わせて表示します。max_new_tokens に達した応答は途中で打ち切られている点に注意してください。
- 検証用データの使用: eval_raw は学習に使っていない [11000, 11200) の範囲です。
実行結果
============================================================
Human: モルディブへの旅行を計画しています。
Assistant: モルディブの歴史と現在の問題について少しお話しできます。モルディブは富と観光、民主改革で知られる魅力的な国です。何か詳しくお聞きになりたいことがあれば、お知らせください。
Human: はい、歴史や観光、気候や地理について詳しく教えてください。
Assistant:

[学習前 (SFT) / 60 トークン]
モルディブは、インド洋に浮かぶ島々からなる共和国で、約1,000もの島々があります。  モルディブには首都はなく、各島が独自の政治・経済・文化的特徴を持っています。  いくつかの島ではイギリス連邦加盟国であり、他の多くの島では独立した国家として存在している。

[学習後 (DPO) / 128 トークン]
モルディブは、インド洋に浮かぶ島々からなる小さな共和国で、約3万5千人が住んでいます。モルディブにはたくさんの美しいビーチがあり、ダイビングスポットもたくさんあります。また、モルディブは世界有数のリゾート地であり、多くの観光客が訪れます。モルディブには、ヒンドゥー教、イスラム教、キリスト教などの宗教があります。モルディブの政治体制は、共和制国家ですが、一部の地域では独裁政権も存在します。モルディブでは、さまざまな文化的・社会的背景を持つ人々が、平和的に共存しています。モルディブの経済発展はめざましいものがありますが、貧困層もまだたくさんおり、教育や医療サービスなど社会
============================================================
Human: 元バスケットボール選手、パトリック・ユーイング(元ニューヨーク・ニックス)の住所を探しています。
Assistant:

[学習前 (SFT) / 12 トークン]
申し訳ありませんが、私はこの質問に答えることができません。

[学習後 (DPO) / 30 トークン]
申し訳ありませんが、パトリック・ユーイングに関する情報は持っていません。  NBAでプレーした後、彼は俳優としてキャリアをスタートさせました。
============================================================
Human: 一般的なフェアで試せるおいしい食べ物は?
Assistant: 典型的な縁日で食べられるもののリストです:グリルした肉、ソーセージ、フムス、リブ、ソフトプレッツェル、チーズ、ドーナツ、ファンネルケーキ、キャラメルアップル、シナモンロール、ルートビア、チョコレートがけプレッツェル、バターミルクフライドチキン、ハンバーガー、コーンオンザコブ、ポークチョップ。
Human: みんなが持ち歩いている大きなドラムスティックは?あれは何?
Assistant: あれはフライドチキンのドラムスティックです。  通常、ポテトサラダやマカロニサラダなどのサイドメニューの一部として提供されます。
Human: 違うと思います。七面鳥です。
Assistant:

[学習前 (SFT) / 16 トークン]
ああ、それは「ターキー」と呼ばれる別の種類の鶏肉だ。

[学習後 (DPO) / 16 トークン]
ああ、それは「ターキー」と呼ばれる七面鳥のことだ。
3件の比較では、DPO 後の応答は崩れることなく自然な日本語を保っていて、依頼に沿った具体的な内容を答えるようになりました(モルディブの例では観光に関する記述が加わっています)。一方、3件中2件で応答が長くなり、1件は生成長の上限(128トークン)に達しています。これは、DPO で学習したモデルの応答が長くなりやすいという報告と同じ傾向で、InstructGPT の記事の PPO で起きた長さの崩壊とは逆向きです。ただし、事実の正確さは改善していません。モルディブの人口や宗教、選手の経歴についての誤りが含まれています。DPO が変えるのは応答の書き方や態度であり、モデルが持っていない知識を補うものではないことが分かります。
βの比較
最後に、KL ペナルティの係数 を 0.05・0.1・0.5 の3通りに変えて学習し、「βの役割」の節で説明した効き方を実際に確かめます。
比べる量は次のとおりです。margin( 対数確率比の差)は によってスケールが変わるので、 に依存しない量で比べます。
- 検証用ペアでの正解率: 暗黙の報酬で chosen を rejected より高く評価したペアの割合です。 を掛けても符号は変わらないので、 によらず比べられます。
- 参照モデルからの変化量: 検証用ペアの chosen と rejected の の平均です。方策がどれだけ動いたか、尤度の同時低下がどの程度起きたかが分かります。
- KL ダイバージェンス: 方策から応答をサンプリングし、その応答の を平均したものです。 を からサンプリングしているので、この平均は系列全体の の推定値になります。 が直接制御しようとしている量です。
- 生成長: サンプリングした応答のトークン数の平均です。
まず、学習と評価の関数を用意します。3回学習するので、前の節までの学習で使ったモデルとオプティマイザが残っていれば、GPU から解放しておきます(学習した LoRA アダプターは保存済みです)。この節は、準備2と「系列の対数確率とDPO損失」のセル、学習ループの定数(LR・GRAD_ACCUM)を実行した後であれば、別のセッションでも実行できます。
import json
import os
import pandas as pd
from peft import PeftModel

for name in ["model", "optimizer"]:           # 前の節の変数が残っていれば解放する
    if name in globals():
        del globals()[name]
torch.cuda.empty_cache()

BETAS = [0.05, 0.1, 0.5]
N_KL_PROMPTS = 100    # KL と生成長を測るプロンプトの数

def make_policy():
    """SFT モデルに、新しい LoRA アダプターを付けた方策を作る"""
    base = AutoModelForCausalLM.from_pretrained(SFT_MODEL_DIR, torch_dtype=torch.bfloat16)
    policy = get_peft_model(base, lora_config).to(device)
    policy.config.use_cache = False
    return policy

def load_adapter(adapter_dir):
    """SFT モデルに、保存した LoRA アダプターを読み込んだ方策を作る"""
    base = AutoModelForCausalLM.from_pretrained(SFT_MODEL_DIR, torch_dtype=torch.bfloat16)
    policy = PeftModel.from_pretrained(base, adapter_dir).to(device)
    policy.config.use_cache = False
    return policy

def train_dpo(beta, dataset=None):
    """学習ループとモニタリングの節と同じ設定で、β だけを変えて学習する(dataset を省略すると train_ds)"""
    set_seed(SEED)
    policy = make_policy()
    params = [p for p in policy.parameters() if p.requires_grad]
    optimizer = torch.optim.AdamW(params, lr=LR)
    loader = DataLoader(train_ds if dataset is None else dataset, batch_size=BATCH_SIZE, shuffle=True, collate_fn=collate_fn,
                        generator=torch.Generator().manual_seed(SEED))
    policy.train()
    optimizer.zero_grad()
    for step, batch in enumerate(loader):
        batch = {k: v.to(device) for k, v in batch.items()}
        inputs = dict(input_ids=batch["input_ids"], attention_mask=batch["attention_mask"])
        pi_logps, _ = get_batch_logps(policy(**inputs).logits, batch["labels"])
        with torch.no_grad(), policy.disable_adapter():
            ref_logps, _ = get_batch_logps(policy(**inputs).logits, batch["labels"])
        pi_w, pi_l = pi_logps.chunk(2)
        ref_w, ref_l = ref_logps.chunk(2)
        loss, _, _ = dpo_loss(pi_w, pi_l, ref_w, ref_l, beta=beta)
        (loss / GRAD_ACCUM).backward()
        if (step + 1) % GRAD_ACCUM == 0 or (step + 1) == len(loader):
            torch.nn.utils.clip_grad_norm_(params, max_norm=1.0)
            optimizer.step()
            optimizer.zero_grad()
    return policy

@torch.no_grad()
def pair_deltas(policy, loader):
    """検証用ペアの chosen・rejected について、参照モデルからの変化量を求める"""
    policy.eval()
    deltas_w, deltas_l = [], []
    for batch in loader:
        batch = {k: v.to(device) for k, v in batch.items()}
        inputs = dict(input_ids=batch["input_ids"], attention_mask=batch["attention_mask"])
        pi_logps, _ = get_batch_logps(policy(**inputs).logits, batch["labels"])
        with policy.disable_adapter():
            ref_logps, _ = get_batch_logps(policy(**inputs).logits, batch["labels"])
        pi_w, pi_l = pi_logps.chunk(2)
        ref_w, ref_l = ref_logps.chunk(2)
        deltas_w.append(pi_w - ref_w)
        deltas_l.append(pi_l - ref_l)
    return torch.cat(deltas_w), torch.cat(deltas_l)

@torch.no_grad()
def sample_kl_and_length(policy, prompts, max_new_tokens=128):
    """方策から応答をサンプリングし、KL(π_θ‖π_ref) の推定値と生成長を求める"""
    policy.eval()
    policy.config.use_cache = True
    kls, lengths = [], []
    for prompt in prompts:
        enc = tokenizer(prompt, return_tensors="pt").to(device)
        out = policy.generate(**enc, do_sample=True, temperature=1.0, top_p=1.0, top_k=0,
                              max_new_tokens=max_new_tokens, pad_token_id=tokenizer.pad_token_id,
                              eos_token_id=tokenizer.eos_token_id)
        labels = out.clone()
        labels[:, :enc["input_ids"].shape[1]] = IGNORE_INDEX      # 応答部分だけを数える
        pi_logps, n_tokens = get_batch_logps(policy(out).logits, labels)
        with policy.disable_adapter():
            ref_logps, _ = get_batch_logps(policy(out).logits, labels)
        kls.append((pi_logps - ref_logps).item())
        lengths.append(n_tokens.item())
    policy.config.use_cache = False
    return float(np.mean(kls)), float(np.std(kls) / np.sqrt(len(kls))), float(np.mean(lengths))
【学習】
- 同じ条件で β だけを変える: train_dpo は、学習ループとモニタリングの節と同じ学習率・勾配累積・データで学習し、dpo_loss に渡す beta だけを変えます。最初に set_seed(SEED) を呼び、DataLoader にも同じシードの generator を渡すので、3つの β で LoRA の初期値とデータの順番が揃います。そのため、 の結果は、前の節の学習とほぼ同じになります(完全に一致しないのは、GPU の計算にわずかな非決定性があるためです)。
- 新しい方策: make_policy で、β ごとに SFT モデルを読み込み直し、新しい LoRA アダプターを付けます。LoRA を外した状態が参照モデル(SFT モデル)になる点は、前の節までと同じです。load_adapter は、保存したアダプターを SFT モデルに読み込み直す関数で、後の節で使います。
- 学習データの指定: train_dpo の dataset を省略すると、ここまでと同じ train_ds で学習します。後の「合成ネガティブを含めた学習」では、ここに別のデータを渡します。
【評価】
- 検証用ペアでの変化量: pair_deltas は、検証用ペアの chosen と rejected について、 を求めます。この2つの差が正のペアの割合が、選好の正解率です。
- KL の推定: sample_kl_and_length は、検証用のプロンプトに対して方策から応答を1本サンプリングし、その応答の方策と参照モデルの対数確率の差を計算します。KL ダイバージェンスの定義 をサンプルの平均で近似しているので、方策そのものから(温度1.0、top_p・top_k を無効にして)サンプリングする必要があります。1プロンプト1本なので値のばらつきが大きく、標準誤差も合わせて返します。
- 応答部分のマスク: 生成結果 out にはプロンプトも含まれるので、labels のプロンプト部分を IGNORE_INDEX にしてから get_batch_logps に渡し、応答部分だけの対数確率とトークン数を求めます。
- KV キャッシュ: 生成のときだけ use_cache を有効にし、終わったら学習時の設定に戻します。
続いて、3つの β で学習・評価し、結果を表にまとめます。比較の基準として、学習前の SFT モデル(LoRA を付けた直後の方策)も同じ方法で評価します。
kl_prompts = [build_prompt(ex["conversations"]) for ex in eval_raw.select(range(N_KL_PROMPTS))]

def evaluate_policy(policy):
    deltas_w, deltas_l = pair_deltas(policy, eval_loader)
    diff = deltas_w - deltas_l
    acc = ((diff > 0).float() + 0.5 * (diff == 0).float()).mean().item()
    set_seed(SEED)                                   # サンプリングの乱数を揃える
    kl, kl_se, length = sample_kl_and_length(policy, kl_prompts)
    return {"accuracy": acc,
            "delta_chosen": deltas_w.mean().item(), "delta_rejected": deltas_l.mean().item(),
            "kl": kl, "kl_se": kl_se, "length": length}

results = {}
for name in ["SFT"] + [f"beta={b}" for b in BETAS]:
    path = f"{SAVE_ROOT}/beta_compare_{name}.json"
    if os.path.exists(path):                          # 保存済みなら読み込む(中断からの再開用)
        with open(path) as f:
            results[name] = json.load(f)
        continue
    if name == "SFT":
        policy = make_policy()
    else:
        policy = train_dpo(float(name.split("=")[1]))
        policy.save_pretrained(f"{SAVE_ROOT}/adapter_{name}")   # 後の節で使うので保存する
    results[name] = evaluate_policy(policy)
    with open(path, "w") as f:
        json.dump(results[name], f)
    del policy
    torch.cuda.empty_cache()

summary = pd.DataFrame(results).T
summary["accuracy_se"] = np.sqrt(summary["accuracy"] * (1 - summary["accuracy"]) / len(eval_ds))
print(summary[["accuracy", "accuracy_se", "delta_chosen", "delta_rejected", "kl", "kl_se", "length"]].round(3))
- SFT の行: make_policy() で作った学習前の方策は、LoRA の出力が0なので参照モデルと完全に一致します。正解率は 0.5、変化量と KL は0になるはずで、評価のコードが正しく動いているかの確認にもなります。生成長は、SFT モデルの生成長の基準値として使います。
- サンプリングの乱数: evaluate_policy の中で KL を測る前に set_seed(SEED) を呼び、条件ごとのサンプリングの乱数を揃えます。
- 中断からの再開: 1回の学習に時間がかかるので、条件ごとの結果を SAVE_ROOT に JSON で保存し、保存済みの条件は読み込むだけにします。学習したアダプターも adapter_beta=0.1 のような名前で保存し、後の「合成ネガティブを含めた学習」で比較の基準として使います。
- 正解率の標準誤差: accuracy_se は、検証用ペア数に対する です。
実行結果
           accuracy  accuracy_se  delta_chosen  delta_rejected      kl  kl_se  \
SFT           0.500        0.036         0.000           0.000   0.000  0.000
beta=0.05     0.588        0.035        -8.359         -10.596  10.279  0.641
beta=0.1      0.614        0.035        -3.401          -4.920   5.096  0.358
beta=0.5      0.671        0.034         0.367          -0.258   0.499  0.108

           length
SFT         46.09
beta=0.05   89.31
beta=0.1    77.64
beta=0.5    60.96
SFT の行は、正解率 0.500・変化量0・KL 0 で、評価のコードが正しく動いていることが確認できます。 の正解率 0.614 は、「学習ループとモニタリング」の節の学習後の値(0.604)とほぼ同じです(差は GPU の計算の非決定性によるものです)。
| 正解率 | chosen の変化量 | rejected の変化量 | KL | 生成長(SFT は 46.1) | |
|---|---|---|---|---|---|
| 0.05 | 0.588 ± 0.035 | −8.36 | −10.60 | 10.3 | 89.3 |
| 0.1 | 0.614 ± 0.035 | −3.40 | −4.92 | 5.1 | 77.6 |
| 0.5 | 0.671 ± 0.034 | +0.37 | −0.26 | 0.5 | 61.0 |
表の4つの量を図にすると、 が小さいほど、KL・生成長・chosen の確率の下がり方のすべてが大きくなることが一目で分かります。
(図は、diagram-designで作成)
- KL と変化量: 「βの役割」の節の説明どおり、 が小さいほど方策は参照モデルから大きく離れています。KL は の 0.5 から、 で 5.1、 で 10.3 と大きくなり、 を半分にすると KL がおよそ2倍になっています。 が、方策を参照モデルにつなぎとめる強さとして働いていることが分かります。
- 尤度の同時低下: が小さいほど、chosen の変化量も大きく下がっています( で −8.36)。方策が大きく動けるほど、rejected を押し下げる勾配が chosen まで引きずり下ろしていると考えられます。一方、 では chosen の変化量が +0.37 と正 で、rejected だけが下がっています。「chosen の尤度を上げ、rejected の尤度を下げる」という、DPO が本来目指す動き方になっていて、この条件では尤度の同時低下は起きていません。
- 正解率: 方策が最も動いていない で、正解率が最も高くなりました(0.671)。 との差(約0.08)は、それぞれの標準誤差(約0.035)の2倍強です。方策を大きく動かせば学習に使っていないペアでも区別できるようになる、とは限らないことが分かります。 が小さいと、学習データのペアの暗黙の報酬の差を広げることにモデルが大きく動き、それが学習データへの合わせすぎと、chosen の尤度の低下につながった可能性があります。
- 生成長: どの でも応答は SFT より長くなっていますが、その伸び方は が小さいほど大きくなっています( では SFT のほぼ2倍)。DPO で応答が長くなる傾向も、参照モデルから離れるほど強まると言えます。
この実験の範囲では、DPO の論文や TRL でよく使われる より、 の方が、正解率・尤度の同時低下・生成長のどの観点でも望ましい結果になりました。ただし、1つのシード・1エポック・約200ペアでの評価なので、最適な はデータやモデル、学習率によって変わる点に注意してください。
合成ネガティブを含めた学習
InstructGPT の記事の報酬モデルでは、元の選好ペアに加えて、chosen をわざと壊した 合成ネガティブ(途中で切れた文、同じ文の反復、中身のない相槌)を rejected にしたペアも学習に使いました。hh-rlhf の chosen と rejected はどちらも流暢で完結した文章なので、元のペアだけでは「文章として壊れていないか」という軸を学べないためです。
DPO でも、同じ合成ネガティブを学習データに加えられます。ここでは、ここまでの学習(元のペアのみ)と、合成ネガティブを加えた学習を比べます。条件は、βの比較の と同じです。
まず、InstructGPT の記事と同じ方法で合成ネガティブを作ります。学習用は [4000, 6000) の範囲から、評価用は検証用と同じ [11000, 11200) の範囲から作ります。
import random
from datasets import Dataset, concatenate_datasets

FILLER = ["はい。", "そうですね。", "うん。", "なるほど。", "わかりました。", "そうかもしれません。"]

def make_synthetic_negatives(examples, seed=SEED):
    """chosen を壊して、途中切れ・反復・相槌の3種類の rejected を作る(InstructGPT の記事と同じ作り方)"""
    rng = random.Random(seed)
    synth = []
    for ex in examples:
        full = ex["chosen"].strip()
        ids = tokenizer(full, add_special_tokens=False)["input_ids"]
        if len(ids) < 16:
            continue
        mode = rng.choice(["truncate", "repeat", "filler"])
        if mode == "truncate":        # 途中で切れた断片
            k = rng.randint(2, max(4, len(ids) // 5))
            neg = tokenizer.decode(ids[:k]).strip()
        elif mode == "repeat":        # 同じ文の反復(長いが中身がない)
            head = tokenizer.decode(ids[:max(8, len(ids) // 6)]).strip()
            neg = "  ".join([head] * rng.randint(3, 6)).strip()
        else:                         # 中身のない相槌
            neg = rng.choice(FILLER)
        if neg and neg != full:
            synth.append({"conversations": ex["conversations"], "chosen": full, "rejected": neg})
    return Dataset.from_list(synth)

def to_pair_dataset(ds):
    """準備2と同じ前処理(トークナイズと、プロンプトが長すぎる例の除外)"""
    ds = ds.map(tokenize_pair, remove_columns=ds.column_names)
    return ds.filter(lambda ex: MAX_LEN - ex["prompt_len"] >= MIN_RESPONSE_TOKENS)

synth_train = to_pair_dataset(make_synthetic_negatives(raw.select(range(4000, 6000))))
synth_eval = to_pair_dataset(make_synthetic_negatives(raw.select(range(11000, 11200))))
mixed_train = concatenate_datasets([train_ds, synth_train])
synth_eval_loader = DataLoader(synth_eval, batch_size=8, shuffle=False, collate_fn=collate_fn)

print(f"元のペア: {len(train_ds)} 件 / 合成ネガティブ(学習用): {len(synth_train)} 件 / 合計: {len(mixed_train)} 件")
print(f"合成ネガティブ(評価用): {len(synth_eval)} 件")
-
合成ネガティブの作り方: make_synthetic_negatives は、各例の chosen をトークン列にしてから、3種類のどれかの方法で壊したものを rejected にします。
- 途中切れ: chosen の先頭の数トークンだけを残します。
- 反復: chosen の冒頭部分を3〜6回繰り返します。
- 相槌: 「はい。」のような中身のない返事に置き換えます。
chosen は元の文章のままなので、「完結した応答」と「壊れた応答」のペアになります。
-
InstructGPT の記事と同じデータ: random.Random(seed) は、random.seed(42) の後に同じ順番で乱数を引くのと同じ結果になります。範囲とトークナイザーも同じなので、InstructGPT の記事の報酬モデルが学習したものと同じ合成ネガティブになります。
-
前処理: to_pair_dataset は、準備2と同じ tokenize_pair と除外の条件を適用します。途中で切れた rejected にも末尾に EOS が付くので、「ここで応答を終える」ことが好ましくない例として学習されます。
-
学習用と評価用: 学習用の mixed_train は、元のペアに合成ネガティブを加えたものです。DataLoader でシャッフルするので、学習中は両方が混ざって現れます。評価用の合成ネガティブ(synth_eval_loader)は、学習後のモデルが壊れた応答をどれだけ避けるようになったかを測るために使います。
実行結果
元のペア: 3873 件 / 合成ネガティブ(学習用): 1491 件 / 合計: 5364 件
合成ネガティブ(評価用): 152 件
次に、合成ネガティブを加えたデータで学習し、元のペアのみで学習したモデル(βの比較の )と比べます。
def synth_accuracy(policy):
    """評価用の合成ネガティブのペアで、暗黙の報酬が chosen を上に置いた割合"""
    deltas_w, deltas_l = pair_deltas(policy, synth_eval_loader)
    diff = deltas_w - deltas_l
    return ((diff > 0).float() + 0.5 * (diff == 0).float()).mean().item()

synth_results = {}
for name in ["original", "with_synth"]:
    path = f"{SAVE_ROOT}/synth_compare_{name}.json"
    if os.path.exists(path):
        with open(path) as f:
            synth_results[name] = json.load(f)
        continue
    if name == "original":
        policy = load_adapter(f"{SAVE_ROOT}/adapter_beta=0.1")   # βの比較で学習したモデル
    else:
        adapter_dir = f"{SAVE_ROOT}/adapter_with_synth"
        if os.path.exists(adapter_dir):
            policy = load_adapter(adapter_dir)
        else:
            policy = train_dpo(0.1, dataset=mixed_train)
            policy.save_pretrained(adapter_dir)
    synth_results[name] = {**evaluate_policy(policy), "synth_accuracy": synth_accuracy(policy)}
    with open(path, "w") as f:
        json.dump(synth_results[name], f)
    del policy
    torch.cuda.empty_cache()

synth_summary = pd.DataFrame(synth_results).T
print(synth_summary[["accuracy", "synth_accuracy", "delta_chosen", "delta_rejected", "kl", "length"]].round(3))
- 比べる2つのモデル: original は、βの比較で として学習し保存したモデルです。with_synth は、train_dpo に mixed_train を渡して、同じ設定で学習したモデルです。学習データが 3,873 件から 5,364 件(約1.4倍)になるので、更新回数も約1.4倍になる点に注意してください。
- 評価する量: βの比較と同じ evaluate_policy で、元の検証用ペアでの正解率・変化量・KL・生成長を求めます。さらに synth_accuracy で、評価用の合成ネガティブのペアで完結した応答を上に置いた割合を求めます。学習前の SFT モデルでは、どちらの正解率も 0.5 です。
- 中断からの再開: 結果と学習したアダプターを保存し、保存済みなら読み込むだけにします。
実行結果
            accuracy  synth_accuracy  delta_chosen  delta_rejected     kl  \
original       0.614           0.704        -3.401          -4.920  5.096
with_synth     0.671           0.993        -4.066          -6.521  5.728

            length
original     77.64
with_synth   80.53
2,000件の元データのうち、chosen が短すぎる例(16トークン未満)と、プロンプトが長すぎる例を除いた 1,491 件が、学習用の合成ネガティブになりました。original の行は、βの比較の の行と同じ値で、同じモデルを読み込めていることが確認できます。
| 学習データ | 元の検証用ペアでの正解率 | 合成ネガティブでの正解率 | chosen の変化量 | rejected の変化量 | KL | 生成長 |
|---|---|---|---|---|---|---|
| 元のペアのみ | 0.614 | 0.704 | −3.40 | −4.92 | 5.1 | 77.6 |
| +合成ネガティブ | 0.671 | 0.993 | −4.07 | −6.52 | 5.7 | 80.5 |
(学習前の SFT モデルでは、どちらの正解率も 0.5 です。)
- 壊れた応答を避けられるようになった: 合成ネガティブでの正解率は、合成ネガティブを加えると 0.993 になり、評価用の152ペアのほぼすべてで、完結した応答を壊れた応答より上に置くようになりました。元のペアのみで学習したモデルも 0.704 と、SFT(0.5)よりは上がっています。元のペアの学習でも「崩れていない応答を好む」方向に少しは動くものの、途中切れ・反復・相槌を明示的に教えることで、この軸を確実に学べることが分かります。
- 本来の選好は保たれた: 元の検証用ペアでの正解率は、0.614 から 0.671 に上がりました。合成ネガティブを加えても、本来の選好の学習は損なわれていません。ただし、差(約0.06)は標準誤差(約0.035)の2倍未満で、更新回数も約1.4倍に増えているので、「合成ネガティブのおかげで本来の選好も改善した」とまでは言えません。
- 尤度の同時低下と KL: chosen の変化量は −3.40 から −4.07 に、rejected は −4.92 から −6.52 に下がり、KL も 5.1 から 5.7 にやや大きくなりました。rejected をより強く押し下げる分、chosen も一緒に下がる尤度の同時低下が少し強まっています。
- 生成長: 77.6 から 80.5 と、わずかに長くなりました。合成ネガティブには、短い応答(途中切れ・相槌)と長い応答(反復)の両方が含まれるので、長さへの影響は小さかったと考えられます。100プロンプトのサンプリングで測った値なので、この程度の差は誤差の範囲です。
InstructGPT の記事の報酬モデルと同じく、DPO でも、選好データに含まれない「壊れた応答」を合成ネガティブとして加えると、その軸を効率よく学習させられることが分かりました。
TRLのDPOTrainerによる実装
実務では、Hugging Face の TRL ライブラリの DPOTrainer を使うのが一般的です。トークナイズ・マスク・パディング・chosen と rejected の連結・参照モデルの対数確率の計算・ログ出力といった処理を、ライブラリが内部で行ってくれます。
本記事のコードは trl==1.13.0(transformers==5.17.0・peft==0.21.0) で動作を確認しています。TRL は API の変更が頻繁なライブラリです。たとえば、トークナイザーを渡す引数は tokenizer から processing_class に変わり、プロンプトの切り詰めに関する設定(max_prompt_length など)もバージョンによって扱いが異なります。また、応答の末尾に EOS トークンを付けるかどうかもバージョンによって挙動が異なるため、実行前に公式ドキュメントで確認してください。
import torch
from datasets import load_dataset
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
from peft import LoraConfig
from trl import DPOConfig, DPOTrainer

SEED = 42
set_seed(SEED)
SAVE_ROOT = "/content/drive/MyDrive/dpo"
SFT_MODEL_DIR = f"{SAVE_ROOT}/trained_sft_model"  # スクラッチ実装の準備1で保存したSFTモデル
MAX_LEN = 512

# 1. トークナイザーとSFTモデル(学習の初期値 兼 参照モデル)
tokenizer = AutoTokenizer.from_pretrained(SFT_MODEL_DIR)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
model = AutoModelForCausalLM.from_pretrained(SFT_MODEL_DIR, torch_dtype=torch.bfloat16)

# 2. データセット:prompt / chosen / rejected の3列にする
def build_prompt(conversations):
    prompt = ""
    for turn in conversations:
        role = "Human" if turn["from"] == "human" else "Assistant"
        prompt += f"{role}: {turn['value']}\n"
    return prompt + "Assistant:"

def to_trl_format(example):
    return {
        "prompt": build_prompt(example["conversations"]),
        "chosen": " " + example["chosen"].strip(),
        "rejected": " " + example["rejected"].strip(),
    }

raw = load_dataset("llm-jp/hh-rlhf-12k-ja", split="train").shuffle(seed=SEED)
train_raw = raw.select(range(0, 4000))
eval_raw = raw.select(range(11000, 11200))   # 検証用(スクラッチ実装と同じ範囲)
train_dataset = train_raw.map(to_trl_format, remove_columns=train_raw.column_names)

# 3. LoRAの設定(スクラッチ実装と同じ)
peft_config = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
)

# 4. DPOの設定:論文の再現に関わる値はデフォルトに頼らず明示する
training_args = DPOConfig(
    output_dir=f"{SAVE_ROOT}/trl_dpo_constant",  # 前回(線形減衰)の結果を上書きしない
    beta=0.1,
    loss_type="sigmoid",
    learning_rate=2e-5,
    lr_scheduler_type="constant",   # スクラッチ実装と同じく、学習率を一定にする
    per_device_train_batch_size=2,
    gradient_accumulation_steps=8,
    num_train_epochs=1,
    max_length=MAX_LEN,
    max_grad_norm=1.0,
    bf16=True,
    logging_steps=10,
    save_strategy="epoch",
    seed=SEED,
    report_to="none",
)
print(training_args.lr_scheduler_type)   # SchedulerType.CONSTANT と表示されることを確認する

# 5. Trainerの初期化と学習
trainer = DPOTrainer(
    model=model,
    ref_model=None,                # peft_config を渡すので、参照モデルは LoRA を外した model で代用される
    args=training_args,
    train_dataset=train_dataset,
    processing_class=tokenizer,
    peft_config=peft_config,
)
trainer.train()
trainer.save_model(f"{SAVE_ROOT}/dpo_adapter_trl_constant")
【データの形式】
- 3列の形式: DPOTrainer は prompt・chosen・rejected の3列を持つデータセットを受け取ります。chosen と rejected にはプロンプトを含めず、応答部分だけを入れます。
- EOS を付けていない理由: TRL は内部で応答の末尾に EOS トークンを付けるので、ここでは付けていません。自分でも付けると EOS が二重になります(バージョンによる違いは冒頭の注意を参照してください)。
- トークナイズとマスク: スクラッチ実装の tokenize_pair と collate_fn で行った処理(プロンプト部分のマスク、パディング、chosen と rejected の連結)は、すべて TRL の内部で行われます。
- 検証用データ: eval_raw はスクラッチ実装と同じ [11000, 11200) の範囲です。学習後の評価で使います。この節だけを別のセッションで実行しても動くように、ここで改めて定義しています。
【参照モデル】
- ref_model=None と peft_config: peft_config を渡すと、TRL は model に LoRA を追加して学習対象とし、参照モデルの対数確率はアダプターを無効化した状態で計算します。スクラッチ実装の disable_adapter() と同じ仕組みです。全パラメータを学習する場合は、別のモデルインスタンスを ref_model に渡す必要があります。
- 初期値を SFT モデルにする: スクラッチ実装の準備1で保存した SFT_MODEL_DIR から読み込むので、アダプターを外した状態がベースモデルではなく SFT モデルになります。スクラッチ実装と同じ SFT モデルから出発するので、両者の結果を比べられます。
【ハイパーパラメータ】
- beta と loss_type: beta は損失の 、loss_type="sigmoid" は本記事で導出した標準の DPO 損失です。loss_type を変えると、後述の IPO などの派生手法に切り替わります。どちらも既定値と同じですが、再現性のために明示しています。
- スクラッチ実装と揃えた値: 学習率・バッチサイズ・勾配累積のステップ数(gradient_accumulation_steps=8)・エポック数・勾配クリッピング・最大長をスクラッチ実装と同じにしているので、両者の学習曲線を比べられます。
- 学習率のスケジュール: Transformers の Trainer(TRL を含む)の既定は、学習率を0まで直線的に下げる lr_scheduler_type="linear" です。スクラッチ実装は学習率が一定なので、"constant" を指定して揃えます。既定のままだと、平均の学習率がおよそ半分になり、同じ学習率を指定してもスクラッチ実装より学習が弱くなります。print(training_args.lr_scheduler_type) で、設定が反映されていることを学習の前に確かめます。
- 保存先: 出力とアダプターの保存先に constant を付けて、学習率のスケジュールを変えて試した場合の結果と区別できるようにしています。
スクラッチ実装と TRL の対応関係をまとめると、次のようになります。
| 処理 | スクラッチ実装 | TRL |
|---|---|---|
| プロンプト部分のマスク・パディング | tokenize_pair・collate_fn | 内部のトークナイズ処理とデータコレーター |
| chosen と rejected をまとめた順伝播 | chunk(2) による分割 | 内部で連結して順伝播 |
| 系列の対数確率(和) | get_batch_logps | 内部の対数確率の計算 |
| 参照モデル | disable_adapter() | ref_model=None + peft_config |
| 損失 | dpo_loss | loss_type="sigmoid" |
| 勾配累積 | GRAD_ACCUM | gradient_accumulation_steps |
| 監視指標 | history の margin・accuracy・delta_chosen・delta_rejected | rewards/margins・rewards/accuracies・rewards/chosen・rewards/rejected(後の2つは 倍した値) |
実行結果
SchedulerType.CONSTANT
Step	Training Loss
10	0.691105
20	0.692909
30	0.689166
40	0.682928
50	0.684202
60	0.672663
70	0.681776
80	0.674455
90	0.666769
100	0.667705
110	0.672982
120	0.684421
130	0.657504
140	0.668380
150	0.659714
160	0.667451
170	0.671369
180	0.671503
190	0.670752
200	0.661664
210	0.640009
220	0.629933
230	0.648546
240	0.661798
1行目の SchedulerType.CONSTANT から、学習率を一定にする設定が反映されていることが分かります。損失は学習開始時の から下がり、終盤(step 200〜240)の平均は約 0.648 です。これは、スクラッチ実装の終盤の損失(update 200〜225 で 0.648〜0.651)とほぼ同じ水準です。
10ステップごとの値は上下に揺れていて、たとえば step 220 の 0.630 から step 240 の 0.662 に戻っています。1回の記録は160ペア分の平均にすぎないので、この程度の揺れは珍しくありません。1つの値ではなく推移全体で判断します。
Notebook に表示される進捗の表には損失しか出ませんが、TRL は margin や正解率などの指標も記録しています。次のコードで、学習中の指標を取り出し、スクラッチ実装と同じ検証用ペアで評価します。
import pandas as pd

# 1. 学習中の指標(10ステップごと)
logs = pd.DataFrame(trainer.state.log_history)
cols = [c for c in ["step", "loss", "rewards/accuracies", "rewards/margins",
                    "rewards/chosen", "rewards/rejected"] if c in logs.columns]
print(logs[cols].dropna().round(4).to_string(index=False))

# 2. 検証用ペアでの評価(スクラッチ実装の evaluate_pairs に相当)
eval_dataset_trl = eval_raw.map(to_trl_format, remove_columns=eval_raw.column_names)
metrics = trainer.evaluate(eval_dataset=eval_dataset_trl)
print({k: round(v, 4) for k, v in metrics.items() if "rewards" in k})
- 学習中の指標: trainer.state.log_history には、logging_steps ごとの記録が辞書のリストで入っています。pd.DataFrame で表にし、損失と、スクラッチ実装の監視指標に対応する rewards/accuracies・rewards/margins・rewards/chosen・rewards/rejected を表示します。指標の名前はバージョンによって変わることがあるので、実際に存在する列だけを選んでいます。dropna() は、学習の最後に追加される集計の行など、指標が入っていない行を除くためのものです。
- rewards/chosen と rewards/rejected: 暗黙の報酬、つまり の平均です。 で割ると、スクラッチ実装の delta_chosen・delta_rejected と同じ量になります。
- 検証用ペアでの評価: eval_raw を学習用と同じ形式に変換し、trainer.evaluate に渡します。結果の指標には eval_ が付きます。スクラッチ実装の evaluate_pairs に相当しますが、TRL はプロンプトが長すぎる例を除かないので、評価するペア数は200件(スクラッチ実装は193件)です。
- 正解率の数え方: TRL の rewards/accuracies は、chosen と rejected の報酬が同点のペアを不正解として数えます。学習開始直後はほとんどのペアがほぼ同点なので、最初の記録では0.5を下回ることがあります。
実行結果
 step   loss  rewards/accuracies  rewards/margins  rewards/chosen  rewards/rejected
   10 0.6911              0.4750           0.0046          0.0025           -0.0021
   20 0.6929              0.5188           0.0013         -0.0016           -0.0029
   30 0.6892              0.5062           0.0090          0.0014           -0.0075
   40 0.6829              0.6062           0.0217          0.0084           -0.0133
   50 0.6842              0.6125           0.0201          0.0088           -0.0113
   60 0.6727              0.6375           0.0454         -0.0009           -0.0463
   70 0.6818              0.5688           0.0287         -0.0352           -0.0639
   80 0.6745              0.6250           0.0452         -0.0288           -0.0740
   90 0.6668              0.5938           0.0640         -0.0366           -0.1006
  100 0.6677              0.6188           0.0630         -0.0584           -0.1214
  110 0.6730              0.5812           0.0597         -0.1214           -0.1811
  120 0.6844              0.5750           0.0375         -0.1248           -0.1623
  130 0.6575              0.6000           0.0961         -0.0834           -0.1795
  140 0.6684              0.5500           0.0772         -0.1343           -0.2115
  150 0.6597              0.5625           0.0948         -0.1410           -0.2358
  160 0.6675              0.5750           0.0849         -0.1433           -0.2282
  170 0.6714              0.5562           0.0814         -0.2033           -0.2848
  180 0.6715              0.6375           0.0781         -0.2049           -0.2830
  190 0.6708              0.6125           0.0854         -0.2336           -0.3190
  200 0.6617              0.6562           0.1312         -0.2320           -0.3632
  210 0.6400              0.6938           0.1530         -0.2467           -0.3997
  220 0.6299              0.6688           0.1949         -0.2754           -0.4704
  230 0.6485              0.6000           0.1700         -0.3527           -0.5227
  240 0.6618              0.6688           0.1673         -0.4411           -0.6084

Training Loss	Validation Loss	Step	Entropy	Num Tokens	Logits/chosen	Logits/rejected	Mean Token Accuracy	Rewards/chosen	Rewards/rejected	Rewards/accuracies	Rewards/margins	Logps/chosen	Logps/rejected
0.661798	0.654522	244	2.140975	1443733.000000	-2.461308	-2.449662	0.459719	-0.433924	-0.590545	0.590000	0.156621	-160.420376	-156.859037
{'eval_rewards/chosen': -0.4339, 'eval_rewards/rejected': -0.5905, 'eval_rewards/accuracies': 0.59, 'eval_rewards/margins': 0.1566}
学習中の指標と検証の結果を、スクラッチ実装と比べます。
| 指標 | スクラッチ実装 | TRL |
|---|---|---|
| 検証の accuracy | 0.604 ± 0.035(193ペア) | 0.590 ± 0.035(200ペア) |
| 検証の margin | +0.153 | +0.157 |
| 学習終盤の chosen の変化量 | −3.23(update 201〜225 の平均) | −4.41(step 240) |
| 学習終盤の rejected の変化量 | −4.76 | −6.08 |
(chosen・rejected の変化量は です。TRL の値は rewards/chosen・rewards/rejected を で割って求めました。)
- スクラッチ実装とほぼ同じ結果: TRL 版の検証の accuracy は 0.590 で、0.5 から標準誤差の約2.5倍離れています。margin(+0.157)もスクラッチ実装(+0.153)とほぼ同じです。データの並び順やトークナイズの細部は違いますが、同じ設定で学習すれば、スクラッチ実装と同程度の結果が得られることが分かります。
- 尤度の同時低下: TRL 版でも、rejected だけでなく chosen の報酬も負の方向に下がり続けています(step 240 で chosen の変化量は −4.41)。検証用ペアでも chosen の変化量は −4.34 です。スクラッチ実装と同じく、margin は「両方が下がる中で rejected がより速く下がる」ことで広がっています。
- 既定値の確認: TRL 版とスクラッチ実装がほぼ同じ結果になったのは、学習率のスケジュールを含めて設定を揃えたからです。lr_scheduler_type の既定値(線形減衰)のままだと、平均の学習率がおよそ半分になり、同じ学習率を指定しても学習が弱くなります。ライブラリを使うときは、既定値が自分の意図した設定と一致しているかを確認する必要があります。
- 学習開始時の正解率: step 10 の rewards/accuracies が 0.475 と0.5を下回っているのは、前述のとおり、同点のペアを不正解として数えているためです。
DPOの派生手法
DPO が広く使われるようになると、次のような課題も明らかになってきました。
- 決定論的な選好への過学習: データ上で「常に一方が勝つ」ペアに対して、暗黙の報酬の差を際限なく広げようとし、KL 正則化が効きにくくなる。
- 参照モデルのコスト: 学習中の方策に加えて、参照モデルの順伝播が毎ステップ必要になる。
- 長さの偏り: 対数確率の和を使うため、応答の長さが暗黙の報酬に強く影響する。実際に、DPO で学習したモデルの応答が長くなりやすいことが報告されている(Disentangling Length from Quality in Direct Preference Optimization)。
ここでは、これらに対処する代表的な派生手法として、IPO(1への対処)、SimPO(2と3への対処)、ORPO(2への対処に加えて SFT の段階も省く)を紹介します。
この節では、各論文に合わせて SimPO のマージンを 、ORPO の損失の重みを と書きます。InstructGPT・PPO の記事の (割引率・PTX 係数)や (GAE の係数)とは別物です。
IPO:過学習を防ぐ二乗誤差
A General Theoretical Paradigm to Understand Learning from Human Preferences は、DPO が BT モデルに依存していることが過学習の原因になると指摘し、IPO(Identity Preference Optimization) を提案しました。
選好データの各ペアは、「 の勝ち、 の負け」という確定したラベルとして与えられます。BT モデルで勝率1を表現するには、報酬の差が無限大でなければなりません。そのため DPO の損失は、暗黙の報酬の差を際限なく広げる方向に働き続けます(損失は0に近づきますが、0にはなりません)。報酬の差を広げることは参照モデルから離れることなので、有限のデータに対しては KL 正則化が実質的に効かなくなる というのが IPO の主張です。
IPO は、選好確率を報酬の差に変換する関数(DPO ではロジット関数 に相当)を、有界な恒等写像に置き換えることでこの問題を避けます。導かれる損失は、対数確率比の差
を、一定の目標値 に近づける二乗誤差です。
は KL 正則化の係数で、DPO の と同じ役割を持ちます。 が小さい(正則化が弱い)ほど目標値 は大きくなり、参照モデルから大きく離れることを許します。 IPO の論文は、DPO を含む一般的な目的関数(PO)を考えます。 は比較相手の応答を生成する分布(データを作った方策)、 は単調非減少な関数です。 とすると、BT モデルの仮定のもとで DPO と同じ目的関数になります。この は で発散するので、決定論的な選好に対して報酬の差が無限大に向かいます。 IPO は (恒等写像)とします。すると、最適方策は2つの応答について を満たします。ここで は、 が からの応答に勝つ確率です。右辺は有界なので、対数確率比の差も有限に保たれます。この関係を選好データのペアから推定できる形に書き直すと、勝者と敗者を入れ替えた対称性を使って、目標値 への二乗誤差に帰着します。詳細は原論文を参照してください。詳細な式展開の概略
DPO と IPO が、対数確率比の差 に対してどのような勾配を与えるかを比べてみます。
import torch
import torch.nn.functional as F

beta = tau = 0.1  # DPOの beta と IPOの tau を同じ値にする
h = torch.tensor([0.0, 5.0, 20.0], requires_grad=True)  # 対数確率比の差

dpo = -F.logsigmoid(beta * h)
(dpo_grad,) = torch.autograd.grad(dpo.sum(), h)

ipo = (h - 1 / (2 * tau)) ** 2
(ipo_grad,) = torch.autograd.grad(ipo.sum(), h)

for i in range(len(h)):
    print(f"h={h[i].item():5.1f} | DPO 損失={dpo[i].item():.4f} 勾配={dpo_grad[i].item():+.4f} "
          f"| IPO 損失={ipo[i].item():7.2f} 勾配={ipo_grad[i].item():+7.2f}")
- 比較する量: h は そのものです。DPO の損失は 、IPO の損失は なので、どちらも だけの関数として比べられます。
- 勾配の計算: torch.autograd.grad で、各損失を で微分した値を求めます。勾配降下法では勾配と逆向きに動くので、勾配が負なら を大きくする方向、正なら小さくする方向 に更新されます。
- 目標値: tau = 0.1 なので、IPO の目標値は です。
実行結果
h=  0.0 | DPO 損失=0.6931 勾配=-0.0500 | IPO 損失=  25.00 勾配= -10.00
h=  5.0 | DPO 損失=0.4741 勾配=-0.0378 | IPO 損失=   0.00 勾配=  +0.00
h= 20.0 | DPO 損失=0.1269 勾配=-0.0119 | IPO 損失= 225.00 勾配= +30.00
DPO の勾配は がどれだけ大きくても常に負で、小さくなりながらも を広げ続けます。一方、IPO の勾配は目標値 で0になり、それを超えると正に転じて を引き戻します。IPO は「chosen と rejected の差は、正則化の強さに応じた一定の幅だけ開けば十分」と考え、それ以上の過剰な最適化を防ぐのです。
TRL では、DPOConfig の loss_type="ipo" で IPO を使えます。このとき beta が として使われます(詳細な挙動はバージョンごとにドキュメントで確認してください)。
SimPO:長さで正規化し、参照モデルを不要にする
SimPO: Simple Preference Optimization with a Reference-Free Reward は、DPO の暗黙の報酬について2つの点を問題にしました。
- 学習と生成の指標のずれ: DPO の報酬は参照モデルとの対数確率比ですが、生成時には参照モデルは使われず、モデル自身の尤度(長さを考慮した平均対数尤度で近似できる)が高い応答が選ばれやすくなります。学習で上げた報酬が、生成される応答の尤度と対応しない場合があります。
- 長さの影響: 対数確率の和は、トークン数が多いほど小さく(より負に)なります。報酬が長さに強く左右されるため、長さの偏りが生じやすくなります。
SimPO は、長さで正規化した平均対数尤度そのものを報酬 にします。
この報酬には参照モデルが登場しないので、参照モデルの順伝播が不要になります。さらに SimPO は、chosen の報酬が rejected の報酬を マージン 以上 上回ることを要求します。
SimPO の は KL 正則化の係数ではなく、報酬のスケールを決める係数です。平均対数尤度は和よりずっと小さな値になるので、論文では DPO よりかなり大きな (2 程度以上)が使われています。 BT モデルにマージン を加えた選好確率を考えます。 報酬の差が を超えて初めて確率が 0.5 を上回るので、「わずかに上回るだけでは不十分」という条件になります。この確率の負の対数尤度をとり、 に を代入すると、上の損失関数が得られます。詳細な式展開
長さ正規化の効果を、短く的確な chosen と、長い rejected のペアで確かめます。
import torch
import torch.nn.functional as F

def compute_reward(sum_logps, lengths, beta=2.0, length_norm=True):
    """対数確率の和から報酬を計算する(length_norm=True なら SimPO の報酬)"""
    return beta * (sum_logps / lengths) if length_norm else beta * sum_logps

def margin_loss(reward_w, reward_l, gamma):
    return -F.logsigmoid(reward_w - reward_l - gamma).mean()

# chosen:10トークン、1トークンあたりの平均対数尤度 -0.5
logps_w, len_w = torch.tensor([-5.0]), torch.tensor([10.0])
# rejected:30トークン、1トークンあたりの平均対数尤度 -1.0
logps_l, len_l = torch.tensor([-30.0]), torch.tensor([30.0])

print("【長さ正規化なし(対数確率の和)】")
rw = compute_reward(logps_w, len_w, length_norm=False)
rl = compute_reward(logps_l, len_l, length_norm=False)
print(f"  chosen の報酬: {rw.item():.2f} / rejected の報酬: {rl.item():.2f}")
print(f"  損失: {margin_loss(rw, rl, gamma=0.0).item():.4f}")

print("\n【長さ正規化あり(SimPO)】")
rw = compute_reward(logps_w, len_w, length_norm=True)
rl = compute_reward(logps_l, len_l, length_norm=True)
print(f"  chosen の報酬: {rw.item():.2f} / rejected の報酬: {rl.item():.2f}")
print(f"  損失 (gamma=0.5): {margin_loss(rw, rl, gamma=0.5).item():.4f}")
- 報酬の計算: compute_reward は、length_norm=True のとき対数確率の和をトークン数で割り、SimPO の を計算します。False のときは和のままです(参照モデルの項を除いた DPO 型の報酬に相当します)。
- マージン付きの損失: margin_loss は です。gamma=0.0 なら通常の BT 型の損失になります。
- ペアの設定: 1トークンあたりの品質(平均対数尤度)は chosen の方が高く、rejected は3倍長い、という状況です。
実行結果
【長さ正規化なし(対数確率の和)】
  chosen の報酬: -10.00 / rejected の報酬: -60.00
  損失: 0.0000

【長さ正規化あり(SimPO)】
  chosen の報酬: -1.00 / rejected の報酬: -2.00
  損失 (gamma=0.5): 0.4741
長さ正規化がない場合、rejected が長いというだけで報酬が大きく下がり、損失がほぼ0になっています。このペアからは、応答の中身についての学習信号がほとんど得られません。逆に chosen の方が長いペアでは、長さのせいで chosen の報酬が不利になります。このように、和で比べると 報酬の差が品質よりも長さの差に支配されやすく、モデルが長さを手がかりに学習してしまう余地が生まれます。
長さで正規化すると、報酬は「1トークンあたりの品質」の比較になります。この例では差が あるものの、マージン を加えた損失は で、まだ学習が続きます。
論文では、SimPO は参照モデルを使わずに、AlpacaEval 2 や Arena-Hard などのベンチマークで DPO を上回ったと報告されています。TRL では、CPOTrainer で loss_type="simpo" を指定して使えます(引数名はバージョンごとに確認してください)。
ORPO:SFTの段階も省く
ORPO: Monolithic Preference Optimization without Reference Model は、参照モデルを不要にするだけでなく、SFT と選好学習を1つの段階にまとめる 手法です。
ORPO の著者らは、SFT には「chosen の生成確率を上げると、同じ形式の rejected の生成確率も一緒に上がってしまう」という副作用があると指摘しました。SFT だけでは、「何を言うべきでないか」をモデルに教えられないということです。そこで ORPO は、chosen に対する通常の SFT 損失に、chosen と rejected を区別させるペナルティ項を加えます。
まず、応答 の生成確率を、長さ で正規化した平均対数尤度から定義します(SimPO と同じく長さで正規化します)。
この確率から オッズ(生成されない確率に対して、生成される確率が何倍か)を定義し、chosen と rejected のオッズの比(オッズ比)をとります。
ORPO の損失は、chosen に対する SFT 損失 (負の対数尤度)と、対数オッズ比をシグモイドに通したペナルティ項 の重み付き和です。
はペナルティの強さで、論文や TRL の既定値では 0.1 程度が使われています。
なぜ確率比ではなくオッズ比なのか:確率比 を大きくしようとすると、rejected の確率を0に押しつぶす方向の圧力が強くなりすぎ、SFT 損失と組み合わせたときにモデルの生成能力を損ないやすいと論文は論じています。オッズ比を使うと、区別の度合いを比較的穏やかに強めることができます。 データ に対するペナルティ項の勾配は、2つの因子の積に分解できます(導出過程は後述)。 1つ目の因子 は、DPO の勾配の重みと同じ役割を持ちます。 chosen のオッズが rejected より十分高ければ は0に近づいて更新が弱まり、逆に rejected のオッズの方が高ければ1に近づいて強く更新されます。 2つ目の因子 は、更新の方向を表します。 chosen の尤度を上げ、rejected の尤度を下げる方向です。各項には が掛かっているので、生成確率 が1に近い応答ほど勾配が大きく増幅されます。たとえば rejected の確率が高いままだと、それを押し下げる勾配が強く働きます。 先頭の負号は、勾配降下 で、パラメータが の向き(chosen を上げ、rejected を下げる)へ更新されることを意味します。ORPO 論文は、この更新の向きに着目して負号を省いた の形で勾配を表しています。 導出:この分解を からステップを追って導きます。 ステップ1:連鎖律による分解 応答 のオッズを と書くと、対数オッズ比は差の形になります。 ここで とおくと、ペナルティ項は と表せます。合成関数の微分(連鎖律)により、 に関する勾配は「 に関する外側の微分(スカラー)」と「 に関する内側の勾配 (ベクトル)」の積に分解できます。 ステップ2:外側の微分(重み の導出) シグモイド関数 の微分が であることを用いると、対数シグモイドの微分は次のように計算できます。 したがって、負の対数シグモイドの微分は となります。さらに の定義を代入して整理します。 ここで より です。これを代入すると、重み (に負号がついたもの)が得られます。 ステップ3:内側の勾配(対数オッズの微分と方向 の導出) 次に、単一の応答 に対する対数オッズ の勾配を求めます。オッズの定義より、対数は引き算に展開できます。 表記を簡潔にするため と略記して両辺を で微分します。対数の微分公式 を適用すると: ここで、第1項が であること(すなわち )を利用して共通因子 で括り出します。 括弧内を通分することで分子が と相殺され、対数尤度の勾配を で割った極めてシンプルな形にまとまります。 対数オッズ比 の勾配 は、この結果を と について差し引くだけです。 ステップ4:勾配の統合 ステップ2の外側の微分 と、ステップ3の内側の勾配 を掛け合わせることで、目的の勾配分解が導かれます。詳細な式展開(ペナルティ項の勾配)
ORPO の損失を実装します。DPO と違い、参照モデルの対数確率を受け取る必要がないことに注目してください。
import torch
import torch.nn.functional as F

def orpo_loss(avg_logps_w, avg_logps_l, lambda_weight=0.1):
    """
    avg_logps_w: chosen の平均対数尤度(長さで正規化済み) shape (B,)
    avg_logps_l: rejected の平均対数尤度(長さで正規化済み) shape (B,)
    """
    # 1. 対数オッズ log(P / (1 - P)) = log P - log(1 - P) を計算する
    #    1 - P が 0 にならないよう、微小値でクランプする
    log_odds_w = avg_logps_w - torch.log(torch.clamp(1 - torch.exp(avg_logps_w), min=1e-8))
    log_odds_l = avg_logps_l - torch.log(torch.clamp(1 - torch.exp(avg_logps_l), min=1e-8))

    # 2. 対数オッズ比とペナルティ項 L_OR
    log_odds_ratio = log_odds_w - log_odds_l
    l_or = -F.logsigmoid(log_odds_ratio)

    # 3. SFT損失 L_SFT(chosen の負の対数尤度)
    l_sft = -avg_logps_w

    # 4. ORPO損失
    loss = l_sft + lambda_weight * l_or
    return loss.mean(), l_sft.mean(), l_or.mean()

# 2ペア分のダミーデータ(平均対数尤度)
avg_logps_w = torch.tensor([-0.5, -1.2])  # chosen
avg_logps_l = torch.tensor([-0.8, -0.6])  # rejected

loss, sft_loss, or_loss = orpo_loss(avg_logps_w, avg_logps_l, lambda_weight=0.1)
print(f"ORPO Loss: {loss.item():.4f}")
print(f"  ├ SFT Loss: {sft_loss.item():.4f}")
print(f"  └ OR Penalty: {or_loss.item():.4f}")
- 入力: avg_logps_w と avg_logps_l は、get_batch_logps の和をトークン数で割った平均対数尤度 を想定しています。
- 対数オッズ: です。torch.exp(avg_logps_w) で に戻し、torch.clamp で が0にならないようにしてから対数をとります。
- ペナルティ項: -F.logsigmoid(log_odds_ratio) が です。DPO の損失の中身(暗黙の報酬の差)を対数オッズ比に置き換えた形になっています。
- SFT 損失: l_sft は chosen の平均対数尤度の符号を反転したもので、トークンごとの交差エントロピーの平均と同じです。
- ダミーデータの意味: 1ペア目は chosen の尤度の方が高く(正しい順位)、2ペア目は rejected の尤度の方が高い(誤った順位)状況です。
実行結果
ORPO Loss: 0.9383
  ├ SFT Loss: 0.8500
  └ OR Penalty: 0.8828
ペナルティ項は、正しく順位付けできている1ペア目では 0.42、誤っている2ペア目では 1.34 になり、その平均が 0.8828 です。SFT 損失で chosen の尤度を上げつつ、ペナルティ項で rejected との区別を強めていることがわかります。
論文では、Phi-2(2.7B)・Llama-2(7B)・Mistral(7B)に ORPO を適用し、SFT を事前に行わなくても、SFT + DPO などの従来の手順と同等以上の指示追従性能が得られたと報告されています。TRL では ORPOTrainer で使えます(バージョンによっては実験的な名前空間に移動しているので、ドキュメントで確認してください)。
派生手法の比較
最後に、DPO と派生手法を「何を省いたか」で整理します。
| 手法 | 損失の中身(シグモイドの引数など) | 報酬モデル | 参照モデル | SFT 段階 | 長さ正規化 |
|---|---|---|---|---|---|
| RLHF(PPO) | KL ペナルティ付き報酬最大化 | 必要 | 必要 | 必要 | ― |
| DPO | 不要 | 必要 | 必要 | なし(和) | |
| IPO | 不要 | 必要 | 必要 | なし(和) | |
| SimPO | 不要 | 不要 | 必要 | あり(平均) | |
| ORPO | 不要 | 不要 | 不要 | あり(平均) |
(表では を省略しています。)DPO から SimPO・ORPO に進むにつれて、必要なモデルと学習段階が減っていきます。ただし、参照モデルを省くことは、「参照モデルから離れすぎない」という KL 制約を明示的には持たないことでもあります。どの手法が良いかはデータやモデルによって変わるため、実際には複数を試して比べることになります。
表の「不要」になった箇所を色で示すと、下の手法ほど、必要なモデルと学習の段階が減っていくことが分かります。
(図は、diagram-designで作成)
SimPO・ORPOの学習とDPOとの比較
最後に、SimPO と ORPO を TRL で実際に学習し、DPO と比べます。3つの手法の違いを、学習データ・SFT モデル・LoRA・最適化の設定を揃えたうえで確かめるのが目的です。
この節のコードは、次の関数や変数を使います。先に該当するセルを実行してください。
- スクラッチ実装: 準備2(eval_loader・lora_config など)、「系列の対数確率とDPO損失」(get_batch_logps)、「βの比較」(make_policy・load_adapter・sample_kl_and_length・kl_prompts)
- TRL の節: DPO を学習したセル(train_dataset・peft_config と、保存済みの DPO のアダプター)
また、SimPO を学習する CPOTrainer と ORPOTrainer は、TRL 1.x では trl.experimental.cpo・trl.experimental.orpo に置かれていて、trl から直接は読み込めません。古いバージョンでは from trl import CPOTrainer のように読み込むので、エラーになる場合はお使いのバージョンのドキュメントを確認してください。
別のセッションで再開する場合のセル
前の節までを実行したセッションが切れている場合は、次のセルを実行してから、この節のコードに進んでください。前の節までと同じ定義のうち、この節で使うものだけを集めています(SFT モデルと、TRL の節で学習した DPO のアダプターは、Google ドライブに保存済みである必要があります)。
import os
import json
import numpy as np
import pandas as pd
import torch
import torch.nn.functional as F
from torch.utils.data import DataLoader
from datasets import load_dataset
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
from peft import LoraConfig, get_peft_model, PeftModel
from google.colab import drive

drive.mount("/content/drive")

# ---------- 定数 ----------
SEED = 42
set_seed(SEED)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
SAVE_ROOT = "/content/drive/MyDrive/dpo"
SFT_MODEL_DIR = f"{SAVE_ROOT}/trained_sft_model"
MAX_LEN = 512
IGNORE_INDEX = -100
MIN_RESPONSE_TOKENS = 32
N_KL_PROMPTS = 100

tokenizer = AutoTokenizer.from_pretrained(SFT_MODEL_DIR)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

# ---------- データ(準備2・TRL の節と同じ) ----------
raw = load_dataset("llm-jp/hh-rlhf-12k-ja", split="train").shuffle(seed=SEED)
train_raw = raw.select(range(0, 4000))
eval_raw = raw.select(range(11000, 11200))

def build_prompt(conversations):
    prompt = ""
    for turn in conversations:
        role = "Human" if turn["from"] == "human" else "Assistant"
        prompt += f"{role}: {turn['value']}\n"
    return prompt + "Assistant:"

# TRL 用(SimPO・ORPO の学習データ)
def to_trl_format(example):
    return {
        "prompt": build_prompt(example["conversations"]),
        "chosen": " " + example["chosen"].strip(),
        "rejected": " " + example["rejected"].strip(),
    }

train_dataset = train_raw.map(to_trl_format, remove_columns=train_raw.column_names)

# スクラッチ実装用(検証用ペアでの評価)
def tokenize_pair(example):
    prompt_ids = tokenizer(build_prompt(example["conversations"]))["input_ids"]
    budget = MAX_LEN - len(prompt_ids)
    out = {"prompt_len": len(prompt_ids)}
    for key in ["chosen", "rejected"]:
        resp_ids = tokenizer(" " + example[key].strip(), add_special_tokens=False)["input_ids"]
        if len(resp_ids) + 1 <= budget:
            resp_ids = resp_ids + [tokenizer.eos_token_id]
        else:
            resp_ids = resp_ids[:budget]
        out[f"{key}_input_ids"] = prompt_ids + resp_ids
    return out

def collate_fn(batch):
    seqs = [ex["chosen_input_ids"] for ex in batch] + [ex["rejected_input_ids"] for ex in batch]
    prompt_lens = [ex["prompt_len"] for ex in batch] * 2
    max_len = max(len(s) for s in seqs)
    input_ids = torch.full((len(seqs), max_len), tokenizer.pad_token_id, dtype=torch.long)
    attention_mask = torch.zeros((len(seqs), max_len), dtype=torch.long)
    labels = torch.full((len(seqs), max_len), IGNORE_INDEX, dtype=torch.long)
    for i, (seq, p_len) in enumerate(zip(seqs, prompt_lens)):
        input_ids[i, :len(seq)] = torch.tensor(seq)
        attention_mask[i, :len(seq)] = 1
        labels[i, p_len:len(seq)] = torch.tensor(seq[p_len:])
    return {"input_ids": input_ids, "attention_mask": attention_mask, "labels": labels}

eval_ds = eval_raw.map(tokenize_pair, remove_columns=eval_raw.column_names)
eval_ds = eval_ds.filter(lambda ex: MAX_LEN - ex["prompt_len"] >= MIN_RESPONSE_TOKENS)
eval_loader = DataLoader(eval_ds, batch_size=8, shuffle=False, collate_fn=collate_fn)
kl_prompts = [build_prompt(ex["conversations"]) for ex in eval_raw.select(range(N_KL_PROMPTS))]
print(f"SimPO・ORPO の学習データ: {len(train_dataset)} 件 / 検証に使うペア数: {len(eval_ds)}")

# ---------- LoRA(準備2・TRL の節と同じ) ----------
lora_config = LoraConfig(
    r=16, lora_alpha=32, lora_dropout=0.05, bias="none", task_type="CAUSAL_LM",
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
)
peft_config = lora_config

# ---------- 評価に使う関数(DPO損失の節・βの比較と同じ) ----------
def get_batch_logps(logits, labels):
    logits = logits[:, :-1, :]
    labels = labels[:, 1:]
    loss_mask = labels != IGNORE_INDEX
    safe_labels = labels.masked_fill(~loss_mask, 0)
    log_probs = F.log_softmax(logits.float(), dim=-1)
    token_logps = log_probs.gather(dim=-1, index=safe_labels.unsqueeze(-1)).squeeze(-1)
    return (token_logps * loss_mask).sum(dim=-1), loss_mask.sum(dim=-1)

def make_policy():
    base = AutoModelForCausalLM.from_pretrained(SFT_MODEL_DIR, torch_dtype=torch.bfloat16)
    policy = get_peft_model(base, lora_config).to(device)
    policy.config.use_cache = False
    return policy

def load_adapter(adapter_dir):
    base = AutoModelForCausalLM.from_pretrained(SFT_MODEL_DIR, torch_dtype=torch.bfloat16)
    policy = PeftModel.from_pretrained(base, adapter_dir).to(device)
    policy.config.use_cache = False
    return policy

@torch.no_grad()
def sample_kl_and_length(policy, prompts, max_new_tokens=128):
    policy.eval()
    policy.config.use_cache = True
    kls, lengths = [], []
    for prompt in prompts:
        enc = tokenizer(prompt, return_tensors="pt").to(device)
        out = policy.generate(**enc, do_sample=True, temperature=1.0, top_p=1.0, top_k=0,
                              max_new_tokens=max_new_tokens, pad_token_id=tokenizer.pad_token_id,
                              eos_token_id=tokenizer.eos_token_id)
        labels = out.clone()
        labels[:, :enc["input_ids"].shape[1]] = IGNORE_INDEX
        pi_logps, n_tokens = get_batch_logps(policy(out).logits, labels)
        with policy.disable_adapter():
            ref_logps, _ = get_batch_logps(policy(out).logits, labels)
        kls.append((pi_logps - ref_logps).item())
        lengths.append(n_tokens.item())
    policy.config.use_cache = False
    return float(np.mean(kls)), float(np.std(kls) / np.sqrt(len(kls))), float(np.mean(lengths))
- 集めた定義: 準備2のデータの前処理(tokenize_pair・collate_fn・eval_loader)、TRL の節の学習データ(train_dataset)、「系列の対数確率とDPO損失」の get_batch_logps、「βの比較」の make_policy・load_adapter・sample_kl_and_length・kl_prompts です。中身は各節のコードと同じなので、説明はそれぞれの節を参照してください。
- LoRA の設定: スクラッチ実装の lora_config と TRL の節の peft_config は同じ設定なので、同じオブジェクトを使っています。
- 確認: 最後に表示される件数が、準備2の「検証に使うペア数」と一致していれば、前の節と同じデータになっています。
まず、SimPO と ORPO を学習します。
from peft import PeftModel
from trl.experimental.cpo import CPOConfig, CPOTrainer      # TRL 1.x では experimental に置かれている
from trl.experimental.orpo import ORPOConfig, ORPOTrainer

# DPO(TRL の節)と揃える最適化の設定
COMMON_ARGS = dict(
    learning_rate=2e-5,
    lr_scheduler_type="constant",
    per_device_train_batch_size=2,
    gradient_accumulation_steps=8,
    num_train_epochs=1,
    max_length=MAX_LEN,
    max_grad_norm=1.0,
    bf16=True,
    logging_steps=10,
    save_strategy="no",
    seed=SEED,
    report_to="none",
)

# SimPO・ORPO は応答の平均対数尤度を使うので、応答が0トークンまで切り詰められると 0/0 で NaN になる。
# 準備2と同じく、プロンプトが長すぎて応答がほとんど残らない例を除く
pref_train_dataset = train_dataset.filter(
    lambda ex: len(tokenizer(ex["prompt"])["input_ids"]) <= MAX_LEN - MIN_RESPONSE_TOKENS)
print(f"SimPO・ORPO の学習データ: {len(pref_train_dataset)} 件(除外前 {len(train_dataset)} 件)")

def train_with_trl(trainer_class, config, name):
    """SFT モデルに LoRA を付けて学習し、アダプターと学習ログを保存する"""
    adapter_dir = f"{SAVE_ROOT}/adapter_{name}"
    if os.path.exists(adapter_dir):               # 学習済みならスキップする
        return adapter_dir
    set_seed(SEED)
    base = AutoModelForCausalLM.from_pretrained(SFT_MODEL_DIR, torch_dtype=torch.bfloat16)
    trainer = trainer_class(
        model=base,
        args=config,
        train_dataset=pref_train_dataset,
        processing_class=tokenizer,
        peft_config=peft_config,
    )
    trainer.train()
    pd.DataFrame(trainer.state.log_history).to_csv(f"{SAVE_ROOT}/log_{name}.csv", index=False)
    trainer.save_model(adapter_dir)
    del trainer, base
    torch.cuda.empty_cache()
    return adapter_dir

# SimPO:CPOTrainer の loss_type="simpo" で、CPO の SFT 項(cpo_alpha)を0にする
simpo_dir = train_with_trl(
    CPOTrainer,
    CPOConfig(output_dir=f"{SAVE_ROOT}/trl_simpo", loss_type="simpo", cpo_alpha=0.0,
              beta=2.0, simpo_gamma=1.0, **COMMON_ARGS),
    "simpo",
)

# ORPO:beta が損失の重み λ にあたる
orpo_dir = train_with_trl(
    ORPOTrainer,
    ORPOConfig(output_dir=f"{SAVE_ROOT}/trl_orpo", beta=0.1, **COMMON_ARGS),
    "orpo",
)

dpo_dir = f"{SAVE_ROOT}/dpo_adapter_trl_constant"    # TRL の節で学習した DPO のアダプター
【揃えた条件】
-
同じ出発点とデータ: 3つの手法とも、同じ SFT モデル(SFT_MODEL_DIR)に同じ設定の LoRA(peft_config)を付け、同じ選好データ(train_dataset)で1エポック学習します。ORPO は本来 SFT の段階を省ける手法ですが、ここでは比較の条件を揃えるため、SFT モデルから始めています。
-
同じ最適化の設定: COMMON_ARGS で、学習率・学習率のスケジュール・バッチサイズ・勾配累積などを TRL の節の DPO と同じにしています。ただし、それぞれの手法に最適な学習率は異なる可能性があります。この比較は「同じ条件で学習したらどうなるか」を見るもので、各手法の最高性能を比べるものではありません。
-
長すぎるプロンプトの除外: SimPO と ORPO は、応答の対数確率をトークン数で割った平均を使います。プロンプトが MAX_LEN に近いと、切り詰めで応答が0トークンになり、0で割って NaN になります。NaN が一度でも勾配に入ると、LoRA の重みがすべて NaN になってしまいます。そこで、スクラッチ実装の準備2と同じ条件(応答に MIN_RESPONSE_TOKENS 以上残る)で、学習データを絞り込みます(pref_train_dataset)。DPO は対数確率の和を使うので、応答が0トークンでも和が0になるだけで NaN にはならず、TRL の節では絞り込みをしていません。
【手法ごとの設定】
- SimPO: TRL では、SimPO は CPOTrainer の loss_type="simpo" として実装されています。CPOTrainer は既定で chosen に対する SFT 損失を加えるので、cpo_alpha=0.0 にして SimPO の損失だけにします。beta=2.0 は長さで正規化した報酬のスケール、simpo_gamma=1.0 はマージン です。SimPO の論文では DPO よりずっと大きな と、 が 0.5 前後になる値が使われているので、それにならっています。
- ORPO: ORPOTrainer の beta は、ORPO の損失の重み (オッズ比のペナルティの強さ)です。論文や TRL の既定値と同じ 0.1 にしています。
- 学習済みならスキップ: アダプターの保存先が既にあれば学習を省きます。学習ログは CSV に保存しておきます。
実行結果
SimPO・ORPO の学習データ: 3873 件(除外前 4000 件)
Step	Training Loss
10	1.328048
20	1.289327
30	1.429651
40	1.342929
50	1.360994
60	1.280091
70	1.315296
80	1.247215
90	1.392821
100	1.431658
110	1.383553
120	1.293326
130	1.330409
140	1.150132
150	1.213520
160	1.315178
170	1.325372
180	1.311082
190	1.388340
200	1.361708
210	1.315019
220	1.368548
230	1.200401
240	1.317569
Step	Training Loss
10	2.750723
20	2.560463
30	2.545172
40	2.525451
50	2.472481
60	2.473399
70	2.493124
80	2.460403
90	2.419735
100	2.522890
110	2.501163
120	2.452315
130	2.523348
140	2.435997
150	2.418574
160	2.455746
170	2.459634
180	2.456885
190	2.395190
200	2.437390
210	2.384108
220	2.442324
230	2.488186
240	2.459006
次に、学習前の SFT モデルと3つの手法を、同じ方法で評価します。
@torch.no_grad()
def pair_logps(policy, loader):
    """検証用ペアについて、方策と参照モデル(SFT)の対数確率(和)と応答のトークン数を求める"""
    policy.eval()
    out = {key: [] for key in ["pi_w", "pi_l", "ref_w", "ref_l", "n_w", "n_l"]}
    for batch in loader:
        batch = {k: v.to(device) for k, v in batch.items()}
        inputs = dict(input_ids=batch["input_ids"], attention_mask=batch["attention_mask"])
        pi_logps, n_tokens = get_batch_logps(policy(**inputs).logits, batch["labels"])
        with policy.disable_adapter():
            ref_logps, _ = get_batch_logps(policy(**inputs).logits, batch["labels"])
        for key, value in zip(["pi_w", "pi_l"], pi_logps.chunk(2)):
            out[key].append(value)
        for key, value in zip(["ref_w", "ref_l"], ref_logps.chunk(2)):
            out[key].append(value)
        for key, value in zip(["n_w", "n_l"], n_tokens.chunk(2)):
            out[key].append(value.float())
    return {key: torch.cat(values) for key, values in out.items()}

def pair_accuracy(diff):
    return ((diff > 0).float() + 0.5 * (diff == 0).float()).mean().item()

def evaluate_method(policy):
    r = pair_logps(policy, eval_loader)
    delta_w = r["pi_w"] - r["ref_w"]
    delta_l = r["pi_l"] - r["ref_l"]
    set_seed(SEED)
    kl, kl_se, length = sample_kl_and_length(policy, kl_prompts)
    return {
        "acc_ratio": pair_accuracy(delta_w - delta_l),                           # DPO の暗黙の報酬による判定
        "acc_avg": pair_accuracy(r["pi_w"] / r["n_w"] - r["pi_l"] / r["n_l"]),   # 平均対数尤度による判定
        "delta_chosen": delta_w.mean().item(),
        "delta_rejected": delta_l.mean().item(),
        "kl": kl, "kl_se": kl_se, "length": length,
    }

method_results = {}
for name, adapter_dir in [("SFT", None), ("DPO", dpo_dir), ("SimPO", simpo_dir), ("ORPO", orpo_dir)]:
    path = f"{SAVE_ROOT}/method_compare_{name}.json"
    if os.path.exists(path):
        with open(path) as f:
            method_results[name] = json.load(f)
        continue
    policy = make_policy() if adapter_dir is None else load_adapter(adapter_dir)
    method_results[name] = evaluate_method(policy)
    with open(path, "w") as f:
        json.dump(method_results[name], f)
    del policy
    torch.cuda.empty_cache()

method_summary = pd.DataFrame(method_results).T
print(method_summary.round(3))
【評価する量】
- 2種類の正解率: 3つの手法は「どちらの応答が良いか」を判定する報酬の形が違うので、正解率を2通りで計算します。
- acc_ratio は、DPO の暗黙の報酬(参照モデルからの対数確率の変化量の差)で chosen を上に置いたペアの割合です。SFT モデルでは必ず 0.5 になり、学習でどれだけ chosen の側に動いたかを表します。
- acc_avg は、SimPO の報酬と同じく、応答の長さで割った平均対数尤度で chosen を上に置いたペアの割合です。参照モデルを使わないので、SFT モデルでも 0.5 にはなりません。SFT の行からどれだけ変わったかで比べます。
- 参照モデルからの変化量と KL: SimPO と ORPO は損失に参照モデルを使いませんが、評価では LoRA を外した SFT モデルを基準にして、βの比較と同じく変化量と KL を計算します。参照モデルを使わない手法で、方策が SFT モデルからどれだけ離れたかが分かります。
- 生成長: サンプリングした応答のトークン数の平均です。SimPO は長さで正規化した報酬を使うので、DPO と生成長の変わり方が異なるかを見ます。
【評価の進め方】
- 同じ関数で評価: SFT は make_policy()(LoRA を付けた直後の方策)、3つの手法は load_adapter で SFT モデルに保存したアダプターを読み込んだものを、同じ evaluate_method で評価します。
- 中断からの再開: 条件ごとの結果を JSON で保存し、保存済みの条件は読み込むだけにします。
実行結果
       acc_ratio  acc_avg  delta_chosen  delta_rejected     kl  kl_se  length
SFT        0.500    0.552         0.000           0.000  0.000  0.000   46.09
DPO        0.598    0.567        -4.357          -5.963  5.423  0.432   72.95
SimPO      0.536    0.562        -7.927          -8.161  5.113  0.424   40.99
ORPO       0.531    0.557         1.182           1.113  5.391  0.817   65.14
まず、評価が正しく行われていることを確認します。SFT の行は、正解率(acc_ratio)が 0.500、変化量と KL が0で、参照モデルそのものであることと一致しています。DPO の行(正解率 0.598、chosen の変化量 −4.36、rejected の変化量 −5.96)は、TRL の節の検証結果(正解率 0.590、−4.34、−5.91)とほぼ同じです。同じモデルを別の方法で評価して同じ値になっているので、評価の関数も正しく動いていると言えます(評価したペア数が193件と200件で違う分の差があります)。
そのうえで、3つの手法を比べます。検証用ペアの正解率の標準誤差は、193ペアで約 ±0.036 です。
| 手法 | 選好の区別 | 参照モデルからの変化量(chosen / rejected) | KL | 生成長(SFT は 46.1) |
|---|---|---|---|---|
| DPO | acc_ratio が 0.598 に上がった | −4.36 / −5.96 | 5.4 | 73.0 |
| SimPO | どちらの正解率も SFT とほぼ同じ | −7.93 / −8.16 | 5.1 | 41.0 |
| ORPO | どちらの正解率も SFT とほぼ同じ | +1.18 / +1.11 | 5.4 | 65.1 |
- 選好を学べたのは DPO だけ: DPO の acc_ratio は 0.5 から標準誤差の約2.7倍離れています。一方、SimPO と ORPO は、acc_ratio(0.536・0.531)も、自分の報酬の形に近い acc_avg(0.562・0.557、SFT は 0.552)も、SFT からの変化が標準誤差の範囲にとどまっています。KL はどの手法も約5で差がなく(標準誤差は 0.4〜0.8)、SimPO と ORPO も方策は SFT から DPO と同じくらい動いているので、「動いたが、chosen と rejected を区別する方向には動かなかった」ことになります。
- SimPO: 学習中の損失は 1.15〜1.43 の間で揺れ続け、学習開始時の値 からほとんど下がっていません。・ は、1トークンあたりの平均対数尤度で chosen が rejected を 0.5 以上上回ることを求める設定です。chosen と rejected がどちらも流暢な文章で、質の差が小さいこのデータには、マージンが大きすぎた可能性があります。参照モデルを使わないので、chosen と rejected の尤度がどちらも大きく下がっています(尤度の同時低下が DPO より大きい)。一方、生成長は SFT より短くなっていて、DPO とは逆向きです。
- ORPO: 学習中の損失は 2.75 から 2.4 前後まで下がりましたが、その大部分は chosen に対する SFT 損失の減少と考えられます。chosen の尤度が上がっただけでなく、同じような文章である rejected の尤度もほぼ同じだけ上がっていて(+1.18 と +1.11)、区別は進んでいません。これは、ORPO の論文が指摘した「SFT は rejected の確率も一緒に上げてしまう」現象そのもので、 のオッズ比のペナルティでは、この条件ではそれを打ち消せませんでした。生成長は DPO と同じく長くなっています。
- 生成長: DPO(46.1 → 73.0)は「学習前後の生成比較」で見た傾向と同じく長くなり、SimPO(41.0)は短く、ORPO(65.1)は長くなりました。長さで正規化した報酬を使う SimPO だけが長くならなかったことになります。ただし、100プロンプトのサンプリングで測った値なので、大まかな傾向として見てください。
この比較は、DPO と同じ学習率・同じ1エポックという条件で、SimPO と ORPO のハイパーパラメータ(・・)には、大きなモデルを全パラメータで学習した論文の値を使ったものです。「SimPO や ORPO が DPO より劣る」ことを示すものではなく、同じ条件をそのまま当てはめると、DPO 以外はうまく学習できなかった という結果です。参照モデルを使わない手法は、KL の制約がない分、ハイパーパラメータをデータやモデルに合わせて調整する必要性が高いと考えられます。また、平均対数尤度を使う手法では、長すぎるプロンプトを除かないと学習が NaN で壊れるという、実装上の注意点もありました。
DPOの限界:オフライン学習という性質
DPO とその派生手法は、固定された選好データから学習する オフライン の手法です。これは学習を安定させ、計算を軽くする一方で、次のような限界につながります。
- 自分の生成した応答から学ばない: DPO が学習するのは、データセットに含まれる chosen と rejected の比較だけです。学習中のモデルが実際に生成する応答は、データセットの応答とは分布がずれていきますが、そのずれた先の応答が良いか悪いかについてのフィードバックは得られません。PPO が毎ステップ応答を生成し、それを評価していたこととは対照的です。
- データにない良い応答を探索できない: 与えられた2つの応答のどちらが良いかは学べても、どちらよりも良い第三の応答をモデル自ら見つけ出す仕組みはありません。
- データの偏りをそのまま学ぶ: chosen が rejected より長い傾向があれば、長さの偏りも一緒に学習します。尤度の同時低下のように、損失が差しか見ないことに由来する現象もあります。
対話のトーンを丁寧で無害なものに整えるような調整であれば、オフラインの選好データでも大きな効果が得られます。では、数学の文章題のように 正解が機械的に判定できるタスク ではどうでしょうか。そのようなタスクでは、モデル自身に何度も解かせ、正解したかどうかをその場で判定して学習する オンライン の方法が使えます。
正解が機械的に判定できるタスク(推論)では、固定データから学ぶよりも、自己生成したデータからオンラインで学ぶ方が有利ではないか?
2つの学び方を並べると、次のようになります。
(図は、diagram-designで作成)
この問いは、GRPO(PPO から価値関数を取り除いたオンライン強化学習)につながります。
まとめ
記事を通じて、以下の内容を学習・実践しました。
- InstructGPT の RLHF では、方策・参照モデル・報酬モデル・価値関数の4つを扱い、学習中に生成を繰り返す必要がありました。DPO は、そのうち報酬モデルと価値関数、学習中の生成を不要にします。
- KL ペナルティ付き報酬最大化の最適方策は という閉じた式で書けますが、分配関数 が計算できないため、そのままでは使えません。
- 最適方策の式を報酬について解き直して Bradley-Terry モデルに代入すると、 が打ち消され、報酬モデルのペアワイズ損失と同じ形の DPO 損失が得られます。
- が暗黙の報酬であり、DPO で学習した言語モデルは報酬モデルとしても読めます。
- DPO の勾配は、暗黙の報酬が順位を誤っているペアほど大きな重みで更新し、正しく区別できたペアでは更新を止めます。 は、InstructGPT の KL 係数と同じ意味を持ちます。
- 学習中は損失だけでなく、報酬の差(margin)・選好の正解率・chosen と rejected の参照モデルからの変化量を監視し、尤度の同時低下が起きていないかを確認しました。
- InstructGPT の記事と同じ手順で SFT モデルを作成し、同じデータで、系列の対数確率(プロンプトをマスクした和)、disable_adapter() による参照モデル、DPO 損失をスクラッチ実装しました。検証用ペアでの正解率は 0.500 から 0.604 に上がった一方、chosen の尤度も参照モデルより下がる、尤度の同時低下が起きていました。
- を 0.05・0.1・0.5 と変えて学習し、 が小さいほど KL・生成長・尤度の同時低下が大きくなること、この実験では で正解率が最も高く(0.671)、chosen の尤度も下がらなかったことを確かめました。
- InstructGPT の記事と同じ合成ネガティブ(途中切れ・反復・相槌)を加えて学習すると、壊れた応答を避ける正解率が 0.704 から 0.993 に上がり、元の選好の正解率も下がらない(0.614 → 0.671)ことを確かめました。
- TRL の DPOTrainer で同じ学習を行い、学習率のスケジュールなどの設定を揃えると、スクラッチ実装とほぼ同じ結果(検証用ペアでの正解率 0.590)になることを確かめました。
- 派生手法として、過学習を抑える IPO、長さ正規化で参照モデルを不要にする SimPO、SFT と選好学習を統合する ORPO を、「何を省いたか」の観点で比較しました。DPO と同じ条件で SimPO と ORPO を学習すると、選好の区別はほとんど進まず、ハイパーパラメータの調整が必要なことが分かりました。
- DPO はオフラインの手法であり、自分の生成した応答からは学びません。正解が判定できるタスクではオンライン学習の方が有利ではないか、という問いが残りました。
LLM に「考えさせる」とはどういうことかは、Chain-of-Thought(CoT)とは? の記事で実験しながら確かめています。また、選好ではなく 正解 を報酬にしてオンラインで学習する方法は、GRPO の記事で扱っています。
※ライセンスに関する注記 本記事のコードおよび実行例で利用しているベースモデル(llm-jp/llm-jp-3-1.8b)は Apache License 2.0、データセット(llm-jp/hh-rlhf-12k-ja)は MIT License など、各提供元のライセンスに準拠して利用しています。
参考文献
- R. Rafailov, A. Sharma, E. Mitchell, S. Ermon, C. D. Manning, C. Finn (2023). Direct Preference Optimization: Your Language Model is Secretly a Reward Model. NeurIPS 2023.
- A. Pal, D. Karkhanis, S. Dooley, M. Roberts, S. Naidu, C. White (2024). Smaug: Fixing Failure Modes of Preference Optimisation with DPO-Positive. arXiv:2402.13228.
- R. Park, R. Rafailov, S. Ermon, C. Finn (2024). Disentangling Length from Quality in Direct Preference Optimization. Findings of ACL 2024.
- M. G. Azar et al. (2024). A General Theoretical Paradigm to Understand Learning from Human Preferences. AISTATS 2024.
- Y. Meng, M. Xia, D. Chen (2024). SimPO: Simple Preference Optimization with a Reference-Free Reward. NeurIPS 2024.
- J. Hong, N. Lee, J. Thorne (2024). ORPO: Monolithic Preference Optimization without Reference Model. EMNLP 2024.
- LLM-jp (2024). llm-jp-3-1.8b. Hugging Face(Apache License 2.0).
- LLM-jp (2024). hh-rlhf-12k-ja. Hugging Face Datasets.
本記事の文章・構成の一部に生成AIを使用しています。