Deep Q-Network (DQN) とは?
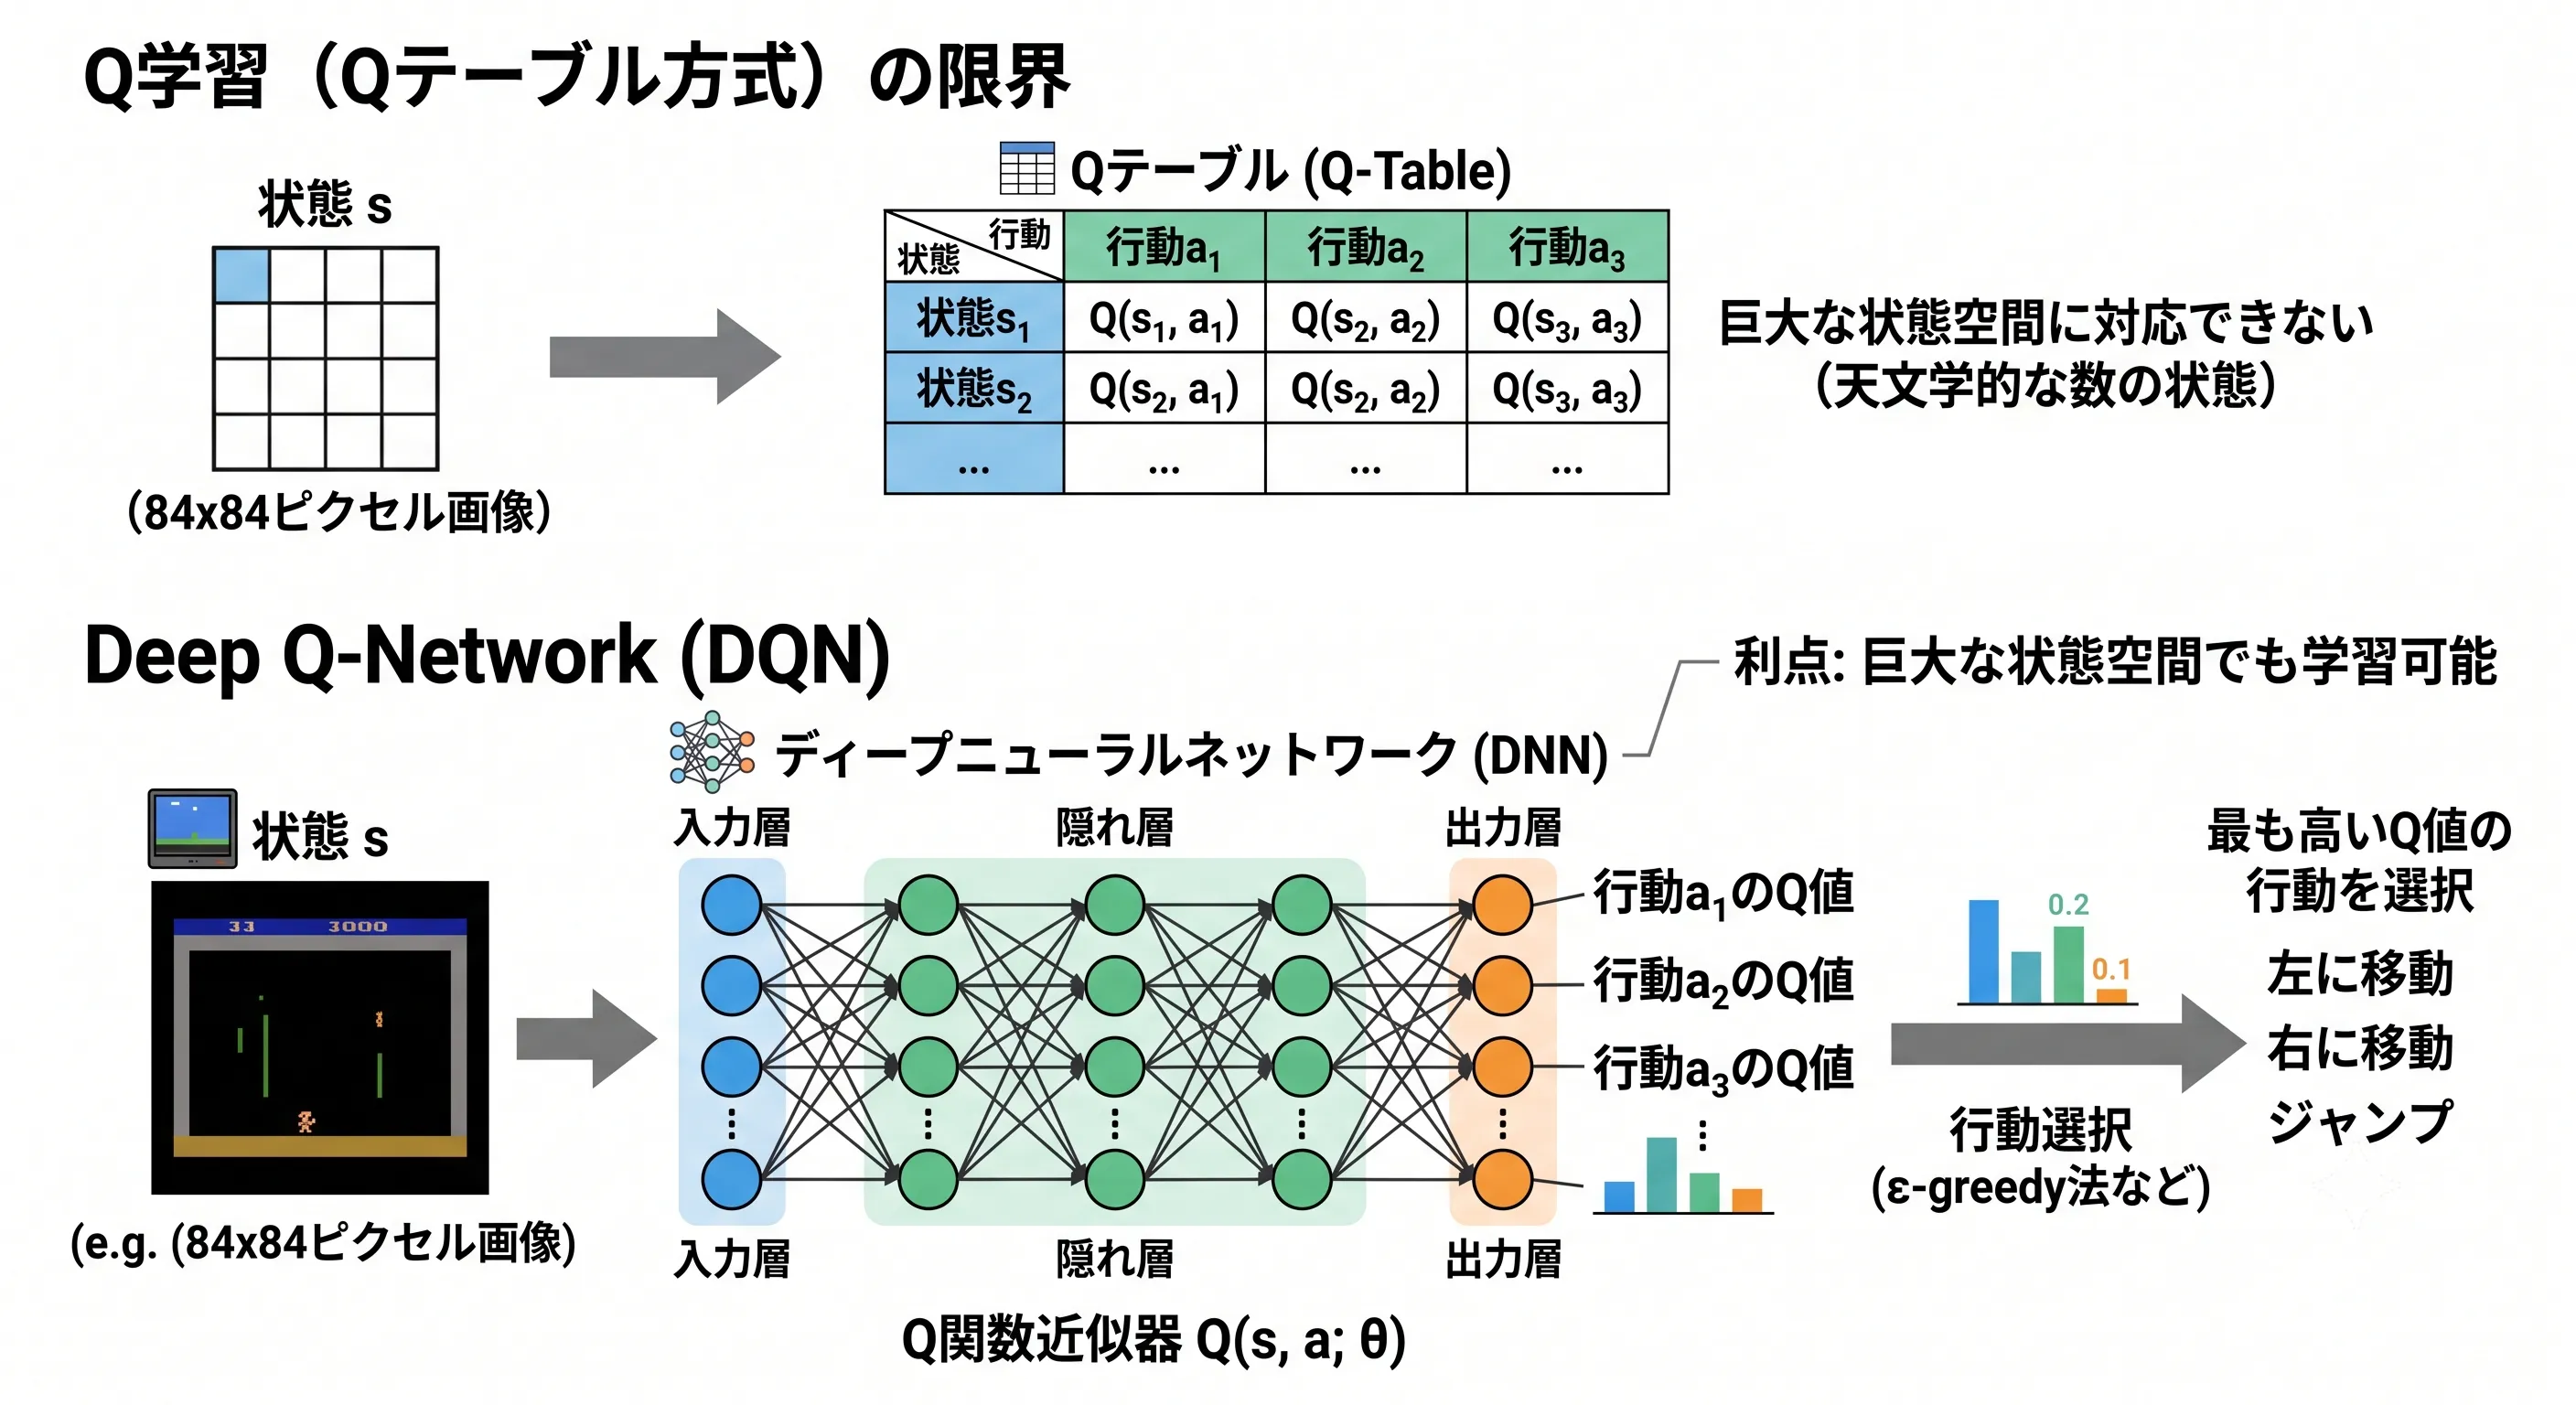 (画像は、Geminiで作成)
状態が多い問題で Q テーブルが使えなくなる理由(次元の呪い)と、Q 値をニューラルネットワークで近似する DQN が、Experience Replay と Fixed Target Network で学習を安定させる仕組みを理解すること。PyTorch によるスクラッチ実装と Stable Baselines3 で CartPole を学習し、ランダムな行動と性能を比べられるようになること。
Deep Q-Network (DQN)の概要
Deep Q-Network(DQN)は、Google DeepMindによって2013年に発表された(Playing Atari with Deep Reinforcement Learning)、ゲーム画面だけからAtari 2600のゲームのプレイを学習する強化学習アルゴリズムです。2015年の Nature の論文(Human-level control through deep reinforcement learning)で Target Network などを加えた版が発表され、49種類のゲームで人間のプロのゲームテスターに匹敵する水準に達しました。 本記事では、DQNの基礎となるQ学習から説き起こし、DQNを構成する2つの中核技術「Experience Replay」と「Fixed Target Network」を解説します。さらに、PythonとPyTorchを用いたスクラッチ実装とその性能の可視化、そして実用的なStable Baselines3ライブラリによる実装を通じて、DQNの仕組みと効果を実践的に学びます。この記事は、より高度なPPOのような方策勾配法を学ぶ上での重要な基礎知識も提供します。
はじめに:Q学習とその限界
DQNを理解するためには、まずその基礎である Q学習(Q-Learning) を理解する必要があります。
Q学習の復習
Q学習は、ある状態 においてある行動 をとった場合の「将来にわたって得られる報酬の期待値(価値)」を学習するアルゴリズムです。この価値を Q値 と呼びます。
最もシンプルなQ学習では、このQ値をQテーブルという表形式で管理します。テーブルの行が「状態」、列が「行動」に対応し、各セルにその状態行動ペアのQ値が格納されます。エージェントは環境と相互作用しながら、以下の更新式(ベルマン方程式に基づきます)に従ってQテーブルの値を少しずつ更新し、最適な行動方針を学習していきます。
ここで、
- は学習率
- は報酬
- は割引率
- は次の状態
- は次の状態で取りうる最も価値の高い行動のQ値
を意味します。
本記事はQ学習の基礎知識を前提としています。Qテーブルの更新プロセスや数式の詳細な意味に不安がある方は、先に Q学習(Q-Learning)とは? の記事をお読みいただくことをおすすめします。
Qテーブルの限界:次元の呪い
Qテーブルはシンプルで強力ですが、現実の多くの問題、特に状態空間が巨大な問題には対応できません。例えば、Atariのゲーム画面を状態として扱う場合を考えてみましょう。DQN の論文と同じく画面を 84x84 ピクセルのグレースケール(256 階調)にしても、1 枚の画面だけで状態の数は という天文学的な数になり(論文はさらに 4 枚の画面を重ねて 1 つの状態にしています)、すべての状態を記録するテーブルを作成することは不可能です。これを 「次元の呪い」 と呼びます。
そこで、このQテーブルを関数で近似するというアイデアが生まれます。状態 を入力すると、各行動 に対するQ値を出力するような関数 です。この関数近似器として、ディープニューラルネットワーク(DNN)を用いたものが Deep Q-Network (DQN) です。
Q テーブルと Q ネットワークの違いを図にすると、次のようになります。
(図は、diagram-designで作成)
DQNのコア技術
単純にQ学習のテーブルをニューラルネットワークに置き換えただけでは、学習はうまくいきません。DQNは、学習を安定させるための2つの重要なテクニックを導入しました。Experience Replay は 2013 年の論文から、Target Network は 2015 年の論文から使われています。
1. Experience Replay(経験再生)
強化学習では、エージェントが経験した一連のデータ(状態、行動、報酬、次状態のシーケンス)は時間的に強い相関を持っています。例えば、ゲームで右に進んでいる間は、似たような画面が連続します。このような相関の強いデータをそのまま学習に使うと、学習が不安定になり、最近の経験に過剰適合してしまいます。
そこでDQNは、エージェントの経験 をリプレイバッファと呼ばれるメモリに一旦すべて保存します。そして、ネットワークを更新する際には、このバッファからランダムにミニバッチをサンプリングして学習に使用します。
これにより、
- データの相関を断ち切る: 時間的に離れた多様な経験を混ぜることで、学習データがi.i.d.(独立同分布)に近くなり、学習が安定します。
- データの再利用: 一度経験したデータを何度も学習に使えるため、データ効率が向上します。
2. Fixed Target Network(ターゲットネットワークの固定)
Q学習の更新式を見てみると、更新したいQ値 と、更新目標(TDターゲット)である の両方に、同じQ関数が使われています。
DQNの損失関数でも使われる「TDターゲット」や「TD誤差」といった、Q学習の根本的な学習メカニズムについて復習したい方は、TD学習(時間的差分学習)とは?の記事をあわせてご覧ください。
これをニューラルネットワークで実装すると、更新対象のネットワーク(Policy Network)のパラメータ が1ステップ更新されるたびに、TDターゲットを計算するためのネットワークも変化してしまいます。これは、「追いかけている目標が常に動き続ける」 ようなもので、学習を非常に不安定にします。
この問題を解決するため、DQNでは2つのネットワークを用意します。
- Policy Network (): 実際に行動を選択し、学習のたびに更新されるメインのネットワーク。
- Target Network (): TDターゲットを計算するためだけのネットワーク。こちらのパラメータ は、普段は固定されており、一定間隔(論文の Atari では 1 万ステップごと)でPolicy Networkの最新の重み がコピーされます。
これにより、TDターゲットが一定期間固定されるため、学習が安定します。損失関数は以下のようになります。
ここで はリプレイバッファを意味します。なお、論文は二乗誤差のうち、誤差が -1〜1 の外にある部分の勾配を切り詰めています。これは、誤差が大きいところで二乗の代わりに絶対値を使う Huber 損失と同じ効果で、本記事の実装も Huber 損失を使います。
DQNの実装(概念的な実装)
理論を理解したところで、実際にDQNをPyTorchで実装してみましょう。環境には、倒立振子のバランスをとるシンプルなタスクである CartPole-v1 を使用します。
ライブラリのインストール
以下のコードでは、DQNの学習と動作検証を行うために必要な環境およびライブラリをインストールします。強化学習の標準的な環境を提供する gymnasium、ディープニューラルネットワークの構築・最適化を担う torch、スコアの推移をプロットするための matplotlib、そして後に実践的な実装例として用いる実績豊富な強化学習ライブラリ stable-baselines3 を一括で導入します。
!pip install gymnasium torch matplotlib
!pip install stable-baselines3[extra]
このコマンドは、プロジェクトに必要なPythonライブラリをインストールします。gymnasium は強化学習の様々なシミュレーション環境を提供します。torch はニューラルネットワークの構築と学習に不可欠です。stable-baselines3 は、最適化済みの強化学習アルゴリズムを手軽に利用できるライブラリで、今回はスクラッチ実装との比較として、実用的なコードのシンプルさを示すために使用します。
QNetworkの定義
import gymnasium as gym
import torch
import torch.nn as nn
import torch.optim as optim
import random
from collections import deque
import numpy as np

# GPU(CUDA)が利用可能であればそれを使用し、不可であればCPUを使用する設定を行います
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

# QNetwork: 状態を入力とし、各行動のQ値を出力するニューラルネットワークを定義します
# 記事内の Q(s, a; θ) に対応するメインネットワーク(Policy Network)と、
# Q(s, a; θ^-) に対応するターゲットネットワーク(Target Network)の両方でこのクラスがインスタンス化されます
class QNetwork(nn.Module):
    def __init__(self, state_dim, action_dim):
        super(QNetwork, self).__init__()
        # 入力層から隠れ層1への全結合(状態の次元数から128次元へ変換)
        self.fc1 = nn.Linear(state_dim, 128)
        # 隠れ層1から隠れ層2への全結合
        self.fc2 = nn.Linear(128, 128)
        # 隠れ層2から出力層への全結合(行動の数だけの次元を出力し、それぞれのQ値を算出)
        self.fc3 = nn.Linear(128, action_dim)

    def forward(self, x):
        # 活性化関数ReLUを適用して非線形性を導入します
        x = torch.relu(self.fc1(x))
        x = torch.relu(self.fc2(x))
        # 出力層では活性化関数を通さず、生のQ値をそのまま返します
        return self.fc3(x)
状態を受け取って各行動の Q 値を出す Q ネットワーク を定義するコードです。
- 入力と出力: 入力は CartPole の状態の 4 次元(カートの位置・速度、ポールの角度・角速度)、出力は行動の数の 2 次元(左に押す・右に押す)です。行動ごとに別々にネットワークを通すのではなく、1 回の計算で全行動の Q 値を出すので、 も 1 回の計算で求められます。
- 大きさ: 隠れ層 128-128 の 3 層は、PyTorch の公式の DQN チュートリアルと同じ構成です(論文は画面を入力にするため、畳み込み層を使います)。
- 出力層に活性化関数を付けない理由: Q 値は将来の報酬の合計の見込みなので、CartPole では 0 から 100 近く(割引率 0.99 で 500 ステップ立ち続けた場合)まで取ります。ReLU などを通すと値の範囲が制限されるため、最後の層はそのまま出力します。
- 2 つのネットワーク: このクラスから、Policy Network と Target Network を同じ構造で 2 つ作ります(DQNAgent を参照)。
ReplayBufferの定義
以下のコードでは、DQNの学習を安定させるための中核技術である「Experience Replay(経験再生)」を処理するためのメモリバッファを実装します。エージェントが環境から得た一連の遷移データを一時的に保存し、そこからランダムに過去の経験をサンプリングしてニューラルネットワークに入力する仕組みを提供します。
# ReplayBuffer: エージェントの過去の経験を保存し、学習時にランダムにサンプリングしてデータの時間的相関を解消するクラス
class ReplayBuffer:
    def __init__(self, capacity):
        # Pythonの標準ライブラリdequeを使用し、最大容量(capacity)に達すると自動的に最も古いデータが破棄されるリングバッファを作成します
        self.buffer = deque(maxlen=capacity)

    def push(self, state, action, reward, next_state, done):
        # 経験(現在の状態、選択した行動、得られた報酬、遷移先の次の状態、エピソード終了フラグ)をタプルとしてバッファに追加します
        self.buffer.append((state, action, reward, next_state, done))

    def sample(self, batch_size):
        # バッファの中から重複なしでbatch_size分のデータをランダムに抽出し、リストとして返します
        return random.sample(self.buffer, batch_size)

    def __len__(self):
        # 現在バッファに保存されているデータの個数を返します
        return len(self.buffer)
Experience Replay のためのリプレイバッファを、Python の標準ライブラリだけで作るコードです。
- リングバッファ: deque(maxlen=capacity) は、上限を超えて追加すると、最も古い要素を自動で捨てます。古すぎる経験は今の方策とかけ離れているので、新しい経験と入れ替えていきます。容量は DQNAgent で 10,000 にします。
- 保存する組: push は、1 ステップ分の (状態, 行動, 報酬, 次の状態, 終了フラグ) を 1 つのタプルにして保存します。TD ターゲット の計算に、次の状態と終了フラグが必要だからです。
- ランダムな取り出し: random.sample は、重複なしでランダムに選びます。続いたステップの経験は似た状態ばかりなので、ランダムに選ぶことで、1 つのミニバッチに時期の違う経験が混ざり、相関が弱まります。
DQNAgentの定義
以下のコードでは、DQNアルゴリズムのエージェントとしての行動選択および学習のコアロジックをカプセル化した DQNAgent クラスを定義します。ここでは、行動を決定する policy_net と、時間差(TD)目標の計算の安定化を担う target_net を管理し、サンプリングした経験データに基づいてベルマン方程式から導出された損失関数に沿ってネットワーク重みの更新(学習)を行います。
# DQNAgent: DQN(Deep Q-Network)の行動選択、経験の蓄積、および重みの更新処理を取りまとめるエージェントクラス
class DQNAgent:
    def __init__(self, state_dim, action_dim, replay_buffer_capacity=10000, batch_size=128, gamma=0.99, lr=3e-4):
        # 状態空間の次元数(CartPoleでは4次元)
        self.state_dim = state_dim
        # 行動空間の数(CartPoleでは2通り: 左・右)
        self.action_dim = action_dim
        # 1回の学習で使用するミニバッチのサイズ
        self.batch_size = batch_size
        # 将来の報酬を割り引く割合(割引率 γ)
        self.gamma = gamma

        # メインネットワーク(Policy Network θ): 行動選択と頻繁な重み更新を行います
        self.policy_net = QNetwork(state_dim, action_dim).to(device)
        # ターゲットネットワーク(Target Network θ^-): TDターゲットの目標値算出のみに使用し、重みは一定期間固定します
        self.target_net = QNetwork(state_dim, action_dim).to(device)
        # 初期状態ではメインネットワークの重みをターゲットネットワークに完全に同期させます
        self.target_net.load_state_dict(self.policy_net.state_dict())
        # ターゲットネットワークは勾配計算やDropout、BatchNormの挙動を防ぐために評価モード(eval)にします
        self.target_net.eval()

        # メインネットワークを最適化するオプティマイザ(PyTorch の DQN チュートリアルと同じ AdamW・amsgrad)
        self.optimizer = optim.AdamW(self.policy_net.parameters(), lr=lr, amsgrad=True)
        # 経験データを一時保存するためのリプレイバッファを生成します
        self.buffer = ReplayBuffer(replay_buffer_capacity)
        # 損失関数:Huber 損失(誤差が 1 以内なら二乗、それより大きければ絶対値に比例)
        # 論文の「TD 誤差を -1〜1 に切り詰める」工夫と同じ効果で、大きな誤差で勾配が暴れるのを防ぎます
        self.loss_fn = nn.SmoothL1Loss()

    def select_action(self, state, epsilon):
        # ε-greedy法に基づき、探索と活用のバランスをとって行動を決定します
        if random.random() < epsilon:
            # 確率εでランダムに行動を選択します(探索: Exploration)
            return random.randrange(self.action_dim)
        with torch.no_grad():
            # 確率 (1 - ε) で現在のQ値が最も高い行動を貪欲(Greedy)に選択します(活用: Exploitation)
            # 入力状態をテンソルに変換し、バッチサイズ1の次元(unsqueeze(0))を追加してデバイスに転送します
            state = torch.FloatTensor(state).unsqueeze(0).to(device)
            # メインネットワークに状態を通し、各行動の予想Q値を出力します
            q_values = self.policy_net(state)
            # 最も高いQ値を持つ行動のインデックスを取得します
            return q_values.max(1)[1].item()

    def learn(self):
        # バッファに十分なデータ(batch_size以上)が貯まるまでは学習を行いません
        if len(self.buffer) < self.batch_size:
            return

        # リプレイバッファからランダムにbatch_size分の遷移データをサンプリングします
        transitions = self.buffer.sample(self.batch_size)
        # サンプリングされたデータの構造を[(s, a, r, s', done), ...]から、各要素ごとのリストにアンパックして再構成します
        batch = list(zip(*transitions))

        # PyTorchの計算効率を最大化するため、各データをテンソルに変換しGPU/CPUデバイスに送ります
        state_batch = torch.FloatTensor(np.array(batch[0])).to(device)
        action_batch = torch.LongTensor(batch[1]).unsqueeze(1).to(device)
        reward_batch = torch.FloatTensor(batch[2]).to(device)
        next_state_batch = torch.FloatTensor(np.array(batch[3])).to(device)
        done_batch = torch.FloatTensor(batch[4]).to(device)

        # 1. 現在のQ値 Q(s, a; θ) の算出
        # メインネットワークに状態バッチを入力し、gatherを用いて実際に選択された行動(action_batch)に対応するQ値のみを抽出します
        current_q_values = self.policy_net(state_batch).gather(1, action_batch)

        # 2. ターゲットとなるQ値(TDターゲット)の算出
        # ターゲットネットワークを用いた目標値計算では、メインネットワークの頻繁な更新による影響を防ぐため勾配計算を無効化します
        with torch.no_grad():
            # 次の状態における各行動の最大Q値 max_a' Q(s', a'; θ^-) をターゲットネットワークで計算します
            next_q_values = self.target_net(next_state_batch).max(1)[0]
            # ベルマン更新目標を算出: r + γ * (1 - done) * max_a' Q(s', a'; θ^-)
            # ポールが倒れて終了した(done が 1)場合は、遷移先がないため将来価値を 0 とします
            # (500 ステップでの打ち切りは失敗ではないので、done には含めません。訓練ループを参照)
            target_q_values = reward_batch + (1 - done_batch) * self.gamma * next_q_values

        # 3. 損失 L(θ) の計算
        # 予測Q値(current_q_values)と、目標Q値(target_q_values)の間の Huber 損失を算出します
        loss = self.loss_fn(current_q_values.squeeze(1), target_q_values)

        # 4. バックプロパゲーションとパラメータ更新
        # 勾配バッファをゼロクリアし、誤差逆伝播で勾配を計算後、メインネットワークのパラメータ θ を更新します
        self.optimizer.zero_grad()
        loss.backward()
        # 勾配の各要素を -100〜100 に切り詰めて、極端な更新を防ぎます(PyTorch の DQN チュートリアルと同じ)
        torch.nn.utils.clip_grad_value_(self.policy_net.parameters(), 100)
        self.optimizer.step()

    def update_target_net(self):
        # 定期的なタイミングで、メインネットワークの重み(θ)をターゲットネットワークの重み(θ^-)に完全にコピー(同期)します
        self.target_net.load_state_dict(self.policy_net.state_dict())
2 つのネットワーク・行動の選び方・1 回分の更新をまとめたエージェントのコードです。learn が、上の損失関数 をそのまま計算します。
- ハイパーパラメータ: バッファ 10,000・バッチ 128・割引率 0.99・学習率 3e-4・AdamW(amsgrad)・Huber 損失(nn.SmoothL1Loss)・勾配の値のクリップ 100 は、PyTorch の DQN チュートリアルと同じ設定です。
- 2 つのネットワーク: policy_net が 、target_net が です。最初に load_state_dict で重みをそろえ、以後は update_target_net が呼ばれたときだけコピーします。オプティマイザには policy_net のパラメータだけを渡すので、target_net は勾配では動きません。
- ε-greedy: select_action は、確率 epsilon でランダムな行動、それ以外は Q 値が最大の行動を選びます。学習の初めは Q 値がでたらめなので、Q 値だけで選ぶと同じ行動ばかり試し、ほかの行動の価値を学べません。
- 予測の Q 値: self.policy_net(state_batch) は (128, 2) の全行動の Q 値です。gather(1, action_batch) で、実際に選んだ行動の列だけを取り出し、(128, 1) の にします。
- TD ターゲット: torch.no_grad() の中で、self.target_net(next_state_batch).max(1)[0] により を求め、 を計算します。done が 1(ポールが倒れた)のときは、その先に価値がないので報酬だけになります。勾配を止めるのは、目標の値に勾配が流れると、予測を目標に近づけるのではなく、目標を予測に近づけてしまうからです。
- 損失と更新: Huber 損失は、誤差が 1 以内なら二乗、それより大きければ絶対値に比例します。学習の初めや Target Network を入れ替えた直後は TD 誤差が大きくなりやすく、二乗のままだと勾配が大きくなりすぎるため、論文の誤差の切り詰めと同じ効果を持つ Huber 損失を使います。
訓練ループ
以下のコードでは、構築した DQNAgent と CartPole-v1 環境を結合させ、実際にエージェントが相互作用しながらエピソードを繰り返す「訓練ループ」を実装します。ここでは、経験データの蓄積、ネットワークの更新、探索率 の段階的な減衰、そしてターゲットネットワークへの定期的なパラメータ同期といった全体の学習サイクルを回します。
# --- ハイパーパラメータの設定 ---
EPISODES = 600                    # 学習するエピソード数(PyTorch の DQN チュートリアルと同じ)
TARGET_UPDATE_FREQUENCY = 200     # ターゲットネットワークへ重みをコピーする間隔(総ステップ数)
EPSILON_START = 0.9               # 探索率 ε の初期値(PyTorch の DQN チュートリアルと同じ)
EPSILON_END = 0.01                # 探索率 ε の最小値(同上)
EPSILON_DECAY = 2500              # ε が (初期値 - 最小値) の 1/e まで下がるステップ数(同上)

# 乱数を固定して、実行結果を再現できるようにします
random.seed(0)
np.random.seed(0)
torch.manual_seed(0)

# --- 環境とエージェントの初期化 ---
# GymnasiumよりCartPole-v1環境を作成します
env = gym.make('CartPole-v1')
# 環境の観測空間(状態)の次元数を取得(CartPoleは4次元)
state_dim = env.observation_space.shape[0]
# 環境の行動空間(エージェントが取れる行動の種類)の数を取得(CartPoleは2種類)
action_dim = env.action_space.n
# 事前に定義したDQNAgentインスタンスを作成
agent = DQNAgent(state_dim, action_dim)

# --- 訓練(学習)メインループ ---
scores = []                       # 各エピソードの獲得スコアを記録するリスト
total_steps = 0                   # 累積された全体の総ステップ数

print("--- DQN (スクラッチ) 学習開始 ---")
for episode in range(EPISODES):
    # エピソードの開始時に環境をリセットし、初期状態を取得します(最初だけ seed を渡すと、以降の初期状態も決まる)
    state, _ = env.reset(seed=0 if episode == 0 else None)
    episode_score = 0             # このエピソードにおける累積報酬(スコア)
    done = False                  # エピソードが終了したかどうかのフラグ

    while not done:
        # 探索率 ε を総ステップ数に応じて指数関数的に下げ、ε-greedy 法で行動を選択します
        epsilon = EPSILON_END + (EPSILON_START - EPSILON_END) * np.exp(-total_steps / EPSILON_DECAY)
        action = agent.select_action(state, epsilon)
        # 選択した行動を実行し、次の状態、報酬、終了フラグ(terminated/truncated)などを取得
        next_state, reward, terminated, truncated, _ = env.step(action)
        # 通常終了、または時間切れ(最大ステップ到達など)のいずれかでエピソード終了と判定
        done = terminated or truncated

        # 経験(遷移データ)をリプレイバッファに保存します
        # 将来価値を 0 にするのはポールが倒れた(terminated)ときだけで、500 ステップでの打ち切りは含めません
        agent.buffer.push(state, action, reward, next_state, terminated)
        # リプレイバッファ内のデータを用いてネットワークを1ステップ更新します
        agent.learn()

        # 状態を次のステップへ移行
        state = next_state
        # 報酬をスコアに加算(CartPoleでは1ステップ生存するごとに報酬 +1)
        episode_score += reward
        # 総ステップ数をカウントアップ
        total_steps += 1

        # 設定された更新ステップ間隔ごとに、ターゲットネットワークの重みを同期します
        if total_steps % TARGET_UPDATE_FREQUENCY == 0:
            agent.update_target_net()

    # このエピソードのスコアを記録
    scores.append(episode_score)
    # 50エピソードごとに直近の平均スコアを出力し、学習の進捗を確認します
    if (episode + 1) % 50 == 0:
        print(f"エピソード {episode + 1}/{EPISODES}: 平均スコア (直近50) {np.mean(scores[-50:]):.1f}  ε {epsilon:.3f}")

# スクラッチ実装による学習履歴を保存
scratch_dqn_scores = scores
print("--- DQN (スクラッチ) 学習完了 ---")
CartPole-v1 で 600 エピソード、1 ステップごとに経験を保存して 1 回更新し、DQN で棒を立て続けられるようになるかを確かめるコードです。
- 設定の出典: 600 エピソードと、ε を 0.9 から 0.01 まで指数関数的に下げる(減衰の速さ 2,500 ステップ)設定は、PyTorch の DQN チュートリアルと同じです。ε は総ステップ数で下げるので、エピソードが長くなるほど早く下がります。
- Target Network の更新間隔: PyTorch のチュートリアルは、毎ステップ θ⁻ を θ に少しずつ近づける方法(ソフト更新、係数 0.005)を使います。本記事は論文と同じく一定間隔でコピーする方法にし、間隔は、係数 0.005 のソフト更新で古い重みの影響が薄れる 200 ステップ(1/0.005)にしています。論文の Atari の 1 万ステップは、CartPole の学習全体(今回は約 23 万ステップ)に対して長すぎます。
- 打ち切りの扱い: 500 ステップでの打ち切り(truncated)は、ポールが倒れたわけではありません。そこで、リプレイバッファには terminated だけを終了フラグとして保存し、打ち切りのときは次の状態の価値を TD ターゲットに含めます。エピソードのループを抜けるかどうかは、両方を見て決めます。
- 乱数の固定: random・numpy・torch の乱数と、最初の env.reset(seed=0) で、実行結果を再現できるようにします。
- 進捗の表示: 1 エピソードのスコアはばらつくので、50 エピソードごとに、直近 50 エピソードの平均と、その時点の ε を表示します。
実行結果
--- DQN (スクラッチ) 学習開始 ---
エピソード 50/600: 平均スコア (直近50) 23.0  ε 0.572
エピソード 100/600: 平均スコア (直近50) 189.6  ε 0.023
エピソード 150/600: 平均スコア (直近50) 328.2  ε 0.010
エピソード 200/600: 平均スコア (直近50) 425.9  ε 0.010
エピソード 250/600: 平均スコア (直近50) 464.9  ε 0.010
エピソード 300/600: 平均スコア (直近50) 322.0  ε 0.010
エピソード 350/600: 平均スコア (直近50) 468.5  ε 0.010
エピソード 400/600: 平均スコア (直近50) 490.0  ε 0.010
エピソード 450/600: 平均スコア (直近50) 500.0  ε 0.010
エピソード 500/600: 平均スコア (直近50) 500.0  ε 0.010
エピソード 550/600: 平均スコア (直近50) 400.3  ε 0.010
エピソード 600/600: 平均スコア (直近50) 500.0  ε 0.010
--- DQN (スクラッチ) 学習完了 ---
- ε の下がり方: 最初の 50 エピソードは平均 23.0 と短いエピソードばかりで、ε は 0.572 までしか下がっていません。50〜100 エピソードで平均が 189.6 に伸びるとステップ数が一気に増え、100 エピソード目には ε は 0.023 まで下がりました。
- 500 に届くまで: 直近 50 エピソードの平均は、150 エピソード目で 328.2、250 エピソード目で 464.9 と伸び、400 エピソード目以降は 490〜500 になりました。学習全体の環境のステップ数は、スコアの合計から約 23 万ステップです。
- 途中の下がり: 300 エピソード目に 322.0、550 エピソード目に 400.3 と、平均が一時的に下がっています。どちらも、その後のエピソードで 500 に戻りました。Q 値の推定は、Target Network とリプレイバッファで安定させても、学習を続けるうちに崩れることがあります。
直近 50 エピソードの平均スコアの推移を図にすると、次のようになります。
(図は、diagram-designで作成)
性能比較と可視化
スクラッチで実装したDQNと、比較対象として完全ランダムに行動した場合のスコアを比較してみましょう。
以下のコードでは、学習を一切行わず完全ランダムに行動するエージェントで、同じ 600 エピソードのスコアを集めます。スクラッチ実装の学習中のスコアと、直近 50 エピソードの移動平均で比べます。
import matplotlib.pyplot as plt

# ==========================================
# ランダム行動エージェントのスコアを収集
# ==========================================
random_scores = []
env_random = gym.make('CartPole-v1')
env_random.action_space.seed(0)  # ランダムな行動の列を、実行ごとに同じにする
print("--- ランダムエージェント 評価開始 ---")
for episode in range(EPISODES):
    env_random.reset(seed=0 if episode == 0 else None)
    done = False
    episode_score = 0
    while not done:
        action = env_random.action_space.sample()
        _, reward, terminated, truncated, _ = env_random.step(action)
        done = terminated or truncated
        episode_score += reward
    random_scores.append(episode_score)
print("--- ランダムエージェント 評価完了 ---")
print(f"ランダム:平均スコア {np.mean(random_scores):.1f}(最大 {max(random_scores):.0f})")

# ==========================================
# グラフ描画(学習曲線の比較)
# ==========================================
def moving_average(data, window_size):
    if len(data) < window_size:
        return np.mean(data)
    return np.convolve(data, np.ones(window_size), 'valid') / window_size

plt.figure(figsize=(12, 7))
window = 50

x = np.arange(window, EPISODES + 1)  # 移動平均の値は、そのエピソードまでの直近 50 回の平均

# スクラッチ実装(学習中)
plt.plot(x, moving_average(scratch_dqn_scores, window), label=f'DQN (Scratch) - MA({window})', color='blue')

# ランダム行動
plt.plot(x, moving_average(random_scores, window), label=f'Random - MA({window})', color='orange', linestyle='--')

plt.title('Training Learning Curve: Scratch DQN vs Random')
plt.xlabel('Episode')
plt.ylabel('Score')
plt.legend()
plt.grid(True)
plt.show()
- ランダムな行動: env_random.action_space.sample() は、左右を等確率で選びます。学習の効果を見るための基準で、乱数は action_space.seed(0) で固定します。
- 移動平均: 1 エピソードのスコアはばらつきが大きいので、np.convolve で直近 50 エピソードの平均にします。mode="valid" の結果は 50 エピソード目から始まるので、横軸を np.arange(window, EPISODES + 1) にして、その平均がどのエピソードまでのものかを合わせます。
実行結果
--- ランダムエージェント 評価開始 ---
--- ランダムエージェント 評価完了 ---
ランダム:平均スコア 22.6(最大 86)
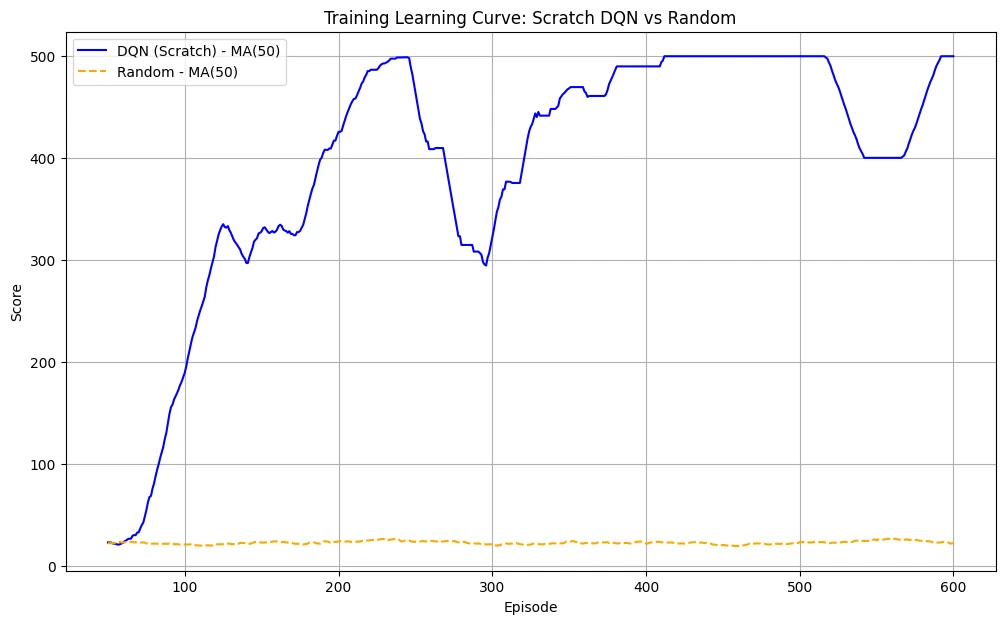
- ランダムな行動: 600 エピソードの平均は 22.6、最大でも 86 で、移動平均は最後まで 20 台のままです。
- DQN: 50 エピソード目まではランダムとほぼ同じ 20 台ですが、そこから急に伸びて、240 エピソード目あたりで 500 近くに届きます。その後、300 エピソード目の前後と 520〜570 エピソード目に下がりますが、どちらも 500 に戻っています。最後の 50 エピソードの平均は 500.0 でした。
Stable Baselines3によるDQN実装
スクラッチ実装はアルゴリズムの理解に役立ちますが、実用上は Stable Baselines3 のような最適化されたライブラリを使うのが一般的です。同じタスクをSB3で解くコードは非常にシンプルになります。
以下のコードでは、Stable Baselines3 (SB3) の DQN で同じ CartPole-v1 を学習し、学習中のスコアの推移と、学習後の方策のスコアを確かめます。
# Gymnasium(環境)とStable Baselines3(DQN)のインポート
import gymnasium as gym
import numpy as np
from stable_baselines3 import DQN
from stable_baselines3.common.evaluation import evaluate_policy
from stable_baselines3.common.monitor import Monitor
import matplotlib.pyplot as plt

# CartPole環境を初期化し、Monitorラッパーでエピソードごとのスコアを自動記録
env_sb3 = Monitor(gym.make('CartPole-v1'))

# DQNモデルの定義:rl-baselines3-zoo の CartPole-v1 の調整済みの設定
model_sb3_dqn = DQN(
    'MlpPolicy',
    env_sb3,
    learning_rate=2.3e-3,        # 学習率
    buffer_size=100_000,         # Experience Replayのバッファサイズ
    learning_starts=1000,        # 学習を始める前に、ランダムに行動して経験を集めるステップ数
    batch_size=64,               # 1回の勾配ステップに使うミニバッチサイズ
    gamma=0.99,                  # 割引率
    train_freq=256,              # 256 ステップ集めるごとに学習する
    gradient_steps=128,          # 1 回の学習で行う勾配ステップの数
    target_update_interval=10,   # Target Network を更新する間隔(環境のステップ数)
    exploration_fraction=0.16,   # 全ステップのうち、ε を下げていく期間の割合
    exploration_final_eps=0.04,  # 探索率 ε の最小値
    policy_kwargs=dict(net_arch=[256, 256]),  # 隠れ層 256-256 の Q ネットワーク
    seed=0,                      # 乱数を固定して、実行結果を再現できるようにする
    verbose=0                    # ログの出力レベル(0は出力なし)
)

print("--- DQN (Stable Baselines3) 学習開始 ---")
model_sb3_dqn.learn(total_timesteps=50_000)   # zoo の設定と同じ 5 万ステップ
print("--- DQN (Stable Baselines3) 学習完了 ---")

# 学習後の方策を、ε を使わない決定的な行動で 20 エピソード評価する
eval_env = Monitor(gym.make('CartPole-v1'))
eval_env.reset(seed=1)
mean, std = evaluate_policy(model_sb3_dqn, eval_env, n_eval_episodes=20, deterministic=True)
rewards = env_sb3.get_episode_rewards()
print(f"学習中のエピソード数:{len(rewards)}、最後の 20 エピソードの平均 {np.mean(rewards[-20:]):.1f}")
print(f"学習後の評価:20 エピソードの平均 {mean:.1f} ± {std:.1f}")

# 学習中のエピソードごとのスコア推移をプロット(学習中は ε でランダムな行動も混ざる)
plt.figure(figsize=(10, 4.5))
plt.plot(rewards)
plt.title('DQN (Stable Baselines3) Learning Curve')
plt.xlabel('Episode')
plt.ylabel('Score')
plt.grid(True)
plt.show()
- 隠される処理: ネットワークの定義、リプレイバッファへの保存とミニバッチの取り出し、Target Network の同期、ε の減衰は、すべて DQN クラスの中で行われます。Monitor は、エピソードごとのスコアを記録するラッパーです。
- 設定の出典: ハイパーパラメータは、Stable Baselines3 の調整済みの設定集 rl-baselines3-zoo の CartPole-v1 の値です(学習の長さの 5 万ステップも同じ)。スクラッチ実装との大きな違いは、1 ステップごとに 1 回更新するのではなく、256 ステップ集めるごとに 128 回まとめて更新すること(train_freq・gradient_steps)と、Target Network を 10 ステップごとに更新することです。
- 学習中と学習後のスコア: 学習中のスコアには、ε によるランダムな行動が混ざります(最後は 4%)。学習後の実力は、evaluate_policy(..., deterministic=True) で、Q 値が最大の行動だけを選んで 20 エピソード動かして測ります。
実行結果
--- DQN (Stable Baselines3) 学習開始 ---
--- DQN (Stable Baselines3) 学習完了 ---
学習中のエピソード数:463、最後の 20 エピソードの平均 406.2
学習後の評価:20 エピソードの平均 500.0 ± 0.0
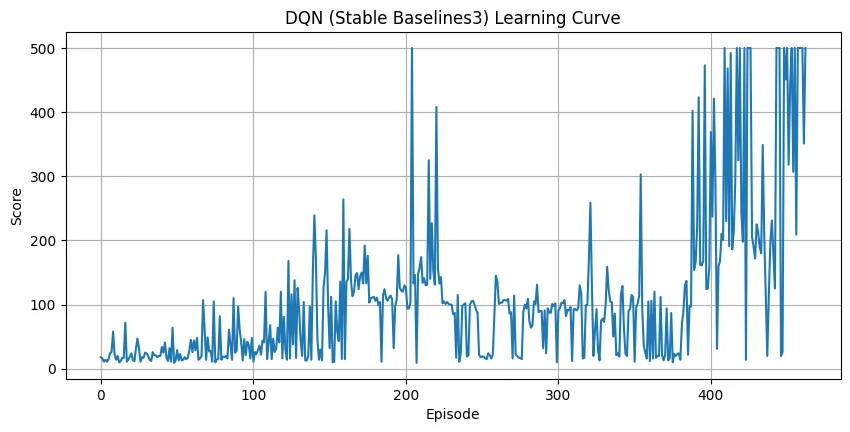
- 学習中: 最初の 400 エピソードほどは、ほとんどが 300 未満で、5 万ステップの多くはこの間に使われています。400 エピソードを過ぎると 500 に届くエピソードが増え、最後の 20 エピソードの平均は 406.2 でした。
- 学習後: ε のランダムな行動を除いて評価すると、20 エピソードすべてで 500 ステップ立ち続けました(平均 500.0 ± 0.0)。学習中のスコアが 500 にそろわないのは、ランダムな行動が混ざるためです。
- スクラッチ実装との比較: スクラッチ実装は 600 エピソード(約 23 万ステップ)かけて学習しましたが、SB3 は zoo の調整済みの設定で 5 万ステップ(463 エピソード)でした。256 ステップごとに 128 回まとめて更新するので、1 ステップごとに 1 回更新するスクラッチ実装より、同じステップ数でも勾配の更新の回数は約 2 分の 1 です(50,000 ÷ 256 × 128 ≒ 25,000 回)。値を調整してあるため、少ない経験で学習できています。
スクラッチ実装と Stable Baselines3 の学習を並べると、次のようになります。
(図は、diagram-designで作成)
PPOへの橋渡し:価値ベース手法の先へ
本記事で学んだDQNは価値ベース(Value-based) の手法と呼ばれます。これは、行動の「価値」を最大化するように学習を進めるアプローチです。DQNはこのアプローチで大きな成功を収めましたが、いくつかの限界も持っています。
- 離散行動空間: DQNは、各行動のQ値を比較して最大のものを選択するため、行動が「左」「右」「ジャンプ」のように離散的(有限個)である必要があります。車のハンドルのように連続的な角度を扱う問題には直接適用できません。
- 決定論的な方策: 最適な行動が常に一つに定まるため、確率的な行動(例えば、じゃんけんでグーを出す確率70%、チョキを30%など)を学習するのが困難です。
これらの課題を克服するのが、PPO(Proximal Policy Optimization)に代表される方策ベース(Policy-based) の手法です。方策ベースの手法は、価値を介さず、ある状態でどのような行動をとるかの方策(Policy) そのものを直接学習します。これにより、連続値の行動を扱ったり、確率的な方策を学習したりすることが可能になります。
PPOは Actor-Critic という、方策(Actor)と価値(Critic)の両方を学習するアーキテクチャを採用しています。本記事で学んだ「ニューラルネットワークによる価値関数の近似」の考え方は、まさにPPOにおける Critic 部分の基礎となっており、DQNの理解はPPOをより深く学ぶための重要なステップとなります。
価値ベースと方策ベースの違いを並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、強化学習の歴史における重要なマイルストーンであるDeep Q-Network (DQN)について、その理論的背景から実践的な実装までを解説しました。Q学習のテーブルベースの手法が抱える「次元の呪い」をニューラルネットワークによる関数近似で克服し、さらに「Experience Replay」と「Fixed Target Network」という2つの独創的なアイデアによって学習を安定化させるDQNの仕組みを学びました。
スクラッチ実装とその性能の可視化、さらにStable Baselines3による実装の紹介を通じて、アルゴリズムの内部構造と、ライブラリが提供する抽象化の利便性の両方を体感しました。最終的に、DQNがランダムな行動をはるかに上回る性能を達成できることを視覚的に確認しました。
DQNは価値ベース手法の代表格であり、そのコンセプトはPPOのようなより高度なActor-Critic手法を理解するための基盤となります。
参考文献
- V. Mnih et al. (2013). Playing Atari with Deep Reinforcement Learning. NIPS Deep Learning Workshop 2013.
- PyTorch. Reinforcement Learning (DQN) Tutorial. GitHub.
- M. Towers et al. (2024). Gymnasium: A Standard Interface for Reinforcement Learning Environments. arXiv:2407.17032.
- A. Raffin, A. Hill, A. Gleave, A. Kanervisto, M. Ernestus, N. Dormann (2021). Stable-Baselines3: Reliable Reinforcement Learning Implementations. Journal of Machine Learning Research, 22(268), 1–8.
- DLR-RM. rl-baselines3-zoo. GitHub.