EMアルゴリズムとは?
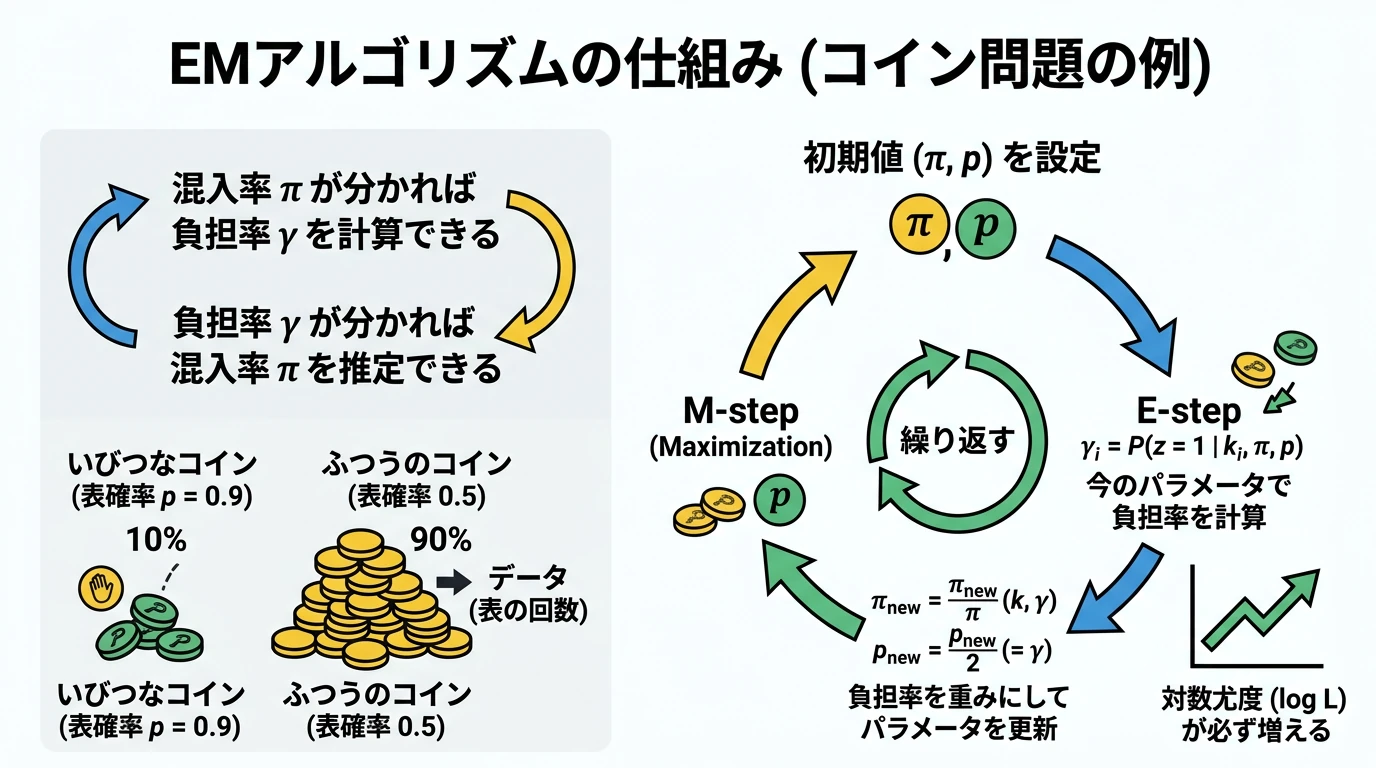 (画像は、Geminiで作成)
EMアルゴリズムの E-step と M-step が「何を計算しているのか」を、手計算できるレベルで理解すること。そして、混入率のような未知のパラメータを、ラベルのないデータから推定できるようになること。
鶏と卵の問題
混合モデルの記事では、ふつうの受験者と、事前に解答を入手した不正受験者が混ざった試験の解答データを混合モデルで表し、各受験者が不正である確率(負担率)を計算しました。ただし、そこでは 不正受験者の混入率 を知っている という前提を置いていました。
現実には、 は分かりません。ここで次の「鶏と卵」の問題が生まれます。
- が分かれば、各受験者の負担率 を計算できる
- 各受験者の負担率 が分かれば、それを平均して を見積もれる
どちらか一方が分かればもう一方が計算できるのに、両方とも分からない。この状況で使える定番の方法が EMアルゴリズム(Expectation-Maximization algorithm) です。それまで個別の問題ごとに使われていた手法を、Dempster, Laird & Rubin(1977)の「Maximum Likelihood from Incomplete Data via the EM Algorithm」が一般的な形にまとめ、名前を付けました。考え方はとてもシンプルで、次のとおりです。
- まず、パラメータを当てずっぽうに決める
- そのパラメータで、隠れた変数(どちらのグループか)の確率を計算する(E-step)
- その確率を使って、パラメータを計算し直す(M-step)
- 2と3を、値が変わらなくなるまで繰り返す
「そんな堂々巡りで、本当に正しい答えにたどり着くのか」と思うかもしれません。本記事では、まずコインの例で実際に手を動かして確かめ、そのあとで「なぜうまくいくのか」を数式で説明します。
EM アルゴリズムの繰り返しを図にすると、次のようになります。
(図は、diagram-designで作成)
コインの袋で EM を手計算する
2種類のコインが混ざった袋は、EMアルゴリズムの入門でよく使われる例です(例:Do & Batzoglou(2008)「What is the expectation maximization algorithm?」)。ここでは、混合モデルの記事と同じ袋を使います。ふつうのコイン(表の確率 )に、いびつなコイン(表の確率 )が10%混ざっています。袋から2000枚を取り出し、1枚ずつ10回投げて、表の回数を記録しました。
ただし今回は、分析する側は次のことしか知らないとします。
- 知っていること: ふつうのコインの表の確率が であること、各コインの表の回数
- 知らないこと: いびつなコインの混入率 、いびつなコインの表の確率 、各コインがどちらの種類か
と の2つを、表の回数のデータだけから推定するのが目標です。
もし種類が分かっていたら
EMアルゴリズムの考え方をつかむために、まず「各コインの種類 が分かっている」という、ずるい状況を考えます。いびつなコインなら 、ふつうのコインなら です。この場合、推定はただの数え上げです。
はコイン の表の回数です。
種類が分からないなら、確率で「数える」
実際には は分かりません。そこで、 の代わりに、「コイン がいびつなコインである確率」である負担率 を使います。
なら、「このコインを0.7枚分だけ、いびつなコインとして数える」と考えます。 を に置き換えると、更新式は次のようになります。
これがコインの例での EM アルゴリズムのすべてです。
- E-step: 今のパラメータ で、各コインの負担率 を計算する
- M-step: 負担率を「重み付きの枚数」として、 と を数え直す
1回目の反復を手計算する
初期値を 、 として、1回目の E-step と M-step を計算してみます。表の回数が同じコインは負担率も同じになるので、表の回数(0〜10回)ごとにまとめて計算できます。
例えば、表が8回のコインの負担率は次のようになります。
import numpy as np
from scipy.stats import binom

# 1. 混合モデルの記事と同じ袋:ふつうのコイン(表0.5)に、いびつなコイン(表0.9)が10%混ざっている
rng = np.random.default_rng(0)
n_coins, n = 2000, 10
z = rng.binomial(1, 0.1, size=n_coins)              # 隠れた変数(分析者には見えない)
heads = rng.binomial(n, np.where(z == 1, 0.9, 0.5))  # 観測できるのは表の回数だけ

# 2. 分析者が知っているのは「ふつうのコインは表0.5」ということだけ
p_normal = 0.5
pi, p_biased = 0.5, 0.6          # 混入率といびつなコインの表の確率は、当てずっぽうの初期値

# 3. 表の回数ごとに集計しておく(同じ回数のコインは負担率も同じになるため)
counts = np.bincount(heads, minlength=n + 1)
ks = np.arange(n + 1)

# 4. E-step:表の回数ごとの負担率
L_normal = binom.pmf(ks, n, p_normal)
L_biased = binom.pmf(ks, n, p_biased)
gamma = pi * L_biased / ((1 - pi) * L_normal + pi * L_biased)
print("表の回数 " + " ".join(f"{k:6d}" for k in ks))
print("枚数     " + " ".join(f"{c:6d}" for c in counts))
print("負担率γ  " + " ".join(f"{g:6.3f}" for g in gamma))

# 5. M-step:負担率を重みにして、π と p_biased を計算し直す
pi_new = np.sum(counts * gamma) / n_coins
p_biased_new = np.sum(counts * gamma * ks) / (n * np.sum(counts * gamma))
print(f"\nπ: {pi:.3f} → {pi_new:.3f}")
print(f"p_biased: {p_biased:.3f} → {p_biased_new:.3f}")
2000枚分のデータを作り、1回目の E-step と M-step を計算しています。
- データの生成: 混合モデルの記事と同じく、隠れた変数 z(コインの種類)を確率0.1で決めてから、表の回数 heads を作っています。z は最後の答え合わせにだけ使い、推定には使いません。
- 袋の設定: 2000枚・10回投げる・混入率0.1・表の確率0.9は、混合モデルの記事と同じです。同じデータで、混合モデルの記事で「 を知っている」として計算した結果と比べられるようにするためです。
- 初期値: pi, p_biased = 0.5, 0.6 は、わざと真値(0.1 と 0.9)から離した当てずっぽうの値です。 を0.5より少しだけ大きくしているのは、0.5にすると「いびつなコイン」と「ふつうのコイン」の分布が同じになり、最初の E-step で負担率がすべて と等しくなって、どのコインも区別できなくなるためです。
- 表の回数ごとの集計 counts: np.bincount で、表が0回、1回、…、10回だったコインがそれぞれ何枚あるかを数えています。2000枚を1枚ずつ計算する代わりに、11通りの表の回数で計算して枚数を掛ければ済みます。
- n + 1 の理由: 10回投げたときの表の回数は、0回から10回までの11通りです。np.arange は終わりの値を含まないので、np.arange(n + 1) で 0〜10 の ks を作っています(np.arange(n) では、表が10回のコインが抜けます)。
- minlength=n + 1 の理由: np.bincount は、データの最大値+1の長さの配列を返します。今回のデータには表10回のコインがあるので長さは11になりますが、データによっては表10回のコインが1枚もなく、長さが10になることがあります。そうなると、長さ11の gamma と counts * gamma で掛け合わせるときに、形がそろわずエラーになります。minlength=n + 1 を付けると、どんなデータでも長さが11にそろい、counts[k] が「表が k 回だったコインの枚数」(なければ0)を指すようになります。
- E-step: 上の負担率の式を、表の回数0〜10のすべてについて一度に計算しています。
- M-step: np.sum(counts * gamma) が「いびつなコインの重み付き枚数」 です。これを全枚数で割ると 、重み付きの表の回数 np.sum(counts * gamma * ks) を重み付きの投げた回数で割ると になります。
実行結果
表の回数      0      1      2      3      4      5      6      7      8      9     10
枚数          4     11     88    214    356    469    363    209    109     99     78
負担率γ   0.097  0.139  0.195  0.266  0.352  0.449  0.550  0.647  0.733  0.805  0.861

π: 0.500 → 0.487
p_biased: 0.600 → 0.609
表が8回のコインの負担率は、手計算と同じ0.733です。初期値の はふつうのコインの と近いので、この段階では負担率は表の回数に応じてなだらかに変わるだけで、どのコインもはっきりとは分けられていません。
それでも、M-step のあとには が0.500から0.487へ(真値0.1の方向へ)、 が0.600から0.609へ(真値0.9の方向へ)と、わずかに正しい方向へ動いています。表の多いコインほど「いびつ」側の重みが大きいので、いびつなコインの表の確率は、全体の平均より少し大きく見積もられるからです。
表の回数ごとの負担率を並べると、次のようになります。
(図は、diagram-designで作成)
反復を続ける
この E-step と M-step を、30回繰り返してみましょう。あわせて、各反復での 混合モデルの対数尤度 も計算します。
これは「パラメータが だとしたら、手元の2000枚分のデータが得られる確率」の対数で、大きいほどデータをよく説明できていることを表します。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google ColabやJupyterでは先頭の ! を付けたまま、ターミナルでは ! を外して実行します)。
!pip install japanize-matplotlib
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. 混合モデルの対数尤度:Σ_k 枚数_k × log{(1-π) P_ふつう(k) + π P_いびつ(k)}
def log_likelihood(pi, p_biased):
    mix = (1 - pi) * binom.pmf(ks, n, p_normal) + pi * binom.pmf(ks, n, p_biased)
    return np.sum(counts * np.log(mix))

# 2. EMアルゴリズム:E-step と M-step を交互に繰り返す
def em_coins(pi, p_biased, n_iter=30):
    history = [(pi, p_biased, log_likelihood(pi, p_biased))]
    for _ in range(n_iter):
        L_b = binom.pmf(ks, n, p_biased)
        L_n = binom.pmf(ks, n, p_normal)
        gamma = pi * L_b / ((1 - pi) * L_n + pi * L_b)                  # E-step
        pi = np.sum(counts * gamma) / n_coins                           # M-step
        p_biased = np.sum(counts * gamma * ks) / (n * np.sum(counts * gamma))
        history.append((pi, p_biased, log_likelihood(pi, p_biased)))
    return np.array(history)

hist = em_coins(0.5, 0.6)
for it in [0, 1, 2, 3, 5, 10, 20, 30]:
    pi_, pb_, ll_ = hist[it]
    print(f"反復 {it:2d}: π = {pi_:.4f}, p_biased = {pb_:.4f}, 対数尤度 = {ll_:.2f}")
print(f"対数尤度が前の反復より下がった回数: {int(np.sum(np.diff(hist[:, 2]) < -1e-9))}")
print(f"参考(隠れた変数から直接数えた値): π = {z.mean():.4f}, p_biased = {heads[z == 1].mean() / n:.4f}")

# 3. 可視化:パラメータと対数尤度の推移
fig, axes = plt.subplots(1, 3, figsize=(13, 3.8))
axes[0].plot(hist[:, 0], 'o-', markersize=3)
axes[0].axhline(0.1, color='red', linestyle='--', label='真値 0.1')
axes[0].set_title('混入率 π')
axes[1].plot(hist[:, 1], 'o-', markersize=3)
axes[1].axhline(0.9, color='red', linestyle='--', label='真値 0.9')
axes[1].set_title('いびつなコインの表の確率')
axes[2].plot(hist[:, 2], 'o-', markersize=3, color='green')
axes[2].set_title('対数尤度(必ず増える)')
for ax in axes:
    ax.set_xlabel('反復回数')
    ax.grid(True, alpha=0.3)
axes[0].legend()
axes[1].legend()
plt.tight_layout()
plt.show()
1回分の計算をループにまとめ、パラメータと対数尤度の推移を記録しています。
- log_likelihood: 上の対数尤度の式です。表の回数ごとに混合モデルの確率 mix を計算し、その対数に枚数 counts を掛けて足しています。
- em_coins: E-step(負担率の計算)と M-step(重み付きの数え直し)を n_iter 回繰り返します。30回は、 と がほぼ横ばいになり、収束していく様子を図で確かめられる回数です(実行結果のとおり、反復20から30での の変化は約0.013で、それ以降はさらに小さくなります)。反復ごとに を history に記録しています。
- 対数尤度の単調性の確認: np.diff(hist[:, 2]) で、隣り合う反復の対数尤度の差を計算し、マイナス(減少)になった回数を数えています。計算誤差を無視するため、-1e-9 より小さいものだけを数えています。
- 答え合わせ: 隠れた変数 z を使って、実際のいびつなコインの割合と、いびつなコインで出た表の割合を計算しています。真値の0.1と0.9は「袋の設計」の値で、2000枚という有限のデータからは、それと少しずれた値が出ているはずだからです。
実行結果
反復  0: π = 0.5000, p_biased = 0.6000, 対数尤度 = -4293.99
反復  1: π = 0.4869, p_biased = 0.6095, 対数尤度 = -4289.06
反復  2: π = 0.4695, p_biased = 0.6176, 対数尤度 = -4283.90
反復  3: π = 0.4495, p_biased = 0.6257, 対数尤度 = -4277.98
反復  5: π = 0.4041, p_biased = 0.6442, 対数尤度 = -4262.92
反復 10: π = 0.2742, p_biased = 0.7172, 対数尤度 = -4199.88
反復 20: π = 0.1136, p_biased = 0.8907, 対数尤度 = -4095.58
反復 30: π = 0.1002, p_biased = 0.9102, 対数尤度 = -4093.65
対数尤度が前の反復より下がった回数: 0
参考(隠れた変数から直接数えた値): π = 0.0995, p_biased = 0.9101
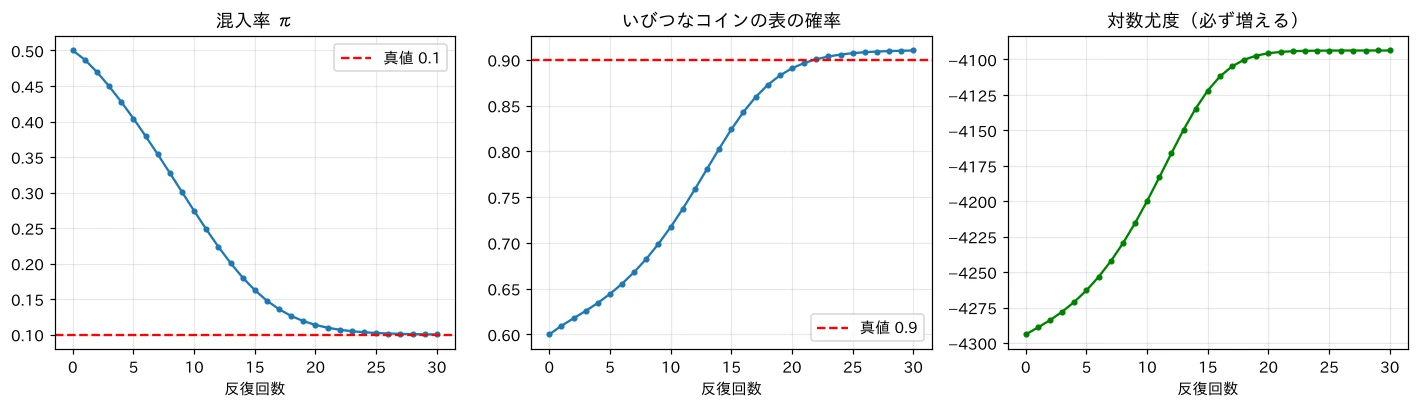
当てずっぽうの初期値から始めたにもかかわらず、30回の反復で 、 にたどり着きました。隠れた変数を直接数えた値( と )とほぼ一致しています。どのコインがいびつなのかを一度も教えていないのに、表の回数の分布だけから、混入率といびつなコインの性質を推定できたことになります。
右の図の対数尤度は、一度も下がることなく増え続けています。これは偶然ではなく、EMアルゴリズムが持つ重要な性質です。次の節で、その理由を見ていきます。
なぜ対数尤度は必ず増えるのか
EMアルゴリズムの正しさは、「1回反復するたびに、対数尤度が決して下がらない」という性質で保証されます。その証明は、イェンセンの不等式 という1つの不等式で組み立てられます。
準備:イェンセンの不等式
対数関数 は上に凸な(山なりの)関数なので、「平均してから対数を取る」ほうが「対数を取ってから平均する」より大きくなります。これを イェンセンの不等式 と呼びます。
等号が成り立つのは、 がすべて同じ値のときだけです。この不等式がなぜ成り立つのかは、イェンセンの不等式の記事で、グラフを使って詳しく解説しています。
対数尤度の「下限」を作る
コイン の対数尤度は、隠れた変数 の2通りの場合の和の対数です。ここで はパラメータをまとめたもので、 は「種類が のコインを取り出し、かつ表が 回出る」確率です。
ここで、 についての任意の確率分布 を用意し、分子と分母に掛けます( を掛けるだけなので、値は変わりません)。
これは「 を、重み で平均したものの対数」という形なので、イェンセンの不等式が使えます。イェンセンの不等式の を に、 を に置き換えると、次のようになります。
左辺は、上の式のとおり そのものです。右辺に名前を付けて、まとめると次のようになります。
が和 の外側にある形(log-sum)から、和の内側にある形(sum-log)に変わりました。 の中に和があると、 や で微分したときに、2つの項が分数の中で絡み合います。 が和の内側に入ると、 を ごとに別々に扱えるので、後の M-step で最大化を式で解けるようになります。これが、下限を作る狙いです。
右辺の は、対数尤度の 下限(lower bound) です。どんな を選んでも、対数尤度を上回ることはありません。EM を「この下限を、 と について交互に大きくする方法」として見る考え方は、Neal & Hinton(1998)の「A View of the EM Algorithm that Justifies Incremental, Sparse, and other Variants」で整理されました。
E-step:下限を対数尤度にぴったり接触させる
等号が成り立つのは、 が によらず一定のときでした。 を に比例させれば、その比は一定になります。合計が1になるように正規化すると、次のようになります。
最後の等号は、ベイズの定理です。ベイズの定理を組み立てている2つの部品を、1つずつ使っています。
- 分母は周辺化(全確率の法則): のすべての場合について同時確率を足すと、 を考えない確率になります。
- 全体は条件付き確率の定義: 同時確率を、条件の側の確率で割ると、条件付き確率になります。
ただし、この式のままでは計算できません。同時確率 が、数式として直接は与えられていないからです。コインの例では、データが次の2段階で生まれると考えていて、数式として手元にあるのは、それぞれの段階の確率です。
- 袋からコインを1枚取り出す。いびつなコインである確率は です。これが 事前確率 で、、 です。
- そのコインを10回投げる。表が 回出る確率は、コインの種類で決まります。これが 尤度 で、、 です。
条件付き確率の定義 の両辺に を掛けると、同時確率を、この2つの掛け算に書き直せます(乗法定理)。「1段目でその種類を引き、かつ2段目でその表の回数が出る」確率は、2つの段階の確率の掛け算になる、ということです。
分子と、分母の各項の同時確率を、この掛け算に置き換えると、ベイズの定理の形になります。
新しいことをしたのではなく、計算できない同時確率を、計算できる事前確率と尤度の掛け算に置き換えただけです。これで右辺は、 と二項分布だけで書けます。表が 回のコインについて、式で書くと次のとおりです。
| 事前確率 | 尤度 | 同時確率(掛け算) | |
|---|---|---|---|
| (いびつ) | |||
| (ふつう) |
手計算した表が8回のコイン(、初期値 、)で、この式に値を入れると、次のようになります。
| 事前確率 | 尤度 | 同時確率(掛け算) | |
|---|---|---|---|
| (いびつ) | |||
| (ふつう) |
手計算の と一致します。一般の について、事前確率と尤度を入れると、前半の負担率の式になります。
これは、今のパラメータでの隠れた変数の事後確率、つまり負担率そのものです(、)。E-step で負担率を計算することは、下限 を、今のパラメータ の位置で対数尤度にぴったり接触させる操作だったのです。
M-step:下限を押し上げる
次に、 を固定したまま、下限 を最大にする を探します。 を展開すると、 に関係するのは次の部分だけです(分母の は を含まないので、最大化には関係しません)。
「 が分かっていたときの対数尤度」の を、 に置き換えた形になっています。これを で微分して0とおくと、次のようになります。
同様に、 を で微分すると、次のようになります。
さきほど「確率で数え直す」と直感的に作った更新式が、下限の最大化から正確に導かれました。
2つを合わせると
E-step と M-step を合わせると、次の不等式の連鎖が成り立ちます。
- 右の等号: E-step で、下限を の位置で対数尤度に接触させたので、等しくなります。
- 真ん中の不等号: M-step で、下限を最大にする を選んだので、 のときより小さくはなりません。
- 左の不等号: 下限は、どんな でも対数尤度を上回らないので成り立ちます。
したがって、 です。「下限を接触させる(E)→ 下限を押し上げる(M)」を繰り返すたびに、対数尤度は階段を登るように増えていきます。この1回分の動きを図にすると、次のようになります。
(図は、diagram-designで作成)
なお、M-step で下限を最大にしなくても、下限を少しでも大きくする を選べば、真ん中の不等号は成り立ちます。この形は、Dempster, Laird & Rubin(1977)で 一般化 EM(GEM) と呼ばれています。
対数尤度が増え続けることは保証されますが、たどり着く先が「最も高い山の頂上(大域的最適解)」である保証はありません。対数尤度の地形に複数の山があると、初期値によっては低い山の頂上(局所最適解)で止まってしまいます。実務では、初期値を変えて何度か実行し、最終的な対数尤度が最も大きい結果を採用するのが一般的です。
試験データに EM を適用する
いよいよ、試験の解答データに EM アルゴリズムを適用します。コインの例との対応は次のとおりです。
| コインの袋 | 試験の解答データ | |
|---|---|---|
| 隠れた変数 | コインの種類 | ふつうの受験者か、不正受験者か |
| 推定するパラメータ | 混入率 、いびつなコインの表の確率 | 混入率 、ふつうの受験者だけの正答率 |
| E-step | 表の回数から負担率を計算 | 解答から負担率を計算 |
| M-step | 重み付きで と を数え直す | 重み付きで と正答率を集計し直す |
ここでのポイントは、問題ごとの正答率もパラメータとして推定し直す ことです。尤度比スコアと混合モデルの記事では、不正受験者も含めて集計した正答率をそのまま正常モデルに使っていました。しかし、不正受験者は難問にも正解するので、難問の正答率は実際より高くなっています。正常モデルが「この難問は意外と解ける」と誤解すると、不正受験者の証拠が弱まってしまいます。
正答率の歪みは、それ自体も問題です。正答率は、問題の難しさを測って次の試験の作問や配点に活かすための大切な指標です。不正受験者のせいで難問が実際より易しく見えてしまうと、試験の設計を誤ることになります。
正答率の歪み方
不正受験者の混入率を とすると、集計された正答率 は、ふつうの受験者の正答率 と、ほぼ必ず正解する不正受験者の混ざったものになります。
ここから、2つのことが分かります。
- 混入率には上限がある: なので、 がすべての問題で成り立ちます。つまり、混入率は 最も難しい問題の正答率 を超えられません。不正受験者は全員その問題にも正解するはずだからです。
- 混入率が分かれば、正答率を補正できる: 式を について解くと、 になります。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib
from scipy.special import expit, logit, logsumexp

T = 100  # 問題数

# 1. 試験のダミーデータ(尤度比スコアの記事と同じ設定)
rng = np.random.default_rng(0)
base_rate = np.sort(rng.uniform(0.03, 0.9, T))[::-1]   # 問題ごとの正答率の目安(後ろの問題ほど難しい)
n_honest, n_cheat = 3000, 60                            # 不正受験者は全体の約2%
a = logit(base_rate) - 0.3                              # 問題の易しさ a_j(ロジットで0.3下げ、少し難しくする)
b = rng.normal(0, 1.0, n_honest)                        # ふつうの受験者の実力 b_i(標準正規分布)
b[:30] += 2.5                                           # 先頭30人は成績上位者(不正受験者に近い点数を取る)
X_honest = rng.binomial(1, expit(a[None, :] + b[:, None]))   # 正解の確率 σ(a_j + b_i) で正誤を引く
X_cheat = rng.binomial(1, 0.99, size=(n_cheat, T))      # 不正受験者:どの問題も99%の確率で正解
X = np.vstack([X_honest, X_cheat]).astype(float)
y = np.r_[np.zeros(n_honest), np.ones(n_cheat)]   # 正解ラベル(評価にだけ使う)

r_obs = X.mean(axis=0)              # 集計された正答率(不正受験者を含む)
r_clean = X_honest.mean(axis=0)     # ふつうの受験者だけの正答率(答え合わせ用。現実には分からない)
hard = slice(90, 100)               # 最も難しい10問(91〜100問目)
print(f"難問10問の平均正答率  観測: {r_obs[hard].mean():.4f} / ふつうの受験者のみ: {r_clean[hard].mean():.4f}")
print(f"混入率の上限 min r_obs = {r_obs.min():.4f}(真の混入率 {n_cheat / len(X):.4f})")
尤度比スコアの記事と同じ試験データを作り、正答率がどれだけ歪んでいるかを確認しています。
- データの生成: 後ろの問題ほど難しい100問の試験を、ふつうの受験者3000人(うち30人は成績上位者)と、どの問題にも99%の確率で正解する不正受験者60人が受けたデータです。
- ふつうの受験者の正解の確率: 受験者 が問題 に正解する確率を としています。 はシグモイド関数(expit)で、どんな実数も0〜1の確率に変換します。その逆関数がロジット(logit)で、確率 を に変換します。 は問題の易しさ、 は受験者の実力で、易しい問題ほど、実力の高い受験者ほど、正解の確率が高くなります。
- 問題の易しさ a: 正答率の目安 base_rate(3〜90%)をロジットに変換し、0.3を引いています。0.3を引くと、どの問題も目安より少し難しくなり、ふつうの受験者の正答率の平均は約50%から約45%に下がります。正答率から直接0.3を引くと、目安3%の問題で確率がマイナスになってしまいますが、ロジットで引けば、シグモイド関数を通した確率は必ず0〜1に収まります。
- 実力 b: 標準正規分布から引いています。実力で高得点を取る受験者もいる、現実に近いデータにするためです。先頭30人に2.5を足すのは、不正受験者に近い点数を取るふつうの受験者(成績上位者)をわざと作り、点数だけでは不正と区別できない状況にするためです。
- 不正受験者: 事前に解答を入手しているので、どの問題も99%の確率で正解します(1%は写し間違い)。60人は全体の約2%で、この混入率をEMで推定します。
- データの作り方の詳しい理由は、尤度比スコアの記事でも説明しています。
- r_obs と r_clean: r_obs は全員で集計した正答率で、現実に手に入るのはこちらです。r_clean はふつうの受験者だけで集計した正答率で、EMの推定結果の答え合わせにだけ使います。
- 難問10問 hard: slice(90, 100) で、最も難しい91〜100問目を指定しています。歪みが最も大きく出る問題です。
- 混入率の上限: r_obs.min() は、上で導いた の上限です。
実行結果
難問10問の平均正答率  観測: 0.0928 / ふつうの受験者のみ: 0.0750
混入率の上限 min r_obs = 0.0588(真の混入率 0.0196)
難問10問の正答率は、ふつうの受験者だけなら7.5%なのに、不正受験者が混ざることで9.3%と、約1.2倍に膨らんでいます。わずか2%の不正受験者でも、もともと正答率の低い難問には大きな影響を与えるのです。
混入率の上限は5.9%で、真の混入率2.0%はたしかにその範囲に収まっています。上限だけでは混入率は決まりませんが、「不正受験者が10%もいる」といった見当違いの推定を排除する手がかりになります。
2つの正答率を並べると、次のようになります。
(図は、diagram-designで作成)
試験データ版の EM アルゴリズム
EM アルゴリズムを使う前に、2つのグループの解答の確率(尤度)を決めます。
- 異常モデル(不正受験者): どの問題も確率 で正解すると考えます。正解数を とすると、受験者 の解答 (正解なら1、不正解なら0を100問分並べたもの)の尤度は次のとおりです。
- 正常モデル(ふつうの受験者): データの作り方と同じく、問題 に正解する確率を とします。 は問題 の正答率で、易しさ の代わりに を使います。実力 は受験者ごとに分からないので、標準正規分布 で平均を取ります(周辺化)。
実力 を受験者ごとに自由に選べるようにすると、ほぼ満点の不正受験者も「とても実力の高い、ふつうの受験者」として説明できてしまい、見分けられなくなります。「実力はふつうこのくらいの範囲に分布している」という事前分布で平均を取ると、成績上位者の高得点は説明しつつ、全問正解のような極端な解答は起こりにくい、と評価できます。詳しくは、尤度比スコアの記事で説明しています。
この2つのモデルを使うと、試験データでの E-step と M-step は、次のようになります。
E-step: 今の と正答率 で、各受験者の負担率を計算します。
M-step: 負担率を重みにして、 と正答率を計算し直します。
正答率の更新式は、「ふつうの受験者である確率 を重みにした、重み付きの正答率」です。不正受験者らしい受験者ほど重みが小さくなり、集計から外れていきます。
上のとおり、正常モデルの正解の確率は で、実力 を周辺化しています。厳密な M-step では、この周辺化した尤度(の下限)を最大にする を数値最適化で求める必要があります。本記事では、分かりやすさを優先して「ふつうらしい受験者だけで集計し直した正答率」を使っています。 の更新は、コインの例と同じく厳密な M-step です。この簡略化の影響は、次の実行結果で確認します。
# 1. 正常モデル(実力の差を周辺化)と異常モデルの対数尤度
B_GRID = np.linspace(-6, 6, 61)
LOG_W = -0.5 * B_GRID ** 2
LOG_W -= logsumexp(LOG_W)

def loglik_normal(X, r):
    a_hat = logit(np.clip(r, 1e-3, 1 - 1e-3))
    Q = np.clip(expit(a_hat[:, None] + B_GRID[None, :]), 1e-12, 1 - 1e-12)
    G = X @ np.log(Q) + (1 - X) @ np.log(1 - Q)
    return logsumexp(G + LOG_W[None, :], axis=1)

def loglik_anom(X, eps=0.01):
    n_correct = X.sum(1)
    return n_correct * np.log(1 - eps) + (X.shape[1] - n_correct) * np.log(eps)

# 2. EMアルゴリズム(π と、不正受験者を除いた正答率 r を交互に更新)
def em_exam(X, pi, n_iter=30):
    r = X.mean(axis=0)                                   # 初期値:観測された正答率
    history = []
    for it in range(n_iter):
        # E-step:各受験者が不正である確率(負担率)
        log_a = np.log(pi) + loglik_anom(X)
        log_n = np.log(1 - pi) + loglik_normal(X, r)
        log_total = np.logaddexp(log_a, log_n)           # log{π L_異常 + (1-π) L_正常}
        gamma = np.exp(log_a - log_total)
        history.append((it, pi, r[-10:].mean(), log_total.sum()))
        # M-step:負担率を重みにして π と正答率を計算し直す
        pi = gamma.mean()
        w = 1 - gamma                                    # ふつうの受験者である重み
        r = (w @ X) / w.sum()                            # ふつうらしい受験者だけの正答率
    return gamma, pi, r, history

gamma, pi_hat, r_hat, history = em_exam(X, pi=0.3)
print("反復      π     難問10問の正答率   対数尤度")
for it, p_, r10, ll in history[:6] + history[-1:]:
    print(f"{it:3d}   {p_:.4f}        {r10:.4f}         {ll:.1f}")
試験データ版の EM アルゴリズムを実装し、初期値 から実行しています。
- loglik_normal: 尤度比スコアの記事と同じ、実力の差を周辺化した正常モデルの対数尤度です。実力 の事前分布(標準正規分布)を、〜 の61点(0.2刻み)の格子で近似しています。 は標準偏差の6倍で、その外側の確率は無視できるほど小さく、0.2刻みにしても結果は変わらない細かさです。正答率の clip(r, 1e-3, 1 - 1e-3) は、正答率が0や1になってロジットが無限大になるのを防ぐためです。正答率 r を引数で受け取るようにしてあり、M-step で更新した正答率をそのまま次の E-step に使えます。
- loglik_anom: 異常モデル(正解の確率 )の対数尤度です。 は、データを作ったときの不正受験者の正解の確率(0.99)に合わせた値です。
- E-step: 尤度が非常に小さな値になるので、負担率の式を対数のまま計算しています。np.logaddexp(log_a, log_n) は を、アンダーフローを起こさずに計算する関数で、負担率の式の分母の対数にあたります。分子の対数 log_a から引いて np.exp すれば、負担率になります。log_total.sum() は、全受験者分の混合モデルの対数尤度です。
- M-step: gamma.mean() が の更新式です。w @ X は、各問題について「ふつうの受験者である重み × 正解したかどうか」を全受験者で足し合わせる計算で、w.sum() で割ると、重み付きの正答率になります。
- 記録: 反復ごとに、、難問10問(r[-10:])の平均正答率、対数尤度を記録しています。
- 初期値: は、上限(5.9%)を大きく超える、わざと見当違いにした値です。反復回数30は、コインの例と同じにしています(この例では2回目以降、値が変わりません)。正答率の初期値は、歪んだままの観測値 r_obs です。
実行結果
反復      π     難問10問の正答率   対数尤度
  0   0.3000        0.0928         -154546.7
  1   0.0196        0.0750         -153308.5
  2   0.0195        0.0751         -153310.2
  3   0.0195        0.0751         -153310.2
  4   0.0195        0.0751         -153310.2
  5   0.0195        0.0751         -153310.2
 29   0.0195        0.0751         -153310.2
見当違いの初期値 から始めても、たった1回の反復で (真値と同じ)に到達し、難問10問の正答率も9.3%から7.5%に補正されました。
コインの例では30回近くかかったのに、なぜこんなに速いのでしょうか。理由は、100問分の解答が持つ証拠の強さです。ふつうの受験者と不正受験者では、対数尤度比 が大きく離れています。尤度比スコアの記事で同じデータを計算すると、100問分では、ふつうの受験者で最も大きい値でも 、不正受験者で最も小さい値でも で、2つのグループの間には0をはさんだ隙間があり、ほとんどの受験者の値は、その隙間からさらに離れています。事前の対数オッズが でも でも、その差に比べれば小さいので、最初の E-step で多くの受験者の負担率がほぼ0か1にはっきり分かれ、M-step で数え直すと、いきなり正しい答えの近くに来るのです。
コインの例では、表8回のコインが「ふつう」と「いびつ」のどちらからも生まれうるため、負担率が0と1の中間の値を取り、少しずつしか進めませんでした。グループどうしの重なりが大きいほど、EMの収束は遅くなります。
ここで、対数尤度の列に注目してください。反復1の から、反復2では へと、わずかに 下がって います。「対数尤度は決して下がらない」はずなのに、なぜでしょうか。
理由は、上の注意書きで触れた正答率の更新式です。対数尤度が下がらないことの証明では、M-step で下限 を 最大化する(少なくとも下げない)ことを使いました。ところが、今回の正答率の更新式は「重み付きで集計し直す」という分かりやすさを優先した近似で、下限を最大化しているわけではありません。そのため、単調性の保証が成り立たないのです。下がり幅は約15万のうちの1.7とごくわずかで、その後は値が変わらず、推定結果にも実質的な影響はありません。それでも、EM の単調性は、M-step が本当に下限を大きくしているときにだけ保証される ことは覚えておきましょう。簡略化した更新を使うときは、対数尤度の推移を記録して確認するのが安全です。
コインの例と試験データの収束を並べると、次のようになります。
(図は、diagram-designで作成)
厳密な M-step で確かめる
正答率の更新を、下限を本当に最大にする形に変えると、対数尤度が下がらなくなることを確かめます。下限のうち正答率に関係する部分は、ふつうの受験者である重み を付けた、正常モデルの対数尤度の和です。
は問題 の易しさです。この最大化は式では解けないので、勾配を使った数値最適化(L-BFGS-B)で求めます。
from scipy.optimize import minimize

A_MIN, A_MAX = logit(1e-3), logit(1 - 1e-3)   # loglik_normal の clip と同じ範囲

def m_step_exact(X, w, a0, maxiter=50):
    """厳密な M-step:Σ_i w_i log L_正常(x_i | a) を最大にする問題の易しさ a を、数値最適化で求める"""
    def neg_obj(a):
        Q = np.clip(expit(a[:, None] + B_GRID[None, :]), 1e-12, 1 - 1e-12)   # 問題 × 実力の格子
        G = X @ np.log(Q) + (1 - X) @ np.log(1 - Q) + LOG_W[None, :]           # 受験者 × 実力の格子
        ll = logsumexp(G, axis=1)                                              # 実力を周辺化した対数尤度
        post = np.exp(G - ll[:, None])                                         # 受験者ごとの実力の事後分布
        # 勾配:Σ_i w_i Σ_g post_ig (x_ij - Q_jg)(実力の事後分布で重み付けした「正解 − 予測」)
        wp = w[:, None] * post                                                 # 受験者 × 格子の重み
        grad = (X.T @ wp).sum(axis=1) - (Q * wp.sum(axis=0)[None, :]).sum(axis=1)
        return -(w @ ll), -grad
    res = minimize(neg_obj, a0, jac=True, method='L-BFGS-B',
                   bounds=[(A_MIN, A_MAX)] * len(a0), options={'maxiter': maxiter})
    return res.x

def em_exam_exact(X, pi, n_iter=30):
    a = logit(np.clip(X.mean(axis=0), 1e-3, 1 - 1e-3))   # 初期値:観測された正答率のロジット
    history = []
    for it in range(n_iter):
        r = expit(a)
        log_a = np.log(pi) + loglik_anom(X)
        log_n = np.log(1 - pi) + loglik_normal(X, r)
        log_total = np.logaddexp(log_a, log_n)
        gamma = np.exp(log_a - log_total)
        history.append((it, pi, log_total.sum()))
        pi = gamma.mean()
        a = m_step_exact(X, 1 - gamma, a)
    return gamma, pi, expit(a), history

g_ex, pi_ex, r_ex, hist_ex = em_exam_exact(X, pi=0.3)
print("反復      π         対数尤度")
for it, p_, ll in hist_ex[:6] + hist_ex[-1:]:
    print(f"{it:3d}   {p_:.4f}     {ll:.1f}")
d = np.diff([h[2] for h in hist_ex])
print(f"対数尤度が下がった回数: {int((d < -1e-6).sum())}(隣り合う反復の差の最小値 {d.min():.2e})")
# 正常モデルが表す「ふつうの受験者全体の正答率」:実力の分布で平均した正解の確率
r_pop = (expit(logit(r_ex)[:, None] + B_GRID[None, :]) * np.exp(LOG_W)[None, :]).sum(axis=1)
print(f"難問10問  簡略版EM {r_hat[hard].mean():.4f} / 厳密版のモデルの正答率 {r_pop[hard].mean():.4f} / ふつうの受験者のみ {r_clean[hard].mean():.4f}")
print(f"π  簡略版 {pi_hat:.4f} / 厳密版 {pi_ex:.4f}(真値 {n_cheat / len(X):.4f})")
print(f"γ > 0.5 で検出(厳密版): 不正 {int(((g_ex > 0.5) & (y == 1)).sum())} 人, ふつうの受験者 {int(((g_ex > 0.5) & (y == 0)).sum())} 人")
- 目的関数と勾配: neg_obj は、上の最大化の目的関数と、その勾配の符号を反転したものを返します。minimize は最小化しかできないので、符号を反転しています。1行ずつが何の式を計算しているかは、このあとの「neg_obj が計算している式」で説明します。
- 最適化の範囲と回数: 易しさ の範囲は、loglik_normal の clip(正答率 0.001〜0.999)と同じロジットの範囲にしています。1回の M-step で最大50回の反復にしているのは、前の M-step の答えから始める(a0)ので、少ない反復で十分に収束するためです。
- E-step と π の更新: 簡略版の em_exam と同じです。変えたのは、正答率の更新だけです。
- モデルの正答率: 厳密版で求めた は、「実力 のふつうの受験者の正解の確率」です。ふつうの受験者全体の正答率と比べるために、実力の分布で平均した値 r_pop を計算しています。
neg_obj が計算している式
neg_obj は、行列の掛け算で式を一度に計算しているので、コードだけでは何をしているかが見えにくい部分です。式と1行ずつ対応させます。
まず、正常モデルを式で書きます。問題 の易しさを 、受験者の実力を とすると、正解の確率は です。実力 は分からないので、〜 の61個の格子点 (B_GRID)で近似し、それぞれの事前確率を (np.exp(LOG_W))とします。最大化したい目的関数は、次のとおりです。
は、ふつうの受験者である重みです。この を、コードは次の順で計算しています(受験者 人、問題 問、格子 61 点)。
| コード | 配列の形 | 計算している式 | 意味 |
|---|---|---|---|
| Q | 問題 × 格子(100 × 61) | 実力が の人が、問題 に正解する確率 | |
| G | 受験者 × 格子(3060 × 61) | 受験者 の実力が だとしたときの、解答全体の対数尤度(+事前確率の対数) | |
| ll | 受験者(3060) | 実力を周辺化した対数尤度(loglik_normal と同じもの) | |
| post | 受験者 × 格子(3060 × 61) | 解答を見たあとの、受験者 の実力の事後分布 | |
| w @ ll | 数1つ | 目的関数 |
- G の行列の積: X @ np.log(Q) は、受験者 と格子 の組ごとに、100問分の を足したものです。正解した問題()の だけを拾い、不正解の問題の は (1 - X) @ np.log(1 - Q) で拾います。100問の を、全受験者・全格子について一度に計算しています。
- ll の logsumexp: は100問分の確率の積なので、 のように小さくなり、そのまま足すとアンダーフローします。logsumexp は、対数のまま を計算します。
- post はベイズの定理: なので、E-step の負担率と同じベイズの定理です。隠れた変数が「不正か否か」から「実力 」に変わっただけで、各行の合計は1になります。
勾配は、次の式になります(導出は下の折りたたみ)。
- wp(受験者 × 格子): です。「ふつうの受験者である重み」と「実力が である確率」を掛けた、受験者と格子の組ごとの重みです。
- 第1項 (X.T @ wp).sum(axis=1): X.T @ wp は「問題 × 格子」の配列で、格子ごとに、重み付きで正解した人数を数えたものです。格子について足すと、問題 の重み付きの 実際の正解数 になります。
- 第2項 (Q * wp.sum(axis=0)[None, :]).sum(axis=1): wp.sum(axis=0) は、格子ごとの重みの合計(その実力の人が、重み付きで何人いるか)です。それに正解の確率 を掛けて格子について足すと、問題 の重み付きの モデルが予測する正解数 になります。
勾配は「実際の正解数 − 予測する正解数」です。実際のほうが多ければ、問題 を易しく( を大きく)し、少なければ難しくします。勾配が0になる最適解では、重み付きの実際の正解数と、モデルが予測する正解数が一致します。簡略版の「ふつうらしい受験者だけで集計し直した正答率」を、実力の差まで考えて正しく合わせ込んだものが、この厳密な M-step です。 を で微分すると、合成関数の微分で次のようになります。 のうち を含むのは、問題 の項 だけです。シグモイドの微分 から、、 なので、次のようになります。 これを に入れると、上の勾配の式になります。勾配の導出
実行結果
反復      π         対数尤度
  0   0.3000     -154546.7
  1   0.0196     -152521.3
  2   0.0196     -152521.3
  3   0.0196     -152521.3
  4   0.0196     -152521.3
  5   0.0196     -152521.3
 29   0.0196     -152521.3
対数尤度が下がった回数: 0(隣り合う反復の差の最小値 4.13e-08)
難問10問  簡略版EM 0.0751 / 厳密版のモデルの正答率 0.0732 / ふつうの受験者のみ 0.0750
π  簡略版 0.0195 / 厳密版 0.0196(真値 0.0196)
γ > 0.5 で検出(厳密版): 不正 60 人, ふつうの受験者 0 人
厳密な M-step にすると、対数尤度は一度も下がりませんでした(隣り合う反復の差は、最小でも です)。収束したときの対数尤度も で、簡略版の より約790大きく、データをよりよく説明できています。推定した混入率は で真値と一致し、負担率0.5で判定すると、60人の不正受験者だけを検出しました。
一方、難問10問の正答率は、厳密版のモデルでは0.0732で、簡略版(0.0751)より答え(0.0750)から少し離れています。厳密版は「実力の分布を標準正規分布と仮定した正常モデル」として最もデータに合うように正答率を決めるので、データを作ったときの実力の分布(成績上位者30人を加えたもの)とのずれが、正答率に表れるためです。正しい M-step は対数尤度の単調な増加を保証しますが、モデルの仮定が実際のデータとずれていれば、推定値もそのぶんずれます。
検出結果と正答率の補正
# 1. 検出結果
flag = gamma > 0.99
print(f"推定した混入率 π = {pi_hat:.4f}(真値 {n_cheat / len(X):.4f})")
print(f"γ > 0.99 で検出: {flag.sum()} 人(不正 {int((flag & (y == 1)).sum())} 人, ふつうの受験者 {int((flag & (y == 0)).sum())} 人)")
print(f"γ > 0.5  で検出: {(gamma > 0.5).sum()} 人(不正 {int(((gamma > 0.5) & (y == 1)).sum())} 人)")

# 2. 正答率の補正:(r_obs - π) / (1 - π) と、EM が推定した正答率を比べる
r_formula = (r_obs - pi_hat) / (1 - pi_hat)
print(f"難問10問の平均正答率  観測 {r_obs[hard].mean():.4f} / 式で補正 {r_formula[hard].mean():.4f} / "
      f"EMの推定 {r_hat[hard].mean():.4f} / ふつうの受験者のみ {r_clean[hard].mean():.4f}")
print(f"全問題の平均絶対誤差(ふつうの受験者のみの正答率との差)  観測: {np.abs(r_obs - r_clean).mean():.4f} / "
      f"EM: {np.abs(r_hat - r_clean).mean():.4f}")

# 3. 可視化:後半50問の正答率と、観測値の水増しの割合
q = np.arange(51, T + 1)
fig, axes = plt.subplots(1, 2, figsize=(13, 4.5))
axes[0].plot(q, r_obs[50:], color='gray', label='観測された正答率(不正受験者を含む)')
axes[0].plot(q, r_hat[50:], color='red', label='EMで補正した正答率')
axes[0].plot(q, r_clean[50:], 'k--', linewidth=1, label='ふつうの受験者だけの正答率(答え)')
axes[0].set_xlabel('問題番号')
axes[0].set_ylabel('正答率')
axes[0].set_title('後半50問の正答率')
axes[0].legend(fontsize=9)
axes[0].grid(True, alpha=0.3)
axes[1].plot(np.arange(1, T + 1), r_obs / r_clean, color='gray', label='観測 ÷ 答え')
axes[1].plot(np.arange(1, T + 1), r_hat / r_clean, color='red', label='EMの推定 ÷ 答え')
axes[1].axhline(1, color='black', linewidth=1)
axes[1].set_xlabel('問題番号')
axes[1].set_ylabel('答えに対する比')
axes[1].set_title('正答率がどれだけ水増しされているか')
axes[1].legend(fontsize=9)
axes[1].grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
EMの結果から不正受験者を検出し、補正した正答率を答えと比べています。
- 検出のしきい値: gamma > 0.99 で「不正である確率が99%以上」(誤検知をほぼ許さない厳しい基準)、gamma > 0.5 で「不正である確率のほうが高い」受験者を数えています。負担率は確率なので、このように業務上の基準をそのまま使えます。
- 式による補正 r_formula: 歪み方の式 を、推定した で逆算したものです。EMの推定 r_hat と比べるために計算しています。
- 平均絶対誤差: 100問それぞれについて、ふつうの受験者だけの正答率との差の絶対値を平均しています。
- 可視化: 左は後半50問の正答率を3通りで比べています。右は、観測値とEMの推定値をそれぞれ答えで割った比で、正答率が何倍に水増しされているかを表します。
実行結果
推定した混入率 π = 0.0195(真値 0.0196)
γ > 0.99 で検出: 57 人(不正 57 人, ふつうの受験者 0 人)
γ > 0.5  で検出: 60 人(不正 60 人)
難問10問の平均正答率  観測 0.0928 / 式で補正 0.0748 / EMの推定 0.0751 / ふつうの受験者のみ 0.0750
全問題の平均絶対誤差(ふつうの受験者のみの正答率との差)  観測: 0.0105 / EM: 0.0001
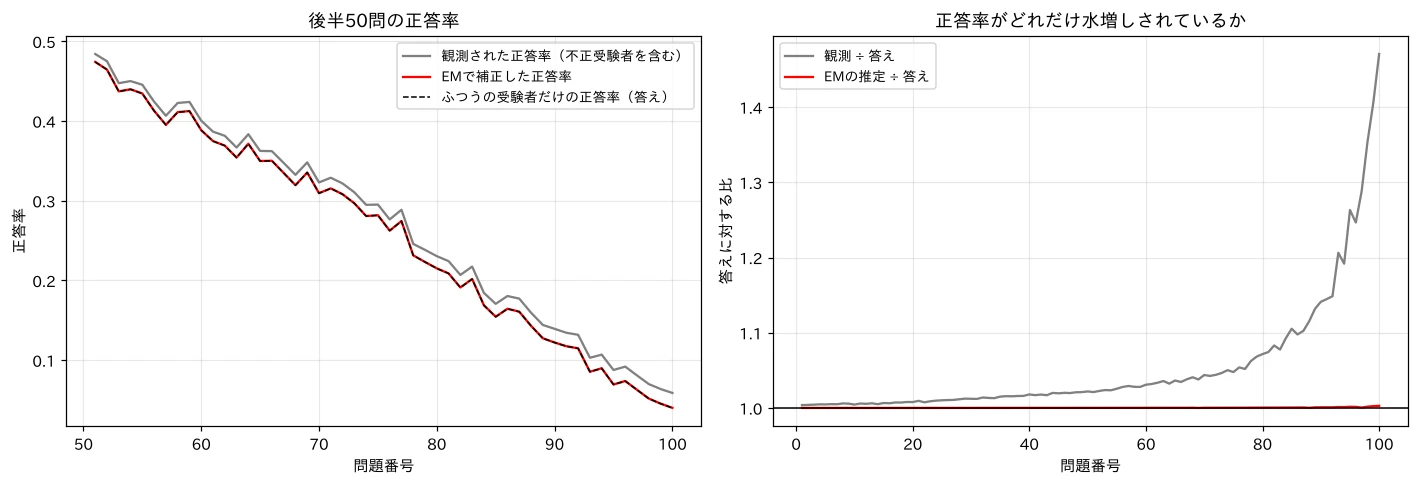
推定した混入率は で、真値 とほぼ一致しました。不正である確率が0.5を超えた受験者は60人で、全員が実際の不正受験者です。そのうち57人は確率0.99以上で検出されました。残りの3人(確率0.78〜0.99)は、写し間違いが2〜3問あって、証拠がやや弱くなった不正受験者です。
EMで推定した正答率は、ふつうの受験者だけの正答率とほぼ完全に一致しています(平均絶対誤差 )。式による補正()もほぼ同じ値で、EMの結果が歪み方の式と整合していることが分かります。
右の図を見ると、観測された正答率(灰色)は、難しい問題ほど大きく水増しされ、最も難しい100問目では答えの約1.47倍になっています。もともとの正答率が低い問題ほど、不正受験者の「必ず正解」の影響を強く受けるからです。EMで補正した正答率(赤)は、どの問題でもほぼ1倍で、水増しが取り除かれています。
検出と正答率の補正の結果を並べると、次のようになります。
(図は、diagram-designで作成)
証拠が弱いときも π を推定できるか
「100問すべての採点を待たずに、最も難しい8問(93〜100問目)の採点結果だけで、不正の疑いがある受験者を早めに見つけたい」という場面を考えます。問題が8問しかないと、1人あたりの証拠はずっと少なくなり、混入率 の値によって判定が変わりやすくなります(混合モデルの記事で、この場面を詳しく扱っています)。この状況でも、EMアルゴリズムで を推定できるか試してみましょう。今度は、大きすぎる初期値(0.3)と小さすぎる初期値(0.001)の両方から始めます。0.001 は、真値(約0.02)の約1/20で、下から近づけるかを確かめるための値です。
# 1. 最も難しい8問(93〜100問目)だけで、初期値を変えて EM を回す
items = slice(92, 100)
for pi_init in [0.3, 0.001]:
    g8, pi8, r8, hist8 = em_exam(X[:, items], pi=pi_init, n_iter=30)
    path = " → ".join(f"{h[1]:.4f}" for h in hist8[:5])
    flag8 = g8 > 0.5
    print(f"初期値 π = {pi_init}: {path} → … → {pi8:.4f}")
    print(f"   γ > 0.5 で検出: 不正 {int((flag8 & (y == 1)).sum())} 人, ふつうの受験者 {int((flag8 & (y == 0)).sum())} 人")
93〜100問目の8問分の解答だけで、初期値を変えて EM アルゴリズムを実行しています。
- データの切り出し: X[:, items] で、93〜100問目の8列だけを渡しています。em_exam は、渡された列から正答率の初期値を計算するので、そのまま使えます。
- 推移の表示: hist8[:5] で、最初の5回分の の推移を矢印でつないで表示しています。
実行結果
初期値 π = 0.3: 0.3000 → 0.0199 → 0.0194 → 0.0194 → 0.0193 → … → 0.0193
   γ > 0.5 で検出: 不正 60 人, ふつうの受験者 1 人
初期値 π = 0.001: 0.0010 → 0.0150 → 0.0191 → 0.0193 → 0.0193 → … → 0.0193
   γ > 0.5 で検出: 不正 60 人, ふつうの受験者 1 人
大きすぎる初期値からも、小さすぎる初期値からも、同じ に収束しました。真の混入率 にかなり近い値です。100問分のときと違い、小さい初期値からは数回の反復をかけて近づいています。
ただし、誤検知の1人は残っています。この受験者は、ふつうの受験者の中でただ1人、難問8問中7問に正解した実力者です(100問全体では85点)。一方、不正受験者60人のうち6人は、8問のうち1問を写し間違えて、同じ「8問中7問正解」になっています。8問分の解答だけでは、この2つは見分けがつきません。EMアルゴリズムは「正しい混入率」を教えてくれますが、データに含まれていない証拠を作り出すことはできません。 判定の精度を上げるには、使う問題を増やすなど、証拠そのものを増やす必要があります。
2つの初期値からの推移を並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
- EMアルゴリズム: 隠れた変数(どのグループか)とパラメータ(混入率など)の「鶏と卵」の問題を、E-step と M-step の交互の更新で解く方法です。
- E-step: 今のパラメータで、隠れた変数の事後確率(負担率)を計算します。
- M-step: 負担率を「重み付きの数」として、パラメータを数え直します。「隠れた変数が分かっていたときの推定式」の を に置き換えた形になります。
- 単調性: E-step で対数尤度の下限を接触させ、M-step でその下限を押し上げるので、対数尤度は反復のたびに決して下がりません。ただし、この保証は M-step が下限を本当に大きくしているときだけです。簡略化した正答率の更新では対数尤度がわずかに下がりましたが、数値最適化による厳密な M-step では一度も下がりませんでした。また、局所最適解に止まる可能性もあるので、初期値を変えて何度か試すのが安全です。
- 試験データへの適用: 不正受験者の混入率 と、不正受験者の影響を取り除いた正答率を同時に推定できました。混入率は「最も難しい問題の正答率」を超えられないという上限も、推定結果の妥当性の確認に使えます。
尤度比スコアの記事の「尤度比で2つのモデルを比べる」、混合モデルの記事の「混入率まで含めた確率にする」に、本記事の「EMアルゴリズムで未知の混入率をデータから推定する」を合わせると、ラベルのないデータから異常を見つける方法が一通りそろいます。同じ考え方は、ボットによる不正アクセスの検出や、センサーの故障検知など、「ふつうのデータの中に、決まったパターンの異常が混ざっている」さまざまな場面に応用できます。また、混合ガウスモデルによるクラスタリングや、隠れマルコフモデル(HMM)の学習など、隠れた変数を持つさまざまなモデルの推定の土台にもなっています。
参考文献
- A. P. Dempster, N. M. Laird, D. B. Rubin (1977). Maximum Likelihood from Incomplete Data via the EM Algorithm. Journal of the Royal Statistical Society: Series B, 39(1), 1–38.
- R. M. Neal, G. E. Hinton (1998). A View of the EM Algorithm that Justifies Incremental, Sparse, and other Variants. In M. I. Jordan (Ed.), Learning in Graphical Models, 355–368. Springer.
- C. B. Do, S. Batzoglou (2008). What is the expectation maximization algorithm?. Nature Biotechnology, 26(8), 897–899.
本記事の文章・構成の一部に生成AIを使用しています。