観察データにおける広告効果の内生性とは?
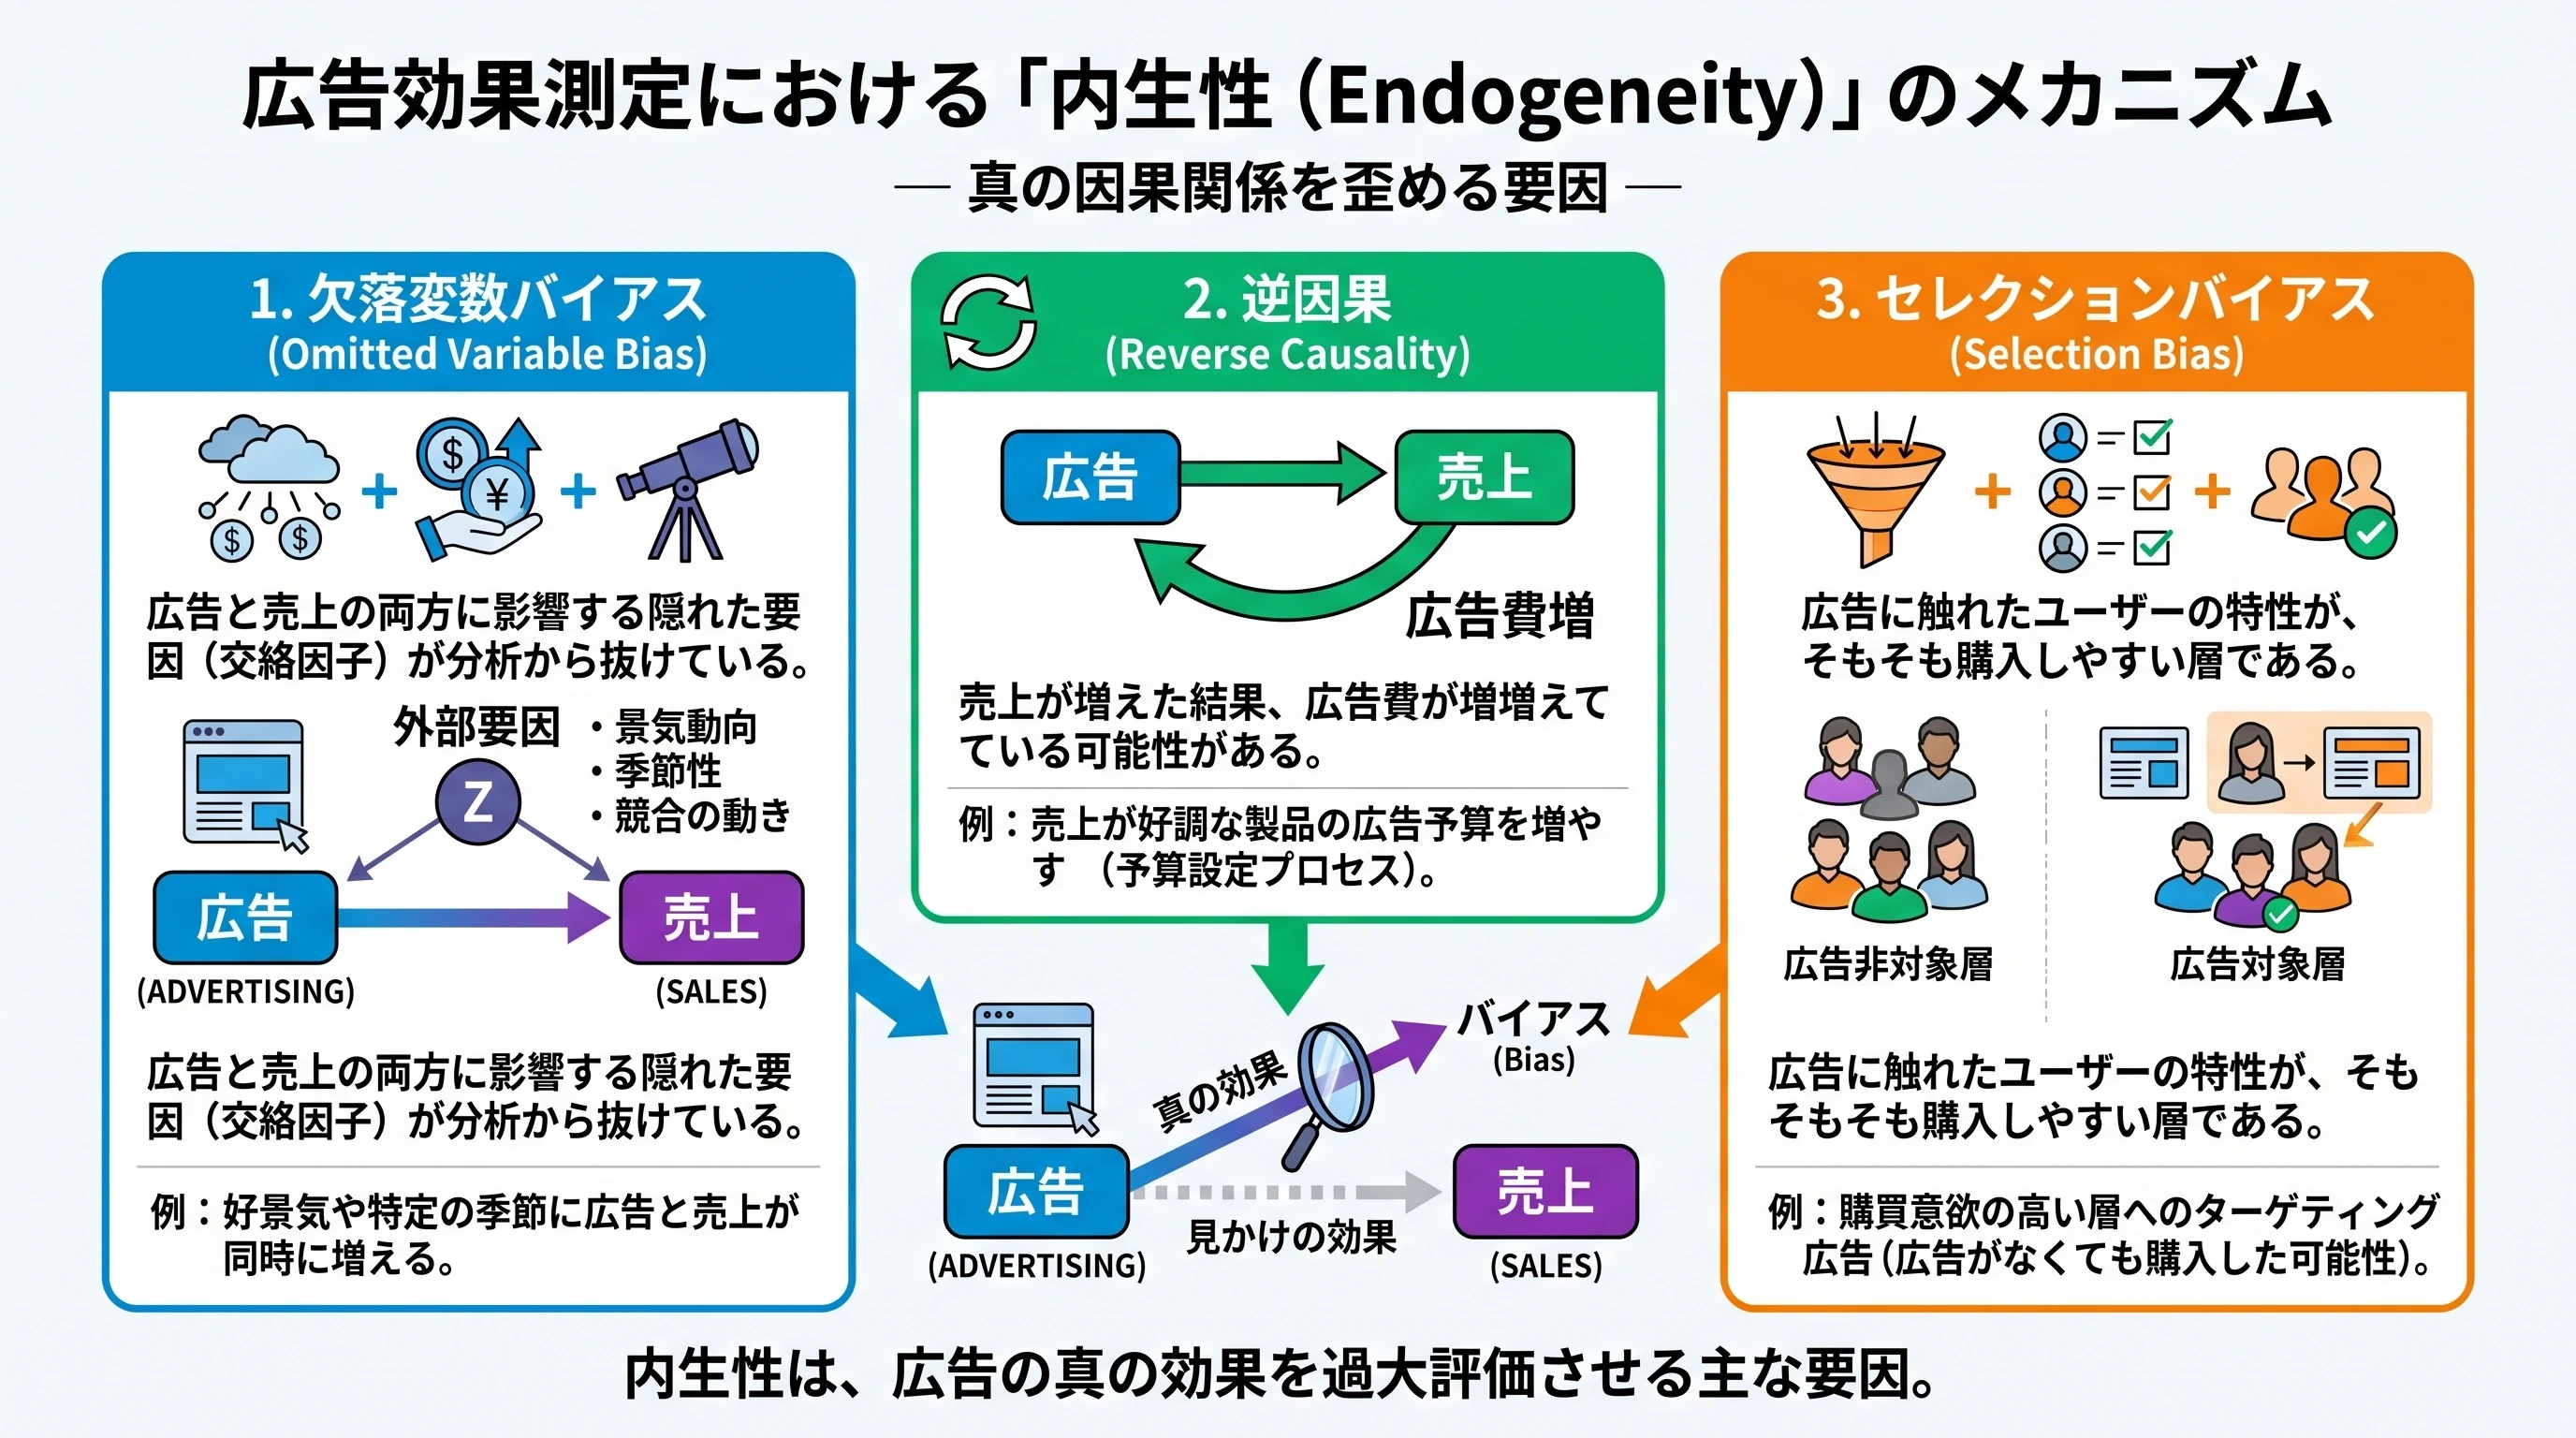 (画像は、Geminiで作成)
観察データの回帰で広告の効果を推定すると、なぜ偏る(内生性が生じる)のかを、欠落変数バイアス・逆因果・セレクションバイアスという3つのメカニズムとして理解すること。シミュレーションで、それぞれのバイアスの方向と、データを増やしても消えないことを確かめ、広告効果の測定に特有の難しさと、実験・DiD・操作変数法などの対処法の全体像を説明できるようになること。
はじめに ── なぜ「内生性」を学ぶ必要があるのか
CausalImpactや差の差法(DiD)の記事では、介入の因果効果を推定する方法を見ました。しかし、これらの手法にはいずれも共通する根本的な課題があります。それが 内生性(endogeneity) の問題です。
複数の広告チャネルの効果を同時に推定する MMM(マーケティングミックスモデル)も、観察データに基づく回帰モデルであり、それだけでは広告出稿と売上の間の因果関係を直接的に識別することはできません。CausalImpactやDiDは因果推論のための手法ですが、処置の割り当てが観測されない要因と相関する場合には、やはりバイアスのある推定結果を返します。
では、なぜ観察データから広告の因果効果を推定することはそもそも難しいのでしょうか?
この記事では、その根本的な原因である「内生性」の概念を正面から取り上げます。内生性が生じる3つの主要なメカニズム ―― 欠落変数バイアス、逆因果、セレクションバイアス ―― を理論的に整理し、Pythonシミュレーションを通じてその影響を直感的に理解します。さらに、広告効果測定における内生性が他の分野と比べて特に深刻である理由を、Facebookでの大規模実験の知見(Gordon et al., 2019)や広告測定の経済学的困難さ(Lewis & Rao, 2015)に基づいて解説します。
本記事は「内生性とは何か」を理解するための概念記事です。内生性への対処法は記事の最後で概観し、そのうち最も確実な方法である「実験で効果を測る方法」は、合成コントロール法とジオ実験の記事で扱います。
内生性とは何か
回帰モデルの「基本仮定」を振り返る
内生性を理解するためには、まず回帰モデルの基本仮定を振り返る必要があります。
最も単純な線形回帰モデルを考えます。
ここで は売上、 は広告出稿量、 は誤差項です。OLS(最小二乗法)で を一致推定するための最も重要な仮定は、説明変数と誤差項が無相関であることです。
この仮定が満たされるとき、説明変数 は外生変数(exogenous variable)と呼ばれます。
内生性の定義
内生性とは、この外生性仮定が破れている状況、すなわち 説明変数と誤差項が相関している状態 を指します。
このとき、説明変数 は内生変数(endogenous variable)と呼ばれ、OLS推定量 は真のパラメータ に対して一致性を失います(Ebbes et al., 2005)。
はサンプルサイズをいくら増やしても真の値 に収束しません。つまり、推定のバイアスはビッグデータでは解決しないのです。
具体的に、OLS推定量のバイアスを確認してみましょう。
単回帰モデルにおけるOLS推定量 は、真のパラメータ と誤差項が及ぼす項に分解できます。
サンプルサイズが十分に大きいとき()、大数の法則により以下のように収束します。
詳細な式変形(ステップ1〜3:代入から確率収束まで)
ステップ1:真のモデルを代入して展開する
真のデータ生成プロセス の両辺の標本平均をとると となるため、平均からの偏差は次のように表せます。
これを分子の に代入すると、偏差の総和の性質()により次のように整理されます。
両辺を分母 で割ると、 が得られます。
右辺の第2項の分子 は、先ほど確認した通り (偏差の積の和)と等価です。 と に相関(内生性)がある場合はこの第2項が消えずに残り、推定量に歪み(バイアス)をもたらします。
ステップ2:標本共分散と標本分散の形に変形する
第2項の分子と分母をそれぞれサンプルサイズ で割ります。
- 分母: は説明変数 の標本分散
- 分子: は説明変数 と誤差項 の標本共分散 (両者に相関・内生性がある場合はゼロにならず値が残ります)
ステップ3:大数の法則による極限(T → ∞)
大数の弱法則(WLLN)および連続写像定理(スラツキーの定理)により、標本分散と標本共分散はそれぞれの母分散・母共分散へと確率収束()します。
したがって、推定量全体の極限は となります。
なぜ内生性があると問題なのか?
この式から、外生性と内生性の本質的な違いが一目でわかります。
- 外生性が満たされる場合():
分子が となるため第2項は綺麗に消え去り、 となります。推定量は真の値へと収束します(一致性が成立)。 - 内生性が生じている場合():
サンプルサイズ をいくら増やしても第2項が消えず、推定量は真の ではなく、バイアス分が足された値に収束してしまいます。
この消えない歪みのことを 漸近バイアス(Asymptotic Bias)と呼びます。
内生性が生じる3つのメカニズム
内生性が生じる主な原因は3つに分類できます(Varian, 2016)。
3つのメカニズムを図にすると、次のようになります。
(図は、diagram-designで作成)
シミュレーションの準備
理論だけでは内生性の影響を実感しにくいため、各メカニズムの直後にPythonシミュレーションを置き、それぞれがOLS推定にどの程度のバイアスを生むかを確認します。
以下のシミュレーションでは、グラフ中の日本語ラベル(凡例やタイトルなど)を文字化けさせずに描画するため、japanize-matplotlib を使用します。実行環境(Google Colabなど)に合わせて事前に以下のコマンドを実行し、インストールしてください。
!pip install japanize-matplotlib
メカニズム① ── 欠落変数バイアス(Omitted Variable Bias)
欠落変数バイアスは、結果変数 と説明変数 の両方に影響を与える変数(交絡因子:confounder)がモデルに含まれていない場合に生じます。
真のデータ生成プロセスが次のモデルだとします。
ここで は交絡因子(例:景気指標、季節要因、消費者の購買意欲など)で、 は と無相関な真の誤差項です。
しかし、 が観測できない、あるいはモデルに含めなかった場合、推定するモデルは次のようになります。
もし が と相関していれば()、 と も相関し、内生性が発生します。
このときのOLS推定量の漸近バイアスは次のように表されます。
広告効果測定での具体例
広告効果測定では、次のような状況で欠落変数バイアスが生じます。
- 消費者の購買意欲:年末商戦など消費意欲が高まる時期に、企業は広告出稿を増やし、消費者も購買を増やす。購買意欲を制御しなければ、広告効果が過大推定される
- 競合他社の動向:競合が大規模なセール(例:楽天スーパーセール)を実施している時期には、自社も広告を強化する。競合の動向が売上に影響するにもかかわらずモデルに含めなければ、推定にバイアスが生じる
- マクロ経済環境:景気の良い時期には広告予算も売上も増加する。景気を制御しなければ、相関が因果として誤って解釈される
シミュレーション① ── 欠落変数バイアス
観測されない交絡因子(季節的な購買意欲)が広告と売上の両方に影響を与えるケースをシミュレーションします。
import numpy as np
import pandas as pd
import statsmodels.api as sm
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフの日本語表示用

np.random.seed(42)
T = 500  # サンプルサイズ

# 真のパラメータ
alpha_true = 50.0   # 切片
beta_true = 0.3     # 広告の真の因果効果
gamma_true = 2.0    # 交絡因子の効果

# データ生成
# Z: 観測されない交絡因子(季節的な購買意欲)
Z = np.random.normal(0, 5, T)

# X: 広告出稿量(Zの影響を受ける + 外生的な変動)
X = 20 + 1.5 * Z + np.random.normal(0, 3, T)

# Y: 売上(広告と交絡因子の両方の影響を受ける)
u = np.random.normal(0, 2, T)  # 真の誤差項
Y = alpha_true + beta_true * X + gamma_true * Z + u

# --- 推定 ---
# モデル1: Zを含まない(欠落変数あり)
X_ols = sm.add_constant(X)
model_biased = sm.OLS(Y, X_ols).fit()

# モデル2: Zを含む(正しいモデル)
X_full = sm.add_constant(np.column_stack([X, Z]))
model_correct = sm.OLS(Y, X_full).fit()

print("=" * 60)
print("シミュレーション①: 欠落変数バイアス")
print("=" * 60)
print(f"真の広告効果 β = {beta_true}")
print(f"")
print(f"【欠落変数モデル(Zなし)】")
print(f"  推定値 β̂ = {model_biased.params[1]:.4f}")
print(f"  バイアス = {model_biased.params[1] - beta_true:.4f}")
print(f"  95%信頼区間 = [{model_biased.conf_int()[1][0]:.4f}, {model_biased.conf_int()[1][1]:.4f}]")
print(f"")
print(f"【正しいモデル(Zあり)】")
print(f"  推定値 β̂ = {model_correct.params[1]:.4f}")
print(f"  バイアス = {model_correct.params[1] - beta_true:.4f}")
print(f"  95%信頼区間 = [{model_correct.conf_int()[1][0]:.4f}, {model_correct.conf_int()[1][1]:.4f}]")

# 理論的な漸近バイアスの計算
theoretical_bias = gamma_true * np.cov(X, Z)[0, 1] / np.var(X)
print(f"")
print(f"理論的な漸近バイアス = γ × Cov(X,Z)/Var(X) = {theoretical_bias:.4f}")
欠落変数バイアスを、交絡因子を含めないモデルと含めるモデルの比較で確認しています。
- データ生成: 交絡因子 Z(季節的な購買意欲)を先に作り、広告出稿量 X と売上 Y の両方に影響させています。X = 20 + 1.5 * Z + ... は「購買意欲が高い時期ほど広告を増やす」、Y = ... + gamma_true * Z + u は「購買意欲が高いと売上も増える」ことを表しています。
- 2つのモデル: sm.add_constant で切片の列を加えたうえで、X だけを説明変数にしたモデル(model_biased)と、X と Z の両方を入れたモデル(model_correct)を最小二乗法で推定しています。
- 推定値と信頼区間の取り出し: 説明変数を NumPy 配列で渡しているため、係数は列の順番で並びます。params[1] が広告の係数で、conf_int()[1] がその95%信頼区間の下限・上限です(0番目は切片)。
- 理論値との比較: 本文の漸近バイアスの式 を、生成したデータから計算しています。欠落変数モデルの実際のバイアスと比べることで、式が現実のずれを説明していることを確かめられます。
実行結果
============================================================
シミュレーション①: 欠落変数バイアス
============================================================
真の広告効果 β = 0.3

【欠落変数モデル(Zなし)】
  推定値 β̂ = 1.4702
  バイアス = 1.1702
  95%信頼区間 = [1.4237, 1.5167]

【正しいモデル(Zあり)】
  推定値 β̂ = 0.3496
  バイアス = 0.0496
  95%信頼区間 = [0.2890, 0.4102]

理論的な漸近バイアス = γ × Cov(X,Z)/Var(X) = 1.1794
交絡因子 をモデルに含めないと、広告効果が真の値 0.3 から大きく過大推定されます。理論的な漸近バイアスの式と実際のバイアスがほぼ一致することも確認できます。
シミュレーション①の推定値を並べると、次のようになります。
(図は、diagram-designで作成)
メカニズム② ── 逆因果(Reverse Causality / Simultaneity)
逆因果(同時性バイアスとも呼ばれます)は、 が に影響を与えると同時に、 も に影響を与える場合に生じます。
広告と売上の関係で考えると、次の2つの方程式が同時に成立する状況です。
需要方程式(広告 → 売上):
予算配分方程式(売上 → 広告):
需要方程式を推定したいのですが、予算配分方程式の存在により は の関数となり、したがって とも相関します。
この連立方程式を解くと、 の均衡値は次のようになります。
が の関数になっていることが明確にわかります。 需要方程式と予算配分方程式を連立させて、 の均衡値を求めます。 1. 需要方程式を予算配分方程式に代入 予算配分方程式は次の通りです。 ここに需要方程式 を代入すると、 が消去され、 のみの式になります。 2. 右辺を展開 を括弧の中に分配します。 3. の項を左辺に集める 右辺にある を左辺に移項します。 左辺を でくくります。 4. 両辺を で割る であれば(すなわちフィードバックループが発散しない範囲であれば)、両辺を で割ることで について解くことができます。 これが本文中の均衡値の式です。定数項の部分()と誤差項の部分()に分けて見ると、 である限り、 の誤差項部分に がそのまま含まれていることが分かります。したがって となり、需要方程式をOLSで推定すると内生性バイアスが生じます。補足:連立方程式を解く過程( の均衡値の導出)
同様に、売上 の均衡値も求められます。
シミュレーションでは、この と の均衡値を使ってデータを生成します。 需要方程式 に、先ほど求めた の均衡値を代入します。以下では分母を と略記します。 と を分母 の分数にそろえて、分子をまとめます。 定数項の部分は となり、 が打ち消し合います。誤差項の部分も と整理できます。したがって次の式になります。 コードの Y_eq は、この式をそのまま書いたものです。補足: の均衡値の導出
広告効果測定での具体例
逆因果は広告効果測定において極めて一般的です。
- 好調な売上 → 広告予算の増額:売上が伸びている製品には追加の広告予算が配分される。結果として、広告と売上の正の相関の一部は「売上が広告を生む」方向の因果関係によるもの
- パフォーマンス広告の動的最適化:リスティング広告やSNS広告では、CVRが高い(売上に直結しやすい)オーディエンスに対して自動的に出稿が増加する。広告プラットフォームのアルゴリズム自体が逆因果を生む
- 在庫連動の広告配信:在庫が多い(=売上が少ない)製品に広告を出す場合、広告と売上が負の相関を示す可能性がある。これも逆因果の一形態
逆因果の方向によって、バイアスの符号が変わります。「売上好調 → 広告増」のパターンでは広告効果が過大推定され、「売上不調 → 広告増」のパターンでは過小推定(場合によっては負の推定値)になります。
シミュレーション② ── 逆因果(同時性バイアス)
広告予算が過去の売上実績に基づいて配分されるケースをシミュレーションします。
np.random.seed(123)
T = 500

# 真のパラメータ
beta_true = 0.3     # 広告の真の因果効果
delta_true = 0.5    # 売上が広告に与える逆因果の強さ

# データ生成(連立方程式から均衡値を導出)
# Y = α1 + β*X + ε1
# X = α2 + δ*Y + ε2
# → 均衡: X = (α2 + δ*α1)/(1 - δ*β) + (δ*ε1 + ε2)/(1 - δ*β)

alpha1 = 50.0
alpha2 = 5.0
eps1 = np.random.normal(0, 3, T)  # 需要ショック
eps2 = np.random.normal(0, 2, T)  # 予算ショック

# 均衡値の計算
denom = 1 - delta_true * beta_true
X_eq = (alpha2 + delta_true * alpha1) / denom + (delta_true * eps1 + eps2) / denom
Y_eq = (alpha1 + beta_true * alpha2) / denom + (eps1 + beta_true * eps2) / denom

# --- 推定 ---
X_ols = sm.add_constant(X_eq)
model_simul = sm.OLS(Y_eq, X_ols).fit()

# 比較: 逆因果がない場合
X_exog = 20 + np.random.normal(0, 5, T)  # 外生的な広告
Y_exog = alpha1 + beta_true * X_exog + eps1
X_ols_exog = sm.add_constant(X_exog)
model_exog = sm.OLS(Y_exog, X_ols_exog).fit()

print("=" * 60)
print("シミュレーション②: 逆因果(同時性バイアス)")
print("=" * 60)
print(f"真の広告効果 β = {beta_true}")
print(f"逆因果の強さ δ = {delta_true}")
print(f"")
print(f"【逆因果あり】")
print(f"  推定値 β̂ = {model_simul.params[1]:.4f}")
print(f"  バイアス = {model_simul.params[1] - beta_true:.4f}")
print(f"")
print(f"【逆因果なし(外生的な広告)】")
print(f"  推定値 β̂ = {model_exog.params[1]:.4f}")
print(f"  バイアス = {model_exog.params[1] - beta_true:.4f}")
広告と売上が互いに影響し合う(逆因果がある)データを、連立方程式の均衡として生成しています。
- 連立方程式の均衡: 売上の式 と、予算配分の式 を同時に満たす と を、コメントに書いた式で直接計算しています。denom = 1 - delta_true * beta_true は、両方の式を解くときに現れる共通の分母です。
- 売上の均衡値: Y_eq は、 の均衡値を売上の式に代入して整理した を計算しています。広告が売上に効く()だけでなく、予算ショック eps2 も 倍されて売上に入り込む点が、 の式との違いです。
- 内生性が生じる仕組み: 均衡の には、売上側の需要ショック eps1 が delta_true * eps1 の形で入り込んでいます。そのため、広告出稿量と売上の誤差項が相関し、外生性の仮定が破れます。
- 比較用の外生的な広告: 逆因果がない世界では、広告出稿量は売上とは無関係に、広告担当者の都合やランダムな割り当てなどで決まります。X_exog = 20 + np.random.normal(0, 5, T) は、平均20・標準偏差5で、売上の結果を一切見ずに広告量を決めている状況を表します(予算配分の式の の項がない状態です)。そのうえで Y_exog = alpha1 + beta_true * X_exog + eps1 として、売上は「基準の売上 + 広告の効果 + 需要ショック」だけで決まります。例えば広告が平均より10多ければ、売上は平均して 増えるだけです。X_exog と eps1 は無関係なので、OLSでも真の効果に近づきます。同じ需要ショック eps1 を使うことで、逆因果の有無だけが違う2つのデータで推定値を比べています。
実行結果
============================================================
シミュレーション②: 逆因果(同時性バイアス)
============================================================
真の広告効果 β = 0.3
逆因果の強さ δ = 0.5

【逆因果あり】
  推定値 β̂ = 0.9179
  バイアス = 0.6179

【逆因果なし(外生的な広告)】
  推定値 β̂ = 0.2346
  バイアス = -0.0654
逆因果があると、推定値は と真の値 の約3倍に過大推定されました。売上が高い時期ほど広告予算が増えるため、「広告が多い時期は売上が高い」という相関の大部分が、実は売上から広告への逆向きの因果によって生じているのです。逆因果のない外生的な広告では、推定値は と、ノイズの範囲で真の値に近い値になっています。
シミュレーション②の推定値を並べると、次のようになります。
(図は、diagram-designで作成)
メカニズム③ ── セレクションバイアス(Selection Bias)
セレクションバイアスは、処置(広告への曝露)がランダムではなく、結果と相関する特性に基づいて選択されている場合に生じます。
RCT(ランダム化比較試験)では、処置群と対照群がランダムに割り当てられるため、観測されない特性も含めて両群が平均的に同質になります。しかし、観察データでは広告に曝露されるかどうかは自己選択やアルゴリズムによる選択に依存するため、処置群と対照群の比較がバイアスを持ちます。
広告効果測定での具体例
Gordon et al. (2019)は、Facebookでの大規模フィールド実験の結果をベンチマークとして、観察データに基づく手法がRCTの因果効果をどの程度再現できるかを検証しました。その結果、観察データベースの手法はRCTの推定値を正確に再現できないことが多いことが実証されています。
セレクションバイアスの主な原因は以下の通りです。
- ターゲティング:広告プラットフォームは、購買確率の高い(=もともと購入しそうな)ユーザーに広告を配信する。これらのユーザーは広告がなくても購入した可能性が高いため、広告効果が過大推定される
- 自己選択:検索広告では、すでに購入意欲のあるユーザーが自ら検索し、広告をクリックする。広告への曝露が購入意欲の結果であり、原因ではない
- メディア接触の偏り:テレビを多く視聴するユーザーとほとんど視聴しないユーザーでは、所得・年齢・ライフスタイルが大きく異なる可能性がある。メディア接触量がそもそも同質でない
セレクションバイアスは、操作変数法やPropensity Score Matchingなどの手法で対処しようとしても、観測されない選択要因が存在する場合には完全に除去できません。これがGordon et al. (2019) の実証結果が示す重要な教訓です。
シミュレーション③ ── セレクションバイアス
広告プラットフォームが購買確率の高いユーザーにターゲティング配信するケースをシミュレーションします。
このシミュレーションは、以下の数式(データ生成プロセス)に基づいています。ここで はユーザーを表し、 はロジスティック関数です。
① 購買意欲(観測されない交絡因子)の生成
は各ユーザーがもともと持っている購買意欲で、分析者には観測できません。
② 広告配信(セレクションバイアスの導入)
は広告に曝露されたかどうか(曝露 = 1、非曝露 = 0)です。(targeting_strength)が大きいほど、購買意欲 の高いユーザーに広告が集中します。
③ 購入の生成
は購入の有無(購入 = 1)で、(true_ad_effect)が広告の真の効果(対数オッズ比)です。私たちが知りたいのはこの ですが、購入には も影響しています。
バイアスが生じる理由
は広告配信 と購入 の両方に影響します。そのため、 を観測できずに を だけで説明しようとすると、 の影響が の係数に混ざり込みます。曝露群は が高いユーザーの集まりになっているため、広告を見たから購入したのか、もともと購入しやすいから広告を見たのかを区別できません。これがセレクションバイアスです。
np.random.seed(456)
N = 5000  # ユーザー数

# 各ユーザーの潜在的な購買意欲(観測されない)
purchase_propensity = np.random.normal(0, 1, N)

# 広告への曝露確率(購買意欲が高いほど広告が配信されやすい)
targeting_strength = 1.5  # ターゲティングの強さ
prob_exposed = 1 / (1 + np.exp(-(targeting_strength * purchase_propensity)))
ad_exposed = np.random.binomial(1, prob_exposed)

# 真の広告効果
true_ad_effect = 2.0

# 購入の有無(広告効果 + 購買意欲 + ノイズ)
purchase_prob = 1 / (1 + np.exp(-(
    -1.5 + true_ad_effect * ad_exposed + 1.0 * purchase_propensity
)))
purchased = np.random.binomial(1, purchase_prob)

# --- 推定 ---
# ナイーブな比較(広告曝露群 vs 非曝露群の購入率の差)
rate_exposed = purchased[ad_exposed == 1].mean()
rate_unexposed = purchased[ad_exposed == 0].mean()
naive_effect = rate_exposed - rate_unexposed

# ロジスティック回帰(購買意欲を制御しない)
X_naive = sm.add_constant(ad_exposed)
model_naive = sm.Logit(purchased, X_naive).fit(disp=0)

# ロジスティック回帰(購買意欲を制御する = 現実には不可能)
X_full = sm.add_constant(np.column_stack([ad_exposed, purchase_propensity]))
model_full = sm.Logit(purchased, X_full).fit(disp=0)

print("=" * 60)
print("シミュレーション③: セレクションバイアス")
print("=" * 60)
print(f"真の広告効果(対数オッズ比)= {true_ad_effect}")
print(f"ターゲティングの強さ = {targeting_strength}")
print(f"")
print(f"【ナイーブな購入率比較】")
print(f"  広告曝露群の購入率:   {rate_exposed:.4f}")
print(f"  広告非曝露群の購入率: {rate_unexposed:.4f}")
print(f"  差分(ナイーブ推定): {naive_effect:.4f}")
print(f"")
print(f"【ロジスティック回帰(購買意欲を制御しない)】")
print(f"  推定値 β̂ = {model_naive.params[1]:.4f}  (真値 = {true_ad_effect})")
print(f"  バイアス = {model_naive.params[1] - true_ad_effect:.4f}")
print(f"")
print(f"【ロジスティック回帰(購買意欲を制御 = 理想的なケース)】")
print(f"  推定値 β̂ = {model_full.params[1]:.4f}  (真値 = {true_ad_effect})")
print(f"  バイアス = {model_full.params[1] - true_ad_effect:.4f}")
広告プラットフォームのターゲティングによって生じるセレクションバイアスを、ユーザー単位のデータで確認しています。
- 購買意欲に基づく配信: 観測されない購買意欲 purchase_propensity をロジスティック関数に通して広告への曝露確率 prob_exposed を作り、np.random.binomial で実際に広告を見たかどうか(0か1)を決めています。targeting_strength が大きいほど、購買意欲の高いユーザーに広告が集中します。
- 購入の生成: 購入確率は、広告の効果(対数オッズで true_ad_effect = 2.0)と購買意欲の両方で決まります。広告を見るかどうかと購入するかどうかの両方に、購買意欲が影響している構造です。
- 3つの推定方法: 曝露群と非曝露群の購入率の単純な差、購買意欲を入れないロジスティック回帰、購買意欲を入れたロジスティック回帰(現実には購買意欲を観測できないため不可能な、理想的なケース)を比べています。fit(disp=0) は、推定の途中経過を表示しない指定です。
- 比較の単位: ロジスティック回帰の係数は対数オッズ比なので、真の値 2.0 と直接比べられます。一方、購入率の差は確率の差なので、単位が異なる点に注意してください。
実行結果
============================================================
シミュレーション③: セレクションバイアス
============================================================
真の広告効果(対数オッズ比)= 2.0
ターゲティングの強さ = 1.5

【ナイーブな購入率比較】
  広告曝露群の購入率:   0.7038
  広告非曝露群の購入率: 0.1401
  差分(ナイーブ推定): 0.5637

【ロジスティック回帰(購買意欲を制御しない)】
  推定値 β̂ = 2.6800  (真値 = 2.0)
  バイアス = 0.6800

【ロジスティック回帰(購買意欲を制御 = 理想的なケース)】
  推定値 β̂ = 2.0185  (真値 = 2.0)
  バイアス = 0.0185
セレクションバイアスのシミュレーションでは、ターゲティングによって「もともと購入確率の高いユーザー」に広告が多く配信されるため、広告効果が過大推定されます。現実にはユーザーの「潜在的な購買意欲」を直接観測することは困難であり、この制御は通常不可能です。
シミュレーション③の推定値を並べると、次のようになります。
(図は、diagram-designで作成)
バイアスの持続性 ── サンプルサイズを増やしても消えない
3つのメカニズムによるバイアスが、サンプルサイズを増やしても消えないことを可視化します。
fig, axes = plt.subplots(1, 3, figsize=(15, 5))

# --- パネル1: 欠落変数バイアス ---
ax1 = axes[0]
sample_sizes = [50, 100, 200, 500, 1000, 2000, 5000]
biases_ovb = []
for n in sample_sizes:
    np.random.seed(42)
    z = np.random.normal(0, 5, n)
    x = 20 + 1.5 * z + np.random.normal(0, 3, n)
    y = 50 + 0.3 * x + 2.0 * z + np.random.normal(0, 2, n)
    m = sm.OLS(y, sm.add_constant(x)).fit()
    biases_ovb.append(m.params[1] - 0.3)

# 理論的バイアスの計算
np.random.seed(42)
z_ref = np.random.normal(0, 5, 5000)
x_ref = 20 + 1.5 * z_ref + np.random.normal(0, 3, 5000)
theoretical_bias = 2.0 * np.cov(x_ref, z_ref)[0, 1] / np.var(x_ref)

ax1.plot(sample_sizes, biases_ovb, 'o-', color='#e74c3c', linewidth=2, markersize=6)
ax1.axhline(y=0, color='gray', linestyle='--', linewidth=1)
ax1.axhline(y=theoretical_bias, color='#e74c3c', linestyle=':', linewidth=1.5,
            alpha=0.7, label=f'理論的バイアス ({theoretical_bias:.2f})')
ax1.set_xlabel('サンプルサイズ', fontsize=11)
ax1.set_ylabel('バイアス (β̂ − β)', fontsize=11)
ax1.set_title('①欠落変数バイアス', fontsize=12)
ax1.set_xscale('log')
ax1.legend(fontsize=9)
ax1.grid(True, alpha=0.3)

# --- パネル2: 逆因果 ---
ax2 = axes[1]
biases_rc = []
for n in sample_sizes:
    np.random.seed(123)
    e1 = np.random.normal(0, 3, n)
    e2 = np.random.normal(0, 2, n)
    d = 1 - 0.5 * 0.3
    x_e = (5 + 0.5 * 50) / d + (0.5 * e1 + e2) / d
    y_e = (50 + 0.3 * 5) / d + (e1 + 0.3 * e2) / d
    m = sm.OLS(y_e, sm.add_constant(x_e)).fit()
    biases_rc.append(m.params[1] - 0.3)

ax2.plot(sample_sizes, biases_rc, 'o-', color='#3498db', linewidth=2, markersize=6)
ax2.axhline(y=0, color='gray', linestyle='--', linewidth=1)
ax2.set_xlabel('サンプルサイズ', fontsize=11)
ax2.set_ylabel('バイアス (β̂ − β)', fontsize=11)
ax2.set_title('②逆因果', fontsize=12)
ax2.set_xscale('log')
ax2.grid(True, alpha=0.3)

# --- パネル3: セレクションバイアス ---
ax3 = axes[2]
biases_sb = []
for n in sample_sizes:
    np.random.seed(456)
    pp = np.random.normal(0, 1, n)
    pr = 1 / (1 + np.exp(-(1.5 * pp)))
    ae = np.random.binomial(1, pr)
    ppr = 1 / (1 + np.exp(-(-1.5 + 2.0 * ae + 1.0 * pp)))
    pu = np.random.binomial(1, ppr)
    m = sm.Logit(pu, sm.add_constant(ae)).fit(disp=0)
    biases_sb.append(m.params[1] - 2.0)

ax3.plot(sample_sizes, biases_sb, 'o-', color='#2ecc71', linewidth=2, markersize=6)
ax3.axhline(y=0, color='gray', linestyle='--', linewidth=1)
ax3.set_xlabel('サンプルサイズ', fontsize=11)
ax3.set_ylabel('バイアス (β̂ − β)', fontsize=11)
ax3.set_title('③セレクションバイアス', fontsize=12)
ax3.set_xscale('log')
ax3.grid(True, alpha=0.3)

plt.suptitle('内生性によるバイアスはサンプルサイズを増やしても消えない', fontsize=14, y=1.02)
plt.tight_layout()
plt.show()
3つのメカニズムそれぞれについて、サンプルサイズを変えながらバイアスを計算し、グラフにしています。
- サンプルサイズのループ: sample_sizes の7通りのサンプルサイズで、それぞれのシミュレーションと同じデータ生成・推定を繰り返し、推定値と真の値の差(バイアス)を記録しています。
- シードの固定: ループの中で毎回 np.random.seed を呼んでいるため、サンプルサイズ以外の条件(乱数の出方)が揃い、「データを増やしたときの変化」だけを比べられます。
- 理論的バイアスの線: 欠落変数バイアスのパネルには、5000件のデータから計算した漸近バイアスを点線で重ねています。推定値がこの線に近づいていく様子から、バイアスが0ではなく理論値に収束することが分かります。
- 横軸の対数目盛り: set_xscale('log') で横軸を対数目盛りにし、50から5000までの幅広いサンプルサイズを1つのグラフに収めています。
実行結果
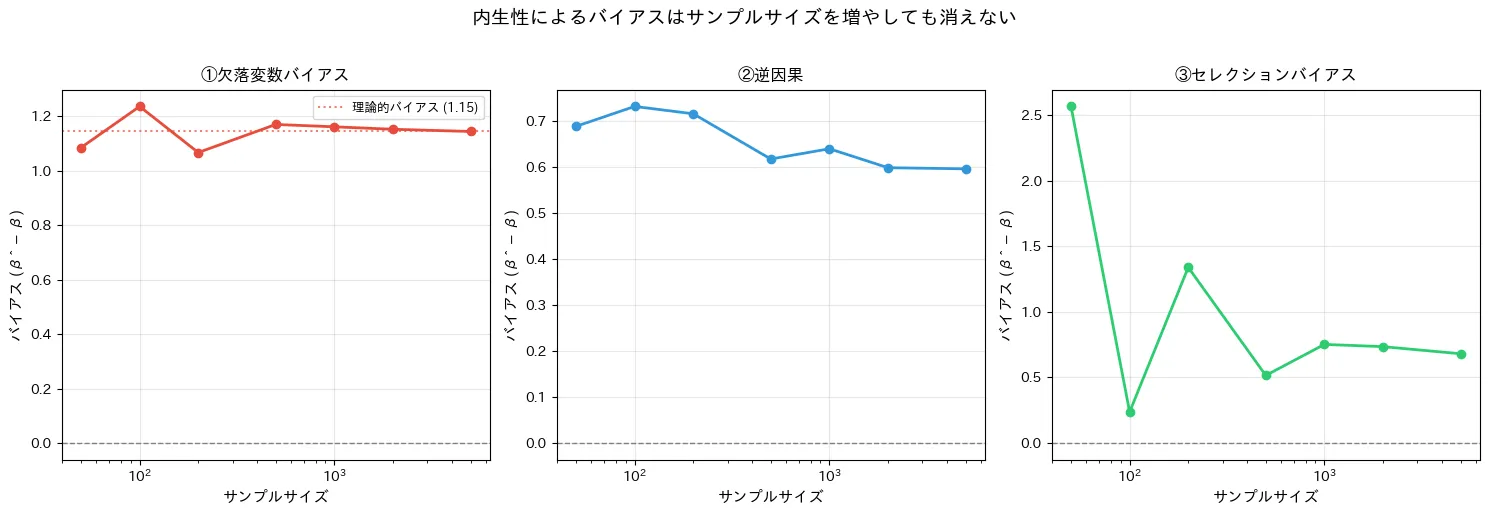
3つのパネルすべてにおいて、サンプルサイズを50から5000に増やしてもバイアスは消えないことが確認できます。これが「内生性のバイアスはビッグデータでは解決しない」という主張の根拠です。
広告効果測定における内生性の特殊な困難さ
ここまで内生性の一般的なメカニズムを見てきましたが、広告効果測定の内生性は他の分野と比べて特に深刻です。その理由を3つの観点から整理します。
困難さ① ── 広告効果のシグナルが極めて小さい(SNR問題)
Lewis & Rao (2015)は、25件の大規模フィールド実験のメタ分析を通じて、広告効果測定の根本的な困難さを明らかにしました。
彼らの主要な発見は、広告の効果サイズは売上の自然な変動(分散)に対して極めて小さいというものです。これは signal-to-noise ratio(SNR)問題 と呼ばれます。
直感的には、あるECサイトの日次売上が平均100万円、標準偏差が30万円だとして、広告による増分が5万円だとすると、SNRは約 0.17 です。この微弱なシグナルを検出するには、RCTであっても数百万人規模のサンプルが必要になります。
RCTでさえ統計的に有意な結果を得ることが困難なほど広告効果のシグナルが小さいのであれば、内生性のバイアスを含む観察データから正確な効果を推定することはさらに困難です。バイアスの大きさがシグナルの大きさを容易に上回ってしまうためです。
困難さ② ── RCTの「ゴールドスタンダード」は常に利用可能ではない
Varian (2016)が指摘するように、RCTは因果推論のゴールドスタンダードですが、広告効果測定においては以下の理由から常に実施可能とは限りません。
| 障壁 | 説明 |
|---|---|
| 倫理的・ビジネス的制約 | 広告をランダムに停止することで売上機会を逸失するリスクがある |
| スピルオーバー効果 | テレビ広告のように、処置群と対照群を完全に分離できないメディアがある |
| 長期効果の検証困難性 | ブランド広告のような長期的な効果は、短期間のRCTでは捕捉できない |
| コスト | Lewis & Rao (2015) が示したように、有意な結果を得るために必要なサンプルサイズが膨大で、実験コストが高い |
このため、多くの場面で観察データに基づく分析に頼らざるを得ず、内生性の問題に正面から向き合う必要があります。
困難さ③ ── デジタル広告のターゲティングが内生性を構造的に生む
Gordon et al. (2019)の研究は、デジタル広告においてターゲティングそのものが内生性を構造的に生むことを示しました。
彼らはFacebookでの15件の大規模フィールド実験を対象に、RCTの結果をベンチマークとして、以下の観察データベースの手法と比較しました。
- 回帰分析(OLS)
- Propensity Score Matching(PSM)
- 操作変数法(IV)
結果は衝撃的でした。ほとんどのケースで観察データベースの手法はRCTの結果を再現できませんでした。その主な原因は、広告のターゲティングによるセレクションバイアスが、既存の統計的手法では十分に除去できないことでした。
Gordon et al. (2019) の結果は、「十分に精緻な統計手法を使えば観察データからでも因果効果を正確に推定できる」という期待に冷水を浴びせるものでした。これは内生性の問題が本質的に困難であることを実証的に示した重要な研究です。
内生性への対処法の概観
本記事では内生性の問題を理解することに焦点を当てましたが、当然ながら対処法も研究されています。対処法は大きく、データの取り方そのものを変えて内生性を断ち切る方法 と、観察データのまま、仮定を置いて内生性を取り除く方法 に分けられます。ここでは3つの系統に整理して概要を紹介します。
① 実験で内生性を断ち切る(RCT・ジオ実験)
最も確実な方法は、広告を出すかどうかを分析者がランダムに決めることです。ランダム化比較試験(RCT)で処置を割り当てれば、広告の出稿は需要や購買意欲といった交絡因子と無関係になり、 が データの取り方によって 保証されます。仮定を信じるのではなく、設計によって外生性を作り出せる点が、他の方法との決定的な違いです。
ユーザー単位のRCTが難しいテレビCMや検索広告でも、地域単位で出稿の有無を割り当てる ジオ実験(Geo Experiment) なら実施できることがあります。実際に、eBayが一部の地域で検索広告を停止した大規模な実験では、観察データから想定されていたよりも、検索広告の効果がはるかに小さいことが示されました(Blake et al., 2015)。本記事で見た「需要が高いときほど検索広告が増える」という内生性が、観察データの分析結果を大きく歪めていたのです。
ただし、実験は期間や対象が限られるため、それだけで全チャネル・全期間の効果を測れるわけではありません。そこで実務では、実験で測った効果を MMM などのモデルに組み込み、観察データからの推定を補正する(キャリブレーションする)アプローチが重視されています。具体的な組み込み方は、MMMの記事で実装しています。
② 観察データのまま識別する(コントロール変数・DiD・操作変数法)
実験ができない場合は、観察データに対して何らかの仮定を置き、内生性を取り除きます。
- コントロール変数: 交絡因子を観測できるなら、モデルに加えることで欠落変数バイアスを解消できます。たとえば、有料検索広告のバイアスについては、交絡因子である検索クエリ量をモデルに取り込んで補正する方法が提案されています(Chen et al., 2018)。ただし、この方法は「交絡因子をすべて観測できている」という仮定に依存します。
- 差の差法(DiD): 施策を受けたグループと受けていないグループの差の変化を見ることで、両グループに共通する観測されない要因を取り除きます。「平行トレンド」の仮定が必要です(詳しくはDiDの記事を参照してください)。
- 操作変数法(IV / 2SLS): 内生変数 と相関するが、誤差項 とは相関しない「操作変数」 を用いて、 の変動のうち外生的な部分だけを取り出して効果を推定します。
操作変数 は、以下の2つの条件を満たす必要があります。
- 関連性(Relevance):(操作変数が内生変数と相関する)
- 外生性(Exogeneity):(操作変数が誤差項と無相関で、売上には広告を通じてしか影響しない)
広告効果測定における操作変数の候補としては、広告の配信障害や入稿ミス(広告の出稿量だけを外生的に変動させる)、広告オークションの価格(クリック単価など)の変動といった、広告の供給側の事情 が挙げられます。
操作変数の2つ目の条件は、データから検証することができません。たとえば「天候」は屋外広告の見られ方を変えるため関連性は満たしそうですが、天候は来店や購買そのものにも直接影響します。売上に広告以外の経路で影響する変数は、操作変数として使えません。
操作変数法の理論(共分散の比と二段階最小二乗法)、弱い操作変数の問題、除外制約が崩れたときの偏りは、操作変数法の記事で、ダミーデータとPythonの実装を使って詳しく解説しています。
③ 操作変数を使わずに補正する(コピュラ補正)
コピュラ補正(Copula Correction) は、適切な操作変数が見つからない場合に、内生変数の分布の形を利用して内生性を補正する手法です(Park & Gupta, 2012)。内生変数の分布を正規分布に変換した項(コピュラ項)をモデルに加えることで、誤差項との相関を吸収します。外部のデータを必要としない点が大きな利点ですが、「内生変数の分布が正規分布ではない」ことなど、独自の仮定が必要です。操作変数を使わずに内生性に対処する方法としては、ほかに潜在操作変数法(Ebbes et al., 2005)なども提案されています。コピュラ補正の理論と実装、前提が崩れたときに推定がどう狂うかは、コピュラ補正の記事で詳しく解説しています。
①の実験で効果を測る方法は、合成コントロール法とジオ実験 の記事で扱います。地域単位の実験をどう設計し、どう分析すれば広告の効果を測れるのかを、理論とPythonの実装で解説します。②の操作変数法と③のコピュラ補正の理論と実装は、操作変数法の記事とコピュラ補正の記事で解説しています。
3つの対処法を図にまとめると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、観察データから広告効果を推定する際に避けて通れない「内生性」の問題を体系的に整理しました。
内生性の3つのメカニズム
| メカニズム | 原因 | 広告での典型例 | バイアスの方向 |
|---|---|---|---|
| 欠落変数バイアス | 交絡因子の未観測 | 季節要因、消費者の購買意欲 | 多くの場合、過大推定 |
| 逆因果 | 結果→説明変数の因果 | 売上好調→広告増額 | 過大推定(通常) |
| セレクションバイアス | 非ランダムな処置割当 | ターゲティング配信 | 過大推定(通常) |
広告効果測定が特に困難な理由
- SNR問題:広告効果のシグナルが売上の変動に対して極めて小さい(Lewis & Rao, 2015)
- RCTの限界:ゴールドスタンダードであるRCTも常に利用可能ではない(Varian, 2016)
- 構造的な内生性:デジタル広告のターゲティングが内生性を自動的に生む(Gordon et al., 2019)
最も重要なメッセージ
内生性によるバイアスはサンプルサイズを増やしても消えません。ビッグデータの時代においても、「多くのデータを集めれば正確な推定ができる」という考えは、内生性の前では通用しません。内生性に対処するためには、データを増やすのではなく、実験によってデータの取り方そのものを変える か、操作変数法などの 識別のための仮定を明示的に置く 必要があります。中でも、実験で測った効果を基準にしてモデルを補正するアプローチ(MMMの記事で実装)が、広告効果測定における最も確実な道筋です。
参考文献
- P. Ebbes, M. Wedel, U. Böckenholt, T. Steerneman (2005). Solving and Testing for Regressor-Error (in)Dependence When no Instrumental Variables are Available: With New Evidence for the Effect of Education on Income. Quantitative Marketing and Economics, 3(4), 365–392.
- H. R. Varian (2016). Causal inference in economics and marketing. Proceedings of the National Academy of Sciences, 113(27), 7310–7315.
- T. Blake, C. Nosko, S. Tadelis (2015). Consumer Heterogeneity and Paid Search Effectiveness: A Large-Scale Field Experiment. Econometrica, 83(1), 155–174.
- A. Chen et al. (2018). Bias Correction For Paid Search In Media Mix Modeling. arXiv:1807.03292.
- S. Park, S. Gupta (2012). Handling Endogenous Regressors by Joint Estimation Using Copulas. Marketing Science, 31(4), 567–586.
- B. R. Gordon, F. Zettelmeyer, N. Bhargava, D. Chapsky (2019). A Comparison of Approaches to Advertising Measurement: Evidence from Big Field Experiments at Facebook. Marketing Science, 38(2), 193–225.
- R. A. Lewis, J. M. Rao (2015). The Unfavorable Economics of Measuring the Returns to Advertising. The Quarterly Journal of Economics, 130(4), 1941–1973.
本記事の文章・構成の一部に生成AIを使用しています。