フィッシャー情報行列(Fisher Information Matrix)とは?
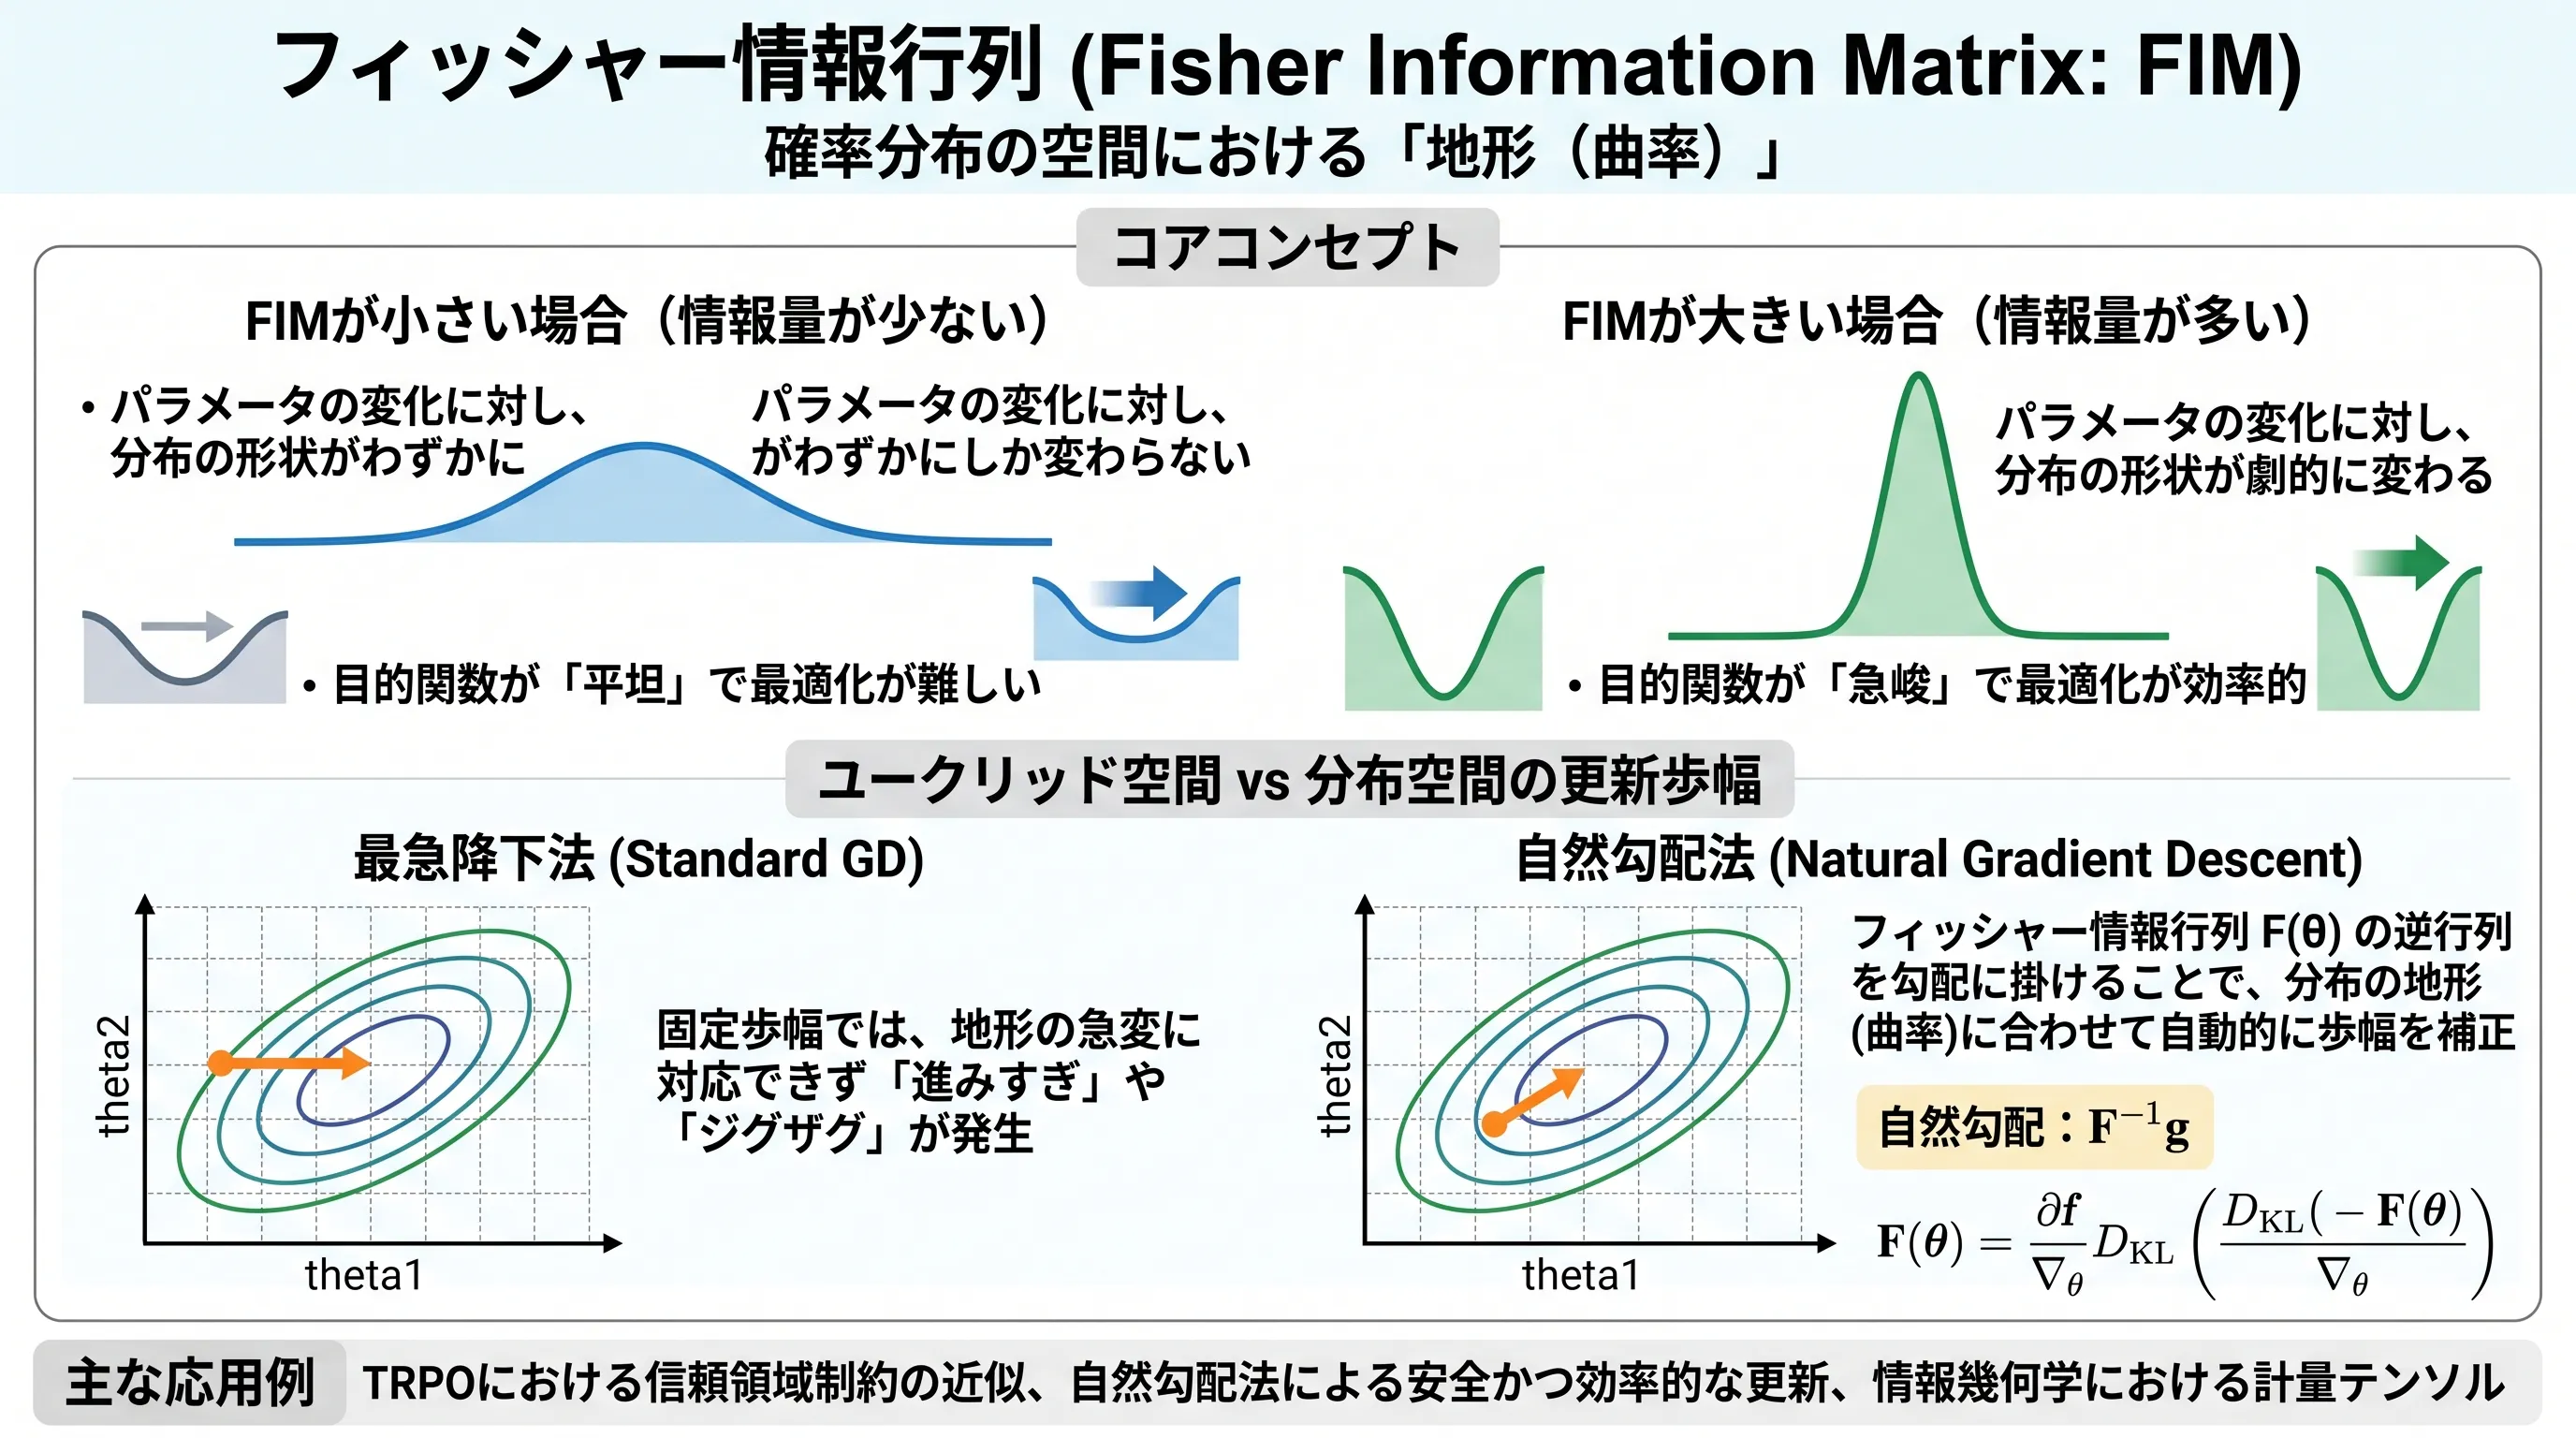 (画像は、Geminiで作成)
フィッシャー情報行列が、パラメータを動かしたときの確率分布の変わりやすさ(KL ダイバージェンスの曲率)を表すことを理解し、それを使う自然勾配法が最急降下法とどう違うのかを説明できるようになること。正規分布のパラメータ推定で2つの方法の探索の軌跡と学習率への強さを比べ、TRPO で自然勾配法が使われる理由を確かめること。
フィッシャー情報行列の概要
フィッシャー情報行列(Fisher Information Matrix: FIM) は、統計学において「観測データが、確率分布の未知のパラメータについてどれだけの情報を持っているか」を定量化する行列です。
機械学習や強化学習(とくに TRPO などの自然勾配法)の文脈においては、単なる統計的な指標という枠を超え、「確率分布の空間における地形(曲率)」を表す計量テンソル として極めて重要な役割を果たします。
ディープラーニングの標準的な最適化手法(最急降下法やAdamなど)は、パラメータ空間の「ユークリッド距離」を基準にパラメータを更新します。しかし、確率分布を扱うアルゴリズムでは、パラメータのわずかな変化が、分布全体の形を致命的に破壊してしまうリスクがあります。フィッシャー情報行列を用いることで、単なる数字の変化量ではなく「確率分布の実際の変化量」を基準にした、安全で効率的な最適化が可能になります。
ユークリッド空間(パラメータ) vs 分布空間
なぜ、通常の勾配降下法ではなくフィッシャー情報行列が必要なのでしょうか? 正規分布 を例に考えてみましょう。
- ケースA: 平均 、標準偏差 から に変更する。
- ケースB: 平均 、標準偏差 から に変更する。
パラメータの「ユークリッド距離(数字上の変化量)」で見ると、どちらも が 変化しただけです。通常の勾配降下法は、この2つを「同じだけ進んだ」とみなします。 しかし、確率分布(ベルカーブ)の形はまったく違う変わり方をします。ケースAでは分布の見た目はほとんど変わりませんが、ケースBでは標準偏差が 2 倍(分散は 4 倍)になり、分布の形が大きく変わります。2 つの分布の違いを KL ダイバージェンスで測って確かめます。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフ日本語表示用

# 2 つの正規分布の KL ダイバージェンス KL(N(μ1, σ1²) || N(μ2, σ2²))
def kl_normal(mu1, s1, mu2, s2):
    return np.log(s2 / s1) + (s1**2 + (mu1 - mu2)**2) / (2 * s2**2) - 0.5

cases = {"ケースA": (10.0, 10.1), "ケースB": (0.1, 0.2)}   # (変更前の σ, 変更後の σ)、平均はどちらも 0
fig, axes = plt.subplots(1, 2, figsize=(12, 4))
for ax, (name, (s_old, s_new)) in zip(axes, cases.items()):
    kl = kl_normal(0.0, s_old, 0.0, s_new)
    print(f"{name}: σ {s_old} → {s_new}  パラメータの距離 {abs(s_new - s_old):.1f}、KL ダイバージェンス {kl:.5f}")
    x = np.linspace(-4 * s_new, 4 * s_new, 400)
    for s, ls in [(s_old, "-"), (s_new, "--")]:
        ax.plot(x, np.exp(-x**2 / (2 * s**2)) / (np.sqrt(2 * np.pi) * s), ls, label=f"N(0, {s}²)")
    ax.set_title(f"{name}:KL = {kl:.4f}")
    ax.set_xlabel("x"); ax.legend(); ax.grid(True, alpha=0.4)
axes[0].set_ylabel("確率密度")
plt.tight_layout()
plt.show()
ケースA とケースB で、パラメータの変化量は同じ 0.1 のまま、分布の違い(KL ダイバージェンス)がどれだけ違うかを確かめるコードです。
- KL ダイバージェンス: 2 つの正規分布の KL ダイバージェンスは、 と式で求まります。kl_normal はこの式そのものです。
- 図: 変更前(実線)と変更後(破線)の確率密度を、それぞれ の範囲で重ねて描きます。横軸の範囲がケースごとに違う(ケースAは ±40、ケースBは ±0.8)ことに注意してください。
実行結果
ケースA: σ 10.0 → 10.1  パラメータの距離 0.1、KL ダイバージェンス 0.00010
ケースB: σ 0.1 → 0.2  パラメータの距離 0.1、KL ダイバージェンス 0.31815
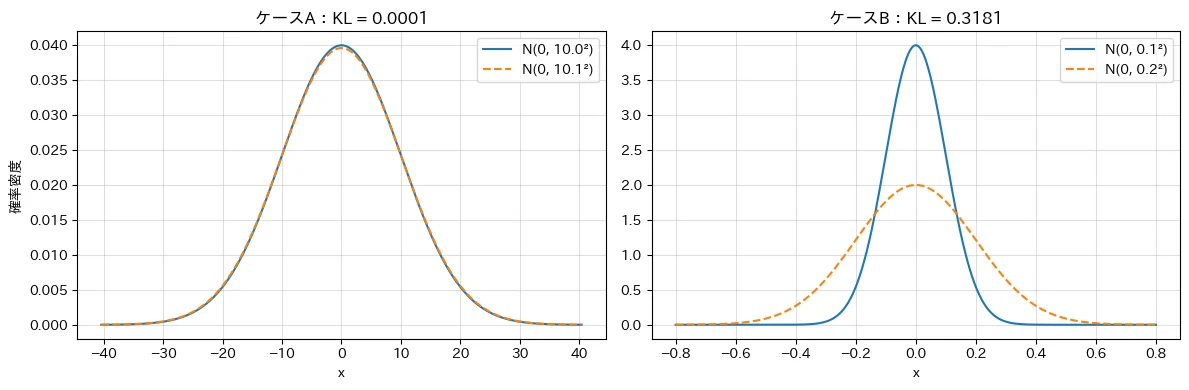
パラメータの変化はどちらも 0.1 ですが、KL ダイバージェンスはケースA が 0.0001、ケースB が 0.318 と、約 3,000 倍違います。ケースA の 2 つの曲線はほぼ重なり、ケースB は山の高さが半分になって幅が 2 倍に広がっています。
このように、「パラメータ空間の距離」と「分布空間での実際の変化量(距離)」は全く一致しません。 フィッシャー情報行列は、現在のパラメータ位置における「分布の変化の激しさ」を行列表現したものです。これの逆行列を勾配に掛ける()ことで、勾配の歩幅を分布空間のスケールに合わせて自動的に補正する 自然勾配法(Natural Gradient Descent) が実現します。
では、なぜ「逆行列を掛ける」ことで歩幅の補正ができるのでしょうか?そして、フィッシャー情報行列は具体的にどのような数式で定義されるのでしょうか。
2つのケースの KL ダイバージェンスを並べると、次のようになります。
(図は、diagram-designで作成)
自然勾配法の仕組みと数学的な定義
なぜ を掛けるのか?
通常の最急降下法は、パラメータ を更新する際、「ユークリッド空間での移動距離 を一定以下に抑えつつ、目的関数を最も改善する方向」 へ進みます。 しかし、確率分布を扱う場合、パラメータの数値的な距離(ユークリッド距離)は「分布の実際の変化量」を正しく測れません。
そこで、「分布間の実際の距離(KLダイバージェンス)の変動を一定以下に抑えつつ、目的関数を最も改善する方向」 を求めます。この制約付き最適化問題を数学的に解くと、通常の勾配 に「KLダイバージェンスの曲率を示す行列」の逆行列を掛けた方向()が進むべき最適な方向として導出されます。
2つの手法の制約と更新を並べると、次のようになります。
(図は、diagram-designで作成)
フィッシャー情報行列の数式
その「曲率を示す行列」であるフィッシャー情報行列 は、数式では以下のように定義されます。
ここで登場する は スコア関数 と呼ばれ、「パラメータ を微小に動かしたとき、データ の出現確率がどれくらい敏感に変化するか」を表すベクトルです。
この数式は、「スコア関数の外積の期待値(=分散)」 を計算しています。つまり、「パラメータを少し動かしたときに、確率分布全体が平均してどれくらい激しく変動するか」という分布空間の曲率を行列として表現しているのです。
KLダイバージェンスとの美しい関係
この の数式は一見複雑ですが、特定の条件下において、KLダイバージェンスの2階微分(ヘッセ行列:Hessian) と完全に一致するという極めて美しい性質を持っています。
フィッシャー情報行列が単なる統計量ではなく、「現在のパラメータ付近における分布空間の歪み具合」そのものを表していることが、この等式からわかります。
KLダイバージェンスの定義から出発し、 で2回微分することで証明できます。
1. KLダイバージェンスの定義
2. について2階微分 の項は に依存しない定数となるため微分で消え、以下のようになります。
3. を代入 これを で評価すると、「負の対数尤度のヘッセ行列の期待値」になります。
4. 期待値がスコア関数の外積と一致する性質 確率の総和が1である性質()を で1回微分すると、定数()の微分なので になります。
ここで、対数関数の微分公式 を変形した を用います。これを代入すると、
となり、「スコア関数の期待値は である」ことが示せます。
次に、先ほどの の式をさらに でもう一度微分します。ここでは と表現し、積の微分法則()を使います。
第一項の に、再び を代入して整理すると、全体が期待値の形になります。
これを移行することで、探していた統計学の基本的な恒等式が導かれます。
結論 ステップ3の結果とステップ4の恒等式を繋げることで、ヘッセ行列がスコア関数の外積の期待値、すなわちフィッシャー情報行列 と完全に一致することがわかります。
TRPOでの活用
TRPO の理論では、「更新前の方策と更新後の方策のKLダイバージェンスを一定以下に抑える」という制約付き最適化問題を解きます。 このKLダイバージェンスの制約を、 の周りで2次のテイラー展開(二次近似)します。式に書き出すと以下のようになります。
この式の各項は次のように評価されます。
- 0次項: 全く同じ分布同士のKLダイバージェンスは になるため、 です。
- 1次項: KLダイバージェンスは常に の値をとり、 で最小値 をとります。最小値(極値)をとる点での微分は になるため、1階微分(勾配)も ベクトルになります(式の は転置を表します)。
- 2次項: KLダイバージェンスの2階微分(ヘッシアン)は、情報幾何学において「フィッシャー情報行列 」と一致することが知られています。これはKLダイバージェンスの定義式から以下のように導出されます。
これを で評価した値 は、対数尤度のヘッシアンの期待値の符号反転であり、まさに統計学におけるフィッシャー情報行列の定義そのものとなります。 最適化や強化学習の文脈ではヘッセ行列(Hessian)由来で と表記されることが多いですが、これは前述の と全く同じものです(※原論文のAppendix Cでは と表記されています)。
これらを踏まえると、次項と次項が完全に消去されるため、KLダイバージェンス制約は次項のみが残り、次のようにシンプルな二次形式で近似されます( を更新ステップ と置きます)。
テイラー展開の各項を図にまとめると、次のようになります。
(図は、diagram-designで作成)
コードによる挙動の確認
Pythonコードを使って、通常の「最急降下法」と、フィッシャー情報行列を用いた「自然勾配法」の挙動を比較してみましょう。 現在の正規分布 のパラメータを調整し、ターゲットとなる標準正規分布 に近づける(KLダイバージェンスを最小化する)問題を考えます。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib

# 目的関数: 今の分布 N(μ, σ²) からターゲット N(0, 1) への KL ダイバージェンス
# KL(N(μ, σ²) || N(0, 1)) = -log(σ) + (σ^2 + μ^2) / 2 - 0.5
def kl_divergence(mu, sigma):
    return -np.log(sigma) + (sigma**2 + mu**2) / 2.0 - 0.5

# ユークリッド空間の勾配(1階微分)
# 記事中の数式 g = [∂KL/∂μ, ∂KL/∂σ]^T に対応
def grad_kl(mu, sigma):
    grad_mu = mu # ∂KL/∂μ = μ
    grad_sigma = sigma - 1.0 / sigma # ∂KL/∂σ = σ - 1/σ
    return np.array([grad_mu, grad_sigma])

# フィッシャー情報行列の逆行列 (N(μ, σ)の場合は対角行列になるため解析的に求まる)
# H = [[1/σ^2, 0], [0, 2/σ^2]]  ->  H^-1 = [[σ^2, 0], [0, σ^2 / 2]]
def fisher_inverse(sigma):
    return np.array([
        [sigma**2, 0.0],
        [0.0, (sigma**2) / 2.0]
    ])

# 探索空間と等高線の設定
mu_vals = np.linspace(-3, 3, 100)
sigma_vals = np.linspace(0.1, 3.5, 100)
M, S = np.meshgrid(mu_vals, sigma_vals)
Z = kl_divergence(M, S)

plt.figure(figsize=(8, 6))
plt.contour(M, S, Z, levels=np.logspace(-1.5, 2, 25), cmap='viridis', alpha=0.8)
plt.title("KLダイバージェンスの等高線 (横軸: μ, 縦軸: σ)")
plt.xlabel("平均 μ")
plt.ylabel("標準偏差 σ")
plt.colorbar(label='KLダイバージェンス')
plt.plot(0, 1, marker='*', color='gold', markersize=15, markeredgecolor='black', label='最適解 N(0, 1)')
plt.legend()
plt.grid(True, linestyle='--', alpha=0.5)
plt.show()
今の分布 をターゲット に近づける問題の、目的関数・勾配・フィッシャー情報行列の逆行列を定義し、目的関数の等高線を描くコードです。
- 目的関数: kl_divergence は、今の分布からターゲットへの KL ダイバージェンス です。 で最小値 0 になります。
- 勾配: grad_kl は、上の式を と で偏微分した です。 が小さいと の項が大きくなり、 方向の勾配が急になります。
- フィッシャー情報行列: パラメータを としたときの正規分布のフィッシャー情報行列は で、対角行列なので逆行列は と各成分の逆数で求まります。fisher_inverse はこれを返します。 が小さいほど が小さくなり、自然勾配の歩幅が縮みます。
- 等高線: は 0 以下で定義できないので、0.1 から 3.5 の範囲で描きます。値の範囲が広いので、np.logspace(-1.5, 2, 25) で対数の間隔に等高線を引きます。
実行結果
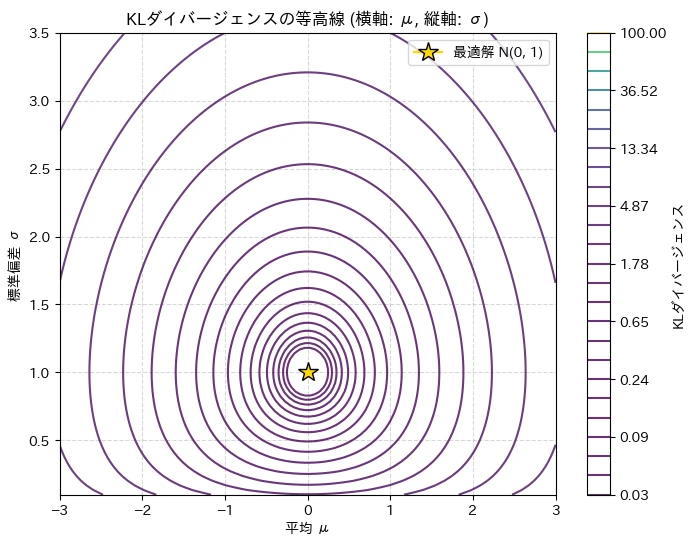
が 0 に近い下側では等高線の間隔が狭く、急な崖になっています。
最急降下法による探索(パラメータ空間での更新)
まず、ユークリッド空間の通常の勾配降下法(学習率 )で最適化を行います。初期値はあえて が小さい状態()からスタートし、勾配が急な崖の近くで 2 つの方法がどう振る舞うかを見ます。
# 初期解の設定:σ を小さくして、勾配が急な崖の近くから始める
init_params = np.array([-2.5, 0.2])  # μ = -2.5, σ = 0.2
alpha_sd = 0.5  # 学習率(両方の方法で同じ値を使う。値による違いは後で比べる)

params_sd = init_params.copy()
path_sd = [params_sd.copy()]

for i in range(50):
    g = grad_kl(params_sd[0], params_sd[1])

    # 勾配の方向へそのまま進む(通常の最急降下法)
    # 数式: θ_{new} = θ_{old} - α * g に対応
    params_sd = params_sd - alpha_sd * g
    path_sd.append(params_sd.copy())

    if np.linalg.norm(g) < 1e-3:
        break

print(f"最急降下法の反復回数: {len(path_sd)-1}")
print(f"1 回目の更新後の (μ, σ): ({path_sd[1][0]:.3f}, {path_sd[1][1]:.3f})")
print(f"到達した (μ, σ): ({params_sd[0]:.4f}, {params_sd[1]:.4f})、KL {kl_divergence(*params_sd):.2e}")

# 探索軌跡の可視化
path_sd_arr = np.array(path_sd)
plt.figure(figsize=(8, 6))
plt.contour(M, S, Z, levels=np.logspace(-1.5, 2, 25), cmap='viridis', alpha=0.6)
plt.plot(path_sd_arr[:, 0], path_sd_arr[:, 1], marker='o', color='red', linestyle='-', linewidth=2, label='最急降下法 (Standard GD)', alpha=0.8)
plt.plot(0, 1, marker='*', color='gold', markersize=15, markeredgecolor='black', label='最適解 N(0, 1)')
plt.title("最急降下法の探索軌跡")
plt.xlabel("平均 μ")
plt.ylabel("標準偏差 σ")
plt.legend()
plt.grid(True, linestyle='--', alpha=0.5)
plt.show()
通常の最急降下法 で、 が小さい点から最適解を目指すコードです。
- 更新: grad_kl の勾配を、学習率 0.5 を掛けてそのまま引きます。勾配の大きさが 0.001 より小さくなったら止め、上限は 50 回です。
- 学習率 0.5: 2 つの方法を同じ学習率で比べるための値です。学習率によって結果がどう変わるかは、後で 0.1〜1.5 で比べます。
- 確かめること: 1 回目の更新後の位置と、到達した位置・KL ダイバージェンスを表示して、崖の近くでの最初の 1 歩がどれだけ大きいかを数値で見ます。
実行結果
最急降下法の反復回数: 13
1 回目の更新後の (μ, σ): (-1.250, 2.600)
到達した (μ, σ): (-0.0003, 1.0000)、KL 4.66e-08
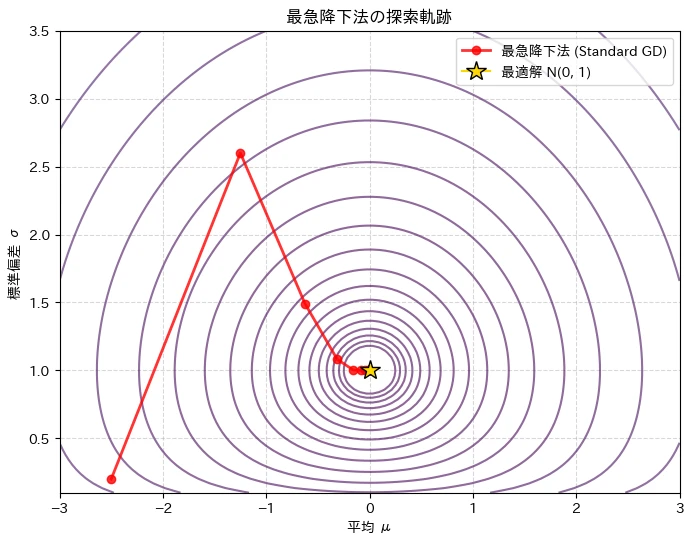
では 方向の勾配が と大きいので、1 回目の更新で は まで跳ね上がりました。分布の幅が 13 倍に広がる、大きな変化です。その後は最適解に戻り、13 回で収束しました。この学習率では速く収束していますが、最初の 1 歩で分布が大きく変わっています。強化学習の方策で同じことが起きると、1 回の更新で行動の確率が大きく変わってしまいます。
自然勾配法による探索(分布空間での更新)
次に、フィッシャー情報行列の逆行列を掛けた「自然勾配法」で更新します。学習率は同じく です。
params_ngd = init_params.copy()
path_ngd = [params_ngd.copy()]

for i in range(50):
    mu, sigma = params_ngd[0], params_ngd[1]
    g = grad_kl(mu, sigma)

    # フィッシャー情報行列の逆行列を勾配に乗じる (Natural Gradient)
    # 数式: natural_grad = F^-1 * g
    F_inv = fisher_inverse(sigma)
    natural_grad = np.dot(F_inv, g)

    # 分布空間のスケールに合わせて補正された自然勾配で更新
    # 数式: θ_{new} = θ_{old} - α * natural_grad に対応
    params_ngd = params_ngd - alpha_sd * natural_grad
    path_ngd.append(params_ngd.copy())

    if np.linalg.norm(g) < 1e-3:
        break

print(f"自然勾配法の反復回数: {len(path_ngd)-1}")
print(f"1 回目の更新後の (μ, σ): ({path_ngd[1][0]:.3f}, {path_ngd[1][1]:.3f})")
print(f"到達した (μ, σ): ({params_ngd[0]:.4f}, {params_ngd[1]:.4f})、KL {kl_divergence(*params_ngd):.2e}")

# 探索軌跡の可視化
path_ngd_arr = np.array(path_ngd)
plt.figure(figsize=(8, 6))
plt.contour(M, S, Z, levels=np.logspace(-1.5, 2, 25), cmap='viridis', alpha=0.6)
plt.plot(path_ngd_arr[:, 0], path_ngd_arr[:, 1], marker='s', color='blue', linestyle='-', linewidth=2, label='自然勾配法 (Natural GD)', alpha=0.8)
plt.plot(0, 1, marker='*', color='gold', markersize=15, markeredgecolor='black', label='最適解 N(0, 1)')
plt.title("自然勾配法の探索軌跡")
plt.xlabel("平均 μ")
plt.ylabel("標準偏差 σ")
plt.legend()
plt.grid(True, linestyle='--', alpha=0.5)
plt.show()
同じ初期値・同じ学習率で、勾配にフィッシャー情報行列の逆行列を掛けた自然勾配 で更新するコードです。
- 自然勾配: np.dot(F_inv, g) が です。 なので、 方向は 、 方向は になります。 が小さいときは、 で大きくなった勾配が で打ち消され、歩幅が小さくなります。
- それ以外は同じ: 学習率・止め方・上限の回数は最急降下法と同じにして、違いが方向と歩幅の補正だけから生まれるようにしています。
実行結果
自然勾配法の反復回数: 20
1 回目の更新後の (μ, σ): (-2.450, 0.248)
到達した (μ, σ): (-0.0005, 0.9999)、KL 1.18e-07
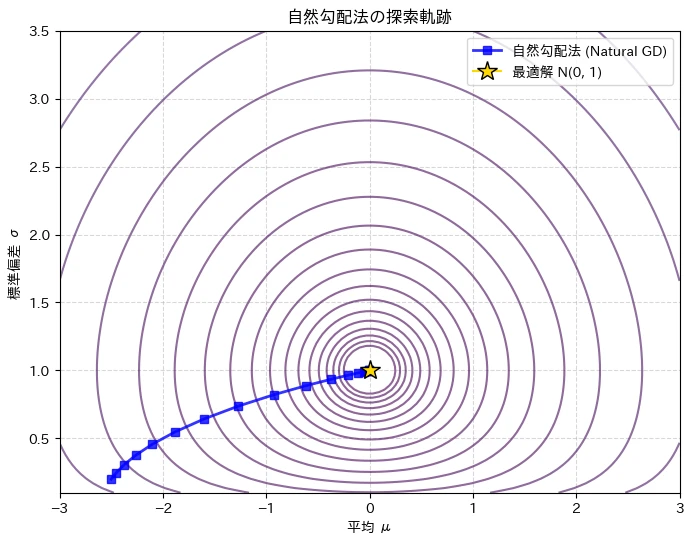
1 回目の更新で は 0.2 から 0.248 へ、 は から へと、少しずつ動きました。 が小さい(分布が鋭い)うちは歩幅が小さく、 が大きくなるにつれて歩幅が広がり、20 回で最適解に着きました。この学習率では、最急降下法(13 回)より回数は多くかかっています。
2つの手法の 1 回目の更新と結果を並べると、次のようになります。
(図は、diagram-designで作成)
探索軌跡の可視化
両者の軌跡を等高線グラフ上で比較します。
path_sd = np.array(path_sd)
path_ngd = np.array(path_ngd)

plt.figure(figsize=(10, 8))
plt.contour(M, S, Z, levels=np.logspace(-1.5, 2, 25), cmap='viridis', alpha=0.6)

# 最急降下法(赤)
plt.plot(path_sd[:, 0], path_sd[:, 1], marker='o', color='red',
         linestyle='-', linewidth=2, label='最急降下法 (Standard GD)', alpha=0.8)

# 自然勾配法(青)
plt.plot(path_ngd[:, 0], path_ngd[:, 1], marker='s', color='blue',
         linestyle='-', linewidth=2, label='自然勾配法 (Natural GD)', alpha=0.8)

plt.plot(0, 1, marker='*', color='gold', markersize=15,
         markeredgecolor='black', label='最適解 N(0, 1)')

plt.title("最急降下法と自然勾配法の比較", fontsize=14, fontweight='bold')
plt.xlabel("平均 μ", fontsize=12)
plt.ylabel("標準偏差 σ", fontsize=12)
plt.legend()
plt.grid(True, linestyle='--', alpha=0.5)
plt.show()
2 つの方法の軌跡を同じ等高線の上に重ねて描き、続けて学習率を変えたときの違いを比べるコードです。
- 重ね描き: 最急降下法を赤の丸、自然勾配法を青の四角で描きます。各点の横軸が 、縦軸が です。
実行結果
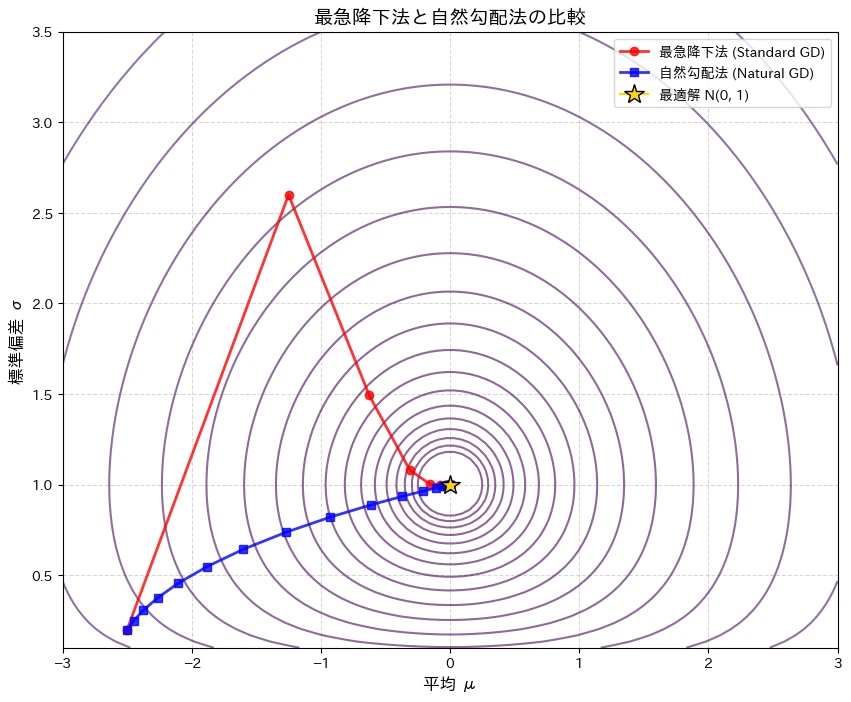
- 赤線(最急降下法): 1 回目で まで跳ね上がり、そこから最適解に戻っています。
- 青線(自然勾配法): と を同時に少しずつ動かし、曲線を描いて最適解に向かっています。
学習率を変えたときの比較
学習率 0.5 では、最急降下法の方が少ない回数で収束しました。自然勾配法の利点がどこにあるかを見るため、学習率を 0.1・0.5・1.0・1.5 に変えて比べます。
# 学習率を変えて、2 つの方法を比べる(同じ初期値・同じ止め方)
def run(alpha, natural, max_iter=200):
    params = init_params.copy()
    sigmas = [params[1]]
    for i in range(max_iter):
        g = grad_kl(params[0], params[1])
        if np.linalg.norm(g) < 1e-3:
            return i, max(sigmas), min(sigmas), kl_divergence(*params)
        step = np.dot(fisher_inverse(params[1]), g) if natural else g
        params = params - alpha * step
        sigmas.append(params[1])
        if params[1] <= 0:                       # σ が 0 以下になると正規分布として成り立たない
            return "σ ≤ 0 で破綻", max(sigmas), min(sigmas), np.nan
    return f"{max_iter} 回で未収束", max(sigmas), min(sigmas), kl_divergence(*params)

for alpha in [0.1, 0.5, 1.0, 1.5]:
    for natural, name in [(False, "最急降下法"), (True, "自然勾配法")]:
        it, smax, smin, kl = run(alpha, natural)
        print(f"学習率 {alpha:<4} {name}: 反復 {it}、σ の範囲 {smin:.3f}〜{smax:.3f}、最後の KL {kl:.1e}")
学習率だけを変えて 2 つの方法を最大 200 回まで動かし、収束までの回数・通った の範囲・最後の KL ダイバージェンスを比べるコードです。
- 止め方: 勾配の大きさが 0.001 より小さくなった時点の更新回数を数えます(上のループは止める前に 1 回多く更新するので、上の表示より 1 少なくなります)。200 回で止まらなければ「未収束」です。
- 破綻の判定: 最急降下法は が 0 以下になることがあり、そうなると正規分布として意味を持たず、 も計算できません。その時点で「破綻」として止めます。
実行結果
学習率 0.1  最急降下法: 反復 75、σ の範囲 0.200〜1.000、最後の KL 4.3e-07
学習率 0.1  自然勾配法: 反復 109、σ の範囲 0.200〜1.000、最後の KL 3.9e-07
学習率 0.5  最急降下法: 反復 12、σ の範囲 0.200〜2.600、最後の KL 1.9e-07
学習率 0.5  自然勾配法: 反復 19、σ の範囲 0.200〜1.000、最後の KL 4.7e-07
学習率 1.0  最急降下法: 反復 200 回で未収束、σ の範囲 0.200〜5.000、最後の KL 1.1e+00
学習率 1.0  自然勾配法: 反復 7、σ の範囲 0.200〜1.000、最後の KL 9.4e-08
学習率 1.5  最急降下法: 反復 σ ≤ 0 で破綻、σ の範囲 -3.497〜7.400、最後の KL nan
学習率 1.5  自然勾配法: 反復 12、σ の範囲 0.200〜1.028、最後の KL 1.2e-07
- 学習率が小さいとき(0.1・0.5): どちらも収束し、回数は最急降下法の方が少なくなりました(75 回・12 回に対し、自然勾配法は 109 回・19 回)。ただし、最急降下法は学習率 0.5 で が 2.6 まで跳ねています。
- 学習率が大きいとき(1.0・1.5): 最急降下法は、学習率 1.0 で が 0.2 と 5.0 の間を行き来して 200 回でも収束せず、1.5 では が負になって破綻しました。自然勾配法は、学習率 1.0 で 7 回、1.5 で 12 回と、通った も 0.2〜1.03 の範囲に収まったまま収束しています。
- 分かること: 自然勾配法の利点は、いつも回数が少ないことではなく、分布の変化の大きさに合わせて歩幅を補正するので、学習率を大きくしても分布が急に変わったり、ありえない値()になったりしにくいことです。最急降下法は、 が小さいところの急な勾配に合わせて学習率を小さくしないと、安定しません。
学習率ごとの結果を表にすると、次のようになります。
(図は、diagram-designで作成)
深層学習(TRPO)への応用と計算コストの壁
自然勾配法は理論上極めて優秀ですが、ディープニューラルネットワークに直接適用しようとすると 計算量の壁 にぶつかります。
パラメータ数が の場合、フィッシャー情報行列 は の巨大な行列になります。 例えばパラメータが100万個あるモデルでは、行列の要素数は1兆個(約4TBのメモリが必要)となり、さらにその逆行列 を求める計算量 は天文学的な数字になります。
この問題をエレガントに解決したのが、TRPO において利用される 「フィッシャー・ベクトル積(FVP)」 と 「共役勾配法(CG)」 の組み合わせです。
- 共役勾配法は、逆行列 を直接求めることなく、方程式 を近似的に解くことができます。
- さらに、PyTorchなどの自動微分の仕組み(二重逆伝播)を利用すると、行列 を一度もメモリ上に構築することなく、「 とベクトル の掛け算の結果()」だけを直接取り出すことができます。
これにより、メモリや計算時間を爆発させることなく、巨大なニューラルネットワークに対しても自然勾配法の恩恵(1 回の更新で方策の分布が変わりすぎないようにすること)をもたらすことが可能になりました。
計算コストの壁と、その回避の仕方を図にすると、次のようになります。
(図は、diagram-designで作成)
まとめ
- フィッシャー情報行列(FIM) は、確率分布のパラメータ空間における「曲率(地形の歪み)」を表す行列です。
- これは KLダイバージェンスのヘッセ行列 と数学的に等価であり、分布間の真の距離を測る計量テンソルとして機能します。
- FIMの逆行列を用いる 自然勾配法 は、パラメータの数値上の変化ではなく「確率分布の形状変化」を基準にします。正規分布の例では、最急降下法が学習率 1.0 で収束せず、1.5 で が負になって破綻したのに対し、自然勾配法は学習率 0.1〜1.5 のすべてで収束しました。ただし、学習率が小さいときの収束の回数は、最急降下法より多くなりました。
- TRPOなどの最先端のアルゴリズムでは、共役勾配法 を組み合わせて計算コストを削減することで、巨大なモデルへの自然勾配法の適用を実現しています。
参考文献
- R. A. Fisher (1925). Theory of Statistical Estimation. Mathematical Proceedings of the Cambridge Philosophical Society, 22(5), 700–725.
- S. Amari (1998). Natural Gradient Works Efficiently in Learning. Neural Computation, 10(2), 251–276.
- J. Schulman, S. Levine, P. Moritz, M. I. Jordan, P. Abbeel (2015). Trust Region Policy Optimization. ICML 2015.
本記事の文章・構成の一部に生成AIを使用しています。