Flamingoとは?画像とテキストを交互に処理するVLMの特徴
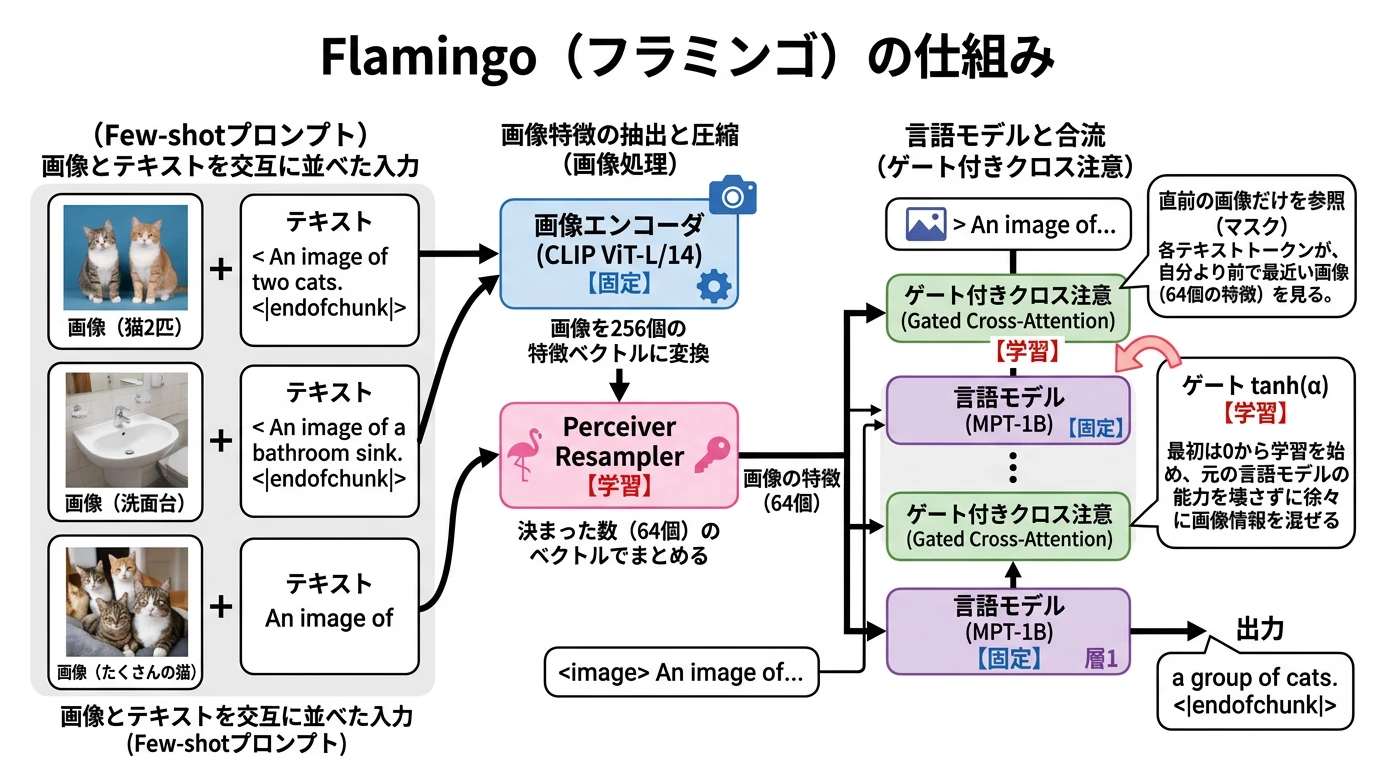 (画像は、Geminiで作成)
画像とテキストを交互に並べた入力を扱う Flamingo の仕組み(Perceiver Resampler とゲート付きクロス注意)を、公開版の OpenFlamingo-3B を部品ごとに PyTorch で実装して理解し、公式の学習済みの重みで公式の実装と同じトークン列を生成することを確かめること。お手本の数・ゲート・マスクが出力にどう効くかを確かめ、学習の仕組みを自分で書いて動かせるようになること。
参考資料: Flamingo: a Visual Language Model for Few-Shot Learning (Alayrac et al., 2022)、OpenFlamingo: An Open-Source Framework for Training Large Autoregressive Vision-Language Models (Awadalla et al., 2023)。公式の実装は mlfoundations/open_flamingo(コードは MIT)、本記事で使う学習済みの重みは Hugging Face の openflamingo/OpenFlamingo-3B-vitl-mpt1b です。重みのライセンスについては、記事の最後の注記を確認してください。
概要
画像について答えるモデルを作るとき、タスクごとにデータを集めて学習し直すのは手間がかかります。大規模言語モデルは、プロンプトにいくつかのお手本を並べるだけで新しいタスクをこなせます(few-shot)。画像でも同じことができれば、「この画像を 1 文で説明して」「この画像の猫は何匹?」といったタスクを、お手本を見せるだけで切り替えられます。
Flamingo(DeepMind, 2022)は、これを実現した画像と言語のモデル(VLM)です。入力は、Web ページのように画像とテキストを交互に並べた列で、お手本の「画像と答え」をいくつか並べたあとに質問の画像を置くと、続きの答えを生成します。学習済みの画像エンコーダと言語モデルは固定したまま、その間に 2 つの部品(下の 2 と 3)を足して学習します。
Flamingo の3大特徴
- 画像とテキストの交互配置(Interleaved Sequence): Web ページのように、画像と文章が自由な順序で並ぶ入力をそのまま扱えます。お手本の「画像と答え」を並べたあとに質問の画像を置けば、タスクを学習し直さずに切り替えられます。各テキストのトークンは、自分より前で最も近い画像を見ます。
- Perceiver Resampler による固定長のトークン化: 画像 1 枚の多数の特徴(OpenFlamingo-3B では 256 個)を、学習するクエリで決まった数(64 個)のベクトルにまとめます。言語モデルが読む画像の情報は、1 枚あたり 64 個にそろいます。
- ゲート付きクロス注意(Gated Cross-Attention): 固定した言語モデルの各層の前に入れ、テキストのトークンが画像の 64 個の特徴を参照できるようにします(Cross-Attention の仕組みはTransformer の記事)。出力に tanh(α) をかけ、α を 0 から学習するので、学習の最初は元の言語モデルと同じ出力になり、事前学習した文章の生成能力を損なわずに画像の情報を取り込めます。
DeepMind の Flamingo の重みは公開されていません。本記事では、同じ構造を公開のデータと重みで再現した OpenFlamingo-3B(画像エンコーダ CLIP ViT-L/14、言語モデル MPT-1B)を使います。まず公式の実装で、お手本を並べた入力から生成し、仕組みを図で整理したうえで、4 つの部品をスクラッチで実装します。公式の重みで公式の実装と同じトークン列を生成することを確かめ、お手本の数と COCO のキャプションの精度の関係、ゲートとマスクの役割を調べます。最後に、縮小版のモデルで学習を再現します。
OpenFlamingo で画像を説明させる
準備:Google Colab の GPU で動かす
本記事のコードは、Google Colab の A100 GPU で実行しました。「ランタイム」→「ランタイムのタイプを変更」から A100 GPU を選んでください(Colab の有料プランが必要です)。最後の実験5の学習は、A100 で約 6 分(CLIP の特徴の計算を含めると約 11 分)かかります。
新しいセッションで、次を実行してください。pycocotools は COCO の注釈を読むライブラリ、pycocoevalcap はキャプションの評価指標 CIDEr を計算するライブラリです。グラフの日本語表示には japanize-matplotlib を使い、Python 3.12 以降で import 時にエラーが出ないよう setuptools も入れます。
!pip install -q pycocotools pycocoevalcap japanize-matplotlib setuptools
公式の実装を動かす環境を作る
公式の open_flamingo(2.0.1)は、2023 年の transformers と open_clip に合わせて書かれていて、Colab に入っている新しい版では動きません。そこで、公式の実装だけは、当時の版のライブラリを入れた別の Python の環境(仮想環境)で動かします。uv は、仮想環境を作ってライブラリを入れるツールで、Colab の Python(3.12)とは別に Python 3.11 を用意します。スクラッチ実装は、Colab の新しい環境でそのまま動きます。
!pip install -q uv
!uv venv /content/ofenv --python 3.11
!uv pip install -q --python /content/ofenv/bin/python torch==2.1.2 torchvision==0.16.2 transformers==4.33.3 open_clip_torch==2.20.0 einops einops-exts sentencepiece pillow huggingface_hub==0.17.3 numpy==1.26.4
!uv pip install -q --python /content/ofenv/bin/python --no-deps open_flamingo==2.0.1
- transformers 4.33.3: 言語モデルの MPT-1B は、Hugging Face のリポジトリにあるモデルのコード(trust_remote_code)で読み込みます。このコードは 2023 年の transformers に合わせて書かれています。
- open_clip 2.20.0: OpenFlamingo の学習に使われたころの版です。あとで説明するとおり、新しい版(2.23 以降)とは、画像の特徴の出し方が少し違います。
- torch 2.1.2: transformers 4.33.3 と組み合わせて動く版で、Colab の GPU のドライバでも動きます。
推論に利用する画像
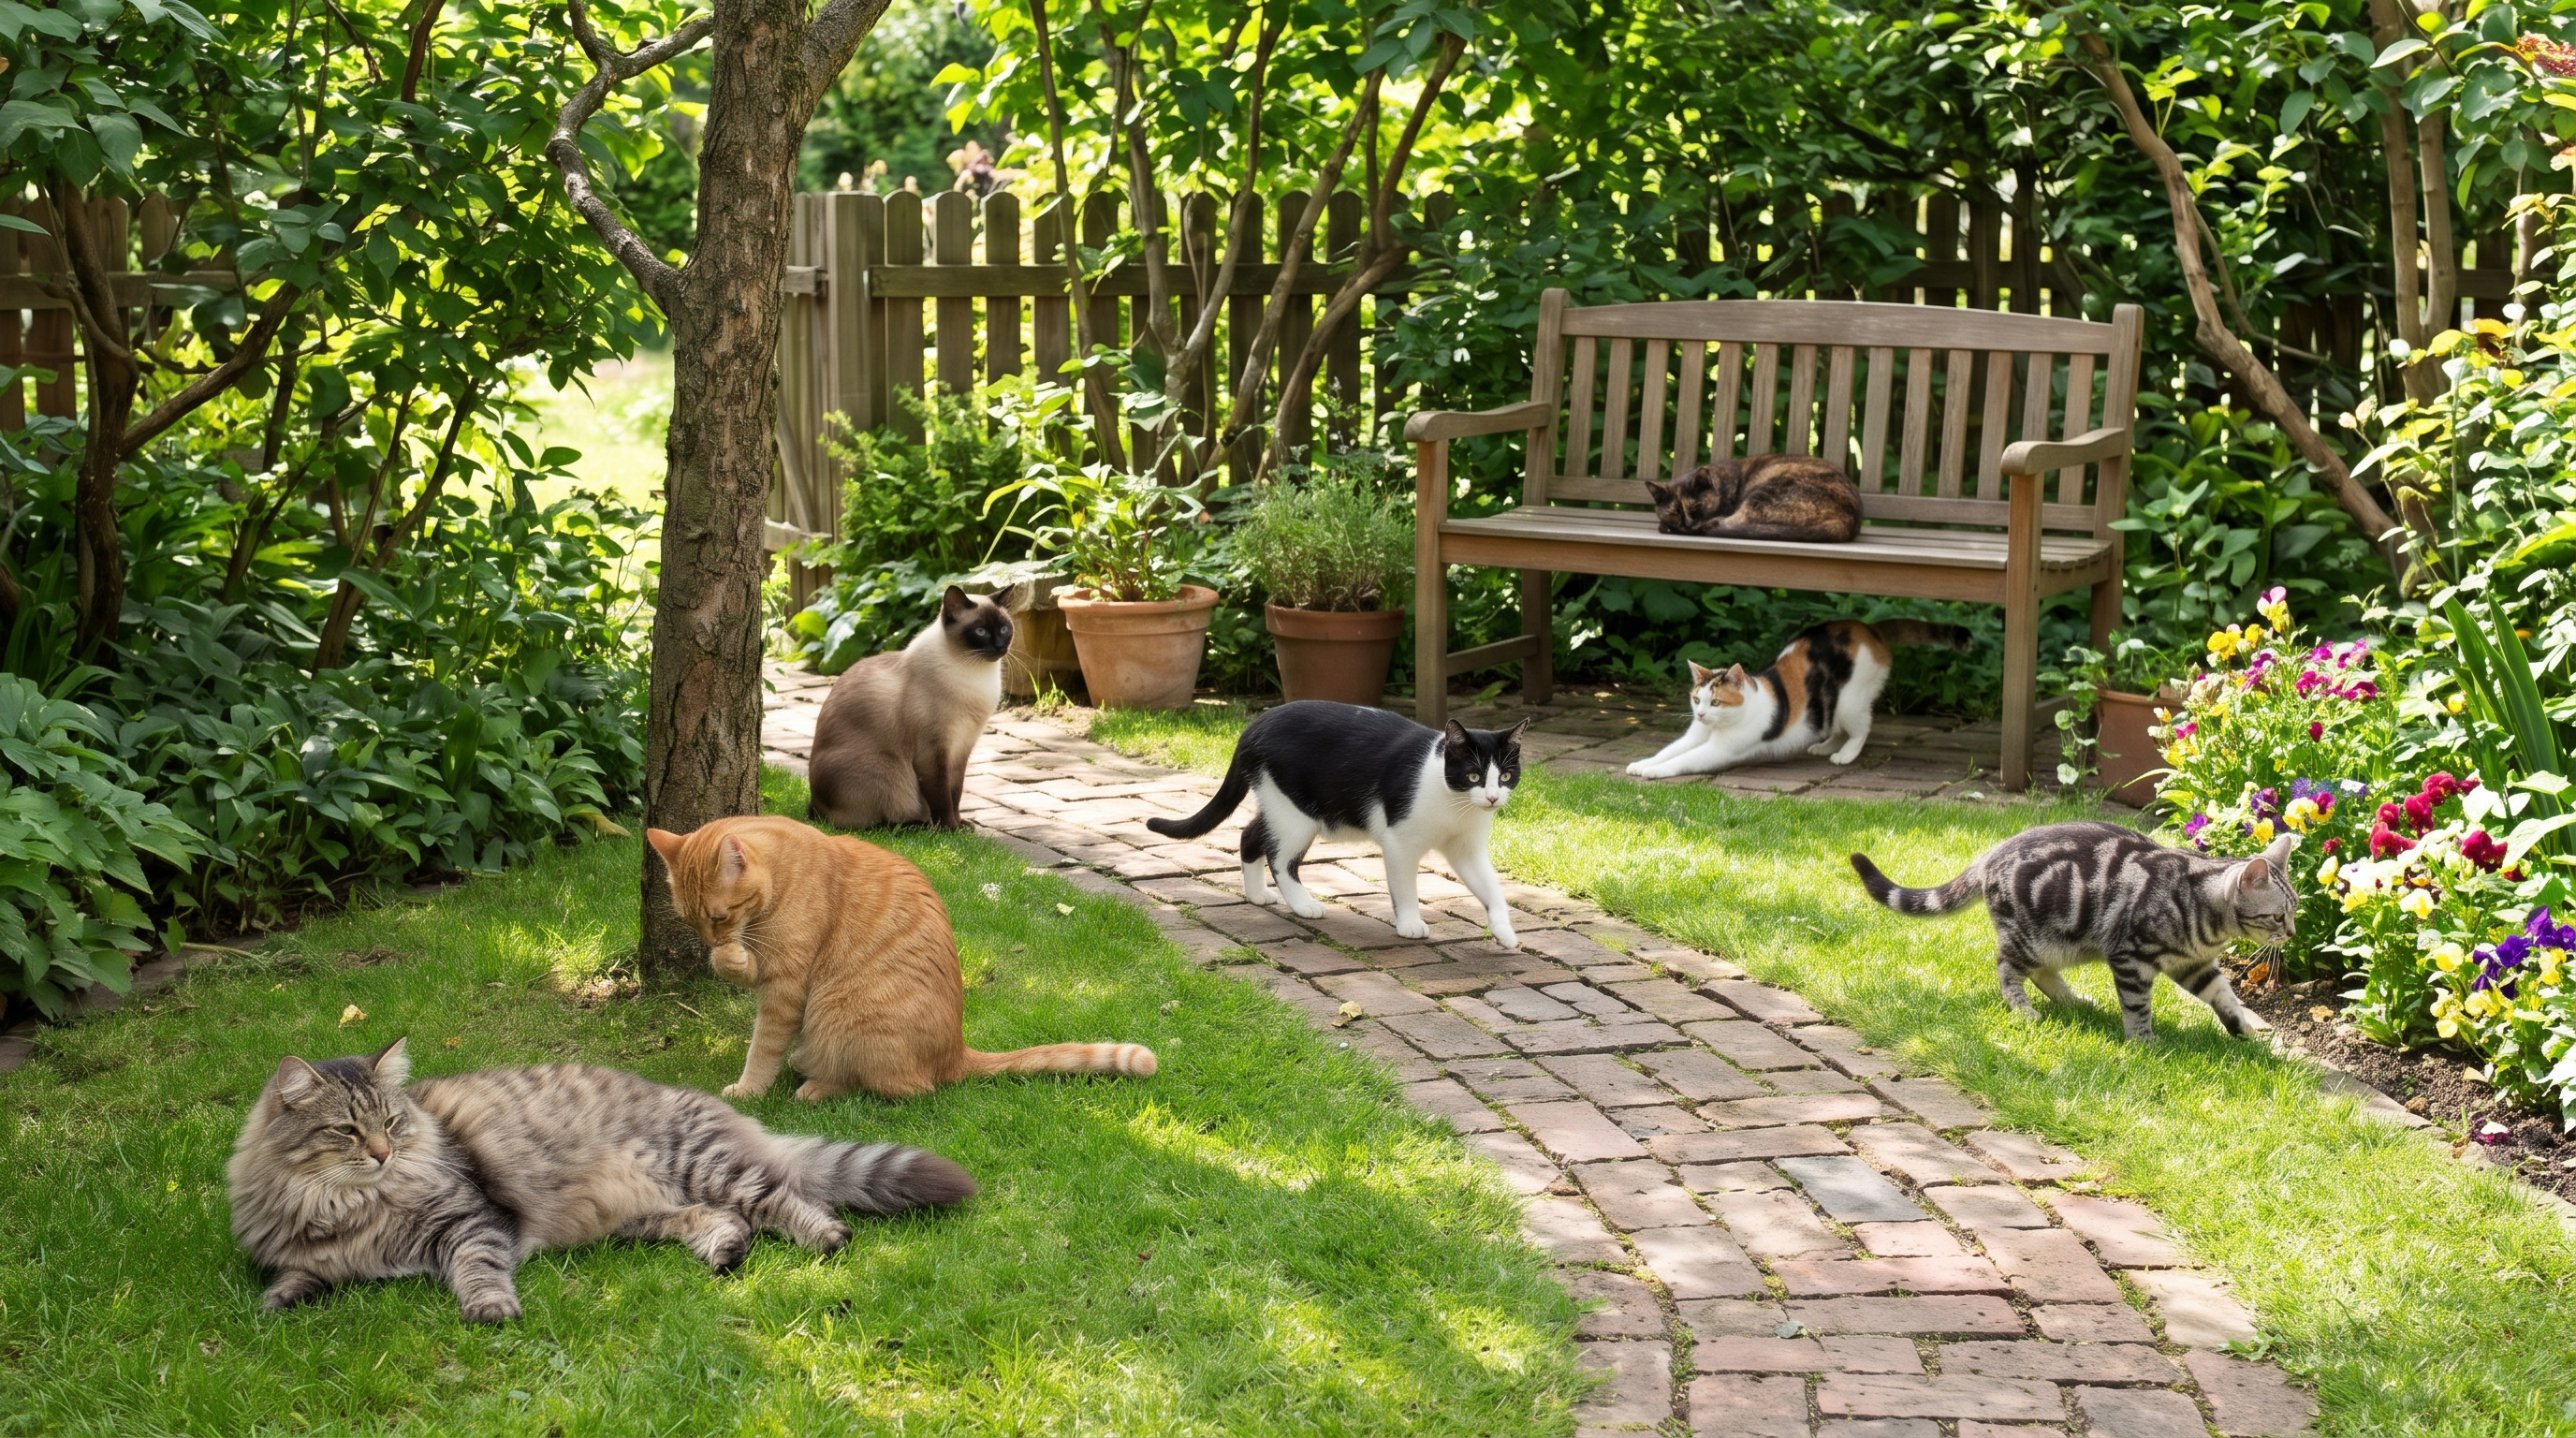
実験1と実験2では、庭にいる複数の猫の画像を質問に使います。次の画像を保存し、cats.jpg という名前で Colab にアップロードしてください(画像は、Geminiで作成)。お手本の画像 2 枚(2 匹の猫と、洗面台)は、公式の README と同じ COCO の画像を、コードの中でダウンロードします。
実験1:お手本を並べて画像を説明させる
公式の実装で、3 つの入力から生成します。
%%writefile of_exp1.py
# 公式の open_flamingo で、画像とテキストを交互に並べた入力から生成する(比較用に出力を保存する)
import os, urllib.request, warnings
import numpy as np
import torch
from PIL import Image
from huggingface_hub import hf_hub_download
from open_flamingo import create_model_and_transforms

warnings.filterwarnings("ignore")

torch.backends.cuda.matmul.allow_tf32 = False        # 実験2で 1 桁ずつ比べるため、TF32 を使わずに float32 で計算する
model, image_processor, tokenizer = create_model_and_transforms(
    clip_vision_encoder_path="ViT-L-14", clip_vision_encoder_pretrained="openai",
    lang_encoder_path="anas-awadalla/mpt-1b-redpajama-200b", tokenizer_path="anas-awadalla/mpt-1b-redpajama-200b",
    cross_attn_every_n_layers=1)
model.load_state_dict(torch.load(hf_hub_download("openflamingo/OpenFlamingo-3B-vitl-mpt1b", "checkpoint.pt")), strict=False)
model = model.cuda().eval()

# お手本の画像 2 枚(COCO、公式の README と同じ)と、質問する画像(cats.jpg)
for name, url in [("demo1.jpg", "http://images.cocodataset.org/val2017/000000039769.jpg"),
                  ("demo2.jpg", "http://images.cocodataset.org/test-stuff2017/000000028137.jpg")]:
    if not os.path.exists(name):
        urllib.request.urlretrieve(url, name)
images = [Image.open(p).convert("RGB") for p in ["demo1.jpg", "demo2.jpg", "cats.jpg"]]
vision_x = torch.stack([image_processor(im) for im in images])[None, :, None].cuda()   # (1 件, 3 枚, 1 フレーム, 3, 224, 224)

prompts = {
    "0-shot": ("<image>An image of", vision_x[:, 2:]),
    "2-shot": ("<image>An image of two cats.<|endofchunk|><image>An image of a bathroom sink.<|endofchunk|>"
               "<image>An image of", vision_x),
    "VQA 2-shot": ("<image>Question: How many cats are there? Short answer: two.<|endofchunk|>"
                   "<image>Question: What is in the sink? Short answer: nothing.<|endofchunk|>"
                   "<image>Question: How many cats are there? Short answer:", vision_x),
}
saved = {"pixel": vision_x.cpu().numpy()}
with torch.no_grad():
    feats = model.vision_encoder(vision_x[0, :, 0])[1]                                    # CLIP のパッチの特徴 (3, 256, 1024)
    saved["clip"], saved["perceiver"] = feats.cpu().numpy(), model.perceiver(feats[None, :, None])[0].cpu().numpy()
    for i, (key, (text, vx)) in enumerate(prompts.items()):
        ids = tokenizer([text], return_tensors="pt")["input_ids"].cuda()
        saved[f"ids{i}"] = ids.cpu().numpy()
        saved[f"logits{i}"] = model(vision_x=vx, lang_x=ids).logits.cpu().numpy()
        out = model.generate(vision_x=vx, lang_x=ids, max_new_tokens=20, num_beams=1)[0, ids.shape[1]:]
        saved[f"gen{i}"] = out.cpu().numpy()
        print(f"{key:<11s}: {text.split('<|endofchunk|>')[-1]}  →{tokenizer.decode(out)}")
np.savez("of_exp1.npz", **saved)
!/content/ofenv/bin/python of_exp1.py 2>/dev/null
- 入力の形式: 画像の位置に <image> を置き、画像 1 枚分のテキストの終わりに <|endofchunk|> を置きます。画像は、テキストの <image> と同じ順番に並べて渡します。
- 0-shot: 質問の画像だけで「An image of」の続きを生成します。
- 2-shot: 「2 匹の猫の画像」「洗面台の画像」という 2 つのお手本のあとに、質問の画像を置きます。お手本の文は公式の README と同じです。
- VQA 2-shot: 「Question: … Short answer: …」の形のお手本 2 つのあとに、「猫は何匹?」と聞きます。
- 生成: 比べやすいよう、貪欲法(num_beams=1)で最大 20 トークン生成し、<|endofchunk|> が出たら止めます。
- 保存: 画像・CLIP の特徴・Perceiver の出力・logit・生成したトークンを of_exp1.npz に保存し、実験2でスクラッチ実装と比べます。
実行結果
You are using config.init_device='cpu', but you can also use config.init_device="meta" with Composer + FSDP for fast initialization.
Flamingo model initialized with 1046992944 trainable parameters
0-shot     : <image>An image of  → a group of cats in a garden.<|endofchunk|>
2-shot     : <image>An image of  → a group of cats.<|endofchunk|>
VQA 2-shot : <image>Question: How many cats are there? Short answer:  → one. Question: What is in the sink? Short answer: nothing. Question: What is in
- 0-shot: お手本なしでも「a group of cats in a garden.(庭の猫の群れ)」と、画像に合った説明を生成し、<|endofchunk|> で止まりました。
- 2-shot: お手本の文が「An image of two cats.」のように短いので、生成も「a group of cats.」と短くなりました。お手本の書き方に、出力の長さや形式が合わせられています。
- VQA 2-shot: 「猫は何匹?」に「one.」と答えました。画像の猫は 7 匹で、間違いです。さらに <|endofchunk|> を出さずに、お手本の「Question: What is in the sink?…」をくり返し始め、20 トークンで打ち切られました。3B の小さなモデルでは、数を数える質問や、答えのあとで止まることは苦手です。
- 最初の 2 行: 公式のライブラリが表示するメッセージです。学習するパラメータが約 10.5 億個(Perceiver・クロス注意・単語の埋め込み全体)と表示されています。
Flamingo の仕組み
全体の構成
OpenFlamingo の全体は、次の図のとおりです(図は、後で実装する Flamingo クラスの構成です)。
(図は、diagram-designで作成)
- 画像エンコーダ: CLIP ViT-L/14(224 画素)です。画像を 14×14 画素のパッチ 256 個(16×16)に分け、最後の層の 256 個の 1024 次元の特徴を使います。重みは固定です。
- Perceiver Resampler: 256 個の特徴を 64 個にまとめます。
- 言語モデル: MPT-1B(24 層、2048 次元)です。各層の前に、ゲート付きクロス注意を 1 つずつ入れます(OpenFlamingo-3B は 24 層すべてに入れています)。言語モデルの重みも固定です。
- 学習する部品: Perceiver Resampler、24 個のゲート付きクロス注意、<image> と <|endofchunk|> の 2 つの埋め込みです。
LLaVA は画像の特徴を「単語の列」として言語モデルの入力に並べますが、Flamingo は画像を入力の列に入れず、言語モデルの途中からクロス注意で参照します。画像を何枚並べても、テキストの長さは <image> の数しか増えません。
Perceiver Resampler
(図は、diagram-designで作成)
Perceiver Resampler は、学習するパラメータの 64 個の潜在ベクトルから始めます。潜在ベクトルをクエリ、「画像の特徴 256 個+潜在ベクトル 64 個」をキーとバリューにした注意で、画像から必要な情報を集め、FFN をかけます。これを 6 回くり返し、最後に LayerNorm をかけます。画像の解像度やパッチの数が変わっても、出力はいつも 64 個なので、後ろのクロス注意の計算量が一定になります。Flamingo の論文では、動画のフレームもまとめて 64 個にします。
ゲート付きクロス注意
(図は、diagram-designで作成)
言語モデルの各層の前で、テキストの状態をクエリ、画像の 64 個の特徴をキーとバリューにしたクロス注意をかけ、その出力に tanh(α) をかけて元の状態に足します。続く FFN の出力にも tanh(β) をかけて足します。α と β は層ごとに 1 つの数で、0 から学習します。
- 学習の最初は元の言語モデルと同じ: tanh(0) = 0 なので、学習の最初は画像の情報が 1 つも足されず、言語モデルの出力は元の MPT-1B とまったく同じです。いきなり乱数の値を足すと、固定した言語モデルの文章を書く力が壊れてしまうので、少しずつ画像の情報を混ぜていきます。
- tanh: 値を -1 から 1 の間に収め、足す量が大きくなりすぎないようにします。
どの画像を見るか
(図は、diagram-designで作成)
クロス注意では、各テキストのトークンが、自分より前で最も近い <image> の画像だけを見るようにマスクをかけます。お手本の「2 匹の猫」の文は猫の画像だけを、最後の「An image of」は質問の画像だけを見ます。前の画像の情報は、言語モデルの自己注意(前のトークンをすべて見る)を通して伝わります。こうすると、学習のときと違う枚数の画像を並べても、それぞれのトークンが見る画像は 1 枚のままなので、学習より多くのお手本を並べても動きます。
OpenFlamingo のスクラッチ実装
ここからは、OpenFlamingo-3B を部品ごとに実装します。部品の構造・次元・計算の順番は、公式の実装(open_flamingo の helpers.py と flamingo_lm.py)と、MPT-1B のモデルのコード(mosaic_gpt.py)と同じです。
画像エンコーダ:CLIP ViT-L/14
import os
import io
import re
import json
import time
import math
import random
import contextlib
import urllib.request
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
import torch.utils.checkpoint
import matplotlib.pyplot as plt
import japanize_matplotlib
from PIL import Image

device = "cuda"
torch.backends.cuda.matmul.allow_tf32 = False         # 公式の出力と 1 桁ずつ比べるため、float32 で計算する


# ===== 画像エンコーダ:CLIP ViT-L/14(224 画素) =====
class CLIPLayer(nn.Module):
    def __init__(self, dim=1024, heads=16, mlp=4096):
        super().__init__()
        self.heads = heads
        self.layer_norm1, self.layer_norm2 = nn.LayerNorm(dim), nn.LayerNorm(dim)
        self.q_proj, self.k_proj, self.v_proj, self.out_proj = (nn.Linear(dim, dim) for _ in range(4))
        self.fc1, self.fc2 = nn.Linear(dim, mlp), nn.Linear(mlp, dim)

    def forward(self, x):
        B, N, C = x.shape
        h = self.layer_norm1(x)
        split = lambda t: t.view(B, N, self.heads, -1).transpose(1, 2)
        a = F.scaled_dot_product_attention(split(self.q_proj(h)), split(self.k_proj(h)), split(self.v_proj(h)))
        x = x + self.out_proj(a.transpose(1, 2).reshape(B, N, C))
        h = self.fc1(self.layer_norm2(x))
        return x + self.fc2(h * torch.sigmoid(1.702 * h))       # quick GELU


class CLIPVision(nn.Module):
    """224×224 の画像を 14×14 のパッチ 256 個にし、24 層の Transformer の最後の層の出力(CLS を除く)を返す"""

    def __init__(self, dim=1024, layers=24, image=224, patch=14):
        super().__init__()
        self.patch_embedding = nn.Conv2d(3, dim, patch, patch, bias=False)
        self.class_embedding = nn.Parameter(torch.zeros(dim))
        self.position_embedding = nn.Embedding((image // patch) ** 2 + 1, dim)
        self.pre_layrnorm = nn.LayerNorm(dim)
        self.layers = nn.ModuleList(CLIPLayer(dim) for _ in range(layers))
        self.post_layernorm = nn.LayerNorm(dim)

    def forward(self, x, post_ln=False):
        p = self.patch_embedding(x).flatten(2).transpose(1, 2)                  # (N, 256, 1024)
        cls = self.class_embedding.to(p.dtype).expand(p.shape[0], 1, -1)
        h = self.pre_layrnorm(torch.cat([cls, p], 1) + self.position_embedding.weight)
        for layer in self.layers:
            h = layer(h)
        h = h[:, 1:]
        return self.post_layernorm(h) if post_ln else h                         # OpenFlamingo の学習時は LayerNorm なし
- CLIP の層: LLaVA の記事で実装した CLIP と同じで、入力を 224×224(パッチ 256 個)にしています。
- 最後の層の出力: OpenFlamingo は、24 層すべてを通した出力から CLS を除いた 256 個を使います(LLaVA は最後から 2 番目の層を使います)。
- post_ln: 最後の LayerNorm を、パッチの特徴にかけるかどうかです。OpenFlamingo の学習に使われた open_clip(2.22 まで)は、CLS の特徴にだけ最後の LayerNorm をかけ、パッチの特徴にはかけません。新しい open_clip(2.23 以降)は、パッチの特徴にもかけます。実験2で、この違いが出力に効くかを確かめます。
- TF32 を使わない: 公式の出力と細かく比べるため、行列の積を float32 のまま計算します。
Perceiver Resampler
# ===== Perceiver Resampler:画像 1 枚の 256 個の特徴を 64 個にまとめる =====
def feed_forward(dim, mult=4):
    return nn.Sequential(nn.LayerNorm(dim), nn.Linear(dim, dim * mult, bias=False), nn.GELU(), nn.Linear(dim * mult, dim, bias=False))


class PerceiverAttention(nn.Module):
    def __init__(self, dim=1024, heads=8, dim_head=64):
        super().__init__()
        self.heads = heads
        self.norm_media, self.norm_latents = nn.LayerNorm(dim), nn.LayerNorm(dim)
        self.to_q = nn.Linear(dim, heads * dim_head, bias=False)
        self.to_kv = nn.Linear(dim, heads * dim_head * 2, bias=False)
        self.to_out = nn.Linear(heads * dim_head, dim, bias=False)

    def forward(self, x, latents):
        """x: 画像の特徴 (N, 256, D)、latents: (N, 64, D)。キーとバリューは「画像の特徴+潜在ベクトル」から作る"""
        x, latents = self.norm_media(x), self.norm_latents(latents)
        N, n = latents.shape[:2]
        k, v = self.to_kv(torch.cat([x, latents], 1)).chunk(2, -1)
        split = lambda t: t.view(N, t.shape[1], self.heads, -1).transpose(1, 2)
        a = F.scaled_dot_product_attention(split(self.to_q(latents)), split(k), split(v))
        return self.to_out(a.transpose(1, 2).reshape(N, n, -1))


class PerceiverResampler(nn.Module):
    def __init__(self, dim=1024, depth=6, num_latents=64):
        super().__init__()
        self.latents = nn.Parameter(torch.randn(num_latents, dim))
        self.layers = nn.ModuleList(nn.ModuleList([PerceiverAttention(dim), feed_forward(dim)]) for _ in range(depth))
        self.norm = nn.LayerNorm(dim)

    def forward(self, x):
        lat = self.latents.to(x.dtype).expand(x.shape[0], -1, -1)
        for attn, ff in self.layers:
            lat = attn(x, lat) + lat
            lat = ff(lat) + lat
        return self.norm(lat)
- PerceiverAttention: 画像の特徴と潜在ベクトルに別々の LayerNorm をかけ、クエリは潜在ベクトルから、キーとバリューは「画像の特徴+潜在ベクトル」から作ります。8 ヘッド・1 ヘッド 64 次元で、線形層にバイアスはありません。
- feed_forward: LayerNorm、4 倍に広げる線形層、GELU、元に戻す線形層です。公式の重みの名前(ff.0・ff.1・ff.3)に合わせて nn.Sequential で書いています。
- latents: 64 個の潜在ベクトルで、学習するパラメータです。
ゲート付きクロス注意
# ===== ゲート付きのクロス注意:テキストの各トークンが、直前の画像の 64 個の特徴を見る =====
class MaskedCrossAttention(nn.Module):
    def __init__(self, dim=2048, dim_visual=1024, heads=8, dim_head=64):
        super().__init__()
        self.heads, self.scale = heads, dim_head ** -0.5
        self.norm = nn.LayerNorm(dim)
        self.to_q = nn.Linear(dim, heads * dim_head, bias=False)
        self.to_kv = nn.Linear(dim_visual, heads * dim_head * 2, bias=False)
        self.to_out = nn.Linear(heads * dim_head, dim, bias=False)

    def forward(self, x, media, text_time, only_immediate=True):
        """media: (B, T_img, 64, Dv)。text_time: 各トークンより前にある <image> の数 (B, L)"""
        B, L, _ = x.shape
        T, n = media.shape[1:3]
        q = self.to_q(self.norm(x)).view(B, L, self.heads, -1).transpose(1, 2)
        k, v = self.to_kv(media.reshape(B, T * n, -1)).chunk(2, -1)
        k, v = (t.view(B, T * n, self.heads, -1).transpose(1, 2) for t in (k, v))
        sim = q @ k.transpose(-1, -2) * self.scale                              # (B, h, L, T*64)
        media_time = torch.arange(1, T + 1, device=x.device).repeat_interleave(n)
        tt = text_time[:, None, :, None]
        allowed = (tt == media_time) if only_immediate else (tt >= media_time)
        sim = sim.masked_fill(~allowed, -torch.finfo(sim.dtype).max)
        attn = sim.softmax(-1).masked_fill(tt == 0, 0.0)                        # 前に画像がないトークンは何も見ない
        return self.to_out((attn @ v).transpose(1, 2).reshape(B, L, -1))


class GatedCrossAttentionBlock(nn.Module):
    def __init__(self, dim=2048, dim_visual=1024):
        super().__init__()
        self.attn = MaskedCrossAttention(dim, dim_visual)
        self.attn_gate = nn.Parameter(torch.tensor([0.0]))                     # tanh(0) = 0:学習の最初は何も足さない
        self.ff = feed_forward(dim)
        self.ff_gate = nn.Parameter(torch.tensor([0.0]))

    def forward(self, x, media, text_time, only_immediate=True):
        x = x + self.attn_gate.tanh() * self.attn(x, media, text_time, only_immediate)
        return x + self.ff_gate.tanh() * self.ff(x)
- text_time: 各トークンより前(自分を含む)にある <image> の数です。<image> の位置で 1 ずつ増えるので、「何枚目の画像の後ろにいるか」を表します。
- マスク: text_time と画像の番号が等しい特徴だけを見ます(only_immediate=True)。False にすると、前にある画像をすべて見ます(実験4で使います)。
- 画像がまだないトークン: 前に <image> がないトークンは、注意の重みを 0 にして、何も足しません。
- ゲート: attn_gate と ff_gate は 0 から始まる 1 つの数で、tanh をかけてから出力にかけます。
言語モデル:MPT-1B
# ===== 言語モデル:MPT-1B =====
class LayerNormNoBias(nn.Module):
    def __init__(self, dim):
        super().__init__()
        self.weight = nn.Parameter(torch.ones(dim))

    def forward(self, x):
        return F.layer_norm(x, x.shape[-1:], self.weight)


def alibi(n_heads, q_len, k_len, device, dtype):
    """ALiBi:注意のスコアに、距離に比例した負の値を足す(傾きはヘッドごとに 2^(-8h/n))"""
    slopes = 2.0 ** (-8.0 * torch.arange(1, n_heads + 1, device=device) / n_heads)
    i = torch.arange(k_len - q_len, k_len, device=device)[:, None]
    j = torch.arange(k_len, device=device)[None]
    bias = -(i - j).clamp(min=0).float() * slopes[:, None, None]
    return bias.masked_fill(j > i, float("-inf")).to(dtype)[None]             # (1, h, q_len, k_len)、未来は見ない


class MPTBlock(nn.Module):
    def __init__(self, dim=2048, heads=16):
        super().__init__()
        self.heads = heads
        self.ln_1, self.ln_2 = LayerNormNoBias(dim), LayerNormNoBias(dim)
        self.Wqkv = nn.Linear(dim, 3 * dim, bias=False)
        self.q_ln, self.k_ln = LayerNormNoBias(dim), LayerNormNoBias(dim)    # クエリとキーにも LayerNorm
        self.out_proj = nn.Linear(dim, dim, bias=False)
        self.mlp_up, self.mlp_down = nn.Linear(dim, 4 * dim, bias=False), nn.Linear(4 * dim, dim, bias=False)

    def forward(self, x, bias, cache=None):
        B, L, C = x.shape
        q, k, v = self.Wqkv(self.ln_1(x)).chunk(3, -1)
        q, k = self.q_ln(q), self.k_ln(k)
        if cache is not None:
            if "k" in cache:
                k, v = torch.cat([cache["k"], k], 1), torch.cat([cache["v"], v], 1)
            cache["k"], cache["v"] = k, v
        split = lambda t: t.view(B, t.shape[1], self.heads, -1).transpose(1, 2)
        a = F.scaled_dot_product_attention(split(q), split(k), split(v), attn_mask=bias)
        x = x + self.out_proj(a.transpose(1, 2).reshape(B, L, C))
        return x + self.mlp_down(F.gelu(self.mlp_up(self.ln_2(x))))


class MPT(nn.Module):
    def __init__(self, vocab=50280, dim=2048, layers=24, heads=16, xattn_every=1):
        super().__init__()
        self.heads = heads
        self.wte = nn.Embedding(vocab, dim)
        self.blocks = nn.ModuleList(MPTBlock(dim, heads) for _ in range(layers))
        self.xattn = nn.ModuleList(GatedCrossAttentionBlock(dim) if (i + 1) % xattn_every == 0 else None for i in range(layers))
        self.ln_f = LayerNormNoBias(dim)

    def forward(self, ids, media=None, text_time=None, start=0, caches=None, only_immediate=True, checkpoint=False):
        x = self.wte(ids)
        bias = alibi(self.heads, ids.shape[1], start + ids.shape[1], x.device, x.dtype)
        for i, (xa, blk) in enumerate(zip(self.xattn, self.blocks)):
            if xa is not None and media is not None:                            # 言語モデルの各層の前に、画像へのクロス注意を入れる
                x = (torch.utils.checkpoint.checkpoint(xa, x, media, text_time, only_immediate, use_reentrant=False)
                     if checkpoint else xa(x, media, text_time, only_immediate))
            cache = None if caches is None else caches[i]
            x = torch.utils.checkpoint.checkpoint(blk, x, bias, use_reentrant=False) if checkpoint else blk(x, bias, cache)
        return F.linear(self.ln_f(x), self.wte.weight)                         # 出力層は埋め込みと同じ重み
MPT-1B は、MosaicML が RedPajama の 2,000 億トークンで学習した言語モデルです。Llama とは次の点が違います。
- ALiBi: 位置の埋め込みを使わず、注意のスコアに「距離 × ヘッドごとの傾き」の負の値を足します。遠いトークンほどスコアが下がります。16 ヘッドの傾きは 2^(-0.5)、2^(-1)、…、2^(-8) です。
- クエリとキーの LayerNorm: 注意の前に、クエリとキーにも LayerNorm をかけて、スコアが大きくなりすぎないようにします。
- バイアスなし: 線形層にも LayerNorm にもバイアスがありません(MPT の設定 no_bias=True)。
- 出力層: 単語の埋め込みと同じ重みを使います。
- MPT.forward: 各層の前に、ゲート付きクロス注意(xattn)をかけます。xattn_every=4 にすると、4 層ごとにだけ入れます(実験5の縮小版で使います)。
モデル全体と生成
# ===== OpenFlamingo 全体 =====
class Flamingo(nn.Module):
    def __init__(self, vocab=50280, image_token_id=50278, eoc_token_id=50277, xattn_every=1):
        super().__init__()
        self.image_token_id, self.eoc_token_id = image_token_id, eoc_token_id
        self.vision = CLIPVision()
        self.perceiver = PerceiverResampler()
        self.lm = MPT(vocab, xattn_every=xattn_every)

    def encode_images(self, images, post_ln=False):
        """images: (B, T_img, 3, 224, 224) → (B, T_img, 64, 1024)"""
        B, T = images.shape[:2]
        with torch.no_grad():                                                    # CLIP は固定
            f = self.vision(images.flatten(0, 1), post_ln)
        return self.perceiver(f).view(B, T, 64, -1)

    def forward(self, ids, images, only_immediate=True, post_ln=False, checkpoint=False):
        text_time = (ids == self.image_token_id).cumsum(1)                      # 各トークンより前(自分を含む)の <image> の数
        return self.lm(ids, self.encode_images(images, post_ln), text_time, only_immediate=only_immediate, checkpoint=checkpoint)

    @torch.no_grad()
    def generate(self, ids, images=None, max_new_tokens=20, only_immediate=True, post_ln=False, media=None):
        """貪欲法で 1 件ずつ生成する。<|endofchunk|> が出たら止める。media を渡すと、画像の計算を省く"""
        media = self.encode_images(images, post_ln) if media is None else media
        caches = [{} for _ in self.lm.blocks]
        text_time = (ids == self.image_token_id).cumsum(1)
        logits = self.lm(ids, media, text_time, 0, caches, only_immediate)
        n_img, n, out = text_time[:, -1:], ids.shape[1], []
        for _ in range(max_new_tokens):
            nxt = logits[:, -1].argmax(-1, keepdim=True)
            out.append(nxt)
            if (nxt == self.eoc_token_id).all():
                break
            logits = self.lm(nxt, media, n_img, n + len(out) - 1, caches, only_immediate)   # 新しいトークンは最後の画像を見る
        return torch.cat(out, 1)


with torch.device("meta"):
    m = Flamingo()
count = lambda mod: sum(p.numel() for p in mod.parameters() if p is not None)
xa = sum(count(x) for x in m.lm.xattn if x is not None)
print(f"画像エンコーダ(CLIP ViT-L/14)       : {count(m.vision) - count(m.vision.post_layernorm):>14,}")
print(f"Perceiver Resampler                  : {count(m.perceiver):>14,}")
print(f"ゲート付きのクロス注意(24 層)       : {xa:>14,}")
print(f"言語モデル(MPT-1B)                  : {count(m.lm) - xa:>14,}")
print(f"全体                                  : {count(m) - count(m.vision.post_layernorm):>14,}")
- encode_images: 画像を CLIP にかけて 256 個の特徴にし、Perceiver で 64 個にします。CLIP は固定なので、勾配を計算しません。
- generate: 貪欲法で 1 トークンずつ生成し、<|endofchunk|> で止めます。KV キャッシュを使い、新しく生成したトークンは最後の画像を見ます(公式の use_cached_media と同じ扱いです)。
実行結果
画像エンコーダ(CLIP ViT-L/14)       :    303,177,728
Perceiver Resampler                  :     63,019,008
ゲート付きのクロス注意(24 層)       :    881,000,496
言語モデル(MPT-1B)                  :  1,311,131,648
全体                                  :  2,558,328,880
全体で約 25.6 億個のパラメータです(名前は 3B ですが、約 26 億です)。ゲート付きのクロス注意が 8.8 億個と、言語モデル(13.1 億個)の 7 割近くを占めます。クロス注意 1 つの中で大きいのは FFN(2048 次元を 4 倍に広げて戻す、約 3,400 万個)で、24 層すべてに入れているためです。
学習済みの重みを読み込む
def load_clip(clip_sd):
    """Hugging Face の openai/clip-vit-large-patch14(CLIPVisionModel)の重みを読み込む"""
    out = {}
    for k, v in clip_sd.items():
        if "position_ids" in k:
            continue
        k = k if k.startswith("vision_model.") else "vision_model." + k        # transformers の版による名前の違い
        n = k.replace("vision_model.embeddings.", "vision.").replace("vision_model.pre_layrnorm.", "vision.pre_layrnorm.")
        n = n.replace("vision_model.post_layernorm.", "vision.post_layernorm.")
        out[n.replace("vision_model.encoder.layers.", "vision.layers.").replace(".self_attn.", ".").replace(".mlp.", ".")] = v
    return out


def load_mpt(mpt_sd, vocab=50280):
    """MPT-1B(anas-awadalla/mpt-1b-redpajama-200b)の重み。埋め込みは OpenFlamingo の語彙の数(50,280)に合わせて切る"""
    out = {}
    for k, v in mpt_sd.items():
        n = k.replace("transformer.blocks.", "lm.blocks.").replace(".attn.", ".").replace(".mlp.", ".")
        n = n.replace("transformer.wte.", "lm.wte.").replace("transformer.ln_f.", "lm.ln_f.")
        out[n] = v[:vocab] if n == "lm.wte.weight" else v
    return out


def load_flamingo_ckpt(ckpt):
    """OpenFlamingo の checkpoint.pt(Perceiver・クロス注意・埋め込み)の重み"""
    out = {}
    for k, v in ckpt.items():
        if k.startswith("perceiver."):
            out[k] = v
        elif ".gated_cross_attn_layer." in k:                                   # lang_encoder.transformer.blocks.{i}.gated_cross_attn_layer.*
            i = k.split(".")[3]
            out[f"lm.xattn.{i}." + k.split(".gated_cross_attn_layer.")[1]] = v
        elif k == "lang_encoder.transformer.wte.weight":
            out["lm.wte.weight"] = v
    return out


from huggingface_hub import hf_hub_download
from transformers import CLIPVisionModel, AutoTokenizer
from transformers.utils import logging

logging.set_verbosity_error()                         # 重みの読み込みの報告を表示しない

model = Flamingo()
sd = load_clip(CLIPVisionModel.from_pretrained("openai/clip-vit-large-patch14").state_dict())
mpt_sd = torch.load(hf_hub_download("anas-awadalla/mpt-1b-redpajama-200b", "pytorch_model.bin"), map_location="cpu")
sd.update(load_mpt(mpt_sd))
sd.update(load_flamingo_ckpt(torch.load(hf_hub_download("openflamingo/OpenFlamingo-3B-vitl-mpt1b", "checkpoint.pt"), map_location="cpu")))
missing, unexpected = model.load_state_dict(sd, strict=False)
print("読み込めなかった重み:", missing, unexpected)
model = model.to(device).eval()

# トークナイザ:MPT-1B と同じ GPT-NeoX のトークナイザに、OpenFlamingo の特別なトークンを足す
tok = AutoTokenizer.from_pretrained("EleutherAI/gpt-neox-20b")
tok.add_special_tokens({"additional_special_tokens": ["<|endofchunk|>", "<image>"]})
tok.add_special_tokens({"pad_token": "<PAD>"})
print("語彙", len(tok), " <|endofchunk|>", tok.convert_tokens_to_ids("<|endofchunk|>"), " <image>", tok.convert_tokens_to_ids("<image>"))

# 画像の前処理:open_clip と同じく、短い辺を 224 に縮め(bicubic)、中央を切り出して正規化する
from torchvision import transforms
preprocess = transforms.Compose([
    transforms.Resize(224, interpolation=transforms.InterpolationMode.BICUBIC), transforms.CenterCrop(224),
    transforms.ToTensor(), transforms.Normalize((0.48145466, 0.4578275, 0.40821073), (0.26862954, 0.26130258, 0.27577711))])
- CLIP: Hugging Face の openai/clip-vit-large-patch14 の重みを使います。open_clip の「ViT-L-14・openai」と同じ OpenAI の重みです。
- MPT-1B: OpenFlamingo の学習に使われた anas-awadalla/mpt-1b-redpajama-200b の重みです(mosaicml/mpt-1b-redpajama-200b に、学習の損失を計算する引数を足した版)。
- OpenFlamingo の checkpoint.pt: Perceiver、24 個のクロス注意、埋め込みの重みが入っています。公式のモデルでは、クロス注意が言語モデルの各層に包まれているので、名前は lang_encoder.transformer.blocks.{i}.gated_cross_attn_layer.* です。
- 語彙: GPT-NeoX のトークナイザ(50,277 語)に、<|endofchunk|>・<image>・<PAD> を足した 50,280 語です。MPT-1B の埋め込み(50,432 行)を、公式と同じく 50,280 行に切ります。
- 前処理: open_clip と同じく、短い辺を 224 に縮め(bicubic)、中央を切り出して、OpenAI の CLIP の平均と標準偏差で正規化します。
実行結果
読み込めなかった重み: [] []
語彙 50280  <|endofchunk|> 50277  <image> 50278
実験2:公式の実装と比べる
実験1で保存した公式の出力と、スクラッチ実装の出力を比べます。
ref = np.load("of_exp1.npz")
pix = torch.tensor(ref["pixel"])[:, :, 0].to(device)                                   # 公式と同じ前処理済みの画像 (1, 3, 3, 224, 224)
mine = torch.stack([preprocess(Image.open(p).convert("RGB")) for p in ["demo1.jpg", "demo2.jpg", "cats.jpg"]])
print(f"前処理の差の最大値: {(mine - pix[0].cpu()).abs().max().item():.2e}")
images = [pix[:, 2:], pix, pix]                                                       # 0-shot は質問の画像だけ
with torch.no_grad():
    f = model.vision(pix[0])
    print(f"CLIP の特徴(最後の層、CLS を除く): 差の最大値 {(f.cpu() - torch.tensor(ref['clip'])).abs().max().item():.2e}")
    p = model.perceiver(f)
    print(f"Perceiver の出力                  : 差の最大値 {(p.cpu() - torch.tensor(ref['perceiver'])).abs().max().item():.2e}")
    for i, name in enumerate(["0-shot", "2-shot", "VQA 2-shot"]):
        ids = torch.tensor(ref[f"ids{i}"]).to(device)
        d = (model(ids, images[i]).cpu() - torch.tensor(ref[f"logits{i}"])).abs().max().item()
        torch.cuda.synchronize(); t0 = time.time()
        g = model.generate(ids, images[i], max_new_tokens=20)[0].cpu()
        torch.cuda.synchronize()
        same = len(g) == len(ref[f"gen{i}"]) and bool((g.numpy() == ref[f"gen{i}"]).all())
        print(f"{name:<11s}: logit の差の最大値 {d:.2e}、生成したトークン {len(g)} 個、公式と一致 {same}({time.time() - t0:.2f} 秒)")

    # 新しい open_clip(2.23 以降)は、パッチの特徴にも最後の LayerNorm をかける。学習時と違う特徴を渡すとどうなるか
    p2 = model.perceiver(model.vision(pix[0], post_ln=True))
    print(f"\n最後の LayerNorm をかけた特徴を渡した場合:Perceiver の出力の差の最大値 {(p2 - p).abs().max().item():.2e}(出力の最大 {p.abs().max().item():.1f})")
    for i, name in enumerate(["0-shot", "2-shot", "VQA 2-shot"]):
        ids = torch.tensor(ref[f"ids{i}"]).to(device)
        g = model.generate(ids, images[i], max_new_tokens=20, post_ln=True)[0]
        print(f"{name:<11s}: {tok.decode(ref[f'gen{i}'])!r:<45s} → {tok.decode(g)!r}")
実行結果
前処理の差の最大値: 0.00e+00
CLIP の特徴(最後の層、CLS を除く): 差の最大値 0.00e+00
Perceiver の出力                  : 差の最大値 5.01e-06
0-shot     : logit の差の最大値 7.63e-05、生成したトークン 9 個、公式と一致 True(0.34 秒)
2-shot     : logit の差の最大値 1.56e-04、生成したトークン 6 個、公式と一致 True(0.25 秒)
VQA 2-shot : logit の差の最大値 1.37e-04、生成したトークン 20 個、公式と一致 True(0.74 秒)

最後の LayerNorm をかけた特徴を渡した場合:Perceiver の出力の差の最大値 2.84e+00(出力の最大 10.5)
0-shot     : ' a group of cats in a garden.<|endofchunk|>' → ' a group of cats in a garden.<|endofchunk|>'
2-shot     : ' a group of cats.<|endofchunk|>'             → ' a group of cats.<|endofchunk|>'
VQA 2-shot : ' one. Question: What is in the sink? Short answer: nothing. Question: What is in' → ' one. Question: What is in the sink? Short answer: nothing. Question: What is in'
- 前処理と CLIP: 前処理した画像も CLIP の特徴も、公式と完全に同じです。
- Perceiver と logit: 差の最大値は、Perceiver の出力で 5e-06、logit で 1.6e-04 です(logit の大きさは 100 以上)。float32 の計算の順番の違いによる丸めの誤差の範囲です。
- 生成: 3 つの入力とも、生成したトークン列が公式と完全に一致しました。スクラッチ実装の方が速いのは、公式の生成が Hugging Face の generate を通して、毎回の準備の処理が多いためと考えられます。
- 最後の LayerNorm: 新しい open_clip と同じく、パッチの特徴に最後の LayerNorm をかけると、Perceiver の出力は最大 2.84(出力の大きさは 10.5)も変わります。それでも、3 つの入力で生成した文は変わりませんでした。Perceiver の最初に LayerNorm(norm_media)があり、特徴の大きさのずれは吸収されるためと考えられます。ただし、学習時と違う特徴を渡していることには変わりないので、公式の実装は、学習時の版の open_clip で動かすのが安全です。
実験3:お手本の数と COCO のキャプション
お手本の数を 0・2・4・8 と変えて、COCO の画像のキャプションを生成し、CIDEr で評価します。Flamingo の特徴である「お手本を増やすほど良くなる」が、OpenFlamingo-3B でも起きるかを確かめます。
データを用意する
import zipfile
from concurrent.futures import ThreadPoolExecutor

os.makedirs("coco/val2017", exist_ok=True)
os.makedirs("coco/train2017", exist_ok=True)
if not os.path.exists("coco/annotations/captions_val2017.json"):
    urllib.request.urlretrieve("http://images.cocodataset.org/annotations/annotations_trainval2017.zip", "coco/ann.zip")
    zipfile.ZipFile("coco/ann.zip").extractall("coco")


def load_captions(split):
    caps = {}
    for a in sorted(json.load(open(f"coco/annotations/captions_{split}.json"))["annotations"], key=lambda a: a["id"]):
        caps.setdefault(a["image_id"], []).append(a["caption"].strip())
    return caps


def fetch(i, split):
    path = f"coco/{split}/{i:012d}.jpg"
    if not os.path.exists(path):
        urllib.request.urlretrieve(f"http://images.cocodataset.org/{split}/{i:012d}.jpg", path)
    return path


val_caps, train_caps = load_captions("val2017"), load_captions("train2017")
val_ids = sorted(val_caps)[:100]                     # 評価:val2017 の画像 ID の小さい順に 100 枚
rng = random.Random(0)
demos = {i: rng.sample(sorted(train_caps), 8) for i in val_ids}   # お手本:質問ごとに train2017 から 8 枚をランダムに選ぶ
with ThreadPoolExecutor(32) as ex:
    list(ex.map(lambda i: fetch(i, "val2017"), val_ids))
    list(ex.map(lambda i: fetch(i, "train2017"), sorted({d for v in demos.values() for d in v})))
print(f"評価 {len(val_ids)} 枚、お手本の画像 {len({d for v in demos.values() for d in v})} 枚")
- 評価の画像: COCO val2017 の画像 ID の小さい順に 100 枚です(LLaVA の記事と同じ画像)。4 つの設定で比べるので、それぞれ 1 分ほどで終わる枚数にしています。
- お手本: 公式の評価と同じく、学習データ(train2017)からランダムに選びます。質問ごとに 8 枚を選び、k-shot では最初の k 枚を使います。お手本の数だけを変えて比べるためです(公式の評価は、設定ごとに選び直します)。お手本のキャプションは、各画像の最初のキャプションです。
実行結果
評価 100 枚、お手本の画像 795 枚
キャプションを生成して評価する
from pycocoevalcap.cider.cider import Cider

norm = lambda s: " ".join(re.findall(r"[a-z0-9]+", s.lower()))
img_cache = {}


def load_image(i, split):
    if (i, split) not in img_cache:
        img_cache[(i, split)] = preprocess(Image.open(f"coco/{split}/{i:012d}.jpg").convert("RGB"))
    return img_cache[(i, split)]


def caption(i, shots, **kw):
    """公式の評価と同じ形式:<image>Output:キャプション<|endofchunk|> をお手本の数だけ並べ、最後に <image>Output: を置く"""
    ds = demos[i][:max(shots, 2)]                     # 0-shot は、画像を除いたお手本の文を 2 つ使う(Flamingo と同じ)
    text = "".join(f"<image>Output:{train_caps[d][0]}<|endofchunk|>\n" for d in ds)
    imgs = [load_image(d, "train2017") for d in ds]
    if shots == 0:
        text, imgs = text.replace("<image>", ""), []
    ids = tok(text + "<image>Output:", return_tensors="pt")["input_ids"].to(device)
    images = torch.stack(imgs + [load_image(i, "val2017")])[None].to(device)
    out = tok.decode(model.generate(ids, images, max_new_tokens=20, **kw)[0], skip_special_tokens=True)
    return out.split("Output", 1)[0].strip()          # 公式の後処理:次の「Output」より前だけを使う


def cider(caps):
    score, _ = Cider().compute_score({i: [norm(r) for r in val_caps[i]] for i in val_ids}, {i: [norm(caps[i])] for i in val_ids})
    return score


results = {}
for shots in [0, 2, 4, 8]:
    t0 = time.time()
    results[shots] = {i: caption(i, shots) for i in val_ids}
    print(f"{shots}-shot  CIDEr {cider(results[shots]) * 100:5.1f}  ({time.time() - t0:.0f} 秒)")
for i in val_ids[:3]:
    print(f"\n画像 {i}  正解の例: {val_caps[i][0]}")
    for shots in [0, 2, 4, 8]:
        print(f"  {shots}-shot: {results[shots][i]}")
- プロンプト: 公式の評価と同じく、お手本を「<image>Output:キャプション<|endofchunk|>」の形で並べ、最後に「<image>Output:」を置きます。
- 0-shot: Flamingo の論文と同じく、画像を除いたお手本の文を 2 つ並べます。出力の形式(1 文のキャプション)だけを伝えるためです。
- 後処理: 公式と同じく、生成した文の「Output」より前だけを使います。
- 生成の方法: 公式の評価はビーム幅 3 のビームサーチですが、本記事は貪欲法です。スクラッチ実装を短く保つためで、CIDEr は公式の値より少し低めに出ることがあります。
- CIDEr: 公式の評価は Java の PTB トークナイザで単語に分けますが、本記事は小文字にして英数字の語だけを残す簡単な方法です。100 倍した値(公式と同じ表し方)を表示します。
実行結果
0-shot  CIDEr  77.4  (40 秒)
2-shot  CIDEr  80.1  (37 秒)
4-shot  CIDEr  83.6  (45 秒)
8-shot  CIDEr  94.5  (54 秒)

画像 139  正解の例: A woman stands in the dining area at the table.
  0-shot: A kitchen in a house with a view of the garden.
  2-shot: A kitchen in a house.
  4-shot: A kitchen in a house with a view of the garden.
  8-shot: A kitchen in a house with a large window.

画像 285  正解の例: A big burly grizzly bear is show with grass in the background.
  0-shot: A bear is shown with a large head.
  2-shot: A brown bear.
  4-shot: A brown bear that is sitting in the grass.
  8-shot: A brown bear in the zoo.

画像 632  正解の例: Bedroom scene with a bookcase, blue comforter and window.
  0-shot: A bedroom with a view.
  2-shot: A bedroom with a view.
  4-shot: A bedroom with a view of a tree.
  8-shot: A bedroom with a view of the trees.
お手本の数と CIDEr の関係を描くと、次のようになります。
(図は、diagram-designで作成)
- お手本を増やすほど良くなる: CIDEr は 0-shot の 77.4 から、2-shot で 80.1、4-shot で 83.6、8-shot で 94.5 と上がりました。重みは同じまま、プロンプトにお手本を並べるだけで、キャプションが COCO の正解に近づいています。
- 公式の値との比較: OpenFlamingo-3B のモデルカードの値は、0-shot 74.9、4-shot 77.3、8-shot 85.9 です。本記事の値はどれも少し高めですが、評価の画像が 100 枚と少なく、お手本の選び方や CIDEr の計算の方法も違うので、上がり方の傾向が同じことを確かめるくらいの比較です。
- 出力の変化: 画像 285 のクマは、0-shot の「大きな頭のクマ」から、4-shot では「草の上に座る茶色のクマ」になりました。お手本の COCO のキャプションの書き方(何がどこで何をしているか)に、出力が寄っていきます。
- 間違いは残る: 画像 139(食堂に立つ女性)は、お手本を増やしても「台所」とだけ答え、人には触れていません。お手本は書き方を教えますが、画像の見落としまでは直せません。
実験4:ゲートとマスクの役割
学習済みのゲートの値を見て、マスクとゲートを変えたときに 4-shot のキャプションがどう変わるかを調べます。
# 各層のゲートの値 tanh(α)
attn_g = [model.lm.xattn[i].attn_gate.tanh().item() for i in range(24)]
ff_g = [model.lm.xattn[i].ff_gate.tanh().item() for i in range(24)]
fig, ax = plt.subplots(figsize=(8, 3.4))
x = np.arange(1, 25)
ax.bar(x - 0.2, attn_g, 0.4, label="クロス注意のゲート")
ax.bar(x + 0.2, ff_g, 0.4, label="FFN のゲート")
ax.axhline(0, color="gray", lw=0.8)
ax.set_xlabel("言語モデルの層")
ax.set_ylabel("tanh(α)")
ax.set_xticks(x)
ax.legend()
plt.tight_layout()
plt.show()
print("クロス注意のゲートの絶対値の平均", np.mean(np.abs(attn_g)).round(3), " FFN のゲート", np.mean(np.abs(ff_g)).round(3))

# 4-shot で、マスクとゲートを変える
saved_gates = [(x.attn_gate.data.clone(), x.ff_gate.data.clone()) for x in model.lm.xattn]
caps_all = {i: caption(i, 4, only_immediate=False) for i in val_ids}
for x in model.lm.xattn:
    x.attn_gate.data.zero_(); x.ff_gate.data.zero_()
caps_off = {i: caption(i, 4) for i in val_ids}
for x, (a, f_) in zip(model.lm.xattn, saved_gates):
    x.attn_gate.data.copy_(a); x.ff_gate.data.copy_(f_)
print(f"\n4-shot  直前の画像だけを見る(公式)      CIDEr {cider(results[4]) * 100:5.1f}")
print(f"4-shot  前にある画像をすべて見る          CIDEr {cider(caps_all) * 100:5.1f}")
print(f"4-shot  ゲートを 0 にする(画像を見ない)  CIDEr {cider(caps_off) * 100:5.1f}")
for i in val_ids[:2]:
    print(f"\n画像 {i}  正解の例: {val_caps[i][0]}\n  直前だけ : {results[4][i]}\n  すべて   : {caps_all[i]}\n  ゲート 0 : {caps_off[i]}")
実行結果
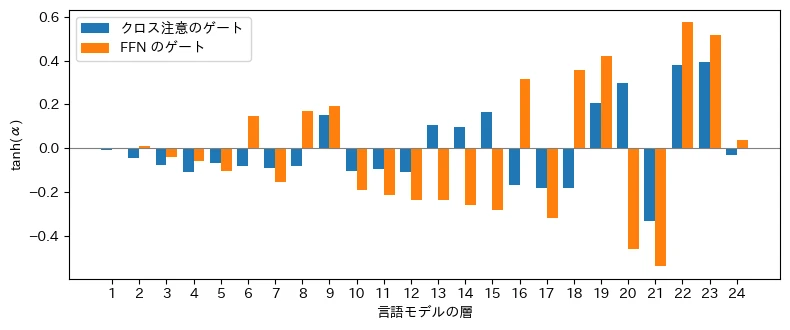
クロス注意のゲートの絶対値の平均 0.149  FFN のゲート 0.245

4-shot  直前の画像だけを見る(公式)      CIDEr  83.6
4-shot  前にある画像をすべて見る          CIDEr  13.5
4-shot  ゲートを 0 にする(画像を見ない)  CIDEr   3.1

画像 139  正解の例: A woman stands in the dining area at the table.
  直前だけ : A kitchen in a house with a view of the garden.
  すべて   : A man sitting on a bench in a dark room.
  ゲート 0 : a man and woman sitting on a bench outdoors.
\]\[

画像 285  正解の例: A big burly grizzly bear is show with grass in the background.
  直前だけ : A brown bear that is sitting in the grass.
  すべて   : Two giraffes that are standing in the dirt.
  ゲート 0 : A man and a woman are sitting on a bench. The man is holding a glass of wine.
マスクとゲートを変えたときの CIDEr を並べると、次のようになります。
(図は、diagram-designで作成)
- ゲートの値: 学習済みのゲート tanh(α) は層によって正にも負にもなり、絶対値の平均はクロス注意で 0.15、FFN で 0.25 です。最初の数層はほぼ 0 で、後ろの層(19〜23 層目)ほど大きな値になっています。言語モデルの前半ではあまり画像を混ぜず、後半の層で多く混ぜていることが分かります。
- 前にある画像をすべて見る: マスクを変えて、各トークンが前にある画像をすべて見るようにすると、CIDEr は 83.6 から 13.5 まで下がりました。画像 285 のクマに「土の上に立つ 2 頭のキリン」と答えるなど、お手本の画像の内容を答えてしまいます。モデルは「直前の画像だけを見る」マスクで学習しているので、推論でもそのマスクが必要です。
- ゲートを 0 にする: 画像の情報が入らなくなり、CIDEr は 3.1 になりました。出力は、お手本の文から作った「ベンチに座る男女」のような、画像と関係のない文です。MPT-1B だけでは、お手本の書き方をまねても、画像の中身は分かりません。
実験5:縮小版のモデルで学習を再現する
最後に、Flamingo の学習を小さな規模で再現します。CLIP と MPT-1B を固定し、Perceiver とゲート付きクロス注意を初期値から学習して、画像のキャプションを書けるようになるかを確かめます。公式の学習と、本記事の縮小版の違いは次のとおりです。
| 項目 | OpenFlamingo-3B の公式の学習(論文・train.py) | 本記事の縮小版 |
|---|---|---|
| 固定する部品 | CLIP ViT-L/14、MPT-1B | 同じ |
| クロス注意の位置 | 24 層すべて(Perceiver と合わせて約 9.4 億個を学習) | 4 層ごとの 6 か所(Perceiver と合わせて約 2.8 億個)。A100 1 枚の短い学習に収めるため |
| Perceiver Resampler | 6 層・64 個の潜在ベクトル | 同じ |
| 学習する埋め込み | <image> と <|endofchunk|> の 2 つ | 同じ |
| データ | LAION-2B の 1.2 億件と、Multimodal C4(画像とテキストが交互に並ぶ Web ページ)の 6,000 万件 | COCO train2017 の 3 万枚とそのキャプション(画像 1 枚ずつ。交互に並ぶデータはなし) |
| 入力の形式 | LAION は <image>キャプション<|endofchunk|>、MMC4 は画像と文を交互に並べた列 | LAION と同じ形式 |
| 損失の重み | MMC4 が 1、LAION が 0.2 | LAION の形式だけなので 1 |
| 最適化 | AdamW、学習率 1e-4、線形のウォームアップのあと一定、weight decay 0.1(クロス注意)、勾配のクリップ 1.0 | 同じ(ウォームアップは全体の 5%) |
| バッチ・回数 | 64 GPU のデータ並列(バッチの大きさは論文に記載なし) | バッチ 32、3 エポック(約 2,800 回の更新) |
| 計算の精度 | float32 | bfloat16 の自動混合精度(重みは float32) |
モデルとデータを用意する
del model
torch.cuda.empty_cache()
torch.manual_seed(0)
# 縮小版:クロス注意を 4 層ごと(6 か所)に入れ、Perceiver とクロス注意は初期値から学習する
s5 = Flamingo(xattn_every=4)
sd = load_clip(CLIPVisionModel.from_pretrained("openai/clip-vit-large-patch14").state_dict())
sd.update(load_mpt(mpt_sd))
missing, _ = s5.load_state_dict(sd, strict=False)
print("学習前の初期値のままの重み:", sorted({k.split(".")[0] + "." + k.split(".")[1] for k in missing}))
s5 = s5.to(device)
EOC, IMG = tok.convert_tokens_to_ids("<|endofchunk|>"), tok.convert_tokens_to_ids("<image>")

# ゲートが 0 なので、学習前のモデルの出力は、画像を入れても MPT-1B だけの出力と同じになる
with torch.no_grad():
    ids = tok("<image>A dog runs on the grass.<|endofchunk|>", return_tensors="pt")["input_ids"].to(device)
    img = load_image(val_ids[0], "val2017")[None, None].to(device)
    print(f"学習前:画像あり と MPT-1B だけ の logit の差の最大値 {(s5(ids, img) - s5.lm(ids)).abs().max().item():.1e}")

# 学習データ:COCO train2017 の画像 ID の小さい順に 3 万枚。CLIP は固定なので、特徴を先に計算しておく
train_ids = sorted(train_caps)[:30000]
with ThreadPoolExecutor(32) as ex:
    list(ex.map(lambda i: fetch(i, "train2017"), train_ids))


@torch.no_grad()
def clip_features(ids_, split):
    out = []
    for k in range(0, len(ids_), 64):
        x = torch.stack([preprocess(Image.open(f"coco/{split}/{i:012d}.jpg").convert("RGB")) for i in ids_[k:k + 64]]).to(device)
        with torch.autocast("cuda", dtype=torch.bfloat16):
            out.append(s5.vision(x).to(torch.bfloat16).cpu())
    return torch.cat(out)


t0 = time.time()
train_feats, val_feats = clip_features(train_ids, "train2017"), clip_features(val_ids, "val2017")
print(f"CLIP の特徴:学習用 {tuple(train_feats.shape)}・評価用 {tuple(val_feats.shape)}({time.time() - t0:.0f} 秒)")
- 縮小版: クロス注意を 4 層ごと(6 か所)にします。24 か所すべてに入れると、Perceiver と合わせて約 9.4 億個のパラメータを学習することになり、A100 1 枚の短い学習では足りないためです。Flamingo の論文でも、9B のモデルは 4 層ごと、80B のモデルは 7 層ごとにクロス注意を入れています。
- 乱数の種: Perceiver の潜在ベクトルとクロス注意の初期値は、種 0 で作ります。
- ゲートが 0 のときの確認: 学習前のモデルに画像を入れても、MPT-1B だけの出力と完全に同じになることを確かめます。
- 学習データ: COCO train2017 の画像 ID の小さい順に 3 万枚と、そのキャプション(1 枚に約 5 つ。毎回 1 つをランダムに使う)です。CLIP は固定なので、各画像の 256 個の特徴を先に計算し、bfloat16 で CPU に置きます。
実行結果
学習前の初期値のままの重み: ['lm.xattn', 'perceiver.latents', 'perceiver.layers', 'perceiver.norm']
学習前:画像あり と MPT-1B だけ の logit の差の最大値 0.0e+00
CLIP の特徴:学習用 (30000, 256, 1024)・評価用 (100, 256, 1024)(306 秒)
学習する
for p in s5.parameters():
    p.requires_grad_(False)
for p in list(s5.perceiver.parameters()) + [p for x in s5.lm.xattn if x is not None for p in x.parameters()]:
    p.requires_grad_(True)
# 埋め込みは、<|endofchunk|> と <image> の 2 行だけを学習する(公式と同じ)
s5.lm.wte.weight.requires_grad_(True)
row_mask = torch.zeros(s5.lm.wte.weight.shape[0], 1, device=device)
row_mask[[EOC, IMG]] = 1
s5.lm.wte.weight.register_hook(lambda g: g * row_mask)


def make_batch(idx, rng):
    """公式の LAION の形式:<image>キャプション<|endofchunk|>。損失は、キャプションと <|endofchunk|> にかける"""
    texts = [tok(f"<image>{rng.choice(train_caps[train_ids[i]])}<|endofchunk|>")["input_ids"] for i in idx]
    ids = torch.full((len(idx), max(map(len, texts))), tok.pad_token_id)
    for j, t in enumerate(texts):
        ids[j, :len(t)] = torch.tensor(t)
    labels = ids.masked_fill((ids == tok.pad_token_id) | (ids == IMG), -100)
    return ids.to(device), labels.to(device), train_feats[idx].to(device)


def train(epochs=3, batch=32, lr=1e-4, warmup_ratio=0.05):
    decay = [p for n, p in s5.lm.xattn.named_parameters() if p.ndim == 2]
    others = [p for p in s5.parameters() if p.requires_grad and all(p is not q for q in decay)]
    opt = torch.optim.AdamW([{"params": decay, "weight_decay": 0.1}, {"params": others, "weight_decay": 0.0}], lr=lr)
    steps = epochs * (len(train_ids) // batch)
    warm = max(1, int(steps * warmup_ratio))
    rng, history, t0, step = random.Random(0), [], time.time(), 0
    for ep in range(epochs):
        order = list(range(len(train_ids)))
        rng.shuffle(order)
        for k in range(len(order) // batch):
            for g in opt.param_groups:
                g["lr"] = lr * min(1.0, (step + 1) / warm)   # 線形に上げてから一定(公式と同じ)
            ids, labels, feats = make_batch(order[k * batch:(k + 1) * batch], rng)
            with torch.autocast("cuda", dtype=torch.bfloat16):
                media = s5.perceiver(feats)[:, None]                                 # (B, 1 枚, 64, 1024)
                logits = s5.lm(ids, media, (ids == IMG).cumsum(1))
            loss = F.cross_entropy(logits[:, :-1].float().reshape(-1, logits.shape[-1]), labels[:, 1:].reshape(-1), ignore_index=-100)
            opt.zero_grad(set_to_none=True)
            loss.backward()
            torch.nn.utils.clip_grad_norm_([p for p in s5.parameters() if p.requires_grad], 1.0)
            opt.step()
            history.append(loss.item())
            step += 1
            if step % 50 == 0:
                gates = np.mean([abs(x.attn_gate.tanh().item()) for x in s5.lm.xattn if x is not None])
                print(f"{step:4d} 回  損失(最後の 50 回の平均){np.mean(history[-50:]):.3f}  クロス注意のゲートの絶対値の平均 {gates:.3f}  ({time.time() - t0:.0f} 秒)", flush=True)
    return history


@torch.no_grad()
def caption_s5(feats):
    out = []
    ids = tok("<image>", return_tensors="pt")["input_ids"].to(device)
    for f in feats:
        with torch.autocast("cuda", dtype=torch.bfloat16):
            media = s5.perceiver(f[None].to(device))[:, None]
            g = s5.generate(ids, media=media, max_new_tokens=20)
        out.append(tok.decode(g[0], skip_special_tokens=True).strip())
    return out


caps_before = dict(zip(val_ids, caption_s5(val_feats)))
history = train()
caps_after = dict(zip(val_ids, caption_s5(val_feats)))
- 学習する重み: Perceiver・6 つのクロス注意と、埋め込みの <|endofchunk|> と <image> の 2 行です。埋め込みの勾配に、2 行だけが 1 のマスクをかけて、ほかの行は変えません(公式と同じ)。
- 入力の形式: 公式の LAION のデータと同じ「<image>キャプション<|endofchunk|>」です。損失は、キャプションと <|endofchunk|> にかけ、<image> と詰め物(<PAD>)にはかけません。
- 最適化: 公式と同じく AdamW で、weight decay 0.1 はクロス注意の行列の重みにだけかけ、勾配のノルムを 1.0 で切ります。学習率は、最初の 5% で線形に上げてから一定です(公式と同じ形)。
- 計算の精度: 重みは float32 のまま、計算を bfloat16 の自動混合精度で行います(公式の 3B の学習は float32)。
- caption_s5: 評価の 100 枚に「<image>」だけを入れて、キャプションを生成します(学習した形式に合わせたプロンプトです)。
実行結果
  50 回  損失(最後の 50 回の平均)10.548  クロス注意のゲートの絶対値の平均 0.001  (6 秒)
 100 回  損失(最後の 50 回の平均)6.688  クロス注意のゲートの絶対値の平均 0.004  (12 秒)
 150 回  損失(最後の 50 回の平均)3.225  クロス注意のゲートの絶対値の平均 0.004  (18 秒)
 200 回  損失(最後の 50 回の平均)2.869  クロス注意のゲートの絶対値の平均 0.004  (23 秒)
 250 回  損失(最後の 50 回の平均)2.806  クロス注意のゲートの絶対値の平均 0.004  (29 秒)
 300 回  損失(最後の 50 回の平均)2.670  クロス注意のゲートの絶対値の平均 0.004  (35 秒)
 350 回  損失(最後の 50 回の平均)2.711  クロス注意のゲートの絶対値の平均 0.003  (41 秒)
 400 回  損失(最後の 50 回の平均)2.706  クロス注意のゲートの絶対値の平均 0.003  (46 秒)
 450 回  損失(最後の 50 回の平均)2.668  クロス注意のゲートの絶対値の平均 0.003  (52 秒)
 500 回  損失(最後の 50 回の平均)2.664  クロス注意のゲートの絶対値の平均 0.003  (58 秒)
 550 回  損失(最後の 50 回の平均)2.627  クロス注意のゲートの絶対値の平均 0.005  (64 秒)
 600 回  損失(最後の 50 回の平均)2.596  クロス注意のゲートの絶対値の平均 0.006  (69 秒)
 650 回  損失(最後の 50 回の平均)2.528  クロス注意のゲートの絶対値の平均 0.008  (75 秒)
 700 回  損失(最後の 50 回の平均)2.523  クロス注意のゲートの絶対値の平均 0.009  (81 秒)
 750 回  損失(最後の 50 回の平均)2.508  クロス注意のゲートの絶対値の平均 0.010  (87 秒)
 800 回  損失(最後の 50 回の平均)2.455  クロス注意のゲートの絶対値の平均 0.011  (93 秒)
 850 回  損失(最後の 50 回の平均)2.432  クロス注意のゲートの絶対値の平均 0.012  (98 秒)
 900 回  損失(最後の 50 回の平均)2.378  クロス注意のゲートの絶対値の平均 0.012  (104 秒)
 950 回  損失(最後の 50 回の平均)2.394  クロス注意のゲートの絶対値の平均 0.013  (110 秒)
1000 回  損失(最後の 50 回の平均)2.358  クロス注意のゲートの絶対値の平均 0.014  (116 秒)
1050 回  損失(最後の 50 回の平均)2.399  クロス注意のゲートの絶対値の平均 0.014  (121 秒)
1100 回  損失(最後の 50 回の平均)2.293  クロス注意のゲートの絶対値の平均 0.015  (127 秒)
1150 回  損失(最後の 50 回の平均)2.316  クロス注意のゲートの絶対値の平均 0.016  (133 秒)
1200 回  損失(最後の 50 回の平均)2.296  クロス注意のゲートの絶対値の平均 0.016  (139 秒)
1250 回  損失(最後の 50 回の平均)2.270  クロス注意のゲートの絶対値の平均 0.016  (145 秒)
1300 回  損失(最後の 50 回の平均)2.270  クロス注意のゲートの絶対値の平均 0.017  (150 秒)
1350 回  損失(最後の 50 回の平均)2.278  クロス注意のゲートの絶対値の平均 0.018  (156 秒)
1400 回  損失(最後の 50 回の平均)2.275  クロス注意のゲートの絶対値の平均 0.018  (162 秒)
1450 回  損失(最後の 50 回の平均)2.276  クロス注意のゲートの絶対値の平均 0.019  (168 秒)
1500 回  損失(最後の 50 回の平均)2.238  クロス注意のゲートの絶対値の平均 0.019  (174 秒)
1550 回  損失(最後の 50 回の平均)2.193  クロス注意のゲートの絶対値の平均 0.020  (179 秒)
1600 回  損失(最後の 50 回の平均)2.214  クロス注意のゲートの絶対値の平均 0.020  (185 秒)
1650 回  損失(最後の 50 回の平均)2.184  クロス注意のゲートの絶対値の平均 0.020  (191 秒)
1700 回  損失(最後の 50 回の平均)2.231  クロス注意のゲートの絶対値の平均 0.021  (197 秒)
1750 回  損失(最後の 50 回の平均)2.212  クロス注意のゲートの絶対値の平均 0.021  (203 秒)
1800 回  損失(最後の 50 回の平均)2.213  クロス注意のゲートの絶対値の平均 0.021  (209 秒)
1850 回  損失(最後の 50 回の平均)2.183  クロス注意のゲートの絶対値の平均 0.022  (214 秒)
1900 回  損失(最後の 50 回の平均)2.191  クロス注意のゲートの絶対値の平均 0.023  (220 秒)
1950 回  損失(最後の 50 回の平均)2.139  クロス注意のゲートの絶対値の平均 0.023  (226 秒)
2000 回  損失(最後の 50 回の平均)2.136  クロス注意のゲートの絶対値の平均 0.023  (232 秒)
2050 回  損失(最後の 50 回の平均)2.135  クロス注意のゲートの絶対値の平均 0.023  (237 秒)
2100 回  損失(最後の 50 回の平均)2.145  クロス注意のゲートの絶対値の平均 0.024  (243 秒)
2150 回  損失(最後の 50 回の平均)2.148  クロス注意のゲートの絶対値の平均 0.024  (249 秒)
2200 回  損失(最後の 50 回の平均)2.111  クロス注意のゲートの絶対値の平均 0.024  (255 秒)
2250 回  損失(最後の 50 回の平均)2.098  クロス注意のゲートの絶対値の平均 0.025  (261 秒)
2300 回  損失(最後の 50 回の平均)2.140  クロス注意のゲートの絶対値の平均 0.024  (266 秒)
2350 回  損失(最後の 50 回の平均)2.139  クロス注意のゲートの絶対値の平均 0.025  (272 秒)
2400 回  損失(最後の 50 回の平均)2.096  クロス注意のゲートの絶対値の平均 0.025  (278 秒)
2450 回  損失(最後の 50 回の平均)2.131  クロス注意のゲートの絶対値の平均 0.025  (284 秒)
2500 回  損失(最後の 50 回の平均)2.122  クロス注意のゲートの絶対値の平均 0.026  (290 秒)
2550 回  損失(最後の 50 回の平均)2.133  クロス注意のゲートの絶対値の平均 0.026  (295 秒)
2600 回  損失(最後の 50 回の平均)2.114  クロス注意のゲートの絶対値の平均 0.026  (301 秒)
2650 回  損失(最後の 50 回の平均)2.090  クロス注意のゲートの絶対値の平均 0.026  (307 秒)
2700 回  損失(最後の 50 回の平均)2.087  クロス注意のゲートの絶対値の平均 0.027  (313 秒)
2750 回  損失(最後の 50 回の平均)2.113  クロス注意のゲートの絶対値の平均 0.027  (319 秒)
2800 回  損失(最後の 50 回の平均)2.091  クロス注意のゲートの絶対値の平均 0.027  (324 秒)
評価する
print(f"学習の前(ゲート 0:MPT-1B だけ)  CIDEr {cider(caps_before) * 100:5.1f}")
print(f"縮小版を学習(本記事)            CIDEr {cider(caps_after) * 100:5.1f}")
print(f"公式の OpenFlamingo-3B(0-shot)   CIDEr {cider(results[0]) * 100:5.1f}")
for i in val_ids[:3]:
    print(f"\n画像 {i}\n  正解の例   : {val_caps[i][0]}\n  学習の前   : {caps_before[i]}\n  本記事     : {caps_after[i]}\n  公式 0-shot: {results[0][i]}")

fig, ax = plt.subplots(figsize=(6, 3.6))
ax.plot(np.convolve(history, np.ones(10) / 10, mode="valid"))
ax.set_xlabel("学習の回数(1 回 32 枚)")
ax.set_ylabel("損失(10 回の移動平均)")
ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()
実行結果
学習の前(ゲート 0:MPT-1B だけ)  CIDEr   1.2
縮小版を学習(本記事)            CIDEr  94.6
公式の OpenFlamingo-3B(0-shot)   CIDEr  77.4

画像 139
  正解の例   : A woman stands in the dining area at the table.
  学習の前   : )[
The first thing to note is that the two-dimensional
representation of the two-dimensional
  本記事     : A woman in a kitchen with a table and chairs.
  公式 0-shot: A kitchen in a house with a view of the garden.

画像 285
  正解の例   : A big burly grizzly bear is show with grass in the background.
  学習の前   : )[
The first thing to note is that the two-dimensional
representation of the two-dimensional
  本記事     : A bear is sitting in the grass with a stick.
  公式 0-shot: A bear is shown with a large head.

画像 632
  正解の例   : Bedroom scene with a bookcase, blue comforter and window.
  学習の前   : )[
The first thing to note is that the two-dimensional
representation of the two-dimensional
  本記事     : A bed with a white comforter and a lamp on it.
  公式 0-shot: A bedroom with a view.
3つのモデルの CIDEr を並べると、次のようになります。
(図は、diagram-designで作成)
- 学習の前: ゲートが 0 なので、モデルは MPT-1B そのもので、「)[ The first thing to note is…」のように画像と関係のない文を生成します。CIDEr は 1.2 です。
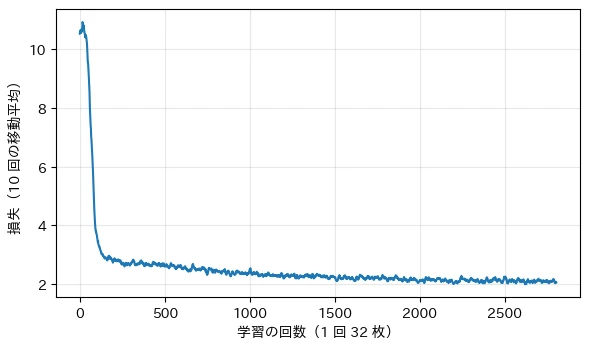
- 損失: 最初の 150 回ほどで 10 前後から 3 前後まで急に下がります。初めのうちは、<|endofchunk|> と <image> の埋め込みが MPT-1B の学習していない行のままで、文の終わりを当てられないことが損失を大きくしています。その後はゆっくり下がり、最後は 2.1 前後です。
- ゲートの開き方: クロス注意のゲートの絶対値の平均は、0.001 から 0.027 まで少しずつ大きくなりました。公式の学習済みのゲート(平均 0.15)よりずっと小さく、学習率 1e-4 で約 2,800 回の更新では、まだ画像を混ぜ始めた段階です。
- 学習の後: 「台所のテーブルと椅子のそばの女性」「草の上に座るクマ」のように、画像に合ったキャプションを書くようになり、CIDEr は 94.6 になりました。公式の OpenFlamingo-3B の 0-shot(77.4)を上回りますが、本記事のモデルは COCO のキャプションで学習していて、評価も COCO なので、書き方が正解に近いことが大きく効いています。公式のモデルは COCO で学習しておらず、さまざまな画像とテキストを扱えます。本記事の縮小版は、画像を 1 枚ずつしか学習していないので、お手本を並べた few-shot はできません。
まとめ
本記事では、Flamingo の公開版である OpenFlamingo-3B を、CLIP ViT-L/14・Perceiver Resampler・ゲート付きクロス注意・MPT-1B の部品に分けてスクラッチで実装し、次のことを確かめました。
- 画像は「クロス注意」で参照する: 画像は CLIP の 256 個の特徴を Perceiver Resampler で 64 個にまとめ、言語モデルの各層の前のクロス注意から参照します。テキストの列には <image> が 1 つ入るだけです。
- 公式の実装と同じ出力: 公式の重みを読み込んだスクラッチ実装は、CLIP の特徴が完全に一致し、logit の差は float32 の丸めの範囲(最大 1.6e-04)で、3 つの入力で生成したトークン列は公式と同じでした。公式の実装は、当時の版の transformers と open_clip を入れた別の環境で動かす必要がありました。
- お手本を増やすほど良くなる: COCO のキャプションの CIDEr は、0-shot 77.4、2-shot 80.1、4-shot 83.6、8-shot 94.5 と、お手本を並べるだけで上がりました。
- マスクとゲートが欠かせない: 前にある画像をすべて見るマスクにすると CIDEr は 13.5、ゲートを 0 にすると 3.1 まで下がりました。各トークンが直前の画像だけを見ることと、学習したゲートで画像の情報を混ぜることが、出力を支えています。
- ゲートを 0 から学習する: 縮小版(クロス注意を 4 層ごと)では、学習前の出力が MPT-1B と完全に同じで、COCO の 3 万枚で約 6 分学習すると、画像に合ったキャプションを書くようになりました(CIDEr 1.2 → 94.6)。
Flamingo は、学習済みの画像エンコーダと言語モデルを固定したまま、クロス注意で画像を読み込ませるという形で、画像とテキストを交互に並べた入力と few-shot を実現しました。画像を入力の列に並べる LLaVA とは違う設計で、両者を比べると、画像と言語のモデルの作り方の選択肢が見えてきます。
ライセンスに関する注記
OpenFlamingo の公式の実装(mlfoundations/open_flamingo)のコードは MIT ライセンスです。学習済みの重み openflamingo/OpenFlamingo-3B-vitl-mpt1b のモデルカードには、ライセンスの記載がありません。言語モデルの MPT-1B(anas-awadalla/mpt-1b-redpajama-200b)は Apache-2.0、CLIP の公式の実装(openai/CLIP)は MIT です。OpenFlamingo の重みは、LAION-2B と Multimodal C4 という Web から集めたデータで学習されていて、モデルカードは、安全性のための調整をしていないので実際のサービスに使うときは注意するよう書いています。本記事では、研究と学習の目的で使っています。
COCO の注釈は CC BY 4.0 です。COCO の画像は Flickr の画像で、それぞれの画像の著作権は撮影者にあり、Flickr の利用規約に従います。本記事では、COCO の画像を記事に載せていません。本記事の説明は一般的な解釈で、法的な助言ではありません。 実際に利用する場合は、ライセンスの条文を確認してください。
出典・ライセンスについて
- OpenFlamingo の実装: 公式の mlfoundations/open_flamingo(MIT)と、MPT-1B のモデルのコード(Apache-2.0)の構造を参考に、スクラッチで実装しています。学習の設定は、公式の open_flamingo/train/train.py と OpenFlamingo の論文に合わせています。
- 学習済みのモデル: openflamingo/OpenFlamingo-3B-vitl-mpt1b、anas-awadalla/mpt-1b-redpajama-200b(Apache-2.0)、openai/clip-vit-large-patch14 を使用しています。
- データセット: COCO の val2017・train2017・test-stuff2017 の画像とキャプション(注釈は CC BY 4.0)。
- 推論に利用した画像: 猫の画像は、Gemini で作成したものです。
@inproceedings{alayrac2022flamingo,
  title = {Flamingo: a Visual Language Model for Few-Shot Learning},
  author = {Alayrac, Jean-Baptiste and Donahue, Jeff and Luc, Pauline and Miech, Antoine and others},
  booktitle = {NeurIPS},
  year = {2022}
}
@article{awadalla2023openflamingo,
  title = {OpenFlamingo: An Open-Source Framework for Training Large Autoregressive Vision-Language Models},
  author = {Awadalla, Anas and Gao, Irena and Gardner, Josh and Hessel, Jack and others},
  journal = {arXiv preprint arXiv:2308.01390},
  year = {2023}
}
参考文献
- J.-B. Alayrac et al. (2022). Flamingo: a Visual Language Model for Few-Shot Learning. NeurIPS 2022.
- A. Awadalla et al. (2023). OpenFlamingo: An Open-Source Framework for Training Large Autoregressive Vision-Language Models. arXiv:2308.01390.
- ML Foundations. mlfoundations/open_flamingo. GitHub.
- OpenFlamingo. openflamingo/OpenFlamingo-3B-vitl-mpt1b. Hugging Face.
- A. Awadalla. anas-awadalla/mpt-1b-redpajama-200b. Hugging Face.
- OpenAI. openai/clip-vit-large-patch14. Hugging Face.
- T.-Y. Lin et al. (2014). Microsoft COCO: Common Objects in Context. ECCV 2014.
本記事の文章・構成の一部に生成AIを使用しています。