Function Calling(関数呼び出し)とは?
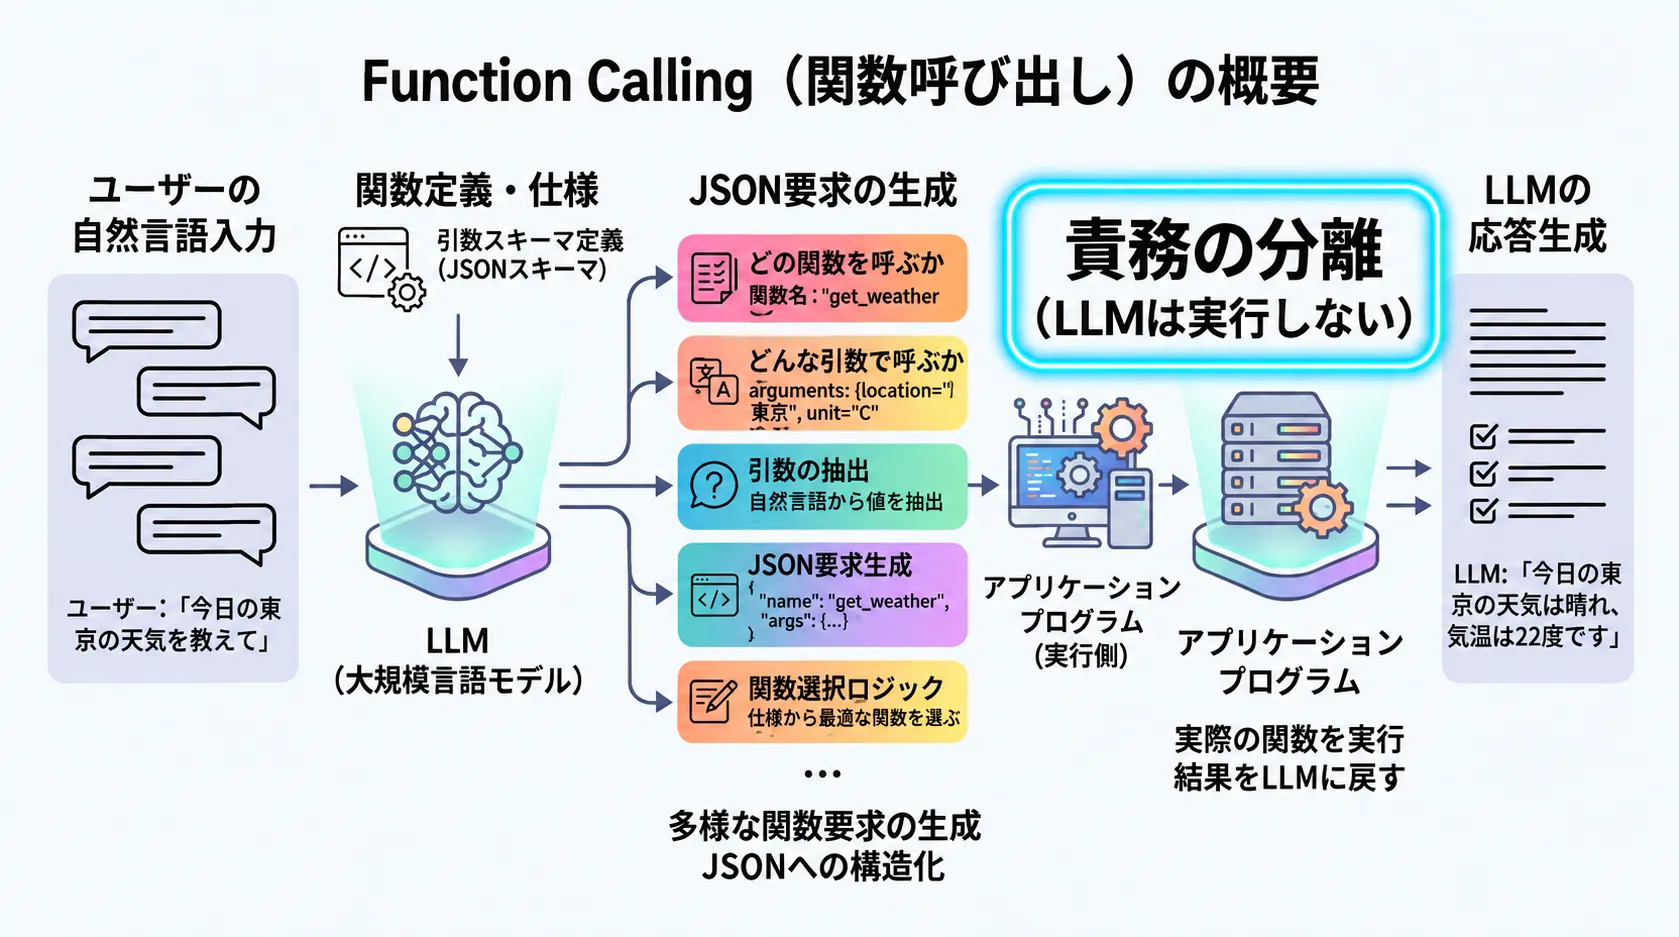
(画像は、Geminiで作成)
LLM に関数の一覧と仕様(JSON Schema)を与え、ツール名と引数を構造化データとして生成させる Function Calling の仕組みと、存在しないツールを呼ぶハルシネーションなどの誤りの分類を理解すること。JSON Schema を手で書くスクラッチ実装と SDK の機能で関数呼び出しを動かし、プロバイダごとの形式の分断やツール数の増加といった限界が、MCP の登場につながったことを説明できるようになること。
Function Calling(関数呼び出し)の概要
Function Calling(関数呼び出し)とは、LLM(大規模言語モデル)に対して「呼び出し可能な関数の一覧とその仕様」を与えておき、ユーザーの自然言語入力に応じて どの関数を・どんな引数で呼ぶべきか を構造化データ(多くはJSON)として生成させる仕組みです。生成された関数呼び出しはアプリケーション側が実際に実行し、その結果を再びモデルへ戻すことで、モデルは自身の重みに含まれない情報や、自身では正確に処理できない計算を扱えるようになります。
重要なのは、LLM自身は関数を実行しないという点です。モデルが出力するのはあくまで「この関数をこの引数で呼んでほしい」という要求であり、実行するのは呼び出し側のプログラムです。この責務の分離がFunction Callingの設計の中心にあります。
本記事は、Function Callingそのものの原理と実装に絞って解説します。まず基本構造と定式化を整理し、外部ライブラリに頼らないスクラッチ実装で内部の挙動を確認したうえで、各社SDKを用いた実践的な実装へ進みます。
記事の後半では、Function Callingを実運用に載せたときに現れる構造的な限界にも触れます。その限界に対する回答として設計されたのがModel Context Protocol(MCP)であり、そちらは別記事で扱っています。
呼び方の変遷:Function Calling と Tool Calling
この技術には複数の呼称があり、実装を読むときに混乱の原因になります。整理しておきます。
- Function Calling:2023年6月にOpenAIがChat Completions APIに導入した際の呼称。リクエストのパラメータ名も functions でした。
- Tool Calling / Tool Use:その後、関数以外の組み込み機能(コード実行、検索など)も同じ枠組みで扱うようになり、パラメータ名は tools へ移行しました。Anthropicは当初から「Tool Use」と呼んでいます。Geminiでは関数定義を function_declarations として Tool オブジェクトにまとめる形式です。
本記事では、技術としての総称を「Function Calling」、モデルに提示される個々の呼び出し可能な機能を「ツール(tool)」と呼びます。研究分野としては、この領域は Tool Learning と呼ばれています。
なぜLLM単体では足りないのか
LLMの能力は、事前学習時に重みへ取り込まれた固定的・パラメトリックな知識の範囲に制約されます。この制約は、大きく3つの形で現れます。
知識の固定性
学習済みの知識は更新されず、新しい情報を取得する手段を持ちません。その結果、表面上はもっともらしいが事実として誤っている、あるいは古い内容を生成しがちです。いわゆるハルシネーションの一因がこれにあたります。
記号処理の不安定さ
加減算や比較的単純な乗算であればある程度こなせますが、除算、べき乗、対数、三角関数といった複雑な合成関数になると精度が大きく落ちます。トークン列の確率的な生成で数値計算を代替していることの限界です。
外部状態へ作用できないこと
LLMは本質的に言語処理器であり、会議室を予約する、フライトを押さえるといった外部への操作を単独で実行する能力を持ちません。テキストを出力する以上のことはできません。
Function Callingは、この3つをいずれも「外部の関数に委譲する」という一点で解決します。検索エンジンやデータベースを呼べば知識が更新でき、計算機やPythonインタプリタを呼べば記号処理が正確になり、業務APIを呼べば外部状態への作用が可能になります。
副次的な効果として、解釈可能性の向上も挙げられます。どのツールをどの引数で呼び、何が返ってきたかが逐一記録されるため、モデルの判断過程が可視化されます。誤った出力が出た場合でも、ユーザーはどの段階で誤りが混入したかを追跡できます。また、ユーザーの言い回しが変わってもツールの入出力は一定であるため、プロンプトの揺らぎに対する頑健性も上がります。
Function Callingの基本構造
4つのステップを、後で実装する get_weather の例で図にすると、次のようになります。
(図は、diagram-designで作成)
1回の関数呼び出しを構成する4つのステップ
もっとも単純な単発の関数呼び出しは、以下の4ステップで完結します。
- プロンプトと関数定義の提示
ユーザー(正確にはアプリケーション開発者)が、プロンプトと併せて関数の定義をモデルに渡します。定義には関数名、関数の説明、各引数の説明が自然言語とスキーマの形で含まれます。 - 引数の生成
モデルは、提示された関数のうち適切なものを選び、その引数を生成します。ここで生成されるのは構造化されたテキスト(JSON)であり、自然言語の応答ではありません。 - 実行と結果の返却
生成された引数が実際の関数に渡されて実行され、その戻り値がモデルへ返されます。この実行を担うのはアプリケーション側のコードです。 - 最終応答の生成
モデルは関数の出力を解析し、元のユーザープロンプトに対する最終的な回答を組み立てます。
注意すべきは、ステップ2で生成されるのが「引数」であるという点です。モデルの出力のうちユーザーの目に触れるのはステップ4の最終応答ですが、実質的な意思決定と生成はステップ2で起きています。この非対称性は、後述するセキュリティ上の論点にも直結します。
Tool Learningの4段階
研究分野としてのTool Learningでは、より一般的なワークフローとして4つの段階に分解して整理されます。上の4ステップよりも粒度が細かく、複数ツール・複数ステップのタスクまで含めた枠組みです。
第1段階:タスクプランニング(Task Planning)
ユーザーの要求を解析し、意図を理解した上で、解決可能なサブ問題へ分解します。タスク間に依存関係がある場合は、その依存と実行順序も決定します。たとえば「金5オンスとAMZN株100万株の合計額を人民元で知りたい」という要求は、「金の現在価格(USD)」「AMZNの現在株価(USD)」「USD/CNYの為替レート」という3つのサブ問題へ分解されます。
第2段階:ツール選択(Tool Selection)
各サブ問題に対して適切なツールを選びます。ツール数が少なければモデルに全ツールの説明を提示して選ばせられますが(LLMベースの選択)、数が多い場合はまず検索器(retriever)で上位K件に絞り込みます(検索ベースの選択)。この2つは排他ではなく、実運用では検索で絞ってからモデルが最終決定する二段構えが一般的です。
第3段階:ツール呼び出し(Tool Calling)
選ばれたツールの仕様に従って、ユーザーの要求から必要な引数を抽出します。ここでモデルに要求されるのは、引数の内容の正しさだけではありません。指定された出力フォーマットへ厳密に従い、余計な文を生成しないことも同時に求められます。必須引数がすべて含まれているか、値が許容範囲と型に収まっているかが、そのまま呼び出しの成否を決めます。
第4段階:応答生成(Response Generation)
ツールの出力を受け取り、ユーザーへの最終応答を構成します。手法は2つに分かれます。ひとつは直接挿入法で、モデルに It's Weather() のような形で応答を生成させ、後から実際の戻り値に置換します。実装は単純ですが、ツール出力が予測不能な場合にユーザー体験を損ないます。もうひとつは情報統合法で、ツールの出力をコンテキストへ入力として戻し、モデルにそれを踏まえた応答を書かせます。こちらが主流ですが、出力が長すぎてコンテキスト長に収まらない問題が生じます。
4つの段階を並べると、次のようになります。
(図は、diagram-designで作成)
一段階解決と反復解決
ワークフローの回し方には2つのパラダイムがあります。
一段階タスク解決(One-step Task Solving)
ユーザーの要求を受けた時点で必要なサブタスクをすべて計画し、選んだツールの結果に基づいて直接応答を生成します。途中でエラーが起きる可能性や、ツールの出力に応じて計画を変える可能性を考慮しません。初期のTool Learning研究はこの形が主流でした。
反復タスク解決(Iterative Task Solving)
最初に完全な計画を確定させず、ツールとの対話を繰り返しながらサブタスクを段階的に調整します。ツールからのフィードバックに応じて計画を継続的に修正するため、問題解決能力が上がります。現在のエージェント的なワークフローはこちらに該当します。
一段階から反復へのこの移行は、Tool Learningにおける明確な前進として位置づけられています。
2つの回し方を図にすると、次のようになります。
(図は、diagram-designで作成)
ツール選択とハルシネーションの定式化
Function Callingの精度を論じるには、「どのツールを選ぶか」と「その呼び出しが正しいか」を分けて定量化する必要があります。本節ではこの2つを定式化します。
なぜツール検索が必要になるのか
利用可能なツールの集合を 、各ツールのメタデータ(名前・説明・引数スキーマ)を文字列化したものを とします。すべてのツールをモデルに提示する場合、入力コンテキストのトークン長 は次のように増加します。
ここで、 はシステムプロンプトや基本命令などの固定部分のトークン長、 はユーザーからの入力(クエリ)を表し、 はそのトークン長です。
第2項が に比例して線形に増えることが本質的な制約です。実世界のシステムは膨大な数のツールを抱えるため、コンテキスト長の上限とレイテンシの双方の観点から、すべてのツール説明をモデルの入力に含めることは現実的ではありません。
そこで、クエリ に対して関連度の高い上位 件だけを先に絞り込みます。
ここで と はそれぞれクエリとツール説明の埋め込み関数、 は類似度関数です。この検索手法は2系統に分かれます。
- 語句ベース(疎検索):TF-IDFやBM25のように、クエリと文書を語を軸とした高次元の疎ベクトルで表現し、語の完全一致で対応づけます。
- 意味ベース(密検索):Sentence-BERTなどのニューラルネットワークでクエリとツール説明の意味的関係を学習し、コサイン類似度などで近さを測ります。
ツールを絞り込む流れを図にすると、次のようになります。
(図は、diagram-designで作成)
検索品質の評価指標
絞り込みの品質は、次の3つの指標で測られます。 をクエリ集合、 をクエリ に対する正解ツールの集合、 をモデルが選んだ上位 件とします。
Recall@K は、正解ツールのうち上位 件に入った割合です。
NDCG@K は、正解が含まれる割合だけでなく、リスト内での順位も考慮します。 は 番目に選ばれたツールの段階的関連度スコア、 は理想的な(正解が最上位から並んだ)ランキングにおけるDCGの最大値(正規化定数)です。
COMP@K は、上位 件が正解集合を完全に包含しているかどうかを測ります。 を正解ツール集合、 を検索結果、 を指示関数とします。
Recall@Kと違い、COMP@Kは「3つ必要なツールのうち2つしか取れなかった」ケースを0として扱います。複数ツールを連携させるタスクでは、ひとつでも欠ければタスク全体が失敗するため、この完全性の観点が重要になります。
ハルシネーションと誤りの区別
ツールを選び引数を生成した結果が「正しいか」を判定するには、実行して確かめる方法がまず思い浮かびます。しかしAPI呼び出しの場合、これはうまく機能しません。たとえば画像分類というタスクひとつをとっても、それを実現するモデルは40種類以上あり、DenseNetという単一のファミリーに絞っても4通りの構成が存在します。正解が複数ある以上、単体テストで機能的等価性を判定することは困難です。
そこで用いられるのが AST部分木マッチング(AST sub-tree matching) です。生成されたコードをASTへパースし、関心のあるAPI呼び出し(たとえば torch.hub.load)を根とする部分木を取り出して、利用可能なAPIのデータベースと照合します。引数ごとに照合対象を事前に定義しておくことで、Pythonのデフォルト引数のような省略可能な要素を除外した比較ができます。
この枠組みを使うと、ハルシネーションを明確に定義できます。生成された呼び出し について、
ここで各記号は以下を意味します。
- :カッコ内の条件を満たす場合に 、満たさない場合に となる指示関数
- :「〜が存在しない」ことを示す記号
- :左辺が右辺の「部分木(サブツリー)として含まれる」ことを示す記号
- :データベースに登録されている『実在する』ツールのツリー
すなわち、データベース内のどのAPIの部分木にもならない呼び出し=存在しないツールを丸ごと想像して呼び出した状態をハルシネーションと定義します。これは「実在するAPIを誤った形で呼び出した」状態とは区別され、後者は単に 誤り(error) として扱われます。
この区別は運用上とても重要です。誤りは引数の検証やリトライで回復できる可能性がありますが、ハルシネーションは存在しないエンドポイントを叩く行為であり、回復手段がありません。
実際、初期のモデルではこのハルシネーションが深刻でした。APIBenchというベンチマークで測定された結果では、検索器なし(ゼロショット)のTorchHubにおいてGPT-4のハルシネーション率は36.55%、HuggingFaceでは37.16%に達しています。典型的な失敗は、AutoModel.from_pretrained(dir_name) に実在しないGitHubリポジトリ名を入れる、あるいは your_model_name のようなプレースホルダをユーザーのローカルパスと想定してしまう、といったものでした。
この問題に対するひとつの回答が、API呼び出しに特化したファインチューニングです。LLaMA-7Bをベースに1,645件のAPI(TorchHub 94件、TensorFlow Hub v2 626件、HuggingFace 925件)から生成した16,450件の「指示とAPIのペア」で学習したGorillaは、ゼロショットのTorchHubで精度59.13%・ハルシネーション率6.98%を記録し、同条件のGPT-4(38.70% / 36.55%)を上回りました。
さらに興味深いのは 検索器を意識した学習(retriever-aware training) です。学習データのユーザープロンプト末尾に Use this API documentation for reference: <retrieved_API_doc_JSON> という形で取得済みのAPIドキュメントを付加しておくことで、モデルは「質問の後半を読んで前半に答える」ことを学習します。これにより、推論時にAPIドキュメントが変更されても追従できるようになります。モデルの再学習サイクルよりAPIの更新頻度のほうが速いという現実的な問題への対処です。
ただし、検索の追加が常に有利とは限らない点には注意が必要です。ファインチューニング時に検索器を使わなかったモデルに対し、推論時だけBM25やGPT-Indexを付けると精度が大きく下がる(TorchHubで21.50%、HuggingFaceで47.57%の低下)という報告もあります。最適でない検索器は、モデルを誤った方向へ誘導します。
スクラッチ実装:JSON Schemaを手で書いてFunction Callingを動かす
Function Callingの実体を理解するために、フレームワークもAPIサービスも使わず、最小構成の実装をゼロから組み立てます。
ここで確認したいのは次の3点です。
- ツール定義(JSON Schema)はアプリケーション側が手で書き、プロンプトに埋め込んでいるだけであること
- ツール選択は、各ツール名に対する生成確率の比較として実装できること
- 生成された引数は、実行前にスキーマとの適合性を検証する必要があること
さらに、この実装ではひとつ仕掛けを入れます。まったく同じ2つのツールについて、OpenAI形式とGemini形式の定義を別々に手書きします。同じ機能なのに記述が二重化することを、コードの上で確認するためです。
実装の全体像
- ツールの実体:add_numbers と get_weather という2つのPython関数。サーバーもプロセス間通信も介在せず、呼び出し側と同一プロセス内にただの関数として置かれます。
- ツール定義:上記2関数のJSON Schemaを、OpenAI形式とGemini形式でそれぞれ手書きします。ただし、実際に推論へ渡すのはOpenAI形式のみです。Gemini形式の定義は同じ内容を別のフォーマットで書き起こした比較用であり、実行経路には関与しません。
- 推論モデル:Hugging Faceの transformers 経由で Qwen/Qwen2.5-0.5B-Instruct をロードします。
- オーケストレーション:スキーマからシステムプロンプトを合成 → ツール選択 → 引数生成 → スキーマ検証 → 実行、という流れをすべて自前で書きます。
実行可能なPythonコード
以下のコードは、必要なライブラリがインストールされた環境であればそのまま実行可能な完全なスクリプトです。
pip install transformers torch accelerate
import json
import re
from typing import Any, Callable

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_ID = "Qwen/Qwen2.5-0.5B-Instruct"

# ==========================================
# 1. ツールの実体(ただのPython関数)
# ==========================================
# サーバーもプロセス間通信も存在しない。呼び出し側と同じプロセスに置かれた
# ローカル関数を、後段でスキーマ経由でLLMに「見せる」だけである。


def add_numbers(a: int, b: int) -> int:
    return a + b


def get_weather(location: str) -> str:
    return f"{location}の天気は晴れ、気温は22度です。"


TOOL_IMPL: dict[str, Callable[..., Any]] = {
    "add_numbers": add_numbers,
    "get_weather": get_weather,
}

# ==========================================
# 2. ツール定義:OpenAI形式(手書き)
# ==========================================
# 関数の実装とは完全に独立した、人間が手で維持するメタデータ。
# 実装を変更してもこちらは自動では追従しない点に注意。

TOOLS_OPENAI = [
    {
        "type": "function",
        "function": {
            "name": "add_numbers",
            "description": "2つの整数を加算して合計を返します。",
            "parameters": {
                "type": "object",
                "properties": {
                    "a": {"type": "integer", "description": "1つ目の整数"},
                    "b": {"type": "integer", "description": "2つ目の整数"},
                },
                "required": ["a", "b"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "指定された都市の現在の天気を取得します。",
            "parameters": {
                "type": "object",
                "properties": {
                    "location": {
                        "type": "string",
                        "description": "都市名(例: Tokyo)",
                    },
                },
                "required": ["location"],
            },
        },
    },
]

# ==========================================
# 3. ツール定義:Gemini形式(手書き・内容は上と同一)
# ==========================================
# 同じ2つの関数を、別のフォーマットでもう一度記述している。
# ネストの深さもキー名も異なるため、機械的な変換も自明ではない。
# なお、この定義は本スクリプトの推論では使用しない。定義の二重化を
# 目に見える形で示すためだけに置いている。

TOOLS_GEMINI = [
    {
        "function_declarations": [
            {
                "name": "add_numbers",
                "description": "2つの整数を加算して合計を返します。",
                "parameters": {
                    "type": "OBJECT",
                    "properties": {
                        "a": {"type": "INTEGER", "description": "1つ目の整数"},
                        "b": {"type": "INTEGER", "description": "2つ目の整数"},
                    },
                    "required": ["a", "b"],
                },
            },
            {
                "name": "get_weather",
                "description": "指定された都市の現在の天気を取得します。",
                "parameters": {
                    "type": "OBJECT",
                    "properties": {
                        "location": {
                            "type": "STRING",
                            "description": "都市名(例: Tokyo)",
                        },
                    },
                    "required": ["location"],
                },
            },
        ]
    }
]

# ==========================================
# 4. モデルのロード
# ==========================================
print(f"Loading model {MODEL_ID}...")
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID, torch_dtype=torch.float32, device_map="auto"
)
model.eval()


# ==========================================
# 5. スキーマからシステムプロンプトを合成
# ==========================================
def build_system_prompt(tools: list[dict]) -> str:
    lines = [
        "あなたはツールを呼び出すアシスタントです。",
        "以下のツールが利用できます。",
        "",
    ]
    for tool in tools:
        fn = tool["function"]
        params = fn["parameters"]
        arg_desc = ", ".join(
            f"{name}({spec['type']}): {spec['description']}"
            for name, spec in params["properties"].items()
        )
        required = ", ".join(params.get("required", []))
        lines.append(f"- {fn['name']}: {fn['description']}")
        lines.append(f"  引数: {arg_desc}")
        lines.append(f"  必須: {required}")
    lines += [
        "",
        "必ず次のJSON形式のみを出力してください。説明文は書かないこと。",
        '{"name": "ツール名", "arguments": {"引数名": 値}}',
    ]
    return "\n".join(lines)


def build_base_prompt(tools: list[dict], user_input: str) -> str:
    messages = [
        {"role": "system", "content": build_system_prompt(tools)},
        {"role": "user", "content": user_input},
    ]
    return tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )


# ==========================================
# 6. ツール選択:各ツール名の対数尤度を直接比較
# ==========================================
@torch.no_grad()
def continuation_logprob(prefix: str, continuation: str) -> float:
    """prefix に続けて continuation が生成される対数尤度の合計を返す。"""
    prefix_ids = tokenizer(prefix, return_tensors="pt").input_ids
    full_ids = tokenizer(prefix + continuation, return_tensors="pt").input_ids
    full_ids = full_ids.to(model.device)

    n_prefix = prefix_ids.shape[1]
    logits = model(full_ids).logits
    logprobs = torch.log_softmax(logits[:, :-1, :], dim=-1)
    targets = full_ids[:, 1:]
    token_lp = logprobs.gather(2, targets.unsqueeze(-1)).squeeze(-1)
    return token_lp[0, n_prefix - 1 :].sum().item()


def select_tool(base_prompt: str, tools: list[dict]) -> tuple[str, dict]:
    # JSONの途中まで確定させた状態を作り、その続きとして
    # 各ツール名がどれだけ生成されやすいかを比較する
    scoring_prefix = base_prompt + '{"name": "'
    scores = {
        tool["function"]["name"]: continuation_logprob(
            scoring_prefix, tool["function"]["name"] + '"'
        )
        for tool in tools
    }
    best = max(scores, key=scores.get)
    return best, scores


# ==========================================
# 7. 引数生成とJSONの抽出
# ==========================================
def extract_json_object(text: str) -> dict:
    """最初に出現する対応の取れた {...} を抜き出してパースする。"""
    start = text.find("{")
    if start == -1:
        raise ValueError("JSONオブジェクトが見つかりません")
    depth = 0
    for i, ch in enumerate(text[start:], start=start):
        if ch == "{":
            depth += 1
        elif ch == "}":
            depth -= 1
            if depth == 0:
                return json.loads(text[start : i + 1])
    raise ValueError("JSONオブジェクトが閉じていません")


@torch.no_grad()
def generate_arguments(base_prompt: str, tool_name: str) -> dict:
    # ツール名までを確定済みのプレフィックスとして与え、引数部分のみ生成させる
    arg_prefix = base_prompt + '{"name": "' + tool_name + '", "arguments": '
    inputs = tokenizer(arg_prefix, return_tensors="pt").to(model.device)
    outputs = model.generate(
        **inputs,
        max_new_tokens=96,
        do_sample=False,
        pad_token_id=tokenizer.eos_token_id,
    )
    generated = tokenizer.decode(
        outputs[0][inputs.input_ids.shape[1] :], skip_special_tokens=True
    )
    return extract_json_object(generated)


# ==========================================
# 8. スキーマ検証(実行前の最後の防波堤)
# ==========================================
TYPE_MAP = {
    "string": str,
    "integer": int,
    "number": (int, float),
    "boolean": bool,
    "array": list,
    "object": dict,
}


def validate_arguments(tool_schema: dict, args: dict) -> None:
    params = tool_schema["function"]["parameters"]
    properties = params.get("properties", {})
    required = params.get("required", [])

    missing = [key for key in required if key not in args]
    if missing:
        raise ValueError(f"必須の引数が不足しています: {missing}")

    unknown = [key for key in args if key not in properties]
    if unknown:
        raise ValueError(f"未定義の引数が含まれています: {unknown}")

    for key, value in args.items():
        expected = TYPE_MAP.get(properties[key].get("type"))
        if expected and not isinstance(value, expected):
            raise TypeError(
                f"引数 '{key}' の型が不正です: "
                f"{properties[key]['type']} を期待しましたが {type(value).__name__} でした"
            )


# ==========================================
# 9. オーケストレーション
# ==========================================
def run_function_calling(user_input: str) -> None:
    print(f"\n--- ユーザー入力: '{user_input}' ---")
    base_prompt = build_base_prompt(TOOLS_OPENAI, user_input)

    tool_name, scores = select_tool(base_prompt, TOOLS_OPENAI)
    score_text = ", ".join(
        f"{name}={score:.3f}"
        for name, score in sorted(scores.items(), key=lambda kv: -kv[1])
    )
    print(f"[Select] ツール選択スコア(対数尤度): {score_text}")

    try:
        args = generate_arguments(base_prompt, tool_name)
    except ValueError as exc:
        print(f"[Parse] 出力のパースに失敗しました: {exc}")
        return
    print(f'[Generate] 生の出力: {{"name": "{tool_name}", "arguments": {json.dumps(args, ensure_ascii=False)}}}')

    schema = next(t for t in TOOLS_OPENAI if t["function"]["name"] == tool_name)
    try:
        validate_arguments(schema, args)
    except (ValueError, TypeError) as exc:
        print(f"[Validate] スキーマ違反: {exc}")
        print("[Abort] 呼び出しを中止しました")
        return
    required = schema["function"]["parameters"].get("required", [])
    print(f"[Validate] スキーマ適合: OK (required={required})")

    arg_text = ", ".join(f"{k}={v!r}" for k, v in args.items())
    print(f"[Execute] {tool_name}({arg_text})")
    result = TOOL_IMPL[tool_name](**args)
    print(f"[Result] {result}")


if __name__ == "__main__":
    print(f"[Setup] ローカル定義のツール: {', '.join(TOOL_IMPL)}")
    print(
        f"[Setup] OpenAI形式の定義: {len(TOOLS_OPENAI)}件 / "
        f"Gemini形式の定義: {len(TOOLS_GEMINI[0]['function_declarations'])}件"
        "(同内容・本実装では未使用)"
    )
    run_function_calling("Tokyoの天気を教えてください。")
    run_function_calling("1250と3845を足すといくつになりますか?")
    run_function_calling("東京の気温を摂氏で教えてください。")
ここでは、transformers のみを用いたFunction Callingのスクラッチ実装について、各コンポーネントの役割と背後にある意図を解説します。Qwen/Qwen2.5-0.5B-Instruct を float32 で読み込むのは、GPU がなくても CPU で動かせる大きさと精度にするためです。
ツールとその定義:
- 実装とメタデータの分離: add_numbers と get_weather はただのローカル関数であり、サーバーもプロトコルも介在しません。LLMがこれらの存在を知る唯一の経路は、手書きされたTOOLS_OPENAIというJSONスキーマです。
- 定義の二重化: TOOLS_GEMINIはTOOLS_OPENAIとまったく同じ2つの関数を表していますが、ネスト構造(function_declarationsでまとめる形)も型の表記(integerとINTEGER)も異なります。実装1つに対して定義が2つ存在し、片方だけ更新されればそこで齟齬が生まれます。なお、以降の処理で参照されるのはTOOLS_OPENAIだけです。TOOLS_GEMINIは比較のために並べた展示物であり、推論には使いません。
推論とツール選択:
- プロンプトへのスキーマ埋め込み: build_system_prompt()が、スキーマを人間可読なテキストへ展開してシステムプロンプトに差し込みます。ツール数が増えればこの文字列がそのまま伸び、コンテキストを圧迫します。
- ツール選択スコアの計算: continuation_logprob()で、{"name": " というJSON途中の状態から各ツール名が続く対数尤度を直接計算し、最大のものを選びます。生成に任せるのではなく候補を明示的にスコアリングすることで、選択の根拠が数値として観測できます。
引数生成と検証:
- プレフィックス制約による生成: generate_arguments()は、ツール名までを確定させたarg_prefixをモデルに与え、引数部分だけを生成させます。生成の自由度を意図的に狭めることで、フォーマット崩れを減らしています。max_new_tokens=96 は、2つのツールの引数の JSON を書き切るのに十分な長さです。
- 実行前のスキーマ検証: validate_arguments()が、必須引数の欠落、未定義引数の混入、型の不一致の3点を実行前に検査します。この検証がなければ、モデルが想像した引数がそのまま実関数へ渡されます。
スクラッチ実装の実行結果
前節のスクリプトを実行した際の動作ログを確認します。小型モデルを使っているため、きれいに成功する例だけでなく失敗も混ざります。そこがむしろ観察のしどころです。
Loading model Qwen/Qwen2.5-0.5B-Instruct...
[Setup] ローカル定義のツール: add_numbers, get_weather
[Setup] OpenAI形式の定義: 2件 / Gemini形式の定義: 2件(同内容・本実装では未使用)

--- ユーザー入力: 'Tokyoの天気を教えてください。' ---
[Select] ツール選択スコア(対数尤度): get_weather=-14.848, add_numbers=-19.772
[Generate] 生の出力: {"name": "get_weather", "arguments": {"location": "Tokyo"}}
[Validate] スキーマ適合: OK (required=['location'])
[Execute] get_weather(location='Tokyo')
[Result] Tokyoの天気は晴れ、気温は22度です。

--- ユーザー入力: '1250と3845を足すといくつになりますか?' ---
[Select] ツール選択スコア(対数尤度): add_numbers=-13.474, get_weather=-17.273
[Parse] 出力のパースに失敗しました: JSONオブジェクトが見つかりません

--- ユーザー入力: '東京の気温を摂氏で教えてください。' ---
[Select] ツール選択スコア(対数尤度): get_weather=-14.164, add_numbers=-15.352
[Generate] 生の出力: {"name": "get_weather", "arguments": {"location": "Tokyo"}}
[Validate] スキーマ適合: OK (required=['location'])
[Execute] get_weather(location='Tokyo')
[Result] Tokyoの天気は晴れ、気温は22度です。
3件のツール選択のスコアを表に並べると、次のようになります。
(図は、diagram-designで作成)
実行ログの解説
-
ツール選択は3件とも正しく機能している
「天気」の2件では get_weather が、「足し算」では add_numbers が最上位に来ています。ツール選択が、コンテキストに条件づけられた生成確率の大小関係として機能していることが確認できます。ここで比較しているのはツール名の対数尤度のみであり、引数はまだ生成されていません。注意したいのは、対数尤度の絶対値には意味がないという点です。値はプレフィックス全体に依存するため、入力が変われば水準ごと動きます。意味を持つのは同一プレフィックス内での差だけです。その差を見ると、1件目が 、2件目が に対し、3件目は しかありません。3件目の「東京の気温を摂氏で」は、気温という語が数値を連想させるぶん add_numbers 側のスコアも上がり、判断が相対的に曖昧になっています。差が小さいケースは選択を誤りやすい領域であり、実務では閾値を設けて「確信が持てない場合はユーザーに聞き返す」といった設計が有効です。
-
選択に成功しても、引数生成で失敗しうる(2件目)
2件目はツール選択では add_numbers が明確に勝っているにもかかわらず、続く引数生成でJSONとして解釈できる出力が得られず、extract_json_object()が例外を投げています。これは、ツール呼び出しの段階がモデルに2つのことを同時に要求していることの帰結です。ひとつは引数の内容の正しさ(1250 と 3845 を取り出すこと)、もうひとつは指定されたフォーマットへの厳密な追従(余計な文を書かず、有効なJSONだけを出すこと)です。0.5Bという小型モデルでは後者が安定しません。プロンプトで「JSON形式のみを出力してください」と指示していても、それは確率分布を傾けるだけで、構文的な保証にはならないためです。
実務での対処は3つあります。第一に、文法ベースの制約付きデコードを用いて、そもそも不正なJSONがサンプリングされないようにすること。第二に、パース失敗を検出してリトライすること。第三に、より大きなモデルか、関数呼び出しに特化して学習されたモデルを使うことです。商用APIのFunction Callingが安定して動くのは、まさにこの部分がサーバー側で解決されているからです。
-
スキーマの説明文が、引数の「値」まで支配している(3件目)
3件目でユーザーは「東京」と日本語で入力していますが、生成された値は "Tokyo" です。これはスキーマの description に「都市名(例: Tokyo)」と書いてあることの効果で、モデルが例示に合わせて表記を正規化しています。説明文が選択確率だけでなく、生成される値の書式まで左右するという事実は、実装上きわめて重要です。引数の期待形式は型だけでは表現しきれないため、description が実質的な仕様書として機能します。逆に言えば、説明文が曖昧だと引数の表記が呼び出しごとに揺れます。
-
スキーマに表現手段がない要求は、静かに落ちる(3件目)
同じ3件目で、ユーザーは「摂氏で」と単位を指定しています。しかし get_weather のスキーマには単位に対応する引数が存在しないため、モデルはこの要求を単純に無視しました。生成されたのは {"location": "Tokyo"} だけです。結果として、この呼び出しはスキーマ検証を通過します。必須引数は揃っており、未定義の引数もなく、型も正しいためです。エラーは一切出ません。しかしユーザーの意図の一部は失われています。
4種類の失敗を区別する
今回のログには、性質の異なる失敗が混ざっています。前節で述べたハルシネーションと誤りの区別に、さらに2つを加えて整理します。
| 失敗の種類 | 今回の該当 | 検証で捕捉できるか |
|---|---|---|
| 出力がパースできず、呼び出しが成立しない | 2件目 | できる(パース時点で失敗する) |
| 存在しないツール名を呼ぶ(ハルシネーション) | なし | できる(ツール名の照合) |
| 実在するツールを不正な引数で呼ぶ(誤り) | なし | できる(スキーマ検証) |
| スキーマ上は妥当だが、意図を満たさない | 3件目 | できない |
上の3つは機械的に検出でき、リトライやエラー応答で回復する余地があります。厄介なのは4つ目です。呼び出しは形式的に完全に正しく、ログにも異常は残りません。これはモデルの問題ではなくスキーマ設計の問題であり、検証を厚くしても解決しません。unit のような引数をスキーマへ追加するか、そもそも表現できない要求は受け付けない旨をユーザーへ伝えるか、という設計判断が必要になります。
4種類の失敗と検証の関係を図にすると、次のようになります。
(図は、diagram-designで作成)
検証関数の動作確認
今回の実行ではvalidate_arguments()が一度も発火しませんでした。生成された引数がいずれもスキーマに適合していたためです。ただし、この関数が不要ということではありません。上の表の3行目に備えるものであり、動作は個別に確認できます。
>>> schema = next(t for t in TOOLS_OPENAI if t["function"]["name"] == "get_weather")

>>> validate_arguments(schema, {"location": "東京", "unit": "celsius"})
ValueError: 未定義の引数が含まれています: ['unit']

>>> validate_arguments(schema, {})
ValueError: 必須の引数が不足しています: ['location']

>>> validate_arguments(schema, {"location": 5})
TypeError: 引数 'location' の型が不正です: string を期待しましたが int でした
もしこの検証がなければ、1つ目のケースでは get_weather(location='東京', unit='celsius') が実行され、Python側の TypeError でアプリケーションが落ちます。モデルが生成した値をそのまま実関数へ渡さないことが、Function Callingを実装する上での最低限の防御線です。
実践的な実装例:SDKネイティブのFunction Calling
スクラッチ実装ではプロンプトへのスキーマ埋め込み、出力のパース、検証をすべて手で書きました。実際の商用APIでは、これらの多くがSDK側で提供されます。ここでは同じ2つのツールを、OpenAI互換のAPIとGeminiのSDKでそれぞれ呼び出します。
実行環境の準備
pip install openai google-genai python-dotenv
APIキーはプロジェクトルートの .env に置きます。
OPENAI_API_KEY=your_api_key_here
GEMINI_API_KEY=your_api_key_here
Gemini APIキーは、Google AI Studioから無料で取得することができます。APIキーの取得・管理方法の詳細については、Googleの公式ドキュメントをご参照ください。 なお、無料枠(Free tier)を利用する場合、入力したデータはGoogleの製品改善やモデル学習のために利用される可能性がある点にご留意ください(機密情報の入力は避け、詳細は公式の利用規約をご確認ください)。
OpenAI(Responses API)での実装
OpenAIには関数呼び出しを扱えるエンドポイントが2つあります。従来からある Chat Completions API(/v1/chat/completions)と、新しい Responses API(/v1/responses)です。
新規の実装では Responses API を選んでください。理由は2つあります。
ひとつは、推論モデル(GPT-5系以降)では Chat Completions と関数ツールの組み合わせに制約が入ったことです。これらのモデルに tools を渡すと、次のエラーが返ります。
openai.BadRequestError: Error code: 400 - {'error': {'message': "Function tools with
reasoning_effort are not supported for gpt-5.6-luna in /v1/chat/completions.
To use function tools, use /v1/responses or set reasoning_effort to 'none'.",
'type': 'invalid_request_error', 'param': 'reasoning_effort', 'code': None}}
紛らわしいのは、reasoning_effort を明示的に渡していなくてもこのエラーが出る点です。これらのモデルは推論の強度に既定値を持つため、tools を送った時点で条件が成立します。
回避策は2つあり、どちらを選ぶかで性質が変わります。
| 回避策 | 挙動 | 評価 |
|---|---|---|
| reasoning_effort="none" を明示する | Chat Completionsのまま使えるが、推論が無効になる | 応急処置。どのツールをどの順で呼ぶかを組み立てる段階が失われるため、複雑なタスクでは精度が落ちる |
| Responses API へ移行する | 推論と関数ツールを両立できる | 恒久的な対処。新規実装ではこちら |
もうひとつの理由は、OpenAI自身が新規プロジェクトに Responses API を推奨していることです。同じ推論モデルでもベンチマークのスコアが高く出る、キャッシュの利用効率が良い、Web検索やコードインタプリタといった組み込みツールはこちらにしか存在しない、といった差があります。
同じOpenAIのAPIでありながら、ツール定義のJSONの形が異なります。
- Chat Completions:{"type": "function", "function": {"name": ..., "description": ..., "parameters": {...}}} と、function キーの下にネストする
- Responses:{"type": "function", "name": ..., "description": ..., "parameters": {...}} と、フラットに並べる
2つの形式は混在できません。片方の形式をもう片方のエンドポイントへ送ることが、パラメータ不正エラーのもっとも多い原因です。
# openai_client.py
import json
import os

from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])

MODEL = "gpt-5.6-luna"


def add_numbers(a: int, b: int) -> int:
    return a + b


def get_weather(location: str) -> str:
    return f"{location}の天気は晴れ、気温は22度です。"


TOOL_IMPL = {"add_numbers": add_numbers, "get_weather": get_weather}

# Responses API のツール定義:name / description / parameters をフラットに置く
# (Chat Completions のように "function" キーでネストしない)
TOOLS = [
    {
        "type": "function",
        "name": "add_numbers",
        "description": "2つの整数を加算して合計を返します。",
        "parameters": {
            "type": "object",
            "properties": {
                "a": {"type": "integer", "description": "1つ目の整数"},
                "b": {"type": "integer", "description": "2つ目の整数"},
            },
            "required": ["a", "b"],
            "additionalProperties": False,
        },
        "strict": True,
    },
    {
        "type": "function",
        "name": "get_weather",
        "description": "指定された都市の現在の天気を取得します。",
        "parameters": {
            "type": "object",
            "properties": {
                "location": {"type": "string", "description": "都市名(例: Tokyo)"},
            },
            "required": ["location"],
            "additionalProperties": False,
        },
        "strict": True,
    },
]


def run(user_input: str) -> None:
    print(f"\n--- ユーザー入力: '{user_input}' ---")

    # Responses API の input は「アイテムの並び」。往復のたびに追記していく
    input_items: list = [{"role": "user", "content": user_input}]

    while True:
        response = client.responses.create(
            model=MODEL,
            input=input_items,
            tools=TOOLS,
            reasoning={"effort": "low"},
        )

        # output はアイテムのフラットなリスト。function_call だけを拾う
        function_calls = [
            item for item in response.output if item.type == "function_call"
        ]
        if not function_calls:
            print(f"[Final] {response.output_text}")
            return

        # モデルの出力(function_call を含む)をそのまま履歴へ戻す
        input_items += response.output

        for call in function_calls:
            args = json.loads(call.arguments)
            print(f"[ToolCall] {call.name}({args})")
            result = TOOL_IMPL[call.name](**args)
            print(f"[Result] {result}")
            # function_call と function_call_output は call_id で対応づける
            input_items.append(
                {
                    "type": "function_call_output",
                    "call_id": call.call_id,
                    "output": json.dumps(result, ensure_ascii=False),
                }
            )


if __name__ == "__main__":
    run("Tokyoの天気を教えてください。")
    run("1250と3845を足すといくつになりますか?")
- スキーマの提示: tools=TOOLSでスクラッチ実装と同じ内容のJSON Schemaを渡しています。プロンプトへの埋め込みとパースはSDKとサーバー側が引き受けますが、スキーマそのものは依然として開発者が手で書いています。
- 厳密モード: strict: Trueを指定すると、生成される引数がスキーマへ厳密に適合することが保証されます。有効にするにはparameters側にadditionalProperties: Falseが必要です。スクラッチ実装のvalidate_arguments()が手で行っていた検証を、API側が引き受ける形にあたります。
- ループ構造: function_callが返らなくなるまで往復を繰り返します。1回で終わる前提を置かないことで、複数ツールの連続呼び出しにも対応できます。
- call_idによる対応づけ: function_callとfunction_call_outputはcall_idで紐づきます。並列に複数のツールが呼ばれた場合に、どの結果がどの呼び出しに対するものかを識別するための仕組みです。
- 実行はアプリケーション側の責務: TOOL_IMPL[call.name](**args)を呼ぶのはこちらのコードです。モデルは実行しません。
実行結果
上記のコードを実行すると以下の結果が得られます。
--- ユーザー入力: 'Tokyoの天気を教えてください。' ---
[ToolCall] get_weather({'location': 'Tokyo'})
[Result] Tokyoの天気は晴れ、気温は22度です。
[Final] 東京の天気は晴れ、気温は22度です。

--- ユーザー入力: '1250と3845を足すといくつになりますか?' ---
[ToolCall] add_numbers({'a': 1250, 'b': 3845})
[Result] 5095
[Final] 5095です。
スクラッチ実装の結果と比べると、違いは明らかです。あちらでは2件目の引数生成が失敗してJSONが得られませんでしたが、ここでは2件とも通っています。この差はモデルの規模だけによるものではありません。strict: Trueを指定しているため、スキーマに適合しない引数はそもそも生成されないように、サーバー側のデコードが制約されているためです。スクラッチ実装で手書きしたextract_json_object()とvalidate_arguments()が担っていた役割が、API側へ移っていることになります。
ログの3行が分かれている点にも注目してください。[ToolCall]はモデルが生成した引数、[Result]はローカル関数の戻り値、[Final]はその戻り値を受け取ってモデルが書いた文章です。基本構造で述べた4つのステップが、そのままログの構造として現れています。
[Result]と[Final]を見比べると、関数の戻り値がそのまま出力されているわけではないことがわかります。Tokyoの天気は晴れ、気温は22度です。 という戻り値に対し、最終応答では Tokyo が 東京 に書き換えられています。応答生成の段で説明した2つの方式のうち、情報統合法が使われている証拠です。直接挿入法であれば戻り値の文字列がそのまま埋め込まれ、この言い換えは起きません。
なお、最終応答の文面は毎回同じにはなりません。2件目が 5095です。 と簡潔になっているのは、reasoning={"effort": "low"}を指定していることとも無関係ではないでしょう。ツール呼び出しの結果は決定的に扱える一方、その先の文章生成には揺れが残る、という前提でUIを設計する必要があります。
Gemini(google-genai)での実装
# gemini_client.py
import os

from dotenv import load_dotenv
from google import genai
from google.genai import types

load_dotenv()
client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])


def add_numbers(a: int, b: int) -> int:
    return a + b


def get_weather(location: str) -> str:
    return f"{location}の天気は晴れ、気温は22度です。"


TOOL_IMPL = {"add_numbers": add_numbers, "get_weather": get_weather}

# 同じ2つのツールを、Gemini向けにもう一度定義し直す
add_numbers_decl = types.FunctionDeclaration(
    name="add_numbers",
    description="2つの整数を加算して合計を返します。",
    parameters=types.Schema(
        type=types.Type.OBJECT,
        properties={
            "a": types.Schema(type=types.Type.INTEGER, description="1つ目の整数"),
            "b": types.Schema(type=types.Type.INTEGER, description="2つ目の整数"),
        },
        required=["a", "b"],
    ),
)

get_weather_decl = types.FunctionDeclaration(
    name="get_weather",
    description="指定された都市の現在の天気を取得します。",
    parameters=types.Schema(
        type=types.Type.OBJECT,
        properties={
            "location": types.Schema(
                type=types.Type.STRING, description="都市名(例: Tokyo)"
            ),
        },
        required=["location"],
    ),
)

TOOLS = [types.Tool(function_declarations=[add_numbers_decl, get_weather_decl])]

CONFIG = types.GenerateContentConfig(
    tools=TOOLS,
    # SDKの自動実行を無効化し、実行タイミングを自分で制御する
    automatic_function_calling=types.AutomaticFunctionCallingConfig(disable=True),
)


def run(user_input: str) -> None:
    print(f"\n--- ユーザー入力: '{user_input}' ---")
    contents = [
        types.Content(role="user", parts=[types.Part.from_text(text=user_input)])
    ]

    response = client.models.generate_content(
        model="gemini-3.8-flash", contents=contents, config=CONFIG
    )

    if not response.function_calls:
        print(f"[Response] {response.text}")
        return

    contents.append(response.candidates[0].content)

    for function_call in response.function_calls:
        name = function_call.name
        args = dict(function_call.args)
        print(f"[ToolCall] {name}({args})")
        result = TOOL_IMPL[name](**args)
        print(f"[Result] {result}")
        contents.append(
            types.Content(
                role="user",
                parts=[
                    types.Part.from_function_response(
                        name=name, response={"result": result}
                    )
                ],
            )
        )

    final = client.models.generate_content(
        model="gemini-3.8-flash", contents=contents, config=CONFIG
    )
    print(f"[Final] {final.text}")


if __name__ == "__main__":
    run("Tokyoの天気を教えてください。")
    run("1250と3845を足すといくつになりますか?")
- 専用の型でスキーマを組む: OpenAI版では素のdictで済んだ定義が、こちらではtypes.FunctionDeclarationとtypes.Schemaを使った記述になります。表現している内容は同じです。
- 自動実行の無効化: AutomaticFunctionCallingConfig(disable=True)を指定しない場合、SDKがPython関数を自動で実行します。ここでは処理の流れを明示するために無効化し、手動で実行しています。
- 結果の返し方: types.Part.from_function_response()で実行結果を包み、会話履歴へ追加します。OpenAI版のrole: "tool"メッセージに相当します。
実行結果
上記のコードを実行すると以下の結果が得られます。
--- ユーザー入力: 'Tokyoの天気を教えてください。' ---
[ToolCall] get_weather({'location': 'Tokyo'})
[Result] Tokyoの天気は晴れ、気温は22度です。
[Final] 現在、Tokyoの天気は晴れで、気温は22度です。

--- ユーザー入力: '1250と3845を足すといくつになりますか?' ---
[ToolCall] add_numbers({'a': 1250, 'b': 3845})
[Result] 5095
[Final] 1250と3845を足すと、**5095**になります。
OpenAI版と並べると、どこが揃っていて、どこが揃っていないかがはっきりします。
揃っているのは[ToolCall]の行です。{'location': 'Tokyo'} も {'a': 1250, 'b': 3845} も、OpenAI版と完全に一致しています。日本語の「Tokyoの天気を教えてください」から location という引数名とその値への写像、そして「1250と3845を足す」から2つの整数への写像が、プロバイダをまたいで同じ答えに収束しました。引数の型も文字列ではなく整数として正しく生成されています。ツール選択と引数生成の層は、事実上プロバイダ非依存で扱えるということです。
揃っていないのは[Final]の行です。現在、Tokyoの天気は晴れで、気温は22度です。 は、OpenAI版の 東京の天気は晴れ、気温は22度です。 と内容こそ同じものの、文面が違います。2件目にいたってはMarkdownの太字まで使われています。最終応答は各モデルの文体や整形の癖が出る層であり、ここを揃えたい場合はプロンプトで書式を指定するか、アプリケーション側で後処理する必要があります。
まとめると、モデルを入れ替えても再現性が期待できるのは引数生成までで、最終応答の文面は揃わないということになります。テストを書く際も、検証すべきは [ToolCall] の内容であって [Final] の文字列ではありません。
そしてここが本節の要点なのですが、これだけ挙動が揃っているにもかかわらず、ツールを定義するコードだけは共通化できていません。この点は本節の最後で改めて整理します。
ツール呼び出しの制御(tool_choice)
Function Callingを実運用する上で欠かせないのが、「モデルにツールを呼ばせるかどうか」の制御です。主要なプロバイダはいずれもこの制御を提供していますが、名前が揃っていません。
| 挙動 | OpenAI (tool_choice) | Gemini (tool_config) | Anthropic (tool_choice) |
|---|---|---|---|
| モデルの判断に任せる | auto | AUTO | auto |
| 必ず何らかのツールを呼ぶ | required | ANY | any |
| 特定のツールを名指しで強制する | {"type": "function", "function": {"name": ...}} | ANY + allowed_function_names | tool |
| ツール呼び出しを禁止する | none | NONE | — |
auto はモデル自身が「ツールを使うべきか、使うならどれか」を判断するモードで、通常はこれを使います。required / ANY は、モデルに必ずいずれかのツールを呼ばせるモードです。ツールを呼ぶことが確定しているワークフロー(たとえば構造化データの抽出)では便利ですが、モデルから「呼ばない」という選択肢を奪うモードでもあります。この性質は、次節で触れる安全性の論点に直結します。
同じツールなのに、定義を何度も書いている
ここまでの実装で、機能的にはまったく同じ add_numbers と get_weather について、4通りの定義を書きました。
| スクラッチ | OpenAI Chat Completions | OpenAI Responses | Gemini | |
|---|---|---|---|---|
| 記述形式 | 自前のプロンプト用テキスト | dictのJSON Schema | dictのJSON Schema | types.Schema オブジェクト |
| 型の表記 | integer | integer | integer | types.Type.INTEGER |
| 名前の位置 | 自前 | function キーの下にネスト | トップレベルにフラット | FunctionDeclaration(name=...) |
| ツールのまとめ方 | リスト | {"type": "function", ...} のリスト | {"type": "function", ...} のリスト | Tool(function_declarations=[...]) |
| 結果の返却 | 自前 | role: "tool" メッセージ | function_call_output アイテム | Part.from_function_response |
注目すべきは、同一プロバイダの2つのエンドポイント間ですら形式が違うことです。OpenAIのChat CompletionsとResponsesは、どちらもJSON Schemaを使いながら name の置き場所が異なり、互いに互換性がありません。分断はプロバイダ間だけの問題ではないわけです。
ツールが2つ、対応先が3系統なので定義は6つで済んでいますが、これは で増えます。ツールが50個、対応先が3系統なら150個の定義を手で維持することになります。しかも、そのいずれもが実装本体とは独立したメタデータであり、関数のシグネチャを変えても自動では追従しません。
この重複は単なる手間の問題にとどまりません。前節の実行ログで見たとおり、ツールの説明文はモデルの選択確率だけでなく生成される引数の値まで左右します。片方の定義でだけ説明を改善した場合、呼び出し先によって挙動が変わることになります。
ツールの定義の数を図にすると、次のようになります。
(図は、diagram-designで作成)
Function Callingが抱えた構造的な限界
4つの限界を並べると、次のようになります。
(図は、diagram-designで作成)
前節で見た定義の重複は、より根の深い問題の表層にすぎません。Function Callingという枠組みそのものが持つ限界を4つに整理します。
スキーマ記述フォーマットの分断
ツールの出所はきわめて多様です。公開API、RESTful API、RapidAPIのようなアグリゲータ、Hugging Face、各社のプラグインリストと、取得元ごとに記述のフォーマットが異なります。Tool Learningの研究でも、この出所の多様性が記述フォーマットの分散を生み、ツール学習の統一的なフレームワークの構築を妨げていることが、この分野の課題として明確に指摘されていました。
各プロバイダのSDKは自社フォーマットへの変換を提供しますが、それは「自社の形に揃える」ことであって、エコシステム全体の標準化ではありません。前節で見たとおり、同一プロバイダの2つのエンドポイント間ですら形式が揃わないことがあり、しかもそれはモデルの世代交代に伴って発生しました。変換の責務はアプリケーション開発者の側に残り続け、モデルを乗り換えるたびに再発します。
ツール数の増加に対するスケーラビリティ
前述のとおり、全ツールの説明をコンテキストに含める方式ではトークン長がツール数に比例して増加します。コンテキスト長の上限とレイテンシの制約から、数千・数万のツールを扱う段階では検索器による絞り込みが不可欠になります。
しかしこの検索は、Function Callingの仕様には含まれていません。どのツールをモデルに見せるかを決めるのはアプリケーション側の責務であり、各開発者がそれぞれに実装することになります。加えて、非最適な検索器はかえって精度を落とすため、この実装は慎重さを要します。
レイテンシの問題も無視できません。ツール連携を入れると、単純なクエリでも解決までに数秒かかることがあり、検索エンジンの応答速度に慣れたユーザー体験を明確に損ないます。
ツールの発見が静的であること
Function Callingにおいて、モデルが知りうるツールはリクエスト時に tools パラメータへ渡されたものだけです。ツールの追加・変更・削除はアプリケーションのコード変更を意味し、実行時にツールの提供側へ「今なにが使えるか」を問い合わせる仕組みはありません。
APIドキュメントの更新頻度がモデルの再学習サイクルを上回るという問題への対処として、retriever-aware trainingのような学習側の工夫が生まれたのも、この静的さが背景にあります。呼び出す側が実行時にツール一覧を取得できるなら、そもそもモデル側でドキュメント変更に適応する必要性は下がります。
通信が一方向であること
Function Callingのやり取りは、モデルからツールへの一方向のリクエストと、その戻り値の受け取りで完結します。ツール側からアプリケーションへ非同期にイベントを送る、進捗を通知する、追加の情報を求める、といったことはできません。長時間かかる処理や、対話的な確認を要する処理を扱うには表現力が足りません。
これら4つは、いずれも「モデルが関数を呼ぶ能力」の問題ではありません。Gorillaのようなアプローチでハルシネーションを抑え、引数生成の精度を上げても、そのままでは解決しない問題です。呼び出す側と呼ばれる側の接続規格が存在しないことに起因する問題であり、だからこそ次に必要になったのはモデルの改良ではなく、プロトコルの標準化でした。
構造化出力という新しい攻撃面
Function Callingは、LLMに新しい能力を与えると同時に、新しい経路も開きました。実装する側が把握しておくべき性質なので、最後に触れておきます。
ポイントは、チャットの応答経路と、引数生成の経路が同じ安全性の水準にあるとは限らないことです。ある研究では、同一の有害な要求について、通常のチャットとして投げた場合と、関数の引数として生成させた場合の挙動を比較しています。結果として、引数生成経路での攻撃成功率が、チャット経路に比べて桁違いに高くなることが報告されました。GPT-4oで98%から12%へ、Claude-3.5-Sonnetで98%から0%へと、経路を変えるだけで成功率が大きく落ちる、という形の比較です。つまり、モデルの安全性訓練はチャット応答に対して行われた分だけ厚く、引数の生成に対しては相対的に薄かったということです。
これに前節の tool_choice の話が重なります。required / ANY のような強制モードでは、モデルは呼び出しを拒否できません。実際、全モデルの設定を auto に変えただけで攻撃成功率が大幅に下がったことも報告されています。呼ぶか呼ばないかをモデル自身に判断させる余地を残すかどうかが、安全性に直接効いているわけです。
さらに、入出力の安全フィルタが関数呼び出しの経路を検査していない場合があることも指摘されています。チャット経路では機能していたフィルタが、引数の生成に対してはまったく作動しない、という状況です。
緩和策としては、関数の説明文(description)に防御的な指示を埋め込む方法が、ユーザープロンプト末尾に入れるよりも安定して効くという結果が示されています。裏を返せば、ツールの説明文がモデルの挙動を強く左右するということでもあります。
この「説明文がモデルの挙動を左右する」という性質は、両刃の剣です。ツールの定義を書くのが自分自身である限り、防御の道具として使えます。しかし、ツールの定義を第三者が提供するようになった瞬間、同じ性質が攻撃の道具に反転します。悪意ある指示を説明文に埋め込んでモデルの挙動を操る手口は ツールポイズニング(Tool Poisoning) と呼ばれ、外部から取得したツールを組み込む構成では主要な脅威のひとつとして扱われています。
本記事の実装のように、ツールを自分で定義して自分のプロセス内に置いている限り、この攻撃面は生じません。裏を返せば、ツールの提供元が自分以外になった時点で、スキーマ検証とは別種の検証が必要になるということです。
まとめ
本記事では、LLMが外部ツールを呼び出す仕組みであるFunction Callingを、原理と実装の両面から整理しました。
技術の中核は、ツールのメタデータ(名前・説明・JSON Schema)をコンテキストへ与え、モデルにツール名と引数を構造化データとして生成させることにあります。スクラッチ実装で確認したとおり、ツール選択は各ツール名に対する生成確率の比較として観測でき、引数生成はスキーマによって制約された生成として扱えます。そして実行前のスキーマ検証が、モデルが想像した引数を実関数へ渡さないための最後の防波堤になります。
精度面の課題は、存在しないツールを呼び出すハルシネーションと、実在するツールを誤った形で呼び出す誤りに分けて考える必要がありました。前者はAST部分木マッチングのような手法で定量化でき、API呼び出しに特化した学習や検索器を意識した学習によって大きく改善されてきました。
一方で、モデル側の精度をいくら上げても解消しない問題が残りました。ツール定義のフォーマットがプロバイダごとに分断されていること、ツール数の増加に対してコンテキストが破綻すること、ツールの発見が静的であること、通信が一方向であること。これらはいずれも、呼び出す側と呼ばれる側の接続規格の不在に起因します。
この接続規格として設計されたのが、Model Context Protocol(MCP)です。ツール定義の記述形式をプロトコルレベルで統一し、実行時にツール一覧を問い合わせる動的ディスカバリと、ツール側からの通知を含む双方向通信を仕様に組み込むことで、本記事で挙げた4つの限界に正面から対処しています。
ただし、MCPはFunction Callingを置き換えるものではありません。モデルがツール名と引数を生成するという中核のメカニズムは同じままで、変わるのはツールをどう記述し、どう発見し、どう接続するかの部分です。本記事のスクラッチ実装で手書きしたJSON Schemaが、プロトコルの上でどこへ移されるのかという観点で読むと、MCPが何を標準化したのかが掴みやすいはずです。
さらに詳しく知りたい方へ
MCPについては、その誕生から最新仕様までを論文ベースで解説した記事があります。関心のあるテーマの記事から読み進められます。
- MCPとは? - MCPの誕生と技術的背景
- MCPのクロスエンティティ攻撃とは? - レジストリ経由で侵入する悪意あるサーバー
- MCPサーバーの実装リスクとは? - OSSエコシステムの実態と安全な運用
- MCPクライアントのツールポイズニング耐性とは? - 7つの主要クライアント比較
- MCPの脅威モデルMCP-38とは? - 最新仕様とステートレス化の潮流
本記事で触れたツールポイズニングはクロスエンティティ攻撃の記事とツールポイズニング耐性の記事で、ツール呼び出しの安全性の体系的な分類はMCP-38の記事で詳しく扱っています。
参考文献
- OpenAI. Function calling. 公式ドキュメント.
- Google. Function calling with the Gemini API. 公式ドキュメント.
- JSON Schema. JSON Schema. 公式サイト.
- Qwen Team (2024). Qwen2.5-0.5B-Instruct. Hugging Face(Apache License 2.0).
本記事の文章・構成の一部に生成AIを使用しています。