グラフ(ネットワーク)とは?
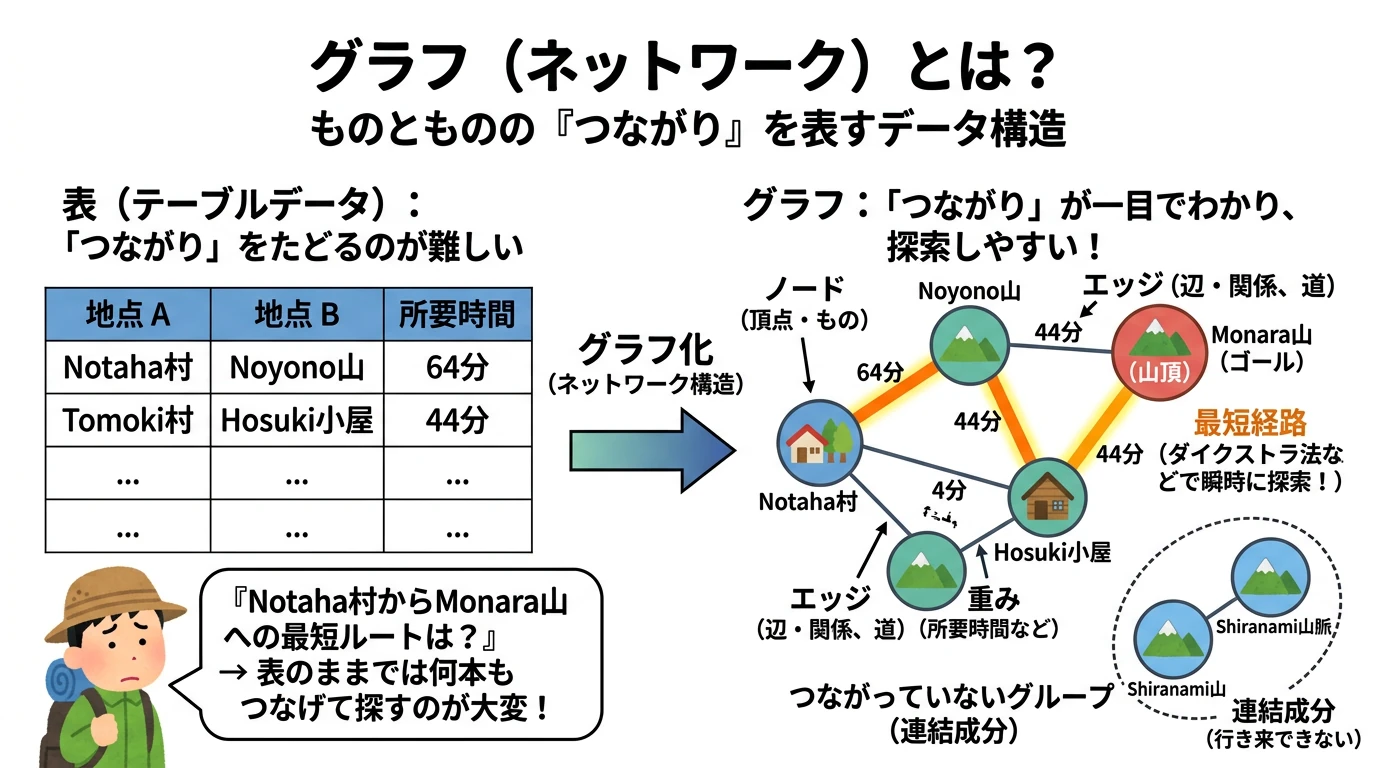 (画像は、Geminiで作成)
ものとものの「つながり」を表すグラフ(ネットワーク)の基本用語(ノード・エッジ・有向と無向・重み・次数)と、コンピュータでの持ち方(隣接行列と隣接リスト)を理解すること。幅優先探索とダイクストラ法で最短経路を、幅優先探索で連結成分を、Python でスクラッチ実装して networkx の結果と一致させ、表のままでは答えにくい「つながりをたどる問い」に、グラフならすぐ答えられる理由を説明できるようになること。
概要
データの多くは、表(行と列)で持たれています。登山道のデータなら、「どの地点とどの地点を結ぶ道で、何分かかるか」を1行に1本ずつ並べた表になります。1本の道について調べるなら、表で十分です。しかし、「この村からあの山頂まで、最短で何分か」「あの山域には、歩いて行けるか」のように、道をいくつもつないでたどる問い になると、表のままでは急に答えにくくなります。
グラフ(ネットワーク) は、このような「つながり」を、ノード(もの) と エッジ(もの同士の関係) で表すデータ構造です。地点をノード、登山道をエッジにすれば、最短経路や、たどり着ける範囲を求めるアルゴリズムがそのまま使えます。交友関係、Web ページのリンク、道路網、論文の引用、知識(「X は Y の一部」のような関係)など、つながりを持つデータは、どれもグラフで表せます。
次の節で、架空の山域の登山道の表を使って、表のままで最短ルートを探す場合と、グラフとして探す場合を比べます。
表のままでは、つながりをたどる問いに答えにくい
実験には、架空の山域の登山道のデータを使います。
- 地点: 3つの山脈(Hoshimi・Akatsuki・Shiranami)に、それぞれ村3つ・山小屋12軒・山頂25座、合わせて120の地点を置きます。
- 登山道: 山脈の中では、すべての地点がつながるように道を引き、さらに回り道ができるように、各地点から近い2地点へ道を引きます。Hoshimi 山脈と Akatsuki 山脈の間には峠越えの道を1本だけ引き、Shiranami 山脈にはほかの山脈からの道を引きません。
- 所要時間: 道の所要時間(分)は、地点の間の距離 (km)から次の式で決めます。 は休憩などによるばらつきで、5〜19分の整数を一様に選びます。
この表から、「Hoshimi 山脈の Notaha 村から、Akatsuki 山脈の Monara 山の山頂まで、最短で何分か」を求めます。
準備:Python の環境
NumPy・pandas・networkx を使います。Google Colab ならインストール済みです。GPU は使いません。記事の数値は、Python 3.13・NumPy 2.5.3・pandas 3.0.5・networkx 3.7 で実行したものです。実行時間(秒・ミリ秒)は、環境によって変わります。
実験1:表のままで最短ルートを探す
import time
import numpy as np
import pandas as pd
import networkx as nx

# 1. 架空の山域:3つの山脈に、村・山小屋・山頂の地点を置く
SYLLABLES = ["ka", "ra", "se", "mo", "ri", "to", "na", "shi", "ku", "yo",
             "ha", "ne", "ta", "mi", "su", "ho", "ki", "no", "wa", "fu"]
RANGES = {"Hoshimi": (0, 0), "Akatsuki": (14, 2), "Shiranami": (40, 0)}   # 山脈の中心の座標(km)
KINDS = {"village": 3, "hut": 12, "summit": 25}                          # 山脈ごとの地点の数


def build_trails(seed=0):
    rng = np.random.default_rng(seed)
    used, rows = set(), []
    for rng_name, (cx, cy) in RANGES.items():
        for kind, count in KINDS.items():
            for _ in range(count):
                while True:
                    name = "".join(rng.choice(SYLLABLES, 3)).capitalize()
                    if name not in used:
                        used.add(name)
                        break
                label = {"village": f"{name} Village", "hut": f"{name} Hut", "summit": f"Mount {name}"}[kind]
                # 「{name} 村」「{name} 小屋(山小屋)」「{name} 山」
                rows.append((label, kind, rng_name, cx + rng.uniform(-6, 6), cy + rng.uniform(-6, 6)))
    points = pd.DataFrame(rows, columns=["name", "kind", "range", "x", "y"])

    # 2. 登山道:山脈ごとに、役割の違う2種類の道を引く
    #    (a) 最小全域木の道:山脈の中のどの地点にもたどり着けるようにする(これだけだと、経路が1通りしかない木になる)
    #    (b) 各地点から近い2地点への道:回り道(閉路)を作る(これだけだと、山脈の中が2〜3個に分かれてしまう)
    #    (a) と (b) は同じ道を選ぶことが多い。道は集合 pairs に (小さい番号, 大きい番号) で入れるので、重なった道は1本になる
    pairs = set()
    for _, g in points.groupby("range"):
        xy, idx = g[["x", "y"]].values, g.index.values                    # idx:山脈の中の番号 0〜39 → 全体の番号
        dist = np.linalg.norm(xy[:, None] - xy[None], axis=-1)          # 山脈の40地点どうしの距離(km)の表(40 × 40)
        # (a) 距離の表を「全地点どうしを、距離を重みにしたエッジで結んだグラフ」とみなし、その最小全域木
        #     (全地点をつなぐ、距離の合計が最小の39本のエッジ)の各エッジ (a, b) を道にする
        for a, b in nx.minimum_spanning_tree(nx.from_numpy_array(dist)).edges():
            pairs.add(tuple(sorted((idx[a], idx[b]))))
        # (b) 各地点から、近い順に1番目と2番目の地点へ道を引く(0番目は距離0の自分自身なので除く)
        for a in range(len(idx)):
            for b in np.argsort(dist[a])[1:3]:
                pairs.add(tuple(sorted((idx[a], idx[b]))))
    # Hoshimi と Akatsuki の間に、峠越えの道を1本だけ引く(Shiranami にはつながない)
    h, k = points[points["range"] == "Hoshimi"], points[points["range"] == "Akatsuki"]
    dist = np.linalg.norm(h[["x", "y"]].values[:, None] - k[["x", "y"]].values[None], axis=-1)
    i, j = np.unravel_index(dist.argmin(), dist.shape)
    pairs.add(tuple(sorted((h.index[i], k.index[j]))))

    # 3. 所要時間(分)= 25 × 距離(km)+ 休憩などのばらつき(5〜19分)
    trails = []
    for u, v in sorted(pairs):
        d = np.hypot(points.x[u] - points.x[v], points.y[u] - points.y[v])
        trails.append((points.name[u], points.name[v], int(round(25 * d + rng.integers(5, 20)))))
    return points, pd.DataFrame(trails, columns=["a", "b", "minutes"])


points, trails = build_trails()
print(f"地点: {len(points)}  登山道: {len(trails)}")
print(trails.head(3).to_string(index=False))

start = "Notaha Village"     # Hoshimi 山脈の村
goal = "Mount Monara"        # Akatsuki 山脈の山頂

# 4. 表のまま答える:登山道の表を1本ずつつなげて、出発点からのルートを全部書き出していく
both = pd.concat([trails.rename(columns={"a": "u", "b": "v"}),
                  trails.rename(columns={"a": "v", "b": "u"})])      # 道はどちら向きにも歩ける
routes = pd.DataFrame({"end": [start], "minutes": [0], "path": [start]})
for hop in range(1, 31):
    t0 = time.time()
    routes = routes.merge(both, left_on="end", right_on="u")        # ルートの終点から出る道をつなぐ
    routes = routes[[v not in p.split("|") for v, p in zip(routes.v, routes.path)]]   # 同じ地点に戻るルートは除く
    routes = pd.DataFrame({"end": routes.v, "minutes": routes.minutes_x + routes.minutes_y,
                           "path": routes.path + "|" + routes.v})
    reached = routes[routes.end == goal]
    if hop >= 24:
        best = reached.minutes.min() if len(reached) else "-"
        print(f"{hop:2d}本の道をつないだ時点  ルート数: {len(routes):7,d}  {goal} に着くルートの最短: {best} 分"
              f"  ({time.time() - t0:.2f} 秒)")

# 5. グラフとして答える:networkx に登山道を入れ、最短経路のアルゴリズムで求める
G = nx.Graph()
G.add_weighted_edges_from(trails.values, weight="minutes")
t0 = time.time()
minutes = nx.shortest_path_length(G, start, goal, weight="minutes")
print(f"\nグラフの最短経路: {minutes} 分({(time.time() - t0) * 1000:.1f} ミリ秒)")
架空の山域の登山道の表を作り、表をつなげていく方法と、グラフの最短経路のアルゴリズムで、最短ルートの所要時間を求めるコードです。
- 地点: build_trails は、RANGES の3つの山脈の中心の周り(±6 km)に、KINDS の数だけ村・山小屋・山頂を置きます。名前は音節を3つつなげて作り、「Notaha Village(村)」「Hosuki Hut(山小屋)」「Mount Monara(山)」のように種類を付けます。
- 登山道を引く理由: 道は、役割の違う2種類を引きます。1つ目の最小全域木の道は、山脈の中のどの地点にもたどり着けるようにするためのものです。ただし、最小全域木は閉路のない木なので、これだけだと、どの2地点の間も経路が1通りしかなく、最短経路を探す意味がなくなります。2つ目の「各地点から近い2地点への道」は、回り道(閉路)を作るためのものです。ただし、地点ごとに近い相手を選ぶだけなので、これだけだと、近い地点どうしで固まったまとまりの間に道ができず、この登山道では、山脈の中が2〜3個のまとまりに分かれてしまいます。2つを合わせて、「どの地点にもたどり着けて、回り道もある」登山道にしています。
- 最小全域木の道: dist は、山脈の40地点どうしの距離の表(40 × 40)です。nx.from_numpy_array(dist) は、この表を隣接行列とみなし、40地点のすべての組を、距離を重みにしたエッジで結んだグラフ(対角の0はエッジにしません)を作ります。nx.minimum_spanning_tree は、そのグラフから、すべての地点をつなぎ、閉路を作らず(エッジは 40 − 1 = 39 本)、重みの合計が最小になるエッジの組(最小全域木)を取り出します。networkx は既定でクラスカル法(短いエッジから順に、閉路ができない限り採用する方法)を使います。.edges() が返す (a, b) は山脈の中での番号(0〜39)なので、idx[a] で地点の表全体の番号に直します。
- 近い2地点への道: np.argsort(dist[a]) は、地点 a から近い順に地点の番号を並べたものです。0番目は距離0の自分自身なので、[1:3] で1番目と2番目に近い地点を選びます。40地点 × 2 で80回道を加えますが、増える道はずっと少なくなります。A と B が互いを近い2地点に選ぶと同じ道になり、また、各地点から1番近い地点への道は、必ず最小全域木に含まれているからです。
- 重なった道を1本にまとめる: 道は、両端の番号を sorted で (小さい番号, 大きい番号) の組にして、集合 pairs に入れます。(A, B) と (B, A) が同じ組になり、集合は同じ組を1つしか持たないので、2種類の道で重なった道や、互いに選び合った道は1本になります。この登山道では、山脈ごとに最小全域木の39本に、新しい道が15〜19本加わり、山脈の中の道は合わせて169本になります(峠越えの1本を足して170本)。
- 峠越えの道: Hoshimi 山脈の地点と Akatsuki 山脈の地点の組のうち、直線距離がいちばん近い2地点を探し、その間に道を1本引きます。
- 地点を山脈ごとに取り出す: h は Hoshimi の40地点、k は Akatsuki の40地点です。
- 全組の距離をまとめて求める: 座標の配列はどちらも形が (40, 2) です。[:, None] で h 側を (40, 1, 2)、[None] で k 側を (1, 40, 2) にしてから引き算すると、NumPy のブロードキャストで (40, 40, 2) の配列になり、[i, j] に「Hoshimi の i 番目と Akatsuki の j 番目の座標の差 」が入ります。np.linalg.norm(..., axis=-1) で最後の軸(長さ2)の長さ を求めると、40 × 40 = 1,600 組の距離の表 dist(40 × 40)が、ループを書かずに1行で得られます。山脈の中の距離の表と同じ書き方で、違いは、同じ地点どうしではなく、2つの山脈の地点どうしを組にしている点です。
- いちばん近い組を探す: dist.argmin() は、表を1列(長さ1,600)に並べたときの最小値の位置(0〜1,599)を返します。np.unravel_index は、その位置を、元の (40, 40) の表での (行, 列) の番号 (i, j) に戻します。
- 全体の番号に直して道にする: i と j は、取り出した h と k の中での順番(0〜39)にすぎないので、h.index[i] と k.index[j] で、地点の表全体での番号(0〜119)に直します。あとは山脈の中の道と同じく、(小さい番号, 大きい番号) の組にして pairs に入れます。
- 所要時間: 直前に示した式で、距離 d から所要時間 minutes を決めます。trails は、道の両端の地点 a・b と所要時間の表です。
- 表のまま答える: both は、道をどちら向きにも歩けるように、向きを逆にした行を足した表です。routes は、出発点からのルート(終点・所要時間の合計・通った地点)の表で、merge で「ルートの終点から出る道」をつなぐたびに、ルートが1本ずつ長くなります。同じ地点を2度通るルートは除きます。24本目からは、Monara 山に着いたルートの中での最短の所要時間と、ルートの数を表示します。
- グラフとして答える: networkx の無向グラフ G に、登山道を所要時間の重み付きのエッジとして入れ、nx.shortest_path_length で最短の所要時間を求めます。重みを指定すると、内部ではダイクストラ法(後の節)が使われます。
実行結果
地点: 120  登山道: 170
             a            b  minutes
Notaha Village Mount Noyono       64
Notaha Village Mount Honeku       64
Tomoki Village   Hosuki Hut       44
24本の道をつないだ時点  ルート数:  34,847  Mount Monara に着くルートの最短: - 分  (0.14 秒)
25本の道をつないだ時点  ルート数:  55,464  Mount Monara に着くルートの最短: 1321 分  (0.20 秒)
26本の道をつないだ時点  ルート数:  87,717  Mount Monara に着くルートの最短: 1319 分  (0.35 秒)
27本の道をつないだ時点  ルート数: 137,381  Mount Monara に着くルートの最短: 1332 分  (0.58 秒)
28本の道をつないだ時点  ルート数: 211,173  Mount Monara に着くルートの最短: 1353 分  (1.06 秒)
29本の道をつないだ時点  ルート数: 316,170  Mount Monara に着くルートの最短: 1376 分  (1.60 秒)
30本の道をつないだ時点  ルート数: 459,643  Mount Monara に着くルートの最短: 1404 分  (2.34 秒)

グラフの最短経路: 1319 分(2.6 ミリ秒)
(和訳)
- 表の列:a・b は道の両端の地点(Village は村、Hut は山小屋、Mount は山)、minutes は所要時間(分)です。
つないだ道の本数ごとに、ルートの数と最短の所要時間を並べると、次のようになります。
(図は、diagram-designで作成)
表をつなげる方法では、Monara 山に初めて着いたのは、25本の道をつないだときでした(1,321分)。しかし、26本つなぐと、もっと短い1,319分のルートが見つかりました。道の本数が少ないルートが、所要時間も短いとは限らないからです。27本以上では長いルートしか見つかりませんでしたが、さらに先に、もっと短いルートがないとは言い切れません。確かめるには、Monara 山を通らずに歩けるルートを、すべて書き出すしかありません。
その間に、ルートの数は1本つなぐたびに約1.5倍に増え、30本の時点で約46万本になりました。道をつなぐたびに枝分かれが掛け算で増える、組み合わせ爆発です(局所探索(山登り法)の記事で扱った、全探索が現実的でなくなる理由と同じです)。
一方、グラフの最短経路のアルゴリズムは、数ミリ秒で 1,319分という答えを出しました。しかも、これが最短であることが、アルゴリズムの仕組みから保証されます。違いは、ルートを全部書き出すのではなく、「どの地点まで、最短で何分で行けるか」を地点ごとに覚えながら広げていく ことにあります。以降の節で、グラフの用語と、この仕組みを順に見ていきます。
グラフの基本用語
グラフは、ノードの集合 と、エッジの集合 の組 です。ノードの数を 、エッジの数を と書きます。登山道のデータでは、地点がノード()、登山道がエッジ()です。
(図は、diagram-designで作成)
- ノード(頂点): グラフの「もの」です。地点、人、Web ページ、論文などにあたります。
- エッジ(辺): 2つのノードの間の「関係」です。登山道、交友関係、リンク、引用などにあたります。
- 無向グラフと有向グラフ: エッジに向きがない(A と B がつながっていれば、B と A もつながっている)グラフが 無向グラフ、向きがある(A から B へのリンクがあっても、B から A へのリンクがあるとは限らない)グラフが 有向グラフ です。登山道はどちら向きにも歩けるので無向グラフ、Web ページのリンクや論文の引用は有向グラフです。
- 重み: エッジに付けた数値です。登山道の所要時間、道路の距離、関係の強さなどを表します。重みのあるグラフを 重み付きグラフ と呼びます。
- 次数: ノードにつながっているエッジの数です(後の節)。
- 経路(パス): エッジでつながったノードの並びです。経路に含まれるエッジの数を 長さ(ホップ数)、重みの合計を 重み付きの長さ と呼びます。
グラフをコンピュータで持つ:隣接行列と隣接リスト
グラフをプログラムで扱うには、2つの持ち方があります。
(図は、diagram-designで作成)
隣接行列 は、ノードに の番号を付け、 の行列 (A)で、ノード と の間にエッジがあるかを表します。
無向グラフでは で、対称な行列になります。
隣接リスト(adj)は、ノードごとに、エッジでつながっているノード(と重み)だけを並べたものです。
ノード の 次数 (degree)は、隣接行列の 行目の和で求まります。すべてのエッジは両端の2つのノードの次数に1ずつ数えられるので、次数の和はエッジの数の2倍になります(握手の補題)。
隣接行列の要素数は で、エッジの数によりません。隣接リストの要素数は次数の和 です。
# 1. 地点に 0, 1, 2, ... の番号を付ける
names = list(points["name"])
index = {n: i for i, n in enumerate(names)}
n, m = len(names), len(trails)

# 2. 隣接行列:A[i, j] = 1(i と j の間に道がある)、0(ない)
A = np.zeros((n, n), dtype=np.int8)
for a, b, _ in trails.itertuples(index=False):
    A[index[a], index[b]] = A[index[b], index[a]] = 1   # 無向グラフなので、対称に入れる

# 3. 隣接リスト:地点ごとに、道でつながっている地点と所要時間のリストを持つ
adj = {name: [] for name in names}
for a, b, w in trails.itertuples(index=False):
    adj[a].append((b, w))
    adj[b].append((a, w))

print("Notaha Village の隣:", adj["Notaha Village"])
print("隣接行列の行の和(Notaha Village):", A[index["Notaha Village"]].sum())

# 4. 次数:k_i = Σ_j A_ij。すべての次数の和は、エッジの数の2倍になる(握手の補題)
degree = A.sum(axis=1)
print(f"\n次数の和: {degree.sum()}  エッジの数の2倍: {2 * m}")
print(f"平均次数: {degree.mean():.2f}  最大次数: {degree.max()}({names[degree.argmax()]})")

# 5. メモリ:隣接行列は n × n、隣接リストは 2m 個の要素
print(f"\n隣接行列の要素数: {n * n:,}(うち 1 は {A.sum():,} 個 = {A.sum() / (n * n):.1%})")
print(f"隣接リストの要素数: {sum(len(v) for v in adj.values()):,}")
for N in [1_000, 100_000, 10_000_000]:
    k = 3   # 平均次数を3とした場合
    print(f"地点が {N:>10,} 個のとき  隣接行列: {N * N / 1e9:>10,.3f} GB(1要素1バイト)"
          f"  隣接リスト: {N * k * 8 / 1e6:>8,.3f} MB(1要素8バイト)")
登山道のグラフを、隣接行列と隣接リストの両方で表し、次数と、持ち方によるメモリの違いを確かめるコードです。
- 番号付け: index は、地点の名前から 0〜119 の番号への対応です。隣接行列は番号で引くので、名前を番号に直す必要があります。
- 隣接行列: np.zeros((n, n), dtype=np.int8) で 120 × 120 の0の行列を作り、道の両端の組 と に1を入れます。0と1しか入らないので、1要素1バイトの int8 にしています。
- 隣接リスト: 地点の名前をキーにした辞書で、値は「(隣の地点, 所要時間)」のリストです。無向グラフなので、1本の道を両方の地点のリストに入れます。
- 次数: A.sum(axis=1) で行ごとの和、つまり各地点の次数を求め、次数の和がエッジの数の2倍になることを確かめます。
- メモリ: 登山道のグラフでの要素数を比べたうえで、地点の数を増やし、平均次数を3とした場合の隣接行列(1要素1バイト)と隣接リスト(1要素8バイト。番号を64ビットの整数で持つ場合)の大きさを計算します。
実行結果
Notaha Village の隣: [('Mount Noyono', 64), ('Mount Honeku', 64)]
隣接行列の行の和(Notaha Village): 2

次数の和: 340  エッジの数の2倍: 340
平均次数: 2.83  最大次数: 6(Mount Horara)

隣接行列の要素数: 14,400(うち 1 は 340 個 = 2.4%)
隣接リストの要素数: 340
地点が      1,000 個のとき  隣接行列:      0.001 GB(1要素1バイト)  隣接リスト:    0.024 MB(1要素8バイト)
地点が    100,000 個のとき  隣接行列:     10.000 GB(1要素1バイト)  隣接リスト:    2.400 MB(1要素8バイト)
地点が 10,000,000 個のとき  隣接行列: 100,000.000 GB(1要素1バイト)  隣接リスト:  240.000 MB(1要素8バイト)
(和訳)
- Notaha 村の隣は、Noyono 山(64分)と Honeku 山(64分)です。
Notaha 村の次数は2で、隣接リストの長さと、隣接行列の行の和が一致しています。次数の和は340で、エッジの数(170)の2倍です。最も次数が大きいのは Horara 山で、6本の道が集まっています。
隣接行列の要素14,400個のうち、1は340個(2.4%)だけで、残りはすべて0です。このように、ほとんどの要素が0のグラフを 疎なグラフ と呼びます。登山道・道路・交友関係・知識のつながりなど、現実のグラフの多くは疎です。地点が10万になると、隣接行列は10 GB になりますが、隣接リストは 2.4 MB で済みます。大きなグラフを扱うときは、隣接リスト(や、0を持たない疎行列)を使います。networkx のグラフも、内部では隣接リスト(辞書の辞書)で持っています。
一方、隣接行列には「 と の間にエッジがあるか」を1回で調べられる、行列の計算(行列の積で2歩先のつながりを数えるなど)がそのまま使える、という利点があります。小さく密なグラフや、行列の演算をしたい場合には、隣接行列が便利です。
次数と次数分布
次数は、ノードがどれだけ多くのものとつながっているかを表す、最も基本的な量です。有向グラフでは、入ってくるエッジの数(入次数)と、出ていくエッジの数(出次数)を分けて数えます。
グラフ全体で次数がどう散らばっているかを、次数分布 (次数が のノードの割合)で見ます。同じ平均次数でも、グラフの作られ方によって、次数分布は大きく変わります。次のコードでは、2種類のランダムなグラフを比べます。
- Erdős–Rényi(ER)モデル: 個のノードに、 本のエッジを一様にランダムに引きます。どのノードも同じ確率でエッジを受け取るので、次数は平均 の周りに集まります(ポアソン分布に近くなります)。
- Barabási–Albert(BA)モデル: ノードを1つずつ加え、新しいノードから既存のノードへ 本のエッジを引きます。このとき、既存のノード が選ばれる確率を、その次数に比例させます(優先的選択)。
すでにつながりの多いノードほど、さらにつながりを得やすくなるので、ごく少数の ハブ(次数が非常に大きいノード)が生まれます。次数分布は、べき乗則 に従うことが知られています。
# 1. 2種類のランダムなグラフ:どちらもノード 10,000 個・平均次数およそ 6
N = 10_000
er = nx.gnm_random_graph(N, 3 * N, seed=0)          # Erdős–Rényi:エッジを一様にランダムに引く
ba = nx.barabasi_albert_graph(N, 3, seed=0)         # Barabási–Albert:次数の大きいノードほど新しいエッジを受けやすい


# 2. 次数分布:次数 k のノードの割合 P(k) と、上位1%のノードが持つエッジの割合
def describe(name, g):
    deg = np.array([d for _, d in g.degree()])
    top = np.sort(deg)[::-1][: len(deg) // 100]
    print(f"{name:16s} 平均次数: {deg.mean():.2f}  最大次数: {deg.max():4d}"
          f"  上位1%のノードが持つエッジの端: {top.sum() / deg.sum():.1%}")
    for lo, hi in [(1, 5), (5, 10), (10, 20), (20, 50), (50, 100), (100, 10_000)]:
        print(f"    次数 {lo:>3}〜{hi - 1:<5}: {np.mean((deg >= lo) & (deg < hi)):6.2%}")


describe("Erdős–Rényi", er)
describe("Barabási–Albert", ba)
同じノードの数と平均次数で、ER モデルと BA モデルのグラフを作り、次数分布を比べるコードです。
- グラフの生成: nx.gnm_random_graph(N, 3 * N) は、ノード1万個に3万本のエッジを一様にランダムに引きます(平均次数6)。nx.barabasi_albert_graph(N, 3) は、新しいノードごとに3本のエッジを優先的選択で引きます(平均次数およそ6)。どちらも seed を固定しています。
- 次数分布: describe は、各ノードの次数を配列にし、平均・最大と、次数の大きい上位1%のノードが、エッジの端(次数の和)の何%を占めるかを求めます。次数の範囲ごとのノードの割合も表示します。
実行結果
Erdős–Rényi      平均次数: 6.00  最大次数:   19  上位1%のノードが持つエッジの端: 2.3%
    次数   1〜4    : 28.52%
    次数   5〜9    : 63.21%
    次数  10〜19   :  8.05%
    次数  20〜49   :  0.00%
    次数  50〜99   :  0.00%
    次数 100〜9999 :  0.00%
Barabási–Albert  平均次数: 6.00  最大次数:  427  上位1%のノードが持つエッジの端: 11.3%
    次数   1〜4    : 60.07%
    次数   5〜9    : 29.09%
    次数  10〜19   :  7.89%
    次数  20〜49   :  2.41%
    次数  50〜99   :  0.40%
    次数 100〜9999 :  0.14%
2つのモデルの次数分布を並べると、次のようになります。
(図は、diagram-designで作成)
平均次数はどちらも6ですが、次数の散らばり方はまったく違います。ER モデルでは、最大の次数は19で、ほとんどのノードの次数が平均の近くにあります。BA モデルでは、最大の次数が427に達し、次数が100以上のハブが0.14%(14個)あります。次数の大きい上位1%のノードが、エッジの端の11.3%を持っています。
Web のリンク、論文の引用、交友関係など、現実の多くのネットワークは、BA モデルのような ハブのある次数分布 を持つことが知られています。文書から「もの」と「関係」を取り出して作るグラフでも、多くの文書に登場する組織や地名がハブになります。ハブは、グラフの中で情報が集まる場所なので、どのノードが重要かを測る(中心性)、ハブを手がかりに密なまとまりを見つける(コミュニティ検出)といった分析の出発点になります。
経路と最短経路
幅優先探索(BFS):何本の道をたどるか
重みを考えずに、出発点 から各ノードまで、最少で何本のエッジをたどればよいか(ホップ数 )を求めるのが、幅優先探索(BFS:Breadth-First Search)です。
- 出発点 のホップ数を とし、待ち行列(キュー)に入れます。
- キューの先頭のノード を取り出し、まだ見つけていない隣のノード に を記録して、キューの末尾に入れます。
- キューが空になるまで、2 を繰り返します。
キューは先に入れたものから取り出すので、ホップ数0のノード、1のノード、2のノード、…の順に、出発点から近い順に広がっていきます。そのため、あるノードを初めて見つけたときのホップ数が、そのノードまでの最少のホップ数になります。各ノードと各エッジを一度ずつしか調べないので、計算量は です。実験1の表をつなげる方法が、すべてのルートを書き出したのに対して、BFS は ノードごとに一度だけ記録する ので、ルートの数が爆発しません。
ダイクストラ法:重みの合計が最小のルート
重み(所要時間)の合計が最小のルートを求めるのが、ダイクストラ法 です。出発点からの暫定の距離 を持ち、次の手順で確定させていきます。
- 、ほかのノードは未定(無限大)とします。
- まだ確定していないノードのうち、 が最小のノード を確定させます。
- の隣のノード について、 を経由した方が短ければ、距離を更新します(緩和)。
- すべてのノードが確定するまで、2〜3 を繰り返します。
重みが負でなければ、2 で選んだノードの距離は、ほかのどのルートを通っても、これより短くなりません(ほかのルートは、 がより大きい未確定のノードを経由するしかないからです)。そのため、確定した距離が最短であることが保証されます。 が最小のノードを取り出すのに、ヒープ(優先度付きキュー)を使うと、計算量は です。
from collections import deque
import heapq


# 1. 幅優先探索(BFS):出発点から近い順に広げ、各地点まで何本の道をたどるか(ホップ数)を求める
def bfs(adj, source):
    hops, parent = {source: 0}, {source: None}
    queue = deque([source])
    while queue:
        u = queue.popleft()                  # 先に見つけた地点から順に取り出す
        for v, _ in adj[u]:
            if v not in hops:                # 初めて見つけた地点だけ記録する
                hops[v], parent[v] = hops[u] + 1, u
                queue.append(v)
    return hops, parent


# 2. ダイクストラ法:所要時間の合計が小さい地点から順に確定させる
def dijkstra(adj, source):
    dist, parent = {source: 0}, {source: None}
    heap, done = [(0, source)], set()
    while heap:
        d, u = heapq.heappop(heap)           # まだ確定していない中で、所要時間が最小の地点
        if u in done:
            continue
        done.add(u)
        for v, w in adj[u]:
            if v not in dist or d + w < dist[v]:   # より短いルートが見つかったら更新する
                dist[v], parent[v] = d + w, u
                heapq.heappush(heap, (d + w, v))
    return dist, parent


def route(parent, goal):
    path = [goal]
    while parent[path[-1]] is not None:
        path.append(parent[path[-1]])
    return path[::-1]


def minutes_of(path):
    w = {frozenset((a, b)): t for a, b, t in trails.itertuples(index=False)}
    return sum(w[frozenset(e)] for e in zip(path, path[1:]))


hops, hop_parent = bfs(adj, start)
dist, dist_parent = dijkstra(adj, start)
p_hop, p_min = route(hop_parent, goal), route(dist_parent, goal)
print(f"BFS(道の本数が最少のルート)   : {len(p_hop) - 1} 本  {minutes_of(p_hop)} 分")
print(f"ダイクストラ法(所要時間が最短): {len(p_min) - 1} 本  {minutes_of(p_min)} 分")
print("所要時間が最短のルートだけが通る地点:", [x for x in p_min if x not in p_hop])

# 3. networkx の結果と一致するか
print("\nnetworkx と一致(ホップ数):", hops == dict(nx.single_source_shortest_path_length(G, start)))
print("networkx と一致(所要時間):", dist == dict(nx.single_source_dijkstra_path_length(G, start, weight="minutes")))
幅優先探索とダイクストラ法をスクラッチで実装し、Notaha 村から Monara 山へのルートを求めて、networkx の結果と比べるコードです。
- 幅優先探索: bfs は、deque(両端から出し入れできるキュー)で、先に見つけたノードから順に取り出します。初めて見つけたノードだけに、ホップ数 hops と、1つ手前のノード parent を記録します。
- ダイクストラ法: dijkstra は、heapq(最小値を取り出せるヒープ)に (暫定の距離, ノード) を入れ、距離が最小のノードから確定させます。同じノードがヒープに何度も入ることがあるので、確定済み(done)のノードは読み飛ばします。より短いルートが見つかれば、距離と手前のノードを更新します。
- ルートの復元: route は、ゴールから parent を出発点までさかのぼって、ルートを並べます。minutes_of は、ルートに含まれる道の所要時間を足します。
- 比較: BFS のルート(道の本数が最少)と、ダイクストラ法のルート(所要時間が最短)の、道の本数と所要時間を表示し、所要時間が最短のルートだけが通る地点を表示します。最後に、出発点からすべての地点へのホップ数と所要時間が、networkx の single_source_shortest_path_length・single_source_dijkstra_path_length と一致するかを確かめます。
実行結果
BFS(道の本数が最少のルート)   : 25 本  1534 分
ダイクストラ法(所要時間が最短): 26 本  1319 分
所要時間が最短のルートだけが通る地点: ['Mount Honeku', 'Mount Hokano', 'Mount Hofuna', 'Mount Tatomi', 'Mount Nahofu', 'Mount Shitora', 'Mount Shisuto']

networkx と一致(ホップ数): True
networkx と一致(所要時間): True
2つの方法で見つけたルートを並べると、次のようになります。
(図は、diagram-designで作成)
BFS は、道の本数が最少の25本のルートを見つけましたが、所要時間は1,534分でした。ダイクストラ法は、道は1本多い26本ですが、所要時間が最短の1,319分のルートを見つけ、実験1の表をつなげる方法で26本目に見つかった値と一致しました。所要時間が最短のルートは、途中の7つの山頂を通る、別の道筋をたどっています。重みのあるグラフでは、「たどるエッジの数が少ない」ことと「重みの合計が小さい」ことは別の問いで、問いに合わせてアルゴリズムを選ぶ必要があります。
なお、BFS が見つけた25本のルートは、25本のルートの中で所要時間が最短のもの(実験1の1,321分)とは限りません。BFS は、ホップ数が最少のルートのうち、先に見つけた1つを返すだけだからです。
スクラッチの実装は、どちらも networkx の結果と、すべての地点について一致しました。
連結成分:たどり着ける範囲
無向グラフで、互いに経路でつながっているノードの最大のまとまりを、連結成分 と呼びます。同じ連結成分の中のノードどうしは、必ず経路でつながっていて、違う連結成分のノードの間には、経路がありません。
連結成分は、BFS で求められます。まだどの成分にも入っていないノードから BFS を始め、たどり着けたノードをすべて1つの成分にします。これを、すべてのノードが成分に入るまで繰り返します。
有向グラフでは、「互いに行き来できる」(強連結成分)と、「向きを無視すればつながっている」(弱連結成分)を分けて考えます。
# 1. 連結成分:まだどの成分にも入っていない地点から BFS を始め、たどり着けた地点を1つの成分にする
def components(adj):
    seen, comps = set(), []
    for s in adj:
        if s in seen:
            continue
        reach, _ = bfs(adj, s)
        seen |= reach.keys()
        comps.append(sorted(reach))
    return comps


comps = components(adj)
for c in comps:
    ranges = points.set_index("name").loc[c, "range"].value_counts().to_dict()
    print(f"成分の大きさ: {len(c):3d}  含まれる山脈: {ranges}")
print("networkx と一致:", sorted(map(len, comps)) == sorted(len(c) for c in nx.connected_components(G)))
print(f"\n{goal} から Shiranami 山脈の山頂に行けるか:",
      nx.has_path(G, goal, points[(points['range'] == 'Shiranami') & (points['kind'] == 'summit')].name.iloc[0]))
登山道のグラフの連結成分を、BFS で求めるコードです。
- 連結成分: components は、地点を順に見て、まだどの成分にも入っていない地点 s から bfs を実行し、たどり着けた地点を1つの成分にします。たどり着けた地点は seen に加え、次の BFS の出発点にしないようにします。
- 確認: 成分ごとに、含まれる地点の山脈を数えます。成分の大きさが networkx の nx.connected_components と一致するかを確かめ、nx.has_path で Monara 山から Shiranami 山脈の山頂への経路があるかを調べます。
実行結果
成分の大きさ:  80  含まれる山脈: {'Hoshimi': 40, 'Akatsuki': 40}
成分の大きさ:  40  含まれる山脈: {'Shiranami': 40}
networkx と一致: True

Mount Monara から Shiranami 山脈の山頂に行けるか: False
登山道のグラフは、2つの連結成分に分かれました。1つは、峠越えの道でつながった Hoshimi 山脈と Akatsuki 山脈の80地点、もう1つは Shiranami 山脈の40地点です。Shiranami 山脈には、ほかの山脈の村からは、登山道だけではたどり着けません。データを作ったときに意図したとおりの結果です。
実際のデータでは、こうした「つながっていない部分」は、設計した覚えのないところに現れます。データの取り込み漏れや、名前の表記の揺れ(同じ地点が別のノードになる)によって、グラフが思わぬ形で分かれることがあります。連結成分の数と大きさを数えるのは、グラフのデータを作ったときの最初の確認として役立ちます。
グラフで表すと何がうれしいのか
実験で見たとおり、グラフで表すと、つながりをたどる問いに、組み合わせ爆発を起こさずに答えられます。データをグラフとして見ることで、次のような分析ができるようになります。
| 問い | グラフでの考え方 |
|---|---|
| A から B へ、最短でどう行くか | 最短経路(BFS・ダイクストラ法) |
| どこまでたどり着けるか、全体はいくつに分かれているか | 連結成分 |
| どのノードが、つながりの中心にあるか | 次数、中心性(PageRank など) |
| 密につながったまとまりは、どこにあるか | コミュニティ検出 |
| ある「もの」について、関係をたどってわかることは何か | 知識をグラフで表したナレッジグラフ |
最後の行のように、「X は Y の一部である」「X は Z に所属する」といった 知識 も、もの(エンティティ)をノード、関係をエッジにしたグラフで表せます。これをナレッジグラフと呼びます。RAG の記事の Modular RAG で触れた、知識グラフを直接検索する構成も、このグラフの上でつながりをたどる仕組みです。また、ベクトル検索でよく使われる索引にも、近いベクトルどうしをエッジで結んだ近傍グラフを、たどって探すものがあります。
グラフを使うときの注意点
- 何をノードとエッジにするかで、答えられる問いが決まる: 登山道を「地点をノード、道をエッジ」にしたので最短経路が求まりましたが、「山脈をノード」にすれば、山脈の間のつながりしか分かりません。グラフにする前に、答えたい問いからノードとエッジを決めます。
- 同じものが別のノードにならないようにする: 名前の表記が揺れると、同じ地点や人が別のノードになり、本来つながっているはずの部分が分かれます。グラフを作るときの名前のそろえ方(名寄せ)は、つながりの分析の結果を大きく左右します。
- 大きなグラフは、持ち方とアルゴリズムの計算量に注意する: 隣接行列は のメモリが必要で、10万ノードで10 GB になります。疎なグラフは隣接リストや疎行列で持ち、計算量が に近いアルゴリズムを選びます。
- ハブに引きずられる: ハブのあるグラフでは、多くの経路がハブを通るので、「ハブを経由すれば何でもつながる」状態になりがちです。分析によっては、ハブを除いたり、重みを調整したりする必要があります。
まとめ
本記事では、ものとものの「つながり」を表すグラフの基本を、架空の山域の登山道のデータで確かめました。
登山道の表を1本ずつつなげて最短ルートを探す方法では、ルートの数が1本ごとに約1.5倍に増え、30本の時点で約46万本になっても、それが最短だと言い切れませんでした。登山道をグラフとして持ち、ダイクストラ法を使うと、数ミリ秒で最短の1,319分を求められ、それが最短であることも保証されます。違いは、ルートを全部書き出すのではなく、地点ごとに最短の距離を一度だけ記録しながら広げていくことにありました。
グラフは、ノードとエッジの組で、隣接行列か隣接リストで持ちます。現実のグラフの多くは疎で、隣接リストで持つのが基本です。次数の分布にはハブのあるものが多く、BFS で最少のホップ数と連結成分を、ダイクストラ法で重みの合計が最小の経路を求められます。これらは、中心性やコミュニティ検出、ナレッジグラフといった、つながりのデータの分析の土台になります。
参考文献
- E. W. Dijkstra (1959). A note on two problems in connexion with graphs. Numerische Mathematik, 1(1), 269–271.
- J. B. Kruskal (1956). On the shortest spanning subtree of a graph and the traveling salesman problem. Proceedings of the American Mathematical Society, 7(1), 48–50.
- A. A. Hagberg, D. A. Schult, P. J. Swart (2008). Exploring Network Structure, Dynamics, and Function using NetworkX. Proceedings of the 7th Python in Science Conference, 11–15.
本記事の文章・構成の一部に生成AIを使用しています。