ナレッジグラフをたどる検索(GraphRAG の Local Search)とは?
 (画像は、Geminiで作成)
GraphRAG の Local Search が、質問に出てくるエンティティを手がかりに、ナレッジグラフの上でつながっている関係・元の文書・レポートを集める仕組みを、コードで理解すること。普通の RAG と比べて、どんな問いで文脈が良くなり、どこに限界があるのか(エンティティリンキング、LLM に数えさせること)を、数値で説明できるようになること。
原著論文: From Local to Global: A GraphRAG Approach to Query-Focused Summarization (Edge et al., arXiv 2024)。Local Search の手順は、論文ではなく Microsoft GraphRAG の公式ドキュメントと公開コードで説明されています。
本記事のコードは、Google Colab の A100 GPU(40GB)で、Python 3.13、transformers 5.22.1、torch 2.14.1、sentence-transformers 5.7.0、networkx 3.7、igraph 1.0.0、leidenalg 0.12.0 を使って実行しました。LLM には Qwen2.5-7B-Instruct(bf16)、埋め込みには SBERT のモデル(multi-qa-mpnet-base-cos-v1)を使います。モデルの読み込みのあとの実行には約8分かかり、そのうち約4分半はグラフとレポートを作るインデキシングの時間です。生成は貪欲法(do_sample=False)で、Leiden 法の乱数も固定しているので、同じ環境では同じ結果になります。
コミュニティ検出には igraph と leidenalg を使います。インストールされていない場合は、事前に次のコマンドを実行してください。
!pip install igraph leidenalg
概要
GraphRAG の記事では、文書からエンティティと関係のグラフを作り、コミュニティごとのレポートを map-reduce で読む Global Search で、「これらの山の主な問題は何か」のような全体を俯瞰する問いに答えました。そして最後に、「Hayate 山脈で落石のあった山はいくつか」のような 関係をたどる問い では、要約を読む Global Search(3山)も普通の RAG(12山)も答えられず、グラフの上で2つのノードの両方とつながる山を数えると、正解の36山になることを確かめました。
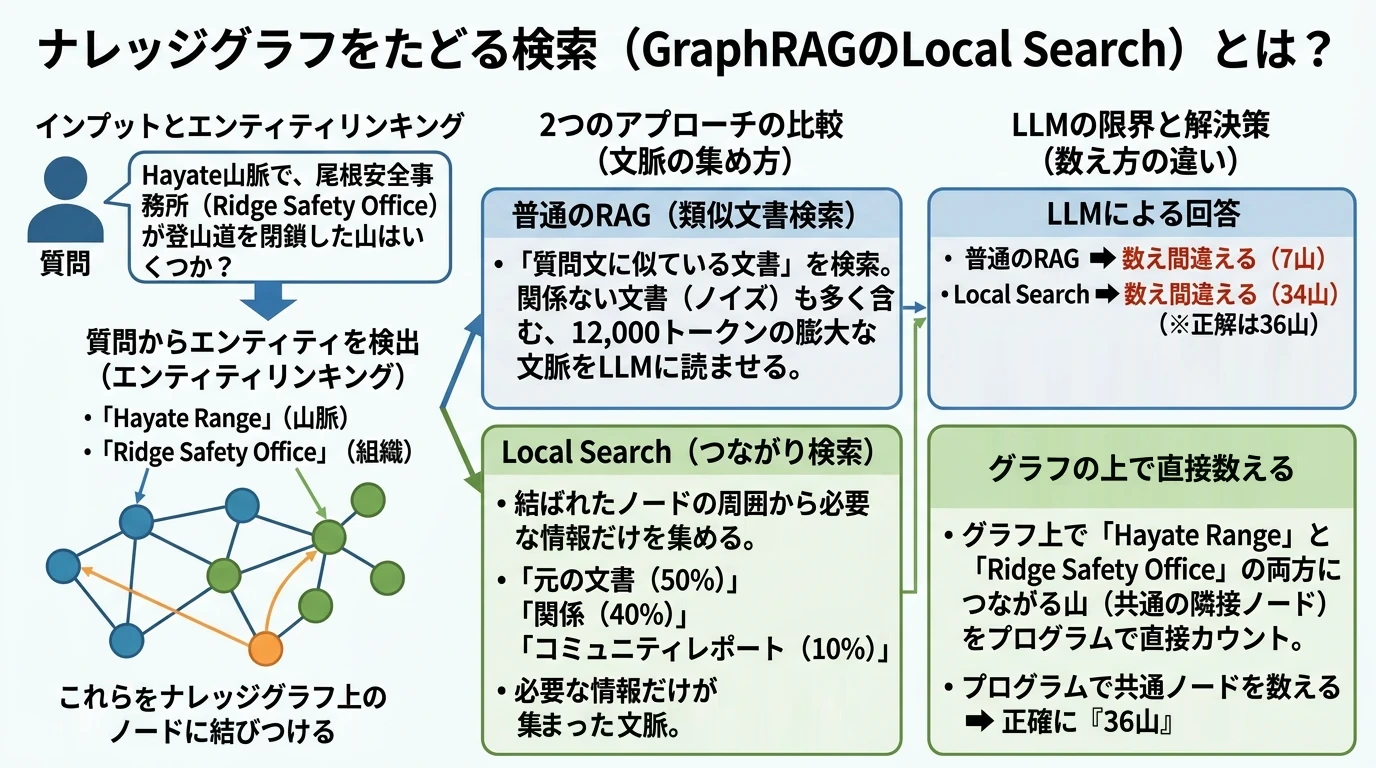
GraphRAG には、こうした特定のエンティティについての問いのために、もう1つの検索方法 Local Search があります。質問に出てくるエンティティ(山・組織・山脈など)をグラフの中で見つけ(エンティティリンキング)、そのノードの周りにある関係・元の文書・コミュニティのレポートを集めて、LLM に1回で答えさせます。普通の RAG が「質問の文と似ている文書」を集めるのに対し、Local Search は「質問のエンティティとグラフでつながっているもの」を集めます。
本記事では、GraphRAG の記事と同じ600件の架空の山の紹介文とグラフで Local Search を実装し、同じトークンの予算の普通の RAG と比べます。Local Search がうまくいく問い、エンティティリンキングでつまずく問い、文脈は正しいのに LLM が数え間違える問いを、順に確かめます。
Local Search の仕組み
(図は、diagram-designで作成)
インデキシングは GraphRAG の記事と同じです。違うのは、エッジに、その関係が出てきた元の文書の番号も貯めておく点です。質問が来たら、次の3つの段階で答えます。
- エンティティリンキング: 質問がどのエンティティについての問いかを決め、グラフのノードに結びます。公式の実装は、質問全体の埋め込みと、エンティティの説明文の埋め込みを比べ、似ている順に10個(top_k_mapped_entities)のエンティティを選びます。
- 文脈を集める: 選んだエンティティから、次の3種類を集め、トークンの予算の割合に分けて詰めます。公式のノートブックの例では、予算は12,000トークンで、元の文書に50%(text_unit_prop)、レポートに10%(community_prop)、残りの40%をエンティティと関係に使います。
- エンティティと関係: 選んだエンティティどうしの関係を先に入れ、外のノードへの関係は、そのノードが選んだエンティティのいくつとつながっているかの多い順に入れます。
- 元の文書: 選んだエンティティの関係が出てきた文書です。GraphRAG では text unit と呼びます。グラフに抜き出した関係だけでなく、元の文の細部も読めるようにするためです。
- コミュニティのレポート: 選んだエンティティを多く含むコミュニティのレポートから入れます。エンティティの周りの、大まかな話題を伝えるためです。
- 答える: 集めた文脈を LLM に1回読ませて答えさせます。Global Search のように、レポートの数だけ LLM を呼ぶことはありません。
ナレッジグラフの考え方はナレッジグラフの記事、グラフの作り方はLLM によるナレッジグラフの構築の記事、コミュニティはコミュニティ検出の記事で解説しています。
実験の準備
架空の山岳コーパス
GraphRAG の記事と同じ、600件の架空の山の紹介文を使います。どの文書にも「山脈・標高・登山道の起点の村・登山の適期」があり、363件には6つの問題(落石150件、山小屋の管理人100件、高山植物の盗掘60件、ライチョウの減少30件、雪崩15件、ごみ8件)のどれか1つが書かれています。山ごとに、山脈・村・問題のテーマを正解として記録しておき、「Avalanche Watch(雪崩監視班)が雪崩を報告した山」「Hayate 山脈で落石のあった山」のような問いの正解を数えます。
import random
import re

SYLLABLES = ["ka", "ra", "se", "mo", "ri", "to", "na", "shi", "ku", "yo",
             "ha", "ne", "ta", "mi", "su", "ho", "ki", "no", "wa", "fu"]
RANGES = ["Hoshimi", "Akatsuki", "Kirisame", "Tsukishiro", "Hayate", "Shiranami"]
VILLAGES = ["Oda", "Kanbe", "Minase", "Toyoura", "Ishida", "Yanagi", "Sakaki", "Hirano"]
SEASONS = ["early summer", "midsummer", "late summer", "early autumn"]

# 6つの問題(テーマ):文書の数、回答がそのテーマに触れたかを見つける正規表現、文書に足す文
THEMES = {
    "rockfall": (150, r"rock ?fall|falling rock|loose rock",
                 "After repeated rockfall, the Ridge Safety Office closed the upper trail of Mount {n} for the season."),
    "hut_keeper": (100, r"keeper|successor|caretaker|\bhuts?\b",
                   "The hut on Mount {n} may close because its keeper is retiring and no successor has been found."),
    "plant_poaching": (60, r"lil(y|ies)|poach",
                       "Rangers found that snow lilies had been dug up and taken from the meadow on Mount {n}."),
    "ptarmigan": (30, r"ptarmigan",
                  "Surveys show that fewer rock ptarmigans nest on Mount {n} than ten years ago."),
    "avalanche": (15, r"avalanche",
                  "Avalanche Watch reported a large avalanche on the north face of Mount {n} last winter."),
    "litter": (8, r"trash|litter|garbage|rubbish",
               "Clean Summit Volunteers collected bags of trash left by hikers on Mount {n}."),
}
# 文の意味:rockfall「落石が続き、尾根安全事務所は {n} 山の上部の登山道を今シーズン閉鎖した」
#   hut_keeper「管理人が引退し後継者が見つからないため、{n} 山の山小屋は閉鎖されるかもしれない」
#   plant_poaching「レンジャーは、{n} 山の草原でスノーリリーが掘り取られて持ち去られているのを見つけた」
#   ptarmigan「調査によると、{n} 山で巣を作るライチョウは10年前より少ない」
#   avalanche「雪崩監視班は、昨冬 {n} 山の北面で大きな雪崩があったと報告した」
#   litter「クリーン・サミット・ボランティアは、{n} 山で登山者が残したごみを何袋も集めた」


def build_corpus(themes, n=600, seed=0):
    rng = random.Random(seed)
    names = set()
    while len(names) < n:                                      # (a) 音節3つの架空の山の名前
        names.add("".join(rng.choice(SYLLABLES) for _ in range(3)).capitalize())
    names = sorted(names)
    labels = [t for t, (count, _, _) in themes.items() for _ in range(count)]
    labels += [None] * (n - len(labels))                       # (b) 問題の文がない山
    rng.shuffle(labels)
    docs = []
    for name, theme in zip(names, labels):
        # 「{name} 山は {山脈} 山脈の峰で、標高 {高さ} メートル。主な登山道は {村} 村から始まる。登山の適期は {季節}。」
        mountain_range, height, village = rng.choice(RANGES), rng.randint(1500, 3999), rng.choice(VILLAGES)
        text = (f"Mount {name} is a peak in the {mountain_range} Range, rising {height:,} meters "
                f"above sea level. The main trail starts from the village of {village}. "
                f"The best season to climb it is {rng.choice(SEASONS)}.")
        if theme:                                              # (c) 問題の文を足し、どのテーマかを記録する
            text += " " + themes[theme][2].format(n=name)
        docs.append({"mountain": name, "range": mountain_range, "village": village, "text": text, "theme": theme})
    return docs


docs = build_corpus(THEMES)
print("文書の数:", len(docs), " 問題の文がある文書:", sum(d["theme"] is not None for d in docs))
print("例:", docs[1]["text"])
架空の山の紹介文を600件作り、問題のテーマ・山脈・登山口の村を、正解として一緒に記録するコードです。GraphRAG・RAPTOR の記事と同じコードなので、同じ600件ができます。
- THEMES: テーマごとに「文書の数、答えがそのテーマに触れたかを判定する正規表現、文書に足す文」を持つ辞書です。本記事では、1つの山の事実の問いで、答えが正しい問題に触れたかの判定に、この正規表現を使います。
- docs: 1件ずつ、山の名前・山脈・村・本文・テーマを持つ辞書のリストです。問いの正解は、すべてこのリストの range・village・theme から数えます。
- (a)〜(c): 音節を3つつないだ架空の名前を600個作り、テーマの並びをでたらめに混ぜて、1件ずつ文書にします。乱数のシードを固定しているので、何度実行しても同じ600件になります。
実行結果
文書の数: 600  問題の文がある文書: 363
例: Mount Fuhoha is a peak in the Kirisame Range, rising 2,859 meters above sea level. The main trail starts from the village of Yanagi. The best season to climb it is early autumn. After repeated rockfall, the Ridge Safety Office closed the upper trail of Mount Fuhoha for the season.
英語の出力の日本語訳:
- 例:「Fuhoha 山は Kirisame 山脈の峰で、標高2,859メートル。主な登山道は Yanagi 村から始まる。登山の適期は初秋。落石が続いたため、尾根安全事務所は Fuhoha 山の上部の登山道を今シーズン閉鎖した。」
LLM と埋め込み
LLM と、使用量(呼び出し回数・入力と出力のトークン数・時間)を数えながら生成する関数は、GraphRAG の記事と同じです。
import time

import numpy as np
import torch
from sentence_transformers import SentenceTransformer
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_ID = "Qwen/Qwen2.5-7B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, padding_side="left")
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, dtype=torch.bfloat16, device_map="cuda")
model.eval()
# 埋め込み:原著論文と同じ SBERT のモデル
embedder = SentenceTransformer("sentence-transformers/multi-qa-mpnet-base-cos-v1", device="cuda")


def n_tokens(text):
    return len(tokenizer(text)["input_ids"])


def new_usage():
    """LLM の使用量を数える入れ物:呼び出し回数・入力と出力のトークン数・時間(秒)"""
    return {"calls": 0, "input_tokens": 0, "output_tokens": 0, "seconds": 0.0}


@torch.no_grad()
def generate(prompts, usage, max_new_tokens=600, batch_size=16):
    """プロンプトのリストをまとめて生成し、使用量を usage に足していく"""
    outputs, start = [], time.time()
    for i in range(0, len(prompts), batch_size):
        texts = [tokenizer.apply_chat_template([{"role": "user", "content": p}], tokenize=False,
                                               add_generation_prompt=True) for p in prompts[i:i + batch_size]]
        inputs = tokenizer(texts, return_tensors="pt", padding=True).to(model.device)
        out = model.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
        for row, mask in zip(out[:, inputs["input_ids"].shape[1]:], inputs["attention_mask"]):
            text = tokenizer.decode(row, skip_special_tokens=True).strip()
            usage["calls"] += 1
            usage["input_tokens"] += int(mask.sum())
            usage["output_tokens"] += n_tokens(text)
            outputs.append(text)
    usage["seconds"] += time.time() - start
    return outputs


def embed(texts):
    """文のリストを、長さ1に正規化した埋め込みにする(内積がそのままコサイン類似度になる)"""
    return embedder.encode(texts, normalize_embeddings=True, batch_size=64)
LLM と埋め込みのモデルを読み込み、生成と埋め込みの関数を用意するコードです。
- generate(prompts, usage, max_new_tokens=600, batch_size=16): プロンプトのリストを batch_size 個ずつまとめて生成し、使用量を usage に足していきます。インデキシングの手間を数えるのに使います。
- embed: 長さを1にそろえたベクトルを返します。内積がそのままコサイン類似度になるので、エンティティリンキングと普通の RAG の検索は、内積を計算して大きい順に並べるだけで済みます。
インデックスを作る
グラフ:エッジに元の文書の番号を貯める
GraphRAG の記事と同じプロンプトで、600件の文書からエンティティと関係を抽出し、関係をエッジにしたグラフを作ります。Local Search で元の文書に戻れるように、エッジに、その関係が出てきた文書の番号を貯めます。
import networkx as nx

EXTRACT = ("Extract the entities and relationships from the text.\n"
           "Write one entity per line as: entity | <name> | <type>\n"
           "Write one relationship per line as: relation | <source> | <target> | <short description>\n"
           "Types are: mountain, range, village, organization, species, other.\n\n"
           "Example text: Mount Taro is a peak in the Akatsuki Range. A bear was seen near its hut.\n"
           "entity | Mount Taro | mountain\n"
           "entity | Akatsuki Range | range\n"
           "entity | bear | species\n"
           "relation | Mount Taro | Akatsuki Range | Mount Taro is a peak in the Akatsuki Range\n"
           "relation | bear | Mount Taro | a bear was seen near the hut on Mount Taro\n\n"
           "Text: {text}")


def parse(text):
    """「entity | 名前 | 種類」「relation | 始点 | 終点 | 説明」の行を取り出す"""
    entities, relations = [], []
    for line in text.splitlines():
        parts = [p.strip() for p in line.split("|")]
        if parts[0] == "entity" and len(parts) >= 3:
            entities.append({"name": parts[1], "type": parts[2]})
        elif parts[0] == "relation" and len(parts) >= 4:
            relations.append({"source": parts[1], "target": parts[2], "description": parts[3]})
    return entities, relations


def key(name):
    """名寄せ:大文字小文字と、先頭の the の違いだけをそろえる"""
    return re.sub(r"^the\s+", "", name.strip().lower())


def build_graph(extractions):
    """関係をエッジにしてグラフを作る。エッジには、重み・説明と、その関係が出てきた文書の番号を貯める"""
    G = nx.Graph()
    for i, text in enumerate(extractions):
        for r in parse(text)[1]:
            s, t = key(r["source"]), key(r["target"])
            if s == t:
                continue
            if not G.has_edge(s, t):
                G.add_edge(s, t, weight=0, descriptions=[], docs=[])
            G[s][t]["weight"] += 1
            G[s][t]["descriptions"].append(r["description"])
            G[s][t]["docs"].append(i)                          # 元の文書(text unit)に戻るための番号
    return G


index_usage = new_usage()
extractions = generate([EXTRACT.format(text=d["text"]) for d in docs], index_usage, max_new_tokens=300)
G = build_graph(extractions)
print(f"ノード {G.number_of_nodes()}  エッジ {G.number_of_edges()}")
print("hayate range の次数:", G.degree["hayate range"], " ridge safety office の次数:", G.degree["ridge safety office"])
print("ridge safety office -- mount fuhoha:", G["ridge safety office"]["mount fuhoha"])
文書ごとにエンティティと関係を抽出させ、関係を集めてグラフにするコードです。抽出のプロンプト EXTRACT、出力を読み取る parse、名寄せの key は、GraphRAG の記事と同じなので、詳しい説明はそちらに任せます。
- build_graph(extractions): 関係の始点と終点をノードにして、エッジを張ります。
- weight: 同じ2つのノードの組が出てきた回数です。コミュニティ検出で、よく出てくる関係を強いつながりとして扱い、Local Search では、同じ順位の関係のうち、よく出てくるものを先に入れるのに使います。
- descriptions: 関係の説明のリストです。文脈に入れるときは、最初の1つを使います。
- docs: その関係が出てきた文書の番号(docs のリストの位置)のリストです。GraphRAG の記事にはなかった項目で、Local Search が「このエンティティの関係が書かれた元の文書」を集めるために使います。公式の実装でも、エンティティと関係は、それが抽出された text unit の番号を持っています。
- エッジを先に作ってから足す: エッジがなければ、重み0・空のリストで作り、そのあと重みに1を足して、説明と文書の番号を追加します。初めての関係と、2回目以降の関係を同じ3行で扱えます。
- max_new_tokens=300: 1件の抽出は7行前後(出力は平均約100トークン)なので、余裕をもって収まる上限です。
実行結果
ノード 728  エッジ 1725
hayate range の次数: 108  ridge safety office の次数: 150
ridge safety office -- mount fuhoha: {'weight': 1, 'descriptions': ['the Ridge Safety Office closed the upper trail of Mount Fuhoha'], 'docs': [1]}
GraphRAG の記事と同じ、ノード728個・エッジ1,725本のグラフができました。Hayate 山脈のノードは108山と、尾根安全事務所(Ridge Safety Office)のノードは落石の150山とつながっています。尾根安全事務所と Fuhoha 山のエッジには、説明「尾根安全事務所が Fuhoha 山の上部の登山道を閉鎖した」と、それが出てきた文書の番号1が入っています。
コミュニティとレポート
GraphRAG の記事の細かい階層(C1)と同じ手順で、グラフをコミュニティに分け、コミュニティごとにレポートを書かせます。Local Search では、レポートは文脈の一部(予算の10%)として使うだけなので、1つの階層で足ります。
import igraph as ig
import leidenalg

REPORT = ("Below are relationships from one part of a knowledge graph about mountains.\n\n{relations}\n\n"
          "Write a short report about this group: a title, then three to five key findings, each one sentence. "
          "Mention specific problems, organizations, or species if they appear.")


def leiden(G, nodes, seed=0):
    """nodes が作る部分グラフを、Leiden 法でモジュラリティが大きくなるように分ける"""
    H = ig.Graph.from_networkx(G.subgraph(nodes))
    partition = leidenalg.find_partition(H, leidenalg.ModularityVertexPartition, weights="weight", seed=seed)
    return [[H.vs[i]["_nx_name"] for i in c] for c in partition]


def communities_c1(G, max_size=50, min_size=3):
    """GraphRAG の記事の C1:全体を Leiden 法で分け、max_size より大きいものをさらに分ける"""
    c1 = []
    for c in leiden(G, list(G.nodes)):
        if len(c) < min_size:
            continue
        parts = leiden(G, c) if len(c) > max_size else [c]
        c1 += [p for p in parts if len(p) >= min_size]
    return c1


def community_context(G, nodes, max_tokens=3000):
    """コミュニティの中のエッジを、両端の次数の和が大きい順に、max_tokens まで並べる"""
    lines, total = [], 0
    edges = sorted(G.subgraph(nodes).edges(data=True), key=lambda e: -(G.degree[e[0]] + G.degree[e[1]]))
    for s, t, a in edges:
        line = f"- {s} -- {t}: {a['descriptions'][0]}"
        total += n_tokens(line)
        if total > max_tokens:
            break
        lines.append(line)
    return "\n".join(lines)


communities = communities_c1(G)
reports = generate([REPORT.format(relations=community_context(G, c)) for c in communities],
                   index_usage, max_new_tokens=300, batch_size=8)
print(f"コミュニティ(C1) {len(communities)}個")
print(f"インデキシング: 呼び出し {index_usage['calls']}回  入力 {index_usage['input_tokens']:,}  "
      f"出力 {index_usage['output_tokens']:,}  時間 {index_usage['seconds']:.0f} 秒")
グラフを Leiden 法で2段に分け、コミュニティごとにレポートを書かせるコードです。
- communities_c1(G, max_size=50, min_size=3): グラフ全体を Leiden 法で分け、ノードが50個より多いまとまりを、その中でもう一度分けます。3個より少ないまとまりは捨てます。GraphRAG の記事の C1 と同じ分け方で、値の理由もそちらで説明しています。
- leiden(G, nodes, seed=0): GraphRAG の記事では、モジュラリティも一緒に返していましたが、ここではコミュニティだけを返します。シードを固定して、何度実行しても同じ分け方になるようにしています。
- community_context と REPORT: GraphRAG の記事と同じです。コミュニティの中のエッジを、両端の次数の和が大きい順に並べて読ませ、タイトルと要点3〜5個のレポートを書かせます。
- index_usage: 抽出とレポートの使用量を、1つの入れ物に足していきます。
実行結果
コミュニティ(C1) 25個
インデキシング: 呼び出し 625回  入力 162,394  出力 62,017  時間 259 秒
GraphRAG の記事と同じく、25個のコミュニティができました。インデキシングでは、LLM を625回(抽出600回とレポート25回)呼び、入力は約16万2千トークン、時間は259秒でした。
エンティティリンキング
公式の方法:質問全体と、エンティティの説明文を比べる
まず、公式の実装と同じく、質問全体の埋め込みと、エンティティの説明文の埋め込みを比べてみます。公式の実装では、エンティティの説明文は、そのエンティティについて抽出された説明を LLM で1つに要約したものです。本記事では、関係の説明をいくつかつないだものを、説明文の代わりにします。
import collections


def entity_index(G, docs, communities, reports, n_descriptions=3):
    """Local Search で使うものをまとめる:エンティティの名前と説明文の埋め込み、エンティティ → コミュニティの対応など"""
    names = list(G.nodes)
    texts = []
    for n in names:
        descriptions = list(dict.fromkeys(d for _, _, a in G.edges(n, data=True) for d in a["descriptions"]))
        texts.append(f"{n}: " + " ".join(descriptions[:n_descriptions]))   # (a) 名前+関係の説明を少し
    community_of = {n: c for c, members in enumerate(communities) for n in members}
    return {"G": G, "docs": docs, "names": names, "texts": texts,
            "description_vecs": embed(texts), "name_vecs": embed(names),
            "community_of": community_of, "reports": reports}


def map_entities(index, question, k=10):
    """公式の方法:質問全体の埋め込みに近い順に、エンティティの説明文を k 個選ぶ"""
    q = embed([question])[0]
    return [index["names"][i] for i in np.argsort(-(index["description_vecs"] @ q))[:k]]


index = entity_index(G, docs, communities, reports)
print("説明文の例:", index["texts"][index["names"].index("avalanche watch")])
for question in ["List all mountains where Avalanche Watch reported an avalanche.",
                 "How many mountains in the Hayate Range had their upper trail closed after rockfall?"]:
    print(question, "\n  →", map_entities(index, question))
Local Search で使うものを1つの辞書にまとめ、公式の方法でエンティティを選ぶコードです。
- entity_index(G, docs, communities, reports, n_descriptions=3): Local Search の関数に渡す辞書を作ります。
- (a) 説明文: ノードの名前に、そのノードのエッジの説明を、重複を除いて最初の3つまでつなぎます。dict.fromkeys は、順番を保ったまま重複を除くために使っています。3つにしたのは、尾根安全事務所のように150本のエッジを持つノードでも、説明文が長くなりすぎず、どんな関係を持つノードかが分かる長さにするためです。
- description_vecs と name_vecs: 説明文の埋め込みと、名前だけの埋め込みです。名前だけの埋め込みは、次の節の方法で使います。
- community_of: ノードの名前 → そのノードが入っているコミュニティの番号の辞書です。小さすぎて捨てたコミュニティのノードは入りません。
- reports: コミュニティの番号 → レポートの文です(リストの位置が番号)。
- map_entities(index, question, k=10): 質問全体の埋め込みと、全ノードの説明文の埋め込みの内積を計算し、大きい順に10個の名前を返します。10個は、公式の実装の既定値(top_k_mapped_entities)です。
実行結果
説明文の例: avalanche watch: Avalanche Watch reported a large avalanche on the north face of Mount Kakuyo Avalanche Watch reported a large avalanche on the north face of Mount Kuhoshi Avalanche Watch reported a large avalanche on the north face of Mount Mikaho
List all mountains where Avalanche Watch reported an avalanche.
  → ['avalanche watch', 'mount sewasu', 'mount kakuyo', 'mount mikaho', 'mount yonewa', 'mount tohaho', 'mount yonamo', 'mount tamiho', 'mount shineto', 'mount miwaki']
How many mountains in the Hayate Range had their upper trail closed after rockfall?
  → ['upper trail', 'mount miwaki', 'mount narana', 'mount hosuyo', 'mount kihase', 'mount hakato', 'mount miyone', 'mount shineto', 'mount shinawa', 'mount hakuse']
英語の出力の日本語訳:
-
説明文の例:「avalanche watch(雪崩監視班):雪崩監視班は Kakuyo 山の北面で大きな雪崩を報告した。雪崩監視班は Kuhoshi 山の北面で大きな雪崩を報告した。雪崩監視班は Mikaho 山の北面で大きな雪崩を報告した。」
-
1つ目の質問:「雪崩監視班が雪崩を報告した山をすべて挙げよ。」
-
2つ目の質問:「Hayate 山脈で、落石のために上部の登山道が閉鎖された山はいくつか。」
-
1つ目の質問では、目的のノードが1番目に来た: 「雪崩監視班」が質問に名前のまま出てくるので、雪崩監視班のノードがいちばん似ていました。残りの9個は、雪崩の山などの山のノードです。
-
2つ目の質問では、Hayate 山脈のノードが10個に入らなかった: 選ばれたのは「upper trail(上部の登山道)」と、9つの山のノードでした。1つの山のノードは、山脈・村・問題の関係を持っているので、説明文に「Hayate Range」「closed the upper trail」が全部入っている山もあり、質問全体と似てしまいます。一方、Hayate 山脈のノードの説明文は「〜山は Hayate 山脈の峰」が3つ並ぶだけなので、質問全体とはそれほど似ません。尾根安全事務所も、質問に名前が出てこないので選ばれませんでした。
質問全体と比べる方法では、質問の中に条件が2つ(Hayate 山脈・落石)あっても、その両方をまとめて1つの埋め込みにするので、条件の1つ1つに当たるノードを選べません。
質問のエンティティを書き出して、1つずつ結ぶ
そこで、質問に出てくるエンティティを LLM に書き出させ、1つずつ、名前の埋め込みがいちばん近いノードに結びます。質問の中の言葉を先に取り出してからグラフのノードに結ぶ方法は、HippoRAG など、グラフを使う後続の RAG の手法でも使われています。
MENTIONS = ("List the entities mentioned in the question: mountains, ranges, villages, organizations, species, "
            "and other things such as problems or events. Write one entity per line and nothing else.\n\n"
            "Question: {question}")


def link_entities(index, question, usage, threshold=0.8):
    """質問に出てくるエンティティを LLM に書き出させ、それぞれを名前の埋め込みがいちばん近いノードに結ぶ"""
    text = generate([MENTIONS.format(question=question)], usage, max_new_tokens=60, batch_size=1)[0]
    mentions = [m.strip("-•* ").strip() for m in text.splitlines() if m.strip()]   # (a) 質問の中の言葉
    sims = embed(mentions) @ index["name_vecs"].T                                   # (b) 言葉 × ノードの名前
    linked = [(m, index["names"][int(s.argmax())], float(s.max())) for m, s in zip(mentions, sims)]
    entities = list(dict.fromkeys(n for _, n, sim in linked if sim >= threshold))  # (c) 似ていなければ結ばない
    return entities, linked


usage = new_usage()
for question in ["List all mountains where Avalanche Watch reported an avalanche.",
                 "How many mountains in the Hayate Range had their upper trail closed after rockfall?",
                 "From which village does the main trail of Mount Fuhoha start, and what problem is reported there?"]:
    entities, linked = link_entities(index, question, usage)
    print(question)
    print("  書き出した言葉 → いちばん近いノード(類似度):", [(m, n, round(s, 2)) for m, n, s in linked])
    print("  結んだエンティティ:", entities)
質問の中のエンティティを書き出させ、グラフのノードに結ぶコードです。
- MENTIONS: 質問に出てくるエンティティ(山・山脈・村・組織・生物と、問題や出来事)を、1行に1つ書かせるプロンプトです。問題や出来事も挙げさせているのは、落石やライチョウのように、問題を表す言葉もノードに結べるかを試すためです。
- link_entities(index, question, usage, threshold=0.8):
- (a): LLM の出力を1行ずつに分け、先頭の「-」「•」「*」や空白を取り除いて、言葉のリストにします。
- (b): 言葉の埋め込みと、全ノードの名前の埋め込みの内積を、まとめて行列の積で計算します。sims は「言葉の数 × ノードの数(728)」の配列で、行ごとの最大値の位置が、その言葉にいちばん近いノードです。
- (c): 類似度が0.8以上のノードだけを結びます。同じノードに2つの言葉が結ばれることもあるので、順番を保ったまま重複を除きます。
- 返り値は、結んだノードの名前のリストと、確かめるための「言葉・いちばん近いノード・類似度」のリストです。
- threshold=0.8: 実行結果のとおり、名前がそのまま一致する言葉の類似度は1.0でした。一方、「village」と「kanbe village」、「mountains」と「mountaintop」のように、別のものを指すノードとの類似度は0.66以下でした。その間の0.8を境にして、ノードにない言葉を、無理に別のノードに結ばないようにしています。表記が少し違うだけの言葉(「rock ptarmigans」と「rock ptarmigan」など)は0.8を超えるので、結ばれます(後の数える問いで確かめます)。
- max_new_tokens=60: 書き出すのは数語なので、短い上限にして生成の時間を抑えています。
実行結果
List all mountains where Avalanche Watch reported an avalanche.
  書き出した言葉 → いちばん近いノード(類似度): [('Avalanche Watch', 'avalanche watch', 1.0)]
  結んだエンティティ: ['avalanche watch']
How many mountains in the Hayate Range had their upper trail closed after rockfall?
  書き出した言葉 → いちばん近いノード(類似度): [('Hayate Range', 'hayate range', 1.0), ('mountains', 'mountaintop', 0.65), ('rockfall', 'rock ptarmigan', 0.4), ('problems', 'not found', 0.39)]
  結んだエンティティ: ['hayate range']
From which village does the main trail of Mount Fuhoha start, and what problem is reported there?
  書き出した言葉 → いちばん近いノード(類似度): [('village', 'kanbe village', 0.66), ('Mount Fuhoha', 'mount fuhoha', 1.0), ('problem', 'not found', 0.39)]
  結んだエンティティ: ['mount fuhoha']
英語の出力の日本語訳:
-
3つ目の質問:「Fuhoha 山の主な登山道は、どの村から始まるか。その山で報告されている問題は何か。」
-
名前が出てくるエンティティは、確実に結べた: 「Avalanche Watch」「Hayate Range」「Mount Fuhoha」は、類似度1.0で、それぞれのノードに結ばれました。
-
「rockfall(落石)」は、どのノードにも結べなかった: 落石にいちばん近いノードは「rock ptarmigan(ライチョウ)」で、類似度は0.40でした。GraphRAG の記事で確かめたとおり、抽出で落石はエンティティにも関係にもならず、グラフに落石のノードがないからです。そのため、2つ目の質問で結んだのは Hayate 山脈だけで、「落石」の条件は、グラフの上では使えません。
-
「village(村)」「problem(問題)」のような一般的な言葉: 類似度が0.8より低いので、結びませんでした。
文脈を集める
結んだノードから、レポート・エンティティと関係・元の文書を、予算の割合に分けて集めます。比べる相手として、同じ予算まで似ている文書を詰める普通の RAG も用意します。
def fill(lines, budget):
    """lines を先頭から、合計 budget トークンまで取る"""
    selected, total = [], 0
    for line in lines:
        n = n_tokens(line)
        if total + n > budget:
            break
        selected.append(line)
        total += n
    return selected


def local_context(index, entities, max_tokens=12000, text_prop=0.5, community_prop=0.1):
    """選んだエンティティから、レポート・エンティティと関係・元の文書を、予算の割合に分けて集める"""
    G, selected = index["G"], set(entities)
    # (a) コミュニティのレポート:選んだエンティティを多く含むコミュニティから
    counts = collections.Counter(index["community_of"][e] for e in entities if e in index["community_of"])
    reports = fill([index["reports"][c] for c, _ in counts.most_common()], max_tokens * community_prop)
    # (b) 関係:選んだエンティティどうしの関係が先。外のノードへの関係は、そのノードが選んだエンティティの
    #     いくつとつながっているかの多い順(選んだエンティティの両方とつながるノードが上に来る)
    links = collections.Counter(x for e in entities for x in G.neighbors(e) if x not in selected)
    edges = {tuple(sorted(e)) for e in G.edges(entities)}

    def rank(edge):
        s, t = edge
        if s in selected and t in selected:
            return (0, 0, -G[s][t]["weight"])
        outside = t if s in selected else s
        return (1, -links[outside], -G[s][t]["weight"])

    lines = [f"- {e} (degree {G.degree[e]})" for e in entities]
    lines += [f"- {s} -- {t}: {G[s][t]['descriptions'][0]}" for s, t in sorted(edges, key=rank)]
    graph_part = fill(lines, max_tokens * (1 - text_prop - community_prop))
    # (c) 元の文書:選んだエンティティの関係が多く出てくる文書から
    doc_counts = collections.Counter(i for e in entities for _, _, a in G.edges(e, data=True) for i in a["docs"])
    sources = fill([index["docs"][i]["text"] for i, _ in doc_counts.most_common()], max_tokens * text_prop)
    return ("-----Reports-----\n" + "\n\n".join(reports) +
            "\n\n-----Entities and relationships-----\n" + "\n".join(graph_part) +
            "\n\n-----Sources-----\n" + "\n".join(sources))


def rag_context(docs, doc_vecs, question, max_tokens=12000):
    """普通の RAG:質問に似ている文書を、同じ予算まで取る"""
    q = embed([question])[0]
    return "\n".join(fill([docs[i]["text"] for i in np.argsort(-(doc_vecs @ q))], max_tokens))


QA = "Data:\n{context}\n\nQuestion: {question}"
doc_vecs = embed([d["text"] for d in docs])
question = "List all mountains where Avalanche Watch reported an avalanche."
entities, _ = link_entities(index, question, new_usage())
context = local_context(index, entities)
print(f"エンティティ {entities}  文脈 {n_tokens(context):,}トークン")
print(context[:1200])
print("…")
print(context[context.index("-----Sources-----"):][:600])
Local Search の文脈と、普通の RAG の文脈を作るコードです。
- fill(lines, budget): 行を先頭から足していき、合計が budget トークンを超える手前で止めます。どの部分も、並べた順に、予算まで入れます。
- local_context(index, entities, max_tokens=12000, text_prop=0.5, community_prop=0.1): 3つの部分を作って、見出しを付けてつなぎます。
- (a) レポート: 結んだノードが入っているコミュニティを数え、多く含むコミュニティのレポートから、予算の10%(1,200トークン)まで入れます。レポート1件は約200〜300トークンなので、4〜5件までです。
- (b) エンティティと関係: 結んだノードの名前と次数を並べ、続けて、結んだノードのエッジを並べます。G.edges(entities) は、どれかのノードにつながる全エッジで、同じエッジが2回出ないように、両端を並べ替えた組の集合にしています。並べ方は rank で決めます。
- 結んだノードどうしのエッジを、いちばん先にします。
- 外のノードへのエッジは、links(外のノード → 結んだノードのいくつとつながっているか)の多い順にします。Hayate 山脈と尾根安全事務所を結んだ場合、両方とつながる山(落石のあった Hayate 山脈の山)の links は2、片方だけとつながる山は1なので、両方の条件を満たす山のエッジが先頭にまとまります。公式の実装と同じ並べ方です。
- links が同じなら、weight(出てきた回数)の多い順にします。
- 予算は、全体から文書とレポートの分を引いた40%(4,800トークン)です。
- (c) 元の文書: 結んだノードのエッジに貯めた文書の番号を数え(doc_counts)、多く出てくる文書から、予算の50%(6,000トークン)まで入れます。結んだノードの2つともの関係が書かれた文書は2回数えられるので、(b) と同じく、両方の条件を満たす文書が先に入ります。
- max_tokens=12000、text_prop=0.5、community_prop=0.1: 公式のノートブックの例の値です。
- rag_context(docs, doc_vecs, question, max_tokens=12000): 普通の RAG です。質問と似ている順に文書を並べ、Local Search と同じ12,000トークンまで詰めます。1件は約60トークンなので、約200件になります。予算をそろえることで、違いが「何を集めるか」だけになるようにしています。
- QA: 「データ:… 質問:…」の形のプロンプトです。Local Search と普通の RAG で同じものを使います。
実行結果
エンティティ ['avalanche watch']  文脈 1,502トークン
-----Reports-----
Title: Recent Avalanche Activity in the Shikune Range

Key Findings:
1. Multiple large avalanches have been reported on the north faces of several mountains in the Shikune range, including Mount Shikune, Mount Miwaki, Mount Miyone, Mount Mohone, Mount Nesemo, and Mount Shineto.
2. Avalanche Watch has issued reports for all these events, indicating significant ongoing activity in the region.
3. Notably, Mount Tohaho and Mount Yonamo also experienced notable events, though not as severe as those on the north faces.
4. The consistent occurrence of large avalanches suggests a heightened risk period for the area, requiring increased monitoring and safety measures.
5. These events highlight the importance of continued collaboration between local authorities and environmental agencies to ensure public safety and prepare for potential hazards.

-----Entities and relationships-----
- avalanche watch (degree 15)
- avalanche watch -- mount sewasu: Avalanche Watch reported a large avalanche on the north face of Mount Sewasu
- avalanche watch -- mount mikaho: Avalanche Watch reported a large avalanche on the north face of Mount Mikaho
- avalanche watch -- mount serane: Avalanc
…
-----Sources-----
Mount Kakuyo is a peak in the Akatsuki Range, rising 2,095 meters above sea level. The main trail starts from the village of Hirano. The best season to climb it is early summer. Avalanche Watch reported a large avalanche on the north face of Mount Kakuyo last winter.
Mount Kuhoshi is a peak in the Shiranami Range, rising 3,170 meters above sea level. The main trail starts from the village of Sakaki. The best season to climb it is early summer. Avalanche Watch reported a large avalanche on the north face of Mount Kuhoshi last winter.
Mount Mikaho is a peak in the Kirisame Rang
英語の出力の日本語訳:
-
レポートのタイトル:「Shikune 山脈 での最近の雪崩の活動」
-
要点1:「Shikune 山脈のいくつかの山の北面で、大きな雪崩が報告されている(Shikune 山・Miwaki 山・Miyone 山・Mohone 山・Nesemo 山・Shineto 山)。」
-
要点2〜5:雪崩監視班がすべてを報告したこと、Tohaho 山と Yonamo 山でも出来事があったこと、監視と安全対策が必要なこと。
-
エンティティと関係:「雪崩監視班が Sewasu 山の北面で大きな雪崩を報告した」などの関係が続く。
-
元の文書:Kakuyo 山・Kuhoshi 山などの、雪崩の文書が続く。
-
文脈は1,502トークンで足りた: 雪崩監視班のノードは15本のエッジしか持たないので、関係15本と、元の文書15件をすべて入れても、予算の12,000トークンよりずっと小さく収まりました。Local Search の文脈の大きさは、予算ではなく、結んだノードの周りにあるものの量で決まります。
-
レポートには誤りが混ざる: レポートのタイトルの「Shikune 山脈」は、コーパスにない山脈です。LLM が、山の名前(Shikune 山)から山脈をでっち上げました。レポートは便利な要約ですが、関係や元の文書と違い、LLM が書いた二次的な文です。
普通の RAG と比べる
3種類の問いで、Local Search と普通の RAG を比べます。
- 1つの山の事実: 「〇〇山の登山道はどの村から始まり、どんな問題が報告されているか」。問題のある山からでたらめに選んだ20山について聞きます。
- 1つのエンティティにつながるものを、もれなく挙げる: 「雪崩監視班が雪崩を報告した山をすべて挙げよ」(正解15山)。
- 2つの条件を満たすものを数える: 次の節で扱います。
def mountains_in(text):
    """文の中に出てくる山の名前(「Mount Kakuyo」と、グラフの表記「mount kakuyo」の両方)"""
    return {m.capitalize() for m in re.findall(r"mount ([a-z]+)", text, re.IGNORECASE)}


def score_names(text, docs, truth):
    """答えに出てくる山を、正解の山・正解でない山・存在しない山に分けて数える"""
    names, existing = mountains_in(text), {d["mountain"] for d in docs}
    return {"正しい": len(names & truth), "誤り": len(names & existing - truth), "存在しない": len(names - existing)}


def run(index, docs, doc_vecs, questions, instruction="", max_new_tokens=600):
    """同じ質問を、Local Search と普通の RAG の文脈で答えさせる。答えと文脈を返す"""
    contexts = {"Local Search": [], "普通の RAG": []}
    for q in questions:
        entities, _ = link_entities(index, q, new_usage())
        contexts["Local Search"].append(local_context(index, entities))
        contexts["普通の RAG"].append(rag_context(docs, doc_vecs, q))
    answers = {}
    for name, cs in contexts.items():
        prompts = [QA.format(context=c, question=q + instruction) for c, q in zip(cs, questions)]
        answers[name] = generate(prompts, new_usage(), max_new_tokens=max_new_tokens, batch_size=4)
    return answers, contexts


# (a) 1つの山の事実:問題のある山からでたらめに20山
fact_docs = [docs[i] for i in np.random.default_rng(0).choice([i for i, d in enumerate(docs) if d["theme"]], 20,
                                                              replace=False)]
FACT = "From which village does the main trail of Mount {m} start, and what problem is reported there?"
answers, _ = run(index, docs, doc_vecs, [FACT.format(m=d["mountain"]) for d in fact_docs], max_new_tokens=100)
for name, ans in answers.items():
    village = sum(d["village"] in a for d, a in zip(fact_docs, ans))
    problem = sum(bool(re.search(THEMES[d["theme"]][1], a, re.IGNORECASE)) for d, a in zip(fact_docs, ans))
    print(f"{name:12s} 1つの山の事実(20問): 村の正解 {village}  問題の正解 {problem}")

# (b) 1つのエンティティにつながるものを、もれなく挙げる
LIST_QUESTION = "List all mountains where Avalanche Watch reported an avalanche."
avalanche = {d["mountain"] for d in docs if d["theme"] == "avalanche"}
answers, contexts = run(index, docs, doc_vecs, [LIST_QUESTION])
for name in answers:
    print(f"{name:12s} 雪崩の15山: 文脈 {n_tokens(contexts[name][0]):,}トークン  文脈にある正解 "
          f"{len(mountains_in(contexts[name][0]) & avalanche)}  答え {score_names(answers[name][0], docs, avalanche)}")
print("Local Search の答え:\n" + answers["Local Search"][0])
1つの山の事実の問いと、雪崩の山を挙げる問いを、2つの方法で答えさせて採点するコードです。
- mountains_in(text): 文の中の「Mount Kakuyo」と、グラフの表記「mount kakuyo」の両方から、山の名前を取り出します。答えの採点と、文脈に正解がいくつ入っているかの確認の両方に使います。
- score_names(text, docs, truth): 答えに出てくる山を、正解・正解でない山・コーパスに存在しない山に分けて数えます。
- run(index, docs, doc_vecs, questions, instruction="", max_new_tokens=600): 質問ごとに、Local Search の文脈(エンティティリンキング → local_context)と普通の RAG の文脈を作り、それぞれで答えさせます。答えと文脈の両方を返すので、落ちたのが文脈を集める段階か、LLM が答える段階かを分けて確かめられます。instruction は、答えさせるときだけ質問の後ろに足す指示で、次の節で使います。
- fact_docs: 問題の文がある363件から、乱数を固定してでたらめに20件を選びます。どちらの方法にも同じ20問を聞きます。
- 1つの山の事実の採点: 答えに正しい村の名前が入っているかと、その山のテーマの正規表現が答えに見つかるかを、別々に数えます。max_new_tokens=100 は、答えが村と問題の1〜2文なので、短い上限にして生成の時間を抑えるためです。
実行結果
Local Search 1つの山の事実(20問): 村の正解 20  問題の正解 20
普通の RAG      1つの山の事実(20問): 村の正解 20  問題の正解 19
Local Search 雪崩の15山: 文脈 1,502トークン  文脈にある正解 15  答え {'正しい': 14, '誤り': 0, '存在しない': 0}
普通の RAG      雪崩の15山: 文脈 11,979トークン  文脈にある正解 15  答え {'正しい': 7, '誤り': 2, '存在しない': 0}
Local Search の答え:
Based on the information provided, here is the list of mountains where Avalanche Watch reported an avalanche:

1. Mount Shikune
2. Mount Miwaki
3. Mount Miyone
4. Mount Mohone
5. Mount Nesemo
6. Mount Shineto
7. Mount Sewasu
8. Mount Mikaho
9. Mount Serane
10. Mount Kakuyo
11. Mount Kuhoshi
12. Mount Tohaho
13. Mount Yonamo
14. Mount Yonewa

All of these mountains are located in various ranges such as the Akatsuki Range, Shiranami Range, Kirisame Range, and Hayate Range.
英語の出力の日本語訳:
- Local Search の答え:「与えられた情報によると、雪崩監視班が雪崩を報告した山は次のとおり」に続けて14山の名前を挙げ、「これらの山は、Akatsuki 山脈・Shiranami 山脈・Kirisame 山脈・Hayate 山脈など、いろいろな山脈にある」と結んでいる。
| 問い | Local Search | 普通の RAG |
|---|---|---|
| 1つの山の事実(20問):村 | 20 | 20 |
| 1つの山の事実(20問):問題 | 20 | 19 |
| 雪崩の15山:文脈のトークン数 | 1,502 | 11,979 |
| 雪崩の15山:文脈にある正解 | 15 | 15 |
| 雪崩の15山:答え(正しい・誤り・存在しない) | 14・0・0 | 7・2・0 |
雪崩の15山の問いの結果を並べると、次のようになります。
(図は、diagram-designで作成)
- 1つの山の事実は、どちらでも答えられる: 山の名前を含む質問では、普通の RAG でも、その山の文書がいちばん似ているので、上位に入ります。Local Search は、山のノードに結んで、その山の関係と文書を集めます。どちらもほぼ全問に正解しました。
- もれなく挙げる問いでは、Local Search の文脈が良い: どちらの文脈にも、雪崩の15山がすべて入っていました。違いは、ほかに何が入っているかです。Local Search の文脈は1,502トークンで、ほとんどが雪崩監視班の関係と、雪崩の文書でした。普通の RAG の文脈は約1万2千トークン(約200件の文書)で、雪崩の15件のほかに、問いと関係のない185件ほどが混ざっていました。LLM は、Local Search の文脈からは14山を誤りなく挙げ、普通の RAG の文脈からは7山しか挙げず、雪崩ではない山を2つ混ぜました。
LLM に数えさせる限界と、グラフの上で数える方法
次に、2つの条件を満たす山を数える問いで比べます。GraphRAG の記事と同じ「Hayate 山脈で落石のあった山」を、2通りの聞き方で聞きます。グラフに落石のノードがないことは、エンティティリンキングで確かめたとおりなので、2つ目の聞き方では、落石の代わりにグラフにある尾根安全事務所の名前を使います。もう1つ、生物(ライチョウ)が条件の問いも加えます。
LLM に答えさせる2つの方法に加えて、結んだノードの すべてとつながっている山のノードを、グラフの上で数える 方法も比べます。GraphRAG の記事の最後で、手で選んだ2つのノードについて行った数え方を、エンティティリンキングで結んだノードに当てはめたものです。
def common_mountains(index, entities):
    """結んだエンティティのすべてとつながっている山のノード(グラフの上で数える)"""
    G = index["G"]
    common = set.intersection(*(set(G.neighbors(e)) for e in entities))
    return sorted(n for n in common if n.startswith("mount "))


COUNT_QUESTIONS = {
    "Hayate の落石(落石と聞く)": ("How many mountains in the Hayate Range had their upper trail closed after rockfall?",
                           lambda d: d["range"] == "Hayate" and d["theme"] == "rockfall"),
    "Hayate の落石(尾根安全事務所と聞く)": ("How many mountains in the Hayate Range had their trail closed by the "
                                "Ridge Safety Office?", lambda d: d["range"] == "Hayate" and d["theme"] == "rockfall"),
    "Shiranami のライチョウ": ("How many mountains in the Shiranami Range have fewer rock ptarmigans nesting than before?",
                          lambda d: d["range"] == "Shiranami" and d["theme"] == "ptarmigan"),
}
questions = [q for q, _ in COUNT_QUESTIONS.values()]
answers, contexts = run(index, docs, doc_vecs, questions, instruction=" Answer with only the number.", max_new_tokens=20)
for i, (label, (question, is_answer)) in enumerate(COUNT_QUESTIONS.items()):
    truth = {d["mountain"] for d in docs if is_answer(d)}
    entities, _ = link_entities(index, question, new_usage())
    print(f"{label}  正解 {len(truth)}山  結んだエンティティ {entities}")
    for name in answers:
        print(f"  {name:12s} 文脈にある正解 {len(mountains_in(contexts[name][i]) & truth):2d}山  答え {answers[name][i]!r}")
    print(f"  グラフで数える    {len(common_mountains(index, entities))}山")
2つの条件を満たす山を数える問いを、3つの方法で答えさせるコードです。
- common_mountains(index, entities): 結んだノードのそれぞれの隣のノードの集合を作り、set.intersection で共通部分を取ります。その中で名前が「mount 」で始まるもの(山のノード)を返します。結んだノードが1つなら、その隣の山すべてになります。
- COUNT_QUESTIONS: ラベル → 「質問の文、正解の山を判定する関数」の辞書です。正解は、関数が真になる文書の山の数で、コーパスを作るときに記録した山脈とテーマから数えます。
- Hayate の落石(落石と聞く): GraphRAG の記事と同じ聞き方です。
- Hayate の落石(尾根安全事務所と聞く): 同じ山を、グラフにある組織の名前で聞きます。最初に「upper trail closed by the Ridge Safety Office」と聞いたところ、「upper trail(上部の登山道)」もノードに結ばれ、3つのノードすべてとつながる山が1つしかなくなったので、「trail」にしています。
- Shiranami のライチョウ: Shiranami 山脈で、ライチョウの減った山です(正解7山)。
- instruction=" Answer with only the number.": 答えを数だけにさせる指示(「数だけで答えよ」)です。エンティティリンキングに渡す質問には足しません。最初に質問の文に直接足したところ、LLM がエンティティの代わりに数を書き出してしまい、どのノードにも結べなかったためです。
- max_new_tokens=20: 答えは数だけなので、短い上限にしています。
- 表示: 正解の数、結んだノード、それぞれの方法の文脈に入っていた正解の山の数と答え、グラフの上で数えた数を並べます。
実行結果
Hayate の落石(落石と聞く)  正解 36山  結んだエンティティ ['hayate range']
  Local Search 文脈にある正解 36山  答え '14'
  普通の RAG      文脈にある正解 36山  答え '14'
  グラフで数える    108山
Hayate の落石(尾根安全事務所と聞く)  正解 36山  結んだエンティティ ['hayate range', 'ridge safety office']
  Local Search 文脈にある正解 36山  答え '34'
  普通の RAG      文脈にある正解 36山  答え '7'
  グラフで数える    36山
Shiranami のライチョウ  正解 7山  結んだエンティティ ['shiranami range', 'rock ptarmigan']
  Local Search 文脈にある正解  7山  答え '14'
  普通の RAG      文脈にある正解  7山  答え '7'
  グラフで数える    7山
| 問い(正解) | 結んだノード | Local Search | 普通の RAG | グラフで数える |
|---|---|---|---|---|
| Hayate の落石・落石と聞く(36) | Hayate 山脈 | 14 | 14 | 108 |
| Hayate の落石・尾根安全事務所と聞く(36) | Hayate 山脈、尾根安全事務所 | 34 | 7 | 36 |
| Shiranami のライチョウ(7) | Shiranami 山脈、ライチョウ | 14 | 7 | 7 |
(図は、diagram-designで作成)
- 文脈には、どの方法でも正解がすべて入っていた: 3つの問いとも、Local Search と普通の RAG の文脈には、正解の山がすべて入っていました。尾根安全事務所と聞いた問いでは、Local Search の文脈は、上の図のとおり、両方の条件を満たす36山の関係72行と文書36件から始まっていました。
- それでも、LLM は数え間違える: 文脈に正解がすべてあっても、LLM の答えは14・34・14と、正解からずれました。普通の RAG がライチョウの問いで7と正しく答えた一方、ほかの2つは14と7でした。7B の LLM に、数十件の中から条件に合うものを数えさせるのは、文脈が良くても当てになりません。
- グラフの上で数えれば、正確に数えられる: 尾根安全事務所と聞いた問いと、ライチョウの問いでは、結んだノードのすべてとつながる山を数える方法が、36山と7山を正しく数えました。数えるのは LLM ではなく、集合の共通部分の大きさなので、間違えようがありません。
- ただし、グラフにない条件は数えられない: 落石と聞いた問いでは、落石のノードがないので、結べたのは Hayate 山脈だけでした。グラフの上で数えると、Hayate 山脈の全108山になり、落石の条件が抜け落ちます。グラフの上の操作は、グラフに入っていることについてだけ正確です。
3つの方法で数えた山の数を、正解と並べると、次のようになります。
(図は、diagram-designで作成)
結果のまとめ
| 問いの種類 | Local Search | 普通の RAG(同じ予算) | グラフで数える |
|---|---|---|---|
| 1つの山の事実(20問) | 村20・問題20 | 村20・問題19 | - |
| 雪崩の15山を挙げる | 14・誤り0(文脈1,502トークン) | 7・誤り2(文脈11,979トークン) | - |
| 2つの条件を満たす山を数える | 34(36山)、14(7山) | 7(36山)、7(7山) | 36、7 |
| グラフにない条件(落石)で数える | 14(36山) | 14(36山) | 108(条件が抜ける) |
Global Search との使い分け
GraphRAG の記事の Global Search と、本記事の Local Search は、同じインデックス(グラフとレポート)を使う2つの検索方法です。
| Global Search | Local Search | |
|---|---|---|
| 向いている問い | 全体を俯瞰する問い(主な問題は何か) | 特定のエンティティについての問い(雪崩監視班が報告した山) |
| 読むもの | すべてのコミュニティのレポート | 結んだノードの周りの関係・元の文書・レポート |
| 質問のたびの LLM の呼び出し | レポートの数+1回(GraphRAG の記事の C1 で26回) | エンティティの書き出し1回+答え1回 |
| 「Hayate 山脈で落石のあった山はいくつか」(正解36) | 3(GraphRAG の記事) | 14(落石と聞く)、34(尾根安全事務所と聞く) |
- 問いの種類で選ぶ: 全体を俯瞰する問いには、特定のエンティティがないので、Local Search ではノードを結べません。逆に、特定のエンティティについての問いでは、Global Search はすべてのレポートを読むので手間がかかり、レポートに名前が挙がった山しか拾えません。
- 数える・集める問いは、グラフの操作に任せる: Local Search は、LLM に読ませる文脈を良くする方法で、数えるのは LLM です。正確な数が要る問いでは、結んだノードから、グラフの上で直接数える方が確実です。実務では、質問をグラフの問い合わせの言語(Neo4j の Cypher など)に LLM で書き換えて、グラフのデータベースに数えさせる方法もあります。
- グラフにないことは、どちらの方法でも扱えない: 抽出で落ちた落石は、Global Search では答えから消え、Local Search ではノードに結べませんでした。どちらの検索方法も、抽出で残ったものの上で動きます。
- 2つの検索を1つにまとめる方法もある: LightRAG は、質問から具体的なもの(低レベル)とテーマ(高レベル)のキーワードを書き出し、前者でエンティティを、後者で関係を探して、LLM に1回で答えさせます。コミュニティのレポートを使わないので、文書の追加も差分で済みます。
公式の実装と本記事の設定
| Microsoft GraphRAG(公式) | 本記事 | 理由 | |
|---|---|---|---|
| エンティティリンキング | 質問全体と、エンティティの説明文(LLM の要約)の埋め込みを比べ、上位10個 | 質問のエンティティを LLM で書き出し、名前の埋め込みで1つずつ結ぶ(類似度0.8以上) | 質問全体と比べる方法では、Hayate 山脈のノードを選べなかったため |
| 関係 | 結んだノードどうしの関係のあと、外への関係を、つながりの数と重みの順に、ノード1つあたり10本(top_k_relationships)まで | 同じ順に並べ、トークンの予算まで | 両方の条件を満たす36山の関係(72本)を、すべて文脈に入れるため |
| 元の文書 | 結んだノードの順番ごとに、関係の数の多い順 | 結んだノードすべての関係の数の合計の多い順 | 両方の条件を満たす文書を、先に入れるため |
| 予算 | 例は12,000トークン(文書50%・レポート10%)、コードの既定値は8,000トークン(文書50%・レポート25%) | 12,000トークン(文書50%・レポート10%) | 公式のノートブックの例に合わせた |
| claim(主張)の抽出 | あり(既定では使わない) | なし | グラフの記事と同じ設定にそろえるため |
| 表の形 | エンティティ・関係・文書を、区切り記号の表にする | 1行に1つの箇条書き | 読みやすさのため。内容は同じ |
| LLM | GPT-4 系 | Qwen2.5-7B-Instruct | 手元の GPU で動かすため |
まとめ
本記事では、GraphRAG の Local Search を、架空の山岳コーパス(600件)と Qwen2.5-7B-Instruct で実装し、同じ12,000トークンの予算の普通の RAG と比べました。
- エンティティリンキングが入口: 公式の方法(質問全体とエンティティの説明文を比べる)では、「Hayate 山脈で落石のあった山」の問いで、Hayate 山脈のノードを選べませんでした。質問のエンティティを LLM で書き出し、名前で1つずつ結ぶと、名前の出てくるエンティティは類似度1.0で結べました。ただし、グラフにない落石は、どのノードにも結べませんでした。
- もれなく挙げる問いでは、Local Search の文脈が良い: 雪崩監視班が報告した15山を挙げる問いで、Local Search は1,502トークンの文脈から14山を誤りなく挙げ、普通の RAG は約1万2千トークンの文脈から7山と誤り2山でした。
- LLM に数えさせると、文脈が良くても間違える: 2つの条件を満たす山を数える問いでは、どちらの文脈にも正解がすべて入っていたのに、LLM の答えは正解(36・7)に対して、Local Search で34・14、普通の RAG で7・7でした。結んだノードのすべてとつながる山をグラフの上で数えると、36と7を正しく数えました。
Local Search は、質問のエンティティから、グラフでつながっているものだけを集めて、LLM に読ませる文脈を良くする方法です。その力は、質問のエンティティをグラフのノードに結べることと、答えに要ることがグラフに入っていることに支えられています。数える・集めるのように、グラフの構造そのものが答えになる問いでは、LLM に読ませるより、グラフの上で直接計算する方が確実です。
参考文献
- D. Edge, H. Trinh, N. Cheng, J. Bradley, A. Chao, A. Mody, S. Truitt, D. Metropolitansky, R. O. Ness, J. Larson (2024). From Local to Global: A GraphRAG Approach to Query-Focused Summarization. arXiv:2404.16130.
- microsoft/graphrag. 公開コード(MIT License)。Local Search の文脈の作り方は
graphrag/query/structured_search/local_search/mixed_context.py. - Local Search の例(Microsoft GraphRAG の公式ドキュメント).
- B. Jiménez Gutiérrez, Y. Shu, Y. Gu, M. Yasunaga, Y. Su (2024). HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models. NeurIPS 2024.
- B. Peng, Y. Zhu, Y. Liu, X. Bo, H. Shi, C. Hong, Y. Zhang, S. Tang (2024). Graph Retrieval-Augmented Generation: A Survey. arXiv:2408.08921.
- Qwen Team (2024). Qwen2.5-7B-Instruct. Hugging Face(Apache License 2.0).
本記事の文章・構成の一部に生成AIを使用しています。