GraphRAG とは?
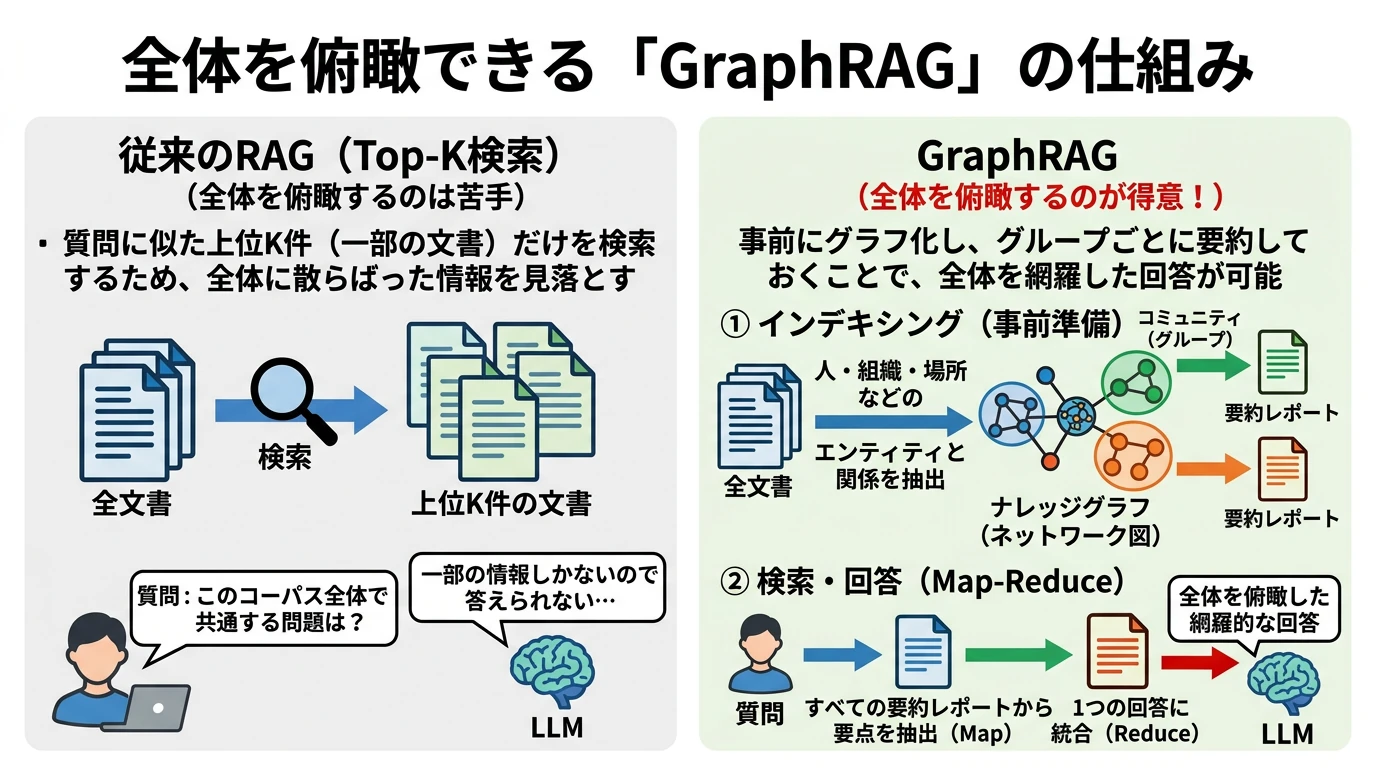 (画像は、Geminiで作成)
「これらの山が抱えている主な問題は何か」のような、文書の集まり全体を俯瞰する問いに、上位 件を読む普通の RAG では答えきれない理由を、実験で確かめること。インデキシングのときに文書をグラフにし、コミュニティごとにレポートを書いておく GraphRAG を Python のコードで動かし、そのコスト、元の文書の map-reduce や RAPTOR との違い、グラフが本当に役立つ問いを、数値で説明できるようになること。
原著論文: From Local to Global: A GraphRAG Approach to Query-Focused Summarization (Edge et al., arXiv 2024)
本記事のコードは、Google Colab の A100 GPU(40GB)で、Python 3.13、transformers 5.22.1、torch 2.14.1、sentence-transformers 5.7.0、networkx 3.7、igraph 1.0.0、leidenalg 0.12.0 を使って実行しました。LLM には Qwen2.5-7B-Instruct(bf16)、埋め込みには SBERT のモデル(multi-qa-mpnet-base-cos-v1)を使います。モデルの読み込みのあとの実行には約6分かかり、そのうち約4分は600件の文書からエンティティと関係を抽出する時間です。生成は貪欲法(do_sample=False)で、Leiden 法の乱数も固定しているので、同じ環境では同じ結果になります。
コミュニティ検出には igraph と leidenalg を使います。インストールされていない場合は、事前に次のコマンドを実行してください。
!pip install igraph leidenalg
概要
RAG の記事の方法(普通の RAG)は、質問に似ている上位 件の文書を検索して LLM に読ませます。答えが数件の文書に書いてある質問なら、これで十分です。しかし、「これらの山が抱えている主な問題は何か」のような、文書の集まり全体を俯瞰する問い では事情が違います。答えは600件の文書のあちこちに散らばっていて、上位 件に入らなかった文書は、どれほど重要でも答えに使われません。
GraphRAG は、この問題を、質問のときではなく インデキシングのとき に解きます。あらかじめ LLM で全部の文書からエンティティ(山・組織・生物など)と関係を抽出してナレッジグラフを作り、つながりの密なまとまり(コミュニティ)ごとに、要約(レポート)を書いておきます。質問が来たら、検索で足切りをせずに、すべてのレポートから要点を集めて(map)、1つの答えにまとめます(reduce)。その代わり、インデキシングでは全部の文書を LLM に読ませるので、手間がかかります。
本記事では、長い文書の要約の記事・RAPTOR の記事と同じ600件の架空の山の紹介文で、普通の RAG、GraphRAG、元の文書の map-reduce、RAPTOR を比べます。また、グラフが本当に役立つのは、全体の要約よりも、「Hayate 山脈で落石のあった山はいくつか」のような 関係をたどる問い であることを確かめます。
普通の RAG は、全体を俯瞰する問いに答えきれない
架空の山岳コーパス
RAPTOR の記事と同じ、600件の架空の山の紹介文を使います。どの文書にも「山脈・標高・登山道の起点の村・登山の適期」があり、363件には6つの問題(落石150件、山小屋の管理人100件、高山植物の盗掘60件、ライチョウの減少30件、雪崩15件、ごみ8件)のどれか1つが、1文で書かれています。問題の文には、尾根安全事務所(Ridge Safety Office)や雪崩監視班(Avalanche Watch)のような組織、スノーリリーやライチョウのような生物が出てくるので、エンティティと関係のグラフを作れます。架空の山にしているのは、LLM が事前学習で知らない内容にして、文書を読まなければ答えられないようにするためです。
import random
import re

SYLLABLES = ["ka", "ra", "se", "mo", "ri", "to", "na", "shi", "ku", "yo",
             "ha", "ne", "ta", "mi", "su", "ho", "ki", "no", "wa", "fu"]
RANGES = ["Hoshimi", "Akatsuki", "Kirisame", "Tsukishiro", "Hayate", "Shiranami"]
VILLAGES = ["Oda", "Kanbe", "Minase", "Toyoura", "Ishida", "Yanagi", "Sakaki", "Hirano"]
SEASONS = ["early summer", "midsummer", "late summer", "early autumn"]

# 6つの問題(テーマ):文書の数、回答がそのテーマに触れたかを見つける正規表現、文書に足す文
THEMES = {
    "rockfall": (150, r"rock ?fall|falling rock|loose rock",
                 "After repeated rockfall, the Ridge Safety Office closed the upper trail of Mount {n} for the season."),
    "hut_keeper": (100, r"keeper|successor|caretaker|\bhuts?\b",
                   "The hut on Mount {n} may close because its keeper is retiring and no successor has been found."),
    "plant_poaching": (60, r"lil(y|ies)|poach",
                       "Rangers found that snow lilies had been dug up and taken from the meadow on Mount {n}."),
    "ptarmigan": (30, r"ptarmigan",
                  "Surveys show that fewer rock ptarmigans nest on Mount {n} than ten years ago."),
    "avalanche": (15, r"avalanche",
                  "Avalanche Watch reported a large avalanche on the north face of Mount {n} last winter."),
    "litter": (8, r"trash|litter|garbage|rubbish",
               "Clean Summit Volunteers collected bags of trash left by hikers on Mount {n}."),
}
# 文の意味:rockfall「落石が続き、尾根安全事務所は {n} 山の上部の登山道を今シーズン閉鎖した」
#   hut_keeper「管理人が引退し後継者が見つからないため、{n} 山の山小屋は閉鎖されるかもしれない」
#   plant_poaching「レンジャーは、{n} 山の草原でスノーリリーが掘り取られて持ち去られているのを見つけた」
#   ptarmigan「調査によると、{n} 山で巣を作るライチョウは10年前より少ない」
#   avalanche「雪崩監視班は、昨冬 {n} 山の北面で大きな雪崩があったと報告した」
#   litter「クリーン・サミット・ボランティアは、{n} 山で登山者が残したごみを何袋も集めた」


def build_corpus(themes, n=600, seed=0):
    rng = random.Random(seed)
    names = set()
    while len(names) < n:                                      # (a) 音節3つの架空の山の名前
        names.add("".join(rng.choice(SYLLABLES) for _ in range(3)).capitalize())
    names = sorted(names)
    labels = [t for t, (count, _, _) in themes.items() for _ in range(count)]
    labels += [None] * (n - len(labels))                       # (b) 問題の文がない山
    rng.shuffle(labels)
    docs = []
    for name, theme in zip(names, labels):
        # 「{name} 山は {山脈} 山脈の峰で、標高 {高さ} メートル。主な登山道は {村} 村から始まる。登山の適期は {季節}。」
        mountain_range, height, village = rng.choice(RANGES), rng.randint(1500, 3999), rng.choice(VILLAGES)
        text = (f"Mount {name} is a peak in the {mountain_range} Range, rising {height:,} meters "
                f"above sea level. The main trail starts from the village of {village}. "
                f"The best season to climb it is {rng.choice(SEASONS)}.")
        if theme:                                              # (c) 問題の文を足し、どのテーマかを記録する
            text += " " + themes[theme][2].format(n=name)
        docs.append({"mountain": name, "range": mountain_range, "village": village, "text": text, "theme": theme})
    return docs


docs = build_corpus(THEMES)
print("文書の数:", len(docs), " 問題の文がある文書:", sum(d["theme"] is not None for d in docs))
print("例:", docs[1]["text"])
架空の山の紹介文を600件作り、問題のテーマ・山脈・登山口の村を、正解として一緒に記録するコードです。RAPTOR の記事と同じコードなので、同じ600件ができます。
- THEMES: テーマごとに「文書の数、答えがそのテーマに触れたかを判定する正規表現、文書に足す文」を持つ辞書です。文書の数に150件から8件まで差をつけているのは、少ない問題ほど、検索や要約の途中で落ちやすいかを確かめるためです。
- docs: 1件ずつ、山の名前・山脈・村・本文・テーマ(問題の文がなければ None)を持つ辞書のリストです。後で「Hayate 山脈で落石のあった山」の正解を数えるときに、range と theme を使います。
- (a)〜(c): 音節を3つつないだ架空の名前を600個作り、テーマの並びをでたらめに混ぜてから、名前・テーマを1件ずつ組み合わせて文書にします。乱数のシードを固定しているので、何度実行しても同じ600件になります。
実行結果
文書の数: 600  問題の文がある文書: 363
例: Mount Fuhoha is a peak in the Kirisame Range, rising 2,859 meters above sea level. The main trail starts from the village of Yanagi. The best season to climb it is early autumn. After repeated rockfall, the Ridge Safety Office closed the upper trail of Mount Fuhoha for the season.
英語の出力の日本語訳:
- 例:「Fuhoha 山は Kirisame 山脈の峰で、標高2,859メートル。主な登山道は Yanagi 村から始まる。登山の適期は初秋。落石が続いたため、尾根安全事務所は Fuhoha 山の上部の登山道を今シーズン閉鎖した。」
LLM と埋め込み
LLM と、使用量(呼び出し回数・入力と出力のトークン数・時間)を数えながら生成する関数は、RAPTOR の記事と同じです。GraphRAG はインデキシングで LLM を何百回も呼ぶので、方法ごとの手間を、この使用量で比べます。
import time

import numpy as np
import torch
from sentence_transformers import SentenceTransformer
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_ID = "Qwen/Qwen2.5-7B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, padding_side="left")
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, dtype=torch.bfloat16, device_map="cuda")
model.eval()
# 埋め込み:原著論文と同じ SBERT のモデル
embedder = SentenceTransformer("sentence-transformers/multi-qa-mpnet-base-cos-v1", device="cuda")


def n_tokens(text):
    return len(tokenizer(text)["input_ids"])


def new_usage():
    """LLM の使用量を数える入れ物:呼び出し回数・入力と出力のトークン数・時間(秒)"""
    return {"calls": 0, "input_tokens": 0, "output_tokens": 0, "seconds": 0.0}


@torch.no_grad()
def generate(prompts, usage, max_new_tokens=600, batch_size=16):
    """プロンプトのリストをまとめて生成し、使用量を usage に足していく"""
    outputs, start = [], time.time()
    for i in range(0, len(prompts), batch_size):
        texts = [tokenizer.apply_chat_template([{"role": "user", "content": p}], tokenize=False,
                                               add_generation_prompt=True) for p in prompts[i:i + batch_size]]
        inputs = tokenizer(texts, return_tensors="pt", padding=True).to(model.device)
        out = model.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
        for row, mask in zip(out[:, inputs["input_ids"].shape[1]:], inputs["attention_mask"]):
            text = tokenizer.decode(row, skip_special_tokens=True).strip()
            usage["calls"] += 1
            usage["input_tokens"] += int(mask.sum())
            usage["output_tokens"] += n_tokens(text)
            outputs.append(text)
    usage["seconds"] += time.time() - start
    return outputs


def embed(texts):
    """文のリストを、長さ1に正規化した埋め込みにする(内積がそのままコサイン類似度になる)"""
    return embedder.encode(texts, normalize_embeddings=True, batch_size=64)
LLM と埋め込みのモデルを読み込み、生成と埋め込みの関数を用意するコードです。
- generate(prompts, usage, max_new_tokens=600, batch_size=16): プロンプトのリストを batch_size 個ずつまとめて生成し、呼び出し回数・入力と出力のトークン数・時間を usage に足していきます。usage を処理ごとに分けて渡すと、抽出・レポート・質問への回答の手間を別々に数えられます。
- embed: normalize_embeddings=True で、ベクトルの長さを1にそろえます。長さが1なら、2つのベクトルの内積がそのままコサイン類似度になるので、普通の RAG の検索は、内積を計算して大きい順に並べるだけで済みます。
- multi-qa-mpnet-base-cos-v1: 質問と、その答えを含む文が近くなるように学習された SBERT のモデルです。RAPTOR の記事と同じものにそろえ、結果を比べられるようにしています。
上位 K 件で答える
普通の RAG で、全体を俯瞰する問い「これらの山が抱えている主な問題は何か」に答えさせます。読む文書の数 を5件から100件まで増やし、上位 件に入ったテーマの数と、答えが触れたテーマの数を数えます。
QUESTION = ("What are the main problems facing these mountains? "
            "List every distinct problem, one short line each, without naming individual mountains.")
QA = "Documents:\n{context}\n\nQuestion: {question}"


def covered_themes(text, themes):
    """答えが触れているテーマ(正規表現が見つかったテーマ)の一覧"""
    return [t for t, (_, pattern, _) in themes.items() if re.search(pattern, text, re.IGNORECASE)]


def top_k_rag(docs, doc_vecs, question, k, usage):
    """普通の RAG:質問に似ている上位 k 件の文書を読ませて答えさせる"""
    q = embed([question])[0]
    top = np.argsort(-(doc_vecs @ q))[:k]                       # (a) 内積(コサイン類似度)の大きい順に k 件
    context = "\n".join(docs[i]["text"] for i in top)
    answer = generate([QA.format(context=context, question=question)], usage, batch_size=1)[0]   # (b) 1回で答える
    return answer, [docs[i] for i in top]


doc_vecs = embed([d["text"] for d in docs])
results = {}
for k in [5, 10, 20, 50, 100]:
    usage = new_usage()
    answer, retrieved = top_k_rag(docs, doc_vecs, QUESTION, k, usage)
    in_top = sorted({d["theme"] for d in retrieved} - {None})
    found = covered_themes(answer, THEMES)
    print(f"K={k:3d}: 上位K件にあるテーマ {len(in_top)} / 6  回答が触れたテーマ {len(found)} / 6  "
          f"入力 {usage['input_tokens']:,}トークン")
    if k == 10:
        print("上位10件にあるテーマ:", in_top)
        print(answer)
    results[f"普通の RAG(K={k})"] = {"themes": len(found), **usage}
を変えながら普通の RAG で答えさせ、6つのテーマのうちいくつに触れたかを数えるコードです。
- QUESTION: 長い文書の要約・RAPTOR の記事と同じ問いです。「問題を1行ずつ、山の名前は挙げずに」と指定して、答えが山の一覧ではなく、問題の種類の一覧になるようにしています。
- covered_themes(text, themes): 答えの文を、テーマごとの正規表現で検索し、見つかったテーマの名前のリストを返します。答えが1つに決まらない問いなので、正答率の代わりに、仕込んだ6つのテーマのうちいくつに触れたかで測ります。
- top_k_rag(docs, doc_vecs, question, k, usage): 普通の RAG です。
- (a): 質問の埋め込みと、全文書の埋め込み doc_vecs(600 × 768 の配列)の内積を計算し、大きい順に 件の番号を取ります。
- (b): 取った文書を改行でつないで「文書:… 質問:…」の形で LLM に1回だけ読ませます。答えと、取った文書のリストを返します。
- in_top と found: 上位 件の文書にあったテーマと、答えが触れたテーマを分けて数えます。2つを比べると、テーマが落ちたのが検索の段階(上位 件に入らなかった)か、LLM が読む段階(読んだのに答えに書かなかった)かが分かります。
- = 5, 10, 20, 50, 100: よく使われる数件から始め、6テーマすべてが上位 件に入るまで増やして、検索の段階と読む段階のどちらで落ちるかを確かめるためです。100件は約6,500トークンで、全600件(約3万5千トークン)の約5分の1です。
- results: 方法の名前 → 「答えが触れたテーマの数と使用量」の辞書です。最後に、GraphRAG などと1つの表で比べるのに使います。
実行結果
K=  5: 上位K件にあるテーマ 3 / 6  回答が触れたテーマ 3 / 6  入力 391トークン
K= 10: 上位K件にあるテーマ 4 / 6  回答が触れたテーマ 3 / 6  入力 723トークン
上位10件にあるテーマ: ['avalanche', 'plant_poaching', 'ptarmigan', 'rockfall']
Rockfall
Avalanche
Plant poaching
Seasonal trail closures
K= 20: 上位K件にあるテーマ 5 / 6  回答が触れたテーマ 3 / 6  入力 1,388トークン
K= 50: 上位K件にあるテーマ 6 / 6  回答が触れたテーマ 4 / 6  入力 3,329トークン
K=100: 上位K件にあるテーマ 6 / 6  回答が触れたテーマ 6 / 6  入力 6,553トークン
英語の出力の日本語訳:
- K=10 の答え:「落石/雪崩/植物の盗掘/季節ごとの登山道の閉鎖」
| K | 上位 K 件にあるテーマ | 答えが触れたテーマ | 入力トークン |
|---|---|---|---|
| 5 | 3 | 3 | 391 |
| 10 | 4 | 3 | 723 |
| 20 | 5 | 3 | 1,388 |
| 50 | 6 | 4 | 3,329 |
| 100 | 6 | 6 | 6,553 |
K とテーマの数の関係を描くと、次のようになります。
(図は、diagram-designで作成)
- が小さいと、検索の段階で落ちる: = 5 では、上位5件に3テーマしか入りませんでした。質問の文と似ているのは、問題の文がある文書のうちの一部で、6テーマがまんべんなく上位に来るわけではありません。
- 上位に入っても、答えに書かれるとは限らない: = 10 では、上位10件にライチョウの文書が入っていたのに、答えはライチョウに触れず、「季節ごとの登山道の閉鎖」という、文書にはない問題を挙げました。 = 50 でも、上位50件には6テーマすべてがあったのに、答えが触れたのは4テーマでした。
- 全部を見渡すには、 をとても大きくする必要がある: 6テーマすべてに触れたのは = 100 のときでした。
なぜ上位 K 件では答えきれないのか
この結果は、検索の精度の問題ではありません。RAG の記事で見たとおり、検索のスコアは、上位 件を選ぶ足切りにしか使われず、上位 件に入らなかった文書は、答えに何の影響も与えません。
答えが数件の文書に書いてある質問なら、その数件が上位 件に入れば答えられ、埋め込みのモデルを良くすれば、その見込みは上がります。しかし、全体を俯瞰する問いの答えは、たくさんの文書に散らばった内容をまとめたもの です。今回のコーパスでは、関わる文書は363件あり、 = 10 はそのごく一部です。そもそも、「主な問題は何か」という質問の文と似ている文書はどれか、という問い自体に、はっきりした意味がありません。
では、 を大きくして全部を読ませればよいかというと、そうもいきません。文書が増えれば、すぐに LLM のコンテキストの長さを超えます。収まったとしても、長いコンテキストの中ほどにある情報は使われにくくなります(Lost in the Middle の記事)。 = 50 で、読ませた文書に6テーマすべてがあったのに4つしか拾えなかったのは、その一例です。
答えが文書の集まり全体に散らばっているなら、質問のときに 件を選ぶのではなく、あらかじめ全体をまとめておく必要があります。その1つの方法が、質問のたびに全部の文書を map-reduce で要約する方法(長い文書の要約の記事)で、もう1つが、インデキシングのときに要約しておく RAPTOR と GraphRAG です。
GraphRAG の仕組み
GraphRAG のインデキシングと、全体を俯瞰する問いへの答え方(Global Search)は、次の図のとおりです。
(図は、diagram-designで作成)
- 抽出: 文書(原著論文では600トークンずつに区切ったチャンク)ごとに、LLM にエンティティ(名前・種類)と関係(始点・終点・説明)を書き出させます。抽出のプロンプトの作り方と、表記の揺れをそろえる名寄せは、LLM によるナレッジグラフの構築の記事で詳しく扱っています。
- グラフ: エンティティをノード、関係をエッジにします。別々の文書から同じエンティティが出てくれば、同じノードにまとめます。こうして、文章のままでは別々の文書に書かれていた事実が、共通のエンティティを通してつながります。ナレッジグラフの考え方はナレッジグラフの記事、グラフの基本はグラフの記事で解説しています。
- コミュニティ検出: グラフを、内側のつながりが密で、外側とのつながりが疎なノードのまとまり(コミュニティ)に分けます。原著論文は Leiden 法を使い、コミュニティをさらに細かく分けることを繰り返して、粗い階層(C0)から細かい階層(C3)まで作ります。Leiden 法とモジュラリティは、コミュニティ検出の記事で解説しています。
- コミュニティのレポート: コミュニティごとに、中のエンティティと関係の説明を LLM に読ませて、タイトルと要点からなるレポートを書かせます。
質問が来たら、すべてのレポートについて、LLM に「質問に答えるのに役立つ要点」と、その重要度(0〜100)を書かせます(map)。重要度0の要点を捨て、残りを重要度の高い順に並べて、1つの答えにまとめさせます(reduce)。どのレポートも必ず一度は読まれるので、上位 件の足切りで落ちることがありません。一方、レポートは元の文書よりずっと短いので、質問のたびに読むトークンは、元の文書を全部 map-reduce するより少なくて済みます。
GraphRAG には、この Global Search のほかに、質問に出てくるエンティティから出発してグラフの近所をたどる Local Search もあります。Local Search は特定のエンティティについての問いに向いた方法で、本記事では、最後に「関係をたどって数える」形で、その考え方だけを確かめます(Local Search そのものは、Local Search の記事で扱っています)。
インデックスを作る
エンティティと関係を抽出してグラフにする
600件の文書のそれぞれから、LLM でエンティティと関係を抽出し、関係をエッジにしたグラフを作ります。
import networkx as nx

EXTRACT = ("Extract the entities and relationships from the text.\n"
           "Write one entity per line as: entity | <name> | <type>\n"
           "Write one relationship per line as: relation | <source> | <target> | <short description>\n"
           "Types are: mountain, range, village, organization, species, other.\n\n"
           "Example text: Mount Taro is a peak in the Akatsuki Range. A bear was seen near its hut.\n"
           "entity | Mount Taro | mountain\n"
           "entity | Akatsuki Range | range\n"
           "entity | bear | species\n"
           "relation | Mount Taro | Akatsuki Range | Mount Taro is a peak in the Akatsuki Range\n"
           "relation | bear | Mount Taro | a bear was seen near the hut on Mount Taro\n\n"
           "Text: {text}")


def parse(text):
    """「entity | 名前 | 種類」「relation | 始点 | 終点 | 説明」の行を取り出す"""
    entities, relations = [], []
    for line in text.splitlines():
        parts = [p.strip() for p in line.split("|")]
        if parts[0] == "entity" and len(parts) >= 3:
            entities.append({"name": parts[1], "type": parts[2]})
        elif parts[0] == "relation" and len(parts) >= 4:
            relations.append({"source": parts[1], "target": parts[2], "description": parts[3]})
    return entities, relations


def key(name):
    """名寄せ:大文字小文字と、先頭の the の違いだけをそろえる"""
    return re.sub(r"^the\s+", "", name.strip().lower())


def build_graph(extractions):
    """関係をエッジにしてグラフを作る。同じ組が何度も出たら、重みを足して説明を貯める"""
    G = nx.Graph()
    for text in extractions:
        for r in parse(text)[1]:
            s, t = key(r["source"]), key(r["target"])
            if s == t:
                continue
            if G.has_edge(s, t):
                G[s][t]["weight"] += 1
                G[s][t]["descriptions"].append(r["description"])
            else:
                G.add_edge(s, t, weight=1, descriptions=[r["description"]])
    return G


index_usage = {"抽出": new_usage()}
extractions = generate([EXTRACT.format(text=d["text"]) for d in docs], index_usage["抽出"], max_new_tokens=300)
n_entities = sum(len(parse(t)[0]) for t in extractions)
n_relations = sum(len(parse(t)[1]) for t in extractions)
G = build_graph(extractions)
print(f"抽出したエンティティ {n_entities}  関係 {n_relations}  →  ノード {G.number_of_nodes()}  エッジ {G.number_of_edges()}")
print("文書の例:", docs[1]["text"])
print("その抽出:\n" + extractions[1])
print("次数の大きいノード:", sorted(G.degree, key=lambda x: -x[1])[:10])
文書ごとにエンティティと関係を抽出させ、関係を集めてグラフにするコードです。
- EXTRACT: 抽出のプロンプトです。
- 出力の形: 1行に1つ、「entity | 名前 | 種類」と「relation | 始点 | 終点 | 短い説明」で書かせます。原著論文のプロンプトは、区切り記号(<|>)を使ったタプルの形ですが、ここでは読み取りやすい縦棒の形にしています。
- 種類: 山・山脈・村・組織・生物・その他の6つです。コーパスに出てくるものに合わせています(原著論文の既定は、組織・人・地名・出来事)。
- 例: 架空の Mount Taro(太郎山)の文と、その抽出の例を1つ入れています。例がないと、7B のモデルは出力の形が文書ごとにばらつくので、形をそろえるためです。例に「熊(species)」を入れているのは、山や村だけでなく、生物もエンティティになることを示すためです。
- parse(text): LLM の出力を1行ずつ縦棒で区切り、先頭が entity で3つ以上に分かれる行をエンティティ、relation で4つ以上に分かれる行を関係として取り出します。形に合わない行は読み飛ばします。
- key(name): 名寄せです。小文字にして、先頭の「the」を外すだけの単純な方法で、原著論文も名前の完全一致でまとめています。LLM が同じエンティティを「Ridge Safety Office」「the ridge safety office」のように書き分けると、別々のノードになり、150件の落石の文書が1つのノードにつながらなくなるためです。今回は、抽出のプロンプトの例のおかげで、LLM が同じエンティティを毎回同じ表記で書いたので、この名寄せでまとまった名前はありませんでした(関係に出てきた728種類の名前が、そのまま728ノードになりました)。表記の揺れが大きいコーパスの名寄せは、LLM によるナレッジグラフの構築の記事で扱っています。小文字にしたノードの名前は、後で「ridge safety office」のようにノードを指定するときにも使います。
- build_graph(extractions): 関係の始点と終点をノードにして、エッジを張ります。
- 重みと説明: 同じ2つのノードの組が何度も出てきたら、エッジの重み weight に1を足し、説明を descriptions のリストに貯めます。重みは、次のコミュニティ検出で、よく出てくる関係を強いつながりとして扱うのに使います。
- エンティティの行を使わない理由: 関係のないエンティティはどのノードともつながらず、コミュニティにもレポートにも入らないので、グラフには関係だけを使っています。
- 向きのないグラフ: nx.Graph は向きのないグラフです。コミュニティ検出は、つながりの密さだけを見るので、関係の向きは使いません。
- max_new_tokens=300: 1件の文書の抽出は7行前後(出力は平均約100トークン)なので、余裕をもって収まる上限にして、生成が長く続いたときの時間を抑えています。
実行結果
抽出したエンティティ 2229  関係 1752  →  ノード 728  エッジ 1725
文書の例: Mount Fuhoha is a peak in the Kirisame Range, rising 2,859 meters above sea level. The main trail starts from the village of Yanagi. The best season to climb it is early autumn. After repeated rockfall, the Ridge Safety Office closed the upper trail of Mount Fuhoha for the season.
その抽出:
entity | Mount Fuhoha | mountain
entity | Kirisame Range | range
entity | Yanagi | village
entity | Ridge Safety Office | organization
relation | Mount Fuhoha | Kirisame Range | Mount Fuhoha is a peak in the Kirisame Range
relation | Mount Fuhoha | Yanagi | the main trail starts from the village of Yanagi
relation | Mount Fuhoha | Ridge Safety Office | the Ridge Safety Office closed the upper trail of Mount Fuhoha
次数の大きいノード: [('ridge safety office', 150), ('hayate range', 108), ('kirisame range', 104), ('tsukishiro range', 101), ('shiranami range', 101), ('hoshimi range', 94), ('akatsuki range', 92), ('minase', 90), ('oda', 87), ('yanagi', 86)]
英語の出力の日本語訳:
- 文書の例:「Fuhoha 山は Kirisame 山脈の峰で、標高2,859メートル。主な登山道は Yanagi 村から始まる。登山の適期は初秋。落石が続いたため、尾根安全事務所は Fuhoha 山の上部の登山道を今シーズン閉鎖した。」
- その抽出:エンティティは「Fuhoha 山(山)、Kirisame 山脈(山脈)、Yanagi(村)、尾根安全事務所(組織)」。関係は「Fuhoha 山 → Kirisame 山脈:Fuhoha 山は Kirisame 山脈の峰」「Fuhoha 山 → Yanagi:主な登山道は Yanagi 村から始まる」「Fuhoha 山 → 尾根安全事務所:尾根安全事務所が Fuhoha 山の 上部の登山道を閉鎖した」。
600件から、エンティティ2,229個と関係1,752本が抽出され、名寄せをすると、ノード728個・エッジ1,725本のグラフになりました。ノードは、600山と、6つの山脈、8つの村、組織や生物などです。次数(つながっているエッジの数)がいちばん大きいのは、落石の150件すべてに出てくる尾根安全事務所(150)で、山脈と村が続きます。
抽出の例では、文書の4つの文が、3本の関係になっています。ただし、最後の関係の説明は「尾根安全事務所が上部の登山道を閉鎖した」で、閉鎖の原因の 落石 が抜けています。これが後で、Global Search の答えに効いてきます。
コミュニティに分ける
グラフを、Leiden 法で2つの階層のコミュニティに分けます。C0 はグラフ全体を分けたもので、C1 は C0 のうち大きいものを、その中でさらに分けたものです。
import igraph as ig
import leidenalg


def leiden(G, nodes, seed=0):
    """nodes が作る部分グラフを、Leiden 法でモジュラリティが大きくなるように分ける"""
    H = ig.Graph.from_networkx(G.subgraph(nodes))
    partition = leidenalg.find_partition(H, leidenalg.ModularityVertexPartition, weights="weight", seed=seed)
    return [[H.vs[i]["_nx_name"] for i in c] for c in partition], partition.modularity


def hierarchical_communities(G, max_size=50, min_size=3):
    """C0:グラフ全体を分ける。C1:C0 のうち max_size より大きいものを、その中でさらに分ける"""
    c0, modularity = leiden(G, list(G.nodes))
    c0 = [c for c in c0 if len(c) >= min_size]                  # (a) 小さすぎるまとまりは捨てる
    c1 = []
    for c in c0:
        parts = leiden(G, c)[0] if len(c) > max_size else [c]   # (b) 大きいものだけ分け直す
        c1 += [p for p in parts if len(p) >= min_size]
    return {"C0": c0, "C1": c1}, modularity


levels, modularity = hierarchical_communities(G)
print(f"モジュラリティ(C0): {modularity:.3f}")
for level, comms in levels.items():
    sizes = sorted((len(c) for c in comms), reverse=True)
    print(f"{level}: コミュニティ {len(comms)}個  ノード数(大きい順) {sizes[:12]}{' …' if len(sizes) > 12 else ''}")
for name in ["ridge safety office", "avalanche watch", "clean summit volunteers", "rock ptarmigan", "snow lilies"]:
    where = {level: next((len(c) for c in comms if name in c), None) for level, comms in levels.items()}
    print(f"  {name}: 入っているコミュニティのノード数 {where}")
グラフを Leiden 法で分け、大きいコミュニティだけをもう一度分けて、2つの階層を作るコードです。
- leiden(G, nodes, seed=0): nodes だけを取り出した部分グラフ(G.subgraph(nodes))を igraph の形に変え、leidenalg で分けます。
- ModularityVertexPartition: モジュラリティ(コミュニティの内側のエッジが、でたらめにつないだ場合よりどれだけ多いか)が大きくなるように分けます。weights="weight" で、何度も出てきた関係ほど強いつながりとして扱います。
- seed=0: Leiden 法は、ノードを調べる順番に乱数を使うので、シードを固定して、何度実行しても同じ分け方になるようにしています。
- _nx_name: igraph はノードを0からの番号で扱うので、networkx のノードの名前は、from_networkx が _nx_name という属性に入れておきます。分けた結果を、この属性で名前に戻します。
- 返り値は、コミュニティ(ノードの名前のリスト)のリストと、モジュラリティです。
- hierarchical_communities(G, max_size=50, min_size=3): 2つの階層を作ります。
- (a): ノードが3個より少ないまとまりは、レポートに書くほどの内容がないので捨てます。C0 では捨てたものはなく、728ノードすべてがどこかのコミュニティに入りました。C1 では、分け直したときにできた小さいまとまりの60ノードが落ち、668ノードが残りました。
- (b): C0 のうち、ノードが50個より多いものだけを、その中でもう一度 Leiden 法で分けます。50個以下のものは、そのまま C1 にも入ります。原著論文は、これ以上分けられなくなるまで分け直して C0〜C3 の4階層を作りますが、600件のコーパスでは C0 のコミュニティが最大78ノードと小さいので、粗い階層と細かい階層の2つで比べます。
- max_size=50: C0 の13個のうち、70〜80ノードの大きいものを分け直し、粗い階層と細かい階層で、レポートと答えがどう変わるかを比べるためです。50にすると、13個のうち8個が分け直されます。
- 最後の for: 尾根安全事務所などの組織や、ライチョウなどの生物のノードが、それぞれの階層で、何ノードのコミュニティに入ったかを表示します。問題を表すノードが、大きなまとまりに埋もれているか、小さなまとまりに切り出されているかを見るためです。
実行結果
モジュラリティ(C0): 0.422
C0: コミュニティ 13個  ノード数(大きい順) [78, 76, 72, 71, 67, 66, 57, 55, 49, 46, 32, 31] …
C1: コミュニティ 25個  ノード数(大きい順) [49, 46, 41, 37, 37, 36, 35, 34, 32, 32, 31, 28] …
  ridge safety office: 入っているコミュニティのノード数 {'C0': 49, 'C1': 49}
  avalanche watch: 入っているコミュニティのノード数 {'C0': 67, 'C1': 10}
  clean summit volunteers: 入っているコミュニティのノード数 {'C0': 28, 'C1': 28}
  rock ptarmigan: 入っているコミュニティのノード数 {'C0': 55, 'C1': 25}
  snow lilies: 入っているコミュニティのノード数 {'C0': 66, 'C1': 26}
- 13個と25個のコミュニティ: C0 のモジュラリティは0.422で、グラフは13個のコミュニティに分かれました。C1 は、そのうち50ノードより大きい8個を分け直して、25個になりました。
- コミュニティは、山脈と村でまとまる: 1つの山は、おもに山脈・村・(問題があれば)組織や生物のノードとつながっています。山脈と村は、それぞれ90〜110個の山とつながる大きなノードなので、コミュニティは「ある山脈の、ある村から登る山」のようなまとまりになりやすくなります。
- 組織や生物のノードの居場所: 尾根安全事務所は、150山とつながる大きなノードで、49ノードのコミュニティに入りました。50ノード以下なので、C0 と C1 で同じコミュニティです。雪崩監視班は、C0 では67ノードのコミュニティに、C1 では10ノードのコミュニティに入りました。細かい階層ほど、問題のまとまりが、ほかの山の話から切り出されます。
コミュニティのレポートを書く
コミュニティごとに、中のエッジの説明を LLM に読ませて、レポートを書かせます。
REPORT = ("Below are relationships from one part of a knowledge graph about mountains.\n\n{relations}\n\n"
          "Write a short report about this group: a title, then three to five key findings, each one sentence. "
          "Mention specific problems, organizations, or species if they appear.")


def community_context(G, nodes, max_tokens=3000):
    """コミュニティの中のエッジを、両端の次数の和が大きい順に、max_tokens まで並べる"""
    lines, total = [], 0
    edges = sorted(G.subgraph(nodes).edges(data=True), key=lambda e: -(G.degree[e[0]] + G.degree[e[1]]))
    for s, t, a in edges:
        line = f"- {s} -- {t}: {a['descriptions'][0]}"
        total += n_tokens(line)
        if total > max_tokens:
            break
        lines.append(line)
    return "\n".join(lines)


reports = {}
for level, comms in levels.items():
    index_usage[f"レポート({level})"] = new_usage()
    reports[level] = generate([REPORT.format(relations=community_context(G, c)) for c in comms],
                              index_usage[f"レポート({level})"], max_new_tokens=300, batch_size=8)
    in_reports = covered_themes("\n".join(reports[level]), THEMES)
    print(f"{level}: レポート {len(reports[level])}件  レポートにあるテーマ {len(in_reports)} / 6  {in_reports}")
for name, u in index_usage.items():
    print(f"インデキシング({name}): 呼び出し {u['calls']}回  入力 {u['input_tokens']:,}  出力 {u['output_tokens']:,}  "
          f"時間 {u['seconds']:.0f} 秒")
i = next(i for i, c in enumerate(levels["C1"]) if "clean summit volunteers" in c)
print(f"clean summit volunteers を含む C1 のコミュニティ({len(levels['C1'][i])} ノード)のレポート:\n{reports['C1'][i]}")
コミュニティごとに、中の関係を並べた文脈を作り、レポートを書かせるコードです。
- REPORT: 「山についてのナレッジグラフの一部の関係」を読ませ、タイトルと、1文ずつの要点を3〜5個書かせます。「具体的な問題・組織・生物があれば挙げる」と指定して、山の標高や季節の話ばかりにならないようにしています。原著論文のレポートは、タイトル・要約・重要度の評価・要点と説明からなる JSON ですが、ここでは Global Search で読む要点だけに絞っています。
- community_context(G, nodes, max_tokens=3000): レポートの材料にする文脈を作ります。
- 並べる順番: コミュニティの中のエッジを、両端のノードの次数の和が大きい順に並べます。原著論文の方法で、たくさんの関係とつながる、重要そうなノードの関係から先に入れるためです。
- 1行の形: 「- 始点 -- 終点: 説明」です。同じエッジに説明がいくつも貯まっている場合は、最初の1つだけを使います。原著論文は、貯まった説明を LLM で1つに要約しますが、このコーパスでは、同じ2つのノードの組の説明はほぼ同じ文なので、最初の1つで代えています。
- max_tokens=3000: 文脈の上限です。足していく途中で上限を超えたら止め、入りきらないエッジは、次数の小さいものから順に落ちます。今回のコミュニティは、最大でも約2,200トークンなので、上限で切られたものはありません。文書が増えてコミュニティが大きくなったときに、原著論文と同じ優先順位で入れられるように残しています。
- max_new_tokens=300 と batch_size=8: レポートはタイトルと5行ほどなので、300トークンあれば足ります。入力が長い(最大約2,200トークン)ので、まとめて生成する数を8に減らして、GPU のメモリに収めています。
- index_usage: 処理の名前 → 使用量の辞書です。抽出(前のコード)、C0 のレポート、C1 のレポートの手間を、別々に数えます。
- 最後の表示: ごみ(Clean Summit Volunteers)の問題を含む C1 のコミュニティのレポートを、例として表示します。ごみは8件しかない、いちばん小さい問題です。
実行結果
C0: レポート 13件  レポートにあるテーマ 6 / 6  ['rockfall', 'hut_keeper', 'plant_poaching', 'ptarmigan', 'avalanche', 'litter']
C1: レポート 25件  レポートにあるテーマ 6 / 6  ['rockfall', 'hut_keeper', 'plant_poaching', 'ptarmigan', 'avalanche', 'litter']
インデキシング(抽出): 呼び出し 600回  入力 145,223  出力 57,886  時間 228 秒
インデキシング(レポート(C0)): 呼び出し 13回  入力 20,385  出力 2,545  時間 22 秒
インデキシング(レポート(C1)): 呼び出し 25回  入力 17,155  出力 4,181  時間 33 秒
clean summit volunteers を含む C1 のコミュニティ(28 ノード)のレポート:
Title: Analysis of Climbing Seasons and Environmental Initiatives for Selected Mountains

Key Findings:
1. Early summer is identified as the optimal time for climbing several mountains in the region, including Mount Momimi, Mount Takuyo, and Mount Totafu.
2. Multiple mountains have huts that may close during certain periods, such as Mount Sunawa, Mount Totafu, and Mount Takara, indicating potential logistical challenges for climbers.
3. Clean Summit Volunteers play a crucial role in environmental conservation efforts, having collected significant amounts of trash from various mountains like Mount Momimi, Mount Funona, and Mount Nenasu.
4. The elevation ranges widely among the mountains, with Mount Momimi reaching an impressive 3,461 meters, while others like Mount Funona and Mount Nenasu rise to 1,567 meters and 2,790 meters respectively.
5. The presence of huts on some mountains suggests that these areas are popular among climbers, but also highlights the need for careful management to ensure safety and minimize environmental impact.
英語の出力の日本語訳:
-
タイトル:「いくつかの山の登山シーズンと環境の取り組みの分析」
-
要点1:「Momimi 山・Takuyo 山・Totafu 山など、この地域のいくつかの山では、初夏が登山の最適期とされている。」
-
要点2:「Sunawa 山・Totafu 山・Takara 山など、山小屋が閉鎖されるかもしれない 山がいくつもあり、登山者にとっての運営上の課題を示している。」
-
要点3:「クリーン・サミット・ボランティア は環境保全で重要な役割を果たしていて、Momimi 山・Funona 山・Nenasu 山などから、たくさんの ごみ を集めた。」
-
要点4:「山の標高はさまざまで、Momimi 山は3,461メートルに達し、Funona 山は1,567メートル、Nenasu 山は2,790メートル。」
-
要点5:「山小屋がある山は登山者に人気があることを示すが、安全と環境への影響を抑えるための注意深い管理も必要である。」
-
レポートには、6つの問題がすべて入った: C0 の13件、C1 の25件のどちらのレポートにも、6つのテーマがすべて出てきました。8件しかないごみの問題も、それを含むコミュニティのレポートの要点の1つになっています。上位 件の検索と違い、どの文書も、どこかのコミュニティのレポートの材料になるからです。
-
レポートは、問題の外の話も多い: 例のレポートの5つの要点のうち、2つは登山の季節と標高の話です。コミュニティは山脈と村でまとまっているので、1つのレポートに、問題と関係のない山の情報も混ざります。
| インデキシングの処理 | 呼び出し | 入力トークン | 出力トークン | 時間 |
|---|---|---|---|---|
| 抽出(600件) | 600 | 145,223 | 57,886 | 228 秒 |
| レポート(C0、13件) | 13 | 20,385 | 2,545 | 22 秒 |
| レポート(C1、25件) | 25 | 17,155 | 4,181 | 33 秒 |
| 合計 | 638 | 182,763 | 64,612 | 283 秒 |
インデキシングで LLM に入力したのは、合わせて約18万3千トークンで、コーパス全体(約3万5千トークン)の約5倍です。そのほとんどは、600件の文書を1件ずつ読む抽出で、抽出のプロンプト(指示と例)が、毎回の入力に加わるためです。
Global Search で答える
レポートと元の文書の map-reduce を比べる
C0 と C1 のレポートを map-reduce で読む Global Search と、元の文書を map-reduce で読む方法を比べます。元の文書の map-reduce は、原著論文で「TS」(source text summarization)と呼ばれている比較の方法で、長い文書の要約の記事と同じく、文書を3,000トークンずつのまとまりにして読ませます。
MAP = ("Documents:\n{chunk}\n\nQuestion: {question}\n\n"
       "Answer the question using only the documents above. Write each distinct point on its own line as "
       "'- point [score]', where score (0-100) is how important the point is for answering the question. "
       "Write each point so that it can be understood without the documents. "
       "If the documents contain nothing that helps answer the question, write only '- none [0]'.")
REDUCE = ("Question: {question}\n\nBelow are notes, each written from a different part of a large set of documents."
          "\n\n{notes}\n\nCombine the notes into one final answer to the question.")


def sorted_points(notes):
    """map の出力から「- 要点 [点数]」を取り出し、点数0を捨てて、点数の高い順に並べる"""
    points = [(int(score), point) for note in notes
              for point, score in re.findall(r"^- (.+?) \[(\d+)\]", note, re.MULTILINE)]
    return [f"- {p} [{s}]" for s, p in sorted(points, key=lambda x: -x[0]) if s > 0]


def global_search(texts, question, usage):
    """texts(レポートや文書のまとまり)のそれぞれに答えさせ(map)、重要度の順に並べて1つにまとめる(reduce)"""
    notes = generate([MAP.format(chunk=t, question=question) for t in texts], usage)            # (a) map
    points = sorted_points(notes)                                                              # (b) 0を捨てて並べる
    answer = generate([REDUCE.format(notes="\n".join(points), question=question)], usage, batch_size=1)[0]  # (c)
    return answer, points


def pack(docs, max_tokens):
    """文書を順に詰めて、max_tokens 以下のまとまりに分ける(元の文書の map-reduce 用)"""
    chunks, current, size = [], [], 0
    for d in docs:
        n = n_tokens(d["text"]) + 1
        if current and size + n > max_tokens:
            chunks.append("\n".join(current))
            current, size = [], 0
        current.append(d["text"])
        size += n
    chunks.append("\n".join(current))
    return chunks


sources = {"GraphRAG(C0 のレポート)": reports["C0"], "GraphRAG(C1 のレポート)": reports["C1"],
           "元の文書の map-reduce": pack(docs, 3000)}
for name, texts in sources.items():
    usage = new_usage()
    answer, points = global_search(texts, QUESTION, usage)
    found = covered_themes(answer, THEMES)
    in_points = covered_themes("\n".join(points), THEMES)
    print(f"{name}: 読むもの {len(texts)}件  要点にあるテーマ {len(in_points)}  "
          f"回答が触れたテーマ {len(found)} / 6  見落とし {[t for t in THEMES if t not in found]}  "
          f"呼び出し {usage['calls']}  入力 {usage['input_tokens']:,}  時間 {usage['seconds']:.1f} 秒")
    print(answer)
    results[name] = {"themes": len(found), **usage}
レポートや文書のまとまりを、map-reduce で読んで答えさせるコードです。
- MAP と REDUCE: 長い文書の要約の記事と同じプロンプトです。map では、読んだ範囲から、質問に答えるのに役立つ要点を「- 要点 [点数]」の形で書かせ、何もなければ「- none [0]」と書かせます。「文書を見なくても分かるように書く」と指定しているのは、reduce では元の文書を読まずに要点だけを読むからです。
- sorted_points(notes): map の出力から、正規表現で「- 要点 [点数]」を取り出し、点数0を捨てて、点数の高い順に並べます。原著論文の Global Search と同じく、重要度の高い要点から reduce の文脈に入るようにするためです。
- global_search(texts, question, usage): (a) texts の1つずつについて map の要点を書かせ、(b) 点数の順に並べ、(c) 並べた要点を1回で1つの答えにまとめさせます。texts にレポートを渡せば GraphRAG の Global Search、元の文書のまとまりを渡せば元の文書の map-reduce になります。同じ関数で比べるので、違いは「何を読むか」だけになります。
- pack(docs, max_tokens): 文書を順に詰めて、max_tokens を超えないまとまりに分けます。3,000トークンにしたのは、長い文書の要約の記事と同じ設定にそろえて、結果を比べられるようにするためです。600件は13個のまとまりになります。
- 表示: 読むものの数、map の要点に出てきたテーマの数、答えが触れたテーマの数と見落としたテーマ、使用量を表示します。要点と答えを比べると、テーマが落ちたのが map の段階か reduce の段階かが分かります。
実行結果
GraphRAG(C0 のレポート): 読むもの 13件  要点にあるテーマ 5  回答が触れたテーマ 5 / 6  見落とし ['rockfall']  呼び出し 14  入力 4,876  時間 12.5 秒
- Shelter challenges for hikers
- Safety concerns and hut closures
- Wildlife affected by environmental changes
- Multiple huts closed or facing closure
- Trash collection needed for environment
- Maintenance issues
- Avalanche activity
- Threat to snow lilies
- Decline in rock ptarmigan population
- Sustainability concerns
- Overcrowding during peak seasons
- Trails and habitats interconnected
- Trail closures
- Late summer climbing season
- Optimal climbing season
- Early summer climbing season
- Potential hut closures
- Impact on visitor experience
- Infrastructure maintenance issues
- Seasonal restrictions
- Recreational activities harming flora and fauna
- Need for maintenance and management
- Potential closure of mountain huts
- Climbing conditions
- Lack of successors for hut keepers
- Elevation challenges
- Need for ongoing management
- Need for improved infrastructure
- Sustainable management practices required
- Lack of clear information on specific challenges
- Importance for outdoor recreation and ecological studies
- Need for continued management and support
- Elevation challenges again
- Importance of rangers in protection
- Safety risks due to lack of proper infrastructure
- Seasonal climbing recommendations
- Need for coordinated efforts
- Concerns about trail maintenance
- Varying trail starting points
- Diverse opportunities for hiking and outdoor recreation
GraphRAG(C1 のレポート): 読むもの 25件  要点にあるテーマ 5  回答が触れたテーマ 5 / 6  見落とし ['rockfall']  呼び出し 26  入力 7,987  時間 11.5 秒
Poaching of snow lilies
Potential hut closures
Environmental trash collection needed
Multiple trail origins
Trail access issues
Maintenance needs
Decline in rock ptarmigan nesting sites
Trail closures
Late summer optimal climbing time
Need for increased conservation resources
Multiple large avalanches
Need for safety and environmental management
Dependence on a single access point
Heightened risk period
Impact on nesting grounds
Seasonal climbing conditions
Lack of successors for keepers
Varying conditions affecting visitor access
Hut closures during certain periods
Need for community support
Environmental impact
Lack of detailed trail information
Importance of continuous monitoring
Potential environmental changes
Specific elevations affecting accessibility
Varying trail elevations
Wide elevation ranges
Potential for overcrowding
Need for safety measures
Base starting points availability
Need for coordinated efforts
Limited alternative accommodation options
Significant elevations
Specific seasons recommended for climbing
Elevation offers significant challenge
元の文書の map-reduce: 読むもの 13件  要点にあるテーマ 6  回答が触れたテーマ 5 / 6  見落とし ['ptarmigan']  呼び出し 14  入力 37,965  時間 13.0 秒
- Trail closures due to rockfall
- Snow lily poaching
- Declining wildlife populations
- Hut closure due to retirement
- Potential closure of huts due to retirement of keepers
- Rockfall poses a risk to climbers
- Littering by hikers
- Seasonal climbing restrictions
- Presence of large avalanches
- Wildlife or plant damage
- Closure of upper trails
- Keeper retirements with no successors
- Decreased wildlife nesting
- Digging and taking of snow lilies
- Recent avalanches reported
- Trash left by hikers
英語の出力の日本語訳:
- C0 のレポートの答え:「登山者の避難所の課題/安全上の懸念と山小屋の閉鎖/環境の変化に影響される野生生物/いくつもの山小屋の閉鎖やそのおそれ/環境のためのごみの回収が必要/保守の問題/雪崩の発生/スノーリリーへの脅威/ライチョウの減少」に続けて、持続可能性、ピークシーズンの混雑、登山道の閉鎖(Trail closures)、登山の季節、インフラの保守、管理人の後継者不足 など、31個の項目を挙げている。
- C1 のレポートの答え:「スノーリリーの盗掘/山小屋の閉鎖のおそれ/環境のためのごみの回収が必要/登山道の起点が複数ある/登山道へのアクセスの問題/保守の必要/ライチョウの巣の減少/登山道の閉鎖(Trail closures)/晩夏が登山の最適期/保全の資源を増やす必要/いくつもの大きな雪崩」に続けて、管理人の後継者不足、標高、混雑など、24個の項目を挙げている。
- 元の文書の map-reduce の答え:「落石による登山道の閉鎖/スノーリリーの盗掘/野生生物の個体数の減少/引退による山小屋の閉鎖/管理人の引退による山小屋の閉鎖のおそれ/落石は登山者に危険/登山者のポイ捨て/季節ごとの登山の制限/大きな雪崩の存在/野生生物や植物の被害/上部の登山道の閉鎖/後継者のいない管理人の引退/野生生物の巣の減少/スノーリリーの掘り取りと持ち去り/最近報告された雪崩/登山者が残したごみ」
| 方法 | 読むもの | 答えが触れたテーマ | 見落とし | 呼び出し | 入力トークン | 時間 |
|---|---|---|---|---|---|---|
| GraphRAG(C0 のレポート) | レポート13件 | 5 / 6 | 落石 | 14 | 4,876 | 12.5 秒 |
| GraphRAG(C1 のレポート) | レポート25件 | 5 / 6 | 落石 | 26 | 7,987 | 11.5 秒 |
| 元の文書の map-reduce | 文書のまとまり13個 | 5 / 6 | ライチョウ | 14 | 37,965 | 13.0 秒 |
3つの方法を並べると、次のようになります。
(図は、diagram-designで作成)
- 質問のたびに読むトークンは、元の文書の13〜21%: どの方法も6テーマ中5つに触れましたが、GraphRAG が読んだのは、C0 で4,876トークン、C1 で7,987トークンで、元の文書の map-reduce(37,965トークン)の13%と21%でした。インデキシングでレポートにまとめておいた分、質問のたびの手間が減っています。
- ライチョウは、元の文書の map-reduce では言い換えで消えた: 元の文書の map-reduce の要点には6テーマすべてがあり、答えにも「野生生物の個体数の減少」「野生生物の巣の減少」が入っています。ただ、ライチョウという語が「野生生物」に言い換えられたので、ライチョウのテーマには触れていないと数えました。長い文書の要約の記事で見たのと同じ言い換えです。
- GraphRAG は、いちばん多い落石を落とした: 150件と最も多い落石の問題が、GraphRAG の答えには出てきませんでした。答えにあるのは「登山道の閉鎖(Trail closures)」だけで、要点の段階ですでに、落石という語は消えていました。レポートには6テーマすべてがあったはずなのに、なぜでしょうか。次の節で、原因を確かめます。
- 答えの長さ: GraphRAG の答えは、要点を並べただけの長い一覧になりました。C0 では40項目あり、「登山の季節」「標高」のような問題ではない項目も多く入っています。レポートに問題の外の話が混ざっていたことが、そのまま答えに出ています。
なぜ落石を落としたのか
グラフのエッジに貯めた関係の説明に、テーマの語が何回出てくるかを数えます。
# 関係の説明(エッジに貯めた説明)に、テーマの語が何回出てくるかを数える
descriptions = [d for _, _, a in G.edges(data=True) for d in a["descriptions"]]
for t, (count, pattern, _) in THEMES.items():
    n = sum(bool(re.search(pattern, d, re.IGNORECASE)) for d in descriptions)
    print(f"{t:15s} 文書 {count:3d}件  関係の説明に出てくる回数 {n:3d}")
n_keeper = sum(bool(re.search(r"keeper|successor", d, re.IGNORECASE)) for d in descriptions)
print(f"  うち、山小屋の問題(keeper・successor)まで書いてある説明: {n_keeper}")
print("ridge safety office と mount fuhoha のエッジの説明:", G["ridge safety office"]["mount fuhoha"]["descriptions"])
グラフの全エッジの説明(1,752個)について、テーマごとの正規表現が見つかった数を数えるコードです。
- descriptions: 全エッジの descriptions のリストを1つにつないだものです。同じ2つのノードの組から何度も説明が貯まったエッジもあるので、エッジの数(1,725)より多い1,752個になり、抽出した関係の数と一致します。
- 山小屋の問題の数え方: 山小屋のテーマの正規表現は、山小屋(hut)という語にも当たります。山小屋の説明のうち、問題(管理人・後継者)まで書いてあるものを別に数えて、山小屋があるという説明と区別します。
実行結果
rockfall        文書 150件  関係の説明に出てくる回数   1
hut_keeper      文書 100件  関係の説明に出てくる回数 140
plant_poaching  文書  60件  関係の説明に出てくる回数  61
ptarmigan       文書  30件  関係の説明に出てくる回数  30
avalanche       文書  15件  関係の説明に出てくる回数  15
litter          文書   8件  関係の説明に出てくる回数   8
  うち、山小屋の問題(keeper・successor)まで書いてある説明: 23
ridge safety office と mount fuhoha のエッジの説明: ['the Ridge Safety Office closed the upper trail of Mount Fuhoha']
英語の出力の日本語訳:
- ridge safety office と mount fuhoha のエッジの説明:「尾根安全事務所が Fuhoha 山の上部の登山道を閉鎖した」
(図は、diagram-designで作成)
テーマごとに、文書の数と関係の説明に出てくる回数を並べると、次のようになります。
(図は、diagram-designで作成)
- 落石は、関係の説明に1回しか出てこない: 落石の文書は150件あるのに、関係の説明に落石という語が出てきたのは1回だけでした。落石の文「落石が続いたため、尾根安全事務所は〜山の上部の登山道を閉鎖した」から、LLM は「尾根安全事務所」と「〜山」の2つのエンティティと、その間の関係「上部の登山道を閉鎖した」を取り出しました。原因の落石は、エンティティでも、2つのエンティティの間の関係でもないので、どこにも書かれませんでした。
- ほかの問題は、関係の説明に残った: 盗掘・ライチョウ・雪崩・ごみは、文書の数とほぼ同じ回数、説明に出てきます。スノーリリーやライチョウは生物(species)として、雪崩監視班やクリーン・サミット・ボランティアは組織として、問題そのものがエンティティになり、関係の説明にも問題が書かれたからです。
- 山小屋の問題も、多くが落ちていた: 山小屋の説明は140個ありますが、管理人や後継者まで書いてあるのは23個で、残りは「Fumiho 山に山小屋がある」のように、山小屋があることだけを書いた説明でした。山小屋のテーマが答えに残ったのは、その23個がレポートと答えに拾われたからです。
- レポートと答えには、残ったものしか出てこない: レポートは、関係の説明だけを読んで書かれます。落石の150件は、どのレポートにも「登山道の閉鎖」として入り、落石という語が出てきたのは、C0 と C1 のレポートでそれぞれ1行だけでした。その結果、Global Search の答えも「登山道の閉鎖」になりました。
GraphRAG は、文書をそのまま読むのではなく、抽出したエンティティと関係を通して 文書の集まりを見ます。抽出で落ちたことは、後のどの段階でも取り戻せません。原著論文は、この弱点を補うために、エンティティについての事実(出来事・日付など)を「claim(主張)」として別に抽出する工夫や、抽出を読み直させて漏れを拾う「gleaning」を使っています。自分のコーパスで使うときは、数十件の文書の抽出を目で確かめ、問題の原因のような、エンティティにならない情報が残っているかを確かめることが大切です。
RAPTOR と比べる
RAPTOR の記事では、同じ600件と同じ問いで、埋め込みのクラスタリングと要約を繰り返して作った要約の木から検索しました。GraphRAG と RAPTOR は、どちらもインデキシングのときに全体をまとめておく方法ですが、まとめ方が違います。
(図は、diagram-designで作成)
| 方法 | インデキシング | 質問のたび | 答えが触れたテーマ |
|---|---|---|---|
| 普通の RAG(K=10) | なし(埋め込みだけ) | 1回、723トークン | 3 / 6 |
| 元の文書の map-reduce | なし | 14回、37,965トークン | 5 / 6(ライチョウを見落とし) |
| RAPTOR(collapsed tree) | 要約140回、入力約6万5千トークン、約2.5分 | 1回、約2,000トークン | 5 / 6(雪崩を見落とし) |
| GraphRAG(C0 のレポート) | 638回、入力約18万3千トークン、約4.7分 | 14回、4,876トークン | 5 / 6(落石を見落とし) |
RAPTOR の数値は、RAPTOR の記事の実験の結果です。
- 全体を俯瞰する問いだけなら、このコーパスではグラフは要らなかった: RAPTOR は、GraphRAG の約3分の1のインデキシングの入力トークンで、同じ5テーマに触れました。質問のたびの手間も、collapsed tree は上位のノードを1回読むだけで、GraphRAG の Global Search(14回)より少なく済みます。
- それぞれ、まとめる段階で落ちるものが違う: RAPTOR は、件数の少ない雪崩(15件)を、要約を重ねる途中で落としました。GraphRAG は、エンティティにならない原因の落石を、抽出の段階で落としました。元の文書の map-reduce は、ライチョウを「野生生物」に言い換えました。どの方法も、何かをまとめる段階で情報を落とすので、落ちやすいものが自分の問いにとって大事かどうかで選びます。
GraphRAG にあって RAPTOR にないものは、インデキシングの後にも グラフが残る ことです。次の節で、グラフが役立つ問いを確かめます。
グラフが役立つのは、関係をたどる問い
「Hayate 山脈で、落石のために上部の登山道が閉鎖された山はいくつか」という問いを考えます。答えるには、「Hayate 山脈の峰である」と「尾根安全事務所に登山道を閉鎖された」という、2つの関係の両方を持つ山を、もれなく数える必要があります。グラフをたどる方法、普通の RAG、Global Search で比べます。
# 関係をたどる問い:Hayate 山脈で、落石のために上部の登山道が閉鎖された山はいくつか
COUNT_QUESTION = ("How many mountains in the Hayate Range had their upper trail closed after rockfall? "
                  "Answer with a number.")
truth = sorted(d["mountain"] for d in docs if d["range"] == "Hayate" and d["theme"] == "rockfall")

# グラフをたどる:「hayate range」と「ridge safety office」の両方につながっている山のノード
both = set(G.neighbors("hayate range")) & set(G.neighbors("ridge safety office"))
from_graph = sorted(n for n in both if n.startswith("mount "))
print(f"正解: {len(truth)}山  グラフをたどった数: {len(from_graph)}山  "
      f"一致: {len({'mount ' + m.lower() for m in truth} & set(from_graph))}山")

usage = new_usage()
rag_answer, _ = top_k_rag(docs, doc_vecs, COUNT_QUESTION, 20, usage)
global_answer, _ = global_search(reports["C1"], COUNT_QUESTION, new_usage())
print("普通の RAG(K=20)の答え:", rag_answer)
print("Global Search(C1)の答え:", global_answer)
関係をたどる問いに、グラフ・普通の RAG・Global Search で答えさせるコードです。
- truth: コーパスを作るときに記録した山脈とテーマから、正解の山を数えます。
- グラフをたどる: 「hayate range」の隣のノードの集合と、「ridge safety office」の隣のノードの集合の共通部分を取り、名前が「mount 」で始まるものを数えます。抽出では、落石の関係は「尾根安全事務所 → 山」のエッジとして残っていたので、落石という語がなくても、この2つのノードの両方につながる山として数えられます。ここでは問いに合わせて、たどる2つのノードを手で選んでいます。質問からノードを選んでたどるところまでを LLM に任せる方法が、GraphRAG の Local Search の考え方です。
- 普通の RAG(K=20)と Global Search(C1): 全体を俯瞰する問いと同じ関数で、問いだけを変えて答えさせます。
実行結果
正解: 36山  グラフをたどった数: 36山  一致: 36山
普通の RAG(K=20)の答え: There are 12 mountains in the Hayate Range that had their upper trails closed after repeated rockfall according to the provided information.
Global Search(C1)の答え: Based on the provided notes, three mountains in the Hayate Range had their upper trails closed after rockfall.
英語の出力の日本語訳:
- 普通の RAG の答え:「与えられた情報によると、落石が続いたために上部の登山道が閉鎖された Hayate 山脈の山は12山です。」
- Global Search の答え:「メモによると、落石のために上部の登山道が閉鎖された Hayate 山脈の山は3山です。」
3つの方法の答えを並べると、次のようになります。
(図は、diagram-designで作成)
正解の36山に対して、グラフをたどった数は36山で、山の名前もすべて一致しました。普通の RAG は、上位20件に入った文書の中から数えたので12山と答え、Global Search は、レポートに名前の挙がった山だけから数えたので3山と答えました。どちらも、読んだ範囲の外にある山を数えられません。全部の山を数えるには、要約ではなく、関係そのものをたどる必要があります。このような問いでは、Global Search ではなく、グラフをたどる Local Search の方が向いています。グラフの辺をたどって、質問に名前の出てこない文書まで1回の検索で集める方法には、HippoRAG もあります。
結果のまとめ
ここまでの結果を、1つの表にまとめます。
print(f"{'方法':32s} テーマ  呼び出し  入力トークン  時間(秒)")
for name, r in results.items():
    print(f"{name:32s} {r['themes']} / 6  {r['calls']:4d}  {r['input_tokens']:10,}  {r['seconds']:8.1f}")
total = {k: sum(u[k] for u in index_usage.values()) for k in ["calls", "input_tokens", "output_tokens", "seconds"]}
print(f"インデキシングの合計: 呼び出し {total['calls']}回  入力 {total['input_tokens']:,}  出力 {total['output_tokens']:,}  "
      f"時間 {total['seconds']:.0f} 秒")
方法ごとの答えが触れたテーマの数と、質問のたびの使用量を並べ、インデキシングの合計の使用量を表示するコードです。results は、普通の RAG と Global Search のコードで、方法の名前ごとに貯めておいた辞書で、index_usage は、抽出と2つの階層のレポートの使用量です。
実行結果
方法                               テーマ  呼び出し  入力トークン  時間(秒)
普通の RAG(K=5)                     3 / 6     1         391       1.0
普通の RAG(K=10)                    3 / 6     1         723       0.6
普通の RAG(K=20)                    3 / 6     1       1,388       0.7
普通の RAG(K=50)                    4 / 6     1       3,329       1.8
普通の RAG(K=100)                   6 / 6     1       6,553       2.0
GraphRAG(C0 のレポート)               5 / 6    14       4,876      12.5
GraphRAG(C1 のレポート)               5 / 6    26       7,987      11.5
元の文書の map-reduce                 5 / 6    14      37,965      13.0
インデキシングの合計: 呼び出し 638回  入力 182,763  出力 64,612  時間 283 秒
| 問い | 普通の RAG | GraphRAG の Global Search | グラフをたどる |
|---|---|---|---|
| 主な問題は何か(6テーマ) | K=10 で3、K=100 で6 | C0・C1 とも5(落石を見落とし) | - |
| Hayate 山脈で落石のあった山はいくつか(正解36) | 12(K=20) | 3(C1) | 36 |
原著論文と本記事の設定
| 原著論文 | 本記事 | 理由 | |
|---|---|---|---|
| 文書 | ポッドキャストの書き起こし(約100万トークン)、ニュース記事(約170万トークン) | 架空の山の紹介文600件(約3万5千トークン) | 答えの分かっている問いを作り、テーマの数で採点するため |
| チャンク | 600トークン(100トークンの重なり) | 1件(約60トークン)をそのまま | 1件が1つの山についての話なので、切ると意味が分かれるため |
| LLM | gpt-4-turbo など GPT-4 系 | Qwen2.5-7B-Instruct | 手元の GPU で動かすため |
| 抽出 | エンティティ・関係・claim、gleaning あり | エンティティと関係だけ、gleaning なし | 仕組みを最小限で確かめるため。claim がないことの影響は、落石の見落としとして現れた |
| 名寄せ | 名前の完全一致 | 小文字にして先頭の the を外す | 「the Ridge Safety Office」の揺れをそろえるため |
| コミュニティ | 階層的な Leiden 法(graspologic)、C0〜C3 の4階層 | Leiden 法(leidenalg)、C0・C1 の2階層 | 600件では C0 のコミュニティが最大78ノードと小さく、2階層で粗い・細かいを比べられるため |
| レポート | タイトル・要約・重要度・要点の JSON | タイトルと要点3〜5個 | Global Search で使う要点に絞るため |
| 評価 | LLM による2つの答えの比較(網羅性・多様性など) | 仕込んだ6テーマのうち、答えが触れた数 | 答えの分かっている問いなので、数えて採点できるため |
原著論文の結果
原著論文は、ポッドキャストの書き起こし(1,669チャンク)とニュース記事(3,197チャンク)で、GraphRAG を評価しました。ポッドキャストのグラフは8,564ノード・20,691エッジで、インデキシングには gpt-4-turbo で281分かかっています。
評価には、LLM に「このコーパスを使う人が尋ねそうな、全体を俯瞰する問い」を各コーパス125個作らせて使いました。答えが1つに決まらないので、2つの方法の答えを LLM に並べて見せ、どちらが良いかを、網羅性(問いのあらゆる側面を扱っているか)、多様性(いろいろな視点を示しているか)、エンパワーメント(読み手の理解と判断に役立つか)、直接性(端的に答えているか)の観点で判定させています。
- 普通の RAG に対して: GraphRAG の Global Search は、普通の RAG(ベクトル検索)に対して、網羅性で72〜83%(ポッドキャスト)・72〜80%(ニュース)、多様性で75〜82%・62〜71%の勝率でした。直接性では普通の RAG が上回り、端的な答えになる代わりに、全体の網羅は犠牲になっています。
- 元の文書の map-reduce(TS)に対して: 細かい階層のレポートでは、網羅性と多様性で小さいながら一貫した勝ちを示しました(網羅性の勝率は、ポッドキャストの C2 で57%、ニュースの C3 で64%)。最も粗い C0 では、TS に勝てませんでした。
- 質問のたびに読むトークン: ポッドキャストでは、TS の1,014,611トークンに対し、C0 のレポートは26,657トークン(2.6%)、C1 は225,756トークン(22.2%)でした。
| 階層 | レポートの数(ポッドキャスト) | トークン数 | TS に対する割合 |
|---|---|---|---|
| C0 | 34 | 26,657 | 2.6% |
| C1 | 367 | 225,756 | 22.2% |
| C2 | 969 | 565,720 | 55.8% |
| C3 | 1,310 | 746,100 | 73.5% |
| TS(元の文書) | 1,669 | 1,014,611 | 100% |
本記事の実験でも、C0 のレポートは元の文書の13%、C1 は21%のトークンで、元の文書の map-reduce と同じ5テーマに触れました。ただし、原著論文が報告した TS への勝ちは、本記事では見られず、抽出で落ちた落石を見落としました。
使い分け
| 問いの種類 | 向いている方法 | 理由(本記事の実験から) |
|---|---|---|
| 答えが数件の文書に書いてある | 普通の RAG | 検索で取れれば、1回の呼び出しで答えられる |
| 全体の傾向・主な問題をまとめる(質問が少ない) | 元の文書の map-reduce | インデキシングが要らない。質問のたびの入力は約3万8千トークン |
| 全体の傾向・主な問題をまとめる(質問が多い) | RAPTOR、GraphRAG の Global Search | インデキシングでまとめておけば、質問のたびの手間が減る。グラフが要らなければ RAPTOR の方が安い |
| 関係をたどって、もれなく数える・集める | グラフをたどる(GraphRAG の Local Search) | 普通の RAG は12山、Global Search は3山と、読んだ範囲でしか数えられなかった。グラフは36山すべてを数えた |
- まず、問いの種類を分ける: 利用者の問いが、特定の事実を尋ねるものか、全体を俯瞰するものか、関係をたどって数えるものかを、実際の問いで確かめます。特定の事実がほとんどなら、普通の RAG で十分です。
- 全体を俯瞰する問いには、安い方法から試す: インデキシングの手間は、元の文書の map-reduce(なし)、RAPTOR、GraphRAG の順に大きくなります。本記事では、GraphRAG のインデキシングは、コーパスの約5倍の入力トークンを使いました。文書が追加・更新されるたびに、抽出とレポートを作り直す必要もあります。コミュニティのレポートを作らずに、エンティティと関係をキーワードで探し、文書の追加も差分で済ませる方法に、LightRAG があります。
- 抽出を確かめる: GraphRAG の答えは、抽出で残ったものからしか作られません。数十件の文書の抽出を目で確かめ、エンティティの種類やプロンプトの例を、自分のコーパスに合わせて直してから、全部の文書に使います。問題の原因のように、エンティティにならない情報が大事なら、claim の抽出を加えます。
- レポートの中身を確かめる: 本記事のコミュニティは山脈と村でまとまり、レポートには問題と関係のない話も混ざりました。いくつかのレポートを読み、問いに関わる内容でまとまっているかを確かめます。
まとめ
本記事では、全体を俯瞰する問いに答える GraphRAG を、架空の山岳コーパス(600件)と Qwen2.5-7B-Instruct で、普通の RAG、元の文書の map-reduce、RAPTOR と比べました。
- 普通の RAG は、上位 K 件の外を読めない: 「主な問題は何か」に、 = 10 では6テーマ中3つにしか触れず、6つすべてに触れたのは = 100(約6,500トークン)のときでした。上位 件に入らなかった文書は、答えに使われません。
- インデキシングの手間: 600件からの抽出で、ノード728個・エッジ1,725本のグラフを作り、Leiden 法で C0 の13個、C1 の25個のコミュニティに分けて、レポートを書きました。LLM の呼び出しは638回、入力は約18万3千トークン(コーパスの約5倍)、時間は283秒でした。
- Global Search: C0 と C1 のレポートを map-reduce で読み、どちらも6テーマ中5つに触れました。質問のたびに読んだトークンは、元の文書の map-reduce の13%と21%でした。ただし、150件と最も多い落石を見落としました。抽出で、落石は関係の説明に1回しか残らず、「登山道の閉鎖」になっていたからです。
- グラフが役立ったのは、関係をたどる問い: 全体を俯瞰する問いだけなら、RAPTOR が約3分の1のインデキシングの入力トークンで、同じ5テーマに触れました。一方、「Hayate 山脈で落石のあった山はいくつか」には、普通の RAG は12山、Global Search は3山と答え、グラフをたどる方法だけが正解の36山を数えました。
GraphRAG の出発点は、上位 件を選ぶ検索では、答えが文書の集まり全体に散らばった問いに答えきれず、質問の前に全体をまとめておく必要がある、という考えです。そのまとめ方にグラフを使う価値は、全体の要約よりも、インデキシングの後に残るグラフで関係をたどれることにあります。
参考文献
- D. Edge, H. Trinh, N. Cheng, J. Bradley, A. Chao, A. Mody, S. Truitt, D. Metropolitansky, R. O. Ness, J. Larson (2024). From Local to Global: A GraphRAG Approach to Query-Focused Summarization. arXiv:2404.16130.
- microsoft/graphrag. 原著論文の公開コード(MIT License).
- V. A. Traag, L. Waltman, N. J. van Eck (2019). From Louvain to Leiden: guaranteeing well-connected communities. Scientific Reports, 9, 5233.
- P. Sarthi, S. Abdullah, A. Tuli, S. Khanna, A. Goldie, C. D. Manning (2024). RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval. ICLR 2024.
- N. Reimers, I. Gurevych (2019). Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks. EMNLP-IJCNLP 2019.
- Qwen Team (2024). Qwen2.5-7B-Instruct. Hugging Face(Apache License 2.0).
本記事の文章・構成の一部に生成AIを使用しています。