Grounding DINOとは?
 (画像は、Geminiで作成)
テキストで指定した物体を検出する Grounding DINO を部品ごとに PyTorch で実装し、公式の学習済みの重みを読み込んで Hugging Face の実装と同じ検出結果になることを確かめること。画像とテキストを混ぜる仕組みと、クラスの層を持たずに「クエリとトークンの内積」で分類する仕組みを理解し、損失を自分で書いて新しい単語を学習させられるようになること。
参考資料: Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection (Liu et al., ECCV 2024)。公式の実装は IDEA-Research/GroundingDINO(Apache-2.0)、本記事で使う学習済みの重みは Hugging Face の IDEA-Research/grounding-dino-tiny(Apache-2.0)です。
概要
YOLO や RT-DETR のような物体検出のモデルは、学習で決めたクラス(COCO なら 80 クラス)しか検出できません。クラスごとの確率を出す最後の層の大きさが、クラスの数で決まっているからです。新しい種類の物体を検出したければ、その物体の画像を集めて学習し直す必要があります。
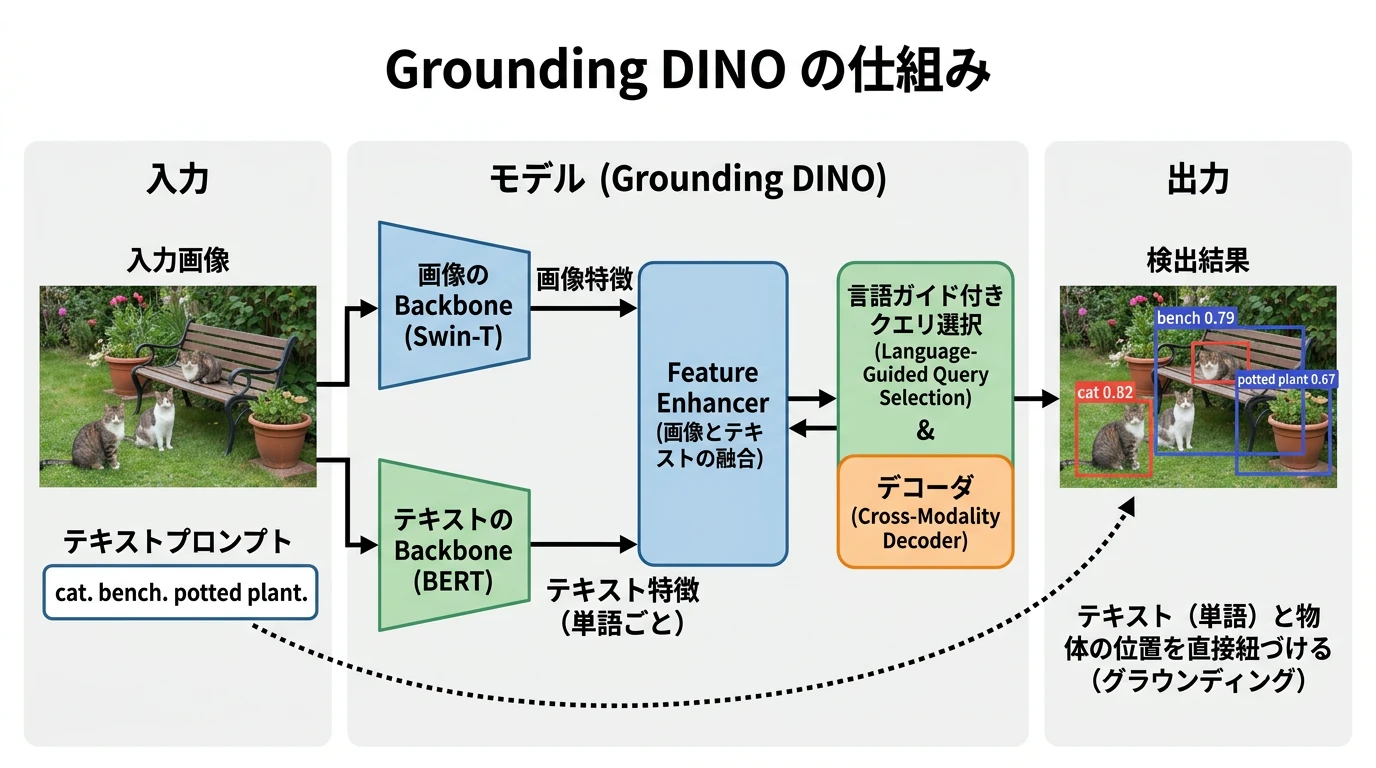
Grounding DINO(IDEA Research, 2023)は、「cat. bench. potted plant.」のようなテキストを画像と一緒に入力し、テキストに書いた物体を検出するオープンセットの物体検出モデルです。クラスの層を持たず、物体の候補(クエリ)の特徴とテキストの各単語(トークン)の特徴の内積を、その単語に当たる確率にします。テキストを書き換えるだけで、検出する対象を変えられます。
Grounding DINO は、RT-DETR の記事で実装した DETR 系の検出器 DINO に、次の 3 つを加えたモデルです。
- Feature Enhancer: 画像の特徴とテキストの特徴を、双方向の注意で何度も混ぜます。
- Language-Guided Query Selection: テキストとよく似た画像の位置を、デコーダのクエリの出発点にします。
- Cross-Modality Decoder: デコーダの各層で、画像に加えてテキストにも注意をかけます(デコーダの Cross-Attention の基本はTransformer の記事)。
本記事では、まず Hugging Face の実装でテキストの書き方による検出の違いを確かめ、仕組みを図で整理したうえで、Grounding DINO-T をスクラッチで実装します。
テキストの書き方で検出が変わる
準備:Google Colab の GPU で動かす
本記事のコードは、Google Colab の A100 GPU で実行しました。「ランタイム」→「ランタイムのタイプを変更」から A100 GPU を選んでください(Colab の有料プランが必要です)。後半の追加学習は、A100 で約 15 分かかります。L4 GPU でも動きますが、時間はもっとかかります。
新しいセッションで、次を実行してください。pycocotools は実験3の COCO の評価に使います。transformers(比較用の Grounding DINO と、テキストを単語に分けるトークナイザ)と scipy(ハンガリアン法)は Colab に最初から入っています。グラフの日本語表示には japanize-matplotlib を使い、Python 3.12 以降で import 時にエラーが出ないよう setuptools も入れます。
!pip install -q pycocotools japanize-matplotlib setuptools
推論に利用する画像
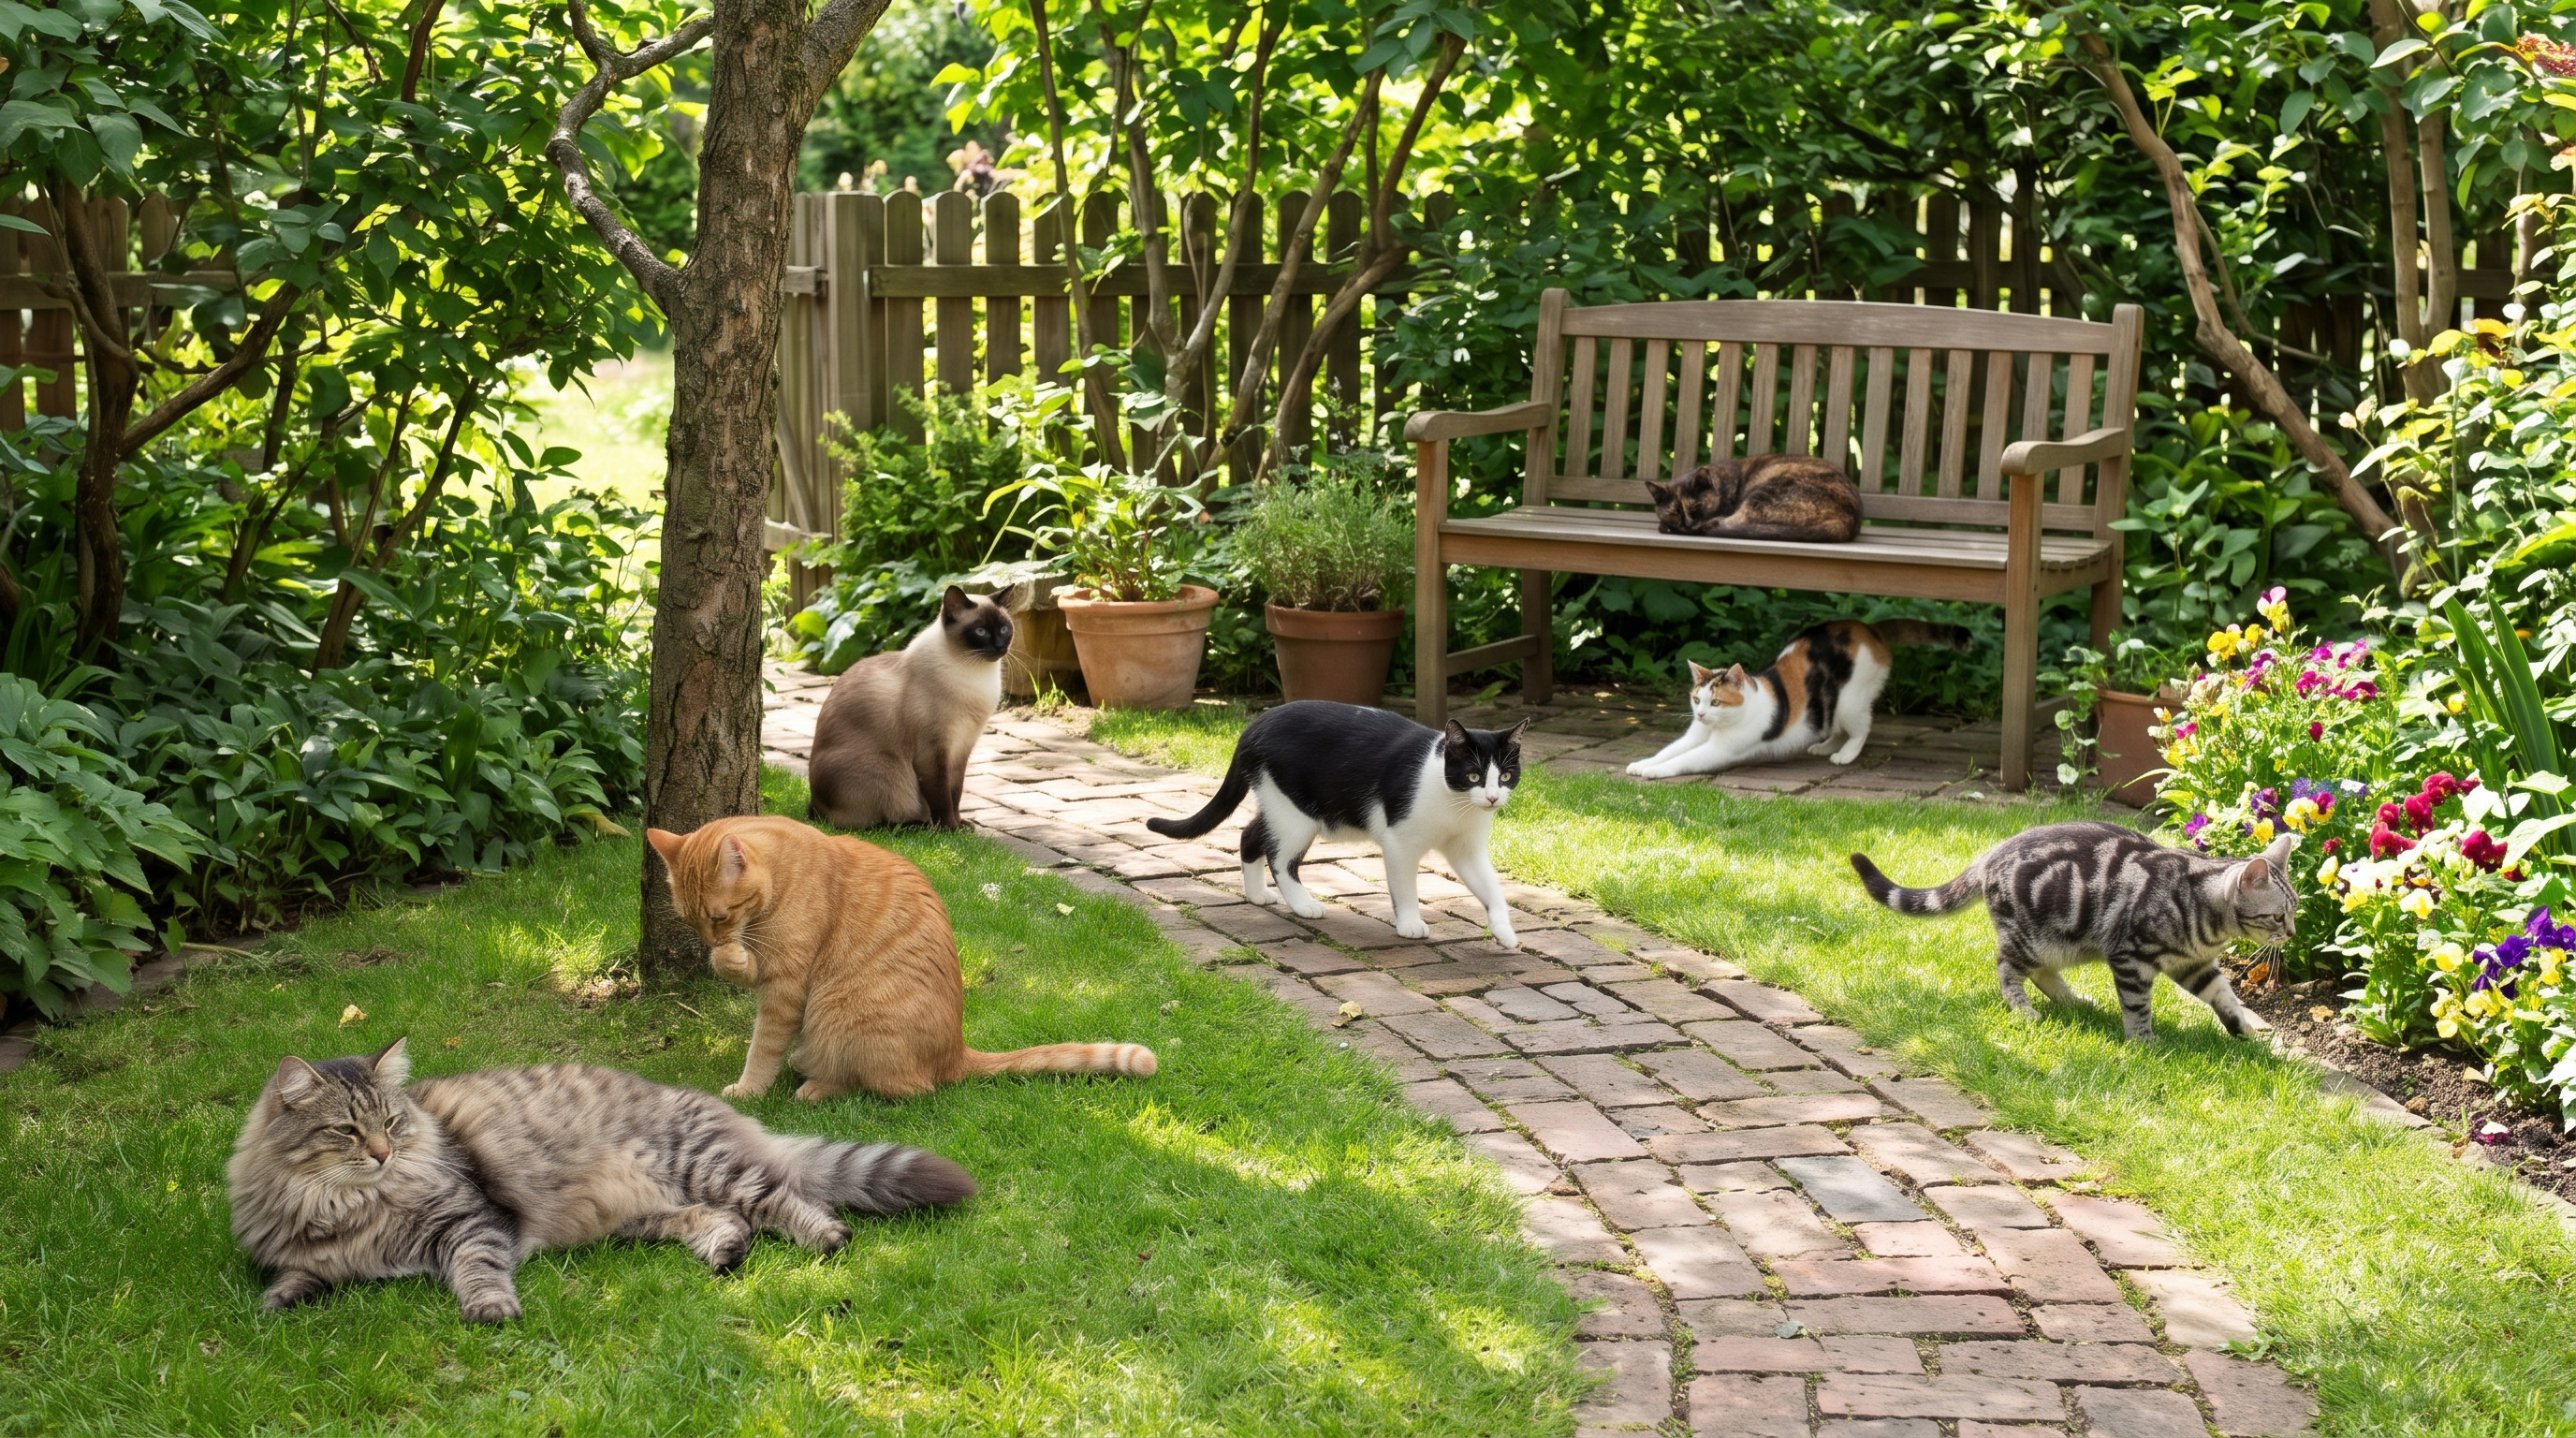
実験1と実験2では、庭にいる複数の猫の画像を使います。次の画像を保存し、cats.jpg という名前で Colab にアップロードしてください(画像は、Geminiで作成)。
実験1:4 つのプロンプトで検出する
Hugging Face の実装で、同じ画像に 4 つのプロンプト(テキスト)を与えて、検出結果を比べます。
import numpy as np
import torch
import matplotlib.pyplot as plt
import japanize_matplotlib
from PIL import Image
from transformers import AutoModelForZeroShotObjectDetection, AutoProcessor

device = "cuda"
hf_model = AutoModelForZeroShotObjectDetection.from_pretrained("IDEA-Research/grounding-dino-tiny").to(device).eval()
processor = AutoProcessor.from_pretrained("IDEA-Research/grounding-dino-tiny")
image = Image.open("cats.jpg").convert("RGB")


def detect_hf(prompt, box_threshold=0.35, text_threshold=0.25):
    """Hugging Face の実装で検出する。句は「.」で区切り、小文字で書く"""
    inputs = processor(images=image, text=prompt, return_tensors="pt").to(device)
    with torch.no_grad():
        outputs = hf_model(**inputs)
    return processor.post_process_grounded_object_detection(
        outputs, inputs["input_ids"], threshold=box_threshold, text_threshold=text_threshold,
        target_sizes=[image.size[::-1]])[0]


prompts = ["cat.", "cat. bench. potted plant.", "black and white cat.", "the cat on the bench."]
fig, axes = plt.subplots(2, 2, figsize=(16, 9.5))
for ax, prompt in zip(axes.flat, prompts):
    r = detect_hf(prompt)
    print(f"「{prompt}」: {len(r['scores'])} 個")
    for box, score, label in zip(r["boxes"], r["scores"], r["text_labels"]):
        print(f"    {label:<22s} {score:.2f}  箱 {[round(v) for v in box.tolist()]}")
    ax.imshow(image)
    for (x0, y0, x1, y1), score, label in zip(r["boxes"].tolist(), r["scores"].tolist(), r["text_labels"]):
        ax.add_patch(plt.Rectangle((x0, y0), x1 - x0, y1 - y0, fill=False, color="red", lw=2))
        ax.text(x0, y0 - 10, f"{label} {score:.2f}", color="white", fontsize=9, backgroundcolor="red")
    ax.set_title(f"「{prompt}」({len(r['scores'])} 個)", fontsize=13)
    ax.axis("off")
plt.tight_layout()
plt.show()
- プロンプトの書き方: 検出したい物体を小文字で書き、「.」で区切ります。Grounding DINO は「.」で区切った 1 つ 1 つを句として扱い、句ごとに検出します。
- 閾値: box_threshold=0.35 は、クエリの確率(全トークンの確率の最大値)の閾値で、これを超えたクエリを検出にします。text_threshold=0.25 は、検出のラベルにするトークンの確率の閾値です。どちらも公式のリポジトリのデモの値です。
- プロンプト: 1 つの物体(cat)、3 つの物体(cat・bench・potted plant)、色で絞り込んだ物体(black and white cat)、位置の関係で絞り込んだ物体(the cat on the bench)の 4 つです。
実行結果
「cat.」: 7 個
    cat                    0.76  箱 [1623, 616, 1973, 781]
    cat                    0.80  箱 [225, 1035, 978, 1327]
    cat                    0.81  箱 [1145, 698, 1531, 953]
    cat                    0.80  箱 [643, 813, 1157, 1107]
    cat                    0.81  箱 [1850, 818, 2304, 1047]
    cat                    0.76  箱 [805, 581, 1024, 833]
    cat                    0.75  箱 [1643, 452, 1864, 544]
「cat. bench. potted plant.」: 11 個
    cat                    0.79  箱 [1623, 616, 1974, 782]
    bench                  0.78  箱 [1404, 288, 2145, 794]
    cat                    0.80  箱 [1850, 819, 2305, 1048]
    cat                    0.81  箱 [644, 813, 1157, 1107]
    cat                    0.82  箱 [224, 1035, 979, 1327]
    cat                    0.81  箱 [1145, 699, 1532, 953]
    cat                    0.74  箱 [1644, 453, 1865, 544]
    cat                    0.72  箱 [805, 581, 1027, 833]
    potted plant           0.68  箱 [1227, 461, 1418, 708]
    potted plant           0.65  箱 [980, 455, 1225, 712]
    potted plant           0.59  箱 [2053, 631, 2207, 810]
「black and white cat.」: 2 個
    cat                    0.45  箱 [220, 1031, 978, 1327]
    cat                    0.36  箱 [1143, 692, 1537, 954]
「the cat on the bench.」: 1 個
    bench                  0.44  箱 [1401, 283, 2147, 793]
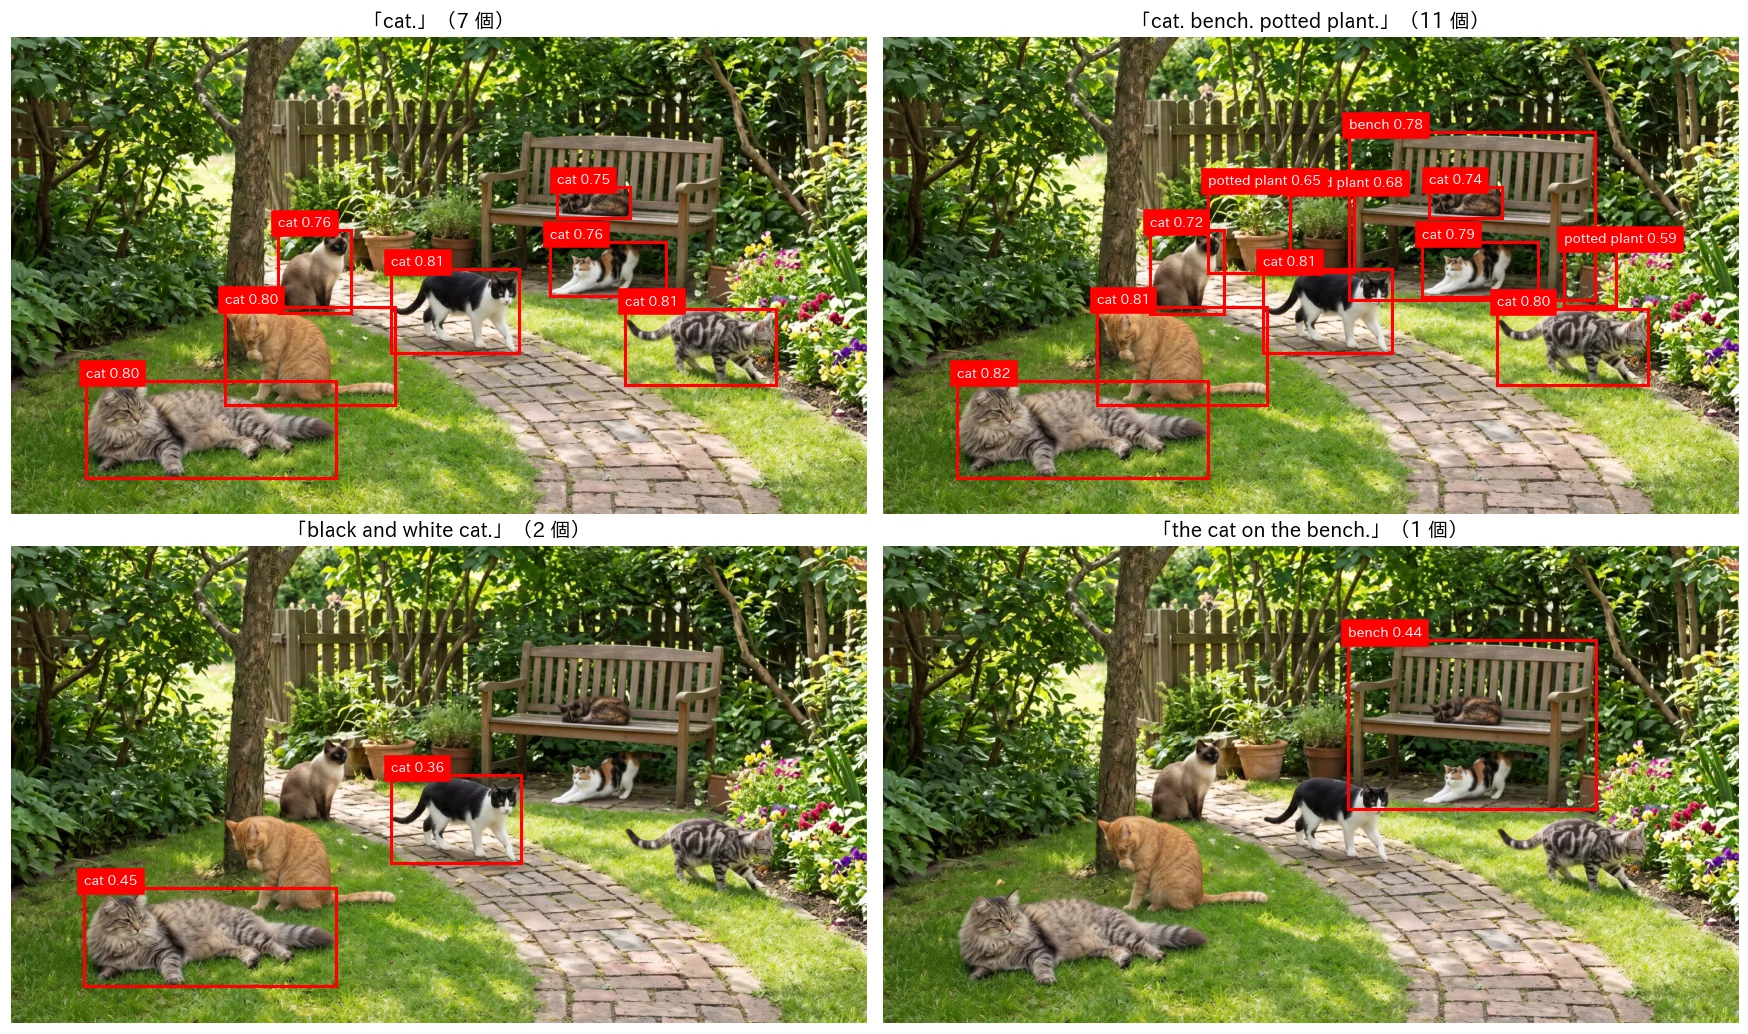
「cat.」では 7 匹の猫を、「cat. bench. potted plant.」では猫・ベンチ・鉢植えの 11 個を検出しました。プロンプトを書き換えるだけで、学習し直さずに検出の対象を変えられます。
一方、「black and white cat.」では、白黒の猫(確率 0.36)より、手前で寝ている長毛の猫(確率 0.45)の方が高い確率になり、ラベルも「cat」だけになりました。「the cat on the bench.」では、猫ではなくベンチを検出しました。Grounding DINO は、物体の名前を手がかりに検出するのは得意ですが、色や位置の関係のような細かい条件は、うまく反映できないことがあります。名前は箱ごとの正解として大量に学習していますが、細かい条件は学習データに少ないためと考えられます。
Grounding DINO の仕組み
全体の構成
Grounding DINO の全体は、次の図のとおりです(図は、後で実装する GroundingDINO クラスの構成です)。
(図は、diagram-designで作成)
- 画像の Backbone: Swin Transformer(Swin-T)で、1/8・1/16・1/32 の解像度の特徴を取り出し、1/32 の特徴にストライド 2 の畳み込みをかけて 1/64 の特徴も作ります。4 段の特徴を 256 チャンネルにそろえ、1 列に並べます(800×1333 の画像で約 2 万位置)。
- テキストの Backbone: BERT-base で、プロンプトのトークンごとに 768 次元の特徴を作り、256 次元に変換します。
- Feature Enhancer: 画像とテキストの特徴を、6 層で混ぜます。
- クエリの選択: 画像の全位置のうち、テキストとよく似た 900 位置の箱を、デコーダの参照箱にします。
- Cross-Modality Decoder: 6 層のデコーダで、900 個のクエリの箱を直します。最後の層の出力が、900 個の箱と、各トークンとの類似度(クラスの logit)です。
Feature Enhancer
(図は、diagram-designで作成)
Feature Enhancer の各層は、次の順に計算します。
- 双方向の注意(BiAttention): 画像の各位置 とテキストの各トークン の類似度 を 1 つの行列で計算し、行方向の softmax で「画像の各位置がどのトークンを見るか」を、列方向の softmax で「各トークンが画像のどの位置を見るか」を求めます。画像の特徴にテキストの情報を、テキストの特徴に画像の情報を、同時に足し込みます。足すときは、学習する係数(初期値 )を掛けます。学習の初めに、事前学習した特徴を大きく崩さないためです(layer scale)。
- 画像の Deformable 自己注意: 約 2 万位置のすべての組に注意をかけると計算が大きすぎるので、各位置の周りの少数の点(8 ヘッド × 4 段 × 4 点)だけを見る Deformable Attention(RT-DETR の記事を参照)を使います。
- テキストの自己注意: プロンプトのトークンどうしの自己注意です。このとき、次の節の「句の区切りのマスク」で、同じ句のトークンだけを見るようにします。
クエリの選択と Cross-Modality Decoder
(図は、diagram-designで作成)
- Language-Guided Query Selection: Feature Enhancer の出力の画像の各位置で、テキストの各トークンとの内積を計算し、その最大値が大きい 900 位置を選びます。テキストに書いた物体がありそうな位置から、デコーダを始めるためです。選んだ位置では、格子のアンカーの箱に修正量を足した箱を予測し、デコーダの参照箱にします。デコーダのクエリの内容は、画像の特徴ではなく、学習した 900 個の埋め込みを使います(DINO の mixed query selection)。
- Cross-Modality Decoder: 各層は、クエリどうしの自己注意 → テキストの全トークンへの注意 → 画像の参照箱の周りへの Deformable 注意 → FFN の順に計算します。層の最後で箱の修正量を予測して参照箱を直し、次の層に渡します。
句の区切りのマスクと、トークン単位の分類
(図は、diagram-designで作成)
- 句の区切りのマスク(sub-sentence level): 「cat. potted plant.」の「plant」が「cat」を見ると、関係のない句の意味が混ざります。そこで、BERT と Feature Enhancer のテキストの自己注意で、同じ句のトークンだけを見るマスクをかけ、位置の番号も句ごとに 0 から数え直します。句を並べる順番を変えても、各句の特徴が変わらないようにするためです。
- トークン単位の分類: クエリ がトークン に当たる確率は、2 つの特徴の内積の sigmoid です。
はデコーダの出力(LayerNorm の後)、 は Feature Enhancer の出力のトークンの特徴です。句の確率は、句のトークンの確率の平均にします。学習では、ハンガリアン法で正解の物体と組になったクエリについて、正解の句のトークンを 1、それ以外を 0 にした目標で、トークンごとに Focal Loss をかけます。テキストの特徴と画像の特徴を近づける対照学習で、クラスの層がないので、プロンプトに書いた語なら何でも検出の対象にできます。
Grounding DINO のスクラッチ実装
ここからは、Grounding DINO-T を部品ごとに実装します。部品の構造・次元・計算の順番は、Hugging Face の GroundingDinoForObjectDetection(公式の実装を移植したもの)と同じにしています。実験2で、学習済みの重みを読み込み、同じ検出結果になることを確かめます。
画像の Backbone:Swin-T
import math
import torch.nn as nn
import torch.nn.functional as F


def window_partition(x, ws):
    B, H, W, C = x.shape
    x = x.view(B, H // ws, ws, W // ws, ws, C).permute(0, 1, 3, 2, 4, 5)
    return x.reshape(-1, ws * ws, C)


def window_reverse(w, ws, H, W):
    C = w.shape[-1]
    x = w.view(-1, H // ws, W // ws, ws, ws, C).permute(0, 1, 3, 2, 4, 5)
    return x.reshape(-1, H, W, C)


def shift_mask(H, W, ws, shift, device):
    """巡回シフトで貼り合わされた 9 つの領域どうしの注意を消すマスク (窓の数, N, N)"""
    h = (torch.arange(H, device=device) >= H - ws).long() + (torch.arange(H, device=device) >= H - shift).long()
    w = (torch.arange(W, device=device) >= W - ws).long() + (torch.arange(W, device=device) >= W - shift).long()
    region = (h[:, None] * 3 + w[None, :]).float()[None, :, :, None]
    mw = window_partition(region, ws).squeeze(-1)
    diff = mw[:, None, :] - mw[:, :, None]
    return diff.masked_fill(diff != 0, -100.0)


class WindowAttention(nn.Module):
    def __init__(self, dim, heads, ws=7):
        super().__init__()
        self.heads, self.ws = heads, ws
        self.q_proj, self.k_proj, self.v_proj, self.o_proj = (nn.Linear(dim, dim) for _ in range(4))
        self.rel_table = nn.Parameter(torch.zeros((2 * ws - 1) ** 2, heads))
        c = torch.stack(torch.meshgrid(torch.arange(ws), torch.arange(ws), indexing="ij")).flatten(1)
        rel = (c[:, :, None] - c[:, None, :]).permute(1, 2, 0) + (ws - 1)
        self.register_buffer("rel_index", rel[..., 0] * (2 * ws - 1) + rel[..., 1], persistent=False)

    def forward(self, x, mask=None):                  # x: (B×窓の数, N, C)
        Bw, N, C = x.shape
        split = lambda t: t.view(Bw, N, self.heads, C // self.heads).transpose(1, 2)
        q, k, v = split(self.q_proj(x)), split(self.k_proj(x)), split(self.v_proj(x))
        attn = (q @ k.transpose(-2, -1)) * (C // self.heads) ** -0.5
        attn = attn + self.rel_table[self.rel_index].permute(2, 0, 1)[None]
        if mask is not None:
            nW = mask.shape[0]
            attn = (attn.view(Bw // nW, nW, self.heads, N, N) + mask[None, :, None]).view(Bw, self.heads, N, N)
        return self.o_proj((attn.softmax(-1) @ v).transpose(1, 2).reshape(Bw, N, C))


class SwinBlock(nn.Module):
    def __init__(self, dim, heads, shift, ws=7):
        super().__init__()
        self.ws, self.shift = ws, shift
        self.norm1, self.norm2 = nn.LayerNorm(dim), nn.LayerNorm(dim)
        self.attn = WindowAttention(dim, heads, ws)
        self.fc1, self.fc2 = nn.Linear(dim, 4 * dim), nn.Linear(4 * dim, dim)

    def forward(self, x):                             # x: (B, H, W, C)
        B, H, W, C = x.shape
        h = self.norm1(x)
        ph, pw = (-H) % self.ws, (-W) % self.ws       # ウィンドウの倍数になるよう右と下を 0 で埋める
        h = F.pad(h, (0, 0, 0, pw, 0, ph))
        Hp, Wp = H + ph, W + pw
        mask = None
        if self.shift:
            h = torch.roll(h, (-self.shift, -self.shift), (1, 2))
            mask = shift_mask(Hp, Wp, self.ws, self.shift, x.device)
        h = window_reverse(self.attn(window_partition(h, self.ws), mask), self.ws, Hp, Wp)
        if self.shift:
            h = torch.roll(h, (self.shift, self.shift), (1, 2))
        x = x + h[:, :H, :W]
        return x + self.fc2(F.gelu(self.fc1(self.norm2(x))))


class PatchMerging(nn.Module):
    def __init__(self, dim):
        super().__init__()
        self.norm, self.reduction = nn.LayerNorm(4 * dim), nn.Linear(4 * dim, 2 * dim, bias=False)

    def forward(self, x):
        x = F.pad(x, (0, 0, 0, x.shape[2] % 2, 0, x.shape[1] % 2))
        x = torch.cat([x[:, 0::2, 0::2], x[:, 1::2, 0::2], x[:, 0::2, 1::2], x[:, 1::2, 1::2]], -1)
        return self.reduction(self.norm(x))


class SwinBackbone(nn.Module):
    """Swin-T。2〜4 段目の出力(1/8・1/16・1/32、192・384・768 チャンネル)を返す"""

    def __init__(self, dim=96, depths=(2, 2, 6, 2), heads=(3, 6, 12, 24)):
        super().__init__()
        self.patch_embed = nn.Conv2d(3, dim, 4, 4)
        self.patch_norm = nn.LayerNorm(dim)
        self.stages = nn.ModuleList(
            nn.ModuleList(SwinBlock(dim * 2 ** i, heads[i], 0 if j % 2 == 0 else 3) for j in range(depths[i]))
            for i in range(4))
        self.merges = nn.ModuleList(PatchMerging(dim * 2 ** i) for i in range(3))
        self.out_norms = nn.ModuleList(nn.LayerNorm(dim * 2 ** i) for i in (1, 2, 3))

    def forward(self, x):
        x = F.pad(x, (0, (-x.shape[3]) % 4, 0, (-x.shape[2]) % 4))
        x = self.patch_norm(self.patch_embed(x).permute(0, 2, 3, 1))
        outs = []
        for i, blocks in enumerate(self.stages):
            for blk in blocks:
                x = blk(x)
            if i >= 1:
                outs.append(self.out_norms[i - 1](x).permute(0, 3, 1, 2))
            if i < 3:
                x = self.merges[i](x)
        return outs
Swin Transformer の記事の実装を、任意の大きさの画像を受け付けるように直したものです。
- パディング: 画像の縦横が 4 の倍数でなければ、右と下を 0 で埋めます(SwinBackbone)。ウィンドウの注意の前には、特徴の縦横を 7(ウィンドウの大きさ)の倍数まで 0 で埋め、注意の後で元の大きさに切り戻します(SwinBlock)。Patch Merging でも、縦横が奇数なら 1 つ埋めます。Grounding DINO は 800×1333 のような正方形でない画像を入力するので、どの段の特徴もウィンドウで割り切れるとは限らないためです。
- シフトのマスク: shift_mask は、巡回シフトで貼り合わされた 9 つの領域どうしの注意に -100 を足して消すマスクを、埋めた後の大きさで作ります。
- 出力: 2〜4 段目の、Patch Merging の前の出力(192・384・768 チャンネル、1/8・1/16・1/32)に、段ごとの LayerNorm をかけて返します。
テキストの Backbone:BERT と句の区切りのマスク
class BertLayer(nn.Module):
    def __init__(self, d=768, heads=12, ffn=3072):
        super().__init__()
        self.heads = heads
        self.query, self.key, self.value, self.attn_out = (nn.Linear(d, d) for _ in range(4))
        self.attn_norm = nn.LayerNorm(d, eps=1e-12)
        self.fc1, self.fc2 = nn.Linear(d, ffn), nn.Linear(ffn, d)
        self.ffn_norm = nn.LayerNorm(d, eps=1e-12)

    def forward(self, x, bias):                       # bias: (B, 1, L, L) の足し算のマスク
        B, L, D = x.shape
        split = lambda t: t.view(B, L, self.heads, D // self.heads).transpose(1, 2)
        q, k, v = split(self.query(x)), split(self.key(x)), split(self.value(x))
        a = ((q @ k.transpose(-2, -1)) / math.sqrt(D // self.heads) + bias).softmax(-1)
        x = self.attn_norm(x + self.attn_out((a @ v).transpose(1, 2).reshape(B, L, D)))
        return self.ffn_norm(x + self.fc2(F.gelu(self.fc1(x))))


class BertEncoder(nn.Module):
    def __init__(self, vocab=30522, d=768, layers=12, max_pos=512):
        super().__init__()
        self.word_embeddings = nn.Embedding(vocab, d)
        self.position_embeddings = nn.Embedding(max_pos, d)
        self.token_type_embeddings = nn.Embedding(2, d)
        self.embed_norm = nn.LayerNorm(d, eps=1e-12)
        self.layers = nn.ModuleList(BertLayer(d) for _ in range(layers))

    def forward(self, input_ids, position_ids, attn_mask):   # attn_mask: (B, L, L)、True が見てよい組
        x = self.word_embeddings(input_ids) + self.position_embeddings(position_ids)
        x = self.embed_norm(x + self.token_type_embeddings(torch.zeros_like(input_ids)))
        bias = torch.zeros(attn_mask.shape, device=x.device).masked_fill(~attn_mask, torch.finfo(x.dtype).min)[:, None]
        for layer in self.layers:
            x = layer(x, bias)
        return x


SPECIAL_TOKENS = [101, 102, 1012, 1029]               # [CLS]・[SEP]・「.」・「?」


def phrase_mask(input_ids):
    """「.」で区切った句の中だけで注意をかけるマスクと、句ごとに 0 から数え直す位置の番号"""
    B, L = input_ids.shape
    special = torch.isin(input_ids, torch.tensor(SPECIAL_TOKENS, device=input_ids.device))
    idx = torch.arange(L, device=input_ids.device).expand(B, L)
    prev = torch.cummax(torch.where(special, idx, torch.full_like(idx, -1)), 1)[0]
    nxt = torch.where(special, idx, torch.full_like(idx, L)).flip(1).cummin(1)[0].flip(1)
    valid = (nxt != 0) & (nxt != L - 1) & (nxt != L)  # [CLS] と [SEP] はどの句にも入れない
    mask = ((nxt[:, :, None] == nxt[:, None, :]) & valid[:, None, :]) | torch.eye(L, dtype=torch.bool, device=input_ids.device)
    pos = torch.where(valid, idx - prev - 1, torch.zeros_like(idx)).clamp(min=0)
    return mask, pos
- BertLayer・BertEncoder: 12 層・12 ヘッド・768 次元の BERT-base です。埋め込みは、単語・位置・文の種類(すべて 0)の 3 つの和で、各層は自己注意と FFN(GELU、3072 次元)からなり、どちらも残差の後に LayerNorm をかけます。注意のマスクは、見てよい組を 0、見ない組を float32 の最小値にして足します。
- phrase_mask: SPECIAL_TOKENS は、BERT のトークナイザで [CLS]・[SEP]・「.」・「?」の番号です。各トークンについて、次に来る区切りの位置(nxt)が同じトークンどうしを同じ句とし、互いに注意をかけてよいことにします。[CLS] と [SEP] はどの句にも入れず、自分自身だけを見ます。位置の番号は、直前の区切りからの距離にして、句ごとに 0 から数え直します。
位置埋め込みと注意の部品
def sine_pos_2d(B, H, W, device, d=256, temperature=20.0):
    """画像の位置埋め込み:縦と横の位置(0〜2π に正規化)を、それぞれ 128 次元の sin・cos で表す"""
    y = torch.arange(1, H + 1, device=device, dtype=torch.float32)[:, None].expand(H, W) / (H + 1e-6) * 2 * math.pi
    x = torch.arange(1, W + 1, device=device, dtype=torch.float32)[None, :].expand(H, W) / (W + 1e-6) * 2 * math.pi
    dim_t = temperature ** (2 * (torch.arange(d // 2, device=device) // 2) / (d // 2))
    px, py = x[..., None] / dim_t, y[..., None] / dim_t
    px = torch.stack([px[..., 0::2].sin(), px[..., 1::2].cos()], -1).flatten(-2)
    py = torch.stack([py[..., 0::2].sin(), py[..., 1::2].cos()], -1).flatten(-2)
    return torch.cat([py, px], -1).flatten(0, 1)[None].expand(B, -1, -1)      # (B, H*W, d)


def sine_embed(coords, d=128, temperature=10000.0):
    """座標(0〜1 の箱、またはテキストの位置の番号)を、1 つの値ごとに d 次元の sin・cos にする"""
    dim_t = temperature ** (2 * (torch.arange(d, device=coords.device) // 2) / d)
    e = [c[..., None] * 2 * math.pi / dim_t for c in coords.unbind(-1)]
    e = [torch.stack([t[..., 0::2].sin(), t[..., 1::2].cos()], -1).flatten(-2) for t in e]
    if len(e) >= 2:
        e[0], e[1] = e[1], e[0]                        # (x, y, …) を (y, x, …) の順にする
    return torch.cat(e, -1)


class MHA(nn.Module):
    def __init__(self, d=256, heads=8):
        super().__init__()
        self.heads = heads
        self.query, self.key, self.value, self.out_proj = (nn.Linear(d, d) for _ in range(4))

    def forward(self, q, k, v, bias=None):
        B, Lq, D = q.shape
        split = lambda t: t.view(B, -1, self.heads, D // self.heads).transpose(1, 2)
        a = (split(self.query(q)) @ split(self.key(k)).transpose(-2, -1)) / math.sqrt(D // self.heads)
        if bias is not None:
            a = a + bias
        return self.out_proj((a.softmax(-1) @ split(self.value(v))).transpose(1, 2).reshape(B, Lq, D))


class DeformableAttention(nn.Module):
    """参照点の周りの少数の点(8 ヘッド × 4 段 × 4 点)だけを見る注意"""

    def __init__(self, d=256, heads=8, levels=4, points=4):
        super().__init__()
        self.heads, self.levels, self.points = heads, levels, points
        self.sampling_offsets = nn.Linear(d, heads * levels * points * 2)
        self.attention_weights = nn.Linear(d, heads * levels * points)
        self.value_proj, self.output_proj = nn.Linear(d, d), nn.Linear(d, d)

    def forward(self, query, ref, value, shapes):
        """ref: (B, Q, 2) の点 (x, y) か、(B, Q, 4) の箱 (cx, cy, w, h)。どれも 0〜1"""
        B, Q, D = query.shape
        Hd, L, P = self.heads, self.levels, self.points
        v = self.value_proj(value).view(B, -1, Hd, D // Hd)
        off = self.sampling_offsets(query).view(B, Q, Hd, L, P, 2)
        w = self.attention_weights(query).view(B, Q, Hd, L * P).softmax(-1).view(B, Q, Hd, L, P)
        if ref.shape[-1] == 2:                        # 点:ずれを各段の格子の大きさで割る
            norm = torch.tensor([[wd, h] for h, wd in shapes], device=query.device, dtype=query.dtype)
            loc = ref[:, :, None, None, None, :] + off / norm[None, None, None, :, None, :]
        else:                                         # 箱:ずれを箱の大きさに比例させる
            loc = ref[:, :, None, None, None, :2] + off / P * ref[:, :, None, None, None, 2:] * 0.5
        grid = 2 * loc - 1
        out, start = 0, 0
        for l, (h, wd) in enumerate(shapes):
            v_l = v[:, start:start + h * wd].permute(0, 2, 3, 1).reshape(B * Hd, D // Hd, h, wd)
            g_l = grid[:, :, :, l].transpose(1, 2).reshape(B * Hd, Q, P, 2)
            s = F.grid_sample(v_l, g_l, mode="bilinear", padding_mode="zeros", align_corners=False)
            out = out + (s * w[:, :, :, l].transpose(1, 2).reshape(B * Hd, 1, Q, P)).sum(-1)
            start += h * wd
        return self.output_proj(out.view(B, Hd, D // Hd, Q).permute(0, 3, 1, 2).reshape(B, Q, D))


class BiAttention(nn.Module):
    """画像→テキストとテキスト→画像の注意を、同じ類似度の行列から同時に計算する"""

    def __init__(self, d=256, e=1024, heads=4):
        super().__init__()
        self.heads, self.hd = heads, e // heads
        self.vision_proj, self.text_proj = nn.Linear(d, e), nn.Linear(d, e)
        self.values_vision_proj, self.values_text_proj = nn.Linear(d, e), nn.Linear(d, e)
        self.out_vision_proj, self.out_text_proj = nn.Linear(e, d), nn.Linear(e, d)

    def forward(self, img, txt, txt_pad):
        B, Ni, _ = img.shape
        Nt = txt.shape[1]
        split = lambda t, n: t.view(B, n, self.heads, self.hd).transpose(1, 2)
        sim = split(self.vision_proj(img) * self.hd ** -0.5, Ni) @ split(self.text_proj(txt), Nt).transpose(-2, -1)
        a_img = sim.masked_fill(txt_pad[:, None, None, :], float("-inf")).softmax(-1)   # 各画素が、どの単語を見るか
        a_txt = sim.transpose(-2, -1).softmax(-1)                                     # 各単語が、どの画素を見るか
        d_img = (a_img @ split(self.values_text_proj(txt), Nt)).transpose(1, 2).reshape(B, Ni, -1)
        d_txt = (a_txt @ split(self.values_vision_proj(img), Ni)).transpose(1, 2).reshape(B, Nt, -1)
        return self.out_vision_proj(d_img), self.out_text_proj(d_txt)


class PredHead(nn.Module):
    def __init__(self, d_in, d_hidden, d_out, n):
        super().__init__()
        dims = [d_in] + [d_hidden] * (n - 1) + [d_out]
        self.layers = nn.ModuleList(nn.Linear(a, b) for a, b in zip(dims[:-1], dims[1:]))

    def forward(self, x):
        for i, layer in enumerate(self.layers):
            x = layer(x) if i == len(self.layers) - 1 else F.relu(layer(x))
        return x
- sine_pos_2d: 画像の位置埋め込みです。縦と横の位置を 0〜2π に正規化し、それぞれ 128 次元の sin・cos で表します。温度 20 は、公式の設定(positional_embedding_temperature)の値です。
- sine_embed: 0〜1 の箱の座標や、テキストの位置の番号を、値ごとに d 次元の sin・cos にします。デコーダでは参照箱の (cx, cy, w, h) を 128 次元ずつ(計 512 次元)にして、MLP でクエリの位置埋め込みにします。テキストでは、句ごとの位置の番号を 256 次元にします。
- MHA: 普通の Multi-Head Attention で、bias にマスクを足します。
- DeformableAttention: RT-DETR の記事と同じ計算で、段の数が 4 です。参照が点 (x, y) のとき(エンコーダ)は、ずれを各段の格子の大きさで割り、箱 (cx, cy, w, h) のとき(デコーダ)は、ずれを箱の大きさに比例させます。
- BiAttention: 4 ヘッド・1024 次元で、画像とテキストの類似度の行列 sim を 1 回だけ計算し、最後の軸で softmax をとれば「画像→テキスト」、転置して softmax をとれば「テキスト→画像」の注意になります。パディングのトークンは、画像→テキストの注意で -inf にして見ないようにします。
- PredHead: 箱の修正量などを出す MLP です。
Feature Enhancer と Decoder の 1 層
# Feature Enhancer の 1 層
class EnhancerLayer(nn.Module):
    def __init__(self, d=256):
        super().__init__()
        # (a) 画像とテキストの双方向の注意(layer scale:最初は 1e-4 倍しか足さない)
        self.fusion_norm_vision, self.fusion_norm_text = nn.LayerNorm(d), nn.LayerNorm(d)
        self.bi_attn = BiAttention(d)
        self.vision_param, self.text_param = nn.Parameter(1e-4 * torch.ones(d)), nn.Parameter(1e-4 * torch.ones(d))
        # (b) テキストの自己注意 + FFN
        self.text_attn = MHA(d, 4)
        self.text_norm1, self.text_norm2 = nn.LayerNorm(d), nn.LayerNorm(d)
        self.text_fc1, self.text_fc2 = nn.Linear(d, 1024), nn.Linear(1024, d)
        # (c) 画像の Deformable 自己注意 + FFN
        self.img_attn = DeformableAttention(d)
        self.img_norm1, self.img_norm2 = nn.LayerNorm(d), nn.LayerNorm(d)
        self.img_fc1, self.img_fc2 = nn.Linear(d, 2048), nn.Linear(2048, d)

    def forward(self, img, img_pos, ref, shapes, txt, txt_pos, txt_pad, txt_bias):
        img, txt = self.fusion_norm_vision(img), self.fusion_norm_text(txt)
        d_img, d_txt = self.bi_attn(img, txt, txt_pad)
        img, txt = img + self.vision_param * d_img, txt + self.text_param * d_txt
        qk = txt + txt_pos
        txt = self.text_norm1(txt + self.text_attn(qk, qk, txt, txt_bias))
        txt = self.text_norm2(txt + self.text_fc2(F.relu(self.text_fc1(txt))))
        img = self.img_norm1(img + self.img_attn(img + img_pos, ref, img, shapes))
        img = self.img_norm2(img + self.img_fc2(F.relu(self.img_fc1(img))))
        return img, txt


# Cross-Modality Decoder の 1 層
class DecoderLayer(nn.Module):
    def __init__(self, d=256):
        super().__init__()
        self.self_attn, self.self_norm = MHA(d), nn.LayerNorm(d)
        self.text_attn, self.text_norm = MHA(d), nn.LayerNorm(d)
        self.img_attn, self.img_norm = DeformableAttention(d), nn.LayerNorm(d)
        self.fc1, self.fc2, self.ffn_norm = nn.Linear(d, 2048), nn.Linear(2048, d), nn.LayerNorm(d)

    def forward(self, q, pos, ref, memory, shapes, txt, txt_bias):
        qk = q + pos
        q = self.self_norm(q + self.self_attn(qk, qk, q))
        q = self.text_norm(q + self.text_attn(q + pos, txt, txt, txt_bias))     # 文の単語を見る
        q = self.img_norm(q + self.img_attn(q + pos, ref, memory, shapes))       # 画像の参照箱の周りを見る
        return self.ffn_norm(q + self.fc2(F.relu(self.fc1(q))))


def logit(x, eps=1e-5):
    x = x.clamp(eps, 1 - eps)
    return torch.log(x / (1 - x))
- EnhancerLayer: (a) 画像とテキストをそれぞれ LayerNorm してから双方向の注意をかけ、結果に vision_param・text_param(初期値 1e-4)を掛けて足します。(b) テキストは、位置埋め込みを Q と K に足して句の中だけの自己注意(4 ヘッド)をかけ、FFN(1024 次元)を通します。(c) 画像は、位置埋め込みを足して Deformable 自己注意をかけ、FFN(2048 次元)を通します。どれも残差の後に LayerNorm をかけます。ヘッドの数と次元は、公式の設定です。
- DecoderLayer: クエリどうしの自己注意 → テキストへの注意(Q にだけ位置埋め込みを足す)→ 画像への Deformable 注意 → FFN の順に計算し、それぞれ残差の後に LayerNorm をかけます。
モデル全体
class GroundingDINO(nn.Module):
    def __init__(self, d=256, num_queries=900, enc_layers=6, dec_layers=6, max_text_len=256):
        super().__init__()
        self.num_queries, self.max_text_len = num_queries, max_text_len
        self.backbone = SwinBackbone()
        self.input_proj = nn.ModuleList(
            [nn.Sequential(nn.Conv2d(c, d, 1), nn.GroupNorm(32, d)) for c in (192, 384, 768)]
            + [nn.Sequential(nn.Conv2d(768, d, 3, 2, 1), nn.GroupNorm(32, d))])
        self.level_embed = nn.Parameter(torch.zeros(4, d))
        self.bert = BertEncoder()
        self.text_proj = nn.Linear(768, d)
        self.enhancer = nn.ModuleList(EnhancerLayer(d) for _ in range(enc_layers))
        # クエリの選択(two-stage)
        self.enc_output, self.enc_output_norm = nn.Linear(d, d), nn.LayerNorm(d)
        self.enc_bbox_head = PredHead(d, d, 4, 3)
        self.query_embed = nn.Embedding(num_queries, d)       # 内容のクエリは学習した埋め込みを使う
        # デコーダ
        self.decoder_layers = nn.ModuleList(DecoderLayer(d) for _ in range(dec_layers))
        self.decoder_norm = nn.LayerNorm(d)
        self.ref_point_head = PredHead(2 * d, d, d, 2)
        self.bbox_embed = PredHead(d, d, 4, 3)                # 全層で共有する箱のヘッド

    def encode_text(self, input_ids, use_phrase_mask=True):
        mask, pos = phrase_mask(input_ids)
        if not use_phrase_mask:                       # 比較用:文全体で注意をかけ、位置も通し番号にする
            L = input_ids.shape[1]
            mask = torch.ones_like(mask)
            pos = torch.arange(L, device=input_ids.device).expand_as(input_ids)
        return self.text_proj(self.bert(input_ids, pos, mask)), mask, pos

    def contrastive(self, x, txt, txt_valid):
        """クラスの logit = クエリの特徴と各トークンの特徴の内積(トークンでない位置は -inf、256 個に埋める)"""
        out = (x @ txt.transpose(-2, -1)).masked_fill(~txt_valid[:, None, :], float("-inf"))
        return F.pad(out, (0, self.max_text_len - out.shape[-1]), value=float("-inf"))

    def forward(self, pixel_values, input_ids, use_phrase_mask=True, hf_text_pos=False):
        B = pixel_values.shape[0]
        # (1) テキスト
        txt, tmask, tpos = self.encode_text(input_ids, use_phrase_mask)
        txt_valid = torch.ones_like(input_ids, dtype=torch.bool)
        txt_pad = ~txt_valid
        txt_pos = sine_embed(tpos.float()[..., None], 256)
        if hf_text_pos:                               # Hugging Face の実装と比べるときだけ:位置埋め込みを整数に丸める
            txt_pos = txt_pos.long().float()
        txt_bias = torch.zeros(tmask.shape, device=txt.device).masked_fill(~tmask, torch.finfo(txt.dtype).min)[:, None]
        # (2) 画像:4 段の特徴を 256 チャンネルにそろえて 1 列に並べる
        feats = self.backbone(pixel_values)
        maps = [p(f) for p, f in zip(self.input_proj[:3], feats)] + [self.input_proj[3](feats[-1])]
        shapes = [tuple(m.shape[-2:]) for m in maps]
        img = torch.cat([m.flatten(2).transpose(1, 2) for m in maps], 1)
        img_pos = torch.cat([sine_pos_2d(B, h, w, img.device) + self.level_embed[l] for l, (h, w) in enumerate(shapes)], 1)
        ref = torch.cat([torch.stack(torch.meshgrid((torch.arange(h, device=img.device) + 0.5) / h,
                                                    (torch.arange(w, device=img.device) + 0.5) / w, indexing="ij")[::-1], -1).view(-1, 2)
                         for h, w in shapes])[None].expand(B, -1, -1)
        # (3) Feature Enhancer
        for layer in self.enhancer:
            img, txt = layer(img, img_pos, ref, shapes, txt, txt_pos, txt_pad, txt_bias)
        # (4) クエリの選択:各位置の特徴と単語の内積が大きい位置を選ぶ
        anchors = []
        for l, (h, w) in enumerate(shapes):
            gy, gx = torch.meshgrid(torch.arange(h, device=img.device), torch.arange(w, device=img.device), indexing="ij")
            xy = torch.stack([(gx + 0.5) / w, (gy + 0.5) / h], -1).view(-1, 2)
            anchors.append(torch.cat([xy, torch.full_like(xy, 0.05 * 2 ** l)], -1))
        anchors = torch.cat(anchors)[None]
        valid = ((anchors > 0.01) & (anchors < 0.99)).all(-1, keepdim=True)
        anchors = logit(anchors, 0).masked_fill(~valid, float("inf"))
        out_memory = self.enc_output_norm(self.enc_output(img.masked_fill(~valid, 0.0)))
        enc_logits = self.contrastive(out_memory, txt, txt_valid)
        enc_boxes = self.enc_bbox_head(out_memory) + anchors
        topk = enc_logits.max(-1).values.topk(self.num_queries, dim=1).indices
        gather = lambda t: t.gather(1, topk[..., None].expand(-1, -1, t.shape[-1]))
        ref_boxes = gather(enc_boxes).detach().sigmoid()
        enc_topk = (gather(enc_logits), ref_boxes)
        q = self.query_embed.weight[None].expand(B, -1, -1)
        # (5) デコーダ
        txt_bias_dec = torch.zeros(B, 1, 1, txt.shape[1], device=txt.device).masked_fill(txt_pad[:, None, None], torch.finfo(txt.dtype).min)
        logits_all, boxes_all = [], []
        for layer in self.decoder_layers:
            pos = self.ref_point_head(sine_embed(ref_boxes, 128))
            q = layer(q, pos, ref_boxes, img, shapes, txt, txt_bias_dec)
            h = self.decoder_norm(q)
            logits_all.append(self.contrastive(h, txt, txt_valid))
            boxes_all.append((self.bbox_embed(h) + logit(ref_boxes)).sigmoid())
            ref_boxes = (self.bbox_embed(q) + logit(ref_boxes)).sigmoid().detach()
        # 全層のクラスの logit と箱、クエリの選択の予測(学習で使う)、エンコーダの全位置の logit(図で使う)
        return torch.stack(logits_all, 1), torch.stack(boxes_all, 1), enc_topk, enc_logits


model = GroundingDINO()
count = lambda m: sum(p.numel() for p in m.parameters())
print(f"画像の Backbone(Swin-T): {count(model.backbone):>11,}")
print(f"テキストの Backbone(BERT): {count(model.bert):>11,}")
print(f"Feature Enhancer          : {count(model.enhancer):>11,}")
print(f"Decoder                   : {count(model.decoder_layers):>11,}")
print(f"全体                      : {count(model):>11,}")
- 入力の変換: Swin の 3 段の出力を、1×1 の畳み込みと GroupNorm で 256 チャンネルにそろえます。4 段目(1/64)は、1/32 の出力にストライド 2 の 3×3 の畳み込みをかけて作ります。位置埋め込みには、段ごとの学習した埋め込み level_embed を足します。
- encode_text: BERT の出力を、線形層で 256 次元にします。use_phrase_mask=False のときは、比較のために句の区切りのマスクを使わず、文全体で注意をかけ、位置も通し番号にします(実験3で使います)。
- contrastive: クエリの特徴と各トークンの特徴の内積を、クラスの logit にします。トークンでない位置は -inf にし、最大のトークン数 256 まで -inf で埋めます。
- hf_text_pos: 実験2の比較のためだけのオプションです。詳しくは実験2で説明します。
- クエリの選択: 画像の全位置の特徴を線形層と LayerNorm で変換し、各トークンとの内積の最大値の上位 900 位置を選びます。選んだ位置の箱(アンカー + 修正量)を参照箱にします。0.05 × 2^段 のアンカーの大きさと、0.01〜0.99 の範囲は、公式の実装の値です。
- デコーダ: 各層の出力を LayerNorm してから、クラスの logit と箱を出します。箱のヘッド(bbox_embed)は 6 層で共有します。次の層の参照箱は、LayerNorm の前の出力から計算し、勾配を止めて渡します(公式の実装と同じ)。
実行結果
画像の Backbone(Swin-T):  27,520,506
テキストの Backbone(BERT): 108,891,648
Feature Enhancer          :  21,905,664
Decoder                   :  10,857,216
全体                      : 172,249,090
全体で約 1.72 億個のパラメータのうち、約 1.09 億個が BERT、約 2,750 万個が Swin-T です。画像とテキストを混ぜる Feature Enhancer とデコーダは、合わせて約 3,300 万個です。
実験2:公式の重みで、Hugging Face と同じ出力になるか
公式の重みの読み込み
def load_hf_grounding_dino(model, sd):
    """Hugging Face の GroundingDinoForObjectDetection の重みを、スクラッチ実装の名前に付け替えて読み込む"""
    import re
    rules = [
        (r"^model\.backbone\.conv_encoder\.model\.swin\.embeddings\.patch_embeddings\.projection\.", "backbone.patch_embed."),
        (r"^model\.backbone\.conv_encoder\.model\.swin\.embeddings\.norm\.", "backbone.patch_norm."),
        (r"^model\.backbone\.conv_encoder\.model\.swin\.encoder\.layers\.(\d+)\.downsample\.", r"backbone.merges.\1."),
        (r"^model\.backbone\.conv_encoder\.model\.swin\.encoder\.layers\.(\d+)\.blocks\.(\d+)\.", r"backbone.stages.\1.\2."),
        (r"^model\.backbone\.conv_encoder\.model\.hidden_states_norms\.stage(\d)\.", lambda m: f"backbone.out_norms.{int(m.group(1)) - 2}."),
        (r"\.attention\.relative_position_bias\.relative_position_bias_table$", ".attn.rel_table"),
        (r"\.attention\.([qkvo]_proj)\.", r".attn.\1."), (r"\.layernorm_before\.", ".norm1."), (r"\.layernorm_after\.", ".norm2."),
        (r"\.mlp\.(fc\d)\.", r".\1."),
        (r"^model\.input_proj_vision\.", "input_proj."), (r"^model\.level_embed$", "level_embed"),
        (r"^model\.text_backbone\.embeddings\.LayerNorm\.", "bert.embed_norm."),
        (r"^model\.text_backbone\.embeddings\.", "bert."),
        (r"^model\.text_backbone\.encoder\.layer\.(\d+)\.attention\.self\.", r"bert.layers.\1."),
        (r"^model\.text_backbone\.encoder\.layer\.(\d+)\.attention\.output\.dense\.", r"bert.layers.\1.attn_out."),
        (r"^model\.text_backbone\.encoder\.layer\.(\d+)\.attention\.output\.LayerNorm\.", r"bert.layers.\1.attn_norm."),
        (r"^model\.text_backbone\.encoder\.layer\.(\d+)\.intermediate\.dense\.", r"bert.layers.\1.fc1."),
        (r"^model\.text_backbone\.encoder\.layer\.(\d+)\.output\.dense\.", r"bert.layers.\1.fc2."),
        (r"^model\.text_backbone\.encoder\.layer\.(\d+)\.output\.LayerNorm\.", r"bert.layers.\1.ffn_norm."),
        (r"^model\.text_projection\.", "text_proj."),
        (r"^model\.encoder\.layers\.(\d+)\.fusion_layer\.layer_norm_vision\.", r"enhancer.\1.fusion_norm_vision."),
        (r"^model\.encoder\.layers\.(\d+)\.fusion_layer\.layer_norm_text\.", r"enhancer.\1.fusion_norm_text."),
        (r"^model\.encoder\.layers\.(\d+)\.fusion_layer\.attn\.", r"enhancer.\1.bi_attn."),
        (r"^model\.encoder\.layers\.(\d+)\.fusion_layer\.(vision|text)_param$", r"enhancer.\1.\2_param"),
        (r"^model\.encoder\.layers\.(\d+)\.text_enhancer_layer\.self_attn\.", r"enhancer.\1.text_attn."),
        (r"^model\.encoder\.layers\.(\d+)\.text_enhancer_layer\.layer_norm_before\.", r"enhancer.\1.text_norm1."),
        (r"^model\.encoder\.layers\.(\d+)\.text_enhancer_layer\.layer_norm_after\.", r"enhancer.\1.text_norm2."),
        (r"^model\.encoder\.layers\.(\d+)\.text_enhancer_layer\.(fc\d)\.", r"enhancer.\1.text_\2."),
        (r"^model\.encoder\.layers\.(\d+)\.deformable_layer\.self_attn\.", r"enhancer.\1.img_attn."),
        (r"^model\.encoder\.layers\.(\d+)\.deformable_layer\.self_attn_layer_norm\.", r"enhancer.\1.img_norm1."),
        (r"^model\.encoder\.layers\.(\d+)\.deformable_layer\.final_layer_norm\.", r"enhancer.\1.img_norm2."),
        (r"^model\.encoder\.layers\.(\d+)\.deformable_layer\.(fc\d)\.", r"enhancer.\1.img_\2."),
        (r"^model\.enc_output\.", "enc_output."), (r"^model\.enc_output_norm\.", "enc_output_norm."),
        (r"^model\.encoder_output_bbox_embed\.", "enc_bbox_head."),
        (r"^model\.query_position_embeddings\.", "query_embed."),
        (r"^model\.decoder\.layers\.(\d+)\.self_attn\.", r"decoder_layers.\1.self_attn."),
        (r"^model\.decoder\.layers\.(\d+)\.self_attn_layer_norm\.", r"decoder_layers.\1.self_norm."),
        (r"^model\.decoder\.layers\.(\d+)\.encoder_attn_text\.", r"decoder_layers.\1.text_attn."),
        (r"^model\.decoder\.layers\.(\d+)\.encoder_attn_text_layer_norm\.", r"decoder_layers.\1.text_norm."),
        (r"^model\.decoder\.layers\.(\d+)\.encoder_attn\.", r"decoder_layers.\1.img_attn."),
        (r"^model\.decoder\.layers\.(\d+)\.encoder_attn_layer_norm\.", r"decoder_layers.\1.img_norm."),
        (r"^model\.decoder\.layers\.(\d+)\.(fc\d)\.", r"decoder_layers.\1.\2."),
        (r"^model\.decoder\.layers\.(\d+)\.final_layer_norm\.", r"decoder_layers.\1.ffn_norm."),
        (r"^model\.decoder\.layer_norm\.", "decoder_norm."),
        (r"^model\.decoder\.reference_points_head\.", "ref_point_head."),
        (r"^bbox_embed\.0\.", "bbox_embed."),
    ]
    out = {}
    for k, v in sd.items():
        if "swin.layernorm" in k or k.startswith("model.decoder.bbox_embed") or re.match(r"^bbox_embed\.[1-9]", k):
            continue                                  # 使わない最後の LayerNorm と、共有した箱のヘッドの別名
        new = k
        for pat, rep in rules:
            new = re.sub(pat, rep, new)
        out[new] = v
    missing, unexpected = model.load_state_dict(out, strict=False)
    assert not missing and not unexpected, (missing[:5], unexpected[:5])
    return model
Hugging Face の重みの名前を、正規表現の置き換えの規則で、スクラッチ実装の名前に付け替えて読み込みます。swin.layernorm は、Swin で画像を分類するときの最後の LayerNorm で、検出では使いません。箱のヘッドは 6 層で同じ重みを共有しているので、1 つ目(bbox_embed.0)だけを読み込みます。最後に、足りない重みも余った重みもないことを assert で確かめます。
出力の一致を確かめる
ours = load_hf_grounding_dino(GroundingDINO(), hf_model.state_dict()).to(device).eval()

inputs = processor(images=image, text="cat. bench. potted plant.", return_tensors="pt").to(device)
L = inputs["input_ids"].shape[1]


def top_dets(logits, boxes, threshold=0.35):
    """確率(トークンの最大値)が閾値を超えたクエリを、確率の高い順に並べる"""
    score = logits[0, :, :L].sigmoid().max(-1).values
    order = score.argsort(descending=True)
    order = order[score[order] > threshold]
    return score[order], boxes[0, order]


with torch.no_grad():
    out_hf = hf_model(**inputs)
    s_hf, b_hf = top_dets(out_hf.logits, out_hf.pred_boxes)
    for hf_text_pos in [True, False]:
        logits, boxes, _, enc_logits = ours(inputs["pixel_values"], inputs["input_ids"], hf_text_pos=hf_text_pos)
        name = "整数に丸める(HF と同じ)" if hf_text_pos else "丸めない(公式の実装と同じ)"
        diff = (out_hf.logits[0, :, :L] - logits[0, -1, :, :L]).abs().max(-1).values
        s, b = top_dets(logits[:, -1], boxes[:, -1])
        print(f"テキストの位置埋め込みを{name}")
        top_hf = out_hf.enc_outputs_class[0].max(-1).values.topk(900).indices
        top_ours = enc_logits[0].max(-1).values.topk(900).indices
        print(f"    クエリに選んだ 900 位置: 集合が同じ {set(top_hf.tolist()) == set(top_ours.tolist())}、"
              f"順番まで同じ位置 {int((top_hf == top_ours).sum())} 個")
        print(f"    900 個のクエリのうち、logit の差が 1e-3 を超えるクエリ: {int((diff > 1e-3).sum())} 個")
        if len(s) == len(s_hf):
            print(f"    確率 0.35 を超える検出: {len(s)} 個(HF も {len(s_hf)} 個)、確率の差の最大値 {(s - s_hf).abs().max().item():.2e}、"
                  f"箱の差の最大値 {(b - b_hf).abs().max().item():.2e}")
        else:
            print(f"    確率 0.35 を超える検出: {len(s)} 個(HF は {len(s_hf)} 個)")
Hugging Face の実装(transformers 5.21.0)を読むと、テキストの位置埋め込みを計算する関数(encode_sinusoidal_position_embedding)が、結果を入力と同じ型に戻しています。テキストの位置の番号は整数なので、sin・cos の値が整数に丸められ、ほとんどが 0 になります。公式の実装(IDEA-Research/GroundingDINO の get_sine_pos_embed)は丸めません。そこで、スクラッチ実装に hf_text_pos のオプションを付け、丸める場合と丸めない場合の両方で、Hugging Face の出力と比べます。
- クエリに選んだ位置: クエリの選択で選んだ 900 位置の集合と順番を比べます。
- クエリごとの差: 900 個のクエリそれぞれの logit の差が 1e-3 を超える数を数えます。
- 検出の差: 確率(トークンの確率の最大値)が 0.35 を超えたクエリを確率の順に並べ、確率と箱の差を比べます。
実行結果
テキストの位置埋め込みを整数に丸める(HF と同じ)
    クエリに選んだ 900 位置: 集合が同じ True、順番まで同じ位置 894 個
    900 個のクエリのうち、logit の差が 1e-3 を超えるクエリ: 885 個
    確率 0.35 を超える検出: 11 個(HF も 11 個)、確率の差の最大値 2.45e-03、箱の差の最大値 1.43e-05
テキストの位置埋め込みを丸めない(公式の実装と同じ)
    クエリに選んだ 900 位置: 集合が同じ False、順番まで同じ位置 46 個
    900 個のクエリのうち、logit の差が 1e-3 を超えるクエリ: 900 個
    確率 0.35 を超える検出: 11 個(HF も 11 個)、確率の差の最大値 1.06e-02、箱の差の最大値 2.13e-04
位置埋め込みを Hugging Face と同じく整数に丸めると、選んだ 900 位置の集合は一致し、894 位置は順番まで一致しました。残り 6 位置は、選択の基準の値がほぼ同じ(差が 1e-4 程度)位置どうしで、計算の順番による誤差で順位が入れ替わったものです。デコーダのクエリの内容は「何番目のクエリか」で決まる学習した埋め込みなので、順番が入れ替わるとそのクエリの出力が変わり、自己注意を通してほかのクエリにも影響します。そのため 900 個中 885 個で logit の差が 1e-3 を超えましたが、確率 0.35 を超える 11 個の検出は一致し、確率の差は最大 2.45e-03、箱の差は最大 1.43e-05 でした。スクラッチ実装が、公式の重みを読み込んで Hugging Face と同じ計算をしていることが確かめられました。
位置埋め込みを丸めない(公式の実装と同じ)と、選ぶ位置が変わり、検出の確率も最大 0.01 ほど変わります。ただし検出の数と箱はほとんど変わらず、実験3の COCO の精度もほぼ同じでした。以降は、公式の実装と同じ丸めない計算を使います。
スクラッチ実装で検出する
def phrase_spans(input_ids):
    """「.」で区切った句ごとに、その句のトークンの位置の一覧を返す"""
    ids = input_ids[0].tolist()
    spans, cur = [], []
    for i, t in enumerate(ids):
        if t in SPECIAL_TOKENS:
            if cur:
                spans.append(cur)
            cur = []
        else:
            cur.append(i)
    return spans


def detect(model, image, prompt, box_threshold=0.35, **kw):
    """句ごとの確率 = その句のトークンの確率の平均。いちばん高い句をラベルにする"""
    inputs = processor(images=image, text=prompt, return_tensors="pt").to(device)
    with torch.no_grad():
        logits, boxes, *_ = model(inputs["pixel_values"], inputs["input_ids"], **kw)
    prob = logits[0, -1].sigmoid()                               # (900, 256)
    spans = phrase_spans(inputs["input_ids"].cpu())
    names = [processor.tokenizer.decode(inputs["input_ids"][0, s]) for s in spans]
    phrase_prob = torch.stack([prob[:, s].mean(-1) for s in spans], -1)   # (900, 句の数)
    score, label = phrase_prob.max(-1)
    keep = score > box_threshold
    W, H = image.size
    cx, cy, w, h = boxes[0, -1][keep].unbind(-1)
    xyxy = torch.stack([(cx - w / 2) * W, (cy - h / 2) * H, (cx + w / 2) * W, (cy + h / 2) * H], -1)
    return xyxy.cpu(), score[keep].cpu(), [names[i] for i in label[keep].tolist()], inputs


xyxy, score, names, inputs = detect(ours, image, "cat. bench. potted plant.")
for b, s, n in sorted(zip(xyxy.tolist(), score.tolist(), names), key=lambda t: -t[1]):
    print(f"{n:<13s} {s:.2f}  箱 {[round(v) for v in b]}")

# 重複の数え上げ:同じ句で IoU 0.5 以上重なる組
iou = torchvision.ops.box_iou(xyxy, xyxy)
same = torch.tensor([[a == b for b in names] for a in names])
print(f"\n検出 {len(names)} 個のうち、同じ句で IoU 0.5 以上重なる組: {int(((iou > 0.5) & same).triu(1).sum())} 組")
- phrase_spans: 区切りのトークンで切って、句ごとにトークンの位置の一覧を作ります。
- detect: 最後の層のトークンの確率から、句ごとの確率(句のトークンの確率の平均)を計算し、最も高い句をラベルにします。確率が 0.35 を超えたクエリを検出にし、0〜1 の (cx, cy, w, h) を画像の座標の (x1, y1, x2, y2) に直します。NMS は使いません。
- 重複の数え上げ: 同じ句の検出で、IoU が 0.5 以上重なる組を数えます。
実行結果
cat           0.82  箱 [225, 1035, 978, 1327]
cat           0.81  箱 [644, 813, 1157, 1107]
cat           0.81  箱 [1145, 699, 1532, 953]
cat           0.80  箱 [1850, 819, 2305, 1048]
cat           0.79  箱 [1623, 616, 1974, 782]
bench         0.79  箱 [1404, 288, 2145, 794]
cat           0.74  箱 [1644, 453, 1865, 544]
cat           0.72  箱 [805, 581, 1028, 833]
potted plant  0.67  箱 [1227, 461, 1418, 707]
potted plant  0.64  箱 [980, 455, 1225, 712]
potted plant  0.58  箱 [2053, 631, 2207, 810]

検出 11 個のうち、同じ句で IoU 0.5 以上重なる組: 0 組
実験1の Hugging Face の実装と同じ 11 個(猫 7 匹・ベンチ・鉢植え 3 つ)を検出し、NMS を使わずに、同じ物体を指す重複は 1 組もありませんでした。
クエリの選択とデコーダの層で、検出がどう変わるか
# クエリの選択の予測と、デコーダの 6 層それぞれの予測で、確率 0.35 を超える検出の数と、同じ句で重なる組(重複)の数を数える
with torch.no_grad():
    logits, boxes, (enc_lg, enc_box), _ = ours(inputs["pixel_values"], inputs["input_ids"])
spans = phrase_spans(inputs["input_ids"].cpu())
stages = [("クエリの選択", enc_lg[0], enc_box[0])] + [(f"デコーダ {l + 1} 層", logits[0, l], boxes[0, l]) for l in range(6)]
for name, lg, bx in stages:
    prob = torch.stack([lg[:, s].sigmoid().mean(-1) for s in spans], -1)
    score, label = prob.max(-1)
    keep = score > 0.35
    xyxy = torch.cat([bx[keep, :2] - bx[keep, 2:] / 2, bx[keep, :2] + bx[keep, 2:] / 2], -1)
    iou = torchvision.ops.box_iou(xyxy, xyxy)
    same = label[keep][:, None] == label[keep][None, :]
    n_dup = int(((iou > 0.5) & same).triu(1).sum())
    print(f"{name:<10s}: 確率 0.35 を超える検出 {int(keep.sum()):3d} 個、同じ句で IoU 0.5 以上重なる組 {n_dup:3d} 組、"
          f"最も高い確率 {score.max().item():.2f}")
クエリの選択の予測(エンコーダの出力の 900 位置)と、デコーダの 6 層それぞれの予測について、確率 0.35 を超える検出の数と重複の数を数えます。
実行結果
クエリの選択    : 確率 0.35 を超える検出  11 個、同じ句で IoU 0.5 以上重なる組   0 組、最も高い確率 0.79
デコーダ 1 層  : 確率 0.35 を超える検出  11 個、同じ句で IoU 0.5 以上重なる組   0 組、最も高い確率 0.85
デコーダ 2 層  : 確率 0.35 を超える検出  11 個、同じ句で IoU 0.5 以上重なる組   0 組、最も高い確率 0.82
デコーダ 3 層  : 確率 0.35 を超える検出  11 個、同じ句で IoU 0.5 以上重なる組   0 組、最も高い確率 0.83
デコーダ 4 層  : 確率 0.35 を超える検出  11 個、同じ句で IoU 0.5 以上重なる組   0 組、最も高い確率 0.86
デコーダ 5 層  : 確率 0.35 を超える検出  11 個、同じ句で IoU 0.5 以上重なる組   0 組、最も高い確率 0.86
デコーダ 6 層  : 確率 0.35 を超える検出  11 個、同じ句で IoU 0.5 以上重なる組   0 組、最も高い確率 0.82
この画像では、クエリの選択の時点で 11 個の検出がそろい、重複もありませんでした。クエリの選択の予測にも、学習でハンガリアンマッチングの損失をかけているためです(two-stage の損失)。デコーダは、検出の数を変えずに、確率を 0.79 から最大 0.86 まで上げ、箱を少しずつ直しています。
実験3:COCO val2017 の 500 枚で、ゼロショットの精度を測る
Grounding DINO-T の学習データ(Objects365・GoldG・Cap4M)には、COCO の検出の正解(アノテーション)が含まれていません。COCO の 80 クラスの名前をプロンプトにして、COCO で学習していないモデルの精度(論文の言うゼロショットの精度)を測ります。あわせて、句の区切りのマスクとテキストの位置埋め込みの丸めが、精度にどれだけ影響するかを比べます。
COCO val2017 の準備
import os
import io
import json
import zipfile
import contextlib
import urllib.request
from concurrent.futures import ThreadPoolExecutor
from pycocotools.coco import COCO
from pycocotools.cocoeval import COCOeval

# COCO val2017 のアノテーションと、画像 ID の小さい順に 500 枚の画像をダウンロードする(RT-DETR の記事と同じ 500 枚)
os.makedirs("coco/val2017", exist_ok=True)
if not os.path.exists("coco/annotations/instances_val2017.json"):
    urllib.request.urlretrieve("http://images.cocodataset.org/annotations/annotations_trainval2017.zip", "coco/ann.zip")
    zipfile.ZipFile("coco/ann.zip").extract("annotations/instances_val2017.json", "coco")
with contextlib.redirect_stdout(io.StringIO()):
    coco = COCO("coco/annotations/instances_val2017.json")
img_ids = sorted(coco.getImgIds())[:500]


def fetch(i):
    path = f"coco/val2017/{i:012d}.jpg"
    if not os.path.exists(path):
        urllib.request.urlretrieve(f"http://images.cocodataset.org/val2017/{i:012d}.jpg", path)


with ThreadPoolExecutor(16) as ex:
    list(ex.map(fetch, img_ids))

cat_ids = sorted(coco.getCatIds())
cat_names = [coco.loadCats(c)[0]["name"] for c in cat_ids]
coco_prompt = ". ".join(cat_names) + "."
n_tokens = len(processor.tokenizer(coco_prompt)["input_ids"])
print(f"画像 {len(img_ids)} 枚、プロンプトは 80 クラスの名前をつないだ {n_tokens} トークン(上限 256)")
print(coco_prompt[:120] + " …")
RT-DETR の記事と同じく、val2017 のアノテーションと、画像 ID の小さい順に 500 枚の画像をダウンロードします。80 クラスの名前を「. 」でつないだ 1 つのプロンプトにします。
実行結果
画像 500 枚、プロンプトは 80 クラスの名前をつないだ 195 トークン(上限 256)
person. bicycle. car. motorcycle. airplane. bus. train. truck. boat. traffic light. fire hydrant. stop sign. parking met …
80 クラスの名前は 195 トークンで、Grounding DINO が一度に扱える 256 トークンに収まります。
3 つの設定で評価する
def evaluate_coco(model, **kw):
    """80 クラスの名前を 1 つのプロンプトにして検出し、COCO の AP を求める"""
    results = []
    for i in img_ids:
        img = Image.open(f"coco/val2017/{i:012d}.jpg").convert("RGB")
        inputs = processor(images=img, text=coco_prompt, return_tensors="pt").to(device)
        with torch.no_grad():
            logits, boxes, *_ = model(inputs["pixel_values"], inputs["input_ids"], **kw)
        if i == img_ids[0]:                                   # 句の位置はどの画像でも同じなので 1 回だけ作る
            spans = phrase_spans(inputs["input_ids"].cpu())
            pmap = torch.zeros(len(spans), logits.shape[-1], device=device)
            for c, s in enumerate(spans):
                pmap[c, s] = 1 / len(s)                         # 句のトークンの確率の平均をクラスの確率にする
        prob = logits[0, -1].sigmoid() @ pmap.T                   # (900, 80)
        score, idx = prob.flatten().topk(100)
        q, c = idx // len(cat_ids), idx % len(cat_ids)
        W, H = img.size
        cx, cy, w, h = boxes[0, -1][q].unbind(-1)
        for x, y, bw, bh, s, l in zip(((cx - w / 2) * W).tolist(), ((cy - h / 2) * H).tolist(), (w * W).tolist(),
                                      (h * H).tolist(), score.tolist(), c.tolist()):
            results.append({"image_id": i, "category_id": cat_ids[l], "bbox": [x, y, bw, bh], "score": s})
    with contextlib.redirect_stdout(io.StringIO()):
        E = COCOeval(coco, coco.loadRes(results), "bbox")
        E.params.imgIds = img_ids
        E.evaluate(); E.accumulate(); E.summarize()
    return E.stats[0], E.stats[1]


for name, kw in [("公式の実装と同じ(位置埋め込みを丸めない・句のマスクあり)", {}),
                 ("位置埋め込みを整数に丸める(HF と同じ)", {"hf_text_pos": True}),
                 ("句のマスクなし(文全体で注意をかける)", {"use_phrase_mask": False})]:
    ap, ap50 = evaluate_coco(ours, **kw)
    print(f"{name}: AP {ap:.3f}  AP50 {ap50:.3f}")
- クラスの確率: 句ごとのトークンの確率の平均を、クラスの確率にします。pmap は、クラスごとに句のトークンに 1/トークン数 を入れた行列で、トークンの確率との積が、句のトークンの確率の平均になります。
- 検出: 900 個のクエリ × 80 クラスの確率の上位 100 個を、その画像の検出にします。100 は、COCO の評価で 1 枚あたりに数える検出の数の上限(maxDets=100)です。
- 3 つの設定: 公式の実装と同じ設定、テキストの位置埋め込みを整数に丸める設定(Hugging Face と同じ)、句の区切りのマスクを使わない設定です。
実行結果
公式の実装と同じ(位置埋め込みを丸めない・句のマスクあり): AP 0.509  AP50 0.660
位置埋め込みを整数に丸める(HF と同じ): AP 0.509  AP50 0.659
句のマスクなし(文全体で注意をかける): AP 0.476  AP50 0.617
3つの設定の AP を並べると、次のようになります。
(図は、diagram-designで作成)
公式の実装と同じ設定で AP 0.509 でした。論文の Grounding DINO-T の COCO val2017 全体でのゼロショットの AP 48.4 と近い値です(500 枚に絞ったので、全体の値とは少し違います)。COCO の正解を学習に使わずに、COCO で学習した RT-DETR-R18(同じ 500 枚で AP 0.496)と同じくらいの精度が出ています。
テキストの位置埋め込みを丸めても、AP は 0.509 で変わりませんでした(AP50 は 0.001 低い)。句の区切りのマスクを使わず、80 クラスの名前を 1 つの文として注意をかけると、AP は 0.476 に下がりました。「person」の特徴に「bicycle」や「car」など、ほかのクラスの名前の情報が混ざり、句ごとの特徴がぼやけるためと考えられます。プロンプトに多くの句を並べるときは、句の区切りのマスクが精度に効いていることが分かります。
実験4:新しい単語と、学習に出ない組み合わせを学習する
最後に、ハンガリアンマッチングとトークン単位の損失を実装し、学習済みの Grounding DINO-T を合成データで追加学習します。形には、既存の単語(circle・triangle)に加えて、この記事で作った単語 dax(十字)と wug(星)を使います。色(red・green・blue・yellow)との 16 通りの組み合わせのうち 4 つを学習に出さず、次の 2 つを確かめます。
- 学習済みのモデルが知らない単語(dax・wug)を、追加学習で覚えられるか。
- 学習で一度も見ていない「色 × 形」の組み合わせ(例:green dax)を、正しく検出できるか。
実装方針:公式の学習との違い
| 項目 | 事前学習(論文と Open-GroundingDino の設定) | 本記事(合成データ) |
|---|---|---|
| 初期の重み | ImageNet で学習した Swin-T と BERT | 公開されている学習済みの Grounding DINO-T 全体(追加学習の例として) |
| データ | Objects365・GoldG・Cap4M(検出・グラウンディング・キャプションのデータ) | 色と形の合成画像 6,000 枚(新しい単語と、学習に出さない組み合わせを自由に作れる) |
| 入力画像 | 短い辺 480〜800 画素(複数の大きさ) | 320×320 の 1 つの大きさ(合成画像の大きさのまま) |
| 学習する部分 | 全体(Backbone と BERT は小さな学習率) | Swin と BERT は固定(Open-GroundingDino の既定と同じく BERT を固定し、さらに画像の Backbone も固定して学習を軽くする) |
| 最適化 | AdamW、学習率 1e-4(Backbone 1e-5)、重み減衰 1e-4、勾配のクリップ 0.1 | 同じ(Backbone は固定) |
| マッチングと損失 | ハンガリアン法(クラス 1・L1 5・GIoU 2)、トークン単位の Focal Loss 2・L1 5・GIoU 2、補助損失 | 同じ |
| ノイズ除去のクエリ | あり(正解の箱にノイズを加えたクエリで学習を速める) | なし(実装を短くするため) |
| エポック・バッチ | 公開されていない(Open-GroundingDino の例は 15 エポック、GPU あたり 4 枚) | 3 エポック、8 枚(A100 で約 15 分で学習するため) |
| 混合精度 | — | bfloat16(A100 で学習を速くするため) |
合成データ
import math
import random
import cv2

IMG = 320
COLORS = {"red": (220, 40, 40), "green": (40, 170, 60), "blue": (40, 70, 220), "yellow": (230, 210, 40)}
SHAPES = ["circle", "triangle", "dax", "wug"]           # dax(十字)と wug(星)は、この記事で作った単語
NEW_WORDS = ["dax", "wug"]
ALL_PHRASES = [f"{c} {s}" for c in COLORS for s in SHAPES]                  # 16 種類
UNSEEN = ["red wug", "green dax", "blue triangle", "yellow circle"]         # 学習に出さない組み合わせ
SEEN = [p for p in ALL_PHRASES if p not in UNSEEN]                          # 12 種類


def overlap(a, b, gap=4):
    return not (a[2] + gap <= b[0] or b[2] + gap <= a[0] or a[3] + gap <= b[1] or b[3] + gap <= a[1])


def make_scene(seed, phrases):
    """灰色の背景に、指定した句(色と形)の物体を 1〜6 個、重ならないように描く"""
    rng = np.random.default_rng(seed)
    g0, g1 = rng.integers(60, 200, 2)
    t = np.linspace(0, 1, IMG)[None, :, None]
    img = (g0 * (1 - t) + g1 * t).repeat(IMG, 0).repeat(3, 2)
    img = np.clip(img + rng.normal(0, 8, img.shape), 0, 255).astype(np.uint8).copy()
    boxes, labels = [], []
    for _ in range(rng.integers(1, 7)):
        for _try in range(30):
            s = math.exp(rng.uniform(math.log(20), math.log(100)))       # 一辺 20〜100 画素
            x0, y0 = rng.uniform(0, IMG - s, 2)
            b = np.array([x0, y0, x0 + s, y0 + s])
            if not any(overlap(b, o) for o in boxes):
                break
        else:
            continue
        k = int(rng.integers(len(phrases)))
        color_name, shape = phrases[k].split()
        color = tuple(int(np.clip(v + rng.integers(-25, 26), 0, 255)) for v in COLORS[color_name])
        x0, y0, x1, y1 = b
        if shape == "circle":
            cv2.circle(img, (int(round((x0 + x1) / 2)), int(round((y0 + y1) / 2))), int(round(s / 2)), color, -1, cv2.LINE_AA)
        elif shape == "triangle":
            pts = np.array([[(x0 + x1) / 2, y0], [x0, y1], [x1, y1]])
            cv2.fillPoly(img, [pts.round().astype(np.int32)], color, cv2.LINE_AA)
        elif shape == "dax":                                          # 十字:太さが一辺の 1/3 の縦と横の棒
            a, b2 = x0 + s / 3, x0 + 2 * s / 3
            c, d = y0 + s / 3, y0 + 2 * s / 3
            cv2.rectangle(img, (int(round(a)), int(round(y0))), (int(round(b2)), int(round(y1))), color, -1)
            cv2.rectangle(img, (int(round(x0)), int(round(c))), (int(round(x1)), int(round(d))), color, -1)
        else:                                                         # wug:5 つの角を持つ星
            ang = -np.pi / 2 + np.arange(10) * np.pi / 5
            r = np.where(np.arange(10) % 2 == 0, s / 2, s / 5)
            pts = np.stack([(x0 + x1) / 2 + r * np.cos(ang), (y0 + y1) / 2 + r * np.sin(ang)], 1)
            cv2.fillPoly(img, [pts.round().astype(np.int32)], color, cv2.LINE_AA)
        boxes.append(b)
        labels.append(phrases[k])
    return img, np.array(boxes, dtype=np.float32).reshape(-1, 4), labels


MEAN = torch.tensor([0.485, 0.456, 0.406]).view(3, 1, 1)
STD = torch.tensor([0.229, 0.224, 0.225]).view(3, 1, 1)


class Scenes(torch.utils.data.Dataset):
    def __init__(self, n, offset, phrases):
        self.n, self.offset, self.phrases = n, offset, phrases

    def __len__(self):
        return self.n

    def __getitem__(self, i):
        img, boxes, labels = make_scene(self.offset + i, self.phrases)
        x = (torch.from_numpy(img).permute(2, 0, 1).float() / 255 - MEAN) / STD   # ImageNet の平均と標準偏差で正規化
        b = torch.from_numpy(boxes) / IMG
        cxcywh = torch.cat([(b[:, :2] + b[:, 2:]) / 2, b[:, 2:] - b[:, :2]], 1)
        return x, {"boxes": cxcywh, "phrases": labels}


def collate(batch):
    return torch.stack([b[0] for b in batch]), [b[1] for b in batch]


def make_prompt(phrases, shuffle=False):
    """句を「.」でつないだプロンプトと、各句のトークンの位置"""
    phrases = list(phrases)
    if shuffle:
        random.shuffle(phrases)
    prompt = ". ".join(phrases) + "."
    ids = processor.tokenizer(prompt, return_tensors="pt")["input_ids"]
    return ids, dict(zip(phrases, phrase_spans(ids)))


fig, axes = plt.subplots(1, 4, figsize=(16, 4.2))
for ax, seed in zip(axes, range(4)):
    img, boxes, labels = make_scene(seed, ALL_PHRASES)
    ax.imshow(img)
    for (x0, y0, x1, y1), l in zip(boxes, labels):
        ax.text(x0, y0 - 3, l, color="white", fontsize=9, backgroundcolor="black")
    ax.axis("off")
plt.tight_layout()
plt.show()
ids, spans = make_prompt(SEEN)
print("学習のプロンプト:", processor.tokenizer.decode(ids[0]))
print("句のトークンの位置:", spans)
- make_scene: 320×320 の灰色のグラデーションとノイズの背景に、指定した句の物体を 1〜6 個、一辺 20〜100 画素の大きさで、4 画素以上離して描きます。背景を灰色にするのは、物体の色と背景の色が紛らわしくならないようにするためです。色は、基準の RGB に ±25 のゆらぎを加えます。
- UNSEEN: 学習に出さない 4 つの組み合わせです。各色・各形がちょうど 1 回ずつ入るように選び、どの色もどの形も、学習ではほかの組み合わせで出てくるようにしました。
- Scenes・collate: 画像を ImageNet の平均と標準偏差で正規化し(Grounding DINO の前処理と同じ)、正解の箱を 0〜1 の (cx, cy, w, h) にします。
- make_prompt: 句を「. 」でつないでプロンプトにし、句ごとのトークンの位置を返します。学習では、毎回句の順番を入れ替えます。句の位置によらず同じように検出できるようにするためです。
実行結果
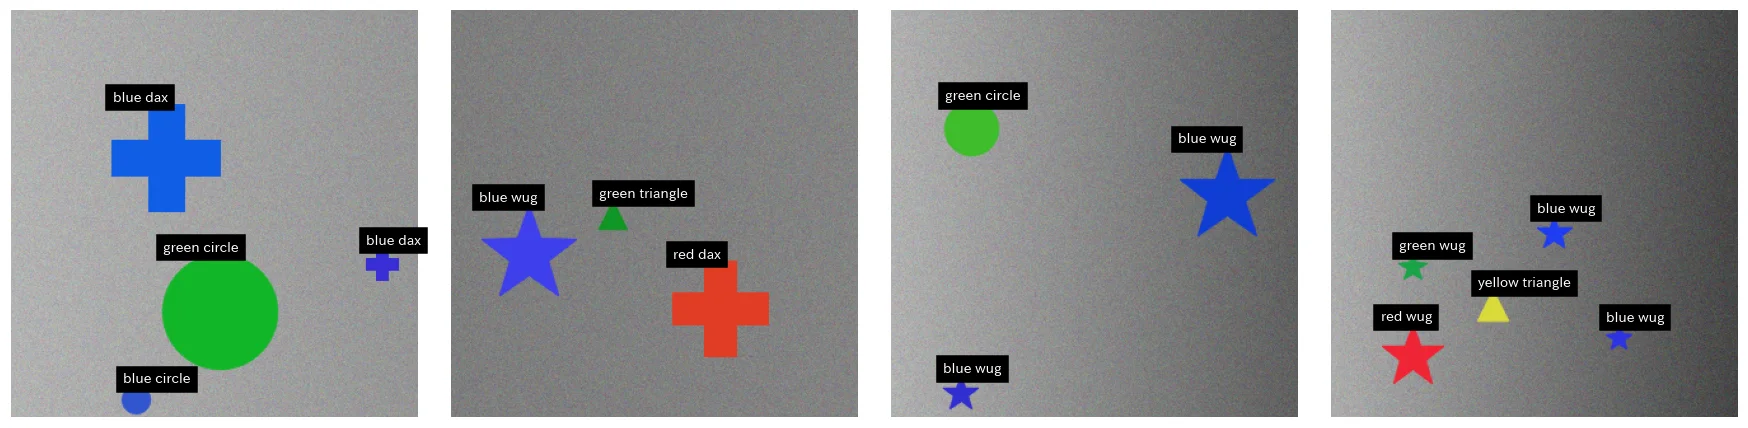
学習のプロンプト: [CLS] red circle. red triangle. red dax. green circle. green triangle. green wug. blue circle. blue dax. blue wug. yellow triangle. yellow dax. yellow wug. [SEP]
句のトークンの位置: {'red circle': [1, 2], 'red triangle': [4, 5], 'red dax': [7, 8], 'green circle': [10, 11], 'green triangle': [13, 14], 'green wug': [16, 17, 18], 'blue circle': [20, 21], 'blue dax': [23, 24], 'blue wug': [26, 27, 28], 'yellow triangle': [30, 31], 'yellow dax': [33, 34], 'yellow wug': [36, 37, 38]}
「wug」は「w」「##ug」の 2 トークンに分かれるので、「green wug」のような句は 3 トークンになります。
ハンガリアンマッチングと損失
from scipy.optimize import linear_sum_assignment


def cxcywh_to_xyxy(b):
    cx, cy, w, h = b.unbind(-1)
    return torch.stack([cx - w / 2, cy - h / 2, cx + w / 2, cy + h / 2], -1)


def generalized_box_iou(a, b):
    area_a, area_b = (a[:, 2:] - a[:, :2]).prod(-1), (b[:, 2:] - b[:, :2]).prod(-1)
    inter = (torch.min(a[:, None, 2:], b[None, :, 2:]) - torch.max(a[:, None, :2], b[None, :, :2])).clamp(0).prod(-1)
    union = area_a[:, None] + area_b[None] - inter
    hull = (torch.max(a[:, None, 2:], b[None, :, 2:]) - torch.min(a[:, None, :2], b[None, :, :2])).clamp(0).prod(-1)
    return inter / union - (hull - union) / hull


def token_targets(target, spans, L=256):
    """正解の箱ごとに、その句のトークンを 1 にした目標 (箱の数, 256)"""
    t = torch.zeros(len(target["phrases"]), L)
    for j, p in enumerate(target["phrases"]):
        t[j, spans[p]] = 1.0
    return t


@torch.no_grad()
def hungarian_match(logits, boxes, targets, spans, w_class=1.0, w_bbox=5.0, w_giou=2.0, alpha=0.25, gamma=2.0):
    """クラスのコストは、正解の句のトークンについての Focal Loss の形のコストの平均"""
    out = []
    for lg, bx, t in zip(logits, boxes, targets):
        tt = token_targets(t, spans).to(lg.device)
        tt = tt / tt.sum(-1, keepdim=True)                                  # 句のトークンの平均をとる重み
        p = lg.sigmoid()
        neg = (1 - alpha) * p ** gamma * -(1 - p + 1e-8).log()
        pos = alpha * (1 - p) ** gamma * -(p + 1e-8).log()
        cost_class = (pos - neg).nan_to_num(0.0) @ tt.T                     # トークンでない位置(-inf)は 0 にする
        cost_bbox = torch.cdist(bx, t["boxes"], p=1)
        cost_giou = -generalized_box_iou(cxcywh_to_xyxy(bx), cxcywh_to_xyxy(t["boxes"]))
        C = w_bbox * cost_bbox + w_class * cost_class + w_giou * cost_giou
        q, g = linear_sum_assignment(C.float().cpu().numpy())
        out.append((torch.as_tensor(q), torch.as_tensor(g)))
    return out


def grounding_loss(logits, boxes, targets, spans, n_tokens, w_cls=2.0, w_bbox=5.0, w_giou=2.0, alpha=0.25, gamma=2.0):
    """トークン単位の Focal Loss(対照学習の分類)と、L1・GIoU の箱の損失"""
    matches = hungarian_match(logits, boxes, targets, spans)
    num = max(sum(len(t["boxes"]) for t in targets), 1)
    target = torch.zeros_like(logits)
    src, tgt = [], []
    for i, ((q, g), t) in enumerate(zip(matches, targets)):
        target[i, q] = token_targets(t, spans).to(logits.device)[g]
        src.append(boxes[i, q])
        tgt.append(t["boxes"][g])
    lg, tg = logits[..., :n_tokens], target[..., :n_tokens]                   # プロンプトのトークンだけで計算する
    p = lg.sigmoid()
    ce = F.binary_cross_entropy_with_logits(lg, tg, reduction="none")
    p_t = p * tg + (1 - p) * (1 - tg)
    loss_cls = ((alpha * tg + (1 - alpha) * (1 - tg)) * (1 - p_t) ** gamma * ce).sum() / num
    src, tgt = torch.cat(src), torch.cat(tgt)
    loss_bbox = F.l1_loss(src, tgt, reduction="sum") / num
    loss_giou = (1 - generalized_box_iou(cxcywh_to_xyxy(src), cxcywh_to_xyxy(tgt)).diagonal()).sum() / num
    return w_cls * loss_cls + w_bbox * loss_bbox + w_giou * loss_giou


def total_loss(logits_all, boxes_all, enc_topk, targets, spans, n_tokens):
    """デコーダの 6 層(補助損失)と、クエリの選択の予測に同じ損失をかけて足す"""
    outs = [(logits_all[:, l], boxes_all[:, l]) for l in range(logits_all.shape[1])] + [enc_topk]
    return sum(grounding_loss(lg.float(), bx.float(), targets, spans, n_tokens) for lg, bx in outs)
- token_targets: 正解の箱ごとに、その句のトークンの位置を 1 にした 256 次元の目標を作ります。
- hungarian_match: クラスのコストは、Focal Loss の形のコストを、正解の句のトークンについて平均したものです。L1 と GIoU のコストと重み付きで足し(重みはクラス 1・L1 5・GIoU 2)、linear_sum_assignment で 1 対 1 の組を求めます。
- grounding_loss: 組になったクエリの目標を正解の句のトークンにし、それ以外のクエリ・トークンを 0 にして、プロンプトのトークンの範囲で Focal Loss(alpha=0.25・gamma=2)をかけます。箱には L1 と GIoU の損失をかけ、どれも正解の箱の数で割ります。重み(Focal 2・L1 5・GIoU 2)とコストの重みは、Hugging Face の実装と Open-GroundingDino の設定の値です。
- total_loss: デコーダの 6 層それぞれと、クエリの選択の予測に、同じ損失をかけて足します(補助損失)。
学習の関数
import time
import copy


def train(model, epochs=3, n_train=6000, batch=8):
    """Swin と BERT は固定し、それ以外(Feature Enhancer・クエリの選択・Decoder・テキストの射影)を学習する"""
    torch.manual_seed(0)
    random.seed(0)
    loader = torch.utils.data.DataLoader(Scenes(n_train, 0, SEEN), batch_size=batch, shuffle=True, num_workers=8,
                                         collate_fn=collate, drop_last=True, persistent_workers=True)
    for p in list(model.backbone.parameters()) + list(model.bert.parameters()):
        p.requires_grad_(False)
    params = [p for p in model.parameters() if p.requires_grad]
    opt = torch.optim.AdamW(params, lr=1e-4, weight_decay=1e-4)
    for epoch in range(1, epochs + 1):
        model.train()
        model.backbone.eval()
        model.bert.eval()
        t0, tot = time.time(), 0.0
        for x, targets in loader:
            ids, spans = make_prompt(SEEN, shuffle=True)          # 句の順番は毎回入れ替える
            x, ids = x.to(device), ids.to(device).expand(len(x), -1)
            targets = [{"boxes": t["boxes"].to(device), "phrases": t["phrases"]} for t in targets]
            with torch.autocast("cuda", dtype=torch.bfloat16):
                logits_all, boxes_all, enc_topk, _ = model(x, ids)
            loss = total_loss(logits_all, boxes_all, enc_topk, targets, spans, ids.shape[1])
            opt.zero_grad(set_to_none=True)
            loss.backward()
            torch.nn.utils.clip_grad_norm_(params, 0.1)
            opt.step()
            tot += loss.item()
        print(f"エポック {epoch}  損失 {tot / len(loader):.3f}  ({time.time() - t0:.0f} 秒)", flush=True)
    return model.eval()
- 学習する部分: Swin と BERT の重みは固定します。BERT の固定は Open-GroundingDino の既定と同じで、Swin も固定するのは、学習を軽くするためです。Feature Enhancer・クエリの選択・デコーダ・テキストの射影の層を学習します。
- 最適化: AdamW で、学習率 1e-4・重み減衰 1e-4・勾配のクリップ 0.1 は、Open-GroundingDino の設定の値です。順伝播は bfloat16 の混合精度で計算し、損失は float32 で計算します。
- プロンプト: 学習に出る 12 種類の句を、バッチごとに順番を入れ替えて並べます。学習に出さない 4 種類は、プロンプトにも入れません。
追加学習の前と後を比べる
@torch.no_grad()
def evaluate_phrases(model, n_test=500):
    """16 種類の句をすべて並べたプロンプトで検出し、句ごとの AP50 を求める(テスト画像には 16 種類すべてが出る)"""
    ids, spans = make_prompt(ALL_PHRASES)
    ids = ids.to(device)
    pmap = torch.zeros(len(ALL_PHRASES), 256, device=device)
    for c, p in enumerate(ALL_PHRASES):
        pmap[c, spans[p]] = 1 / len(spans[p])
    loader = torch.utils.data.DataLoader(Scenes(n_test, 10**6, ALL_PHRASES), batch_size=25, num_workers=8, collate_fn=collate)
    dets, n_gt = {p: [] for p in ALL_PHRASES}, {p: 0 for p in ALL_PHRASES}
    for x, targets in loader:
        logits, boxes, *_ = model(x.to(device), ids.expand(len(x), -1))
        prob = logits[:, -1].float().sigmoid() @ pmap.T                       # (B, 900, 16)
        for i, t in enumerate(targets):
            score, idx = prob[i].flatten().topk(100)
            q, c = idx // len(ALL_PHRASES), idx % len(ALL_PHRASES)
            pred = cxcywh_to_xyxy(boxes[i, -1, q].float()).cpu()
            gt = cxcywh_to_xyxy(t["boxes"])
            used = torch.zeros(len(gt), dtype=torch.bool)
            iou = torchvision.ops.box_iou(pred, gt) if len(gt) else torch.zeros(len(pred), 0)
            for p in t["phrases"]:
                n_gt[p] += 1
            for j in range(len(pred)):                                       # 確率の高い順に、同じ句の正解と対応づける
                name = ALL_PHRASES[c[j]]
                ok = torch.tensor([gp == name for gp in t["phrases"]], dtype=torch.bool) & ~used
                hit = False
                if ok.any():
                    v, k = (iou[j] * ok).max(0)
                    if v >= 0.5:
                        used[k], hit = True, True
                dets[name].append((score[j].item(), int(hit)))
    ap = {}
    for p in ALL_PHRASES:
        d = sorted(dets[p], key=lambda x: -x[0])
        tp = np.cumsum([x[1] for x in d])
        fp = np.cumsum([1 - x[1] for x in d])
        rec, prec = tp / max(n_gt[p], 1), tp / np.maximum(tp + fp, 1e-9)
        mrec, mpre = np.concatenate(([0], rec, [1])), np.concatenate(([1], prec, [0]))
        mpre = np.flip(np.maximum.accumulate(np.flip(mpre)))
        k = np.where(mrec[1:] != mrec[:-1])[0]
        ap[p] = float(np.sum((mrec[k + 1] - mrec[k]) * mpre[k + 1]))
    return ap


def report(name, ap):
    """句を「学習に出たか」と「形が既存の単語か、新しい単語か」で 4 つに分けて、AP50 の平均を出す"""
    print(name)
    for seen_name, group in [("学習に出た組み合わせ", SEEN), ("学習に出ない組み合わせ", UNSEEN)]:
        for word_name, is_new in [("既存の単語(circle・triangle)", False), ("新しい単語(dax・wug)", True)]:
            ps = [p for p in group if (p.split()[1] in NEW_WORDS) == is_new]
            print(f"    {seen_name}・{word_name}: AP50 {np.mean([ap[p] for p in ps]):.3f}  ({', '.join(f'{p} {ap[p]:.2f}' for p in ps)})")


ap_before = evaluate_phrases(ours)
report("追加学習の前(公式の重みのまま)", ap_before)
tuned = train(copy.deepcopy(ours))
ap_after = evaluate_phrases(tuned)
report("追加学習の後", ap_after)
torch.save({k: v for k, v in tuned.state_dict().items()}, "tuned.pt")
- evaluate_phrases: テスト用の 500 枚(乱数の種 100 万から)には、16 種類すべての物体が出てきます。16 種類の句をすべて並べたプロンプトで検出し、句ごとの AP50 を求めます。
- report: 句を「学習に出たか・出ないか」と「形が既存の単語か・新しい単語か」の 4 つに分けて、AP50 の平均を出します。
実行結果
追加学習の前(公式の重みのまま)
    学習に出た組み合わせ・既存の単語(circle・triangle): AP50 0.691  (red circle 0.99, red triangle 0.39, green circle 0.86, green triangle 0.54, blue circle 0.96, yellow triangle 0.41)
    学習に出た組み合わせ・新しい単語(dax・wug): AP50 0.142  (red dax 0.16, green wug 0.09, blue dax 0.15, blue wug 0.20, yellow dax 0.08, yellow wug 0.17)
    学習に出ない組み合わせ・既存の単語(circle・triangle): AP50 0.592  (blue triangle 0.29, yellow circle 0.89)
    学習に出ない組み合わせ・新しい単語(dax・wug): AP50 0.096  (red wug 0.12, green dax 0.07)
エポック 1  損失 2.781  (372 秒)
エポック 2  損失 3.263  (268 秒)
エポック 3  損失 3.790  (266 秒)
追加学習の後
    学習に出た組み合わせ・既存の単語(circle・triangle): AP50 1.000  (red circle 1.00, red triangle 1.00, green circle 1.00, green triangle 1.00, blue circle 1.00, yellow triangle 1.00)
    学習に出た組み合わせ・新しい単語(dax・wug): AP50 0.998  (red dax 0.99, green wug 1.00, blue dax 1.00, blue wug 1.00, yellow dax 1.00, yellow wug 1.00)
    学習に出ない組み合わせ・既存の単語(circle・triangle): AP50 1.000  (blue triangle 1.00, yellow circle 1.00)
    学習に出ない組み合わせ・新しい単語(dax・wug): AP50 0.994  (red wug 1.00, green dax 0.99)
追加学習の前と後の AP50 を並べると、次のようになります。
(図は、diagram-designで作成)
追加学習の前、学習済みのモデルは、既存の単語の句(red circle など)をある程度検出できました(AP50 0.691)。ただし triangle の句は 0.29〜0.54 と低めでした。この記事で作った単語 dax・wug の句は、AP50 0.096〜0.142 で、ほとんど検出できません。
追加学習の後は、4 つのグループすべてで AP50 が 0.99 以上になりました。
- 新しい単語: 学習で見せた dax(十字)と wug(星)の句は、AP50 0.998 になりました。クラスの層を足さなくても、テキストのトークンと画像の特徴の対応を学習するだけで、新しい単語を覚えられることが分かります。
- 学習に出ない組み合わせ: 一度も学習で見ていない red wug と green dax も、AP50 1.00 と 0.99 でした。「red」は red circle などで、「wug」は green wug などで学習しているので、色の語と形の語を組み合わせた句を、正しく対応づけています。
なお、学習の損失は 1 エポック目の 2.781 から 3 エポック目の 3.790 に増えました。評価は向上しているので、学習が壊れたわけではありませんが、損失が増えた原因はこの記事では調べていません。
検出結果を見る
# 学習に出ない組み合わせ(橙色の枠)を含むテスト画像で、追加学習の前と後の検出を比べる
ids, spans = make_prompt(ALL_PHRASES)
pmap = torch.zeros(len(ALL_PHRASES), 256, device=device)
for c, p in enumerate(ALL_PHRASES):
    pmap[c, spans[p]] = 1 / len(spans[p])
fig, axes = plt.subplots(2, 4, figsize=(16, 8.6))
for col in range(4):
    x, t = Scenes(1, 10**6 + col, ALL_PHRASES)[0]
    img = (x * STD + MEAN).permute(1, 2, 0).clamp(0, 1).numpy()
    for row, (name, m) in enumerate([("追加学習の前", ours), ("追加学習の後", tuned)]):
        with torch.no_grad():
            logits, boxes, *_ = m(x[None].to(device), ids.to(device))
        score, label = (logits[0, -1].sigmoid() @ pmap.T).max(-1)
        keep = score > 0.35
        ax = axes[row, col]
        ax.imshow(img)
        for (x0, y0, x1, y1), s, l in zip((cxcywh_to_xyxy(boxes[0, -1][keep]) * IMG).tolist(), score[keep].tolist(), label[keep].tolist()):
            n = ALL_PHRASES[l]
            c = "orange" if n in UNSEEN else "red"
            ax.add_patch(plt.Rectangle((x0, y0), x1 - x0, y1 - y0, fill=False, color=c, lw=2))
            ax.text(x0, y0 - 3, f"{n} {s:.2f}", color="white", fontsize=8, backgroundcolor=c)
        ax.set_title(f"{name}(検出 {int(keep.sum())} 個、正解 {len(t['phrases'])} 個)", fontsize=11)
        ax.axis("off")
plt.tight_layout()
plt.show()
print("正解:", [Scenes(1, 10**6 + col, ALL_PHRASES)[0][1]["phrases"] for col in range(4)])
テスト用の 4 枚の画像について、16 種類の句を並べたプロンプトで、確率 0.35 を超える検出を描きます。上の段が追加学習の前、下の段が後で、学習に出ない組み合わせは橙色の枠です。
実行結果
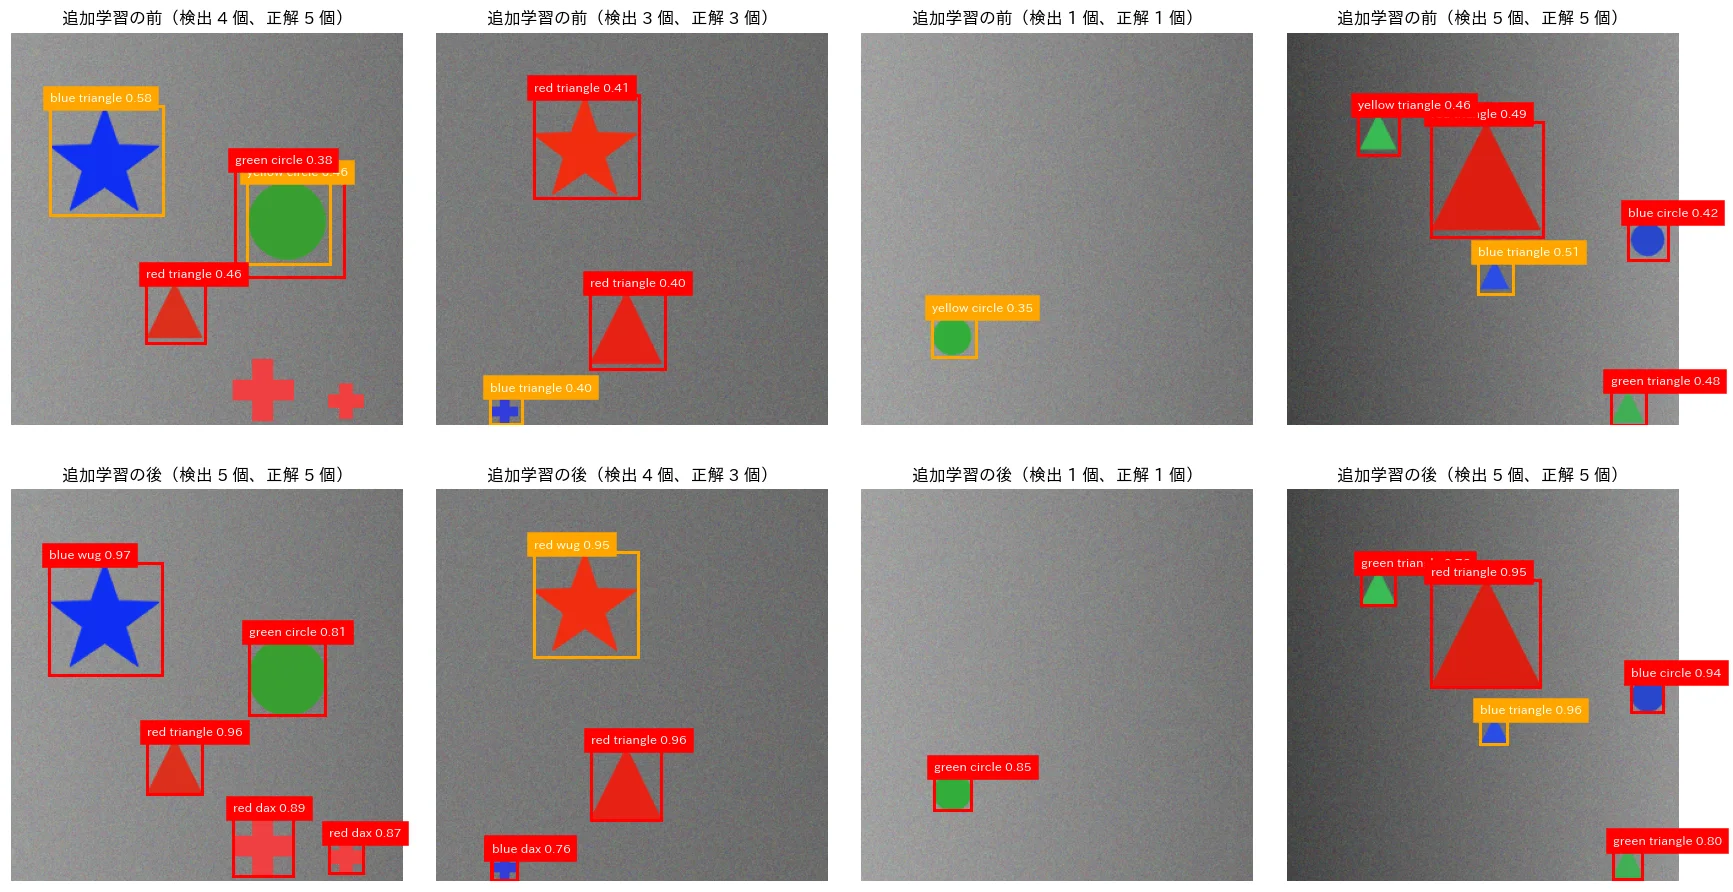
正解: [['red triangle', 'blue wug', 'red dax', 'green circle', 'red dax'], ['red triangle', 'blue dax', 'red wug'], ['green circle'], ['green triangle', 'blue circle', 'red triangle', 'green triangle', 'blue triangle']]
追加学習の前のモデルは、星(wug)や十字(dax)を「blue triangle」「red triangle」のように、知っている形の単語の句に当てはめていました(左の 2 枚)。1 枚目の赤い十字のように、検出できない物体もありました。追加学習の後は、学習に出ない red wug(2 枚目)や、学習に出た blue wug・red dax を、正しい句で検出しています。2 枚目だけは、正解の 3 個に対して検出が 4 個で、1 個多く出ました。
まとめ
本記事では、テキストで指定した物体を検出する Grounding DINO を、PyTorch のスクラッチ実装で確かめました。
- テキストで検出の対象を変える(実験1): 「cat.」で猫 7 匹を、「cat. bench. potted plant.」で 11 個を、学習し直さずに検出しました。一方、「black and white cat」のような色の条件や、「the cat on the bench」のような位置の関係は、うまく反映できませんでした。
- スクラッチ実装(実験2): Swin-T・BERT・Feature Enhancer・クエリの選択・Cross-Modality Decoder を実装し、公式の学習済みの重みを読み込みました。テキストの位置埋め込みを Hugging Face と同じく丸めると、確率 0.35 を超える 11 個の検出が一致しました(確率の差は最大 2.45e-03、箱の差は最大 1.43e-05)。Hugging Face の実装(transformers 5.21.0)は、公式の実装と違い、テキストの位置埋め込みを整数に丸めていることも分かりました。
- ゼロショットの精度(実験3): COCO の正解で学習していないモデルが、COCO val2017 の 500 枚で AP 0.509 を出しました。句の区切りのマスクを外すと AP は 0.476 に下がり、多くの句を並べるプロンプトでマスクが効いていることを確かめました。
- 新しい単語の学習(実験4): ハンガリアンマッチングとトークン単位の Focal Loss を実装し、合成データで追加学習しました。この記事で作った単語 dax・wug の句の AP50 は 0.14 から 0.998 に上がり、学習に一度も出していない「red wug」「green dax」も AP50 0.99 以上で検出できました。
Grounding DINO は、物体を検出してから別のモデルに渡す使い方が多いモデルです。たとえば、検出した箱を SAM に渡して物体の領域を切り出す Grounded-SAM がよく知られています。後継の Grounding DINO 1.5 は、より大きなモデルとデータで精度と速さを高めています。
ライセンスに関する注記
Grounding DINO の公式の実装(IDEA-Research/GroundingDINO)と、Hugging Face の学習済みの重み(IDEA-Research/grounding-dino-tiny)は、Apache-2.0 で公開されています。Apache-2.0 は、商用利用・改変・再配布ができるライセンスです。再配布するときは、ライセンスの全文と著作権の表示を含め、改変したファイルには改変したことを明記してください。テキストの Backbone の BERT(bert-base-uncased)も Apache-2.0 です。COCO のアノテーションは CC BY 4.0 で、画像はそれぞれの撮影者の Flickr のライセンスに従います。本記事の説明は一般的な解釈で、法的な助言ではありません。 実際に利用する場合は、ライセンスの条文を確認してください。
出典・ライセンスについて
- Grounding DINO の実装: 公式の IDEA-Research/GroundingDINO と Hugging Face の transformers(どちらも Apache-2.0)の構造を参考に、スクラッチで実装しています。学習の設定は Open-GroundingDino を参考にしています。
- 学習済みのモデル: IDEA-Research/grounding-dino-tiny(Apache-2.0)を使用しています。
- 評価データ: COCO val2017(アノテーションは CC BY 4.0)の一部を使用しています。
- 推論に利用した画像: Gemini で作成した画像です。
@inproceedings{liu2024grounding,
  title = {Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection},
  author = {Liu, Shilong and Zeng, Zhaoyang and Ren, Tianhe and Li, Feng and Zhang, Hao and Yang, Jie and Jiang, Qing and Li, Chunyuan and Yang, Jianwei and Su, Hang and Zhu, Jun and Zhang, Lei},
  booktitle = {European Conference on Computer Vision (ECCV)},
  year = {2024}
}
参考文献
- S. Liu et al. (2024). Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection. ECCV 2024.
- IDEA Research. IDEA-Research/GroundingDINO. GitHub.
- IDEA Research. IDEA-Research/grounding-dino-tiny. Hugging Face.
- Z. Long. longzw1997/Open-GroundingDino. GitHub.
- T.-Y. Lin et al. (2014). Microsoft COCO: Common Objects in Context. ECCV 2014.
本記事の文章・構成の一部に生成AIを使用しています。