GRPO(Group Relative Policy Optimization)とは?
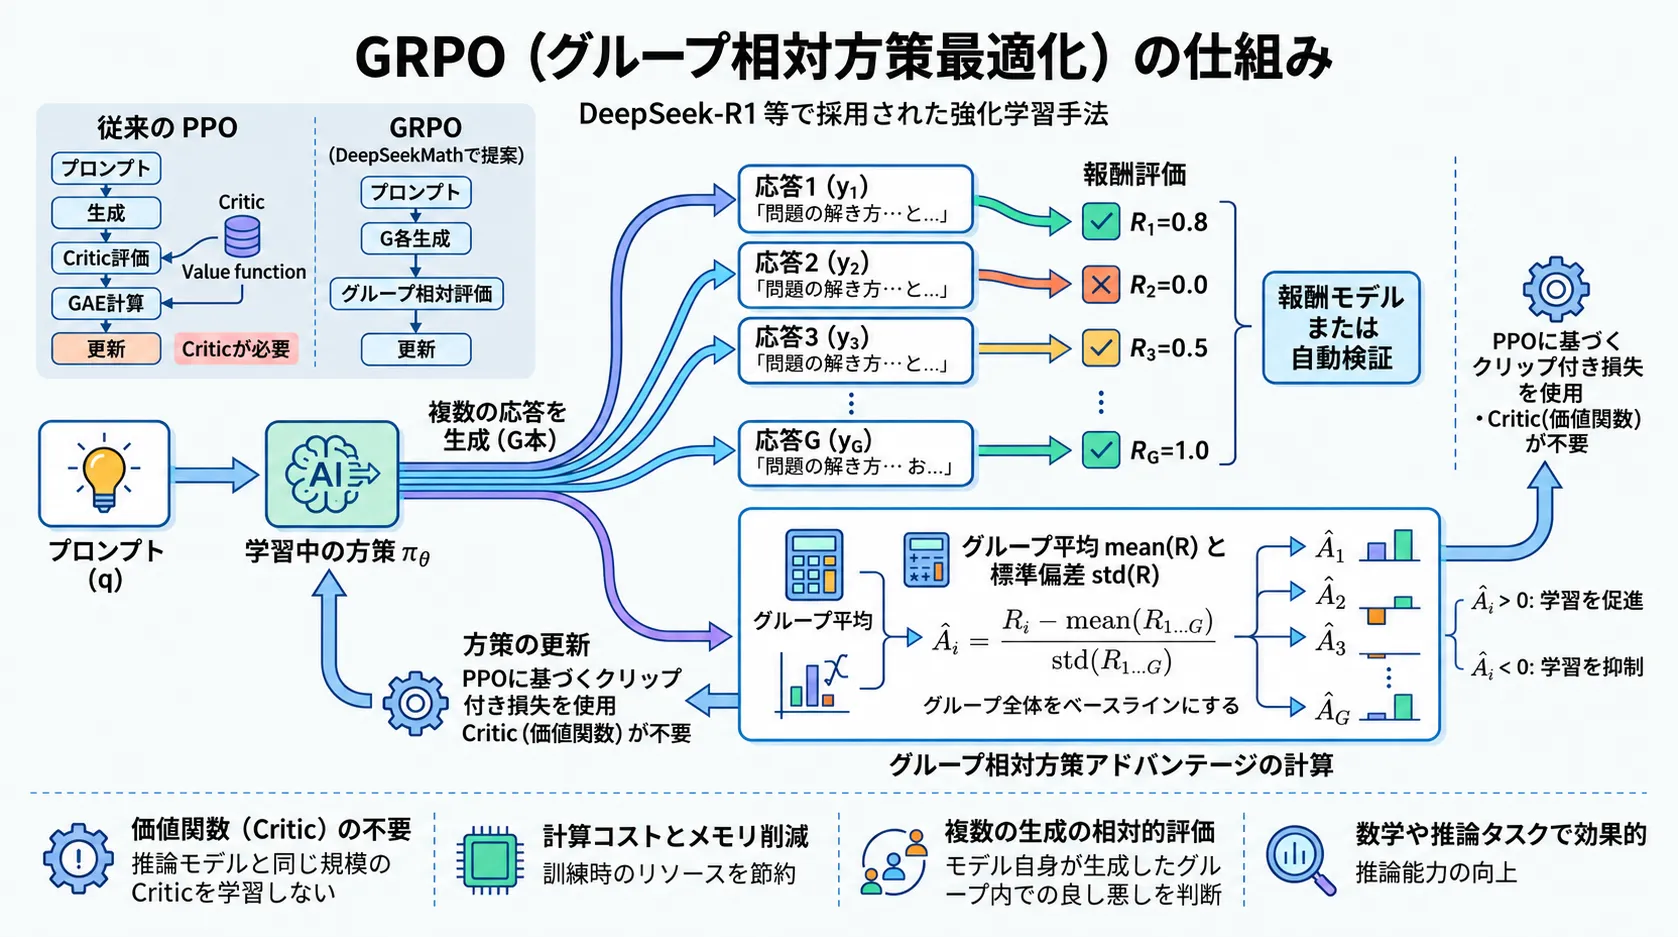 (画像は、Geminiで作成)
価値関数(Critic)の代わりに、同じ問題から生成した複数の応答の報酬をグループ内で正規化してアドバンテージにする GRPO の仕組みと、PPO との違い、正解を報酬にする検証可能な報酬(RLVR)の考え方を理解すること。Qwen2.5-0.5B-Instruct と算数ワールドで GRPO をスクラッチ実装し、TRL の GRPOTrainer と比べながら、正解率がどこまで伸びるか、学習信号が0になる問題をどう避けるかを確かめること。
GRPOの概要
GRPO(Group Relative Policy Optimization)は、DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models(Shao et al., 2024)で提案された、大規模言語モデル(LLM)のための強化学習アルゴリズムです。後に DeepSeek-R1-Zero・DeepSeek-R1 の強化学習にも使われました。
InstructGPTの記事で扱った PPO による強化学習では、学習する方策(言語モデル)とは別に、ほぼ同じ規模の 価値関数(Critic) を用意して一緒に学習する必要がありました。GRPO は、この価値関数を使いません。代わりに、同じ問題に対してモデル自身に複数の応答(グループ)を生成させ、グループ内の報酬の平均と標準偏差で正規化した値 をアドバンテージとして使います。
【PPO のアドバンテージ】
方策が応答を生成 → 報酬モデルが採点 → 価値関数 V(s_t) を学習し、GAE でトークンごとに計算

【GRPO のアドバンテージ】
方策が同じ問題から G 本生成 → 各応答を採点 → グループ内の平均と標準偏差で正規化(価値関数なし)
DPOの記事の最後では、固定データから学ぶオフラインの手法には「自分が生成した応答から学べない」という限界があり、正解が機械的に判定できるタスクではオンラインの学習が有利ではないか、という問いを残しました。GRPO はその答えの1つです。価値関数を捨てて PPO を軽くし、正解判定をそのまま報酬にすることで、モデルが自分で解いた結果からオンラインで学習できるようにします。
本記事では、次の順に解説します。
- 背景: PPO を LLM に使うときの負担
- GRPO の仕組み: グループ相対アドバンテージと目的関数
- PPO との差分: 価値関数と GAE の削除、KL の入れ方と k3 推定量、応答長による正規化
- 検証可能な報酬(RLVR): ルールベースの報酬と、そのハッキングの防ぎ方
- グループ内の報酬がすべて同じ問題: 学習信号が0になる問題と、難易度の関係
- DeepSeekMath の考察: 「RL は maj@k を上げるが pass@k はあまり上げない」、結果監督と過程監督、反復的な RL
- 統一的な見方: SFT・RFT・DPO・PPO・GRPO を勾配係数で整理する
- 発展: Dr. GRPO が指摘したバイアスと DAPO
- 実装と考察: スクラッチ実装と TRL の GRPOTrainer で学習し、結果が出たところで順に考察する
- この実験の限界と、DeepSeek-R1 との関係
プロンプト(問題)を 、応答を 、応答のトークン数を と書きます。同じ に対するグループ内の 番目の応答を (、 はグループサイズ)、学習中の方策を 、参照モデルを 、応答を生成した時点の方策を と書きます。DeepSeekMath の論文では、プロンプトを 、応答を と書いています。
ルールベースの(検証可能な)報酬は、学習済み報酬モデル と区別するため大文字で と書き、 とします。KL 正則化の係数は 、クリップ幅は です。PPOの記事で と書いていた確率比は、報酬 と紛らわしいので、本記事では と書きます。
背景:PPOをLLMに使うときの負担
4つのモデルとメモリ
InstructGPTの記事で見たように、PPO による RLHF では次の4つのモデルを扱います。GRPO で何が不要になるかを並べて示します。
| モデル | 役割 | PPO(InstructGPT) | GRPO |
|---|---|---|---|
| 方策 | 学習する言語モデル | 必要(学習) | 必要(学習) |
| 参照モデル | KL の基準(SFT モデル) | 必要(固定) | 必要(固定) |
| 報酬モデル | 応答を採点する | 必要(固定) | ルールベースの報酬なら不要 |
| 価値関数 | 各時点の期待報酬を予測する | 必要(学習) | 不要 |
価値関数は方策とほぼ同じ規模のネットワークで、学習もするので、勾配とオプティマイザの状態(Adam では重みの2倍)まで保持する必要があります。InstructGPT の記事の TRL 版で問題になったメモリ不足の大きな原因の1つです。
トークンごとの価値を推定する難しさ
PPO の価値関数は、各トークンの時点で「この先に得られる報酬の期待値 」を予測し、GAE でアドバンテージを計算するための基準に使われます。
しかし、算数や数学の問題では、報酬は応答を最後まで書き終えた時点で、正解かどうかの1回しか与えられません。「したがって」や「12 - 5 =」を書いた途中の時点で、最終的に正解するかを予測するのは難しい回帰問題です。価値関数の予測が不正確だと、アドバンテージも不正確になり、方策の学習を妨げます。
方策と同じ規模の価値関数を学習するコストを払わずに、自分で生成した応答から安定して学習できないか?
これに対する DeepSeekMath の答えが GRPO です。
GRPOの仕組み
(図は、diagram-designで作成)
GRPO の発想は、「価値関数に基準値を予測させる代わりに、同じ問題をモデルに何度か解かせ、その平均点を基準値にする」というものです。
グループ相対アドバンテージ
問題 に対して、応答を生成した時点の方策 から 本の応答 を生成します(DeepSeekMath では 、本記事の実験では )。各応答を採点して報酬 を得たら、グループ内の平均と標準偏差で正規化したものをアドバンテージにします。
報酬が応答の最後にだけ与えられる(結果報酬の)場合、このアドバンテージは応答 のすべてのトークン で同じ値です。実装では、標準偏差が0のときに割り算で発散しないよう、分母に小さな定数を足します。また、TRL を含む多くの実装では標準偏差として不偏標準偏差( で割るもの)を使うので、本記事のスクラッチ実装もそれに合わせます。
- 平均より報酬が高い応答: アドバンテージが正になり、その応答のトークンの確率が上がる方向に更新されます。
- 平均より報酬が低い応答: アドバンテージが負になり、確率が下がる方向に更新されます。
- 問題の難しさの影響: 平均を引くので、「どの問題も難しくて報酬が低い」といった問題ごとの難易度の違いは打ち消され、同じ問題の中での相対的な良し悪しだけが残ります。
実装2で計算する の3つのグループで、アドバンテージの計算を並べると次のようになります。
(図は、diagram-designで作成)
REINFORCEの記事で扱ったように、方策勾配では、行動に依存しない基準値(ベースライン)を報酬から引いても勾配の期待値は変わらず、分散だけを小さくできます。REINFORCE の実装では、1エピソード分の割引報酬和に対して discounted_rewards = (discounted_rewards - discounted_rewards.mean()) / (discounted_rewards.std() + eps) として、平均0・標準偏差1に標準化していました。GRPO のアドバンテージは、これとまったく同じ形の操作を、「1エピソードの各時刻」ではなく 「同じ問題に対する 本の応答」 に対して行うものです。GRPO のグループ平均は、問題 ごとの期待報酬をモンテカルロ法で推定したベースラインと見なせます。A2Cの記事の Actor-Critic では、このベースラインを価値関数で学習していました。GRPO は、それを「同じ問題を 回解いた平均」で置き換えたものです。
ただし、ベースラインが分散だけを小さくするのは「引く値が、その応答 に依存しない」場合です。グループ平均 には自分自身の報酬 も含まれているので、この条件を満たしていないように見えます。
これは、自分以外の 本の平均
を使って書き直すと解消します。まず、グループ平均を「自分」と「自分以外」に分けます。 なので、
となります。これを に代入し、 の項をまとめます。
は を含まないので、ベースラインの条件を満たします。つまり、グループ平均を引いた値は、条件を満たすベースラインを引いた値を 倍したもの にすぎません。この係数は応答 にも問題 にもよらない定数なので、学習率を 倍したのと同じことで、勾配の向きは変わりません( なら 0.875 倍です)。自分自身を含めても問題にならないのは、このためです。
一方、標準偏差で割る操作は、問題ごとに異なる値で割ることになるため、勾配の大きさを問題ごとに変えてしまいます。定数倍ではなくなるので、上のような整理はできません。これが後述する Dr. GRPO の指摘の1つです。
GRPOの目的関数
GRPO は、PPO と同じクリップ付きの目的関数に、KL 正則化の項を加えたものを 最大化 します。DeepSeekMath の形で書くと次のとおりです。
期待値は、問題 をデータから選び、 で 本の応答を生成することについてとります。各記号の意味は次のとおりです。
- 確率比 :更新中の方策と、応答を生成した時点の方策とで、そのトークンの確率が何倍になったかです。
- クリップ:PPOの記事と同じく、確率比が の範囲を超えて得をしないようにして、1回の更新で方策が大きく変わるのを防ぎます。
- :各応答の中でトークンについての平均をとります。
- KL 項:方策が参照モデルから離れすぎないようにします。推定には後述の k3 推定量を使います。
なお、DeepSeekMath の設定のように、生成した応答で方策を1回だけ更新する場合は、更新の時点で なので となり、クリップは効きません。このとき、目的関数の勾配はアドバンテージで重み付けした方策勾配(と KL 項の勾配)そのものになります。同じ応答で複数回更新する場合に、クリップが意味を持ちます。
PPOとGRPOの差分
PPOの記事のクリップ付き目的関数は、トークン の確率比 と GAE で求めたアドバンテージ を使って、 と書けました。GRPO の目的関数と見比べると、クリップの形は同じで、違いは次の3点です。
| 観点 | PPO(InstructGPT) | GRPO(DeepSeekMath) |
|---|---|---|
| 1. アドバンテージ | 価値関数を学習し、GAE でトークンごとに計算 | 価値関数なし。グループ内の平均と標準偏差で正規化し、応答内の全トークンで共通 |
| 2. KL 正則化 | トークンごとの報酬から を引く | 報酬には混ぜず、目的関数に k3 推定量の項として加える |
| 3. 損失の集計 | トークンについての和や平均(実装による) | 応答ごとに長さ で割って平均し、それをグループで平均する |
差分1:価値関数とGAEの削除
PPO では、各時点の価値 と TD 誤差 から、GAE でトークンごとのアドバンテージを計算していました。GRPO では、応答全体の報酬 からグループ相対アドバンテージを1つ計算し、応答内の全トークンに同じ値を割り当てます。価値関数の学習も、GAE の ・ の調整も不要になります。
その代わり、1つの問題について 本の応答を生成する必要があります。GRPO は「価値関数の学習」というコストを、「同じ問題を何度も解かせる生成のコスト」に置き換えた手法だと言えます。
差分2:KLを損失に入れる、k3推定量
InstructGPT の PPO では、トークンごとの報酬を次のように作っていました(InstructGPTの記事を参照)。
報酬モデルのスコアは最後のトークンだけに与え、KL のペナルティは各トークンの報酬から引きます。この方式では、KL のペナルティがアドバンテージの計算に入り込むので、価値関数は「タスクの報酬と KL のペナルティを合わせたもの」を予測しなければなりません。
GRPO では、報酬 はタスクの評価(正解かどうか)だけにして、KL は目的関数の中に独立した項として入れます。アドバンテージは純粋にタスクの出来だけで決まり、KL は別の項として方策を参照モデルに引き戻します。
k3推定量
KL ダイバージェンス を、方策からサンプリングしたトークンで推定する方法はいくつかあります。DeepSeekMath は、Schulman のブログ記事 Approximating KL Divergence で紹介された k3 推定量 を使います。サンプリングしたトークンについて、参照モデルと方策の確率比を
と置きます(1トークン分の KL は、語彙全体について和をとれば厳密にも計算できますが、参照モデルのロジットを全語彙分そろえる必要があります。実際に生成したトークンの対数確率だけで済むこの推定量が、実装では使われます)。
ブログ記事では、この から作る推定量が3つ挙げられています。k1・k2・k3 という名前は、単にその並び順から来ています。
推定量の 期待値が、推定したい真の値とぴったり一致する ことを不偏(unbiased)といいます。ずれ をバイアス(偏り)と呼び、これが0だという意味です。1回の推定値が正しいという意味ではなく、「何度も繰り返して平均をとれば真の値になる」という平均的な性質を指します。標本分散で ではなく で割るのは、このずれをちょうど打ち消して不偏にするためです。
ここでは、1トークンから計算した値そのものは KL ダイバージェンスではないけれども、 からサンプリングしたトークン全体で平均をとると KL に一致する、ということを指しています。学習では何千トークン分の平均を使うので、この性質があれば「KL を測っている」と言えます。
ただし、不偏であれば十分というわけではありません。1つ1つの値のばらつき(分散)が大きいと、有限個のサンプルでの推定値は不安定になります。バイアスと分散はトレードオフになることが多く、k2 は「偏りを許して分散を下げる」側の選択です。
k1 は、KL ダイバージェンスの定義そのものです。 なので、 からサンプリングした1トークンの が、そのまま不偏な推定量になります。ただし、期待値は0以上でも、1つ1つの値は のトークンで負になります。0以上のはずの量の推定値が負になり、しかもばらつきが大きい、というのが k1 の弱点です。
k2 は です。2乗なので常に0以上で、分散も小さくなりますが、不偏ではありません(期待値が KL からずれます)。
k3 は、この2つの良いところを両立させるために作られたものです。出発点は、 の期待値が0になることです。
期待値が0の量は、何倍して足しても期待値を変えません(制御変量 と呼ばれる考え方です)。そこで、k1 に を足します。これが k3 です。
期待値は k1 のまま、つまり KL ダイバージェンスに一致します(不偏)。そのうえで、足す係数を1にすると、ちょうど都合の良いことが起きます。よく知られた不等式 (、等号は のときだけ)から、 が常に成り立つのです。関数 の形からも確かめられます。 は で0になり、 なので、 は下に凸で、 で最小値 をとります。
3つの推定量の性質をまとめると、次のようになります。
| 推定量 | 式 | 不偏か | 常に0以上か | 分散 |
|---|---|---|---|---|
| k1 | 不偏 | 負になりうる | 大きい | |
| k2 | 偏りあり | 常に0以上 | 小さい | |
| k3 | 不偏 | 常に0以上 | 小さい |
k3 だけが、不偏でありながら常に0以上 という性質を持ちます。また、 の近くで展開すると となり、k2 と同じく分散も小さくなります。KL の項は「方策が参照モデルから離れたら罰を与える」ためのものなので、離れていないのに負の値が出ることのない k3 が、この用途に向いています。
import torch

# 方策と参照モデルの対数確率の差 log(pi_theta / pi_ref)
log_ratio = torch.tensor([-1.0, -0.2, 0.0, 0.2, 1.0])
d = -log_ratio                       # log u = log(pi_ref / pi_theta)

kl_k1 = log_ratio                    # k1 = -log u
kl_k3 = torch.exp(d) - d - 1.0       # k3 = u - log u - 1

for i in range(len(log_ratio)):
    print(f"log(pi/ref)={log_ratio[i].item():+4.1f} | k1={kl_k1[i].item():+6.3f} | k3={kl_k3[i].item():6.3f}")
- 対数のまま計算する: d は です。k3 を torch.exp(d) - d - 1.0 と書くと、確率比 をいったん作ってから対数をとり直す必要がなく、 が非常に大きくなったときに inf - inf で NaN になることも避けられます。
- 比較する値: 方策の対数確率が参照モデルより1だけ低い場合から、1だけ高い場合までの5通りです。
実行結果
log(pi/ref)=-1.0 | k1=-1.000 | k3= 0.718
log(pi/ref)=-0.2 | k1=-0.200 | k3= 0.021
log(pi/ref)=+0.0 | k1=+0.000 | k3= 0.000
log(pi/ref)=+0.2 | k1=+0.200 | k3= 0.019
log(pi/ref)=+1.0 | k1=+1.000 | k3= 0.368
k1 は方策の確率が参照モデルより低いトークンで負になりますが、k3 は常に0以上です。差が小さい()ときは、k3 はどちらの向きでもほぼ同じ小さな値(約 )になります。一方、差が大きくなると非対称になり、方策の確率が参照モデルより低い 向き( が大きい)では に比例して急に大きくなり、高い向きではゆるやかにしか増えません。
5つの値を k1 と k3 の曲線の上に置くと、次のようになります。
(図は、diagram-designで作成)
差分3:応答長による正規化
GRPO の目的関数では、各応答のトークンについての和を応答長 で割っています。長い応答ほどトークン数が多いので、和のままだと長い応答が損失を支配してしまいます。長さで割ることで、各応答の寄与を揃えるのが狙いです。
ただし、この正規化は、正解した応答と誤った応答で長さの扱いが非対称になるという副作用を持ちます。これは後の「Dr. GRPO」の節で扱います。
検証可能な報酬(RLVR)
学習済み報酬モデルとハッキング
InstructGPTの記事では、人間の選好から学習した報酬モデルを使って PPO を行い、報酬モデルの弱点を突いて点数だけを上げる 報酬ハッキング と、応答が短くなり続ける 長さの崩壊 を観察しました。学習済みの報酬モデルは人間の評価の近似にすぎないので、方策が報酬モデルの苦手な領域に入ると、点数と実際の質がずれていきます。
ルールベースの報酬
算数や数学の問題、テストケースのあるプログラミング、パズルなどでは、最終的な答えが正しいかどうかをプログラムで判定できます。このような判定を報酬にした強化学習は、Tülu 3: Pushing Frontiers in Open Language Model Post-Training(Lambert et al., 2024)で RLVR(Reinforcement Learning with Verifiable Rewards、検証可能な報酬による強化学習) と名付けられました。
本記事の基本の報酬は次のとおりです。
なお、DeepSeekMath の GRPO 自体は、ルールベースの判定ではなく 学習済みの報酬モデル を使っていました。GRPO は報酬の作り方を問わないアルゴリズムで、ルールベースの報酬と組み合わせて大規模に使われたのは DeepSeek-R1 からです(DeepSeek-R1の記事で扱います)。本記事では、学習済み報酬モデルのハッキングを避けるため、ルールベースの報酬と組み合わせます。
ルールベースの報酬のハッキングと防ぎ方
ルールベースの報酬でも、答えの抽出規則に隙があればハッキングは起こりえます。
- 答えを複数書く: 「答え: 10 または 17」のように候補を並べると、「回答行の最後の数値」を取る抽出規則では、どれかが偶然正解に当たることがあります。
- 答えを書き直す: 「答え:」の行を複数書いておくと、最後の行だけを見る規則では、いくつも答えを出しておいて最後に当てにいくことができます。
Chain-of-Thoughtの記事の extract_answer は、さまざまな書き方の出力から答えを拾うための 評価用 の関数なので、こうした出力にも答えを返します。そこで報酬には、「答え:」の行がちょうど1つあり、その行に整数がちょうど1つだけ書かれている場合にだけ答えを返す、より厳しい抽出規則 を使います(実装で確認します)。
形式に従ったことへの小さな報酬(本記事では 0.1)を与えると、学習の初期に「答え:」の行を書く習慣がつきやすくなります。ただし、形式の報酬を大きくしすぎると、「正解はできないが形式だけ整えて点数を稼ぐ」という別のハッキングが起こるので、正解の報酬(1.0)より十分小さくします。
グループ内の報酬がすべて同じ問題
GRPO を使うときに重要なのが、グループ内の 本がすべて正解、またはすべて不正解だった問題からは、方策を改善する学習信号が得られない という性質です。
なぜ学習信号が0になるのか
グループ内の報酬がすべて同じなら、どの応答についても なので、アドバンテージはすべて0になります。標準偏差も0ですが、分母には小さな定数を足しているので、 のままです。
全員不正解 [0, 0, 0, 0] → 平均 0.0、標準偏差 0 → アドバンテージ [0, 0, 0, 0](学習信号なし)
全員正解   [1, 1, 1, 1] → 平均 1.0、標準偏差 0 → アドバンテージ [0, 0, 0, 0](学習信号なし)
正誤が混在 [1, 0, 0, 1] → 平均 0.5、標準偏差 > 0 → アドバンテージ [+, -, -, +](学習信号あり)
このとき目的関数に残るのは KL の項だけなので、その問題は「参照モデルに近づける」方向にしか働きません。さらに、バッチ全体で損失を平均する実装では、こうした問題もバッチの問題数に数えられるので、有効な問題が少ないと1ステップあたりの学習信号が薄まります。
有効なグループの割合と難易度
「グループ内の報酬がすべて同じになる確率」は、簡単な確率の計算で見積もれます。ある問題について、1本の応答が正解する確率を とします。GRPO では、同じ問題から 本を 独立に サンプリングするので、 本の正誤は「表が出る確率 のコインを 回投げる」のと同じです( 本のうちの正解数は二項分布 に従います)。
学習信号が0になるのは、次の2つの場合です。
- 本すべてが正解: 1本ごとに独立に確率 で正解するので、確率は
- 本すべてが不正解: 同じく、確率は
この2つは同時には起こらない(排反な)事象なので、「すべて同じ結果になる確率」は単純に足して です。知りたいのはその 余事象、つまり「少なくとも1本は正解し、かつ少なくとも1本は不正解」になる確率なので、全体の確率1から引いて
となります。これが、グループ内の報酬の標準偏差が0にならず、アドバンテージが0でない値を持つ確率です。
この式からは、2つの性質がすぐに読み取れます。1つは、 を に入れ替えても2つの項が入れ替わるだけで値は変わらないので、 を軸に左右対称 だということです。「9割解ける問題」と「1割しか解けない問題」は、学習信号の出やすさでは同じ、ということになります。もう1つは、 が で最小になるので、有効なグループの割合は で最大 になり、その値が
になることです( なら 、 なら )。いくつかの と で計算して確かめます。
import numpy as np

p = np.array([0.05, 0.1, 0.3, 0.5, 0.7, 0.9, 0.95])   # 1本の応答の正解率
for G in [4, 8]:
    effective = 1 - p**G - (1 - p)**G                 # 全員正解でも全員不正解でもない確率
    print(f"G={G}: " + "  ".join(f"p={pi:.2f}→{e:.3f}" for pi, e in zip(p, effective)))
- 計算の内容: p の各値について、 と で を計算します。NumPy の配列の演算なので、7つの をまとめて計算できます。
実行結果
G=4: p=0.05→0.185  p=0.10→0.344  p=0.30→0.752  p=0.50→0.875  p=0.70→0.752  p=0.90→0.344  p=0.95→0.185
G=8: p=0.05→0.337  p=0.10→0.570  p=0.30→0.942  p=0.50→0.992  p=0.70→0.942  p=0.90→0.570  p=0.95→0.337
結果を表にまとめると、次のようになります。
| 1本の正解率 | 0.05 | 0.1 | 0.3 | 0.5 | 0.7 | 0.9 | 0.95 |
|---|---|---|---|---|---|---|---|
| 0.185 | 0.344 | 0.752 | 0.875 | 0.752 | 0.344 | 0.185 | |
| 0.337 | 0.570 | 0.942 | 0.992 | 0.942 | 0.570 | 0.337 |
上で求めたとおり、表は を軸に左右対称になっており、最大値も で 0.875、 で 0.992 と に一致しています。ここから、次のことが分かります。
- 簡単すぎる問題( が1に近い)と 難しすぎる問題( が0に近い)では、多くのグループが全員正解・全員不正解になり、学習がほとんど進みません。
- グループを大きくすると、正解率が低い問題でも1本は正解を引ける確率が上がり、有効なグループが増えます。 のとき、 では約34%ですが、 では約57%になります。
- この計算の前提: 正解率 が1本ごとに同じで、 本が独立であることを仮定しています。同じ問題・同じ方策からサンプリングするので、この仮定は成り立ちます。ただし は 問題ごとに違う(それが難易度です)ので、学習データ全体での有効なグループの割合は、問題ごとの の分布で決まります。
表の値を曲線にすると、次のようになります。
(図は、diagram-designで作成)
そのため GRPO では、学習を始める時点のモデルが、対象のタスクで ある程度は正解できるが、完璧ではない ことが重要です。DeepSeekMath が、ベースモデルではなく指示追従の SFT を行ったモデル(DeepSeekMath-Instruct)から強化学習を始めているのも、この条件を満たしやすくする設計と解釈できます。本記事の実験でも、学習前のモデルでステップ数ごとの有効なグループの割合を測ります。
DeepSeekMathの考察
DeepSeekMath の論文は、GRPO の提案に加えて、LLM の強化学習についていくつかの考察を行っています。
「RLはmaj@kを上げるが、pass@kはあまり上げない」
論文の Figure 7 では、指示追従モデル(Instruct)と、そこから強化学習したモデル(RL)を、GSM8K と MATH で比べています(maj@k・pass@k の定義は Chain-of-Thoughtの記事を参照)。
- maj@k:RL モデルの方が高くなります。
- pass@k: が大きくなると、両者の差はほとんどなくなります。
論文はこの結果から、強化学習は モデルが解けなかった問題を解けるようにする(基本的な能力を上げる)というより、 本の候補の中にもともと含まれていた正解が、上位に来るように出力分布を整えている と解釈しています。Chain-of-Thoughtの記事では、「pass@k は高いのに maj@k が低い」という差を、強化学習で埋められるのではないかという問いとして残しました。DeepSeekMath の結果は、強化学習が埋めるのは主にこの差であり、pass@k の上限そのものはあまり動かない、ということを示唆しています。本記事の実験でも、学習前後の maj@k と pass@k を比べます。
結果監督と過程監督
推論の強化学習には、最終的な答えの正誤だけを評価する 結果監督(outcome supervision) と、推論の1ステップごとに評価する 過程監督(process supervision) があります(Let's Verify Step by Step、Lightman et al., 2023)。DeepSeekMath は、ステップごとの報酬を使う GRPO(アドバンテージを各ステップ以降の報酬の和にする)も定式化し、実験では過程監督の方が結果監督より良い結果になったと報告しています。ただし、ステップごとの報酬を出す過程報酬モデル(PRM)を作るのはコストがかかります。後の DeepSeek-R1 は、結果監督だけで高い推論能力を得ました。PRM については、DeepSeek-R1の記事で扱います。
反復的な強化学習
方策が学習で変化すると、古い報酬モデルでは新しい方策の応答をうまく評価できなくなっていきます。DeepSeekMath の 反復的な強化学習(iterative RL) では、現在の方策の応答を使って報酬モデルを学習し直し(過去のデータも一部混ぜる)、参照モデルも現在の方策に置き換えてから、強化学習を続けます。これを繰り返すことで、特に1回目の反復で性能が上がったと報告されています。ルールベースの報酬では報酬モデルの学習し直しは不要ですが、参照モデルを更新する考え方は同じように使えます。
統一的な見方:SFT・RFT・DPO・PPO・GRPO
DeepSeekMath の論文の Section 5.2.1 では、さまざまな学習手法を1つの勾配の形で整理しています。
どの手法も「あるデータ の各トークンの対数尤度を、係数 (gradient coefficient、勾配係数)で重み付けして上げ下げする」という形をしていて、違いは データの出どころ・報酬・勾配係数 の3つだけ、という見方です。
| 手法 | データの出どころ | 報酬 | 勾配係数 |
|---|---|---|---|
| SFT | 人手で作ったデータ | なし | 常に1 |
| RFT | SFT モデルから生成し、正解だけ残す | ルール | 正解なら1、不正解なら0 |
| DPO | SFT モデルから生成した、正解と不正解のペア | ルール | 暗黙の報酬の差で決まるシグモイドの重み(DPOの記事の勾配の解釈を参照) |
| Online RFT | 学習中の方策 から生成し、正解だけ残す | ルール | 正解なら1、不正解なら0 |
| PPO | 学習中の方策 から生成 | 報酬モデル | アドバンテージ(GAE) |
| GRPO | 学習中の方策 から 本生成 | 報酬モデル(本記事ではルール) | グループ相対アドバンテージ + KL 項の勾配 |
各手法の出どころは次のとおりです。
- SFT: Instruction Tuningの記事・InstructGPTの記事で扱いました。
- RFT(Rejection sampling Fine-Tuning): Scaling Relationship on Learning Mathematical Reasoning with Large Language Models(Yuan et al., 2023)で提案された手法です。SFT 済みモデルに問題を解かせ、正解した推論過程だけ を集めて増強データとし、それで改めて SFT をします。同じ考え方の手法として、STaR(Zelikman et al., 2022)・RAFT(Dong et al., 2023)・ReST(Gulcehre et al., 2023)があります。独立した記事としては扱っていませんが、この「自分で解かせて正解だけ残す」という操作は、DeepSeek-R1 や推論の蒸留のリジェクションサンプリングや、教師データを正解だけに絞るフィルタリングとして再び出てきます。
- Online RFT: DeepSeekMath の論文が、RFT との対比のために導入した変種 です(元になった別の論文はありません)。RFT との違いは、応答をサンプリングするモデルが SFT モデル(固定)か学習中の方策かという1点だけで、オンライン化の効果だけを取り出して測るための条件になっています。
- DPO: DPOの記事で扱いました。
- PPO: PPOの記事で扱いました。
この表から、2つの傾向が読み取れます。
- オフラインからオンラインへ: SFT・RFT・DPO は、学習前のモデル(SFT モデル)が作ったデータで学習します。Online RFT・PPO・GRPO は、学習中の方策が生成したデータで学習するので、方策の変化に合わせてデータも変わります。論文では、学習が進んだ段階で Online RFT が RFT を大きく上回ったと報告されています。DPOの記事で残した「オフラインとオンライン」の問いに対する、1つの実験的な答えです。
- 正の強化だけでなく、負の強化も: RFT と Online RFT の勾配係数は、正解なら1、不正解なら0です。つまり、正解の確率を上げるだけで、誤りの確率を直接下げることはしません。GRPO は、グループ内の相対評価によって、誤った応答には負の係数を与えて確率を下げ、正解にも報酬の差に応じた大きさの係数を与えます。論文では、この違いによって GRPO が Online RFT を上回ったと説明しています。
6つの手法を、データの出どころと勾配係数の2つの軸で並べると、次のようになります。
(図は、diagram-designで作成)
発展:Dr. GRPOが指摘したバイアスとDAPO
GRPO の目的関数に含まれる2つの正規化(応答長で割る・標準偏差で割る)には、意図しない偏りがあることが指摘されています。
Dr. GRPO:2つのバイアス
Understanding R1-Zero-Like Training: A Critical Perspective(Liu et al., 2025)は、GRPO の目的関数に次の2つのバイアスがあると指摘し、それを取り除いた Dr. GRPO(GRPO Done Right)を提案しました。
バイアス1:応答長のバイアス
目的関数では、各応答の損失を で割っています。すると、1トークンあたりの勾配の大きさが、応答の長さに反比例します。
- 正解の応答():短いほど1トークンあたりの勾配が大きくなり、確率が強く引き上げられます。正解の中では短い応答が優遇されます。
- 誤った応答():長いほど1トークンあたりのペナルティが薄まります。誤った応答の中では、長い応答ほど罰せられにくくなります。
その結果、学習が進むにつれて 誤った応答が長くなっていく 傾向が生じます。論文は、R1-Zero のような学習で観察される生成長の増加の一部は、推論が深まったためではなく、このバイアスでも説明できると指摘しています。
バイアス2:標準偏差による難易度のバイアス
アドバンテージを標準偏差で割ると、報酬のばらつきが小さい問題ほどアドバンテージが大きくなります。正誤の2値報酬で の場合、8本中4本が正解なら標準偏差は約0.53ですが、8本中1本だけが正解なら約0.35です(不偏標準偏差)。つまり、ほとんど解ける問題やほとんど解けない問題 ほど、アドバンテージが大きく拡大され、学習で大きな重みを持ちます。
2つのバイアスを図にすると、次のようになります。
(図は、diagram-designで作成)
Dr. GRPOの修正
Dr. GRPO は、応答長 で割る代わりに固定の定数(たとえば最大生成長)で割り、標準偏差でも割らないようにします。論文では、この修正によって、正解率を保ったまま、特に誤った応答の生成長が伸びにくくなる(トークンを無駄に使わなくなる)ことが報告されています。TRL では、loss_type と scale_rewards の設定で、この2つを切り替えられます(実装で扱います)。
DAPO:非対称なクリップと動的サンプリング
DAPO: An Open-Source LLM Reinforcement Learning System at Scale(Yu et al., 2025)は、大規模な GRPO 型の学習を安定させるための工夫をまとめています。ここでは2つを紹介します。
- Clip-Higher(非対称なクリップ): 確率比のクリップの上限側を広げます(下限 、上限 )。上限が厳しいと、確率の低いトークンの確率を上げにくく、出力の多様性(エントロピー)が急速に失われます。上限を緩めることで、探索の余地を残します。
- 動的サンプリング(Dynamic Sampling): 全員正解・全員不正解のグループを除外し、正誤が混在するグループでバッチが埋まるまで追加で生成します。生成のコストは増えますが、1ステップあたりの有効な学習信号の量を一定に保てます。
このほか DAPO は、損失を応答ごとではなくバッチ内の全トークンで平均する(トークン単位の損失)ことで、応答長のバイアスを和らげる工夫も提案しています。
実装
GRPO を、Qwen2.5-0.5B-Instruct と算数ワールドで実装します。まずスクラッチ実装で仕組みを確認し、次に TRL の GRPOTrainer で同じ学習を行います。
実装は次の順に進みます。実装4以降は、実行結果が出たところでその場で考察します。
| 何をするか | そこで分かること | |
|---|---|---|
| 実装1〜3 | 算数ワールド・報酬とアドバンテージ・モデルと評価関数の準備 | (準備) |
| 実装4 | 学習前の評価と、有効なグループの割合 | 学習がどの難易度の問題から進みそうか |
| 実装5 | GRPO の損失と学習ループ | 報酬・KL・生成長・有効なグループの割合が学習中にどう動くか |
| 実装6 | 学習後の評価(算数ワールドと GSM8K) | どの難易度で伸びたか、学習していない問題に広がるか |
| TRL | GRPOTrainer での学習と比較 | スクラッチ実装と同じ結果になるか、maj@k と pass@k はどう動くか |
| Dr. GRPO | loss_type と scale_rewards を変えた学習 | 論文が指摘した応答長のバイアスが現れるか |
実験設定
- モデル:
Qwen/Qwen2.5-0.5B-Instruct。DeepSeekMath と同じく、指示に従える(SFT 済みの)モデルから強化学習を始めます。チャットテンプレートを使い、途中の計算を1行ずつ書いて最後の行に「答え: 整数」と書くよう指示したうえで、その書き方の解答例を1つ会話の形で示します(1-shot)。 - 学習方式: bf16 + LoRA。参照モデルは別途読み込まず、disable_adapter() で LoRA を外した状態として再現します(InstructGPTの記事と同じ工夫です)。
- データ: Chain-of-Thoughtの記事と同じ算数ワールド。学習用はステップ数1〜5を混ぜた5,000問(seed=0、評価用との重複を除外)、評価用は共通の500問(seed=2026)です。
- 外部評価: GSM8K のテストセットから無作為に選んだ200問。
- 実行環境: bf16 を使うので、L4 や A100 などの GPU を想定しています(T4 は bf16 に対応していません)。
DeepSeekMath の設定と本記事の設定の違いは次のとおりです。
| 項目 | DeepSeekMath | 本記事 | 変えた理由 |
|---|---|---|---|
| モデル | DeepSeekMath-Instruct 7B | Qwen2.5-0.5B-Instruct | Colab で動かせる規模にする |
| 学習方式 | 全パラメータ | LoRA | メモリの節約。参照モデルを disable_adapter() で再現できる |
| グループサイズ | 64 | 8 | 生成のコストを抑える |
| 最大生成長 | 1,024 | 256 | 算数ワールドの問題は短い推論で解ける |
| 学習率 | 1e-6 | 2e-5 | LoRA は全パラメータ学習より大きな学習率を使うことが多い |
| KL 係数 | 0.04 | 0.04 | 同じ値 |
| 1回の生成あたりの更新回数 | 1 | 1 | 同じ(確率比は常に1になる) |
| 報酬 | 学習済みの報酬モデル | ルールベース(正解 1.0 + 形式 0.1) | RLVR として実装する |
ライブラリのインストールとGoogleドライブのマウント
!pip install --upgrade transformers accelerate peft datasets trl
!pip install matplotlib-fontja
!pip uninstall -y torchao
- ライブラリ: transformers と peft はモデルと LoRA、datasets は GSM8K の読み込み、trl は後半の GRPOTrainer に使います。互いの内部 API に依存しているので、まとめて新しい版に揃えます。
- torchao の削除: 新しい peft は、環境に torchao があると、そのバージョンを確認して量子化関連の機能を読み込もうとします。Colab にあらかじめ入っている古い torchao だと、LoRA を付けるときに「互換性のないバージョン」というエラーになります。本記事は量子化を使わないので、あらかじめ削除しておきます(削除した後は、ランタイムを再起動してから以降のセルを実行してください)。
- matplotlib-fontja: matplotlib のグラフに日本語を表示するためのライブラリです。import matplotlib_fontja とするだけで、日本語フォントが設定されます。同じ目的の japanize_matplotlib は、Python 3.12 以降で削除された distutils を使っているため、新しい Colab ではそのままでは読み込めません。
import os
from google.colab import drive

drive.mount("/content/drive")

SAVE_ROOT = "/content/drive/MyDrive/grpo"
os.makedirs(SAVE_ROOT, exist_ok=True)
- 保存先: 学習した LoRA アダプター・学習の記録・評価結果は、セッションが切れても残るように SAVE_ROOT 以下に保存します。
実装1:算数ワールドと答えの抽出
算数ワールドの生成器と、評価用の答えの抽出関数・指標です。Chain-of-Thoughtの記事と同じコードなので、設計の説明はそちらを参照してください。
import numpy as np

ITEMS = ["りんご", "みかん", "クッキー", "ノート", "シール", "えんぴつ"]
MAX_VALUE = 10_000
OP_SYMBOL = {"add": "+", "sub": "-", "mul": "×", "div": "÷"}

def sample_operation(rng, current):
    """現在の値に適用できる演算を1つ選ぶ(条件を満たさなければ選び直す=棄却サンプリング)"""
    while True:                              # 条件を満たす組み合わせが出るまで繰り返す
        # rng.choice は NumPy の文字列型で返るので、str() で Python の文字列に戻す
        op = str(rng.choice(["add", "sub", "mul", "div"]))
        if op in ("add", "sub"):
            val = int(rng.integers(2, 51))   # 2〜50
        elif op == "mul":
            val = int(rng.integers(2, 6))    # 2〜5倍
        else:
            val = int(rng.integers(2, 10))   # 2〜9等分

        if op == "add":
            new = current + val
        elif op == "sub":
            new = current - val
        elif op == "mul":
            new = current * val
        else:
            if current % val != 0:
                continue                     # 割り切れない除算は棄却
            new = current // val

        if 1 <= new <= MAX_VALUE:            # 中間結果は 1 以上 10,000 以下
            return op, val, new

def make_problem(rng, n_steps):
    """ステップ数 n_steps(=四則演算の回数)の算数文章題を1問生成する"""
    item = str(rng.choice(ITEMS))
    current = int(rng.integers(10, 51))
    story = [f"{item}が{current}個あります。"]
    steps = []
    for _ in range(n_steps):
        op, val, new = sample_operation(rng, current)
        if op == "add":
            story.append(f"{val}個もらいました。")
        elif op == "sub":
            story.append(f"{val}個使いました。")
        elif op == "mul":
            story.append(f"{item}の数が{val}倍になりました。")
        else:
            story.append(f"{val}等分して、そのうち1つ分だけを残しました。")
        steps.append(f"{current} {OP_SYMBOL[op]} {val} = {new}")
        current = new
    question = "".join(story) + f"いま{item}は何個ありますか。"
    gold_steps = "。".join(steps) + f"。答え: {current}"
    return {"question": question, "answer": current, "gold_steps": gold_steps, "n_steps": n_steps}

def make_dataset(n_per_step, seed, exclude=None):
    """ステップ数1〜5の問題を n_per_step 問ずつ生成する。exclude に含まれる問題文と重複は除外する"""
    rng = np.random.default_rng(seed)
    seen = set(exclude) if exclude else set()
    dataset = []
    for s in [1, 2, 3, 4, 5]:
        count = 0
        while count < n_per_step:
            prob = make_problem(rng, s)
            if prob["question"] in seen:
                continue
            seen.add(prob["question"])
            dataset.append(prob)
            count += 1
    return dataset


import re
import unicodedata
from collections import Counter
import numpy as np

def _last_integer(s):
    """文字列中の最後の整数を返す(引き算の式の「-」は符号として扱わない)"""
    # (?<!\d) は「直前が数字でない」という条件(否定後読み)。
    # これがないと「12-5」の「-5」を負の数として拾ってしまう
    nums = re.findall(r"(?<!\d)-?\d+", s)
    return int(nums[-1]) if nums else None

def extract_answer(text):
    """生成テキストから最終回答の整数を抽出する(抽出できなければ None)"""
    if not text:
        return None
    text = unicodedata.normalize("NFKC", text).replace(",", "")   # 全角→半角、カンマ除去

    # 1. <answer> タグ
    m = re.search(r"<answer>(.*?)</answer>", text, re.DOTALL)
    if m and _last_integer(m.group(1)) is not None:
        return _last_integer(m.group(1))

    # 2. 「答え:」の行(複数あれば最後の行)
    lines = re.findall(r"(?:答え|Answer)\s*[::]\s*([^\n]*)", text, re.IGNORECASE)
    for line in reversed(lines):
        if _last_integer(line) is not None:
            return _last_integer(line)

    # 3. テキスト中の最後の数値
    return _last_integer(text)

def pass_at_k(n, c, k):
    """Codex 論文の pass@k の不偏推定量:n 本中 c 本正解のとき、k 本に1本以上正解が含まれる確率"""
    if n - c < k:
        return 1.0                           # 不正解が k 本より少ない → 必ず正解が混ざる
    # 「k 本すべてが不正解」の確率を、1本ずつ引いていく積の形で計算する
    # (二項係数を直接計算すると値が大きくなりすぎるため)
    prob_all_wrong = 1.0
    for i in range(1, k + 1):
        prob_all_wrong *= (n - c - i + 1) / (n - i + 1)
    return 1.0 - prob_all_wrong

def majority_vote(preds):
    """None を除いた答えの最頻値(同数なら先に出た答え)"""
    valid = [p for p in preds if p is not None]
    if not valid:
        return None
    return Counter(valid).most_common(1)[0][0]

def maj_at_k(preds, target, k, n_perm=1000, seed=0):
    """n 本から k 本を無作為に選んで多数決をとったときの正解率(並べ替えを変えて平均する)"""
    rng = np.random.default_rng(seed)
    hits = 0
    for _ in range(n_perm):
        # n 本を並べ替えて先頭 k 本を取る=k 本の無作為な選び方を1通り作る
        subset = [preds[i] for i in rng.permutation(len(preds))[:k]]
        hits += majority_vote(subset) == target     # True は 1 として足される
    return hits / n_perm                            # 選び方を変えた平均が maj@k の推定値

eval_dataset = make_dataset(n_per_step=100, seed=2026)          # 評価用:CoT・R1・蒸留の記事と共通の500問
eval_questions = {p["question"] for p in eval_dataset}         # 重複判定用の集合(set)
train_dataset = make_dataset(n_per_step=1000, seed=0, exclude=eval_questions)  # 学習用5,000問
print(f"評価用: {len(eval_dataset)} 問 / 学習用: {len(train_dataset)} 問")
- データ: make_dataset で、評価用500問(ステップ数1〜5を100問ずつ)と、評価用と重複しない学習用5,000問を生成します。Chain-of-Thought の記事と同じシードなので、評価用の問題も同じです。
- 評価用の抽出: extract_answer は、タグ・「答え:」の行・最後の数値の順に答えを探す、Chain-of-Thoughtの記事と共通の評価用の関数です。
- 指標: pass_at_k・majority_vote・maj_at_k は、学習前後の maj@k と pass@k の比較に使います。式の定義と導出は Chain-of-Thoughtの記事にあります。pass_at_k を二項係数ではなく積の形で計算する理由、maj_at_k が並べ替えを繰り返して平均をとる理由は、コード中のコメントに書いています。
実行結果
評価用: 500 問 / 学習用: 5000 問
実装2:報酬とグループ相対アドバンテージ
報酬には、評価用の extract_answer より厳しい抽出規則を使います。
import re
import unicodedata

# 「答え: 〜」または「Answer: 〜」の行を探す正規表現。
# (?:...) は取り出さないグループ、([^\n]*) が「コロンの後ろから行末まで」で取り出す部分
ANSWER_LINE = re.compile(r"(?:答え|Answer)\s*[::]\s*([^\n]*)", re.IGNORECASE)
CORRECT_REWARD = 1.0
FORMAT_REWARD = 0.1

def extract_answer_strict(text):
    """報酬用の厳格な抽出:「答え:」の行がちょうど1つあり、その行の整数がちょうど1つのときだけ返す"""
    text = unicodedata.normalize("NFKC", text).replace(",", "")   # 全角→半角、カンマ除去
    lines = ANSWER_LINE.findall(text)        # 「答え:」の行の、コロンより後ろの部分のリスト
    if len(lines) != 1:
        return None                          # 答えの行が0個または2個以上 → 形式違反
    nums = re.findall(r"(?<!\d)-?\d+", lines[0])
    return int(nums[0]) if len(nums) == 1 else None   # その行に整数が2つ以上あっても形式違反

def compute_reward(text, target):
    """形式を守れば 0.1、さらに正解なら 1.0 を加える"""
    pred = extract_answer_strict(text)
    if pred is None:
        return 0.0
    return FORMAT_REWARD + (CORRECT_REWARD if pred == target else 0.0)
- 厳しい抽出規則: extract_answer_strict は、「答え:」の行がちょうど1つあり、その行の整数がちょうど1つの場合にだけ答えを返します。答えを複数並べたり、答えの行を書き直したりした出力は、答えなし(報酬0)になります。
- 正規表現の読み方: ANSWER_LINE の (?:答え|Answer) は「答え」または「Answer」で、(?:...) は「まとめるだけで取り出さない」グループです。\s*[::]\s* が空白を挟んだ半角または全角のコロン、([^\n]*) が「改行以外の文字の並び」=コロンから行末までで、丸かっこで囲んだこの部分が findall の戻り値になります。
- マイナス記号の扱い: 整数を拾う (?<!\d)-?\d+ の (?<!\d) は「直前が数字ではない」という条件(否定後読み)です。これがないと「12-5」の「-5」を負の数として拾ってしまいます。引き算の式が本文に並ぶので、この指定が必要になります。
- 報酬の構成: 形式を守った出力に FORMAT_REWARD(0.1)を与え、さらに正解なら CORRECT_REWARD(1.0)を加えます。形式の報酬は、正解の報酬より十分小さくしています。
- 評価との関係: 評価には従来どおり extract_answer を使います。報酬を厳しくしておくと、評価では正解に数えられるが報酬は得られない出力(答えを複数書くなど)が学習で強化されにくくなります。
次に、報酬からグループ相対アドバンテージを計算する関数です。
import torch

def compute_group_advantages(rewards, G, scale=True, eps=1e-4):
    """
    rewards: (プロンプト数 × G,) の報酬。同じプロンプトの G 本が連続して並んでいる
    戻り値: 同じ形のアドバンテージと、各グループが有効か(報酬がすべて同じでないか)
    """
    grouped = rewards.view(-1, G)                # 1次元 → (プロンプト数, G) の2次元に並べ替える
    # keepdim=True で形を (プロンプト数, 1) に保つ。こうすると次の引き算・割り算で
    # ブロードキャストが効き、行ごとの平均・標準偏差が G 本すべてに配られる
    mean = grouped.mean(dim=1, keepdim=True)
    std = grouped.std(dim=1, keepdim=True)       # 不偏標準偏差(G - 1 で割る。torch の既定)
    advantages = grouped - mean
    if scale:
        advantages = advantages / (std + eps)    # scale=False なら Dr. GRPO と同じく割らない
    # 報酬がすべて同じなら最大値 = 最小値。そうでなければ学習信号が出る「有効なグループ」
    effective = grouped.max(dim=1).values > grouped.min(dim=1).values
    return advantages.view(-1), effective        # 応答の並び順に戻して返す
- 形の変換: 生成した応答は「プロンプト数 × 」本が、同じプロンプトごとに連続して並んでいます。rewards.view(-1, G) で「プロンプトごとの行」に並べ替えてから、行ごとに平均と標準偏差をとります。-1 は「残りの長さから自動で決める」という指定で、32本・ なら (4, 8) になります。最後に advantages.view(-1) で元の1次元に戻すので、応答の並び順は入力と同じままです。
- keepdim=True の役割: mean(dim=1) は本来 (プロンプト数,) の1次元になりますが、keepdim=True で (プロンプト数, 1) の形を保ちます。こうすると次の grouped - mean でブロードキャスト(形の自動的な引き伸ばし)が働き、各行の平均がその行の 本すべてに引かれます。keepdim を付けないと形が合わずエラーになります。
- 標準偏差で割るかどうか: scale=True が DeepSeekMath の GRPO、scale=False が Dr. GRPO の設定です。eps は、標準偏差が0のときに割り算で発散しないための定数です。
- 標準偏差の分母: torch の std() は、既定で で割る不偏標準偏差です(TRL の GRPOTrainer も同じです)。NumPy の np.std は既定が で割る形なので、別の環境で追試するときは注意してください。 で8本中4本が正解の場合、前者は約0.53、後者は0.50になります。
- 有効なグループ: effective は、グループ内の報酬がすべて同じでない(最大値が最小値より大きい)かどうかです。浮動小数点の誤差で標準偏差がわずかに0からずれても判定が変わらないよう、最大値と最小値で比べています。学習中に有効なグループの割合を記録するのに使います。
報酬とアドバンテージの動作を確認します。
# 想定する問題:「12個あります。5個もらいました。いま何個ありますか」→ 正解は 12 + 5 = 17
TARGET = 17
tests = [
    "12 + 5 = 17\n答え: 17",                     # 形式も答えも正しい
    "12 - 5 = 7\n答え: 7",                       # 「もらいました」を引き算と読み違えた
    "答え: 10 または 17",                          # 答えの行に整数が2つある
    "12 + 5 = 17 なので17個です。",                 # 「答え:」の行がない
    "答え: 17\n見直すと 12 + 5 = 18\n答え: 18",    # 「答え:」の行が2つある
]
for text in tests:
    shown = text.replace("\n", " / ")
    print(f"報酬 {compute_reward(text, TARGET):.1f} | 共通の抽出 {extract_answer(text)!s:>4} | {shown}")

rewards = torch.tensor([1.1, 0.1, 1.1, 0.1,    # グループ0:2本正解
                        0.1, 0.1, 0.1, 0.1,    # グループ1:全員不正解(形式のみ)
                        1.1, 0.1, 0.1, 0.1])   # グループ2:1本だけ正解
advantages, effective = compute_group_advantages(rewards, G=4)
for g in range(3):
    r = [round(x, 1) for x in rewards.view(-1, 4)[g].tolist()]
    a = [f"{x:+.3f}" for x in advantages.view(-1, 4)[g].tolist()]
    print(f"グループ{g}: 報酬 {r} → アドバンテージ {a} / 有効: {effective[g].item()}")
- 報酬のテスト: 「12個あります。5個もらいました。いま何個ありますか」(正解は 12 + 5 = 17)に対する5通りの出力で、報酬と、評価用の extract_answer が返す答えを比べます。報酬の3つの水準(正解 1.1 / 形式のみ 0.1 / 形式違反 0.0)を1つずつ確かめる構成です。
- 報酬は答えだけを見る: 2つ目の 12 - 5 = 7 は、引き算としては正しい計算です。それでも報酬が 0.1 なのは、compute_reward が 最終的な答えを TARGET と比べるだけで、途中の式が正しいかは判定していない ためです。答えが 7 で正解の 17 と違うので、形式報酬だけが残ります。これが「結果監督と過程監督」の節で触れた 結果監督 の性質です。途中の式を1ステップずつ採点するには、過程報酬モデル(PRM)が必要になります。
- アドバンテージのテスト: で、「2本正解」「全員不正解(形式のみ)」「1本だけ正解」の3つのグループを並べています。
実行結果
報酬 1.1 | 共通の抽出   17 | 12 + 5 = 17 / 答え: 17
報酬 0.1 | 共通の抽出    7 | 12 - 5 = 7 / 答え: 7
報酬 0.0 | 共通の抽出   17 | 答え: 10 または 17
報酬 0.0 | 共通の抽出   17 | 12 + 5 = 17 なので17個です。
報酬 0.0 | 共通の抽出   18 | 答え: 17 / 見直すと 12 + 5 = 18 / 答え: 18
グループ0: 報酬 [1.1, 0.1, 1.1, 0.1] → アドバンテージ ['+0.866', '-0.866', '+0.866', '-0.866'] / 有効: True
グループ1: 報酬 [0.1, 0.1, 0.1, 0.1] → アドバンテージ ['+0.000', '+0.000', '+0.000', '+0.000'] / 有効: False
グループ2: 報酬 [1.1, 0.1, 0.1, 0.1] → アドバンテージ ['+1.500', '-0.500', '-0.500', '-0.500'] / 有効: True
- 報酬のハッキングへの対策: 3つ目(答えを2つ並べる)と5つ目(答えの行を書き直す)は、評価用の抽出では正解の17や別の答えの18として拾われますが、報酬は0になります。4つ目は正しい計算をしていますが、指示された形式で答えていないので報酬は0です。
- グループ1: 4本とも形式だけを守った誤答で報酬が同じなので、アドバンテージはすべて0です。このグループからは学習信号が得られません。
- グループ0と2の比較: どちらも正解した応答のアドバンテージは正ですが、1本だけ正解したグループ2では +1.500 と、2本正解したグループ0(+0.866)より大きくなります。標準偏差で割ることによる難易度のバイアス(Dr. GRPO の指摘)が、この小さな例にも現れています。
実装3:モデル・生成・評価
モデルに LoRA を付け、グループ生成と評価の関数を用意します。
import json
import contextlib
import pandas as pd
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
from peft import LoraConfig, get_peft_model

SEED = 42
set_seed(SEED)
device = torch.device("cuda")

MODEL_ID = "Qwen/Qwen2.5-0.5B-Instruct"
SYSTEM_PROMPT = ("あなたは算数が得意なアシスタントです。途中の計算を1行に1つずつ式で書き、"
                 "最後の行に「答え: 整数」の形で答えを1つだけ書いてください。")
MAX_NEW_TOKENS = 256
TEMPERATURE = 0.7

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
tokenizer.padding_side = "left"     # 生成時は左側にパディングする(理由は下の解説)
base_model = AutoModelForCausalLM.from_pretrained(MODEL_ID, torch_dtype=torch.bfloat16).to(device)
# 生成を止めるトークンの一覧。1個のときは整数、複数のときはリストで入っているので、
# 常にリストとして扱えるように揃えておく
EOS_IDS = base_model.generation_config.eos_token_id
EOS_IDS = EOS_IDS if isinstance(EOS_IDS, list) else [EOS_IDS]

lora_config = LoraConfig(
    r=16, lora_alpha=32, lora_dropout=0.0, bias="none", task_type="CAUSAL_LM",
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
)
model = get_peft_model(base_model, lora_config)   # base_model に LoRA を付けて方策にする
model.print_trainable_parameters()                # 学習するパラメータ数を表示する

# 途中の計算の書き方を示す解答例(学習用データのうち、ステップ数3の最初の問題)
# next(...) は、条件に合う最初の要素を1つ取り出す書き方
DEMO = next(p for p in train_dataset if p["n_steps"] == 3)
DEMO_ANSWER = "\n".join(DEMO["gold_steps"].split("。"))   # 式を1行ずつ並べ、最後の行に「答え:」

def build_messages(question):
    return [
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": DEMO["question"]},        # 解答例の問題
        {"role": "assistant", "content": DEMO_ANSWER},         # 解答例(途中の計算を書いた解き方)
        {"role": "user", "content": question},
    ]

def build_prompt(question):
    # tokenize=False で文字列のまま返す。add_generation_prompt=True で、
    # 応答の書き出し(アシスタントの話し手を表すトークン)まで付けてくれる
    return tokenizer.apply_chat_template(build_messages(question), tokenize=False, add_generation_prompt=True)

def make_completion_mask(completion_ids):
    """最初の EOS までを1、それより後(パディング)を0にする。EOS がない応答は打ち切られた応答"""
    is_eos = torch.isin(completion_ids, torch.tensor(EOS_IDS, device=completion_ids.device))
    has_eos = is_eos.any(dim=1)
    length = completion_ids.shape[1]
    first_eos = torch.where(has_eos, is_eos.int().argmax(dim=1),
                            torch.full_like(has_eos, length, dtype=torch.long))
    positions = torch.arange(length, device=completion_ids.device).unsqueeze(0)
    return (positions <= first_eos.unsqueeze(1)).long(), ~has_eos

@torch.no_grad()       # 生成に勾配は不要なので、計算グラフを作らずメモリを節約する
def generate_group(questions, G, temperature=TEMPERATURE, use_adapter=True):
    """各問題から G 本を生成する。temperature=0 なら貪欲探索(G=1 で使う)"""
    # 複数の問題をまとめてトークン化する。padding=True で長さを揃える
    enc = tokenizer([build_prompt(q) for q in questions], return_tensors="pt", padding=True).to(device)
    kwargs = dict(max_new_tokens=MAX_NEW_TOKENS, num_return_sequences=G,
                  pad_token_id=tokenizer.pad_token_id, repetition_penalty=1.0)
    if temperature > 0:
        kwargs.update(do_sample=True, temperature=temperature, top_p=1.0, top_k=0)
    else:
        kwargs.update(do_sample=False)               # 貪欲探索(毎回、最も確率の高いトークン)
    # use_adapter=True  → nullcontext(何もしない)→ LoRA 込みの方策で生成
    # use_adapter=False → disable_adapter()      → LoRA を外した参照モデルで生成
    with (contextlib.nullcontext() if use_adapter else model.disable_adapter()):
        out = model.generate(**enc, **kwargs)        # out は (問題数 × G, プロンプト長 + 生成長)
    # 出力は「問題ごとに G 本が連続」の順に並ぶので、プロンプト側も同じ順に複製して揃える
    prompt_ids = enc["input_ids"].repeat_interleave(G, dim=0)
    prompt_mask = enc["attention_mask"].repeat_interleave(G, dim=0)
    completion_ids = out[:, prompt_ids.shape[1]:]    # プロンプトの後ろ=生成した部分だけを切り出す
    completion_mask, truncated = make_completion_mask(completion_ids)
    texts = tokenizer.batch_decode(completion_ids, skip_special_tokens=True)  # 採点用の文字列
    return prompt_ids, prompt_mask, completion_ids, completion_mask, truncated, texts

def evaluate(data, n_samples=8, batch_size=16, use_adapter=True):
    """貪欲探索で1本と、温度付きサンプリングで n_samples 本を生成して採点する"""
    model.eval()                                 # ドロップアウトなどを評価用の動作にする
    records = []
    for b in range(0, len(data), batch_size):    # batch_size 問ずつ処理する
        batch = data[b:b + batch_size]
        qs = [p["question"] for p in batch]
        # pass@1 用:貪欲探索で1本(戻り値のうち使わないものは _ で受け取る)
        _, _, _, g_mask, g_trunc, g_texts = generate_group(qs, 1, temperature=0.0, use_adapter=use_adapter)
        if n_samples > 0:
            # maj@k・pass@k 用:温度付きサンプリングで n_samples 本
            _, _, _, _, s_trunc, s_texts = generate_group(qs, n_samples, use_adapter=use_adapter)
        for j, p in enumerate(batch):
            # s_texts は「問題ごとに n_samples 本が連続」の順なので、
            # 問題 j の k 本目は j * n_samples + k 番目にある
            preds = [] if n_samples == 0 else [
                None if s_trunc[j * n_samples + k] else extract_answer(s_texts[j * n_samples + k])
                for k in range(n_samples)]
            records.append({
                "n_steps": p["n_steps"], "answer": p["answer"],
                # 打ち切られた応答は答えなし(不正解)として扱う
                "greedy_pred": None if g_trunc[j] else extract_answer(g_texts[j]),
                "greedy_format": extract_answer_strict(g_texts[j]) is not None,   # 形式を守ったか
                "greedy_length": int(g_mask[j].sum()),   # マスクの1の数=有効なトークン数
                "greedy_text": g_texts[j], "preds": preds,
            })
    return records

def summarize(records, n_samples=8):
    """問題ごとの指標の表を作る"""
    rows = []
    for r in records:
        row = {"n_steps": r["n_steps"], "pass@1": r["greedy_pred"] == r["answer"],
               "format": r["greedy_format"], "length": r["greedy_length"]}
        if n_samples > 0:
            c = sum(p == r["answer"] for p in r["preds"])     # n_samples 本のうちの正解数
            row.update({f"maj@{n_samples}": majority_vote(r["preds"]) == r["answer"],
                        f"pass@{n_samples}": pass_at_k(n_samples, c, n_samples),
                        "sample_acc": c / n_samples,
                        # 正解も不正解も混ざっている=GRPO で学習信号が出る問題
                        "mixed": 0 < c < n_samples})
        rows.append(row)
    return pd.DataFrame(rows)
【モデル】
-
LoRA の設定: lora_dropout=0.0 にしています。ドロップアウトがあると、応答を生成したときと損失を計算するときで方策が微妙に変わり、確率比や KL の計算がずれるためです。
-
Critic が要らないこと: InstructGPT の記事の PolicyValueLM は、言語モデルに価値を出力するヘッドを追加したクラスでした。GRPO では、通常の因果言語モデルに LoRA を付けるだけで済みます。
-
EOS トークン: Qwen2.5-Instruct は、会話の終わりを表す im_end などで生成を止めます。generation_config.eos_token_id から、生成を止めるトークンの一覧を取り出しておきます。モデルによって整数1個のこともリストのこともあるので、isinstance で判定して常にリストに揃えています。後の torch.isin がリストを前提にしているためです。
-
左パディング: 複数の問題をまとめて生成するとき、プロンプトの長さを揃えるパディングを 右側 に入れると、生成がパディングの後ろから始まってしまいます。tokenizer.padding_side = "left" で左側に詰めることで、どの行も「プロンプトの直後」から生成が始まります。そのかわり、位置の番号は後の position_ids で補正が必要になります。
-
解答例を1つ示す(1-shot): 指示文だけでは、小さなモデルは途中の計算を書かずに答えの行だけを書くことがあります。途中の計算を書かずに答えると、演算が2回以上の問題はほとんど解けず(Chain-of-Thoughtの記事の標準 Few-shot を参照)、GRPO の学習信号も得られません。そこで、学習用データの問題(DEMO)と、式を1行ずつ書いた解答(DEMO_ANSWER)を、会話の1往復として先に示します。チャット形式の Few-shot CoT にあたります。解答例は学習用データから選んでいるので、評価用の問題とは重複しません。
-
解答例の形式: DEMO_ANSWER は、gold steps(「26 - 13 = 13。13 + 30 = 43。…。答え: 30」)の「。」を改行に置き換えたものです。「答え:」の行が1つだけなので、厳しい抽出規則(extract_answer_strict)でも答えを取り出せる形になっています。
【生成】
-
サンプリングの設定を明示する: Qwen2.5-Instruct の generation_config には、top_p・top_k・repetition_penalty の既定値が設定されています。これらが効いたまま生成すると、応答は方策の確率分布とは別の分布から生成されたことになり、方策勾配の前提が崩れます。そこで top_p=1.0・top_k=0・repetition_penalty=1.0 を明示して無効にし、温度だけを使います。
-
グループの形: num_return_sequences=G で、各問題から 本を生成します。出力は「問題数 × 」本が問題ごとに連続して並ぶので、プロンプト側も repeat_interleave(G, dim=0) で同じ形に揃えます。
-
応答のマスク: make_completion_mask は、最初の EOS までを1、その後のパディングを0にします。EOS が出ないまま max_new_tokens に達した応答は、打ち切られた応答として truncated(~has_eos)を True にします。テンソル演算だけで書いてあるので、処理を1行ずつ追える形で下に補足します。
-
参照モデルでの生成と nullcontext(): use_adapter=False のときは disable_adapter() の中で生成するので、学習前のモデル(=参照モデル)の応答になります。この切り替えに使っている contextlib.nullcontext() は「何もしない with」です。model.disable_adapter() は、with 文に渡すためのオブジェクト(コンテキストマネージャ)を返します。with のブロックに入るときに LoRA を無効にし、ブロックを抜けるときに自動で元へ戻す、という働きです。ここでは use_adapter で「LoRA を外す/外さない」を切り替えたいのですが、外さない場合に with へ渡すものがありません。そこで contextlib.nullcontext()(入っても抜けても何もしないコンテキストマネージャ)を用意し、条件式でどちらかを選んでいます。
- use_adapter=True → with contextlib.nullcontext(): → 何も変えずに生成(学習中の方策 )
- use_adapter=False → with model.disable_adapter(): → LoRA を外して生成(参照モデル = 学習前のモデル)
if と else に分けて model.generate の呼び出しを2回書いても同じことができますが、同じ処理を2か所に書かずに済むので、この書き方がよく使われます。
-
勾配を作らない: @torch.no_grad() は関数全体を「勾配を計算しないモード」にするデコレータです。生成は学習の対象ではないので、計算グラフを作らないことでメモリと時間を節約します。損失を計算する completion_logps は、勾配が必要なのでこの外側で呼びます。
-
戻り値の6つ: generate_group は「プロンプトのトークン列・そのマスク・応答のトークン列・そのマスク・打ち切られたか・応答の文字列」を返します。前の4つは損失の計算に、truncated と texts は採点に使います。呼び出し側では、必要のない戻り値を _ で受け取っています。
make_completion_mask の処理を1行ずつ追う
この関数は、「最初に EOS が現れる位置を求め、そこまでを1・それ以降を0にする」処理を、for 文を使わずに 行(応答)ごとまとめて 計算しています。トークン列が [10, 20, EOS, 0, 0](長さ5、EOS はインデックス2)の1行を例に追うと、次のようになります。
| 変数 | 何をするか | 例の値 |
|---|---|---|
| is_eos | 各トークンが EOS かを判定する | [False, False, True, False, False] |
| has_eos | any(dim=1) で、行内に EOS が1つでもあるか | True |
| first_eos | 最初の EOS の位置。is_eos.int() が [0, 0, 1, 0, 0] なので、argmax(dim=1) が最初の1の位置を返す | 2 |
| positions | 比較用の列番号 [0, 1, …, length-1] | [[0, 1, 2, 3, 4]] |
| 戻り値 | positions <= first_eos.unsqueeze(1) をブロードキャストで比較し、.long() で 1/0 にする | [[1, 1, 1, 0, 0]] |
- argmax を使う理由: is_eos.int() は EOS の位置だけが1の列なので、「最大値が最初に現れる位置」を返す argmax が、そのまま「最初の EOS の位置」になります。
- EOS がない行の扱い: argmax は、すべて0の行でも 0 を返してしまいます。そこで torch.where で、has_eos が False の行には末尾の次である length を入れます。こうすると positions <= length がすべて True になり、応答全体が有効領域になります。
- EOS 自身を含める: 比較が < ではなく <= なので、最初の EOS のトークンもマスクに入ります。「ここで応答を終える」という判断も学習の対象にするためです。
- 戻り値の第2要素: ~has_eos は has_eos の論理否定で、「EOS が一度も現れなかった=途中で打ち切られた」応答を示すフラグです。
【評価】
- 2種類の生成: evaluate は、貪欲探索の1本(pass@1 用)と、温度 0.7 の 本(maj@8・pass@8 用)を生成します。評価の抽出には共通の extract_answer を使い、打ち切られた応答は不正解にします。
- 記録する量: 貪欲探索の応答の正誤・形式を守ったか・生成長と、8本それぞれの予測を保存します。summarize で、問題ごとの pass@1・maj@8・pass@8 と、8本の正誤が混在したか(mixed)を計算します。mixed の割合は、 で学習したときの有効なグループの割合の目安になります。
実行結果
trainable params: 8,798,208 || all params: 502,830,976 || trainable%: 1.7497
実装4:学習前の評価と有効なグループの割合
学習を始める前に、モデルの正解率と、ステップ数ごとの「8本の正誤が混在する問題の割合」を測ります。
before_records = evaluate(eval_dataset, use_adapter=False)   # LoRA を外した=学習前のモデル
with open(f"{SAVE_ROOT}/eval_before.json", "w", encoding="utf-8") as f:
    json.dump(before_records, f, ensure_ascii=False)         # 後で学習後と並べるために保存する

before_df = summarize(before_records)                        # 1行 = 1問の指標の表にする
# ステップ数(難易度)ごとの平均
print(before_df.groupby("n_steps")[["pass@1", "sample_acc", "mixed", "format", "length"]].mean().round(3))
# 500問全体の平均
print(before_df[["pass@1", "maj@8", "pass@8", "mixed", "format", "length"]].mean().round(3))
- 学習前のモデル: use_adapter=False で LoRA を外して評価します。LoRA は初期状態では出力に影響しないので、元の Qwen2.5-0.5B-Instruct と同じです。
- ステップ数ごとの集計: groupby("n_steps") で、ステップ数ごとの pass@1、サンプリングした1本あたりの正解率(sample_acc)、正誤が混在する割合(mixed)、形式を守った割合、生成長を表示します。
- 見るべき点: mixed が低いステップ数の問題は、全員正解または全員不正解になりやすく、GRPO の学習信号をほとんど生みません。学習がどの難易度の問題から進むかを予想する手がかりになります。
実行結果
         pass@1  sample_acc  mixed  format  length
n_steps
1          0.36       0.402   0.56    0.88   22.85
2          0.15       0.139   0.46    0.90   36.18
3          0.09       0.081   0.29    0.91   41.14
4          0.01       0.020   0.12    0.86   53.03
5          0.00       0.002   0.01    0.93   56.59
pass@1     0.122
maj@8      0.162
pass@8     0.322
mixed      0.288
format     0.896
length    41.958
dtype: float64
考察:学習の出発点
- 学習前から途中の計算は書けている: 平均生成長は約42トークンで、ステップ数が増えるほど長くなっています(ステップ数1で約23、ステップ数5で約57トークン)。解答例を1つ示したことで、途中の計算を書く状態から学習を始められています。形式を守った割合も 0.896 と高い値です。
- それでも正解率は低い: pass@1 は全体で 0.122、ステップ数4で 0.01、ステップ数5で 0.00 と、難しい問題はほとんど解けていません。書き方は真似できていても、1回ずつの演算が正しくないということです。
- 学習信号はステップ数1〜3から来るはず: 正誤が混在する割合(mixed)は、ステップ数1で 0.56、2で 0.46、3で 0.29 ですが、ステップ数4で 0.12、5で 0.01 まで落ちます(全体で 0.288)。「グループ内の報酬がすべて同じ問題」の節のとおり、mixed が0に近い問題ではアドバンテージが0になり、学習信号がほとんど出ません。つまりこの学習は、主にステップ数1〜3の問題によって進む はずです。ステップ数4・5の問題がどうなるかは、実装6の評価で確かめます。
実装5:GRPOの損失と学習ループ
GRPO の損失と、「生成 → 採点 → アドバンテージ → 更新」を繰り返す学習ループを実装します。
本記事の学習ループの1ステップを図にすると、次のようになります。
(図は、diagram-designで作成)
def completion_logps(model, prompt_ids, prompt_mask, completion_ids, completion_mask):
    """応答部分の各トークンの対数確率(生成時と同じく温度で割ったロジットから計算)"""
    input_ids = torch.cat([prompt_ids, completion_ids], dim=1)       # プロンプト+応答を連結する
    attention_mask = torch.cat([prompt_mask, completion_mask], dim=1)
    position_ids = (attention_mask.cumsum(dim=1) - 1).clamp(min=0)   # 左パディングを考慮した位置
    logits = model(input_ids=input_ids, attention_mask=attention_mask, position_ids=position_ids).logits
    n = completion_ids.shape[1]                                      # 応答のトークン数
    logits = logits[:, -n - 1:-1, :].float() / TEMPERATURE            # 応答の各トークンを予測する位置
    # gather で「実際に生成されたトークンの対数確率」だけを語彙の次元から取り出す。
    # unsqueeze(-1) で添字の形を logits に合わせ、取り出した後に squeeze(-1) で元の形に戻す
    return torch.gather(logits.log_softmax(dim=-1), 2, completion_ids.unsqueeze(-1)).squeeze(-1)

def grpo_loss(logps, old_logps, ref_logps, advantages, mask, clip_eps=0.2, beta=0.04):
    """応答ごとの損失(最小化する値)と、監視用の KL・クリップされた割合を返す。形は (系列数,)"""
    # 1. 確率比 rho とクリップ付きの目的関数
    ratio = torch.exp(logps - old_logps)                   # 対数の差の exp = 確率の比
    adv = advantages.unsqueeze(1)                          # (系列数,) → (系列数, 1)。応答内の全トークンで共通
    surr1 = ratio * adv
    surr2 = torch.clamp(ratio, 1 - clip_eps, 1 + clip_eps) * adv    # 比を [1-eps, 1+eps] に制限した版
    policy_term = torch.min(surr1, surr2)                  # 小さい方をとる=更新しすぎを抑える
    # 2. k3 推定量による KL
    d = ref_logps - logps                                  # d = log u(u = pi_ref / pi_theta)
    kl = torch.exp(d) - d - 1.0                            # k3 = u - log u - 1
    # 3. 目的関数(最大化)の符号を反転して損失にし、応答ごとに長さで割る
    per_token_loss = -(policy_term - beta * kl)
    lengths = mask.sum(dim=1).clamp(min=1)                 # 有効なトークン数(0除算を防ぐ)
    # mask を掛けてから足すことで、パディング部分を計算から外す
    per_seq_loss = (per_token_loss * mask).sum(dim=1) / lengths
    per_seq_kl = (kl * mask).sum(dim=1) / lengths
    # surr2 < surr1 なら min がクリップ側を選んだ=そのトークンでクリップが効いた
    clipped = ((surr2 < surr1).float() * mask).sum(dim=1) / lengths
    return per_seq_loss, per_seq_kl.detach(), clipped.detach()      # 監視用の2つは勾配を切る
【対数確率】
- 応答部分だけを取り出す: 左パディングしたプロンプトの後ろに応答を連結しているので、応答は系列の最後の n トークンです。位置 のロジットは次のトークンを予測するので、logits[:, -n - 1:-1, :] で「応答の各トークンを予測する位置」を取り出します。
- 位置の番号: 左パディングがあると、先頭からの番号をそのまま位置として使うと、生成時とずれてしまいます。position_ids を attention_mask の累積和から作り、パディングを除いた位置を渡します。
- 温度で割る: 応答は温度 0.7 で生成しているので、その応答を生成した分布は「ロジットを 0.7 で割ったソフトマックス」です。対数確率も同じ分布で計算するため、TEMPERATURE で割ります(TRL も同じ処理をしています)。
- float32 で計算: 語彙が約15万あるので、bf16 のまま log_softmax をとると精度が落ちます。float() で変換してから計算します。
- gather で「実際に出たトークン」の確率だけを取り出す: log_softmax の結果は (系列数, 応答長, 語彙数) の3次元で、各位置に語彙15万個分の対数確率が並んでいます。必要なのはそのうち「実際に生成されたトークン」の1つだけです。torch.gather(..., 2, index) は、3番目の次元(語彙)から index で指定した位置の値を抜き出します。添字は値と同じ次元数である必要があるので、completion_ids.unsqueeze(-1) で (系列数, 応答長, 1) にしてから渡し、抜き出した後に squeeze(-1) で (系列数, 応答長) に戻しています。
【損失】
- 数式との対応: policy_term が 、kl が k3 推定量です。目的関数は最大化するものなので、符号を反転して損失にします。
- 長さで割る: per_seq_loss は、応答ごとに有効なトークン数 lengths で割った平均です。これが GRPO の です。
- マスクの掛け方: パディング部分を計算から外すため、per_token_loss * mask のように掛けてから sum(dim=1) で足しています。mask が0の位置は足しても0なので、実質的に無効なトークンを無視できます。割る数の lengths も mask.sum(dim=1) なので、平均をとる対象が揃います。clamp(min=1) は、万一 lengths が0になったときの0除算を防ぐためです。
- クリップが効いたかの判定: policy_term は min(surr1, surr2) なので、surr2 < surr1 が成り立つときだけクリップ側が選ばれています。この真偽値を float() で 1/0 にして平均すると、クリップが効いたトークンの割合になります。本実装では1回の生成につき1回だけ更新するため、確率比は常に1でこの値は0になります。
- 監視用の値: per_seq_kl は KL の平均、clipped はクリップが効いたトークンの割合です。勾配には使わないので detach() しています。detach() は「この値から先は勾配を伝えない」という指定で、記録のためだけに使う値に付けておくと、余計な計算グラフが残りません。
続いて学習ループです。
import numpy as np

N_PROMPTS = 4       # 1ステップあたりの問題数
G = 8               # グループサイズ
MICRO_BATCH = 8     # 損失を計算するときに一度に処理する系列数
NUM_STEPS = 200
LR = 2e-5
BETA = 0.04
CLIP_EPS = 0.2
LOG_EVERY = 10
SAVE_EVERY = 50

def mean_or_nan(x):
    """空のテンソルの平均は NaN にする(全問正解のステップでは「誤った応答」が0本になる)"""
    return x.float().mean().item() if x.numel() > 0 else float("nan")

# 学習するのは LoRA のパラメータだけ(requires_grad が True のもの)
optimizer = torch.optim.AdamW([p for p in model.parameters() if p.requires_grad], lr=LR)
rng = np.random.default_rng(SEED)
history = []

for step in range(1, NUM_STEPS + 1):
    # 学習用データから N_PROMPTS 問を重複なし(replace=False)で選ぶ
    batch = [train_dataset[i] for i in rng.choice(len(train_dataset), N_PROMPTS, replace=False)]

    # 1. グループ生成:4問 × 8本 = 32本
    model.eval()
    prompt_ids, prompt_mask, completion_ids, completion_mask, truncated, texts = generate_group(
        [p["question"] for p in batch], G)

    # 2. 報酬とグループ相対アドバンテージ
    # 各問題の正解を G 回ずつ並べて、応答の並び順(問題ごとに G 本が連続)に合わせる
    targets = [p["answer"] for p in batch for _ in range(G)]
    rewards = torch.tensor([compute_reward(t, a) for t, a in zip(texts, targets)], device=device)
    advantages, effective = compute_group_advantages(rewards, G)

    # 3. 損失と更新(メモリ節約のため MICRO_BATCH 本ずつ逆伝播して勾配をためる)
    model.train()
    optimizer.zero_grad()                                     # 前のステップの勾配を消す
    n_seqs = completion_ids.shape[0]                          # 32本(= N_PROMPTS × G)
    kls, clips = [], []
    for s in range(0, n_seqs, MICRO_BATCH):
        sl = slice(s, s + MICRO_BATCH)                        # 添字の範囲をまとめた slice オブジェクト
        args = (prompt_ids[sl], prompt_mask[sl], completion_ids[sl], completion_mask[sl])
        with torch.no_grad(), model.disable_adapter():        # with は2つ同時に書ける
            ref_logps = completion_logps(model, *args)        # 参照モデル = LoRA を外した状態
        logps = completion_logps(model, *args)                # *args でタプルを4つの引数に展開する
        old_logps = logps.detach()                            # 1回の生成につき1回だけ更新するので pi_old = pi_theta
        per_seq_loss, per_seq_kl, clipped = grpo_loss(
            logps, old_logps, ref_logps, advantages[sl], completion_mask[sl], CLIP_EPS, BETA)
        (per_seq_loss.sum() / n_seqs).backward()              # 全系列の平均になるように割る
        kls.append(per_seq_kl)                                # 監視用の値をためる
        clips.append(clipped)
    # 勾配のノルムが1を超えたら縮める(更新が大きくなりすぎるのを防ぐ)
    torch.nn.utils.clip_grad_norm_([p for p in model.parameters() if p.requires_grad], 1.0)
    optimizer.step()                                          # ためた勾配で1回だけ更新する

    # 4. 記録
    lengths = completion_mask.sum(dim=1)                      # 応答ごとの有効なトークン数
    correct = rewards >= 1.0                                  # 報酬 1.1 = 正解、0.1 と 0.0 = 不正解
    history.append({
        "step": step,
        "reward": rewards.mean().item(),
        "accuracy": correct.float().mean().item(),
        "kl": torch.cat(kls).mean().item(),
        "clip_frac": torch.cat(clips).mean().item(),
        "length": lengths.float().mean().item(),
        "length_correct": mean_or_nan(lengths[correct]),
        "length_wrong": mean_or_nan(lengths[~correct]),
        "effective_groups": effective.float().mean().item(),
        "truncated": truncated.float().mean().item(),
    })
    if step % LOG_EVERY == 0:
        h = pd.DataFrame(history[-LOG_EVERY:]).mean()         # 直近 LOG_EVERY ステップの平均を表示
        print(f"step {step:4d} | reward {h['reward']:.3f} | acc {h['accuracy']:.3f} | kl {h['kl']:.4f} | "
              f"len {h['length']:.1f} | effective {h['effective_groups']:.2f} | trunc {h['truncated']:.2f}")
    if step % SAVE_EVERY == 0:
        model.save_pretrained(f"{SAVE_ROOT}/scratch/step{step}")
        with open(f"{SAVE_ROOT}/scratch/history.json", "w") as f:
            json.dump(history, f)
【1ステップの流れ】
- グループ生成: 学習用データから4問を選び、各問題から8本、計32本の応答を生成します。生成中は勾配が不要なので、generate_group は torch.no_grad() の中で動きます。
- 報酬とアドバンテージ: targets は、各問題の正解を 回ずつ並べたもので、応答の並び順と一致します。compute_group_advantages で問題ごとに正規化します。
- 参照モデル: model.disable_adapter() の中で対数確率を計算すると、LoRA を外した元のモデル(=参照モデル)の値が得られます。
- 古い方策 old_logps: 本実装は DeepSeekMath と同じく、生成した応答で1回だけ更新します。更新の時点では方策と生成時の方策が同じなので、logps.detach() をそのまま として使います。確率比は常に1で、クリップは効きません(clip_frac は0になります)。同じ応答で複数回更新する場合は、生成直後に計算した対数確率を保存して使います。
- マイクロバッチ: 32本をまとめて処理すると、語彙15万 × 256トークン分のロジットでメモリが足りなくなるので、MICRO_BATCH 本ずつ損失を計算して逆伝播し、勾配をためてから1回だけ更新します。損失を全系列数 n_seqs で割るので、全体として「32本の応答ごとの損失の平均」になります。backward() を呼ぶたびに勾配は 足し込まれる ので、ループの前に optimizer.zero_grad() で消しておき、ループの後で optimizer.step() を1回だけ呼びます。
- slice と *args: sl = slice(s, s + MICRO_BATCH) は [s:s+MICRO_BATCH] という添字の範囲を変数にしたものです。4つのテンソルに同じ範囲を何度も書かずに済みます。そのうえで args にまとめ、completion_logps(model, *args) の * でタプルを4つの引数に展開して渡しています。方策と参照モデルで同じ入力を2回使うので、この形にしています。
- with を2つ並べる: with torch.no_grad(), model.disable_adapter(): は、2つのコンテキストマネージャを同時に適用する書き方です(入れ子に書くのと同じ意味です)。「勾配を作らず、かつ LoRA を外した状態」で参照モデルの対数確率を計算しています。
- mean_or_nan: 正解・不正解に分けた生成長を記録するとき、全問正解のステップでは「誤った応答」が0本になります。空のテンソルの平均は警告付きの NaN になるので、明示的に NaN を返しておき、図を描くときにその点が抜けるようにしています。
【記録する指標】
- 報酬と正解率: 学習中に生成した応答の平均報酬と、正解した割合です。
- KL: 参照モデルからの離れ具合です。 が小さすぎると大きくなり続けます。
- 生成長: 全体の平均に加え、正解した応答(length_correct)と誤った応答(length_wrong)に分けて記録します。Dr. GRPO が指摘した「誤った応答が長くなる」傾向があるかを確認するためです。
- 有効なグループの割合: effective_groups は、4問のうち報酬がすべて同じでなかった問題の割合です。モデルが上達して全員正解が増えると下がります。
- 打ち切り率: max_new_tokens に達して打ち切られた応答の割合です。
実行結果
step   10 | reward 0.221 | acc 0.128 | kl 0.0039 | len 36.0 | effective 0.55 | trunc 0.00
step   20 | reward 0.301 | acc 0.206 | kl 0.0338 | len 33.5 | effective 0.47 | trunc 0.00
step   30 | reward 0.389 | acc 0.291 | kl 0.0801 | len 33.1 | effective 0.47 | trunc 0.00
step   40 | reward 0.433 | acc 0.334 | kl 0.0955 | len 33.4 | effective 0.45 | trunc 0.00
step   50 | reward 0.515 | acc 0.416 | kl 0.1387 | len 39.5 | effective 0.45 | trunc 0.00
step   60 | reward 0.662 | acc 0.562 | kl 0.1109 | len 35.6 | effective 0.33 | trunc 0.00
step   70 | reward 0.672 | acc 0.572 | kl 0.2078 | len 39.1 | effective 0.45 | trunc 0.00
step   80 | reward 0.778 | acc 0.678 | kl 0.1203 | len 39.0 | effective 0.23 | trunc 0.00
step   90 | reward 0.740 | acc 0.641 | kl 0.4092 | len 41.3 | effective 0.40 | trunc 0.00
step  100 | reward 0.784 | acc 0.684 | kl 0.1489 | len 41.2 | effective 0.28 | trunc 0.00
step  110 | reward 0.819 | acc 0.719 | kl 0.1520 | len 39.8 | effective 0.25 | trunc 0.00
step  120 | reward 0.894 | acc 0.794 | kl 0.1484 | len 42.0 | effective 0.38 | trunc 0.00
step  130 | reward 1.059 | acc 0.959 | kl 0.2000 | len 39.7 | effective 0.17 | trunc 0.00
step  140 | reward 0.900 | acc 0.800 | kl 0.1321 | len 38.7 | effective 0.25 | trunc 0.00
step  150 | reward 0.959 | acc 0.859 | kl 0.1846 | len 39.8 | effective 0.30 | trunc 0.00
step  160 | reward 0.930 | acc 0.831 | kl 0.1690 | len 45.2 | effective 0.23 | trunc 0.00
step  170 | reward 0.947 | acc 0.847 | kl 0.2494 | len 36.8 | effective 0.23 | trunc 0.00
step  180 | reward 0.937 | acc 0.838 | kl 0.1394 | len 44.0 | effective 0.20 | trunc 0.00
step  190 | reward 0.909 | acc 0.809 | kl 0.2430 | len 43.4 | effective 0.23 | trunc 0.00
step  200 | reward 0.909 | acc 0.809 | kl 0.1650 | len 40.2 | effective 0.25 | trunc 0.00
学習の推移を図にします。
import matplotlib.pyplot as plt
import matplotlib_fontja   # グラフに日本語を表示する

# rolling(window=10) は直近10ステップの移動平均。min_periods=1 で先頭も欠損にしない
hist = pd.DataFrame(history).rolling(window=10, min_periods=1).mean()
fig, axes = plt.subplots(2, 2, figsize=(12, 8))    # axes は 2×2 の配列
axes[0, 0].plot(hist["step"], hist["reward"], label="報酬")
axes[0, 0].plot(hist["step"], hist["accuracy"], label="正解率")
axes[0, 1].plot(hist["step"], hist["kl"])
axes[1, 0].plot(hist["step"], hist["length_correct"], label="正解した応答")
axes[1, 0].plot(hist["step"], hist["length_wrong"], label="誤った応答")
axes[1, 1].plot(hist["step"], hist["effective_groups"])
titles = ["報酬と正解率", "KL(k3 推定量)", "生成長(トークン数)", "有効なグループの割合"]
for ax, title in zip(axes.flat, titles):           # axes.flat で 2×2 を1列に平らにして回す
    ax.set_title(title)
    ax.set_xlabel("ステップ")
axes[0, 0].legend()
axes[1, 0].legend()
plt.tight_layout()
plt.show()
- 移動平均: 1ステップあたり4問しかないので、値のばらつきが大きくなります。rolling(window=10) で平滑化して描きます。
- 4つの図: 報酬と正解率、KL、正解・不正解別の生成長、有効なグループの割合です。import matplotlib_fontja で日本語フォントを設定しているので、タイトルや凡例を日本語で書けます。
実行結果
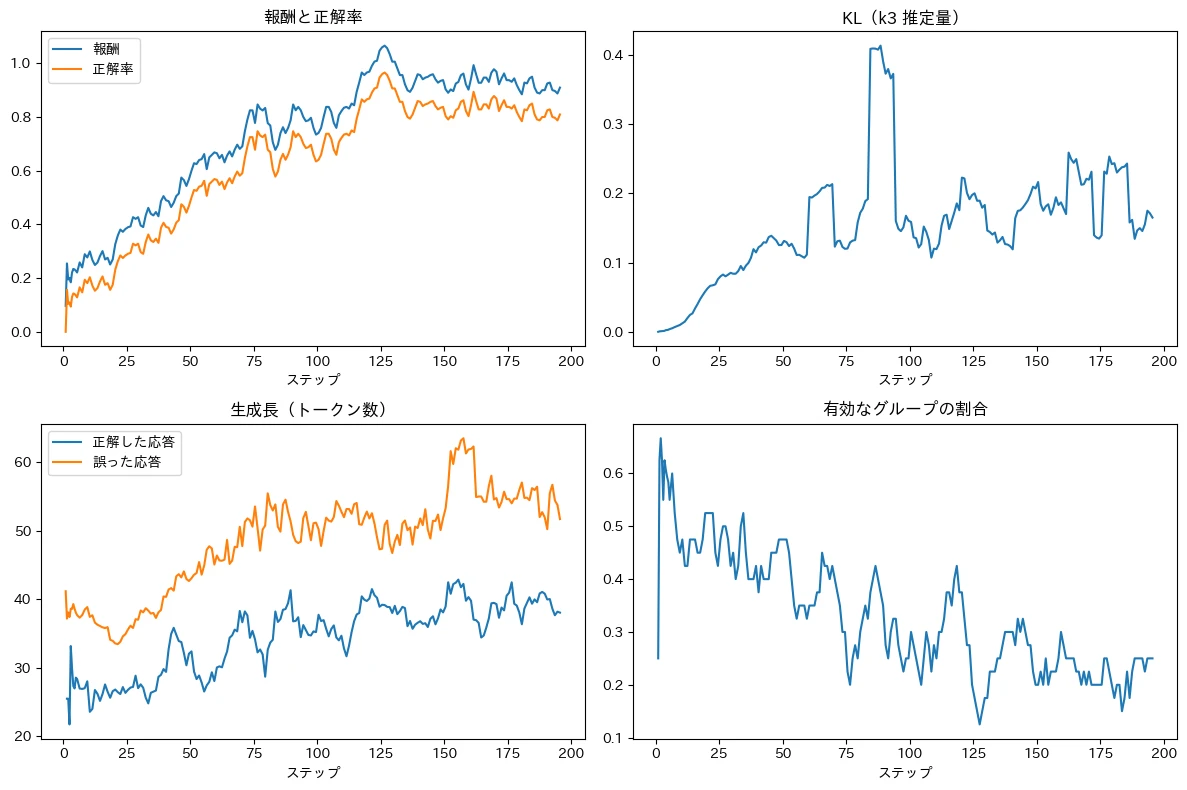
考察:学習曲線
学習中のログ(10ステップごとの平均)からは、次のことが読み取れます。
- 報酬と正解率: 学習中の正解率は、最初の10ステップの 0.13 から、step 60 で 0.56、step 120 で 0.79 と上がり、step 130 以降は 0.80〜0.96 の間で推移しています。
- KL: 0.004 から始まって 0.1〜0.25 程度まで増え、その範囲で安定しています(step 90 だけ 0.41)。 の KL の項によって、方策が参照モデルから際限なく離れることは起きていません。
- 生成長: 学習中の応答は33〜45トークンの範囲で推移し、大きく長くなることも短くなることもありませんでした。打ち切られた応答もありません。
- 有効なグループの割合: 最初の10ステップは 0.55 でしたが、正解率が上がるにつれて下がり、後半は 0.2〜0.25 程度になりました。全員正解のグループが増えて、学習信号を生む問題が減っていく様子が分かります。
実装6:学習後の評価
学習後のモデルを同じ500問で評価し、学習前と比べます。さらに、学習に使っていない GSM8K(英語の算数文章題)でも評価します。
from datasets import load_dataset

after_records = evaluate(eval_dataset, use_adapter=True)     # LoRA 込み=学習後のモデル
with open(f"{SAVE_ROOT}/eval_after_scratch.json", "w", encoding="utf-8") as f:
    json.dump(after_records, f, ensure_ascii=False)
after_df = summarize(after_records)

# 1. ステップ数ごとの pass@1
by_step = pd.DataFrame({
    "before": before_df.groupby("n_steps")["pass@1"].mean(),
    "after": after_df.groupby("n_steps")["pass@1"].mean(),
})
by_step["diff"] = by_step["after"] - by_step["before"]
print(by_step.round(3))

# 2. 全体の指標(pass@1・maj@8・pass@8・形式・生成長)
cols = ["pass@1", "sample_acc", "maj@8", "pass@8", "format", "length"]
print(pd.DataFrame({"before": before_df[cols].mean(), "after": after_df[cols].mean()}).round(3))

# 3. GSM8K(テストセットから200問、貪欲探索のみ)
gsm = load_dataset("openai/gsm8k", "main", split="test").shuffle(seed=SEED).select(range(200))
# GSM8K の answer 列は「解説 #### 答え」の形。#### の後ろを取り出して整数にする。
# 算数ワールドのステップ数に相当する情報はないので n_steps は 0 にしておく
gsm_data = [{"question": ex["question"], "n_steps": 0,
             "answer": int(ex["answer"].split("####")[-1].strip().replace(",", ""))} for ex in gsm]
for name, use_adapter in [("before", False), ("after", True)]:
    # n_samples=0 でサンプリングを省き、貪欲探索の1本だけで採点する
    df = summarize(evaluate(gsm_data, n_samples=0, use_adapter=use_adapter), n_samples=0)
    acc = df["pass@1"].mean()
    print(f"GSM8K {name}: pass@1 = {acc:.3f} ± {np.sqrt(acc * (1 - acc) / len(df)):.3f}")
- 学習前後の比較: 学習前の結果(before_df)と、学習後に同じ関数で評価した結果(after_df)を並べます。ステップ数ごとの差(diff)を見ると、どの難易度の問題で伸びたかが分かります。
- maj@8 と pass@8: DeepSeekMath の「RL は maj@k を上げるが pass@k はあまり上げない」を確かめるための指標です。500問の標準誤差は最大で約 なので、差がこれより小さい場合は「変化がない」と判断します。
- GSM8K の正解: GSM8K の answer 列は、解説の後に「#### 答え」の形で最終的な答えが書かれています。split("####") で取り出し、カンマを除いて整数にします。
- GSM8K の注意: 問題は英語で、システムプロンプトは日本語のままです。また、GSM8K は公開されて長いベンチマークなので、Qwen2.5 が事前学習で見ている可能性があります。
実行結果
         before  after  diff
n_steps
1          0.36   1.00  0.64
2          0.15   1.00  0.85
3          0.09   0.94  0.85
4          0.01   0.80  0.79
5          0.00   0.53  0.53
            before   after
pass@1       0.122   0.854
sample_acc   0.129   0.814
maj@8        0.162   0.852
pass@8       0.322   0.922
format       0.896   1.000
length      41.958  38.718
GSM8K before: pass@1 = 0.370 ± 0.034
GSM8K after: pass@1 = 0.325 ± 0.033
考察:ステップ数ごとの正解率(学習前後)
実装4では「学習は主にステップ数1〜3の問題で進むはず」と予想しました。実際にどうなったかを、評価用500問での貪欲探索の正解率(pass@1)で見ます。
| ステップ数 | 学習前 | 学習後(スクラッチ) | 差 | 学習前の正誤混在の割合 |
|---|---|---|---|---|
| 1 | 0.36 | 1.00 | +0.64 | 0.56 |
| 2 | 0.15 | 1.00 | +0.85 | 0.46 |
| 3 | 0.09 | 0.94 | +0.85 | 0.29 |
| 4 | 0.01 | 0.80 | +0.79 | 0.12 |
| 5 | 0.00 | 0.53 | +0.53 | 0.01 |
| 全体 | 0.122 | 0.854 | +0.732 | 0.288 |
- どのステップ数でも大きく伸びた: 学習後の正解率は全体で 0.854 になり、ステップ数1・2では 1.00 に達しました。伸びはどのステップ数でも標準誤差(100問で最大約 ±0.05)をはるかに超えています。
- 学習前にほぼ解けなかった問題も解けるようになった: 学習前の正誤混在の割合は、ステップ数4で 0.12、ステップ数5で 0.01 と低く、これらの問題からはほとんど学習信号が得られなかったはずです。それでも、学習後はステップ数4で 0.80、ステップ数5で 0.53 まで伸びました。学習は主にステップ数1〜3の問題で進みましたが、そこで身についた「1回の演算を正しく行い、結果を次の式に引き継ぐ」力が、演算の回数の多い問題にも効いたと考えられます。算数ワールドの問題は、同じ種類の演算の組み合わせなので、易しい問題での学習が難しい問題にも移りやすい構造になっています。
ステップ数ごとの学習前後の正解率と、学習前の正誤混在の割合を並べると、次のようになります。
(図は、diagram-designで作成)
考察:GSM8K
| 条件 | pass@1(n = 200) |
|---|---|
| 学習前 | 0.370 ± 0.034 |
| 学習後(スクラッチ) | 0.325 ± 0.033 |
GSM8K の正解率は 0.370 から 0.325 に下がりましたが、差(約0.045)は、2つの標準誤差を合わせた大きさ(約0.047)と同程度で、差があるとは言えません。算数ワールドでの学習は、学習に使っていない英語の文章題の正解率を上げることも、大きく下げることもありませんでした。算数ワールドで大きく伸びた能力は、少なくともこの規模の学習では、問題の分布を超えては広がっていないと言えます。
TRLのGRPOTrainerによる実装
同じ学習を、TRL の GRPOTrainer で行います。スクラッチ実装とは別のセッションで実行することを想定しています(実装1〜3のセルを先に実行してください)。
本記事のコードは trl==1.13.0(transformers==5.17.0・peft==0.21.0) で確認しています。GRPOTrainer はバージョンごとに既定値や引数が大きく変わっているので、DeepSeekMath の GRPO を再現する場合は、次の値を必ず明示してください。
- loss_type: 損失の集計方法です。バージョンによって既定値が異なり、DAPO 型のトークン単位の集計などが既定になっていることがあります。応答ごとに長さで割って平均する DeepSeekMath の形は "grpo"、Dr. GRPO の形は "dr_grpo" です。
- beta: KL 係数です。バージョンによっては既定値が0(KL 項なし)になっています。DeepSeekMath と同じにするには 0.04 を指定します。
- scale_rewards: 報酬をグループの標準偏差で割るかどうかです。バージョンによって、真偽値ではなく "group"・"batch"・"none" のような文字列で指定する形になっています。
- per_device_train_batch_size: GRPO では、問題の数ではなく応答(completion)の数 です。num_generations で割り切れる値にする必要があります。
- temperature・top_p・top_k: 生成の設定です。スクラッチ実装と揃えるため、明示します。
from datasets import Dataset
from trl import GRPOConfig, GRPOTrainer

# 1. データセット:会話形式の prompt と、正解の target
trl_train = Dataset.from_list(
    [{"prompt": build_messages(p["question"]), "target": p["answer"]} for p in train_dataset])

# 2. 報酬関数:スクラッチ実装と同じ compute_reward を使う
def correctness_reward(completions, target, **kwargs):
    # prompt を会話形式で渡すと completions もメッセージのリストで届くので、本文を取り出す。
    # **kwargs は、TRL が渡す他の列を受け取って無視するための書き方
    texts = [c[0]["content"] if isinstance(c, list) else c for c in completions]
    return [compute_reward(t, a) for t, a in zip(texts, target)]   # 応答ごとの報酬のリストを返す

def make_grpo_config(output_dir, loss_type="grpo", scale_rewards=True):
    return GRPOConfig(
        output_dir=output_dir,
        learning_rate=2e-5,
        lr_scheduler_type="constant",     # スクラッチ実装と同じく、学習率を一定にする
        per_device_train_batch_size=32,     # 応答の数(4問 × G=8)
        gradient_accumulation_steps=1,
        num_generations=8,                  # グループサイズ G
        max_completion_length=256,
        temperature=0.7, top_p=1.0, top_k=0, repetition_penalty=1.0,
        beta=0.04,                          # KL 係数(k3 推定量)
        epsilon=0.2,                        # クリップ幅
        num_iterations=1,                   # 1回の生成につき1回だけ更新
        loss_type=loss_type,
        scale_rewards=scale_rewards,
        max_steps=200,
        logging_steps=10,
        save_steps=50,
        bf16=True,
        seed=SEED,
        report_to="none",
    )

def train_with_trl(output_dir, loss_type="grpo", scale_rewards=True):
    # LoRA を付けていない素のモデルを渡す(LoRA は peft_config 側で指定する)
    trl_model = AutoModelForCausalLM.from_pretrained(MODEL_ID, torch_dtype=torch.bfloat16)
    trainer = GRPOTrainer(
        model=trl_model,
        reward_funcs=correctness_reward,
        args=make_grpo_config(output_dir, loss_type, scale_rewards),
        train_dataset=trl_train,
        processing_class=tokenizer,
        peft_config=LoraConfig(
            r=16, lora_alpha=32, lora_dropout=0.0, bias="none", task_type="CAUSAL_LM",
            target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"]),
    )
    trainer.train()
    trainer.save_model(f"{output_dir}/final")      # 学習した LoRA アダプターを保存する
    return trainer                                # 学習ログ(state.log_history)を後で使う

trainer_grpo = train_with_trl(f"{SAVE_ROOT}/trl_grpo", loss_type="grpo", scale_rewards=True)
【データと報酬】
- 会話形式のプロンプト: prompt にメッセージのリストを入れると、TRL がチャットテンプレートを適用します。このとき報酬関数が受け取る completions も、メッセージのリストの形(c[0]["content"] が本文)になります。
- 追加の列: データセットの target 列は、同じ名前の引数として報酬関数に渡されます。応答と同じ順に並んでいるので、スクラッチ実装と同じ compute_reward で採点できます。
【設定】
- バッチの大きさ: per_device_train_batch_size=32 は応答の数で、num_generations=8 で割ると1ステップあたり4問になります。スクラッチ実装の N_PROMPTS × G と同じです。
- 原典どおりの損失: loss_type="grpo"・scale_rewards=True・beta=0.04 で、DeepSeekMath の形(応答ごとに長さで割る、標準偏差で割る、k3 の KL 項あり)にします。
- 1回だけの更新: num_iterations=1 で、生成した応答で1回だけ更新します。スクラッチ実装で old_logps = logps.detach() としたのと同じです。
- 学習率のスケジュール: Transformers の Trainer(TRL を含む)の既定は、学習率を0まで直線的に下げる lr_scheduler_type="linear" です。スクラッチ実装は学習率が一定なので、"constant" を指定して揃えます。既定のままだと、平均の学習率がおよそ半分になり、同じ学習率を指定してもスクラッチ実装とは異なる学習になります。
- モデルの渡し方: model には LoRA を付けていない通常のモデルを渡し、LoRA の設定は peft_config で渡します。LoRA を付けたモデルを渡して、さらに peft_config も渡すと、二重に適用しようとしてエラーや意図しない動作の原因になります。参照モデルは、TRL が内部でアダプターを無効にして計算します。
スクラッチ実装と TRL の対応は次のとおりです。
| 処理 | スクラッチ実装 | TRL |
|---|---|---|
| グループ生成 | generate_group(num_return_sequences=G) | num_generations |
| 1ステップの規模 | N_PROMPTS × G = 32本 | per_device_train_batch_size=32 |
| 報酬 | compute_reward | reward_funcs |
| アドバンテージ | compute_group_advantages(scale) | scale_rewards |
| 確率比とクリップ | grpo_loss の clip_eps | epsilon |
| KL(k3) | grpo_loss の beta | beta |
| 応答長で割る | per_seq_loss | loss_type="grpo" |
| 参照モデル | disable_adapter() | peft_config を渡すと自動 |
| 古い方策 | old_logps = logps.detach() | num_iterations=1 |
| 学習率のスケジュール | 一定(LR) | lr_scheduler_type="constant" |
実行結果
Step	Training Loss
10	0.000258
20	0.001159
30	0.003754
40	0.004630
50	0.005867
60	0.004353
70	0.008028
80	0.006317
90	0.008942
100	0.008333
110	0.010325
120	0.006341
130	0.005099
140	0.005315
150	0.006989
160	0.006941
170	0.009084
180	0.006429
190	0.006605
200	0.006544
TRL が表示する損失は、0.0003〜0.010 程度の小さな値で推移しています。これは学習がうまく進んでいないという意味ではありません。グループ相対アドバンテージはグループ内で平均が0になるので、目的関数のうち方策勾配の項の値はほぼ0になり、損失の値には主に KL の項 が残ります。実際、スクラッチ実装の学習中の KL(0.1〜0.25)に を掛けると 0.004〜0.01 となり、step 30 以降の TRL の損失(0.004〜0.010)と同じ程度です。GRPO では、損失の値ではなく、報酬や正解率の推移で学習の進み具合を判断します。
TRL で学習したモデルも、スクラッチ実装と同じ評価用の500問で評価し、学習前・スクラッチ実装と並べます。
from peft import PeftModel

# 1. TRL で学習したモデルを評価する(evaluate が使う model を置き換える)
trl_eval_path = f"{SAVE_ROOT}/eval_after_trl.json"
if not os.path.exists(trl_eval_path):             # 評価済みならスキップする
    if "model" in globals():                      # 前の model が残っていれば GPU から解放する
        del model
        torch.cuda.empty_cache()
    trl_base = AutoModelForCausalLM.from_pretrained(MODEL_ID, torch_dtype=torch.bfloat16).to(device)
    # 保存したアダプターを読み込み、変数 model に入れる(evaluate はこの model を使う)
    model = PeftModel.from_pretrained(trl_base, f"{SAVE_ROOT}/trl_grpo/final")
    trl_records = evaluate(eval_dataset, use_adapter=True)
    with open(trl_eval_path, "w", encoding="utf-8") as f:
        json.dump(trl_records, f, ensure_ascii=False)

# 2. 学習前・スクラッチ実装・TRL の結果を並べる
cols = ["pass@1", "sample_acc", "maj@8", "pass@8", "format", "length"]
comparison = {}
for name, filename in [("before", "eval_before.json"), ("scratch", "eval_after_scratch.json"),
                       ("trl", "eval_after_trl.json")]:
    with open(f"{SAVE_ROOT}/{filename}", encoding="utf-8") as f:
        comparison[name] = summarize(json.load(f))[cols].mean()
print(pd.DataFrame(comparison).round(3))
- 評価するモデルの差し替え: 実装3の evaluate と generate_group は、変数 model のモデルで生成します。そこで、元のモデル(実装3で LoRA を付けたもの)を GPU から解放し、TRL で保存したアダプター(trl_grpo/final)を読み込んだモデルを model に入れます。TRL の学習は、スクラッチ実装と同じチャットテンプレートとシステムプロンプト(build_messages)で行っているので、同じ evaluate で比べられます。
- 保存した結果を並べる: 学習前(実装4)とスクラッチ実装の学習後(実装6)の評価結果は JSON に保存してあるので、別のセッションでも読み込んで並べられます。summarize で問題ごとの指標にしてから平均をとり、学習前・スクラッチ実装・TRL の3つを並べた表を表示します。
- globals() の判定: if "model" in globals() は「変数 model が定義されているか」の確認です。スクラッチ実装から続けて実行した場合は定義済みなので解放が必要ですが、別のセッションで TRL の節だけを実行した場合は定義されていません。どちらでも動くようにしています。
- 再開できる設計: TRL のモデルの評価結果も JSON に保存し、既にあれば評価を省きます。
実行結果
            before  scratch     trl
pass@1       0.122    0.854   0.936
sample_acc   0.129    0.814   0.924
maj@8        0.162    0.852   0.938
pass@8       0.322    0.922   0.960
format       0.896    1.000   1.000
length      41.958   38.718  39.484
考察:maj@k と pass@k、スクラッチ実装と TRL の差
| 指標 | 学習前 | 学習後(スクラッチ) | 学習後(TRL) |
|---|---|---|---|
| pass@1(貪欲探索) | 0.122 | 0.854 | 0.936 |
| サンプリング1本あたりの正解率 | 0.129 | 0.814 | 0.924 |
| maj@8 | 0.162 | 0.852 | 0.938 |
| pass@8 | 0.322 | 0.922 | 0.960 |
| 形式を守った割合 | 0.896 | 1.000 | 1.000 |
| 平均生成長 | 42.0 | 38.7 | 39.5 |
- pass@8 も大きく伸びた: pass@1 と maj@8 だけでなく、pass@8 も 0.322 から 0.922 に上がりました。「RL は maj@k を上げるが pass@k はあまり上げない」という DeepSeekMath の報告とは異なる結果です。本記事の は論文( まで)よりずっと小さいこと、そして実装6の考察のとおり、易しい問題での学習が難しい問題にも移る構造のデータであることが、違いの理由として考えられます。学習前は8本のうちに正解がなかった問題(とくにステップ数4以上)でも、1回ずつの演算が確実になったことで、正解を出せるようになりました。
- 形式と生成長: 形式を守った割合は 1.000 になり、平均生成長はわずかに短くなりました。
- スクラッチ実装と TRL: TRL の pass@1 は 0.936 で、スクラッチ実装(0.854)より約0.08高くなりました。学習率のスケジュールも含めて設定を揃えていますが、差は残りました。表の標準誤差(500問で約0.015)は、評価に使う問題の選び方によるばらつきだけを表していて、学習そのもののばらつき(生成のサンプリングやデータの並び順による、学習結果の違い)は含んでいません。強化学習は同じ設定でも学習ごとの結果のばらつきが大きく、スクラッチ実装と TRL は乱数の使い方やデータの並び順が異なります。1回ずつの学習なので、この差が実装の違いによるものか、学習ごとのばらつきによるものかは、この実験だけでは判断できません。確かめるには、シードを変えてそれぞれ複数回学習する必要があります。どちらの実装でも、学習前の 0.122 から大きく伸びている点は同じです。
Dr. GRPOとの比較:生成長の推移
最後に、loss_type と scale_rewards を Dr. GRPO の設定に変えて学習し、生成長の推移を比べます。
import matplotlib.pyplot as plt
import matplotlib_fontja   # グラフに日本語を表示する

trainer_dr = train_with_trl(f"{SAVE_ROOT}/trl_dr_grpo", loss_type="dr_grpo", scale_rewards=False)

def get_log(trainer, candidates):
    """バージョンによって異なるログのキー名から、最初に見つかったものの推移を返す"""
    logs = [h for h in trainer.state.log_history if any(k in h for k in candidates)]
    key = next(k for k in candidates if k in logs[0])    # 実際に存在したキー名を1つ決める
    return [h["step"] for h in logs], [h[key] for h in logs]   # (x の列, y の列) を返す

LENGTH_KEYS = ["completions/mean_length", "completion_length"]
REWARD_KEYS = ["reward"]
fig, axes = plt.subplots(1, 2, figsize=(12, 4))
for trainer, label in [(trainer_grpo, "GRPO"), (trainer_dr, "Dr. GRPO")]:
    # * で (x, y) のタプルを2つの引数に展開して plot に渡す
    axes[0].plot(*get_log(trainer, REWARD_KEYS), label=label)
    axes[1].plot(*get_log(trainer, LENGTH_KEYS), label=label)
axes[0].set_title("報酬")
axes[1].set_title("平均生成長(トークン数)")
for ax in axes:
    ax.set_xlabel("ステップ")
    ax.legend()
plt.tight_layout()
plt.show()
- Dr. GRPO の設定: loss_type="dr_grpo" で応答長で割る代わりに定数で割り、scale_rewards=False で標準偏差で割らないようにします(バージョンによっては "none" と指定します)。それ以外の設定は同じです。
- ログの取り出し: trainer.state.log_history には、logging_steps ごとの記録が辞書のリストで入っています。生成長のキー名はバージョンによって異なるので、get_log で候補の中から見つかったものを使います。
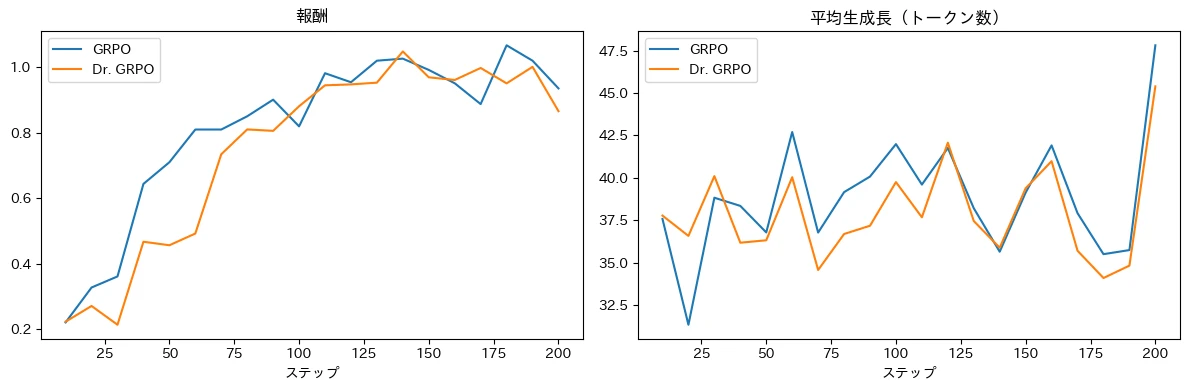
- 見るべき点: 報酬が同程度に伸びているか、そして GRPO の方が生成長が長くなっていく傾向があるかです。小規模な実験なので、差が出ない可能性もあります。
実行結果
考察:GRPO と Dr. GRPO
TRL で学習した2つの設定の、報酬と平均生成長の推移を比べます。
- 報酬: どちらも学習とともに1.0に近づきました。step 100 前後までは GRPO の方が早く上がり、それ以降はほぼ同じ推移です。
- 生成長: どちらも約37.5〜42.5トークンの間で上下を繰り返し、その値と動き方もほぼ同じでした。最後の step 200 で、どちらも約47.5トークンに上がっています。
学習の前半で GRPO の報酬が早く上がったのは、標準偏差で割るかどうかの違いで説明できます。正誤の報酬では、グループ内の標準偏差は1より小さいので、GRPO(標準偏差で割る)のアドバンテージは Dr. GRPO(割らない)より大きくなり、1回の更新で方策を大きく動かします。特に、8本中1本だけが正解するような「ほとんど解けない」問題で、この差は大きくなります(「発展」の節の、標準偏差による難易度のバイアス)。学習の後半は、どちらもほとんどの問題を解けるようになるので、差が小さくなったと考えられます。
生成長については、Dr. GRPO の論文が指摘した「GRPO では誤った応答が長くなりやすい」傾向は見られませんでした。応答が40トークン前後と短く、学習も200ステップと短い本実験では、応答長のバイアスの影響は小さかったと考えられます。また、2つの設定は同じシードで学習しているので、各ステップで同じ問題を解いています。生成長の上下や、最後の step 200 の上昇が2つの設定で同時に起きているのは、学習の違いではなく、そのステップに含まれる問題の難しさ(演算の回数)の違いを反映していると考えられます。
この実験の限界
- モデルと学習の規模: 0.5B のモデルを LoRA で、1ステップ4問 × 8本、200ステップだけ学習しています。DeepSeekMath(7B、)や DeepSeek-R1 の規模とは大きく異なり、同じ現象が同じ強さで現れるとは限りません。
- 合成データの偏り: 算数ワールドは四則演算だけの単純な文章題です。証明や幾何、複数の条件を組み合わせる問題などで同じ結果になるとは限りません。
- シードが1つ: 強化学習の結果は、生成のランダム性によって大きくばらつきます。本記事は1つのシードでの結果なので、確かな結論には複数のシードでの追試が必要です。
- 報酬と評価の抽出規則の違い: 報酬には厳しい抽出規則、評価には共通の緩い抽出規則を使っています。形式を守った割合が学習で大きく変わると、正解率の変化の一部は形式の変化によるものになる可能性があります。本実験では、形式を守った割合の変化は 0.896 から 1.000(約0.10)で、正解率の伸び(0.122 から 0.854)の大部分は、形式の変化では説明できません。
- プロンプトの影響: 途中の計算の書き方を示すため、解答例を1つ示しています(1-shot)。解答例の選び方や書式を変えると、学習前の正解率や学習の進み方が変わる可能性があります。
- Qwen2.5 の事前学習: Qwen2.5 は数学のデータを大量に含むデータで事前学習されていると考えられます。学習で上がった正解率の一部は、新しく身につけた能力ではなく、もともと持っていた能力を引き出しただけの可能性があります(Dr. GRPO の論文でも指摘されています)。
まとめ
記事を通じて、以下の内容を学習・実践しました。
- 価値関数を使わないアドバンテージ: GRPO は、同じ問題から 本の応答を生成し、報酬をグループ内の平均と標準偏差で正規化してアドバンテージにします。グループ平均は、問題ごとのベースラインをモンテカルロ法で推定したものと見なせます。
- PPO との差分: 次の3点が異なります。
- 価値関数と GAE をなくし、応答内の全トークンに同じアドバンテージを割り当てます
- KL を報酬に混ぜずに目的関数の項として加え、常に0以上の k3 推定量 で推定します
- 各応答の損失を応答長で割って平均します
- 検証可能な報酬(RLVR): 学習済み報酬モデルの代わりに、ルールベースの正解判定を報酬にします。ルールベースでも、答えを複数書くなどのハッキングの余地があるので、報酬には厳しい抽出規則を使いました。
- 学習信号が0になる問題: グループ内の報酬がすべて同じ問題では、アドバンテージが0になります。有効なグループの割合は で、学習を始める時点で正解率が中間にあることが重要になります。
- DeepSeekMath の考察: RL は主に maj@k を上げ、pass@k はあまり上げないと報告されています。結果監督と過程監督の違いや反復的な RL、そして SFT・RFT・DPO・PPO・GRPO を「データの出どころ × 報酬 × 勾配係数」で統一的に整理できることを見ました。
- 発展: Dr. GRPO が指摘した応答長のバイアスと標準偏差による難易度のバイアス、DAPO の非対称なクリップと動的サンプリングを紹介しました。
- 実装: Qwen2.5-0.5B-Instruct と算数ワールドで、グループ生成・報酬・グループ相対アドバンテージ・クリップ・k3 の KL・disable_adapter() による参照モデルをスクラッチ実装し、TRL の GRPOTrainer との対応を整理しました。
- 実験の結果:
- 途中の計算の書き方を解答例で示してから GRPO を行うと、評価用500問の正解率(pass@1)は 0.122 から 0.854 に上がりました。学習前にほとんど解けなかったステップ数4・5の問題も、0.80・0.53 まで伸びました。
- pass@8 も 0.322 から 0.922 に上がり、「RL は pass@k をあまり上げない」という DeepSeekMath の報告とは異なる結果になりました。学習に使っていない GSM8K の正解率は、有意な変化がありませんでした。
- TRL でも同じ設定で学習すると pass@1 は 0.936 になり、スクラッチ実装と同様に大きく伸びました。Dr. GRPO の設定では、学習の前半の報酬の上がり方が GRPO より遅かったものの、最終的な報酬と生成長の推移はほぼ同じでした。
DeepSeek-R1 との関係
本記事では、指示追従の SFT を済ませたモデルから GRPO を行い、算数の正解率を上げることを試みました。
では、SFT すらしていない ベースモデル に、思考の書き方の例も与えず、「正解したかどうか」だけを報酬にして強化学習を行ったら、何が起きるでしょうか。
教えられなくても、モデルは自分から長い思考過程を書き、途中で誤りに気づいて見直すようになるのだろうか?
この問いに答えたのが、DeepSeek-R1-Zero と、その問題点を多段階の学習で改善した DeepSeek-R1 です(詳しくはその記事で解説しています)。
※ライセンスに関する注記 本記事の実験で利用したモデル(Qwen/Qwen2.5-0.5B-Instruct)は Apache License 2.0、評価に用いた GSM8K は MIT License で公開されています。各提供元のライセンスに準拠して利用しています。
参考文献
- Z. Shao et al. (2024). DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300.
- N. Lambert et al. (2024). Tulu 3: Pushing Frontiers in Open Language Model Post-Training. arXiv:2411.15124.
- H. Lightman et al. (2024). Let's Verify Step by Step. ICLR 2024.
- Z. Yuan et al. (2023). Scaling Relationship on Learning Mathematical Reasoning with Large Language Models. arXiv:2308.01825.
- E. Zelikman, Y. Wu, J. Mu, N. D. Goodman (2022). STaR: Bootstrapping Reasoning With Reasoning. NeurIPS 2022.
- H. Dong et al. (2023). RAFT: Reward rAnked FineTuning for Generative Foundation Model Alignment. Transactions on Machine Learning Research.
- C. Gulcehre et al. (2023). Reinforced Self-Training (ReST) for Language Modeling. arXiv:2308.08998.
- Z. Liu et al. (2025). Understanding R1-Zero-Like Training: A Critical Perspective. arXiv:2503.20783.
- Q. Yu et al. (2025). DAPO: An Open-Source LLM Reinforcement Learning System at Scale. NeurIPS 2025.
- J. Schulman (2020). Approximating KL Divergence. Blog.
- Qwen Team (2024). Qwen2.5-0.5B-Instruct. Hugging Face(Apache License 2.0).
- OpenAI (2021). gsm8k. Hugging Face Datasets(MIT License).
本記事の文章・構成の一部に生成AIを使用しています。