山登り法(局所探索アルゴリズム)とは? 局所解の罠
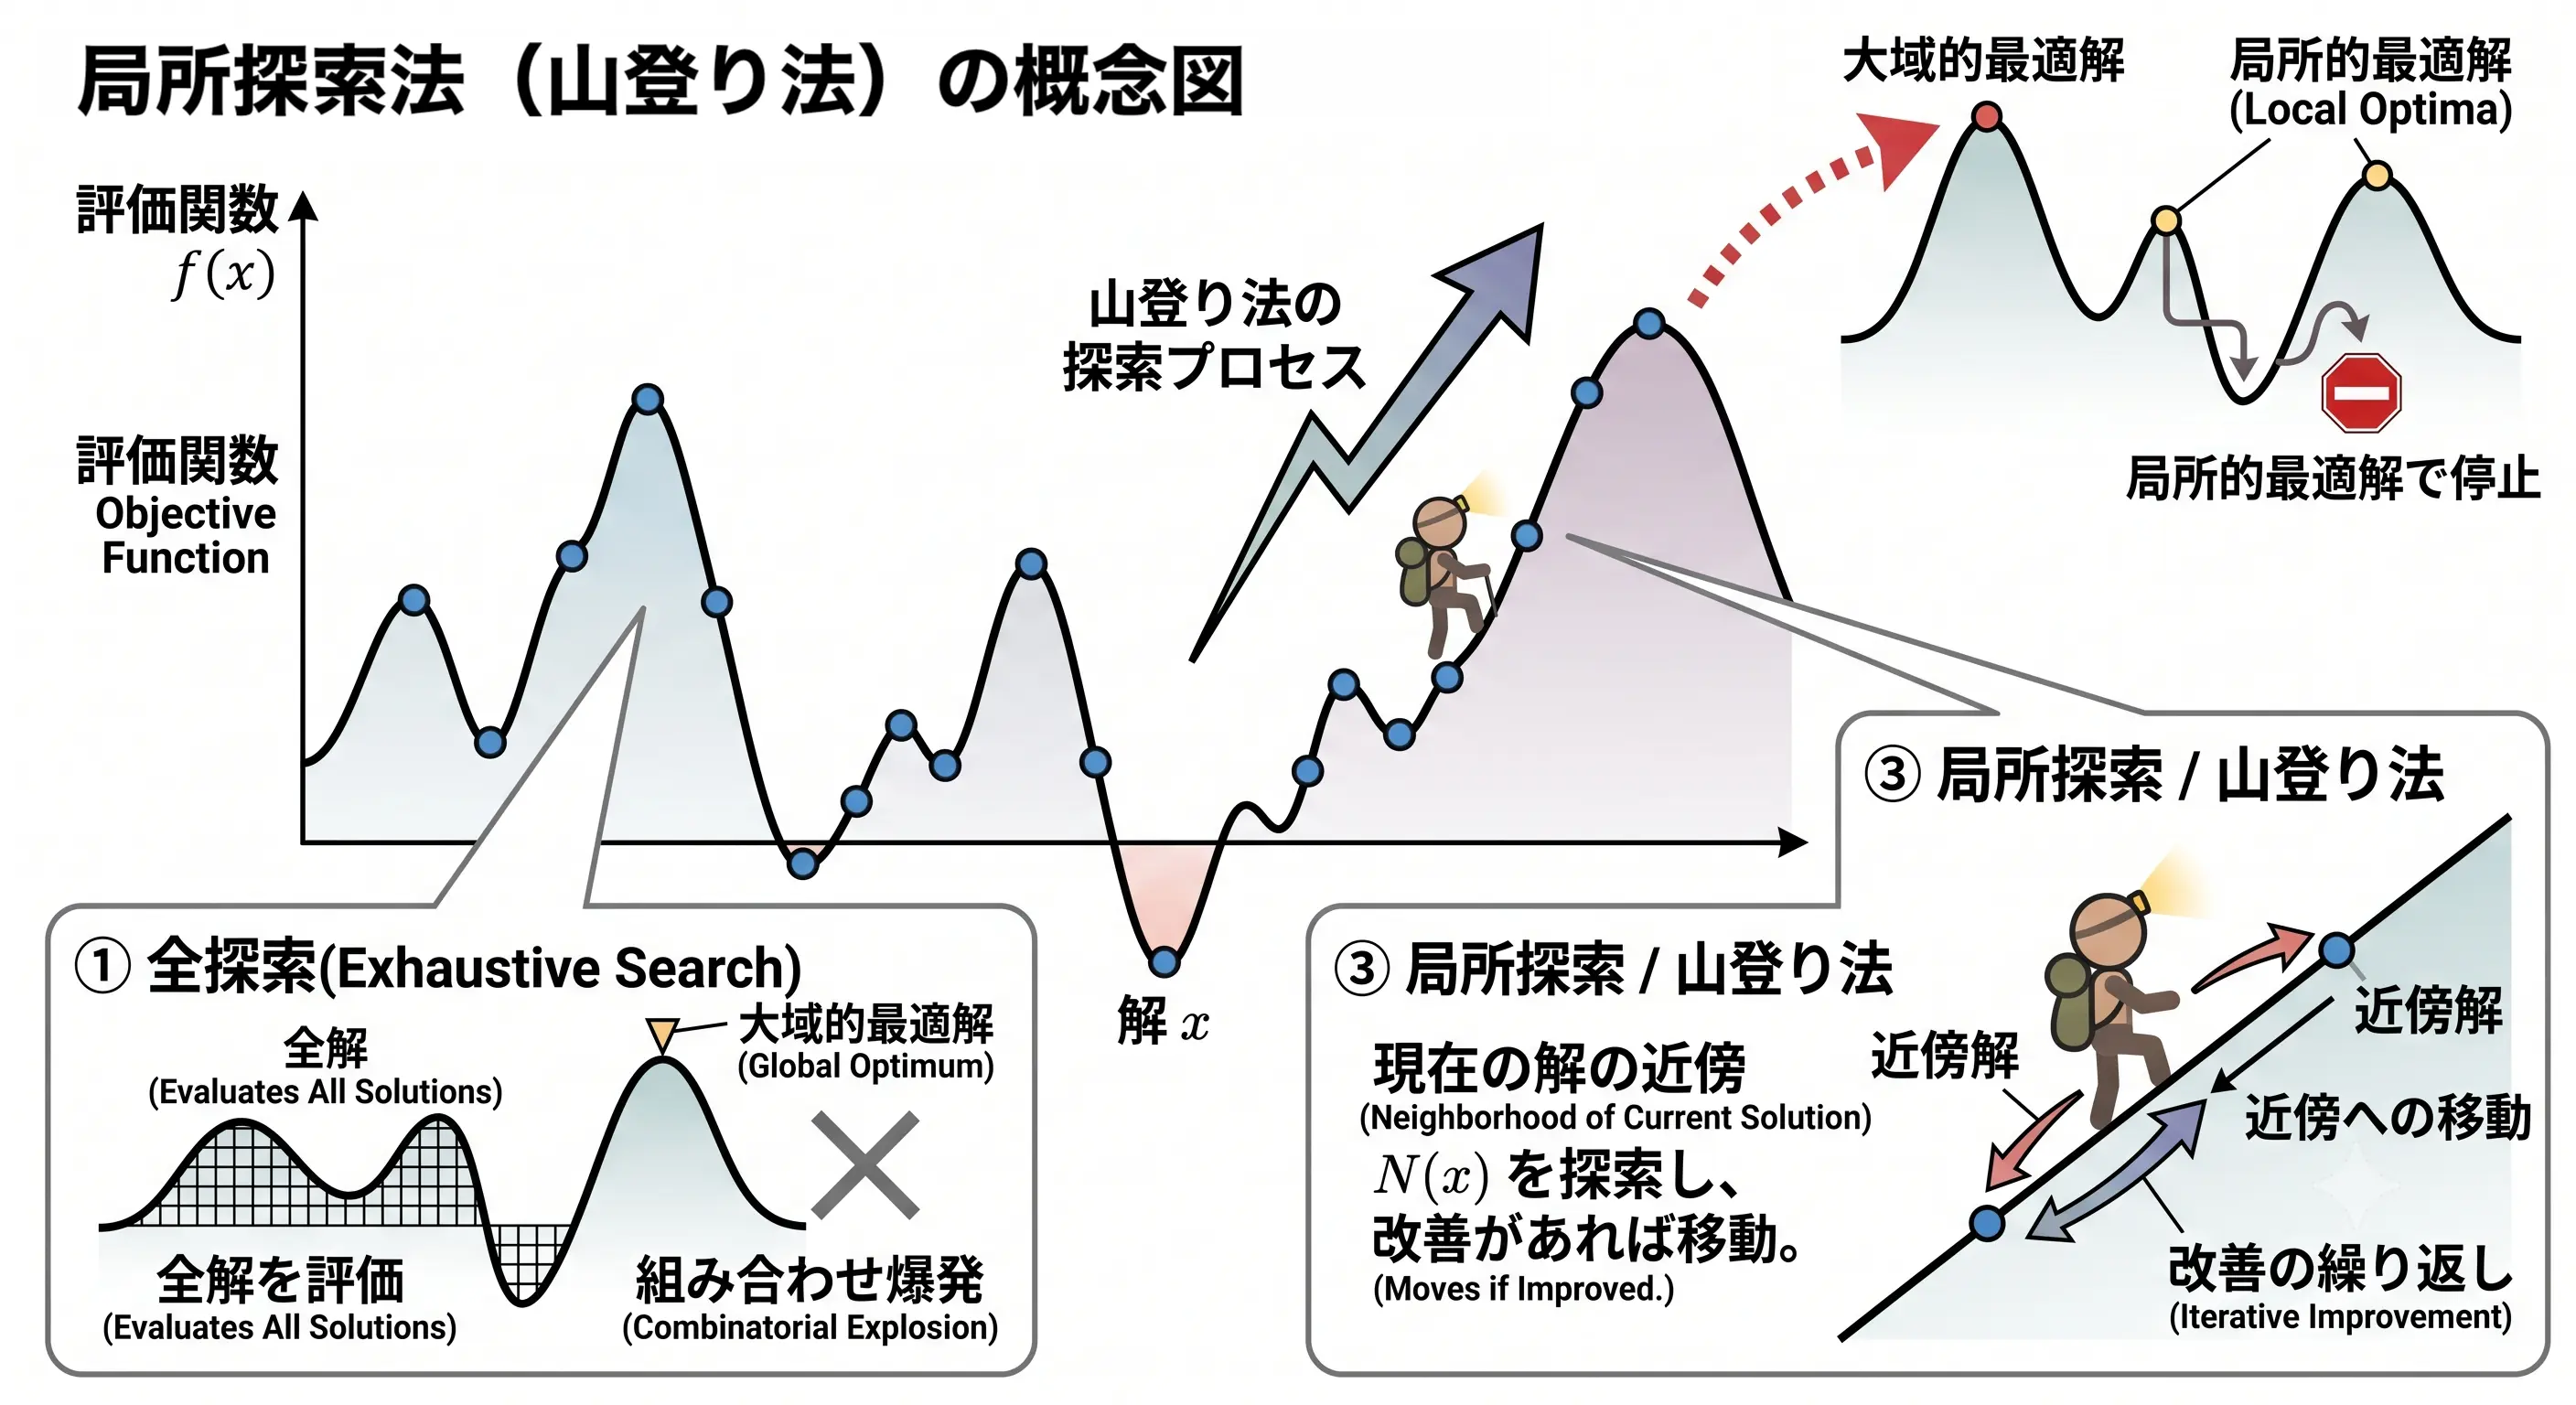 (画像は、Geminiで作成)
組み合わせ最適化で、全探索やランダム探索と比べながら、「今より良い近くの解へ移動し続ける」局所探索(山登り法)の考え方を理解すること。複数の山を持つ1次元の関数の最大化で3つの探索方法の結果を比べ、山登り法が速く改善できる一方で、初期位置によっては小さな山の頂上(局所解)で止まってしまうことを、探索の軌跡で確かめること。
局所探索(山登り法)アルゴリズムの概要
局所探索(Local Search)、特にその代表的でシンプルなアルゴリズムである 山登り法(Hill Climbing) は、組み合わせ最適化問題に対する直感的で強力な近似解法の一つです。
山登り法のアルゴリズムは、次の3ステップです。
- 初期解を決める: 探索を始める解を1つ選びます(本記事のコードでは などから始めます)。
- 近傍を評価して移動する: 現在の解の近傍(本記事では、左右に 0.1 だけ動いた2点)の評価値を計算し、最も良い近傍が今より良ければ、そこへ移動します。
- 改善しなくなったら終了する: どの近傍も今より良くなければ、その点を頂上(局所的最適解)とみなして終了します。そうでなければ 2 に戻ります。
配送ルートの最適化(巡回セールスマン問題)や、シフトスケジューリングなど、実社会の課題の多くは「組み合わせ最適化問題」として定式化されます。しかし、これらの問題は要素数が増えると組み合わせの数が爆発的に増加(組み合わせ爆発)するため、すべてのパターンを計算して完璧な正解を見つける「全探索(Exhaustive Search)」では、スーパーコンピュータを使っても宇宙の寿命以上の時間がかかってしまうという大きな課題がありました。
この課題を解決するため、必ずしも「厳密な最適解(大域的最適解)」でなくとも、実用上十分な「良い解」を高速に見つけ出す手法としてヒューリスティクス(近似解法)が発展しました。その基礎となるのが局所探索です。
山登り法は、「現在の解の『すぐ近く(近傍)』を少しだけ探索し、今より良い解があればそちらに移動する」という操作を繰り返す手法です。実装が非常にシンプルでありながら、初期解から高速に解を改善できるというメリットがあります。しかし、「現在の位置から見て上り坂(改善方向)」しか見ないため、小さな山の頂上(局所的最適解:Local Optimum)に到達すると、そこからもっと高い山(大域的最適解)が遠くにあっても探索が止まってしまうという弱点を持っています。この弱点を克服するために、後に「焼きなまし法(Simulated Annealing)」(焼きなまし法の記事)や「タブー探索(Tabu Search)」(タブー探索の記事)といった高度なメタヒューリスティクスへと発展していくことになります。
各探索アルゴリズムの比較
最適化したい評価関数(目的関数)を とし、その値を最大化することを目的とします。現在の解 に対して、少しだけ変更を加えた解の集合を近傍 とします。各探索手法がどのように解を決定するかを見ます。
① 全探索 (Exhaustive Search)
取りうるすべての解の集合 に対して を計算し、最大となる を見つけます。
- 探索方針:
確実に最適な解が見つかりますが、解の空間 が大きくなると計算量が となり、現実的な時間で終了しなくなるという致命的な弱点があります。
② ランダム探索 (Random Search)
解の集合 からランダムに複数の解を生成・評価し、これまでに見つかった最大の を保持します。
- 探索方針:
完全に運任せの探索となるため、特定の局所解に捕らわれることはありませんが、膨大な空間の中から「たまたま」良い解を引き当てる確率は低く、探索効率は非常に悪いです。
③ 局所探索 / 山登り法 (Hill Climbing)
現在の解 の近傍 の中から最も良い解 を探し、それが現在の解より良ければ移動します。
-
探索方針(評価関数の差分):
-
更新条件:
現在の状態から「常に良くなる方向」のみへ進みます。近傍 内のすべての解について となった場合(どこへ移動しても悪くなる場合)、その地点を頂上(局所的最適解)とみなして探索を終了します。過去の履歴を保持する必要がなく、メモリ消費も最小限で済みます。
3つの探索の違いを図にまとめると、次のようになります。
(図は、diagram-designで作成)
コードによる挙動の確認
Pythonのコードを使って、シンプルな1次元関数の最大化問題を例に、それぞれのアルゴリズムがどのように解を探索するのかを見ていきましょう。
今回は、複数の山(局所的最適解)と一番高い山(大域的最適解)を持つ関数 を最大化する問題を設定します。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google ColabやJupyterでは先頭の「!」を付けたまま、ターミナルでは「!」を外して実行します)。japanize-matplotlib は distutils を使うので、Python 3.12 以降で import エラーになる場合は、setuptools も一緒にインストールしてください。
!pip install japanize-matplotlib setuptools
import math
import random
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフの日本語表示用。事前に pip install japanize-matplotlib が必要です

# 評価関数(目的関数):最大化したい対象の関数
# 複数の山(局所的最適解)と、1つの最も高い山(大域的最適解)を持っています
def f(x):
    return math.sin(x) + math.cos(0.5 * x)

# 探索空間の設定(0.0 から 10.0 の範囲を探索)
x_min, x_max = 0.0, 10.0
step_size = 0.1  # 探索のステップ幅(近傍への移動距離)

print("--- 準備 ---")
print(f"探索範囲: {x_min} から {x_max}")

# --- 可視化のためのデータ生成 ---

# 探索範囲内を step_size 刻みで分割した x の値のリストを作成
x_vals = []
current_x = x_min
while current_x <= x_max:
    x_vals.append(current_x)
    current_x += step_size

# 作成した各 x に対する評価関数 f(x) の値を計算してリストに格納
y_vals = [f(x) for x in x_vals]

# グラフの描画設定
plt.figure(figsize=(10, 6))
plt.plot(x_vals, y_vals, color='#1f77b4', linewidth=2, label='目的関数 f(x)')

# グラフのタイトルと軸ラベルの設定
plt.title("評価関数 f(x) = sin(x) + cos(0.5x) の形状", fontsize=14, fontweight='bold')
plt.xlabel("変数 x", fontsize=12)
plt.ylabel("評価値 f(x)", fontsize=12)

# グリッド(補助線)と凡例を表示
plt.grid(True, linestyle='--', alpha=0.6)
plt.legend()

# グラフを画面に出力
plt.show()
最大化する評価関数を定義し、その形をグラフで確かめるコードです。
- 評価関数: f は です。周期の違う2つの波を足すと、高さの違う山が2つできるので、「低い山の頂上で止まる」という山登り法の弱点を1次元で見せられます。
- 探索範囲: 0.0〜10.0 にするのは、一番高い山()と、低い山()の両方を含め、その間に谷()を挟むためです。
- ステップ幅: step_size の 0.1 は、全探索の刻み幅と、山登り法の1歩の大きさの両方に使います。範囲を101点で調べられ、頂上(1.27)に 1.30 まで近づける細かさで、評価の回数も多くなりすぎません。
- グラフ: 探索を始める前に、山が2つあることと、どちらが高いかを目で確かめるために描きます。
実行結果
--- 準備 ---
探索範囲: 0.0 から 10.0
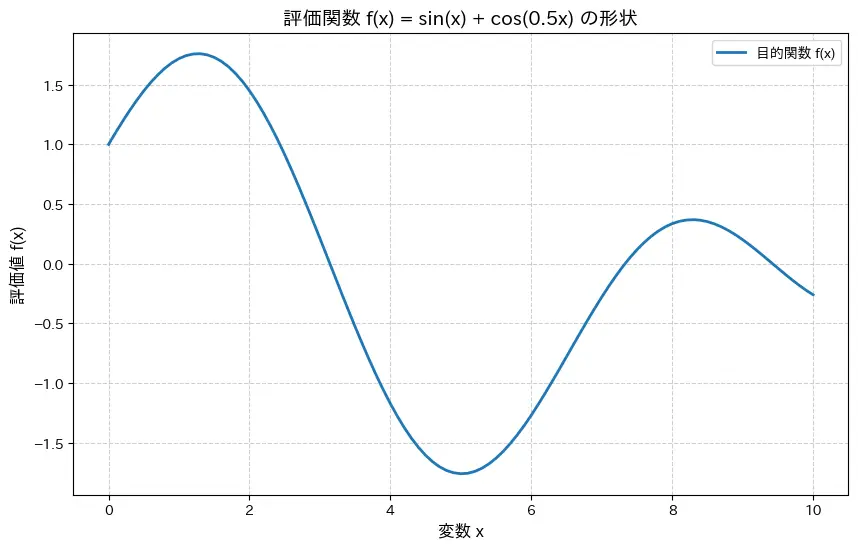
このプロットからわかるように、評価関数 には複数の盛り上がり(山)が存在しています。 具体的には、 付近(厳密には )に最も高い「大域的最適解(グローバル最適解)」があり、 付近にそれよりは低い「局所的最適解(ローカル最適解、あるいは局所解)」が存在します。 ここからは、全探索、ランダム探索、そして山登り法(局所探索)が、この空間をどのように探索していくかを具体的に見ていきます。
全探索 (Exhaustive Search)
以下のコードでは、指定された範囲を細かいステップで全て網羅し、最も高い値を見つけます。
# 最適解を保持する変数。初期値として探索範囲の最小値(x_min)とそのスコアを設定します
best_x = x_min
best_score = f(best_x)

# 探索範囲内(x_min から x_max)を step_size 刻みですべて調べる(全探索)
current_x = x_min
while current_x <= x_max:
    score = f(current_x)
    # これまでに見つかったスコアよりも高い値が見つかれば、最適解を更新
    if score > best_score:
        best_score = score
        best_x = current_x
    # 次の探索地点へ進む
    current_x += step_size

print(f"全探索の最適解: x = {best_x:.2f}, スコア = {best_score:.4f}")
print("⭕ 利点: 確実に一番高い山(大域的最適解)を見つけられる。")
print("❌ 課題: 次元が増え空間が広くなると計算が終わらない。\n")
範囲全体を 0.1 刻みですべて評価し、最も高い点を探すコードです。
- 比べる基準: 全探索の結果は、確実に一番高い点です。後のランダム探索と山登り法の結果を、これと比べます。
- 初期値: best_x と best_score に範囲の左端の値を入れておくのは、最初の比較の相手を作るためです。
- 評価の回数: 0.0〜10.0 を 0.1 刻みで、101回評価します。1次元なら一瞬ですが、変数が増えると、この回数は変数の数の指数で増えます。
実行結果
全探索の最適解: x = 1.30, スコア = 1.7596
⭕ 利点: 確実に一番高い山(大域的最適解)を見つけられる。
❌ 課題: 次元が増え空間が広くなると計算が終わらない。
current_x を 0.0 から 10.0 まで、0.1 刻みで全て計算して評価しています。1次元であれば一瞬で終わりますが、実問題で変数が数千〜数万になると、このループ回数は天文学的な数字になります。
なお、0.1 刻みで調べているため、見つかる解も刻みの上にある になります。関数の真の頂上は (スコア約 )にあり、刻み幅を細かくするほどこれに近づきますが、そのぶん評価回数も増えていきます。
ランダム探索 (Random Search)
以下のコードでは、ランダムに数点だけピックアップし、その中で最も良いものを選びます。簡易化のため、探索回数を10回に制限しています。
# 乱数のシード値を固定(結果の再現性を保つため)
random.seed(42)

# 初期のランダム探索地点を1点決定し、そのスコアを初期の暫定最適値とします
best_x_rand = random.uniform(x_min, x_max)
best_score_rand = f(best_x_rand)

# ランダムに10回だけ探索(試行回数を10回に制限)
for _ in range(10):
    # 探索空間(x_min から x_max)内から、一様分布に従ってランダムな実数 x を生成
    x_rand = random.uniform(x_min, x_max)
    score = f(x_rand)

    # より良いスコアが見つかれば、暫定最適解を更新
    if score > best_score_rand:
        best_score_rand = score
        best_x_rand = x_rand

print(f"ランダム探索の最適解: x = {best_x_rand:.2f}, スコア = {best_score_rand:.4f}")
print("⭕ 利点: 局所解に捕らわれず、計算手順もシンプル。")
print("❌ 課題: 運任せのため精度が保証されず、次元が増えると良い解を引き当てにくい。\n")
範囲からランダムに選んだ点だけを評価し、その中で最も高い点を選ぶコードです。
- 乱数: random.seed(42) でシードを固定するのは、何度実行しても同じ点が選ばれ、記事と同じ結果になるようにするためです。42 は慣習的によく使われる値で、結果がこの値に有利になるように選んだものではありません(シードを変えたときのばらつきは、実行結果の後で説明します)。
- 評価の回数: 初期の1点と、ループの10点で、合わせて11回です。全探索(101回)の約10分の1の回数で、どこまで頂上に近づけるかを見ます。
- 一様分布: random.uniform で範囲のどこも同じ確率で選ぶのは、山の位置を何も知らない状態で探す、という条件にするためです。
実行結果
ランダム探索の最適解: x = 0.87, スコア = 1.6709
⭕ 利点: 局所解に捕らわれず、計算手順もシンプル。
❌ 課題: 運任せのため精度が保証されず、次元が増えると良い解を引き当てにくい。
random.uniform を用いて無作為に選んだ座標を評価しています。今回は運よく大域的最適解の山の中腹()に当たりましたが、頂上(、スコア約 )には届いていません。また、乱数のシードを変えると、到達する解は 付近の低い場所から頂上付近まで大きくばらつきます。
今回の問題は1次元で探索範囲も狭く、しかも一番高い山の裾野が広いため、11回の試行でもそれなりの解を引き当てられました。しかし変数の数(次元)が増えると、探索空間は指数関数的に広がり、同じ試行回数で良い解を引き当てる確率は急激に下がります。限られた試行回数の中では、ランダム探索のみで高い精度の解を安定して見つけ出すのは困難です。
局所探索 / 山登り法 (Hill Climbing)
以下のコードでは、適当な初期位置からスタートし、左右(近傍)を見て高い方へ移動し続ける山登り法を実装します。
初期値が3.0の場合
# 初期解(スタート地点を 3.0 に設定)
current_x_hc = 3.0

while True:
    # 近傍の生成:現在の位置から左右にステップ幅(step_size = 0.1)だけ移動した2つの候補点
    neighbors = [current_x_hc - step_size, current_x_hc + step_size]

    # 探索空間の範囲内(x_min から x_max)に収まっている候補点のみにフィルタリング
    valid_neighbors = [nx for nx in neighbors if x_min <= nx <= x_max]

    # 暫定の最良候補を現在の位置に設定
    best_neighbor = current_x_hc
    best_neighbor_score = f(current_x_hc)

    # 有効な近傍候補点を順番に評価
    for nx in valid_neighbors:
        score = f(nx)
        # 現在保持している最高スコアよりも高い値を持つ近傍があれば更新
        if score > best_neighbor_score:
            best_neighbor_score = score
            best_neighbor = nx

    # 近傍のどれを探索しても改善しない(頂上、すなわち局所最適解に達した)場合は終了
    if best_neighbor_score <= f(current_x_hc):
        break

    # 現在地を最も高かった近傍(best_neighbor)に更新し、探索を繰り返す
    current_x_hc = best_neighbor

print(f"山登り法の解: x = {current_x_hc:.2f}, スコア = {f(current_x_hc):.4f}")
print("⭕ 利点: 高速に解を改善できる。")
左右の隣の点を見て、高い方へ1歩ずつ進み、どちらも低くなったら止まるコードです。
- 初期値: 3.0 は、谷()より左、つまり一番高い山の側にあります。初期値が良い位置にあれば、山登り法が頂上に着けることを確かめるためです。
- 近傍: neighbors は、現在地の左右に step_size だけ動いた2点です。1次元なので、「すぐ近く」はこの2点だけです。
- 範囲の確認: valid_neighbors で範囲の外の点を除くのは、範囲の端で、探索空間の外に出てしまわないようにするためです。
- 止まる条件: 最良の近傍が現在地より高くなければ break します。上り坂がどこにもない=頂上に着いた、という判定です。
- 評価の回数: 3.0 から 1.30 まで17歩進みます。近傍の評価は1歩につき2点なので、止まるまでの18回で36回です。全探索の101回より少なく、同じ頂上に着いています。
実行結果
山登り法の解: x = 1.30, スコア = 1.7596
⭕ 利点: 高速に解を改善できる。
初期解を とした場合、山登り法は 、スコア に到達しました。 これは全探索で見つけた解(、スコア )と一致しており、大域的最適解の山の頂上を、全探索の3分の1ほどの評価回数(36回 対 101回)で発見できていることを意味します。 このように、初期解が良い位置にあれば、山登り法は非常に強力で効率的なアルゴリズムとして機能します。
初期値が8.0の場合
# 初期解(少し意地悪なスタート地点として 8.0 に設定)
current_x_hc = 8.0

while True:
    # 近傍の生成:現在の位置から左右にステップ幅だけ移動した2つの候補点
    neighbors = [current_x_hc - step_size, current_x_hc + step_size]

    # 探索空間の範囲内に収まっている候補点のみにフィルタリング
    valid_neighbors = [nx for nx in neighbors if x_min <= nx <= x_max]

    # 暫定の最良候補を現在の位置に設定
    best_neighbor = current_x_hc
    best_neighbor_score = f(current_x_hc)

    # 有効な近傍候補点を順番に評価
    for nx in valid_neighbors:
        score = f(nx)
        # より良いスコアが見つかれば最良近傍候補を更新
        if score > best_neighbor_score:
            best_neighbor_score = score
            best_neighbor = nx

    # 近傍のどれを探索しても改善しない場合は終了
    if best_neighbor_score <= f(current_x_hc):
        break

    # 現在地を最良近傍に更新
    current_x_hc = best_neighbor

print(f"山登り法の解: x = {current_x_hc:.2f}, スコア = {f(current_x_hc):.4f}")
print("❌ 課題: スタート地点によっては小さな山の頂上で止まってしまう。")
コードは初期値 3.0 の場合と同じで、初期値だけを 8.0 に変えたコードです。
- 初期値: 8.0 は、谷()より右、つまり低い山の側にあります。初期値が悪い位置にあると、山登り法が低い山の頂上で止まることを確かめるためです。
- コードを変えない理由: 初期値以外を同じにすることで、結果の違いが初期値だけによることを示します。
実行結果
山登り法の解: x = 8.30, スコア = 0.3690
❌ 課題: スタート地点によっては小さな山の頂上で止まってしまう。
neighbors = [current_x_hc - step_size, current_x_hc + step_size] によって、現在の位置のすぐ両隣だけを評価します。もし隣の方が値が高ければ、current_x_hc = best_neighbor で位置を更新します。しかし結果を見ると、大域的最適解( 付近)ではなく、 という中途半端な解(局所的最適解)で探索が止まってしまっています。これが、山登り法における「局所解の罠」と呼ばれる決定的な弱点です。
ここまでの4つの結果を並べると、次のようになります。
(図は、diagram-designで作成)
3つの探索の評価回数を並べると、次のようになります。
(図は、diagram-designで作成)
探索軌跡の可視化と局所解の罠
上記の山登り法が、どのように「局所的最適解」に陥ってしまうのかをグラフで確認します。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib

# NumPy用の評価関数の定義(ベクトル演算に対応させるため)
def f_np(x):
    return np.sin(x) + np.cos(0.5 * x)

# 1. 関数の全体形状を描画するためのデータを生成
# 0.0 から 10.0 の間を均等に 200 分割した配列を作成
x_vals = np.linspace(0, 10, 200)
y_vals = f_np(x_vals)

# 2. 初期位置と山登り法のシミュレーション(軌跡を記録)
start_x = 8.0
path_x = [start_x]  # 探索した x 座標の履歴を保存するリスト
current_x = start_x
step = 0.1

while True:
    neighbors = [current_x - step, current_x + step]
    best_n = current_x
    best_score = f_np(current_x)

    # 左右の近傍を評価してより高い方を探す
    for nx in neighbors:
        if 0 <= nx <= 10 and f_np(nx) > best_score:
            best_score = f_np(nx)
            best_n = nx

    # 改善がなければ終了
    if best_score <= f_np(current_x):
        break

    current_x = best_n
    path_x.append(current_x)

# 探索軌跡の f(x) の値を算出
path_y = [f_np(x) for x in path_x]

# 3. グラフの描画
plt.figure(figsize=(10, 6))
# 元の評価関数の曲線を青線でプロット
plt.plot(x_vals, y_vals, color='#1f77b4', linewidth=2, label='目的関数 f(x)')
# 山登り法の探索の軌跡を赤丸と点線でプロット
plt.plot(path_x, path_y, marker='o', color='red', markersize=5, linestyle='--', label='山登り法の軌跡')

# グラフ上に「スタート地点」「局所的最適解」「大域的最適解」の注釈を矢印付きで追加
plt.annotate('スタート地点', xy=(path_x[0], path_y[0]), xytext=(7.5, 0.5),
             arrowprops=dict(facecolor='black', shrink=0.05, width=1, headwidth=6))
plt.annotate('局所的最適解で\n探索がストップ', xy=(path_x[-1], path_y[-1]), xytext=(5.5, 1.2),
             arrowprops=dict(facecolor='black', shrink=0.05, width=1, headwidth=6))
plt.annotate('本当の最高地点\n(大域的最適解)', xy=(1.27, f_np(1.27)), xytext=(2.2, 0.5),
             arrowprops=dict(facecolor='red', shrink=0.05, width=1, headwidth=6))

# タイトル、軸ラベル、凡例、グリッドを設定
plt.title("山登り法の探索プロセスと局所解への収束", fontsize=14, fontweight='bold')
plt.xlabel("変数 x", fontsize=12)
plt.ylabel("評価値 f(x)", fontsize=12)
plt.legend()
plt.grid(True, linestyle='--', alpha=0.6)
plt.show()
初期値 8.0 の山登り法の軌跡を記録し、評価関数のグラフに重ねて描くコードです。
- NumPy の評価関数: f_np を別に定義するのは、np.linspace の配列に、1回で評価関数を適用するためです(math.sin は配列を受け取れません)。
- 曲線の点の数: 200点にするのは、0.1 刻み(101点)より細かくして、曲線を滑らかに描くためです。
- 軌跡の記録: path_x に、移動するたびに現在地を足します。止まった点が低い山の頂上であることを、グラフで見るためです。
- 注釈: plt.annotate で、スタート地点・止まった点・一番高い点に矢印を付けるのは、軌跡が一番高い点に届いていないことを、ひと目で分かるようにするためです。
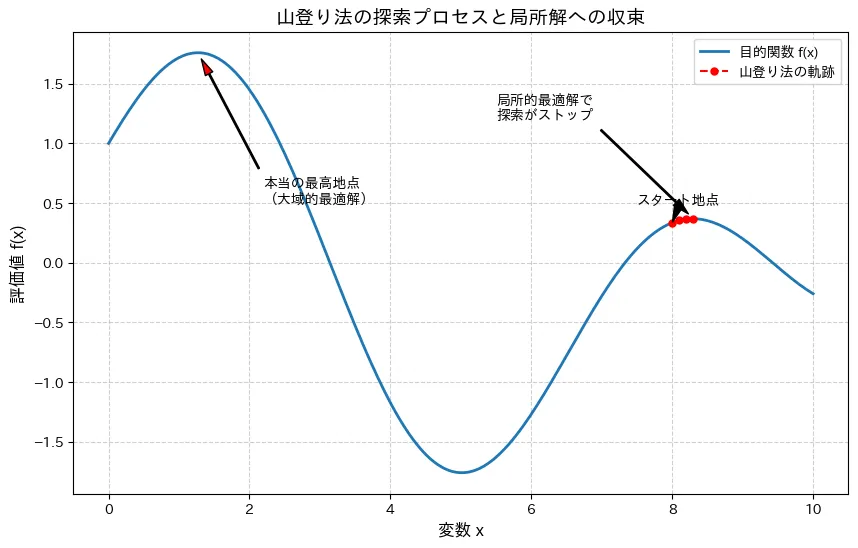
このコードブロックでは、山登り法の最大の特徴であり弱点でもある「局所的最適解(Local Optima)への収束」をシミュレーションし、グラフ化しています。上記コードを実行すると、次のようなグラフが描画されます。
軌跡グラフからわかる山登り法の限界
- 近傍探索による着実な改善: 赤い点線が山登り法の軌跡です。スタート地点()から始まり、関数が大きくなる方向(上り坂)に向かって一歩ずつ着実に進んでいることがわかります。
- 局所的最適解(Local Optima)の罠: 探索は小さな山の頂上( 付近)に到達するとストップしてしまいます。なぜなら、その頂上から見て「右に行っても左に行っても値が下がる()」ため、アルゴリズムは「ここが最も高い場所だ」と判断してしまうからです。
- 大域的最適解への未到達: グラフ全体を見ると、 付近により高い山(大域的最適解)が存在することがわかります。しかし、山登り法は「一時的に谷を下る(一時的にスコアの悪化を許容する)」ことができないため、この本当の最高地点にたどり着くことができません。
まとめ
本記事では、組み合わせ最適化アルゴリズムの基礎となる局所探索(山登り法)について、その理論的背景から具体的な挙動までを解説しました。
本記事では、以下の点について解説しました。
-
山登り法のコアコンセプトの理解: 全探索やランダム探索と比較して、「近くのより良い解へ移動し続ける」というシンプルかつ高速なアイデアを学びました。
-
Pythonによる挙動の比較検証: 各探索アルゴリズムをコードでシミュレートし、山登り法が確実にスコアを改善できる一方で、初期位置に依存するという特性を確認しました。
-
探索プロセスと局所解の可視化: グラフを通じて、上り坂のみを進む性質ゆえに、「小さな山の頂上」で探索が終了してしまうという最大の課題を直感的に理解しました。
山登り法は、実装が容易でありながら強力なベースラインとなるアルゴリズムです。実社会の複雑な問題では局所解に陥るリスクが高いため、この「谷を下れない」弱点を克服するために、一時的な改悪を許容する焼きなまし法(Simulated Annealing) や、過去の探索履歴を記憶するタブー探索(Tabu Search) といった発展的な手法が考案されています。まずはこの山登り法のメカニズムをしっかり理解することが、高度な最適化手法を学ぶための第一歩となります。
なお、局所解の罠は1次元の練習問題に限った話ではありません。MMMによる予算配分の最適化の記事では、TVのS字カーブがあるために、山登り法が「TVに1円も配分しない」局所解で止まってしまう実例を扱っています。
本記事の例は、連続の変数 を、決まった歩幅 0.1 の近傍で動かしています。連続な関数では、進む方向を勾配で決めたうえで、どれだけ進むか(歩幅)を1回ごとに決める 直線探索(Line Search) という考え方もあります。山登り法が近傍の候補を比べて移動先を選ぶのに対し、直線探索は1つの方向の上で歩幅を調整します。
参考文献
- S. Russell, P. Norvig (2020). Artificial Intelligence: A Modern Approach (4th ed.). Pearson.
本記事の文章・構成の一部に生成AIを使用しています。