HippoRAG とは? PageRank で複数の文書をまたぐ検索
 (画像は、Geminiで作成)
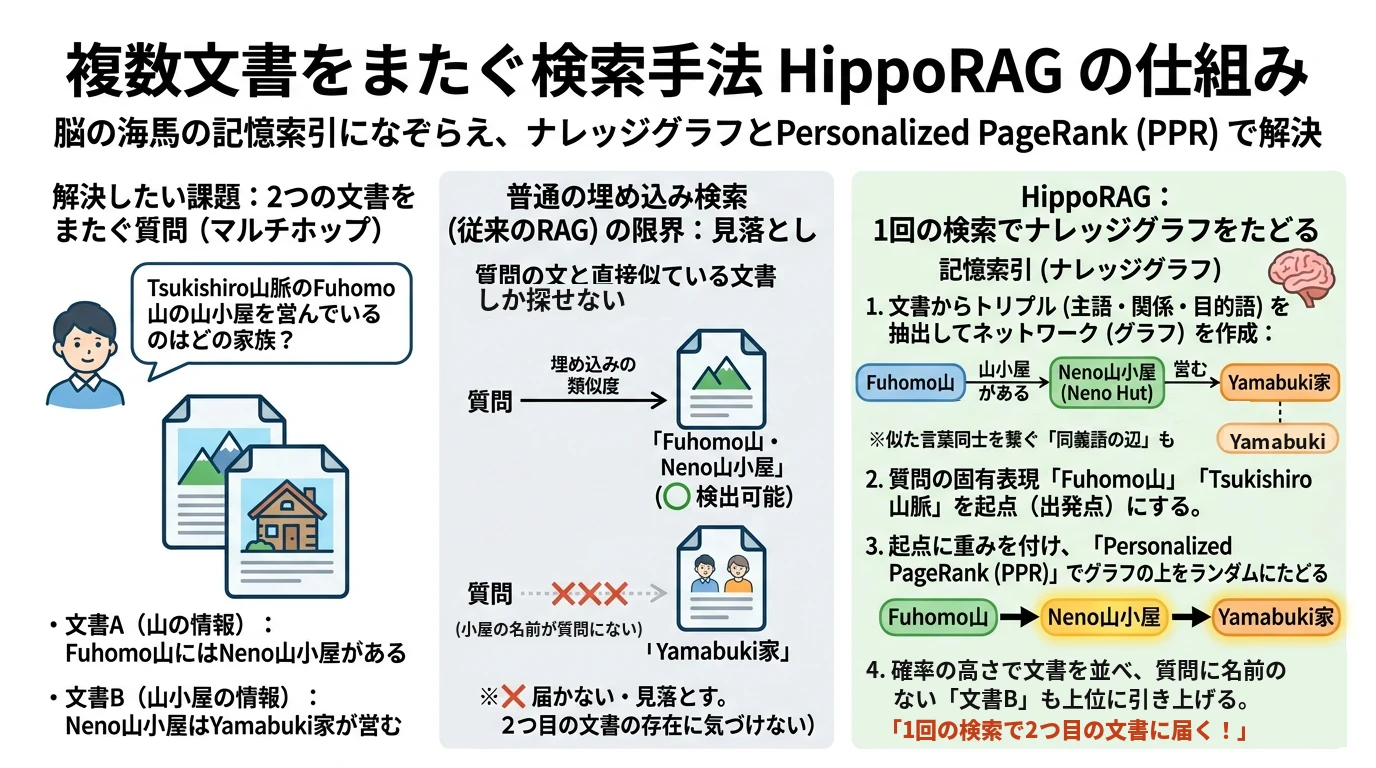
2つ以上の文書をまたがないと答えられない質問で、普通の埋め込み検索が2つ目の文書を見落とす理由と、HippoRAG がナレッジグラフの上の Personalized PageRank で、それを1回の検索で集める仕組みを、コードで理解すること。PPR・ノードの特異性・同義語の辺が、それぞれ検索の精度にどう効くのかを、数値で説明できるようになること。
原著論文: HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models (Jiménez Gutiérrez, Shu, Gu, Yasunaga, Su, NeurIPS 2024)
本記事のコードは、Google Colab の L4 GPU(24GB)で、Python 3.13、transformers 5.22.1、torch 2.14.1、sentence-transformers 5.7.0、networkx 3.7、scipy 1.16.3 を使って実行しました。LLM には Qwen2.5-7B-Instruct(bf16)、埋め込みには原著論文と同じ Contriever(facebook/contriever)を使います。全体の実行には約13分かかり、そのうち約12分は、660件の文書からトリプルを抜き出すインデキシングの時間です。生成は貪欲法(do_sample=False)なので、同じ環境では同じ結果になります。
概要
RAG(RAG の記事)は、質問の文と似た文書を探して LLM に読ませます。しかし、「Tsukishiro 山脈の Mount Fuhomo の山小屋を営んでいるのは、どの家族か」のような質問では、答えが2つの文書に分かれています。山の文書には小屋の名前(Neno Hut)が書かれ、小屋の文書には運営者(Yamabuki 家)が書かれていて、小屋の文書には山の名前が出てきません。このような マルチホップ の質問では、1つ目の文書を読んで初めて、2つ目の文書を探す手がかり(小屋の名前)がわかります。質問の文と似た文書を1回探すだけでは、2つ目の文書は見つかりにくく、検索と推論を何度も繰り返す方法(IRCoT など)は、LLM を何度も呼ぶので時間と費用がかかります。
HippoRAG(Jiménez Gutiérrez et al., NeurIPS 2024)は、脳の海馬が記憶の「索引」として働くという説(海馬の記憶索引理論)にならい、文書を読む前に、文書から抜き出した名詞句を ナレッジグラフ につないでおきます。質問が来たら、質問の固有表現に対応するノードから Personalized PageRank(PPR)でグラフをたどり、山 → 小屋のように、つながった先の文書まで、1回の検索で集めます。原著論文では、繰り返し検索する方法と同程度の精度を、10〜30倍安く、6〜13倍速く出しています。
本記事では、GraphRAG の記事と同じ架空の山岳コーパスに、山小屋の文書を足して、2つの文書をまたぐ質問を60問作ります。HippoRAG のインデキシングと検索をスクラッチ実装し、普通の埋め込み検索と比べたうえで、PPR・ノードの特異性・同義語の辺のどれが効いているかを確かめます。
HippoRAG の仕組み
(図は、diagram-designで作成)
HippoRAG の名前は、海馬(hippocampus)から来ています。神経科学の「海馬の記憶索引理論」では、出来事の内容そのものは大脳の新皮質に蓄えられ、海馬は「どの内容とどの内容が結びつくか」の索引だけを持つと考えます。手がかりの一部が来ると、海馬の索引をたどって、関係する記憶の全体を思い出せます(パターン補完)。HippoRAG は、この役割分担を次のように置き換えます。
- 新皮質 → LLM: 文書を読んで、固有表現とトリプル(主語・関係・目的語)を抜き出します(OpenIE)。
- 海馬傍回 → 埋め込みのモデル: 似た名前のノードの間に同義語の辺を張り、質問の固有表現をグラフのノードに結びます。
- 海馬 → ナレッジグラフと PPR: 名詞句をノードにしたグラフを索引として持ち、質問のノードから PPR でたどって、関係するノードと文書を一度に集めます。
インデキシング(オフライン)では、文書ごとに1回だけ、次のものを作ります。
- ナレッジグラフ: OpenIE で抜き出したトリプルの主語と目的語を、ノードにします。同じ名前は小文字にそろえて同じノードにし、同じ組が何度も出てきたら、辺の重みを足します。
- 同義語の辺: 埋め込みのコサイン類似度が閾値 以上のノードの組に、類似度を重みにした辺を足します。「Yamabuki family」と「Yamabuki」のような、表記の違うノードをつなぐためです。
- 文書×ノードの行列: 文書ごとに、どのノードが何回出てくるかを数えた行列です。検索の最後に、ノードの確率を文書のスコアに変えるのに使います。
検索(オンライン)では、質問ごとに1回、次の計算をします。
- 質問の固有表現を抜き出す: LLM で、質問に出てくる固有表現(例:Mount Fuhomo、Tsukishiro Range)を抜き出します。
- ノードに結ぶ: 固有表現ごとに、埋め込みが最も近いノードを1つ選びます。これが PPR の出発点 です。
- Personalized PageRank: 出発点に重みを付け、グラフの上をランダムにたどったときに、各ノードにいる確率を求めます。
- 文書のスコア: ノードの確率に、文書×ノードの行列をかけ、文書ごとのスコアにして並べます。
PPR とノードの特異性の式は、検索のコードの直前で示します。PPR そのものは、PageRank の記事で、べき乗法のスクラッチ実装と一緒に解説しています。
(図は、diagram-designで作成)
原著論文は、マルチホップの質問を2種類に分けています。
- 経路をたどる質問(path-following): 本記事の「山 → 小屋 → 運営者」のように、出発点から1本の道を順にたどれば答えに着く質問です。検索と推論を繰り返す IRCoT でも解けます。HippoRAG は、これを1回の検索で済ませます。
- 経路を探す質問(path-finding): 原著論文の例は「スタンフォード大学の教授で、アルツハイマー病の神経科学を研究しているのは誰か」です。スタンフォード大学の教授も、アルツハイマー病の研究者も大勢いるので、どちらの条件から1本ずつたどっても候補が絞れません。PPR は、2つの出発点から同時に確率を流すので、両方につながるノード(Thomas Südhof)の確率が高くなります。原著論文は、このような質問で、ColBERTv2 や IRCoT が正解の文書を集められず、HippoRAG が集められた例を挙げています。
本記事の実験で扱うのは、経路をたどる質問です。
実験の準備
架空の山と山小屋のコーパス
GraphRAG の記事と同じ、600件の架空の山の紹介文を使い、そのうち60山に山小屋を足します。山の文書の最後に「Mount Fuhomo has a mountain hut, Neno Hut, below its summit.」のような文を足し、小屋の名前だけを書きます。小屋の運営者は、別の文書「Neno Hut is a mountain hut run by the Yamabuki family. …」に書き、こちらには山の名前を書きません。こうすると、「Tsukishiro 山脈の Mount Fuhomo の山小屋を営んでいるのは、どの家族か」という質問は、山の文書と小屋の文書の 両方を読まないと答えられない 2段の質問になります。名前はすべて架空なので、LLM が事前の知識で答えることはできません。
import random
import re

SYLLABLES = ["ka", "ra", "se", "mo", "ri", "to", "na", "shi", "ku", "yo",
             "ha", "ne", "ta", "mi", "su", "ho", "ki", "no", "wa", "fu"]
RANGES = ["Hoshimi", "Akatsuki", "Kirisame", "Tsukishiro", "Hayate", "Shiranami"]
VILLAGES = ["Oda", "Kanbe", "Minase", "Toyoura", "Ishida", "Yanagi", "Sakaki", "Hirano"]
SEASONS = ["early summer", "midsummer", "late summer", "early autumn"]

# 6つの問題(テーマ):文書の数、回答がそのテーマに触れたかを見つける正規表現、文書に足す文
THEMES = {
    "rockfall": (150, r"rock ?fall|falling rock|loose rock",
                 "After repeated rockfall, the Ridge Safety Office closed the upper trail of Mount {n} for the season."),
    "hut_keeper": (100, r"keeper|successor|caretaker|\bhuts?\b",
                   "The hut on Mount {n} may close because its keeper is retiring and no successor has been found."),
    "plant_poaching": (60, r"lil(y|ies)|poach",
                       "Rangers found that snow lilies had been dug up and taken from the meadow on Mount {n}."),
    "ptarmigan": (30, r"ptarmigan",
                  "Surveys show that fewer rock ptarmigans nest on Mount {n} than ten years ago."),
    "avalanche": (15, r"avalanche",
                  "Avalanche Watch reported a large avalanche on the north face of Mount {n} last winter."),
    "litter": (8, r"trash|litter|garbage|rubbish",
               "Clean Summit Volunteers collected bags of trash left by hikers on Mount {n}."),
}
# 文の意味:rockfall「落石が続き、尾根安全事務所は {n} 山の上部の登山道を今シーズン閉鎖した」
#   hut_keeper「管理人が引退し後継者が見つからないため、{n} 山の山小屋は閉鎖されるかもしれない」
#   plant_poaching「レンジャーは、{n} 山の草原でスノーリリーが掘り取られて持ち去られているのを見つけた」
#   ptarmigan「調査によると、{n} 山で巣を作るライチョウは10年前より少ない」
#   avalanche「雪崩監視班は、昨冬 {n} 山の北面で大きな雪崩があったと報告した」
#   litter「クリーン・サミット・ボランティアは、{n} 山で登山者が残したごみを何袋も集めた」


def build_corpus(themes, n=600, seed=0):
    rng = random.Random(seed)
    names = set()
    while len(names) < n:                                      # (a) 音節3つの架空の山の名前
        names.add("".join(rng.choice(SYLLABLES) for _ in range(3)).capitalize())
    names = sorted(names)
    labels = [t for t, (count, _, _) in themes.items() for _ in range(count)]
    labels += [None] * (n - len(labels))                       # (b) 問題の文がない山
    rng.shuffle(labels)
    docs = []
    for name, theme in zip(names, labels):
        # 「{name} 山は {山脈} 山脈の峰で、標高 {高さ} メートル。主な登山道は {村} 村から始まる。登山の適期は {季節}。」
        mountain_range, height, village = rng.choice(RANGES), rng.randint(1500, 3999), rng.choice(VILLAGES)
        text = (f"Mount {name} is a peak in the {mountain_range} Range, rising {height:,} meters "
                f"above sea level. The main trail starts from the village of {village}. "
                f"The best season to climb it is {rng.choice(SEASONS)}.")
        if theme:                                              # (c) 問題の文を足し、どのテーマかを記録する
            text += " " + themes[theme][2].format(n=name)
        docs.append({"mountain": name, "range": mountain_range, "village": village, "text": text, "theme": theme})
    return docs


FAMILIES = ["Tokiwa", "Asagiri", "Hotaru", "Kurenai", "Sumire", "Yamabuki", "Shirasagi", "Kazahana", "Tachibana", "Momiji"]
FOODS = ["buckwheat noodles", "curry", "stew", "rice balls"]


def add_huts(docs, n=60, seed=1):
    """n 山に山小屋を足す。山の文書に小屋の名前を、別の文書に小屋の運営者を書き、2段の質問と正解の文書を記録する"""
    rng = random.Random(seed)
    names, questions = set(), []
    for i in sorted(rng.sample(range(len(docs)), n)):
        while True:                                            # (a) 重複しない小屋の名前
            hut = "".join(rng.choice(SYLLABLES) for _ in range(2)).capitalize() + " Hut"
            if hut not in names:
                break
        names.add(hut)
        family, food, beds = rng.choice(FAMILIES), rng.choice(FOODS), rng.randint(12, 40)
        m = docs[i]
        # (b) 山の文書に「小屋の名前」だけを足す(運営者は書かない)
        m["text"] += f" Mount {m['mountain']} has a mountain hut, {hut}, below its summit."
        # (c) 小屋の文書:山の名前は書かない
        docs.append({"mountain": None, "range": None, "village": None, "theme": None,
                     "text": f"{hut} is a mountain hut run by the {family} family. It has {beds} beds and serves {food} to climbers."})
        # (d) 2段の質問:山の文書で小屋を知り、小屋の文書で運営者を知る
        questions.append({"question": f"Which family runs the mountain hut on Mount {m['mountain']} in the {m['range']} Range?",
                          "answer": family, "gold": [i, len(docs) - 1]})
    return questions
# 文の意味:山の文書に足す文「Mount {山} には、山頂の下に山小屋 {小屋} がある」
#   小屋の文書「{小屋} は {家族} 家が営む山小屋で、ベッドは {数} 床、登山者に {料理} を出す」
#   質問「{山脈} 山脈の Mount {山} の山小屋を営んでいるのは、どの家族か」


docs = build_corpus(THEMES)
questions = add_huts(docs)
print("文書の数:", len(docs), " 質問の数:", len(questions))
q = questions[0]
print("質問:", q["question"], " 正解:", q["answer"])
for i in q["gold"]:
    print(f"  正解の文書 {i}:", docs[i]["text"])
架空の山の紹介文600件に、山小屋の文書60件を足し、2段の質問と、正解の文書2件を記録するコードです。
- build_corpus: GraphRAG の記事・Local Search の記事と同じコードなので、同じ600件ができます。どの文書にも、山脈・標高・登山口の村・登山の適期が書かれ、363件には落石などの問題の文が1つ足されます。
- add_huts(docs, n=60, seed=1): 60山を選び、(b) 山の文書に小屋の名前だけを足し、(c) 運営者を書いた小屋の文書を別に作ります。小屋の文書に山の名前を書かないのは、質問の文と似た文書を探すだけでは、小屋の文書に届かないようにするためです。
- gold: 質問ごとに、正解の文書2件(山の文書と小屋の文書)の番号を記録します。検索の評価は、この2件が上位に入ったかで数えます。
- 家族の名前は10種類: 60の小屋に10の家族を割り当てるので、同じ家族が複数の小屋を営みます。小屋の文書を見つけずに当て推量で答えると、ほとんど外れます。
実行結果
文書の数: 660  質問の数: 60
質問: Which family runs the mountain hut on Mount Fuhomo in the Tsukishiro Range?  正解: Yamabuki
  正解の文書 2: Mount Fuhomo is a peak in the Tsukishiro Range, rising 3,870 meters above sea level. The main trail starts from the village of Sakaki. The best season to climb it is late summer. After repeated rockfall, the Ridge Safety Office closed the upper trail of Mount Fuhomo for the season. Mount Fuhomo has a mountain hut, Neno Hut, below its summit.
  正解の文書 600: Neno Hut is a mountain hut run by the Yamabuki family. It has 26 beds and serves buckwheat noodles to climbers.
英語の出力の日本語訳:
- 質問:「Tsukishiro 山脈の Mount Fuhomo の山小屋を営んでいるのは、どの家族か」。正解は Yamabuki 家。
- 正解の文書 2:「Fuhomo 山は Tsukishiro 山脈の峰で、標高3,870メートル。主な登山道は Sakaki 村から始まる。登山の適期は晩夏。落石が続いたため、尾根安全事務所は Fuhomo 山の上部の登山道を今シーズン閉鎖した。Fuhomo 山には、山頂の下に山小屋 Neno Hut がある。」
- 正解の文書 600:「Neno Hut は Yamabuki 家が営む山小屋で、ベッドは26床、登山者にそばを出す。」
LLM と埋め込み
LLM と、使用量(呼び出し回数・入力のトークン数・時間)を数えながら生成する関数は、Local Search の記事と同じです。埋め込みのモデルだけ、原著論文と同じ Contriever に変えています。
import time

import numpy as np
import torch
from sentence_transformers import SentenceTransformer
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_ID = "Qwen/Qwen2.5-7B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, padding_side="left")
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, dtype=torch.bfloat16, device_map="cuda")
model.eval()
# 埋め込み:原著論文と同じ Contriever(トークンの埋め込みの平均を、文の埋め込みにする)
embedder = SentenceTransformer("facebook/contriever", device="cuda")


def n_tokens(text):
    return len(tokenizer(text)["input_ids"])


def new_usage():
    """LLM の使用量を数える入れ物:呼び出し回数・入力と出力のトークン数・時間(秒)"""
    return {"calls": 0, "input_tokens": 0, "output_tokens": 0, "seconds": 0.0}


@torch.no_grad()
def generate(prompts, usage, max_new_tokens=600, batch_size=16):
    """プロンプトのリストをまとめて生成し、使用量を usage に足していく"""
    outputs, start = [], time.time()
    for i in range(0, len(prompts), batch_size):
        texts = [tokenizer.apply_chat_template([{"role": "user", "content": p}], tokenize=False,
                                               add_generation_prompt=True) for p in prompts[i:i + batch_size]]
        inputs = tokenizer(texts, return_tensors="pt", padding=True).to(model.device)
        out = model.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
        for row, mask in zip(out[:, inputs["input_ids"].shape[1]:], inputs["attention_mask"]):
            text = tokenizer.decode(row, skip_special_tokens=True).strip()
            usage["calls"] += 1
            usage["input_tokens"] += int(mask.sum())
            usage["output_tokens"] += n_tokens(text)
            outputs.append(text)
    usage["seconds"] += time.time() - start
    return outputs


def embed(texts):
    """文のリストを、長さ1に正規化した埋め込みにする(内積がそのままコサイン類似度になる)"""
    return embedder.encode(texts, normalize_embeddings=True, batch_size=64, show_progress_bar=False)
LLM と埋め込みのモデルを読み込み、生成と埋め込みの関数を用意するコードです。
- generate(prompts, usage, max_new_tokens=600, batch_size=16): プロンプトのリストを16個ずつまとめて生成し、使用量を usage に足していきます。インデキシングで LLM を何回呼んだかを数えるのに使います。
- embedder: Contriever は、ラベルのない文書だけで対照学習した検索用の埋め込みのモデルです。HippoRAG では、普通の埋め込み検索だけでなく、同義語の辺を張るときと、質問の固有表現をノードに結ぶときにも、このモデルを使います。
- embed: 長さを1にそろえたベクトルを返すので、内積がそのままコサイン類似度になります。
埋め込み検索は、2つ目の文書を見つけにくい
はじめに、質問の文と似た文書を探す普通の埋め込み検索が、2つの文書をまたぐ質問で、どこまで正解の文書を集められるかを確かめます。
(図は、diagram-designで作成)
質問と660件の文書を Contriever で埋め込み、コサイン類似度の大きい順に並べます。評価には、原著論文と同じ Recall@k(正解の文書2件のうち、上位 k 件に入った割合の、60問の平均)を使います。山の文書だけが上位に入り、小屋の文書が入らなければ、その質問の Recall@k は 0.5 です。
def recall_at(rankings, questions, k):
    """正解の文書(2件)のうち、上位 k 件に入った割合の平均"""
    return float(np.mean([len(set(r[:k]) & set(q["gold"])) / len(q["gold"]) for r, q in zip(rankings, questions)]))


# 普通の埋め込み検索:質問と文書の埋め込みのコサイン類似度で並べる
doc_vecs = embed([d["text"] for d in docs])
dense = [np.argsort(-(doc_vecs @ v), kind="stable") for v in embed([q["question"] for q in questions])]
for k in (2, 5):
    print(f"Recall@{k}: {recall_at(dense, questions, k):.3f}", end="  ")
mountain_top = np.mean([r[0] == q["gold"][0] for r, q in zip(dense, questions)])
hut_in5 = np.mean([q["gold"][1] in r[:5] for r, q in zip(dense, questions)])
print(f"\n山の文書が1位: {mountain_top:.3f}  小屋の文書が5位以内: {hut_in5:.3f}")
q, r = questions[0], dense[0]
print("質問:", q["question"])
for rank, d in enumerate(r[:5], 1):
    print(f"{rank}位 文書{d} {'(正解)' if d in q['gold'] else ''}: {docs[d]['text'][:70]}…")
print("小屋の文書の順位:", int(np.where(r == q["gold"][1])[0][0]) + 1)
普通の埋め込み検索で60問を検索し、Recall@2・Recall@5 と、山の文書・小屋の文書がそれぞれ上位に入ったかを数えるコードです。
- recall_at(rankings, questions, k): 質問ごとに、正解の文書2件のうち上位 k 件に入った割合を求め、平均します。以降の HippoRAG の評価にも、同じ関数を使います。
- dense: 質問ごとの、文書の番号を類似度の大きい順に並べたものです。kind="stable" は、同じスコアの文書の並びを毎回同じにするためです。
- 山の文書が1位・小屋の文書が5位以内: Recall だけでは、どちらの文書を取りこぼしたかがわからないので、別々に数えます。
実行結果
Recall@2: 0.358  Recall@5: 0.492
山の文書が1位: 0.567  小屋の文書が5位以内: 0.150
質問: Which family runs the mountain hut on Mount Fuhomo in the Tsukishiro Range?
1位 文書616 : Futo Hut is a mountain hut run by the Yamabuki family. It has 14 beds …
2位 文書628 : Yoto Hut is a mountain hut run by the Shirasagi family. It has 16 beds…
3位 文書656 : Fusu Hut is a mountain hut run by the Asagiri family. It has 18 beds a…
4位 文書630 : Fuki Hut is a mountain hut run by the Tokiwa family. It has 18 beds an…
5位 文書601 : Kimo Hut is a mountain hut run by the Hotaru family. It has 23 beds an…
小屋の文書の順位: 52
英語の出力の日本語訳:
-
1〜5位:いずれも「〇〇 Hut は △△ 家が営む山小屋で、ベッドは□床…」という、ほかの小屋の文書。
-
小屋の文書は、5位以内に15%しか入らない: 質問 0 の正解の小屋の文書(Neno Hut)は52位でした。質問に出てくる「family」「mountain hut」という語は、60件の小屋の文書のすべてに出てくるので、上位はほかの小屋の文書で埋まります。正解の小屋の文書をほかの59件と区別する手がかりは、小屋の名前(Neno Hut)だけで、それは質問には書かれていません。
-
山の文書も、1位になるのは57%: 質問 0 では、上位5件がすべて小屋の文書で、山の文書(文書 2)も5位以内に入りませんでした。質問の文の多くが「山小屋を営む家族」の話なので、山の名前よりも、小屋の文書の言い回しに引っ張られています。
-
1回の検索では、2つ目の文書の手がかりがない: 山の文書を読めば「Neno Hut」という手がかりが手に入りますが、それは検索のあとです。IRCoT のような方法は、ここで LLM に山の文書を読ませ、「Neno Hut」で2回目の検索をします。HippoRAG は、この手がかりを、インデキシングのときにグラフの辺として持っておきます。
インデキシング
OpenIE:文書からトリプルを抜き出す
HippoRAG の公式の実装と同じく、LLM を2回呼んで、文書からトリプルを抜き出します。1回目で固有表現のリストを抜き出し、2回目で、文書と固有表現のリストを一緒に渡して、(主語, 関係, 目的語) のトリプルを抜き出します。どちらのプロンプトにも、1つの例を見せます(one-shot)。公式の実装の例は Wikipedia の段落なので、本記事では架空の山の文書に置き換えました。
(図は、diagram-designで作成)
import json


def parse_json(text, key):
    """LLM の出力から最初の { … } を取り出し、key の値(リスト)を返す。読めなければ空のリスト"""
    m = re.search(r"\{.*\}", text, re.S)
    try:
        value = json.loads(m.group(0))[key] if m else []
    except (json.JSONDecodeError, KeyError, TypeError):
        return []
    return value if isinstance(value, list) else []


# HippoRAG の公式の実装と同じ、1つの例を見せる2段の OpenIE(固有表現の抽出 → トリプルの抽出)
EXAMPLE = ("Mount Kasumi is a peak in the Aoba Range. Its main trail starts from the village of Tono. "
           "The Aoba Rescue Team trains on Mount Kasumi every spring.")
EXAMPLE_NER = '{"named_entities": ["Mount Kasumi", "Aoba Range", "Tono", "Aoba Rescue Team", "spring"]}'
EXAMPLE_TRIPLES = ('{"triples": [["Mount Kasumi", "is a peak in", "Aoba Range"], '
                   '["Mount Kasumi", "main trail starts from", "Tono"], '
                   '["Aoba Rescue Team", "trains on", "Mount Kasumi"], ["Aoba Rescue Team", "trains in", "spring"]]}')
# 例の意味:「Mount Kasumi は Aoba 山脈の峰。主な登山道は Tono 村から始まる。Aoba 救助隊は毎年春に Mount Kasumi で訓練する」
NER_PROMPT = ("Your task is to extract named entities from the given paragraph. Respond with a JSON list of entities.\n\n"
              "Paragraph:\n" + EXAMPLE + "\n\n" + EXAMPLE_NER + "\n\nParagraph:\n{passage}\n\n")
# 「段落から固有表現を抜き出し、JSON のリストで答えてください」
TRIPLE_PROMPT = ("Your task is to construct an RDF graph from the given passage and named entity list. "
                 "Respond with a JSON list of triples. Each triple should contain at least one, but preferably two, "
                 "of the named entities. Resolve pronouns to their specific names.\n\n"
                 "Paragraph:\n" + EXAMPLE + "\n\n" + EXAMPLE_NER + "\n\n" + EXAMPLE_TRIPLES + "\n\n"
                 "Paragraph:\n{passage}\n\n{entities}\n\n")
# 「段落と固有表現のリストから RDF のグラフを作り、トリプルの JSON のリストで答えてください。各トリプルには固有表現を
#   少なくとも1つ、できれば2つ含め、代名詞は具体的な名前に置き換えてください」


def openie(passages, usage):
    """各文書から、固有表現(あとでノードになる)と、(主語, 関係, 目的語) のトリプルを抜き出す"""
    ners = [parse_json(o, "named_entities") for o in
            generate([NER_PROMPT.replace("{passage}", p) for p in passages], usage, max_new_tokens=200)]
    prompts = [TRIPLE_PROMPT.replace("{passage}", p).replace("{entities}", json.dumps({"named_entities": n}))
               for p, n in zip(passages, ners)]
    triples = [[t for t in parse_json(o, "triples") if isinstance(t, list) and len(t) == 3]
               for o in generate(prompts, usage, max_new_tokens=400)]
    return ners, triples


usage = new_usage()
ners, triples = openie([d["text"] for d in docs], usage)
print(f"LLM の呼び出し {usage['calls']} 回、入力 {usage['input_tokens']:,} トークン、{usage['seconds']:.0f} 秒")
print("トリプルの数:", sum(map(len, triples)), " 1文書あたり:", round(sum(map(len, triples)) / len(docs), 1))
for i in questions[0]["gold"]:
    print(f"文書 {i}:", triples[i])
660件の文書のそれぞれから、LLM で固有表現とトリプルを抜き出すコードです。
- parse_json(text, key): LLM の出力から、最初の波かっこで囲まれた部分を取り出して JSON として読み、key の値を返します。7B の LLM は、JSON の前後に説明の文を付けることがあるので、その部分を捨てます。読めないときは空のリストにして、その文書のトリプルを0個として先に進みます。
- NER_PROMPT・TRIPLE_PROMPT: 公式の実装のプロンプトの指示文と同じです。トリプルのプロンプトの「各トリプルには固有表現を少なくとも1つ、できれば2つ含める」という指示で、主語と目的語が、ステップ 1 で決めた名前にそろいやすくなります。名前がそろうと、違う文書に出てくる同じ名前が、グラフの同じノードになります。
- openie(passages, usage): 660件の固有表現の抽出をまとめて生成し、その結果を使って、トリプルの抽出をまとめて生成します。どちらも文書の数だけ LLM を呼ぶので、660件で1,320回です。
実行結果
LLM の呼び出し 1320 回、入力 313,258 トークン、715 秒
トリプルの数: 3005  1文書あたり: 4.6
文書 2: [['Mount Fuhomo', 'is a peak in', 'Tsukishiro Range'], ['Mount Fuhomo', 'rises to', '3,870 meters above sea level'], ['Mount Fuhomo', 'main trail starts from', 'Sakaki'], ['late summer', 'is the best season to climb', 'Mount Fuhomo'], ['Ridge Safety Office', 'closed the upper trail of', 'Mount Fuhomo'], ['Mount Fuhomo', 'has a mountain hut', 'Neno Hut'], ['Neno Hut', 'is below', 'the summit of Mount Fuhomo']]
文書 600: [['Neno Hut', 'is run by', 'Yamabuki family'], ['Neno Hut', 'has', '26 beds'], ['Neno Hut', 'serves', 'buckwheat noodles']]
英語の出力の日本語訳:
-
文書 2:(Fuhomo 山, の峰である, Tsukishiro 山脈)、(Fuhomo 山, の標高は, 3,870メートル)、(Fuhomo 山, の主な登山道の起点は, Sakaki)、(晩夏, が登山の適期である, Fuhomo 山)、(尾根安全事務所, の上部の登山道を閉鎖した, Fuhomo 山)、(Fuhomo 山, に山小屋がある, Neno Hut)、(Neno Hut, の下にある, Fuhomo 山の山頂)
-
文書 600:(Neno Hut, を営むのは, Yamabuki 家)、(Neno Hut, がある, 26床)、(Neno Hut, で出す, そば)
-
山と小屋が、Neno Hut でつながった: 山の文書から(Mount Fuhomo, has a mountain hut, Neno Hut)、小屋の文書から(Neno Hut, is run by, Yamabuki family)が出ました。両方の「Neno Hut」が同じノードになるので、グラフの上で、山 → 小屋 → 運営者が2本の辺でつながります。
-
インデキシングの手間: 660件で LLM を1,320回呼び、L4 で715秒かかりました。これは文書を追加したときに1回だけかかる手間で、質問のたびにはかかりません。原著論文では、GPT-3.5 Turbo で1万件あたり約15ドル・約60分と報告されています。
-
文の書き方で、トリプルは変わる: 本記事の最初の試行では、山の文書に足す文を「Climbers who stay overnight on Mount Fuhomo use Neno Hut below the summit.」(登山者は Neno Hut に泊まる)にしていました。このとき LLM は(Climbers, use, Neno Hut below the summit)のように、主語を登山者にしたトリプルを出し、山と小屋の辺ができませんでした。グラフにない関係は、PPR でもたどれません。原著論文のエラー分析でも、失敗の28%が OpenIE によるものでした。
ナレッジグラフと同義語の辺
抜き出したトリプルから、グラフと、検索の最後に使う2つの行列を作ります。
- ノード: トリプルの主語と目的語です。公式の実装と同じく、小文字にして英数字と空白以外を除いた名前を使うので、「Neno Hut」と「neno hut」は同じノードになります。
- 辺: トリプルごとに、主語と目的語の間に辺を張ります。同じ組が何度も出てきたら、辺の重みを1ずつ足します。
- 同義語の辺: Contriever の埋め込みのコサイン類似度が閾値 以上のノードの組に、類似度を重みにした辺を足します。ノードごとに、類似度の大きい順に最大100個までにします。表記の違う同じもの(「Yamabuki family」と「the Yamabuki family」など)をつなぐためです。
- 文書×トリプル、トリプル×ノードの行列: 文書のスコアを、ノードの確率から計算するのに使います(後の節の式)。
(図は、diagram-designで作成)
import networkx as nx
from scipy.sparse import csr_matrix


def norm(phrase):
    """HippoRAG と同じく、小文字にして英数字と空白以外を除く(表記の小さな違いを同じノードにする)"""
    return " ".join(re.sub(r"[^a-z0-9 ]", " ", str(phrase).lower()).split())


def build_index(triples, sim_threshold=0.8, max_synonyms=100, synonym=True):
    """(a) トリプルからノードと辺、(b) 文書→トリプル→ノードの行列、(c) 似た名前のノードの間に同義語の辺"""
    facts = [(d, norm(s), norm(o)) for d, ts in enumerate(triples) for s, _, o in ts if norm(s) and norm(o)]
    phrases = sorted({p for _, s, o in facts for p in (s, o)})
    pid = {p: i for i, p in enumerate(phrases)}
    graph = nx.Graph()
    graph.add_nodes_from(range(len(phrases)))
    for _, s, o in facts:                                      # (a) 同じ組が何度も出てきたら、重みを足していく
        if s != o:
            w = graph.get_edge_data(pid[s], pid[o], {"weight": 0.0})["weight"]
            graph.add_edge(pid[s], pid[o], weight=w + 1.0)
    # (b) 文書 × トリプル、トリプル × ノード(主語と目的語)の行列
    doc_fact = csr_matrix(([1.0] * len(facts), ([d for d, _, _ in facts], range(len(facts)))), shape=(len(triples), len(facts)))
    fact_phrase = csr_matrix(([1.0] * 2 * len(facts), ([k for k in range(len(facts)) for _ in (0, 1)],
                              [pid[p] for _, s, o in facts for p in (s, o)])), shape=(len(facts), len(phrases)))
    n_docs = np.asarray(((doc_fact @ fact_phrase) > 0).sum(axis=0)).ravel()   # 各ノードが出てくる文書の数
    vecs = embed(phrases)
    n_syn = 0
    if synonym:                                                # (c) 各ノードの、類似度が閾値以上の近いノード(最大100個)
        sims = vecs @ vecs.T
        for i in range(len(phrases)):
            if len(re.sub(r"[^a-z0-9]", "", phrases[i])) <= 2:  # 2文字以下の名前は、同義語を探さない
                continue
            near = [j for j in np.argsort(-sims[i]) if j != i and sims[i, j] >= sim_threshold][:max_synonyms]
            for j in near:
                if not graph.has_edge(i, j):
                    graph.add_edge(i, int(j), weight=float(sims[i, j]))
                    n_syn += 1
    return {"phrases": phrases, "pid": pid, "vecs": vecs, "graph": graph, "doc_fact": doc_fact,
            "fact_phrase": fact_phrase, "n_docs": n_docs, "n_facts": len(facts), "n_syn": n_syn}


index = build_index(triples)
print("ノード:", len(index["phrases"]), " トリプル:", index["n_facts"], " 辺:", index["graph"].number_of_edges(),
      "(うち同義語の辺", index["n_syn"], ")")
for p in ["neno hut", "tsukishiro range", "sakaki"]:
    if p in index["pid"]:
        print(f"{p}: 出てくる文書 {index['n_docs'][index['pid'][p]]} 件、つながるノード {index['graph'].degree(index['pid'][p])} 個")
トリプルからナレッジグラフを作り、同義語の辺を足して、文書・トリプル・ノードの関係を行列にするコードです。
- norm(phrase): 公式の実装と同じ正規化です。小文字にし、英数字と空白以外を空白に置き換えます。「3,870 meters」は「3 870 meters」になります。
- facts: (文書の番号, 主語, 目的語) のリストです。関係(is run by など)は、ノードにも辺の種類にも使いません。HippoRAG のグラフは、どのノードとどのノードが一緒に出てきたかだけを持ちます。
- (a) 辺の重み: 同じ主語と目的語の組が別の文書でも出てきたら、重みを足します。PPR は、重みの大きい辺ほど多く確率を流します。
- (b) doc_fact・fact_phrase: doc_fact は、文書にトリプルがあれば1の行列、fact_phrase は、トリプルの主語と目的語の列が1の行列です。n_docs は、2つをかけて0より大きい要素を数えたもので、各ノードが出てくる文書の数 です。次の節の特異性に使います。
- (c) 同義語の辺: すべてのノードの組のコサイン類似度を計算し、ノードごとに、閾値以上のものを大きい順に最大100個つなぎます。2文字以下の名前(「1」「a」など)は、意味のない一致が多いので、公式の実装と同じく同義語を探しません。トリプルの辺がすでにある組には足しません。
- synonym=True: (c) の同義語の辺を足すかどうかの切り替えです。synonym=False にすると (c) を飛ばし、トリプルの辺だけのグラフを作ります。ノード・2つの行列・各ノードが出てくる文書の数は (c) より前に作るので、synonym を変えても同じです。後の節で、同義語の辺が検索の役に立っているかを確かめる(同義語の辺を外して比べる)ために使います。sim_threshold=0.8 と max_synonyms=100 は、(c) の閾値 と、1つのノードからつなぐ同義語の辺の上限で、どちらも原著論文の値です。
(b) の2つの行列の作り方を、文書2と文書600のトリプルの一部で描くと、次のようになります。
(図は、diagram-designで作成)
実行結果
ノード: 1737  トリプル: 3005  辺: 33814 (うち同義語の辺 30841 )
neno hut: 出てくる文書 2 件、つながるノード 5 個
tsukishiro range: 出てくる文書 101 件、つながるノード 101 個
sakaki: 出てくる文書 83 件、つながるノード 83 個
- 小屋の名前は、2件の文書にしか出てこない: neno hut は、山の文書と小屋の文書の2件だけに出てきます。少ない文書にしか出てこないノードは、その文書を特定する強い手がかりになります。
- 山脈や村は、ハブのノードになる: tsukishiro range は101件、sakaki は83件の文書に出てきて、それぞれ101個・83個のノード(山)とつながっています。多くの山とつながるノードを通ると、確率がどの山にも広がります。
- 同義語の辺が、トリプルの辺より多い: 同義語の辺は30,841本で、トリプルの辺(2,973本)の10倍です。どんな組がつながったかは、後の節で確かめます。
検索:特異性で重みを付けた Personalized PageRank
質問が来たら、次の3つを計算します。
1. 質問のノード: LLM で質問の固有表現を抜き出し、固有表現ごとに、埋め込みが最も近いノードを1つ選びます。選んだノードの集合を とします。
2. 出発点の重み(ノードの特異性): ノード の特異性を、そのノードが出てくる文書の数 の逆数にします。
出発点の分布 は、 のノードに特異性を入れ、合計が1になるように割ったものです( にないノードは0)。
山脈のように多くの文書に出てくるノードは、質問の文書を絞る力が弱いので、出発点としての重みを小さくします。文書の検索の IDF(逆文書頻度)と同じ考え方です。
(図は、diagram-designで作成)
3. PPR と文書のスコア: PageRank の記事の Personalized PageRank を、テレポート先を にして求めます。
- :各ノードにいる確率(PPR のスコア)
- :辺の重みを行ごとに合計1に割った、遷移の行列
- :辺をたどる確率(damping)。原著論文と同じ0.5にします。確率0.5で出発点に戻るので、出発点から遠いノードには確率があまり届きません。
文書 のスコアは、その文書のトリプル の主語と目的語の確率の合計です。
行列で書くと、 です。 は文書×トリプル、 はトリプル×ノードの行列(前の節の doc_fact と fact_phrase)です。原著論文では、PPR のあとのノードの確率の分布 に、各ノードが各文書に何回出てくるかの行列 をかけて文書のスコアを求めています。本記事の が 、 が にあたります。
QUERY_NER_PROMPT = ("Please extract all named entities that are important for solving the questions below. "
                    "Place the named entities in json format.\n\n"
                    "Question: Which village is the trailhead of the mountain where the Aoba Rescue Team trains?\n\n"
                    '{"named_entities": ["Aoba Rescue Team"]}\n\nQuestion: {question}\n\n')
# 「下の質問に答えるのに重要な固有表現をすべて抜き出し、JSON で答えてください」
# 例の質問「Aoba 救助隊が訓練する山の登山口の村はどこか」


def link(entities, index):
    """質問の固有表現を、埋め込みが最も近いノードに1つずつ結ぶ"""
    if not entities:
        return []
    sims = embed([str(e) for e in entities]) @ index["vecs"].T
    return [int(np.argmax(s)) for s in sims]


def hipporag_scores(seeds, index, specificity=True, ppr=True, damping=0.5):
    """結んだノードから Personalized PageRank でたどり、文書ごとのスコアを返す"""
    # (a) 出発点の重み:ノードの特異性(そのノードが出てくる文書の数の逆数)
    reset = {s: (1.0 / max(index["n_docs"][s], 1) if specificity else 1.0) for s in seeds}
    node_prob = np.zeros(len(index["phrases"]))
    if ppr:                                                    # (b) 確率 damping で辺をたどり、1 - damping で出発点に戻る
        for node, p in nx.pagerank(index["graph"], alpha=damping, personalization=reset, weight="weight").items():
            node_prob[node] = p
    else:                                                      # 比較用:たどらずに、出発点の重みだけを使う
        for node, w in reset.items():
            node_prob[node] = w
    # (c) 文書のスコア:文書のトリプルに出てくるノードの確率の合計
    return index["doc_fact"] @ (index["fact_phrase"] @ node_prob)


q_entities = [parse_json(o, "named_entities") for o in
              generate([QUERY_NER_PROMPT.replace("{question}", q["question"]) for q in questions], usage, max_new_tokens=100)]
q_seeds = [link(e, index) for e in q_entities]

q = questions[0]
print("質問:", q["question"])
print("固有表現 → ノード:", [(e, index["phrases"][s], int(index["n_docs"][s])) for e, s in zip(q_entities[0], q_seeds[0])])
scores = hipporag_scores(q_seeds[0], index)
for rank, d in enumerate(np.argsort(-scores, kind="stable")[:5], 1):
    print(f"{rank}位 文書{d} {'(正解)' if d in q['gold'] else ''} {scores[d]:.4f}: {docs[d]['text'][:70]}…")
60問の質問の固有表現を LLM で抜き出してノードに結び、質問 0 で HippoRAG の検索を行うコードです。
- QUERY_NER_PROMPT: 公式の実装の、質問から固有表現を抜き出すプロンプトの指示文と同じです。例の質問は、架空の山の質問に置き換えました。
- link(entities, index): 固有表現ごとに、ノードの埋め込みとの内積(コサイン類似度)が最大のノードを1つ選びます。閾値は設けないので、グラフにない名前でも、どれかのノードに結ばれます。
- hipporag_scores(seeds, index, specificity=True, ppr=True, damping=0.5): (a) 出発点の重みを特異性 にし、(b) networkx の pagerank で PPR を求め、(c) 行列の積で文書のスコアにします。nx.pagerank の alpha は式の で、personalization は合計1に割って にしてくれます。specificity=False と ppr=False は、次の節で部品を外して比べるためのものです。ppr=False では、グラフをたどらず、出発点のノードの重みだけで文書のスコアを計算します。
実行結果
質問: Which family runs the mountain hut on Mount Fuhomo in the Tsukishiro Range?
固有表現 → ノード: [('Mount Fuhomo', 'mount fuhomo', 1), ('Tsukishiro Range', 'tsukishiro range', 101)]
1位 文書2 (正解) 3.4001: Mount Fuhomo is a peak in the Tsukishiro Range, rising 3,870 meters ab…
2位 文書584  0.1703: Mount Yonafu is a peak in the Tsukishiro Range, rising 2,784 meters ab…
3位 文書518  0.1651: Mount Tayoho is a peak in the Kirisame Range, rising 1,812 meters abov…
4位 文書600 (正解) 0.1578: Neno Hut is a mountain hut run by the Yamabuki family. It has 26 beds …
5位 文書310  0.1294: Mount Nohato is a peak in the Tsukishiro Range, rising 3,018 meters ab…
英語の出力の日本語訳:
-
2・3・5位:「Yonafu 山は Tsukishiro 山脈の峰で…」「Tayoho 山は Kirisame 山脈の峰で…」「Nohato 山は Tsukishiro 山脈の峰で…」という、ほかの山の文書。
-
4位:「Neno Hut は Yamabuki 家が営む山小屋で…」という、正解の小屋の文書。
-
山の文書が1位、小屋の文書が4位: 埋め込み検索では52位だった小屋の文書が、4位に上がりました。質問には「Neno Hut」が書かれていないのに、mount fuhomo から neno hut へ辺をたどって届いています。
-
小屋の文書の上に、ほかの山の文書が2件入った: 2位と3位は、正解と関係のない山の文書です。なぜ小屋の文書より上に来たのかは、次の図で確かめます。
(図は、diagram-designで作成)
- 確率は、隣のノードにほぼ均等に流れる: damping が0.5なので、確率の半分は出発点の mount fuhomo に残り、残りは1歩先の隣のノードに、辺の重みに応じてほぼ均等に分かれます。neno hut(0.048)も、ハブの sakaki(0.039)や late summer(0.040)も、同じくらいの確率になります。
- ハブのノードを多く含む文書が、スコアを稼ぐ: 3位の文書 518 は、Kirisame 山脈の別の山で、正解と関係がありません。それでも、Sakaki 村・晩夏・尾根安全事務所(2回)というハブのノードを含むので、その確率の合計が0.165になりました。小屋の文書は、neno hut を3つのトリプルに含んで0.158で、わずかに及びません。
- 特異性は、出発点にだけ効く: 特異性で重みを下げたのは、出発点の tsukishiro range だけです。PPR で流れた先の sakaki や late summer は、多くの文書に出てくるのに、確率を割り引かれません。
埋め込み検索と比べ、部品を1つずつ外す
60問で、埋め込み検索と HippoRAG を比べます。HippoRAG から、特異性・PPR・同義語の辺を1つずつ外したものも比べて、どの部品が効いているかを確かめます。原著論文の Table 5(アブレーション)と同じ比べ方です。
# 埋め込み検索(dense)は、前の節で計算したもの
index_nosyn = build_index(triples, synonym=False)
runs = {
    "埋め込み検索": dense,
    "HippoRAG": [np.argsort(-hipporag_scores(s, index), kind="stable") for s in q_seeds],
    "特異性なし": [np.argsort(-hipporag_scores(s, index, specificity=False), kind="stable") for s in q_seeds],
    "PPR なし": [np.argsort(-hipporag_scores(s, index, ppr=False), kind="stable") for s in q_seeds],
    "同義語の辺なし": [np.argsort(-hipporag_scores(link(e, index_nosyn), index_nosyn), kind="stable") for e in q_entities],
}


def rank_of(ranks, k):
    """各質問で、k 番目の正解の文書(0: 山、1: 小屋)が何位に来たか(0 始まり)"""
    return np.array([list(r).index(q["gold"][k]) for r, q in zip(ranks, questions)])


print(f"{'方法':<12}{'Recall@2':>10}{'Recall@5':>10}{'山が1位':>8}{'小屋が5位以内':>10}")
for name, ranks in runs.items():
    print(f"{name:<12}{recall_at(ranks, questions, 2):>10.3f}{recall_at(ranks, questions, 5):>10.3f}"
          f"{np.mean(rank_of(ranks, 0) == 0):>10.3f}{np.mean(rank_of(ranks, 1) < 5):>12.3f}")
5つの方法で60問を検索し、Recall@2・Recall@5 と、山の文書が1位になった割合、小屋の文書が5位以内に入った割合を表にするコードです。
- index_nosyn: build_index を synonym=False で呼び、同義語の辺を足さずに作り直したインデックスです。グラフの辺は、トリプルの辺の2,973本だけになります(HippoRAG のグラフは、これに同義語の辺30,841本を足した33,814本)。特異性と PPR は hipporag_scores の引数で外せますが、同義語の辺はインデキシングのときにグラフに入ってしまうので、インデックスごと作り直します。ノードの集合と埋め込みは同じなので、link で、質問の固有表現は同じノードに結ばれます。違うのは、PPR で確率が流れる辺だけです。
- runs: 方法の名前と、質問ごとの文書の並びの辞書です。特異性なし(出発点の重みをすべて同じにする)と PPR なし(グラフをたどらない)は、同じインデックスで hipporag_scores の引数だけを変えています。
- rank_of(ranks, k): 正解の山の文書(k=0)または小屋の文書(k=1)が、何位に来たかを返します。
実行結果
方法            Recall@2  Recall@5    山が1位   小屋が5位以内
埋め込み検索           0.358     0.492     0.567       0.150
HippoRAG         0.617     0.767     1.000       0.533
特異性なし            0.500     0.500     1.000       0.000
PPR なし           0.500     0.500     1.000       0.000
同義語の辺なし          0.708     0.767     1.000       0.533
(図は、diagram-designで作成)
- HippoRAG は、埋め込み検索より Recall@2 で0.26、Recall@5 で0.28高い: 山の文書は60問すべてで1位になり、小屋の文書は53%の質問で5位以内に入りました。埋め込み検索では15%でした。質問に出てくる山の名前から、グラフの辺で小屋のノードへ届いた分です。
- PPR を外すと、小屋の文書に1度も届かない: PPR なしでは、出発点の mount fuhomo と tsukishiro range のノードだけで文書のスコアを計算します。小屋の文書には、どちらのノードも出てこないので、スコアは0です。山の文書は必ず1位になりますが、Recall はちょうど0.5になります。小屋に届いたのは、辺をたどったからだとわかります。
- 特異性を外しても、小屋の文書に1度も届かない: 出発点の重みを0.5ずつにすると、tsukishiro range に半分の確率が入り、そこから同じ山脈の約100の山に流れます。同じ山脈の山の文書がどれも tsukishiro range を含むので、上位がそれらで埋まり、小屋の文書は5位以内に入りませんでした。原著論文でも、特異性を外すと平均の Recall@2 が57.4から54.7に下がっています。本記事では、どの質問にも山脈の名前が入っているので、その影響がもっと大きく出ました。
- 同義語の辺を外すと、Recall@2 が上がった: 同義語の辺なしは、HippoRAG のグラフから同義語の辺30,841本を除き、トリプルの辺だけで PPR を回したものです。Recall@2 は0.617から0.708に上がり、原著論文(同義語の辺を外すと57.4から56.2に下がる)と逆になりました。同義語の辺は、表記の違う同じもの(「Yamabuki family」と「the Yamabuki family」など)をつなぎ、トリプルの辺だけではたどれない文書に確率を届けるための辺です。それを外した方が良くなったのは、本記事のコーパスでは、同義語の辺が関係のない山へ確率を流していたからです。どんな名前の組がつながっていたかを、次の節で確かめます。
同義語の辺とハブのノード
同義語の辺に、どんな名前の組がつながったのかと、質問 0 の PPR で、どのノードに確率が流れたのかを確かめます。
# (a) 同義語の辺:どんな名前の組がつながったか
triple_pairs = {frozenset((index["pid"][norm(s)], index["pid"][norm(o)])) for ts in triples for s, _, o in ts if norm(s) and norm(o)}
syn_pairs = [(d["weight"], index["phrases"][i], index["phrases"][j]) for i, j, d in index["graph"].edges(data=True)
             if frozenset((i, j)) not in triple_pairs]
n_height = sum("meters above sea level" in a and "meters above sea level" in b for _, a, b in syn_pairs)
print(f"同義語の辺 {len(syn_pairs)} 本のうち、標高どうしの辺: {n_height} 本")
height = [p for p in syn_pairs if "meters above sea level" in p[1]]
other = [p for p in syn_pairs if "meters above sea level" not in p[1] + p[2]]
for w, a, b in height[:2] + sorted(other, key=lambda x: -x[0])[:4]:
    print(f"  {w:.3f}  {a}  ―  {b}")

# (b) 質問 0 の PPR で、確率の高いノード
reset = {s: 1.0 / index["n_docs"][s] for s in q_seeds[0]}
prob = nx.pagerank(index["graph"], alpha=0.5, personalization=reset, weight="weight")
for node, p in sorted(prob.items(), key=lambda x: -x[1])[:8]:
    print(f"  {index['phrases'][node]:<32} 確率 {p:.4f}  出てくる文書 {index['n_docs'][node]} 件")
同義語の辺の中身と、質問 0 の PPR で確率の高いノードを表示するコードです。
- (a) syn_pairs: グラフの辺のうち、トリプルの主語と目的語の組でないもの、つまり同義語の辺として足したものです。frozenset にしているのは、(主語, 目的語) と (目的語, 主語) を同じ組として比べるためです。
- (a) 標高どうしの辺: 両方の名前に「meters above sea level」が入っている辺を数えます。600の山の標高は、どれも「〇〇 meters above sea level」というトリプルの目的語になっています。
- (b) prob: 質問 0 の出発点の重みで PPR を回した、ノードごとの確率です。hipporag_scores の中で計算しているものと同じです。
実行結果
同義語の辺 30841 本のうち、標高どうしの辺: 28377 本
  0.928  1 505 meters above sea level  ―  1 530 meters above sea level
  0.901  1 505 meters above sea level  ―  1 525 meters above sea level
  0.968  the best season to climb mount yomimi  ―  the best season to climb mount yonomi
  0.968  mount nohato  ―  summit of mount nohato
  0.967  mount raseshi  ―  summit of mount raseshi
  0.965  mount mohowa  ―  the summit of mount mohowa
  mount fuhomo                     確率 0.5105  出てくる文書 1 件
  neno hut                         確率 0.0476  出てくる文書 2 件
  tsukishiro range                 確率 0.0446  出てくる文書 101 件
  ridge safety office              確率 0.0411  出てくる文書 150 件
  late summer                      確率 0.0401  出てくる文書 163 件
  the summit of mount fuhomo       確率 0.0399  出てくる文書 1 件
  sakaki                           確率 0.0392  出てくる文書 83 件
  3 870 meters above sea level     確率 0.0368  出てくる文書 1 件
- 同義語の辺の92%は、標高の数値が違うだけの組: 「1,505 meters above sea level」と「1,530 meters above sea level」は、Contriever の類似度が0.928でした。文の埋め込みは、数値の違いをあまり区別しないので、意味の違う標高どうしが「同義語」としてつながります。「the best season to climb mount yomimi」と「… mount yonomi」も、1文字違いの別の山です。これらの辺は、確率を関係のない山に流します。
- 役に立つ同義語の辺もある: 「mount nohato」と「summit of mount nohato」のように、同じ山を指す名前どうしもつながっています。ただ、本記事のコーパスでは、名前の表記の揺れがほとんどないので、役に立つ辺より、関係のない山へ確率を流す辺の方が多くなりました。原著論文の Wikipedia の段落には、同じ人や場所が違う表記で出てくることが多く、同義語の辺が効く余地があります。
- ハブのノードにも、隣と同じだけ確率が流れる: 質問 0 で、neno hut(2件)とハブの ridge safety office(150件)・late summer(163件)・sakaki(83件)の確率は、ほぼ同じでした。どの文書にも出てくるノードに流れた確率は、それを含む多くの文書のスコアに少しずつ足され、小屋の文書を追い抜く文書が出てきます。
LLM に答えさせる
最後に、上位5件の文書を LLM に読ませて、家族の名前を答えさせます。
QA_PROMPT = ("Answer the question using only the passages. Reply with the family name only.\n\n"
             "Passages:\n{passages}\n\nQuestion: {question}\nAnswer:")
# 「文書だけを使って質問に答えてください。家族の名前だけを答えてください」


def answer(rankings, k=5):
    """上位 k 件の文書を LLM に読ませて答えさせ、正解の家族の名前が答えに入っている割合を返す"""
    prompts = [QA_PROMPT.replace("{passages}", "\n".join(docs[d]["text"] for d in r[:k])).replace("{question}", q["question"])
               for r, q in zip(rankings, questions)]
    outputs = generate(prompts, usage, max_new_tokens=10)
    return float(np.mean([q["answer"].lower() in o.lower() for o, q in zip(outputs, questions)])), outputs


for name in ["埋め込み検索", "HippoRAG"]:
    acc, outputs = answer(runs[name])
    print(f"{name}: 正解率 {acc:.3f}  例: {outputs[0]!r}(正解 {questions[0]['answer']})")
埋め込み検索と HippoRAG のそれぞれで、上位5件の文書を LLM に読ませて答えさせ、正解の家族の名前が答えに入っている割合を数えるコードです。
- QA_PROMPT: 文書だけを使って答え、家族の名前だけを返すように指示します。採点を、正解の名前が答えに入っているかで簡単に行うためです。
- answer(rankings, k=5): 上位5件の文書を改行でつないでプロンプトに入れます。5件にしたのは、HippoRAG で小屋の文書が4位や5位に来る質問があるためです。max_new_tokens=10 は、家族の名前だけを答えさせるので、短い上限にしています。
実行結果
埋め込み検索: 正解率 0.267  例: 'Yamabuki'(正解 Yamabuki)
HippoRAG: 正解率 0.533  例: 'Yamabuki'(正解 Yamabuki)
- 正解率は、小屋の文書が5位以内に入った割合とほぼ同じ: HippoRAG の正解率0.533は、小屋の文書が5位以内に入った割合(0.533)と同じでした。小屋の文書を読めれば、LLM は運営者の名前を答えられます。
- 埋め込み検索の正解率は、小屋の文書の割合(0.150)より高い: 質問 0 では、上位5件に正解の小屋の文書がないのに「Yamabuki」と答えて正解になっています。1位の文書 616 も Yamabuki 家の小屋だったためで、10の家族を60の小屋に割り当てているので、ほかの小屋の文書から偶然当たることがあります。
- 答えの良し悪しは、検索で決まる: どちらも同じ LLM と同じプロンプトなので、正解率の差(0.267 → 0.533)は、2つ目の文書を集められたかの差です。
原著論文の結果
原著論文は、マルチホップの QA の3つのデータセット(MuSiQue・2WikiMultiHopQA・HotpotQA、各1,000問)で、1回の検索の Recall@2・Recall@5 を比べています。
(図は、diagram-designで作成)
| 検索の方法 | MuSiQue | 2Wiki | HotpotQA | 平均 |
|---|---|---|---|---|
| Contriever | 34.8 / 46.6 | 46.6 / 57.5 | 57.2 / 75.5 | 46.2 / 59.9 |
| ColBERTv2 | 37.9 / 49.2 | 59.2 / 68.2 | 64.7 / 79.3 | 53.9 / 65.6 |
| HippoRAG(Contriever) | 41.0 / 52.1 | 71.5 / 89.5 | 59.0 / 76.2 | 57.2 / 72.6 |
| HippoRAG(ColBERTv2) | 40.9 / 51.9 | 70.7 / 89.1 | 60.5 / 77.7 | 57.4 / 72.9 |
(Recall@2 / Recall@5。原著論文の Table 2)
- 2Wiki で差が最も大きい: 2WikiMultiHopQA は、人物や作品の名前を手がかりに2つの記事をたどる質問が多く、固有表現から辺をたどる HippoRAG に向いています。Recall@5 は、Contriever の57.5から89.5に上がりました。
- HotpotQA では、ColBERTv2 に及ばない: 原著論文は、HotpotQA の質問は、ほかの2つのデータセットに比べて、複数の文書の知識をつなぐ必要が小さいためと考察しています。
- 部品を外したときの平均の Recall@2: PPR を使わずに質問のノードだけを使うと50.7、質問のノードとその隣だけを使うと42.2、特異性なしで54.7、同義語の辺なしで56.2でした(すべての部品ありで57.4)。PPR と特異性が効いているのは本記事と同じで、同義語の辺の効果は小さめです。
- OpenIE の LLM: GPT-3.5 Turbo の代わりに Llama-3.1-8B-Instruct を使うと54.4、Llama-3.1-70B-Instruct で57.1でした。REBEL(トリプルの抽出に特化した小さなモデル)では46.2に下がります。
- 速さと費用: 繰り返し検索する IRCoT と同程度の精度を、1,000問の検索あたり約0.1ドル・約3分で出し、IRCoT(1〜3ドル・20〜40分)より10〜30倍安く、6〜13倍速いと報告しています。HippoRAG と IRCoT を組み合わせると、さらに精度が上がります。
- 失敗の内訳: 失敗の48%は質問の固有表現の抽出(NER)、28%は OpenIE、24%は PPR によるものでした。本記事の最初の試行で、文の書き方のせいで山と小屋の辺ができなかったのは、OpenIE の失敗にあたります。
原著論文の設定と本記事の設定
| 項目 | 原著論文 | 本記事 |
|---|---|---|
| データ | MuSiQue・2WikiMultiHopQA・HotpotQA(各1,000問。文書は6,119〜11,656件) | 架空の山と山小屋の文書660件、2段の質問60問 |
| OpenIE の LLM | GPT-3.5 Turbo(1106)。Llama-3.1-8B/70B-Instruct でも比較 | Qwen2.5-7B-Instruct |
| OpenIE の手順 | 固有表現の抽出 → トリプルの抽出(それぞれ1つの例を見せる) | 同じ(例は山の文書に置き換えた) |
| 埋め込みのモデル | Contriever または ColBERTv2 | Contriever |
| 同義語の閾値 | 0.8(ノードごとに最大100個) | 同じ |
| PPR の damping | 0.5 | 同じ |
| ノードの特異性 | 同じ | |
| 評価 | Recall@2・Recall@5、QA の EM・F1 | Recall@2・Recall@5、答えに正解の家族の名前が入っている割合 |
- データ: 原著論文の3つのデータセットは、Wikipedia の段落からなる公開のベンチマークです。本記事では、LLM が事前の知識で答えられないように、山と小屋の名前を架空にし、正解の文書を作るときに記録しています。
- LLM: GPT-3.5 Turbo の代わりに、手元の GPU で動く Qwen2.5-7B-Instruct を使いました。原著論文では、OpenIE を Llama-3.1-8B-Instruct にしても、平均の Recall@2 は 57.4 から 54.4 に下がる程度でした。
- 閾値・damping・最大100個: 原著論文の値(MuSiQue の学習データの100問で調整したもの)を、そのまま使っています。
まとめ
本記事では、HippoRAG のインデキシング(OpenIE・ナレッジグラフ・同義語の辺)と検索(特異性で重みを付けた PPR)をスクラッチ実装し、架空の山と山小屋の文書660件・2段の質問60問で、埋め込み検索と比べました。
- 埋め込み検索は、2つ目の文書を見つけにくい: 質問に名前の出てこない小屋の文書が5位以内に入ったのは15%で、Recall@2 は0.358でした。
- HippoRAG は、1回の検索で2つ目の文書に届く: 山の名前から、グラフの辺で小屋のノードへたどり、Recall@2 は0.617、小屋の文書が5位以内に入った割合は53%になりました。上位5件を読ませた答えの正解率は、0.267から0.533に上がりました。
- PPR と特異性は、どちらも欠かせない: PPR を外すと小屋の文書に1度も届かず、特異性を外すと、山脈のノードから同じ山脈の山に確率が流れて、やはり1度も届きませんでした(どちらも Recall@2 は0.500)。
- 同義語の辺とハブのノードは、確率を関係のない文書に流す: 同義語の辺30,841本のうち92%は、標高の数値が違うだけの名前の組でした。同義語の辺を外すと Recall@2 は0.708に上がりました。PPR で流れた先の Sakaki 村や晩夏のようなハブのノードは、特異性で割り引かれないので、関係のない山の文書が小屋の文書を追い抜くことがありました。
- インデキシングの手間は、文書ごとに LLM 2回: 660件で1,320回・715秒(L4)で、3,005個のトリプルができました。
HippoRAG は、検索のたびに LLM で推論を繰り返す代わりに、文書を読んだときに名詞句のつながりをグラフとして覚えておき、質問の固有表現から PPR で一度にたどる方法です。そのため、精度は、OpenIE がつながりを正しく抜き出せるか、同義語の辺が本当に同じものだけをつなぐか、確率がハブに散らないかに左右されます。本記事のように名前の表記がそろったコーパスでは同義語の辺を外す、数値のノードを同義語の対象から外すなど、コーパスに合わせた調整の余地があります。
参考文献
- B. Jiménez Gutiérrez, Y. Shu, Y. Gu, M. Yasunaga, Y. Su (2024). HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models. NeurIPS 2024.
- OSU-NLP-Group/HippoRAG(legacy ブランチ). 原著論文の公開コード(MIT License)。OpenIE のプロンプト、グラフの作り方、検索(
src/hipporag.pyのrank_docs)。 - T. J. Teyler, P. DiScenna (1986). The Hippocampal Memory Indexing Theory. Behavioral Neuroscience, 100(2), 147–154.
- H. Trivedi, N. Balasubramanian, T. Khot, A. Sabharwal (2023). Interleaving Retrieval with Chain-of-Thought Reasoning for Knowledge-Intensive Multi-Step Questions. ACL 2023.(IRCoT)
- G. Izacard, M. Caron, L. Hosseini, S. Riedel, P. Bojanowski, A. Joulin, E. Grave (2022). Unsupervised Dense Information Retrieval with Contrastive Learning. TMLR.(Contriever)
- T. H. Haveliwala (2002). Topic-Sensitive PageRank. WWW 2002.(Personalized PageRank)
- Qwen Team (2024). Qwen2.5-7B-Instruct. Hugging Face(Apache License 2.0).
本記事の文章・構成の一部に生成AIを使用しています。