HVA(High Value Audience)分析とは?
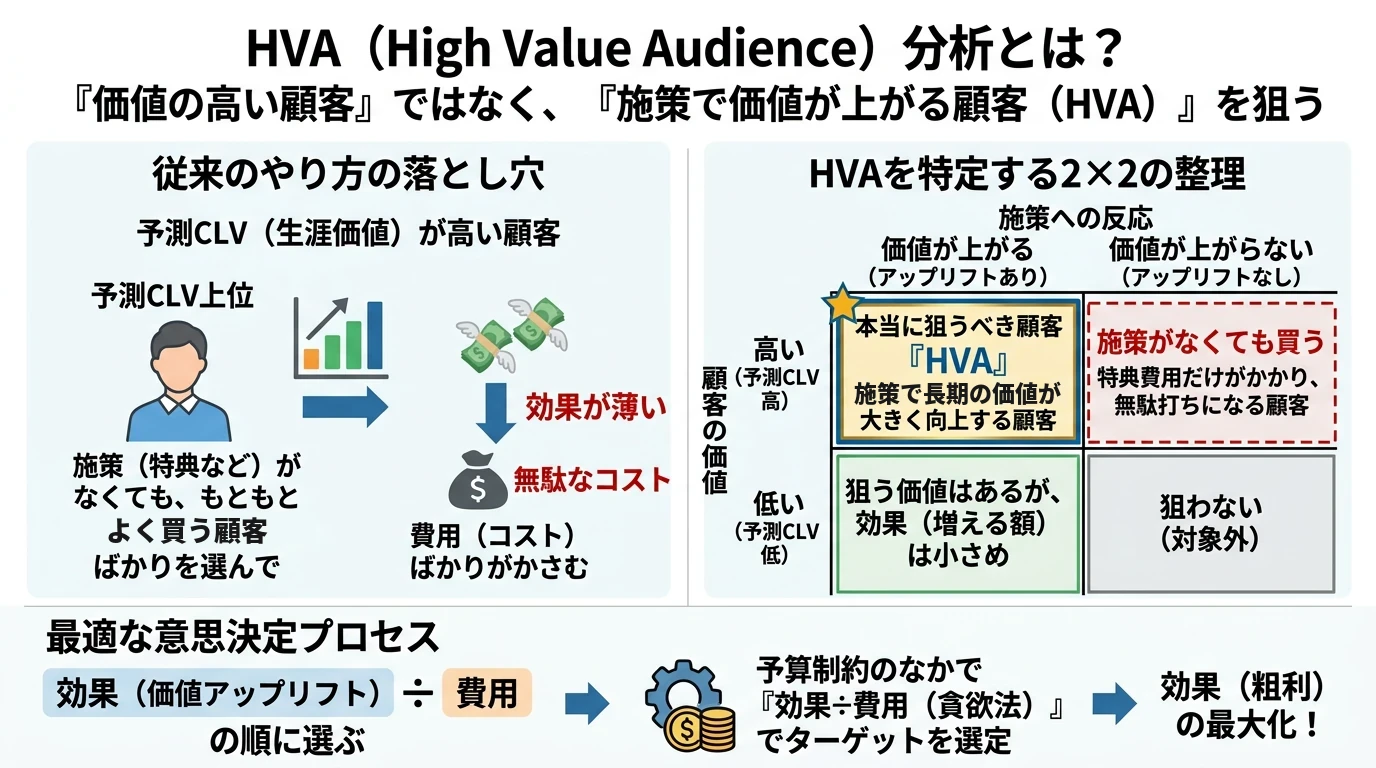 (画像は、Geminiで作成)
予測CLVと価値アップリフトを組み合わせて「施策を打つべき価値の高い顧客(HVA)」を定義し、予算の制約のもとでターゲティングの方策を作れるようになること。そのために、予測CLVの上位を狙う素朴なやり方の落とし穴、価値の高低と施策への反応の2×2の整理、売上・粗利へのCATEの推定、「効果 ÷ 費用」の順に選ぶ貪欲法と方策価値による評価を、真の効果を仕込んだダミーデータで確かめること。
概要
広告やCRMの現場では、「価値の高い顧客(High Value Audience、HVA)」に予算を集中させよう、という考え方がよく使われます。そのとき素朴に思いつくのは、CLV予測の記事で作った 予測CLV(pCLV)の上位の顧客 をHVAとすることです。
しかし、pCLVが高い顧客は、施策がなくてもよく買う顧客です。そうした顧客に特典やクーポンを渡しても、購買はあまり増えず、特典の費用だけがかかるかもしれません。Ascarza (2018) は、解約リスクが高い顧客を狙う解約防止の施策について、「リスクが高い顧客」と「施策に反応する顧客」は別物で、リスクの高さで狙っても効果が出にくいことを、実際のフィールド実験で示しました。価値の高さについても同じことが言えます。
本記事では、HVAを「施策によって価値が上がる顧客」として定義し直し、次の順に解説します。
- 価値の高低と施策への反応の2×2の整理と、予算の制約を入れた定式化
- pCLVの上位を狙うと何が起きるか
- 売上・粗利へのCATE(価値アップリフト)の推定
- 予算の制約のもとで「効果 ÷ 費用」の順に選ぶ方策と、方策価値による3つの方策の比較
- 広告配信への活用(アクティベーション)
アップリフトモデルの評価の記事では、施策の効果を「30日以内に買ったか」という短期の成果(CV)で測りました。本記事では、成果を 1年間の粗利 に変えます。目的変数を変えるだけで、メタラーナーの記事の手法がそのまま使えることも確かめます。
本記事のコードは、Python 3.13、NumPy 2.4.6、pandas 3.0.5、scikit-learn 1.9.1、LightGBM 4.7.0、matplotlib 3.11.2 で動作を確認しました。
アップリフトモデルの評価の記事と同じく、施策の有無を (1: 施策あり、0: なし)、方策(誰に施策を行うかのルール)を と書きます。コードでは施策の有無を T_rct とします。特徴量に含まれる列 T は「初回購買から基準日までの日数」で、施策の とは関係ありません。
HVAの考え方
2×2の整理:価値の高低 × 施策への反応
顧客を「施策がなかった場合の価値(pCLV)の高低」と「施策で価値が上がるか」の2つの軸で分けると、次の4つのグループになります。
| 施策で価値が上がる | 施策で価値が上がらない | |
|---|---|---|
| 価値が高い | 本当に狙うべき顧客(HVA) | 施策がなくても買う。費用だけがかかる |
| 価値が低い | 狙う価値はあるが、増える額は小さめ | 狙わない |
pCLVの上位を狙うと、上の行の2つのグループをまとめて選ぶことになります。右上のグループが多いと、費用がかさむ割に価値はあまり増えません。一方、短期のCV率への効果(CVアップリフト)で選ぶと、「施策のおかげで一度は買うが、その後は続かない」顧客が集まりやすく、長期の価値は増えにくくなります(サロゲートインデックスの記事で見た、短期と長期の効果のずれです)。狙うべきなのは、施策によって 長期の価値 が上がる顧客です。
4つのグループと、方策ごとに選ばれる範囲を図にすると、次のようになります。
(図は、diagram-designで作成)
価値アップリフト
顧客 の1年間の粗利を、施策を受けた場合 、受けなかった場合 とします。施策の費用(特典やクーポンの値引き額)は、受けた場合の粗利 から差し引いておきます。価値アップリフト は、粗利へのCATEです。
CVアップリフト ( は30日以内に買ったかの0/1)と比べると、成果の変数が から に変わっただけです。そのため、S/T/X-Learner などのメタラーナーは、目的変数を粗利に変えるだけで使えます。
予算の制約を入れた定式化
施策の予算を 、顧客 に施策を行った場合の費用を 、施策を行うかを とします。予算の範囲で、粗利の増加の合計を最大にする問題は、次のように書けます。
と は、価値アップリフトと費用の予測値です。これはナップサック問題で、厳密に解くのは大変ですが、次の 貪欲法 で十分によい解が得られます。
- の顧客だけを候補にする(効果がマイナスと予測される顧客には、予算が余っても施策を行わない)
- 候補を「効果 ÷ 費用」 の大きい順に並べる
- 費用の合計が を超えない範囲で、上から順に選ぶ
を0と1の間の値も取れるようにした問題(線形計画緩和)では、この順に選ぶのが最適解になります。1人あたりの費用が予算 に比べて十分に小さければ、0/1 に限った問題でも、最適解との差はわずかです。
選んだ方策の良し悪しは、アップリフトモデルの評価の記事の 方策価値 で測ります。本記事では、誰にも施策を行わない場合と比べた、粗利の増加の合計を使います。
本記事では、次の3つの方策を、同じ予算のもとで比べます。
| 方策 | 選ぶ順番 | 考え方 |
|---|---|---|
| ① pCLV上位 | 予測CLV の大きい順 | 価値の高い顧客を狙う(素朴なHVA) |
| ② CVアップリフト上位 | CVアップリフトの大きい順 | 施策で買うようになる顧客を狙う |
| ③ 価値アップリフト ÷ 費用の上位 | の大きい順 | 費用あたりの価値の増加が大きい顧客を狙う |
本記事で方策を作り、評価して、配信につなげるまでの流れは、次のとおりです。
(図は、diagram-designで作成)
検証用ダミーデータの生成
顧客ワールドと特徴量の再生成
RFMの記事から使っている「顧客ワールド」と、CLV予測の記事の行動ログの特徴量を、同じコードで生成します。 コードはRFMの記事と同じです。生成の規則を式でまとめると、次のとおりです。 顧客 の隠れた性質は、次の分布から1つずつ引きます(ガンマ分布は形状とレートで書きます。NumPy の rng.gamma は形状と尺度(レートの逆数)を引数にとるので、コードではレートの逆数を渡しています)。 (lam)は1日あたりの購買ペース、(p_drop)は繰り返し購買の直後に離脱する確率、(nu)は購買金額の尺度、(first_day)は初回購買日です。 購買ログは、初回購買日 から、次の規則で730日目まで作ります。 は 回目の購買から次の購買までの日数(平均 日)、 は1回ごとの購買金額です(形状6は p_gg)。2回目以降の購買(繰り返し購買)の直後には、確率 で離脱し、それ以降は買いません。初回購買の直後には離脱の判定をしません。1回あたりの平均購買金額は (truth['mean_amount'])で、離脱した日(death_day)が365日目以降なら、基準日に生存している(truth['alive'])とします。 購買と離脱の部分は BG/NBDモデル、購買金額の部分は Gamma-Gammaモデルの生成過程で、BTYDの記事で詳しく説明しています。顧客ワールドの生成式
import numpy as np
import pandas as pd

# 1. 乱数と観測期間の設定(時間の単位は日)
rng = np.random.default_rng(42)
N = 10_000          # 顧客数
CALIB_END = 365     # 0〜364日目: 分析に使う期間(前半1年)
OBS_END = 730       # 365〜729日目: 答え合わせ用のホールドアウト期間(後半1年)

# 2. 顧客ごとの隠れた性質(分析者には観測できない「答え」)
r, alpha = 0.6, 25.0                         # 購買ペースのばらつきを決めるパラメータ
a, b = 0.8, 3.0                              # 離脱のしやすさのばらつきを決めるパラメータ
p_gg, q_gg, gamma_gg = 6.0, 4.0, 1500.0      # 購買金額のばらつきを決めるパラメータ
lam = rng.gamma(r, 1 / alpha, size=N)        # 購買ペース(1日あたりの平均購買回数)
p_drop = rng.beta(a, b, size=N)              # 2回目以降の購買の直後に離脱する確率
nu = rng.gamma(q_gg, 1 / gamma_gg, size=N)   # 購買金額の尺度(平均購買金額は p_gg / nu)
first_day = rng.uniform(0, CALIB_END, size=N)  # 初回購買日(最初の1年で少しずつ獲得)

# 3. 購買ログの生成
records = []
death_day = np.full(N, np.inf)   # 離脱した日(観測期間内に離脱しなければ inf)
for i in range(N):
    t = first_day[i]
    records.append((i, t, rng.gamma(p_gg, 1 / nu[i])))   # 初回購買
    while True:
        t += rng.exponential(1 / lam[i])   # 次の購買までの待ち時間
        if t >= OBS_END:
            break
        records.append((i, t, rng.gamma(p_gg, 1 / nu[i])))
        if rng.uniform() < p_drop[i]:      # 購買の直後に、一定の確率で離脱する
            death_day[i] = t
            break

# 4. 分析者が観測できる購買ログ(購買日は整数の日付、金額は10円単位)
log = pd.DataFrame(records, columns=['customer_id', 'day', 'amount'])
log['day'] = np.floor(log['day']).astype(int)
log['amount'] = log['amount'].round(-1).astype(int)

# 5. 答え合わせ用の真値(分析には使わない)
truth = pd.DataFrame({
    'lam': lam,                          # 購買ペース
    'p_drop': p_drop,                    # 購買の直後に離脱する確率
    'mean_amount': p_gg / nu,            # 平均購買金額
    'alive': death_day >= CALIB_END,     # ホールドアウト期間の開始時点で生存しているか
})

# 6. RFMの記事と同じデータになっていることの確認
print(f"購買ログの件数: {len(log):,} 件、ホールドアウト期間の開始時点で生存している顧客: {truth['alive'].mean():.1%}")
RFMの記事と同じコードで、BTYDの記事の4つの仮定(購買はポアソン過程、購買ごとに一定の確率で離脱、購買ペースと離脱確率は顧客ごとにガンマ分布・ベータ分布に従う)に従って、1万人の購買ログを生成しています。
- 乱数と観測期間の設定: np.random.default_rng(42) で乱数生成器 rng を作り、シードを固定しているので、何度実行しても同じデータになります。顧客数は N = 10_000、時間の単位は日で、CALIB_END = 365 より前(0〜364日目)を分析に使う期間、OBS_END = 730 まで(365〜729日目)をホールドアウト期間とします。
- 顧客ごとの隠れた性質: 購買ペース lam を rng.gamma(r, 1 / alpha, size=N)(ガンマ分布)、離脱確率 p_drop を rng.beta(a, b, size=N)(ベータ分布)、購買金額の尺度 nu を rng.gamma(q_gg, 1 / gamma_gg, size=N)(ガンマ分布)から、顧客ごとに1つずつ引いています。NumPy の rng.gamma は形状と尺度(レートの逆数)を引数にとるので、レート alpha・gamma_gg は逆数にして渡しています。初回購買日 first_day は、rng.uniform(0, CALIB_END, size=N) で最初の1年の一様分布から引きます。
- 購買ログの生成: death_day を np.full(N, np.inf) で全員無限大(離脱しない)に初期化し、for i in range(N) で1人ずつ、初回購買を記録してから、t += rng.exponential(1 / lam[i]) で指数分布の待ち時間だけ時間を進めて次の購買を records に追加する処理を、OBS_END に達するまで繰り返します。1回の購買金額は rng.gamma(p_gg, 1 / nu[i]) で引き、顧客 の平均購買金額は p_gg / nu[i] になります。2回目以降の購買の直後に rng.uniform() < p_drop[i] なら(確率 p_drop[i] で)離脱としてループを抜け、その日を death_day[i] に記録します。初回購買の直後には離脱の判定をしません。
- 観測できる購買ログ: log には、顧客ID・購買日・金額の3列だけを入れます。購買日は np.floor で整数の日付に、金額は round(-1) で10円単位に丸めています。顧客IDは0〜9,999の連番で、配列 lam などの位置(インデックス)と一致します。
- 答え合わせ用の真値: truth には、購買ペース・離脱確率・平均購買金額(p_gg / nu)と、離脱した日が365日目以降かどうか(death_day >= CALIB_END。基準日に生存しているか)を入れています。lam(購買ペース)、p_drop(離脱確率)、nu(購買金額の尺度)、death_day(離脱した日)とあわせて、分析者には観測できない値です。この記事では、特典の効果を作るときに使います。
- 確認: 購買ログの件数と、基準日に生存している顧客の割合(truth['alive'].mean())を表示し、これまでの記事と同じデータになっていることを確かめています。
実行結果
購買ログの件数: 57,667 件、ホールドアウト期間の開始時点で生存している顧客: 67.8%
続いて、RFMの集計と、行動ログの特徴量(直近30日の訪問回数・カート追加回数、メール開封率、閲覧した商品の平均価格、アプリの利用)を作ります。 コードはCLV予測の記事と同じです。作り方を式でまとめると、次のとおりです。 基準日に生存しているかを (生存していれば1、離脱していれば0。alive_now)、シグモイド関数を とすると、5つの特徴量は次のように作ります。 、 は顧客ごとのノイズです。左辺は順に visits_30d(直近30日のサイト訪問回数)、cart_30d(直近30日のカート追加回数)、email_open_rate(24通のメールの開封率)、viewed_price(閲覧した商品の平均価格。10円単位に丸める)、app_user(アプリを利用しているか)で、 は visit_rate、 は open_prob です。乱数は、顧客ワールドとは別の乱数生成器 rng_feat(シード43)で引きます。行動ログの特徴量の生成式
# 1. 分析に使う期間と、答え合わせ用のホールドアウト期間に分ける
calib = log[log['day'] < CALIB_END]
holdout = log[log['day'] >= CALIB_END]

# 2. 顧客ごとに x, t_x, T と、1回あたりの平均購買金額を集計する
g = calib.groupby('customer_id')
summary = pd.DataFrame({
    'first_day': g['day'].min(),
    'last_day': g['day'].max(),
    'n_purchases': g['day'].size(),     # 購買回数(RFMの F)
    'monetary': g['amount'].mean(),     # 1回あたりの平均購買金額(RFMの M)
})
summary['x'] = summary['n_purchases'] - 1                       # 繰り返し購買の回数
summary['t_x'] = summary['last_day'] - summary['first_day']     # 初回購買から最後の購買までの日数
summary['T'] = CALIB_END - summary['first_day']                 # 初回購買から基準日までの日数
summary['recency'] = summary['T'] - summary['t_x']              # RFMの R(基準日から最後の購買までの日数)

# 3. 予測の対象: ホールドアウト期間(翌1年)の購買回数と売上
summary['holdout_n'] = holdout.groupby('customer_id').size().reindex(summary.index, fill_value=0)
summary['holdout_sales'] = holdout.groupby('customer_id')['amount'].sum().reindex(summary.index, fill_value=0)

# ---- 行動ログの特徴量(CLV予測の記事と同じ) ----
# 1. 特徴量は別の乱数生成器で作る(顧客ワールドの値を変えないため)
rng_feat = np.random.default_rng(43)
alive_now = truth['alive'].values

# 2. 直近30日のサイト訪問回数とカート追加回数(生存している顧客は購買ペースに応じて行動する)
visit_rate = np.where(alive_now, 0.01 + 3 * lam, 0.005)     # 1日あたりの訪問回数の平均
features = pd.DataFrame(index=summary.index)
features['visits_30d'] = rng_feat.poisson(30 * visit_rate)
features['cart_30d'] = rng_feat.poisson(30 * 1.5 * lam * alive_now)

# 3. メールマガジン(24通)の開封率(離脱しにくい顧客ほど開封し、離脱した顧客はあまり開封しない)
open_prob = 1 / (1 + np.exp(-(1.0 - 5 * p_drop + rng_feat.normal(0, 0.5, size=N)))) * np.where(alive_now, 1.0, 0.3)
features['email_open_rate'] = rng_feat.binomial(24, open_prob) / 24

# 4. 閲覧した商品の平均価格(平均購買金額のまわりでばらつく)と、アプリの利用(購買ペースが高いほど使う)
features['viewed_price'] = np.round(truth['mean_amount'].values * np.exp(rng_feat.normal(0, 0.35, size=N)), -1)
features['app_user'] = rng_feat.binomial(1, 1 / (1 + np.exp(-(np.log(lam * 365) - 2.0))))

# 5. モデルに使う特徴量の行列(購買履歴の6列 + 行動ログの5列)
X = pd.concat([summary[['x', 't_x', 'T', 'recency', 'n_purchases', 'monetary']], features], axis=1)
print(X.shape)
print(X.head().round(2).to_string())
CLV予測の記事と同じコードで、購買履歴の集計と行動ログの特徴量を作り、モデルに使う特徴量の行列 X にまとめています。
-
期間の分割: log[log['day'] < CALIB_END] で分析に使う期間の購買 calib を、log['day'] >= CALIB_END でホールドアウト期間(365〜729日目)の購買 holdout を取り出しています。
-
購買履歴の集計: calib.groupby('customer_id') で顧客ごとにまとめ、初回購買日(g['day'].min())・最後の購買日(g['day'].max())・購買回数(g['day'].size())・1回あたりの平均購買金額(g['amount'].mean())を summary に入れます。そこから、繰り返し購買の回数 x(購買回数 − 1)、初回購買から最後の購買までの日数 t_x、初回購買から基準日までの日数 T、基準日から最後の購買までの日数 recency(T - t_x)を計算しています。
-
ホールドアウト期間の集計: holdout.groupby('customer_id') で、翌1年の購買回数(holdout_n)と売上(holdout_sales)を集計しています。翌1年に買わなかった顧客は集計結果に現れないので、reindex(summary.index, fill_value=0) で全員の行をそろえ、0で埋めています。
-
行動ログの特徴量: 顧客ワールドの rng とは別の乱数生成器 rng_feat(シード43)で作ります。rng から続けて乱数を引くと、これまでの記事とデータが変わってしまうためです。alive_now は基準日に生存しているか(True/False)です。
- 訪問とカート: 1日あたりの訪問回数の平均 visit_rate を、np.where(alive_now, 0.01 + 3 * lam, 0.005) で生存している顧客は購買ペースに応じた値、離脱した顧客は0.005にし、rng_feat.poisson(30 * visit_rate) で直近30日の訪問回数 visits_30d を引きます。カート追加 cart_30d は、生存している顧客だけが購買ペースの1.5倍のペースで行います(lam * alive_now は、離脱した顧客で0になります)。
- メールの開封率: 開封確率 open_prob は、1.0 - 5 * p_drop に顧客ごとのノイズ rng_feat.normal(0, 0.5, size=N) を加えてシグモイド関数 1 / (1 + np.exp(-z)) に通し、離脱した顧客は0.3倍にしたものです。rng_feat.binomial(24, open_prob) / 24 で、24通のうち開封した割合にしています。
- 閲覧価格とアプリ: viewed_price は、真の平均購買金額に対数正規のノイズ np.exp(rng_feat.normal(0, 0.35, size=N)) を掛けて10円単位に丸めたもの、app_user は、年間の購買ペースの対数 np.log(lam * 365) から2を引いた値をシグモイド関数に通した確率で1になる2値の特徴量です。
それぞれの式は、下の折りたたみにまとめました。
-
特徴量の行列: pd.concat([...], axis=1) で、購買履歴の6列(x・t_x・T・recency・n_purchases・monetary)と行動ログの5列を横につなぎ、合計11列の X を作っています。いずれも招待の前(基準日まで)に分かる値で、pCLV やアップリフトのモデルの特徴量として使います。X.shape で行列の形(行数, 列数)を、X.head() で先頭5人の値を表示しています。
実行結果
(10000, 11)
             x  t_x    T  recency  n_purchases  monetary  visits_30d  cart_30d  email_open_rate  viewed_price  app_user
customer_id
0            6  114  147       33            7   1348.57           2         0             0.79        2450.0         0
1            4   85  297      212            5   3708.00           0         0             0.21        2690.0         0
2            0    0  139      139            1   1630.00           0         0             0.33        3740.0         0
3            2   13   24       11            3   3146.67           3         3             0.83        1730.0         1
4            0    0  338      338            1   2180.00           0         0             0.79        2740.0         0
施策データの生成:会員特典への招待
サロゲートインデックスの記事のクーポンは、1年間の売上への効果が平均で数百円と小さく、顧客ごとの売上の大きなばらつきに埋もれてしまいます(1万人の実験で1年待って直接比べても、全体の平均効果の推定値の標準偏差は518円でした)。全体の平均すら精度よく推定できないので、顧客ごとの効果の違いを学習するのはさらに困難です。そこで本記事では、効果がより大きい別の施策として、「3か月間の会員特典(送料無料とポイント5%)への招待」を考えます。半数の顧客をランダムに招待したRCTのデータです。
施策の効果は、顧客のタイプによって次のように違います。
- 特典期間だけ買う顧客:平均購買金額が小さい顧客ほど、送料無料につられて特典期間中だけ購買が増えます。CVは増えますが、1件あたりの金額が小さいので、送料(1件500円)の負担で粗利はかえって減りがちです。
- 特典をきっかけに定着する顧客:メールを読む離脱しにくい顧客で、平均購買金額が大きく、もともとの購買ペースが年8回より少ない(伸びしろがある)顧客ほど、特典をきっかけに定着し、特典期間が終わった後も購買ペースが3倍になります。
- よく買う顧客:もともとの購買ペースが高い顧客は、特典がなくても買うので、購買はほとんど増えず、送料とポイントの費用だけがかかります。
生成は、コードの手順に沿って次の流れで行います。
- ① 特典の効果を決める確率(特典期間中の上乗せと、定着する確率)を決め、定着するかを乱数で決める(手順1)
- ② 招待した場合に上乗せされる購買の回数と金額を、乱数で作る(手順2)
- 招待しなかった場合の値を、顧客ワールドの購買ログから集計する(手順3)
- 招待した場合の値と、③ 粗利と特典の費用を計算する(手順4)
- ④ 答え合わせ用の真のCATEを、乱数について期待値をとって計算する(手順5)
- RCT で半数をランダムに招待し、観測できる値を選ぶ(手順6)
①〜④を、式で示します。
① 特典の効果を決める確率
顧客 の購買ペース(1日あたり)を (lam)、離脱確率を (p_drop)、平均購買金額を (mean_amount)、基準日(365日目)に生存しているかを (alive_now)、シグモイド関数を とします。特典期間中に上乗せされる購買ペース (boost_short)と、特典をきっかけに定着する確率 (p_settle)は、
です。定着するかどうか (settle)は確率 で決まり、定着した顧客には、特典期間の開始から離脱するまで、購買ペース (boost_long)が上乗せされます。
② 招待した場合に上乗せされる購買
期間 のうち離脱するまでの日数を (関数 exposure で計算し、、、 は E30・E90・E_rest)とすると、招待した場合に上乗せされる購買の回数(特典期間の最初の30日とその後の60日が n_30・n_60、その後が n_rest)は、ポアソン分布に従います。
1回の購買金額は顧客ワールドと同じ なので、 回の合計は に従います(関数 total_amount。 は p_gg、 は nu)。
③ 粗利と特典の費用
招待しなかった場合の値は、顧客ワールドの購買ログそのものです。粗利率を とし、定価での1年間の売上を 、特典期間の注文件数と売上を 、 とすると、特典の費用 (cost1)と1年間の粗利の潜在的結果 (profit0・profit1)は次のとおりです。
④ 答え合わせ用の真のCATE
答え合わせ用の 真のCATE は、乱数(定着するか、上乗せされる購買の回数と金額)について期待値をとったものです。
- 1年間の粗利への真のCATE (tau_val_true):上乗せされる売上の期待値に粗利率を掛け、特典の費用の期待値 (cost_true)を差し引いたもの
- 30日以内に買うかへの真のCATE (tau_cv_true):「招待しなければ買わなかった顧客が、上乗せされた購買で買う確率」
詳細な式展開(真のCATE ・ と費用の期待値 )
上乗せされる購買ペースの期待値は、特典期間中が (extra_rate_program)、その後が です。特典期間の注文件数の期待値は、もともとの購買と上乗せの合計 で、1件あたりの費用の期待値は、送料500円と平均購買金額の5%のポイント です( は顧客 の1回あたりの平均購買金額 mean_amount で、1回の購買金額の分布 の平均 です。注文ごとの金額はばらつきますが、ポイントの期待値は平均購買金額の5%になります)。したがって、費用の期待値 と は
です。 は、招待しなくても買う確率 (p_buy0)を使って、「招待しなければ買わなかった顧客が、上乗せされた購買で買う確率」として計算します。定着した場合(確率 )は上乗せのペースが 、定着しなかった場合は なので、
です。
# 1. 特典の効果を決める性質(分析者には観測できない「答え」)
rng_hva = np.random.default_rng(46)
def sigmoid(z):
    return 1 / (1 + np.exp(-z))

alive_now = truth['alive'].values
mean_amount = truth['mean_amount'].values
PROGRAM_END = CALIB_END + 90                    # 特典の期間:365〜454日目
boost_short = alive_now * 0.03 * sigmoid(2 * (np.log(3000) - np.log(mean_amount)))          # b_i:特典期間中に上乗せされる購買ペース
p_settle = (alive_now * 0.9 * (1 - p_drop) * sigmoid(2 * (np.log(mean_amount) - np.log(3000)))
            * sigmoid(-2 * (np.log(lam * 365) - np.log(8))))                                 # q_i:特典をきっかけに定着する確率
settle = rng_hva.uniform(size=N) < p_settle
boost_long = np.where(settle, 2 * lam, 0.0)     # 定着した顧客は、購買ペースが3倍になる(上乗せ分 2 λ_i)

# 2. 招待した場合に上乗せされる購買(回数はポアソン分布、金額の合計はガンマ分布)
def exposure(start, end):                       # 期間 [start, end) のうち、離脱するまでの日数
    return np.clip(np.minimum(death_day, end) - start, 0, None)

E30, E90, E_rest = exposure(CALIB_END, CALIB_END + 30), exposure(CALIB_END, PROGRAM_END), exposure(PROGRAM_END, OBS_END)
n_30 = rng_hva.poisson((boost_short + boost_long) * E30)
n_60 = rng_hva.poisson((boost_short + boost_long) * (E90 - E30))
n_rest = rng_hva.poisson(boost_long * E_rest)
def total_amount(n):                            # 1回の金額が Gamma(p, nu) なので、n 回の合計は Gamma(n p, nu)
    return np.where(n > 0, rng_hva.gamma(np.maximum(n, 1) * p_gg, 1 / nu), 0.0)
extra_program = total_amount(n_30) + total_amount(n_60)
extra_rest = total_amount(n_rest)

# 3. 招待しなかった場合(顧客ワールドの購買ログそのもの)の値
day, cid, amount = log['day'].values, log['customer_id'].values, log['amount'].values
def per_customer(mask, values=None):
    return np.bincount(cid[mask], weights=None if values is None else values[mask], minlength=N)
buy30_0 = (per_customer((day >= CALIB_END) & (day < CALIB_END + 30)) > 0).astype(int)
orders_program0 = per_customer((day >= CALIB_END) & (day < PROGRAM_END))
sales_program0 = per_customer((day >= CALIB_END) & (day < PROGRAM_END), amount)
sales_year0 = per_customer(day >= CALIB_END, amount)

# 4. 招待した場合の値と、1年間の粗利(粗利率30%、特典の費用は送料1件500円と売上の5%のポイント)
MARGIN, SHIPPING, POINT_RATE = 0.3, 500, 0.05
buy30_1 = ((buy30_0 == 1) | (n_30 > 0)).astype(int)
cost1 = SHIPPING * (orders_program0 + n_30 + n_60) + POINT_RATE * (sales_program0 + extra_program)   # 特典の費用 c_i
profit0 = MARGIN * sales_year0
profit1 = MARGIN * (sales_year0 + extra_program + extra_rest) - cost1

# 5. 真のCATE(乱数について期待値をとったもの):30日以内の購買と、1年間の粗利
extra_rate_program = boost_short + 2 * lam * p_settle                       # 特典期間に上乗せされる購買ペースの期待値
p_buy0 = 1 - np.exp(-lam * E30)
tau_cv_true = (1 - p_buy0) * (p_settle * (1 - np.exp(-(boost_short + 2 * lam) * E30))
                              + (1 - p_settle) * (1 - np.exp(-boost_short * E30)))
cost_true = (SHIPPING + POINT_RATE * mean_amount) * (lam * E90 + extra_rate_program * E90)
tau_val_true = MARGIN * mean_amount * (extra_rate_program * E90 + 2 * lam * p_settle * E_rest) - cost_true

# 6. RCT:半数にランダムに招待する(観測できるのは、招待された側の値だけ)
T_rct = rng_hva.binomial(1, 0.5, size=N)
Y_cv = np.where(T_rct == 1, buy30_1, buy30_0)
Y_val = np.where(T_rct == 1, profit1, profit0)
C = np.where(T_rct == 1, cost1, 0.0)

print(f"招待した割合 {T_rct.mean():.1%}、特典をきっかけに定着する顧客 {settle.sum():,} 人")
print(f"全員を招待した場合の真の平均効果: 30日以内の購買率 {tau_cv_true.mean():+.3f}、1年間の粗利 {tau_val_true.mean():+.1f} 円、特典の費用 {cost_true.mean():.1f} 円")
print(f"(実現値での確認)30日以内の購買率 {(buy30_1 - buy30_0).mean():+.3f}、1年間の粗利 {(profit1 - profit0).mean():+.1f} 円、特典の費用 {cost1.mean():.1f} 円")
上の式を、そのまま順に計算しています。
- 乱数とシグモイド関数: 顧客ワールドや特徴量の値を変えないように、施策データは別の乱数生成器 rng_hva(シード46)で作っています。sigmoid は です。PROGRAM_END = CALIB_END + 90 は特典期間の終わりで、特典期間は365〜454日目です。
- 特典の効果を決める性質: boost_short は式の 、p_settle は をそのまま計算したものです。sigmoid(-2 * (np.log(lam * 365) - np.log(8))) は、年間の購買ペースが8回より少ないほど1に近づく項で、「伸びしろがある」顧客ほど定着しやすくしています。rng_hva.uniform(size=N) < p_settle で、各顧客が確率 p_settle で定着する(settle が True)かを決め、定着した顧客には np.where(settle, 2 * lam, 0.0) で上乗せの購買ペース (boost_long)を与えます。
- 離脱するまでの日数: exposure(start, end) は、np.minimum(death_day, end) - start で、期間の終わりと離脱した日の早い方から期間の始まりを引き、np.clip(..., 0, None) で負の値を0にしたものです。期間が始まる前に離脱した顧客は0日になり、離脱した日以降は特典があっても買いません。E30・E90・E_rest は、特典期間の最初の30日、特典期間の90日、特典期間の後(455〜729日目)の日数です。
- 上乗せされる購買の回数: rng_hva.poisson((boost_short + boost_long) * E30) のように、上乗せの購買ペースに日数を掛けた値を平均とするポアソン分布から回数を引いています。特典期間の残り60日は E90 - E30 日、特典期間の後は定着した顧客の上乗せ boost_long だけです。
- 上乗せされる購買の金額: total_amount(n) は、rng_hva.gamma(n * p_gg, 1 / nu) で 回分の金額の合計を1回で引く関数です。np.maximum(n, 1) は、 の顧客で形状が0になってエラーになるのを防ぐためで、その顧客の値は np.where(n > 0, ..., 0.0) で0にしています。
- 招待しなかった場合: per_customer(mask, values) は、np.bincount(cid[mask], weights=values[mask], minlength=N) で、条件 mask を満たす購買を顧客IDごとに数える(values を渡すとその合計をとる)関数です。minlength=N で、購買のない顧客も0として全員分の長さにそろえています。これで、365〜394日目の購買の有無(buy30_0)、特典期間の注文件数と売上(orders_program0・sales_program0)、1年間の売上(sales_year0)を集計しています。
- 招待した場合と粗利: buy30_1 は、もともと30日以内に買うか、上乗せの購買が30日以内に1回以上ある(n_30 > 0)ときに1です。特典の費用 cost1 は、特典期間の注文件数(もともとの注文と上乗せの注文)× 送料500円と、特典期間の売上 × ポイント5%の和で、粗利 profit0・profit1 は、1年間の売上に粗利率30%を掛け、招待した場合は特典の費用を引いたものです。
- 真のCATE: tau_cv_true・cost_true・tau_val_true は、上の折りたたみの式を、乱数(定着するか、上乗せの購買の回数と金額)について期待値をとった形で計算しています。p_buy0 = 1 - np.exp(-lam * E30) は、招待しなくても30日以内に買う確率です。
- RCT と観測できるデータ: rng_hva.binomial(1, 0.5, size=N) で半数をランダムに招待します(T_rct)。np.where(T_rct == 1, buy30_1, buy30_0) のように、招待された顧客は招待した場合の値、それ以外は招待しなかった場合の値だけが観測できます。Y_cv は30日以内に買ったか、Y_val は1年間の粗利、C は特典の費用(招待しなかった顧客は0円)です。
- 確認: 招待した割合と定着する顧客の人数、全員を招待した場合の真の平均効果(期待値)を表示し、乱数の実現値で計算した平均効果((buy30_1 - buy30_0).mean() など)とも比べて、期待値の計算が生成と整合していることを確かめています。
実行結果
招待した割合 50.3%、特典をきっかけに定着する顧客 1,589 人
全員を招待した場合の真の平均効果: 30日以内の購買率 +0.210、1年間の粗利 +243.2 円、特典の費用 1261.4 円
(実現値での確認)30日以内の購買率 +0.216、1年間の粗利 +260.2 円、特典の費用 1265.8 円
全員を招待すると、30日以内の購買率は約21ポイント上がりますが、1年間の粗利の増加は1人あたり約240円で、特典の費用(約1,260円)を差し引くとわずかしか残りません。「全員に配る」は割に合わない施策で、誰を招待するかが重要になります。実現値(最後の行)は、乱数の分だけ期待値とずれますが、近い値です。
pCLVの上位を狙うと何が起きるか
まず、素朴なHVAとして、予測CLV(pCLV、pclv)を作ります。ここでのpCLVは、招待しなかった場合の1年間の粗利の予測値 です。RCTの対照群(招待されなかった顧客)のデータで、特徴量 から粗利 を予測するモデル を学習し、
とします。CLV予測の記事と同じく5分割の交差適合で、自分のデータを学習に使っていないモデルの予測にします。ここでは LightGBM(二乗誤差)を使いますが、CLV予測の記事のZILN損失のモデルを使ってもかまいません。
続いて、pCLVの上位20%を「価値が高い」とし、真のCATE が正か(特典で粗利が増えるか)と組み合わせて、2×2の表を作ります。
import lightgbm as lgb
from sklearn.model_selection import KFold

kf = KFold(n_splits=5, shuffle=True, random_state=0)
params = dict(n_estimators=200, learning_rate=0.05, num_leaves=15, min_child_samples=50,
              random_state=0, n_jobs=1, verbose=-1)

# 1. 予測CLV(pCLV):招待しなかった場合の1年間の粗利を、対照群のデータで学習して予測する
pclv = np.zeros(N)
for train_idx, test_idx in kf.split(X):
    control = train_idx[T_rct[train_idx] == 0]
    model = lgb.LGBMRegressor(**params).fit(X.iloc[control], Y_val[control])
    pclv[test_idx] = model.predict(X.iloc[test_idx])
print(f"pCLV と、招待しなかった場合の粗利の相関: {np.corrcoef(pclv, profit0)[0, 1]:.3f}")

# 2. 2×2の整理:価値(pCLV の上位20%か)× 特典で粗利が増えるか(真のCATE > 0)
high_value = pclv >= np.quantile(pclv, 0.8)
grid = pd.DataFrame({
    '価値': np.where(high_value, '高い(pCLV上位20%)', '低い'),
    '特典への反応': np.where(tau_val_true > 0, '粗利が増える', '粗利が増えない'),
    '真のCATE': tau_val_true,
})
print("\n人数")
print(pd.crosstab(grid['価値'], grid['特典への反応'])[['粗利が増える', '粗利が増えない']].to_string())
print("\n真のCATEの合計(万円)")
print((grid.pivot_table(index='価値', columns='特典への反応', values='真のCATE', aggfunc='sum')[['粗利が増える', '粗利が増えない']] / 1e4).round(1).to_string())
print(f"\npCLV上位20%の真のCATEの平均: {tau_val_true[high_value].mean():+.0f} 円(特典の費用 {cost_true[high_value].mean():.0f} 円)、"
      f"それ以外: {tau_val_true[~high_value].mean():+.0f} 円({cost_true[~high_value].mean():.0f} 円)")
pCLV を予測し、価値の高低と特典への反応の2×2で、人数と真のCATEを集計しています。
- 交差適合の準備: KFold(n_splits=5, shuffle=True, random_state=0) で顧客をランダムに5つに分け、各回でテスト用の顧客の予測だけを書き込むことで、全員の予測を、その顧客を学習に使っていないモデルでそろえます。params は LightGBM の設定で、木の数200本、学習率0.05、葉の数15、1つの葉に最低50人です。以降の節でも同じ kf と params を使います。
- pCLV の学習: train_idx[T_rct[train_idx] == 0] で、学習用の顧客のうち対照群(招待しなかった顧客)だけを選び、その1年間の粗利 Y_val を予測する回帰モデルを学習して、テスト用の顧客の粗利を予測しています。対照群だけを使うのは、pCLV が「招待しなかった場合の価値」だからです。np.corrcoef(pclv, profit0)[0, 1] で、招待しなかった場合の実際の粗利との相関を確認しています。
- 2×2の分類: np.quantile(pclv, 0.8) は pCLV の80%点で、それ以上の顧客を「価値が高い」(high_value)とします。特典への反応は、真のCATE tau_val_true が正かどうかで分けています。np.where で、それぞれをラベルの文字列にしています。
- 2×2の表: pd.crosstab で人数を、pivot_table(..., aggfunc='sum') で真のCATEの合計を集計し、/ 1e4 で万円単位にしています。[['粗利が増える', '粗利が増えない']] は、列の順番をそろえるための指定です。最後に、pCLV上位20%とそれ以外で、真のCATEの平均と特典の費用の平均を比べています。
実行結果
pCLV と、招待しなかった場合の粗利の相関: 0.700

人数
特典への反応         粗利が増える  粗利が増えない
価値
低い               2598     5402
高い(pCLV上位20%)     921     1079

真のCATEの合計(万円)
特典への反応         粗利が増える  粗利が増えない
価値
低い              229.4   -114.5
高い(pCLV上位20%)   308.5   -180.3

pCLV上位20%の真のCATEの平均: +641 円(特典の費用 2877 円)、それ以外: +144 円(858 円)
- pCLV の精度: pCLV と、招待しなかった場合の実際の粗利との相関は0.70で、価値の高い顧客はそれなりに当てられています。
- 価値が高い顧客でも、約半数は粗利が増えない: pCLV上位20%の2,000人のうち、特典で粗利が増えるのは921人で、残りの1,079人は増えない(送料とポイントの分だけ減る)顧客です。増える顧客の合計 +308.5万円のうち、半分以上(−180.3万円)を増えない顧客が打ち消しています。
- 費用が高い: pCLV上位20%の真のCATEの平均は +641円と、それ以外(+144円)より大きいですが、特典の費用も平均2,877円と、それ以外(858円)の3倍以上です。よく買う顧客ほど、注文のたびに送料とポイントがかかるためです。予算に限りがある場合、費用1円あたりの効果で比べる必要があります。
4つのグループの人数と真の CATE の合計を図にすると、次のようになります。
(図は、diagram-designで作成)
価値アップリフトの推定
次に、CVアップリフトと価値アップリフト(予測 は tau_cv_hat・tau_val_hat)を、メタラーナーの記事の X-Learner で推定します。成果 を、30日以内に買ったか(Y_cv)にするか、1年間の粗利(Y_val)にするかを変えるだけで、同じ関数を使います。
X-Learner の計算は、次の3段階です。施策群で学習した (m1)と対照群で学習した (m0)から、擬似的な効果 (D1・D0)を作り、
それぞれを特徴量から予測するモデル (tau1・tau0)を学習して、重み で加重平均します。RCTでは招待の確率が0.5と分かっているので、 です。
費用の予測 (予測値 は cost_hat)は、招待した顧客の費用 を特徴量から予測する回帰モデル で作ります。 を計算するときに、0円に近い予測で割らないよう、 の下限を10円にします。
推定したスコアの良し悪しは、スコアの十分位ごとに、費用1円あたりの粗利の増加(真のCATEの合計 ÷ 真の費用の合計)で比べます。十分位 に入る顧客の集合を とすると、
です。
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. X-Learner:成果 y を変えるだけで、CVアップリフトにも価値アップリフトにも使える(RCT なので g = 0.5)
def x_learner(y, task):
    Model = lgb.LGBMClassifier if task == 'classification' else lgb.LGBMRegressor
    def predict(model, X_):
        return model.predict_proba(X_)[:, 1] if task == 'classification' else model.predict(X_)
    tau_hat = np.zeros(N)
    for train_idx, test_idx in kf.split(X):
        X_tr, X_te, T_tr, y_tr = X.iloc[train_idx], X.iloc[test_idx], T_rct[train_idx], y[train_idx]
        treated, control = T_tr == 1, T_tr == 0
        m1 = Model(**params).fit(X_tr[treated], y_tr[treated])         # μ̂_1(x)
        m0 = Model(**params).fit(X_tr[control], y_tr[control])         # μ̂_0(x)
        D1 = y_tr[treated] - predict(m0, X_tr[treated])                 # D^1_i = Y_i - μ̂_0(X_i)
        D0 = predict(m1, X_tr[control]) - y_tr[control]                 # D^0_i = μ̂_1(X_i) - Y_i
        tau1 = lgb.LGBMRegressor(**params).fit(X_tr[treated], D1)       # τ̂_1(x)
        tau0 = lgb.LGBMRegressor(**params).fit(X_tr[control], D0)       # τ̂_0(x)
        tau_hat[test_idx] = 0.5 * tau0.predict(X_te) + 0.5 * tau1.predict(X_te)
    return tau_hat

tau_cv_hat = x_learner(Y_cv, 'classification')    # CVアップリフト
tau_val_hat = x_learner(Y_val, 'regression')      # 価値アップリフト(1年間の粗利)

# 2. 費用の予測:招待した顧客の特典の費用を、特徴量から予測する
cost_hat = np.zeros(N)
for train_idx, test_idx in kf.split(X):
    treated = train_idx[T_rct[train_idx] == 1]
    cost_hat[test_idx] = lgb.LGBMRegressor(**params).fit(X.iloc[treated], C[treated]).predict(X.iloc[test_idx])
cost_hat = np.maximum(cost_hat, 10)               # 0円に近い予測で割らないよう、下限を10円にする

print(f"CVアップリフトの予測と真のCATEの相関: {np.corrcoef(tau_cv_hat, tau_cv_true)[0, 1]:.3f}")
print(f"価値アップリフトの予測と真のCATEの相関: {np.corrcoef(tau_val_hat, tau_val_true)[0, 1]:.3f}")
print(f"費用の予測と真の費用の相関: {np.corrcoef(cost_hat, cost_true)[0, 1]:.3f}")

# 3. 3つのスコアの十分位ごとに、真のCATEの合計 ÷ 真の費用の合計(費用1円あたりの粗利の増加)を比べる
scores = {'① pCLV': pclv, '② CVアップリフト': tau_cv_hat, '③ 価値アップリフト / 費用': tau_val_hat / cost_hat}
deciles = {}
for name, s in scores.items():
    decile = pd.qcut(pd.Series(-s).rank(method='first'), 10, labels=range(1, 11))
    sums = pd.DataFrame({'tau': tau_val_true, 'cost': cost_true}).groupby(decile, observed=True).sum()
    deciles[name] = sums['tau'] / sums['cost']
deciles = pd.DataFrame(deciles)
deciles.index.name = '十分位(1がスコア上位)'
print()
print(deciles.round(2).to_string())

# 4. 可視化
ax = deciles.plot.bar(figsize=(10, 5), rot=0, color=['C0', 'C1', 'C2'])
ax.axhline(0, color='black', linewidth=0.8)
ax.set_ylabel('費用1円あたりの粗利の増加(真の値、円)')
ax.set_title('スコアの十分位ごとの、特典の費用対効果')
ax.grid(True, axis='y', alpha=0.3)
plt.tight_layout()
plt.show()
X-Learner で CVアップリフトと価値アップリフトを推定し、費用も予測して、3つのスコアの費用対効果を比べています。
- X-Learner の関数: x_learner は、アップリフトモデルの評価の記事の X-Learner と同じ計算を、成果 y と、分類(0/1の成果)か回帰(金額の成果)かの種類 task を引数にして関数にしたものです。Model には、task に応じて lgb.LGBMClassifier か lgb.LGBMRegressor のクラスそのものを入れ、内側の関数 predict で、分類のときは予測確率(predict_proba(X_)[:, 1])、回帰のときは予測値を返すように切り替えています。
- X-Learner の手順: 各分割で、施策群・対照群のモデル m1・m0()を学習し、擬似的な効果 D1(施策群の実際の成果 − m0 の予測)と D0(m1 の予測 − 対照群の実際の成果)を作ります。それを予測する回帰モデル tau1・tau0 を学習し、RCT なので傾向スコアが全員0.5で 0.5 * tau0.predict(X_te) + 0.5 * tau1.predict(X_te) と平均しています。
- 2つのアップリフト: 同じ関数に、30日以内に買ったか Y_cv を渡すと CVアップリフト tau_cv_hat、1年間の粗利 Y_val を渡すと価値アップリフト tau_val_hat になります。成果の変数を変えるだけで、同じ手法が使えます。
- 費用の予測: 施策群(train_idx[T_rct[train_idx] == 1])の顧客だけで、特典の費用 C を予測する回帰モデルを交差適合で学習しています。対照群の費用は0円なので、学習に使いません。np.maximum(cost_hat, 10) で、予測費用の下限を10円にしています。後で を計算するとき、0円に近い値で割って極端な値になるのを防ぐためです。
- 予測の確認: 3つの予測(CVアップリフト・価値アップリフト・費用)と、それぞれの真の値との相関を表示しています。
- 十分位の集計: 3つのスコアを辞書 scores にまとめ、③のスコアは (tau_val_hat / cost_hat)とします。pd.Series(-s).rank(method='first') で、スコアの大きい順に1から順位をつけ(同じ値にも別の順位を付ける)、pd.qcut(..., 10) で10等分しています。十分位ごとに真のCATEと真の費用を groupby(decile, observed=True).sum() で合計し、その比を「費用1円あたりの粗利の増加」としています。
- 可視化: deciles.plot.bar で、十分位ごとに3つのスコアの棒を並べています。ax.axhline(0) で0の線を引き、費用対効果がマイナスになる十分位を見やすくしています。
実行結果
CVアップリフトの予測と真のCATEの相関: 0.838
価値アップリフトの予測と真のCATEの相関: 0.550
費用の予測と真の費用の相関: 0.843

              ① pCLV  ② CVアップリフト  ③ 価値アップリフト / 費用
十分位(1がスコア上位)
1               0.20       -0.00             3.91
2               0.25        0.12             1.72
3               0.22        0.28             0.77
4               0.17        0.37             0.36
5               0.18        0.47             0.15
6               0.14        0.44            -0.01
7               0.06        0.05            -0.19
8               0.07       -0.17            -0.25
9              -0.01       -0.31            -0.37
10              0.52       -0.33            -0.13
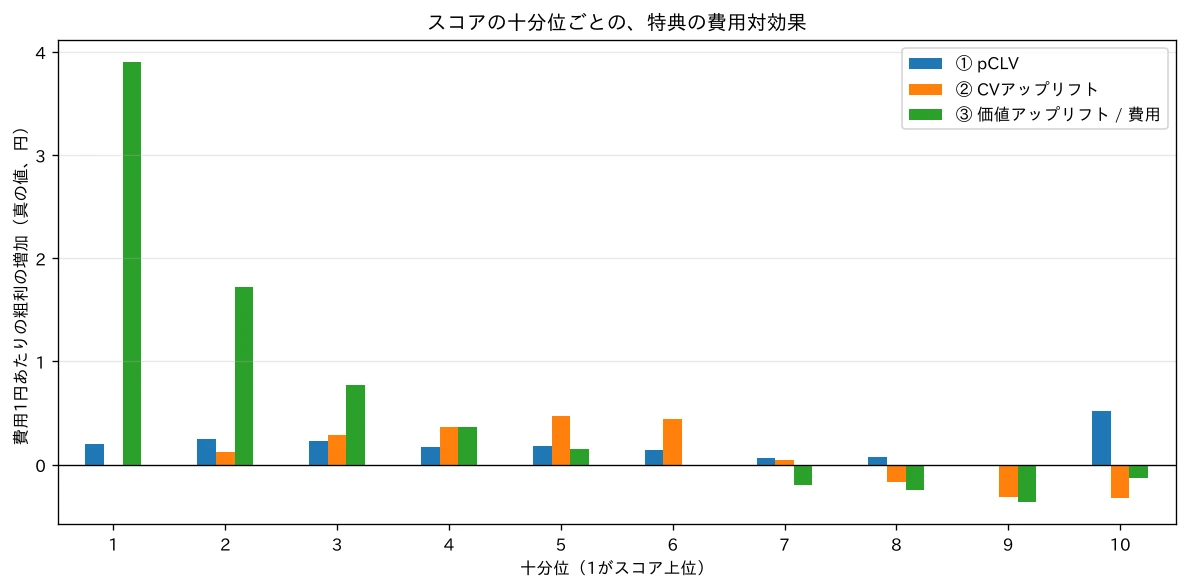
- 推定の精度: CVアップリフトの予測と真のCATEの相関は0.84、価値アップリフトの予測は0.55です。粗利は顧客ごとのばらつきが大きいので、0/1のCVより推定は難しくなりますが、顧客の違いはある程度とらえられています。費用の予測の相関は0.84です。
- ① pCLV: どの十分位でも、費用1円あたりの粗利の増加は0.2円前後で、スコアが高い顧客ほど費用対効果が良い、という関係がありません(最下位の十分位は、費用も効果もほとんどない顧客の比なので、値が不安定です)。
- ② CVアップリフト: CVアップリフトの最上位の十分位は、費用対効果がほぼ0です。送料無料につられて特典期間だけ買う、平均購買金額の小さい顧客が集まるためです。
- ③ 価値アップリフト ÷ 費用: 最上位の十分位は、費用1円あたり3.9円の粗利の増加で、スコアの順に費用対効果がきれいに下がっています。下位の十分位はマイナスで、こうした顧客は招待しない方が得です。
予算の制約のもとでのターゲティング
3つの方策の比較
予測した と を使って、予算の制約を入れた定式化で示した貪欲法で方策(関数 greedy_policy が返す0/1の配列 )を作ります。各方策のスコアを (policies の1つ目の要素)とすると、スコアの大きい順に並べた顧客を、予測費用の累積和が予算 以下の範囲で選びます。
③では、さらに の顧客に限ります。方策の良し悪しは、真のCATEの合計 (value_gain)で比べます。比較のために、ランダムに選ぶ方策と、真のCATEと真の費用を知っている「神の視点」の方策( の順に選ぶ)も加えます。
# 1. 予算制約のもとでの貪欲法:スコアの高い順に、予測費用の合計が予算 B に収まるまで選ぶ
def greedy_policy(score, budget, tau_for_sign=None):
    order = np.argsort(-score, kind='stable')
    chosen = order[np.cumsum(cost_hat[order]) <= budget]
    if tau_for_sign is not None:
        chosen = chosen[tau_for_sign[chosen] > 0]       # 効果の予測が0以下の顧客は招待しない
    pi = np.zeros(N, dtype=int)
    pi[chosen] = 1
    return pi

# 2. 方策価値の増分(真の値):招待した顧客の真のCATEの合計 Σ π_i τ_i
def value_gain(pi):
    return tau_val_true[pi == 1].sum()

policies = {
    'ランダム': (np.random.default_rng(0).uniform(size=N), None),
    '① pCLV上位': (pclv, None),
    '② CVアップリフト上位': (tau_cv_hat, None),
    '③ 価値アップリフト / 費用の上位': (tau_val_hat / cost_hat, tau_val_hat),
    '神の視点(真のCATE / 真の費用)': (tau_val_true / np.maximum(cost_true, 10), tau_val_true),
}
budgets = np.arange(0, 3_000_001, 100_000)
curves = {name: [value_gain(greedy_policy(s, b, sign)) for b in budgets] for name, (s, sign) in policies.items()}

# 3. 予算100万円での比較
BUDGET = 1_000_000
rows = {}
for name, (s, sign) in policies.items():
    pi = greedy_policy(s, BUDGET, sign)
    rows[name] = {'招待する人数': pi.sum(), '粗利の増加(万円)': value_gain(pi) / 1e4,
                  '真の費用(万円)': cost_true[pi == 1].sum() / 1e4,
                  'pCLVの平均(円)': pclv[pi == 1].mean()}
table = pd.DataFrame(rows).T
table['招待する人数'] = table['招待する人数'].astype(int)
print(table.round(1).to_string())

# 4. 予算と方策価値の関係を描く
styles = [dict(color='gray', linestyle=':'), dict(color='C0'), dict(color='C1'), dict(color='C2'),
          dict(color='black', linestyle='--')]
plt.figure(figsize=(9, 5.5))
for (name, c), style in zip(curves.items(), styles):
    plt.plot(budgets / 1e4, np.array(c) / 1e4, label=name, **style)
plt.axhline(0, color='black', linewidth=0.8)
plt.xlabel('予算(予測した特典の費用の合計、万円)')
plt.ylabel('粗利の増加(真の値、万円)')
plt.title('予算と方策価値の関係')
plt.legend(fontsize=9)
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
予算の制約のもとで、5つの方策を貪欲法で作り、方策価値を比べています。
- 貪欲法: greedy_policy は、np.argsort(-score, kind='stable') でスコアの大きい順に顧客を並べ、np.cumsum(cost_hat[order]) <= budget で予測費用の累積和が予算以下の顧客を選びます(式の )。3つ目の引数 tau_for_sign を渡すと、その値が正の顧客だけに絞ります(③と神の視点で、効果の予測が0以下の顧客を招待しないため)。最後に、選んだ顧客の位置を1にした0/1の配列 pi を返します。
- 方策価値の増分: value_gain は、tau_val_true[pi == 1].sum() で、招待した顧客の真のCATEを合計したもの()です。
- 5つの方策: 辞書 policies に、方策ごとに(スコア, 符号の判定に使う値)の組を入れています。ランダムは一様乱数をスコアにした方策、神の視点は真のCATEを真の費用で割ったものです(真の費用の下限も10円にしています)。
- 予算を変える: np.arange(0, 3_000_001, 100_000) で予算を0円から300万円まで10万円刻みで変え、辞書内包表記で、方策ごと・予算ごとに粗利の増加(真の値)を計算しています。
- 予算100万円での比較: BUDGET = 1_000_000 で方策を作り、招待する人数(pi.sum())、粗利の増加、実際にかかる費用(cost_true[pi == 1].sum())、選んだ顧客の pCLV の平均を表にしています。
- 可視化: 予算(横軸)と粗利の増加(縦軸)を万円単位で描いています。styles で、ランダムを灰色の点線、神の視点を黒の破線にしています。
実行結果
                     招待する人数  粗利の増加(万円)  真の費用(万円)  pCLVの平均(円)
ランダム                    814       15.9      97.4      1909.8
① pCLV上位                227       24.1     111.7     20327.5
② CVアップリフト上位            667       -3.5      99.4       992.2
③ 価値アップリフト / 費用の上位     1828      212.3      96.7      1492.8
神の視点(真のCATE / 真の費用)     659      314.3     106.7      4762.9
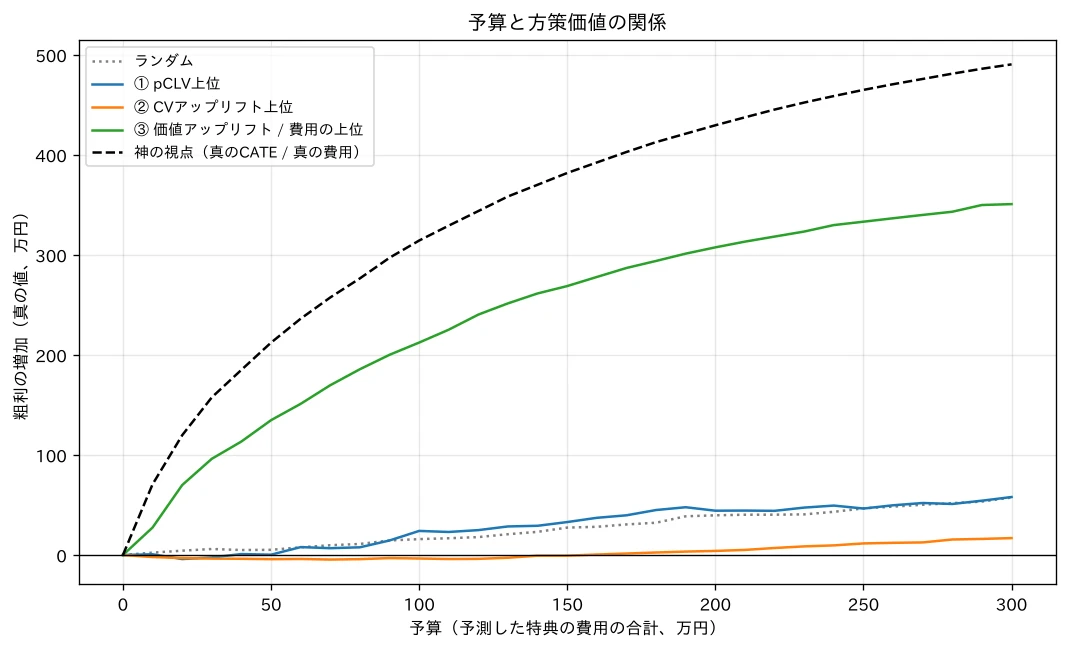
- ① pCLV上位: 予算100万円で招待できるのは、費用の高い顧客ばかりの227人で、粗利の増加は24.1万円です。ランダム(15.9万円)とほとんど変わりません。選んだ顧客の pCLV の平均は約2万円と高く、「価値の高い顧客」を選ぶことには成功していますが、その多くは特典がなくても買う顧客です。
- ② CVアップリフト上位: 粗利の増加は −3.5万円で、ランダムより悪くなりました。CVは増えますが、増えるのは送料の負担が重い少額の注文です。短期のCVで選ぶと長期の価値を損なう、というサロゲートインデックスの記事の教訓と同じことが起きています。
- ③ 価値アップリフト ÷ 費用の上位: 粗利の増加は212.3万円で、①の約9倍です。費用の安い顧客を多く(1,828人)招待し、そのうち効果が見込める顧客に絞っています。神の視点(314.3万円)には届きませんが、その約7割を実現しています。
- 予算との関係: 図のとおり、③はどの予算でも①②を大きく上回ります。予算を増やすほど1円あたりの増加は小さくなり(曲線が寝ていき)、効果の大きい顧客から順に使い切っていく様子が分かります。
予算100万円での5つの方策の粗利の増加を並べると、次のようになります。
(図は、diagram-designで作成)
実験データで方策価値を推定する
上の比較は、真のCATEを知っているダミーデータだからできたものです。実務では、RCTのデータから方策価値を推定します。アップリフトモデルの評価の記事のDR推定量を、方策価値の増分 に当てはめると、顧客ごとの DRスコア (gamma)を使って、次のように書けます。
は観測された粗利(Y_val)、 はRCTの招待の確率です。 の期待値は、(予測値は mu1_hat・mu0_hat)が多少ずれていても に一致します(二重にロバスト)。標準誤差は、顧客を復元抽出(番号は boot_idx)して を500回計算し直した値の標準偏差(ブートストラップ)で求めます。
# 1. アウトカムモデル(交差適合)と、顧客ごとの DR スコア Γ_i
mu1_hat, mu0_hat = np.zeros(N), np.zeros(N)
for train_idx, test_idx in kf.split(X):
    tr_t, tr_c = train_idx[T_rct[train_idx] == 1], train_idx[T_rct[train_idx] == 0]
    mu1_hat[test_idx] = lgb.LGBMRegressor(**params).fit(X.iloc[tr_t], Y_val[tr_t]).predict(X.iloc[test_idx])
    mu0_hat[test_idx] = lgb.LGBMRegressor(**params).fit(X.iloc[tr_c], Y_val[tr_c]).predict(X.iloc[test_idx])
e = 0.5                                                # RCT なので配布確率は全員0.5
gamma = mu1_hat - mu0_hat + T_rct * (Y_val - mu1_hat) / e - (1 - T_rct) * (Y_val - mu0_hat) / (1 - e)

# 2. 方策価値の増分の DR 推定 Σ π_i Γ_i と、ブートストラップの標準誤差
boot_rng = np.random.default_rng(0)
boot_idx = [boot_rng.integers(0, N, size=N) for _ in range(500)]
rows = {}
for name, (s, sign) in policies.items():
    if name.startswith('神の視点'):
        continue
    pi = greedy_policy(s, BUDGET, sign)
    rows[name] = {'真の値(万円)': value_gain(pi) / 1e4,
                  'DR推定(万円)': (pi * gamma).sum() / 1e4,
                  '標準誤差(万円)': np.std([(pi[idx] * gamma[idx]).sum() for idx in boot_idx]) / 1e4}
print(pd.DataFrame(rows).T.round(1).to_string())
実験データだけで方策価値の増分を推定し、真の値と比べています。
- アウトカムモデル: train_idx[T_rct[train_idx] == 1]・train_idx[T_rct[train_idx] == 0] で学習用の施策群・対照群(tr_t・tr_c)を選び、それぞれで粗利を予測する LightGBM の回帰モデルを学習して、テスト用の顧客の (mu1_hat)と (mu0_hat)を予測しています(T-Learner の2つのモデルと同じものです)。交差適合なので、どの顧客の予測も、その顧客を学習に使っていないモデルによるものです。
- DRスコア: gamma は、上の の式をそのまま計算したものです。施策群の顧客(T_rct が1)では T_rct * (Y_val - mu1_hat) / e が、対照群の顧客では (1 - T_rct) * (Y_val - mu0_hat) / (1 - e) が残り、アウトカムモデルの予測の差に、予測の誤差を逆確率で重み付けして足し戻します。RCT なので e = 0.5 です。
- 方策価値の推定: (pi * gamma).sum() で、方策 pi が選んだ顧客の gamma を合計したものが、方策価値の増分の推定値 です。神の視点の方策は真の値を使って作った方策なので、continue で比較から除いています。
- ブートストラップ: boot_rng.integers(0, N, size=N) で顧客を復元抽出した位置の組を500通り作っておき、(pi[idx] * gamma[idx]).sum() を計算し直して、その標準偏差(np.std)を標準誤差としています。すべての方策で同じ500通りの組を使うので、方策の間の比較が公平になります。
実行結果
                    真の値(万円)  DR推定(万円)  標準誤差(万円)
ランダム                   15.9      67.5      24.5
① pCLV上位               24.1      21.0      67.2
② CVアップリフト上位           -3.5      17.3       9.8
③ 価値アップリフト / 費用の上位    212.3     224.8      56.8
③の推定値は224.8万円(標準誤差56.8万円)で、真の値(212.3万円)に近く、①②より大きいことが、実験データからも読み取れます。ランダムでは、推定値と真の値の差が標準誤差の約2倍と大きめですが、これは推定のばらつきの範囲です。
なお、ここでは方策を作るのに使ったのと同じ実験データで評価しています。スコアは交差適合で作っていますが、方策の候補をたくさん比べて一番良いものを選ぶと、評価が楽観的になりがちです。実務では、方策を決めた後に、評価用の実験(選んだ方策と、ランダムや既存のルールを比べるRCT)を改めて行うのが確実です。
DR 推定と真の値を並べると、次のようになります。
(図は、diagram-designで作成)
アクティベーション:HVAを広告配信につなげる
推定した価値アップリフトは、CRM(メールやアプリのプッシュ通知、特典の配布)だけでなく、広告の配信にも使えます。ここでは、代表的な2つの使い方を紹介します。
- 価値ベース入札:Google 広告の「コンバージョン値の最大化」や「目標広告費用対効果(tROAS)」のような価値ベース入札は、コンバージョンの数ではなく、コンバージョンの 価値 の合計が大きくなるように入札を調整する仕組みです(Google 広告ヘルプ)。広告プラットフォームに送るコンバージョン値を、購買金額ではなく pCLV(将来の価値)にすれば、将来の価値が高い顧客の獲得に予算が寄ります。さらに、本記事のような価値アップリフトの考え方を取り入れると、「広告がなくても買う顧客」に入札が集中するのを避けられます。
- 類似オーディエンスの種:広告プラットフォームの類似オーディエンス(既存の顧客リストに似たユーザーへの配信)は、種にする顧客リストで、届く相手が変わります。pCLV上位を種にすると「よく買う顧客に似た人」に、価値アップリフト上位を種にすると「施策をきっかけに定着する顧客に似た人」に配信されます。
どちらも、広告プラットフォーム側の最適化は「送った値が大きいユーザー」を探すものです。何を送るか、何を種にするかが、そのまま HVA の定義になる、と言えます。仕様は頻繁に変わるので、使うときは各プラットフォームの最新のドキュメントを確認してください。
2つの使い方を図にすると、次のようになります。
(図は、diagram-designで作成)
発展:方策学習とバンディット
本記事では、「CATE を推定してから、効果 ÷ 費用の順に選ぶ」という2段階で方策を作りました。これに対して、方策学習(policy learning) は、方策そのものを直接学習します。Athey & Wager (2021) は、DRスコア を使って、
のように、深さ2の決定木などの解釈しやすい方策のクラス の中で、方策価値の推定値が最大になる方策を選ぶ方法を提案し、その性能を理論的に保証しました。「メール開封率が○○以上で、平均購買金額が○○円以上の顧客を招待する」のような、現場で説明しやすいルールが得られるのが利点です。
また、CATE の推定には、本記事の X-Learner のほかに、DRスコア を特徴量で回帰する DR-Learner(Kennedy, 2023)もよく使われます。
本記事の方策は、1回の実験のデータから作る「一度きり」の意思決定でした。施策を配りながら、その結果を見て配り方を少しずつ改善していくのが、アップリフトモデルの評価の記事で紹介した バンディット の考え方です。
まとめ
本記事では、施策を打つべき価値の高い顧客 ── HVA(High Value Audience) ── を定義し、予算の制約のもとでターゲティングの方策を作る方法を解説しました。
- pCLVの上位は、HVAとは限らない:pCLVの上位20%には、特典で粗利が増えない顧客が約半数含まれ、費用も平均の3倍以上かかりました。予算100万円で pCLV の上位に配ると、粗利の増加はランダムとほとんど変わりませんでした。
- 2×2の整理:狙うべきなのは「価値が高く、かつ施策で価値が上がる顧客」です。価値の高さだけで選ぶと「施策がなくても買う顧客」が、短期のCVへの効果だけで選ぶと「一度は買うが続かない顧客」が集まります。
- 価値アップリフト:成果を30日以内の購買から1年間の粗利に変えるだけで、X-Learner などのメタラーナーがそのまま使えます。粗利は顧客ごとのばらつきが大きいので、推定はCVより難しくなります。
- 予算制約のもとでの貪欲法: の顧客を「効果 ÷ 費用」の順に、予算に収まるまで選びます。この方策は、同じ予算で pCLV 上位の約9倍の粗利の増加をもたらし、DR推定でも実験データからその差を確かめられました。
これで、HVA関連の記事(RFM分析、生存時間分析、BTYDモデル、CLV予測、アップリフトモデルの評価、サロゲートインデックス、本記事)がそろいました。マーケティングの意思決定のループの記事では、MMM関連の記事の「どのチャネルにいくら配分するか」と、HVA関連の記事の「そのチャネルで誰を狙うか」をつなぎ、マーケティングの意思決定のループとしてまとめます。
参考文献
- E. Ascarza (2018). Retention Futility: Targeting High-Risk Customers Might be Ineffective. Journal of Marketing Research, 55(1), 80–98.
- S. Athey, S. Wager (2021). Policy Learning With Observational Data. Econometrica, 89(1), 133–161.
- E. H. Kennedy (2023). Towards optimal doubly robust estimation of heterogeneous causal effects. Electronic Journal of Statistics, 17(2), 3008–3049.
- Google. 価値に基づく入札戦略を使用するスマート自動入札について. Google 広告ヘルプ.
本記事の文章・構成の一部に生成AIを使用しています。