Instruction Tuningとは?
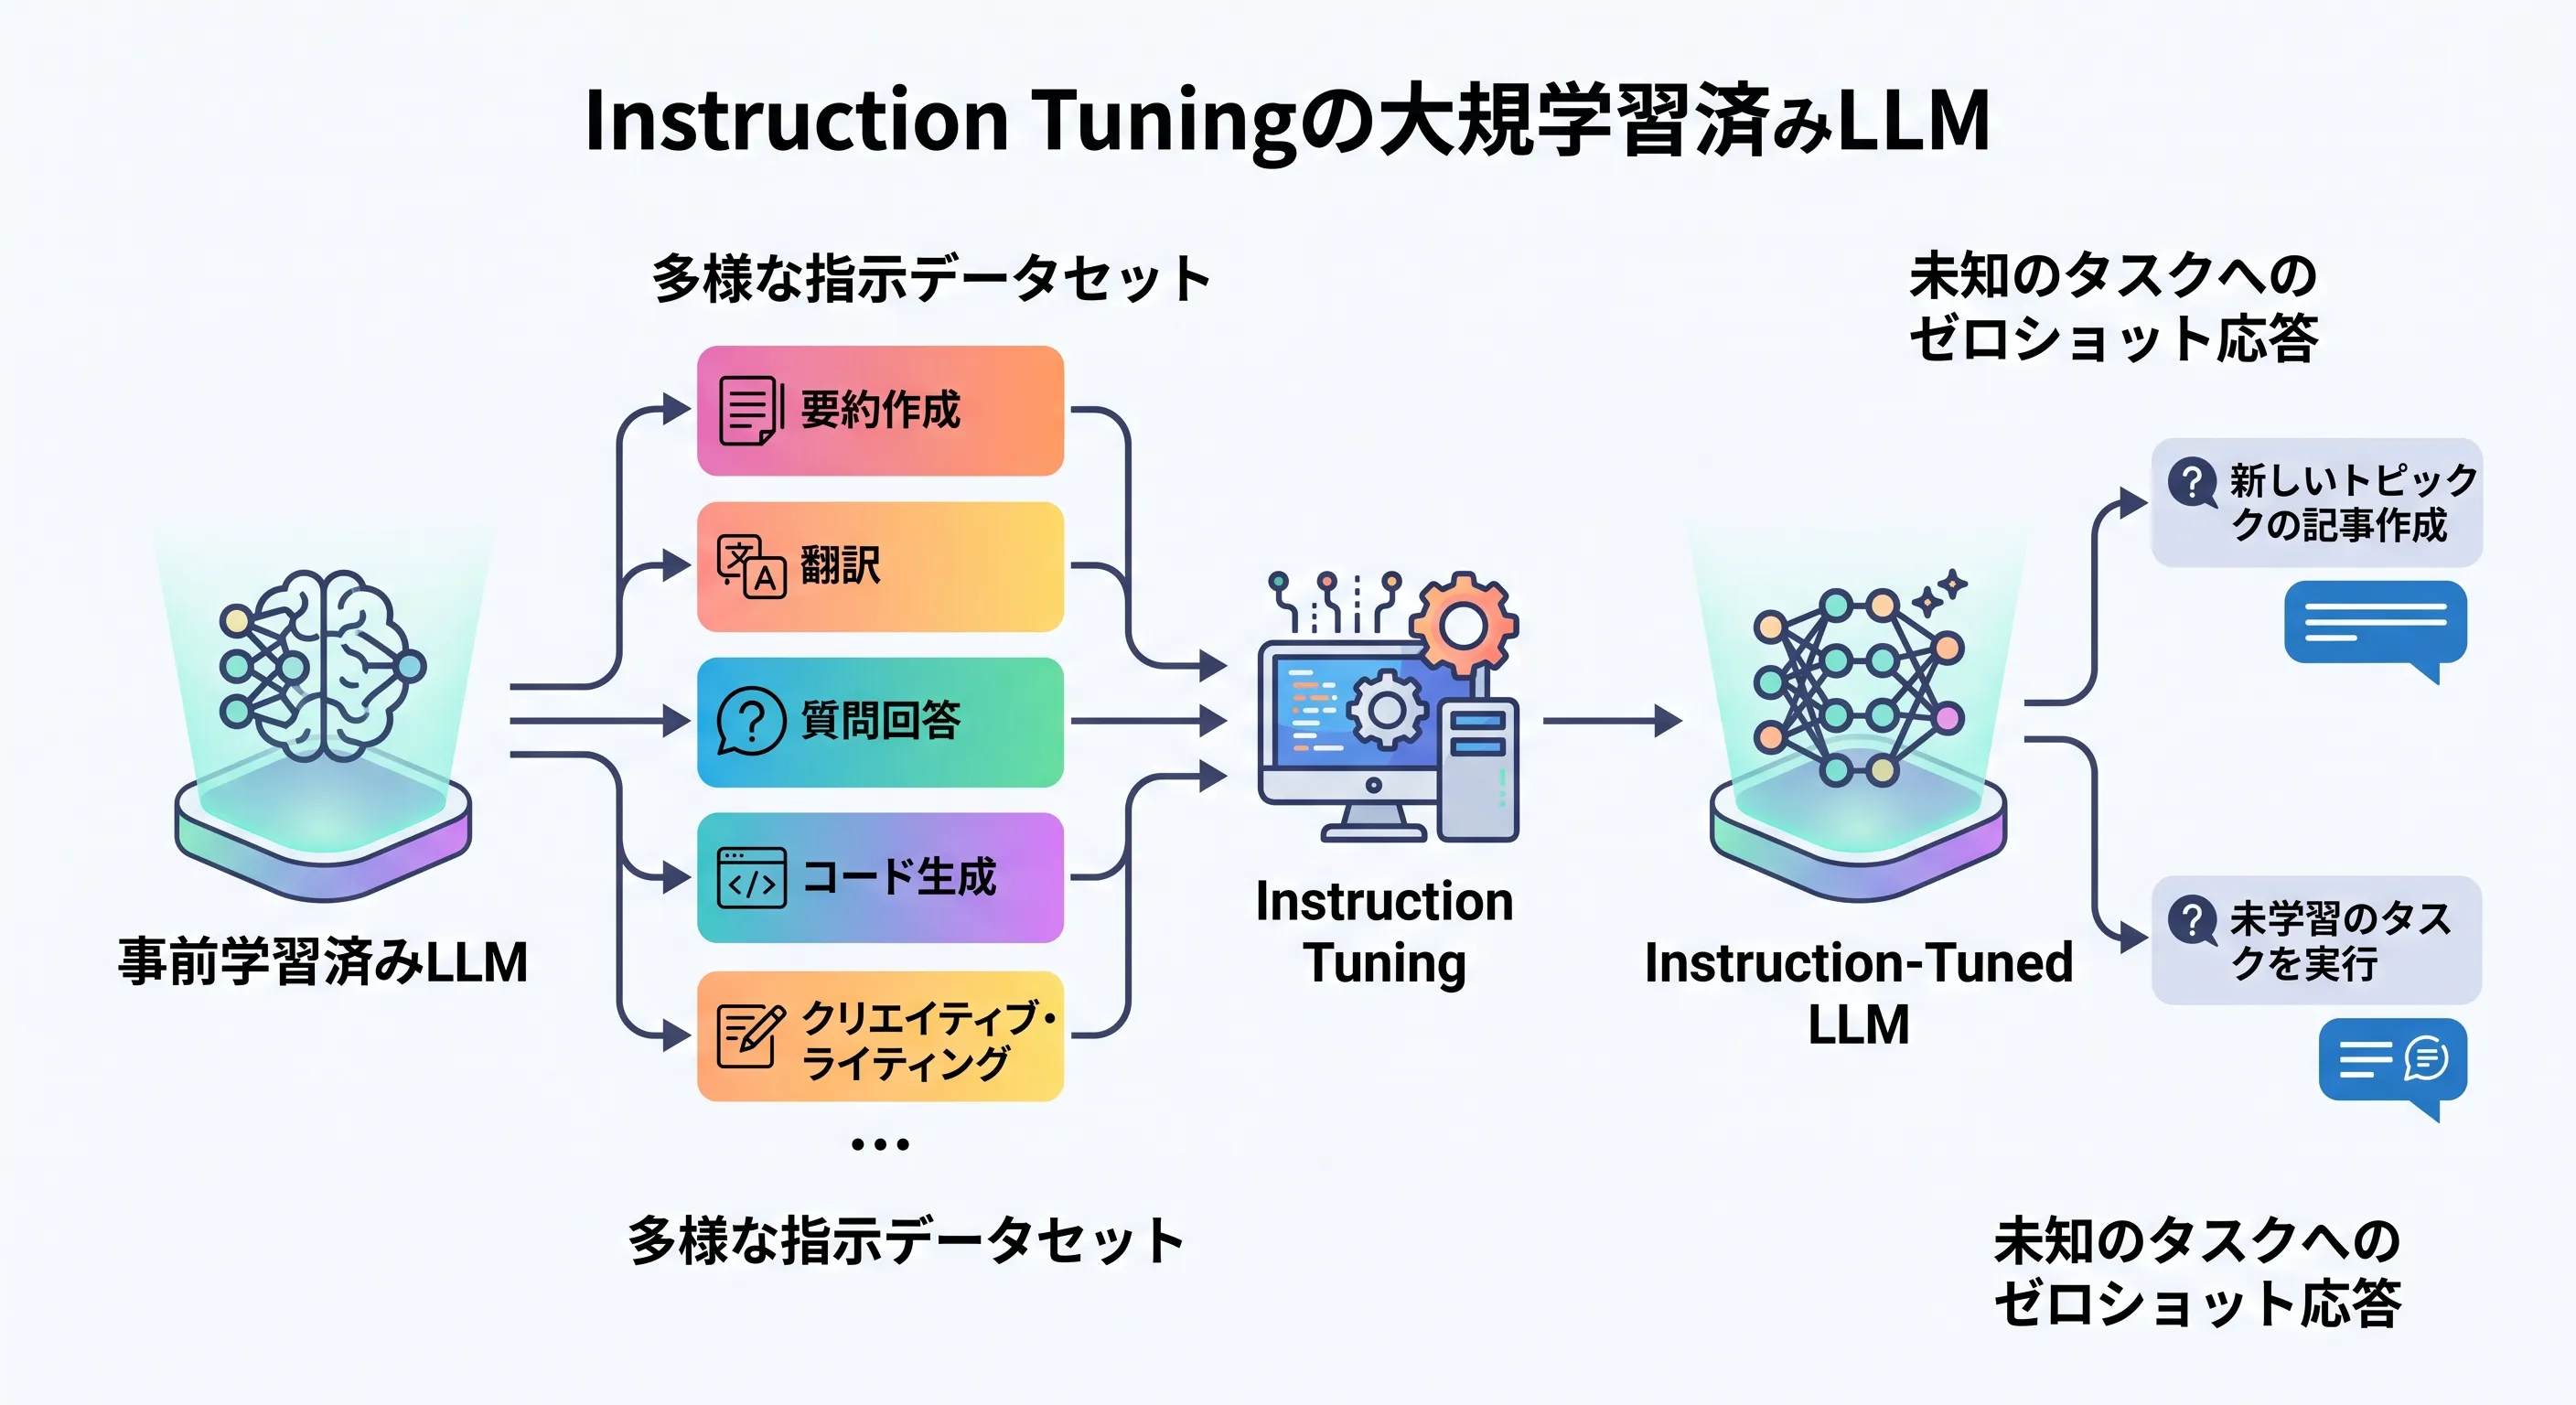 (画像は、Geminiで作成)
指示(Instruction)の形式のデータでファインチューニングすると、学習していないタスクにも指示に従って答えられるようになる Instruction Tuning(SFT)の仕組みを理解すること。プロンプト部分の損失のマスク・パディング・LoRA を使った学習を PyTorch でスクラッチ実装し、TRL の SFTTrainer との対応を確かめて、少ないデータでは書式は身につくが中身は丸暗記に引きずられることを説明できるようになること。
Instruction Tuningの概要
Instruction Tuning(インストラクション・チューニング)は、大規模言語モデル(LLM)のゼロショット学習能力を向上させるためのシンプルで強力な手法です。
モデルに対して、自然言語の「指示(Instruction)」の形式で記述された多数のデータセットを用いてファインチューニングを行うことで、学習時に見たことのない未知のタスク(unseen tasks)に対する性能を劇的に向上させることができます。
Googleの研究チームによって提案された「FLAN(Finetuned Language Net)」というモデルで実証され、137B(1370億)パラメータの事前学習済みモデルにこの手法を適用することで、ゼロショット性能が大幅に向上し、評価した25のタスクのうち20のタスクで175BのGPT-3のゼロショット性能を上回る結果を示しました。現在では、Supervised Fine-tuning (SFT) とも呼ばれ、LLMを人間の意図に沿わせる(アライメント)ための最も基本的な手法として広く普及しています。
これまでのパラダイムの課題とInstruction Tuningの位置づけ
言語モデルの活用において、FLAN提案以前には主に2つのパラダイムが存在していましたが、それぞれに課題がありました。
- Pretrain-finetune パラダイム(BERTやT5など): 事前学習済みモデルを特定のタスクごとにファインチューニングする手法です。高い性能を発揮しますが、タスクごとに多数の専用の学習データが必要であり、さらにタスクごとに個別のモデルを用意しなければならないという欠点がありました。
- Prompting パラダイム(GPT-3など): 少数の例をプロンプトとして与えるFew-shotプロンプティングにより、単一のモデルで様々なタスクを解くことができるようになりました。しかし、例を与えないZero-shotの性能は非常に低く、特に読解や自然言語推論のようなタスクでは苦戦していました。これは、プロンプトの形式が事前学習データ(通常のWebテキスト)の形式と似ていない場合、モデルがうまく応答できないためだと考えられています。
Instruction Tuning は、これら両者の魅力的な側面を組み合わせたアプローチです。 ファインチューニングによる「教師あり学習」の力を利用して、推論時のテキストによる指示(プロンプト)に対するモデルの応答能力自体を向上させることを目的としています。これにより、1つの汎用的なモデルで、多数のタスクをZero-shotで解くことが可能になります。
3つのパラダイムを並べると、次のようになります。
(図は、diagram-designで作成)
Instruction Tuningの処理概要
FLANにおけるInstruction Tuningの学習プロセスは、以下のようなステップで行われます。
- タスクのクラスタリング: 多様な既存のNLPデータセット(62種類)を収集し、それらをタスクのタイプ(自然言語推論、機械翻訳、常識推論、感情分析など)ごとに12の「タスククラスタ」にグループ化します。
- プロンプトテンプレートによる変換: 各データセットの入出力を、自然言語の指示を含む形式に変換します。多様性を高めるため、1つのデータセットにつき10個の独自のテンプレート(タスクの反転を含む)を手作業で作成し、ランダムに適用します。
- 混合データセットでのファインチューニング: これらすべてのタスクを混ぜ合わせたデータセットを用いて、巨大な事前学習済み言語モデル(LaMDA-PT)をファインチューニングします。
- 未知のタスクでの推論(Zero-shot評価): 学習時には特定のタスククラスタ(例:自然言語推論)を完全に除外しておき、推論時に初めてそのタスクの指示を与えてゼロショットで評価します。これにより「未知のタスクに対しても指示に従えるか」を検証します。
4つのステップを図にすると、次のようになります。
(図は、diagram-designで作成)
ゼロショット性能を飛躍させるメカニズムとスケーリング則
Instruction Tuningの最大のモチベーションは、「指示によって記述されたタスクを実行するようにモデルを訓練すれば、モデルは『指示に従う』こと自体を学習し、未知のタスクにもそれが適用できるだろう」という直感に基づいています。 結果として、自然言語推論、読解、クローズドブックQA、翻訳などの未知のタスククラスタにおいて、ベースモデルやGPT-3を大きく上回る性能を達成しました。
モデル規模(パラメータ数)の重要性
非常に興味深い発見として、Instruction Tuningの恩恵はモデルの規模が十分に大きい場合にのみ創発することが分かっています。 論文では、422M・2B・8B・68B・137B の5つの大きさのモデルで比べています。100B 前後の2つ(68B と 137B)では、学習に使っていないタスクの性能が大幅に向上したのに対し、8B 以下のモデルに Instruction Tuning を適用すると、未知のタスクに対する性能が逆に悪化しました。 論文は、小規模なモデルでは約40のタスクを学習することでモデルのキャパシティが埋まってしまい、新しいタスクに汎化する余裕がなくなるためではないか、と考察しています。一方、大規模モデルは容量に余裕があり、指示に従う方法を学習しつつ、未知のタスクにも汎化することが可能になります。
Instruction Tuningの構成要素(詳細)
モデルが指示を正確に理解し、望ましいフォーマットで出力できるようにするための重要な工夫がいくつかあります。
Options suffix(選択肢の提示)
分類タスク(例:感情分析や推論)では、出力空間が「Yes/No」や「Positive/Negative」などに限られますが、単なる言語生成モデルは様々な自由記述のテキストを生成してしまう可能性があります。
FLANでは、これを防ぐためにプロンプトの末尾に OPTIONS という接尾辞を追加し、モデルが応答すべき選択肢のリストを明示的に提示するアプローチをとっています。
例(自然言語推論):
Premise: At my age you will probably have learnt one lesson.
Hypothesis: It's not certain how many lessons you'll learn by your thirties.
Does the premise entail the hypothesis?
OPTIONS:
- yes
- it is not possible to tell
- no

(訳):
前提:私の年齢になれば、おそらく一つの教訓を学んでいることでしょう。
仮説:30代までにいくつの教訓を学ぶかは定かではありません。
前提は仮説を導き出しますか?
選択肢:
- はい
- 判断できません
- いいえ
多様なテンプレートの用意
1つのタスクに対して単一の定型文だけで学習すると、特定のフレーズに過剰適合してしまいます。FLANでは1つのデータセットに対して最大10種類の独自の自然言語テンプレートを作成しました。 また、例えば「映画のレビューを読んで感情を分類するタスク」に対して、逆に「感情(Positive)を入力として、それに合う映画レビューを生成させる」といったタスクを反転させたテンプレートも数個含めることで、生成の多様性を高めています。
大規模言語モデル(LLM)アライメントへの応用と発展
Instruction Tuning(SFT)は、FLANによってその有効性が示された後、ChatGPTなどの現在のLLM開発において不可欠なアライメントパイプラインの一部として急速に発展しました。
データセット構築の進化
FLANの時代(Human-crafted Data)は、既存のNLPデータセット(SNLIやSQuADなど)をプロンプト化して利用するのが主流でした。しかし現在では、より多様で高度な指示データを集めるため、以下のような手法が使われています。
-
蒸留(Distillation)による合成データの生成:
GPT-4のような非常に強力なモデルに指示を与え、その出力結果を収集して小規模モデル(LLaMAなど)のファインチューニングデータとして使用する手法(Alpaca、WizardLMなど)。 -
自己改善(Self-Improvement):
少数のシードとなる指示データから、LLM自身に新しい指示と応答を大量に生成させる手法(Self-Instruct法など)。
RLHF/DPOとInstruction Tuning (SFT) の関係
LLMを人間の好みに合わせるための技術として、RLHF(人間からのフィードバックによる強化学習)やDPO(直接選好最適化)といった強化学習ベースの手法が注目されています。しかし、これらの高度な手法を用いる場合でも、初期段階としてのInstruction Tuning (SFT) は依然として不可欠です。
RLHFやDPOをゼロから(ベースの事前学習モデルに対して直接)行うのは非常に不安定で困難です。そのため、まずは高品質なSFTデータセットを用いてモデルに「ユーザーとの対話フォーマット」や「指示に従うという基本的なスタイル」を教え込み、妥当なベースポリシーを確立してから、強化学習によって微調整を行うのが一般的なパイプラインとなっています。
SFT と RLHF・DPO の関係を図にすると、次のようになります。
(図は、diagram-designで作成)
データセットのフォーマットと学習イメージ
Instruction Tuningで用いられるデータセットは、一般的に以下のようなJSON(またはJSONL)フォーマットで表現されます。
[
  {
    "instruction": "次の文をスペイン語に翻訳してください。",
    "input": "新しいオフィスビルは3ヶ月足らずで建設されました。",
    "output": "El nuevo edificio de oficinas se construyó en tres meses."
  },
  {
    "instruction": "与えられた前提から、仮説が推論できるか判定してください。",
    "input": "前提:私の年齢になれば、おそらく一つの教訓を学んでいるでしょう。\\n仮説:30代までにいくつの教訓を学ぶかは不確実です。\\nOPTIONS:\\n- はい\\n- 判別できない\\n- いいえ",
    "output": "判別できない"
  }
]
学習時には、これらの instruction と input を組み合わせてプロンプト文字列を構築し、モデルに入力します。そしてモデルが自己回帰的に output を生成できるように、通常の言語モデリングの損失関数(Cross Entropy Loss)を用いて教師あり学習(Supervised Fine-Tuning)を行います。この際、モデルが「指示(プロンプト)」の生成まで学習してしまわないよう、入力部分(指示+入力)のトークンに対する損失計算をマスク(除外)し、応答部分(出力)のみの生成に対して最適化を行うのが一般的な実装上の工夫です。
また、数百億パラメータの大規模モデル全体を学習することは計算資源の観点で現実的ではないため、実際の開発では LoRA(Low-Rank Adaptation) などのパラメータ効率的ファインチューニング(PEFT)手法と組み合わせて、モデルの一部パラメータのみを更新するアプローチが広く採られています。
論文の実験と本記事の実装の違い
ここからは、Instruction Tuning の学習の仕組みを、小さなモデルで実装して確かめます。FLAN の論文の実験は、137B のモデルを 62 のデータセットで学習する大規模なものなので、本記事では「指示形式のデータで、応答部分だけを学習する」という仕組みが動くかの確認に絞ります。
| 項目 | FLAN(論文) | 本記事 | 違う理由 |
|---|---|---|---|
| モデル | LaMDA-PT(137B) | Qwen2.5-0.5B | Colab の GPU 1枚で、数分で学習できる大きさにするため |
| 学習データ | 62 のデータセット(1データセットあたり最大3万件) | hh-rlhf-12k-ja の8件 | 学習ループが正しく動くかを、8件を丸暗記できるかで確かめるため |
| 指示の形式 | データセットごとに10個のテンプレート | 1つのテンプレート(共通の指示文) | 1つのデータセットしか使わないため |
| 学習するパラメータ | すべて | LoRA(全体の約1.7%) | GPU のメモリと学習時間を抑えるため |
| 学習の長さ | 3万ステップ(バッチ 8,192 トークン、Adafactor、学習率 3e-5) | 40エポック = 40回の更新(AdamW、学習率 2e-4) | 8件の損失が横ばいになるまで |
| 評価 | 学習に使っていないタスクのクラスタで、ゼロショットで評価 | 学習した8件の再現と、学習に使っていない3件の質問の出力 | 仕組みの確認が目的のため。未知のタスクへの汎化は、この規模では確かめられない |
記事の実行結果は、Google Colab の L4 GPU で、torch 2.11.0・transformers 5.21.0・peft 0.21.2・trl 1.17.1・torchao 0.18.0・datasets 4.8.5 を使って実行したものです。学習は bfloat16 で行うので、bfloat16 に対応していない T4 GPU では動きません。実行時間は、モデルのダウンロードを除いて、スクラッチ実装と TRL の実装を合わせて3分ほどです。
Instruction Tuningの実装(概念的なシンプルな実装)
ライブラリのインストール
以下のコードでは、Instruction Tuning の実装に使うライブラリをインストールします。
!pip install transformers datasets peft trl torch
# Colab に入っている torchao(0.10.0)は、peft 0.21 が対応する版(0.16.0 より新しい版)より古く、
# LoRA を適用するときに ImportError になるため、新しい版に更新する
!pip install --upgrade torchao
- peft: パラメータ効率的ファインチューニング(PEFT)のライブラリで、LoRA の設定と適用に使います。
- trl: SFT(Supervised Fine-Tuning)や強化学習による LLM の学習をまとめたライブラリで、後半の TRL 版の実装で使います。
- torchao の更新: peft は LoRA を適用するときに torchao の版を確かめ、古い版(Colab に入っている 0.10.0)では
ImportError: Found an incompatible version of torchaoで止まります。そのため、新しい版に更新しています。
ライブラリのインポート、ハイパーパラメータの設定
以下のコードでは、必要なモジュールをインポートし、学習を制御するハイパーパラメータを定義します。本格的な学習ではなく、学習ループが正しく動くかを短時間で確かめるための設定です。
import torch # PyTorchのコアモジュール
from torch.utils.data import Dataset, DataLoader # データセット管理とバッチ作成用モジュール
from torch.optim import AdamW # 重み減衰(Weight Decay)をサポートするAdamオプティマイザ
from torch.nn.utils.rnn import pad_sequence # 系列長を揃えるパディング関数
from transformers import AutoModelForCausalLM, AutoTokenizer, get_cosine_schedule_with_warmup # HFのモデル読込とスケジューラ
from datasets import load_dataset # HF Datasetsライブラリからのデータ読み込み
from peft import get_peft_model, LoraConfig # PEFT(LoRA)を適用するための関数群

torch.manual_seed(0) # LoRA の重みの初期値を固定し、結果を再現できるようにする

MODEL_ID     = "Qwen/Qwen2.5-0.5B" # 指示チューニングされていないベースモデル(0.5Bなので L4 1枚で数分で学習できる)
N_SAMPLES    = 8    # 学習に使う件数。8件を丸暗記できるかで、学習ループが正しく動くかを数分で確かめる
N_HELDOUT    = 3    # 学習に使わない質問の件数。丸暗記と、書式の学習を見分けるために使う
MAX_LENGTH   = 512  # 最大トークン長。絞り込んだ650件でも最長241トークンなので、切り捨ては起きない
BATCH_SIZE   = 8    # 8件を1バッチにまとめ、1エポック = 1回の更新にする
ACCUM_STEPS  = 1    # 勾配を蓄積するステップ数(8件が1バッチに収まるので蓄積は不要)
EPOCHS       = 40   # 損失が0.01を下回って横ばいになるまで(実行結果のログを参照)
LR           = 2e-4 # LoRAの学習率。QLoRA論文が 7B/13B のモデルで使った値
LOG_EVERY    = 5    # 何回の更新ごとに損失を表示するか(40回の更新を8行で追える間隔)
IGNORE_INDEX = -100 # プロンプト部分の損失を計算から外すための値(PyTorchの CrossEntropyLoss の既定の ignore_index)
- MODEL_ID: 学習のベースにする事前学習済みモデルです。指示チューニングをしていないベースモデル(Qwen2.5-0.5B。Instruct 版ではないもの)を使うのは、学習の前後で、指示に従う振る舞いが変わるかを見るためです。
- N_SAMPLES = 8 と EPOCHS = 40: 少ないデータを何度も学習させて丸暗記(過学習)させ、損失が下がり、正解の応答をそのまま出力できるかで、学習ループが正しく動いているかを確かめます。40エポックは、実行結果のログで損失が0.01を下回り、それ以上ほとんど下がらなくなる長さです。
- N_HELDOUT = 3: 学習に使わない質問です。丸暗記した8件だけを見ると、モデルが「指示の書式」を学んだのか、「8件の答え」を覚えただけなのかを区別できないため、学習に使っていない質問への出力も比べます。
- BATCH_SIZE = 8: 8件を1つのバッチにまとめるので、1エポックが1回の更新になり、40エポックで40回更新します。
- LR = 2e-4: LoRA の学習率です。LoRA で追加する行列は0から学習を始めるので、フルチューニング(FLAN は 3e-5)より大きな学習率を使うのが一般的で、QLoRA の論文が 7B と 13B のモデルで使った値にしています。
- IGNORE_INDEX = -100: PyTorch の交差エントロピー誤差(CrossEntropyLoss)が、既定で損失の計算から外す値です。後のステップで、プロンプト部分のラベルをこの値にして、プロンプトを学習しないようにします。
モデルとトークナイザのロード
以下のコードでは、事前学習済みのベースモデルと、テキストをトークン列に変換するトークナイザをロードします。
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

# Causal LM(因果的言語モデル)をロード
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, device_map="auto")
# 貪欲法で生成し、学習前後の出力を再現できるようにする。
# max_new_tokens は、絞り込んだ650件の応答の最長(150トークン)を出し切れる長さにする
GEN_KWARGS = dict(max_new_tokens=160, do_sample=False, repetition_penalty=1.0)
- AutoModelForCausalLM.from_pretrained: 指定したモデルの構成と重みをロードします。device_map="auto" で、GPU があれば GPU に載せます。
- tokenizer.pad_token: バッチの長さをそろえるパディング用のトークンがない場合に、文末トークン(eos_token)で代用する設定です。Qwen2.5 では、パディング用のトークンと文末トークンがどちらも
<|endoftext|>(ID 151643)です。 - GEN_KWARGS: 生成の設定です。do_sample=False で、ランダム性のない貪欲法(Greedy Search)にして、学習の前後の出力を同じ条件で比べられるようにします。max_new_tokens=160 は、正解の応答を最後まで生成できる長さで、後で「正解と全文が一致するか」を判定するために必要です。repetition_penalty=1.0 は繰り返しを抑えない設定で、学習前のベースモデルが同じ語を繰り返す様子を、そのまま見るためです。
データセット準備(Instruction形式への変換)
以下のコードでは、日本語の HH-RLHF データセットを読み込み、指示・入力・応答の形式に変換します。
raw = load_dataset("llm-jp/hh-rlhf-12k-ja", split="train")

def to_instruction_format(ex):
    # すべてのデータに共通の指示(Instruction)を付ける
    instruction = "あなたは親切で安全なAIアシスタントです。ユーザーの入力に対して適切に回答し、有害または非倫理的な要求には安全に配慮して対応してください。"
    # 最初のユーザー発言を Input、望ましい応答(chosen)を Output とする
    user_input = ex["conversations"][0]["value"]
    output = ex["chosen"].strip()
    # 指示・入力・応答の見出しを付けたプロンプト文字列にする(「### 応答:」の後をモデルに続けさせる)
    prompt = f"### 指示:\n{instruction}\n\n### 入力:\n{user_input}\n\n### 応答:\n"
    return {
        "instruction": instruction,
        "input": user_input,
        "output": output,
        "prompt": prompt,
        "completion": output # モデルが生成すべき正解部分
    }

data_all = (raw
        # 役に立つ応答を集めた helpful-base だけを使う
        # (harmless-base には、差別的な発言や危険な依頼への応答が含まれるため)
        .filter(lambda x: x["source"] == "helpful-base")
        # 1往復の会話で、入力が80文字以内、応答が20〜200文字のものに絞る
        # (20文字未満は「どういたしまして」のような短い返事が多く、学習の確認に向かないため)
        .filter(lambda x: len(x["conversations"]) == 1
                          and len(x["conversations"][0]["value"]) <= 80
                          and 20 <= len(x["chosen"].strip()) <= 200)
        .map(to_instruction_format, remove_columns=raw.column_names))

# 先頭の8件を学習に、続く3件を「学習に使わない質問」に使う
data    = data_all.select(range(N_SAMPLES))
heldout = data_all.select(range(N_SAMPLES, N_SAMPLES + N_HELDOUT))
print(f"絞り込み後: {len(data_all)}件 / 学習: {len(data)}件 / 学習に使わない質問: {len(heldout)}件")
実行結果:
絞り込み後: 650件 / 学習: 8件 / 学習に使わない質問: 3件
- source == "helpful-base": hh-rlhf-12k-ja は、Anthropic の HH-RLHF の4つのグループ(harmless-base、helpful-base、helpful-online、helpful-rejection-sampled)から3,000件ずつを選び、日本語に訳したデータセットです。このうち harmless-base は、有害な依頼に対する応答を集めたもので、差別的な発言や危険な依頼がそのまま含まれます。本記事では、役に立つ応答を集めた helpful-base だけを使います。
- 文字数での絞り込み: 1往復の会話で、入力が80文字以内、応答が20〜200文字のものに絞ります。短い会話にするのは、8件を数分で丸暗記させ、生成も短時間で済ませるためです。応答の下限の20文字は、「どういたしまして」のような短い返事(データセットで最も多い応答)を外すためです。絞り込むと、helpful-base の3,000件が650件になります。
- to_instruction_format: 共通の指示文(instruction)、ユーザーの入力(input)、望ましい応答(output)を、「### 指示:」「### 入力:」「### 応答:」の見出しを付けた1つのプロンプト文字列(prompt)にまとめます。prompt と completion(正解の応答)を分けておくのは、後のステップで応答部分だけの損失を計算するためです。
- data と heldout: 先頭の8件を学習に、続く3件を学習に使わない質問にします。
ヘルパー関数とDatasetの実装
以下のコードでは、学習の前後の出力を比べるための生成の関数と、損失のマスクを作るカスタム Dataset を定義します。
def generate_responses(m, dataset):
    m.eval() # モデルを推論モードに変更(Dropout等を無効化)
    results = []
    for i in range(len(dataset)):
        # プロンプトをトークン化し、モデルと同じデバイス(GPU等)へ転送
        ins = tokenizer(dataset[i]["prompt"], return_tensors="pt").to(m.device)
        with torch.no_grad(): # 推論時は勾配計算を無効化してメモリを節約
            out = m.generate(**ins, **GEN_KWARGS)
        # 入力プロンプト部分を削り、新たに生成されたトークンのみをデコード(文字列化)
        gen = tokenizer.decode(out[0][ins["input_ids"].shape[1]:], skip_special_tokens=True).strip()
        results.append(gen)
    return results

print("\n■ SFT前(ベースモデル)の出力を取得中...")
before_generations = generate_responses(model, data)
before_heldout = generate_responses(model, heldout)

class SFTDataset(Dataset):
    def __init__(self, data, tokenizer, max_length=MAX_LENGTH):
        self.data = data
        self.tokenizer = tokenizer
        self.max_length = max_length

    def __len__(self):
        return len(self.data)

    def __getitem__(self, idx):
        item = self.data[idx]
        # プロンプトと応答をそれぞれ別々にトークン化
        # 特殊トークンは手動で追加するため add_special_tokens=False とする
        prompt_ids   = self.tokenizer(item["prompt"],     add_special_tokens=False)["input_ids"]
        response_ids = self.tokenizer(item["completion"], add_special_tokens=False)["input_ids"]

        # 最大長に収まるよう、プロンプトの長さを調整
        max_prompt_len = self.max_length - len(response_ids) - 1
        if max_prompt_len < 1:
            # 応答が長すぎる場合は応答側も切り詰める
            response_ids = response_ids[: self.max_length - 1]
            prompt_ids = []
        else:
            # プロンプトは先頭から切り捨てる(応答の直前の「### 応答:」を残すため)
            prompt_ids = prompt_ids[-max_prompt_len:]

        # input_ids: プロンプト + 応答 + EOSトークン(EOS も学習させ、応答の終わりで止まれるようにする)
        input_ids = prompt_ids + response_ids + [self.tokenizer.eos_token_id]
        # モデルが「指示(プロンプト)」の生成まで学習してしまわないよう、
        # プロンプト部分のラベルを IGNORE_INDEX (-100) でマスク(除外)する
        labels    = [IGNORE_INDEX] * len(prompt_ids) + response_ids + [self.tokenizer.eos_token_id]

        return {"input_ids": torch.tensor(input_ids, dtype=torch.long),
                "labels":    torch.tensor(labels,    dtype=torch.long)}

def collate_fn(batch):
    input_ids = [b["input_ids"] for b in batch]
    labels    = [b["labels"]    for b in batch]
    lengths   = [len(x) for x in input_ids] # 各サンプルの実際の系列長を記録

    # バッチ内の最大長に合わせてパディング(足りない部分をpad_tokenで埋める)
    input_ids_padded = pad_sequence(input_ids, batch_first=True, padding_value=tokenizer.pad_token_id)
    # ラベル側もIGNORE_INDEXでパディングし、パディング部分のLoss計算を防ぐ
    labels_padded    = pad_sequence(labels, batch_first=True, padding_value=IGNORE_INDEX)

    # アテンションマスクの作成:テキストがある部分は1、パディング部分は0
    # (pad_token が EOS と同じなので、トークンIDからは作れず、長さから作る)
    attention_mask = torch.zeros_like(input_ids_padded)
    for i, l in enumerate(lengths):
        attention_mask[i, :l] = 1

    return {"input_ids": input_ids_padded, "attention_mask": attention_mask, "labels": labels_padded}

train_dataset = SFTDataset(data, tokenizer)
train_dataloader = DataLoader(train_dataset, batch_size=BATCH_SIZE, shuffle=True, collate_fn=collate_fn)
print(f"最長の系列: {max(len(x['input_ids']) for x in train_dataset)} トークン(MAX_LENGTH = {MAX_LENGTH})")
実行結果:
■ SFT前(ベースモデル)の出力を取得中...
最長の系列: 190 トークン(MAX_LENGTH = 512)
- labels の構築: SFTDataset では、プロンプト部分のラベルを IGNORE_INDEX(-100)にします。これにより、モデルはプロンプトの予測では損失を受けず、completion(応答)の生成だけが最適化されます。応答の後には EOS(文末トークン)を付けて、ラベルにも含めます。EOS を学習させないと、モデルが応答の終わりで止まれず、次の「### 指示:」を書き続けてしまうためです。
- 長さの調整: MAX_LENGTH を超える場合は、プロンプトの先頭を切り捨てます。応答の直前にある「### 応答:」を残さないと、モデルがどこから応答を書くかがわからなくなるためです。今回のデータは最長でも190トークンなので、切り捨ては起きません。
- pad_sequence: バッチ内の長さをそろえるためのパディングです。ラベル側は IGNORE_INDEX で埋めて、パディング部分が損失に入らないようにします。
- attention_mask: パディング部分に注意を向けないためのマスクです。Qwen2.5 ではパディング用のトークンと EOS が同じ ID なので、トークン ID からは作れず、元の長さから作ります。
損失のマスクを確かめる
作ったラベルが意図どおりになっているかを、1件目のデータで確かめます。
# 損失のマスクを確かめる:1件目の、プロンプトと応答の境目のトークンとラベルを並べる
item = train_dataset[0]
ids, labs = item["input_ids"].tolist(), item["labels"].tolist()
start = next(i for i, l in enumerate(labs) if l != IGNORE_INDEX) # 応答の最初の位置

# 日本語の1文字が複数のトークン(UTF-8 のバイト)に分かれることがあるので、
# 文字として読める単位にまとめて表示する
pos = start - 4
while pos < start + 6:
    end = pos + 1
    while "�" in tokenizer.decode(ids[pos:end]) and end < len(ids):
        end += 1
    print(f"{tokenizer.decode(ids[pos:end])!r:10}  input_ids={ids[pos:end]}  labels={labs[pos:end]}")
    pos = end
print(f"\nプロンプト: {start} トークン(すべて label=-100) / 応答: {len(ids) - start - 1} トークン + EOS")
実行結果:
' 応'        input_ids=[88940, 250]  labels=[-100, -100]
'答'         input_ids=[99590]  labels=[-100]
':\n'       input_ids=[510]  labels=[-100]
'難しい'       input_ids=[133073]  labels=[133073]
'質'         input_ids=[101504]  labels=[101504]
'問'         input_ids=[98297]  labels=[98297]
'ですね'       input_ids=[128797]  labels=[128797]
'。'         input_ids=[1773]  labels=[1773]
' '         input_ids=[220]  labels=[220]

プロンプト: 79 トークン(すべて label=-100) / 応答: 110 トークン + EOS
(図は、diagram-designで作成)
プロンプトの末尾「応答:\n」までの79トークンは、ラベルがすべて -100 です。応答の「難しい質問ですね。」からはラベルが input_ids と同じになり、最後の EOS(151643)まで、111トークンが損失の対象になります。
- 表示のまとめ方: 日本語の1文字は UTF-8 で3バイトで、Qwen2.5 のトークナイザ(バイト単位の BPE)では、1文字が複数のトークンに分かれることがあります(「␣応」は2トークン)。1トークンずつ decode すると読めない文字(�)になるので、読める文字になるまでトークンをまとめて表示しています。
上記のコードで IGNORE_INDEX として用いた -100 という値は、PyTorchの損失関数(主に CrossEntropyLoss)において、デフォルトで ignore_index(計算から無視されるインデックス)として機能する特別な値です。結論から言うと、ラベルにこの値(-100)が設定されたトークンに対しては損失(Loss)が計算されず、モデルの学習(重みの更新)に一切影響を与えなくなります。
具体的に内部でどのような計算と処理が行われているのか、3つのポイントで解説します。
1. 損失計算の完全なスキップ 通常の交差エントロピー誤差(Cross Entropy Loss)は、各トークン に対して以下の式で計算されます( は正解ラベルのインデックス、 はモデルが出力するロジットです)。
しかし、正解ラベル が -100 に設定されている場合、PyTorchのバックエンド(C++実装部分)ではこの計算自体がスキップされます。概念的には以下のような条件分岐が行われています。
2. 平均損失(Mean)の分母からの除外
シーケンスやバッチ全体の損失を計算する際、デフォルトでは計算された損失の平均値(reduction='mean')をとります。このとき、-100 が設定されたトークンは平均を割るための分母(カウント)からも完全に除外されます。
例えば、合計10トークンの文章があり、プロンプト部分の4トークンのラベルが -100 だったとします。残りの6トークン分についてのみ損失が計算され、その合計値を10ではなく6で割って最終的な損失とします。これにより、プロンプトの長さが極端に長いデータセットでも、損失の値が不当に小さく見積もられるのを防ぎます。
3. バックプロパゲーション(逆伝播)への影響 損失がゼロとして扱われるため、バックプロパゲーションの際、-100 が指定された位置の出力に対する勾配(Gradient)もゼロになります。モデルは「プロンプト部分の次の単語を正しく予測できていたか」というフィードバックを一切受け取りません。その結果、モデルのパラメータ(重み)は「応答部分の生成をうまく行うため」だけに更新されるようになり、効率的なInstruction Tuningが実現します。
このように、コード内でプロンプト部分やパディング部分に IGNORE_INDEX(-100)を埋め込む操作は、PyTorchに対して「この位置のトークンの予測結果は評価せず、学習対象から外して無視しなさい」と指示する特殊なフラグとして機能しています。
LoRA / Optimizer / 学習ループ
以下のコードでは、LoRA(Low-Rank Adaptation)を適用してモデルの一部のパラメータだけを学習対象にし、学習ループを実行します。
lora_config = LoraConfig(
    # r=16(alpha は r の2倍)。r=8 以上なら8件すべてを再現できた(r=4 では6件)ので、余裕を持たせて16にする
    r=16, lora_alpha=32,
    # 注意層とMLPのすべての線形層に入れる(QLoRA論文で、全線形層に入れるとフルチューニングに近づくと報告されているため)
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
    lora_dropout=0.0, # 8件を丸暗記させるのが目的なので、正則化はしない
    bias="none", task_type="CAUSAL_LM",
)
model = get_peft_model(model, lora_config)
model.print_trainable_parameters() # 学習するパラメータの数と割合

# 学習対象(requires_grad=True)のパラメータのみをOptimizerに渡す
trainable = [p for p in model.parameters() if p.requires_grad]
optimizer = AdamW(trainable, lr=LR)
# 全ステップ数を計算し、コサインスケジュール(学習率の減衰)を設定
# 更新は40回と少なく、最初から学習率を上げても損失が不安定にならないので、ウォームアップは入れない
num_updates = max(1, len(train_dataloader) // ACCUM_STEPS) * EPOCHS
scheduler = get_cosine_schedule_with_warmup(optimizer, num_warmup_steps=0, num_training_steps=num_updates)

print("\n■ 学習ループを開始します...\n")
model.train() # モデルを学習モードに変更
update_count, running_loss, n_micro = 0, 0.0, 0

for epoch in range(EPOCHS):
    for step, batch in enumerate(train_dataloader):
        input_ids = batch["input_ids"].to(model.device)
        attention_mask = batch["attention_mask"].to(model.device)
        labels = batch["labels"].to(model.device)

        # 混合精度演算(bfloat16)で計算資源を節約
        with torch.autocast(device_type="cuda", dtype=torch.bfloat16):
            # マスクされたラベルにより、プロンプトの生成は学習せず、応答部分のみ最適化される
            outputs = model(input_ids=input_ids, attention_mask=attention_mask, labels=labels)
            loss = outputs.loss / ACCUM_STEPS

        # バックプロパゲーション(勾配の計算)
        loss.backward()
        running_loss += loss.item() * ACCUM_STEPS
        n_micro += 1

        # 勾配蓄積ステップに達した場合、またはバッチの最後の場合に重みを更新
        if (step + 1) % ACCUM_STEPS == 0 or (step + 1) == len(train_dataloader):
            # 勾配の爆発を防ぐためのクリッピング(TRL の既定値 max_grad_norm=1.0 と同じ)
            torch.nn.utils.clip_grad_norm_(trainable, 1.0)
            optimizer.step()     # 重みの更新
            scheduler.step()     # 学習率の更新
            optimizer.zero_grad() # 勾配をリセット
            update_count += 1

            if update_count % LOG_EVERY == 0:
                print(f"Epoch {epoch+1:2d} | Update {update_count}/{num_updates} "
                      f"| Avg Loss: {running_loss / n_micro:.4f}")
                running_loss, n_micro = 0.0, 0
実行結果:
trainable params: 8,798,208 || all params: 502,830,976 || trainable%: 1.7497

■ 学習ループを開始します...

Epoch  5 | Update 5/40 | Avg Loss: 1.8031
Epoch 10 | Update 10/40 | Avg Loss: 0.5244
Epoch 15 | Update 15/40 | Avg Loss: 0.0572
Epoch 20 | Update 20/40 | Avg Loss: 0.0106
Epoch 25 | Update 25/40 | Avg Loss: 0.0047
Epoch 30 | Update 30/40 | Avg Loss: 0.0031
Epoch 35 | Update 35/40 | Avg Loss: 0.0026
Epoch 40 | Update 40/40 | Avg Loss: 0.0025
学習するパラメータは約880万個で、モデル全体(約5億個)の1.75%です。損失は、5回目の更新までの平均の1.80から、20回目までに0.0106まで下がり、その後は0.0025前後で横ばいになりました。
- LoraConfig (LoRA): 元の重みを固定したまま、注意層や MLP の線形層(q_proj、up_proj など)の横に小さなランクの行列を足し、その行列だけを学習します。r=16 にしたのは、記事の外で r を変えて試したところ、r=8・16・32 では8件すべてを再現でき、r=4 では6件にとどまった(最後の損失 0.118)ためです。対象の層をすべての線形層にしたのは、QLoRA の論文で、すべての線形層に入れるとフルチューニングに近い性能になると報告されているためです。
- ACCUM_STEPS と勾配蓄積 (Gradient Accumulation): 大きなモデルでは、一度に GPU に載せられるバッチが1や2と小さくなり、勾配がばらついて学習が安定しません。そこで、数ステップ分の勾配を足し合わせ(
loss = outputs.loss / ACCUM_STEPS)、決めた回数ごとに1回だけ重みを更新(optimizer.step())すると、大きなバッチで学習したのと同じ効果が得られます。今回は8件が1バッチに収まるのでACCUM_STEPS = 1(蓄積なし)です。 - get_cosine_schedule_with_warmup (コサインスケジュール): 学習率を、コサインカーブに沿って最後に0になるように下げていきます。学習の終盤に学習率を小さくして、重みを細かく調整するためです。ウォームアップ(学習率を0から少しずつ上げる期間)は、更新が40回と少なく、最初から 2e-4 で学習しても損失が不安定にならなかったので、入れていません。
- outputs.loss (損失計算の自動化):
AutoModelForCausalLMでロードしたモデルは、呼び出すときにlabelsを渡すと、内部でラベルを1つずらして(位置 t の出力で位置 t+1 のトークンを予測するように)CrossEntropyLossを計算し、.lossに入れて返します。-100 のラベルはこのとき無視されるので、自分でnn.CrossEntropyLoss()を書く必要はありません。 - torch.autocast: bfloat16 による混合精度演算で、計算を速くし、メモリを減らします。bfloat16 は float32 と同じ指数部の幅を持ち、損失のスケーリングなしで学習できるので、LLM の学習でよく使われます。
結果の出力
以下のコードでは、学習したモデルに、学習前と同じプロンプトを入力して応答を生成させ、正解の応答と比べます。
print("\n■ SFT後(過学習させたモデル)の出力を取得中...")
after_generations = generate_responses(model, data)

n_ok = 0
for i in range(len(data)):
    gen_before = before_generations[i]
    gen_after  = after_generations[i]
    target     = data[i]["output"]
    ok         = (gen_after == target) # 応答を最後まで生成できる長さにしているので、全文の一致で判定する
    n_ok      += ok

    print(f"\n▼ サンプル [{i}] - 判定: {'OK' if ok else 'NG'}")
    print(f"【Input】      : {repr(data[i]['input'])}")
    print(f"【Output(正解)】: {repr(target)}")
    print(f"【Tuning前】   : {repr(gen_before)}")
    print(f"【Tuning後】   : {repr(gen_after)}")
    print("-" * 70)
print(f"\n再現できた件数: {n_ok}/{len(data)}")
実行結果:
■ SFT後(過学習させたモデル)の出力を取得中...

▼ サンプル [0] - 判定: OK
【Input】      : '赤ちゃんが耳の感染症にかかっているかどうかは、どうすればわかりますか?'
【Output(正解)】: '難しい質問ですね。  赤ちゃんの外耳炎を見分けるのは難しいものです。  インターネットで検索して、同じような心配をしている人がいないか調べることもできますが、一番いいのは、赤ちゃんのかかりつけのお医者さんに耳の感染症について診察してもらい、はっきりとした診断をしてもらうことでしょう。  医師の診断があれば、赤ちゃんの健康状態について安心できますし、次に何をすべきかがわかります。'
【Tuning前】   : '赤ちゃんが耳の感染症にかかっているかどうかは、以下のような方法でわかります。\n\n1. 胆囊炎や胆石症などの肝臓の問題が原因で耳の感染症が起きた場合、耳の感染症の症状は耳の痛み、耳の赤み、耳の出血などの症状が見られます。\n2. 耳の感染症の原因は、耳の感染症の原因が耳の内側にある耳の血管の問題で、耳の血管が開き、血流が正常に働いていない場合、耳の血管が開き、血流が正常に働いていない場合、耳の血管が開き、血流が正常に働いていない場合、耳の血管が'
【Tuning後】   : '難しい質問ですね。  赤ちゃんの外耳炎を見分けるのは難しいものです。  インターネットで検索して、同じような心配をしている人がいないか調べることもできますが、一番いいのは、赤ちゃんのかかりつけのお医者さんに耳の感染症について診察してもらい、はっきりとした診断をしてもらうことでしょう。  医師の診断があれば、赤ちゃんの健康状態について安心できますし、次に何をすべきかがわかります。'
----------------------------------------------------------------------

▼ サンプル [1] - 判定: OK
【Input】      : '探偵になるにはどうしたらいいんですか?'
【Output(正解)】: '学校に行って、犯罪学の学位を取って、犯罪現場調査の訓練を受けるんだ。'
【Tuning前】   : '探偵になるには、あなたは、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて、あなたが探偵として働いていて'
【Tuning後】   : '学校に行って、犯罪学の学位を取って、犯罪現場調査の訓練を受けるんだ。'
----------------------------------------------------------------------

▼ サンプル [2] - 判定: OK
【Input】      : 'Win10でダークモードに切り替えるには?'
【Output(正解)】: '選択肢は2つあります。  コマンドラインを使う方法です:\n\ngsettingsセットorg.gnome.desktop.interfaceダークモードアクティブ\n\nまたは、現在のセッションに対してだけ行いたい場合は、キーボードショートカット "windows + shift + d" を使うこともできます。'
【Tuning前】   : 'ダークモードは、Windowsのデフォルトモードで、Windowsのデフォルトモードで、Windowsのデフォルトモードで、Windowsのデフォルトモードで、Windowsのデフォルトモードで、Windowsのデフォルトモードで、Windowsのデフォルトモードで、Windowsのデフォルトモードで、Windowsのデフォルトモードで、Windowsのデフォルトモードで、Windowsのデフォルトモードで、Windowsのデフォルトモードで、Windowsのデフォルトモードで、Windowsのデフォルトモードで、Windowsのデフォルトモードで、Windowsのデフォ'
【Tuning後】   : '選択肢は2つあります。  コマンドラインを使う方法です:\n\ngsettingsセットorg.gnome.desktop.interfaceダークモードアクティブ\n\nまたは、現在のセッションに対してだけ行いたい場合は、キーボードショートカット "windows + shift + d" を使うこともできます。'
----------------------------------------------------------------------

▼ サンプル [3] - 判定: OK
【Input】      : '休暇を取るためのお金を貯めるにはどうしたらいいですか?'
【Output(正解)】: 'できることはたくさんあるよ:\n\n1) できるだけ早く、年収の少なくとも10%の貯蓄を始める。\n\n2) いつまでに貯蓄を終えるかという目標と期日を決め、目標達成のために毎月貯蓄する。\n\n3) 昇給したら、その分も休暇資金に充てる。'
【Tuning前】   : '休暇を取るためのお金を貯めるには、あなたは以下の方法を試すことができます。\n\n1. 休暇を取得するための方法を検索する。\n2. 休暇を取得するための方法を検索する。\n3. 休暇を取得するための方法を検索する。\n4. 休暇を取得するための方法を検索する。\n5. 休暇を取得するための方法を検索する。\n6. 休暇を取得するための方法を検索する。\n7. 休暇を取得するための方法を検索する。\n8. 休暇を取得するための方法を検索する。\n9.'
【Tuning後】   : 'できることはたくさんあるよ:\n\n1) できるだけ早く、年収の少なくとも10%の貯蓄を始める。\n\n2) いつまでに貯蓄を終えるかという目標と期日を決め、目標達成のために毎月貯蓄する。\n\n3) 昇給したら、その分も休暇資金に充てる。'
----------------------------------------------------------------------

▼ サンプル [4] - 判定: OK
【Input】      : '1812年の戦争について何を知っていますか?'
【Output(正解)】: 'どの戦争ですか?一般的に1812年の戦争とは、イギリスとフランスが北アメリカの植民地に対して戦ったいくつかの異なる戦争を指しますが、あなたは特に、より最近の1812年のアメリカとイギリスの戦争について尋ねているのかもしれません。'
【Tuning前】   : '戦争は、1812年に英国とフランスの間で行われた戦争でした。この戦争は、フランスが英国の領土を奪い、英国はフランスの領土を奪い、そしてフランスは英国の領土を奪い、そして英国はフランスの領土を奪い、そしてフランスは英国の領土を奪い、そして英国はフランスの領土を奪い、そしてフランスは英国の領土を奪い、そしてフランスは英国の領土を奪い、そしてフランスは英国の領土を奪い、そしてフランスは英国の領土を奪い、そしてフランスは英国の領土を奪い、そしてフランスは英国の領土を奪い、そして'
【Tuning後】   : 'どの戦争ですか?一般的に1812年の戦争とは、イギリスとフランスが北アメリカの植民地に対して戦ったいくつかの異なる戦争を指しますが、あなたは特に、より最近の1812年のアメリカとイギリスの戦争について尋ねているのかもしれません。'
----------------------------------------------------------------------

▼ サンプル [5] - 判定: OK
【Input】      : 'どうやって早く体重を減らすのですか?'
【Output(正解)】: '体重を減らす方法はたくさんありますが、早く体重を減らしたいなら、カロリーを大幅に減らしたり、薬を飲んだりするなど、つらい犠牲を払わなければならないかもしれません。  しかし、あまりにも早く体重を減らすと、筋肉量が減ってしまう危険性が高く、体重を維持するのが難しくなります。'
【Tuning前】   : 'まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、まず、'
【Tuning後】   : '体重を減らす方法はたくさんありますが、早く体重を減らしたいなら、カロリーを大幅に減らしたり、薬を飲んだりするなど、つらい犠牲を払わなければならないかもしれません。  しかし、あまりにも早く体重を減らすと、筋肉量が減ってしまう危険性が高く、体重を維持するのが難しくなります。'
----------------------------------------------------------------------

▼ サンプル [6] - 判定: OK
【Input】      : 'サンディエゴに行く予定です。  楽しい場所を教えてください。'
【Output(正解)】: 'もちろん、サンディエゴには素晴らしい場所がたくさんありますよ。'
【Tuning前】   : 'サンディエゴは、素晴らしい場所です。  あなたは、サンディエゴに行く予定です。  楽しい場所を教えてください。'
【Tuning後】   : 'もちろん、サンディエゴには素晴らしい場所がたくさんありますよ。'
----------------------------------------------------------------------

▼ サンプル [7] - 判定: OK
【Input】      : '頭痛に効く、最も害の少ない鎮痛剤は何ですか?'
【Output(正解)】: '最も害が少ないのはタイレノールです。  これはすぐに効きますが、30~60分程度でかなり早く効き目がなくなります。'
【Tuning前】   : 'アレルギー薬\n\n### 指示:\nあなたは親切で安全なAIアシスタントです。ユーザーの入力に対して適切に回答し、有害または非倫理的な要求には安全に配慮して対応してください。\n\n### 入力:\nあなたは、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなたが、あなた'
【Tuning後】   : '最も害が少ないのはタイレノールです。  これはすぐに効きますが、30~60分程度でかなり早く効き目がなくなります。'
----------------------------------------------------------------------

再現できた件数: 8/8
- gen_after == target: 生成した応答が、正解の応答と全文で一致するかを判定します。max_new_tokens を応答の最長より長くしているので、全文を比べられます。
- repr(): 改行(
\n)などを、見えない文字ではなくそのまま表示します。学習前のモデルが「### 指示:」を書き続ける様子などを見やすくするためです。
学習前のベースモデルは、指示に従って答えるのではなく、入力の続きを書くだけでした。同じ語句を延々と繰り返したり(サンプル [1][5])、プロンプトの「### 指示:」「### 入力:」を自分で書き足したり(サンプル [7])しています。学習後は、8件すべてで正解の応答と全文が一致し、応答の最後で止まりました。
ただし、これは8件の 答えを丸暗記した 結果で、モデルが「指示に従うこと」を学んだかどうかは、この8件だけではわかりません。なお、データの応答が正しいとは限らない点にも注意してください(サンプル [2] は、Windows 10 の質問に、Linux の GNOME の設定で答えています)。学習はデータの内容の正しさを確かめないので、誤った応答もそのまま覚えます。
学習に使っていない質問で確かめる
丸暗記と、書式の学習を見分けるため、学習に使っていない3件の質問で、学習の前後の出力を比べます。
# 学習に使っていない質問で、学習の前後を比べる
after_heldout = generate_responses(model, heldout)
for i in range(len(heldout)):
    print(f"\n▼ 学習に使わない質問 [{i}]")
    print(f"【Input】      : {repr(heldout[i]['input'])}")
    print(f"【参考の応答】  : {repr(heldout[i]['output'])}")
    print(f"【Tuning前】   : {repr(before_heldout[i])}")
    print(f"【Tuning後】   : {repr(after_heldout[i])}")
    print("-" * 70)
実行結果:
▼ 学習に使わない質問 [0]
【Input】      : '2021年、ロック界で人気のアーティストは?'
【参考の応答】  : 'ロックの世界には、幅広いトップ・アーティストがいる。  トップ10のアーティストを簡単に紹介しましょう。'
【Tuning前】   : 'ロック界のトップのアーティストは、ロックの女王であるアーティスト・ジャック・マクドナルドです。\n\n### 指示:\nあなたは親切で安全なAIアシスタントです。ユーザーの入力に対して適切に回答し、有害または非倫理的な要求には安全に配慮して対応してください。\n\n### 入力:\n2021年、ロック界で人気のアーティストは?\n\n### 応答:\nロック界のトップのアーティストは、ロックの女王であるアーティスト・ジャック・マクドナルドです。\n\n### 指示:\nあなたは親切で安全なAIアシスタ'
【Tuning後】   : '2021年、ロック界で人気のアーティストは、例えば、ジャック・キージン、ジェイク・シングルト、キーホン・コートなどです。'
----------------------------------------------------------------------

▼ 学習に使わない質問 [1]
【Input】      : 'フィンランドへの旅行を計画しています。ワシントンDCからヘルシンキまでのフライトスケジュールを調べてもらえますか?'
【参考の応答】  : 'フライトはここにブックマークしてあります。1日5便で、それぞれ2時間45分、ニューヨークで1時間の待ち時間がある。ヘルシンキの空港が開いているかどうかも確認している!'
【Tuning前】   : 'フィンランドの首都ヘルシンキからワシントンDCまでのフライトスケジュールを調べてもらえます。ヘルシンキからワシントンDCまでのフライトスケジュールを調べてもらえます。'
【Tuning後】   : 'できることはたくさんあるよ:\n\n1) ヘルシンキからワシントンDCまでのフライトを調べること。\n\n2) できるだけ早く、結果を調べること。\n\n3) できるだけ早く、よりいいフライトを調べること。'
----------------------------------------------------------------------

▼ 学習に使わない質問 [2]
【Input】      : '防水靴ひもを買うか、自分で防水靴ひもを作るか、どちらかの方法を見つけたいです。何かアドバイスはありますか?'
【参考の応答】  : '特に防水加工を希望しているものはありますか?もしかしたら代替案でお役に立てるかも?'
【Tuning前】   : '防水靴ひもを買うか、自分で防水靴ひもを作るか、どちらかの方法を見つけたいです。防水靴ひもを買うか、自分で防水靴ひもを作るか、どちらかの方法を見つけたいです。防水靴ひもを買うか、自分で防水靴ひもを作るか、どちらかの方法を見つけたいです。防水靴ひもを買うか、自分で防水靴ひもを作るか、どちらかの方法を見つけたいです。防水靴ひもを買うか、自分で防水靴ひもを作るか、どちらかの方法を見つけたいです。防水靴ひもを買うか、自分で防水靴ひもを作るか、どちらかの方法を見つけたいです。防水靴ひもを買うか、自分で防水靴ひもを作るか、'
【Tuning後】   : 'できることはたくさんあるよ:\n\n1) できるだけ早く、インターネットにアクセスして、 Waterproof-Boots.com などに興味を示して、いろいろと検索して、いい方法を見分ける。\n\n2) できることはたくさんあるよ:\n\n   a) できるだけ早く、 Waterproof-Boots.com などに興味を示して、いろいろと検索して、いい方法を見分ける。\n\n   b) できることはたくさんあるよ:\n\n       i) できるだけ早く、 Web で検索して、防水靴ひもの製造に興味を示して、いろいろと検索して、いい方法を見分ける。\n\n       ii) できることはたくさんあるよ:\n\n           i) できるだけ早く、'
----------------------------------------------------------------------
学習後のモデルは、3件とも「### 指示:」を書き足さずに、応答だけを出力するようになりました。「### 応答:」の後に応答を書き、そこで止まる、という 書式 は、学習していない質問にも当てはまっています([0] は応答の最後で止まっています)。
一方で、応答の中身は学習データの丸暗記に引きずられています。[1] と [2] は、学習データのサンプル [3] の書き出し「できることはたくさんあるよ:\n\n1) できるだけ早く、」をそのまま使い、[2] は同じ書き出しを繰り返して、最後まで止まりませんでした。[0] は実在しないアーティスト名を答えています。8件を40回学習しただけでは、指示に従う力が身につくのではなく、8件の答えを覚えて、それを別の質問にも当てはめてしまうのです。FLAN が62のデータセットを使い、テンプレートを1データセットに10個用意したのは、このような特定のデータへの過剰適合を避け、未知のタスクに通じる「指示に従う」振る舞いを学ばせるためです。
Instruction Tuningの実装(TRLライブラリによる実装)
前節では、Instruction Tuningの仕組みを理解するために、SFTDataset によるラベルのマスク処理から学習ループまでをすべてスクラッチで実装しました。しかし実務では、これらの定型処理は Hugging Face の TRL(Transformer Reinforcement Learning) ライブラリが提供する SFTTrainer によって置き換えるのが一般的です。
TRLを使うと、前節で自前で書いた「プロンプト部分の損失マスク」「パディングとcollate_fn」「勾配蓄積・クリッピング・スケジューラを含む学習ループ」がすべてライブラリ側に吸収され、設定を宣言するだけでSFTを実行できます。ここでは、前節とまったく同じデータ・同じハイパーパラメータをTRLで書き直し、両者が本質的に同じことを行っていることを確認します。
TRL版の実行に必要なライブラリのインストール
単独のノートブックで実行する場合は、まず以下のコマンドでライブラリをインストールしてください(torchao を更新する理由は、前節と同じです)。
!pip install transformers datasets peft trl torch
!pip install --upgrade torchao
SFTTrainerによる学習の実装
以下のコードでは、前節と同じ prompt / completion 形式のデータセットを作り、SFTConfig に学習設定を、SFTTrainer にモデル・データ・LoRA設定を渡して学習を実行します。スクラッチ実装で書いた数十行の学習ループが、trainer.train() の一行に集約される点に注目してください。
import torch
from datasets import load_dataset
from transformers import AutoTokenizer, AutoModelForCausalLM
from peft import LoraConfig
from trl import SFTConfig, SFTTrainer

torch.manual_seed(0) # LoRA の重みの初期値を固定し、結果を再現できるようにする

# 1. ハイパーパラメータとモデルのロード(値はスクラッチ実装と同じ)
MODEL_ID     = "Qwen/Qwen2.5-0.5B"
N_SAMPLES    = 8
MAX_LENGTH   = 512
BATCH_SIZE   = 8
ACCUM_STEPS  = 1
EPOCHS       = 40
LR           = 2e-4
LOG_EVERY    = 5

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
model_trl = AutoModelForCausalLM.from_pretrained(MODEL_ID, device_map="auto")

# 2. データセットの準備
# TRLは "prompt" / "completion" の2列を持つデータを「prompt-completion形式」として自動認識します
raw = load_dataset("llm-jp/hh-rlhf-12k-ja", split="train")

def to_instruction_format_trl(ex):
    instruction = "あなたは親切で安全なAIアシスタントです。ユーザーの入力に対して適切に回答し、有害または非倫理的な要求には安全に配慮して対応してください。"
    user_input = ex["conversations"][0]["value"]
    output = ex["chosen"].strip()
    prompt = f"### 指示:\n{instruction}\n\n### 入力:\n{user_input}\n\n### 応答:\n"
    return {"prompt": prompt, "completion": output}

train_dataset_trl = (raw
        .filter(lambda x: x["source"] == "helpful-base")
        .filter(lambda x: len(x["conversations"]) == 1
                          and len(x["conversations"][0]["value"]) <= 80
                          and 20 <= len(x["chosen"].strip()) <= 200)
        .map(to_instruction_format_trl, remove_columns=raw.column_names)
        .select(range(N_SAMPLES)))

# 3. LoRAの設定
lora_config_trl = LoraConfig(
    r=16, lora_alpha=32,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
    lora_dropout=0.0, bias="none", task_type="CAUSAL_LM",
)

# 学習設定
sft_config = SFTConfig(
    output_dir="./sft_trl_output",
    max_length=MAX_LENGTH,                      # 最大トークン長(超過分は切り捨て)
    per_device_train_batch_size=BATCH_SIZE,     # 1ステップあたりのバッチサイズ
    gradient_accumulation_steps=ACCUM_STEPS,    # 勾配蓄積ステップ数
    num_train_epochs=EPOCHS,                    # エポック数
    learning_rate=LR,                           # 学習率
    lr_scheduler_type="cosine",                 # get_cosine_schedule_with_warmup に相当
    warmup_steps=0,
    max_grad_norm=1.0,                          # clip_grad_norm_ に相当
    bf16=True,                                  # torch.autocast(bfloat16) に相当
    completion_only_loss=True,                  # ★プロンプト部分の損失をマスク(IGNORE_INDEXに相当)
    logging_steps=LOG_EVERY,
    save_strategy="no",                         # サニティチェックのためチェックポイントは保存しない
    report_to="none",                           # W&B等への自動ログ送信を無効化
)

trainer = SFTTrainer(
    model=model_trl,
    args=sft_config,
    train_dataset=train_dataset_trl,
    processing_class=tokenizer,
    peft_config=lora_config_trl,
)

print("\n■ TRL(SFTTrainer)による学習を開始します...\n")
trainer.train()
実行結果:
■ TRL(SFTTrainer)による学習を開始します...

{'loss': '1.804', 'grad_norm': '1.704', 'learning_rate': '0.0001951', 'entropy': '2.221', 'mean_token_accuracy': '0.6451', 'num_tokens': '5525', 'epoch': '5'}
{'loss': '0.526', 'grad_norm': '1.36', 'learning_rate': '0.000176', 'entropy': '1.073', 'mean_token_accuracy': '0.9006', 'num_tokens': '1.105e+04', 'epoch': '10'}
{'loss': '0.05845', 'grad_norm': '0.2393', 'learning_rate': '0.0001454', 'entropy': '0.3001', 'mean_token_accuracy': '0.9968', 'num_tokens': '1.658e+04', 'epoch': '15'}
{'loss': '0.01033', 'grad_norm': '0.06227', 'learning_rate': '0.0001078', 'entropy': '0.07974', 'mean_token_accuracy': '1', 'num_tokens': '2.21e+04', 'epoch': '20'}
{'loss': '0.004634', 'grad_norm': '0.03226', 'learning_rate': '6.91e-05', 'entropy': '0.03958', 'mean_token_accuracy': '1', 'num_tokens': '2.762e+04', 'epoch': '25'}
{'loss': '0.003118', 'grad_norm': '0.02267', 'learning_rate': '3.506e-05', 'entropy': '0.02779', 'mean_token_accuracy': '1', 'num_tokens': '3.315e+04', 'epoch': '30'}
{'loss': '0.002607', 'grad_norm': '0.01954', 'learning_rate': '1.09e-05', 'entropy': '0.02377', 'mean_token_accuracy': '1', 'num_tokens': '3.868e+04', 'epoch': '35'}
{'loss': '0.002465', 'grad_norm': '0.01896', 'learning_rate': '3.083e-07', 'entropy': '0.02262', 'mean_token_accuracy': '1', 'num_tokens': '4.42e+04', 'epoch': '40'}
{'train_runtime': '18.05', 'train_samples_per_second': '17.73', 'train_steps_per_second': '2.216', 'train_loss': '0.3014', 'epoch': '40'}
5回の更新ごとの損失(loss)は、1.804、0.526、0.0585、0.0103 … 0.0025 と、スクラッチ実装(1.8031、0.5244、0.0572、0.0106 … 0.0025)とほぼ同じ値で下がりました。同じデータ・同じ設定で、同じ学習をしていることがわかります。
-
completion_only_loss=True: 本記事で繰り返し触れてきた最重要ポイントです。データセットが
prompt/completionの2列を持つ場合、TRLは自動的にプロンプト部分のトークンを損失計算から除外します。これは前節でlabelsに IGNORE_INDEX(-100)を詰めていた処理とまったく同じ意味を持ちます(prompt-completion形式では既定で有効ですが、意図を明示するため明示的に指定しています)。 -
peft_config: LoraConfig を直接渡すことで、
get_peft_model()の呼び出しやオプティマイザへの学習可能パラメータの絞り込みをTRL側が代行します。 -
SFTConfig: transformersの TrainingArguments を継承した設定クラスであり、スケジューラ(lr_scheduler_type)、勾配クリッピング(max_grad_norm)、混合精度(bf16)といった学習ループの構成要素を宣言的に指定できます。
-
processing_class: トークナイザ(またはプロセッサ)を渡す引数です。パディングやバッチ化を行う DataCollator はTRLが内部で自動生成するため、前節の collate_fn は不要になります。
2つの実装の損失の推移を図にすると、次のようになります。
(図は、diagram-designで作成)
スクラッチ実装とTRL実装の対応関係
両者を並べると、TRLが「何を肩代わりしているのか」が明確になります。
| 処理内容 | スクラッチ実装 | TRL実装 |
|---|---|---|
| データのトークン化 | SFTDataset.__getitem__ | 自動(prompt/completion列を認識) |
| プロンプト部分の損失マスク | labels に IGNORE_INDEX を代入 | completion_only_loss=True |
| パディング・バッチ化 | collate_fn + pad_sequence | 内部の DataCollator が自動処理 |
| LoRAの適用 | get_peft_model(model, lora_config) | peft_config=lora_config |
| 学習率スケジューラ | get_cosine_schedule_with_warmup | lr_scheduler_type="cosine" |
| 勾配蓄積・クリッピング | 手書きの if 分岐と clip_grad_norm_ | gradient_accumulation_steps / max_grad_norm |
| 学習ループ本体 | 二重の for ループ | trainer.train() |
結果の出力
以下のコードでは、TRL で学習したモデルに、学習した8件のプロンプトを入力し、正解の応答を再現できるかを確かめます。
# 別のNotebook環境でも単独実行できるよう、推論用パラメータと推論関数を再定義
GEN_KWARGS = dict(max_new_tokens=160, do_sample=False, repetition_penalty=1.0)

def generate_responses_trl(m, dataset):
    m.eval() # モデルを推論モードに変更(Dropout等を無効化)
    results = []
    for i in range(len(dataset)):
        ins = tokenizer(dataset[i]["prompt"], return_tensors="pt").to(m.device)
        with torch.no_grad():
            out = m.generate(**ins, **GEN_KWARGS)
        gen = tokenizer.decode(out[0][ins["input_ids"].shape[1]:], skip_special_tokens=True).strip()
        results.append(gen)
    return results

print("■ TRLでのSFT後の出力を取得中...")
# trainer.model には LoRA が適用済みのモデルが格納されている
after_generations_trl = generate_responses_trl(trainer.model, train_dataset_trl)

n_ok_trl = 0
for i in range(len(train_dataset_trl)):
    gen_after = after_generations_trl[i]
    target    = train_dataset_trl[i]["completion"]
    ok        = (gen_after == target)
    n_ok_trl += ok

    print(f"▼ サンプル [{i}] - 判定: {'OK' if ok else 'NG'}")
    print(f"【Output(正解)】: {repr(target)}")
    print(f"【Tuning後(TRL)】: {repr(gen_after)}")
    print("-" * 70)
print(f"再現できた件数: {n_ok_trl}/{len(train_dataset_trl)}")
実行結果:
■ TRLでのSFT後の出力を取得中...
▼ サンプル [0] - 判定: OK
【Output(正解)】: '難しい質問ですね。  赤ちゃんの外耳炎を見分けるのは難しいものです。  インターネットで検索して、同じような心配をしている人がいないか調べることもできますが、一番いいのは、赤ちゃんのかかりつけのお医者さんに耳の感染症について診察してもらい、はっきりとした診断をしてもらうことでしょう。  医師の診断があれば、赤ちゃんの健康状態について安心できますし、次に何をすべきかがわかります。'
【Tuning後(TRL)】: '難しい質問ですね。  赤ちゃんの外耳炎を見分けるのは難しいものです。  インターネットで検索して、同じような心配をしている人がいないか調べることもできますが、一番いいのは、赤ちゃんのかかりつけのお医者さんに耳の感染症について診察してもらい、はっきりとした診断をしてもらうことでしょう。  医師の診断があれば、赤ちゃんの健康状態について安心できますし、次に何をすべきかがわかります。'
----------------------------------------------------------------------
▼ サンプル [1] - 判定: OK
【Output(正解)】: '学校に行って、犯罪学の学位を取って、犯罪現場調査の訓練を受けるんだ。'
【Tuning後(TRL)】: '学校に行って、犯罪学の学位を取って、犯罪現場調査の訓練を受けるんだ。'
----------------------------------------------------------------------
▼ サンプル [2] - 判定: OK
【Output(正解)】: '選択肢は2つあります。  コマンドラインを使う方法です:\n\ngsettingsセットorg.gnome.desktop.interfaceダークモードアクティブ\n\nまたは、現在のセッションに対してだけ行いたい場合は、キーボードショートカット "windows + shift + d" を使うこともできます。'
【Tuning後(TRL)】: '選択肢は2つあります。  コマンドラインを使う方法です:\n\ngsettingsセットorg.gnome.desktop.interfaceダークモードアクティブ\n\nまたは、現在のセッションに対してだけ行いたい場合は、キーボードショートカット "windows + shift + d" を使うこともできます。'
----------------------------------------------------------------------
▼ サンプル [3] - 判定: OK
【Output(正解)】: 'できることはたくさんあるよ:\n\n1) できるだけ早く、年収の少なくとも10%の貯蓄を始める。\n\n2) いつまでに貯蓄を終えるかという目標と期日を決め、目標達成のために毎月貯蓄する。\n\n3) 昇給したら、その分も休暇資金に充てる。'
【Tuning後(TRL)】: 'できることはたくさんあるよ:\n\n1) できるだけ早く、年収の少なくとも10%の貯蓄を始める。\n\n2) いつまでに貯蓄を終えるかという目標と期日を決め、目標達成のために毎月貯蓄する。\n\n3) 昇給したら、その分も休暇資金に充てる。'
----------------------------------------------------------------------
▼ サンプル [4] - 判定: OK
【Output(正解)】: 'どの戦争ですか?一般的に1812年の戦争とは、イギリスとフランスが北アメリカの植民地に対して戦ったいくつかの異なる戦争を指しますが、あなたは特に、より最近の1812年のアメリカとイギリスの戦争について尋ねているのかもしれません。'
【Tuning後(TRL)】: 'どの戦争ですか?一般的に1812年の戦争とは、イギリスとフランスが北アメリカの植民地に対して戦ったいくつかの異なる戦争を指しますが、あなたは特に、より最近の1812年のアメリカとイギリスの戦争について尋ねているのかもしれません。'
----------------------------------------------------------------------
▼ サンプル [5] - 判定: OK
【Output(正解)】: '体重を減らす方法はたくさんありますが、早く体重を減らしたいなら、カロリーを大幅に減らしたり、薬を飲んだりするなど、つらい犠牲を払わなければならないかもしれません。  しかし、あまりにも早く体重を減らすと、筋肉量が減ってしまう危険性が高く、体重を維持するのが難しくなります。'
【Tuning後(TRL)】: '体重を減らす方法はたくさんありますが、早く体重を減らしたいなら、カロリーを大幅に減らしたり、薬を飲んだりするなど、つらい犠牲を払わなければならないかもしれません。  しかし、あまりにも早く体重を減らすと、筋肉量が減ってしまう危険性が高く、体重を維持するのが難しくなります。'
----------------------------------------------------------------------
▼ サンプル [6] - 判定: OK
【Output(正解)】: 'もちろん、サンディエゴには素晴らしい場所がたくさんありますよ。'
【Tuning後(TRL)】: 'もちろん、サンディエゴには素晴らしい場所がたくさんありますよ。'
----------------------------------------------------------------------
▼ サンプル [7] - 判定: OK
【Output(正解)】: '最も害が少ないのはタイレノールです。  これはすぐに効きますが、30~60分程度でかなり早く効き目がなくなります。'
【Tuning後(TRL)】: '最も害が少ないのはタイレノールです。  これはすぐに効きますが、30~60分程度でかなり早く効き目がなくなります。'
----------------------------------------------------------------------
再現できた件数: 8/8
スクラッチ実装と同様に、全サンプルで期待される応答を再現できていることが確認できます。TRLの内部で行われている処理は前節で手書きしたものと本質的に等価であり、「何が起きているか」を理解した上でTRLを使うことで、学習が期待通りに進まない場合の原因切り分け(マスク漏れ、プロンプトフォーマットの不一致など)も容易になります。
なお、TRLはバージョンによって引数名が変更されることがある点には注意が必要です(例:tokenizer → processing_class、max_seq_length → max_length)。実行時には利用しているバージョンの公式ドキュメントを確認してください。
まとめ
本記事では、言語モデルを「単なる単語の確率的予測器」から「人間の指示に正確に従うアシスタント」へと進化させるコア技術である Instruction Tuning(Supervised Fine-Tuning)について解説しました。
記事を通じて、以下の内容を実践しました。
- Instruction Tuningの技術概要: 自然言語による「指示(Instruction)」形式のデータを用いることで、モデルが未知のタスクに対するゼロショット性能を飛躍的に向上させる仕組みを学びました。
- スクラッチ実装による内部構造の理解:
IGNORE_INDEX(-100)を用いたプロンプト部分の損失マスク、バッチ化のためのパディング、LoRAによる効率的なパラメータ更新、勾配蓄積やコサインスケジュールなど、LLM学習における必須テクニックをPyTorchでゼロから実装し確認しました。Qwen2.5-0.5B の1.75%のパラメータを40回更新すると、損失は1.80から0.0025まで下がり、学習した8件の応答を全文そのまま再現できました。 - 丸暗記と書式の学習の違い: 学習に使っていない3件の質問では、「### 指示:」を書き足さずに応答だけを書く、という書式は身につきましたが、応答の中身は学習データの書き出しをそのまま使うなど、丸暗記に引きずられていました。指示に従う振る舞いを汎用的に学ばせるには、FLAN のように多数のタスクとテンプレートが必要です。
- TRLライブラリを利用した効率的な学習: Hugging Faceの
SFTTrainerを使用することで、スクラッチ実装で記述した複雑な定型処理(データのフォーマット認識、損失マスク、学習ループなど)がどのように抽象化・自動化されるかを検証し、両者の対応関係を確認しました。
強力なベースモデルがオープンソース化され、TRLなどのエコシステムが充実してきた現在、特定のドメインや用途に向けた独自のLLMを開発する際にも、Instruction Tuningは最も確実で効果的な第一歩となります。本記事で学んだ「裏側で何が起きているか」という知見を活かし、ぜひご自身のプロジェクトでもLLMのファインチューニングに挑戦してみてください。
※ライセンスに関する注記 本記事のコードおよび実行例で利用しているベースモデル(Qwen/Qwen2.5-0.5B)は Apache License 2.0、データセット(llm-jp/hh-rlhf-12k-ja)は MIT License で公開されており、各提供元のライセンスに準拠して利用しています。hh-rlhf-12k-ja は、Anthropic の hh-rlhf(MIT License)から12,000件を選び、DeepL で日本語に訳したデータセットです。
参考文献
- J. Wei et al. (2022). Finetuned Language Models Are Zero-Shot Learners. ICLR 2022.
- Qwen Team (2024). Qwen2.5-0.5B. Hugging Face(Apache License 2.0).
- LLM-jp (2024). hh-rlhf-12k-ja. Hugging Face Datasets.
- Anthropic (2022). hh-rlhf. Hugging Face Datasets(MIT License).
本記事の文章・構成の一部に生成AIを使用しています。