操作変数法(IV・2SLS)とは?
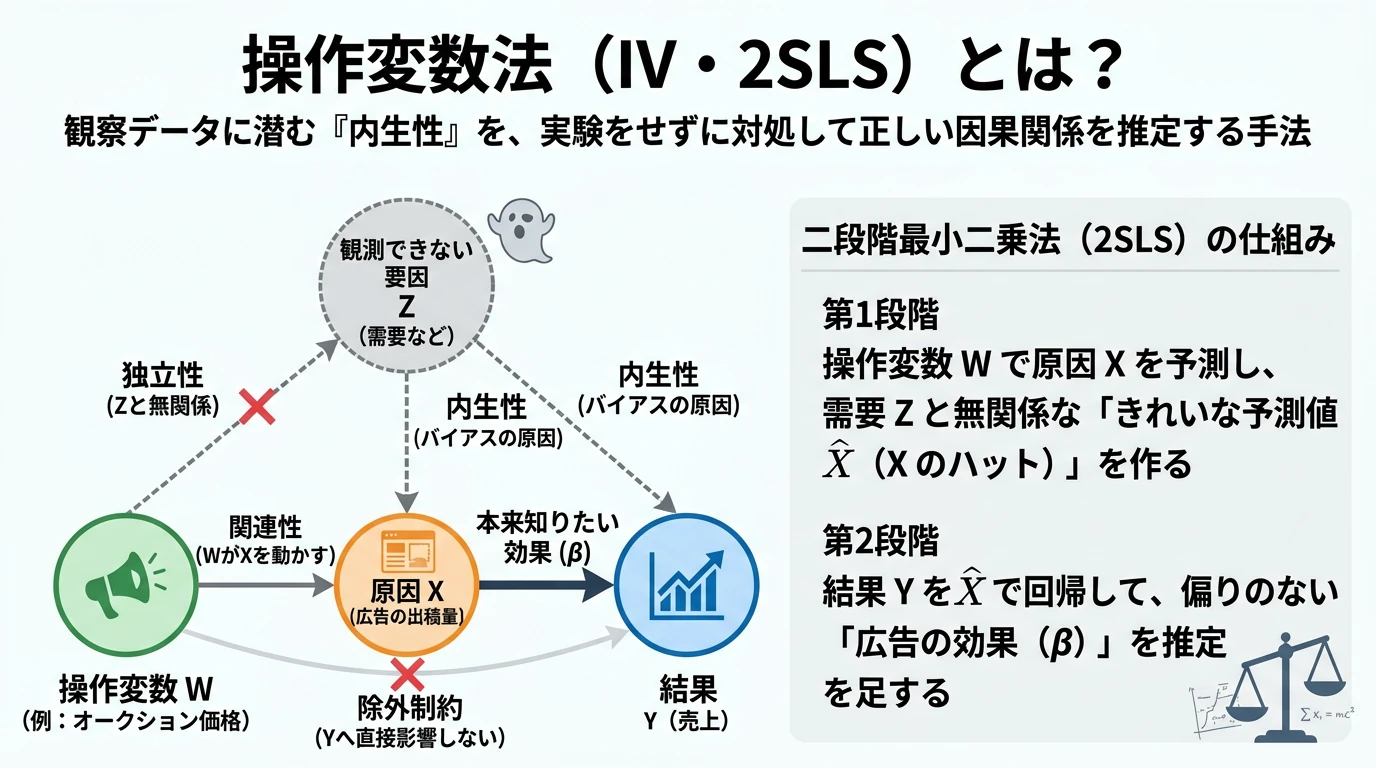 (画像は、Geminiで作成)
観察データの内生性に、実験をせずに対処する操作変数法(IV)を理解し、Pythonで実装できるようになること。そのために、操作変数の3つの条件、共分散の比で効果を取り出す仕組み、二段階最小二乗法(2SLS)と正しい標準誤差を、真値を仕込んだダミーデータで確かめること。あわせて、弱い操作変数や除外制約の崩れによって推定が大きく狂うことを、シミュレーションで確認すること。
概要
内生性の記事では、需要が高い時期ほど広告を増やすと、広告と売上の相関に「もともと売れるはずだった分」が混ざり、最小二乗法(OLS)で推定した広告の効果が大きく偏ることを見ました。この偏りは、データを増やしても消えません。
最も確実な対処は、RCTやジオ実験で広告の出し方を分析者が決めることです。しかし、実験ができない場面もあります。そのとき、観察データのまま内生性に対処する代表的な方法が、本記事で扱う 操作変数法(Instrumental Variables、IV)です。
操作変数法の考え方は、広告の出稿量の変動のうち、需要とは関係のない理由で動いた部分だけ を取り出して、その部分と売上の関係から効果を推定する、というものです。その「需要とは関係のない理由」の役割を果たす変数を 操作変数 と呼びます。
本記事では、次の順に解説します。
- 操作変数の3つの条件
- 共分散の比で効果を取り出す仕組みと、二段階最小二乗法(2SLS)
- ダミーデータでの実装と、正しい標準誤差
- 弱い操作変数の問題(第1段階のF統計量)
- 除外制約が崩れたときに何が起きるか
- 広告の効果測定で使える操作変数と、注意点
内生性の記事の記号に合わせて、売上を 、広告の出稿量を 、観測できない交絡因子(需要)を 、操作変数を と書きます。操作変数法の教科書では操作変数を と書くことが多いのですが、本記事では交絡因子を と書くので、操作変数は とします。
本記事のコードは、Python 3.13、NumPy 2.4.6、pandas 3.0.5、statsmodels 0.15.0、linearmodels 7.1、matplotlib 3.11.2 で動作を確認しました。
操作変数の考え方
内生性の問題をもう一度
内生性の記事の欠落変数バイアスと同じ設定から始めます。売上 は広告の出稿量 と、観測できない需要 で決まるとします。
知りたいのは、広告の効果 です。 が観測できないので、実際に推定できるのは ()です。需要 が高い時期ほど広告 を増やすと、 と誤差項 が相関し()、OLSの推定値は からずれます。
操作変数の3つの条件
そこで、広告の出稿量 を動かすけれども、需要とは関係のない変数 を探します。たとえば、広告オークションの価格(クリック単価やインプレッション単価)の変動 です。競合の入札が増えて価格が上がると、同じ予算で買える広告の量は減ります。価格が上がったこと自体は、自社の商品の需要とは関係がなさそうです。
このような変数 が操作変数として使えるのは、次の3つの条件を満たすときです。
- 関連性(relevance): が広告の出稿量 を動かす()
- 独立性(independence): が、観測できない需要 などの交絡因子と無関係である
- 除外制約(exclusion restriction): は、広告の出稿量 を通してしか売上 に影響しない
2と3をまとめると、「 は誤差項 と無相関」()という条件になります。内生性の記事では、この2つをまとめて「外生性」と呼びました。
(図は、diagram-designで作成)
図のように、操作変数 から売上 へは、広告の出稿量 を通る道しかありません。そのため、 が動いたときに売上がどれだけ動くかを見れば、それは広告を通じた効果だけを反映しています。
1の関連性は、データで確かめられます(後で見る第1段階のF統計量)。一方、2の独立性と3の除外制約は、データからは確かめられません。 が観測できない以上、 と が無関係かどうかも、データでは分からないからです。この2つは、ビジネスの仕組みについての知識をもとに、議論して納得するしかありません。
共分散の比で効果を取り出す
3つの条件が成り立つと、効果 を次のように取り出せます。売上の式 の両辺と の共分散をとると、
です(2つ目の等号で を使いました)。(関連性)なら、両辺を割って
となります。データの共分散で置き換えたものが、操作変数推定量(IV推定量)です。
分母と分子を で割ると、意味が分かりやすくなります。分母は「 を で回帰した傾き」、分子は「 を で回帰した傾き」です。
たとえば、価格が1上がると広告の出稿量が2減り、売上が0.6減るなら、「広告が2減ると売上が0.6減る」ので、広告1あたりの効果は です。価格は需要と関係なく動くので、この比には需要の影響が混ざりません。
二段階最小二乗法(2SLS)
同じ推定量を、2回の回帰で計算する方法が 二段階最小二乗法(Two-Stage Least Squares、2SLS)です。
- 第1段階:広告の出稿量 を操作変数 で回帰し、予測値 を作ります。 は、 の変動のうち「価格で説明できる部分」、つまり需要と無関係な部分です。
- 第2段階:売上 を、 の代わりに で回帰します。その傾きが です。
式の矢印 は、「左の式の回帰をデータに当てはめて、右の値を計算する」という手順を表しています。
- 第1段階の左の式(データの構造):広告の出稿量 は、価格 で決まる部分 と、それ以外の部分 が合わさったものです。本記事のダミーデータでは、 に需要 による変動(需要が高いほど広告を増やす分)が含まれています。この が、内生性の原因です。
- 第1段階の右の式(予測値): を で回帰して係数 を推定し、各期の を価格 だけから予測した値が です。文字の上のハット記号(^)は、データから計算した推定値・予測値であることを表します。予測値 には が入らないので、需要による変動を含みません。つまり第1段階は、 から需要を含む部分 を取り除き、価格で説明できる部分だけを取り出す操作です。
- 第2段階:売上 を、取り出した で回帰し、その傾きを とします。 は需要と無関係に動くので、この傾きには需要の影響が混ざりません。
操作変数が1つ、内生変数が1つのときは、 は上の と一致します。2SLS の形は、操作変数や、需要以外のコントロール変数が複数ある場合にもそのまま使えるので、実務ではこちらの形で計算するのが一般的です。 第2段階の傾きは、OLS の傾きの式どおり、 と の共分散を の分散で割ったものです。 ここに を代入します。そのために、共分散と分散の2つの性質を使います( は定数、 は変数です)。 この2つを、、、 として当てはめると、分子と分母は次のようになります。 したがって、 となり、分母と分子の が1つ約分されます。第1段階の傾きは、同じく OLS の傾きの式から なので、これを代入すると、分母の も消えて が得られます。詳細な式展開(操作変数が1つのとき、2SLS と IV推定量が一致する理由)
2つの段階を図にすると、次のようになります。
(図は、diagram-designで作成)
検証用ダミーデータの生成
内生性の記事の欠落変数バイアスのシミュレーションと同じ設定に、操作変数(広告オークションの価格の変動)を1つ加えます。データの生成の流れは次のとおりです(コードの手順番号を添えます)。
- 観測できない需要 と、広告オークションの価格の変動 を、互いに独立に生成する(手順2)
- 広告の出稿量 を、需要が高いほど増え(内生性)、価格が上がるほど減る(操作変数)ように生成する(手順3)
- 売上 を、広告と需要から生成する。価格 は売上の式に入れない(除外制約)(手順4)
式で書くと、次のとおりです。
真の値は、広告の効果 (beta_true)、需要の効果 (gamma_true)、切片 (alpha_true)、価格が広告を動かす強さ (pi1)、需要が広告を動かす強さ (lam)、 です。 と がどちらも正なので、OLS は広告の効果を過大に推定するはずです。
後の節でも、操作変数の強さを変えて同じデータを何度も作るので、生成を関数 make_data にまとめます。
!pip install japanize-matplotlib linearmodels
グラフの日本語表示に japanize-matplotlib を、2SLS のライブラリに linearmodels を使います。Python 3.12 以降で japanize-matplotlib の import がエラーになる場合は、setuptools も一緒にインストールしてください。
import numpy as np
import pandas as pd
import statsmodels.api as sm
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフの日本語表示用

# 1. 真のパラメータ
alpha_true, beta_true, gamma_true = 50.0, 0.3, 2.0   # 売上の式:切片、広告の効果、需要の効果
pi0, pi1, lam = 20.0, -2.0, 1.5                      # 広告の式:切片、価格の効果、需要の効果
T = 500

def make_data(T=500, pi1=-2.0, kappa=0.0, seed=42):
    """操作変数 W(広告の価格の変動)を含むデータを作る。kappa は W が売上に直接効く強さ(除外制約の崩れ)"""
    rng = np.random.default_rng(seed)
    # 2. 観測できない需要 Z と、広告オークションの価格の変動 W(互いに独立)
    Z = rng.normal(0, 5, T)
    W = rng.normal(0, 2, T)
    # 3. 広告の出稿量 X:需要が高いほど増え(内生性)、価格が上がるほど減る(操作変数)
    X = pi0 + pi1 * W + lam * Z + rng.normal(0, 3, T)
    # 4. 売上 Y:広告と需要で決まる。kappa = 0 なら、価格 W は売上に直接は効かない
    Y = alpha_true + beta_true * X + gamma_true * Z + kappa * W + rng.normal(0, 2, T)
    return pd.DataFrame({'Y': Y, 'X': X, 'W': W, 'Z': Z})

df = make_data()

# 5. 3つの条件の確認(Z は本来観測できないが、答え合わせのために使う)
print(f"関連性:W と X の相関 {df['W'].corr(df['X']):+.3f}")
print(f"独立性:W と Z の相関 {df['W'].corr(df['Z']):+.3f}")
print(f"内生性:X と Z の相関 {df['X'].corr(df['Z']):+.3f}")
操作変数を含むダミーデータを生成し、操作変数の条件を確かめています。
- 真のパラメータ: 売上の式の alpha_true・beta_true・gamma_true と、広告の式の pi0・pi1・lam は、コードの直前に示した式の です。
- 生成の関数: make_data は、期間の長さ T、操作変数の強さ pi1、価格が売上に直接効く強さ kappa、乱数のシード seed を引数にとります。kappa は除外制約を崩すための引数で、ここでは0(除外制約が成り立つ)です。後の節で、引数を変えて同じ形のデータを何度も作るために関数にしています。
- 乱数: np.random.default_rng(seed) で関数ごとに独立した乱数生成器を作るので、同じ seed なら同じデータが再現されます。 と は別々に正規乱数から引くので、互いに独立です(独立性の条件)。
- 広告と売上: 広告の出稿量 X は、需要 Z が高いほど増え(lam * Z)、価格 W が上がるほど減ります(pi1 * W)。売上 Y の式に W が入るのは kappa * W の項だけで、kappa = 0 なら除外制約が成り立ちます。
- 条件の確認: df['W'].corr(df['X']) などで相関を表示します。需要 Z は分析者には観測できない変数ですが、ダミーデータなので答え合わせに使えます。
実行結果
関連性:W と X の相関 -0.471
独立性:W と Z の相関 -0.009
内生性:X と Z の相関 +0.819
- 関連性: 価格の変動 と広告の出稿量 の相関は −0.47 で、価格が上がると広告が減る関係がはっきり出ています。
- 独立性: と需要 の相関は −0.009 で、ほぼ0です。価格の変動は需要と無関係に生成しているので、当然の結果です。
- 内生性: 広告の出稿量 と需要 の相関は 0.82 と強く、需要が高い時期ほど広告を増やしていることが分かります。このまま OLS で推定すると、広告の効果に需要の効果が混ざります。
ただし、現実のデータでは は観測できないので、確かめられるのは1行目の関連性だけです。
操作変数法による推定
OLS と IV推定量の比較
まず、OLS と、共分散の比で計算した IV推定量を比べます。コードで計算するのは、次の2つです( は np.cov で計算します)。
あわせて、IV推定量の分母と分子を、それぞれ と を で回帰した傾き(第1段階の傾き (first_slope)と、売上を価格で回帰した傾き(reduced_slope))として計算し、その比が IV推定量と一致することも確かめます。
# 1. OLS:売上 Y を広告 X で回帰(需要 Z は観測できないのでモデルに入れられない)
ols = sm.OLS(df['Y'], sm.add_constant(df['X'])).fit()

# 2. IV推定量:共分散の比
cov = lambda a, b: np.cov(a, b)[0, 1]
beta_iv = cov(df['W'], df['Y']) / cov(df['W'], df['X'])

# 3. 分母と分子を、それぞれ W で回帰した傾きとして計算する
first_slope = sm.OLS(df['X'], sm.add_constant(df['W'])).fit().params['W']    # 価格 → 広告
reduced_slope = sm.OLS(df['Y'], sm.add_constant(df['W'])).fit().params['W']  # 価格 → 売上

print(f"真の広告の効果  : {beta_true:.3f}")
print(f"OLS            : {ols.params['X']:.3f}")
print(f"IV推定量       : {beta_iv:.3f}")
print(f"価格 → 広告の傾き {first_slope:+.3f}、価格 → 売上の傾き {reduced_slope:+.3f}、"
      f"比 {reduced_slope / first_slope:.3f}")
OLS と IV推定量で広告の効果を推定し、真の値と比べています。
- OLS: sm.add_constant で切片の列を加え、sm.OLS(...).fit() で売上を広告で回帰しています。需要 Z は観測できない前提なので、説明変数に入れていません。
- IV推定量: np.cov(a, b) は2行2列の共分散行列を返すので、[0, 1] で2つの変数の共分散だけを取り出す関数 cov を作っています。 をそのまま計算したものが beta_iv です。
- 傾きの比: first_slope は広告を価格で回帰した傾き、reduced_slope は売上を価格で回帰した傾きです。どちらも分母が の回帰係数なので、その比は IV推定量と一致するはずです。
実行結果
真の広告の効果  : 0.300
OLS            : 1.167
IV推定量       : 0.352
価格 → 広告の傾き -2.087、価格 → 売上の傾き -0.734、比 0.352
- OLS は約4倍に過大評価: OLS の推定値は 1.167 で、真の値 0.3 の約4倍です。需要が高い時期に広告も売上も増えるので、「需要による売上の増加」まで広告の効果として数えています。
- IV推定量は真の値の近く: 共分散の比による IV推定量は 0.352 で、真の値 0.3 に近い値です。差の 0.05 は、500期間という有限のデータによるばらつきです(後のシミュレーションで、1,000回の中央値が 0.30 になることを確かめます)。
- 傾きの比: 価格が1上がると、広告の出稿量は 2.087 減り、売上は 0.734 減ります。広告が 2.087 減ったことで売上が 0.734 減ったと考えると、広告1あたりの効果は で、IV推定量と一致します。
2つの傾きと比を図にすると、次のようになります。
(図は、diagram-designで作成)
二段階最小二乗法と、正しい標準誤差
次に、二段階最小二乗法を手で計算し、ライブラリ(linearmodels の IV2SLS)と比べます。ここで注意が必要なのは 標準誤差 です。
第2段階を普通の OLS として実行すると、残差を (予測値 を使った残差)で計算してしまいます。しかし、モデルの誤差は本来の広告の出稿量 を使った です。正しい標準誤差は、この残差の分散 (sigma2)を使って、次のように計算します( は の平均)。
あわせて、第1段階の F統計量 も計算します。操作変数が1つのときは、第1段階の傾き の 値の2乗です。操作変数がどれだけ強く広告を動かしているかの目安で、後の節で詳しく扱います。
from linearmodels.iv import IV2SLS

# 1. 第1段階:広告 X を操作変数 W で回帰し、予測値 X_hat を作る
first = sm.OLS(df['X'], sm.add_constant(df['W'])).fit()
X_hat = first.fittedvalues
F_first = first.tvalues['W'] ** 2

# 2. 第2段階:売上 Y を X_hat で回帰する(係数は正しいが、標準誤差は誤り)
second = sm.OLS(df['Y'], sm.add_constant(X_hat.rename('X_hat'))).fit()
a_hat, b_hat = second.params['const'], second.params['X_hat']

# 3. 正しい標準誤差:残差は X_hat ではなく、本来の X で計算する
resid = df['Y'] - a_hat - b_hat * df['X']
sigma2 = (resid ** 2).sum() / (T - 2)
se_correct = np.sqrt(sigma2 / ((X_hat - X_hat.mean()) ** 2).sum())

# 4. ライブラリ(linearmodels)による 2SLS
iv_res = IV2SLS.from_formula('Y ~ 1 + [X ~ W]', data=df).fit(cov_type='unadjusted')

print(f"第1段階:価格の係数 {first.params['W']:+.3f}、F統計量 {F_first:.1f}")
print(f"2SLS(手計算)  :係数 {b_hat:.3f}、第2段階の OLS の標準誤差 {second.bse['X_hat']:.3f}、正しい標準誤差 {se_correct:.3f}")
print(f"2SLS(linearmodels):係数 {iv_res.params['X']:.3f}、標準誤差 {iv_res.std_errors['X']:.3f}")
print(f"OLS             :係数 {ols.params['X']:.3f}、標準誤差 {ols.bse['X']:.3f}")
二段階最小二乗法を手計算とライブラリで実行し、標準誤差を比べています。
- 第1段階: 広告 df['X'] を操作変数 df['W'] で回帰し、予測値 first.fittedvalues を X_hat とします。F統計量 F_first は、操作変数が1つなので、価格の係数の 値 first.tvalues['W'] の2乗で計算しています。
- 第2段階: 売上を X_hat で回帰します。rename('X_hat') は、係数の名前を分かりやすくするためだけのものです。この回帰の係数 b_hat は 2SLS の推定値として正しいのですが、second.bse(OLS としての標準誤差)は、残差を X_hat で計算しているので誤りです。
- 正しい標準誤差: 残差 resid を本来の広告 df['X'] で計算し直し、自由度 T - 2 で割って sigma2 とします。それを の偏差の2乗和で割った平方根が se_correct で、コードの直前に示した式のとおりです。
- linearmodels: IV2SLS.from_formula の式 'Y ~ 1 + [X ~ W]' は、「Y を切片と X で説明し、X は W を操作変数とする内生変数」という意味です。角括弧の中に「内生変数 ~ 操作変数」を書きます。cov_type='unadjusted' は、誤差の分散が一定と仮定した通常の標準誤差で、手計算の se_correct と同じ仮定です(分散が一定でない場合は 'robust' を使います)。ライブラリは内部で、第1段階・第2段階と、本来の を使った残差の計算をまとめて行っています。
実行結果
第1段階:価格の係数 -2.087、F統計量 141.8
2SLS(手計算)  :係数 0.352、第2段階の OLS の標準誤差 0.126、正しい標準誤差 0.098
2SLS(linearmodels):係数 0.352、標準誤差 0.098
OLS             :係数 1.167、標準誤差 0.028
- 係数は3つとも一致: 手計算の 2SLS、linearmodels の IV2SLS、共分散の比による IV推定量は、どれも 0.352 です。操作変数が1つのときは、2SLS と IV推定量が同じになることが確かめられました。第1段階の F統計量は 141.8 で、操作変数は十分に強いと言えます。
- 第2段階の OLS の標準誤差は誤り: 第2段階をそのまま OLS として扱った標準誤差は 0.126 で、正しい標準誤差 0.098 と一致しません。正しい値は linearmodels の結果(0.098)と一致します。この例では誤った標準誤差の方が大きくなりましたが、どちらにずれるかはデータによります。2SLS を手で計算するときは、係数だけを使い、標準誤差はライブラリで計算するのが安全です。
- IV は精度を犠牲にする: IV の標準誤差 0.098 は、OLS の 0.028 の約3.5倍です。IV は広告の変動のうち「価格で動いた部分」しか使わないので、使える情報が減り、推定のばらつきが大きくなります。OLS は精度は高いのですが、1.167 という間違った値の周りに集中しています。偏りのない推定のために、精度を手放しているわけです。
推定値と標準誤差を並べると、次のようになります。
(図は、diagram-designで作成)
弱い操作変数の問題
第1段階のF統計量
操作変数が広告の出稿量をほとんど動かさない場合( が0に近い場合)、IV推定量の分母 が0に近くなります。0に近い数で割るので、推定値は大きくばらつき、さらに OLS の方向に偏る ことが知られています(Staiger & Stock, 1997)。こうした操作変数を 弱い操作変数(weak instrument)と呼びます。
操作変数の強さは、第1段階の F統計量で確かめます。経験則として、F統計量が10を下回る と弱い操作変数を疑います(Staiger & Stock, 1997)。 データの共分散は、真の共分散にサンプルのばらつきが加わったものです。IV推定量の分母と分子をそれぞれ「真の値 + ばらつき」に分けると、 です。 は、真の値は0でも、サンプルではばらつきます。操作変数が強ければ分母が大きいので、この項は小さく抑えられます。 ところが、操作変数が弱いと、分母 は、真の値 よりも、ばらつきの部分の方が大きくなります。 のばらつきの部分には需要 が含まれ、 にも需要が含まれるので、分母のばらつきと分子のばらつきは、同じ向きに動きます。極端に弱い操作変数では、分母も分子も「需要を通じたばらつき」でほぼ決まるので、その比は 、つまり OLS の偏りに近づきます。補足:なぜ弱い操作変数は OLS の方向に偏るのか
シミュレーション:操作変数の強さを変える
価格が広告を動かす強さ (pi1)を、(強い)、(弱い)、(とても弱い)の3通りに変え、それぞれ1,000回データを作り直して IV推定量と第1段階の F統計量を計算します。推定値の分布を、真の値(0.3)と OLS の典型的な値と比べます。
# 1. 操作変数の強さを3通りに変え、それぞれ 1,000 回データを作り直す
strengths = {'強い(π1 = -2.0)': -2.0, '弱い(π1 = -0.5)': -0.5, 'とても弱い(π1 = -0.1)': -0.1}
n_rep = 1000
results = {}
for name, p in strengths.items():
    est, F, est_ols = [], [], []
    for r in range(n_rep):
        d = make_data(pi1=p, seed=1000 + r)
        est.append(cov(d['W'], d['Y']) / cov(d['W'], d['X']))
        F.append(sm.OLS(d['X'], sm.add_constant(d['W'])).fit().tvalues['W'] ** 2)
        est_ols.append(cov(d['X'], d['Y']) / d['X'].var())
    results[name] = (np.array(est), np.array(F), np.array(est_ols))

# 2. 推定値の中央値・5〜95%点と、F統計量の中央値
for name, (est, F, est_ols) in results.items():
    lo, hi = np.percentile(est, [5, 95])
    print(f"{name}: IV推定値の中央値 {np.median(est):+.3f}(5〜95%点 {lo:+.2f} 〜 {hi:+.2f})、"
          f"F統計量の中央値 {np.median(F):6.1f}、OLS の中央値 {np.median(est_ols):.3f}")

# 3. 推定値の分布を描く(見やすさのため -1.5〜3.0 の範囲だけを表示)
fig, axes = plt.subplots(1, 3, figsize=(13, 3.8), sharey=True)
for ax, (name, (est, F, est_ols)) in zip(axes, results.items()):
    ax.hist(np.clip(est, -1.5, 3.0), bins=np.linspace(-1.5, 3.0, 46), color='C0', alpha=0.8)
    ax.axvline(beta_true, color='black', linestyle='--', label='真の値 0.3')
    ax.axvline(np.median(est_ols), color='C3', linestyle=':', label='OLS の中央値')
    ax.set_title(f"{name}\nF統計量の中央値 {np.median(F):.1f}")
    ax.set_xlabel('IV推定値')
axes[0].set_ylabel('回数(1,000回中)')
axes[0].legend(fontsize=9)
plt.tight_layout()
plt.show()
操作変数の強さを変えて、IV推定量の分布がどう変わるかを調べています。
- 繰り返し: 辞書 strengths の3通りの pi1 について、make_data(pi1=p, seed=1000 + r) でシードを変えながら1,000回データを作り直します。シードを1000から始めているのは、最初の節のデータ(seed=42)と重ならないようにするためです。
- 推定: 毎回、共分散の比で IV推定値を、第1段階の 値の2乗で F統計量を、cov(d['X'], d['Y']) / d['X'].var() で OLS の推定値を計算しています。OLS の値は、IV推定値がどちらの方向に偏るかを比べるための目安です。
- 集計: np.percentile(est, [5, 95]) で推定値の5%点と95%点を求めます。弱い操作変数の推定値は極端な値をとることがあり、平均は外れ値に振り回されるので、中央値で比べています。
- 可視化: np.clip で、−1.5〜3.0 の範囲の外の値を両端に寄せてからヒストグラムを描いています。黒の破線が真の値、赤の点線が OLS の中央値です。
実行結果
強い(π1 = -2.0): IV推定値の中央値 +0.301(5〜95%点 +0.08 〜 +0.48)、F統計量の中央値  123.0、OLS の中央値 1.223
弱い(π1 = -0.5): IV推定値の中央値 +0.307(5〜95%点 -1.35 〜 +0.82)、F統計量の中央値    7.7、OLS の中央値 1.433
とても弱い(π1 = -0.1): IV推定値の中央値 +1.102(5〜95%点 -4.53 〜 +6.21)、F統計量の中央値    0.6、OLS の中央値 1.449
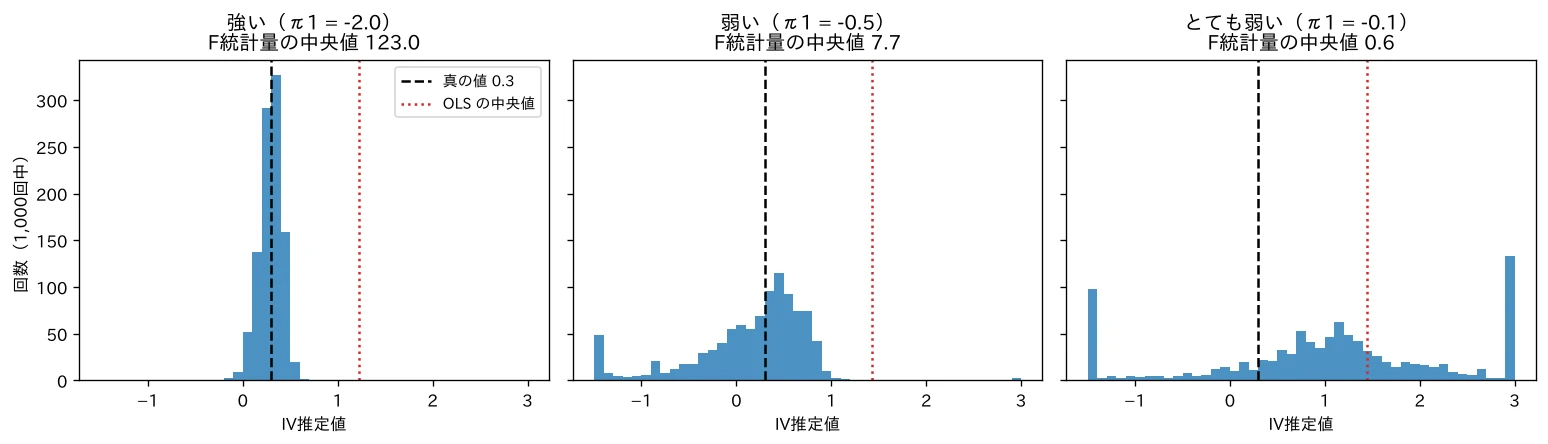
- 強い操作変数(F統計量の中央値 123): 推定値は真の値 0.3 の周りに集まり、90%が 0.08〜0.48 に収まります。
- 弱い操作変数(F統計量の中央値 7.7): 中央値は 0.307 と真の値に近いままですが、5〜95%点は −1.35〜0.82 と大きく広がりました。1回の分析で得られる推定値は、効果がマイナスに見えることも珍しくありません。F統計量の中央値は10を下回っており、目安どおり「弱い」と判定できます。
- とても弱い操作変数(F統計量の中央値 0.6): 推定値は −4.5〜6.2 にばらつき、中央値は 1.10 と、真の値 0.3 より OLS の中央値 1.45 に近くなりました。操作変数がほとんど広告を動かさないと、IV推定量は「需要を通じたばらつき」の比になり、OLS と同じ方向に偏ります。図の両端の棒は、−1.5〜3.0 の範囲を超えた推定値で、極端な値が頻繁に出ていることが分かります。
弱い操作変数では、推定値がばらつくだけでなく、標準誤差や信頼区間も当てにならなくなります。第1段階の F統計量は、必ず推定値と一緒に報告します。
除外制約が崩れると何が起きるか
操作変数のもう1つの落とし穴が、除外制約の崩れです。たとえば、広告オークションの価格が上がるのは、競合が大規模なセールをしている時期かもしれません。そうであれば、価格の上昇は、広告を通さずに直接、自社の売上を下げます。
価格 が売上にも直接 だけ効く場合(kappa)、共分散の比の分子に が加わります。 なので、IV推定量は次の値に収束します。
詳細な式展開(除外制約が崩れたときに IV推定量が収束する値)
ダミーデータの生成式に、価格が売上に直接効く項 を加えたモデルを考えます。
価格 は、需要 とも、ノイズ とも独立に生成しているので(独立性の条件は成り立っている)、 です。
分母 : の式を代入し、共分散を項ごとに分けます(定数 は共分散に影響せず、定数倍は外に出ます。2SLS の折りたたみで使った性質です)。
自分自身との共分散は分散なので、 です。
分子 : の式を代入して、同じように項ごとに分けます。
除外制約が成り立つ()なら、分子は だけになり、共分散の比で がそのまま取り出せました。 だと、価格が売上を直接動かす分 が、分子に余分に加わります。
比をとる:分子を分母で割ると、
となります。IV推定量 は、この比の共分散をデータから計算した値 で置き換えたものです。データの数 が大きくなると、データから計算した共分散は真の共分散に近づくので、 も に近づきます。矢印 は、この「データが増えるにつれて、その値に近づく」(確率収束する)ことを表しています。
たとえば、後のシミュレーションの 、 では、 です。同じ でも なら になり、偏りは4倍になります。 が分母にあるので、操作変数が弱いほど、同じ大きさの崩れが大きな偏りになるわけです。
偏りは です。競合のセールで価格が上がり、売上が下がる例では 、 なので、偏りは正になり、広告の効果を過大に推定します。操作変数が弱い( が小さい)ほど、除外制約のわずかな崩れが大きな偏りになります。 シミュレーションで確かめます。
# 1. 除外制約の崩れ kappa と、操作変数の強さ pi1 を変えて、IV推定値の中央値を求める
rows = []
for p in [-2.0, -0.5]:
    for k in [0.0, -0.2, -0.5]:
        est = [cov(d['W'], d['Y']) / cov(d['W'], d['X'])
               for d in (make_data(pi1=p, kappa=k, seed=2000 + r) for r in range(n_rep))]
        rows.append({'π1(操作変数の強さ)': p, 'κ(売上への直接の効果)': k,
                     'IV推定値の中央値': np.median(est), '理論値 β + κ/π1': beta_true + k / p})

# 2. 表にまとめる
print(pd.DataFrame(rows).round(3).to_string(index=False))
除外制約の崩れの大きさと、操作変数の強さを変えて、IV推定値がどれだけずれるかを調べています。
- 条件の組み合わせ: 操作変数の強さ p(強い −2.0、弱い −0.5)と、価格が売上に直接効く強さ k(0、−0.2、−0.5)の6通りを試しています。make_data の kappa 引数で、売上の式に kappa * W の項が加わります。
- 繰り返し: ジェネレーター式 (make_data(...) for r in range(n_rep)) で1,000回分のデータを順に作り、それぞれの IV推定値をリスト内包表記で集めています。シードは2000から始め、前の節と重ならないようにしています。
- 理論値: コードの直前に示した式のとおり、beta_true + k / p を並べて表示し、シミュレーションの中央値と比べています。
実行結果
 π1(操作変数の強さ)  κ(売上への直接の効果)  IV推定値の中央値  理論値 β + κ/π1
        -2.0           0.0      0.301          0.30
        -2.0          -0.2      0.400          0.40
        -2.0          -0.5      0.551          0.55
        -0.5           0.0      0.307          0.30
        -0.5          -0.2      0.709          0.70
        -0.5          -0.5      1.302          1.30
- 理論値どおりにずれる: どの組み合わせでも、IV推定値の中央値は理論値 とほぼ一致しました。
- 強い操作変数では、ずれは小さめ: のとき、 でも推定値は 0.55 で、真の値 0.3 から 0.25 のずれです。
- 弱い操作変数では、ずれが大きい: のとき、同じ で推定値は 1.30 になり、OLS の推定値(1.167)よりも真の値から離れました。除外制約が崩れた弱い操作変数は、内生性を補正するどころか、OLS より悪い推定をもたらすことがあります。
は、価格の上昇が広告を通さずに売上を動かす強さで、データからは推定できません。操作変数を使うときは、「この変数が売上に直接効く経路はないか」を、ビジネスの仕組みに照らして検討する必要があります。
表の値を並べると、次のようになります。
(図は、diagram-designで作成)
広告の効果測定で使える操作変数と注意点
操作変数の候補
広告の効果測定で、操作変数の候補になるのは、広告の供給側の事情 で出稿量が動く変数です(内生性の記事でも紹介しました)。
- 広告オークションの価格の変動:本記事の例です。競合の入札や、媒体側の在庫の変化で価格が動くと、同じ予算で買える広告の量が変わります。
- 配信の障害や入稿ミス:システムの障害で広告が止まった期間や、入稿の遅れで配信が始まらなかった期間は、需要とは関係なく出稿量が動きます。
- 予算の上限に達するタイミング:日予算を使い切って配信が止まる時刻は、オークションの状況などの偶然で決まる部分があります。
- 実験のランダムな割り付け:広告を出す地域や顧客をランダムに選んだものの、実際に広告が届いたかどうかが顧客の行動で変わる場合、ランダムな割り付けそのものを操作変数にできます(「広告を見たこと」の効果を推定する場合)。
3つの条件を疑う
どの候補も、3つの条件を満たすとは限りません。
- 独立性:競合が入札を増やすのは、季節的に需要が高い時期かもしれません。そうであれば、価格の変動は需要 と相関し、独立性が崩れます。季節や曜日をコントロール変数として2SLSに加えることで、ある程度は対処できます。
- 除外制約:前の節で見たとおり、価格の上昇が競合のセールを通じて売上に直接効くなら、除外制約が崩れます。操作変数が弱いほど、その偏りは大きくなります。
- 関連性:F統計量で必ず確かめます。弱い操作変数では、推定値が大きくばらつき、OLS と同じ方向に偏ります。
Rossi (2014) は、マーケティングの実証研究で使われてきた操作変数の多くが、弱いか、除外制約が疑わしいことを指摘し、「操作変数法を使えば内生性が解決する」と考えることに警鐘を鳴らしています。操作変数法は、条件を満たす操作変数がある場合には強力ですが、その条件の大部分はデータで確かめられない、という点を忘れないことが大切です。
本記事のダミーデータでは、広告の効果 は全期間で同じでした。効果が状況によって違う場合、操作変数法で推定できるのは、操作変数によって出稿量が動いた場合の効果(局所平均処置効果、LATE)です(Imbens & Angrist, 1994)。たとえば、価格の変動で動くのは、入札の弱い、効果の小さい配信面の広告かもしれません。その場合、IV推定量は「価格の変動で増減した広告の効果」であり、広告全体の平均の効果とは限りません。
まとめ
本記事では、観察データの内生性に、実験をせずに対処する操作変数法を解説しました。
- 操作変数の3つの条件:広告の出稿量を動かし(関連性)、需要と無関係で(独立性)、広告を通してしか売上に影響しない(除外制約)変数を操作変数として使います。関連性はデータで確かめられますが、独立性と除外制約は確かめられません。
- 共分散の比と 2SLS:IV推定量は「価格が売上をどれだけ動かすか」を「価格が広告をどれだけ動かすか」で割ったもので、需要とは関係のない広告の変動だけから効果を推定します。2SLS でも同じ値になりますが、第2段階をそのまま OLS として扱うと標準誤差を誤ります。
- 弱い操作変数:操作変数が出稿量をほとんど動かさないと、推定値は大きくばらつき、OLS の方向に偏ります。第1段階の F統計量が10を下回るときは注意が必要です。
- 除外制約の崩れ:操作変数が売上にも直接効くと、推定値は だけずれます。操作変数が弱いほど、わずかな崩れが大きな偏りになります。
条件を満たす操作変数が見つからない場合もあります。「コピュラ補正とは?」の記事では、操作変数を使わずに、内生変数の分布の形を手がかりに内生性を補正する方法を扱います。
参考文献
- P. E. Rossi (2014). Even the Rich Can Make Themselves Poor: A Critical Examination of IV Methods in Marketing Applications. Marketing Science, 33(5), 655–672.
- D. Staiger, J. H. Stock (1997). Instrumental Variables Regression with Weak Instruments. Econometrica, 65(3), 557–586.
- G. W. Imbens, J. D. Angrist (1994). Identification and Estimation of Local Average Treatment Effects. Econometrica, 62(2), 467–475.
- K. Sheppard. linearmodels. GitHub.