傾向スコアによる逆確率重みづけ(IPTW)とは?
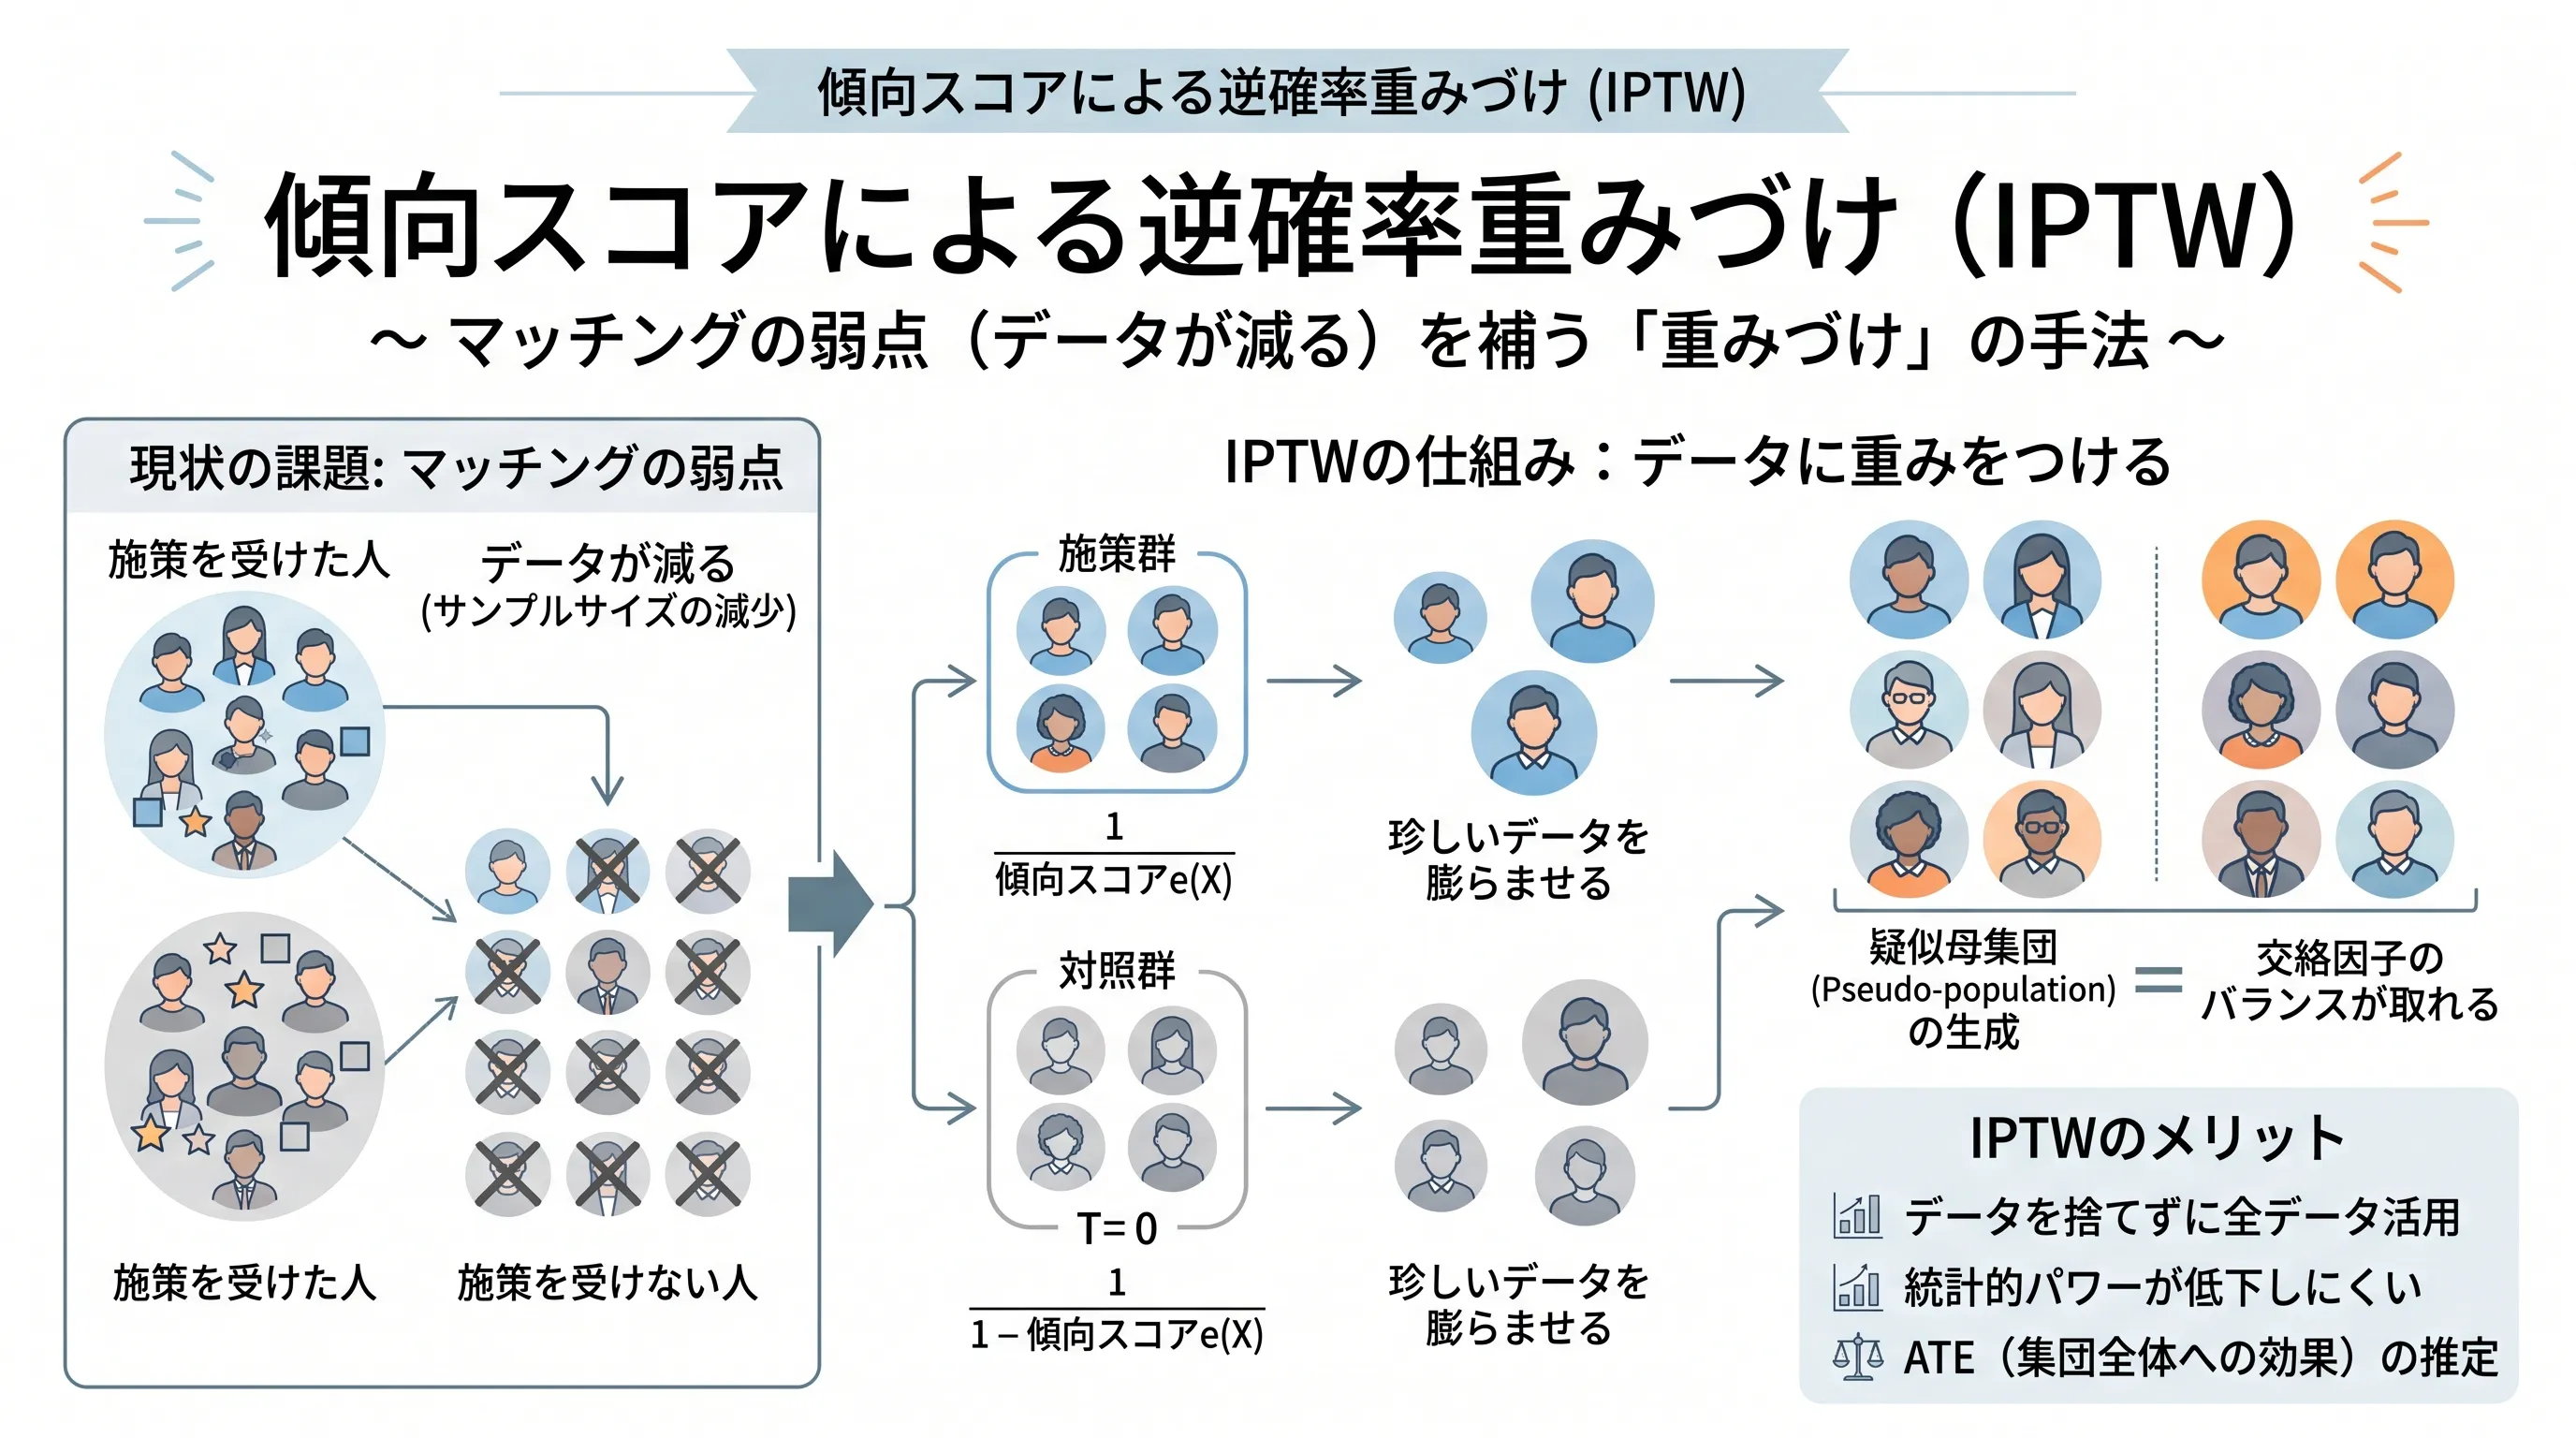 (画像は、Geminiで作成)
傾向スコアの逆数を重みにして、データを捨てずに「全員が施策を受けた(受けなかった)」疑似的な集団を作り、集団全体への効果(ATE)を推定する IPTW の考え方を理解すること。スクラッチ実装とライブラリで効果を推定し、傾向スコアが0や1に近いときの重みの暴れと対処法、PSM との使い分けを説明できるようになること。
傾向スコアによる逆確率重みづけ(IPTW)とは?
IPTW(Inverse Probability of Treatment Weighting)は、「施策を受ける確率(傾向スコア)」の逆数を各人の重みにして、観察データから施策の効果(集団全体への平均処置効果、ATE)を推定する手法 です。施策を受けやすい人ほど施策群に多く集まるという偏り(セレクションバイアス)を、重みで打ち消します。傾向スコアマッチング(PSM)のようにペアの見つからないデータを捨てないので、全員のデータを使って推定できます。傾向スコアそのものの定義と推定、共通台と SMD による確かめ方は、傾向スコアの記事で扱います。
この記事の読み方
目的に合わせて、次の節から読み始めてください。
| 知りたいこと | 読む節 |
|---|---|
| すぐに使ってみたい | 直後の「最短の使い方」(scikit-learn で ATE を推定する関数) |
| なぜ逆数の重みで偏りが消えるのか | ロジック:逆確率重みづけの数式と「疑似母集団」の考え方 |
| 1行ずつ実装して確かめたい | スクラッチでの実装 |
| 重みづけがうまくいったかの確かめ方 | 共変量バランスの確認(SMD)と有効サンプルサイズ(ESS) |
| 推定値の信頼区間 | ブートストラップ法による標準誤差の推定 |
| PSM とどちらを使うべきか | 使い分け:マッチング vs 重みづけ |
最短の使い方:scikit-learn で ATE を推定する
傾向スコアの推定から ATE の計算までを、1つの関数にまとめます。データは本文の「検証用ダミーデータの生成」と同じ作り方・同じ乱数の種で作るので、本文の結果と数値が一致します。
import numpy as np
import pandas as pd
from sklearn.linear_model import LogisticRegression

def iptw_ate(df, treatment, outcome, covariates):
    """傾向スコアの逆数を重みにして、平均処置効果(ATE)を推定する"""
    X = df[covariates]
    t = df[treatment].to_numpy()
    y = df[outcome].to_numpy()
    # (a) 傾向スコア e(X):共変量から「施策を受ける確率」を推定する
    e = LogisticRegression().fit(X, t).predict_proba(X)[:, 1]
    # (b) 重み:施策群は 1 / e(X)、対照群は 1 / (1 - e(X))
    w = np.where(t == 1, 1 / e, 1 / (1 - e))
    # (c) 重み付き平均の差:全員が施策を受けた場合と受けなかった場合の差
    treated = np.average(y[t == 1], weights=w[t == 1])
    control = np.average(y[t == 0], weights=w[t == 0])
    return treated - control

# 本文と同じダミーデータ(真の効果は +1500)
# 年齢と購買金額が高い人ほど DM が送られやすく、売上も高い
np.random.seed(42)
N = 2000
age = np.random.normal(40, 10, N)
history = np.random.exponential(5000, N)
logit_p = -3.0 + 0.05 * age + 0.0002 * history
treatment = np.random.binomial(1, 1 / (1 + np.exp(-logit_p)))
noise = np.random.normal(0, 1000, N)
sales = 2000 + 30 * age + 0.5 * history + 1500 * treatment + noise
df = pd.DataFrame({"age": age, "history": history,
                   "treatment": treatment, "sales": sales})

is_treated = df["treatment"] == 1
naive = df[is_treated]["sales"].mean() - df[~is_treated]["sales"].mean()
ate = iptw_ate(df, "treatment", "sales", ["age", "history"])
print(f"単純な平均の差: {naive:.2f}")
print(f"IPTW による ATE: {ate:.2f}")
- iptw_ate(df, treatment, outcome, covariates): データフレームと、処置・目的変数・共変量の列名を引数で受け取ります。列名を変えれば、自分のデータにもそのまま使えます。
- (a) 傾向スコア: 共変量(年齢 age と過去の購買金額 history)から、施策を受ける確率 をロジスティック回帰で推定します。施策の有無を決めた要因を共変量に入れておくことが、IPTW で偏りを取り除くための前提です。
- (b) 重み: 施策を受けた人には 、受けなかった人には をかけます。「施策を受けにくいのに受けた人」ほど重みが大きくなり、施策群の中で少数派になっている人たちを、元の集団での割合まで水増しします。
- (c) 重み付き平均の差: 施策群と対照群それぞれで重み付き平均を取り、その差を ATE とします。重みの合計で割る形(np.average)にしているので、重みの合計が人数とずれても平均が崩れません。
- データ: 年齢と購買金額が高い人ほど DM(施策)が送られやすく、売上も高くなるように作っています。真の効果は +1500 で、単純な平均の差がどれだけ偏るかと、IPTW でどこまで戻せるかを比べられます。
実行結果
単純な平均の差: 3303.11
IPTW による ATE: 1451.11
CPU で数秒で終わります。単純な平均の差は 3303.11 で、真の効果 1500 の2倍以上に過大評価されています。もともと売上が高くなりやすい人(年齢や購買金額が高い人)に DM が多く送られているためです。IPTW で重みをかけると 1451.11 になり、真の効果に近づきました。
ただし、推定値が出ただけでは、重みづけがうまくいったかは分かりません。実務では、重みをかけた後に共変量の偏りが消えているか(SMD)、一部の人に重みが集中していないか(ESS)、推定値の信頼区間はどれくらいか(ブートストラップ)を必ず確かめます。本文では、この3つを順に確かめます。
PSMとの違い:データを捨てずに重みをかける
傾向スコアマッチング(PSM)の記事では、セレクションバイアスを取り除き、施策の「真の効果」を測るための代表的な手法として、傾向スコアマッチングを解説しました。
傾向スコアマッチングは、傾向スコア(施策を受ける確率)が近いユーザー同士をペアにして比較するという、非常に直感的で説明しやすい手法です。
しかし、マッチングを行うためにキャリパー(許容距離)を設定すると、ペア相手が見つからなかったデータは分析から除外されてしまいます。これによって統計的なパワーが低下したり、最終的に残ったペアが「元の集団全体」を代表していない偏った集団になってしまうリスクがあります。
この弱点を克服するために用いられるもう1つの強力な手法が、傾向スコアによる逆確率重みづけ(IPTW: Inverse Probability of Treatment Weighting)です。
IPTWは、マッチングのようにペアを探してデータを捨てることはしません。その代わり、傾向スコアを用いて全員のデータに「重み(ウェイト)」をかけます。この重み付けによって、背景要因(交絡因子)のバランスが取れた仮想的な集団を作り出し、バイアスを調整します。
2つの手法のデータの扱い方の違いを図にすると、次のようになります(円の大きさは説明用です)。
(図は、diagram-designで作成)
ロジック:逆確率重みづけの数式と「疑似母集団」の考え方
IPTWのメカニズムを理解するために、「逆確率」という言葉の意味と「疑似母集団(Pseudo-population)」の概念を紐解いていきましょう。
傾向スコアの逆数をウェイトにする数式
あるユーザー が、自身の持つ特徴量(共変量 )に基づいて施策を受ける確率を、傾向スコア とします。
IPTWでは、各ユーザーが実際に受けた処置(施策の有無)の「確率の逆数」を、そのユーザーの重み として計算します。
施策を受けたグループ(処置群:)の重み:
施策を受けなかったグループ(対照群:)の重み:
なぜ「逆数」をかけるのか?(疑似母集団生成)
なぜ逆数をかけることでバイアスが消えるのでしょうか?ここでは仕組みを掴むために、説明用に単純化した架空の例を考えます。「元々購買意欲が高く、80%の確率でDM(施策)が送られる層(A層、)」と、「購買意欲が低く、20%の確率でしかDMが送られない層(B層、)」の2種類の人だけがいる世界を想定してください。
ここでの80%・20%は「全体のうち何%が施策を受けたか」ではなく、その層に属する個人がDMを受け取る確率(傾向スコア) である点に注意してください。したがって内訳は、A層では80%が施策あり・20%が施策なし、B層では20%が施策あり・80%が施策なし、となります。
施策を受けたグループ(処置群)の中で:
- A層で施策を受けた人(その層の80%)には、重み をかけます。これにより「80%しかいなかった施策を受けた人」を1.25倍に引き伸ばし、「A層の100%(全員)が施策を受けたと仮定した状態」を復元します。
- B層で施策を受けた人(その層のわずか20%)には、重み をかけます。これにより「20%しかいなかった施策を受けた人」を5倍に膨らませ、「B層の100%(全員)が施策を受けたと仮定した状態」を復元します。
施策を受けなかったグループ(対照群)の中で:
- A層で施策を受けなかった人(その層のわずか20%)には、重み をかけます。これにより「20%しかいなかった施策を受けなかった人」を5倍に膨らませ、「A層の100%(全員)が施策を受けなかったと仮定した状態」を復元します。
- B層で施策を受けなかった人(その層の80%)には、重み をかけます。これにより「80%しかいなかった施策を受けなかった人」を1.25倍に引き伸ばし、「B層の100%(全員)が施策を受けなかったと仮定した状態」を復元します。
表にまとめると、4つのケースは次のように対応しています。
| 施策を受けた人(処置群) | 施策を受けなかった人(対照群) | |
|---|---|---|
| A層() | 層の80% → 重み | 層の20% → 重み |
| B層() | 層の20% → 重み | 層の80% → 重み |
このように「珍しい結果になった人(傾向スコアと逆の行動をとった人)」のデータを大きく膨らませ(重みを重くし)、「順当な結果になった人」の重みを小さくするのがIPTWの仕組みです。
なお、A層・B層という区切りはあくまで説明のための単純化です。実際の分析では傾向スコアは 0.13、0.47、0.82 …… のようにユーザーごとに異なる連続値を取り、「層」という単位は存在しません(本記事で後述するダミーデータも、ロジスティックモデルから連続値の傾向スコアが生成されます)。とはいえ重みの計算式は変わらず、各ユーザー に対してその人自身の を使い、 または を割り当てるだけです。上の例は、その計算を「同じスコアを持つ人をまとめて見るとどうなるか」という形で可視化したものと捉えてください。
この重み付けにより、元のデータは、「全員が施策を受けた仮想的な集団」と「全員が施策を受けなかった仮想的な集団」の2つの疑似母集団(Pseudo-population)に変換されます。この仮想集団の間では交絡因子の分布が(大標本のもとで期待的に)バランスするため、単純な平均の差を計算することで、集団全体における施策の平均処置効果(ATE: Average Treatment Effect)を推定できるようになります。
A層・B層を10人ずつにして、重みのかかり方を図にすると、次のようになります。
(図は、diagram-designで作成)
検証用ダミーデータの生成
今回は、PSM の記事と全く同じデータ生成プロセスを用いてダミーデータを作成します。「年齢(Age)」と「過去の購買金額(History)」が高い人ほどDM(施策)が送られやすく、かつ売上も高くなりやすいというセレクションバイアスを含んだデータです。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import japanize_matplotlib

np.random.seed(42)

# データサイズの指定
N = 2000

# 1. 交絡因子(特徴量)の生成
# age: 年齢 (20〜60), history: 過去の購買金額
age = np.random.normal(40, 10, N)
history = np.random.exponential(5000, N)

# 2. 施策割り当て(セレクションバイアスの導入)
logit_p = -3.0 + 0.05 * age + 0.0002 * history
propensity = 1 / (1 + np.exp(-logit_p))

# 確率に基づいて施策群(1)と対照群(0)を割り当て
treatment = np.random.binomial(1, propensity)

# 3. 目的変数(売上)の生成
# 真の施策効果(True Effect)を +1500 とする
true_effect = 1500
sales = 2000 + 30 * age + 0.5 * history + true_effect * treatment + np.random.normal(0, 1000, N)

# データフレームの作成
df = pd.DataFrame({
    'age': age,
    'history': history,
    'treatment': treatment,
    'sales': sales
})

# 施策群と対照群の単純な平均の比較
print("単純比較での売上の差:", df[df['treatment'] == 1]['sales'].mean() - df[df['treatment'] == 0]['sales'].mean())
このダミーデータは、以下の数式(データ生成プロセス)に基づいています。
① 目的変数(売上)の生成
私たちが最終的に知りたいのは、この式にある (施策による真の効果)です。しかし、売上には「年齢」や「購買金額」といった要素(交絡因子)も同時に影響を与えています。
② 交絡因子の生成
(※ 数学的な慣例では指数分布を と率パラメータ で表記しますが、本記事ではPython(numpy)の実装パラメータと対応させるため、平均値を示す scale=5000( に相当)として明記しています。)
③ 施策割り当て(セレクションバイアスの導入)
年齢と購買金額が高い顧客ほど DM を受け取りやすく、売上も高くなるデータを作り、単純な比較で効果がどれだけずれるかを確かめるコードです。
- 交絡因子: 年齢 age は平均40・標準偏差10の正規分布、過去の購買金額 history は平均5,000の指数分布から作ります。購買金額を指数分布にするのは、少額の顧客が多く、ごく一部に高額の顧客がいる、右に裾の長い分布にするためです。
- 施策の割り当て: 年齢と購買金額が高いほど、DM を受け取る確率(傾向スコア)が上がるようにしています。切片の は、全体の約半分(48%)が施策を受ける水準です。傾向スコアは0.08〜0.998の範囲にばらつき、施策を受けやすさが顧客によって大きく違う状況になります。
- 売上: 年齢と購買金額は、売上も押し上げます。施策の割り当てと売上の両方に影響するので、交絡因子になります。真の効果1500は、誤差(標準偏差1000)より大きく、推定値と比べやすい値です。
- 単純比較: 施策群と対照群の売上の平均の差を表示し、交絡によって効果がどれだけ過大になるかを確かめます。
- 乱数: np.random.seed(42) で固定しているので、PSM の記事と同じデータになります。
実行結果
単純比較での売上の差: 3303.112367632807
真の効果は 1500 ですが、年齢や購買履歴による底上げが影響し、単純比較では 3303 と大きく過大評価されています。これをIPTWを使って補正します。
スクラッチでの実装(IPTWによる効果算出)
Pythonを用いて、ロジスティック回帰による傾向スコアの算出と、IPTW(逆確率重みづけ)の計算をスクラッチで実装してみましょう。
from sklearn.linear_model import LogisticRegression
import seaborn as sns

# 1. ロジスティック回帰で傾向スコアを算出
X = df[['age', 'history']]
y = df['treatment']

# モデルの学習
model = LogisticRegression()
model.fit(X, y)

# 傾向スコア(施策を受ける確率 e(X))の予測
e_X = model.predict_proba(X)[:, 1]
df['propensity_score'] = e_X

# 2. IPTW(逆確率重み)の計算
# 施策群(T=1)の重み: 1 / e(X)
# 対照群(T=0)の重み: 1 / (1 - e(X))
df['weight'] = np.where(df['treatment'] == 1,
                        1 / df['propensity_score'],
                        1 / (1 - df['propensity_score']))

# 3. 重み付き加重平均による効果の算出(ATEの推定)
# 施策群の重み付き平均
treated_weighted_mean = np.average(df[df['treatment'] == 1]['sales'],
                                   weights=df[df['treatment'] == 1]['weight'])

# 対照群の重み付き平均
control_weighted_mean = np.average(df[df['treatment'] == 0]['sales'],
                                   weights=df[df['treatment'] == 0]['weight'])

# ATE(平均処置効果)
iptw_ate = treated_weighted_mean - control_weighted_mean

print(f"IPTWによる推定効果 (ATE): {iptw_ate:.2f}")

# --- (参考) 重みの分布の可視化 ---
plt.figure(figsize=(8, 5))
sns.histplot(data=df, x='weight', hue='treatment', bins=50, kde=True)
plt.title("計算された逆確率重み (Weight) の分布")
plt.xlabel("Weight")
plt.ylabel("Count")
plt.show()
- 重みの計算: np.where を使い、数式の通り施策群には 1 / e(X) を、対照群には 1 / (1 - e(X)) を計算して weight 列として付与しています。
- 加重平均の算出: np.average(..., weights=...) を用いて、算出した重みに基づく加重平均を施策群・対照群のそれぞれで計算します。ペアリングをして一部のデータを捨てるのではなく、すべてのデータを使って計算しています。
- ATEの導出: 重み付き平均の差分をとることで、バイアスが除去された集団全体に対する平均処置効果(ATE)が得られます。重みの分布を描くのは、極端に大きな重みがないかを確かめるためです(後の節で扱います)。
ここで計算しているATE(平均処置効果)の根本的な定義は、全員が施策を受けた場合の結果 と、全員が受けなかった場合の結果 の期待値の差として、以下の式で表されます。
IPTWでは、観察データからこの値を推定するために、以下の数式(正規化されたIPTW推定量)を用いて計算しています。
なぜこのような分数(割り算)の式になるのか? この式の構造は、実はシンプルに「重み付き平均(加重平均)の引き算」を行っているだけです。
- 左側の項(処置群の重み付き平均): 分子 は、施策を受けた人の売上()にそれぞれの重みを掛けて足し合わせた「売上の重み付き合計」です。 分母 は、「重みそのものの合計」です。 合計を重みの合計で割ることで、施策を受けたグループが元の集団全体(100%)だった場合の「平均売上( の推定値)」を正しく算出しています。
- 右側の項(対照群の重み付き平均): 同様に、施策を受けなかった人の「売上の重み付き合計」を「重みの合計」で割り、元の集団全体が施策を受けなかった場合の「平均売上( の推定値)」を算出しています。
この計算によって、交絡因子の偏りを調整した仮想的な疑似母集団における と をそれぞれ求め、その差分をとることで ATE を導き出しています。Pythonのコード上で np.average(..., weights=...) を用いているのも、まさにこの「重み付き平均」を計算するためです。 (※ は目的変数の値、 は処置の有無、 は傾向スコアを表します。)
実行結果
IPTWによる推定効果 (ATE): 1451.11

結果として、真の効果である 1500 に非常に近い値が推定できました。マッチングのようにデータを捨てることなく、全データを利用してバイアスを取り除くことに成功しています。
重み付けによる共変量バランスの確認(SMD)
そもそも、なぜ交絡因子のバランスを取る必要があるのでしょうか。今回のデータでは、年齢が高く過去の購買金額が大きい人ほどDMが送られやすくなっています。つまり処置群には「元々よく買う優良顧客」が偏って集まり、対照群には「元々あまり買わない人」が偏っています。この2群をそのまま比べると、得られる差はDMの効果と「元々の購買力の差」が混ざったものになってしまいます。
実際、単純比較での差は 3303 と、真の効果 1500 の2倍以上に膨らんでいました。上乗せされた約1800円は、DMを送ったから生まれた売上ではなく、「そもそもDMを送りたくなるような顧客だったから」生じた差です。これを見て「DMには3300円の効果がある」と判断してしまうと、施策の費用対効果を大幅に見誤り、本来は投資すべきでない施策に予算を投じることになりかねません。
この誤りを避けるには、年齢や購買履歴が同じ条件の人同士を比較している状態を作る必要があります。IPTWはそれを重み付けによって実現する手法ですが、「重みをかけたから当然バランスしているはず」と信じ込むのは危険です。傾向スコアのモデルが誤っていれば(必要な共変量が抜けている、非線形性を捉えられていない等)、重み付け後も偏りが残り、推定値にバイアスが残ります。そこで、重み付けが意図通りに機能したかを数値で検証する工程が必要になります。
本当にバイアスが取り除けたのか(交絡因子の分布が均衡したか)を確認するためには、標準化平均差(SMD: Standardized Mean Difference) を用います。IPTWの標準的な診断では、「重み付け前」と「重み付け後(加重平均)」のSMDを比較します。
SMDは、処置群と対照群における共変量の平均の差を、2群の分散をプールした標準偏差で割った値として定義されます。
( は処置群・対照群における共変量の平均、 はそれぞれの分散)
無次元でサンプルサイズにも依存しないため、スケールの異なる共変量を横並びで比較でき、慣例的に をバランスの目安とします。
定義の詳細(なぜp値ではなくSMDを使うのか、0.1という基準の意味)は、RCTの記事「標準化平均差(SMD)による評価」で解説しています。
IPTWでは、この定義式の平均と分散を、逆確率重み で加重したものに置き換えて用います(Austin & Stuart, 2015)。
ここで、各群 の重み付き平均と重み付き分散は次のように定義されます。
分散の分母が単純な ではなく複雑な形をしているのは、重み付きの場合の不偏分散にするための補正です。重みがすべて 1 のとき、この式は通常の不偏分散 に一致します。
今回のデータについて、実際にこの計算をPythonで実装してSMDを確認してみましょう。
def weighted_var(x, w):
    """Austin & Stuart (2015) に基づく重み付き分散"""
    mean_w = np.average(x, weights=w)
    sum_w, sum_w2 = w.sum(), (w ** 2).sum()
    return np.sum(w * (x - mean_w) ** 2) / (sum_w - sum_w2 / sum_w)

def smd(x_t, x_c, w_t=None, w_c=None):
    """標準化平均差(SMD)。重みを与えると重み付きSMDを返す"""
    if w_t is None:
        # 重み付け前:通常の平均差とプールした分散
        mean_diff = x_t.mean() - x_c.mean()
        pooled_var = (x_t.var(ddof=1) + x_c.var(ddof=1)) / 2
    else:
        # 重み付け後:加重平均と重み付き分散に置き換える
        mean_diff = np.average(x_t, weights=w_t) - np.average(x_c, weights=w_c)
        pooled_var = (weighted_var(x_t, w_t) + weighted_var(x_c, w_c)) / 2
    return mean_diff / np.sqrt(pooled_var)

# 処置群・対照群に分割して、共変量ごとにSMDを算出
treated = df[df['treatment'] == 1]
control = df[df['treatment'] == 0]
covariates = ['age', 'history']

balance = pd.DataFrame([
    {
        '変数': v,
        '重み付け前のSMD': round(smd(treated[v].values, control[v].values), 4),
        '重み付け後のSMD': round(smd(treated[v].values, control[v].values,
                                     treated['weight'].values,
                                     control['weight'].values), 4),
    }
    for v in covariates
])
balance['判定 (|SMD| < 0.1)'] = np.where(balance['重み付け後のSMD'].abs() < 0.1, 'OK', 'NG')

print(balance.to_string(index=False))
- 重み付き分散の実装: weighted_var は上記の数式をそのまま実装したものです。np.average には weights 引数がありますが、分散には対応していないため自前で計算しています。
- 1つの関数で前後を両方計算: smd は重みを渡さなければ「重み付け前」、渡せば「重み付け後」を返します。分子の平均差と分母の分散をそれぞれ加重版に差し替えているだけで、式の構造は同じです。
- 判定基準: 因果推論の実務では が均衡の目安とされるため、判定列を付けて機械的に確認できるようにしています。
実行結果
     変数  重み付け前のSMD  重み付け後のSMD 判定 (|SMD| < 0.1)
    age     0.4088     0.0151               OK
history     0.7500     0.0044               OK
結果を見ると、重み付け前は 0.4 や 0.75 といった大きな偏り(バイアス)が存在していましたが、逆確率による重み付けを行った後はどちらの変数も 0.1 を大きく下回る 0.01 台にまで激減しています。これにより、交絡因子の分布が適切にバランスされた仮想集団(疑似母集団)が正しく生成された ことが数値として裏付けられました。
なお、同じデータに対してPSM記事で確認したマッチング後のSMDは 0.0269(age)、0.0364(history)でした。前提として、PSMは「実際に施策を受けた層(ATT)」をターゲットに調整しているのに対し、今回のIPTWは「集団全体(ATE)」をターゲットに重み付けしているため、厳密には対象としている仮想的な集団(推定対象)が異なります。その違いを踏まえた上でも、重み付け手法はデータを1件も捨てることなく、マッチド標本と同等以上の強い均衡を達成できていることが分かります。ただしこれは「重みのばらつき」という別のコストと引き換えであり、その代償は次節のESSで確認します。
重み付け前後の SMD を並べると、次のようになります。
(図は、diagram-designで作成)
深掘り: 実際の重みのばらつきと有効サンプルサイズ(ESS)
ヒストグラムの右裾が長く伸びていることからも分かるように、今回のダミーデータには実際に極端な重みを持つユーザーが存在しています。
IPTWは「データを捨てない」手法ではありますが、重みにばらつきがあることで実質的な情報量は目減りします。これを測る指標が 有効サンプルサイズ(ESS) です。
有効サンプルサイズは Kish (1965) による指標で、群 ごとに次のように定義されます。
分子は「重みの合計の2乗」、分母は「重みの2乗の合計」です。この式は、重みのばらつきが大きいほど値が小さくなる性質を持っています。
- すべての重みが等しい場合(): となり、実データ数と一致します。
- 重みにばらつきがある場合:常に となります。
なぜばらつきで目減りするのかは、重みの変動係数 を使って書き直すと明快です。
分母の は調査統計の分野で デザイン効果(design effect) と呼ばれる量です。重みが均一なら なので分母は 1、つまり目減りゼロ。ばらつきが大きいほど分母が膨らみ、実効的な情報量が削られていきます。
今回のダミーデータで実際に計算すると次のようになります。
# 傾向スコアと重みの範囲を確認
print(f"傾向スコアの範囲: {df['propensity_score'].min():.4f} 〜 {df['propensity_score'].max():.4f}")
print(f"重みの範囲: {df['weight'].min():.4f} 〜 {df['weight'].max():.4f}")
print(f"重み上位5件: {np.round(df['weight'].nlargest(5).values, 2)}")
print("-" * 50)

# 重みのばらつき(変動係数)とデザイン効果の確認
for label, g in [('処置群', df[df['treatment'] == 1]), ('対照群', df[df['treatment'] == 0])]:
    w = g['weight'].values
    ess = w.sum()**2 / (w**2).sum()
    cv = w.std(ddof=0) / w.mean()
    print(f"{label}: n={len(w)}, CV(w)={cv:.4f}, デザイン効果={1 + cv**2:.4f}, "
          f"ESS={ess:.1f} ({100 * (1 - ess / len(w)):.1f}%減)")
- スコアと重みの確認: Pandasの min() や max() メソッドを使用して傾向スコアと重みの範囲を確認し、nlargest(5) で極端な重みが存在するか上位5件を抽出して評価しています。
- 有効サンプルサイズの算出: 処置群・対照群のそれぞれに対して、Kishの数式である w.sum()2 / (w2).sum() を用いて有効サンプルサイズ(ESS)を算出しています。
- デザイン効果の算出: w.std(ddof=0) / w.mean() で重みの変動係数(CV)を求め、1 + cv**2 でデザイン効果を計算することで、重みのばらつきがどれだけ情報量を削っているのかを定量的に確認しています。
実行結果
傾向スコアの範囲: 0.0869 〜 0.9985
重みの範囲: 1.0015 〜 29.4308
重み上位5件: [29.43 19.07 16.98 13.25 13.18]
--------------------------------------------------
処置群: n=961, CV(w)=0.4579, デザイン効果=1.2096, ESS=794.4 (17.3%減)
対照群: n=1039, CV(w)=0.7842, デザイン効果=1.6150, ESS=643.4 (38.1%減)
傾向スコアが約0.966の対照群ユーザー1人が、重み「29.4(=約29人分)」として加重平均に強く影響しています()。つまり、2000件のデータの中でたった1件が29人分の影響力を持ってしまっている状態です。
対照群の重みの変動係数が処置群の約1.7倍あり、これがそのまま ESS の減少率の差(17.3% 対 38.1%)に表れています。実際、今回のデータで極端な重み(上位5件)を持っているのはすべて「本来は施策を受けやすい(傾向スコアが高い)のに、たまたま施策を受けなかった対照群のユーザー」でした。この極端な重みの影響で、対照群は実効的なサンプルサイズが約38%も目減りしていることが分かります。
人数と有効サンプルサイズを並べると、次のようになります。
(図は、diagram-designで作成)
深掘り: 信頼区間の算出(ブートストラップ法による標準誤差の推定)
これまでの計算では点推定値のみを求めましたが、実務においては「その推定値がどの程度信頼できるか(標準誤差や信頼区間)」を示す必要があります。
IPTWにおいて非常に重要な注意点として、通常の加重平均の標準誤差の公式をそのまま使うと誤った結果になります。なぜなら、傾向スコア自体が「推定された値」であり、かつ極端な重みのばらつきが存在するためです。そのため、IPTWの標準誤差を正しく評価するには、ロバスト標準誤差(サンドイッチ推定量)を用いるか、ブートストラップ法(リサンプリング) を用いる必要があります。
推定したい ATE を 、観測データから得た点推定値を とします。ブートストラップは、次の手順を 回(本記事では )繰り返します。
- 元データ 件から、復元抽出で 件のリサンプルを作る
- そのリサンプルに対して傾向スコアの推定からやり直し、重みを計算して ATE を求める →
こうして得られた 個の推定値 のばらつきが、 の標本分布の近似になります。
標準誤差(SE)は、この 個の標準偏差として求めます。
95%信頼区間は、 個の推定値を小さい順に並べ、下から 2.5% と 97.5% の位置にある値を取ります(パーセンタイル法)。
以下は、これらを実装して標準誤差と95%信頼区間を算出するPythonコードの例です。コード中の boot.std(ddof=1) が の式に、np.percentile(boot, [2.5, 97.5]) がパーセンタイル法にそれぞれ対応しています。
from sklearn.linear_model import LogisticRegression

def estimate_ate(data):
    # サンプルデータごとに傾向スコアを再学習・再計算
    m = LogisticRegression().fit(data[['age', 'history']], data['treatment'])
    p = m.predict_proba(data[['age', 'history']])[:, 1]

    # 重みの計算
    w = np.where(data['treatment'] == 1, 1 / p, 1 / (1 - p))
    t = data['treatment'] == 1

    # 加重平均の差分(ATE)を返す
    return np.average(data['sales'][t], weights=w[t]) - np.average(data['sales'][~t], weights=w[~t])

# 500回のブートストラップ・サンプリングを実行
rng = np.random.default_rng(0)
boot = np.array([estimate_ate(df.iloc[rng.integers(0, len(df), len(df))]) for _ in range(500)])

# 95%信頼区間と標準誤差の算出
lo, hi = np.percentile(boot, [2.5, 97.5])
print(f"ATE: {estimate_ate(df):.2f} / SE: {boot.std(ddof=1):.2f} / 95%CI: [{lo:.2f}, {hi:.2f}]")
- ATE推定関数の定義: リサンプリングのたびに傾向スコアの不確実性を正しく反映させるため、estimate_ate 関数内で毎回 LogisticRegression を初期化・学習させ、スコアと重みの再計算を行っています。
- ブートストラップサンプリングの実行: rng.integers(0, len(df), len(df)) を用いてインデックスの復元抽出を行い、df.iloc で作成したリサンプルデータに対して estimate_ate を500回実行し、ATEの推定値の分布を作成しています。500回にするのは、標準誤差と95%区間を安定して求められる回数で、傾向スコアのモデルを毎回学習し直しても、計算時間が数十秒以内で済むためです。
- 標準誤差と信頼区間の導出: ブートストラップ分布の標準偏差を boot.std(ddof=1) で計算し標準誤差(SE)としています。また、np.percentile(boot, [2.5, 97.5]) によってパーセンタイル法に基づく95%信頼区間を算出しています。
実行結果
ATE: 1451.11 / SE: 127.52 / 95%CI: [1198.10, 1706.56]
95%信頼区間が [1198.10, 1706.56] となり、真の効果である 1500 がしっかりと区間内に含まれていることが確認できます。
なお、この標準誤差 127.52 は、前節で確認した有効サンプルサイズ(ESS)の目減りを反映した値になっています。重みのばらつきが小さければ ESS は 2000 に近づき、標準誤差もその分小さくなります。「データを捨てないから精度が高い」とは限らず、重みの分布次第で実効的な精度は変わる、という点が IPTW を扱ううえでの勘所です。
手順2(モデルの再学習)が重要な理由 上記のコードでは estimate_ate 関数の中で毎回 LogisticRegression().fit(...) を呼び直しています。ここを「最初に推定した傾向スコアを使い回す(重み固定)」形にしてしまうと、傾向スコアの推定手順そのものが標準誤差の評価から欠落し、不正確な結果を招きます。実は、推定された傾向スコアを用いる場合、それを「既知(真のスコア)」として扱うと、IPTWの分散は過大評価される傾向にあります(Hirano, Imbens & Ridder (2003) 等)。実際に今回のデータで重みを固定してブートストラップを回すと標準誤差は約191.46となり、再学習版の127.52よりも不必要に区間が広がってしまうことが確認できます。正しくモデルを再学習する方が、妥当でタイトな標準誤差を得ることができます。
IPTWをはじめとする傾向スコアを用いた因果推論には、3つの大前提(強く無視できる割り当て・正値性・SUTVA)が必要です(詳細はPSMの記事を参照)。
IPTWを実行する際、方法論的に最も致命的な課題となるのが、この中の 正値性の仮定(すべてのユーザーに施策を受ける/受けない確率が0より大きく1より小さい確率で存在すること) が実務上どう問題化するか、つまり「極端な重み(extreme weights)」の扱いです。
傾向スコアが 0.001 や 0.999 のように極めて 0 や 1 に近いユーザーが存在すると、逆数をとった際に重みが 1000 などの異常に大きな値になってしまいます。PSMであればキャリパーで足切りして除外(マッチング不成立)できますが、IPTWは極端なスコアの個体もそのまま計算に含めてしまうため、少数のユーザーが加重平均の結果を大きく歪め、推定量が直接不安定になるという弱点があります。
実務では、この問題に対処するため、重みの最大値に上限を設ける「Weight truncation(重みの刈り込み)」や、重みのスケールを安定させる「Weight stabilization(重みの安定化)」といった手法が頻繁に用いられます。
ライブラリを用いた簡単な実装
PSMの記事でも紹介した causalinference ライブラリを使用すると、IPTWによる点推定を数行のコードで簡単に実行できます。
!pip install causalinference
from causalinference import CausalModel

# CausalModelの初期化
cm = CausalModel(
    Y=df['sales'].values,
    D=df['treatment'].values,
    X=df[['age', 'history']].values
)

# 傾向スコアの推定
cm.est_propensity_s()

# IPTWによる効果測定
cm.est_via_weighting()

# 結果の出力
print(cm.estimates)
- CausalModelクラスの初期化: causalinference の CausalModel クラスに、目的変数 Y(売上)、処置変数 D(施策の有無)、共変量 X(年齢と購買履歴)を配列で渡し、モデルを構築しています。
- 傾向スコアの推定: cm.est_propensity_s() メソッドを呼び出すことで、内部的に変数の選択やロジスティック回帰が行われ、自動的に傾向スコアが算出されます。
- 効果の測定と結果出力: cm.est_via_weighting() メソッドによってIPTW(逆確率重みづけ)の計算と加重平均に基づく効果推定が行われ、cm.estimates でサマリーを出力しています。
実行結果(抜粋)
Treatment Effect Estimates: Weighting

                     Est.       S.e.          z      P>|z|      [95% Conf. int.]
--------------------------------------------------------------------------------
           ATE   1483.408     56.580     26.218      0.000   1372.512   1594.305
スクラッチでの実装(1451.11)と近いATE(1483.408)が得られていますが、点推定値や出力された標準誤差(S.e. = 56.580)がスクラッチ版と異なる理由には注意が必要です。
実は causalinference ライブラリの est_via_weighting は、単なる重み付き平均(Hájek推定量)ではなく、重み付けに加えて共変量 による回帰調整も同時に行う加重最小二乗法(WLS:)を実行しています。つまり、そもそも推定量が異なるため、スクラッチ版と直接比較することはできません。回帰調整によって効率が上がる(分散が小さくなる)ため、標準誤差は56.580と非常に小さくなっています(HC0サンドイッチ分散が使われます)。このように重み付けと回帰調整を組み合わせた推定は、傾向スコアのモデルと回帰のモデルのどちらかが正しければ偏りなく推定できる「二重頑健性」を持ちます(詳しくは二重頑健推定(DR)の記事で解説しています)。 ただし、このライブラリが報告する標準誤差は「傾向スコアの推定に伴う不確実性」を織り込んでいないため、真のばらつき(モンテカルロ・シミュレーション等で確認すると約62.9)と比べるとわずかに楽観的(過小評価)になります。より厳密な標準誤差を求めたい場合や、純粋な重み付けのみの分散を知りたい場合は、前節のように自前でブートストラップ法を回すことが推奨されます。
使い分け:マッチング vs 重みづけ
これまで解説してきた「傾向スコアマッチング(PSM)」と「逆確率重みづけ(IPTW)」は、どちらも傾向スコアを用いてバイアスを調整する手法ですが、アプローチの違いから明確なメリットとデメリットが存在します。以下の表に、実務における使い分けのポイントをまとめました。
| 比較項目 | 傾向スコアマッチング(PSM) | 逆確率重みづけ(IPTW) |
|---|---|---|
| 基本ロジック | スコアが似た者同士の「ペア」を作り、ペア以外を捨てる | データを捨てず、全員のデータにスコアの逆数で「重み」をつける |
| データの活用効率 | 悪い(ペアが見つからないデータは破棄され、サンプルサイズが減る) | 良い(データ自体は破棄しないが、重みのばらつきに応じて実効サンプルサイズ(ESS)は減少する) |
| 算出される効果 | ATT(実際に施策を受けた人に対する効果)になりやすい | ATE(集団全員に対する効果)を算出できる。 ※既定ではATEだが、重みの定義(処置群を1、対照群を )次第でATTも推定可能 |
| ステークホルダーへの説明 | 容易(「条件の似た人を探して比べた」と直感的に言える) | 難しい(「逆確率の重みによる疑似母集団」の概念が必要) |
| 極端なスコアの影響 | キャリパー(許容距離)で足切りされるため、影響を受けにくい | 極端に 0 や 1 に近いスコアがあると、重みが爆発して結果が不安定になる(Weight stabilization/truncationの処理が必要) |
実務での選択基準
- 「説明責任」や「透明性」が重視される場合(PSMの出番): 経営層やクライアントなど、統計に明るくないステークホルダーに対して効果測定の結果を報告する場合、「条件が近い人同士を抽出して比較しました」と説明できるPSMが好まれる傾向にあります。マーケティング実務では、実際にキャンペーン対象となった層に対する効果(ATT)を知りたいケースが多く、PSMの性質がマッチします。
- 「データ活用効率」や「集団全体への効果」が重視される場合(IPTWの出番): データ量が少なく、マッチングによってデータを捨てる余裕がない場合や、疫学研究などで「この施策をもし集団全体に適用したらどうなるか(ATE)」というマクロな因果効果を厳密に推定したい場合はIPTWが力を発揮します。
まとめ
本記事では、傾向スコアマッチング(PSM)の「データが減少してしまう」という弱点を補う強力な手法として、傾向スコアによる逆確率重みづけ(IPTW) について解説しました。
重要なポイントは以下の通りです。
- 疑似母集団によるバイアス調整: IPTWはデータを捨てるのではなく、傾向スコアの逆数をウェイトとしてかけることで、「集団全員が施策を受けた(あるいは受けなかった)仮想的な状態」を復元し、交絡因子のバランスを取ります。
- 全データを用いたATEの算出: ペアリングから漏れたデータを直接破棄することはないため、全データを活用して集団全体に対する平均処置効果(ATE)を推定できます(ただし、極端な重みの影響で実効的な情報量は目減りする場合があります)。
- 極端な重みへの注意: 傾向スコアが極端に0や1に近いと重みが爆発し結果が不安定になるリスクがあるため、実務では重みの刈り込みなどの対処が必要です。
- PSMとの使い分け: ステークホルダーへの「説明のしやすさ(ATT)」を重視するならPSMを、「データの活用効率や集団全体への効果(ATE)」を重視するならIPTWを、というように目的に応じて手法を選択することが因果推論の実務において重要です。
正しい仮定を置き、データの特徴に合わせて適切な手法を使い分けることで、より精度の高い効果測定が実現できるようになります。
参考文献
- P. C. Austin, E. A. Stuart (2015). Moving towards best practice when using inverse probability of treatment weighting (IPTW) using the propensity score to estimate causal treatment effects in observational studies. Statistics in Medicine, 34(28), 3661–3679.
- K. Hirano, G. W. Imbens, G. Ridder (2003). Efficient Estimation of Average Treatment Effects Using the Estimated Propensity Score. Econometrica, 71(4), 1161–1189.
- L. Kish (1965). Survey Sampling. Wiley.
- L. Wong. causalinference: Causal Inference in Python. GitHub.
本記事の文章・構成の一部に生成AIを使用しています。