イェンセンの不等式とは?
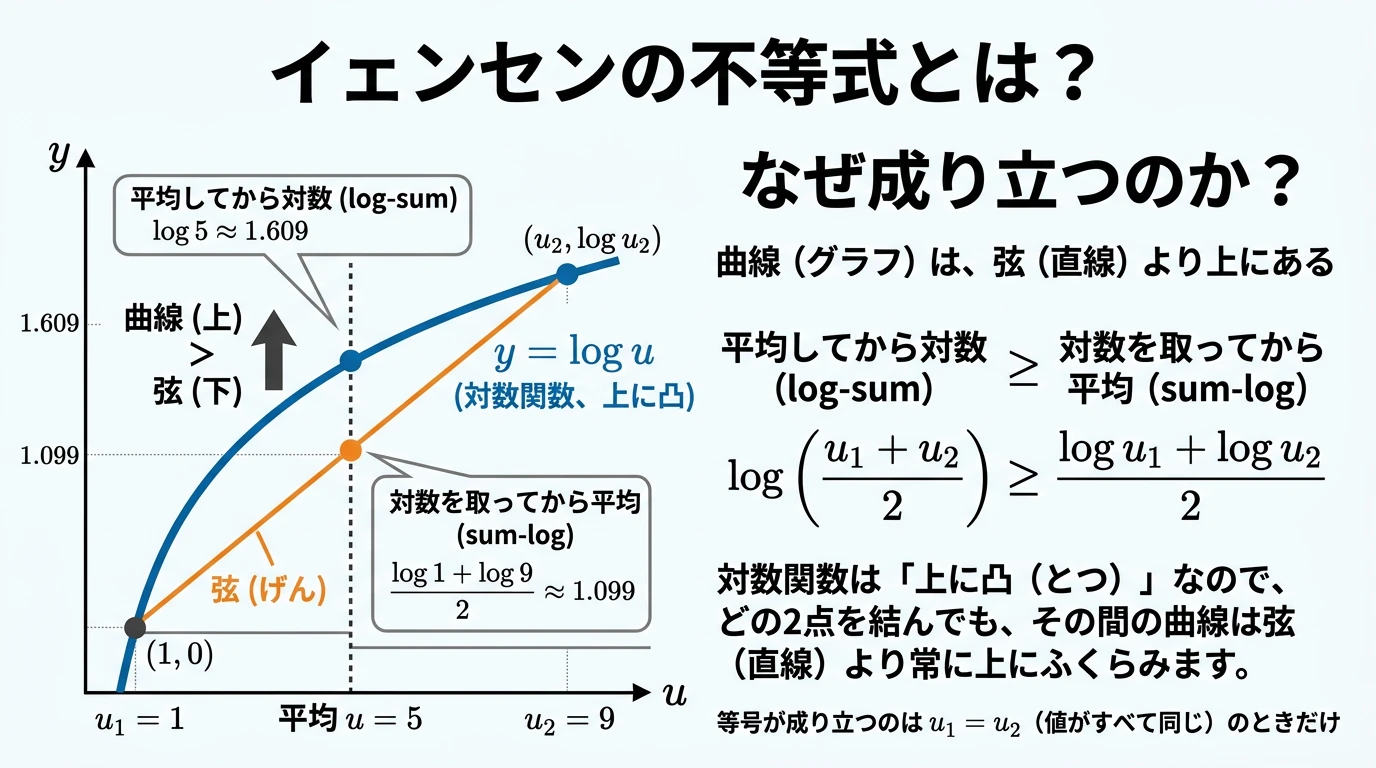 (画像は、Geminiで作成)
「平均してから対数を取った値(log-sum)は、対数を取ってから平均した値(sum-log)以上になる」というイェンセンの不等式が、なぜ成り立つのかを、対数関数のグラフで説明できるようになること。等号が成り立つ条件と、それが EM アルゴリズムの E-step にどうつながるかを理解すること。
概要
EMアルゴリズムの記事では、対数尤度が反復のたびに下がらないことを示すために、次の不等式を使いました。
これが イェンセンの不等式 です(Jensen, 1906)。 は正の値、 は合計が1の重みです。左辺は「 を重み で平均してから対数を取ったもの」、右辺は「 の対数を取ってから、同じ重みで平均したもの」で、違うのは、平均と対数のどちらを先にするかだけです。
EM アルゴリズムでこの不等式が役に立つのは、対数の中に和がある左辺は、パラメータで微分すると項どうしが絡み合って扱いにくい一方、和の中に対数がある右辺は、項ごとに別々に扱えるからです。扱いにくい左辺の代わりに、それを超えない右辺(下限)を大きくしていけば、左辺も押し上げられます。
本記事では、この不等式がなぜ成り立つのかを、対数関数のグラフを使って説明します。2点の場合から始めて、3点以上の場合、等号が成り立つ条件へと進み、最後に Python で数値を確かめます。
本記事のコードは、Python 3.13、NumPy 2.5.3、SciPy 1.18.1、matplotlib 3.11.2 で動作を確認しました。どのコードも CPU で数秒で終わります。乱数のシードを固定しているので、同じ環境では同じ結果になります。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google ColabやJupyterでは先頭の ! を付けたまま、ターミナルでは ! を外して実行します)。Python 3.12 以降で import 時にエラーが出る場合は、setuptools も一緒にインストールしてください。
!pip install japanize-matplotlib setuptools
2点の場合をグラフで見る
まず、 が2通りしかない場合を考えます。値を 、重みを と とすると、不等式は次のようになります。
具体的に、、、重みを ずつにして、両辺を計算してみます。
- 左辺(log-sum): 平均は なので、 です。
- 右辺(sum-log): 、 なので、その平均は です。
たしかに左辺のほうが大きくなりました。この2つの値を、対数関数 のグラフの上に描くと、次のようになります。
(図は、diagram-designで作成)
2つの値は、どちらも横軸の同じ位置(平均の )での高さです。
- 左辺は、曲線上の点の高さ: 横軸で先に平均を取って に移り、そこで曲線の高さ を読んだものです。
- 右辺は、弦の上の点の高さ: 曲線上の2点 と を結ぶ線分(弦)を引くと、弦の上の点は、両端の点を重み と で混ぜた位置にあります。横の位置が になる点では、高さも同じ重みで混ざって になります。直線の上では、横の位置と高さが同じ割合で動くからです。
つまり、イェンセンの不等式は「同じ横の位置では、曲線のほうが弦より上にある」と言い換えられます。
対数関数が「上に凸」だから、曲線は弦より上にある
グラフで見ると、 の曲線は、 が小さいところでは急に上がり、 が大きくなるにつれて傾きがゆるやかになる、山なりの形をしています。傾き(微分)は で、 が大きいほど小さくなります。
傾きがだんだん小さくなる曲線では、2点を結ぶ弦を引くと、その間の曲線は必ず弦より上にふくらみます。左端から出発すると、曲線は最初のうち弦より急な傾きで上がって弦の上に出て、後半はゆるやかになって右端で弦に追いつかれるからです。このように、どの2点の間でも曲線が弦より上にある関数を 上に凸(concave)と呼びます。式で書くと、どの とどの についても、次が成り立つことです。
これは、2点の場合のイェンセンの不等式そのものです。2点の場合のイェンセンの不等式は、「対数関数が上に凸である」ことを式で書いたものだと言えます。
相加平均と相乗平均の関係
2点の場合の不等式の両辺に を取ると、 は大小を変えないので、次のようになります。
左辺は重み付きの相加平均、右辺は重み付きの相乗平均です。 なら、高校で習う「相加平均 ≥ 相乗平均」 そのものです。上の例では、相加平均が 、相乗平均が で、sum-log の は、ちょうど に当たります。log-sum と sum-log の比較は、相加平均と相乗平均の比較を、対数の目盛りで見たものだと言えます。
3点以上でも成り立つ理由
EM アルゴリズムの下限では、 が3通り以上の場合も使います。3点の場合を、2点の場合を2回使って確かめます。重みを (合計1)とし、 とします。
まず、2点目と3点目だけを、重みを足して1になるように正規化した重み と で平均した値を とします。
すると、3点の平均は「 と を、重み と で平均したもの」と書き直せます。
これに2点の場合の不等式を、2回使います。
3点の場合も成り立ちました。4点以上でも、同じように「1点と、残りの点の平均」の2点に分けることを繰り返せば成り立ちます(数学的帰納法)。
グラフで言えば、曲線上の点をいくつ取っても、それらを重みで混ぜた点(重心)は、点を結んだ多角形の内側にあり、その多角形は曲線の下にあります。重心の横の位置での曲線の高さ(左辺)は、重心の高さ(右辺)以上になる、ということです。
重み を確率分布と見ると、 は、 が分布 に従うときの の期待値 です。そのため、イェンセンの不等式は、期待値を使って次のようにも書けます。
隠れた変数 が連続の値を取る場合は、和が積分 に変わりますが、積分も重み付きの平均なので、同じく成り立ちます。
3点の場合の分け方を図にすると、次のようになります。
(図は、diagram-designで作成)
等号が成り立つ条件
グラフから、等号が成り立つのは、曲線上の点と弦の上の点が重なるときだけだと分かります。 は、傾きが少しずつ変わり続ける曲線なので、2点が離れていれば、その間で曲線は必ず弦より上にふくらみます。重なるのは、弦が長さを持たない、つまり のとき(または、どちらかの重みが0で、1点だけを見ているとき)です。
3点以上でも同じで、等号が成り立つのは、重みが0でないすべての で、 が同じ値 のときです。
この条件が、EM アルゴリズムの E-step そのものです。EM アルゴリズムの記事では、 として、この不等式で対数尤度の下限を作りました。等号の条件「 が によらず一定」は、 を に比例させれば満たされます。合計を1にそろえると、 は隠れた変数の事後確率(負担率)になります。E-step で負担率を計算することは、イェンセンの不等式の等号を成り立たせて、下限を対数尤度にぴったり接触させる操作でした。
Python で確かめる
不等式と等号の条件
2点の手計算と、でたらめな値での3点以上の場合、等号の条件を、数値で確かめます。
import numpy as np

# 1. 2点の場合:u = 1 と 9 を、重み 0.5 ずつで平均する
u = np.array([1.0, 9.0])
q = np.array([0.5, 0.5])
print(f"log-sum(平均してから対数): log({q @ u:.1f}) = {np.log(q @ u):.4f}")
print(f"sum-log(対数を取ってから平均): ({np.log(u[0]):.4f} + {np.log(u[1]):.4f}) / 2 = {q @ np.log(u):.4f}")

# 2. 3点以上の場合:でたらめな u と重み q の組を10万通り作り、いつも log-sum ≥ sum-log かを確かめる
rng = np.random.default_rng(0)
n_trials, n_points = 100_000, 5
U = rng.uniform(0.01, 10, size=(n_trials, n_points))   # 正の値 u(z)
W = rng.dirichlet(np.ones(n_points), size=n_trials)    # 重み q(z):0以上で、合計が1
gap = np.log((W * U).sum(axis=1)) - (W * np.log(U)).sum(axis=1)   # log-sum − sum-log
print(f"\n10万通りでの差(log-sum − sum-log): 最小 {gap.min():.2e}  負になった回数 {(gap < 0).sum()}")

# 3. 等号の条件:u がすべて同じ値なら、差は0になる
u_same = np.full(n_points, 3.0)
w = W[0]
print(f"u がすべて3のとき: log-sum {np.log(w @ u_same):.4f}  sum-log {w @ np.log(u_same):.4f}")
イェンセンの不等式の両辺を、いくつかの場合で計算するコードです。
- (1) 2点の場合: 上の手計算と同じ 、重み で、両辺を計算します。q @ u は、重みと値の内積で、重み付きの平均 です。q @ np.log(u) は、対数の重み付きの平均 です。
- (2) 3点以上の場合: 5点の値 と重み の組を、乱数で10万通り作り、すべての組で「log-sum − sum-log」が0以上になるかを確かめます。
- U(10万 × 5): 値 です。対数が取れるように、0.01〜10 の正の値から一様に引いています。
- W(10万 × 5): 重み です。rng.dirichlet(np.ones(5)) は、0以上で合計が1になる5つの数を、偏りなくでたらめに引きます。重みの条件(0以上、合計1)を、作るだけで満たせるので使っています。
- gap(10万): 組ごとの「log-sum − sum-log」です。(W * U).sum(axis=1) が行ごとの重み付きの平均、(W * np.log(U)).sum(axis=1) が行ごとの対数の重み付きの平均です。
- 10万通り・5点: 結果は、組の数や点の数に左右されないので、どんな組でも不等式が破れないことを見るのに十分な数にしています。
- (3) 等号の条件: 値をすべて同じ3にして、重みは (2) の1組目を使います。重みがどんな値でも、値がすべて同じなら両辺が一致することを確かめます。
実行結果
log-sum(平均してから対数): log(5.0) = 1.6094
sum-log(対数を取ってから平均): (0.0000 + 2.1972) / 2 = 1.0986

10万通りでの差(log-sum − sum-log): 最小 3.66e-05  負になった回数 0
u がすべて3のとき: log-sum 1.0986  sum-log 1.0986
- 2点の場合: 手計算と同じく、log-sum が 、sum-log が で、log-sum のほうが大きくなりました。
- 3点以上の場合: 10万通りのどの組でも、差は負になりませんでした。最も小さい差は で、5つの値がたまたま近い組です。値が近いほど、曲線上の点が近くに集まり、曲線と弦の隙間が小さくなるからです。
- 等号の条件: 値がすべて3のときは、重みに関係なく、両辺がどちらも になりました。
3つの確認の結果を表にすると、次のようになります。
(図は、diagram-designで作成)
EM アルゴリズムの下限で確かめる
EM アルゴリズムの記事の、コインの例で確かめます。表が10回中8回出たコイン1枚について、隠れた変数 ( がふつうのコイン、 がいびつなコイン)の重み を変えながら、下限と対数尤度を比べます。パラメータは、EM アルゴリズムの記事の初期値(混入率 、いびつなコインの表の確率 )です。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib
from scipy.stats import binom

# 1. EMアルゴリズムの記事のコイン:表が8回のコイン、パラメータは初期値 π = 0.5、p = 0.6
pi, p, k = 0.5, 0.6, 8
joint = np.array([(1 - pi) * binom.pmf(k, 10, 0.5),   # P(k, z=0):ふつうのコインを引き、表が8回
                  pi * binom.pmf(k, 10, p)])          # P(k, z=1):いびつなコインを引き、表が8回
log_lik = np.log(joint.sum())                          # 対数尤度 log P(k)(log-sum)
gamma = joint[1] / joint.sum()                         # 負担率(事後確率)P(z=1 | k)


def lower_bound(q1, joint):
    """下限 B(q) = Σ_z q(z) log{P(k, z) / q(z)}(sum-log)。q(z=1) = q1、q(z=0) = 1 - q1"""
    q = np.array([1 - q1, q1])
    return q @ np.log(joint / q)


# 2. q(z=1) をいろいろ変えて、下限が対数尤度を超えないこと、負担率で接することを確かめる
for q1 in [0.1, 0.5, gamma, 0.9]:
    print(f"q(z=1) = {q1:.3f}: 下限 {lower_bound(q1, joint):.4f}  対数尤度 {log_lik:.4f}  "
          f"差 {log_lik - lower_bound(q1, joint):.4f}")

# 3. 可視化:q(z=1) を 0.01〜0.99 で動かしたときの下限
q1s = np.linspace(0.01, 0.99, 197)
plt.figure(figsize=(7, 4))
plt.plot(q1s, [lower_bound(q1, joint) for q1 in q1s], label='下限 B(q)(sum-log)')
plt.axhline(log_lik, color='red', linestyle='--', label=f'対数尤度 log P(k) = {log_lik:.3f}(log-sum)')
plt.axvline(gamma, color='gray', linestyle=':', label=f'負担率 γ = {gamma:.3f}')
plt.xlabel('q(z=1):いびつなコインに割り当てる確率')
plt.ylabel('値')
plt.title('下限は対数尤度を超えず、q が負担率のときに接する')
plt.legend()
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
コイン1枚について、重み を変えながら下限を計算し、対数尤度と比べるコードです。
- (1) 同時確率 joint: 「種類が のコインを引き、かつ表が8回出る」確率 を、 の順に並べた配列です。それぞれ「種類を引く確率( または )× その種類のコインで表が8回出る確率(二項分布)」で、値は約 と約 です。
- log_lik: 2つを足した の対数で、イェンセンの不等式の左辺(log-sum)にあたります。
- gamma: の事後確率(負担率) です。「表が8回出た」という結果を見たあとで、このコインがいびつなコインである確率を表し、 になります。表が8回という偏った結果は、ふつうのコインよりいびつなコインで出やすいので、引く前の確率 よりも大きくなります。EM アルゴリズムの記事の手計算の と同じものです。
- lower_bound(q1, joint): 重み での下限 です。イェンセンの不等式の を に置き換えた右辺(sum-log)にあたります。joint / q が の配列で、その対数と重みの内積を取っています。
- (2) 重みの比較: を、0.1・0.5・負担率・0.9 の4通りにして、下限と対数尤度の差を表示します。負担率の前後の値を選び、負担率のときだけ差が0になるかを見るためです。
- (3) 可視化: を 0.01〜0.99 で動かしたときの下限の曲線に、対数尤度(赤の破線)と負担率の位置(灰色の点線)を重ねます。0と1をよけているのは、 だと が0での割り算になるからです。
実行結果
q(z=1) = 0.100: 下限 -3.3916  対数尤度 -2.4957  差 0.8959
q(z=1) = 0.500: 下限 -2.6187  対数尤度 -2.4957  差 0.1230
q(z=1) = 0.733: 下限 -2.4957  対数尤度 -2.4957  差 0.0000
q(z=1) = 0.900: 下限 -2.5818  対数尤度 -2.4957  差 0.0861
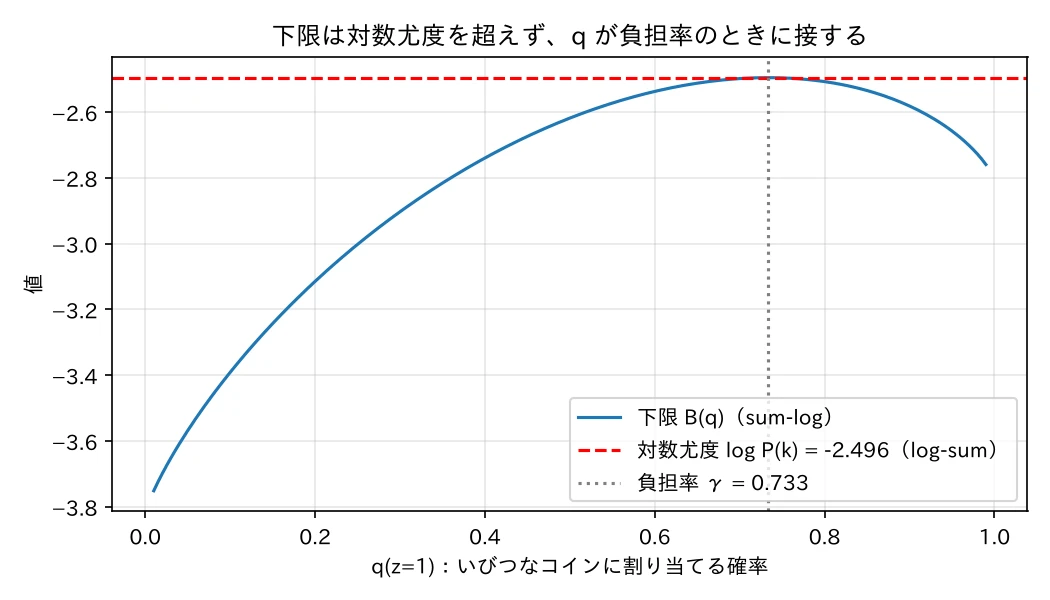
- 下限は、対数尤度を超えない: をどの値にしても、下限は対数尤度 以下でした。イェンセンの不等式のとおりです。
- 負担率のときだけ、ぴったり接する: (負担率)のとき、差は になりました。このとき は、 でも でも になり、「 がすべて同じ値」という等号の条件を満たします。図でも、下限の曲線は、負担率の位置で対数尤度の線に下から接しています。
- 負担率から離れるほど、差が大きくなる: 差は、 で 、 で でした。この差は、重み と事後確率 の分布のずれ(KL ダイバージェンス)に等しくなります(下の折りたたみ)。
差が KL ダイバージェンスになることの導出
同時確率を と分けて、下限の式に入れます。
第1項は、 が によらず、 なので、 そのものです。したがって、対数尤度と下限の差は、次のようになります。
KL ダイバージェンスは、2つの分布が同じときだけ0で、それ以外は正になります。これは、イェンセンの不等式の「差は0以上で、等号は が事後確率のときだけ」を、別の角度から言い直したものです。
実行結果の数値でも確かめられます。事後確率は 、 なので、 のとき、次のようになり、実行結果の差 と一致します。
EM アルゴリズムの E-step は、この図の頂点(負担率)を選んで、下限を対数尤度に接触させる操作です。続く M-step では、 を固定したままパラメータを動かして下限を押し上げます。下限は対数尤度を超えないので、対数尤度も押し上げられます。
下に凸な関数では、向きが逆になる
ここまでは上に凸な を使いましたが、イェンセンの不等式は、ほかの関数でも成り立ちます。上に凸な関数 では、 と同じく です。
反対に、 のように、傾きがだんだん大きくなる谷型の関数(下に凸、convex)では、曲線が弦より下にくるので、向きが逆になります。
右辺から左辺を引いたものは、重み での の分散です。この不等式は「分散は0以上」を言い換えたものになっています。どちらの向きになるかは、関数のグラフが山型(上に凸)か谷型(下に凸)かで決まります。
2つの形の関数を並べると、次のようになります。
(図は、diagram-designで作成)
対数変換した予測を戻すときにも現れる
イェンセンの不等式は、EM アルゴリズム以外でも、身近なところに現れます。売上のように右に裾の長い値を予測するとき、対数 に変換してから学習し、予測を で元に戻すことがあります。このとき、モデルが予測するのは で、それを戻した は、イェンセンの不等式から、平均 以下になります。
まず、イェンセンの不等式から、対数を取ってから平均した値(sum-log)は、平均してから対数を取った値(log-sum)以下です。これまでの式の左右を入れ替え、戻した予測の側を左に書いています。
次に、両辺に をかけます。 は値が大きいほど結果も大きくなる(増加する)関数なので、不等号の向きは変わりません。また、 と は打ち消し合うので、右辺は に戻ります。
戻した予測は、平均ではなく相乗平均に近い値になるので、合計を小さく見積もります。機械学習による CLV 予測の記事では、対数変換して学習したモデルの予測の合計が、実際の合計の0.689倍にとどまりました。
予測を戻すときの関係を図にすると、次のようになります。
(図は、diagram-designで作成)
まとめ
- イェンセンの不等式: 上に凸な関数 では、平均してから対数を取った値(log-sum)は、対数を取ってから平均した値(sum-log)以上になります。 を重み0.5ずつで平均すると、log-sum が 、sum-log が でした。
- グラフでの意味: log-sum は曲線上の点の高さ、sum-log は2点を結ぶ弦の上の点の高さです。 は傾きがだんだん小さくなる山なりの関数なので、曲線はいつも弦より上にあります。
- 3点以上: 「1点と、残りの点の平均」の2点に分けて、2点の場合を繰り返し使えば成り立ちます。10万通りのでたらめな値と重みでも、差が負になることはありませんでした。期待値や積分の形でも同じく成り立ちます。
- 等号の条件: 重みが0でないすべての で が同じ値のときだけ、等号が成り立ちます。EM アルゴリズムでは、 を負担率にするとこの条件が満たされ、下限が対数尤度に接します(コインの例で、 のときに差が0)。それ以外の での差は、 と事後確率の KL ダイバージェンスです。
参考文献
- J. L. W. V. Jensen (1906). Sur les fonctions convexes et les inégalités entre les valeurs moyennes. Acta Mathematica, 30, 175–193.
- C. M. Bishop (2006). Pattern Recognition and Machine Learning. Springer.(1.6節でイェンセンの不等式、9.4節で EM アルゴリズムの下限を扱っています)
本記事の文章・構成の一部に生成AIを使用しています。