LLM によるナレッジグラフの構築とは?
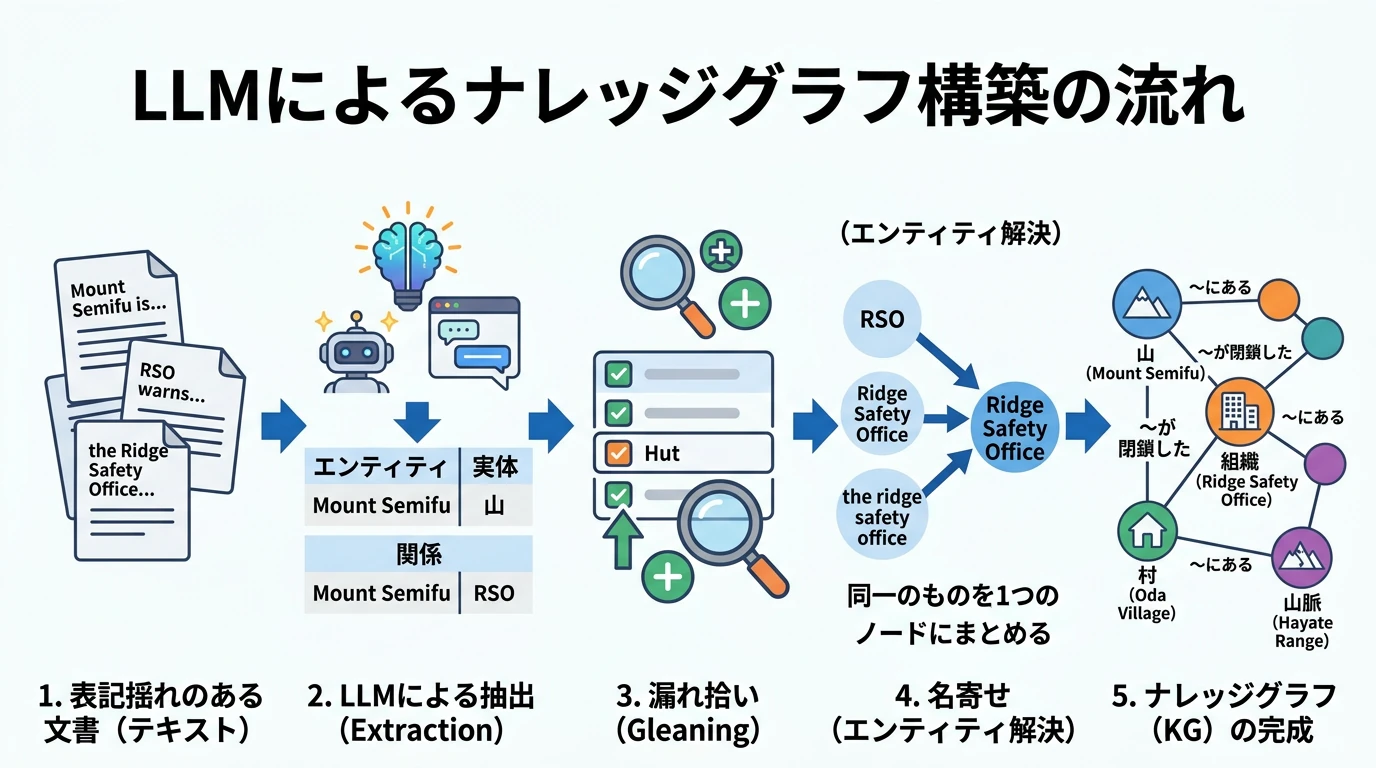 (画像は、Geminiで作成)
文書から LLM で エンティティ と 関係 を抜き出してナレッジグラフを作る流れ(抽出 → gleaning → 名寄せ)を理解すること。抽出の出力の形と gleaning の効果を、正解のあるコーパスで数えて比べられるようになること。名前の正規化・ルール・埋め込みの類似度・LLM による判定で名寄せをしたときに、別のものをまとめる誤り(誤統合) と 同じものを分ける誤り(誤分割) がどう変わるかを説明できるようになること。
概要
ナレッジグラフの記事では、Wikidata のように人が整えたナレッジグラフに SPARQL で問い合わせ、「ザルツブルク生まれの作曲家」のような関係をたどる問いに答えました。その記事の最後で触れたとおり、自分の組織の文書からナレッジグラフを作るには、文章から エンティティ(山・組織・生物種のような「もの」)と 関係(「この山はこの山脈にある」)を抜き出し、同じものを指す名前をそろえる必要があります。最近は、この抜き出しを LLM に任せる方法が広く使われています。GraphRAG(Edge et al. 2024)も、文書を LLM に読ませてエンティティと関係を抜き出すところから始まります。
LLM に抜き出しを頼むこと自体は、プロンプトを1つ書けばできます。難しいのは、その後です。同じ組織が、ある文書では「the Ridge Safety Office」、別の文書では「RSO」と書かれていると、名前のままグラフにすると別々のノードになります。逆に、名前の似た別の山を1つにまとめてしまうと、存在しない関係がグラフに入ります。同じものを指す名前を1つにまとめる作業を 名寄せ(エンティティ解決、entity resolution)と呼び、この記事の中心はここです。
本記事では、略称・大文字小文字・「the」の有無・「Mountains」と「Range」のような表記揺れを意図的に入れた架空の山岳コーパス(600文書)を作り、Qwen2.5-14B-Instruct で抽出から名寄せまでを行います。正解が分かっているので、抽出の漏れ、名寄せの誤統合と誤分割を、すべて数えて比べられます。
文書からナレッジグラフを作る流れ
(図は、diagram-designで作成)
LLM でナレッジグラフを作る流れは、大きく3つの段階に分かれます。
- 抽出(extraction): 文書ごとに、LLM にエンティティ(名前と種類)と関係(始点・終点・説明)を書き出させます。自然言語処理で 固有表現抽出(named entity recognition)と 関係抽出(relation extraction)と呼ばれてきた2つの作業を、1回の呼び出しでまとめて行います。
- gleaning(漏れ拾い、任意): GraphRAG の原著論文の工夫で、1回目の抽出の会話に続けて「まだ多くのエンティティが漏れている。同じ形式で追加して」と頼み、漏れを拾わせます。
- 名寄せ: 同じものを指す名前を1つのノードにまとめます。たとえば「RSO」「ridge safety office」「Ridge Safety Office (RSO)」を、すべて「Ridge Safety Office」という1つのノードにします。
抽出:まず、名前のままグラフにする
準備:Python の環境
LLM には、ローカルで動かす Qwen2.5-14B-Instruct(bf16 で約30GB の GPU メモリ)を使います。名前の埋め込みには sentence-transformers の all-MiniLM-L6-v2 を使います。記事の数値は、Google Colab の A100(40GB)で、Python 3.13・PyTorch 2.11.0・transformers 5.22.0・accelerate 1.15.0・sentence-transformers 5.7.0・NumPy 2.4.6・matplotlib 3.10.0 を使って実行したものです。グラフの日本語表示には japanize-matplotlib を使います(Python 3.12 以降で import 時にエラーが出る場合は、setuptools も一緒に入れてください)。
!pip install transformers accelerate sentence-transformers japanize-matplotlib setuptools
実験1:表記揺れのあるコーパスから抽出し、名前のままグラフにする
架空の山の紹介文を600件作ります。どの文書も「山・山脈・登山口の村」の2文で、350件には、組織や生物種が出てくる話題の文(落石・救助・山小屋・盗掘)が1文加わります。表記揺れは、次のように入れています。
- 組織: 「the Ridge Safety Office」「the ridge safety office」「RSO」「the Ridge Safety Office (RSO)」のように、大文字小文字・略称・括弧での定義が文書ごとに変わります。略称だけが出てくる文書もあり、そこでは文書の中に正式名がありません。
- 似た別の組織: 落石を扱う Ridge Safety Office(RSO)と、救助を扱う Ridge Rescue Office(RRO)は、名前の半分が同じ別の組織です。
- 山脈・村・山: 「the Hayate Range」「the Hayate range」「the Hayate Mountains」、「Oda Village」「the village of Oda」、「Mt. Fuhoha」「Fuhoha」が混ざります。村には、1文字違いの Oda と Odai があります。
まず、コーパスを作ります。あわせて、答え合わせに使う 正解 も作っておきます。
import collections
import random
import re

SYLLABLES = ["ka", "ra", "se", "mo", "ri", "to", "na", "shi", "ku", "yo",
             "ha", "ne", "ta", "mi", "su", "ho", "ki", "no", "wa", "fu"]
RANGES = ["Hoshimi", "Akatsuki", "Kirisame", "Tsukishiro", "Hayate", "Shiranami"]
VILLAGES = ["Oda", "Odai", "Kanbe", "Minase", "Toyoura", "Ishida", "Yanagi", "Sakaki", "Hirano"]

# 話題:(文書の数, 正しい名前, 種類, 文書での書き方の候補, 文のひな形)
TOPICS = {
    "rockfall": (150, "Ridge Safety Office", "organization",
                 ["the Ridge Safety Office", "the ridge safety office", "RSO", "the Ridge Safety Office (RSO)"],
                 "After repeated rockfall, {x} closed the upper trail of {mt}."),
    "rescue": (40, "Ridge Rescue Office", "organization",
               ["the Ridge Rescue Office", "RRO", "the Ridge Rescue Office (RRO)"],
               "An injured climber was carried down from {mt} by {x}."),
    "hut": (100, "Hut Keepers' Guild", "organization",
            ["the Hut Keepers' Guild", "the Hut Keepers Guild", "the hut keepers' guild", "HKG",
             "the Hut Keepers' Guild (HKG)"],
            "The hut on {mt} may close soon, according to {x}."),
    "lily": (60, "snow lily", "species",
             ["snow lilies", "Snow Lilies", "snow lily plants"],
             "Collectors illegally dig up {x} on the slopes of {mt}."),
}
# 文のひな形の意味:rockfall「落石が続き、{x} が {mt} の上部の登山道を閉鎖した」、rescue「けが人が {x} によって
#   {mt} から運び下ろされた」、hut「{x} によると、{mt} の山小屋はまもなく閉まるかもしれない」、
#   lily「収集家が {mt} の斜面で {x} を違法に掘り取っている」


def key(name):
    """評価で名前を引くときの形:小文字にして、先頭の the とアポストロフィを外す"""
    return name.lower().replace("'", "").removeprefix("the ").strip()


def build_corpus(n=600, seed=0):
    rng = random.Random(seed)
    names = set()
    while len(names) < n:                                          # (a) 音節3つの架空の山の名前
        names.add("".join(rng.choice(SYLLABLES) for _ in range(3)).capitalize())
    names = sorted(names)
    topics = [t for t, (count, *_) in TOPICS.items() for _ in range(count)]
    topics += [None] * (n - len(topics))                           # (b) 話題の文がない文書
    rng.shuffle(topics)

    docs = []
    for i, (name, topic) in enumerate(zip(names, topics)):
        rg, vl = rng.choice(RANGES), rng.choice(VILLAGES)
        mt, rg_name, vl_name = f"Mount {name}", f"{rg} Range", f"{vl} Village"   # 正しい名前
        forms = {mt: [f"Mount {name}", f"Mt. {name}", name],                       # (c) ありうる書き方
                 rg_name: [f"the {rg} Range", f"the {rg} range", f"the {rg} Mountains", rg],
                 vl_name: [f"{vl} Village", f"{vl} village", f"the village of {vl}", vl]}
        mt_s = rng.choice(forms[mt][:2])                                          # 文書で使う書き方を選ぶ
        text = (f"{mt_s} is a peak in {rng.choice(forms[rg_name][:3])}. "
                f"{mt_s} can be climbed from {rng.choice(forms[vl_name][:3])}.")
        # 「{山} は {山脈} の峰です。{山} には {村} から登れます。」
        entities = {mt: "mountain", rg_name: "range", vl_name: "village"}
        relations = {frozenset([mt, rg_name]), frozenset([mt, vl_name])}
        if topic:
            _, canonical, kind, surfaces, template = TOPICS[topic]
            text += " " + template.format(x=rng.choice(surfaces), mt=rng.choice([mt_s, name]))
            entities[canonical] = kind
            relations.add(frozenset([canonical, mt]))
            forms[canonical] = surfaces
        # (d) 評価用の対応表:書き方(と正しい名前)→ 正しい名前
        forms = {key(f): c for c, fs in forms.items() for f in fs + [c]}
        docs.append({"id": i, "text": text, "entities": entities, "relations": relations, "forms": forms})
    return docs


docs = build_corpus()
gold_entities = {e: t for d in docs for e, t in d["entities"].items()}
print("文書の数:", len(docs), " 正解のエンティティ:", len(gold_entities),
      dict(collections.Counter(gold_entities.values())), " 正解の関係:", sum(len(d["relations"]) for d in docs))
for i in range(3):
    print(f"例{i}:", docs[i]["text"])
for abbr in ["RSO", "RRO", "HKG"]:
    print(f"{abbr} が出てくる文書: {sum(abbr in d['text'] for d in docs):3d}  うち「({abbr})」と定義している文書: "
          f"{sum(f'({abbr})' in d['text'] for d in docs)}")
架空の山岳コーパスと、答え合わせのための正解を作るコードです。
- 山の名前: (a) 20個の音節から3つを選んでつなげ、600個の架空の山の名前を作ります。音節が少ないので、「Kahoka」と「Kakaha」のように、文字の似た名前がたくさんできます。これは、後で埋め込みの類似度の弱点を見るための設定です。
- 話題: (b) TOPICS の数(落石150、山小屋100、盗掘60、救助40)だけ、ランダムに選んだ文書に話題の文を付け、残りの250件は話題の文なしにします。数を変えているのは、よく出てくる組織と、あまり出てこない組織の両方を入れるためです。
- 表記揺れ: (c) forms は、正しい名前ごとの「ありうる書き方」の一覧です。たとえば Hayate Range なら、「the Hayate Range」「the Hayate range」「the Hayate Mountains」「Hayate」の4つです。文書を作るときは、名前だけの「Hayate」を除いた最初の3つから1つを選びます([:3])。名前だけの書き方は、文書には出てきませんが、LLM が「Hayate」とだけ書き出すことがあるので、一覧に入れておきます。
- 正解: 文書ごとに、正しい名前のエンティティ entities(名前 → 種類)と、関係 relations(正しい名前の組。向きは問わないので frozenset)を持たせます。
- 関係は端点の組だけ: 関係は、どの2つのエンティティがつながっているかだけを正解にし、関係の種類(「山脈にある」「村から登れる」など)は評価しません。LLM が書く関係の説明は、「is a peak in」「is located in」のように言い回しが毎回違ううえ、この記事で確かめたい誤り(関係の端点を登山道などに取り違えることと、名寄せでつながりが別のノードに分かれること)は、端点の組だけで数えられるためです。たとえば例0の正解の関係は、「Mount Fufuki と Kirisame Range」「Mount Fufuki と Sakaki Village」の2つの組です。
- 向きも問わない: LLM は「RSO → Mt. Fuhoha」と「Mt. Fuhoha → RSO」のどちらの向きでも書くので、順序のない frozenset にして、向きが逆なだけで外れにならないようにしています。
- 評価用の対応表: (d) forms を「書き方 → 正しい名前」の辞書に作り直し、文書に持たせます。キーは key で、小文字にして先頭の「the」とアポストロフィを外した形にそろえます。次の実験で、LLM が書いた名前を、この表で正解に対応づけます。
- 数値の意味: n=600 は、Qwen2.5-14B-Instruct の抽出が A100 で数分で終わる量です。seed=0 は再現のための固定値で、値そのものに意味はありません。
実行結果
文書の数: 600  正解のエンティティ: 619 {'mountain': 600, 'range': 6, 'village': 9, 'organization': 3, 'species': 1}  正解の関係: 1550
例0: Mount Fufuki is a peak in the Kirisame range. Mount Fufuki can be climbed from Sakaki village.
例1: Mt. Fuhoha is a peak in the Shiranami Mountains. Mt. Fuhoha can be climbed from the village of Ishida. After repeated rockfall, the Ridge Safety Office (RSO) closed the upper trail of Fuhoha.
例2: Mt. Fuhomo is a peak in the Hayate Mountains. Mt. Fuhomo can be climbed from the village of Yanagi. After repeated rockfall, the ridge safety office closed the upper trail of Mt. Fuhomo.
RSO が出てくる文書:  69  うち「(RSO)」と定義している文書: 31
RRO が出てくる文書:  30  うち「(RRO)」と定義している文書: 17
HKG が出てくる文書:  39  うち「(HKG)」と定義している文書: 25
英語の出力の日本語訳:
-
例0:「Fufuki 山は Kirisame 山脈の峰である。Fufuki 山へは Sakaki 村から登れる。」
-
例1:「Fuhoha 山は Shiranami 山地の峰である。Fuhoha 山へは Ishida 村から登れる。落石が続いたため、尾根安全事務所(RSO)は Fuhoha の上部の登山道を閉鎖した。」
-
例2:「Fuhomo 山は Hayate 山地の峰である。Fuhomo 山へは Yanagi 村から登れる。落石が続いたため、尾根安全事務所(ridge safety office)は Fuhomo 山の上部の登山道を閉鎖した。」
-
正解のエンティティは619: 山600・山脈6・村9・組織3・生物種1です。名寄せが完璧なら、ノードは619個になります。
-
略称だけの文書: 「RSO」が出てくる69文書のうち、「(RSO)」と括弧で定義しているのは31文書です。残りの38文書は「RSO」としか書かれていないので、その文書だけを読んでも正式名は分かりません。
-
例1: 1文目では「Mt. Fuhoha」、3文目では「Fuhoha」と、同じ文書の中でも山の書き方が変わります。
次に、LLM(Qwen2.5-14B-Instruct)と、複数のプロンプトをまとめて生成する関数を用意します。
import time

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_ID = "Qwen/Qwen2.5-14B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, padding_side="left")
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, dtype=torch.bfloat16, device_map="cuda")
model.eval()
usage = {"calls": 0, "input_tokens": 0, "output_tokens": 0, "seconds": 0.0}   # 呼び出し回数・トークン数・時間


def as_chat(prompt):
    """文字列なら1つの発言に、会話(発言のリスト)ならそのまま"""
    return prompt if isinstance(prompt, list) else [{"role": "user", "content": prompt}]


@torch.no_grad()
def generate(prompts, max_new_tokens=300, batch_size=32):
    outputs, start = [], time.time()
    for i in range(0, len(prompts), batch_size):
        texts = [tokenizer.apply_chat_template(as_chat(p), tokenize=False, add_generation_prompt=True)
                 for p in prompts[i:i + batch_size]]
        inputs = tokenizer(texts, return_tensors="pt", padding=True).to(model.device)
        out = model.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
        for row, mask in zip(out[:, inputs["input_ids"].shape[1]:], inputs["attention_mask"]):
            text = tokenizer.decode(row, skip_special_tokens=True).strip()
            usage["calls"] += 1
            usage["input_tokens"] += int(mask.sum())
            usage["output_tokens"] += len(tokenizer(text)["input_ids"])
            outputs.append(text)
    usage["seconds"] += time.time() - start
    return outputs


def reset_usage():
    usage.update(calls=0, input_tokens=0, output_tokens=0, seconds=0.0)
Qwen2.5-14B-Instruct を読み込み、まとめて生成する関数を用意するコードです。
- 会話の形にそろえる as_chat: 文字列を渡されたら「user の発言1つ」の会話にし、すでに会話(発言のリスト)なら、そのまま使います。後の gleaning では、1回目の答えを含む会話を渡すためです。
- まとめて生成 generate: 32件ずつ、長さを左側の詰め物(パディング)でそろえて生成します。padding_side="left" にするのは、生成は右端から続けて書くので、詰め物を左に置かないと、詰め物の後ろに文章が続いてしまうためです。
- 貪欲法: do_sample=False で、毎回いちばん確率の高いトークンを選びます。同じプロンプトなら同じ出力になるので、方法どうしの比較に乱数の影響が入りません。
- コストの記録: 呼び出しのたびに、呼び出し回数・入力トークン数・出力トークン数・かかった時間を usage に足します。reset_usage で0に戻してから各段階を実行し、段階ごとのコストを比べます。
いよいよ抽出です。プロンプトは、エンティティを「entity | 名前 | 種類」、関係を「relation | 始点 | 終点 | 説明」の形で1行ずつ書かせ、例を1つ見せます(few-shot、In-Context Learning の記事を参照)。
# 文書ごとに、エンティティと関係を「|」区切りで1行ずつ書き出させる
EXTRACT = (
    "Extract the entities and relationships from the text.\n"
    "Write one entity per line as: entity | <name> | <type>\n"
    "Write one relationship per line as: relation | <source> | <target> | <short description>\n"
    "Types are: mountain, range, village, organization, species, event, other.\n\n"
    "Example text: Mount Taro is a peak in the Akatsuki Range. A bear was seen near its hut.\n"
    "entity | Mount Taro | mountain\n"
    "entity | Akatsuki Range | range\n"
    "entity | bear | species\n"
    "relation | Mount Taro | Akatsuki Range | Mount Taro is a peak in the Akatsuki Range\n"
    "relation | bear | Mount Taro | a bear was seen near the hut on Mount Taro\n\n"
    "Text: {text}")
# 「テキストからエンティティと関係を抽出してください。エンティティは『entity | 名前 | 種類』、関係は
#   『relation | 始点 | 終点 | 短い説明』の形で1行に1つずつ書いてください。種類は、山・山脈・村・組織・生物種・出来事・その他。
#   (例)テキスト:Taro 山は Akatsuki 山脈の峰です。山小屋の近くでクマが目撃されました。… テキスト:…」


def parse_pipe(text, doc_id):
    entities, relations, bad = [], [], 0
    for line in text.splitlines():
        parts = [p.strip() for p in line.split("|")]
        if parts[0] == "entity" and len(parts) == 3:
            entities.append({"name": parts[1], "type": parts[2].lower(), "doc": doc_id})
        elif parts[0] == "relation" and len(parts) == 4:
            relations.append({"source": parts[1], "target": parts[2], "doc": doc_id})
        elif line.strip():
            bad += 1                                  # 形式に合わない行
    return entities, relations, bad


reset_usage()
raw_pipe = generate([EXTRACT.format(text=d["text"]) for d in docs])
cost = {"抽出(「|」区切り)": dict(usage)}
pipe = [parse_pipe(t, d["id"]) for d, t in zip(docs, raw_pipe)]
print("抽出したエンティティ:", sum(len(e) for e, _, _ in pipe), " 関係:", sum(len(r) for _, r, _ in pipe),
      " 形式に合わない行:", sum(b for _, _, b in pipe))
文書ごとに LLM でエンティティと関係を抜き出すコードです。
- プロンプト EXTRACT: 形式と種類(山・山脈・村・組織・生物種・出来事・その他)を指定し、例のテキストと、その答えを1つ見せます。種類を決めておくのは、後で「組織と山の関係」のように種類で絞り込めるようにするためです。
- 読み取り parse_pipe: 生成した行を「|」で分け、「entity」で始まり3つに分かれる行をエンティティ、「relation」で始まり4つに分かれる行を関係にします。どちらにも当てはまらない空でない行は、形式に合わない行として bad に数えます。
- max_new_tokens=300: 1文書から抜き出すのは多くても十行ほどなので、300トークンあれば足ります。
実行結果
抽出したエンティティ: 2164 関係: 1556 形式に合わない行: 0
例1の文書の答えは、次のとおりでした。
entity | Mt. Fuhoha | mountain
entity | Shiranami Mountains | range
entity | Ishida | village
entity | Ridge Safety Office (RSO) | organization
relation | Mt. Fuhoha | Shiranami Mountains | Mt. Fuhoha is a peak in the Shiranami Mountains
relation | Mt. Fuhoha | Ishida | Mt. Fuhoha can be climbed from the village of Ishida
relation | Ridge Safety Office (RSO) | Mt. Fuhoha | the Ridge Safety Office closed the upper trail of Fuhoha after repeated rockfall
抜き出しはおおむね正しいのですが、「Shiranami Mountains」「Ishida」「Ridge Safety Office (RSO)」のように、名前は文書に書かれたままの形か、それを少し変えた形 で出てきます。どれだけ正しく抜き出せたかを数えるには、LLM が書いた名前が、正解のどのエンティティを指すかを決める必要があります。そこで、コーパスを作るときに用意した対応表で引きます。
(図は、diagram-designで作成)
def gold_label(name, doc):
    """抜き出した名前が、その文書の正解のどれを指すか(対応表になければ None = 正解外)"""
    return doc["forms"].get(key(name))


def evaluate(extracted):
    found_e = found_r = extra_e = extra_r = 0
    for d, (ents, rels, _) in zip(docs, extracted):
        labels = [gold_label(e["name"], d) for e in ents]
        pairs = [frozenset([gold_label(r["source"], d), gold_label(r["target"], d)]) for r in rels]
        found_e += len(set(labels) & set(d["entities"]))           # (a) 抜き出せた正解のエンティティ
        found_r += len(set(pairs) & d["relations"])                # (b) 抜き出せた正解の関係
        extra_e += labels.count(None)                              # (c) 正解外のエンティティ
        extra_r += sum(p not in d["relations"] for p in pairs)     # (d) 正解外の関係
    return {"エンティティの再現率": round(found_e / sum(len(d["entities"]) for d in docs), 3),
            "関係の再現率": round(found_r / sum(len(d["relations"]) for d in docs), 3),
            "正解外のエンティティ": extra_e, "正解外の関係": extra_r}


print(evaluate(pipe))

# 名前のままグラフにすると、ノードはいくつになるか
nodes = {e["name"] for ents, _, _ in pipe for e in ents}
print("ノードの数:", len(nodes), "(正解のエンティティは", len(gold_entities), ")")
for g in ["Ridge Safety Office", "Hut Keepers' Guild", "Hayate Range", "Oda Village"]:
    names = collections.Counter(e["name"] for d, (ents, _, _) in zip(docs, pipe) for e in ents
                                if gold_label(e["name"], d) == g)
    print(f"{g}({len(names)}個のノード):", dict(names.most_common()))
抜き出した名前を正解に対応づけて抽出の質を数え、名前のままグラフにしたときのノードを数えるコードです。
- 正解への対応づけ gold_label: 名前を key でそろえて、その文書の対応表 forms で引くだけです。表になければ None(正解外)を返します。対応表は文書ごとなので、「Oda」は Oda 村の出てくる文書でだけ Oda Village になります。
- 評価 evaluate: 文書ごとに次の4つを数えます。
- (a) 正解のエンティティのうち、1回でも抜き出せたもの。全文書の正解の数(2,150)で割って、エンティティの 再現率 にします。
- (b) 正解の関係のうち、始点と終点の両方を正解に対応づけられ、その組が正解だったもの。正解の関係の数(1,550)で割って、関係の再現率にします。
- (c)(d) 正解に対応づかないエンティティと関係の数(正解外)です。「injured climber」のように、文書に書いてあるが正解に入れていないものも含みます。
- 名前のままのグラフ: nodes は、名前が完全に一致するものだけを同じノードにしたときのノードです。正解の組織や山脈が、何個のノードに分かれたかを数えます。
実行結果
{'エンティティの再現率': 1.0, '関係の再現率': 0.989, '正解外のエンティティ': 8, '正解外の関係': 17}
ノードの数: 663 (正解のエンティティは 619 )
Ridge Safety Office(4個のノード): {'Ridge Safety Office': 44, 'RSO': 38, 'ridge safety office': 37, 'Ridge Safety Office (RSO)': 31}
Hut Keepers' Guild(5個のノード): {"Hut Keepers' Guild": 28, 'HKG': 20, 'Hut Keepers Guild': 20, "hut keepers' guild": 19, "Hut Keepers' Guild (HKG)": 19}
Hayate Range(3個のノード): {'Hayate Mountains': 35, 'Hayate range': 31, 'Hayate Range': 30}
Oda Village(3個のノード): {'Oda Village': 24, 'Oda village': 19, 'Oda': 13}
- 抽出そのものはよくできている: エンティティの再現率は 1.0、関係の再現率は 0.989 です。短い文書なら、14B の LLM で、正解のエンティティはすべて抜き出せました。
- 名前のままだとノードが分かれる: ノードは663個で、正解の619個より44個多くなりました。Ridge Safety Office は、「Ridge Safety Office」(44文書)・「RSO」(38)・「ridge safety office」(37)・「Ridge Safety Office (RSO)」(31)の 4つのノード に分かれています。Hut Keepers' Guild は5つ、Hayate Range と Oda Village は3つです。
抽出がほぼ完璧でも、名前のままグラフにすると、同じ組織が4つに分かれます。「RSO が関わる山はいくつ?」とグラフに聞くと、4つのノードのどれを選ぶかで答えが変わってしまいます。名寄せの前に、抽出の出力の形と gleaning を見ておきます。
出力の形:「|」区切りと JSON
抽出の答えを、プログラムで読み取れる形で返させる方法は、いくつかあります。
- 区切り文字の行: 実験1の「entity | 名前 | 種類」のような形です。1行ずつ読むので、一部の行が崩れても残りは使えます。GraphRAG の実装も、区切り文字の形で抜き出させています。
- JSON: 入れ子の構造を表せ、Python の json.loads でそのまま読めますが、閉じかっこが1つ欠けるだけで、全体が読めなくなります。
- JSON Schema による構造化出力: API に JSON Schema(型の定義)を渡し、生成するトークンをスキーマに合うものだけに制限させる方法です(Function Calling の記事で、関数の引数をスキーマで定義したのと同じ仕組みです)。Gemini の response_schema や、OpenAI の response_format で指定できます。形の崩れは起きなくなりますが、何を抜き出すかは、プロンプトの中身で決まる点は同じです。
実験2:同じ内容を JSON で書き出させる
実験1と同じ指示・同じ例を、JSON の形にしたプロンプトで抜き出し、「|」区切りと比べます。
import json

# 実験1と同じ内容・同じ例を、JSON で書き出させる
EXTRACT_JSON = (
    "Extract the entities and relationships from the text.\n"
    "Answer only with JSON. Types are: mountain, range, village, organization, species, event, other.\n\n"
    "Example text: Mount Taro is a peak in the Akatsuki Range. A bear was seen near its hut.\n"
    '{{"entities": [{{"name": "Mount Taro", "type": "mountain"}}, {{"name": "Akatsuki Range", "type": "range"}}, '
    '{{"name": "bear", "type": "species"}}], '
    '"relationships": [{{"source": "Mount Taro", "target": "Akatsuki Range"}}, '
    '{{"source": "bear", "target": "Mount Taro"}}]}}\n\n'
    "Text: {text}")
# 「テキストからエンティティと関係を抽出してください。JSON だけで答えてください。種類は、山・山脈・村・組織・
#   生物種・出来事・その他。(例)テキスト:… → {"entities": [...], "relationships": [...]} テキスト:…」


def parse_json(text, doc_id):
    try:
        data = json.loads(text)                                        # (a) JSON として読む
        entities = [{"name": e["name"], "type": e["type"], "doc": doc_id} for e in data["entities"]]
        relations = [{"source": r["source"], "target": r["target"], "doc": doc_id}
                     for r in data["relationships"]]
        return entities, relations, 0
    except (json.JSONDecodeError, KeyError, TypeError):
        return [], [], 1                                               # (b) 読めなければ、その文書は空にする


reset_usage()
raw_json = generate([EXTRACT_JSON.format(text=d["text"]) for d in docs], max_new_tokens=400)
cost["抽出(JSON)"] = dict(usage)
by_json = [parse_json(t, d["id"]) for d, t in zip(docs, raw_json)]
print("JSON として読めなかった文書:", sum(b for _, _, b in by_json))
print("「|」区切り:", evaluate(pipe))
print("JSON      :", evaluate(by_json))
LLM に JSON で抜き出させ、「|」区切りと比べるコードです。
- プロンプト EXTRACT_JSON: 実験1と同じ例を、JSON の形で見せます。波かっこを2つ重ねているのは、Python の format で、波かっこそのものを出すための書き方です({{ が「{」になります)。
- 読み取り parse_json: (a) json.loads で読み、決めたキー(entities・relationships・name など)を取り出します。(b) 読めなかったり、決めたキーがなかったりした文書は、エンティティも関係も空として数えます。
- max_new_tokens=400: JSON は、かっこやキー名の分だけ出力が長くなるので、実験1の300より多くしています。
実行結果
JSON として読めなかった文書: 0
「|」区切り: {'エンティティの再現率': 1.0, '関係の再現率': 0.989, '正解外のエンティティ': 8, '正解外の関係': 17}
JSON      : {'エンティティの再現率': 0.98, '関係の再現率': 0.971, '正解外のエンティティ': 48, '正解外の関係': 46}
- 読めなかった文書は0: 例で形を見せたので、JSON の形の崩れは1件もありませんでした。
- 質はほぼ同じ: 再現率はエンティティ 0.98、関係 0.971 と、「|」区切り(1.0、0.989)とほぼ同じでした。正解外は、エンティティが8個から48個、関係が17個から46個に増えましたが、600文書の中では小さな差です。
この規模では、出力の形を変えても、抽出の質はほとんど変わりませんでした。どちらを使うかは、読み取るプログラムの都合で決めてよく、大事なのは、例を見せて形をはっきり伝えることです。
gleaning:漏れを拾わせる
GraphRAG の原著論文(Edge et al. 2024)は、1回目の抽出の後に、LLM に「MANY entities were missed in the last extraction」(前回の抽出では多くのエンティティが漏れていた)と伝えて、漏れを拾わせる工夫を入れています。論文はこれを、抜き出しを「glean(拾い集める)」させる、と表現しています。決めた回数まで繰り返し、毎回の前に、まだ漏れがあるかを LLM に「はい/いいえ」で答えさせ、「いいえ」なら止めます。論文の付録の図では、GPT-4 は、600トークンの長さに区切った文書から、2,400トークンに区切った場合のほぼ2倍のエンティティの言及を抜き出し、gleaning の回数を増やすと、抜き出す数がさらに増えていました。長い文書ほど、1回の抽出で漏れが出やすいためです。
実験3:gleaning を1回行う
実験1の会話に続けて、漏れを追加させます。LLM には、次の3つの発言を1つの会話として渡します。
(図は、diagram-designで作成)
# 1回目の抽出の会話に続けて「まだ漏れがある。同じ形式で追加して」と頼む(GraphRAG の gleaning)
CONTINUE = ("MANY entities and relationships were missed in the last extraction. "
            "Add them below using the same format:")
# 「前回の抽出では、多くのエンティティと関係が漏れていました。同じ形式で、下に追加してください。」

conversations = [[{"role": "user", "content": EXTRACT.format(text=d["text"])},   # 1回目の依頼
                  {"role": "assistant", "content": first},                       # 1回目の答え
                  {"role": "user", "content": CONTINUE}]                         # 追加の依頼
                 for d, first in zip(docs, raw_pipe)]
reset_usage()
raw_glean = generate(conversations)
cost["gleaning(1回)"] = dict(usage)

gleaned, new_names = [], collections.Counter()
for d, first, extra in zip(docs, pipe, raw_glean):
    e2, r2, b2 = parse_pipe(extra, d["id"])
    gleaned.append((first[0] + e2, first[1] + r2, first[2] + b2))   # 1回目と追加を合わせる
    before = {e["name"] for e in first[0]}
    for e in e2:
        if e["name"] not in before:                                    # 1回目になかった名前だけを数える
            new_names[e["name"]] += 1
print("1回目だけ    :", evaluate(pipe))
print("gleaning あり:", evaluate(gleaned))
print("1回目になかった名前:", sum(new_names.values()), " 多い順:", new_names.most_common(8))
実験1の会話に続けて gleaning を1回行い、増えたものを数えるコードです。
- 会話を組み立てる: conversations は、文書ごとの3つの発言のリストです。2つ目の発言(assistant)には、実験1で LLM が実際に答えた文字列 raw_pipe をそのまま入れます。LLM から見ると「自分はこう答えた。そのうえで、漏れがあると言われた」という状況になります。
- 生成: generate は、会話(発言のリスト)もそのまま受け取れるようにしてあるので、実験1と同じ関数で生成できます。
- 1回だけ: 原著論文は「まだ漏れがあるか」を毎回聞いて繰り返しますが、ここでは追加を1回だけ頼みます。本記事の文書は2〜3文と短いので、1回で効果が見えなければ、繰り返しても効果は小さいと考えたためです。
- 増えたものを数える: 1回目と追加の答えを合わせたもの gleaned を、実験1と同じ evaluate で評価します。さらに、1回目に出てこなかった名前だけを new_names に数えます。
実行結果
1回目だけ    : {'エンティティの再現率': 1.0, '関係の再現率': 0.989, '正解外のエンティティ': 8, '正解外の関係': 17}
gleaning あり: {'エンティティの再現率': 1.0, '関係の再現率': 0.989, '正解外のエンティティ': 211, '正解外の関係': 327}
1回目になかった名前: 195  多い順: [('rockfall', 66), ('hut', 63), ('collectors', 20), ('climber', 17), ('Rockfall', 3), ('hut on Mt. Totase', 2), ('hut on Hofumo', 1), ('hut on Homina', 1)]
- 再現率は変わらず、正解外だけが増えた: エンティティの再現率は 1.0、関係の再現率は 0.989 のまま変わらず、正解外のエンティティは8個から211個に、正解外の関係は17個から327個に増えました。
- 増えた名前は正解外ばかり: 1回目になかった名前195個は、「rockfall」(落石)、「hut」(山小屋)、「collectors」(収集家)、「climber」(登山者)などでした。文書には書いてありますが、山・組織・生物種ではなく、グラフに入れたいものではありません。
- 漏れがあると言われると、何かを足そうとする: たとえば例1では「Let's review the text again to ensure no entities or relationships were missed」(漏れがないか、もう一度テキストを見直しましょう)と書き、1回目と同じ答えを繰り返していました。漏れがないときにも「漏れている」と伝えるので、LLM は新しいものを探して、正解外のものを足してしまいます。
- コスト: 1回目の会話をすべて入力し直すので、入力トークンは1回目の約1.6倍(209,266)、時間は約2.8倍(519秒)かかりました(後の実験7の表)。
gleaning は、1回の抽出では漏れが出るほど長い文書(原著論文の 600〜2,400 トークン)のための工夫です。本記事のように短い文書では、拾える漏れがなく、ノイズだけが増えました。使うかどうかは、文書を区切る長さと、1回目の抽出の再現率を確かめてから決めます。
名寄せ:同じものを指す名前を1つにまとめる
ここからが本題の名寄せです。名寄せの誤りには、2種類あります。
(図は、diagram-designで作成)
- 誤統合(over-merging): 別のものを1つにまとめる誤りです。名前の似た2つの山を1つにすると、片方の山の関係がもう片方の山の関係として数えられ、グラフに存在しない関係が入ります。
- 誤分割(under-merging): 同じものを複数のノードに分ける誤りです。「RSO」と「Ridge Safety Office」が別のノードのままだと、「この組織が関わる山はいくつ?」に、一部しか数えられません。
2つの誤りは、片方を減らそうとすると、もう片方が増えやすい関係にあります。積極的にまとめれば誤分割は減りますが、誤統合が増えます。慎重にまとめれば、その逆です。以下では、実験1の抽出(「|」区切り)で抜き出した名前を、方法を変えてまとめ、ノード数(正解は619)・誤統合(2つ以上の正解が混ざったノードの数)・誤分割(2つ以上のノードに分かれた正解の数)を数えます。
実験4:正規化とルール
まず、LLM を使わない方法を試します。名前を小文字にして「the」や記号を外す 正規化 と、略称の辞書などの ルール です。
# 名寄せの対象:抜き出した名前(重複なし)と、評価のための正解
label = {}
for d, (ents, _, _) in zip(docs, pipe):
    for e in ents:
        if gold_label(e["name"], d):
            label[e["name"]] = gold_label(e["name"], d)
names = sorted(label)
print("名寄せの対象の名前:", len(names), " 指している正解のエンティティ:", len(set(label.values())))


def score(cluster_of):
    """cluster_of(名前 → ノード)でまとめたときの、ノード数・誤統合・誤分割"""
    golds_in_node = collections.defaultdict(set)    # (a) ノード → そこに入った正解
    nodes_of_gold = collections.defaultdict(set)    # (b) 正解 → それが入ったノード
    for n in names:
        golds_in_node[cluster_of(n)].add(label[n])
        nodes_of_gold[label[n]].add(cluster_of(n))
    return {"ノード数": len(golds_in_node),
            "誤統合": sum(len(g) > 1 for g in golds_in_node.values()),   # 2つ以上の正解が混ざったノード
            "誤分割": sum(len(n) > 1 for n in nodes_of_gold.values())}   # 2つ以上のノードに分かれた正解


results = {"完全一致": score(lambda n: n)}


# 正規化:大文字小文字・先頭の the・括弧・記号・Mt. をそろえる
def normalize(name):
    n = name.lower()
    n = re.sub(r"\s*\(.*?\)", "", n)        # 「ridge safety office (rso)」→「ridge safety office」
    n = n.removeprefix("the ")
    n = n.replace("mt. ", "mount ")         # 「mt. fuhoha」→「mount fuhoha」
    n = re.sub(r"['.,]", "", n)             # 「keepers' guild」→「keepers guild」
    return n.strip()


results["正規化"] = score(normalize)

# ルール:文書の「正式名 (略称)」から略称の辞書を作り、山脈・村・山の書き方をそろえる
aliases = {}
for d in docs:
    # 大文字で始まる単語の並び(Ridge Safety Office)の直後に、括弧で大文字だけの略称(RSO)が続く形を探す
    for full, abbr in re.findall(r"((?:[A-Z][\w']*\s)+)\(([A-Z]+)\)", d["text"]):
        aliases[abbr.lower()] = normalize(full)
print("文書から集めた略称:", aliases)
mountains = {normalize(n).removeprefix("mount ") for n in names if normalize(n).startswith("mount ")}


def rule_key(name):
    n = normalize(name)
    n = aliases.get(n, n)                                       # 「rso」→「ridge safety office」
    n = re.sub(r"^village of (\w+)$", r"\1 village", n)        # 「village of oda」→「oda village」
    n = re.sub(r"^(\w+) mountains$", r"\1 range", n)           # 「hayate mountains」→「hayate range」
    if n.capitalize() in VILLAGES:                              # 「oda」→「oda village」
        n += " village"
    if n in mountains:                                          # 「fuhoha」→「mount fuhoha」
        n = "mount " + n
    return n


results["正規化+ルール"] = score(rule_key)
for k, v in results.items():
    print(f"{k}: {v}")
正規化とルールで名前をまとめ、誤統合と誤分割を数えるコードです。
- 名寄せの対象 label: 抜き出した名前のうち、正解に対応づいたものです(正解外の「climber」などは除きます)。名前 → 正解の辞書で、660個の名前が、619個の正解を指しています。
- 評価 score: 名前をノードに対応づける関数 cluster_of を受け取り、2つの表を作ります。
- (a) golds_in_node: ノードごとに、そこに入った正解の集まりです。2つ以上の正解が入っていれば誤統合です。たとえば、ノード「mount kahoka」に正解の Mount Kahoka と Mount Kakaha の両方が入っていれば、誤統合1個です。
- (b) nodes_of_gold: 正解ごとに、それが入ったノードの集まりです。2つ以上なら誤分割です。たとえば、正解の Ridge Safety Office が、ノード「ridge safety office」とノード「rso」に分かれていれば、誤分割1個です。
- (1) 完全一致: 名前そのものをノードにします(実験1と同じ)。score には「名前 → ノード」の関数を渡すので、名前をそのまま返す lambda n: n を渡します(def exact(name): return name を1行で書いたものです)。たとえば「RSO」はノード「RSO」、「Ridge Safety Office」はノード「Ridge Safety Office」になり、別々のノードとして数えられます。正規化では normalize、ルールでは rule_key を渡すので、score の中身は変えずに、渡す関数を差し替えるだけで方法どうしを比べられます。
- (2) 正規化 normalize: 小文字にし、括弧の中(「(RSO)」)、先頭の「the」、記号を外し、「Mt.」を「mount」にそろえます。どの分野の名前にも使える、一般的な処理です。
- (3) ルール rule_key: 正規化に、次の3つのルールを足します。
- 略称の辞書 aliases: すべての文書から「Ridge Safety Office (RSO)」のような、大文字で始まる単語の並びの直後に括弧で大文字の略称が続く形を正規表現で探し、「rso → ridge safety office」の辞書にします。括弧で定義している文書が1つでもあれば、略称だけが出てくる文書の「RSO」も正式名にそろえられます。
- 書き方のルール: 「village of oda」→「oda village」、「hayate mountains」→「hayate range」にそろえます。
- 名前だけの書き方: 村の名前だけ(「oda」)は「oda village」に、山の名前だけ(「fuhoha」)は「mount fuhoha」にします。山の名前の一覧 mountains は、「mount 〜」の形で抜き出された名前から作ります。
実行結果
名寄せの対象の名前: 660  指している正解のエンティティ: 619
文書から集めた略称: {'rso': 'ridge safety office', 'rro': 'ridge rescue office', 'hkg': 'hut keepers guild'}
完全一致: {'ノード数': 660, '誤統合': 0, '誤分割': 19}
正規化: {'ノード数': 638, '誤統合': 0, '誤分割': 19}
正規化+ルール: {'ノード数': 620, '誤統合': 0, '誤分割': 1}
- 正規化だけでは足りない: 正規化でノードは660個から638個に減り、誤統合は0のままですが、誤分割は19個のまま減りませんでした。「ridge safety office」と「Ridge Safety Office」はまとまりますが、「rso」、「hayate mountains」と「hayate range」、「oda」と「oda village」は別のままです。正規化でまとまるのは、大文字小文字や記号だけが違う名前に限られます。
- ルールを足すとほぼ正解: 略称の辞書と書き方のルールを足すと、ノードは620個、誤分割は1個まで減り、誤統合は0のままでした。残った1個は「snow lily」と「snow lilies」で、単数形と複数形の違いはルールに書いていなかったためです。
- ルールの弱点: ルールは、書いたことしかまとめません。複数形のような違いを見つけるたびに、ルールを足す必要があります。また、このルールはこのコーパスの書き方に合わせたもので、別の分野の文書にはそのまま使えません。
実験5:埋め込みの類似度でまとめる
ルールを書かずにまとめる方法として、名前を埋め込み(ベクトル)にして、コサイン類似度がしきい値以上の組を同じノードにする方法がよく使われます。正規化した名前を埋め込み、しきい値を変えて試します。
import japanize_matplotlib  # グラフの日本語表示のため
import matplotlib.pyplot as plt
import numpy as np
from sentence_transformers import SentenceTransformer


class UnionFind:
    """「AとBが同じ」「BとCが同じ」をつないで、グループ(ノード)にまとめる"""

    def __init__(self, items):
        self.parent = {x: x for x in items}     # 最初は、どの名前も自分だけのグループ

    def find(self, x):                          # グループの代表をたどる
        while self.parent[x] != x:
            x = self.parent[x]
        return x

    def union(self, a, b):                      # 2つのグループを1つにする
        self.parent[self.find(a)] = self.find(b)


keys = sorted({normalize(n) for n in names})
embedder = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2", device="cuda")
emb = embedder.encode(keys, normalize_embeddings=True)
sim = emb @ emb.T                               # すべての組のコサイン類似度


def embed_clusters(threshold):
    uf = UnionFind(keys)
    for i, j in zip(*np.where(sim >= threshold)):
        if i < j:
            uf.union(keys[i], keys[j])
    return lambda n: uf.find(normalize(n))


thresholds = [0.70, 0.75, 0.80, 0.85, 0.90, 0.95, 1.00]
sweep = [score(embed_clusters(t)) for t in thresholds]
for t, s in zip(thresholds, sweep):
    print(f"しきい値 {t:.2f}: {s}")

key_label = {normalize(n): label[n] for n in names}
pairs = [(round(float(sim[i, j]), 3), keys[i], keys[j]) for i in range(len(keys)) for j in range(i + 1, len(keys))]
print("別のものなのに似ている:", sorted([p for p in pairs if key_label[p[1]] != key_label[p[2]]], reverse=True)[:5])
print("同じものなのに似ていない:", sorted([p for p in pairs if key_label[p[1]] == key_label[p[2]]])[:5])
results["正規化+埋め込み(0.95)"] = sweep[thresholds.index(0.95)]

plt.figure(figsize=(7, 4))
plt.plot(thresholds, [s["誤統合"] for s in sweep], marker="o", label="誤統合(別のものが混ざったノード)")
plt.plot(thresholds, [s["誤分割"] for s in sweep], marker="s", label="誤分割(分かれたままの正解)")
plt.xlabel("コサイン類似度のしきい値")
plt.ylabel("個数")
plt.legend()
plt.grid(alpha=0.3)
plt.tight_layout()
plt.savefig("kg_construction_threshold.png", dpi=150)
plt.show()
正規化した名前を埋め込み、類似度がしきい値以上の組をまとめるコードです。
- 埋め込み: all-MiniLM-L6-v2 は、文を384次元のベクトルにする、小さく速い sentence-transformers のモデルです。normalize_embeddings=True で長さを1にしているので、内積 emb @ emb.T がそのままコサイン類似度になります。sim[i, j] は、i番目と j番目の名前の類似度です。
- つなぎ方 UnionFind: 「AとBが同じ」という組を次々に受け取り、グループにまとめるデータ構造です。parent は「自分の親」を指す辞書で、最初はどの名前も自分自身が親(1人だけのグループ)です。union(a, b) は、a のグループの代表の親を b のグループの代表にして、2つのグループを1つにします。find(x) は、親をたどって代表を返します。たとえば、union("mount sukiku", "mount suhoku") の後に union("mount suhoku", "mount sukiho") をすると、3つの名前の代表が同じになり、1つのノードになります。
- しきい値: 0.70から1.00まで0.05刻みで試します。i < j で、同じ組を2回つながないようにしています。
- 例: 正解では別のものなのに類似度が高い組と、同じものなのに類似度が低い組を、それぞれ5つずつ表示します。
実行結果
しきい値 0.70: {'ノード数': 43, '誤統合': 10, '誤分割': 4}
しきい値 0.75: {'ノード数': 103, '誤統合': 29, '誤分割': 9}
しきい値 0.80: {'ノード数': 253, '誤統合': 79, '誤分割': 11}
しきい値 0.85: {'ノード数': 426, '誤統合': 70, '誤分割': 18}
しきい値 0.90: {'ノード数': 551, '誤統合': 46, '誤分割': 19}
しきい値 0.95: {'ノード数': 632, '誤統合': 6, '誤分割': 19}
しきい値 1.00: {'ノード数': 638, '誤統合': 0, '誤分割': 19}
別のものなのに似ている: [(0.965, 'mount kahoka', 'mount kakaha'), (0.955, 'mount tohaho', 'mount tohoho'), (0.955, 'mount hosuyo', 'mount hoyoyo'), (0.952, 'mount yosuki', 'mount yoyoki'), (0.952, 'mount sekuku', 'mount sekuto')]
同じものなのに似ていない: [(0.071, 'ridge safety office', 'rso'), (0.161, 'hkg', 'hut keepers guild'), (0.184, 'ridge rescue office', 'rro'), (0.694, 'shiranami mountains', 'shiranami range'), (0.708, 'tsukishiro mountains', 'tsukishiro range')]
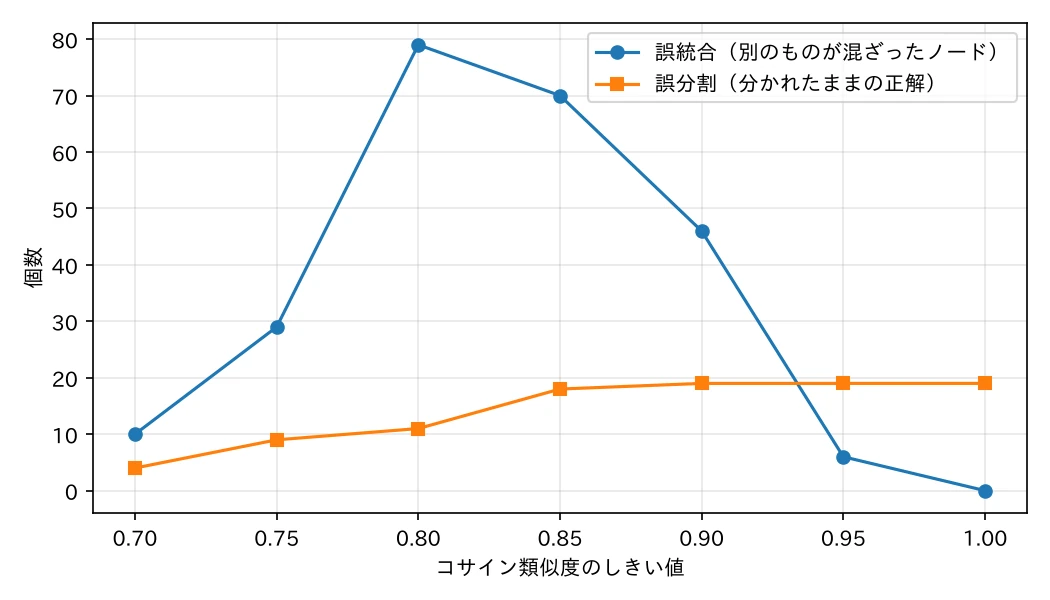
- しきい値を下げると、誤統合が一気に増える: しきい値 0.95 で、誤統合はすでに6個です。0.80 まで下げると、253個のノードのうち79個が誤統合になります。それでも、誤分割は11個残ります。しきい値をどこに置いても、誤統合と誤分割の両方が残りました(0.70 で誤統合が10個に減っているのは、たくさんの名前が数個の巨大なノードにまとまり、誤統合の「ノードの数」としては少なく数えられるためです)。
- 似ているのに別の山: 類似度が最も高い別のものの組は、「mount kahoka」と「mount kakaha」(0.965)、「mount tohaho」と「mount tohoho」(0.955)のような、文字の並びが似た別の山でした。架空の固有名詞では、埋め込みは意味ではなく、主に文字の重なりで近さが決まります。HippoRAG の記事でも、類似度0.8以上の名前の間に張る同義語の辺が、1文字違いの別の山や、標高の数値だけが違う名前をつなぎ、検索の精度を下げました。
- 同じなのに似ていない: 逆に、「rso」と「ridge safety office」は 0.071、「hkg」と「hut keepers guild」は 0.161 しかありません。略称と正式名は、文字がほとんど重ならないためです。「shiranami mountains」と「shiranami range」も 0.694 で、高いしきい値ではまとまりません。
さらに、しきい値でまとめる方法には、つないだ組が 鎖のように広がる という弱点があります。
(図は、diagram-designで作成)
しきい値 0.90 では、隣どうしの組がしきい値を超えるだけで、両端の類似度が 0.725 しかない「mount sukiku」と「mount suseho」まで、4つの別の山が1つのノードになりました。名前の似た別のもの(同じ地域の山、番号違いの製品)が多いデータでは、しきい値でまとめる方法は危険です。
実験6:埋め込みで候補を絞り、LLM で判定する
埋め込みの類似度は「同じかどうか」の判定には使えませんが、「同じかもしれない組」の候補を絞るのには使えます。そこで、名前ごとに類似度の高い上位3個を候補の組にし、候補の組だけを LLM に「同じものか」判定させます。この「候補を絞る → 判定する」の2段階は、名寄せでは ブロッキング(blocking)と照合(matching)と呼ばれ、LLM を使う名寄せの研究(たとえば KGGen、Mo et al. 2025)でも使われています。全部の組(約20万組)を LLM に聞くと時間がかかりすぎるので、まず候補を絞ります。
LLM への聞き方は2通り試します。そのまま「同じ実体か」と聞く 素直な聞き方 と、「綴りの違う固有名詞は別の実体。ただし、略称や短く(長く)した形は除く」という判断の基準を1文足した聞き方です。
# 名前ごとに、その名前が出てくる文書を1つ覚えておく(判定のときに文脈として見せる)
context = {}
for d, (ents, _, _) in zip(docs, pipe):
    for e in ents:
        context.setdefault(normalize(e["name"]), d["text"])

# 素直な聞き方
SIMPLE = ('Text 1 mentions "{a}": {ta}\n'
          'Text 2 mentions "{b}": {tb}\n'
          'Is "{a}" in Text 1 the same real-world entity as "{b}" in Text 2? Answer only yes or no.')
# 「テキスト1は『{a}』に触れている:… テキスト2は『{b}』に触れている:… テキスト1の『{a}』とテキスト2の『{b}』は、
#   同じ実体ですか? yes か no だけで答えてください。」

# 判断の基準を1文足した聞き方
STRICT = ('Text 1 mentions "{a}": {ta}\n'
          'Text 2 mentions "{b}": {tb}\n'
          'Is "{a}" in Text 1 the same real-world entity as "{b}" in Text 2? '
          "Proper names spelled differently are different entities, unless one is an abbreviation "
          "or a shorter or longer form of the other. Answer only yes or no.")
# 足した1文:「綴りの違う固有名詞は別の実体です。ただし、片方が略称か、片方を短く(長く)した形の場合は除きます。」

# 候補の組:正規化した名前ごとに、埋め込みが似ている上位3個
candidates = set()
for i in range(len(keys)):
    for j in np.argsort(-sim[i])[1:4]:           # (a) 似ている順に並べ、先頭(自分自身)を飛ばして3個
        candidates.add(tuple(sorted((keys[i], keys[j]))))
candidates = sorted(candidates)
same = [(a, b) for a, b in candidates if key_label[a] == key_label[b]]
print(f"候補の組: {len(candidates)}(全部の組は {len(keys) * (len(keys) - 1) // 2:,})  うち同じものの組: {len(same)}")


def llm_merge(prompt):
    """候補の組を1組ずつ LLM に聞き、yes の組をつないでまとめる"""
    answers = generate([prompt.format(a=a, b=b, ta=context[a], tb=context[b]) for a, b in candidates],
                       max_new_tokens=3, batch_size=64)
    yes = [(a, b) for (a, b), ans in zip(candidates, answers) if ans.lower().startswith("yes")]
    uf = UnionFind(keys)
    for a, b in yes:                              # (b) yes の組をつなぐ
        uf.union(a, b)
    print(f"  yes: {len(yes)}  うち別のもの: {[p for p in yes if p not in same]}")
    print(f"  同じなのに no: {[p for p in same if p not in yes]}")
    return yes, lambda n: uf.find(normalize(n)) if normalize(n) in uf.parent else normalize(n)


merged, said_yes = {}, {}
for name, prompt in [("素直な聞き方", SIMPLE), ("基準を足した聞き方", STRICT)]:
    print(name)
    reset_usage()
    said_yes[name], merged[name] = llm_merge(prompt)
    results[f"正規化+埋め込み候補+LLM({name})"] = score(merged[name])
    cost[f"名寄せの判定({name})"] = dict(usage)
for k, v in results.items():
    print(f"{k}: {v}")

# 5つの組で、埋め込みの類似度・しきい値 0.95・LLM の判定を並べる
examples = [("rso", "ridge safety office"), ("mount kahoka", "mount kakaha"), ("mount mimiri", "mount mirari"),
            ("shiranami mountains", "shiranami range"), ("oda", "oda village")]
for a, b in examples:
    pair = tuple(sorted((a, b)))
    s = float(sim[keys.index(a), keys.index(b)])
    judged = {n: ("yes" if pair in y else "no") if pair in candidates else "候補外" for n, y in said_yes.items()}
    print(f"{a} / {b}: 正解は{'同じもの' if key_label[a] == key_label[b] else '別のもの'}  類似度 {s:.3f}"
          f"  しきい値0.95で{'まとまる' if s >= 0.95 else '分かれる'}  LLM: {judged}")
埋め込みで候補の組を絞り、LLM に同じものかどうかを判定させて、名寄せするコードです。
- 文脈 context: 正規化した名前ごとに、その名前が出てくる文書を1つ覚えておきます。名前だけでは判定しにくい組(「oda」は村か山か)も、文書があれば判断できるようにするためです。
- プロンプト: SIMPLE と STRICT は、最後の1文だけが違います。どちらも、2つの名前と、それぞれが出てくる文書を見せ、「yes」か「no」だけで答えさせます。
- 候補の組: (a) 名前ごとに、類似度 sim[i] を大きい順に並べ(np.argsort(-sim[i]))、先頭の自分自身を飛ばして3個を候補にします。「a と b」と「b と a」を同じ組として数えるため、名前の組を並べ替えて(sorted)集合に入れます。same は、候補のうち本当に同じものの組で、答え合わせに使います。
- 判定とまとめ llm_merge: 候補の組ごとにプロンプトを作って生成し、答えが「yes」で始まる組を集めます。(b) yes の組を Union-Find でつなぎます。yes と答えた組 said_yes と、名前をノードに対応づける関数の2つを返します。max_new_tokens=3 は、「yes」か「no」の1語を書くのに足りる長さです。
- 5つの組の比較 examples: 下の図で使う5つの組について、正解、埋め込みの類似度 sim、しきい値 0.95 でまとまるか、2つの聞き方での LLM の答えを並べて表示します。候補の組に入らなかった組は、LLM に聞いていないので「候補外」と表示します。
実行結果
候補の組: 1350(全部の組は 203,203)  うち同じものの組: 16
素直な聞き方
  yes: 16  うち別のもの: [('mount mimiri', 'mount mirari'), ('mount mohori', 'mount mohowa'), ('mount sunamo', 'mount sunawa'), ('mount towaha', 'mount towaka')]
  同じなのに no: [('akatsuki mountains', 'akatsuki range'), ('minase', 'minase village'), ('oda', 'oda village'), ('snow lilies', 'snow lily')]
基準を足した聞き方
  yes: 9  うち別のもの: []
  同じなのに no: [('akatsuki mountains', 'akatsuki range'), ('hayate mountains', 'hayate range'), ('kirisame mountains', 'kirisame range'), ('minase', 'minase village'), ('oda', 'oda village'), ('shiranami mountains', 'shiranami range'), ('snow lilies', 'snow lily')]
完全一致: {'ノード数': 660, '誤統合': 0, '誤分割': 19}
正規化: {'ノード数': 638, '誤統合': 0, '誤分割': 19}
正規化+ルール: {'ノード数': 620, '誤統合': 0, '誤分割': 1}
正規化+埋め込み(0.95): {'ノード数': 632, '誤統合': 6, '誤分割': 19}
正規化+埋め込み候補+LLM(素直な聞き方): {'ノード数': 622, '誤統合': 4, '誤分割': 7}
正規化+埋め込み候補+LLM(基準を足した聞き方): {'ノード数': 629, '誤統合': 0, '誤分割': 10}
rso / ridge safety office: 正解は同じもの  類似度 0.071  しきい値0.95で分かれる  LLM: {'素直な聞き方': '候補外', '基準を足した聞き方': '候補外'}
mount kahoka / mount kakaha: 正解は別のもの  類似度 0.965  しきい値0.95でまとまる  LLM: {'素直な聞き方': 'no', '基準を足した聞き方': 'no'}
mount mimiri / mount mirari: 正解は別のもの  類似度 0.656  しきい値0.95で分かれる  LLM: {'素直な聞き方': 'yes', '基準を足した聞き方': 'no'}
shiranami mountains / shiranami range: 正解は同じもの  類似度 0.694  しきい値0.95で分かれる  LLM: {'素直な聞き方': 'yes', '基準を足した聞き方': 'no'}
oda / oda village: 正解は同じもの  類似度 0.772  しきい値0.95で分かれる  LLM: {'素直な聞き方': 'no', '基準を足した聞き方': 'no'}
(図は、diagram-designで作成)
| 名寄せの方法 | ノード数 | 誤統合 | 誤分割 |
|---|---|---|---|
| 完全一致 | 660 | 0 | 19 |
| 正規化 | 638 | 0 | 19 |
| 正規化+ルール | 620 | 0 | 1 |
| 正規化+埋め込み(しきい値0.95) | 632 | 6 | 19 |
| 正規化+埋め込み候補+LLM(素直な聞き方) | 622 | 4 | 7 |
| 正規化+埋め込み候補+LLM(基準を足した聞き方) | 629 | 0 | 10 |
(正解のノード数は619)
- 候補を絞る効果: 正規化した名前の組は203,203組ありますが、候補は1,350組(0.7%)に絞られました。そのうち本当に同じものの組は16組です。略称と正式名の組(「rso」と「ridge safety office」など)は、類似度が低いので候補に入りませんでした。
- 素直な聞き方は、まとめすぎる: LLM は16組に yes と答え、うち4組は「mount mimiri」と「mount mirari」のような、名前の似た別の山でした。綴りが少し違うだけの名前を、書き間違いと考えたようです。誤統合が4個できました。
- 基準を足すと、分けすぎる: 基準の1文を足すと、別の山に yes と答えることはなくなり(誤統合0)、ノード数は629個になりました。一方で、「hayate mountains」と「hayate range」、「oda」と「oda village」のように本当に同じ組にも no と答え、誤分割は10個に増えました。
- ルールに届かなかった: どちらの聞き方でも、正規化+ルール(誤統合0、誤分割1)より誤りが多くなりました。LLM の判定は、聞き方を変えると「まとめすぎ」と「分けすぎ」の間を動き、しきい値を動かすのと似たふるまいをします。本記事の 14B のモデルでは、手で書いたルールのほうが正確でした。
LLM による判定は、ルールを書かずに済む点が魅力ですが、判定する LLM の能力と聞き方に結果が大きく左右されます。使うときは、正解の分かっている少数の組で、先に誤統合と誤分割を数えてから使います。
実験7:名寄せの違いで、グラフの答えが変わる
最後に、名寄せの結果でグラフを作り、「その組織が関わる山はいくつ?」に答えます。
def org_mountains(cluster_of, org):
    """cluster_of でまとめたグラフで、org のノードとつながった山(正解の山)の数"""
    target, found = cluster_of(org), set()
    for d, (_, rels, _) in zip(docs, pipe):
        for r in rels:
            ends = [(cluster_of(r["source"]), r["target"]), (cluster_of(r["target"]), r["source"])]
            for node, other in ends:                       # 関係の片方が org のノードなら、もう片方を見る
                if node == target and gold_entities.get(gold_label(other, d)) == "mountain":
                    found.add(gold_label(other, d))
    return len(found)


methods = {"完全一致": lambda n: n, "正規化": normalize, "正規化+ルール": rule_key,
           "正規化+埋め込み候補+LLM(基準を足した聞き方)": merged["基準を足した聞き方"]}
for org in ["Ridge Safety Office", "Hut Keepers' Guild", "Ridge Rescue Office"]:
    answer = sum(org in d["entities"] for d in docs)       # 正解:その組織が出てくる文書の数=山の数
    print(f"{org}(正解 {answer}):", {m: org_mountains(f, org) for m, f in methods.items()})

for step, u in cost.items():
    print(f"{step}: 呼び出し {u['calls']}  入力 {u['input_tokens']:,}  出力 {u['output_tokens']:,}"
          f"  時間 {u['seconds']:.0f} 秒")
名寄せの方法ごとに、組織のノードとつながった山を数え、各段階のコストを表示するコードです。
- 数え方 org_mountains: 抜き出した関係の始点と終点を、cluster_of でノードに置き換えます。始点か終点のどちらかが組織のノードなら、もう片方を正解に対応づけ、山だったものを数えます。同じ山が何度出てきても1座と数えます(set)。たとえば「RSO | Mt. Fuhoha」という関係は、完全一致では「RSO」のノードの関係なので、正式名「Ridge Safety Office」の山としては数えられません。ルールでまとめると、「rso」が「ridge safety office」になるので数えられます。
- 正解: どの文書でも、話題の組織は1つの山についてしか書かれていないので、その組織が出てくる文書の数が、正解の山の数です。
- コスト: cost に記録した、各段階の呼び出し回数・入力と出力のトークン数・時間を表示します。
実行結果
Ridge Safety Office(正解 150): {'完全一致': 44, '正規化': 101, '正規化+ルール': 139, '正規化+埋め込み候補+LLM(基準を足した聞き方)': 101}
Hut Keepers' Guild(正解 100): {'完全一致': 28, '正規化': 82, '正規化+ルール': 94, '正規化+埋め込み候補+LLM(基準を足した聞き方)': 82}
Ridge Rescue Office(正解 40): {'完全一致': 10, '正規化': 27, '正規化+ルール': 40, '正規化+埋め込み候補+LLM(基準を足した聞き方)': 27}
抽出(「|」区切り): 呼び出し 600  入力 133,340  出力 57,926  時間 188 秒
抽出(JSON): 呼び出し 600  入力 123,140  出力 92,652  時間 262 秒
gleaning(1回): 呼び出し 600  入力 209,266  出力 126,842  時間 519 秒
名寄せの判定(素直な聞き方): 呼び出し 1350  入力 209,869  出力 2,299  時間 36 秒
名寄せの判定(基準を足した聞き方): 呼び出し 1350  入力 240,919  出力 2,398  時間 41 秒
- 名寄せで答えが3倍になる: Ridge Safety Office が関わる山は、完全一致では44座しか数えられませんが、正規化で101座、ルールを足すと139座になりました(正解は150座)。名寄せをしないと、正しく抜き出せていた関係の大部分が、別のノードにつながったままになります。Ridge Rescue Office は、ルールで40座すべてを数えられました。
- LLM の判定(基準を足した聞き方)は正規化と同じ: 略称が候補に入らないので、「RSO」とつながった山は数えられず、正規化と同じ101座でした。
- 残りの11座は抽出の誤り: ルールでも139座なのは、残りの文書では、名寄せではなく抽出の段階で関係が取れていなかったためです。たとえば「the ridge safety office closed the upper trail of Kihase」から、関係の終点を山ではなく「upper trail of Kihase」(登山道)にしていました。名寄せが完璧でも、抽出の誤りは直せません。
- コスト: 抽出は600回の呼び出しで約3分、gleaning は約9分でした。名寄せの判定は1,350回の呼び出しですが、答えが1語なので出力が少なく、40秒ほどで終わりました。
| 段階 | 呼び出し回数 | 入力トークン | 出力トークン | 時間 |
|---|---|---|---|---|
| 抽出(「|」区切り) | 600 | 133,340 | 57,926 | 188秒 |
| 抽出(JSON) | 600 | 123,140 | 92,652 | 262秒 |
| gleaning(1回) | 600 | 209,266 | 126,842 | 519秒 |
| 名寄せの判定(素直な聞き方) | 1,350 | 209,869 | 2,299 | 36秒 |
| 名寄せの判定(基準を足した聞き方) | 1,350 | 240,919 | 2,398 | 41秒 |
論文は何を示したか
本記事の実験は、短い文書と小さなコーパスでの結果です。LLM によるナレッジグラフの構築について、主な論文が示したことと比べます。
| 論文 | 何を調べたか | 主な結果 | 本記事との対応 |
|---|---|---|---|
| Zhu et al. 2023(2305.13168) | GPT-4 などの、KG の構築(エンティティ・関係・イベントの抽出)と推論(リンク予測・質問応答)の能力 | 抽出では、GPT-4 の zero-shot・one-shot は、ファインチューニングした最先端のモデルに届かない(例:DuIE2.0 で one-shot の F1 が 41.91、最先端は 69.42)。推論ではそれに近いか上回る。著者らは、LLM は「抽出器よりも推論の助手に向く」とまとめた。各データセットから20〜25件ほどを選んだ小規模な評価 | 本記事の短く単純な文書では、14B のモデルでも再現率は高かった。ただし、関係の端点を「登山道」にする誤りは、実験7でも見られた |
| Edge et al. 2024(2404.16130、GraphRAG) | 文書から LLM で KG を作り、コミュニティの要約で文書全体についての質問に答える | 文書を短く区切るほど、また gleaning を繰り返すほど、抜き出すエンティティの言及が増える(600トークンで区切ると、2,400トークンのほぼ2倍)。エンティティは名前の完全一致でまとめ、重複が残っても、後のコミュニティの要約で同じコミュニティに入るので影響は小さいとしている | gleaning は、短い文書では正解を増やさず、正解外を増やした(実験3)。完全一致のままでは、組織が4〜5個のノードに分かれ、組織とつながった山を数える問いの答えが大きく変わった(実験1・7) |
| Mo et al. 2025(2502.09956、KGGen) | 抽出した KG の、まばらさ(同じものが別のノードに分かれる)を減らす | 埋め込み(と BM25)で候補を集め、LLM に重複を判定させて代表の名前を決める名寄せを入れ、知識の再現を測るベンチマーク MINE で、GraphRAG(47.80%)や OpenIE(29.84%)より高い 66.07% を得た | 「埋め込みで候補 → LLM で判定」の2段階は、実験6と同じ構成。本記事の 14B のモデルでは、聞き方によって誤統合か誤分割が残り、ルールに届かなかった |
| Pan et al. 2024(2306.08302) | LLM と KG を組み合わせる研究の全体像 | 「KG で LLM を強める」「LLM で KG を強める(構築・補完など)」「両者を対等に組み合わせる」の3つの枠組みに整理した | 本記事は、2つ目の「LLM で KG を作る」に当たる |
| Bian 2025(2510.20345) | LLM による KG 構築のサーベイ | 構築を、オントロジー(スキーマ)の設計・知識の抽出・知識の融合の3段階に分けて整理し、融合(名寄せを含む)では、LLM を照合の判定や候補からの選択に使う方法が増えていると述べている | 抽出(実験1〜3)と融合(実験4〜6)。本記事では、スキーマ(種類の一覧)は最初に固定した |
LLM でナレッジグラフを作るときの注意点
- 名寄せは、まずルールで: 正規化と、略称の定義を集めるような機械的なルールは、誤統合を起こさずに、誤分割のほとんどを減らせました。LLM の判定は、ルールで残った細かな違いに使い、まずは少数の組で精度を確かめます。
- 埋め込みのしきい値でまとめない: 名前の似た別のもの(同じ地域の山、番号違いの製品、同姓の人物)が多いデータでは、類似度のしきい値でまとめると、誤統合が一気に増え、鎖のように広がります。埋め込みは、候補を絞るのに使います。そのとき、略称のように文字が重ならない組は候補に入らないので、別の方法(ルールや別名の辞書)で拾う必要があります。
- LLM の判定は、聞き方で結果が変わる: 同じモデルでも、聞き方を1文変えるだけで、誤統合4・誤分割7から、誤統合0・誤分割10に変わりました。誤統合はグラフに存在しない関係を入れるので、誤分割より害が大きいことが多く、どちらを避けたいかを決めてから聞き方を選びます。
- gleaning は、文書の長さで決める: 短い文書では、正解外のものが増えるだけでした。文書を区切る長さと、1回目の抽出の再現率を確かめ、漏れが多いときに使います。
- 出力の形より、例を見せること: 「|」区切りと JSON で、抽出の質はほとんど変わりませんでした。どちらでも、例を1つ見せて形をはっきり伝えると、読めない出力はなくなりました。
- 評価には、小さくても正解を作る: 抽出の再現率も、名寄せの誤統合・誤分割も、正解がないと数えられません。数十文書でも、人手で正解(と書き方の対応表)を付けておくと、方法の比較ができます。
- コストは「呼び出し回数 × 入力の長さ」で見積もる: 抽出は文書の数だけ、gleaning は会話を入力し直すので、入力トークンが約1.6倍になりました。名寄せの判定は、全部の組ではなく候補だけを聞き、答えを1語にすることで、短い時間で済みました。
まとめ
- 抽出: 表記揺れのある600文書から、Qwen2.5-14B-Instruct はエンティティの再現率 1.0、関係の再現率 0.989 で抜き出せました。しかし、名前のままグラフにすると、ノードは正解の619個に対して663個になり、Ridge Safety Office は4つのノードに分かれました。
- 出力の形: 「|」区切りと JSON のどちらでも、読めなかった文書は0で、抽出の質もほぼ同じでした。
- gleaning: 短い文書では再現率は変わらず、正解外のエンティティが8個から211個に増えました。
- 名寄せ: 正規化だけでは誤分割が19個のまま、略称の辞書などのルールを足すと1個になり、誤統合は0でした。埋め込みのしきい値でまとめると、0.95 でも誤統合が6個でき、下げると鎖のように広がりました。埋め込みで候補を絞って LLM に判定させると、聞き方によって誤統合4・誤分割7、または誤統合0・誤分割10となり、ルールに届きませんでした。
- グラフの答え: 「Ridge Safety Office が関わる山」は、完全一致では44座、ルールでまとめると139座(正解150座)でした。残りの11座は抽出の段階の誤りで、名寄せでは直せませんでした。
参考文献
- Y. Zhu, X. Wang, J. Chen, S. Qiao, Y. Ou, Y. Yao, S. Deng, H. Chen, N. Zhang (2023). LLMs for Knowledge Graph Construction and Reasoning: Recent Capabilities and Future Opportunities. arXiv:2305.13168.
- S. Pan, L. Luo, Y. Wang, C. Chen, J. Wang, X. Wu (2024). Unifying Large Language Models and Knowledge Graphs: A Roadmap. IEEE Transactions on Knowledge and Data Engineering, 36(7), 3580–3599.
- D. Edge, H. Trinh, N. Cheng, J. Bradley, A. Chao, A. Mody, S. Truitt, D. Metropolitansky, R. O. Ness, J. Larson (2024). From Local to Global: A Graph RAG Approach to Query-Focused Summarization. arXiv:2404.16130.
- B. Mo, K. Yu, J. Kazdan, J. Cabezas, P. Mpala, L. Yu, C. Cundy, C. Kanatsoulis, S. Koyejo (2025). KGGen: Extracting Knowledge Graphs from Plain Text with Language Models. arXiv:2502.09956.
- H. Bian (2025). LLM-empowered knowledge graph construction: A survey. arXiv:2510.20345.
- N. Reimers, I. Gurevych (2019). Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks. EMNLP 2019.
- Qwen Team (2024). Qwen2.5 Technical Report. arXiv:2412.15115.
本記事の文章・構成の一部に生成AIを使用しています。